PaliGemma 正式发布 — Google 最新发布的前沿开放视觉语言模型
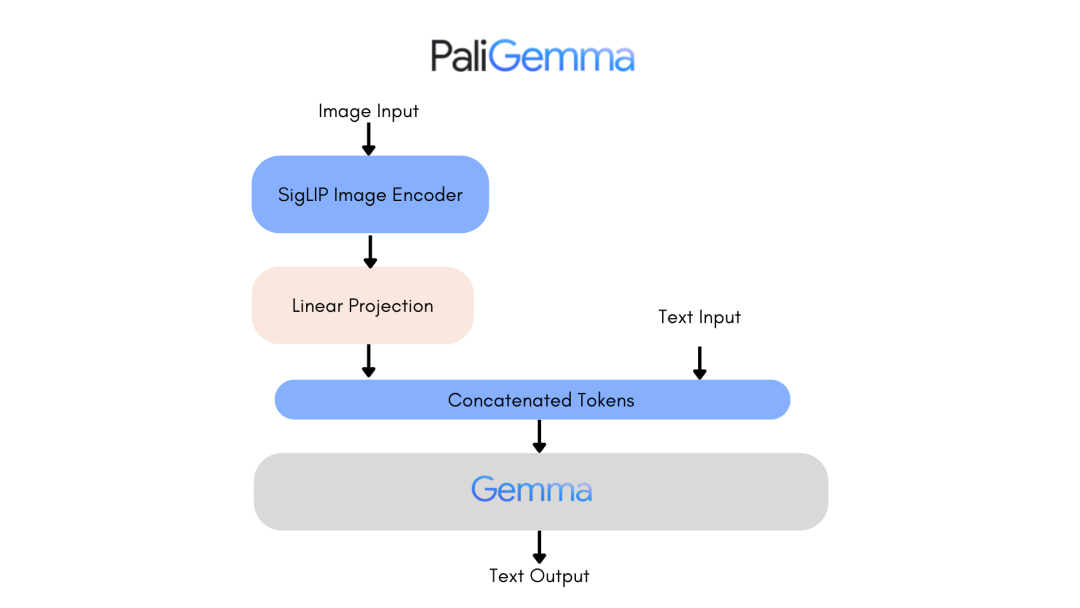
PaliGemma 是 Google 推出的新一代视觉语言模型家族,能够接收图像与文本输入并生成文本输出。 Google 团队已推出三种类型的模型:预训练 (PT) 模型、混合模型和微调 (FT) 模型,这些模型分辨率各异,提供多种精度以便使用。 所有模型均在 Hugging Face Hub 的模型库中发布,配备了模型说明和许可证,并且支持 transformers 集成。 PaliGemma 是什么? PaliGemma ( Github ) 是一系列具有视觉和语言处理能力的模型,由 SigLIP-So400m 作为图像编码器和 Gemma-2B 作为文本解码器构成。SigLIP 是一个顶尖的模型,可以同时解析图像和文本。它的工作方式类似于 CLIP,包括图像和文本编码器的联合训练。与 PaLI-3 相似,PaliGemma 模型在图像-文本数据上进行预训练后,可轻松针对下游任务 (如图像标题生成或指代分割) 进行微调。 Gemma 是一个专为文本生成设计的解码器模型。通过线性适配器将 SigLIP 的图像编码功能与 Gemma 结合,使 PaliGemma 成为一个功能强大的视觉语言模型。 Github https://github.com/google-research/big_vision/blob/main/big_vision/configs/proj/paligemma/README.md SigLIP-So400m https://hf.co/google/siglip-so400m-patch14-384 Gemma-2B https://hf.co/google/gemma-2b PaLI-3 https://arxiv.org/abs/2310.09199 Gemma https://hf.co/blog/gemma PaliGemma 的发布包括三种模型类型: PT 检查点:预训练模型,可用于下游任务的微调; 混合检查点:已针对任务混合进行微调的 PT 模型,适合使用自由文本提示进行通用推理,仅限研究使用; FT 检查点:针对不同学术基准进行微调的模型,提供多种分辨率,仅限研究使用。 这些模型提供三种分辨率 (224x224、448x448、896x896) 和三种精度 (bfloat16、float16、float32) 。每个版本都包含给定分辨率和任务的检查点,每种精度有三个版本。每个版本的main分支包含float32检查点,而bfloat16和float16版本则包含相应精度的检查点。同时提供了与 transformers 兼容的模型,以及原始 JAX 实现的版本。 正如后续详细说明的,高分辨率模型因输入序列较长而需要更多内存。虽然它们可能有助于执行细粒度任务,如 OCR,但对大多数任务的质量提升较小。224 版本已足够应对大多数场景。 你可以在这个 Hugging Face 合集 中找到所有相关模型和 Space 应用。 合集 https://hf.co/collections/google/paligemma-release-6643a9ffbf57de2ae0448dda 模型功能 PaliGemma 是一个单轮视觉语言模型,不适用于对话场景,最佳应用是针对特定用例进行微调。 你可以通过设置任务前缀,如“detect”或“segment”,来配置模型解决的任务。预训练模型即是通过这种方式训练的,赋予其丰富的功能 (问题回答、图像标题生成、图像分割等) 。然而,这些模型并非设计为直接使用,而是通过微调以适应特定任务,使用类似的提示结构。对于交互式测试,你可以使用已对多任务进行微调的“mix”系列模型。 以下是使用混合检查点展示的一些功能示例。 图像标题生成 当被提示时,PaliGemma 能够为图像生成标题。你可以尝试使用混合检查点进行各种标题生成提示,看看它们如何反应。 视觉问题回答 PaliGemma 能够回答关于图像的问题,只需将你的问题连同图像一起传入即可。 检测 PaliGemma 可以使用detect [entity]提示来检测图像中的实体。它会以特殊的<loc[value]>令牌形式输出边界框坐标的位置,其中value是一个表示归一化坐标的数字。每次检测都由四个位置坐标代表——ymin, xmin, ymax, xmax,后跟检测到的框中的标签。要将这些值转换为坐标,你需要首先将数字除以 1024,然后将y乘以图像高度,x乘以宽度。这将给你提供相对于原始图像大小的边界框坐标。 指代表达分割 PaliGemma 混合检查点也能够在给定 segment [entity] 提示时对图像中的实体进行分割。这称为指代表达分割,因为我们使用自然语言描述来引用感兴趣的实体。输出是位置和分割标记的序列。位置标记代表如上所述的一个边界框。分割标记可以进一步处理,生成分割掩模。 文档理解 PaliGemma 混合检查点具备出色的文档理解与推理能力。 混合基准 以下是混合检查点的得分数据。 模型 MMVP 准确率 POPE 准确率 (随机/流行/对抗) mix-224 46.00 88.00 86.63 85.67 mix-448 45.33 89.37 88.40 87.47 微调检查点 除了预训练和混合模型之外,Google 还发布了已针对各种任务进行微调的模型。这些模型对应于研究社区可用于比较性能的学术基准。以下是一些选定的模型,这些模型也提供了不同的分辨率。你可以查看任何一个模型的模型卡以获取所有度量指标。 模型名称 数据集/任务 转移任务中的得分 paligemma-3b-ft-vqav2-448 图解理解 在 VQAV2 上的准确率为 85.64 paligemma-3b-ft-cococap-448 COCO 标题 CIDEr 为 144.6 paligemma-3b-ft-science-qa-448 科学问题回答 在没有 CoT 的 ScienceQA Img 子集上的准确率为 95.93 paligemma-3b-ft-refcoco-seg-896 图像中特定对象的理解 在 refcoco 上的平均 IoU 为 76.94,在 refcoco+ 上为 72.18,在 refcocog 上为 72.22 paligemma-3b-ft-rsvqa-hr-224 遥感视觉问题回答 在 test 上的准确率为 92.61,在 test2 上为 90.58 paligemma-3b-ft-vqav2-448 https://hf.co/google/paligemma-3b-ft-vqav2-448 paligemma-3b-ft-cococap-448 https://hf.co/google/paligemma-3b-ft-cococap-448 paligemma-3b-ft-science-qa-448 https://hf.co/google/paligemma-3b-ft-science-qa-448 paligemma-3b-ft-refcoco-seg-896 https://hf.co/google/paligemma-3b-ft-refcoco-seg-896 paligemma-3b-ft-rsvqa-hr-224 https://hf.co/google/paligemma-3b-ft-rsvqa-hr-224 演示 作为此次发布的一部分,我们提供了一个 Space 应用 ,直接用 bigvision 仓库 中的参考实现,并提供了一个简便的方式来使用混合模型。 Space 应用 https://hf.co/spaces/google/paligemma bigvision 仓库 https://github.com/google-research/big_vision 我们还有一个与 Transformers 兼容的 演示版本 ,展示了如何使用 PaliGemma transformers API。 演示版本 https://hf.co/spaces/google/paligemma-hf 如何运行推理 要获取 PaliGemma 模型的访问权限,你需要接受 Gemma 许可条款和条件。如果你已经可以访问 Hugging Face 中的其他 Gemma 模型,那么你已经准备好了。否则,请访问任何一个 PaliGemma 模型,并在你同意许可时接受它。一旦你获得了访问权限,你需要通过 notebooklogin 或 huggingface-cli login 进行认证。登录后,你就可以开始了! notebooklogin https://hf.co/docs/huggingface_hub/v0.21.2/en/package_reference/login#huggingfacehub.notebooklogin huggingface-cli login https://hf.co/docs/huggingface_hub/en/guides/cli#huggingface-cli-login 你还可以立即在 此 notebook 中尝试运行推理。 此 notebook https://colab.research.google.com/drive/1gOhRCFyt9yIoasJkd4VoaHcIqJPdJnlg?usp=sharing 使用 Transformers 你可以使用PaliGemmaForConditionalGeneration类来推断任何已发布的模型。只需使用内置的处理器预处理提示和图像,然后传递预处理输入进行生成。 fromtransformersimportAutoProcessor,PaliGemmaForConditionalGenerationmodel_id="google/paligemma-3b-mix-224"model=PaliGemmaForConditionalGeneration.from_pretrained(model_id)processor=AutoProcessor.from_pretrained(model_id)prompt="Whatisontheflower?"image_file="https://huggingface.co/datasets/huggingface/documentation-images/resolve/main/bee.jpg?download=true"raw_image=Image.open(requests.get(image_file,stream=True).raw)inputs=processor(prompt,raw_image,return_tensors="pt")output=model.generate(**inputs,max_new_tokens=20)print(processor.decode(output[0],skip_special_tokens=True)[len(prompt):])#bee 你还可以按以下方式加载 4 位模型。 fromtransformersimportBitsAndBytesConfigbnb_config=BitsAndBytesConfig(load_in_4bit=True,bnb_4bit_quant_type="nf4",bnb_4bit_compute_dtype=torch.bfloat16)model=PaligemmaForConditionalGeneration.from_pretrained(model_id,quantization_config=bnb_config,device_map={"":0}) 除了 4 位 (或 8 位) 加载,transformers 集成还允许你利用 Hugging Face 生态系统中的其他工具,例如: 训练和推理脚本以及示例 序列化到安全文件 safetensors https://hf.co/docs/safetensors/en/index 与工具集成,如 PEFT (参数效率微调) https://hf.co/docs/peft/en/index 实用工具和助手 https://hf.co/docs/transformers/v4.34.0/en/internal/generationutils 来运行模型生成 详细推理过程 如果你想编写自己的预处理或训练代码,或想更详细地了解 PaliGemma 如何工作,以下是输入图像和文本的处理步骤: 输入文本会正常进行标记化。会在开头添加一个 标记,并附加一个额外的换行标记 (\n) 。这个换行标记是模型训练中输入提示的重要部分,因此明确添加它以确保它始终存在。标记化的文本还以固定数量的标记为前缀。 需要多少个?这取决于输入图像的分辨率和 SigLIP 模型使用的贴片大小。PaliGemma 模型预先训练在三种正方形大小 (224x224、448x448 或 896x896) 之一,并始终使用 14 的贴片大小。因此,要添加的标记数量是 224 模型的 256 (224/14 224/14) ,448 模型的 1024,896 模型的 4096。 更大的图像导致输入序列显著增长,因此需要更多的内存。在考虑使用哪种模型时,请记住这一点。对于细粒度任务,如 OCR,使用较大图像可能有助于实现更好的结果,但对于大多数任务,质量提升不大。在决定升级到更高分辨率之前,请先在你的任务上进行测试! 这个完整的“提示”通过语言模型的文本嵌入层,并生成每个标记 2048 维的标记嵌入。 与此同时,输入图像经过调整大小,使用双三次重采样至所需的输入大小 (对于最小分辨率模型为 224x224) 。然后,它通过 SigLIP 图像编码器生成每个贴片 1152 维的图像嵌入。这里线性投影器发挥作用:将图像嵌入投影以获取 2048 维每贴片的表示,与文本标记获得的表示相同。最终的图像嵌入然后与<image>文本嵌入合并,这是用于自回归文本生成的最终输入。 生成在自回归模式下正常工作,对整个输入 (image + bos + prompt + \n) 使用完整块注意力,并对生成的文本使用因果注意力掩码。 所有这些细节都在处理器和模型类中自动处理,因此可以使用前面示例中所示的熟悉的高级 transformers API 进行推理。 微调 使用 bigvision PaliGemma 是在 bigvision 代码库中训练的。该代码库已用于开发如 BiT、原始 ViT、LiT、CapPa、SigLIP 等模型。 bigvision https://github.com/google-research/big_vision 项目配置文件夹 configs/proj/paligemma/ 包含一个README.md。预训练模型可以通过运行 transfers/ 子文件夹中的配置文件进行转移,我们的所有转移结果都是通过运行其中提供的配置文件获得的。如果你想转移自己的模型,可以复制示例配置 transfers/forkme.py 并按照注释中的说明调整它以适应你的用例。 configs/proj/paligemma/ https://github.com/google-research/big_vision/blob/main/big_vision/configs/proj/paligemma/ transfers/ https://github.com/google-research/big_vision/blob/main/big_vision/configs/proj/paligemma/transfers/ transfers/forkme.py https://github.com/google-research/big_vision/blob/main/big_vision/configs/proj/paligemma/transfers/forkme.py 还有一个 Colab: finetunepaligemma.ipynb ,它运行一个简化的微调,可在免费 T4 GPU 运行时上运行。为了适应有限的主机和 GPU 内存,Colab 中的代码仅更新注意力层中的权重 (170M 参数) ,并使用 SGD (而不是 Adam) 。 finetunepaligemma.ipynb https://colab.research.google.com/github/google-research/big_vision/blob/main/big_vision/configs/proj/paligemma/finetune_paligemma.ipynb 使用 transformers 通过 transformers 进行 PaliGemma 的微调非常简单,也还可以进行 QLoRA 或 LoRA 微调。在这个例子中,我们将简要微调解码器,然后展示如何切换到 QLoRA 微调。我们将安装 transformers 库的最新版本。 pipinstallgit+https://github.com/huggingface/transformers.git 就像在推理部分一样,我们将进行身份验证以访问模型,使用notebooklogin()。 fromhuggingface_hubimportnotebook_loginnotebook_login() 对于这个例子,我们将使用 VQAv2 数据集,并微调模型以回答有关图像的问题。让我们加载数据集。我们只会使用 question、multiplechoiceanswer 和 image 列,所以让我们删除其他列。我们还将拆分数据集。 fromdatasetsimportload_datasetds=load_dataset('HuggingFaceM4/VQAv2',split="train")cols_remove=["question_type","answers","answer_type","image_id","question_id"]ds=ds.remove_columns(cols_remove)ds=ds.train_test_split(test_size=0.1)train_ds=ds["train"]val_ds=ds["test"] 我们现在将加载处理器,其中包含图像处理和标记化部分,并预处理我们的数据集。 fromtransformersimportPaliGemmaProcessormodel_id="google/paligemma-3b-pt-224"processor=PaliGemmaProcessor(model_id) 我们将创建一个提示模板,以调整 PaliGemma 回答视觉问题。由于标记器填充输入,我们需要将我们标签中的填充设置为与标记器中的填充标记不同,以及图像标记。 注意:在标记化部分,我们传递一个tokenizenewlineseparately标志,因为换行用于提示条件,必须单独标记化。在推理期间,默认为True。 device="cuda"image_token=processor.tokenizer.convert_tokens_to_ids("<image>")defcollate_fn(examples):texts=["answer"+example["question"]+"\n"+example['multiple_choice_answer']forexampleinexamples]images=[example["image"].convert("RGB")forexampleinexamples]tokens=processor(text=texts,images=images,return_tensors="pt",padding="longest",tokenize_newline_separately=False)labels=tokens["input_ids"].clone()labels[labels==processor.tokenizer.pad_token_id]=-100labels[labels==image_token]=-100tokens["labels"]=labelstokens=tokens.to(torch.bfloat16).to(device)returntokens 你可以直接加载模型,或者为 QLoRA 加载 4 位模型。以下是如何直接加载模型。我们将加载模型,并冻结图像编码器和投影器,仅微调解码器。如果你的图像属于特定领域,这些领域可能不在模型预训练的数据集中,你可能想跳过冻结图像编码器。 model=PaliGemmaForConditionalGeneration.from_pretrained(model_id,torch_dtype=torch.bfloat16).to(device)forparaminmodel.vision_tower.parameters():param.requires_grad=Falseforparaminmodel.multi_modal_projector.parameters():param.requires_grad=True 如果你想为 QLoRA 加载 4 位模型,你可以添加以下更改: fromtransformersimportBitsAndBytesConfigfrompeftimportget_peft_model,LoraConfigbnb_config=BitsAndBytesConfig(load_in_4bit=True,bnb_4bit_quant_type="nf4",bnb_4bit_compute_type=torch.bfloat16)lora_config=LoraConfig(r=8,target_modules=["q_proj","o_proj","k_proj","v_proj","gate_proj","up_proj","down_proj"],task_type="CAUSAL_LM",)model=PaliGemmaForConditionalGeneration.from_pretrained(model_id,quantization_config=bnb_config,device_map={"":0})model=get_peft_model(model,lora_config)model.print_trainable_parameters()#trainableparams:11,298,816||allparams:2,934,634,224||trainable%:0.38501616002417344 我们将初始化 Trainer 和 TrainingArguments。如果你将进行 QLoRA 微调,请将优化器设置为 pagedadamw8bit。 fromtransformersimportTrainingArgumentsargs=TrainingArguments(num_train_epochs=2,remove_unused_columns=False,per_device_train_batch_size=16,gradient_accumulation_steps=4,warmup_steps=2,learning_rate=2e-5,weight_decay=1e-6,adam_beta2=0.999,logging_steps=100,optim="adamw_hf",save_strategy="steps",save_steps=1000,push_to_hub=True,save_total_limit=1,bf16=True,report_to=["tensorboard"],dataloader_pin_memory=False) 初始化 Trainer,传入数据集、数据整合函数和训练参数,并调用 train() 开始训练。 fromtransformersimportTrainertrainer=Trainer(model=model,train_dataset=train_ds,eval_dataset=val_ds,data_collator=collate_fn,args=args)trainer.train() 额外资源 视觉语言模型解析 https://hf.co/blog/vlms 模型文档 https://hf.co/docs/transformers/modeldoc/paligemma 推理笔记本 https://colab.research.google.com/drive/1gOhRCFyt9yIoasJkd4VoaHcIqJPdJnlg?usp=sharing Big vision PaliGemma 演示 https://hf.co/spaces/google/paligemma 🤗 transformers PaliGemma 演示 https://hf.co/spaces/google/paligemma-hf 所有 PaliGemma 模型的集合 https://hf.co/collections/google/paligemma-release-6643a9ffbf57de2ae0448dda 所有 PaliGemma 微调模型的集合 https://hf.co/collections/google/paligemma-ft-models-6643b03efb769dad650d2dda 原始实现 https://github.com/google-research/big_vision/blob/main/big_vision/models/proj/paligemma/paligemma.py 感谢 Omar Sanseviero、Lucas Beyer、Xiaohua Zhai 和 Matthias Minderer 对本博客文章的全面审校。 英文原文:https://hf.co/blog/paligemma 原文作者: Merve Noyan、Andreas P. Steiner (Google)、Pedro Cuenca 译者: Luke, Hugging Face Fellow 本文分享自微信公众号 - Hugging Face(gh_504339124f0f)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。