首页 文章 精选 留言 我的

精选列表

搜索[分区技术],共10000篇文章
优秀的个人博客,低调大师

Kiro 技术功能与案例分析

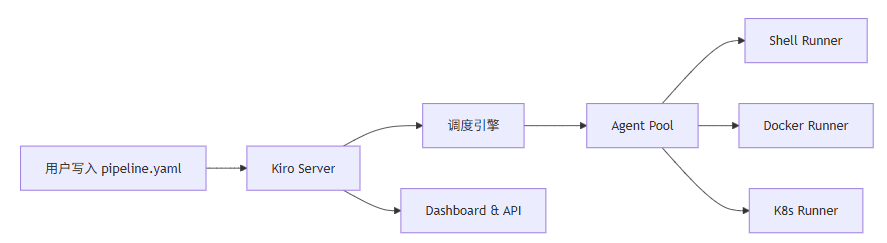
Kiro 是一个面向现代开发团队的轻量级、高性能的任务编排与自动化引擎。它借鉴了工作流引擎的设计理念,但又避免了传统 BPMN 的重型配置,专注于用简洁的 YAML 描述将多个工具、脚本和 API 串联成可靠的自动化流水线。无论是 CI/CD 中的复杂部署流程,还是数据处理中的 ETL 管道,Kiro 都能以极低的接入成本提供可观测、可重试、可回滚的编排能力。

优秀的个人博客,低调大师

Vercel 通过 AI 技术裁减团队

Vercel 是一家成立于2015年的云平台公司,专为开发者提供构建和部署网站与应用程序的工具。最近,该公司决定通过训练人工智能(AI)代理来提升销售团队的工作效率,进而将原本的10人销售团队缩减至仅剩1人和一台机器人。Vercel 的新策略旨在将员工从基础性工作中解放出来,让他们能够专注于更具创造性和价值的任务。 该公司的首席运营官珍妮・德威特・格罗瑟表示,训练 AI 代理的过程始于今年6月。她带领三位工程师,围绕公司表现最好的销售代表进行了一项内部项目,记录下他们的工作流程。经过六周的跟踪和观察,团队成功开发出一个 AI 代理,模仿该销售代表的工作模式。如今,这个 “主代理” 能够自动处理大量原本由多名销售代表完成的工作,包括审核入站消息、过滤垃圾邮件、资格审核潜在客户等。该代理还会通过内部数据库和 OpenAI 的 Deep Research 工具收集公司信息,起草个性化回复,并自动转发支持查询。 人类管理者会在 Slack 上审核 AI 代理的工作,并给予反馈,以帮助系统不断学习和改进。从部署以来,该 AI 代理已经帮助 Vercel 成功将10人团队缩减至1人,其余的9位员工则转向更具挑战性和复杂性的外部拓展工作。格罗瑟表示,这一转变并不是为了裁员,实际上公司在过去一年中的员工数量有所增加。 目前,Vercel 已部署了六个 AI 代理,计划在接下来的6到12个月内再推出数百个,这些代理都是基于公司顶尖员工的工作模式进行开发的。格罗瑟强调,最终人类员工将专注于更具创造性和智力挑战的工作,而不是繁琐的重复性任务。

优秀的个人博客,低调大师

AI+低代码技术揭秘

概述​ VTJ.PRO 是一个 AI 驱动的 Vue3 低代码开发平台,支持 Vue 单文件组件 (SFC) 和领域特定语言 (DSL) 表示之间的双向转换。VTJ 构建在具有同步版本控制的 monorepo 架构之上,为可视化设计、代码生成和多平台部署提供了一个全面的软件包生态系统,同时保持与现有 Vue 3 开发工作流程的兼容性。 目的和范围​ 本文档简要概述了 VTJ 低代码平台,包括其架构、关键组件和设计理念。有关特定组件(如 Engine 和 Provider 系统)的详细信息,请参阅核心架构 ,或者有关工程和块模型的详细信息,请参阅工程和块模型 。 主要特点​ 双向代码流:在视觉设计和 Vue 源代码之间无缝转换 AI 集成:智能代码生成、优化和图像到代码转换功能 Vue 3 基础:建立在最新的 Vue 生态系统之上,支持 TypeScript 和 Vite 多平台支持:面向 Web 应用程序、移动应用程序和 UniApp(跨平台)项目 低学习曲线:专为 Vue 开发人员设计,需要最少的额外知识 非侵入式实施:与现有项目集成,无代码污染 系统架构概述​ VTJ 遵循模块化架构,在多个软件包中明确分离关注点,从基础到平台特定的实现,按层组织。 Monorepo 包架构​ 项目脚手架系统​ AI 增强的设计时到运行时流程​ VTJ 的核心创新是 Vue SFC 和低代码 DSL 之间的双向转换,并通过 AI 功能进行了增强: 双向代码管道​ 数据结构流​ AI 驱动的开发功能​ VTJ 将 AI 功能集成到整个开发管道中,重点是图像到代码的生成和智能辅助: AI 集成架构​ 开始​ VTJ 提供了几种开始使用该平台的方法: 使用 create-vtj 创建项目​ create-vtj脚手架工具使用预配置的构建系统生成特定于平台的项目: shell # Web applications (PC) - uses @vtj/web platform npm create vtj@latest --registry=https://registry.npmmirror.com -- -t app # Mobile H5 applications - uses @vtj/h5 platform npm create vtj@latest --registry=https://registry.npmmirror.com -- -t h5 # Cross-platform apps - uses @vtj/uni-app platform npm create vtj@latest --registry=https://registry.npmmirror.com -- -t uniapp # Component development - uses @vtj/materials npm create vtj@latest --registry=https://registry.npmmirror.com -- -t material 开发环境设置​ 对于 VTJ 本身的本地开发: shell git clone https://gitee.com/newgateway/vtj.git cd vtj npm run setup && npm run build && npm run app:dev 与现有项目集成​ VTJ 通过特定于平台的软件包与现有的 Vue 3 项目无缝集成。有关详细的集成模式,请参阅 集成指南 多平台部署架构​ VTJ 通过专门的平台包支持多个部署目标,每个平台包都针对特定环境进行了优化: 平台 包 目标环境 关键依赖项 Web @vtj/web 桌面 Web 应用程序 element-plus、@vtj/core、@vtj/renderer 设计器 @vtj/pro 使用 Designer 的企业平台 @vtj/renderer、@vtj/local、 @vtj/materials 移动式 H5 @vtj/h5 移动 Web 应用程序 vant、@vtj/core、@vtj/renderer UniApp @vtj/uni-app 跨平台应用(iOS/Android/小程序) @dcloudio/uni-app、@vtj/uni、@vtj/renderer 平台架构​ 当前版本​ VTJ 的当前版本是 0.12.40,在 monorepo 中的所有软件包之间同步。 结论​ VTJ.PRO 是专为 Vue 3 开发人员设计的综合性低代码平台。通过实现视觉设计和 Vue 源代码之间的双向转换,它可以加速开发,同时保持直接代码访问的灵活性和强大功能。该平台的模块化架构、AI 集成和多平台支持使其适用于广泛的应用程序开发场景。

优秀的个人博客,低调大师

浅谈LocalCache | 京东云技术团队

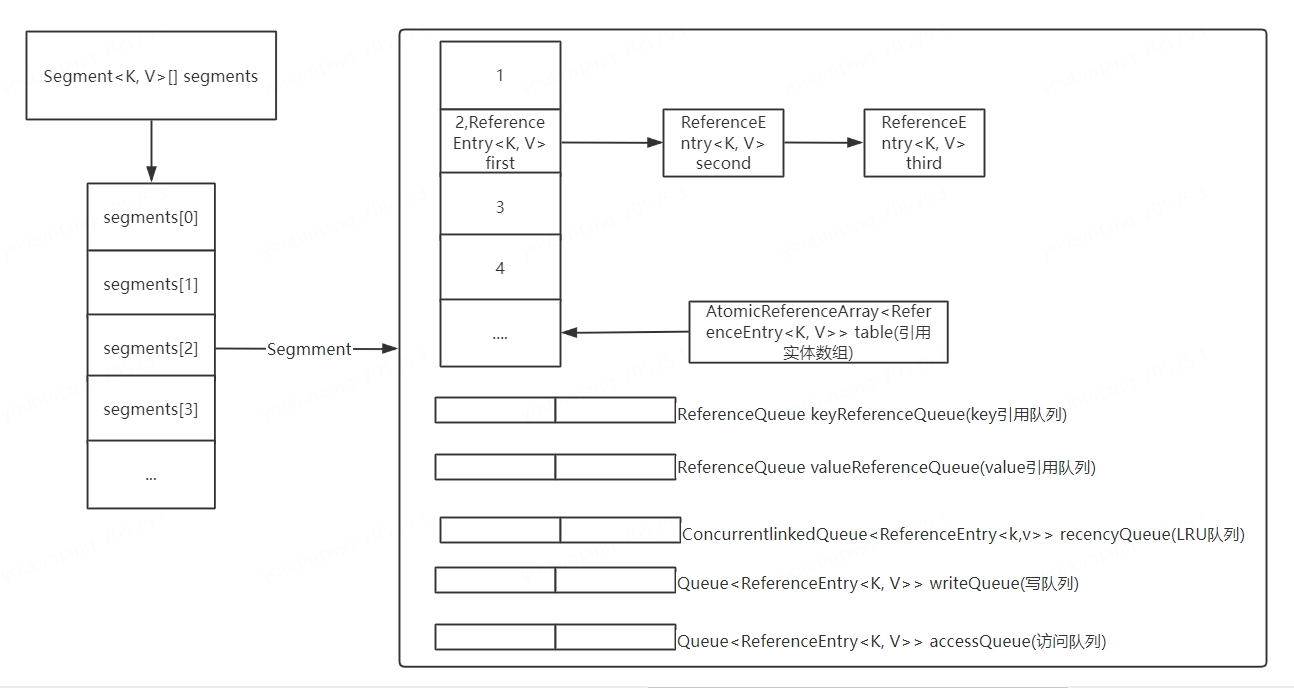
1、什么是LocalCache? 本地缓存是一种将数据存储在应用程序内存中的机制,用于提高数据访问的性能和响应速度。它通过在内存中维护一个键值对的存储结构,允许应用程序快速检索和访问数据,而无需每次都从慢速的数据源(如数据库或网络)获取数据。 2、LocalCache优缺点 1)优点 •快速访问:LocalCache将数据存储在内存中,因此可以快速访问缓存数据,提高应用程序的性能。 •减轻后端负载:通过将经常访问的数据存储在本地缓存中,可以减少对后端数据源的访问次数,降低后端负载,提高系统的整体性能。 •灵活性:LocalCache提供了一些配置选项,如最大容量、过期时间等,可以根据需求进行调整。这使得开发人员能够灵活地控制缓存的行为,以适应不同的业务场景。 2)缺点 •有限的容量:由于LocalCache是基于内存的,因此容量是有限的。如果缓存数据量过大,可能会导致内存消耗过高,影响系统的稳定性。 •单点故障:LocalCache存储在单个应用程序中,如果应用程序崩溃或重启,缓存数据将丢失。这可能会导致缓存冷启动和性能下降。 3、LocalCache应用场景 LocalCache适用于许多不同的使用场景,特别是以下几种情况: 1.**频繁访问的数据:**如果应用程序中有一些频繁被访问的数据,将这些数据存储在LocalCache中可以大大提高访问速度。由于数据存储在内存中,相比于从磁盘或网络中读取数据,从本地缓存中获取数据的速度更快。 2.**减轻后端负载:**通过将经常访问的数据存储在本地缓存中,可以减少对后端数据源(如数据库或API)的访问次数。这样可以降低后端的负载,提高系统的整体性能。 3.**降低网络延迟:**在分布式系统或微服务架构中,不同的服务可能位于不同的节点上,通过网络进行通信。使用本地缓存可以减少对远程服务的调用次数,从而减少网络延迟,提高系统的响应速度。 4.灵活性和可配置性:LocalCache提供了一些配置选项,如最大容量、过期时间等,可以根据需求进行调整。这使得开发人员能够灵活地控制缓存的行为,以适应不同的业务场景。 4、LocalCache实际使用场景 1.**数据库中间件:**数据库中间件是位于应用程序和后端数据库之间的软件层,常见的数据库中间件包括MySQL Proxy、Cobar、MyCat等。这些中间件可以使用LocalCache来缓存查询结果,以减轻后端数据库的负载并提高查询性能。当应用程序发出相同的查询请求时,中间件可以先检查LocalCache中是否有相应的缓存结果,如果有则直接返回缓存结果,否则再向后端数据库发起查询请求。 2.**消息队列:**消息队列是一种用于异步通信的中间件,常见的消息队列系统包括Apache Kafka、RabbitMQ等。在消息队列系统中,LocalCache可以用来缓存消息,以提高消息的处理速度和响应能力。当消费者需要处理消息时,它可以先在LocalCache中查找是否有相应的消息缓存,如果有则直接消费缓存消息,否则再从消息队列中获取消息。 3.**前端应用:**前端应用包括各种Web应用、移动应用和桌面应用,常见的前端框架如React、Angular、Vue.js等。在前端应用中,LocalCache可以用于缓存静态资源(如JavaScript、CSS、图像等)或动态数据,以提高应用的加载速度和用户体验。例如,前端应用可以先检查LocalCache中是否有相应的资源缓存,如果有则直接使用缓存资源,否则再从服务器获取资源并将其缓存到LocalCache中。 4.**服务端应用:**服务端应用包括各种后端服务、微服务和RESTful API等,常见的服务端框架如Spring、Node.js、Ruby on Rails等。LocalCache可以在服务端应用中使用,用于缓存计算结果、数据库查询结果等,以提高性能和减少对外部资源的依赖。例如,当服务端应用需要进行频繁的计算或查询时,它可以先检查LocalCache中是否有相应的缓存结果,如果有则直接返回缓存结果,否则再进行计算或查询,并将结果缓存到LocalCache中。 5.**开源框架:**许多开源框架提供了自己的LocalCache实现,以方便开发人员在应用中使用。这些框架通常提供了丰富的配置选项和高性能的缓存实现,可以根据应用需求进行定制。例如,Guava、Caffeine和Ehcache等是常见的Java开源框架,它们提供了LocalCache的实现,可以用于缓存计算结果、数据库查询结果等。 5、LocalCache在Guava实践 Guava cache 继承了 ConcurrentHashMap 的思路,使用多个 segments 方式的细粒度锁,在保证线程安全的同时,支持高并发场景需求。 1、CacheBuilder 缓存构建器。构建缓存的入口,指定缓存配置参数并初始化本地缓存。采用 Builder 设计模式提供了设置好各种参数的缓存对象。 CacheBuilder<Object,Object> cacheBuilder =CacheBuilder.newBuilder(); 2、LocalCache 数据结构。缓存核心类 LocalCache 数据结构与 ConcurrentHashMap 很相似,由多个 segment 组成,且各 segment 相对独立,互不影响,所以能支持并行操作,每个 segment 由一个 table 和若干队列组成。缓存数据存储在 table 中,其类型为AtomicReferenceArray,具体结构图及代码解释如下。 #Guava中LocalCache声明segments变量 final LocalCache.Segment<K, V>[] segments; #Guava中初始化segments this.segments = this.newSegmentArray(segmentCount); final LocalCache.Segment<K, V>[] newSegmentArray(int ssize) { return new LocalCache.Segment[ssize]; } #获取Segment Segment<K, V> segmentFor(int hash) { return segments[(hash >>> segmentShift) & segmentMask]; } #Guava中Segment声明table变量用于存储数据 volatile AtomicReferenceArray<LocalCache.ReferenceEntry<K, V>> table; V put(K key, int hash, V value, boolean onlyIfAbsent) { #保证线程安全 lock(); #获取数据 AtomicReferenceArray<ReferenceEntry<K, V>> table = this.table; int index = hash & (table.length() - 1); ReferenceEntry<K, V> first = table.get(index); for (ReferenceEntry<K, V> e = first; e != null; e = e.getNext()) { if (e.getHash() == hash && entryKey != null && map.keyEquivalence.equivalent(key, entryKey)) { } } } 3、在Guava中,CacheBuilder提供了一系列方法,用于指定缓存的大小、过期策略、并发级别等属性。 1.配置缓存属性:通过一系列方法来配置缓存的属性,例如: •maximumSize(long size):指定缓存的最大容量,当缓存达到最大容量时,根据缓存策略淘汰部分缓存项。 •expireAfterWrite(Duration duration):指定缓存项的写入后过期时间,过期后的缓存项将被自动移除。 •expireAfterAccess(Duration duration):指定缓存项的最后一次访问后过期时间,过期后的缓存项将被自动移除。 •concurrencyLevel(int level):指定并发级别,即同时可以进行缓存操作的线程数。 Cache<Object,Object> cache = cacheBuilder.maximumSize(1000) .expireAfterWrite(Duration.ofMinutes(10)) .concurrencyLevel(4) .build(); 2. 使用缓存:通过Cache对象的方法来进行缓存的读取、写入和移除操作。例如: •get(Object key):根据键获取缓存项的值。 •put(Object key, Object value):向缓存中添加或更新一个缓存项。 •invalidate(Object key):移除指定键的缓存项。 3. 其他功能:Guava的LocalCache还提供了其他功能,如统计信息、监听器、加载器等,用于监控缓存的状态、处理缓存未命中的情况等。 CacheStats stats = cache.stats(); cache.asMap().forEach((key, value)->System.out.println(key +": "+ value)); cache.cleanUp(); 总结来说,Guava的LocalCache使用CacheBuilder构建和配置缓存,通过Cache对象进行缓存的读取、写入和移除操作。开发人员可以根据自己的需求使用相应的方法和功能来定制和管理缓存。 6、后记 设计一个可用的 Cache 绝对不是一个普通的 Map 这么简单,这里小结一下关于 Guava Cache 的知识。 回归LocalCache 的源头,我是希望可以了解 设计一个缓存要考虑什么?,局部性原理 是一个系统性能提升的最直接的方式(编程上,硬件上当然也可以),缓存的出现就是根据 局部性原理 所设计的。 缓存作为存储金字塔的一部分,一定需要考虑以下几个问题: 1.何时加载 在设计何时加载的问题上,Guava Cache 提供了一个 Loader 接口,让用户可以自定义加载过程,在由 Cache 在找不到对象的时候主动调用 Loader 去加载,还通过一个巧妙的方法,既保证了 Loader 的只运行一次,还能保证锁粒度极小,保证并发加载时,安全且高性能。 2. 何时失效 失效处理上,Guava Cache 提供了基于容量、有限时间(读有限时、写有限时)等失效策略,在官方文档上也写明,在基于限时的情况下,并不是使用一个线程去单独清理过期 K-V,而是把这个清理工作,均摊到每次访问中。假如需要定时清理,也可以调用 CleanUp 方法,定时调用就可以了。 3. 如何保持热点数据有效性 在 Cache 容量有限时, LRU 算法是一个通用的解决方案,在源码中,Guava Cache 并不是严格地保证全局 LRU 的,只是针对一个 Segment 实现 LRU 算法。这个前提是 Segment 对用户来说是随机的,所以全局的 LRU 算法和单个 Segment 的算法是基本一致的。 4. 写回策略 在 Guava Cache 里,并没有实现任何的写回策略。原因在于,Guava Cache 是一个本地缓存,直接修改对象的数据,Cache 的数据就已经是最新的了,所以在数据能够写入 DB 后,数据就已经完成一致了。 参考文献:Google Guava Cache 全解析 作者:京东科技 游斌平 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

技术分享| anyRTC之RTN网络

RTN(Real-time Network)中文名:实时音视频传输网络。 RTN是最近几年由各大RTC的云厂商提出的一个全新架构的音视频实时传输网络概念。类似于直播的CDN网络,RTN是对音视频的实时性又强烈要求的场景而设计的,原理上全球端到端的时延通过RTN网络可以控制在300ms以内。 anyRTC是RTC的云厂商中较早一批提出RTN概念的厂商,anyRTC是如何实现RTN网络的呢?下面我们来详细介绍一下: 一.介绍 首先介绍几个专用名词: A.SN:推流节点 – 多种协议的客户端推流到此节点。 B.RN:路由节点 – 将流路由给不同区域的客户端。 C.GN:拉流节点 – 将流分发给多种协议的客户端。 D.RoutePath:路由线路 – 流从一个区域到另外一个区域的路径。 anyRTC实现的是可配置化的动态RTN网络,网络可大可小,最小的可以只有一台机器,最大的是可以支持千万级的并发,覆盖全球的RTN网络。 二.实现场景 1.单机版 单机服务只需要推流和拉流的功能,A用户推流,B用户拉流。 适用场景: A.测试,不需要复杂的网络架构。 B.业务量较小的私有化音视频通讯场景。 2.进阶版 如果业务中需要2个服务,这时候必须有RN节点,通过RN节点,可以将区域A的流路由到区域B,反之亦然。 适用场景: A.内外网穿透:在很多行业中,比如金融,公安,消防等领域,对于网络安全要求非常高,需要做到内外网隔离,通过固定端口进行数据互通。 B.跨区互通:比如一个公司新疆和上海都有业务,如果服务只部署在新疆或者上海,对应的另外一个区域的用户体验就会非常差,通过各自区域部署节点,本国用户用各自的节点,只有在两区域之间有互动时,通过RN把流中转给对方。 C.跨国运营:比如一个公司中国和美国都有业务,如果美国要求本国的数据必须本地化存储和传输,通过各自区域部署节点,本国用户用各自的节点,进行数据存储和传输,只有在两国之间有互动时,通过RN把流中转给对方。 3.高阶版 多区域的RTN网络,适用于高并发高接入量的应用场景,这时候RN服务独立出来,专门做流路由的工作,SN和GN也可以分离,因为当应对大并发时,拉流的业务需求会多得多。 适用场景: A.RTC云服务厂商,服务有大量RTC接入或者直播接入的场景。 B.多国运营,针对不同国家提供可落地的个性化服务,结合当地法律适配更多场景的运营策略。 C.更低延时的直播CDN分发,CDN厂家可以使用RTN网络来传输节点之间的数据流,然后在各自的落地点进行直播CDN分发。 D.更高规格的网络安全,在行业内,存在网络的隔离区特别多的业务需求,这时候可以使用多区域RTN部署,解决各个网络之间的透传。 E.垮多运营商,比如移动,联通,电信,沃达丰等,各个运营商之间如果直连效果可能不会太好,此时可以在不同运营商的机房中部署服务,RN节点部署在三线机房,通过RN节点进行数据互传。 三.总结 anyRTC通过可配置化的RTN网络,组建了一张全球的RTC传输网络,anyRTC的RTN网络自上线以来实现了超过1000+天的连续稳定运行,平均每日服务的客户接入量超过50w+。同时不久的将来,anyRTC也会开放RTN网络服务,敬请期待吧!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册