首页 文章 精选 留言 我的

精选列表

搜索[自我进化],共7192篇文章
优秀的个人博客,低调大师

AI到底有没有可能进化成我们想象的样子?从Workbuddy成长计划看AI成长历程

AI这段时间的变化我们都看在眼里,相信接触AI的人都知道,AI这两年的变化其实是非常快的。从只有国外AI才是好的,到国内的国产AI逐渐的能够去在日常的生活场景甚至工作场景中熟练运用,这中间发生了太多的事情。而我们和AI的关系,以及我们和AI之间的互动也发生了根本性的变化。那么要把这个东西说清楚,我们需要先聊一下一些前置的话题。

优秀的个人博客,低调大师

产品更新 | Coco AI v0.8 与 Easysearch v1.15 全新功能上线,AI 搜索体验再进化!

INFINI Labs 产品更新发布!此次更新主要包括 Coco AI v0.8 新增窗口管理插件,新的插件类型 View,Linux 文件搜索以及更多的连接器;Easysearch v1.15 新增 UI 插件,提供了轻量级界面化管理功能,不再依赖第三方对集群进行管理,真正做到开箱即用,AI 插件正式提供混合搜索能力,结合了关键词搜索和语义搜索,以提升搜索相关性。 以下为详细更新介绍: Coco AI v0.8 Coco AI 是一款完全开源、跨平台的企业级智能搜索与助手系统,专为现代企业打造。它通过统一搜索入口,连接企业内外部的异构数据源,融合大模型能力,帮助团队高效访问知识,智能决策协作。 Coco AI 本次详细更新记录如下: Coco AI 客户端 v0.8 功能特性 (Features) 改进版本升级,跳过此版本的按钮 支持从本地安装插件 子插件的 JSON 现在也可以设置 platforms 字段 插件设置页面现在可以卸载插件 新增插件设置项 'hide_before_open' App 搜索索引 app 的名字,现在索引多种语言的 app 名字,英文、中文以及系统语言 Debug 模式下,支持 context menu 为 Linux (GNOME/KDE) 实现文件搜索 实现 MacOS 窗口管理插件 新增插件类型 View 对于文件搜索的结果,现在可以打开文件所在的文件夹 问题修复 (Bug Fixes) 修复更新检查失败的问题 修复 web 组件,登录状态的问题 修复快捷键无法打开插件商店的问题 修复设置插件快捷键在 Windows 上崩溃的问题 修复无法通过 "coco://" deeplink 登录的问题 MacOS 文件搜索,确保 mdfind 进程不会成为僵尸进程 修复设置窗口打开是空白的问题 尽最大努力,确保用户添加的 search path 中的文件会被 indexer 索引 修复 MacOS 某些 app 设置空的 CFBundleDisplayName/CFBundleName 导致 app 名字为空的问题 改进优化 (Improvements) 将 query_coco_fusion() 函数拆分 清理 tauri::AppHandle's 类型的范型参数 R 检查各个安装渠道的 plugin.json 文件,确保合法 在 MacOS 上不再为窗口设置 CanJoinAllSpaces 的属性 修复 web 组件构建的问题 为第三方插件安装的过程上锁 MacOS/iOS: 支持从 Assets.car 提取 app 图标,从而不再跳过它们 放宽 MacOS 文件搜索的条件,避免无法搜到的问题 确保 Coco app 在呼出时,不会拿 focus 对于 web 组件,跳过登录检查 对于 View 插件,处理 HTML 文件,使用 convertFileSrc()处理如下 2 个 tag:"link[href]" and "img[src]" Coco APP 相关截图 Coco AI 服务端 v0.8 重大变更(Breaking Changes) 更新语雀的文档 ID 重构数据源同步管理 功能特性 (Features) 支持通过路径层次方式访问数据源中的文档 处理文档搜索的 path_hierarchy 配置 Confluence Wiki 连接器 为 Notion 连接器提取内容 新增网络存储连接器 新增 PostgreSQL 连接器 新增 MySQL 连接器 新增 GitHub 连接器 新增 飞书/Lark 连接器 新增 GitLab 连接器 新增 Salesforce 连接器 新增 Gitea 连接器 新增 MSSQL 连接器 新增 Oracle 连接器 问题修复 (Bug Fixes) 修正助手更新逻辑 生成唯一图标键以防止意外删除所有图标 在 Coco 服务器登录期间修改 access_token URL 修复 Web 小部件的权限问题 由于在搜索框中导入图标而导致的额外高度 全屏模式下页面滚动不工作 解决 API 令牌列表分页问题 MSSQL 分页错误 修复 S3 连接器图标 改进优化 (Improvements) 移除未使用的 WebSocket API 为 Google Drive 添加缺失的根文件夹 更新创建/修改连接器页面上的默认连接器设置表单 调整数据源详情的标题 重构摘要处理器 为 Google Drive 添加缺失的文档 将 Easysearch 初始管理员密码更新为复杂规则 统一许可证头 更新默认数据源编辑页面 重构 OAuth 连接组件 将数据源列表的默认大小设置为 12 在设置中添加搜索设置 在集成全屏中支持页面模式 为列表项添加图标 重构非托管模式的 security API 支持通过路径层次方式访问 local_fs 连接器中的文档 支持通过路径层次方式访问 S3、网络驱动器、GitHub、GitLab 和 Gitee 连接器中的文档 Coco Server 相关截图 Easysearch v1.15 重大变更(Breaking Changes) 针对安全模块的角色名称进行规范,废弃不符合规范的角色 更新创建搜索管道的 API 的 json 结构和说明文档 功能特性 (Features) 新增 ui 插件,涵盖从集群,节点,索引,到分片等不同维度的监控和管理功能以及备份快照、跨集群复制、数据流、热点线程、限流限速配置等管理功能 ai 插件正式提供混合搜索能力,结合了关键词搜索和语义搜索,以提升搜索相关性 ai 插件正式提供混合搜索能力 允许动态的跨模板重用设置 改进优化 (Improvements) index-management 从 plugin 移动到 modules 精简证书错误时的日志输出 改进 search_pipeline 的统计指标 改进角色名称和描述 增加 数据流(Data streams)说明文档 更新搜索管道相关文档 去掉 ILM 配置索引的前缀,并兼容旧索引 Easysearch 新增的 UI 插件为 Easysearch 提供了轻量级界面化管理功能,不再依赖第三方对集群进行管理,真正做到开箱即用。 UI 相关截图如下: 图1:集群登录 ![](https://infinilabs.cn/img/blog/2025/release-20250928/overview.png) 图2:集群概览 ![](https://infinilabs.cn/img/blog/2025/release-20250928/node.png) 图3:节点管理 ![](https://infinilabs.cn/img/blog/2025/release-20250928/index.png) 图4:索引管理 ![](https://infinilabs.cn/img/blog/2025/release-20250928/shard.png) 图5:分片管理 ![](https://infinilabs.cn/img/blog/2025/release-20250928/devtools.png) 图6:开发工具 ![](https://infinilabs.cn/img/blog/2025/release-20250928/lifecycle-policy.png) 图7:生命周期-新增策略 ![](https://infinilabs.cn/img/blog/2025/release-20250928/backup-policy.png) 图8:备份管理-新增备份策略 更多详情请查看以下各产品的 Release Notes 或联系我们的技术支持团队! Coco AI App Coco AI Server INFINI Easysearch 期待反馈 欢迎下载体验使用,如果您在使用过程中遇到如何疑问或者问题,欢迎前往 INFINI Labs Github(https://github.com/infinilabs) 中的对应项目中提交 Feature Request 或提交 Bug。 下载地址: https://infinilabs.cn/download 邮件 :hello@infini.ltd 电话 :(+86) 400-139-9200 Discord :https://discord.gg/4tKTMkkvVX 也欢迎大家微信添加小助手(INFINI-Labs),加入用户群一起讨论交流。 关于极限科技(INFINI Labs) 极限科技,全称极限数据(北京)科技有限公司,是一家专注于实时搜索与数据分析的软件公司。旗下品牌极限实验室(INFINI Labs)致力于打造极致易用的数据探索与分析体验。 极限科技是一支年轻的团队,采用天然分布式的方式来进行远程协作,员工分布在全球各地,希望通过努力成为中国乃至全球企业大数据实时搜索分析产品的首选,为中国技术品牌输出添砖加瓦。 官网:https://infinilabs.cn

优秀的个人博客,低调大师

格灵深瞳AI大脑进化史:算法工业化生产如何将研发和交付提速10倍以上?

云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! AI 前线导读: 为了应对 AI 公司对于算法的快速生产与落地,需要兼顾数据源、数据仓库、标注、算法训练、评价体系、算法使用平台、人力物力算力成本等多方面的限制。也就是需要关注整个算法的生命周期,以及数据闭环。格灵深瞳设计了完整的数据→标注→算法→评测→发布上线的业务体系,具体由 3 大中台并行协作,分别是数据中台、算法中台和应用中台组合完成的。通过该方案,我们将原来的算法研发速度和交付速度提升到了原来的 10 倍以上。本文从 产品角度、项目角度、研发与架构角度 来阐述和描绘算法工业化生产时代到来的必要性和应对之策。本篇文章适合 AI 产品经理、算法研发、数据研发、标注团队、AI 相关项目经理、与 AI 有关的高级管理人员、算法工程化、算法框架研发、算法应用研发等人员阅读,希望可以带来启发。 一、一切从算法需求开始 人工智能是当今的一个非常热门的领域,随着时间的不断向前推移,越来越多的 AI 需求被提出,也有越来越多的 AI 应用落地在不同的领域,如安防、自动驾驶、AI+ 医疗、新零售、智能家居等。从 2019 年来看,AI 貌似进入到了一个落地略微缓慢的时期,但是笔者认为,AI 应用正如当年智能机时代的 App 一样,个人 PC 一样,工业革命时代的蒸汽机一样,量子物理与相对论一样,一旦踹开了历史的大门,就永远不会关闭,除非在未来被更加先进的技术替代,一切也都只是时间的问题。 1. 算法人的窘境 无论是怎样的行业和怎样的应用,AI 都是从某个算法的需求开始的,落实到实际的实现者,往往是算法人员。下面就是一个算法人员的窘境: “我是一个算法工程师,我需要实现一个算法” “哦,看起来我需要让我的算法分数更高” “或许可以尝试 Paper 中提到的新的方法” “我发现算法方法达到了瓶颈,我需要更多的数据” “这些数据看起来需要我全部标注一遍” “看起来分数还有待提高,我需要把上面的过程再多来几遍” “...” “终于算法达到了要求” “但是...” “又有 N 个算法的需求在等着我” 上述的情况我想是大家司空见惯的一个流程,一个 AI 算法的实现,都不是直接敲几行代码就可以完成的,往往需要经历一个漫长的探索和转化过程。 "What is the best alogrithm?" "No Free Lunch Theorems for Optimization" 2. 需求驱动下的算法迭代流程 如下图所示,是从项目角度出发的一个算法的迭代流程,数据是算法的燃料和基础条件,算法结构和优化方法是算法实现的优秀工具,目标 Loss 是算法的终点和约束,需要这三者同时迭代,和相互左右才可以一步步推动算法的前进。 3.AI 需求驱动下的需求链演进: 3.1 朴素需求链 在上述的 AI 需求拉动的算法迭代背景下,算法团队(部门)本身也在发生不同的演进,或许您的产品 / 部门也在这其中的某个阶段: 从上面的分析,从产品所提出的算法需求,衍生出了训练需求和数据需求两部分,而仅仅拥有数据本身是不够的,需要有标注需求对数据打标签(Label),因为通常情况下我们绝大部分的算法需求都是属于有监督学习(Supervised Learning)。通常处在该阶段的算法团队,算法需求的精度要求并不太高,训练、数据、标注需求也都是由算法工程师自己来完成的,属于最初原始期朴素的需求链。 3.2 第一次需求扩张 - 团队扩张 随着算法种类越来越多,且算法要求的精度也越来越高,训练需求、数据需求、标注需求也跟着进行了进一步的延伸和扩大: 训练需求: 需要更多的 GPU 算力设备,于此同时不同的算法框架(Pytorch / Caffe / MXNet / Tensorflow 等)对于环境的要求也不尽相同(OpenCV/Cuda/Cudnn/OpenCL 等),而且无法混合使用,这样便衍生出了多环境支持的需求。 数据需求: 对于数据需求的扩展主要来自于越来越多的数据需要被处理和存储(总体来讲叫做 治理),不同的算法有不同的数据采集过程支撑,同一个算法也有不同批次的数据采集流程,因此需要有数据仓库对于数据进行合理的规划存储,于此同时,越来越多的数据的到来,使得算法人员需要花大量的时间进行数据的处理,否则就会造成延期,因此数据自动化处理的需求也孕育而生。 标注需求: 最朴素的标注工具就是文件和文件夹,但是随着数量的增大(从千量级变到 100w 量级),则需要重新定义标注工具,并进行开发,使得更多的标注需求可以被更快速的满足。曾经最初的时候所有的标注工具是由算法工程师来兼职做的,目前需要更多专职的标注人员来满足这样的需求。 3.3 第二次需求扩张 - 平台化 在上一节的需求分裂归根接地来自于算法 / 产品需求和交付压力,但是即使是扩大团队本身也会出现诸多问题: 训练方面: 显卡因为高成本,但是无论租用 / 购买多少,都觉得不够;多人复用 GPU 环境,造成环境依赖紊乱,环境冲突,需要 Case By Case 的进行环境的修复,给算法的训练造成了非常大的影响 数据方面: 越来越多的数据自动化需求,且逐步增加了精细化数据清洗的需求,单机无法完成,使得算法人员陷入到了数据处理的困境当中无法自拔;巨大的数据量日益增加,无论是数据存储,数据存储复杂度,还是数据量,都变得更加复杂,同时还需要考虑数据运维和数据备份的策略 标注方面: 越来越多的不同类型的标注需求使得对于标注工具的开发需求日益增多,同时逐步增加的标注成本,对于标注人员的日产出量也有了很高的要求。 至此,算法团队的算法工程师们已经无法满足上面的诸多变化了,也因此造成了算法交付的延期。至此,对于平台的需求呼之欲出。 从最初的人工维护,变成了平台支撑,是一步巨大的跨越,同时也开启了工业化生产的第一步——基础生产设备的研发 3.4 面向更大规模生产的业务中心化 随着平台越做越大,为了支撑整个体系的算法业务研发,数据平台、训练平台标注平台逐步向中台演进,于此同时需求的增加,衍生出了算法发布中心、监控中心、用户权限中心、集成中心和应用中心等需求。 所有的资源都需要有监控和权限管理,因此增加了监控中心和用户权限管理中心的业务,至此,从需求来看,作为一个成熟的 AI 公司,至少需要以上的内部研发业务需求才可以支持更加大规模的模型生产。但是上述各个中心都是独立的吗,如果不是有怎样的联系?是否可以进行业务归并?到底需要怎样规模的若干个项目来支撑上述呢?下面的章节将会从实现的角度,将算法生产流程拆分成不同的阶段,进而演化成为数据、算法、应用三大中台。 二、AI 生产阶段化 上一个章节是从原始的需求进行了演化和梳理,本章节从微观的角度来描述数据是如何转化成应用的。 对于当前的深度学习来讲,任何算法都要来源于数据,而数据本身也需要大致经过采集、清洗、入库、挖掘、标注等步骤变成一个可供学习的训练集。就算法本身而言,需要至少经过训练、评测这两个阶段生产出符合要求的模型,同时还要考虑不同的深度学习框架所带来的影响。产出模型之后,有时候我们需要在不同的 GPU 硬件平台(P 卡、T 卡、NPU 等)运行我们的模型,那么我们就需要将模型针对所要适配的平台进行转换和加密。服务程序通过载入模型,生成 API,供应用使用。 1. 数据阶段 我们都知道一个深度学习的模型是需要从训练集开始作为输入的,但是训练集本身也不是现成的很快获得的产物,是需要进行一个生产流程才可以完成。而且训练集本身表征了算法的拟合目标的复杂程度,越复杂的目标,越需要更加大量、多变的数据来尽量表征全部的情况。 "All Data for All Conditions Is The Best Solution" 除了现成的公开数据集,我们的算法往往需要更多的自采集数据集,然而这些采集来的数据往往不具有直接可学习性,因此需要一个流程进行数据的有效性转化,最终生产出可用的训练集,这个转化的过程特别像是“美酒酿造”的过程,从最初的原料采集,到杂质的一层层过滤,通过一些蒸馏、萃取的办法,逐步获得纯净的美酒佳酿。如下图就是训练集的生产阶段: 数据业务层:通过不同的采集业务(离线 / 在线 / 切分 / 日志 / 爬虫)等将粗略的数据原料进行大量的收集,这里的数据量大,复杂,包含大量信息,但是不可学习,同时也并不需要太过频繁的访问。 数据 ETL 层:数据的 ETL 也就是数据的抽取 [Extract]、转换 [Transform]、入库 [Load] 的过程。不同的方式有不同的抽取方法,抽取的目的就是为了从海量原始数据中提取有用的有效的信息,记性数据的清洗和过滤。数据转换的流程是为了将抽取出来的有用的信息进行结构化的表征,通过这样的结构化(时间信息、空间信息、蕴含的初步知识信息等),有用的数据具有了初步的含义和特征,方便后面的精细化操作。数据的入库则是将数据记录到数据仓库中。数据的 ETL 层与数据采集层一样都包含了诸多的自动化 / 半自动化业务线,通常这些业务可以通过任务触发的方式或者是自动化定时任务进行。 数据仓库层:数据仓库层用来进行大规模数据治理和索引,目的是为了确保数据的快速查找、稳定不丢失、可被随意入库出库,灵活的数据动态组织。 数据精加工层:数据精加工层主要的目的不是为了筛选数据,而是为了将数据打上有用的标签(Labeling)。通常这一层可以有 2 中不同的工作方式,一种是数据标注体系,一种是数据挖掘体系,当然这两种体系也有混合使用的情况。通常数据挖掘有两个目的: (1)为了节省数据标注的资源消耗,因为数据标注归根结底是人力成本的消耗,使用数据挖掘是希望通过数据本身的特征、相关性、时空关系等进行标签的批量生成。 (2)数据挖掘是为了发现蕴藏在数据中的新的特征规律,这些规律未来会演化成“数据智能”的方法和产业,不在此篇文章中描述。 数据集市层:数据集市层其实也是一种数据的仓库,但是这样仓库是专门为了之后的算法训练而准备的。因为我们希望数据尽量覆盖全部场景下的全部情况,所以数据集市本身是面向不同算法的,多种版本的训练集、评测集的集合。 2. 模型阶段 模型阶段如下图所示,共分为训练层、评测层、模型转换层以及模型发布层: 训练层:训练层主要的目的其实是载入训练集,编写训练代码,进行模型训练。在训练层主要考虑的问题有训练集载入、GPU 的资源使用、算法框架的使用和编写、模型的训练、分布式训练、神经架构搜索、模型优化方式等。 评测层:评测层相对简单,在模型训练的时候本身是存在验证集(ValidationSet)的验证的过程的,但是这样的过程无法说明模型本身就是优秀的,正如 Kaggle 竞赛中一样,总是会有评测集(TestSet)被保存下来,不会引入到模型的训练流程中,在模型产出后希望向后续进行的时候,会进行评测验证,在这一层还需要考虑的问题是评测方法是怎样的例如常见的方法(RoC / PR / AUC / F-Score / mAP 等)。 模型转换层:产出的模型即使通过验证,往往也需要支持在不同的显卡和平台上运行,例如 Turing、Pascal、NNIE、ARM 等,因此需要模型可以被转换到些平台上进行专门的加速;于此同时模型还可能会进行压缩,目的是为了提高效率例如 mimic、Distilling、Prunning、Int8 Quantization 等;还有些时候我们需要对模型进行加密输出。 模型发布层:对于模型的发布事实上是一种库的管理,基于这样的库来记录模型的版本,位置,访问权限等 3. 应用阶段 集成层:集成层主要是为了将算法进行工程化改造,将“数学模型”改造成工程代码中易用的“函数”,因此集成层的主要输出是 SDK,通常这些 SDK 的目的是为了支持不同语言、不同平台(云或者嵌入式设备)、不同应用需求(基于不同的应用会有不同的 pipeline 或者算法组合)。 应用层:应用层较为灵活,主要有两种形态存在,一种是服务,中是 AI 应用(手机端、云端、Saas、系统)。该层主要的核心,应该在于模型的快速打包上线,以及运维部署。 4. 数据 - 模型 - 应用的转化图 一个完整的算法周期如下图所示,总共分为三个阶段,分别是 数据阶段、模型阶段、应用阶段,这三个阶段代表了一个算法的需求从提出到最终解决所经历的所有“工序”,而且无论对于怎样的企业,怎样的算法团队,这样的工序中的每一步使用怎样的工具、基础设施和人才,这样的转化流程是客观存在的,我们叫它数据 - 模型 - 应用流转图。 数据 - 模型 - 应用 流转图 根据三种不同的阶段,可以将真个 AI 生产业务拆分成为数据中台、算法中台、应用中台三部分。下面的章节将对于这三大中台进行技术架构分析。 三、数据中台体系与架构 数据中台架构如下图所示: 底层的原始数据有在线和离线,但是为了做好自动化,需要有 Airflow 或者 Azkaban 这样的计划任务管理作为支持。但是面对不同的业务线,随时会用源源不断的原始数据流入,因此,对于原始数据的实时(分布式)处理显得尤为重要。Kafka/Nsq 充当了任务异步下放或者数据总线的角色。Nsq 极易操作,在架构早期或者是突发数据业务,建议使用,后期由于中台业务的发展,对于业务吞吐有了一定的要求以及集群资源的扩充,可以延伸至 Kafka。 对于数据仓库,可以使用多种不同的方式同时存储,因为不同的存储各有所长,不过基本上的搭配是“结构化搭配非结构化”,“分布式搭配集中式”。 结构化搭配非结构化,例如,Postgres+Weedfs 或者 HDFS+HIVE 或者 WeedFS +HIVE + HBase 属于结构化搭配非结构化。这么做的原因是结构化数据与非结构化数据的特性以及读写需求不同,因此需要在存储上进行各自区别存储。非结构化数据磁盘占用量大,只需要 key 作为唯一索引,读取次数较少(在训练以前),对于存储需要频繁写操作,因此只需要选用对象存储即可。结构化数据对于索引、关联需求较大,所占空间较小,因此可以选型 SQL 类型的关系数据库。事实上在后续的数据挖掘过程中,非结构化数据(图像、视频、语音等)通常访问很少,大部分只用到了结构化信息。 分布式搭配集中式,分布式如 Ceph、HDFS 等都属于典型的分布式文件系统,集中式例如 Postgres、Weedfs 本质上更适合集中式管理,当然如果基于数据的 Domain 做成类分布式,但是本质一样。两者搭配首先对于数据进行了冗余存储,分布式易于快速访问,以及上层的分布式挖掘计算,集中式写稳定,易于进行后续的备份、数据质检、对于断电重启容忍度较高,不用关心 Re-Balance 等分布式事务带来的诸多困扰。 四、算法中台体系与架构 算法中台体系如下图所示: 之所以是混合云环境,是因为这样可以合理利用好云上和云下的优缺点,云上具有极好的资源可扩展性,通常分布式训练,神经架构搜索,自动化调参,大规模机器学习实验因为其要求时间较长,且对于集群的稳定性和速度具有极高的要求,因此最适合在云上进行;而云下更加适合保密性的且与数据相关的操作。对于混合云架构可以使用双重加密方法,既 数据型加密 和 网络型加密,数据型加密保证了云上所在的数据具有不可逆性,无法被直接访问或者解码,网络型加密例如防火墙白名单、IPSec、SSL 层都是类似,使得对于云上设备通信进行信道的加密和权限的管理。 Kubenetes 作为当前最好用的云原生管理平台,可以很好的保证 GPU 资源的动态分配和再利用,基于它和周围的组件使得交互式的实验环境、离线训练方法、分布式训练、大规模训练得到了有效的利用。 还有一点就是训练中台事实上是 GPU 云的任务下放中台,对于数据集(盘)的动态分配显得尤为重要,这里可能会有三种方式:SSD-NFS 方式、Ceph-RBD 方式以及对象存储 OSS 方式。 五、应用中台 此部分可以略去架构图,因为不同的企业和方案对应的应用中台是不同的。总体架构图如下: 模型的载入层提供接口进行动态模型的下载,计算资源动态规划有两种,分别是程序内的动态资源规划与平台级动态资源规划,如果是程序内的动态资源规划需要决定显存中模型的存放位置和大小,动态释放不用的模型,来保证对于热模型的快速调用,而平台级动态资源规划,则是把一个载入模型的服务作为一个 Deployment 资源,交给 Kubernentes 进行动态的分配。通常情况下模型的本身应该是被加密过的,因此在载入的时候需要进行模型的编解码,于此同时,数据也是如此,为了保护用户数据防止泄漏,真正存储的数据是需要被加密的,只有在读入的时候进行解密。 六、面向 AI 的工业化生产体系——AI 大脑 根据前文所述,整体的 AI 生产业务架构如图所示: 而这三大中台本身的实现有慢慢会向一个非常大的平台融合,这个“大平台”本身不应该是一个一贯的(例如一个 repo、一份代码、一种编程语言)开发的平台,而是多个平台形成的多个中台的上层业务合并,根据我们前面梳理的业务,笔者总结出了大脑的业务地铁图,从数据到模型再从模型到应用,最终从应用又回到了数据,这样的一个数据流、算法流、应用流形成的闭环就是 AI 大脑。 说几个宏观一点的指标,在整个深瞳大脑构建的项目中,我们成功的将整个数据业务到训练集生产的进度从之前的遥遥无期(2 月为单位)压缩到 2 周内,算法模型的发布流程从月为单位压缩成天为单位(提升 10 倍以上),GPU 集群平均使用率从 15% 提升至 70%(4 倍以上),GPU 显卡资源使用量压缩到原来的 60%,但是仍然很好的支撑全公司的算法生产业务。 七、结束语与未来展望 本文主要介绍的是以深度学习为核心的大规模 AI 生产的演化过程以及其衍生结果算法中台、数据中台以及应用中台的架构设计以及业务流程设计,通过描述最早期原始的算法手工作坊的方式到后面数据中台、算法中台、应用中台三大中台配合的方式,演绎了面向算法研发效率提升的迭代改进。当前的算法生产还是在面临成本高,产出小,周期长的问题,但是随着越来越多的中台和自动化引入,会将算法的流程不断加快,成本不断降低,只有在数据、算法、应用三者紧密配合的前提下,才可以有效的提升整个 AI 业务的流程。 云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 原文发布时间:2020-1-11本文作者:黄严本文来自阿里云云栖号合作伙伴“AI前线”,了解相关信息可以关注“AI前线”

优秀的个人博客,低调大师

94倍性能进化!阿里云企业级ECS发布会推出最新一代异构计算产品

随着深度学习对人工智能的巨大推动,深度学习所构建的多层神经网络模型的参数空间已从百万级上升到百亿级,这对计算能力提出了新的挑战。 在8月9日的阿里云企业级ECS发布会上,最新一代异构计算通用GPU实例GN5规格族就是一款用于搭建深度学习加速平台的云端利器,相比上一代GPU计算型实例,GN5最高性能提升了整整94倍。 “品学兼优”的GN5采用了NVIDIA Pascal架构旗舰级P100 GPU,可在云端按需构建敏捷弹性、高性能和高性价比的深度学习平台,让用户以最简便地方式享用阿里云遍布全球的高效、稳定的云基础设施资源。与上一代相比,GN5的单实例性能拓展了5倍,单实例最多可提供8个 NVIDIA P100 GPU,提供2万多个并行处理核心,最高75TFLOPS FP32单精度浮点、150 TFLOPS FP16半精度浮点和38 TFL

优秀的个人博客,低调大师

ToolForge v0.2.1 正式发布:新增 20+ 款在线插件,插件下载统计上线,Rust + Tauri 开源工具箱持续进化!

最近一直在持续完善自己的开源桌面工具箱 ToolForge,今天正式发布 v0.2.1! ToolForge 是一款基于 Rust + Tauri 2 构建的开源桌面工具箱,面向开发者和效率工作者,通过插件化架构整合开发调试、数据处理、文件管理、系统工具以及日常效率工具。 在之前的 v0.2.0 中,我们重点完善了 WASM 插件运行时、在线插件市场以及官网一键安装能力。 这次 v0.2.1,我们继续围绕插件生态进行扩展,同时也开始完善插件分发基础设施。 本次更新的主要亮点: 新增 20 多款在线插件,覆盖开发调试、数据分析、生活效率和益智娱乐。 新增统一插件下载统计,官方网站可以展示插件下载量。 完善基于腾讯云 COS 的插件分发与下载统计流程。 新增 Protobuf 兼容性分析、GeoJSON 检查、CBOR/MessagePack 检查等开发工具。 增强 Markdown 编辑器、JWT、时间戳转换、图片拼接等现有工具。 优化插件自动构建、发布和部署流程。 相比之前几个版本,这次不再局限于增加传统开发工具,还开始尝试将 ToolForge 扩展到更多日常场景。 一、插件下载统计正式上线 这是 v0.2.1 在插件基础设施方面的一项重要更新。 随着 ToolForge 在线插件数量不断增加,我们需要知道: 哪些插件真正有人使用?哪些工具更受欢迎? 此前,插件市场已经支持安装、更新和卸载,但缺少统一的下载统计能力。 本次新增了插件下载统计服务,并与插件发布流程和官方网站进行了集成。 1. 官网展示插件下载量 现在 ToolForge 官方网站的插件卡片可以展示对应的下载统计信息。 通过这些数据,可以更加直观地了解不同插件的下载情况,也为后续插件开发和维护提供参考。 官方网站: https://toolforge.devlive.org/ 2. 统一插件下载统计服务 本次增加了一套独立的插件统计服务,用于统一处理在线插件的下载统计。 插件文件通过腾讯云 COS 托管,配合下载统计服务完成相关流程。 主要包括: 统一管理插件下载统计。 支持私有 COS 存储桶的预签名下载。 提供可供官网读取的统计数据。 支持跨域读取统计接口。 让插件目录能够展示下载量。 这套机制没有依赖 COS 访问日志进行统计,而是通过独立服务处理插件下载请求及统计逻辑。 对于后续建设插件市场来说,这也是一项基础能力。 3. 自动化部署与发布 为了减少服务维护成本,本次还增加了插件统计服务的自动化部署能力。 包括: 一条命令初始化统计服务。 自动构建统计服务。 使用 SSH 和 SCP 完成部署。 支持在 dev 分支更新后自动部署。 完善插件目录数据导入。 修复服务配置和部署路径相关问题。 插件发布流程也进行了优化。 现在可以只上传重新打包的插件,并安全地重建插件索引,避免每次发布都重复上传全部插件。 同时,应用版本发布后也会触发官方网站重新构建,让网站展示的信息与发布内容保持同步。 二、开发者工具继续扩展 这次新增了多款面向实际开发场景的工具,尤其针对接口调试、数据格式、构建分析和测试报告等方向。 1. Protobuf 兼容性对比 新增 Protobuf Diff 在线插件。 在微服务和跨语言通信场景中,Protocol Buffers 是很常见的数据序列化协议。 但随着接口不断迭代,.proto 定义也可能发生变化。 例如字段编号、字段类型或消息结构发生调整时,可能影响旧版本客户端的兼容性。 这次新增的 Protobuf Diff 可以对描述符进行兼容性差异分析,辅助开发者检查协议变更。 对于长期维护 gRPC 接口的项目来说非常实用。 2. CBOR / MessagePack 检查器 新增 CBOR/MessagePack Inspector。 CBOR 和 MessagePack 都是常见的二进制数据序列化格式。 相比 JSON,它们通常具有更紧凑的数据表示形式。 但二进制格式不如 JSON 直观,排查数据问题时经常需要专门的工具。 现在可以通过 ToolForge 离线检查 CBOR 和 MessagePack 数据。 3. GeoJSON 检查器 新增 GeoJSON Inspector。 支持按照 RFC 7946 对 GeoJSON 数据进行离线检查。 对于 WebGIS、地图应用、地理空间数据处理等场景,可以帮助开发者检查 GeoJSON 数据结构。 4. CORS 预检检查器 新增 CORS Inspector。 前后端分离开发中,跨域问题几乎是每个开发者都遇到过的情况。 尤其是涉及自定义请求头、请求方法或者身份认证时,浏览器可能先发送 OPTIONS 预检请求。 新增的工具可以离线检查 CORS 预检相关配置,辅助分析跨域请求问题。 5. XML 格式化与 XPath 查询 新增 XML Formatter 在线插件,支持有边界限制的 XPath 查询。 对于需要处理 XML 配置、接口响应或历史系统数据的开发者,可以通过 XPath 快速定位目标节点。 6. Bundle 构建产物分析 新增 Bundle Analyzer。 支持分析构建工具产生的 Metafile 数据。 在前端项目中,随着依赖增加,构建产物可能越来越大。 通过 Metafile 分析,可以辅助开发者了解打包产物的模块组成,为构建优化提供参考。 7. JUnit 测试报告查看器 新增 JUnit Viewer。 支持离线查看 JUnit 测试报告。 很多 Java 项目和 CI 测试工具会输出 JUnit 格式的测试结果。 现在可以通过 ToolForge 查看这些报告,而不必依赖完整的 CI 平台界面。 8. Windows 注册表文件检查器 新增 Registry Viewer。 支持检查和比较 .reg 导出文件。 对于需要管理 Windows 配置、分析注册表变更的开发者和系统管理员来说,可以更方便地查看文件内容与差异。 9. 系统代理配置检查器 新增 Proxy Inspector。 提供只读的系统代理来源检查能力。 在开发过程中,代理配置问题有时比较难排查,尤其是系统配置、应用配置和不同网络环境之间存在差异时。 这一工具可以辅助检查代理配置来源,并以只读方式进行分析。 10. Pairwise 组合测试生成 新增 Pairwise 插件。 支持带约束条件的组合测试矩阵生成。 在软件测试中,如果存在多个配置维度,完全枚举所有组合可能产生大量测试用例。 Pairwise 两两组合测试是一种常见的组合测试设计方法。 通过这项工具,可以根据测试参数和约束生成测试组合,辅助减少重复测试设计工作。 三、日常效率工具进一步丰富 ToolForge 最初主要面向开发者,但我也希望它能够帮助用户解决更多日常工作中的小问题。 因此,这次增加了一些不完全属于传统开发场景的工具。 1. 多时区会议规划 Timestamp 工具新增 多时区会议规划标签页。 对于跨地区协作的开发团队来说,安排会议经常需要换算多个时区。 现在可以通过统一界面进行多时区时间规划,减少手动计算带来的麻烦。 2. Markdown 编辑器增强 Markdown Editor 新增: 多文件标签页 可配置的自动保存 对于经常编写 README、技术文档和 Markdown 笔记的开发者,可以更加方便地切换多个文档。 3. 图片拼接支持 PDF 联系表 Image Stitcher 新增 Contact Sheet PDF 导出。 除了将多张图片拼接成单张图片,现在也支持将图片联系表导出为 PDF。 适合整理产品截图、图片素材和需要集中展示的图片内容。 4. 家庭事务轮换规划 新增 Chores 插件。 支持家庭事务的轮换安排。 例如家庭成员之间需要轮流承担不同任务时,可以通过工具进行规划。 5. 冰箱库存管理 新增 Fridge Inventory。 支持按照批次管理库存。 适合记录日常食品库存,尤其是需要区分不同采购批次的场景。 6. 旅行打包清单 新增 Packing List。 提供离线旅行物品清单管理能力。 出行之前可以整理需要携带的物品,减少遗漏。 7. 多人费用分摊 新增 Expense Splitter。 支持离线记录和计算多人费用分摊。 适用于朋友旅行、聚餐、多人共同消费等场景。 本次还完善了付款记录后的余额更新和实际结算明细保留逻辑。 8. 健身训练记录 新增 Workout Log。 提供离线力量训练日志功能。 可以用于记录日常训练内容,方便回顾训练情况。 9. 编织行数与针数记录 新增 Knitting。 支持编织过程中的行数和针数跟踪。 这类功能虽然比较小众,但也体现了插件化工具平台的优势:不同场景可以通过独立插件满足,而不需要让所有用户都使用相同的工具。 10. 间隔复习闪卡 新增 Flashcards。 支持间隔复习的闪卡工具。 适合单词记忆、知识点复习和其他需要反复记忆的学习场景。 四、新增多款益智与创意插件 这次还有一个比较有意思的变化: ToolForge 的插件市场开始出现更多游戏和创意类工具。 对于一个桌面工具平台来说,插件不一定只能用于格式转换和开发调试。 1. 数独风格的 Nonogram 逻辑填图 新增 Nonogram。 这是一类根据行列数字线索填充网格的逻辑谜题。 本次插件还加入了解的唯一性验证能力。 2. 照片拼图 新增 Jigsaw。 支持将照片用于拼图游戏。 3. 迷宫生成 新增 Maze。 支持生成可复现的迷宫谜题。 对于需要重复生成相同谜题的场景,可以利用可复现机制获得一致结果。 4. 分形图形探索 新增 Fractal Explorer。 支持探索: Mandelbrot 集 Julia 集 对于数学可视化和分形图形感兴趣的用户,可以通过工具进行交互探索。 5. Low Poly 图片艺术 新增 Low Poly。 支持将照片处理为可编辑的低多边形风格艺术图形。 6. 桌游计分 新增 Boardgame Score。 支持按回合记录桌游得分。 对于需要多轮计分的桌游场景,可以减少手动统计。 这些工具的加入,也让 ToolForge 的插件市场开始覆盖更多兴趣和娱乐用途。 五、已有开发工具继续增强 除了新增插件,本次还对已有功能进行了补充。 JWT 支持 JWE 调试 JWT 工具新增 JWE Compact 解密调试能力,并迁移到在线插件市场。 对于需要处理 JSON Web Encryption 的开发者,可以使用该工具辅助排查加密 Token 的相关问题。 HTTP Client 交互优化 为 HTTP Client 集合工具栏中的图标按钮补充了提示信息。 让图标操作的含义更加清晰。 JSON Schema 编辑体验优化 调整 JSON Schema 的编辑区域: 编辑器内部独立滚动。 Instance 和 Schema 保持并排展示。 方便同时检查待验证数据和 Schema 定义。 插件图标视觉优化 在线插件现在可以根据 Manifest 中定义的强调色展示图标颜色。 让不同插件具有更好的视觉辨识度。 六、插件构建和发布流程优化 随着在线插件数量不断增加,如何稳定地构建和发布这些插件,也成为项目维护的重要部分。 本次对相关流程进行了多项调整。 主要包括: 固定插件构建使用的 Rust 工具链。 优化私有 COS 存储桶的读取流程。 修复插件状态序列化问题。 优化插件打包后的回读检查。 仅上传重新打包的插件文件。 安全重建插件索引。 自动部署下载统计服务。 在版本发布后重新构建官方网站。 完善插件工作区依赖和锁文件。 另外,还针对多个新插件补充了严格的 Rust CI 检查和相关测试。 包括: GeoJSON Inspector CBOR/MessagePack Inspector Registry Viewer Proxy Inspector Low Poly 其中,Low Poly 还补充了 PNG 和 SVG 渲染检查。 这些工作虽然不像新增工具那样容易被用户直接感知,但对开源项目的持续维护来说同样重要。 七、问题修复与稳定性提升 本次还修复了一些使用体验和运行稳定性问题。 1. 下载资源处理 优化资源下载时的失败重试机制,并保留任务错误详情。 在下载失败时,可以保留更有价值的错误信息,方便排查。 2. Expense Splitter 修复记录付款后余额计算不正确的问题,并完善结算明细的保留。 3. CSP Inspector 修正部分序列化字段的命名格式,并优化资源列表的内部留白。 4. Chores 修复分类 ID 使用问题。 5. Port Manager 继续改进端口监听归属相关测试,减少不稳定情况。 6. 在线插件市场 修复相关构建、状态处理和插件图标展示问题,完善插件发布流程的可靠性。 八、从开发者工具箱到可扩展的桌面工具平台 回顾最近几个版本,ToolForge 的发展方向越来越清晰。 版本 主要更新 v0.1.7 文件夹对比、Hex 查看器、PDF、文本编码转换等基础工具 v0.1.8 文档转换、JSON 查询、图片取色、日期计算等工具扩展 v0.1.9 键鼠统计、PDF OCR、Excel 查看器以及插件后台服务 v0.1.10 插件市场、WASM 运行时、签名 .tfp 插件包和独立发布 v0.2.0 官网一键安装、WASM 网络能力增强以及更多在线插件 v0.2.1 统一下载统计、20 多款新插件以及插件分发基础设施完善 最初开发 ToolForge 时,我希望它是一个轻量、实用的开发者桌面工具箱。 但随着工具数量不断增加,我开始更多地思考: 能不能让不同开发者根据自己的需求扩展 ToolForge,而不是所有工具都由应用本身统一维护? 这也是后来引入插件市场、WASM Component 运行时以及独立插件分发机制的原因。 从 v0.1.10 到 v0.2.1,ToolForge 已经逐步具备: 内置工具与在线插件并存。 在线安装、更新和卸载。 独立插件包与签名分发。 WASM 插件运行能力。 官网一键安装插件。 插件独立构建和发布。 插件下载统计。 工具执行历史。 而这次新增的生活效率、益智游戏和创意类工具,也让插件生态开始覆盖更多场景。 我希望未来的 ToolForge 不只是一个开发者工具集合,而是一个能够由社区共同扩展的桌面工具平台。 当然,项目目前仍然在持续开发中,插件开发体验、权限管理、文档和整体稳定性还有不少需要完善的地方。 九、项目地址与下载 项目名称: ToolForge 当前版本: v0.2.1 技术栈: Rust + Tauri 2 官方网站: https://toolforge.devlive.org/ GitHub: https://github.com/devlive-community/toolforge 版本下载: https://github.com/devlive-community/toolforge/releases 完整版本变更: https://github.com/devlive-community/toolforge/compare/v0.2.0...v0.2.1 项目完全开源,欢迎大家体验。 如果之前使用过 ToolForge,可以升级到 v0.2.1,体验新的插件和功能。 也可以通过官方网站浏览在线插件目录,选择自己需要的工具进行安装。 十、最后 对于我来说,v0.2.1 是一次工具生态和基础设施同时扩展的版本。 一方面,我们继续增加各种实用插件,尝试覆盖更多开发、学习和日常生活场景。 另一方面,也开始完善插件下载统计、分发服务、自动化构建和部署流程。 相比单纯增加工具数量,我更希望 ToolForge 能够形成一套可以长期维护和持续扩展的插件体系。 未来希望有更多开发者参与进来,一起开发工具、完善插件 SDK 和改进使用体验。 如果 ToolForge 对你有所帮助,欢迎在 GitHub 点个 Star。 也欢迎通过 Issue 或 Pull Request 反馈问题、提出建议和参与开发。 最后想和大家讨论一个问题: 你觉得一个插件化的桌面工具箱,应该专注于开发者工具,还是也应该像现在这样,逐渐覆盖生活效率、学习和创意工具? 欢迎在评论区交流! GitHub: https://github.com/devlive-community/toolforge 官方网站: https://toolforge.devlive.org/ Releases: https://github.com/devlive-community/toolforge/releases

优秀的个人博客,低调大师

ToolForge v0.1.8 正式发布:一口气新增 11 款实用工具,开源桌面工具箱持续进化!

ToolForge v0.1.8 正式发布! ToolForge 是一款基于 Rust + Tauri 2 构建的开源桌面工具箱,面向开发者和效率工作者,致力于将日常开发、文件处理和效率工具整合到一个应用中。 继 v0.1.7 之后,我们继续扩展工具生态。本次 v0.1.8 带来了 11 款全新工具,涵盖文档处理、数据转换、开发辅助、系统管理以及日常效率等多个领域。 同时,我们还优化了插件的跨平台兼容能力,修复了部分已知问题,进一步提升整体使用体验。 ✨ 本次更新亮点 📄 文档格式转换 新增文档转换工具,支持 Word、Excel 和 PDF 等常见办公文档格式之间的转换。 无需频繁切换不同的软件,让日常文档处理更加便捷。 📊 表格格式转换 新增表格转换工具,支持常见表格数据格式之间的转换。 方便开发者进行数据整理、格式适配以及不同系统之间的数据交换。 🔍 JSON 查询 新增 JSON 查询工具,支持: jq 表达式查询 JSONPath 路径查询 面对复杂的 JSON 数据,无需手动逐层查找,使用表达式即可快速提取所需内容。 🎨 图片取色与调色板 新增图片颜色提取工具。 支持从图片中选取颜色,并自动提取图片调色板,适用于 UI 设计、前端开发以及品牌配色分析。 🔗 URL 解析工具 新增 URL 解析与编辑工具。 可以快速解析 URL 结构,并编辑查询参数,让接口调试和链接处理更加方便。 📅 日期计算器 新增日期计算工具,支持: 日期加减计算 工作日计算 日历查看 适用于项目排期、工作计划以及日常日期计算等场景。 🔢 数字金额转换 新增数字转文字工具。 支持人民币金额大写、数字文字表达等转换功能,适用于财务文档及日常文本处理。 🏷️ 条形码工具 新增条形码生成与识别功能。 可以快速生成或读取条形码,方便开发测试与日常使用。 🎲 随机工具 新增随机工具集合,支持: 随机数字 随机姓名抽取 随机分组 掷骰子 适用于随机测试、活动抽签、团队分组等场景。 🖥️ Windows 右键菜单管理 新增 Windows 右键菜单管理工具。 可以集中管理 Windows 系统右键菜单,让日常文件操作更加高效。 🖼️ 图标生成器增强 在已有应用图标生成器的基础上,新增: 图标模板 文件夹图标设置 让应用资源制作和文件夹个性化更加方便。 🛠️ 优化与修复 除了新增功能,本次版本还带来多项改进: 跨平台支持:插件现在可以声明支持的操作系统平台,为不同系统提供更准确的工具展示。 PDF 页面编辑:优化页面拖拽排序,增加拖放位置提示。 压缩文件处理:修复压缩包内中文文件名和文本的解码问题。 图标生成器:修复 Windows desktop.ini 文件的 UTF-16 读取问题。 剪贴板权限:完善需要复制结果的插件权限声明。 稳定性改进:优化端口管理器测试及发布流程。 🌱 开源社区建设 本次更新还完善了 GitHub 社区协作体验: 新增中英文 Pull Request 模板。 新增中英文 Issue 表单。 补充新增工具的使用文档。 我们希望让更多开发者能够轻松参与 ToolForge 的开发与维护。 🚀 关于 ToolForge ToolForge 是一个持续发展的开源桌面工具项目。 我们希望它不仅仅是几个小工具的集合,而是一个真正实用、轻量、可扩展的桌面工具平台。 项目主要特点: Rust + Tauri 2:构建轻量化桌面应用。 插件化架构:工具模块独立,方便持续扩展。 本地化处理:重视数据隐私与本地操作体验。 跨平台设计:根据平台能力提供对应工具。 现代化界面:统一的工具交互体验。 开源免费:欢迎社区贡献与交流。 从 v0.1.7 到 v0.1.8,我们持续丰富工具生态,希望逐步减少开发者在不同工具和网站之间反复切换的成本。 🔗 项目地址 GitHub: https://github.com/devlive-community/toolforge 版本: v0.1.8 欢迎大家下载体验! 如果 ToolForge 对你有所帮助,欢迎在 GitHub 点个 Star ⭐。 也欢迎通过 Issue 或 Pull Request 提出建议、反馈问题,或者一起开发新的工具插件。 你最希望 ToolForge 下一步增加什么功能?欢迎在评论区交流!

优秀的个人博客,低调大师

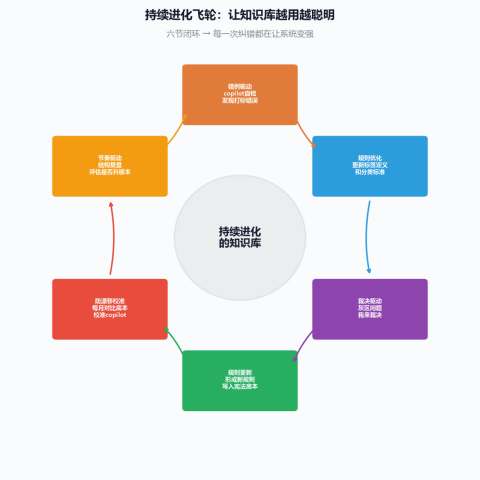
技术专访|GEO高级优化师、落地工程师、AIGC应用工程师罗长才:自省约束工程——工业实体与大模型知识库的自我校验机制

记者:罗工,在大量工业实体GEO落地项目,例如伊斯提亚铸铁厂这类制造主体的知识库治理工作中,除实体对齐、信源清洗、向量召回之外,你反复提到“自省约束”这一工程概念。同时你经常引用荀子、曾国藩、林则徐的历史文本,把人文自省思想映射到技术架构,能否先解释,为什么工业实体知识库,需要引入“自省校验”的元数据体系?

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。


用户登录
用户注册