LlamaFactory × 多模态RAG × Chat-BI,万字长文揭秘RAG进化迷踪,打造专业AI助手!
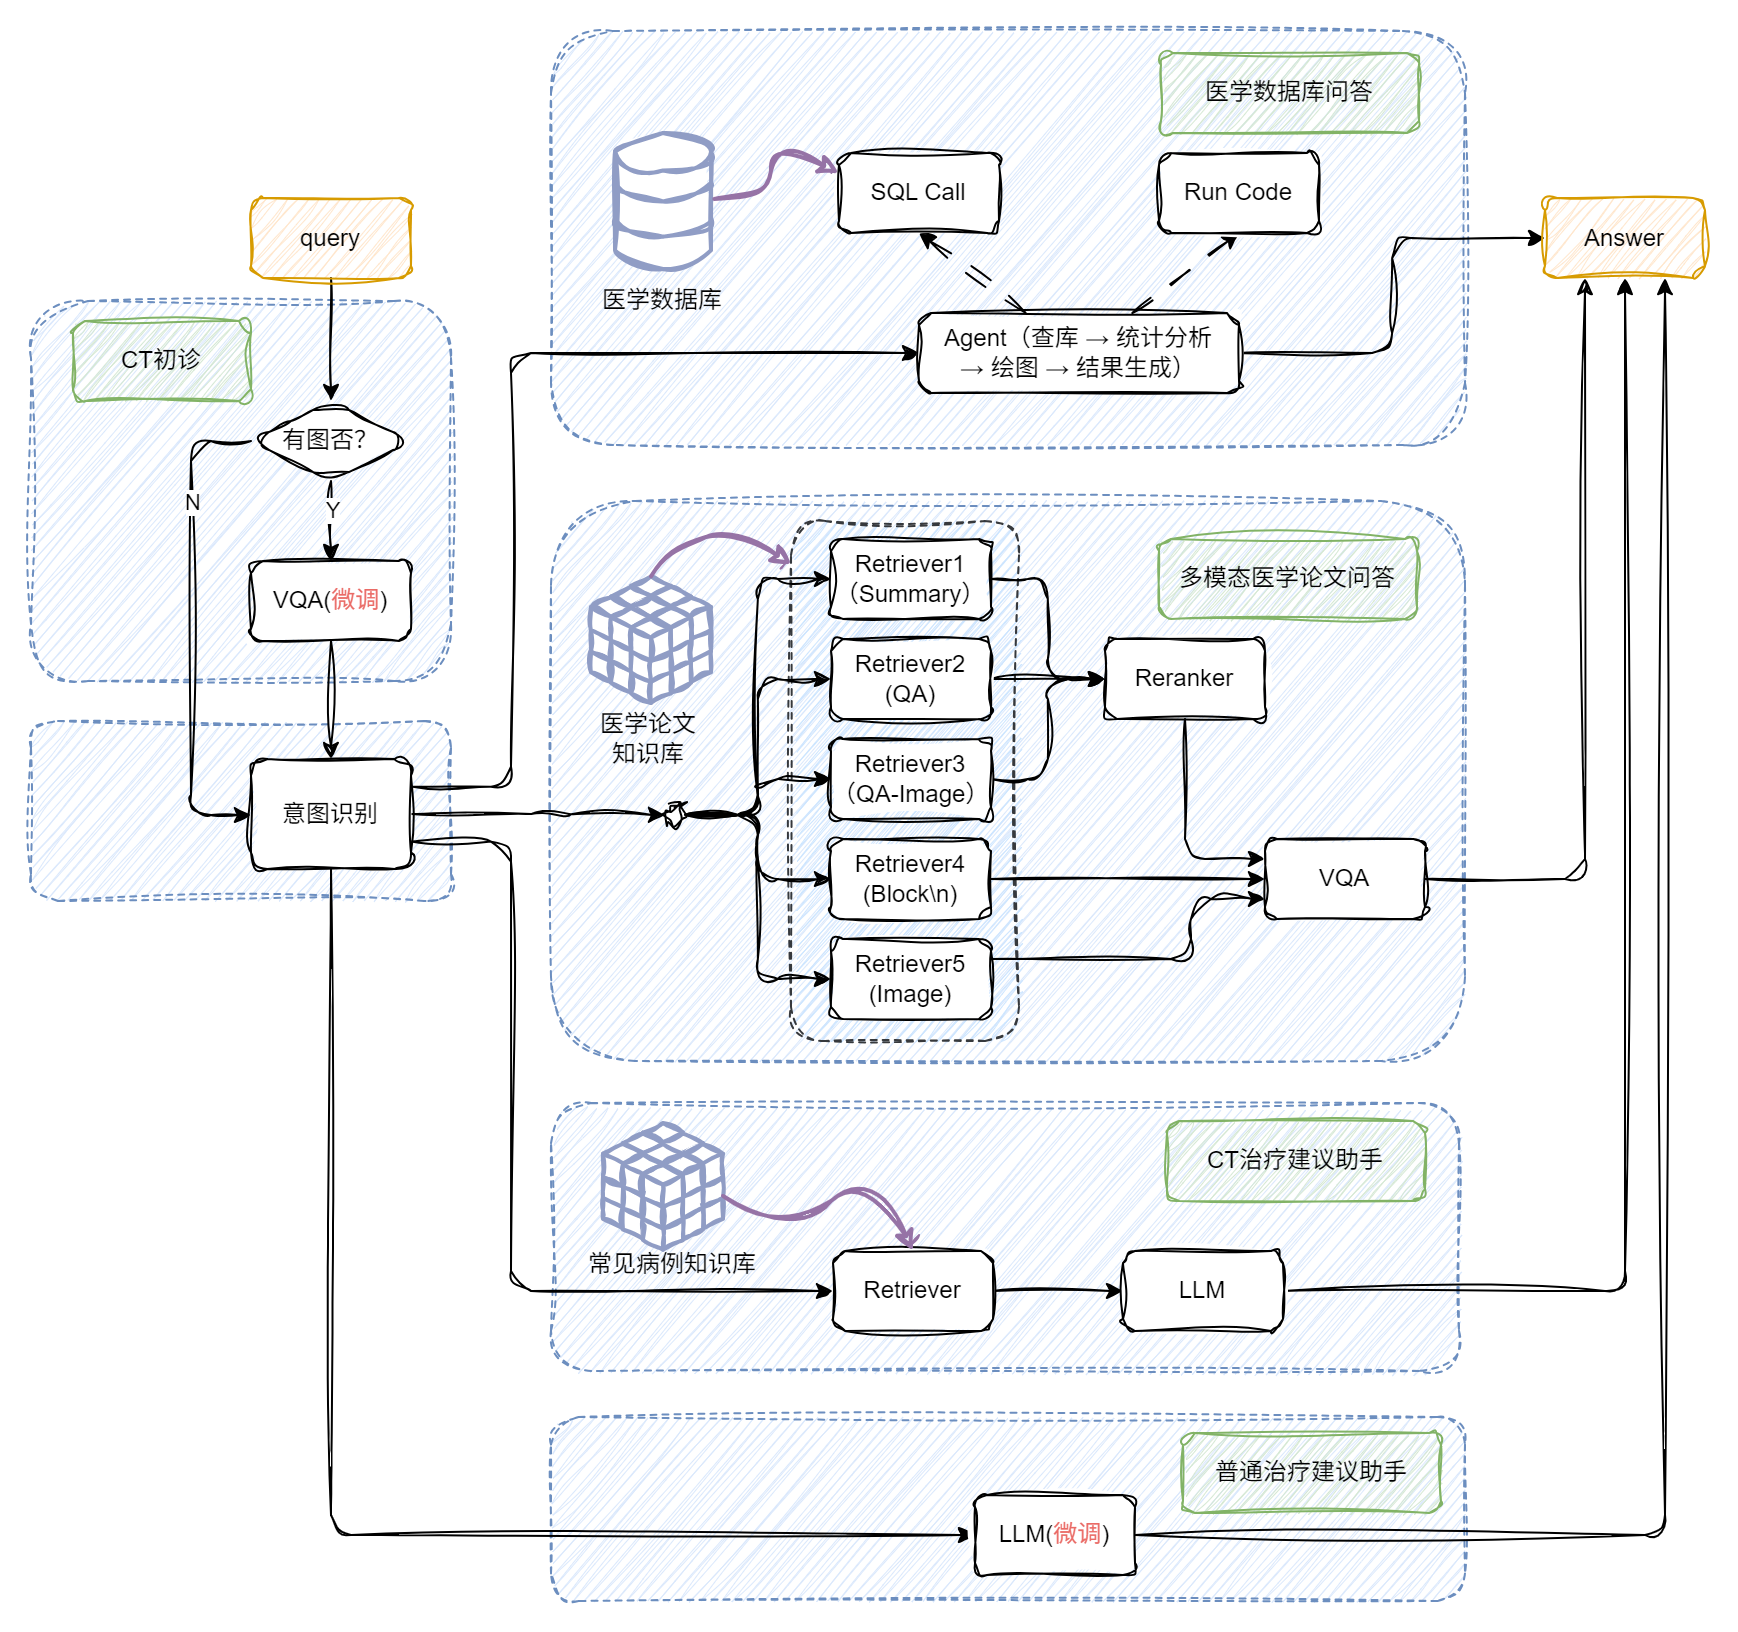
你有没有想过,大模型如何更聪明地回答问题?🤔当传统 RAG 遇上多模态与商业智能(BI),会碰撞出怎样的火花?🤔 今天我们将围绕医学这个专业领域,一步步搭建出一个集众多本领于一身的小型智能AI医学问答系统,全程干货预警,记得备好笔记本! 下图和视频效果是我们今天的目标!涉及多路召回多模态RAG、多模态问答、Chat-BI、Agent、LLM微调、多模态模型微调等等。让我们开始吧! 😽 小声说一句 文末有免费大礼包 一、朴素 RAG:大模型的「初代智能助手」 什么是 RAG?让 AI 边查资料边回答! RAG(检索增强生成,Retrieval-Augmented Generation)是一种结合信息检索(Retrieval)和文本生成(Generation)的技术,用于提高大模型的准确性和实用性。通过在生成文本前检索外部知识库中的相关信息,RAG 可以让大模型在回答问题时结合最新、最相关的数据,从而减少幻觉现象,并提升答案的专业性和时效性。 简单说就是:让大模型在回答问题前,先去「翻书」(检索知识库),再结合最新资料输出答案! ✨核心优势: 告别「幻觉」:用真实数据撑腰,拒绝瞎编 与时俱进:实时抓取最新信息,知识不过期 专业度 UP:领域知识库加持,回答更靠谱 Naive RAG:AI 的「基础解题套路」 先来看最基础的 RAG 工作流,像不像学生写作业? 💡 步骤分解: 审题(用户提问):比如「推荐适合上班族的护眼食物」 查资料(检索模块):从食谱数据库中找出含维生素 A、叶黄素的食材列表 写答案(生成模块):结合检索到的食材,推荐食谱并解释原理 🔍关键技术点: ① 检索(Retrieval) 用户输入问题后,系统会基于该输入在外部知识库或向量数据库中检索相关内容。通常使用语义搜索(Semantic Search)或 BM25、Dense Retrieval(DPR)、Embedding-based Retrieval 等技术来匹配最相关的文档片段。 ② 增强(Augmented) 检索到的文本内容会作为额外的上下文,与用户输入一起提供给 大模型。这一阶段涉及 Prompt 设计,确保大模型在生成回答时充分利用检索到的信息,而非仅依赖其内部知识。 ③ 生成(Generatation) 大模型结合检索到的信息和自身的预训练知识,生成最终的回答。这一过程可能涉及对检索信息的重构、摘要或融合,以确保答案的连贯性、准确性和可读性。 🌟 优点: 简单高效:由于模块化设计,容易实现和调试。✅ 可扩展性强:检索模块和生成模块可以独立优化或替换。✅ ⚠️ 局限性: 单模态依赖:仅依赖文本作为输入和检索内容,无法有效处理多模态数据。❌ 领域水土不服:通常直接使用通用领域LLM,未针对领域知识或任务需求进行微调。❌ 二、多模态能力接入:让模型秒变「图文全能王」 多模态 RAG:让模型拥有「超级感官」 传统 RAG 只能 “读文字”,多模态 RAG 却能 “看图片、听声音”!通过多模态嵌入技术,把文字、图像、音频全塞进同一个 “语义魔法空间”,让模型既能精准检索图文中的隐藏信息,又能生成会 “动起来” 的回答。在医学领域,多模态RAG的跨模态检索与生成能力正在展现出颠覆性价值,例如在肺部疾病诊断中,系统可以同时针对患者的CT影像切片、病理报告文本对患者做出诊断。下面我们将从整体架构出发,带领读者深入了解多模态 RAG 的基本原理及其作用。 多模态 RAG VS 基础 RAG:升级点大揭秘! 基础的RAG主要针对文本数据进行了检索与生成。然而,要支持多模态输入和输出,需要对基础 RAG 架构进行一定的调整和扩展。 首先,需要修改的模块包括: 检索模块:从仅支持文本检索,到需要扩展为支持多模态检索,例如图像、音频等信息的索引和匹配。 生成模块:基础 RAG 仅针对文本生成,现在需要扩展支持多模态输出,如文本结合图像、音频的生成能力。 其次,需要新增的模块包括以下四个部分: 模块 功能 多模态编码器🛠️ 用于对不同模态的数据(文本、图像、音频等)进行编码,以便统一表示并用于检索和生成。 多模态融合器🧪 用于融合不同模态的信息,使其能够协同作用,提高生成内容的准确性和丰富度。 跨模态检索器🔍 支持输入多种数据格式,并能在多模态知识库中找到相关信息。 多模态解码器🎬 负责将生成结果解码为多种形式,如文本、图片、语音等,以适应不同的输出需求。 多模态RAG的核心组件 为了支持多模态输入和输出,调整和扩展后的多模态RAG 流程图如下。 下面简单讲一下每个组件的功能以及相关输入输出示例。 ✨ 多模态编码与融合:打破信息次元壁 在多模态RAG系统中,多模态编码模块是将不同类型的输入(如文本、图像、音频等)统一映射到向量空间的关键组件。其主要作用是对用户查询和知识库内容进行编码,以便进行相似度检索与上下文构建。 相比于传统仅处理文本的 RAG,多模态 RAG 需要将图文等多源信息编码进行统一编码,从而实现跨模态信息的理解与匹配。 📖 文本编码常用模型: BAAI/bge系列(如 bge-m3:支持多语言和长文本处理,生成高质量语义嵌入) Cohere Embed(提供高效的语义编码和上下文理解,适用于文本检索与生成任务) GTE-large(专注于高精度语义匹配与检索,适合大规模文本数据处理) 🎨 多模态编码常用模型: 图像编码:NFNet-F6、ViT、CLIP ViT 音频编码:Whisper、CLAP 视频编码:CMVC 在RAG系统中,多模态数据编码的融合是一个核心问题。为实现跨模态信息的有效交互与检索,我们需要将不同模态的数据映射到一个统一的向量空间中。这样,不论是文字还是非文字信息,都可以在同一语义空间中进行相似性度量、检索和生成任务。这里介绍三种常用方法。 统一模态:将非文本模态(如图像、音频、表格)转换为描述性文本,再用文本编码器统一编码,得到语义向量。 共享向量空间:通过多模态编码器(如CLIP、CLAP)直接将多模态数据编码到同一向量空间,无需中间转换,保留原始信息,统一接口,工程友好。 分离检索:不同模态使用专门模型分别编码,检索阶段融合结果,灵活性强,适配性好,适合复杂场景。 🔍 多模态检索模块:想查什么就查什么 1.基础检索 处理单一模态的查询,如文本到文本、图像到图像的匹配。例如当输入为文本查询,如"患者出现持续性干咳、低热,胸部CT显示双肺磨玻璃影"时,则会输出相关文本段落,如 "持续性干咳、低热伴双肺磨玻璃影常见于病毒性肺炎、间质性肺病或早期肺结核";而当输入为图像查询时,如一张胸部CT图像时,则会输出胸部CT的相关图像。 2.跨模态检索 支持跨模态查询,例如文本查询匹配图像,或图像查询匹配文本。例如当输入为文本时,如"一张胸部正位CT图像",则会输出最相关的胸部CT的图片;而当输入为胸部CT的照片时,则会输出相关描述文本,如 "这是一张胸部正位CT图像,存在左侧气胸"。 🎨 多模态生成模块:会输出图片的 AI 写手 原有 RAG 仅支持文本生成,现在扩展为支持多模态输出,例如生成带有图片的回答或结合语音的解释。当输入为文本查询时,如"查询数据库中所有论文的题目,基于题目内容将论文聚类为5类,用柱状图展示每类的论文数量,此外每类分别列举几个文章。" ,则会将相关检索结果(文本、图片)传给大模型,最后输出图文回答,如相关文本 + 一张论文类别数量的柱状图。 三、多模态 + BI:复杂 RAG 架构实战 通过前面的探索,我们已经了解了朴素 RAG 如何让大模型具备「查资料再回答」的基础能力,也见证了多模态 RAG 通过图文融合实现的「感官升级」。但当实际应用场景涉及「医院年度病例统计分析」「科研文献数据可视化呈现」等需求时,单纯的多模态处理仍显不足 —— 这类场景既需要解析医学影像、病历文本等非结构化数据,又要对接数据库完成指标计算、图表生成等 BI任务。 如何让 RAG 系统同时驾驭多模态理解与结构化数据分析?接下来要展开的「多模态 + BI」复杂架构实战,正是为解决这类「既要又要」的高阶需求而生,我们将在朴素 RAG 基础上层层叠加关键模块,最终打造出能同时处理影像诊断、数据统计、图表生成的「全能型 AI 助手」! 首先登场的是 —— VQA 模块(Visual Question Answering) 当用户提问中包含图片时,系统会自动触发 VQA,对图像进行结构化信息提取,挖掘上下文关键内容;若没有图像,就跳过这步,直接进入文本处理环节,效率UPUP❗❗ 接下来,系统通过意图识别模块,将不同类型的问题智能分流: 🔹 论文问答? 走传统 RAG 路线!向量检索+大模型生成,精准提取相关文献内容。 🔹 统计问答? 开启 SQL 模式!从提问中抽取结构化信息(如指标、维度、过滤条件),自动生成 SQL 查询,查询结果再由大模型「翻译」成自然语言,一目了然。 ✅ 与传统 RAG 的核心差异 维度 传统 RAG 系统 多模态 + BI 的 RAG 系统 输入类型 仅文本 query 文本 + 可选图像 感知能力 无图像理解 引入 VQA,具备视觉问答能力 意图处理 默认文本问答 多路径意图识别(论文问答 vs 统计问答) 检索类型 向量检索文本块 文本向量检索 + 图像信息提取 + 表格 SQL 检索 响应方式 直接生成答案 根据意图生成带统计分析的答案或论文图文回答 应用场景 普通问答、文档 QA 支持论文 QA + 数据分析(BI)混合场景 数据准备 以 ArXivQA 数据集为例,从 Papers-2024.md 中的100篇论文构建知识库和数据库,在准备数据之前需要先下载论文信息文件(内含论文链接),可以离线下载或者以下命令进行下载: wget https://raw.githubusercontent.com/taesiri/ArXivQA/main/Papers-2024.md -O 2024.md 我们需要从两方面去准备数据(以医学领域为例): 📚 医学知识库:存储论文全文到指定目录,用于文献类问答 📊 医学数据库:提取论文元信息(如标题、作者等)到本地数据库,用于统计类问答,论文信息如title、author等 以下脚本可以一步搭建医学论文信息的数据库👇 import re import os import requests import time import json from tqdm import tqdm from bs4 import BeautifulSoup import sqlite3 # 医学相关关键词列表 keywords = ['brain', 'disease', 'cancer', 'tumor', 'medical', 'health', 'clinical', 'biomedical', 'neuro', 'diagnosis', 'imaging'] def contains_keyword(text, keywords): text = text.lower() for kw in keywords: if kw.lower() in text: return True return False def download_pdf(pdf_url, title): try: safe_title = re.sub(r'[\\/*?:"<>|]', "", title)[:200] os.makedirs('kbs', exist_ok=True) filename = f"kbs/{safe_title}.pdf" if os.path.exists(filename): return filename response = requests.get(pdf_url, stream=True, timeout=50) response.raise_for_status() with open(filename, 'wb') as f: for chunk in response.iter_content(chunk_size=8192): if chunk: f.write(chunk) return filename except Exception as e: print(f"下载PDF失败: {e}") return None def spider(url): try: response = requests.get(url, timeout=10) response.raise_for_status() except requests.RequestException as e: print(f"请求失败:{e}") return None res = {'title': '', 'author': '', 'subject': ''} soup = BeautifulSoup(response.text, 'html.parser') title_ele = soup.find(class_='title mathjax') if title_ele: res['title'] = title_ele.get_text().replace("Title:", '').strip() authors_ele = soup.find(class_='authors') authors = [] if authors_ele: links = authors_ele.find_all('a') for link in links: authors.append(link.get_text()) res['author'] = ';'.join(authors) subject_ele = soup.find(class_='tablecell subjects') if subject_ele: res['subject'] = subject_ele.get_text().strip() pdf_link = soup.find('a', text='View PDF') if pdf_link: pdf_url = 'https://arxiv.org' + pdf_link['href'] pdf_path = download_pdf(pdf_url, res['title']) if contains_keyword(res['title'], keywords) or contains_keyword(res['subject'], keywords): return res else: return None def get_information(): with open('2024.md') as f: texts = f.readlines()[2:] reses = [] target_num = 100 for text in tqdm(texts): if not contains_keyword(text, keywords): continue abs_url = re.findall(r'\[.*?\]\((https?://arxiv.*?)\)', text) if abs_url: res = spider(abs_url[0]) if res is not None: reses.append(res) print(f"已保存 {len(reses)} 篇相关论文") if len(reses) >= target_num: print(f"已保存{target_num}篇相关论文,停止爬取。") break time.sleep(5) with open('test.txt', 'w') as f: json.dump({"data": reses}, f) def write_into_table(): with open('test.txt', 'r') as f: data = json.load(f) data = data['data'] conn = sqlite3.connect('papers.db') cursor = conn.cursor() cursor.execute(''' CREATE TABLE IF NOT EXISTS papers ( id INTEGER PRIMARY KEY AUTOINCREMENT, title TEXT UNIQUE, author TEXT, subject TEXT ) ''') for paper in data: try: cursor.execute(''' INSERT OR IGNORE INTO papers (title, author, subject) VALUES (?, ?, ?) ''', (paper['title'], paper['author'], paper['subject'])) except sqlite3.Error as e: print(f"插入数据库错误:{e}") conn.commit() conn.close() if __name__ == "__main__": get_information() write_into_table() 上述代码是根据获取的信息,创建对应的医学数据库信息,并把记录信息写入,用于 SQL Call 查询。现在完成数据准备,我们得到了医学数据库文件papers.db 。 下面是获取到的PDF: 依赖模块详解 🧭 意图识别:RAG 路上的第一道分水岭 在复杂的多模态 RAG 系统中,第一步当然是搞清楚用户到底想问什么!这个模块的职责就是读取用户的提问内容(包括上下文),判断他们的意图属于哪一类: 是走传统的知识问答路线?📚 还是涉及结构化数据处理的统计问答?📊 为此,我们使用了 LazyLLM 内置的意图识别工具 —— IntentClassifier 它能智能识别用户的文本输入和上下文,快速对齐到系统预设的意图类型,让后续处理路径不再迷路,稳准狠地走向正确流程 ✅ import lazyllm from lazyllm.tools import IntentClassifier classifier_llm = lazyllm.OnlineChatModule(source="qwen") chatflow_intent_list = ["论文问答", "统计问答", "普通医疗问诊","CT医疗问诊"] classifier = IntentClassifier(classifier_llm, intent_list=chatflow_intent_list) classifier.start() print(classifier('论文中的weighted ILI 是什么?')) # 输出 >>> 论文问答 print(classifier('查询数据库中有多少篇论文')) # 输出 >>> 统计问答 print(classifier('医生,我最近总是头晕,是怎么回事?')) # 输出 >>> 医疗问诊 print(classifier('医生,我最近做了一次胸部 CT,报告上写着‘右肺上叶磨玻璃结节’,这个是什么意思?严重吗?需要进一步检查或治疗吗?')) # 输出 >>> CT医疗问诊 🧠 SQL Pipeline:结构化问答的“最强大脑” 🛠️ SQL Manager —— 数据库的超级管家 数据库管理模块 SQL Manager 基于Python 中主流的 ORM 框架——SQLAlchemy。其提供了统一的数据库操作接口,不仅支持本地数据库,也支持各种主流云数据库,极大地提升了数据库交互的灵活性和可扩展性。通过SQLManager,用户可以非常简单地连接本地或云上的数据库,只需在配置中指定数据库地址、账号密码等信息,就可以一键启动: 数据库交互能力 统一调用 SQL 查询 执行 SQL-Call 相关操作 这个模块让数据库不再是“难啃的骨头”,而是贴心的“数据服务员”。 from lazyllm.tools import SqlManager # 连接本地医学数据库 sql_manager = SqlManager("sqlite", None, None, None, None, db_name="papers.db", tables_info_dict=table_info) # 连接远程数据库 # sql_manager = SqlManager(type="PostgreSQL", user="", password="", host="",port="", name="",) # 查询所有论文数量 res = sql_manager.execute_query("select count(*) as total_papser from papers;") print("rrr: ", res) # >>> [{"total_papser": 100}] # 查询带有 LLM 的论文标题 res = sql_manager.execute_query("select title from papers where title like '%disease%'") print("res:: ", res) # >>> [{"title": "A Machine Learning Approach for Crop Yield and Disease Prediction Integrating Soil Nutrition and Weather Factors"}, {"title": "An early warning indicator trained on stochastic disease-spreading models with different noises"}, {"title": "Enhancing Gait Video Analysis in Neurodegenerative Diseases by Knowledge Augmentation in Vision Language Model"}, {"title": "Exploring the Generalization of Cancer Clinical Trial Eligibility Classifiers Across Diseases"}, {"title": "Leave No Patient Behind: Enhancing Medication Recommendation for Rare Disease Patients"}] 注意,db_name 参数需要传入构建好的数据库文件路径,tables_info_dict 参数需传入数据库基本信息字典(表名、列名等),我们以论文数据库为例,基本信息的定义如下。 table_info = { "tables": [{ "name": "papers", "comment": "论文数据", "columns": [ { "name": "id", "data_type": "Integer", "comment": "序号", "is_primary_key": True, }, {"name": "title", "data_type": "String", "comment": "标题"}, {"name": "author", "data_type": "String", "comment": "作者"}, {"name": "subject", "data_type": "String", "comment": "领域"}, ], }] } 💬 SQL Call —— 把自然语言变成数据库语言的魔法师 统计问答的第一步:当然是拿到正确的数据! 这一步交给了 SQL Call 模块,它在 SQL Manager 的基础上完成了两个关键任务: 指定目标数据库和数据表,创建 sql_manager; 实例化一个 LLM,让它具备“理解人话+写 SQL”的能力。 随后,这二者组成一个 SQL Call 工作流,能将用户的自然语言问题 ⏩ 转换成可执行的 SQL 查询,并返回结果 。 你只需要提问,系统就能代你“动手动脑”,帮你查数、汇总、返回答案! import lazyllm from lazyllm.tools import SqlManager, SqlCall sql_manager = SqlManager("sqlite", None, None, None, None, db_name="papers.db", tables_info_dict=table_info) sql_llm = lazyllm.OnlineChatModule() sql_call = SqlCall(sql_llm, sql_manager, use_llm_for_sql_result=False) query = "库中一共多少篇文章" print(sql_call(query)) # >>> [{"total_papers": 100}] 🤖 Agent 全流程 —— 数据分析 + 图表生成,一步到位 我们还基于 SQL Call 构建了一个全能型 Agent,具备: 📌 数据库查询 → 数据分析 → 图表生成 → 结果汇总 的完整能力闭环。 也就是说,用户只需一句问题,Agent 就能自动完成整个流程,从查数到出图,一条龙服务!!! 首先定义两个工具(Tool),分别用于 SQL 查询 和 代码执行,并将它们作为可选工具提供给 Agent,支持其在执行任务过程中完成数据库查询和统计分析。这两个工具配合使用,使 Agent 能够动态完成从数据获取到分析执行的全流程任务。 Tool1:run_sql_query 方法基于前面构建的 SQL Call 工作流封装而成,Agent 可在从用户查询中解析出 SQL 相关需求后调用该方法,获取结构化查询结果。 @fc_register("tool") def run_sql_query(query: str): """ Translates a natural language data request into SQL, executes it, and returns structured results. � Args: query (str): A natural language description of the desired database query. � Returns: list[dict]: A list of records returned from the SQL query, where each record is represented as a dictionary. """ sql_manager = SqlManager("sqlite", None, None, None, None, db_name="papers.db", tables_info_dict=table_info) sql_llm = lazyllm.OnlineChatModule(stream=False) sql_call = SqlCall(sql_llm, sql_manager, use_llm_for_sql_result=False) return sql_call(query) Tool2: run_code 用于接收并执行大模型生成的统计分析代码。该方法会返回执行结果为大模型下一步的决策和行动提供反馈依据 @fc_register("tool") def run_code(code: str): """ Run the given code in a separate thread and return the result. Args: code (str): code to run. Returns: dict: { "text": str, "error": str or None, } """ result = { "text": "", "error": None, } def code_thread(): … thread = threading.Thread(target=code_thread) thread.start() thread.join(timeout=10) … return result 接下来实现agent定义,使用lazyllm内置的ReactAgent工具,将前文中定义的两个工具传入tools参数,即可实现模型自动调用。 ReactAgent是按照 Thought->Action->Observation->Thought...->Finish 的流程一步一步的通过LLM和工具调用来显示解决用户问题的步骤,最后输出最终答案。 from lazyllm.tools.agent import ReactAgent agent = ReactAgent( llm=lazyllm.OnlineChatModule(stream=False), tools=['run_code', 'run_sql_query'], return_trace=True, max_retries=3, ) 完整代码如下: with pipeline() as sql_ppl: sql_ppl.formarter = lambda query: sql_prompt.format(query=query, image_path=IMAGE_PATH) sql_ppl.agent = ReactAgent( llm=lazyllm.OnlineChatModule(stream=False), tools=['run_code', 'run_sql_query’], return_trace=True, max_retries=3, ) sql_ppl.clean_output = lazyllm.ifs(lambda x: "Answer:" in x, lambda x: x.split("Answer:")[-1], lambda x:x) if __name__ == '__main__': lazyllm.WebModule(sql_ppl, port=23456, static_paths=image_save_path).start().wait() ⚔️ RAG Pipeline:多模态知识问答的“升级打怪”之路 这部分我们聚焦在医学论文问答场景,结合文本+图像的多模态输入,构建一个更智能的 RAG 系统,并支持返回可视化图表。整体框架的细节如下: 首先,我们将PDF解析成文本和图像;文本部分我们可以通过\n切分、LLM(总结)和 LLM(QA)等方式构造不同的block文本节点;图像部分我们通过多模态大模型构建相应的QA文本节点qapair_img和图像根节点;接下来,我们将所有节点统一编码入库,并通过多路召回机制进行语义匹配与内容检索;在召回阶段之后,引入重排序机制,进一步优化检索结果的相关性与准确性;最后,系统会将用户的查询(query)与召回得到的上下文(context)内容一并输入至多模态大模型,由其生成最终答案。整体代码实现如下: embed_mltimodal = lazyllm.TrainableModule("colqwen2-v0.1") embed_text = lazyllm.TrainableModule("bge-m3") embeds = {'vec1': embed_text, 'vec2': embed_mltimodal} qapair_llm = lazyllm.LLMParser(lazyllm.OnlineChatModule(stream=False), language="zh", task_type="qa") qapair_img_llm = lazyllm.LLMParser( lazyllm.OnlineChatModule(source="sensenova", model="SenseNova-V6-Turbo"), language="zh", task_type="qa_img") summary_llm = lazyllm.LLMParser(lazyllm.OnlineChatModule(stream=False), language="zh", task_type="summary") documents = lazyllm.Document(dataset_path=tmp_dir.rag_dir, embed=embeds, manager=False) documents.add_reader("*.pdf", MagicPDFReader) documents.create_node_group(name="block", transform=lambda s: s.split("\n") if s else '') documents.create_node_group(name="summary", transform=lambda d: summary_llm(d), trans_node=True) documents.create_node_group(name='qapair', transform=lambda d: qapair_llm(d), trans_node=True) documents.create_node_group(name='qapair_img', transform=lambda d: qapair_img_llm(d), trans_node=True, parent='Image') with lazyllm.pipeline() as ppl: with lazyllm.parallel().sum as ppl.mix: with lazyllm.pipeline() as ppl.mix.rank: with lazyllm.parallel().sum as ppl.mix.rank.short: ppl.mix.rank.short.retriever1 = lazyllm.Retriever(documents, group_name="summary", embed_keys=['vec1'], similarity="cosine", topk=4) ppl.mix.rank.short.retriever2 = lazyllm.Retriever(documents, group_name="qapair", embed_keys=['vec1'], similarity="cosine", topk=4) ppl.mix.rank.short.retriever3 = lazyllm.Retriever(documents, group_name="qapair_img", embed_keys=['vec1'], similarity="cosine", topk=4) ppl.mix.rank.reranker = lazyllm.Reranker("ModuleReranker", model="bge-reranker-large", topk=3) | bind(query=ppl.mix.rank.input) ppl.mix.retriever4 = lazyllm.Retriever(documents, group_name="block", embed_keys=['vec1'], similarity="cosine", topk=2) ppl.mix.retriever5 = lazyllm.Retriever(documents, group_name="Image", embed_keys=['vec2'], similarity="maxsim", topk=2) ppl.prompt = build_vlm_prompt | bind(_0, ppl.input) ppl.vlm = lazyllm.OnlineChatModule(source="sensenova", model="SenseNova-V6-Turbo").prompt(lazyllm.ChatPrompter(gen_prompt)) lazyllm.WebModule(ppl, port=range(23468, 23470), static_paths=get_image_path()).start().wait() 注意:由于在RAG中我们这里采用了多路召回,summary、qapair、qapair_img等节点组所在的路都会调用大模型,所以知识库越大的话,那么所消耗的时间和token都会很大,建议知识库中可以先用一两篇论文做尝试(论文中需要带图片)。 效果展示: 📈 多模态 + 统计分析:双剑合璧,能力翻倍! 在已有的多模态论文问答系统基础上,我们进一步集成了统计分析机制,让系统不仅能“看图识意”,还能“分析数据、输出结论”。这样一来,系统就不仅仅是一个问答助手,更像是一个拥有知识库+分析大脑+视觉理解力的超级 AI 学者 🤓。主要实现代码如下: def build_paper_assistant(): llm = OnlineChatModule(source='qwen', stream=False) vqa = lazyllm.OnlineChatModule(source="sensenova",\ model="SenseNova-V6-Turbo").prompt(lazyllm.ChatPrompter(gen_prompt)) with pipeline() as ppl: ppl.ifvqa = lazyllm.ifs( lambda x: x.startswith('<lazyllm-query>'), vqa, lambda x:x) with IntentClassifier(llm) as ppl.ic: ppl.ic.case["论文问答", paper_ppl] ppl.ic.case["统计问答", sql_ppl] return ppl if __name__ == "__main__": main_ppl = build_paper_assistant() lazyllm.WebModule(main_ppl, port=23494, static_paths="./images", encode_files=True).start().wait() 四、LlamaFactory 微调:让大模型「持证上岗」 通过前面的实战我们已经看到,多模态 + BI 的复杂 RAG 架构如同为大模型搭建了一套「专业工作流」—— 从图像解析到数据检索,从意图识别到 SQL 生成,让 AI 在复杂任务中实现了流程化协作。 🤔但你有没有想过,当大模型进入专业领域时,就像新手入职需要培训一样,也需要「特训」才能精准上岗?在医疗、法律等专业领域,大模型如何从「都会一点」变成「专业能手」?这一节我们就来揭秘 LlamaFactory 微调的神奇魔法,让大模型轻松拿捏专业场景! 微调:大模型的「特训营」,能力狂飙升级 在 RAG 架构里,大模型就像团队的「大脑担当」,它的能力直接决定了整个系统的输出质量。但通用大模型就像「全科生」,遇到医疗、金融等专业领域时,难免会「水土不服」。别担心!针对性的微调策略就是「特训秘籍」,能让大模型快速适应领域需求,输出更规范、更专业,堪称 RAG 系统的「神助攻」! 举个医疗领域的例子🌡️:当医生面对「患者表现出高血压症状,收缩压为 150mmHg」这样的医疗报告时,需要将其转换成包含症状、血压读数等关键信息的 JSON 格式。如果让没经过微调的通用模型来做,可能会漏信息、格式出错,甚至误解专业术语。但经过微调的大模型,就能像「专业书记员」一样,精准搞定! 🎯 微调带来的「超能力」,每一项都很能打! 精确信息提取:火眼金睛揪出关键数据📝微调就像给模型装上「信息探测器」,再也不怕重要信息「躲猫猫」! 上下文理解:前后逻辑全吃透🔍自然语言里,一句话的意思往往和上下文紧密相关。微调后的模型能「读懂」这些隐藏的逻辑,转换信息时更贴合实际场景,再也不是「断章取义」的憨憨啦! 格式严格把关:强迫症患者的福音📄JSON 等结构化文本就像「规范考场」,格式错误直接「不及格」。微调能让模型严格遵守格式要求,生成的文本就像「印刷体」一样工整! 术语专业处理:秒变领域「本地人」⚕️医疗领域的「收缩压」「舒张压」,金融领域的「市盈率」「复利」…… 这些专业术语就像领域的「方言」。微调让模型熟悉「行业黑话」,交流起来毫无障碍,再也不会闹「术语笑话」啦! 实战!用 LlamaFactory 给医疗模型「特训」 说了这么多,到底怎么操作呢?别急,这就带你用 LlamaFactory 实现医疗领域的 LoRA 微调,让模型从「门外汉」变身「医疗小能手」! 我们先选一个「潜力股」小模型,用权威的 Huatuo Llama Med Chinese 数据集来特训。以前的通用模型虽然能回答医疗问题,但专业术语用得不准、临床推理也不够强,就像「半吊子实习生」。现在通过权威医学对话数据的「魔鬼训练」,模型能严格按照医学证据回答,术语准确、逻辑严谨,完全符合临床规范,妥妥的「专业医师助手」! 整体微调步骤如下: 📚 第一步:准备「医学教材」—— 数据集 🌟 数据集:医学知识的「超级题库」 我们选用Huatuo Llama Med Chinese数据集(https://github.com/SCIR-HI/Huatuo-Llama-Med-Chinese/tree/main/data),该数据集由8658个问题组成,这些问题是通过医学知识图谱和GPT-3.5 API构建而成,包含大量基于中文医学知识的指令-响应对,覆盖疾病诊断、药物信息、健康咨询等场景,旨在提升LLM在医疗领域的问答与对话能力。 🧩数据结构:病例诊断的「标准模板」 数据集里的每个「知识点」长啥样?举个🌰: { "instruction": "小王,男性,45岁,近期出现上腹部隐痛、嗳气和隐痛,伴有恶心、呕吐,实验室检查发现血淀粉酶升高。请问可能患上了什么疾病?如何诊治?", "input": "", "output": "根据症状情况和实验室检查结果,考虑可能是十二指肠憩室引起的急性胰腺炎。建议进行X线钡餐检查、CT检查或十二指肠镜检查确诊。治疗原则为禁食、控制炎症、解除痉挛、液体支持等,同时给予相应的药物治疗,如抗生素、止痛药、抗酸药等。严重者需要手术治疗。" } 数据格式完全符合 Alpaca 指令微调的「万能拼图模板」,不用改格式就能直接用,简直是「懒人福音」 📜 Alpaca指令微调数据格式 Alpaca格式是一种用于指令微调的数据格式,它包含了指令、输入、输出、系统提示词和历史对话等信息。该格式适用于单轮和多轮对话场景,允许模型根据历史信息生成更准确的回答。 [ { "instruction": "人类的指令(必填)", "input": "额外的输入信息(选填)", "output": "模型的回答(必填)", "system": "系统的提示词(选填)", "history": [ ["第一轮的指令(选填)", "第一轮的回答(选填)"], ["第二轮的指令(选填)", "第二的轮回答(选填)"] ] } ] 🚀 第二步:给问题加个「模板滤镜」—— 数据处理 我们从原数据集中抽取出instruction字段与模板进行拼接,模板是:"下面是一个问题,运用医学知识来正确回答提问.\n{instruction}\n\n\n### 回答:\n"。 template = "下面是一个问题,运用医学知识来正确回答提问.\n{instruction}\n\n\n### 回答:\n" def build_train_data(data): """Format training data using predefined template""" extracted_data = [] for item in data: extracted_item = { "instruction": template.format(instruction=item["instruction"]), "input": "", "output": item["output"] } extracted_data.append(extracted_item) return extracted_data 我们取处理后的一条数据如下: [ { 'instruction': '下面是一个问题,运用医学知识来正确回答提问.\n一名年龄在70岁的女性,出现了晕厥、不自主颤抖、情绪不稳等症状,请详细说明其手术治疗和术前准备。\n\n\n### 回答:\n', 'input': '', 'output': '该病需要进行电极导线、脉冲发生器和永久心脏起搏器置入术,并需要使用镇静药物和局麻对病人进行手术治疗。术前准备包括1-3天的时间进行术前检查和生活方式的调整。' }, ... 为了测评微调后的模型效果,我们需要将数据集切分为训练集和测试集并保存,切分比例为9:1。 from sklearn.model_selection import train_test_split train_data, test_data = train_test_split(extracted_data, test_size=0.1, random_state=42) with open(train_output_path, 'w') as f: for item in train_data: f.write(json.dumps(item, ensure_ascii=False) + '\n') with open(test_output_path, 'w') as f: for item in test_data: f.write(json.dumps(item, ensure_ascii=False) + '\n') ⚙️ 第三步:给模型定制「训练计划」—— 微调模型 数据准备好了,该让模型「开练」啦! 微调相关配置代码主要如下所示: import lazyllm from lazyllm import finetune, deploy, launchers model = lazyllm.TrainableModule(model_path)\ .mode('finetune')\ .trainset(train_data_path)\ .finetune_method((finetune.llamafactory, { 'learning_rate': 1e-4, 'cutoff_len': 5120, 'max_samples': 20000, 'val_size': 0.05, 'per_device_train_batch_size': 2, 'num_train_epochs': 2.0, 'launcher': launchers.sco(ngpus=8) }))\ .prompt(dict(system='You are a helpful assistant.', drop_builtin_system=True))\ .deploy_method(deploy.Vllm) model.evalset(test_data) model.update() 上面代码中,使用LazyLLM的TrainableModule来实现:微调->部署->推理: 模型配置: model_path指定了我们要微调的模型,这里我们用Internlm2-Chat-7B,直接指定其所在路径即可; 微调配置: -.mode设置了启动微调模式finetune; -.trainset 设置了训练用的数据集路径; -.finetune_method 设置了用哪个微调框架及其参数,这里传入了一个元组(只能设置两个元素): ➡️第一个元素指定了使用的微调框架是Llama-Factory:finetune.llamafactory ➡️第二个元素是一个字典,包含了对该微调框架的参数配置 推理配置: .prompt 设置了推理时候用的Prompt,注意,这里为了和微调的Prompt中的system字段保持一致,所以开启drop_builtin_system以将原system-prompt给替换为`You are a helpful assistant.`; .deploy_method 设置了部署用的推理框架,这里指定了vLLM这个推理框架。 评测配置: 这里通过.evalset来配置评测集; 启动任务: .update 触发任务的开始:模型先进行微调,微调完成后模型会部署起来,部署好后会自动使用评测集全部都过一遍推理以获得结果。 微调loss曲线: 🏆 第四步:「成果验收」检实力 —— 效果评测 在上一步微调并获得评测集的推理结果后,我们需要拿着结果和评测集的正确答案做个对比,以确认我们微调的效果是什么样的。 在这个任务当中,我们使用语义相似度来评测模型的效果。语义相似度定义如下: 相应的代码实现如下,这里不含求平均,只是其中一项,同时假设文本已经被BGE模型(bge-large-zh-v1.5)向量化了: import numpy as np def cosine(x, y): product = np.dot(x, y) norm = np.linalg.norm(x) * np.linalg.norm(y) raw_cosine = product / norm if norm != 0 else 0.0 return max(0.0, min(raw_cosine, 1.0)) 在共866题的测试集中,模型Internlm2-Chat-7B微调前后的语义相似度如下所示: Internlm2-Chat-7B 微调前 微调后 语义相似度 63.98% 76.96% ✨ 微调效果展示 微调前: { "question": "下面是一个问题,运用医学知识来正确回答提问.\n王女士,45岁,近日出现面部疼痛,伴有刺痛感和头皮肿胀,且左侧面部出现营养性溃疡,有角膜结痂和发痒症状,初步诊断为何种疾病?\n\n\n### 回答:\n", "true_answer": "根据临床表现,该患者初步诊断为三叉神经营养性损害。需要进一步检查确定病因。", "prediction": "根据王女士的症状描述,她可能患有一种称为带状疱疹的疾病,也称为水痘-带状疱疹病毒感染。带状疱疹是由水痘-带状疱疹病毒(Varicella-Zoster Virus,VZV)引起的,这种病毒初次感染人体时会导致水痘,随后潜伏在神经系统中。在免疫系统减弱或老化时,病毒可能会重新激活,导致带状疱疹。\n\n以下是带状疱疹的典型症状和王女士描述的症状的对应情况:\n\n1. **面部疼痛**:带状疱疹可引起神经痛,王女士描述了面部疼痛。\n2. **刺痛感和头皮肿胀**:这种疼痛通常为灼烧感、刺痛感和麻木感,并可能伴随着头皮肿胀。\n3. **营养性溃疡**:带状疱疹可以导致皮肤溃烂,形成溃疡。\n4. **角膜结痂和发痒症状**:带状疱疹病毒感染也可能影响眼睛,导致角膜结痂和发痒。\n\n初步诊断为带状疱疹是基于这些症状的相似性。然而,为了确诊,医生可能会进行进一步的检查,如皮肤拭子检查、血液检查或神经功能测试。\n\n治疗带状疱疹通常包括使用抗病毒药物来减轻症状和缩短病程,以及疼痛管理,如非处方药、处方药、物理疗法或神经阻滞剂。对于营养性溃疡和角膜结痂,医生可能会建议局部治疗或抗生素治疗以预防感染。\n\n请记住,这只是一个初步诊断,确诊应由医疗专业人员进行。如果您或您认识的人有类似的症状,请及时就医以获得适当的治疗。", "cosine_score": 0.32186800394435827 } 微调后: { "question": "下面是一个问题,运用医学知识来正确回答提问.\n王女士,45岁,近日出现面部疼痛,伴有刺痛感和头皮肿胀,且左侧面部出现营养性溃疡,有角膜结痂和发痒症状,初步诊断为何种疾病?\n\n\n### 回答:\n", "true_answer": "根据临床表现,该患者初步诊断为三叉神经营养性损害。需要进一步检查确定病因。", "prediction": "根据病例描述,初步诊断为三叉神经营养性损害。建议进行进一步检查以确定病因,并采取适当的治疗方案。", "cosine_score": 0.9675316856997899 } 五、用 LlamaFactory 玩转多模态 RAG 模型微调🎯 在上一节中,我们已经见证了通过 LlamaFactory 微调让大模型在医疗文本领域「持证上岗」的魔力。而对多模态模型进行微调,能够有效提升模型在特定多模态领域的适应能力。 例如,在医学图像领域,基于多模态模型实现简单的诊断。甚至就不需要额外上下文信息。 当医生拿着CT片问AI:"这片脑区有梗塞吗?" 普通AI:"抱歉,我无法提供诊断建议" ❌(急死个人!) LlamaFactory微调后的AI:"右侧基底节区可见低密度灶,考虑急性梗塞" ✅(专业!) 想知道怎么让AI从"小白"变身"影像科大神"吗? 跟我一起探索吧! 🔧数据集简介 VQA-RAD 是一个关于放射影像的问题-答案对数据集(https://huggingface.co/datasets/flaviagiammarino/vqa-rad )。 训练集 测试集 问题 1,793 451 图像 313 203 🚀 数据集用途 训练和测试医学影像VQA(视觉问答)系统 支持开放式问题(如“病灶位置?”)和二元问题(如“是否存在肿瘤?”) 🔍 数据来源 基于MedPix(开放医学影像数据库) 由临床医生手动标注,确保专业性 🌟 核心优势 首个专注放射影像的VQA数据集 结构清晰,覆盖临床常见问题类型 📊 数据处理 数据获取 from datasets import load_dataset dataset = load_dataset("flaviagiammarino/vqa-rad") 处理前 { "image": <PIL.JpegImagePlugin.JpegImageFile image mode=RGB size=566x555>, "question": 'are regions of the brain infarcted?', "answer": 'yes' } 处理后(OpenAI格式): [ { "messages": [ { "content": "<image>are regions of the brain infarcted?", "role": "user" }, { "content": "yes", "role": "assistant" } ], "images": [ path/to/train_image_0.jpg" ] }, 💡微调模型 import lazyllm model_path = 'path/to/Qwen2.5-VL-3B-Instruct' data_path = 'path/to/vqa_rad_processed/train.json' # 需要将环境中的transformers和llamafactory升级到最新的开发分支 m = lazyllm.TrainableModule(model_path) .mode('finetune') .trainset(data_path) .finetune_method( (lazyllm.finetune.llamafactory,{ 'learning_rate': 1e-4, 'cutoff_len': 5120, 'max_samples': 20000, 'val_size': 0.01, 'num_train_epochs': 2.0, 'per_device_train_batch_size': 16, })) m.update() ⚒️模型配置: model_path指定了我们要微调的模型,这里我们用Qwen2.5-VL-3B-Instruct,直接指定其所在路径即可; ⚒️微调配置: .mode设置了启动微调模式finetune; .trainset 设置了训练用的数据集路径; .finetune_method 设置了用哪个微调框架及其参数,这里使用的是 llamafactory 框架(一个支持 LoRA、QLoRA 等高效微调技术的库); learning_rate:1e-4学习率,表示模型每一步更新参数的幅度。较高值训练更快但可能不稳定; cutoff_len: 5120输入序列的最大长度,超过这个长度的文本会被截断。适用于长对话或长描述任务; max_samples: 20000用于训练的最大样本数。如果你不想训练整个数据集,可以限制在一定数量; val_size: 0.01验证集占比。这里是 1%,意味着 99% 的数据用于训练,1% 用于评估模型训练过程中的性能; num_train_epochs: 2.0训练轮数。每个 epoch 表示模型看完整个训练集一次; per_device_train_batch_size: 16每个设备(通常是 GPU)上的训练批大小。根据显存大小选择合适的 batch size。 ⚒️启动任务: .update 触发任务的开始:模型先进行微调,微调完成后模型会部署起来,部署好后会自动使用评测集全部都过一遍推理以获得结果。 微调loss曲线 🏆 模型评测 在共451题的测试集中,模型Qwen2.5-VL-3B-Instruct微调前后的精确匹配率和语义相似度如下所示: Qwen2.5-VL-3B-Instruct 微调前 微调后 精确匹配率 0.0% 55.43% 语义相似度 31.85% 80.64% 📌精确匹配度 我们将精确匹配度定义如下: 其中: N:测试样本总数; yi:第i个样本的标准答案; yi^:模型预测结果; Ⅱ:指示函数(完全匹配时取1,否则取0)。 该指标的特性在于:预测结果与标准答案需要完全一致。 📌语义相似度 我们将语义相似度定义如下: 其中: N:测试样本总数; yi:第i个样本的标准答案; yi^:模型预测结果; emb():是基于BGE模型(bge-large-zh-v1.5)的向量编码,它可以把自然语言编码为一个向量,即:emb(text)=BGE_Encoder(text)。 🚨注意:该评价指标将原本[-1,0)的数值进行了截断,只要是负相关的语义都给0分,得分只能是正相关的。 示例:针对如下影像,微调前后的输出 微调前: { "query": "is the liver visible in the image?", "true": "no", "infer": "yes, the liver is visible in the image. it appears as a large, dark gray structure located in the upper left quadrant of the abdomen.", "exact_score": 0, "cosine_score": 0.3227266048281184 } 微调后: { "query": "is the liver visible in the image?", "true": "no", "infer": "no", "exact_score": 1, "cosine_score": 1.0 } 🤖 CT医疗诊断助手 模型「魔鬼训练」完毕,已经从「半吊子实习生」晋升为「专业医师助手」!那接下来,怎么让它真的派上用场?答案就是——构建医疗知识库 + RAG 检索增强生成,让模型不止「会说」,更能「精准说」! 我们来一步步操作,带你搭建一个属于你的CT医疗诊断助手,让模型不再孤军奋战,而是背后站着一整个医疗知识库做后盾! 🧠 整理知识库——医学资料大合集 我们选用Huatuo-Lite数据集(https://huggingface.co/datasets/FreedomIntelligence/Huatuo26M-Lite ),这是目前最大的中文医疗问答数据集,这些问答对通过文本清洗和数据去重的方法,从多个来源精心收集而来,包括在线医疗咨询网站、医学百科全书和医学知识库,覆盖了广泛的医疗知识。该数据集的创建显著扩大了医疗领域问答数据集的规模,并为中文医疗领域的自然语言处理和人工智能研究提供了一个前所未有的资源。 通过如下代码,我们可以获取数据,构建知识库: from datasets import load_dataset # 下载数据集 ds = load_dataset("FreedomIntelligence/Huatuo26M-Lite", split="train") output_path = "huatuo_cleaned.txt" count = 0 with open(output_path, "w", encoding="utf-8") as f: for sample in ds: question = sample.get("question", "").strip().replace("\n", " ") answer = sample.get("answer", "").strip().replace("\n", " ") diseases = sample.get("related_diseases", []) if isinstance(diseases, list): diseases = ", ".join([d.strip() for d in diseases]) else: diseases = diseases.strip() if question and answer: line = f"Question: {question}\tAnswer: {answer}\tRelated Diseases: {diseases}" f.write(line + "\n") count += 1 print(f"✅ 数据处理完成,共写入 {count} 条记录 -> {output_path}") 🧪 实现RAG——模型+知识双保险 📌 原理:输入(用户带CT提问+微调后的VQA的初诊结果) → 向量检索相关医学知识 → 与输入拼接 → 喂给模型生成回答。 RAG 就像给模型配了「助理医生」,先去查资料,再结合自身能力回答,大大提升准确率和可信度。我们对输入的QA对进行拼接,并要求大模型根据提供的问题和CT影像的初步诊断结果,结合知识库召回结果进行回答: import lazyllm #加载知识库 documents = lazyllm.Document(dataset_path="./kb") documents.create_node_group(name="block", transform=lambda s: s.split("\n") if s else '') #构建检索器 retriever = lazyllm.Retriever( doc=documents, group_name="block", # 分组方式可自定义 similarity="bm25_chinese", # 中文 BM25 向量检索 topk=5 # 召回前5条问答作为上下文 ) #加载 LLM 组件(可以选用适配医学任务的模型) llm = lazyllm.OnlineChatModule(source="qwen", model="qwen-max-latest", stream=False) #设计提示词 prompt = ( "你是一个专业的医学问答助手,用户会提供问题和CT影像的初步诊断结果,以及用来补充参考的医学知识。" "请根据用户提供的信息给出相关的诊断结果和治疗建议,若用户不存在问题可以不用给出治疗建议。\n\n" "注意:如果资料中没有明确提到答案,也请你基出于医学常识尽力做解释。\n\n" ) llm.prompt(lazyllm.ChatPrompter(instruction=prompt, extra_keys=['context_str'])) 最后构建输入并执行问答: #检索文档内容作为上下文 doc_node_list = retriever(query=query) context = "".join([node.get_content() for node in doc_node_list]) #构建输入 & 执行问答 response = llm({ "query": query, "context_str": context }) #输出最终回答 print(f"Query: {query}\n") print("📘 检索到的知识片段:\n") for i, node in enumerate(doc_node_list, 1): print(f"[{i}] {node.get_content()}\n") print("💡 回答:") print(response) 🔍 效果展示 🚀 input:下面是CT医疗问诊的问题以及CT图像初步诊断。问题:does the gallbladder appear distended?;图像初步诊断:yes; 🧰 output: 可以看到小助手召回了相关片段并给出了回答! 通过微调+RAG,LLM不再「闭门造车」,而是真正拥有了「读万卷书 + 亲临临床」的实力,成为你身边靠谱的「AI 医学助理」! 要不要试试看搭一个属于你自己的智能医疗顾问? 六、多模态 + BI + 医疗落地:打造懂医学的 RAG 系统 🩺 基于前面多模态与 BI 能力的深度融合实践,我们进一步将 RAG 系统向医疗垂直场景做了进阶升级 —— 如今这套架构不仅能处理常规的文本问诊,更能通过 VQA 模块与医学知识库的联动,实现 CT 影像解析与智能诊断辅助的核心能力,打通了从临床咨询到辅助决策的全流程服务闭环。下面就带大家看看这套融合多模态理解、数据统计与专业知识的医疗 RAG 系统是如何落地的! 主要实现代码如下: # 搭建具备知识问答和统计问答能力的主工作流 def build_paper_assistant(): llm = OnlineChatModule(source='qwen', stream=False) with pipeline() as ppl: ppl.ifvqa = lazyllm.ifs( lambda x: x.startswith('<lazyllm-query>'), vqa_ppl, lambda x:x) with IntentClassifier(llm) as ppl.ic: ppl.ic.case["论文问答", paper_ppl] ppl.ic.case["统计问答", sql_ppl] ppl.ic.case["普通医疗问诊", inquiry_ppl] ppl.ic.case["CT医疗问诊", ct_ppl] return ppl if __name__ == "__main__": main_ppl = build_paper_assistant() lazyllm.WebModule(main_ppl, port=23494, static_paths="./images", encode_files=True).start().wait() 在这篇文章中,我们带您从朴素 RAG 出发,逐步走向具备多模态感知与 BI 能力的复杂智能问答系统,结合了 LlamaFactory 的微调实践,全面展现了多模态 RAG 的落地路径。但这只是开始——更多技术细节,欢迎移步LazyLLM gzh讨论!