首页 文章 精选 留言 我的

精选列表

搜索[整合],共10000篇文章
优秀的个人博客,低调大师

整合spring cloud云架构 --spring cloud分布式系统中实现分布式锁

一、简介 一般来说,对数据进行加锁时,程序先通过acquire获取锁来对数据进行排他访问,然后对数据进行一些列的操作,最后需要释放锁。Redis 本身用 watch命令进行了加锁,这个锁是乐观锁。使用 watch命令对于频繁访问的键会引起性能的问题。 二、redis命令介绍 SETNX命令(SET if Not eXists) 当且仅当 key 不存在,将 key 的值设为 value ,并返回1;若给定的 key 已经存在,则 SETNX 不做任何动作,并返回0。 SETEX命令 设置超时时间 GET命令 返回 key 所关联的字符串值,如果 key 不存在那么返回特殊值 nil 。 DEL命令 删除给定的一个或多个 key ,不存在的 key 会被忽略。 三、实现思路 由于redis的setnx命令天生就适合用来实现锁的功能,这个命令只有在键不存在的情况下为键设置值。获取锁之后,其他程序再设置值就会失败,即获取不到锁。获取锁失败。只需不断的尝试获取锁,直到成功获取锁,或者到设置的超时时间为止。 另外为了防治死锁,即某个程序获取锁之后,程序出错,没有释放,其他程序无法获取锁,从而导致整个分布式系统无法获取锁而导致一系列问题,甚至导致系统无法正常运行。这时需要给锁设置一个超时时间,即setex命令,锁超时后,从而其它程序就可以获取锁了。 四、编码实现 本文采用springboot结合redis 取实现的,所以你需要装一个redis。 首先引入创建springboot工程,引入redis 。 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> <!-- 开启web--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <!-- redis--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> 2.创建一个锁类 /** * 全局锁,包括锁的名称 * Created by fangzhipeng on 2017/4/1. */ public class Lock { private String name; private String value; public Lock(String name, String value) { this.name = name; this.value = value; } public String getName() { return name; } public String getValue() { return value; } } 3.创建分布式锁的具体方法,思路已经说清楚了,代码注释也写好了,就不讲解了。 import org.apache.commons.lang.StringUtils; import org.slf4j.Logger; import org.slf4j.LoggerFactory; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.data.redis.core.StringRedisTemplate; import org.springframework.data.redis.core.ValueOperations; import org.springframework.stereotype.Component; import java.util.concurrent.TimeUnit; /** * Created by fangzhipeng on 2017/4/1. */ @Component public class DistributedLockHandler { private static final Logger logger = LoggerFactory.getLogger(DistributedLockHandler.class); private final static long LOCK_EXPIRE = 30 * 1000L;//单个业务持有锁的时间30s,防止死锁 private final static long LOCK_TRY_INTERVAL = 30L;//默认30ms尝试一次 private final static long LOCK_TRY_TIMEOUT = 20 * 1000L;//默认尝试20s @Autowired private StringRedisTemplate template; /** * 尝试获取全局锁 * * @param lock 锁的名称 * @return true 获取成功,false获取失败 */ public boolean tryLock(Lock lock) { return getLock(lock, LOCK_TRY_TIMEOUT, LOCK_TRY_INTERVAL, LOCK_EXPIRE); } /** * 尝试获取全局锁 * * @param lock 锁的名称 * @param timeout 获取超时时间 单位ms * @return true 获取成功,false获取失败 */ public boolean tryLock(Lock lock, long timeout) { return getLock(lock, timeout, LOCK_TRY_INTERVAL, LOCK_EXPIRE); } /** * 尝试获取全局锁 * * @param lock 锁的名称 * @param timeout 获取锁的超时时间 * @param tryInterval 多少毫秒尝试获取一次 * @return true 获取成功,false获取失败 */ public boolean tryLock(Lock lock, long timeout, long tryInterval) { return getLock(lock, timeout, tryInterval, LOCK_EXPIRE); } /** * 尝试获取全局锁 * * @param lock 锁的名称 * @param timeout 获取锁的超时时间 * @param tryInterval 多少毫秒尝试获取一次 * @param lockExpireTime 锁的过期 * @return true 获取成功,false获取失败 */ public boolean tryLock(Lock lock, long timeout, long tryInterval, long lockExpireTime) { return getLock(lock, timeout, tryInterval, lockExpireTime); } /** * 操作redis获取全局锁 * * @param lock 锁的名称 * @param timeout 获取的超时时间 * @param tryInterval 多少ms尝试一次 * @param lockExpireTime 获取成功后锁的过期时间 * @return true 获取成功,false获取失败 */ public boolean getLock(Lock lock, long timeout, long tryInterval, long lockExpireTime) { try { if (StringUtils.isEmpty(lock.getName()) || StringUtils.isEmpty(lock.getValue())) { return false; } long startTime = System.currentTimeMillis(); do{ if (!template.hasKey(lock.getName())) { ValueOperations<String, String> ops = template.opsForValue(); ops.set(lock.getName(), lock.getValue(), lockExpireTime, TimeUnit.MILLISECONDS); return true; } else {//存在锁 logger.debug("lock is exist!!!"); } if (System.currentTimeMillis() - startTime > timeout) {//尝试超过了设定值之后直接跳出循环 return false; } Thread.sleep(tryInterval); } while (template.hasKey(lock.getName())) ; } catch (InterruptedException e) { logger.error(e.getMessage()); return false; } return false; } /** * 释放锁 */ public void releaseLock(Lock lock) { if (!StringUtils.isEmpty(lock.getName())) { template.delete(lock.getName()); } } } 4.用法: @Autowired DistributedLockHandler distributedLockHandler; Lock lock=new Lock("lockk","sssssssss); if(distributedLockHandler.tryLock(lock){ doSomething(); distributedLockHandler.releaseLock(); } 五、注意点 在使用全局锁时为了防止死锁采用 setex命令,这种命令需要根据具体的业务具体设置锁的超时时间。另外一个就是锁的粒度性。比如在redis实战中有个案列,为了实现买卖市场交易的功能,把整个交易市场都锁住了,导致了性能不足的情况,改进方案只对买卖的商品进行加锁而不是整个市场。

优秀的个人博客,低调大师

跨平台GEO度量框架:从多源数据整合到效果评估的系统化指南

GEO效果不能只看“AI是否提到了链接”。本文以公开预印本 arXiv 2604.25707 的两阶段研究为基础,提出跨平台GEO度量框架:先记录“引用选择”,再判断“引用吸收”,并按平台分别汇总,避免总平均值掩盖广度与深度的分化。面向GEO从业者与品牌测量人员,用于把月报中的“提及率”升级为“引用吸收度”。

优秀的个人博客,低调大师

HMS Core图片分类服务教你快速筛选、分类、整合相册

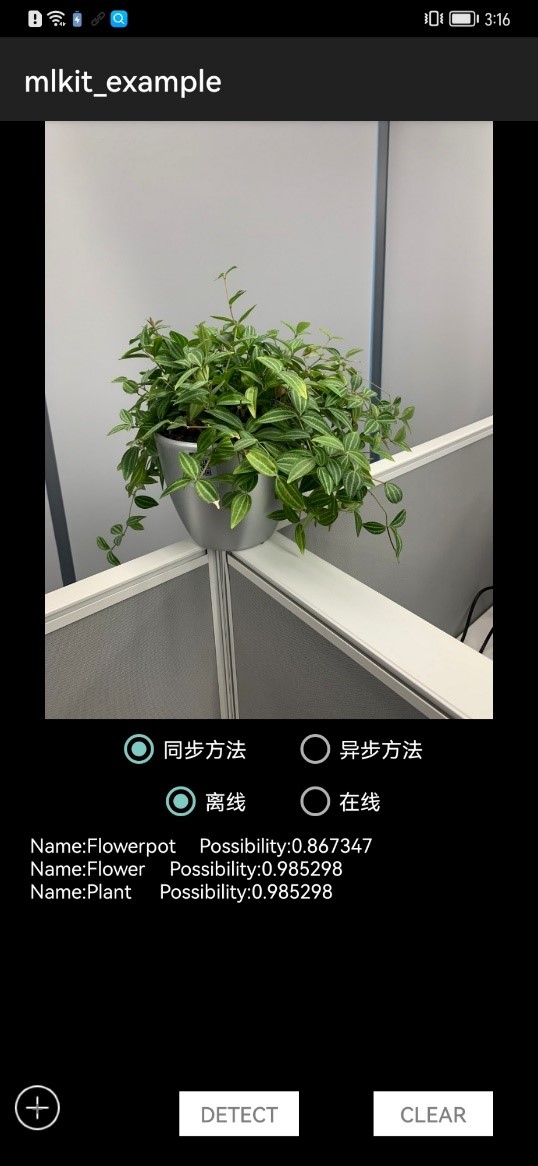
如今手机摄影越来越方便,随手一拍就能记录美好生活。但照片越多,整理越麻烦,有的时候我们想对照片进行二次加工、分享,需要不停翻找相册。HMS Core机器学习服务(ML Kit)提供了图片分类服务,方便用户在多个场景下快速筛选图片集、定义图片题材并标注分类信息。比如,期末老师时常会要求家长和孩子一起制作亲子成长手册,教育服务类App集成图片分类服务后可以把一个学期以来的所有照片分类汇总成相册;出去玩了多个景点或途径不同城市,旅游分享类App可以帮助用户整理基于某个位置或某个实物进行图片分类;在全场景下手机相册需要把照片同步到大屏上轮播,文件分享类App可以设置分享规则,分类上传。 接下来,请开发者们通过以下开发实战进行体验,同时期待大家将便捷的图片分类服务进一步带给用户~ 开发实战 1 开发准备 在进行开发前需要配置HMS Core SDK的Maven仓地址: repositories { maven { url'https://cmc.centralrepo.rnd.huawei.com/artifactory/product_maven/' } } 并集成本SDK: dependencies { // 引入基础SDK implementation 'com.huawei.hms:ml-computer-vision-classification:3.3.0.300' // 引入图片分类模型包 implementation 'com.huawei.hms:ml-computer-vision-image-classification-model:3.3.0.300' } 然后请参见云端鉴权信息使用须知,设置您应用的鉴权信息 2 编辑工程集成 2.1 设置应用的鉴权信息 可以通过api_key或者Access Token来设置应用鉴权信息。 通过setAccessToken方法设置Access Token,在应用启动时初始化设置一次即可,无需多次设置。 MLApplication.getInstance().setAccessToken("your access token"); 通过setApiKey方法设置api_key,在应用启动时初始化设置一次即可,无需多次设置。 MLApplication.getInstance().setApiKey("your ApiKey"); 2.2 创建静态图片检测器 // 方式一:端侧识别使用自定义参数配置。 MLLocalClassificationAnalyzerSetting setting = new MLLocalClassificationAnalyzerSetting.Factory() .setMinAcceptablePossibility(0.8f) .create(); MLImageClassificationAnalyzer analyzer = MLAnalyzerFactory.getInstance().getLocalImageClassificationAnalyzer(setting); // 方式二:端侧识别使用默认参数配置。 MLImageClassificationAnalyzer analyzer = MLAnalyzerFactory.getInstance().getLocalImageClassificationAnalyzer(); 2.3 创建MLFrame // 通过bitmap创建MLFrame,bitmap为输入的Bitmap格式图片数据。支持的图片格式包括:jpg/jpeg/png/bmp,建议图片尺寸不小于112*112像素。 MLFrame frame = MLFrame.fromBitmap(bitmap); 2.4 调用asyncAnalyseFrame方法进行图像分类 Task<List<MLImageClassification>> task = analyzer.asyncAnalyseFrame(frame); task.addOnSuccessListener(new OnSuccessListener<List<MLImageClassification>>() { @Override public void onSuccess(List<MLImageClassification> classifications) { // 识别成功。 // 遍历返回的列表MLImageClassification,获取分类名称等信息。 } }).addOnFailureListener(new OnFailureListener() { @Override public void onFailure(Exception e) { // 识别失败。 // Recognition failure. try { MLException mlException = (MLException)e; // 获取错误码,开发者可以对错误码进行处理,根据错误码进行差异化的页面提示。 int errorCode = mlException.getErrCode(); // 获取报错信息,开发者可以结合错误码,快速定位问题。 String errorMessage = mlException.getMessage(); } catch (Exception error) { // 转换错误处理。 } } }); 2.5 识别完成后停止分析器 try { if (analyzer != null) { analyzer.stop(); } } catch (IOException e) { // 异常处理。 } 3 演示及说明 3.1说明 图片分类功能包含静态端侧、静态云侧、动态检测,以上示例仅为静态端侧功能。 3.2 演示 了解更多详情>> 访问华为开发者联盟官网 获取开发指导文档 华为移动服务开源仓库地址:GitHub、Gitee 关注我们,第一时间了解 HMS Core 最新技术资讯~

优秀的个人博客,低调大师

SpringBoot2.0高级案例(04): 整合sharding-jdbc中间件,实现数据分库分表

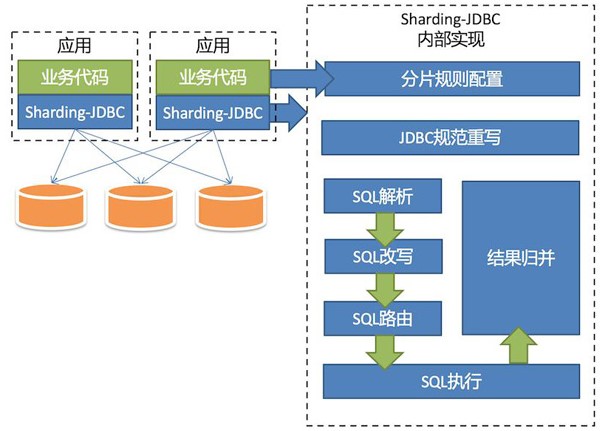
一、水平分割 1、水平分库 1)、概念: 以字段为依据,按照一定策略,将一个库中的数据拆分到多个库中。 2)、结果 每个库的结构都一样;数据都不一样; 所有库的并集是全量数据; 2、水平分表 1)、概念 以字段为依据,按照一定策略,将一个表中的数据拆分到多个表中。 2)、结果 每个表的结构都一样;数据都不一样; 所有表的并集是全量数据; 二、Shard-jdbc 中间件 1、架构图 2、特点 1)、Sharding-JDBC直接封装JDBC API,旧代码迁移成本几乎为零。 2)、适用于任何基于Java的ORM框架,如Hibernate、Mybatis等 。 3)、可基于任何第三方的数据库连接池,如DBCP、C3P0、 BoneCP、Druid等。 4)、以jar包形式提供服务,无proxy代理层,无需额外部署,无其他依赖。 5)、分片策略灵活,可支持等号、between、in等多维度分片,也可支持多分片键。 6)、SQL解析功能完善,支持聚合、分组、排序、limit、or等查询。 三、项目演示 1、项目结构 springboot 2.0 版本 druid 1.1.13 版本 sharding-jdbc 3.1 版本 2、数据库配置 一台基础库映射(shard_one) 两台库做分库分表(shard_two,shard_three)。 表使用:table_one,table_two 3、核心代码块 数据源配置文件 spring: datasource: # 数据源:shard_one dataOne: type: com.alibaba.druid.pool.DruidDataSource druid: driverClassName: com.mysql.jdbc.Driver url: jdbc:mysql://localhost:3306/shard_one?useUnicode=true&amp;characterEncoding=UTF8&amp;zeroDateTimeBehavior=convertToNull&amp;useSSL=false username: root password: 123 initial-size: 10 max-active: 100 min-idle: 10 max-wait: 60000 pool-prepared-statements: true max-pool-prepared-statement-per-connection-size: 20 time-between-eviction-runs-millis: 60000 min-evictable-idle-time-millis: 300000 max-evictable-idle-time-millis: 60000 validation-query: SELECT 1 FROM DUAL # validation-query-timeout: 5000 test-on-borrow: false test-on-return: false test-while-idle: true connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 # 数据源:shard_two dataTwo: type: com.alibaba.druid.pool.DruidDataSource druid: driverClassName: com.mysql.jdbc.Driver url: jdbc:mysql://localhost:3306/shard_two?useUnicode=true&amp;characterEncoding=UTF8&amp;zeroDateTimeBehavior=convertToNull&amp;useSSL=false username: root password: 123 initial-size: 10 max-active: 100 min-idle: 10 max-wait: 60000 pool-prepared-statements: true max-pool-prepared-statement-per-connection-size: 20 time-between-eviction-runs-millis: 60000 min-evictable-idle-time-millis: 300000 max-evictable-idle-time-millis: 60000 validation-query: SELECT 1 FROM DUAL # validation-query-timeout: 5000 test-on-borrow: false test-on-return: false test-while-idle: true connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 # 数据源:shard_three dataThree: type: com.alibaba.druid.pool.DruidDataSource druid: driverClassName: com.mysql.jdbc.Driver url: jdbc:mysql://localhost:3306/shard_three?useUnicode=true&amp;characterEncoding=UTF8&amp;zeroDateTimeBehavior=convertToNull&amp;useSSL=false username: root password: 123 initial-size: 10 max-active: 100 min-idle: 10 max-wait: 60000 pool-prepared-statements: true max-pool-prepared-statement-per-connection-size: 20 time-between-eviction-runs-millis: 60000 min-evictable-idle-time-millis: 300000 max-evictable-idle-time-millis: 60000 validation-query: SELECT 1 FROM DUAL # validation-query-timeout: 5000 test-on-borrow: false test-on-return: false test-while-idle: true connectionProperties: druid.stat.mergeSql=true;druid.stat.slowSqlMillis=5000 数据库分库策略 /** * 数据库映射计算 */ public class DataSourceAlg implements PreciseShardingAlgorithm<string> { private static Logger LOG = LoggerFactory.getLogger(DataSourceAlg.class); @Override public String doSharding(Collection<string> names, PreciseShardingValue<string> value) { LOG.debug("分库算法参数 {},{}",names,value); int hash = HashUtil.rsHash(String.valueOf(value.getValue())); return "ds_" + ((hash % 2) + 2) ; } } 数据表1分表策略 /** * 分表算法 */ public class TableOneAlg implements PreciseShardingAlgorithm<string> { private static Logger LOG = LoggerFactory.getLogger(TableOneAlg.class); /** * 该表每个库分5张表 */ @Override public String doSharding(Collection<string> names, PreciseShardingValue<string> value) { LOG.debug("分表算法参数 {},{}",names,value); int hash = HashUtil.rsHash(String.valueOf(value.getValue())); return "table_one_" + (hash % 5+1); } } 数据表2分表策略 /** * 分表算法 */ public class TableTwoAlg implements PreciseShardingAlgorithm<string> { private static Logger LOG = LoggerFactory.getLogger(TableTwoAlg.class); /** * 该表每个库分5张表 */ @Override public String doSharding(Collection<string> names, PreciseShardingValue<string> value) { LOG.debug("分表算法参数 {},{}",names,value); int hash = HashUtil.rsHash(String.valueOf(value.getValue())); return "table_two_" + (hash % 5+1); } } 数据源集成配置 /** * 数据库分库分表配置 */ @Configuration public class ShardJdbcConfig { // 省略了 druid 配置,源码中有 /** * Shard-JDBC 分库配置 */ @Bean public DataSource dataSource (@Autowired DruidDataSource dataOneSource, @Autowired DruidDataSource dataTwoSource, @Autowired DruidDataSource dataThreeSource) throws Exception { ShardingRuleConfiguration shardJdbcConfig = new ShardingRuleConfiguration(); shardJdbcConfig.getTableRuleConfigs().add(getTableRule01()); shardJdbcConfig.getTableRuleConfigs().add(getTableRule02()); shardJdbcConfig.setDefaultDataSourceName("ds_0"); Map<string,datasource> dataMap = new LinkedHashMap&lt;&gt;() ; dataMap.put("ds_0",dataOneSource) ; dataMap.put("ds_2",dataTwoSource) ; dataMap.put("ds_3",dataThreeSource) ; Properties prop = new Properties(); return ShardingDataSourceFactory.createDataSource(dataMap, shardJdbcConfig, new HashMap&lt;&gt;(), prop); } /** * Shard-JDBC 分表配置 */ private static TableRuleConfiguration getTableRule01() { TableRuleConfiguration result = new TableRuleConfiguration(); result.setLogicTable("table_one"); result.setActualDataNodes("ds_${2..3}.table_one_${1..5}"); result.setDatabaseShardingStrategyConfig(new StandardShardingStrategyConfiguration("phone", new DataSourceAlg())); result.setTableShardingStrategyConfig(new StandardShardingStrategyConfiguration("phone", new TableOneAlg())); return result; } private static TableRuleConfiguration getTableRule02() { TableRuleConfiguration result = new TableRuleConfiguration(); result.setLogicTable("table_two"); result.setActualDataNodes("ds_${2..3}.table_two_${1..5}"); result.setDatabaseShardingStrategyConfig(new StandardShardingStrategyConfiguration("phone", new DataSourceAlg())); result.setTableShardingStrategyConfig(new StandardShardingStrategyConfiguration("phone", new TableTwoAlg())); return result; } } 测试代码执行流程 @RestController public class ShardController { @Resource private ShardService shardService ; /** * 1、建表流程 */ @RequestMapping("/createTable") public String createTable (){ shardService.createTable(); return "success" ; } /** * 2、生成表 table_one 数据 */ @RequestMapping("/insertOne") public String insertOne (){ shardService.insertOne(); return "SUCCESS" ; } /** * 3、生成表 table_two 数据 */ @RequestMapping("/insertTwo") public String insertTwo (){ shardService.insertTwo(); return "SUCCESS" ; } /** * 4、查询表 table_one 数据 */ @RequestMapping("/selectOneByPhone/{phone}") public TableOne selectOneByPhone (@PathVariable("phone") String phone){ return shardService.selectOneByPhone(phone); } /** * 5、查询表 table_one 数据 */ @RequestMapping("/selectTwoByPhone/{phone}") public TableTwo selectTwoByPhone (@PathVariable("phone") String phone){ return shardService.selectTwoByPhone(phone); } } 四、项目源码 GitHub地址:知了一笑 https://github.com/cicadasmile/middle-ware-parent 码云地址:知了一笑 https://gitee.com/cicadasmile/middle-ware-parent

优秀的个人博客,低调大师

《私有云计算整合、虚拟化和面向服务的基础设施》一2.4存储虚拟化

2.4存储虚拟化 存储虚拟化是存储模块的主要焦点(参见图2-2),它抽象了服务器应用访问数据时的逻辑表现与数据的物理位置,实现了位置无关性(云计算的基本特征之一)。虚拟系统负责管理卷到实际物理位置的映射过程,使逻辑实体以卷的形式展现给用户。虚拟化软件或虚拟化设备负责维护映射表,它也是元数据的一部分。映射粒度小至物理磁盘的一部分,大至整个物理磁盘,在这样的环境中,单个信息块由其LUN,也即物理磁盘,以及LUN内的偏移地址一起确定,这一偏移地址也称为逻辑块地址(Logical Block Address,LBA)[16]。逻辑实体通常指虚拟磁盘,物理磁盘之间的地址空间映射由它们各自的LUN确定。说明:物理磁盘也可以仅为存储的一部分,例如从底层磁盘子系统中的RAID阵列切出来的一块。从另一个角度来看,传统存储管理通常采用到主机系统的DAS

优秀的个人博客,低调大师

《私有云计算整合、虚拟化和面向服务的基础设施》一1.4云计算分类

1.4云计算分类 云计算不是一个完全崭新的概念,值得一提的是最初的云雏形源自对TCP/IP的抽象,以Internet为标志。随着超文本传送协议(HyperText Transfer Protocol,HTTP)的诞生,万维网(World Wide Web,WWW)数据抽象在第一代云基础上创建了第二代云。新兴的云技术提倡由服务器、应用程序、数据以及异构平台组成一个抽象的基础设施,处于比前二者更底层的位置。根据美国国家技术与标准局(National Institute of Stardard and Technology,NIST)[3]对云计算的定义分类,种类繁多的云均可以被涵盖在四个发布模型和三个服务模型之内。 1.4.1部署模式 按部署模式不同,可以将云系统分成以下四种: 公有云(public cloud):云基础设施属于某些提供云服

优秀的个人博客,低调大师

苹果发布 Core AI 框架:整合 CPU、GPU 与神经网络引擎的设备端 AI 推理平台

苹果在WWDC 2026期间正式发布了Core AI框架,这是一款专为Apple芯片设计的设备端AI模型运行框架,开发者可通过它在自己的应用中构建、运行和部署AI模型。Core AI的核心理念是将最新模型架构和推理技术与苹果自研芯片的异构计算能力相结合——CPU、GPU和神经网络引擎(Neural Engine)协同工作,根据任务负载自动分配计算资源。 Core AI采用Swift API设计,常用任务可以直接调用高层接口完成,同时在需要时也支持对模型专门化(specialization)、缓存策略和推理性能进行精细控制。框架与Xcode深度集成,提供Core AI调试仪表盘和Core AI性能分析工具,帮助开发者在开发过程中监控和优化推理效率。此外,coreai-build命令行工具支持在构建阶段提前编译模型,进一步缩短应用上线后的首次推理准备时间。 配合Core AI框架,苹果还同步推出了配套工具链。Core AI Optimization用于将模型针对Apple芯片进行优化,随后通过Core AI PyTorch Extensions转换为.aimodel格式供Core AI直接加载。Core AI Debugger应用则提供模型结构可视化和数值级调试能力,开发者可以直接将张量数值追溯回Python源代码。对于需要调试和性能分析的场景,这套工具链覆盖了从模型准备到生产环境监控的完整流程。 值得注意的是,Core AI面向的是神经网络类模型。如果应用需要使用决策树或表格类特征工程的模型类型,苹果建议继续使用Core ML框架——这是Apple原有的机器学习框架,与Core AI形成互补,后者在WWDC 2026前处于Beta状态,面向的正是日益增长的设备端生成式AI推理需求。 从开发者角度看,Core AI的发布意味着在苹果生态内构建AI功能有了官方统一入口。此前,开发者需要在Core ML、第三方推理框架和自研方案之间做选择,Core AI则提供了一个苹果背书、性能经过深度优化的标准路径。结合苹果芯片在能效上的既有优势,Core AI很可能成为未来苹果平台AI应用开发的基础组件。 参考来源: https://developer.apple.com/documentation/coreai/ https://github.com/apple/coreai-models

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册