动手实操丨基于随机森林算法进行硬盘故障预测
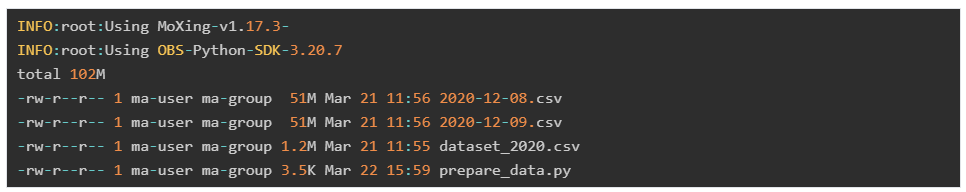
摘要:业界期望使用机器学习技术来构建硬盘故障预测的模型,更准确地提前感知硬盘故障,降低运维成本,提升业务体验。本案例将使用随机森林算法来训练一个硬盘故障预测模型。 本文分享自华为云社区《基于随机森林算法进行硬盘故障预测》,原文作者:山海之光。 实验目标 掌握使用机器学习方法训练模型的基本流程; 掌握使用pandas做数据分析的基本方法; 掌握使用scikit-learn进行随机森林模型的构建、训练、保存、加载、预测、统计准确率指标和查看混淆矩阵的方法; 案例内容介绍 随着互联网、云计算的发展,数据的存储需求与日倍增,大规模海量数据存储中心是必不可少的基础性设施。虽然新的存储介质例如SSD,已经很多方面拥有了比磁盘更好的性能,但就目前来讲,其高昂的花费仍然使大部分数据中心难以负担,因此,大型数据中心依然会采用传统的机械硬盘作为存储介质。 机械硬盘生命周期通常为3到5年,在2到3年后故障率明显升高,导致换盘量陡增。据统计,在服务器硬件故障中,硬盘故障占比达到48%+,是影响服务器运行可靠性的重要因素。早在上个世纪九十年代,人们就意识到数据的宝贵性远胜于硬盘自身价值,渴望有种技术能对硬盘故障进行预测并实现相对安全的数据保护,因此S.M.A.R.T.技术应运而生。 S.M.A.R.T.,全称为“Self-Monitoring Analysis and Reporting Technology”,即“自我监测、分析及报告技术”,是一种自动的硬盘状态检测与预警系统和规范。通过在硬盘硬件内的检测指令对硬盘的硬件如磁头、盘片、马达、电路的运行情况进行监控、记录并与厂商所设定的预设安全值进行比较,若监控情况将或已超出预设安全值的安全范围,就可以通过主机的监控硬件或软件自动向用户作出警告并进行轻微的自动修复,以提前保障硬盘数据的安全。除一些出厂时间极早的硬盘外,现在大部分硬盘均配备该项技术。关于该技术的更多介绍,请查看S.M.A.R.T.-百度百科。 虽然硬盘厂商采用了S.M.A.R.T.技术来监测硬盘的健康状态,但是大多数厂商都是基于设计规则制定的故障预测手段,预测效果非常差,不能满足日渐严格的提前预测硬盘故障的需求。因此,业界期望使用机器学习技术来构建硬盘故障预测的模型,更准确地提前感知硬盘故障,降低运维成本,提升业务体验。 本案例将带大家使用一份开源的S.M.A.R.T.数据集和机器学习中的随机森林算法,来训练一个硬盘故障预测模型,并测试效果。 关于随机森林算法的理论讲解, 可参考此视频。 注意事项 如果你是第一次使用 JupyterLab,请查看《ModelAtrs JupyterLab使用指导》了解使用方法; 如果你在使用 JupyterLab 过程中碰到报错,请参考《ModelAtrs JupyterLab常见问题解决办法》尝试解决问题。 实验步骤 1. 数据集介绍 本案例使用的数据集是来自于Backblaze公司的开源数据集,它是一家计算机备份和云存储服务提供商。自2013年以来,Backbreze每年都会公开发布他们的数据中心所使用硬盘的S.M.A.R.T.日志数据,有效地推动了使用机器学习技术进行硬盘故障预测的发展。 由于Backblaze公司发布的S.M.A.R.T.日志数据量较大,本案例为快速演示使用机器学习构建硬盘故障预测模型的过程,仅使用了该公司发布的2020年的数据,相关数据已经准备好,放在OBS中,运行如下代码即可下载这部分数据。 注意:本步下载数据的代码需要在华为云ModelArts Codelab上运行 import os import moxing as mox if not os.path.exists('./dataset_2020.zip'): mox.file.copy('obs://modelarts-labs-bj4/course/ai_in_action/2021/machine_learning/hard_drive_disk_fail_prediction/dataset_2020.zip', './dataset_2020.zip') os.system('unzip dataset_2020.zip') if not os.path.exists('./dataset_2020'): raise Exception('错误!数据不存在!') !ls -lh ./dataset_2020 数据解释: 2020-12-08.csv:从backblaze公司发布的2020 Q4数据集中抽取出来的2020-12-08这天的S.M.A.R.T.日志数据 2020-12-09.csv:从backblaze公司发布的2020 Q4数据集中抽取出来的2020-12-09这天的S.M.A.R.T.日志数据 dataset_2020.csv:已经处理过的2020年全年S.M.A.R.T.日志数据,下文中“第2.6节 类别均衡度分析”会解释如何得到这部分数据 prepare_data.py: 运行该脚本,会下载2020年全年S.M.A.R.T.日志数据,并进行处理,得到dataset_2020.csv。运行该脚本需要20G的本地存储空间 2. 数据分析 使用机器学习构建任何模型之前,都需要先对数据集进行分析,了解数据集的规模、属性名、属性值、各类统计指标及空值情况。因为我们要先了解数据,才能用好数据。 2.1 读取csv文件 pandas是常用的python数据分析模块,我们先用它来加载数据集中的csv文件。以2020-12-08.csv为例,我们先加载该文件来分析S.M.A.R.T.日志数据的情况 2.2 查看单个csv文件数据的规模 2.3 查看头5行数据 使用pandas加载csv后,得到的是一个DataFrame对象,可以理解为一个表格,调用该对象的head()函数,可以查看表格的头5行数据 df_data.head() 5 rows × 149 columns 如上所示是表格的头5行数据,表头是属性名,属性名下面是属性值,backblaze网站解释了属性值的含义,翻译为如下: 2.4 查看数据的统计指标 查看完表格的头5行数据,我们再调用DataFrame对象的describe()函数,计算表格数据的统计指标 df_data.describe() 8 rows × 146 columns 如上所示是表格数据的统计指标,describe()函数默认对数值类型的列进行统计分析,由于表格的前三列’date’、‘serial_number’、'model’是字符串类型,所以这三列没有统计指标。 各行统计指标的含义解释如下: count: 该列有多少个非空值 mean: 该列的均值 std: 该列数值的标准差 min: 该列数值的最小值 25%: 该列数值的25%中位值 50%: 该列数值的50%中位值 75%: 该列数值的75%中位值 max: 该列数值的最大值 2.5 查看数据空值情况 从上面的输出可以观察到,某些属性的count指标比较小,比如smart_2_raw的count数就比df_train的总行数要小很多,因此我们要再进一步看看各列属性的空值情况,执行如下代码可以查看空值情况 df_data.isnull().sum() date 0 serial_number 0 model 0 capacity_bytes 0 failure 0 smart_1_normalized 179 smart_1_raw 179 smart_2_normalized 103169 smart_2_raw 103169 smart_3_normalized 1261 smart_3_raw 1261 smart_4_normalized 1261 smart_4_raw 1261 smart_5_normalized 1221 smart_5_raw 1221 smart_7_normalized 1261 smart_7_raw 1261 smart_8_normalized 103169 smart_8_raw 103169 smart_9_normalized 179 smart_9_raw 179 smart_10_normalized 1261 smart_10_raw 1261 smart_11_normalized 161290 smart_11_raw 161290 smart_12_normalized 179 smart_12_raw 179 smart_13_normalized 161968 smart_13_raw 161968 smart_15_normalized 162008 ... smart_232_normalized 160966 smart_232_raw 160966 smart_233_normalized 160926 smart_233_raw 160926 smart_234_normalized 162008 smart_234_raw 162008 smart_235_normalized 160964 smart_235_raw 160964 smart_240_normalized 38968 smart_240_raw 38968 smart_241_normalized 56030 smart_241_raw 56030 smart_242_normalized 56032 smart_242_raw 56032 smart_245_normalized 161968 smart_245_raw 161968 smart_247_normalized 162006 smart_247_raw 162006 smart_248_normalized 162006 smart_248_raw 162006 smart_250_normalized 162008 smart_250_raw 162008 smart_251_normalized 162008 smart_251_raw 162008 smart_252_normalized 162008 smart_252_raw 162008 smart_254_normalized 161725 smart_254_raw 161725 smart_255_normalized 162008 smart_255_raw 162008 Length: 149, dtype: int64 这种显示方式不太方便查看,我们把可以空值的数量绘制成曲线图,看起来更直观 import numpy as np import matplotlib.pyplot as plt %matplotlib inline df_data_null_num = df_data.isnull().sum() x = list(range(len(df_data_null_num))) y = df_data_null_num.values plt.plot(x, y) plt.show() 从上面的结果可以看出,表格中的某些属性有大量的空值。 在机器学习领域中,数据集中存在空值是很常见的现象,引起空值的原因有很多种,比如一份用户画像中有很多个属性,但又不是所有用户都有对应的属性值,这时就产生了空值。或者某些数据因为传输超时,导致没有采集上来,也可能会出现空值。 2.6 类别均衡度分析 我们要实现的任务是“硬盘故障预测”,即预测某个硬盘在某个时间是正常还是损坏,这就是一个故障预测问题或异常检测问题,这类问题有个特点就是:正常样本非常多,故障样本非常少,两类样本的数量差异非常大。 比如,执行如下代码,可以看到df_data中硬盘正常的样本有16万个以上,故障的样本却只有8个,类别极度不均衡。 由于大多数机器学习方法的学习过程都是基于统计学的思路来进行学习的,如果直接使用上面这样类别不均衡的数据进行训练,那么模型的能力可能会明显偏向于类别多的样本,类别少的样本就会被“淹没”掉了,在学习过程中发挥不了作用,因此我们需要平衡不同类别的数据。 为了获得更多的故障样本数据,我们可以从backblaze公司发布的2020年全年S.M.A.R.T.日志数据中将所有的故障样本都挑选出来,同时也随机挑出相同数量的正常样本,可以通过下面的代码来实现。 这段代码已被注释掉,如需运行,需要20G的本地存储空间。您也可以不必运行这段代码,因为本案例开头已经下载了dataset_2020.zip,这个压缩包中已经提供了dataset_2020.csv,该csv就是运行下面这段代码得到的文件 import gc del df_data # 删除 df_data 对象 gc.collect() # 由于接下来的代码将加载日志数据到df_data对象中,为避免内存溢出的风险,可以在此处先手动回收内存,因为jupyterlab在运行过程中不会自动回收环境中的内存 2.7 加载类别均衡的数据集 dataset_2020.csv是已经经过类别均衡处理的硬盘S.M.A.R.T.日志数据,下面我们加载该文件,再确认一下类别均衡情况 可以看到,正常样本和故障样本都是1497个 3. 特征工程 准备好可用的训练集之后,接下来要做特征工程,通俗地讲,特性工程就是要选择表格中的哪些属性来构建机器学习模型。人工设计特征的好坏,很大程度上决定了机器学习模型效果的好坏,所以机器学习领域的研究人员需耗费大量精力在人工设计特征上,是一项比较耗时、耗力,且需要专家经验的工程。 3.1 SMART属性与硬盘故障的相关研究 (1)BackBlaze分析了其HDD故障和SMART属性之间的相关性,并发现了SMART 5、187、188、197、198与HDD故障的相关率最高,这些SMART属性还与扫描错误,重新分配计数和试用计数有关[1]; (2)El-Shimi等发现在随机森林模型中除了以上5个特征外,还有SMART 9、193、194、241、242这5个属性有最大权重[2]; (3)Pitakrat等人评估了21种用于预测硬盘故障的机器学习算法,发现在测试的21种机器学习算法中,随机森林算法在ROC曲线下有最大面积,而KNN分类器具有最高的F1值[3]; (4)Hughes等人也研究用于预测硬盘故障的机器学习方法,他们分析了SVM、朴素贝叶斯的表现,SVM实现了最高性能,检测率为50.6%,误报率为0%[4]; [1] Klein, Andy. “What SMART Hard Disk Errors Actually Tell Us.” Backblaze Blog Cloud Storage & Cloud Backup,6 Oct. 2016,http://www.backblaze.com/blog/what-smart-stats-indicate-hard-drive-failures/ [2] El-Shimi, Ahmed. “Predicting Storage Failures.” VAULT-Linux Storage and File Systems Conference.VAULT-Linux Storage and File Systems Conference, 22 Mar. 2017, Cambridge. [3] Pitakrat, Teerat, André van Hoorn, and Lars Grunske. “A comparison of machine learning algorithms for proactive hard disk drive failure detection.” Proceedings of the 4th international ACM Sigsoft symposium on Architecting critical systems. ACM, 2013. [4] Hughes, Gordon F., et al. “Improved disk-drive failure warnings.” IEEE Transactions on Reliability 51.3 (2002):350-357. 如上就是前人的一些研究成果,本案例计划采用随机森林模型,因此可以根据上面第2条研究成果,选择SMART 5, 9, 187, 188, 193, 194, 197, 198, 241, 242这些属性来作为特征,它们的含义分别是: SMART 5: 重映射扇区计数 SMART 9: 通电时间累计 SMART 187: 无法校正的错误 SMART 188: 指令超时计数 SMART 193: 磁头加载/卸载计数 SMART 194: 温度 SMART 197: 等待被映射的扇区数 SMART 198: 报告给操作系统的无法通过硬件ECC校正的错误 SMART 241: 逻辑块寻址模式写入总数 SMART 242: 逻辑块寻址模式读取总数 另外,由于不同硬盘厂商的不同型号硬盘记录SMART日志数据的标准可能不一样,所以我们最好将同一型号的硬盘数据挑出来作为训练数据,专门训练一个预测该型号硬盘是否故障的模型。如果需要预测多个不同型号的硬盘是否故障,则可能需要分别训练多个模型。 3.2 硬盘型号选择 执行下面的代码,看一下每种型号的硬盘数据量有多少 df_data.model.value_counts() ST12000NM0007 664 ST4000DM000 491 ST8000NM0055 320 ST12000NM0008 293 TOSHIBA MG07ACA14TA 212 ST8000DM002 195 HGST HMS5C4040BLE640 193 HGST HUH721212ALN604 153 TOSHIBA MQ01ABF050 99 ST12000NM001G 53 HGST HMS5C4040ALE640 50 ST500LM012 HN 40 TOSHIBA MQ01ABF050M 35 HGST HUH721212ALE600 34 ST10000NM0086 29 ST14000NM001G 23 HGST HUH721212ALE604 21 ST500LM030 15 HGST HUH728080ALE600 14 Seagate BarraCuda SSD ZA250CM10002 12 WDC WD5000LPVX 11 WDC WUH721414ALE6L4 10 ST6000DX000 9 TOSHIBA MD04ABA400V 3 ST8000DM004 2 ST18000NM000J 2 Seagate SSD 2 ST4000DM005 2 ST8000DM005 1 ST16000NM001G 1 DELLBOSS VD 1 TOSHIBA HDWF180 1 HGST HDS5C4040ALE630 1 HGST HUS726040ALE610 1 WDC WD5000LPCX 1 Name: model, dtype: int64 可以看到 ST12000NM0007 型号的硬盘数据量最多,因此我们把该型号硬盘的数据过滤出来 df_data_model = df_data[df_data['model'] == 'ST12000NM0007'] 3.3 特征选择 选取上文提到的10个属性作为特征 有空值存在,所以先要填充空值 3.4 划分训练集和测试集 使用sklearn的train_test_split即可划分训练集和测试集,test_size表示测试集的比例,一般取值为0.3、0.2或0.1 from sklearn.model_selection import train_test_split X_train, X_test, Y_train, Y_test = train_test_split(X_data, Y_data, test_size=0.2, random_state=0) 4. 开始训练 4.1 构建模型 准备好训练集和测试集之后,就可以开始构建模型了,构建模型的步骤非常简单,直接调用机器学习框架sklearn中的RandomForestClassifier即可 from sklearn.ensemble import RandomForestClassifier rfc = RandomForestClassifier() 随机森林算法的超参数有很多个,取不同的参数值构建模型会得到不同的训练效果,对于初学者,可以直接使用库中提供的默认参数值,在对随机森林算法的原理有一定的了解之后,可以尝试修改模型的参数来调整模型的训练效果。 4.2 数据拟合 模型训练的过程,也就是拟合训练数据的过程,实现也非常简单,调用fit函数即可开始训练 /home/ma-user/anaconda3/envs/XGBoost-Sklearn/lib/python3.6/site-packages/sklearn/ensemble/forest.py:248: FutureWarning: The default value of n_estimators will change from 10 in version 0.20 to 100 in 0.22. "10 in version 0.20 to 100 in 0.22.", FutureWarning) RandomForestClassifier(bootstrap=True, class_weight=None, criterion='gini', max_depth=None, max_features='auto', max_leaf_nodes=None, min_impurity_decrease=0.0, min_impurity_split=None, min_samples_leaf=1, min_samples_split=2, min_weight_fraction_leaf=0.0, n_estimators=10, n_jobs=None, oob_score=False, random_state=None, verbose=0, warm_start=False) 5 开始预测 调用predict函数即可开始预测 Y_pred = rfc.predict(X_test) 5.1 统计预测准确率 在机器学习中,分类问题的性能指标,常用的有四种:accuracy(精度)、precision(查准率)、recall(查全率)、F1-Score,四种指标越接近1,表示效果越好。sklearn库中有这四种指标的函数,直接调用即可。 关于四种指标的理论解释, 可参考此文章 每次进行随机森林模型的训练,会得到该模型不同的测试准确率指标,这是由于随机森林算法的训练过程具有一定的随机性导致的,是正常现象。但是同一模型、同一样本的预测结果是确定不变的。 5.2 模型保存、加载、再预测 模型保存 import pickle with open('hdd_failure_pred.pkl', 'wb') as fw: pickle.dump(rfc, fw) 模型加载 with open('hdd_failure_pred.pkl', 'rb') as fr: new_rfc = pickle.load(fr) 模型再预测 5.3 查看混淆矩阵 要分析分类模型的效果如何,还可以使用混淆矩阵来查看,混淆矩阵的横轴表示预测结果的各个类别,纵轴表示真实标签的类别,矩阵方格中的值就代表对应横纵坐标重叠的测试样本数量。 import seaborn as sns import matplotlib.pyplot as plt from sklearn.metrics import confusion_matrix LABELS = ['Healthy', 'Failed'] conf_matrix = confusion_matrix(Y_test, Y_pred) plt.figure(figsize =(6, 6)) sns.heatmap(conf_matrix, xticklabels = LABELS, yticklabels = LABELS, annot = True, fmt ="d"); plt.title("Confusion matrix") plt.ylabel('True class') plt.xlabel('Predicted class') plt.show() 6. 改进模型的思路 如上内容是使用随机森林算法构建硬盘故障预测模型的过程演示,模型精度并不算高,有如下几个思路可以提升模型的精度: (1)本案例只使用了Backblaze公司2020年的数据,您可以尝试使用更多的训练数据; (2)本案例只使用了10个SMART属性作为特征,您可以尝试使用其他方法来构建特征; (3)本案例使用了随机森林算法来训练模型,您可以尝试使用其他的机器学习算法; 点击进入华为云ModelArts Codelab可直接运行本案例代码 点击关注,第一时间了解华为云新鲜技术~