首页 文章 精选 留言 我的

精选列表

搜索[IDEA大会],共10000篇文章
优秀的个人博客,低调大师

SpringBoot-04:SpringBoot在idea中的俩种创建方式

------------吾亦无他,唯手熟尔,谦卑若愚,好学若饥------------- 创建SpringBoot工程有很多种方式,我只讲俩种最为常见的 一,依托springboot官网提供的模板。(好处:简单,最新版本) 二,从一个Maven项目中拓展成springboot。(好处:可以控制版本,离线创建) 开始案例 一,通过官网骨架 1.开始创建 2.Next 3.Next 4.Next 5.finish 项目骨架如下 二,通过maven 在第一次通过官网创建过后,我们的maven库里已经有了一个版本的springboot,没有必要每次都下最新版本的,所以,我们可以通过maven仓库创建离线版本 1.正常的maven webapp项目的创建 2.在pom文件中将springboot的节点粘过来 <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>cn.dawn</groupId> <artifactId>z01springbootmyself</artifactId> <version>0.0.1-SNAPSHOT</version> <packaging>jar</packaging> <name>Z01SpringBootMyself</name> <description>Demo project for Spring Boot</description> <!--springboot的核心--> <parent> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-parent</artifactId> <version>2.0.0.RELEASE</version> <relativePath/> <!-- lookup parent from repository --> </parent> <!--jdk和编码--> <properties> <project.build.sourceEncoding>UTF-8</project.build.sourceEncoding> <project.reporting.outputEncoding>UTF-8</project.reporting.outputEncoding> <java.version>1.8</java.version> </properties> <dependencies> <!--web工程需要的--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-web</artifactId> </dependency> <!--单测需要的--> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-test</artifactId> <scope>test</scope> </dependency> </dependencies> <build> <!--maven的插件--> <plugins> <plugin> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-maven-plugin</artifactId> </plugin> </plugins> </build> </project> 3.按照springboot的骨架创建java,resourse等,上面那张图所示

优秀的个人博客,低调大师

IntelliJ IDEA + Maven环境编写第一个hadoop程序

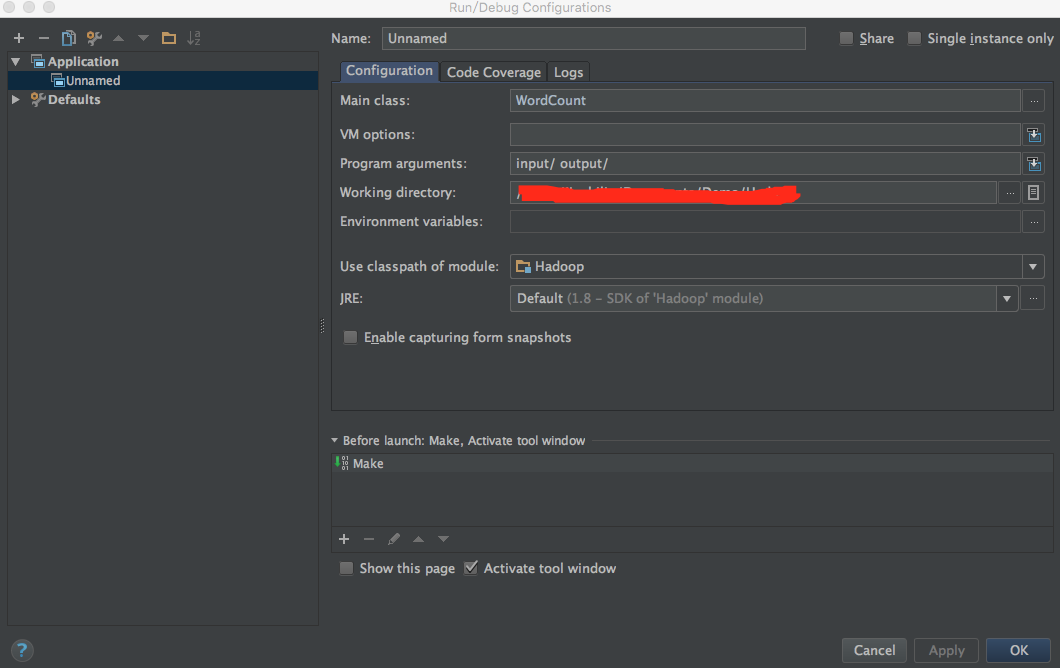
1. 新建IntelliJ下的maven项目 点击File->New->Project,在弹出的对话框中选择Maven,JDK选择你自己安装的版本,点击Next 2.填写Maven的GroupId和ArtifactId 你可以根据自己的项目随便填,点击Next 这样就新建好了一个空的项目 这里程序名填写WordCount,我们的程序是一个通用的网上的范例,用来计算文件中单词出现的次数 3. 设置程序的编译版本 打开Intellij的Preference偏好设置,定位到Build, Execution, Deployment->Compiler->Java Compiler, 将WordCount的Target bytecode version修改为你的jdk版本(我的是1.8) 4. 配置依赖 编辑pom.xml进行配置 1)添加apache源 在project内尾部添加 <repositories> <repository> <id>apache</id> <url>http://maven.apache.org</url> </repository> </repositories> 2) 添加hadoop依赖 这里只需要用到基础依赖hadoop-core和hadoop-common;如果需要读写HDFS,则还需要依赖hadoop-hdfs和hadoop-client;如果需要读写HBase,则还需要依赖hbase-client 在project内尾部添加 <dependencies> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-core</artifactId> <version>1.2.1</version> </dependency> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-common</artifactId> <version>2.7.2</version> </dependency> </dependencies> 修改pom.xml完成后,Intellij右上角会提示Maven projects need to be Imported,点击Import Changes以更新依赖,或者点击Enable Auto Import 最后,我的完整的pom.xml如下: <?xml version="1.0" encoding="UTF-8"?> <project xmlns="http://maven.apache.org/POM/4.0.0" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xsi:schemaLocation="http://maven.apache.org/POM/4.0.0 http://maven.apache.org/xsd/maven-4.0.0.xsd"> <modelVersion>4.0.0</modelVersion> <groupId>com.fun</groupId> <artifactId>hadoop</artifactId> <version>1.0-SNAPSHOT</version> <repositories> <repository> <id>apache</id> <url>http://maven.apache.org</url> </repository> </repositories> <dependencies> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-core</artifactId> <version>1.2.1</version> </dependency> <dependency> <groupId>org.apache.hadoop</groupId> <artifactId>hadoop-common</artifactId> <version>2.7.2</version> </dependency> </dependencies> <build> <plugins> <plugin> <artifactId>maven-dependency-plugin</artifactId> <configuration> <excludeTransitive>false</excludeTransitive> <stripVersion>true</stripVersion> <outputDirectory>./lib</outputDirectory> </configuration> </plugin> </plugins> </build> </project> 5. 编写主程序 WordCount.java /** * Created by jinshilin on 16/12/7. */ import java.io.IOException; import java.util.StringTokenizer; import org.apache.hadoop.conf.Configuration; import org.apache.hadoop.fs.Path; import org.apache.hadoop.io.IntWritable; import org.apache.hadoop.io.Text; import org.apache.hadoop.mapreduce.Job; import org.apache.hadoop.mapreduce.Mapper; import org.apache.hadoop.mapreduce.Reducer; import org.apache.hadoop.mapreduce.lib.input.FileInputFormat; import org.apache.hadoop.mapreduce.lib.output.FileOutputFormat; public class WordCount { public static class TokenizerMapper extends Mapper<Object, Text, Text, IntWritable> { private final static IntWritable one = new IntWritable(1); private Text word = new Text(); public void map(Object key, Text value, Context context ) throws IOException, InterruptedException { StringTokenizer itr = new StringTokenizer(value.toString()); while (itr.hasMoreTokens()) { word.set(itr.nextToken()); context.write(word, one); } } } public static class IntSumReducer extends Reducer<Text, IntWritable, Text, IntWritable> { private IntWritable result = new IntWritable(); public void reduce(Text key, Iterable<IntWritable> values, Context context ) throws IOException, InterruptedException { int sum = 0; for (IntWritable val : values) { sum += val.get(); } result.set(sum); context.write(key, result); } } public static void main(String[] args) throws Exception { Configuration conf = new Configuration(); Job job = Job.getInstance(conf, "word count"); job.setJarByClass(WordCount.class); job.setMapperClass(TokenizerMapper.class); job.setCombinerClass(IntSumReducer.class); job.setReducerClass(IntSumReducer.class); job.setOutputKeyClass(Text.class); job.setOutputValueClass(IntWritable.class); FileInputFormat.addInputPath(job, new Path(args[0])); FileOutputFormat.setOutputPath(job, new Path(args[1])); System.exit(job.waitForCompletion(true) ? 0 : 1); } } 6. 配置输入和输出结果文件夹 1) 添加和src目录同级的input文件夹到项目中 在input文件夹中放置一个或多个输入文件源 我的输入文件源如下: test.segmented: dfdfadgdgagaadadsfudflclcckcerfadfdfdfadgdgagfudflclfuckfuckfuckfuckhahaaaa 2) 配置运行参数在Intellij菜单栏中选择Run->Edit Configurations,在弹出来的对话框中点击+,新建一个Application配置。配置Main class为WordCount(可以点击右边的...选择), Program arguments为input/ output/,即输入路径为刚才创建的input文件夹,输出为output 由于Hadoop的设定,下次运行时务必删除output文件夹! 好了,运行程序,结果如下: aaa 1aadads 1cckcer 1dfdfadgdgag 2fadf 1fuck 2fuckfuck 1fudflcl 2haha 1 至此,一个简单的hadoop程序完成!


优秀的个人博客,低调大师

RSAC 2020安全大会的二十个酷产品

如果你觉得RSAC2020创新沙盒冠军Securiti.AI并不够酷,那么下面安全牛联合现场参展的中国厂商代表,为大家扫货推荐今年RSAC2020的“酷产品”(我们尽量避开此前已经多次报道过的10家创新沙盒公司的产品): 1、Vulcan Cyber Vulcan Cyber是创新沙盒十强中唯一的一家以色列公司,在2019年曾入选Gartner 在Security and Risk Management的Cool Vendor。Vulcan Cyber为企业提供了一套自动化漏洞威胁缓解(Automated Vulnerability Remediation)解决方案,通过对已有开发、运维工具的集成与整合,实现对突发安全漏洞的快速响应,将企业受到安全威胁的时间窗口从数周、数月缩短到小时级。 虽然没能拿到创新沙盒的冠军,但是Vulcan Cyber得到了包括奇安信、360和绿盟科技等国内安全企业高管的一致好评,对该产品概念在国内市场的前景也是一致看好,普遍认为该产品不但有情怀(SOAR落地)而且很实用,解决了企业的安全痛点。 2. Cyberint:托管威胁捕获 Cyberint的托管威胁搜寻功能可主动连续搜寻企业环境中的网络威胁,恶意活动,以及违规活动。该服务利用了第三方的端点技术和安全流程自动化编排和响应(SOAR)解决方案。 展位:北展馆 #4425 3、Cyber Armor:DevOps的服务到服务控制 Cyber Armor使DevOps能够跨云原生、混合和多云环境无缝部署本地零信任工作负载。通过安全自动化和加速产品交付来消除Sec与Dev之间的摩擦。其基于身份的零信任控制平面可以确保只有经过身份验证的工作负载才能运行、传输和访问数据,并确保从CI/CD到运行时都能保持一致的安全性。 展位:南展馆 #735F 4、Attivo Networks 端点检测网络(EDN) EDN是Attivo Networks Threat Defend产品线最新产品,号称能够“在端点阻击攻击者”。该产品增强的功能使企业能够发现各种攻击矢量威胁,在端点就锁住攻击者,使其无法通过从端点发起的Active Directory侦察、访问凭据、发现活动端口或网络资产、中间人攻击等方式横向移动。 展位:南展馆 #2127 5、42Crunch:面向中小企业的自助式API安全平台 42Crunch号称提供市场上最全面的API安全解决方案,涵盖Web API生命周期的所有阶段,包括:API设计和开发过程中的安全审核、安全性测试和运行保护。该平台以前的定位是面向大型企业的高价产品,但是42Crunch重新设计并定位了产品,推出了可供中小企业使用的自助式的低价产品。 6、Devo Technology :Devo安全运营平台 Devo Security Operations将集成SIEM软件、威胁情报平台、案例管理解决方案以及用户和实体行为分析(UEBA)等常用功能,并与分析师工作流程集成整合到一个方案中。Devo Security Operation安全运营在数据分析平台的基础上提供数据自动Enrich、威胁情报、社区协作以及中央证据数据库等功能,帮助分析人员更有效地识别和阻止威胁。 展位:南展馆#2339 7、Devolution:Devolution密码服务器 Devolutions Password Server是特权访问管理(PAM)产品,专为中小型企业和创业公司(员工数少于1000人)的需要开发的密码服务器。IT团队可以使用密码服务器在本地部署安全解决方案来控制对特权账户的访问并管理远程会话。目的是减少内部威胁和数据泄露风险,这些威胁通常是由于凭据滥用或者泄露引起。 展位:北展馆 #6381 8、Egnyte下一代内容服务平台 内容和隐私合规的可视性是今年安全创新的热点之一,Egnyte的下一代内容服务平台为内容治理、数据隐私、合规性和工作流自动化提供了统一的平台。该平台基于机器学习和人工智能技术为企业提供了高可视性的内容资产控制“交钥匙”方案。Egnyte还支持内容丰富的工作流程协作,可以轻松远程访问大型文件。 展位:南展馆 #3232 9、eSentire:esCloud 新冠肺炎疫情下的全民远程办公,使得MDR等托管安全服务成为中国安全业界关注的热点。esCLOUD是eSentire的网络安全服务产品组合,将该公司的托管检测和响应(MDR)和威胁搜寻专业知识扩展到云端(AWS、Azure、Google Cloud Platform)。esCLOUD能持续监控客户云环境的不当配置和漏洞,防止数据丢失和破坏。 展位:南展馆 #S-1453 10、Essence SigmaDots嵌入式物联网安全平台 Essence SigmaDots是一个由四个产品(动态防火墙、分布式MQTT网络协议即服务、端到端加密服务、安全运营监控和警报)组成的物联网综合安全平台,平台采用完全嵌入式、分布式和多层方法,基于分布式架构保护物联网设备。平台中的四个产品也可以单独实现和使用。 展位:南展馆# 735 11、Fidelis Elevate 9.3版 Fidelis Elevate整合了网络与云流量分析、端点检测和响应,以及欺骗技术。主要特色有:开放的威胁情报源、基于云的沙箱和高级恶意软件分析、自动化威胁检测调查和响应。 通过对新的失陷指标和元数据的追溯应用,Fidelis可以对端点活动、网络和云流量进行实时追溯性元数据分析,检测调查与分析的自动化脚本和预案。 展位:南展馆 #1441 12、FireEye Verdin Threat Actor Assurance Module(TAMM) Fire Eye Verodin攻击者防护模块(TAAM)将威胁情报集成到Verodin平台中,使企业对网络安全方案防御针对性威胁的能力做到了然于胸。FireEye Verodin TAAM的目标是帮助企业优化针对已知威胁的防御方案,降低业务风险。 展位:北展馆 #6069 13、FortiAI智能威胁检测一体机 FortiAI是Fortinet推出的,号称业界首个整合了深度神经网络(DNN)的企业内网威胁缓解一体机,同时还能处理耗时繁重的安全分析任务。FortiAI为企业网络嵌入一个虚拟安全分析师,能在不到一秒的时间内检测到高级威胁。 展位:北展馆 #5855 14、金士顿IronKey D300 line加密U盘存储器 金士顿IronKey D300 line是当下安全性最高的加密U盘之一,很多方面都做到了极致。通过了北约限制级认证、FIPS 140-2 3认证,具备序列化和序列化受管两个型号。在XTS模式下提供256位AES硬件加密,存储单元方面采用最新的NAND闪存和控制技术,确保高速数据传输性能,采用数字签名固件不受BadUSB漏洞影响。总之,金士顿这款加密U盘用最少的功能实施了高度复杂的密码保护,是当下企业数据安全和数据丢失保护的最佳实践和标杆产品。 展位:#4509 15、LUMU:基于云威胁情报的应用持续危害智能评估 LUMU基于应用持续危害评估的原理,构建了一个强大的闭环自学习解决方案,可以帮助安全团队加快威胁检测,并提高整个基础架构的实时可见性。其云解决方案可收集和标准化来自整个网络的元数据,并通过人工智能技术将不同数据源的威胁情报关联起来,以隔离确认后的危害点。 展位:北展馆 #4315 16、Menlo Security全球云数据丢失防护(DLP)代理平台 Cloud Data Loss Prevention(DLP)是市场上第一个由Isolation Core支持的DLP解决方案,通过隔离和云代理技术,Cloud DLP可以根据文件类型、正则表达式或设置数据类型库来识别并标记敏感数据类型,监视并防止用户的数据泄露。 展位:北展馆 #6370 17、Netsurion事件追踪器(Mitre ATT&CK框架仪表盘) Netsurion宣布将Mitre ATT&CK框架与即将推出的9.3版本SIEM、事件追踪联合管理器集成。ATT&CK框架可以帮助防御者识别不同的攻击活动TTP和攻击者,有助于构筑更加有效的防御体系。 展位:南展馆 #241 18、ProcessUnity:供应商风险管理(VRM)最佳实践配置 ProcesssUnity的VRM Best Practices Configureation是预先配置的第三方风险管理程序,包含开箱即用的工作流、评估、计算、风险分析和报告功能。该产品目前已经拥有数百家客户,得到持续打磨,为企业评估供应商风险提供了一个“开箱即用”的、高质量、系统化可重复评估流程。 展位:#4609 19、Perimeter 81 SASE平台 Perimeter 81与SonicWall合作,宣布推出SASE平台。SASE是云原生架构模型,通过整合安全web网关、云访问安全代理、FWaaS和SDWANaaS等多种网络虚拟化安全技术,实现动态安全访问企业资产。 展位:南展馆#1365 20、Zero Networks访问编排器 Zero Networks的访问编排器能够实现最小化权限网络访问策略制定、实施和维护的自动化。能通过网络监控了解用户与设备的通讯方式,然后通过一种创新方法,自动创建策略将可访问资源限制在最小化范围。当新连接或者异常连接产生时,将会激活自助式的双因素认证机制。 展位:北展馆 #5358 【本文是51CTO专栏作者“李少鹏”的原创文章,转载请通过安全牛(微信公众号id:gooann-sectv)获取授权】 戳这里,看该作者更多好文

优秀的个人博客,低调大师

世界5G大会参会总结和思考

5G方案综述 5G简介和新价值 5G相对于4G在网络速率,时延和连接数上都有数量级的提升,基本上是10倍的关系。4G的基站的空口的速率标称是100Mbps,5Gbps是大于1Gbps,当前最高可达1.9Gbps。空口的时延也从10ms缩短到了1ms。 之前的几代通信主要聚焦在人与人之间的互联,5G部署后将实现人与人,人与物,物与物之间的广泛互联。 对于我国来讲,2019年是5G的商用元年。移动,电信,联通,广电都获得了5G运营牌照。截止目前,移动,电信,联通都已经开了5G商用局点。 但5G并不仅仅是一个空口速率的提升,更涉及到5G基站后面的传送网和核心网的架构的变革。因为5G是一个整体解决方案,包括三张网,无线网(空口设备),承载网(光纤和固网),核心网(各种控制网元)。其实2G/3G/4G也包括这三张网。 5G相对于4G,对于固定网络部分最大的变革是MEC(multi-access edge computing)和切片网络。 从这两个技术方向上可以清晰的看出运营商要大规模进军企业市场的决心。具体分析见后面商业模式分析。 5G的发展现状 当前整个5G产业发展很快,已有58家运营商开始开启了5G建设,覆盖了400多万用户。 在5G的商业化方面,当前大家比较一致认可的一个可以快速实现商业模式变现的领域是高清视频。比如体育赛事和重大活动的高清视频直播。 5G所面临的挑战 5G产业自身也有很大挑战,比如说5G基站的能耗比4G高3倍以上,5G基站的部署数量也要比4G更多,而国内某大运营商一年的4G基站电费就是200多亿,5G大规模部署之后光电费这一项成本支出一年就有可能上千亿。 而在OPEX(operating expense)数倍增加的前提下,用户的ARPU(Average revenue per user)可能不会有特别显著的提升,可能会比当前的60元/月要高一些,但要翻倍增长可能难度很大。这意味着在C端领域,运营商的收益有限。但运营商仍愿意大规模积极推进5G,其原因在于B端市场。下文有更详细的分析。 5G的长期布局 在2G/3G/4G时代,运营商主要是一个简单管道,差异化的网络服务能力和商业模型十分有限。 在5G场景下借助边缘网络架构,借助核心网云化所带来的切片能力,以及SDN网络的端到端控制下的QOS能力,可以为企业用户很便捷的提供差异化的网络服务。在完成差异化服务产品化之后就可以大规模进军庞大的企业市场。 5G商业模式 C端领域 对于用户来讲 ,5G带来的主要好处就是大带宽和低时延,其中大带宽对于C端用户价值更高一些。一些对带宽需求量比较大的应用,如云游戏,高清体育赛事直播,AR/VR/MR等领域。 对运营商来讲,这种大带宽应用的使用,必然会快速消耗公网流量。借助这些应用,运营商的ARPU值冲高是很有可能的,但目前看不会翻倍增长。以韩国SKT运营商为例,5G最土豪不限流量的套餐每月是月110美金,相对于4G的同档套餐,价格提升约75%,也就意味着ARPU值增长约75%左右。 对手机终端制造商来讲,从4G手机升级到5G手机,需要换手机,对手机制造商是绝对的利好。 对通信设备制造商来讲,升级到5G网络可以给运营商卖无线基站设备,如果核心网升级到SA独立组网,可以给运营商卖核心网的设备,基本上全部是利好。 对国家来讲,通过基础设施投资可以提升通信基础设施的升级换代,刺激工业和其他行业的发展,提升国家生产总值等。 B端领域 5G会重点在垂直行业发力,比如工业互联网。 对运营商来讲,在3G/4G时代最成功的2B的垂直行业应用就是虚拟专有拨号网络3G/4G VPDN (Virtual Private Dial Network)的虚拟专网服务。 VPDN的高价值垂直行业是金融行业的离行ATM机,通过3G/4G和总行进行交互的场景。 VPDN的低价值垂直行业是物联网卡,如共享单车上的智能锁,通过通过3G/4G和服务器进行交互的场景。 但对于工业互联网,这个方案基本的基本上没有渗透进去。原因就是上面提到的VPDN是虚拟专网,而对于工业网络或大型垂直行业网络,一般是专网专用。比如对于电力行业,会采用公开授权的无线频段自建LTE无线网络,做工业互联网。 在上面的垂直行业中,用户采用的架构是自建4G LTE网络,可以看到运营商没有分到蛋糕。 在5G中,运营商的一个考虑的是怎么能渗透入这些这些垂直行业?渗透进这个行业的武器就是5G网络切片。 5G切片 网络切片这个词,对于做无线网络的能可能很好理解,因为无线里面有频分,时分,码分,不管哪种分都是把资源进行分片;但对于搞固定网络的人反而不是能很直观的理解,固定网络中除了传输网络,带宽一般都是共享或独占,资源切分的概念还比较少。 5G切片其实就是给不同用户提供了带宽,时延,稳定性有端到端Qos保障的虚拟专网。这里面的端到端,指的是无线接入侧,传输网络,核心网络都有刚性的带宽保障,确定的传输时延保障。这个要比上面提到的VPDN要厉害很多,VPDN这个除了隔离之外,在带宽,时延上面其实都没啥保障,所以时延敏感的工业互联网采用了自建LTE专网,没有采用VPDN的方式。 从上面的分析可以看到,5G切片是在运营商自建的大网总做虚拟化做隔离。如果5G切片的技术和产品化方案做的好。理论上,垂直行业就不需要自建无线专网了,用运营商提供的5G切片解决方案即可。 上面只是以电力行业作为举例,实际上有相应需求的垂直行业还包括工业制造,石油石化,公共安全,轨道交通,媒体赛事等等。 通过5G切片技术,可以减少了垂直行业的基础设施投资成本。同时5G切片技术和产品化的方案可以让运营商成功渗透入工业互联网领域。整体上是一个双赢的局面。整体上市场空间也是十分广阔的。 5G MEC边缘计算 继续上面的垂直行业渗透的话题,有很多垂直行业的专网是对时延很敏感的,比如很多工作制造领域的SCADA(Supervisory Control And Data Acquisition)系统的端到端双向时延要求小于50ms。上面提到,如果用户自建专网,终端,LTE无线网络和工控服务器都在一个园区中,相当于一个大局域网。这个时延要求是很容易满足的。 如果用运营商提供的网络,如果没有边缘计算的能力,这种端到端的低时延要求还真不好满足。 工厂中的数据从基站接入后,要到运营商的城域承载网和核心网转圈才能回到工厂的工控服务器。这个时延很容易就大于50ms了。 引入5G MEC后,用户可以直接从边缘MEC所在的位置拉一根物理专线出来,接到工控服务器的机房。而MEC所在的位置可以是基站所在的位置。这样基本上和用户自建的园区无线专网在架构上就一致了。 MEC的部署位置,在5G网络中十分灵活,下面是ETSI(European Telecommunications Standards Institute)标准化组织的4个部署标准。可以很靠近用户,直接在基站侧,也可以挂在核心网。 下面这个是中国移动和海尔的联合创新的5G MEC智慧工厂项目。 云计算公司5G下的机会点 5G核心网云化部署 实际上4G核心网已经开始云化和NFV(Network Function Virtualization)化了,而NFV这个概念最早的提出也是运营商提出的,主要是解决无线核心网中专用设备网元的成本高的问题。 在4G时代运营商在核心网虚拟化已经积累了很多经验,大部分以私有云为主,但也有部署到共有云上的案例。如Affirmed公司就基于公有云提供vEPC的解决方案。 5G MEC 对于智慧园区或智慧工厂类的垂直行业,大部分的服务器要求部署在园区,通过MEC网关设备将园区服务器和运营商MEC打通。 对于这种MEC相关的垂直行业,云计算公司的优势是虚拟化云平台,AI,IOT,区块链,大数据。 中国移动提出的是5G+AICDE。 中国联通提出的是5G+AIBCDE。 整体看,云计算公司和运营商合作的空间还是比较大的。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册