首页 文章 精选 留言 我的

精选列表

搜索[视频解析],共10000篇文章
优秀的个人博客,低调大师

AnalyticDB for MySQL技术架构解析

企业数据需求不断变化,近年来变化趋势日益明显,从数据的3V特性看:体积,速度和变化;Big Data强调数据量,PB级以上,是静态数据。而Fast Data在数据量的基础上,意味着速度和和变化,意味着客户可以更加实时化、更加快速地进行数据处理。 在Forrester最近的一项研究中,超过75%的受访公司已经使用Fast Data解决方案。 在接受调查的人中,88%表示他们需要近乎实时地对数据执行分析。 AnalyticDB是阿里巴巴自主研发、唯一经过超大规模以及核心业务验证的PB级实时数据仓库,是FastData的最佳代表。自2012年第一次在集团发布上线以来,至今已累计迭代发布近百个版本,支撑起集团内的电商、广告、菜鸟、文娱、飞猪等众多在线分析业务。AnalyticDB于2014年在阿里云开始正式对外输出,支撑行业既包括传统的大中型

优秀的个人博客,低调大师

ConcurrentHashMap 1.8原理解析

JDK 1.8中,Hash家族有这么一些存在,HashMap,HashTable,LinkedHashMap,ConcurrentHashMap。这里面支持线程安全的有HashTable以及ConcurrentHashMap。对Hash有一个基本了解可以参考本人的从Hash到一致性Hash原理(深度好文) 。 那既然说到ConcurrentHashMap,自然要讨论的就是它的线程安全性和效能。我们先来看一下HashTable的线程安全性以及效能的低下。 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) { throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } public synchronized V get(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return (V)e.value; } } return null; } 我们对比一下HashMap 1.7的这两个方法(因为1.8点HashMap会生成红黑树,我们暂时先不考虑红黑树的问题) public V put(K key, V value) { if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); return null; } public V get(Object key) { if (key == null) return getForNullKey(); Entry<K,V> entry = getEntry(key); return null == entry ? null : entry.getValue(); } final int hash(Object k) { int h = 0; if (useAltHashing) { if (k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h = hashSeed; } h ^= k.hashCode(); // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). //一种算法,进行4次位移,得到相对比较分散的链表 h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 在这里我们可以看到,他们除了key的hash算法不同,HashTable的比较简单,只是用key的哈希值与0x7FFFFFFF(十进制2147483647,二进制1111111111111111111111111111111)进行一次与运算,即为只要相同二进制位上不论0,1全部都变成1,再对table数组的长度取模。而HashMap 1.7则为key的哈希值进行各位无符号位移加异或运算,取得最终哈希值。然后是HashTable不接收null的key,而HashMap接受。他们最大的区别就在于synchronized显示器锁了。 synchronized的本质是所有对象的字节码中有一个monitor的对象头,任何线程拿到了这个monitor的对象头就可以对这个对象进行操作,而拿不到monitor对象头的线程就只能等待,直到拿到了monitor的线程放弃,其他线程才能争夺这个对象头来对对象进行操作。那么问题来了,当大量线程高并发的时候,只要有一个线程拿到了这个对象头,其他线程对这个对象是既不能读也不能写。而对于HashMap来说,如果多线程对其进行操作,那么任意线程都可以胡乱修改里面值的内容造成脏读,所以HashMap是线程不安全的。 那么我们今天的主角登场了ConcurrentHashMap。我们同样来看一下这两个方法。以下是1.8的源码,首先我们要清楚的是1.8跟1.7已经完全不同,1.7是使用segements(16个segement),每个segement都有一个table(Map.Entry数组),相当于16个HashMap,同步机制为分段锁,每个segment继承ReentrantLock;而1.8只有1个table(Map.Entry数组),同步机制为CAS + synchronized保证并发更新。如果不搞清楚这个问题,那么你看1.8的源码可能会很懵逼。 public V put(K key, V value) { return putVal(key, value, false); } final V putVal(K key, V value, boolean onlyIfAbsent) { //无论key还是value,不允许空 if (key == null || value == null) throw new NullPointerException(); //此处获取hash值的方法与HashTable类似 int hash = spread(key.hashCode()); int binCount = 0; //无限循环 for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; //如果节点数组为null,或者长度为0,初始化节点数组 if (tab == null || (n = tab.length) == 0) tab = initTable(); //如果节点数组的某个节点为null,则put的时候就会采用无锁竞争来获取该节点的头把交椅 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null))) break; // no lock when adding to empty bin } //需要扩容的时候先扩容,再写入 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else { //如果hash冲突的时候,即多线程操作时,大家都有一样的hash值 V oldVal = null; synchronized (f) { //锁定节点数组的该节点 if (tabAt(tab, i) == f) { //如果当前该节点为链表形态 if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; //找链表中找到相同的key,把新value替代老value if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; //如果找不到key,就添加到链表到末尾 if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null); break; } } } //如果当前为红黑树形态,进行红黑树到查找和替代(存在相同的key),或者放入红黑树到新叶节点上(key不存在) else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { //如果链表长度超过了8,链表转红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } } } //统计节点个数,检查是否需要扩容 addCount(1L, binCount); return null; } public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 读取的时候,我们没有看见锁到存在,说明读不受多线程影响。 对比ConcurrentHashMap和HashTable,我们可以明显的看到,ConcurrentHashMap在写的时候,并没有锁住整个节点数组,在新节点上使用的是无锁竞争,在老节点上锁住的仅仅是一个节点,读的时候如果不是恰好读到写线程写入相同Hash值的位置,不受影响(可以认为我们的操作一般是读多写少,这种几率也比较低)。而HashTable是对整个节点数组进行锁定,读到时候不能写,写的时候不能读,这么一对比就可以明显感觉到性能差距是巨大的。 虽然ConcurrentHashMap的并发性能还算比较优异,但在亿级计算中,却依然会成为性能瓶颈,具体可以参考本人的Fork/Join框架原理和使用探秘 至于这里为什么会慢,我认为在这种超高并发下,节点数组的单节点的的写写竞争是互斥的,其次,由于红黑树具有读快写慢的特性,它要不断保持树的平衡而不断返转,所以才会使得高并发写的性能急剧下降。
优秀的个人博客,低调大师

Redis radix tree源码解析

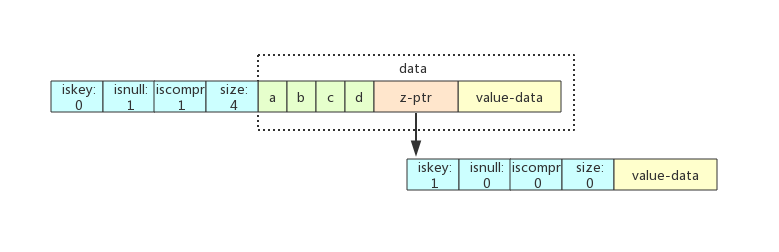
Redis实现了不定长压缩前缀的radix tree,用在集群模式下存储slot对应的的所有key信息。本文将详述在Redis中如何实现radix tree。 核心数据结构 raxNode是radix tree的核心数据结构,其结构体如下代码所示: typedef struct raxNode { uint32_t iskey:1; uint32_t isnull:1; uint32_t iscompr:1; uint32_t size:29; unsigned char data[]; } raxNode; iskey:表示这个节点是否包含key 0:没有key 1:表示从头部到其父节点的路径完整的存储了key,查找的时候按子节点iskey=1来判断key是否存在 isnull:是否有存储value值,比如存储元数据就只有key,没有value值。value值也是存储在data中 iscompr:是否有前缀压缩,决定了data存储的数据结构 size:该节点存储的字符个数 data:存储子节点的信息 iscompr=0:非压缩模式下,数据格式是:[header strlen=0][abc][a-ptr][b-ptr][c-ptr](value-ptr?),有size个字符,紧跟着是size个指针,指向每个字符对应的下一个节点。size个字符之间互相没有路径联系。 iscompr=1:压缩模式下,数据格式是:[header strlen=3][xyz][z-ptr](value-ptr?),只有一个指针,指向下一个节点。size个字符是压缩字符片段 Rax Insert 以下用几个示例来详解rax tree插入的流程。假设j是遍历已有节点的游标,i是遍历新增节点的游标。 场景一:只插入abcd z-ptr指向的叶子节点iskey=1,使用了压缩前缀。 场景二:在abcd之后插入abcdef 从abcd父节点的每个压缩前缀字符比较,遍历完所有abcd节点后指向了其空子节点,j = 0, i < len(abcded)。 查找到abcd的空子节点,直接将ef赋值到子节点上,成为abcd的子节点。ef节点被标记为iskey=1,用来标识abcd这个key。ef节点下再创建一个空子节点,iskey=1来表示abcdef这个key。 场景三:在abcd之后插入ab ab在abcd能找到前两位的前缀,也就是i=len(ab),j < len(abcd)。 将abcd分割成ab和cd两个子节点,cd也是一个压缩前缀节点,cd同时被标记为iskey=1,来表示ab这个key。 cd下挂着一个空子节点,来标记abcd这个key。 场景四:在abcd之后插入abABC abcABC在abcd中只找到了ab这个前缀,即i < len(abcABC),j < len(abcd)。这个步骤有点复杂,分解一下: step 1:将abcd从ab之后拆分,拆分成ab、c、d 三个节点。 step 2:c节点是一个非压缩的节点,c挂在ab子节点上。 step 3:d节点只有一个字符,所以也是一个非压缩节点,挂在c子节点上。 step 4:将ABC 拆分成了A和BC, A挂在ab子节点上,和c节点属于同一个节点,这样A就和c同属于父节点ab。 step 5:将BC作为一个压缩前缀的节点,挂在A子节点下。 step 6:d节点和BC节点都挂一个空子节点分别标识abcd和abcABC这两个key。 场景五:在abcd之后插入Aabc abcd和Aabc没有前缀匹配,i = 0,j = 0。 将abcd拆分成a、bcd两个节点,a节点是一个非压缩前缀节点。 将Aabc拆分成A、abc两个节点,A节点也是一个非压缩前缀节点。 将A节点挂在和a相同的父节点上。 同上,在bcd和abc这两个节点下挂空子节点来分别表示两个key。 Rax Remove 删除 删除一个key的流程比较简单,找到iskey的节点后,向上遍历父节点删除非iskey的节点。如果是非压缩的父节点并且size > 1,表示还有其他非相关的路径存在,则需要按删除子节点的模式去处理这个父节点,主要是做memove和realloc。 合并 删除一个key之后需要尝试做一些合并,以收敛树的高度。 合并的条件是: iskey=1的节点不能合并 子节点只有一个字符 父节点只有一个子节点(如果父节点是压缩前缀的节点,那么只有一个子节点,满足条件。如果父节点是非压缩前缀的节点,那么只能有一个字符路径才能满足条件) 结束语 云数据库Redis版(ApsaraDB for Redis)是一种稳定可靠、性能卓越、可弹性伸缩的数据库服务。基于飞天分布式系统和全SSD盘高性能存储,支持主备版和集群版两套高可用架构。提供了全套的容灾切换、故障迁移、在线扩容、性能优化的数据库解决方案。欢迎各位购买使用:云数据库 Redis 版 作者:羽洵 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Android Handler原理实践解析

前言 Handler消息处理机制在Android开发中起着举足轻重的作用,我们有必要好好理解下其原理,下面我们先从一个简单的例子出发 一、日常使用 假设我们有这么一个需要,请求网络然后将图片展示出来,我们知道网络请求是不允许在主线程执行的,而UI是不能在子线程(具体是不允许在非创建UI的原始线程)更新的,因此我们需要在子线程请求网络获得了数据以后再切换回主线程更新UI,这个例子中Handler就是起着切换线程的作用,下面的代码演示了这个例子 classMainActivity : AppCompatActivity() { private lateinit var mImageView: ImageView override fun onCreate(savedInstanceState: Bundle?){

优秀的个人博客,低调大师

应用基础框架全面解析

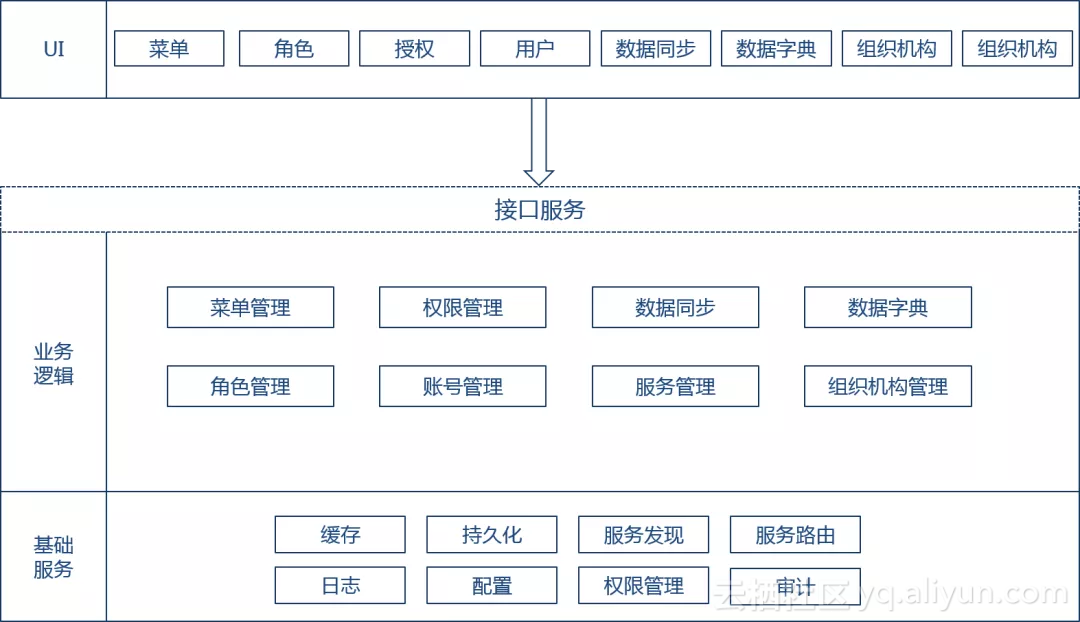
引言: 应用基础框架Coframe是EOS产品自带的开源应用基础框架,提供了资源管理、权限管理、用户以及角色管理等业务应用基础能力,用户可以根据自己的需要进行二次开发与扩展。本文向大家分享Coframe的主要功能和设计实现方案。 目录: 一、简介 二、系统资源 三、权限管理 四、组织管理 一、简介 应用基础框架也叫Coframe,是产品自带的开源应用基础框架,提供了一些基础功能,用户可以根据自己的需要进行二次开发与扩展。 Coframe提供3大核心功能: 系统资源:提供了功能菜单管理、字典码表、应用管理折几个应用框架基础能力。 权限管理:提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 组织管理:提供了机构、岗位、员工、 用户、工作组等组织机构相关管理功能,支持与已有业务系统对接,使得基于普元EOS Platform 8.0开发的应用可方便地使用同一套组织机构。 逻辑架构逻辑架构图展示了基础应用框架的基本功能模块,前端Restful形式接口调用后端服务。进程架构应用基础框架有两种部署模式:微服务架构Coframe集成模式和单应用架构Coframe集成模式。 单应用架构很好理解,即直接使用Coframe源码或者jar包开发应用,后端只有一个server,而集成模式可以将应用要对外暴露的服务封装在Coframe中,这样Coframe可以对应用进行权限管理。前端使用VUE开发,可以很方便的使用源码进行二次开发。 数据模型应用基础框架的数据模型即DB表结构,展示了主要的一些表结构,包括权限表,用户表等。用户可以很方便的进行二次开发扩展应用。 二、系统资源 菜单管理 菜单框架支持两级菜单,用户可以自定义菜单的路径和打开方式等。应用基础框架提供了几个基础的菜单,用户可以在页面编辑菜单或者直接在数据库端编辑菜单。目前应用基础框架前端Ui支持二级菜单,用户可以根据自己的需求扩展到三级菜单。 字典码表 字典码表即为系统内部定义的具有业务属性的数据字典。系统管理员可以配置字典类型和字典项,用于管理系统中的枚举类型的基础数据,并且支持excel导入导出。字典类型和字典数据均支持一级子项。 字典类型:对数据进行分类管理 字典数据项:需要管理的枚举数据 应用管理 应用管理又叫服务权限控制,是指在多应用系统以及单应用系统下,实现对应用的服务功能的权限控制。实现角色、用户、功能的灵活绑定。在需要进行权限管理的功能接口方法定义上添加@TarestOperation注解,发布服务。 @RequestMapping("/say-hello") @TarestService(group = "SP1", displayName = "服务提供组1", version = "1.0.0.0", groupName = "服务提供组1", name = "ISampleAppHello") public interface ISampleAppHello { @GetMapping @TarestOperation(checkPermission=false,name="DEMO_001",displayName="功能1") String sayHello(); /** * @TarestOperation 在@TarestOperation中默认是不进行权限管理的 * 通过设置checkPermission = true,打开权限控制功能 * **/ @GetMapping(value = "/user") @TarestOperation(checkPermission =true,name="DEMO_002",displayName="功能2") String insertDemo(@RequestParam String name, @RequestParam Integer age); } 单应用系统即只有一个后端应用的系统,(直接以嵌入方式集成Coframe)无需新建应用。 多应用系统即有多个后端应用的系统,Coframe作为一个独立的应用部署的系统,需要在coframe中新建应用。如图所示: 三、权限管理 提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 角色:角色是Coframe一个重要的对象,也可以成为权限集,表示系统中权限一个子集,用于控制用户可以使用的功能集合,赋予用户一个角色表示给用户一定功能的使用权限。Coframe中角色的分配本身赋予某些用户,员工,机构等之外,还要向角色授予可访问某些功能,模块,表单,视图等资源的权限。拥有某角色的用户可访问角色被授予的资源的权限。 用户:所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。 用户管理所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。当Coframe使用IAM的统一认证登录的时候能够同步IAM端的同一租户下的用户信息。 Coframe的用户账号由其登录认证方式决定是本地创建的还是又IAM即同一认真平台同步过来的用户信息。 本地登录:用户账号及其认证密码在本地存储,本地认证配置可以参考:http://t.cn/EUrzEtL 单点登录:即与IAM集成的sso方式登录,可以参考:http://t.cn/EUrZPOs 授权管理 目前提供了菜单授权与服务授权,授权管理即将资源与参与者之间建立关系。如下图所示,菜单和应用: 即可以视为资源,而账号、角色、组织机构、工作中等,即可以视为参与者。授权表结构如下图所示: 此注解用来标志一个数据实体为授权实体,授权实体需要指定类型:资源、授权主体,比如: @Entity // 此实体名称为order,类型为resource @AuthEntity(name = "order", type = AuthEntityType.RESOURCE) @Table(name = "SAMPLE_ORDER") public class SampleOrder { @Id @GeneratedValue private Long id; private String name; private Date date; } 四、组织管理 机构管理机构指企业的组织机构,一般包含机构、岗位、员工等信息。 机构管理通过对一棵机构人员树的维护把机构、岗位、人员等信息和关系维护好,并可设置这些组织对象的角色。工作组管理工作组与机构类似,是为了将项目组、工作组等临时性的组织机构管理起来,业务上通常工作组有一定的时效性,是一个非常设机构。 工作组是企业动态创建的组织机构分组,工作组下可以有子工作组、员工信息。总结: 以上介绍了应用基础框架的主要基础功能,以及设计过程中的一些理念,比如授权模型等。 作为开源应用基础框架会随着规划发展不断完善,用户可以根据自身的需求来更改适配。也非常欢迎大家能够更多参与使其更加健壮。 原文发布时间为:2018-12-19本文作者:许方杰本文来自云栖社区合作伙伴“ EAWorld”,了解相关信息可以关注“eaworld”微信公众号

优秀的个人博客,低调大师

Hystrix降级技术解析-Fallback

一、降级 所谓降级,就是指在在Hystrix执行非核心链路功能失败的情况下,我们如何处理,比如我们返回默认值等。如果我们要回退或者降级处理,代码上需要实现HystrixCommand.getFallback()方法或者是HystrixObservableCommand. HystrixObservableCommand()。 publicclassCommandHelloFailureextendsHystrixCommand<String>{ privatefinalStringname; publicCommandHelloFailure(Stringname){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.name=name; } @Override protectedStringrun(){ thrownewRuntimeException("thiscommandalwaysfails"); } @Override protectedStringgetFallback(){ return"HelloFailure"+name+"!"; } } 二、Hystrix的降级回退方式 Hystrix一共有如下几种降级回退模式: 1、Fail Fast 快速失败 @Override protectedStringrun(){ if(throwException){ thrownewRuntimeException("failurefromCommandThatFailsFast"); }else{ return"success"; } } 如果我们实现的是HystrixObservableCommand.java则 重写 resumeWithFallback方法 @Override protectedObservable<String>resumeWithFallback(){ if(throwException){ returnObservable.error(newThrowable("failurefromCommandThatFailsFast")); }else{ returnObservable.just("success"); } } 2、Fail Silent 无声失败 返回null,空Map,空List fail silent.png @Override protectedStringgetFallback(){ returnnull; } @Override protectedList<String>getFallback(){ returnCollections.emptyList(); } @Override protectedObservable<String>resumeWithFallback(){ returnObservable.empty(); } 3、Fallback: Static 返回默认值 回退的时候返回静态嵌入代码中的默认值,这样就不会导致功能以Fail Silent的方式被清楚,也就是用户看不到任何功能了。而是按照一个默认的方式显示。 @Override protectedBooleangetFallback(){ returntrue; } @Override protectedObservable<Boolean>resumeWithFallback(){ returnObservable.just(true); } 4、Fallback: Stubbed 自己组装一个值返回 当我们执行返回的结果是一个包含多个字段的对象时,则会以Stubbed 的方式回退。Stubbed 值我们建议在实例化Command的时候就设置好一个值。以countryCodeFromGeoLookup为例,countryCodeFromGeoLookup的值,是在我们调用的时候就注册进来初始化好的。CommandWithStubbedFallback command = new CommandWithStubbedFallback(1234, "china");主要代码如下: publicclassCommandWithStubbedFallbackextendsHystrixCommand<UserAccount>{ protectedCommandWithStubbedFallback(intcustomerId,StringcountryCodeFromGeoLookup){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.customerId=customerId; this.countryCodeFromGeoLookup=countryCodeFromGeoLookup; } @Override protectedUserAccountgetFallback(){ /** *Returnstubbedfallbackwithsomestaticdefaults,placeholders, *andaninjectedvalue'countryCodeFromGeoLookup'thatwe'lluse *insteadofwhatwewouldhaveretrievedfromtheremoteservice. */ returnnewUserAccount(customerId,"UnknownName", countryCodeFromGeoLookup,true,true,false); } 5、Fallback: Cache via Network 利用远程缓存 通过远程缓存的方式。在失败的情况下再发起一次remote请求,不过这次请求的是一个缓存比如redis。由于是又发起一起远程调用,所以会重新封装一次Command,这个时候要注意,执行fallback的线程一定要跟主线程区分开,也就是重新命名一个ThreadPoolKey。 Cache via Network.png publicclassCommandWithFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; protectedCommandWithFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueCommand"))); this.id=id; } @Override protectedStringrun(){ //RemoteServiceXClient.getValue(id); thrownewRuntimeException("forcefailureforexample"); } @Override protectedStringgetFallback(){ returnnewFallbackViaNetwork(id).execute(); } privatestaticclassFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; publicFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueFallbackCommand")) //useadifferentthreadpoolforthefallbackcommand //sosaturatingtheRemoteServiceXpoolwon'tprevent //fallbacksfromexecuting .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("RemoteServiceXFallback"))); this.id=id; } @Override protectedStringrun(){ MemCacheClient.getValue(id); } @Override protectedStringgetFallback(){ //thefallbackalsofailed //sothisfallback-of-a-fallbackwill //failsilentlyandreturnnull returnnull; } } } 6、Primary + Secondary with Fallback 主次方式回退(主要和次要) 这个有点类似我们日常开发中需要上线一个新功能,但为了防止新功能上线失败可以回退到老的代码,我们会做一个开关比如使用zookeeper做一个配置开关,可以动态切换到老代码功能。那么Hystrix它是使用通过一个配置来在两个command中进行切换。 Primary + Secondary with Fallback.png /** *Sample{@linkHystrixCommand}patternusingasemaphore-isolatedcommand *thatconditionallyinvokesthread-isolatedcommands. */ publicclassCommandFacadeWithPrimarySecondaryextendsHystrixCommand<String>{ privatefinalstaticDynamicBooleanPropertyusePrimary=DynamicPropertyFactory.getInstance().getBooleanProperty("primarySecondary.usePrimary",true); privatefinalintid; publicCommandFacadeWithPrimarySecondary(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimarySecondaryCommand")) .andCommandPropertiesDefaults( //wewanttodefaulttosemaphore-isolationsincethiswraps //2otherscommandsthatarealreadythreadisolated //采用信号量的隔离方式 HystrixCommandProperties.Setter() .withExecutionIsolationStrategy(ExecutionIsolationStrategy.SEMAPHORE))); this.id=id; } //通过DynamicPropertyFactory来路由到不同的command @Override protectedStringrun(){ if(usePrimary.get()){ returnnewPrimaryCommand(id).execute(); }else{ returnnewSecondaryCommand(id).execute(); } } @Override protectedStringgetFallback(){ return"static-fallback-"+id; } @Override protectedStringgetCacheKey(){ returnString.valueOf(id); } privatestaticclassPrimaryCommandextendsHystrixCommand<String>{ privatefinalintid; privatePrimaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("PrimaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa600mstimeoutforprimary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(600))); this.id=id; } @Override protectedStringrun(){ //performexpensive'primary'servicecall return"responseFromPrimary-"+id; } } privatestaticclassSecondaryCommandextendsHystrixCommand<String>{ privatefinalintid; privateSecondaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("SecondaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("SecondaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa100mstimeoutforsecondary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(100))); this.id=id; } @Override protectedStringrun(){ //performfast'secondary'servicecall return"responseFromSecondary-"+id; } } publicstaticclassUnitTest{ @Test publicvoidtestPrimary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",true); assertEquals("responseFromPrimary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } @Test publicvoidtestSecondary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",false); assertEquals("responseFromSecondary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } } } 三、总结 降级的处理方式,返回默认值,返回缓存里面的值(包括远程缓存比如redis和本地缓存比如jvmcache)。 但回退的处理方式也有不适合的场景: 1、写操作 2、批处理 3、计算 以上几种情况如果失败,则程序就要将错误返回给调用者。 参考资料:https://github.com/Netflix/Hystrix/wiki

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册