首页 文章 精选 留言 我的

精选列表

搜索[智能问数],共10000篇文章
优秀的个人博客,低调大师

7个连环问揭开java多线程背后的弯弯绕

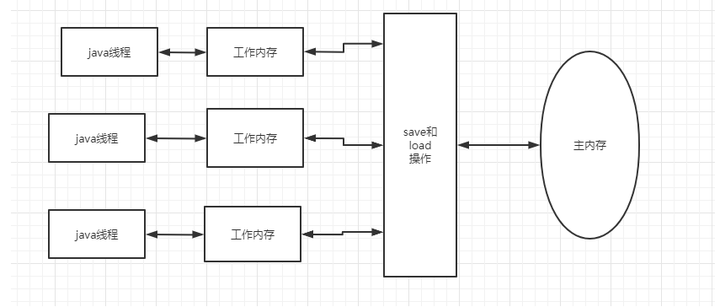
摘要:很多java入门新人一想到java多线程, 就会觉得很晕很绕,什么可见不可见的,也不了解为什么sync怎么就锁住了代码。 本文分享自华为云社区《java多线程背后的弯弯绕绕到底是什么? 7个连环问题为你逐步揭开背后的核心原理!》,作者:breakDraw 。 很多java入门新人一想到java多线程, 就会觉得很晕很绕,什么可见不可见的,也不了解为什么sync怎么就锁住了代码。 因此我在这里会提多个问题,如果能很好地回答这些问题,那么算是你对java多线程的原理有了一些了解,也可以借此学习一下这背后的核心原理。 Q: java中的主内存和工作内存是指什么? A:java中, 主内存中的对象引用会被拷贝到各线程的工作内存中, 同时线程对变量的修改也会反馈到主内存中。 主内存对应于java堆中的对象实例部分(物理硬件的内存) 工作内存对应于虚拟机栈中的部分区域( 寄存器,高速缓存) 工作内存中是拷贝的工作副本 拷贝副本时,不会吧整个超级大的对象拷贝过来, 可能只是其中的某个基本数据类型或者引用。 因此我们知道各线程使用内存数据时,其实是有主内存和工作内存之分的。并不是一定每次都从同一个内存里取数据。 或者理解为大家使用数据时之间有一个缓存。 Q: 多线程不可见问题的原因是什么? A:这里先讲一下虚拟机定义的内存原子操作: lock: 用于主内存, 把变量标识为一条线程独占的状态 unlock : 主内存, 把锁定状态的变量释放 read: 读取, 从主内存读到工作线程中 load: 把read后的值放入到 工作副本中 use: 使用工作内存变量, 传给工作引擎 assign赋值: 把工作引擎的值传给工作内存变量 store: 工作内存中的变量传到主内存 write: 把值写入到主内存的变量中 根据这些指令,看一下面这个图, 然后再看图片之后的流程解释,就好理解了。 read和load、store、write是按顺序执行的, 但是中间可插入其他的操作。不可单独出现。 assgin之后, 会同步后主内存。即只有发生过assgin,才会做工作内存同步到主内存的操作。 新变量只能在主内存中产生 工作内存中使用某个变量副本时,必须先经历过assign或者load操作。 不可read后马上就use lock操作可以被同一个线程执行多次,但相应地解锁也需要多次。 执行lock时,会清空工作内存中该变量的值。 清空后如果要使用,必须重新做load或者assign操作 unlock时,需要先把数据同步回主内存,再释放。 因此多线程普通变量的读取和写入操作存在并发问题, 主要在于2点: 只有assgin时, 才会更新主内存, 但由于指令重排序的情况,导致有时候某个assine指令先执行,然后这个提前被改变的变量就被其他线程拿走了,以至于其他线程无法及时看到更新后的内存值。 assgin时从工作内存到主内存之间,可能存在延迟,同样会导致数据被提前取走存到工作线程中。 Q: 那么volatile关键字为什么就可以实现可见性? 可见性就是并发修改某个值后,这个值的修改对其他线程是马上可见的。 A: java内存模型堆volatile定义了以下特殊规则: 当一个线程修改了该变量的值时,会先lock住主存, 再立刻把新数据同步回内存。 使用该值时,其他工作内存都要从主内存中刷新! 这个期间会禁止对于该变量的指令重排序 禁止指令重排序的原理是在给volatile变量赋值时,会加1个lock动作, 而前面规定的内存模型原理中, lock之后才能做load或者assine,因此形成了1个内存屏障。 Q: 上面提到lock后会限制各工作内存要刷新主存的值load进来后才能用, 这个在底层是怎么实现的? A:利用了cpu的总线锁+ 缓存一致性+嗅探机制实现, 属于计算机组成原理部分的知识。 这也就是为什么violate变量不能设置太多,如果设置太多,可能会引发总线风暴,造成cpu嗅探的成本大大增加。 Q: 那给方法加上synchronized关键字的原理是什么?和volatie的区别是啥? A: synchronized的重量级锁是通过对象内部的监视器(monitor)实现 monitor的线程互斥就是通过操作系统的mutex互斥锁实现的,而操作系统实现线程之间的切换需要从用户态到内核态的切换,所以切换成本非常高。 每个对象都持有一个moniter对象 具体流程如下: 首先,class文件的方法表结构中有个访问标志access_flags, 设置ACC_SYNCHRONIZED标志来表示被设置过synchronized。 线程在执行方法前先判断access_flags是否标记ACC_SYNCHRONIZED,如果标记则在执行方法前先去获取monitor对象。 获取成功则执行方法代码且执行完毕后释放monitor对象 如果获取失败则表示monitor对象被其他线程获取从而阻塞当前线程 注意,如果是sync{}代码块,则是通过在代码中添加monitorEnter和monitorExit指令来实现获取和退出操作的。 如果对C语言有了解的,可以看看这个大哥些的文章Java精通并发-通过openjdk源码分析ObjectMonitor底层实现 Q: synchronized每次加锁解锁需要切换内核态和用户态, jvm是否有对这个过程做过一些优化? A:jdk1.6之后, 引入了锁升级的概念,而这个锁升级就是针对sync关键字的 锁的状态总共有四种,级别由低到高依次为:无锁、偏向锁、轻量级锁、重量级锁 四种状态会随着竞争的情况逐渐升级,而且是不可逆的过程, 只能进行锁升级(从低级别到高级别),不能锁降级(高级别到低级别) 因此sync关键字不是一开始就直接使用很耗时的同步。而是一步步按照情况做升级 当对象刚建立,不存在锁竞争的时候, 每次进入同步方法/代码块会直接使用偏向锁 偏向锁原理: 每次尝试在对象头里设置当前使用这个对象的线程id, 只做一次,如果成功了就设置好threadId, 只要没有出现新的thread访问且markWord被修改,那么久) 2. 当发现对象头的线程id要被修改时,说明存在竞争时。升级为轻量级锁 轻量级锁采用的是自旋锁,如果同步方法/代码块执行时间很短的话,采用轻量级锁虽然会占用cpu资源但是相对比使用重量级锁还是更高效的。 CAS的对象是对象头的Mark Word, 此时仍然不会去调系统底层的方法做阻塞。 3. 但是如果同步方法/代码块执行时间很长,那么使用轻量级锁自旋带来的性能消耗就比使用重量级锁更严重,这时候就会升级为重量级锁,也就是上面那个问题中提到的操作。 Q: 锁只可以升级不可以降级, 确定是都不能降级吗? A:有可能被降级, 不可能存在共享资源竞争的锁。 java存在一个运行期优化的功能 需要开启server模式外加+DoEscapeAnalysis表示开启逃逸分析。 如果运行过程中检测到共享变量确定不会逃逸,则直接在编译层面去掉锁 举例: StringBuffer.append().append() 例如如果发现stringBuffer不会逃逸,则就会去掉这里append所携带的同步 而这种情况肯定只能发生在偏向锁上, 所以偏向锁可以被重置为无锁状态。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

三色标记原理,我给应聘者问懵了...

摘要:知道三色标记吗?是红黄蓝三色标记吗? 本文分享自华为云社区《从三色标记说开去》,原文作者:java初中生。 【1】关于三色标记 前几天,公司临时派我去面试一个java实习生,由于没有这方面的任何经验,于是一不小心,我就问超纲了。 问过了java基础,我随口又问了一句,知道三色标记吗? 他显然是懵逼了一瞬间,但也仅仅一瞬间,然后振振有词地反问,是红黄蓝三色标记吗? 这倒是反把我问住了。 面试有问题答不出来,这其实可以理解,不懂就说不懂,不会就说不会,子曾经曰过,知之为知之。 三色标记,正经来说,就只有黑白灰三个颜色。 但实际上,三色标记,和颜色其实没有任何关系,只与一次扫描状态相关。 黑色节点,代表根节点或者已扫描完的节点,该节点的子节点也被扫描完; 灰色节点,代表已扫描完的节点,该节点的子节点存在未被扫描的情况; 白色节点,代表未被扫描的节点。 上图中,A就是黑色节点,B为灰色,因为B的子节点C未被扫描,C则是白色节点。 如果,扫描结束,C依旧是白色,则C被回收。 但这里会存在一个问题,如果在上图的情况下,BC的引用断掉,而AC的引用被建立,如下图: 则会出现以下情况: B扫描完,无引用,变黑。 C,按道理说,也会变灰,然后变黑。 但A此时已经是黑色节点,则不会扫描其引用,所以C不会被扫描,还是白色。 最后,C会被当垃圾回收。 这显然是一个误操作,因为C当前是根可达的,那该问题怎么办呢? 常用的垃圾回收器,CMS和G1都给出了解决方案。 CMS的方法叫做Incremental Update算法。 该算法从结果入手,判断扫描完结时,是否有白色对象被黑色对象引用,如果被引用,则通过write barrier写屏障技术,把黑色的对象重新标记为灰色,然后重新扫描。 G1的方法叫做SATB算法。 该算法从源头入手,GC开始之前拍摄快照,设定所有存在引用的对象,都是存活的。 GC扫描之后,再次拍摄快照,将新引用的存活对象标记。 然后将快照叠加。 这样,C显示的是被A,B两个对象引用。 但这样会有一个弊端,如果此时,AC之间的引用没有被建立,则C本来应该被回收,但此轮却并没有被回收。 【2】跨代引用的问题 跨代引用这个概念被提出来的时候,很多人都有似曾相识的感觉。但具体要说,很多人就说不出所以然来了。 其实,java堆说到底就两个代(年轻代和老年代),持久代在jdk的某个版本后,就被放到本地方法栈了。 跨代引用,即父节点在一个代,而引用对象在另一个代。 一般来说,父节点都在老年代,引用对象在年轻代。 如上图,X引用和Y引用都是属于跨代引用。 跨代引用一般多发生在G1回收器中,因为G1的内存采用分块的模式,内存区域不稳定。 那么,年轻代回收(young GC)时,是否要根据可达性分析,遍历所有的老年代关联,直到根节点呢。 不需要。 只要父节点在老年代,则一律视为根节点。 在这里(跨代引用)要引入两个概念,结果集和卡表。卡表可以看作一个老年代分区的集合或者数组,如下图。 结果集,就是一组类似于map的容器,key存放卡表的下标,value存放引用关系 想想这样做的好处是什么? 【3】安全点和安全区域 java工作线程和垃圾回收线程,一般情况下,是不能同时进行的。 通常老师讲到这个问题的时候,会打个比方:吃饭和洗碗擦桌子。 之所以工作线程和垃圾回收线程不能同时进行,是因为人不能一边吃饭一边收拾碗筷(触手怪除外)。 同理,还有一个问题,你也不能把饭吃到一半,把碗拿过去洗。 所以,你必须在吃完饭的时候,洗碗。 吃完饭的这个时间,就是安全点。 一般来说,安全点是某个线程的结束或者中断的时间,可以是方法调用,循环跳转,异常跳转等。 再回头说说垃圾回收的全过程。 业务线程执行过程中,会不断轮询一个标志位,该标志位处于垃圾回收线程中; 如果需要做垃圾回收,回收线程会将标志位改掉; 业务线程收到标志位信息,会走到安全点,然后停止; 垃圾回收线程启动,回收垃圾。 那么,安全区域是什么呢? 一个区域所有的点都是安全点,这一部分就是安全区域。 还是拿原来那个例子,如果你晚上减肥,不想吃饭,碗什么的,随时都可以洗。 【4】如何查看GC日志 直接上命令:-XX+PrintGCDetails。 该命令可以在控制台打印GC日志。 日志内容如下: 【5】终:垃圾回收各指标 吞吐量:指在应用程序的生命周期内,应用程序所花费的时间和系统总运行时间的比值。 公式:吞吐量=系统应用时间/系统总运行时间 垃圾回收器负载:和吞吐量正好相反,垃圾回收器负载指垃圾回收器耗时与系统运行总时间的比值。 公式:吞吐量=垃圾回收时间/系统总运行时间 停顿时间(延迟):指垃圾回收器正在运行时,应用程序的暂停时间。 PS:独占回收器延迟长,但吞吐量高,并发回收器,延迟少,但吞吐量低。 垃圾回收频率:指垃圾回收器多长时间会运行一次。 PS:垃圾回收器的频率应该是越低越好。 反应时间:指当一个对象被称为垃圾后多长时间内,它所占据的内存空间会被释放。 PS:即垃圾回收的周期 over~~ 堆分配:不同的垃圾回收器对堆内存的分配方式可能是不同的。一个良好的垃圾收集器应该有一个合理的堆内存区间划分。 本文参考资料:https://blog.csdn.net/xingkongjuhao/article/details/101801460 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

面试被问:Kafka 会不会丢消息?我是这么答的

点击“程序员内点事”关注,选择“设置星标” 坚持学习,好文每日送达! 大型互联网公司一般都会要求消息传递最大限度的不丢失,比如用户服务给代金券服务发送一个消息,如果消息丢失会造成用户未收到应得的代金券,最终用户会投诉。 为避免上面类似情况的发生,除了做好补偿措施,更应该在系设计的时候充分考虑各种异常,设计一个稳定、高可用的消息系统。 认识Kafka 看一下维基百科的定义 Kafka是分布式发布-订阅消息系统。它最初由LinkedIn公司开发,之后成为Apache项目的一部分。 Kafka是一个分布式的,可划分的,冗余备份的持久性的日志服务。它主要用于处理活跃的流式数据。 kafka架构 Kafka的整体架构非常简单,是显式分布式架构,主要由producer、broker(kafka)和consumer组成。 Kafka架构(精简版) Producer(生产者)可以将数据发布到所选择的topic(主题)中。生产者负责将记录分配到topic的哪一个 partition(分区)中。可以使用循环的方式来简单地实现负载均衡,也可以根据某些语义分区函数(如记录中的key)来完成。 Consumer(消费者)使用一个consumer group(消费组)名称来进行标识,发布到topic中的每条记录被分配给订阅消费组中的一个消费者实例。消费者实例可以分布在多个进程中或者多个机器上。 Kafka到底会不会丢失消息? 在讨论kafka是否丢消息前先来了解一下什么是消息传递语义。 消息传递语义 message delivery semantic 也就是消息传递语义,简单说就是消息传递过程中消息传递的保证性。主要分为三种: at most once:最多一次。消息可能丢失也可能被处理,但最多只会被处理一次。 at least once:至少一次。消息不会丢失,但可能被处理多次。可能重复,不会丢失。 exactly once:精确传递一次。消息被处理且只会被处理一次。不丢失不重复就一次。 理想情况下肯定是希望系统的消息传递是严格exactly once,也就是保证不丢失、只会被处理一次,但是很难做到。 回到主角Kafka,Kafka有三次消息传递的过程: 生产者发消息给Kafka Broker。 Kafka Broker 消息同步和持久化 Kafka Broker 将消息传递给消费者。 在这三步中每一步都有可能会丢失消息,下面详细分析为什么会丢消息,如何最大限度避免丢失消息。 生产者丢失消息 先介绍一下生产者发送消息的一般流程(部分流程与具体配置项强相关,这里先忽略): 生产者是与leader直接交互,所以先从集群获取topic对应分区的leader元数据; 获取到leader分区元数据后直接将消息发给过去; Kafka Broker对应的leader分区收到消息后写入文件持久化; Follower拉取Leader消息与Leader的数据保持一致; Follower消息拉取完毕需要给Leader回复ACK确认消息; Kafka Leader和Follower分区同步完,Leader分区会给生产者回复ACK确认消息。 生产者发送数据流程 生产者采用push模式将数据发布到broker,每条消息追加到分区中,顺序写入磁盘。消息写入Leader后,Follower是主动与Leader进行同步。 Kafka消息发送有两种方式:同步(sync)和异步(async),默认是同步方式,可通过producer.type属性进行配置。 Kafka通过配置request.required.acks属性来确认消息的生产: 0表示不进行消息接收是否成功的确认;不能保证消息是否发送成功,生成环境基本不会用。 1表示当Leader接收成功时确认;只要Leader存活就可以保证不丢失,保证了吞吐量。 -1或者all表示Leader和Follower都接收成功时确认;可以最大限度保证消息不丢失,但是吞吐量低。 kafka producer 的参数acks 的默认值为1,所以默认的producer级别是at least once,并不能exactly once。 敲黑板了,这里可能会丢消息的! 如果acks配置为0,发生网络抖动消息丢了,生产者不校验ACK自然就不知道丢了。 如果acks配置为1保证leader不丢,但是如果leader挂了,恰好选了一个没有ACK的follower,那也丢了。 all:保证leader和follower不丢,但是如果网络拥塞,没有收到ACK,会有重复发的问题。 Kafka Broker丢失消息 Kafka Broker 接收到数据后会将数据进行持久化存储,你以为是下面这样的: 消息持久化,无cache 没想到是这样的: 消息持久化,有cache 操作系统本身有一层缓存,叫做 Page Cache,当往磁盘文件写入的时候,系统会先将数据流写入缓存中,至于什么时候将缓存的数据写入文件中是由操作系统自行决定。 Kafka提供了一个参数 producer.type 来控制是不是主动flush,如果Kafka写入到mmap之后就立即 flush 然后再返回 Producer 叫同步 (sync);写入mmap之后立即返回 Producer 不调用 flush 叫异步 (async)。 敲黑板了,这里可能会丢消息的! Kafka通过多分区多副本机制中已经能最大限度保证数据不会丢失,如果数据已经写入系统 cache 中但是还没来得及刷入磁盘,此时突然机器宕机或者掉电那就丢了,当然这种情况很极端。 消费者丢失消息 消费者通过pull模式主动的去 kafka 集群拉取消息,与producer相同的是,消费者在拉取消息的时候也是找leader分区去拉取。 多个消费者可以组成一个消费者组(consumer group),每个消费者组都有一个组id。同一个消费组者的消费者可以消费同一topic下不同分区的数据,但是不会出现多个消费者消费同一分区的数据。 消费者群组消费消息 消费者消费的进度通过offset保存在kafka集群的__consumer_offsets这个topic中。 消费消息的时候主要分为两个阶段: 1、标识消息已被消费,commit offset坐标; 2、处理消息。 敲黑板了,这里可能会丢消息的! 场景一:先commit再处理消息。如果在处理消息的时候异常了,但是offset 已经提交了,这条消息对于该消费者来说就是丢失了,再也不会消费到了。 场景二:先处理消息再commit。如果在commit之前发生异常,下次还会消费到该消息,重复消费的问题可以通过业务保证消息幂等性来解决。 总结 那么问题来了,kafka到底会不会丢消息?答案是:会! Kafka可能会在三个阶段丢失消息: (1)生产者发送数据; (2)Kafka Broker 存储数据; (3)消费者消费数据; 在生产环境中严格做到exactly once其实是难的,同时也会牺牲效率和吞吐量,最佳实践是业务侧做好补偿机制,万一出现消息丢失可以兜底。 - END - 说两句:学习是一件时而郁郁寡欢时而开环大笑的事情,越过瓶颈又是一片新天地,坚持坚持坚持。 如果对你有用,欢迎 在看、点赞、转发 ,您的认可是我最大的动力。 整理了几百本各类技术电子书,送给小伙伴们。关注公号回复【666】自行领取。和一些小伙伴们建了一个技术交流群,一起探讨技术、共同学习进步,如果感兴趣就加入我们吧! 关注,迈开成长的第一步 本文分享自微信公众号 - 程序员内点事(chengxy-nds)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

再有人问Java中的注解就把这篇文章丢给他!

什么是注解? 用一个词就可以描述注解,那就是元数据,即一种描述数据的数据。所以,可以说注解就是源代码的元数据。比如,下面这段代码: 上面的代码中,我重写了toString()方法并使用了@Override注解。但是,即使我不使用@Override注解标记代码,程序也能够正常执行。那么,该注解表示什么?这么写有什么好处吗?事实上,@Override告诉编译器这个方法是一个重写方法(描述方法的元数据),如果父类中不存在该方法,编译器便会报错,提示该方法没有重写父类中的方法。如果我不小心拼写错误,例如将toString()写成了toStrring(){double r},而且我也没有使用@Override注解,那程序依然能编译运行。但运行结果会和我期望的大不相同。现在我们了解了什么是注解,并且使用注解有助于阅读程序。 Annotation是一种应用于类、方法、参数、变量、构造器及包声明中的特殊修饰符。它是一种由JSR-175标准选择用来描述元数据的一种工具。 为什么要引入注解? 使用Annotation之前(甚至在使用之后),XML被广泛的应用于描述元数据。不知何时开始一些应用开发人员和架构师发现XML的维护越来越糟糕了。他们希望使用一些和代码紧耦合的东西,而不是像XML那样和代码是松耦合的(在某些情况下甚至是完全分离的)代码描述。如果你在Google中搜索“XML vs. annotations”,会看到许多关于这个问题的辩论。最有趣的是XML配置其实就是为了分离代码和配置而引入的。上述两种观点可能会让你很疑惑,两者观点似乎构成了一种循环,但各有利弊。下面我们通过一个例子来理解这两者的区别。 假如你想为应用设置很多的常量或参数,这种情况下,XML是一个很好的选择,因为它不会同特定的代码相连。如果你想把某个方法声明为服务,那么使用Annotation会更好一些,因为这种情况下需要注解和方法紧密耦合起来,开发人员也必须认识到这点。 另一个很重要的因素是Annotation定义了一种标准的描述元数据的方式。在这之前,开发人员通常使用他们自己的方式定义元数据。例如,使用标记interfaces,注释,transient关键字等等。每个程序员按照自己的方式定义元数据,而不像Annotation这种标准的方式。 目前,许多框架将XML和Annotation两种方式结合使用,平衡两者之间的利弊。 Annotation是如何工作的?怎么编写自定义的Annotation? 在讲述这部分之前,建议你首先下载Annotation的示例代码AnnotationsSample.zip 。下载之后放在你习惯使用的IDE中,这些代码会帮助你更好的理解Annotation机制。 编写Annotation非常简单,可以将Annotation的定义同接口的定义进行比较。我们来看两个例子:一个是标准的注解@Override,另一个是用户自定义注解@Todo。 对于@Override注释你可能有些疑问,它什么都没做,那它是如何检查在父类中有一个同名的函数呢。当然,不要惊讶,我是逗你玩的。@Override注解的定义不仅仅只有这么一点代码。这部分内容很重要,我不得不再次重复:Annotations仅仅是元数据,和业务逻辑无关。理解起来有点困难,但就是这样。如果Annotations不包含业务逻辑,那么必须有人来实现这些逻辑。元数据的用户来做这个事情。Annotations仅仅提供它定义的属性(类/方法/包/域)的信息。Annotations的用户(同样是一些代码)来读取这些信息并实现必要的逻辑。 当我们使用Java的标注Annotations(例如@Override)时,JVM就是一个用户,它在字节码层面工作。到这里,应用开发人员还不能控制也不能使用自定义的注解。因此,我们讲解一下如何编写自定义的Annotations。 我们来逐个讲述编写自定义Annotations的要点。上面的例子中,你看到一些注解应用在注解上。 J2SE5.0版本在 java.lang.annotation提供了四种元注解,专门注解其他的注解: @Documented –注解是否将包含在JavaDoc中 @Retention –什么时候使用该注解 @Target? –注解用于什么地方 @Inherited – 是否允许子类继承该注解 @Documented–一个简单的Annotations标记注解,表示是否将注解信息添加在java文档中。 @Retention– 定义该注解的生命周期。 RetentionPolicy.SOURCE– 在编译阶段丢弃。这些注解在编译结束之后就不再有任何意义,所以它们不会写入字节码。@Override, @SuppressWarnings都属于这类注解。 RetentionPolicy.CLASS– 在类加载的时候丢弃。在字节码文件的处理中有用。注解默认使用这种方式。 RetentionPolicy.RUNTIME– 始终不会丢弃,运行期也保留该注解,因此可以使用反射机制读取该注解的信息。我们自定义的注解通常使用这种方式。 @Target– 表示该注解用于什么地方。如果不明确指出,该注解可以放在任何地方。以下是一些可用的参数。需要说明的是:属性的注解是兼容的,如果你想给7个属性都添加注解,仅仅排除一个属性,那么你需要在定义target包含所有的属性。 ElementType.TYPE:用于描述类、接口或enum声明 ElementType.FIELD:用于描述实例变量 ElementType.METHOD ElementType.PARAMETER ElementType.CONSTRUCTOR ElementType.LOCAL_VARIABLE ElementType.ANNOTATION_TYPE另一个注释 ElementType.PACKAGE用于记录java文件的package信息 @Inherited– 定义该注释和子类的关系 那么,注解的内部到底是如何定义的呢?Annotations只支持基本类型、String及枚举类型。注释中所有的属性被定义成方法,并允许提供默认值。 下面的例子演示了如何使用上面的注解。 @Todo(priority=Todo.Priority.MEDIUM,author="Yashwant",status=Todo.Status.STARTED) publicvoidincompleteMethod1(){ } 如果注解中只有一个属性,可以直接命名为“value”,使用时无需再标明属性名。 但目前为止一切看起来都还不错。我们定义了自己的注解并将其应用在业务逻辑的方法上。现在我们需要写一个用户程序调用我们的注解。这里我们需要使用反射机制。如果你熟悉反射代码,就会知道反射可以提供类名、方法和实例变量对象。所有这些对象都有getAnnotation()这个方法用来返回注解信息。我们需要把这个对象转换为我们自定义的注释(使用 instanceOf()检查之后),同时也可以调用自定义注释里面的方法。看看以下的实例代码,使用了上面的注解: 注解用例 注解的功能很强大,Spring和Hebernate这些框架在日志和有效性中大量使用了注解功能。注解可以应用在使用标记接口的地方。不同的是标记接口用来定义完整的类,但你可以为单个的方法定义注释,例如是否将一个方法暴露为服务。 在最新的servlet3.0中引入了很多新的注解,尤其是和servlet安全相关的注解。 HandlesTypes–该注解用来表示一组传递给ServletContainerInitializer的应用类。 HttpConstraint– 该注解代表所有HTTP方法的应用请求的安全约束,和ServletSecurity注释中定义的HttpMethodConstraint安全约束不同。 HttpMethodConstraint – 指明不同类型请求的安全约束,和ServletSecurity 注解中描述HTTP协议方法类型的注释不同。 MultipartConfig–该注解标注在Servlet上面,表示该Servlet希望处理的请求的 MIME 类型是 multipart/form-data。 ServletSecurity该注解标注在Servlet继承类上面,强制该HTTP协议请求遵循安全约束。 WebFilter– 该注解用来声明一个Server过滤器; WebInitParam– 该注解用来声明Servlet或是过滤器的中的初始化参数,通常配合 @WebServlet 或者 @WebFilter 使用。 WebListener–该注解为Web应用程序上下文中不同类型的事件声明监听器。 WebServlet–该注解用来声明一个Servlet的配置。 ADF (应用程序框架)和注解 现在我们开始讨论文章的最后一部分了。应用程序框架,被称为ADF,由Oracle开发用来创建Oracle融合应用。我们已经了解了注解的优缺点,也知道如何编写自定义的注解,但我们应该将注解应用在ADF的哪部分呢?ADF是否提供了一些朴素的注解?很好的问题,确实在ADF中大量使用注解有一些限制。之前提到的应用框架如Spring和Hibernate使用AOP(面向侧面的程序设计)。在AOP中,框架提供了一种机制,在事件的预处理和后续处理中注入代码。例如:你有一个钩子用来在方法执行之前和之后添加代码,所以你可以在这些地方编写你的用户代码。ADF不使用AOP。如果我们有任何注解的用例可用,我们可能需要通过继承的方式实现。 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:860113481 群内提供免费的Java架构学习资料(里面有高可用、高并发、高性能及分布式、Jvm性能调优、Spring源码,MyBatis,Netty,Redis,Kafka,Mysql,Zookeeper,Tomcat,Docker,Dubbo,Nginx等多个知识点的架构资料)合理利用自己每一分每一秒的时间来学习提升自己,不要再用"没有时间“来掩饰自己思想上的懒惰!趁年轻,使劲拼,给未来的自己一个交代!
资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册