首页 文章 精选 留言 我的

精选列表

搜索[计费相关],共10005篇文章
优秀的个人博客,低调大师

MaxCompute(原ODPS)开发入门指南——计量计费篇

MaxCompute(原ODPS)开发入门指南 写在最前面 >>>进入了解更多>>>阿里云数加·MaxCompute大数据计算服务. 近期介绍大量数据上云用户关于MaxCompute的一些问题,现就MaxCompute产品线的一些工具栈可以和大家进行交流,也欢迎大家拍砖和来扰,一起学习一起进步!也希望能够在帮助到大家! 系列文章会涉及到的内容 0.MaxCompute概述:是什么?可以做什么?收费模式? 1.数据上云工具介绍:Log、Logstash、Flume、Fluentd、DataX等 2.MaxCompute开发工具:Data IDE和MaxCompute Studio 3.数据分析展现工具概述:Quick BI MaxCompute概述 MaxCompute(原ODPS)是一项大数据计算服务,它能提供快速

优秀的个人博客,低调大师

Twitter 广告平台实时计费系统的架构增强之道

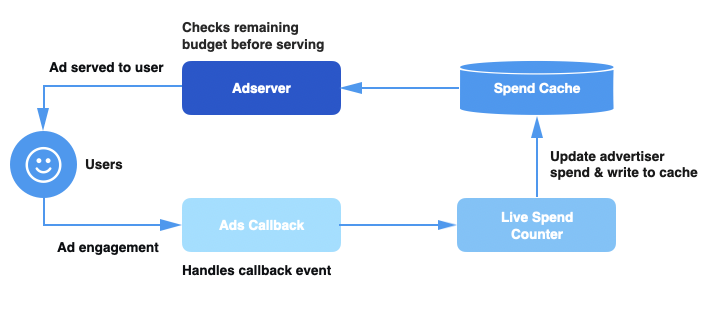
Twitter 是广告商吸引受众的一个热门平台。当广告商发起一个新的广告活动,它们会限定一个广告预算。Twitter 的广告服务器会检查广告活动的预算,以便确定是否还能继续投放广告。如果没有这个检查机制,我们可能会在广告活动达到预算限额后继续提供广告服务。我们把这种情况叫作超支。超支会导致 Twitter 的收入损失(由于机会成本的增加——例如,我们本可以在那个位置显示其他广告)。所以,我们要建立一个可靠的系统来防止发生超支。 - 背景简述 - 在深入研究超支是如何发生前,先来了解一下我们的广告系统是如何提供广告服务的。下面是我们广告服务管道的高级架构图: 支出缓存(Spend Cache)——一个分布式缓存服务,可以跟踪每个广告活动的当前预算支出。 实时广告支出计数器(Live Spend Counter,LSC)——一个基于 Apache Heron 的服务,负责聚合广告活动并更新支出缓存。 广告回调(Ads Callback)——处理用户浏览事件的管道,为事件添加上下文信息,并将它们发送到 LSC。 广告服务器(Ad Server)——在处理请求时,决定是否应该从广告支出缓存中获取当前活动的支出。需要注意的是,这里所说的广告服务器包括了向用户提供广告的多种服务。 当用户在 Twitter 上浏览广告时,我们会向广告回调管道发送一个事件。一旦活动支出计数器收到这个事件,它将计算活动的总支出,并在支出缓存中更新活动的支出。对于每个传入的请求,广告服务器管道都会查询支出缓存,以便获得活动的当前支出,并根据剩余的预算确定是否继续提供服务。 - 广告预算超支 - 因为我们处理的广告活动的规模比较大(数据中心每秒有数以百万计的广告浏览事件),所以延迟或硬件故障随时都可能在我们的系统中发生。如果支出缓存没有更新最新的活动支出,广告服务器就会获取到陈旧的信息,并继续为已经达到预算上限的活动提供广告服务。我们将永远无法收取超出广告预算的那部分费用,导致 Twitter 的收入损失。 例如,假设有一个每天预算为 100 美元的广告活动,每一次点击的价格为 0.01 美元。在没有超支的情况下,这将为活动创造每天 10000 次点击的机会。 假设广告回调管道或 LSC 出现故障,导致支出缓存没有更新,丢失了价值 10 美元的事件,支出缓存只会报告支出为 90 美元,而实际上活动已经支出了 100 美元,那么该活动将获得额外的 1000 次免费点击机会。 - 跨数据中心一致性 - Twitter 有多个数据中心,每个数据中心都部署了整个广告服务管道的副本,包括广告回调管道、实时支出计数器和支出缓存。当用户点击广告时,回调事件被路由到其中的一个数据中心,这个数据中心里的回调管道将负责处理这个事件。 那么,问题就来了:每个数据中心计算的总支出只计算该数据中心接收到的事件,不包括其他数据中心的数据。由于广告客户的预算是跨数据中心的,这意味着每个数据中心的支出信息是不完整的,可能会少算了广告客户的实际支出。 为了解决这个问题,我们给回调事件队列添加了跨数据中心复制功能,以便让每个数据中心都能够处理所有的事件。这确保了每个数据中心中的支出信息是完整和准确的。 - 单个数据中心的故障 - 尽管复制事件为我们带来了更好的一致性和更准确的支出信息,但系统的容错能力仍然不是很强。例如,每隔几周,跨数据中心复制失败就会导致支出缓存由于事件丢失或滞后而失效。通常,广告回调管道会出现系统问题,例如垃圾收集停顿或数据中心的不可靠网络连接导致的事件处理延迟。由于这些问题发生在数据中心本地,该数据中心中的 LSC 接收到的事件与延迟成正比,因此支出缓存的更新也将延迟,从而导致超支。 在过去,如果一个数据中心发生这些故障,我们会禁用这个数据中心的 LSC,并让其他数据中心的 LSC 同时更新本地缓存和发生故障的数据中心的 LSC,直到出现滞后的广告调管道和 LSC 重新追上来。 这种解决方法有效地避免了临时性的超支问题,但仍然有几个不足的地方: 手动切换:启用跨数据中心写入是一个手动执行的过程,需要按一定的顺序进行多个设置更改。我们最终使用了脚本,但仍然需要一个待命工程师手动执行脚本。 手动选择数据中心:需要一个包含多个步骤的手动执行过程来确定哪个数据中心是健康的以及启用跨数据中心写入是否安全。当故障恢复需要回到初始配置时,必须重复类似的过程。有时候,这个过程需要来自不同团队的多个待命工程师共同努力。 高运维成本:由于管理工作区涉及了多个手动步骤,回调基础设施问题会带来很高的运维成本。 - 跨数据中心写入方案 - 由于这种架构存在很多问题,我们重新设计了管道,让它能更有弹性地应对故障,并减少运维人员的干预。这个解决方案有两个主要组成部分: 跨数据中心写入:LSC 总是同时更新“备用”数据中心的支出缓存和本地缓存。它还会写入一些有关数据运行状况的元数据。每个 LSC 实例维护两个单独的数据集,一个只计算本地的信息,另一个只计算来自远程实例写入的数据。 数据集健康检查:在处理请求时,广告服务器管道读取两个版本的数据,并根据哪个数据集更健康自动选择使用哪个版本。 在正常情况下,新解决方案的工作原理与之前的设计完全一致。但是,如果本地支出缓存落后了,广告服务器能够检测到,并自动切换到包含来自远程写入数据的数据集。当本地的问题解决之后,广告服务器将自动切换回本地数据集。 我们怎么知道哪个数据集更健康? 我们通过常见的故障场景来决定数据集的健康情况: 延迟:当广告回调管道/LSC 无法及时处理大量的事件,就会出现延迟。事件是按照它们到达的顺序处理的,所以我们更倾向于选择包含最新事件的数据集。 丢失事件:在某些故障场景中,事件可能会完全丢失掉。例如,如果广告回调管道的跨数据中心复制失败,其中一个数据中心将丢失一些远程事件。因为所有的数据中心都应该处理所有的事件,所以我们应该选择处理了最多事件的那个数据集。 为了构建一个包含这两个因素的健康检查机制,我们引入了支出直方图的概念。 - 支出直方图 - 假设我们有一个滚动窗口,显示每个数据中心的 LSC 在任意给定时刻正在处理的事件计数。滚动窗口包含最近 60 秒内每毫秒处理了多少事件的计数。当到达窗口的末尾,我们删除头部的计数,并计算后面 1 毫秒的计数。我们可以看到 LSC 在 60 秒内处理的“事件计数”的直方图。直方图如下图所示: 为了能够选择最佳的数据集(在广告服务端),我们利用了这个直方图和最近的事件时间戳。LSC 将这些元数据与支出数据一起写入支出缓存。 LSC 在写入时不会序列化/反序列化整个直方图。在写入之前,它会汇总窗口中所有计数器的计数,并写入一个聚合值。这里使用事件的近似值就足够了,近似值可以作为这个数据中心的 LSC 总体健康状况的信号。这是由故障的本质决定的——如果故障足够严重,我们将立即看到故障的影响,计数会显著下降。如果不是很严重的话,数量几乎是一样的。 包含元数据的结构体是这样的: struct SpendHistogram { i64 approximateCount; i64 timestampMilliSecs;} 复制代码 在处理请求时,广告服务器同时读取本地和远程的数据集。它使用 SpendHistogram 根据下面描述的数据中心选择逻辑来决定使用哪个数据集作为事实数据来源。 - 数据中心的选择 - 选择数据集的逻辑如下: · 从两个数据中心获取 SpendHistogram。 · 首选具有最新时间戳和最高事件计数的数据集。 · 如果它们非常相近且都处于正常状态,就首选本地数据集,这样可以避免由于小的延迟而在两个数据中心之间来回切换。 这可以总结成以下的真值表: x = LocalTimeStamp - RemoteTimeStamp y = LocalApproxCount - RemoteApproxCount ts = ThresholdTimeStamp tc = ThresholdApproxCountPercent 在切换到使用来自远程数据中心的数据集之前,我们使用 ts 和 tc 来确定容忍度阈值。如果差值在阈值内,我们会更倾向于使用本地数据集。我们尝试找到阈值,以便在不需要进行数据中心切换的情况下尽早检测故障。广告服务器在处理每个请求时都会发生这个选择过程,因此我们会在本地进行缓存,每隔几秒刷新一次,以防止频繁的网络访问影响整体性能。 下面是切换使用数据中心数据的可视化表示。当 DC1 的 LSC 发生故障时,会导致 DC1 的广告服务器自动选择使用 DC2 的数据。 - 扩展到多个数据中心 - 到目前为止,我们讨论的方法只涉及两个数据中心。通过引入跨数据中心复制因子的概念,我们可以将设计扩展到“N”个数据中心。复制因子控制每个 LSC 服务写入的远程数据中心的数量。在读取数据时,我们使用了相同的逻辑,并做了一些优化,比如一次读取(批读取)所有必要数据,而不是分多次读取。 例如,假设 ReplicationFactor 设置为 2,DC1 中的 LSC 将写入到 DC1、DC2 和 DC3 的支出缓存,DC2 中的 LSC 将写入到 DC2、DC3 和 DC4 的支出缓存,DC3 中的 LSC 将写入到 DC3、DC4 和 DC1 的支出缓存。下图显示了三个数据中心的复制原理图。在每个数据中心中,广告服务器将读取三个支出直方图,并从所有这些数据中心选择首选的数据集。根据我们的网络和存储约束,我们选择 2 作为复制因子。 - 结论 - 在推出这些变更之后,我们注意到团队的运维成本发生了重大变化。之前每个季度由于系统问题会导致多次超支事件,而在过去的一年,都没有发生此类事件。这节省了大量的工程时间,并避免了由于基础设施问题而向广告商发放补偿。 通过识别系统健康关键指标,设计出最简单的工程解决方案,并根据这些指标自动采取行动,我们解决了一个影响服务管道正确性的关键性问题。我们不仅构建了一个具有容错能力和弹性的系统,而且释放了工程资源,把它们用在更有价值的地方。 - END - 往期回顾 ◆使用契约测试提高分布式系统的质量 ◆构建前瞻性应用架构的优秀实践 ◆监控全覆盖,接入只需 5 分钟:爱奇艺内容中台基于 CAT 的服务监控实践 本文分享自微信公众号 - 互联网后端架构(fullstack888)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Hive优化相关设置

参数 hive.optimize.cp=true:列裁剪 hive.optimize.prunner:分区裁剪 hive.limit.optimize.enable=true:优化LIMIT n语句 hive.limit.row.max.size=1000000: hive.limit.optimize.limit.file=10:最大文件数 1. 本地模式(小任务): 需要满足以下条件: 1.job的输入数据大小必须小于参数:hive.exec.mode.local.auto.inputbytes.max(默认128MB) 2.job的map数必须小于参数:hive.exec.mode.local.auto.tasks.max(默认4) 3.job的reduce数必须为0或者1 hive.exec.mode.local.auto.inputbytes.max=134217728 hive.exec.mode.local.auto.tasks.max=4 hive.exec.mode.local.auto=true hive.mapred.local.mem:本地模式启动的JVM内存大小 2. 并发执行: hive.exec.parallel=true ,默认为false hive.exec.parallel.thread.number=8 3.Strict Mode: hive.mapred.mode=true,严格模式不允许执行以下查询:分区表上没有指定了分区没有limit限制的order by语句笛卡尔积:JOIN时没有ON语句 4.动态分区: hive.exec.dynamic.partition.mode=strict:该模式下必须指定一个静态分区 hive.exec.max.dynamic.partitions=1000 hive.exec.max.dynamic.partitions.pernode=100:在每一个mapper/reducer节点允许创建的最大分区数 DATANODE:dfs.datanode.max.xceivers=8192:允许DATANODE打开多少个文件 5.推测执行: mapred.map.tasks.speculative.execution=true mapred.reduce.tasks.speculative.execution=true hive.mapred.reduce.tasks.speculative.execution=true; 6.Single MapReduce MultiGROUP BY hive.multigroupby.singlemar=true:当多个GROUP BY语句有相同的分组列,则会优化为一个MR任务 7. 是否提供虚拟列 hive.exec.rowoffset:是否提供虚拟列 8. 分组 两个聚集函数不能有不同的DISTINCT列,以下表达式是错误的:INSERT OVERWRITE TABLE pv_gender_agg SELECT pv_users.gender, count(DISTINCT pv_users.userid), count(DISTINCT pv_users.ip) FROM pv_users GROUP BY pv_users.gender;SELECT语句中只能有GROUP BY的列或者聚集函数。 9. hive.map.aggr=true;在map中会做部分聚集操作,效率更高但需要更多的内存。 hive.groupby.mapaggr.checkinterval:在Map端进行聚合操作的条目数目 10. hive.groupby.skewindata=true:数据倾斜时负载均衡,当选项设定为true,生成的查询计划会有两个MRJob。第一个MRJob 中,Map的输出结果集合会随机分布到Reduce中,每个Reduce做部分聚合操作,并输出结果,这样处理的结果是相同的GroupBy Key有可能被分发到不同的Reduce中,从而达到负载均衡的目的;第二个MRJob再根据预处理的数据结果按照GroupBy Key分布到Reduce中(这个过程可以保证相同的GroupBy Key被分布到同一个Reduce中),最后完成最终的聚合操作。 11.Multi-Group-By Inserts: FROM test INSERT OVERWRITE TABLE count1 SELECT count(DISTINCT test.dqcode) GROUP BY test.zipcode INSERT OVERWRITE TABLE count2 SELECT count(DISTINCT test.dqcode) GROUP BY test.sfcode; 12.排序 ORDER BY colName ASC/DESC hive.mapred.mode=strict时需要跟limit子句 hive.mapred.mode=nonstrict时使用单个reduce完成排序 SORT BY colName ASC/DESC :每个reduce内排序 DISTRIBUTE BY(子查询情况下使用 ):控制特定行应该到哪个reducer,并不保证reduce内数据的顺序 CLUSTER BY :当SORT BY 、DISTRIBUTE BY使用相同的列时。 13.合并小文件 hive.merg.mapfiles=true:合并map输出 hive.merge.mapredfiles=false:合并reduce输出 hive.merge.size.per.task=256*1000*1000:合并文件的大小 hive.mergejob.maponly=true:如果支持CombineHiveInputFormat则生成只有Map的任务执行merge hive.merge.smallfiles.avgsize=16000000:文件的平均大小小于该值时,会启动一个MR任务执行merge。 14.map/reduce数目 减少map数目: set mapred.max.split.size set mapred.min.split.size set mapred.min.split.size.per.node set mapred.min.split.size.per.rack set hive.input.format=org.apache.hadoop.hive.ql.io.CombineHiveInputFormat增加map数目:当input的文件都很大,任务逻辑复杂,map执行非常慢的时候,可以考虑增加Map数,来使得每个map处理的数据量减少,从而提高任务的执行效率。假设有这样一个任务: select data_desc, count(1), count(distinct id),sum(case when …),sum(case when ...),sum(…) from a group by data_desc如果表a只有一个文件,大小为120M,但包含几千万的记录,如果用1个map去完成这个任务,肯定是比较耗时的,这种情况下,我们要考虑将这一个文件合理的拆分成多个,这样就可以用多个map任务去完成。 set mapred.reduce.tasks=10; create table a_1 as select * from a distribute by rand(123);这样会将a表的记录,随机的分散到包含10个文件的a_1表中,再用a_1代替上面sql中的a表,则会用10个map任务去完成。每个map任务处理大于12M(几百万记录)的数据,效率肯定会好很多。 reduce数目设置: 参数1:hive.exec.reducers.bytes.per.reducer=1G:每个reduce任务处理的数据量 参数2:hive.exec.reducers.max=999(0.95*TaskTracker数):每个任务最大的reduce数目 reducer数=min(参数2,总输入数据量/参数1) set mapred.reduce.tasks:每个任务默认的reduce数目。典型为0.99*reduce槽数,hive将其设置为-1,自动确定reduce数目。 15.使用索引: hive.optimize.index.filter:自动使用索引 hive.optimize.index.groupby:使用聚合索引优化GROUP BY操作

优秀的个人博客,低调大师

常见java相关问题

HashMap的put怎么实现,如何解决hash冲突。 调用putval,计算相应hash码,然后初始化(默认64的capacity)或调用resize函数调整大小,判断bucket是否有值,若没有在数组初始化改值。若有则以拉链法(链表的形式)解决hash冲突,这里和ThreadLocalMap不一样,ThreadLocalMap使用的是线性探测法,接着将相应节点加入链表头部。如果超过8个元素会进化为RBtree,防止hash攻击。 RBtree是怎样的数据结构,有什么性质? 二叉树,有序的,四种性质。从而推得路径最长2n,最短n。复杂度为log2N.(此处省略n多话,感兴趣的同学请自行Google) RBtree什么时候会变色? 旋转时,共有四种旋转方式。一般是为了保持平衡,如左边太长,右边太短这样。(打哈哈过去,具体记不清了) hashmap什么时候会调整大小? 根据负载因子来搞事,默认为0.75。 什么是负载因子? 根据capacity来,举个例子,当capacity为100时,如果HashMap的ele的数量到了75就会resize,resize后的大小为原来的2倍,这样可以直接使用位运算得到原来的元素新的hash值。 扩容存在什么问题? (楞了一会,发现应该是说多线程的情况)然后说了多线程会有死循环问题。如果要解决可以使用concurrentHashMap。 为什么有死循环? 扯了半天,发现不画图,只通过电话根本扯不清。然后说就是因为1.7扩容后链表会逆序,1.8不会,所以1.8没这个问题,1.7就是两个线程同时扩容,一个扩到一半,到另一个了开始并完成扩容,之前那个再继续,就会出现。(然后说小姐姐,有机会我当面画给你看,开个玩笑) 8.你刚才提到concurrentHashMap,你知道怎么实现吗? 1.7使用分段锁,分为16个,每个segment可以视为一个hashtable,然后一次一个线程只锁一个segment,减小了锁的粒度,提高了并发。1.7使用的是Lock的实现类,可重入锁来同步的。1.8使用的是CAS和synchronized。如果已有元素,需要解决hash冲突,会使用synchronized锁住相应的bucket,然后再添加,同样元素在八个以上会转化为RBtree。 9.你提到Lock,知道哪些相应的锁? 读写锁,可重入锁 10.知道AQS吗,他的实现是怎样的?AQS可重入吗? 知道,读写锁,可重入锁都是通过AQS实现的,AQS维护一个链表,并主要提供tryacquire和tryrelease方法。默认为非公平锁,此时当一个线程需要请求锁时... 11.AQS如何实现可重入 维护一个int类型的status作为计数器,同一个线程acquire就加1,release就减1.到0就释放锁。读写说则是将status分为两部分使用。内部维护一个shift变量做位运算的变化。。。(AQS可以看占小狼的blog或者并发编程的艺术) 12.volatile、aba问题 13.volatile什么作用 指令重排序,内存可见性 14、指令重排序指什么?指令重排序的好处是什么?如何防止指令重排序。编译器重排序,cpu重排序,内存重排序。好处是流水线技术,提高并发性能等。通过禁止编译器优化,以及汇编使用Lock信号,java中的cpp加入volatile等防止。 15.内存可见性具体指什么?volatile通过什么机制防止 讲了下JMM,以及计组原理中的三级cache,buffer,缓存行等。 顺便扯了下c语言的volatile只保证防止编译器优化以及内存可见性的语义,而不能保证顺序性。然后是C11的acquire,release语义 接着回归java,扯了下内存屏障的实现与作用。(并发编程的艺术)然后扯了下#LOCK信号,包括总线锁,mesi的缓存一致性等。最后是先行发生的语义(语无伦次,不过基本点都讲到了) 16.synchronized内部分为几种锁,他们的使用场景是什么 偏向锁,轻量级锁,重量级锁(又有自旋锁等),然后详细讲了实现和使用场景(周志明的书和并发编程的艺术都有讲,此处省略)。 17.nio、bio 没有,讲了下自己准备学习netty,然后谈了下c语言的nio,包括Nginx和redis的多路复用,然后讲了下select和epoll的区别。以及epoll的优点和实现。然后设想java里的nio应该也是映射到epoll里面。 18.netty是怎么实现? 18. 操作系统调度进程有哪些算法? 优先级,时间片,FIFO,最近deadline什么的。 19.Redis有几种持久化方式? 四种,2种被废弃,比如磁盘交换。目前主要使用rdb,aof。rdb属于物理备份,aof属于逻辑日志(逐行追加)。然后又讲了aof重写。rdb和aof的配置。以及aof的rewrite机制。 18.Redis分布式的实现方式 (此处省略,Redis的设计与实现有详解) 19。 数据库特性 ACID,顺便分别提了下实现原理 20.具体讲下隔离性。 四种隔离级别和实现方式 https://www.cnblogs.com/fjdingsd/p/5273008.html 21.如何理解一致性? 说了下单个事务的一致性,以及分布式一致性。 22 一致性的三种级别 强,弱,最终一致性 23,持久性的实现方式 redo,同时使用insert buffer等方式。 24数据库mysql innodb myISAM区别

优秀的个人博客,低调大师

code push 相关命令

code-push login 登陆 code-push logout 注销 code-push access-key ls 列出登陆的token code-push access-key rm <accessKye> 删除某个 access-key 输入code-push app add <appName>即可完成注册。 code-push app add 在账号里面添加一个新的app code-push app remove 或者 rm 在账号里移除一个app code-push app rename 重命名一个存在app code-push app list 或则 ls 列出账号下面的所有app code-push app transfer 把app的所有权转移到另外一个账号 code-push deployment -k ls <appName>获取 部署秘钥 code-push deployment ls ckhsAndroid -k code-push release-react <appName> <platform> -t 版本 -d 环境 --des 描述 -m true (强制更新) code-push release-react MyApp-iOS ios --t 1.0.0 --dev false --d Production --des "1.优化操作流程" --m true 其中参数--t为二进制(.ipa与apk)安装包的的版本;--dev为是否启用开发者模式(默认为false);--d是要发布更新的环境分Production与Staging(默认为Staging);--des为更新说明;--m 是强制更新。 关于code-push release-react更多可选的参数,可以在终端输入code-push release-react进行查看。 script脚本 "codepush-ios": "code-push release-react ckhsIOS ios -m true", "codepush-android": "code-push release-react ckhsAndroid android -m true", "codepush-product-ios":"code-push release-react ckhsIOS ios --d Production --m true", "codepush-product-android":"code-push release-react ckhsAndroid android --d Production -m true", 更新规则 1> CodePush部署版本 > App版本 更新可用,但当前版本比运行版本高。不作更新 2> CodePush部署版本 < App版本 不执行更新处理 3> CodePush部署版本 == App版本 自动下载更新,并根据加载策略加载最新bundle 回滚 当部署的版本不同时,不能跨版本回滚。 例如:CodePush历史版本中为2.10.1,此时发布2.10.2版本。当从2.10.2发起回滚操作回到2.10.1时,是不可行的。 问题探讨: 用户安装版本为1.0.1 迭代更新上传 版本 1.1.0 上传到应用市场新的包 针对1.0.1做更新,1.1.0 运行版本大于发布的热更新版本 不做更新,1.0.1的用户可进行更新。 问题来了:当版本迭代到1.2.0时 每次迭代都要针对1.0.1 的用户,1.1.0的用户?如果发了n多个版本都要针对安装不同的用户版本去发布更新内容吗? 测试下之后:

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册