首页 文章 精选 留言 我的

精选列表

搜索[计费相关],共10005篇文章
优秀的个人博客,低调大师

elasticsearch监控相关接口

转自官网:https://www.elastic.co/guide/en/elasticsearch/reference/1.6/cat.html 转自csdn:http://blog.csdn.net/yangwenbo214/article/details/74000458 转自cnblogs:https://www.cnblogs.com/smail-bao/p/7448392.html Cluster Health The cluster health API allows to get a very simple status on the health of the cluster. $ curl -XGET 'http://localhost:9200/_cluster/health?pretty=true' The API can also be executed against one or more indices to get just the specified indices health: $ curl -XGET 'http://localhost:9200/_cluster/health/test1,test2' Cluster State The cluster state API allows to get a comprehensive state information of the whole cluster. As the cluster state can grow (depending on the number of shards and indices, your mapping, templates), it is possible to filter the cluster state response specifying the parts in the URL. $ curl -XGET 'http://localhost:9200/_cluster/state/{metrics}/{indices}' A couple of example calls: # return only metadata and routing_table data for specified indices $ curl -XGET 'http://localhost:9200/_cluster/state/metadata,routing_table/foo,bar' # return everything for these two indices $ curl -XGET 'http://localhost:9200/_cluster/state/_all/foo,bar' # Return only blocks data $ curl -XGET 'http://localhost:9200/_cluster/state/blocks' Cluster Stats The Cluster Stats API allows to retrieve statistics from a cluster wide perspective. The API returns basic index metrics (shard numbers, store size, memory usage) and information about the current nodes that form the cluster (number, roles, os, jvm versions, memory usage, cpu and installed plugins). curl -XGET 'http://localhost:9200/_cluster/stats?human&pretty' Pending cluster tasks The pending cluster tasks API returns a list of any cluster-level changes (e.g. create index, update mapping, allocate or fail shard) which have not yet been executed. $ curl -XGET 'http://localhost:9200/_cluster/pending_tasks' Cluster Reroute The reroute command allows to explicitly execute a cluster reroute allocation command including specific commands. For example, a shard can be moved from one node to another explicitly, an allocation can be canceled, or an unassigned shard can be explicitly allocated on a specific node. Cluster Update Settings Allows to update cluster wide specific settings. Settings updated can either be persistent (applied cross restarts) or transient (will not survive a full cluster restart). Nodes Stats The cluster nodes stats API allows to retrieve one or more (or all) of the cluster nodes statistics. curl -XGET 'http://localhost:9200/_nodes/stats' curl -XGET 'http://localhost:9200/_nodes/nodeId1,nodeId2/stats' The first command retrieves stats of all the nodes in the cluster. The second command selectively retrieves nodes stats of onlynodeId1andnodeId2 Nodes Info The cluster nodes info API allows to retrieve one or more (or all) of the cluster nodes information. curl -XGET 'http://localhost:9200/_nodes' curl -XGET 'http://localhost:9200/_nodes/nodeId1,nodeId2' The first command retrieves information of all the nodes in the cluster. The second command selectively retrieves nodes information of onlynodeId1andnodeId2. All the nodes selective options are explainedhere. By default, it just returns all attributes and core settings for a node. It also allows to get only information onsettings,os,process,jvm,thread_pool,network,transport,httpandplugins: curl -XGET 'http://localhost:9200/_nodes/process' curl -XGET 'http://localhost:9200/_nodes/_all/process' curl -XGET 'http://localhost:9200/_nodes/nodeId1,nodeId2/jvm,process' # same as above curl -XGET 'http://localhost:9200/_nodes/nodeId1,nodeId2/info/jvm,process' curl -XGET 'http://localhost:9200/_nodes/nodeId1,nodeId2/_all The_allflag can be set to return all the information - or you can simply omit it. plugins- if set, the result will contain details about the loaded plugins per node: name: plugin name description: plugin description if any site:trueif the plugin is a site plugin jvm:trueif the plugin is a plugin running in the JVM url: URL if the plugin is a site plugin Nodes hot_threads An API allowing to get the current hot threads on each node in the cluster. Endpoints are/_nodes/hot_threads, and/_nodes/{nodesIds}/hot_threads. The output is plain text with a breakdown of each node’s top hot threads. Nodes Shutdown The nodes shutdown API allows to shutdown one or more (or all) nodes in the cluster.

优秀的个人博客,低调大师

Android笔记:CoverFlow相关

====================效果一,修改getChildDrawingOrder方法================================= 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 // 重载视图显示顺序让左到中间显示,再到右到中间显示 protected int getChildDrawingOrder( int childCount, int i) { // long t = getSelectedItemId(); // int h = getSelectedItemPosition(); // if (i < childCount / 2) // { // return i; // } // return childCount - i - 1 + childCount / 2; // Reset the last position variable everytime we are starting a new // drawing loop if (i == 0 ) lastPosition = 0 ; int centerPosition = getSelectedItemPosition() - getFirstVisiblePosition(); if (i == childCount - 1 ) { return centerPosition; } else if (i >= centerPosition) { lastPosition++; return childCount - lastPosition; } else { return i; } } 修改后效果: ==============================参考资料=========================================== 1.Gallery重叠效果 http://www.eoeandroid.com/forum.php?mod=viewthread&tid=97392&reltid=186440&pre_pos=8&ext= 2.Modifying Coverflow to use xml file http://stackoverflow.com/questions/16078716/modifying-coverflow-to-use-xml-file 3.使用Android自带Gallery组件实现CoverFlow,源码+解析 http://www.eoeandroid.com/thread-39709-1-1.html 4.Android实现CoverFlow效果 http://blog.csdn.net/jxsmallmouse/article/details/7732341 5.CoverFlow http://www.inter-fuser.com/2010/01/android-coverflow-widget.html http://www.inter-fuser.com/2010/02/android-coverflow-widget-v2.html 本文转自 glblong 51CTO博客,原文链接:http://blog.51cto.com/glblong/1290635,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hadoop的相关资料

1 HDFS 1.1 概念 Hadoop分布式文件系统(HDFS)被设计成适合运行在通用硬件(commodity hardware)上的分布式文件系统 1.2 特点 - 高度容错性 - 硬件要求低 - 能提供高吞吐量的数据访问 1.3 文件系统命令行 1.3.1 获取帮助 1 hadoopfs-help 1.3.2 ls命令 1 2 hadoopfs- ls / hadoopfs- ls -R /user 1.3.3 getconf命令 1 2 hdfsgetconf-help hdfsgetconf-namenodes 1.3.4 版本信息 1 hdfsversion 注:由于与linux系统指令用法接近,详细请参阅文后的官方链接。 2 MapReduce 2.1 MapReduce的简介 MapReduce是一种编程模型,用于大规模数据集(大于1TB)的并行运算。 2.2 工作原理 假若一个盘子中有黑豆、黄豆、绿豆、红豆,你现在想挑出其中的红豆。 MapReduce方法则是: step1 找一个团队来处理(相当于一群服务器组成的集群) step2 把豆子平均分配给团队里的每成员(相当于给群集中的服务器分配数据) step3 让团队的成员开始挑选出其中的红豆(相当于群集的计算机并行地处理数据) step4 把团队成员挑出来的豆子汇聚(相当于群集汇总并输出结果) 3 Hive 3.1 Hive的简介 3.1.1 概念 Hive是一个基于Hadoop的数据仓库平台。 3.1.2 Hive的作用 通过hive,我们可以方便地进行ETL的工作 hive定义了一个类似于SQL的查询语言 HQL能够将用户编写的QL转化为相应的Mapreduce程序基于Hadoop执行 3.1.3 Hive项目的历史 Hive是Facebook 2008年8月刚开源的一个数据仓库框架,其系统目标与Pig有相似之处,但它有一些Pig目前还不支持的机制。 比如:更丰富的类型系统、更类似SQL的查询语言、Table/Partition元数据的持久化等。 4 impala 4.1 Impala的简介 Impala 是 Cloudera 在受到 Google 的 Dremel 启发下开发的实时交互 SQL 大数据查询工具,Impala 没有再使用缓慢的 Hive+MapReduce 批处理,而是通过使用与商用并行关系数据库中类似的分布式查询引擎(由 Query Planner、Query Coordinator 和 Query Exec Engine 三部分组成),可以直接从 HDFS 或 HBase 中用 SELECT、JOIN 和统计函数查询数据,从而大大降低了延迟。 4.2 Impala的shell 4.2.1 启动shell 1 impala-shell 4.2.2 版本查询 1 select version(); 4.3 库的操作 4.3.1 查询数据库 1 showdatabases; 4.3.2 创建数据库 1 2 createdatabasetestdb; createdatabasetestdb2; 数据库存储路径: 1 hdfsdfs- ls /user/hive/warehouse/ 4.3.3 使用数据库 1 usetestdb; 4.3.4 显示当前数据库 1 select current_database(); 4.3.5 删除数据库 1 dropdatabasetestdb; 4.4 表操作 4.4.1 创建表 1 2 3 createtablet1(xint); createtablet3( id int,wordstring); createtablecity( id int,namestring,countrycodestring,districtstring,populationint); 4.4.2 显示数据库中的表 1 2 3 showtables; showtables in testdb; showtables in testdblike 't*' ; 4.4.3 表结构描述 1 describecity; 4.4.4 修改表名称 1 altertablet3renametot2; 4.4.5 插入数据 1 2 insertintot1values(1),(3),(2),(4); insertintot2values(1, "one" ),(3, "three" ),(5, 'five' ); 4.4.6 数据查询 1 2 select min(x),max(x), sum (x),avg(x)fromt1; select wordfromt1 join t2on(t1.x=t2. id ); 5 sentry 5.1 开启权限 5.1.1 开启权限 Hive/Impala > Configuration > Service-Wide > Sentry Service > 选择“sentry” 5.1.2 指定认证服务器 Hive > Configuration >Service-Wide > Advanced > Server Name for Sentry Authorization(hive.sentry.server) > 填写sentry服务器名称或IP地址 5.1.3 设置特权用户 Hive > Configuration >Service-Wide > Security > Bypass Sentry Authorization Users(sentry.metastore.service.users) > 填写绕过的linux用户名(hive,impala,hue,hdfs等) 5.1.4 配置Hive的代理用户 HDFS > Configuration >Service-Wide > Proxy > Hive Proxy User Groups(hadoop.proxyuser.hive.groups) >填写代理的linux用户名(hive,impala,hue,hdfs等) 5.1.5 重启服务 重启Hive/Impala的服务 5.2 授权 5.2.1 创建数据库用户和组 1 2 3 groupaddgp1 useradd user1-Ggp1 useradd user2-Ggp1 5.2.2 切换执行用户 1 su -impala 5.2.3 创建数据库 切换到hive shell 1 hive 新建库 1 createdatabasetestdb; 退出hive shell 1 quit; 5.2.4 创建角色 切换到impala shell 1 impala-shell 创建角色 1 createrolero1; 5.2.5 确认创建的角色 1 showroles; 5.2.6 用户组和角色的关联 1 grantrolero1togroupgp1; 5.2.7 角色授权 1 grantallondatabasetestdbtorolero1; 本文转自 tanzhenchao 51CTO博客,原文链接:http://blog.51cto.com/cmdschool/1843887,如需转载请自行联系原作者

优秀的个人博客,低调大师

cisco 日志相关信息

下面的内容来自:http://bbs.51cto.com/thread-911912-1.html 5#大侠唐在飞 发的内容 ,我存在自己的博客里就是为了方便以后查看 日志消息通常是指Cisco IOS中的系统错误消息。其中每条错误信息都被分配了一个严重级别,伴随一些只是问题或事件的严重性分析。Cisco IOS发送日志消息(包括debug命令的输出)到日志记录过程。默认情况下,只发送到控制台接口,可可以将日志记录到路由器内部缓存,终端线路,系统日志服务器和SNMP管理站。一、日志消息格式 在Cisco IOS设备中,日志消息采用下面的格式:%<facility>-<severity>-<mnemonic>:<message_text> 下面是一个简单的例子:%LINK-5-CHANGED:Interface Ethernet1,changed state toadministratively down 假设为日志消息已经启用了时间戳和序列号,对于日志消息,将看到以下信息,首先是序列号,紧接着是时间戳,然后才是消息:000022:Jan 02 15:42:11.048:%LINK-5-CHANGED:Interface Ethernet0,changed state to administratively down二、基本日志记录配置 在设置日志记录时,需要完成两个基本的任务:打开日志记录和控制日志在线路上的显示。1、打开日志记录 默认地,日志记录只在路由器的控制台线路上打开,要在其他地方记录日志,则必须相应地打开日志记录并进行配置。使用以下命令打开日志记录:Router(config)#logging on 使用logging on命令,可以为日志记录打开其他已配置的目的地,如系统日志服务器或路由器的内部缓存。在将系统消息记录到除了控制台端口的其他位置之前,必须执行该命令;但是,使用其他的logging命令,可以单独控制哪个过程将接收日志消息。例如,已经配置了命令,将日志消息记录到系统日志服务器,但是没有执行logging on命令,则Cisco IOS只将消息记录到控制台线路。二、配置同步日志记录 logging synchronous命令的主要目的是将日志消息输出和调试输出同步到路由器线路上:控制台、辅助和VTY线路。 同步日志的主要目的是控制何时消息被显示在路由器的线路上。当启用这个特性时,同步日志使得Cisco IOS显示消息,然后执行一个等价的Ctrl-R的命令,这使得路由器将已经输入的信息重新显示在命令行上。 可以使用logging synchronous命令来影响日志消息的显示:Router(config)#line type #Router(config)-line)#logging synchronous [level severity_level|all][limit #_of_lines] 严重程度是指日志消息的严重程度,这些消息是异步显示的。严重性数值比该值高的消息(更低严重性的消息)被同步显示;数值更低的(更严重)消息被异步显示。默认的严重级别是2。参数all使得所有消息都被异步显示,不管分配的严重级别。 参数limit指定在路由器开始丢弃新的消息前,有多少个同步消息可以排在队列中。默认是20条消息。如果到达该阀值,路由器必须丢弃消息时,就会看到以下日志消息,说明路由器必须丢弃的消息数目:%SYS-3-MSGLOST #_of_messages due to overflow 同步日志的主要缺点是当路由器正在产生许多消息,而我们正在CLI中很慢地输入时,路由器必须丢弃超过阀值地任何消息。因此,将无法在线路上看到这些消息。如果看到这类事件对你来说很关键,建议将它们记录在路由器内部缓存、系统日志服务器或者SNMP管理台。 在给非控制台线路(如VTY)设置很大地队列极限值时要小心。如果黑客可以进入路由器上的VTY,而VTY上打开了同步日志,则黑客可以在输入命令期间使VTY线路空闲。这将导致Cisco IOS用消息填满很大的队列,可能会耗尽路由器的整个内存。三、日志记录目的地 可以将日志信息转发到以下4种基本目的地●线路;●内部缓存;●系统日志服务器;●SNMP管理台。1、严重级别 每个日志消息被关联一个严重级别,用来分类消息的严重等级:数字越低,消息越严重。严重级别的范围从0(最高)到7(最低)。使用logging命令可以用数字或者名称来指定严重性。 日志消息的严重级别参数级别 系统日志描述 描述emergencies0LOG_EMERG系统不可用alerts1LOG_ALERT在端口下是需要立即操作的critical2LOG_CRIT路由器上存在一个关键状态errors3LOG_ERR路由器上存在一个错误状态warnings4LOG_WARNING路由器上存在一个警告状态notifications5LOG_NOTICE路由器上发生了一个平常的但重要的事件informational6LOG_INFO路由器上发生了一个信息事件debugging7LOG_DEBUG来自debug命令的输出缺省地,console、monitor、buffer的logging被设置为debugging级,而trap(syslog)服务器的logging被设置为informational 如果在ACL语句中使用log关键字,则只有严重级别设为6或者7时,才会在控制台上显示输出。 对于日志记录功能可以控制的一个选项是,哪些消息被记录到4个目的地。例如,在控制台上,可以限制记录严重级别为4(即显示从0到4的消息)的日志消息;但是对系统日志服务器,可以设置为6(0到6)。2、线路日志 有两个命令可用于控制日志消息被发送到路由器的线路上: Router(config)#logging console [severity_level] Router(config)#logging monitor [severity_level] logging console命令是指将日志记录到物理的TTY,如控制台和辅助线路。logging monitor命令将日志记录到逻辑VTY。默认地,记录日志到控制台对所有级别都打开;但是可以通过改变logging console命令中的严重级别来修改。 将日志记录到VTY和AUX默认是关闭的,要打开就要执行特权级的EXEC命令terminal monitor,将控制台日志消息复制到VTY,或者配置logging monitor命令。如果使用了后者,在初次访问路由VTY时,则不需要执行terminal monitor命令来查看TTY命令行的日志输出。在配置logging monitor命令时,如果不指定严重级别,则默认为7(调试)。 对两个命令,都必须使用logging on命令来打开日志记录。 由于将消息显示在终端线路上,如控制台,会给路由器增加处理负担,所以建议将严重级别改到比调试更高的严重级别(较低的数字)。如果要查看较低严重级别的消息,可以使用路由器内部缓存、系统日志服务器,或者SNMP管理台。 如果在生成错误和调试消息的过程中,关闭logging on命令,会大大降低路由器的速度,直到这些消息显示在路由器的线路上。因此为显示在控制台线路的日志消息分配严重级别时要小心。3、内部缓存日志 记录日志消息到TTY或者VTY存在的一个问题是,如果没在看连接线路的屏幕输出,消息滚过屏幕并超出了终端软件的历史缓存,则没有任何机制可以再看到那些丢失的消息。如果把日志消息记录到除了线路以外的其他目的地,则可以避免这个问题。 一个解决方案是将日志消息记录到路由器的内部缓存,根据路由器平台的不同,该项可能是默认打开或关闭的;大多数平台下,默认是打开的。使用以下命令将日志记录到路由器的缓存: Router(config)#logging buffered [buffer_size|severity_level] 该命令有两个参数,buffer_size指定为内部缓存分配多大的内存,以字节为单位。使用default logging buffered命令将缓存大小设回出厂的默认值。severity_level指出应该记录的严重级别。默认的大小和严重级别(通常是7)依赖于平台型号。4、系统日志服务器日志 以下是将日志记录到系统日志服务器的基本命令: Router(config)#logging on Router(config)#logging host {IP_address|hostname} Router(config)#logging trap severity_level Router(config)#logging source-interface interface_type_interface_#Router(config)#logging origin-id {hostname|ip|string string} Router(config)#logging facility facility_type logging on命令允许将日志记录到非控制台目的地。logging host命令指定系统日志服务器的IP地址、主机名或者完全合格的域名(FQDN)。如果不只一次输入该命令,指定不同的系统日志服务器目的地,可以建立路由器使用的系统日志服务器列表。 在Cisco IOS12.2(15)T版本之前,使用logging {hostname|IP_address}命令打开陷阱日志记录,现在使用logging host命令。 logging trap命令指定要发送到系统日志服务器的日志消息的严重级别。默认是informational。 默认地,路由器用来到达系统日志服务器的接口IP地址将作为IP数据包头中的源IP地址。使用logging source-interface命令来生成一致的日志条目。这样路由器使用一个相同的源地址。使用该命令时,必须指定接口的名称和编号。只有路由器有两个或更多接口可以到达系统日志服务器时,该命令才是必需的。但是为了一致性,要确保在系统日志数据包中使用相同的源地址。这使得在系统日志服务器上执行过滤规则来阻止的不希望的日志消息变得更容易。 在12.2(15)T版本中,Cisco增加了将路由器身份信息添加到系统日志消息的功能,这样可以基于每个路由器,更容易地在系统日志服务器上搜寻或者分离信息。这是由logging origin-id实现的。该命令默认是关闭的。身份信息可以选择hostname(使用hostname命令配置的名称)、IP地址(发送接口的IP地址)和string(用来定义路由器身份信息的字符串)。如果字符串包含空格,则必须用引号将它括起来。 logging facility命令定义在运行UNIX的系统日志服务器上使用的工具,日志信息将保存在该服务器上。 系统日志工具类型 参数 描述auth授权系统cronCron工具daemon系统守护程序kern内核local0到local7本地定义的消息(从0到7)lpr打印机系统mailE-mail系统newsUSENET新闻sys9到sys14系统使用syslog系统日志user用户定义进程uucpUNIX到UNIX的复制系统 如果不指定工具,默认是local7。在UNIX上,可以通过编辑适当的配置文件来为指定的工具指定日志文件的保存位置。例如,编辑/etc/syslog配置文件,可以为工具创建一个条目。如:local7.debugging /usr/adm/logs/router.log 该例中,工具级别是local7,debugging关键字指定了系统日志记录级别。系统日志级别将决定哪个级别的消息将保存在以下的文件中:任何该严重级别及更高级别的消息将存储在这个特定的文件中。5、SNMP日志 要将日志消息发送到SNMP管理台,要执行以下命令: Router(config)#snmp-server enable trap syslog 然后,有三个命令控制将日志消息记录到管理台: Router(config)#logging on Router(config)#logging history severity_level Router(config)#logging history size number 第二个命令指定哪些严重级别的日志消息应该被发送到SNMP管理台。默认级别是warning。由于SNMP使用UDP,而UDP是不可靠的连接,系统日志陷阱保存在路由器的历史表中。至少一条系统日志消息(最新的一条)被保存在历史表中(默认是一条消息)。可以用logging history size将这个值增加到500条。 从Cisco IOS12.2(1.4)版本开始,Cisco IOS可以使用ip nat log translations syslog命令来记录每个NAT转换。四、其他日志命令1、日期和时间戳 默认地,日志消息不包括日期和时间戳。使用以下两个命令中的一个来添加日期和时间戳: Router(config)#service timestamps {debug|log} uptime 或者 Router(config)#service timestamps {debug|log} datetime [msec] [localtime] [show-timezone] [year] 可以在两种类型的消息中添加时间戳:调试和日志消息。使用debug参数使Cisco IOS在调试输出时包括时间戳。使用log参数则在每种日志消息中添加一个时间戳。第一个命令包括了uptime参数,使得Cisco IOS在消息中包括路由器开机以来的时间,如: 1w0d:%sys-5-CONFIG_I:Configured from console by console 如果要知道准确的日期和时间,则使用datetime参数。这个参数使得Cisco IOS在消息中包括日期和时间(日期和时间使用UTC格式),标准格式是:MMM DD HH:MM:SS。当使用datetime参数时,有一些可选的参数可用。msec参数在消息中包括毫秒信息。localtime显示基于路由器本地配置的时区时间。默认情况下,年份信息不包括在时间信息中,但是使用可选的year则可以包括该信息。show-timezone参数在日期和时间输出中包括时区名称。下面是一个log参数和datetime、localtime和show-timezone选项一起使用的简单例子: (.May 23 11:13:25 UTC: %SYS-5-CONFIG_I:Configured from console by consle) 日志消息一般是从三种字符的一种开始的:空格、星号或者句点。 日志消息起始字符参数名称描述 空格路由器的时钟被手动设置,或者和NTP时间服务器同步*星号路由器的始终没有被设置,或者没有和NTP服务器同步.句点路由器的时钟被设置为同步,但和NTP服务器失去联系2、序列号 除了将时间戳添加到日志消息中外,还可以让Cisco IOS在每条消息中显示序列号。可以使用以下命令来实现: Router(config)#service sequence-numbers3、速率限制 从Cisco IOS12.1(3)T版本开始,可以用logging rate-limit命令以秒为单位限制记录日志消息的速率 Router(config)#logging rate-limit {number|all number|console number}[except severity] 默认地,路由器上没有速率限制。通过指定一个从1到10,000的数。可以将每秒记录的日志消息数限制到该值。all关键字,后面跟一个数值,将作用于所有日志记录和调试消息。console关键字则限制将日志消息记录到控制台的速率。except参数对指定严重级别或者根高级别的消息建立一个例外。 强烈建议使用该命令,特别是在控制台接口上。在受到攻击时,会出现泛洪,该命令可以减少路由器需要处理的消息量。五、日志记录验证1、show logging命令 show logging显示了当前系统日志错误和事件记录的状态,包括所有配置的系统日志服务器地址,哪种类型日志打开,以及日志记录统计。以下是命令的格式: Router#show logging [summary] 使用clear logging命令清除内部缓存器中的日志消息。2、show logging history命令 该命令显示了系统日志历史表的大小、表中的消息的状态以及消息本身。六、日志记录和错误计数 如果正在使用路由器内部缓存,并且较老的消息正在老化时,该特性非常有用。使用该特性,Cisco IOS仍然会跟踪特定日志消息的发生数,以及该消息最后一次发生的情况。如果内部缓存不能够保留所有消息,而同样的错误或者问题却持续发生时,则该特性很有用。该特性基本上可以替代上面讨论的show logging summary命令 在配置模式执行以下命令启用该特性: Router(config)#logging count 该命令对每个日志消息进行计数,包括每种消息类型最后一次发生的时间戳。 启用该特性后,可以使用show logging count命令来查看错误计数。 本文转自孤舟夜航之家博客51CTO博客,原文链接http://blog.51cto.com/cysky/773537如需转载请自行联系原作者 cysky

优秀的个人博客,低调大师

lvm相关命令学习

1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 104 105 106 107 108 109 110 111 112 113 114 115 116 117 118 119 120 121 122 123 124 125 126 127 128 129 130 131 132 133 134 135 136 137 138 139 140 141 142 143 144 145 146 147 148 149 150 151 152 153 154 155 156 157 158 159 160 161 162 163 164 165 166 167 168 169 170 171 172 173 174 175 176 177 178 179 180 181 182 183 184 185 186 187 188 189 190 191 192 193 194 195 196 197 198 199 200 201 202 203 204 205 206 207 208 209 210 211 212 213 214 我的博客已迁移到xdoujiang.com请去那边和我交流 基础环境 1、当前版本 cat /etc/debian_version 7.8 2、安装包lvm2 apt-get install lvm2-y 一、将sdbsdcsdd三块分区加到卷组(hadoop),并创建5G的逻辑卷(hadoop1),PE默认 1、使用pvcreate命令将sdbsdcsdd分区创建成物理卷(pvcreate-initializeadiskorpartition for usebyLVM) pvcreate /dev/sdb /dev/sdc /dev/sdd Writingphysicalvolumedatatodisk "/dev/sdb" Physicalvolume "/dev/sdb" successfullycreated Writingphysicalvolumedatatodisk "/dev/sdc" Physicalvolume "/dev/sdc" successfullycreated Writingphysicalvolumedatatodisk "/dev/sdd" Physicalvolume "/dev/sdd" successfullycreated EXAMPLES Initializepartition #4onthethirdSCSIdiskandtheentirefifthSCSIdiskforlaterusebyLVM: pvcreate /dev/sdc4 /dev/sde 2、使用pvs或pvdisplay命令查看 1)pvs(pvs-reportinformationaboutphysicalvolumes) PVVGFmtAttrPSizePFree /dev/sdb lvm2a--10.00g10.00g /dev/sdc lvm2a--10.00g10.00g /dev/sdd lvm2a--10.00g10.00g 2)pvdisplay(pvdisplay-displayattributesofaphysicalvolume) "/dev/sdb" isanewphysicalvolumeof "10.00GiB" ---NEWPhysicalvolume--- PVName /dev/sdb VGName PVSize10.00GiB AllocatableNO PESize0 TotalPE0 FreePE0 AllocatedPE0 PVUUIDOkVC5O-SWOq-daXZ-BrNy-Hy83-G9Sm-d8bMT4 "/dev/sdc" isanewphysicalvolumeof "10.00GiB" ---NEWPhysicalvolume--- PVName /dev/sdc VGName PVSize10.00GiB AllocatableNO PESize0 TotalPE0 FreePE0 AllocatedPE0 PVUUID7vg9eM-pIRR-Ahi0-BNvn-A1pr-WQa0-hvdC9X "/dev/sdd" isanewphysicalvolumeof "10.00GiB" ---NEWPhysicalvolume--- PVName /dev/sdd VGName PVSize10.00GiB AllocatableNO PESize0 TotalPE0 FreePE0 AllocatedPE0 PVUUIDMyPYTC-Vk4P-ltjL-SX6w-jK3V-422c-HACxOK 3、使用vgcreate命令创建hadoop卷组并将sdbsdcsdd加入到卷组里(vgcreate-createavolumegroup) vgcreatehadoop /dev/sdb /dev/sdc /dev/sdd Volumegroup "hadoop" successfullycreated 这里使用默认的PE4MB EXAMPLES Tocreateavolumegroupnamedtest_vgusingphysicalvolumes /dev/sdk1 ,and /dev/sdl1 withdefaultphysicalextentsizeof4MB: vgcreatetest_vg /dev/sdk1 /dev/sdl1 4、使用vgs或vgdisplay命令查看 1)vgs(vgs-reportinformationaboutvolume groups ) VG #PV#LV#SNAttrVSizeVFree hadoop300wz--n-29.99g29.99g 2)vgdisplay(vgdisplay-displayattributesofvolume groups ) ---Volumegroup--- VGNamehadoop SystemID Formatlvm2 MetadataAreas3 MetadataSequenceNo1 VGAccess read /write VGStatusresizable MAXLV0 CurLV0 OpenLV0 MaxPV0 CurPV3 ActPV3 VGSize29.99GiB PESize4.00MiB TotalPE7677 AllocPE/Size0/0 FreePE/Size7677/29.99GiB VGUUID9BpObQ-0qNt-7MRM-cJ4Y-aMyE-5ZEd-GoSi9N 5、使用lvcreate命令创建逻辑卷为hadoop1大小是5G(lvcreatecreatesanewlogicalvolume in avolumegroup) lvcreate-L5G-nhadoop1hadoop Logicalvolume "hadoop1" created -L,--sizeLogicalVolumeSize[bBsSkKmMgGtTpPeE] Givesthesizetoallocate for thenewlogicalvolume.AsizesuffixofK for kilobytes,M for megabytes, G for gigabytes,T for terabytes,P for petabytesorE for exabytesisoptional.Defaultunitismegabytes. 6、使用lvs或lvdisplay命令查看 1)lvs(lvs-reportinformationaboutlogicalvolumes) LVVGAttrLSizePoolOriginData%MoveLogCopy%Convert hadoop1hadoop-wi-a---5.00g 2)lvdisplay(lvdisplay-displayattributesofalogicalvolume) ---Logicalvolume--- LVPath /dev/hadoop/hadoop1 LVNamehadoop1 VGNamehadoop LVUUIDy8CHyc-G7du-h9jZ-XV4T-dvZC-bzv1-NdsbS0 LVWriteAccess read /write LVCreationhost, time debian,2015-06-1223:51:09-0400 LVStatusavailable #open0 LVSize5.00GiB CurrentLE1280 Segments1 Allocationinherit Readaheadsectorsauto -currently set to256 Blockdevice254:0 7、将 /dev/hadoop/hadoop1 格式化成ext4 mkfs.ext4 /dev/hadoop/hadoop1 8、写进 /etc/fatab 中并挂载 /dev/mapper/hadoop-hadoop1 /hadoop ext4defaults00 mount -a 9、查看是否挂载成功 df -Th FilesystemTypeSizeUsedAvailUse%Mountedon rootfsrootfs9.2G1.7G7.1G19%/ udevdevtmpfs10M010M0% /dev tmpfstmpfs99M256K99M1% /run /dev/disk/by-uuid/f730250f-21de-45dd-a3e7-6c5d74508f4b ext49.2G1.7G7.1G19%/ tmpfstmpfs5.0M05.0M0% /run/lock tmpfstmpfs961M0961M0% /run/shm /dev/sda5 ext417G180M16G2% /opt /dev/mapper/hadoop-hadoop1 ext45.0G138M4.6G3% /hadoop 二、将 /dev/mapper/hadoop-hadoop1 逻辑卷夸大到40G并挂载 1、使用pvcreate命令将sde分区创建成物理卷 pvcreate /dev/sde Writingphysicalvolumedatatodisk "/dev/sde" Physicalvolume "/dev/sde" successfullycreated 2、使用vgextend命令将sde加入到卷组hadoop(vgextend-addphysicalvolumestoavolumegroup) vgextendhadoop /dev/sde Volumegroup "hadoop" successfullyextended Examples vgextendvg00 /dev/sda4 /dev/sdn1 triestoextendtheexistingvolumegroupvg00 bythenewphysicalvolumes(seepvcreate(8)) /dev/sdn1 and /dev/sda4 . 3、先查看下卷组有多少PE vgdisplay ---Volumegroup--- VGNamehadoop SystemID Formatlvm2 MetadataAreas4 MetadataSequenceNo8 VGAccess read /write VGStatusresizable MAXLV0 CurLV1 OpenLV1 MaxPV0 CurPV4 ActPV4 VGSize39.98GiB PESize4.00MiB TotalPE10236 AllocPE/Size8956/34.98GiB FreePE/Size1280/5.00GiB VGUUID9BpObQ-0qNt-7MRM-cJ4Y-aMyE-5ZEd-GoSi9N 一共有10236个PE 4、使用lvextend命令将现有逻辑卷为hadoop1增大到40G(lvextend-extendthesizeofalogicalvolume) lvextend-l10236 /dev/hadoop/hadoop1 Extendinglogicalvolumehadoop1to39.98GiB Logicalvolumehadoop1successfullyresized -l,--extents[+]LogicalExtentsNumber[%{VG|LV|PVS|FREE|ORIGIN}] Extendor set thelogicalvolumesize in units oflogicalextents. 5、使用resize2fs命令扩大文件系统(resize2fs-ext2 /ext3/ext4 file systemresizer) resize2fs /dev/hadoop/hadoop1 resize2fs1.42.5(29-Jul-2012) Filesystemat /dev/hadoop/hadoop1 ismountedon /hadoop ;on-lineresizingrequired old_desc_blocks=1,new_desc_blocks=3 Performinganon-lineresizeof /dev/hadoop/hadoop1 to10481664(4k)blocks. Thefilesystemon /dev/hadoop/hadoop1 isnow10481664blockslong. 6、最后检查下是否扩大到40G了 df -Th FilesystemTypeSizeUsedAvailUse%Mountedon rootfsrootfs9.2G1.7G7.1G19%/ udevdevtmpfs10M010M0% /dev tmpfstmpfs99M260K99M1% /run /dev/disk/by-uuid/f730250f-21de-45dd-a3e7-6c5d74508f4b ext49.2G1.7G7.1G19%/ tmpfstmpfs5.0M05.0M0% /run/lock tmpfstmpfs961M0961M0% /run/shm /dev/sda5 ext417G180M16G2% /opt /dev/mapper/hadoop-hadoop1 ext440G143M38G1% /hadoop 三、参考文章 https: //wiki .archlinux.org /index .php /LVM_ %28%E7%AE%80%E4%BD%93%E4%B8%AD%E6%96%87%29 本文转自 xdoujiang 51CTO博客,原文链接:http://blog.51cto.com/7938217/1661595,如需转载请自行联系原作者

优秀的个人博客,低调大师

FFMPEG相关开源项目

1.FFmpeg build for android random architectures with example jnihttps://github.com/appunite/AndroidFFmpeg2.ijkplayer - Android/iOS 基于FFMPEG库的播放器http://git.oschina.net/bbcallen/ijkplayergit下载地址: http://git.oschina.net/bbcallen/ijkplayer.git git@git.oschina.net:bbcallen/ijkplayer.git https://github.com/bbcallen/ijkplayer 3. KxMovie - IOS平台基于FFMPEG播放器https://github.com/kolyvan/kxmovie4.Vitamio - Android/IOS平台上的多媒体框架,带有硬件加速解码和渲染.https://github.com/yixia/VitamioBundle5.YUV2RGB - 顾名思义,YUV转RGB http://wss.co.uk/pinknoise/yuv2rgb/ 6.TSDemux - 将TS流解码为PES或ES 下载这个源码需要FQ。 http://code.google.com/p/tsdemuxer/ 7.MPlayer - 跨平台的视频播放器,可在Linux和其他类Unix系统、Windows及Mac OS X系统使用 http://www.mplayerhq.hu/design7/dload.html 8.VLC - 跨平台的视频播放器。现在也有安卓版本。也可以作为流媒体服务器。 http://www.videolan.org/vlc/index.html 9.FFDshow - 免费的编解码软件,基于windows平台。原因就是directshow就是微软开发的,只能用于windows平台。 http://sourceforge.NET/projects/ffdshow-tryout/ 这是笔者目前接触到的,等以后遇到了,再整理。

优秀的个人博客,低调大师

大数据平台相关

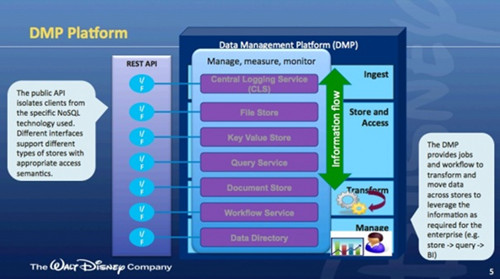
尽量减少所有开发者之间同类工作中的重复劳动 引用:http://www.csdn.net/article/2012-09-24/2810270-Disney Hadoop、NoSQL数据库和其他开源技术 购买缺点:高昂的成本是一个很重要的因素,但是最关键的还是灵活性的问题,这是作出最终决定的根本原因。 迪士尼大数据平台是基于Hadoop,Cassandra和MongoDB进行开发的 大数据在迪斯尼扮演的角色: 数据管理平台: 数据管理平台目标: 收集,搜索,分析应用数据: 使用案例的演化: 推荐引擎:

优秀的个人博客,低调大师

注意这五点 跳出云供应商的计费陷阱

有一个公认的事实是,将业务迁移到云上将有助于节约小型业务的成本。然而,使用云服务是要付出一些关联代价的,虽然那些代价一开始看起来微不足道,但如果你不加以关注的话,它就会像滚雪球一样由小变大,这是云服务供应商“温水煮青蛙”的陷阱。如果你想继续在云端获得基本的收益,就必须采取措施,压低你的云计算成本。以下是一些小小的建议,关于如何防止云变得过于昂贵。 若掉进供应商挖的坑 云服务也不便宜 不选择独立服务 云服务的类型是多种多样的,而且有许多服务是独立的,这毫无疑问将会使云成本增加。 正如上面所说,如果你不够小心,云计算的成本就会增加。而对于独立服务,成本就更高。很容易就会落入“50美元一个月/100美元一个月真的有差别?”的陷阱。而在你意识到问题的所在之前,你的云服务预算已经扶摇直上九万里了。 解决这一问题的最好办法之一,就是找到一个提供一整套产品的服务供应商。这个方法往往比独立的产品要昂贵一点点。 此外,从一个能够为你提供问题中心点解决方案的供应商处购买云服务,可以节约你很多时间,过一段时间之后,也将因此为你省下很多成本。 经验很重要 如果你确实需要一个独立的云服务来集成套件,最好确保你身边有一个经验丰富的集成顾问来做这个工作。 集成往往是非常复杂的,一位经验丰富的顾问通常可以在较短时间内完成这项工作,从而达到节约成本的目的。 另外,集成有误将导致服务停机和错误,这两种情况都会消耗大量的资源。在你把他们拉上船之前,至少要确保那些顾问知道自己要做什么。 优先考虑备份 如果你把自己的所有数据都看得同样重要,云备份的存储就会在短期内变得非常昂贵。为了保持低成本,你需要检查储存在云上的数据防止出现以下问题: ·需要你长期存储的这些数据有多少个版本?版本越多,云存储的成本就会约稿。 ·你需要满足什么样的监管需求?你的某些数据可能需要访问五年,另外一些数据或许可以在九十天后就删除。 ·你需要多块的备份访问速度?如果你可以等待一两天,那么你就可以将数据存放在更便宜一些的服务器上或者甚至从你的供应商数据中心脱机。 删除用户 很多云服务供应商会根据你的业务在其系统中所拥有的用户数量收费。如果你不去维护你的用户列表,你就可能会为那些已经脱离业务很久的用户支付额外的费用。 为了避免这种情况,你需要在必要的时候将那些用户从系统中删除。此外,定期进行审计是很有用的,比如每隔六个月到一年的时间,以确保云中的用户列表是最新的。 主动监控 最后,向你的云服务供应商询问是否可以主动监控你的账户,这样他们就能够在问题变得严重之前对你发出警报。这是非常重要的,你必须拥有“按需支付”许可,让费用的产生基于资源和存储的使用。 这样会避免你在打开每月云服务账单时,看到一个“大大的惊喜”。 如果你真的收到这样一个“惊喜”,最好在未来与你的云服务供应商一同工作,以监控你的使用程度。另外,向他们询问成本管理建议。虽然看起来,向你的云服务供应商询问如何节约云服务成本是违反常理的,但是对于他们来说,你作为一个长期客户的价值远远高于每月高出的那一点点费用。 本文转自d1net(转载)

优秀的个人博客,低调大师

Docker容器相关的命令

创建容器和启动容器 创建容器命令:dockerrun对应参数说明:-i :表示运行容器-t:表示容器启动后进入该容器执行命令,加入俩个参数后,容器创建就能登录进去,分配一个伪终端-name:为创建的容器命名-v:表示目录映射关系(前面是宿主机目录,后者是容器的目录)可以使用多个-v做多个目录或者文件的映射,注意:最好使用目录映射,在宿主机上修改文件,然后共享到容器中-d :在run后面加-d参数,则会创建一个守护进程在后台运行(这样创建后就不会自动登录容器,如果只加-it就会在创建容器中进入容器)-p :表示端口映射,前者是宿主机端口,后者是容器的银蛇端口,可以使用多个-p做多个端口的映射(1)交互式的创建容器 docker run -it(-i -t) --name=容器名称 镜像名称:标签 /bin/bash 退出当前容器 exit (2) 后台启动容器的进程 docker run -d --name=容器名称 镜像名称:标签 (3) 登录守护进程容器的方式 docker exec -it 容器名称(或者容器ID) /bin/bash案例:docker exec -it mycentos2 /bin/bash 查看容器 查看正在运行的容器 docker ps 查看所有的容器 docker ps -a 查看最后一次运行的容器 docker ps -l 查看停止的容器 docker ps -f status=exited 停止与启动容器 停止容器: docker stop 容器名称(或者容器ID) 启动容器: docker start 容器名称(或者容器ID) 文件拷贝 如果我们需要将文件拷贝容器内可以使用cp命令 docker cp 需要拷贝的文件或者目录 容器名称:容器目录 也可以将文件从容器拷贝出来 docker cp 容器名称:容器目录 需要拷贝的文件或目录 目录挂载 我们可以在创建容器的时候,将宿主机的目录与容器的目录进行映射,这样我们就可以通过修改宿主机某个目录的文件从而影响容器。创建容器 添加-v参数 宿主机目录:容器目录 docker run -di -v /usr/local/myhtml:/usr/local/myhtml --name=mycentos3 centos 可以共享多个目录,可以出现权限不足。 selinux权限去掉,--privileged=true来解决目录没有权限的问题 查看容器的ip 我们可以通过以下命令查看容器的运行各种参数 docker inspect 容器名称(容器ID) 也可以执行执行命令输出ip docker inspect --format='{{.NetworkSettings.IPAddress}}' 容器名称(容器ID) 删除容器 docker rm 容器名称(容器ID) 注意:删除imagedocker rmi imageid 前期是根据这个image的容器要删除docker rm 容器名称 删除容器 要先停止对应的容器

优秀的个人博客,低调大师

CSS相关知识点

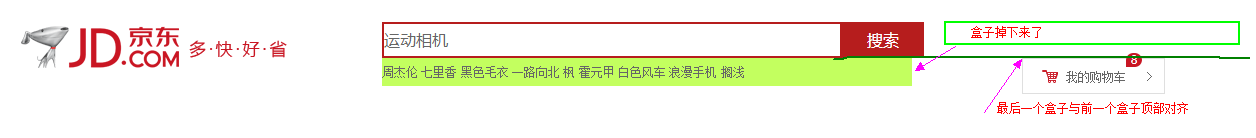
1、高和行高也可以撑开盒子,背景图不行。 2、文字若不设置行高,是包含文字的盒子的行高。 4、如果给了定位,但是没有给left,top等值,默认会腾出行内元素、padding的位置,有的时候我们可以使用这些特性,有的时候我们不熟悉的话可能产生bug。 5、较少功能使用较少代码(a代替ui>li>a) 6、如果盒子都是左对齐的话,最后一个盒子在右边的位置不够的话,会掉下来,如果第一个盒子A比第二个盒子B高,那么最后一个盒子C掉下来后跟第二个盒子B左对齐,而不是跟第一个盒子A左对齐。如果最后一个盒子C后面还有一个盒子D的话,D盒子的顶端跟C对齐。(下图 JD logo 是 A 盒子, 搜索框是 B 盒子, 周杰伦的歌是 C 盒子,我的购物车是 D 盒子。) 7、标准流中的文字不会被浮动的盒子盖住。所以一个大盒子中的小盒子要么都浮动要么都不浮动。 8、父盒子高度为0 ,子盒子如果是浮动的话不占位置,下面的标准流盒子将会跑到子盒子下面。 或者使用了定位,父盒子高度为0,然后子绝父相,下面的标准流盒子依然会跑到子盒子下面。 (这个可以做类似京东的侧边栏,如果侧边栏挡住了跑上来的标准流盒子,那么把包含标准流的整个大盒子定位:position: relative ,因为定位的层级高,所以就可以显示标准流的所有内容了。) 9、想要盒子随着界面变大变小,而盒子随着界面的中线能够移动的时候(类似定位/脱标的盒子居中对齐),不要加版心(margin: 0 auto;)。 10、父盒子有高度,但是子盒子太高,父盒子会被撑破;如果父盒子没有高度,那么父盒子会被撑开,是所有子盒子最高的高度。撑开的盒子可能会产生影响。(不要让浮动的盒子超出父盒子) 11、浮动盒子的相互影响,不管是否在一个大盒子里面(蓝盒子是包含在粉红盒子里面的,紫盒子和粉红盒子是并列的)。 12、谷歌浏览器不支持12号以下字体大小。 13、子盒子不占位置,父盒子高度为0,会导致下面的盒子顶上来了。(清除浮动) 14、curser: pointer; 模拟鼠标小手样式。 15、<a href=""></a> 如果 href 值为空,刷新页面。 如果 href 值为#,跳转到页面顶端,不刷新页面。 如果 href 值为javascript:; 或者javascript:void(0) ,不刷新页面,也不跳转。 16、定位的时候,left 的权限比 right 权限高,top 比 bottom 高,提高权限也没用。 17、图片半透明 opacity:0.4; 优点方便。缺点:里面的内容也会半透明。 CSS3的技术来解决半透明: background: rgba(0,0,0,0.3); background: rgba(0,0,0, .3); 18、行高可以继承。 19、如果一个大盒子装的是 li 标签,而且 li 标签是浮动的,如果 li 里面的内容超过了大盒子的话,会有 li 标签掉下来,如何使得所有的 li 标签在一行显示呢?用一个辅助盒子装下所有的 li 标签,然后大盒子只装辅助盒子,这样对于大盒子来说,所有的 li 标签都会在一行显示,即使大盒子很小。而辅助盒子可以使用 ul 来代替,给 ul 一个所有 li 加起来的宽度多一点即可,但是多的一点要少于一个 li 的宽度。 20、行内元素给了定位,不需要转block,只有static, relative定位的时候需要转 block。 21、盒子的border有重叠怎么办,可以往左上移动border的margin来覆盖。 22、background: url("spirit.png") -135px 0; 关于背景の问题: 有时候我发现background后面两个px可以调节位置,有的时候又必须使用left,top等调位置。其实后面的两个px本来就是调位置的,而且调的是整个背景的位置,当背景是整张图片的时候,调节这两个px就可以了,但是精灵图因为需要的只是背景图中的某一个区域,调节这两个px只是将选中的区域移动到定位的原点,然后再使用left,top等将选定的区域调节到定位的具体位置。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册