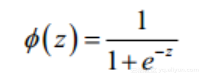首页 文章 精选 留言 我的

精选列表

搜索[Python],共10000篇文章
优秀的个人博客,低调大师

Python实现ECS自动镜像创建&镜像复制至其他地域

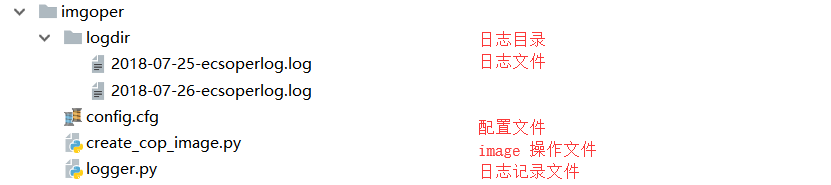
一、背景 1.1 问题: 同事反馈有可以鉴于目前几次大的公有云事故,腾讯云/阿里云两大公有云厂商尚且存在这样令人触目惊心的时刻,更何况其他厂商和我们的日常操作,有人的地方就有误操作,百分之一的风险但如果一旦发生就是100%的问题,虽SLA但或多或少存在影响,客户反馈如果阿里的A地域发生故障,例如地质灾害或不可控因素引发的ecs无法访问,用户数据都在云上无法操作情况下该如何,但考虑到不同地域灾备的高额度IT成本,想采用每天ecs的冷备。 1.2 思路: 在最大程度的降低IT成本,又想在不可控大规模地域性灾难面前做些什么,每天凌晨业务低峰期对ECS制作镜像,同时复制到其他的不同地域,如北京的镜像复制到上海,当北京整个region异常情况下,可利用复制在目标地域的ECS创建出来,在此抛砖引玉,后续可以将ecs在目标地域开出来并关机,归档删除之前的镜像,等等。同样可以将RDS备份也同样备份到异地OSS内,目前阿里已经有EBS非常方便的灾难情况下恢复RDS。利用此思路同意的适用于其他场景下。 二、代码 2.1 结构 如果多个实例可同时写入配置文件,用,进行分割。 2.2 核心代码 配置文件 # 阿里云ak配置,建议采用子账户只授权ecs镜像操作 [common] # 阿里云acccesskeyid accessKeyId = LTAIhfXlcjyln6tW # 阿里云accesssecret accessSecret = GwfAMvR4K2ELmt76184oqLTVgRfAso # log目录名称 logdir_name = logdir # log文件名称 logfile_name = ecsoperlog.log # ecs源地域配置信息段 #支持在华北 1、华北 2、华北 3、华北 5、华东 1、华东 2 和华南 1 地域之间复制镜像。涉及其他国家和地区地域时,可以 提交工单 申请 [source] # 源地域实例regionid,可以参考:https://help.aliyun.com/document_detail/40654.html?spm=a2c1g.8271268.10000.5.5f98df25B98bhJ s_RegionId = cn-shanghai # 源实例id,可指定多个用,进行分隔 s_InstanceId = i-uf661wb708uvqc9jyhem,i-uf661wb708uvqc9jyhel # 源端制作镜像name s_ImageName = api-source-image # 源镜像描述信息 s_Description = api-source-image源镜像描述信息 # 镜像复制目的地域配置信息段 [destination] # 目的地域实例regionid, d_DestinationRegionId = cn-qingdao # 复制过来的镜像名称 d_DestinationImageName = api-destination-image # 复制过来的镜像描述信息 d_DestinationDescription = api-destination-image目的镜像描述信息 image操作(制作镜像->查看镜像制作状态->复制镜像) # 创建实例生成器 def _get_Instance(self): for Instance in self.s_InstanceId_list.split(','): yield Instance def _create_image(self): """ 创建镜像 :return:返回镜像id """ s_timer = time.strftime("%Y-%m-%d-%H:%M", time.localtime(time.time())) request = CreateImageRequest.CreateImageRequest() request.set_accept_format('json') request.add_query_param('RegionId', self.s_RegionId) request.add_query_param('InstanceId', self.s_InstanceId) request.add_query_param('ImageName', self.s_ImageName + s_timer) request.add_query_param('Description', self.s_Description + s_timer) response = self.ecshelper.do_action_with_exception(request) self.logoper.info('创建镜像任务已提交,镜像id:%s' % json.loads(response)["ImageId"]) print('创建镜像任务已提交,镜像id:%s' % json.loads(response)["ImageId"]) return json.loads(response)["ImageId"] def _describe_image(self,imageid): """ 查询image状态 :param imageid: :return: """ request = DescribeImagesRequest.DescribeImagesRequest() request.set_accept_format('json') request.add_query_param('RegionId', self.s_RegionId) request.add_query_param('ImageId', imageid) response = self.ecshelper.do_action_with_exception(request) # 进度 json.loads(response)['Images']['Image'][0]['Progress'] self.logoper.info('镜像创建进度:%s' %json.loads(response)['Images']['Image'][0]['Progress']) # 镜像状态 return json.loads(response)['Images']['Image'][0]['Status'] #镜像复制 def _copy_image(self,imageid): """ 镜像复制 :param imageid:源镜像id :return: 复制成功后的镜像id """ flag = True while flag: try: if self._describe_image(imageid) == 'Available': flag = False else: time.sleep(300) except Exception as e: pass print('镜像已经创建完成') d_timer = time.strftime("%Y-%m-%d-%H:%M", time.localtime(time.time())) request = CopyImageRequest.CopyImageRequest() request.set_accept_format('json') request.add_query_param('RegionId', self.s_RegionId) request.add_query_param('DestinationRegionId', self.d_DestinationRegionId) request.add_query_param('DestinationImageName', self.d_DestinationImageName + d_timer) request.add_query_param('DestinationDescription', self.d_DestinationDescription + d_timer) request.add_query_param('ImageId', imageid) response = self.ecshelper.do_action_with_exception(request) self.logoper.info('复制镜像任务已提交,镜像id:%s' % json.loads(response)['ImageId']) print('复制镜像任务已提交,镜像id:%s' % json.loads(response)['ImageId']) return json.loads(response)['ImageId'] 三、测试 3.1 查看运行结果 3.2 查看web控制台 源镜像 添加了时间戳,方便查看 目的地域镜像 3.3 查看日志 四、优化 可以后续增加对制定天数的镜像进行归档删除

优秀的个人博客,低调大师

【理论+案例实战】Python数据分析之逻辑回归(logistic regression)

逻辑回归是分类当中极为常用的手段,它属于概率型非线性回归,分为二分类和多分类的回归模型。对于二分类的logistic回归,因变量y只有“是”和“否”两个取值,记为1和0。假设在自变量x1,x2,……,xp,作用下,y取“是”的概率是p,则取“否”的概率是1-p。下面将对最为常用的二分类logistic回归模型的原理以及应用进行介绍。(不想看原理的可以直接调至后半部分,有代码演示) sigmoid函数 在logistic回归的二分类问题中,要用到的函数就是sigmoid函数。sigmoid函数非常简单,他的表达式是 因变量x取值范围是(-∞,+∞),但是sigmoid函数的值域是(0, 1)。因此不管x取什么值其对应的sigmoid函数值一定会落到(0,1)范围内。它的基本图形如下: (当z为0的时候,函数值为0.5;随着z的增大,函数值

优秀的个人博客,低调大师

Python机器学习(sklearn)——分类模型评估与调参总结(下)

21.集成方法有随机森林(random forest)和梯度提升树(gradient boosted decision tree)GBDT 随机森林中树的随机化方法有两种: (1)通过选择用于构造树的数据点构造随机森林需要确定用于构造的树的个数为了确保树与树之间的区别,对每棵树的数据进行自助采样从样本数据中有放回的多次抽取(一个样本可能被抽取多次),抽取创建的新数据集要和原数据集大小相等(数据数量相同) (2)通过选择每次划分测试集的特征在每个节点处,算法随机选择特征的一个子集,并对其中一个特征寻找最佳测试,而不是对每个节点都寻找最佳测试。使用参数max_features, 如果max_features= n_features,则每次考虑所有特征,即第二种随机性没用上当max_features较大,随机森林中每棵树都会很相似(因为采用的

优秀的个人博客,低调大师

Python机器学习(sklearn)——分类模型评估与调参总结(上)

1.如果只划分测试集和训练集 经验是75%作为训练集 sklearn中的train_test_split()默认这样划分from sklearn.model_selection import train_test_splitX_train, X_test, y_train, y_test = train_test_split() 2.通常使用sklearn中的score方法计算结果的精度(正确预测比例) 3.KNN算法有两个重要参数:邻居个数和数据点之间距离的度量方法在实践中,选择较小的邻居个数(例如3或5个)效果较好,sklearn中默认使用欧氏距离构建KNN模型速度很快,若训练集很大(特征数多或样本数多),预测速度可能较慢对于稀疏数据集(大多数特征值为0),KNN效果很不好 4.普通最小二乘法,即要求预测值和真实值均方误差最小

优秀的个人博客,低调大师

第02章节-Python3.5-JS正则详解1

1、JS 正则 (https://www.cnblogs.com/moqing/archive/2016/07/13/5665126.html) (https://www.cnblogs.com/wupeiqi/archive/2016/07/13/5602773.html) test - 判断字符串是否符合规定的正则 正则表达式写法: rep = /\d+/; /\d+/ rep.test("dsfdsjkh1243824fdsfdskjg") true rep.test("dsfdsjkhfdsfdskjg") false 在浏览器打开调试工具F12如下图: p3a1.png p1.png exec - 获取匹配的数据方法: image.png image.png JavaScript全局匹配:(var pattern = /\bJava\w*\b/g;)正则后加g text="JavaScript is more fun than Java or JavaBeans!" "JavaScript is more fun than Java or JavaBeans!" var pattern = /\bJava\w*\b/g; undefined pattern.exec(text) ["JavaScript", index: 0, input: "JavaScript is more fun than Java or JavaBeans!", groups: undefined] pattern.exec(text) ["Java", index: 28, input: "JavaScript is more fun than Java or JavaBeans!", groups: undefined] pattern.exec(text) ["JavaBeans", index: 36, input: "JavaScript is more fun than Java or JavaBeans!", groups: undefined] image.png image.png

优秀的个人博客,低调大师

纯Python实现鸢尾属植物数据集神经网络模型

尝试使用过各大公司推出的植物识别APP吗?比如微软识花、花伴侣等这些APP。当你看到一朵不知道学名的花时,只需要打开植物识别APP,拍摄一张你所想辨认的植物照片并上传,APP会自动识别出该花的品种及详细介绍,感觉手机中装了一个知识渊博的生物学家,是不是很神奇?其实,背后的原理很简单,是一个图像分类的过程,将上传的图像与手机中预存的数据集或联网数据进行匹配,将其分类到对应的类别即可。随着深度学习方法的应用,图像分类的精度越来越高,在部分数据集上已经超越了人眼的能力。 相对于传统神经网络的方法而言,深度学习方法一般对数据集规模、硬件平台有着比较高的要求,如果只是单纯的想尝试了解图像分类任务的基本流程,建议采用小数据集样本及传统的神经网络方法实现。本文将带领读者采用鸢尾属植物数据集(Iris Data Set)

优秀的个人博客,低调大师

Python---试除法求质数的三种方式对比

此三种方法都是基于试除法,即不断地尝试能否整除。比如要判断自然数 x 是否质数,就不断尝试小于 x 且大于1的自然数,只要有一个能整除,则 x 是合数;否则,x 是质数。 方式1:从 2 一直尝试到 x-1。方式2:从 2 一直尝试到 x/2。方式3:从 2 一直尝试到√x。 代码部分 import time import math def f1(x): a = [] for i in range(2, x+1): for j in range(2, i): if i % j == 0: break else: a.append(i) # print(a) def f2(x): a = [] for i in range(2, x+1): y = int(i//2+1) for j in range(2, y): if i % j == 0: break else: a.append(i) # print(a) def f3(x): a = [] for i in range(2, x+1): y = int(math.sqrt(i)+1) for j in range(2, y): if i % j == 0: break else: a.append(i) # print(a) if __name__ == '__main__': t1 = time.clock() f1(100) t2 = time.clock() print('第一种方式所用时间为{}秒'.format(t2-t1)) t3 = time.clock() f2(100) t4 = time.clock() print('第二种方式所用时间为{}秒'.format(t4-t3)) t5 = time.clock() f3(100) t6 = time.clock() print('第三种方式所用时间为{}秒'.format(t6-t5)) 运行结果 第一种方式所用时间为0.00011377787891367015秒 第二种方式所用时间为0.00010088897856798095秒 第三种方式所用时间为0.0001515556902717247秒 在计算100以内质数时三种方法的运算速度差不多,第二种似乎占据一定优势,那来看一看如果不断增大范围,三种方法的运行速度到底有多大的差别。。。。。。 三种方式差别 显而易见,在范围10000之前,三种方式差别不大,但在10000以后,他们之间的差距呈几何扩大,可得,第三种方法远远快于前两种方法 后续,还可以尝试先将偶数去除(除2以外),再来进行试除,速度一定再上一个台阶,当然求质数还有其他N种方法,比如筛法,其发明人是公元前250年左右的一位希腊大牛——埃拉托斯特尼 首先,2是公认最小的质数,所以,先把所有2的倍数去掉;然后剩下的那些大于2的数里面,最小的是3,所以3也是质数;然后把所有3的倍数都去掉,剩下的那些大于3的数里面,最小的是5,所以5也是质数...... 上述过程不断重复,就可以把某个范围内的合数全都除去(就像被筛子筛掉一样),剩下的就是质数了!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册