首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 深入理解 Sora 技术原理

OpenAI 发布的视频生成模型 Sora(https://openai.com/sora),能根据文本生成长达一分钟的高质量视频,理论上支持任意分辨率,如 1920x1080 、1080x1920 ,生成能力远超此前只能生成 25 帧 576x1024 图像的顶尖视频生成模型 Stable Video Diffusion。 一起公布的,还有一篇非常简短的技术报告,报告大致介绍了 Sora 的架构及应用场景,并未对模型的原理做过多的介绍。技术报告链接:https://openai.com/research/video-generation-models-as-world-simulators 笔者参考了大量的资料,试着深入理解 Sora 的技术原理,最终将 Sora 生成视频的原理总结成以下大致的步骤: 通过收集大量不同分辨率不同时长的视频,并对视频进行降维处理得到视频的潜在空间数据,并在潜在空间中进行文本标注与训练。 使用 DALLE3 的重标注技术,对人工标注的文本进行训练,生成能更加详细描述视频的标注信息。 视频生成时,获取随机噪声视频,通过训练的视频压缩网络,将噪声视频压缩成低维度的潜在空间数据,以便更好的处理视频数据。 将压缩后的潜在空间数据分解成空间时间补丁 Patches,这些补丁包含了视频中空间和时间的关系,并将这些补丁转为一维的 Tokens 数据。 将Tokens数据提交给经过扩散模型训练后的Transformer(DiT),利用 Transformer 的注意力机制,时刻关注文本提示词中的关键信息,结合扩散模型(Diffusion Model)对 Tokens 数据进行去噪声,并循环采样观察去噪音后的结果数据是否符合提示词的要求。 将去除噪音后的结果数据,利用视频解码器进行解码,将低维潜在空间数据还原成原始视频数据,这里可以实现不同分辨率的视频解码。 如果你不想查看冗余的细节,看到这里就可以结束了,如果你还希望了解相关的细节,可以继续往下看,可能有理解不全面的地方欢迎大家补充交流。 一、文本生成图片的流程 在理解文本生成视频的原理之前,我们可以先回顾下文本生成图片的原理,笔者的另一篇文章有做过相关介绍:AIGC 文生图原理与实践分享。 本文我们不讨论传统的通过对抗网络生成图片的方式,我们主要讨论的是基于扩散模型生成图片的方式,开源的 Stable Diffusion 就是基于 LDM,即 Latent Diffusion Model(潜在的扩展模型)实现的,另外 Stable Diffusion 通过引入 Transformer 架构实现了对提示词的支持,能够在去除图片噪音的过程中进行精确的控制。 潜在的扩散模型 Stable Diffusion 背后的技术方案被称为 Latent Diffusion Model,即潜在的扩散模型,此外 Stable Diffusion 模型在原始的 UNet 模型中加入了 Transformer 结构,这么做可谓一举两得,因为 Transformer 结构不但能提升噪声去除效果,还是实现 Prompt 控制图像内容的关键技术。 在深度学习领域中,潜在空间(Latent Space)是指模型学习到的表示数据的抽象空间。这个潜在空间通常是一个低维的向量空间,其中每个点(向量)代表着模型对输入数据的一种表示或特征。潜在空间的概念在各种生成模型和表示学习方法中被广泛应用。 以下是潜在空间对模型的作用: 数据的抽象表示: 潜在空间可以被视为对输入数据的一种抽象表示。通过学习到的潜在空间可以更好地捕捉输入数据的特征和结构,有助于模型更高效地学习和生成数据。 降维和去噪: 潜在空间通常是一个低维空间,相比原始数据空间具有更低的维度。通过将数据映射到潜在空间,可以实现数据的降维和去噪,将数据的主要特征和模式表示在更紧凑的空间中。 生成和重建: 在生成模型中,潜在空间扮演着重要角色,可以在潜在空间中生成新的数据样本。模型可以从潜在空间中采样并解码生成具有逼真特征的数据样本,这种生成过程通常通过解码器(Decoder)实现。 插值和操作: 在潜在空间中,向量表示不同的数据特征或属性,可以通过向量之间的插值或操作来探索数据空间中的变化和关系。例如,通过在潜在空间中沿着不同方向移动向量,可以观察到在数据生成过程中对应的变化。 扩散模型的一个大概的过程可以描述为:对原始图片不断的加噪音可以得到一张噪声图,然后再对噪声图不断的去除噪音的同时再添加其他信息,就可以得到一张新图片。 Stable Diffusion 生成图片的大致流程如下: Stable Diffusion 使用一个新颖的文本编码器(OpenCLIP),将文本输入转换为一个向量表示。这个向量表示可以捕捉文本的语义信息,并与图像空间对齐。 Stable Diffusion 使用一个扩散模型(Diffusion Model),将一个随机噪声图像逐渐变换为目标图像。扩散模型是一种生成模型,可以从训练数据中学习出一个概率分布,并从中采样出新的数据。 在扩散过程中,Stable Diffusion 利用文本向量和噪声图像作为条件输入,给出每一步变换的概率分布。这样,Stable Diffusion 可以根据文本指导噪声图像向目标图像收敛,并保持图像的清晰度和连贯性。 最后,Stable Diffusion 使用一个超分辨率放大器(Upscaler Diffusion Model),将生成的低分辨率图像放大到更高的分辨率。超分辨率放大器也是一个扩散模型,可以从低分辨率图像中恢复出细节信息,并增强图像质量。 以下是 Latent Diffusion 模型的技术架构: Latent Diffusion Models 整体框架如图,首先需要训练好一个自编码模型(AutoEncoder,包括一个编码器 ε 和一个解码器 δ )。这样一来,我们就可以利用编码器对图片进行压缩,然后在潜在表示空间上做 Diffusion 操作,最后我们再用解码器恢复到原始像素空间即可,论文将这个方法称之为感知压缩(Perceptual Compression)。个人认为这种将高维特征压缩到低维,然后在低维空间上进行操作的方法具有普适性,可以很容易推广到文本、音频、视频等领域。 在潜在表示空间上做 Diffusion 操作其主要过程和标准的扩散模型没有太大的区别,所用到的扩散模型的具体实现为 Time-Conditional UNet。但是有一个重要的地方是论文为 Diffusion 操作引入了条件机制(Conditioning Mechanisms),通过 Cross-Attention 的方式来实现多模态训练,使得条件图片生成任务也可以实现。 https://github.com/CompVis/latent-diffusion Transformer架构 Transformer 架构是 2017 年 6 月由 Google 提出的,是一种基于自注意力机制(Self-Attention)的模型,它有效解决了 RNN 类方法的并行计算和长时依赖两大痛点。原本研究的重点是翻译任务,随后推出了几个有影响力的模型,以下是 Transformer 模型简短历史中的一些关键节点: Transformer 的架构设计如下图所示: 第一张图是 Transformers 架构的一个简单表示形式,第二张图是 Transformers 架构的一个完整表示形式,其中有一个重要的 Multi-Head Attention组件,称为注意力层。 Transformer 模型的一个关键特性是注意力层。事实上,谷歌在发布 Transformer 架构的论文时,文章的标题就是“注意力就是你所需要的”。注意力层将告诉模型在处理每个单词的表示时,要特别重视传递给它的句子中的某些单词,也可以是或多或少地忽略其他单词。通过注意力层,模型可以不断修正自己处理的结果,以符合输入的文本的意图。 总结来说 Transformer 通过注意力层,来理解并观察输入文本的上下文,在 Decoder 的过程中,通过多头注意力层来控制结果的输出是符合上下文语境的。 可以参考下面这篇文章,更详细的了解 Transformer 的实现原理: https://jalammar.github.io/illustrated-transformer/ 在回顾完 Stable Diffusion 的原理后,我们可以想象下,对于视频的生成该怎么做呢? 是否可以尝试把预训练 Stable Diffusion 拓展成视频生成模型呢。例如在拓展时,将视频的每一帧都单独输入进 Stable Diffusion 的自编码器,再重新构成一个压缩过的图像序列。这就是 VideoLDM 尝试解决的问题,然而经过 VideoLDM 研究发现直接对视频使用之前的图像自编码器,会令输出视频出现闪烁的现象。为此,该工作对自编码器的解码器进行了微调,加入了一些能够处理时间维度的模块,使之能一次性处理整段压缩视频,并输出连贯的真实视频。 二、Sora生成视频的流程 那 Sora 是怎么做的呢?接下来我们通过一张图来了解下 Sora 的工作流程,大概可以简化为三个部分: 简单来说,Sora 就是依赖了两个模型 Latent Diffusion Model (LDM) 加上 Diffusion Transformer (DiT)。我们先简要回顾一下这两种模型架构。 LDM 就是 Stable Diffusion 使用的模型架构。扩散模型的一大问题是计算需求大,难以拟合高分辨率图像。为了解决这一问题,实现 LDM 时,会先训练一个几乎能无损压缩图像的自编码器,能把 512x512 的真实图像压缩成 64x64 的压缩图像并还原。接着,再训练一个扩散模型去拟合分辨率更低的压缩图像。这样,仅需少量计算资源就能训练出高分辨率的图像生成模型。 LDM 的扩散模型使用的模型是 U-Net。而根据其他深度学习任务中的经验,相比 U-Net,Transformer 架构的参数可拓展性强,即随着参数量的增加,Transformer 架构的性能提升会更加明显。这也是为什么大模型普遍都采用了 Transformer 架构。从这一动机出发,DiT 应运而生。DiT 在 LDM 的基础上,把 U-Net 换成了 Transformer。 总结来说 Sora 是一个视频版的 DiT 模型,让我们看一下 Sora 在 DiT 上做了哪些改进。 视频压缩网络 首先,Sora 通过一个叫做“视频压缩网络”的技术,将输入的图片或视频压缩成一个更低维度的数据,即潜在空间数据,为了实现视频压缩,Sora 从头训练了一套能直接压缩视频的自编码器。相比之前的工作,Sora 的自编码器不仅能在空间上压缩图像,还能在时间上压缩视频长度。 输入的视频在经过 Sora 的自编码器后,会被转换成一段空间和时间维度上都变小的压缩视频。这段压缩视频就是 Sora 的 DiT 的拟合对象。 这一过程类似于将不同尺寸和分辨率的照片“标准化”,便于处理和存储,但压缩并不意味着忽略原始数据的独特性,而是将它们转换成一个对 Sora 来说更容易理解和操作的格式。 报告中反复提及,Sora 在训练和生成时使用的视频可以是任何分辨率(在 1920x1080 以内)、任何长宽比、任何时长的,这意味着视频训练数据不需要做缩放、裁剪等预处理,因为 Sora 会把这些视频进行压缩以获得符合模型训练的数据。 空间时间补丁 接下来,Sora 将这些压缩后的数据进一步分解为“空间时间补丁”(Spacetime Patches),这些补丁可以看作是视觉内容的基本构建块,例如照片可以分解为包含独特景观、颜色和纹理的小片段。这样不管原始视频的长度、分辨率或风格如何,Sora 都可以将它们处理成一致的格式。 有了空间时间补丁之后,还需要将这些补丁转换成一维的数据序列,以便提供给 Transformer 模型进行处理,因为 Transformer 只能处理一维序列数据。 Sora 的这种性质还是得益于 Transformer 架构。虽然 Transformer 的计算与输入顺序无关,但必须用位置编码来指明每个数据的位置。尽管报告没有提及,我觉得 Sora 的 DiT 使用了类似于 (x,y,t) 的位置编码来表示一个图块的时空位置。这样不管输入的视频的大小如何,长度如何,只要给每个图块都分配一个位置编码,DiT 就能分清图块间的相对关系了。 Diffusion Transformer 最后,Sora 扩展了 Transformer 模型,以便适用于视频生成,这里的视频就是一帧帧的静态图片加上了时间维度的信息,所以只需要用 Transformer 模型来生成携带时间维度信息的图片。 需要注意的是,Transformer 本来是用于文本任务的,它只能处理一维的序列数据。为了让 Transformer 处理二维图像,通常会把输入图像先切成边长为 p 的图块,再把每个图块整理成一维数据。也就是说,原来边长为 I 的正方形图片,经图块化后,变成了长度为 (I/p)² 的一维序列数据。 DiT 在处理输入图块(也就是空间时间补丁)时,因为每个视频图块被编上了类似 (x,y,t) 这样的位置编码,输入视频可以是任何分辨率、任何长度。将每个空间时间补丁输入 Transformer,作为输入的 Token,接着 Transformer 会完成每个空间时间补丁的噪声去除,最后所有的空间时间补丁都完成噪声去除后,再通过解码器将 Transformer 处理后的张量数据还原成视频数据。 下图展示了 DiT 的架构,左:我们训练调节的潜 DiT 模型。输入潜变量被分解成几个 Patch 并由几个 DiT 块处理。右:DiT 块的细节。我们对标准 Transformer 的变体进行了实验,这些变体通过自适应层归一化、交叉注意力和额外的输入 Token 做调节。自适应层归一化效果最好。 假设输入是一张 256x256x3 的图片,对图片做 Patch 后经过投影得到每个 Patch 的 Token,得到 32x32x4 的 Latent 潜在空间(在推理时输入直接是 32x32x4 的噪声)。结合当前的 Step t, 将 Label y 作为输入, 经过 N 个 DiT Block 处理,处理中通过 MLP 进行控制输出,得到输出的噪声以及对应的协方差矩阵,经过 T 个 Step 采样,得到 32x32x4 的降噪后的 Latent。 得到处理后的 Latent 之后,通过 Visual Decoder 对 Latent 进行解码,最终得到生成的视频。 三、从训练到生成视频全流程 视频标注与训练 收集视频及其文本标注 初始步骤是收集大量视频数据,并获取或创建这些视频对应的文本标注。这些文本简要描述了视频内容,是训练模型理解视频主题的关键。 预处理视频数据 对视频进行预处理,包括调整分辨率、格式转换、裁剪长度等,以确保数据格式统一,适合模型处理。 生成高度描述性的文本标注 使用 DALLE3 的技术,首先训练一个模型,这个模型专门用于为视频内容生成高度描述性的文本标注。这一步是为了提升文本标注的质量,让其更加详细和具体。对训练集中的所有视频应用这个模型,产生新的、更加详细的文本标注。 之前大部分文生图扩散模型都是在人工标注的图片-文字数据集上训练的。后来大家发现,人工标注的图片描述质量较低,纷纷提出了各种提升标注质量的方法。Sora 复用了自家 DALL·E 3 的重标注技术,用一个训练的能生成详细描述的标注器来重新为训练视频生成标注。这种做法不仅解决了视频缺乏标注的问题,且相比人工标注质量更高。Sora 的部分结果展示了其强大了抽象理解能力(如理解人和猫之间的交互),这多半是因为视频标注模型足够强大,视频生成模型学到了视频标注模型的知识。但同样,视频标注模型的相关细节完全没有公开。 扩散模型训练 Sora 作为一个扩散模型,通过预测从含噪声补丁到原始清晰补丁的转换过程进行训练。这个过程涉及到大量的迭代,逐步提高生成视频的质量。 视频生成与处理 视频压缩和空间时间补丁生成 开发并训练一个视频压缩网络,将高维的视频数据压缩到一个低维的潜在空间,简化后的数据表示更容易被模型处理。将压缩后的视频表示分解成空间时间补丁,这些补丁既包含空间上的信息也包含随时间变化的信息。 利用 Transformer 架构处理时空关系 基于 Transformer 架构,处理这些空间时间补丁。由于 Transformer 架构在处理序列数据(如文本)方面的强大能力,这里用于捕获视频补丁之间复杂的时空关系。 通过 GPT 模型理解并优化提示词 类似于 DALLE3,Sora 在处理用户提供的文本提示时,也可以利用 GPT 模型来扩展或优化这些提示。GPT 模型可以将简短的用户提示转化成更详细、更富有描述性的文本,这有助于 Sora 更准确地理解并生成符合用户意图的视频。 利用扩散模型生成视频 用户提供一个文本提示,Sora 根据这个提示在潜在空间中初始化视频的生成过程。利用训练好的扩散模型,Sora 从这些初始化的空间时间补丁开始,逐步生成清晰的视频内容。 视频解码与处理 使用与视频压缩相对应的解码器将潜在空间中的视频转换回原始像素视频。 对生成的视频进行可能的后处理,如调整分辨率、裁剪等,以满足发布或展示的需求。 参考文档:https://openai.com/research/video-generation-models-as-world-simulators https://zhuanlan.zhihu.com/p/583124756 https://mp.weixin.qq.com/s/Prn1G_EpXvnM4me9a_SPBw https://mp.weixin.qq.com/s/KUnXlDlg-Rs_6D5RFpQbnQ *文/逅弈 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | 万字带你了解 ChatGLM

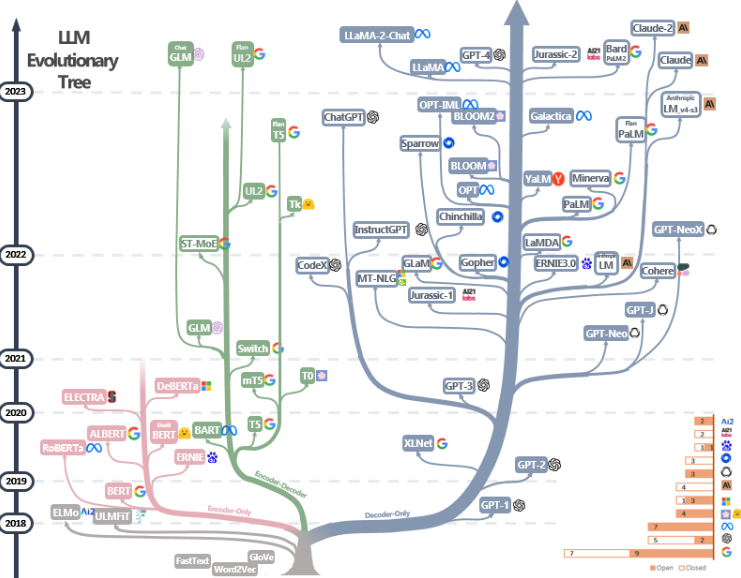
本文分享自华为云社区《【云驻共创】华为云之昇思MindSpore大模型专题(第二期)-第一课:ChatGLM》,作者: 愚公搬代码。 前言 1.昇思MindSpore 昇思MindSpore是华为公司推出的一款全场景AI计算框架。它提供了自动微分、分布式训练和推理、模型部署等功能,支持多种硬件平台,包括CPU、GPU和Ascend AI 处理器。MindSpore采用图和算子相结合的编程模型,能够高效地处理复杂的深度学习任务。它具有灵活的设计、高效的性能和易于使用的接口,使开发者能够更快地开发和部署AI应用。MindSpore还支持自定义操作和算法,可以满足不同场景下的需求。 2.大模型 大模型是指具有数百万到数十亿个参数的深度学习模型。这些模型通常用于处理大规模数据集,并能够在各种任务上取得出色的性能。大模型通常需要大量的计算资源进行训练,并且需要更长的时间来收敛。然而,由于其具有更多的参数,大模型可以更好地捕捉数据中的复杂关系,从而提升模型的预测性能。大模型的应用范围非常广泛,包括自然语言处理、计算机视觉、语音识别等领域。 3.ChatGLM ChatGLM是一种生成式语言模型,用于聊天和对话任务。它是基于OpenAI的GPT模型框架构建的,采用了大规模的预训练数据集来学习语言模式和生成文本的能力。ChatGLM可以理解上下文并生成连贯、自然的回复。它可以用于构建对话系统、智能客服、聊天机器人等应用,能够提供更加交互性和人性化的对话体验。ChatGLM模型的训练和优化过程需要大量的计算资源和数据,而且模型的生成性质也需要进行适当的监督和过滤,以确保生成的回复符合预期的行为准则和标准。 一、GLM Model Architecture 1.Evolution Tree of LLMs Evolution Tree of LLMs(Language Model Megasuite的演化树)是指由OpenAI发布的一系列语言模型的历史和演化关系图。 OpenAI的LLMs系列是一系列基于深度学习的语言模型,旨在生成人类语言的自然文本。这些模型中的每一个都是通过对大量文本进行训练而得到的,可以用于自动回答问题、生成文章、翻译文本等自然语言处理任务。 Evolution Tree of LLMs图中展示了这些模型的发展历程。从最早的模型开始,每个后续模型都是在前一个模型的基础上进行改进和扩展。这些改进可能涉及模型的规模增加、训练数据的增加、架构的改进等。通过不断地改进和提升模型,OpenAI致力于推动语言模型的发展,使其在各种自然语言处理任务上表现更加出色。 Evolution Tree of LLMs图不仅展示了各个模型之间的关系,还反映了OpenAI在不同时间点的研究重点和技术进展。这个图可以帮助研究人员和开发者了解LLMs系列的发展历程,从而更好地理解和应用这些语言模型。 2.Autoregressive Blank Infilling 2.1 Autoregressive、Autoencoding、Encoder-Decoder “Autoregressive”、"Autoencoding"和"Encoder-Decoder"是三种常见的神经网络模型结构,用于处理序列数据或生成模型。 Autoregressive(自回归)模型是一种生成模型,它将序列数据的生成建模为一个逐步预测每个元素的条件概率的过程。在每个时间步,模型根据之前生成的元素预测当前元素的概率分布。常见的Autoregressive模型包括语言模型,如OpenAI GPT模型,它可以生成与输入序列相似的新文本。 Autoencoding(自编码)模型是一类无监督学习方法,用于学习输入数据的紧凑表示。它由一个编码器和一个解码器组成。编码器将输入数据映射到低维表示,解码器将该低维表示恢复到原始数据空间。Autoencoding模型的目标是尽可能准确地重建输入数据,同时学习到有用的特征表示。常见的Autoencoding模型包括Variational Autoencoder (VAE)和Denoising Autoencoder。 Encoder-Decoder(编码器-解码器)模型是一种常用的序列到序列(Sequence-to-Sequence)模型,用于处理输入和输出都是序列数据的任务。它由两个部分组成:编码器和解码器。编码器将输入序列映射为固定大小的向量表示,解码器使用该向量表示生成输出序列。Encoder-Decoder模型可以在不同长度的输入和输出序列之间进行转换,例如机器翻译和文本摘要等任务。 GLM(自回归填空)模型是一种灵活且多样化的语言模型,可以根据给定的上下文生成缺失的部分内容。根据已知的部分文本内容生成可能的填空内容。它可以用于自动文本补全、问答系统、语义理解和生成等多个自然语言处理任务中。 2.1 OpenAI GPT系列模型 自然语言处理领域的GPT(Generative Pre-trained Transformer)系列模型是由OpenAI开发的一系列强大的自然语言处理模型。下面是GPT系列模型的发展历程: GPT-1: GPT模型是于2018年发布的第一代模型。它使用了Transformer架构,预训练了一个大规模的语言模型,并使用无标签的文本数据进行模型训练。这个模型的特点是生成连贯的文本,能够完成一些基础的自然语言处理任务,如语言模型、文本分类和文本生成等。 GPT-2: 在2019年,OpenAI发布了GPT-2模型作为GPT的后续版本。GPT-2模型采用了更大的预训练模型,使用无标签的互联网文本进行训练。这个模型在生成文本方面取得了突破性的进展,可以生成高质量、连贯的文本,使得生成的文本内容更具有逼真性。由于考虑到模型被滥用可能带来的风险,OpenAI最初限制了GPT-2的访问,并未发布完整的模型。 GPT-3: GPT-3是在2020年发布的GPT系列的第三代模型。参数量达到了1750亿个,训练了十几万小时。GPT-3在文本生成、文本补全、问答系统等任务上表现出色,其生成的文本能够接近人类水平的表达能力。GPT-3还可以通过提供一些文本提示来理解并回答问题,具有较强的语言理解和推理能力。 GPT-4:在2023年,OpenAI发布了GPT-4,这是GPT系列的第四个模型。GPT-4比GPT-3系列大得多,具有1.8万亿个参数,而GPT-3只有1750亿个参数。GPT4是一种多模态模型,而GPT3系列是一种自然语言处理模型。自然语言模型只能听或看懂语言,而多模态模型可以处理多种媒体数据,并且将他们整合到统一的语义空间之中。GPT4可接收的文字输入长度达到了惊人的32000字,而GPT3系列,只能输入3000字。 2.3 Autoregressive Blank Infilling Autoregressive Blank Infilling(ABI)是一种用于填充时间序列数据中缺失值的方法。在时间序列数据中,由于种种原因,可能会存在一些缺失值,这些缺失值会影响数据的完整性和准确性。ABI方法通过基于自回归模型,利用其他已有的数据来预测并填补缺失值。 ABI方法的基本思想是根据时间序列数据的自相关性,使用已有的数据点来逐个预测缺失值。具体来说,ABI方法使用AR模型(自回归模型)来建模时间序列数据中的缺失值和非缺失值之间的关系。然后,根据该模型,利用其他已有的数据点来预测缺失值的数值。 ABI方法在填充缺失值时,通常还会考虑一些其他因素,如数据的趋势、季节性和周期性等。通过综合考虑这些因素,ABI方法能够更准确地填充缺失值,从而提高数据的完整性和可靠性。 案例片段介绍如下: 顺序分为A部分和B部分: A部分:带掩码跨度的序列 B部分:在A部分中被掩盖的原始跨度 如果多个跨度被遮罩,它们将在B部分中被打乱 B部分中的每个跨度都以[S]作为输入,以[E]作为输出。 该模型自回归生成B部分——它基于前一部分预测下一个令牌。 A部分可以自行处理,但不能处理B部分 B部分可以关注A及其在B中的经历 2.4 Multi-Task Pretraining Multi-Task Pretraining是一种多任务预训练的方法。在传统的预训练方法中,语言模型通过在大规模文本数据上进行训练来学习语言的通用模式和表示。然而,在Multi-Task Pretraining中,模型同时在多个任务上进行训练,这些任务需要不同类型的语言理解能力。 Multi-Task Pretraining的思想是通过在多个任务上训练语言模型,可以学习到更加通用和鲁棒的语言表示。这是因为不同的任务需要不同的语言技能,如句法分析、语义理解或文档级连贯性。通过让模型接触多样化的任务,它可以学习捕捉不同任务之间的共同语言模式,并利用这些模式更好地泛化到新任务上。 Multi-Task Pretraining已被证明可以提高语言模型在下游任务上的性能。例如,预训练在多个任务上的模型在各种自然语言处理基准测试中取得了最先进的结果,如问答、文本分类和命名实体识别。 其中一种常见的Multi-Task Pretraining方法是基于Transformer的模型,如BERT(双向编码器表示来自Transformer的方法)和RoBERTa(经过优化的鲁棒BERT方法)。这些模型在掩码语言建模、下一个句子预测和其他辅助任务上进行预训练。 案例片段介绍如下: 通过改变遮盖内容的长度和数量,从而使模型能够基于natural language understanding, conditional generation, unconditional generation三类任务进行预训练,实现“三合一” 改变缺失跨度的数量和长度: 2.5 Finetuning Finetuning是指在预训练的基础上,将模型进一步调整和优化以适应特定任务或特定数据集的过程。在机器学习中,预训练模型通常在大规模的数据上进行训练,学习到通用的模式和特征表示。然而,这些预训练模型可能不直接适用于特定的任务或数据集。 通过Finetuning,可以利用预训练模型的通用知识和特征表示来快速适应特定的任务或数据集。这通常涉及解冻预训练模型的一部分或全部层,并在目标任务上进行进一步的训练。通过在目标任务上微调模型参数,可以使其更好地适应任务的特定要求和数据特征。 Finetuning的过程通常包括以下步骤: 选择预训练模型:选择与目标任务相匹配的预训练模型,如BERT或GPT等。 初始化参数:将预训练模型加载到模型中,并冻结所有或部分层的参数。 构建任务特定层:根据目标任务的需求,构建一个或多个任务特定的层。 训练:使用目标任务的数据集,通过反向传播和梯度下降等优化算法,更新模型的参数。 调整超参数:对模型进行验证和评估,并根据结果调整超参数,如学习率、批大小等。 重复迭代:根据需要,多次迭代训练和调整模型,直到达到满意的性能。 Finetuning可以大大减少在特定任务上的训练时间和样本需求,同时利用预训练模型的知识提供了更好的初始参数和特征表示。它已经被广泛应用于自然语言处理、计算机视觉和其他领域中的许多任务,如文本分类、问答、命名实体识别等。 案例片段介绍如下: GLM将NLG和NLU类下游任务统一为完型填空的生成式任务,如对于分类任务,将输入x写成一个填空问题c(x),后将生成的答案v(y)映射至标签y 2.6 LLM Reversal Curse LLM(Large Language Model)是指一种非常大的语言模型,它由数十亿个参数组成,具有强大的语言理解和生成能力。大模型LLM可以实现诸如问答、摘要、对话生成等任务,被广泛应用于自然语言处理领域。 LLM Reversal Curse(逆转诅咒)是指在使用大模型LLM进行任务生成时,其生成结果出现明显的逆转或反转现象。具体而言,当模型用于生成某个任务的结果时,相比原始输入,生成的结果可能会出现与原始意图相反的内容或表达。 例如,在问答任务中,当用户提出一个问题时,大模型LLM应该生成一个准确且与问题相符的答案。然而,由于模型的复杂性和训练数据的特点,有时候模型会出现生成与问题相反甚至荒谬的答案的情况。 这种逆转诅咒可能是由于模型在训练过程中接触到了大量的噪声数据、错误标注的数据或具有偏见的数据,导致模型在生成过程中出现了一些意料之外的结果。 为了解决大模型LLM的逆转诅咒问题,需要进一步优化模型的训练数据、标注过程和生成算法,以提高模型的生成质量和准确性。 案例片段介绍如下: 3. 2D Positional Encoding 2D positional encoding是一种将2D网格或图像中元素的位置信息进行编码的技术。位置编码通常在自然语言处理任务中使用,例如机器翻译或语言建模,来表示句子中单词的顺序或位置。然而,它也可以应用于2D网格或图像。 对于2D网格或图像,位置编码可以用于编码每个元素的空间位置。这样,模型可以有一种对元素之间的相对位置的感知,并捕捉它们之间的空间关系。 一个常见的2D位置编码的方法是使用不同频率的正弦和余弦函数。其思想是创建一个根据网格或图像内位置而变化的正弦信号。然后将这个位置编码作为每个元素在网格或图像中的额外输入或特征。 位置编码可以使用以下公式定义: PE(x,2i) = sin(x / (10000^(2i / d_model))) PE(x,2i+1) = cos(x / (10000^(2i / d_model))) 其中,PE(x, i)表示位置i处元素x的位置编码,d_model是模型的维度。 通过使用正弦和余弦函数的不同频率,位置编码可以捕捉位置信息中的不同模式或关系。 案例片段介绍如下: 模型输入的position ids分为两种,从而使得模型可以学习到片段生成的长度 Position 1: Part A中token的绝对位置 Part A:从1开始排列 Part B:每一个span对应Part A中[MASK]的位置 Position 2:intra-span position,masked span内部的相对位置 Part A:0 Part B:每个span的token从1开始排列 3.1 大模型训练最大挑战:训练稳定性 权衡利弊:训练稳定性(高精度低效)还是训练效率(低精度高效) 目前已开源训练过程大模型的解决方案 FB OPT-175B:训练崩溃时反复调整学习率/跳过数据(权宜之计,损失性能) HF BLOOM 176B:embedding norm和BF16(损失性能,有限适配平台) 3.2 GLM-130B:稳定训练方法 GLM-130B是一个稳定训练方法,它是机器学习中的一种算法。GLM代表广义线性模型,130B表示这个算法的特定版本。 稳定训练方法是指通过一定的技巧和策略来增强模型的稳定性和鲁棒性,使其能够更好地处理噪声和异常数据。在训练过程中,稳定训练方法会对输入样本或特征进行一些改变或调整,以减少模型对于噪声的敏感性。 GLM-130B的稳定训练方法可能包括以下几个方面: 数据预处理:对输入数据进行去噪、归一化、特征选择等预处理操作,以减少噪声对模型训练的影响。 正则化:通过添加正则化项来限制模型的复杂度,防止过拟合,提高模型的泛化能力。 异常值处理:通过识别和处理异常值,减少它们对模型训练的影响。 随机化:引入随机化因素,如随机选择样本、随机初始化参数等,以增加模型的稳定性和抗噪能力。 交叉验证:使用交叉验证来评估模型的性能,并选择最佳的参数配置,避免对特定数据集过拟合。 集成学习:通过集成多个模型的预测结果,综合考虑它们的意见,提高整体模型的性能和稳定性。 案例片段介绍如下: Attention score 层:Softmax in 32 避免上下溢出 调小 Embedding 层梯度,缓解前期梯度爆炸问题 word_embedding = word_embedding * alpha + word_embedding .detach() * (1 ‒ alpha) 3.2 GLM-130B:大量实验确定最优架构 有时候需要进行多次实验来确定最佳的架构设计。这些实验可能包括调整不同的参数、添加或移除不同的组件,以及测试不同的配置选项。GLM-130B是根据这些实验的结果和分析,确定出的最佳架构。 案例片段介绍如下: DeepNorm:稳定训练 1000 层 Post-LN 的方法 旋转位置编码(RoPE):适用于 GLM 的相对位置编码 门控注意单元(GLU):FFN 层的替换,稳定提升模型性能 3.3 Post LayerNorm Post LayerNorm(后层归一化)是一种神经网络层归一化的方法,用于解决深层神经网络中梯度消失和梯度爆炸问题。传统的 LayerNorm(层归一化)是在每个神经网络层的输入上进行归一化操作,而 Post LayerNorm 是在每个神经网络层的输出上进行归一化操作。 具体来说,在每个神经网络层的输入和激活函数之间,先进行 LayerNorm 的归一化操作,然后再进行激活函数的计算。这样可以使得每个神经网络层的输出都在相似的尺度上,避免了梯度消失和梯度爆炸的问题。 与之相比,传统的 LayerNorm 在每个神经网络层的输入上进行归一化操作,但在深层网络中,由于每层的输入分布不稳定,因此归一化操作的效果可能会下降。而 Post LayerNorm 能够在每个神经网络层的输出上进行归一化操作,保证了归一化的效果,提高了网络的稳定性和训练效果。 Post LayerNorm 是在 Transformer 网络中被提出的,并在各个任务上取得了显著的性能提升。它被认为是一种更加有效和稳定的归一化方法,在大规模深层网络的训练中具有重要的作用。 案例片段介绍如下: 重新排列层规范化和剩余连接的顺序 3.4 GLU GLU(Gated Linear Unit)是一种门控线性单元,用于增强神经网络的表示能力。通过将GLU应用于MindSpore框架中的大型模型,可以进一步提升模型的性能和效果。 GLU的核心思想是将输入进行分割成两部分,然后通过门控机制控制两部分的信息传递。这种门控机制可以帮助模型更好地理解输入数据中的相关性,从而提高模型的表达能力和泛化能力。 在MindSpore框架中,GLU可以被用于各种任务,包括自然语言处理、计算机视觉和语音识别等。通过使用MindSpore大模型GLU,研究人员和开发人员可以更轻松地构建和训练复杂的模型,并获得更好的结果。 案例片段介绍如下: 用GeLU替换ReLU激活 3.5 并行策略:高效训练千亿模型 存下 GPT-3 模型需要 2.8T 显存存放训练状态 + 中间激活函数值 挑战:远超单卡显存(40GB),采取何种并行方式高效训练? 采用 ZeRO 优化器在数据并行组内分摊优化器状态 → ~25% 远超单卡显存,如何高效训练? 模型并行:将模型参数分布到多个 GPU 上 张量并行:切分参数矩阵,每 GPU 计算一部分 → 额外通信,降低计算粒度 流水线并行:将网络分成多段并行 → 引入流水线气泡 ZeRO-3:将参数分布到数据并行组中,算之前先取回参数 → 额外通信时间 分析:流水线的气泡占比: 𝑛⁄𝑡 $ 1 ,n / t << 4m 的时候可以忽略不计 并行策略:张量并行随着模型规模增大缓慢扩展,但不超过单机规模( <=8),其余全部使用流水线并行,通过调整微批处理大小减少气泡占比 其他优化 算子融合:融合多个 element-wise 算子 → 提升 ~10% 计算速度 流水线平衡:流水线首尾阶段各少放置一个层平衡占用 → 节省 ~10% 显存 跨平台兼容:swDeepSpeed 训练库  与 DeepSpeed API 兼容 支持申威架构,一行代码无缝替换兼容 实现并行通信策略,混合精度策略,ZeRO 优化器 同一套训练框架可在三个集群上对齐训练曲线 import swDeepSpeed as deepspeed model, optimizer, _, _ = deepspeed.initialize( model=model, model_parameters=param_groups, args=args, mpu=mpu, dist_init_required=False, config_params=config_params ) 测试集群配置: A100 集群(A100): 96 台 DGX-A100,每台 2 张 200GB IB 网卡 硬件差异性大 海光GPU(Hygon):3000 台机器,每台 4 张 DCU 加速卡、4 张 50G IB 网卡 申威处理器(Sunway):8192 个节点,每节点一块 SW26010-PRO 处理器 训练 GPT-3 175B 规模的模型,按照相同的 300B 单词量估计训练时间: 4.Rotary Positional Embedding 4.1 Introduction of Positional Embedding Positional Embedding(位置编码)是一种用于处理序列数据的技术,主要应用于自然语言处理(NLP)任务中。在序列数据中,单词的顺序和位置对于语义的理解非常重要。位置编码的目的是为了将单词的位置信息融入到模型的表示中,使得模型能够更好地理解单词的顺序和上下文关系。 传统的词向量表示只考虑了单词的语义信息,而没有考虑单词的位置。位置编码通过为每个单词分配一个唯一的位置向量来解决这个问题。常用的位置编码方法包括相对位置编码、绝对位置编码、正弦位置编码等。 在相对位置编码中,每个单词的位置编码是相对于其他单词的位置差异而得到的。绝对位置编码则是将每个单词的位置映射为一个唯一的位置向量。正弦位置编码是一种常用的绝对位置编码方法,通过使用正弦和余弦函数来生成位置向量,从而捕捉到不同位置之间的相对关系。 位置编码的作用是为模型提供位置信息,帮助模型在处理序列数据时更好地理解单词的上下文和关系。它通常与注意力机制和Transformer等模型结构一起使用,为模型提供更丰富的上下文信息。 案例片段介绍如下: 自注意力机制主要关注词语之间的相互关系,在计算中,根据词语之间的语义关系来计算注意力分数,并不会考虑词语之间的位置关系。 即使打乱序列中词语的顺序,依旧会得到相同的语义表达因此需要额外增加位置信息。 The dog chased the pig. = The pig chased the dog. = chased pig The the dog. 位置信息的表示有很多种,如 absolute positional embeddings: 原理:对于第k个位置的向量xk,添加位置向量pk(仅依赖于位置编号k),得到xk+pk 举例/应用模型:sinusoidal positional embedding(Transformer)、learned absolute positional embedding(BERT/RoBERTa/GPT) relative positional embeddings: 原理:对于第m个和第n个位置的向量xm、xn,将相对位置m-n的信息添加到self-attention matrix中 举例/应用模型:T5 rotary positional embeddings 原理:使用旋转矩阵对绝对位置进行编码,并同时在自注意力公式中引入了显式的相对位置依赖。 举例/应用模型:PaLM/GPT-Neo/GPT-J/LLaMa1&2/ChatGLM1&2 4.2 Sinusoidal Positional Embedding Sinusoidal Positional Embedding(正弦位置编码)是一种用于编码序列数据中单词位置信息的方法,最初在Transformer模型中被引入。它是一种绝对位置编码方法,通过正弦和余弦函数来生成位置向量,从而捕捉到不同位置之间的相对关系。 在正弦位置编码中,每个单词的位置编码由两个维度的正弦和余弦函数计算得到。具体计算公式如下: PE(pos,2i) = sin(pos / 10000^(2i/d_model)) PE(pos,2i+1) = cos(pos / 10000^(2i/d_model)) 其中,pos表示单词在序列中的位置,i表示位置向量的维度索引,d_model表示模型的维度。这样,每个单词的位置编码可以由位置索引pos和维度索引i计算得到。 正弦位置编码的特点是,不同位置之间的位置向量是正弦和余弦函数的周期函数。这使得不同位置之间的位置向量能够保持一定的相似性,从而帮助模型更好地理解位置信息并捕捉到序列中的顺序关系。 正弦位置编码通常与注意力机制和Transformer模型一起使用,用于为模型提供序列数据的位置信息。它的优点是简单且可解释,能够有效地表达不同位置之间的相对关系。 案例片段介绍如下: 通过sine和cosine函数计算每个位置的positional embedding 优点:1. 可以反应相对位置信息;2. 模型可以接受不同长度的输入 缺点:数值为固定值,无法参与学习 PE(pos, 2i)=sin(pos/10000^2i/d_model) PE(pos, 2i+1)=cos⁡(pos/10000^2i/d_model) 4.3 Learned Positional Embedding Learned Positional Embedding是一种在自然语言处理任务中用于编码位置信息的技术。在传统的Transformer模型中,位置编码是通过固定的数学公式(如正弦函数或余弦函数)来计算得到的。而Learned Positional Embedding则是通过在模型的嵌入层中引入可学习的参数来学习位置信息的表示。 传统的位置编码方法只能对句子的位置进行大致的编码,而Learned Positional Embedding可以更准确地表示不同位置的信息。当模型学习到不同位置的嵌入表示时,它可以更好地区分不同位置的词语,并捕捉到位置信息对任务的影响。 Learned Positional Embedding的一个优点是可以根据任务的需要进行调整。传统的位置编码是固定的,不会随着训练进行调整。而Learned Positional Embedding可以通过反向传播算法来优化参数,以更好地适应不同任务的需求。 案例片段介绍如下: 将表示位置的position ids放入nn.Embedding,获取大小为hidden size的positional embedding 优点:可以随模型训练进行参数更新 缺点:可扩展性差,只能表征在max_seq_length以内的位置 4.4 Relative Positional Embedding 相对位置嵌入(Relative Positional Embedding)是一种用于编码序列中元素之间相对位置关系的技术,常用于自然语言处理和序列建模任务中。 在传统的位置嵌入方法中,如正弦/余弦位置嵌入(Sinusoidal Positional Embedding)或学习位置嵌入(Learned Positional Embedding),每个位置的嵌入向量是固定的,不考虑其与其他位置的关系。但在很多任务中,序列中的元素之间的相对位置关系对于理解序列的语义和结构非常重要。 相对位置嵌入通过将每个元素的位置嵌入向量与其他位置的偏移向量进行组合,来编码元素之间的相对距离。这样,每个元素的位置嵌入向量会随着其与其他元素的位置关系而变化,从而更好地捕捉序列中的局部结构信息。 相对位置嵌入常用于Transformer模型中,在自注意力机制(Self-Attention)中使用。通过引入相对位置嵌入,Transformer可以更好地处理序列中元素之间的相对位置关系,从而提高序列建模的性能。在相对位置嵌入中,常见的方法是使用距离编码矩阵(Distance Encoding Matrix)来计算偏移向量,然后与位置嵌入向量相加。 案例片段介绍如下: 在计算自注意力分数时,在query和key的dot product,以及最终注意力权重和value矩阵乘时,分别额外添加一个表示位置m和位置n相对位置信息的bias,仅依赖于m-n 优点: 可以直观记录词语的相对位置信息 模型可接受不同长度的输入 缺点: 训练和推理速度慢(尤其是长序列的时候) 4.5 Rotary Positional Embedding 相关代码如下: 4.5.1 2D case Rotary Positional Embedding - 2D case是一种用于编码二维序列中位置信息的方法,特别适用于Transformer等模型中的注意力机制。 在传统的位置嵌入方法中,如正弦/余弦位置嵌入(Sinusoidal Positional Embedding)或学习位置嵌入(Learned Positional Embedding),每个位置的嵌入向量是固定的,不考虑其与其他位置的关系。但对于二维序列,仅使用位置索引的编码方法无法很好地捕捉到元素在二维空间中的相对位置关系。 Rotary Positional Embedding - 2D case通过引入角度信息,能够更好地编码二维序列中元素的位置关系。具体来说,它使用了旋转操作来编码位置信息,这可以看作是将位置嵌入向量绕原点旋转一定的角度。通过在嵌入向量中引入角度信息,可以更好地表示元素在二维空间中的相对位置。 在2D案例中,Rotary Positional Embedding通常与自注意力机制(Self-Attention)一起使用。在注意力机制中,通过将位置嵌入向量与注意力权重相乘,并进行相应的运算,将位置信息引入注意力计算中。这样,模型可以更好地理解元素之间的相对位置关系,从而提高序列建模的性能。 案例片段介绍如下: 以2D word vector为例,第m个位置的词语可以用一个二维的向量xm表示,我们将它的query和key向量在2D平面上进行逆时针旋转,旋转角度取决于位置索引m dog:单词dog在第0位,不进行旋转 The dog:单词dog在第1位,旋转角度θ The pig chased the dog:单词dog在第4位,旋转角度4 这样在计算xm和xnquery,key的点积时,结果仅和(m-n)θ有关,而非m或n 优点: 计算self-attention q,k点积时,保留了词语的相对位置信息(不会因词语的绝对位置发生改变) 前面位置的positional embedding不受后续新增token的影响(easier to cache) token之间的依赖会随着相对距离的增长而逐步衰减(符合认知,距离越远的词普遍关联不大) 4.5.2 general form Rotary Positional Embedding - general form是一种用于编码位置信息的方法,通用形式适用于各种序列数据,包括一维、二维或其他维度的序列。 在传统的位置嵌入方法中,如正弦/余弦位置嵌入(Sinusoidal Positional Embedding)或学习位置嵌入(Learned Positional Embedding),每个位置的嵌入向量是固定的,不考虑其与其他位置的关系。但是,这种方法无法很好地捕捉到元素在序列中的相对位置关系。 Rotary Positional Embedding - general form通过引入旋转操作,能够更好地编码序列中元素的位置关系。具体来说,它使用了旋转矩阵来对位置嵌入进行变换,这可以看作是将位置嵌入向量绕一个固定的轴旋转一定的角度。通过在嵌入向量中引入旋转信息,可以更好地表示元素在序列中的相对位置。 在一般形式中,Rotary Positional Embedding可以与注意力机制(Attention Mechanism)一起使用。在注意力机制中,通过将位置嵌入向量与注意力权重相乘,并进行相应的运算,将位置信息引入注意力计算中。这样,模型可以更好地理解元素之间的相对位置关系,从而提高序列建模的性能。 案例片段介绍如下: 将单词的词向量大小设定为2的倍数 第m个位置的词向量在第i组2D sub-space(即向量中的2i,2i+1元素)的旋转角度为mθ_i,θ_i与i以及词向量的hidden size有关 二、From GLM to ChatGLM 1.传统NLP的挑战 1.1 挑战1:传统NLP vs 复杂问题 传统NLP(自然语言处理)方法通常用于处理简单的文本任务,例如文本分类、命名实体识别和情感分析等。这些方法主要依赖于规则和模式,以及统计和机器学习算法。 对于复杂问题,传统NLP方法可能面临一些挑战。复杂问题通常具有多义性、歧义性和上下文依赖性。例如,理解一个句子的意思可能需要考虑上下文信息和背景知识。此外,复杂问题还可能涉及多种语言和跨语言的处理。 为了应对复杂问题,研究者们开始使用深度学习方法,如循环神经网络(RNN)和注意力机制等。这些方法能够更好地处理语义理解和生成,以及更好地捕捉文本的上下文信息。 复杂问题还可能需要结合其他领域的知识,例如知识图谱、计算机视觉和知识推理等。这样可以提供更全面的语义理解和推理能力。 1.2 挑战2:传统NLP vs 动态知识 传统NLP(自然语言处理)是一种基于规则和模式的方法,它主要依赖于人工编码的语言规则和语法结构来理解和处理文本。这些规则和结构需要事先定义,并且通常需要大量的人工工作。 动态知识(Dynamic Knowledge)则是一种基于知识图谱和自动学习的方法,它能够根据实时的数据来自动更新和扩展知识库。动态知识利用机器学习和图谱技术,可以从大量的文本和语料库中自动提取和建立知识模型。 传统NLP的一个主要优势是其可解释性,因为所有的规则和模式都是人工定义的,所以可以清楚地理解其工作原理。然而,它也存在一些缺点,例如需要大量的人工工作来编写和维护规则,而且对于复杂的语言现象和变化的语言规则往往无法适应。 相比之下,动态知识能够通过机器学习和自动学习的方式,自动地从大量的文本中提取和建立知识模型。它可以自动学习语言现象和规则的变化,并且可以根据实时的数据来更新和扩展知识库。动态知识的优点是其能够处理复杂的语言现象和变化的语言规则,并且具有较强的适应性和灵活性。 但动态知识也存在一些挑战,例如其可解释性相对较差,因为知识模型是通过机器学习自动学习的,所以很难直观地理解其工作原理。此外,动态知识的构建和维护也需要大量的计算资源和数据支持。 案例片段介绍如下: 千亿模型的动态知识欠缺、知识陈旧、缺乏可解释性 知识欠缺:长尾知识 例如: 世界第二高的山峰(答案: K2格里峰) 知识陈日:GPT-3的训练数据截止2020年前 不可解释:缺乏答案的参考源 1.3 挑战3:传统NLP vs 人类对齐 传统NLP是基于机器学习和统计的方法,利用大量已标注的语料库来训练模型。这些模型可以识别和理解文本的语法结构、词义和语义关系等。传统NLP方法包括语法分析、词性标注、命名实体识别、情感分析等技术。这些技术可以自动处理大规模的文本数据,并提供一些高级的语言处理功能。 人类对齐是指通过人工的方式对文本进行处理和理解。人类对齐可以是通过人工标注和标记的方式,也可以是通过人工阅读和理解的方式。人类对齐可以更准确地理解文本的含义和语境,尤其在处理一些复杂的语言结构和语义问题时更具优势。人类对齐可以包括人工智能助手和人工翻译等应用。 传统NLP和人类对齐两种方法各有优缺点。传统NLP方法可以在处理大规模数据时提供高效的处理能力,但在面对复杂语义问题时可能存在理解不准确或无法捕捉语境的问题。而人类对齐可以更准确地理解文本的含义和语境,但在大规模处理和实时处理方面可能存在效率和成本的问题。 案例片段介绍如下: 例如:请用几句话给一个6岁小孩解释登月 缺少高效"Prompt工程",GPT-3和GLM-130B都很难尽人意 2.从千亿模型到ChatGLM的技术路线 千亿模型GLM-130B是一个大规模语言模型,具有130亿个参数,用于自然语言处理任务。它采用了Transformer架构和大规模预训练技术,可以生成高质量的文本。 GLM-130B+是在GLM-130B的基础上进行了改进和优化。它针对语言模型的训练过程进行了一些调整,提升了模型的性能和效果。GLM-130B+在更多的自然语言处理任务上具有更好的表现。 GLM-130B++是在GLM-130B+的基础上进一步改进的版本。它引入了更多的新技术和优化策略,使得模型在处理长文本、多语种和多任务上表现更出色。GLM-130B++具有更强大的表达能力和更好的泛化能力。 ChatGLM模型是基于GLM系列模型的一种变种,专门用于生成对话文本。它在GLM-130B++的基础上进行了一些改进,使得模型在对话生成任务上更加适用和有效。ChatGLM模型在生成对话内容时可以更好地理解上下文和语境,并生成更具连贯性和合理性的对话文本。 3.ChatGLM的应用场景 3.1 撰写博客提纲 3.2 写邮件 3.3 介绍自己的优点缺点 3.4 写剧本梗概 3.5 写代码 3.6 查询常见知识/教程 3.7 多轮问答 3.8 文字冒险游戏 三、ChatGLM Demo 完整的课程学习地址:完整的课程学习地址 1.使用NPU+MindSpore Transformers试用ChatGLM推理 1.1 OpenI启智运行ChatGLM模型 1、到OpenI启智申请账号,开启云脑任务(NPU)/自己用GPU创建环境 OpenI启智申请账号地址:https://openi.pcl.ac.cn/user/sign_up 2、创建项目 3、打开新创建的项目,点击云脑,新建调试任务 4、点击调试 5、进入终端 其他操作如下面1.2小结,这边只是用OpenI启智NPU+MindSpore进行在线部署调试,部署结果如下图: 1.2 MindSpore运行ChatGLM模型 安装MindSpore和MindSpore Transformers a) MindSpore安装:参考:MindSpore官网(如果用OpenI启智NPU+MindSpore,可以忽略这一步,这步属于本地部署) b) MindSpore Transformers安装: 1、git clone -b dev https://gitee.com/mindspore/mindformers.git 2、cd mindformers 3、bash build.sh 4、如果使用MindSpore1.10版本,请安装MindFormers 0.6版本(git clone -b r0.6 …) c) 克隆昇思MindSpore技术公开课代码仓: git clone https://github.com/mindspore-courses/step_into_llm.git d)cd step_into_llm/Season2.step_into_llm/01.ChatGLM/ e) 下载ckpt和tokenizer文件 1、ckpt:wget https://ascend-repo-modelzoo.obs.cn-east-2.myhuaweicloud.com/XFormer_for_mindspore/glm/glm_6b.ckpt 2、tokenizer:wget https://ascend-repo-modelzoo.obs.cn-east-2.myhuaweicloud.com/XFormer_for_mindspore/glm/ice_text.model f) 运行推理部署文件:python cli_demo.py import os import platform import signal import numpy as np import mindspore as ms from mindformers.models.glm import GLMConfig, GLMChatModel from mindformers.models.glm.chatglm_6b_tokenizer import ChatGLMTokenizer from mindformers.models.glm.glm_processor import process_response config = GLMConfig( position_encoding_2d=True, use_past=True, is_sample_acceleration=True) ms.set_context(mode=ms.GRAPH_MODE, device_target="GPU", device_id=0) model = GLMChatModel(config) # https://ascend-repo-modelzoo.obs.cn-east-2.myhuaweicloud.com/XFormer_for_mindspore/glm/glm_6b.ckpt ms.load_checkpoint("./glm_6b.ckpt", model) # https://ascend-repo-modelzoo.obs.cn-east-2.myhuaweicloud.com/XFormer_for_mindspore/glm/ice_text.model tokenizer = ChatGLMTokenizer('./ice_text.model') os_name = platform.system() clear_command = 'cls' if os_name == 'Windows' else 'clear' stop_stream = False def build_prompt(history): prompt = "欢迎使用 ChatGLM-6B 模型,输入内容即可进行对话,clear 清空对话历史,stop 终止程序" for query, response in history: prompt += f"\n\n用户:{query}" prompt += f"\n\nChatGLM-6B:{response}" return prompt def signal_handler(): global stop_stream stop_stream = True def main(): history = [] global stop_stream print("欢迎使用 ChatGLM-6B 模型,输入内容即可进行对话,clear 清空对话历史,stop 终止程序") while True: query = input("\n用户:") if query.strip() == "stop": break if query.strip() == "clear": history = [] os.system(clear_command) print("欢迎使用 ChatGLM-6B 模型,输入内容即可进行对话,clear 清空对话历史,stop 终止程序") continue count = 0 inputs = tokenizer(query) outputs = model.generate(np.expand_dims(np.array(inputs['input_ids']).astype(np.int32), 0), max_length=config.max_decode_length, do_sample=False, top_p=0.7, top_k=1) response = tokenizer.decode(outputs) response = process_response(response[0]) history = history + [(query, response)] if stop_stream: stop_stream = False break else: count += 1 if count % 8 == 0: os.system(clear_command) print(build_prompt(history), flush=True) signal.signal(signal.SIGINT, signal_handler) os.system(clear_command) print(build_prompt(history), flush=True) if __name__ == "__main__": main() 总结 MindSpore作为一种强大的深度学习框架,提供了丰富的工具和功能,使得模型的开发和训练更加高效和灵活。其支持端到端的深度学习解决方案,可以应用于各种任务和场景。而ChatGLM作为一种生成式语言模型,通过对话的方式生成自然流畅的文本,可以用于智能对话和智能客服等应用。 结合使用MindSpore和ChatGLM,我们可以实现更加智能和交互性的应用。首先,MindSpore可以用来训练ChatGLM模型,通过大量的对话数据进行学习,使得生成的文本更加贴近真实的对话。MindSpore提供了分布式训练的功能,可以在多个设备和计算节点上进行模型的并行训练,加速训练过程。其自动微分功能也可以帮助优化ChatGLM模型的训练效果。 通过MindSpore的强大功能和ChatGLM的生成式语言模型,我们可以构建出高效、准确和自然流畅的智能对话系统,提升用户体验并开拓更多的应用领域。这种结合使用不仅有助于推动机器学习和人工智能的发展,还为带来更多的创新和可能性。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 糟糕,被 SimpleDateFormat 坑到啦!

1. 问题背景 问题的背景是这样的,在最近需求开发中遇到需要将给定目标数据通过某一固定的计量规则进行过滤并打标生成明细数据,其中发现存在一笔目标数据的时间在不符合现有日期规则的条件下,还是通过了规则引擎的匹配打标操作。故而需要对该错误匹配场景进行排查,定位其根本原因所在。 2. 排查思路 2.1 数据定位 在开始排查问题之初,先假定现有的Aviator规则引擎能够对现有的数据进行正常的匹配打标,查询在存在问题数据(图中红框所示)同一时刻进行规则匹配时的数据都有哪些。发现存在五笔数据在同一时刻进行规则匹配落库。   继续查询具体的匹配规则表达式,发现针对loanPayTime时间区间在[2022-07-16 00:00:00, 2023-05-11 23:59:59]的范围内进行匹配,目标数据的时间为2023-09-19 11:27:29,理论上应该不会被匹配到。   但是观测匹配打标的明细数据发现确实打标成功了(如红框所示)。   所以重新回到最初的和目标数据同时落库的五笔数据发现,这五笔数据的loanPayTime时间确实在规则[2022-07-16 00:00:00, 2023-05-11 23:59:59]之内,所以在想有没有可能是在目标数据匹配规则引擎前,其它的五笔数据中的其中一笔对该数据进行了修改导致误匹配到了这个规则。顺着这个思路,首先需要确认下Aviator规则引擎在并发场景下是否线程安全的。   2.2 规则引擎 由于在需求中使用到用于给数据匹配打标的是Aviator规则引擎,所以第一直觉是怀疑Aviator规则引擎在并发的场景中可能会存在线程不安全的情况。   首先简单介绍下Aviator规则引擎是什么,Aviator是一个高性能的、轻量级的java语言实现的表达式求值引擎,主要用于各种表达式的动态求值,相较于其它的开源可用的规则引擎而言,Aviator的设计目标是轻量级和高性能 ,相比于Groovy、JRuby的笨重,Aviator非常小,加上依赖包也才450K,不算依赖包的话只有70K; 当然,Aviator的语法是受限的,它不是一门完整的语言,而只是语言的一小部分集合。其次,Aviator的实现思路与其他轻量级的求值器很不相同,其他求值器一般都是通过解释的方式运行,而Aviator则是直接将表达式编译成Java字节码,交给JVM去执行。简单来说,Aviator的定位是介于Groovy这样的重量级脚本语言和IKExpression这样的轻量级表达式引擎之间。(具体Aviator的相关介绍不是本文的重点,具体可参见) 通过查阅相关资料发现,Aviator中的AviatorEvaluator.execute() 方法本身是线程安全的,也就是说只要表达式执行逻辑和传入的env是线程安全的,理论上是不会出现并发场景下线程不安全问题的。(详见) 2.3 匹配规则引擎的env   通过前面Aviator的相关资料发现传入的env如果在多线程场景下不安全也会导致最终的结果是错误的,故而定位使用的env发现使用的是HashMap,该集合类确实是线程不安全的(具体可详见),但是线程不安全的前提是多个线程同时对其进行修改,定位代码发现在每次调用方式时都会重新生成一个HashMap,故而应该不会是由于这个线程不安全类导致的。   继续定位发现,loanPayTime这个字段在进行Aviator规则引擎匹配前使用SimpleDateFormat进行了格式化,所以有可能是由于该类的线程不安全导致的数据错乱问题,但是这个类应该只是对日期进行格式化处理,难不成还能影响最终的数据。带着这个疑问查询资料发现,emm确实是线程不安全的。   好家伙,嫌疑对象目前已经有了,现在就是寻找相关证据来佐证了。 3. SimpleDateFormat 还能线程不安全? 3.1 先写个demo试试 话不多说,直接去测试一下在并发场景下,SimpleDateFormat类会不会对需要格式化的日期进行错乱格式化。先模拟一个场景,对多线程并发场景下格式化日期,即在[0,9]的数据范围内,在偶数情况下对2024年1月23日进行格式化,在奇数情况下对2024年1月22日进行格式化,然后观测日志打印效果。 import java.text.SimpleDateFormat; import java.time.Duration; import java.time.LocalDateTime; import java.util.Date; import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; import java.util.concurrent.TimeUnit; public class ThreadSafeDateFormatDemo { static SimpleDateFormat dateFormat = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static void main(String[] args) { ExecutorService executor = Executors.newFixedThreadPool(10); LocalDateTime startDateTime = LocalDateTime.now(); Date date = new Date(); for (int i = 0; i < 1000; i++) { int finalI = i; executor.submit(() -> { try { if (finalI % 2 == 0) { String formattedDate = dateFormat.format(date); //第一种 // String formattedDate = DateUtil.formatDate(date); //第二种 // String formattedDate = DateSyncUtil.formatDate(date); //第三种 // String formattedDate = ThreadLocalDateUtil.formatDate(date); System.out.println("线程 " + Thread.currentThread().getName() + " 时间为: " + formattedDate + " 偶数i:" + finalI); } else { Date now = new Date(); now.setTime(now.getTime() - TimeUnit.MILLISECONDS.convert(1, TimeUnit.DAYS)); String formattedDate = dateFormat.format(now); //第一种 // String formattedDate = DateUtil.formatDate(now); //第二种 // String formattedDate = DateSyncUtil.formatDate(now); //第三种 // String formattedDate = ThreadLocalDateUtil.formatDate(now); System.out.println("线程 " + Thread.currentThread().getName() + " 时间为: " + formattedDate + " 奇数i:" + finalI); } } catch (Exception e) { System.err.println("线程 " + Thread.currentThread().getName() + " 出现了异常: " + e.getMessage()); } }); } executor.shutdown(); try { executor.awaitTermination(30, TimeUnit.SECONDS); } catch (InterruptedException e) { e.printStackTrace(); } // 计算总耗时 LocalDateTime endDateTime = LocalDateTime.now(); Duration duration = Duration.between(startDateTime, endDateTime); System.out.println("所有任务执行完毕,总耗时: " + duration.toMillis() + " 毫秒"); } } 具体demo代码如上所示,执行结果如下,理论上来说应该是2024年1月23日和2024年1月22日打印日志的次数各5次。实际结果发现在偶数的场景下仍然会出现打印格式化2024年1月22日的场景。明显出现了数据错乱赋值的问题,所以到这里大概可以基本确定就是SimpleDateFormat类在并发场景下线程不安全导致的。   3.2 SimpleDateFormat为什么线程不安全? 查询相关资料发现,从SimpleDateFormat类提供的接口来看,实在让人看不出它与线程安全有什么关系,进入SimpleDateFormat源码发现类上面确实存在注释提醒:意思就是, SimpleDateFormat中的日期格式不是同步的。推荐(建议)为每个线程创建独立的格式实例。如果多个线程同时访问一个格式,则它必须保持外部同步。   继续分析源码发现,SimpleDateFormat线程不安全的真正原因是继承了DateFormat,在DateFormat中定义了一个protected属性的 Calendar类的对象:calendar。由于Calendar类的概念复杂,牵扯到时区与本地化等等,jdk的实现中使用了成员变量来传递参数,这就造成在多线程的时候会出现错误。   注意到在format方法中有一段如下代码: public StringBuffer format(Date date, StringBuffer toAppendTo, FieldPosition pos) { pos.beginIndex = pos.endIndex = 0; return format(date, toAppendTo, pos.getFieldDelegate()); } // Called from Format after creating a FieldDelegate private StringBuffer format(Date date, StringBuffer toAppendTo, FieldDelegate delegate) { // Convert input date to time field list calendar.setTime(date); boolean useDateFormatSymbols = useDateFormatSymbols(); for (int i = 0; i < compiledPattern.length; ) { int tag = compiledPattern[i] >>> 8; int count = compiledPattern[i++] & 0xff; if (count == 255) { count = compiledPattern[i++] << 16; count |= compiledPattern[i++]; } switch (tag) { case TAG_QUOTE_ASCII_CHAR: toAppendTo.append((char)count); break; case TAG_QUOTE_CHARS: toAppendTo.append(compiledPattern, i, count); i += count; break; default: subFormat(tag, count, delegate, toAppendTo, useDateFormatSymbols); break; } } return toAppendTo; } calendar.setTime(date)这条语句改变了calendar,稍后,calendar还会用到(在subFormat方法里),而这就是引发问题的根源。 想象一下,在一个多线程环境下,有两个线程持有了同一个SimpleDateFormat的实例,分别调用format方法: 线程1调用format方法,改变了calendar这个字段。 中断来了。 线程2开始执行,它也改变了calendar。 又中断了。 线程1回来了,此时,calendar已然不是它所设的值,而是走上了线程2设计的道路。 如果多个线程同时争抢calendar对象,则会出现各种问题,时间不对,线程挂死等等。 分析一下format的实现,我们不难发现,用到成员变量calendar,唯一的好处,就是在调用subFormat时,少了一个参数,却带来了这许多的问题。 其实,只要在这里用一个局部变量,一路传递下去,所有问题都将迎刃而解。 这个问题背后隐藏着一个更为重要的问题–无状态:无状态方法的好处之一,就是它在各种环境下,都可以安全的调用。衡量一个方法是否是有状态的,就看它是否改动了其它的东西,比如全局变量,比如实例的字段。format方法在运行过程中改动了SimpleDateFormat的calendar字段,所以,它是有状态的。 4. 如何解决? 4.1 每次在需要时新创建实例 在需要进行格式化日期的地方新建一个实例,不管什么时候,将有线程安全问题的对象由共享变为局部私有都能避免多线程问题,不过也加重了创建对象的负担。在一般情况下,这样其实对性能影响比不是很明显的。代码示例如下。 import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; /** * @author * @date 2024/1/23 20:04 */ public class DateUtil { public static String formatDate(Date date) throws ParseException { SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); return sdf.format(date); } public static Date parse(String strDate) throws ParseException { SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); return sdf.parse(strDate); } }​ 4.2 同步SimpleDateFormat对象 import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; /** * @author * @date 2024/1/23 20:04 */ public class DateSyncUtil { private static SimpleDateFormat sdf = new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); public static String formatDate(Date date) throws ParseException { synchronized (sdf) { return sdf.format(date); } } public static Date parse(String strDate) throws ParseException { synchronized (sdf) { return sdf.parse(strDate); } } } 说明:当线程较多时,当一个线程调用该方法时,其他想要调用此方法的线程就要block,多线程并发量大的时候会对性能有一定的影响。 4.3 ThreadLocal import java.text.DateFormat; import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; public class ConcurrentDateUtil { private static ThreadLocal<DateFormat> threadLocal = new ThreadLocal<DateFormat>() { @Override protected DateFormat initialValue() { return new SimpleDateFormat("yyyy-MM-dd HH:mm:ss"); } }; public static Date parse(String dateStr) throws ParseException { return threadLocal.get().parse(dateStr); } public static String format(Date date) { return threadLocal.get().format(date); } } 另一种写法 import java.text.DateFormat; import java.text.ParseException; import java.text.SimpleDateFormat; import java.util.Date; /** * @author * @date 2024/1/23 15:44 * @description 线程安全的日期处理类 */ public class ThreadLocalDateUtil { /** * 日期格式 */ private static final String date_format = "yyyy-MM-dd HH:mm:ss"; /** * 线程安全处理 */ private static ThreadLocal<DateFormat> threadLocal = new ThreadLocal<>(); /** * 线程安全处理 */ public static DateFormat getDateFormat() { DateFormat df = threadLocal.get(); if (df == null) { df = new SimpleDateFormat(date_format); threadLocal.set(df); } return df; } /** * 线程安全处理日期格式化 */ public static String formatDate(Date date) { return getDateFormat().format(date); } /** * 线程安全处理日期解析 */ public static Date parse(String strDate) throws ParseException { return getDateFormat().parse(strDate); } } 说明:使用ThreadLocal, 也是将共享变量变为独享,线程独享肯定能比方法独享在并发环境中能减少不少创建对象的开销。如果对性能要求比较高的情况下,一般推荐使用这种方法 4.4 抛弃JDK,使用其他类库中的时间格式化类 • 使用Apache commons 里的FastDateFormat,宣称是既快又线程安全的SimpleDateFormat, 可惜它只能对日期进行format, 不能对日期串进行解析。 • 使用Joda-Time类库来处理时间相关问题。 5. 性能比较 通过追加时间监控,将原有数据范围扩充到[0,999],线程池保留10个线程不变,观察三种情况下性能情况。 • 第一种:耗时40ms   • 第二种:耗时33ms   • 第三种:耗时30ms   通过性能压测发现4.3中的ThreadLocal性能最优,耗时30ms,4.1每次新创建实例性能最差,需要耗时40ms,当然了在极致的高并发场景下提升效果应该会更加明显。性能问题不是本文探讨的重点,在此不多做赘述。 6. 总结 以上就是针对本次问题排查的主要思路及流程,刚开始的排查思路也一直局限于规则引擎的线程不安全或者是传入的env(由于使用的是HashMap)线程不安全,还是受到组内大佬的启发和帮助才进一步去分析SimpleDateFormat类可能会存在线程不安全。本次问题排查确实提供一个经验,打破常规思路,比如SimpleDateFormat类看起来只是对日期进行格式化,很难和在并发场景下线程不安全会导致数据错乱关联起来。 作者:京东科技 宋慧超 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 探索 Seata 项目开源开发之旅

作者:尹祥琨,清华大学,Seata 开源之夏学生参与者 Seata 是一款开源的分布式事务解决方案,致力于在微服务架构下提供高性能和简单易用的分布式事务服务。在今年的开源之夏活动中,我加入了 Apache Seata (Incubator) 社区,完成了开源之夏的课题,并从此一直积极参与社区。我有幸在云栖大会-开发者秀场上分享了我的开发者经验。在本文中,我将与大家分享我在 Seata 社区中的开发者之旅,以及在这个旅程中积累的经验和见解。希望通过我的故事,能够激励更多人踏上这充满挑战和激励的开源之路,为开源社区的繁荣做出自己的贡献。 相关背景 在正式介绍我的经历之前,我想先提供一些相关的背景信息,以解释为什么我要参与开源以及如何参与开源。关于参与开源的原因,我相信每个人都有不同的动机。以下是我认为一些主要的原因: 学习: 参与开源使我们有机会为不同组织开发的开源项目做出贡献,与行业专家互动,提供了学习的机会。 技能提升: 以我为例,我通常使用 Java 和 Python 进行后端开发。但在参与 Seata 项目时,我有机会学习 Go 语言,拓宽了我的后端技术栈。此外作为学生,我很难接触到生产级框架或应用,而开源社区为我提供了这个机会。 兴趣: 我身边的朋友都是热衷于开源的,他们享受编程,对开源充满热情。 求职: 参与开源可以丰富我们的作品集,为简历增加分量。 工作需求: 有时参与开源是为了解决工作中遇到的问题或满足工作需求。 这些都是参与开源的原因,对我来说,学习、技能提升和兴趣是我参与开源的主要动机。无论你是在校学生还是在职人员,如果你有参与开源的意愿,不要犹豫,任何人都可以为开源项目做出贡献。年龄、性别、工作和所在地都不重要,关键是你的热情和对开源项目的好奇心。 我参与开源的契机是参加了中科院软件所举办的开源之夏活动。 开源之夏是一个面向高校开发者的开源活动,社区发布开源项目,学生开发者在导师的指导下完成项目的开发,结项成果贡献给社区,合入社区仓库,获得项目奖金和证书。开源之夏是踏入开源社区的一个绝佳契机,也是我第一次比较正式地接触开源项目,而这个经历为我打开了一扇全新的大门。自此我深刻地认识到参与开源项目的建设,分享自己的技术成果,让更多的开发者能够使用你所贡献的东西,是一件极富乐趣和意义的事情。 下面我分享的这张图片是开源之夏官方公开的数据,从 2020 年开始参与的社区数量还有学生数量都在逐年增加,活动也是越办越好。可以看到今年的参与的社区项目共有 133 个,每个社区又提供了若干个课题,而每位学生只能选择一个课题。想要在这么多个社区中找到想要参与的社区和适合自己的课题是一个相对复杂的任务。 综合考虑社区的活跃程度、技术栈契合度、新人引导情况等,最终我选择加入 Seata 社区。 Seata 是一款开源的分布式事务框架,提供了完整的分布式事务解决方案,包括 AT、TCC、Saga 和 XA 事务模式,可支持多种编程语言和数据存储方案。从 19 年开源起到今年已经走过了5个年头,社区中有超过 300 多位贡献者,项目收获了24k+ 星标,是一个非常成熟的社区。同时 Seata 兼容10余种主流 RPC 框架和 RDBMS,与20多个社区存在集成和被集成的关系,被几千家客户应用到业务系统中,可以说是分布式事务解决方案的事实标准。 2023 年 10 月 29 日,Seata 正式捐赠给了 Apache 软件基金会,成为孵化项目。经过孵化之后,Seata 将有望成为首个 Apache 软件基金会的分布式事务框架顶级项目。这次捐赠也将推动 Seata 更广泛地发展,对生态系统的建设产生深远的影响,从而使更多的开发者受益。这个重要的里程碑也为 Seata 带来更广阔的发展空间。 开发之旅 介绍完了一些基本情况,后文中我将分享我在 Seata 社区的开发之旅。 在正式开始开发之前,我进行了许多准备工作。因为 Seata 已经经历了五年的发展,积累了数十万行代码,因此直接参与开发需要一定的上手成本。我分享了一些准备经验,希望能够为大家提供一些启发。 1. 文档和博客是第一手材料 文档和博客这类的文本材料可以帮助社区新人迅速了解项目背景和代码结构。 首先,官方文档是最主要的参考资料,从这里可以了解到一切官方认为你需要了解的东西。 博客,仅次于官方文档的材料,一般是开发者或者是深度用户编写的,和文档不同的点在于博客可能会更深入到某个专项上去介绍,比如一些项目的理论模型、项目结构、某个模块的源码分析等等。 公众号,和博客类似,一般是偏技术性的文章,公众号还有个优点是可以订阅推送,利用碎片时间阅读一些技术。 此外,开源社区的一些在线分享或线下 Meetup 公开的幻灯片也是非常有意义的文本资料。 除了官方资料之外,还有许多第三方资料可供学习,比如可以通过用户分享的 use cases 了解项目的具体实施和实践;通过第三方社区的集成文档了解项目的生态;还有就是通过第三方的视频教程来学习。但在所有这些资料中,我认为官方文档和博客是最有帮助的。 2. 熟悉使用框架 当然刚才说的这些文本资料肯定不需要面面俱到的看完,纸上得来终觉浅,看到感觉差不多明白了就可以去实践了。可以按照官方文档的"Get Started"章节逐步了解项目的基本流程。另一种方法是查找官方提供的示例或演示,构建并运行它们,理解代码和配置的含义,并通过使用项目了解项目的需求、目标以及现有功能和架构。 例如,Seata有一个名为 seata-samples 的仓库,其中包含20多种用例,比如 Seata 和 Dubbo 集成,和 SCA, Nacos 集成的案例,基本可以覆盖到支持的所有场景。 3. 粗略阅读源代码把握主要逻辑 在准备阶段,粗略地阅读源代码以把握项目的主要逻辑也很重要。了解如何高效地把握项目的主要内容是一个需要长期积累的技能。首先,通过前述的准备步骤,了解项目的概念、交互和流程模型是很有帮助的。 以 Seata 为例,通过官方文档和实际操作,可以了解 Seata 事务领域的三个角色:TC(Transaction Coordinator)、TM(Transaction Manager)和 RM(Resource Manager)。TC 作为独立部署的 Server 用于维护全局和分支事务的状态,是 Seata 实现高可用的关键;TM 用于与 TC 交互,定义全局事务的开始、提交或回滚;RM 用于管理分支事务处理的资源,与 TC 交互以注册分支事务和报告分支事务的状态,并驱动分支事务提交或回滚。粗略地了解这些角色之间的交互后,可以更轻松地把握项目的主要逻辑。 脑海里刻下了这些模型的印象,对源码的主干提取就相对得心应手了一些。比如 Seata TC 事务协调者,作为 Server 端,是一个独立于业务部署的单独应用。那为了分析源码,就可以直接在本地把 server 起起来,通过启动类开始追踪。可以分析到一些初始化的逻辑比如服务注册、全局锁的初始化等等。还有可以通过 RPC 的调用来追踪到交互逻辑的代码,比如 TC 是如何对全局事务和分支事务进行持久化,如何驱动全局事务提交或者回滚的。 然而内嵌客户端的框架代码,没有一个启动类入口可以入手分析。那其实可以从一个 sample 入手,找到其对框架代码的引用从而进行阅读。比如 Seata 一个很重要的注解是 GlobalTransaction,用于标识一个全局事务。想要知道 TM 是如何对这个注解分析的,那我们通过 IDE 的搜索功能,找到 GlobalTransaction 的拦截器即可分析其中的逻辑。 还有一个小 tips 分享给大家,往往来说单测注重于单一模块的职能,可以通过阅读单测可以了解一个模块的输入输出、逻辑边界,也可以顺着单测的调用链去阅读代码,也是理解源码一个很重要的手段。 万事俱备只欠东风,做完充足的准备,下一步就是区积极参与到社区之中。 参与的方式也有很多种,最常见的参与方式是查看项目的 Issues 列表,社区通常会为新贡献者标记一些带有特殊标签的 Issue,如“good-first-issue”、“contributions-welcome”和“help-wanted”等。可以通过这些标签筛选感兴趣的任务。 除了 Issues,GitHub 还提供了讨论的功能,可以参与一些公开的讨论并获取新的想法。 此外,社区通常会定期举行会议,比如周会或双周会,可以通过参加这些会议来了解社区的最新进展,提出问题以及与其他社区成员交流。 总结与心得 我加入 Seata 社区最初是通过开源之夏活动。我完成了我的课题,为 Seata Saga 实现了一些新的功能,也做了一系列的优化。但我不止于此,因为在 Seata 的开源经历中我获得了学生生涯中最宝贵的一次开发者体验,在之后的时间我也持续通过上述参与方式持续活跃在社区中。这主要得益于以下几个方面: 沟通与社交 导师制度为我提供了重要的支持。在开发过程中,我与我的导师亦夏之间的密切合作对我适应社区文化和工作流程起到了关键作用。他不仅帮助我适应了社区,还为我提供了程序设计的思路,也与我分享了一些在工作中的经验和见解,这些都对我的发展非常有帮助。此外,Seata 社区创始人清铭也提供了很多帮助,包括建立了与其他同学的联系,帮助我进行 Code Review,也为我提供了许多机会。 正反馈 在 Seata 的开发过程中,我经历了一个良性的循环。许多细节为我提供了许多正反馈,例如我的贡献能被用户广泛使用和受益,比如开发得到了社区的认可。这些正反馈加强了我继续在 Seata 社区贡献的意愿。 技能提升再就是参与 Seata 开发,对我能力的提升也是巨大的。在这里,我能学习到生产级别的代码,包括性能优化,接口设计,边界判断的技巧。可以直接参与一个开源项目的运作,包括项目计划,安排,沟通等。当然还了解一个分布式事务框架是如何设计并实现的。 除了这些宝贵的开发者体验,我也从这次经历中体悟到了一些关于参与开源的个人心得,为激励其他有兴趣参与开源社区的同学,我做了简单的总结: 了解和学习社区文化和价值观 每个开源社区都有不同的文化和价值观。了解社区的文化和价值观对于成功参与社区至关重要。观察和了解社区其他成员的日常开发和交流方式是学习社区文化的好方法。在社区中要尊重他人的意见和包容不同的观点。 敢于迈出第一步 不要害怕面对困难,迈出第一步是参与开源社区的关键。可以通过领取标有"good-first-issue"等标签的 Issue,编写文档、单元测试等方式来开始。重要的是要克服畏难情绪,积极尝试并学习。 对自己的工作要充满信心 不要怀疑自己的能力。每个人都是从零开始的,没有人天生就是专家。参与开源社区是一个学习和成长的过程,需要不断的实践和积累经验。 积极参与讨论,持续学习不同技术 不要害怕提出问题,无论是关于项目的具体技术还是开发过程中的挑战。同时也不要局限于一个领域。尝试学习和掌握不同编程语言、框架和工具,这可以拓宽技术视野,为项目提供有价值的洞见。 通过我的开源之旅,我积累了宝贵的经验和技能,这些不仅帮助我成长为一个更有价值的开发者,也让我深刻地了解了开源社区的力量。然而,我不仅仅是个别的参与者,我代表着 Seata 社区的一部分。Seata 作为一个正在不断成长和演变的开源项目,有着巨大的潜力,同时也面临着新的挑战。因此我要强调 Seata 社区的重要性和未来的潜力,它已经进入 Apache 软件基金会的孵化阶段,这个重要的里程碑将为 Seata 带来更广阔的发展空间。Seata 欢迎更多的开发者和贡献者的加入,让我们共同推动这个开源项目的发展,为分布式事务领域的进步贡献一份力量。 搜索钉钉群号 加入 Seata Group 开源交流群(群号:32033786)

优秀的个人博客,低调大师

每日一博 | 揭开事件循环的神秘面纱

作者 |小萱 导读 这篇文章会全方位讲解事件循环机制,从这篇文章你可以学到,「事件循环」和「浏览器渲染」的关系,浏览器setTimeout、requestAnimationFrame(RAF)、requestIdleCallback(RIC)等API在事件循环的「执行时机」,导致浏览器卡顿的原因、交互指标是如何测量的以及如何提升网站的交互性能。 全文10503字,预计阅读时间27分钟。 01 前言 我们常常会提到页面性能,为什么要优化长任务,又为什么React要做时间切片呢。这篇文章把浏览器的渲染、事件循环与页面性能串联起来。 从这篇文章你可以学到,「事件循环」和「浏览器渲染」的关系,浏览器setTimeout、 requestAnimationFrame(RAF)、requestIdleCallback(RIC)等API在事件循环的「执行时机」,导致浏览器卡顿的原因、交互指标是如何测量的以及如何提升网站的交互性能。 学完这些,你可以对为什么动画要用RAF、又何时去用RIC、该不该选择setTimeout、如何规避长任务之类的问题应对自如。 02 事件循环概述 2.1 为什么要了解事件循环? 深入了解事件循环是性能优化的基础。在讨论事件循环之前,我们需要先了解浏览器的多进程和多线程架构。 2.2 浏览器的架构 回顾浏览器的架构,现代浏览器都是多进程和多线程的。 2.2.1 多进程 Chrome浏览器使用多进程架构,意味着每个标签页(在某些浏览器中也包括每个扩展程序)通常在其自己的进程中运行。这样做的好处是,一个标签页崩溃不会影响到其他标签页。 站点隔离特性,浏览器每个tab,都是独立的渲染进程,这点的好处是假设你打开三个标签页,一个标签卡死不影响其他两个。但如果三个标签共用一个进程,一个卡死会导致全部都卡,这样体验很差。 △浏览器的多进程示意图 2.2.2 多线程 每个浏览器进程都可以包含多个线程。例如,主线程用于执行 JavaScript 代码和处理页面布局,而其他线程可能用于网络请求、渲染等任务。 主线程 Web 应用程序需要在此单个主线程上执行某些关键操作。当您导航到 Web 应用程序时,浏览器将创建并向您的应用程序授予该线程,以便您的代码在其上执行。 主线程指的是渲染进程下的主线程,负责解析HTML、计算CSS样式、执行JavaScript、计算布局、绘制图层等任务。 △主进程即渲染进程包含的线程图 某些任务必须 在主线程上运行。例如,任何直接需要访问 DOM(即 DOM document)的操作都必须在主线程上运行(因为 DOM 不是线程安全的)。这将包括大多数 UI 相关代码。 主线程上一次只能运行 一个任务。 此外,一个任务必须在主线程上运行完成,然后才能运行另一个任务。浏览器没有“部分”执行任务的机制,每个任务都完整地运行直至完成。 在下面的示例中,在浏览器展示界面的时候,按顺序运行下面的任务,并且每个任务都在主线程上完成: 03 事件循环的具体流程 我们这里主要讨论的是window event loop。也就是浏览器一个渲染进程内主线程所控制的Event Loop。 △发生一次事件循环的具体流程 发生一次事件循环,也就是浏览器一帧中可以用于执行JS的流程如下: 从task queue取出一个task(宏任务)执行并删除 -> 执行并清空队列中全部job(微任务) -> requestAnimationFrame -- 浏览器更新渲染 -- requestIdleCallback 3.1 更新渲染的步骤 前两个步骤,耳熟能详,这里不再讨论,重点讨论「更新渲染」之后的步骤。 1. Rendering opportunities: 标志是否一次事件循环后会发生渲染。在每次事件循环的结束,不一定会发生渲染。导致不渲染的可能:无法维持当前刷新率、浏览器上下文不可见、浏览器判断更新不会造成视觉改变并且raf的回调为空。 如果这些条件都不满足,当前文档不为空,设置 hasARenderingOpportunity 为 true。 2.如果窗口变化,执行resize。 3.如果滚动,执行scroll。 4.媒体查询。 5.canvas 。 6.执行RAF回掉,传递回掉参数DOMHighResTimeStamp,开始执行回调的时间。 7.重新执行Layout等计算,渲染绘制界面。 8.如果满足 任务队列和微任务队列都为空,并且渲染时机hasARenderingOpportunity为false,执行算法是否执行requestIdleCallback 的回调函数。 3.2 执行顺序与渲染 来一道简单的题目,将创建宏任务、微任务、RIC、RAF的代码同时定义,输出执行顺序。 console.log('开始执行'); console.log('start'); setTimeout(() => { console.log('setTimeout'); }, 0); requestAnimationFrame(() => { console.log('requestAnimationFrame'); }); new Promise((resolve, reject) => { console.log('Promise'); resolve('promise resolved'); }) requestIdleCallback(() => { console.log('requestIdleCallback'); }); (async function asyncFunction() { console.log(await 'asyncFunction'); })(); console.log('执行结束'); // 开始执行 // Promise // 执行结束 // promise resolved // asyncFunction // setTimeout // requestAnimationFrame // requestIdleCallback 你可能会疑问为什么RAF会在setTimeout(fn, 0)之前执行,setTimeout(fn, 0)的执行时机是延迟0-4ms,RAF可以粗暴理解为settimeout(fn, Math.random() * 16.6),因此setTimeout会优先。但如果在setTimeout执行之前主线程被其他的任务跑满了,超过了一帧的耗时,setTimeout会在RAF的回调之后执行(用例见下面的代码段),因此setTimeout的延迟时间并不稳定,RAF的执行时机稳定,在一帧内注册的,都会在这一帧的结束,下一帧的开始之前执行。 let task = new Array(10000).fill(null).map((_, i) => () => { const span = document.createElement("span"); span.innerText = i; console.log("==>task", i); }); task.forEach((i) => i()); requestAnimationFrame(() => { console.log("===>requestAnimationFrame"); }); setTimeout(() => { console.log("===>setTimeout"); }, 0); //输出: // ===>requestAnimationFrame // ===>setTimeout 注意,Promise.then的回调可以保证第一轮的准确性,如果继续.then发生的行为和浏览器版本有关,开发时不要过分依赖多.then的回调顺序,这是不可靠的。 上面提到渲染是在一次事件循环的「最后」发生,那么对于多次「修改dom」的操作,是会被合并取最后一次的结果作为布局渲染。 const btn = document.querySelector(".btn"); btn.addEventListener("click", () => { box.style.transform = "translateX(400px)"; box.style.transition = "transform 1s ease-in-out"; box.style.transform = "translateX(200px)"; }); 外层父容器400px,这段代码,表现是盒子从0到200px,盒子设置400px的动作,被合并掉了。那如何实现盒子从400px呢,可以采取延迟到下一帧渲染。 △演示效果 btn.addEventListener("click", () => { box.style.transform = "translateX(400px)"; requestAnimationFrame(() => { requestAnimationFrame(() => { box.style.transition = "transform 1s ease-in-out"; box.style.transform = "translateX(200px)"; }); }); }); 「嵌套的RAF」可以保证回调在下一帧执行。当然,此处用setTimeout也可以达到同样的延迟效果。 △延迟后的演示效果 04 任务队列与执行时机 执行 JavaScript task 是在渲染之前,如果在一帧之内 JavaScript 执行时间过长就会阻塞渲染,同样会导致丢帧、卡顿,这里的js执行时间过长,就是长任务,下面会仔细介绍。 对长任务的定义:如果任务耗时超过50ms,则认为该任务是长任务。 当我们谈到长任务造成页面卡顿时,通常指的是主线程(Main Thread)上的任务。主线程指的是渲染进程下的主线程,负责解析HTML、计算CSS样式、执行JavaScript、计算布局、绘制图层等任务。当主线程上的一个任务(例如一个JavaScript函数)运行时间过长时,它会阻塞主线程上的其他任务,包括但不限于UI更新和用户交互事件的处理,从而导致页面卡顿或不响应。 JS的执行和渲染的关系: JS执行与Paint任务都发生在主线程,具体的绘制操作是交由合成线程完成,与主线程并不互斥,但是JS的执行时间过长,会导致Paint整理好的数据没有及时提交给合成线程,因此页面有帧没有执行绘制,也就是掉帧。 △JS的执行和渲染的关系图 4.1 为什么不使用setTimeout做动画 raf和setTimeout对比: (https://jsfiddle.net/hixuanxuan/mrw6upgs/3/__) 1.不同步与显示刷新率: 浏览器通常以每秒60帧的速度刷新,大约每16.67毫秒刷新一次。如果你使用setTimeout来创建动画,并尝试每16.67毫秒运行一帧,你的代码不会完全与浏览器的刷新速率同步,导致丢帧 2.延迟执行: setTimeout的延迟时间参数只是一个最小延迟时间,而不是保证执行的精确时间。如果主线程忙于其他任务,setTimeout的回调可能会被延迟,导致丢帧 3.计时器合并: 浏览器渲染有渲染时机(Rendering opportunity),也就是浏览器会根据当前的浏览上下文判断是否进行渲染,因为考虑到硬件的刷新频率限制、页面性能以及页面是否存在后台等等因素,宏任务之间不一定会伴随着浏览器绘制。如果两个Task距离的很近,他们可能会被合并在一次渲染任务,得到的结果是意料之外的,如果Task距离较大,那他跟不上浏览器的刷新频率,会导致丢帧。 RAF的执行时机是在下一次渲染前调用,也就是说使用这个API允许你在下一次渲染开始之前更改DOM,然后在本次渲染中立即体现,因此他是制作动画的绝佳选择。 4.2 requestIdleCallback的执行时机 主要在浏览器的主线程空闲时执行,为了保证响应性,会计算一个截止时间,computeDeadline,它将决定何时执行requestIdleCallback中注册的回调。下面是计算截止时间算法的简要概述: 1.设置初始截止时间: 初始化时,将事件循环的最后闲置周期开始时间设置为当前时间。 设置一个基本的截止时间,该时间是事件循环的最后闲置周期开始时间加上50毫秒(为了保证对新用户输入的响应性)。为什么要加这个50ms,是因为浏览器为了提前应对一些可能会突发的用户交互操作,比如用户输入文字。如果给的时间太长了,你的任务把主线程卡住了,那么用户的交互就得不到回应了。50ms 可以确保用户在无感知的延迟下得到回应。 2.检查是否有待处理的渲染: 初始化一个变量 hasPendingRenders 为 false。 遍历相同事件循环的所有窗口,检查每个窗口是否有未执行的RAF回调或可能的渲染更新。如果有,将 hasPendingRenders 设置为 true。 3.基于timeout调整截止时间: 如果 RIC 传入第二个参数 timeout,更新截止时间为timeout。这会强制浏览器不管多忙,都在超过这个时间之后去执行 rIC 的回调函数。 4.考虑渲染的时间: 如果 hasPendingRenders 为 true,计算下一个渲染的截止时间,基于事件循环的最后渲染机会时间和当前的刷新率。 如果下一个渲染的截止时间早于当前设置的截止时间,那么更新截止时间为下一个渲染的截止时间。 5.返回最终的截止时间: 返回计算出的截止时间,这个时间将用于确定何时执行 requestIdleCallback 中注册的回调。 6.开始空闲期: 对于相同事件循环的每个窗口,执行“开始空闲期”算法,使用 computeDeadline 作为参数,确定何时执行 requestIdleCallback 中注册的回调。 也就是说,这个timeRemaining()的计算非常动态,会根据上面这些因素去决定。 4.3 React如何实现Time slice,没有使用RIC、setTimeout的原因是什么 没使用RIC的原因是他在部分浏览器表现不佳,比如safari。 需要满足的条件: 1.暂停 JS 执行,将主线程去执行style、layout、paint等任务,让浏览器有机会更新页面。 2.在未来某个时刻可以继续调度任务,执行上次还没有完成的任务。 对于react的Time Slice,他的目的是中断当前js的执行,让他去执行渲染相关任务,因此需要的API是在浏览器的Paint之后执行,浏览器并未提供除了RIC这样的API。RAF的执行时机是在一帧的结束,此时创建宏任务开启下一轮Task,渲染的任务放在RAF里在这一帧执行。如果使用setTimeout(fn, 0)创建宏任务,如果timeout嵌套的层级超过了 5 层,最低会有4ms的延迟,具体定义的代码可以参考chrome对计时器的定义(https://chromium.googlesource.com/chromium/blink/+/master/Source/core/frame/DOMTimer.cpp),因此首选的是message channel,优先级高于setTimeout可以在上一帧渲染结束后立即执行,这样就实现了可以中断的JS执行的效果。 4.4 模拟实现requestIdecallback 要模拟实现requestIdecallback的效果,定义的任务队列在浏览器完成渲染任务之后执行,扩展来说也可以用来测量浏览器渲染任务的执行时间。 Background Tasks API - Web API 接口参考 | MDN(https://developer.mozilla.org/zh-CN/docs/Web/API/Background_Tasks_API) // 当到时间了,立即执行的函数 const performWorkUntilDeadline = () => { if (scheduledHostCallback !== null) { const currentTime = getCurrentTime(); // 分配任务的剩余时间,这个可执行时间是根据fps动态算的 deadline = currentTime + yieldInterval; const hasTimeRemaining = true; // 调用已计划的回调,并传递剩余时间和当前时间。 const hasMoreWork = scheduledHostCallback( hasTimeRemaining, currentTime, ); if (!hasMoreWork) { isMessageLoopRunning = false; scheduledHostCallback = null; } else { // If there's more work, schedule the next message event at the end // of the preceding one. port.postMessage(null); } } else { isMessageLoopRunning = false; } // 给浏览器一个绘制的机会,并重置需要绘制的标志。 needsPaint = false; }; const channel = new MessageChannel(); const port = channel.port2; channel.port1.onmessage = performWorkUntilDeadline; requestHostCallback = function(callback) { scheduledHostCallback = callback; if (!isMessageLoopRunning) { isMessageLoopRunning = true; port.postMessage(null); } }; 05 交互性能指标与优化方法 长任务对页面的影响,带来「卡顿」、「掉帧」等不好的体验,常用衡量交互性能的指标有TTI和FID,这些均可使用web-vital库进行测量。下面展开对指标的详细介绍。 5.1 交互性能的衡量指标 衡量交互性能的指标主要关注以下几个方面: 5.1.1TTI (理想可交互时间) 1.定义可交互: 首先,需要明确什么是“可交互”。一个页面被认为是可交互的,意味着页面的主要内容已经加载完毕,用户可以进行点击、输入等交互操作,而且页面能够快速响应。 2.监测首次内容绘制 (FCP) 和 DOMContentLoaded: 测量TTI的过程通常开始于监测首次内容绘制 (FCP) 和 DOMContentLoaded 事件。这两个事件分别表示浏览器开始绘制页面内容和DOM结构加载完毕的时刻。 3.长任务监测: 长任务是指那些执行时间超过50毫秒的任务。长任务通常会阻塞主线程,延迟页面的交互可用性。通过监测长任务,可以了解主线程何时变得空闲。 4.寻找交互窗口: 为了确定TTI,需要找到一个至少5秒钟主线程空闲的窗口,且该窗口应在首次内容绘制 (FCP) 之后。在这个5秒空闲窗口期间,没有长任务执行,意味着用户可以与页面交互。一旦找到这个空闲窗口,记录TTI。如果未找到长任务,则TTI与 FCP 相同。 △TTI测量示意图(源于web.dev) 5.1.2FID(首次输入延迟) FID,即 First Input Delay,用于量化用户在页面加载时首次交互的响应延迟。一个低的FID表示页面是快速响应用户交互的,而一个高的FID表示页面在响应用户交互时有延迟。 1.事件监听: 为了计算FID,浏览器需要监听用户的交互事件,如点击、键盘输入或者触摸事件。当用户与页面交互时,会触发这些事件。 2.事件处理时间: 当事件被触发时,浏览器会计算从事件触发到浏览器开始处理事件的时间。这个时间就是FID。它包括了浏览器将事件放入事件队列、事件队列的等待时间、以及浏览器开始处理事件的时间。 3.事件处理: 一旦事件开始被处理,浏览器会记录下处理开始的时间。如果页面在处理事件时非常忙碌,或者有其他高优先级的任务,那么事件处理可能会被延迟,这会增加FID。 5.1.3 INP(交互到下一次绘制) INP,即Interaction to Next Paint,主要关注的是用户交互(如点击、滚动或按键操作)到页面响应的时间长度,具体到页面上的某个元素的可视更新。 比起来FID关注的是页面加载完成后用户首次交互,INP 关注的是所有交互的最长渲染延迟,因此INP 不仅仅代表第一印象,可以全面评估响应情况, 使INP 比 FID在衡量用户交互体验上更为可靠。 INP将会在2024年3月取代FID成为标准性能指标。 △交互到绘制的时间 5.2 如何优化交互性能指标 1、拆分任务,这是避免长任务的有效手段。 利用performance进行分析,找出long task 针对long task,进行每个步骤的任务拆分,执行优先级高的,剩下的部分利用延迟代码执行的方法进行中断。 比如,有个Input框,当输入的内容发生变更,需要进行大量计算/创建dom等耗时操作,造成输入卡顿。因此我们需要在用户「尝试发生互动」的时候,「退让主线程」。 // 通过Promise实现中断后继续执行,setTimeout调用来延迟任务 function yieldToMain () { return new Promise(resolve => { setTimeout(resolve, 0); }); } async function saveSettings(tasks) { let deadline = performance.now() + 50; while (tasks.length > 0) { // 判断当前是否有用户交互,isInputPending Chrome87+支持。 // 可以采用判断Expire Time达到类似效果 if ( navigator.scheduling?.isInputPending() || performance.now() >= deadline ) { // 如果有,退让主线程,等主线程任务完成再回来继续执行。 await yieldToMain(); deadline = performance.now() + 50; continue; } const task = tasks.shift(); task(); } } const performLongTask = () => { // 创建耗时的任务 let task = new Array(10000).fill(null).map((_, i) => () => { const span = document.createElement("span"); span.innerText = i; }); saveSettings(task); // 任务切片 }; input.addEventListener("input", (e) => { input.value = e.target.value; performLongTask(); }); 2、非关键模块 延迟执行。对于点击率不高、非核心模块等,采取dynamic import的方式,用到了再加载,或是延迟到一定时间后再加载,减少首次主线程所需要执行的任务。 3、对于视口内不可见的内容,延迟加载。 图片的延迟加载。 为img标签loading设为lazy,延迟加载资源,直到资源达到与视口的计算距离,Chrome77+支持。 利用IntersectionObserver监测图片是否在可视区域,再进行渲染。推荐使用lazy-load-image-component(https://www.npmjs.com/package/react-lazy-load-image-component) 等库。 减少大量dom的渲染。使用 content-visibility 延迟渲染屏幕外元素,Chrome85+支持。 4、灵活的缓存策略。 用service-worker跨站资源共享。 除了资源可以采取强缓存+协商缓存配合的方式,用service-worker实现更为灵活的缓存策略。比如站点a和站点b仅满足同源,技术栈渲染方式都完全不同,如何实现在访问a的时候可以预取b的资源。站点a空闲的时候注册service-worker,访问站点b即可从cache里读取缓存,提升加载速度。sw不仅在缓存方面表现优秀,也可以帮我们实现离线应用,以及无法被浏览器强缓存的文件手动添加缓存(不同浏览器对可以强缓存的文件的体积限制不同)。 △使用sw做跨站资源预取 06 总结 1.浏览器是多进程和多线程的,通常说主线程指的是渲染进程下的主线程。 2.主线程上一次只能运行一个任务,浏览器的绘制和主线程并不互斥,但长任务会导致延迟进入合成,甚至在这一帧不发生合成也就是掉帧。 3.在每次事件循环的结束,不一定会发生渲染。setTimeout的执行时机并不稳定。 4.RAF的执行时机稳定是在当前帧的最后,下一帧的开始之前,非常适合做动画。 5.RIC的执行时机并不稳定,computeDeadline由被多因素影响计算得出,但可以传递timeout控制执行的deadline。 6.用TTI和FID(INP)去衡量页面的交互性能。 7.用长任务拆分、延迟非关键模块执行、延迟非可视区域图片加载、减少页面渲染以及配置灵活的缓存策略等手段,提升网站的交互性能。 ——END—— 参考资料: [1]HTML living standand - evnet loop processing model: https://html.spec.whatwg.org/multipage/webappapis.html#event-loop-processing-model 推荐阅读: 百度搜索展现服务重构:进步与优化 百度APP iOS端包体积50M优化实践(七)编译器优化 百度搜索内容HTAP表格存储系统 大模型时代,“人人可AI”的百度开发者平台长什么样? 数十万QPS,百度热点大事件搜索的稳定性保障实践

优秀的个人博客,低调大师

每日一博 | PWA 离线方案研究报告

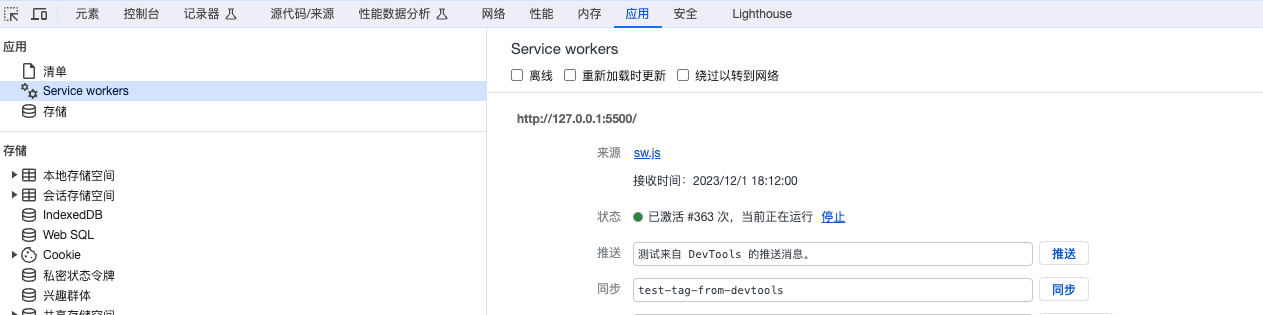
本文并不是介绍如何将一个网页配置成离线应用并支持安装下载的。研究PWA的目的仅仅是为了保证用户的资源可以直接从本地加载,来忽略全国或者全球网络质量对页面加载速度造成影响。当然,如果页面上所需的资源,除了资源文件外并不需要任何的网络请求,那它除了不支持安装到桌面,已经算是一个离线应用了。 什么是PWA PWA(Progressive Web App)是一种结合了网页和原生应用程序功能的新型应用程序开发方法。PWA 通过使用现代 Web 技术,例如 Service Worker 和 Web App Manifest,为用户提供了类似原生应用的体验。 从用户角度来看,PWA 具有以下特点: 1. 可离线访问:PWA 可以在离线状态下加载和使用,使用户能够在没有网络连接的情况下继续浏览应用; 2. 可安装:用户可以将 PWA 添加到主屏幕,就像安装原生应用一样,方便快捷地访问; 3. 推送通知:PWA 支持推送通知功能,可以向用户发送实时更新和提醒; 4. 响应式布局:PWA 可以适应不同设备和屏幕大小,提供一致的用户体验。 从开发者角度来看,PWA 具有以下优势: 1. 跨平台开发:PWA 可以在多个平台上运行,无需单独开发不同的应用程序; 2. 更新便捷:PWA 的更新可以通过服务器端更新 Service Worker 来实现,用户无需手动更新应用; 3. 可发现性:PWA 可以通过搜索引擎进行索引,增加应用的可发现性; 4. 安全性:PWA 使用 HTTPS 协议传输数据,提供更高的安全性。 总之,PWA 是一种具有离线访问、可安装、推送通知和响应式布局等特点的新型应用开发方法,为用户提供更好的体验,为开发者带来更高的效率。 我们从PWA的各种能力中,聚焦下其可离线访问的能力。 Service Worker 离线加载本质上是页面所需的各种js、css以及页面本身的html,都可以缓存到本地,不再从网络上请求。这个能力是通过Service Worker来实现的。 Service Worker 是一种在浏览器背后运行的脚本,用于处理网络请求和缓存数据。它可以拦截和处理网页请求,使得网页能够在离线状态下加载和运行。Service Worker 可以缓存资源,包括 HTML、CSS、JavaScript 和图像等,从而提供更快的加载速度和离线访问能力。它还可以实现推送通知和后台同步等功能,为 Web 应用带来更强大的功能和用户体验。 某些情况下,Service Worker 和浏览器插件的 background 很相似,但在功能和使用方式上有一些区别: 功能差异: Service Worker 主要用于处理网络请求和缓存数据,可以拦截和处理网页请求,实现离线访问和资源缓存等功能。而浏览器插件的 background 主要用于扩展浏览器功能,例如修改页面、拦截请求、操作 DOM 等。 运行环境: Service Worker 运行在浏览器的后台,独立于网页运行。它可以在网页关闭后继续运行,并且可以在多个页面之间共享状态。而浏览器插件的 background 也在后台运行,但是它的生命周期与浏览器窗口相关,关闭浏览器窗口后插件也会被终止。 权限限制: 由于安全考虑,Service Worker 受到一定的限制,无法直接访问 DOM,只能通过 postMessage() 方法与网页进行通信。而浏览器插件的 background 可以直接操作 DOM,对页面有更高的控制权。 总的来说,Service Worker 更适合用于处理网络请求和缓存数据,提供离线访问和推送通知等功能;而浏览器插件的 background 则更适合用于扩展浏览器功能,操作页面 DOM,拦截请求等。 注册 注册一个Service Worker其实是非常简单的,下面举个简单的例子 <!-- index.html --> <!DOCTYPE html> <html> <head> <title>Service Worker 示例</title> </head> <body> <script> if ('serviceWorker' in navigator) { window.addEventListener('load', function() { navigator.serviceWorker.register('/service-worker.js') .then(function(registration) { console.log('Service Worker 注册成功:', registration.scope); }) .catch(function(error) { console.log('Service Worker 注册失败:', error); }); }); } </script> </body> </html> // service-worker.js // 定义需要预缓存的文件列表 const filesToCache = [ '/', '/index.html', '/styles.css', '/script.js', '/image.jpg' ]; // 安装Service Worker时进行预缓存 self.addEventListener('install', function(event) { event.waitUntil( caches.open('my-cache') .then(function(cache) { return cache.addAll(filesToCache); }) ); }); // 激活Service Worker self.addEventListener('activate', function(event) { event.waitUntil( caches.keys().then(function(cacheNames) { return Promise.all( cacheNames.filter(function(cacheName) { return cacheName !== 'my-cache'; }).map(function(cacheName) { return caches.delete(cacheName); }) ); }) ); }); // 拦截fetch事件并从缓存中返回响应 self.addEventListener('fetch', function(event) { event.respondWith( caches.match(event.request) .then(function(response) { return response || fetch(event.request); }) ); }); 上述示例中,注册Service Worker的逻辑包含在HTML文件的<script>标签中。当浏览器加载页面时,会检查是否支持Service Worker,如果支持,则注册Service Worker文件/service-worker.js。 Service Worker文件中,首先定义了需要预缓存的文件列表filesToCache。在install事件中,将这些文件添加到缓存中。在activate事件中,删除旧缓存。在fetch事件中,拦截请求并从缓存中返回响应。 Service Worker文件service-worker.js需要放置在页面的主域名下。在调用navigator.serviceWorker.register('/service-worker.js')时,可以在第二个参数中设置scope,用来确定Service Worker的影响范围,默认是sw文件所在path的作用域。 需要注意的是,如果sw文件被放置在/a目录下,是不能设置作用域为/的。因为文件本身路径的级别小于根路径。 使用 当我们按照上面的示例,配置好了html及对应的sw.js后,启动服务并刷新页面,应该就能看到控制台打印出了Service Worker 注册成功的日志。 如果在chrome浏览器中,可以打开控制台,切换到应用Tab,就能看到我们刚注册好的应用了。  此时在浏览器的缓存空间中,也能发现我们开辟的缓存my-cache,内部存储着我们指定的预缓存文件index.html。由于我的项目只有根页面,所以只有一个条目。  此时如果页面所需的所有文件都被缓存了,即使将浏览器设置成断网模式,刷新页面也是能打开的。本文的目的并不是创建离线应用,下面我们讲讲上面方式会面临的问题。 如何确定预缓存范围 如果我们的项目只有一个仓库,可以使用一些webpack插件,可以直接帮我们生成sw文件。每次重新构建都会生成新的文件,这样就不用担心多存或者少存文件了。同时,在下一章节的删除旧缓存中,每次更新版本号就好了。  Workbox 是一个用于创建离线优先的网络应用程序的JavaScript库。它提供了一套工具和功能,帮助开发人员创建可靠的离线体验,并使网页应用程序能够在网络连接不稳定或断开的情况下正常工作。Workbox可以用于缓存和提供离线资源,实现离线页面导航,处理后台同步和推送通知等功能。它能够简化离线应用程序的开发过程,并提供强大的缓存管理和资源加载能力。 对于有统一配置后台的微前端项目,这个问题有些棘手。 1. 由于有后台管理,更新某个模块的文件很常见,但并不想每次都更新sw.js。 2. 由于资源的不确定性,无法在precache中列举出所有的资源列表,即使列举出了,可能用户永远也不会用到某个文件,造成缓存浪费或溢出。 3. 出于第1、2条缘由,更新sw文件后,无法确定如何删除旧缓存。 对于这个问题,首先确定的是,先在precache中列举出所有的基础底座的资源文件,并单独占用一个cacheName。 对于剩下的不确定性的业务文件,可以使用动态缓存的方式,这个会在后面具体讲解,也是本文要研究的重点。 资源更新 由于刷新页面后,所有资源都从缓存中获取,此时修改html后,再刷新浏览器,页面并没有更新。 这个问题其实不用太担心,虽然我们的资源都被缓存了,但是sw.js本身是不会被缓存的。即使我们在下一次更新中,删除了页面上注册Service Worker的代码,已经注册的Service Worker也会一直激活,直到我们主动的删除它。 对于一般的SPA项目,上线后资源一般是不变的,如果我们希望更新页面,只需要更新sw.js就好。当注册的Service Worker文件发生变化时,浏览器会自动下载新的Service Worker文件,并在下一次访问页面时激活新的Service Worker。 更新文件需要注意几个问题: 1. 删除旧缓存: 示例代码中,在activate阶段,我们执行了删除缓存的逻辑。真实环境中,一般会将cacheName带上版本号,每次更新sw都更新下版本号。这样每次都会将旧缓存删掉,并重新开辟新版本的缓存。各浏览器对于缓存超出后的处理是不同的,例如chrome就是缓存逐出策略。及时的清理缓存,可以防止出现一些奇怪的问题。 const version = 'v1'; const preCacheName = 'pre-cache-'+ version; // 将后文调用的 ’my-cache‘的位置替换为 preCacheName 2. Service Worker 更新不及时: 同一个域下,只能有一个Service Worker被激活,只有所有该域下的页面都关闭了,下一个注册的Service Worker才能被激活并取代上一个。对于某些用户来说,这个时间太长了。 因此,我们需要在install事件中,等待precache环节结束后,调用self.skipWaiting();来立即激活新的Service Worker,但并不会立即接管控制所有客户端(即浏览器标签页)。这意味着旧的Service Worker仍然会处理当前打开的页面,直到这些页面被关闭或重新加载。 为了确保新的Service Worker可以立即接管所有客户端,在activate事件中调用clients.claim()方法。这个方法会在新的Service Worker激活后,立即接管所有已打开的页面,而不需要等待这些页面重新加载。这样可以确保新的Service Worker能够立即生效,提供更新的功能和服务。 更改完后的代码如下,这样修改后,skipWaiting()和clients.claim()方法会在异步操作完成后被调用,确保新的Service Worker在安装完成后立即激活并接管所有客户端。 // 安装Service Worker时进行预缓存 self.addEventListener('install', function (event) { event.waitUntil( (async function () { await caches .open(preCacheName) .then(function (cache) { return cache.addAll(filesToCache); }) .then(() => { self.skipWaiting(); }); })() ); }); // 激活Service Worker self.addEventListener('activate', function (event) { event.waitUntil((async function () { await clearOutdateResources(); self.clients.claim(); })()); }); 现在,更新下index.html,然后将上述sw.js的更新保存,接着刷新两次页面(不要着急,给注册和加载资源一些时间,可以在控制台中观察下Service Worker的活跃状态以及缓存的变化)。  可以在某个时刻,发现同时存在两个Service Worker,一个处于激活状态,是我们正在使用的,另一个处于待激活状态,因为正在进行install。此时缓存空间也会同时存在两个版本的缓存,等新的Service Worker激活后,就会删除旧缓存。然后就只存在一个最新的Service Worker了,同时缓存也只剩一个了。 现在每次用户打开新的页面, 优先从缓存中获取资源 如果发现sw文件被更新,安装新的文件 文件内会下载新的资源,同时删除旧缓存,并且接管所有页面 用户下一次打开新页面或刷新当前页面,就会展示最新的内容 能力扩展 基础操作搞定了。但是上面我们还欠了点技术债,即如果不确定到底有哪些资源,怎么动态的做出缓存。不要着急,现在先进行下扩展阅读。 缓存的几种策略 当谈到Service Worker缓存策略时,有以下几种常见的策略: Cache First(优先缓存):首先尝试从缓存中获取响应,如果缓存中存在该资源,则直接返回;如果没有缓存或缓存过期,则向网络发送请求。 Network First(优先网络):首先尝试从网络获取响应,如果网络请求成功,则返回网络响应;如果网络请求失败,则从缓存中获取响应,即使缓存过期也会返回缓存的响应。 Cache Only(仅缓存):只从缓存中获取响应,不向网络发送请求。适用于完全离线可访问的资源。 Network Only(仅网络):只从网络获取响应,不使用缓存。适用于需要实时数据的场景。 Stale-While-Revalidate(同时更新和使用缓存):首先尝试从缓存中获取响应,如果缓存过期,则向网络发送请求获取最新响应,并更新缓存。同时返回缓存的响应,以便快速展示内容。 上文中我们使用的,就是缓存优先模式。对于不怎么更新或者只有一个仓库的应用来说,使用sw.js文件的更新来说已经足够了。毕竟代码写的越多,bug就越多。同比,更新的越频繁,系统就越不稳定。 Stale-While-Revalidate 其他策略如果有兴趣,可以自行搜索,现在我们来讲下动态缓存是怎么实现的。毕竟对于微服务来说,不更新sw是最好的,如果能忘了它就更好了。 上文中我们介绍了Cache First,重新附下代码 // 拦截fetch事件并从缓存中返回响应 self.addEventListener('fetch', function (event) { event.respondWith( caches.match(event.request).then(function (response) { return response || fetch(event.request); }) ); }); 新增一个mock.js,脚本会向body中新增一个字符串。将js文件使用script的方式加载。 // mock.js const div = document.createElement('div'); div.innerText = 'Hello World'; document.body.appendChild(div); // index.html <script src="./mock.js" type="text/javascript"></script> 同时调整下sw的拦截逻辑。 // 新增runtime缓存 const runtimeCacheName = 'runtime-cache-' + version; // 符合条件也是缓存优先,但是每次都重新发起网络请求更新缓存 const isStaleWhileRevalidate = (request) => { const url = request.url; const index = ['http://127.0.0.1:5500/mock.js'].indexOf(url); return index !== -1; }; self.addEventListener('fetch', function (event) { event.respondWith( // 尝试从缓存中获取响应 caches.match(event.request).then(function (response) { var fetchPromise = fetch(event.request).then(function (networkResponse) { // 符合匹配条件才克隆响应并将其添加到缓存中 if (isStaleWhileRevalidate(event.request)) { var responseToCache = networkResponse.clone(); caches.open(runtimeCacheName).then(function (cache) { cache.put(event.request, responseToCache.clone()); }); } return networkResponse; }); // 返回缓存的响应,然后更新缓存中的响应 return response || fetchPromise; }) ); }); 现在每次用户打开新的页面, 优先从缓存中获取资源,同时发起一个网络请求 有缓存则直接返回缓存,没有则返回一个fetchPromise fetchPromise内部更新符合缓存条件的请求 用户下一次打开新页面或刷新当前页面,就会展示最新的内容 通过修改isStaleWhileRevalidate中url的匹配条件,就能够控制是否更新缓存。在上面的示例中,我们可以将index.html从precache列表中移除,放入runtime中,或者专门处理下index.html的放置规则,去更新precache中的缓存。最好不要出现多个缓存桶中存在同一个request的缓存,那样就不知道走的到底是哪个缓存了。 一般来说,微前端的应用,资源文件都有个固定的存放位置,文件本身通过在文件名上增加hash或版本号来进行区分。我们在isStaleWhileRevalidate函数中匹配存放资源位置的路径,这样用户在第二次打开页面时,就可以直接使用缓存了。如果是内嵌页面,可以与平台沟通,是否可以在应用冷起的时候,偷偷访问一个资源页面,提前进行预加载,这样就能在首次打开的时候也享受本地缓存了。 缓存过期 即使我们缓存了一些资源文件,例如Iconfont、字体库等只会更新自身内容,但不会变化名称的文件。仅使用Stale-While-Revalidate其实也是可以的。用户会在第二次打开页面时看到最新的内容。 但为了提高一些体验,例如,用户半年没打开页面了,突然在今天打开了一下,展示历史的内容就不太合适了,这时候可以增加一个缓存过期的策略。 如果我们使用的是Workbox,通过使用ExpirationPlugin来实现的。ExpirationPlugin是Workbox中的一个缓存插件,它允许为缓存条目设置过期时间。示例如下所示 import { registerRoute } from 'workbox-routing'; import { CacheFirst, StaleWhileRevalidate } from 'workbox-strategies'; import { ExpirationPlugin } from 'workbox-expiration'; // 设置缓存的有效期为一小时 const cacheExpiration = { maxAgeSeconds: 60 * 60, // 一小时 }; // 使用CacheFirst策略,并应用ExpirationPlugin registerRoute( ({ request }) => request.destination === 'image', new CacheFirst({ cacheName: 'image-cache', plugins: [ new ExpirationPlugin(cacheExpiration), ], }) ); // 使用StaleWhileRevalidate策略,并应用ExpirationPlugin registerRoute( ({ request }) => request.destination === 'script', new StaleWhileRevalidate({ cacheName: 'script-cache', plugins: [ new ExpirationPlugin(cacheExpiration), ], }) ); 或者我们可以实现一下自己的缓存过期策略。首先是增加缓存过期时间。在原本的更新缓存的基础上,设置自己的cache-control,然后再放入缓存中。示例中直接删除了原本的cache-control,真正使用中,需要判断下,比如no-cache类型的资源,就不要使用缓存了。 每次命中缓存时,都会判断下是否过期,如果过期,则直接返回从网络中获取的最新的请求,并更新缓存。 self.addEventListener('fetch', function (event) { event.respondWith( // 尝试从缓存中获取响应 caches.match(event.request).then(function (response) { var fetchPromise = fetch(event.request).then(function (networkResponse) { if (isStaleWhileRevalidate(event.request)) { // 检查响应的状态码是否为成功 if (networkResponse.status === 200) { // 克隆响应并将其添加到缓存中 var clonedResponse = networkResponse.clone(); // 在存储到缓存之前,设置正确的缓存头部 var headers = new Headers(networkResponse.headers); headers.delete('cache-control'); headers.append('cache-control', 'public, max-age=3600'); // 设置缓存有效期为1小时 // 创建新的响应对象并存储到缓存中 var cachedResponse = new Response(clonedResponse.body, { status: networkResponse.status, statusText: networkResponse.statusText, headers: headers, }); caches.open(runtimeCacheName).then((cache) => { cache.put(event.request, cachedResponse); }); } } return networkResponse; }); // 检查缓存的响应是否存在且未过期 if (response && !isExpired(response)) { return response; // 返回缓存的响应 } return fetchPromise; }) ); }); function isExpired(response) { // 从响应的headers中获取缓存的有效期信息 var cacheControl = response.headers.get('cache-control'); if (cacheControl) { var maxAgeMatch = cacheControl.match(/max-age=(\d+)/); if (maxAgeMatch) { var maxAgeSeconds = parseInt(maxAgeMatch[1], 10); var requestTime = Date.parse(response.headers.get('date')); var expirationTime = requestTime + maxAgeSeconds * 1000; // 检查当前时间是否超过了缓存的有效期 if (Date.now() < expirationTime) { return false; // 未过期 } } } return true; // 已过期 } 从Service Worker发起的请求,可能会被浏览器自身的内存缓存或硬盘缓存捕获,然后直接返回。 精确清理缓存 下面的内容,默认为微前端应用。 随着微前端应用的更新,会逐渐出现失效的资源文件一直出现在缓存中,时间长了可能会导致缓存溢出。 定时更新 例如以半年为期限,定期更新sw文件的版本号,每次更新都会一刀切的将上一个版本中的动态缓存干掉,此操作会导致下次加载变慢,因为会重新通过网络请求的方式加载来创建缓存。但如果更新频率控制得当,并且资源拆分合理,用户感知不会很大。 处理不常用缓存 上文中的缓存过期策略,并不适用于此处。因为微服务中资源文件中,只要文件名不变,内容就应该不变。我们只是期望删除超过一定时间没有使用的条目,防止缓存溢出。这里也使用Stale-While-Revalidate的原因是为了帮助我们识别长期不使用的js文件,方便删除。 本来可以使用self.registration.periodicSync.register来创建一个周期性任务,但是由于兼容性问题,放弃了。需要的可自行研究,附上网址。 这里我们换一个条件。每当有网络请求被触发时,启动一个延迟20s的debounce函数,来处理缓存问题。先把之前的清除旧版本缓存的函数改名成clearOldResources。然后设定缓存过期时间为10s,刷新两次页面来触发网路请求,20s之后,runtime缓存中的mock.js就会被删除了。真实场景下,延迟函数和缓存过期都不会这么短,可以设置成5min和3个月。 function debounce(func, delay) { let timerId; return function (...args) { clearTimeout(timerId); timerId = setTimeout(() => { func.apply(this, args); }, delay); }; } const clearOutdateResources = debounce(function () { cache .open(runtimeCacheName) .keys() .then(function (requests) { requests.forEach(function (request) { cache.match(request).then(function (response) { // response为匹配到的Response对象 if (isExpiredWithTime(response, 10)) { cache.delete(request); } }); }); }); }); function isExpiredWithTime(response, time) { var requestTime = Date.parse(response.headers.get('date')); if (!requestTime) { return false; } var expirationTime = requestTime + time * 1000; // 检查当前时间是否超过了缓存的有效期 if (Date.now() < expirationTime) { return false; // 未过期 } return true; // 已过期 } 重新总结下微前端应用下的缓存配置: 1. 使用版本号,并初始化preCache和runtimeCache 2. preCache中预缓存基座数据,使用Cache First策略,sw不更新则基座数据不更新 3. runtimeCache使用Stale-While-Revalidate策略负责动态缓存业务资源的数据,每次访问页面都动态更新一次 4. 使用debounce函数,每次访问页面都会延迟清除过期的缓存 5. 如果需要更新preCache中的基座数据,则需要升级版本号并重新安装sw文件。新服务激活后会删除上一个版本的数据 6. runtimeCache和preCache不能同时存储一个资源,否则可能导致混乱。 最终示例 下面是最终的sw.js,我删除掉了缓存过期的逻辑,如有需要请自行从上文代码中获取。顺便我增加了一点点丧心病狂的错误处理逻辑。 理论上,index.html应该放入预缓存的列表里,但我懒得写在Stale-While-Revalidate里分别更新preCache和runtimeCache了,相信看完上面内容的你,一定可以自己实现对应逻辑。 如果你用了下面的文件,每次刷新完页面的20s后,runtime的缓存就会被清空,因为我们过期时间只设置了10s。而每次发起请求后的20s后就会进行过期判断。 在真实的验证过程中,有部分 const version = 'v1'; const preCacheName = 'pre-cache-' + version; const runtimeCacheName = 'runtime-cache'; // runtime不进行整体清除 const filesToCache = []; // 这里将index.html放到动态缓存里了,为了搭自动更新的便车。这个小项目也没别的需要预缓存的了 const maxAgeSeconds = 10; // 缓存过期时间,单位s const debounceClearTime = 20; // 延迟清理缓存时间,单位s // 符合条件也是缓存优先,但是每次都重新发起网络请求更新缓存 const isStaleWhileRevalidate = (request) => { const url = request.url; const index = [`${self.location.origin}/mock.js`, `${self.location.origin}/index.html`].indexOf(url); return index !== -1; }; /*********************上面是配置代码***************************** */ const addResourcesToCache = async () => { return caches.open(preCacheName).then((cache) => { return cache.addAll(filesToCache); }); }; // 安装Service Worker时进行预缓存 self.addEventListener('install', function (event) { event.waitUntil( addResourcesToCache().then(() => { self.skipWaiting(); }) ); }); // 删除上个版本的数据 async function clearOldResources() { return caches.keys().then(function (cacheNames) { return Promise.all( cacheNames .filter(function (cacheName) { return ![preCacheName, runtimeCacheName].includes(cacheName); }) .map(function (cacheName) { return caches.delete(cacheName); }) ); }); } // 激活Service Worker self.addEventListener('activate', function (event) { event.waitUntil( clearOldResources().finally(() => { self.clients.claim(); clearOutdateResources(); }) ); }); // 缓存优先 const isCacheFirst = (request) => { const url = request.url; const index = filesToCache.findIndex((u) => url.includes(u)); return index !== -1; }; function addToCache(cacheName, request, response) { try { caches.open(cacheName).then((cache) => { cache.put(request, response); }); } catch (error) { console.error('add to cache error =>', error); } } async function cacheFirst(request) { try { return caches .match(request) .then((response) => { if (response) { return response; } return fetch(request).then((response) => { // 检查是否成功获取到响应 if (!response || response.status !== 200) { return response; // 返回原始响应 } var clonedResponse = response.clone(); addToCache(runtimeCacheName, request, clonedResponse); return response; }); }) .catch(() => { console.error('match in cacheFirst error', error); return fetch(request); }); } catch (error) { console.error(error); return fetch(request); } } // 缓存优先,同步更新 async function handleFetch(request) { try { clearOutdateResources(); // 尝试从缓存中获取响应 return caches.match(request).then(function (response) { var fetchPromise = fetch(request).then(function (networkResponse) { // 检查响应的状态码是否为成功 if (!networkResponse || networkResponse.status !== 200) { return networkResponse; } // 克隆响应并将其添加到缓存中 var clonedResponse = networkResponse.clone(); addToCache(runtimeCacheName, request, clonedResponse); return networkResponse; }); // 返回缓存的响应,然后更新缓存中的响应 return response || fetchPromise; }); } catch (error) { console.error(error); return fetch(request); } } self.addEventListener('fetch', function (event) { const { request } = event; if (isCacheFirst(request)) { event.respondWith(cacheFirst(request)); return; } if (isStaleWhileRevalidate(request)) { event.respondWith(handleFetch(request)); return; } }); function debounce(func, delay) { let timerId; return function (...args) { clearTimeout(timerId); timerId = setTimeout(() => { func.apply(this, args); }, delay); }; } const clearOutdateResources = debounce(function () { try { caches.open(runtimeCacheName).then((cache) => { cache.keys().then(function (requests) { requests.forEach(function (request) { cache.match(request).then(function (response) { const isExpired = isExpiredWithTime(response, maxAgeSeconds); if (isExpired) { cache.delete(request); } }); }); }); }); } catch (error) { console.error('clearOutdateResources error => ', error); } }, debounceClearTime * 1000); function isExpiredWithTime(response, time) { var requestTime = Date.parse(response.headers.get('date')); if (!requestTime) { return false; } var expirationTime = requestTime + time * 1000; // 检查当前时间是否超过了缓存的有效期 if (Date.now() < expirationTime) { return false; // 未过期 } return true; // 已过期 } 注意 在真实的验证过程中,有部分资源获取不到date这个数据,因此为了保险,我们还是在存入缓存时,自己补充一个存入时间 // 克隆响应并将其添加到缓存中 var clonedResponse = networkResponse.clone(); // 在存储到缓存之前,设置正确的缓存头部 var headers = new Headers(networkResponse.headers); headers.append('sw-save-date', Date.now()); // 创建新的响应对象并存储到缓存中 var cachedResponse = new Response(clonedResponse.body, { status: networkResponse.status, statusText: networkResponse.statusText, headers: headers, }); 在判断过期时,取我们自己写入的key即可。 function isExpiredWithTime(response, time) { var requestTime = Number(response.headers.get('sw-save-date')); if (!requestTime) { return false; } var expirationTime = requestTime + time * 1000; // 检查当前时间是否超过了缓存的有效期 if (Date.now() < expirationTime) { return false; // 未过期 } return true; // 已过期 } 不可见响应 还记得上面为了安全考虑,在存入缓存时,对响应的状态做了判断,非200的都不缓存。然后就又发现异常场景了。 // 检查是否成功获取到响应 if (!response || response.status !== 200) { return response; // 返回原始响应 } opaque 响应通常指的是跨源请求(CORS)中的一种情况,在该情况下,浏览器出于安全考虑,不允许访问服务端返回的响应内容。opaque 响应通常发生在服务工作者(Service Workers)进行的跨源请求中,且没有CORS头部的情况下。 opaque 响应的特征是: 响应的内容无法被JavaScript访问。 响应的大小无法确定,因此Chrome开发者工具中会显示为 (opaque)。 响应的状态码通常是 0,即使实际上服务器可能返回了不同的状态码。 因此我们需要做一些补充动作。不单是补充cors模式,还得同步设置下credentials。 const newRequest = request.url === 'index.html' ? request : new Request(request, { mode: 'cors', credentials: 'omit' }); 在Service Workers发起网络请求时,如果页面本身需要认证,那就像上面代码那样,对页面请求做个判断。request.url === 'index.html'是我写的示例,真实请求中,需要拼出完整的url路径。而对于资源文件,走非认证的cors请求即可。将请求的request改为我们变更后的newRequest,请求资源就可以正常的被缓存了。 var fetchPromise = fetch(newRequest).then(function (networkResponse) 销毁 离线缓存用得好升职加薪,用不好就删库跑路。除了上面的一点点的防错逻辑,整体的降级方案一定要有。 看到这里,应该已经忘了Service Worker是如何被注册上的吧。没事,我们看个新的脚本。在原本的基础上,我们加了个变量SW_FALLBACK,如果离线缓存出问题了,赶紧到管理后台,把对应的值改成true。让用户多刷新两次就好了。只要不是彻底的崩溃导致html无法更新,这个方案就没问题。 // 如果有问题,将此值改成true SW_FALLBACK = false; if ('serviceWorker' in navigator) { if (!SW_FALLBACK) { navigator.serviceWorker .register('/eemf-service-worker.js') .then((registration) => { console.log('Service Worker 注册成功!'); }) .catch((error) => { console.log('Service Worker 注册失败:', error); }); } else { navigator.serviceWorker.getRegistration('/').then((reg) => { reg && reg.unregister(); if(reg){ window.location.reload(); } }); } } 对于没有管理后台配置html的项目,可以将上面的脚本移动到sw-register.js的脚本中,在html以script的形式加载该脚本,并将该文件缓存设置为no-cache,也不要在sw中缓存该文件。这样出问题后,覆写下该文件即可。 总结 所有要说的,在上面都说完了。PWA的离线方案,是一种很好的解决方案,但是也有其局限性。本项目所用的demo已经上传到了github,可自行查看。 参考文档 Service Worker Service worker overview Workbox GPT问答 作者:CHO 张鹏程 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 理解 Mysql 索引原理及特性

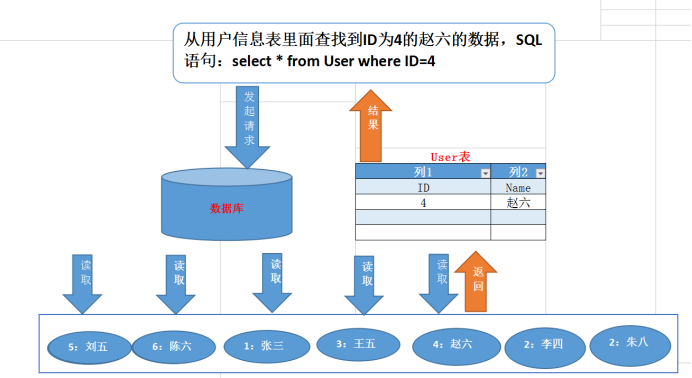
作为开发人员,碰到了执行时间较长的sql时,基本上大家都会说”加个索引吧”。但是索引是什么东西,索引有哪些特性,下面和大家简单讨论一下。 1 索引如何工作,是如何加快查询速度 索引就好比书本的目录,提高数据库表数据访问速度的数据库对象。当我们的请求打过来之后,如果有目录,就会快速的定位到章节,再从章节里找到数据。如果没有目录,如大海捞针一般,难度可见一斑。这就是我们经常碰到的罪魁祸首,全表扫描。 一条索引记录中包含的基本信息包括:键值(即你定义索引时指定的所有字段的值)+逻辑指针(指向数据页或者另一索引页)。通常状况下,由于索引记录仅包含索引字段值(以及4-9字节的指针),索引实体比真实的数据行要小许多,索引页相较数据页来说要密集许多。一个索引页可以存储数量更多的索引记录,这意味着在索引中查找时在I/O上占很大的优势,理解这一点有助于从本质上了解使用索引的优势,也是大部分性能优化所需要切入的点。 1)没有索引的情况下访问数据: 2)使用平衡二叉树结构索引的情况下访问数据: 第一张图没有使用索引我们会进行顺序查找,依照数据顺序逐个进行匹配,进行了5次寻址才查询出所需数据,第二张图用了一个简单的平衡二叉树索引之后我们只用了3次,这还是数据量小的情况下,数据量大了效果更明显,所以总结来说创建索引就是为了加快数据查找速度; 2 索引的组成部分和种类 常见的索引的实现方式有很多种,比如hash、数组、树,下面为大家介绍下这几种模型使用上有什么区别 2.1 hash hash思路简单,就是把我们插入的key通过hash函数算法(以前一般是取余数,就好比hashmap的计算方式移位异或之类的),计算出对应的value,把这个value放到一个位置,这个位置叫做哈希槽。对应磁盘位置指针放入hash槽里面。一句话总结hash索引,就是存储了索引字段的hash值和数据所在磁盘文件指针。 但是不可避免的是,无论什么算法,数据量大了之后难免会出现不同的数据被放在一个hash槽里面。比如字典上的 “吴”和”武”就是同音,你查字典的时候到这里只能顺序往下去找了。索引的处理也是这样,会拉出一个链表,需要的时候顺序遍历即可。 缺点:无序索引,区间查询性能低,因为区间查询会造成多次访问磁盘,多次io耗时是很难接受的。 优点:insert迅速,只需往后补就行 场景:等值查询, 比如memcached 。不适用大量重复数据的列,避免hash冲突 总结:想成java的hashmap即可 2.2 有序数组 如果我们需要区间查询的时候,hash索引的性能就不尽如人意了。这个时候有序数组的优势就能体现出来了。 当我们需要从一个有序数组里取A和B之间的值时,只需要通过二分法定位到A的位置,时间复杂度O(log(N)),接着从A遍历到B即可,论速度的话,基本上可以说是最快的了。但是当我们需要更新的时候,需要进行的操作就很多了。如果需要插入一条数据,你需要挪动数据之后的所有数据,浪费性能。所以总结来说,只有不怎么变化的数据适合有序数组结构的索引。 缺点:insert新数据的时候,需要改变后续所有数据,成本略高。 优点:查询速度很快,理论最大值。 场景:归档查询,日志查询等极少变化的 总结:就是顺序排的数组 2.3 二叉搜索树 基本原则是树的左节点都小于父节点,右节点都大于父节点 这里我们就能看出来,二叉搜索树的查询效率原则上是O(log(N)),为了保证是平衡二叉树,更新效率也是O(log(N))。但是数据很多的情况树的高度会达到很高,过多次访问磁盘,是不可取的。并且极端情况下,树退化成链表,查询的复杂度会被拉成O(n)。 进化成多叉树,也就是多个子节点的时候,会大大的减少树的高度,降低访问磁盘。 缺点:数据量大的时候,树会过高,导致多次访问磁盘 优点:进化成多叉树,会降低树高,访问磁盘次数。 场景:适用很多场景 总结:左小右大的树 2.4 B树 在每个节点存储多个元素,在每个节点尽可能多的存储数据。每个节点可以存储1000个索引(16k/16=1000),这样就将二叉树改造成了多叉树,通过增加树的叉树,将树从高瘦变为矮胖。构建1百万条数据,树的高度只需要2层就可以(1000*1000=1百万),也就是说只需要2次磁盘IO就可以查询到数据。磁盘IO次数变少了,查询数据的效率也就提高了。 这种数据结构我们称为B树,B树是一种多叉平衡查找树 2.5 B+树 B+树和B树最主要的区别在于非叶子节点是否存储数据的问题。 B树:非叶子节点和叶子节点都会存储数据。 B+树:只有叶子节点才会存储数据,非叶子节点至存储键值。叶子节点之间使用双向指针连接,最底层的叶子节点形成了一个双向有序链表。 正是因为B+树的叶子节点是通过链表连接的,所以找到下限后能很快进行区间查询,比正常的中序遍历快 3 索引的维护 当你insert一条数据的时候,索引需要做出必要的操作来保证数据的有序型。一般自增数据直接在后面加就行了,特殊情况下如果数据加到了中间,就需要挪动后面所有的数据,这样效率比较受影响。 最糟糕的情况,如果当前的数据页(页是mysql存储的最小单位)存满了,需要申请一个新的数据页,这个过程被称为页分裂。如果造成了页分裂的话,势必会造成性能的影响。但是mysql并不是无脑的数据分裂,如果你是从中间进行数据分裂的话,对于自增主键,会导致一半的性能浪费。mysql会根据你的索引的类型,和追踪插入数据的情况决定分裂的方式,一般都存在mysql数据页的head里面,如果是零散的插入,会从中间分裂。如果是顺序插入,一般是会选择插入点开始分裂,或者插入点往后几行导致的。决定是否从中间分裂,还是从最后分裂。 如果插入的是不规则的数据,没法保证后一个值比前一个大,就会触发上面说的分裂逻辑,最后达到下面的效果 所以绝大多数情况下,我们都需要使用自增索引,除非需要业务自定义主键,最好能保证只有一个索引,且索引是唯一索引。这样可以避免回表,导致查询搜索两棵树。保证数据页的有序性,可以更好的使用索引。 4 回表 通俗的讲就是,如果索引的列在 select 所需获得的列中(因为在 mysql 中索引是根据索引列的值进行排序的,所以索引节点中存在该列中的部分值)或者根据一次索引查询就能获得记录就不需要回表,如果 select 所需获得列中有大量的非索引列,索引就需要先找到主键,再到表中找到相应的列的信息,这就叫回表。 要介绍回表自然就得介绍聚集索引和非聚集索引 InnoDB聚集索引的叶子节点存储行记录,因此, InnoDB必须要有,且只有一个聚集索引: 如果表定义了主键,则PK就是聚集索引; 如果表没有定义主键,则第一个非空唯一索引(not NULL unique)列是聚集索引; 否则,InnoDB会创建一个隐藏的row-id作为聚集索引; 当我们使用普通索引查询方式,则需要先搜索普通索引树,然后得到主键 ID后,再到 ID 索引树搜索一次。因为非主键索引的叶子节点里面,实际存的是主键的ID。这个过程虽然用了索引,但实际上底层进行了两次索引查询,这个过程就称为回表。也就是说,基于非主键索引的查询需要多扫描一棵索引树。因此,我们在应用中应该尽量使用主键查询。或者有高频请求时,合理建立联合索引,防止回表。 5 索引覆盖 一句话表达的话,是只需要在一棵索引树上就能获取SQL所需的所有列数据,无需回表,速度更快。落实到sql上的话,只要执行计划里面的输出结果Extra字段为Using index时,能够触发索引覆盖。 常见的优化手段,就是上面提到的,将查询的字段都建到索引里面,至于dba愿不愿意让你建,那就需要你们自己battle了。 一般索引覆盖适用的场景包括 全表count查询优化、列查询回表、分页回表。高版本的mysql已经做了优化,当命中联合索引的其中一个字段,另外一个是id的时候,会自动优化,无需回表。因为二级索引的叶子上存了primary key,也算索引覆盖,无需额外成本。 6 最左匹配原则 简单来说,就是你使用 ‘xx%’的时候,符合条件的话也会使用索引。 如果是联合索引的话,我举个例子,创建一个(a,b)的联合索引 可以看到a的值是有顺序的,1,1,2,2,3,3,而b的值是没有顺序的1,2,1,4,1,2。但是我们又可发现a在等值的情况下,b值又是按顺序排列的,但是这种顺序是相对的。这是因为MySQL创建联合索引的规则是首先会对联合索引的最左边第一个字段排序,在第一个字段的排序基础上,然后在对第二个字段进行排序。所以b=2这种查询条件没有办法利用索引。举个例子,我弄一个索引, KEYidx_time_zone(time_zone,time_string) USING BTREE 执行第一条sql,全表扫描 执行第二条sql,可以看到使用了索引。 再看两条sql,建立的索引是 KEYidx_time_zone(time_zone,time_string) USING BTREE 按照正常逻辑来说,第二条sql是不符合索引字段的顺序的,应该不能使用索引才对,但是实际情况却和我们期望的不太一样,这是为啥呢? 从mysql被oracle收购以后,mysql加入了很多oracle以前的技术,高版本mysql自动优化了where条件的先后顺序。简单来说就是查询优化器做了这一步操作,sql会做预处理,那一条能更好的查询就会使用那种规则。 顺便提一下mysql的查询优化器能帮忙干的一些事 6.1 条件转化 例如where a=b and b=2,可以得到a=2,条件传递。最后的sql是 a=2 and b=2 > < = like 都可以传递 6.2 无效代码的排除 例如 where 1=1 and a=2, 1=1永远是正确的,所以最后会优化成 a=2 在比如 where 1=0 永远是false的,这样的也会被排除掉,整sql无效 或者非空字段 where a is null ,这样的也会被排除 6.3 提前计算 包含数学运算的部分,例如 where a= 1+2 会帮你算好,where a=3 6.4 存取类型 当我们评估一个条件表达式,MySQL判断该表达式的存取类型。下面是一些存取类型,按照从最优到最差的顺序进行排列: system系统表,并且是常量表 const 常量表 eq_ref unique/primary索引,并且使用的是’=’进行存取 ref 索引使用’=’进行存取 ref_or_null 索引使用’=’进行存取,并且有可能为NULL range 索引使用BETWEEN、IN、>=、LIKE等进行存取 index 索引全扫描 ALL 表全扫描 经常看执行计划的,一眼就能看出来这是啥意思,举个例子 where index_col=2 and normal_col =3 这里就会选用index_col=2 会作为驱动项。驱动项的意思是指一个sql选定他的执行计划的时候,可能有多条执行路径,一个是全表扫描,再过滤是否符合索引字段及非索引字段的值。另一种是通过索引字段,键值=2找到对应的索引树,过滤后的结果,再比较是否符合非索引字段的值。一般情况下,走索引都比全表扫描需要读取磁盘的次数少,所以称它为更好的执行路径,也就是通过索引字段,作为其驱动表达式 6.5 范围存取 简单来说,a in(1,2,3) 和 a=1 or a=2 or a=3 是一样的,between 1 and 2 和 a>1 and a<2也是一样的, 无需可以优化。 6.6 索引存取类型 避免使用相同前缀的索引,也就是一个字段不要在多个索引上有相同的前缀。比如一个字段已经建立了唯一索引,这个时候如果再给他建立一个联合索引,会导致优化器并不知道你要使用哪个索引。或者你建了前缀相同的一个单索引,一个联合索引,就算你写上了条件,也不一定能用上联合索引。当然,可以force,这就另说了。 6.7 转换 简单的表达式可以进行转换,比如 where -2 = a 会自动变成 where a= -2 ,但是如果牵扯到数学运算,就不能转换了 比如 where 2= -a 这时候不会自动转成 where a =-2. 第二条sql就可以使用索引 所以 我们在开发的过程中,需要注意sql的写法,自觉写成 where a=-2 6.8 and、union、order by、group by等 1)and and条件后,如果都没索引,扫描全表。有一个存取类型更好,见5.4 ,会使用存储类型更好的索引,如果都一样,哪个索引先创建,用哪个。 2)union union 每条语句单独优化 这里就会分别执行两条sql,用到索引,再合并结果集 3)order by order by 会过滤无效排序,比如一个字段本来就有索引 第二条sql和第一条的查询效果是一样的 所以,写sql的时候,不要写无用排序,比如order by ‘xxx’ 这样没有意义。 4)group by 简单来说 group by 的字段,有索引会走索引,group by a order by a 这里的order by等于没写,结果集已经是排序完毕的了,参考 6.8-3 order by select distinct col_a from table a 等价于 select col_a from a group by col_a 7 索引下推 主要的核心点就在于把数据筛选的过程放在了存储引擎层去处理,而不是像之前一样放到Server层去做过滤。 如果在一张表上,name和age都建立索引,查询条件为 where name like ‘xx%’ and age=11,在低版本的mysql(5.6 以下)的根据索引的最左匹配原则,可以得到放弃了age,只根据name过滤数据。根据name拿到所有的id之后,再根据id回表。 高版本mysql里,没有忽略age这个属性,带着age属性过滤,直接过滤掉了age为11的数据,假设不根据age过滤的数据为10条,过滤后只剩3条,就少了7次回表。减少了io会大量减少性能消耗 8 小表驱动大表 小表驱动大表,也是我们听惯了的话了,其含义主要是指小表的数据集驱动大表的数据集,减少连接次数。打个比方: 表A有1w数据,表B有100w数据,如果A表作为驱动表,处于循环的外层,那么只需要1w次的连接即可。如果B表在外层,那么则需要循环100w次。 下面我们实际测试看看,准备环境mysql 5.7+ 准备两张表,一张表 ib_asn_d 数据 9175, 一张表 bs_itembase_ext_attr 数据 1584115,都在商品编码字段上有索引。 首先小表驱动大表 多次反复测试,执行时间大概7秒。 接下来看看大表驱动小表。 将近300秒,不是一个量级的。 接下来分别分析执行计划,执行计划里第一条就是驱动表。 小表驱动大表,大表用了索引,小表全表扫描,只扫描8000多行 大表驱动小表,大表全表扫描,需要扫描147w行。 经过多次测试得出了结论: 当使用left join时,左表是驱动表,右表是被驱动表 ; 当使用right join时,右表是驱动表,左表是被驱动表 ; 当使用inner join时,mysql会选择数据量比较小的表作为驱动表,大表作为被驱动表 ; 驱动表索引不生效,非驱动表索引生效 保证小表是驱动表很重要。 9 总结 覆盖索引:如果查询条件使用的是普通索引(或是联合索引的最左原则字段),查询结果是联合索引的字段或是主键,不用回表操作,直接返回结果,减少IO磁盘读写读取整行数据,所以高频字段建立联合索引是很有必要的 最左前缀:联合索引的最左 N 个字段,也可以是字符串索引的最左 M 个字符。建立索引的时候,注意左前缀不要重复,避免查询优化器无法判定如何使用索引 索引下推:name like ‘hello%’and age >10 检索,MySQL 5.6版本之前,会对匹配的数据进行回表查询。5.6版本后,会先过滤掉age<10的数据,再进行回表查询,减少回表率,提升检索速度 作者:京东物流吴思维 来源:京东云开发者社区 转载请注明来源
优秀的个人博客,低调大师

每日一博 | 深度解读 Cascades 查询优化器

数据库中查询优化器是数据库的核心组件,其决定着 SQL 查询的性能。Cascades 优化器是 Goetz 在 volcano optimizer generator 的基础上优化之后诞生的一个搜索框架。 本期技术贴将带大家了解 Cascades 查询优化器。首先介绍 SQL 查询优化器,接着分析查询优化基本原理,最后对 Cascades 查询优化器进行重点介绍。 一、SQL 查询优化器 用户与数据库交互时只需要输入声明式 SQL 语句,数据库优化器则负责将用户输入的 SQL 语句进行各种规则优化,生成最优的执行计划,并交由执行器执行。优化器对于 SQL 查询具有十分重要的意义。 如图 1 所示,SQL 语句经过语法和词法解析生成抽象语法树(AST),经过**基于规则的查询优化(Rule-Based Optimizer)和基于代价的查询优化(Cost-Based Optimizer)**生成可执行计划。 图 1 基于规则的优化算法:基于规则的优化方法的要点在于结构匹配和替换。应用规则的算法一般需要先在关系代数结构上匹配一部分局部的结构,再根据结构的特点进行变换乃至替换操作。 基于成本的优化算法:现阶段主流的方法都是基于成本(Cost)估算的方法。给定某一关系代数代表的执行方案,对这一方案的执行成本进行估算,最终选择估算成本最低的方案。尽管被称为基于成本的方法,这类算法仍然往往要结合规则进行方案的探索。基于成本的方法其实是通过不断的应用规则进行变换得到新的执行方案,然后对比方案的成本优劣进行最终选择。 二、查询优化的基本原理 优化器一般由三个组件组成:统计信息收集、开销模型、计划列举。 如图 2 所示,开销模型使用收集到的统计信息以及构造的不同开销公式,估计某个特定查询计划的成本,帮助优化器从众多备选方案中找到开销最低的计划。 图 2 SQL 语句查询优化基于关系代数这一模型: SQL 查询可以转化为关系代数; 关系代数可以进行局部的等价变换,变换前后返回的结果不变但是执行成本不同; 通过寻找执行成本最低的关系代数表示,我们就可以将一个 SQL 查询优化成更为高效的方案。 寻找执行成本最低的关系代数表示,可以分为基于动态规划的自底向上和基于 Cascades/Volcano 的自顶向下两个流派。 自底向上搜索:从叶子节点开始计算最低成本,并利用已经计算好的子树成本计算出母树的成本,就可以得到最优方案; 自顶向下搜索:先从关系算子树的顶层开始,以深度优先的方式来向下遍历,遍历过程中进行剪枝。 自底向上的优化器从零开始构建最优计划,这类方法通常采用动态规划策略进行优化,采用这类方法的优化器包括IBMSystem R。自顶向下的优化策略的优化器包括基于 Volcano 和 Cascades 框架的优化器。 三、Cascades 查询优化器 Cascades 查询优化器采用自顶向下的搜索策略,并在搜索过程中利用 Memo 结构保存搜索的状态。 Cascades 关键组件构成: Expression:Expression 表示一个逻辑算子或物理算子。如 Scan、Join 算子; Group:表示等价 Expression 的集合,即同一个 Group 中的 Expression 在逻辑上等价。Expression 的每个子节点都是以一个 Group 表示的。一个逻辑算子可能对应多个物理算子,例如一个逻辑算子 Join(a,b),它对应的物理算子包括{HJ(a, b), HJ(b, a), MJ(a, b), MJ(b, a), NLJ(a, b), NLJ(b, a)}。我们将这些逻辑上等价的物理算子称为一个 Group(组)。注:HJ 表示 HashJoin 算子,MJ 表示 MergeJoin 算子,NLJ 表示 NestLoopJoin 算子; Memo:由于 Cascades 框架采用自顶向下的方式进行枚举,因此,枚举过程中可能产生大量的重复计划。为了防止出现重复枚举,Cascades 框架采用 Memo 数据结构。Memo 采用一个类似树状(实际是一个图状)的数据结构,它的每个节点对应一个组,每个组的成员通过链表组织起来; Transformation Rule:是作用于 Expression 和 Group 上的等价变化规则,用来扩大优化器搜索空间。 Cascades 首先将整个 Operator Tree 按节点拷贝到一个 Memo 的数据结构中,Memo 由一系列的 Group 构成,每个算子放在一个 Group,对于有子节点的算子来说,将原本对算子的直接引用,变成对 Group 的引用。 图 3 如图 3 所示,生成该语法树的 Memo 初始结构。Memo 结构中一个圆角框代表一个算子,圆角框右下角是对其 Children’s Groups 的引用,左下角是唯一标识符。生成初始的 Memo 结构后,可以采用 transform rule 进行逻辑等价转换,规则如下: 对于一个逻辑算子,其所有基于关系代数的等价表达式保存在同一个 Group 内,例如 join(A,B) -> join(B,A); 在一个 Group 内,对于一个逻辑算子,会生成一个或多个物理算子,例如 join -> hash join,merge join,NestLoop join; 一个 Group 内,一个算子,其输入(也可以理解为subplan)可以来自多个 Group 的表达式。 在图 4 中,描述了一个部分扩展的 Memo结构,与图 1 中的初始 Memo 相比,在同一个 Group 内,增加了等价的逻辑算子,以及对应的物理算子。 图 4 在探索的过程中,优化器就会通过开销模型 Coster 借助统计信息来计算子步骤的开销,遍历完每个 Memo Group之后,归总得到每个完整计划的总开销,最终选择 Memo 中开销最低的计划。 图5 图 5 中有三个 Group,分别对应三个逻辑算子:Join(a, b), GET(a) 和 GET(b)。Group 1(Group 2)中包含了所有对应 GET(a) (GET(b))的物理算子,我们可以估算每个物理算子的代价,选取其中最优的算子保留下来。 为了防止枚举过程出现重复枚举某个表达式,Memo 结构体中还包含一个哈希表(exprHT),它以表达式为哈希表的键,用来快速查找某个表达式是否已经存在于 Memo 结构体中。 Cascades 采用自顶向下的方式来进行优化,以计划树的根节点为输入,递归地优化每个节点或表达式组。如图所示,整个优化过程从 Group 0 开始,实际上要先递归地完成两个子节点(Group 1 和 Group 2)的优化。 因此,实际的优化完成次序是 Group 1 -> Group2 -> Group 0。在优化每个 Group 时,依次优化每个组员;在优化每个组员时,依次递归地优化每个子节点。依次估算当前组里每个表达式 e 的代价 cost(e),选择最低得代价结果保存在 bestHT 中。优化结束时,查询 Join(a,b)对应的 Memo 结构体,获取最低的执行计划。

优秀的个人博客,低调大师

每日一博 | 语言大模型的推理技巧

本文探讨了一系列语言大模型的推理优化技巧,涵盖KV缓存、量化和稀疏性等方法,并分享了如何有效实施这些技术。对于想要优化Transformer模型,以期提升推理速度或效率的人来说值得一读。 本文作者为机器学习研究员Finbarr Timbers,他曾是DeepMind的工程师。 (本文由OneFlow编译发布,转载请联系授权。原文: https://www.artfintel.com/p/transformer-inference-tricks) 作者 |Finbarr Timbers OneFlow编译 翻译|杨婷、宛子琳 1 键值(KV)缓存 目前,键值(KV)缓存是最常见(也是最重要)的解码器优化方法。在解码器模型中,对于每次解码迭代,提示的键和值将是相同的。此外,一旦你运行了一个词元,该词元的键和值将在后续的每个迭代中保持不变。因此,你可以缓存提示,并在解码时逐渐将每个词元的KV张量添加到缓存中,这样可以减少大量计算。在注意力机制中,我们能够将形状为(batch, context_length, feature_dim)的两个张量相乘,变为将形状为(batch, 1, feature_dim)的查询张量与形状为(batch, context_length, feature_dim)的KV张量相乘。因此,采样的复杂度不再是二次方,这使我们能够获得更长上下文长度的良好解码(采样)性能。 实际上,这会在你的实现中增加复杂性,因为现在你不仅仅是运行纯函数,而且有了状态(state),所以即便一个序列已经完成了推理,你仍需要持续运行推理(参见Google MaxText的实现,https://github.com/google/maxtext)。 KV缓存需要2 * n_layers * n_heads * d_head个参数。对于GPT-3,其中n_layers = 96,n_heads = 96,d_head = 128,这意味着每个上下文中的词元需要2.4m个参数。使用典型的16位精度,每个词元需要5MB;如果上下文窗口有2048个词元,那就需要将10GB的HBM用于KV缓存。这虽然昂贵,但每GB的消耗都物有所值。 这些内存需求是在消费级GPU上训练语言大模型如此困难的重要原因之一。目前最强大的消费级显卡是4090,只有24GB的HBM。虽然其每秒浮点运算次数(FLOPS)可与企业级芯片相媲美,但其内存限制要低得多,这使得难以将权重和KV缓存置入内存。 2 推测性解码 推测性解码是一种在计算能力充裕时使用的技术,通常用于本地推理设置。它利用了现代加速器的特性,即在批次数据上运行推理所需的时间与在单个数据点上运行推理的时间相同。以A100为例,你可以在相同的时间内对多达160个数据点进行推理,所需推理时间与单个数据点相同。因此,现在已经出现了许多利用这一特性的技术,如束搜索(beam search)、MCTS(蒙特卡洛树搜索)或推测性解码。 推测性解码包括两个模型:一个小而快的模型以及大而慢的模型。由于现代解码器的推理速度与参数数量成正比,使用较小的模型可以在大型模型运行一次推理所需的时间内运行多次推理。 现代解码器模型(如GPT系列)使用了自回归采样技术,即要对N个词元的序列进行采样,模型会进行N次推理,每次推理都要使用前一次推理的结果。 在推测性解码中,你会并行运行这两个模型。快速模型会运行一批推理并猜测大模型将预测哪些词元,然后将这些猜测相叠加。与此同时,大模型在后台运行,检查较小模型是否记录了相同结果。较小模型能够在大模型进行一次推理的时间内进行多次猜测。然而,鉴于我们有多余的计算能力,大模型能够并行评估所有猜测。因此,我们支付顺序生成序列成本的唯一地方是在较小的模型上。 推测性解码的主要缺点是它需要一个“草稿(draft)”模型,该模型能够预测较大模型的输出,而且你必须让两个模型同时存在于同一台机器的内存中(或者在多GPU设置下的同一节点上)。这增加了复杂性,需要额外的工作,因为你必须训练两个模型(原始模型和“草稿”模型)。此外,任何性能提升都受限于小模型能够在多大程度上精确地预测大模型。如果小模型始终能够准确预测大模型的行为,那么我们就可以直接使用它!因此,推测性解码能够发挥作用的程度存在根本差距。HuggingFace声称它通常可以将解码速率提高一倍,这与原始论文(https://arxiv.org/abs/2211.17192)中声称的2至3倍的提升一致。 最近出现了一种试图改进推测性解码的前向解码(Lookahead Decoding)技术(https://lmsys.org/blog/2023-11-21-lookahead-decoding/),该技术让模型生成n-gram,然后在无需草稿模型的情况下递归匹配这些n-gram。这种技术被称为Jacobi解码(来自他们的博客截图),可能是对贪婪解码的潜在改进。Jacobi解码的工作原理是在生成词元的每一点上生成n个词元,对整个序列进行“猜测”。然后,将其与先前的猜测相验证,如果两者匹配,就接受该猜测。这可以在没有副作用的情况下减少时延,因为在最坏的情况下,它会变成贪婪解码。 前向解码通过保留解码过程中生成的n-gram,并尝试将它们用作猜测,进一步改进了这一技术。鉴于已生成的文本与将要生成的文本之间存在很高的相关性,这也有可能以极低的成本,显著改进时延。这一技巧非常巧妙。考虑到这项技术才发布不久,我非常好奇它在实际场景中的性能表现。 3 有效稀疏性 在仅解码器Transformer中,模型核心是注意力机制,可总结为如下的注意力方程: softmax操作会使非最大值变得很小。 因此,我们将数值张量(在注意力方程中用V表示)与一个主要由零(zero)组成的张量相乘。结果,注意力机制的输出中包含了大量的零,最高可达97%(https://x.com/YesThisIsLion/status/1647747069086666752?s=20)。类似地,在多层感知器网络(MLP)中的每个ReLU之后,我们也得到了大量稀疏性。 不幸的是,现在要实际利用这一点比较困难。如果权重中存在稀疏性,那么可通过结构化稀疏性(例如tor‍ch.sparse)做大量工作,但目前还不清楚系统能够多大程度地利用激活的稀疏性。 可以进行的一个优化是:如果某个激活为零,那么可以跳过加载与该激活对应的权重,并避免相应计算。据我所知,这并未很好地得到主流张量计算程序的支持,但对于Llama.cpp等自定义推理实现来说,这一优化比较容易实现。 这是因为激活是每个词元的函数,因此有效稀疏性也是随机分布在词元上。因此,这种优化的效果会随着批大小的增加呈指数级衰减。假设我们的有效稀疏性为X%,批大小为N,那么对于一个给定激活的所有条目在整个批次中都为零的概率可以表示为X^N。我制作了一张表格,列出了不同X和N值的情况。这种衰减效应非常显著。 因此,除批大小为1的情况,利用这一方法十分困难,即使在这种情况下,使用推测性解码通常更为有效。但如果你想要在本地运行推理,并且确实需要降低时延,这可能是一个很棒的技巧。 4 量化 量化是人们更为熟悉的技巧之一。我之前已经写过量化的相关内容(https://finbarrtimbers.substack.com/p/efficient-llm-inference),所以不打算在具体方法上花费太多时间。我们很难精确度量量化的效果。GPTQ论文等文献所使用的模型与SOTA模型差距较大,因为大型实验室并未公开其所使用的模型,并且学术界无法与大型实验室所拥有的资源相匹敌。 例如,GPTQ报告了OPT和BLOOM模型的量化结果,这些结果远不如当前的一系列开源模型,更不用说GPT-4了。 当然,大型实验室并未公开其研究进展,而我看到的大部分个案报告都来自那些试图在消费级硬件上运行较小模型的人,这种硬件的内存非常有限。我认为,很多业余爱好者(即非大型实验室研究人员)都被在本地运行庞大模型的吸引力所诱惑,因此他们对量化产生了浓厚兴趣。但实际上,量化并不具备固有优势!从第一性原则出发,如果你有两个位数相同的模型,它们应该具有相同数量的词元/秒,并且应该具有类似的性能水平。只有在使用更高精度格式的位数时做得很糟,才会有较大差异。 但文献中的观点与我的直觉不一致。上述GPTQ论文发现,将模型量化为低至4倍的精度时,性能的下降微乎其微。我认为,这是因为性能更差的模型更容易在量化过程中保持其性能不受损。如果假设两个相同的LLM,一个经过2万亿词元的训练,另一个经过5000亿词元的训练(分别称为LLM-2T、LLM-500B),在进行量化时,我认为经过更多词元训练的模型在性能上受到的影响更大,因为它应该更充分地利用这些词元。我们仍然预计经过量化的LLM-2T会优于LLM-500B,但我认为从LLM-2T到经过量化的LLM-2T的性能下降,会比从LLM-500B到经过量化的LLM-500B的下降更显著。 注:虽然上述论点很有说服力,但实际上并没有相关的文献支持。量化似乎确实非常接近于“免费的午餐”。 近期的研究,如关于k-bit推理规模定律的论文(https://arxiv.org/abs/2212.09720),在一系列LLM架构上进行了大量实验,得出了不同的位数分配对模型性能的影响。他们研究了在给定精度水平下使用N个参数的模型与使用2N个参数和一半精度的模型之间的权衡。其结果非常引人注目,与未进行量化的性能几乎没有差别(至少对于4位或更多位而言)。 基本上,他们发现可以将精度降至4位而不损失任何性能,量化几乎不会导致任何权衡。你可以运行一个小4倍的模型而不会显著降低性能。由于在现代加速器上推理性能等于处理的位数(即使用较少精度时每秒可以获得更多的运算次数),这点很有帮助。 因此,我的结论是:推荐采纳“k-bit推理论文”的建议。然而,对于生产负载,我对使用低于8位的精度还有些犹豫。fp8是目前现代加速器本地支持的最低精度浮点格式,即使如此,支持也是有限的。我建议在fp8精度下进行训练和推理,并观察进一步量化可能带来的精度损失对你的用例来说是否可以接受。当生产环境中缺乏来自这些平台(例如Nvidia和Torch/JAX团队)的本地支持时,我很难推荐在生产环境中使用更低级别的精度。 根据我从文献中了解到的(这与我的直觉相符),fp8严格来说优于int8,但在硬件上的支持有限。如果你在一个GPU资源充沛的组织,并且能够将H100用于所有任务,那么请使用fp8。否则,也可以使用int8,而且相比起来要容易得多(PyTorch使其变得相当容易,尽管API不太稳定)。 关于实际进行模型量化,PyTorch团队已经撰写了一篇关于如何具体操作的文章(https://pytorch.org/blog/accelerating-generative-ai/),并提供了一系列API用于简化操作,尽管它们不太稳定。此外,bitsandbytes是另一个出色的量化库,不过我个人还未使用过。 (特别感谢@cis_female与我讨论稀疏性的复杂性,以及@nostalgebraist纠正量化部分中的错误。我现在认为,证据表明,至少量化到4位或更多位,在性能方面的权衡非常小。) 其他人都在看 大型语言模型的推理演算 LoRA微调语言大模型的实用技巧 可复现的语言大模型推理性能指标 ChatGPT规模化服务的经验与教训 机器学习硬件十年:性能变迁与趋势 微调语言大模型选LoRA还是全参数? 语言大模型推理性能工程:最佳实践 语言大模型的分布式训练与高效微调指南 试用OneFlow: github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Promise 规范与原理解析

摘要 Promise对象用于清晰的处理异步任务的完成,返回最终的结果值,本次分享主要介绍Promise的基本属性以及Promise内部的基础实现,能够帮我们更明确使用场景、更快速定位问题。 Promise出现的原因 首先我们先来看一段代码:异步请求的层层嵌套 function fn1(params) { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn1Data = {name: 'fn1'} console.log(fn1Data, 'fn1Data'); // 请求2 (function fn2() { xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn2Data = {name: `${fn1Data.name}-fn2`} console.log(fn2Data, 'fn2Data'); // 请求3 (function fn2() { xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { const fn3Data = {name: `${fn2Data.name}-fn3`} console.log(fn3Data, 'fn3Data'); } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); })() } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); })() } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); } fn1() 或者我们可以将上面的代码优化为下面这样 function fn1(params) { console.log(`我是fn1,我在函数${params}中执行!!!`); } function fn2(params) { try { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log(`我是fn2,我在函数${params}中执行!!!结果是:`,params.data); fn1('fn2') } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); } catch (error) { console.error(error); } } function fn3() { try { const xmlHttp = new XMLHttpRequest(); xmlHttp.onreadystatechange = function(){ if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log('fn3请求已完成'); fn2('fn3') } } xmlHttp.open("GET","https://v0.yiketianqi.com/api?unescape=1&version=v61", true); xmlHttp.send(); console.log('我是f3函数呀'); } catch (error) { console.error(error); } } fn3() 由上面的两种写法的请求可见,在promise之前,为了进行多个异步请求并且依赖上一个异步请求的结果时,我们必须进行层层嵌套,大多数情况下,我们又对异步结果进行数据处理,这样使得我们的代码非常难看,并且难以维护,这就形成了回调地狱,由此Promise开始出现了。 回调地狱缺点 代码臃肿 可读性差 耦合性高 不好进行异常处理 Promise的基本概念 含义 ES6将其写进了语言标准里统一了用法,是一个构造函数,用来生成Promise实例 参数为一个执行器函数(执行器函数是立即执行的),该函数有两个函数作为参数,第一个参数是成功时的回调,第二个参数是失败时的回调 函数的方法有resolve(可以处理成功和失败)、reject(只处理失败)、all等方法 then、catch、finally方法为Promise实例上的方法 状态 pending --- 等待状态 Fulfilled --- 执行状态 (resolve回调函数,then) Rejected --- 拒绝状态 (reject回调函数,catch) 状态一旦改变就不会再变,状态只可能是两种改变,从pending->Fulfilled,pending->Rejected 有两个关键的属性:PromiseState --- 状态改变,PromiseResult --- 结果数据改变 const p1 = Promise.resolve(64) const p2 = Promise.reject('我错了') const p3 = Promise.then() const p4 = Promise.catch() // 状态改变PromiseState 结果改变PromiseResult console.log(new Promise(()=>{}), 'Promise'); // PromiseState='pending' PromiseResult=undefined console.log(p1,'p1'); // PromiseState='Fulfilled' PromiseResult=64 console.log(p2,'p2'); // PromiseState="Rejected" PromiseResult='我错了' console.log(p3, 'p3'); // then为实例上的方法,报错 console.log(p4, 'p4'); // catch为实例上的方法,报错  特点 1. 错误信息清晰定位:可以在外层捕获异常信息(网络错误、语法错误都可以捕获),有“冒泡”性质,会一直向后传递,直到被捕获,所以在最后写一个catch就可以了 2. 链式调用:每一个then和catch都会返回一个新的Promise,把结果传递到下一个then/catch中,因此可以进行链式调用 --- 代码简洁清晰 结果由什么决定 resolve 如果传递的参数是非Promise类型的对象,则返回的结果是成功状态的Promise对象,进入下一个then里面 如果传递的参数是Promise类型的对象,则返回的结果由返回的Promise决定,如果返回的是resolve则是成功的状态,进入下一个then里,如果返回的是reject则是失败的状态,进入下一个catch里 reject 如果传递的参数是非Promise类型的对象,则返回的结果是拒绝状态的Promise对象,进入下一个catch里面或者是下一个then的第二个参数reject回调里面 如果传递的参数是Promise类型的对象,则返回的结果由返回的Promise决定,如果返回的是resolve则是成功的状态,进入下一个then里,如果返回的是reject则是拒绝的状态,进入下一个catch里面或者是下一个then的第二个参数reject回调里面 这在我们自己封装的API里面也有体现:为什么code为1时都是then接收,其他都是catch接收,就是因为在then里面也就是resolve函数中对code码进行了判断,如果是1则返回Promise.resolve(),进入then里处理,如果是非1则返回Promise.reject(),进入catch里处理。 流程图  简单使用 // 模拟一个promise的get请求 let count = 0 function customGet(url){ count += 1 return new Promise((resolve, reject)=>{ const xmlHttp = new XMLHttpRequest(); xmlHttp.open("GET",url, true); xmlHttp.onload = ()=>{ console.log(xmlHttp, 'xmlHttp---onload'); if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { console.log('customGet请求成功了'); // 返回非Promise,结果为成功状态 resolve({data:`第${count}次请求获取数据成功`}) // 返回Promise,结果由Promise决定 // resolve(Promise.reject('resolve中返回reject')) } else { reject('customGet请求错误了') } } // Promise状态改变就不会再变 // onreadystatechange方法会被执行四次 // 当地次进来的时候,readyState不等于4,执行else逻辑,执行reject,状态变为Rejected,所以即使再执行if,状态之后不会再改变 // xmlHttp.onreadystatechange = function(){ // console.log(xmlHttp,'xmlHttp---onreadystatechange') // if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { // console.log('customGet请求成功了'); // resolve({data:`第${count}次请求获取数据成功`}) // } else { // reject('customGet请求错误了') // } // } xmlHttp.send(); }) } // 使用Promise,并且进行链式调用 customGet('https://v0.yiketianqi.com/api/cityall?appid=&appsecret=').then((res)=>{ console.log(res.data); return '第一次请求处理后的数据' }).then((data)=>{ console.log(data) // console.log(data.toFixed()); return customGet('https://v0.yiketianqi.com/api/cityall?appid=&appsecret=') }).then((res)=>{ console.log(res.data); }).catch((err)=>{ // 以类似'冒泡'的性质再外层捕获所有的错误 console.error(err, '这是catch里的错误信息'); }) 手写实现简单的Promise 通过上面的回顾,我们已经了解了Promise的关键属性和特点,下面我们一起来实现一个简单的Promise吧 // 1、封装一个Promise构造函数,有一个函数参数 function Promise(executor){ // 7、添加对象属性PromiseState PromiseResult this.PromiseState = 'pending' this.PromiseResult = null // 14、创建一个保存成功失败回调函数的属性 this.callback = null // 8、this指向问题 const that = this // 4、executor有两个函数参数(resolve,reject) function resolve(data){ // 10、Promise状态只能修改一次(同时记得处理reject中的状态) if(that.PromiseState !== 'pending') return // console.log(this, 'this'); // 5、修改对象的状态PromiseState that.PromiseState = 'Fulfilled' // 6、修改对象的结果PromiseResult that.PromiseResult = data // 15、异步执行then里的回调函数 if(that.callback?.onResolve){ that.callback.onResolve(that.PromiseResult) } } function reject(data){ console.log(that.PromiseState, 'that.PromiseState'); if(that.PromiseState !== 'pending') return // 9、处理失败函数状态 that.PromiseState = 'Rejected' that.PromiseResult = data console.log(that.PromiseResult, 'that.PromiseResult'); console.log(that.PromiseState, 'that.PromiseState'); // 16、异步执行then里的回调函数 if(that.callback?.onReject){ that.callback.onReject(that.PromiseResult) } } // 3、执行器函数是同步调用的,并且有两个函数参数 executor(resolve,reject) } // 2、函数的实例上有方法then Promise.prototype.then = function(onResolve,onReject){ // 20、处理onReject没有的情况 if(typeof onReject !== 'function'){ onReject = reason => { throw reason } } // 21、处理onResolve没有的情况 if(typeof onResolve !== 'function'){ onResolve = value => value } // 17、每一个then方法都返回一个新的Promise,并且把上一个then返回的结果传递出去 return new Promise((nextResolve,nextReject)=>{ // 11、处理成功或失败 if(this.PromiseState === 'Fulfilled'){ // 12、将结果传递给函数 // onResolve(this.PromiseResult) // 18、拿到上一次执行完后返回的结果,判断是不是Promise const result = onResolve(this.PromiseResult) if(result instanceof Promise){ result.then((v)=>{ nextResolve(v) },(r)=>{ nextReject(r) }) } else { nextResolve(result) } } // 当你一步步写下来的时候有没有怀疑过为什么不用else if(this.PromiseState === 'Rejected'){ // 第12步同时处理此逻辑 // onReject(this.PromiseResult) // 22、处理catch异常穿透捕获错误 try { const result = onReject(this.PromiseResult) if(result instanceof Promise){ result.then((v)=>{ nextResolve(v) }).catch((r)=>{ nextReject(r) }) } else { nextReject(result) } } catch (error) { nextReject(this.PromiseResult) } } // 13、异步任务时处理成功或失败,想办法等异步任务执行完成后才去执行这两个函数 if(this.PromiseState === 'pending'){ this.callback = { onResolve, onReject } console.log(this.callback, 'this.callback'); } }) } // 19、函数实例上有方法catch Promise.prototype.catch = function(onReject) { return this.then(null,onReject) } // 使用自定义封装的Promise const customP = new Promise((resolve,reject)=>{ // 模拟异步执行请求 // const xmlHttp = new XMLHttpRequest(); // xmlHttp.open("GET",'https://v0.yiketianqi.com/api/cityall?appid=&appsecret=', true); // xmlHttp.onload = ()=>{ // if (xmlHttp.readyState === 4 && xmlHttp.status === 200) { // resolve('success') // } else { // reject('error') // } // } // xmlHttp.send(); // 同步执行 resolve('success') // reject('error') }) console.log(customP, 'customP'); customP.then((res)=>{ console.log(res, 'resolve回调'); return '第一次回调' // return new Promise((resolve,reject)=>{ // reject('错错错') // }) },(err)=>{ console.error(err, 'reject回调'); return '2121' }).then(()=>{ console.log('then里面输出'); }).then().catch((err)=>{ console.error(err, 'catch里的错误'); }) 针对resolve中返回Promise对象时的内部执行顺序  总结 以上就是我们常用的Promise基础实现,在实现过程中对比了Promise和函数嵌套处理异步请求的优缺点,Promise仍存在缺点,但是的确方便很多,同时更清晰的理解到错误处理如何进行异常穿透的,也能帮助我们更规范的使用Promise以及快速定位问题所在。 作者:京东物流孙琦 来源:京东云开发者社区 自猿其说Tech 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 聊聊前端框架的未来 Signals

Signals 在目前前端框架的选型中遥遥领先! 国庆节前最后一周在 Code Review 新同学的 React 代码,发现他想通过 memo 和 useCallback 只渲染被修改的子组件部分。事实上该功能在 React 中是难以做到的。因为 React 状态变化后,会重新执行 render 函数。也就是在组件中调用 setState 之后,整个函数将会重新执行一次。 React 本身做不到。但是基于 Signals 的框架却不会这样,它通过自动状态绑定和依赖跟踪使得当前状态变化后仅仅只会重新执行用到该状态代码块。 个人当时没有过多的解释这个问题,只是匆匆解释了一下 React 的渲染机制。在这里做一个 Signals 的梳理。 优势 对比 React,基于 Signals 的框架状态响应粒度非常细。这里以 Solid 为例: import { createSignal, onCleanup } from "solid-js"; const CountingComponent = () => { // 创建一个 signal const [count, setCount] = createSignal(0); // 创建一个 signal const [count2] = createSignal(666); // 每一秒递增 1 const interval = setInterval(() => { setCount((c) => c + 1); }, 1000); // 组件销毁时清除定时器 onCleanup(() => clearInterval(interval)); return ( <div> <div> count: {count()} {console.log("count is", count())} </div> <div> count2: {count2()} {console.log("count2 is", count2())} </div> </div> ); }; 上面这段代码在 count 单独变化时,只会打印 count,压根不会打印 count2 数据。 控制台打印如下所示: count is 0 count2 is 666 count is 1 count is 2 ... 从打印结果来看,Solid 只会在最开始执行一次渲染函数,后续仅仅只会渲染更改过的 DOM 节点。这在 React 中是不可能做到的,React 是基于视图驱动的,状态改变会重新执行整个渲染函数,并且 React 完全无法识别状态是如何被使用的,开发者甚至可以通过下面的代码来实现 React 的重新渲染。 const [, forceRender] = useReducer((s) => s + 1, 0); 除了更新粒度细之外,使用 Signals 的框架心智模型也更加简单。其中最大的特点是:开发者完全不必在意状态在哪定义,也不在意对应状态在哪渲染。如下所示: import { createSignal } from "solid-js"; // 把状态从过组件中提取出来 const [count, setCount] = createSignal(0); const [count2] = createSignal(666); setInterval(() => { setCount((c) => c + 1); }, 1000); // 子组件依然可以使用 count 函数 const SubCountingComponent = () => { return <div>{count()}</div>; }; const CountingComponent = () => { return ( <div> <div> count: {count()} {console.log("count is", count())} </div> <div> count2: {count2()} {console.log("count2 is", count2())} </div> <SubCountingComponent /> </div> ); }; 上述代码依然可以正常运行。因为它是基于状态驱动的。开发者在组件内使用 Signal 是本地状态,在组件外定义 Signal 就是全局状态。 Signals 本身不是那么有价值,但结合派生状态以及副作用就不一样了。代码如下所示: import { createSignal, onCleanup, createMemo, createEffect, onMount, } from "solid-js"; const [count, setCount] = createSignal(0); setInterval(() => { setCount((c) => c + 1); }, 1000); // 计算缓存 const doubleCount = createMemo(() => count() * 2); // 基于当前缓存 const quadrupleCount = createMemo(() => doubleCount() * 2); // 副作用 createEffect(() => { // 在 count 变化时重新执行 fetch fetch(`/api/${count()}`); }); const CountingComponent = () => { // 挂载组件时执行 onMount(() => { console.log("start"); }); // 销毁组件时执行 onCleanup(() => { console.log("end"); }); return ( <div> <div>Count value is {count()}</div> <div>doubleCount value is {doubleCount()}</div> <div>quadrupleCount value is {quadrupleCount()}</div> </div> ); }; 从上述代码可以看到,派生状态和副作用都不需要像 React 一样填写依赖项,同时也将副作用与生命周期分开(代码更好阅读)。 实现机制 细粒度,高性能,同时还没有什么限制。不愧被誉为前端框架的未来。那么它究竟是如何实现的呢? 本质上,Signals 是一个在访问时跟踪依赖、在变更时触发副作用的值容器。 这种基于响应性基础类型的范式在前端领域并不是一个特别新的概念:它可以追溯到十多年前的 Knockout observables 和 Meteor Tracker 等实现。Vue 的选项式 API 也是同样的原则,只不过将基础类型这部分隐藏在了对象属性背后。依靠这种范式,Vue2 基本不需要优化就有非常不错的性能。 依赖收集 React useState 返回当前状态和设置值函数,而 Solid 的 createSignal 返回两个函数。即: type useState = (initial: any) => [state, setter]; type createSignal = (initial: any) => [getter, setter]; 为什么 createSignal 要传递 getter 方法而不是直接传递对应的 state 值呢?这是因为框架为了具备响应能力,Signal 必须要收集谁对它的值感兴趣。仅仅传递状态是无法提供 Signal 任何信息的。而 getter 方法不但返回对应的数值,同时执行时创建一个订阅,以便收集所有依赖信息。 模版编译 要保证 Signals 框架的高性能,就不得不结合模版编译实现该功能,框架开发者通过模版编译实现动静分离,配合依赖收集,就可以做到状态变量变化时点对点的 DOM 更新。所以目前主流的 Signals 框架没有使用虚拟 DOM。而基于虚拟 DOM 的 Vue 目前依靠编译器来实现类似的优化。 下面我们先看看 Solid 的模版编译: const CountingComponent = () => { const [count, setCount] = createSignal(0); const interval = setInterval(() => { setCount((c) => c + 1); }, 1000); onCleanup(() => clearInterval(interval)); return <div>Count value is {count()}</div>; }; 对应编译后的的组件代码。 const _tmpl$ = /*#__PURE__*/ _$template(`<div>Count value is `); const CountingComponent = () => { const [count, setCount] = createSignal(0); const interval = setInterval(() => { setCount((c) => c + 1); }, 1000); onCleanup(() => clearInterval(interval)); return (() => { const _el$ = _tmpl$(), _el$2 = _el$.firstChild; _$insert(_el$, count, null); return _el$; })(); }; 执行 _tmpl$ 函数,获取对应组件的静态模版 提取组件中的 count 函数,通过 _$insert 将状态函数和对应模版位置进行绑定 调用 setCount 函数更新时,比对一下对应的 count,然后修改对应的 _el$ 对应数据 其他 大家可以看一看使用 Signals 的主流框架: Vue Ref Angular Signals Preact Signals Solid Signals Qwik Signals Svelte 5(即将推出) 不过目前来看 React 团队可能不会使用 Signals。 Signals 性能很好,但不是编写 UI 代码的好方式 计划通过编译器来提升性能 可能会添加类似 Signals 的原语 PREACT 作者编写了 @preact/signals-react 为 React 提供了 Signals。不过个人不建议在生产环境使用。 篇幅有限,后续个人会解读 @preact/signals-core 的源码。 参考资料 精读《SolidJS》 Solid.js Introducing runes 鼓励一下 如果你觉得这篇文章不错,希望可以给与我一些鼓励,在我的 github 博客下帮忙 star 一下。 博客地址

优秀的个人博客,低调大师

每日一博 | 语言大模型的进化轨迹

ChatGPT的发布是语言大模型(LLM)发展史的转折点,它让人们意识到LLM的潜力,并引发了“AI竞赛”,世界上主要人工智能实验室和初创公司都参与其中。在这之后,基于LLM的聊天机器人层出不穷。 ChatGPT及相关LLM模型让我们共同见证了AI的历史性变革,很多人好奇,LLM和它们的运作方式究竟是怎样的?它们是如何被构建的?未来又将走向何方?本文对此进行了深入探讨。 本文作者Etienne Bernard是人工智能和机器学习专家,NuMind的联合创始人兼CEO,该企业创建由LLM提供支持的自定义NLP模型。Etienne曾在Wolfram Research工作八年,主要担任机器学习负责人,并领导了自动学习工具、用户友好的深度学习框架以及各种机器学习应用程序的开发。 (以下内容经授权后由OneFlow编译,转载请联系OneFlow获得授权。来源:https://www.numind.ai/blog/what-are-large-language-models) 作者 |Etienne Bernard OneFlow编译 翻译 | 宛子琳、贾川、杨婷 1 语言模型 简单来说,语言模型能够以某种方式生成文本。它的应用十分广泛,例如,可以用语言模型进行情感分析、标记有害内容、回答问题、概述文档等等。但理论上,语言模型的潜力远超以上常见任务。 想象你有一个完备的语言模型,可生成任意类型的文本,并且人们还无法辨别这些内容是否由计算机生成,那么我们就可以使其完成很多事,例如生成具有代表性的内容,如电子邮件、新闻稿、书籍和电影剧本等。再进一步来看,还可以用其生成计算机程序,甚至构建整个软件。只要愿意,我们还可以让它生成科学论文。如果语言模型真正“完备”,那么它们生成的论文将能够以假乱真,与真实论文没有区别,这意味着必须对语言模型展开实质性研究! 当然,就目前而言,完备的语言模型还无法实现,不过也展示出了这些系统的潜力。语言模型不仅仅能“预测文本”,它们的潜力可能远超想象。 现在我们回顾一下语言模型的发展历程,从最初的朴素语言模型到目前基于Transformer的LLM(语言大模型)。 2 朴素语言模型 语言模型是机器学习模型,因此它们会学习如何生成文本。教授它们的方法(即训练阶段)是提供一个大规模文本语料库,它们将从中学习如何模仿生成这些文本的过程。 也许这听起来有些抽象,但创建一个朴素语言模型实际上非常简单。你可以将文本语料库分成一定大小的字符串块,并测量它们的频率。下面是我使用大小为2的字符串得到的结果: 图源:《机器学习导论》 这些字符串块被称为n-gram(其中n表示字符串的大小,因此此处n=2)。通过这些n-gram,你可以像玩多米诺骨牌一样生成文本。从一个初始的n-gram开始,例如“th”,然后根据测量的频率随机选择一个以初始n-gram结尾的n-gram 。在这个例子中,如果选择“hi”,就会形成“th” + “hi” = “thi”。然后再继续添加以“i”开头的 n-gram,以此类推,生成整段文本。不过正如你所想,这些n-gram模型并不能生成足够连贯的文本。以下是我继续执行这一过程时得到的结果: 说实话,这一结果并不太理想!但也说得通,因为该模型的记忆能力很有限,只通过前一个字符来预测下一个字符。如果我们使用n=4的字符串,结果会稍微好一些: “complaine building thing Lakers inter blous of try sure camp Fican chips always and to New Semested and the to have being severy undiscussion to can you better is early shoot on” 现在出现了一些拼写正确的单词,但结果仍不够理想!理论上,进一步增加n的值,输出结果会得到改善,但在实践中,我们无法显著增加n值,因为这需要一个庞大的数据集来训练模型。最后,我们可以尝试将单词而不是字符作为基本单位(在自然语言处理术语中称为“词元(token)”)。这会改善输出结果,但因为n<6,生成的文本仍然缺乏连贯性。 这些朴素语言模型的记忆能力始终有限,因此无法生成超过一定长度的连贯文本。尽管如此,它们仍具备一定用途。几年前,朴素语言模型被广泛用于文本分类和语音识别,且如今仍被用于语言识别等任务。然而,对于更高级的文本理解和文本生成任务来说,朴素语言模型就捉襟见肘了。因此需要神经网络。 3 基于神经网络的语言模型 现代语言模型基于(人工)神经网络。神经网络是受人脑启发开发出的计算机,能够通过任务示例学习如何执行任务。这种机器学习形式也被称为深度学习,因为其中的网络由多个计算层组成(因此被称为“深度”网络)。在神经网络中,通过遍历任务示例并迭代修改网络参数以优化任务目标,从而实现学习。你可以将这些参数想象成一组旋钮(knob),通过左右旋动以改进目标,但区别是计算机为你进行改进,并且知道如何同时正确地朝着改进方向进行调整(得益于著名的反向传播算法)。因此,网络会遍历任务示例(通常以几百个示例为一批),并在这一过程中优化目标。以下是一个正在被优化的目标示例(称为成本函数,数值越小越好): 成本函数随训练迭代次数的变化。图源:《机器学习导论》 随着模型的训练,成本函数值会逐渐下降,意味着模型在任务处理上变得更加优秀。 在该案例中,我们想要生成文本。目前,标准的方法是训练一个模型,通过前面的单词预测后面的单词。由于下一个单词有多种可能性,模型会学习为每个可能的单词关联一个概率。以下是对“the cat sat on the”之后可能出现单词的概率分布可视化图像: 改编自《机器学习导论》 一旦拥有这样的预测模型,就可以从预测概率中抽样来生成下一个单词,然后将该单词重新输入到网络,再抽样一个新的单词,以此类推,从而生成文本。这一生成过程被称为自回归,因为网络利用自己的预测结果来生成新的预测。虽然有人对此提出了异议,认为这并非最佳方法,但目前而言,这就是最实际的操作方式,且效果也出奇地好! 曾经用于建模语言的第一类神经网络是RNN(循环神经网络),尤其是LSTM(长短期记忆网络)架构。RNN就像一个逐个阅读单词的小型机器,在这一过程中,它会更新思维状态(mental state)。这种思维状态如同记忆,使它们在生成文本时能大概记住一段时间的信息。相比n-gram模型,RNN模型能够获得更为优越的性能。 RNN创建之初,神经对话模型(Neural Conversational Model)给我留下了深刻印象。该模型是Google于2015年基于电影字幕训练的一个特殊LSTM模型,当时这个模型已经算得上是LLM了(也可能是首个LLM):拥有3亿参数,并在约10亿词的数据上进行训练。由于电影字幕是对话形式,因此可直接将该模型用作聊天机器人。以下是不同人类输入对应的回答示例: 人类:你叫什么名字? 机器:我叫朱莉娅。 人类:你是什么时候出生的? 机器:7月20日。 人类:我的名字是大卫。我的名字是什么? 机器:大卫。 人类:天行者是谁? 机器:他是一个英雄。 人类:天空是什么颜色? 机器:蓝色。 人类:血液是什么颜色? 机器:和黑眼圈的颜色相同。 如你所见,该模型能够闲聊,同时也对世界有一定了解,这些知识完全是通过学习如何预测文本获得的!我记得自己曾对这一事实很感兴趣:学习预测文本迫使你理解世界(但并不意味着这个过程很容易)。然而,该模型也有一些明显的短板:它经常出错,并且与类似基于LSTM的模型一样,无法生成长篇连贯的文本。理论上,循环神经网络可以长时间记忆事物,但在实践中,它们却往往很快就忘记了:经过几十到一百个词之后,它们就会开始偏离主题,不再连贯。 2017年,人们针对短期记忆问题提出一种解决方案——Transformer。Transformer是一种基于注意力机制的新型神经网络架构(本质上是一种选择操作),下图来自介绍Transformer的论文,用以说明其在翻译任务中的工作原理: Transformer架构。来源:https://arxiv.org/abs/1706.03762 Transformer在各个方面都可圈可点,但最值得一提的是,该架构在文本建模方面表现非常出色,并且很适合在GPU上运行,从而处理(和学习)大量数据。正是有了Transformer这种架构,才使得现代LLM得以兴起(或至少起到了很强的促进作用)。 4 现代语言大模型 Transformer的发明标志着现代LLM时代的开始。自2018年以来,AI实验室开始训练规模越来越大的模型。令众人惊讶的是,这些模型的质量也在不断提高!下图对这些模型进行了可视化,我们将重点介绍其中值得关注的模型: LLM进化树。来源:https://github.com/Mooler0410/LLMsPracticalGuide 这些语言模型主要分为三类。一是“仅编码器(encoder-only)”组(上图中的粉色部分),该类语言模型擅长文本理解,因为它们允许信息在文本的两个方向上流动。二是“仅解码器(decoder-only)”组(上图中的蓝色部分),该类语言模型擅长文本生成,因为信息只能从文本的左侧向右侧流动,以自回归方式有效生成新词汇。三是“编码器-解码器(encoder-decoder)”组(上图中的绿色部分),该类语言模型对上述两种模型进行了结合,用于完成需要理解输入并生成输出的任务,例如翻译。 这一切都主要始于文本理解类模型。最初是使用RNN的ELMo,之后是谷歌著名的BERT模型及其派生模型(如RoBERTa),它们都基于Transformer。这些模型通常具有几亿个参数(相当于约1GB的计算机内存),在大约10GB到100GB的文本上进行训练(通常为几十亿个单词),并且可以在现代笔记本电脑上以约0.1秒的速度处理一段文本。这些模型极大地提升了文本理解任务的性能,如文本分类、实体检测和问题回答等。这已然是NLP(自然语言处理)领域的一场革命,不过才刚刚拉开序幕…… 在文本理解类语言模型发展的同时,OpenAI开始基于Transformer创建文本生成类语言模型。首先是2018年的GPT-1,有1亿个参数;然后是2019年的GPT-2,拥有高达15亿个参数,并在40GB的文本上进行了训练。至少对我来说,GPT-2的创建是一个至关重要的时刻。以下是GPT-2可以生成的文本示例,从一个由人类撰写的段落开始: 来源:https://cdn.openai.com/better-language-models/language_models_are_unsupervised_multitask_learners.pdf 生成的英语文本质量很不错,而且具有连贯性。例如,科学家的名字没有改变,而这在基于RNN的模型中是个经典问题。由于GPT-2在所生成文本的质量上取得了巨大突破,为避免滥用,OpenAI最初决定不向公众发布。可以说GPT-2标志着LLM正朝着正确的方向发展。需要注意的是:使用这类语言模型需要先提供一个起始文本,这个起始文本被称为提示(prompt)。 一年后(2020年),OpenAI创建了GPT-3。GPT-3是一个具有1750亿个参数的模型(需要700GB的计算机内存来存储模型!),该模型不仅规模显著扩大,文本生成质量也有重大改进。除了性能的提升外,GPT-3还让人们对未来如何使用LLM大开眼界。 首先,GPT-3能够编写代码。例如,你可以使用GPT-3来生成(非常)简单的网站,只需在提示中描述网站的外观即可。以下是一个示例,让GPT-3使用HTML创建一个按钮: 这些基本的编码能力在当时并不十分实用,但它们的出现意味着软件开发在未来可能会发生根本性转变。 GPT-3另一令人瞩目的能力是能够进行上下文学习,它可以通过提示中所展示的示例来学习如何执行任务。这意味着你可以通过编写提示来定制LLM,而无需更改它们的权重。这一能力开辟了一种全新的、完全基于提示的自然语言处理方式,如今十分受欢迎。 总而言之,GPT-3展示了“提示”作为一种新方式的潜力,可以让机器通过自然语言按照我们的意愿执行任务。 注意:GPT-3比GPT-2要大得多。自2018年以来,模型的规模急剧增加。以下是一些值得关注的LLM及其规模: 在两年时间里,模型参数的数量增加了1000倍,目前最大的模型(如GPT-4)已接近1万亿个参数,这是因为模型规模的增加与性能的改善密切相关,并且目前还未达到性能瓶颈。这些模型规模十分庞大,与人脑相比,人脑约有1000亿个神经元,每个神经元平均与其他1000个神经元相连接,总共约有100万亿个连接。从某种意义上说,最大的LLM仍然比人脑小100倍。当然,这只是一个非常宽泛的比较,因为人脑和当前LLM使用的架构和学习方法都截然不同。 另一个有趣的指标是这些模型在训练阶段所“阅读(read)”的单词数量。 如你所见,数量十分庞大。这些模型在训练过程中会接触超1000亿个单词,是一个人在一生中听到或阅读单词数量的100倍以上!这显示出神经网络与人脑的不同之处:神经网络的学习速度比人类慢得多,但可以获得比人类接触的多得多的数据。 需要注意的是,LLM在训练过程中所接触到的单词数量并未像参数数量那样迅速增长(从GPT-1到GPT-3只增长了3倍)。这是因为优先考虑模型规模,不过结果证明这是一个小小的失误。最新的模型并没有比GPT-3大很多,但通过处理更多单词来进行训练。 这种对数据的渴求导致了一个问题,即可用文本的总量存在硬性限制,约为数万亿个单词,而模型正在接近这一限制。虽然仍有可能循环遍历所有文本,但这会导致模型性能的回报递减。总而言之,可得出结论:网络在训练阶段处理的有效限制是几十万亿个单词,比GPT-4的数量约多出10倍。 另一个问题是,通过用更多的数据训练更大的模型,计算成本也在增加。以下是训练上述模型的预估计算成本: 为显著超越当前模型的性能,下一代模型需要耗费数亿美元的计算资源。虽然考虑到这些模型能带来的好处,这一成本是合理的,但如此巨大的花费仍然是一个问题。 模型的扩展变得越来越困难。幸运的是,扩大规模并不是改进LLM的唯一途径。2022年末,一项创新开启了另一场革命,这次的影响远远超出了NLP领域。 5 指令调优和聊天机器人LLM GPT-3揭示了提示的潜力,但撰写提示并不容易。事实上,传统语言模型经训练可以模仿其在网络上看到的内容。因此,要想创建一个好的提示,你必须清楚网络上哪种起始文本可能会引导模型生成你所期望的结果。这是一种奇怪的游戏,也是一种找到正确表述的艺术,你需要改变措辞,假装自己是专家,展示如何逐步思考的示例等等。这一过程叫做提示工程,这使得使用这些LLM变得困难。 为解决这个问题,研究人员一直在探索如何修改基础LLM,以让其更好地遵循人类指令。现主要有两种方法:一是使用人类编写的指令-回答对(instruction-answer pairs),并在此数据集上对基础LLM进行微调(即继续训练)。二是让LLM生成几个可能的答案,然后由人类对答案评分,并使用强化学习在此数据集上对LLM微调。这就是著名的RLHF(人类反馈的强化学习)的过程。此外,我们还可以将两种方法相结合,OpenAI在InstructGPT和ChatGPT中就对这两者进行了结合。 InstructGPT和ChatGPT的指令调整步骤。来源:https://openai.com/blog/chatgpt(修改自https://arxiv.org/abs/2203.02155) 将这两种技术结合在一起可以得到一个经过指令调整的LLM。调整后的LLM比基础模型更擅长遵循人类指令,使用起来更加容易。 经过指令调整的LLM已经非常出色了,但还有最后一步才能将这些LLM真正转化为每个人都可以使用的东西——聊天机器人。OpenAI在2022年12月发布了ChatGPT,一个基于GPT-3.5的聊天机器人。它的创建方式与InstructGPT相同,但这次使用的是整个对话而不仅仅是指令-回答对。 ChatGPT发布后,基于LLM的新型聊天机器人开始层出不穷。OpenAI使用GPT-4来代替GPT-3.5,对ChatGPT进行了改进,Anthropic发布了Claude,Google推出Bard,Meta也研发出了LLaMA,还有几个开源LLM正在发布过程中。这是一次真正的模型大爆炸,将会带来许多令人兴奋的应用,NuMind也会为此出一份力。 ChatGPT发布两个月后,迅速拥有了上亿用户,成为有史以来用户增长最快的产品。人们用ChatGPT来根据要点编写电子邮件、重新组织文本、总结文本、编写代码,或学习东西(在此之前,搜索引擎一直垄断着这项任务)。ChatGPT的发布是LLM发展史的转折点,它让人们意识到了LLM的潜力,引发了“AI竞赛”,世界上主要人工智能实验室和初创公司都参与其中。 值得注意的是,LLM的突然普及也引发了人们的担忧。人们担心LLM被有心人利用,做一些有害的事情,所以创建开放式LLM聊天机器人必须确保它们的“安全”性(或“与人类价值观保持一致”),也就是说它们不能帮助制造炸弹等。目前有一些方法可以绕过聊天机器人的安全防御措施,但随着时间推移,这些安全措施会逐渐完善,想绕过它们将变得十分困难。 6 语言大模型的未来 近年来,LLM取得了很大进步,人们对它的热情达到了空前高度,在这一领域投入了大量精力。那么,LLM的未来将如何发展?虽然预测未来很难,但我们也有一些看法: 模型大小和训练规模将继续扩大。扩展在过去取得了非常好的效果,且仍有提升空间,但问题是,模型的训练成本急剧增长,逐渐让人望而却步(>1亿美元)。更好的GPU和新的专用硬件有助于扩展模型规模,但它们的开发和生产需要时间。此外,最大的模型已经迭代了所有书籍和整个网络,这意味着我们正在达到可用训练数据的极限(即“词元危机”)。 因此,可以肯定的是,在未来几年内,参数数量不会像过去那样出现爆发式增长。最大的模型今年应该会稳定在1万亿参数以下规模,然后以每年50%的速度增长。 LLM将超越纯语言模型,将图像和视频纳入训练数据,成为多模态模型。从图像和视频中学习可能有助于模型更好地理解世界。GPT-4就是在图像和文本上进行训练的,且取得了少许性能提升。利用视频数据训练LLM可能给这一领域带来质的改变,但这需要大量计算。预计还需两年多的时间才能真正实现利用视频训练“语言”大模型。 扩大规模、实现语言模型向多模态模型的转变需要大量算力。为缓解这一问题,我们可以采用更好的神经架构和训练程序,这些架构和训练程序要么计算强度较低,要么可以用更少的数据进行学习(人类大脑证明这是可能的)。然而更可能的是类似于RNN的内存会卷土重来,因为这种内存运行时的效率非常高(例如最近的RWKV架构)。 此外,还可能有一些更大的变化,例如LLM不以自回归的方式生成,而是以自上而下的方式生成(例如在生成单词之前做出(随机)决定),这种做法可能更合乎逻辑(这就是神经网络目前生成图像的方式)。到底何时会开发出这样的新架构/方法还很难说,但我们预计应该就在未来几年,一旦开发出来,LLM模型的性能将得到大幅提升。 另一个改进方向是继续进行指令调优,让更多人参与到“教育”LLM(即与AI对齐)的过程中。这可以由私人AI实验室来实现,也可以是一个更像维基百科的众包项目,以改进和对齐开放模型的LLM能力。在这个问题上,我们还是希望偏离传统的RLHF,而是让人们与模型对话来进行教导,就像我们对待孩子一样。我不确定这种项目的具体时间线,但我已经思考了一段时间,非常希望看到它的实现。 上文我们只讨论了改进实际模型的方法,但实际上有一些方法可以在不改变模型的情况下改进LLM。方法之一就是为LLM提供工具。这种工具可以是用于查找准确信息的搜索引擎,或者是用于进行基本数学计算的计算器。此外,它还可以是一个结合了推理引擎(符号人工智能的经典组件)的知识库,如Wolfram Alpha,用于查找事实、进行逻辑推理或其他神经网络不擅长的计算。当然,这个工具还可以是一个用于编写和运行代码的完整编程环境。LLM可以通过生成触发API调用的特殊词元(单词)来使用这些工具,然后将API的输出插入到生成的文本中。 LLM使用工具示例。来源:https://arxiv.org/abs/2302.04761 上述趋势实际上已经开始了(例如,ChatGPT 插件、LangChain 库和 Toolformer 论文),我相信这些工具将成为LLM的核心。 改进LLM的另一个方法是以更智能的方式使用它们,让它们更好地完成任务。这可以通过巧妙的提示或更高级的程序来实现。比如说我们可以让LLM按步骤进行思考(即思想链提示( chain-of-thoughts prompting)),并提高LLM在逻辑任务上的表现。以下是提示LLM按步骤思考的示例: 思维链提示示例。来源:https://arxiv.org/abs/2201.11903 同样地,我们可以要求LLM反思、批判自己的输出,并对其进行迭代修改。通过迭代,我们可以显著提高LLM性能,尤其是生成代码方面的性能。我们还可以更进一步,创建完全自主的智能体,这些智能体可以管理任务列表并迭代任务,直到达到主要目标(请参考AutoGPT和 BabyAGI)。目前,这些自动化智能体的运行效果并不理想,但它们的效果会逐步提升,很难说这些自动化智能体会发展到何种程度,对LLM产生何种影响。 由于LLM可以通过这些程序(思想链、迭代批评等)改进答案,因此,我们可以使用这些程序创建指令-答案对,然后在指令-答案对上按顺序对LLM微调以提高其性能。这种自我完善是可能的(参见https://arxiv.org/abs/2210.11610),我相信它具有很大的潜力。例如,我们可以想象模型为了变得更加自洽而与自身进行讨论,这是一种自我反思过程。可能会进一步提升LLM的表现。 LLM可能还有其他改进方向,总的来说,我们无法确定LLM的未来,但显然它们将继续发展下去。理解和生成文本的能力使LLM成为了一项基本技术。即使在目前的发展情况下,LLM也将解锁大量应用程序,日常工作中的数字助理就是一个很好的例子,更疯狂的是,LLM甚至可能引导我们创造某种超级智能。 其他人都在看 关于语言大模型的八大论断 NCCL源码解析④:建图过程 揭示GPT Tokenizer的工作原理 语言大模型100K上下文窗口的秘诀 GPT总设计师:大型语言模型的未来 OneEmbedding:单卡 训练TB级推荐模型不是梦 GLM训练加速:性能最高提升3倍,显存节省1/3 试用OneFlow: github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 深入浅出线程池

一、线程 1、什么是线程 线程(thread)是操作系统能够进行运算调度的最小单位。它被包含在进程之中,是进程中的实际 运作单位。一条线程指的是进程中一个单一顺序的控制流,一个进程中可以并发多个线程,每条线 程并行执行不同的任务。 2、如何创建线程 2.1、JAVA中创建线程 /** * 继承Thread类,重写run方法 */ class MyThread extends Thread { @Override public void run() { System.out.println("myThread..." + Thread.currentThread().getName()); } } /** * 实现Runnable接口,实现run方法 */ class MyRunnable implements Runnable { @Override public void run() { System.out.println("MyRunnable..." + Thread.currentThread().getName()); } } /** * 实现Callable接口,指定返回类型,实现call方法 */ class MyCallable implements Callable<String> { @Override public String call() throws Exception { return "MyCallable..." + Thread.currentThread().getName(); } } 2.2、测试一下 public static void main(String[] args) throws Exception { MyThread thread = new MyThread(); thread.run(); //myThread...main thread.start(); //myThread...Thread-0 MyRunnable myRunnable = new MyRunnable(); Thread thread1 = new Thread(myRunnable); myRunnable.run(); //MyRunnable...main thread1.start(); //MyRunnable...Thread-1 MyCallable myCallable = new MyCallable(); FutureTask<String> futureTask = new FutureTask<>(myCallable); Thread thread2 = new Thread(futureTask); thread2.start(); System.out.println(myCallable.call()); //MyCallable...main System.out.println(futureTask.get()); //MyCallable...Thread-2 } 2.3、问题 既然我们创建了线程,那为何我们直接调用方法和我们调用start()方法的结果不同?new Thread() 是否真实创建了线程? 2.4、问题分析 我们直接调用方法,可以看到是执行的主线程,而调用start()方法就是开启了新线程,那说明new Thread()并没有创建线程,而是在start()中创建了线程。 那我们看下Thread类start()方法: class Thread implements Runnable { //Thread类实现了Runnalbe接口,实现了run()方法 private Runnable target; public synchronized void start() { ... boolean started = false; try { start0(); //可以看到,start()方法真实的调用时start0()方法 started = true; } finally { ... } } private native void start0(); //start0()是一个native方法,由JVM调用底层操作系统,开启一个线程,由操作系统过统一调度 @Override public void run() { if (target != null) { target.run(); //操作系统在执行新开启的线程时,回调Runnable接口的run()方法,执行我们预设的线程任务 } } } 2.5、总结 1. JAVA不能直接创建线程执行任务,而是通过创建Thread对象调用操作系统开启线程,在由操作系 统回调Runnable接口的run()方法执行任务; 2. 实现Runnable的方式,将线程实际要执行的回调任务单独提出来了,实现线程的启动与回调任务 解耦; 3. 实现Callable的方式,通过Future模式不但将线程的启动与回调任务解耦,而且可以在执行完成后 获取到执行的结果; 二、多线程 1、什么是多线程 多线程(multithreading),是指从软件或者硬件上实现多个线程并发执行的技术。同一个线程只 能处理完一个任务在处理下一个任务,有时我们需要多个任务同时处理,这时,我们就需要创建多 个线程来同时处理任务。 2、多线程有什么好处 2.1、串行处理 public static void main(String[] args) throws Exception { System.out.println("start..."); long start = System.currentTimeMillis(); for (int i = 0; i < 5; i++) { Thread.sleep(2000); //每个任务执行2秒 System.out.println("task done..."); //处理执行结果 } long end = System.currentTimeMillis(); System.out.println("end...,time = " + (end - start)); } //执行结果 start... task done... task done... task done... task done... task done... end...,time = 10043 2.2、并行处理 public static void main(String[] args) throws Exception { System.out.println("start..."); long start = System.currentTimeMillis(); List<Future> list = new ArrayList<>(); for (int i = 0; i < 5; i++) { Callable<String> callable = new Callable<String>() { @Override public String call() throws Exception { Thread.sleep(2000); //每个任务执行2秒 return "task done..."; } }; FutureTask task = new FutureTask(callable); list.add(task); new Thread(task).start(); } list.forEach(future -> { try { System.out.println(future.get()); //处理执行结果 } catch (Exception e) { } }); long end = System.currentTimeMillis(); System.out.println("end...,time = " + (end - start)); } //执行结果 start... task done... task done... task done... task done... task done... end...,time = 2005 2.3、总结 1. 多线程可以把一个任务拆分为几个子任务,多个子任务可以并发执行,每一个子任务就是一个线程。 2. 多线程是为了同步完成多项任务,不是为了提高运行效率,而是为了提高资源使用效率来提高系统 的效率。 2.4、多线程的问题 上面示例中我们可以看到,如果每来一个任务,我们就创建一个线程,有很多任务的情况下,我们 会创建大量的线程,可能会导致系统资源的耗尽。同时,我们知道线程的执行是需要抢占CPU资源 的,那如果有太多的线程,就会导致大量时间用在线程切换的开销上。 再有,每来一个任务都需要创建一个线程,而创建一个线程需要调用操作系统底层方法,开销较 大,而线程执行完成后就被回收了。在需要大量线程的时候,创建线程的时间就花费不少了。 三、线程池 1、如何设计一个线程池 由于多线程的开发存在上述的一些问题,那我们是否可以设计一个东西来避免这些问题呢?当然可以! 线程池就是为了解决这些问题而生的。那我们该如何设计一个线程池来解决这些问题呢?或者说,一个线程池该具备什么样的功能? 1.1、线程池基本功能 1. 多线程会创建大量的线程耗尽资源,那线程池应该对线程数量有所限制,可以保证不会耗尽系统资 源; 2. 每次创建新的线程会增加创建时的开销,那线程池应该减少线程的创建,尽量复用已创建好的线 程; 1.2、线程池面临问题 1. 我们知道线程在执行完自己的任务后就会被回收,那我们如何复用线程? 2. 我们指定了线程的最大数量,当任务数超出线程数时,我们该如何处理? 1.3、创新源于生活 先假设一个场景:假设我们是一个物流公司的管理人员,要配送的货物就是我们的任务,货车就是 我们配送工具,我们当然不能有多少货物就准备多少货车。那当顾客源源不断的将货物交给我们配 送,我们该如何管理才能让公司经营的最好呢? 1. 最开始货物来的时候,我们还没有货车,每批要运输的货物我们都要购买一辆车来运输; 2. 当货车运输完成后,暂时还没有下一批货物到达,那货车就在仓库停着,等有货物来了立马就可以 运输; 3. 当我们有了一定数量的车后,我们认为已经够用了,那后面就不再买车了,这时要是由新的货物来 了,我们就会让货物先放仓库,等有车回来在配送; 4. 当618大促来袭,要配送的货物太多,车都在路上,仓库也都放满了,那怎么办呢?我们就选择临 时租一些车来帮忙配送,提高配送的效率; 5. 但是货物还是太多,我们增加了临时的货车,依旧配送不过来,那这时我们就没办法了,只能让发 货的客户排队等候或者干脆不接受了; 6. 大促圆满完成后,累计的货物已经配送完成了,为了降低成本,我们就将临时租的车都还了; 1.4、技术源于创新 基于上述场景,物流公司就是我们的线程池、货物就是我们的线程任务、货车就是我们的线程。我 们如何设计公司的管理货车的流程,就应该如何设计线程池管理线程的流程。 1. 当任务进来我们还没有线程时,我们就该创建线程执行任务; 2. 当线程任务执行完成后,线程不释放,等着下一个任务进来后接着执行; 3. 当创建的线程数量达到一定量后,新来的任务我们存起来等待空闲线程执行,这就要求线程池有个 存任务的容器; 4. 当容器存满后,我们需要增加一些临时的线程来提高处理效率; 5. 当增加临时线程后依旧处理不了的任务,那就应该将此任务拒绝; 6. 当所有任务执行完成后,就应该将临时的线程释放掉,以免增加不必要的开销; 2、线程池具体分析 上文中,我们讲了该如何设计一个线程池,下面我们看看大神是如何设计的; 2.1、 JAVA中的线程池是如何设计的 2.1.1、 线程池设计 看下线程池中的属性,了解线程池的设计。 public class ThreadPoolExecutor extends AbstractExecutorService { //线程池的打包控制状态,用高3位来表示线程池的运行状态,低29位来表示线程池中工作线程的数量 private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0)); //值为29,用来表示偏移量 private static final int COUNT_BITS = Integer.SIZE - 3; //线程池的最大容量 private static final int CAPACITY = (1 << COUNT_BITS) - 1; //线程池的运行状态,总共有5个状态,用高3位来表示 private static final int RUNNING = -1 << COUNT_BITS; //接受新任务并处理阻塞队列中的任务 private static final int SHUTDOWN = 0 << COUNT_BITS; //不接受新任务但会处理阻塞队列中的任务 private static final int STOP = 1 << COUNT_BITS; //不会接受新任务,也不会处理阻塞队列中的任务,并且中断正在运行的任务 private static final int TIDYING = 2 << COUNT_BITS; //所有任务都已终止, 工作线程数量为0,即将要执行terminated()钩子方法 private static final int TERMINATED = 3 << COUNT_BITS; // terminated()方法已经执行结束 //任务缓存队列,用来存放等待执行的任务 private final BlockingQueue<Runnable> workQueue; //全局锁,对线程池状态等属性修改时需要使用这个锁 private final ReentrantLock mainLock = new ReentrantLock(); //线程池中工作线程的集合,访问和修改需要持有全局锁 private final HashSet<Worker> workers = new HashSet<Worker>(); // 终止条件 private final Condition termination = mainLock.newCondition(); //线程池中曾经出现过的最大线程数 private int largestPoolSize; //已完成任务的数量 private long completedTaskCount; //线程工厂 private volatile ThreadFactory threadFactory; //任务拒绝策略 private volatile RejectedExecutionHandler handler; //线程存活时间 private volatile long keepAliveTime; //是否允许核心线程超时 private volatile boolean allowCoreThreadTimeOut; //核心池大小,若allowCoreThreadTimeOut被设置,核心线程全部空闲超时被回收的情况下会为0 private volatile int corePoolSize; //最大池大小,不得超过CAPACITY private volatile int maximumPoolSize; //默认的任务拒绝策略 private static final RejectedExecutionHandler defaultHandler = new AbortPolicy(); //运行权限相关 private static final RuntimePermission shutdownPerm = new RuntimePermission("modifyThread"); ... } 小结一下:以上线程池的设计可以看出,线程池的功能还是很完善的。 1. 提供了线程创建、数量及存活时间等的管理; 2. 提供了线程池状态流转的管理; 3. 提供了任务缓存的各种容器; 4. 提供了多余任务的处理机制; 5. 提供了简单的统计功能; 2.1.2、线程池构造函数 //构造函数 public ThreadPoolExecutor(int corePoolSize, //核心线程数 int maximumPoolSize, //最大允许线程数 long keepAliveTime, //线程存活时间 TimeUnit unit, //存活时间单位 BlockingQueue<Runnable> workQueue, //任务缓存队列 ThreadFactory threadFactory, //线程工厂 RejectedExecutionHandler handler) { //拒绝策略 if (corePoolSize < 0 || maximumPoolSize <= 0 || maximumPoolSize < corePoolSize || keepAliveTime < 0) throw new IllegalArgumentException(); if (workQueue == null || threadFactory == null || handler == null) throw new NullPointerException(); this.corePoolSize = corePoolSize; this.maximumPoolSize = maximumPoolSize; this.workQueue = workQueue; this.keepAliveTime = unit.toNanos(keepAliveTime); this.threadFactory = threadFactory; this.handler = handler; } 小结一下: 1. 构造函数告诉了我们可以怎样去适用线程池,线程池的哪些特性是我们可以控制的; 2.1.3、线程池执行 2.1.3.1、提交任务方法 • public void execute(Runnable command); • Future<?> submit(Runnable task); • Future submit(Runnable task, T result); • Future submit(Callable task); public Future<?> submit(Runnable task) { if (task == null) throw new NullPointerException(); RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); return ftask; } 可以看到submit方法的底层调用的也是execute方法,所以我们这里只分析execute方法; public void execute(Runnable command) { if (command == null) throw new NullPointerException(); int c = ctl.get(); //第一步:创建核心线程 if (workerCountOf(c) < corePoolSize) { //worker数量小于corePoolSize if (addWorker(command, true)) //创建worker return; c = ctl.get(); } //第二步:加入缓存队列 if (isRunning(c) && workQueue.offer(command)) { //线程池处于RUNNING状态,将任务加入workQueue任务缓存队列 int recheck = ctl.get(); if (! isRunning(recheck) && remove(command)) //双重检查,若线程池状态关闭了,移除任务 reject(command); else if (workerCountOf(recheck) == 0) //线程池状态正常,但是没有线程了,创建worker addWorker(null, false); } //第三步:创建临时线程 else if (!addWorker(command, false)) reject(command); } 小结一下:execute()方法主要功能: 1. 核心线程数量不足就创建核心线程; 2. 核心线程满了就加入缓存队列; 3. 缓存队列满了就增加非核心线程; 4. 非核心线程也满了就拒绝任务; 2.1.3.2、创建线程 private boolean addWorker(Runnable firstTask, boolean core) { retry: for (;;) { int c = ctl.get(); int rs = runStateOf(c); ​ //等价于:rs>=SHUTDOWN && (rs != SHUTDOWN || firstTask != null || workQueue.isEmpty()) //线程池已关闭,并且无需执行缓存队列中的任务,则不创建 if (rs >= SHUTDOWN && ! (rs == SHUTDOWN && firstTask == null && ! workQueue.isEmpty())) return false; ​ for (;;) { int wc = workerCountOf(c); if (wc >= CAPACITY || wc >= (core ? corePoolSize : maximumPoolSize)) return false; if (compareAndIncrementWorkerCount(c)) //CAS增加线程数 break retry; c = ctl.get(); // Re-read ctl if (runStateOf(c) != rs) continue retry; // else CAS failed due to workerCount change; retry inner loop } } ​ //上面的流程走完,就可以真实开始创建线程了 boolean workerStarted = false; boolean workerAdded = false; Worker w = null; try { w = new Worker(firstTask); //这里创建了线程 final Thread t = w.thread; if (t != null) { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { // Recheck while holding lock. // Back out on ThreadFactory failure or if // shut down before lock acquired. int rs = runStateOf(ctl.get()); ​ if (rs < SHUTDOWN || (rs == SHUTDOWN && firstTask == null)) { if (t.isAlive()) // precheck that t is startable throw new IllegalThreadStateException(); workers.add(w); //这里将线程加入到线程池中 int s = workers.size(); if (s > largestPoolSize) largestPoolSize = s; workerAdded = true; } } finally { mainLock.unlock(); } if (workerAdded) { t.start(); //添加成功,启动线程 workerStarted = true; } } } finally { if (! workerStarted) addWorkerFailed(w); //添加线程失败操作 } return workerStarted; } 小结:addWorker()方法主要功能; 1. 增加线程数; 2. 创建线程Worker实例加入线程池; 3. 加入完成开启线程; 4. 启动失败则回滚增加流程; 2.1.3.3、工作线程的实现 private final class Worker //Worker类是ThreadPoolExecutor的内部类 extends AbstractQueuedSynchronizer implements Runnable { final Thread thread; //持有实际线程 Runnable firstTask; //worker所对应的第一个任务,可能为空 volatile long completedTasks; //记录执行任务数 ​ Worker(Runnable firstTask) { setState(-1); // inhibit interrupts until runWorker this.firstTask = firstTask; this.thread = getThreadFactory().newThread(this); } public void run() { runWorker(this); //当前线程调用ThreadPoolExecutor中的runWorker方法,在这里实现的线程复用 } ​ ...继承AQS,实现了不可重入锁... } 小结:工作线程Worker类主要功能; 1. 此类持有一个工作线程,不断处理拿到的新任务,持有的线程即为可复用的线程; 2. 此类可看作一个适配类,在run()方法中真实调用runWorker()方法不断获取新任务,完成线程复用; 2.1.3.4、线程的复用 final void runWorker(Worker w) { //ThreadPoolExecutor中的runWorker方法,在这里实现的线程复用 Thread wt = Thread.currentThread(); Runnable task = w.firstTask; w.firstTask = null; w.unlock(); // allow interrupts boolean completedAbruptly = true; //标识线程是否异常终止 try { while (task != null || (task = getTask()) != null) { //这里会不断从任务队列获取任务并执行 w.lock(); //线程是否需要中断 if ((runStateAtLeast(ctl.get(), STOP) || (Thread.interrupted() && runStateAtLeast(ctl.get(), STOP))) && !wt.isInterrupted()) wt.interrupt(); try { beforeExecute(wt, task); //执行任务前的Hook方法,可自定义 Throwable thrown = null; try { task.run(); //执行实际的任务 } catch (RuntimeException x) { thrown = x; throw x; } catch (Error x) { thrown = x; throw x; } catch (Throwable x) { thrown = x; throw new Error(x); } finally { afterExecute(task, thrown); //执行任务后的Hook方法,可自定义 } } finally { task = null; //执行完成后,将当前线程中的任务制空,准备执行下一个任务 w.completedTasks++; w.unlock(); } } completedAbruptly = false; } finally { processWorkerExit(w, completedAbruptly); //线程执行完成后的清理工作 } } 小结:runWorker()方法主要功能; 1. 循环从缓存队列中获取新的任务,直到没有任务为止; 2. 使用worker持有的线程真实执行任务; 3. 任务都执行完成后的清理工作; 2.1.3.5、队列中获取待执行任务 private Runnable getTask() { boolean timedOut = false; //标识当前线程是否超时未能获取到task对象 ​ for (;;) { int c = ctl.get(); int rs = runStateOf(c); ​ // Check if queue empty only if necessary. if (rs >= SHUTDOWN && (rs >= STOP || workQueue.isEmpty())) { decrementWorkerCount(); return null; } ​ int wc = workerCountOf(c); ​ // Are workers subject to culling? boolean timed = allowCoreThreadTimeOut || wc > corePoolSize; ​ if ((wc > maximumPoolSize || (timed && timedOut)) && (wc > 1 || workQueue.isEmpty())) { if (compareAndDecrementWorkerCount(c)) //若线程存活时间超时,则CAS减去线程数量 return null; continue; } ​ try { Runnable r = timed ? workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) : //允许超时回收则阻塞等待 workQueue.take(); //不允许则直接获取,没有就返回null if (r != null) return r; timedOut = true; } catch (InterruptedException retry) { timedOut = false; } } } 小结:getTask()方法主要功能; 1. 实际在缓存队列中获取待执行的任务; 2. 在这里管理线程是否要阻塞等待,控制线程的数量; 2.1.3.6、清理工作 private void processWorkerExit(Worker w, boolean completedAbruptly) { if (completedAbruptly) // If abrupt, then workerCount wasn't adjusted decrementWorkerCount(); ​ final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { completedTaskCount += w.completedTasks; workers.remove(w); //移除执行完成的线程 } finally { mainLock.unlock(); } ​ tryTerminate(); //每次回收完一个线程后都尝试终止线程池 ​ int c = ctl.get(); if (runStateLessThan(c, STOP)) { //到这里说明线程池没有终止 if (!completedAbruptly) { int min = allowCoreThreadTimeOut ? 0 : corePoolSize; if (min == 0 && ! workQueue.isEmpty()) min = 1; if (workerCountOf(c) >= min) return; // replacement not needed } addWorker(null, false); //异常终止线程的话,需要在常见一个线程 } } 小结:processWorkerExit()方法主要功能; 1. 真实完成线程池线程的回收; 2. 调用尝试终止线程池; 3. 保证线程池正常运行; 2.1.3.7、尝试终止线程池 final void tryTerminate() { for (;;) { int c = ctl.get(); //若线程池正在执行、线程池已终止、线程池还需要执行缓存队列中的任务时,返回 if (isRunning(c) || runStateAtLeast(c, TIDYING) || (runStateOf(c) == SHUTDOWN && ! workQueue.isEmpty())) return; //执行到这里,线程池为SHUTDOWN且无待执行任务 或 STOP 状态 if (workerCountOf(c) != 0) { interruptIdleWorkers(ONLY_ONE); //只中断一个线程 return; } ​ //执行到这里,线程池已经没有可用线程了,可以终止了 final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { if (ctl.compareAndSet(c, ctlOf(TIDYING, 0))) { //CAS设置线程池终止 try { terminated(); //执行钩子方法 } finally { ctl.set(ctlOf(TERMINATED, 0)); //这里将线程池设为终态 termination.signalAll(); } return; } } finally { mainLock.unlock(); } // else retry on failed CAS } } 小结:tryTerminate()方法主要功能; 1. 实际尝试终止线程池; 2. 终止成功则调用钩子方法,并且将线程池置为终态。 2.2、JAVA线程池总结 以上通过对JAVA线程池的具体分析我们可以看出,虽然流程看似复杂,但其实有很多内容都是状态重复校验、线程安全的保证等内容,其主要的功能与我们前面所提出的设计功能一致,只是额外增加了一些扩展,下面我们简单整理下线程池的功能; 2.2.1、主要功能 1. 线程数量及存活时间的管理; 2. 待处理任务的存储功能; 3. 线程复用机制功能; 4. 任务超量的拒绝功能; 2.2.2、扩展功能 1. 简单的执行结果统计功能; 2. 提供线程执行异常处理机制; 3. 执行前后处理流程自定义; 4. 提供线程创建方式的自定义; 2.2.3、流程总结 以上通过对JAVA线程池任务提交流程的分析我们可以看出,线程池执行的简单流程如下图所示;  2.3、JAVA线程池使用 线程池基本使用验证上述流程: public static void main(String[] args) throws Exception { //创建线程池 ThreadPoolExecutor threadPoolExecutor = new ThreadPoolExecutor( 5, 10, 100, TimeUnit.SECONDS, new ArrayBlockingQueue(5)); //加入4个任务,小于核心线程,应该只有4个核心线程,队列为0 for (int i = 0; i < 4; i++) { threadPoolExecutor.submit(new MyRunnable()); } System.out.println("worker count = " + threadPoolExecutor.getPoolSize()); //worker count = 4 System.out.println("queue size = " + threadPoolExecutor.getQueue().size()); //queue size = 0 //再加4个任务,超过核心线程,但是没有超过核心线程 + 缓存队列容量,应该5个核心线程,队列为3 for (int i = 0; i < 4; i++) { threadPoolExecutor.submit(new MyRunnable()); } System.out.println("worker count = " + threadPoolExecutor.getPoolSize()); //worker count = 5 System.out.println("queue size = " + threadPoolExecutor.getQueue().size()); //queue size = 3 //再加4个任务,队列满了,应该5个热核心线程,队列5个,非核心线程2个 for (int i = 0; i < 4; i++) { threadPoolExecutor.submit(new MyRunnable()); } System.out.println("worker count = " + threadPoolExecutor.getPoolSize()); //worker count = 7 System.out.println("queue size = " + threadPoolExecutor.getQueue().size()); //queue size = 5 //再加4个任务,核心线程满了,应该5个热核心线程,队列5个,非核心线程5个,最后一个拒绝 for (int i = 0; i < 4; i++) { try { threadPoolExecutor.submit(new MyRunnable()); } catch (Exception e) { e.printStackTrace(); //java.util.concurrent.RejectedExecutionException } } System.out.println("worker count = " + threadPoolExecutor.getPoolSize()); //worker count = 10 System.out.println("queue size = " + threadPoolExecutor.getQueue().size()); //queue size = 5 System.out.println(threadPoolExecutor.getTaskCount()); //共执行15个任务 //执行完成,休眠15秒,非核心线程释放,应该5个核心线程,队列为0 Thread.sleep(1500); System.out.println("worker count = " + threadPoolExecutor.getPoolSize()); //worker count = 5 System.out.println("queue size = " + threadPoolExecutor.getQueue().size()); //queue size = 0 //关闭线程池 threadPoolExecutor.shutdown(); } 作者:京东零售 秦浩然 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

每日一博 | 实时数仓混沌演练实践

一、背景介绍 目前实时数仓提供的投放实时指标优先级别越来越重要,不再是单独的报表展示等功能,特别是提供给下游规则引擎的相关数据,直接对投放运营的广告投放产生直接影响,数据延迟或者异常均可能产生直接或者间接的资产损失。 从投放管理平台的链路全景图来看,实时数仓是不可或缺的一环,可以快速处理海量数据,并迅速分析出有效信息,同时支持投放管理平台的手动控盘。实时节点事故,将可能导致整个投放链路无法正常运行,另外,投放规则引擎是自动化操作,服务需要24小时运行,所以需要配置及时有效的数据质量监控预警,能快速识别到波动异常或者不符合业务的数据,从而计划引入混沌工程,希望可以通过主动注入故障的方式、尽可能提前感知风险、发现潜在问题,并针对性地进行防范、加固,避免故障发生时所带来的严重后果,提高实时数仓整体抗风险能力。 二、演练范围 为了能更细致反应出混沌演练情况,根据演练的内容不同,将实时数仓混沌分为两部分:技术侧和业务侧。 技术侧混沌:基于中间件、数据库、JVM、基础资源、网络、服务等注入常见的异常,根据实际业务中梳理的应用核心场景进行混沌演练,检验系统的脆弱性和应急响应能力,从而提升团队的稳定性保障处理能力。 业务侧混沌:对于电商活动密集型的公司来说,各种到达率、曝光率,以及更加宏观的 GMV、用户拉新数、用户召唤数等,都能表现出业务的健康程度,在实际生活中,为了描述一种稳定状态,我们需要一组指标构成一种模型,而不是单一指标。无论是否采用混沌工程,识别出这类指标的健康状态都是至关重要的,所以要围绕它们建立一整套完善的数据采集、监控、预警机制,当业务指标发生波动较大时,我们能搞快速感知、定位、修复止血。 过往数仓混沌工程均是技术侧,此次在投放链路已搭建完成主备链路的前提下,期望通可以通过多轮业务侧混沌,提高系统整体的数据异动感知能力。 三、演练计划 工欲善其事,必先利其器,在执行混沌演练前,需要准备好前置工作,制定合理的演练SOP、方案、计划,对演练环境、脚本、数据、工具,场景及爆炸半径等进行可能性评估,在确认可行性ok的情况下,约好关联方时间,再进行实践操作。 本篇主要和大家分享基于业务侧的实时数仓混沌演练过程: 1.编写演练SOP SOP是一种标准的作业程序,就是将某一事件的操作步骤和要求,进行细化、量化及优化,形成一种标准的操作过程,关于业务侧混沌,尤其是实时数仓数据相关的演练,我们也是第一次做,目前在业界也没有找到相关的演练指导参考,处于探索阶段,为了方便项目进度的顺利进行及后续演练操作更加规范、高效,在演练前期大家经过沟通、讨论后,项目前期梳理的SOP演练模板,如下: 2.演练方案调研 先收集实时数仓投放链路核心指标范围,在此基础上,拉取一段时间内的历史数据进行分析,找到每个指标对应的健康波动阀值,从而在配置相应的DQC规则监控,对于波动不在健康阀值的异常指标,在分钟级别(预期15min)内及时告警,并快速排查响应。为此,在演练前期,我们经历过一系列的方案调研、探索,如下: 「下文提供的方案,指标数据都是以设备激活数为例进行分析」 方案一: 按照天维度,收集最近一段时间,同一天每个整点设备激活数,占当天大盘占比,统计出最小值、最大值,作为该指标的健康波动阀值; 方案二: 按照天维度,收集一段时间内,同一天相邻整点指标波动数据找规律,比如每天上午9点到10点的波动数据,然后分别通过一系列的数学分布方法进行数据统计,从而希望找一个相对稳定的波动区间; 方案三: 按照天维度,收集一段时间内,相邻天整点指标波动数据找规律,比如昨天上午9点到前天上午9点的波动数据,然后分别通过一系列的数学分布方法进行数据统计,从而希望找一个相对稳定的波动区间; 方案四:在前面三种方案的基础上,指标在工作日和周末的波动可能不一样,所以我们在日维度统计的基础上,我们也调研了周维度同比波动分布情况,比如每周一上午9点到上午10点的波动数据,然后分别通过一系列的数学分布方法进行数据统计,从而希望找一个相对稳定的波动区间; 方案五:同理,我们也调研了周维度环比波动分布情况,比如本周一上午9点到上周一上午9点的波动数据,然后分别通过一系列的数学分布方法进行数据统计,从而希望找一个相对稳定的波动区间; 方案六:基于主备链路,在source源相同的情况下,经过实时数仓计算出的指标,在同一段时间两条链路sink出来的结果数据,正常应该是保持一致,或者波动较小,比如10分钟延迟的主备链路,波动不超过10%,平均差异做到一致性做到90%以上。 方案1到5,都尝试过一遍,每个方案场景数据通过最大值、最小值、平均值、各百分位分布、方差、标准差等统计出来的数据分析,很难找到一个相当稳定的波动规律,也无法框定指标具体的阀值区间,实际演练过程,如果设置的波动告警阀值过大,真实生产上业务数据波动异常时,无法及时告警发现;设置过小,将导致告警频繁,对其准确性、有效性可能存在质疑,而且,实时投放的核心指标有几十个,每个指标对应的健康阀值都不一样,要收集、分析成本非常高,从演练的效果上看,也不是很明显。 整体评估下来,演练主要采用的是方案六:涉及到的实时投放核心指标数共收集29个,一段时间内(15min),主备链路指标波动差异不超过10%。 3.演练方式 红蓝对抗演练,将团队分为红(防)蓝(攻)两组。 测试人员组成蓝军:负责制定混沌演练方案,执行目标系统故障注入,详细记录演练过程; 实时数仓开发为红军:负责发现故障、应急响应、排除故障,同时验证系统在不同故障场景下的容错能力、监控能力、人员响应能力、恢复能力等可靠性能力。 四、演练流程 整体演练过程,大致分为三个阶段:准备阶段、攻防阶段及复盘阶段。 1.准备阶段 方案准备完评审通过后,确认好链路计划; 蓝军按计划根据事先制定的攻击方案,提前准备好相应的测试数据、脚本; ‍ 红军按计划根据事先制定的攻击方案,在演练前,提前确保环境可用,并进行监控防御、应急响应措施。 2.攻防阶段 蓝队根据事先制定的攻击方案,模拟真实的攻击行为,按照约定的时间在演练链路(备用链路)进行攻击,进行故障注入,同时记录好相应的操作步骤,方便后续报告梳理; 红队在蓝军攻击后,通过飞书/邮件告警等通知方式实时关注监控系统运行情况,如有异常告警,需第一时间进行问题排查定位,在评估修复方案; 在攻防对抗的过程中,蓝军可根据红军的防御措施进行调整和改进攻击策略,尽力突破系统的防御并达到既定目标,同时红军也可分析蓝军的攻击手法和行为模型,不断改进防御措施来加强防御。 3.复盘和改进阶段 在混沌演练结束后,进行总结和评估,分析红队和蓝队的表现,评估系统的安全性和抗攻击能力; 总结经验教训,总结成功的防御措施和失败的攻击手法,以便于改进系统的安全策略; ‍ 根据评估结果和总结经验,制定改进计划,修补系统中的漏洞和薄弱点,提升系统的抗风险能力。 五、攻防实战 本次演练共计有29个指标波动case,整体演练操作大同小异。 以其中case17 “召回商品收藏uv在某个渠道下整点波动异常”为例,具体的演练操作流程如下。 1.数据准备 通过后台数据库,拉出生产主(备)链路,某个渠道(如media_id = '2')下某个整点(如hour = 10)下,召回商品收藏uv对应的整体统计值N。 --渠道小时整点维度下,商品收藏uv汇总数据 select `指标名称`, `日期`, '2' as `指标ID`, `小时段`, sum(`指标值`) from table_a where date = date_format(now(), '%Y%m%d') and `指标名称` in ( '商品收藏uv' ) and `小时段` = 10 AND `指标id` = '2' GROUP BY `指标名称`, `日期`, `小时段` order by 指标名称; 拉出备用链路,某个渠道(如media_id = '2')下某个整点(如hour = 10)下,具体的一条明细数据,记录商品收藏uv对应的值为n,把n改为n+0.1N,后续注入进备用链路,从而使得主备波动差异在10%。 -- 明细数据 select t.指标名称,t.账户id,t.计划ID,t.设备类型,t.指标值 from ( select `账户id`, `计划id`, `指标名称`, `指标值`, `设备类型` , row_number() over (partition by 指标名称 order by 指标值 desc ) as rn from table_a where date = date_format(now(), '%Y%m%d') and `指标名称` in ('商品收藏uv') and `设备类型` = '召回' and `小时段` = 10 AND `指标id` = '2' ) t where t.rn = 1 ORDER BY 指标名称; 整理后得到需要注入的数据数据,见标黄部分。 2.故障注入odps 将需要注入的数据导入odps。 导入前,需要在datawork空间中新建测试表du_qa_dw_dev.hundun_case,用于导入演练数据 -- drop table if EXISTS du_qa_dw_dev.hundun_case; CREATE TABLE IF NOT EXISTS hundun_case ( message STRING COMMENT '消息内容' ) COMMENT '混沌演练' ; 往du_qa_dw_dev.hundun_case表里灌数。 验证数据导入是否成功。 3.odps同步到kafka 执行flink同步脚本,将odsp du_qa_dw_dev.hundun_case表表数据同步到对应的kafka topic中。 flink任务脚本: --SQL --********************************************************************-- --odps同步到kakfa脚本,用于实时数仓混沌演练异常注入使用 --********************************************************************-- -- 基本函数 CREATE FUNCTION JsonParseField AS 'com.alibaba.blink.udx.log.JsonParseField'; CREATE FUNCTION jsonStringUdf AS 'com.alibaba.blink.udx.udf.JsonStringUdfV2'; ---同步账号表 CREATE TABLE `source` ( message VARCHAR ) WITH ( 'connector' = 'du-odps', 'endPoint' = '***', 'project' = '***', 'tableName' = 'hundun_case_01', 'accessId' = '*******', 'accessKey' = '*******' ); CREATE TABLE `kafka_sink` ( `messageKey` VARBINARY, `message` VARBINARY, PRIMARY KEY (`messageKey`) NOT ENFORCED ) WITH ( 'connector' = 'du-kafka', 'topic' = '********', 'properties.bootstrap.servers' = '*******', 'properties.compression.type' = 'gzip', 'properties.batch.size' = '40960', 'properties.linger.ms' = '1000', 'key.format' = 'raw', 'value.format' = 'raw', 'value.fields-include' = 'EXCEPT_KEY' ); INSERT INTO kafka_sink SELECT cast(MD5(message) as VARBINARY), cast(message as VARBINARY) FROM source ; 4.kafka平台查询数据 执行完flink同步任务后,可通过后台查询,对应的数据是否同步成功。 5.异常注入通知 在异常注入完成后,可以通过飞书群通知,告知红军,如收到告警,需第一时间群告知。 蓝军:蓝军已完成数据准备,请红军在演练前确保环境OK且已完成规则配置,另外务必将演练时间计划及时同步通知到下游关联方; 蓝军:已完成注入。 6.告警触发通知 红军在演练前,可通过监控平台提前配置好防御规则。 在异常注入后,如符合预期,在15min内发现指标波动异常,红军需及时同步到演练群中。 中危**双链路主备一致监控 服务名:**** 环境:****** 告警时间:****** 触发条件:**双链路比对波动异常,持续10分钟 告警详情:指标:prd_collect_uv主对比备下降:[-10%] 主:1066 备:956 业务域:实时数仓 应用负责人:*** 如不符合预期,未在15min内发现指标波动异常,红军需及时定位、跟进问题,并在修复后,沟通后续演练验证修复结果。 红军:15min内未收到告警,定位中 红军:原因已找到,由于***造成,导致告警数据没有及时发出,正在修复处理 红军:已修复,请红军重新发起攻击 7.演练过程记录 收集、汇总记录演练过程中的每个操作,含时间点、执行人、操作等,如下: 六、演练总结 七、未来展望 实时数仓业务侧的混沌演练,从0到1,在经过一系列的探索实践后,通过主备链路比对方式,演练期间对于异常波动的指标,可以快速识别感知,从演练结果上,取得了不错的成效,但也存在一定的局限性,如: 演练期间,通过人工注入的异常数据,如无法快速清除,可能影响到备用链路使用。 对于没有备链路的实时指标波动,需要制定更精细化的可行方案,找寻指标健康波动范围。 这些都需要团队进一步去探索、解决,同时在演练的过程中,我们将不断积累、丰富演练case、完善演练库,后续计划通过引入工具(平台)、建立演练协助机制、定期定时演练等手段,使混沌演练更加自动化、规范化、常态化,提高实时数仓整体数据稳定。 *文 / 袁宵 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册