首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 极致优化 SSD 并行读调度

作者 | GL 导读 提升检索漏斗一致性,要求在粗排阶段引入更丰富的信号,这些信号的需求量已经远远超出了内存的承受能力。为此,我们考虑引入基于NVMe SSD的分层存储。本文详细探讨了一种长尾可控的方法论,以及在这个方法论的约束下,如何极致优化读调度。这些方法对于实施类似LargerThanMem的技术也将提供有价值的启发。 全文10593字,预计阅读时间27分钟。 01 业务背景 业务需要更大存储空间,需求量预期远超过内存可承受。 举例来说,客户落地页是客户营销内容的核心阵地,增强对客户落地页内容特征理解,才能实现用户兴趣和客户投放的精准匹配,提升用户体验和转化率,凤巢正排服务引入 URL 明文是关键一步。凤巢正排服务检索查询完全基于内存,内存存储着亿级别广告物料和检索线程需要的上下文。凤巢正排服务实例上万,单实例内存 Quota 已高达云原生红线,常态利用率 85+%,URL 明文引入后,即使业务上极致去重压缩,单实例还需增加数十GB,预期随广告库会继续增长,内存已远远不够。 广告检索过程引入基于 NVMe SSD 的分级存储,长尾控制尤其关键。 检索效果对处理性能极为敏感,若查询超时导致检索 KPI 失效,将可能造成广告丢失,从而带来收入损失。以凤巢正排服务来看,单 PV 召回广告创意量在万级别,正排服务通过多分库分包实现并行,即使在单个包内,广告创意数量也可达数百。从检索系统的算力分配来看,针对百条 URL 明文的查询,其长尾性能空间仅为 5ms。 02 技术背景 SSD 作为内存存储扩展,缺点是读写干扰不可控。 SSD[1] 的操作要求必须按页进行读写,否则会导致读写放大效应。此外,SSD 硬件特性还要求“擦除后写”,因此写数据会额外引起数据搬运损耗和擦除损耗,而擦除操作的耗时往往是读操作时间的 1000 倍!更令人担忧的是,对于那些需要极低随机读取的业务而言,SSD 就像一个无法调节的『黑匣子』,应用无法直接干预由读写干扰带来的查询长尾问题。 业界常用访盘优化手段,未能控制读长尾。 业界常用软件写盘优化,确实可以显著提升吞吐,但对长尾控制力度有限,主要手段是:① 把随机写转化为对齐写、顺序写,② 整文件大块删除,③ 流量低峰期触发盘 GC。比如论文 FAST' 15《F2FS: A New File System for Flash Storage》[2] 介绍了一种面向 SSD 的全新文件系统F2FS,基于 Log-Structured File System 的技术,将所有的写入操作转换为日志记录,从而减少写放大效应,并提高了写入吞吐。下图中展示 F2FS v.s. ext4 在随机写场景(varmail、oltp)获得吞吐优势: △F2FS: A New File System for Flash Storage》 图4 业界涌现出新硬件控制读长尾。 硬件标准如 OpenChannel[3,4],在块存储之外还额外提供了接口,使得业务可以更加精细地控制数据位置和命令调度,从而结合业务特点,在一定程度上实现了读写隔离,进而控制了长尾效应。曾经,Linux LightNVM[5] 试图标准化对 OpenChannel 的操作,但由于难以定义合理且简单的块操作接口,最终被放弃,这也催生了 Zoned Namespace SSD(ZNS)[6] 新的硬件标准。ZNS 硬件并不是传统的块存储,而是一种称为 Zone 存储的概念。整个固态硬盘被划分为多个等长的区域,称为 Zone。Zone 内的数据必须以顺序的页对齐方式进行写入,并且在进行 Zone 内数据复写之前,需要对整个 Zone 进行 reset 操作。ZNS 硬件层面,也按 Zone 接口做了擦除单元隔离。 △《ZNS: Avoiding the Block Interface Tax for Flash-based SSDs》图5 新硬件的引入和打磨需要较长的周期,短期的业务需求亟需满足。 从长远来看,ZNS 固态硬盘是未来的发展趋势,我们也已经和基础架构团队共同探索。然而,在当前情况下,我们需要充分利用现有的检索池中的 Nvme 存储。为此,我们发起了 Ecomm Uniform SSD Layer - SsdEngine 项目,其目标是在底层集成各种硬件(包括 NVMe、ZNS),在上层根据典型的商业业务场景封装接口,让商业业务最大限度用上硬件发展和软硬件结合的技术红利。 △SsdEngine整体架构 通用场景 NVMe 长尾完全不可控,检索特化场景长尾可控。 Nvme SSD 在实际应用中确实受到多种读写干扰因素的影响,其主要因素包括读写单元大小(ValueSize)、读写频次(IOPS)、数据生命周期一致性(Lifetime)等等。这些影响因素的作用是复杂的,且无法简单地通过公式化加以描述 [7]。然而,检索业务也有应用特殊性:检索业务属于重读轻写的场景,在满足足够吞吐用于回溯止损的前提下,我们甚至愿意在一定程度上牺牲一部分写吞吐,以换取更为稳定的读性能。基于这一背景,结合检索业务的独特特点,我们采用了硬件友好的磁盘访问模式(Disk Access Pattern),并设计了一套基准测试(Benchmark)方案,以此来进行系统性能评测。在评测中,我们针对占检索池大头的数种 NVMe 盘型号进行了测试,最终得出以下结论:通过控制读单元大小(ValueSize = 4K)以及调整读写吞吐比(IOPS Pattern),能够有效操控读写影响,从而实现对读操作长尾的控制。下图是对于Intel P3600 盘,在读 999per 5ms 的情况下,物理盘最佳“读写配比”。 △Intel P3600 读长尾可控的读写配比 混布环境下控制单盘 IOPS 是涉及多层次的复杂问题,本文只分享单实例实践。 在单个实例中,要严格控制读写吞吐,就要从默认的基于 PageCache 的读写模式,转换为使用 Direct I/O(以下简称 DIO)模式,以便获取硬件级别的读写控制权。操作系统将数据存储在 PageCache 中,以供后续的 I/O 操作直接从内存中读取或写入,从而显著提高读写性能。在切换到 DIO 读写模式时,为了弥补缺少 PageCache 的性能影响,我们引入了 Libaio/IoUring 异步访问机制,充分发挥 SSD 的并行处理能力。下图是随机读 randread 和顺序读 read 混合的评测,如果纯顺序读,那么 PageCache 吞吐可达 1+G,且具备性能优势,为此我们也进一步做了页缓存的工作,此处先按下不表。 △单机吞吐评测数据 03 解决方案 3.1 集成 Libaio Linux Libaio 的操作接口和工作原理十分直观。 常规操作接口分三步: (1)通过 io_prepare 准备异步请求。 (2)io_submit 发送一批请求。 (3) io_getevents 采用 polling 的方式等待所有请求结束。 工作原理层面,io_submit 将所有请求都提交给了 IO 调度器,IO 调度器做完合并、排序类调度优化后,通过对应的设备驱动程序提交给具体的设备。经过一段时间,读请求被设备处理完成,CPU 将收到中断信号,设备驱动程序注册的处理函数将在中断上下文中被调用,调用 end_request 函数来结束这次请求,将 IO 请求的处理结果填回对应的 io_event 中,唤醒 io_getevents。 △Libaio 接口示例 SsdEngine 集成 Libaio 的方式也非常直观。 (1)初始化 IO 任务队列大小为 iodepth。 (2)批量设置 nr 个 IO 任务的读参数,包含文件的句柄、大小、偏移量。 (3)一次性提交 nr 个 IO 任务的读请求。 (4)针对提交的 IO 任务,我们采用分批次等待的方法,设置参数 min_wait_nr 和 batch_timeout,其中 min_wait_nr 的值为 min(nr >> 2, nr - completed) ,作用是减少 io_getevents 系统调用损耗,并实现 IO 任务与后续 CPU 任务的并行化。batch_timeout 会配合整体 timeout,控制整体超长耗时。 // 初始化 Libaio 队列 io_queue_init(iodepth, context) // 设置 nr 个 IO 任务的读参数 for (int i = 0; i < nr; i++) { io_prep_pread(iocb_list[i], fd, page[i], page_size[i], page_offset[i]); } // 提交 nr 个 IO 任务 io_submit(context, nr, iocb_list /*start*/); // 分批次等待,设置最小等待个数 min_wait_nr,最大等待个数 max_nr - completed,以及超时 ts while (completed < nr) { int res = io_getevents(context, min_wait_nr, max_nr - completed/*nr*/, events, &ts); // IO 任务正确性校验 for (int = 0; i < res; i++) { assert(events[i] == page_size[index]); } completed += res; if (total_time_cost > pv_timeout) { io_cancel(); } } 3.2 初步集成 IoUring **IoUring 执行过程和 Libaio 大同小异,但更高性能。**IoUring 通过实现两个 Ring 结构,将其映射到用户空间并与内核共享,以降低元数据复制和系统调用开销。Submission Ring 包含应用程序发出的 I/O 请求。Completion ring 包含已完成的 I/O 请求的结果。应用程序可以通过更新 Ring 的头/尾指针来插入和检索 I/O 请求,而不需要使用系统调用。总结来说,IoUring 之所以比 Libaio 的性能更优,主要有以下三点: 1、系统调用少:Libaio 在设计上每次 IO 操作需要两个系统调用,IoUring 仅在 IO 任务提交时有系统调用,等待 IO 任务完成则不需要,比 Libaio 少一次系统调用。 2、数据复制:Libaio 存在元数据的复制,IoUring 通过用户空间和内核共享,则不需要数据复制。 3、数据中断:Libaio 依赖基于数据中断的完成通知,IoUring 在 polling 模式下不依赖硬件中断;使用 polling 需要使用内核线程 kthread,我们是混部环境,该方式不采用。 △IoUring 实现原理 SsdEngine 集成 IoUring 的过程却经历了一番探索。 我们希望使用和 Libaio 同一语义的接口 io_uring_wait_cqes,IoUring Manual[14] 中解释了该函数的核心参数为,最小等待 IO 任务数 wait_nr 和等待超时 timeout,但是对 timeout 发生时,已经完成多少个 IO 任务,以及对已完成 IO 任务的处理方式没有做过多的介绍。我们先尝试参考 Libaio 同语义接口和参数,假设返回的 IO 任务都在 cqe 队列中直到 nullptr,又尝试了作者在 issue [15]中的回答,使用宏 io_uring_for_each_cqe 处理已完成的 IO 任务,但都会在任务的结果校验环节发生错误。最终通过对 kernel 5.10 源码的跟踪,我们发现在 io_uring_wait_cqes 函数实现中增加了 io_uring_prep_timeout 超时任务,需要业务单独处理。我们还发现不同版本内核,超时任务处理并不相同。 io_uring_wait_cqes:填入 wait_nr 等待任务数和 ts 超时参数 1. __io_uring_submit_timeout(ring, wait_nr, ts); 该函数的一个重点是,给 sqe 队列添加了一个超时任务:io_uring_prep_timeout,这个任务是管理 wait_nr 和 ts 的关键 2. __io_uring_get_cqe(ring, cqe_ptr, to_submit, wait_nr, sigmask); 2.1 _io_uring_get_cqe(ring, cqe_ptr, &data); 这个函数是最终调用的主要处理逻辑 2.1.1 __io_uring_peek_cqe(ring, &cqe, &nr_available); 该函数不阻塞直接获取完成任务的队列 head,并且表明当前队列有 nr_available 个; 一个观察是在返回值没有 error, cqe 不为 null 时, nr_available 才有含义,因为通过打点,有 cqe 为 null,但 nr_aviailable 不为 0 的情况; 2.1.2 __sys_io_uring_enter2(ring->enter_ring_fd, data->submit, data->wait_nr, flags, data->arg,data->sz); 提交 sqe 队列。io_uring_submit 最终调用的也是该函数,使用该接口不需要再显示调用 io_uring_submit! 面向 io_uring_wait_cqes 实现的 kernel 版本自适应编程。 总之,我们遇到的问题是在不同内核版本中 io_uring_wait_cqes 的内部实现方式有所不同。具体而言,在 kernel 5.10 及其之前的版本,会在函数实现中新增 io_uring_prep_timeout 任务处理超时,等待超时退出时,用户需要感知并单独处理该超时任务。而在 kernel 5.11 及其之后的版本中,函数实现则不再添加 io_uring_prep_timeout 任务。我们线上使用的内核版本属于前者,因此,在集成 IoUring 时,我们采取添加超时任务标识(LIBURING_UDATA_TIMEOUT)判断的方式来兼容这两个内核版本。在超时退出时,低版本内核生成的超时任务会匹配 LIBURING_UDATA_TIMEOUT 的条件分支,此时我们会跳过对该任务的额外处理。而高版本内核则不会触发这个条件分支。 // 初始化 IoUring 队列 io_uring_queue_init(iodepth, io_uring, 0 /*flags*/); // 设置 nr 个 IO 任务的读参数 for (int i = 0; i < nr; i++) { io_uring_prep_readv(sqe, fd, iovecs[i], 1, page_offset[i]); } // 一次性提交任务【debug 之后发现,使用 io_uring_wait_cqes 接口不需要再显示的提交任务】 // - io_uring_submit(io_uring); // 设置 ts 超时参数, wait_nr 等待任务数限制;该函数的返回,要么等到 wait_nr 个任务结束,要么等待超时 while (completed < nr) { io_uring_wait_cqes(_s_p_local_io_uring, &wait_cqe, wait_nr, &ts, nullptr /*sigmask*/); io_uring_for_each_cqe(io_uring, head, cqe) { // 判断是否为超时 IO 任务 if (cqe->user_data == LIBURING_UDATA_TIMEOUT) { continue; } process(cqe); io_uring_cq_advance(io_uring, 1); completed++; } } 3.3 自适应切换 Libaio/IoUring IoUring 有 8% 性能优势。 无论是 FIO 压测效果,还是 SsdEngine 集成效果,都能看出在厂内机器环境下,IoUring 较 Libaio 可提升 8% 的吞吐。 SsdEngine 要尽可能使用 IoUring。 但 IoUring 依赖内核版本升级,这也是个较长期的过程。为此我们实现了自适应切换并行调度器,在 5 系之下内核的机器上,自动切换为 Libaio,在 5 系之上内核的机器,自动切换为 IoUring,并且优先 IoUring。 if (io_uring_queue_init(env_test_iodepth, &ring, 0) == 0) { io_uring_queue_exit(&ring); return new(std::nothrow) UringPageScheduler; } else { return new(std::nothrow) AioPageScheduler; } 3.4 流水线设计 在分层存储中,存在两种经典的索引方式:HashKV[8,9] 和 LSM[10]。HashKV 一般是全内存索引,基于哈希函数将键映射到存储位置,因此适用于快速查找,但在范围查询上表现相对较差。相比之下,LSM(Log-Structured Merge)索引采用多层次、顺序写入的方式,适合高吞吐量的写入操作和范围查询,但可能在单个键查找上略显繁琐。对于检索多读少写且点查的场景下,我们采用了 HashKV。 检索过程中,一次请求会有多个 KV 查询操作,引入异步并行 IO 的简易模式是:基于内存串行查询 HashTable 获取 value 存储地址,一次性发起并行访盘 IO 操作,再等待任务结束。 特别说明: (1)对于跨多页的大 Value,在构造查询任务时候,会拆分为多个按页大小子查询任务。 (2)不足一页按页查询。 (3)一次 PV 中重复页面查询会被去重。 简易查询模式抽象如下图。横轴代表时间线,纵轴从上到下依次为应用层代码的调用顺序,在一次批量查询 IO 任务个数 batch_size 大于并行 IO 队列的大小(iodepth)时,会重复进行调度流程:schedule- 批量(iodepth 个)查询内存中的 HashKV 获取 value 存储地址,pread - 批量(iodepth 个)设置 IO 任务的参数,submit- 批量(iodepth 个)提交 IO 任务进行处理,wait- 根据 min_nr/max_nr 和 timeout 参数分批次等待 IO 任务的完成,在等待 IO 任务的过程中,并行进行这部分的数据校验,直到等到所有(iodepth 个)IO 任务的完成。 △简单查询模式 我们的优化思路是:把当前的串行的 schedule-submit-wait 模式,改为流水线,增加 IO 和 CPU 的处理并行度。具体实现上,分批次提交任务,等待任务的过程中,执行 HashTable 查询。面向用户接口方面,我们额外引入了两个流水线控制参数,这样业务可选择均衡小批量带来的系统调用开销和性能提升: 1、batch_submit,一次性提交的 IO 任务数。默认等于 iodepth,即一次性提交任务。 2、iodepth_low,默认等于 1,流水线跑起来之后,IO 任务队列中低于 iodepth - iodepth_low 个任务的时候,就开始后续任务的填充。 引用流水线后,查询模式抽象见下图。核心变化集中在:submit - 原本攒够 iodepth 个才提交任务,变成攒够 batch_submit 个就提交任务,这使得 IO 任务可以提前进入 wait 状态。wait - 原本等完 iodepth 个任务,变成等待 iodepth_low 个任务。schedule - 查询 HashTable 也因此流水线起来,提升了整体的 IO 任务和 CPU 任务的并行空间(灰色区域)。 △流水线查询模式 3.5 流水线效果评测 评测环境 评测均采用单线程运行的进程,运行环境机型是 CPU INTEL Xeon Platinum 8350C 2.6GHZ ,L1d cache: 48K,L1i cache 32K,L2 cache:1280K,L3 cache:49152K,内核是 64 位 5.10 系,编译器是 GCC 8.2,编译优化选项是 -O2。 评测内容 为了充分验证流水线效果,我们评测了两种读盘场景:场景一、海量 KV,大量读盘和 HashTable 查询;场景二、超大 Value,大量读盘,但极少量 HashTable 查询。 场景一、海量KV 设置一次查询 pv 会发起 1024 次 kv,其中 value 大小为 4K,基本对应到 1024 次 HashTable 访存查询和 1024 个访盘 IO 任务。设置 iodepth=512,iodepth_low=1,调整 batch_submit 为 512、256、128、64、32,观察不同参数下,IO 任务的平响(io_us)、99 分位(io_us_99) ,评测数据见下。 △海量 KV 查询耗时 场景二、超大Value 设置一次查询 pv 会发起 20 个 kv 查询,其中 value 大小为 1M,基本对应到 20 次 HashTable 访存查询和 245*20=4900 个访盘 IO 任务。设置 iodepth=512,iodepth_low=1,调整 batch_submit 为 512、256、128、64、32,观察不同参数下,IO 任务的平响(io_us)、99 分位(io_us_99) ,评测数据见下。 △超大 Value 查询耗时 评测结论 以 Libaio 评测数据为例。在海量 KV 场景下,batch_submit=512(iodepth) 时,没有开启流水线,IO 任务平响 4110us,batch_submit=128 时,是开启流水线的最佳平响参数,IO 任务平响 3373us,有 15%+ 的平响优化。在超大 Value 场景下,batch_submit=512 (iodepth)时,没有开启流水线,IO 任务平响 11.5ms, batch_submit=64 时,是开启流水线的最佳平响参数,IO 任务平响 7.7ms,有 30%+ 的平响优化。IoUring 和 Libaio 的评测效果趋势一致。 04 应用场景 正如背景中所指出的,引入落地页信号对于用户体验和总体收入都具有积极的影响。然而,在过去迫于凤巢正排服务的内存容量限制,粗排环节仅能使用 64 位的签名 Sign 推导出归一化 URLID,整条计算链路环节过多,带来了一致性方面的问题。经过最近一个季度的努力,通过在凤巢正排服务中引入URL明文,得到了准确的 URLID,我们显著提高了体验评估的 QLQ 准确性,实验组相较对照组提升了10.8pp,业务收入也得到了明显增长。未来,我们还将把落地页信号引入到更多的粗排 Q 中,进一步提升总体收入。 05 相关工作 广告基础检索系统的模块,可被视为一种业务特化的内存数据库。我们观察到,在内存数据库领域中出现了类似的发展趋势:在上世纪 90 年代,随着内存成本的降低和容量的增加,内存数据库得到了发展。然而,随着业务存储量的不断增加,内存的限制逐渐显现。进入 2010 年代,LargerThanMem 分支应运而生[11,12,13],从历届论文看,该分支还比较学术,主要研究两个关键问题: 1、如何引入分层存储,但又避免引入过多的 I/O 开销,即研究热/冷执行路径(Hot/Cold Execution Path)。 2、在分层存储后,如何设计自适应的冷热数据淘汰和检索策略。 问题 1 是系统设计的技术问题,而当前的 SsdEngine 设计主要关注了这一问题,我们在缓存、调度和访盘等方面都有明确的规划和实现。在广告检索业务中,冷热数据的分布特性明显存在。当前,我们只针对广告库的场景,通过商业广告同步系统的旁路实现,实现了业务分层。未来,在词表场景中,我们还将探索问题 2 的解决方案。 长尾控制在某些特定生产环境中才会成为一个突出问题,我们可以将其视为 LargerThanMem 在广告检索中所特有的挑战。如上所述,在混合部署的环境中,对单盘的 IOPS 进行控制是一个涉及多个层次的复杂任务。广告基础检索服务的特点是写少读多且具备稳定量化的局部性,单实例频控 + 超时控制,已足够控制读长尾。但随着 SsdEngine 进一步推广应用,包括单盘的 Adhoc 组网通信以及集群按照 IOPS 分配,也需要应用起来。 ——END—— 参考资料: [1]《深入浅出SSD》 [2] {F2FS}: A new file system for flash storage,2015 [3] Open-Channel SSD (What is it Good For),2016 [4] An efficient design and implementation of LSM-tree based keyvalue store on open-channel SSD,2014 [5] LightNVM: The Linux Open-Channel SSD Subsystem,2017 [6] ZNS: Avoiding the Block Interface Tax for Flash-based SSDs,2021 [7] Understanding Performance of I/O Intensive Containerized Applications for NVMe SSDs,2016 [8] FlashStore: High throughput persistent key-value store,2010 [9] SkimpyStash: RAM space skimpy key-value store on flash-based storage,2011 [10] The log-structured merge-tree (LSM-tree),1996 [11] Larger-than-Memory Data Management on Modern Storage Hardware for In-Memory OLTP Database Systems,2016 [12] LeanStore: In-Memory Data Management Beyond Main Memory,2018 [13] Rethinking Logging, Checkpoints, and Recovery for High-Performance Storage Engines,2020 [14] LibUring Manualio_uring_wait_cqeshttps://man7.org/linux/man-pages/man3/io_uring_wait_cqes.3.html,2021 [15]How to wait for a timeout efficiently https://github.com/axboe/liburing/issues/347,2021 推荐阅读: AI文本创作在百度App发文的实践 DeeTune:基于 eBPF 的百度网络框架设计与应用 百度自研高性能ANN检索引擎,开源了 存储方案作为产品——Midgard探索 百度垂类离线计算系统发展历程
优秀的个人博客,低调大师

每日一博 | 分享 8 个 CSS 小技巧

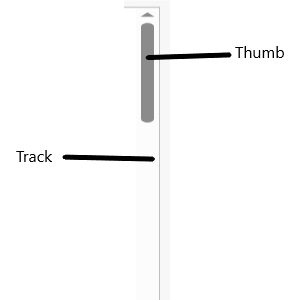
前言 在网页设计和前端开发中,CSS属性是非常重要的一部分。掌握常用的CSS属性不仅可以使你的网页看起来更美观,还能提升用户体验,今天小编为大家介绍8个常见的CSS小技巧: 1.修改滚动条样式 下图是我们常见的滚动条,现在需要改变滚动条的宽度和颜色了,并把它画的圆一点。 (常见的滚动条) 可以用::-webkit-scrollbar来实现: /*设置滚动条的宽度*/ ::-webkit-scrollbar{ width: 10px; } /*将轨道改为蓝色,并设置圆形边框*/ ::-webkit-scrollbar-track{ background-color: blue; border-radius: 10px; } /* 将滚动条设置为灰色并将其设置为圆形*/ ::-webkit-scrollbar-thumb{ background: gray; border-radius: 10px } /*悬停时呈深灰色*/ ::-webkit-scrollbar-thumb:hover{ background: darkgray; } ​ (改变之后的滚动条) 2.修改光标停留在页面上的样式 一般情况下鼠标的样式是一个箭头,改变鼠标光标的样式为其他类型: /*类为first的元素,设置鼠标为不可用状态 。 */ .first{ cursor: not-allowed; } /* 类为second的元素,将鼠标指针设置为放大镜效果 */ .second{ cursor: zoom-in; } /* 类为third的元素,将鼠标指针设置为十字准星形状*/ .third{ cursor: crosshair; } ​ (改变之后的光标) 3.保持组件的纵横比大小 在构建响应式组件的时候,组件的高度与宽度的不协调经常会导致视频和图像会出现拉伸的情况,影响读者的观感,因此我们需要设置组件的纵横比属性: .example{ /* 设置纵横比 */ aspect-ratio: 1 / .25; /* 设置宽度后,高度自动设置 */ width: 200px; /*设置边框.*/ border: solid black 1px; } 设置了宽度之后,我们将自动得到等于125像素的高度,以保持长宽比。 ​ (显示效果) 4.页面平滑的滚动 通过代码实现平滑地从一个页面跳转到另一个页面: <!DOCTYPE html\> <html\> <head\> <style\> /*设置页面平滑地滚动*/ html { scroll-behavior: smooth; } #section1 { height: 600px; background-color: pink; } #section2 { height: 600px; background-color: yellow; } <style\> <head\> <body> <h1\>Smooth Scroll</h1\> <div class="main" id="section1"\> <h2>Section 1</h2> <p>Click on the link to see the "smooth" scrolling effect.</p> <a href="\#section2">Click Me to Smooth Scroll to Section 2 Below</a> <p>Note: Remove the scroll-behavior property to remove smooth scrolling.</p> </div> <div class="main" id="section2"> <h2>Section 2</h2> <a href="#section1">Click Me to Smooth Scroll to Section 1 Above</a> </div> <p><strong>Note:</strong> The scroll-behavior property is not supported in Internet Explorer.</p> </body> </html> 点击这里查看效果: 5.筛选 使用 CSS 向图像添加滤镜: img{ filter: /*YOUR VALUE */; } 有许多可用的过滤器。您可以模糊、增亮和饱和滤镜。您可以将图像设为灰度、更改其不透明度、反转颜色等等。 ​ 正常图像(左)、模糊图像(中)和高对比度图像(右) ​ 增亮图像(左)、灰度图像(中)和色调旋转图像(右) 点击此页面了解更多关于筛选的详细信息。 6.背景效果 使用backdrop-filter在图片中添加背景。 <div class="image"\> <div class="effect"> backdrop-filter: blur(5px); </div> </div> <style> .image{ background-image: url(YOUR URL); background-size: cover; width: 400px; height: 400px; display: flex; align-items: center; justify-content: center; } .effect{ font-size: x-large; color: white; font-weight: 800; background-color: rgba(255, 255, 255, .3); backdrop-filter: blur(5px); padding: 20px; } </style> ​ (实现的效果) 7.组件反射 在 SVG 下方创建反射: .example{ /* 反射将出现在下面。其他可能的值如下:| left | right */ -webkit-box-reflect: below; } ​ (方框反射) 抵消反射: .example{ /* 反射将出现在下面。其他可能的值如下:| left | right */ -webkit-box-reflect: below 20px; } ​ (带有偏移的反射) 渐变反射: .example{ /* 反射将出现在下面。其他可能的值如下:| left | right */ -webkit-box-reflect: below 0px linear-gradient(to bottom, rgba(0,0,0,0), rgba(0,0,0,.5)); } ​ (渐变反射) 8. 检查浏览器是否支持某个属性 使用@Supports检查 CSS 是否支持特定属性。 /* 检查浏览器是否支持显示 */ @supports (display: flex){ /* 如果支持,则显示为flex。*/ div{ display: flex } } 以上就是关于CSS的8个小技巧,希望可以帮助到大家。 本文为翻译,原文地址: https://medium.com/@anirudh.munipalli/10-powerful-css-properties-that-every-web-developer-must-know-e5d7f8f04e10 扩展链接: 高级SQL分析函数-如何用窗口函数进行排名计算 3D模型+BI分析,打造全新的交互式3D可视化大屏开发方案 React + Springboot + Quartz,从0实现Excel报表自动化

优秀的个人博客,低调大师

每日一博 | 得物推荐引擎 - DGraph

1 前言 随着得物业务规模的不断增加,推荐业务也越来越复杂,对推荐系统也提出了更高的要求。我们于2022年下半年启动了DGraph的研发,DGraph是一个C++项目,目标是打造一个高效易用的推荐引擎。推荐场景的特点是表多、数据更新频繁、单次查询会涉及多张表。了解这些特点,对于推荐引擎的设计非常重要。通过阅读本文,希望能对大家了解推荐引擎有一定帮助。为什么叫DGraph?因为推荐场景主要是用x2i(KVV)表推荐为主,而x2i数据是图(Graph)的边,所以我们给得物的推荐引擎取名DGraph。 2 正文 2.1 整体架构 DGraph可以划分为索引层&服务层。索引层实现了索引的增删改查。服务层则包含Graph算子框架、对外服务、Query解析、输出编码、排序框架等偏业务的模块。 图1 2.2 索引框架 在DGraph里面参考图1,索引的管理被抽象成5个模块:Reader 索引查询、Writer 索引写入、Compaction 增量全量合并、LifeCycle 索引生命周期管理、Schema 索引配置信息。 不同类型的索引只需要实现上面的5个类即可,不同类型的索引只需要关注索引本身的实现方式,而不需要关心索引的管理问题,通过这种模式,索引管理模块实现了索引的抽象管理,如果业务需要,可以快速在DGraph面加入一种新的索引。 DGraph数据的管理都是按表(table)进行的(图2),复杂的索引会使用到DGraph的内存分配器D-Allocator,比如KVV/KV的增量部分 & 倒排索引 & 向量索引等。在DGraph所有数据更新都是DUMP(耗时)->索引构建(耗时)->引擎更新(图3),索引平台会根据DGraph引擎的内存情况自动选择在线更新还是分批重启更新。这种方式让DGraph引擎的索引更新速度&服务的稳定性得到了很大的提升。 图2 图3 2.3 索引 数据一致性 相比订单、交易等对于数据一致性要求非常严格的场景。在搜推场景,数据不需要严格的一致性,只需要最终一致性。若一个集群有N个引擎,通过增量向集群写入一条数据,每个引擎是独立更新这条数据的,因为是独立的,所以有些机器会更新快一点,有些机器会更新慢一点,这个时间尺度在毫秒级附近,理论上在某一时刻,不同引擎上的数据是不一致的,但这对业务影响不大,因为最终这些数据会保持一致。 最终一致性这个特性非常重要,因为实现严格的一致性很复杂,2PC&3PC等操作在分布式场景下,代价很高。所以事情就变得简单了很多,引擎的读写模型只需要满足最终一致性即可。这可以让我们的系统,更偏向于提供更高的读性能。这个前提也是DGraph目前很多设计的根因。 读写模型 推荐场景需要支持在线服务更新数据,因此引擎有读也有写,所以它也存在读写问题。另外引擎还需要对索引的空间进行管理,类似于JAVA系统里面JVM的内存管理工作,不过引擎做的简单很多。读写问题常见的解决方案是数据加锁。数据库和大部分业务代码里面都可以这么做,这些场景加锁是解决读写问题最靠谱的选择。但是在推荐引擎里面,对于读取的性能要求非常高,核心数据的访问如果引入锁,会让引擎的查询性能受到很大的限制。 推荐引擎是一个读多写少的场景,因此我们在技术路线上选择的是无锁数据结构RCU。RCU在很多软件系统里面有应用,比如Linux 内核里面的kfifo。大部分RCU的实现都是基于硬件提供的CAS机制,支持无锁下的单写单读、单写多读、多写单读等。DGraph选择的是单写多读+延迟释放类型的无锁机制。效率上比基于CAS机制的RCU结构好一点,因为CAS虽然无锁,但是CAS会锁CPU缓存总线,这在一定程度上会影响CPU的吞吐率。 如果简单描述DGraph的索引结构,可以理解为实现了RcuDoc(正排)、RcuRoaringBitMap(倒排)、RcuList、RcuArray、RcuList、RcuHashMap等。用推荐场景可推池来举一个例子,可推池表的存储结构可以抽象成RcuHashMap<Key, RcuDoc> table。这里用RcuList来举例子,可以用来理解DGraph的RCU机制。其中MEMORY_BARRIER是为了禁止编译器对代码重排,防止乱序执行。 图4 图5 图5是删除的例子,简单讲一下,在RcuList里面,删除一个元素的时候,比如Node19,因为删除期间可能有其他线程在访问数据,所以对List的操作和常规的操作有些不同,首先将Node11的Next节点指向Node29,保证后面进来的线程不会访问Node19,然后把Node19的Next指向Null,因为这个时候可能还有线程在访问Node19,因此我们不能立即把Node19删除,而是把Node19放入删除队列,延迟15秒之后再删除,另外删除的动作不是主动的,而是由下一个需要申请内存的操作触发,因此删除是延时且Lazy的。 数据持久化 在DGraph里面我们构建了一个内存分配器D-Allocator(每个索引只能申请一个/可选),用于存储增量或者倒排索引等复杂数据结构。采用了类似TcMalloc按大小分类的管理模式。D-Allocator利用Linux系统的mmap方法每次从固定的空间申请128M ~ 1GB大小,然后再按块划分&组织。由系统的文件同步机制保证数据的持久化。目前64位x86 CPU实际寻址空间只有48位,而在Linux下有效的地址区间是 0x00000000 00000000 ~ 0x00007FFF FFFFFFFF 和 0xFFFF8000 00000000 ~ 0xFFFFFFFF FFFFFFFF 两个地址区间。而每个地址区间都有128TB的地址空间可以使用,所以总共是256TB的可用空间。在Linux下,堆的增长方向是从下往上,栈的增长方向是从上往下,为了尽可能保证系统运行的安全性,我们把0x0000 1000 0000 0000 到 0x0000 6fff ffff ffff分配给索引空间,一共96TB,每个内存分配器可以最大使用100GB空间。为了方便管理,我们引入了表keyID,用于固定地址寻址,表地址 = 0x0000 1000 0000 0000 + keyId * 100GB, 引擎管理平台会统一管理每个集群的keyId,偶数位分配给表,奇数位保留作为表切换时使用。keyId 0 - 600 分配给集群独享表,keyId 600-960分配给全局表。因此单个集群可以最多加载300个独享表+最多180共享表(备注:不是所有表都需要D-Allocator,目前没有增量的KVV/KV表不受这个规则限制)。 图6 KV/KVV索引 KV -> Map<Key, Object> 、 KVV -> Map<Key, List<Object>>。推荐引擎绝大部分表都是KVV索引,数据更新特点是,定期批量更新 & 大部分表没有实时增量。针对这些业务特性,DGraph设计了内存紧凑型KV\KVV索引(图7)。这里简单讲一下DenseHashMap的实现,传统的HashMap是ArrayList+List或者ArrayList+红黑树的结构。DGraph的DenseHashMap,采用的ArrayList(Hash)+ArrayList(有序)方式,在ArrayList(Hash)任意桶区域,存储的是当前桶的首个KVPair信息,以及当前桶Hash冲突的个数,冲突数据地址偏移量,存储在另外一个ArrayList(有序)地址空间上(Hash冲突后可以在这块区域用二分查找快速定位数据)。这种结构有非常好的缓存命中率,因为它在内存空间是连续的。但是它也是有缺点的,不能修改,全量写入也非常复杂。首先我们要把数据加载到一个普通的HashMap,然后计算每个Hash桶上面元素的个数,知道了桶的数量和每个桶下面的元素个数,遍历HashMap,把数据固化成DenseHash。KV/KVV的增量部分则是由RcuHashMap + RcuDoc基于D-Allocator(图6)实现。 图7 Invert索引 基于开源RoaringBitmap实现的RCU版本(基于D-Allocator实现)。RoaringBitmap 将一个文档ID(uint32)分为高位和低位,高16位的ID用来建一级索引,低16位的ID用来构建二级索引(原文称之为Container),在二级索引中,因为2^16=65536,一个short占用空间16bit,65536刚好可以存储4096个short,因此当分段内文档数量少于等于4096是,用short数组存储文档,当分段内的文档数量大于4096时则转为Bitmap存储,最多可以存储65536个文档。这种设计对于稀疏倒排&密集倒排在存储空间利用率&计算性能上都表现优异。 图8 Embedding索引 基于开源的Kmeans聚类。Kmeans聚类后,引擎会以每个中心向量(centroids)为基点,构建倒排,倒排的数据结构也是RoaringBitmap,同一个聚簇的向量都回插入同一个RoaringBitmap里面。这样的好处是,可以在向量检索中包含普通文本索引,比如你可以在向量召回的基础上限制商品的tile必须要包含椰子、男鞋、红色等文本信息。 图9 2.4 算子调度框架 推荐存储引擎最开始只提供了简单的数据查询&数据补全功能,由于扩招回需要,后期又引入了算子框架,初步提供了基本的多算子融合调度能力(Merge/LeftJoin/Query),可以将多次引擎查询合并为单次查询,降低召回RT, 提升召回能力。老的框架有很多问题:1)只提供了JAVA API接入,API可解释性比较差,用户接入上存在一定困难。2)算子调度框架效率偏低,采用OMP+阶段策略调度,对服务器硬件资源利用率偏低,部分场景集群CPU超过20%后99线95线即开始恶化。3)Graph运行时中间数据采用行式存储,在空间利用率和运算开销上效率低,导致部分业务在迁移算子框架后RT反而比之前高。4)缺少调试 & 性能分析手段。 DGraph后期针对这些问题我们做了很多改进:1)引入了Graph存储,用于可以通过传入GraphID访问一个图,配合引擎管理平台的DAG展示&构图能力,降低图的使用门槛。2)开发了全新的调度框架:节点驱动+线程粘性调度。3)算子中间结果存取等计算开销比较大的环节,通过引入了列存储,虚拟列等有效的降低了运行时开销。上线后在平均RT和99线RT都取得了不错的结果。 图10 3 后记 DGraph是得物在推荐业务上一次非常成功的探索,并在算法指标、稳定性、机器成本等多方面取得了收益。搜推场景是互联网中算力开销特别大的场景之一,数据更新频繁,日常业务迭代复杂,因此对系统的挑战非常高。在DGraph的研发过程中,我们投入了非常多的精力在系统的稳定性 & 易用性上面,积累了很多些经验,简单总结下:1)平台侧需要做好数据的校验,数据的增删的改是搜推场景最容易引发事故的源头。2)提供灵活的API,类SQL或者DAG都可以,在C++内部做业务开发是非常危险的。3)索引必须是二进制结构并且采用mmap方式加载,这样即使发生崩溃的情况,系统可以在短时间快速恢复,日常调试重启等操作也会很快。 *文/寻风 本文属得物技术原创,更多精彩文章请看:得物技术官网 未经得物技术许可严禁转载,否则依法追究法律责任!

优秀的个人博客,低调大师

每日一博 | Koordinator 异构资源 / 任务调度实践

前言 Koordinator 是阿里云基于过去我们建设的统一调度系统中积累的技术和实践经验,对外开源了新一代的调度系统。Koordinator 支持 Kubernetes 上多种工作负载的混部调度。它的目标是提高工作负载的运行时效率和可靠性(包括延迟敏感型负载和批处理任务)。Koordinator 不仅擅长混部场景,也同样支持大数据、AI 训练等任务调度场景。本文分享了使用 Koordinator 支持异构资源管理和任务调度场景的实践经验。 AI/LLMs 带来新机遇和新挑战 从 2022 年 11 月 ChatGPT 发布到现在,ChatGPT 所引起的关注、产生的影响可能已经超越了信息技术历史上的几乎所有热点。众多业界专家都被它征服,比如阿里云 CEO 张勇的看法是:“所有行业、应用、软件、服务,都值得基于大模型能力重做一遍。”NVIDIA CEO 黄仁勋称它带来了 AI 的 iPhone 时刻。ChatGPT 开启了新的时代,国内外的企业和科研机构纷纷跟进,几乎每周都有一个甚至多个新模型推出,从自然语言处理、计算机视觉到人工智能驱动的科学研究、生成式 AI 等,应用百花齐放;大模型成为业务提效和打开下一个增长点的关键。同样对于云计算、基础设施、分布式系统的需求也扑面而来。 为支撑百亿级、千亿级别参数量的大模型训练需求,云计算和基础设施需要提供更强大、可扩展的计算和存储资源。大模型训练依赖的的核心技术之一是分布式训练,分布式训练需要在多个计算节点之间传递大量的数据,因此需要一个带宽更高、延迟更低的高性能网络。为了发挥计算、存储和网络资源的最佳效能,保障训练效率,调度和资源管理系统需要设计更合理的策略。在此基础上,基础设施还需要在可靠性上持续增强,具备节点故障治愈和容错能力,确保训练任务的持续运行。 大模型训练离不开异构计算设备,典型的就是我们熟知的 GPU。在 GPU 领域,NVIDIA 仍然占据着主导地位,其他厂商如 AMD 和国内的芯片制造商的机会在努力追赶。以 NVIDIA 为例,其强大的产品设计能力、扎实的技术实力和灵活的市场策略使其能够快速推出更优秀的芯片,但产品间的架构差异较大,例如 NVIDIA A100 型号和 NVIDIA H100 型号的系统架构差异十分明显,使用方式上也存在许多需要注意的细节,这给上层的调度系统和资源管理系统带来了不小的挑战。 Koordinator+KubeDL 的强强联合 我们在阿里云支撑的大模型训练场景中,使用了 Koordinator 来解决基本的任务调度需求和异构设备资源管理需求。同时,使用 KubeDL 管理训练作业生命周期和训练作业排队调度需求。 Koordinator 不仅擅长混部调度场景,还针对大数据、AI 模型训练场景,提供了包括弹性 Quota 调度、Gang 调度等通用的任务调度能力。此外,它还具备精细化的资源调度管理能力,不仅支持中心化分配 GPU,还能感知硬件系统拓扑分配资源,同时支持 GPU&RDMA 的联合分配和设备共享能力。 我们选择使用 KubeDL 来管理训练作业生命周期,是因为它不仅在支撑了内部大量 AI 领域相关场景,而且得益于其优秀的设计和实现都十分优秀,可运维性、可靠性和功能扩展性都非常出色,自身是一个统一的 controller,可以支持多种训练工作负载,如 TensorFlow、PyTorch、Mars 等。此外,它还可以适配不同调度器提供的 Gang 调度能力,可以帮助已经使用 KubeDL 项目的存量场景平滑的切换到 Koordinator;KubeDL 还内置了一个通用的作业排队机制,可以有效解决作业自身的调度需求。 Koordinator 和 KubeDL 的强强联合,可以很好的解决大模型训练的调度需求。 Job 调度 Job 是一种更高层次的抽象,通常具有特定的计算任务或操作。它可以分割成多个子任务并行完成,也可以拆分成多个子任务协作完成。通常 Job 不会依赖其他的工作负载,可以独立的运行。而且 Job 比较灵活,在时间维度、空间维度、或者资源方面的约束都比较少。 Job 排队 Job 同样需要经过调度程序调度,这也就意味着 Job 同样在调度时需要排队。那为什么需要排队呢?或者说我们可以通过排队解决哪些问题? 是因为系统中的资源有限的,我们的预算也是有限的,而 Job 的数量和计算需求往往是无限的。如果不进行排队和调度,那些计算需求较高或者执行时间较长的 Job 就会占用大量的资源,导致其他 Job 无法获取到足够的资源进行计算,甚至可能导致集群系统崩溃。 因此,为保证各个 Job 能够公平的获得资源,避免资源争夺和冲突,就需要对 Job 进行排队和调度。 我们使用 KubeDL提供的通用的 Job 排队和调度机制解决这个问题。KubeDL 因为本身就内置支持了多种训练工作负载,因此它天然支持按照 Job 粒度进行调度;并且它具备多租户间的公平性保障机制,减少 Job 间的资源争夺和冲突,排队和调度的过程中,KubeDL 根据 Job 的计算需求、优先级、资源需求等因素进行评估和分配,确保每个 Job 都能够得到合适的资源进行计算。KubeDL 支持多种扩展插件,如 Filter 插件,Score 插件等,可以进一步扩展其功能和特性满足不同场景的需求。 弹性 Quota Job 排队要解决的核心问题之一是资源供给的公平性,一般在调度系统中都是通过弹性 Quota 机制来解决。 弹性 Quota 机制要解决的几个核心问题:首先是保障公平性,不能让某一些任务的资源需求过高导致其他任务被饿死,应尽量让大部分任务都能得到资源;其次需要有一定的弹性能力,能够把空闲的额度共享给当下更需要资源的任务,同样还要能够在需要资源时,把共享出去的资源拿回来,这意味还需要提供具备灵活的策略满足不同场景的需求。 Koordinator 实现了弹性 Quota 调度能力,可以保障租户间的公平性。我们在设计之初就考虑兼容 scheduler-plugins 社区项目中定义的 ElaticQuota CRD,这样方便存量的集群和用户可以平滑的过度到 Koordinator。 另外,我们不仅是兼容 ElasticQuota 原有按照 Namespace 管理 Quota 的能力,还支持按照支持按照树形结构进行管理,可以跨 Namespace。这样的方式可以很好的支持一个复杂的组织的额度管理需求,比如一家公司里多个产品线,每个产品线的预算和使用情况都不一样,都可以转为 Quota 进行管理,并借助弹性 Quota,把暂时没有用到的空闲资源通过额度的形式临时共享给其他部门使用。 Coscheduling 当一个 Job 经过排队被调度后,Job Controller 会创建出一批子任务,对应到 K8s,就是一批 Pod。这些 Pod 往往需要协调一致的启动运行。这也就要求调度器在调度时一定要按照一组 Pod 分配资源,这一组 Pod 一定都可以那可以申请到资源或者一旦有一个 Pod 拿不到资源都认为是调度失败。这也就是调度器需要提供的 All-or-Nothing 调度语义。 如果我们不这样按照一组调度,会出现因为多个作业在资源调度层面出现争抢,是有可能出现资源维度的死锁,即至少两个 Job 会出现拿不到资源的情况,即使原本空闲资源足够其中一个 Job 运行的,也会拿不到。 比如下图中,Job A 和 Job B 同时创建一批 Pod,如果不在中间的 Scheduling Queue 进行排序而是随意的调度,就会出现 Job A 和 Job B 的 Pod 各持有了一部分节点的部分资源,如果此时集群资源紧张,很有可能 Job A 和 Job B 都可能拿不到资源。但如果排序后,我们尝试先让其中一个 Job 的 Pod 先一起尝试优先分配资源,那么至少保障一个 Job 可以运行。 当一个 Job 切分的一组 Pod 非常大时,而集群内的资源又不是十分充足,或者 Quota 不是很多时,可以把这样的一组 Pod 切分成更多个子组,这个切割的大小以能运行任务为基础,假设一个 Job 要求最小切割粒度是每组 3 个 Pod,那么这个最小粒度,一般在调度域中称为 min available。 具体到 AI 模型训练领域,一些特殊的 Job 比如 TFJob,它的子任务有两种角色,这两种角色在生产环境中,也是需要设置不同的 min available 的。这种不同角色的区分的场景还有可能要求每个角色的 min available 都满足时才可以认为符合 All-or-Nothing 语义。 Koordinator 内置了 Coscheduling 调度能力,它兼容社区的 scheduler-plugins/coscheduling 定义 PodGroup CRD,还支持把多个 PodGroup 联合调度,这样就可以支持按角色设置 min available 场景。Koordinator 实现了一个 KubeDL Gang Scheduler 插件,这样就可以和 KubeDL 做集成一起支撑这类调度场景。 精细化设备管理 K8s 设备管理的局限性 K8s 是通过 kubelet 负责设备管理和分配,并和 device plugin 交互实现整套机制,这套机制在 K8s 早期还是够用的,其他厂商如 AMD 和国内的芯片制造商也抓住机会努力追赶。 kubelet 与 device plugin 协作流程 首先 K8s 只允许通过 kubelet 来分配设备,这样就导致无法获得全局最优的资源编排,也就是从根本上无法发挥资源效能。比如一个集群内有两台节点,都有相同的设备,剩余的可分配设备数量相等,但是实际上两个节点上的设备所在的硬件拓扑会导致 Pod 的运行时效果差异较大,没有调度器介入的情况下,是可能无法抵消这种差异的。 其次是不支持类似 GPU 和 RDMA 联合分配的能力。大模型训练依赖高性能网络,而高性能网络的节点间通信需要用到 RDMA 协议和支持 RDMA 协议的网络设备,而这些设备又和 GPU 在节点上的系统拓扑层面是紧密协作的,比如下面这张图是 NVIDIA 的 A100 型号机型的硬件拓扑图,我们可以看到,PCIe Switch 下挂了 GPU 和高性能网卡,我们需要就近分配这两个设备,才能做到节点间通信的低延迟。而且这里比较有意思的是,当如果需要分配多个 GPU 时,如果涉及到了多个 PCIe Switch,就意味着需要分配多个网卡,这就和 K8s 的另一个限制有关系,即声明的资源协议是定量的,而不是随意变化的,也就是说用户实际上也不知道这个 Pod 需要多少支持 RDMA 的网卡,用户只知道要多少个 GPU 设备,并期望就近分配 RDMA 的网卡而已。 而且 kubelet 也不支持设备的初始化和清理功能,更不支持设备的共享机制,后者在训练场景一般用不到,但在线推理服务会用到。在线推理服务本身也有很明显的峰谷特征,很多时刻并不需要占用完整的 GPU 资源。 K8s 这种节点的设备管理能力一定程度上已经落后时代了,虽然现在最新的版本里支持了 DRA 分配机制(类似于已有的 PVC 调度机制),但是这个机制首先只在最新版本的 K8s 才支持,但实际情况是还有大量存量集群在使用,并且升级到 K8s 最新版本也并不是一个小事情,所以我们得想其他办法。 Koordinator 精细化设备管理机制 我们在 Koordinator 中提出了一种方案,可以解决这些问题,做到精细化的资源调度。 Koordinator 精细化设备管理机制 从上面的图中可以看到,用户创建的一个 Pod,由 koord-scheduler 调度器根据 koordlet 上报的 Device CRD 分配设备,并写入到 Pod Annotation 中,再经 kubelet 拉起 Sandbox 和 Container,这中间 kubelet 会发起 CRI 请求到 containerd/docker,但在 Koordinator 方案中,CRI 请求会被 koord-runtime-proxy 拦截并转发到 koordlet 内的 GPU 插件,感知 Pod Annotation 上的设备分配结果并生成必要的设备环境变量等信息返回给 koord-runtime-proxy,再最终把修改后的 CRI 请求转给 containerd/docker,最终再返回给 kubelet。这样就可以无缝的介入整个容器的生命周期实现自定义的逻辑。 Koordinator Device CRD 用来描述节点的设备信息,包括 Device 的拓扑信息,这些信息可以指导调度器实现精细化的分配逻辑。 Koordinator Device 对象 Future: NRI 模式 前面提到了 Koordinator 单机侧依靠 koord-runtime-proxy 协作完成设备信息注入,我们自己也意识到,koord-runtime-proxy 这种方式其实不太好在大家的集群内落地。这涉及到修改 kubelet 的启动参数问题。 所以 Koordinator 社区后续会引入 NRI/CDI 等机制解决这个场景的问题。这块工作正在和 Intel 相关团队共建。 NRI/CDI 是 containerd 支持的一种插件化机制。其部署方式有点类似于大家熟悉的 CNI,支持在启动 Sandbox/Container 前后获得机会修改参数或者实现一些定制逻辑。这相当于是 containerd 内置的 runtimeproxy 机制。 GPU&RDMA 按照硬件拓扑联合分配 前面也提到,大模型训练不仅仅只用到了 GPU,还依赖 RDMA 网络设备。要确保 GPU 和 RDMA 之间的延迟尽可能的低,否则会因为设备间的延迟放大到整个分布式训练网络中,拖慢整体的训练效率。 这就要求在分配 GPU 和 RDMA 时需要感知硬件拓扑,尽可能就近分配这种设备。尝试按照同 PCIe,同 NUMA Node,同 NUMA Socket 和 跨 NUMA 的顺序分配,延迟依次升高。 而且我们还发现同一个硬件厂商的不同型号的 GPU,它们的硬件系统拓扑是不一样的,这就要求我们的调度器需要感知这些差异。比如下图是 NVIDIA A100 型号的 System Topology 和 NVIDIA H100 的一个简单的设备连接图。 NVIDIA A100 System Topology NVIDIA A100 GPU 之间的 NVLINK 联通方式和 NVIDIA H100 型号就不一样,NVSwitch 的数量也不一样,这种差异就会给使用方式带来很大的差异。 NVIDIA H100 NVIDIA-based system 在多租模式下的差异 NVIDIA H100 GPU 在多租 VM 场景下的特殊之处,多个 GPU 之间联通需要操作 NVSwitch 才可以实现。 在多租场景中,NVIDIA 为保障安全,会通过 NVSwitch 管理 NVLink 的隔离状态,并且要求只能由授信的软件操作 NVSwitch。这个授信软件是可以自定义的。 NVIDIA 支持多种模式,一种是 Full Passthrough 模式,这种模式把 GPU 和 NVSwitch 都直通到 VM 的 Guest OS,这样做的好处是使用起来很简单,但代价是当 GPU VM 多了,NVLINK 的带宽会减少(原文:Reduced NVLink bandwidth for two and four GPU VMs)。 另一种称为 Shared NVSwitch 多租户模式,它只要求把 GPU 直通到 Guest OS,然后通过一个特殊的 VM,称为 Service VM 管理 NVSwitch,并通过 ServiceVM 调用 NVIDIA Fabric Manager 激活 NVSwitch 实现 GPU 间通信。这种模式就不会出现因为 Full Passthrough 模式的弊端,但使用方式明显要更复杂一些。这种特殊的硬件架构和使用方式,还导致在分配 GPU 时有一些额外的要求。NVIDIA 定义了哪些 GPU 设备实例可以组合一起分配,比如用户申请分配 4个 GPU,那必须是按照规定的 1,2,3,4 号一起或者 5,6,7,8 一起分,否则就会导致 Pod 无法运行。 这种特殊的分配方式的背后原因我们不得而知,但分析这些分配约束可以发现,厂商规定的这种组合关系正好符合硬件系统拓扑结构,也就是可以满足前面讲到的 GPU&RDMA 联合分配期望的分配结果。 NVIDIA H100 System Topology 作者:李涛(吕风) 点击立即免费试用云产品 开启云上实践之旅! 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | 关系代数和 SQL 语法

数据分析的语言接口 OLAP计算引擎是一架机器,而操作这架机器的是编程语言。使用者通过特定语言告诉计算引擎,需要读取哪些数据、以及需要进行什么样的计算。编程语言有很多种,任何人都可以设计出一门编程语言,然后设计对应的编译器做解析。编程语言从分类上来说,可以分为命令式,声明式。 命令式编程语言是我们最常见的编程语言,C/C++/Java等都是命令式编程语言,这类语言明确的告诉机器应该执行什么样的指令,留给编译器优化的空间很小了。 声明式编程描述程序应该获得什么结果,至于如何做到,并不关注细节。SQL就是一种声明式编程语言。例如SQL语句select count(1) from department where kpi =3.25,指明计算kpi=3.25的人数,但不会具体指定如何完成计算。这给后续的优化器留下了很大的操作空间,优化器可以根据SQL的需求和实际的数据做各种各样的探索,寻找到最佳的执行方式。 一个优秀的分析语言应该具有以下几个特征: 语言简单,门槛低 语意明确,无歧义 资料丰富,方便学习 生态丰富,工具多 方便扩展,可编排复杂的逻辑 SQL是一种历史悠久的,使用比较广泛的分析语言。在关系型数据库时代就广泛使用的一种语言。在21世纪初,出现了MapReduce算法,数据分析师需要编写MapReduce程序来分析数据。MapReduce程序是一种命令式语言,编写过程非常麻烦,堪比写程序,这就需要数据分析师不仅具备算法能力,还要具备工程能力,使用体验非常糟糕。这就需要两个团队来合作,BI团队把分析需求传递给开发团队,由开发团队去开发分析程序。为了改善分析体验,出现了SQL on Hadoop的解决方案,典型的如Hive,提供SQL接口,并把用户输入的SQL转写成MapReduce执行计划,因而极大的提升了数据分析的体验,实现了BI团队的自主分析,降低了数据分析的门槛,大大增加了受众范围。因此,SQL的影响力是非常大的。从Hive开始,大数据的主要使用接口就转移到了SQL上。而工程师们可以在SQL这张皮之下,专心的优化性能,无缝的升级计算引擎,保持使用接口的一致性。 SQL的语法简单,逻辑清晰,了解了最简单的查询语句之后,就可以嵌套多层表达很复杂的逻辑。SQL基于关系代数,有理论基础,保证语意明确没有歧义。SQL的发展历史非常久远,因而学习资料也比较多,方便新入门者学习。同时围绕SQL的生态也比较丰富,有很多工具使用SQL做分析。 除了SQL之外,也有一些软件推出自定义的语言,例如Elasticsearch使用Lucene语法,Prometheus推出了自定义的PromQL,而Splunk推出了SPL。每一种新的语法,对于新用户而言,都存在一定的学习门槛。因而都不如SQL使用广泛。可以说SQL是数据分析的事实标准。 数据模型 数据模型(DataModel) 用于描述数据在数据库中的组织形式。常见的模型有关系模型(Relational),键值模型(Key/Value),图模型(Graph),文档模型(Document),列簇模型(Column-family)等。 关系型数据库采用关系模型。Redis采用键值模型。图数据库采用图模型。MongolDB采用文档模型。 关系模型中的关系有点绕口,在英文中是Relational,硬翻译成了关系,我的理解,关系指的是一些相互之间有关系的属性组成的一个实体,因为各个列属性之间存在关联关系,而被称为一个关系,其实指的是属性之间的相关性,这种相关性体现在:属于同一行;满足列之间的约束条件;满足行之间的约束条件;满足不同关系之间的约束条件。通过不同的约束条件,是全部的数据形成一种有组织的存在。 数据库通过关系模型,定义出一个个关系实体,确保内容之间满足一定的约束标间,并且提供编程接口去读写数据库内容。一个数据库包含一堆关系,每个关系是一个多行多列的表格。每一行的各个列之间是相关的,也可能会定义一些约束条件。行与行之间,也可能通过定义唯一键(Primary Key),定义排序方式来约束行之间的关系。关系与关系之间,可以通过外部键来实现。 这种列之间和行之间的约束关系,在OLTP场景中比较实用,因为OLTP关注的数据本身,因此在存储数据时,更多关注数据的存储形式。而OLAP关注的数据的分析,所以在数仓中,这些约束条件是弱化的,因此,在数仓中,我们只需关注一张多行多列的表格即可,像PK、排序这类约束属性,更多只是用来做数据加速的手段。关系模型用来作为一种严密的理论,给执行器的优化提供理论基础。但是这个名字毕竟太绕口,在后续文章中,除非涉及到关系模型相关的理论,会使用关系这个词,一般情况下,会用表来指代一个关系。 关系代数(Relational Algebra) 关系模型和关系代数是SQL的理论基础。代数不仅是我们所熟知的简单的加减乘除等数学计算。在计算机行业,我们见到过多种algebra,在神经网络中常用的线性代数(linear algebra),在电路中用到的布尔代数(boolean algebra),香农把布尔代数带入到了逻辑电路设计中,为计算机二进制计算提供了理论依据。此外还有N多种algebra,这里不一一列举。 关系代数,源自于集合代数,讲述集合之间的变换关系。关系代数中的一系列操作,接受一个或两个关系作为输入,产生一个新的关系作为结果。由于输入和输出都是一个关系,我们可以串联多个算子,形成更加复杂的算子。关系代数中包含的算子有:σ (select,从一个关系中筛选出部分行,形成一个新的关系),Π(projection,从一个关系中筛选出部分列,形成一个新的关系),∪(Union,合并两个关系), ∩(Intersection,取两个关系的交集部分), –(difference,取两个关系的差集部分), ×(Product,两个关系的笛卡尔积),⋈(Join,两个关系在满足某些条件下的连接),ρ(Rename,重命名关系中的列), ←(Assignments,把一个临时的查询命名成一个新的关系), δ(Duplicate Eliminating,去重), γ(Aggregation,对部分列做聚合计算,结果形成一个新关系), τ(Sorting,排序结果形成一个新关系)。这里定义了常用的关系操作,名字已经表示出了其操作的含义,在这里不再介绍每个操作的明细了。在语法解析和优化器阶段我们会再次接触到关系代数,并且借助于关系代数的理论依据,来做一些语法树上的转换。在这里我们只需要知道在关系代数上有这些操作,并且在之后的SQL语法上看到如何用SQL语法来表达这些操作。 SQL SQL语言的发展历史 SQL的发展历史,可以追溯到机械化数据分析的历史。在20世纪初,IBM主要的业务是打孔卡业务,也就是使用卡上的孔来记录信息,然后利用电路的通断判断是否有孔,并通过电路驱动机械装置,累计计算结果。打孔卡类似我们现代使用的答题卡,答题卡的每一个题目,都提供了四个选项,然后用铅笔涂黑对应的选项;打孔卡不同的地方在于,选中的部分穿透成孔,当放置到电路板上时,有孔的部分会有电流通过,进而触发之后的动作。这是在当时是一项非常先进的数据分析方法,相较于古老的依赖人去计数,也让大数据的自动化分析成为可能。在20世纪初,要统计数千万人口的信息,需要投入大量的人力资源,而打孔卡这种创世纪的发明,带来了数据分析行业的快速发展。因此可以说IBM的业务主要是提供数据分析的机器,主要的客户场景是联邦政府的人口普查,以及业机构做商业分析。这个时候,数据存储以来打孔卡,而数据计算是机械装置,计算结果输出到打印机。 到20世纪50年代,随着电气化的发展,磁带取代打孔卡成为新的存储设备,电气装置取代机械装置做计数。计算结果可以继续存储到磁带上。磁带的存储空间很大,不过磁带的缺点是只能顺序读写,这导致数据处理的程序不得不适应这种特性按照顺序处理。 到了60、70年代,磁盘被发明出来,磁盘可以被随机读写,这极大的改变了数据处理方式。数据结构无需考虑数据之间的顺序,一些更加复杂的数据模型被发明出来,例如网状模型或者层次化模型。1970年,Edgar Codd定义了关系模型,给出了非过程式的查询数据的方法,关系型数据库诞生了。关系模型非常简洁,并且提供了理论基础。非过程式的查询方法,屏蔽了实现的细节,使用者只需要声明所需要的结果即可,实现的过程则交给优化器给出最优的执行计划,这极大的降低了使用门槛。关系模型的发明者也因此获得了图灵奖。尽管关系模型在学术上非常吸引人,但是在现实中,在性能上还比不上已经存在的数据库。 到了70年代后期、80年代,IBM推出了一个突破性的项目System R,在项目中研发了至关重要的能够使关系型数据库非常高效的技术。在System R中,IBM推出了SQL的最早期版本,称为Sequal,后来演化成了SQL(Structed Query Language结构化查询语言)。这个项目虽然是个原型,但是它促进了之后IBM推出了第一个商用的关系模型的数据库产品System/38(1979),SQL/DS(1981),DB2(1983)。其中DB2目前还是活跃的商用数据库,在大学中也有DB2的使用课程。至此,SQL语言出现了,并且被其他的商用数据库系统所采用,比如Oracle的数据库。在数十年内,SQL语言凭借着其易用性,击败了其他需要关心底层实现的数据库产品,成为了事实上的标准。 1986年ANSI标准推出了SQL标准,称为SQL86,就是我们常说的ANSI SQL。之后标准经过陆续补充,以添加新的特性,陆续出现了SQL89,SQL92,SQL1999(正则式,触发器,OO), SQL2003(XML,窗口函数,Sequence,自增ID),SQL2006, SQL2008(清空表语法,Fancy Sorting), SQL2011(临时表,管道式DML), 最近的是SQL2016(Json,多态表)。 一般来说,一个数据分析系统,不一定完全遵循SQL的标准,这主要是由分析系统的特有特性所决定的,有些特性,在SQL标准里边是没有的,所以一般会在SQL标准上做一些拓展,号称是兼容ANSI SQL。一个系统需要支持的最小功能集合是SQL92标准。 SQL的功能 SQL语法包含了几个类别的功能,分别是 Data Manipulation Language(DML):数据操作语言,用于增删改查数据。 Data Definition Language(DDL):数据定义语言,用于定义表的格式。 Data Control Language(DCL):数据控制语言,用于控制权限等。 虽然DML和DCL是SQL系统的基础功能,本文的关注重点更多是数据处理的技术,以及如何加快数据处理的技术,因此更多关注DDL。 在DDL中,也有增删改查,在这几项中,本文更多关注查的部分内容,即如何加快数据的读取和计算。而数据的写入、存储部分的优化手段,也是为了满足加速数据计算的目的。 SQL的处理过程 SQL全称Structed Query Language(结构化查询语言)。SQL语法简单,易学易用,是数据分析领域最通用的语言。SQL是数据分析的操作工具,对于用户而言SQL代表浙用户的操作语义,但是对于程序而言,只是接收到一串字符串。程序需要理解SQL的意义,要经过词法分析、语法分析、语义分析、构造成抽象语法树。词法分析、语法分析是非常基础的操作。大学的计算机的编译原理课程应该包含了本部分内容,词法分析和语法分析的模式是固定的,玩不出花样,无助于提升计算速度。不过作为OLAP引擎中必不可少的第一环,还是有必要对词法分析和语法分析做出简单的介绍,有助于了解后续章节中的查询计划和优化器,但是本章不会占用太多篇幅,本文的重点是关于计算速度的内容。 开发者也可以研发自定义的分析语言,只要语言符合一定的规则,没有歧义,在语义上完整,也能过称为一种语言。不过开发一个新的语言非常困难,大多数的新语言采用程序式编程,每一个短语表示一个简单的操作;或者采用管道式声明语法,每一部分代表输入,计算和输出,但是要定义一种能够无限扩展而没有歧义的语法是很难的。在语义完整程度上是不能和SQL相比较的。无论是开发一门新的语言,还是采用SQL,流程都和下图类似。OLAP引擎解析SQL,生成抽象语法树,再转化成逻辑执行计划,经过优化后,生成高性能的算子组合。这就是编译和优化的过程。 图2-1 程序编译和SQL编译 在了解编译之前,我们首先了解一下SQL的结构定义。SQL是围绕着关系进行的。可以在关系上定义各种操作,也可以定义多个关系的操作。 关系 ​ SQL操作的对象是结构化数据。SQL语法的基础语法以及嵌套扩展,都是围绕着“关系”进行的。“关系”可以想象成数据库中的表,由多行多列组成。一个SQL,接受一个或多个“关系”的输入,并输出一个“关系”。在嵌套查询时,内部查询输出一个中间“关系”,并作为外层查询的输入“关系”,类似于Linux命令行中的管道语法。在下文中,用“表”来表示“关系”。 SQL 语法 单表上的操作 在一个表上,可以进行过滤(WHERE)、转换(scalar函数)、聚合(聚合或分组聚合)、聚合后过滤(HAVING)、排序(ORDER BY)、投影(SELECT)、截断行数(LIIMIT)等操作。各个操作之间的执行时间存在先后顺序。一个典型的SQL语法如: [WITH with_query [,...]] SELECT expr FROM TABLE WHERE bool_expr GROUP BY columns HAVING Condition ORDER BY expr LIMIT count 在执行顺序上,首先从表中select出需要的列;然后执行WHERE语句;过滤完后,执行GROUP BY聚合计算;聚合后的结果执行HAVING执行二次过滤;然后执行ORDER BY排序结果;最后根据LIMIT限定输出的行数。 图2-2 SQL执行顺序 经过以上步骤,完成对一个表的操作,并且输出一个新的表。当需要嵌套查询时,把内部的结果表用括号包含起来,即可视同内部查询为一个普通表,然后执行上述相同的操作。因而,SQL的语法可以无限的嵌套。对于嵌套查询,除了用括号把子查询包含起来作为子表,另一种做法是用with语句定义子查询。下文予以详细介绍。 SELECT子句 最简单的SELECT操作是SELECT select_expr from TABLE。表示从表中获取数据,也允许在数据之上增加一些列的计算。在select可跟的表达式有: SELECT 列名.表示从表中读取列的原始数据。 SELECT scalar_function(列名),表示读取列的原始数据,并且经过scalar_function逐行转换每一行原始数据,输出转换后结果。Scalar Function是转换函数,表示1行到1行的转换。经过转换后的数据行数不会发生改变。一个典型的转换函数是round函数,表示把原始数据截断后保留几个小数位。 SELECT aggregate_function(列名),表示读取原始数据,并且对所有的原始数据做聚合计算,输出聚合后的结果,结果只包含一行一列数据。 SELECT后的表达式有可以有1个或者多个,可用逗号来连接多个表达式,如果是第1或第2种情况,两种表达式可以混合使用,例如SELECT column1, scalar_function(column2),可以并列出现无限多个列名或者转换函数。对于第3种情况,在没有group by语句的情况下,聚合函数只能和其他聚合函数混合使用,例如SELECT aggretate_function1(column1), aggregate_function2(column2),在同级别不能出现1或者2的情况,当然聚合函数内是可以嵌套转换函数的,例如SELECT aggregate_function(scalar_function(column))。对于有group by的情况,group by的列名以及列名之上的转换函数可以出现在select中。原理也很简单,因为case 1和2不改变结果行数,case 3聚合计算只输出一行结果,所以是不能在同级别混用的。 转换函数(scalar function) 如上文所说,转换函数对每一行输入,经过计算后,输出对应一行的结果,即,转换函数不会改变输入数据的行数。scalar function的scalar就代表是对原有数据的线性伸缩,不改变原数据的维度空间。转换函数的输入参数可以是0个或者多个;输出只有1个,即无论输入多少列参数,输出只有一列。如果希望输出多列,则需要把输出结果整合到一个复杂类型里,例如数组array或者字典map,再通过嵌套查询展开结果。 由于转换函数不改变结果的行数,因此可以无限嵌套调用转换函数,例如fun1(fun2(fun3(fun4(fun5(key))))),尽管大多数情况下无限层次的嵌套并不是必要的,一到两层的嵌套是常见的场景。 转换函数定义好了输入输出模式,函数实现并不属于执行框架的内容,执行框架无需关注函数的内部实现,只需要调用该函数,并且把对应的参数传入函数,然后获得输出结果并传递给后续的算子即可。 基于这套机制,用户可以开发更多自定义的UDF,并且注册到执行引擎中。开发者在开发UDF的过程中,只需要关心UDF的格式定义,而无需关注执行引擎内部复杂的实现逻辑。 ​ 转换函数的一个样例,key列取一位小数输出: SELECT round(key,1) FROM table 图2-3 聚合函数 聚合函数和转换函数的不同点在于:聚合函数无论接受多少行输入数据,输出数据都只有一个值,即一行一列;如果是按照窗口聚合(group by某些列),那么每个窗口内的输入数据只会产生一个输出数据。例如求均值的函数avg,无论输入的数据有多少行,最终都只输出一个均值。另一个不同点在于,转换函数没有内部状态,输入数据后可以立马得到输出结果;而聚合函数,要在内存中保存一个状态,直到全部数据都输入结束后,才能拿到最终的结果。例如avg函数,在内存中保存一个sum和一个count这两个值作为状态,分别表示输入数据的求和值以及输入行数,每输入一个新的数据,都更新状态,最终输出时才把两者相除,获得均值。 聚合函数也是一种UDAF(用户自定义聚合函数)。用户可以开发自己的UDAF,并且注册到执行引擎中供调用。 聚合函数的一个样例,求访问日志的平均延时: SELECT status,avg(dValue) FROM accesslog group by status 按照status划分窗口,分别有200和500两个窗口,每个窗口内的数据分别计算avg这个集合函数,产生一个聚合结果。 图2-4 聚合函数 选择性聚合 如果在SQL里边只有一个聚合函数,我们只期望对部分数据做聚合计算,那么只需要把过滤条件放在where中,先过滤出自己想要的数据即可。但是,如果有多个聚合函数呢,每个聚合函数需要的过滤条件不一样呢?对于count算子,有对应的count_if函数可以附加过滤条件。对于其他的聚合函数,也可以使用case when先过滤出来需要的数据,然后再执行聚合计算,例如avg(case when status=200 then latency end)。不过case when并不是专门用来做过滤的,语法使用起来也不叫复杂,也不是所有聚合函数都满足这种过滤的语意。除了case when,还有一种专门的选择性聚合算子,可以对每个聚合函数附加一个过滤条件。具体语法如: SELECT key, AGG1(x) FILTER (WHERE condition1), AGG2(y) FILTER (WHERE condition2), AGG3(z) FILTER (WHERE condition3), ... FROM 每个聚合算子后都跟着一个filter( where bool表达式),满足bool表达式的内容才会参与对应的聚合。在同一层的的各个聚合函数,可以指定各自的过滤条件,也可以不指定过滤条件,每个聚合函数对应的过滤条件之间没有任何关系,可以相同,也可以不同。这就是选择性聚合,在语法层面给多样化的聚合提供了方便。 Distinct 聚合 在聚合函数中,所有的输入都会参与到聚合中。但是有一种场景,先把数据做去重,再做聚合。最常见的使用场景是count(distinct key),先对key做去重,在计算count值。除了count,其他的聚合函数也可以使用该语法,例如avg(distinct key),先去重再聚合。 聚合函数内的完整语法是: aggregate_function(all key) aggregate_function(distinct key) 第一种语法不做去重,全部数据参与计算。第二种语法先做去重,再做聚合计算。默认是第一种语法,因此all关键字不是必须的。 聚合中的Null值 在聚合函数的输入参数中,如果参数值是null,那么不参与计算。例如sum(key),只统计非null值的和。count(key)只统计非null的个数。此处有个例外,就是count(*),因为*并不是具体的列,不存在null或非null的差别,因此所有的行都会统计在内。 如果聚合函数的所有输入,排除掉null值后,只有0行有效数据,那么聚合函数的返回结果是null,因为没有任何有效数据参与计算。以sum为例,如果全都是null,或者只有0行输入,返回0或者其他特殊值是不合适的,因为没有特殊值可以唯一代表这种场景,只有返回null才合适。在所有的聚合函数中,除了count之外,都符合这一定义,count 0行输入的结果是0。 GROUP BY分组聚合 只有聚合函数的场景,所有的输入都聚合成一个结果。如果要把输入分到多个分组中,每个分组分别生成聚合结果,则需要用group by指定分组。 Group by后跟一列或者多列、或者有某些列经过转换函数计算后的结果。Group by子句是配合聚合算子使用的。没有group by的情况下,聚合算子接受所有的输入数据,产生一个计算结果;有group by的情况,称为分组聚合,各行数据先按照group by中指定的列或列的转换结果,计算所属分组,每个分组内无论有多少行数据,都会计算产生一行聚合结果。图2-4是一个group by分组聚合的样例,按照status分组,总共有2个分组,每个分组产生一行聚合结果,即共两行聚合结果。 Group by的一个样例,求访问日志中每个站点的平均延时: SELECT avg(latency), host from accesslog GROUP BY host 在一个分组内,可以执行多个聚合函数,每个聚合函数产生一列聚合结果。即分组的数量决定结果行数,聚合函数的数量决定结果的列数。 在有group by的场景下,select中指定的表达式,除了聚合函数外,还可以select某些列,或者某些列经过转换函数计算后的结果,这些列是有限制条件的,只能是group by中出现的列。如果是非group by的列,就会出现一个难以抉择的问题,因为分组是按照group by的列分组的,每个分组只输出一行结果,如果select 非group by的列,那么在分组中,会有多行数据进入同一分组,在输出时到底选择哪一行作为解决呢?这没有明确的答案。有几种可能性,第一种是随机的选择一行;第二种是选择第一行;第三种是选择最后一行;第四种是全部输出。可能性太多,如果用户不明确的告诉SQL选择哪一种选项,就会造成误判,输出结果不一定满足用户预期。每一种选项都会有对应的聚合函数实现。当然在mysql系统中,是按照第一种选项输出的。 对于需要在分组内产生多行聚合结果的使用场景,可以参考窗口函数。 如果要分组的列是null值,则null值会作为一个单独的分组。 一般的场景下,一个原始数据只会在一个分组内参与聚合计算,不会同时出现在多个分组中。但也有一些高级用法就是grouping set操作,在下文详细介绍。 Grouping sets操作 上文介绍的group by子句,是比较简单的一种分组聚合操作。全量的数据,会按照分组条件分到不同的组里边,每一行数据,都只会在一个分组中参与聚合。还有一种更加复杂的分组聚合操作是grouping sets操作。相关关键字是grouping sets, cube, rollup。该算子可以允许在一次查询中,按照不同的分组条件,多次分组。每一条数据,都会按照不同的分组条件多次参与聚合。 例如,如果你希望按照多个分组聚合(grade, class), (grade),(class),如果使用group by,那么要分别执行三次group by操作。使用grouping sets则可以在一次查询中完成,语法是select grade,class,count(1) from log group by grouping sets((grade, class), (grade),(class))。在输出的结果中,grade class两列都会输出,但是在后两个集合中,只group by了一列,另一列以null出现在结果中。 Rollup语法是一种特殊的grouping sets语法,roll up后跟的集合,会按照层级聚合的方式,枚举出所有的前缀集合。例如group by rollup(grade, class),相当于group by grouping sets ((grade, class),(grade),())。最后一个分组条件是空分组,也就是不分组,相当于没有group by的场景。 Cube语法也是一种特殊的grouping sets语法,cube和roll up不同之处在于,cube会枚举所有可能的集合。例如group by cube(grade,class),相当于group by grouping sets((grade,class),(grade),(class),())。 窗口函数 转换函数输入一行数据,输出一行数据。聚合函数把多行数据聚合成一行。有没有一种聚合函数,实现聚合,但是不改变输入行数呢?答案是窗口函数。 窗口函数在表达结果上类似于转换函数,针对每一行输入,都会产生一行输出,不会改变结果的行数。但在使用上,在窗口函数内部,可以使用聚合计算函数。窗口函数根据某些列分成多个桶,把每一行数据分发到对应的桶中去,然后在每一个桶上执行聚合函数,并且把结果写回到每一行。因此,相当于窗口函数把聚合函数当成了转换函数来使用。转换函数是把一行输入转换成一行输出;窗口函数是把窗口内的若干行聚合后生成一个结果,但是每一行都会有一个结果。 窗口函数的逻辑如图2-4所示,有窗口列,排序列,参与聚合的列。在每个窗口内对指定的若干行进行聚合计算,并且写入到当前行的结果中。输出的结果行数和输入的行数相同。 图2-5 窗口函数示意图 ​ 窗口函数最简单的场景,例如:avg(key2) over(),表示把所有数据当成一个分组做avg聚合,并且写回每条数据中,虽然结果中的每行数字都相同,但是没有改变结果行数。如下图中的out3的结果所示,所有行的均值为3,3就是每一行对应的结果。 再复杂一点的窗口函数场景,例如:avg(key2) over(partition by key1),表示按照key1作为分组,每个分组内分别执行avg聚合计算,并且更新到每个分组的每条数据中。如下图的out1所示,a这个窗口的均值是1.5,窗口内所有的结果都填充为1.5。b这个窗口内均值是4,窗口内所有的结果都填充成4。 ​ 更加复杂一点的窗口函数样例如:avg(key2) over(partition by key1 order by key2),表示按照key1作为分组,在每个分组内再按照key2排序,计算窗口内从第一行到当前行为止的数据的avg聚合结果,也就是分组内每一行的结果可能是不一样的。参考下图中的out2这个结果,a这个窗口,第一行数据是1,均值就是1;第二行数据是2,第二行对应的窗口均值就是第一行和第二行的均值,也就是1.5。因此结果中,第一行的结果是1,第二行的结果是1.5。这个和out1的对比比较明显,out1的结果中,每个窗口内的结果都是一样的。 ​ 上边的样例还不是最复杂的,前2个样例,都是在分组内的所有数据上执行聚合;加上order by之后,是聚合从第一行到当前行的数据。那有没有一种方法,只聚合当前行附近的几行呢?能否更加灵活的指定窗口内哪些行参与聚合计算呢?答案是可以的。窗口函数可以指定当前行的前后若干行参与聚合计算,例如avg(key2) over(partition by key1 order by key2 range between unbounded preceding and current row),表示从第一行到当前行。range between 1 precedingand 2 following,表示包含前一行、当前行、后两行总共4行组成的数据进行聚合,更新到当前行的结果。参与聚合的行称为一个frame,一个frame内的数据聚合生成一个结果。 图2-6窗口函数的输出 在窗口函数中,除了普通的聚合函数,还有一些特殊的、专门用于窗口运算的聚合函数。例如:rank()用于窗口内的排序,输出排序后的序号,相同的值序号相同,但是相同的值会占用计数值,例如100、102、102、103,输出序号是1、2、2、4,注意最后一个序号是4。如果期望输出的需要是去重排序后的序号,则应该用dense_rank函数,针对上述例子,输出序号为1、2、2、3。此外还有row_number输出行号。cume_dist排序后从窗口第一行开始的累积百分比,和rank类似,相同的值输出相同的结果,输出结果为rank()/total。percent_rank输出(rank()-1)/total-1)。cume_dist和percent_rank的差别在于,后者从0开始累积。 运算符和函数 ​ 在内部实现和表达效果上中,运算符和函数是相同的。两者的区别在于语法形式不同,函数有明确的函数名,包含0个或者多个参数的参数列表;运算符则是通过常见的符号来表达意义,例如+-*/等符号。运算符包含1个或者2个参数。双目运算符包含两个参数,例如+运算符,需要左右参数。单目运算符包含一个参数,例如-运算符,代表符号的取反操作。运算符需要在语法文件中显式定义语法形式。而函数名是不需要定义在语法文件中的,在语法文件中只是一个普通的字符串而已,直到语意检查阶段才需要检查函数是否存在。 表达式 表达式是一种有一个或多个函数、运算符、连接符组成的一个完整表达式(Expression)。表达式的作用等同于转换函数,输入0个或多个字段,输出一行一列结果。常见的表达式有bool表达式,逻辑表达式,比较表达式,函数调用,lambda表达式等。 比较表达式 比较表达式通过比较运算符>,>=,<,<=,=,<>等连接两个表达式,用于判定两个表达式的大小关系。左右的表达式不一定是基础类型,也可能是复杂的表达式,例如函数调用表达式。基础类型的数据包括integer、bigint等数值类型,也可能是varchar,char等字符串类型。除了上述比较算法,还有between关键字,key between x to y,等价于key >=x and key <=y,是一个闭区间。 Bool表达式 ​ bool表达式指的是返回结果为bool类型的一类表达式。Bool表达式广泛的应用于各种过滤条件中,例如WHERE,HAVING,ON等。一些转换函数可以返回bool类型结果,还有一些比较运算符可以返回bool结果。例如>,< 等比较运算符。 逻辑表达式 ​ 函数可以代表一个简单的表达式,如果要表达复杂的逻辑,除了函数嵌套函数,还可以用逻辑链接符号组合多个表达式,形成一个复杂的bool表达式。逻辑表达式由逻辑运算符AND、OR、NOT连接1个或者2个bool表达式,并且返回bool结果。其中AND和OR是双目运算符,NOT是单目运算符。 Lambda表达式 ​ Lambda表达式又称为是匿名函数,没有函数名称,只有参数列表和计算表达式。Lambda表达式可以用于让用户自定义处理逻辑,相当于一种UDF。通常在使用中,lambda表达也可以作为函数的参数传入函数,然后在函数内调用该lambda表达式迭代处理数据。 ​ 一个简单的lambda表达式如:x -> x + 1,表示接受一个参数x,返回x+1。 WHERE子句 Where子句后跟一个bool表达式,表示从表中读取数据后,会对每一行数据评估该bool表达式的结果。如果表达式评估结果为true,则该行数据就会传递后给后续的算子做进一步计算;如果评估结果为false或者位置状态,则丢弃改行数据,不再参与后续计算。 Bool表达式可以是一个简单的表达式,例如a=1;也可以是嵌套多层转换函数组成的bool表达式,例如a%10=1;或者由逻辑运算符连接起来的逻辑表达式,例如 a AND b。Bool表达式中的函数都是转换函数,不能是聚合函数。 Where子句的操作发生在聚合计算之前。Where 子句非常重要,可以帮助减少读取和计算的数据量,常常用于加速计算。在优化器中,有一些规则帮助把过滤条件尽可能的下推到叶子结点。filter下推是一种非常常用且有效的加速手段。 Where子句的一个样例,获取学生中所有的男生信息: SELECT * FROM student where gender = ‘male’ HAVING子句 Having子句常常跟随group by子句出现。Having子句类似于where,是一个bool表达式。但Having应用于group by聚合计算之后,每个分组的计算结果会用来继续评估Having表达式的结果,只有满足having子句为true的分组,才能输出到后续的算子。 Having和where的区别在于:1, where在group by之前完成,having 在group by之后执行;2,where应用于每条原始数据上,having应用于group by分组聚合结果上。 理论上而言,即便没有group by计算,只有一个全局聚合操作,能够使用having,但是全局聚合的结果只有一样,那么这个时候having的作用就是判断这一行结果是否满足条件。例如select avg(latency) as avg_latency from log having avg_latency > 100 即便没有group by没有任何聚合函数,select中只有原始列或者转换函数的结果时,也可以用having,但这时候having就没有意义了,因为having中的条件是可以合并到where中的。例如select * from log where latency > 10000000 having status>200,完全可以写成select * from log where latency > 10000000 and status>200。 总而言之,having子句一般和group by语句联合使用,用于过滤分组聚合后的结果,筛选出分组聚合结果满足特定条件的某些分组。 Having子句的一个样例,求访问日志中平均延时大于10秒的站点及其延时: SELECT avg(latency), host from accesslog GROUP BY host HAVING avg(latency) > 10 having子句的执行发生在group by之后,order by之前。顺序参考图2-2。 Order By子句 Order by子句包含一个或多个表达式,用于排序输出的结果。在order by中可以指定多个表达式,每个表达式指定排序方式,可以升序,也可以降序,默认是升序排列。排序时多个表达式从左到右依次评估。当左侧表达式评估出来的多个行结果一样时,会评估右侧表达式的值用于排序。例如order by key1 asc, key2 desc 表示按照key1升序排列,当key1相同时,按照key2降序排列。 Order by子句的一个样例,学生按照分数排序:Select * from student order by score asc Limit 子句 Limit子句用于限制返回结果的行数。当之前的算子输出行数超出了limit指定的行数时,会丢弃超出的部分。由于Limit算子可以减少传递给下游的数据量。因而在优化中非常有用。例如order by和limit算子合并,在排序阶段就大大减少用于排序的数据量;把limit算子尽可能向叶子结点的方向下推。通常而言,limit算子会和order by联合使用。如果单独使用limit算子,输出结果不保证顺序,也就是说每次执行会获得不同的结果。和order by联合使用时,才能保证每次查询结果的一致性。 一个查询样例:SELECT * FROM student limit 100,表示获取100个学生信息。 通常而言,limit限定最多的返回行数。在MySQL中,还可以通过limit offset,line这个翻页语法,从第offset行开始,读取line行结果。而对于OLAP引擎而言,支持翻页并不现实,因为每次提交翻页请求,都是要计算一遍SQL,获得结果后再翻页返回,因而代价非常大。除非OLAP引擎把计算结果缓存在内存中,等待下次翻页获取。MySQL之所以能够支持翻页,一方面是因为MySQL的查询一般是事务性查询,另一方面数据量比较小,翻页的代价不大。 多个表间操作 在一层SQL查询中,数据源可以是一个表,也可以是多个表。对多个表进行操作并产出一个新的表。表之前的操作包括连接操作(join),集合操作(set)。 Join Join可以把多个表(左右)连接成一个表,根据一定的条件让多个表对应的行输出到同一行,左表的一行数据和右表的一行数据连接成一行,左表和右表的列都会出现在结果中。Join的操作类型包括Inner Join、Left Join、Right Join、Full Join、Cross Join。各种Join的策略参考下图所示,Inner Join输出左右两表的交集,即满足连接条件的行,输出结果中,左表和右表的列都不为null。Left Join不管左表是否满足条件都输出,而右表只输出满足条件的行,其他行以null输出。Right Join和Left Join相反。Full Join同时输出左右表,对于满足条件的行,输出对应的左右表连接后的结果,对于不满足的行,输出左表(右表)的行,同时右表(左表)以null输出,相当于集合了Left Join和Right Join的特性。Cross Join没有链接条件,输出两个表的笛卡尔积。 Join操作是SQL所有算子中,计算复杂度最高的算子之一。针对Join的优化是SQL中一个非常重要的课题,Join的执行方式、执行顺序,左右表的大小等因素都会影响Join的性能。在后续章节中,会介绍基于规则的优化器和基于代价的优化器来优化Join算子。 图2-7 不同的Join类型 Set Set操作是一种集合操作,集合的元素是行,用于把多个表前后拼接成一个表。拼接后不改变列的个数,原表中的一行,原样输出到结果中,参与set操作的左右表的列个数和类型必须保持一致。set操作和join操作的差别在于,join是左右表列与列按照连接条件拼接成一行,set操作是行与行拼接成更多行,不改变原始一行的内容。Set操作包括Union、Intersect、Except。分别代表并集、交集、差集。 集合的理论基础是集合代数,默认场景下,集合是不包含重复元素的。集合运算符后可以添加distinct或者all关键字,分别表示结果去重和不去重。默认是去重的结果。例如table1 union table2,输出两个表去重后的结果。 嵌套查询 在一个最简单的查询中,from语句指定了要从什么表中读取数据。在from中,最简单的情况是指定一个表,从这一个表中读取数据出来;稍微复杂的情况是from多张表的join结果;再复杂一点,from的来源,根本不是一张表,而是另一个查询的输出结果。我们都知道,一个SQL查询的结果也能成为一个新的表,这个新的表可以作为另一个查询的输入。这就是关系模型的优秀之处,任何关系经过计算后,形成第二个关系,再经过第二次计算,则形成了第三个关系。理论上,表活着关系可以经过无数轮计算,组成一个单向流动的链表。这就是嵌套查询。嵌套查询的结果,可以像一张普通的表一样,参与下游的计算、join、union等。 在SQL中,写嵌套查询有两种形式,第一种,最直观的就是from 后写一个子查询,并且把子查询用()包含起来,形成一个完整的整体,例如: select abc from ( select abc from table) ()内部的即为一个完整的子查询。 第二种是with语法: with temp_table1 as (select abc from table), temp_table2 as (select abc from temp_table1) select * from temp_table2 通过with语法,可以定义多个视图,视图用括号左右包含起来。多个临时表之间,用逗号分隔。with语句的最后不需要加逗号,直接跟select语句。 with语句比较简洁,可以做到每一行只定义一个视图,视图的定义和使用可以分开到不同的地方,在使用时只需要引用视图的表名即可。定义一次视图甚至可以多次引用。而嵌套式查询,临时表的定义和使用放在一起,每使用一次就需要定义一次。外层的查询语句内部是一个子查询,from关键字在整个SQL语句的中间位置,导致外层查询的前半部分在子查询前边,后半部分在子查询后边,同一层查询语意被一个复杂的字查询分隔开,不利于对SQL语意理解。因此在使用前套查询时,推荐使用with语法。 with查询中定义一个视图,在后续可以引用多次该视图。视图并不是物化视图,如果引用多次视图,会展开执行多次。 子查询表达式 子查询除了作为一种关系在from语句中被引用。还有一种用途是作为表达式被引用,例如where语句中的引用子查询结果作为一个集合,判断某个值和这个集合的关系。子查询表达式和嵌套查询的区别在于,子查询表达式在plan中扮演一个表达式,而嵌套查询扮演一个视图。在子查询中,可以引用外层查询的属性,而外层查询中,不能引用子查询的属性。 除了from后,嵌套子查询可以出现在SQL的几乎每个位置。 出现在select输出结果中,select (select 1) as one from student。 出现在where中,select name from student where id in (select id from applied)。 对于判断外层查询属性和内层子查询结果之间关系的判定方式,有几种方式: ALL 表示外层表达式要满足子查询的所有结果。 ANY表示外层表达式需要满足子查询的至少一个结果。 IN 等同于ANY。 EXISTS表示至少有一行结果返回。 按照输出结果,子查询包括三种类型: 标量子查询(scalar subquery):只返回一行一列结果。 多行输出子查询:输出多行一列,或多行多列。 exists子查询:输出结果是bool类型。 按是否引用外层查询的属性,分为: 关联子查询:子查询中引用到了外层查询的属性。 无关联子查询:子查询没有引用外层查询的属性。 标量子查询表达式 ​ 标量子查询的结果只有一行一列一个值。针对这个特性,可以有很多优化手段。在后续的优化器章节会给出介绍。理论上来说,对于外层查询的每一行数据,都需要去执行一次子查询表达式。但是这里还有些不同点,对于相关子查询和不相关子查询的处理是不同的。对于不相关子查询,子查询没有引用外部的任何列,因此对于外部的每一行数据,子查询的执行结果都是相同的,因此执行一次即可。这种场景下,子查询只会执行一次。 标量子查询可以用于case表达式、select子句、where子句、order by子句、函数的参数等。由于标量子查询只返回一行一列,因此可以当成单个值使用。 scalar 子查询在被使用之处,只能要求出现一个结果,但并未在语法上约束子查询返回一个结果。用户可以写一个聚合子查询只返回一个结果,或者用limit 1限定返回一个结果;也可以写一个可能返回多行数据的SQL,只有在执行时,如果实际返回多行结果则会报错。 例如select count(1) from log where latency >= (select avg(latency) from log),子查询中时聚合函数,一定会返回一行结果,因而可以正常执行。但加入用户写这样一个子查询select count(1) from log where latency >= (select (latency) from log),则存在三种可能,返回0行结果,返回1行结果,返回大于1行结果。如果返回0行结果,则以null作为子查询的输出,如果返回大于1行结果,则运行报错。因为标量子查询的外层需要一行一列输入。或者说,标量子查询之所以称为是标量子查询,是因为外层查询要求子查询输出一行一列,而不是子查询本身通过语法或者实际运行只能得到一行一列结果。 除了where中,还可以在select中,例如select *, (select max(latency) from log )from log,在每一行都输出最大的latency值。如果写成select *, (select latency from log )from log则会报错。 也可以作为函数参数:select *, abs((select max(latency) from log) )from log。基本上,在需要单个值的地方就可以使用标量子查询。 子查询用于判断集合从属关系 in和not in用于判定外层查询的属性是否属于内层子查询结果的集合内。例如: select * from course where student_id in (select student_id from student where apply_year='2018') in和not in除了用于子查询,还可以指定一个list常量,例如: select * from course where student_id in(1,2,3) Exists子查询用于判定是否是空集合 ​ Exists子查询检查子查询是否有输出结果,如果有至少一行结果,则判定为true,否则判定为false。通常Exists子查询被用于关联子查询,也就是说针对外层查询的每一行数据,判定Exists子查询的结果。 如果是非关联子查询,则对于外层查询的每一行数据,Exists的结果都是一行的结果,这样做没有意义。 例如,SELECT name FROM websites WHERE EXISTS ( select count from access_log WHERE websites.id = access_log.site_id and count > 100) 表示输出访问日志中count > 100的网站的名字。 not exists是相反的语意,表示子查询的结果为空集合。 Exists查询也可以用in语法来表达,in语法表示判断某一列的每一行是否在子查询的输出结果中。例如上述的逻辑,可以用in语法来表达:SELECT name FROM websites WHERE id in ( SELECT site_id from access_log where count > 100)。显然,在in查询中,子查询是不相关查询,因此,子查询只需要执行一次即可,因而查询效率较高。 子查询用于比较级和数值大小关系 ​ 外层查询可以和子查询的结果进行对比,对比的运算符包括<,>, <=, >=, =, <>。子查询的结果可以包含修饰符SOME,ANY,ALL。外层表的每一行会逐个和子查询结果的每一行进行对比,返回true或者false。如果是SOME或者ANY修饰符,那么只需要至少1行对比为true即可。如果是ALL修饰符,那么就需要所有的行对比结果都为true才行。=ANY的语义和IN相同。<>ALL的意义和NOT IN相同。 ​ 一个样例:SELECT Num FROM Test2 WHERE Num > ANY (SELECT Num FROM Test1)表示Test2这张表中的Num,如果在Test1表中存在比之小的值,则该行数据满足条件,会输出到下游算子中。 ​ 量化子查询会在优化器章节进行深入的介绍其优化方法。 子查询用于判定集合是否包含重复值 和exists类似,还有一个unique关键字,用于判断子查询的所有行是否包含重复值,如果包含重复值,那么返回false;如果不包含重复值,则返回true。 例如: select * from log where unique (select projectName from log) 子查询的实际运行方式 一般来说,上述几种子查询,如果是非关联子查询,每一行判定结果都一样,意义不是很大。所以,通常上边的这些子查询都会是关联子查询,这样才会每一行结果不一样。而关联子查询一般会在plan优化阶段,转化为join计算。 子查询是一种语法表示形式,在物化plan中,是没有子查询这种执行方式的,一般需要需要转化为等价的关系代数表达形式。 除了常规的几种join(left,right,full,cross),还有两种特殊的join形式,semijon和antijoin。semijoin用于in或exists查询,表示只要满足条件,就输出左表的数据,每行数据只输出一次。antijoin用于not in或not exists,表示只要不满足条件,就输出左表的数据,每行数据只输出一次。虽然semejoin和antijoin有等价的表示形式,但是这两种特化的表达形式可以获得更好的执行性能。 Null 处理 对于常规的数据处理是很简单的,但是往往有一些非法的case需要处理。null就是一个典型的场景。一个非法值,或者不知道具体值的值就用null表示。 在聚合函数中,输入null值的处理在上文已经描述过了。在这个章节中,主要考虑转换函数输入null的情况。 对于一个转换函数或者转换表达式,如果返回值是非boolean的情况,例如代数运算,如果输入是null,那么输出也是null。 如果转换函数或者转换表达式返回值是boolean的情况,例如一个比较表达式,正常情况输出只有true、false两种场景,如果输入的一个参数是null,无法明确判定是true还是false的情况下,则需要第三种状态,即unkonwn状态用于判断。为什么简单粗暴的输出null呢?这是因为,unknown代表的信息量要大于null。在后续的计算中,即便存在unkonwn状态,也能过推断出结果。 针对and、or、not逻辑表达式,当出现unkonwn时,甚至可以借助短路求值的思想,获得最终结果,无需关心unknown到底是true还是false。 AND: 如果是true and unknown,结果取决于unkonwn,那么结果就是unkonwn;如果是false and unkonwn,无论unkonwn是true还是false,结果都是false。 OR:如果是true or unkonwn,无论unknown是true还是false,结果都是true;如果是false or unknown,结果取决于unknown,结果仍为unknown。 NOT: not unknown,结果仍是unknown。 Is null语法和is not null语法:is null可以判断一个表达式是否是null,is not null正好相反。同时在SQL标准中,还有is unknown语法和is not unknown语法,不过这两个关于unknown的语法并不是所有的SQL引擎都支持。 在用于分组操作时,例如group by,distinct,union等, 如果指定的列中包含null,那么所有对应null的行都会作为一个分组。这一点和计算表达式中的表现是不同的,例如判断null=null,那么输出将是unknown,而不是true。 Unnest语法 ​ 在SQL中,生成新的数据依赖于表达式或者函数,在上文中提到,函数分成两种类型,分别是标量转换函数,另一种是聚合计算函数。标量计算函数把一行输入数据转换成一行一列输出结果;聚合计算函数把多行输入数据转换成一行一列输出结果。如果我们要输出一列转换成多列,那么可以通过多个表达式实现。如果我们需要把一行转化成多行,该怎么处理呢?在这种需求场景下,就用到了Unnest语法。 ​ Unnest语法可以把一行数据转换成多行数据。例如输入数据是一个数组类型,那么可以把数组中的每一个元素作为一行结果输出。语法如: ​ SELECT element FROM (VALUES ( ARRAY[1,2,3]) ) as t(element)。输出结果为3行,分别是1、2、3.。 其他SQL语法 ​ 除了SELECT语法,还有其他的语法例如INSERT/CREATE 等DDL语句。 小结 本文介绍了SQL和查询相关的一些核心语法规则,有助于读者了解SQL能够完成哪些方面的计算。在后续的章节中,我们继续了解SQL语言如何转化成抽象语法树的。 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

每日一博 | Android 架构模式如何选择

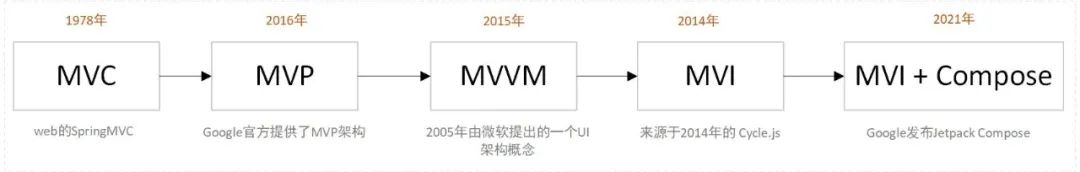
作者:vivo 互联网客户端团队-Xu Jie Android架构模式飞速演进,目前已经有MVC、MVP、MVVM、MVI。到底哪一个才是自己业务场景最需要的,不深入理解的话是无法进行选择的。这篇文章就针对这些架构模式逐一解读。重点会介绍Compose为什么要结合MVI进行使用。希望知其然,然后找到适合自己业务的架构模式 一、前言 不得不感叹,近些年android的架构演进速度真的是飞快,拿笔者工作这几年接触的架构来说,就已经有了MVC、MVP、MVVM。正当笔者准备把MVVM应用到自己项目当中时,发现谷歌悄悄的更新了开发者文档(应用架构指南 | Android 开发者 | Android Developers (google.cn))。这是一篇指导如何使用MVI的文章。那么这个文章到底为什么更新,想要表达什么?里面提到的Compose又是什么?难道现在已经有的MVC、MVP、MVVM不够用吗?MVI跟已有的这些架构又有什么不同之处呢? 有人会说,不管什么架构,都是围绕着“解耦”来实现的,这种说法是正确的,但是耦合度高只是现象,采用什么手段降低耦合度?降低耦合度之后的程序方便单元测试吗?如果我在MVC、MVP、MVVM的基础上做解耦,可以做的很彻底吗? 先告诉你答案, MVC、MVP、MVVM无法做到彻底的解耦,但是MVI+Compose可以做到彻底的解耦,也就是本文的重点讲解部分。本文结合具体的代码和案例,复杂问题简单化,并且结合较多技术博客做了统一的总结,相信你读完会收获颇丰。 那么本篇文章编写的意义,就是为了能够深入浅出的讲解MVI+Compose,大家可以先试想下这样的业务场景,如果是你,你会选择哪种架构实现? 业务场景考虑 使用手机号进行登录 登录完之后验证是否指定的账号A 如果是账号A,则进行点赞操作 上面三个步骤是顺序执行的,手机号的登录、账号的验证、点赞都是与服务端进行交互之后,获取对应的返回结果,然后再做下一步。 在开始介绍MVI+Compose之前,需要循序渐进,了解每个架构模式的缺点,才知道为什么Google提出MVI+Compose。 正式开始前,按照架构模式的提出时间来看下是如何演变的,每个模式的提出往往不是基于android提出,而是基于服务端或者前端演进而来,这也说明设计思路上都是大同小异的: 二、架构模式过去式? 2.1MVC已经存在很久了 MVC模式提出时间太久了,早在1978年就被提出,所以一定不是用于android,android的MVC架构主要还是源于服务端的SpringMVC,在2007年到2017年之间,MVC占据着主导地位,目前我们android中看到的MVC架构模式是这样的。 MVC架构这几个部分的含义如下,网上随便找找就有一堆说明。 MVC架构分为以下几个部分 【模型层Model】:主要负责网络请求,数据库处理,I/O的操作,即页面的数据来源 【视图层View】:对应于xml布局文件和java代码动态view部分 【控制层Controller】:主要负责业务逻辑,在android中由Activity承担 (1)MVC代码示例 我们举个登录验证的例子来看下MVC架构一般怎么实现。 这个是controller MVC架构实现登录流程-controller public class MvcLoginActivity extends AppCompatActivity { private EditText userNameEt; private EditText passwordEt; private User user; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_mvc_login); user = new User(); userNameEt = findViewById(R.id.user_name_et); passwordEt = findViewById(R.id.password_et); Button loginBtn = findViewById(R.id.login_btn); loginBtn.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View view) { LoginUtil.getInstance().doLogin(userNameEt.getText().toString(), passwordEt.getText().toString(), new LoginCallBack() { @Override public void loginResult(@NonNull com.example.mvcmvpmvvm.mvc.Model.User success) { if (null != user) { // 这里免不了的,会有业务处理 //1、保存用户账号 //2、loading消失 //3、大量的变量判断 //4、再做进一步的其他网络请求 Toast.makeText(MvcLoginActivity.this, " Login Successful", Toast.LENGTH_SHORT) .show(); } else { Toast.makeText(MvcLoginActivity.this, "Login Failed", Toast.LENGTH_SHORT) .show(); } } }); } }); } } 这个是model MVC架构实现登录流程-model public class LoginService { public static LoginUtil getInstance() { return new LoginUtil(); } public void doLogin(String userName, String password, LoginCallBack loginCallBack) { User user = new User(); if (userName.equals("123456") && password.equals("123456")) { user.setUserName(userName); user.setPassword(password); loginCallBack.loginResult(user); } else { loginCallBack.loginResult(null); } }} 例子很简单,主要做了下面这些事情 写一个专门的工具类LoginService,用来做网络请求doLogin,验证登录账号是否正确,然后把验证结果返回。 activity调用LoginService,并且把账号信息传递给doLogin方法,当获取到结果后,进行对应的业务操作。 (2)MVC优缺点 MVC在大部分简单业务场景下是够用的,主要优点如下: 结构清晰,职责划分清晰 降低耦合 有利于组件重用 但是随着时间的推移,你的MVC架构可能慢慢的演化成了下面的模式。拿上面的例子来说,你只做登录比较简单,但是当你的页面把登录账号校验、点赞都实现的时候,方法会比较多,共享一个view的时候,或者共同操作一个数据源的时候,就会出现变量满天飞,view四处被调用,相信大家也深有体会。 不可避免的,MVC就存在了下面的问题 归根究底,在android里面使用MVC的时候,对于Model、View、Controller的划分范围,总是那么的不明确,因为本身他们之间就有无法直接分割的依赖关系。所以总是避免不了这样的问题: View与Model之间还存在依赖关系,甚至有时候为了图方便,把Model和View互传,搞得View和Model耦合度极高,低耦合是面向对象设计标准之一,对于大型项目来说,高耦合会很痛苦,这在开发、测试,维护方面都需要花大量的精力。 那么在Controller层,Activity有时既要管理View,又要控制与用户的交互,充当Controller,可想而知,当稍微有不规范的写法,这个Activity就会很复杂,承担的功能会越来越多。 花了一定篇幅介绍MVC,是让大家对MVC中Model、View、Controller应该各自完成什么事情能深入理解,这样才有后面架构不断演进的意义。 2.2 MVP架构的由来 (1)MVP要解决什么问题? 2016年10月, Google官方提供了MVP架构的Sample代码来展示这种模式的用法,成为最流行的架构。 相对于MVC,MVP将Activity复杂的逻辑处理移至另外的一个类(Presenter)中,此时Activity就是MVP模式中的View,它负责UI元素的初始化,建立UI元素与Presenter的关联(Listener之类),同时自己也会处理一些简单的逻辑(复杂的逻辑交由 Presenter处理)。 那么MVP 同样将代码划分为三个部分: 结构说明 View:对应于Activity与XML,只负责显示UI,只与Presenter层交互,与Model层没有耦合; Model: 负责管理业务数据逻辑,如网络请求、数据库处理; Presenter:负责处理大量的逻辑操作,避免Activity的臃肿。 来看看MVP的架构图: 与MVC的最主要区别 View与Model并不直接交互,而是通过与Presenter交互来与Model间接交互。而在MVC中View可以与Model直接交互。 通常View与Presenter是一对一的,但复杂的View可能绑定多个Presenter来处理逻辑。而Controller回归本源,首要职责是加载应用的布局和初始化用户界面,并接受并处理来自用户的操作请求,它是基于行为的,并且可以被多个View共享,Controller可以负责决定显示哪个View。 Presenter与View的交互是通过接口来进行的,更有利于添加单元测试。 (2)MVP代码示意 ① 先来看包结构图 ②建立Bean MVP架构实现登录流程-model public class User { private String userName; private String password; public String getUserName() { return ... } public void setUserName(String userName) { ...; } } ③建立Model接口 (处理业务逻辑,这里指数据读写),先写接口方法,后写实现 MVP架构实现登录流程-model public interface IUserBiz { boolean login(String userName, String password);} ④建立presenter(主导器,通过iView和iModel接口操作model和view),activity可以把所有逻辑给presenter处理,这样java逻辑就从activity中分离出来。 MVP架构实现登录流程-model public class LoginPresenter{ private UserBiz userBiz; private IMvpLoginView iMvpLoginView; public LoginPresenter(IMvpLoginView iMvpLoginView) { this.iMvpLoginView = iMvpLoginView; this.userBiz = new UserBiz(); } public void login() { String userName = iMvpLoginView.getUserName(); String password = iMvpLoginView.getPassword(); boolean isLoginSuccessful = userBiz.login(userName, password); iMvpLoginView.onLoginResult(isLoginSuccessful); }} ⑤View视图建立view,用于更新ui中的view状态,这里列出需要操作当前view的方法,也是接口IMvpLoginView MVP架构实现登录流程-model public interface IMvpLoginView { String getUserName(); String getPassword(); void onLoginResult(Boolean isLoginSuccess);} ⑥ activity中实现IMvpLoginView接口,在其中操作view,实例化一个presenter变量。 MVP架构实现登录流程-model public class MvpLoginActivity extends AppCompatActivity implements IMvpLoginView{ private EditText userNameEt; private EditText passwordEt; private LoginPresenter loginPresenter; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_mvp_login); userNameEt = findViewById(R.id.user_name_et); passwordEt = findViewById(R.id.password_et); Button loginBtn = findViewById(R.id.login_btn); loginPresenter = new LoginPresenter(this); loginBtn.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View view) { loginPresenter.login(); } }); } @Override public String getUserName() { return userNameEt.getText().toString(); } @Override public String getPassword() { return passwordEt.getText().toString(); } @Override public void onLoginResult(Boolean isLoginSuccess) { if (isLoginSuccess) { Toast.makeText(MvpLoginActivity.this, getUserName() + " Login Successful", Toast.LENGTH_SHORT) .show(); } else { Toast.makeText(MvpLoginActivity.this, "Login Failed", Toast.LENGTH_SHORT).show(); } }} (3)MVP优缺点 因此,Activity及从MVC中的Controller中解放出来了,这会Activity主要做显示View的作用和用户交互。每个Activity可以根据自己显示View的不同实现View视图接口IUserView。 通过对比同一实例的MVC与MVP的代码,可以证实MVP模式的一些优点: 在MVP中,Activity的代码不臃肿; 在MVP中,Model(IUserModel的实现类)的改动不会影响Activity(View),两者也互不干涉,而在MVC中会; 在MVP中,IUserView这个接口可以实现方便地对Presenter的测试; 在MVP中,UserPresenter可以用于多个视图,但是在MVC中的Activity就不行。 但还是存在一些缺点: 双向依赖:View 和 Presenter 是双向依赖的,一旦 View 层做出改变,相应地 Presenter 也需要做出调整。在业务语境下,View 层变化是大概率事件; 内存泄漏风险:Presenter 持有 View 层的引用,当用户关闭了 View 层,但 Model 层仍然在进行耗时操作,就会有内存泄漏风险。虽然有解决办法,但还是存在风险点和复杂度(弱引用 / onDestroy() 回收 Presenter)。 三、MVVM其实够用了 3.1MVVM思想存在很久了 MVVM最初是在2005年由微软提出的一个UI架构概念。后来在2015年的时候,开始应用于android中。 MVVM 模式改动在于中间的 Presenter 改为 ViewModel,MVVM 同样将代码划分为三个部分: View:Activity 和 Layout XML 文件,与 MVP 中 View 的概念相同; Model:负责管理业务数据逻辑,如网络请求、数据库处理,与 MVP 中 Model 的概念相同; ViewModel:存储视图状态,负责处理表现逻辑,并将数据设置给可观察数据容器。 与MVP唯一的区别是,它采用双向数据绑定(data-binding):View的变动,自动反映在 ViewModel,反之亦然。 MVVM架构图如下所示: 可以看出MVVM与MVP的主要区别在于,你不用去主动去刷新UI了,只要Model数据变了,会自动反映到UI上。换句话说,MVVM更像是自动化的MVP。 MVVM的双向数据绑定主要通过DataBinding实现,但是大部分人应该跟我一样,不使用DataBinding,那么大家最终使用的MVVM架构就变成了下面这样: 总结一下: 实际使用MVVM架构说明 View观察ViewModel的数据变化并自我更新,这其实是单一数据源而不是双向数据绑定,所以MVVM的双向绑定这一大特性我这里并没有用到 View通过调用ViewModel提供的方法来与ViewMdoel交互。 3.2 MVVM代码示例 (1)建立viewModel,并且提供一个可供view调取的方法 login(String userName,String password) MVVM架构实现登录流程-model public class LoginViewModel extends ViewModel { private User user; private MutableLiveData<Boolean> isLoginSuccessfulLD; public LoginViewModel() { this.isLoginSuccessfulLD = new MutableLiveData<>(); user = new User(); } public MutableLiveData<Boolean> getIsLoginSuccessfulLD() { return isLoginSuccessfulLD; } public void setIsLoginSuccessfulLD(boolean isLoginSuccessful) { isLoginSuccessfulLD.postValue(isLoginSuccessful); } public void login(String userName, String password) { if (userName.equals("123456") && password.equals("123456")) { user.setUserName(userName); user.setPassword(password); setIsLoginSuccessfulLD(true); } else { setIsLoginSuccessfulLD(false); } } public String getUserName() { return user.getUserName(); }} (2)在activity中声明viewModel,并建立观察。点击按钮,触发 login(String userName, String password)。持续作用的观察者loginObserver。只要LoginViewModel 中的isLoginSuccessfulLD变化,就会对应的有响应 MVVM架构实现登录流程-model public class MvvmLoginActivity extends AppCompatActivity { private LoginViewModel loginVM; private EditText userNameEt; private EditText passwordEt; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_mvvm_login); userNameEt = findViewById(R.id.user_name_et); passwordEt = findViewById(R.id.password_et); Button loginBtn = findViewById(R.id.login_btn); loginBtn.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View view) { loginVM.login(userNameEt.getText().toString(), passwordEt.getText().toString()); } }); loginVM = new ViewModelProvider(this).get(LoginViewModel.class); loginVM.getIsLoginSuccessfulLD().observe(this, loginObserver); } private Observer<Boolean> loginObserver = new Observer<Boolean>() { @Override public void onChanged(@Nullable Boolean isLoginSuccessFul) { if (isLoginSuccessFul) { Toast.makeText(MvvmLoginActivity.this, "登录成功", Toast.LENGTH_SHORT) .show(); } else { Toast.makeText(MvvmLoginActivity.this, "登录失败", Toast.LENGTH_SHORT) .show(); } } };} 3.3MVVM优缺点 通过上面的代码,可以总结出MVVM的优点: 在实现细节上,View 和 Presenter 从双向依赖变成 View 可以向 ViewModel 发指令,但 ViewModel 不会直接向 View 回调,而是让 View 通过观察者的模式去监听数据的变化,有效规避了 MVP 双向依赖的缺点。 但 MVVM 在某些情况下,也存在一些缺点: (1)关联性比较强的流程,liveData太多,并且理解成本较高 当业务比较复杂的时候,在viewModel中必然存在着比较多的LiveData去管理。当然,如果你去管理好这些LiveData,让他们去处理业务流程,问题也不大,只不过理解的成本会高些。 (2)不便于单元测试 viewModel里面一般都是对数据库和网络数据进行处理,包含了业务逻辑在里面,当要去对某一流程进行测试时,并没有办法完全剥离数据逻辑的处理流程,单元测试也就增加了难度。 那么我们来看看缺点对应的具体场景是什么,便于我们后续进一步探讨MVI架构。 (1)在上面登录之后,需要验证账号信息,然后再自动进行点赞。那么,viewModel里面对应的增加几个方法,每个方法对应一个LiveData MVVM架构实现登录流程-model public class LoginMultiViewModel extends ViewModel { private User user; // 是否登录成功 private MutableLiveData<Boolean> isLoginSuccessfulLD; // 是否为指定账号 private MutableLiveData<Boolean> isMyAccountLD; // 如果是指定账号,进行点赞 private MutableLiveData<Boolean> goThumbUp; public LoginMultiViewModel() { this.isLoginSuccessfulLD = new MutableLiveData<>(); this.isMyAccountLD = new MutableLiveData<>(); this.goThumbUp = new MutableLiveData<>(); user = new User(); } public MutableLiveData<Boolean> getIsLoginSuccessfulLD() { return isLoginSuccessfulLD; } public MutableLiveData<Boolean> getIsMyAccountLD() { return isMyAccountLD; } public MutableLiveData<Boolean> getGoThumbUpLD() { return goThumbUp; } ... public void login(String userName, String password) { if (userName.equals("123456") && password.equals("123456")) { user.setUserName(userName); user.setPassword(password); setIsLoginSuccessfulLD(true); } else { setIsLoginSuccessfulLD(false); } } public void isMyAccount(@NonNull String userName) { try { Thread.sleep(1000); } catch (Exception ex) { } if (userName.equals("123456")) { setIsMyAccountSuccessfulLD(true); } else { setIsMyAccountSuccessfulLD(false); } } public void goThumbUp(boolean isMyAccount) { setGoThumbUpLD(isMyAccount); } public String getUserName() { return user.getUserName(); }} (2)再来看看你可能使用的一种处理逻辑,在判断登录成功之后,使用变量isLoginSuccessFul再去做 loginVM.isMyAccount(userNameEt.getText().toString());在账号验证成功之后,再去通过变量isMyAccount去做loginVM.goThumbUp(true); MVVM架构实现登录流程-model public class MvvmFaultLoginActivity extends AppCompatActivity { private LoginMultiViewModel loginVM; private EditText userNameEt; private EditText passwordEt; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_mvvm_fault_login); userNameEt = findViewById(R.id.user_name_et); passwordEt = findViewById(R.id.password_et); Button loginBtn = findViewById(R.id.login_btn); loginBtn.setOnClickListener(new View.OnClickListener() { @Override public void onClick(View view) { loginVM.login(userNameEt.getText().toString(), passwordEt.getText().toString()); } }); loginVM = new ViewModelProvider(this).get(LoginMultiViewModel.class); loginVM.getIsLoginSuccessfulLD().observe(this, loginObserver); loginVM.getIsMyAccountLD().observe(this, isMyAccountObserver); loginVM.getGoThumbUpLD().observe(this, goThumbUpObserver); } private Observer<Boolean> loginObserver = new Observer<Boolean>() { @Override public void onChanged(@Nullable Boolean isLoginSuccessFul) { if (isLoginSuccessFul) { Toast.makeText(MvvmFaultLoginActivity.this, "登录成功,开始校验账号", Toast.LENGTH_SHORT).show(); loginVM.isMyAccount(userNameEt.getText().toString()); } else { Toast.makeText(MvvmFaultLoginActivity.this, "登录失败", Toast.LENGTH_SHORT) .show(); } } }; private Observer<Boolean> isMyAccountObserver = new Observer<Boolean>() { @Override public void onChanged(@Nullable Boolean isMyAccount) { if (isMyAccount) { Toast.makeText(MvvmFaultLoginActivity.this, "校验成功,开始点赞", Toast.LENGTH_SHORT).show(); loginVM.goThumbUp(true); } } }; private Observer<Boolean> goThumbUpObserver = new Observer<Boolean>() { @Override public void onChanged(@Nullable Boolean isThumbUpSuccess) { if (isThumbUpSuccess) { Toast.makeText(MvvmFaultLoginActivity.this, "点赞成功", Toast.LENGTH_SHORT) .show(); } else { Toast.makeText(MvvmFaultLoginActivity.this, "点赞失败", Toast.LENGTH_SHORT) .show(); } } };} 毫无疑问,这种交互在实际开发中是可能存在的,页面比较复杂的时候,这种变量也就滋生了。这种场景,就有必要聊聊MVI架构了。 四、MVI有存在的必要性吗? 4.1 MVI的由来 MVI 模式来源于2014年的 Cycle.js(一个 JavaScript框架),并且在主流的 JS 框架 Redux 中大行其道,然后就被一些大佬移植到了 Android 上(比如最早期用Java写的 mosby)。 既然MVVM是目前android官方推荐的架构,又为什么要有MVI呢?其实应用架构指南中并没有提出MVI的概念,而是提到了单向数据流,唯一数据源,这也是区别MVVM的特性。 不过还是要说明一点,凡是MVI做到的,只要你使用MVVM去实现,基本上也能做得到。只是说在接下来要讲的内容里面,MVI具备的封装思路,是可以直接使用的,并且是便于单元测试的。 MVI的思想:靠数据驱动页面 (其实当你把这种思想应用在各个框架的时候,你的那个框架都会更加优雅) MVI架构包括以下几个部分 Model:主要指UI状态(State)。例如页面加载状态、控件位置等都是一种UI状态。 View: 与其他MVX中的View一致,可能是一个Activity或者任意UI承载单元。MVI中的View通过订阅Model的变化实现界面刷新。 Intent: 此Intent不是Activity的Intent,用户的任何操作都被包装成Intent后发送给Model层进行数据请求。 看下交互流程图: 对流程图做下解释说明: (1)用户操作以Intent的形式通知Model (2)Model基于Intent更新State。这个里面包括使用ViewModel进行网络请求,更新State的操作 (3)View接收到State变化刷新UI。 4.2 MVI的代码示例 直接看代码吧 (1)先看下包结构 (2)用户点击按钮,发起登录流程 loginViewModel.loginActionIntent.send(LoginActionIntent.DoLogin(userNameEt.text.toString(), passwordEt.text.toString()))。 此处是发送了一个Intent出去 MVI架构代码-View loginBtn.setOnClickListener { lifecycleScope.launch { loginViewModel.loginActionIntent.send(LoginActionIntent.DoLogin(userNameEt.text.toString(), passwordEt.text.toString())) } } (3)ViewModel对Intent进行监听 initActionIntent()。在这里可以把按钮点击事件的Intent消费掉 MVI架构代码-Model class LoginViewModel : ViewModel() { companion object { const val TAG = "LoginViewModel" } private val _repository = LoginRepository() val loginActionIntent = Channel<LoginActionIntent>(Channel.UNLIMITED) private val _loginActionState = MutableSharedFlow<LoginActionState>() val state: SharedFlow<LoginActionState> get() = _loginActionState init { // 可以用来初始化一些页面或者参数 initActionIntent() } private fun initActionIntent() { viewModelScope.launch { loginActionIntent.consumeAsFlow().collect { when (it) { is LoginActionIntent.DoLogin -> { doLogin(it.username, it.password) } else -> { } } } } } } (4)使用respository进行网络请求,更新state MVI架构代码-Repository class LoginRepository { suspend fun requestLoginData(username: String, password: String) : Boolean { delay(1000) if (username == "123456" && password == "123456") { return true } return false } suspend fun requestIsMyAccount(username: String, password: String) : Boolean { delay(1000) if (username == "123456") { return true } return false } suspend fun requestThumbUp(username: String, password: String) : Boolean { delay(1000) if (username == "123456") { return true } return false }} MVI架构代码-更新state private fun doLogin(username: String, password: String) { viewModelScope.launch { if (username.isEmpty() || password.isEmpty()) { return@launch } // 设置页面正在加载 _loginActionState.emit(LoginActionState.LoginLoading(username, password)) // 开始请求数据 val loginResult = _repository.requestLoginData(username, password) if (!loginResult) { //登录失败 _loginActionState.emit(LoginActionState.LoginFailed(username, password)) return@launch } _loginActionState.emit(LoginActionState.LoginSuccessful(username, password)) //登录成功继续往下 val isMyAccount = _repository.requestIsMyAccount(username, password) if (!isMyAccount) { //校验账号失败 _loginActionState.emit(LoginActionState.IsMyAccountFailed(username, password)) return@launch } _loginActionState.emit(LoginActionState.IsMyAccountSuccessful(username, password)) //校验账号成功继续往下 val isThumbUpSuccess = _repository.requestThumbUp(username, password) if (!isThumbUpSuccess) { //点赞失败 _loginActionState.emit(LoginActionState.GoThumbUpFailed(username, password)) return@launch } //点赞成功继续往下 _loginActionState.emit(LoginActionState.GoThumbUpSuccessful(true)) } } (5)在View中监听state的变化,做页面刷新 MVI架构代码-Repository fun observeViewModel() { lifecycleScope.launch { loginViewModel.state.collect { when(it) { is LoginActionState.LoginLoading -> { Toast.makeText(baseContext, "登录中", Toast.LENGTH_SHORT).show() } is LoginActionState.LoginFailed -> { Toast.makeText(baseContext, "登录失败", Toast.LENGTH_SHORT).show() } is LoginActionState.LoginSuccessful -> { Toast.makeText(baseContext, "登录成功,开始校验账号", Toast.LENGTH_SHORT).show() } is LoginActionState.IsMyAccountSuccessful -> { Toast.makeText(baseContext, "校验成功,开始点赞", Toast.LENGTH_SHORT).show() } is LoginActionState.GoThumbUpSuccessful -> { resultView.text = "点赞成功" Toast.makeText(baseContext, "点赞成功", Toast.LENGTH_SHORT).show() } else -> {} } } } } 通过这个流程,可以看到用户点击登录操作,一直到最后刷新页面,是一个串行的操作。在这种场景下,使用MVI架构,再合适不过 4.2 MVI的优缺点 (1)MVI的优点如下: 可以更好的进行单元测试 针对上面的案例,使用MVI这种单向数据流的形式要比MVVM更加的合适,并且便于单元测试,每个节点都较为独立,没有代码上的耦合。 订阅一个 ViewState 就可以获取所有状态和数据 不需要像MVVM那样管理多个LiveData,可以直接使用一个state进行管理,相比 MVVM 是新的特性。 但MVI 本身也存在一些缺点: State 膨胀: 所有视图变化都转换为 ViewState,还需要管理不同状态下对应的数据。实践中应该根据状态之间的关联程度来决定使用单流还是多流; 内存开销: ViewState 是不可变类,状态变更时需要创建新的对象,存在一定内存开销; 局部刷新: View 根据 ViewState 响应,不易实现局部 Diff 刷新,可以使用 Flow#distinctUntilChanged() 来刷新来减少不必要的刷新。 更关键的一点,即使单向数据流封装的很多,仍然避免不了来一个新人,不遵守这个单向数据流的写法,随便去处理view。这时候就要去引用Compose了。 五、不妨利用Compose升级MVI 这一章节是本文的重点。 2021年,谷歌发布Jetpack Compose1.0,2022年,又更新了文章应用架构指南,在进行界面层的搭建时,建议方案如下: 在屏幕上呈现数据的界面元素。您可以使用 View 或 Jetpack Compose 函数构建这些元素。 用于存储数据、向界面提供数据以及处理逻辑的状态容器(如 ViewModel 类)。 为什么这里会提到Compose? 使用Compose的原因之一 即使你使用了MVI架构,但是当有人不遵守这个设计理念时,从代码层面是无法避免别人使用非MVI架构,久而久之,导致你的代码混乱。 意思就是说,你在使用MVI架构搭建页面之后,有个人突然又引入了MVC的架构,是无法避免的。Compose可以完美解决这个问题。 接下来就是本文与其他技术博客不一样的地方,把Compose如何使用,为什么这样使用做下说明,不要只看理论,最好实战。 5.1Compose的主要作用 Compose可以做到界面view在一开始的时候就要绑定数据源,从而达到无法在其他地方被篡改的目的。 怎么理解? 当你有个TextView被声明之后,按照之前的架构,可以获取这个TextView,并且给它的text随意赋值,这就导致了TextView就有可能不止是在MVI架构里面使用,也可能在MVC架构里面使用。 5.2MVI+Compose的代码示例 MVI+Compose架构代码 class MviComposeLoginActivity : ComponentActivity() { override fun onCreate(savedInstanceState: Bundle?) { super.onCreate(savedInstanceState) lifecycleScope.launch { setContent { BoxWithConstraints( modifier = Modifier .background(colorResource(id = R.color.white)) .fillMaxSize() ) { loginConstraintToDo() } } } } @Composable fun EditorTextField(textFieldState: TextFieldState, label : String, modifier: Modifier = Modifier) { // 定义一个可观测的text,用来在TextField中展示 TextField( value = textFieldState.text, // 显示文本 onValueChange = { textFieldState.text = it }, // 文字改变时,就赋值给text modifier = modifier, label = { Text(text = label) }, // label是Input placeholder = @Composable { Text(text = "123456") }, // 不输入内容时的占位符 ) } @SuppressLint("CoroutineCreationDuringComposition") @Composable internal fun loginConstraintToDo(model: ComposeLoginViewModel = viewModel()){ val state by model.uiState.collectAsState() val context = LocalContext.current loginConstraintLayout( onLoginBtnClick = { text1, text2 -> lifecycleScope.launch { model.sendEvent(TodoEvent.DoLogin(text1, text2)) } }, state.isThumbUpSuccessful ) when { state.isLoginSuccessful -> { Toast.makeText(baseContext, "登录成功,开始校验账号", Toast.LENGTH_SHORT).show() model.sendEvent(TodoEvent.VerifyAccount("123456", "123456")) } state.isAccountSuccessful -> { Toast.makeText(baseContext, "账号校验成功,开始点赞", Toast.LENGTH_SHORT).show() model.sendEvent(TodoEvent.ThumbUp("123456", "123456")) } state.isThumbUpSuccessful -> { Toast.makeText(baseContext, "点赞成功", Toast.LENGTH_SHORT).show() } } } @Composable fun loginConstraintLayout(onLoginBtnClick: (String, String) -> Unit, thumbUpSuccessful: Boolean){ ConstraintLayout() { //通过createRefs创建三个引用 // 初始化声明两个元素,如果只声明一个,则可用 createRef() 方法 // 这里声明的类似于 View 的 id val (firstText, secondText, button, text) = createRefs() val firstEditor = remember { TextFieldState() } val secondEditor = remember { TextFieldState() } EditorTextField(firstEditor,"123456", Modifier.constrainAs(firstText) { top.linkTo(parent.top, margin = 16.dp) start.linkTo(parent.start) centerHorizontallyTo(parent) // 摆放在 ConstraintLayout 水平中间 }) EditorTextField(secondEditor,"123456", Modifier.constrainAs(secondText) { top.linkTo(firstText.bottom, margin = 16.dp) start.linkTo(firstText.start) centerHorizontallyTo(parent) // 摆放在 ConstraintLayout 水平中间 }) Button( onClick = { onLoginBtnClick("123456", "123456") }, // constrainAs() 将 Composable 组件与初始化的引用关联起来 // 关联之后就可以在其他组件中使用并添加约束条件了 modifier = Modifier.constrainAs(button) { // 熟悉 ConstraintLayout 约束写法的一眼就懂 // parent 引用可以直接用,跟 View 体系一样 top.linkTo(secondText.bottom, margin = 20.dp) start.linkTo(secondText.start, margin = 10.dp) } ){ Text("Login") } Text(if (thumbUpSuccessful) "点赞成功" else "点赞失败", Modifier.constrainAs(text) { top.linkTo(button.bottom, margin = 36.dp) start.linkTo(button.start) centerHorizontallyTo(parent) // 摆放在 ConstraintLayout 水平中间 }) } } 关键代码段就在于下面: MVI+Compose架构代码 Text(if (thumbUpSuccessful) "点赞成功" else "点赞失败", Modifier.constrainAs(text) { top.linkTo(button.bottom, margin = 36.dp) start.linkTo(button.start) centerHorizontallyTo(parent) // 摆放在 ConstraintLayout 水平中间}) TextView的text在页面初始化的时候就跟数据源中的thumbUpSuccessful变量进行了绑定,并且这个TextView不可以在其他地方二次赋值,只能通过这个变量thumbUpSuccessful进行修改数值。当然,使用这个方法,也解决了数据更新是无法diff更新的问题,堪称完美了。 5.3MVI+Compose的优缺点 MVI+Compose的优点如下: 保证了框架的唯一性 由于每个view是在一开始的时候就被数据源赋值的,无法被多处调用随意修改,所以保证了框架不会被随意打乱。更好的保证了代码的低耦合等特点。 MVI+Compose的也存在一些缺点: 不能称为缺点的缺点吧。 由于Compose实现界面,是纯靠kotlin代码实现,没有借助xml布局,这样的话,一开始学习的时候,学习成本要高些。并且性能还未知,最好不要用在一级页面。 六、如何选择框架模式 6.1 架构选择的原理 通过上面这么多架构的对比,可以总结出下面的结论。 耦合度高是现象,关注点分离是手段,易维护性和易测试性是结果,模式是可复用的经验。 再来总结一下上面几个框架适用的场景: 6.2框架的选择原理 如果你的页面相对来说比较简单些,比如就是一个网络请求,然后刷新列表,使用MVC就够了。 如果你有很多页面共用相同的逻辑,比如多个页面都有网络请求加载中、网络请求、网络请求加载完成、网络请求加载失败这种,使用MVP、MVVM、MVI,把接口封装好更好些。 如果你需要在多处监听数据源的变化,这时候需要使用LiveData或者Flow,也就是MVVM、MVI的架构好些。 如果你的操作是串行的,比如登录之后进行账号验证、账号验证完再进行点赞,这时候使用MVI更好些。当然,MVI+Compose可以保证你的架构不易被修改。 切勿混合使用架构模式,分析透彻页面结构之后,选择一种架构即可,不然会导致页面越来越复杂,无法维护 上面就是对所有框架模式的总结,大家根据实际情况进行选择。建议还是直接上手最新的MVI+Compose,虽然多了些学习成本,但是毕竟Compose的思想还是很值得借鉴的。 END 猜你喜欢 明修"栈"道——越过Android启动栈陷阱 Android系统服务DropBoxManagerService详解与实践应用 vivo官网App模块化开发方案-ModularDevTool 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | GaussDB 技术解读丨高级压缩

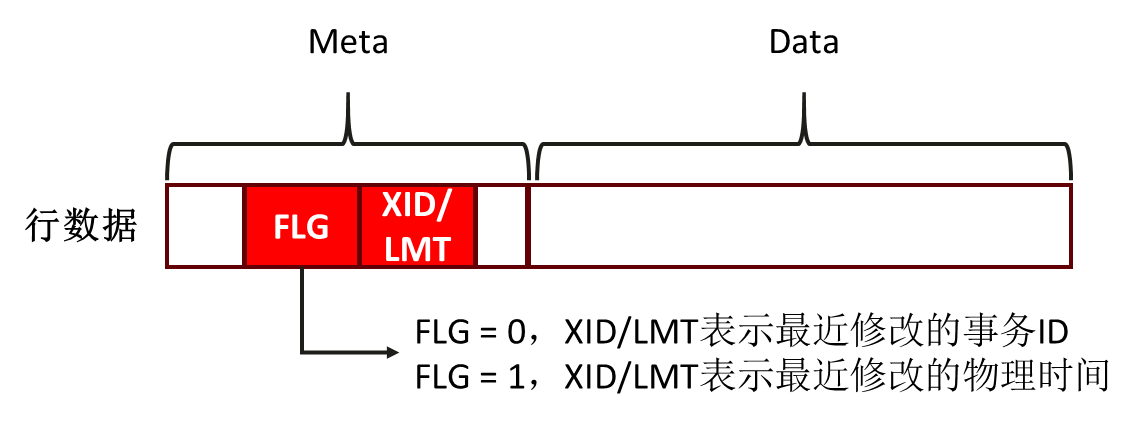
本文作者|华为云数据库GaussDB首席架构师 冯柯 【背景介绍】 数据压缩与关系数据库的结合,早已不是一个新鲜的话题,当前我们已经看到了各种各样数据库压缩的产品和解决方案。对于GaussDB来说,在今天引入数据压缩,究竟能够给客户带来什么不一样的价值,是过去一段时间我们一直在思考的问题。 为了回答这个问题,我们首先对各种通用压缩算法进行了广泛的测试,从性能最好的LZ4/Snappy,到性能与压缩率均衡的Zstd/Zlib,再到强调压缩率的LZMA/BZip。我们发现:即使是性能最好的压缩算法,仍然无法做到对一个在线数据库的性能不产生显著影响。我们也调研了数据库领域的各种编码方法,包括近几年学术界发布的一些基于预测和线性拟合的编码方法,从研究发布的测试结果及实测来看,数据库编码用于解决特定数值分布的可压缩性问题,与压缩算法的成熟度相比,当前并没有一种通用的数据库编码方法,能够在大多数真实数据集中的场景下提供稳定的压缩率。 这是我们对于数据库压缩这个领域的一个基本技术判断。过去的产品实践也验证了这一点,我们看到很多商业数据库和开源数据库都提供了对于压缩的支持,绝大多数时候,留给客户的选择就是决定要不要在特定的表上开启压缩。开启压缩意味着空间节省,但同时意味着性能下降,这个看似简单的选择恰恰是客户最难做的。这也是为什么有了这么多数据库压缩的产品,我们却很少能看到数据压缩真正广泛应用在数据库在线业务中的根本原因。 这给了我们更多的启示。我们相信,真正可被应用的数据库压缩技术,能够去兼顾压缩率与业务影响的平衡,应该是选择性的。即我们能够基于技术去判定数据的温度,并基于这样的判定,去选择性地压缩业务中相对较冷的数据,而不去碰那些相对较热的数据。 这样的技术选择意味着我们无法去满足所有业务场景,我们要求业务的数据温度分布,必须满足80-20分布规则。即我们去压缩那些占用80%存储需求、但只占用20%计算需求的冷数据,而不去碰那些只占用20%存储需求、但却占用80%计算需求的热数据。幸运的是,我们发现绝大多数对于容量控制有需求的业务,都具备这样的特征。 【场景及目标选择】 通过对大量业务场景的分析,我们发现业务对于数据库压缩技术的需求是多元化的,有在线交易业务(OLTP)存储压缩的场景,有分析业务(OLAP)存储压缩的场景,有历史业务存储压缩的场景,也有容灾业务传输压缩的场景。不同的场景,对于压缩技术的诉求,如果从压缩性能、压缩率、解压性能的三维指标去看,从对业务侵入的容忍度去看,是完全不同的。 这意味着如果我们想要打造一个全场景的GaussDB高级压缩特性,它应该是多个技术的组合,包括不同的压缩算法、不同的冷热判定模型及方法、不同的数据存储组织等,通过不同的技术组合及应用去满足不同的场景需求。 这同时意味着我们在不同压缩适用场景的支持上需要有个优先级的取舍。我们的答案是选择去优先支持OLTP存储压缩场景,这是我们认为数据库压缩技术最有价值的业务领域,当然也是技术挑战最大的领域。 确定场景之后,接下来是确定技术目标,我们面向这个场景,究竟要打造什么样的核心竞争力,这取决于我们对于典型客户场景的分析。我们识别了两类典型客户场景: 场景A:客户业务来自于IBM小机,单库容量50TB,迁移到开放平台后,面临容量过大和运维窗口过长问题。选择拆库意味着分布式改造,对于一个已经稳定运行许多年的存量关键业务来说,这种技术选择风险过高。选择压缩可以显著降低容量风险,但业务最初的设计并没有考虑冷热分离(比如基于时间维度建立分区),需要一种零侵入的压缩技术支持,同时对业务性能影响足够低。 场景B:客户业务基于分布式集群部署,单集群容量已经超过1PB,并且仍在快速增长,需要定期扩容。选择压缩可以降低扩容频率,显著降低业务的软硬件成本,并减少变更风险。但业务的数据分布设计是面向扩展性的(比如基于用户维度建立分区),没有考虑冷热分离,因此同样的,业务需要一种零侵入的压缩技术支持,同时对性能影响足够低。 通过对客户典型场景的需求梳理,我们确定了GaussDB OLTP存储压缩的基本设计目标:1)冷热判定对业务应该是零侵入的,不应对业务的已有数据分布、逻辑模型有任何依赖;2)对业务影响必须足够低,我们定义目标低于10%,并挑战5%;3)提供合理的压缩率,我们定义目标不低于2:1。基本设计目标的定义,使得我们能够将后续每个具体场景中的技术选择都变成一个确定性问题。 【冷热判定】 确定设计目标后,我们开始进行工程落地。有三个问题需要解决:1)如何实现对数据的冷热判定;2)如何实现压缩后数据的存储组织;3)如何实现有竞争力的压缩算法。 对于冷热判定,首先要确定判定的粒度。数据的冷热判定可以基于不同粒度实现,行级、块级或表/分区级,粒度越粗,实现的复杂度越低,但对业务的侵入也越大。基于设计目标,很自然的,我们选择行级的冷热判定,这是对业务数据分布依赖最小的方案,我们需要解决的,是如何控制引入冷热判定的代价。 我们利用GaussDB存储引擎已有的机制巧妙地解决了这一问题。具体来说,GaussDB存储引擎在每行数据的元数据Meta中记录了最近一次修改该行的事务ID(XID),该信息被用来支持事务的可见性判定,从而实现多版本并发控制(MVCC)。对于特定行来说,如果其XID足够“老”,老到它对所有当前已经活跃的事务都可见,那么这时候我们实际上已经不关注XID的具体值,我们可以通过引入一个特定的标志位(FLG)来记录这一点,而原来XID中填充的值可以被一个物理时间来代替,这个物理时间就表征了其所属行最后一次修改时间的上限(LMT,Last Modified Time)。很显然,LMT可以用来支持冷热判定(具体见图1): 图1:行级冷热判定 上述方案的好处是引入LMT并没有增加额外开销,对业务的逻辑模型也没有任何依赖,在大多数时候,如果不是特别严格要求,业务可以定义一个简单的规则来实现冷热判定,比如: AFTER 3 MONTHS OF NO MODIFICATION 此时系统会扫描目标表,对于所有满足当前时间减去LMT超过3个月的行进行压缩。 注意在上述方案中,我们实际上只识别了行的写热点,但并没有识别行的读热点,我们只知道满足条件的行3个月内未发生任何更新,但我们无法确认这些行在3个月内是否被频繁读取。维护行的读热点,目前从技术上没有低成本的解决方案。对于像订单明细这样的流水类业务,这个方案可以很好地工作,因为数据的读和写呈现出相同的温度特征,其访问频率随着未修改时间的增加不断衰减。但对于像手机相册这样的收藏类业务,仅识别写可能是不够的,因为一个很早建立的收藏关系仍然可能被频繁访问。 这意味着,即使系统进行了冷热判定,我们仍然需要去优化业务可能访问压缩数据的场景,我们把这个问题留给了存储组织和压缩算法,对于压缩算法来说,我们更关注其解压性能。 另一个问题是在某些场景下,使用默认的冷热判定可能是不够的,比如对于某些类型的交易而言,其产生的订单明细可能在3个月内确实不会被修改,但会在达到一个特定的触发条件后被更新(比如解冻担保交易)。这种场景在实际业务中并不常见,但如果业务确实关注性能,那么我们支持在默认的冷热判定规则以外,允许业务自定义规则,比如: AFTER 3 MONTHS OF NO MODIFICATION ON (order_status = "finished") 此时系统会仅压缩3个月未修改、且订单状态已经完结的数据。 当前我们支持的自定义规则,是任意合法的行表达式,业务可以写任意复杂的表达式来表征数据的冷热判定规则,但表达式中所引用的任何字段,只能是目标表上的合法字段。通过这种默认和自定义规则的组合使用,我们提供了业务足够低的使用门槛和更好的灵活性。 【存储组织】 当满足冷热判定条件的行被压缩时,我们需要决定如何存储这些压缩后的数据,基于设计目标,我们选择了对业务侵入最小的存储组织实现——块内压缩。 我们知道关系数据库的存储组织都是基于固定长度的分块的,在GaussDB数据库中,典型的数据块大小为8KB,选择更大的数据块显然有利于压缩,但对业务性能会造成更大的影响。所谓块内压缩,是指:1)单个块内所有满足冷热判定条件的行,会作为一个整体进行压缩;2)压缩后形成的数据就存放在当前的数据块中,存放区域称为BCA(Block Compressed Area),它通常位于块的尾部。 块内压缩的设计意味着解压任何数据只依赖于当前块,而不需要访问其它的数据块,从压缩率的视角看,这样的设计并不是最友好的,但它非常有利于控制业务影响。注意在我们前面的讨论中,即使业务定义了冷热判定条件,仍然存在一定的概率会访问压缩数据,我们希望这个访问代价能够有一个确定性的上限。 图2给出了块内压缩的详细流程:首先,当压缩被触发时,系统扫描数据块中的所有行,根据指定的冷热判定条件,识别出R1和R3是冷数据(图2(a));接着,系统将R1和R3作为一个整体进行压缩,将压缩后的数据就存放在该数据块的BCA中(图2(b));如果业务后续需要更新R1,那么系统会为更新后的数据生成一个新的拷贝R4,并标识BCA中的R1已经被删除(如图2(c));最后,当系统在该数据块上需要更多空间时,可以回收BCA中属于R1的空间(图2(d))。 图2:块内压缩 在整个设计中有两点需要注意:1)我们实际上只压缩了用户数据Data,并没有压缩相应的元数据Meta,后者通常用来支持事务的可见性;2)我们支持将冷数据重新变为热数据,以消除因为冷热误判而带来的影响。同样地,从压缩率的视角,这样的设计并不是最友好的,但它极大地减少了对业务的侵入。简单来说,业务对于压缩数据的访问,与正常数据完全相同,在功能上没有任何限制,在事务语义上也没有任何差别。这是非常重要的原则:我们的OLTP存储压缩对于业务是完全透明的,这是当前这个特性,以及后续GaussDB高级压缩系列所有特性都将遵循的基本原则。 【压缩算法】 基于设计目标,如果从压缩率、压缩性能、解压性能的三维指标来看,我们实际上需要的是一个能够提供合理的压缩率、合理的压缩性能、但是极致的解压性能的压缩算法,这是我们压缩算法设计的基础。 我们首先测试了直接使用LZ4进行压缩,LZ4是目前已知的压缩性能和解压性能最好的开源三方库,从实测结果看,LZ4的压缩率是偏低的。我们仔细分析了其算法原理,LZ4是基于LZ77算法的一种实现,LZ77算法的思想非常简单,就是把要压缩的数据看成一个字节流,算法从字节流的当前位置开始,前向寻找和当前位置相同的匹配字符串,然后用匹配到的字符串的长度以及与当前位置的偏移,用来表示被匹配的字符串,从而达到压缩的效果。从算法原理上看,LZ77算法对于长文本会有比较好的压缩效果,但是对于结构化数据中大量的短文本以及数值类型,效果就有限,我们实际的测试也验证了这一点。 接下来,我们将压缩算法分为了两层:第一层,我们按列对一些数值类型进行了编码,我们选择了简单的差值编码,这种编码足够轻量级,解压特定字段不需要依赖其它字段的值;第二层,我们将编码后的数据再调用LZ4进行压缩。注意在第一层中,我们实际上是按列编码、按行存储,这和业界的一般实现(按列编码并存储)有很大不同,按列存储对压缩率会更加友好,但是按列存储意味着同一行的数据会被分散到BCA的不同区域,这种传统的设计无法支持我们后续希望实现的部分解压,我们将在结束语中更详细地说明这一问题。 通过实测,我们发现这种列编码+通用压缩的实现方式有效地提升了压缩率,同时控制了业务影响的明显增加,但两层实现之间是松耦合的,这引入了许多额外的开销。因此我们在仔细权衡之后,决定放弃LZ4,而是完全基于LZ77算法,重新实现一个紧耦合的压缩算法。 这在当时看来是一个非常冒险的尝试,事实上,在我们之前,还没有任何数据库内核团队,会选择自己去实现一个通用压缩算法。但从最后取得的收益来看,我们实际上是打开了一扇全新的大门。当列编码与LZ77算法之间的边界被打破时,我们引入了一系列的优化创新,考虑篇幅原因,我们无法展现全部技术细节,在这里,我们只介绍两个小的优化: 第一个优化是内置行边界。我们发现,当系统采用两层压缩算法后,我们需要额外地保存每一行数据在编码后的长度,因为我们需要在LZ77算法解压后找到每一行的边界,这是一个不小的开销。为了消除这个开销,我们选择在LZ77的编码格式中嵌入一个行边界的标记,这个标记只占用了1个位,其开销较现有方案大幅降低。当然,这个标记位被占用后,LZ77前向搜索的最大窗口长度减少了一半,但在我们这个场景中,这并不是什么问题,因为我们的典型页面长度只有8KB。 第二个优化是2字节短编码。原有LZ4的实现中,为了提高压缩性能,系统使用3字节编码来描述一个匹配,这意味着系统能够识别的最短匹配为4字节。但是在结构化数据中,3字节的匹配是非常普遍的,参考下面一个例子: A = 1 … B = 2 其中,A和B是同一行数据中的两个整数型字段,它们的值分别为1和2,基于当前的字节序,该行数据实际在内存中存放的形式如下所示: 01 00 00 00 … 02 00 00 00 注意上面标红的部分,很明显,这里面有一个3字节的匹配,但是它无法被LZ4识别。 我们通过在LZ77算法中额外引入2字节短编码来解决这一问题,2字节短编码可以识别最小3字节的匹配,从而相对LZ4能够提升压缩率。当然,引入短编码会有额外的开销:1)压缩性能会有一定程度的下降,因为我们需要建立两个独立的HASH表,幸运的是,在我们这个场景中,极致压缩性能并不是我们追求的目标;2)2字节编码减少了表达匹配串与被匹配串之间距离的位宽,这意味着3字节的匹配必须离得更近才能被识别,在我们这个场景中,这并不是什么问题,因为相对于这个限制,一个典型数据行的长度已经是足够小的。 【效果评估】 我们使用标准的TPCC测试来评估启用OLTP存储压缩特性对业务的影响。TPCC模型共包含9张表,其中空间会动态增长的流水表共有3张,在这3张表中,订单明细表(Orderline表)的空间增长比其它表多一个数量级,因此我们选择在这张表上开启压缩。基于TPCC的业务语义,每笔订单一旦完成配送,其订单状态就进入完结状态,完结的订单不会再被修改,但仍有一定的概率被查询。基于这个语义,我们选择冷热判定原则为只压缩已经完结的订单。 我们分别测试了在不开启压缩和开启压缩状态下系统的性能值,结果如图3所示: 图3:业务影响评估 测试结果表明:在TPCC测试场景下,开启压缩与不开启压缩相比,系统性能大概降低了1.5%。这是一个非常不错的结果,这意味着即使在超过百万tpmC的业务峰值场景中,系统也可以开启压缩。我们不知道在此之前,业内是否有其它数据库产品也能够达到这一水平。 我们测试了Orderline表的压缩率,作为更丰富的数据集,我们同时选择了TPCH模型中的4张表(Lineitem、Orders、Customer、Part表)进行测试。为了便于比较,对于每个数据集,我们同时测试了LZ4、ZLIB和我们的压缩算法的压缩率表现,其中ZLIB是强调压缩解压性能和压缩率均衡的算法,其压缩解压性能较LZ4低了5-10倍。最终结果如图4所示: 图4:压缩率评估 测试结果与我们预期的相符,在数值型字段较多时,我们的压缩算法的压缩率要高于所有通用压缩算法,但在文本型字段较多时,我们的压缩算法的压缩率会介于LZ类和LZ + Huffman组合类的压缩算法之间。 【运维TIPS】 注意我们的压缩方案实际上是离线的,也就是数据刚生成时必然是热数据,它们不会触发压缩,业务访问这些数据的性能也不会受任何影响;随着时间的推移,这些数据的温度会逐渐降低,最终被独立的压缩任务识别为冷数据并进行压缩。 选择在业务低峰期运行这些压缩任务、并控制其资源消耗是运维端需要关注的问题。在这块我们提供了丰富的运维手段,包括指定运维窗口、压缩任务的并行度、每个压缩任务的压缩数据量等。对于绝大多数业务来说,单位时间内新增的数据量实际是比较有限的,因此业务也可以选择一个特定的时间段集中完成压缩任务,比如每个月第一天的凌晨两点到四点,完成3个月前新增冷数据的压缩。 业务在决定开启压缩之前,可能希望先了解开启压缩后的收益,并根据收益大小做出决策。为此我们提供了一个压缩率评估工具,能够对目标表的数据进行采样,并使用和实际压缩过程完全相同的算法对采样数据进行压缩,计算压缩率,但不会实际生成BCA,不会修改任何数据。 如果业务将压缩数据迁移到另一个表,可能会导致所有数据从压缩状态变为非压缩状态,从而导致空间膨胀,这并非我们的方案引入的,而是所有压缩方案都需要解决的问题。如果冷热判定规则非常确定,那么业务可以手动执行压缩任务使压缩立即生效;对于耗时较长的大容量压缩表的迁移,业务仍然可以选择定期地开启自动压缩任务来完成。 最后,对于压缩的开启和关闭,我们提供最细粒度的控制,无论是普通表、普通分区表中的单个分区,还是二级分区中的任意单个分区、子分区,业务都可以单独开启或关闭压缩。这使得对于业务本身已经对数据区分了冷热(比如基于时间分区)的场景,仍然可以和我们的压缩特性很好地配合。 【结束语】 在OLTP表压缩这个特性中,我们引入了一系列的技术创新,包括全新的压缩算法、细粒度的自动冷热判定和块内压缩支持等,可以在提供合理压缩率的同时,大幅度降低对业务的影响,我们希望这个特性能够在支持关键在线业务的容量控制中发挥重要价值。 接下来我们还将在降低引入压缩对业务的影响、部分解压特性、OLTP索引压缩等方面持续创新迭代,我们希望能够有开创性的技术突破来解决相关的问题,为业务创造更大价值。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 凹语言中文语法设计

设计理念 凹语言的中文语法(下面简称凹中文版)的设计理念是: 简洁:尽量减少冗余信息。例如:关键字尽量选择单字。 易读:代码读起来应当尽量贴近自然语言。关键语法信息应当足够醒目。 灵活:不必拘泥于英文编程语言的传统语法,可以尝试灵活的设计。 符号:作为中文编程语言,并不排除,而是妙用标点符号和拼音字母。 凹中文版的语法设计主要受到了文言编程语言的启发。 但与文言编程语言的主要区别,在于上述的第一条理念:简洁。 我认为文言文相对于白话文,最大的特色就是简洁。 而简洁的需求正是由于时代的背景所决定的:当时的书写工具和文字承载工具都非常昂贵,因此惜字如金并不只是比喻。 因此,为了尽量继承文言文的简洁精神,我在设计凹中语法时,与文言编程语言的风格有了很大的区别。 凹中文版的语法设计还参考了: 凹英文语法。凹语言的中文和英文语法是相互兼容的,每个语法结构都能找到对应。并且到现在为止,凹中的解析前端还是和凹语言英文语法强耦合的。 Go语言。凹语言初版的实现是用Go写的,且前端代码也是从Go语言的前端移植过来的,因此在设计与实现中会更倾向于贴近Go的风格。 Kotlin和D语言。凹语言的中文语法设计中,也借鉴了一些Kotlin和D的语法设计。 提示:凹中文版语法还处于早期探索阶段,很有可能会发生变化。 我们计划在完成凹中文前端的重构(即完全脱离现有的Go前端)之时,得到一套稳定的中文语法。 现在可运行的示例,请参考凹语言工程中的可执行示例。 简单示例 下面是Hello World的凹中文版示例: 引于 "书" 【启】: 书·说:“你好,凹语言!” 。 上面的代码中: 引于(import)是关键字。 【】是函数定义的标志,相当于func。 书·说:“你好,凹语言”是函数调用,相当于:fmt.println(“你好,凹语言!”) :和。是一个程序块的开始和结束符号。相当于{和}。 这些设计都是为了简洁和易读原则而做出的选择。 这段代码用凹英文版写出来就是: import "fmt" func main { fmt.println("你好,凹语言!") } 下面是一个更复杂的示例,展示了其他几个已经实现的基本语法: 引于 "书" 【启】: // 基本函数调用 书·说:"你好,凹语言!" // 调用自定义函数 书·说:"[自定义函数]:40+2=" 书·曰:加:40、2 // 简单的条件判断 书·说:"[条件判断]:" 设零之数 = 0 若零==1则: 书·说:"是的,零和1是相等的。" 否则: 书·说:"错了,零和1是不同的。" 。 // 简单的自定义类型 设某=点{横:10, 纵:2} 书·说:"[自定义类型]点(10,2)的纵坐标和横坐标之和:" 书·曰:某·横 + 某·纵 书·说:"[自定义类型]点(10,2)的纵坐标和横坐标之平方和:" 书·曰:某·平方距: // 循环 // 类似range 书·说:"[简单范围] 从0到3:" 自0至3,有i: 书·曰:i 。 // 类似三段式for循环,注意,由于中英文语义不同,这里的j==8是停止条件,和for循环的“持续条件”正好相反 书·说:"[循环语句] 从0到8:" 从j=0,到j==8,有j++: 书·曰:j 。 书·说:"[循环语句] 从10到0:" 设步=1 从i=10,到i>=100,有: i+=步 书·曰:i 。 // 类似until语句 书·说:"[直到语句] 直到5:" 设i=0 直到i>=5,有: 书·曰:i i++ 。 // 多路选择 书·说:"[多路输出]k=3" 设k=3 当k: 为1,则:书·说:"一" 为2,则:书·说:"二" 为3,则:书·说:"三" 否则:书·说:"不中" 。 。 《点》: 横之数 纵之数 。 【点·平方距】() => 数 : 归于:此·纵*此·纵 + 此·横*此·横 。 【加】(甲, 乙之数) => 数 : 归于:甲+乙 。 详细介绍 本节详细介绍上面几种语法的设计,以及为何这样设计的缘由。 函数定义和函数块 先看Hello World: 引于 "书" 【启】: 书·说:“你好,凹语言!” 。 在凹中文版里,函数的定义用实心方括号【】来表达。方括号之中的是函数名称。 这里的【启】函数,是整个程序的启动函数,即我们常说的主函数。 本来我打算直接用以没有直接选择【主】,但写出来之后,这段代码读起来就有“主说:‘要有光’”的味道了,总有点怪怪的感觉。所以只好换了个字。 其实最开始我的设计几乎相当于对英文版的关键字替换: 函数 主函数 { 打印(“温故而知新,可以为师矣。”) } 这里遇到了设计的第一个问题,直译的关键字变成中文之后读起来太过生硬了,而且也不够简洁。 这种风格的中文编程早就存在了,我相信这也是很多人一听到“中文编程”,就会产生的第一印象。 我认为这里有历史的原因,但也有习惯的原因。 ”函数“、”打印“这种双字词,最开始翻译时,是用于技术文章,而不是程序的,因此简洁并不是翻译者的第一要务。 当时面对这些中文还没有的技术性新概念,采用这种翻译是非常合理的。 实际上,最早的英文编程语言中,关键字读起来也是冗长而生硬的:"procedure"(后来被简化成proc),”function“(最近才简化成func\fun\fn), 可以看出英文关键字的演变也是有一个从陌生到习惯、从冗长明确到简洁的过程的。 中文没法像英文那么容易缩略,但中文也有优势,我们有非常多的单字词可以选择。 因此我当时选择了”方“这个字,表示”方程、配方“的意味,用来替代”函数“;又选择了”曰“这个所有人都认识的单字来替代”打印“: 方 启 { 曰(”温故而知新,可以为师矣。“) } 这样已经有一点”文言”编程语言的意味了。上面的代码完全可以用“文言”编程语言的风格来读: 吾有一方,其名曰【启】,其方如下: 一、曰:“温故而知新,可以为师矣。” 方止于此。 这个风格其实用来编程已经没有太大问题,既有简洁又清晰,相当于“文言”编程语言的简略版,其效用和英文版几乎一致。 但我多看了几趟,仍然觉得有点别扭。 再看看、再瞅瞅,终于发现别扭的地方了:我们没有适应过高度抽象话的中文编程,所以下意识还是会把它当做中文句子来读。 那么,不符合中文文本惯例的地方,就会显得有些跳脱,也就有了别扭感。 而这里最大的别扭感,来自于【空格】的使用。标准的中文文本里,是鲜有空格的。 我们的标点符号是全角,本身就自带了空白分隔。因此在这里用空格直接连接“方”和“启”字,就会有别扭感。 空格问题有两个解决办法: 一是把空格改成文本和标点,回归中文叙述。这也是“文言”编程语言选择的办法。因此即使它用的都是文言文,我们也觉得读起来比较顺畅。 但这个办法会增加大量冗余文字,在程序比较简单的时候还行,一旦比较复杂后,多出来的字词读起来就会浪费精力了; 另一个问题是这样平铺直述的表达是线性的,用来表示嵌套的逻辑时很难搞清楚层级。 第二个办法,就是巧妙地利用中文标点符号自带的空白,以他们来顶替空格的作用。 【启】: 曰:“温故而知新,可以为师矣。” 。 仔细观察,这里不论是实心方括号【】,还是中文冒号:,都既有充实的间隔感,又自带了空白,而且是符合中文阅读时内心的停顿节奏的空白。 因此即使我用了很奇怪的组合:和。来替代{},都不会显得很别扭。 (实际上我最初选的结束符号是办公文本常见的■,这个符号本身就是结束符的意思。但由于这个符号远没有句号。好打出来,而它在凹中文版中又那么常用,因此我放弃它改用句号了。) 这个办法还有一个好处,类似【】这样的中文标点非常醒目,因此用来定位程序关键要素时很方便。读代码时,目光一扫就能感受到大概有几个函数。 看看上面的“文言”的例子,最抓眼球的字,是不是就是【启】?这也是为什么我选择实心方括号而不是空心的原因。 另外,由于【】的特殊性,我们连方这个关键词都可以不用了。 至此,读者应该还有一个问题,那问什么要把{}也换掉呢? 【启】{ 曰(”温故而知新,可以为师矣。“) } 这确实也是让我头疼的一个选择。'{'的作用本质上是开启新的名字空间。编程语言的名字空间是树状结构,{}开辟一个新的子空间,这里头可以继续引用上层的名称,但也可以新建只有自己(以及自己的子孙空间)才能访问的局部名称。要在程序中表达这样一个新的子空间,需要一个开始符号和一个结束符号。 常见的编程语言有三种方式来表达子空间: 括号。包括C系列语言的花括号{}和LISP系的()。 缩进。Python等语言采用的方法。优点是阅读的简洁性更强,更符合自然语言习惯。缺点是层次太多以后容易搞错层级。 单独的end。Lua等语言用这个方法。很多时候开启新的子空间之前都有特殊的程序结构,例如上面的“函数定义”,所以不需要单独指定开启字符。但为了避免混淆,需要指定一个结束字符。end就是最常用的结束关键词。这种方式比{}更接近自然语言的风格,同时也不用考虑缩进的问题,算是前两种方法的折衷。 我本来选择的是第三种: 【启】 曰(“温故而知新,可以为师矣。”) 。 但多看了几遍之后又觉得有点别扭,最后还是把【启】后面的冒号加上了: 【启】: 曰(“温故而知新,可以为师矣。”) 。 这个冒号虽然实际上是冗余的,但在阅读时提供的节奏感,我现在认为是必要的。 这样实际上又回归了和{}完全等效的局面::对应{,。对应}。还挺合适。 最后一个问题,问什么用冒号来表示函数调用: 曰:“温故而知新,可以为师矣。” 曰(“温故而知新,可以为师矣。”) 再对比一下,其实没有本质的区别。非要说的话,怪我选的这个例子吧。实在是和《论语》 原文太像了: 子曰:“温故而知新,可以为师矣。” 这种平铺直叙的命令式,实在是太符合自然语言习惯了。 那么冒号会不会遇到问题呢?多个参数时怎么办?参数又是函数调用的嵌套时,又该怎么办?这个问题比较复杂,我会在后面函数相关的话题里专门描述。总之,一旦嵌套了,还是得有括号帮忙。 至此我们完成了HelloWorld的对比,也大致了解了凹中文版在语法设计时所衡量的因素。接下来,我们看看更复杂的情况。 变量 凹英文版变量的定义方式如下: // 使用关键字var var a: int = 1 a = a + 1 // 快速定义语法 b := 2 凹语言的变量定义和Go语言基本一致,主要的区别在于变量和类型之间用:分隔,更接近Kotlin等语言的风格。 在凹中文版中,用关键字“设”来表示变量的定义: 设甲=1 甲=甲+1 而用来赋值的操作符是=和英文版一致。 当然,类似abc这样的拼音符号,我认为在中文编程中并不需要避讳。因此上面的代码也可以写成: 设a=1 a=a+1 要指明变量的类型,如果按照英文版的方式来的话,会是这样: 设a:数=1 a=a+1 但我感觉这样读起来会有些卡顿感。由于中文缺乏空格,这里的冒号就显得太突兀了。况且冒号已经用在代码块和函数调用上了。 解决办法有三种。 一种是变量和类型一起用括号包裹起来: 设(甲:数)=1 或者类似于函数定义,用独立的符号把变量名包裹起来,而不是包裹类型: 设「甲」数=1 第三种是直接把“之”字做成关键字,用来替代冒号: 设甲之数=1 现在暂时没有找到最佳的方案,我决定暂时用“之”关键字分隔的方式。等有了更多的代码体验之后,再确定正式方案。 数据类型 凹中文版最初版本只支持两个基本类型:《数》和《文》。它们分别对应与Go语言的int和string类型。更多的类型支持,留待整个编译器雏形搭建好之后再慢慢扩充。 复合类型中最常见的是数组(array)和映射(map)。 【启】: // 数组 设a=[1,2,3] // 映射 设b={1:2, 3:4, 5:6} 。 如果需要指明类型,则这么定义: 【启】: // 数组 设a之[数]=[1,2,3] // 映射 设b之{数:数}={1:2, 3:4, 5:6} 。 这里数组和映射的类型名称语法和英文版不一样。英文版沿用了Go的写法: 数组:[]int 映射:map[int]int 而中文版则选择了和字面量几乎一致的形式。 数组:[数] 映射:{数:数} 这也得益于中文版并没有采用{}来表示代码块,因此可以把{}留给映射的类型标记用。 TODO: 这个功能暂时还没实现。 自定义函数 凹英文版定义函数的语法如下: func add(a: int, b: int) => int { return a+b } func main { println(add(1, 2)) } 和Go语言类似,但有两点区别: 参数列表和返回类型之间有个=>符号分隔,这样让函数定义在整个文件中更醒目。当前版本这个=>是可以省略的。 如果函数参数为空,则可以把括号省略掉,比如这里的func main就直接接{了。 凹中文版的形式如下: 【和】(a之数、b之数)=> 数: 归于:a+b 。 【启】: 曰:和:1、2 。 这里: 【和】是函数名,【】表示定义一个新函数,相当于func。 参数列表和英文版基本一致,只不过参数的分隔由逗号,变成了顿号、。 归于:是关键字,和return一样。 这里为什么选择和英文版几乎一致的形式?是因为我做过几个其他尝试之后,并没有找到更清晰且可读的方法。 因此在初始版本里,这么写已经足够好了。并且也符合凹中文版的设计原则:简洁、清晰可读且妙用了符号。因此我就不去特意发明新符号去替代了。 这里只有一个小遗憾,=>这个箭头在中文里是没有的,用英文版的话,也没有足够好的空间,必须在右侧加一个空格。我现在用的字体会自动把=>两个字符转换成⇒这一个字符的样子,因此看起来还比较和谐。但由于⇒这个字符没有办法直接输入,只能战术放弃。 函数的调用 函数的调用采用的是“:”加参数列表的格式,而不是传统语言中双括号的格式。 和:1、2 相当于add(1, 2)。 如果需要嵌套,可以用括号表示优先级: 积:5、(和:2、3) 相当于:mul(5, add(2, 3)) 可以看到,凹中文版的函数调用语法的实际效用,和英文版并没有本质差别。 用:的主要好处是增加了简单调用的可读性,让普通代码中的一行行函数调用看起来更像是对话。但缺点是遇到复杂的调用组合,可能可读性不如英文版。我觉得这里也可能有习惯性的问题,所以打算先试用一段时间,看看是否真的有这个问题。 另外,函数调用的冒号和代码块的冒号是有冲突的,这一点需要再仔细验证一下。如果不行,可能考虑回归传统的()调用。 还有一个问题,即如果没有参数,该如何表示? 我暂时的设计是如果没有参数,还是回归() 【感叹】: 书·曰:“呜呼!” 。 【启】: 感叹() 。 总之,这里的设计还是不太成熟,需要再探讨探讨。 类型 用户自定义类型在高级编程语言中是非常重要的设计。很多设计模式都是依托于类型系统。 凹中文版的类型系统基本继承自Go语言,即不支持继承等传统OOP,而支持面向数据的类型体系,以及基于组装(composition)和接口模式的类型体系。 先看最基本的类型定义。让我们定义一个“点”类型(即Point),它的有两个成员,一个表示横坐标(x),另一个表示纵坐标(y),类型为整数(int)。 凹英文版: type Point struct { x: int y: int } func main { p := Point{x:1, y:2} println(p.x+p.y) } 凹中文版: 《点》: 纵之数 横之数 。 【启】: 设p=点{横:1,纵:2} 曰:p·x+p·y 。 这里和英文版唯一的区别就是用《》来表示类型定义,替代英文版的type <name> struct。 在struct中,成员的定义和英文版一致,只是用之来代替英文版的:,用于分隔成员名称和类型。 类型的组合模式还没有仔细研究,初步设想如下: 《三维点》: 有:点 深之数 。 这里的关键字“有”表示has-a关系,即《三维点》中包含《点》的成员。这样实际上和英文版的组合模式是一样的。 方法 方法是与类型绑定的函数。本质上它的运行和普通函数是一样的,但与类型绑定之后,我们可以非常自然地使用“主谓宾”的语法结构,而不是传统函数的“谓主宾”结构。 方法还有其他好处,比如可以和接口模式或组合模式结合起来,实现更复杂的类型系统。 凹英文版的方法定义如下: func Point.Length() => int { return math.sqrt(this.x*this.x + this.y*this.y) } fn main { p := Point{x:1, y:2} println(p.Length()) } 和Go不同之处在于,凹语言的方法定义之比普通函数在名称前多了一个前缀。Point.Length,表示Length方法是属于Point类型的。 这种方式和Scala、Kotlin等语言风格类似。 在方法之内,用this关键字表示Point类型的实例;即,在p.Length()中,this其实就是p。 凹中文版也沿用了这种方法,只是类型和方法名之间的间隔改为更适应中文的·,而this改为此: 【点·长度】=> 数: 归于:开方:此·纵*此·纵+此·横*此·横 。 【启】: 设p为点{横:1,纵:2} 曰:p·长度() 。 控制流 if-else语句 凹英文版的if-else语句如下: a := 1 b := 2 if a>b { println("bigger") } else if a==b { println("equals") } else { println("smaller") } 凹中文版则是: 若1>0则: 曰:“1>0” 又若1=0则: 曰:“1==0” 否则: 曰:“1<=0” 。 这里的关键字“若”表示if,关键字“又若”表示else if,关键字“否则”表示else,每个条件之后加了则关键字,以增加可读性。 循环 凹英文版的循环有三种形式: 三段式for循环 sum := 0 for i:=0;i<10;i++ { sum += i } println(sum) while循环 i := 1 for i <= 10 { println(i) i++ } 无限循环 for { println("looping...") if condition() { break } } 第一种三段式循环,for <初始化>;<条件>;<递进>,三段操作分别是初始化循环变量、判断循环结束条件、以及每次执行完循环体之后做的递进更新。 第二种和第三种形式其实是这三段操作的省略而已。 凹中文版这样支持三段式:从<初始化>,到<结束条件>,有<递进>:<循环体>。例如: 设和=0 从i=0,到i==10,有i++: 和+=i 。 这个语法还是比较清晰的。 注意,我没有找到一个关键字可以表示“只要条件成立,就继续执行”的意思,所以只能用到这样的字表示“只要条件城里,就结束循环”。正好和for循环的条件是反的。 没办法,这就是中英文的习惯不同。 非要和for循环一致的话,大概只能: 设和=0 从i=0,若i<10,则i++: 和+=i 。 但只读这句话,总感觉想问“这个到哪里才结束啊?”。总之还是别扭。 为了支持for循环的习惯用户,我还是支持了这种写法。 另外,由于用关键字替代了符号,在省略时就不如for循环好看了: 设i=0 设和=0 从,到i==0,有: 和+=i i++ 。 这显然好看,所以我加了一个新关键字“直到“,可以这么写: 设i=0 设和=0 直到i==0,有: 和+=i i++ 。 这就和while差不多了。或者更确切的说,相当于until语句。 至于全部省略的无限循环,只好用类似于“循环”这样的关键字了。 循环: 若xx则: 停止 。 。 这显然不太雅观。还需要再改进。 switch语句 凹英文版的switch语句: a := 2 switch i { case 1: println("one") case 2: println("two") case 3, 4: println("three and four") case i < 10: println("smaller than ten") default: println("nah") } 中文版初步的想法是模仿Kotlin的when语句: 当i: 为1,则:曰:“一” 为2,则:曰:“二” 为3,则:曰:“三” 否则:曰:“不中” 。 关键字当、为、则、否则分别表示switch、case、:和default。 这个语法和when其实也一致,因此未来可以扩充到更复杂的语句。 接口 凹英文版的接口: type duck interface { quack() } 这样,包含quack()方法的类型都可以当做duck来看待。 在凹中文版中,类型定义是双书名号《》,因此接口的定义自然用单书名号〈〉,所以: 〈鸭子〉: 【嘎嘎】 。 意思就是“鸭子”这个接口,包含一个“嘎嘎”方法。这样,任何包含“嘎嘎”方法的类型都可以当做“鸭子”来看待。 注:这个特性现在还没实现。 展望 到现在(2023年4月初)为止,上述的中文语法几乎都实现了,但是还有一些细节需要完善。 凹中文版2023年的目标就是完全重写前端解析模块,完善所有语言特性的语法,与英文版做到100%对应。并作出正式的凹中文版标准语法。 届时就可以考虑给中文语法扩充更贴近中文用户使用习惯的特殊新语法了。 凹中文版的目标,不是让人人都用中文版语法、抛弃英文版语法,而是想抛砖引玉,启发所有人都来设计与开发更适合总国人的编程语言。

优秀的个人博客,低调大师

每日一博 | MongoDB 索引操作引起的 Crash

摘要:本文详细阐述了根据引起 Crash 操作进行从配置到源码的分析过程,层层递进,定位复现并给出解决故障方案。 作者:徐耀荣 爱可生南区交付服务部 DBA 团队成员,主要负责 MySQL 故障处理以及相关技术支持。爱好电影,旅游。 本文来源:原创投稿 爱可生开源社区出品,原创内容未经授权不得随意使用,转载请联系小编并注明来源。 故障现象 近日,朋友遇到一个 MongoDB 实例 Crash 的问题,找到我帮忙一起分析原因,事情经过以及分析过程如下,可供学习。 操作过程 运维人员在优化慢查询时针对性创建了一个索引,语句如下: db.c1.createIndex('name':1,background:true) 随后又将表上一个没能用上的索引删除,语句如下: db.c1.dropIndex('idx_age') 在主节点上很顺利的就完成了,但是不久后就发现从节点发生了 Crash,日志中包含下列崩溃信息。 2023-04-13T07:00:50.752+0000 E STORAGE [conn3569849] WiredTiger error (-31802) [1681369250:752455][9937:0x7fe740144700], WT_CONNECTION.open_session: __open_session, 2058: out of sessions, configured for 20030 (including internal sessions): WT_ERROR: non-specific WiredTiger error Raw: [1681369250:752455][9937:0x7fe740144700], WT_CONNECTION.open_session: __open_session, 2058: out of sessions, configured for 20030 (including internal sessions): WT_ERROR: non-specific WiredTiger error 2023-04-13T07:00:50.752+0000 I NETWORK [listener] connection accepted from xxx.xxx.xxx.xxx #3570023 (20576 connections now open) 2023-04-13T07:00:50.753+0000 F - [conn3569849] Invariant failure: conn->open_session(conn, NULL, "isolation=snapshot", &_session) resulted in status UnknownError: -31802: WT_ERROR: non-specific WiredTiger error at src/mongo/db/storage/wiredtiger/wiredtiger_session_cache.cpp 111 其它信息 变更表是一张几千万的大表; 数据库架构为 MongoDB 4.0.14 的 PSA 架构; 应用开启了读写分离,从节点也存在大量只读请求。 问题分析 根据日志信息,初步怀疑是连接打满了,检查最大连接数配置。 初步排查 shard1:PRIMARY> db.serverStatus().connections; { "current" : 7, "available" : 29993, "totalCreated" : 7, "active" : 2 } 最大连接数是由 maxIncomingConnections 参数和 ulimit 决定的。 net: maxIncomingConnections: 30000 在测试环境模拟连接数打满的情况,发现在连接数满了的情况下实例只会拒绝新的连接,而非直接 Crash。 connecting to: mongodb://10.186.64.88:27017/admin?gssapiServiceName=mongodb 2023-04-19T13:59:26.578+0000 I NETWORK [js] DBClientConnection failed to receive message from 10.186.64.88:27017 - HostUnreachable: Connection closed by peer 2023-04-19T13:59:26.579+0000 E QUERY [js] Error: network error while attempting to run command 'isMaster' on host '10.186.64.88:27017' : connect@src/mongo/shell/mongo.js:344:17 @(connect):2:6 exception: connect failed 根据 SERVER-30462 描述怀疑是 WT_SESSION 打满的情况。 WT_SESSION 是 MongoDB Server 和 WiredTiger 存储引擎内部交互使用的会话,几乎所有操作都是在 WT_SESSION 的上下文中执行的。因此 WT_SESSION 在超过限制后将会触发较为严重的情况。 源码分析 在源码 mongo/wiredtiger_kv_engine.cpp 中可以看到 WT_SESSION 硬编码指定为 20000。 std::stringstream ss; ss << "create,"; ss << "cache_size=" << cacheSizeMB << "M,"; ss << "cache_overflow=(file_max=" << maxCacheOverflowFileSizeMB << "M),"; ss << "session_max=20000,"; ss << "eviction=(threads_min=4,threads_max=4),"; ss << "config_base=false,"; ss << "statistics=(fast),"; 这一点也能在启动日志中进一步得到验证。 如果 WT_SESSION 数量超过 20000,将会触发 out of sessions 的报错。 /* Find the first inactive session slot. */ for (session_ret = conn->sessions, i = 0; i < conn->session_size; ++session_ret, ++i) if (!session_ret->active) break; if (i == conn->session_size) WT_ERR_MSG(session, WT_ERROR, "out of sessions, configured for %" PRIu32 " (including " "internal sessions)", conn->session_size); 提出疑问 分析到这开始疑惑 WT_SESSION 打满与索引操作存在什么样的关系?为什么相同的操作在主节点可以正常完成,而从节点会发生 Crash? 在创建索引时指定 background:true 可以在后台构建索引,不会加锁阻塞集合上的其它操作,这也是我们日常添加索引常用的方式。 但在删除索引时,我们有一点需要注意,但又常常被忽略,在主节点删除索引后同步到从节点回放时,如果从节点正在跑同一个集合上后台创建索引的操作,那么删除索引的操作将会被阻塞,更严重的是这时候实例上所有 namespace 的访问都将会被阻塞。针对这一现象在官网 dropIndex 文档中有提及: Avoid dropping an index on a collection while any index is being replicated on a secondary. If you attempt to drop an index from a collection on a primary while the collection has a background index building on a secondary, reads will be halted across all namespaces and replication will halt until the background index build completes. 当任何创建索引操作复制到 Secondary 时,应避免在集合上删除索引。如果你试图在 Primary 上删除一个索引,而该集合在 Secondary 上有一个索引正在后台创建,那么所有 namespace 的访问将被停止,复制也会停止,直到后台索引建立完成。 回到错误日志中查找更多内容,就能发现从节点在后台创建索引时,又执行了同一个集合上的删除索引操作。 2023-04-13T05:34:27.002+0000 I - [repl index builder 178] Index Build (background): 122873800/640018757 19% 2023-04-13T05:34:30.002+0000 I - [repl index builder 178] Index Build (background): 122976300/640018769 19% 2023-04-13T05:34:30.434+0000 I COMMAND [repl writer worker 11] CMD: dropIndexes test.c1 初步结论 到此,我们得出初步结论。事情起因是主节点在同一个集合上执行创建索引和删除索引后,在从节点回放时出现了很严重的阻塞,大量的只读请求开始不断积压,最后导致 WT_SESSION 消耗殆尽,Server 无法与 WiredTiger 进行内部通信,最终导致实例 Crash。 问题复现 下面的案例在测试环境复现 WT_SESSION 超过限制的情况,dropIndex 导致从节点锁阻塞的问题有兴趣可自己测试复现,这里就不做演示了。 WT_SESSION 上限是由 wiredtiger_open 配置中的 session_max 决定的,但 MongoDB 并未直接暴露 session_max的 配置方式,只能通过下列方式进行覆盖设置。 mongod -f /etc/mongod.conf --wiredTigerEngineConfigString="session_max=5" 然后在数据库内部发起一个全局排它锁。 mongo> db.fsyncLock() 编写下列 Python 脚本模拟并发线程。 #!/usr/bin/python # -*- coding: UTF-8 -*- import multiprocessing import pymongo def find(): cnx_args = dict(username='root', password='abcd123#', host='127.0.0.1', port=27018, authSource='admin') client=pymongo.MongoClient(**cnx_args) db=client['test'] results=db.tab100.insert_one({"name":"jack"}) if __name__ == "__main__": x=1 while x<350: p=multiprocessing.Process(target=find) p.start() print("start thread:",x) x+=1 p.join() 这时 MongoDB 实例还在正常运行,因为我们的请求还没有真正的进入到 WiredTiger 引擎层,但一旦我们手动释放排它锁,所有请求都会在短时间内进入 WiredTiger 引擎,WT_SESSION 瞬间超过限制,实例紧接着发生 Crash。 mongo> db.fsyncUnlock() 错误日志如下,与生产日志相同。 总结 net.maxIncomingConnections 设置应小于 WT_SESSION; 可以根据实际需求调整游标超时时间,避免出现大面积积压的情况; 避免创建索引和删除索引先后执行,特别是先执行后台创建索引的情况下; 4.2 版本中废弃了 background 选项,对索引创建过程进行了优化,只会在索引创建的开始和结束时持有 exclusive lock;并且 4.0 版本官方已经停止提供服务了,建议尽快升级。 本文关键字:#MongoDB# #WiredTiger# #源码# 关于 SQLE 爱可生开源社区的 SQLE 是一款面向数据库使用者和管理者,支持多场景审核,支持标准化上线流程,原生支持 MySQL 审核且数据库类型可扩展的 SQL 审核工具。 SQLE 获取 类型 地址 版本库 https://github.com/actiontech/sqle 文档 https://actiontech.github.io/sqle-docs/ 发布信息 https://github.com/actiontech/sqle/releases 数据审核插件开发文档 https://actiontech.github.io/sqle-docs-cn/3.modules/3.7_auditplugin/auditplugin_development.html

优秀的个人博客,低调大师

每日一博 | 百度离线资源治理

作者 |百度MEG离线优化团队 导读 近些年移动互联网的高速发展驱动了数据爆发式的增长,各大公司之间都在通过竞争获得更大的增长空间,大数据计算的效果直接影响到公司的发展,而这背后其实依赖庞大的算力及数据作为支撑,因此在满足业务迭代的前提下如何控制成本是公司非常重要的一环。 本文将介绍百度MEG(移动生态事业群组)在离线资源降本增效方面用到的一些技术以及取得的一些成果。 全文4478字,预计阅读时间12分钟。 01 业务背景 随着百度App的日活用户的持续增长,为了满足广大用户对信息资讯更加精准的需求,MEG的各个业务模块对于离线算力和存储的需求也不断增加通过其驱动上层模型获得更好的效果,因此离线成本也逐年增加,如何满足业务增长的情况下最小化机器资源成本是本文重点关注的问题。就拿百度App后端推荐服务(后简称Feed)举例,拥有离线大数据计算数百万核、分布式存储数百PB,成本以亿为单位,而且还在持续增长,因此我们希望能够在满足推荐效果的前提下优化降低离线的成本。整体离线计算主要分为两大类,即数据挖掘类和数据分析类,其中挖掘类场景主要是通过python脚本提交的MapReduce任务为主,分析类场景主要是Spark及SQL类为主,底层集群资源都是EMR,存储统一使用百度公司分布式文件存储Appendonly File Storage(后简称AFS)。 02 优化思路 下面介绍下我们的优化思路,在此之前说下整个离线的业务背景,主要从三个方面说明,第一是管理混乱,队列失控、任务失控;第二是成本高,千万核计算、EB级的存储使用率低,同时增量的需求无法满足;第三是效率,包括任务运行的效率和资源交付的效率,主要表现为队列拥堵,任务跑不动。 针对以上问题及痛点,首先针对管理混乱的问题我们通过平台进行离线资源任务的全生命周期管理;其次是针对资源使用率低成本高的问题,我们自研智能调度机制实现对不同使用率队列的削峰填谷,基于存算分离技术实现快速合池,通过潮汐算力分时调度优化白天紧张的算力供给增量业务,再就是与INF共建RSS技术并规模化落地优化混部资源的稳定性,还有就是针对EB级的存储进行动态扩缩容实现存储的优化和供给。整体的挑战是如何利用有限的资源满足无限的需求。 03 算力优化 3.1 合池技术 接下来介绍下算力优化的第一个优化点,合池技术,首先说下为什么要合池,因为碎片化的队列会导致弹性不足、使用率很难最大化,维护成本高。如下图所示,一个大约5w核的队列,它的峰值是达到上限了,但是均值很低,很难满足更大资源量但是执行较快的需求,因此一方面是期望能把小的这种队列合并,另一方面提升整体的使用率,如下图第二个队列,最终实现降本增效。 合池最大的挑战分两块,一是合池后如何保证任务的性能不退化,同时如何保障资源效率,二如何对业务无感透明合池。 接下来大致粗略的说一下合池的过程,如下图所示:就是将等量资源的几个小队列进行合并,提升队列的使用率上限,满足业务需求的同时退订一部分资源。 整体的技术方案主要包括两部分,一是智能调度,二是存算分离技术,下面会分开介绍下这两项技术的实现。 3.1.1 智能调度 如下图所示,智能调度的整体架构如下,首先一个基于python的client,负责将用户的程序、参数、环境依赖等等进行打包,然后通过智能调度系统异步提交,系统会根据任务维度多维的特征,比如优先级、并发、所需资源等信息结合资源实时的水位进行智能最优匹配,其中调度系统比较核心的也是首要的就是排序,即要解决先调度谁后调度谁的问题,如下图中的排序策略,首先是一个FIFO的队列模型,排序策略会根据任务的优先级、等待轮数进行加权,然后结合任务的并发系数进而计算出来先后顺序,优先级分位三挡,VERY-HIGH、HIGH、NORMAL,优先级越高权重越大,其次是等待的时长越长权重越大,越优先调度;有了顺序后后面会根据任务要读取数据的地域就近匹配计算队列,减少跨地域网络IO的开销,此外还有队列资源打满或异常等过滤策略,以及任务使用资源超限降级等策略,最后是针对排好序的任务进行队列分配,根据实时获取的队列资源水位结合任务提交所需要的资源量(并发数*单并发核数),分配好队列,任务会被worker正式提交到集群上面去。智能调度在整个合池过程中充当非常重要的角色,它能保障任务在合池后性能不退化,通过合理的编排,针对峰谷不一的资源进行打平调度,重复利用闲散资源提升整体资源利用率。 3.1.2 存算分离 刚才介绍的是调度提交的过程,此外在合池过程中另外一项核心的技术是存算分离,它是解决碎片化队列快速合池的关键,核心的点是说我们会提前在各个集群新建一个计算的ugi,并且给这个ugi分配好计算所需要的临时存储并开通合池队列的计算权限,UGI存算分离后,原来用户的UGI只作为读写数据使用,代理计算的UGI提前开通各集群的权限,并分配好中间存储,调度系统会自动调度到有资源的合池队列,用户不需要改代码,合池透明化。 总结下合池以后的效果,资源池化以后,千万核计算资源整体的使用率从55%提升到80%,增量供给和优化退订了数百万核资源,成本年化降低数千万。此外池化是得资源的交付效率大幅提升,从之前周级、月级缩短到天级,任务的整体耗时通过合理的调度和编排也降低了30%。 3.2 潮汐算力 接下来我介绍下算力优化的第二个优化点,潮汐,它的特点是体量大、数百万核、夜间特定时间段供给,成本低,免费用。可以用潮汐技术的场景包括策略模型调研类,数据回溯类等。如何把这部分资源充分利用好是项目的核心,主要通过如下三种方式实现潮汐的规模化应用,第一是显式的注册引导,第二是对存量可在夜间运行任务的画像挖掘,第三是对资源使用超限的分时管控,如下图所示: △潮汐规模化应用的方式 潮汐的挑战有两个,第一是如何对存量任务画像、怎么尽可能保障在潮汐退场前执行完,如下图所示,接下来重点介绍下方案,就是通过隐式挖掘存量任务转潮汐,因为潮汐资源是0点供给5点准时退场,因此我们期望对一些存量例行的任务进行画像让它能够通过潮汐时间段加速实现算力优化,释放更多白天的算力,这里画像主要包括执行周期、频次、并发数、task总量等,利用这些信息给任务打一个潮汐的tag,在这个任务下次提交的时候使用一个时间加速模型判断其是否能在潮汐退场前执行完,该模型主要是通过例行任务常规的运行时间以及map、reduce的数量、并发量等计算出一轮计算缩需要的时间,然后乘以提升并发量以后要跑的轮数,算出来加速后的预期完成时间,然后判断是否能在潮汐退场前执行完,这块分两种情况,0-5点,5-24点,公式略有差异。 △潮汐时间加速模型 下面介绍一下潮汐的第二个技术点,也即是前面提到的另一个挑战,如何保障潮汐任务瞬时退场后不失败,第二天潮汐窗口来临后继续跑,解决方案是在现有的合池队列上进行扩展,在潮汐退场前提前降低并发,白天低速运行。 总结下潮汐在离线大规模应用的效果,首先是规模,目前潮汐的资源规模达到300W核,通过画像挖掘存量转夜间实现了年化约600万成本的节省。业务方面的话,有100+回溯、调研类任务通过潮汐实现了资源的满足,加速了模型调研的效率,提升了模型的效果。 △潮汐队列断点续跑 3.3RSS技术 接下来我介绍下算力优化的第三个优化点,RSS(Remote Shuffle Service)技术的规模化应用,大背景是离线标准型资源稳定,但成本高、稀缺,而混部资源成本低容易供给,但稳定性差、失败率高容易被抢占,如下图所示,失败率比较高。 △混部资源task失败率高 如果reduce2运行中被抢占,需要从所有上游map重新拉取数据,而上游map已经被另一个任务占用,也需要重新排队计算因此造成时长增加,因此RSS技术的核心是把shuffle数据存远程文件系统,这样reduce被抢占的话直接从afs拉取map产出,map不需要重算,开启RSS的任务执行时间基本与标准型资源性能持平。 04 储存优化 4.1 背景介绍 存储资源预算逐年收紧,为应对接下来的业务增长,需求基本靠优化来满足。当前整个公司储存空间的使用率大约为60%,从使用率维度看任然有一定的提升空间。Google Research于2021年发表了一篇名为Autopilot的论文《Autopilot: Workload Autoscaling at Google Scale》,核心思想是Quota Auto Resize By workloads,即根据实际quota使用情况动态分配,可引入一些简单的模型预测quota的需求变化量,该思想是我们实现AFS Quota超售的基本技术支撑,即按实际使用分配同时保障使用的时候能分配到,这样最大的好处就是存储是一个可被全局调度的大池,既能最大化提高存储流转回收的效率又可以提升整体存储的使用率进而达到成本优化的目的还能节省大量的运维成本,可谓一箭三雕。 回到我们实际的业务场景,大部分情况下业务申请预算都是按照全年需求的总量申请quota,实际交付后需要较长的时间才能将资源的使用率提升上来,这样就导致很大一部分quota的价值没有发挥出来,闲置在那,其他人也不起来,因此我们要实现quota的动态分配,实现资源全局最优。 4.2 Quota Resize 下面介绍下基于quota resize的优化模型,它会针对使用率低的存量账号进行动态的缩容,增量需求不再一次性分配,而是初始少量,根据实际使用情况逐步分配。 △quota resize简版方案 下面介绍下resize的整体流程,首先是收口增量需求,所有的需求申请通过平台流程中心进行,例如申请1P先初始化300T,容量管理服务会根据实时的资源使用水位结合滑动窗口通过集团云的升降配接口进行动态扩缩,核心的技术点是分钟级感知资源水位,和buffer池的预留设计以及基于滑动窗口的阶梯缩容机制。 △afs quota resize流程架构 总结下resize项目的效果,首先是EB级存储的使用率从63%提升到78%,成本降低数千万,同时使用率方面与业界持平,此外资源的交付效率也大幅提升。 05 总结 本文主要介绍了百度MEG离线大数据计算和分布式文件存储的治理及优化思路,取得了阶段性的优化效果,业务覆盖方面目前覆盖了MEG超过80%的离线资源,优化使得每年计算成本降低约4000万,存储成本降低约3000万,降本的同时很好的支撑了增量不断的业务需求。离线资源的治理是个长期持久的工作,需要不断优化不断挖掘新的方式,技术方面也需要不断创新,后续会持续更新分享优化经验。 ——END—— 推荐阅读: 百度APP iOS端包体积50M优化实践(三) 资源优化 代码级质量技术之基本框架介绍 基于openfaas托管脚本的实践 百度工程师移动开发避坑指南——Swift语言篇 百度工程师移动开发避坑指南——内存泄漏篇 增强型语言模型——走向通用智能的道路?

优秀的个人博客,低调大师

每日一博 | 如何做架构设计

也许您对软件设计存在一些疑惑,或者缺乏明确思路,那么本文将非常适合您。 1、设计很重要 我们可以看一下周边的事物,那些好的东西,他们并不会天然存在,都是被设计出来的,因此设计就是创造和改善事物的重要过程。设计的重要之处在于,最初的设计往往决定最终的结果,甚至决定着事物的长期的发展。例如两个品牌的手机之间,他们可以使用同一个代工厂,但他们差异在设计时就已经决定了。 架构设计也是如此,我见过很多的软件系统,他们经过了很多年的演进,在没有完全重构的情况下,始终无法改变最初设计模样,最初的设计决定了长期的发展。而对于业务深度耦合的系统,重构成本非常高,风险也非常大,变化也更加不确定,所以要更加重视设计。 我们要寻求更好的技术方案,推动架构的良性演进,每一步都是经过深度思考的,而架构设计方法就是帮助我们思考的框架。 通过做架构设计,我们应该提升软件的质量和效率,降低风险和成本。 2、架构设计的目的是什么? 是为了解决软件系统复杂度带来的问题(架构的目标是用于管理复杂性、易变性和不确定性,以确保在长期的系统演化过程中,一部分架构的变化不会对其它部分产生不必要的负面影响。这样做可以确保业务和研发效率的敏捷,让应用的易变部分能够频繁地变化,对应用的其它部分的影响尽可能地小。) 要解决复杂度问题,首先需要识别复杂度的来源,主要集中在以下三个方面: 业务复杂度:流程多,参与者多、状态和变量多等;由业务本身决定,但业务复杂不代表软件系统复杂,例如工作流引擎并不复杂,但他可以做非常复杂的业务,在面对复杂业务时,我们常使用抽象思维,不要让软件逻辑与业务逻辑绑定在一起。 技术复杂度:高性能、高可用、高可扩展、安全,成本、规模等;这部分复杂度常常由技术本身决定,也应该由技术本身解决,通常是采用更合理的框架和工具;避免这些技术特性穿透到应用层。也可以有所取舍,在不同业务情况下,采用不同的实现程度。 设计复杂度:职责不是最小的完备的、概念不清晰的、层次不清的、业务逻辑与技术实现绑定的,组件过多以及关联依赖复杂的;这部分是由设计不合理导致的,也是对业务系统影响最大的一部分,要通过良好的设计来解决。 3、架构设计的主要内容是什么? 找到系统中的元素并搞清楚他们之间关系(如果我们不知道系统是怎么运行的,那么他一定是很复杂的。对于庞大的软件系统,如何才可以被掌控?这就需要将大系统分解为很元素,每个元素需要足够简单,并且元素与元素之间的关系清晰) 软件架构是一种结构,结构中包含了一些元素和元素之间的关系描述; 元素的种类:系统、子系统、模块,组件、服务、类、接口... 关系的种类:层次关系、数据关系、调用关系、影响力关系... "架构表示对一个系统的成型起关键作用的设计决策,架构定系统基本就成型了,这里的关键性可以由变化的成本来决定。"-- Grady Booch. ) "Architecture represents the significant design decisions that shape a system, where significant is measured by cost of change." -- Grady Booch. 4、架构设计有什么原则? 合适原则:“合适优于业界领先”。 真正优秀的架构都是在企业当前人力、条件、业务等各种约束下设计出来的,能够合理地将资源整合在一起并发挥出最大功效,并且能够快速落地。 简单原则:“简单优于复杂”。 优先使用直接的不复杂的方案解决问题; 演化原则:“演化优于一步到位”。软件需要根据业务的发展不断地变化,架构要不断地在实际应用过程中迭代,在某个阶段必定有所取舍,但架构的演化必须是低成本的,当业务发生变化时能够最高效的迭代;在这个过程中修复缺陷的设计,积累优秀的设计; 5、架构师的职责是什么? 业务分析:梳理对业务和技术的理解和判断、形成业务领域知识、明确的业务目标和本质的业务诉求; 系统建设:降低系统复杂性、规划系统远期架构、推动架构的合理演化; 技术方案:选择合适的技术、提供对业务的解决方案,把控全局,包括质量、效率、成本、风险; 关键问题:攻克难点,解决关键问题,指导研发落地; 知识沉淀:以体系化的表达方式,面向不同人员的视图语言,持续完善知识系统; 6、架构设计过程如何? 过程:全局分析业务 → 设计方案 → 概要设计 → 详细设计 → 补充设计 视角:业务级 → 系统级 → 应用级 → 模块级 → 技术级 → 代码级 → 实施级; 架构师的协作链路较长,每一个过程都应该留下资料,越下游的角色往往需要更全面的资料;架构设计文档应该包含架构师参与的所有环节,以及这些环节产生的图文说明;不仅仅是空洞的结果,应该包含架构师的思路和想法; 全局分析阶段 这阶段需要对业务需求进行全面分析,需要将名词罗列出来,区分名词是功能、流程、名词、参与者的哪一种。再通过分析业务的本质并找到其中的关键名词,关键的名词被称之为领域,可以围绕关键的领域构建业务模型; 在这个过程中,需要统一语言、识别核心领域、按照相关性将功能归属到对应的领域,对领域之间的关系做出必要的描述,输出物是名词与解释、领域以及拥有的能力,业务架构。 名词的概念必须是清晰的,领域的职责必须是明确的,领域拥有的能力必须是相关的; 其中业务架构可按照场景层、功能层、领域层、依赖层划分,例如下图; 设计方案阶段 在完成全局分析之后,我们应该设计技术方案,尽可能提供多个备选方案的图文说明。需要对备选方案做充分的优劣分析,最终取舍一项最合适的方案,没有被选择的方案(或者取舍的部分)也要被说明; 我们需要找到各项约束条件(时间、人力、硬件等),评估在约束条件允许的情况下,哪个备选方案更合适,我们可能考虑如下方面: 方案对业务影响:主要判断需求覆盖程度、实现业务的短期目标、考虑业务的长期目标; 方案的技术需求:安全是否满足、性能是否满足、规模是否满足、可维护性; 方案的可扩展性、方案的复杂程度、方案是否能够演进、方案演进成本如何(高成本的 慎重考虑)、方案的影响力传播如何(对上下游影响较大的 慎重考虑); 架构设计阶段-应用架构 用以说明当前系统的元素(系统、子系统、模块,组件)以及他们之间的关系(层次关系、依赖关系) 重点是将可复用的组件抽象后下沉,越往下层越是稳定和通用,由上层承接不稳定的业务; 应用架构图体现了层次关系,以及不完全体现了依赖关系,依赖只能是上层依赖下层,示例如下图 架构设计阶段-部署架构 用以说明支持应用所需要的硬件能力、以及外部中间件、网络、机房等情况;可参考下面两张图; 架构设计阶段-数据架构 描述数据资产结构、存储、流转、灾备的情况;最常用的是ER图; 架构设计阶段-技术架构 描述一些关键技术的说明,比如性能、安全、交互等; 描述技术选型和代码框架的说明,比如DDD推荐的菱形对称架构,文字和图片描述都可以; 详细设计阶段 详细设计是对质量的把关、是对研发落地的指导; 这部分涉及的内容较多,比如服务、事件、接口、实体和值对象、时序图、数据库设计等等; 领域服务、领域事件 时序图 实体关系图 7、有什么方法能做的更好? 学习和使用领域驱动设计,使用正确的方法梳理和理解业务,并落实到架构过程; 尽早的介入,从业务领域建模和在产品方案阶段介入、推动领域知识的传递、为后续做好铺垫; 积累业务能力和洞察力,需要识别关键部分与辅助部分、预料可扩展部分与不变部分,识别水平能力与垂直扩展; 对于架构设计产物,不要只画图,多辅以文字表述图中内容; 8、还需要掌握什么知识? 业务知识:业务架构(是对当前业务、领域、能力、流程、参与者、场景的介绍),现状架构(是对当前架构的描述,可以包含应用架构、技术架构、部署架构、数据架构等),愿景架构( 是架构应该演进到的完美情况),存在问题(现在面对的痛点、无用部分、缺陷部分) 高性能:多线程、队列、缓存、分片、异步化,前置化、静态化、预处理; 高可用:限流、降级、冗余、灾备、回滚、灰度; 扩展性:多态、防腐,依赖反转(业务身份、扩展点、SPI),抽象化(比如流程引擎、规则引擎等)、事件驱动、设计模式; 本文部分图片来源于互联网 作者:京东科技 董健 来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | Flutter 热更新技术探索

一,需求背景: APP发布到市场后,难免会遇到严重的BUG阻碍用户使用,因此有在不发布新版本APP的情况下使用热更新技术立即修复BUG需求。原生APP(例如:Android & IOS)的热更新需求已经比较成熟,但Flutter技术栈目前还缺少类似的技术方案,因此Flutter研发团队,也需要类似的热更新技术。 二,Flutter热更新技术方向分析: 经过分析目前可能有三种可行的方案: 1)类似RN框架; 2)页面动态组件框架; 3)Dart虚拟机定制方案; 方案名称 原理 优点 缺点 开源方案 类似RN的方案 用JS以Flutter语法写dart,然后用JavaScript把XML DSL转为Flutter的原子widget组件,然后再让Flutter来渲染 由于ios系统内置支持js,ios上完全可以实现更新 1)由于跨语言执行,对于性能有影响;学习成本高 2)Android 端需要额外引入JS库 手Q的MXFlutter,58同城的Fair 页面动态组件方案 编译期时插桩/预埋好DynamicWidget到代码中,然后动态下发Json 数据,通过协定好的语义匹配到JSON内的数据,动态替换Widget内容来实现更新 能支持Android/iOS 两端的更新 1)UI更新相对较容易,业务逻辑动态化较麻烦; 2)语义解析器开发成本相对较大,且不易维护 3)需要一整套前后端服务和工具 天猫的Tangram,淘宝的DinamicX等 Dart虚拟机定制方案 通过分析Dart虚拟机的原理,修改Flutter Engine层Java/C++代码实现热更新的目标; 性能影响小,动态性很高,技术上可以替换所有Flutter页面(包括UI,逻辑,资源文件) 由于使用的是定制引擎,需要维护不同版本的Flutter引擎代码; 未开源 因为其他方式都有开源的示例,本案将重点以第三种“Dart虚拟机定制方案”为目标,做方案的研究讲解。 三,预备知识 在开始了解技术方案之前,需要提前了解一些相应的技术概念: 3.1 Flutter编译模式 Flutter开发语言是Dart,它的编译模式来自Dart的编译模式,主要有JIT(Just In Time)和AOT(Ahead Of Time)。 编译模式名称 特点 优点 缺点 JIT 即时编译,典型例子V8,它可以即时编译运行JS,只需要输入源代码字符串,就可以编译运行代码 可以动态下发和执行代码,不用管CPU架构,可以提供动态化内容 1,大量字符串代码让JIT编译器花费时间和内存; 2,性能不好; AOT 预先编译,典型例子C/C++,通过GCC编译成二进制代码,然后安装取得权限后才可以加载执行 事先编译好的,加载和执行速度快 1,编译时区分CPU架构; 2,生成的二进制代码包比较大; 3,二进制代码需要取得权限才可以执行,无法在ios系统上动态更新 Flutter编译模式有:Debug,Release,Profile; Flutter编译模式 特点 Debug 对应JIT模式,支持设备和模拟器; 打开了断言,支持快速开发,支持HotReload; 并未对包大小,执行速度做优化; Release 对应AOT模式,支持真机,不支持模拟器; 禁止了所有断言调试信息; 对包大小,启动和执行速度进行了优化; Profile 类似Release模式,保留了一些调试功能,帮助性能分析; 3.2 Flutter编译产物分析 Flutter下的iOS/Android工程本质上是一个标准的iOS/Android的工程;IOS平台: Flutter通过在BuildPhase中添加shell(xcode_backend.sh)来生成和嵌入App.framework和Flutter.framework到ios; Android平台: Flutter通过gradle来添加flutter.jar和编译完的二进制文件添加到Android; 3.2.1 引擎层结构分析: 3.2.2 Android编译产物的分析 3.2.3 IOS编译产物的分析 四,热更新技术方案分析 4.1 业务代码分析 根据“3.3.1” ~“3.3.2”的分析可以确定无论是IOS还是Android APP业务代码都是由四个段组成:kDartVmSnapshotData、kDartVmSnapshotInstructions、kDartIsolateSnapshotData、kDartIsolateSnapshotInstructions;理论上只要能动态替换加载的代码段&数据段代码即可实现目标。 名称 注释 作用 注释 kDartIsolateSnapshotData Dart isolate数据段 类信息,全局变量,函数指针等 允许动态下发 kDartIsolateSnapshotInstructions Dart isolate指令段 包含由Dart isolate执行的AOT代码 IOS不允许动态下发 kDartVmSnapshotData vm isolate数据段 isolate 之间共享的 Dart 堆 (heap) 的初始状态 允许动态下发 kDartVmSnapshotInstructions vm isolate指令段 包含 VM 中所有 Dart isolate 之间共享的通用程序的 AOT 指令 IOS不允许动态下发 注释: isolate, snapshot, vm isolate含义解释如下: 名称 含义 isolate Dart是单线程,isolate跟线程差不多,可以理解为 Dart 中的线程。 isolate 与线程的区别:线程与线程之间是共享内存的,而 isolate 和 isolate 之间是内存不共享的。 不存在锁竞争问题,两个Isolate完全是两条独立的执行线,且每个Isolate都有自己的事件循环,它们之间只能通过发送消息通信,所以它的资源开销低于线程。 snapshot 将类信息、全局变量、函数指令直接以序列化的方式存在磁盘中,称为 Snapshot(快照)。 vm isolate 同一个进程里可以有很多isolate,但两个 isolate 的堆区是不能共享的,所以官方设计了 VM isolate,也就是 kDartVmSnapshot,用来多个 isolate 之间的交互。 4.2 业务代码的加载分析(运行时) 按照4.1的分析思路,我们首先需要了解Flutter运行时代码加载的完整流程,经过梳理分析流程如下: 1 )Android- APP业务代码的加载流程: 2)IOS- APP业务代码的加载流程: 4.3 业务代码的编译生成(编译时) 根据以上的分析,我们知道了Flutter业务代码的数据结构,也知道了在运行时如何加载,因此我们只需要在编译时做更改,产生自己需要的代码段,和数据段文件。在运行时加载自己的构建产物即可达到目标。 1)在此以 IOS 构建自己的业务代码流程做详细分析: **有完成构建流程可以分析,基本流程是“Dart Code(业务代码)” -> (通过Dart编译器gen_snapshot.cc) 生成 snapshot_assemble.S 的汇编文件 -> (通过xcrun工具)生成 snapshot_assemble.o的obj文件 -> (通过xcun clang工具链) 生成了 App.Framework。 2)Android的产物构建流程和IOS类似。由于Android有其他更简单的方案, 因此省略详细的构建流程分析,大致如下: 4.4 实现热更新的方案探索 根据上面的技术分析结果,已经可以独立生成自己的代码段,数据段文件。通过需改虚拟机底层代码的方式,也可以动态的加载运行。但由于IOS系统目前底层的系统还不能动态加载可读写的代码段数据到内存中,所以还有技术难点需要突破。但Android端有更简单的路径可以解决,因此下面以Android端为例重点分析思路,大致如下图所示: 由上图可以得知,Android端 热修复核心步骤如下: 1, 修改Flutter Engine代码,加载指定路径的libapp.so和flutter_aasets,比如私有目录(data/data/files); 2, 编译APK时,利用Gradle Transform插件,根据Flutter SDK的engine version动态替换官方的Flutter engine,最终写入修改后的engine到APK; 3, 生成补丁包:利用BSdiff算法比较新旧APK文件,生成patch补丁包 4, APP启动时访问后端接口,根据参数(app的版本号,补丁包版本号,md5,flutter SDK版本号,Engine版本号)拉取补丁包; 5, 合成补丁包:校验md5,app版本号,补丁版本号,安装时间; 6, 自定义Flutter Engine加载指定路径的libapp.so和flutter_assets资源文件; 作者:京东科技 刘振中、周智 内容来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | Nodejs 应用编译构建提速建议

编译构建的整体过程 拉取编译镜像 拉取缓存镜像 拉取项目源码 挂载缓存目录 执行编译命令(用户自定义) 持久化缓存 上传编译镜像 为什么在本地构建就快, 但编译机上很慢 在编辑机上每次的构建环境都是全新的, 完成一次构建比本地需要多一些步骤: 现成的全局包缓存 VS 重新构建缓存: 咱可以先简单理解为咱使用 npm 的时候那个全局的缓存目录, 编辑机需要准备持久化的缓存的环境, 包括下载、挂载以重建缓存, 如果缓存内容过大, 时间也会相对更长, 本地构建直接使用了稳定的本地文件系统; 增量安装依赖 VS 全量安装依赖: 本地不太经常需要执行 install 的过程, 即使需要, 也因为有持久的 node_modules 目录存在, 不需要全量安装, 但编辑机环境每次需要重新安装这个项目需要的所有依赖; 增量构建 VS 全量构建: 本地构建默认会将构建缓存放到 node_modules 目录下, 第二次构建的时候这些构建就能被用起来, 使得后面的构建更快, 但这个构建的默认缓存位置在编辑机上不会被持久化, 也就是每次需要全量构建. 网络环境: 有些依赖包安装依赖外部网络甚至海外网络, 本地的网络环境比较顺畅, 但编辑机的网络对与海外网的访问没有保证. 难以利用的优势: 多核大内存, nodejs项目的构建, 大部分工作都在一个线程上执行了, 不好直接利用编译机的多核优势 额外的步骤: 编译机需要下载镜像、制作并上传运行镜像、缓存内容持久化, 而本地一般只是产出包. 所以从以上角度入手, 我们可以基于这样的一些思路进行构建速度的优化: 优化镜像大小; 善用持久化缓存实现增量构建(编辑机会对 /cache/ 目录下的内容进行持久缓存) 充分利用多核优势: 比如 ts-loader 的类型校验就可以通过其它插件在单独的线程执行, eslint-loader 也支持多线程(但目前有bug, 不建议使用). 再比如我们可以对项目的各功能模块解耦, 拆成多个构建同时进行。 减少不必要的构建: 比如合理配置 exclude 以精简构建文件范围; 对于不常变动的文件, 拆出来一次构建, 下次复用. 判断是否可能有其它方式去掉对外网依赖的包 如何分析构建速度 检查 /cache/ 目录大小: 在编译命令中加入:du -sh /cache, 通过构建日志查看目录大小 在整体编译命令前后都加上date, 可以看自己项目的构建过程耗时, 即编译命令执行时间 在主要的编译命令的每一行前面加上time, eg:time npm install可以看 install 过程的实际耗时, build 过程同理. 对比整体构建时间(网页上直接显示的任务时间)与编译命令执行时间(末尾的 date 时间 - 开头的 date 时间), 如果整体时间超过编译命令执行时间很多(> 1min30s), 可能是 /cache/ 目录或镜像过大导致的。 以下为详情介绍: 使用更小的运行镜像 如果有较大的镜像, 建议联系运维进行优化. 善用持久缓存 缓存可以对应用构建带来提速的效果, 但如果缓存目录持续增长, 大到一定程度反倒可能让速度变慢. 了解缓存机制: 1. 缓存目录: /cache/ 2. 默认行为: 对于 nodejs 的应用, 目前持久缓存会为 npm, pnpm 提供安装包的缓存, 以加快 npm install / pnpm install 的过程 3. 工作原理: 3.1 /cache/ 目录下的内容会构建成功后自动上传到服务器进行存储, 并在下次构建任务执行前进行挂载 3.2 /cache/ 与 当前工作目录(即 './', 拉取的源码存放位置) 不在同一个文件系统(相当于是缓存在C盘而源码在D盘), pnpm install的行为将从 hark link回退为文件复制(硬链接的方式相对于大量小文件的拷贝, 速度要快很多) 3.3 /cache/ 的工作涉及上传、下载过程, 如果过大也将会影响整个构建过程的速度 排除全局缓存对构建速度的影响 检查 /cache/ 的大小, 可以在编译命令中加入:du -sh /cache, 查看日志, 如果文件夹超过 1G(仅供参考), 建议咚咚联系行云部署(j-one)对应用缓存进行清理 解决缓存跨盘造成的性能损失 主要思路: 使源码与 /cache/ 处于同一个文件系统. 目前对于 pnpm 的应用推荐该方式. 原理: 使源码与 /cache/ 处于同一个文件系统, 这可以让 pnpm 的 hard link 方式生效, 相对于node_modules那些数以万计的小文件复制, 执行效率会得到可观的提升. 参考:Pnpm 是否可以跨多个驱动器或文件系统工作? 方式: 将当前工作目录的代码复制到 /cache/ 下再执行 install、build 命令. 参考命令: # 记下当前工作目录 CUR_WORKSPACE=`pwd` # 存放源码 # 咱统一用 /cache/source 放源码就好, 虽然也可以改成其它目录的名字 mkdir -p /cache/source # 拷贝当前目录的代码, 到 /cache/source 下 rsync -r ./ /cache/source --exclude=node_modules --exclude=.git # 切换 workspace cd /cache/source ########## 这里替换成自己需要的内容 ########### # 执行 install pnpm i # 执行 build pnpm run build ########## 这里替换成自己需要的内容 ########### # 将构建结果拷贝到抽包地址 ########## 如果不是 dist, 请根据需要换成其它目录, 就是你项目构建完生成的目标代码目录 cp -r ./dist/* ${CUR_WORKSPACE}/.build # 删除不需要被缓存的文件 cd ../ && rm -rf /cache/source 以上编译命令基于行云部署前端项目本身精简 请大家在理解原理、思路的基础上根据自身需要修改. 缓存构建结果 webpack 及其插件, 会对构建结果进行缓存. 我们可以利用 /cache/ 的持久化缓存来实现代码构建缓存. 其它构建工具也可以参考相关文档进行配置. 如果使用 webpack4 或依赖webpack4 的构建工具, 比如 @vue/cli-service 等, 通常会使用 cache-loader 对构建结果进行缓存, babel-loader 也会有自己的构建缓存, 但默认都放在 node_modules/.cache 目录下, 建议参考相关文档将 cache 目录设置为 /cache/build (或者其它 /cache/ 的子目录) 对于 webpack5, 自己就已经集成了 cache 功能, 可以删掉 cache-loader 等插件, 减少不必要的工作. 参考:webpack cache 如果是 monorepo 的应用, 还可以实现子项目级别的缓存, 比如使用nx进行monorepo 的管理, 则可以配置 NX_CACHE_DIRECTORY 来设置缓存地址, eg: export NX_CACHE_DIRECTORY=/cache/jdos3-console-ui/.nx eslint 也是一个很费时的操作, 它也支持缓存, 但默认不开启, 如果有需要也可以开启缓存, 但缓存策略需要使用 'content', 因为每次构建文件的 createTime 都会改变, metadata 的策略会失灵. 参考:eslint cache 通常我们需要同时兼容本地开发和行云部署的构建, 可以通过环境变量的方式实现, 以 webpack5 为例: webpack5 的缓存配置: { cache: { type: 'filesystem', profile: true, cacheDirectory: process.env.BUILD_CACHE_DIRECTORY, compression: 'gzip', }, } 同时在行云部署的编译命令中增加: export BUILD_CACHE_DIRECTORY=/cache/.webpack 另一种利用缓存的思路: 缓存 node_modules (编译团队提出了这种思路, 我目前没有进行相关尝试, 产品上针对该思路的通用解决方案在探索中)主要思路: 模拟本地构建(本地构建会持久保留 node_modules目录)收益: 1. 加速 install 的过程, 减少包的安装. 2. 利用代码构建缓存: webpack5 或 babel-loader 等一般会在 node_modules/.cache目录下存放构建缓存, 这也是很多应用本地构建较快的原因. 当然 .cache 目录会持续增长, 需要定时清理, 有兴趣大家可以看看本地的代码里是否有这个目录, 占多大空间. 参考命令: 大体上与上面 '解决缓存跨盘造成的性能损失' 过程相同, 只是最后rm 的过程保留 node_modules 目录, 以供下次使用 ####### 与上面 解决缓存跨盘造成的性能损失 一致 ######### # 记下当前工作目录 CUR_WORKSPACE=`pwd` # 存放源码 mkdir -p /cache/source # 拷贝当前目录代码到 /cache/ 下 rsync -r ./ /cache/source --exclude=node_modules --exclude=.git # 切换 workspace cd /cache/source # 执行 install npm i # 执行 build npm run build # 将构建结果拷贝到抽包地址 cp -r ./dist/* ${CUR_WORKSPACE}/.build ####### 差异: 删除时排除 node_modules 目录 ######### # 删除不需要被缓存的文件 ls -A | grep -vE "^\.$|^\.\.$|^node_modules"|xargs rm -rf 减少源码 避免在 coding 中提交 node_modules 以及各种大的二进制文件 优化编译过程 优化依赖包安装的过程 有些项目依赖了 image-minimizer-webpack-plugin, 这是一个用于压缩图片的工具, 该资源依赖的 cwebp-bin 等资源需要从海外的网站下载, 这个过程可能会很慢甚至失败. 如果可能, 建议直接提交压缩后的图片到代码库, 同时去掉对这个插件的引用. 可以在编译命令前加上 time, 比如time pnpm install来观察这一步骤的耗时, 如果这一步骤很长, 可以看是否有可以去掉的依赖包, 或者禁用对可选依赖包的安装, 有时候升级构建工具也能使包依赖得到优化. 优化构建过程 对于webpack构建的应用, 对 rules、plugin(如果支持) 检查是否正确设置了 exclude, 用以减少不必要的文件构建 启用构建缓存(但缓存的持续增长还是需要关注, 缓存过大的问题后续可能从产品层面得以优化) ts-loader 通常可以开启 transpileOnly: true, 并通过fork-ts-checker-webpack-plugin进行类型检查 eslint的优化, 可以对规则进行优化, 有些校验规则是非常耗时的, 但同时受益并不是很大, 可以考虑关闭. 具体可以这么做: 4.1 设置 __TIMING__环境变量, 可以启用对每个 eslint rule 的性能分析,export TIMING = 1; 4.2 在本地正常执行构建, 检测 eslint rule performance 的输出, 分析耗时较长的规则, 确认是否必要 补充: 关于eslint的多线程问题: 对eslint开启多线程之后会导致 build 过程发现的规则异常不能抛出, 导致规则实际会失效. 该问题参考Issue, 这个问题挺久了, 一直没有得到有效解决. 同时也可以考虑将 eslint 的校验作为 git hook 执行, 避免提交不规范的代码, 此时在 build 过程可以省略这一步骤. 5.代码 minify 的过程, 推荐使用 esbuild, 在webpack里面就可以配置. { optimization: { minimize: true, minimizer: [ new TerserPlugin({ minify: TerserPlugin.esbuildMinify, }), ], } } 6.对于不经常变动的部分, 建议提前编译, 或通过DllPlugin进行优化. 比如行云部署项目本身依赖 monaco editor, 但每次对它的源码进行构建很耗时, 所以直接将提前编译好的代码提交了, 后续直接用. 7.注意避免一个项目被 build 多次, 比如: 7.1 对于使用 vue-cli-service 的应用, v5.0.0-beta.0 开始, 可能会根据浏览器列表配置生成不同的包, 会导致多次构建 7.2 有一些项目需要微前端接入, 可能会为独立运行时、子应用模式采用不同的入口, 从而构建两次. 比如JModule的用户, 由于极早期 webpack-jmodule-plugin 的版本不能自定义入口文件, 通常会构建两次, 建议升级为最新的 @jmodule/plugin-webpack, 并且采用同一个入口文件构建一次. 8.如果是一个相对简单的应用, 可以考虑换其它构建工具, 比如 esbuild、swc, 编程语言带来的性能差异, 确实能形成降维打击. 9.如果可能, 分析项目代码间的依赖, 拆分为多个构建并行执行, 编译机的最大优势就是多核, 咱可以充分利用. 10.升级webpack以及其它构建插件, 通常也能带来一定程度的速度提升, 我们 jci 项目的编译就从升级中获得了一些受益. 补充: webpack 的更多细节优化, 可以参考https://webpack.docschina.org/configuration/cache/ 同样这里也可以考虑在 build 命令前加 time, 比如time npm run build, 便于观察这一步的时间. 还可以用 ‘speed-measure-webpack-plugin’ 对 webpack 的构建时长进行辅助分析. 前端构建的提速是一项比较复杂且细节的工程, 目前产品上在持续跟踪构建慢的应用, 努力优化编译速度, 但前端本身拥有一个比较自由的技术环境, 没有统一的构建工具与流程, 另外语言本身的执行效率、单线程的构建也不好让编译机发挥其最大能力, 所以目前全局的通用优化手段还是会比较局限, 还是依赖项目自身的优化. 希望大家一起努力共建美好的明天. 作者:京东科技 林光辉 内容来源:京东云开发者社区

优秀的个人博客,低调大师

每日一博 | 如何说服技术老大用 Redis ?

这个问题很微妙,可能这位同学内心深处,觉得 Redis 是所有应用缓存的标配。 缓存的世界很广阔,对于应用系统来讲,我们经常将缓存划分为本地缓存和分布式缓存。 本地缓存 :应用中的缓存组件,缓存组件和应用在同一进程中,缓存的读写非常快,没有网络开销。但各应用或集群的各节点都需要维护自己的单独缓存,无法共享缓存。 分布式缓存:和应用分离的缓存组件或服务,与本地应用隔离,多个应用可直接共享缓存。 1 缓存的本质 我们常常会讲:“加了缓存,我们的系统就会更快” 。 所谓的“更快”,本质上做到了如下两点: 减小 CPU 消耗 将原来需要实时计算的内容提前算好、把一些公用的数据进行复用,这可以减少 CPU 消耗,从而提升响应性能。 减小 I/O 消耗 将原来对网络、磁盘等较慢介质的读写访问变为对内存等较快介质的访问,从而提升响应性能。 假如可以通过增强 CPU、I/O 本身的性能来满足需求的话,升级硬件往往是更好的解决方案,即使需要一些额外的投入成本,也通常要优于引入缓存后可能带来的风险。 从开发角度来说,引入缓存会提高系统复杂度,因为你要考虑缓存的失效、更新、一致性等问题。 从运维角度来说,缓存会掩盖掉一些缺陷,让问题在更久的时间以后,出现在距离发生现场更远的位置上。 从安全角度来说,缓存可能泄漏某些保密数据,也是容易受到攻击的薄弱点。 因此,缓存是把双刃剑。 2 本地缓存 JDK Map JDK Map 经常用于缓存实现: HashMap HashMap 是一种基于哈希表的集合类,它提供了快速的插入、查找和删除操作。可以将键值对作为缓存项的存储方式,将键作为缓存项的唯一标识符,值作为缓存项的内容。 ConcurrentHashMap ConcurrentHashMap 是线程安全的 HashMap,它在多线程环境下可以保证高效的并发读写操作。 LinkedHashMap LinkedHashMap 是一种有序的 HashMap ,它保留了元素插入的顺序,可以按照插入顺序或者访问顺序进行遍历。 TreeMap TreeMap 是一种基于红黑树的有序 Map,它可以按照键的顺序进行遍历。 笔者曾经负责艺龙红包系统,红包活动就是存储在 ConcurrentHashMap 中 ,通过定时任务刷新缓存 。 核心流程: 1、红包系统启动后,初始化一个 ConcurrentHashMap 作为红包活动缓存 ; 2、数据库查询所有的红包活动 , 并将活动信息存储在 Map 中 ; 3、定时任务每隔 30 秒 ,执行缓存加载方法,刷新缓存。 为什么红包系统会将红包活动信息存储在本地内存 ConcurrentHashMap 呢 ? 红包系统是高并发应用,快速将请求结果响应给前端,大大提升用户体验; 红包活动数量并不多,就算全部放入到 Map 里也不会产生内存溢出的问题; 定时任务刷新缓存并不会影响红包系统的业务。 笔者见过很多单体应用都使用这种方案,该方案的特点是简洁易用,工程实现也容易 。 3 本地缓存框架 虽然使用 JDK Map 能快捷构建缓存,但缓存的功能还是比较孱弱的。 因为现实场景里,我们可能需要给缓存添加缓存统计、过期失效、淘汰策略等功能。 于是,本地缓存框架应运而生。 流行的 Java 缓存框架包括: Ehcache , Google Guava , Caffine Cache 。 下图展示了 Caffine 框架的使用示例。 虽然本地缓存框架的功能很强大,但是本地缓存的缺陷依然明显。 1、高并发的场景,应用重启之后,本地缓存就失效了,系统的负载就比较大,需要花较长的时间才能恢复; 2、每个应用节点都会维护自己的单独缓存,缓存同步比较头疼。 4 分布式缓存 分布式缓存是指将缓存数据分布在多台机器上,以提高缓存容量和并发读写能力的缓存系统。分布式缓存通常由多台机器组成一个集群,每台机器上都运行着相同的缓存服务进程,缓存数据被均匀地分布在集群中的各个节点上。 Redis 是分布式缓存的首选,甚至我们一提到缓存,很多后端工程师首先想到的就它。 下图是神州专车订单的 Redis 集群架构 。将 Redis 集群拆分成四个分片,每个分片包含一主一从,主从可以切换。 应用 A 根据不同的缓存 key 访问不同的分片。 与本地缓存相比,分布式缓存具有以下优点: 1、容量和性能可扩展 通过增加集群中的机器数量,可以扩展缓存的容量和并发读写能力。同时,缓存数据对于应用来讲都是共享的。 2、高可用性 由于数据被分布在多台机器上,即使其中一台机器故障,缓存服务也能继续提供服务。 但是分布式缓存的缺点同样不容忽视。 1、网络延迟 分布式缓存通常需要通过网络通信来进行数据读写,可能会出现网络延迟等问题,相对于本地缓存而言,响应时间更长。 2、复杂性 分布式缓存需要考虑序列化、数据分片、缓存大小等问题,相对于本地缓存而言更加复杂。 笔者曾经也认为无脑上缓存 ,系统就一定更快,但直到一次事故,对于分布式缓存的观念才彻底改变。 2014年,同事开发了比分直播的系统,所有的请求都是从分布式缓存 Memcached 中获取后直接响应。常规情况下,从缓存中查询数据非常快,但在线用户稍微多一点,整个系统就会特别卡。 通过 jstat 命令发现 GC 频率极高,几次请求就将新生代占满了,而且 CPU 的消耗都在 GC 线程上。初步判断是缓存值过大导致的,果不其然,缓存大小在 300k 到 500k 左右。 解决过程还比较波折,分为两个步骤: 修改新生代大小,从原来的 2G 修改成 4G,并精简缓存数据大小 (从平均 300k 左右降为 80k 左右); 把缓存拆成两个部分,第一部分是全量数据,第二部分是增量数据(数据量很小)。页面第一次请求拉取全量数据,当比分有变化的时候,通过 websocket 推送增量数据。 经过这次优化,笔者理解到:缓存虽然可以提升整体速度,但是在高并发场景下,缓存对象大小依然是需要关注的点,稍不留神就会产生事故。另外我们也需要合理地控制读取策略,最大程度减少 GC 的频率 , 从而提升整体性能。 5 多级缓存 开源中国网站最开始完全是用本地缓存框架 Ehcache 。 后来随着访问量的激增,出现了一个可怕的问题:“因为 Java 程序更新很频繁,每次更新的时候都要重启。一旦重启后,整个 Ehcache 缓存里的数据都被清掉。重启后若大量访问进来的话,开源中国的数据库基本上很快就会崩掉”。 于是,开源中国开发了多级缓存框架 J2Cache,使用了多级缓存 Ehcache + Redis 。 多级缓存有如下优势: 离用户越近,速度越快; 减少分布式缓存查询频率,降低序列化和反序列化的 CPU 消耗; 大幅度减少网络 IO 以及带宽消耗。 本地缓存做为一级缓存,分布式缓存做为二级缓存,首先从一级缓存中查询,若能查询到数据则直接返回,否则从二级缓存中查询,若二级缓存中可以查询到数据,则回填到一级缓存中,并返回数据。若二级缓存也查询不到,则从数据源中查询,将结果分别回填到一级缓存,二级缓存中。 2018年,笔者服务的一家电商公司需要进行 app 首页接口的性能优化。笔者花了大概两天的时间完成了整个方案,采取的是两级缓存模式,同时利用了 Guava 的惰性加载机制,整体架构如下图所示: 缓存读取流程如下: 1、业务网关刚启动时,本地缓存没有数据,读取 Redis 缓存,如果 Redis 缓存也没数据,则通过 RPC 调用导购服务读取数据,然后再将数据写入本地缓存和 Redis 中;若 Redis 缓存不为空,则将缓存数据写入本地缓存中。 2、由于步骤1已经对本地缓存预热,后续请求直接读取本地缓存,返回给用户端。 3、Guava 配置了 refresh 机制,每隔一段时间会调用自定义 LoadingCache 线程池(5个最大线程,5个核心线程)去导购服务同步数据到本地缓存和 Redis 中。 优化后,性能表现很好,平均耗时在 5ms 左右。最开始我以为出现问题的几率很小,可是有一天晚上,突然发现 app 端首页显示的数据时而相同,时而不同。 也就是说: 虽然 LoadingCache 线程一直在调用接口更新缓存信息,但是各个 服务器本地缓存中的数据并非完成一致。 说明了两个很重要的点: 1、惰性加载仍然可能造成多台机器的数据不一致 2、LoadingCache 线程池数量配置的不太合理, 导致了线程堆积 最终,我们的解决方案是: 1、惰性加载结合消息机制来更新缓存数据,也就是:当导购服务的配置发生变化时,通知业务网关重新拉取数据,更新缓存。 2、适当调大 LoadigCache 的线程池参数,并在线程池埋点,监控线程池的使用情况,当线程繁忙时能发出告警,然后动态修改线程池参数。 6 没有银弹 没有银弹是 Fred Brooks 在 1987 年所发表的一篇关于软件工程的经典论文。 论文强调真正的银弹并不存在,而所谓的银弹则是指没有任何一项技术或方法可以能让软件工程的生产力在十年内提高十倍。 通俗来讲:在技术领域中没有一种通用的解决方案可以解决所有问题。 技术本质上是为了解决问题而存在的,每个问题都有其独特的环境和限制条件,没有一种通用的技术或工具可以完美地解决所有问题。 虽然技术不断发展和进步,但是对于复杂的问题,仍需要结合多种技术和方法,进行系统性的思考和综合性的解决方案设计,才能得到最优解决方案。 回到文章开头的问题 ,如何说服技术老大用 Redis ? 假如应用就是一个单体应用,缓存可以不共享,通过定时任务刷新缓存对业务没有影响,而且本地内存可以 Hold 住缓存的对象大小,那么你的技术老大的方案没有问题。 假如应用业务比较复杂,需要使用缓存提升系统的性能,同时分布式缓存共享的特性对于研发来讲开发更加快捷,Redis 确实是个不错的选择,可以从研发成本、代码维护、人力模型等多个角度和技术老大提出自己的观点。 总而言之,在技术领域中,没有银弹。我们需要不断探索和研究新的技术,但同时也需要认识到技术的局限性,不盲目追求所谓的“银弹”,而是结合具体问题和需求,选择最适合的解决方案。 如果我的文章对你有所帮助,还请帮忙点赞、在看、转发一下,你的支持会激励我输出更高质量的文章,非常感谢!

优秀的个人博客,低调大师

每日一博 | 精准测试之过程与实践

作者:京东工业 宛煜昕 一、怎样的技术 •百度百科: 精准测试是一套计算机测试辅助分析系统。 精准测试的核心组件包含的软件测试示波器、用例和代码的双向追溯、智能回归测试用例选取、覆盖率分析、缺陷定位、测试用例聚类分析、测试用例自动生成系统,这些功能完整的构成了精准测试技术体系。 •其他定义 精准测试是中国自己有知识产权的完全的理论体系,它同时关注功能点和代码相关逻辑这样一个方法论,是一种灰盒的测试模式。 最开始在2014年的国际软件测试大会上发布精准测试的时候,它叫穿线测试,英文名字叫Threading Test,表达了精准测试的本质,Threading这个英文单词本身有两个含义,一个是穿线一个是线程,建立用例和代码的关系,相当于把黑盒和白盒关联起来,做黑盒测试也能看到白盒数据,同时把开发和测试能够关联起来,测试一做完,开发的逻辑马上就能自动生成。另一个层面,精准测试最本质就是线程测试,因为精准测试基于覆盖率白盒理论产生,它跟白盒最大的区别是它的覆盖率是线程级的,也就是说要追溯到用例这个级别。 二、技术发展 •历史发展 •成熟度模型的五级划分 三、知识与技能 这里介绍两款,分别为JAVA和C/C++相关, 第一,开发的基础和核心(编程)知识及所需要用到的版本管理工具(GIT)等。 第二,领域特定的知识、技术需要具备如下: JAVA:Javassist(官网- https://www.javassist.org/ ), ASM3.0(官网- https://asm.ow2.io/ ), JaCoCo(官网- https://www.eclemma.org/jacoco/)。 C/C++:汇编、反汇编,PE,逆向工程(IDA)。 要用C/C++实现,通用与效率等方面没得说,但各协议的插桩,代码信息的收集,复杂程度和工作量都不是一般人所能承受,要做好心里建设。 直接使用JaCoCo需要注意覆盖率的误差,一些语句行,分支层级,其误差会被指数级放大。其更适用于偏向辅助个人开发者和小型项目组对项目覆盖率进行非常基础的评估。 •误差产生的具体成因: 1.复杂系统通常由大量子模块组成,JaCoCo无法实现对于内部被调用的子模块进行插装,因此对于子模块覆盖率的评估会产生显著的误差。 2.如果某个子模块没有被调用,那么对于JaCoCo来说,该模块内的方法等同于不存在。JaCoCo需要调用该子模块,才能将该子模块内的代码计入覆盖率计算的“分母”。 3.除了几种既定的逻辑意外事件,JaCoCo无法正确处理例外情况(Exception),如果在控制流程中遇到Exception,JaCoCo会把这种情况直接标记为未覆盖,这种判定方式直接的影响到了对程序逻辑关系的把控,造成对于覆盖率无法准确评估。 •误差引发的后果: 1.伪瓶颈的产生,以及对测试质量的错误高估。第一种情况,测试人员投入大量工作之后,却无法进一步提升覆盖率,造成对资源和实践的浪费;第二种情况,会让用户误将未达标的系统判定为达标,有可能引发严重的生产事故。 2.无法实现缺陷定位,大量的算法和应用依托覆盖率的输入,而缺陷定位更是其中最主要的实践。 3.回归测试的精准度,受到了严重的影响。 •无损插桩技术(推荐) 精准测试推出的SABI和SASI是中国自己的技术 SABI,SouceCode Analyzer ByteCode Intrumentation,就是说源码分析,字节码查看,观测和分析是在源码,插桩是在字节码。 SASI,SouceCode Analyzer SouceCode Intrumentation,这是传统商用白盒最基础的技术,有时候对源码进行分析,直接在源码插装。源码插装以后,代码经过高级语言、高级编译器的编译,直接生成最后发布包。这种是完全无损的标准技术,插装代码经过编译器编译后执行可靠性更高。 四、总结与介绍 大纲 1、测试范围,代码分析 2、差异化 3、调用关系 4、度量与分析 5、质量评估 6、知识库兼优化 7、用例预分析 8、自动化测试与精准测试 五、平台 >设计思路 从产品的需求、功能模块,开发的代码到测试的用例,从正向到逆向的覆盖,追溯和可视。 >大纲 >调用链与代码覆盖 使用的是插桩,有点类似C++中的Hook技术,获取所需数据信息。 协议,HTTP,MySql,Dubbo,Redis等,需要先进行分析,找到关键插桩位置,然后结合使用设计模式进行收集(所需)信息。 设计模式推荐两个,1、反射+适配器,2、动态代理。 需要注意,代码膨胀问题。 >影响范围 假如有个应用系统开发出A版本提测,通过前端功能发起HTTP接口,平台的实时快照收到HTTP接口信息,将该次的接口相关信息(类、方法、执行代码行数)保存为系统快照; 当A版本开发后变为A_01版本,使用平台对两次版本(Jar包或War包)进行比对,通过系统快照中信息会分析出变更项与影响项,如:类、方法、接口。 根据影响用例中的菜单与接口,到接口测试工具中进行执行。 >实现与应用 通过数据进行可视化,显示服务/应用的启动,拓扑图,调用链,代码覆盖,版本比对等信息。 >>项目列表 添加,服务/应用 >>项目动态 启动,服务/应用 1、搜索 可显示多个服务/应用的拓扑关系图 1)详情视图 •表结构,可查看接口与数据库表间的关联 •热点,可查看接口与数据库表的关联个数 2)展开快照 这里显示的节点是保存到系统快照的。 •表结构-数据库表,远程服务-调用的rpc接口,源码-代码关系图层; •远程服务,显示远程调用接口,如dubbo接口; •源代码关系图谱,可查看代码关联关系和覆盖程度; •清除图谱,清除表结构、远程服务、源代码关系节点; •详情页,跳转到快照详情页; •概要,显示快照详情中图片; •删除节点,删除显示的节点; 3)搜索 •搜索数据库表中,表名,字段名,筛选条件; •搜索接口,HTTP接口; 2、监控台 通过HTTP接口实时获取到协议、代码相关信息,不同于通过单元测试得到代码覆盖率,然后将这些信息保存下来(我的快照和系统快照)。 1)实时监控 实时展示接口的调用链及链上各节点信息 2)我的快照 实时监控中可保存为我的快照, 2.1)调用链和链路分析的可视化 调用链即是服务与中间件的调用链拓扑图层;链路分析即是代码链路分析关系图谱。 •"流程图(拓扑图)"中可查看到覆盖后端及各中间件信息; •"堆栈列表"中展示服务与中间件的应用名,类型,服务/方法,用时等信息; •点击"</>"弹窗为代码图谱(代码链路分析关系图谱),点击某个节点,即显示某个方法的方法名称、执行到的代码行数、代码总数、代码覆盖率和圈复杂度信息, 根据某个尾节点,能寻到开始节点; 2.2)查看代码覆盖率报告 代码覆盖率信息列表,显示我的快照列表中所有覆盖率信息,类名、方法名、执行代码行数、方法行数、覆盖率、圈复杂度; 3、应用中心 1)在线应用 2)应用 2.1)系统快照 快照目录,点击链接进入系统快照详情页 系统快照详情页,基本信息页签 系统快照详情页,流程图页签 系统快照详情页,堆栈列表页签,点击</>打开代码关系图层(代码关系链) 2.2)版本比对 比对文件格式为Jar或War包,比对之后会产生记录报告 开始比对后的结果显示,能查看报告,显示差异项,(比对)日志输出(新增、修改、变更、删除的文件与方法,类与方法的影响数) 2.2.1)报告 比对成功后查看报告,显示变更项,影响用例,对比日志;点击影响用例链接,会跳转到(系统)快照详情页 参考 1、百度百科-精准测试, https://baike.baidu.com/item/精准测试/22355867 2、精准测试白皮书v3.0-2019最新版,作者:星云精准测试, https://wenku.baidu.com/view/fe7e99a401d276a20029bd64783e0912a2167c23.html 3、《不测的秘密-精准测试之路》,作者:TMQ精准测试实践团队。 4、网易严选的精准测试实践, https://www.infoq.cn/article/xuu91crqa4hcjz8uomjs

优秀的个人博客,低调大师

每日一博 | 得物直播低延迟探索

1.背景 直播的时效性保证了良好的用户体验,根据经验在交易环节,延迟越低转化效果也会越好。传统的直播延迟问题已经成为了一个不容忽视的问题,高延迟不仅破坏了用户的观看体验,也让主播难以实时获取到用户的反馈。为了进一步优化直播时效体验,我们需要对产生延迟的原因以及整个交互链路有个清晰的认知,才能稳定的实施相关方案。 2.主观体验 我们团队内部观察了其他电商平台的延时,其中 TOP1 的平台,端到端的延迟在 3s 左右,而得物在 5s 左右,提升空间还是比较明显,我们需要进一步明确具体原因。 3.延迟降低有什么好处 3.1 提升交易环节顺畅度 在得物的直播场景中有添加秒杀商品的环节,秒杀商品的倒计时是实时进行的,假如直播画面有将近8s的延迟才能追上,在这一过程中无论是用户还是主播沟通中都会存在gap。在直播过程中用户在延迟高的场景中提问了但是主播迟迟没有反馈,在这个期间用户有可能退出直播间或者跳过这个商品,这个结果无论是对主播或者是对交易转换都不太能接受。 3.2 提升体验,不同用户之间延迟差别太大 A、B两个用户可能在看某一个直播间,A用户可能很早就进直播间了,而B用户是新进来的,但是B用户的延迟却比A用户的低了几秒,A用户看到可能就会怀疑自己手机、网络、APP是不是哪个有问题,造成不好的体验反馈。 4.直播延迟是如何产生的? 要搞清楚延迟是如何产生的,我们势必要了解到其中哪些程序可能出现延迟,并且是可优化的。 主播 --> 云服务器 --> CDN节点 --> 用户 云服务器 --> 主播: 直播内容转码、压缩等处理 CDN节点 --> 用户: 直播内容分发到多个边缘节点 用户 --> 设备: 接收直播内容 --> 显示直播内容 4.1 在这些过程中,可能会产生延迟的地方 (部分解释来源第三方文献) 主播端所使用的采集编码设备可能存在延迟 主要包含编码延迟以及发送缓存引入的延迟,这个环节的延迟优化空间不多,虽然通过调节编码器参数可有效降低编码延迟,但带来的是画质的损失,同时也影响压缩效果,因此多数集中在优化弱网传输,出发点是为了提供用户观看流畅体验,而不仅限于降低延迟 云服务器对直播内容的转码、压缩等处理的时间 对于直播平台而言,实时转码是非常必要的一项技术。通过对视频流进行实时转码,可以将高清视频流优化为多个分辨率,满足不同终端设备的兼容性和带宽需求,并且减小了网络传输的开销。但是,实时转码过程中必然会带来一定的延迟,这是因为: 转码过程需要对视频流进行分析和处理,比如压缩、格式转换等。这个过程需要一定的计算资源和时间。 转码后的视频需要重新传输到CDN节点中,再由观众设备进行播放。这个过程可能会受到网络带宽、传输速率等因素的影响,导致一定的延迟。 因此,针对转码延迟的问题,需要在减小延迟和提高视频质量之间进行权衡。采用一些高级的转码算法、减少图片质量降低对视频画质的伤害、优化编码参数等方法,但也同样会带来画质与压缩率的损失,因此这部分延迟需要根据实际场景综合来考虑,如果对延迟要求很高,可以略微调整下。 CDN节点的网络传输延迟 不考虑回源的情况,这个环节主要影响延迟的是 gop cache 策略,各类 CDN 厂商称呼都不一致,有的又叫(RTMP、FLV、HLS...)Delay,即在边缘节点缓存一路流最新的几个 gop(一般媒体时长平均为 5 ~ 7s),目的是为了在拉流请求建立时,可以有媒体数据即时发送,优化首帧和卡顿,这样也就导致了播放端收到的第一帧数据就是 5 ~ 7s 前的旧数据,第一帧的延迟就达到了 5 ~ 7s,这个环节是端到端延迟过大的根因。 播放器的防卡顿缓存buffer固定延迟n(s) 在直播拉流播放过程中,为了提高播放的流畅度和用户体验,通常进行缓存一部分buffer。缓存是指在播放器开始播放之前,预先加载一定量的视频数据到本地缓存中,以便后续播放时能够快速读取缓存中的数据,避免卡顿和不流畅的现象。这种“预加载”的缓存被称为“缓存buffer”。 缓存buffer大小不同可能会导致延迟时间也不同,常见的缓存buffer大小为2秒或者更小,这意味着播放器会预先从视频源中加载2秒到本地缓存中,等播放器播放到接近缓存末尾时,会再次预加载2秒内容到缓存中,以保证播放的流畅性。 固定延迟是指播放器在接收到网络数据之后,为保证数据正常播放而需要等待一定的固定时间,一般用于防止视频播放过程中的卡顿和不流畅。例如,如果设置的固定延迟为1秒,那么从数据包到达手机端再到数据包真正播放出来这个过程,就需要多等待1秒左右的时间,这就是固定延迟产生的效果。 通常情况下,播放器会自动根据当前的网络环境动态调整缓存buffer大小和固定延迟时间,以保证最佳的播放效果。不过,如果网络环境不太理想,仍有可能出现视频卡顿和不流畅的情况,此时可以通过配置和优化缓存buffer大小和固定延迟时间来改善播放效果。 用户设备的接收、解码等操作产生的延迟 假设用户的设备硬件性能较为低端,在接收和解码直播数据时出现卡顿等问题。为此,可以通过优化码流参数,如对码率、分辨率等进行调节,使其更加适应用户设备的硬件性能;或者采用尽量少的传输协议,以减少解码时间和相关计算资源的使用。 综合所述 其中任何一个环节出现问题,都有可能导致直播过程中产生延迟。为了减少这种延迟,可以优化各个环节的处理效率,并优化网络传输等方面的参数和设置。 在直播的传输环节里,对延迟影响大的主要是CDN的传输、转码、分发和播放缓冲,使用实时的转码模式,转码器引入的延迟一般在 300ms 以内甚至更短。CDN 的分发环节也会带来一定的延迟,但相对也较短。而为了对抗网络抖动引入的播放缓冲区引入的延迟播放缓冲引入的延迟常常会有 5s 甚至更多。 4.2如何知道具体延迟? 方法一: 采用端到端的测试方法,即计算播放端到推流端的时间差作为延迟。 找一个在线的精确到毫秒的时钟:http://www.daojishiqi.com/bjtime.asp A. 打开上述网页,推流端对准该网页或者抓取窗口 B. 播放端:到对应直播间观看对应的时间差 对A、B(屏幕)进行对比,截图计算时间差。 方法二: 编码的时候把时间戳写到 SEI 信息中,播放器通过拉流成功后解析 SEI 信息然后与当前时间戳做差值对比。 SEI 需要涉及到推拉流侧底层开发,所以暂选的方法一进行测试,测试结果发现现阶段最保守以及快速的解决方式是直接调整云直播控制台的延迟档位。如果要调整延迟档位,那势必要了解到调整之后会带来什么影响以及变化,这其中就涉及到了 GOP 相关的知识点。 4.3 GOP 以及 GOP cache 是什么?我们为什么要了解它? 顾名思义 GOP cache,是一组存于 CDN 服务端的 GOP 缓存,GOP cache 越大延迟影响也越大。通过了解 GOP cache 我们能在直播延迟链路中能做出更精准的优化。GOP cache 是某一方厂商提出的名词,各大 CDN 的称呼也不一致,有的云厂商又称之为(RTMP、FLV、HLS...)Delay。与推流 GOP 或者 转码播流 GOP 配合,就形成完整的端到端延迟。 GOP(Group of Pictures) 而 GOP 是一组连续的视频帧,通常包括一个I帧(关键帧)和若干个P帧(预测帧)和B帧(双向预测帧)。在直播过程中,如果 GOP 的大小过大,会导致接收端在等待I帧的到来时需要等待相对较长的时间,这就会增加视频的延迟。因此,降低 GOP 大小可以在一定程度上减小视频的延迟。 直播控制台的延迟(GOP cache) 配置路径 (域名配置->直播延迟配置) 选项中选择 推流 GOP & 转码 GOP 关系 <!----> 无转码的情况下,推流 GOP == 播流的 GOP 有转码的情况下,如果转码模板配置了 GOP ,则播流的 GOP == 转码配置的 GOP 如果转码模板未指定具体的 GOP,则推流 GOP == 转码后的 GOP <!----> 延迟配置的描述,强调的都是推流 gop,是否有误导问题? 不算完全算误导,一方面不是所有直播流都走转码,甚至修改 GOP。另一方面推流 GOP 对流传输效率可能存在一定影响。主要描述没有把转码 GOP 的影响和区别包括进去。 缓存的单位 duration or size? 得物使用的直播缓存的单位是 duration 在直播延迟中,缓存的单位可以是时间(duration)或大小(size)。 以时间(duration)为单位的缓存指的是,在视频采集、编码和推送到云服务器的过程中,视频数据会先被存放在缓冲区中,等待一定的时间(也就是缓存时间)后,才会被推送到CDN分发节点上进行播放。 以大小(size)为单位的缓存则是根据缓存容量进行控制,视频在采集、编码和推送到云服务器的过程中,每当视频数据达到一定的大小,就会被推送到CDN分发节点上进行播放。 在实际的直播过程中,通常会综合使用时间和大小两种缓存单位来进行延迟控制。如果对延迟比较在意,可以适当增加缓存时间和大小,保证接收端有足够的缓存时间进行播放,减少出现卡顿和停顿的概率。如果实时性比较重要的话,可以适当降低缓存时间和大小,缩短延迟时间,保证直播的实时性。 需要注意的是,缓存时间和缓存大小是直播平台优化延迟的两个关键因素。合理的设置能够显著减小延迟,提升用户体验。但同时,缓存过多或者过少都可能会带来一定的问题,因此需要根据实际情况进行调整和优化。 缓存的 gop 数? 不固定,且没有 GOP 数量的概念,是以时长论大小,取决于 CDN 侧的 buffer ,不管 buffer 多大,发送数据是按照至少一个 delay, 最多 delay + gop 发送的,流数据是不断产生新数据的,发送的时候内容不断在滑动。对延迟没有直接的影响关系。 基础时间值 RTMP :低(2s)中(4s)高(8s) FLV :低(2s)中(4s)高(8s) 计算延迟方式:[RtmpDelay, RtmpDelay + GOP] 这里的 GOP,转码前用的推流设置的 GOP,转码后用的转码模板配置的 GOP自定义模版配置的 1080p,gop = 10s = 200桢 的情况下 理论上最小最大值就下面的几种范围[2,12],[4,14],[8,18] flv 播放的话,delay设置2秒,gop 设置1秒,理论上端到端的延迟基本在3秒左右,如果码率高的情况下,还得适当提升 delay 的值保证直播的流畅。另外除了 CDN 缓存延迟以外,播放器缓存策略也需要考虑。 如果要实现稳定2秒,可以考虑超低延迟直播的方案。 5.后续可实施的有效降低直播延迟手段 降低 CDN 正式环境的 gopCache 至低档位 调整完之后端到端延迟预计能从 5s-8s 降低至 3s-5s 推流 GOP 调整为 1s,平均端到端延迟再下降 1s 理论上来说降低推流 GOP,是对延迟有帮助的,将 GOP 降至1秒,则每秒会推送一个关键帧,接收端就可以在接收到关键帧后直接播放,进一步减小延迟。同时,由于每秒会推送更多关键帧,对视频的画质和稳定性也会产生积极的影响。 推流 GOP 的大小不是唯一的影响直播延迟的因素。还有视频编码、推流服务器的 配置、网络环境等因素都会对延迟产生影响,因此只有在综合考虑到各种因素后,合理设置推流GOP大小,才能够最大程度地降低直播延迟。 增加 buffer 中视频数据的消费速度,有效降低延迟,例如倍速播放或者直接丢帧,策略需要更精细化 也就是说增加拉流侧的消费速度,在有需求的情况下配合倍速追桢的策略,加快视频的播放速度,在某一个阀值中开启或者停止。 推流侧在推流的过程中把关键帧打入时间戳到 SEI 信息里去 拉流侧在拉流的过程中解码成功之后把对应的 SEI 信息里的时间戳解析出来 然后根据服务端的在线时间对比两者之差,决定播放器的播放器倍速,例如 (1.0 ~ 1.4s) 之间逐渐增加和递减,最终在符合预期的延迟时间停止加速消费 确认自研播放器 buffer 缓存当前现状是多少秒,对齐竞品至少 2s buffer 常见的直播播放器缓存buffer大小为2秒,主要是出于减少卡顿和停顿的概率,提升用户体验的考虑。播放器缓存buffer是指播放器预先缓存一定量的视频数据进行播放。当网络状况不好、视频流传输中断或者延迟过高时,播放器缓存就会派上用场,保证播放过程的连续性和流畅性。一般来说,播放器缓存buffer大小会根据网络环境和带宽等因素而不同。如果缓存过小,会导致卡顿和停顿;如果缓存过大,会增加延迟,影响实时性。经过优化,常见的直播播放器缓存buffer大小为2秒左右,既能够保证播放过程的流畅性,又不会过度增加延迟。不同的直播平台(PC、移动端)、不同的网络(WIFI、4G、5G)和设备(不同厂商)可能会有不同的播放器缓存 buffer 大小设置,因此在实际使用中需要根据具体情况进行调整和优化。 使用阿里云的 RTS 或者,字节的 RTM 协议,如果使用超低延时方案还需确认使用场景(例如头部热门直播间有需要的才采用) 阿里云的 RTS(Real-Time Streaming)和字节的 RTM(RTM,Real Time Media)都是超低延时商业化方案,有着使延迟降低至<=1s的效果, 在具体的应用场景和功能方面都差不多。 RTS全链路延时监控、CDN 传输协议改造、UDP 等底层技术优,可以提供低延迟的流媒体数据传输和处理服务,支持高并发、低卡顿、秒开流畅的直播体验。 RTM通过链路传输协议改造为 UDP 等底层技术优化,解决 TCP 协议自身局限和网络抖动引起延迟累加,支持高并发、高可靠性的优质直播观看体验。 以上两种商业化方案都需要配合播放器SDK使用,且 RTM 需要配合火山 CDN 环境使用,两者费用也不一样。需要针对我们当前架构和现状作出权衡考虑。 使用 QUIC 协议(底层UDP协议理论上延迟会更低),已在三方播放器上验证过。普通 flv <=5s 下降到 <=2s 常规直播推流底层协议是基于TCP的,理论上极限在3秒左右已经是最低的了。 而 QUIC(Quick UDP Internet Connections)是一种基于用户数据报协议(UDP)的协议,它在传输上相比于传统的传输层协议(TCP)有以下优势,导致延迟更低: 连接建立时间短, TCP 协议需要经过三次握手的过程来建立连接,而QUIC协议只需要一次握手,这样就大大减少了连接建立的时间,提高了通信效率。 报文传输方式不同, TCP 协议在发送数据之前首先需要进行慢启动过程,以逐步增加发送速率并监测网络拥塞。QUIC 协议通过动态地调整窗口大小和传输速率,使得数据传输更加高效。 多路复用支持度更好, QUIC 协议支持多路复用,这意味着可以在单个连接上同时传输多个流,从而保证更高的带宽利用率和更低的延迟。 减少网络服务的依赖, QUIC协议能够在连接失效或者网络服务不可用的情况下,进行快速恢复,从而保证了稳定的数据传输。 综上所述,由于QUIC协议在连接建立、报文传输、多路复用和网络故障处理等方面都有着比. TCP协议更好的表现,因此它可以提供更低的延迟,更高的速率以及更可靠的连接。另外一个使用QUIC(UDP)也需要综合考虑一些问题,它带来更低的延迟后,会不会有一些其他方面受到负面影响,例如拉流成功率、稳定性问题之类的。所以最终实施方案还需要做更详细的测试权衡利弊。 6.一些思考 直播延迟问题涉及的因素较多,包括推流端和播放端的缓存设置、传输协议、GOP控制等方面。为了解决延迟问题,在实际开发中,为了达到更好的用户体验,我们需要对这些因素进行综合考虑和优化,在不断的实践和实验中寻找最佳方案,通过综合使用这些技术方案,可以更好地提高直播平台的实时性和观看体验。 活动推荐:得物技术社招开始啦!点击关注得物技术公众号了解详情! 本文属得物技术原创,来源于:得物技术官网 得物技术文章可以任意分享和转发,但请务必注明版权和来源:得物技术官网

优秀的个人博客,低调大师

每日一博 | 何为神经网络卷积层?

摘要:本文深度讲解了卷积计算的原理,并详细介绍了构成所有卷积网络主干的基本元素,包括卷积层本身、填充和步幅的基本细节、用于在相邻区域汇聚信息的汇聚层,最后给出卷积层和汇聚层的代码示例和CNN框架结构图。 本文分享自华为云社区《神经网络基础部件-卷积层详解》,作者: 嵌入式视觉 。 前言 在全连接层构成的多层感知机网络中,我们要通过将图像数据展平成一维向量来送入模型,但这会忽略了每个图像的空间结构信息。理想的策略应该是要利用相近像素之间的相互关联性,将图像数据二维矩阵送给模型中学习。 卷积神经网络(convolutional neural network,CNN)正是一类强大的、专为处理图像数据(多维矩阵)而设计的神经网络,CNN 的设计是深度学习中的一个里程碑式的技术。在 Transformer 应用到 CV 领域之前,基于卷积神经网络架构的模型在计算机视觉领域中占主导地位,几乎所有的图像识别、目标检测、语义分割、3D目标检测、视频理解等任务都是以 CNN 方法为基础。 卷积神经网络核心网络层是卷积层,其使用了卷积(convolution)这种数学运算,卷积是一种特殊的线性运算。另外,通常来说,卷积神经网络中用到的卷积运算和其他领域(例如工程领域以及纯数学领域)中的定义并不完全一致。 一,卷积 在理解卷积层之前,我们首先得理解什么是卷积操作。 卷积与傅里叶变换有着密切的关系。例如两函数的傅里叶变换的乘积等于它们卷积后的傅里叶变换,利用此一性质,能简化傅里叶分析中的许多问题。 operation 视语境有时译作“操作”,有时译作“运算”,本文不做区分。 1.1,卷积运算定义 为了给出卷积的定义, 这里从现实世界会用到函数的例子出发。 假设我们正在用激光传感器追踪一艘宇宙飞船的位置。我们的激光传感器给出 一个单独的输出 x(t)x(t),表示宇宙飞船在时刻 tt的位置。xx和 tt都是实值的,这意味着我们可以在任意时刻从传感器中读出飞船的位置。 现在假设我们的传感器受到一定程度的噪声干扰。为了得到飞船位置的低噪声估计,我们对得到的测量结果进行平均。显然,时间上越近的测量结果越相关,所 以我们采用一种加权平均的方法,对于最近的测量结果赋予更高的权重。我们可以采用一个加权函数 w(a)w(a) 来实现,其中 aa表示测量结果距当前时刻的时间间隔。如果我们对任意时刻都采用这种加权平均的操作,就得到了一个新的对于飞船位置的平滑估计函数s: 这种运算就叫做卷积(convolution)。更一般的,卷积运算的数学公式定义如下: 以上卷积计算公式可以这样理解: 先对函数g(t) 进行反转(reverse),相当于在数轴上把g(t) 函数从右边褶到左边去,也就是卷积的“卷”的由来。 然后再把g(t) 函数向左平移x个单位,在这个位置对两个函数的对应点相乘,然后相加,这个过程是卷积的“积”的过程。 1.2,卷积的意义 对卷积这个名词,可以这样理解:所谓两个函数的卷积(f∗g),本质上就是先将一个函数翻转,然后进行滑动叠加。在连续情况下,叠加指的是对两个函数的乘积求积分,在离散情况下就是加权求和,为简单起见就统一称为叠加。 因此,卷积运算整体来看就是这么一个过程: 翻转—>滑动—>叠加—>滑动—>叠加—>滑动—>叠加… 多次滑动得到的一系列叠加值,构成了卷积函数。 这里多次滑动过程对应的是t的变化过程。 那么,卷积的意义是什么呢?可以从卷积的典型应用场景-图像处理来理解: 为什么要进行“卷”?进行“卷”(翻转)的目的其实是施加一种约束,它指定了在“积”的时候以什么为参照。在空间分析的场景,它指定了在哪个位置的周边进行累积处理。 在图像处理的中,卷积处理的结果,其实就是把每个像素周边的,甚至是整个图像的像素都考虑进来,对当前像素进行某种加权处理。因此,“积”是全局概念,或者说是一种“混合”,把两个函数进行时间(信号分析)或空间(图像处理)上进行混合。 1.3,从实例理解卷积 一维卷积的实例有 “丢骰子” 等经典实例,这里不做展开描述,本文从二维卷积用于图像处理的实例来理解。 一般,数字图像可以表示为如下所示矩阵: 而卷积核g也可以用一个矩阵来表示,如: 按照卷积公式的定义,则目标图片的第(u,v) 个像素的二维卷积值为: 展开来分析二维卷积计算过程就是,首先得到原始图像矩阵中 (u,v) 处的矩阵: 然后将图像处理矩阵翻转(两种方法,结果等效),如先沿x轴翻转,再沿y轴翻转(相当于将矩阵g旋转 180 度): 最后,计算卷积时,就可以用f和g′ 的内积: 计算过程可视化如下动图所示,注意动图给出的是 gg不是 g′g′。 以上公式有一个特点,做乘法的两个对应变量a,b的下标之和都是 (u,v),其目的是对这种加权求和进行一种约束,这也是要将矩阵g进行翻转的原因。上述计算比较麻烦,实际计算的时候,都是用翻转以后的矩阵,直接求矩阵内积就可以了。 1.4,图像卷积(二维卷积) 在机器学习和图像处理领域,卷积的主要功能是在一个图像(或某种特征) 上滑动一个卷积核(即滤波器),通过卷积操作得到一组新的特征。一幅图像在经过卷积操作后得到结果称为特征映射(Feature Map)。如果把图像矩阵简写为 II,把卷积核 Kernal 简写为 KK,则目标图片的第 (i,j) 个像素的卷积值为: 可以看出,这和一维情况下的卷积公式 2 是一致的。因为卷积的可交换性,我们也可以把公式 3 等价地写作: 通常,下面的公式在机器学习库中实现更为简单,因为m和n的有效取值范围相对较小。 卷积运算可交换性的出现是因为我们将核相对输入进行了翻转(flip),从m增 大的角度来看,输入的索引在增大,但是卷积核的索引在减小。我们将卷积核翻转的唯一目 的是实现可交换性。尽管可交换性在证明时很有用,但在神经网络的应用中却不是一个重要的性质。相反,许多神经网络库会实现一个互相关函数(corresponding function),它与卷积相同但没有翻转核: 互相关函数的运算,是两个序列滑动相乘,两个序列都不翻转。卷积运算也是滑动相乘,但是其中一个序列需要先翻转,再相乘。 1.5,互相关和卷积 互相关和卷积运算的关系,可以通过下述公式理解: 其中⊗ 表示互相关运算,∗ 表示卷积运算, rot180(⋅) 表示旋转 180 度,Y为输出矩阵。从上式可以看出,互相关和卷积的区别仅仅在于卷积核是否进行翻转。因此互相关也可以称为不翻转卷积. 离散卷积可以看作矩阵的乘法,然而,这个矩阵的一些元素被限制为必须和另外一些元素相等。 在神经网络中使用卷积是为了进行特征抽取,卷积核是否进行翻转和其特征抽取的能力无关(特别是当卷积核是可学习的参数时),因此卷积和互相关在能力上是等价的。事实上,很多深度学习工具中卷积操作其实都是互相关操作,用来减少一些不必要的操作或开销(不反转 Kernal)。 总的来说, 我们实现的卷积操作不是原始数学含义的卷积,而是工程上的卷积,但一般也简称为卷积。 在实现卷积操作时,并不会反转卷积核。 二,卷积层 在传统图像处理中,线性空间滤波的原理实质上是指指图像 ff与滤波器核 ww进行乘积之和(卷积)运算。核是一个矩阵,其大小定义了运算的邻域,其系数决定了该滤波器(也称模板、窗口滤波器)的性质,并通过设计不同核系数(卷积核)来实现低通滤波(平滑)和高通滤波(锐化)功能,因此我们可以认为卷积是利用某些设计好的参数组合(卷积核)去提取图像空域上相邻的信息。 2.1,卷积层定义 在全连接前馈神经网络中,如果第l层有Ml​ 个神经元,第l−1 层有Ml−1​ 个 神经元,连接边有Ml​×Ml−1​ 个,也就是权重矩阵有Ml​×Ml−1​ 个参数。当Ml​ 和Ml−1​ 都很大时,权重矩阵的参数就会非常多,训练的效率也会非常低。 如果采用卷积来代替全连接,第l层的净输入z(l) 为第l−1 层激活值a(l−1)和滤波器w(l)∈RK的卷积,即 其中 b(l)∈R 为可学习的偏置。 上述卷积层公式也可以写成这样的形式:Z=W∗A+b 根据卷积层的定义,卷积层有两个很重要的性质: 2.1.1,局部连接 局部连接:在卷积层(假设是第 ll层)中的每一个神经元都只和下一层(第 l−1l−1 层)中某个局部窗口内的神经元相连,构成一个局部连接网络。其实可能表达为稀疏交互更直观点,传统的网络层是全连接的,使用矩阵乘法来建立输入与输出的连接关系。矩阵的每个参数都是独立的,它描述了每个输入单元与输出单元的交互。这意味着每个输出单元与所有的输入单元都产生关联。而卷积层通过使用卷积核矩阵来实现稀疏交互(也称作稀疏连接,或者稀疏权重),每个输出单元仅仅与特定的输入神经元(其实是指定通道的 feature map)产生关联。 下图显示了全连接层和卷积层的每个输入单元影响的输出单元比较: 对于传统全连接层,每个输入单元影响了所有的输出单元。 对于卷积层,每个输入单元只影响了3个输出单元(核尺寸为3时)。 2.1.2,权重共享 权重共享:卷积层中,同一个核会在输入的不同区域做卷积运算。全连接层和卷积层的权重参数比较如下图: 对于传统全连接层: x3→s3x3​→s3​ 的权重 w3,3w3,3​ 只使用了一次 。 对于卷积层: x3→s3x3​→s3​ 的权重 w3,3w3,3​ 被共享到 xi→si,i=12,4,5xi​→si​,i=12,4,5。 全连接层和卷积层的可视化对比如下图所示: 总结:一个滤波器(3维卷积核)只捕捉输入数据中的一种特定的局部特征。为了提高卷积网络的表示能力,可以在每一层使用多个不同的特征映射,即增加滤波器的数量,以更好地提取图像的特征。 2.2,卷积层理解 前面章节内容中,卷积的输出形状只取决于输入形状和卷积核的形状。而神经网络中的卷积层,在卷积的标准定义基础上,还引入了卷积核的滑动步长和零填充来增加卷积的多样性,从而可以更灵活地进行特征抽取。 步长(Stride):指卷积核每次滑动的距离 零填充(Zero Padding):在输入图像的边界填充元素(通常填充元素是0) 卷积层定义:每个卷积核(Kernel)在输入矩阵上滑动,并通过下述过程实现卷积计算: 在来自卷积核的元素和输入特征图子矩阵的元素之间进行乘法以获得输出感受野。 然后将相乘的值与添加的偏差相加以获得输出矩阵中的值。 卷积层数值计算过程可视化如下图 1 所示: 图片来源论文 Improvement of Damage Segmentation Based on Pixel-Level Data Balance Using VGG-Unet。 注意,卷积层的输出 Feature map 的大小取决于输入的大小、Pad 数、卷积核大小和步长。在 Pytorch 框架中,图片(feature map)经卷积 Conv2D 后输出大小计算公式如下: 其中 ⌊⌋⌊⌋ 是向下取整符号,用于结果不是整数时进行向下取整(Pytorch 的 Conv2d 卷积函数的默认参数 ceil_mode = False,即默认向下取整, dilation = 1),其他符号解释如下: 输入图片大小 W×W(默认输入尺寸为正方形) Filter 大小 F×F 步长 S padding的像素数 P 输出特征图大小 N×N 上图1侧重于解释数值计算过程,而下图2则侧重于解释卷积层的五个核心概念的关系: 输入 Input Channel 卷积核组 WeightsBias 过滤器 Filter 卷积核 kernal 输出 Feature Map 上图是三通道经过两组过滤器的卷积过程,在这个例子中,输入是三维数据 3×32×323×32×32,经过权重参数尺寸为 2×3×5×52×3×5×5 的卷积层后,输出为三维 2×28×282×28×28,维数并没有变化,只是每一维内部的尺寸有了变化,一般都是要向更小的尺寸变化,以便于简化计算。 假设三维卷积(也叫滤波器)尺寸为 (cin,k,k)(cin​,k,k),一共有 coutcout​ 个滤波器,即卷积层参数尺寸为 (cout,cin,k,k)(cout​,cin​,k,k) ,则标准卷积层有以下特点: 输出的 feature map 的数量等于滤波器数量 coutcout​,即卷积层参数值确定后,feature map 的数量也确定,而不是根据前向计算自动计算出来; 对于每个输出,都有一个对应的过滤器 Filter,图例中 Feature Map-1 对应 Filter-1; 每个 Filter 内都有一个或多个卷积核 Kernal,对应每个输入通道(Input Channel),图例为 3,对应输入的红绿蓝三个通道; 每个 Filter 只有一个 Bias 值,图例中 Filter-1 对应 b1; 卷积核 Kernal 的大小一般是奇数如:1×11×1,3×33×3。 注意,以上内容都描述的是标准卷积,随着技术的发展,后续陆续提出了分组卷积、深度可分离卷积、空洞卷积等。详情可参考我之前的文章-MobileNetv1论文详解。 2.3,卷积层 api Pytorch 框架中对应的卷积层 api 如下: class torch.nn.Conv2d(in_channels, out_channels, kernel_size, stride=1, padding=0, dilation=1, groups=1, bias=True) 主要参数解释: in_channels(int) – 输入信号的通道。 out_channels(int) – 卷积产生的通道。 kerner_size(int or tuple) - 卷积核的尺寸。 stride(int or tuple, optional) - 卷积步长,默认值为 1 。 padding(int or tuple, optional) - 输入的每一条边补充 0 的层数,默认不填充。 dilation(int or tuple, optional) – 卷积核元素之间的间距,默认取值 1 。 groups(int, optional) – 从输入通道到输出通道的阻塞连接数。 bias(bool, optional) - 如果 bias=True,添加偏置。 示例代码: ###### Pytorch卷积层输出大小验证 import torch import torch.nn as nn import torch.autograd as autograd # With square kernels and equal stride # output_shape: height = (50-3)/2+1 = 24.5,卷积向下取整,所以 height=24. m = nn.Conv2d(16, 33, 3, stride=2) # # non-square kernels and unequal stride and with padding # m = nn.Conv2d(16, 33, (3, 5), stride=(2, 1), padding=(4, 2)) # 输出shape: torch.Size([20, 33, 28, 100]) # # non-square kernels and unequal stride and with padding and dilation # m = nn.Conv2d(16, 33, (3, 5), stride=(2, 1), padding=(4, 2), dilation=(3, 1)) # 输出shape: torch.Size([20, 33, 26, 100]) input = autograd.Variable(torch.randn(20, 16, 50, 100)) output = m(input) print(output.shape) # 输出shape: torch.Size([20, 16, 24, 49]) 三,卷积神经网络 卷积神经网络一般由卷积层、汇聚层和全连接层构成。 3.1,汇聚层 通常当我们处理图像时,我们希望逐渐降低隐藏表示的空间分辨率、聚集信息,这样随着我们在神经网络中层叠的上升,每个神经元对其敏感的感受野(输入)就越大。 汇聚层(Pooling Layer)也叫子采样层(Subsampling Layer),其作用不仅是进降低卷积层对位置的敏感性,同时降低对空间降采样表示的敏感性。 与卷积层类似,汇聚层运算符由一个固定形状的窗口组成,该窗口根据其步幅大小在输入的所有区域上滑动,为固定形状窗口(有时称为汇聚窗口)遍历的每个位置计算一个输出。然而,不同于卷积层中的输入与卷积核之间的互相关计算,汇聚层不包含参数。相反,池运算是确定性的,我们通常计算汇聚窗口中所有元素的最大值或平均值。这些操作分别称为最大汇聚层(maximum pooling)和平均汇聚层(average pooling)。 在这两种情况下,与互相关运算符一样,汇聚窗口从输入张量的左上⻆开始,从左往右、从上往下的在输入张量内滑动。在汇聚窗口到达的每个位置,它计算该窗口中输入子张量的最大值或平均值。计算最大值或平均值是取决于使用了最大汇聚层还是平均汇聚层。 值得注意的是,与卷积层一样,汇聚层也可以通过改变填充和步幅以获得所需的输出形状。 3.2.,汇聚层 api Pytorch 框架中对应的聚合层 api 如下: class torch.nn.MaxPool2d(kernel_size, stride=None, padding=0, dilation=1, return_indices=False, ceil_mode=False) 主要参数解释: kernel_size(int or tuple):max pooling 的窗口大小。 stride(int or tuple, optional):max pooling的窗口移动的步长。默认值是kernel_size`。 padding(int or tuple, optional):默认值为 0,即不填充像素。输入的每一条边补充 0 的层数。 dilation:滑动窗中各元素之间的距离。 ceil_mode:默认值为 False,即上述公式默认向下取整,如果设为 True,计算输出信号大小的时候,公式会使用向上取整。 Pytorch 中池化层默认ceil mode = false,而 Caffe 只实现了 ceil mode= true 的计算方式。 示例代码: import torch import torch.nn as nn import torch.autograd as autograd # 大小为3,步幅为2的正方形窗口池 m = nn.MaxPool2d(kernel_size=3, stride=2, padding=1) # pool of non-square window input = autograd.Variable(torch.randn(20, 16, 50, 32)) output = m(input) print(output.shape) # torch.Size([20, 16, 25, 16]) 四,卷积神经网络结构 一个典型的卷积网络结构是由卷积层、汇聚层、全连接层交叉堆叠而成。如下图所示: 一个简单的 CNN 网络连接图如下所示。 经典 CNN 网络的总结,可参考我之前写的文章-经典 backbone 网络总结。 目前,卷积网络的整体结构趋向于使用更小的卷积核(比如 1×11×1 和 3×33×3) 以及更深的结构(比如层数大于 50)。另外,由于卷积层的操作性越来越灵活(同样可完成减少特征图分辨率),汇聚层的作用越来越小,因此目前的卷积神经网络逐渐趋向于全卷积网络。 另外,可通过这个网站可视化 cnn 的全部过程。 参考资料 AI EDU-17.3 卷积的反向传播原理 Visualizing the Feature Maps and Filters by Convolutional Neural Networks 《神经网络与深度学习》-第5章 《动手学深度学习》-第6章 https://www.zhihu.com/question/22298352 卷积神经网络 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | 实践指南 - 前端性能提升 270%

cover 一、背景— 当我们疲于开发一个接一个的需求时,很容易忘记去关注网站的性能,到了某一个节点,猛地发现,随着越来越多代码的堆积,网站变得越来越慢。 本文就是从这样的一个背景出发,着手优化网站的前端性能,并总结出一套开发习惯,让我们在日常开发时,也保持高性能,而不是又一次回过头来优化性能。 先来看看优化的成果,Lighthouse 的 Performance 评分合计提升 279%: 指标名称 优化前 优化后 提升 Lighthouse Performance 评分 29 81 279% FCP(First Contentful Paint 首次内容绘制) 0.7s 0.7s LCP(Largest Contentful Paint 最大内容绘制) 6.2s 2.5s 248% TTI(Time to Interactive 可交互时间) 10.1s 2.1s 480% Speed Index(速度指数) 5.6s 1.8 311% TBT(Total Blocking Time 总阻塞时间) 820ms 120ms 683% 优化前后对比: 优化前后对比 二、优化前— 接下来就是介绍下优化前我们要做哪些事件: 了解性能指标及测量工具 分析需要优化的地方 1. 了解测量工具及性能指标 一开始我们只是感受到网站的页面打开时白屏时间较长,感觉性能是比较差的,那么具体有哪些性能指标需要去关注呢? 这里我使用的是 Chrome devtools 内置的 Lighthouse[1],Lighthouse 是一种开源的自动化工具,用于提高 Web 应用程序的质量。 Lighthouse 会在一系列的测试下运行网页,比如不同尺寸的设备和不同的网络速度。它还会检查页面对辅助功能指南的一致性,例如颜色对比度和 ARIA 最佳实践。 打开 Chrome devtools Lighthouse 即可使用。 在比较短的时间内,Lighthouse 可以给出这样一份报告。 这份报告从 5 个方面来分析页面:性能、辅助功能、最佳实践、搜索引擎优化和 PWA。像性能方面,会给出一些常见的耗时统计。 优化前 1.1 Performance Performance 评分统计,包括了以下指标: 1.1.1 FCP FCP 测量在用户导航到页面后浏览器呈现第一段 DOM 内容所花费的时间。页面上的图像、非白色<canvas>元素和 SVG 被视为 DOM 内容;不包括 iframe 内的任何内容。 1.1.2 LCP LCP 测量视口中最大的内容元素何时呈现到屏幕上。这近似于页面的主要内容对用户可见的时间。 需要注意的是 LCP 的计算是一个动态的过程,如下图最后的图片才是这个页面中的最大内容绘制的元素。 lcp 1.1.3 TTI TTI 测量页面完全交互所需的时间。 TTI 是如何计算的呢,如下图首先沿时间轴正向搜索时长至少为 5 秒的安静窗口(安静窗口是指没有长任务且不超过两个正在处理的网络 get 请求),然后沿时间轴反向搜索安静窗口之前的最后一个长任务,如果没有找到长任务,则在 FCP 步骤停止执行,TTI 就是安静窗口之前最后一个长任务的结束时间,如果没有找到长任务的话,则与 FCP 值相同。 TTI 1.1.4 Speed Index Speed Index 衡量页面加载期间内容以视觉方式显示的速度。Lighthouse 首先捕获浏览器中页面加载的视频,并计算帧之间的视觉进度。 1.1.5 TBT TBT 测量页面被阻止响应用户输入(例如鼠标点击、屏幕点击或键盘按下)的总时间。 通过添加 First Contentful Paint 和 Time to Interactive 之间所有长任务的阻塞部分来计算总和。任何执行时间超过 50 毫秒的任务都是长任务。 50 毫秒后的时间量是阻塞部分。例如,如果 Lighthouse 检测到一个 70 毫秒长的任务,则阻塞部分将为 20 毫秒。 如下图淡红色区域的时间总和就是这个页面的 TBT 分数。 TBT 1.2 最佳实践 用于检测 Web 应用程序整体代码健康状况,包括是否包含文档类型、图片宽高比是否正确等等。 1.3 SEO 用于检测搜索引擎对网页内容的理解程度。 2. 分析需要优化的地方 了解了关键的性能指标后,就可以测量看看当前网站的性能了, 上面看到综合评分是非常低的,Lighthouse 给出了应该从哪些地方开始优化的建议。 2.1 Performance 性能优化建议主要包括以下几点: 减少未使用的 JS; 合理使用图片的格式,webp 或者 avif 更快; 延迟加载不在视图的图片; JS 压缩; 图片的尺寸大小应该适当; 减少未使用的 CSS。 性能优化建议 Lighthouse 诊断出的网站存在的问题: 需要加载的资源太多太大,有 147 个请求,合计 11mb; 有 40 个静态资源的缓存只有 1 小时 滚动事件没有添加标记 {passive: true}),导致需要等待侦听器完成执行后再滚动页面; 图像元素没有设置明确的宽度和高度; JS 文件太多,主线程工作量太大、JS 执行时间太长; 存在的问题 2.2 最佳实践 最佳实践方面有以下问题: 图片的分辨率太低,清晰度不够; 没有设置 CSP 策略。 最佳实践的问题 2.3 SEO SEO 有以下问题: 没有 meta description; 图片没有 alt 属性; robots.txt 是无效的。 SEO的问题 三、优化 Performance— 根据上面 Lighthouse 报告,捋一捋项目中影响性能最大的因素,包括以下几点: 体积太大,达 11mb; 图片太大,图片格式也有影响。 1. 体积优化 1.1 代码压缩 检查是否还有压缩空间,或者有无工具库未压缩的。 1.2 代码分包 通过 webpack-bundle-analyzer 插件分析包体积,将一些大的 npm 包和 runtimeChunk 独立分包,减小包体积。 1.3 组件按需加载 React.lazy + Suspense 封装懒加载组件,路由级组件引入懒加载组件。同时使用骨架屏作为懒加载的兜底组件,可以让用户感知加载更快。在鼠标移入导航栏时预加载路由组件,可以加快页面展示。 1.4 工具库按需加载 通过 import('xx').then(xx) 按需加载工具库。 1.5 静态资源上传 CDN 项目内有一些 json 文件存储的静态数据,这部分文件上传至 CDN,改为 fetch 的方式按需引入。 1.6 删除不需要的资源 检查项目中引入的 mf、npm 资源,将没有使用到的删除。 1.7 避免重复的 npm 包引入 发现业务组件库通过 npm 引入的原子组件库,而项目本身又是通过 mf 引入的原子组件库,相对于引入了 2 遍原子组件库。 这时就需要改造业务组件库,也改成用 mf 的方法引入。 1.8 避免 esm 依赖嵌套 因为 webpack 的按需加载是通过 import、export 来标记的,因此想要一个好的按需加载的效果,就需要避免依赖嵌套的问题。 1.9 图标按需加载 原子组件库 mf 暴露的方式会导致只用了 1 个 icon,就会加载组件库下所有 icon 对应的 chunk,导致资源浪费。 新建一个 icon 的 npm 包用于 icon 的按需引入。 1.10 小结 通过以上优化手段,体积从 11.7mb 降低至 1.1mb,降低 10.6 倍。 优化前: 优化前 优化后: 优化后 2. 图片优化 1.1 图片懒加载 对非首屏的图片采用图片懒加载策略。 1.2 图片尺寸 使用图片时,设置图片的合理尺寸。 1.3 图片格式设置 优先使用 webp 格式图片。 四、优化最佳实践— 1. 设置 CSP 策略 2. 设置合理的图片的分辨率 优化项目内的图片分辨率。 五、优化 SEO— 1. meta description、keywords 优化 详细的 meta description、keywords 可以加快 SEO。 <metaname="keywords"content="xx"/><metaname="description"content="xx"/> 2. 图片加上 alt 属性 <imgsrc="smiley.gif"alt="Smileyface"/> 六、优化前后对比— 再来回顾下前后对比: 优化前,明显的感知白屏时间长: 优化前 优化后,在清缓存的情况下也能实现秒开: 优化后 整体性能提升 270%: 优化前后对比 七、性能监控— 为了在后续的迭代过程中,保持高性能,引入内部前端监控平台 - 烛龙[2],可视化的监控前端性能。 第一步,加载 cdn 插件: <scriptdefersrc="https://h5static.m.jd.com/act/jd-jssdk/latest/jd-jssdk.min.js"></script> 第二步,在入口文件中,初始化 cdn 插件: useEffect(()=>{//初始化测速组件,在这里可以打开一些控制的开关,如是否上报接口if(IS_PROD){//@ts-ignorejmfe.profilerInit({flag:xxx,//这是应用ID,需要先在烛龙申请应用autoReport:true,autoAddStaticReport:true,autoAddApiReport:true,autoAddImageReport:false,//支持所有图片上报,如果图片多,切记关闭,否则存在性能问题performanceReportTime:8000,profilingRate:1,})}},[]) 第三步,查看监控数据: 在烛龙平台,小工具性能评分达 96分: 查看监控数据 第四步,新增告警,实时监控: 烛龙平台支持多维度的告警服务,增加性能指标相关的告警,在性能异动时,及时发现问题,优化性能。 新增告警 小结— 本文详细介绍了一个前端项目优化的详细过程,从优化前的问题分析,到具体的优化措施,最终实现了前端性能提升了近 3 倍。同时也将性能指标落到监控平台,实现可视化的监控前端性能指标。 希望能对你有所帮助,感谢阅读~ 参考资料— [1]Lighthouse: https://developer.chrome.com/docs/lighthouse/ [2]烛龙: http://dra.jd.com/ [3]被删的前端游乐场-前端性能优化-归纳篇: https://godbasin.github.io/front-end-playground/front-end-basic/performance/front-end-performance-optimization.html#%E6%97%B6%E9%97%B4%E8%A7%92%E5%BA%A6%E4%BC%98%E5%8C%96-%E5%87%8F%E5%B0%91%E8%80%97%E6%97%B6 [4]前端缓存 API 请求数据的解决方案: https://blog.csdn.net/qq_41581588/article/details/128565077 [5]PLUS 前端 H5 性能优化实践: http://sd.jd.com/article/2195?shareId=3946&isHideShareButton=1 本文分享自微信公众号 - 凹凸实验室(AOTULabs)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | Hive 和 Spark 分区策略剖析

作者:vivo 互联网搜索团队- Deng Jie 随着技术的不断的发展,大数据领域对于海量数据的存储和处理的技术框架越来越多。在离线数据处理生态系统最具代表性的分布式处理引擎当属Hive和Spark,它们在分区策略方面有着一些相似之处,但也存在一些不同之处。 一、概述 随着技术的不断的发展,大数据领域对于海量数据的存储和处理的技术框架越来越多。在离线数据处理生态系统最具代表性的分布式处理引擎当属Hive和Spark,它们在分区策略方面有着一些相似之处,但也存在一些不同之处。本篇文章将分析Hive与Spark分区策略的异同点、它们各自的优缺点,以及一些优化措施。 二、Hive和Spark分区概念 在了解Hive和Spark分区内容之前,首先,我们先来回顾一下Hive和Spark的分区概念。在Hive中,分区是指将表中的数据划分为不同的目录或者子目录,这些目录或子目录的名称通常与表的列名相关联。比如,一个名为“t_orders_name”的表可以按照日期分为多个目录,每个目录名称对应一个日期值。这样做的好处是可以大大提高查询效率,因为只有涉及到特定日期的查询才需要扫描对应的目录,而不需要去扫描整个表。Spark的分区概念与Hive类似,但是有一些不同之处,我们将在后文中进行讨论。 在Hive中,分区可以基于多个列进行,这些列的值组合形成目录名称。例如,如果我们将“t_orders_name”表按照日期和地区分区,那么目录的名称将包含日期和地区值的组合。在Hive中,数据存储在分区的目录下,而不是存储在表的目录下。这使得Hive可以快速访问需要的数据,而不必扫描整个表。另外,Hive的分区概念也可以用于数据分桶,分桶是将表中的数据划分为固定数量的桶,每个桶包含相同的行。 而与Hive不同的是,Spark的分区是将数据分成小块以便并行计算处理。在Spark中,分区的数量由Spark执行引擎根据数据大小和硬件资源自动计算得出。Spark的分区数越多,可以并行处理的数据也就越多,因此也能更快的完成计算任务。但是,如果分区数太多,将会导致过多的任务调度和数据传输开销,从而降低整体的性能。因此,Spark分区数的选择应该考虑数据大小、硬件资源和计算任务复杂度等因素。 三、Hive和Spark分区的应用场景 在了解Hive和Spark的分区概念之后,接下来,我们来看看Hive和Spark分区在不同的应用场景中有哪些不同的优势。 3.1 Hive分区 Hive分区适用于大数据场景,可以对数据进行多级分区,以便更细粒度地划分数据,提高查询效率。例如,在游戏平台的充值数据中,可以按照道具购买日期、道具付款状态、游戏用户ID等多个维度进行分区。这样可以方便的进行数据统计、分析和查询操作,同时避免单一分区数据过大导致的性能问题。 3.2 Spark分区 Spark分区适用于大规模数据处理场景,可以充分利用集群资源进行并行计算处理。比如,在机器学习算法的训练过程中,可以将大量数据进行分区,然后并行处理每个分区的数据,从而提高算法的训练速度和效率。另外,Spark的分布式计算引擎也可以支持在多个节点上进行数据分区和计算,从而提高整个集群的计算能力和效率。 简而言之,Hive和Spark分区在大数据处理和分布式计算场景这都有广泛的应用,可以通过选择合适的分区策略和优化措施,进一步提高数据处理的效率和性能。 四、如何选择分区策略 在熟悉了Hive和Spark的分区概念以及应用场景后。接下来,我们来看看在Hive和Spark中如何选择分区策略。分区策略的选择对数据处理的效率和性能有着重要的影响。下面将分别阐述Hive和Spark分区策略的优缺点以及如何选择分区策略。 4.1 Hive分区策略 优点: Hive的分区策略可以提高查询效率和数据处理性能,特别是在大数据集上表现突出。另外,Hive还支持多级分区,允许更细粒度的数据划分。 缺点: 在Hive中,分区是以目录的形式存在的,这会导致大量的目录和子目录,如果分区过多,将会占用过多的存储空间。此外,Hive的分区策略需要在创建表时进行设置,如果数据分布出现变化,需要重新设置分区策略。 4.2 Spark分区策略 优点: Spark的分区策略可以根据数据大小和硬件资源自动计算分区数,这使得计算任务可以并行计算处理,从而提高了处理效率和性能。 缺点: 如果分区数设置不当,将会导致过多的任务调度和数据传输开销,从而影响整体性能。此外,Spark的分区策略也需要根据数据大小、硬件资源和计算任务复杂度等因素进行调整。 4.3 分区策略选择 在实际项目开发使用中,选择合适的分区策略可以显著提高数据处理的效率和性能。但是,如何选择分区策略需要根据具体情况进行考虑,这里总结了一些分区策略选择的场景: 数据集大小:如果数据集较大,可以考虑使用Hive的多级划分策略,以便更细粒度的划分数据,提高查询效率。如果数据集较小,可以使用Spark自动计算分区策略,以便充分利用硬件资源并提高计算效率。 计算任务复杂度:如果计算任务比较复杂,例如需要进行多个JOIN操作,可以使用Hive的分桶策略,以便加快数据访问速度,减少JOIN操作的开销。 硬件资源:分区策略的选择也需要考虑硬件资源的限制。如果硬件资源比较充足,可以增加分区数以提高计算效率。如果硬件资源比较紧张,需要减少分区数以避免任务调度和数据传输的开销。 综上所述,选择合适的分区策略需要根据具体的情况进行考虑,包括数据集大小、计算任务复杂度和硬件资源等因素。在实际使用中,可以通过实验和调试来找到最佳的分区策略。 五、如何优化分区性能 除了选择合适的分区策略之外,还可以通过一些优化措施来进一步提高分区的性能。在Spark中,大多数的Spark任务可以通过三个阶段来表述,它们分别是读取输入数据、使用Spark处理、保持输出数据。Spark虽然实际数据处理主要发生在内存中,但是Spark使用的是存储在HDFS上的数据来作为输入和输出,任务的调度执行会使用大量的 I/O,存在性能瓶颈。 而Hive分区数据是存储在HDFS上的,然而HDFS对于大量小文件支持不太友好,因为在每个NameNode内存中每个文件大概有150字节的存储开销,而整个HDFS集群的IOPS数量是有上限的。当文件写入达到峰值时,会对HDFS集群的基础架构的某些部分产生性能瓶颈。 5.1 通过减少 I/O 带宽来优化性能 在Hadoop集群中,它依靠大规模并行 I/O 来支持数千个并发任务。比如现有一个大小为96TB的数据节点,磁盘的大小有两种,它们分别是8TB和16TB。具有8TB磁盘的数据节点有12块这样的磁盘,而具有16TB磁盘的数据节点有6块这样的磁盘。我们可以假设每个磁盘的平均读写吞吐量约为100MB/s,而这两种不同的磁盘分布,它们对应的带宽和IOPS,具体详情如下表所示: 5.2 通过设置参数来优化性能 在Hadoop集群中,每个数据节点为每个卷运行一个卷扫描器,用于扫描块的状态。由于卷扫描器与应用程序竞争磁盘资源,因此限制其磁盘带宽很重要。配置 dfs.block.scanner.volume.bytes.per.second 属性值来定义卷扫描器每秒可以扫描的字节数,默认为1MB/s。 比如设置带宽为5MB/s,扫描12TB所需要的时间为 12TB / 5MBps = (12 * 1024 * 1024 / (3600 * 24)) = 29.13天。 5.3 通过优化Spark处理分区任务来提升性能 假如,现在需要重新计算历史分区的数据表,这种场景通常用于修复错误或者数据质量问题。在处理包含一年数据的大型数据集(比如1TB以上)时,可能会将数据分成几千个Spark分区来进行处理。虽然,从表面上看,这种处理方法并不是最合适的,使用动态分区并将数据结果写入按照日期分区的Hive表中将产生多达上百万个文件。 下面,我们将任务分区数缩小,现有一个包含3个分区的Spark任务,并且想将数据写入到包含3个分区的Hive表。在这种情况下,希望发送的是将3个文件写入到HDFS中,所有数据都存储在每个分区的单个文件中。最终会生成9个文件,并且每个文件都有1个记录。使用动态分区写入Hive表时,每个Spark分区都由执行程序来并行处理。 处理Spark分区数据时,每次执行程序在给定的Spark分区中遇到新的分区时,它都会打开一个新文件。默认情况下,Spark对数据会使用Hash或者Round Robin分区器。当应用于任意数据时,可以假设这两种方法在整个Spark分区中相对均匀且随机分布数据。如下图所示: 理想情况下,目标文件大小应该大约是HDFS块大小的倍数,默认情况下是128MB。在Hive中,提供了一些配置参数来自动将结果写入到合理大小的文件中,从开发者的角度来看几乎是透明的,比如设置属性 hive.merge.smallfiles.avgsize 和 hive.merge.size.per.task 。但是,Spark中不存在此类功能,因此,我们需要自己开发实现,来确定一个数据集,应该写入多少文件。 5.3.1 基于大小的计算 理论上,这是最直接的方法,设置目标大小,估算数据的大小,然后进行划分。但是,在很多情况下,文件被写入磁盘时会进行压缩,并且其格式与存储在 Java 堆中的记录格式有所不同。这意味着估算写入磁盘时内存的记录大小不是一件容易的事情。虽然可以使用 Spark SizeEstimator应用程序通过内存中的数据的大小进行估算。但是,SizeEstimator会考虑数据帧、数据集的内部消耗,以及数据的大小。总体来说,这种方式不太容易准确实现。 5.3.2 基于行数的计算 这种方法是设置目标行数,计算数据集的大小,然后执行除法来估算目标。我们的目标行数可以通过多种方式确定,或者通过为所有数据集选择一个静态数字,或者通过确定磁盘上单个记录的大小并执行必要的计算。哪种方式最优,取决于你的数据集数量及其复杂性。计算相对来说成本较低,但是需要在计算前缓存以避免重新计算数据集。 5.3.3 静态文件计算 最简单的解决方案是,只要求开发者在每个写入任务的基础上,告诉Spark总共应该写入多少个文件。这种方式需要给开发者一些其他方法来获取具体的数字,可以通过这种方式来替代昂贵的计算。 5.4. 优化Spark分发数据方式来提升性能 即使我们知道了如何将文件写入磁盘,但是,我们仍须让Spark以符合实际的方式来构建我们的分区。在Spark中,它提供了许多工具来确定数据在整个分区中的分布方式。但是,各种功能中隐藏着很多复杂性,在某些情况下,它们的含义并不明显,下面将介绍Spark提供的一些选项来控制Spark输出文件的数量。 5.4.1 合并 Spark Coalesce是一个特殊版本的重新分区,它只允许减少总的分区,但是不需要完全的Shuffle,因此比重新分区要快得多。它通过有效的合并分区来实现这一点。如下图所示: Coalesce在某些情况下看起来是不错的,但是也有一些问题。首先,Coalesce有一个难以使用的行为,以一个非常基础的Spark应用程序为例,代码如下所示: Spark load().map(…).filter(…).save() 比如,设置的并行度为1000,但是最终只想写入10个文件,可以设置如下: Spark load().map(…).filter(…).coalesce(10).save() 但是,Spark会尽可能早的有效的将合并操作下推,因此这将执行为如下代码: Spark load().coalesce(10).map(…).filter(…).save() 有效的解决这种问题的方法是在转换和合并之间强制执行,代码如下所示: Spark val df = load().map(…).filter(…).cache()df.count()df.coalesce(10) 在Spark中,缓存是必须的,否则,你将不得不重新计算数据,这可能会重新消耗计算资源。然后,缓存是需要消费一定资源的,如果你的数据集无法放入内存中,或者无法释放内存,将数据有效的存储在内存中两次,那么必须使用磁盘缓存,这有其自身的局限性和显著的性能损失。 此外,正如我们看到的,通常需要执行Shuffle来获得我们想要的更复杂的数据集结果。因此,Coalesce仅适用于特定的情况,比如如下场景: 保证只写入一个Hive分区; 目标文件数少于你用于处理数据的Spark分区数; 有充足的缓存资源。 5.4.2 简单重新分区 在Spark中,一个简单的重新分区,可以通过设置参数来实现,比如df.repartition(100)。在这种情况下,使用循环分区器,这意味着唯一的保证是输出数据具有大致相同大小的Spark分区,这种分区仅适用于以下情况: 保证只需要写入一个Hive分区; 正在写入的文件数大于你的Spark分区数,或者由于某些原因你无法使用合并。 5.4.3 按列重新分区 按列重新分区接收目标Spark分区计数,以及要重新分区的列序列,例如,df.repartition(100,$"date")。这对于强制要求Spark将具有相同键的数据,分发到同一个分区很有用。一般来说,这对许多Spark操作(比如JOIN)很有用。 按列重新分区使用HashPartitioner,将具有相同值的数据,分发给同一个分区,实际上,它将执行以下操作: 但是,这种方法只有在每个分区键都可以安全的写入到一个文件时才有效。这是因为无论有多少特定的Hash值,它们最终都会在同一个分区中。按列重新分区仅在你写入一个或者多个小的Hive分区时才有效。在任何其他情况下,它都是无效的,因为每个Hive分区最终都会生成一个文件,仅适用于最小的数据集。 5.4.4 按具有随机因子的列重新分区 我们可以通过添加约束的随机因子来按列修改重新分区,具体代码如下: Spark df.withColumn("rand", rand() % filesPerPartitionKey).repartition(100, $"key", $"rand") 理论上,只要满足以下条件,这种方法应该会产生排序规则的数据和大小均匀的文件: Hive分区的大小大致相同; 知道每个Hive分区的目标文件数并且可以在运行时对其进行编码。 但是,即使我们满足上述这些条件,还有另外一个问题:散列冲突。假设,现在正在处理一年的数据,日期作为分区的唯一键。如果每个分区需要5个文件,可以执行如下代码操作: Spark df.withColumn("rand", rand() % 5).repartition(5*365, $"date", $"rand") 在后台,Scala将构造一个包含日期和随机因子的键,例如(,<0-4>)。然后,如果我们查看HashPartitioner代码,可以发现它将执行以下操作: Spark class HashPartitioner(partitions: Int) extends Partitioner { def getPartition(key: Any): Int = key match { case null => 0 case _ => Utils.nonNegativeMod(key.hashCode, numPartitions) }} 实际上,这里面所做的事情,就是获取关键元组的散列,然后使用目标数量的Spark分区获取它的mod。我们可以分析一下在这种情况下我们的数据将如何实现分布,具体代码如下: Spark import java.time.LocalDate def hashCodeTuple(one: String, two: Int, mod: Int): Int = { val rawMod = (one, two).hashCode % mod rawMod + (if (rawMod < 0) mod else 0)}def hashCodeSeq(one: String, two: Int, mod: Int): Int = { val rawMod = Seq(one, two).hashCode % mod rawMod + (if (rawMod < 0) mod else 0)} def iteration(numberDS: Int, filesPerPartition: Int): (Double, Double, Double) = { val hashedRandKeys = (0 to numberDS - 1).map(x => LocalDate.of(2019, 1, 1).plusDays(x)).flatMap( x => (0 to filesPerPartition - 1).map(y => hashCodeTuple(x.toString, y, filesPerPartition*numberDS)) ) hashedRandKeys.size // Number of unique keys, with the random factor val groupedHashedKeys = hashedRandKeys.groupBy(identity).view.mapValues(_.size).toSeq groupedHashedKeys.size // number of actual sPartitions used val sortedKeyCollisions = groupedHashedKeys.filter(_._2 != 1).sortBy(_._2).reverse val sortedSevereKeyCollisions = groupedHashedKeys.filter(_._2 > 2).sortBy(_._2).reverse sortedKeyCollisions.size // number of sPartitions with a hashing collision // (collisions, occurences) val collisionCounts = sortedKeyCollisions.map(_._2).groupBy(identity).view.mapValues(_.size).toSeq.sortBy(_._2).reverse ( groupedHashedKeys.size.toDouble / hashedRandKeys.size.toDouble, sortedKeyCollisions.size.toDouble / groupedHashedKeys.size.toDouble, sortedSevereKeyCollisions.size.toDouble / groupedHashedKeys.size.toDouble )} val results = Seq( iteration(365, 1), iteration(365, 5), iteration(365, 10), iteration(365, 100), iteration(365 * 2, 100), iteration(365 * 5, 100), iteration(365 * 10, 100)) val avgEfficiency = results.map(_._1).sum / results.lengthval avgCollisionRate = results.map(_._2).sum / results.lengthval avgSevereCollisionRate = results.map(_._3).sum / results.length (avgEfficiency, avgCollisionRate, avgSevereCollisionRate) // 63.2%, 42%, 12.6% 上面的脚本计算了3个数量: 效率:非空的Spark分区与输出文件数量的比率; 碰撞率:(date,rand)的Hash值发送冲突的Spark分区的百分比; 严重冲突率:同上,但是此键上的冲突次数为3或者更多。 冲突很重要,因为它们意味着我们的Spark分区包含多个唯一的分区键,而我们预计每个Spark分区只有1个。我们从分析的结果可知,我们使用了63%的执行器,并且可能会出现严重的偏差,我们将近一半的执行正在处理比预期多2到3倍或者在某些情况下高达8倍的数据。 现在,有一个解决方法,即分区缩放。在之前示例中,输出的Spark分区数量等于预期的总文件数。如果将N个对象随机分配给N个插槽,可以预期会有多个插槽包含多个对象,并且有几个空插槽。因此,需要解决此问题,必须要降低对象与插槽的比率。 我们通过缩放输出分区计数来实现这一点,通过将输出Spark分区数乘以一个大因子,类似于: Spark df.withColumn("rand", rand() % 5).repartition(5*365*SCALING_FACTOR, $"date", $"rand") 具体分析代码如下所示: Spark import java.time.LocalDate def hashCodeTuple(one: String, two: Int, mod: Int): Int = { val rawMod = (one, two).hashCode % mod rawMod + (if (rawMod < 0) mod else 0)} def hashCodeSeq(one: String, two: Int, mod: Int): Int = { val rawMod = Seq(one, two).hashCode % mod rawMod + (if (rawMod < 0) mod else 0)} def iteration(numberDS: Int, filesPerPartition: Int, partitionFactor: Int = 1): (Double, Double, Double, Double) = { val partitionCount = filesPerPartition*numberDS * partitionFactor val hashedRandKeys = (0 to numberDS - 1).map(x => LocalDate.of(2019, 1, 1).plusDays(x)).flatMap( x => (0 to filesPerPartition - 1).map(y => hashCodeTuple(x.toString, y, partitionCount)) ) hashedRandKeys.size // Number of unique keys, with the random factor val groupedHashedKeys = hashedRandKeys.groupBy(identity).view.mapValues(_.size).toSeq groupedHashedKeys.size // number of unique hashes - and thus, sPartitions with > 0 records val sortedKeyCollisions = groupedHashedKeys.filter(_._2 != 1).sortBy(_._2).reverse val sortedSevereKeyCollisions = groupedHashedKeys.filter(_._2 > 2).sortBy(_._2).reverse sortedKeyCollisions.size // number of sPartitions with a hashing collision // (collisions, occurences) val collisionCounts = sortedKeyCollisions.map(_._2).groupBy(identity).view.mapValues(_.size).toSeq.sortBy(_._2).reverse ( groupedHashedKeys.size.toDouble / partitionCount, groupedHashedKeys.size.toDouble / hashedRandKeys.size.toDouble, sortedKeyCollisions.size.toDouble / groupedHashedKeys.size.toDouble, sortedSevereKeyCollisions.size.toDouble / groupedHashedKeys.size.toDouble )} // With a scale factor of 1val results = Seq( iteration(365, 1), iteration(365, 5), iteration(365, 10), iteration(365, 100), iteration(365 * 2, 100), iteration(365 * 5, 100), iteration(365 * 10, 100)) val avgEfficiency = results.map(_._2).sum / results.length // What is the ratio of executors / output filesval avgCollisionRate = results.map(_._3).sum / results.length // What is the average collision rateval avgSevereCollisionRate = results.map(_._4).sum / results.length // What is the average collision rate where 3 or more hashes collide (avgEfficiency, avgCollisionRate, avgSevereCollisionRate) // 63.2% Efficiency, 42% collision rate, 12.6% severe collision rate iteration(365, 5, 2) // 37.7% partitions in-use, 77.4% Efficiency, 24.4% collision rate, 4.2% severe collision rateiteration(365, 5, 5)iteration(365, 5, 10)iteration(365, 5, 100) 随着我们的比例因子接近无穷大,碰撞很快接近于0,效率接近100%。但是,这会产生另外一个问题,即大量Spark分区输出将为空。同时这些空的Spark分区也会带来一些资源开销,增加Driver的内存大小,会使我们更容易遇到,由于异常错误而导致分区键空间意外增大的问题。 这里的一个常见方法,是在使用这种方法时不显示设置分区(默认并行度和缩放),如果不提供分区计数,则依赖Spark默认的spark.default.parallelism值。虽然,通常并行度自然高于总输出文件数(因此,隐式提供大于1 的缩放因子)。如果满足以下条件,这种方式依然是一种有效的方法: Hive分区的文件数大致相等; 可以确定平均分区文件数应该是多少; 大致知道唯一分区键的总数。 5.4.5 按范围重新分区 按范围重新分区是一个特列,它不使用RoundRobin和Hash Partitioner,而是使用一种特殊的方法,叫做Range Partitioner。 范围分区器根据某些给定键的顺序在Spark分区之间进行拆分行,但是,它不仅仅是全局排序,而且还拥有以下特性: 具有相同散列的所有记录将在同一个分区中结束; 所有Spark分区都将有一个最小值和最大值与之关联; 最小值和最大值将通过使用采样来检测关键频率和范围来确定,分区边界将根据这些估计值进行初始设置; 分区的大小不能保证完全相等,它们的相等性基于样本的准确性,因此,预测的每个Spark分区的最小值和最大值,分区将根据需要增大或缩小来保证前两个条件。 总而言之,范围分区将导致Spark创建与请求的Spark分区数量相等的Bucket数量,然后它将这些Bucket映射到指定分区键的范围。例如,如果你的分区键是日期,则范围可能是(最小值2022-01-01,最大值2023-01-01)。然后,对于每条记录,将记录的分区键与存储Bucket的最小值和最大值进行比较,并相应的进行分配。如下图所示: 六、总结 在选择分区策略时,需要根据具体的应用场景和需求进行选择。常见的分区策略包括按照时间、地域、用户ID等多个维度进行分区。在应用分区策略时,还可以通过一些优化措施来进一步提高分区的性能和效率,例如合理设置分区数、避免过多的分区列、减少重复数据等。 总之,分区是大数据处理和分布式计算中非常重要的技术,可以帮助我们更好的管理和处理大规模的数据,提高数据处理的效率和性能,进而帮助我们更好的应对数据分析和业务应用的挑战。 参考: https://github.com/apache/spark https://github.com/apache/hive https://spark.apache.org/ https://hive.apache.org/ END 猜你喜欢 用户行为分析模型实践(三)——H5通用分析模型 从0到1设计通用数据大屏搭建平台 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 以前端视角,漫谈「云端」

作者:京东零售郑炳懿 前言: 当今世界,云计算技术在快速发展,不断为我们带来新的应用场景和解决方案。作为一名前端开发者,了解云技术并掌握如何在前端中应用它们是必不可少的。本篇文章将介绍云计算技术的基本概念,并从前端角度探讨如何使用云技术提高应用的可扩展性、安全性、性能和用户体验。 一、云技术 1.1 什么是云技术 在开始之前,我们需要先了解一下什么是云计算。云计算是一种基于互联网的计算方式,它将计算资源、存储和网络功能提供给用户,使得用户能够在云端快速构建和部署应用程序。云计算有三种主要的服务模式:Infrastructure as a Service(IaaS,基础设施即服务)、Platform as a Service(PaaS,平台即服务)和Software as a Service(SaaS,软件即服务)。 其中,IaaS模式提供基础设施的租用,包括计算资源、存储空间、网络连接等。PaaS模式则提供更高级别的服务,用户只需要关注应用程序的开发,不需要担心底层基础设施的维护。而SaaS模式则直接提供应用程序,无需用户自行搭建。 1.2 云技术的发展阶段 1. 虚拟化时代(2003-2006):以VMware为首的虚拟化技术逐渐成熟,使得服务器的利用率得到提高,IT管理员的工作也得到简化。 2. 弹性计算时代(2006-2008):Amazon推出了首个基于云的弹性计算服务EC2,这种按需使用的计算资源概念,迅速得到了广泛的认知和应用。 3. 平台时代(2008-2010):Google、Salesforce、Microsoft等大厂开始推出基于云的平台服务,支持用户快速创建和部署应用程序。 4. 基础设施时代(2010-2014):IBM、HP、Amazon等大厂建立了自己的公共云平台,使云服务的利用率更高,用户可以选择适合自己的服务、资源和应用。 5. 混合云时代(2014-今):随着企业对数据安全和灵活性的更加重视,混合云成为新的发展趋势,既有公有云资源的外部环境,也有私有云资源的内部环境,或者通过多云、跨云的方式进行部署。 二、云技术在前端中的应用 前端在云计算中扮演着非常重要的角色。前端工程师可以使用各种云计算平台和工具来开发和部署应用程序。以下是一些前端在云计算中的具体作用: 前端负责构建和维护用户界面,以便用户可以与云应用程序进行交互。 前端开发人员可以利用云计算平台提供的工具和服务,如云存储、API管理等,来加快应用程序的开发速度。 前端可以使用云计算平台提供的自动化工具和流程,如自动化构建、测试和部署,来提高应用程序的质量和稳定性。 前端可以利用云计算平台提供的大数据分析和机器学习工具,来构建更智能的应用程序。 以下从四个方面来阐述云技术在前端中的应用: 2.1 前端框架和库的部署和管理 前端应用程序通常使用许多框架和库来完成各种任务,如UI开发、路由、状态管理、数据可视化等。使用云技术,前端开发人员可以将这些框架和库部署到云端,并使用云服务来管理这些资源。例如,使用AWS S3存储和分发前端静态内容,使用AWS Lambda处理前端应用程序中的函数,使用AWS CloudFormation自动化前端部署等。 2.2 前端云存储 前端应用程序需要保存用户的数据和文件,使用云存储技术可以将这些数据和文件保存到云端,提高可靠性和可扩展性。例如,使用AWS S3存储用户上传的文件和图像,使用AWS DynamoDB存储前端应用程序中的用户数据等。 下面以 Amazon S3 为例,介绍如何在前端应用程序中使用云存储服务。 Amazon S3 是一个可扩展的云存储服务,可以存储和检索任意数量的数据,从任意位置进行访问。它可以在不同的地理位置进行存储,并且可以根据需要自动扩展。 要在前端应用程序中使用 Amazon S3,我们可以使用 AWS SDK for JavaScript,它是一个 JavaScript 库,提供了与 Amazon Web Services 的 API 交互的功能。我们可以使用它来上传、下载和管理存储桶中的对象。 以下是一个简单的示例,展示了如何使用 AWS SDK for JavaScript 上传一个文件到 Amazon S3: const AWS = require('aws-sdk'); const fs = require('fs'); // 配置 Amazon S3 客户端 const s3 = new AWS.S3({ accessKeyId: 'YOUR_ACCESS_KEY_ID', secretAccessKey: 'YOUR_SECRET_ACCESS_KEY', region: 'YOUR_REGION' }); // 读取要上传的文件 const fileContent = fs.readFileSync('path/to/file'); // 设置上传参数 const params = { Bucket: 'YOUR_BUCKET_NAME', Key: 'path/to/remote/file', Body: fileContent }; // 上传文件到 Amazon S3 s3.upload(params, function(err, data) { if (err) { console.log("Error uploading file:", err); } else { console.log("File uploaded successfully. Location:", data.Location); } }); 通过使用 AWS SDK for JavaScript,我们可以轻松地将文件上传到 Amazon S3,并获取上传后的文件位置。这样我们就可以在前端应用程序中使用这些文件了。 2.3 跨域资源共享(CORS) 在云计算中,应用程序和资源通常被部署到不同的服务器和域名上。因此,前端应用程序需要使用CORS技术来允许跨域访问。使用云服务可以更容易地配置和管理CORS策略。例如,使用AWS API Gateway配置前端应用程序的API访问控制,使用AWS S3配置前端静态内容的CORS策略等。 2.4 前端云计算 前端应用程序需要处理各种任务,如数据转换、图像处理、音频转换等。使用云计算技术,可以将这些任务放到云端处理,减少前端应用程序的负担。例如,使用AWS Lambda运行前端应用程序中的函数,使用AWS Batch处理前端应用程序中的批处理任务等。 三、云技术与前端技术的结合 云计算平台是指使用云计算技术搭建的基础设施、服务和应用程序,它可以提供许多基础性服务,如计算、存储和网络。而前端技术则是指构建互联网应用所需的前端技术,包括 HTML、CSS 和 JavaScript 等。 云计算平台与前端技术的结合可以大大改善开发流程和用户体验。通过云计算平台,我们可以减少本地机器的压力,提高开发效率;通过前端技术,我们可以打造出更加美观、易用的界面。 3.1 结合示例 使用云计算平台(如亚马逊 Web 服务)部署一个简单的 Node.js 后端程序,提供两个 API:一个获取当前时间,一个获取随机数。Node代码如下: const express = require('express'); const app = express(); app.get('/time', (req, res) => { res.json({ time: new Date() }); }); app.get('/random', (req, res) => { res.json({ random: Math.random() }); }); app.listen(8080, () => { console.log('Server started on port 8080'); }); 接下来使用 React 前端技术构建一个简单的 SPA(单页应用),展示两个 API 返回的数据。前端代码如下: import React, { useState, useEffect } from 'react'; import ReactDOM from 'react-dom'; function App() { const [time, setTime] = useState(null); const [random, setRandom] = useState(null); useEffect(() => { fetch('/time') .then(res => res.json()) .then(data => setTime(data.time)); fetch('/random') .then(res => res.json()) .then(data => setRandom(data.random)); }, []); return ( <div> <p>The current time is: {time ? time.toString() : "loading..."}</p> <p>A random number is: {random ? random.toString() : "loading..."}</p> </div> ); } ReactDOM.render(<App />, document.getElementById('root')); 这个示例使用 React Hooks 和 useEffect 之类的功能,将后端 API 调用作为组件的副作用,一旦得到数据,就会触发重新渲染。用户可以看到时间和随机数的值,并在页面中显示出来。 通过这个简单的示例,我们可以看出云计算平台与前端技术结合的巨大潜力。仅仅通过几行代码,我们就能够创建一个功能强大的应用程序,能够在多个设备和平台上使用,并可以随时进行升级和扩展。 3.2 结合实践 使用云存储服务(如 Amazon S3 或 Google Cloud Storage)存储和分发前端应用程序的静态资源。这些服务可以让我们轻松地上传、下载和管理文件,同时还提供全球性的内容分发网络(CDN)功能,能够加速页面加载速度。 <script src="https://cdn.example.com/app.js"></script> 使用云服务器(如 Amazon EC2 或 Microsoft Azure Virtual Machines)托管前端应用程序的动态内容,或者使用云函数(如 Amazon Lambda 或 Google Cloud Functions)实现后端服务的逻辑。这些服务可以让我们灵活地配置和管理服务器资源,同时还提供高可用性、弹性伸缩等功能。 fetch('/api/data') .then(res => res.json()) .then(data => console.log(data)); 使用云数据库(如 Amazon DynamoDB 或 Google Cloud Datastore)存储和查询应用程序的数据。这些服务可以让我们存储和检索海量数据,并提供高可用性、弹性伸缩等功能。 const AWS = require('aws-sdk'); const ddb = new AWS.DynamoDB.DocumentClient(); function getData() { const params = { TableName: 'my-table', Key: { id: '123' } }; return ddb.get(params).promise(); } 云计算平台与前端技术结合的实践可以让我们更加高效地开发和运营应用程序,这对于企业和个人都是非常有价值的。同时,也需要注意云计算平台和前端技术的安全性和稳定性,避免出现数据泄露、服务宕机等问题。 四、云技术的安全性和稳定性 云技术的安全性和稳定性是非常重要的,因为这关系到应用程序的可靠性和用户体验。关于安全性,一方面我们需要确保前端应用程序在运行时不会泄露敏感信息或受到攻击;另一方面我们也需要保护用户的数据不会被非法获取或篡改。 4.1 前端安全问题和云技术的解决方案 1. XSS(跨站脚本攻击):攻击者通过注入恶意代码来获取用户信息或执行其他恶意操作。云技术可以使用 Web 应用防火墙(WAF)或其他安全措施来防范这种攻击。 2. CSRF(跨站请求伪造):攻击者通过利用用户已登录的状态来执行恶意请求(例如发起转账、删除数据等)。云技术可以使用 Token 或其他防范措施来解决这种攻击。 3. 数据泄露:在传输和存储数据时,需要使用 SSL/TLS 等协议来保护数据不被窃取。此外,还需要对数据进行加密、备份和审计等安全措施。 4.2 云技术提供稳定性和可靠性功能保护 1. 高可用性:云技术可以使用负载均衡、多机房部署等技术来提高应用程序的可用性。 2. 弹性伸缩:云技术可以根据应用程序的负载情况来自动调整服务器的资源配置,以提高应用程序的性能和可靠性。 3. 监控和告警:云技术可以提供实时监控和告警功能,帮助我们及时发现和解决故障和异常情况。 4. 灾备和恢复:云技术可以使用冷备、热备或异地备份等技术来保障业务数据的安全和可靠性。 云技术的安全性和稳定性对于前端应用程序的成功运行来说十分重要。通过使用云平台提供的安全和稳定功能,我们可以更好地保护用户数据和应用程序的可靠性,从而提升用户体验和企业价值。 五、云技术未来最具潜力的发展方向 云计算是一个非常庞杂而快速发展的技术领域,其中包含了各种技术体系和范式,涵盖了整个软件工程的方方面面。前端作为应用的展示层,需要紧密地与云应用及云平台打交道,实现云计算领域的相关技术及运维要求。 从前端视角出发,我觉得以下几个方向可能是未来最具潜力的发展方向: 5.1 云原生框架 随着云计算迅速发展,云原生框架越来越受到关注。这种框架是一种开发和部署应用程序的方法,它基于微服务架构,强调应用程序的可移植性、可扩展性、可靠性和自动化。 云原生框架包含了很多应用程序的运行时环境、服务发现、负载均衡、容错、监控、日志和安全等方面的支持,使得开发和运维人员可以更加便捷的管理和维护应用程序。同时,使用云原生框架可以使得应用程序更容易在不同的云环境中运行和跨云平台进行部署。 5.2 容器化技术 容器化技术是一种软件打包和分发的方式,其本质是将应用程序和所有依赖的库和配置打包成一个轻量级的容器,使得应用程序可以运行在不同的操作系统和云环境中,并且保证运行环境的一致性和可靠性。 容器化技术具有很多优势,比如便于进行持续交付和部署、应用程序更容易迁移和扩展、实现应用程序的隔离和安全性等。因此,容器化技术已经成为云计算领域中的一个核心技术,也是大量云原生框架和平台的基础。 5.3 Serverless架构 Serverless架构通过无需维护服务器、按量付费等特性,使得开发者可以专注于写代码,而无需考虑底层的基础设施。借助Serverless技术,开发者可以开发出更为轻量化的应用程序,同时,Serverless也提供了一个高效的方式处理需要大量计算的应用场景,如图像识别等。 5.4 GraphQL技术 GraphQL是一种用于API开发的技术,它使得开发者可以基于类型定义来定义数据结构,并定义一些静态问题和重复问题。并且GraphQL旨在通过接口降低前端和后端的耦合,大大提升前端谷的开发效率。 5.5 WebAssembly技术 WebAssembly是一种可以在所有现代网络浏览器中运行的二进制代码格式,它可以让开发者使用其他语言(如C++,Rust等)来开发Web应用程序,同时其性能更加优越,这将使得Web应用程序更加接近原生应用的性能。 总之,随着云技术的不断发展和前端技术的创新,可以预见到,前端技术将与云技术越来越融合,共同推动数字化转型和业务创新的深入,同时也会带来更多机会和挑战。 最后: 作为一名前端开发工程师,整篇文章可能只从前端的视角去分析和理解,观点可能有些浅薄了,在这里仅作为一点个人的看法和分享,如果对您有所帮助,那便是我所期望看到的,如果您有更好的想法,欢迎咚咚交流学习。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册