首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | 限速器的优化实践探索

限速器(rate limiter)是一个非常基础的网络包处理功能,被广泛应用于各类网元设备,在流量调度、网络安全等领域发挥着重要作用。常见的限速器的实现方式基于令牌桶(token bucket),尽管令牌桶的原理已经被人熟知,在具体实践中,我们也发现了一些挑战和共性问题。本文总结了近两年字节跳动系统与技术工程团队(简称 STE 团队)在限速器优化方面的一些探索,将一些经验和教训总结出来,以飨读者。 令牌桶限速器的基本原理 相信每个写网络包处理的工程师都写过基本的令牌桶限速器。令牌桶是一个形象的描述,既可以想象有一个桶可以容纳一定量的令牌(token),每放行一个数据包便消耗一定量的令牌,数据包的放行与否取决于令牌桶中的令牌个数。 图1 令牌桶图示 比如,如果令牌桶限制的是 PPS (Packet Per Second),假设一个令牌代表一个数据包。那么一个限定 PPS 为 300K/s 的限速器,每秒会产生的令牌数则是 300K 个。任何一个数据包经过这个限速器,则消耗一个令牌,如果令牌消耗到 0,则进行丢包。 假设\(P_t \) 表示到达时间是\(t\) 的数据包,令牌桶上一个经过的数据包的时间为\(t' \) ,那么在这段时间内,令牌桶产生的令牌数为: \((t-t')*rate\) 令牌桶里剩余的令牌桶的个数为\(T \),那么当\(P_t \) 到达时,令牌桶内的令牌为: \((t-t')*rate+T\) 令牌桶是有容量的,上述公式的值可能会超过令牌桶的容量,假设令牌桶的容量为\(Burst \),如果上述计算的值超过了这个限定,则令牌数等于\(Burst \)。 此时因为数据包\(P_t\)要经过,则应该消耗 1个令牌,于是更新令牌桶的时间戳为\(t' \)并按照上述计算更新令牌桶内的令牌数目。如果通过计算发现产生的令牌数超过了消耗,那么放行数据包;如果不是,则需要丢弃数据包。 可能会有人疑惑,为何令牌桶的容量是有限的,而为何最大的容量取名为\(Burst\),这其实是因为令牌桶其实是允许在特定的时间窗口内的速率超过限定值。以 300Kpps 限速器为例子,假设\(Burst\)等于 300K,并且当前令牌桶是满的,此时,即使 100ms 内来了 300K 个包,那么令牌桶也会放行所有数据包(因为令牌桶的令牌数是够用的),而在这 100ms 内,实际速率不是 300Kpps,而是 3Mpps。顾名思义,令牌桶的容量其实限定了其允许的突发速率。 在具体实践中,令牌桶具有实现简单、效率高等特点,在很多场景下,提到限速器,基本是令牌桶的代名词。 存在的问题 在具体工程时间中,我们遇到了以下三个问题: 1. 精度问题 实际工程实践中,时间计量单位其实是受限于系统,比如时间戳可能是以微秒(us)为单位,而每次计算的时间差可能只有 1~2us。那么一个 PPS=300K 的限速器,可能一次计算,所产生的令牌是 0.3 个,容易被整数运算忽略。最终的结果则是,实际限制为 300K/s,最后效果是只有 250Kpps 流量放行。精度过低,效果不理想。 这种解决方式也比较简单,可以让一个数据包消耗的令牌量不是 1个,而是 1000个。这样,即使 1us,令牌桶产生的令牌数是 300个,而非 0.3个,这样便保证了精度。但此时又引入了新的问题,因为令牌数扩大了 1000 倍,此时需要考虑令牌桶的深度是否会溢出 32bit。一旦溢出,则会出现其他诡异的问题。 2. 级联补偿问题 图2 限速器级联补偿 我们在实践中发现,多个限速器级联的时候,需要补偿令牌。比如对于限速器 A,这个包是放行,消耗了 A 的令牌。对于限速器 B,这个包是丢弃,因为 B 没令牌了。此时包被丢了。那么此时 A 的令牌就白白消耗了,即消耗了 token,然后包还是丢了。如果想达到一个准确的限速效果,限速器A的令牌应该被补偿。如图 2 所示那样。 级联补偿使得多个限速器互相耦合,在代码编写上也比较麻烦。我们在实际中发现,如果限速器 A 和限速器 B 的限速值接近,并且都有丢包,那么缺乏级联补偿会对精度有严重影响。但如果限速值差的很远,则对精度的影响没有那么大。 3. TCP对丢包敏感问题 令牌桶是没有缓存的,一旦速率超过限定值,则会出现丢包。而 TCP 协议则对丢包非常敏感,一旦出现丢包,TCP 的对速率的调整比较激进。令牌桶这一特性使得他在应用于 TCP 这种流量时,经常会导致限制 100Mbps,实际上最多只能跑到 80Mbps,因为不断的丢包导致 TCP 不断地降低发送窗口。 在 vSwitch 的使用时,BPS (Bits Per Second)限速对 TCP 的损耗尤其大,这是因为,一般虚拟网卡都开启了 TSO(TCP Segmentation Offload)优化,开启 TSO 情况下,主机向外发送的 TCP 包都很大,一个包有可能是 64K 字节,在这么大的情况下,随便丢若干个包,就对 TCP 的速率影响非常明显了。 第一次改进:端口借贷反压限速器 我们在实践中发现,级联补偿反馈问题虽然存在但不是非常突出,原因是一般级联的限速器的限速值差距很大,比如单网卡的速率和整机速率,一般差距较大,不容易出现精度问题。最严重的问题是 TCP 丢包敏感导致的限速带宽达不到,影响用户体验。由图3所示,随着 TCP RTT 的增加,实际可以达到的带宽会明显下降。 图3 流量通过1Gbps限速器之后,实际获得速率 反压(backpressure),就是针对 TCP 对丢包敏感这一问题进行的改进。我们在第一次设计的时候,其实针对的是一个特定的场景。既虚机的虚拟网卡进行限速。而且我们的限速器正好是每个网卡有一个特定的限速器。 每个虚拟网卡都有若干队列,vSwitch 会持续的轮询这些队列拿到数据包发出。这些队列本质上其实就是包的缓存区。反压,其实就是停止或者延缓对这些队列的轮询发包,让数据包在队列上堆积,而达到将压力反馈到 Guest Kernel 的目的,这样 Guest Kernel 的 TCP 栈就会感知到拥塞,调整发送的节奏。 图4 反压限速器 当时我们设计反压限速器的时候,有一个限制影响了最后的实现: 虚机的虚拟网卡没有提供 Peek 功能,即 vSwitch 只是 Peek 数据包,而非真正将数据包从队列中拿出。这一个限制导致了我们利用了“借贷”的思想。既设置一个开始轮询的准许时间点,如果当前时间超过了准许时间点,那么将队列中的数据包一股脑全部发出,不考虑令牌是否足够,如果令牌足够则没有问题,但是当令牌不够了,那么就考虑向未来借贷一笔令牌,反向计算出一个未来的时间戳,那么在这个时间戳之前,vSwitch 停止轮询虚拟网卡。 借贷方法的提出,一开始只是为了性能考虑,避免好不容易将数据包从虚机队列拷贝出来,却发现令牌不够又只能丢弃。既然不想丢弃,索性就向未来借贷一笔令牌都发出去。 如今回过头来看这个设计,和 Peek 相比,其实有好有坏: 1)每次借贷的令牌量,不可控。这会导致公平性问题。大象流会不断的获取借贷资格,而小流则会趋向于饿死,在限速器竞争中,如果一方取得了优势,优势方容易持续获得优势。 2)简单的时间戳比较,开销比 peek 低。如果能够 peek 数据包,就不会有借贷的机制,也就没有停止轮询的可能,而是每次都会去虚拟队列里查看,反而开销有点大。 3)反过来,有 peek 功能的话,也可以先看看队列里积压的数据包,可以等待队列积累了一定量数据包之后,计算将下一次 Batch 个数据包发出的时间戳,在此之前都停止轮询。这对增加 batch 提升性能反而有好处。 反压限速器因为反压的是虚机的网卡队列,只能对虚机往外发数据包有限制,而无法限制虚机的收方向的流量。这是因为我们无法反压物理网卡的数据包,物理网卡的数据包可能发往不同的虚拟网卡,每个网卡的限速值是不一样的,我们无法计算出一个确切的时间点,在这个时间点之前可以不用轮询数据包。况且,物理网卡队列满了之后,只会丢包,而虚机网卡队列满了之后,可以反压 TCP 协议栈,两者效果是不一样的。 因此在入向流量的限制上,我们只是延续了准许时间戳的思想。如果当前时间超过准许时间,就放行所有数据包,如果没有,则丢弃所有数据包。 第二次改进:Carousel限速器 Carousel 限速器是 Google 在 SIGCOMM 17' 上的论文提出的一种限速器算法[2],实际上想法也很简单,即给每个数据包计算一个发出的时间戳,如果当前时间戳小于发出时间戳,则缓存在一个时间轮里,即不是丢包,而是将数据包延迟发送。 图5 Carousel限速器 我们基于这个算法基本原理,在 OVS-DPDK 实现了一个类似限速器,这中间有很多细节决定了算法的参数,比如一次轮询的时间粒度是 1us 还是 10us ?实际使用的限速器的速率区间在什么范围?是 300Kpps 还是 3Mpps?这些都直接决定了算法的参数设置,诸多细节就不展开说明了。 Carousel 最大的一个好处是引入了缓存。时间轮的本质就是一个缓存,这个对 TCP 流量有明显的好处,同时,时间轮也解决了虚机入向流量的无法反压的问题,使得所有的流量都能统一在一个时间轮下。第三个好处,可能有点意想不到,就是它一定程度的消除了级联补偿的必要性,因为数据包不在丢包,而是延迟发送。在没有丢包的情况下,不需要级联补偿。 下图是在限速 10Gbps 下,通过 iperf 工具,测试 100s 情况下,虚机出入向,在使用老的反压限速器和新的 Carousel 限速器的对比效果。 横轴是时间(s),竖轴是吞吐(Gbps),即每秒 iperf 报告出的当前的吞吐性能。可以看到入向流量增加了 500Mbps。更靠近 10Gbps。 出向吞吐性能,可以看出 Carousel 限速器更加稳定: 这些改进的源头,都来自于缓存对 TCP 流量的平滑作用。 未来的改进和小结 1. 进一步改进 基于借贷机制的反压限速,当限速值较大时,因借贷超发的数据包对整个限速抖动影响是有限的。比如限速 1G,在某个时刻超发几个包,对限速的抖动影响是比较小的。但是如果限速值很小,比如小到 5Mbps,那么超发几个数据包的影响就会比较大。此时,通过时间戳控制虚机端口的轮询,会带来 ON-OFF 效应,既在虚机看来,出向流量的路径上,好像有一个闸门,一会打开,一会关闭。 但这只是在虚机发送端视角看到的情况,接收端因为有时间轮的调节,速率会比较稳定。为在发送端带来比较稳定的体验,需要将反压的效果更加细化,既降低超发的几率。 此外,基于端口粒度的限速可以通过控制端口的轮询来实现,但是对于粒度小于端口的限速,则不好实现反压。为了实现更细粒度的反压,Google 在论文 PicNIC[3] 中,在Carousel 之上,利用 virtio 支持 OOO completion (乱序完成) 的特点,实现了更细粒度的反压,这些都为进一步优化限速器提供了思路。 2. 主动限速(基于ECN或者修改TCP window选项) 我们可以在 vSwitch 中对 TCP 的 Window 窗口进行跟踪修改,协商一个小窗口进行的方式,获得更平稳的 TCP 吞吐。同时ECN标记也可以在 vSwitch 中进行感知,通过直接或者间接的方式反馈到虚机内部,或者影响 vSwitch 的轮询频率。 3. 锁机制改进 以上所有的限速器改进均是针对网络方面,系统方面由于多核存在,而限速器的粒度经常跨越线程,如何设计一个无锁的限速器也是一个值得探索的方向。 4. 小结 从限速器的改进历史中可以看出,当前的算法已经越来越和实际场景相关。算法不再只是一个独立的组件,而越来越和实际的运行系统和产品特性紧密耦合。 参考文献 [1] Traffic policing in eBPF: applying token bucket algorithm [2] Carousel: Scalable Traffic Shaping at End Hosts, SIGCOMM 2017. [3] PicNIC: Predictable Virtualized NIC, SIGCOMM 2019

优秀的个人博客,低调大师

每日一博 | 朴素系统优化思维的实践

作者:京东物流 严孝男 一、问题 去年年中时候,我有个好朋友(可以叫他华哥)顶着当时还很严重的疫情形式激情创业,斥巨资承包了他原公司食堂的几个摊位,摇身一变成了老板。当了老板的华哥没有丝毫懈怠,不但做了充足的市场调研,还结合他自己以前就餐时的痛点做了创新,比如以前食堂除了最常规的面,饺子,米线一类的之外就是一份份的卖炒菜,差不多一份荤菜十几块,一份素菜近十块的样子,这就导致一个问题,一般男生花了几十块钱也就只能吃到2-3个菜,不但营养不够丰富,万一踩坑遇到了原本抱有很高期待但发现实际菜并不好吃的情况,体验就更差了。 所以华哥借鉴了市面上麻辣烫自选称重模式的特点推出了自助选菜称重的模式,餐台上会摆放很多种做好的菜(荤素凉都有),大家根据自己的喜好自己打菜,主食的米饭和馒头免费,粥和汤也免费,然后还提供一些收费的主食比如红薯,玉米一类的,打菜的流程就是大家从台子两边按顺序开始自选打菜,然后选择主食,然后选择汤粥,然后结账刷卡,如下图所示: 华哥不愧是前互联网大厂的金牌产品经理,其敏锐的抓住了用户的痛点,并很好的给出了相应的解决方案,自助称重模式自从推出后就受到了同事们的热烈欢迎,每次都排了长长的队伍,甚至中午11点半开餐,不到11点20就有很多同事在排队等着,写到这里我想举个排长队的例子给大家一个直观的印象,我最开始想到的例子是五道口那个枣糕店门口排的长队,后来一想现在京东2号楼B座4楼餐厅里排瓦罐的队伍好像更贴切。 华哥开始的时候非常开心,但一个月后做了营收盘点发现有点不对,虽然看上去队伍排得很长很火爆的样子,但实际上营收并不如预期。华哥分析了一下排除了客单价低的因素,自选模式下好多菜大家看到后都想来一点,一来二去就会打好大一盘,基本都是20元起步的客单价;然后就剩下单量低这个可能性了,实际分析一下就可以发现,因为菜的可选品种很多,所以选菜环节每个人需要花很长的时间选菜,再加上需要打汤和打饭,一个人实际完成整个取餐的过程耗时是很长的,虽然后面的同事可以跟在前面同事后面串行打菜,但因为每个人的喜好不一样,所以每个人在不同菜前的停留时间不一样,这就导致当前面的同事在某个菜盘前耗时稍长的时候,后面的同事是处于等待状态的。 而且有的时候还会遇到一些极端的情况,比如有些同事会在某些他爱吃的菜前停留很久挑挑拣拣,还有些同事会在打免费汤时拿着大勺顺逆时针交替着疯狂搅动,以此企图捞起汤里那些零散的沉底的菜叶和鸡蛋白,华哥就亲眼目睹了他以前汇报的经理在辣子鸡丁菜盆里翻来覆去的寻找隐匿在辣椒深处的那一点点鸡肉,每发现一块鸡肉时经理的脸上还会露出那种心满意足充满成就感的笑容,话说回来其实在经理挑鸡肉时整个队伍实际是处于完全停滞状态的,所以综合来看整个队伍的执行就餐过程是非常缓慢的,也就导致实际打完餐付费的人数并不如想象中多。 二、方案 后来在一次好友聚会时,华哥和我聊起了这个事情,他问我:你们搞技术的不都各种吹嘘什么系统优化,降本增效一类的吗,你帮我想想办法。听完华哥这略带挑衅意味的要求,我突然觉得自己身上有了很重的责任感,觉得自己要守住技术人的尊严。于是自己好好想了想,然后觉得这个商业问题实际上也可以看成一个技术问题,这个餐台可以看成一个系统,打餐的流程可以认为是系统的一次交互流程,每个打菜的同事可以看成是一次调用,因为每次调用执行起来的性能太差,导致系统整体的吞吐量太低,影响了整体系统的效能,因此整个系统的效能很低,虽然当时已经是酒过三巡,脑子不太清醒了,但是自己还是尽力给华哥想了好几个办法。 2.1 系统扩容 第一个想到的办法就是扩容,在工程技术领域当遇到系统性能不达标时,第一个想到的解决方案也一般都是扩容,工程领域里的扩容一般可以分垂直扩容和水平扩容两种方式:垂直扩容是通过提升单体实例的硬件能力来提升单体处理能力,水平扩容则是通过增加实例节点的方式来增加整个系统的处理能力。 套用这两个理论,看看怎么提升餐台的吞吐,好像垂直扩容这块能做的不多,总不能把打饭的勺子升级一下变成德国原装进口高温武火蹴练镀金勺吧;不过虽然垂直扩容没什么好办法, 但是水平扩容好像能做的事情很多了,只要多增加几套打菜餐台,这样并行执行的2条打饭队伍就可以变成4条,甚至8条,直接实现了多线程并发,这样系统整体的吞吐能力可以立马获得翻倍式提升,效果不但见效块,效果也可谓是立竿见影,于是我给画了一个水平扩容示意图,如下图所示: 不过水平扩容的方案很快就被华哥否了,虽然在工程技术领域,随着云原生技术的成熟,应用级别的扩容缩容都是很成熟的提升系统处理能力的解决方案了,但是在华哥这里,想再搭一个餐台是不可能的,且不说华哥承包的摊位没有这么大的地方去搞第二个餐台,就算有,从新施工装修,水电改造一系列的成本也几乎是不可能实现的。 虽然这个世界上能用钱解决的问题都不叫问题,但现在的问题是华哥没钱了。 2.2 单次执行优化 提升系统并发能力的路走不通后,那么提升系统的吞吐量的办法就是缩短单条请求的处理执行时间,这样单位时间内系统处理的请求条数就会有提升,从而提升系统吞吐量,那回到餐台这里,就变成了需要缩短单人打餐的时间,尤其是遇到华哥前经理那种在单个菜盘前会耗费大量时间的情况该如何优化呢? 我们拆分一下每次调用,把在每个菜盘前打菜的过程可以模拟理解为执行一段逻辑,这样全部的打菜过程可以被拆解成一个个小的代码块,总的调用时间是由这些代码块的执行时间之和决定的,从工程技术视角的话就是保证每段逻辑都在一个可预期的时间内完成,所以每段逻辑都可以通过一个超时判断逻辑来控制每段代码的执行时间,这里举一个百度搜索的例子,百度为了增强返回结果的多样性,推出了阿拉丁架构,每个query经过星图模型解析后会分发给不同的垂类,每个垂类会加工生产属于自己业务领域的卡片,然后阿拉丁的root应用聚合垂类返回的各个结果并返回给用户,那某些垂类场景执行会比较慢,比如当遇到用户搜一款药的场景时,健康垂类的应用会根据搜索人的经纬度筛选附近的o2o的药店,并计算该药品在该门店的促销折扣价,这种计算往往会耗时很久,所以root应用会增加一个380ms的超时判断,对所有的垂类应用都是一样,当你返回的内容超过这个时间后结果会被丢弃,举这个例子让大家可以明白通过增加对每个环节的超时设置,这样可以保证整体的流程在一个可控的时间范围内得到执行,从而保证用户体验的一致性。 程序里的超时好加,因为程序没有喜怒哀乐,但打餐的场景不一样,总不能在每个菜后面安排一个服务员在背后数123计时,超过5s往前推他一把,总不能这样吧,究其原因就是打菜是主观能动的,他想在一个菜前停多久就停多久,想到这个问题后,我有了主意,把用户自主停留的权利给剥夺,创造统一的停留时间,所以我给华哥设计了一套超时装置,那就是在餐台的两边各增加一套自动传送装置,类似于飞机场里安检后赶去航站楼的传送带一样,这样人们在两边打菜时不需要自己走动了,而且每个人在每个菜盘前停留时间是一样的,就不会出现一个人在某个菜前停留时间过久的问题,也避免了餐台因前面某个人的长时间停留而出现整体停滞的问题,提升了餐台的吞吐量,而且传送带的增加还有个好处就是人不多时可以开得很慢甚至停掉,在高峰期时可以适当增加传送带的速度,从而控制每一个人打菜的时间,保障整个餐台的吞吐率。 华哥听到我这个有点天才的想法后愣了很久,盘算了一下可能性后他觉得这个办法还真的可行,只是需要等到十一或者五一长假期间动工在两边增加传送带,终于听到一个可行方案的华哥有点兴奋,两腮也泛出了点点的红晕。 2.3 非核心流程剔除 看到华哥接纳了我的这个方案,我顿时感受到了很大的鼓励,于是又继续思考这块流程还能怎么优化,在工程技术领域,一个流程在承受很大流量时还可以做的一个事情就是流程简化,只保留核心的流程环节,也就是大家常说的黄金流程,而将非核心的业务节点从主流程中剔除,这样精简后的主流程可以一定程度上缩短执行时间,而且主流程执行的逻辑少了,出错的概率也同时就降低了,举一个京东零售的下单计算流程为例,零售侧结算时需要做以下的事情: 实际上结算这块还有很多的非主要节点要处理,比如删除购物车中相关已结算商品,预占自提柜等等,但是这些属于非核心的流程,可以从主流程中剔掉。 回到餐台这里,什么流程是黄金流程,没错,就是那些和营收直接相关的流程,而那些不产生收益的项目,比如米饭馒头,汤粥的环节就可以认为是非主要流程,可以从主流程中剔掉,这样不断简化了大家取餐的主流程,而且还节省了餐厅的空间,剩余的空间可以用来做几件事,一个是可以多放一些收费的主食或者增加一些菜品,以此可以增加收入,第二个可以增加一些自助收银设备,之前2个收银台在之前打餐比较慢时可以满足需求,但现在整个流程简化了,整体每个人的打餐速度提升了,这样2个收银台就会变成新的瓶颈,尤其是遇到有扫码直付的同学就会瓶颈的更明显,这样通过增加收银台的数量,从而提升了收银环节的并发处理能力,保证了整个取餐流程的流畅,避免新的性能瓶颈的出现,完美! 华哥听完这个建议很满意,他正嫌餐台太小摆放的菜系不够多呢,这样空间被更合理的利用到能带来收益的食品上了,正合华哥之意,华哥很开心的敬了我一个。 2.4 分布式缓存 除此之外,互联网增加系统吞吐能力,缩短单次执行时间的一个很主要的法宝利器就是利用分布式缓存技术,分布式缓存技术可以让很多存在系统瓶颈的调用通过缩短数据获取时间从而极大缩短处理时间,在这里分布式缓存技术是不是也可以利用到餐台这里呢。 我想了一下,前面从主流程中拿掉的免费主食部分和汤粥部分可以利用缓存的原理,尤其是CDN缓存的原理,把主食和汤粥分布式的放在离同事们就餐的餐桌附近,这样可以让就餐的同事们最近范围就可以盛到主食和汤粥,表面上看对营收没提升,但实际上一是大家打饭近了,就餐体验好了,二是大家打饭加饭方便了,就餐的时间就会降低,从而提升餐桌的利用率。保证下一个打到饭的同事能快速找到座位,体验同样也会提升。这里我就不画图了,相信大家都能明白。 三、后记 华哥整体听完我的优化方案后低头陷入了沉思,许久之后他抬起头看着我,眼神有些许迷离,我顿时有点紧张,以为他要系统点评一下我的方案,没想到华哥开口问我的是,现在几点了,我才意识到华哥刚才是喝多了低头睡着了。

优秀的个人博客,低调大师

每日一博 | 软件高可用实践那些事儿

作者:京东零售 刘慧卿 一 前言 关于软件的高可用,是一个老生常谈的话题。“高可用性”(High Availability)通常来描述一个系统经过专门的设计,从而减少停工时间,而保持其服务的高度可用性。其计算公式是:可用率=(总时间-不可用时间)/总时间。 本文重点从落地实践的视角作为切入点,带领大家从协作效率,技术落地和运营规范几个方面来展现高可用的实施步骤和落地细节。为了方便理解,先来统一语言话术,看一下软件交付过程中的各个阶段,如下图:  为什么说软件的高可用会面临着诸多挑战呢? ◦ 从需求交付链路来看,要完成目标交付,需要产品,研发,测试,运维,运营等多方利益相关者的密切配合。有些项目需求,合作者有时能够达到上百人,每个人职责分工各不相同,但却相互配合依赖,任何一个环节出现纰漏,可用率就有可能受到影响; ◦ 从时间角度来看,如果要达到全年99.99%的可用率,就意味着一年当中,允许有故障的时间为:365*24*60*(100%-99.99%)=52分钟,如果要达到5个9的可用率,允许故障的时间仅为5分钟,这差不多是我们发现问题后,重启应用的耗时; ◦ 从迭代效率来看,不迭代,不上线,问题出现的概率一定会小很多。软件的迭代效率和可用率之间存在着负相关的关系,平衡好两者之间的关系,也会面临着不小的挑战。 总结一下,我们具体面临的问题如下: ◦ 如何解决需求交付相关协作者多,链路长的问题? ◦ 如何应对故障时间容忍度低的问题? ◦ 如何在频繁需求迭代的现状下,保持可用率不受到大的冲击问题? 二 协作效率保障 认知误区 从整个需求交付链路我们可以发现,随着链路的逐级递增,信息的传递链路分支就会越多,传递层级就会越深。这会导致两个问题: 1. 信息传递效率降低; 2. 信息准确性变差。 这两个问题最终导致的结果,就是协作效率的降低。   一个没有实战经验的同学往往会认为增加人数,就会提高需求交付效率。其实这种想法不完全正确,具体关系参考下图:   这就像盖楼房,如果一个人按部就班的建设,需要100天完成。如果请了100个人来帮忙,能否用1天的时间完成房子建设呢?答案是否定的。 这里面有协作的成本,比如:团队默契(设计师,瓦工,泥工,水电工),岗位匹配,风险控制; 这里面有流程的依赖,比如:施工依赖于设计,软装总在硬装之后; 这里面有成本预算,比如:整个组织的人才梯度,规模大小(承建方,代理商,承包商); 以上这些,都不是简单的通过人力铺设来解决的。 流程规范 提高协作效率的底层逻辑是通过减少交付链路层级,缩短信息传递链路,进而保证信息的准确性和传递效率。(组织建设层面的内容这里不做展开) 这就要求具有今日事,今日毕的行动力。组织层面这叫流程规范,个人层面这叫做事方法,责任心。 尽量避免将当下的事情拖延到下一个环节,否则就会影响后续链路的排期计划和交付效率,极端情况甚至会出现返工的情形。简言之,考虑清楚,不埋坑。产品需求对研发,研发设计对测试,测试用例对产品等各个交付节点都是如此,交付物一定是靠谱的。 三 技术落地保障 在需求响应周期中,高质量的落实架构设计,编码实现,安全上线,部署运营等生产阶段,是软件高可用落地保障的前提和基础。 架构设计 架构设计往往影响着系统的前期实现成本(即ROI)和后续运维难度,属于软件的顶层设计,这里面既包含宏观的设计方案,也包含落地细节里的范式约束。 • 流程保障 邀请架构师参与:核心交易节点、重大需求改动邀请架构师参与,这是闭坑最直接有效的方式; 重视设计文档:方案描述清楚了,并取得相关利益者的认可,是走在正确道路上的前提。 • 设计保障 容灾设计:要预留后路,提前想清楚,做好容灾设计。可回滚,可熔断,可重试,可降级。 鲁棒性设计:无状态设计,防重设计,幂等设计,数据一致性设计 编码实现 如果说架构设计是骨架,那么编码实现就是神经,血管和肌肉。前者决定了能走多稳,走多久,后者决定着走多快,走多远。落实到编码层面,就是代码的衰老腐败程度。 • 流程规范 代码评审机制:代码评审不仅仅是发现系统中存在的问题这么简单。它是一种长期行为,是进行组织文化贯彻和传承的一种形式和载体。评审的过程中,明确了业务职责边界,设计与编码共识,优秀的标准导向等研发共识。相当于通过具象化的案例,给出针对性的指导,这些都是保证团队战斗力的基石。 研发过程中的很多问题,通过代码评审机制可以被发现和解决,比如: ◦ 如何对待临时需求的设计与实现? ◦ 如何看待“Hello World!”的N中写法? ◦ 如何理解设计模式和过度设计的边界? ◦ 如何评价当前阶段的交付物? ◦ 是否有必要引入单元测试? • 编码规范 ◦ 有没有对错误进行处理?对于调用的外部服务,是否检查了返回值或处理了异常? ◦ 设计是否遵从已知的设计模式或项目中常用的模式? ◦ 开发者新写的代码能否用已有的SDK/Framework中的功能实现?在本项目中是否存在类似的功能可以调用而不用全部重新实现? ◦ 工程中是否引入了无用的,功能重复的,不同版本的jar包依赖?(json类库,各种utils) ◦ 有没有无用的代码可以清除? ◦ 代码可读性如何?有没有足够的注释? ◦ 参数传递有无错误,有没有使用断言(Assert)或判断来保证我们认为不变的条件真的得到满足? ◦ 边界条件是如何处理的? switch语句的default分支是如何处理的?循环有没有可能出现死循环? ◦ 对资源的利用,是在哪里申请,在哪里释放的?有无可能存在资源泄漏(包括超时时间,内存、文件、对象引用,大对象,线程数等)?有没有优化的空间? ◦ 代码的效能如何?最坏的情况是怎样的? ◦ 代码中,特别是循环中是否有明显可优化的部分(string的操作是否能用StringBuilder来优化)? ◦ 对于系统和网络的调用是否会超时?如何处理? ◦ 代码是否易于测试(方法行数,圈复杂度,出入参定义是否合理)? ◦ 改动是否影响到旧版本、历史数据、上游能否兼容? ◦ 接口设计是否有考虑幂等、并发、越权,降级等问题? ◦ 是否存在缓存、数据库性能问题以及多数据源数据一致性的问题? ◦ 上线方案是否考虑了灰度方案,数据状态不一致问题? 安全上线 线上70%的故障都是由某种变更而触发的,其中相当一部分占比是不规范的上线引起的。所以安全上线这一环节至关重要。 • 流程规范 ◦ 严禁频繁上线:比如,每周不大于2次; ◦ 严禁高峰期上线:降低问题影响范围; ◦ 严禁私自上线:有改动,必须通过测试验证,产品回归确认; • 过程规范 ◦ 摘流量:选择第一批机器jsf下线/np摘流量(选为冷备); ◦ 看日志:观察日志确认摘除机器无流量; ◦ 服务预热:确认机器启动成功,核心业务接口需要接口预热; ◦ 挂流量:挂载上线机器流量; ◦ 看指标:观察上线机器mdc指标是否异常(cpu、内存、负载)、日志是否有异常 部署运营 实现高可用的一个很重要的手段就是能力冗余。下面给出方向和思路,具体落地细节和策略,可以根据具体情况各自延展。 • 网络 ◦ 运营商层面,联通,电信,移动等; ◦ 链路节点方面,VIP,CDN,路由器/交换机,反向代理,客户端,浏览器等; • 存储 ◦ 无论是数据库主从架构,还是ES的副本架构,都是实现存储高可用的手段,重要数据要利用好相关特性; ◦ 在进行数据结构设计时,同样也需要做好分流策略,容量规划,数据拆分或异构。比如:避免缓存热key,数据库表吞吐量瓶颈,数据库连接数限制等各种影响高可用的问题出现。 • 服务 ◦ 横向扩容:服务要保证可以通过添加资源的方式进行能力扩容,这一点非常重要; ◦ 服务分组:按照业务方或使用场景,对服务进行不同粒度的隔离,防止极端情况导致服务相互影响; ◦ 极限策略:主要是一些极端异常情况下的防御策略,目的是意外发生后,尽量保持服务的可靠性。比如:限流,熔断,重试,快速失败等; ◦ 灰度策略:新功能上线,往往是最容易出现问题的时候,拥有成熟的流量灰度能力,是控制问题影响范围的关键; 四 运营规范保障 运营规范 1. 可监控:系统运行状况 2. 可报警:异常情况能够通知到系统相关人员 3. 可定位:出现问题后,能够快速定位问题原因 4. 可修复:出现异常情况,能够在第一时间进行问题修复; 应急预案 高可用意味着对故障时间的容忍性差,意味着没有时间进行故障排查和修复,更没有时间打开代码进行漏洞排查。这就要求我们有一套完备的应急预案,这套预案能够解决大部分可预见的故障问题。 • 流程规范 ◦ 恢复生产第一; ◦ 排查问题第二; 详细事故应急处理手册,可以参照下图:   • 过程规范 ◦ 网络,服务,存储分三个维度制定对应方案,并将应急预案清单(文件名:checklist)填写到自己的代码库中,保持内容传承和更新; ◦ 可预见性,即问题触发场景要写清楚。举例:按照当前进度(1万/天),随着数据库数据的增加,预计10个月后,数据库表(xxx表名)会出现慢查询; ◦ 可执行性,能够消除问题的解决方案。举例:启动历史数据归档任务(xxxWorker),将历史数据进行转移到归档数据库中; 规范达标 再好的流程和规范都需要有对应的机制来贯彻执行,否则就是镜中花,水中月,看着美好,实则没用。可执行,能度量,是按照目标变好的前提。所以这里给出一个《高可用达标定期自查表》的工具,辅助规范落地。 五 总结 本文从“高可用为什么存在着很大挑战?”的问题展开探讨,强调了需求交付过程中,协作效率的重要性,并指出了为什么要遵从“今日事,今日毕”的工作原则。又从架构设计,编码实现,安全上线,部署运营等几个方面,详细介绍了技术落地保障相关的指导规范和落地细节。最后又从上线后运营的角度,给出了应急预案三板斧,规范达标定期自查表等比较实用的运营保障工具。希望能够给读者带来帮助。

优秀的个人博客,低调大师

每日一博 | 可插拔组件设计机制 — SPI

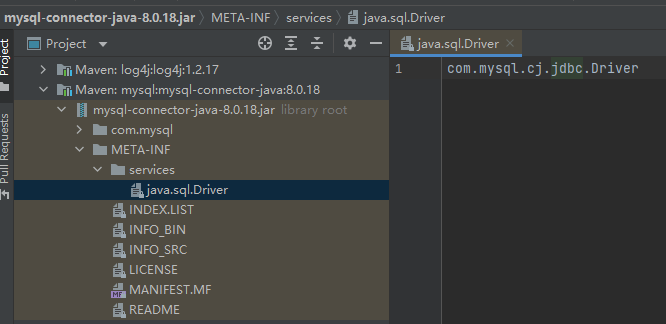
作者:京东物流 孔祥东 1.SPI 是什么? SPI 的全称是Service Provider Interface,即提供服务接口;是一种服务发现机制,SPI 的本质是将接口实现类的全限定名配置在文件中,并由服务加载器读取配置文件,加载实现类。这样可以在运行时,动态为接口替换实现类。正因此特性,我们可以很容易的通过 SPI 机制为我们的程序提供拓展功能。 如下图: 系统设计的各个抽象,往往有很多不同的实现方案,在面对象设计里,一般推荐模块之间基于接口编程,模块之间不对实现硬编码,一旦代码涉及具体的实现类,就违反了可插拔的原则。Java SPI 就是提供这样的一个机制,为某一个接口寻找服务的实现,有点类似IOC 的思想,把装配的控制权移到程序之外,在模块化涉及里面这个各尤为重要。与其说SPI 是java 提供的一种服务发现机制,倒不如说是一种解耦思想。 2.使用场景? 数据库驱动加载接口实现类的加载;如:JDBC 加载Mysql,Oracle... 日志门面接口实现类加载,如:SLF4J 对log4j、logback 的支持 Spring中大量使用了SPI,特别是spring-boot 中自动化配置的实现 Dubbo 也是大量使用SPI 的方式实现框架的扩展,它是对原生的SPI 做了封装,允许用户扩展实现Filter 接口。 3.使用介绍 要使用 Java SPI,需要遵循以下约定: 当服务提供者提供了接口的一种具体实现后,需要在JAR 包的META-INF/services 目录下创建一个以“接口全限制定名”为命名的文件,内容为实现类的全限定名; 接口实现类所在的JAR放在主程序的classpath 下,也就是引入依赖。 主程序通过java.util.ServiceLoder 动态加载实现模块,它会通过扫描META-INF/services 目录下的文件找到实现类的全限定名,把类加载值JVM,并实例化它; SPI 的实现类必须携带一个不带参数的构造方法。 示例: spi-interface 模块定义 定义一组接口:public interface MyDriver spi-jd-driver spi-ali-driver 实现为:public class JdDriver implements MyDriver public class AliDriver implements MyDriver 在 src/main/resources/ 下建立 /META-INF/services 目录, 新增一个以接口命名的文件 (org.MyDriver 文件) 内容是要应用的实现类分别 com.jd.JdDriver和com.ali.AliDriver spi-core 一般都是平台提供的核心包,包含加载使用实现类的策略等等,我们这边就简单实现一下逻辑:a.没有找到具体实现抛出异常 b.如果发现多个实现,分别打印 public void invoker(){ ServiceLoader<MyDriver> serviceLoader = ServiceLoader.load(MyDriver.class); Iterator<MyDriver> drivers = serviceLoader.iterator(); boolean isNotFound = true; while (drivers.hasNext()){ isNotFound = false; drivers.next().load(); } if(isNotFound){ throw new RuntimeException("一个驱动实现类都不存在"); } } spi-test public class App { public static void main( String[] args ) { DriverFactory factory = new DriverFactory(); factory.invoker(); } } 1.引入spi-core 包,执行结果 2.引入spi-core,spi-jd-driver 包 3.引入spi-core,spi-jd-driver,spi-ali-driver 4.原理解析 看看我们刚刚是怎么拿到具体的实现类的? 就两行代码: ServiceLoader<MyDriver> serviceLoader = ServiceLoader.load(MyDriver.class); Iterator<MyDriver> drivers = serviceLoader.iterator(); 所以,首先我们看ServiceLoader 类: public final class ServiceLoader<S> implements Iterable<S>{ //配置文件的路径 private static final String PREFIX = "META-INF/services/"; // 代表被加载的类或者接口 private final Class<S> service; // 用于定位,加载和实例化providers的类加载器 private final ClassLoader loader; // 创建ServiceLoader时采用的访问控制上下文 private final AccessControlContext acc; // 缓存providers,按实例化的顺序排列 private LinkedHashMap<String,S> providers = new LinkedHashMap<>(); // 懒查找迭代器,真正加载服务的类 private LazyIterator lookupIterator; //服务提供者查找的迭代器 private class LazyIterator implements Iterator<S> { ..... private boolean hasNextService() { if (nextName != null) { return true; } if (configs == null) { try { //全限定名:com.xxxx.xxx String fullName = PREFIX + service.getName(); if (loader == null) configs = ClassLoader.getSystemResources(fullName); else configs = loader.getResources(fullName); } } while ((pending == null) || !pending.hasNext()) { if (!configs.hasMoreElements()) { return false; } pending = parse(service, configs.nextElement()); } nextName = pending.next(); return true; } private S nextService() { if (!hasNextService()) throw new NoSuchElementException(); String cn = nextName; nextName = null; Class<?> c = null; try { //通过反射获取 c = Class.forName(cn, false, loader); } if (!service.isAssignableFrom(c)) { fail(service, "Provider " + cn + " not a subtype"); } try { S p = service.cast(c.newInstance()); providers.put(cn, p); return p; } } ........ 大概的流程就是下面这张图: 应用程序调用ServiceLoader.load 方法 应用程序通过迭代器获取对象实例,会先判断providers对象中是否已经有缓存的示例对象,如果存在直接返回 如果没有存在,执行类转载读取META-INF/services 下的配置文件,获取所有能被实例化的类的名称,可以跨越JAR 获取配置文件通过反射方法Class.forName()加载对象并用Instance() 方法示例化类将实例化类缓存至providers对象中,同步返回。 5.总结 优点:解耦 SPI 的使用,使得第三方服务模块的装配控制逻辑与调用者的业务代码分离,不会耦合在一起,应用程序可以根据实际业务情况来启用框架扩展和替换框架组件。 SPI 的使用,使得无须通过下面几种方式获取实现类 代码硬编码import 导入 指定类全限定名反射获取,例如JDBC4.0 之前;Class.forName("com.mysql.jdbc.Driver") 缺点: 虽然ServiceLoader也算是使用的延迟加载,但是基本只能通过遍历全部获取,也就是接口的实现类全部加载并实例化一遍。如果你并不想用某些实现类,它也被加载并实例化了,这就造成了浪费。获取某个实现类的方式不够灵活,只能通过Iterator形式获取,不能根据某个参数来获取对应的实现类。 6.对比

优秀的个人博客,低调大师

每日一博 | 深入了解视觉语言模型

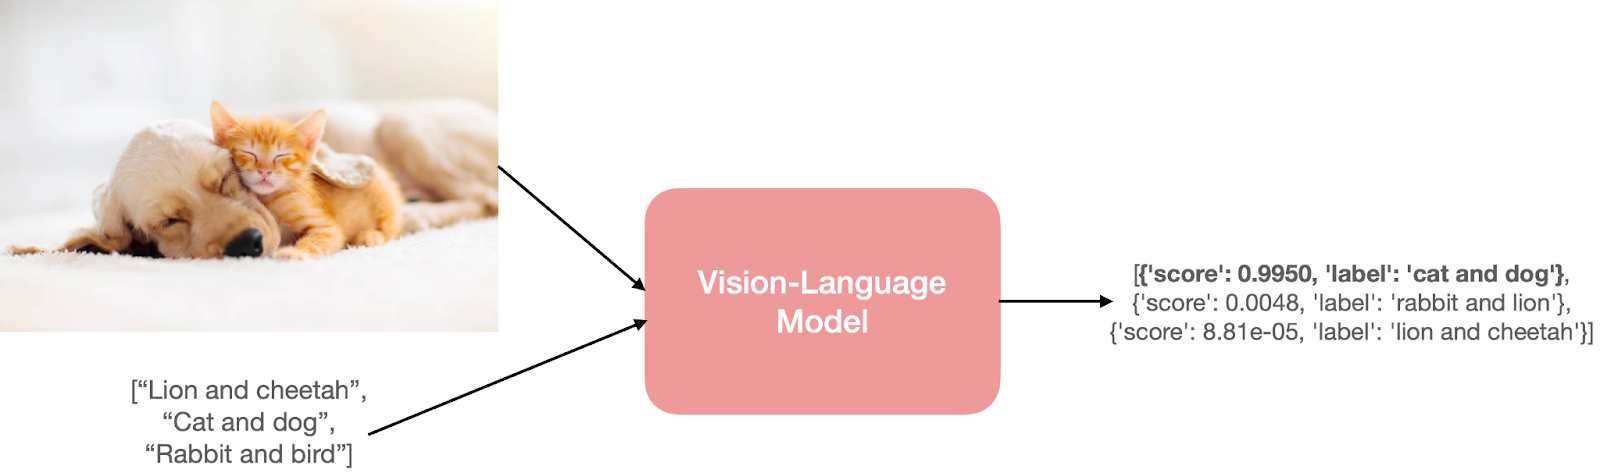
人类学习本质上是多模态 (multi-modal) 的,因为联合利用多种感官有助于我们更好地理解和分析新信息。理所当然地,多模态学习的最新进展即是从这一人类学习过程的有效性中汲取灵感,创建可以利用图像、视频、文本、音频、肢体语言、面部表情和生理信号等各种模态信息来处理和链接信息的模型。 自 2021 年以来,我们看到大家对结合视觉和语言模态的模型 (也称为联合视觉语言模型) 的兴趣越来越浓,一个例子就是 OpenAI 的 CLIP。联合视觉语言模型在非常具有挑战性的任务中表现出了让人眼前一亮的能力,诸如图像标题生成、文本引导图像生成、文本引导图像操作以及视觉问答等。这个领域在不断发展,其零样本泛化能力也在不断改进,从而产生了各种实际应用。 本文,我们将介绍联合视觉语言模型,重点关注它们的训练方式。我们还将展示如何利用 🤗 Transformers 对该领域的最新进展进行实验。 简介 将模型称为 “视觉语言” 模型是什么意思?一个结合了视觉和语言模态的模型?但这到底是什么意思呢? 有助于定义此类模型的一个特性是它们处理图像 (视觉) 和自然语言文本 (语言) 的能力。而这个过程体现在输入、输出以及要求这些模型执行的任务上。 以零样本图像分类任务为例。我们将传给模型如下一张图像和一些候选提示 (prompt),以获得与输入图像最匹配的提示。 小动物图片出自: https://www.istockphoto.com/photos/dog-cat-love 为了预测类似的东西,模型需要理解输入图像和文本提示。它将使用单独或融合的视觉和语言编码器来达到理解的目的。 输入和输出可以有多种形式。下面仅举几例: 用自然语言文本来检索图像。 短语关联 (Phrase grounding),即在输入图像中检测出文本中提到的短语 (例如: 一个 年轻人 挥动 球拍)。 视觉问答,即在输入图像中找到自然语言问题的答案。 为给定图像生成标题。该任务还有一个形式就是条件文本生成,此时输入变成了两个,即自然语言提示和图像。 从包含图像和文本模态的社交媒体内容中检测仇恨言论。 学习策略 视觉语言模型通常由 3 个关键元素组成: 图像编码器、文本编码器以及融合两个编码器的信息的策略。这些关键元素紧密耦合在一起,因为损失函数是围绕模型架构和学习策略设计的。虽然视觉语言模型研究算不上是一个新的研究领域,但此类模型的设计随着时间的变迁发生了巨大变化。早期的研究采用手工设计的图像描述子、预训练词向量或基于频率的 TF-IDF 特征,而最新的研究主要采用 transformer 架构的图像和文本编码器来单独或联合学习图像和文本特征。我们使用战略性的预训练目标来训练这些模型,从而使之可用于各种下游任务。 在本节中,我们将讨论视觉语言模型的一些典型预训练目标和策略,这些模型已被证明有良好的迁移性能。我们还将讨论其他有趣的东西,它们要么特定于某些预训练目标,要么可以用作预训练的通用组件。 我们将在预训练目标中涵盖以下主题: 对比学习: 以对比方式将图像和文本对齐到联合特征空间 PrefixLM: 通过将图像视作语言模型的前缀来联合学习图像和文本嵌入 基于交叉注意力的多模态融合: 将视觉信息融合到具有交叉注意力机制的语言模型的各层中 MLM / ITM: 使用掩码语言建模 (Masked-Language Modeling,MLM) 和图像文本匹配 (Image-Text Matching,ITM) 目标将图像的各部分与文本对齐 无训练: 通过迭代优化来利用独立视觉和语言模型 请注意,本节并未详尽陈述所有方法,还有各种其他方法以及混合策略,例如 Unified-IO。如需更全面地了解多模态模型,请参阅 这项工作 1) 对比学习 对比预训练和零样本图像分类,上图出处: https://openai.com/blog/clip 对比学习是视觉模型常用的预训练目标,也已被证明同时是视觉语言模型的高效预训练目标。近期的工作如 CLIP、CLOOB、ALIGN 和 DeCLIP 在 {图像,标题} 对组成的大型数据集上,通过使用对比损失函数联合训练文本编码器和图像编码器,从而桥接视觉和语言两个模态。对比学习旨在将输入图像和文本映射到相同的特征空间,使得图像 - 文本对的嵌入之间的距离在两者匹配时最小化,而在不匹配时最大化。 CLIP 仅采用文本和图像嵌入之间的余弦距离作为距离度量。而 ALIGN 和 DeCLIP 等模型则设计了自己的距离度量,这些距离在设计时考虑了数据集是有噪声的。 另一项工作 LiT 引入了一种冻结图像编码器而仅使用 CLIP 预训练目标来微调文本编码器的简单方法。作者将这个想法解释为 * 一种教文本编码器更好地读懂图像编码器生成的图像嵌入的方法 *。这种方法已被证明是有效的,并且比 CLIP 的样本效率更高。 FLAVA 等其他工作将对比学习和其他预训练策略相结合来对齐视觉和语言嵌入。 2) PrefixLM PrefixLM 预训练策略框图, 上图出处: https://ai.googleblog.com/2021/10/simvlm-simple-visual-language-model-pre.html 另一种训练视觉语言模型的方法是使用 PrefixLM 目标。 SimVLM 和 VirTex 等模型使用该预训练目标并使用一个统一的由 transformer 编码器和 transformer 解码器组成的多模态架构,有点类似于自回归语言模型。 让我们拆解一下,看看它是如何工作的。具有前缀目标的语言模型在给定输入文本作为前缀的情况下预测下一个词。例如,给定序列 “一个男人站在墙角”,我们可以使用” 一个男人站在” 作为前缀并训练模型以预测下一个词: 可以是 “墙角” 或另一个合理的补全词。 Visual transformers (ViT) 通过将每个图像划分为多个块 (patch) 并将这些块按顺序输入给模型,从而将相同的前缀概念应用于图像。利用这个想法,SimVLM 实现了这样一种架构,将图像块序列和前缀文本序列串接起来作为最终的前缀,输入给编码器,然后由解码器来预测该文本序列的接续文本。上图描述了该思想。 SimVLM 模型首先在前缀中没有图像块的文本数据集上进行预训练,然后在对齐的图像文本数据集上进行预训练。这些模型用于图生文 / 图像标题生成和 VQA 任务。 利用统一的多模态架构将视觉信息融合到语言模型 (Language Model,LM) 中,最终生成的模型在图像引导类任务中显示出令人印象深刻的能力。然而,仅使用 PrefixLM 策略的模型在应用领域上可能会受到限制,因为它们主要为图像标题生成或视觉问答这两个下游任务而设计。例如,给定一组包含人的图像,我们通过图像的描述来查询符合描述的图像 (例如,“一群人站在一起微笑着站在建筑物前”) 或使用以下视觉推理问题来查询: “有多少人穿着红色 T 恤?” 图像。另一方面,学习多模态表示或采用混合方法的模型可以适用于各种其他下游任务,例如目标检测和图像分割。 冻结 PrefixLM 冻结 PrefixLM 预训练策略, 上图出处: https://lilianweng.github.io/posts/2022-06-09-vlm 虽然将视觉信息融合到语言模型中非常有效,但能够使用预训练语言模型 (LM) 而无需微调会更有效。因此,视觉语言模型的另一个预训练目标是学习与冻结语言模型对齐的图像嵌入。 Frozen、MAPL 和 ClipCap 使用了冻结 PrefixLM 预训练目标。它们在训练时仅更新图像编码器的参数以生成图像嵌入,这些图像嵌入可以用作预训练的冻结语言模型的前缀,其方式与上面讨论的 PrefixLM 目标类似。 Frozen 和 ClipCap 都在对齐的图像文本 (标题) 数据集上进行训练,目的是在给定图像嵌入和前缀文本的情况下生成标题中的下一个词。 最后,Flamingo 索性把预训练视觉编码器和语言模型都冻结了,并在一系列广泛的开放式视觉和语言任务上刷新了少样本学习的最高水平。 Flamingo 通过在预训练的冻结视觉模型之上添加一个感知器重采样器 (Perceiver Resampler) 模块并在冻结的预训练 LM 层之间插入新的交叉注意层以根据视觉数据调节 LM 来达到这个性能。 冻结 PrefixLM 预训练目标的一个很好的优势是它可以使用有限的对齐图像文本数据进行训练,这对于那些没有对齐多模态数据集的领域特别有用。 3) 多模态融合与交叉注意力 使用交叉注意力机制将视觉信息直接融合到语言模型中, 上图出处: https://www.semanticscholar.org/paper/VisualGPT%3A-Data-efficient-Adaptation-of-Pretrained-Chen-Guo/616e0ed02ca024a8c1d4b86167f7486ea92a13d9 将预训练语言模型用于多模态任务的另一种方法是使用交叉注意机制将视觉信息直接融合到语言模型解码器的层中,而不是使用图像作为语言模型的附加前缀。 VisualGPT、VC-GPT 和 Flamingo 使用此预训练策略并在图像标题任务和视觉问答任务上进行训练。此类模型的主要目标是在把视觉信息融入文本生成能力时在这两者间取得高效的平衡,这在没有大型多模态数据集的情况下非常重要。 VisualGPT 等模型使用视觉编码器来生成图像嵌入,并将视觉嵌入提供给预训练语言解码器模块的交叉注意层,以生成合理的标题。最近的一项工作 FIBER 将具有门控机制的交叉注意力层插入到视觉和语言的主干模型中,以实现更高效的多模态融合,并使能各种其他下游任务,如图文互搜、开放域 (open-vocabulary) 目标检测等。 4) 掩膜语言建模及图文匹配 另一派视觉语言模型把掩码语言建模 (MLM) 和图文匹配 (ITM) 目标组合起来使用,将图像的特定部分与文本对齐,并使能各种下游任务,例如视觉问答、视觉常识推理、文搜图以及文本引导的目标检测。遵循这种预训练设置的模型包括 VisualBERT、FLAVA、ViLBERT、LXMERT 和 BridgeTower。 将图像与文本按部分相应对齐, 上图出处: https://arxiv.org/abs/1908.02265 让我们解释一下 MLM 和 ITM 目标。给定一个部分遮盖的标题,MLM 的目标是根据相应的图像预测遮盖的单词。请注意,MLM 目标需要使用带有边界框的标注丰富的多模态数据集,或者使用目标检测模型为部分输入文本生成候选目标区域。 对于 ITM 目标,给定图像和标题对,任务是预测标题是否与图像匹配。负样本通常是从数据集中随机抽取的。 MLM 和 ITM 目标通常在多模态模型的预训练期间结合使用。例如,VisualBERT 提出了一种类似 BERT 的架构,它使用预训练的目标检测模型 Faster-RCNN 来检测目标。VisualBERT 在预训练期间结合了 MLM 和 ITM 目标,通过自注意力机制隐式对齐输入文本的元素和相应输入图像中的区域。 另一项工作 FLAVA 由一个图像编码器、一个文本编码器和一个多模态编码器组成,用于融合和对齐图像和文本表示以进行多模态推理,所有这些都基于 transformers。为了实现这一点,FLAVA 使用了多种预训练目标: MLM、ITM,以及 掩膜图像建模 (Masked-Image Modeling,MIM) 和对比学习。 5) 无训练 最后,各种优化策略旨在使用预训练的图像和文本模型来桥接图像和文本表示,或者使预训练的多模态模型能够在无需额外训练的情况下适应新的下游任务。 例如,MaGiC 提出通过预训练的自回归语言模型进行迭代优化,为输入图像生成标题。为此,MaGiC 使用生成的词的 CLIP 嵌入和输入图像的 CLIP 嵌入来计算基于 CLIP 的 “魔法分数 (magic score) ”。 用预训练的冻结的单模态图像和文本编码器创建一个相似性搜索空间 ASIF 提出了一种简单的方法,可以使用相对较小的多模态数据集将预训练的单模态图像和文本模型转换为多模态模型来用于图像标题生成,无需附加训练。 ASIF 背后的关键直觉是相似图像的标题也彼此相似。因此,我们可以通过使用小型数据集里的真实多模态对的来构建一个相对表示空间,然后在该空间执行基于相似性的搜索。 数据集 视觉语言模型通常根据预训练目标在结构各异的大型图像和文本数据集上进行训练。在对它们进行预训练后,再使用特定于任务的数据集进一步针对各种下游任务进行微调。本节概述了一些用于训练和评估视觉语言模型的流行的预训练和下游数据集。 预训练数据集 一般来讲,我们从网上收集大量的多模态数据并将它们组织成图像 / 视频 - 文本对数据集。这些数据集中的文本数据可以是人工生成的标题、自动生成的标题、图像元数据或简单的目标类别标签。此类大型数据集有 PMD 和 LAION-5B 等。 PMD 数据集结合了多个较小的数据集,例如 Flickr30K、COCO 和 Conceptual Captions 数据集。 COCO 检测和图像标题 (>330K 图像) 数据集分别由图像实例和其所含目标的文本标签及描述对组成。 Conceptual Captions (> 3.3M images) 和 Flickr30K (> 31K images) 数据集中的图像以及它们的对应的用自然语言描述图像的标题都是从网上爬取的。 即使是那些人工生成标题的图像文本数据集 (例如 Flickr30K) 也存在固有的噪声,因为用户并不总是为其图像编写描述性或反应图像内容的标题。为了克服这个问题,LAION-5B 等数据集利用 CLIP 或其他预训练的多模态模型来过滤噪声数据并创建高质量的多模态数据集。此外,一些视觉语言模型,如 ALIGN,提出了进一步的预处理步骤并创建了自己的高质量数据集。还有些视觉语言数据集包含了视频和文本双模态,例如 LSVTD 和 WebVid 数据集,虽然它们规模较小。 下游数据集 预训练视觉语言模型通常还会针对各种下游任务进行训练,例如视觉问答、文本引导目标检测、文本引导图像修复、多模态分类以及各种独立的 NLP 和计算机视觉任务。 针对问答类下游任务进行微调的模型,例如 ViLT 和 GLIP,一般使用 VQA (视觉问答) 、VQA v2、NLVR2, OKVQA, TextVQA, TextCaps 和 VizWiz 数据集。这些数据集的图像通常都配有多个开放式问题和答案。此外,VizWiz 和 TextCaps 等数据集也可用于图像分割和目标定位这些下游任务。其他一些有趣的多模态下游数据集有,用于多模态分类的 Hateful Memes,用于视觉蕴含预测的 SNLI-VE,以及用于视觉语言组合推理的 Winoground。 请注意,视觉语言模型也可用于各种经典的 NLP 和计算机视觉任务,例如文本或图像分类。此时,通常使用单模态数据集如 SST2,ImageNet-1k 来完成此类下游任务。此外,COCO 和 Conceptual Captions 等数据集也常用于预训练模型以及标题生成等下游任务。 在 🤗 Transformers 中支持视觉语言模型 使用 Hugging Face Transformers,你可以轻松下载、运行和微调各种预训练视觉语言模型,或者混合搭配预训练视觉模型和预训练语言模型来搭建你自己的模型。 🤗 Transformers 支持的一些视觉语言模型有: CLIP FLAVA GIT BridgeTower GroupViT BLIP OWL-ViT CLIPSeg X-CLIP VisualBERT ViLT LiT (VisionTextDualEncoder 的一个实例) TrOCR (VisionEncoderDecoderModel 的一个实例) VisionTextDualEncoder VisionEncoderDecoderModel 这里 CLIP、FLAVA、BridgeTower、BLIP、LiT 和 VisionEncoderDecoder 等模型会生成联合图像 - 文本嵌入,可用之于零样本图像分类等下游任务,而其他模型则针对有趣的下游任务进行训练。此外,FLAVA 是基于单模态和多模态两个预训练目标训练的,因此可用于单模态视觉或语言任务以及多模态任务。 例如,OWL-ViT 使能 了零样本 - 文本引导目标检测和单样本 - 图像引导目标检测任务,CLIPSeg 和 GroupViT 使能 了文本和图像引导的图像分割任务,VisualBERT、GIT 和 ViLT 使能 了视觉问答以及其他各种任务。 X-CLIP 是一种使用视频和文本模态进行训练的多模态模型,它能够 使能 类似于 CLIP 的零样本图像分类的视频分类任务。 与其他模型不同,VisionEncoderDecoderModel 是一个标准化的模型,可用于初始化任意图像转文本模型,这类模型可以使用任何预训练的基于 Transformer 的视觉模型作为编码器 (例如 ViT、BEiT、DeiT、Swin) 以及任何预训练的语言模型作为解码器 (例如 RoBERTa、GPT2、BERT、DistilBERT)。事实上,TrOCR 是这个标准类的一个实例。 让我们继续试验其中的一些模型。我们将使用 ViLT 进行视觉问答,使用 CLIPSeg 进行零样本图像分割。首先,我们要安装 🤗Transformers: pip install transformers。 基于 ViLT 的 VQA 让我们从 ViLT 开始,下载一个在 VQA 数据集上预训练的模型。我们可以简单地初始化相应的模型类然后调用 “from_pretrained ()” 方法来下载想要的 checkpoint。 from transformers import ViltProcessor, ViltForQuestionAnswering model = ViltForQuestionAnswering.from_pretrained ("dandelin/vilt-b32-finetuned-vqa") 接下来,我们随便下载一张有两只猫的图像,并对该图像和我们的查询问题进行预处理,将它们转换为模型期望的输入格式。为此,我们可以方便地使用相应的预处理器类 (ViltProcessor) 并使用相应 checkpoint 的预处理配置对其进行初始化。 import requests from PIL import Image processor = ViltProcessor.from_pretrained ("dandelin/vilt-b32-finetuned-vqa") # download an input image url = "http://images.cocodataset.org/val2017/000000039769.jpg" image = Image.open (requests.get (url, stream=True).raw) text = "How many cats are there?" # prepare inputs inputs = processor (image, text, return_tensors="pt") 最后,我们可以使用预处理后的图像和问题作为输入进行推理,并打印出预测答案。但是,要牢记的重要一点是确保你的文本输入与训练时所用的问题模板相似。你可以参考 论文和数据集 来了解如何生成这些问题。 import torch # forward pass with torch.no_grad (): outputs = model (**inputs) logits = outputs.logits idx = logits.argmax (-1).item () print ("Predicted answer:", model.config.id2label [idx]) 直截了当,对吧?让我们用 CLIPSeg 做另一个演示,看看我们如何用几行代码执行零样本图像分割。 使用 CLIPSeg 做零样本图像分割 我们将从初始化 CLIPSegForImageSegmentation 及其相应的预处理类开始,并加载我们的预训练模型。 from transformers import CLIPSegProcessor, CLIPSegForImageSegmentation processor = CLIPSegProcessor.from_pretrained ("CIDAS/clipseg-rd64-refined") model = CLIPSegForImageSegmentation.from_pretrained ("CIDAS/clipseg-rd64-refined") 接下来,我们将使用相同的输入图像,并用描述待分割目标的文本来查询模型。与其他预处理器类似,CLIPSegProcessor 将输入转换为模型期望的格式。由于我们要分割多个目标,我们分别对每个描述文本都使用相同的输入图像。 from PIL import Image import requests url = "http://images.cocodataset.org/val2017/000000039769.jpg" image = Image.open (requests.get (url, stream=True).raw) texts = ["a cat", "a remote", "a blanket"] inputs = processor (text=texts, images=[image] * len (texts), padding=True, return_tensors="pt") 与 ViLT 类似,重要的是要参考 原作,看看他们用什么样的文本提示来训练模型,以便在推理时获得最佳性能。虽然 CLIPSeg 在简单的对象描述 (例如 “汽车”) 上进行训练的,但其 CLIP 主干是在设计好的文本模板 (例如 “汽车图像”、“汽车照片”) 上预训练的,并在随后的训练中冻结。输入经过预处理后,我们可以执行推理以获得每个文本查询的二值分割图。 import torch with torch.no_grad (): outputs = model (**inputs) logits = outputs.logits print (logits.shape) >>> torch.Size ([3, 352, 352]) 让我们可视化一下结果,看看 CLIPSeg 的表现如何 (代码改编自 这篇文章) import matplotlib.pyplot as plt logits = logits.unsqueeze (1) _, ax = plt.subplots (1, len (texts) + 1, figsize=(3*(len (texts) + 1), 12)) [a.axis ('off') for a in ax.flatten ()] ax [0].imshow (image) [ax [i+1].imshow (torch.sigmoid (logits [i][0])) for i in range (len (texts))]; [ax [i+1].text (0, -15, prompt) for i, prompt in enumerate (texts)] 太棒了,不是吗? 视觉语言模型支持大量有用且有趣的用例,并不仅限于 VQA 和零样本分割。我们鼓励你尝试将本节中提到的模型用于不同的应用。有关示例代码,请参阅模型的相应文档。 新兴研究领域 伴随着视觉语言模型的巨大进步,我们看到了新的下游任务和应用领域的出现,例如医学和机器人技术。例如,视觉语言模型越来越多地被用于医疗,产生了诸如 Clinical-BERT 之类的工作来根据放射照片来进行医学诊断和报告生成,以及 MedFuseNet 来用于医学领域的视觉问答。 我们还看到大量将联合视觉语言表示应用于各种领域的工作,如用于图像处理 (例如,StyleCLIP、StyleMC,DiffusionCLIP)、基于文本的视频检索 (例如,X-CLIP) 、基于文本的操作 (例如,Text2Live 以及 基于文本的 3D 形状和纹理操作 (例如,AvatarCLIP,CLIP-NeRF, Latent3D, CLIPFace, Text2Mesh)。在类似的工作中,MVT 提出了一种联合 3D 场景 - 文本表示模型,可用于各种下游任务,例如 3D 场景补全。 虽然机器人研究尚未大规模利用视觉语言模型,但我们看到 CLIPort 等工作利用联合视觉语言表示进行端到端模仿学习,并宣称比之前的 SOTA 有了很大的改进。我们还看到,大型语言模型越来越多地被用于机器人任务,例如常识推理、导航和任务规划。例如,ProgPrompt 提出了一个使用大语言模型 (Large Language Model,LLM) 生成情境机器人任务计划的框架。同样,SayCan 使用 LLM 根据给定的环境及环境中物体的视觉描述,选择最合理的动作。尽管这些进展令人印象深刻,但由于目标检测数据集的限制,机器人研究仍然局限在有限的环境和目标集中。随着 OWL-ViT 和 GLIP 等开放集目标检测模型的出现,我们可以期待多模态模型与机器人导航、推理、操作和任务规划框架的集成会更紧密。 结论 近年来,多模态模型取得了令人难以置信的进步,视觉语言模型在性能、用例以及应用的多样性方面取得了显著的飞跃。在这篇文章中,我们讨论了视觉语言模型的最新进展,可用的多模态数据集以及我们可以使用哪些预训练策略来训练和微调此类模型。我们还展示了如何将这些模型集成到 🤗 Transformers 中,以及如何使用它们通过几行代码来执行各种任务。 我们将继续集成最具影响力的计算机视觉和多模态模型,并希望收到你的回音。要了解多模态研究的最新消息,欢迎在 Twitter 上关注我们: @adirik,@NielsRogge,@apsdehal,@a_e_roberts,@RisingSayak 和 @huggingface。 致谢: 我们感谢 Amanpreet Singh 和 Amy Roberts 的严格审查。此外,还要感谢 Niels Rogge、Younes Belkada 和 Suraj Patil,以及 Hugging Face 的许多其他人,他们为促进基于 Transformers 的多模态模型的使用奠定了基础。 英文原文: <url> https://huggingface.co/blog/vision_language_pretraining </url> 作者: Alara Dirik, Sayak Paul 译者: Matrix Yao (姚伟峰),英特尔深度学习工程师,工作方向为 transformer-family 模型在各模态数据上的应用及大规模模型的训练推理。 审校、排版: zhongdongy (阿东)

优秀的个人博客,低调大师

每日一博 | 浅析 SeaweedFS 与 JuiceFS 架构异同

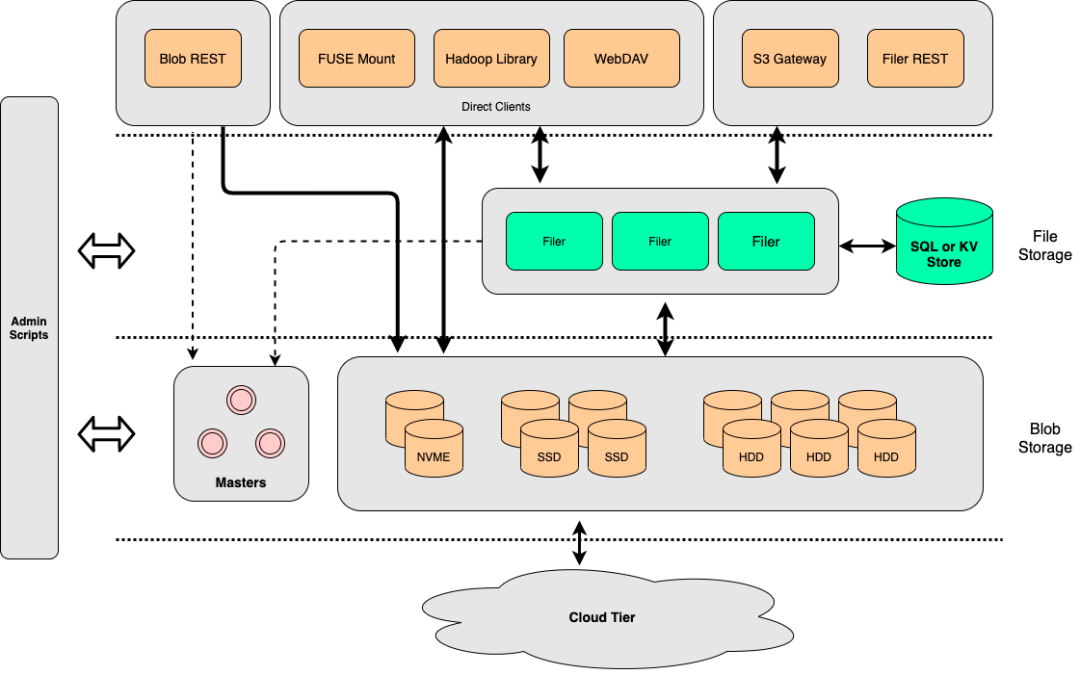
SeaweedFS 是一款高效的分布式文件存储系统,最早的设计原型参考了 Facebook 的 Haystack,具有快速读写小数据块的能力。本文将通过对比 SeaweedFS 与 JuiceFS 在设计与功能上的差异,以帮助读者进行更适合自己的选择。 SeaweedFS 系统结构 SeaweedFS 由 3 部分组成,底层存储文件的 Volume Server,用于管理集群的 Master Server,以及一个向上提供更多特性的 Filer 可选组件。 Volume Server 与 Master Server 在系统运作上,Volume Server 与 Master Server 一并服务于文件的存储。Volume Server 专注于数据的写入与读取,而 Master Server 则偏向是一个集群与 Volumes 的管理服务。 在读写数据时,SeaweedFS 的实现与 Haystack 相似,用户创建的一个 Volume 即是一个大磁盘文件(下图的 Superblock)。在此 Volume 中,用户写入的所有文件(下图的 Needle)都会被合并到该大磁盘文件中。 在开始写入数据之前,调用者需要向 SeaweedFS(Master Server)进行写入申请,随后 SeaweedFS 会根据当前的数据量返回一个 File ID(由 Volume ID 与 offset 组成),在写入的过程中,一并被写入的还有基础的元数据信息(文件长度与 Chunk 等信息);当写入完成之后,调用者需要在一个外部系统(例如 MySQL)中对该文件与返回的 File ID 进行关联保存。在读取数据时,由于 File ID 已经包含了计算文件位置(偏移)的所有信息,因此可以高效地将文件的内容读取出来。 Filer 在上述的底层存储单元之上,SeaweedFS 提供了一个名为 Filer 的组件。通过向下对接 Volume Server 与 Master Server,对外提供丰富的功能与特性(如 POSIX 支持、WebDAV、S3 接口等)。与 JuiceFS 相同,Filer 也需要对接一个外部数据库以保存元数据信息。 为了方便阐述,下文中所指的 SeaweedFS,皆包含了 Filer 组件。 JuiceFS 系统结构 JuiceFS 采用「数据」与「元数据」分离存储的架构,文件数据本身会被切分保存在对象存储(如 Amazon S3)当中,而元数据则是会被保存在用户自行选择的数据库里(如 Redis、MySQL)。通过共享同一个份数据库与对象存储,JuiceFS 实现了一个强一致性保证的分布式文件系统,同时还具有「POSIX 完全兼容」、「高性能」等诸多特性。 元数据对比 SeaweedFS 与 JuiceFS 都支持通过外部数据库以存储文件系统的元数据信息。在数据库支持层面,SeaweedFS 支持多达 24 种数据库。 JuiceFS 对数据库事务能力要求高(见下文),当前支持了 3 类共 10 种事务型数据库。 原子性操作 为了保证所有元数据操作的原子性,JuiceFS 在实现层面需要使用有事务处理能力的数据库。而 SeaweedFS仅在执行 rename 操作时启用了部分数据库(SQL、ArangoDB 和 TiKV)的事务, 对于数据库的事务能力要求较低。同时,由于Seaweed FS 在 rename 操作中拷贝元数据时,未对原目录或文件进行加锁,可能会导致过程中更新的数据丢失。 变更日志(changelog) SeaweedFS 会为所有的元数据操作生成变更日志,此日志可被进一步用于数据复制(见下文)、操作审计等功能,而 JuiceFS 则暂未实现此特性。 存储对比 如前文所述,SeaweedFS 的数据存储由 Volume Server + Master Server 实现,支持小数据块的「合并存储」、「纠删码」等特性。而 JuiceFS 的数据存储则是依托于对象存储服务服务,相关的特性也都由用户选择的对象存储提供。 文件拆分 在存储数据时,SeaweedFS 与 JuiceFS 都会将文件拆分成若干个小块再持久化到底层的数据系统中。SeaweedFS 将文件拆分成 8MB 的块,对于超大文件(超过 8GB),它会将 Chunk 索引也保存到底层的数据系统中。而 JuiceFS 则是先拆成 64MB 的 Chunk,再拆成 4MB 的 Object,通过内部一个 Slice 的概念对随机写、顺序读、重复写等性能进行了优化。(详情见读取清求处理流程) 分层存储 对于新创建的 Volume,SeaweedFS 会把数据存储在本地,而对于较旧的 Volume,SeaweedFS 支持将他们上传至云端以达到冷热数据的分离。在此方面,JuiceFS 则需要依赖外部的服务。 数据压缩 JuiceFS 支持使用 LZ4 或者 ZStandard 来为所有写入的数据进行压缩,而 SeaweedFS 则是根据写入文件的扩展名、文件类型等信息来选择是否进行压缩。 存储加密 JuiceFS 支持传输中加密(encryption in transit)及静态加密(encryption at rest),在用户开启了静态加密时,需要用户传递一个自行管理的密钥,所有写入的数据都会基于此密钥进行数据的加密。详情见 《数据加密》。 SeaweedFS 同样支持传输中加密与静态加密。在开启了数据加密后,所有写入 Volume Server 的数据都会使用随机的密钥进行加密,而这些对应的随机密钥信息则由维护「metadata」的「Filer」进行管理。 访问协议 POSIX 兼容性 JuiceFS 完全兼容 POSIX, 而 SeaweedFS 目前只实现了部分的 POSIX 兼容(「Issue 1558」 与 Wiki),功能还持续完善中。 S3 协议 JuiceFS 通过 MinIO S3 网关实现了 S3 网关的功能。它为 JuiceFS 中的文件提供跟 S3 兼容的 RESTful API,在不方便挂载的情况下能够用 s3cmd、AWS CLI、MinIO Client(mc)等工具管理 JuiceFS 上存储的文件。 SeaweedFS 当前支持了约 20 个 S3 API,覆盖了常用的读写查删等请求,对一些特定的请求(如 Read)还做了功能上的扩展,详细见 Amazon-S3-API。 WebDAV 协议 JuiceFS 与 SeaweedFS 皆支持 WebDAV 协议。 HDFS 兼容性 JuiceFS 完整兼容 HDFS API。不仅兼容 Hadoop 2.x 和 Hadoop 3.x,还兼容 Hadoop 生态系统中的各种组件。SeaweedFS 则是提供了对 HDFS API 的基础兼容,对于部分操作(如 turncate、concat、checksum 和扩展属性等)则尚未支持。 CSI 驱动 JuiceFS 与 SeaweedFS 皆提供了 「Kubernetes CSI Driver」 以帮助用户在 Kubernetes 生态中使用对应的文件系统。 扩展功能 客户端缓存 JuiceFS 有着多种客户端缓存策略,涵盖从元数据到数据缓存的各个部分,允许用户根据自己的应用场景进行调优(详情),而 SeaweedFS 不具备客户端缓存能力。 集群数据复制 对于多个集群之间的数据复制,SeaweedFS 支持「Active-Active」与「Active-Passive」两种异步的复制模式,2 种模式都是通过传递 changelog 再应用的机制实现了不同集群数据间的一致性,对于每一条 changelog,其中会有一个签名信息以保证同一个修改不会被循环多次。在集群节点数量超过 2 个节点的 Active-Active 模式下,SeaweedFS 的一些操作(如重命名目录)会受到一些限制。 JuiceFS 尚未原生支持集群之间的数据同步功能,需要依赖元数据引擎和对象存储自身的数据复制能力。 云上数据缓存 SeaweedFS 可以作为云上对象存储的缓存来使用,支持通过命令手动预热数据。对于缓存数据的修改,会异步同步到对象存储中。JuiceFS 需要将文件分块存储到对象存储中,尚不支持为对象存储中已有的数据提供缓存加速。 回收站 JuiceFS 默认开启回收站功能,会自动将用户删除的文件移动到 JuiceFS 根目录下的 .trash 目录内,保留指定时间后才将数据真正清理。 SeaweedFS 暂不支持此功能。 运维工具 JuiceFS 提供了 juciefs stats 以及 juicefs profile 两种子命令,允许用户实时查看当前或回放某一时间段的性能指标。同时,JuiceFS 还对外开发 metrics 接口,用户能够方便地将监控数据接入到 Prometheus 与 Grafana 中。 SeaweedFS 则同时实现了 Push 与 Pull 2种方式对接 Prometheus 与Grafana ,同时提供了 weed shell 的交互式工具方便使用者进行一系列运维工作(如查看当前集群状态、列举文件列表等)。 其它 在发布时间上,SeaweedFS 于 2015 年 4 月发布,目前累计 stars 为 16.4K,而 JuiceFS 于 2021 年 1 月发布,截止目前累计 7.3K stars。 在项目上,JuiceFS 与 SeaweedFS 皆采用了对商用更友好的 Apache License 2.0,SeaweedFS 主要由 Chris Lu 个人进行维护,而 JuiceFS 则主要由 Juicedata 公司进行维护。 JuiceFS 与 SeaweedFS 皆采用 Go 语言进行编写。 对比清单 SeaweedFS JuiceFS 元数据 多引擎 多引擎 元数据操作原子性 未保证 通过数据库事务保证 变更日志 有 无 数据存储 包含 外部服务 纠删码 支持 依赖外部服务 数据合并 支持 依赖外部服务 文件拆分 8MB 64MB + 4MB 分层存储 支持 依赖外部服务 数据压缩 支持(基于扩展名) 支持(全局设置) 存储加密 支持 支持 POSIX 兼容性 基本 完整 S3 协议 基本 基本 WebDAV 协议 支持 支持 HDFS 兼容性 基本 完整 CSI 驱动 支持 支持 客户端缓存 不支持 支持 集群数据复制 双向异步、多模式 不支持 云上数据缓存 支持(手动同步) 不支持 回收站 不支持 支持 运维工具 提供 提供 发布时间 2015.4 2021.1 主要维护者 个人(Chris Lu) 公司(Juicedata Inc) 语言 Go Go 开源协议 Apache License 2.0 Apache License 2.0 如有帮助的话欢迎关注我们项目 Juicedata/JuiceFS 哟! (0ᴗ0✿)

优秀的个人博客,低调大师

每日一博 | API 网关策略的二三事

作者暴渊,API7.ai 技术工程师,Apache APISIX Committer。 近些年随着云原生和微服务架构的日趋发展,API 网关以流量入口的角色在技术架构中扮演着越来越重要的作用。API 网关主要负责接收所有请求的流量并进行处理转发至上游服务,API 网关的策略决定了 API 网关处理这些流量的逻辑与规则,直接决定了实际的业务流量行为。 什么是 API 网关策略? API 网关一般位于所有的上游服务之前,当用户向服务发送请求后请求会先到 API 网关,API 网关接收到请求之后一般会判断几件事情: 请求是否合法,比如是否来自被禁止访问的用户列表中; 这个请求是否通过认证,访问的内容是否是经过授权的; 请求是否触发了某些限制规则,比如限流限速等; 请求应该转发给哪个上游服务。 经过这一系列步骤,这个请求要么不符合预设的规则被拒绝,要么经过了层层处理正确到达指定的上游服务中。我们将这些处理规则称之为 API 网关的策略。这些规则由网关的管理员在网关运行时不断添加至网关中,网关接受这些规则并根据这些规则作出正确的流量处理行为。 以 API 网关 Apache APISIX 为例,APISIX 的配置信息有两种:网关启动用的配置文件,比如 config.yaml,这个文件决定了网关正常启动所必须的一些配置。另外在运行时管理员可以通过 Admin API 动态创建各种规则与配置,比如 Route、Consumer、Plugin 等等。API 网关的策略就是管理员通过 Admin API 动态创建的各种规则与配置。 本文不再额外描述基本常用场景,而是针对认证授权、安全、流量处理与可观测性这四类 API 网关中重要的场景进行阐述,介绍每种场景下包含的一些 API 网关策略的作用以及使用方法。 认证和授权策略 认证可以确认 API 调用者的身份,授权主要限制调用者仅能访问权限内的资源。 比如说一位乘客前往车站出行,进入车站之前会使用身份证进行“认证”确认身份,在进入车站后出示车票,经工作人员确认后被“授权”进入某班列车。 认证授权类策略主要目的是保证网关转发到上游服务的所有请求都是经过认证和授权的,不会出现非法请求。并且访问的都是权限范围内的资源。比较常用的策略有下面几种: Basic Auth 基本访问认证策略,这是一种最简单的访问控制技术。一般由用户的 HTTP 代理在发出请求时携带用于认证的请求头,一般为:Authorization: Basic <credentials>,credentials 中即包含了用户认证需要的用户 ID 和密码,使用 : 隔离。这种方式不需要登陆页面、cookie 等繁杂的设置,仅仅基于请求头中的简单凭据信息进行认证,一般为用户名和密码,配置使用起来较为简单。 携带基本认证的 cURL 请求的示例如下,用户名为 username,密码为 password: curl -i -u 'username:password' http://127.0.0.1:8080/hello 需要注意的是 credentials 中的信息在传输过程中并不会被加密,仅仅做 Base64 编码,所以通常需要和 HTTPS 一起使用来保证密码的安全性。 在网关中实施这一策略后,未携带凭据的请求将无法正常通过网关转发,除非在请求中携带了正确的认证信息,实现了最小成本下为 API 添加了访问验证。 Key Auth Key Auth 策略通过在 API 中添加 Key 来限制 API 调用,并识别请求携带的 Key 来进行访问资源的控制。只有携带了正确的 Key 之后的请求才能正常访问,可以在请求头中或 Query 中携带。通常还可以通过这个 Key 来区分不同的 API 调用方,从而可以针对不同的调用方实施不同的其他策略或资源控制。同样的 Key 在 HTTP 中是明文传输的,确保请求使用了 HTTPS 以保证安全。 以 APISIX 的 key-auth 插件为例,插件需要通过 Admin API 创建一个具有唯一 key 值的 Consumer: curl http://127.0.0.1:9180/apisix/admin/consumers \ -H 'X-API-KEY: edd1c9f034335f136f87ad84b625c8f1' -X PUT -d ' { "username": "jack", "plugins": { "key-auth": { "key": "jack-key" } } }' 这一请求创建了一个名字为 jack 的 Consumer,它的 key 值为 jack-key。在路由中启用插件时需要配置网关从请求中读取 Key 值的位置和字段名称。默认的配置位置为 header ,字段名称为 apikey, 那么正确的请求这个路由的示例为: curl -i http://127.0.0.1:8080/hello -H 'apikey: jack-key' APISIX 在收到这一请求后会从请求中解析出 Key,然后从配置的所有 Key 中找到和这个请求匹配的 Consumer jack,这样网关就清楚这个请求是 jack 发出的。如果没有找到匹配的 Key 即可判定为非法请求。 JSON Web Token JSON Web Token (JWT) 是一个开放的标准,它定义了一种以 json 对象形式在各方之间安全传递信息的方式。JWT 策略可以集认证和授权于一身,在用户取得授权后会向用户传输一个 JWT Token,在后面的所有请求中调用方都会携带这个 Token 从而保证请求是被授权的。 在 API 网关中可以通过 JWT 策略将 JWT 身份验证能力添加到网关中,从而把这层逻辑从业务中抽离出来,业务实现者可以更加专注实现业务逻辑。以 APISIX 的 jwt-auth 插件为例,插件需要在 Consumer 中启用并配置唯一的 Key、加密用的公私钥、加密算法、Token 过期时间等。同时还需要在路由中启用这一插件并配置网关读取 Token 的位置和字段,比如 header、query、cookie 等。该插件会在 API 网关中添加一个 API 用于签发 Token。在发送请求之前需要请求签发 token 的 API 获得 Token,发送请求时需要根据配置信息在指定的位置上携带这一 Token。在请求到达网关后网关会按照配置信息从请求的指定位置读取 Token 并验证 Token 的有效性,验证通过后该请求才能被转发至上游服务。 相较于前两种策略,JWT 策略包含了过期时间选项,签发的 Token 随着时间流逝是可以过期的,但是 Basic Auth 和 Key Auth 的有效期是永久的,除非服务端更换了密码或 Key。除此之外 JWT 策略可以在多个服务之间公用,尤其是针对单点登录场景下很有用。 OpenID Connect OpenID Connect 是建立在 OAuth2.0 协议之上的身份认证方法,为应用的授权提供了比较完整的方案,API 网关中的 OpenID Connect 策略将允许上游服务从身份提供者(IdP)中获取请求中的用户信息,从而保护 API 安全。常见的身份提供者有 Keycloak、Ory Hydra、Okta、Auth0 等等。以 Apache APISIX 为例网关中的 OpenID Connect 策略工作流程如下: 客户端向网关发出请求 网关收到请求后向 IdP 发出认证请求 用户将被重定向到 IdP 提供的页面完成登陆认证 IdP 重定向到网关并携带认证 code 网关通过 code 向 IdP 请求 Access Token 从而获取用户信息 网关向上游转发请求时即可携带用户信息 通过这一流程可以将认证和鉴权从业务中独立出来放置于网关中解决,使架构更加清晰。关于更多 APISIX 的认证授权方法可以参考 API Gateway Authentication。 安全策略 API 网关安全策略像门卫一样保证 API 安全访问,允许正常请求被网关转发并在网关上拦截非法请求。根据 OWASP API Security Project,在 API 的调用者中存在着大量可能的威胁和攻击。使用 API 网关安全策略可以对所有的 API 请求进行安全验证,在 API 免于遭受这些安全威胁上起到了重要作用。 以下是几种比较重要的 API 网关安全策略。 IP 访问限制 IP 限制策略通过将某些 IP 或 CIDR 设置为白名单或者黑名单来限制某些客户端对 API 的访问,确保重要数据不会被随意访问。正确配置这一策略很大程度上提高了 API 的安全性,实现了更高的 API 安全治理。 URI 拦截 URI 拦截策略主要通过设置 URI 的一些规则来阻止潜在的危险 API 请求。比如一些安全攻击通过嗅探 URI 路径从而发现潜在的安全漏洞进而攻击。 Apache APISIX 提供了 uri-blocker 插件来提供这一能力。通过 uri-blocker 插件可以设置一些正则规则,如果请求命中规则就可以拦截当前用户的请求,例如设置 root.exe、admin ,这一插件就可以阻止 */root.exe 和 */admin 这种类似的请求,进一步保护 API 安全。 CORS CORS 即浏览器针对跨域请求作出的安全策略。一般情况下在浏览器中发出 xhr 请求前浏览器会验证请求地址和当前地址是否为同一域,如果在同一域下请求可以直接发出,否则浏览器会先出发一个 OPTION 类型的跨域预检请求,然后在该请求的响应头中会有 CORS 相关的设置,例如允许跨域请求的方法、允许请求携带的凭据等。浏览器会根据这些信息决定是否发出正式的请求,详细可以参考 CORS。 一般情况下包含 CORS 设置的响应是由后端服务设置的,但是如果服务数量很多,在网关层面针对不同服务统一处理会更加便捷安全。CORS 策略可以在不同的 API 上设置不同的跨域解决策略,上游服务无需再处理这些逻辑。 CSRF CSRF 即跨站请求伪造攻击,通常情况下会使终端用户在他们已经认证的站点中执行非自愿的动作。这种攻击通常伴随着社会工程学(通过电子邮件向攻击者发送攻击链接),当用户点击这一链接后利用攻击者在网站中已登陆认证的身份执行攻击操作。在网站看来因为用户已经登陆,所以所做的任何操作都是正常的。 通常网站的后端服务需要添加额外的中间件处理这部分逻辑,防范的方法也都有统一的标准。使用 CSRF 策略可以为网关提供防范这一攻击的能力,在网关层统一做 CSRF 安全处理,简化上游服务逻辑复杂度。 流量处理策略 流量处理策略主要保证 API 网关进行流量转发的上游负载都在健康范围内,同时在请求转发前或者返回给调用者前对请求进行按需改写。这一类型的策略主要围绕限流限速、熔断、缓存、重写等功能展开。 限流限速 在资源有限的情况下,API 可以提供的服务能力是有一定限度的,如果调用超过了这一限制可能会使上游服务崩溃继而引起一些连锁反应。限流限速可以防范这种情况的发生,另一方面也可以有效防止 API 遭受 DDOS 攻击。 在限流限速策略中可以设置一个时间窗口和可允许最大的请求数量,在时间窗口内超过这个数量的请求会被拒绝并返回设置的信息,直到请求数量低于设定的值或到下一个时间窗口后会允许继续访问。 请求计数的凭据可以设置为请求中的变量或着某一个请求头等,例如根据不同的 IP 设置相应的限速策略。实现更加灵活的控制。 熔断 API 熔断策略可以为上游服务提供熔断能力,使用这一策略时需要设置上游服务健康和不健康的状态码,用于网关判断上游服务状态。另外还需要设置触发熔断或者恢复健康的请求次数,连续达到这一次数后即判定为对应的状态。当上游服务连续向网关返回一定次数的不健康状态码后,网关就会熔断该上游服务一段时间,在这段时间内不再向该上游转发请求而是由网关直接返回错误。可以防止上游服务因为错误后继续接收请求出现 “雪崩”,保护业务服务。超过这一时间后网关会再次尝试向上游转发请求,如果还是返回不健康的状态码,网关就会继续熔断更长的时间(加倍)。直到转发请求后上游连续返回了一定次数的健康状态码,则网关认为上游服务恢复健康,后续会继续往该上游节点转发流量。 在这个策略中还需要设置当不健康后需要返回的状态码和信息,当上游服务不健康后请求在网关层面直接返回,保护业务服务稳定。 流量拆分 流量拆分策略可以动态控制将流量按比例转发给不同的上游服务,这在灰度发布或蓝绿发布中非常有用。 灰度发布又名金丝雀发布,当服务发布新功能时可以仅让一部分请求使用新的服务,另一部分仍然停留在旧的服务中。如果新服务保持稳定,则可以增加比例逐步将所有请求转移到新的服务中,直至比例完全切换,完成服务升级。 蓝绿发布则是另一种发布模式,可以做到在用户使用的高峰期进行发布,同时不会中断服务。服务的旧版本和新版本会同时共存。一般会将生产环境(蓝色)复制到一个相同但是单独的容器中(绿色)。在绿色环境中发布新的更新,之后将绿色和蓝色一同发布至生产环境。之后就可以在绿色环境中进行测试和修复,在这期间用户访问的还是蓝色系统。之后可以使用某些负载均衡策略将请求重定向到绿色环境中。蓝色环境即可保持待机作为灾难恢复选项或者用作下一次更新。 APISIX 的 traffic-split 插件通过流量拆分对上述提到的两种发布类型都进行了很好的支持,使得业务部署更加便捷可靠。 请求重写 在现代微服务架构中,尤其是服务端与服务、服务与服务之间充斥各种不同的协议,或着请求数据格式不统一,这些问题如果单独在各自服务之间实现转换处理会产生很多冗余的逻辑代码并且难以管理。一些请求重写策略可以处理一些协议转换、请求体改写等逻辑。 APISIX 提供了 response-rewrite 插件可以用来修改上游服务返回的 Body 或者 Header 信息内容,支持添加或者删除响应头,设置规则修改响应体等。这在设置 CORS 响应头实现跨域请求设置或者设置 Location 实现重定向等场景中很有用。 另一方面,对于请求重写 APISIX 则提供了 proxy-rewrite 插件也可以处理代理到上游服务的请求内容,可以对请求的 URI、方法、请求头等重写,在很多场景下为业务处理提供了便捷。 故障注入 故障注入测试是一种软件测试方法,通过在系统中故意引入错误来确保系统的行为正常。通常在部署之前进行测试以保证在生产环境中没有潜在的故障。在一些混沌测试场景下,需要对服务注入一些错误来验证服务的可靠性。 软件的故障注入可以分为编译时注入和运行时注入。编译时注入指在编写软件的过程中通过改变某些代码或逻辑来实现;运行时注入通过向正在运行的软件环境中设置错误来测试软件的行为。故障注入策略可以在网关中以运行时注入的方式,模拟应用网络请求中的故障。通过在策略中设置一个比例,命中这个比例内的请求会执行设置好的故障逻辑,比如延迟时间返回,或直接返回设置的错误码和错误信息给调用方。 通过这种方式可以增加软件的适应性,让开发人员提前看到可能出现的一些错误情况,在发布之前针对问题做出适应性修改。 协议转换 协议转换类的策略可以做一些常见协议之间的转换。比如常见的 HTTP 请求和 gRPC 之间的转换。Apache APISIX 提供了 grpc-transcode 插件可以实现在网关接收到 HTTP 请求之后,将请求转码并转发给 gRPC 类型的服务,接收到响应后以 HTTP 的格式返回给客户端。这样客户端无需关注上游 gRPC 的类型,只处理 HTTP 即可。 可观测性策略 可观测性指在一个系统中通过系统的输出数据来衡量这个系统运行状态的能力。在一些简单的系统中,因为系统组件数量相对较少,出现问题时可以通过分析各个组件状态得到答案。但是在大型分布式系统中,各种微服务组件数量非常大,对组件一一进行排查显然是不现实的,这个时候就需要系统具备可观测性。可观测性提供了对分布式系统的“可见性”,当系统出现问题时它可以提供工程师所需的控制能力,准确定位问题。 可观测性的数据收集可以在应用程序组件内实现,也可以在其他位置实现。API 网关作为所有流量的入口,在 API 网关中实现系统的可观测性,可以清晰反映出系统 API 的使用情况。API 网关的可观测性策略可以帮助到公司的每个团队: 工程师团队可以监控并解决 API 问题; 产品团队可以了解 API 的使用情况以挖掘背后的商业价值; 销售和增长团队可以监控 API 使用情况,观察商业机会并确保 API 提供正确的数据。 可观测性策略根据输出的数据类型一般分为三类:Tracing,Metrics 和 Logging。 Tracing 在大型分布式系统中服务之间的调用关系错综复杂,Tracing(链路追踪)可以在分布式应用中追踪完整的调用链路、应用之间的依赖分析以及请求统计等内容。在系统出现问题时可以帮助工程师确定排查范围和位置。 Tracing 策略可以在 API 网关上集成一些其他的分布式调用链路追踪系统,收集信息并记录。常见的服务比如 Zipkin、SkyWalking 等。通过 Tracing 策略将这些服务集成到 API 网关中,实现在网关上数据收集和与这些服务之间的通信,可以帮助工程师解决诸如这个请求接触了什么服务以及引入了多少延迟等问题。Tracing 策略使工程师能够进一步确认在特定的会话或相关的 API 调用中要看哪些日志,确认排查范围。 Metrics Metrics 指在服务运行期间收集到的一个时间间隔内软件自己的各种观测数据,这些数据默认是结构化的,可以更好地实现查询和可视化。通过对这些数据分析可以掌握系统当下的运行状态和行为。 Metrics 策略可以在 API 网关中集成 Prometheus 或 Datadog 这一类服务,为系统提供监控、报警等能力。这一策略通过 API 网关中的各种接口收集网关运行过程中的数据,并将数据上报至上述服务中。通过将这些数据可视化后开发者可以清晰看到网关的运行状态,API 请求的统计信息等数据统计图。 Logging 日志是在某个特定时间系统事件的文本记录,当系统出现问题时日志是首要排查的地方。当服务出现一些意外情况时工程师依赖日志内容查看系统“发生了什么”从而找出对应的解决方法。日志内容一般分为两类:API 请求日志和网关自身的运行日志。API 请求日志记录了 API 网关在运行期间所有的 API 请求记录,通过这些记录工程师可以掌握 API 访问情况,及时发现并排查异常请求。网关自身的运行日志则包含了网关在工作期间发生的所有事件的记录,当 API 网关自身出现异常时可以作为排查问题的重要依据。 Logging 策略可以将 API 网关中的日志存储在服务器磁盘中或是推送到一些其他的日志服务器中,比如 HTTP 日志服务器、TCP 日志服务器、UDP 日志服务器等,或者是其他的日志系统比如 Apache Kafka、Apache RocketMQ、Clickhouse 等。 总结 这篇文章介绍了什么是 API 网关策略,并针对认证授权、安全、流量处理与可观测性这四类 API 网关中常用的策略进行描述。API 网关在所有上游服务之前接收请求的流量,控制一个请求是否要转发以及如何进行转发,对不安全的、未授权的请求直接拒绝或进行限制,这些行为都可以由 API 网关策略决定。

优秀的个人博客,低调大师

每日一博 | WebAssembly:无需容器的 Docker (下)

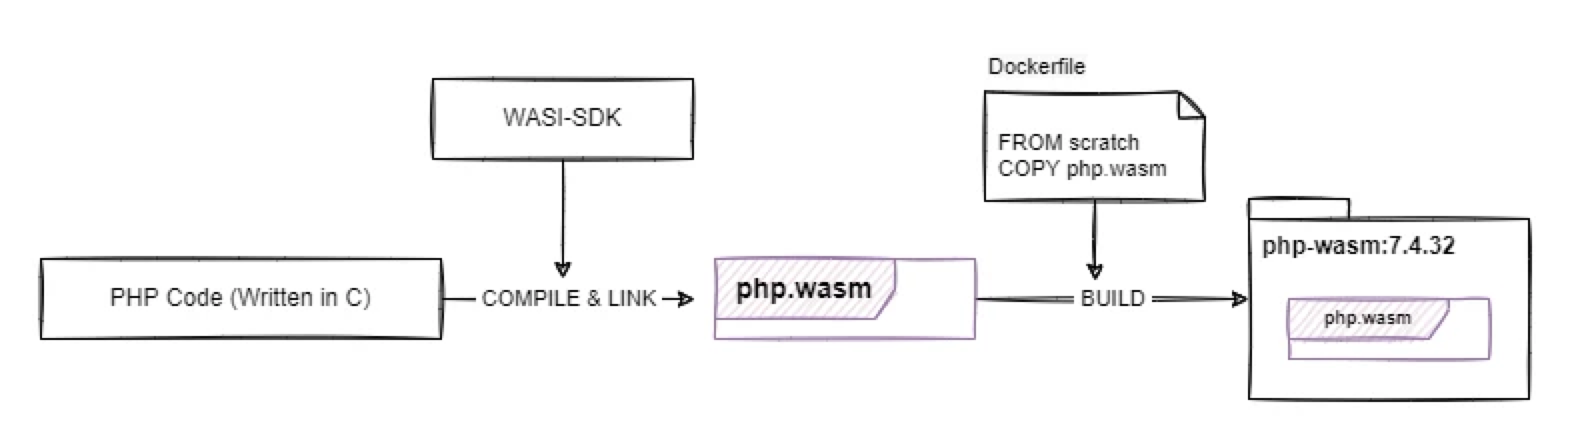
本文翻译自 Wasm Labs @ VMware OCTO 的 blog: WebAssembly: Docker without container。这是 Wasm Labs 在 2022 年 12 月 15 日在冬季Docker Community All Hands 7 的关于 Docker+WebAssembly 的演讲的文字版。 作者:Asen Alexandrov,Wasm Labs 工程师。文中的我们均指作者或 Wasm Labs。本篇文章将更具实践性,将以 PHP 为例带领大家实践 Docker + Wasm。 上篇文章我们了解了服务端 Wasm 为什么有着重要的作用、什么是 WasmEdge 以及如何让解释型语言编写的程序在 Wasm 里运行,这篇文章,我们将通过动手示例了解在 Docker + Wasm 背景下的 Wasm container 有什么好处以及如何运行一个服务 WordPress 的 php.wasm 镜像。 动手示例 让我们开始吧! 在动手示例中,我们将使用编译为 Wasm 的 PHP 解释器。 我们会: 构建一个 Wasm 容器。 比较 Wasm 和原生二进制文件。 比较传统容器和 Wasm 容器。 展示 Wasm 的可移植性 前期准备 如果想在本地重现这些示例,你需要使用以下部分或全部内容来准备你的环境: WASI SDK - 从构建 C 代码构建 WebAssembly 应用程序 PHP - 为了比较而运行本机 PHP 二进制文件 WasmEdge Runtime - 运行 WebAssembly 应用程序 Docker Desktop + Wasm (本文写作时,作为稳定 beta 版在 Docker Desktop4.15版可用) - 能够运行 Wasm 容器 我们还充分运用 webassembly-language-runtimes repo,它提供了将 PHP 解释器构建为 WebAssembly 应用程序的方法。 可以像这样查看 demo 分支: git clone --depth=1 -b php-wasmedge-demo \ https://github.com/vmware-labs/webassembly-language-runtimes.git wlr-demo cd wlr-demo 构建一个 Wasm 容器 第一个示例,我们将展示如何构建基于 C 的应用程序,例如 PHP 解释器。 该构建使用 WASI-SDK 工具集。 它包括一个可以构建到 wasm32-wasi 目标的 clang 编译器,以及在 WASI 之上实现基本 POSIX 系统调用接口的 wasi-libc。 使用 WASI SDK,我们可以从 PHP 的代码库中构建一个用 C 编写的 Wasm 模块,。之后,我们需要一个非常简单的基于 scratch 的 Dockerfile 来制作一个可以使用 Docker+Wasm 运行的 OCI 镜像。 构建一个 WASM 二进制码 假设你现在位于 wlr-demo 文件夹,这是前期准备工作的一部分,可以运行以下命令来构建 Wasm 二进制文件。 export WASI_SDK_ROOT=/opt/wasi-sdk/ export WASMLABS_RUNTIME=wasmedge ./wl-make.sh php/php-7.4.32/ && tree build-output/php/php-7.4.32/bin/ ... ( a few minutes and hundreds of build log lines)几分钟和数百行构建日志 build-output/php/php-7.4.32/bin/ ├── php-cgi-wasmedge └── php-wasmedge PHP 是用 autoconf 和 make 构建的。 所以如果你看一眼脚本 scripts/wl-build.sh ,你会注意到我们设置了所有相关变量,如 CC、LD、 CXX 等,以使用来自 WASI_SDK 的编译器。 export WASI_SYSROOT="${WASI_SDK_ROOT}/share/wasi-sysroot" export CC=${WASI_SDK_ROOT}/bin/clang export LD=${WASI_SDK_ROOT}/bin/wasm-ld export CXX=${WASI_SDK_ROOT}/bin/clang++ export NM=${WASI_SDK_ROOT}/bin/llvm-nm export AR=${WASI_SDK_ROOT}/bin/llvm-ar export RANLIB=${WASI_SDK_ROOT}/bin/llvm-ranlib 然后,进一步深入查看 php/php-7.4.32/wl-build.sh,可以看到像通常一样,我们使用 autoconf 构建过程。 ./configure --host=wasm32-wasi host_alias=wasm32-musl-wasi \ --target=wasm32-wasi target_alias=wasm32-musl-wasi \ ${PHP_CONFIGURE} || exit 1 ... make -j ${MAKE_TARGETS} || exit 1 WASI 是一项正在进行的工作,许多 POSIX 调用仍然不能在它之上实现。 因此,要构建 PHP,我们必须在原始代码库之上应用多个补丁。 我们在上面看到输出二进制文件会转到 build-output/php/php-7.4.32。 在下面的示例中,我们将使用专门为 WasmEdge 构建的 php-wasmedge 二进制文件,因为它提供服务端 socket 支持,服务端 socket 支持还不是 WASI 的一部分。 优化二进制码 Wasm 是一个虚拟指令集,因此任何运行时的默认行为都是即时解释这些指令。 当然,这在某些情况下可能会让速度变慢。 因此,为了通过 WasmEdge 获得两全其美的效果,你可以创建一个 AOT(提前编译)优化的二进制文件,它可以在当前机器上原生运行,但仍然可以在其他机器上进行解释。 要创建优化的二进制文件,请运行以下命令: wasmedgec --enable-all --optimize 3 \ build-output/php/php-7.4.32/bin/php-wasmedge \ build-output/php/php-7.4.32/bin/php-wasmedge-aot 我们在下面的例子中使用这个 build-output/php/php-7.4.32/bin/php-wasmedge-aot 二进制码。要了解有关 WasmEdge AOT 优化二进制文件的更多信息,请查看这里。 构建 OCI 镜像 现在我们有了一个二进制文件,我们可以将它包装在一个 OCI 镜像中。 让我们看一下这个 images/php/Dockerfile.cli。 我们需要做的就是复制 Wasm 二进制文件并将其设置为 ENTRYPOINT。 FROM scratch ARG PHP_TAG=php-7.4.32 ARG PHP_BINARY=php COPY build-output/php/${PHP_TAG}/bin/${PHP_BINARY} /php.wasm ENTRYPOINT [ "php.wasm" ] 我们还可以在镜像添加更多内容,当 Docker 运行它时,Wasm 二进制文件可以访问这些内容。 例如,在 images/php/Dockerfile.server 中,我们还添加了一些 docroot 内容,在容器启动时由 php.wasm 提供服务。 FROM scratch ARG PHP_TAG=php-7.4.32 ARG PHP_BINARY=php COPY build-output/php/${PHP_TAG}/bin/${PHP_BINARY} /php.wasm COPY images/php/docroot /docroot ENTRYPOINT [ "php.wasm" , "-S", "0.0.0.0:8080", "-t", "/docroot"] 基于以上文件,我们可以轻松地在本地构建我们的 php-wasm 镜像。 docker build --build-arg PHP_BINARY=php-wasmedge-aot -t ghcr.io/vmware-labs/php-wasm:7.4.32-cli-aot -f images/php/Dockerfile.cli . docker build --build-arg PHP_BINARY=php-wasmedge-aot -t ghcr.io/vmware-labs/php-wasm:7.4.32-server-aot -f images/php/Dockerfile.server . 原生 vs Wasm 现在让我们将原生 PHP 二进制文件与 Wasm 二进制文件在本地和 Docker 容器中分别进行比较。 我们将使用相同的 index.php 文件并将运行它时得到的结果与以下内容进行比较: php php-wasmedge-aot 在传统容器中运行的 php 在 Wasm 容器中运行的 php-wasmedge-aot 在下面所有的示例中,我们使用同样的 images/php/docroot/index.php 文件,让我们来看一下。简而言之,该脚本将: 使用 phpversion 和 php_uname 展示解释器版本和它运行的平台 打印脚本可以访问的所有环境变量的名称 打印一条包含当前时间和日期的问候消息 列出根文件夹的内容 / <html> <body> <h1>Hello from PHP <?php echo phpversion() ?> running on "<?php echo php_uname()?>"</h1> <h2>List env variable names</h2> <?php $php_env_vars_count = count(getenv()); echo "Running with $php_env_vars_count environment variables:\n"; foreach (getenv() as $key => $value) { echo $key . " "; } echo "\n"; ?> <h2>Hello</h2> <?php $date = getdate(); $message = "Today, " . $date['weekday'] . ", " . $date['year'] . "-" . $date['mon'] . "-" . $date['mday']; $message .= ", at " . $date['hours'] . ":" . $date['minutes'] . ":" . $date['seconds']; $message .= " we greet you with this message!\n"; echo $message; ?> <h2>Contents of '/'</h2> <?php foreach (array_diff(scandir('/'), array('.', '..')) as $key => $value) { echo $value . " "; } echo "\n"; ?> </body> </html> Native PHP 运行 index.js 我们使用本地 php 二进制码时,看到一个基于 Linux 的平台。 58 个环境变量的列表,脚本可以在需要时访问 / 中所有文件和文件夹的列表,如果需要,脚本可以再次访问这些文件和文件夹 $ php -f images/php/docroot/index.php <html> <body> <h1>Hello from PHP 7.4.3 running on "Linux alexandrov-z01 5.15.79.1-microsoft-standard-WSL2 #1 SMP Wed Nov 23 01:01:46 UTC 2022 x86_64"</h1> <h2>List env variable names</h2> Running with 58 environment variables: SHELL NVM_INC WSL2_GUI_APPS_ENABLED rvm_prefix WSL_DISTRO_NAME TMUX rvm_stored_umask TMUX_PLUGIN_MANAGER_PATH MY_RUBY_HOME NAME RUBY_VERSION PWD NIX_PROFILES LOGNAME rvm_version rvm_user_install_flag MOTD_SHOWN HOME LANG WSL_INTEROP LS_COLORS WASMTIME_HOME WAYLAND_DISPLAY NIX_SSL_CERT_FILE PROMPT_COMMAND NVM_DIR rvm_bin_path GEM_PATH GEM_HOME LESSCLOSE TERM CPLUS_INCLUDE_PATH LESSOPEN USER TMUX_PANE LIBRARY_PATH rvm_loaded_flag DISPLAY SHLVL NVM_CD_FLAGS LD_LIBRARY_PATH XDG_RUNTIME_DIR PS1 WSLENV XDG_DATA_DIRS PATH DBUS_SESSION_BUS_ADDRESS C_INCLUDE_PATH NVM_BIN HOSTTYPE WASMER_CACHE_DIR IRBRC PULSE_SERVER rvm_path WASMER_DIR OLDPWD BASH_FUNC_cr-open%% _ <h2>Hello</h2> Today, Wednesday, 2022-12-14, at 12:0:36 we greet you with this message! <h2>Contents of '/'</h2> apps bin boot dev docroot etc home init lib lib32 lib64 libx32 lost+found media mnt nix opt path proc root run sbin snap srv sys tmp usr var wsl.localhost </body> </html> php-aot-wasm 运行 index.js 如果我们在 WasmEdge 使用 php-aot-wasm 我们看到 一个 wasi/wasm32 平台 没有环境变量,因为没有明确暴露给 Wasm 应用程序 Wasm 应用程序未获得对 / 的明确访问权限,因此尝试列出其内容失败并出现错误 自然地,为了让 php-wasmedge-aot 能够读取 index.php 文件,我们必须明确地向 WasmEdge 声明我们想要预先打开 images/php/docroot 以便在 Wasm 应用程序的上下文中作为 /docroot 进行访问。这显而易见展示了 Wasm 除了可移植性之外的最大优势之一。 我们得到了更佳的安全性,因为除非明确说明,否则无法访问任何内容。 $ wasmedge --dir /docroot:$(pwd)/images/php/docroot \ build-output/php/php-7.4.32/bin/php-wasmedge-aot -f /docroot/index.php <html> <body> <h1>Hello from PHP 7.4.32 running on "wasi (none) 0.0.0 0.0.0 wasm32"</h1> <h2>List env variable names</h2> Running with 0 environment variables: <h2>Hello</h2> Today, Wednesday, 2022-12-14, at 10:8:46 we greet you with this message! <h2>Contents of '/'</h2> Warning: scandir(/): failed to open dir: Capabilities insufficient in /docroot/index.php on line 27 Warning: scandir(): (errno 76): Capabilities insufficient in /docroot/index.php on line 27 Warning: array_diff(): Expected parameter 1 to be an array, bool given in /docroot/index.php on line 27 Warning: Invalid argument supplied for foreach() in /docroot/index.php on line 27 </body> </html> 容器中的 PHP 运行 index.js 当我们从一个传统的容器中使用 php 时我们看到 基于 Linux 的平台 脚本有权访问的 14 个环境变量的列表 带有当前时间和日期的问候消息 包含根文件夹内容的列表 / 与在主机上使用 php 运行它相比,已经明显有区别,表现更佳。 由于 / 的环境变量和内容是“虚拟的”并且仅存在于容器内。 docker run --rm \ -v $(pwd)/images/php/docroot:/docroot \ php:7.4.32-cli \ php -f /docroot/index.php <html> <body> <h1>Hello from PHP 7.4.32 running on "Linux 227b2bc2f611 5.15.79.1-microsoft-standard-WSL2 #1 SMP Wed Nov 23 01:01:46 UTC 2022 x86_64"</h1> <h2>List env variable names</h2> Running with 14 environment variables: HOSTNAME PHP_INI_DIR HOME PHP_LDFLAGS PHP_CFLAGS PHP_VERSION GPG_KEYS PHP_CPPFLAGS PHP_ASC_URL PHP_URL PATH PHPIZE_DEPS PWD PHP_SHA256 <h2>Hello</h2> Today, Wednesday, 2022-12-14, at 10:15:35 we greet you with this message! <h2>Contents of '/'</h2> bin boot dev docroot etc home lib lib64 media mnt opt proc root run sbin srv sys tmp usr var </body> </html> php-aot-wasm 在一个容器中运行 index.js 如果我们在 WasmEdge 使用 php-aot-wasm 我们看到 一个 wasi/wasm32 平台 只有 2 个基础设施环境变量,使用在 containerd 中运行的 WasmEdge shim 预先设置 容器中 /内所有文件和文件夹的列表,明确预打开以供 Wasm 应用程序访问(WasmEdge shim 中的逻辑的一部分) 注意:如果你仔细观察,会发现要从这个镜像运行一个容器,我们必须: 通过 --runtime=io.containerd.wasmedge.v1 将命令行参数直接传递给 php.wasm 明确声明运行时,而不包括二进制文件本身。 拉到上面可以看到我们可以使用传统的 PHP 容器明确编写完整的命令,包括 php 二进制文件(不是必需的)。 最后一点,即使使用 Docker,Wasm 也加强了运行 index.php 的安全性,因为暴露给它的要少得多。 docker run --rm \ --runtime=io.containerd.wasmedge.v1 \ -v $(pwd)/images/php/docroot:/docroot \ ghcr.io/vmware-labs/php-wasm:7.4.32-cli-aot \ -f /docroot/index.php <html> <body> <h1>Hello from PHP 7.4.32 running on "wasi (none) 0.0.0 0.0.0 wasm32"</h1> <h2>List env variable names</h2> Running with 2 environment variables: PATH HOSTNAME <h2>Hello</h2> Today, Wednesday, 2022-12-14, at 11:33:10 we greet you with this message! <h2>Contents of '/'</h2> docroot etc php.wasm </body> </html> 传统容器 vs Wasm 容器 我们构建并运行了一个 Wasm 二进制文件,并将其作为容器运行。 我们看到了 Wasm 和传统容器之间的输出差异以及 Wasm 带来的高级“沙箱隔离”。我们可以轻松看到的两种容器之间的其他差异。 首先,我们将运行两个 daemon 容器,看看我们如何解释有关它们的一些统计信息。 然后我们将检查容器镜像的差异。 容器数据 让我们运行两个 daemon 容器 - 一个是从传统的 php 镜像,另一个是从 php-wasm 镜像。 docker run --rm -d \ -p 8083:8080 -v $(pwd)/images/php/docroot:/docroot \ php:7.4.32-cli \ -S 0.0.0.0:8080 -t /docroot docker run --rm -d \ --runtime=io.containerd.wasmedge.v1 \ -p 8082:8080 -v $(pwd)/images/php/docroot:/docroot \ ghcr.io/vmware-labs/php-wasm:7.4.32-cli-aot -S 0.0.0.0:8080 -t /docroot 但是如果我们看 docker stats,我们只看到传统容器的数据。这之后可能会变化,因为 Docker+Wasm 现在是 beta 版特性。 所以,如果真的想看看发生了什么,可以改为监视对照组。 每个传统容器都有自己的控制组,如 docker/ee44...。另一方面,Wasm 容器作为 podruntime/docker 控制组的一部分包含在内,可以间接观察它们的 CPU 或内存消耗。 $ systemd-cgtop -kP --depth=10 Control Group Tasks %CPU Memory podruntime 145 0.1 636.3M podruntime/docker 145 0.1 636.3M docker 2 0.0 39.7M docker/ee444b... 1 0.0 6.7M 镜像大小 首先,探索镜像,我们看到 Wasm 容器镜像比传统镜像小得多。 即使是 alpine 版本的 php 容器也比 Wasm 容器大。 $ docker images REPOSITORY TAG IMAGE ID CREATED SIZE php 7.4.32-cli 680c4ba36f1b 2 hours ago 166MB php 7.4.32-cli-alpine a785f7973660 2 minutes ago 30.1MB ghcr.io/vmware-labs/php-wasm 7.4.32-cli-aot 63460740f6d5 44 minutes ago 5.35MB 这是意料之中的,因为对于 Wasm,我们只需要在容器内添加可执行二进制文件,而对于传统容器,我们仍然需要来自运行二进制文件的操作系统的一些基本库和文件。这种大小差异对于第一次拉取镜像的速度以及进行在本地存储库中占用的空间非常有帮助。 Wasm 可移植性 Wasm 最大优势之一就是它的可移植性。 当人们想要一个可移植的应用程序时,Docker 已经提供了传统的容器作为一种选择。 然而,除了镜像特别大之外,传统容器还绑定到它们运行的平台架构。 作为程序员,相比许多人都经历过这种坎坷:针对不同的架构,必须构建支持的软件版本,并为每种架构打包对应镜像。 WebAssembly 带来了真正的可移植性。 构建一次二进制文件,就能在任何地方运行它。 作为这种可移植性的证明,我们准备了几个通过我们为 WebAssembly 构建的 PHP 解释器运行 WordPress 的示例。 当 PHP 作为独立的 Wasm 应用程序运行时,它会为 WordPress 提供服务。 它也可以在 Docker+Wasm 容器中运行。 此外,它还能在嵌入 Wasm 运行时的任何应用程序中运行。 在我们的示例中,这是 apache httpd,它可以通过 mod_wasm 使用 Wasm 应用程序作为内容处理程序。 最后,PHP.wasm 也可以在浏览器中运行。 通过 WasmEdge 服务 WordPress 我们为本次演示准备了一个紧凑的 WordPress+Sqlite 示例。 由于它是 ghcr.io/vmware-labs/php-wasm:7.4.32-server-wordpress 容器镜像的一部分,我们先将其下载到本地。 此命令将只创建一个临时容器(拉取镜像),将 WordPress 文件复制到 /tmp/wp/docroot,然后删除容器。 container_id=$(docker create ghcr.io/vmware-labs/php-wasm:7.4.32-server-wordpress) && \ mkdir /tmp/wp && \ docker cp $container_id:/docroot /tmp/wp/ && \ docker rm $container_id 现在我们有了 WordPress,让我们添加服务器: wasmedge --dir /docroot:/tmp/wp/docroot \ build-output/php/php-7.4.32/bin/php-wasmedge-aot \ -S 0.0.0.0:8085 -t /docroot 可以访问 http://localhost:8085 ,使用由 PHP Wasm 解释器服务的 WordPress。 通过 Docker+Wasm 服务 WordPress 自然的,有了 Docker 会容易很多。 docker run --rm --runtime=io.containerd.wasmedge.v1 \ -p 8086:8080 -v /tmp/wp/docroot/:/docroot/ \ ghcr.io/vmware-labs/php-wasm:7.4.32-cli-aot -S 0.0.0.0:8080 -t /docroot 可以访问 http://localhost:8086 并使用由 PHP Wasm 解释器服务的 WordPress,这回是在 Docker 容器中运行。 通过 mod_wasm in Apache HTTPD 服务 WordPress Apache HTTPD 是使用最广泛的 HTTP 服务器之一。 现在有了 mod_wasm,它还可以运行 WebAssembly 应用程序。 为了避免在本地安装和配置它,我们准备了一个容器,其中包含 Apache HTTPD、mod_wasm 和 WordPress。 docker run -p 8087:8080 projects.registry.vmware.com/wasmlabs/containers/php-mod-wasm:wordpress 可以访问 http://localhost:8087 并使用由 PHP Wasm 解释器服务的 WordPress,它由 Apache HTTPD 中的 mod_wasm 加载。 直接在浏览器中服务 WordPress 访问 https://wordpress.wasmlabs.dev 获得示例。 你将看到一个框架,其中 PHP Wasm 解释器会现场渲染 WordPress。 结论 感谢阅读本文。 需要消化的内容很多,但我们希望本文有助于理解 WebAssembly 的能力以及它如何与你现有的代码库和工具(包括 Docker)结合运行。 期待看到你使用 Wasm 编程! 如果你觉得 WasmEdge 不错,不要忘了给我们点个赞! https://github.com/WasmEdge/WasmEdge

优秀的个人博客,低调大师

每日一博 | WebAssembly:无需容器的 Docker (上)

本文翻译自 Wasm Labs @ VMware OCTO 的 blog: WebAssembly: Docker without container,已获得授权这是 Wasm Labs 在 2022 年 12 月 15 日在冬季Docker Community All Hands 7 的关于 Docker+WebAssembly 的演讲的文字版。 作者:Asen Alexandrov,Wasm Labs 工程师 文中的我们均指作者或 Wasm Labs。由于文章内容翔实、篇幅较长我们将分成上下两篇分享,上篇将注重在概念阐释,如 Wasm 是什么,Wasm 与 Docker 的关系是什么。下篇文章将更具实践性,将以 PHP 为例带领大家实践 Docker + Wasm。 最近,Docker 宣布与 WasmEdge 合作支持 WebAssembly。 本文将解释什么是 WebAssembly(Wasm),为什么它与 Docker 生态相关,并提供一些实践示例供大家尝试。 我们假设你已经熟悉 Docker 工具。 我们将使用我们在 PHP 的 WebAssembly 端口上做的工作来演示如何构建 PHP 解释器,将其打包为 OCI 镜像的一部分,并使用 Docker 运行它。 请注意,本文专注动手经验,而不是讨论技术细节。 WebAssembly 是什么?为什么选它? 本节是对 WebAssembly 的基本介绍。 已经熟悉 Wasm 的小伙伴,可以快速重温一下,明天的文章将介绍更多实践。 什么是 WebAssembly? WebAssembly 是一种定义二进制指令格式的开放标准,它支持从不同的源语言创建可移植的二进制可执行文件。 这些二进制文件可以在各种环境中运行。 它起源于 Web,并得到各大主流浏览器的支持。 Wasm 如何在浏览器中工作? 浏览器引擎集成了一个 Wasm 虚拟机,通常称为 Wasm 运行时,可以运行 Wasm 二进制指令。 编译器工具链(如 Emscripten)可以将源代码编译为 Wasm 目标。 这允许将现有的应用程序移植到浏览器,并直接与在客户端 Web 应用程序中运行的 JS 代码通信。 这些技术能让传统的桌面应用程序在浏览器中运行。现在它们可以在任何装了浏览器的设备上运行。 一些著名的例子包括 Google Earth 和用于计算机视觉的 Open CV库。 Wasm 如何在服务器上运行? 除了浏览器,也有可以在浏览器之外运行的 Wasm 运行时,包括 Linux、Windows 和 macOS 等传统操作系统。 因为无法依赖可用的 JavaScript 引擎,所以他们使用不同的接口与外界通信,例如 WASI(WebAssembly 系统接口)。 这些运行时允许 Wasm 应用程序以与 POSIX 类似(但不完全相同)的方式与其 host 系统交互。 WASI SDK 和 wasi-libc 等项目帮助人们将现有的兼容 POSIX 的应用程序编译为 WebAssembly。 你只需将应用程序编译成 Wasm 模块一次,然后这个同样的二进制文件就可以在任何地方运行。 Wasm 有什么了不起的? 下面这些特性让 Wasm 在浏览器大放异彩,也使得它用在服务端开发颇具优势: 🌐 开放——它是业界广泛采用的标准。 与过去的浏览器争夺战相反,各大公司正积极合作,实现 WASI 和 WebAssembly 应用程序的标准化。 🚀 快速——它可以通过大多数运行时的 JIT/AOT 能力提供类似原生的速度。 与启动 VM 或启动容器不同的是,它没有冷启动。 🔒 安全——默认情况下,Wasm 运行时是沙箱化的,允许安全访问内存。 基于能力的模型确保 Wasm 应用程序只能访问得到明确允许的内容。软件供应链更加安全。 💼 可移植——几个主要的 Wasm 运行时支持大多数 CPU(x86、ARM、RISC-V)和大多数操作系统,包括 Linux、Windows、macOS、Android、ESXi,甚至非 Posix 操作系统。 🔋 高效——最小的内存占用和最低的 CPU 门槛就能运行 Wasm 应用程序。 🗣️ 支持多语言——40 多种编程语言可以编译成 Wasm,有现代的、不断改进的工具链。 服务器平台发展的下一步是什么? 也许你已经看过 Solomon Hykes (Docker的创始人之一)这句话: 如果在2008年已经有了 WASM + WASI,我们根本不需要创建 Docker。 Wasm 就有这么重要。 服务端的 WebAssembly 是计算的未来。 事实上,WASM+WASI 似乎的确是服务端软件基础设施发展的下一步。 最早,我们有物理硬件可以使用。 我们会给机房里每个服务器精心安装操作系统和应用程序,并一一维护。 然后随着 VMware 开创的 VM 的采用,一切变得更容易了。 人们可以跨硬件机器复制、克隆和移动虚拟机。 但这仍然需要在 VM 中安装操作系统和应用程序。 随后出现了由 Docker 推广的容器,这使得在最小打包的上下文下运行应用程序配置变得更加容易,而不会影响主机操作系统上的任何其他应用程序。 但是,仍然需要分发与其运行时和必要的库捆绑在一起的应用程序。 安全边界由 Linux 内核提供。 现在有了 WebAssembly。 它的技术特性和可移植性使得分发应用程序成为可能,无需 ship 操作系统级别的依赖项,并且可以在严格的安全约束下运行。 鉴于所有这些,开发者通常将 WebAssembly 视为容器的“继承者”,以及基础设施部署的自然而然的下一步。 然而,另一种看待 WebAssembly 的方式是将其作为 Docker 工具的另一个“后端”选择。 可以使用相同的命令行工具和工作流,替代 Linux 容器,使用基于 WebAssembly 的容器等同等的东西来实现。 本文的其余部分探讨了这个概念,这就是标题所说的“没有容器的 Docker”。 Wasm 如何结合 Docker 运行? Docker Desktop 现在加入了对 WebAssembly 的支持。 它是通过 containerd shim 实现的,该 shim 可以使用名为 WasmEdge 的 Wasm 运行时来运行 Wasm 应用程序。 这意味着,现在可以在 WasmEdge 运行时(模拟容器)中运行 Wasm 应用程序,而不是用典型的 Windows 或 Linux 容器运行容器镜像中二进制文件的单独进程。 因此,容器镜像不需要包含正在运行的应用程序的操作系统或运行时上下文——单个 Wasm 二进制文件就足够了。 这在 Docker 的 Wasm 技术预览文章中有详细解释。 WasmEdge 是什么? WasmEdge 是一个高性能的 WebAssembly 运行时: 是开源的,属于 CNCF。 支持所有主要的 CPU 架构(x86、ARM、RISC-V)。 支持所有主要操作系统(Linux、Windows、macOS)以及其他操作系统,例如 seL4 RTOS、Android。 针对云原生和边缘应用程序进行了优化。 可扩展并支持标准和新兴技术 使用 Tensorflow、OpenVINO、PyTorch 进行人工智能推理 Tokio 的异步网络。 支持微服务、数据库客户端、消息队列等。 与容器生态、Docker 和 Kubernetes 无缝集成(如本文所示!) 解释型语言呢? 到目前为止,我们只提到了 C 和 Rust 等编译语言可以编译为 WebAssembly。 对于 Python、Ruby 和 PHP 等解释型语言,方法有所不同:它们的解释器是用 C 语言编写的,可以编译为 WebAssembly。 然后这个解释器编译成的 Wasm 可以用来执行源代码文件,通常以 .py、.rb、.php 等结尾。 一旦编译为 Wasm,任何带有 Wasm 运行时的平台都将能够运行这些解释型语言,即使实际的解释器从未为该平台原生编译过。 下一篇文章我们将介绍,如何将 PHP 解释器编译 Wasm ,并打包成 OCI 镜像,并使用内置了 WasmEdge 的 Docker Desktop 运行这个 OCI 镜像,我们也将介绍传统容器与 Wasm 容器的不同之处。 关于WasmEdge WasmEdge 是轻量级、安全、高性能、可扩展、兼容OCI的软件容器与运行环境。目前是 CNCF 沙箱项目。WasmEdge 被应用在 SaaS、云原生,service mesh、边缘计算、边缘云、微服务、流数据处理等领域。 GitHub:https://github.com/WasmEdge/WasmEdge 官网:https://wasmedge.org/ Discord群:https://discord.gg/U4B5sFTkFc 文档:https://wasmedge.org/book/en

优秀的个人博客,低调大师

每日一博 | 8000 字详解 Thread Pool Executor

摘要:Java是如何实现和管理线程池的? 本文分享自华为云社区《JUC线程池: ThreadPoolExecutor详解》,作者:龙哥手记 。 带着大厂的面试问题去理解 提示 请带着这些问题继续后文,会很大程度上帮助你更好的理解相关知识点。@pdai 为什么要有线程池? Java是实现和管理线程池有哪些方式? 请简单举例如何使用。 为什么很多公司不允许使用Executors去创建线程池? 那么推荐怎么使用呢? ThreadPoolExecutor有哪些核心的配置参数? 请简要说明 ThreadPoolExecutor可以创建哪是哪三种线程池呢? 当队列满了并且worker的数量达到maxSize的时候,会怎么样? 说说ThreadPoolExecutor有哪些RejectedExecutionHandler策略? 默认是什么策略? 简要说下线程池的任务执行机制? execute –> addWorker –>runworker (getTask) 线程池中任务是如何提交的? 线程池中任务是如何关闭的? 在配置线程池的时候需要考虑哪些配置因素? 如何监控线程池的状态? 为什么要有线程池 线程池能够对线程进行统一分配,调优和监控: 降低资源消耗(线程无限制地创建,然后使用完毕后销毁) 提高响应速度(无须创建线程) 提高线程的可管理性 ThreadPoolExecutor例子 Java是如何实现和管理线程池的? 从JDK 5开始,把工作单元与执行机制分离开来,工作单元包括Runnable和Callable,而执行机制由Executor框架提供。 WorkerThread public class WorkerThread implements Runnable { private String command; public WorkerThread(String s){ this.command=s; } @Override public void run() { System.out.println(Thread.currentThread().getName()+" Start. Command = "+command); processCommand(); System.out.println(Thread.currentThread().getName()+" End."); } private void processCommand() { try { Thread.sleep(5000); } catch (InterruptedException e) { e.printStackTrace(); } } @Override public String toString(){ return this.command; } } SimpleThreadPool import java.util.concurrent.ExecutorService; import java.util.concurrent.Executors; public class SimpleThreadPool { public static void main(String[] args) { ExecutorService executor = Executors.newFixedThreadPool(5); for (int i = 0; i < 10; i++) { Runnable worker = new WorkerThread("" + i); executor.execute(worker); } executor.shutdown(); // This will make the executor accept no new threads and finish all existing threads in the queue while (!executor.isTerminated()) { // Wait until all threads are finish,and also you can use "executor.awaitTermination();" to wait } System.out.println("Finished all threads"); } } 程序中我们创建了固定大小为五个工作线程的线程池。然后分配给线程池十个工作,因为线程池大小为五,它将启动五个工作线程先处理五个工作,其他的工作则处于等待状态,一旦有工作完成,空闲下来工作线程就会捡取等待队列里的其他工作进行执行。 这里是以上程序的输出。 pool-1-thread-2 Start. Command = 1 pool-1-thread-4 Start. Command = 3 pool-1-thread-1 Start. Command = 0 pool-1-thread-3 Start. Command = 2 pool-1-thread-5 Start. Command = 4 pool-1-thread-4 End. pool-1-thread-5 End. pool-1-thread-1 End. pool-1-thread-3 End. pool-1-thread-3 Start. Command = 8 pool-1-thread-2 End. pool-1-thread-2 Start. Command = 9 pool-1-thread-1 Start. Command = 7 pool-1-thread-5 Start. Command = 6 pool-1-thread-4 Start. Command = 5 pool-1-thread-2 End. pool-1-thread-4 End. pool-1-thread-3 End. pool-1-thread-5 End. pool-1-thread-1 End. Finished all threads 输出表明线程池中至始至终只有五个名为 "pool-1-thread-1" 到 "pool-1-thread-5" 的五个线程,这五个线程不随着工作的完成而消亡,会一直存在,并负责执行分配给线程池的任务,直到线程池消亡。 Executors 类提供了使用了 ThreadPoolExecutor 的简单的 ExecutorService 实现,但是 ThreadPoolExecutor 提供的功能远不止于此。我们可以在创建 ThreadPoolExecutor 实例时指定活动线程的数量,我们也可以限制线程池的大小并且创建我们自己的 RejectedExecutionHandler 实现来处理不能适应工作队列的工作。 这里是我们自定义的 RejectedExecutionHandler 接口的实现。 RejectedExecutionHandlerImpl.java import java.util.concurrent.RejectedExecutionHandler; import java.util.concurrent.ThreadPoolExecutor; public class RejectedExecutionHandlerImpl implements RejectedExecutionHandler { @Override public void rejectedExecution(Runnable r, ThreadPoolExecutor executor) { System.out.println(r.toString() + " is rejected"); } } ThreadPoolExecutor 提供了一些方法,我们可以使用这些方法来查询 executor 的当前状态,线程池大小,活动线程数量以及任务数量。因此我是用来一个监控线程在特定的时间间隔内打印 executor 信息。 MyMonitorThread.java import java.util.concurrent.ThreadPoolExecutor; public class MyMonitorThread implements Runnable { private ThreadPoolExecutor executor; private int seconds; private boolean run=true; public MyMonitorThread(ThreadPoolExecutor executor, int delay) { this.executor = executor; this.seconds=delay; } public void shutdown(){ this.run=false; } @Override public void run() { while(run){ System.out.println( String.format("[monitor] [%d/%d] Active: %d, Completed: %d, Task: %d, isShutdown: %s, isTerminated: %s", this.executor.getPoolSize(), this.executor.getCorePoolSize(), this.executor.getActiveCount(), this.executor.getCompletedTaskCount(), this.executor.getTaskCount(), this.executor.isShutdown(), this.executor.isTerminated())); try { Thread.sleep(seconds*1000); } catch (InterruptedException e) { e.printStackTrace(); } } } } 这里是使用 ThreadPoolExecutor 的线程池实现例子。 WorkerPool.java import java.util.concurrent.ArrayBlockingQueue; import java.util.concurrent.Executors; import java.util.concurrent.ThreadFactory; import java.util.concurrent.ThreadPoolExecutor; import java.util.concurrent.TimeUnit; public class WorkerPool { public static void main(String args[]) throws InterruptedException{ //RejectedExecutionHandler implementation RejectedExecutionHandlerImpl rejectionHandler = new RejectedExecutionHandlerImpl(); //Get the ThreadFactory implementation to use ThreadFactory threadFactory = Executors.defaultThreadFactory(); //creating the ThreadPoolExecutor ThreadPoolExecutor executorPool = new ThreadPoolExecutor(2, 4, 10, TimeUnit.SECONDS, new ArrayBlockingQueue<Runnable>(2), threadFactory, rejectionHandler); //start the monitoring thread MyMonitorThread monitor = new MyMonitorThread(executorPool, 3); Thread monitorThread = new Thread(monitor); monitorThread.start(); //submit work to the thread pool for(int i=0; i<10; i++){ executorPool.execute(new WorkerThread("cmd"+i)); } Thread.sleep(30000); //shut down the pool executorPool.shutdown(); //shut down the monitor thread Thread.sleep(5000); monitor.shutdown(); } } 注意在初始化 ThreadPoolExecutor 时,我们保持初始池大小为 2,最大池大小为 4 而工作队列大小为 2。因此如果已经有四个正在执行的任务而此时分配来更多任务的话,工作队列将仅仅保留他们(新任务)中的两个,其他的将会被 RejectedExecutionHandlerImpl 处理。 上面程序的输出可以证实以上观点。 pool-1-thread-1 Start. Command = cmd0 pool-1-thread-4 Start. Command = cmd5 cmd6 is rejected pool-1-thread-3 Start. Command = cmd4 pool-1-thread-2 Start. Command = cmd1 cmd7 is rejected cmd8 is rejected cmd9 is rejected [monitor] [0/2] Active: 4, Completed: 0, Task: 6, isShutdown: false, isTerminated: false [monitor] [4/2] Active: 4, Completed: 0, Task: 6, isShutdown: false, isTerminated: false pool-1-thread-4 End. pool-1-thread-1 End. pool-1-thread-2 End. pool-1-thread-3 End. pool-1-thread-1 Start. Command = cmd3 pool-1-thread-4 Start. Command = cmd2 [monitor] [4/2] Active: 2, Completed: 4, Task: 6, isShutdown: false, isTerminated: false [monitor] [4/2] Active: 2, Completed: 4, Task: 6, isShutdown: false, isTerminated: false pool-1-thread-1 End. pool-1-thread-4 End. [monitor] [4/2] Active: 0, Completed: 6, Task: 6, isShutdown: false, isTerminated: false [monitor] [2/2] Active: 0, Completed: 6, Task: 6, isShutdown: false, isTerminated: false [monitor] [2/2] Active: 0, Completed: 6, Task: 6, isShutdown: false, isTerminated: false [monitor] [2/2] Active: 0, Completed: 6, Task: 6, isShutdown: false, isTerminated: false [monitor] [2/2] Active: 0, Completed: 6, Task: 6, isShutdown: false, isTerminated: false [monitor] [2/2] Active: 0, Completed: 6, Task: 6, isShutdown: false, isTerminated: false [monitor] [0/2] Active: 0, Completed: 6, Task: 6, isShutdown: true, isTerminated: true [monitor] [0/2] Active: 0, Completed: 6, Task: 6, isShutdown: true, isTerminated: true 注意 executor 的活动任务、完成任务以及所有完成任务,这些数量上的变化。我们可以调用 shutdown() 方法来结束所有提交的任务并终止线程池。 ThreadPoolExecutor使用详解 其实java线程池的实现原理很简单,说白了就是一个线程集合workerSet和一个阻塞队列workQueue。当用户向线程池提交一个任务(也就是线程)时,线程池会先将任务放入workQueue中。workerSet中的线程会不断的从workQueue中获取线程然后执行。当workQueue中没有任务的时候,worker就会阻塞,直到队列中有任务了就取出来继续执行。 Execute原理 当一个任务提交至线程池之后: 线程池首先当前运行的线程数量是否少于corePoolSize。如果是,则创建一个新的工作线程来执行任务。如果都在执行任务,则进入2. 判断BlockingQueue是否已经满了,倘若还没有满,则将线程放入BlockingQueue。否则进入3. 如果创建一个新的工作线程将使当前运行的线程数量超过maximumPoolSize,则交给RejectedExecutionHandler来处理任务。 当ThreadPoolExecutor创建新线程时,通过CAS来更新线程池的状态ctl. 参数 public ThreadPoolExecutor(int corePoolSize, int maximumPoolSize, long keepAliveTime, TimeUnit unit, BlockingQueue<Runnable> workQueue, RejectedExecutionHandler handler) corePoolSize 线程池中的核心线程数,当提交一个任务时,线程池创建一个新线程执行任务,直到当前线程数等于corePoolSize, 即使有其他空闲线程能够执行新来的任务, 也会继续创建线程;如果当前线程数为corePoolSize,继续提交的任务被保存到阻塞队列中,等待被执行;如果执行了线程池的prestartAllCoreThreads()方法,线程池会提前创建并启动所有核心线程。 workQueue 用来保存等待被执行的任务的阻塞队列. 在JDK中提供了如下阻塞队列: 具体可以参考JUC 集合: BlockQueue详解 ArrayBlockingQueue: 基于数组结构的有界阻塞队列,按FIFO排序任务; LinkedBlockingQueue: 基于链表结构的阻塞队列,按FIFO排序任务,吞吐量通常要高于ArrayBlockingQueue; SynchronousQueue: 一个不存储元素的阻塞队列,每个插入操作必须等到另一个线程调用移除操作,否则插入操作一直处于阻塞状态,吞吐量通常要高于LinkedBlockingQueue; PriorityBlockingQueue: 具有优先级的无界阻塞队列; LinkedBlockingQueue比ArrayBlockingQueue在插入删除节点性能方面更优,但是二者在put(), take()任务的时均需要加锁,SynchronousQueue使用无锁算法,根据节点的状态判断执行,而不需要用到锁,其核心是Transfer.transfer(). maximumPoolSize 线程池中允许的最大线程数。如果当前阻塞队列满了,且继续提交任务,则创建新的线程执行任务,前提是当前线程数小于maximumPoolSize;当阻塞队列是无界队列, 则maximumPoolSize则不起作用, 因为无法提交至核心线程池的线程会一直持续地放入workQueue. keepAliveTime 线程空闲时的存活时间,即当线程没有任务执行时,该线程继续存活的时间;默认情况下,该参数只在线程数大于corePoolSize时才有用, 超过这个时间的空闲线程将被终止; unit keepAliveTime的单位 threadFactory 创建线程的工厂,通过自定义的线程工厂可以给每个新建的线程设置一个具有识别度的线程名。默认为DefaultThreadFactory handler 线程池的饱和策略,当阻塞队列满了,且没有空闲的工作线程,如果继续提交任务,必须采取一种策略处理该任务,线程池提供了4种策略: AbortPolicy: 直接抛出异常,默认策略; CallerRunsPolicy: 用调用者所在的线程来执行任务; DiscardOldestPolicy: 丢弃阻塞队列中靠最前的任务,并执行当前任务; DiscardPolicy: 直接丢弃任务; 当然也可以根据应用场景实现RejectedExecutionHandler接口,自定义饱和策略,如记录日志或持久化存储不能处理的任务。 三种类型 newFixedThreadPool public static ExecutorService newFixedThreadPool(int nThreads) { return new ThreadPoolExecutor(nThreads, nThreads, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>()); } 线程池的线程数量达corePoolSize后,即使线程池没有可执行任务时,也不会释放线程。 FixedThreadPool的工作队列为无界队列LinkedBlockingQueue(队列容量为Integer.MAX_VALUE), 这会导致以下问题: 线程池里的线程数量不超过corePoolSize,这导致了maximumPoolSize和keepAliveTime将会是个无用参数 由于使用了无界队列, 所以FixedThreadPool永远不会拒绝, 即饱和策略失效 newSingleThreadExecutor public static ExecutorService newSingleThreadExecutor() { return new FinalizableDelegatedExecutorService (new ThreadPoolExecutor(1, 1, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>())); } 初始化的线程池中只有一个线程,如果该线程异常结束,会重新创建一个新的线程继续执行任务,唯一的线程可以保证所提交任务的顺序执行. 由于使用了无界队列, 所以SingleThreadPool永远不会拒绝, 即饱和策略失效 newCachedThreadPool public static ExecutorService newCachedThreadPool() { return new ThreadPoolExecutor(0, Integer.MAX_VALUE, 60L, TimeUnit.SECONDS, new SynchronousQueue<Runnable>()); } 线程池的线程数可达到Integer.MAX_VALUE,即2147483647,内部使用SynchronousQueue作为阻塞队列; 和newFixedThreadPool创建的线程池不同,newCachedThreadPool在没有任务执行时,当线程的空闲时间超过keepAliveTime,会自动释放线程资源,当提交新任务时,如果没有空闲线程,则创建新线程执行任务,会导致一定的系统开销; 执行过程与前两种稍微不同: 主线程调用SynchronousQueue的offer()方法放入task, 倘若此时线程池中有空闲的线程尝试读取 SynchronousQueue的task, 即调用了SynchronousQueue的poll(), 那么主线程将该task交给空闲线程. 否则执行(2) 当线程池为空或者没有空闲的线程, 则创建新的线程执行任务. 执行完任务的线程倘若在60s内仍空闲, 则会被终止. 因此长时间空闲的CachedThreadPool不会持有任何线程资源. 关闭线程池 遍历线程池中的所有线程,然后逐个调用线程的interrupt方法来中断线程. 关闭方式 - shutdown 将线程池里的线程状态设置成SHUTDOWN状态, 然后中断所有没有正在执行任务的线程. 关闭方式 - shutdownNow 将线程池里的线程状态设置成STOP状态, 然后停止所有正在执行或暂停任务的线程. 只要调用这两个关闭方法中的任意一个, isShutDown() 返回true. 当所有任务都成功关闭了, isTerminated()返回true. ThreadPoolExecutor源码详解 几个关键属性 //这个属性是用来存放 当前运行的worker数量以及线程池状态的 //int是32位的,这里把int的高3位拿来充当线程池状态的标志位,后29位拿来充当当前运行worker的数量 private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0)); //存放任务的阻塞队列 private final BlockingQueue<Runnable> workQueue; //worker的集合,用set来存放 private final HashSet<Worker> workers = new HashSet<Worker>(); //历史达到的worker数最大值 private int largestPoolSize; //当队列满了并且worker的数量达到maxSize的时候,执行具体的拒绝策略 private volatile RejectedExecutionHandler handler; //超出coreSize的worker的生存时间 private volatile long keepAliveTime; //常驻worker的数量 private volatile int corePoolSize; //最大worker的数量,一般当workQueue满了才会用到这个参数 private volatile int maximumPoolSize; 内部状态 private final AtomicInteger ctl = new AtomicInteger(ctlOf(RUNNING, 0)); private static final int COUNT_BITS = Integer.SIZE - 3; private static final int CAPACITY = (1 << COUNT_BITS) - 1; // runState is stored in the high-order bits private static final int RUNNING = -1 << COUNT_BITS; private static final int SHUTDOWN = 0 << COUNT_BITS; private static final int STOP = 1 << COUNT_BITS; private static final int TIDYING = 2 << COUNT_BITS; private static final int TERMINATED = 3 << COUNT_BITS; // Packing and unpacking ctl private static int runStateOf(int c) { return c & ~CAPACITY; } private static int workerCountOf(int c) { return c & CAPACITY; } private static int ctlOf(int rs, int wc) { return rs | wc; } 其中AtomicInteger变量ctl的功能非常强大: 利用低29位表示线程池中线程数,通过高3位表示线程池的运行状态: RUNNING: -1 << COUNT_BITS,即高3位为111,该状态的线程池会接收新任务,并处理阻塞队列中的任务; SHUTDOWN: 0 << COUNT_BITS,即高3位为000,该状态的线程池不会接收新任务,但会处理阻塞队列中的任务; STOP : 1 << COUNT_BITS,即高3位为001,该状态的线程不会接收新任务,也不会处理阻塞队列中的任务,而且会中断正在运行的任务; TIDYING : 2 << COUNT_BITS,即高3位为010, 所有的任务都已经终止; TERMINATED: 3 << COUNT_BITS,即高3位为011, terminated()方法已经执行完成 任务的执行 execute –> addWorker –>runworker (getTask) 线程池的工作线程通过Woker类实现,在ReentrantLock锁的保证下,把Woker实例插入到HashSet后,并启动Woker中的线程。 从Woker类的构造方法实现可以发现: 线程工厂在创建线程thread时,将Woker实例本身this作为参数传入,当执行start方法启动线程thread时,本质是执行了Worker的runWorker方法。 firstTask执行完成之后,通过getTask方法从阻塞队列中获取等待的任务,如果队列中没有任务,getTask方法会被阻塞并挂起,不会占用cpu资源; execute()方法 ThreadPoolExecutor.execute(task)实现了Executor.execute(task) public void execute(Runnable command) { if (command == null) throw new NullPointerException(); /* * Proceed in 3 steps: * * 1. If fewer than corePoolSize threads are running, try to * start a new thread with the given command as its first * task. The call to addWorker atomically checks runState and * workerCount, and so prevents false alarms that would add * threads when it shouldn't, by returning false. * * 2. If a task can be successfully queued, then we still need * to double-check whether we should have added a thread * (because existing ones died since last checking) or that * the pool shut down since entry into this method. So we * recheck state and if necessary roll back the enqueuing if * stopped, or start a new thread if there are none. * * 3. If we cannot queue task, then we try to add a new * thread. If it fails, we know we are shut down or saturated * and so reject the task. */ int c = ctl.get(); if (workerCountOf(c) < corePoolSize) { //workerCountOf获取线程池的当前线程数;小于corePoolSize,执行addWorker创建新线程执行command任务 if (addWorker(command, true)) return; c = ctl.get(); } // double check: c, recheck // 线程池处于RUNNING状态,把提交的任务成功放入阻塞队列中 if (isRunning(c) && workQueue.offer(command)) { int recheck = ctl.get(); // recheck and if necessary 回滚到入队操作前,即倘若线程池shutdown状态,就remove(command) //如果线程池没有RUNNING,成功从阻塞队列中删除任务,执行reject方法处理任务 if (! isRunning(recheck) && remove(command)) reject(command); //线程池处于running状态,但是没有线程,则创建线程 else if (workerCountOf(recheck) == 0) addWorker(null, false); } // 往线程池中创建新的线程失败,则reject任务 else if (!addWorker(command, false)) reject(command); } 为什么需要double check线程池的状态? 在多线程环境下,线程池的状态时刻在变化,而ctl.get()是非原子操作,很有可能刚获取了线程池状态后线程池状态就改变了。判断是否将command加入workque是线程池之前的状态。倘若没有double check,万一线程池处于非running状态(在多线程环境下很有可能发生),那么command永远不会执行。 addWorker方法 从方法execute的实现可以看出: addWorker主要负责创建新的线程并执行任务 线程池创建新线程执行任务时,需要 获取全局锁: private final ReentrantLock mainLock = new ReentrantLock(); private boolean addWorker(Runnable firstTask, boolean core) { // CAS更新线程池数量 retry: for (;;) { int c = ctl.get(); int rs = runStateOf(c); // Check if queue empty only if necessary. if (rs >= SHUTDOWN && ! (rs == SHUTDOWN && firstTask == null && ! workQueue.isEmpty())) return false; for (;;) { int wc = workerCountOf(c); if (wc >= CAPACITY || wc >= (core ? corePoolSize : maximumPoolSize)) return false; if (compareAndIncrementWorkerCount(c)) break retry; c = ctl.get(); // Re-read ctl if (runStateOf(c) != rs) continue retry; // else CAS failed due to workerCount change; retry inner loop } } boolean workerStarted = false; boolean workerAdded = false; Worker w = null; try { w = new Worker(firstTask); final Thread t = w.thread; if (t != null) { // 线程池重入锁 final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { // Recheck while holding lock. // Back out on ThreadFactory failure or if // shut down before lock acquired. int rs = runStateOf(ctl.get()); if (rs < SHUTDOWN || (rs == SHUTDOWN && firstTask == null)) { if (t.isAlive()) // precheck that t is startable throw new IllegalThreadStateException(); workers.add(w); int s = workers.size(); if (s > largestPoolSize) largestPoolSize = s; workerAdded = true; } } finally { mainLock.unlock(); } if (workerAdded) { t.start(); // 线程启动,执行任务(Worker.thread(firstTask).start()); workerStarted = true; } } } finally { if (! workerStarted) addWorkerFailed(w); } return workerStarted; } Worker类的runworker方法 private final class Worker extends AbstractQueuedSynchronizer implements Runnable{ Worker(Runnable firstTask) { setState(-1); // inhibit interrupts until runWorker this.firstTask = firstTask; this.thread = getThreadFactory().newThread(this); // 创建线程 } /** Delegates main run loop to outer runWorker */ public void run() { runWorker(this); } // ... } 继承了AQS类,可以方便的实现工作线程的中止操作; 实现了Runnable接口,可以将自身作为一个任务在工作线程中执行; 当前提交的任务firstTask作为参数传入Worker的构造方法; 一些属性还有构造方法: //运行的线程,前面addWorker方法中就是直接通过启动这个线程来启动这个worker final Thread thread; //当一个worker刚创建的时候,就先尝试执行这个任务 Runnable firstTask; //记录完成任务的数量 volatile long completedTasks; Worker(Runnable firstTask) { setState(-1); // inhibit interrupts until runWorker this.firstTask = firstTask; //创建一个Thread,将自己设置给他,后面这个thread启动的时候,也就是执行worker的run方法 this.thread = getThreadFactory().newThread(this); } runWorker方法是线程池的核心: 线程启动之后,通过unlock方法释放锁,设置AQS的state为0,表示运行可中断; Worker执行firstTask或从workQueue中获取任务: 进行加锁操作,保证thread不被其他线程中断(除非线程池被中断) 检查线程池状态,倘若线程池处于中断状态,当前线程将中断。 执行beforeExecute 执行任务的run方法 执行afterExecute方法 解锁操作 通过getTask方法从阻塞队列中获取等待的任务,如果队列中没有任务,getTask方法会被阻塞并挂起,不会占用cpu资源; final void runWorker(Worker w) { Thread wt = Thread.currentThread(); Runnable task = w.firstTask; w.firstTask = null; w.unlock(); // allow interrupts boolean completedAbruptly = true; try { // 先执行firstTask,再从workerQueue中取task(getTask()) while (task != null || (task = getTask()) != null) { w.lock(); // If pool is stopping, ensure thread is interrupted; // if not, ensure thread is not interrupted. This // requires a recheck in second case to deal with // shutdownNow race while clearing interrupt if ((runStateAtLeast(ctl.get(), STOP) || (Thread.interrupted() && runStateAtLeast(ctl.get(), STOP))) && !wt.isInterrupted()) wt.interrupt(); try { beforeExecute(wt, task); Throwable thrown = null; try { task.run(); } catch (RuntimeException x) { thrown = x; throw x; } catch (Error x) { thrown = x; throw x; } catch (Throwable x) { thrown = x; throw new Error(x); } finally { afterExecute(task, thrown); } } finally { task = null; w.completedTasks++; w.unlock(); } } completedAbruptly = false; } finally { processWorkerExit(w, completedAbruptly); } } getTask方法 下面来看一下getTask()方法,这里面涉及到keepAliveTime的使用,从这个方法我们可以看出线程池是怎么让超过corePoolSize的那部分worker销毁的。 private Runnable getTask() { boolean timedOut = false; // Did the last poll() time out? for (;;) { int c = ctl.get(); int rs = runStateOf(c); // Check if queue empty only if necessary. if (rs >= SHUTDOWN && (rs >= STOP || workQueue.isEmpty())) { decrementWorkerCount(); return null; } int wc = workerCountOf(c); // Are workers subject to culling? boolean timed = allowCoreThreadTimeOut || wc > corePoolSize; if ((wc > maximumPoolSize || (timed && timedOut)) && (wc > 1 || workQueue.isEmpty())) { if (compareAndDecrementWorkerCount(c)) return null; continue; } try { Runnable r = timed ? workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) : workQueue.take(); if (r != null) return r; timedOut = true; } catch (InterruptedException retry) { timedOut = false; } } } 注意这里一段代码是keepAliveTime起作用的关键: boolean timed = allowCoreThreadTimeOut || wc > corePoolSize; Runnable r = timed ? workQueue.poll(keepAliveTime, TimeUnit.NANOSECONDS) : workQueue.take(); allowCoreThreadTimeOut为false,线程即使空闲也不会被销毁;倘若为ture,在keepAliveTime内仍空闲则会被销毁。 如果线程允许空闲等待而不被销毁timed == false,workQueue.take任务: 如果阻塞队列为空,当前线程会被挂起等待;当队列中有任务加入时,线程被唤醒,take方法返回任务,并执行; 如果线程不允许无休止空闲timed == true, workQueue.poll任务: 如果在keepAliveTime时间内,阻塞队列还是没有任务,则返回null; 任务的提交 submit任务,等待线程池execute 执行FutureTask类的get方法时,会把主线程封装成WaitNode节点并保存在waiters链表中, 并阻塞等待运行结果; FutureTask任务执行完成后,通过UNSAFE设置waiters相应的waitNode为null,并通过LockSupport类unpark方法唤醒主线程; public class Test{ public static void main(String[] args) { ExecutorService es = Executors.newCachedThreadPool(); Future<String> future = es.submit(new Callable<String>() { @Override public String call() throws Exception { try { TimeUnit.SECONDS.sleep(2); } catch (InterruptedException e) { e.printStackTrace(); } return "future result"; } }); try { String result = future.get(); System.out.println(result); } catch (Exception e) { e.printStackTrace(); } } } 在实际业务场景中,Future和Callable基本是成对出现的,Callable负责产生结果,Future负责获取结果。 Callable接口类似于Runnable,只是Runnable没有返回值。 Callable任务除了返回正常结果之外,如果发生异常,该异常也会被返回,即Future可以拿到异步执行任务各种结果; Future.get方法会导致主线程阻塞,直到Callable任务执行完成; submit方法 AbstractExecutorService.submit()实现了ExecutorService.submit() 可以获取执行完的返回值, 而ThreadPoolExecutor 是AbstractExecutorService.submit()的子类,所以submit方法也是ThreadPoolExecutor`的方法。 // submit()在ExecutorService中的定义 <T> Future<T> submit(Callable<T> task); <T> Future<T> submit(Runnable task, T result); Future<?> submit(Runnable task); // submit方法在AbstractExecutorService中的实现 public Future<?> submit(Runnable task) { if (task == null) throw new NullPointerException(); // 通过submit方法提交的Callable任务会被封装成了一个FutureTask对象。 RunnableFuture<Void> ftask = newTaskFor(task, null); execute(ftask); return ftask; } 通过submit方法提交的Callable任务会被封装成了一个FutureTask对象。通过Executor.execute方法提交FutureTask到线程池中等待被执行,最终执行的是FutureTask的run方法; FutureTask对象 public class FutureTask<V> implements RunnableFuture<V> 可以将FutureTask提交至线程池中等待被执行(通过FutureTask的run方法来执行) 内部状态 /* The run state of this task, initially NEW. * ... * Possible state transitions: * NEW -> COMPLETING -> NORMAL * NEW -> COMPLETING -> EXCEPTIONAL * NEW -> CANCELLED * NEW -> INTERRUPTING -> INTERRUPTED */ private volatile int state; private static final int NEW = 0; private static final int COMPLETING = 1; private static final int NORMAL = 2; private static final int EXCEPTIONAL = 3; private static final int CANCELLED = 4; private static final int INTERRUPTING = 5; private static final int INTERRUPTED = 6; 内部状态的修改通过sun.misc.Unsafe修改 get方法 public V get() throws InterruptedException, ExecutionException { int s = state; if (s <= COMPLETING) s = awaitDone(false, 0L); return report(s); } 内部通过awaitDone方法对主线程进行阻塞,具体实现如下: private int awaitDone(boolean timed, long nanos) throws InterruptedException { final long deadline = timed ? System.nanoTime() + nanos : 0L; WaitNode q = null; boolean queued = false; for (;;) { if (Thread.interrupted()) { removeWaiter(q); throw new InterruptedException(); } int s = state; if (s > COMPLETING) { if (q != null) q.thread = null; return s; } else if (s == COMPLETING) // cannot time out yet Thread.yield(); else if (q == null) q = new WaitNode(); else if (!queued) queued = UNSAFE.compareAndSwapObject(this, waitersOffset,q.next = waiters, q); else if (timed) { nanos = deadline - System.nanoTime(); if (nanos <= 0L) { removeWaiter(q); return state; } LockSupport.parkNanos(this, nanos); } else LockSupport.park(this); } } 如果主线程被中断,则抛出中断异常; 判断FutureTask当前的state,如果大于COMPLETING,说明任务已经执行完成,则直接返回; 如果当前state等于COMPLETING,说明任务已经执行完,这时主线程只需通过yield方法让出cpu资源,等待state变成NORMAL; 通过WaitNode类封装当前线程,并通过UNSAFE添加到waiters链表; 最终通过LockSupport的park或parkNanos挂起线程; run方法 public void run() { if (state != NEW || !UNSAFE.compareAndSwapObject(this, runnerOffset, null, Thread.currentThread())) return; try { Callable<V> c = callable; if (c != null && state == NEW) { V result; boolean ran; try { result = c.call(); ran = true; } catch (Throwable ex) { result = null; ran = false; setException(ex); } if (ran) set(result); } } finally { // runner must be non-null until state is settled to // prevent concurrent calls to run() runner = null; // state must be re-read after nulling runner to prevent // leaked interrupts int s = state; if (s >= INTERRUPTING) handlePossibleCancellationInterrupt(s); } } FutureTask.run方法是在线程池中被执行的,而非主线程 通过执行Callable任务的call方法; 如果call执行成功,则通过set方法保存结果; 如果call执行有异常,则通过setException保存异常; 任务的关闭 shutdown方法会将线程池的状态设置为SHUTDOWN,线程池进入这个状态后,就拒绝再接受任务,然后会将剩余的任务全部执行完 public void shutdown() { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { //检查是否可以关闭线程 checkShutdownAccess(); //设置线程池状态 advanceRunState(SHUTDOWN); //尝试中断worker interruptIdleWorkers(); //预留方法,留给子类实现 onShutdown(); // hook for ScheduledThreadPoolExecutor } finally { mainLock.unlock(); } tryTerminate(); } private void interruptIdleWorkers() { interruptIdleWorkers(false); } private void interruptIdleWorkers(boolean onlyOne) { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { //遍历所有的worker for (Worker w : workers) { Thread t = w.thread; //先尝试调用w.tryLock(),如果获取到锁,就说明worker是空闲的,就可以直接中断它 //注意的是,worker自己本身实现了AQS同步框架,然后实现的类似锁的功能 //它实现的锁是不可重入的,所以如果worker在执行任务的时候,会先进行加锁,这里tryLock()就会返回false if (!t.isInterrupted() && w.tryLock()) { try { t.interrupt(); } catch (SecurityException ignore) { } finally { w.unlock(); } } if (onlyOne) break; } } finally { mainLock.unlock(); } } shutdownNow做的比较绝,它先将线程池状态设置为STOP,然后拒绝所有提交的任务。最后中断左右正在运行中的worker,然后清空任务队列。 public List<Runnable> shutdownNow() { List<Runnable> tasks; final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { checkShutdownAccess(); //检测权限 advanceRunState(STOP); //中断所有的worker interruptWorkers(); //清空任务队列 tasks = drainQueue(); } finally { mainLock.unlock(); } tryTerminate(); return tasks; } private void interruptWorkers() { final ReentrantLock mainLock = this.mainLock; mainLock.lock(); try { //遍历所有worker,然后调用中断方法 for (Worker w : workers) w.interruptIfStarted(); } finally { mainLock.unlock(); } } 更深入理解 为什么线程池不允许使用Executors去创建? 推荐方式是什么? 线程池不允许使用Executors去创建,而是通过ThreadPoolExecutor的方式,这样的处理方式让写的同学更加明确线程池的运行规则,规避资源耗尽的风险。 说明:Executors各个方法的弊端: newFixedThreadPool和newSingleThreadExecutor: 主要问题是堆积的请求处理队列可能会耗费非常大的内存,甚至OOM。 newCachedThreadPool和newScheduledThreadPool: 主要问题是线程数最大数是Integer.MAX_VALUE,可能会创建数量非常多的线程,甚至OOM。 推荐方式 1 首先引入:commons-lang3包 ScheduledExecutorService executorService = new ScheduledThreadPoolExecutor(1, new BasicThreadFactory.Builder().namingPattern("example-schedule-pool-%d").daemon(true).build()); 推荐方式 2 首先引入:com.google.guava包 ThreadFactory namedThreadFactory = new ThreadFactoryBuilder().setNameFormat("demo-pool-%d").build(); //Common Thread Pool ExecutorService pool = new ThreadPoolExecutor(5, 200, 0L, TimeUnit.MILLISECONDS, new LinkedBlockingQueue<Runnable>(1024), namedThreadFactory, new ThreadPoolExecutor.AbortPolicy()); // excute pool.execute(()-> System.out.println(Thread.currentThread().getName())); //gracefully shutdown pool.shutdown(); 推荐方式 3 spring配置线程池方式:自定义线程工厂bean需要实现ThreadFactory,可参考该接口的其它默认实现类,使用方式直接注入bean调用execute(Runnable task)方法即可 <bean id="userThreadPool" class="org.springframework.scheduling.concurrent.ThreadPoolTaskExecutor"> <property name="corePoolSize" value="10" /> <property name="maxPoolSize" value="100" /> <property name="queueCapacity" value="2000" /> <property name="threadFactory" value= threadFactory /> <property name="rejectedExecutionHandler"> <ref local="rejectedExecutionHandler" /> </property> </bean> //in code userThreadPool.execute(thread); 配置线程池需要考虑因素 从任务的优先级,任务的执行时间长短,任务的性质(CPU密集/ IO密集),任务的依赖关系这四个角度来分析。并且近可能地使用有界的工作队列。 性质不同的任务可用使用不同规模的线程池分开处理: CPU密集型: 尽可能少的线程,Ncpu+1 IO密集型: 尽可能多的线程, Ncpu*2,比如数据库连接池 混合型: CPU密集型的任务与IO密集型任务的执行时间差别较小,拆分为两个线程池;否则没有必要拆分。 监控线程池的状态 可以使用ThreadPoolExecutor以下方法: getTaskCount() Returns the approximate total number of tasks that have ever been scheduled for execution. getCompletedTaskCount() Returns the approximate total number of tasks that have completed execution. 返回结果少于getTaskCount()。 getLargestPoolSize() Returns the largest number of threads that have ever simultaneously been in the pool. 返回结果小于等于maximumPoolSize getPoolSize() Returns the current number of threads in the pool. getActiveCount() Returns the approximate number of threads that are actively executing tasks. 参考文章 《Java并发编程艺术》 https://www.jianshu.com/p/87bff5cc8d8c https://blog.csdn.net/programmer_at/article/details/79799267 https://blog.csdn.net/u013332124/article/details/79587436 https://www.journaldev.com/1069/threadpoolexecutor-java-thread-pool-example-executorservice 点击关注,第一时间了解华为云新鲜技术~

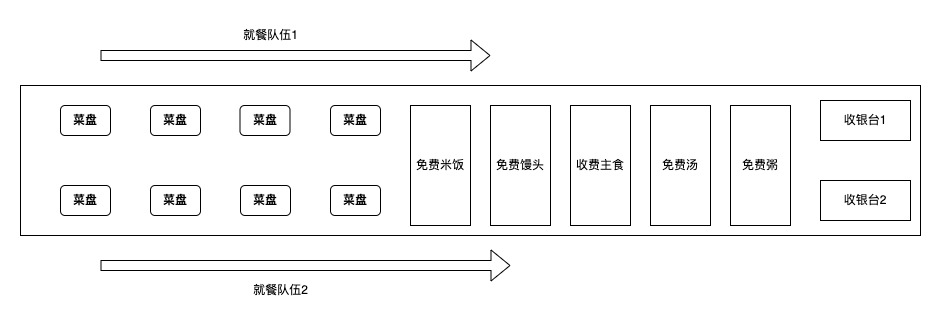
优秀的个人博客,低调大师

每日一博 | 广告倒排服务极致优化

作者 | XY 导读 漏斗优化是检索系统不变的话题,过去一年来,广告漏斗优化一改往日做“加法”,而通过简化漏斗,提升全系统一致性。如百度这样庞大的广告库规模、高流量规模以及复杂的业务规则,要做到极简的漏斗层次,需要最高效的策略设计和最极致的工程实现。本文重点介绍了百度Geeker们在倒排数据结构上如何“抠细节”达到倒排召回无截断,对大家做高性能系统也将有所启发。 全文6162字,预计阅读时间16分钟。 01 业务背景 - 全系统Limitless 大家都清楚,广告漏斗包括召回、粗排、精排这三部分,理想中的漏斗上宽下窄很规整,而现实中因为种种原因,漏斗已经略显飘逸了,这种不一致性会带来很多业务继续发展的复杂度。我们希望达到:模型一致,精简漏斗,全系统Limitless。 我们对Limitless的认识:细节处见真章,挑战软件工程性能极限,方能漏斗近似无截断。 今天想跟大家聊聊『BS Limitless』项目里我们怎么抠细节的,整个项目其实挑战很大,网络、计算和存储方方面面都涉及到,一篇短文很难讲透,因此我决定选一个数据结构-倒排表,让大家感受到『极致』优化。 02 技术背景 - 倒排表 先介绍一下优化前的倒排表,它的组成比较经典特点,HashMap<keysign, SkipList>。一次检索pv根据触发的N个词(keysign)扫描拉链(SkipList),广告业务投放特点天然会有长链、超长链,为此链表需要有序,做过漏斗的同学知道,在倒排阶段排序能用的信息其实是很少的,这也说明了扫描Limitless对业务的高价值。 这样一个小小的数据结构承担了各方的要求,1、读性能决定有限时间能放出多少量,2、实时插入决定客户投放能不能立即生效,3、单库规模巨大,内存损耗要低。对工程的合理要求,确实是既要...又要...还要...。在Limitless的大背景下,我们要显著提升1达到scan limitless,但是不能损害到2和3。 回过头来看,这么简单的数据结构,Limitless的瓶颈到底是什么?大家回忆一下计算机体系结构的内容。cpu并不直接访存,而通过层层缓存到达内存,存储层次越低,它的容量越大但延迟越高,mem和L2、L1之间有量级差距[1]。List这种数据结构显然缺乏空间局部性。 缓存不亲和的List对比缓存友好的Array,在扫描上究竟有多差呢?我们做了如下的评测,其中横轴代表链长或数组长度,纵轴是平均到单条元素的扫描耗时,结果是10+差距。换成数组Array,也是不行的,客户要求实时生效,为了低效拷贝损耗需要O(2N)的增长速度,内存成本要求也不能满足。 03 方案 - HybridIndexTable 我们针对业务的特点和Limitless的要求进行极致设计和优化,推出了新一代的内存数据结构HybridIndexTable,简称HIT。升级后的倒排表: 1、用HashMap索引keysign, 2、短链采用连续存储,长链则是一棵叶子连续存储的前缀树,前缀树则参考了业界AdaptiveRadixTree,简称ART, 3、短链和叶子的)连续存储都采用了自研的RowContainer,简称RC。 在简短的数据结构之外,还要和大家分享两个关键细节: 1、Key序路由兜底超长链有序, 2、RC间无序,以RC为单位扫描。 HIT这样的数据结构有如下三点优势,恰到好处地满足了前面的三个要求。 读取性能高,连续存储+前缀树降低cachemiss,线程安全做法reader-friendly,还有面向负载的优化; 更新时效性高,连续存储但append-only/mark-delete; 内存损耗少,应用了大量的自适应算法。 HIT上线后拿到了非常可观的业务收益,Limitless的道路上 技术就是生产力! 04 HIT缘起,内存索引ModernCPU的探索 内存索引领域已在面向Modern Cpu深耕,ModernCpu由于Cpu运行得很快,使得缓存一致性的影响、访存的影响成为高性能的瓶颈。内存索引在2000s也有些阶段性的标志成果,包括FAST[4],它是面向体系结构的数据结构设计的典型,无论是思想还是成果非常适用于静态数据;CSBtree[2][3],它提出数据结构上通过KV分离,使得一次访存能比较多个Key,同时还提出了SMO的无锁解法;还有ART前缀树[5]。有序索引中BTree居多,我们为何注意到了前缀树呢? 链表类型的缓存失效发生在每次访问下一个节点,缓存失效复杂度O(n)。排序树类型的缓存失效发生在访问下一层节点,缓存失效复杂度O(lgn)。而对于前缀树来说,缓存失效只和 键长k(len)/扇出s(pan) 有关,缓存失效复杂度O(k/s)。如下图[5],假设k是键长的bit数,随着存储数据量上涨2^(k/8)、2^(k/4)、...,完全平衡树高不断增加,分别是k/8、k/4、...,而对于一颗前缀树,树高对于给定的span是恒定的,如针对span=8和4,树高分别是k/8、k/4。前缀树更加缓存友好。 这里简单介绍下前缀树,英文是Trie、Prefix tree或Digit tree,左图是维基百科的实例,这是个典型的没有任何优化的前缀树,一方面,只有单分叉的情况下也多分出一级,比如inn;另一方面,由于在分支节点需要分配 2 ^ s * pointer 的内存,对于实际扇出极少的场景,内存损耗非常大。 RadixTree是一种通过合并前缀(PathCompression)优化内存的前缀树。合并前缀是指压缩掉仅有一个孩子的分支节点,这样存在的节点或者是叶子节点,或者是有分叉的分支节点。名字中的radix=2^span,它在radix=2的情况下,也叫做Patricia tree[6]。Linux PageCache页面缓存用的是RadixTree,以太坊币ETH的核心数据结构是Merkle Patricia tree。中间图是按照RadixTree重新组织的。 即便有合并前缀,由于大部分扇出是填不满,浪费了空间。比如上面例子的RadixTree(radix = 256, s=8),那么即便在第一级只有t、A、i,也需要多分配 253 * 8 ~ 1Kbytes。调整radix(span = lg(radix))是一种内存优化方式,但这提高了树高增加了缓存失效[5]。2013年,A(daptive)R(adix)T(ree)[6]用自适应的节点类型来解决问题,用适合数据分布的最紧凑的节点表示,而不是固定的Node256。论文中 InnerNode 分为 Node4、Node16、Node80和Node256这四种,按照实际需要的分叉数选择,通过类分摊算法(Amortization Alg)复杂度分析方法,可证明理论上这棵树内存复杂度是O(52N),其中N是存储数据量。ART论文提供了一种方式,在提高扇出降低树高的同时,还能大幅度降低内存开销。按照ART重新组织上面例子中的RadixTree,如图所示。 05 HIT优化,RC实现ShortList+LongList Leaf的自适应 我们定义 RC_x 为不超过x个元素的连续存储空间,支持Append-Only和Mark-Delete操作,单元素额外成本不超过8byte。接下来看RC的设计要点。 既然RC被设计为只支持Append-Only/Mark-Delete修改的数据类型,为此元数据需有cursor和valids。同时针对不同容量的RC,为了控制理论上单条数据损耗不超过8byte,需要分别设计和实现,我们不希望引入继承virtual指针的内存开销,采用根据type分发的实现方案。 RC1元数据8byte,可轻松容纳cursor和valids,那么下一阶的RC_x,x是几呢?按照分摊分析方法,RC_x至少有2个元素,也就是16byte的预算,在分配前还是要先看选型,RC_x需要变长因此元数据还有留出来8byte给dataptr,这样的话,valids不能采用std::bitset<N>,因为bitset的实现至少需要一个字也就是8byte。valids和cursor用bit field 的方式来做分配看上去还是比较充裕的,存放58个数据元素都没问题,实际上考虑到系统分配器的特点,我们并没有这样做。 主流的系统分配器大部分是slab-based,在实际应用时,除过理论单条数据损耗,还需要考虑因内存池带来的对齐损耗。一方面,RC1所在的链约占整体的80%,这样海量的小对象适合用内存池来管理,为避免检索时候多一次内存池地址转化,我们把vaddr存储在元数据中,释放时再使用。另一方面,分散式地分配 N*sizeof(data),会造成每类slab的内部非充分使用,为此RC16+采取了Array of data_array的组织方式。 RC设计有不少实现细节,包括什么时候一次性多申请多少空间,控制内存成本和操作效率。时间关系就不多介绍了。 06 LeafCompaction优化稀疏 前缀树在缓存失效方面优于BTree,ART进一步地采用自适应节点类型,既能增加扇出优化缓存访问,又能控制内存损耗。然而实际应用中,ART仍然受到key值分布稀疏的影响,这表现为在部分子树扇出很小很深(较Node256),树高无法全面降低,从而影响点查的缓存。HOT[7]提出一种自适应动态span提升平均扇出,进而降低树高的方法,具体来说,定义节点最大扇出k,寻找一种树的划分,在每个划分的分支节点数不大于k-1的前提下,沿着叶子到根的划分数的最大值取最小,这样的实际效果就是对于稀疏段的span足够大,对于密集段的span足够小,整体扇出逼近最大扇出k。如中图所示。 对于ART+目标的连续性应用场景来说,仅仅提升扇出降低树高是不够的,我们发现存在扇出很高,但扇出后叶子数据很稀疏,同时总数据量也不高,这显然影响了扫描性能。我们提出叶子合并(LeafCompaction),它包括判定器和操作算法。给定一个分支节点,如果它被判定为合并,则用一个叶子节点替换它,该叶子节点的前缀同该树的前缀,内容是该树的数据,后续插入/删除过程遵从叶子的操作方式;如果它被判定为不变,则保持。给定一个叶子节点,如果它被判定为分裂,则用一颗树替换它,该树的前缀同该叶子的前缀,内容通过BulkLoad的方式生成,如果它被判定为不变,则保持。判定器的默认算法依据子树平均和总数,节点压缩率高达90%。如图所示。 实际评测效果,平均到单条数据的扫描性能,稀疏场景下LC版本优于普通版本一倍。 07 RCU面向读者实现读写安全 一般使用深度优化的细粒度锁来保护倒排数据结构的并行操作,但锁竞争带来的性能抖动,完全抹杀了访存优化,我们必须探索出一种无锁(lock-free)安全模式。提到无锁lock-free,大家都觉得是CAS,其实一方面CAS不是银弹,CAS常见的写法是whileloop直到成功,如果有10个线程都在高速修改一个链表尾巴,这时候CAS只是说把陷入内核省掉了,但是还是要不停地重做,这并不能完全释放并行的能力,最好能从业务上打散。另一方面,CAS也有问题,多核下 CPU cache coherence protocol总线仲裁,导致破坏流水线。 Read-Copy-Update 是Linux内核中的一种同步机制,被用来降低读者侧的锁开销,同时提供安全的写机制,具体地来说,多个读者(reader)并行地访问临界资源,写者(writer)在更新临界资源(critical resource)时候,拷贝一份副本作为修改基础,修改后原子性替换掉。当所有读者释放了这个临界资源后(Grace peroid),再释放资源(reclaimer)。 Linux还需要较复杂的机制: 1、探测静止状态 Quiescent Status,当所有CPU都经历过至少一次静止状态时,才认为Grace peroid结束; 2、多写者间同步,避免丢失修改。 对于检索服务来说,它有下面3个特点,这些特点大幅度地降低了我们的设计复杂度: 1、单写者,我们可能有其他的准备线程并行做更重的准备工作,但只有Reload单线程负责物料更新; 2、非事务,检索线程召回的多条数据间没有严格约束; 3、读者持有时间有限,检索线程有严格的超时要求。这些特点大幅度地降低了我们的设计复杂度。 08 LearnedIndex面向Workload自适应 最后,我再介绍下进行中的工作L2I。刚才都是对单链的优化缓存失效,已有不错的效果,但从更宏观全局的视角来看,我们系统还有可挖掘空间:一方面,广告投放天然导致存在较多超短链,另一方面,需要扫描过程跨表查询做各类过滤逻辑等等。这些已不单单是数据分布的问题,而是在线流量和客户投放的匹配,需要用更智能的手段来解决。 行业里面,JeffDean&TimK 联合发表了Learned Index[8]引入RMI、CDF的模型,后续TimK团队又有动态化、多维索引、sagedb等多种方向的发展,本质是构建面向负载的半自动化寻优系统。我们既要引入负载特征,但由于扫描过程很轻量,不能做过重的预测,同时作为对客户有承诺的商业系统,不能产生错误。借鉴L2I的思想,我们还做了两个事情,一方面、通过触发出口离线计算共现关系,用来合并超短链、短链,用上HIT的高性能的连续扫描能力;另一方面,取熵最大的组合<pid,cid>,提取到倒排表的bit位,确定不过1,否则为0,对于后者 fallback到点查计算。 ——END—— 参考资料: [1] Software Engineering Advice from Building Large-Scale Distributed Systems, 2002 [2] Cache conscious indexing for decision-support in main memory,1999 [3] Making B+-trees cache conscious in main memory,2000 [4] FAST: fast architecture sensitive tree search on modern CPUs and GPUs,2010 [5] The Adaptive Radix Tree: ARTful Indexing for Main-Memory Databases,2013 [6] PATRICIA --Practical Algorithm To Retrieve Information Coded in Alphanumeric,1968 [7] HOT: A height optimized trie index for main-memory database systems, 2018 [8] The Case for Learned Index Structures, 2018 推荐阅读: 为什么 OpenCV 计算的视频 FPS 是错的 百度 Android 直播秒开体验优化 iOS SIGKILL 信号量崩溃抓取以及优化实践 如何在几百万qps的网关服务中实现灵活调度策略 深入浅出DDD编程 百度APP iOS端内存优化实践-内存管控方案

优秀的个人博客,低调大师

每日一博 | 使用 Svelte 来构建 Web Component

每个开发人员都应该关注代码中的可重用性以及代码的业务隔离,这样可以让业务逻辑与应用架构分离,提升系统的扩展性。而 Web Component 就是这样一个技术,可以让我们创建一个独立的可重用组件。 本文将介绍使用 Svelte 创建通用的 Web Component 的完成过程。『通用』指的是该组件不局限于 Svelte 应用,还可以用于任何 JavaScript 应用程序(如 Vue、React 等),同时还将介绍使用 Svelte 创建 Web Component 的一些局限性。 什么是 Web Component? Web Component 可以让我们创建可重用的、自定义的封装了样式以及功能的 HTML 元素。 例如,我们使用如下代码来创建一个导航条: <style> /* CSS code for our navbar */ </style> <navbar> <!-- Some long code for our navbar --> </navbar> 如果用 Web Component 技术,我们可以定义一个自定义元素(如 <custom-navbar/>),然后你可以在网页任一地方使用该元素显示导航条,同时这个导航条的样式和页面其他元素的样式是完全隔离的,不会相互影响。而这项技术被称之为 Shadow DOM (影子 DOM)。 什么是 Shadow DOM? Shadow DOM 是一个较小的、独立的 DOM,它与主 DOM 分开渲染,允许我们将样式和标记行为隔离到单个组件中。Shadow DOM 本质上允许我们将组件功能进行封装和隔离,我们可以单独对其设置样式、编写功能脚本,而不会干扰应用程序的其余元素。 你大概对 Web Component 有一个基本的认识,下面我们开始用 Svelte 来编写一个简单的组件。 构建 Web Component 准备工作 为了完成本文剩余的内容学习,需要你对掌握以下知识: 对 HTML, CSS 和 JavaScript 有基本的认识 熟悉命令行操作环境 需要一个文本编辑器 最好对 Svelte 有一些基本的了解(可以看看我之前翻译的文章https://my.oschina.net/javayou/blog/5309554) 开始 本文我们将开发两个组件: 第一个组件是一个卡片组件,接收三个属性分别是:卡片标题、卡片描述以及图片,该组件名为<my-card/> 第二个组件是一个带样式的按钮,接收一个type的属性,通过该属性来确定按钮的显示样式,组件名称为<cool-button/> 同时我们将使用两种组件的发布方式,一个是打包到单一文件,另外一个是每个组件发布到一个独立的文件中。 下图显示的是两个组件运行后的外观: 我们从创建一个 Svelte 应用开始,并安装必须的包: npx degit sveltejs/template web-component-tut cd web-component-tut npm install 上述命令执行完毕就可以使用如下命令启动一个测试环境: npm run dev 然后我们打开浏览器访问http://localhost:8080就可以看到一个最基础的 Svelte 应用运行起来后的样子: 开发一个组件 使用 Svelte 生成通用 Web Component 的过程类似于创建常规 Svelte 组件的过程,只是进行了一些修改。 为了创建第一个卡片组件,我们首先创建一个文件src/Card.svelte并定义组件的属性、样式以及 HTML 标签,代码如下: <script> // component props // Camel case not supported for props, see drawback section. export let card_title, card_desc, card_img; </script> <main> <div class="card-container"> <div class="card"> <img src={card_img} alt="My product" /> <div class="card-body"> <div class="row"> <div class="card-title"> <h2>{card_title}</h2> </div> </div> <p> {card_desc} </p> <button>Do Something</button> </div> </div> </div> </main> <style> .card { max-width: 350px; border-radius: 5px; box-shadow: 0 4px 6px 0 #00000033; padding: 0 0 10px 0; } .card img { width: 100%; height: auto; } .card-body { padding: 5px 10px; } .card-body p { color: #575757; margin-bottom: 20px; font-size: 14px; } </style> 你可以在其他组件中使用这个卡片组件,如下所示(这一步可忽略): <script> import Card from "./Card.svelte"; </script> <main> <Card card_title="My Card Title" card_desc="Lorem ipsum dolor…" card_img="path/to/my-image.png" /> </main> 接下来是按钮组件,文件名/src/Button.svelte代码如下: <script> // Component props export let type = "solid"; </script> <button class={type == "solid" ? "btn-solid" : "btn-outline"}> <slot /> </button> <style> button { padding: 10px; color: #fff; font-size: 17px; border-radius: 5px; border: 1px solid #ccc; cursor: pointer; } .btn-solid { background: #20c997; border-color: #4cae4c; } .btn-outline { color: #20c997; background: transparent; border-color: #20c997; } </style> 该组件的使用方法如下(可忽略): import Button from "./Button.svelte"; <Button type="outline">Click me</Button> 将自定义组件转成通用组件 我们需要将自定义 Svelte 组件转成通用的 Web Component ,这样才可以在其他框架中直接使用。 要做这个转换操作,我们需要在 Svelte 配置文件中设置让编译器生成自定义元素。打开rollup.config.js在 plugins 增加一个compilerOptions配置项,在该配置项下增加 customElement: true 配置信息,如下所示: ... plugins: [ svelte({ compilerOptions: { dev: !production, customElement: true, ... 然后我们需要给两个组件分别定义一个元素名称,打开Card.svelte文件,在文件开头第一行插入如下内容: <svelte:options tag="my-card" /> 上述tag属性值代表组件的标签名称。 同样的,打开 Button.svelte 给第二个组件指定一个标签名称: <svelte:options tag="cool-button" /> 最后一步是在main.js中引入这两个组件,打开/src/main.js将里面的内容替换成如下两行: import Button from "./Button.svelte"; import Card from "./Card.svelte"; 这里我们已经完成了两个组件的开发步骤,下一步就是打包组件以便其他的应用可以使用这两个组件,打开命令行窗口进入项目所在目录执行如下命令: npm run build 该命令将生成两个文件,分别是build.js和build.map.js, 文件位于项目下的/build目录。其中build.js是打包的两个组件,而build.map.js是build.js源代码映射文件。 如果上述步骤顺利完成,我们就可以将bundle.js拷贝到一个新目录,然后创建一个index.html文件,内容如下: <!DOCTYPE html> <html> <head> <title>My website</title> <script src="./build.js"></script> </head> <body> <div class="container"> <div class="row"> <div class="col"> <my-card card_title="Red Person" card_desc=" Lorem ipsum dolor sit, amet consectetur.." card_img="https://bit.ly/34B3zHX" > </my-card> <!-- Image credit - Shubham Dhage on unsplash.com --> </div> <div class="col"> <div class="border-bottom py-5"> <cool-button> Solid Cool Button </cool-button> <cool-button type="outline"> Outlined Cool Button </cool-button> </div> </div> </div> </div> </body> </html> 这是一个再简单不过的 HTML 页面了,该页面使用了上述两个组件,在浏览器中显示为如下效果: 组件分割 在某些情况下我们不需要将多个组件打包到同一个 js 文件中,我们希望每个组件有一个独立的 js 文件。要实现这个场景只需在rollup.config.js的input 和 output 中进行配置即可。 在 input 的配置中我们可以指定一个数组,数组的元素就是每个组件的文件路径,而 output 指定为输出的目录即可: export default { input: ["src/Card.svelte", "./src/Button.svelte"], output: { format: "iife", dir: "public/build/", }, ... 修改完成后再次执行npm run build,我们就可以在 build 目录中看到两个文件Button.js和Card.js。 使用方法类似: <script src="Button.js" type="module"></script> <cool-button type="outline">Click Me</cool-button> <!-- another-page.html --> <script src="Card.js" type="module"></script> <my-card card_title="..."></my-card> 主要缺点 到这里我们已经掌握了使用 Svelte 开发 Web Component 的方法,这个过程非常之简单,但是,使用 Svelte 开发 Web 组件会有一些缺点如下: 组件的属性名称不允许使用驼峰命名法,例如你会发现使用形如 cardTitle 这样的属性名就无法正常工作,而驼峰命名法又是 JavaScript 推荐的命名风格。这是一个 Bug,不过如果你使用的是 Vite ,那么有一个workaround plugin可以解决这个问题。 如果不标记Web组件,就无法在Svelte中重用它们 - 不幸的是,您还必须标记要在自定义Web组件中使用的每个Svelte组件 加入你有一个Header.svelte文件需要作为<my-header/>组件输出,但同时这个组件又依赖另外一个Nav.svelte文件,而 Nav.svelte 我们不希望作为 Web 组件输出,这个问题使得我们必须将 Nav.svelte 也作为组件输出,否则程序就会报错。好在这个问题现在也有解了(详情请看 这里),我们可以通过配置来解决这个问题,虽然看起来不是那么的爽,就这样吧,又不是不能用。 浏览器的支持问题 — JavaScriptcustomElementAPI 就是用来创建 Web Component 的底层 API,该 API 目前并没有被所有的浏览器支持,我们需要引入 Polyfill 来解决这个文件,详情请看webcomponents official。 总结 在本文中,我们学习了如何使用 Svelte 创建通用卡片和按钮组件,生成捆绑文件,拆分它们,甚至在单独的 HTML 页面中重用此组件。 动手试试吧? 本文翻译自:Build web components with Svelte - LogRocket Blog

优秀的个人博客,低调大师

每日一博 | 优先级反转那些事儿

从一个线上问题说起 最近在线上遇到了一些[HMDConfigManager remoteConfigWithAppID:]卡死 初步分析 观察了下主线程堆栈,用到的锁是读写锁随后又去翻了下持有着锁的子线程,有各种各样的情况,且基本都处于正常的执行状态,例如有的处于打开文件状态,有的处于read状态,有的正在执行NSUserDefaults的方法...通过观察发现,出问题的线程都有QOS:BACKGROUND标记。整体看起来持有锁的子线程仍然在执行,只是留给主线程的时间不够了。为什么这些子线程在持有锁的情况下,需要执行这么久,直到主线程的8s卡死?一种情况就是真的如此耗时,另一种则是出现了优先级反转。 解决办法 在这个案例里面,持有读写锁且优先级低的线程迟迟得不到调度(又或者得到调度的时候又被抢占了,或者得到调度的时候时间已然不够了),而具有高优先级的线程由于拿不到读写锁,一直被阻塞,所以互相死锁。iOS8之后引入了QualityOfService的概念,类似于线程的优先级,设置不同的QualityOfService的值后系统会分配不同的CPU时间、网络资源和硬盘资源等,因此我们可以通过这个设置队列的优先级 。 方案一:去除对NSOperationQueue的优先级设置 在 Threading Programming Guide 文档中,苹果给出了提示: Important: It is generally a good idea to leave the priorities of your threads at their default values. Increasing the priorities of some threads also increases the likelihood of starvation among lower-priority threads. If your application contains high-priority and low-priority threads that must interact with each other, the starvation of lower-priority threads may block other threads and create performance bottlenecks. 苹果的建议是不要随意修改线程的优先级,尤其是这些高低优先级线程之间存在临界资源竞争的情况。所以删除相关优先级设置代码即可解决问题。 方案二:临时修改线程优先级 在 pthread_rwlock_rdlock(3pthread) 发现了如下提示: Realtime applications may encounter priority inversion when using read-write locks. The problem occurs when a high priority thread "locks" a read-write lock that is about to be "unlocked" by a low priority thread, but the low priority thread is preempted by a medium priority thread. This scenario leads to priority inversion; a high priority thread is blocked by lower priority threads for an unlimited period of time. During system design, realtime programmers must take into account the possibility of this kind of priority inversion.They can deal with it in a number of ways, such as by having critical sections that are guarded by read-write locks execute at a high priority, so that a thread cannot be preempted while executing in its critical section. 尽管针对的是实时系统,但是还是有一些启示和帮助。按照提示,对有问题的代码进行了修改:在线程通过pthread_rwlock_wrlock拿到_rwlock的时候,临时提升其优先级,在释放_rwlock之后,恢复其原先的优先级。 - (id)remoteConfigWithAppID:(NSString *)appID { ....... pthread_rwlock_rdlock(&_rwlock); HMDHeimdallrConfig *result = ....... // get existing config pthread_rwlock_unlock(&_rwlock); if(result == nil) { result = [[HMDHeimdallrConfig alloc] init]; // make a new config pthread_rwlock_wrlock(&_rwlock); qos_class_t oldQos = qos_class_self(); BOOL needRecover = NO; // 临时提升线程优先级 if (_enablePriorityInversionProtection && oldQos < QOS_CLASS_USER_INTERACTIVE) { int ret = pthread_set_qos_class_self_np(QOS_CLASS_USER_INTERACTIVE, 0); needRecover = (ret == 0); } ...... pthread_rwlock_unlock(&_rwlock); // 恢复线程优先级 if (_enablePriorityInversionProtection && needRecover) { pthread_set_qos_class_self_np(oldQos, 0); } } return result; } 值得注意的是,这里只能使用pthread的api,NSThread提供的API是不可行的 Demo 验证 为了验证上述的手动调整线程优先级是否有一定的效果,这里通过demo进行本地实验:定义了2000个operation(目的是为了CPU繁忙),优先级设置NSQualityOfServiceUserInitiated,且对其中可以被100整除的operation的优先级调整为NSQualityOfServiceBackground,在每个operation执行相同的耗时任务,然后对这被选中的10个operation进行耗时统计。 for (int j = 0; j < 2000; ++j) { NSOperationQueue *operation = [[NSOperationQueue alloc] init]; operation.maxConcurrentOperationCount = 1; operation.qualityOfService = NSQualityOfServiceUserInitiated; // 模块1 // if (j % 100 == 0) { // operation.qualityOfService = NSQualityOfServiceBackground; // } // 模块1 [operation addOperationWithBlock:^{ // 模块2 // qos_class_t oldQos = qos_class_self(); // pthread_set_qos_class_self_np(QOS_CLASS_USER_INITIATED, 0); // 模块2 NSTimeInterval start = CFAbsoluteTimeGetCurrent(); double sum = 0; for (int i = 0; i < 100000; ++i) { sum += sin(i) + cos(i) + sin(i*2) + cos(i*2); } start = CFAbsoluteTimeGetCurrent() - start; if (j % 100 == 0) { printf("%.8f\n", start * 1000); } // 模块2 // pthread_set_qos_class_self_np(oldQos, 0); // 模块2 }]; } 统计信息如下图所示 A B C (注释模块1和模块2代码) (只打开模块1代码) (同时打开模块1和模块2代码) 11.8190561 94.70210189 15.04005137 可以看到 正常情况下,每个任务的平均耗时为:11.8190561; 当operation被设置为低优先级时,其耗时大幅度提升为:94.70210189; 当operation被设置为低优先级时,又在Block中手动恢复其原有的优先级,其耗时已经大幅度降低:15.04005137( 耗时比正常情况高,大家可以思考下为什么) 通过Demo可以发现,通过手动调整其优先级,低优先级任务的整体耗时得到大幅度的降低,这样在持有锁的情况下,可以减少对主线程的阻塞时间。 上线效果 该问题的验证过程分为2个阶段: 第一个阶段如第1个红框所示,从3月6号开始在版本19.7上有较大幅度的下降,主要原因:堆栈中被等待的队列信息由QOS:BACKGROUND变为了com.apple.root.default-qos,队列的优先级从QOS_CLASS_BACKGROUND提升为QOS_CLASS_DEFAULT,相当于实施了方案一,使用了默认优先级。 第二个阶段如第2个红框所示,从4月24号在版本20.3上开始验证。目前看起来效果暂时不明显,推测一个主要原因是:demo中是把优先级从QOS_CLASS_BACKGROUND提升为QOS_CLASS_USER_INITIATED,而线上相当于把队列的优先级从默认的优先级QOS_CLASS_DEFAULT提升为QOS_CLASS_USER_INITIATED所以相对来说,线上的提升相对有限。 QOS_CLASS_BACKGROUND的Mach层级优先级数是4; QOS_CLASS_DEFAULT的Mach层级优先级数是31; QOS_CLASS_USER_INITIATED的Mach层级优先级数是37; 深刻理解优先级反转 那么是否所有锁都需要像上文一样,手动提升持有锁的线程优先级?系统是否会自动调整线程的优先级?如果有这样的机制,是否可以覆盖所有的锁?要理解这些问题,需要深刻认识优先级反转。 什么是优先级反转? 优先级反转,是指某同步资源被较低优先级的进程/线程所拥有,较高优先级的进程/线程竞争该同步资源未获得该资源,而使得较高优先级进程/线程反而推迟被调度执行的现象。根据阻塞类型的不同,优先级反转又被分为Bounded priority inversion和Unbounded priority inversion。这里借助 Introduction to RTOS - Solution to Part 11 (Priority Inversion) 的图进行示意。 Bounded priority inversion 如图所示,高优先级任务(Task H)被持有锁的低优先级任务(Task L)阻塞,由于阻塞的时间取决于低优先级任务在临界区的时间(持有锁的时间),所以被称为bounded priority inversion。只要Task L一直持有锁,Task H就会一直被阻塞,低优先级的任务运行在高优先级任务的前面,优先级被反转。 这里的任务也可以理解为线程 Unbounded priority inversion 在Task L持有锁的情况下,如果有一个中间优先级的任务(Task M)打断了Task L,前面的bounded就会变为unbounded,因为Task M只要抢占了Task L的CPU,就可能会阻塞Task H任意多的时间(Task M可能不止1个) 优先级反转常规解决思路 目前解决Unbounded priority inversion有2种方法:一种被称作优先权极限(priority ceiling protocol),另一种被称作优先级继承(priority inheritance)。 Priority ceiling protocol 在优先权极限方案中,系统把每一个临界资源与1个极限优先权相关联。当1个任务进入临界区时,系统便把这个极限优先权传递给这个任务,使得这个任务的优先权最高;当这个任务退出临界区后,系统立即把它的优先权恢复正常,从而保证系统不会出现优先权反转的情况。该极限优先权的值是由所有需要该临界资源的任务的最大优先级来决定的。 如图所示,锁的极限优先权是3。当Task L持有锁的时候,它的优先级将会被提升到3,和Task H一样的优先级。这样就可以阻止Task M(优先级是2)的运行,直到Task L和Task H不再需要该锁。 Priority inheritance 在优先级继承方案中,大致原理是:高优先级任务在尝试获取锁的时候,如果该锁正好被低优先级任务持有,此时会临时把高优先级线程的优先级转移给拥有锁的低优先级线程,使低优先级线程能更快的执行并释放同步资源,释放同步资源后再恢复其原来的优先级。 priority ceiling protocol和priority inheritance都会在释放锁的时候,恢复低优先级任务的优先级。同时要注意,以上2种方法只能阻止Unbounded priority inversion,而无法阻止Bounded priority inversion(Task H必须等待Task L执行完毕才能执行,这个反转是无法避免的)。 可以通过以下几种发生来避免或者转移Bounded priority inversion: 减少临界区的执行时间,减少Bounded priority inversion的反转耗时; 避免使用会阻塞高优先级任务的临界区资源; 专门使用一个队列来管理资源,避免使用锁。 优先级继承必须是可传递的。举个栗子:当T1阻塞在被T2持有的资源上,而T2又阻塞在T3持有的一个资源上。如果T1的优先级高于T2和T3的优先级,T3必须通过T2继承T1的优先级。否则,如果另外一个优先级高于T2和T3,小于T1的线程T4,将抢占T3,引发相对于T1的优先级反转。因此,线程所继承的优先级必须是直接或者间接阻塞的线程的最高优先级。 如何避免优先级反转? QoS 传递 iOS 系统主要使用以下两种机制来在不同线程(或queue)间传递QoS: 机制1:dispatch_async dispatch_async()automatically propagates the QoS from the calling thread, though it will translate User Interactive to User Initiated to avoid assigning that priority to non-main threads. Captured at time of block submission, translate user interactive to user initiated. Used if destination queue does not have a QoS and does not lower the QoS (ex dispatch_async back to the main thread) 机制2:基于 XPC 的进程间通信(IPC) 系统的 QoS 传递规则比较复杂,主要参考以下信息: 当前线程的QoS 如果是使用dispatch_block_create() 方法生成的dispatch_block,则考虑生成block时所调用的参数 dispatch_async或IPC的目标queue或线程的QoS 调度程序会根据这些信息决定block以什么优先级运行。 如果没有其他线程同步地等待此block,则block就按上面所说的优先级来运行。 如果出现了线程间同步等待的情况,则调度程序会根据情况调整线程的运行优先级。 如何触发优先级反转避免机制? 如果当前线程因等待某线程(线程1)上正在进行的操作(如block1)而受阻,而系统知道block1所在的目标线程(owner),系统会通过提高相关线程的优先级来解决优先级反转的问题。反之如果系统不知道block1所在目标线程,则无法知道应该提高谁的优先级,也就无法解决反转问题; 记录了持有者信息(owner)的系统 API 如下: pthread mutex、os_unfair_lock、以及基于这二者实现的上层 API dispatch_once的实现是基于os_unfair_lock的 NSLock、NSRecursiveLock、@synchronized等的实现是基于pthread mutex dispatch_sync、dispatch_wait xpc_connection_send_with_message_sync 使用以上这些API能够在发生优先级反转时使系统启用优先级反转避免机制。 基础API验证 接下来对前文提到的各种「基础系统API」进行验证 测试验证环境:模拟器 iOS15.2 pthread mutex pthread mutex的数据结构pthread_mutex_s其中有一个m_tid字段,专门来记录持有该锁的线程Id。 //types_internal.h structpthread_mutex_s{ longsig; _pthread_locklock; union{ uint32_tvalue; structpthread_mutex_options_soptions; }mtxopts; int16_tprioceiling; int16_tpriority; #ifdefined(__LP64__) uint32_t_pad; #endif union{ struct{ uint32_tm_tid[2];//threadidofthreadthathasmutexlocked uint32_tm_seq[2];//mutexsequenceid uint32_tm_mis[2];//formisalignedlocksm_tid/m_seqwillspan intohere }psynch; struct_pthread_mutex_ulock_sulock; }; #ifdefined(__LP64__) uint32_t_reserved[4]; #else uint32_t_reserved[1]; #endif }; 代码来验证一下:线程优先级是否会被提升? //printThreadPriority用来打印线程的优先级信息 voidprintThreadPriority(){ thread_tcur_thread=mach_thread_self(); mach_port_deallocate(mach_task_self(),cur_thread); mach_msg_type_number_tthread_info_count=THREAD_INFO_MAX; thread_info_data_tthinfo; kern_return_tkr=thread_info(cur_thread,THREAD_EXTENDED_INFO,(thread_info_t)thinfo,&thread_info_count); if(kr!=KERN_SUCCESS){ return; } thread_extended_info_textend_info=(thread_extended_info_t)thinfo; printf("pth_priority:%d,pth_curpri:%d,pth_maxpriority:%d\n",extend_info->pth_priority,extend_info->pth_curpri,extend_info->pth_maxpriority); } 先在子线程上锁并休眠,然后主线程请求该锁 dispatch_async(dispatch_get_global_queue(DISPATCH_QUEUE_PRIORITY_BACKGROUND, 0), ^{ printf("begin : \n"); printThreadPriority(); printf("queue before lock \n"); pthread_mutex_lock(&_lock); //确保 backgroundQueue 先得到锁 printf("queue lock \n"); printThreadPriority(); dispatch_async(dispatch_get_main_queue(), ^{ printf("before main lock\n"); pthread_mutex_lock(&_lock); printf("in main lock\n"); pthread_mutex_unlock(&_lock); printf("after main unlock\n"); }); sleep(10); printThreadPriority(); printf("queue unlock\n"); pthread_mutex_unlock(&_lock); printf("queue after unlock\n"); }); begin : pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 queue before lock queue lock pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 before main lock pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 queue unlock in main lock after main unlock queue after unlock 可以看到,低优先级子线程先持有锁,当时的优先级为4,而该锁被主线程请求的时候,子线程的优先级被提升为47 os_unfair_lock os_unfair_lock用来替换OSSpinLock,解决优先级反转问题。等待os_unfair_lock锁的线程会处于休眠状态,从用户态切换到内核态,而并非忙等。os_unfair_lock将线程ID保存到了锁的内部,锁的等待者会把自己的优先级让出来,从而避免优先级反转。验证一下: dispatch_async(dispatch_get_global_queue(DISPATCH_QUEUE_PRIORITY_BACKGROUND, 0), ^{ printf("begin : \n"); printThreadPriority(); printf("queue before lock \n"); os_unfair_lock_lock(&_unfair_lock); //确保 backgroundQueue 先得到锁 printf("queue lock \n"); printThreadPriority(); dispatch_async(dispatch_get_main_queue(), ^{ printf("before main lock\n"); os_unfair_lock_lock(&_unfair_lock); printf("in main lock\n"); os_unfair_lock_unlock(&_unfair_lock); printf("after main unlock\n"); }); sleep(10); printThreadPriority(); printf("queue unlock\n"); os_unfair_lock_unlock(&_unfair_lock); printf("queue after unlock\n"); }); begin : pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 queue before lock queue lock pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 before main lock pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 queue unlock in main lock after main unlock queue after unlock 结果和pthread mutex一致 pthread_rwlock_t 在pthread_rwlock_init有如下提示: Caveats: Beware ofpriority inversionwhen using read-write locks. A high-priority thread may be blocked waiting on a read-write lock locked by a low-priority thread. The microkernel has no knowledge of read-write locks, and therefore can't boost the low-priority thread to prevent the priority inversion. 大意是内核不感知读写锁,无法提升低优先级线程的优先级,从而无法避免优先级反转。通过查询定义发现:pthread_rwlock_s包含了字段rw_tid,专门来记录持有写锁的线程,这不由令人好奇:为什么pthread_rwlock_s有owner信息却仍然无法避免优先级反转? structpthread_rwlock_s{ longsig; _pthread_locklock; uint32_t unused:29, misalign:1, pshared:2; uint32_trw_flags; #ifdefined(__LP64__) uint32_t_pad; #endif uint32_trw_tid[2];//threadidofthreadthathasexclusive(write)lock uint32_trw_seq[4];//rwsequenceid(at128-bitalignedboundary) uint32_trw_mis[4];//formisalignedlocksrw_seqwillspan intohere #ifdefined(__LP64__) uint32_t_reserved[34]; #else uint32_t_reserved[18]; #endif }; https://news.ycombinator.com/item?id=21751269链接中提到: xnu supports priority inheritance through "turnstiles", a kernel-internal mechanism which is used by default by a number of locking primitives (list at [1]), including normal pthread mutexes (though not read-write locks [2]), as well as the os_unfair_lock API (via the ulock syscalls). With pthread mutexes, you can actually explicitly request priority inheritance by calling pthread_mutexattr_setprotocol [3] with PTHREAD_PRIO_INHERIT; the Apple implementation supports it, but currently ignores the protocol setting and just gives all mutexes priority inheritance. 大意是:XNU使用turnstiles内核机制进行优先级继承,这种机制被应用在pthread mutex和os_unfair_lock上。 顺藤摸瓜,在ksyn_wait方法中找到了_kwq_use_turnstile的调用,其中的注释对读写锁解释的比较委婉,添加了at least sometimes pthread mutexes andrwlocks both (at least sometimes) know their owner and can use turnstiles. Otherwise, we pass NULL as the tstore to the shims so they wait on the global waitq. //libpthread/kern/kern_synch.c int ksyn_wait(ksyn_wait_queue_tkwq,kwq_queue_type_tkqi,uint32_tlockseq, intfit,uint64_tabstime,uint16_tkwe_flags, thread_continue_tcontinuation,block_hint_tblock_hint) { thread_tth=current_thread(); uthread_tuth=pthread_kern->get_bsdthread_info(th); structturnstile**tstore=NULL; intres; assert(continuation!=THREAD_CONTINUE_NULL); ksyn_waitq_element_tkwe=pthread_kern->uthread_get_uukwe(uth); bzero(kwe,sizeof(*kwe)); kwe->kwe_count=1; kwe->kwe_lockseq=lockseq&PTHRW_COUNT_MASK; kwe->kwe_state=KWE_THREAD_INWAIT; kwe->kwe_uth=uth; kwe->kwe_thread=th; kwe->kwe_flags=kwe_flags; res=ksyn_queue_insert(kwq,kqi,kwe,lockseq,fit); if(res!=0){ //panic("psynch_rw_wrlock:failedtoenqueue\n");//XXXksyn_wqunlock(kwq); returnres; } PTHREAD_TRACE(psynch_mutex_kwqwait,kwq->kw_addr,kwq->kw_inqueue, kwq->kw_prepost.count,kwq->kw_intr.count); if(_kwq_use_turnstile(kwq)){ //pthreadmutexesandrwlocksboth(atleastsometimes)knowtheir //ownerandcanuseturnstiles.Otherwise,wepassNULLasthe //tstoretotheshimssotheywaitontheglobalwaitq. tstore=&kwq->kw_turnstile; } ...... } 再去查看_kwq_use_turnstile的定义,代码还是很诚实的,只有在KSYN_WQTYPE_MTX才会启用turnstile进行优先级反转保护,而读写锁的类型为KSYN_WQTYPE_RWLOCK,这说明读写锁不会使用_kwq_use_turnstile,所以无法避免优先级反转。 #defineKSYN_WQTYPE_MTX0x01 #defineKSYN_WQTYPE_CVAR0x02 #defineKSYN_WQTYPE_RWLOCK0x04 #defineKSYN_WQTYPE_SEMA0x08 staticinlinebool _kwq_use_turnstile(ksyn_wait_queue_tkwq) { //Ifwehadwriter-ownerinformationfromthe //rwlockthenwecouldusetheturnstiletopushonit.Fornow,only //plainmutexesuseit. return(_kwq_type(kwq)==KSYN_WQTYPE_MTX); } 另外在_pthread_find_owner也可以看到,读写锁的owner是0 void _pthread_find_owner(thread_tthread, structstackshot_thread_waitinfo*waitinfo) { ksyn_wait_queue_tkwq=_pthread_get_thread_kwq(thread); switch(waitinfo->wait_type){ casekThreadWaitPThreadMutex: assert((kwq->kw_type&KSYN_WQTYPE_MASK)==KSYN_WQTYPE_MTX); waitinfo->owner=thread_tid(kwq->kw_owner); waitinfo->context=kwq->kw_addr; break; /*Ownerofrwlocknotstoredinkernelspaceduetoraces.Punt *andhopethattheuserspaceaddressishelpfulenough.*/ casekThreadWaitPThreadRWLockRead: casekThreadWaitPThreadRWLockWrite: assert((kwq->kw_type&KSYN_WQTYPE_MASK)==KSYN_WQTYPE_RWLOCK); waitinfo->owner=0; waitinfo->context=kwq->kw_addr; break; /*Condvarsdon'thaveowners,sojustgivetheuserspaceaddress.*/ casekThreadWaitPThreadCondVar: assert((kwq->kw_type&KSYN_WQTYPE_MASK)==KSYN_WQTYPE_CVAR); waitinfo->owner=0; waitinfo->context=kwq->kw_addr; break; casekThreadWaitNone: default: waitinfo->owner=0; waitinfo->context=0; break; } } 把锁更换为读写锁,验证一下前面的理论是否正确: pthread_rwlock_init(&_rwlock, NULL); dispatch_async(dispatch_get_global_queue(DISPATCH_QUEUE_PRIORITY_BACKGROUND, 0), ^{ printf("begin : \n"); printThreadPriority(); printf("queue before lock \n"); pthread_rwlock_rdlock(&_rwlock); //确保 backgroundQueue 先得到锁 printf("queue lock \n"); printThreadPriority(); dispatch_async(dispatch_get_main_queue(), ^{ printf("before main lock\n"); pthread_rwlock_wrlock(&_rwlock); printf("in main lock\n"); pthread_rwlock_unlock(&_rwlock); printf("after main unlock\n"); }); sleep(10); printThreadPriority(); printf("queue unlock\n"); pthread_rwlock_unlock(&_rwlock); printf("queue after unlock\n"); }); begin : pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 queue before lock queue lock pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 before main lock pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 queue unlock queue after unlock in main lock after main unlock 可以看到读写锁不会发生优先级提升 dispatch_sync 这个API都比较熟悉了,这里直接验证: // 当前线程为主线程 dispatch_queue_attr_t qosAttribute = dispatch_queue_attr_make_with_qos_class(DISPATCH_QUEUE_SERIAL, QOS_CLASS_BACKGROUND, 0); _queue = dispatch_queue_create("com.demo.test", qosAttribute); printThreadPriority(); dispatch_async(_queue, ^{ printf("dispatch_async before dispatch_sync : \n"); printThreadPriority(); }); dispatch_sync(_queue, ^{ printf("dispatch_sync: \n"); printThreadPriority(); }); dispatch_async(_queue, ^{ printf("dispatch_async after dispatch_sync: \n"); printThreadPriority(); }); pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 dispatch_async before dispatch_sync : pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 dispatch_sync: pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 dispatch_async after dispatch_sync: pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 _queue是一个低优先级队列(QOS_CLASS_BACKGROUND),可以看到dispatch_sync调用压入队列的任务,以及在这之前dispatch_async压入的任务,都被提升到较高的优先级47(和主线程一致),而最后一个dispatch_async的任务则以优先级4来执行。 dispatch_wait // 当前线程为主线程 dispatch_queue_attr_t qosAttribute = dispatch_queue_attr_make_with_qos_class(DISPATCH_QUEUE_SERIAL, QOS_CLASS_BACKGROUND, 0); _queue = dispatch_queue_create("com.demo.test", qosAttribute); printf("main thread\n"); printThreadPriority(); dispatch_block_t block = dispatch_block_create(DISPATCH_BLOCK_INHERIT_QOS_CLASS, ^{ printf("sub thread\n"); sleep(2); printThreadPriority(); }); dispatch_async(_queue, block); dispatch_wait(block, DISPATCH_TIME_FOREVER); _queue是一个低优先级队列(QOS_CLASS_BACKGROUND),当在当前主线程使用dispatch_wait进行等待时,输出如下,低优先级的任务被提升到优先级47 main thread pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 sub thread pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 而如果将dispatch_wait(block, DISPATCH_TIME_FOREVER)注释掉之后,输出如下: main thread pth_priority: 47, pth_curpri: 47, pth_maxpriority: 63 sub thread pth_priority: 4, pth_curpri: 4, pth_maxpriority: 63 值得注意的是,dispatch_wait是一个宏(C11的泛型),或者是一个入口函数,它可以接受dispatch_block_t,dispatch_group_t,dispatch_semaphore_t3种类型的参数,但是这里的具体含义应该是指dispatch_block_wait,只有dispatch_block_wait会调整优先级,避免优先级反转。 intptr_t dispatch_wait(void*object,dispatch_time_ttimeout); #if__has_extension(c_generic_selections) #definedispatch_wait(object,timeout)\ _Generic((object),\ dispatch_block_t:dispatch_block_wait,\ dispatch_group_t:dispatch_group_wait,\ dispatch_semaphore_t:dispatch_semaphore_wait\ )((object),(timeout)) #endif 神秘的信号量 dispatch_semaphore 之前对dispatch_semaphore的认知非常浅薄,经常把二值信号量和互斥锁划等号。但是通过调研后发现:dispatch_semaphore没有QoS的概念,没有记录当前持有信号量的线程(owner),所以有高优先级的线程在等待锁时,内核无法知道该提高哪个线程的调试优先级(QoS)。如果锁持有者优先级比其他线程低,高优先级的等待线程将一直等待。Mutex vs Semaphore: What’s the Difference?一文详细比对了Mutex和Semaphore之间的区别。 Semaphores are for signaling (sames a condition variables, events) while mutexes are for mutual exclusion.Technically, you can also use semaphores for mutual exclusion (a mutex can be thought as a binary semaphore) but you really shouldn't.Right, but libdispatch doesn't have a mutex. It has semaphores and queues.So if you're trying to use libdispatch and you don't want the closure-based aspect of queues, you might be tempted to use a semaphore instead. Don't do that, use os_unfair_lock or pthread_mutex(or a higher-level construct like NSLock) instead. 这些是一些警示,可以看到dispatch_semaphore十分危险,使用需要特别小心。 这里通过苹果官方提供的demo进行解释: __block NSString *taskName = nil; dispatch_semaphore_t sema = dispatch_semaphore_create(0); [self.connection.remoteObjectProxy requestCurrentTaskName:^(NSString *task) { taskName = task; dispatch_semaphore_signal(sema); }]; dispatch_semaphore_wait(sema, DISPATCH_TIME_FOREVER); return taskName; 假设在主线程执行这段代码,那么当前线程的优先级是QOS_CLASS_USER_INTERACTIVE; 由于从主线程进行了异步,异步任务队列的QoS将会被提升为QOS_CLASS_USER_INITIATED; 主线程被信号量sema阻塞,而负责释放该信号量的异步任务的优先级QOS_CLASS_USER_INITIATED低于主线程的优先级QOS_CLASS_USER_INTERACTIVE,因此可能会发生优先级反转。 值得一提的是,Clang专门针对这种情况进行了静态检测: https://github.com/llvm-mirror/clang/blob/master/lib/StaticAnalyzer/Checkers/GCDAntipatternChecker.cpp staticautofindGCDAntiPatternWithSemaphore()->decltype(compoundStmt()){ constchar*SemaphoreBinding="semaphore_name"; autoSemaphoreCreateM=callExpr(allOf( callsName("dispatch_semaphore_create"), hasArgument(0,ignoringParenCasts(integerLiteral(equals(0)))))); autoSemaphoreBindingM=anyOf( forEachDescendant( varDecl(hasDescendant(SemaphoreCreateM)).bind(SemaphoreBinding)), forEachDescendant(binaryOperator(bindAssignmentToDecl(SemaphoreBinding), hasRHS(SemaphoreCreateM)))); autoHasBlockArgumentM=hasAnyArgument(hasType( hasCanonicalType(blockPointerType()) )); autoArgCallsSignalM=hasAnyArgument(stmt(hasDescendant(callExpr( allOf( callsName("dispatch_semaphore_signal"), equalsBoundArgDecl(0,SemaphoreBinding) ))))); autoHasBlockAndCallsSignalM=allOf(HasBlockArgumentM,ArgCallsSignalM); autoHasBlockCallingSignalM= forEachDescendant( stmt(anyOf( callExpr(HasBlockAndCallsSignalM), objcMessageExpr(HasBlockAndCallsSignalM) ))); autoSemaphoreWaitM=forEachDescendant( callExpr( allOf( callsName("dispatch_semaphore_wait"), equalsBoundArgDecl(0,SemaphoreBinding) ) ).bind(WarnAtNode)); returncompoundStmt( SemaphoreBindingM,HasBlockCallingSignalM,SemaphoreWaitM); } 如果想使用该功能,只需要打开xcode设置即可: 另外,dispatch_group跟semaphore类似,在调用enter()方法时,无法预知谁会调用leave(),所以系统也无法知道其owner是谁,所以同样不会有优先级提升的问题。 信号量卡死现身说法 dispatch_semaphore给笔者的印象非常深刻,之前写过一段这样的代码:使用信号量在主线程同步等待相机授权结果。 __blockBOOLauth=NO; dispatch_semaphore_tsemaphore=dispatch_semaphore_create(0); [KTAuthorizeServicerequestAuthorizationWithType:KTPermissionsTypeCameracompletionHandler:^(BOOLallow){ auth=allow; dispatch_semaphore_signal(semaphore); }]; dispatch_semaphore_wait(semaphore,DISPATCH_TIME_FOREVER); 上线后长期占据卡死top1,当时百思不得其解,在深入了解到信号量无法避免优先级反转后,终于豁然开朗,一扫之前心中的阴霾。这类问题一般通过2种方式来解决: 使用同步API BOOL auth = [KTAuthorizeService authorizationWithType:KTPermissionsTypeCamera]; // do something next 异步回调,不要在当前线程等待 [KTAuthorizeService requestAuthorizationWithType:KTPermissionsTypeCamera completionHandler:^(BOOL allow) { BOOL auth = allow; // do something next via callback }]; 几个概念 turnstile 前文提到XNU使用turnstile进行优先级继承,这里对turnstile机制进行简单的描述和理解。在XNU内核中,存在着大量的同步对象(例如lck_mtx_t),为了解决优先级反转的问题,每个同步对象都必须对应一个分离的数据结构来维护大量的信息,例如阻塞在这个同步对象上的线程队列。可以想象一下,如果每个同步对象都要分配一个这样的数据结构,将造成极大的内存浪费。为了解决这个问题,XNU采用了turnstile机制,一种空间利用率很高的解决方案。该方案的提出依据是同一个线程在同一时刻不能同时阻塞于多个同步对象上。这一事实允许所有同步对象只需要保留一个指向turnstile的指针,且在需要的时候去分配一个turnstile即可,而turnstile则包含了操作一个同步对象需要的所有信息,例如阻塞线程的队列、拥有这个同步对象的线程指针。turnstile是从池中动态分配的,这个池的大小会随着系统中已分配的线程数目增加而增加,所以turnstile总数将始终低于或等于线程数,这也决定了turnstile的数目是可控的。turnstile由阻塞在该同步对象上的第一个线程负责分配,当没有更多线程阻塞在该同步对象上,turnstile会被释放,回收到池中。turnstile的数据结构如下: structturnstile{ structwaitqts_waitq;/*waitqembeddedinturnstile*/ turnstile_inheritor_tts_inheritor;/*thread/turnstileinheritingthepriority(IL,WL)*/ union{ structturnstile_listts_free_turnstiles;/*turnstilefreelist(IL)*/ SLIST_ENTRY(turnstile)ts_free_elm;/*turnstilefreelistelement(IL)*/ }; structpriority_queue_sched_maxts_inheritor_queue;/*Queueofturnstilewithusasaninheritor(WL)*/ union{ structpriority_queue_entry_schedts_inheritor_links;/*Inheritorqueuelinks*/ structmpsc_queue_chaints_deallocate_link;/*threaddeallocatelink*/ }; SLIST_ENTRY(turnstile)ts_htable_link;/*linkageforturnstileinglobalhashtable*/ uintptr_tts_proprietor;/*hashkeylookupturnstile(IL)*/ os_refcnt_tts_refcount;/*referencecountforturnstiles*/ _Atomicuint32_tts_type_gencount;/*gencountusedforprioritychaining(IL),typeofturnstile(IL)*/ uint32_tts_port_ref;/*numberofexplicitrefsfromportsonsendturnstile*/ turnstile_update_flags_tts_inheritor_flags;/*flagsforturnstileinheritor(IL,WL)*/ uint8_tts_priority;/*priorityofturnstile(WL)*/ #ifDEVELOPMENT||DEBUG uint8_tts_state;/*currentstateofturnstile(IL)*/ queue_chain_tts_global_elm;/*globalturnstilechain*/ thread_tts_thread;/*threadtheturnstileisattachedto*/ thread_tts_prev_thread;/*threadtheturnstilewasattachedbeforedonation*/ #endif }; 优先级数值 在验证环节有一些优先级数值,这里借助「Mac OS® X and iOS Internals 」解释一下:实验中涉及到的优先级数值都是相对于Mach层而言的,且都是用户线程数值 用户线程的优先级是0~63; NSQualityOfServiceBackground的Mach层级优先级数是4; NSQualityOfServiceUtility的Mach层级优先级数是20; NSQualityOfServiceDefault的Mach层级优先级数是31; NSQualityOfServiceUserInitiated的Mach层级优先级数是37; NSQualityOfServiceUserInteractive的Mach层级优先级是47; 内核线程的优先级是80~95; 实时系统线程的优先级是96~127; 64~79被保留给系统使用; 总结 本文主要阐述了优先级反转的一些概念和解决思路,并结合iOS平台的几种锁进行了详细的调研。通过深入的理解,可以去规避一些不必要的优先级反转,从而进一步避免卡死异常。字节跳动APM团队也针对线程的优先级做了监控处理,进而达到发现和预防优先级反转的目的。 加入我们 字节跳动 APM 中台致力于提升整个集团内全系产品的性能和稳定性表现,技术栈覆盖iOS/Android/Server/Web/Hybrid/PC/游戏/小程序等,工作内容包括但不限于性能稳定性监控,问题排查,深度优化,防劣化等。长期期望为业界输出更多更有建设性的问题发现和深度优化手段。 欢迎对字节APM团队职位感兴趣的同学投递简历到邮箱xushuangqing@bytedance.com。 参考文档 WWDC18 What' s New in LLVM - actorsfit https://developer.apple.com/videos/play/wwdc2015/718 https://developer.apple.com/forums/thread/124155 https://developer.apple.com/library/archive/documentation/Cocoa/Conceptual/Multithreading/CreatingThreads/CreatingThreads.html https://developer.apple.com/library/archive/documentation/Performance/Conceptual/EnergyGuide-iOS/PrioritizeWorkWithQoS.html https://github.com/llvm-mirror/clang/blob/google/stable/lib/StaticAnalyzer/Checkers/ GCDAntipatternChecker.cpp Don't use dispatch semaphores where mutexes (or dispatch queues) would suffice Concurrency Problems Written by Scott Grosch https://www.jianshu.com/p/af64e05de503 https://pubs.opengroup.org/onlinepubs/7908799/xsh/pthread_rwlock_wrlock.html iOS中各种“锁”的理解及应用 不再安全的 OSSpinLock https://blog.actorsfit.com/a?ID=00001-499b1c8e-8a7f-4960-a1c1-c8e2f42c08c6 https://objccn.io/issue-2-1/#Priority-Inversion Introduction to RTOS - Solution to Part 11 (Priority Inversion) https://threadreaderapp.com/thread/1229999590482444288.html# 深入理解iOS中的锁 Threads can infect each other with their low priority 添加小助手回复【APM】可加入性能监控交流群,获取更多技术干货

优秀的个人博客,低调大师

每日一博 | 源码级深度理解 Java SPI

作者:vivo 互联网服务器团队- Zhang Peng SPI 是一种用于动态加载服务的机制。它的核心思想就是解耦,属于典型的微内核架构模式。SPI 在 Java 世界应用非常广泛,如:Dubbo、Spring Boot 等框架。本文从源码入手分析,深入探讨 Java SPI 的特性、原理,以及在一些比较经典领域的应用。 一、SPI 简介 SPI 全称 Service Provider Interface,是 Java 提供的,旨在由第三方实现或扩展的 API,它是一种用于动态加载服务的机制。Java 中 SPI 机制主要思想是将装配的控制权移到程序之外,在模块化设计中这个机制尤其重要,其核心思想就是 解耦。 Java SPI 有四个要素: SPI 接口:为服务提供者实现类约定的的接口或抽象类。 SPI 实现类:实际提供服务的实现类。 SPI 配置:Java SPI 机制约定的配置文件,提供查找服务实现类的逻辑。配置文件必须置于 META-INF/services 目录中,并且,文件名应与服务提供者接口的完全限定名保持一致。文件中的每一行都有一个实现服务类的详细信息,同样是服务提供者类的完全限定名称。 ServiceLoader:Java SPI 的核心类,用于加载 SPI 实现类。ServiceLoader 中有各种实用方法来获取特定实现、迭代它们或重新加载服务。 二、SPI 示例 正所谓,实践出真知,我们不妨通过一个具体的示例来看一下,如何使用 Java SPI。 2.1 SPI 接口 首先,需要定义一个 SPI 接口,和普通接口并没有什么差别。 package io.github.dunwu.javacore.spi; public interface DataStorage { String search(String key); } 2.2 SPI 实现类 假设,我们需要在程序中使用两种不同的数据存储——MySQL 和 Redis。因此,我们需要两个不同的实现类去分别完成相应工作。 MySQL查询 MOCK 类 package io.github.dunwu.javacore.spi; public class MysqlStorage implements DataStorage { @Override public String search(String key) { return "【Mysql】搜索" + key + ",结果:No"; } } Redis 查询 MOCK 类 package io.github.dunwu.javacore.spi; public class RedisStorage implements DataStorage { @Override public String search(String key) { return "【Redis】搜索" + key + ",结果:Yes"; } } service 传入的是期望加载的 SPI 接口类型 到目前为止,定义接口,并实现接口和普通的 Java 接口实现没有任何不同。 2.3 SPI 配置 如果想通过 Java SPI 机制来发现服务,就需要在 SPI 配置中约定好发现服务的逻辑。配置文件必须置于 META-INF/services 目录中,并且,文件名应与服务提供者接口的完全限定名保持一致。文件中的每一行都有一个实现服务类的详细信息,同样是服务提供者类的完全限定名称。以本示例代码为例,其文件名应该为io.github.dunwu.javacore.spi.DataStorage, 文件中的内容如下: io.github.dunwu.javacore.spi.MysqlStorage io.github.dunwu.javacore.spi.RedisStorage 2.4 ServiceLoader 完成了上面的步骤,就可以通过 ServiceLoader 来加载服务。示例如下: import java.util.ServiceLoader; public class SpiDemo { public static void main(String[] args) { ServiceLoader<DataStorage> serviceLoader = ServiceLoader.load(DataStorage.class); System.out.println("============ Java SPI 测试============"); serviceLoader.forEach(loader -> System.out.println(loader.search("Yes Or No"))); } } 输出: ============ Java SPI 测试============ 【Mysql】搜索Yes Or No,结果:No 【Redis】搜索Yes Or No,结果:Yes 三、SPI 原理 上文中,我们已经了解 Java SPI 的要素以及使用 Java SPI 的方法。你有没有想过,Java SPI 和普通 Java 接口有何不同,Java SPI 是如何工作的。实际上,Java SPI 机制依赖于 ServiceLoader 类去解析、加载服务。因此,掌握了 ServiceLoader 的工作流程,就掌握了 SPI 的原理。ServiceLoader 的代码本身很精练,接下来,让我们通过走读源码的方式,逐一理解 ServiceLoader 的工作流程。 3.1 ServiceLoader 的成员变量 先看一下 ServiceLoader 类的成员变量,大致有个印象,后面的源码中都会使用到。 public final class ServiceLoader<S> implements Iterable<S> { // SPI 配置文件目录 private static final String PREFIX = "META-INF/services/"; // 将要被加载的 SPI 服务 private final Class<S> service; // 用于加载 SPI 服务的类加载器 private final ClassLoader loader; // ServiceLoader 创建时的访问控制上下文 private final AccessControlContext acc; // SPI 服务缓存,按实例化的顺序排列 private LinkedHashMap<String,S> providers = new LinkedHashMap<>(); // 懒查询迭代器 private LazyIterator lookupIterator; // ... } 3.2 ServiceLoader 的工作流程 (1)ServiceLoader.load 静态方法 应用程序加载 Java SPI 服务,都是先调用 ServiceLoader.load 静态方法。 ServiceLoader.load 静态方法的作用是: ① 指定类加载 ClassLoader 和访问控制上下文; ② 然后,重新加载 SPI 服务 清空缓存中所有已实例化的 SPI 服务 根据 ClassLoader 和 SPI 类型,创建懒加载迭代器 这里,摘录 ServiceLoader.load 相关源码,如下: // service 传入的是期望加载的 SPI 接口类型 // loader 是用于加载 SPI 服务的类加载器 public static <S> ServiceLoader<S> load(Class<S> service, ClassLoader loader) { return new ServiceLoader<>(service, loader); } public void reload() { // 清空缓存中所有已实例化的 SPI 服务 providers.clear(); // 根据 ClassLoader 和 SPI 类型,创建懒加载迭代器 lookupIterator = new LazyIterator(service, loader); } // 私有构造方法 // 重新加载 SPI 服务 private ServiceLoader(Class<S> svc, ClassLoader cl) { service = Objects.requireNonNull(svc, "Service interface cannot be null"); // 指定类加载 ClassLoader 和访问控制上下文 loader = (cl == null) ? ClassLoader.getSystemClassLoader() : cl; acc = (System.getSecurityManager() != null) ? AccessController.getContext() : null; // 然后,重新加载 SPI 服务 reload(); } (2)应用程序通过 ServiceLoader 的 iterator 方法遍历 SPI 实例 ServiceLoader 的类定义,明确了 ServiceLoader 类实现了Iterable<T>接口,所以,它是可以迭代遍历的。实际上,ServiceLoader 类维护了一个缓存 providers(LinkedHashMap对象),缓存 providers 中保存了已经被成功加载的 SPI 实例,这个 Map 的 key 是 SPI 接口实现类的全限定名,value 是该实现类的一个实例对象。 当应用程序调用 ServiceLoader 的 iterator 方法时,ServiceLoader 会先判断缓存 providers 中是否有数据:如果有,则直接返回缓存 providers 的迭代器;如果没有,则返回懒加载迭代器的迭代器。 public Iterator<S> iterator() { return new Iterator<S>() { // 缓存 SPI providers Iterator<Map.Entry<String,S>> knownProviders = providers.entrySet().iterator(); // lookupIterator 是 LazyIterator 实例,用于懒加载 SPI 实例 public boolean hasNext() { if (knownProviders.hasNext()) return true; return lookupIterator.hasNext(); } public S next() { if (knownProviders.hasNext()) return knownProviders.next().getValue(); return lookupIterator.next(); } public void remove() { throw new UnsupportedOperationException(); } }; } (3)懒加载迭代器的工作流程 上面的源码中提到了,lookupIterator 是 LazyIterator 实例,而 LazyIterator 用于懒加载 SPI 实例。那么, LazyIterator 是如何工作的呢? 这里,摘取 LazyIterator 关键代码 hasNextService 方法: 拼接META-INF/services/+ SPI 接口全限定名 通过类加载器,尝试加载资源文件 解析资源文件中的内容,获取 SPI 接口的实现类的全限定名nextName nextService 方法: hasNextService()方法解析出了 SPI 实现类的的全限定名 nextName,通过反射,获取 SPI 实现类的类定义 Class。 然后,尝试通过 Class 的 newInstance 方法实例化一个 SPI 服务对象。如果成功,则将这个对象加入到缓存 providers 中并返回该对象。 private boolean hasNextService() { if (nextName != null) { return true; } if (configs == null) { try { // 1.拼接 META-INF/services/ + SPI 接口全限定名 // 2.通过类加载器,尝试加载资源文件 // 3.解析资源文件中的内容 String fullName = PREFIX + service.getName(); if (loader == null) configs = ClassLoader.getSystemResources(fullName); else configs = loader.getResources(fullName); } catch (IOException x) { fail(service, "Error locating configuration files", x); } } while ((pending == null) || !pending.hasNext()) { if (!configs.hasMoreElements()) { return false; } pending = parse(service, configs.nextElement()); } nextName = pending.next(); return true; } private S nextService() { if (!hasNextService()) throw new NoSuchElementException(); String cn = nextName; nextName = null; Class<?> c = null; try { c = Class.forName(cn, false, loader); } catch (ClassNotFoundException x) { fail(service, "Provider " + cn + " not found"); } if (!service.isAssignableFrom(c)) { fail(service, "Provider " + cn + " not a s"); } try { S p = service.cast(c.newInstance()); providers.put(cn, p); return p; } catch (Throwable x) { fail(service, "Provider " + cn + " could not be instantiated", x); } throw new Error(); // This cannot happen } 3.3 SPI 和类加载器 通过上面两个章节中,走读 ServiceLoader 代码,我们已经大致了解 Java SPI 的工作原理,即通过 ClassLoader 加载 SPI 配置文件,解析 SPI 服务,然后通过反射,实例化 SPI 服务实例。我们不妨思考一下,为什么加载 SPI 服务时,需要指定类加载器 ClassLoader 呢? 学习过 JVM 的读者,想必都了解过类加载器的双亲委派模型(Parents Delegation Model)。双亲委派模型要求除了顶层的 BootstrapClassLoader 外,其余的类加载器都应有自己的父类加载器。这里类加载器之间的父子关系一般通过组合(Composition)关系来实现,而不是通过继承(Inheritance)的关系实现。 双亲委派机制约定了:一个类加载器首先将类加载请求传送到父类加载器,只有当父类加载器无法完成类加载请求时才尝试加载。 双亲委派的好处:使得 Java 类伴随着它的类加载器,天然具备一种带有优先级的层次关系,从而使得类加载得到统一,不会出现重复加载的问题: 系统类防止内存中出现多份同样的字节码 保证 Java 程序安全稳定运行 例如:java.lang.Object 存放在 rt.jar 中,如果编写另外一个 java.lang.Object 的类并放到 classpath 中,程序可以编译通过。因为双亲委派模型的存在,所以在 rt.jar 中的 Object 比在 classpath 中的 Object 优先级更高,因为 rt.jar 中的 Object 使用的是启动类加载器,而 classpath 中的 Object 使用的是应用程序类加载器。正因为 rt.jar 中的 Object 优先级更高,因为程序中所有的 Object 都是这个 Object。 双亲委派的限制:子类加载器可以使用父类加载器已经加载的类,而父类加载器无法使用子类加载器已经加载的。——这就导致了双亲委派模型并不能解决所有的类加载器问题。Java SPI 就面临着这样的问题: SPI 的接口是 Java 核心库的一部分,是由 BootstrapClassLoader 加载的; 而 SPI 实现的 Java 类一般是由 AppClassLoader 来加载的。BootstrapClassLoader 是无法找到 SPI 的实现类的,因为它只加载 Java 的核心库。它也不能代理给 AppClassLoader,因为它是最顶层的类加载器。这也解释了本节开始的问题——为什么加载 SPI 服务时,需要指定类加载器 ClassLoader 呢?因为如果不指定 ClassLoader,则无法获取 SPI 服务。 如果不做任何的设置,Java 应用的线程的上下文类加载器默认就是 AppClassLoader。在核心类库使用 SPI 接口时,传递的类加载器使用线程上下文类加载器,就可以成功的加载到 SPI 实现的类。线程上下文类加载器在很多 SPI 的实现中都会用到。 通常可以通过Thread.currentThread().getClassLoader()和 Thread.currentThread().getContextClassLoader() 获取线程上下文类加载器。 3.4 Java SPI 的不足 Java SPI 存在一些不足: 不能按需加载,需要遍历所有的实现,并实例化,然后在循环中才能找到我们需要的实现。如果不想用某些实现类,或者某些类实例化很耗时,它也被载入并实例化了,这就造成了浪费。 获取某个实现类的方式不够灵活,只能通过 Iterator 形式获取,不能根据某个参数来获取对应的实现类。 多个并发多线程使用 ServiceLoader 类的实例是不安全的。 四、SPI 应用场景 SPI 在 Java 开发中应用十分广泛。首先,在 Java 的 java.util.spi package 中就约定了很多 SPI 接口。下面,列举一些 SPI 接口: TimeZoneNameProvider: 为 TimeZone 类提供本地化的时区名称。 DateFormatProvider: 为指定的语言环境提供日期和时间格式。 NumberFormatProvider: 为 NumberFormat 类提供货币、整数和百分比值。 Driver: 从 4.0 版开始,JDBC API 支持 SPI 模式。旧版本使用 Class.forName() 方法加载驱动程序。 PersistenceProvider: 提供 JPA API 的实现。 等等 除此以外,SPI 还有很多应用,下面列举几个经典案例。 4.1 SPI 应用案例之 JDBC DriverManager 作为 Java 工程师,尤其是 CRUD 工程师,相必都非常熟悉 JDBC。众所周知,关系型数据库有很多种,如:MySQL、Oracle、PostgreSQL 等等。JDBC 如何识别各种数据库的驱动呢? 4.1.1 创建数据库连接 我们先回顾一下,JDBC 如何创建数据库连接的呢? 在 JDBC4.0 之前,连接数据库的时候,通常会用 Class.forName(XXX) 方法来加载数据库相应的驱动,然后再获取数据库连接,继而进行 CRUD 等操作。 Class.forName("com.mysql.jdbc.Driver") 而 JDBC4.0 之后,不再需要用Class.forName(XXX) 方法来加载数据库驱动,直接获取连接就可以了。显然,这种方式很方便,但是如何做到的呢? (1)JDBC 接口:首先,Java 中内置了接口 java.sql.Driver。 (2)JDBC 接口实现:各个数据库的驱动自行实现 java.sql.Driver 接口,用于管理数据库连接。 MySQL:在 MySQL的 Java 驱动包 mysql-connector-java-XXX.jar 中,可以找到 META-INF/services 目录,该目录下会有一个名字为java.sql.Driver 的文件,文件内容是com.mysql.cj.jdbc.Driver。 com.mysql.cj.jdbc.Driver 正是 MySQL 版的 java.sql.Driver 实现。如下图所示: PostgreSQL 实现:在 PostgreSQL 的 Java 驱动包 postgresql-42.0.0.jar 中,也可以找到同样的配置文件,文件内容是 org.postgresql.Driver,org.postgresql.Driver 正是 PostgreSQL 版的 java.sql.Driver 实现。 (3)创建数据库连接 以 MySQL 为例,创建数据库连接代码如下: final String DB_URL = String.format("jdbc:mysql://%s:%s/%s", DB_HOST, DB_PORT, DB_SCHEMA); connection = DriverManager.getConnection(DB_URL, DB_USER, DB_PASSWORD); 4.1.2 DriverManager 从前文,我们已经知道 DriverManager 是创建数据库连接的关键。它究竟是如何工作的呢? 可以看到是加载实例化驱动的,接着看 loadInitialDrivers 方法: private static void loadInitialDrivers() { String drivers; try { drivers = AccessController.doPrivileged(new PrivilegedAction<String>() { public String run() { return System.getProperty("jdbc.drivers"); } }); } catch (Exception ex) { drivers = null; } // 通过 classloader 获取所有实现 java.sql.Driver 的驱动类 AccessController.doPrivileged(new PrivilegedAction<Void>() { public Void run() { // 利用 SPI,记载所有 Driver 服务 ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); // 获取迭代器 Iterator<Driver> driversIterator = loadedDrivers.iterator(); try{ // 遍历迭代器 while(driversIterator.hasNext()) { driversIterator.next(); } } catch(Throwable t) { // Do nothing } return null; } }); // 打印数据库驱动信息 println("DriverManager.initialize: jdbc.drivers = " + drivers); if (drivers == null || drivers.equals("")) { return; } String[] driversList = drivers.split(":"); println("number of Drivers:" + driversList.length); for (String aDriver : driversList) { try { println("DriverManager.Initialize: loading " + aDriver); // 尝试实例化驱动 Class.forName(aDriver, true, ClassLoader.getSystemClassLoader()); } catch (Exception ex) { println("DriverManager.Initialize: load failed: " + ex); } } } 上面的代码主要步骤是: 从系统变量中获取驱动的实现类。 利用 SPI 来获取所有驱动的实现类。 遍历所有驱动,尝试实例化各个实现类。 根据第 1 步获取到的驱动列表来实例化具体的实现类。 需要关注的是下面这行代码: ServiceLoader<Driver> loadedDrivers = ServiceLoader.load(Driver.class); 这里实际获取的是java.util.ServiceLoader.LazyIterator 迭代器。调用其 hasNext 方法时,会搜索 classpath 下以及 jar 包中的 META-INF/services 目录,查找 java.sql.Driver 文件,并找到文件中的驱动实现类的全限定名。调用其 next 方法时,会根据驱动类的全限定名去尝试实例化一个驱动类的对象。 4.2 SPI 应用案例之 Common-Loggin common-logging(也称 Jakarta Commons Logging,缩写 JCL)是常用的日志门面工具包。common-logging 的核心类是入口是 LogFactory,LogFatory 是一个抽象类,它负责加载具体的日志实现。 其入口方法是 LogFactory.getLog 方法,源码如下: public static Log getLog(Class clazz) throws LogConfigurationException { return getFactory().getInstance(clazz); } public static Log getLog(String name) throws LogConfigurationException { return getFactory().getInstance(name); } 从以上源码可知,getLog 采用了工厂设计模式,是先调用 getFactory 方法获取具体日志库的工厂类,然后根据类名称或类型创建日志实例。 LogFatory.getFactory 方法负责选出匹配的日志工厂,其源码如下: public static LogFactory getFactory() throws LogConfigurationException { // 省略... // 加载 commons-logging.properties 配置文件 Properties props = getConfigurationFile(contextClassLoader, FACTORY_PROPERTIES); // 省略... // 决定创建哪个 LogFactory 实例 // (1)尝试读取全局属性 org.apache.commons.logging.LogFactory if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Looking for system property [" + FACTORY_PROPERTY + "] to define the LogFactory subclass to use..."); } try { // 如果指定了 org.apache.commons.logging.LogFactory 属性,尝试实例化具体实现类 String factoryClass = getSystemProperty(FACTORY_PROPERTY, null); if (factoryClass != null) { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Creating an instance of LogFactory class '" + factoryClass + "' as specified by system property " + FACTORY_PROPERTY); } factory = newFactory(factoryClass, baseClassLoader, contextClassLoader); } else { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] No system property [" + FACTORY_PROPERTY + "] defined."); } } } catch (SecurityException e) { // 异常处理 } catch (RuntimeException e) { // 异常处理 } // (2)利用 Java SPI 机制,尝试在 classpatch 的 META-INF/services 目录下寻找 org.apache.commons.logging.LogFactory 实现类 if (factory == null) { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Looking for a resource file of name [" + SERVICE_ID + "] to define the LogFactory subclass to use..."); } try { final InputStream is = getResourceAsStream(contextClassLoader, SERVICE_ID); if( is != null ) { // This code is needed by EBCDIC and other strange systems. // It's a fix for bugs reported in xerces BufferedReader rd; try { rd = new BufferedReader(new InputStreamReader(is, "UTF-8")); } catch (java.io.UnsupportedEncodingException e) { rd = new BufferedReader(new InputStreamReader(is)); } String factoryClassName = rd.readLine(); rd.close(); if (factoryClassName != null && ! "".equals(factoryClassName)) { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Creating an instance of LogFactory class " + factoryClassName + " as specified by file '" + SERVICE_ID + "' which was present in the path of the context classloader."); } factory = newFactory(factoryClassName, baseClassLoader, contextClassLoader ); } } else { // is == null if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] No resource file with name '" + SERVICE_ID + "' found."); } } } catch (Exception ex) { // note: if the specified LogFactory class wasn't compatible with LogFactory // for some reason, a ClassCastException will be caught here, and attempts will // continue to find a compatible class. if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] A security exception occurred while trying to create an" + " instance of the custom factory class" + ": [" + trim(ex.getMessage()) + "]. Trying alternative implementations..."); } // ignore } } // (3)尝试从 classpath 目录下的 commons-logging.properties 文件中查找 org.apache.commons.logging.LogFactory 属性 if (factory == null) { if (props != null) { if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] Looking in properties file for entry with key '" + FACTORY_PROPERTY + "' to define the LogFactory subclass to use..."); } String factoryClass = props.getProperty(FACTORY_PROPERTY); if (factoryClass != null) { if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] Properties file specifies LogFactory subclass '" + factoryClass + "'"); } factory = newFactory(factoryClass, baseClassLoader, contextClassLoader); // TODO: think about whether we need to handle exceptions from newFactory } else { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] Properties file has no entry specifying LogFactory subclass."); } } } else { if (isDiagnosticsEnabled()) { logDiagnostic("[LOOKUP] No properties file available to determine" + " LogFactory subclass from.."); } } } // (4)以上情况都不满足,实例化默认实现类 org.apache.commons.logging.impl.LogFactoryImpl if (factory == null) { if (isDiagnosticsEnabled()) { logDiagnostic( "[LOOKUP] Loading the default LogFactory implementation '" + FACTORY_DEFAULT + "' via the same classloader that loaded this LogFactory" + " class (ie not looking in the context classloader)."); } factory = newFactory(FACTORY_DEFAULT, thisClassLoader, contextClassLoader); } if (factory != null) { /** * Always cache using context class loader. */ cacheFactory(contextClassLoader, factory); if (props != null) { Enumeration names = props.propertyNames(); while (names.hasMoreElements()) { String name = (String) names.nextElement(); String value = props.getProperty(name); factory.setAttribute(name, value); } } } return factory; } 从 getFactory 方法的源码可以看出,其核心逻辑分为 4 步: 首先,尝试查找全局属性org.apache.commons.logging.LogFactory,如果指定了具体类,尝试创建实例。 利用 Java SPI 机制,尝试在 classpatch 的 META-INF/services 目录下寻找org.apache.commons.logging.LogFactory 的实现类。 尝试从 classpath 目录下的 commons-logging.properties 文件中查找org.apache.commons.logging.LogFactory 属性,如果指定了具体类,尝试创建实例。 以上情况如果都不满足,则实例化默认实现类,即org.apache.commons.logging.impl.LogFactoryImpl。 4.3 SPI 应用案例之 Spring Boot Spring Boot 是基于 Spring 构建的框架,其设计目的在于简化 Spring 应用的配置、运行。在 Spring Boot 中,大量运用了自动装配来尽可能减少配置。 下面是一个 Spring Boot 入口示例,可以看到,代码非常简洁。 import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; import org.springframework.web.bind.annotation.GetMapping; import org.springframework.web.bind.annotation.RequestParam; import org.springframework.web.bind.annotation.RestController; @SpringBootApplication @RestController public class DemoApplication { public static void main(String[] args) { SpringApplication.run(DemoApplication.class, args); } @GetMapping("/hello") public String hello(@RequestParam(value = "name", defaultValue = "World") String name) { return String.format("Hello %s!", name); } } 那么,Spring Boot 是如何做到寥寥几行代码,就可以运行一个 Spring Boot 应用的呢。我们不妨带着疑问,从源码入手,一步步探究其原理。 4.3.1 @SpringBootApplication 注解 首先,Spring Boot 应用的启动类上都会标记一个 @SpringBootApplication 注解。 @SpringBootApplication 注解定义如下: @Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited @SpringBootConfiguration @EnableAutoConfiguration @ComponentScan( excludeFilters = {@Filter( type = FilterType.CUSTOM, classes = {TypeExcludeFilter.class} ), @Filter( type = FilterType.CUSTOM, classes = {AutoConfigurationExcludeFilter.class} )} ) public @interface SpringBootApplication { // 略 } 除了@Target、@Retention、@Documented、@Inherited 这几个元注解, @SpringBootApplication 注解的定义中还标记了@SpringBootConfiguration、@EnableAutoConfiguration、@ComponentScan 三个注解。 4.3.2 @SpringBootConfiguration 注解 从@SpringBootConfiguration 注解的定义来看,@SpringBootConfiguration 注解本质上就是一个 @Configuration 注解,这意味着被@SpringBootConfiguration 注解修饰的类会被 Spring Boot 识别为一个配置类。 @Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) @Documented @Configuration public @interface SpringBootConfiguration { @AliasFor( annotation = Configuration.class ) boolean proxyBeanMethods() default true; } 4.3.3 @EnableAutoConfiguration 注解 @EnableAutoConfiguration 注解定义如下: @Target({ElementType.TYPE}) @Retention(RetentionPolicy.RUNTIME) @Documented @Inherited @AutoConfigurationPackage @Import({AutoConfigurationImportSelector.class}) public @interface EnableAutoConfiguration { String ENABLED_OVERRIDE_PROPERTY = "spring.boot.enableautoconfiguration"; Class<?>[] exclude() default {}; String[] excludeName() default {}; } @EnableAutoConfiguration 注解包含了 @AutoConfigurationPackage与 @Import({AutoConfigurationImportSelector.class}) 两个注解。 4.3.4 @AutoConfigurationPackage 注解 @AutoConfigurationPackage 会将被修饰的类作为主配置类,该类所在的 package 会被视为根路径,Spring Boot 默认会自动扫描根路径下的所有 Spring Bean(被 @Component 以及继承 @Component 的各个注解所修饰的类)。——这就是为什么 Spring Boot 的启动类一般要置于根路径的原因。这个功能等同于在 Spring xml 配置中通过 context:component-scan 来指定扫描路径。@Import 注解的作用是向 Spring 容器中直接注入指定组件。@AutoConfigurationPackage 注解中注明了@Import({Registrar.class})。Registrar 类用于保存 Spring Boot 的入口类、根路径等信息。 4.3.5 SpringFactoriesLoader.loadFactoryNames 方法 @Import(AutoConfigurationImportSelector.class) 表示直接注入AutoConfigurationImportSelector。 AutoConfigurationImportSelector 有一个核心方法getCandidateConfigurations 用于获取候选配置。该方法调用了SpringFactoriesLoader.loadFactoryNames 方法,这个方法即为 Spring Boot SPI 的关键,它负责加载所有 META-INF/spring.factories 文件,加载的过程由 SpringFactoriesLoader 负责。 Spring Boot 的 META-INF/spring.factories 文件本质上就是一个 properties 文件,数据内容就是一个个键值对。 SpringFactoriesLoader.loadFactoryNames 方法的关键源码: // spring.factories 文件的格式为:key=value1,value2,value3 // 遍历所有 META-INF/spring.factories 文件 // 解析文件,获得 key=factoryClass 的类名称 public static List<String> loadFactoryNames(Class<?> factoryType, @Nullable ClassLoader classLoader) { String factoryTypeName = factoryType.getName(); return loadSpringFactories(classLoader).getOrDefault(factoryTypeName, Collections.emptyList()); } private static Map<String, List<String>> loadSpringFactories(@Nullable ClassLoader classLoader) { // 尝试获取缓存,如果缓存中有数据,直接返回 MultiValueMap<String, String> result = cache.get(classLoader); if (result != null) { return result; } try { // 获取资源文件路径 Enumeration<URL> urls = (classLoader != null ? classLoader.getResources(FACTORIES_RESOURCE_LOCATION) : ClassLoader.getSystemResources(FACTORIES_RESOURCE_LOCATION)); result = new LinkedMultiValueMap<>(); // 遍历所有路径 while (urls.hasMoreElements()) { URL url = urls.nextElement(); UrlResource resource = new UrlResource(url); // 解析文件,得到对应的一组 Properties Properties properties = PropertiesLoaderUtils.loadProperties(resource); // 遍历解析出的 properties,组装数据 for (Map.Entry<?, ?> entry : properties.entrySet()) { String factoryTypeName = ((String) entry.getKey()).trim(); for (String factoryImplementationName : StringUtils.commaDelimitedListToStringArray((String) entry.getValue())) { result.add(factoryTypeName, factoryImplementationName.trim()); } } } cache.put(classLoader, result); return result; } catch (IOException ex) { throw new IllegalArgumentException("Unable to load factories from location [" + FACTORIES_RESOURCE_LOCATION + "]", ex); } } 归纳上面的方法,主要作了这些事: 加载所有 META-INF/spring.factories 文件,加载过程有 SpringFactoriesLoader 负责。 在 CLASSPATH 中搜寻所有 META-INF/spring.factories 配置文件。 然后,解析 spring.factories 文件,获取指定自动装配类的全限定名。 4.3.6 Spring Boot 的 AutoConfiguration 类 Spring Boot 有各种 starter 包,可以根据实际项目需要,按需取材。在项目开发中,只要将 starter 包引入,我们就可以用很少的配置,甚至什么都不配置,即可获取相关的能力。通过前面的 Spring Boot SPI 流程,只完成了自动装配工作的一半,剩下的工作如何处理呢 ? 以 spring-boot-starter-web 的 jar 包为例,查看其 maven pom,可以看到,它依赖于 spring-boot-starter,所有 Spring Boot 官方 starter 包都会依赖于这个 jar 包。而 spring-boot-starter 又依赖于 spring-boot-autoconfigure,Spring Boot 的自动装配秘密,就在于这个 jar 包。 从 spring-boot-autoconfigure 包的结构来看,它有一个 META-INF/spring.factories ,显然利用了 Spring Boot SPI,来自动装配其中的配置类。 下图是 spring-boot-autoconfigure 的 META-INF/spring.factories 文件的部分内容,可以看到其中注册了一长串会被自动加载的 AutoConfiguration 类。 以 RedisAutoConfiguration 为例,这个配置类中,会根据 @ConditionalXXX 中的条件去决定是否实例化对应的 Bean,实例化 Bean 所依赖的重要参数则通过 RedisProperties 传入。 RedisProperties 中维护了 Redis 连接所需要的关键属性,只要在 yml 或 properties 配置文件中,指定 spring.redis 开头的属性,都会被自动装载到 RedisProperties 实例中。 通过以上分析,已经一步步解读出 Spring Boot 自动装载的原理。 五、SPI 应用案例之 Dubbo Dubbo 并未使用 Java SPI,而是自己封装了一套新的 SPI 机制。Dubbo SPI 所需的配置文件需放置在 META-INF/dubbo 路径下,配置内容形式如下: optimusPrime = org.apache.spi.OptimusPrime bumblebee = org.apache.spi.Bumblebee 与 Java SPI 实现类配置不同,Dubbo SPI 是通过键值对的方式进行配置,这样可以按需加载指定的实现类。Dubbo SPI 除了支持按需加载接口实现类,还增加了 IOC 和 AOP 等特性。 5.1 ExtensionLoader 入口 Dubbo SPI 的相关逻辑被封装在了 ExtensionLoader 类中,通过 ExtensionLoader,可以加载指定的实现类。 ExtensionLoader 的 getExtension 方法是其入口方法,其源码如下: public T getExtension(String name) { if (name == null || name.length() == 0) throw new IllegalArgumentException("Extension name == null"); if ("true".equals(name)) { // 获取默认的拓展实现类 return getDefaultExtension(); } // Holder,顾名思义,用于持有目标对象 Holder<Object> holder = cachedInstances.get(name); if (holder == null) { cachedInstances.putIfAbsent(name, new Holder<Object>()); holder = cachedInstances.get(name); } Object instance = holder.get(); // 双重检查 if (instance == null) { synchronized (holder) { instance = holder.get(); if (instance == null) { // 创建拓展实例 instance = createExtension(name); // 设置实例到 holder 中 holder.set(instance); } } } return (T) instance; } 可以看出,这个方法的作用就是:首先检查缓存,缓存未命中则调用 createExtension 方法创建拓展对象。那么,createExtension 是如何创建拓展对象的呢,其源码如下: private T createExtension(String name) { // 从配置文件中加载所有的拓展类,可得到“配置项名称”到“配置类”的映射关系表 Class<?> clazz = getExtensionClasses().get(name); if (clazz == null) { throw findException(name); } try { T instance = (T) EXTENSION_INSTANCES.get(clazz); if (instance == null) { // 通过反射创建实例 EXTENSION_INSTANCES.putIfAbsent(clazz, clazz.newInstance()); instance = (T) EXTENSION_INSTANCES.get(clazz); } // 向实例中注入依赖 injectExtension(instance); Set<Class<?>> wrapperClasses = cachedWrapperClasses; if (wrapperClasses != null && !wrapperClasses.isEmpty()) { // 循环创建 Wrapper 实例 for (Class<?> wrapperClass : wrapperClasses) { // 将当前 instance 作为参数传给 Wrapper 的构造方法,并通过反射创建 Wrapper 实例。 // 然后向 Wrapper 实例中注入依赖,最后将 Wrapper 实例再次赋值给 instance 变量 instance = injectExtension( (T) wrapperClass.getConstructor(type).newInstance(instance)); } } return instance; } catch (Throwable t) { throw new IllegalStateException("..."); } } createExtension 方法的的工作步骤可以归纳为: 通过 getExtensionClasses 获取所有的拓展类 通过反射创建拓展对象 向拓展对象中注入依赖 将拓展对象包裹在相应的 Wrapper 对象中 以上步骤中,第一个步骤是加载拓展类的关键,第三和第四个步骤是 Dubbo IOC 与 AOP 的具体实现。 5.2 获取所有的拓展类 Dubbo 在通过名称获取拓展类之前,首先需要根据配置文件解析出拓展项名称到拓展类的映射关系表(Map<名称, 拓展类>),之后再根据拓展项名称从映射关系表中取出相应的拓展类即可。相关过程的代码分析如下: private Map<String, Class<?>> getExtensionClasses() { // 从缓存中获取已加载的拓展类 Map<String, Class<?>> classes = cachedClasses.get(); // 双重检查 if (classes == null) { synchronized (cachedClasses) { classes = cachedClasses.get(); if (classes == null) { // 加载拓展类 classes = loadExtensionClasses(); cachedClasses.set(classes); } } } return classes; } 这里也是先检查缓存,若缓存未命中,则通过 synchronized 加锁。加锁后再次检查缓存,并判空。此时如果 classes 仍为 null,则通过 loadExtensionClasses 加载拓展类。下面分析 loadExtensionClasses 方法的逻辑。 private Map<String, Class<?>> loadExtensionClasses() { // 获取 SPI 注解,这里的 type 变量是在调用 getExtensionLoader 方法时传入的 final SPI defaultAnnotation = type.getAnnotation(SPI.class); if (defaultAnnotation != null) { String value = defaultAnnotation.value(); if ((value = value.trim()).length() > 0) { // 对 SPI 注解内容进行切分 String[] names = NAME_SEPARATOR.split(value); // 检测 SPI 注解内容是否合法,不合法则抛出异常 if (names.length > 1) { throw new IllegalStateException("more than 1 default extension name on extension..."); } // 设置默认名称,参考 getDefaultExtension 方法 if (names.length == 1) { cachedDefaultName = names[0]; } } } Map<String, Class<?>> extensionClasses = new HashMap<String, Class<?>>(); // 加载指定文件夹下的配置文件 loadDirectory(extensionClasses, DUBBO_INTERNAL_DIRECTORY); loadDirectory(extensionClasses, DUBBO_DIRECTORY); loadDirectory(extensionClasses, SERVICES_DIRECTORY); return extensionClasses; } loadExtensionClasses 方法总共做了两件事情,一是对 SPI 注解进行解析,二是调用 loadDirectory 方法加载指定文件夹配置文件。SPI 注解解析过程比较简单,无需多说。下面我们来看一下 loadDirectory 做了哪些事情。 private void loadDirectory(Map<String, Class<?>> extensionClasses, String dir) { // fileName = 文件夹路径 + type 全限定名 String fileName = dir + type.getName(); try { Enumeration<java.net.URL> urls; ClassLoader classLoader = findClassLoader(); // 根据文件名加载所有的同名文件 if (classLoader != null) { urls = classLoader.getResources(fileName); } else { urls = ClassLoader.getSystemResources(fileName); } if (urls != null) { while (urls.hasMoreElements()) { java.net.URL resourceURL = urls.nextElement(); // 加载资源 loadResource(extensionClasses, classLoader, resourceURL); } } } catch (Throwable t) { logger.error("..."); } } loadDirectory 方法先通过 classLoader 获取所有资源链接,然后再通过 loadResource 方法加载资源。我们继续跟下去,看一下 loadResource 方法的实现。 private void loadResource(Map<String, Class<?>> extensionClasses, ClassLoader classLoader, java.net.URL resourceURL) { try { BufferedReader reader = new BufferedReader( new InputStreamReader(resourceURL.openStream(), "utf-8")); try { String line; // 按行读取配置内容 while ((line = reader.readLine()) != null) { // 定位 # 字符 final int ci = line.indexOf('#'); if (ci >= 0) { // 截取 # 之前的字符串,# 之后的内容为注释,需要忽略 line = line.substring(0, ci); } line = line.trim(); if (line.length() > 0) { try { String name = null; int i = line.indexOf('='); if (i > 0) { // 以等于号 = 为界,截取键与值 name = line.substring(0, i).trim(); line = line.substring(i + 1).trim(); } if (line.length() > 0) { // 加载类,并通过 loadClass 方法对类进行缓存 loadClass(extensionClasses, resourceURL, Class.forName(line, true, classLoader), name); } } catch (Throwable t) { IllegalStateException e = new IllegalStateException("Failed to load extension class..."); } } } } finally { reader.close(); } } catch (Throwable t) { logger.error("Exception when load extension class..."); } } loadResource 方法用于读取和解析配置文件,并通过反射加载类,最后调用 loadClass 方法进行其他操作。loadClass 方法用于主要用于操作缓存,该方法的逻辑如下: private void loadClass(Map<String, Class<?>> extensionClasses, java.net.URL resourceURL, Class<?> clazz, String name) throws NoSuchMethodException { if (!type.isAssignableFrom(clazz)) { throw new IllegalStateException("..."); } // 检测目标类上是否有 Adaptive 注解 if (clazz.isAnnotationPresent(Adaptive.class)) { if (cachedAdaptiveClass == null) { // 设置 cachedAdaptiveClass缓存 cachedAdaptiveClass = clazz; } else if (!cachedAdaptiveClass.equals(clazz)) { throw new IllegalStateException("..."); } // 检测 clazz 是否是 Wrapper 类型 } else if (isWrapperClass(clazz)) { Set<Class<?>> wrappers = cachedWrapperClasses; if (wrappers == null) { cachedWrapperClasses = new ConcurrentHashSet<Class<?>>(); wrappers = cachedWrapperClasses; } // 存储 clazz 到 cachedWrapperClasses 缓存中 wrappers.add(clazz); // 程序进入此分支,表明 clazz 是一个普通的拓展类 } else { // 检测 clazz 是否有默认的构造方法,如果没有,则抛出异常 clazz.getConstructor(); if (name == null || name.length() == 0) { // 如果 name 为空,则尝试从 Extension 注解中获取 name,或使用小写的类名作为 name name = findAnnotationName(clazz); if (name.length() == 0) { throw new IllegalStateException("..."); } } // 切分 name String[] names = NAME_SEPARATOR.split(name); if (names != null && names.length > 0) { Activate activate = clazz.getAnnotation(Activate.class); if (activate != null) { // 如果类上有 Activate 注解,则使用 names 数组的第一个元素作为键, // 存储 name 到 Activate 注解对象的映射关系 cachedActivates.put(names[0], activate); } for (String n : names) { if (!cachedNames.containsKey(clazz)) { // 存储 Class 到名称的映射关系 cachedNames.put(clazz, n); } Class<?> c = extensionClasses.get(n); if (c == null) { // 存储名称到 Class 的映射关系 extensionClasses.put(n, clazz); } else if (c != clazz) { throw new IllegalStateException("..."); } } } } } 如上,loadClass 方法操作了不同的缓存,比如 cachedAdaptiveClass、cachedWrapperClasses 和 cachedNames 等等。除此之外,该方法没有其他什么逻辑了。 参考资料 Java SPI 思想梳理 Dubbo SPI springboot 中 SPI 机制 SpringBoot 的自动装配原理、自定义 starter 与 spi 机制,一网打尽

优秀的个人博客,低调大师

每日一博 | 流程引擎的架构设计

1 什么是流程引擎 流程引擎是一个底层支撑平台,是为提供流程处理而开发设计的。流程引擎和流程应用,以及应用程序的关系如下图所示。 常见的支撑场景有:Workflow、BPM、流程编排等。本次分享,主要从BPM流程引擎切入,介绍流程引擎的架构设计方法。 1.1 什么是流程 简单来说,流程就是一系列活动的组合。比如,用于企业办公的OA系统中,就存在大量的申请审批类的流程。在生产制造业,有大量的从销售端的订单,到生产制造,再到签收回款的生产销售流程。在机器学习领域,有亚马逊AWS Sagemaker的大数据处理、机器学习的应用。综上,流程是一个概念,在和具体实现结合时,就产生了不同的流程产品,如DevOps、Spring Data Stream等。 在流程实现方面,主要可以分为2种实现方式,一种是用代码实现,比如:用代码实现一个加班申请,那么就要自己对接SSO进行单点登录,通过接口拿到发起人和审批人的信息,同时保存表单数据。另一种方式是使用流程引擎来实现,流程引擎对接应用场景所需数据,如加班申请,流程引擎对接SSO、OU、审批人配置、权限等,实现这样一个流程,只需要关心流程配置、流程节点和流程表单即可,流程流转以及流程的数据处理,都通过流程引擎来完成。 流程引擎可以快速落地流程实现,这也是流程引擎存在的价值。 1.2 什么是引擎 一般而言,引擎是一个程序或一套系统的支持部分。常见的程序引擎有游戏引擎、搜索引擎、杀毒引擎等。引擎是脱离具体业务场景的某一类业务场景的高度抽象和封装。 比如,某OA公司,封装了一套审批用的workflow,实施人员只需要配置流程和表单即可交付项目。再比如,美国某公司做了一个AI引擎做NBA(Next Best Action)推荐,封装了推荐领域的常用算法,在不同的场景自动选择和组合多种算法,进行智能推荐。 1.3 流程设计器 流程设计器是流程和引擎的连接方,用户通过流程设计器,将某种layout和rule固化成某种流程,然后通过数据和数据上下文,使用流程引擎自动按照某种固化的流程进行执行。 我将目前见到的流程设计器的理论基础,分为以下三类:1,自定义系;2,UML中的活动图系;3,BPMN系。 1.3.1 自定义系 用于Sagemaker等场景的AWS Step Function(自定义流程节点) 1.3.2 UML Activity Diagram Flowportal BPM的流程设计器 1.3.3 BPMN系 activiti的流程设计器 炎黄盈动的流程设计器 题外话:炎黄盈动的流程设计器,和processon中的流程设计器界面几乎一样,因为本质上是一家的。 2 流程引擎的应用 2.1 Workflow 工作流管理联盟(Workflow Management Coalition,WfMC)作为工作流管理的标准化组织而成立。 WfMC对工作流给出定义为:工作流是指一类能够完全自动执行的经营过程,根据一系列过程规则,将文档、信息或任务在不同的执行者之间进行传递与执行。 在workflow中,流程引擎主要用于支撑流程审批和数据流转,应用场景非常广泛。 国外产品(开源或商用)通常需求和操作比较简单,不会有国内的需求那么复杂。国内的产品,经历了众多客户的锤炼,功能目前都比较强大。 一般而言,workflow使用场景最多的是OA产品。在OA办公中,包含了企业办公中的大量元素,这些元素足够形成特定的产品,比如门户系统、移动办公。在OA的项目落地过程中,结合行业、业务侧重点又可以形成行业解决方案和专题方案。 以下是某OA公司产品和解决方案。 2.2 BPM(Business Process Management) Workflow主要是解决审批和数据流转,而BPM主要是解决端到端、信息孤岛等问题而存在的。大多数用BPM产品的客户,都是在BPM基础上进行系统搭建,比如在BPM上面搭建OA、CRM、HR等系统。 BPM的使用场景,比Workflow更广泛,BPM产品中包含大量的和第三方系统交互的组件和自定义SQL、代码组件。比如,BPM系统中的文件触发器,可以在海关等交互场景下,通过监控FTP服务器中的文件,自动触发流程实例;可以通过定时器Timer,自动每日执行数据同步,并通过Mail节点将同步结果通知到相关运营成员等。 BPM的应用,可以按照执行前、执行中和执行后来划分。 2.3 流程编排 流程编排是脱离流程业务领域的更高一层抽象,使用方可以通过流程编排系统,结合自己的业务场景进行业务定制。比如,可以将相关业务代码,封装成function,然后通过云厂商平台的FAAS平台,将不同业务的function进行关联和调度,从而完成某项任务。 3 流程引擎的架构设计 鉴于一些朋友可能没有使用和接触过流程引擎,先介绍流程引擎的组成单元,再介绍基于某个BPM产品的项目是如何进行开发的。我们通过BPM项目开发,对流程引擎的作用有个初步的认识。 3.1 BPM流程引擎的组成单元 组织、角色、用户、成员的组织架构托管; 流程资源文件的配置、校验、存储和执行,对不同的流程节点,流程引擎自动结合配置、数据处理其对应的业务逻辑,流程数据自动处理; 表单配置、数据绑定,表单数据的根据流程配置自动处理; 通用的数据接口; 3.1.1 组织架构的设计 3.1.2 流程设计器 流程设计器包含左侧的分组节点列表,和右侧的画布。左侧的节点可以如下进行设计。 问题:对于一个XML或JSON格式的流程图,如何进行解析? 不同的节点,按照不同的业务场景,配置不同的配置项。比如,对于Human Node需要配置审批人,配置审批环节的展示表单,审批环节能够修改哪些字段,哪些字段的修改要进行留痕等。 3.1.3 表单设计器 这种是按照表单相关数据表,生成出一个表单,然后对表单字段进行配置和数据绑定。 这种是Drag&Drop控件,然后配置控件的属性,如绑定字段等。 这种是Drag&Drop控件,无需关联数据库表字段的表单 数据表生成表单的概要流程如下图所示。 拖拽控件绑定数据表字段的概要流程如下。 拖拽控件无需绑定数据表字段的概要流程。使用NoSQL的Document记录或使用RDS提供的JSON类型进行保存会比较方便。 3.1.4 接口设计 结合Activity的接口设计,如下图所示 一些系统在创建一个流程任务的时候,要先按照流程模板先创建一个应用示例,再关联发起人和备注,调用RuntimeService,执行到StartNode,这类设计因人而异,这么做略显繁琐。 3.2 基于流程引擎的项目开发实践 3.2.1 流程项目实践流程 确定组织架构 确定流程,包括流程布局、审批人设置、权限 确定表单信息(字段、类型、数据源、校验规则)和表单样式 确定页面布局、样式、数据字段、搜索、导入、导出 报表 3.2.2 组织架构 组织架构实现,有两种方法,一种是按照维度进行数据管理,另一种是在同一棵组织架构树下进行管理。 按照集团、公司、部门、用户等不同维度,进行数据管理,比较常见,这里不做讨论。下图为按维度维护数据的示例。 按照同一棵组织架构树进行数据维护,界面一般显示为左树右表。大多数商业化产品,都会将此组织架构树进行内存缓存,以方便审批人查找、开窗选择OrgUnit、Role、User、Member等场景。Member的引入是为了解决一人多职等场景。一般发起流程的时候,需要带出发起人拥有的Member列表,从而后续节点取合适的审批人。 对于组织架构而言,需要考虑,系统本身要具备OU存储的能力,对于没有组织架构的用户,可以直接在系统的组织架构中新建组织架构。同时,对于已有系统的客户,可以通过组织架构数据同步来进行数据自动维护。对于用AD域内部管控的客户来说,需要具备AD域身份认证的能力。对于复杂场景,比如用户是SaaS化等复杂场景,组织架构也需要在系统内部,支持使用API的方式来获取组织信息。 所以在组织架构设计的时候,要使用插件的方式来做,具体使用哪种插件,可以在配置文件中进行配置。以下为一个商业产品的组织架构操作界面示例。 常见的组织架构操作还有组织架构同步,比如流程系统同步微信企业号、钉钉等,这里不再展开。 3.2.3 流程设计 我们想象的流程,可能是向下面的这种简单流程。 而实际项目,碰到的流程,一般是如下图所示的情景。 初步看几个流程的模型文件是什么样的,先有个印象。 <?xml version="1.0" encoding="UTF-8" ?> <definitions id="definitions" targetNamespace="http://activiti.org/bpmn20" xmlns="http://www.omg.org/spec/BPMN/20100524/MODEL" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:activiti="http://activiti.org/bpmn"> <process id="vacationRequest" name="Vacation request"> <startEvent id="request" activiti:initiator="employeeName"> <extensionElements> <activiti:formProperty id="numberOfDays" name="Number of days" type="long" value="1" required="true"/> <activiti:formProperty id="startDate" name="First day of holiday (dd-MM-yyy)" datePattern="dd-MM-yyyy hh:mm" type="date" required="true" /> <activiti:formProperty id="vacationMotivation" name="Motivation" type="string" /> </extensionElements> </startEvent> <sequenceFlow id="flow1" sourceRef="request" targetRef="handleRequest" /> <userTask id="handleRequest" name="Handle vacation request" > <documentation> ${employeeName} would like to take ${numberOfDays} day(s) of vacation (Motivation: ${vacationMotivation}). </documentation> <extensionElements> <activiti:formProperty id="vacationApproved" name="Do you approve this vacation" type="enum" required="true"> <activiti:value id="true" name="Approve" /> <activiti:value id="false" name="Reject" /> </activiti:formProperty> <activiti:formProperty id="managerMotivation" name="Motivation" type="string" /> </extensionElements> <potentialOwner> <resourceAssignmentExpression> <formalExpression>management</formalExpression> </resourceAssignmentExpression> </potentialOwner> </userTask> <sequenceFlow id="flow2" sourceRef="handleRequest" targetRef="requestApprovedDecision" /> <exclusiveGateway id="requestApprovedDecision" name="Request approved?" /> <sequenceFlow id="flow3" sourceRef="requestApprovedDecision" targetRef="sendApprovalMail"> <conditionExpression xsi:type="tFormalExpression">${vacationApproved == 'true'}</conditionExpression> </sequenceFlow> <task id="sendApprovalMail" name="Send confirmation e-mail" /> <sequenceFlow id="flow4" sourceRef="sendApprovalMail" targetRef="theEnd1" /> <endEvent id="theEnd1" /> <sequenceFlow id="flow5" sourceRef="requestApprovedDecision" targetRef="adjustVacationRequestTask"> <conditionExpression xsi:type="tFormalExpression">${vacationApproved == 'false'}</conditionExpression> </sequenceFlow> <userTask id="adjustVacationRequestTask" name="Adjust vacation request"> <documentation> Your manager has disapproved your vacation request for ${numberOfDays} days. Reason: ${managerMotivation} </documentation> <extensionElements> <activiti:formProperty id="numberOfDays" name="Number of days" value="${numberOfDays}" type="long" required="true"/> <activiti:formProperty id="startDate" name="First day of holiday (dd-MM-yyy)" value="${startDate}" datePattern="dd-MM-yyyy hh:mm" type="date" required="true" /> <activiti:formProperty id="vacationMotivation" name="Motivation" value="${vacationMotivation}" type="string" /> <activiti:formProperty id="resendRequest" name="Resend vacation request to manager?" type="enum" required="true"> <activiti:value id="true" name="Yes" /> <activiti:value id="false" name="No" /> </activiti:formProperty> </extensionElements> <humanPerformer> <resourceAssignmentExpression> <formalExpression>${employeeName}</formalExpression> </resourceAssignmentExpression> </humanPerformer> </userTask> <sequenceFlow id="flow6" sourceRef="adjustVacationRequestTask" targetRef="resendRequestDecision" /> <exclusiveGateway id="resendRequestDecision" name="Resend request?" /> <sequenceFlow id="flow7" sourceRef="resendRequestDecision" targetRef="handleRequest"> <conditionExpression xsi:type="tFormalExpression">${resendRequest == 'true'}</conditionExpression> </sequenceFlow> <sequenceFlow id="flow8" sourceRef="resendRequestDecision" targetRef="theEnd2"> <conditionExpression xsi:type="tFormalExpression">${resendRequest == 'false'}</conditionExpression> </sequenceFlow> <endEvent id="theEnd2" /> </process> </definitions> 一个屏幕截图都截不完的流程,如果用代码去实现整个流程,其工作量和效率,可想而知。而实际做项目,使用基于流程引擎的产品来做项目的时候,只需要确定节点、节点配置、数据配置和权限即可。 问题:一般流程,都带有邮件通知的节点,如何实现邮件通知节点?请考虑以下情景。 流程流转和执行的时候,会遇到各种情况的错误,比如找不到审批人等,此时流程引擎要对数据做rollback,而邮件通知节点的业务逻辑已经执行过了。 权限方面,对于流程资源,哪些部门可以申请,哪些角色不可申请,都应该做流程控制。而在流程执行过程中,流程数据、不是路程的相关人也都不应该看到流程,处理过流程的审批人,不可以再对流程进行处理等,都是权限方面要考虑的问题。 3.2.4 表单设计 如下图所示的表单,可以分析以下,一个流程表单有多个主表信息和多个子表信息。一般而言,如果是通过流程引擎做非流程的数据处理,子表通过主表ID来做关联,如果通过流程引擎做流程的数据处理,子表和主表通过TaskId来做关联。以下为示例。 流程系统需要表单设计器,一个流程的不同节点可以挂接不同的表单,以方便不同角色的人关注不同维度的流程信息 3.2.5 页面设计 一般而言,对于流程的发起、审批、历史记录等,都是通用的系统界面。而一些业务场景,需要单独做列表界面,以方便使用。对于已有门户系统的客户,需要融合其界面样式。以下为曾经做过的项目示例。 3.2.6 报表 由于不是所有客户都有报表系统,所以流程系统需要具备一个基本的报表功能。下图为示例。 有报表系统的客户,可以使用其商业版报表系统,获取(直接取、数仓)数据进行展示。常见的报表系统有FineReport、Tableau、PowerBI等。 3.3 BPM流程引擎架构设计 3.3.1 流程引擎的架构设计 3.3.2 发起流程 流程引擎处理过程 执行节点处理过程 问题:在流程引擎处理过程中,如果一个节点有多条连线,如何寻找FromNodeId是某个Node的连线? 人工处理时,指定连线text 3.4 流程引擎架构设计 3.4.1 业务识别 识别业务场景中的配置项,使用集合或分组的方式,让业务可配置 支撑业务流程过程的可配置化 支撑业务场景中的数据,自动处理 3.4.2 流程引擎的实现 资源相关服务,资源加载,资源保存,资源加密等 配置项相关服务 PVM虚拟机的实现,即通过某个节点(发起时为开始节点)作为初始节点,按照某个连线的action进行节点的自动执行的虚拟机 数据配置、数据权限 流程数据和业务数据的自动处理 4 商业机会 Business Process Analysis (BPA) 流程分析,帮助企业进行流程调整和优化 Process Assets Library(PAL)流程资产库,对企业流程进行知识化沉淀,将制度和流程落地做绑定,让审批人知晓流程中对应的职责 Process Simulate 流程模拟,自动化测试 Process Forecast 流程预测 低代码平台 更广泛的机会,在于业务领域+流程引擎,比如:DevOps、RPA、应用与服务编排、数据编排、FaaS编排等。 作者:马瑞

优秀的个人博客,低调大师

每日一博 | 前端动效讲解与实战

作者:vivo 互联网前端团队- ZhaoJie 本文将从各个角度来对动画整个体系进行分类,并且介绍各种前端动画的实现方法,最后我们将总结在实际开发中的各个场景的动画选择方案。 一、背景 前端动画场景需求多 对众多动画场景的技术实现方案选择上比较模糊 各动画方案的优劣及适用场景认识模糊 现有动画库太多,不知道选哪个 主流动画库的适用场景认识模糊 下面首先让我们从各个角度来对动画整个体系进行分类,让我们清晰的了解动画整个体系。 二、分类 2.1 用途角度 首先我们从动画的用途或者说是业务的角度来进行区分,将我们平时的动画分为展示型动画和交互型动画。 2.1.1 展示型动画 类似于一张GIF图,或者一段视频。比如在开启宝箱的时候,我们会加入一个切场过渡动画,来替代原有的生硬等待结果。 展示型动画在实际使用的场景中,实现的方法很多,比如用GIF图,canvas,CSS3动画等,但是最终输出的结果是不带有交互的,也就是从动画起始状态到结束状态一气呵成,这个过程用户可以感知,但是无法参与。 2.1.2 交互型动画 用户自已参与的,对于交互性动画而言,我们可以在动画播放的某个时间节点触发相应的操作,进而让用户参与到其中,最常见的例子红包雨,不仅仅能提升用户的体验,还能提升我们的产品的多元性。 然而交互性动画经常面临的一个问题就是,通过原生代码实现交互动画是很复杂的,同时性能和兼容性是不得不认真考虑的问题,比较好的解决方案还是寻求相关的框架。 2.2 绘制技术角度 不管采用什么方式来制作动画,最终呈现到前端页面的无非是以下三种形式: Canvas div SVG PS:为了简单也可以用视频,但除非动画的播放场景固定,不然移动端视频在不同app、不同机型、不同系统的播放显示都不太一样,容易踩不少坑。 2.2.1 不同绘制技术的性能差异 Canvas 效率高、性能好、可控性高,只能处理位图,内存占用恒定 依赖分辨率 不支持事件处理器 弱的文本渲染能力 能够以 .png 或 .jpg 格式保存结果图像 最适合图像密集型的游戏,其中的许多对象会被频繁重绘 div 包括CSS控制的DOM动画、JS控制的DOM动画 比较适合简单的数量较少的复杂度较低的动画 SVG 处理矢量图,不失真 不依赖分辨率 支持事件处理器 最适合带有大型渲染区域的应用程序(比如谷歌地图) 复杂度高会减慢渲染速度(任何过度使用 DOM 的应用都不快) 不适合游戏应用 2.2.2 Canvas和SVG比较 一句话总结:都是2D做图,svg是矢量图,canvas是位图。canvas 是逐像素进行渲染的,适合游戏。 SVG SVG绘制的是矢量图,缩放不影响显示,所以最适合带有大型渲染区域的应用程序(比如谷歌地图) SVG 是一种使用 XML 描述 2D 图形的语言。 SVG 基于 XML,这意味着 SVG DOM 中的每个元素都是可用的。您可以为某个元素附加 JavaScript 事件处理器。 在 SVG 中,每个被绘制的图形均被视为对象。如果 SVG 对象的属性发生变化,那么浏览器能够自动重现图形。 Canvas Canvas 通过 JavaScript 来绘制 2D 图形。 Canvas 是逐像素进行渲染的。 在 Canvas 中,一旦图形被绘制完成,它就不会继续得到浏览器的关注。如果其位置发生变化,那么整个场景也需要重新绘制,包括任何或许已被图形覆盖的对象。 Canvas只占用一个DOM节点,在做一些烟花、飘雪等运动元素很多的动画时,会比CSS/SVG性能好。 性能比较 一般情况下,随着屏幕大小的增大,canvas将开始降级,因为需要绘制更多的像素。 随着屏幕上的对象数目增多,SVG 将开始降级,因为我们正不断将这些对象添加到 DOM 中。 这些度量不一定准确,以下方面的不同一定会引起变化:实现和平台、是否使用完全硬件加速的图形,以及 JavaScript 引擎的速度。 2.3 动画类型角度 前端动效开发,首先应该确定的是 动画用途->确认动画类型->确认绘制技术->确认动画的实现方式。 虽然最终呈现动画的载体(绘制技术)就三种,但实现动画的方式却很多,得从动画类型出发讨论动画的实现方式: (1)逐帧动画(序列帧动画) GIF实现 CSS实现(animation) JS+DOM实现 JS+canvas实现 (2)补间动画(Tween动画\关键帧动画) CSS实现(transition、animation等)使用一些缓动函数 JS实现 (3)SVG动画 使用 XML 格式定义图形 可以用AI等SVG编辑工具生成SVG图片后,配合anime.js、GSAP等现有库进行动画制作 (4)骨骼动画 一般采用Spine、DragonBones等工具导出相应资源图片和JSON动画配置资源后使用。 (5)3D动画 DOM操作用CSS 3D实现。(perspective属性、css3d-engine) 场景搭建用webGL(Three.js等) 3D模型动画用Blender或maya等制作完成后导出使用 2.3.1 逐帧动画(序列帧动画) 逐帧动画是在时间帧上逐帧绘制帧内容,由于是一帧一帧的画,所以逐帧动画具有非常大的灵活性,几乎可以表现任何想表现的内容。 由于逐帧动画的帧序列内容不一样,不仅增加制作负担而且最终输出的文件量也很大,但它的优势也很明显:因为它相似与电影播放模式,很适合于表演很细腻的动画,如3D效果、人物或动物急剧转身等等效果。 所以逐帧动画的实现核心是什么,就是将我们的这些静态的图片进行快速的循环播放,形成了一个动态的动画效果。这就是帧动画。 2.3.1.1 GIF实现 我们可以将帧动画导出成GIF图,GIF图会连续播放,无法暂停,它往往用来实现小细节动画,成本较低、使用方便。但其缺点也是很明显的: 画质上,GIF 支持颜色少(最大256色)、Alpha 透明度支持差,图像锯齿毛边比较严重; 交互上,不能直接控制播放、暂停、播放次数,灵活性差; 性能上,GIF 会引起页面周期性的绘画,性能较差。 2.3.1.2 CSS实现 CSS3帧动画是我们今天需要重点介绍的方案,最核心的是利用CSS3中Animation动画,确切的说是使用animation-timing-function的阶梯函数steps(number_of_steps, direction)来实现逐帧动画的连续播放。 帧动画的实现原理是不断切换视觉内图片内容,利用视觉滞留生理现象来实现连续播放的动画效果,下面我们来介绍制作CSS3帧动画的几种方案。 (1)连续切换动画图片地址src(不推荐) 我们将图片放到元素的背景中(background-image),通过更改background-image的值实现帧的切换。但是这种方式会有以下几个缺点,所以该方案不推荐。 多张图片会带来多个 HTTP 请求 每张图片首次加载会造成图片切换时的闪烁 不利于文件的管理 (2)连续切换雪碧图位置(推荐)我们将所有的帧动画图片合并成一张雪碧图,通过改变background-position的值来实现动画帧切换。分两步进行: 步骤一: 将动画帧合并为雪碧图,雪碧图的要求可以看上面素材准备,比如下面这张帧动画雪碧图,共20帧。 (图片来源于:帧动画的多种实现方式与性能对比) 步骤二: 使用steps阶梯函数切换雪碧图位置 写法一: <div class="sprite"></div> .sprite { width: 300px; height: 300px; background-repeat: no-repeat; background-image: url(frame.png); animation: frame 333ms steps(1,end) both infinite; } @keyframes frame { 0% {background-position: 0 0;} 5% {background-position: -300px 0;} 10% {background-position: -600px 0;} 15% {background-position: -900px 0;} 20% {background-position: -1200px 0;} 25% {background-position: -1500px 0;} 30% {background-position: -1800px 0;} 35% {background-position: -2100px 0;} 40% {background-position: -2400px 0;} 45% {background-position: -2700px 0;} 50% {background-position: -3000px 0;} 55% {background-position: -3300px 0;} 60% {background-position: -3600px 0;} 65% {background-position: -3900px 0;} 70% {background-position: -4200px 0;} 75% {background-position: -4500px 0;} 80% {background-position: -4800px 0;} 85% {background-position: -5100px 0;} 90% {background-position: -5400px 0;} 95% {background-position: -5700px 0;} 100% {background-position: -6000px 0;} } 针对以上动画有疑问? 问题一:既然都详细定义关键帧了,是不是可以不用steps函数了,直接定义linear变化不就好了吗? animation: frame 10s linear both infinite; 如果我们定义成这样,动画是不会阶梯状,一步一步执行的,而是会连续的变化背景图位置,是移动的效果,而不是切换的效果,如下图: 问题二:不是应该设置为20步吗,怎么变成了1? 这里我们先来了解下animation-timing-function属性。CSSanimation-timing-function属性定义CSS动画在每一动画周期中执行的节奏。 综上我们可以知道,因为我们详细定义了一个动画周期,也就是说0% ~ 5%之间变化一次,5% ~ 10%变化一次,所以我们这样写才能达到想要的效果。 写法二: <div class="sprite"></div>.sprite { width: 300px; height: 300px; background-repeat: no-repeat; background-image: url(frame.png); animation: frame 333ms steps(20) both infinite; } @keyframes frame { 0% {background-position: 0 0;}//可省略 100% {background-position: -6000px 0;} } 这里我们定义了关键帧的开始和结束,也就是定义了一个关键帧周期,但因为我们没有详细的定义每一帧的展示,所以我们要将0%~100%这个区间分成20步来阶段性展示。 (3)连续移动雪碧图位置(移动端推荐) 跟第二种基本一致,只是切换雪碧图的位置过程换成了transform:translate3d()来实现,不过要加多一层overflow: hidden;的容器包裹,这里我们以只定义初始和结束帧为例,使用transform可以开启GPU加速,提高机器渲染效果,还能有效解决移动端帧动画抖动的问题。 <div class="sprite-wp"> <div class="sprite"></div></div> .sprite-wp { width: 300px; height: 300px; overflow: hidden; } .sprite { width: 6000px; height: 300px; will-change: transform; background: url(frame.png) no-repeat center; animation: frame 333ms steps(20) both infinite; } @keyframes frame { 0% {transform: translate3d(0,0,0);} 100% {transform: translate3d(-6000px,0,0);} } steps() 函数详解 从上面的代码我们可以发现,CSS实现的核心就是使用animation-timing-function缓动函数的阶梯函数steps(number_of_steps, direction)来实现逐帧动画的连续播放的。 接着我们来了解下steps() 函数: steps 指定了一个阶梯函数,包含两个参数: 第一个参数指定了函数中的间隔数量(必须是正整数); 第二个参数可选,指定在每个间隔的起点或是终点发生阶跃变化,接受 start 和 end 两个值,默认为 end。 start 第一帧是第一步动画的结束,end 第一帧是第一步动画的开始。 除了 steps 函数,animation-timing-function 还有两个与逐帧动画相关的属性值 step-start 与 step-end: step-start 等同于 steps(1,start) step-end 等同于 steps(1,end) 2.3.1.3 JS实现 (1)通过JS来控制img的src属性切换(不推荐) 和上面CSS3帧动画里面切换元素background-image属性一样,会存在多个请求等问题,所以该方案我们不推荐,但是这是一种解决思路。 (2)通过JS来控制canvas图像绘制 通过canvas制作帧动画的原理是用drawImage方法将图片绘制到canvas上,不断擦除和重绘就能得到我们想要的效果。 <canvas id="canvas" width="300" height="300"></canvas>(function () { var timer = null, canvas = document.getElementById("canvas"), context = canvas.getContext('2d'), img = new Image(), width = 300, height = 300, k = 20, i = 0; img.src = "frame.png"; function drawImg() { context.clearRect(0, 0, width, height); i++; if (i == k) { i = 0; } context.drawImage(img, i * width, 0, width, height, 0, 0, width, height); window.requestAnimationFrame(drawImg); } img.onload = function () { window.requestAnimationFrame(drawImg); } })(); 上面是通过改变裁剪图像的X坐标位置来实现动画效果的,也可以通过改变画布上放置图像的坐标位置实现,如下: context.drawImage(img, 0, 0, width*k, height,-i*width,0,width*k,height); (3)通过JS来控制CSS属性值变化 这种方式和前面CSS3帧动画一样,有三种方式,一种是通过JS切换元素背景图片地址background-image,一种是通过JS切换元素背景图片定位background-position,最后一种是通过JS移动元素transform:translate3d(),第一种不做介绍,因为同样会存在多个请求等问题,不推荐使用,这里实现后面两种。 切换元素背景图片位置background-position .sprite { width: 300px; height: 300px; background: url(frame.png) no-repeat 0 0; } <div class="sprite" id="sprite"></div>(function(){ var sprite = document.getElementById("sprite"), picWidth = 300, k = 20, i = 0, timer = null; // 重置背景图片位置 sprite.style = "background-position: 0 0"; // 改变背景图位置 function changePosition(){ sprite.style = "background-position: "+(-picWidth*i)+"px 0"; i++; if(i == k){ i = 0; } window.requestAnimationFrame(changePosition); } window.requestAnimationFrame(changePosition); })(); 移动元素背景图片位置transform:translate3d() .sprite-wp { width: 300px; height: 300px; overflow: hidden; } .sprite { width: 6000px; height: 300px; will-change: transform; background: url(frame.png) no-repeat center; } <div class="sprite-wp"> <div class="sprite" id="sprite"></div></div> (function () { var sprite = document.getElementById("sprite"), picWidth = 300, k = 20, i = 0, timer = null; // 重置背景图片位置 sprite.style = "transform: translate3d(0,0,0)"; // 改变背景图移动 function changePosition() { sprite.style = "transform: translate3d(" + (-picWidth * i) + "px,0,0)"; i++; if (i == k) { i = 0; } window.requestAnimationFrame(changePosition); } window.requestAnimationFrame(changePosition); })(); 2.3.1.4 性能分析 我们通过Chrome浏览器的各种工具,查看了每种方案的 FPS、CPU占用率、GPU占用、Scripting、Rendering、Painting、内存的使用情况,得到以下数据: 通过分析以上数据我们可以得出以下几点: 除了CSStransform:translate3d()方案,其他方案的FPS都能达到60FPS的流畅程度,但该方案的FPS 也不是很低。 CPU占用率最低的方案是CSStransform:translate3d()方案。 GPU占用最低的方案是JS canvas 绘制方案。 CSS 方案没有脚本开销。 Rendering 最少的是CSStransform:translate3d()方案。 Painting 最少的是CSStransform:translate3d()方案。 各方案内存占用区别不大。 结论:我们看到,在7个指标中,CSStransform:translate3d()方案将其中的4个指标做到了最低,从这点看,我们完全有理由选择这种方案来实现CSS帧动画。 2.3.2 补间动画(Tween动画\关键帧动画) 补间动画是动画的基础形式之一,又叫做中间帧动画,渐变动画,指的是人为设定动画的关键状态,也就是关键帧,而关键帧之间的过渡过程只需要由计算机处理渲染的一种动画形式。 说白了,就是我们在做动画的时候,只需要指定几个特殊时刻动画的状态,其余的状态由计算机自动计算补充。 实现补间动画常见的手段主要由以下几种: CSS3 Animation:通过animation(除steps()以外的时间函数)属性在每个关键帧之间插入补间动画。 CSS3 Transition:区别于animation,transition只能设定初始和结束时刻的两个关键帧状态。 利用JavaScript实现动画:例如JavaScript动画库或框架,Anime.js 或者TweenJS,它是CreateJS的其中一个套件。另外,在Flash业界久负盛名的GreenSock推出的GSAP(GreenSock Animation Platform)也新引入了对Javascript动画的支持。 2.3.2.1 CSS实现 (1)transition 动画 transition允许CSS的属性值在一定的时间区间内平滑地过渡,即指定元素的初始状态 和末尾状态,既可以完成一个动画,中间的变化完全有浏览器自己决定。动画的效果主要还是看transition相关属性即可。 然而利用transition制作的动画也有着显著的缺点: transition需要事件触发,所以没法在网页加载时自动发生。 transition是一次性的,不能重复发生,除非一再触发。 transition只能定义开始状态和结束状态,不能定义中间状态,也就是说只有两个状态。 一条transition规则,只能定义一个属性的变化,不能涉及多个属性。 (2)animation 动画 利用animation可以完成一个完整的CSS补间动画,如上面所说,我们只需要定义几个特殊时刻的动画状态即可。这个特殊时刻通常我们叫做关键帧。 keyframes 关键帧 Keyframes具有其自己的语法规则,他的命名是由"@keyframes"开头,后面紧接着是这个“动画的名称”加上一对花括号“{}”,括号中就是一些不同时间段样式规则,有点像我们CSS的样式写法一样。 对于一个"@keyframes"中的样式规则是由多个百分比构成的,如“0%”到"100%"之间,我们可以在这个规则中创建多个百分比,我们分别给每一个百分比中给需要有动画效果的元素加上不同的属性,从而让元素达到一种在不断变化的效果,比如说移动,改变元素颜色,位置,大小,形状等。 不过有一点需要注意的是,我们可以使用“fromt”“to”来代表一个动画是从哪开始,到哪结束,也就是说这个 "from"就相当于"0%"而"to"相当于"100%",值得一说的是,其中"0%"不能像别的属性取值一样把百分比符号省略,我们在这里必须加上百分符号(“%”)如果没有加上的话,我们这个keyframes是无效的,不起任何作用。因为keyframes的单位只接受百分比值。看一下具体的代码: @keyframes IDENT { from { Properties:Properties value; } Percentage { Properties:Properties value; } to { Properties:Properties value; } } /*或者全部写成百分比的形式:*/ @keyframes IDENT { 0% { Properties:Properties value; } Percentage { Properties:Properties value; } 100% { Properties:Properties value; } } 其中IDENT是一个动画名称,你可以随便取,当然语义化一点更好,Percentage是百分比值,我们可以添加许多个这样的百分比,Properties为CSS的属性名,比如说left,background等,value就是相对应的属性的属性值。 2.3.2.2 JS实现 利用JavaScript实现动画,可以采用开源的JavaScript动画库或框架进行实现,例如:Anime.js或者TweenJS 下面我们以Anime.js为例进行演示如何实现一个补间动画。 一定程度上,anime.js也是一个CSS3动画库,适用所有的CSS属性,并且实现的@keyframes能更方便的实现帧动画,替代CSS3复杂的定义方式。使用对象数组的形式定义每一帧。 戳我:keyframes实例 anime({ targets: 'div', translateX: [ { value: 250, duration: 1000, delay: 500, elasticity: 0 }, //第一帧 { value: 0, duration: 1000, delay: 500, elasticity: 0 } //第二帧 ] }) //这个例子实现了目标元素在两帧中实现水平位移 提供的Timeline能实现更为复杂的动画效果,通过这个Timeline,我们可以维护不同的动画之间的关系,进而通过多个不同的动画组成一个更为复杂的动画。 戳我:Timeline实例 var myTimeline = anime.timeline(); //通过.add()方法添加动画 myTimeline .add({ targets: '.square', translateX: 250 }) .add({ targets: '.circle', translateX: 250 }) .add({ targets: '.triangle', translateX: 250 }); 2.3.3 SVG动画 当我们在实现动画的时候,慢慢会发现,大部分的元素都是图片,而且图片是提前预设好的,不能更改,只能用新的图片替换,例如当我们要实现微笑动画的时候,需要画两张图,一幅是闭着嘴的,一幅是张嘴笑的,然后逐帧播放。这样的画面当你有足够多帧图片的时候,并不会看出生硬,一旦低于 24 帧就是变得不自然了,那怎么在不增加工作量的前提下,实现流畅的变化呢?我们将关键帧动画的思维嫁接到元素自身扭曲变化上,就催生出了「柔性动画」的概念。 2.3.3.1 SVG动画讲解 (图片来源于:GSAP官网) 从上图可以看出,元素之间是可以相互变化的,而且非常的流畅,这样的动画并不需要 canvas 这种重武器,简单的 DOM 就可以实现,SVG 真的是一个神器,不仅在实现图标,字体上特点鲜明,在实现柔性动画方面也独树一帜。 SVG 依然是 DOM ,他有自己独有的 Animation 标签,但也支持 CSS 的属性,其实现动画的本质是依赖于线条和填充,线条的变化,导致填充区域的改变,从而引起形状的变化。而线条则依赖于路径和锚点,路径和锚点的改变,直接影响了线条的变化。 可以用AI等SVG编辑工具生成SVG图片后,配合anime.js、GSAP等现有库进行动画制作。 下面我们通过anime.js来实现一个SVG路径动画. SVG 绘制路径 戳我:SVG实例 var path = anime.path('.motion-path-demo path'); anime({ targets: '.motion-path-demo .el', translateX: path('x'), translateY: path('y'), rotate: path('angle'), easing: 'linear', duration: 2000, loop: true }); (图片来源于:animejs官网) 2.3.4 骨骼动画 SVG 实现的动画比较局部和小巧,使用范围也比较狭窄,但是当我们实现复杂的柔性动画,甚至游戏的时候,就还是需要用骨骼动画来实现。 (图片来源于:DragonBones官网) 从上图我们可以看到龙的翅膀是一张图片,但是可以通过图片的局部的扭曲和变形,来实现煽动翅膀时带来的肌肉收缩和舒张。这样的动画是怎么实现的呢?这就要引出骨骼动画中,一个非常重要的概念:网格。 这里我们比较浅显的讨论下这个概念,要实现图片的局部变化,我们就要把图片分块,分的每一块就称为网格,每个网格都有自己的顶点和边,顶点的位移会引起网格形状的变化,形状的变化就会带来所附属的图片的变化。网格的概念是不是很像路径和锚点,不论怎样的技术,在实现逻辑上都大同小异,重要的不是一直盯着不同和变化的部分,而是发现那些不变的地方,才能达到触类旁通的效果。 制作这样的动画并不复杂,你可以使用类似 Spine 和 DragonBones 这样的工具,但是做动画真的是一个体力活,你需要不断的调试,以求达到一种让人看起来舒服的状态。 2.3.4.1 骨骼动画讲解 骨骼动画就是把角色的各部分身体部件图片绑定到一根根互相作用连接的“骨头”上,通过控制这些骨骼的位置、旋转方向和放大缩小而生成的动画。 我们常说的骨骼动画一般分为两个部分: 骨架(Skeleton) 蒙皮(Skin) 骨架涉及的数据包括两个: 一是骨架的拓扑结构(连接、父子关系)。 二是骨架的各种pose,也就是每个动作对应的整个骨架的位置信息。 蒙皮则表达的是依附在骨骼上的顶点的信息。 骨骼绑定的过程就是确定每个顶点受哪几根骨骼的影响,每根骨骼影响的权重有多大,譬如肘部的皮肤可能同时受大臂和小臂两根骨头的影响,而远离手肘的部分可能就只受小臂骨头影响。一般在3D骨骼动画里,每个顶点最多支持4-8根骨骼同时影响它就已经可以很精确地表达整个蒙皮的效果了。 骨骼动画的优势: 骨骼动画比传统的逐帧动画要求更高的处理器性能,但同时它也具有更多的优势: 动画更加生动逼真。 图片资源占最小的存储空旷:骨骼动画的图片容量可以减少90%(配置文件H5的压缩方案后面详解)。 动画切换自动补间:过渡动画自动生成,让动作更加灵动。 骨骼可控 :可以通过代码控制骨骼,轻松实现角色装备更换,甚至可对某骨骼做特殊控制或事件监听。 骨骼事件帧:动画执行到某个动作或某个帧,触发自定义事件行为。 动作数据继承:多角色可共用一套动画数据。 可结合物理引擎和碰撞检测。 2.3.4.2 骨骼动画制作 首先我们来了解一下,骨骼动画是如何进行制作的: 制作骨骼动画主要是使用 Spine 和 DragonBones 这样的工具进行制作。 DragonBones (图片来源于:DragonBones官网) DragonBones是从Flash动画开始创作的,初衷是减小资源量,同时实现更为细粒度的动作(比如交互式的),让美术从繁琐的逐帧绘制Sprie Sheet的工作中解放出来,所以它把一个角色每一帧的sprite sheet拆分成一个个更小的基本图块,譬如胳膊,腿,躯干等等,而每个基本图块仍然是最小的可控制单位。 以下游戏&渲染引擎都支持渲染DragonBones导出的文件: (图片来源于:DragonBones官网) Spine (图片来源于:Spine官网) Spine 是一款针对游戏开发的 2D 骨骼动画编辑工具。Spine 旨在提供更高效和简洁 的工作流程,以创建游戏所需的动画。 业界收费专业2D骨骼动画编辑工具,动画设计师推荐易用稳定,以下游戏&渲染引擎都支持渲染Spine导出的文件: (图片来源于:Spine官网) 下面我们来制作一个骨骼动画小案例 创建骨骼 首先我们需要创建手部的骨骼,如下图所示: 1确保左上角为SETUP模式 确保选中右边视图中的根骨骼,创建骨骼时必须要选中父骨骼 单击左下角的Create按钮 开始依次创建出5根骨骼 创建蒙皮网格 然后我们需要给手部创建蒙皮网格(MESH),如下图所示: 首先,单击创建骨骼的Create按钮,退出骨骼创建模式 选中手部贴图(Attachment) 勾选其底部的Mesh选项 单击右下角的Edit按钮 呼出了Edit Mesh菜单 勾选Edit Mesh菜单中的Deformed选项 单击Edit Mesh菜单中的Create按钮 开始在手部创建网格顶点 可以单击Edit Mesh菜单中的Modify按钮对顶点进行位移 设置网格点权重 我们需要给网格顶点设置各个骨骼的权重,整个过程如下图所示: 首先,关闭Edit Mesh菜单 确认勾选的还是手部的贴图 单击左下角的Weights按钮,呼出Weights菜单 单击Weights菜单底部的Bind按钮,来绑定骨骼 选择手部的五根骨骼,直到它们都出现Weights菜单里,注意不同的骨骼颜色是不一样的 单击Weights菜单的Auto按钮或者按`esc`键,来触发Spine的自动权重计算 勾选Weights菜单的Overlay,我们可以看到绑定后的权重热力图 动起来! 现在我们要让手动起来了,我们只展示一个弯曲手臂的动画即可。 首先,我们需要设置关键帧,让我们在第1帧和第30帧设置好关键帧,这两个关键帧对应的手臂位置是完全一样的,因为我们需要循环播放动画。 具体步骤如下图: 确保左上角的模式处于ANIMATE模式 选中手部的五根骨骼(按住`cmd`键或`control`键依次点选) 选中第0帧 单击Rotate下的钥匙按钮,我们对手臂的旋转属性设置关键帧 选择第30帧 重复第4步的操作,使第30帧的关键帧与第0帧完全相同 接下来我们只需轻轻旋转手臂,并在0-30帧中间找一个帧当做关键帧即可:我们选择第15帧作为中间的关键帧。 选择第15帧 确保Rotate按钮被选中 向上旋转5根骨骼到一个角度 按下K帧按钮进行关键帧设置 按下播放按钮来预览动画 额外的,我给另一只手、嘴巴、脸部和头发都做了MESH,以下是动画的效果图: 2.3.4.3 前端展示骨骼动画 用Spine将制作好的骨骼动画进行导出输出资源(合图信息文件:atlas;动画信息文件:json,图片合图:png),将这些资源交由前端进行展示。 前端开发根据Spine或者DragonBones能够支持的渲染引擎,在项目中导入渲染引擎进行展示骨骼动画。 2.3.5 3D动画 前端3D动画实现可以通过perspective属性操作用CSS 3D来实现,或者直接借助开源的Three.js开源库进行实现。 由于3D动画涉及的内容较多,篇幅有限,后面我们将专门开一章来讲解前端3D动画。 三、现有方案总结 3.1 纯CSS实现 适合场景:简单的展示型动画 使用transition\animation属性,设置相应的关键帧状态,并且借助一些缓动函数来进行实现一些简单化的动画。 优点:开发成本低,不需要导入任何额外的依赖包 缺点与不足:只能够胜任做一些比较简单化的动画,无法实现一些过于负责的动画。 3.2 Anime.js 适用场景:简单的展示型动画+弱交互型动画 Anime.js是一个轻量级的js驱动的动画库,主要的功能有: 支持keyframes,连接多个动画 支持Timeline,为实现更为复杂的动画提供了可能 支持动画状态的控制playback control,播放,暂停,重新启动,搜索动画或时间线。 支持动画状态的callback,在动画开始,执行中,结束时提供回调函数 支持SVG动画 可以自定义贝塞尔曲线 任何包含数值的DOM属性都可以设置动画 GitHub:https://github.com/juliangarn... codepen仓库:https://codepen.io/collection... 文档演示:http://animejs.com/documentat... 功能介绍: 一定程度上,anime.js也是一个CSS3动画库,适用所有的CSS属性,并且实现的@keyframes能更方便的实现帧动画,替代CSS3复杂的定义方式。使用对象数组的形式定义每一帧。 戳我:keyframes实例 anime({ targets: 'div', translateX: [ { value: 250, duration: 1000, delay: 500, elasticity: 0 }, //第一帧 { value: 0, duration: 1000, delay: 500, elasticity: 0 } //第二帧 ] }) //这个例子实现了目标元素在两帧中实现水平位移 提供的Timeline能实现更为复杂的动画效果,通过这个Timeline,我们可以维护不同的动画之间的关系,进而通过多个不同的动画组成一个更为复杂的动画。 戳我:Timeline实例 var myTimeline = anime.timeline(); //通过.add()方法添加动画 myTimeline .add({ targets: '.square', translateX: 250 }) .add({ targets: '.circle', translateX: 250 }) .add({ targets: '.triangle', translateX: 250 }); 动画播放的控制,常见的有暂停,重播,继续,动画状态的跟踪,自动播放,循环次数,抖动效果 戳我:playback controls实例 为动画提供了回调函数,在动画或时间线完成的开始,期间或之时执行回调函数。 戳我:callback实例 var myAnimation = anime({ targets: '#begin .el', translateX: 250, delay: 1000, begin: function(anim) { // callback console.log(anim.began); // true after 1000ms } }); 支持promise,动画结束后,调用anime.finished会返回一个promise对象。 戳我:promise实例 支持svg绘制路径,目前不支持canvas绘制。 戳我:SVG实例 对于input这样带有数值的元素标签,也可以通过anime实例来设置动画。 戳我:DOM ATTRIBUTES实例 anime({ targets: input, value: 1000, // Animate the input value to 1000 round: 1 // Remove decimals by rounding the value }); 优点: 显而易见,anime.js不仅实现了CSS3动画的深度封装,更多的是通过js驱动来实现操作动画的状态,timeline实现了对于多个分支动画的管理,对于实现更为复杂的动画提供了可能。 通过anime.js提供的playback controls和callback,同时对于promise的支持,让我们对于动画的简单交互有了操作的空间。 虽然不支持canvas,但是支持svg绘制路径。 浏览器兼容性比较好,Android 4以上全部支持。 缺点: Anime.js做展示型动画是可以胜任的,但是对于特别复杂的动画也是不太能够实现,在做交互性动画方面还是需要看场景,它更多适合做一些小型的交互动画,类似于通过触摸屏幕踢足球这种强交互的,anime.js就不是很有优势了。 3.3 Lottie 适用场景:复杂的展示型动画 通过AE 上的 Bodymovin 插件将 AE 中制作好的动画导出成一个 json 文件,通过Lottie对JSON进行解析,最后以SVG/canvas/html的方式渲染动画。 能够完好的展示设计师设计的各种各样复杂的动画。 官方文档:http://airbnb.io/lottie/ codepen仓库:https://codepen.io/collection... 优点: 跨平台,一次绘制、一次转换、随处可用。 文件更小,获取AE导出的JSON,最后通过lottie渲染为canvas/svg/html格式。 可以通过api操纵动画的一些属性,比如动画速度;添加动画各个状态的回调函数。 动画都是在After Effects中创建的,使用Bodymovin导出,并且本机渲染无需额外的工程工作。 解放前端工程师的生产力,提高设计师做动效的自由度。 缺点: Bodymovin插件待完善,仍然有部分 AE 效果无法成功导出。 对于交互方面支持的还不是很好,更多的是用来展示动画。 Lottie对json文件的支持待完善,目前有部分能成功导出成json文件的效果在移动端上无法很好的展现。 很多AE的效果是不支持的查看支持的特性:Supported Features。 3.4 PixiJs 适用场景:交互型动画,动画小游戏 PixiJS是一个2D 渲染引擎, Pixi 主要负责渲染画面。可以创建丰富的交互式图形,动画和游戏,而无需深入了解WebGL API或处理浏览器和设备兼容性的问题。与此同时,PixiJS具有完整的WebGL支持,如果需要,可以无缝地回退到HTML5的canvas。PixiJs默认使用WebGL渲染,也可以通过声明指定canvas渲染,WebGL在移动端Android 4.4 browser并不支持,不过可以使用canvas优雅降级。 Github:https://github.com/pixijs/pix... 官方文档:http://pixijs.download/releas... 官方网站:http://www.pixijs.com/ Examples:https://pixijs.io/examples/#/... 特性(摘自官方DOCS): 支持WebGL渲染 支持canvas渲染(官方称PixiJS在canvas渲染方面现在是最快的) 非常简单易用的API 丰富的交互事件,比如完整的鼠标和移动端的触控事件 Pixi使用和canvasDrawing几乎一致的 api,但不同于canvas的绘画 api,使用 Pixi 绘制的图形是通过WebGL在GPU上渲染 还有一系列特性需要在学习PixiJs之后了解 优点: 最大优势莫过于通过WebGL来调用GPU渲染动画,这样极大的提升了性能。 无需深入了解WebGL API或者是浏览器兼容性(因为下面这条原因)。 支持canvas回退,当前设备不支持WebGL时,PixiJs会使用canvas渲染动画。 完整的DOCS,比较活跃的社区,有利于深入的学习。不过我感觉PixiJs学习成本相对来说还是很高的。 缺点: 首先是兼容的问题,WebGL在Android 4.4是不支持的,只能使用canvas进行降级。 Pixi 主要负责渲染画面,很多其它功能开发者得自己写或搭配其它库来使用,不过按照目前来看,是满足我们的需求的。 性能: 对于手机版本Android4.4以上的手机,除了代码层面造成的性能不足,通过WebGL调用GPU渲染,性能还是有保障的。然而对于Android4.4只能使用canvas渲染,性能还是要看动画的复杂度,以及代码的优化 3.5 总结 简单的展示型动画: 对于比较简单的动画,我们可以先尝试使用原生CSS的transition\animation属性来进行实现。 简单的展示型动画+弱交互: 对于简单的动画展示并且需要有简单的交互行为,比如用户点击一下暂停执行相应操作,待操作完成继续播放动画,交互方面比较偏弱,可以采用Anime.js的方案。 Anime.js不仅仅支持所有的CSS属性,而且可以通过Timeline,callback,playback controls来控制动画执行的各个状态,并且Anime.js可以配合实现SVG动画。 复杂的展示型动画: 如果所需的资源很小,可以先考虑使用GIF动图或者逐帧动画CSS实现; 如果所需的资源较大,可以使用Lottie方案,然后设计同学用AE到处动画json,将动画还原为svg/canvas/html。 强交互&互动小游戏&骨骼动画: 对于交互场景比较负责或者需要做一个小游戏,可以采用PixiJs,通过WebGL来渲染,利用硬件资源,极大的提升性能,在兼容性方面,对于不支持WebGL的浏览器,可以使用canvas渲染来平稳回退; 如果是需要展示骨骼动画,可以通过PixiJs方案进行渲染由Spine或DragonBones输出的文件。

优秀的个人博客,低调大师

每日一博 | 详谈 MySQL 8.0 原子 DDL 原理

柯煜昌 青云科技研发顾问级工程师 目前从事 RadonDB 容器化研发,华中科技大学研究生毕业,有多年的数据库内核开发经验。 文章字数 3800+,阅读时间 15 分钟 背景 MySQL 5.7 的字典信息保存在非事务表中,并且存放在不同的文件中(.FRM,.PAR,.OPT,.TRN,.TRG 等)。所有 DDL 操作都不是 Crash Safe,而且对于组合 DDL(ALTER 多个表)会出现有的成功有的失败的情况,而不是总体失败。这样主从复制就出现了问题,也导致基于复制的高可用系统不再安全。 MySQL 8.0 推出新特性 - 原子 DDL,解决了以上的问题。 什么是原子 DDL? DDL 是指数据定义语言(Data Definition Language),负责数据结构的定义与数据对象的定义。原子 DDL 是指一个 DDL 操作是不可分割的,要么全成功要么全失败。 有哪些限制? MySQL 8.0 只有 InnoDB 存储引擎支持原子 DDL。 支持语句:数据库、表空间、表、索引的 CREATE、ALTER 以及 DROP 语句,以及 TRUNCATE TABLE 语句。 MySQL 8.0 系统表均以 InnoDB 存储引擎存储,涉及到字典对象的均支持原子 DDL。 支持的语句:存储过程、触发器、视图以及用户定义函数(UDF)的 CREATE 和 DROP 、ALTER 操作,用户和角色的 CREATE、ALTER、DROP 语句,以及适用的 RENAME 语句,以及 GRANT 和 REVOKE 语句。 不支持的语句: INSTALL PLUGIN、UNINSTALL PLUGIN INSTALL COMPONENT、UNINSTALL COMPONENT REATE SERVER、ALTER SERVER、DROP SERVER 实现原理是什么? 首先,8.0 将字典信息存放到事务引擎的系统表(InnoDB 存储引擎)中。这样 DDL 操作转变成一组对系统表的 DML 操作,从而失败后可以依据事务引擎自身的事务回滚保证系统表的原子性。 似乎 DDL 原子性就此就可以完成,但实际上并没有这么简单。首先字典信息不光是系统表,还有一组字典缓存,如: Table Share 缓存 DD 缓存 InnoDB 中的 dict 此外,字典信息只是数据库对象的元数据,DDL 操作不光要修改字典信息,还要实实在在的操作对象,以及对象本身在内存中缓存。 表空间 Dynamic meta Btree ibd 文件 buffer pool 中表空间的 page 页 此外,binlog 也要考虑 DDL 失败的情况。 因此,原子 DDL 在处理 DDL 失败的时候,不光是直接回滚系统表的数据,而且也要保证内存缓存,数据库对象也能回滚到一致状态。 实现细节 为了解决 DDL 失败情况中数据库对象的回滚,8.0 引入了系统表 DDL_LOG。该表在 mysql 库中。不可见,也不能人为操作。如果想了解该表的结果,先编译一个 debug 版的 MySQL: SET SESSION debug='+d,skip_dd_table_access_check'; show create table mysql.innodb_ddl_log; 可以看到如下表结构: CREATE TABLE `innodb_ddl_log` ( `id` bigint unsigned NOT NULL AUTO_INCREMENT, `thread_id` bigint unsigned NOT NULL, `type` int unsigned NOT NULL, `space_id` int unsigned DEFAULT NULL, `page_no` int unsigned DEFAULT NULL, `index_id` bigint unsigned DEFAULT NULL, `table_id` bigint unsigned DEFAULT NULL, `old_file_path` varchar(512) CHARACTER SET utf8 COLLATE utf8_bin DEFAULT NULL, `new_file_path` varchar(512) CHARACTER SET utf8 COLLATE utf8_bin DEFAULT NULL, PRIMARY KEY (`id`), KEY `thread_id` (`thread_id`) ) /*!50100 TABLESPACE `mysql` */ ENGINE=InnoDB AUTO_INCREMENT=48 DEFAULT CHARSET=utf8 COLLATE=utf8_bin STATS_PERSISTENT=0 ROW_FORMAT=DYNAMIC 在 8.0 中,这个表需要满足两个场景以及两个任务: 场景 1: 符合 DDL 失败的场景,需要回滚部分完成的 DDL。 场景 2:DDL 进行中,发生故障(掉电、软硬件故障等),重启机器需要完成部分 DDL。 两个任务: 任务 1:失败后回滚,执行反向操作。 任务 2:如果成功,则执行清理工作。 也许有人会问,为什么执行成功需要执行清理工作呢? 之所以要执行清理工作,因为 ibd 文件和索引一旦删除就不能恢复。为了实现回滚,DDL 删除这些对象时候,并不是真正删除,而是先将它们备份一下,以备回滚时使用。所以只有确认 DDL 已经执行成功,这些备份对象不需要了,才执行清理工作。 举个例子 为了将这个原理将清楚,我们流程相对简单的 CREATE TABLE 讲起,管中窥豹,可见一斑。假设已经有编译好了 8.0 debug 版本,并且 innodb_file_per_table 为 on,先执行以下命令: mysql> set global log_error_verbosity=3; Query OK, 0 rows affected (0.00 sec) mysql> set global innodb_print_ddl_logs = on; Query OK, 0 rows affected (0.00 sec) 从而开启了ddl log的日志,然后创建表: mysql> create table t2 (a int); Query OK, 0 rows affected (25 min 26.42 sec) 可以看到如下日志: XXXXX 8 [Note] [MY-012473] [InnoDB] DDL log insert : [DDL record: DELETE SPACE, id=20, thread_id=8, space_id=6, old_file_path=./test/t2.ibd] XXXXX 8 [Note] [MY-012478] [InnoDB] DDL log delete : 20 XXXXX 8 [Note] [MY-012477] [InnoDB] DDL log insert : [DDL record: REMOVE CACHE, id=21, thread_id=8, table_id=1067, new_file_path=test/t2] XXXXX 8 [Note] [MY-012478] [InnoDB] DDL log delete : 21 XXXXX 8 [Note] [MY-012472] [InnoDB] DDL log insert : [DDL record: FREE, id=22, thread_id=8, space_id=6, index_id=157, page_no=4] XXXXX 8 [Note] [MY-012478] [InnoDB] DDL log delete : 22 XXXXX 8 [Note] [MY-012485] [InnoDB] DDL log post ddl : begin for thread id : 8 XXXXX 8 [Note] [MY-012486] [InnoDB] DDL log post ddl : end for thread id : 8 create table 的 DDL 只有反向操作日志记录,而无清理操作日志记录。细心的读者可能看到日志中插入某条 DDL log,随后又将其删除,会心生疑惑。但这正是 MySQL 原子 DDL 的秘密所在。我们选 DELETE SPACE 这个 DDL 日志写入函数Log_DDL::write_delete_space_log 来揭秘这个过程。 dberr_t Log_DDL::write_delete_space_log(trx_t *trx, const dict_table_t *table, space_id_t space_id, const char *file_path, bool is_drop, bool dict_locked) { ut_ad(trx == thd_to_trx(current_thd)); ut_ad(table == nullptr || dict_table_is_file_per_table(table)); if (skip(table, trx->mysql_thd)) { return (DB_SUCCESS); } uint64_t id = next_id(); ulint thread_id = thd_get_thread_id(trx->mysql_thd); dberr_t err; trx->ddl_operation = true; DBUG_INJECT_CRASH("ddl_log_crash_before_delete_space_log", crash_before_delete_space_log_counter++); if (is_drop) { //(1) err = insert_delete_space_log(trx, id, thread_id, space_id, file_path, dict_locked); if (err != DB_SUCCESS) { return err; } DBUG_INJECT_CRASH("ddl_log_crash_after_delete_space_log", crash_after_delete_space_log_counter++); } else { // (2) err = insert_delete_space_log(nullptr, id, thread_id, space_id, file_path, dict_locked); if (err != DB_SUCCESS) { return err; } DBUG_INJECT_CRASH("ddl_log_crash_after_delete_space_log", crash_after_delete_space_log_counter++); DBUG_EXECUTE_IF("DDL_Log_remove_inject_error_2", srv_inject_too_many_concurrent_trxs = true;); err = delete_by_id(trx, id, dict_locked); //(3) ut_ad(err == DB_SUCCESS || err == DB_TOO_MANY_CONCURRENT_TRXS); DBUG_EXECUTE_IF("DDL_Log_remove_inject_error_2", srv_inject_too_many_concurrent_trxs = false;); DBUG_INJECT_CRASH("ddl_log_crash_after_delete_space_delete", crash_after_delete_space_delete_counter++); } return (err); } 在create table 这个过程中调用write_delete_space_log,is_drop 为false,执行以上代码执行分支 (2) 和 (3) 。注意的是 insert_delete_space_log 第一个参数为空,这意味着会在创建一个后台事务(调用trx_allocate_for_background)插入DELETE_SPACE 记录到innodb_ddl_log 表中,然后提交该事务。注意到(3) 处delete_by_id 第一个参数为trx , 这里的trx 即本次 DDL 的事务,(3) 所做的动作是在本次事务中删除(2)插入的记录。 为什么是这样的逻辑呢? 以下分两种情况来讨论,如上图所示: 如果插入 DDL log 之后,DDL 的各个步骤都成功执行,最后事务trx 成功提交,那么 innodb_ddl_log 并没有该 DDL 的记录,因此在后续的post_ddl 中什么也不做(post_ddl 在后面会描述)。 如果插入 DDL log 之后,DDL 的某个步骤失败,则 DDL 所在的事务trx会回滚。此时,上图中delete [DELETE SPACE, id=20]这个动作也会回滚。最后,innodb_ddl_log 中就会存在DELETE SPACE 这条记录,后续执行post_ddl 进行 Replay(重演), 从而删除这次失败的create table 的 DDL 已经创建的表空间。你可以发现,create table 的 DDL 创建表空间,就一定会以这样的机制往innodb_ddl_log 中插入一条相反的动作DELETE SPACE的日志记录,所以也被称为反向操作日志。 其它 DDL log 记录的操作如REMOVE CACHE 、FREE 日志记录的写入也是类似的逻辑。复杂的 DDL,不光是会插入反向操作日志记录,也会插入清理操作日志。比如TRUNCATE 表操作会将原有的表空间重命名为一个零时表空间,当 DDL 成功之后,需要通过post_ddl Replay DDL log 记录,将临时表空间删除。如果失败,又需要 post_ddl重演 DDL log,执行反向操作,将临时表空间重命名为原来的表空间。总之,如果是反向操作日志,则使用background trx 插入并提交,然后使用trx 删除;如果是清理日志,则使用trx 插入即可。 注意:innodb_ddl_log表与其他 InnoDB 表一样,对该表所有操作 InnoDB 引擎都会产生 Redo 日志与 Undo 记录,所以不要将 DDL log 表中反向操作记录看作 Undo log,这两者不在同一个抽象层次上。而且反向操作在另一个事务中执行,而回滚时,Undo log 则是在原有同一个事务上执行。 需要探讨的几个问题 DDL 是否有必要日志刷盘? 我们知道 MySQL 有一个 innodb_flush_log_at_trx_commit 参数,当设置为 0 时,提交时并不会立刻将 Redo log 刷入持久存储中。虽然能提高性能,但在掉电或者停机时会有一定概率丢失已经提交的事务。对于 DML 操作来说,这样仅仅是丢失事务,但对于 DDL 来说,丢失 DDL 的事务,就会导致数据库元数据与其他数据不一致,以至数据库系统无法正常工作。 所以,在trx_commit 会根据该事务是否为 DDL 操作,进行特殊处理: 无论innodb_flush_log_at_trx_commit参数如何设置,与 DDL 有关的事务,提交时必须日志刷盘! DDL log 的写入时机 在理解了 DDL log 的机制之后,笔者问大家一个问题,对于create table 来说,是先执行write_delete_space_log 还是先创建表空间呢? 我们先假设是先创建表空间(A 动作),再写反向操作日志(B 动作)。如果 A 执行结束后出现掉的情况,此时 B 还未执行,此时create table 动作并没有完成,而innodb_ddl_log 不存在DELETE SPACE 这样的 DDL 反向日志记录,数据库崩溃恢复后,数据库系统会将系统表数据回滚,但是 A 创建的表空间却没有删除,由于存在中间状态,此时create table 就不是原子DDL 了。 所以,在 DDL 中每个步骤中,先写入该步骤的反向操作日志记录到innodb_ddl_log ,再执行该步骤。也就是说 DDL Log 写入时机在执行步骤之前。如果create table 已经写入了 DDL log, 但是没有创建表空间就出现掉电情况呢? 这并不要紧,在 post_ddl 做 Replay 的时候,会进行处理。 Replay 的调用逻辑 在 DDL 操作完成之后,无论 DDL 的事务提交还是回滚,都会调用post_ddl 函数,post_ddl 则会调用replay函数进行 Replay。此外,MySQL 8.0 数据库崩溃恢复过程中,与 MySQL 5.7 相比,也多了ha_post_recover的过程,它会调用log_ddl->recover 将 innodb_ddl_log 所有的日志记录进行 Replay。 在post_ddl调用的是replay_by_thread_id,崩溃恢复中ha_post_recover 调用的是replay_all,其逻辑如下描述: 依据传入的thread_id 为索引(thread_id 与trx 是可以一一对应的),以逆序方式将所有记录获取出来,然后根据记录的内容,依次执行 Replay 动作,最后删除已经重演的记录。 replay_all 将innodb_ddl_log 所有记录逆序方式获取出来,依次执行 Replay 动作,最后删除已经重演的记录。 可以看到,以上两个函数都有将记录逆序的获取的过程,为什么要逆序呢? 逆函数 1、反向操作 我们如果将 DDL 中每个步骤看做一个函数,参数为数据库系统。假设第 i 个步骤函数为oi,那么n个步骤就是 n 个函数的复合函数: 也即,复合函数的逆时所有步骤逆函数的反向复合。所以反向操作需要将 DDL log 逆序进行处理。 2、清理操作 DDL 的清理动作往往没有顺序要求,逆向操作与正向操作效果往往是一样的,所以统一进行逆序处理也没有问题。 幂等性 与 Redo、Undo 类似,每个类型的日志重演均要考虑其幂等性。 所谓幂等性,就是执行多次和执行一次的效果是一样的。特别是在崩溃恢复的时候,在重演反向操作的时候,尚未完成时发生掉电故障,重新进行崩溃恢复。此时某项重演操作可能发生多次。 因此,MySQL 8.0 实现这些重演操作,必须要考虑幂等性。最典型是重演一些删除操作,必须先判断数据库对象是否存在。如果存在,才进行删除,否则什么都不做。 Tips:说到这里,笔者推荐一本书《具体数学:计算机科学中的一块基石》此书讲解了许多计算机科学中用到的数学知识及技巧,并特别著墨于算法分析方面。 Server 层的动作 DDL 开始更新,无论失败与否,table share 都要进行缓存更新,tdc_remove_table; DDL 成功之后,执行事务提交,否则执行事务回滚; 无论事务提交还是回滚,都要调用 post_ddl , post_ddl 作用在前面已经描述,用以r Replay 系统表 innodb_ddl_log 记录的日志; 崩溃恢复时候,除了执行 Redo 日志,回滚未提交的事务之后,还需要执执行 ha_post_recover,而 InnoDB 的 ha_post_recover 就是调用 post_ddl 执行 DDL 的反向操作; binglog 处理只有一个原则,就是 DDL 事务成功。并且提交之后,才调用 write_bin_log 写 binlog。 注意事项 MySQL 8.0 支持原子 DDL,并不意味着 DDL 可以通过 SQL 语句命令进行回滚。实际上除了 SQLServer 外,几乎所有的数据库系统不支持 DDL 的 SQL 命令进行回滚,DDL 回滚引入的问题远远多于其带来的好处。 MySQL 8.0 只承诺单个 DDL 语句的原子性,并不能保证多个 DDL 组合也能保持原子性。某大厂为了实现 Truncate table flashback ,仅仅在 MySQL 的 Server 层将 truncate table 动作转换为 rename table 动作,flashback 的时候将表、索引、约束重新以 RENAME DDL 组合执行来实现 flashback,这个是及其危险的,不保证其原子性。笔者也完成过此功能,并没有如此取巧,而是老老实实的从 Server 层、InnoDB 存储引擎、binlog 各方面进行改造,完整保证其原子性。 MySQL 8.0 用这种方法实现原子 DDL,并不意味着其它数据库也是这种方式实现原子DDL。 参考 https://dev.mysql.com/doc/refman/8.0/en/atomic-ddl.html https://www.slideshare.net/StleDeraas/dd-and-atomic-ddl-pl17-dublin https://dev.mysql.com/blog-archive/atomic-ddl-in-mysql-8-0/

优秀的个人博客,低调大师

每日一博 | 社区收藏缓存设计重构实战

原创 Sky 得物技术 一、背景 社区收藏业务是一个典型的读多写少的场景,社区各种核心Feeds流都需要依赖用户是否收藏的数据判断,早期缓存设计时由于流量不是很大,未体现出明显的问题,近期通过监控平台等相关手段发现了相关的一些问题,因此我们针对这些问题对缓存做了重构设计,以保障收藏业务的性能和稳定性。 二、问题分析定位 2.1 接口RT偏大 通过监控平台查看「判断是否收藏接口」的RT在最高在8ms左右,该接口的主要作用是判断指定单个用户是否已收藏一批内容,其实如果缓存命中率高的话,接口RT就应该趋近于Redis的RT水平,也就是1-2ms左右。 (图中有单根尖刺,这个具体问题要具体分析优化,我们这里主要阐述整体水平的优化) 2.2 Redis&MySQL访问QPS偏高 通过监控平台可以看到从上游服务过来的收藏查询QPS相对访问Redis缓存的QPS放大了15倍,并且MySQL查询的最高QPS占上游访问量接近37%,这说明缓存并没有很高的命中率,导致回表查询的概率还是很大。 QPS访问量见下图: Redis访问量 MySQL访问量 基于以上分析我们现在有了明确的优化切入点,接下来我们来看下具体的找下原因是什么。 接下来我们来看一下伪代码的实现: //判断用户是否对指定的动态收藏 func IsLightContent(userId uint64,contentIds []uint64){ index := userId%20 cacheKey := key + "_" + fmt.Sprintf("%d", index) pipe := redis.GetClient().Pipeline() for _, item := range contentIds { InitCache(userId, contentId) pipe.SisMember(cacheKey, userId) } pipe.Exec() //...... } //缓存初始化判断,不存在则初始化数据缓存 func InitCache(userId uint64,contentId uint64){ index := userId%20 cacheKey := key + "_" + fmt.Sprintf("%d", index) ttl,_ := redis.GetClient().TTL(cacheKey) if ttl <= 0{//key不存在或者未设置过期时间 // query from db // sql := "select userId from trendFav where userId%20 = index and content_id = contentId" // save to redis }else{ redis.GetClient().Expire(cacheKey,time.Hour()*48) } } 从上面的伪代码中,我们能够很清晰的看到,该方法会遍历内容id集合,然后对每个内容去查询缓存下来的用户集合,判断该当前用户是否收藏。也就是说缓存设计是按照内容维度和用户1:N来设计的,将单个动态下所有收藏过内容的用户id查出来缓存起来。并且基于大Key的考虑,代码又将用户集合分片成20组。这无疑又再次放大了Redis缓存Key的数量。并且每个Key都使用TTL命令来判断是否过期。这样一来Redis的QPS和缓存Key就会被放大很多倍。 正是由于分片策略+缓存时效短,导致了MySQL查询的QPS居高不下。 三、解决方案 基于以上对问题的分析定位,我们思考的解决思路就是一次接口请求降低Redis查询操作,尽可能减少放大的情况,初步判断有如下两个实现路径: 去掉遍历内容查询,改为一次性查询 去掉用户集分片存储,改为单Key存储 上游的调用参数用户和内容是一对多的关系,因此要实现的Redis查询也是要满足一对多的关系,那么显而易见我们的缓存应该是按照用户的维度来存储已经收藏过的内容集合。 用户收藏的内容比较少的话,我们很简单的就可以从数据库全部查询出来放在缓存,但如果用户收藏的内容比较多呢,那也会可能造成大Key问题,如果继续分片存储的话又会回到了原来的方案。我们讨论出以下两种方案: 方案1. 处理大数据大部分常规思路就是要么分片,要么冷热分离 因为业务逻辑的特点,推荐流下用户看到的内容绝大部份基本都是一年以内的,我们可以缓存用户一年以内的收藏内容,这样就限制了用户收藏的极端数量。如果看到的内容发布超过一年时间,可以用MySQL直接查询,这种场景的case概率是很小的。但仔细考虑了下实现,这个需要依赖业务方,我们需要去查询内容的发布时间,以此来判断是否在我们的缓存内,这样会加重整个接口的逻辑,反而得不偿失,因此该思路很快就被否定了。 方案2. 既然不能依赖第三方,就是要从自身拥有的信息上,来能够缓存一部分最热的数据,使得查询能够大范围落到这些数据 我们目前只有内容id,而内容id都是纯数字,数字本身的话可以按照大小来排列。业务查询本身都是最近一段时间的内容,所以查询的内容id都是近期较大的id。那我们可以按照内容id降序排列,取用户收藏过的若干条数据来缓存。只要查询的id都比缓存最小的id大,那么我们就可以只通过缓存来判断出用户是否收藏这些内容了。 示例: 初始化缓存时我们按照内容id降序排列,拿到前5000个内容id: 如果查询结果不满5000,那么这个用户缓存了全部收藏记录,此时小缓存的内容id为0 如果大于等于5000,说明还有部分未缓存的记录,此时最小缓存的内容id为第5000个内容ID 等到查询判断时,将查询的内容id数组和缓存的最小内容id对比,如果全部大于,则说明都在缓存范围内,如果有小于,则是超过缓存范围,届时单独去数据库判断,当然这种概率在业务上的发生几率是比较小的。 这里缓存的数量的抉择显得尤为重要,如果太小,那缓存的命中率不高,导致MySQL回表查询概率变大,如果太大,则初始化时比较耗费时间,或产生大Key问题。经过分析线上数据,目前以5000这个数字能够比较好的权衡。 下面是查询缓存判断流程图: 缓存方式由原来的set结构,改为Hash结构,TTL延长到7 * 24 hour。 这样一来,原来的独立调用的TTL和sismember命令,可以合并成一个Hmget命令,减少了一半的Redis访问次数,这个改进收益是相当可观的。 四、优化成果 截止本文撰写时,我们对收藏的功能进行了优化改造并上线,取得了很不错的进展。所有数据为最近7天的数据4.14 - 4.20,优化效果在4.15号17点左右开始。 4.1 RPC接口响应RT降低 1 IsCollectionContent RPC接口,判断动态是否缓存。平均RT提高了接近3倍,并且RT比较稳定。 4.2 Redis负载降低 1 TTL 查询 查询Key有效期,用来判断延长Key有效期。QPS直接降到0 2 SISMEMBER查询 原来旧的收藏缓存查询,已经改为HMGET查询QPS降低到0 3 HMGET查询 新的收藏缓存查询QPS数量和上游过来查询的QPS正好能对应上 4 Redis 内存降低 新的缓存较旧缓存在占用内存和Key数量这2个指标均降低了3倍左右 4.3 MySQL负载降低 1 content_collection表select查询降低 QPS降低了24倍左右并且保持在一个比较稳定的水位 2 MySQL连接并发数降低 查询QPS的减少也降低了并发连接数,大概降低了3倍左右,最终也降低了等待连接次数。 五、总结 经过对本次问题的分析和解决,不难看出一个良好的缓存设计对于服务来说是多么的重要。好的缓存设计不仅能够提升性能,同时可以降低资源使用,整体提升了资源利用率。同时下游的流量和上游基本持平,在流量上升时,不会对下游造成很大的压力,这样服务整体的抗并发能力也提升了很多。 *文/Sky 关注得物技术,每周一三五晚 18:30 更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~

优秀的个人博客,低调大师

每日一博 | 爬虫与反爬虫技术简介

vivo 互联网安全团队- Xie Peng 互联网的大数据时代的来临,网络爬虫也成了互联网中一个重要行业,它是一种自动获取网页数据信息的爬虫程序,是网站搜索引擎的重要组成部分。通过爬虫,可以获取自己想要的相关数据信息,让爬虫协助自己的工作,进而降低成本,提高业务成功率和提高业务效率。 本文一方面从爬虫与反反爬的角度来说明如何高效的对网络上的公开数据进行爬取,另一方面也会介绍反爬虫的技术手段,为防止外部爬虫大批量的采集数据的过程对服务器造成超负载方面提供些许建议。 爬虫指的是按照一定规则自动抓取万维网信息的程序,本次主要会从爬虫的技术原理与实现,反爬虫与反反爬虫两个方面进行简单的介绍,介绍的案例均只是用于安全研究和学习,并不会进行大量爬虫或者应用于商业。 一、爬虫的技术原理与实现 1.1爬虫的定义 爬虫分为通用爬虫和聚焦爬虫两大类,前者的目标是在保持一定内容质量的情况下爬取尽可能多的站点,比如百度这样的搜索引擎就是这种类型的爬虫,如图1是通用搜索引擎的基础架构: 首先在互联网中选出一部分网页,以这些网页的链接地址作为种子URL; 将这些种子URL放入待抓取的URL队列中,爬虫从待抓取的URL队列依次读取; 将URL通过DNS解析,把链接地址转换为网站服务器对应的IP地址; 网页下载器通过网站服务器对网页进行下载,下载的网页为网页文档形式; 对网页文档中的URL进行抽取,并过滤掉已经抓取的URL; 对未进行抓取的URL继续循环抓取,直至待抓取URL队列为空。 图1.通用搜索引擎的基础架构 爬虫通常从一个或多个 URL 开始,在爬取的过程中不断将新的并且符合要求的 URL 放入待爬队列,直到满足程序的停止条件。 而我们日常见到的爬虫基本为后者,目标是在爬取少量站点的情况下尽可能保持精准的内容质量。典型的比如图2抢票软件所示,就是利用爬虫来登录售票网络并爬取信息,从而辅助商业。 图2.抢票软件 了解了爬虫的定义后,那么应该如何编写爬虫程序来爬取我们想要的数据呢。我们可以先了解下目前常用的爬虫框架,因为它可以将一些常见爬虫功能的实现代码写好,然后留下一些接口,在做不同的爬虫项目时,我们只需要根据实际情况,手写少量需要变动的代码部分,并按照需要调用这些接口,即可以实现一个爬虫项目。 1.2爬虫框架介绍 常用的搜索引擎爬虫框架如图3所示,首先Nutch是专门为搜索引擎设计的爬虫,不适合用于精确爬虫。Pyspider和Scrapy都是python语言编写的爬虫框架,都支持分布式爬虫。另外Pyspider由于其可视化的操作界面,相比Scrapy全命令行的操作对用户更加友好,但是功能不如Scrapy强大。 图3.爬虫框架对比 1.3 爬虫的简单示例 除了使用爬虫框架来进行爬虫,也可以从头开始来编写爬虫程序,步骤如图4所示: 图4.爬虫的基本原理 接下来通过一个简单的例子来实际演示上述的步骤,我们要爬取的是某应用市场的榜单,以这个作为例子,是因为这个网站没有任何的反爬虫手段,我们通过上面的步骤可以轻松爬取到内容。 图5.网页与其对应的源代码 网页与其对应的源代码如图5所示,对于网页上的数据,假定我们想要爬取排行榜上每个app的名称以及其分类。 我们首先分析网页源代码,发现可以直接在网页源代码中搜索到“抖音”等app的名称,接着看到app名称、app类别等都是在一个<li>标签里,所以我们只需要请求网页地址,拿到返回的网页源代码,然后对网页源代码进行正则匹配,提取出想要的数据,保存下来即可,如图6所示。 #获取网页源码def get_one_page(url): try: response = requests.get(url) if response.status_code == 200: return response.text return None except RequestException: return None #正则匹配提取目标信息并形成字典def parse_one_page(html): pattern = re.compile('<li>.*?data-src="(.*?)".*?<h5>.*?det.*?>(.*?)</a>.*?p.*?<a.*?>(.*?)</a>.*?</li>',re.S) items = re.findall(pattern, html) j = 1 for item in items[:-1]: yield {'index': str(j), 'name': item[1], 'class':item[2] } j = j+1 #结果写入txtdef write_to_file(content): with open(r'test.txt', 'a', encoding='utf-8') as f: f.write(json.dumps(content, ensure_ascii=False)+'\n') 图6.爬虫的代码以及结果 二、反爬虫相关技术 在了解具体的反爬虫措施之前,我们先介绍下反爬虫的定义和意义,限制爬虫程序访问服务器资源和获取数据的行为称为反爬虫。爬虫程序的访问速率和目的与正常用户的访问速率和目的是不同的,大部分爬虫会无节制地对目标应用进行爬取,这给目标应用的服务器带来巨大的压力。爬虫程序发出的网络请求被运营者称为“垃圾流量”。开发者为了保证服务器的正常运转或降低服务器的压力与运营成本,不得不使出各种各样的技术手段来限制爬虫对服务器资源的访问。 所以为什么要做反爬虫,答案是显然的,爬虫流量会提升服务器的负载,过大的爬虫流量会影响到服务的正常运转,从而造成收入损失,另一方面,一些核心数据的外泄,会使数据拥有者失去竞争力。 常见的反爬虫手段,如图7所示。主要包含文本混淆、页面动态渲染、验证码校验、请求签名校验、大数据风控、js混淆和蜜罐等,其中文本混淆包含css偏移、图片伪装文本、自定义字体等,而风控策略的制定则往往是从参数校验、行为频率和模式异常等方面出发的。 图7.常见的反爬虫手段 2.1 CSS偏移反爬虫 在搭建网页的时候,需要用CSS来控制各类字符的位置,也正是如此,可以利用CSS来将浏览器中显示的文字,在HTML中以乱序的方式存储,从而来限制爬虫。CSS偏移反爬虫,就是一种利用CSS样式将乱序的文字排版成人类正常阅读顺序的反爬虫手段。这个概念不是很好理解,我们可以通过对比两段文字来加深对这个概念的理解: HTML文本中的文字:我的学号是 1308205,我在北京大学读书。 浏览器显示的文字:我的学号是 1380205,我在北京大学读书。 以上两段文字中浏览器显示的应该是正确的信息,如果我们按之前提到的爬虫步骤,分析网页后正则提取信息,会发现学号是错的。 接着看图8所示的例子,如果我们想爬取该网页上的机票信息,首先需要分析网页。红框所示的价格467对应的是中国民航的从石家庄到上海的机票,但是分析网页源代码发现代码中有 3 对 b 标签,第 1 对 b 标签中包含 3 对 i 标签,i 标签中的数字都是 7,也就是说第 1 对 b 标签的显示结果应该是 777。而第 2 对 b 标签中的数字是 6,第 3 对 b 标签中的数字是 4,这样的话我们会无法直接通过正则匹配得到正确的机票价格。 图8.CSS 偏移反爬虫例子 2.2 图片伪装反爬虫 图片伪装反爬虫,它的本质就是用图片替换了原来的内容,从而让爬虫程序无法正常获取,如图9所示。这种反爬虫的原理十分简单,就是将本应是普通文本内容的部分在前端页面中用图片来进行替换,遇到这种案例可以直接用ocr识别图片中的文字就可以绕过。而且因为是用图片替换文本显示,所以图片本身会相对比较清晰,没有很多噪声干扰,ocr识别的结果会很准确。 图9.图片伪装反爬虫例子 2.3 自定义字体反爬虫 在 CSS3 时代,开发者可以使用@font-face为网页指定字体。开发者可将心仪的字体文件放在 Web 服务器上,并在 CSS 样式中使用它。用户使用浏览器访问 Web 应用时,对应的字体会被浏览器下载到用户的计算机上,但是我们在使用爬虫程序时,由于没有相应的字体映射关系,直接爬取就会无法得到有效数据。 如图10所示,该网页中每个店铺的评价数、人均、口味、环境等信息均是乱码字符,爬虫无法直接读取到内容。 图10.自定义字体反爬虫例子 2.4 页面动态渲染反爬虫 网页按渲染方式的不同,大体可以分为客户端和服务端渲染。 服务端渲染,页面的结果是由服务器渲染后返回的,有效信息包含在请求的 HTML 页面里面,通过查看网页源代码可以直接查看到数据等信息; 客户端渲染,页面的主要内容由 JavaScript 渲染而成,真实的数据是通过 Ajax 接口等形式获取的,通过查看网页源代码,无有效数据信息。 客户端渲染和服务器端渲染的最重要的区别就是究竟是谁来完成html文件的完整拼接,如果是在服务器端完成的,然后返回给客户端,就是服务器端渲染,而如果是前端做了更多的工作完成了html的拼接,则就是客户端渲染。 图11.客户端渲染例子 2.5 验证码反爬虫 几乎所有的应用程序在涉及到用户信息安全的操作时,都会弹出验证码让用户进行识别,以确保该操作为人类行为,而不是大规模运行的机器。那为什么会出现验证码呢?在大多数情形下是因为网站的访问频率过高或者行为异常,或者是为了直接限制某些自动化行为。归类如下: 很多情况下,比如登录和注册,这些验证码几乎是必现的,它的目的就是为了限制恶意注册、恶意爆破等行为,这也算反爬的一种手段。 一些网站遇到访问频率过高的行为的时候,可能会直接弹出一个登录窗口,要求我们登录才能继续访问,此时的验证码就直接和登录表单绑定在一起了,这就算检测到异常之后利用强制登录的方式进行反爬。 一些较为常规的网站如果遇到访问频率稍高的情形的时候,会主动弹出一个验证码让用户识别并提交,验证当前访问网站的是不是真实的人,用来限制一些机器的行为,实现反爬虫。 常见的验证码形式包括图形验证码、行为验证码、短信、扫码验证码等,如图12所示。对于能否成功通过验证码,除了能够准确的根据验证码的要求完成相应的点击、选择、输入等,通过验证码风控也至关重要;比如对于滑块验证码,验证码风控可能会针对滑动轨迹进行检测,如果检测出轨迹非人为,就会判定为高风险,导致无法成功通过。 图12.验证码反爬虫手段 2.6 请求签名校验反爬虫 签名验证是防止服务器被恶意链接和篡改数据的有效方式之一,也是目前后端API最常用的防护方式之一。签名是一个根据数据源进行计算或者加密的过程,用户经过签名后会一个具有一致性和唯一性的字符串,它就是你访问服务器的身份象征。由它的一致性和唯一性这两种特性,从而可以有效的避免服务器端,将伪造的数据或被篡改的数据当初正常数据处理。 前面在2.4节提到的网站是通过客户端渲染网页,数据则是通过ajax请求拿到的,这种在一定程度上提升了爬虫的难度。接下来分析ajax请求,如图13所示,会发现其ajax请求是带有请求签名的,analysis就是加密后的参数,而如果想要破解请求接口,就需要破解该参数的加密方法,这无疑进一步提升了难度。 图13.请求榜单数据的ajax请求 2.7蜜罐反爬虫 蜜罐反爬虫,是一种在网页中隐藏用于检测爬虫程序的链接的手段,被隐藏的链接不会显示在页面中,正常用户无法访问,但爬虫程序有可能将该链接放入待爬队列,并向该链接发起请求,开发者可以利用这个特点区分正常用户和爬虫程序。如图14所示,查看网页源码,页面只有6个商品,col-md-3的 <div>标签却有 8 对。该 CSS 样式的作用是隐藏标签,所以我们在页面只看到 6 件商品,爬虫程序会提取到 8 件商品的 URL。 图14.蜜罐反爬虫例子 三、反反爬相关技术 针对上一节提到的反爬虫相关技术,有以下几类反反爬技术手段:css偏移反反爬、自定义字体反反爬、页面动态渲染反反爬、验证码破解等,下面对这几类方法进行详细的介绍。 3.1 CSS偏移反反爬 3.1.1CSS偏移逻辑介绍 那么对于以上2.1css偏移反爬虫的例子,怎么才能得到正确的机票价格呢。仔细观察css样式,可以发现每个带有数字的标签都设定了样式,第 1 对 b 标签内的i 标签对的样式是相同的,都是width: 16px;另外,还注意到最外层的 span 标签对的样式为width:48px。 如果按照 css样式这条线索来分析的话,第 1 对 b 标签中的 3 对 i 标签刚好占满 span 标签对的位置,其位置如图15所示。此时网页中显示的价格应该是 777,但是由于第 2 和第 3 对 b 标签中有值,所以我们还需要计算它们的位置。由于第 2 对 b 标签的位置样式是 left:-32px,所以第 2 对 b 标签中的值 6 就会覆盖原来第 1 对 b 标签中的中的第 2 个数字 7,此时页面应该显示的数字是 767。 按此规律推算,第 3 对 b 标签的位置样式是 left:-48px,这个标签的值会覆盖第 1 对 b 标签中的第 1 个数字 7,最后显示的票价就是 467。 图15.偏移逻辑 3.1.2 CSS偏移反反爬代码实现 因此接下来我们按以上css样式的规律来编写代码对该网页爬取获取正确的机票价格,代码和结果如图16所示。 if __name__ == '__main__': url = 'http://www.porters.vip/confusion/flight.html' resp = requests.get(url) sel = Selector(resp.text) em = sel.css('em.rel').extract() for element in range(0,1): element = Selector(em[element]) element_b = element.css('b').extract() b1 = Selector(element_b.pop(0)) base_price = b1.css('i::text').extract() print('css偏移前的价格:',base_price) alternate_price = [] for eb in element_b: eb = Selector(eb) style = eb.css('b::attr("style")').get() position = ''.join(re.findall('left:(.*)px', style)) value = eb.css('b::text').get() alternate_price.append({'position': position, 'value': value}) print('css偏移值:',alternate_price) for al in alternate_price: position = int(al.get('position')) value = al.get('value') plus = True if position >= 0 else False index = int(position / 16) base_price[index] = value print('css偏移后的价格:',base_price) 图16. CSS 偏移反反爬代码与结果 3.2 自定义字体反反爬 针对于以上2.3自定义字体反爬虫的情况,解决思路就是提取出网页中自定义字体文件(一般为WOFF文件),并将映射关系包含到爬虫代码中,就可以获取到有效数据。解决的步骤如下: 发现问题:查看网页源代码,发现关键字符被编码替代,如&#xefbe 分析:检查网页,发现应用了css自定义字符集隐藏 查找:查找css文件url,获取字符集对应的url,如PingFangSC-Regular-num 查找:查找和下载字符集url 比对:比对字符集中的字符与网页源代码中的编码,发现编码的后四位与字符对应,也即网页源代码对应的口味是8.9分 3.3 页面动态渲染反反爬 客户端渲染的反爬虫,页面代码在浏览器源代码中看不到,需要执行渲染并进一步获取渲染后结果。针对这种反爬虫,有以下几种方式破解: 在浏览器中,通过开发者工具直接查看ajax具体的请求方式、参数等内容; 通过selenium模拟真人操作浏览器,获取渲染后的结果,之后的操作步骤和服务端渲染的流程一样; 如果渲染的数据隐藏在html结果的JS变量中,可以直接正则提取; 如果有通过JS生成的加密参数,可以找出加密部分的代码,然后使用pyexecJS来模拟执行JS,返回执行结果。 3.4 验证码破解 下面举例一个识别滑块验证码的例子,如图17所示,是使用目标检测模型来识别某滑块验证码缺口位置的结果示例,这种破解滑块验证码的方式对应的是模拟真人的方式。不采用接口破解的原因一方面是破解加密算法有难度,另一方面也是加密算法可能每天都会变,这样破解的时间成本也比较大。 图17.通过目标检测模型识别滑块验证码的缺口 3.4.1 爬取滑块验证码图片 因为使用的目标检测模型yolov5是有监督学习,所以需要爬取滑块验证码的图片并进行打标,进而输入到模型中训练。通过模拟真人的方式在某场景爬取部分验证码。 图18.爬取的滑块验证码图片 3.4.2 人工打标 本次使用的是labelImg来对图片人工打标签的,人工打标耗时较长,100张图片一般耗时40分钟左右。自动打标代码写起来比较复杂,主要是需要分别提取出验证码的所有背景图片和缺口图片,然后随机生成缺口位置,作为标签,同时将缺口放到对应的缺口位置,生成图片,作为输入。 图19.对验证码图片打标签以及打标签后生成的xml文件 3.4.3目标检测模型yolov5 直接从github下clone yolov5的官方代码,它是基于pytorch实现。 接下来的使用步骤如下: 数据格式转换:将人工标注的图片和标签文件转换为yolov5接收的数据格式,得到1100张图片和1100个yolov5格式的标签文件; 新建数据集:新建custom.yaml文件来创建自己的数据集,包括训练集和验证集的目录、类别数目、类别名; 训练调优:修改模型配置文件和训练文件后,进行训练,并根据训练结果调优超参数。 转换xml文件为yolov5格式的部分脚本: for member in root.findall('object'): class_id = class_text.index(member[0].text) xmin = int(member[4][0].text) ymin = int(member[4][1].text) xmax = int(member[4][2].text) ymax = int(member[4][3].text) # round(x, 6) 这里我设置了6位有效数字,可根据实际情况更改 center_x = round(((xmin + xmax) / 2.0) * scale / float(image.shape[1]), 6) center_y = round(((ymin + ymax) / 2.0) * scale / float(image.shape[0]), 6) box_w = round(float(xmax - xmin) * scale / float(image.shape[1]), 6) box_h = round(float(ymax - ymin) * scale / float(image.shape[0]), 6) file_txt.write(str(class_id)) file_txt.write(' ') file_txt.write(str(center_x)) file_txt.write(' ') file_txt.write(str(center_y)) file_txt.write(' ') file_txt.write(str(box_w)) file_txt.write(' ') file_txt.write(str(box_h)) file_txt.write('\n') file_txt.close() 训练参数设置: parser = argparse.ArgumentParser()parser.add_argument('--weights', type=str, default='yolov5s.pt', help='initial weights path')parser.add_argument('--cfg', type=str, default='./models/yolov5s.yaml', help='model.yaml path')parser.add_argument('--data', type=str, default='data/custom.yaml', help='data.yaml path')parser.add_argument('--hyp', type=str, default='data/hyp.scratch.yaml', help='hyperparameters path')# parser.add_argument('--epochs', type=int, default=300)parser.add_argument('--epochs', type=int, default=50)# parser.add_argument('--batch-size', type=int, default=16, help='total batch size for all GPUs')parser.add_argument('--batch-size', type=int, default=8, help='total batch size for all GPUs')parser.add_argument('--img-size', nargs='+', type=int, default=[640, 640], help='[train, test] image sizes')parser.add_argument('--rect', action='store_true', help='rectangular training')parser.add_argument('--resume', nargs='?', const=True, default=False, help='resume most recent training')parser.add_argument('--nosave', action='store_true', help='only save final checkpoint')parser.add_argument('--notest', action='store_true', help='only test final epoch')parser.add_argument('--noautoanchor', action='store_true', help='disable autoanchor check')parser.add_argument('--evolve', action='store_true', help='evolve hyperparameters')parser.add_argument('--bucket', type=str, default='', help='gsutil bucket')parser.add_argument('--cache-images', action='store_true', help='cache images for faster training')parser.add_argument('--image-weights', action='store_true', help='use weighted image selection for training')parser.add_argument('--device', default='cpu', help='cuda device, i.e. 0 or 0,1,2,3 or cpu')parser.add_argument('--multi-scale', action='store_true', help='vary img-size +/- 50%%')parser.add_argument('--single-cls', action='store_true', help='train multi-class data as single-class')parser.add_argument('--adam', action='store_true', help='use torch.optim.Adam() optimizer')parser.add_argument('--sync-bn', action='store_true', help='use SyncBatchNorm, only available in DDP mode')parser.add_argument('--local_rank', type=int, default=-1, help='DDP parameter, do not modify')parser.add_argument('--workers', type=int, default=8, help='maximum number of dataloader workers')parser.add_argument('--project', default='runs/train', help='save to project/name')parser.add_argument('--entity', default=None, help='W&B entity')parser.add_argument('--name', default='exp', help='save to project/name')parser.add_argument('--exist-ok', action='store_true', help='existing project/name ok, do not increment')parser.add_argument('--quad', action='store_true', help='quad dataloader')parser.add_argument('--linear-lr', action='store_true', help='linear LR')parser.add_argument('--label-smoothing', type=float, default=0.0, help='Label smoothing epsilon')parser.add_argument('--upload_dataset', action='store_true', help='Upload dataset as W&B artifact table')parser.add_argument('--bbox_interval', type=int, default=-1, help='Set bounding-box image logging interval for W&B')parser.add_argument('--save_period', type=int, default=-1, help='Log model after every "save_period" epoch')parser.add_argument('--artifact_alias', type=str, default="latest", help='version of dataset artifact to be used')opt = parser.parse_args() 3.4.4目标检测模型的训练结果 模型基本在50次迭代的时候在precision和recall以及mAP上已经达到了瓶颈。预测结果也有如下问题:大部分能够是能够准确框出缺口,但也出现少量框错、框出两个缺口、框不出缺口的情况。 图20. 上:模型的训练结果走势图; 下:模型对部分验证集的预测结果 四、总结 本次简单对爬虫以及反爬虫的技术手段进行了介绍,介绍的技术和案例均只是用于安全研究和学习,并不会进行大量爬虫或者应用于商业。 对于爬虫,本着爬取网络上公开数据用于数据分析等的目的,我们应该遵守网站robots协议,本着不影响网站正常运行以及遵守法律的情况下进行数据爬取;对于反爬虫,因为只要人类能够正常访问的网页,爬虫在具备同等资源的情况下就一定可以抓取到。所以反爬虫的目的还是在于能够防止爬虫在大批量的采集网站信息的过程对服务器造成超负载,从而杜绝爬虫行为妨碍到用户的体验,来提高用户使用网站服务的满意度。 END 猜你喜欢 vivo 全球商城:电商平台通用取货码设计 基于 iframe 的微前端框架 —— 擎天 vivo前端智能化实践:机器学习在自动网页布局中的应用 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册