首页 文章 精选 留言 我的

精选列表

搜索[赛博朋克],共10000篇文章
优秀的个人博客,低调大师

每日一博 | MySQL 最朴素的监控方式

对于当前数据库的监控方式有很多,分为数据库自带、商用、开源三大类,每一种都有各自的特色;而对于mysql数据库由于其有很高的社区活跃度,监控方式更是多种多样,不管哪种监控方式最核心的就是监控数据,获取得到全面的监控数据后就是灵活的展示部分。那我们今天就介绍一下完全采用mysql自有方式采集获取监控数据,在单体下达到最快速、方便、损耗最小。 本次文章完全使用mysql自带的show命令实现获取,从connects、buffercache、lock、SQL、statement、Database throughputs、serverconfig7大方面全面获取监控数据。 1 连接数(Connects) 最大使用连接数:show status like ‘Max_used_connections’ 当前打开的连接数:show status like ‘Threads_connected’ 2 缓存(bufferCache) 未从缓冲池读取的次数:show status like ‘Innodb_buffer_pool_reads’ 从缓冲池读取的次数:show status like ‘Innodb_buffer_pool_read_requests’ 缓冲池的总页数:show status like ‘Innodb_buffer_pool_pages_total’ 缓冲池空闲的页数:show status like ‘Innodb_buffer_pool_pages_free’ 缓存命中率计算:(1-Innodb_buffer_pool_reads/Innodb_buffer_pool_read_requests)*100% 缓存池使用率为:((Innodb_buffer_pool_pages_total-Innodb_buffer_pool_pages_free)/Innodb_buffer_pool_pages_total)*100% 3 锁(lock) 锁等待个数:show status like ‘Innodb_row_lock_waits’ 平均每次锁等待时间:show status like ‘Innodb_row_lock_time_avg’ 查看是否存在表锁:show open TABLES where in_use>0;有数据代表存在锁表,空为无表锁 备注:锁等待统计得数量为累加数据,每次获取得时候可以跟之前得数据进行相减,得到当前统计得数据 4 SQL 查看mysql开关是否打开:show variables like ‘slow_query_log’,ON为开启状态,如果为OFF,set global slow_query_log=1 进行开启 查看mysql阈值:show variables like ‘long_query_time’,根据页面传递阈值参数,修改阈值 set global long_query_time=0.1 查看mysql慢sql目录:show variables like ‘slow_query_log_file’ 格式化慢sql日志:mysqldumpslow -s at -t 10 /export/data/mysql/log/slow.log 注:此语句通过jdbc执行不了,属于命令行执行。 意思为:显示出耗时最长的10个SQL语句执行信息,10可以修改为TOP个数。显示的信息为:执行次数、平均执行时间、SQL语句 备注:当mysqldumpslow命令执行失败时,将慢日志同步到本地进行格式化处理。 5 statement insert数量:show status like ‘Com_insert’ delete数量:show status like ‘Com_delete’ update数量:show status like ‘Com_update’ select数量:show status like ‘Com_select’ 6 吞吐(Database throughputs) 发送吞吐量:show status like ‘Bytes_sent’ 接收吞吐量:show status like ‘Bytes_received’ 总吞吐量:Bytes_sent+Bytes_received 7 数据库参数(serverconfig) show variables 8 慢SQL 慢SQL指的是MySQL慢查询,具体指运行时间超过long_query_time值的SQL。 我们常听MySQL中有二进制日志binlog、中继日志relaylog、重做回滚日志redolog、undolog等。针对慢查询,还有一种慢查询日志slowlog,用来记录在MySQL中响应时间超过阀值的语句。慢SQL对实际生产业务影响是致命的,所以测试人员在性能测试过程中,对数据库SQL语句执行情况实施监控,给开发提供准确的性能优化意见显得尤为重要。那怎么使用Mysql数据库提供的慢查询日志来监控SQL语句执行情况,找到消耗较高的SQL语句,以下详细说明一下慢查询日志的使用步骤: 确保打开慢SQL开关slow_query_log 设置慢SQL域值long_query_time 这个long_query_time是用来定义慢于多少秒的才算“慢查询”,注意单位是秒,我通过执行sql指令set long_query_time=1来设置了long_query_time的值为1, 也就是执行时间超过1秒的都算慢查询,如下: 查看慢SQL日志路径 通过慢sql分析工具mysqldumpslow格式化分析慢SQL日志 mysqldumpslow慢查询分析工具,是mysql安装后自带的,可以通过./mysqldumpslow —help查看使用参数说明 常见用法: 取出使用最多的10条慢查询 ./mysqldumpslow -s c -t 10 /export/data/mysql/log/slow.log 取出查询时间最慢的3条慢查询 ./mysqldumpslow -s t -t 3 /export/data/mysql/log/slow.log 注意: 使用mysqldumpslow的分析结果不会显示具体完整的sql语句,只会显示sql的组成结构; 假如: SELECTFROM sms_send WHERE service_id=10 GROUP BY content LIMIT 0, 1000; mysqldumpslow命令执行后显示: Count: 2 Time=1.5s (3s) Lock=0.00s (0s) Rows=1000.0 (2000), vgos_dba[vgos_dba]@[10.130.229.196]SELECTFROM sms_send WHERE service_id=N GROUP BY content LIMIT N, N mysqldumpslow的分析结果详解: Count:表示该类型的语句执行次数,上图中表示select语句执行了2次。 Time:表示该类型的语句执行的平均时间(总计时间) Lock:锁时间0s。 Rows:单次返回的结果数是1000条记录,2次总共返回2000条记录。 通过这个工具就可以查询出来哪些sql语句是慢SQL,从而反馈研发进行优化,比如加索引,该应用的实现方式等。 常见慢SQL排查 不使用子查询 SELECTFROM t1 WHERE id (SELECT id FROM t2 WHERE name=’hechunyang’); 子查询在MySQL5.5版本里,内部执行计划器是这样执行的:先查外表再匹配内表,而不是先查内表t2,当外表的数据很大时,查询速度会非常慢。 在MariaDB10/MySQL5.6版本里,采用join关联方式对其进行了优化,这条SQL会自动转换为 SELECT t1.FROM t1 JOIN t2 ON t1.id = t2.id; 但请注意的是:优化只针对SELECT有效,对UPDATE/DELETE子 查询无效, 生产环境尽量应避免使用子查询。 避免函数索引 SELECTFROM t WHERE YEAR(d) >= 2016; 由于MySQL不像Oracle那样⽀持函数索引,即使d字段有索引,也会直接全表扫描。 应改为 > SELECTFROM t WHERE d >= ‘2016-01-01’; 用IN来替换OR低效查询 慢SELECTFROM t WHERE LOC_ID = 10 OR LOC_ID = 20 OR LOC_ID = 30; 高效查询 > SELECTFROM t WHERE LOC_IN IN (10,20,30); LIKE双百分号无法使用到索引 SELECTFROM t WHERE name LIKE ‘%de%’; 使用SELECTFROM t WHERE name LIKE ‘de%’; 分组统计可以禁止排序 SELECT goods_id,count() FROM t GROUP BY goods_id; 默认情况下,MySQL对所有GROUP BY col1,col2…的字段进⾏排序。如果查询包括GROUP BY,想要避免排序结果的消耗,则可以指定ORDER BY NULL禁止排序。 使用SELECT goods_id,count() FROM t GROUP BY goods_id ORDER BY NULL; 禁止不必要的ORDER BY排序 SELECT count(1) FROM user u LEFT JOIN user_info i ON u.id = i.user_id WHERE 1 = 1 ORDER BY u.create_time DESC; 使用SELECT count(1) FROM user u LEFT JOIN user_info i ON u.id = i.user_id; 9 总结 任何东西不应过重关注其外表,要注重内在的东西,往往绚丽的外表下会有对应的负担和损耗。 mysql数据库的监控支持通过SQL方式从performance_schema库中访问对应的表数据,前提是初始化此库并开启监控数据写入。 对于监控而言,不在于手段的多样性,而需要明白监控的本质,以及需要的监控项内容,找到符合自身项目特色的监控方式。 在选择监控工具对mysql监控时,需要关注监控工具本身对于数据库服务器的消耗,不要影响到其自身的使用。 作者:安甲舒

优秀的个人博客,低调大师

每日一博 | Cube 渲染设计的前世今生

作者:何瑾(潇珺) 本文为《Cube 技术解读》系列第四篇文章,往期文章欢迎大家回顾。 《Cube 技术解读 | Cube 小程序技术详解》 《Cube 技术解读 | 支付宝新一代动态化技术架构与选型综述》 《Cube 技术解读 | Cube 卡片技术栈详解》 阿里是个重运营的公司,前端开发者居多,2016-2017年,在Weex还是1.0时代,React Native开源还没多久,Flutter还没诞生的时候,如何在贴合前端开发环境的前提下,快速铺到android/iOS双平台是个大热点,支付宝内部孵化一个动态化跨平台方案顺势而生。 前面三篇文章分别介绍了Cube当前架构,Cube卡片和Cube小程序技术产品形态。这篇文章主要讨论Cube的渲染设计,帮助大家了解Cube卡片渲染技术的前世今生。 Native原生渲染的问题 我们都知道一个原生view渲染上屏需要几个步骤,以android举例:create、measure、layout、draw,这些需要在主线程完成,当实现原生列表时,即使完美复用item,对不同数据渲染时,也需要measure、layout、draw几步缺一不可,而且随着view嵌套层级越深,对主线程资源消耗越大,当列表fly起来以后,帧率快速下降,造成页面卡顿,基于这个问题,cube在调研期间,如何解决渲染效率是重要的一part。 通常来说优化列表滚动帧率,也就是view层级、布局复杂度、去掉不必要背景色,解决过度绘制,图片懒加载、item复用等方面下手,但根本还是绕不过measure、layout、draw。彼时的weex和RN,也都还是将html中的标签映射到平台层view,在某些场景下,开发者又不能像原生开发一样自行优化,在渲染性能上饱受诟病。因此cube调研期间渲染目标是:优化渲染效率+跨平台。 跨平台异步渲染方案 异步渲染 基于上面提到的背景和需求,那么我们就想,能否有一种方式,把关键步骤移除出线程呢,即异步渲染。在列表滚动时基本只有系统手势和列表本身滚动算法、动画需要占用主线程,将大大提高帧率。视图内元素绘制的产物是一个像素缓存(Cube采用的设计是Bitmap),回到主线程给视图进行刷新显示。 跨平台架构 另一个目标跨平台,是要做到可以快速扩展其他平台,cube将涉及平台的部分分离出来,形成platform 层。 platform 这里提供了各平台通用的标准c++原子接口,在不同平台用平台语言实现,初步只实现了android、iOS两个平台,android通过jni调用java方法,iOS在实现文件中c++、OC混编。如果未来需要扩展其他平台例如macOS,只需实现platform层定义的接口即可,可以达到快速扩展其他平台的目标。 core library是基于platform原子接口用c++实现的是基础库,例如文件IO、UI控件、图片下载、消息通讯等,供上层引擎使用。library之上,就是cube渲染的核心实现,渲染部分包括数据模型和渲染逻辑,组件库指cube内部支持的一些系统实体控件,或者开发者可外接的实体组件。 下图是第一版cube渲染架构图。 cube渲染架构图 异步渲染技术选型 前面提到了,异步渲染方案里异步绘制的“产物”是一张bitmap交给“容器”View,为什么是bitmap呢,看起来对内存很不友好,View又是个什么View,有没有特殊性,下面聊聊cube调研时期都研究过哪些方案,最终为什么选型bitmap。 Android平台技术选型 android的选型之路坎坷崎岖,最先能想到的支持独立渲染线程的textureView、GLSurfaceView做为容器,但有明显缺陷,是不能用于常见业务的列表场景的,只能应用于特定场景。 SurfaceView、GLSurfaceView SurfaceView从android1.0开始就有,主要特点是它的渲染可以在子线程中实现,因此存在的问题是,虽然它继承View,但是它拥有独立的Surface,不在View hierachy中,它的显示也不受View的属性控制,因此不能像普通view一样缩放平移,更不能作为item放在listView/RecycleView中当作普通view使用,滚动起来会有不同步的问题。 GLSurfaceView继承SurfaceView,它自带GLThread,有和GLSurfaceView相同的问题,总之,这两个view更适合单个视频渲染或者像地图类渲染场景。 有人可能要问,整个页面都用SurfaceView/GLSurfaceView不就行了,连列表也在render线程实现?这里两个问题: 1、如果列表容器也在render线程实现,正如现在的flutter一样,那么列表滑动手势处理需要自己实现,比如drag,fling,各种列表滚动个动画,以及滚动加速度计算等,成本很高。并且,touch事件捕获仍然依赖平台层,而处理事件需要切换到render线程,这中间一定有线程切换成本造成的不跟手的体验问题。现在很多基于flutter引擎改造的渲染引擎,正面临着这些问题; 2、在当时cube团队的主要目标是快速验证 ,列表的实现这种成本过高,不是主要矛盾所在。 TextureVIew textureView是google从android4.0开始提供的,它的出现很大程度上是为了弥补SurfaceView、GLSurfaceView与原生View融合的不足,基于上面一节描述的这两个view与原生view一起动画的问题,textureView似乎更适合我们的场景,既能支持独立render线程,又能保证与原生view完美融合。 但是,在实际的调研过程中发现,textureView的渲染机制,不适用于长列表,如果每个列表的item是一个textureView,那么就涉及到出屏回收,进屏创建,否则会带来内存问题。而回收和创建SurfaceTexture是异步过程,出现了闪黑屏问题。除此之外,进一步发现textureView的数量和容量(每个view的尺寸累计)存在某个上限,而且不同手机上限也差异很大。简单说,这是一个看起来很美好,但是兼容性坑无数的技术路线。 Bitmap+普通View 最终选择了bitmap看起来并不完美的方案,虽然这被大多数android开发认为bitmap带来大量内存消耗,视为不可接受,但随着cube的应用范围越来越广,这逐渐被证明是在当时,最普适的一个方案。 每一个layer对应一个系统view,每个view的绘制内容在子线程通过CanvasAPI异步绘制在bitmap上,当view上屏时,系统onDraw绘制这个bitmap“产物”。 BitmapCache 虽然用了Bitmap绘制方案,但必须要考虑内存过载的问题,这里我们采用了BitmapCache,主要针对列表类型场景,依赖系统的item回收回调通知,将bitmap画布放入Cache,item上屏渲染时,优先从cache取bitmap画布使用,优先取相同大小的,如果不存在,则取width、height大于目标width、height,让view只绘制bitmap局部,达到正确渲染的目的 iOS平台技术选型 iOS的实现原理与android大致相同,区别是,iOS异步线程绘制完成的“产物”,不会在UIView的drawRect里利用CoreGraphics进行渲染,这种方式效率很低,页面卡顿明显,最终采用的是将画布赋值给UIView的layer,托管给系统渲染layer。 渲染技术的演进 上面讲了cube异步渲染大体方案和关键技术选型,事实上,从19年初上线答答星球,到现在,cube在支付宝内应用越来越广泛,这中间也伴随着cube团队根据实际业务场景不断摸索、优化的过程,渲染链路经历了两次重构。需要强调的,这个演进过程是在严格的内存/性能下完成的,而且要对Android兼容性做出妥协。一些看起来不那么优雅或者先进的设计,事实上是不得不这么做,比如选择Bitmap作为像素缓冲,比如接入三方组件的设计等。从某种意义上,抛开约束谈论技术优劣也意义不大。我们曾经借鉴flutter的部分,但Cube最终还是沿着适合自身场景的技术路线往前走。 常见术语 LayoutTree:DomApi通过add、update、remove构建的经过yoga布局的,用来描述节点父子关系,包含布局信息的原始树型结构; RenderTree:用来描述绘制节点父子关系,包含绘制信息的树型结构,与layoutTree的区别举例:一个layoutNode visible为gone,则该节点不会在RenderTree中出现; Layer:一般情况下,根节点及其子节点绘制在同一个画布上,定义为一个layer,对应平台层一个view,当子节点有动画属性,或者超出父节点范围,则需要独立出一个layer; LayerTree:上面提到的layer节点,构建的树型结构,一个layer对应平台层一个view,我们叫ContainerView; 实体节点:需要独立layer的节点为实体节点; 虚拟节点:除了实体节点以外,其他节点均会被绘制在父容器的画布上,这些是虚拟节点。 演进过程 调研初期——1.0验证方案的可行性 调研时期验证方案可行性,场景比较简单,以支付宝内朋友动态页面为验证场景,每条状态(一个item/cell)作为一个渲染单元,这里只考虑了layerTree只有一个layer的情况,头像、昵称、时间、配图、“赞”、“赏”,“评”等元素均绘制在root节点对应的layer上,“赞”、“赏”,“评”文本旁边的小图标则作为外接实体组件,通过addSubView添加在rootLayer的View上。 数据模型 如下图所示,根据layoutTree构建RenderTree,但非渲染节点不在renderTree上,layerTree只有一个自绘制layer(rootLayer),和其他自定义组件X,最终除自定义组件外,其他所有节点都绘制在rootLayer上。 渲染流程 bridge线程通过DomApi构建layoutTree,当主线程触发渲染时,主线程根据layoutTree构建RenderTree,构建过程中遇到外接实体组件,创建实例并addSubView,之后切换子线程绘制RenderTree,即rootLayer上的所有虚拟节点,绘制完成后切换主线程贴图(bitmap“产物”)。 缺点 不能支持多layer结构 实体view没有复用,也就是朋友动态列表中有多少item/cell,就会有多少“赞”、“赏”,“评”实体组件 但这个调研验证了异步渲染的可行性,在列表滚动时帧率大幅提升。 产品化时期——2.0支持多layer 前面验证了可行性,在进行产品化设计时,就必须要满足多layer结构了,即实际的一张卡片中,会有一个或几个不同的节点被设置为layer,这些节点及其子节点,分别绘制在不同画布上,供不同的layer渲染。 数据模型 改进之处时layerTree里有个多layer节点,layer节点下面的子虚拟节点,将绘制在该layer的bitmap“产物”上。 渲染流程 brige线程构建layoutTree的过程中,每个指令(addNode、removeNode……)都会相应分发到render模块的主线程,render根据指令构建RenderTree,并用指令信息生成task入队,当VSync信号来时,触发任务出队并去重,构建layerTree,不同layer分发到不同draw线程绘制,绘制完成后切主线程贴图(bitmap“产物”)。 缺点 主线程计算量大,可能造成卡顿 render节点既包含绘制信息,是绘制对象,还包含逻辑,例如display:"none"节点忽略不显示,职责不清晰。 优化时期——3.0取长补短 上面可以看到renderTree的构建以及layerTree的构建,都是在UI线程,在节点数比较多活复杂的情况下会造成UI的卡顿,为了追求极致滚动帧率,尽可能减少主线程计算内容,优化3.0版本将renderObject构建layer、以及计算节点变更导致的绘制影响范围,的部分改在子线程完成,形成了现在线上运行的版本。 数据模型 新增了PaintTree这个结构,它挂载在Layer节点上,样式和属性值从RenderTree拷贝而来,但不涉及任何逻辑处理,单纯的是一个绘制对象,每个绘制任务只绘制paintTree上的paint节点,与layerTree和renderTree没有并发问题。 渲染流程 layout线程构建layoutTree,切换到render线程构建renderTree,当平台层触发渲染,切换到renderTree构建layerTree,并计算影响范围等,切换到主线程将layer对应的实体化View添加在容器View上,生成绘制任务在paint线程执行,绘制结束后切换主线程贴图(bitmap产物)。 缺点 render线程繁忙时造成的闪白率升高 以上就是cube渲染从诞生到现在线上方案的演进,目前在支付宝端内卡片形态接入业务超过20+,线上运行的卡片模版个数达到500多个,显示PV过百亿,经受住了各业务方的考验。 但在技术支持中也发现了一些问题,例如渲染任务过多时,render线程阻塞排队,不能及时消费导致白屏概率变大,最近cube也在继续研究优化方案。 存在的问题 两端一致性问题 cube目前的绘制api,采用的系统平台层提供的CanvasApi(iOS是CoreGraphics),这就导致了两个平台在绘制点线面的细节上必须两端人工代码对齐,否则就会产生效果差异,当新增一些feature,例如支持点划线,需要两个平台各自实现DrawDottedLine接口,但这个问题,cube团队正调研自绘制,即使用skia api将绘制接口下沉到c++,实现跨平台自绘制; 文本也是容易产生差异的一个点,利用平台层api对文本进行布局,在绘制时调用布局的api进行绘制,因此可能会产品平台差异,但cube团队目前已经在Cube小程序上把文本布局,布局算法下沉在c++层,不依赖平台api,实现双平台一致;限于内存/性能的约束尚未在Cube卡片上应用。 闪白问题 因为滚动采用的异步渲染,所以必然会产生主线程卡片已经上屏,异步绘制还未完成造成的闪白问题,线程切换有成本,这个闪白理论上一定存在,只是时间长短问题,cube团队致力于提高渲染效率,将线程切换带来的损耗降到最低,使用户在列表滚动中体验提升。 未来规划 针对目前已知的问题,cube团队致力于持续优化,主要优化点包括但不限于以下: 渲染快照,提高冷启的渲染效率,减少闪白时间; 渲染策略,例如预渲染、同异步绘制自适应、线程模型优化、组件缓存和预加载等,减少闪白率,提升渲染效率; 用于Cube卡片的yoga布局引擎优化,提升layout布局效率; skia自绘制实现,实现双端一致性; cube的渲染技术的应用包含卡片和小程序两种技术形态,场景包括支付宝端内、端外、IOT等多样化场景,团队成员将持续在渲染性能、用户体验、以及工具链等方向持续发力,努力把产品打磨好,把开发者服务好,成长为具有竞争力的跨平台动态化渲染方案。 关注【阿里巴巴移动技术】,阿里前沿移动干货&实践给你思考!

优秀的个人博客,低调大师

每日一博 | 一文详解 Kafka API

摘要:Kafka的API有Producer API,Consumer API还有自定义Interceptor (自定义拦截器),以及处理的流使用的Streams API和构建连接器的Kafka Connect API。 本文分享自华为云社区《【Kafka笔记】Kafka API详细解析 Java版本(Producer API,Consumer API,拦截器等)》,作者: Copy工程师。 简介 Kafka的API有Producer API,Consumer API还有自定义Interceptor (自定义拦截器),以及处理的流使用的Streams API和构建连接器的Kafka Connect API。 Producer API Kafka的Producer发送消息采用的是异步发送的方式。在消息发送过程中,涉及两个线程:main线程和Sender线程,以及一个线程共享变量RecordAccumulator。main线程将消息发送给RecordAccmulator,Sender线程不断地从RecordAccumulator中拉取消息发送给Kafka broker。 这里的ACk机制,不是生产者得到ACK返回信息才开始发送,ACK保证的是生产者不丢失数据。例如: 而是只要有消息数据,就向broker发送。 消息发送流程 生产者使用send方法,经过拦截器之后在经过序列化器,然后在走分区器。然后通过分批次把数据发送到PecordAccumulator,main线程到此过程就结束了,然后在回去执行send。 Sender线程不断的获取RecordAccumulator的数据发送到topic。 消息发送流程是异步发送的,并且顺序是一定的拦截器-》序列化器-》分区器 异步发送API 需要用到的类: KafkaProducer: 需要创建一个生产者对象,用来发送数据 ProducerConfig:获取所需要的一系列配置参数 ProducerRecord:每条数据都要封装成一个ProducerRecord对象 实例: public class KafkaProducerDemo { public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXXXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 0; i < 10 ; i++) { producer.send(new ProducerRecord<>("my-topic","ImKey-"+i,"ImValue-"+i)); } // 关闭资源 producer.close(); } } 配置参数说明: send():方法是异步的,添加消息到缓冲区等待发送,并立即返回。生产者将单个的消息批量在一起发送来提高效率。 ack:是判断请求是否完整的条件(就会判断是不是成功发送了,也就是上次说的ACK机制),指定all将会阻塞消息,性能低但是最可靠。 retries:如果请求失败,生产者会自动重试,我们指定是1次,但是启动重试就有可能出现重复数据。 batch.size:指定缓存的大小,生产者缓存每个分区未发送的消息。值越大的话将会产生更大的批量,并需要更大的内存(因为每个活跃的分区都有一个缓存区)。 linger.ms:指示生产者发送请求之前等待一段时间,设置等待时间是希望更多地消息填补到未满的批中。默认缓冲可以立即发送,即便缓冲空间还没有满,但是如果想减少请求的数量可以设置linger.ms大于0。需要注意的是在高负载下,相近的时间一般也会组成批,即使等于0。 buffer.memory:控制生产者可用的缓存总量,如果消息发送速度比其传输到服务器的快,将会耗尽这个缓存空间。当缓存空间耗尽,其他发送调用将被阻塞,阻塞时间的阈值通过max.block.ms设定,之后将会抛出一个TimeoutException key.serializer和value.serializer将用户提供的key和value对象ProducerRecord转换成字节,你可以使用附带的ByteArraySerializaer或StringSerializer处理简单的string或byte类型。 运行日志: [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.clients.producer.ProducerConfig[main] - ProducerConfig values: acks = all batch.size = 16384 bootstrap.servers = [XXXXXX:9093] buffer.memory = 33554432 client.id = compression.type = none connections.max.idle.ms = 540000 enable.idempotence = false interceptor.classes = null key.serializer = class org.apache.kafka.common.serialization.StringSerializer linger.ms = 1 max.block.ms = 60000 max.in.flight.requests.per.connection = 5 max.request.size = 1048576 metadata.max.age.ms = 300000 metric.reporters = [] metrics.num.samples = 2 metrics.recording.level = INFO metrics.sample.window.ms = 30000 partitioner.class = class org.apache.kafka.clients.producer.internals.DefaultPartitioner receive.buffer.bytes = 32768 reconnect.backoff.max.ms = 1000 reconnect.backoff.ms = 50 request.timeout.ms = 30000 retries = 1 retry.backoff.ms = 100 sasl.jaas.config = null sasl.kerberos.kinit.cmd = /usr/bin/kinit sasl.kerberos.min.time.before.relogin = 60000 sasl.kerberos.service.name = null sasl.kerberos.ticket.renew.jitter = 0.05 sasl.kerberos.ticket.renew.window.factor = 0.8 sasl.mechanism = GSSAPI security.protocol = PLAINTEXT send.buffer.bytes = 131072 ssl.cipher.suites = null ssl.enabled.protocols = [TLSv1.2, TLSv1.1, TLSv1] ssl.endpoint.identification.algorithm = null ssl.key.password = null ssl.keymanager.algorithm = SunX509 ssl.keystore.location = null ssl.keystore.password = null ssl.keystore.type = JKS ssl.protocol = TLS ssl.provider = null ssl.secure.random.implementation = null ssl.trustmanager.algorithm = PKIX ssl.truststore.location = null ssl.truststore.password = null ssl.truststore.type = JKS transaction.timeout.ms = 60000 transactional.id = null value.serializer = class org.apache.kafka.common.serialization.StringSerializer [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.common.utils.AppInfoParser[main] - Kafka version : 0.11.0.3 [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.common.utils.AppInfoParser[main] - Kafka commitId : 26ddb9e3197be39a [Godway] WARN 2019-11-14 14:46 - org.apache.kafka.clients.NetworkClient[kafka-producer-network-thread | producer-1] - Error while fetching metadata with correlation id 1 : {my-topic=LEADER_NOT_AVAILABLE} [Godway] INFO 2019-11-14 14:46 - org.apache.kafka.clients.producer.KafkaProducer[main] - Closing the Kafka producer with timeoutMillis = 9223372036854775807 ms. Process finished with exit code 0 有一条警告{my-topic=LEADER_NOT_AVAILABLE} 提示该topic不存在,但是没有关系kafka会自动给你创建一个topic,不过创建的topic是有一个分区和一个副本: 查看一下该topic的消息: 消息已经在topic里了 上面的实例是没有回调函数的,send方法是有回调函数的: public class KafkaProducerCallbackDemo { public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 10; i < 20 ; i++) { producer.send(new ProducerRecord<String, String>("my-topic", "ImKey-" + i, "ImValue-" + i), new Callback() { @Override public void onCompletion(RecordMetadata recordMetadata, Exception e) { if (e == null){ System.out.println("消息发送成功!"+recordMetadata.offset()); }else { System.err.println("消息发送失败!"); } } }); } producer.close(); } } 回调函数会在producer收到ack时调用,为异步调用,该方法有两个参数,分别是RecordMetadata和Exception,如果Exception为null,说明消息发送成功,如果Exception不为null说明消息发送失败。 注意:消息发送失败会自动重试,不需要我们在回调函数中手动重试,使用回调也是无阻塞的。而且callback一般在生产者的IO线程中执行,所以是非常快的,否则将延迟其他的线程消息发送。如果需要执行阻塞或者计算的回调(耗时比较长),建议在callbanck主体中使用自己的Executor来并行处理! 同步发送API 同步发送的意思就是,一条消息发送之后,会阻塞当前的线程,直到返回ack(此ack和异步的ack机制不是一个ack)。 此ack是Future阻塞main线程,当发送完成就返回一个ack去通知main线程已经发送完毕,继续往下走了 public Future<RecordMetadata> send(ProducerRecord<K,V> record,Callback callback) send是异步的,并且一旦消息被保存在等待发送的消息缓存中,此方法就立即返回。这样并行发送多条消息而不阻塞去等待每一条消息的响应。 发送的结果是一个RecordMetadata,它指定了消息发送的分区,分配的offset和消息的时间戳。如果topic使用的是CreateTime,则使用用户提供的时间戳或发送的时间(如果用户没有指定指定消息的时间戳)如果topic使用的是LogAppendTime,则追加消息时,时间戳是broker的本地时间。 由于send调用是异步的,它将为分配消息的此消息的RecordMetadata返回一个Future。如果future调用get(),则将阻塞,直到相关请求完成并返回该消息的metadata,或抛出发送异常。 Throws: InterruptException - 如果线程在阻塞中断。 SerializationException - 如果key或value不是给定有效配置的serializers。 TimeoutException - 如果获取元数据或消息分配内存话费的时间超过max.block.ms。 KafkaException - Kafka有关的错误(不属于公共API的异常)。 public class KafkaProducerDemo { public static void main(String[] args) throws ExecutionException, InterruptedException { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 20; i < 30 ; i++) { RecordMetadata metadata = producer.send(new ProducerRecord<>("my-topic", "ImKey-" + i, "ImValue-" + i)).get(); System.out.println(metadata.offset()); } producer.close(); } } API生产者自定义分区策略 生产者在向topic发送消息的时候的分区规则: public ProducerRecord(String topic, Integer partition, Long timestamp, K key, V value, Iterable<Header> headers) public ProducerRecord(String topic, Integer partition, Long timestamp, K key, V value) public ProducerRecord(String topic, Integer partition, K key, V value, Iterable<Header> headers) public ProducerRecord(String topic, Integer partition, K key, V value) public ProducerRecord(String topic, K key, V value) public ProducerRecord(String topic, V value) 根据send方法的参数的构造方法就可以看出来, 指定分区就发送到指定分区 没有指定分区,有key值,就按照key值的Hash值分配分区 没有指定分区,也没有指定key值,轮询分区分配(只分配一次,以后都按照第一次的分区顺序) 自定义分区器 自定义分区器需要实现org.apache.kafka.clients.producer.Partitioner接口。并且实现三个方法 public class KafkaMyPartitions implements Partitioner { @Override public int partition(String s, Object o, byte[] bytes, Object o1, byte[] bytes1, Cluster cluster) { return 0; } @Override public void close() { } @Override public void configure(Map<String, ?> map) { } } 自定义分区实例: KafkaMyPartitions: public class KafkaMyPartitions implements Partitioner { @Override public int partition(String s, Object o, byte[] bytes, Object o1, byte[] bytes1, Cluster cluster) { // 这里写自己的分区策略 // 我这里指定为1 return 1; } @Override public void close() { } @Override public void configure(Map<String, ?> map) { } } KafkaProducerCallbackDemo: public class KafkaProducerCallbackDemo { public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 指定自定义分区 props.put("partitioner.class","com.firehome.newkafka.KafkaMyPartitions"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); for (int i = 20; i < 25 ; i++) { producer.send(new ProducerRecord<String, String>("th-topic", "ImKey-" + i, "ImValue-" + i), new Callback() { @Override public void onCompletion(RecordMetadata recordMetadata, Exception e) { if (e == null){ System.out.printf("消息发送成功!topic=%s,partition=%s,offset=%d \n",recordMetadata.topic(),recordMetadata.partition(),recordMetadata.offset()); }else { System.err.println("消息发送失败!"); } } }); } producer.close(); } } 返回日志: 消息发送成功!topic=th-topic,partition=1,offset=27 消息发送成功!topic=th-topic,partition=1,offset=28 消息发送成功!topic=th-topic,partition=1,offset=29 消息发送成功!topic=th-topic,partition=1,offset=30 消息发送成功!topic=th-topic,partition=1,offset=31 可以看到直接发送到了分区1上了。 多线程发送消息 Producer API是线程安全的,直接就可以使用多线程发送消息,实例: public class KafkaProducerThread implements Runnable { private KafkaProducer<String,String> kafkaProducer; public KafkaProducerThread(){ } public KafkaProducerThread(KafkaProducer kafkaProducer){ this.kafkaProducer = kafkaProducer; } @Override public void run() { for (int i = 0; i < 20 ; i++) { String key = "ImKey-" + i+"-"+Thread.currentThread().getName(); String value = "ImValue-" + i+"-"+Thread.currentThread().getName(); kafkaProducer.send(new ProducerRecord<>("th-topic", key, value)); System.out.printf("Thread-name = %s, key = %s, value = %s",Thread.currentThread().getName(),key,value); } } public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers", "XXXXXXXX:9093");//kafka集群,broker-list props.put("acks", "all"); props.put("retries", 1);//重试次数 props.put("batch.size", 16384);//批次大小 props.put("linger.ms", 1);//等待时间 props.put("buffer.memory", 33554432);//RecordAccumulator缓冲区大小 props.put("key.serializer", "org.apache.kafka.common.serialization.StringSerializer"); props.put("value.serializer", "org.apache.kafka.common.serialization.StringSerializer"); // 创建KafkaProducer客户端 KafkaProducer<String, String> producer = new KafkaProducer<>(props); KafkaProducerThread producerThread1 = new KafkaProducerThread(producer); //KafkaProducerThread producerThread2 = new KafkaProducerThread(producer); Thread one = new Thread(producerThread1, "one"); Thread two = new Thread(producerThread1, "two"); System.out.println("线程开始"); one.start(); two.start(); } } 这里只是一个简单的实例。 Consumer API kafka客户端通过TCP长连接从集群中消费消息,并透明地处理kafka集群中出现故障服务器,透明地调节适应集群中变化的数据分区。也和服务器交互,平衡均衡消费者。 偏移量和消费者的位置 kafka为分区中的每条消息保存一个偏移量(offset),这个偏移量是该分区中一条消息的唯一标示符。也表示消费者在分区的位置。例如,一个位置是5的消费者(说明已经消费了0到4的消息),下一个接收消息的偏移量为5的消息。实际上有两个与消费者相关的“位置”概念: 消费者的位置给出了下一条记录的偏移量。它比消费者在该分区中看到的最大偏移量要大一个。 它在每次消费者在调用poll(long)中接收消息时自动增长。 “已提交”的位置是已安全保存的最后偏移量,如果进程失败或重新启动时,消费者将恢复到这个偏移量。消费者可以选择定期自动提交偏移量,也可以选择通过调用commit API来手动的控制(如:commitSync 和 commitAsync)。 这个区别是消费者来控制一条消息什么时候才被认为是已被消费的,控制权在消费者。 消费者组和主题订阅 Kafka的消费者组概念,通过进程池瓜分消息并处理消息。这些进程可以在同一台机器运行,也可分布到多台机器上,以增加可扩展性和容错性,相同group.id的消费者将视为同一个消费者组。 分组中的每个消费者都通过subscribe API动态的订阅一个topic列表。kafka将已订阅topic的消息发送到每个消费者组中。并通过平衡分区在消费者分组中所有成员之间来达到平均。因此每个分区恰好地分配1个消费者(一个消费者组中)。所有如果一个topic有4个分区,并且一个消费者分组有只有2个消费者。那么每个消费者将消费2个分区。 消费者组的成员是动态维护的:如果一个消费者故障。分配给它的分区将重新分配给同一个分组中其他的消费者。同样的,如果一个新的消费者加入到分组,将从现有消费者中移一个给它。这被称为重新平衡分组。当新分区添加到订阅的topic时,或者当创建与订阅的正则表达式匹配的新topic时,也将重新平衡。将通过定时刷新自动发现新的分区,并将其分配给分组的成员。 从概念上讲,你可以将消费者分组看作是由多个进程组成的单一逻辑订阅者。作为一个多订阅系统,Kafka支持对于给定topic任何数量的消费者组,而不重复。 这是在消息系统中常见的功能的略微概括。所有进程都将是单个消费者分组的一部分(类似传统消息传递系统中的队列的语义),因此消息传递就像队列一样,在组中平衡。与传统的消息系统不同的是,虽然,你可以有多个这样的组。但每个进程都有自己的消费者组(类似于传统消息系统中pub-sub的语义),因此每个进程都会订阅到该主题的所有消息。 此外,当分组重新分配自动发生时,可以通过ConsumerRebalanceListener通知消费者,这允许他们完成必要的应用程序级逻辑,例如状态清除,手动偏移提交等 它也允许消费者通过使用assign(Collection)手动分配指定分区,如果使用手动指定分配分区,那么动态分区分配和协调消费者组将失效。 发现消费者故障 订阅一组topic,当调用poll(long)时,消费者将自动加入到消费者组中。只要持续调用poll,消费者将一直保持可用,并继续从分配的分区中接收数据。此外,消费者向服务器定时发送心跳。如果消费者崩溃或无法再session.timeout.ms配置的时间内发送心跳,则消费者就被视为死亡,并且其分区将被重新分配。 还有一种可能,消费者可能遇到活锁的情况,它持续的发送心跳,但是没有处理。为了预防消费者在这总情况下一直拥有分区,我们使用max.poll.interval.ms活跃监测机制。在此基础上,如果你调用的poll的频率大于最大间隔,则客户端将主动地离开组,以便其他消费者接管该分区。发生这种情况时,你会看到offset提交失败( 调用commitSync()引发的CommitFailedException )。这是一种安全机制,保障只有活动成员能够提交offset。所以要留在组中,你必须持续调用poll。 消费者提供两种配置设置来控制poll循环: max.poll.interval.ms: 增大poll的间隔,可以为消费者提供更多的时间去处理返回的消息(调用poll(long)返回的消息,通常返回的消息都是一批),缺点是此值越大将会延迟组重新平衡。 max.poll.records:此设置限制每次调用poll返回的消息数,这样可以更容易的预测每次poll间隔要处理的最大值。通过调整此值,可以减少poll间隔,减少重新平衡分组的 对于消息处理时间不可预测地情况,这些选项是不够的。 处理这种情况的推荐方法是将消息处理移到另一个线程中,让消费者继续调用poll。 但是必须注意确保已提交的offset不超过实际位置。另外,你必须禁用自动提交,并只有在线程完成处理后才为记录手动提交偏移量。 还要注意, 你需要pause暂停分区,不会从poll接收到新消息,让线程处理完之前返回的消息(如果你的处理能力比拉取消息的慢,那创建新线程将导致机器内存溢出)。 实例: 自动提交偏移量 public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers","xxxxxxxxxx:9093"); props.put("group.id","test-6");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","true");//自动提交offset props.put("auto.commit.interval.ms","1000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props); // 可以写多个topic consumer.subscribe(Arrays.asList("my-topic")); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (ConsumerRecord<String, String> record : records) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } System.out.println("处理了一批数据!"); } } 配置说明: bootstrap.servers: 集群是通过配置bootstrap.servers指定一个或多个broker。不用指定全部的broker,它将自动发现集群中的其余的borker(最好指定多个,万一有服务器故障) enable.auto.commit: 自动提交偏移量,如果设置了自动提交偏移量,下面这个设置就必须要用到了。 auto.commit.interval.ms:自动提交时间间隔,和自动提交偏移量配合使用 max.poll.records:控制从 broker拉取的消息条数 poll(long time): 当消费者获取不到消息时,就会使用这个参数,为了减轻无效的循环请求消息,消费者会每隔long time的时间请求一次消息,单位是毫秒。 session.timeout.ms: broker通过心跳机器自动检测消费者组中失败的进程,消费者会自动ping集群,告诉进群它还活着。只要消费者能够做到这一点,它就被认为是活着的,并保留分配给它分区的权利,如果它停止心跳的时间超过session.timeout.ms,那么就会认为是故障的,它的分区将被分配到别的进程。 auto.offset.reset:这个属性很重要,一会详细讲解 这里说明一下auto.commit.interval.ms以及何时提交消费者偏移量,经过测试: 设置props.put("auto.commit.interval.ms","60000"); 自动提交时间为一分钟,也就是你在这一分钟内拉取任何数量的消息都不会被提交消费的当前偏移量,如果你此时关闭消费者(一分钟内),下次消费还是从和第一次的消费数据一样,即使你在一分钟内消费完所有的消息,只要你在一分钟内关闭程序,导致提交不了offset,就可以一直重复消费数据。 设置props.put("auto.commit.interval.ms","3000"); 但是在消费过程中设置sleep。 public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers","xxxxxxxxxxxx:9093"); props.put("group.id","test-6");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","true");//自动提交offset props.put("auto.commit.interval.ms","100000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); // KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props); // 可以写多个topic consumer.subscribe(Arrays.asList("my-topic")); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (ConsumerRecord<String, String> record : records) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } try { Thread.sleep(5000L); System.out.println("等待了5秒了!!!!!!!!!!!!开始等待15秒了"); Thread.sleep(5000L); } catch (InterruptedException e) { e.printStackTrace(); } System.out.println("处理了一批数据!"); } } 这里如果你消费了第一批数据,在执行第二次poll的时候,关闭程序也不会提交偏移量,只有在执行第二次poll的时候才会把上一次的最后一个offset提交上去。 auto.offset.reset讲解: auto.offset.reset的值有三种:earliest,latest,none,代表者不同的意思 earliest: 当各分区下有已经提交的offset时,从提交的offset开始消费;无提交的offset时,从头开始消费,最常用的值 latest: 当各分区下有已提交的offset时,从提交的offset开始消费;无提交的offset时,消费新产生的该分区下的数据 none: topic各分区都存在已提交的offset时,从offset后开始消费,只要有一个分区不存在已提交的offset,则抛出异常 !!注意:当使用了latest,并且分区没有已提交的offset时,消费新产生的该分区下的数据,其实是把offset的值直接设置到最后一个消息的位置。例如,有个30条数据的demo的topic,各分区无提交offset,使用了latest,再看offset就会发现已经在30的位置了,所以才只能消费新产生的数据!!!! 手动提交偏移量 不需要定时提交偏移量,可以自己控制offset,当消息已经被我们消费过后,再去手动提交他们的偏移量。这个很适合我们的一些处理逻辑。 手动提交offset的方法有两种:分别是commitSync(同步提交) 和commitAsync(异步提交)。两者的相同点,都会将本次poll的一批数据最高的偏移量提交;不同点是commitSync会失败重试,一直到提交成功(如果有不可恢复的原因导致,也会提交失败),才去拉取新数据。而commitAsync则没有重试机制(提交了就去拉取新数据,不管这次的提交有没有成功),故有可能提交失败。 实例: public static void main(String[] args) { Properties props = new Properties(); props.put("bootstrap.servers","XXXXXC:9093"); props.put("group.id","test-11");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","false");//自动提交offset props.put("auto.commit.interval.ms","1000"); // 自动提交时间间隔 props.put("max.poll.records","20"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String,String> consumer = new KafkaConsumer<>(props); consumer.subscribe(Arrays.asList("my-topic")); int i= 0; while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (ConsumerRecord<String, String> record : records) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); i++; } if (i == 20){ System.out.println("i_num:"+i); // 同步提交 consumer.commitSync(); // 异步提交 // consumer.commitAsync(); }else { System.out.println("不足二十个,不提交"+i); } i=0; } } 这些都是全部提交偏移量,如果我们想更细致的控制偏移量提交,可以自定义提交偏移量: public static void main(String[] args) throws InterruptedException { Properties props = new Properties(); props.put("bootstrap.servers","XXXXXXXXXX:9093"); props.put("group.id","test-18");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","false");//自动提交offset props.put("auto.commit.interval.ms","1000000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String,String> consumer = new KafkaConsumer<>(props); consumer.subscribe(Arrays.asList("my-topic")); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (TopicPartition partition : records.partitions()) { List<ConsumerRecord<String, String>> partitionRecords = records.records(partition); for (ConsumerRecord<String, String> record : partitionRecords) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } long lastOffset = partitionRecords.get(partitionRecords.size() - 1).offset(); consumer.commitAsync(Collections.singletonMap(partition, new OffsetAndMetadata(lastOffset + 1)), new OffsetCommitCallback() { @Override public void onComplete(Map<TopicPartition, OffsetAndMetadata> map, Exception e) { for (Map.Entry<TopicPartition,OffsetAndMetadata> entry : map.entrySet()){ System.out.println("提交的分区:"+entry.getKey().partition()+",提交的偏移量:"+entry.getValue().offset()); } } }); } } } 订阅指定的分区 通过消费者Kafka会通过分区分配分给消费者一个分区,但是我们也可以指定分区消费消息,要使用指定分区,只需要调用assign(Collection)消费指定的分区即可: public static void main(String[] args) throws InterruptedException { Properties props = new Properties(); props.put("bootstrap.servers","XXXXXXXXX:9093"); props.put("group.id","test-19");//消费者组,只要group.id相同,就属于同一个消费者组 props.put("enable.auto.commit","false");//自动提交offset props.put("auto.commit.interval.ms","1000000"); // 自动提交时间间隔 props.put("max.poll.records","5"); // 拉取的数据条数 props.put("session.timeout.ms","10000"); // 维持session的时间。超过这个时间没有心跳 就会剔出消费者组 props.put("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer"); props.put("auto.offset.reset", "earliest"); KafkaConsumer<String,String> consumer = new KafkaConsumer<>(props); // 你可以指定多个不同topic的分区或者相同topic的分区 我这里只指定一个分区 TopicPartition topicPartition = new TopicPartition("my-topic", 0); // 调用指定分区用assign,消费topic使用subscribe consumer.assign(Arrays.asList(topicPartition)); while (true){ ConsumerRecords<String, String> records = consumer.poll(5000); for (TopicPartition partition : records.partitions()) { List<ConsumerRecord<String, String>> partitionRecords = records.records(partition); for (ConsumerRecord<String, String> record : partitionRecords) { System.out.printf("offset = %d, key = %s, value = %s%n", record.offset(), record.key(), record.value()); } long lastOffset = partitionRecords.get(partitionRecords.size() - 1).offset(); consumer.commitAsync(Collections.singletonMap(partition, new OffsetAndMetadata(lastOffset + 1)), new OffsetCommitCallback() { @Override public void onComplete(Map<TopicPartition, OffsetAndMetadata> map, Exception e) { for (Map.Entry<TopicPartition,OffsetAndMetadata> entry : map.entrySet()){ System.out.println("提交的分区:"+entry.getKey().partition()+",提交的偏移量:"+entry.getValue().offset()); } } }); } } } 一旦手动分配分区,你可以在循环中调用poll。消费者分区任然需要提交offset,只是现在分区的设置只能通过调用assign 修改,因为手动分配不会进行分组协调,因此消费者故障或者消费者的数量变动都不会引起分区重新平衡。每一个消费者是独立工作的(即使和其他的消费者共享GroupId)。为了避免offset提交冲突,通常你需要确认每一个consumer实例的groupId都是唯一的。 注意: 手动分配分区(assgin)和动态分区分配的订阅topic模式(subcribe)不能混合使用。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

每日一博 | Jetpack Compose 中的新特性

Jetpack Compose 1.0 正式版已经发布快一年的时间了,我们看到社区正以极大的热情采纳和使用 Compose: Kotlin 语法的简洁性以及使开发界面变得更快速、更简单的声明式开发方式得到了广大开发者们的赞赏。 Compose 在社区中的反响 我们看到 许多公司已经在大规模采纳 Compose 为其应用开发最新、最具创造性的功能。例如,与我们密切合作的 Play 商店团队很早便开始使用 Compose,通过他们我们了解到,使用 Compose 不仅更有趣,且对他们团队生产力的提高也大有助益。Play 商店团队还告诉我们 "Play 商店的所有新功能都建立在该框架之上,Compose 有助于为应用解锁更快的速度以及更顺畅地发布"。与此同时,Twitter 也已经在应用的不同部分使用了 Jetpack Compose 并从中受益,因为 "Compose 让我们更容易定义自己的组件,并使它们的 API 更明确、灵活和直观。"Airbnb 团队同样也采用了 Compose: "Jetpack Compose 是我们技术战略的重要组成部分,生产力因此获得了大幅提高。" 我们很高兴地看到这些团队在大规模和复杂的生产环境中仔细地评估并使用了 Compose,所带来的结果也不仅是让界面开发更清晰有趣,也带来了更多工程上的收益。这只是其中几个案例,因为 Play 商店排名前 1,000 的应用中有超过 100 个正在使用 Compose。 我们在开发过程中始终保持着与这些团队的密切合作,并不断听取广大 Android 社区的反馈,这也是我们推进 路线图 的关键。如今,我们专注于提供新的 API 和特性改进以支持您实现更高级的需求,这些改进将和新的工具一起助力您更轻松地使用 Compose 构建应用。Compose 从根本上改变了界面的构建方式,为了帮助您实现必要的思维转变,我们将发布更多关于高级主题的指南、演讲和 Codelab,以及更具深度的视频,以便您编写外观和性能同样出色的应用。以下是 Compose 1.2 Beta 版本的新特性: Compose 1.2 Beta 我们在今年的 Google I/O 大会上发布了 Compose 1.2 的第一个 Beta 版本,其中包含了许多特性和改进: 文本改进 字体边距 我们在问题跟踪器中定位到了 得票最高的问题之一,并通过将 includeFontPadding 设置为自定义参数来解决它。我们推荐您将该值设为 false,因为这会使布局中的文本更精确地对齐。我们计划在未来的版本中将 false 设为默认值。如果将值设为 false 导致您的应用出现问题,请在上述错误报告中告知我们。此外,当 includeFontPadding 被设置为 false 时,您可通过设置 lineHeightStyle 参数来调整 Text 可组合项的行高。两个参数结合使用的效果如下: △ 以多行的 Text 可组合项为例:左图为设置 includeFontPadding 为 true (当前默认值) 的效果,右图为设置 includeFontPadding 为 false 且设置了 lineHeightStyle 的效果 Text( text = myText, style = TextStyle( lineHeight = 2.5.em, platformStyle = PlatformTextStyle( includeFontPadding = false ), lineHeightStyle = LineHeightStyle( alignment = Alignment.Center, trim = Trim.None ) ) ) 可下载字体 Compose 1.2 还加入了 可下载字体。您可以使用 Compose 的新 API 来异步访问 Google Fonts,甚至还可以定义备用字体,这些操作无需任何复杂的配置。通过可下载字体,您可以保持较小的 APK 文件体积并改善用户的系统运行状况,因为多个应用可通过提供程序共享相同字体。 文本放大镜 Android 文本提供了放大镜组件,通过放大镜可以更轻松地选择文本。Compose 现已支持文本放大镜。 拖动选择图标时会显示放大镜,以便于您查看指尖下方的内容。Compose 1.1.0 已支持在所选择的文本字段中使用放大镜,Compose 1.2.0 在文本字段和 SelectionContainer 中都支持放大镜。Compose 放大镜也得到了增强以匹配 View 中放大镜的精确行为。 布局功能和改进 惰性布局 惰性布局在不断发展,随着网格 API LazyVerticalGrid 和 LazyHorizontalGrid 顺利通过实验性使用阶段,我们新增了一个实验性 API——LazyLayout,它允许开发者实现自定义惰性布局。想要了解这些 API 的更多信息,请观看I/O 大会演讲: Compose 中的惰性布局。 与 CoordinatorLayout 互操作 从现在起,当您在 View 系统的 CoordinatorLayout 中嵌套了一个支持滚动的可组合项时,您可以确保它们的滚动行为是可互操作的。这让可折叠工具栏的配置变得更加简单。您可以调用新的实验性 API rememberNestedScrollInteropConnection,并将其调用结果传入 nestedScroll 修饰符来启用该行为,可以查看这个 示例代码了解更多: 窗口边衬区 Accompanist 中的 insets 库 现已升级到 Compose Foundation 库中,请改为使用 WindowInsets 类。如需了解更多,请查阅 将 Compose 与现有界面集成 技术文档。 窗口大小类 为了更简单地设计、开发以及测试可调整尺寸布局,我们发布了窗口大小类——一组主观的视窗断点。它们现在作为 Material 3 系列库的一部分,在新库 material3-window-size-class 的 alpha 版本中可用。如需了解更多有关窗口大小类的信息,请查阅支持不同屏幕尺寸以及 Crane 中的示例实现。 专注于性能 为帮助您了解和提升应用的性能,我们花费了大量精力为您提供新的性能工具和指南。这些内容可以帮助您更轻松地理解应用可能出现卡顿的原因和位置。 从 Android Studio Dolphin 开始,您可以使用 Layout Inspector 检查可组合项发生重组的频率。预期外的大量重组可以为您指明可优化的可组合项。此外,Android Studio Electric Eel 现已包含一个重组高亮指示器,它是一个视觉辅助工具,可以查看哪些可组合项在何时发生重组。更多关于该新工具的信息请查阅博客 Android Studio 中的新特性。 △ Layout Inspector 显示重组计数和重组高亮指示器 Compose 从根本上改变了您编写界面的方式,您可以遵循我们发布的最佳实践来确保应用的高性能。例如,您可以通过该 文档 了解关于如何编写和配置您的 Compose 应用以实现最佳性能的建议。在 I/O 演讲 Jetpack Compose 中常见的性能问题 中,Compose 团队介绍了常见的性能错误以及这些错误的解决方法。 性能是一个需要持续关注的领域,我们正在努力改进并扩展相关工具和指南。同时,我们非常感谢您对我们迄今为止所有工作的反馈。您可以在 问题跟踪器 中提出您开发中遇到的问题,也可以在 KotlinLang Slack 群组中提问。 新工具 除了完善 Compose 之外,我们还增加了新工具来帮助您更高效地使用 Compose。Android Studio Dolphin 目前已处于 Beta 阶段,为 Compose 开发带来了非常激动人心的特性。除了重组计数,新工具还包含了能帮助您一次查看和浏览所有动画的 Animation Coordination,以及能帮助您为多个屏幕尺寸构建应用的 MultiPreview 注解。此外为了帮助您快速迭代,Android Studio Electric Eel (Canary 版) 还带来了 LiveEdit 这个新特性。 请查阅 I/O 演讲: Android 开发工具中的新特性 以了解所有详细信息,同时我们希望能得到您的反馈,从而塑造更符合您需求的 Compose 工具。 Compose for Wear OS Beta 版发布 如果有什么比 Compose 更出色,那就是更多更全面的 Compose。因此,我们很高兴见证 Compose for Wear OS 进入 Beta 阶段。遵循与其他 Jetpack 库相同的原则,Beta 意味着它的功能完整且 API 稳定,您可以开始准备为生产环境构建应用。如需了解更多信息,请查阅 这篇博客文章。 更完善的指南 我们增加并修订了关于 Compose 的一系列指南供您参考和学习: 关于在 Compose 中使用状态的 研讨会 和改版的 Codelab 关于 Compose 中基础布局的 研讨会 和改版的 Codelab 全新的 Compose 性能说明文档 更新的 自定义输入文档 I/O 演讲视频: Jetpack Compose 中常见的性能问题 以及 Compose 中的惰性布局 对于新手开发者,可查阅 Android 基础课程: 使用 Compose Happy Composing! 我们期待您能像我们一样为这些新特性感到兴奋,如果您尚未开始,那么现在正是学习 Jetpack Compose 的好时机,了解它如何适配您的团队和开发过程,这样您便能体验到提高效率和开发者生产力所带来的好处。Happy Composing! 欢迎您 点击这里 向我们提交反馈,或分享您喜欢的内容、发现的问题。您的反馈对我们非常重要,感谢您的支持!

优秀的个人博客,低调大师

每日一博 | StarRocks 技术内幕:查询原理浅析

一条查询 SQL 在关系型分布式数据库中的处理,通常需要经过 3 大步骤: 1. 将 SQL 文本转换成一个 “最佳的”分布式物理执行计划 2. 将执行计划调度到计算节点 3. 计算节点执行具体的物理执行计划 本文将详细解释在 StarRocks 中如何完成一条查询 SQL 的处理。 首先来了解 StarRocks 中的基本概念: FE: 负责查询解析,查询优化,查询调度和元数据管理 BE: 负责查询执行和数据存储 #01 从 SQL 文本到执行计划 — 从 SQL 文本到分布式物理执行计划, 在 StarRocks 中,需要经过以下 5 个步骤: 1. SQL Parse:将 SQL 文本转换成一个 AST(抽象语法树) 2. SQL Analyze:基于 AST 进行语法和语义分析 3. SQL Logical Plan:将 AST 转换成逻辑计划 4. SQL Optimize:基于关系代数、统计信息、Cost 模型,对逻辑计划进行重写、转换,选择出 Cost “最低” 的物理执行计划 5. 生成 Plan Fragment:将 Optimizer 选择的物理执行计划转换为 BE 可以直接执行的 Plan Fragment SQL Parse 图 1 Query Parse 的输入是 SQL 的 String 字符串,Query Parse 的输出是 Abstract Syntax Tree,每个节点都是一个 ParseNode 。 一个查询 SQL Parse 后生成一个 QueryStmt, 由 SelectList, FromClause, wherePredicate, GroupByClause, havingPredicate, OrderByElement, LimitElement 等组成,基本和 SQL 文本一一对应。 StarRocks 目前使用的 Parser 是 ANTLR4,语法规则定义的文件可在 GitHub 搜索StarRocks g4 获取。 SQL Analyze StarRocks 获取到 AST 后,接着会进行语法分析和语义分析,完成下面的工作: 1. 检查并绑定 Database, Table, Column 等元信息 2. SQL 的合法性检查:Where 中不能有 Grouping 操作, HLL 和 Bitmap 列不能 Sum 等 3. Table 和 Column 的别名处理 4. 函数参数的合法性检测: Sum的参数类型必须是数值类型,Lead 和 Lag 窗口函数第 2 和第 3 个参数必须常量等 5. 类型检查和类型转换:BIGINT 和 DECIMAL 比较,BIGINT 类型需要 Cast 成 DECIMAL SQL Analyze 的结果是一个有层级结构的 Relation,如图 2 所示,比如一个 From 子句对应一个 TableRelation, 一个子查询对应一个 SubqueryRelation。 SQL Logical Plan 图 2 接下来,StarRocks 会将 Relations 转化成一颗 Logical Plan Tree, 如图 2 所示,可以简单理解为每个集合操作都会对应一个 Logical Node。 SQLOptimize 图 3 StarRocks Optimizer 的输入是一棵逻辑计划树,输出是一棵 Cost “最低” 的分布式物理计划树。 一般 SQL 越复杂,Join 的表越多,数据量越大,Optimizer 的意义就越大,因为不同执行方式的性能差别可能有成百上千倍。StarRocks 优化器完全自研,主要基于 Cascades 和 ORCA 论文实现,并结合 StarRocks 执行器和调度器进行了深度定制,优化和创新。 它完整支持了 TPC-DS 99 条 SQL,实现了公共表达式复用,相关子查询重写,Lateral Join, CTE 复用,Join Rorder,Join 分布式执行策略选择,Global Runtime Filter 下推,低基数字典优化等重要功能和优化。 Logical Plan Rewrite 图 4 在正式进入 CBO 之前,StarRocks 会首先进行一系列 Logical Plan 的 Rewrite,Rewrite 阶段的 Rule 我们认为都会生成更优的 Logical Plan,主要的 Rewrite Rule 有下面这些: 各种表达式的重写和化简 列裁剪 谓词下推 Limit Merge, Limit 下推 聚合 Merge 等价谓词推导(常量传播) Outer Join 转 Inner Join 常量折叠 公共表达式复用 子查询重写 Lateral Join 化简 分区分桶裁剪 Empty Node 优化 Empty Union, Intersect, Except 裁剪 Intersect Reorder Count Distinct 相关聚合函数重写 CBO Transform 我们在 Logical Plan Rewrite 完成后,正式基于 Columbia 论文进行 CBO 优化,主要包括下面的优化: 多阶段聚合优化:普通聚合(count, sum, max, min 等)会拆分成两阶段,单个 Count Distinct 查询会拆分成三阶段或是四阶段。 Join 左右表调整:StarRocks 始终用右表构建 Hash 表,所以右表应该是小表,StarRocks 可以基于 cost 自动调整左右表顺序,也会自动把 Left Join 转 Right Join。 Join 多表 Reorder:多表 Join 如何选择出正确的 Join 顺序,是 CBO 优化器的核心。当 Join 表的数量小于等于 5 时,StarRocks 会基于 Join 交换律和结合律进行 Join Reorder,大于 5 时,StarRocks 会基于贪心算法和动态规划进行 Join Reorder。 Join 分布式执行选择:StarRocks 支持的分布式 Join 方式有 Broadcast、Shuffle、单边 Shuffle、Colocate、Replicated。StarRocks 会基于 Cost 估算和 Property Enforce 机制选择出 “最佳” 的 Join 分布式执行方式。 Push Down Aggregate to Join 物化视图选择与重写 图 5 如图 5 所示, 在 CBO 优化中,Logical Plan 会先转成 Memo 的数据结构。Memo 的中文含义是备忘录,所有的逻辑计划和物理计划都会记录在 Memo 中, Memo 就构成了整个搜索空间 。 然后如图 6 所示,StarRocks 应用各种 Rule 扩展搜索空间,并生成对应的物理执行计划,再基于统计信息和 Cost 估计从 Memo 中选择一组 Cost 最低的物理执行计划。 图 6 统计信息 和 Cost 估计 CBO 优化器好坏的关键之一是 Cost 估计是否准确,而 Cost 估计是否准确的关键点之一是统计信息是否收集及时准确。 StarRocks 目前支持表级别和列级别的统计信息,支持自动收集和手动收集两种方式。无论自动还是手动,都支持全量和抽样收集两种方式。 有了统计信息之后, StarRocks 就会基于统计信息进行 Cost 估算。StarRocks 估算 Cost 时会考虑 CPU、内存、网络、IO 等资源因子,每个资源因子会有不同的权重,每个执行算子的 Cost 计算公式都不太一样。 当你使用 StarRocks 发现 Join 左右表不合理、Join 分布式执行策略不合理时,可以参考 StarRocks CBO 使用文档收集统计信息。 生成 Plan fragment 图 7 StarRocks Optimizer 的输出是一棵分布式物理执行计划树,但并不能直接被 BE 节点执行,所以需要转换成 BE 可以直接执行的 PlanFragment。转换过程基本是个一一映射的过程。 #02 执行计划的调度 — 在生成查询的分布式 Plan 之后,FE 调度模块会负责 PlanFragment 的执行实例生成、PlanFragment 的调度、每个 BE 执行状态的管理、查询结果的接收。 图 8 有了分布式执行计划之后,我们需要解决下面的问题: 1. 哪个 BE 执行哪个 PlanFragment 2. 每个 Tablet 选择哪个副本去查询 3. 多个 PlanFragment 如何调度 StarRocks 会首先确认 Scan Operator 所在的 Fragment 在哪些 BE 节点执行,每个 Scan Operator 有需要访问的 Tablet 列表。然后对于每个 Tablet,StarRocks 会先选择版本匹配的、健康的、所在的 BE 状态正常的副本进行查询。在最终决定每个 Tablet 选择哪个副本查询时,采用的是随机方式,不过 StarRocks 会尽可能保证每个 BE 的请求均衡。假如我们有 10 个 BE、10 个 Tablet,最终调度的结果理论上就是每个 BE 负责 1 个 Tablet 的 Scan。 当确定包含 Scan 的 PlanFragment 由哪些 BE 节点执行后,其他的 PlanFragment 实例也会在 Scan 的 BE 节点上执行 (也可以通过参数选择其他 BE 节点 ),不过具体选择哪个 BE 是随机选取的。 当 FE 确定每个 PlanFragment 由哪个 BE 执行,每个 Tablet 查询哪个副本后,FE 就会将 PlanFragment 执行相关的参数通过 Thrift 的方式发送给 BE。 目前 FE 对多个 PlanFragment 调度的方式是 All At Once 的方式,是按照自顶向下的方式遍历 PlanFragment 树,将每个 PlanFragment 的执行信息发送给对应的 BE。 #03 执行计划的执行 — StarRocks 是通过 MPP 多机并行机制来充分利用多机的资源,通过 Pipeline 并行机制来充分利用单机上多核的资源,通过向量化执行来充分利用单核的资源,进而达到极致的查询性能。 MPP 多机并行执行 MPP 是大规模并行计算的简称,核心做法是将查询 Plan 拆分成很多可在单个节点上执行的计算实例,然后多个节点并行执行。每个节点不共享 CPU、内存、磁盘资源。MPP 数据库的查询性能可以随着集群的水平扩展而不断提升。 图 9 如图 9 所示,StarRocks 会将一个查询在逻辑上切分为多个 Query Fragment(查询片段),每个 Query Fragment 可以有一个或者多个 Fragment 执行实例,每个 Fragment 执行实例会被调度到集群某个 BE 上执行。一个 Fragment 可以包括一个或者多个 Operator(执行算子),图中的 Fragment 包括了Scan、Filter、Aggregate。每个 Fragment 可以有不同的并行度。 图 10 如图 10 所示,多个 Fragment 之间会以 Pipeline 的方式在内存中并行执行,而不是像批处理引擎那样 Stage By Stage 执行。Shuffle (数据重分布)操作是 MPP 数据库查询性能可以随着集群的水平扩展而不断提升的关键,也是实现高基数聚合和大表 Join 的关键。 Pipeline 单机并行执行 StarRocks 在 Fragment 和 Operator 之间引入了 Pipeline 的概念,一个 Pipeline 内的数据没有到达终点前不需要 Materialize,遇到需要 Materialize 的算子(Agg, Sort, Join),则需要拆分出一个新的 Pipeline,所以 1 个 Fragment 会对应多个 Pipeline。 图 11 如图 11 所示,一个 Pipeline 由多个 Operator 组成。第一个 Operator 是 Source Operator,负责产生数据,一般是 Scan 节点 和 Exchange 节点。最后一个 Operator 是 Sink Operator,负责物化或者消费数据。中间的 Operator 负责对数据进行 Transform。 图 12 那么 Pipeline 如何并行呢?答案是 Pipeline 和 Fragment 一样,可以生成多个实例,每个实例称为一个 Pipeline Driver。当一个 Pipeline 需要 N 个并行度去执行时,一个 Pipeline 就会生成 N 个 Pipeline Driver,如图 12 所示,并行度是 3,一个 Pipeline 就产生了 3个 Pipeline Driver。 图 13 如图 13 所示,一个 Pipeline 执行中,当前一个 Operator 可以产生数据,且后一个 Operator 可以消费数据时,Pipeline 的执行线程就会从前一个 Operator Pull 出数据,然后 Push 到后一个 Operator。每个 Pipeline 的执行状态是很清晰的,简单可以理解为有 Ready、Running、Blocked 等 3 种状态。当前面的 Operator 无法产生数据,或者后面的 Operator 不需要消费数据时,Pipeline 就会处于 Blocked 的状态。 图 14 如图 14 所示, Pipeline 并行执行框架的核心是实现一个用户态的协程调度,不再依赖操作系统的内核态线程调度,减少线程创建、线程销毁、线程上下文切换的成本。 在 Pipeline 并行执行框架中,StarRocks 会启动机器 CPU 核数个执行线程,每个执行线程会从一个多级反馈就绪队列中获取 Ready 状态的 Pipeline 去执行,同时会有一个全局 Poller 线程不断检查 Blocked 队列中的 Pipeline 是否解除了阻塞,可以变为 Ready 状态。如果可以变为了 Ready 状态,就可以把 Pipeline 从 阻塞队列移到多级反馈就绪队列中。 向量化执行 图 15、16 随着数据库执行的瓶颈逐渐从 IO 转移到 CPU,为了充分发挥 CPU 的执行性能,StarRocks 基于向量化技术重新实现了整个执行引擎,向量化执行引擎是为了充分利用单核 CPU 的能力。 向量化在实现上主要是算子和表达式的向量化,图 15 是算子向量化的示例,图 16 是表达式向量化的示例,算子和表达式向量化执行的核心是批量按列执行。相比于单行执行,批量执行可以有更少的虚函数调用,更少的分支判断;相比于按行执行,按列执行对 CPU Cache 更友好,更易于 SIMD 优化。 向量化执行不仅仅是数据库所有算子的向量化和表达式的向量化,而是一项巨大和复杂的性能优化工程,包括数据在磁盘、内存、网络中的按列组织,数据结构和算法的重新设计,内存管理的重新设计,SIMD 指令优化,CPU Cache 优化,C++ Level 优化等。经过努力,StarRocks 向量化执行引擎相比之前的按行执行,取得了整体 5 到 10 倍的性能提升。 每个算子和表达式具体如何实现、如何进行向量化,之后的文章会详细解释,本文不再赘述。 #04 总结 — 本文主要介绍了 StarRocks 如何完成一条查询 SQL 的处理: 1. 通过高效强大的 CBO 优化器生成最佳的分布式物理执行计划; 2. 通过查询调度器选择合适的数据副本,并将分布式物理执行计划调度到合适的计算节点进行计算; 3. 通过 MPP 分布式执行框架充分利用多机的资源,做到查询性能可以随着机器数量近似线性扩展; 4. 通过 Pipeline 并行执行框架充分利用多核资源,做到查询性能可以随着机器核数近似线性扩展; 5. 通过向量化执行引擎充分利用 CPU 单核资源,将单核执行性能做到极致。 作者 康凯森 | StarRocks 核心研发、StarRocks 查询团队负责人

优秀的个人博客,低调大师

每日一博 | 详细解读推荐算法架构——召回

导语|召回模块面对几百上千万的推荐池物料规模,候选集十分庞大。由于后续有排序模块作为保障,故不需要十分准确,但必须保证不要遗漏和低延迟。目前主要通过多路召回来实现,一方面各路可以并行计算,另一方面取长补短。召回通路主要有非个性化和个性化两大类。 一、推荐算法总体架构 (一)推荐算法意义 随着互联网近十年来的大力发展,用户规模和内容规模均呈现迅猛发展。用户侧日活过亿早已不是什么新鲜事,内容侧由于UGC生产方式的普及,拥有几十亿内容库的平台也屡见不鲜。如何让海量用户在海量内容中找到自己喜欢的,以及如何让海量内容被海量用户精准消费,一直以来都是每个公司十分核心的问题。在这个背景下,搜索系统和推荐系统应运而生。搜索系统主要解决用户寻找感兴趣的内容,偏主动型消费。推荐系统则主要解决内容推送给合适用户,偏被动型消费。二者一边牵引用户,一边牵引内容,是实现用户与内容匹配的中间媒介。推荐系统在每个公司都是十分核心的地位,其意义主要有: 用户侧,为用户及时精准的推送感兴趣的个性化内容,并不断发现和培养用户的潜在兴趣,满足用户消费需求,提升用户体验,从而提升用户活跃度和留存。 内容侧,作为流量分发平台,对生产者(如UGC作者、电商卖家等)有正向反馈刺激能力,通过扶持有潜力的中小生产者,可以促进整体内容生态的繁荣发展。 平台侧,推荐系统对内容分发的流量和效率都至关重要。通过提升用户体验,可提升用户留存,从而提升日活。通过提升用户转化和流量效率,可提升电商平台订单量和内容平台用户人均时长等核心指标。通过提升用户消费深度,可提升平台整体流量,为商业化目标(如广告)打下基础,提升ARPU(每用户平均收入)等核心指标。推荐系统与公司很多核心指标息息相关,有极大的牵引和推动作用,意义十分重要。 (二)推荐算法基本模块 当前基于算力和存储的考虑,还没办法实现整体端到端的推荐。一般来说推荐系统分为以下几个主要模块: 推荐池:一般会基于一些规则,从整体物料库(可能会有几十亿甚至百亿规模)中选择一些item进入推荐池,再通过汰换规则定期进行更新。比如电商平台可以基于近30天成交量、商品在所属类目价格档位等构建推荐池,短视频平台可以基于发布时间、近7天播放量等构建推荐池。推荐池一般定期离线构建好就可以了。 召回:从推荐池中选取几千上万的item,送给后续的排序模块。由于召回面对的候选集十分大,且一般需要在线输出,故召回模块必须轻量快速低延迟。由于后续还有排序模块作为保障,召回不需要十分准确,但不可遗漏(特别是搜索系统中的召回模块)。目前基本上采用多路召回解决范式,分为非个性化召回和个性化召回。个性化召回又有content-based、behavior-based、feature-based等多种方式。 粗排:获取召回模块结果,从中选择上千item送给精排模块。粗排可以理解为精排前的一轮过滤机制,减轻精排模块的压力。粗排介于召回和精排之间,要同时兼顾精准性和低延迟。一般模型也不能过于复杂。 精排:获取粗排模块的结果,对候选集进行打分和排序。精排需要在最大时延允许的情况下,保证打分的精准性,是整个系统中至关重要的一个模块,也是最复杂,研究最多的一个模块。精排系统构建一般需要涉及样本、特征、模型三部分。 重排:获取精排的排序结果,基于运营策略、多样性、context上下文等,重新进行一个微调。比如三八节对美妆类目商品提权,类目打散、同图打散、同卖家打散等保证用户体验措施。重排中规则比较多,但目前也有不少基于模型来提升重排效果的方案。 混排:多个业务线都想在Feeds流中获取曝光,则需要对它们的结果进行混排。比如推荐流中插入广告、视频流中插入图文和banner等。可以基于规则策略(如广告定坑)和强化学习来实现。 推荐系统包含模块很多,论文也是层出不穷,相对来说还是十分复杂的。我们掌握推荐系统算法最重要的还是要梳理清楚整个算法架构和大图,知道每个模块是怎么做的,有哪些局限性和待解决问题,可以通过什么手段优化等。并通过算法架构大图将各个模块联系起来,融会贯通。从而不至于深陷某个细节,不能自拔。看论文的时候也应该先了解它是为了解决什么问题,之前已经有哪些解决方案,再去了解它怎么解决的,以及相比其他方案有什么改进和优化点。本文主要讲解推荐算法架构大图,帮助读者掌握全局,起到提纲挈领作用。 二、召回 (一)多路召回 召回模块面对几百上千万的推荐池物料规模,候选集十分庞大。由于后续有排序模块作为保障,故不需要十分准确,但必须保证不要遗漏和低延迟。目前主要通过多路召回来实现,一方面各路可以并行计算,另一方面取长补短。召回通路主要有非个性化和个性化两大类。 非个性化召回 非个性化召回与用户无关,可以离线构建好,主要有: 热门召回:比如近7天播放vv比较高的短视频,可以结合CTR和时间衰减做平滑,并过滤掉人均时长偏低的疑似骗点击item。还可以选择用户点赞多、好评多的item等。这部分主要基于规则实现即可。由于热门item容易导致马太效应,如果热门召回占整体通路比例过大,可以考虑做一定打压。 高效率召回:比如高CTR、高完播率、高人均时长的短视频,这类item效率较高,但可能上架不久,历史播放vv不多,好评也需要时间积累,有可能不在热门召回内。 运营策略召回:例如运营构建的各个类目的榜单、片单,最新上架item等。 个性化召回 个性化召回与用户相关,千人千面,根据构建方式主要有: content-based:基于内容,可以通过用户标签,比如新注册时填写的喜欢的导演、演员、类目等信息,也可以通过用户历史行为作为trigger,来选取与之内容相似的item。主要有: 标签召回:比如演员、导演、item标签tag、类目等。 知识图谱。 多模态:比如标题语义相似的item,首图相似的item,视频理解相似的item等。 一般先离线构建好倒排索引,在线使用时通过用户标签或者历史行为item作为trigger,取出对应候选即可。基于内容来构建倒排索引,不需要item有丰富的行为,对冷启item比较友好。 behavior-based:基于行为,主要是userCF和itemCF两种,都是通过行为来找相似,需要user或者item有比较丰富的行为。userCF先找到与user行为相似的user,选取他们行为序列中的item作为候选。itemCF则找到每个item被行为相似的其他item,构建倒排索引。 二者使用的时候有什么区别呢,个人认为主要有: userCF需要user行为较为丰富,itemCF则需要item被行为比较丰富。所以对于新闻类等item实时性要求高的场景,由于冷启item很多,所以可以考虑userCF。 一般来说用户量要远大于推荐池的item数量,也就是user向量远多于item向量,故userCF的存储压力和向量检索压力都要大于itemCF。同时也导致user向量远比item向量要稀疏,相似度计算准确性不如itemCF。 协同过滤有哪些缺点呢? 由于大部分user只对很少一部分item有行为,导致user与item的行为矩阵十分稀疏,甚至有些user根本没有任何行为,影响了向量相似度计算准确性。 user和item数量都很大,行为矩阵存储压力很大。 矩阵稀疏也带来一个问题,就是头部热门item容易与大多数item均相似,产生哈利波特问题,导致极其严重的马太效应。 那怎么解决这些问题呢,矩阵分解MF应运而生。它将user与item的行为矩阵,分解为user和item两个矩阵,M*N的矩阵转化为M*K和K*N的两个矩阵,user矩阵每一行就是一个K维user向量,item矩阵每一列就是一个K维item向量。由于不像CF中向量是基于行为产生的,有比较明确的含义,故MF中的向量也叫user隐向量和item隐向量。通过MF,可以解决CF向量过于稀疏的问题,同时由于K远小于M和N,使得高维稀疏向量实现了低维稠密化,大大减小了存储压力。 MF矩阵分解有哪些实现方法呢,可以基于SVD和梯度下降来计算。由于SVD有一定限制条件,基于梯度下降的比较多。因此MF也被称为model-based CF。 MF本质上仍然是基于用户行为来构建的,没有充分利用user和item的各种feature,比如用户性别年龄,导致有大量的信息丢失。LR和FM就应运而生。 feature-based:基于特征,比如user的年龄、性别、机型、地理位置、行为序列等,item的上架时间、视频时长、历史统计信息等。基于特征的召回构建方式,信息利用比较充分,效果一般也比较好,对冷启也比较友好,是最近几年来的研究重点。又主要分为: 线性模型:比如FM、FFM等,就不具体展开了。 深度模型:比如基于DNN的DSSM双塔(EBR、MOBIUS)、youtubeDNN(又叫deepMatch)。基于用户序列的Mind、SDM、CMDM、BERT4Rec。基于GNN的Node2Vec、EGES、PingSage等。这一块就不一一展开,是很大的话题。 线上使用时,可以有两种方式: 向量检索:通过生成的user embedding,采用近邻搜索,寻找与之相似的item embedding,从而找到具体item。检索方式有哈希分桶、HNSW等多种方法。 i2i倒排索引:通过item embedding,找到与本item相似的其他item,离线构建i2i索引。线上使用时,通过用户历史行为中的item作为trigger,从倒排索引中找到候选集。 social-network:通过好友点赞、关注关系、通信录关系等,找到社交链上的其他人,然后通过他们来召回item。原则就是好友喜欢的item,大概率也会喜欢,物以类聚人以群分嘛。 (二)召回优化 多路召回的各通路主要就是这些,那召回中主要有哪些问题呢,个人认为主要有: 负样本构建问题:召回是样本的艺术,排序是特征的艺术,这句话说的很对。召回正样本可以选择曝光点击的样本,但负样本怎么选呢?选择曝光未点击的样本吗,肯定不行。 曝光未点击样本,能从已有召回、粗排、精排模块中竞争出来,说明其item质量和相关性都还是不错的,作为召回负样本肯定不合适。 SSB问题,召回面向的全体推荐池,但能得到曝光的item只是其中很小的子集,这样构建负样本会导致十分严重的SSB(sample selection bias)问题,使得模型严重偏离实际。 基于这个问题,我们可以在推荐池中随机选择item作为负样本,但又会有一个问题,随机选择的item,相对于正样本来说,一般很容易区分,所以需要有hard negative sample来刺激和提升召回模型效果。构建hard negative sample,是目前召回研究中比较多的一个方向,主要有: 借助模型:比如Facebook EBR选取上一版召回打分处于中间位置的item,排名101~500左右的item,它们不是很靠前,可以看做负样本,也不是吊车尾,与正样本有一定相关性,区分起来有一定难度。EBR、Mobius、PinSage等都有类似思路。这种方法很难定义清楚到底什么样的item是有点相似,但又不那么相似,可能需要多次尝试。 业务规则:比如选择同类目、同价格档位等规则的item,可以参考Airbnb论文的做法。 in-batch:batch内其他用户正样本,作为本用户的负样本。 主动学习:召回结果进行人工审核,bad case作为负样本。 一般会将hard negative与easy negative,按照一定比例,比如1: 100,同时作为召回负样本。一般easy negative还是占绝大多数的。 SSB问题:召回面向的是全体推荐池,item数量巨大,故需要做一定的负采样,有比较大的SSB样本选择偏差问题。故需要让选择出来的负样本,尽可能的能代表全体推荐池,从而提升模型泛化能力。主要问题仍然是负采样,特别是hard negative sample的问题。阿里ESAM尝试用迁移学习,通过loss正则使得曝光样本上的模型,可以应用在非曝光item上,从而优化SSB问题。其他更多的方法则考虑从负样本采样出发,结合easy negative和hard negative。比如EBR、Airbnb Embedding、Mobius、PinSage等,都有hard negative的优化思路。 目标不一致问题:目前的召回目标仍然是找相似,不论是基于内容的,还是基于行为和特征的。但精排和最终实际业务指标仍然看的是转化,相似不代表就能得到很好的转化,比如极端情况,全部召回与用户最近播放相似的短视频,显然最终整体的转化是不高的。百度Mobius在召回阶段引入CPM,将业务目标作为向量检索后的截断,可优化相关性高但转化率低的item。阿里的TDM则通过最大堆树重构了ANN召回检索过程,大大降低了检索计算量,从而可容纳复杂模型,比如DIN,使得召回与排序在结构上可以对齐(当然样本上会差异很大),也算是对此类问题有一定的优化。 竞争问题:各召回通路最终会做merge去重,各通道之间重复度过高则没有意义,特别是新增召回通路,需要对历史通路有较好的补充增益作用,各召回通路之间存在一定的重叠和竞争问题。同时,召回通路的候选item,不一定能在精排中竞争透出,特别是历史召回少的item,由于其曝光样本很少,精排中打分不高,所以不一定能透出。召回和精排的相爱相杀,还需要通过全链路优化来缓解。 作者简介 谢杨易 腾讯应用算法研究员。

优秀的个人博客,低调大师

每日一博 | 深入分析 Z-Order

Z-Order最早是1966提出的一项将多维数据映射到一维的方法.随着数据库技术的发展,这种映射方法由于其特性,被应用到了数据库技术中,特别是在大数据时代再次被提及,在hudi、iceberg中都有应用。本文将对数据库领域使用Z-Order的情形进行介绍,分析其使用场景,最后对比多个数据库领域的相关技术,得出Z-Order的特点。 第一部分 数据库领域的Z-Order 在数据库领域,Z-Order的应用可以分为两个阶段:OLTP和OLAP阶段。这两个阶段由于面向的场景不同,导致其存储引擎在数据堆叠机制上无法统一,进而影响了Z-Order的使用方式。但无论是OLTP还是OLAP,使用Z-Order的动机都是相同的。本节分析Z-Order的使用动机,接着对Z-Order不同阶段的使用进行分开描述。 1.1 最左匹配原则 CREATE TABLE members( id int not null, age int not null, viplevel int not null; …… constraint PK_members primary key(id,viplevel) // * ); SELECT avg(age) FROM members WHERE id >= 1 and id <= 3; // 1 SELECT avg(age) FROM members WHERE viplevel >= 1 and viplevel <= 3; // 2 代码清单1 表结构和查询语句 考虑代码清单1中的查询语句与对应的表结构,members表中的主键是一个复合主键,数据库会对主键做B+树索引。B+树索引的本质是将数据按照自然顺序进行排列,以提升范围查询的性能。因此,在执行代码清单中//1号语句时,由于主键已经做了B+树索引,id在[1,3]之间的数据已经被连续地放在了一起,因此可以相对高效的完成查询。 图1复合索引的影响 但是,当执行//2号语句时,对viplevel进行范围查询。由于viplevel在索引中在右侧,排序时必须首先按照id进行排序,id相同的数据才按照viplevel排序。因此,viplevel在[1,3]之间的数据并没有聚集到一起。 图1描述了一个可能的排序,可以说明这情况。在图1中,ID∈[1,3]的数据连续堆放在一起,因此通过一次匹配即可快速完成查询。viplevel作为索引的第二个排序键,需要优先保证第一排序键的有序,因此在整体数据中被分割成了4个区域,需要对索引项进行遍历才能取得所有数据。 该现象体现了数据库查询的最左匹配原则。数据库对B+树类型的索引进行匹配时,查询条件精确匹配最左边的一列或连续的多列时,才会命中索引,否则无法命中索引。当不满足最左原则时,索引对于查询性能的提升起到的作用已经不大了。 1.2 Z-Order动机 Z-Order索引通过其特殊的排序机制,可以有效避免B+树带来的最左匹配原则。其被应有于数据索引的目的就是为了解决B+树类型的索引在不满足最左匹配原则的情况下失效的问题。 传统的B+树对数据进行排序时使用自然顺序,因此在遇到复合索引时,按照从左至右的顺序对排序键进行处理。首先完成最左侧排序键的排序,在此基础上完成后续排序键的排序。由此带来了最左匹配原则。 图2 Z-Order示意图 而Z-Order这是将两个或多个排序键同时进行排序,按照间隔排列的顺序对数据进行排列。可以简单理解为当AB两个属性进行Z-Order索引时,假设AB两个属性从小达到排列后为{a1,a2,a3,……,an}和{b1,b2,b3,……,bn}第一个数据是AB同时最小的即(a1,b1)、第二个数据是A次小的和B最小的即(a2,b1)、第三个数据是剩余的AB中A最小的B次小的即(a1,b2)、第四个数据是剩余AB中同时最小的即(a2,b2)……图2展示了这种情况的示例,图中2(一)中表格中的数字是排序的序号,由于其顺序类似于因为字母Z,因此被称为Z-ORDER。 图2(二)中展示了三维维度下的Z-Order的顺序排列示意。Z-Order可以推广到N维的场景下,为更多维度的复合主键提供索引。 1.3 OLTP Z-Order由于其特殊的数据聚集特性,解决了B+树类型的联合索引在不满足最左原则时的失效问题,因此在传统数据库中可以用于联合索引中。但是实际上,并没有多少数据库真正使用了该索引技术,大部分事务数据库的索引依旧以B+树索引解决范围查询问题。 OLTP时代,Z-Order并没有被大规模应用。一个很重要的原因在于OLTP时代的存储引擎,数据一般按照事务顺序写入磁盘。在这种情况下,即使使用了Z-Order对数据进行了索引,保证了数据在索引上的聚集效应。但是实际上,数据存储在磁盘上依然是不连续的。因此,Z-Order的应用仅仅只是减少了遍历索引的时间,获得索引信息后,依然需要从不连续的磁盘上获取真实数据。即Z-Order带来的加速效应无法直接影响磁盘的IO时间。 同时,由于数据在物理磁盘上不连续,因此对于事务性数据库完全可以对复合索引建立多个B+树索引来解决该问题,而不一定需要使用复杂的Z-Order索引。 除了上述提到的两个原因之外,还有一个更核心原因:Z-Order客观上的确提升了B+树的索引效果,但同时也付出了一些代价。该内容会在本文第三部分进行分析。正是由于Z-Order付的的代价和带来的收益不成正比,因此只是在事务数据库的阶段昙花一现。 1.4 OLAP OLAP时代,Z-Order重新进入人们的视野。在OLAP阶段,由于不需要提供复杂的事务支持,因此存储引擎的设计和事务数据库产生了很大的区别。其中一个重要的特性是:OLAP的存储引擎不需要按照数据的插入顺序来堆叠数据。而可以依据不同的排序策略,对数据进行堆叠。这个特性使的Z-Order在OLTP阶段的两个小问题获得了根本性的解决。 第一个问题是Z-Order带来的加速效应无法直接影响磁盘的IO时间。这个问题本质上是由于索引顺序并不等于存储引擎中数据的物理顺序。而在OLAP数据库中,完全可以按照索引顺序来安排OLAP数据库的物理存储顺序,因此,Z-Order获得的加速效应可以直接影响磁盘的IO时间,从而获得性能的极大提升。 第二个问题是事务数据库可以对多个排序键建立多个有序索引,来获得和Z-Order同样的加速效果。这个优化在OLAP中是做不到的。因为数据在磁盘上的物理顺序只能有一种。按照A有序排序了就不能再按照B有序排序,按照B有序排序了就不能再按照A排序。事务数据库由于数据的物理顺序和索引顺序本身不一致,所以可以做到多个顺序索引并存,也正是由于两种顺序不一致,使得多个顺序索引并存达到的加速效应一致。而对于OLAP数据库,将物理顺序和索引顺序保持一致可以提高查询性能,在这个前提下,物理顺序只能有一种,因此对于复合索引,Z-Order的用武之地大增。 综上,在OLAP时代,由于底层存储引擎不需要像事务数据库一样,按照事务顺序堆叠数据,可以将物理顺序和索引顺序保持一致,因此,Z-Order在OLTP数据库时代的几大问题都不再存在。Z-Order开始在OLAP阶段发力。 第二部分 Z-Order效率分析 第一部分向读者介绍了Z-Order解决问题以及在不同阶段的应用,本章将基于图2的例子,对Z-Order的加速效率进行分析。 2.1 按照A进行查询 图2(三)展示了基于A字段进行查询的例子,即执行了where a >= a1 and a <= a2语句。在这种查询条件下,只需要最多读取阴影部分的一般数据即可,阴影部分之外的数据不可能存在满足条件的数据,因此可以对阴影部分之外的数据进行跳过。换句话说,使用了Z-Order后,对A进行范围查询,至少能跳过50%的数据。 2.2 按照B进行查询 图2(四)展示了基于B字段进行查询的例子,即执行了where b >= b1 and b <= b2语句。同2.1的情况,只需要读取阴影部分的数据即可,可以跳过非阴影部分的数据。同样跳过了50%的数据。但由于 2.3 总结 通过图2的例子,不难发现,对于一个二维的查询条件来说,无论对A还是对B进行范围查询,都能至少过滤掉50%的数据量。如果放到OLAP的大数据场景下,是一个非常可观的收益。推广到一般情况,通过Z-Order排序的数据,至少可以保证一部分数据,过滤效果与查询条件的覆盖率成反比,查询的范围越小,过滤效果越明显。而不像单一顺序索引一样,过滤效果无法预估,最差的情况可能需要遍历数据。 第三部分 Z-Order缺陷 架构就是有得必有失,不分析代价的架构分析都是不全面的。本章将对Z-Order的缺陷进行分析。 表格1 两种不同顺序数据堆叠方式 序号 (A,B)自然顺序 Z-Order顺序 0 a1,b1 a1,b1 1 a1,b2 a1,b2 2 a1,b3 a2,b1 3 a1,b4 a2,b2 4 a2,b1 a1,b3 5 a2,b2 a1,b4 6 a3,b3 a2,b3 7 a4,b4 a2,b4 表格1中展示了图2例子中两种不同顺序的数据堆叠方式,表格中加深的单元格表示执行where A=a1时返回的数据。很明显可以看出,Z-Order顺序相比于(A,B)自然顺序排序,在满足最左原则的情况下,由于A的不连续,需要多进行一次磁盘IO,拖慢了满足最左原则场景下的查询速度。 需要注意的是,表格1中的数据只是为了说明原理,实际上由于操作系统的IO机制,对于例子中这么少的数据量来说,差距几乎为0。但在真实的OLAP所面向的大数据场景时,这个现象会非常明显。 的确,使用Z-Order顺序后,无论以A作为查询条件还是以B作为查询条件,都只能跳过50%的数据。但是在满足查询满足最左原则的情况下,由于Z-Order将原本自然顺序下有序的数据变得无序了,因此反而降低了满足最左原则下的查询效率。这种现象在小数据的情况下不明显,但是当数据量增加时,这种现象带来的影响会越来越大。 第四部分 总结及建议 Z-Order本质上是牺牲了主排序键的查询性能换取次排序键查询性能的提升。客观上降低了数据库工程师建模能力的要求(使用Z-Order可以在任何场景下获得不算差的查询性能,不需要数据库工程师按照业务去优化数据表)。同时也更加适用于一些数据需求多变而无法事先确定哪一列比较常用的场景。 目前hudi、iceberg都有了一些应用Z-Order的方案,读者在应用Z-Order方案时,应当充分理解您的数据需求。Z-Order并不一定能在所有情况下提升查询速度。因此,如果读者的数据需求比较确定,还是建议读者使用最原始的自然顺序。客观来讲,Z-Order是一种牺牲了极致性能的中庸的方案,没有极致的优点,也没有明显的缺点。这也是为什么hudi、iceberge只是提供了方案,但并没有将Z-Order作为默认索引的原因。读者应当充分考虑,您是否真的需要这么一种中庸的方案。 当然,如果读者遇到的不满足最左原则的数据需求比较多,且无法固定,此时使用Z-Order会给您带来惊喜,他不能给您带来极致的查询速度,但他能给您带来平均不慢的速度。不会像ClickHouse一样,一旦不满足最左原则,性能急剧下降,甚至是之前的数十、数百倍的性能差距(也有解决办法,但不是依靠zorder)。

优秀的个人博客,低调大师

每日一博 | Java 的 jmap 命令使用详解

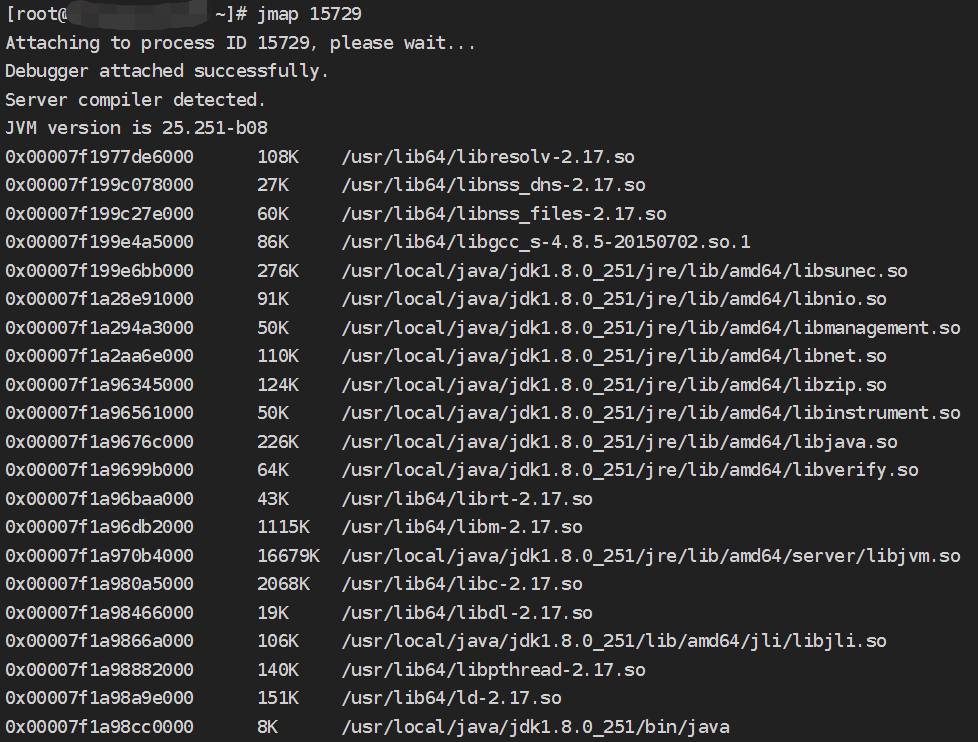
jmap命令简介 jmap(Java Virtual Machine Memory Map)是JDK提供的一个可以生成Java虚拟机的堆转储快照dump文件的命令行工具。除此以外,jmap命令还可以查看finalize执行队列、Java堆和方法区的详细信息,比如空间使用率、当前使用的什么垃圾回收器、分代情况等等。 和jinfo命令一样,在Windows系统上使用还是有一些限制的。在没有dbgeng.dll的Windows系统中,必须安装用于Windows的调试工具才能使jinfo命令正常工作,PATH环境变量应该包含jvm.dll的位置。 jmap命令参数 命令语法: jmap [options] pid 命令参数说明: option:jmap命令的可选参数。如果没有指定这个参数,jinfo命令会显示Java虚拟机进程的内存映像信息,如下图: pid:要打印配置信息的Java虚拟机的进程ID。 想要要获取运行的Java虚拟机进程的列表,可以使用ps命令(Linux系统中)或tasklist命令(Windows系统中),如果Java虚拟机进程没有在单独的docker实例中运行,可以使用jps命令。 option都有哪些参数呢?我们来看一下。 -heap 显示Java堆的如下信息: 被指定的垃圾回收算法的信息,包括垃圾回收算法的名称和垃圾回收算法的详细信息。 堆的配置信息,可能是由命令行选项指定,或者由Java虚拟机根据服务器配置选择的。 堆的内存空间使用信息,包括分代情况,每个代的总容量、已使用内存、可使用内存。如果某一代被继续细分(例如,年轻代),则包含细分的空间的内存使用信息。 比如: -histo[:live] 显示Java堆中对象的统计信息,包括:对象数量、占用内存大小(单位:字节)和类的完全限定名。比如: 要获得某个对象的大小,可以将其总大小除以该对象类型的数量。如果指定了live参数,则只计算活动的对象。比如: -clstats 显示Java堆中元空间的类加载器的统计信息,包括: class_loader:当Java虚拟机运行时,类加载器对象的地址 classes:已加载类的数量 bytes:该类加载器加载的所有类的元数据所占的字节数 parent_loader:父类加载器对象的地址,如果没有显示null。 alive:是否存活的标识,表示类加载器对象是否将被垃圾回收。 type:该类加载器的类名。 比如: -finalizerinfo 显示在F-Queue中等待Finalizer线程执行finalize方法的对象。比如: -dump:[live,]format=b,file=<filename> 生成Java虚拟机的堆转储快照dump文件。具体说明如下: live参数是可选的,如果指定,则只转储堆中的活动对象;如果没有指定,则转储堆中的所有对象。 format=b表示以hprof二进制格式转储Java堆的内存。 file=<filename>用于指定快照dump文件的文件名。 比如: -F 强制模式。如果指定的pid没有响应,可以配合-dump或-histo一起使用。此模式下,不支持live参数。比如: -h 和 -help 显示jinfo命令的帮助信息。 最后,谢谢你这么帅,还给我点赞和关注。

优秀的个人博客,低调大师

每日一博 | JavaScript 的事件循环机制浅析

前言 JavaScript是一门单线程的弱类型语言,但是我们在开发中,经常会遇到一些需要异步或者等待的处理操作。 类似ajax,亦或者ES6中新增的promise操作用于处理一些回调函数等。 概念 在JavaScript代码执行过程中,可以分为同步队列和异步队列。 同步任务类似我们常说的立即执行函数,不需要等待可以直接进行,可以直接进入到主线程中去执行,类似正常的函数调用等。 异步队列则是异步执行函数,类似ajax请求,我们在发起的过程中,会进入到一个异步队列,加载到任务当中时,需要进行等待,之后才能进行返回值的处理。 举个栗子 下面一段代码,我们可以先了解一些一些关于事件循环机制的一些基本的原理 console.log('1'); setTimeout(function() { console.log('4'); }, 0); Promise.resolve().then(function() { console.log('2'); }).then(function() { console.log('3'); }); console.log('5'); 我们将代码打印到控制台当中,输出结果是:1,5,2,3,4 我们知道,在JavaScript中,类似定时器,以及ES6新增的promise是异步函数,回到我们上面所说的队列的概念当中,不难得出,1和5为同步执行队列 在执行完同步队列中的代码之后,再执行异步队列中的代码。 TIP 在解析异步队列的promise和定时器中,我们发现,定时器setTimeout是后执行于promise,这里我们引入JavaScript规范中的宏任务**(Macro Task**)和微任务**(Micro Task)**的概念 在JavaScript中,宏任务包含了:script( 整体代码)、setTimeout、setInterval、I/O、UI 交互事件、setImmediate(Node.js 环境) 微任务:Promise、MutaionObserver、process.nextTick(Node.js 环境) 再回到上面的定时器和promise的问题,这时候我们知道,JavaScript中,当有异步队列的时候,优先执行微任务,再执行宏任务 再次举个栗子 假如在异步队列当中存在异步队列时,我们需要怎么处理 console.log(1); setTimeout(function() { console.log(5); }, 10); new Promise(resolve => { console.log(2); resolve(); setTimeout(() => console.log(3), 10); }).then(function() { console.log(4); }) console.log(6); 将代码执行到控制台中,得出的打印顺序是:1,2,6,4,5,3 不同于例子1当中的promise,打印2是优先于6执行的,由此我们可以知道,new Promise在执行过程中,在未执行resolve或者rejected前,所执行的代码均为同步队列中的代码。 再看4,5,3的执行顺序,在执行微任务promise执行回调resolve之后,对应的then立即执行 在打印结果中,定时器5优先执行于---->属于微任务promise中的宏任务定时器3,定时器5这个宏任务是在promise微任务这个队列之后就加进去,在promise执行完成then回调之后,promise中的宏任务才加入到队列当中,因此在定时器5之后执行 总结 在JavaScript中,宏任务包含了:script( 整体代码)、setTimeout、setInterval、I/O、UI 交互事件、setImmediate(Node.js 环境) 微任务:Promise、MutaionObserver、process.nextTick(Node.js 环境); 在执行过程中,同步代码优先于其他任务队列中的代码, 定时器,promise这类任务,在执行过程中,会先加入队列, 在执行完同步代码之后,再根据宏任务和微任务的分类,先执行微任务队列,再执行宏任务队列。 文章个人博客地址:JavaScript的事件循环机制

优秀的个人博客,低调大师

每日一博 | 使用 Python Poetry 进行依赖管理

摘要:在本教程中,您探索了如何创建新的 Python Poetry 项目以及如何将 Poetry 添加到现有项目中。 本文分享自华为云社区《使用 Python Poetry 进行依赖管理》,作者: Yuchuan。 当您的 Python 项目依赖于外部包时,您需要确保使用每个包的正确版本。更新后,软件包可能无法像更新前那样工作。PythonPoetry 之类的依赖项管理器可帮助您指定、安装和解析项目中的外部包。通过这种方式,您可以确保始终在每台机器上使用正确的依赖版本。 使用Poetry将帮助您启动新项目、维护现有项目并掌握依赖项管理。您将准备好使用pyproject.toml文件,这将是在 Python 项目中定义构建需求的标准。 要完成本教程并充分利用它,您应该对虚拟环境、模块和包以及pip. 虽然本教程侧重于依赖项管理,但 Poetry 还可以帮助您构建和打包项目。如果您想分享您的工作,那么您甚至可以将您的 Poetry 项目发布到Python Packaging Index (PyPI)。 注意先决条件 在深入研究 Python Poetry 的细节之前,您需要了解一些先决条件。首先,您将阅读本教程中将遇到的术语的简短概述。接下来,您将安装 Poetry 本身。 相关术语 如果您曾经import在 Python 脚本中使用过语句,那么您就已经使用过modules。其中一些模块可能是您自己编写的 Python 文件。其他可能是内置模块,例如datetime。但是,有时 Python 提供的还不够。那时您可能会转向外部的打包模块。当您的 Python 代码依赖于外部模块时,您可以说这些包是您项目的依赖项。 您可以在PyPI 中找到不属于Python 标准库的包。在了解其工作原理之前,您需要在系统上安装 Poetry。 Python Poetry安装 要在命令行中使用 Poetry,您应该在系统范围内安装它。如果您只是想尝试一下,那么您可以使用pip. 但是您应该谨慎尝试这种方法,因为 Poetry 将安装自己的依赖项,这可能会与您在项目中使用的其他包冲突。 安装 Poetry的推荐方法是使用官方install-poetry脚本。您可以手动下载并运行此Python 文件,也可以在下方选择您的操作系统以使用相应的命令: 视窗 Linux + macOS PS C:\> (Invoke-WebRequest -Uri https://raw.githubusercontent.com/python-poetry/poetry/master/install-poetry.py -UseBasicParsing).Content | python - 如果您使用的是 Windows,那么您可以使用Invoke-Webrequest带有-UseBasicParsing选项的cmdlet将请求的 URL 的内容下载到标准输出流 (stdout)。随着管道字符(|),你移交输出到标准输入流(标准输入)的python。在这种情况下,您将的内容通过管道install-poetry.py传输到 Python 解释器。 注意:有些用户在 Windows 10 上使用 PowerShell 命令时会报告错误。 在输出中,您应该看到安装完成的消息。您可以poetry --version在终端中运行以查看是否poetry有效。此命令将显示您当前的 Poetry 版本。如果要更新 Poetry,则可以运行poetry self update. Python Poetry入门 安装 Poetry 后,是时候看看 Poetry 是如何工作的了。在本节中,您将学习如何开始一个新的 Poetry 项目以及如何将 Poetry 添加到现有项目中。您还将看到项目结构并检查pyproject.toml文件。 创建一个新的Poetry项目 您可以使用new命令和项目名称作为参数来创建新的 Poetry 项目。在本教程中,该项目称为rp-poetry. 创建项目,然后进入新创建的目录: $ poetry new rp-poetry $ cd rp-poetry 通过运行poetry new rp-poetry,您可以创建一个名为 的新文件夹rp-poetry/。当您查看文件夹内部时,您会看到一个结构: rp-poetry/ │ ├── rp_poetry/ │ └── __init__.py │ ├── tests/ │ ├── __init__.py │ └── test_rp_poetry.py │ ├── README.rst └── pyproject.toml Poetry 会自动为您规范化包名。它将-项目名称中的破折号 ( ) 转换_为文件夹名称中的下划线 ( ) rp_poetry/。否则,Python 中将不允许使用该名称,因此您无法将其作为模块导入。为了更好地控制创建包名称,您可以使用该--name选项以不同于项目文件夹的方式命名: $ poetry new rp-poetry --name realpoetry 如果您更喜欢将源代码存储在额外的src/父文件夹中,那么 Poetry 可以让您使用以下--src标志来遵守该约定: $ poetry new --src rp-poetry $ cd rp-poetry 通过添加--src标志,您创建了一个名为 的文件夹src/,其中包含您的rp_poetry/目录: rp-poetry/ │ ├── src/ │ │ │ └── rp_poetry/ │ └── __init__.py │ ├── tests/ │ ├── __init__.py │ └── test_rp_poetry.py │ ├── README.rst └── pyproject.toml 创建新的 Poetry 项目时,您将立即收到一个基本的文件夹结构。 检查项目结构 该rp_poetry/子文件夹本身是不是很壮观呢。在这个目录中,你会找到一个__init__.py包含你的包版本的文件: # rp_poetry/__init__.py __version__ = "0.1.0" 当您跳到tests/文件夹并打开 时test_rp_poetry.py,您会注意到它rp_poetry已经是可导入的: # tests/test_rp_poetry.py from rp_poetry import __version__ def test_version(): assert __version__ == "0.1.0" Poetry 还为该项目添加了第一个测试。该test_version()函数检查 的__version__变量是否rp_poetry/__init__.py包含预期的版本。但是,该__init__.py文件并不是您定义包版本的唯一位置。另一个位置是pyproject.toml文件。 使用pyproject.toml文件 使用 Poetry 最重要的文件之一是pyproject.toml文件。这个文件不是 Poetry 的发明。这是 PEP 518 中定义的配置文件标准: 此 PEP 指定 Python 软件包应如何指定它们具有的构建依赖项以执行其选择的构建系统。作为本规范的一部分,为软件包引入了一个新的配置文件,用于指定它们的构建依赖项(期望相同的配置文件将用于未来的配置细节)。(来源) 作者考虑了上面引用中提到的“新配置文件”的几种文件格式。最后,他们决定采用TOML格式,即Tom's Obvious Minimal Language 的缩写。在他们看来,TOML 足够灵活,比其他选项(YAML、JSON、CFG 或 INI)具有更好的可读性和更少的复杂性。要查看 TOML 的外观,请打开pyproject.toml文件: 1# pyproject.toml 2 3[tool.poetry] 4name = "rp-poetry" 5version = "0.1.0" 6description = "" 7authors = ["Philipp <philipp@realpython.com>"] 8 9[tool.poetry.dependencies] 10python = "^3.9" 11 12[tool.poetry.dev-dependencies] 13pytest = "^5.2" 14 15[build-system] 16requires = ["poetry-core>=1.0.0"] 17build-backend = "poetry.core.masonry.api" 您可以在pyproject.toml文件中看到四个部分。这些部分称为表。它们包含诸如 Poetry 之类的工具识别和用于依赖项管理或构建例程的指令。 如果表名是特定于工具的,则必须以tool.为前缀。通过使用这样的子表,您可以为项目中的不同工具添加说明。在这种情况下,只有tool.poetry. 但是,你可能会看到这样的例子[tool.pytest.ini_options]为pytest在其他项目中。 在[tool.poetry]上面第 3 行的子表中,您可以存储有关您的 Poetry 项目的一般信息。您的可用键由 Poetry 定义。虽然有些键是可选的,但您必须指定四个键: name: 你的包名 version: 包的版本,最好遵循语义版本控制 description:您的包裹的简短描述 authors: 作者列表,格式 name <email> 第[tool.poetry.dependencies]9 行和[tool.poetry.dev-dependencies]第 12行的子表对于您的依赖项管理至关重要。在下一部分向 Poetry 项目添加依赖项时,您将了解有关这些子表的更多信息。现在,重要的是要认识到的包相关性和发展依赖之间的区别。 该pyproject.toml文件的最后一个表位于第[build-system]15 行。该表定义了 Poetry 和其他构建工具可以使用的数据,但由于它不是特定于工具的,因此它没有前缀。Poetry 创建了pyproject.toml具有两个键的文件: requires:构建包所需的依赖项列表,使此键成为必需 build-backend:用于执行构建过程的 Python 对象 如果您想更多地了解pyproject.toml文件的这一部分,那么您可以通过阅读PEP 517 中的源代码树来了解更多信息。 当您使用 Poetry 开始一个新项目时,这就是pyproject.toml您开始的文件。随着时间的推移,您将添加有关您的包和您正在使用的工具的配置详细信息。随着 Python 项目的增长,您的pyproject.toml文件也会随之增长。对于子表[tool.poetry.dependencies]和[tool.poetry.dev-dependencies]. 在下一节中,您将了解如何扩展这些子表。 使用 Python Poetry 一旦你设置了一个 Poetry 项目,真正的工作就可以开始了。一旦 Poetry 到位,您就可以开始编码。在此过程中,您将了解 Poetry 如何为您提供虚拟环境并处理您的依赖项。 使用 Poetry 的虚拟环境 当您开始一个新的 Python 项目时,创建一个虚拟环境是一种很好的做法。否则,您可能会混淆来自不同项目的不同依赖项。使用虚拟环境是 Poetry 的核心功能之一,它永远不会干扰您的全局 Python 安装。 但是,Poetry 不会在您启动项目时立即创建虚拟环境。您可以通过让 Poetry 列出连接到当前项目的所有虚拟环境来确认 Poetry 尚未创建虚拟环境。如果你还没有,cd进入rp-poetry/然后运行一个命令: $ poetry env list 目前,不应该有任何输出。 当您运行某些命令时,Poetry 会一路创建一个虚拟环境。如果您想更好地控制虚拟环境的创建,那么您可能决定明确告诉 Poetry 您要为其使用哪个 Python 版本,然后从那里开始: $ poetry env use python3 使用此命令,您将使用与安装 Poetry 相同的 Python 版本。使用python3的作品,当你在你的Python可执行程序PATH。 注意:或者,您可以将绝对路径传递给 Python 可执行文件。它应该与您可以在pyproject.toml文件中找到的 Python 版本约束相匹配。如果没有,那么您可能会遇到麻烦,因为您使用的 Python 版本与项目所需的版本不同。在您的环境中运行的代码在另一台机器上可能有问题。 更糟糕的是,外部包通常依赖于特定的 Python 版本。因此,安装包的用户可能会收到错误消息,因为您的依赖项版本与其 Python 版本不兼容。 当你运行时env use,你会看到一条消息: Creating virtualenv rp-poetry-AWdWY-py3.9 in ~/Library/Caches/pypoetry/virtualenvs Using virtualenv: ~/Library/Caches/pypoetry/virtualenvs/rp-poetry-AWdWY-py3.9 如您所见,Poetry 为您的项目环境构建了一个唯一名称。该名称包含项目名称和 Python 版本。中间看似随机的字符串是您的父目录的哈希值。通过中间的这个唯一字符串,Poetry 可以处理系统上具有相同名称和相同 Python 版本的多个项目。这很重要,因为默认情况下,Poetry 在同一个文件夹中创建所有虚拟环境。 Poetry 无需任何其他配置,在virtualenvs/Poetry缓存目录的文件夹中创建虚拟环境: 如果要更改默认缓存目录,则可以编辑Poetry 的配置。当您已经在使用virtualenvwrapper或其他第三方工具来管理您的虚拟环境时,这会很有用。要查看当前配置,包括已配置的cache-dir,您可以运行以下命令: $ poetry config --list 通常,您不必更改此路径。如果您想了解有关与 Poetry 的虚拟环境交互的更多信息,那么 Poetry 文档包含有关管理环境的一章。 只要您在项目文件夹中,Poetry 就会使用与之关联的虚拟环境。如果您有疑问,可以env list再次运行以下命令检查虚拟环境是否已激活: $ poetry env list 这将显示类似rp-poetry-AWdWY-py3.9 (Activated). 有了激活的虚拟环境,您就可以开始管理一些依赖项并看到 Poetry 的魅力了。 声明你的依赖 Poetry 的一个关键元素是它对依赖项的处理。在开始之前,先看一下文件中的两个依赖表pyproject.toml: # rp_poetry/pyproject.toml (Excerpt) [tool.poetry.dependencies] python = "^3.9" [tool.poetry.dev-dependencies] pytest = "^5.2" 当前为您的项目声明了两个依赖项。一个是 Python 本身。另一个是pytest,一个广泛使用的测试框架。正如您之前看到的,您的项目包含一个tests/文件夹和一个test_rp_poetry.py文件。使用pytest作为依赖项,Poetry 可以在安装后立即运行您的测试。 注意:在编写本教程时,pytest使用Python 3.10运行Poetry不起作用。Poetry 安装了一个与 Python 3.10 不兼容的 pytest 版本。 Poetry 开发人员已经意识到这个问题,它将随着 Poetry 1.2 的发布而得到修复。 确保您在rp-poetry/项目文件夹中并运行命令: $ poetry install 使用该install命令,Poetry 检查您的pyproject.toml文件中的依赖项,然后解析并安装它们。当您有许多依赖项需要使用不同版本的不同第三方包时,解析部分尤其重要。在安装任何包之前,Poetry 会确定哪个版本的包满足其他包设置为其要求的版本限制。 除了pytest它的要求之外,Poetry 还安装了项目本身。这样,您可以立即导入rp_poetry到您的测试中: # tests/test_rp_poetry.py from rp_poetry import __version__ def test_version(): assert __version__ == "0.1.0" 安装项目包后,您可以导入rp_poetry测试并检查__version__字符串。随着pytest安装,您可以使用poetry run命令来执行测试: 1$ poetry run pytest 2========================= test session starts ========================== 3platform darwin -- Python 3.9.1, pytest-5.4.3, py-1.10.0, pluggy-0.13.1 4rootdir: /Users/philipp/Real Python/rp-poetry 5collected 1 item 6 7tests/test_rp_poetry.py . [100%] 8 9========================== 1 passed in 0.01s =========================== 您当前的测试已成功运行,因此您可以放心地继续编码。但是,如果您仔细观察第 3 行,就会发现有些奇怪。它说pytest-5.4.3,5.2不像pyproject.toml文件中所说的那样。接得好! 回顾一下,文件中的pytest依赖项pyproject.toml如下所示: # rp_poetry/pyproject.toml (Excerpt) [tool.poetry.dev-dependencies] pytest = "^5.2" ^前面的插入符号 ( )5.2具有特定的含义,它是 Poetry 提供的版本约束之一。这意味着 Poetry 可以安装与版本字符串最左边的非零数字匹配的任何版本。这意味着5.4.3允许使用。版本6.0将不被允许。 当 Poetry 尝试解析依赖版本时,像插入符号这样的符号将变得很重要。如果只有两个要求,这并不太难。你声明的依赖越多,它就越复杂。让我们看看 Poetry 如何通过将新包安装到您的项目中来处理这个问题。 安装带有 Poetry 的包 您pip之前可能使用过安装不属于 Python 标准库的包。如果您pip install使用包名作为参数运行,则pip在Python Package Index上查找包。您可以以同样的方式使用 Poetry。 如果你想在requests你的项目中添加一个外部包,那么你可以运行一个命令: $ poetry add requests 通过运行poetry add requests,您正在将最新版本的requests库添加到您的项目中。您可以使用版本约束,requests<=2.1或者requests==2.24如果您想更具体。当您不添加任何约束时,Poetry 将始终尝试安装最新版本的软件包。 有时,您只想在开发环境中使用某些包。使用pytest,您已经发现其中之一。另一种常见的库包括一个代码格式化像黑色,一个文档生成等斯芬克斯,和类似的一个静态分析工具pylint的,Flake8,mypy,或coverage.py。 要明确告诉 Poetry 一个包是一个开发依赖项,您可以poetry add使用该--dev选项运行。您还可以使用速记-D选项,它与以下内容相同--dev: $ poetry add black -D 您添加requests为项目依赖项和black开发依赖项。Poetry 在后台为您做了一些事情。一方面,它将您声明的依赖项添加到pyproject.toml文件中: # rp_poetry/pyproject.toml (Excerpt) [tool.poetry.dependencies] python = "^3.9" requests = "^2.26.0" [tool.poetry.dev-dependencies] pytest = "^5.2" black = "^21.9b0" Poetry 将该requests包作为项目依赖项添加到tool.poetry.dependencies表中,同时将其black作为开发依赖项添加到tool.poetry.dev-dependencies. 区分项目依赖项和开发依赖项可以防止安装用户不需要运行程序的需求。开发依赖项仅与您的包的其他开发人员相关,他们希望pytest使用black. 当用户安装您的软件包时,他们只会安装requests它。 注意:您可以更进一步并声明可选的依赖项。当您想让用户选择安装一个不需要但增强您的包的特定数据库适配器时,这会很方便。您可以在Poetry 文档 中了解有关可选依赖项的更多信息。 除了对pyproject.toml文件的更改之外,Poetry 还创建了一个名为poetry.lock. 在此文件中,Poetry 会跟踪您在项目中使用的所有包和确切版本。 处理 poetry.lock 当您运行该poetry add命令时,Poetry 会自动更新pyproject.toml并固定poetry.lock文件中的已解析版本。但是,您不必让 Poetry 完成所有工作。您可以手动向pyproject.toml文件添加依赖项并在之后锁定它们。 引脚依赖关系 poetry.lock 如果您想使用 Python 构建网络爬虫,那么您可能需要使用Beautiful Soup来解析您的数据。将其添加到文件中的tool.poetry.dependencies表中pyproject.toml: # rp_poetry/pyproject.toml (Excerpt) [tool.poetry.dependencies] python = "^3.9" requests = "^2.26.0" beautifulsoup4 = "4.10.0" 通过添加beautifulsoup4 = "4.10.0",您告诉 Poetry 它应该完全安装这个版本。当您向pyproject.toml文件添加需求时,它尚未安装。只要poetry.lock你的项目中没有文件存在,你就可以poetry install在手动添加依赖后运行,因为 Poetry 会先查找poetry.lock文件。如果没有找到,Poetry 将解析pyproject.toml文件中列出的依赖项。 一旦poetry.lock文件存在,Poetry 将依赖该文件来安装依赖项。仅运行poetry install会触发警告,提示两个文件不同步并会产生错误,因为 Poetry 尚不知道beautifulsoup4项目中的任何版本。 要将pyproject.toml文件中手动添加的依赖项固定到poetry.lock,您必须首先运行以下poetry lock命令: $ poetry lock Updating dependencies Resolving dependencies... (1.5s) Writing lock file 通过运行poetry lock,Poetry 处理pyproject.toml文件中的所有依赖项并将它们锁定到poetry.lock文件中。诗歌并不止于此。运行时poetry lock,Poetry 还会递归遍历并锁定您的直接依赖项的所有依赖项。 注意:poetry lock如果有适合您的版本限制的新版本可用,该命令还会更新您现有的依赖项。如果您不想更新poetry.lock文件中已有的任何依赖项,则必须将--no-update选项添加到poetry lock命令中: $ poetry lock --no-update Resolving dependencies... (0.1s) 在这种情况下,Poetry 仅解析新的依赖项,但poetry.lock不会更改文件中的任何现有依赖项版本。 现在您已经固定了所有依赖项,是时候安装它们以便您可以在您的项目中使用它们。 安装依赖项 poetry.lock 如果您按照上一节中的步骤操作,那么您已经安装pytest并black使用了该poetry add命令。您还锁定了beautifulsoup4,但您还没有安装 Beautiful Soup。要验证beautifulsoup4尚未安装,请使用以下命令打开Python 解释器poetry run: $ poetry run python3 执行poetry run python3将在 Poetry 的环境中打开一个交互式REPL会话。首先,尝试导入requests. 这应该完美无缺。然后尝试 importing bs4,这是 Beautiful Soup 的模块名称。这应该会引发错误,因为尚未安装 Beautiful Soup: >>> >>> import requests >>> import bs4 Traceback (most recent call last): File "<stdin>", line 1, in <module> ModuleNotFoundError: No module named 'bs4' 正如预期的那样,您可以requests毫无困难地导入,并且bs4找不到模块。通过键入exit()并点击退出交互式 Python 解释器Enter。 使用poetry lock命令锁定依赖项后,您必须运行该poetry install命令,以便您可以在项目中实际使用它们: $ poetry install Installing dependencies from lock file Package operations: 2 installs, 0 updates, 0 removals • Installing soupsieve (2.2.1) • Installing beautifulsoup4 (4.10.0) Installing the current project: rp-poetry (0.1.0) 通过运行poetry install,Poetry 读取poetry.lock文件并安装其中声明的所有依赖项。现在,bs4已准备好在您的项目中使用。要对此进行测试,请输入poetry run python3并导入bs4Python 解释器: >>> >>> import bs4 >>> bs4.__version__ '4.10.0' 完美的!这次没有错误,并且您拥有您声明的确切版本。这意味着 Beautiful Soup 已正确固定在您的poetry.lock文件中,已安装在您的项目中,并且可以使用了。要列出项目中的可用包并检查它们的详细信息,您可以使用该show命令。当您使用--help标志运行它时,您将看到如何使用它: $ poetry show --help 要检查包,您可以使用show包名称作为参数,也可以使用--tree选项将所有依赖项以树的形式列出。这将帮助您查看项目的嵌套需求。 更新依赖 为了更新您的依赖项,Poetry 根据两种情况提供了不同的选项: 更新版本约束内的依赖项。 更新版本约束之外的依赖项。 您可以在pyproject.toml文件中找到版本限制。当新版本的依赖项仍然满足您的版本限制时,您可以使用以下update命令: $ poetry update 该update命令将在版本限制内更新所有包及其依赖项。之后,Poetry 将更新您的poetry.lock文件。 如果你想更新一个或多个特定的包,那么你可以将它们作为参数列出: $ poetry update requests beautifulsoup4 使用此命令,Poetry 将搜索满足文件中列出的版本限制的新版本requests和新版本。然后它将解析您项目的所有依赖项并将版本固定到您的文件中。您的文件将保持不变,因为列出的约束仍然有效。beautifulsoup4pyproject.tomlpoetry.lockpyproject.toml 如果要使用比pyproject.toml文件中定义的版本更高的版本来更新依赖项,则需要pyproject.toml事先调整文件。另一种选择是add使用版本约束或latest标签运行命令: $ poetry add pytest@latest --dev 当您运行add带有latest标记的命令时,它会查找包的最新版本并更新您的pyproject.toml文件。包含latest标签或版本约束对于使用该add命令至关重要。如果没有它,您会收到一条消息,表明该包已存在于您的项目中。另外,不要忘记--dev为开发依赖项添加标志。否则,您会将包添加到常规依赖项中。 添加新版本后,您必须运行install您在上一节中学到的命令。只有这样,您的更新才会被锁定到poetry.lock文件中。 如果您不确定更新会为您的依赖项引入哪些基于版本的更改,您可以使用该--dry-run标志。此标志适用于命令update和add命令。它在您的终端中显示操作而不执行任何操作。这样,您可以安全地发现版本更改并决定哪种更新方案最适合您。 区分pyproject.toml和poetry.lock 虽然pyproject.toml文件中的版本要求可能很宽松,但 Poetry 会锁定您在poetry.lock文件中实际使用的版本。这就是为什么在使用Git 时应该提交此文件的原因。通过poetry.lock在Git 存储库中提供文件,您可以确保所有开发人员都将使用所需软件包的相同版本。当您遇到包含poetry.lock文件的存储库时,最好使用 Poetry。 使用poetry.lock,您可以确保您使用的版本与其他开发人员使用的版本完全相同。如果其他开发人员不使用 Poetry,您可以将其添加到未使用 Poetry 设置的现有项目中。 将poetry添加到现有项目 很有可能,您的项目不是从poetry new命令开始的。或者,您可能继承了一个不是用 Poetry 创建的项目,但现在您想使用 Poetry 进行依赖管理。在这些类型的情况下,您可以将 Poetry 添加到现有的 Python 项目中。 添加pyproject.toml到脚本文件夹 如果您的项目只包含一些 Python 文件,那么您仍然可以添加 Poetry 作为未来构建的基础。在这个例子中,只有一个文件,hello.py: # rp-hello/hello.py print("Hello World!") 这个脚本唯一能做的就是输出字符串"Hello World!"。但也许这只是一个宏伟项目的开始,因此您决定将 Poetry 添加到您的项目中。poetry new您将使用以下poetry init命令,而不是使用之前的命令: $ poetry init This command will guide you through creating your pyproject.toml config. Package name [rp-hello]: rp-hello Version [0.1.0]: Description []: My Hello World Example Author [Philipp <philipp@realpython.com>, n to skip]: License []: Compatible Python versions [^3.9]: Would you like to define your main dependencies interactively? (yes/no) [yes] no Would you like to define your development dependencies interactively? (yes/no) [yes] no Generated file 该poetry init命令将启动交互式会话以创建pyproject.toml文件。 Poetry 为您提供了大多数需要设置的配置的建议,您可以按下Enter以使用它们。当您不声明任何依赖项时,pyproject.tomlPoetry 创建的文件如下所示: # rp-hello/pyproject.toml [tool.poetry] name = "rp-hello" version = "0.1.0" description = "My Hello World Example" authors = ["Philipp <philipp@realpython.com>"] [tool.poetry.dependencies] python = "^3.9" [tool.poetry.dev-dependencies] [build-system] requires = ["poetry-core>=1.0.0"] build-backend = "poetry.core.masonry.api" 内容看起来与您在前几节中经历的示例相似。 现在您可以使用 Poetry 项目提供的所有命令。有了pyproject.toml文件,您现在可以运行脚本: $ poetry run python3 hello.py Creating virtualenv rp-simple-UCsI2-py3.9 in ~/Library/Caches/pypoetry/virtualenvs Hello World! 因为 Poetry 没有找到任何可以使用的虚拟环境,所以它在执行您的脚本之前创建了一个新环境。执行此操作后,它会显示您的Hello World!消息而没有任何错误。这意味着您现在有一个正在运行的 Poetry 项目。 使用现有requirements.txt文件 有时您的项目已经有一个requirements.txt文件。看看requirements.txt这个Python 网络爬虫的文件: $ cat requirements.txt beautifulsoup4==4.9.3 certifi==2020.12.5 chardet==4.0.0 idna==2.10 requests==2.25.1 soupsieve==2.2.1 urllib3==1.26.4 使用该cat实用程序,您可以读取文件并将内容写入标准输出。在本例中,它显示了网络爬虫项目的依赖项。使用 创建 Poetry 项目后poetry init,您可以将该cat实用程序与以下poetry add命令结合使用: $ poetry add `cat requirements.txt` Creating virtualenv rp-require-0ubvZ-py3.9 in ~/Library/Caches/pypoetry/virtualenvs Updating dependencies Resolving dependencies... (6.2s) Writing lock file Package operations: 7 installs, 0 updates, 0 removals • Installing certifi (2020.12.5) • Installing chardet (4.0.0) • Installing idna (2.10) • Installing soupsieve (2.2.1) • Installing urllib3 (1.26.4) • Installing beautifulsoup4 (4.9.3) • Installing requests (2.25.1) 当需求文件像这样简单时,使用poetry add和cat可以为您节省一些手动工作。 requirements.txt然而,有时文件会更复杂一些。在这些情况下,您可以执行测试运行并查看结果,或者手动将需求添加到文件中的[tool.poetry.dependencies]表中pyproject.toml。要查看您的结构pyproject.toml是否有效,您可以在poetry check之后运行。 创建requirements.txt自poetry.lock 在某些情况下,您必须有一个requirements.txt文件。例如,也许您想在 Heroku 上托管您的 Django 项目。对于这种情况,Poetry 提供了export命令。如果你有一个 Poetry 项目,你可以requirements.txt从你的poetry.lock文件中创建一个文件: $ poetry export --output requirements.txt poetry export以这种方式使用该命令会创建一个requirements.txt包含散列和环境标记的文件。这意味着您可以确保处理与poetry.lock文件内容类似的非常严格的要求。如果您还想包含您的开发依赖项,您可以添加--dev到命令中。要查看所有可用选项,您可以选中poetry export --help。 命令参考 本教程向您介绍了 Poetry 的依赖管理。在此过程中,您使用了一些 Poetry 的命令行界面 (CLI) 命令: 您可以查看Poetry CLI 文档以了解有关上述命令和 Poetry 提供的其他命令的更多信息。您还可以poetry --help直接在终端中运行以查看信息! 结论 在本教程中,您探索了如何创建新的 Python Poetry 项目以及如何将 Poetry 添加到现有项目中。Poetry 的一个关键部分是pyproject.toml文件。与 结合使用poetry.lock,您可以确保安装项目所需的每个包的确切版本。当您跟踪poetry.lockGit 存储库中的文件时,您还要确保项目中的所有其他开发人员在他们的机器上安装相同的依赖项版本。 点击关注,第一时间了解华为云新鲜技术~
优秀的个人博客,低调大师

每日一博 | 基于 esbuild 的 universal bundler 设计

——字节跳动前端 ByteFE :杨健 背景 由于Lynx(公司自研跨端框架)编译工具和传统Web编译工具链有较大的差别(如不支持动态style和动态script基本告别了bundleless和code splitting,模块系统基于json而非js,没有浏览器环境),且有在Web端实时编译(搭建系统)、web端动态编译(WebIDE),服务端实时编译(服务端编译下发)、和多版本切换等需求,因此我们需要开发一个即支持在本地也支持在浏览器工作且可以根据业务灵活定制开发的bundler,即universal bundler,在开发universal bundler的过程中也碰到了一些问题,最后我们基于esbuild开发了全新的universal bundler,解决了我们碰到的大部分问题。 什么是bundler bundler的工作就是将一系列通过模块方式组织的代码将其打包成一个或多个文件,我们常见的bundler包括webpack、rollup、esbuild等。 这里的模块组织形式大部分指的是基于js的模块系统,但也不排除其他方式组织的模块系统(如wasm、小程序的json的usingComponents,css和html的import等),其生成文件也可能不仅仅是一个文件如(code spliting生成的多个js文件,或者生成不同的js、css、html文件等)。 大部分的bundler的核心工作原理都比较类似,但是其会偏重某些功能,如 webpack :强调对web开发的支持,尤其是内置了HMR的支持,插件系统比较强大,对各种模块系统兼容性最佳(amd,cjs,umd,esm等,兼容性好的有点过分了,这实际上有利有弊,导致面向webpack编程),有丰富的生态,缺点是产物不够干净,产物不支持生成esm格式, 插件开发上手较难,不太适合库的开发。 rollup: 强调对库开发的支持,基于ESM模块系统,对tree shaking有着良好的支持,产物非常干净,支持多种输出格式,适合做库的开发,插件api比较友好,缺点是对cjs支持需要依赖插件,且支持效果不佳需要较多的hack,不支持HMR,做应用开发时需要依赖各种插件。 esbuild: 强调性能,内置了对css、图片、react、typescript等内置支持,编译速度特别快(是webpack和rollup速度的100倍+),缺点是目前插件系统较为简单,生态不如webpack和rollup成熟。 bundler如何工作 bundler的实现和大部分的编译器的实现非常类似,也是采用三段式设计,我们可以对比一下 llvm: 将各个语言通过编译器前端编译到LLVM IR,然后基于LLVM IR做各种优化,然后基于优化后的LLVM IR根据不同处理器架构生成不同的cpu指令集代码。 bundler: 将各个模块先编译为module graph,然后基于module graph做tree shaking && code spliting &&minify等优化,最后将优化后的module graph根据指定的format生成不同格式的js代码。 LLVM和bundler的对比 GJWJP 这也使得传统的LLVM的很多编译优化策略实际上也可在bundler中进行,esbuild就是将这一做法推广到极致的例子。 因为rollup的功能和架构较为精简,我们以rollup为例看看一个bundler的是如何工作的。 rollup的bundle过程分为两步rollup和generate,分别对应了bundler前端和bundler后端两个过程。 src/main.js import lib from './lib'; console.log('lib:', lib); src/lib.js const answer = 42; export default answer; 首先通过生成module graph const rollup = require('rollup'); const util = require('util'); async function main() { const bundle = await rollup.rollup({ input: ['./src/index.js'], }); console.log(util.inspect(bundle.cache.modules, { colors: true, depth: null })); } main(); 输出内容如下 [ { code: 'const answer = 42;\nexport default answer;\n', ast: xxx, depenencies: [], id: 'Users/admin/github/neo/examples/rollup-demo/src/lib.js' ... }, { ast: xxx, code: 'import lib from './lib';\n\nconsole.log('lib:', lib);\n', dependencies: [ '/Users/admin/github/neo/examples/rollup-demo/src/lib.js' ] id: '/Users/admin/github/neo/examples/rollup-demo/src/index.js', ... }] 我们的生成产物里已经包含的各个模块解析后的ast结构,以及模块之间的依赖关系。 待构建完module graph,rollup就可以继续基于module graph根据用户的配置构建产物了。 const result = await bundle.generate({ format: 'cjs', }); console.log('result:', result); 生成内容如下 exports: [], facadeModuleId: '/Users/admin/github/neo/examples/rollup-demo/src/index.js', isDynamicEntry: false, isEntry: true, type: 'chunk', code: "'use strict';\n\nconst answer = 42;\n\nconsole.log('lib:', answer);\n", dynamicImports: [], fileName: 'index.js', 所以一个基本的JavaScript的bundler流程并不复杂,但是其如果要真正的应用于生产环境,支持复杂多样的业务需求,就离不开其强大的插件系统。 插件系统 大部分的bundler都提供了插件系统,以支持用户可以自己定制bundler的逻辑。如rollup的插件分为input插件和output插件,input插件对应的是根据输入生成Module Graph的过程,而output插件则对应的是根据Module Graph生成产物的过程。 我们这里主要讨论input插件,其是bundler插件系统的核心,我们这里以esbuild的插件系统为例,来看看我们可以利用插件系统来做什么。 input的核心流程就是生成依赖图,依赖图一个核心的作用就是确定每个模块的源码内容。input插件正提供了如何自定义模块加载源码的方式。 大部分的input 插件系统都提供了两个核心钩子 onResolve(rollup 里叫resolveId, webpack里叫factory.hooks.resolver): 根据一个moduleid决定实际的的模块地址 onLoad(rollup里叫loadId,webpack里是loader):根据模块地址加载模块内容) load这里esbuild和rollup与webpack处理有所差异,esbuild只提供了load这个hooks,你可以在load的hooks里做transform的工作,rollup额外提供了transform的hooks,和load的职能做了显示的区分(但并不阻碍你在load里做transform),而webpack则将transform的工作下放给了loader去完成。 这两个钩子的功能看似虽小,组合起来却能实现很丰富的功能。(插件文档这块,相比之下webpack的文档简直垃圾) esbuild插件系统相比于rollup和webpack的插件系统,最出色的就是对于virtual module的支持。我们简单看几个例子来展示插件的作用。 loader 大家使用webpack最常见的一个需求就是使用各种loader来处理非js的资源,如导入图片css等,我们看一下如何用esbuild的插件来实现一个简单的less-loader。 export const less = (): Plugin => { return { name: 'less', setup(build) { build.onLoad({ filter: /.less$/ }, async (args) => { const content = await fs.promises.readFile(args.path); const result = await render(content.toString()); return { contents: result.css, loader: 'css', }; }); }, }; }; 我们只需要在onLoad里通过filter过滤我们想要处理的文件类型,然后读取文件内容并进行自定义的transform,然后将结果返回给esbuild内置的css loader处理即可。是不是十分简单 大部分的loader的功能都可以通过onLoad插件实现。 sourcemap && cache && error handle 上面的例子比较简化,作为一个更加成熟的插件还需要考虑transform后sourcemap的映射和自定义缓存来减小load的重复开销以及错误处理,我们来通过svelte的例子来看如何处理sourcemap和cache和错误处理。 let sveltePlugin = { name: 'svelte', setup(build) { let svelte = require('svelte/compiler') let path = require('path') let fs = require('fs') let cache = new LRUCache(); // 使用一个LRUcache来避免watch过程中内存一直上涨 build.onLoad({ filter: /.svelte$/ }, async (args) => { let value = cache.get(args.path); // 使用path作为key let input = await fs.promises.readFile(args.path, 'utf8'); if(value && value.input === input){ return value // 缓存命中,跳过后续transform逻辑,节省性能 } // This converts a message in Svelte's format to esbuild's format let convertMessage = ({ message, start, end }) => { let location if (start && end) { let lineText = source.split(/\r\n|\r|\n/g)[start.line - 1] let lineEnd = start.line === end.line ? end.column : lineText.length location = { file: filename, line: start.line, column: start.column, length: lineEnd - start.column, lineText, } } return { text: message, location } } // Load the file from the file system let source = await fs.promises.readFile(args.path, 'utf8') let filename = path.relative(process.cwd(), args.path) // Convert Svelte syntax to JavaScript try { let { js, warnings } = svelte.compile(source, { filename }) let contents = js.code + `//# sourceMappingURL=` + js.map.toUrl() // 返回sourcemap,esbuild会自动将整个链路的sourcemap进行merge return { contents, warnings: warnings.map(convertMessage) } // 将warning和errors上报给esbuild,经esbuild再上报给业务方 } catch (e) { return { errors: [convertMessage(e)] } } }) } } require('esbuild').build({ entryPoints: ['app.js'], bundle: true, outfile: 'out.js', plugins: [sveltePlugin], }).catch(() => process.exit(1)) 至此我们实现了一个比较完整的svelte-loader的功能。 virtual module esbuild插件相比rollup插件一个比较大的改进就是对virtual module的支持,一般bundler需要处理两种形式的模块,一种是路径对应真是的磁盘里的文件路径,另一种路径并不对应真实的文件路径而是需要根据路径形式生成对应的内容即virtual module。 virtual module有着非常丰富的应用场景。 glob import 举一个常见的场景,我们开发一个类似https://rollupjs.org/repl/之类的repl的时候,通常需要将一些代码示例加载到memfs里,然后在浏览器上基于memfs进行构建,但是如果例子涉及的文件很多的话,一个个导入这些文件是很麻烦的,我们可以支持glob形式的导入。 examples/ examples index.html index.tsx index.css import examples from 'glob:./examples/**/*'; import {vol} from 'memfs'; vol.fromJson(examples,'/'); //将本地的examples目录挂载到memfs 类似的功能可以通过vite或者babel-plugin-macro来实现,我们看看esbuild怎么实现。 实现上面的功能其实非常简单,我们只需要 在onResolve里将自定义的path进行解析,然后将元数据通过pluginData和path传递给onLoad,并且自定义一个namespace(namespace的作用是防止正常的file load逻辑去加载返回的路径和给后续的load做filter的过滤) 在onLoad里通过namespace过滤拿到感兴趣的onResolve返回的元数据,根据元数据自定义加载生成数据的逻辑,然后将生成的内容交给esbuild的内置loader处理 const globReg = /^glob:/; export const pluginGlob = (): Plugin => { return { name: 'glob', setup(build) { build.onResolve({ filter: globReg }, (args) => { return { path: path.resolve(args.resolveDir, args.path.replace(globReg, '')), namespace: 'glob', pluginData: { resolveDir: args.resolveDir, }, }; }); build.onLoad({ filter: /.*/, namespace: 'glob' }, async (args) => { const matchPath: string[] = await new Promise((resolve, reject) => { glob( args.path, { cwd: args.pluginData.resolveDir, }, (err, data) => { if (err) { reject(err); } else { resolve(data); } } ); }); const result: Record<string, string> = {}; await Promise.all( matchPath.map(async (x) => { const contents = await fs.promises.readFile(x); result[path.basename(x)] = contents.toString(); }) ); return { contents: JSON.stringify(result), loader: 'json', }; }); }, }; }; esbuild基于filter和namespace的过滤是出于性能考虑的,这里的filter的正则是golang的正则,namespace是字符串,因此esbuild可以完全基于filter和namespace进行过滤而避免不必要的陷入到js的调用,最大程度减小golang call js的overhead,但是仍然可以filter设置为/.*/来完全陷入到js,在js里进行过滤,实际的陷入开销实际上还是能够接受的。 virtual module不仅可以从磁盘里获取内容,也可以直接内存里计算内容,甚至可以把模块导入当函数调用。 memory virtual module 这里的env模块,完全是根据环境变量计算出来的 let envPlugin = { name: 'env', setup(build) { // Intercept import paths called "env" so esbuild doesn't attempt // to map them to a file system location. Tag them with the "env-ns" // namespace to reserve them for this plugin. build.onResolve({ filter: /^env$/ }, args => ({ path: args.path, namespace: 'env-ns', })) // Load paths tagged with the "env-ns" namespace and behave as if // they point to a JSON file containing the environment variables. build.onLoad({ filter: /.*/, namespace: 'env-ns' }, () => ({ contents: JSON.stringify(process.env), loader: 'json', })) }, } // import { NODE_ENV } from 'env' // env为虚拟模块, function virtual module 把模块名当函数使用,完成编译时计算,甚至支持递归函数调用。 build.onResolve({ filter: /^fib((\d+))/ }, args => { return { path: args.path, namespace: 'fib' } }) build.onLoad({ filter: /^fib((\d+))/, namespace: 'fib' }, args => { let match = /^fib((\d+))/.exec(args.path), n = +match[1] let contents = n < 2 ? `export default ${n}` : ` import n1 from 'fib(${n - 1}) ${args.path}' import n2 from 'fib(${n - 2}) ${args.path}' export default n1 + n2` return { contents } }) // 使用方式 import fib5 from 'fib(5)' // 直接编译器获取fib5的结果,是不是有c++模板的味道 stream import 不需要下载node_modules就可以进行npmrun dev import { Plugin } from 'esbuild'; import { fetchPkg } from './http'; export const UnpkgNamepsace = 'unpkg'; export const UnpkgHost = 'https://unpkg.com/'; export const pluginUnpkg = (): Plugin => { const cache: Record<string, { url: string; content: string }> = {}; return { name: 'unpkg', setup(build) { build.onLoad({ namespace: UnpkgNamepsace, filter: /.*/ }, async (args) => { const pathUrl = new URL(args.path, args.pluginData.parentUrl).toString(); let value = cache[pathUrl]; if (!value) { value = await fetchPkg(pathUrl); } cache[pathUrl] = value; return { contents: value.content, pluginData: { parentUrl: value.url, }, }; }); build.onResolve({ namespace: UnpkgNamepsace, filter: /.*/ }, async (args) => { return { namespace: UnpkgNamepsace, path: args.path, pluginData: args.pluginData, }; }); }, }; }; // 使用方式 import react from 'react'; //会自动在编译器转换为 import react from 'https://unpkg.com/react' 上面几个例子可以看出,esbuild的virtual module设计的非常灵活和强大,当我们使用virtual module时候,实际上我们的整个模块系统结构变成如下的样子 无法复制加载中的内容 针对不同的场景我们可以选择不同的namespace进行组合 本地开发: 完全走本地file加载,即都走file namespace 本地开发免安装node_modules: 即类似deno和snowpack的streaming import的场景,可以通过业务文件走file namespace,node_modules文件走unpkg namespace,比较适合超大型monorepo项目开发一个项目需要安装所有的node_modules过慢的场景。 web端实时编译场景(性能和网络问题):即第三方库是固定的,业务代码可能变化,则本地file和node_modules都走memfs。 web端动态编译:即内网webide场景,此时第三方库和业务代码都不固定,则本地file走memfs,node_modules走unpkg动态拉取 我们发现基于virtual module涉及的universal bundler非常灵活,能够灵活应对各种业务场景,而且各个场景之间的开销互不影响。 universal bundler 大部分的bundler都是默认运行在浏览器上,所以构造一个universal bundler最大的难点还是在于让bundler运行在浏览器上。 区别于我们本地的bundler,浏览器上的bundler存在着诸多限制,我们下面看看如果将一个bundler移植到浏览器上需要处理哪些问题。 rollup 首先我们需要选取一个合适的bundler来帮我们完成bundle的工作,rollup就是一个非常优秀的bundler,rollup有着很多非常优良的性质 treeshaking支持非常好,也支持cjs的tree shaking 丰富的插件hooks,具有非常灵活定制的能力 支持运行在浏览器上 支持多种输出格式(esm,cjs,umd,systemjs) 正式因为上述优良的特性,所以很多最新的bundler|bundleness工具都是基于rollup或者兼容rollup的插件体系,典型的就是vite和wmr, 不得不说给rollup写插件比起给webpack写插件要舒服很多。 我们早期的universal bundler实际上就是基于rollup开发的,但是使用rollup过程中碰到了不少问题,总结如下 对CommonJS的兼容问题 但凡在实际的业务中使用rollup进行bundle的同学,绕不开的一个插件就是rollup-plugin-commonjs,因为rollup原生只支持ESM模块的bundle,因此如果实际业务中需要对commonjs进行bundle,第一步就是需要将CJS转换成ESM,不幸的是,Commonjs和ES Module的interop问题是个非常棘手的问题(搜一搜babel、rollup、typescript等工具下关于interop的issuehttps://sokra.github.io/interop-test/,其两者语义上存在着天然的鸿沟,将ESM转换成Commonjs一般问题不太大(小心避开default导出问题),但是将CJS转换为ESM则存在着更多的问题。 rollup-plugin-commonjs虽然在cjs2esm上下了很多功夫,但是实际仍然有非常多的edge case,实际上rollup也正在重写该核心模块https://github.com/rollup/plugins/pull/658。 一些典型的问题如下 循环引用问题 由于commonjs的导出模块并非是live binding的,所以导致一旦出现了commonjs的循环引用,则将其转换成esm就会出问题 动态require的hoist问题 同步的动态require几乎无法转换为esm,如果将其转换为top-level的import,根据import的语义,bundler需要将同步require的内容进行hoist,但是这与同步require相违背,因此动态require也很难处理 Hybrid CJS和ESM 因为在一个模块里混用ESM和CJS的语义并没有一套标准的规范规定,虽然webpack支持在一个模块里混用CJS和ESM(downlevel to webpack runtime),但是rollup放弃了对该行为的支持(最新版可以条件开启,我没试过效果咋样) 性能问题 正是因为cjs2esm的复杂性,导致该转换算法十分复杂,导致一旦业务里包含了很多cjs的模块,rollup其编译性能就会急剧下降,这在编译一些库的时候可能不是大问题,但是用于大型业务的开发,其编译速度难以接受。 浏览器上cjs转esm 另一方面虽然rollup可以较为轻松的移植到到memfs上,但是rollup-plugin-commonjs是很难移植到web上的,所以我们早期基于rollup做web bundler只能借助于类似skypack之类的在线cjs2esm的服务来完成上述转换,但是大部分这类服务其后端都是通过rollup-plugin-commonjs来实现的,因此rollup原有的那些问题并没有摆脱,并且还有额外的网络开销,且难以处理非node_modules里cjs模块的处理。 幸运的是esbuild采取的是和rollup不同的方案,其对cjs的兼容采取了类似node的module wrapper,引入了一个非常小的运行时,来支持cjs(webpack实际上也是采用了运行时的方案来兼容cjs,但是他的runtime不够简洁。。。)。 其通过彻底放弃对cjs tree shaking的支持来更好的兼容cjs,并且同时可以在不引入插件的情况下,直接使得web bundler支持cjs。 virutual module的支持 rollup的virtual module的支持比较hack,依赖路径前面拼上一个'\0',对路径有入侵性,且对一些ffi的场景不太友好(c++string把'\0'视为终结符),当处理较为复杂的virtual module场景下,'\0'这种路径非常容易处理出问题。 filesystem 本地的bundler都是访问的本地文件系统,但是在browser是不存在本地文件系统的,因此如何访问文件呢,一般可以通过将bundler实现为与具体的fs无关来实现,所有的文件访问通过可配置的fs来进行访问。https://rollupjs.org/repl/即是采用此方式。因此我们只需要将模块的加载逻辑从fs里替换为浏览器上的memfs即可,onLoad这个hooks正可以用于替换文件的读取逻辑。 node module resolution 当我们将文件访问切换到memfs时,一个接踵而至的问题就是如何获取一个require和import的id对应的实际路径格式,node里将一个id映射为一个真实文件地址的算法就是module resolution, 该算法实现较为复杂需要考虑如下情况,详细算法见https://tech.bytedance.net/articles/6935059588156751880 file|index|目录三种情形 js、json、addon多文件后缀 esm和cjs loader区别 main field处理 conditional exports处理 exports subpath NODE_PATH处理 递归向上查找 symlink的处理 除了node module resolution本身的复杂,我们可能还需要考虑main module filed fallback、alias支持、ts等其他后缀支持等webpack额外支持但在社区比较流行的功能,yarn|pnpm|npm等包管理工具兼容等问题。自己从头实现这一套算法成本较大,且node 的module resolution算法一直在更新,webpack的enhanced-resolve模块基本上实现了上述功能,并且支持自定义fs,可以很方便的将其移植到memfs上。 我觉得这里node的算法着实有点over engineering而且效率低下(一堆fallback逻辑有不小的io开销),而且这也导致了万恶之源hoist盛行的主要原因,也许bare import配合import map,或者deno|golang这种显示路径更好一些。 main field main field也是个较为复杂的问题,主要在于没有一套统一的规范,以及社区的库并不完全遵守规范,其主要涉及包的分发问题,除了main字段是nodejs官方支持的,module、browser、browser等字段各个bundler以及第三方社区库并未达成一致意见如 cjs和esm,esnext和es5,node和browser,dev和prod的入口该怎么配置 module| main 里的代码应该是es5还是esnext的(决定了node_module里的代码是否需要走transformer) module里的代码是应该指向browser的实现还是指向node的实现(决定了node bundler 和browser bundler情况下main和module的优先级问题) node和browser差异的代码如何分发处理等等 unpkg 接下来我们就需要处理node_modules的模块了,此时有两种方式,一种是将node_modules全量挂载到memfs里,然后使用enhanced-resolve去memfs里加载对应的模块,另一种方式则是借助于unpkg,将node_modules的id转换为unpkg的请求。这两种方式都有其适用场景 第一种适合第三方模块数目比较固定(如果不固定,memfs必然无法承载无穷的node_modules模块),而且memfs的访问速度比网络请求访问要快的多,因此非常适合搭建系统的实现。 第二种则适用第三方模块数目不固定,对编译速度没有明显的实时要求,这种就比较适合类似codesandbox这种webide场景,业务可以自主的选择其想要的npm模块。 shim 与 polyfill web bundler碰到的另一个问题就是大部分的社区模块都是围绕node开发的,其会大量依赖node的原生api,但是浏览器上并不会支持这些api,因此直接将这些模块跑在浏览器上就会出问题。此时分为两种情况 一种是这些模块依赖的实际就是些node的utily api例如utils、path等,这些模块实际上并不依赖node runtime,此时我们实际上是可以在浏览器上模拟这些api的,browserify实际上就是为了解决这种场景的,其提供了大量的node api在浏览器上的polyfill如path-browserify,stream-browserify等等, 另一种是浏览器和node的逻辑分开处理,虽然node的代码不需要在浏览器上执行,但是不期望node的实现一方面增大浏览器bundle包的体积和导致报错,此时我们需要node相关的模块进行external处理即可。 一个小技巧,大部分的bundler配置external可能会比较麻烦或者没办法修改bundler的配置,我们只需要将require包裹在eval里,大部分的bundler都会跳过require模块的打包。如eval('require')('os') polyfill与环境嗅tan,矛与盾之争 polyfill和环境嗅tan是个争锋相对的功能,一方面polyfill尽可能抹平node和browser差异,另一方面环境嗅tan想尽可能从差异里区分浏览器和node环境,如果同时用了这俩功能,就需要各种hack处理了 webassembly 我们业务中依赖了c++的模块,在本地环境下可以将c++编译为静态库通过ffi进行调用,但是在浏览器上则需要将其编译为webassembly才能运行,但是大部分的wasm的大小都不小,esbuild的wasm有8M左右,我们自己的静态库编译出来的wasm也有3M左右,这对整体的包大小影响较大,因此可以借鉴code split的方案,将wasm进行拆分,将首次访问可能用到的代码拆为hot code,不太可能用到的拆为cold code, 这样就可以降低首次加载的包的体积。 我们可以在哪里使用esbuild esbuild有三个垂直的功能,既可以组合使用也可以完全独立使用 minifier transformer bundler 更高效的register和minify工具 利用esbuild的transform功能,使用esbuild-register替换单元测试框架ts-node的register,大幅提升速度:见https://github.com/aelbore/esbuild-jest,不过ts-node现在已经支持自定义register了,可以直接将register替换为esbuild-register即可,esbuild的minify性能也是远远超过terser(100倍以上) 更高效的prebundle工具 在一些bundleness的场景,虽然不对业务代码进行bundle,但是为了一方面防止第三方库的waterfall和cjs的兼容问题,通常需要对第三方库进行prebundle,esbuild相比rollup是个更好的prebundle工具,实际上vite的最新版已经将prebundle功能从rollup替换为了esbuild。 更好的线上cjs2esm服务 使用esbuild搭建esmcdn服务:esm.sh就是如此 node bundler 相比于前端社区,node社区似乎很少使用bundle的方案,一方面是因为node服务里可能使用fs以及addon等对bundle不友好的操作,另一方面是大部分的bundler工具都是为了前端设计的,导致应用于node领域需要额外的配置。但是对node的应用或者服务进行bundle有着非常大的好处 减小了使用方的node_modules体积和加快安装速度,相比将node应用的一堆依赖一起安装到业务的node_modules里,只安装bundle的代码大幅减小了业务的安装体积和加快了安装速度,pnpm和yarn就是使用esbuild将所有依赖bundle实现零依赖的正面典型https://twitter.com/pnpmjs/status/1353848140902903810?s=21 提高了冷启动的速度,因为bundle后的代码一方面通过tree shaking减小了引起实际需要parse的js代码大小(js的parse开销在大型应用的冷启动速度上占据了不小的比重,尤其是对冷启动速度敏感的应用),另一方面避免了文件io,这两方面都同时大幅减小了应用冷启动的速度,非常适合一些对冷启动敏感的场景,如serverless 避免上游的semver语义破坏,虽然semver是一套社区规范,但是这实际上对代码要求非常严格,当引入了较多的第三方库时,很难保证上游依赖不会破坏semver语义,因此bundle代码可以完全避免上游依赖出现bug导致应用出现bug,这对安全性要求极高的应用(如编译器)至关重要。 因此笔者十分鼓励大家对node应用进行bundle,而esbuild对node的bundle提供了开箱即用的支持。 tsctransformer替代品 tsc即使支持了增量编译,其性能也极其堪忧,我们可以通过esbuild来代替tsc来编译ts的代码。(esbuid不支持ts的type check也不准备支持),但是如果业务的dev阶段不强依赖type checker,完全可以dev阶段用esbuild替代tsc,如果对typechecker有强要求,可以关注swc,swc正在用rust重写tsc的type checker部分,https://github.com/swc-project/swc/issues/571 monorepo与monotools esbuild是少有的对库开发和应用开发支持都比较良好的工具(webpack库支持不佳,rollup应用开发支持不佳),这意味着你完全可以通过esbuild统一你项目的构建工具。 esbuild原生支持react的开发,bundle速度极其快,在没有做任何bundleness之类的优化的情况下,一次的完整的bundle只需要80ms(包含了react,monaco-editor,emotion,mobx等众多库的情况下) 这带来了另一个好处就是你的monorepo里很方便的解决公共包的编译问题。你只需要将esbuild的main field配置为['source','module','main'],然后在你公共库里将source指向你的源码入口,esbuild会首先尝试去编译你公共库的源码,esbuild的编译速度是如此之快,根本不会因为公共库的编译影响你的整体bundle速度。我只能说TSC不太适合用来跑编译,too slow && too complex。 esbuild存在的一些问题 调试麻烦 esbuild的核心代码是用golang编写,用户使用的直接是编译出来的binary代码和一堆js的胶水代码,binary代码几乎没法断点调试(lldb|gdb调试),每次调试esbuild的代码,需要拉下代码重新编译调试,调试要求较高,难度较大 只支持target到es6 esbuild的transformer目前只支持target到es6,对于dev阶段影响较小,但目前国内大部分都仍然需要考虑es5场景,因此并不能将esbuild的产物作为最终产物,通常需要配合babel | tsc | swc做es6到es5的转换 golang wasm的性能相比native有较大的损耗,且wasm包体积较大, 目前golang编译出的wasm性能并不是很好(相比于native有3-5倍的性能衰减),并且go编译出来wasm包体积较大(8M+),不太适合一些对包体积敏感的场景 插件api较为精简 相比于webpack和rollup庞大的插件api支持,esbuild仅支持了onLoad和onResolve两个插件钩子,虽然基于此能完成很多工作,但是仍然较为匮乏,如code spliting后的chunk的后处理都不支持 🔥 火山引擎 APMPlus 应用性能监控是火山引擎应用开发套件 MARS 下的性能监控产品。我们通过先进的数据采集与监控技术,为企业提供全链路的应用性能监控服务,助力企业提升异常问题排查与解决的效率。 目前我们面向中小企业特别推出_「APMPlus 应用性能监控企业助力行动」_,为中小企业提供应用性能监控免费资源包。现在申请,有机会获得60天免费性能监控服务,最高可享6000万条事件量。 👉 点击这里,立即申请

优秀的个人博客,低调大师

每日一博 | TCP 长连接实践与挑战

👉 点这里立即申请 本文介绍了tcp长连接在实际工程中的实践过程,并总结了tcp连接保活遇到的挑战以及对应的解决方案。 作者:字节跳动终端技术 ——— 陈圣坤 概述 众所周知,作为传输层通信协议,TCP是面向连接设计的,所有请求之前需要先通过三次握手建立一个连接,请求结束后通过四次挥手关闭连接。通常我们使用TCP连接或者基于TCP连接之上的应用层协议例如HTTP 1.0等,都会为每次请求建立一次连接,请求结束即关闭连接。这样的好处是实现简单,不用维护连接状态。但对于大量请求的场景下,频繁创建、关闭连接可能会带来大量的开销。因此这种场景通常的做法是保持长连接,一次请求后连接不关闭,下次再对该端点发起的请求直接复用该连接,例如HTTP 1.1及HTTP 2.0都是这么做的。然而在工程实践中会发现,实现TCP长连接并不像想象的那么简单,本文总结了实现TCP长连接时遇到的挑战和解决方案。 事实上TCP协议本身并没有规定请求完成时要关闭连接,也就是说TCP本身就是长连接的,直到有一方主动关闭连接为止。实现TCP连接遇到的挑战主要有两个:连接池和连接保活。 连接池 长连接意味着连接是复用的,每次请求完连接不关闭,下次请求继续使用该连接。如果请求是串行的,那完全没有问题。但在并发场景下,所有请求都需要使用该连接,为了保证连接的状态正确,加锁不可避免,如果连接只有一个,就意味着所有请求都需要排队等待。因此长连接通常意味着连接池的存在:连接池中将保留一定数量的连接不关闭,有请求时从池中取出可用的连接,请求结束将连接返回池中。 用go实现一个简单的连接池(参考《Go语言实战》): import ( "errors" "io" "sync" ) type Pool struct { m sync.Mutex resources chan io.Closer closed bool } func (p *Pool) Acquire() (io.Closer, error) { r, ok := <-p.resources if !ok { return nil, errors.New("pool has been closed") } return r, nil } func (p *Pool) Release(r io.Closer) { p.m.Lock() defer p.m.Unlock() if p.closed { r.Close() return } select { case p.resources <- r: default: // pool is full , just close r.Close() } } func (p *Pool) Close() error { p.m.Lock() defer p.m.Unlock() if p.closed { return nil } p.closed = true close(p.resources) for r := range p.resources { if err := r.Close(); err != nil { return err } } return nil } func New(fn func() (io.Closer, error), size uint) (*Pool, error) { if size <= 0 { return nil, errors.New("size too small") } res := make(chan io.Closer, size) for i := 0; i < int(size); i++ { c, err := fn() if err != nil { return nil, err } res <- c } return &Pool{ resources: res, }, nil } 池的对象只需实现io.Closer接口即可,利用go缓冲通道的特性可以轻松地实现连接池:获取连接时从通道中接收一个对象,释放连接时将该对象发送到连接池中。由于go的通道本身就是goroutine安全的,因此不需要额外加锁。Pool使用的锁是为了保证Release操作和Close操作的并发安全,防止连接池在关闭的同时再释放连接,造成预期外的错误。 连接池经常遇到的一个问题就是池大小的控制:过大的连接池会带来资源的浪费,同时对服务端也会带来连接压力;过小的连接池在高并发场景下会限制并发性能。通常的解决办法是延迟创建和设置空闲时间,延迟创建是指连接只在请求到来时才创建,空闲时间是指连接在一定时间内未被使用则将被主动关闭。这样日常情况下连接池控制在较小的尺度,当并发请求量较大时会为新的请求创建新的连接,这些连接在请求完毕后返还连接池,其中的大部分会在闲置一定时间后被主动关闭,这样就做到了并发性能和IO资源之间较好的平衡。 连接保活 长连接的第二个问题就是连接保活的问题。虽然TCP协议并没有限制一个连接可以保持多久,理论上只要不关闭连接,连接就一直存在。但事实上由于NAT等网络设备的存在,一个连接即使没有主动关闭,它也不会一直存活。 NAT NAT(Network Address Translation)是一种被广泛应用的网络设备,直观地解释就是进行网络地址转换,通过一定策略对tcp包的源ip、源端口、目的ip和目的端口进行替换。可以说,NAT有效缓解了ipv4地址紧缺的问题,虽然理论上ipv4早已耗尽,但正由于NAT设备的存在,ipv4的寿命超出了所预计的时间。公司内部的网络也是通过NAT构建起来的。 虽然NAT有如此的优点,但它也带来了一些新的问题,对TCP长连接的影响就是其中之一。我们将一个通过NAT连接的网络简化成下面的模型: A如果想保持对B的长连接,它实际并不与B直接建立连接,而是与NAT A建立长连接,而NAT A又与NAT B、NAT B与B建立长连接。如果NAT设备任由下面的机器保持连接不关闭,那它很容易就耗尽所能支持的连接数,因此NAT设备会定时关闭一定时间内没有数据包的连接,并且它不会通知网络的双方。这就是为什么我们有时候会遇到这种错误: error: read tcp4 1.1.1.1:8888->2.2.2.2:9999: i/o timeout 按照TCP的设计,连接有一方要关闭连接时会有“四次挥手”的过程,通过一个关闭的连接发送数据时会抛出Broken pipe的错误。但NAT关闭连接时并不通知连接双方,发送方不知道连接已关闭,会继续通过该连接发送数据,并且不会抛出Broken pipe的错误,而接收方也不知道连接已关闭,还会持续监听该连接。这样发送方请求能成功发送,但接收方无法接收到该请求,因此发送方自然也等不到接收方的响应,就会阻塞至接口超时。经过实践发现公司的NAT超时是一个小时,也就是保持连接不关闭并闲置一个小时后,再通过该连接发送请求时,就会出现上述timeout的错误。 我们上面提到连接池大小的控制问题,其实看起来有点类似NAT的超时控制,那既然我们允许连接池关闭超时的闲置连接,为什么不能接受NAT设备关闭呢?答案就是上面提到的,NAT设备关闭连接时并未通知连接双方,因此客户端使用连接请求时并不知道该连接实际上是否可用,而如果是由连接池主动关闭连接,那它自然知道连接是否是可用的。 Keepalive 通过上面的描述我们就知道怎么解决了,既然NAT会关闭一定时间内没有数据包的连接,那我们只需要让这个连接定时自动发送一个小数据包,就能保证连接不会被NAT自动关闭。 实际上TCP协议中就包含了一个keepalive机制:如果keepalive开关被打开,在一段时间(保活时间:tcp_keepalive_time) 内此连接不活跃,开启保活功能的一端会向对端发送一个保活探测报文。只要我们保证这个tcp_keepalive_time小于NAT的超时时间,这个探测报文的存在就能保证NAT设备不会关闭我们的连接。 unix系统为TCP开发封装的socket接口通常都有keepalive的相关设置,以go语言为例: conn, _ := net.DialTCP("tcp4", nil, tcpAddr) _ = conn.SetKeepAlive(true) _ = conn.SetKeepAlivePeriod(5 * time.Minute) 另一个常见的保活机制是HTTP协议的keep-alive,不同于TCP协议,HTTP 1.0设计上默认是不支持长连接的,服务器响应完立即断开连接,通过请求头中的设置“connection: keep-alive”保持TCP连接不断开(HTTP 1.1以后默认开启)。 流水线控制 尽管使用连接池一定程度上能平衡好并发性能和io资源,但在高并发下性能还是不够理想,这是因为可能有上百个请求都在等同一个连接,每个请求都需要等待上一个请求返回后才能发出: : 这样无疑是低效的,我们不妨参考HTTP协议的流水线设计,也就是请求不必等待上一个请求返回才能发出,一个TCP长连接会按顺序连续发出一系列请求,等到请求发送成功后再统一按顺序接收所有的返回结果: 这样无疑能大大减少网络的等待时间,提高并发性能。随之而来的一个显而易见的问题是如何保证响应和请求的正确对应关系?通常有两种策略: 如果服务端是单线程/进程地处理每个连接,那服务端天然就是以请求的顺序依次响应的,客户端接收到的响应顺序和请求顺序是一致的,不需要特殊处理; 如果服务端是并发地处理每个连接上的所有请求(例如将请求入队列,然后并发地消费队列,经典的如redis),那就无法保证响应的顺序与请求顺序一致,这时就需要修改客户端与服务端的通信协议,在请求与响应的数据结构中带上独一无二的序号,通过匹配这个序号来确定响应和请求之间的映射关系; HTTP 2.0实现了一个多路复用的机制,其实可以看成是这种流水线的优化,它的响应与请求的映射关系就是通过流ID来保证的。 总结 以上就是对TCP长连接实践中遇到的挑战和解决思路的总结,结合笔者在公司内部的实践经验分别探讨了连接池、连接保活和流水线控制等问题,梳理了实现TCP长连接经常遇到的问题,并提出了解决思路,在降低频繁创建连接的开销的同时尽可能地保证高并发下的性能。 参考 TCP keepalive的探究 HTTP keep-alive和TCP keepalive的区别,你了解吗? HTTP/1.x 的连接管理 - HTTP | MDN 🔥 火山引擎 APMPlus 应用性能监控是火山引擎应用开发套件 MARS 下的性能监控产品。我们通过先进的数据采集与监控技术,为企业提供全链路的应用性能监控服务,助力企业提升异常问题排查与解决的效率。目前我们面向中小企业特别推出「APMPlus 应用性能监控企业助力行动」,为中小企业提供应用性能监控免费资源包。现在申请,有机会获得60天免费性能监控服务,最高可享6000万*条事件量。 👉 点击这里,立即申请

优秀的个人博客,低调大师

每日一博 | 详谈水平分库分表

一、背景 提起分库分表,对于大部分服务器开发来说,其实并不是一个新鲜的名词。随着业务的发展,我们表中的数据量会变的越来越大,字段也可能随着业务复杂度的升高而逐渐增多,我们为了解决单表的查询性能问题,一般会进行分表操作。 同时我们业务的用户活跃度也会越来越高,并发量级不断加大,那么可能会达到单个数据库的处理能力上限。此时我们为了解决数据库的处理性能瓶颈,一般会进行分库操作。不管是分库操作还是分表操作,我们一般都有两种方式应对,一种是垂直拆分,一种是水平拆分。 关于两种拆分方式的区别和特点,互联网上参考资料众多,很多人都写过相关内容,这里就不再进行详细赘述,有兴趣的读者可以自行检索。 此文主要详细聊一聊,我们最实用最常见的水平分库分表方式中的一些特殊细节,希望能帮助大家避免走弯路,找到最合适自身业务的分库分表设计。 【注1】本文中的案例均基于Mysql数据库,下文中的分库分表统指水平分库分表。 【注2】后文中提到到M库N表,均指共M个数据库,每个数据库共N个分表,即总表个数其实为M*N。 二、什么是一个好的分库分表方案? 2.1 方案可持续性 前期业务数据量级不大,流量较低的时候,我们无需分库分表,也不建议分库分表。但是一旦我们要对业务进行分库分表设计时,就一定要考虑到分库分表方案的可持续性。 **那何为可持续性?**其实就是:业务数据量级和业务流量未来进一步升高达到新的量级的时候,我们的分库分表方案可以持续使用。 一个通俗的案例,假定当前我们分库分表的方案为10库100表,那么未来某个时间点,若10个库仍然无法应对用户的流量压力,或者10个库的磁盘使用即将达到物理上限时,我们的方案能够进行平滑扩容。 在后文中我们将介绍下目前业界常用的翻倍扩容法和一致性Hash扩容法。 2.2 数据偏斜问题 一个良好的分库分表方案,它的数据应该是需要比较均匀的分散在各个库表中的。如果我们进行一个拍脑袋式的分库分表设计,很容易会遇到以下类似问题: a、某个数据库实例中,部分表的数据很多,而其他表中的数据却寥寥无几,业务上的表现经常是延迟忽高忽低,飘忽不定。 b、数据库集群中,部分集群的磁盘使用增长特别块,而部分集群的磁盘增长却很缓慢。每个库的增长步调不一致,这种情况会给后续的扩容带来步调不一致,无法统一操作的问题。 这边我们定义分库分表最大数据偏斜率为 :(数据量最大样本 - 数据量最小样本)/ 数据量最小样本。一般来说,如果我们的最大数据偏斜率在5%以内是可以接受的。 三、常见的分库分表方案 3.1 Range分库分表 顾名思义,该方案根据数据范围划分数据的存放位置。 举个最简单例子,我们可以把订单表按照年份为单位,每年的数据存放在单独的库(或者表)中。如下图所示: /** * 通过年份分表 * * @param orderId * @return */ public static String rangeShardByYear(String orderId) { int year = Integer.parseInt(orderId.substring(0, 4)); return "t_order_" + year; } 通过数据的范围进行分库分表,该方案是最朴实的一种分库方案,它也可以和其他分库分表方案灵活结合使用。时下非常流行的分布式数据库:TiDB数据库,针对TiKV中数据的打散,也是基于Range的方式进行,将不同范围内的[StartKey,EndKey)分配到不同的Region上。 下面我们看看该方案的缺点: a、最明显的就是数据热点问题,例如上面案例中的订单表,很明显当前年度所在的库表属于热点数据,需要承载大部分的IO和计算资源。 b、新库和新表的追加问题。一般我们线上运行的应用程序是没有数据库的建库建表权限的,故我们需要提前将新的库表提前建立,防止线上故障。 这点非常容易被遗忘,尤其是稳定跑了几年没有迭代任务,或者人员又交替频繁的模块。 c、业务上的交叉范围内数据的处理。举个例子,订单模块无法避免一些中间状态的数据补偿逻辑,即需要通过定时任务到订单表中扫描那些长时间处于待支付确认等状态的订单。 这里就需要注意了,因为是通过年份进行分库分表,那么元旦的那一天,你的定时任务很有可能会漏掉上一年的最后一天的数据扫描。 3.2 Hash分库分表 虽然分库分表的方案众多,但是Hash分库分表是最大众最普遍的方案,也是本文花最大篇幅描述的部分。 针对Hash分库分表的细节部分,相关的资料并不多。大部分都是阐述一下概念举几个示例,而细节部分并没有特别多的深入,如果未结合自身业务贸然参考引用,后期非常容易出现各种问题。 在正式介绍这种分库分表方式之前,我们先看几个常见的错误案例。 常见错误案例一:非互质关系导致的数据偏斜问题 public static ShardCfg shard(String userId) { int hash = userId.hashCode(); // 对库数量取余结果为库序号 int dbIdx = Math.abs(hash % DB_CNT); // 对表数量取余结果为表序号 int tblIdx = Math.abs(hash % TBL_CNT); return new ShardCfg(dbIdx, tblIdx); } 上述方案是初次使用者特别容易进入的误区,用Hash值分别对分库数和分表数取余,得到库序号和表序号。其实稍微思索一下,我们就会发现,以10库100表为例,如果一个Hash值对100取余为0,那么它对10取余也必然为0。 这就意味着只有0库里面的0表才可能有数据,而其他库中的0表永远为空! 类似的我们还能推导到,0库里面的共100张表,只有10张表中(个位数为0的表序号)才可能有数据。这就带来了非常严重的数据偏斜问题,因为某些表中永远不可能有数据,最大数据偏斜率达到了无穷大。 那么很明显,该方案是一个未达到预期效果的错误方案。数据的散落情况大致示意图如下: 事实上,只要库数量和表数量非互质关系,都会出现某些表中无数据的问题。 证明如下: 那么是不是只要库数量和表数量互质就可用用这种分库分表方案呢?比如我用11库100表的方案,是不是就合理了呢? 答案是否定的,我们除了要考虑数据偏斜的问题,还需要考虑可持续性扩容的问题,一般这种Hash分库分表的方案后期的扩容方式都是通过翻倍扩容法,那11库翻倍后,和100又不再互质。 当然,如果分库数和分表数不仅互质,而且分表数为奇数(例如10库101表),则理论上可以使用该方案,但是我想大部分人可能都会觉得使用奇数的分表数比较奇怪吧。 常见错误案例二:扩容难以持续 如果避开了上述案例一的陷阱,那么我们又很容易一头扎进另一个陷阱,大概思路如下; 我们把10库100表看成总共1000个逻辑表,将求得的Hash值对1000取余,得到一个介于[0,999)中的数,然后再将这个数二次均分到每个库和每个表中,大概逻辑代码如下: public static ShardCfg shard(String userId) { // ① 算Hash int hash = userId.hashCode(); // ② 总分片数 int sumSlot = DB_CNT * TBL_CNT; // ③ 分片序号 int slot = Math.abs(hash % sumSlot); // ④ 计算库序号和表序号的错误案例 int dbIdx = slot % DB_CNT ; int tblIdx = slot / DB_CNT ; return new ShardCfg(dbIdx, tblIdx); } 该方案确实很巧妙的解决了数据偏斜的问题,只要Hash值足够均匀,那么理论上分配序号也会足够平均,于是每个库和表中的数据量也能保持较均衡的状态。 但是该方案有个比较大的问题,那就是在计算表序号的时候,依赖了总库的数量,那么后续翻倍扩容法进行扩容时,会出现扩容前后数据不在同一个表中,从而无法实施。 如上图中,例如扩容前Hash为1986的数据应该存放在6库98表,但是翻倍扩容成20库100表后,它分配到了6库99表,表序号发生了偏移。这样的话,我们在后续在扩容的时候,不仅要基于库迁移数据,还要基于表迁移数据,非常麻烦且易错。 看完了上面的几种典型的错误案例,那么我们有哪些比较正确的方案呢?下面将结合一些实际场景案例介绍几种Hash分库分表的方案。 常用姿势一:标准的二次分片法 上述错误案例二中,整体思路完全正确,只是最后计算库序号和表序号的时候,使用了库数量作为影响表序号的因子,导致扩容时表序号偏移而无法进行。 事实上,我们只需要换种写法,就能得出一个比较大众化的分库分表方案。 public static ShardCfg shard2(String userId) { // ① 算Hash int hash = userId.hashCode(); // ② 总分片数 int sumSlot = DB_CNT * TBL_CNT; // ③ 分片序号 int slot = Math.abs(hash % sumSlot); // ④ 重新修改二次求值方案 int dbIdx = slot / TBL_CNT ; int tblIdx = slot % TBL_CNT ; return new ShardCfg(dbIdx, tblIdx); } 大家可以注意到,和错误案例二中的区别就是通过分配序号重新计算库序号和表序号的逻辑发生了变化。它的分配情况如下: 那为何使用这种方案就能够有很好的扩展持久性呢?我们进行一个简短的证明: 通过上面结论我们知道,通过翻倍扩容后,我们的表序号一定维持不变,库序号可能还是在原来库,也可能平移到了新库中(原库序号加上原分库数),完全符合我们需要的扩容持久性方案。 【方案缺点】 1、翻倍扩容法前期操作性高,但是后续如果分库数已经是大几十的时候,每次扩容都非常耗费资源。 2、连续的分片键Hash值大概率会散落在相同的库中,某些业务可能容易存在库热点(例如新生成的用户Hash相邻且递增,且新增用户又是高概率的活跃用户,那么一段时间内生成的新用户都会集中在相邻的几个库中)。 常用姿势二:关系表冗余 我们可以将分片键对应库的关系通过关系表记录下来,我们把这张关系表称为"路由关系表"。 public static ShardCfg shard(String userId) { int tblIdx = Math.abs(userId.hashCode() % TBL_CNT); // 从缓存获取 Integer dbIdx = loadFromCache(userId); if (null == dbIdx) { // 从路由表获取 dbIdx = loadFromRouteTable(userId); if (null != dbIdx) { // 保存到缓存 saveRouteCache(userId, dbIdx); } } if (null == dbIdx) { // 此处可以自由实现计算库的逻辑 dbIdx = selectRandomDbIdx(); saveToRouteTable(userId, dbIdx); saveRouteCache(userId, dbIdx); } return new ShardCfg(dbIdx, tblIdx); } 该方案还是通过常规的Hash算法计算表序号,而计算库序号时,则从路由表读取数据。因为在每次数据查询时,都需要读取路由表,故我们需要将分片键和库序号的对应关系记录同时维护在缓存中以提升性能。 上述实例中selectRandomDbIdx方法作用为生成该分片键对应的存储库序号,这边可以非常灵活的动态配置。例如可以为每个库指定一个权重,权重大的被选中的概率更高,权重配置成0则可以将关闭某些库的分配。当发现数据存在偏斜时,也可以调整权重使得各个库的使用量调整趋向接近。 该方案还有个优点,就是理论上后续进行扩容的时候,仅需要挂载上新的数据库节点,将权重配置成较大值即可,无需进行任何的数据迁移即可完成。 如下图所示:最开始我们为4个数据库分配了相同的权重,理论上落在每个库的数据概率均等。但是由于用户也有高频低频之分,可能某些库的数据增长会比较快。当挂载新的数据库节点后,我们灵活的调整了每个库的新权重。 该方案似乎解决了很多问题,那么它有没有什么不适合的场景呢?当然有,该方案在很多场景下其实并不太适合,以下举例说明。 a、每次读取数据需要访问路由表,虽然使用了缓存,但是还是有一定的性能损耗。 b、路由关系表的存储方面,有些场景并不合适。例如上述案例中用户id的规模大概是在10亿以内,我们用单库百表存储该关系表即可。但如果例如要用文件MD5摘要值作为分片键,因为样本集过大,无法为每个md5值都去指定关系(当然我们也可以使用md5前N位来存储关系)。 c、饥饿占位问题,如下详叙: 我们知道,该方案的特点是后续无需扩容,可以随时修改权重调整每个库的存储增长速度。但是这个愿景是比较缥缈,并且很难实施的,我们选取一个简单的业务场景考虑以下几个问题。 【业务场景】:以用户存放文件到云端的云盘业务为例,需要对用户的文件信息进行分库分表设计,有以下假定场景: ①假定有2亿理论用户,假设当前有3000W有效用户。 ②平均每个用户文件量级在2000个以内 ③用户id为随机16位字符串 ④初期为10库,每个库100张表。 我们使用路由表记录每个用户所在的库序号信息。那么该方案会有以下问题: 第一:我们总共有2亿个用户,只有3000W个产生过事务的用户。若程序不加处理,用户发起任何请求则创建路由表数据,会导致为大量实际没有事务数据的用户提前创建路由表。 笔者最初存储云盘用户数据的时候便遇到了这个问题,客户端app会在首页查询用户空间使用情况,这样导致几乎一开始就为每个使用者分配好了路由。随着时间的推移,这部分没有数据的"静默"的用户,随时可能开始他的云盘使用之旅而“复苏”,从而导致它所在的库迅速增长并超过单个库的空间容量极限,从而被迫拆分扩容。 解决这个问题的方案,其实就是只针对事务操作(例如购买空间,上传数据,创建文件夹等等)才进行路由的分配,这样对代码层面便有了一些倾入。 第二、按照前面描述的业务场景,一个用户最终平均有2000条数据,假定每行大小为1K,为了保证B+数的层级在3层,我们限制每张表的数据量在2000W,分表数为100的话,可以得到理论上每个库的用户数不能超过100W个用户。 也就是如果是3000W个产生过事务的用户,我们需要为其分配30个库,这样会在业务前期,用户平均数据量相对较少的时候,存在非常大的数据库资源的浪费。 解决第二个问题,我们一般可以将很多数据库放在一个实例上,后续随着增长情况进行拆分。也可以后续针对将满的库,使用常规手段进行拆分和迁移。 常用姿势三:基因法 还是由错误案例一启发,我们发现案例一不合理的主要原因,就是因为库序号和表序号的计算逻辑中,有公约数这个因子在影响库表的独立性。 那么我们是否可以换一种思路呢?我们使用相对独立的Hash值来计算库序号和表序号。 public static ShardCfg shard(String userId) { int dbIdx = Math.abs(userId.substring(0, 4).hashCode() % DB_CNT ); int tblIdx = Math.abs(userId.hashCode() % TBL_CNT); return new ShardCfg(dbIdx, tblIdx); } 如上所示,我们计算库序号的时候做了部分改动,我们使用分片键的前四位作为Hash值来计算库序号。 这也是一种常用的方案,我们称为基因法,即使用原分片键中的某些基因(例如前四位)作为库的计算因子,而使用另外一些基因作为表的计算因子。该方案也是网上不少的实践方案或者是其变种,看起来非常巧妙的解决了问题,然而在实际生成过程中还是需要慎重。 笔者曾在云盘的空间模块的分库分表实践中采用了该方案,使用16库100表拆分数据,上线初期数据正常。然而当数据量级增长起来后,发现每个库的用户数量严重不均等,故猜测该方案存在一定的数据偏斜。 为了验证观点,进行如下测试,随机2亿个用户id(16位的随机字符串),针对不同的M库N表方案,重复若干次后求平均值得到结论如下: 8库100表 min=248305(dbIdx=2, tblIdx=64), max=251419(dbIdx=7, tblIdx=8), rate= 1.25% √ 16库100表 min=95560(dbIdx=8, tblIdx=42), max=154476(dbIdx=0, tblIdx=87), rate= 61.65% × 20库100表 min=98351(dbIdx=14, tblIdx=78), max=101228(dbIdx=6, tblIdx=71), rate= 2.93% 我们发现该方案中,分库数为16,分表数为100,数量最小行数仅为10W不到,但是最多的已经达到了15W+,最大数据偏斜率高达61%。按这个趋势发展下去,后期很可能出现一台数据库容量已经使用满,而另一台还剩下30%+的容量。 该方案并不是一定不行,而是我们在采用的时候,要综合分片键的样本规则,选取的分片键前缀位数,库数量,表数量,四个变量对最终的偏斜率都有影响。 例如上述例子中,如果不是16库100表,而是8库100表,或者20库100表,数据偏斜率都能降低到了5%以下的可接受范围。所以该方案的隐藏的"坑"较多,我们不仅要估算上线初期的偏斜率,还需要测算若干次翻倍扩容后的数据偏斜率。 例如你用着初期比较完美的8库100表的方案,后期扩容成16库100表的时候,麻烦就接踵而至。 常用姿势四:剔除公因数法 还是基于错误案例一启发,在很多场景下我们还是希望相邻的Hash能分到不同的库中。就像N库单表的时候,我们计算库序号一般直接用Hash值对库数量取余。 那么我们是不是可以有办法去除掉公因数的影响呢?下面为一个可以考虑的实现案例: public static ShardCfg shard(String userId) { int dbIdx = Math.abs(userId.hashCode() % DB_CNT); // 计算表序号时先剔除掉公约数的影响 int tblIdx = Math.abs((userId.hashCode() / TBL_CNT) % TBL_CNT); return new ShardCfg(dbIdx, tblIdx); } 经过测算,该方案的最大数据偏斜度也比较小,针对不少业务从N库1表升级到N库M表下,需要维护库序号不变的场景下可以考虑。 常用姿势五:一致性Hash法 一致性Hash算法也是一种比较流行的集群数据分区算法,比如RedisCluster即是通过一致性Hash算法,使用16384个虚拟槽节点进行每个分片数据的管理。关于一致性Hash的具体原理这边不再重复描述,读者可以自行翻阅资料。 这边详细介绍如何使用一致性Hash进行分库分表的设计。 我们通常会将每个实际节点的配置持久化在一个配置项或者是数据库中,应用启动时或者是进行切换操作的时候会去加载配置。配置一般包括一个[StartKey,Endkey)的左闭右开区间和一个数据库节点信息,例如: 示例代码: private TreeMap<Long, Integer> nodeTreeMap = new TreeMap<>(); @Override public void afterPropertiesSet() { // 启动时加载分区配置 List<HashCfg> cfgList = fetchCfgFromDb(); for (HashCfg cfg : cfgList) { nodeTreeMap.put(cfg.endKey, cfg.nodeIdx); } } public ShardCfg shard(String userId) { int hash = userId.hashCode(); int dbIdx = nodeTreeMap.tailMap((long) hash, false).firstEntry().getValue(); int tblIdx = Math.abs(hash % 100); return new ShardCfg(dbIdx, tblIdx); } 我们可以看到,这种形式和上文描述的Range分表非常相似,Range分库分表方式针对分片键本身划分范围,而一致性Hash是针对分片键的Hash值进行范围配置。 正规的一致性Hash算法会引入虚拟节点,每个虚拟节点会指向一个真实的物理节点。这样设计方案主要是能够在加入新节点后的时候,可以有方案保证每个节点迁移的数据量级和迁移后每个节点的压力保持几乎均等。 但是用在分库分表上,一般大部分都只用实际节点,引入虚拟节点的案例不多,主要有以下原因: a、应用程序需要花费额外的耗时和内存来加载虚拟节点的配置信息。如果虚拟节点较多,内存的占用也会有些不太乐观。 b、由于mysql有非常完善的主从复制方案,与其通过从各个虚拟节点中筛选需要迁移的范围数据进行迁移,不如通过从库升级方式处理后再删除冗余数据简单可控。 c、虚拟节点主要解决的痛点是节点数据搬迁过程中各个节点的负载不均衡问题,通过虚拟节点打散到各个节点中均摊压力进行处理。 而作为OLTP数据库,我们很少需要突然将某个数据库下线,新增节点后一般也不会从0开始从其他节点搬迁数据,而是前置准备好大部分数据的方式,故一般来说没有必要引入虚拟节点来增加复杂度。 四、常见扩容方案 4.1 翻倍扩容法 翻倍扩容法的主要思维是每次扩容,库的数量均翻倍处理,而翻倍的数据源通常是由原数据源通过主从复制方式得到的从库升级成主库提供服务的方式。故有些文档将其称作"从库升级法"。 理论上,经过翻倍扩容法后,我们会多一倍的数据库用来存储数据和应对流量,原先数据库的磁盘使用量也将得到一半空间的释放。如下图所示: 具体的流程大致如下: ①、时间点t1:为每个节点都新增从库,开启主从同步进行数据同步。 ②、时间点t2:主从同步完成后,对主库进行禁写。 此处禁写主要是为了保证数据的正确性。若不进行禁写操作,在以下两个时间窗口期内将出现数据不一致的问题: a、断开主从后,若主库不禁写,主库若还有数据写入,这部分数据将无法同步到从库中。 b、应用集群识别到分库数翻倍的时间点无法严格一致,在某个时间点可能两台应用使用不同的分库数,运算到不同的库序号,导致错误写入。 ③、时间点t3:同步完全完成后,断开主从关系,理论上此时从库和主库有着完全一样的数据集。 ④、时间点t4:从库升级为集群节点,业务应用识别到新的分库数后,将应用新的路由算法。 一般情况下,我们将分库数的配置放到配置中心中,当上述三个步骤完成后,我们修改分库数进行翻倍,应用生效后,应用服务将使用新的配置。这里需要注意的是,业务应用接收到新的配置的时间点不一定一致,所以必定存在一个时间窗口期,该期间部分机器使用原分库数,部分节点使用新分库数。这也正是我们的禁写操作一定要在此步完成后才能放开的原因。 ⑤、时间点t5:确定所有的应用均接受到库总数的配置后,放开原主库的禁写操作,此时应用完全恢复服务。 ⑥、启动离线的定时任务,清除各库中的约一半冗余数据。 为了节省磁盘的使用率,我们可以选择离线定时任务清除冗余的数据。也可以在业务初期表结构设计的时候,将索引键的Hash值存为一个字段。那么以上述常用姿势四为例,我们离线的清除任务可以简单的通过sql即可实现(需要防止锁住全表,可以拆分成若干个id范围的子sql执行): delete from db0.tbl0 where hash_val mod 4 <> 0; delete from db1.tbl0 where hash_val mod 4 <> 1; delete from db2.tbl0 where hash_val mod 4 <> 2; delete from db3.tbl0 where hash_val mod 4 <> 3; 具体的扩容步骤可参考下图: 总结:通过上述迁移方案可以看出,从时间点t2到t5时间窗口呢内,需要对数据库禁写,相当于是该时间范围内服务器是部分有损的,该阶段整体耗时差不多是在分钟级范围内。若业务可以接受,可以在业务低峰期进行该操作。 当然也会有不少应用无法容忍分钟级写入不可用,例如写操作远远大于读操作的应用,此时可以结合canel开源框架进行窗口期内数据双写操作以保证数据的一致性。 该方案主要借助于mysql强大完善的主从同步机制,能在事前提前准备好新的节点中大部分需要的数据,节省大量的人为数据迁移操作。 但是缺点也很明显,一是过程中整个服务可能需要以有损为代价,二是每次扩容均需要对库数量进行翻倍,会提前浪费不少的数据库资源。 4.2 一致性Hash扩容 我们主要还是看下不带虚拟槽的一致性Hash扩容方法,假如当前数据库节点DB0负载或磁盘使用过大需要扩容,我们通过扩容可以达到例如下图的效果。 下图中,扩容前配置了三个Hash分段,发现[-Inf,-10000)范围内的的数据量过大或者压力过高时,需要对其进行扩容。 主要步骤如下: ①、时间点t1:针对需要扩容的数据库节点增加从节点,开启主从同步进行数据同步。 ②、时间点t2:完成主从同步后,对原主库进行禁写。 此处原因和翻倍扩容法类似,需要保证新的从库和原来主库中数据的一致性。 ③、时间点t3:同步完全完成后,断开主从关系,理论上此时从库和主库有着完全一样的数据集。 ④、时间点t4:修改一致性Hash范围的配置,并使应用服务重新读取并生效。 ⑤、时间点t5:确定所有的应用均接受到新的一致性Hash范围配置后,放开原主库的禁写操作,此时应用完全恢复服务。 ⑥、启动离线的定时任务,清除冗余数据。 可以看到,该方案和翻倍扩容法的方案比较类似,但是它更加灵活,可以根据当前集群每个节点的压力情况选择性扩容,而无需整个集群同时翻倍进行扩容。 五、小结 本文主要描述了我们进行水平分库分表设计时的一些常见方案。 我们在进行分库分表设计时,可以选择例如范围分表,Hash分表,路由表,或者一致性Hash分表等各种方案。进行选择时需要充分考虑到后续的扩容可持续性,最大数据偏斜率等因素。 文中也列举了一些常见的错误示例,例如库表计算逻辑中公约数的影响,使用前若干位计算库序号常见的数据倾斜因素等等。 我们在实际进行选择时,一定要考虑自身的业务特点,充分验证分片键在各个参数因子下的数据偏斜程度,并提前规划考虑好后续扩容的方案。 作者:vivo平台产品开发团队-Han Lei

优秀的个人博客,低调大师

每日一博 | 网易有道 REDIS 云原生实战

摘要 本次以Redis为范例,阐述了有道基础架构团队在基础设施容器化道路上的实践,主要将从声明式管理,Operator工作原理,容器编排,主从模式,集群模式,高可用策略,集群扩缩容等方面展开。 youdao 背景 ydtech Redis 是业务系统中较为常用的缓存服务,常用于流量高峰、数据分析、积分排序等场景,并且通过中间件可以实现系统之间的解耦,提升系统的可扩展性。 传统物理机部署中间件,需要运维人员手动搭建,启动时间较长,也不利于后期维护,无法满足业务快速发展的需求。 云原生相较于传统IT,可以助力业务平滑迁移、快速开发、稳定运维,大幅降低技术成本,节约硬件资源。 云原生中间件是指依托容器化、服务网格、微服务、Serverless等技术,构建可扩展的基础设施,持续交付用于生产系统的基础软件,在功能不变的前提下,提高了应用的可用性与稳定性。 在这种大趋势下,有道基础架构团队开始了云原生中间件的实践,除了本文介绍的 Redis,还包括 Elasticsearch、ZooKeeper 等。 youdao 面临的挑战 ydtech 利用云原生技术可以解决当前Redis部署缓慢,资源利用率低等问题,同时容器化 Redis 集群也面临着一些挑战: Kubernetes 如何部署 Redis 有状态服务; 容器 Crash 后如何不影响服务可用性; 容器重启后如何保证 Redis 内存中的数据不丢; 节点水平扩容时如何做到 Slots 迁移时不影响业务; Pod ip变化后集群的状态如何处理。 youdao 声明式管理 ydtech 对于一个 Redis 集群,我们的期望是能够 7x24 小时无间断提供服务,遇故障可自行修复。这与Kubernetes API的声明式特点如出一辙。 所谓“声明式”, 指的就是我们只需要提交一个定义好的 API 对象来“声明”我所期望的状态是什么样子,Kubernetes中的资源对象可在无外界干扰的情况下,完成当前状态到期望状态的转换,这个过程就是Reconcile过程。例如,我们通过yaml创建了一个Deployment ,Kubernetes将“自动的”根据yaml中的配置,为其创建好Pod,并拉取指定存储卷进行挂载,以及其他一系列复杂要求。 因此,我们的Redis集群是否可以使用一个类似的服务去完成这个过程呢?即我们需要定义这样的对象,定义服务Reconcile的过程。Kubernetes的Operator刚好可以满足这个需求,可以简单的理解Operator由资源定义和资源控制器构成,在充分解读集群和Operator的关系后,我们将整体架构图设计如下: Operator集群本身采用Deployment部署,由ETCD 完成选主,上层与Kubernetes的Api Server 、Controller Manager等组件进行通信,下层持续调和Redis集群状态。 哨兵模式中Redis服务用一套哨兵集群,使用StatefulSet部署,持久化配置文件。Redis server也采用 StatefulSet部署, 哨兵模式的实例为一主多从。 集群模式中的每个分片使用StatefulSet部署,代理采用Deployment部署。原生Pod、StatefulSet、Service、调度策略等由Kubernetes本身负责。 Redis的资源定义在ETCD中存储一份即可,我们只需要预先提交自定义资源的 yaml配置。如下所示为创建三个副本的Redis主从集群: apiVersion: Redis.io/v1beta1kind: RedisClustermetadata: name: my-releasespec: size: 3 imagePullPolicy: IfNotPresent resources: limits: cpu: 1000m memory: 1Gi requests: cpu: 1000m memory: 1Gi config:maxclients:"10000" 其中,kind定义使用的CR名称,size为副本数,resources定义资源配额,config对应Redis Server的config,该定义存储在Kubernetes的ETCD数据库中,后续的具体资源申请与使用由Operator的Controller完成。 youdao Operator工作原理 ydtech Operator 是 Kubernetes 的扩展模式,由CRD、Controller构成。它利用定制资源管理特定应用及其组件,Operator 遵循 Kubernetes 的理念。 Operator 无需任何修改,即可从 Kubernetes 核心中获得许多内置的自动化功能,如使用 Kubernetes 自动化部署和运行工作负载,甚至可以自动化 Kubernetes 自身。 Kubernetes 的 Operator 模式可在不修改 Kubernetes 自身的代码基础上,通过控制器关联到一个以上的定制资源,即可以扩展集群的行为。Operator 是 Kubernetes API 的客户端,核心功能是充当定制资源的控制器。 CRD: Custom Resource Definition, 在Kubernetes中一切皆是资源,资源就是CRD,用户自定义的Kubernetes资源是一个类型 ,比如默认自带的由Deployment,Pod ,Service等。 CR:Custom Resource 是实现CRD的具体实例。 用户创建一个CRD自定义资源,ApiServer把CRD转发给webhook,webhook 进行缺省值配置 验证配置和修改配置,webhook处理完成后的的配置会存入ETCD中 ,返回给用户是否创建成功信息。Controller 会监测到CRD,按照预先写的业务逻辑,处理这个CRD,比如创建Pod、处理新节点与旧集群关系等,保证运行的状态与期望的一致。 youdao 容器编排 ydtech Redis 集群在 Kubernetes 中的最小部署单位为 Pod,因此在架构设计之前,需预先考虑Redis特性、资源限制、部署形态、数据存储、状态维护等内容,为不同类型的Redis集群配置合适的部署方式。 资源限制: Kubernetes 采用 request 和 limit 两种限制类型来对资源进行分配。 request(资源需求):即运行Pod的节点必须满足运行Pod的最基本需求才能启动。 limit(资源限制):即运行Pod期间,可能内存使用量会增加,那最多能使用多少内存,这就是资源限额。 Redis 基本不会滥用 cpu,因此配置1-2个核即可。内存根据具体业务使用分配,考虑到部分场景下会fork较多的内存,例如 aof 频繁刷写,aof 重写过程中,Redis 主程序称依旧可以接收写操作,这时会采用 copy on write (写时复制)的方法操作内存数据,若业务使用特点为“写多读少”,那么刷写期间将产生大量的内存拷贝,从而导致 OOM,服务重启。 一个有效的解决方式为减少刷写次数,将刷写操作放在夜间低流量时段进行。减少刷写次数的方法为适当增加auto-aof-rewrite-min-size的大小,可配置使用内存的5倍甚至更大的最小刷写量;其次可以主动触发刷写,判断内存使用达到的配额两倍时进行刷写,实际部署时一般也会预留50%的内存防止OOM。 部署的基本形态: 依据数据是否需要持久化或是否需要唯一标识区分服务为无状态和有状态的服务,Redis集群需要明确主从、分片标识,大部分场景也需要数据持久化,Kubernetes使用StatefulSet来满足这一类需求。StatefulSet的顺序部署、逆序自动滚动更新更能提高Redis集群的可用性。 具体的: Redis Server 使用 StatefulSet 启动,为标识为{StatefulSetName}-0的Pod设置Master角色,给其他Pod设置为该Master的从节点。 Proxy无需存储任何数据,使用Deployment部署,便于动态扩展。 配置文件: Redis Server 启动时需要一些配置文件,里面涉及到用户名和密码,我们使用 Configmap 和 Secret 来存储的。Configmap 是 Kubernetes的Api 对象,常用于存储小于1MB的非机密键值对。而 Secret 可以用于存储包含敏感信息的密码、令牌、密钥等数据的对象。 两种资源均可以在 Pod 运行的时候通过 Volume 机制挂载到 Pod 内部。 存储: 存储使用的是 PVC(PersistentVolumeClaim)加 PV (Persistent Volumes),PV为Kubernetes集群中的资源,由存储类StorageClass来动态供应,PV支持多种访问模式:ReadWriteOnce、ReadOnlyMany 或 ReadWriteMany,通过PV定义存储资源,PVC申请使用该存储资源。另外通过根据存储的 StorageClass 字段 可抽象不同的存储后端,如Cephfs、Cephrbd、Openebs、LocalStorage 等。 youdao 主从模式 ydtech 1. 主从拓扑图 Redis容器化后建立的每个 CR 表示一个完整的Redis服务,具体的服务模式包括哨兵模式和集群模式两种,在进行容器化过程中,除覆盖裸服务器部署结构外,也对架构进行了一定程度的优化。 原哨兵模式: 原哨兵模式为每套实例配一组哨兵。 共用哨兵模式: 所有实例共用一组哨兵将进一步提高实例启动速度,并在一定程度上可提高硬件资源利用率,实测单组哨兵可轻松应对百规模的主从集群。 2. 调和原理 Reconcile 实现持续监测并对主从集群进行修复的功能。 1. 检查是否按照预期启动了全部的Pod,比如创建3个Server,那么需要按照预期启动三个才能继续进行后面的操作。 2. 检查Master的数量,确保该实例仅有一个主节点(数量为0主动选一个;数量大于1手动修复)。 3. 检查哨兵: (1)所有的哨兵是否监控了正确的Master; (2)所有的哨兵均知道相同的Slave; (3)再次检查哨兵的数量,确保哨兵均可用。 4. 检查 Service,使Service 的Endpoints指向正确的Master。 5. 检查Redis config是否有做修改,有则对所有节点重写config参数。 youdao 集群模式 ydtech 1. 集群拓扑图 Redis Cluster + Proxy模式: 通过在传统Redis Cluster架构中引入代理功能,实现动态路由分发,并基于Kubernetes原生动态扩缩容特性,更易应对突发流量,合理分配使用资源。 代理基础转发规则如下: 对于操作单个Key的命令,Proxy会根据Key所属的Slot(槽)将请求发送给所属的数据分片。 对于操作多个Key的命令,如果这些Key是储存在不同的数据分片,Proxy会将命令拆分成多个命令分别发送给对应的分片。 服务部署前,也对代理的部分功能进行了补充,例如移除不可用节点等。 2. 调和原理 reconcile 实现持续监测并对Redis Cluster进行修复功能。 确保集群健康的步骤: 1. 等待所有 Pod 状态变为 Ready 且每个节点相互识别后,Operator 会在每个 StatefulSet 的 Pod 中挑选一个作为 Master 节点,其余节点为该 Master 的 Slave。 2. 获取实例集群所有Pod的ip、所有Pod的cluster info(包含nodeIP,主从关系等)。 3. 进入恢复流程 (1)处理失败节点, 对部分节点重启后的无效ip、状态为noaddr的僵尸节点进行forget操作; (2)处理不可信节点 (所有handshake状态的节点),发生于某一个节点被移除(由forget node触发),但试图加入集群时,即该Pod在Operator角度下存在,但实际集群节点并不需要该节点,处理方式为删掉这个Pod,并再次做forget操作直到Pod被删除。 4. 任选一个节点,使用CLUSTER MEET给该节点加入所有已知节点。 5. 为StatefulSet中的Pod建立主从关系,同时给其分配Slots。若当前Master数量同预期不一致,则对应扩缩容操作,具体见’集群扩缩容’的横向扩缩容小节。 6. 检查Redis config是否有做修改,有则对所有节点重写config参数。 确保代理健康的步骤: 1. 获取所有Running状态代理的Pod ip。 2. 从代理获取Redis Server信息,将集群信息同步到所有的代理上,代理中不存在的Server ip做移除操作。 3. 若代理中无可用Redis Server, 表示被全部移除,则添加一个,代理可自动发现集群其他Redis节点。 youdao 高可用策略 ydtech 1. Kubernetes保证的高可用 (1) 容器部署保证高可用: Redis部署最小资源对象为Pod,Pod是Kubernetes创建或部署的最小/最简单的基本单位。 当启动出错,例如出现“CrashLoopBackOff”时,Kubernetes将自动在该节点上重启该Pod,当出现物理节点故障时,Kubernetes将自动在其他节点上重新拉起一个。 Pod未出问题,但程序不可用时,依托于健康检查策略,Kubernetes也将重启该Redis节点。 (2) 滚动升级: 节点纵向扩容时,使用StatefulSet的滚动升级机制,Kubernetes将逆序重启更新每个Pod,提高了服务的可用性。 (3) 调度的高可用: Kubernetes本身不处理Redis 多个Pod组建的集群之间的部署关系,但提供了部署策略,为保证特定场景下的高可用,如因物理节点导致所有Redis节点均宕机,CRD在设计中加入了亲和与反亲和字段。 默认使用 podAntiAffinity 做节点打散,如下所示实例instance1的所有 Pod 将被尽可能调度到不同的节点上。 spec: affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - podAffinityTerm: labelSelector: matchLabels: Redis.io/name: instance1 topologyKey: Kubernetes.io/hostname weight: 1 2. Redis集群的高可用 Redis 服务运行期间不可避免的出现各种特殊情况,如节点宕机、网络抖动等,如何持续监测这类故障并进行修复,实现 Redis 集群的高可用,也是 Operator 需解决的问题,下面以哨兵模式模式为例描述集群如何进行故障恢复。 主节点宕机:因物理节点驱逐、节点重启、进程异常结束等导致的Redis主节点宕机情况,哨兵会进行切主操作,然后Kubernetes会在可用物理节点上重新拉起一个Pod。 从节点宕机:哨兵模式的Redis集群未开启读写分离,从节点宕机对服务无影响,后续Kubernetes会重启拉起一个Pod,Operator会将该Pod设置为新主节点的从节点。 集群全部节点宕机:发生概率极小,但基于持久化可将服务影响降至最低,集群恢复后可继续提供服务。 节点网络故障:主从模式下配置了三个哨兵用于集群选主操作,哨兵集群的每一个节点会定时对 Redis 集群的所有节点发心跳包检测节点是否正常。如果一个节点在down-after-milliseconds时间内没有回复Sentinel节点的心跳包,则该Redis节点被该Sentinel节点主观下线。 当节点被一个 Sentinel 节点记为主观下线时,并不意味着该节点肯定故障了,还需要Sentinel集群的其他Sentinel节点共同判断为主观下线才行。 该 Sentinel 节点会询问其他Sentinel节点,如果 Sentinel 集群中超过 quorum 数量的 Sentinel 节点认为该 Redis 节点主观下线,则该 Redis 客观下线。 如果客观下线的 Redis 节点是从节点或者是Sentinel节点,则操作到此为止,没有后续的操作了;如果客观下线的Redis节点为主节点,则开始故障转移,从从节点中选举一个节点升级为主节点。 集群模式故障转移与上述类似,不过不需要哨兵干预,而是由节点之间通过PING/PONG实现。 youdao 监控观测 ydtech Redis 的监控采用经典的 Exporter+Promethus 的方案,Exporter 用于指标采集,数据存储在 Prometheus 或其他数据库中,最终 Grafana 前端将服务状态可视化。 youdao 集群扩缩容 ydtech (1)纵向扩缩容 纵向扩缩容主要指Pod的CPU、内存资源的调整,基于Kubernetes的特性,只需修改实例对应的spec字段,Operator的调和机制将持续监测参数变化,并对实例做出调整 。当修改cpu 、内存等参数时,Operator同步更新StatefulSet的limit、request信息,Kubernetes将逆序滚动更新Pod,滚动更新时,若停掉的是主节点,主节点的preStop功能会先通知哨兵或者集群进行数据保存,然后做主从切换操作,从而将服务的影响降至最低。更新后的主从关系建立以及哨兵monitor主节点功能也由Operator一并处理,全过程对客户端无感知。主从版、集群版在该场景下均支持秒级断闪。 (2)横向扩缩容 横向扩缩容主要指副本数或节点数的调整,得益于 Kubernetes 的声明式 API,可以通过更改声明的资源规模对集群进行无损弹性扩容和缩容。 Redis Server扩容操作时,主从版本中Operator将获取新节点ip, 新启动节点将在下一轮调和时触发slaveof 主节点操作,且同步过程中,哨兵不会将该节点选为主节点。集群版本中Operator将在同步节点信息后进行分片迁移,保证所有节点上的Slots尽可能均匀分布。 Redis Server缩容操作时,主从版本中Operator将逆序销毁Pod,销毁时会先询问哨兵,自己是否为主节点,若为主节点则进行先failover操作再退出。集群版本中Operator中会先进行分片迁移,再对该节点做删除操作。 代理的扩缩容,更易实现,根据流量波峰波谷规律,可手动定期在波峰到来时对 Proxy 进行扩容,波峰过后对 Proxy 进行缩容;也可根据HPA实现动态扩缩容,HPA也是Kubernetes的一种资源,可以依据Kubernetes 的Metrics API的数据,实现基于CPU使用率、内存使用率、流量的动态扩缩容。 youdao 总结与展望 ydtech 本次以 Redis 为范例,阐述了有道基础架构团队在基础设施容器化道路上的实践,Redis上云后将大幅缩短集群部署时间,支持秒级部署、分钟级启动、启动后的集群支持秒级自愈,集群依托于哨兵和代理的特性,故障切换对用户无感知。 有道架构团队最终以云平台的形式提供中间件能力,用户无需关注基础设施的资源调度与运维,重点关注具体业务场景,助力业务增长。未来,将进一步围绕Redis实例动态扩缩容、故障分析诊断、在线迁移、混合部署等内容展开探索。 Redis 容器化后有哪些优势? Kubernetes 是一个容器编排系统,可以自动化容器应用的部署、扩展和管理。Kubernetes 提供了一些基础特性: 部署:部署更快,集群建立无需人工干预。容器部署后可保证每个的Redis节点服务正常,节点启动后将由Operator持续监测调和Redis集群状态,包括主从关系、集群关系、哨兵监控、故障转移等。 资源隔离:如果所有服务都用同一个集群,修改了Redis集群配置的话,很可能会影响到其他的服务。但如果你是每个系统独立用一个Redis群的话,彼此之间互不影响,也不会出现某一个应用不小心把集群给打挂了,然后造成连锁反应的情况。 故障恢复: (1)实例的重启:容器化后的健康检查可以实现服务自动重启功能; (2) 网络故障:因宿主机网络故障带来的实例延迟高,哨兵可进行主从切换,而为了保证集群的健康,将由Operator负责同步集群信息。 扩缩容:容器部署可根据limit和request限制实例的cpu和内存,也可以进行扩缩容操作,扩容后的故障恢复由Operator处理 节点调整:基于Operator对CRD资源的持续调和,可在Operator的Controller中为每个Redis实例进行状态维护,因此,节点调整后带来的主副关系建立、集群Slots迁移等均可自动完成。 数据存储:容器化可挂载Cephfs、LocalStorage等多种存储卷。 监控与维护:实例隔离后搭配Exporter、Prometheus等监控工具更容易发现问题。 - END - 往期推荐 本文分享自微信公众号 - 有道技术团队(youdaotech)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

每日一博 | 低代码行业现状简析

低代码究竟是什么 这些年,自从 SaaS(Software-as-a-Service) 厂商 Salesforce 市值水涨船高,还和其大手笔的商业并购案,逐渐引起了国内互联网行业人的关注,习惯进行国内外产品对标的互联网圈子兴起了一股 SaaS 风潮,在后移动互联网时代下,部分人也期待 SaaS 可以成为国内互联网的一个新增长点。 随着不同的用户诉求,一些系统衍生出新的形态,不同于既定的 SaaS 产品形态,用户可以通过可视化拖拽界面、表单配置等方式,快速定制出一个完整的应用,而且这一类系统基本不用编写太多的代码,即可以实现定制化应用。随着这一形态的系统越来越多,久而久之,大家就形象地称之为”低代码”(low-code),另外也有人称之为 ”aPaaS“,即应用平台即服务(属于是互联网造词老技能了🤖...)。 低代码这个概念真正火热起来,还是在于这两年 Outsystems 相继完成了数轮过亿元美金的融资,估值早早地站上了十亿美金级别,成为一方独角兽。由于国内这一领域缺少体量对等的厂商,所以大家自然也在期待哪家厂商能成长为中国的 Outsystems。与此同时,国内低代码赛道上选手也渐渐进入了大家的视野,例如钉钉宜搭、即刻应用、氚云、简道云等等。 (材料来源于iRearch) 低代码系统长什么样 虽然低代码平台的形态很多,但是其中的核心还是脱离不开编程思想,基本都有以下功能模块:页面搭建、数据逻辑、数据模型,在线部署和管理系统。根据不同的业务场景,具体的平台形态分化为表单/数据模型驱动、界面驱动等形态。 表单/数据模型驱动 表单/数据模型驱动是围绕数据结构来定义整个应用的形态和流程,其中表单驱动指用户通过配置表单界面,元素大多是文本输入、下拉选择器、日期选择器等组件,配置表单界面后自动生成数据模型,并基于该表单做数据及流程管理,而数据模型驱动则更复杂,需要用户进行数据建模和定义模型关系,此操作和 SQL 数据库搭建类似,配置主键、索引,类型等等,然后基于该数据表单搭建上层的管理系统。该模式比较多应用在搭建 CRM、ERP 等管理系统。 (维格表配置界面) 界面驱动 界面驱动比较好理解,就是用户通过拖拽组件方式可视化搭建界面,然后配置页面的交互逻辑,比如页面的跳转、数据获取等等。这种形式大多应用在搭建通用程序的低代码平台 (iVx配置界面) 这种模式与端应用开发的套路基本一致,只是将代码编辑修改为画布拖拽和表单配置。这里举一个简单的例子,在界面按钮设置一个点击事件,事件逻辑为拉取数据。该流程就是将编程概念提取为交互表单操作,里面还是会出现入参出参字段、回调等等概念,遵循编程的思想。 当用户将应用搭建完成后,可以直接在平台上完成发布工作,然后就可以通过给出的链接访问应用(大多数低代码平台制作出来都是 web 应用)。 低代码概念虽然比较新颖,但是低代码平台已经发展了很久了(Outsystems 建立于 2001 年,国内的道一云建立于 2004 年)。总体来说,经过这些年的发展探索,低代码平台的形态也趋于稳定,各家的创新也是基于面对的用户场景而做的微创新,本质上也没有跳脱出编程思想。 低代码怎么做个性化定制 这里有同学会问了,低代码平台怎么满足个性化需求?诚然,受限于低代码平台所提供的组件和逻辑配置表单,只能解决一些通用化场景,当用户的诉求超脱出这个圈圈时,是不是就无能为力了?商业公司肯定不会这么幼稚,以下简单列举搜集到的一些个性化定制的方法: 用户可以在平台定制的规则下录入组件 提供 API 访问数据库 生成源代码做二次开发(低代码变代码了...) 填写反馈等平台更新 除了这些固定的章程,低代码厂商还有工程师群体,当用户登录到低代码平台,立即就有专人跟进,询问诉求等等,后续可以根据用户诉求给出合适的配置方案,乃至专门定制个性化场景。到这里就闻到了一丝外包的气味,不过这确实是一个可以带来收入的场景。 低代码有没有用? “低代码究竟有没有用?” 这个问题浮现在各个论坛上。这个问题可以理解为低代码的声量和其能力不匹配,用户对低代码信心不足。对于目前低代码平台的问题,存在主观和客观的因素。 首先很多低代码平台能力还没有足够完善成熟,这是一个很核心的因素。对于很多初次使用的用户来说,概念繁多,逻辑复杂,在一番体验以后,预期和实际有落差。使用起来总体耗时跟源码开发相差无几,显得工具比较鸡肋。客观上,国内的人力资源情况相比欧美还是比较便宜,很多有定制应用诉求的客户,首先会想到的是找外包,或者招聘开发岗位,而不是找低代码工具自己动手。另外大家对于低代码的认知也还不足,很难成为一个备选项。 思考这个问题,我们先想一个简单问题,“一个可以降低门槛,提高效率的工具有没有用”,答案很显然是肯定的。低代码平台的宗旨,不就是“降低门槛”,“降本增效”么。 个人觉得,这些问题大概是时间的问题。就目前市面上的低代码工具而言,从实际需求出发,当深入体验过以后,其实是可以深切感受到工具带来的红利。花上几天,我一个人就可以实现前后端应用,以及运维监控,拿到一套可运行的程序。随着行业关注度的提升和资源的投入,上述遇到的问题大多可以得到解决。低代码从“可用”到“好用”的进化,也是需要在实际场景中摸爬滚打中历练进化。 目前低代码发展状况 前面说了,低代码的热度持续提升,最明显的举动就是资本真金白银的投资。 (材料来源于iResearch) 另外有一个举动也很巧妙。钉钉发布了一个低代码聚合平台,宜搭、氚云、简道云、易鲸云等头部低代码厂商入驻。钉钉拥有国内最大的商务用户人群,而低代码在国内比较成功的落地场景是定制企业管理系统(例如 CRM),将低代码平台对接到巨大的对口流量之上,这种契合的操作颇有几分微信接入微信支付一般痛快。 虽然目前发展势头不错,但是打铁还需自身硬,避免共享经济那样一地鸡毛。低代码只有切实地把门槛降低、降本增效目标落在产品上,才可以长久地生存下去。 我们的探索尝试 Deco 智能代码项目(ling-deco.jd.com)是我们团队在「前端智能化」方向上的探索,我们尝试从设计稿生成代码(Design To Code)这个切入点入手,通过 AI 的手段,对现有的设计到研发这一环节进行能力补全,进而提升产研效率。 在一个日常需求开发流程中,对于前端工程师来说,输入源是视觉稿 + PRD,输出结果是可上线的页面代码。而在 Deco 的开发模式下,直接从设计稿转化成前端页面,然后通过可视化画布和表单配置配置页面的逻辑,最终输出可运行的多端代码。更多信息,大家可以通过以下链接更多 ling-deco.jd.com

优秀的个人博客,低调大师

每日一博 | FlutterWeb 性能优化探索与实践

美团外卖商家端基于 FlutterWeb 的技术探索已久,目前在多个业务中落地了App、PC、H5的多端复用,有效提升了产研的整体效率。在这过程中,性能问题是我们面临的最大挑战,本文结合实际业务场景进行思考,介绍美团外卖商家端在 FlutterWeb 性能优化上所进行的探索和实践,希望对大家能有所帮助或启发。 一、背景 1.1 关于FlutterWeb 时间回拨到 2018 年,Google 首次公开 FlutterWeb Beta 版,表露出要实现一份代码、多端运行的愿景。经过无数工程师两年多的努力,在今年年初(2021 年 3 月份),Flutter 2.0 正式对外发布,它将 FlutterWeb 功能并入了 Stable Channel,意味着 Google 更加坚定了多端复用的决心。 当然 Google 的“野心”不是没有底气的,主要体现在它强大的跨端能力上,我们看一下 Flutter 的跨端能力在 Web 侧是如何体现的: 上图分别是 FlutterNative 和 FlutterWeb 的架构图。通过对比可以看出,应用层 Framework 是公用的,意味着在 FlutterWeb 中我们也可以直接使用 Widgets、Gestures 等组件来实现逻辑跨端。而关于渲染跨端,FlutterWeb 提供了两种模式来对齐 Engine 层的渲染能力:Canvaskit Render 和 HTML Render,下方表格对两者的区别进行了对比: Canvaskit Render 模式:底层基于 Skia 的 WebAssembly 版本,而上层使用 WebGL 进行渲染,因此能较好地保证一致性和滚动性能,但糟糕的兼容性(WebAssembly 从 Chrome 57 版本才开始支持)是我们需要面对的问题。此外 Skia 的 WebAssembly 文件大小达到了 2.5M,且 Skia 自绘引擎需要字体库支持,这意味着需要依赖超大的中文字体文件,对页面加载性能影响较大,因此目前并不推荐在 Web 中直接使用 Canvaskit Render(官方也建议将 Canvaskit Render 模式用于桌面应用)。 HTML Render 模式:利用 HTML + Canvas 对齐了 Engine 层的渲染能力,因此兼容性表现优秀。另外,MTFlutterWeb 对滚动性能已有过探索和实践,目前能够应对大部分业务场景。而关于加载性能,此模式下的初始包为 1.2M,是 Canvaskit Render 模式产物体积的 1/2,且我们可对编译流程进行干预,控制输出产物,因此优化空间较大。 基于以上原因,美团外卖技术团队选择在 HTML Render 模式下对 FlutterWeb 页面的性能进行优化探索。 1.2 业务现状 美团外卖商家端以 App、PC 等多元化的形态为商家提供了订单管理、商品维护、顾客评价、外卖课堂等一系列服务,且 App、PC 双端业务功能基本对齐。此外,我们还在 PC 上特供了针对连锁商家的多店管理功能。同时,为满足平台运营诉求,部分业务具有外投 H5 场景,例如美团外卖商家课堂,它是一个以文章、视频等形式帮助商家学习外卖运营知识、了解行业发展和跟进经营策略的内容平台,具有较强的传播属性,因此我们提供了站外分享的能力。 为了实现多端(App、PC、H5)复用,提升研发效率,我们于 2021 年年初开始着手 MTFlutterWeb 研发体系的建设。目前,我们基于 MTFlutterWeb 完成提效的业务超过了 9 个,在 App 中,能够基于 FlutterNative 提供高性能的服务;在 PC 端和 Mobile 浏览器中,利用 FlutterWeb 做到了低成本适配,提升了产研的整体效率。 然而,加载性能问题是 MTFlutterWeb 应用推广的最大障碍。这里依然以美团外卖商家课堂业务为例,在项目之初页面完全加载时间 TP90 线达到了 6s 左右,距离我们的指标基线值(页面完全加载时间 TP90 线不高于 3s,基线值主要依据美团外卖商家端的业务场景、用户画像等来确定)有些差距,用户访问体验有很大的提升空间,因此 FlutterWeb 页面加载性能优化,是我们亟需解决的问题。 二、挑战 不过,想要突破 FlutterWeb 页面加载的性能瓶颈,我们面临的挑战也是巨大的。这主要体现在 FlutterWeb 缺失静态资源的优化策略,以及复杂的架构设计和编译流程。下图展示了 Flutter 业务代码被转换成 Web 平台产物的流程,我们来具体进行分析: Framework、Flutter_Web_SDK(Flutter_Web_SDK 基于 HTML、Canvas,承载 HTML Render 模式的具体实现)等底层 SDK 是可被业务代码直接引入的,帮助我们快速开发出跨端应用; flutter_tools 是各平台(Android、iOS、Web)的编译入口,它接收 flutter build web 命令和参数并开始编译流程,同时等待处理结果回调,在回调中我们可对编译产物进行二次加工; frontend_server 负责将 Dart 转换为 AST,生成 kernel 中间产物 app.dill 文件(实际上各平台的编译过程都会生成这样的中间产物),并交由各平台 Compiler 进行转译; Dart2JS Compiler 是 Dart-SDK 中具体负责转译 JS 的模块,它将上述中间产物 app.dill 进行读取和解析,并注入 Math、List、Map 等 JS 工具方法,最终生产出 Web 平台所能执行的 JS 文件。 编译产物主要为 main.dart.js、index.html、images 等静态资源,FlutterWeb 对这些静态资源缺少常规 Web 项目中的优化手段,例如:文件 Hash 化、文件分片、CDN 支持等。 可以看出,要完成对 FlutterWeb 编译产物的优化,就需要干预 FlutterWeb 的众多编译模块。而为了提升整体的编译效率,大部分模块都被提前编译成了 snapshot 文件( 一种 Dart 的编译产物,可被 Dart VM 所运行,用于提升执行效率),例如:flutter_tools.snapshot、frontend_server.snapshot、dart2js.snapshot 等,这又加大了对 FlutterWeb 编译流程进行干预的难度。 三、整体设计 如前文所述,为了实现逻辑、渲染跨平台,Flutter 的架构设计及编译流程都具有一定的复杂性。但由于各平台(Android、iOS、Web)的具体实现是解耦的,因此我们的思路是定位各模块(Dart-SDK、Framework、Flutter_Web_SDK、flutter_tools)的 Web 平台实现并寻求优化,整体设计图如下所示: SDK 瘦身:我们分别对 FlutterWeb 所依赖的 Dart-SDK、Framework、Flutter_Web_SDK 进行了瘦身,并将这些精简版 SDK 集成合入 CI/CD(持续集成与部署)系统,为减小产物包体积奠定了基础; 编译优化:此外,我们在 flutter_tools 中的编译流程做了干预,分别进行了 JS 文件分片、静态资源 Hash 化、资源文件上传 CDN 等优化,使得这些在常规 Web 应用中基础的性能优化手段得以在 FlutterWeb 中落地。同时加强了 FlutterWeb 特殊场景下的资源优化,如:字体图标精简、Runtime Manifest 隔离、Mobile/PC 分平台打包等; 加载优化:在编译阶段进行静态资源优化后,我们在前端运行时,支持了资源预加载与按需加载,通过设定合理的加载时机,从而减小初始代码体积,提升页面首屏的渲染速度。 下面,我们分别对各项优化进行详细的说明。 四、设计与实践 4.1 精简 SDK 4.1.1 包体积分析 工欲善其事,必先利其器,在开始做体积裁剪之前,我们需要一套类似于 webpack-bundle-analyzer 的包体积分析工具,便于直观地比较各个模块的体积占比,为优化性能提供帮助。 Dart2JS 官方提供了 --dump-info 命令选项来分析 JS 产物,但其表现差强人意,它并不能很好地分析各个模块的体积占比。这里更推荐使用 source-map-explorer ,它的原理是通过 sourcemap 文件进行反解,能清晰地反映出每个模块的占用大小,为 SDK 的精简提供了指引。下图展示了 FlutterWeb JS 产物的反解信息(截图仅包含 Framework 和 Flutter_Web_SDK): 4.1.2 SDK 裁剪 FlutterWeb 依赖的 SDK 主要包括 Dart-SDK、Framework 和 Flutter_Web_SDK,这些 SDK 对包体积的影响是巨大的,几乎贡献了初始化包的所有大小。虽然在 Release 模式下的编译流程中,Dart Compiler 会利用 Tree-Shaking 来剔除那些引入但未使用的 packages、classes、functions 等,很大程度上减少了包体积。但这些 SDK 中仍然存在一些能被进一步优化的代码。 以 Flutter Framework 为例,由于它是全平台公用的模块,因此不可避免地存在各平台的兼容逻辑(通常以 if-else、switch 等条件判断形式出现),而这部分代码是不能被 Tree-Shaking 剔除的,我们观察如下的代码: // FileName: flutter/lib/src/rendering/editable.dart void _handleKeyEvent(RawKeyEvent keyEvent) { if (kIsWeb) { // On web platform, we should ignore the key. return; } // Other codes ... } 上述代码选自 Framework 中的 RenderEditable 类,当 kIsWeb 变量为真,表示当前应用运行在 Web 平台。受限于 Tree-Shaking 的机制原理,上述代码中,其它平台的兼容逻辑即注释 Other codes 的部分是无法被剔除的,但这部分代码,对 Web 平台来说却是 Dead Code(永远不可能被执行到的代码),是可以被进一步优化的。 上图展示了 SDK 的一部分功能构成,从图中可以看出,FlutterWeb 依赖的这些 SDK 中包含了一些使用频率较低的功能,例如:蓝牙、USB、WebRTC、陀螺仪等功能的支持。为此,我们提供了对这些长尾功能的定制能力(这些功能默认不开启,但业务可配置),将未被启用长尾的功能进行裁剪。 通过上述分析可得,我们的思路就是对 Dead Code 进行二次剔除,以及对这些长尾功能做裁剪。基于这样的思路,我们深入 Dart-SDK、Framework 和 Flutter_Web_SDK 各个击破,最终将 JS Bundle 产物体积由 1.2M 精简至 0.7M,为 FlutterWeb 页面性能优化打下了坚实的基础。 4.1.3 SDK 集成 CI/CD 为了提升构建效率,我们将 FlutterWeb 依赖的环境定制为 Docker 镜像,集成入 CI/CD(持续集成与部署)系统。SDK 裁剪后,我们需要更新 Docker 镜像,整个过程耗时较长且不够灵活。因此,我们将 Dart-SDK、Framework、Flutter_Web_SDK 按版本打包传至云端,在编译开始前读取 CI/CD 环境变量:sdk_version(SDK 版本号),远程拉取相应版本的 SDK 包,并替换当前 Docker 环境中的对应模块,基于以此方案实现 SDK 的灵活发布,具体流程图如下图所示: 4.2 JS 分片 FlutterWeb 编译之后默认会生成 main.dart.js 文件,它囊括了 SDK 代码以及业务逻辑,这样会引起以下问题: 功能无法及时更新:为了实现浏览器的缓存优化,我们的项目开启了对静态资源的强缓存,若 main.dart.js 产物不支持 Hash 命名,可能导致程序代码不能被及时更新; 无法使用 CDN:FlutterWeb 默认仅支持相对域名的资源加载方式,无法使用当前域名以外的 CDN 域名,导致无法享受 CDN 带来的优势; 首屏渲染性能不佳:虽然我们进行了 SDK 瘦身,但 main.dart.js 文件依然维持在 0.7M 以上,单一文件加载、解析时间过长,势必会影响首屏的渲染时间。 针对文件 Hash 化和 CDN 加载的支持,我们在 flutter_tools 编译流程中对静态资源进行二次处理:遍历静态资源产物,增加文件 Hash(文件内容 MD5 值),并更新资源的引用;同时通过定制 Dart-SDK,修改了 main.dart.js、字体等静态资源的加载逻辑,使其支持 CDN 资源加载。 更详细的方案设计请参考《Flutter Web在美团外卖的实践》一文。下面我们重点介绍 main.dart.js 分片相关的一些优化策略。 4.2.1 Lazy Loading Flutter 官方提供 deferred as 关键字来实现 Widget 的懒加载,而 dart2js 在编译过程中可以将懒加载的 Widget 进行按需打包,这样的拆包机制叫做 Lazy Loading。借助 Lazy Loading,我们可以在路由表中使用 deferred 引入各个路由(页面),以此来达到业务代码拆离的目的,具体使用方法和效果如下所示: // 使用方式 import 'pages/index/index.dart' deferred as IndexPageDefer; { '/index': (context) => FutureBuilder( future: IndexPageDefer.loadLibrary(), builder: (context, snapshot) => IndexPageDefer.Demo(), ) ... ... } 使用 Lazy Loading 后,业务页面的代码会被拆分到了多个 PartJS(对应图中 xxx.part.js 文件) 中。这样看似解决了业务代码与 SDK 耦合的问题,但在实际操作过程中,我们发现每次业务代码的变动,仍然会导致编译后的 main.dart.js 随之发生变化(文件 Hash 值变化)。经过定位与跟踪,我们发现这个变化的部分是 PartJS 的加载逻辑和映射关系,我们称之为 Runtime Manifest。因此,需要设计一套方案对 Runtime Manifest 进行抽离,来保证业务代码的修改对 main.dart.js 的影响达到最低。 4.2.2 Runtime Manifest抽离 通过对业务代码的抽离,此时 main.dart.js 文件的构成主要包含 SDK 和 Runtime Manifest: 那如何能将 Runtime Manifest 进行抽离呢?对比常规 Web 项目,我们的处理方式是把 SDK、Utils、三方包等基础依赖,利用 Webpack、Rollup 等打包工具进行抽离并赋予一个稳定的 Hash 值。同时,将 Runtime Manifest (分片文件的加载逻辑和映射关系)注入到 HTML 文件中,这样保证了业务代码的变动不会影响到公共包。借助常规 Web 项目的编译思路,我们深入分析了 FlutterWeb 中 Runtime Manifest 的生成逻辑和 PartJS 的加载逻辑,定制出如下的解决方案: 在上图中,Runtime Manifest 的生成逻辑位于 Dart2JS Compiler 模块,在该生成逻辑中,我们对 Runtime Manifest 代码块进行了标记,之后在 flutter_tools 中将标记的 Runtime Manifest 代码块抽离并写入 HTML 文件中(以 JS 常量形式存在)。而在 PartJS 的加载流程中,我们将 manifest 信息的读取方式改为了 JS 常量的获取。按照这样的拆分方式,业务代码的变更只会改变 Runtime Manifest 信息 ,而不会影响到 main.dart.js 公共包。 4.2.3 main.dart.js 切片 经过以上引入 Lazy Loading、Runtime Manifest 抽离,main.dart.js 文件的体积稳定在 0.7M 左右,浏览器对大体积单文件的加载,会有很沉重的网络负担,所以我们设计了切片方案,充分地利用浏览器对多文件并行加载的特性,提升文件的加载效率。 具体实现方案为:将 main.dart.js 在 flutter_tools 编译过程拆分成多份纯文本文件,前端通过 XHR 的方式并行加载并按顺序拼接成 JavaScript 代码置于< script >标签中,从而实现切片文件的并行加载。 4.3 预加载方案 如上一节所述,虽然我们做了很多工作来稳定 main.dart.js 的内容,但在 Flutter Tree-Shaking 的运行机制下,各个项目引用不同的 Framework Widget,就会导致每个项目生成的 main.dart.js 内容不一致。随着接入 FlutterWeb 的项目越来越多,每个业务的页面互访概率也越来越高,我们的期望是当访问 A 业务时,可以预先缓存 B 业务引用的 main.dart.js,这样当用户真正进入 B 业务时就可以节省加载资源的时间,下面为详细的技术方案。 4.3.1 技术方案 我们把整体的技术方案分为编译、监听、运行三个阶段。 编译阶段,在发布流水线上根据前期定制的匹配规则,筛选出符合条件的资源文件路径,生成云端 JSON 并上传; 监听阶段,在 DOMContentLoaded 之后,对网络资源、事件、DOM 变动进行监听,并对监听结果根据特定规则进行分析加权,得到一个首屏加载完成的状态标识; 运行阶段,在首屏加载完成之后对配置平台下发的云端 JSON 文件进行解析,对符合配置规则的资源进行 HTTP XHR 预加载,从而实现文件的预缓存功能。 下图为预缓存的整体方案设计: 编译阶段 编译阶段会扩展现有的发布流水线,在 flutter build 之后增加 prefetch build 作业,这样 build 之后就可以对产物目录进行遍历和筛选,得到我们所需资源进而生成云端 JSON,为运行阶段提供数据基础。下面的流程图为编译阶段的详细方案设计: 编译阶段分为三部分: 第一部分:根据不同的发布环境,初始化线上/线下的配置平台,为配置文件的读写做好准备; 第二部分:下载并解析配置平台下发的资源组 JSON,筛选出符合配置规则的资源路径,更新 JSON 文件并发布到配置平台; 第三部分:通过发布流水线提供的 API,把 PROJECT_ID、发布环境注入HTML文件中,为运行阶段提供全局变量以便读取。 通过对流水线编译期的整合,我们可以生成新的云端 JSON 并上传到云端,为运行阶段的下发提供数据基础。 监听阶段 我们知道,浏览器对文件请求的并发数量是有限制的,为了保证浏览器对当前页面的渲染处于高优先级,同时还能完成预缓存的功能,我们设计了一套对缓存文件的加载策略,在不影响当前页面加载的情况下,实现对缓存文件的加载操作。以下为详细的技术方案: 在页面 DOMContentLoaded 之后,我们会监听三部分的的变化。 第一部分是监听 DOM 的变化。这部分主要是在页面发生 Ajax 请求之后,随着MV模式的变动,DOM 也会随之发生变化。我们使用浏览器提供的 MutationObserver API 对 DOM 变化进行收集,并筛选有效节点进行深度优先遍历,计算每个 DOM 的递归权重值,低于阈值我们就认为首屏已加载完成。 第二部分是监听资源的变化。我们利用浏览提供的 PerformanceObserver API,筛选出 img/script 类型的资源,在 3 秒内收集的资源没有增加时,我们认为首屏已加载完成。 第三部分是监听 Event 事件。当用户发生 click、wheel、touchmove 等交互行为时,我们就认为当前页面处于一个可交互的状态,即首屏加载已完成,这样会在后续进行资源的预缓存。 通过上述步骤,我们就可以得到一个首屏渲染完成的时机,之后就可以实现预缓存功能了。以下为预缓存功能的实现。 运行阶段 预缓存的整体流程为:下载编译阶段生成的云端 JSON,解析出需要进行预缓存资源的 CDN 路径,最后通过 HTTP XHR 进行缓存资源进行请求,利用浏览器本身的缓存策略,把其他业务的资源文件写入。当用户访问已命中缓存的页面时,资源已被提前加载,这样可以有效地减少首屏的加载时间。下图为运行阶段的详细方案设计: 在监听阶段,我们可以获取到页面的首屏渲染完成的时机,会获取到云端 JSON,首先判断该项目的缓存是否为启用状态。当该项目可用时,会根据全局变量 PROJECT_ID 进行资源数组的匹配,再以 HTTP XHR 方式进行预访问,把缓存文件写入浏览器缓存池中。至此,资源预缓存已执行完毕。 4.3.2 效果展示与数据对比 当有页面间互访问命中预缓存时,浏览器会以 200(Disk Cache)的方式返回数据,这样就节省了大量资源加载的时间,下图为命中缓存后资源加载情况: 目前,美团外卖商家端业务已有 10+ 个页面接入了预缓存功能,资源加载 90 线平均值由 400ms 下降到 350ms,降低了 12.5%;50 线平均值由 114ms 下降到 100ms,降低了 12%。随着项目接入接入越来越多,预缓存的效果也会越发的明显。 4.4 分平台打包 如前文所述,美团外卖商家业务大部分都是双端对齐的。为了实现提效的最大化,我们对 FlutterWeb 的多平台适配能力进行加强,实现了 FlutterWeb 在 PC 侧的复用。 在 PC 适配过程中,我们不可避免地需要书写双端的兼容代码,如:为了实现在列表页面中对卡片组件的复用。为此我们开发了一个适配工具 ResponsiveSystem,分别传入 PC 和 App 的各端实现,内部会区分平台完成适配: // ResponsiveSystem 使用举例 Container( child: ResponsiveSystem( app: AppWidget(), pc: PCWidget(), ), ) 上述代码能较方便的实现 PC 和 App 适配,但 AppWidget 或 PCWidget 在编译过程中都将无法被 Tree-Shaking 去除,因此会影响包体积大小。对此,我们将编译流程进行优化,设计分平台打包方案: 修改 flutter-cli,使其支持 --responsiveSystem 命令行参数; 我们在 flutter_tools 中的 AST 分析阶段增加了额外的处理:ResponsiveSystem 关键字的匹配,同时结合编译平台(PC 或 Mobile)来进行 AST 节点的改写; 去除无用 AST 节点后,生成各个平台的代码快照(每份快照仅包含单独平台代码); 根据代码快照编译生成 PC 和 App 两套 JS 产物,并进行资源隔离。而对于 images、fonts 等公用资源,我们将其打入 common 目录。 通过这样的方式,我们去除了各自平台的无用代码,避免了 PC 适配过程中引起的包体积问题。依然以美团外卖商家课堂业务(6 个页面)为例,接入分平台打包后,单平台代码体积减小 100KB 左右。 4.5 图标字体精简 当访问 FlutterWeb 页面时,即使在业务代码中并未使用 Icon 图标,也会加载一个 920KB 的图标字体文件:MaterialIcons-Regular.woff。通过探究,我们发现是 Flutter Framework 中一些系统 UI 组件(如:CalendarDatePicker、PaginatedDataTable、PopupMenuButton 等)使用到了 Icon 图标导致,且 Flutter 为了便于开发者使用,提供了全量的 Icon 图标字体文件。 Flutter 官方提供的 --tree-shake-icons 命令选项是将业务使用到的 Icon 与 Flutter 内部维护的一个缩小版字体文件(大约 690KB)进行合并,能一定程度上减小字体文件大小。而我们需要的是只打包业务使用的 Icon,所以我们对官方 tree-shake-icons 进行了优化,设计了 Icon 的按需打包方案: 扫描全部业务代码以及依赖的 Plugins、Packages、Flutter Framework,分析出所有用到的 Icon; 把扫描到的所有 Icon 与 material/icons.dart(该文件包含 Flutter Icon 的 unicode 编码集合)进行对比,得到精简后的图标编码列表:iconStrList; 使用 FontTools 工具把 iconStrList 生成字体文件 .woff,此时的字体文件仅包含真正使用到的 Icon。 通过以上的方案,我们解决了字体文件过大带来的包体积问题,以美团外卖课堂业务(业务代码中使用了 5 个 Icon)为例,字体文件从 920KB 精简为 11.6kB。 五、总结与展望 综上所述,我们基于 HTML Render 模式对 FlutterWeb 性能优化进行了探索和实践,主要包括 SDK(Dart-SDK、Framework、Flutter_Web_SDK)的精简,静态资源产物优化(例如:JS 分片、文件 Hash、字体图标文件精简、分平台打包等)和前端资源加载优化(预加载与按需请求)。最终使得 JS 产物由 1.2M 减少至 0.7M(非业务代码),页面完全加载时间 TP90 线由 6s 降到了 3s,这样的结果已能满足美团外卖商家端的大部分业务要求。而未来的规划将聚焦于以下3个方向: 降低 Web 端适配成本:目前已有 9+ 个业务借助 MTFlutterWeb 实现多端复用,但在 Web 侧(尤其是 PC 侧)的适配效率依然有优化空间,目标是将适配成本降低到 10% 以下(目前大约是 20% ); 构建 FlutterWeb 容灾体系:Flutter 动态化包有一定的加载失败概率,而 FlutterWeb 作为兜底方案,能提升整体业务的加载成功率。此外 FlutterWeb 可以提供“免安装更新”的能力,降低 FlutterNative 老旧历史版本的维护成本; 性能优化的持续推进:性能优化的阶段性成果为 MTFlutterWeb 的应用推广巩固了基础,但依然是有进一步优化空间的,例如:目前我们仅将业务代码和 Runtime Manifest 进行了拆离,而 Framework 及 三方包在一定程度上也影响到了浏览器缓存的命中率,将这部分代码进行抽离,可进一步提升页面加载性能。 阅读美团技术团队更多技术文章合集 前端 | 算法 | 后端 | 数据 | 安全 | 运维 | iOS | Android | 测试 | 在公众号菜单栏对话框回复【2020年货】、【2019年货】、【2018年货】、【2017年货】等关键词,可查看美团技术团队历年技术文章合集。 | 本文系美团技术团队出品,著作权归属美团。欢迎出于分享和交流等非商业目的转载或使用本文内容,敬请注明“内容转载自美团技术团队”。本文未经许可,不得进行商业性转载或者使用。任何商用行为,请发送邮件至tech@meituan.com申请授权。

优秀的个人博客,低调大师

每日一博 | 一文带你熟知 ForkJoin

摘要:ForkJoin将复杂的计算当做一个任务,而分解的多个计算则是当做一个个子任务来并行执行。 本文分享自华为云社区《【高并发】什么是ForkJoin?看这一篇就够了!》,作者:冰 河。 在JDK中,提供了这样一种功能:它能够将复杂的逻辑拆分成一个个简单的逻辑来并行执行,待每个并行执行的逻辑执行完成后,再将各个结果进行汇总,得出最终的结果数据。有点像Hadoop中的MapReduce。 ForkJoin是由JDK1.7之后提供的多线程并发处理框架。ForkJoin框架的基本思想是分而治之。什么是分而治之?分而治之就是将一个复杂的计算,按照设定的阈值分解成多个计算,然后将各个计算结果进行汇总。相应的,ForkJoin将复杂的计算当做一个任务,而分解的多个计算则是当做一个个子任务来并行执行。 Java并发编程的发展 对于Java语言来说,生来就支持多线程并发编程,在并发编程领域也是在不断发展的。Java在其发展过程中对并发编程的支持越来越完善也正好印证了这一点。 Java 1 支持thread,synchronized。 Java 5 引入了 thread pools, blocking queues, concurrent collections,locks, condition queues。 Java 7 加入了fork-join库。 Java 8 加入了 parallel streams。 并发与并行 并发和并行在本质上还是有所区别的。 并发 并发指的是在同一时刻,只有一个线程能够获取到CPU执行任务,而多个线程被快速的轮换执行,这就使得在宏观上具有多个线程同时执行的效果,并发不是真正的同时执行,并发可以使用下图表示。 并行 并行指的是无论何时,多个线程都是在多个CPU核心上同时执行的,是真正的同时执行。 分治法 基本思想 把一个规模大的问题划分为规模较小的子问题,然后分而治之,最后合并子问题的解得到原问题的解。 步骤 ①分割原问题; ②求解子问题; ③合并子问题的解为原问题的解。 我们可以使用如下伪代码来表示这个步骤。 if(任务很小){ 直接计算得到结果 }else{ 分拆成N个子任务 调用子任务的fork()进行计算 调用子任务的join()合并计算结果 } 在分治法中,子问题一般是相互独立的,因此,经常通过递归调用算法来求解子问题。 典型应用 二分搜索 大整数乘法 Strassen矩阵乘法 棋盘覆盖 合并排序 快速排序 线性时间选择 汉诺塔 ForkJoin并行处理框架 ForkJoin框架概述 Java 1.7 引入了一种新的并发框架—— Fork/Join Framework,主要用于实现“分而治之”的算法,特别是分治之后递归调用的函数。 ForkJoin框架的本质是一个用于并行执行任务的框架, 能够把一个大任务分割成若干个小任务,最终汇总每个小任务结果后得到大任务的计算结果。在Java中,ForkJoin框架与ThreadPool共存,并不是要替换ThreadPool 其实,在Java 8中引入的并行流计算,内部就是采用的ForkJoinPool来实现的。例如,下面使用并行流实现打印数组元组的程序。 public class SumArray { public static void main(String[] args){ List<Integer> numberList = Arrays.asList(1,2,3,4,5,6,7,8,9); numberList.parallelStream().forEach(System.out::println); } } 这段代码的背后就使用到了ForkJoinPool。 说到这里,可能有读者会问:可以使用线程池的ThreadPoolExecutor来实现啊?为什么要使用ForkJoinPool啊?ForkJoinPool是个什么鬼啊?!接下来,我们就来回答这个问题。 ForkJoin框架原理 ForkJoin框架是从jdk1.7中引入的新特性,它同ThreadPoolExecutor一样,也实现了Executor和ExecutorService接口。它使用了一个无限队列来保存需要执行的任务,而线程的数量则是通过构造函数传入,如果没有向构造函数中传入指定的线程数量,那么当前计算机可用的CPU数量会被设置为线程数量作为默认值。 ForkJoinPool主要使用**分治法(Divide-and-Conquer Algorithm)**来解决问题。典型的应用比如快速排序算法。这里的要点在于,ForkJoinPool能够使用相对较少的线程来处理大量的任务。 比如要对1000万个数据进行排序,那么会将这个任务分割成两个500万的排序任务和一个针对这两组500万数据的合并任务。以此类推,对于500万的数据也会做出同样的分割处理,到最后会设置一个阈值来规定当数据规模到多少时,停止这样的分割处理。 比如,当元素的数量小于10时,会停止分割,转而使用插入排序对它们进行排序。那么到最后,所有的任务加起来会有大概200万+个。问题的关键在于,对于一个任务而言,只有当它所有的子任务完成之后,它才能够被执行。 所以当使用ThreadPoolExecutor时,使用分治法会存在问题,因为ThreadPoolExecutor中的线程无法向任务队列中再添加一个任务并在等待该任务完成之后再继续执行。而使用ForkJoinPool就能够解决这个问题,它就能够让其中的线程创建新的任务,并挂起当前的任务,此时线程就能够从队列中选择子任务执行。 那么使用ThreadPoolExecutor或者ForkJoinPool,性能上会有什么差异呢? 首先,使用ForkJoinPool能够使用数量有限的线程来完成非常多的具有父子关系的任务,比如使用4个线程来完成超过200万个任务。但是,使用ThreadPoolExecutor时,是不可能完成的,因为ThreadPoolExecutor中的Thread无法选择优先执行子任务,需要完成200万个具有父子关系的任务时,也需要200万个线程,很显然这是不可行的,也是很不合理的!! 工作窃取算法 假如我们需要做一个比较大的任务,我们可以把这个任务分割为若干互不依赖的子任务,为了减少线程间的竞争,于是把这些子任务分别放到不同的队列里,并为每个队列创建一个单独的线程来执行队列里的任务,线程和队列一一对应,比如A线程负责处理A队列里的任务。但是有的线程会先把自己队列里的任务干完,而其他线程对应的队列里还有任务等待处理。干完活的线程与其等着,不如去帮其他线程干活,于是它就去其他线程的队列里窃取一个任务来执行。而在这时它们会访问同一个队列,所以为了减少窃取任务线程和被窃取任务线程之间的竞争,通常会使用双端队列,被窃取任务线程永远从双端队列的头部拿任务执行,而窃取任务的线程永远从双端队列的尾部拿任务执行。 工作窃取算法的优点: 充分利用线程进行并行计算,并减少了线程间的竞争。 工作窃取算法的缺点: 在某些情况下还是存在竞争,比如双端队列里只有一个任务时。并且该算法会消耗更多的系统资源,比如创建多个线程和多个双端队列。 Fork/Join框架局限性: 对于Fork/Join框架而言,当一个任务正在等待它使用Join操作创建的子任务结束时,执行这个任务的工作线程查找其他未被执行的任务,并开始执行这些未被执行的任务,通过这种方式,线程充分利用它们的运行时间来提高应用程序的性能。为了实现这个目标,Fork/Join框架执行的任务有一些局限性。 (1)任务只能使用Fork和Join操作来进行同步机制,如果使用了其他同步机制,则在同步操作时,工作线程就不能执行其他任务了。比如,在Fork/Join框架中,使任务进行了睡眠,那么,在睡眠期间内,正在执行这个任务的工作线程将不会执行其他任务了。 (2)在Fork/Join框架中,所拆分的任务不应该去执行IO操作,比如:读写数据文件。 (3)任务不能抛出检查异常,必须通过必要的代码来出来这些异常。 ForkJoin框架的实现 ForkJoin框架中一些重要的类如下所示。 ForkJoinPool 框架中涉及的主要类如下所示。 1.ForkJoinPool类 实现了ForkJoin框架中的线程池,由类图可以看出,ForkJoinPool类实现了线程池的Executor接口。 我们也可以从下图中看出ForkJoinPool的类图关系。 其中,可以使用Executors.newWorkStealPool()方法创建ForkJoinPool。 ForkJoinPool中提供了如下提交任务的方法。 public void execute(ForkJoinTask<?> task) public void execute(Runnable task) public <T> T invoke(ForkJoinTask<T> task) public <T> List<Future<T>> invokeAll(Collection<? extends Callable<T>> tasks) public <T> ForkJoinTask<T> submit(ForkJoinTask<T> task) public <T> ForkJoinTask<T> submit(Callable<T> task) public <T> ForkJoinTask<T> submit(Runnable task, T result) public ForkJoinTask<?> submit(Runnable task) 2.ForkJoinWorkerThread类 实现ForkJoin框架中的线程。 3.ForkJoinTask<V>类 ForkJoinTask封装了数据及其相应的计算,并且支持细粒度的数据并行。ForkJoinTask比线程要轻量,ForkJoinPool中少量工作线程能够运行大量的ForkJoinTask。 ForkJoinTask类中主要包括两个方法fork()和join(),分别实现任务的分拆与合并。 fork()方法类似于Thread.start(),但是它并不立即执行任务,而是将任务放入工作队列中。跟Thread.join()方法不同,ForkJoinTask的join()方法并不简单的阻塞线程,而是利用工作线程运行其他任务,当一个工作线程中调用join(),它将处理其他任务,直到注意到目标子任务已经完成。 我们可以使用下图来表示这个过程。 ForkJoinTask有3个子类: RecursiveAction:无返回值的任务。 RecursiveTask:有返回值的任务。 CountedCompleter:完成任务后将触发其他任务。 4.RecursiveTask<V> 类 有返回结果的ForkJoinTask实现Callable。 5.RecursiveAction类 无返回结果的ForkJoinTask实现Runnable。 6.CountedCompleter<T> 类 在任务完成执行后会触发执行一个自定义的钩子函数。 ForkJoin示例程序 package io.binghe.concurrency.example.aqs; import lombok.extern.slf4j.Slf4j; import java.util.concurrent.ForkJoinPool; import java.util.concurrent.Future; import java.util.concurrent.RecursiveTask; @Slf4j public class ForkJoinTaskExample extends RecursiveTask<Integer> { public static final int threshold = 2; private int start; private int end; public ForkJoinTaskExample(int start, int end) { this.start = start; this.end = end; } @Override protected Integer compute() { int sum = 0; //如果任务足够小就计算任务 boolean canCompute = (end - start) <= threshold; if (canCompute) { for (int i = start; i <= end; i++) { sum += i; } } else { // 如果任务大于阈值,就分裂成两个子任务计算 int middle = (start + end) / 2; ForkJoinTaskExample leftTask = new ForkJoinTaskExample(start, middle); ForkJoinTaskExample rightTask = new ForkJoinTaskExample(middle + 1, end); // 执行子任务 leftTask.fork(); rightTask.fork(); // 等待任务执行结束合并其结果 int leftResult = leftTask.join(); int rightResult = rightTask.join(); // 合并子任务 sum = leftResult + rightResult; } return sum; } public static void main(String[] args) { ForkJoinPool forkjoinPool = new ForkJoinPool(); //生成一个计算任务,计算1+2+3+4 ForkJoinTaskExample task = new ForkJoinTaskExample(1, 100); //执行一个任务 Future<Integer> result = forkjoinPool.submit(task); try { log.info("result:{}", result.get()); } catch (Exception e) { log.error("exception", e); } } } 点击关注,第一时间了解华为云新鲜技术~

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册