首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

Tablestore入门手册--局部事务

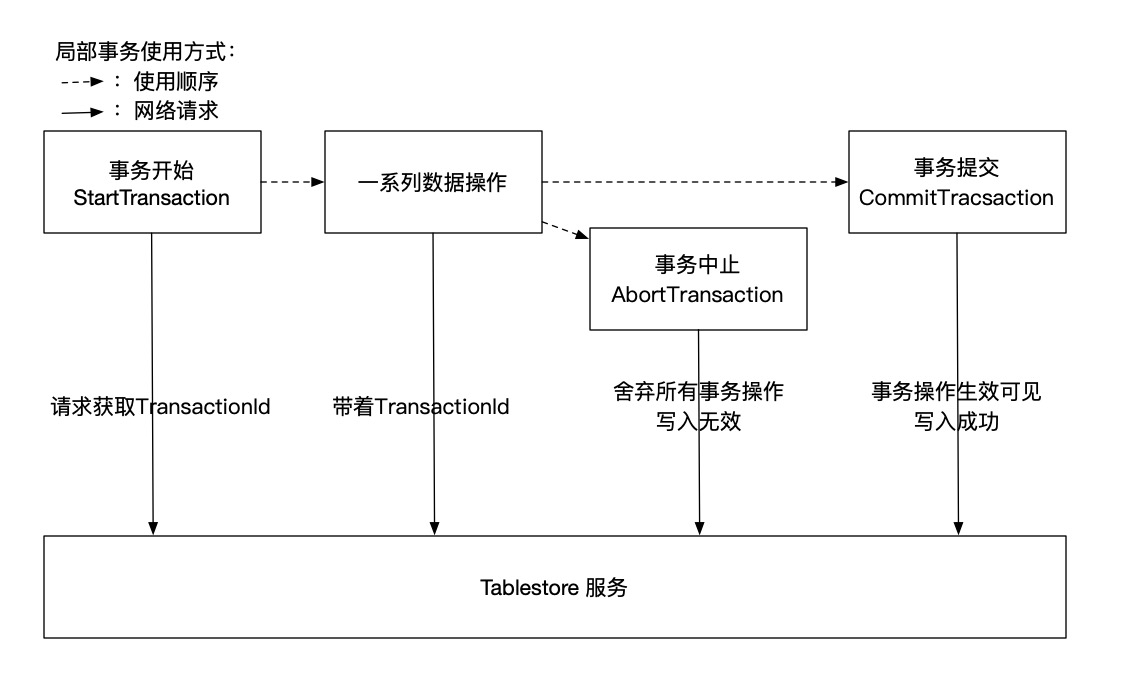
局部事务介绍 表格存储提供的局部事务也可以称为是分区键事务:可以指定某个分区键下的操作是原子的,要么全部成功要么全部失败,并且所提供的隔离级别为串行化。也就是说表格存储的局部事务可以防止以下问题 脏读:事务之外的操作读到了尚未提交的写入 脏写:事务之外的写入覆盖了本事务尚未提交的写入 不可重复读:在事务中的多次对同一行数据的读操作读到了不同的值 更新丢失:本事务提交已提交之后被其他并行执行的事务所覆盖(与脏写不同,脏写是两个事务都没有提交时发生的) 局部事务基本使用流程如下图所示 Tablestore的局部事务在启动事务时或首先获取到分区键下的锁,所有后续对该分区键的写操作与启动事务操作都会被阻塞至原事务提交或者超时以保证操作的隔离性,有如下的一些特性: 在事务提交或者中止之前,不能有另外一个事务在同分区键下启动事务 在事务提交或中止之前,非本事务的写入将被阻塞或超时失败 在事务提交和中止之前,非本事务的读取操作无法读取到事务中未提交的写入,而本事务的读操作可以获取到本事务中的写入 局部事务的使用 事务的启动、提交与中止 启动事务 // 局部事务需要指定一个分区键(第一列主键) PrimaryKey transactionPK = new PrimaryKey(Collections.singletonList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)) )); StartLocalTransactionRequest startTransactionRequest = new StartLocalTransactionRequest(TABLE_NAME, transactionPK); StartLocalTransactionResponse startTransactionResponse = syncClient.startLocalTransaction(startTransactionRequest); // 启动事务成功后会返回一个transactionId,任意实现了TxnRequest抽象类的请求都可以通过setTransactionId方法指定事务 final String transactionId = startTransactionResponse.getTransactionID(); 提交事务 // 提交事务,所有与该transactionId相关的写入操作将被永久地写入到Tablestore中 syncClient.commitTransaction(new CommitTransactionRequest(transactionId)); 中止事务 // 中止事务,所有与改transactionId相关的写入操作将被回滚 syncClient.abortTransaction(new AbortTransactionRequest(transactionId)); 基本用法 分别用同一个transactionId两次写入数据并提交,要么全部失败,要么全部失败写入第一行数据 PutRowRequest typeAPutRequest = new PutRowRequest(new RowPutChange( TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeA)) )) ).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_a"))); // 设置事务ID,由启动事务返回 typeAPutRequest.setTransactionId(transactionId); syncClient.putRow(typeAPutRequest); 通过事务ID读取上面写入的数据 GetRowRequest getRowRequest = new GetRowRequest(); SingleRowQueryCriteria singleRowQueryCriteria = new SingleRowQueryCriteria( TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeA)) )) ); singleRowQueryCriteria.setMaxVersions(1); getRowRequest.setRowQueryCriteria(singleRowQueryCriteria); // 这边需要设置事务ID getRowRequest.setTransactionId(transactionId); GetRowResponse getRowResponse = syncClient.getRow(getRowRequest); // 可以正常获取到数据 Assert.assertNotNull(getRowResponse.getRow()); 不通过事务ID读取 GetRowRequest getRowRequest = new GetRowRequest(); SingleRowQueryCriteria singleRowQueryCriteria = new SingleRowQueryCriteria( TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeA)) )) ); singleRowQueryCriteria.setMaxVersions(1); getRowRequest.setRowQueryCriteria(singleRowQueryCriteria); GetRowResponse getRowResponse = syncClient.getRow(getRowRequest); // 不设置事务ID获取,由于Tablestore提供的隔离级别为串行化,这边不能读取到未提交的写入 Assert.assertNull(getRowResponse.getRow()); 写入第二行数据 PutRowRequest typeBPutRequest = new PutRowRequest(new RowPutChange( TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeB)) )) ).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_b"))); typeBPutRequest.setTransactionId(transactionId); syncClient.putRow(typeBPutRequest); 提交 // 提交事务,提交事务后,其他读操作就可以获取到之前的写入 syncClient.commitTransaction(new CommitTransactionRequest(transactionId)); 中止事务 // 中止事务,所有与改transactionId相关的写入操作将被回滚 syncClient.abortTransaction(new AbortTransactionRequest(transactionId)); 启动事务后使用后其他操作非本事务的操作尝试写入 本示例展示的是一个在事务执行期间有另外一个同分区键的写入时的场景,由于在分区键下启动事务会直接锁定分区键下所有的写操作,在事务执行期间任何向同分区下的写入操作将被阻塞至事务提交或超时。下面的流程图展示了两个线程在通过事务写入的一些情景: 写入第一行 // put row A with transactionID PutRowRequest typeAPutRequest = new PutRowRequest(new RowPutChange( TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeA)) )) ).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_a"))); // set transactionId in startTransactionResponse typeAPutRequest.setTransactionId(transactionId); syncClient.putRow(typeAPutRequest); 写入第二行时不带事务ID,模拟非本事务的操作尝试写入,写入失败,返回的错误码为OTSRowOperationConflict // put row B without transactionID PutRowRequest typeBPutRequest = new PutRowRequest(new RowPutChange( TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeB)) )) ).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_b"))); // put without transactionId, due to PK_USE_ID is locked by another transaction, this action will fail try { syncClient.putRow(typeBPutRequest); Assert.fail(); } catch (TableStoreException e) { // ok Assert.assertEquals("OTSRowOperationConflict", e.getErrorCode()); } Batch写入 使用batch写入第一行和第二行 BatchWriteRowRequest batchWriteRowRequest = new BatchWriteRowRequest(); batchWriteRowRequest.addRowChange(new RowPutChange(TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeA)) ))).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_a"))); batchWriteRowRequest.addRowChange(new RowPutChange(TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeB)) ))).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_b"))); batchWriteRowRequest.setTransactionId(transactionId); syncClient.batchWriteRow(batchWriteRowRequest); 使用batch写入第三行和第四行 BatchWriteRowRequest batchWriteRowRequest = new BatchWriteRowRequest(); batchWriteRowRequest.addRowChange(new RowPutChange(TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeC)) ))).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_c"))); batchWriteRowRequest.addRowChange(new RowPutChange(TABLE_NAME, new PrimaryKey(Arrays.asList( new PrimaryKeyColumn(PK_USER_ID, PrimaryKeyValue.fromString(userId)), new PrimaryKeyColumn(PK_TYPE, PrimaryKeyValue.fromString(typeD)) ))).addColumn(COLUMN_CONTENT, ColumnValue.fromString("content_d"))); batchWriteRowRequest.setTransactionId(transactionId); syncClient.batchWriteRow(batchWriteRowRequest);


优秀的个人博客,低调大师

Nginx Ingress Controller 入门实践

Ingress是什么? 在 Kubernetes 集群中,Ingress是授权入站连接到达集群服务的规则集合,提供七层负载均衡能力。可以给 Ingress 配置提供外部可访问的 URL、负载均衡、SSL、基于名称的虚拟主机等。简单来说Ingress说一些规则集合,这些规则可以实现url到Kubernetes中的service这一层的路由功能。既然Ingress只是规则,那么这些规则的具体实现是怎么样的呢?是有Ingress-Controller来实现的,目前比较常见使用较多的是Nginx-Ingress-Controller。 可以这样理解一下,nginx-ingress-controller是一个nginx应用,它能干什么呢?它能代理后端的service,它能根据Ingress的配置,将对应的配置翻译成nginx应用的配置,来实现七层路由的功能。既然nginx-ingress-controller是作为一个类似网关的这么一个应用,那么我的nginx-ingress-controller这个应用本身就是需要在集群外能够访问到的,那么我是需要对外暴露nginx-ingress-controller这个应用的,在k8s中是通过创建一个LoadBalancer的Service:nginx-ingress-lb来暴露nginx-ingress-controller这个应用的。对应的,我们也就知道了nginx-ingress-controller这个应用从外部访问是通过nginx-ingress-lb这个service关联的SLB(负载均衡产品)来进行的。至于对应的slb的相关配置策略可以参考一下之前的文章,关于服务实现的内容。 简单的请求链路如下: 客户端 --> slb --> nginx-ingress-lb service --> nginx-ingress-controller pod --> app service --> app pod 我们使用Ingress来暴露服务,那么需要创建对应的资源,要想功能正常,nginx-ingress-controller的pod需要正常运行,nginx-ingress-lb service和slb监听配置正常才行,Ingress要关联的后端应用服务也是需要配置正确,包括应用pod运行正常,应用的service配置正确。 然后我们需要创建对应的Ingress来实现我们的需求。我们先创建一个简单的Ingress来大体看下具体的功能是什么样子的。我们这条Ingress的目的要实现:请求域名:ingress.test.com,实际请求会到后端的tomcat应用中。 相关配置: apiVersion: apps/v1beta2 kind: Deployment metadata: labels: app: tomcat name: tomcat namespace: default spec: progressDeadlineSeconds: 600 replicas: 1 revisionHistoryLimit: 10 selector: matchLabels: app: tomcat strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: labels: app: tomcat spec: containers: - image: 'tomcat:latest' imagePullPolicy: Always name: tomcat resources: requests: cpu: 100m memory: 200Mi terminationMessagePath: /dev/termination-log terminationMessagePolicy: File dnsPolicy: ClusterFirst restartPolicy: Always schedulerName: default-scheduler securityContext: {} terminationGracePeriodSeconds: 30 --- apiVersion: v1 kind: Service metadata: name: tomcat-svc namespace: default spec: clusterIP: 172.21.6.143 ports: - port: 8080 protocol: TCP targetPort: 8080 #service常见配置错误的地方,targetPort必须是pod暴露的端口,不能是其他的 selector: app: tomcat sessionAffinity: None type: ClusterIP --- apiVersion: extensions/v1beta1 kind: Ingress metadata: name: tomcat namespace: default spec: rules: - host: ingress.test.com http: paths: - backend: serviceName: tomcat-svc servicePort: 8080 path: / 在Ingress创建成功后会自动生成一个端点IP,我们应该将域名:ingress.test.com做A记录解析到这个端点IP。这样我们访问域名:ingress.test.com,实际请求会请求到我们的tomcat应用。 测试结果: #curl http://端点IP -H "host:ingress.test.com" -I HTTP/1.1 200 Date: Thu, 26 Sep 2019 04:55:39 GMT Content-Type: text/html;charset=UTF-8 Connection: keep-alive Vary: Accept-Encoding nginx-ingress-controller 配置分析 yaml如下: apiVersion: apps/v1beta2 kind: Deployment metadata: labels: app: ingress-nginx name: nginx-ingress-controller namespace: kube-system spec: progressDeadlineSeconds: 600 replicas: 2 revisionHistoryLimit: 10 selector: matchLabels: app: ingress-nginx strategy: rollingUpdate: maxSurge: 25% maxUnavailable: 25% type: RollingUpdate template: metadata: annotations: prometheus.io/port: '10254' prometheus.io/scrape: 'true' labels: app: ingress-nginx spec: affinity: podAntiAffinity: preferredDuringSchedulingIgnoredDuringExecution: - podAffinityTerm: labelSelector: matchExpressions: - key: app operator: In values: - ingress-nginx topologyKey: kubernetes.io/hostname weight: 100 containers: - args: - /nginx-ingress-controller - '--configmap=$(POD_NAMESPACE)/nginx-configuration' - '--tcp-services-configmap=$(POD_NAMESPACE)/tcp-services' - '--udp-services-configmap=$(POD_NAMESPACE)/udp-services' - '--annotations-prefix=nginx.ingress.kubernetes.io' - '--publish-service=$(POD_NAMESPACE)/nginx-ingress-lb' - '--v=2' env: - name: POD_NAME valueFrom: fieldRef: apiVersion: v1 fieldPath: metadata.name - name: POD_NAMESPACE valueFrom: fieldRef: apiVersion: v1 fieldPath: metadata.namespace image: >- registry-vpc.cn-shenzhen.aliyuncs.com/acs/aliyun-ingress-controller:v0.22.0.5-552e0db-aliyun imagePullPolicy: IfNotPresent livenessProbe: failureThreshold: 3 httpGet: path: /healthz port: 10254 scheme: HTTP initialDelaySeconds: 10 periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 name: nginx-ingress-controller ports: - containerPort: 80 name: http protocol: TCP - containerPort: 443 name: https protocol: TCP readinessProbe: failureThreshold: 3 httpGet: path: /healthz port: 10254 scheme: HTTP periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 resources: {} securityContext: capabilities: add: - NET_BIND_SERVICE drop: - ALL procMount: Default runAsUser: 33 terminationMessagePath: /dev/termination-log terminationMessagePolicy: File volumeMounts: - mountPath: /etc/localtime name: localtime readOnly: true dnsPolicy: ClusterFirst initContainers: - command: - /bin/sh - '-c' - | sysctl -w net.core.somaxconn=65535 sysctl -w net.ipv4.ip_local_port_range="1024 65535" sysctl -w fs.file-max=1048576 sysctl -w fs.inotify.max_user_instances=16384 sysctl -w fs.inotify.max_user_watches=524288 sysctl -w fs.inotify.max_queued_events=16384 image: 'registry-vpc.cn-shenzhen.aliyuncs.com/acs/busybox:latest' imagePullPolicy: Always name: init-sysctl resources: {} securityContext: privileged: true procMount: Default terminationMessagePath: /dev/termination-log terminationMessagePolicy: File nodeSelector: beta.kubernetes.io/os: linux restartPolicy: Always schedulerName: default-scheduler securityContext: {} serviceAccount: nginx-ingress-controller serviceAccountName: nginx-ingress-controller terminationGracePeriodSeconds: 30 volumes: - hostPath: path: /etc/localtime type: File name: localtime --- apiVersion: v1 kind: Service metadata: labels: app: nginx-ingress-lb name: nginx-ingress-lb namespace: kube-system spec: clusterIP: 172.21.11.181 externalTrafficPolicy: Local healthCheckNodePort: 32435 ports: - name: http nodePort: 31184 port: 80 protocol: TCP targetPort: 80 - name: https nodePort: 31972 port: 443 protocol: TCP targetPort: 443 selector: app: ingress-nginx sessionAffinity: None type: LoadBalancer 其中需要特别注意的配置是容器的args配置: --configmap=$(POD_NAMESPACE)/nginx-configuration 表明nginx-ingress-controller使用是哪个namespace下configmap来读取nginx-ingress-controller的nginx配置。默认是使用kube-system/nginx-configuration这个configmap。 --publish-service=$(POD_NAMESPACE)/nginx-ingress-lb 表明选择使用nginx-ingress-controller的Ingress的端点地址是使用的哪一个LoadBalancer的Service的扩展IP。默认是使用kube-system/nginx-ingress-lb这个Service。 --ingress-class=INGRESS_CLASS 这个配置是对nginx-ingress-controller自身的一个标识,表示我是谁,没有配置就是默认的“nginx”。这个配置有什么用呢?是用来让Ingress选择我要使用的ingress-controller是谁,Ingress通过注解:kubernetes.io/ingress.class: ""决定选择哪一个ingress-controller,如果没有配置那么就是选择--ingress-class=“nginx”这个ingress-controller。 如何在一个阿里云kubernetes集群里面部署多套Nginx Ingress Controller参考文档: https://yq.aliyun.com/articles/645856 之前我们也说了Ingress是规则,会下发到ingress-controller实现相关功能,那我们就来看下下发到ingress-controller的配置究竟是什么样。我们可以进入到nginx-ingress-controller的pod内来查看一下nginx配置。在pod内的/etc/nginx/nginx.conf里面,除了一些公共的配置外,上面的Ingress生成了如下的nginx.conf配置: ## start server ingress.test.com server { server_name ingress.test.com ; listen 80; set $proxy_upstream_name "-"; location / { set $namespace "default"; set $ingress_name "tomcat"; set $service_name "tomcat-svc"; set $service_port "8080"; set $location_path "/"; rewrite_by_lua_block { balancer.rewrite() } access_by_lua_block { balancer.access() } header_filter_by_lua_block { } body_filter_by_lua_block { } log_by_lua_block { balancer.log() monitor.call() } port_in_redirect off; set $proxy_upstream_name "default-tomcat-svc-8080"; set $proxy_host $proxy_upstream_name; client_max_body_size 100m; proxy_set_header Host $best_http_host; # Pass the extracted client certificate to the backend # Allow websocket connections proxy_set_header Upgrade $http_upgrade; proxy_set_header Connection $connection_upgrade; proxy_set_header X-Request-ID $req_id; proxy_set_header X-Real-IP $the_real_ip; proxy_set_header X-Forwarded-For $the_real_ip; proxy_set_header X-Forwarded-Host $best_http_host; proxy_set_header X-Forwarded-Port $pass_port; proxy_set_header X-Forwarded-Proto $pass_access_scheme; proxy_set_header X-Original-URI $request_uri; proxy_set_header X-Scheme $pass_access_scheme; # Pass the original X-Forwarded-For proxy_set_header X-Original-Forwarded-For $http_x_forwarded_for; # mitigate HTTPoxy Vulnerability # https://www.nginx.com/blog/mitigating-the-httpoxy-vulnerability-with-nginx/ proxy_set_header Proxy ""; # Custom headers to proxied server proxy_connect_timeout 10s; proxy_send_timeout 60s; proxy_read_timeout 60s; proxy_buffering off; proxy_buffer_size 4k; proxy_buffers 4 4k; proxy_request_buffering on; proxy_http_version 1.1; proxy_cookie_domain off; proxy_cookie_path off; # In case of errors try the next upstream server before returning an error proxy_next_upstream error timeout; proxy_next_upstream_tries 3; proxy_pass http://upstream_balancer; proxy_redirect off; } } ## end server ingress.test.com Nginx.conf里面的配置比较多,这里就不在一一详解,后续我们再针对一些常见的功能配置进行说明。 同时最新版本的nginx-ingress-controller已经默认开启了Upstream的动态更新,可以在nginx-ingress-controller的pod内请求:curl http://127.0.0.1:18080/configuration/backends 查看。具体内容如下: [{"name":"default-tomcat-svc-8080","service":{"metadata":{"creationTimestamp":null},"spec":{"ports":[{"protocol":"TCP","port":8080,"targetPort":8080}],"selector":{"app":"tomcat"},"clusterIP":"172.21.6.143","type":"ClusterIP","sessionAffinity":"None"},"status":{"loadBalancer":{}}},"port":8080,"secureCACert":{"secret":"","caFilename":"","pemSha":""},"sslPassthrough":false,"endpoints":[{"address":"172.20.2.141","port":"8080"}],"sessionAffinityConfig":{"name":"","cookieSessionAffinity":{"name":"","hash":""}},"upstreamHashByConfig":{"upstream-hash-by-subset-size":3},"noServer":false,"trafficShapingPolicy":{"weight":0,"header":"","cookie":""}},{"name":"upstream-default-backend","port":0,"secureCACert":{"secret":"","caFilename":"","pemSha":""},"sslPassthrough":false,"endpoints":[{"address":"127.0.0.1","port":"8181"}],"sessionAffinityConfig":{"name":"","cookieSessionAffinity":{"name":"","hash":""}},"upstreamHashByConfig":{},"noServer":false,"trafficShapingPolicy":{"weight":0,"header":"","cookie":""}}] 我们可以看到这里有ingress关联的service及其endpoint的映射关系,这样可以就可以请求到具体的pod的业务了。 路由配置的动态更新可以参考文档了解一下:https://yq.aliyun.com/articles/692732 在后续的文章我们再详细讲一些常见的使用场景。

优秀的个人博客,低调大师

Docker入门-Dockerfile的使用

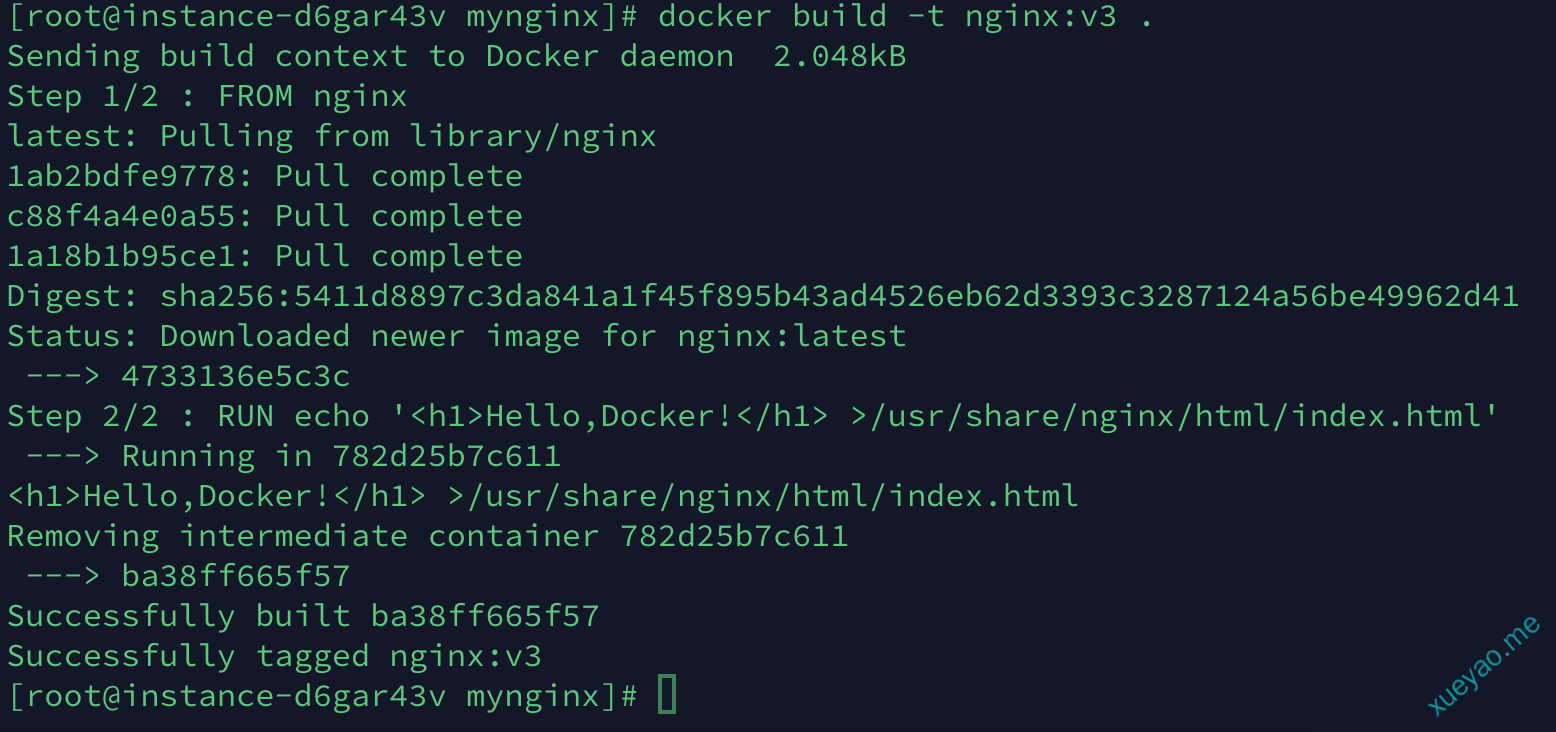
使用Dockerfile定制镜像 镜像的定制实际上就是定制每一层所添加的配置、文件。我们可以把每一层修改、安装、构建、操作的命令都写入一个脚本,这个脚本就是Dockerfile。 Dockerfile是一个文本文件,其内包含了一条条的指令,每一条指令构建一层,因此每一条指令的内容,就是描述该层应当如何构建。 接下来我们以官方nginx镜像为例,使用Dockerfile来定制。 在一个空白目录中,建立一个文本文件,并命名为Dockerfile: mkdir mynginx cd mynginx touch Dockerfile 其内容为: FROM nginx RUN echo '<h1> Hello,Docker!</h1>' >/usr/share/nginx/html/index.html 这个Dockerfile很简单,一共就两行。涉及到了两条指令,FROM和RUN。 FROM指定基础镜像 所谓定制镜像,一定是以一个镜像为基础,在其上进行定制。基础镜像是必须指定的,而FROM就是指定基础镜像,因此一个Dockerfile中FROM是必备的指令,并且必须是第一条指令。在Docker Hub上有非常多的高质量的官方镜像,有可以直接拿来使用的服务类的镜像,如nginx、redis、mysql、tomcat等;可以在其中寻找一个最符合我们最终目标的镜像为基础镜像进行定制。 如果没有找到对应服务的镜像,官方镜像中还提供了一些更为基础的操作系统镜像,如ubuntu、debian、centos、alpine等,这些操作系统的软件库为我们提供了更广阔的扩展空间。 除了选择现有镜像为基础镜像外,Docker还存在一个特殊的镜像,名为scratch。这个镜像是虚拟的概念,并不实际存在,它表示一个空白的镜像。 FROM scratch ... 如果你以scratch为基础镜像的话,意味着你不以任何镜像为基础,接下来所写的指令将作为镜像第一层开始存在。 对于Linux下静态编译的程序来说,并不需要有操作系统提供运行时支持,所需的一切库都已经在可执行文件里了,因此直接FROM scratch会让镜像体积更加小巧。使用Go语言开发的应用很多会使用这种方式来制作镜像,这也是为什么有人认为Go是特别适应容器微服务架构的语言的原因之一。 RUN执行命令 RUN指令是用来执行命令行命令的。由于命令行的强大能力,RUN指令在定制镜像时是最常用的指令之一。其格式有两种: shell格式:RUN <命令> RUN echo '<h1>Hello,Docker~</h1>' > /usr/share/nginx/html/index.html exec格式: RUN ["可执行文件",“参数1”,“参数2”] RUN tar -xzf redis.tar.gz -C /usr/src/redis --strip-components=1 RUN make -C /usr/src/redis RUN make -C /usr/src/redis install 上面我们利用Dockerfile定制了nginx镜像,现在我们明白了这个Dockerfile的内容,接下来我们来构建这个镜像。 在Dockerfile文件所在目录执行: docker build -t nginx:v3 . 从命令的输出结果中,我们可以清晰的看到镜像的构建过程。在Step2中,RUN指令启动了一个容器782d25b7c611,执行了所要示的命令,并最后提交了这一层ba38ff665f57,随后删除了所用到的这个容器782d25b7c611。 启动构建的Nginx docker run --name nginx-test -p 8081:80 -d nginx:v3 如图所示 Dockerfile指令详解 COPY复制文件 格式: COPY <源路径>...<目标路径> COPY ["<源路径1>",..."<目标路径>"] COPY指令将从构建上下文目录中<源路径>的文件/目录复制到新的一层的镜像内的<目标路径>位置。比如: COPY package.json /usr/src/app/ <源路径>可以是多个,甚至可以是通配符,如: COPY hom* /mydir/ COPY hom?.txt /mydir/ ADD更高级的复制文件 ADD指令和COPY的格式和性质基本一致。但是在COPY基础上增加了一些功能。比如<源路径>可以是一个URL,这种情况下,Docker引擎会试图去下载这个链接的文件放到<目标路径>去。 在Docker官方的Dockerfile最佳实践文档中要求,尽可能的使用COPY,因此COPY的语义很明确,就是复制文件而已,而ADD则包含了更复杂的功能,其行为也不一定很清晰。最适合使用ADD的场合,就是所提及的需要自动解压缩的场合。 因此在COPY和ADD指令中选择的时候,可以遵循这样的原则,所有的文件复制均使用COPY指令,仅在需要自动解压缩的场合使用ADD。 CMD容器启动命令 CMD指令的格式和RUN相似,也是两种格式: shell格式:CMD <命令> exec格式:CMD ["可执行文件",“参数1”,“参数2”] 参数列表格式:CMD [“参数1”,“参数2”...]。在指定了ENTRYPOINT指令后,用CMD指定具体参数。 Docker不是虚拟机,容器就是进程。既然是进程,那么在启动容器的时候,需要指定所运行的程序及参数。CMD指令就是用于指定默认的容器主进程启动命令的。 ENTRYPOINT入口点 ENTRYPOINT的目的和CMD一样,都是在指定容器启动程序及参数。ENTRYPOINT在运行也可以替代,不过比CMD要略显繁琐,需要通过docker run的参数 --entrypoint来指定。 当指定了ENTRYPOINT后,CMD的含义就发生了改变,不再是直接的运行其命令,而是将CMD的内容作为参数传给ENTRYPOINT指令,换句话说实际执行时,将变为: <ENTRYPOINT>"<CMD>" ENV设置环境变量 格式有两种: ENV ENV ==... 这个指令很简单,就是设置环境变量而已,无论是后面的其它指令,如RUN,还是运行时的应用,都可以直接使用这里定义的环境变量。 ENV VERSION=1.0 DEBUG=on NAME="Happy Feet" $VERSION #使用环境变量 下列指令可以支持环境变量展开:ADD、COPY、ENV、EXPOSE、LABEL、USER、WORKDIR、VOLUME、STOPSIGNAL、ONBUILD。 ARG构建参数 格式: ARG <参数名>[=<默认值>]构建参数和ENV的效果一样,都是设置环境变量。所不同的是,ARG所设置的构建环境的环境变量,在将来容器运行时是不会存在这些环境变量的。但是不要因此就使用ARG保存密码之类的信息,因此docker history还是可以看到所有值的。 Dockerfile中的ARG指令是定义参数名称,以及定义其默认值。该默认值可以在构建命令docker build中用 --build-arg <参数名>=<值>来覆盖。 VOLUME定义匿名卷 格式为: VOLUME ["<路径1>","[路径2]"...] VOLUME <路径> 容器运行时应该尽量保持容器存储层不发生写操作,对于数据库需要保存动态数据的应用,其数据库文件应该保存于卷(volume)中,为了防止运行时用户忘记将动态文件所保存目录挂载为卷,在Dockerfile中,我们可以事先指定某些目录挂载为匿名卷,这样在运行时如果用户不指定挂载,其应用也可以正常运行,不会向容器存储层写入大量数据 VOLUME /data 这里的/data目录就会在运行时自动挂载为匿名卷,任何向/data中写入的信息都不会记录进容器存储层,从而保证了容器存储层的无状态化。当然,运行时可以覆盖这个挂载设置。 比如: docker run -d -v mydata:/data xxxx 在这行命令中,就使用了mydata这个命名卷挂载到了/data这个位置,替代了Dockerfile中定义的匿名卷的挂载配置。 EXPOSE声明端口 格式为EXPOSE <端口1>[<端口2>...]。 EXPOSE指令是声明运行时容器提供服务端口,这只是一个声明,在运行时并不会因为这个声明应该就会开启这个端口的服务。 在Dockerfile中写入这样的声明有两个好处: 是帮助镜像使用者理解这个镜像服务的守护端口,以方便配置映射; 在运行是使随机端口映射时,也就是docker run -P时,会自动随机映射EXPOSE端口。 WORKDIR指定工作目录 格式为WORKDIR <工作目录路径> 使用WORKDIR指令可以来指定工作目录(或者称为当前目录),以后各层的当前目录就被改为指定的目录,如该目录不存在,WORKDIR会帮你建立目录。 之前提到一些初学者常犯的错误是把Dockerfile等同于Shell脚本来书写,这种错误的理解还可能会导致出现下面这样的错误: RUN cd /app RUN echo "hello">world.txt 如果将这个Dockerfile进行构建镜像运行后,会发现找不到 /app/world.txt文件。 原因 在Shell中,连续两行是同一个进程执行环境,因此前一个命令修改的内存状态,会直接影响后一个命令。 而在Dockerfile中,这两行RUN命令的执行环境根本不同,是两个完全不同的容器。这就是对Dockerfile构建分层存储的概念不了解导致的错误。 每一个RUN都是启动一个容器、执行命令、然后提交存储层文件变量。第一层RUN cd /app的执行仅仅是当前进程的工作目录变量,一个内存上的变化而已,其结果不会造成任何文件变更。而到第二层的时候,启动的是一个全新的容器,跟第一层的容器更完全没关系,自然不可能继承前一层构建过程中的内存变化。 因此如果需要改变以后各层的工作目录的位置,那么应该使用WORKIDR指令。 USER指定当前用户 格式:USER <用户名> USER指令和WORKDIR相似,都是改变环境状态并影响以后的层。WORKDIR是改变工作目录,USER则是改变之后层的执行RUN,CMD以及ENTRYPOINT这类命令的身份。 当前,和WORKDIR一样,USER只是帮助你切换到指定用户而已,这个用户必须是事先建立好的,否则无法切换。 RUN groupadd -r redis && useradd -r -g redis redis USER redis RUN ["redis-server"] HEALTHCHECK健康检查 格式: HEALTHCHECK [选项] CMD <命令>:设置检查容器健康状况的命令 HEALTHCHECK NONE:如果基础镜像有健康检查指令,可以屏蔽掉其健康检查指令 HEALTHCHECK指令是告诉Docker应该如何进行判断容器的状态是否正常,这是Docker1.12引入的新指令。通过该指令指定一行命令,用这行命令来判断容器主进程的服务状态是否还正常,从而比较真实的反应容器实际状态。 一个镜像指令HEALTHCHECK指令后,用其启动容器,初始状态会为starting,在执行健康检查成功后变为healthy,如果连续一定次数失败,则会变为unhealthy。 HEALTHCHECK支持下列选项: --interval=<间隔>:两次健康检查的间隔,默认为30秒; --timeout=<时长>:健康检查命令运行超时时间,如果超过这个时间,本次健康检查就被视为失败,默认30秒; --retries=<次数>:当连续失败指定次数后,则将容器状态视为unhealthy,默认3次。 为了帮助排障,健康检查命令的输出(包括stdout以及stderr)都会被存储于健康状态里,可以用docker inspect来查看。 ONBUILD为他人做嫁衣裳 格式: ONBUILD <其它指令>ONBUILD是一个特殊的指令,它后面跟的是其它指令,比如RUN,COPY等,而这些指令,在当前镜像构建时并不会被执行。只有当以前镜像为基础镜像,去构建下一级镜像的时候才会被执行。 Dockerfile中的其它指令都是为了定制当前镜像而准备的,唯有ONBUILD是为了帮助别人定制自己而准备的。 其他制作镜像方式 docker save和docker load Docker还提供了docker load和docker save命令,用以将镜像保存为一个tar文件,然后传输到另一个位置上,再加载进来。这是在没有Docker Registry时的做法,现在已经不推荐,镜像迁移应该直接使用Docker Registry,无论是直接使用Docker Hub还是使用内网私有Registry都可以。 例如:保存nginx镜像 docker save nginx|gzip > nginx-latest.tar.gz 然后我们将nginx-latest.tar.gz文件复制到了另一个机器上,再次加载镜像: docker load -i nginx-latest.tar.gz

优秀的个人博客,低调大师

Docker入门-介绍和安装

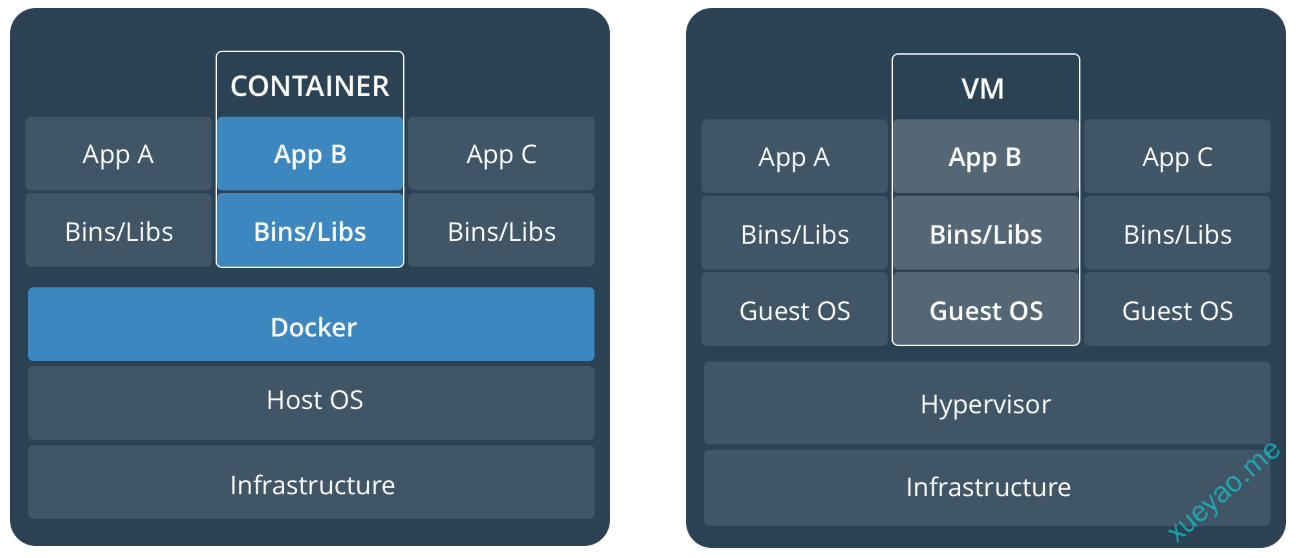
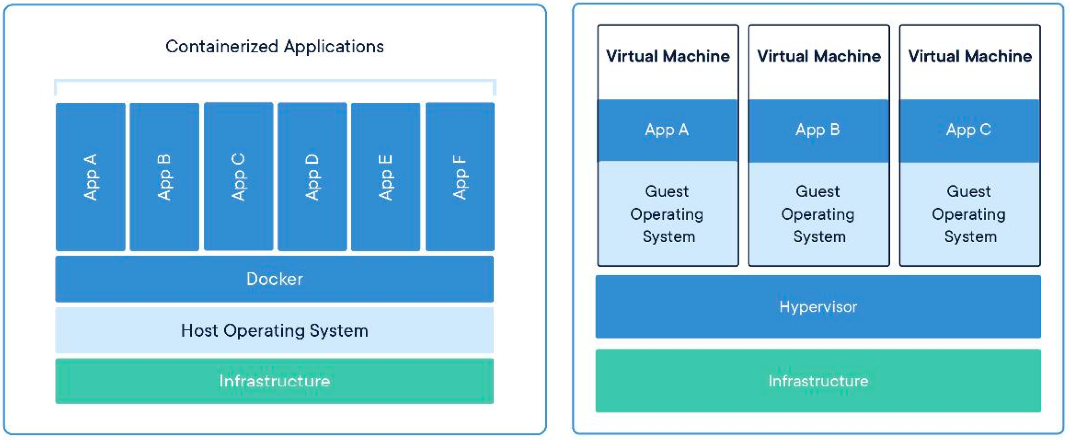
Docker容器 Docker是什么 Docker最初是dotCloud公司创建人Solomon Hykes在法国期间发起的一个公司内部项目,它是基于dotCloud公司多年云服务技术的一次革新,并于2013年3月以Apache2.0授权协议开源,主要项目代码在Github上进行维护。Docker项目后来加入了Linux基金会,并成立推动开放容器联盟(OCI). Docker使用Google公司推出的Go语言进行开发实现,基于Linux内核的cgroup,namespace,以及AUFS类的Union FS等技术,对进程进行封装隔离,属于操作系统层面的虚拟化技术。由于隔离的进程独立于宿主和其它的隔离的进程,因此也称为容器。 Docker在容器的基础上,进行了进一步的封装,从文件系统、网络互联至进程隔离等待,极大的简化了容器的创建和维护。使得Docker技术比虚拟机技术更为轻便、快捷。 Docker和传统虚拟机 传统虚拟机技术是虚拟出一套硬件后,在其上运行一个完整操作系统,在该系统上再运行所需应用进程; 而容器内的应用进程直接运行于宿主的内核,容器内没有自己的内核,而且也没有进行硬件虚拟。因此容器要比传统虚拟机更为轻便。 为什么要使用Docker Docker优势 更高效的利用系统资源 更快速的启动时间 一致的运行环境 持续交付和部署 更轻松的迁移 更轻松的维护和扩展 对比传统虚拟机总结 特性 容器 虚拟机 启动 秒级 分钟级 硬盘使用 一般为MB 一般为GB 性能 接近原生 较弱 系统支持量 单机支持上千个容器 一般几十个 Docker架构 Docker使用客户端-服务器(C/S)架构模式,使用远程API来管理和创建Docker容器。 Docker基本概念 Docker镜像 我们都知道,操作系统分为内核和用户空间。对于Linux而言,内核启动后,会挂载root文件系统为其提供用户空间支持。而Docker镜像(Image),就相当于是一个root文件系统。比如官方镜像centos:7.6就包含了完整的一套centos7.6最小系统的root文件系统。 Docker镜像是一个特殊的文件系统,除了提供容器运行时所需的程序、库、资源、配置等文件外,还包含了一些为运行时准备的一些配置参数(如匿名半卷、环境变量、用户等)。镜像不包含任何动态数据,其内容在构建之后也不会被改变。 Docker镜像分层存储 因为镜像包含操作系统完整的root文件系统,其体积往往是庞大的,因此在Docker设计时将其设计为分层存储的架构。镜像只是一个虚拟的概念,其实际体现并非由一个文件组成,而是由一组文件系统组成,或者说,由多层文件系统联合组成。 镜像构建时,会一层层构建,前一层是后一层的基础。每一层构建完就不会再发生改变,后一层上的任何改变只发生在自己这一层。在构建镜像的时候,需要额外小心,每一层尽量只包含该层需要添加的东西,任何额外的东西应该在该层构建结束前清理掉。 分层存储的特征还使得镜像的复用、定制变的更为容易。甚至可以用之前构建好的镜像作为基础层,然后进一步添加新的层,以定制自己所需的内容,构建新的镜像。 Docker容器 镜像(Image)和容器(Container)的关系,就像Java中的类和实例一样,镜像是静态的定义,容器是镜像运行时的实体。容器可以被创建、启动、停止、删除、暂停等。 前面讲过镜像使用的是分层存储,容器也是如此。每一个容器运行时,是以镜像基础层,在其上创建一个当前容器的存储层,我们可以称这个为容器运行时读写而准备的存储层为容器存储层。 容器存储层的生存周期和容器一样,容器消亡时,容器存储层也随之消亡。因此,任何保存于容器存储层的信息都会随容器删除而丢失。 按照Docker最佳实践的要求,容器不应该向其存储内写入任何数据,容器存储层要保持无状态化。所有的文件写入操作,都应该使用Volume数据卷、或者绑定宿主目录,在这些位置的读写会跳过容器存储层,直接对宿主(或网络存储)发生读写,其性能和稳定性更高。 数据卷的生存周期独立于容器,容器消亡,数据卷不会消亡。因此,使用数据卷后,容器删除或者重新运行之后,数据却不会丢失。 Docker仓库 镜像构建完成后,可以很容易的在当前宿主机上运行,但是,如果需要在其它服务器上使用这个镜像,我们就需要一个集中的存储、分发镜像的服务,Docker Registry就是这样的服务。 一个Docker Registry中可以包含多个仓库(Repository);每个仓库可以包含多个标签(Tag);每个标签对应一个镜像。 通常,一个仓库会包含同一个软件不同版本的镜像,而标签就常用于对应软件的各个版本。我们可以通过<仓库名>:<标签>的格式来指定具体是这个软件哪个版本的镜像。如果不给出标签,将以latest作为默认标签。 以centos镜像为例,centos是仓库的名字,其内包含有不同的版本标签,如,6.9,7.5。我们可以通过centos:6.9,或者centos:7.5来具体指定所需哪个版本的镜像。如果忽略了标签,比如centos,那将视为centos:latest。 仓库名经常以两段式路径形式出现,比如study/nginx,前者往往意味着Docker Registry多用户环境下的用户名,后者则往往是对应的软件名。但这并非绝对,取决于所使用的具体Docker Registry的软件或服务。 Docker Registry公开仓库 常用的Registry是官方的Docker Hub,这也是默认的Registry。除此以外,还有CoreOS的Quay.io,CoreOS相关的镜像存储在这里;Google的Google Container Registry,Kubernetes的镜像使用的就是这个服务。 国内的一些云服务商提供了针对Docker Hub的镜像服务。这些镜像服务被称为加速器。常见的有阿里加速器、DaoCloud加速器等。使用加速器会直接从国内的地址下载Docker Hub的镜像,比直接从Docker Hub下载速度会提高很多。 国内也有一些云服务商推荐类型于Docker Hub的公开服务。如网易云镜像服务、DaoCloud镜像市场、阿里云镜像库等。 安装 Docker版本命名 Docker在1.13版本之后,从2017年的3月1日开始,版本命名规则变为如 项目 说明 版本格式 YY.MM Stable版本 每个季度发行 Edge版本 每个月发行 当前Docker CE Stable版本 18.09 当前Docker CE Edge版本 18.09 同时Docker划分为CE和EE。CE即社区版(免费,支持周期三个月)强调安全,付费使用。 CentOS安装Docker 1、系统要求 Docker CE支持64位版本CentOS7,并且要求内核版本不低于3.10。 # 查看当前系统内核 uname -r 2、卸载旧版本 旧版本的Docker称为docker或者docker-engine,使用以下命令卸载旧版本: sudo yum remove docker docker-common docker-selinux docker-engine 3、使用yum安装 sudo yum install docker-ce 4、使用脚本安装 在测试或开发环境中Docker官方为了简化安装流程,提供了一套便捷的安装脚本,系统上可以使用这套脚本安装: curl -fsSL https://get.docker.com -o get-docker.sh sudo sh get-docker.sh --mirror Aliyun 执行这个命令后,脚本就会自动的将一切做准备工作做好,并且把Docker CE的Edge装在系统中。 5、启动Docker CE sudo systemctl enable docker #设置开启启动 sudo systemctl start docker 6、建立docker用户组 默认情况下,docker命令会使用Unix socket与Docker引擎通讯。而只有root用户和docker组的用户才可以访问Docker引擎的Unix socket。一般Linux系统上不会直接使用root用户进行操作。因此,需要将使用docker的用户加入docker用户组。 sudo groupadd docker #建立docker组 sudo usermod -aG docker #USER #将当前用户加入docker组 7、测试Docker是否安装正确 docker run hello-world #启动一个基于hello-world镜像的容器 若能正常输出以上信息,则说明安装成功。 CentOS卸载Docker 1、 删除docker安装包 sudo yum remove docker-ce 2、删除docker镜像 sudo rm -rf /var/lib/docker 镜像加速器 国内从Docker Hub拉取镜像有时会遇到困难,此时可以配置镜像加速器。Docker官方和国内很多云服务商都提供了国内加速器服务,例如: Docker官方提供的中国registry mirror 阿里云加速器 DaoCloud加速器 163加速器 接下来我们以163加速器为例进行介绍。 CentOS7配置镜像加速 对于使用systemd的系统,请在/etc/docker/daemon.json中写入如下内容(如果文件不存在请新建该文件) { "registry-mirrors":[ "http://hub-mirror.c.163.com" ] } 重新启动服务生效 sudo systemctl daemon-reload sudo systemctl restart docker 查看当前docker信息 docker info

优秀的个人博客,低调大师

菜鸟的Hadoop快速入门

一、相关概念 1、大数据 大数据是一门概念,也是一门技术,是以Hadoop为代表的大数据平台框架上进行各种数据分析的技术。 大数据包括了以Hadoop和Spark为代表的基础大数据框架,还包括实时数据处理,离线数据处理,数据分析,数据挖掘和用机器算法进行预测分析等技术。 2、Hadoop Hadoop是一个开源的大数据框架,是一个分布式计算的解决方案。 Hadoop的两个核心解决了数据存储问题(HDFS分布式文件系统)和分布式计算问题(MapRe-duce)。 举例1:用户想要获取某个路径的数据,数据存放在很多的机器上,作为用户不用考虑在哪台机器上,HD-FS自动搞定。 举例2:如果一个100p的文件,希望过滤出含有Hadoop字符串的行。这种场景下,HDFS分布式存储,突破了服务器硬盘大小的限制,解决了单台机器无法存储大文件的问题,同时MapReduce分布式计算可以将大数据量的作业先分片计算,最后汇总输出。 二、Hadoop特点 优点 1、支持超大文件。HDFS存储的文件可以支持TB和PB级别的数据。 2、检测和快速应对硬件故障。数据备份机制,NameNode通过心跳机制来检测DataNode是否还存在。 3、高扩展性。可建构在廉价机上,实现线性(横向)扩展,当集群增加新节点之后,NameNode也可以感知,将数据分发和备份到相应的节点上。 4、成熟的生态圈。借助开源的力量,围绕Hadoop衍生的一些小工具。 缺点 1、不能做到低延迟。高数据吞吐量做了优化,牺牲了获取数据的延迟。 2、不适合大量的小文件存储。 3、文件修改效率低。HDFS适合一次写入,多次读取的场景。 三、HDFS介绍 1、HDFS框架分析 HDFS是Master和Slave的主从结构。主要由Name-Node、Secondary NameNode、DataNode构成。 NameNode 管理HDFS的名称空间和数据块映射信存储元数据与文件到数据块映射的地方。 如果NameNode挂掉了,文件就会无法重组,怎么办?有哪些容错机制? Hadoop可以配置成HA即高可用集群,集群中有两个NameNode节点,一台active主节点,另一台stan-dby备用节点,两者数据时刻保持一致。当主节点不可用时,备用节点马上自动切换,用户感知不到,避免了NameNode的单点问题。 Secondary NameNode 辅助NameNode,分担NameNode工作,紧急情况下可辅助恢复NameNode。 DataNode Slave节点,实际存储数据、执行数据块的读写并汇报存储信息给NameNode。 2、HDFS文件读写 文件按照数据块的方式进行存储在DataNode上,数据块是抽象块,作为存储和传输单元,而并非整个文件。 文件为什么要按照块来存储呢? 首先屏蔽了文件的概念,简化存储系统的设计,比如100T的文件大于磁盘的存储,需要把文件分成多个数据块进而存储到多个磁盘;为了保证数据的安全,需要备份的,而数据块非常适用于数据的备份,进而提升数据的容错能力和可用性。 数据块大小设置如何考虑? 文件数据块大小如果太小,一般的文件也就会被分成多个数据块,那么在访问的时候也就要访问多个数据块地址,这样效率不高,同时也会对NameNode的内存消耗比较严重;数据块设置得太大的话,对并行的支持就不太好了,同时系统如果重启需要加载数据,数据块越大,系统恢复就会越长。 3.2.1 HDFS文件读流程 1、向NameNode通信查询元数据(block所在的DataNode节点),找到文件块所在的DataNode服务器。 2、挑选一台DataNode(就近原则,然后随机)服务器,请求建立socket流。 3、DataNode开始发送数据(从磁盘里面读取数据放入流,以packet为单位来做校验)。 4、客户端已packet为单位接收,现在本地缓存,然后写入目标文件,后面的block块就相当于是append到前面的block块最后合成最终需要的文件。 3.2.2 HDFS文件写流程 1、向NameNode通信请求上传文件,NameNode检查目标文件是否已存在,父目录是否存在。 2、NameNode返回确认可以上传。 3、client会先对文件进行切分,比如一个block块128m,文件有300m就会被切分成3个块,一个128m、一个128m、一个44m。请求第一个block该传输到哪些DataNode服务器上。 4、NameNode返回DataNode的服务器。 5、client请求一台DataNode上传数据,第一个DataNode收到请求会继续调用第二个DataNode,然后第二个调用第三个DataNode,将整个通道建立完成,逐级返回客户端。 6、client开始往A上传第一个block,当然在写入的时候DataNode会进行数据校验,第一台DataNode收到后就会传给第二台,第二台传给第三台。 7、当一个block传输完成之后,client再次请求NameNode上传第二个block的服务器。 四、MapReduce介绍 1、概念 MapReduce是一种编程模型,是一种编程方法,是抽象的理论,采用了分而治之的思想。MapReduce框架的核心步骤主要分两部分,分别是Map和Reduce。每个文件分片由单独的机器去处理,这就是Map的方法,将各个机器计算的结果汇总并得到最终的结果,这就是Reduce的方法。 2、工作流程 向MapReduce框架提交一个计算作业时,它会首先把计算作业拆分成若干个Map任务,然后分配到不同的节点上去执行,每一个Map任务处理输入数据中的一部分,当Map任务完成后,它会生成一些中间文件,这些中间文件将会作为Reduce任务的输入数据。Reduce任务的主要目标就是把前面若干个Map的输出汇总到一起并输出。 3、运行MapReduce示例 运行Hadoop自带的MapReduce经典示例Word-count,统计文本中出现的单词及其次数。首先将任务提交到Hadoop框架上。 查看MapReduce运行结束后的输出文件目录及结果内容。 可以看到统计单词出现的次数结果 五、Hadoop安装 墙裂推荐:史上最详细的Hadoop环境搭建(https://blog.csdn.net/hliq5399/article/details/78193113) 1、Hadoop部署模式 本地模式 伪分布式模式 完全分布式模式 以上部署模式区分的依据是NameNode、Data-Node、ResourceManager、NodeManager等模块运行在几个JVM进程、几个机器上。 2、安装步骤(以伪分布式模式为例) 学习Hadoop一般是在伪分布式模式下进行。这种模式是在一台机器上各个进程上运行Hadoop的各个模块,伪分布式的意思是虽然各个模块是在各个进程上分开运行的,但是只是运行在一个操作系统上的,并不是真正的分布式。 5.2.1 JDK包下载、解压安装及JAVA环境变量配置 exportJAVA_HOME=/home/admin/apps/jdk1.8.0_151 exportCLASSPATH=.:$JAVA_HOME/lib/dt.jar:$JAVA_HOME/lib/tools.jar exportPATH=$JAVA_HOME/bin:$PATH 5.2.2 Hadoop包下载、解压安装及Hadoop环境变量配置 exportHADOOP_HOME="/zmq/modules/hadoop/hadoop-3.1.0" exportPATH=$HADOOP_HOME/bin:$HADOOP_HOME/sbin:$PATH 5.2.3 配置Hadoop-env.sh、mapred-env.sh、yarn-env.sh文件的JAVA_HOME参数 exportJAVA_HOME="/home/admin/apps/jdk1.8.0_151" 5.2.4 配置core-site.xml,配置的是HDFS的地址和Hadoop临时目录 5.2.5 配置hdfs-site.xml,设置HDFS存储时的备份数量,这里是伪分布式部署,就填写1 5.2.6 格式化HDFS,启动NameNode、Data-Node、SecondaryNameNode,查看进程 5.2.7 搭建完成,操作HDFS(常用的新建目录、上传下载文件等),以及运行MapReduceJob 六、Hadoop更多 以上介绍的仅是对Hadoop的初步学习和使用,Ha-doop的HA完全分布式部署、Hadoop的资源调度YARN、Hadoop的高可用和容错机制、Hadoop生态圈的其他组件等等还没有去研究,感叹Hadoop水很深,哈哈。 作者简介:梦琴,两年+测试经验,当前主要负责内部平台产品的测试及部分外部交付项目测试。

优秀的个人博客,低调大师

【译】Spark NLP使用入门

原文链接: [https://www.kdnuggets.com/2019/06/spark-nlp-getting-started-with-worlds-most-widely-used-nlp-library-enterprise.html) 译者:辰石,阿里巴巴计算平台事业部EMR团队技术专家,目前从事大数据存储以及Spark相关方面的工作。 AI在企业中的应用 关于AI在企业中应用的年度O‘Reilly报告已经在2019年2月发布, 该报告针对多个垂直行业的1300多从业人员进行调查, 该调查包含受访者所在企业中生产环境的AI项目,这些AI项目是如何在企业中应用,以及AI如何快速的扩展到深度学习,人机互助系统,知识图谱, 强化学习中。该调查包含了受访者企业主要使用ML以及AI的框架以及工具情况,下图为使用情况总结的展示图: 其中

优秀的个人博客,低调大师

Kubernetes Ingress日志分析入门

本文主要介绍如何基于日志服务构建Kubernetes Ingress日志分析平台,并提供一些简单的动手实验方便大家快速了解日志服务相关功能。 部署Ingress日志方案 登录容器服务管理控制台。 将上述CRD配置保存成编排模板。编排模板文档请参见创建编排模板。 基于该模板创建应用,选择您所在集群的default命名空间。 apiVersion: log.alibabacloud.com/v1alpha1 kind: AliyunLogConfig metadata: # your config name, must be unique in you k8s cluster name: k8s-nginx-ingress spec: # logstore name to upload log logstore: nginx-i

优秀的个人博客,低调大师

【Kafka】《Kafka权威指南》入门

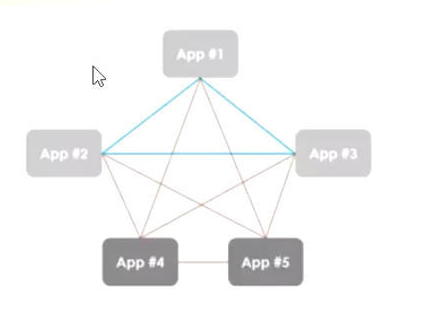
发布与订阅消息系统 在正式讨论Apache Kafka (以下简称Kafka)之前,先来了解发布与订阅消息系统的概念, 并认识这个系统的重要性。数据(消息)的发送者(发布者)不会直接把消息发送给接收 者,这是发布与订阅消息系统的一个特点。发布者以某种方式对消息进行分类,接收者 (订阅者)订阅它们,以便接收特定类型的消息。发布与订阅系统一般会有一个 broker,也就是发布消息的中心点。 发布与订阅消息系统的大部分应用场景都是从一个简单的消息队列或一个进程间通信开始的。比如电商系统中,包含会员模块、订单模块、商品模块、推荐模块、配送物流模块等,多个模块(子系统)间涉及消息的传递。 最早的应用解决方案就是采用(子系统间)直连的方式,使得很多子系统交错复杂。这种点对点的连接方式,形成网状的连接,弊端很多,不一一赘述。 后来,为了解决子系统间直连交错的问题,出现了队列系统。下图所示的架构包含了 3 个独立的发布与订阅系统。 这种方式比直接使用点对点的连接要好得多,但这里有太多重复的地方。你的公司因此要为数据队列维护多个系统,每个系统又有各自的缺陷和不足。而且,接下来可能会有更多的场景需要用到消息系统。 此时,你真正需要的是一个单一的集中式系统,它可以用来发布通用类型的数据,其规模可以随着公司业务的增长而增长。这时Kafka登场了。 Kafka登场 Kafka就是为了解决上述问题而设计的一款基于发布与订阅的消息系统。它一般被称为 “分布式提交日志”或者“分布式流平台”。文件系统或数据库提交日志用来提供所有事务 的持久记录 , 通过重放这些日志可以重建系统的状态。同样地, Kafka 的数据是按照 一定顺序持久化保存的,可以按需读取 。 此外, Kafka 的数据分布在整个系统里,具备数据故障保护和性能伸缩能力。 消息和批次 Kafka的数据单元被称为消息。如果你在使用 Kafka之前已经有数据库使用经验,那么可 以把消息看成是数据库里的一个“数据行”或一条“记录”。消息由字节数组组成,所以 对于 Kafka来说,消息里的数据没有特别的格式或含义。消息可以有一个可选的元数据, 也就是键(key)。键也是一个字节数组,与消息一样,对于 Kafka来说也没有特殊的含义。 当消息以一种可控的方式写入不同的分区时,会用到键。最简单的例子就是为键生成一个一致 性散列值,然后使用散列值对主题分区数进行取模,为消息选取分区 。这样可 以保证具有 相同键的消息总是被写到相同的分区上。 为了提高效率,消息被分批次写入 Kafka。 批次就是一组消息,这些消息属于同一个主题 和分区。如果每一个消息都单独穿行于网络,会导致大量的网络开销,把消息分成批次传 输可以减少网络开销。不过,这要在时间延迟和吞吐量之间作出权衡;批次越大,单位时间内处理的消息就越多,单个消息的传输时间就越长。批次数据会被压缩,这样可以提升 数据的传输和存储能力,但要做更多的计算处理。 主题(topic)和分区(partition) Kafka 的悄息通过 主题进行分类。主题就好比数据库的表,或者文件系统里的文件夹。主题可以被分为若干个分区 , 一个分区就是一个提交日志。消息以追加的方式写入分区,然后以先入先出的顺序读取。要注意,由于一个主题一般包含几个分区,因此无法在整个主题范围内保证消息的顺序,但可以保证消息在单个分区内的顺序。下图 所示的主题有 4 个分区,消息被迫加写入每个分区的尾部。 Kaflca通过分区来实现数据冗余和伸缩性。分区可以分布在不同的服务器上,也就是说, 一个主题可以横跨多个服务器,以此来提供比 单个服务器更强大的性能。 我们通常会使用流这个词来描绘Kafka这类系统对数据。很多时候,人们把一个主题的数据看成一个流,不管它有多少个分区。流是一组从生产者移动到消费者的数据。当我们讨 论流式处理时,一般都是这样描述消息的。 Kaflca Streams、 Apache Samza 和 Storm 这些框 架以实时的方式处理消息,也就是所谓的流式处理。我们可以将流式处理与离线处理进行比较,比如 Hadoop 就是被设计用于在稍后某个时刻处理大量的数据。 生产者和消费者 Kafka 的客户端就是 Kafka 系统的用户,它们被分为两种基本类型 : 生产者和消费者。除此之外,还有其他高级客户端 API——用于数据集成的 Kaflca Connect API 和用于流式处理 的 Kaflca Streams。这些高级客户端 API 使用生产者和消费者作为内部组件,提供了高级的 功能。 生产者创建消息。在其他发布与订阅系统中,生产者可能被称为发布者或写入者。一般情 况下,一个消息会被发布到一个特定的主题(topic)上。生产者在默认情况下把消息均衡地分布到主题的所有分区上,而并不关心特定消息会被写到哪个分区。不过,在某些情况下,生产者会把消息直接写到指定的分区。这通常是通过消息键和分区器来实现的,分区器为键生 成一个散列值,并将其映射到指定的分区上。这样可以保证包含同一个键的消息会被写到 同一个分区上。生产者也可以使用自定义的分区器,根据不同的业务规则将消息映射到分 区。下一章将详细介绍生产者。 消费者读取消息。在其他发布与订阅系统中,消费者可能被称为订阅者或读者 。 消费者订阅一个或多个主题,并按照消息生成的顺序读取它们。消费者通过检查消息的偏移盘来区 分已经读取过的消息。 偏移量是另一种元数据,它是一个不断递增的整数值,在创建消息 时, Kafka 会把它添加到消息里。在给定的分区里,每个悄息的偏移量都是唯 一 的。消费 者把每个分区最后读取的悄息偏移量保存在 Zookeeper或 Kafka上,如果悄费者关闭或重 启,它的读取状态不会丢失。 消费者是消费者群组的一部分,也就是说,会有一个或多个消费者共同读取一个主题。 群组保证每个分区只能被一个消费者使用 。下图所示的群组中,有 3 个消费者同时读取一 个主题。其中的两个消费者各自读取一个分区,另外一个消费者读取其他两个分区。消费 者与分区之间的映射通常被称为悄费者对分区的所有权关系 。 通过这种方式,消费者可以消费包含大量消息的主题。而且,如果一个消费者失效,群组 里的其他消费者可以接管失效悄费者的工作。第 4章将详细介绍消费者和悄费者群组。 broker和集群 一个独立的 Kafka服务器被称为 broker。 broker接收来自 生产者的消息,为消息设置偏移 量,并提交消息到磁盘保存。 broker 为消费者提供服务,对读取分区的请求作出响应,返 回已经提交到磁盘上的消息。根据特定的硬件及其性能特征,单个 broker可以轻松处理数 千个分区以及每秒百万级的消息量。 Broker可以看作是消息中间件处理节点,一个Kafka节点就是一个broker,一个或者多个Broker可以组成一个Kafka集群。 broker是集群的组成部分。每个集群都有一个 broker 同时充当了集群控制器的角色(自动 从集群的活跃成员中选举出来)。控制器负责管理工作,包括将分区分配给 broker和监控 broker. 在集群中, 一个分区从属于一个 broker, i亥 broker被称为分区的首领。一个分区 可以分配给多个 broker,这个时候会发生分区复制(见下图)。这种复制机制为分区提供 了消息冗余,如果有一个 broker失效,其他 broker可以接管领导权。不过,相关的消费者 和生产者都要重新连接到新的首领。 保留消息(在一定期限内)是 Kafka的一个重要特性。 Kafka broker默认的消息保留策略 是这样的:要么保留一段时间(比如 7天),要么保留到消息达到一定大小的字节数(比 如 1GB)。当消息数量达到这些上限时,旧消息就会过期井被删除,所以在任何时刻, 可 用消息的总量都不会超过配置参数所指定的大小。主题可以配置自己的保留策略,可以将 悄息保留到不再使用它们为止。例如,用于跟踪用户活动的数据可能需要保留几天,而应 用程序的度量指标可能只需要保留几个小时。可以通过配置把主题当作 紧凑型日志, 只有 最后一个带有特定键的消息会被保留下来。这种情况对于变更日志类型的数据来说比较适 用,因为人们只关心最后时刻发生的那个变更。 为什么选择 Kafka 多个生产者 Kafka 可以无缝地支持多个生产者,不管客户端在使用单个 主题还是多个主题。所以它很 适合用来从多个前端系统收集数据,并以统一的格式对外提供数据。例如, 一个包含了 多 个微服务的网站,可以为页面视图创建一个单独的主题,所有服务都以相同的消息格式向 该主题写入数据。消费者应用程序会获得统一的页面视图,而无需协调来自不同生产者的 数据流。 多个消费者 除了支持多个生产者外, Kafka也支持多个消费者从一个单独的消息流上读取数据,而且 消费者之间直不影响。这与其他队列系统不同,其他队列系统的消息一旦被一个客户端读 取,其他客户端就无法再读取它。另外,多个消费者可以组成一个群组,它们共享一个消息流,并保证整个群组对每个给定的消息只处理一次。 基于磁盘的数据存储 Kafka不仅支持多个消费者,还允许消费者非实时地读取消息,这要归功于 Kafka的数据 保留特性。?肖息被提交到磁盘,根据设置的保留规则进行保存。每个主题可以设置单独的 保留规则,以便满足不同消费者的需求,各个主题可以保留不同数量的消息。消费者可能 会因为处理速度慢或突发的流量高峰导致无陆及时读取消息,而持久化数据可以保证数据 不会丢失。?肖费者可以在进行应用程序维护时离线一小段时间,而无需担心消息丢失或堵 塞在生产者端。 消费者可以被关闭,但消息会继续保留在 Kafka里。消费者可以从上次中 断的地方继续处理消息。 伸缩性 为了能够轻松处理大量数据, Kafka 从一开始就被设计成一个具有灵活伸缩性的系统。用 户在开发阶段可以先使用单个 broker,再扩展到包含 3 个 broker 的小型开发集群,然后随 着数据盐不断增长,部署到生产环境的集群可能包含上百个 broker。对在线集群进行扩展 丝毫不影响整体系统的可用性。也就是说, 一个包含多个 broker的集群,即使个别 broker 失效,仍然可以持续地为客户提供服务。要提高集群的容错能力,需要配置较高的复制系 数。 高性能 上面提到的所有特性,让 Kafka成为了一个高性能的发布与订阅消息系统。通过横向扩展 生产者、消费者和 broker, Kafka可以轻松处理巨大的消息流。在处理大量数据的同时, 它还能保证亚秒级的消息延迟。

优秀的个人博客,低调大师

Docker之1 入门简介

什么是Docker Docker是一种容器技术,是用于在某种程度上替换系统虚拟化的解决方案。 使用Docker可以很快速及便捷的交付应用,不用在考虑硬件及系统的兼容性,使而更关注与业务的发展。 Docker 和硬件虚拟化方式的差异在于Docker是在OS层面上实现虚拟化,而基于硬件虚拟化方式则是在HW层面实现。P.S. 图片来自网络 为什么用docker 使用Docker可以更敏捷的在开发流程中快速迭代的不停创建应用版本,而且便于在不同的环境(开发、生产、测试)中实现隔离,而且对于容器的创建是秒级的,高效的进行部署和扩容。 高效的部署和扩容 Docker可以运行于windows、linux、macos等,无论硬件层面是否存在差异都不影响对容器的迁移。对于容器的批量创建基本都是秒级别实现快速的大量容器创建,用户可以通过脚本、配置中心等去实现不同环境的隔离和管理。 更高的资源利用率 Docker对于硬件资源的利用是复用Docker主机操作系统的,基本除了对容器运行的应用会消耗硬件资源、本身的容器系统所占用的硬件资源开销是非常低的。对于容器来讲,可以极高的利用到系统的硬件资源。 更简单的管理 Docker定义了镜像之后,可以依赖于配置中心、脚本等工具实现批量的程序配置更新,取代传统的人工手动实现配置的修改或发布。从而可以更加高效的实现自动化管理。 Docker服务架构 Docker引擎是一个Client/Server结构的应用,Client通过REST API与Server进程通信实现容器、镜像、网络、卷等资源的管理。P.S. 图片来自网络 相关的资源概念 镜像(image) 镜像包含了系统及应用。对于用户只能在镜像新增一个写入层实现封装,无法在原有镜像直接写入修改。用户可以使用镜像创建 Docker 容器。 仓库(repository) 仓库是用于镜像文件的托管。用户可以使用仓库对镜像进行取出(pull)或者存入(push)及删除等操作的管理。 容器(container) 容器是用于运行应用的载体,并且容器是基于镜像进行运行的,在运行中数据是相当于在镜像的只读层上在加多了一层可写层,用户可以基于镜像创建一个或多个容器。 数据卷(volumes) 数据卷是提供持久化数据的载体。在容器中,数据会随着容器的生命周期关闭而消失,但在数据卷中数据是持久化的。 网络(network) 网络(network)是为了实现容器间或容器与外接进行通信,Docker提供了6种网络模式来解决不同场景下的连接方案,分别是bridge、host、overlay、macvlan、none、network plugin。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册