首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

Vue3开发入门

### 1、基础环境相关版本信息 ``` C:\Users\xxxxx>node -v v14.17.0 C:\Users\xxxxx>npm -v 7.18.1 ``` ### 2、新建vue3项目 ``` # a.切换到项目代码目录 cd /d D:\Development\Vue # b.新建项目 D:\Development\Vue>npm init @vitejs/app Need to install the following packages: @vitejs/create-app Ok to proceed? (y) √ Project name: ... study-admin √ Select a framework: » vue √ Select a variant: » vue-ts Scaffolding project in D:\Development\Vue\study-admin... Done. Now run: cd study-admin npm install npm run dev # c.安装依赖,运行项目,运行时会有一个报错,解决办法是手动执行node脚本安装spawn D:\Development\Vue>cd study-admin D:\Development\Vue\study-admin>npm install added 91 packages in 4s D:\Development\Vue\study-admin>npm run dev > dev > vite events.js:353 throw er; // Unhandled 'error' event ^ Error: spawn D:\Development\Vue\study-admin\node_modules\esbuild\esbuild.exe ENOENT at Process.ChildProcess._handle.onexit (internal/child_process.js:269:19) at onErrorNT (internal/child_process.js:467:16) at processTicksAndRejections (internal/process/task_queues.js:82:21) Emitted 'error' event on ChildProcess instance at: at Process.ChildProcess._handle.onexit (internal/child_process.js:275:12) at onErrorNT (internal/child_process.js:467:16) at processTicksAndRejections (internal/process/task_queues.js:82:21) { errno: -4058, code: 'ENOENT', syscall: 'spawn D:\\Development\\Vue\\study-admin\\node_modules\\esbuild\\esbuild.exe', path: 'D:\\Development\\Vue\\study-admin\\node_modules\\esbuild\\esbuild.exe', spawnargs: [ '--service=0.12.9', '--ping' ] } # 解决errno: -4058,code: 'ENOENT',spawn 相关报错 D:\Development\Vue\study-admin>node D:\Development\Vue\study-admin\node_modules\esbuild\install.js D:\Development\Vue\study-admin>npm run dev > dev > vite Pre-bundling dependencies: vue (this will be run only when your dependencies or config have changed) vite v2.3.7 dev server running at: > Local: http://localhost:3000/ > Network: use `--host` to expose ready in 693ms. ``` ### 3、修改vite启动参数相关配置,vite.config.ts > 参考文档:https://cn.vitejs.dev/config/ ``` import { defineConfig } from 'vite' import vue from '@vitejs/plugin-vue' // 需要安装 @types/node -> npm i @types/node -D import { resolve } from 'path' // https://vitejs.dev/config/ export default defineConfig({ plugins: [vue()], resolve: { alias: { '@': resolve(__dirname, 'src') // 设置 `@` 指向 `src` 目录 } }, server: { port: 4000, // 服务端口号 open: true, // 启动时自动打开浏览器 cors: true // 允许跨域访问 } }) ``` ### 4、集成vue-router路由模块 > 参考文档:https://next.router.vuejs.org/zh/introduction.html ``` # a.安装vue-router v4.x,只有v4版本支持vue3 D:\Development\Vue\study-admin>npm i vue-router@4 added 2 packages in 2s # b.创建 src/router/index.ts 文件 import { createRouter, createWebHashHistory, Router, RouteRecordRaw } from 'vue-router' import Login from '@/views/Login.vue' const routes: Array = [ { path: '/', name: 'Login', component: Login }, { path: '/admin', name: 'Admin', component: () => import('@/views/Admin.vue') // 懒加载 Admin 组件 } ] const router: Router = createRouter({ history: createWebHashHistory(), routes: routes }) export default router # c.在 src 下创建 views 目录,用来存储页面组件。在 views 目录下创建 Login.vue 、Admin.vue。 # Login.vue Login 登陆 # Admin.vue Admin # d.在 main.ts 文件中加载路由配置 import { createApp } from 'vue' import App from '@/App.vue' import router from './router/index' createApp(App).use(router).mount('#app') # e.修改App.vue,添加路由映射 APP Module ``` ### 5、集成UI框架Element Plus ``` # a.安装element-plus和vite-plugin-style-import npm i element-plus npm i vite-plugin-style-import -D # b.修改vite.config.ts配置按需加载 import { defineConfig } from 'vite' import vue from '@vitejs/plugin-vue' // 需要安装@types/node -> npm i @types/node -D import { resolve } from 'path' // 需要安装vite-plugin-style-import -> npm i vite-plugin-style-import -D import styleImport from 'vite-plugin-style-import'; // https://vitejs.dev/config/ export default defineConfig({ plugins: [ vue(), // 按需载入 Element Plus styleImport({ libs: [ { libraryName: 'element-plus', esModule: true, ensureStyleFile: true, resolveStyle: (name) => { return `element-plus/lib/theme-chalk/${name}.css` }, resolveComponent: (name) => { return `element-plus/lib/${name}` } } ] }) ], resolve: { alias: { '@': resolve(__dirname, 'src') // 设置 `@` 指向 `src` 目录 } }, server: { port: 4000, // 设置服务启动端口号 open: true, // 设置服务启动时是否自动打开浏览器 cors: true // 允许跨域 } }) # c.在main.ts中加载element-plus import { createApp } from 'vue' import App from '@/App.vue' import router from './router/index' // 按需引入需要的element-plus组件 import { ElIcon, ElLoading, ElCard, ElButton } from 'element-plus' // 创建Vue3实例 const app = createApp(App) // 加载默认路由 app.use(router) // 加载element-plus组件 app.use(ElButton).use(ElCard).use(ElLoading).use(ElIcon) // 挂载到DOM app.mount('#app') # d.修改Login.vue将登陆链接改为element-plus的el-button组件,验证UI组件是否正确引入 Login 登陆 --> 登陆 ```

优秀的个人博客,低调大师

ShardingSphere-JDBC入门实战

前言 Apache ShardingSphere 是一套开源的分布式数据库解决方案组成的生态圈,它由 JDBC、Proxy 和 Sidecar(规划中)这 3 款既能够独立部署,又支持混合部署配合使用的产品组成;接下来的几篇文章将重点分析ShardingSphere-JDBC,从数据分片,分布式主键,分布式事务,读写分离,弹性伸缩等几个方面来介绍。 简介 ShardingSphere-JDBC定位为轻量级 Java 框架,在 Java 的 JDBC 层提供的额外服务。 它使用客户端直连数据库,以 jar 包形式提供服务,无需额外部署和依赖,可理解为增强版的 JDBC 驱动,完全兼容 JDBC 和各种 ORM 框架。整体架构图如下(来自官网): ShardingSphere-JDBC包含了众多的功能模块包括数据分片,分布式主键,分布式事务,读写分离,弹性伸缩等等;作为一个数据库中间件最核心的功能当属数据分片了,ShardingSphere-JDBC提供了很多分库分表的策略和算法,接下来看看具体是如何使用这些策略的; 数据分片 作为一个开发者我们希望中间件可以帮我们屏蔽底层的细节,让我们在面对分库分表的场景下,可以像使用单库单表一样简单;当然ShardingSphere-JDBC不会让大家失望,引入了分片数据源、逻辑表等概念; 分片数据源和逻辑表 逻辑表:逻辑表是相对物理表来说的,通常做分表处理,某一张表会被分成多张表,比如订单表被拆分成10张表,分别是t_order_0到t_order_9,而对应的逻辑表就是t_order,对于开发者来说只需要使用逻辑表即可; 分片数据源:对于分库来说,通常会有多个库,或者说是多个数据源,所以这些数据源需要被统一管理起来,引入了分片数据源的概念,常见的ShardingDataSource 有了以上两个最基本的概念当然还不够,还需要分库分表策略算法帮助我们做路由处理;但是这两个概念可以让开发者有一种使用单库单表的感觉,就像下面这样一个简单的实例: DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); String sql = "select id,user_id,order_id from t_order where order_id = 103"; PreparedStatement preparedStatement = conn.prepareStatement(sql); ResultSet set = preparedStatement.executeQuery(); 以上根据真实数据源列表,分库分表策略生成了一个抽象数据源,可以简单理解就是ShardingDataSource;接下来的操作和我们使用jdbc操作正常的单库单表没有任何区别; 分片策略算法 ShardingSphere-JDBC在分片策略上分别引入了分片算法、分片策略两个概念,当然在分片的过程中分片键也是一个核心的概念;在此可以简单的理解分片策略 = 分片算法 + 分片键;至于为什么要这么设计,应该是ShardingSphere-JDBC考虑更多的灵活性,把分片算法单独抽象出来,方便开发者扩展; 分片算法 提供了抽象分片算法类:ShardingAlgorithm,根据类型又分为:精确分片算法、区间分片算法、复合分片算法以及Hint分片算法; 精确分片算法:对应PreciseShardingAlgorithm类,主要用于处理 = 和 IN的分片; 区间分片算法:对应RangeShardingAlgorithm类,主要用于处理 BETWEEN AND, >, <, >=, <= 分片; 复合分片算法:对应ComplexKeysShardingAlgorithm类,用于处理使用多键作为分片键进行分片的场景; Hint分片算法:对应HintShardingAlgorithm类,用于处理使用 Hint 行分片的场景; 以上所有的算法类都是接口类,具体实现交给开发者自己; 分片策略 分片策略基本和上面的分片算法对应,包括:标准分片策略、复合分片策略、Hint分片策略、内联分片策略、不分片策略; 标准分片策略:对应StandardShardingStrategy类,提供PreciseShardingAlgorithm和RangeShardingAlgorithm两个分片算法,PreciseShardingAlgorithm是必须的,RangeShardingAlgorithm可选的; public final class StandardShardingStrategy implements ShardingStrategy { private final String shardingColumn; private final PreciseShardingAlgorithm preciseShardingAlgorithm; private final RangeShardingAlgorithm rangeShardingAlgorithm; } 复合分片策略:对应ComplexShardingStrategy类,提供ComplexKeysShardingAlgorithm分片算法; public final class ComplexShardingStrategy implements ShardingStrategy { @Getter private final Collection<String> shardingColumns; private final ComplexKeysShardingAlgorithm shardingAlgorithm; } 可以发现支持多个分片键; Hint分片策略:对应HintShardingStrategy类,通过 Hint 指定分片值而非从 SQL 中提取分片值的方式进行分片的策略;提供HintShardingAlgorithm分片算法; public final class HintShardingStrategy implements ShardingStrategy { @Getter private final Collection<String> shardingColumns; private final HintShardingAlgorithm shardingAlgorithm; } 内联分片策略:对应InlineShardingStrategy类,没有提供分片算法,路由规则通过表达式来实现; 不分片策略:对应NoneShardingStrategy类,不分片策略; 分片策略配置类 在使用中我们并没有直接使用上面的分片策略类,ShardingSphere-JDBC分别提供了对应策略的配置类包括: StandardShardingStrategyConfiguration ComplexShardingStrategyConfiguration HintShardingStrategyConfiguration InlineShardingStrategyConfiguration NoneShardingStrategyConfiguration 实战 有了以上相关基础概念,接下来针对每种分片策略做一个简单的实战,在实战前首先准备好库和表; 准备 分别准备两个库:ds0、ds1;然后每个库分别包含两个表:t_order0,t_order1; CREATE TABLE `t_order0` ( `id` bigint(20) NOT NULL AUTO_INCREMENT, `user_id` bigint(20) NOT NULL, `order_id` bigint(20) NOT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8 准备真实数据源 我们这里有两个数据源,这里都使用java代码的方式来配置: // 配置真实数据源 Map<String, DataSource> dataSourceMap = new HashMap<>(); // 配置第一个数据源 BasicDataSource dataSource1 = new BasicDataSource(); dataSource1.setDriverClassName("com.mysql.jdbc.Driver"); dataSource1.setUrl("jdbc:mysql://localhost:3306/ds0"); dataSource1.setUsername("root"); dataSource1.setPassword("root"); dataSourceMap.put("ds0", dataSource1); // 配置第二个数据源 BasicDataSource dataSource2 = new BasicDataSource(); dataSource2.setDriverClassName("com.mysql.jdbc.Driver"); dataSource2.setUrl("jdbc:mysql://localhost:3306/ds1"); dataSource2.setUsername("root"); dataSource2.setPassword("root"); dataSourceMap.put("ds1", dataSource2); 这里配置的两个数据源都是普通的数据源,最后会把dataSourceMap交给ShardingDataSourceFactory管理; 表规则配置 表规则配置类TableRuleConfiguration,包含了五个要素:逻辑表、真实数据节点、数据库分片策略、数据表分片策略、分布式主键生成策略; TableRuleConfiguration orderTableRuleConfig = new TableRuleConfiguration("t_order", "ds${0..1}.t_order${0..1}"); orderTableRuleConfig.setDatabaseShardingStrategyConfig( new StandardShardingStrategyConfiguration("user_id", new MyPreciseSharding())); orderTableRuleConfig.setTableShardingStrategyConfig( new StandardShardingStrategyConfiguration("order_id", new MyPreciseSharding())); orderTableRuleConfig.setKeyGeneratorConfig(new KeyGeneratorConfiguration("SNOWFLAKE", "id")); 逻辑表:这里配置的逻辑表就是t_order,对应的物理表有t_order0,t_order1; 真实数据节点:这里使用行表达式进行配置的,简化了配置;上面的配置就相当于配置了: db0 ├── t_order0 └── t_order1 db1 ├── t_order0 └── t_order1 数据库分片策略:这里的库分片策略就是上面介绍的五种类型,这里使用的StandardShardingStrategyConfiguration,需要指定分片键和分片算法,这里使用的是精确分片算法; public class MyPreciseSharding implements PreciseShardingAlgorithm<Integer> { @Override public String doSharding(Collection<String> availableTargetNames, PreciseShardingValue<Integer> shardingValue) { Integer index = shardingValue.getValue() % 2; for (String target : availableTargetNames) { if (target.endsWith(index + "")) { return target; } } return null; } } 这里的shardingValue就是user_id对应的真实值,每次和2取余;availableTargetNames可选择就是{ds0,ds1};看余数和哪个库能匹配上就表示路由到哪个库; 数据表分片策略:指定的**分片键(order_id)**和分库策略不一致,其他都一样; 分布式主键生成策略:ShardingSphere-JDBC提供了多种分布式主键生成策略,后面详细介绍,这里使用雪花算法; 配置分片规则 配置分片规则ShardingRuleConfiguration,包括多种配置规则:表规则配置、绑定表配置、广播表配置、默认数据源名称、默认数据库分片策略、默认表分片策略、默认主键生成策略、主从规则配置、加密规则配置; 表规则配置 tableRuleConfigs:也就是上面配置的库分片策略和表分片策略,也是最常用的配置; 绑定表配置 bindingTableGroups:指分⽚规则⼀致的主表和⼦表;绑定表之间的多表关联查询不会出现笛卡尔积关联,关联查询效率将⼤⼤提升; 广播表配置 broadcastTables:所有的分⽚数据源中都存在的表,表结构和表中的数据在每个数据库中均完全⼀致。适⽤于数据量不⼤且需要与海量数据的表进⾏关联查询的场景; 默认数据源名称 defaultDataSourceName:未配置分片的表将通过默认数据源定位; 默认数据库分片策略 defaultDatabaseShardingStrategyConfig:表规则配置可以设置数据库分片策略,如果没有配置可以在这里面配置默认的; 默认表分片策略 defaultTableShardingStrategyConfig:表规则配置可以设置表分片策略,如果没有配置可以在这里面配置默认的; 默认主键生成策略 defaultKeyGeneratorConfig:表规则配置可以设置主键生成策略,如果没有配置可以在这里面配置默认的;内置UUID、SNOWFLAKE生成器; 主从规则配置 masterSlaveRuleConfigs:用来实现读写分离的,可配置一个主表多个从表,读面对多个从库可以配置负载均衡策略; 加密规则配置 encryptRuleConfig:提供了对某些敏感数据进行加密的功能,提供了⼀套完整、安全、透明化、低改造成本的数据加密整合解决⽅案; 数据插入 以上准备好,就可以操作数据库了,这里执行插入操作: DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); String sql = "insert into t_order (user_id,order_id) values (?,?)"; PreparedStatement preparedStatement = conn.prepareStatement(sql); for (int i = 1; i <= 10; i++) { preparedStatement.setInt(1, i); preparedStatement.setInt(2, 100 + i); preparedStatement.executeUpdate(); } 通过以上配置的真实数据源、分片规则以及属性文件创建分片数据源ShardingDataSource;接下来就可以像使用单库单表一样操作分库分表了,sql中可以直接使用逻辑表,分片算法会根据具体的值就行路由处理; 经过路由最终:奇数入ds1.t_order1,偶数入ds0.t_order0;以上使用了最常见的精确分片算法,下面继续看一下其他几种分片算法; 分片算法 上面的介绍的精确分片算法中,通过PreciseShardingValue来获取当前分片键值,ShardingSphere-JDBC针对每种分片算法都提供了相应的ShardingValue,具体包括: PreciseShardingValue RangeShardingValue ComplexKeysShardingValue HintShardingValue 区间分片算法 用在区间查询的时候,比如下面的查询SQL: select * from t_order where order_id>2 and order_id<9 以上两个区间值2、9会直接保存到RangeShardingValue中,这里没有指定user_id用来做库路由,所以会访问两个库; public class MyRangeSharding implements RangeShardingAlgorithm<Integer> { @Override public Collection<String> doSharding(Collection<String> availableTargetNames, RangeShardingValue<Integer> shardingValue) { Collection<String> result = new LinkedHashSet<>(); Range<Integer> range = shardingValue.getValueRange(); // 区间开始和结束值 int lower = range.lowerEndpoint(); int upper = range.upperEndpoint(); for (int i = lower; i <= upper; i++) { Integer index = i % 2; for (String target : availableTargetNames) { if (target.endsWith(index + "")) { result.add(target); } } } return result; } } 可以发现会检查区间开始和结束中的每个值和2取余,是否都能和真实的表匹配; 复合分片算法 可以同时使用多个分片键,比如可以同时使用user_id和order_id作为分片键; orderTableRuleConfig.setDatabaseShardingStrategyConfig( new ComplexShardingStrategyConfiguration("order_id,user_id", new MyComplexKeySharding())); orderTableRuleConfig.setTableShardingStrategyConfig( new ComplexShardingStrategyConfiguration("order_id,user_id", new MyComplexKeySharding())); 如上在配置分库分表策略时,指定了两个分片键,用逗号隔开;分片算法如下: public class MyComplexKeySharding implements ComplexKeysShardingAlgorithm<Integer> { @Override public Collection<String> doSharding(Collection<String> availableTargetNames, ComplexKeysShardingValue<Integer> shardingValue) { Map<String, Collection<Integer>> map = shardingValue.getColumnNameAndShardingValuesMap(); Collection<Integer> userMap = map.get("user_id"); Collection<Integer> orderMap = map.get("order_id"); List<String> result = new ArrayList<>(); // user_id,order_id分片键进行分表 for (Integer userId : userMap) { for (Integer orderId : orderMap) { int suffix = (userId+orderId) % 2; for (String s : availableTargetNames) { if (s.endsWith(suffix+"")) { result.add(s); } } } } return result; } } Hint分片算法 在一些应用场景中,分片条件并不存在于 SQL,而存在于外部业务逻辑;可以通过编程的方式向 HintManager 中添加分片条件,该分片条件仅在当前线程内生效; // 设置库表分片策略 orderTableRuleConfig.setDatabaseShardingStrategyConfig(new HintShardingStrategyConfiguration(new MyHintSharding())); orderTableRuleConfig.setTableShardingStrategyConfig(new HintShardingStrategyConfiguration(new MyHintSharding())); // 手动设置分片条件 int hitKey1[] = { 2020, 2021, 2022, 2023, 2024 }; int hitKey2[] = { 3020, 3021, 3022, 3023, 3024 }; DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); for (int i = 1; i <= 5; i++) { final int index = i; new Thread(new Runnable() { @Override public void run() { try { HintManager hintManager = HintManager.getInstance(); String sql = "insert into t_order (user_id,order_id) values (?,?)"; PreparedStatement preparedStatement = conn.prepareStatement(sql); // 分别添加库和表分片条件 hintManager.addDatabaseShardingValue("t_order", hitKey1[index - 1]); hintManager.addTableShardingValue("t_order", hitKey2[index - 1]); preparedStatement.setInt(1, index); preparedStatement.setInt(2, 100 + index); preparedStatement.executeUpdate(); } catch (SQLException e) { e.printStackTrace(); } } }).start(); } 以上实例中,手动设置了分片条件,分片算法如下所示: public class MyHintSharding implements HintShardingAlgorithm<Integer> { @Override public Collection<String> doSharding(Collection<String> availableTargetNames, HintShardingValue<Integer> shardingValue) { List<String> shardingResult = new ArrayList<>(); for (String targetName : availableTargetNames) { String suffix = targetName.substring(targetName.length() - 1); Collection<Integer> values = shardingValue.getValues(); for (int value : values) { if (value % 2 == Integer.parseInt(suffix)) { shardingResult.add(targetName); } } } return shardingResult; } } 不分片 配置NoneShardingStrategyConfiguration即可: orderTableRuleConfig.setDatabaseShardingStrategyConfig(new NoneShardingStrategyConfiguration()); orderTableRuleConfig.setTableShardingStrategyConfig(new NoneShardingStrategyConfiguration()); 这样数据会插入每个库每张表,可以理解为广播表 分布式主键 面对多个数据库表需要有唯一的主键,引入了分布式主键功能,内置的主键生成器包括:UUID、SNOWFLAKE; UUID 直接使用UUID.randomUUID()生成,主键没有任何规则;对应的主键生成类:UUIDShardingKeyGenerator; SNOWFLAKE 实现类:SnowflakeShardingKeyGenerator;使⽤雪花算法⽣成的主键,⼆进制表⽰形式包含 4 部分,从⾼位到低位分表为:1bit 符号位、41bit 时间戳位、10bit ⼯作进程位以及 12bit 序列号位;来自官网的图片: 扩展 实现接口:ShardingKeyGenerator,实现自己的主键生成器; public interface ShardingKeyGenerator extends TypeBasedSPI { Comparable<?> generateKey(); } 实战 使用也很简单,直接使用KeyGeneratorConfiguration即可,配置对应的算法类型和字段名称: orderTableRuleConfig.setKeyGeneratorConfig(new KeyGeneratorConfiguration("SNOWFLAKE", "id")); 这里使用雪花算法生成器,对应生成的字段是id;结果如下: mysql> select * from t_order0; +--------------------+---------+----------+ | id | user_id | order_id | +--------------------+---------+----------+ | 589535589984894976 | 0 | 0 | | 589535590504988672 | 2 | 2 | | 589535590718898176 | 4 | 4 | +--------------------+---------+----------+ 分布式事务 ShardingSphere-JDBC使用分布式事务和使用本地事务没什么区别,提供了透明化的分布式事务;支持的事务类型包括:本地事务、XA事务和柔性事务,默认是本地事务; public enum TransactionType { LOCAL, XA, BASE } 依赖 根据具体使用XA事务还是柔性事务,需要引入不同的模块; <dependency> <groupId>org.apache.shardingsphere</groupId> <artifactId>sharding-transaction-xa-core</artifactId> </dependency> <dependency> <groupId>org.apache.shardingsphere</groupId> <artifactId>shardingsphere-transaction-base-seata-at</artifactId> </dependency> 实现 ShardingSphere-JDBC提供了分布式事务管理器ShardingTransactionManager,实现包括: XAShardingTransactionManager:基于 XA 的分布式事务管理器; SeataATShardingTransactionManager:基于 Seata 的分布式事务管理器; XA 的分布式事务管理器具体实现包括:Atomikos、Narayana、Bitronix;默认是Atomikos; 实战 默认的事务类型是TransactionType.LOCAL,ShardingSphere-JDBC天生面向多数据源,本地模式其实是循环提交每个数据源的事务,不能保证数据的一致性,所以需要使用分布式事务,具体使用也很简单: //改变事务类型为XA TransactionTypeHolder.set(TransactionType.XA); DataSource dataSource = ShardingDataSourceFactory.createDataSource(dataSourceMap, shardingRuleConfig, new Properties()); Connection conn = dataSource.getConnection(); try { //关闭自动提交 conn.setAutoCommit(false); String sql = "insert into t_order (user_id,order_id) values (?,?)"; PreparedStatement preparedStatement = conn.prepareStatement(sql); for (int i = 1; i <= 5; i++) { preparedStatement.setInt(1, i - 1); preparedStatement.setInt(2, i - 1); preparedStatement.executeUpdate(); } //事务提交 conn.commit(); } catch (Exception e) { e.printStackTrace(); //事务回滚 conn.rollback(); } 可以发现使用起来还是很简单的,ShardingSphere-JDBC会根据当前的事务类型,在提交的时候判断是走本地事务提交,还是使用分布式事务管理器ShardingTransactionManager进行提交; 读写分离 对于同一时刻有大量并发读操作和较少写操作类型的应用系统来说,将数据库拆分为主库和从库,主库负责处理事务性的增删改操作,从库负责处理查询操作,能够有效的避免由数据更新导致的行锁,使得整个系统的查询性能得到极大的改善。 主从配置 在上面章节介绍分片规则的时候,其中有说到主从规则配置,其目的就是用来实现读写分离的,核心配置类:MasterSlaveRuleConfiguration: public final class MasterSlaveRuleConfiguration implements RuleConfiguration { private final String name; private final String masterDataSourceName; private final List<String> slaveDataSourceNames; private final LoadBalanceStrategyConfiguration loadBalanceStrategyConfiguration; } name:配置名称,当前使用的4.1.0版本,这里必须是主库的名称; masterDataSourceName:主库数据源名称; slaveDataSourceNames:从库数据源列表,可以配置一主多从; LoadBalanceStrategyConfiguration:面对多个从库,读取的时候会通过负载算法进行选择; 主从负载算法类:MasterSlaveLoadBalanceAlgorithm,实现类包括:随机和循环; ROUND_ROBIN:实现类RoundRobinMasterSlaveLoadBalanceAlgorithm RANDOM:实现类RandomMasterSlaveLoadBalanceAlgorithm 实战 分别给ds0和ds1准备从库:ds01和ds11,分别配置主从同步;读写分离配置如下: List<String> slaveDataSourceNames0 = new ArrayList<String>(); slaveDataSourceNames0.add("ds01"); MasterSlaveRuleConfiguration masterSlaveRuleConfiguration0 = new MasterSlaveRuleConfiguration("ds0", "ds0", slaveDataSourceNames0); shardingRuleConfig.getMasterSlaveRuleConfigs().add(masterSlaveRuleConfiguration0); List<String> slaveDataSourceNames1 = new ArrayList<String>(); slaveDataSourceNames1.add("ds11"); MasterSlaveRuleConfiguration masterSlaveRuleConfiguration1 = new MasterSlaveRuleConfiguration("ds1", "ds1", slaveDataSourceNames1); shardingRuleConfig.getMasterSlaveRuleConfigs().add(masterSlaveRuleConfiguration1); 这样在执行查询操作的时候会自动路由到从库,实现读写分离; 总结 本文重点介绍了ShardingSphere-JDBC的数据分片功能,这也是所有数据库中间件的核心功能;当然分布式主键、分布式事务、读写分离等功能也是必不可少的;同时ShardingSphere还引入了弹性伸缩的功能,这是一个非常亮眼的功能,因为数据库分片本身是有状态的,所以我们在项目启动之初都固定了多少库多少表,然后通过分片算法路由到各个库表,但是业务的发展往往超乎我们的预期,这时候如果想扩表扩库会很麻烦,目前看ShardingSphere官网弹性伸缩处于alpha开发阶段,非常期待此功能。 参考 https://shardingsphere.apache.org/document/current/cn/overview/ 感谢关注 可以关注微信公众号「回滚吧代码」,第一时间阅读,文章持续更新;专注Java源码、架构、算法和面试。

优秀的个人博客,低调大师

Git 从入门到跑路

作者:吴小龙同学 1 今天是左小白入职新公司的第一天,这是左小白第二家公司,第一家公司工作 2 年,左小白后面已经能独立做整个项目,本想毕业就来这家公司,现在能力自我感觉也不错,是该涨波工资了,于是他找到领导,希望能涨 2 K,领导巴拉巴拉说了很多,就是没说涨工资,左小白心寒,这是宁愿再招人也不愿意给老员工涨薪! 第二天,左小白就开始进入项目,他发现新公司版本控制是用的 Git,之前是 SVN,问了旁边的同事,跟他说,Git 和 SVN 没什么区别的,会 git add和git commit就够了,左小白心想,SVN 他已经用的很溜,Git 那岂不是信手拈来,拿起键盘就干起来了。 2 左小白首先安装 Git,git config好了邮箱和姓名,然后git clone项目,就看起了代码,熟悉项目。可能因为左小白是新人,组长先分给他简单的任务,登录页面实现,这对于左小白完全是杀鸡用牛刀,不到两个小时,他就完成了,自测也 OK,可以提交代码了。 修改涉及到页面 login_activity.xml、LoginActivity.java、LoginModel.java、ApiStores.java 总共四个文件,按照同事说的,先 add 再 commit,git add ApiStores.java、git add LoginActivity.java、git add LoginModel.java、git add login_activity.xml,草(一种植物),终于 add 完了,再git commit,填上提交信息“Login”,以为这样就 OK 了,没想到这幕被组长正巧看到,左小白完全察觉到组长站在身后,大概工作太认真。 3 组长:小白,你这样提交就 OK 了吗? 左小白:嗯,是的,我之前 SVN,这样就好了啊。 组长:不,你要了解 Git 和 SVN 还是有些不同,你要了解下工作区、暂存区、本地仓库、远程仓库。 左小白:什么…… 组长:况且,你这这样一个 add 是不是有点费劲,现在就 4 个修改,看你都 add 很久,有 10 个 20 个甚至 100 个文件,怎么办,一个个 add 不得死人啊。 左小白:那应该怎么 add 啊? 组长:你起来,我操作一遍给你看下。 4 只见组长一顿操作,“我先把你提交回退掉,演示一遍给你看看”,等等,回退,那我今天代码岂不是白敲,组长估计看出了我疑惑,他接着说,你的代码还在,你看下我首先用的是git status .看下有哪些修改: git status . On branch master Your branch is up to date with 'origin/master'. Untracked files: (use "git add <file>..." to include in what will be committed) ApiStores.java LoginActivity.java LoginModel.java login_activity.xml nothing added to commit but untracked files present (use "git add" to track) 看到有 4 个文件修改,接下来看好了,我是用git add . 命令,而不是你那样一个个 add,这个.代码当前目录所有修改和新建,另外你 commit 是提交到本地仓库,明白了吗? 5 左小白这时有点懵逼,原来 Git 这么复杂,他此时很想锤旁边的同事,是他说 Git 和 SVN 差不多,害他在领导面前出丑。他现在有 3 个疑问: 1、工作区、暂存区、本地仓库、远程仓库都是啥? 2、他刚刚提交好了,组长一顿操作是如何回退的? 3、他如果删除了文件,怎么 add?他是没敢问组长,太丢人了。 6 等组长走了,左小白就带着这三个疑问去寻求答案,首先工作区、暂存区、本地仓库、远程仓库都是啥?一顿搜索引擎,看了几篇文章,大概是明白了。 原来新增,更改,删除文件这些动作,就是发生在工作区,当我们使用命令git add,那么这些更新就会出现在暂存区中。而本地仓库和远程仓库又是什么鬼?原来执行git commit,代码是提交到本地仓库,再执行git push,才把代码提交到远程仓库,这和 SVN 还是有很大的区别的,怪不得组长问我 git commit就提交了?我太菜了。 问题来了,我如果git add,我又不想 add 了,要怎么操作?亦或是git commit,我想撤销,怎么做?这也是第二个疑惑“他刚刚提交好了,组长一顿操作是如何回退的?”,带着这个疑惑,左小白又是一顿搜索引擎,搜了好十几页才得到答案,某度真是辣鸡。 如果git add后想撤销,可以通过命令git reset HEAD <file>,如果git commit后想撤销,可以通过命令git reset HEAD^,牛逼啊,今天学到知识了,左小白觉得还不够,再整个图,加深记忆。 当小白画完这个图,一看时间已经来到 22:30 了,心想赶紧溜,狗命要紧,第三个疑问明天再整吧。 坐了一个小时的地铁,小白终于到家了,洗洗刷个抖音,满足地睡去了。 7 叮咚叮咚……7 点的闹钟响了…… 起床,咦,内内怎么湿乎乎的,好像昨晚梦到女神,还跟她**,OMG。 又是一个小时的地铁,来到公司,左小白还想着“他如果删除了文件,怎么 add?” git add -u 提交所有被删除和修改的文件到数据暂存区。 git add . 提交所有修改的和新建的数据暂存区。 git add -A 提交所有被删除、被替换、被修改和新增的文件到数据暂存区。 左小白测试了一下,发现git add .和git add -A功能是一样的,不管了。 8 组长:小白,你登录功能是做好了吧。 左小白:嗯,做好了。 组长:自测没问题的话,把代码提交上来吧,然后找项目经理 review 下。 左小白:好的。 之前组长已经帮左小白 add 好了,小白就直接 commit,然后 push 成功了。微信上他就找项目经理,帮忙 review 下代码,大约 20 分钟后,项目经理来消息了,丢了一个文档,小白一头雾水,有点不好意思,但代码还得上库,鼓起勇气问道:“这是什么?” 项目经理:这是代码提交规范,你的这个提交信息“Login”不符合规范,按照“[模块][bug/feature]描述”改下。 好吧,这给小白带来了难点,他代码都已经上去了,还怎么改提交消息?难道要把代码 Abandoned 重新提交?那就试试吧!当左小白执行git status .,提示根本就没有文件修改,这行不通啊,怎么办?怎么办? 9 就在左小白焦头烂额不知道怎么办的时候,他居然发现页面上可以直接改这个提交消息,握草,so easy? 改完了,小白又找项目经理 review 代码,过了 10 分钟,项目经理回复道:“注释,注释,你代码啥注释都没有吧,适当地加点”。 问题又回到了“我代码都提交了,还怎么修改?”左小白实在没头绪,只能问问身边的同事 A。 左小白:A 哥,现在登录功能做好,代码上传了,项目经理 review 需要我加点注释,我代码都提交了,还能怎么改啊? 同事 A:你可以把之前的提交 Abandoned 点,使用命令git reset --hard。 左小白:啊?具体怎么操作啊? 同事 A:你还是搜下git reset --hard吧。 “MD,就不能教教我,你吊”左小白心里暗骂,但是还是去搜了git reset --hard,这个命令是可以回退版本,意思我回到之前修改的版本,就能继续提交了。 首先左小白通过git log .,看下提交记录: git log commit 85be09a7962a03815e5248a7b845297bd5467938 (HEAD -> master, origin/master, origin/HEAD) Author: WuXiaolong <wuxiaolong.me@qq.com> Date: Sat Apr 18 17:43:29 2020 +0800 Login commit 6b071d867e230479892a86beedc0484c8accac94 Author: 吴小龙同學 <wuxiaolong.me@gmail.com> Date: Wed Dec 25 22:16:36 2019 +0800 Update README.md 看到第一笔就是自己修改的,左小白要回退到上一笔: git reset --hard 6b071d867e230479892a86beedc0484c8accac94 等等,我的修改怎么没了,握草,不会吧,MD,想锤死身边的同事,欲哭无泪,不想搞了…… 10 天台上,左小白一个人,地上有一堆香烟头,左小白郁闷不已,工作 2 年多了,还是这么菜!越想越难受,又狂抽两支烟,这时组长来消息了,“登录代码上库了吗”,“马上上库”。 回到工位,左小白把登录代码重新写了一遍,花了一个小时,这回,他直接加了注释,完成了,左小白赶紧提交了代码,又去找项目经理 review,“小白啊,代码不要出现中文,改下吧,统一放到 string.xml,方便维护”,“好的,我马上改”。 去你大爷的,又要改,就不能一次把要改的点说完吗!左小白内心一万个草泥马。 没办法,左小白还是使用命令git reset --hard,这回聪明了,把修改内容保存了,不一会,他修改好了,又去找项目经理 review。 项目经理:小白,你座位在哪里?我来找你。 左小白有点慌,还是要改? 左小白:我在 44 楼 H。 “你是左小白,我是 XXX” “X 经理,好” 没想到,这么快,项目经理就来了。 项目经理:小白,你应该是才来公司不久是吧。 左小白:是的,今天是第三天。 项目经理:不错啊,马上就开始做项目了,发给你规范文档看了吗? 左小白:看了(其实没细看)。 项目经理:这个项目很多人参与,人多了就得严格把控代码质量。 左小白:明白。 项目经理:今天 review 你的登录代码,已经写的很不错了,提个建议,这两处逻辑是不是有问题,if 语句是不是不会走进去。 左小白看了看,握草,确实不会走进去,又得改。 左小白:是的,我把 if 删掉吧。 项目经理:好的,你改下就没其他问题了。 当左小白再次要 Abandoned 时,项目经理表示很疑惑,“小白,你干嘛要 Abandoned” 左小白:我要回退版本,修改代码啊。 项目经理:不不不,你可以直接修改,提交的时候使用git commit --amend。 左小白:这么神奇! 左小白不禁大叫起来,这个命令真是救星啊。 项目经理:你修改完成,正常git add,提交用git commit --amend,这样就在原本提交基础上修改了,之前难道都用git reset --hard回退? 左小白:是的,每次git reset --hard都会多一笔提交记录……真的耶,git commit --amend在以前的基础修改了。 项目经理:小白,知道你初来乍到,遇到问题要多问问同事哈。 左小白:好的,谢谢 X 经理。 11 哎,今天差点把左小白玩废了,下班回去感觉整个人都瘫了,明天就五一放假了,要不大宝贱走一波,放松一下。 12 正当左小白要去大宝贱走一波,看到部门群来了条重要通知:“公司方针改变,xx 项目将于 6 月中旬上线,为了按时上线,五一全员上班,无特殊事宜,不准请假。” WTF? 左小白看了时间,将近 12 点了,还要不要大宝贱,纠结了一会,还是算了吧,明天去上班。 洗澡,随着身体的一阵颤抖,什么大宝贱已经变的索然无味。 13 跟往常一样,又是一个多小时的地铁,到了公司,拿起键盘就是干,一顿复制粘贴,这一天完成了商品列表功能,商品详情,左小白感觉已经适应了新公司的节奏了。 临近下班,项目经理跟大家说:大家下班前,要把今天写的代码都提交下,明天起,我们要拉个 dev 分支,在这个分支上开发。 分支?什么是分支,左小白心里犯嘀咕,不管了,先下班,明天再说吧。 14 又是新的一天,左小白刚坐下工位,组长过来了,问:大家今天要拉 dev 分支,有什么疑问吗?左小白很明显看出大家对分支是有疑问了,于是主动发问:组长,什么是分支?为什么要分支? 组长回答:我们现在用的主分支,就是 master 分支,之前一直在主分支开发没有什么影响,现在项目马上进入收尾阶段,需要有个稳定的分支可以随时发版本,也就是 master 分支,dev 分支我们会一直在上面开发,明白吗? 呃……明白!其实左小白并不明白,怎么创建分支?又怎么把 dev 分支代码合入 master 分支,小白没敢继续问。 组长继续说:应该好多人对分支还没有概念,大家来小白位置,我演示一遍给大家看看。 15 因为远程已经拉出来 dev 分支,大家要做的就是本地创建一个分支 dev,和远程 dev 分支关联起来就可以了,首先我们来看下小白本地有哪些分支: git branch -a * master remotes/origin/HEAD -> origin/master remotes/origin/dev remotes/origin/master 这里星号意思当前指向哪个分支,那接下来我们创建 dev 分支和远程 dev 关联起来: git checkout -b dev origin/dev Branch 'dev' set up to track remote branch 'dev' from 'origin'. Switched to a new branch 'dev' 这样我们就创建了 dev 分支,可以用命令git branch -vv查看分支关联关系: git branch -vv * dev 85be09a [origin/dev] Login master 85be09a [origin/master] Login 接下来,提交代码就跟之前一样提交,master 现在已经是稳定的版本,如果需要将 dev 分支代码合入 master 上,我会通知你们的,好了,应该没有什么不明白的吧,大家干活。 经过组长这么一讲解,左小白又愉快敲起了代码。 又是一天,累但很充实的一天。 16 组长:小白,今天你完成的 epub 阅读功能要合入主分支。 左小白:好的。 左小白还不知道要怎么合并分支,搜了搜,先要切回主分支,然后使用命令git merge进行合并: $ git merge dev Auto-merging config.xml CONFLICT (content): Merge conflict in config.xml Automatic merge failed; fix conflicts and then commit the result. 这是成功了吗?等等,好像有文件冲突了啊。 17 左小白还想着如何解决分支合并冲突问题,一到公司就被经理叫到会议室,“卧槽,不会出什么事吧,我也就代码没有提交啊”,小白当时害怕极了。 “是这样的,说下昨晚开会客户的决策……没什么重要事,不要紧张兮兮的”,经理看出来我很紧张,停了下继续说:“客户觉得我们效率低,担心完不成,希望安排人去现场支持,看得出小白是个很努力的人,想安排你去支援,可以吗?” “是去哪里?” “深圳。” “这么远啊?” “不要担忧,飞机住宿都是可以报销的,你先去,后面陆续安排其他同事去”,嘀嘀咕咕说了很多。 “好吧!” 其实左小白内心是拒绝的。 “什么时间去啊?” “今天是周五,你马上买机票,下周一就过去”。 18 回到座位,左小白下载了航旅纵横 APP,看了周一去深圳的航班,6 点一班,15 点一班,那只能买 6 点了,意味着早上 4 点要起床去机场,这么早,怎么去机场还是问题,滴滴?想想就很难受。 周六还去公司加班了,周日睡了一天,吵闹的 4 点闹钟开始起床,试试滴滴,还真有人接单。40 分钟车程到了机场,匆匆忙忙过了安检。 到了深圳就开干,一刻没歇,冲突的问题还得解决,上次命令git merge进行合并报错如下: $ git merge dev Auto-merging config.xml CONFLICT (content): Merge conflict in config.xml Automatic merge failed; fix conflicts and then commit the result. 左小白先用命令 git status 查看状态: git status On branch master You have unmerged paths. (fix conflicts and run "git commit") Unmerged paths: (use "git add <file>..." to mark resolution) both modified: config.xml no changes added to commit (use "git add" and/or "git commit -a") 打开 config.xml 文件: <<<<<<< HEAD:config.xml <div id="footer">contact : email.support@github.com</div> ======= <div id="footer"> please contact us at support@github.com </div> >>>>>>> dev:config.xml 卧槽,好复杂,不想看了!却默默打开了搜索引擎,搜索关键字“Git”、“分支”、“冲突”,原来这表示 <<<<<<< 到======= 部分指 master 分支所在的位置,=======到>>>>>>>部分指 dev 分支所在的位置 。 为了解决冲突,必须选择使用由 ======= 分割的两部分中的一个,或者也可以自行合并这些内容。 当解决了所有文件里的冲突之后,对每个文件使用 git add 命令来将其标记为冲突已解决,最后git commit来提交,搞定。 19 还有 5 分钟就要迟到了,急忙往公司赶,准备上楼时看到一位高挑妹纸疾风而过,好漂亮啊,小白愣住了,这不就是小白心中的女神啊,这是哪个公司啊,小白心想。妈妈呀,要迟到了,电梯怎么还不来,爬楼吧,最后还是迟到了 3 秒,都怪那个妹纸,要找她算帐! 回到工位,又看到了那妹纸,还做她旁边?“难道她是我们公司,没见过啊?” 下午 3 时,小白为一个 bug,正没有头绪,焦头烂额,突然被一个人敲了下肩,小白气不打一处来,要发火了,只见那妹纸对她笑着说:“请问下,我git add已经提交了,我还要改点代码,如果再 add 是不是会成两条提交记录啊” “嗯,是的”,左小白很确定地说。 “一次 bug 修复我只想有一个提交记录,有办法吗” “这么强迫症,难道你是处女座?” “这都被你猜到了”,妹纸有点急了。 “你可以使用命令git reset HEAD^从本地仓库撤销到工作区,这样就可以继续修改,之前提交的那条记录会没有的。” "本地仓库?工作区?"妹纸一脸懵逼。 “工作区:你现在修改区域;通过命令git add把代码放到暂存区,使用命令git commit提交代码并不是真的提上来了,而是放在本地仓库,git push才真的提交到远程仓库,我这样简单解释“工作区”、“暂存区”、“本地仓库”、“远程仓库”四个概念可以理解吗?”我问妹纸。 “让我消化下……也就是说 Git 是不受网络影响,随时随地可以提交代码,反正也是先提交到本地仓库”。 “可以啊,都能延伸了啊”我给妹纸竖了大拇指。 “话虽如此,可我还是不敢撤销,万一操作坏了!” 好吧,左小白手把手帮妹纸操作一遍,妹纸投来敬仰的眼光,左小白内心乐开了花。 20 晚上 10 点,终于可以下班了。 “我请你吃夜宵吧,今天帮我一个大忙”,妹纸向左小白说。 “好啊。” “我今天第一次来,周围还不熟悉……” “没事,离我们不远有家串串店很好吃,我们去吃吧,哦,你可以吃辣吗?” “可以啊,我可无辣不欢。” 路程大概 10 分钟,左小白 20 多年来还很少单独跟妹纸相处,不禁有些紧张起来,为了不尴尬,左小白找着话题尬聊起来。 “哎呀,我居然还不知道你的名字呢。” “右小爱。” “我左小白,我们名字似乎有点般配啊,哈哈” …… “小爱,你是我们公司吗,怎么没见过你啊?” “不是,我来苏州无为科技有限公司。” “我是无锡思锐科技有限公司的,无锡知道吗,就是旁边的城市。” “知道的,这个项目缺人,我刚毕业,啥不会,公司让我来凑数的。” “没有啦,看你代码很溜,还以为你工作好几年了呢。” 吃串串时,两人你一句我一句瞎聊着,右小爱就是深圳人,高考没考好,就选了苏州大学,目前实习。 21 "小白,我git add加到暂存区,我想撤销怎么搞?就是从暂存区撤销到工作区怎么搞?"小爱问到。 “命令git reset HEAD <file>” “果然可以。” “小白,经理说这个 bug 不用改了,我工作区修改的代码可以不要了,难道要把我修改的代码再改回去?” “不用,命令git checkout <file>即可。” 过了一会,小爱很开心地对小白说:“你真厉害。” “小爱,看你写了一天代码,有什么成果啊?” “解了 5 个 bug 了。” “你可以看你写了多少代码的。” “这么神奇?怎么看啊?” “ git diff --shortstat "@{0 day ago}"查看今天你写了多少行代码。" “牛啊,小白!你知道这么多,都是怎么学的?” “我之前有看过吴小龙同学写的博客,公号 吴小龙同学 后台回复 Git 可以获取 Git 完整资料。” “好的,我这就去公号 吴小龙同学 后台回复 Git 获取资料。” “牛逼,还有 Git 思维导图,我平时用到的命令都有,啧啧,原来你教我都是来自吴小龙同学啊。” “嘿嘿。” 22 有了小爱“陪伴”时光好像过的格外的快,转眼三个月过去了,左小白和右小爱从一开始都不知道对方名字,到慢慢熟悉,到后面直接称兄道弟,可小爱实习期到了,小爱当然是要在深圳留在她爸妈身边的,因此她要先回苏州,办理离职。 “小白,你今后打算啊。” “不知道啊,可能要留在无锡吧。” 小爱没有继续说话,这一天都没有跟左小白说句话。 自从小爱回去了,左小白整天提不起精神来,总感觉是缺少了什么,不行,左小白喜欢上右小爱了。 第三天右小爱回到了深圳,小白想向小爱表白,但是又很担心,万一不答应,不要最后兄弟都没得做,在这种纠结中,小白发烧了。 很明显感觉她有些不高兴。 小白急了,豁出去吧。 要晕,要晕,小白假装晕了过去。 只见小爱轻轻地点点了头。 小爱狠狠捶了小白胸口一下。 第二天,左小白提了离职申请,从此左小白和右小爱过上了没羞没臊的幸福生活。

优秀的个人博客,低调大师

JVM-入门了解篇

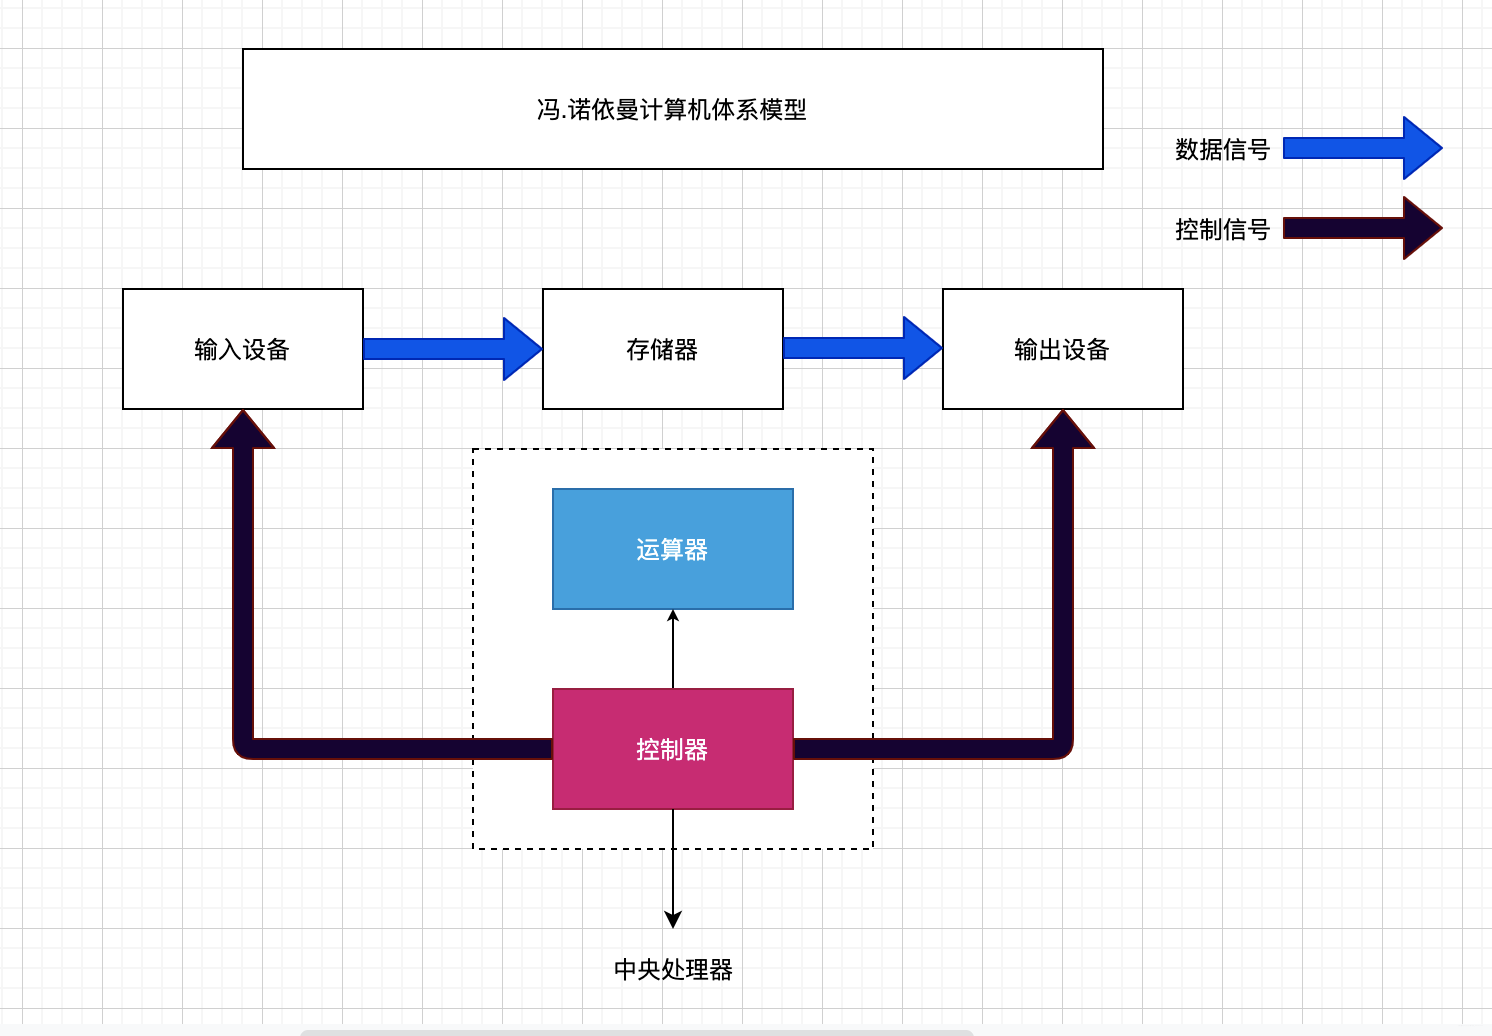
引言:任何软件语言的设计都有对应的硬件设备作为参考,同理我们理解对应知识结构或设计思想也可以参考对应的体系模型进行理解。 计算机体系结构: 计算机处理数据过程: (1)提取阶段:由输入设备把原始数据或信息输入给计算机存储器存起来 (2)解码阶段:根据CPU的指令集架构(ISA)定义将数值解译为指令 (3)执行阶段:再由控制器把需要处理或计算的数据调入运算器 (4)最终阶段:由输出设备把最后运算结果输出 本质就是CPU处理数据并且返回 CPU = 控制器+运算器+存储器 什么问题需要JVM来解决? 如果你在线上遇到了OOM,你是否会束手无策。 线上卡顿是否可能是因为频繁Full GC造成的。 新项目上线,服务器数量以及配置不足,对于性能的扩展只能靠服务器的增加,而不能通过JVM的 调优达到实现服务器性能的突破。 面试经常会问到JVM的一些问题,但是当面试官问到你实际的落地点时,你就会茫然不知所措,没 有条理性,或者答非所问。 JVM是什么? JVM:Java Virtual Machine (Java虚拟机),特性:Write Once Run Anywhere 一次写入跨平台运行。

优秀的个人博客,低调大师

Docker镜像管理快速入门

简介 介绍如何使用Docker构建镜像,并通过阿里云镜像服务分发到ECS服务器,运行该镜像。 背景知识 容器技术容器是一个允许我们在资源隔离的过程中,运行应用程序和其依赖项的 、轻量的 、操作系统级别的虚拟化技术, 运行应用程序所需的所有必要组件都打包为单个镜像,这个镜像是可以重复使用的。当镜像运行时,它是运行在独立的环境中,并不会和其他的应用共享主机操作系统的内存、CPU或磁盘。这保证了容器内的进程不会影响到容器外的任何进程。 镜像仓库(Registry)Docker的镜像存储中心通常被称为Registry。当您需要获取自己私有镜像时,首先需要登录Registry,然后拉取镜像。修改过镜像之后,您可以再次将镜像推送回Registry中去。或者在本地通过Docker镜像构建的功能生成镜像,再推送到Registry中。 容器镜像服务ACR(Alibaba Cloud Container Registry)阿里云容器镜像服务ACR默认实例版提供基础的容器镜像服务,包括安全的应用镜像托管能力、精确的镜像安全扫描功能、稳定的国内外镜像构建服务以及便捷的镜像授权功能,从而方便用户进行镜像全生命周期管理。 连接ECS服务器(如未购买可在此处体验ECS) 1.打开系统自带的终端工具。Windows:CMD或Powershell。MAC:Terminal。 在终端中输入连接命令ssh [username]@[ipaddress]。您需要将其中的username和ipaddress替换为第1小节中创建的ECS服务器的登录名和公网地址。例如: ssh root@123.123.123.123 命令显示结果如下: 3.输入yes,同意继续后将会提示输入登录密码。 密码为已创建的云服务的ECS的登录密码。 搭建Docker服务 Docker 是一个开源的容器引擎,用于创建、管理和编排容器,可以轻松为任何应用创建一个轻量级、可移植、自给自足的容器。本步骤将在ECS上部署一个Docker服务,并配置DockerHub的镜像加速器。 安装Docker的依赖库。 yum install -y yum-utils device-mapper-persistent-data lvm2 添加Docker CE的软件源信息。 yum-config-manager --add-repo http://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo 安装Docker CE。 yum makecache fast && yum -y install docker-ce 启动Docker服务。 systemctl start docker 配置DockerHub镜像加速器。 tee /etc/docker/daemon.json <<-'EOF' { "registry-mirrors": ["https://registry.docker-cn.com"] } EOF 重启Docker服务。 systemctl restart docker 准备应用代码和Dockerfile 本步骤操作将在工作空间下创建一个基于Golang的HelloWorld代码文件和一个用来构建运行Hello代码所需环境镜像的Dockerfile文件。 创建工作空间。 mkdir -p /tmp/demo && cd /tmp/demo 在工作空间下创建HelloWorld代码文件,用来在容器环境中监听HTTP服务,输出HelloWorld字符串。 cat > /tmp/demo/main.go << EOF package main import ( "fmt" "net/http" ) func main() { http.HandleFunc("/", func(w http.ResponseWriter, r *http.Request) { fmt.Fprintf(w, "Hello! World\n") }) fmt.Println("start to serve...") http.ListenAndServe(":80", nil) } EOF 在工作空间下创建Dockerfile文件。 cat > /tmp/demo/Dockerfile << EOF FROM golang:1.12-alpine # change current working dir WORKDIR /go/src/app # copy main.go into /go/src/app COPY . . # go build and install the app RUN go install -v ./... # run the app by default CMD ["app"] EOF 本地构建镜像并运行镜像 本步骤将指导您使用Docker基本命令构建和运行镜 使用docker build命令构建镜像。 docker build . -t demo:v1 命令运行结果如下所示: 说明:参数.表示指定当前路径作为构建上下文,即Dockerfile所在的本地路径。参数-t demo:v1指定镜像名称和标签。 使用docker run命令运行镜像。 docker run -d -p 8000:80 demo:v1 命令运行结果如下所示: 说明: 参数-d设置容器运行模式为后台运行。参数-p 8000:80将容器内部使用的网络端口映射到主机上,其中8000为主机端口,80为容器内部使用端口。 使用curl工具访问容器中的HelloWorld服务。 curl localhost:8000 命令运行结果如下所示: 4.使用docker rm命令删除容器。 docker rm -f $(docker ps -a | grep "demo:v1" | awk '{print $1}') 命令运行结果如下所示: 创建远程镜像仓库 本步骤操作将指导您使用自己的阿里云账号开通容器镜像服务并创建镜像仓库。阿里云容器镜像服务默认实例版可免费使用,其使用限制请参见容器镜像服务计费说明。 1.使用您的阿里云主账号登录容器镜像服务控制台。 2.【前往开通】》单击【设置Registry登录密码】》设置阿里云Docker Registry登录密码,然后单击 【确定】 。3.在容器镜像服务控制台,依次单击 【默认实例】 > 【命名空间】 > 【创建命名空间】,在 【创建命名空间】 弹框中填写命令空间名称,然后单击 【确定】 。 单击 【本地仓库】 > 【创建镜像仓库】 。在镜像仓库列表,选择上一步创建的镜像仓库,单击 【管理】 ,查看镜像仓库详情。 推送镜像 本步骤操作将本地镜像推送到远程仓库中,并运行远程仓库中的指定版本镜像。请将本步骤命令中涉及的远程镜像地址替换为步骤六中创建的镜像仓库的公网地址。 1.执行以下命令登录到阿里云Docker Registry。 docker login --username="用户名" registry.cn-hangzhou.aliyuncs.com 说明: 请将下面命令中的用户名替换为您的阿里云账号全名,回车后输入远程镜像仓库密码,密码为步骤六开通服务时设置的密码。 请登录阿里云用户中心查看您的主账号用户名称。命令运行结果如下所示: 2.标记本地镜像,将其归入远程仓库。 docker tag demo:v1 registry.cn-hangzhou.aliyuncs.com/space_test/demo:v1 3.将本地镜像推送到远程仓库。 docker push registry.cn-hangzhou.aliyuncs.com/space_test/demo:v1 命令运行结果如下所示: 拉取指定版本的远程镜像。 docker pull registry.cn-hangzhou.aliyuncs.com/space_test/demo:v1 命令运行结果如下所示: 运行拉取的远程镜像。 docker run -d -p 8000:80 registry.cn-hangzhou.aliyuncs.com/space_test/demo:v1 命令运行结果如下所示: 访问HelloWorld服务。 curl localhost:8000 命令运行结果如下所示:

优秀的个人博客,低调大师

写给小白的 kubectl 入门

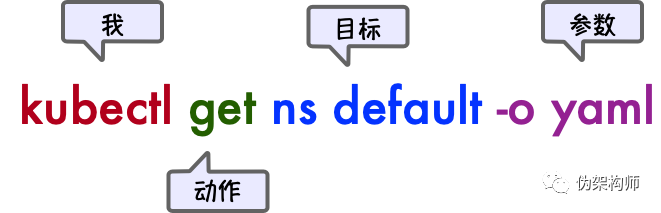
前言 意外又看到不少正在学 Kubernetes 新手。想想本人写过各种自己懂或不懂、信或不信的原理、机制、方法和工具等等各种东西,唯独没写过 kubectl,其实这东西也是值得一写的——比如说去年我才从一线同学的操作里学会用 -A 代替 --all-namespaces。理顺 kubectl 的用法,也会对 Kubernetes 的知识体系以及运维工作有很大的帮助。 对 Kubernetes 稍有了解的读者应该都知道声明式 API 的说法,kubectl 就是一个这种 API 的客户端,所以 kubectl 的主要功能就是用来操作对象的。 开局两张图 下图是个常见的使用方式: 其实本来想写主谓宾定状补的,后来想想还得复习一下,算了算了。 一般的 kubectl 使用都是这么个顺序,参数是可以调整位置的,暂且如此就可以了。 用一个思维导图来归纳一下: 动作 在 kubectl 中被称为 command 也就是命令。使用 kubectl --help 能看到可用的命令列表: $ kubectl --helpkubectl controls the Kubernetes cluster manager. Find more information at: https://kubernetes.io/docs/reference/kubectl/overview/Basic Commands (Beginner): create Create a resource from a file or from stdin.... run 在集群中运行一个指定的镜像...Basic Commands (Intermediate): explain 查看资源的文档 get 显示一个或更多 resources...Deploy Commands: rollout Manage the rollout of a resource... 可以看到 kubectl 的命令行帮助非常不错,不仅有功能说明、分类,还有难度标识,甚至有部分的中文说明,kubectl 的每个命令都可以用 --help 查看进一步的帮助说明。 这里列出了很多可用的命令,按照操作能力,主流命令基本可以分为增删改查(CRUD)四种。 C 新建命令用于在集群中创建对象,最常用的新建命令应该是 create、run 了,create 能够创建多种对象,而 run 则主要用来创建 Pod。这两个命令都需要在命令行中使用参数的方式来表达待创建的对象的字段内容,其表达力非常粗糙和有限,并且带有明显的命令式 API 风味,在我的日常工作中已经很少用到这样的命令了。 但是这种命令往往有个妙用,--dry-run=client(旧版本中是 --dry-run),可以在不产生实际操作的情况下,测试命令的输出,加上 -o yaml,可以帮助输出 YAML 文档。 R get 是最常用的查询指令,用于获取对象列表和基本信息,而 describe 则用于获取一个对象的详细信息。另外一个常用的读取指令就是 Debug 常用的日志查看指令:kubectl logs。 U 最重要的更新命令可以说是 apply,edit 了,patch、label、annotation、scale 等命令也算常用。 apply 是把 yaml 提交给 Kubernetes 集群的最常用方式,而 edit patch 都是用于修改线上负载的常用手段。label 和 annotation 命令则是用于修改对象元数据的,例如标签和注解。 D 这个没什么好说——delete 获取帮助 kubectl 的所有命令、子命令都支持 --help 参数,可以用这种方式获取帮助。 kubectl options 命令能够获取 kubectl 的所有全局参数。 常用参数 -f:很多指令(不只是 apply 和 create)都可以用 -f <文件名> 的方式进行输入,如果使用管道操作,则可以用参数 -f - 接收 STDIN 的输入。 -l:可以使用各种对象上的标签对操作范围进行过滤,例如 -l app=hello -o:指定输出格式,这个参数相对复杂,最常用的是 yaml 或者 json 用于输出机器报文,还可以用 JSON Path 或者 Go Template 对结果进行处理。 对象 对象通常是类型+名称的一个组合,可以用 kubectl 获得当前集群支持的对象类型: 如上图,输出内容包含几个列:名称、简称、API 群组、是否归属命名空间以及对象的 Kind 属性。例如常用的 Deployment: 名称:Deployment 简称:Deploy API 群组:apps 归属命名空间:是 Kind:Deployment 使用命令 kubectl get deploy,就能获得当前命名空间中的 Deployment 对象列表,如果在尾巴上加入 Deployment 的名称,就能得到符合名称要求的 Deployment 对象, Schema 前面提到的 -f 参数,或者是 get -o yaml,都要用到具体的对象数据结构,这个结构到底是哪里规定的呢?基本结构可以分为三个部分,以一个 Namespace 为例: apiVersion: v1kind: Namespacemetadata: name: defaultspec: finalizers: - kubernetes 一般会分为四个基础字段:apiVersion、kind、metadata、status 以及 spec。 apiVersion:格式为 <apiGroup>/<apiVersion>,一个对象的 API Group,可以用前文提到的 api-resources 命令查到,而版本则可以通过 kubectl api-versions 查询得到。 kind:对应 api-resources 命令输出的字段。 metadata:元数据,其中包括标签、注解、名称等字段,如果对象是属于命名空间的,也会把命名空间写在这里。 status:这个字段的内容通常是由 Kubenretes 自动填写的。经常会被省略掉。 spec:具体的对象内容,可以由几个途径获取其定义结构 部分资源可以使用 kubectl explain <对象类别> 获得解释 如果该资源在集群中有对象存在,可以使用 kubectl get <对象类别> <对象名称> -o yaml 的方式获得原文,向其致敬。 如果前两种方法都没有,就需要去查看 Kubernetes 或者第三方的 API Reference 了。 最后 看了上面的解释,是不是对 Kubernetes 的控制台操作有点底了? 文章转载自伪架构师。点击这里阅读原文了解更多。 CNCF概况(幻灯片) 扫描二维码联系我们! CNCF (Cloud Native Computing Foundation)成立于2015年12月,隶属于Linux Foundation,是非营利性组织。 CNCF(云原生计算基金会)致力于培育和维护一个厂商中立的开源生态系统,来推广云原生技术。我们通过将最前沿的模式民主化,让这些创新为大众所用。请长按以下二维码进行关注。 本文分享自微信公众号 - CNCF(lf_cncf)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

云计算快速入门指南

本文简单介绍了云计算的概念、架构、部署及市场等多方面的内容: 云计算是什么? 简单来说,云计算就是按需计算服务的交付,服务涵盖:应用程序、存储和处理能力,通常通过互联网并按需付费。 云计算如何工作? 公司无需拥有自己计算基础设施或数据中心,可以直接从云服务提供商租用资源。所以,公司可以避免建立和维护自己的IT基础设施的成本和复杂性,只需要在使用时支付使用费用即可。 反过来,云计算服务提供商可以通过向广泛的客户提供相同的服务,从规模经济中受益。 云计算服务有哪些? 云计算涵盖了广泛的服务,基础性的服务有:存储、网络和处理能力,再到高阶一点的:自然语言处理、人工智能、办公应用程序。基本上,只要是不需要在物理上接近的服务,都可以通过云来提供。 举个栗子? 云计算是众多服务的基础。例如你的QQ邮箱,或者你手机上照片的云备份,往大点说还包括允许大型企业托管其所有数据、并在云中运行其应用程序的服务。哔哩哔哩、爱奇艺等就是用云计算来运行其视频流服务和其他业务系统。 并且,云计算正在成为许多应用程序的默认选择,越来越多的软件供应商将其应用程序作为服务在互联网上提供。但是,云计算也有潜在的弊端,它会给公司带来新的成本和新的风险。 为什么叫云计算? 云计算服务的位置很大程度上与用户无关,而云的隐喻是从传统的的电信网络示意图中借用来的,公共电话网(以及后来的互联网)通常被表示为一个云,云涵盖了里面的很多细节问题。当然,这有些过度简化了,对于许多客户来说,服务和数据的位置仍然是一个关键问题。 云计算的历史? 云计算这一术语自2000年代初就出现了,但在这之前,“计算即服务”的概念已经存在了很长时间,最早可以追溯到1960年代,当时计算机局允许公司租用主机。 后来,这种“按时收费”的服务被个人电脑的兴起所取代,人们买得起一台计算机了,后来,公司数据中心也开始兴起,公司不需要租赁就可以存储大量数据。 但是,租用计算能力的概念后来又再次出现,在1990年代末和2000年代初,应用服务提供商,公用事业计算和网格计算都体现了租用计算能力的概念。紧接着,云计算出现了,它随着软件即服务和超大规模云计算提供商(例如Amazon Web Services)的出现而发展起来。 云有多重要? Synergy Research Group对过去十年中企业IT支出的调查显示,云基础设施服务的年度支出从几乎为零增加到近1000亿美元。 同时,在过去十年的大部分时间里,企业在数据中心硬件和软件上的支出一直停滞不前。尽管服务器的出货量保持持平,但由于服务器的配置变得更丰富,价格更高,2018年数据中心支出确实增加了。 不过,2018年数据中心支出的增加并没有影响云支出的增长,云基础设施服务支出在2019年又增长了近40%。在过去十年中,数据中心的年均支出增长为4%(主要是由于前三年),而对于云服务,这一比例为56%。2019年标志着企业在云服务(IaaS、PaaS和托管私有云)上的支出首次超过数据中心设备。 什么是基础架构即服务(IaaS)? 云计算可以分为三个云服务模型:基础设施即服务(IaaS)、平台即服务(PaaS)、软件即服务(SaaS)。 IaaS 是云服务的最底层,指可以租用的基础资源:物理或虚拟服务器、存储和网络。如果公司要从头开始构建应用程序并打算自己完全控制所有元素,IaaS是个不错的选择,不过这需要公司具有相应技术,才能协调服务。 甲骨文的研究发现,三分之二的IaaS用户表示,使用在线基础设施能让公司更具有创新力,减少了他们部署新应用程序和服务的时间,并大大降低了维护成本。但是,也有一半的人说IaaS对于大多数关键数据而言不够安全。 什么是平台即服务(PaaS)? 平台即服务(PaaS)将IaaS与一个抽象的中间件服务、软件开发和部署工具相结合,使机构能够以统一的方式,在云中或内部环境中创建和部署应用。 PaaS提供了一组一致的编程和中间件服务,确保开发人员以行之有效的集成方式,在云计算环境中创建应用。 PaaS环境将开发和部署放在一起,共同创造了一种更易于管理的方式,来构建和部署应用。PaaS需要基础设施服务。 什么是软件即服务(SaaS)? 软件即服务(SaaS)是大多数人日常接触到的云计算,底层硬件和操作系统与用户无关,用户通过Web浏览器或应用程序访问该服务。 使用云计算的益处 从根本上说,使用云服务意味着公司不必购买、维护自己的计算基础架构,不再需要购买服务器、更新应用程序或操作系统,这一切都由供应商负责。 像电子邮件之类的应用程序最好使用云提供商的,而不是依靠企业自己建立,要知道,一家专业运行这些服务的公司肯定比小企业可以雇用的人有着更好的技能和经验,因此云服务可以为用户提供更安全,更高效的服务。 同时,使用云服务意味着企业可以更快地进行项目开发和测试概念,无需花费大量的采购时间和高昂的前期成本,因为企业只需为自己消耗的资源付费。云倡导者经常将这种业务敏捷性称为关键优势。而且,如果新应用程序变得非常流行,则云的弹性特征意味着应用程序可以更容易、更快速地进行扩展。 像一些应用程序仅在特定时间(例如一年中的某一周)高峰使用,在其他很多时间都闲着,这种情况不需要专门进行硬件和软件铺设,直接将其托管在云中能节省很多成本。 云计算的缺点 云计算不一定比其他形式的计算更便宜,因为从长远来看,租金不一定比购买划算。如果应用程序对计算服务有着长期稳定的需求,在内部提供该服务可能更经济。 还有一些公司不愿意将敏感数据迁移到SaaS应用程序中,因为其竞争对手也可能使用相同的应用程序,特别是当这个应用程序对其的核心业务至关重要时,使用相同的应用程序就没有竞争优势了。 在某项业务刚开始时使用云应用程序很容易,但是如果是将现有数据或应用程序迁移到云中可能会很复杂和昂贵。有相当一部分有经验的云用户表示,他们认为前期迁移成本最终超过了IaaS带来的长期节省。 云技能短缺也是一个问题,同时拥有DevOps、多云监控及管理知识的工作人员尤其紧缺。 云计算安全性如何? 云计算的安全性在很大程度上取决于现有系统的安全性,公司自己管理内部系统可能比由专业的云提供商监控的系统更容易泄漏。 尽管安全漏洞很少发生,但现在仍有许多公司担心云服务的安全性,尤其是对于在许多云服务之间传输数据的公司而言,这导致了云安全工具的增长,云安全工具可以监视来往于云和云之间以及云平台之间的数据。这些工具可以识别云数据的欺诈使用、未经授权的下载和恶意软件。但是,这不仅会增加成本,并且对性能也会产生一定的副作用:云安全工具可以将云的投资回报率降低5%到10%,并将性能降低5%到15%。 什么是公有云? 公有云是典型的云计算模型,用户可以通过互联网使用大量的计算能力(无论是IaaS、PaaS还是SaaS)。使用公有云的一个重要好处是能够快速扩展服务。 云计算供应商拥有大量的计算能力,它们在众多客户之间共享这些能力,即“多租户”架构。它们的巨大规模意味着它们有足够的备用容量,当客户需要更多的资源时可以轻松应对,所以它经常被用于对敏感度要求不高的应用程序。 全球公有云服务终端用户支出预测(单位:百万美元) 来源:Gartner(2020年11月) 什么是私有云? 私有云隐藏在企业防火墙后面。使用私有云,公司可以精确地控制数据存放的位置,并可以按照他们想要的方式构建基础设施(主要是针对IaaS或PaaS项目),可以按需扩展而不会危及安全。但是成本也是一个问题,很少有公司能有AWS、Microsoft或Google那样大的规模,这意味着它们将无法创造同样的规模经济。尽管如此,对于需要额外安全性的公司来说,私有云能帮助他们理解云服务或重建云的内部应用程序,然后再将其转移到公有云中。 什么是混合云/多云? 混合云就是公司的一些数据在公有云中,一些项目在私有云中,公司拥有多个供应商,使用不同级别的云。使用混合云的主要好处是是如果发生意外故障,混合云可以避免灾难性的数据丢失,以及在扩展现有数据中心时避免硬件成本。 多云是混合云的一种特殊情况,即公司使用来自多个公有云提供商的服务。 混合云和多云的区别是:混合云总是将私有云和公有云(如OpenStack私有云和AWS)结合在一起,而多云总是涉及两个或多个公有云,如Azure、AWS和Google。 采用云计算对公司支出有何影响? 公司使用云服务同时意味着公司的支出从资本支出(购买各种长期资产)转移到运营支出。公司不会像之前那样在新项目中看到大幅增加的IT支出。 ZDNet的调查指出:“ CIO越来越多地转向云基础架构和服务,以提高灵活性并缓解资本预算的压力。” 当然,这并不意味着云计算一定比将在内部运行应用程序便宜,对于那些有着稳定计算能力需求的应用程序,将其保留在内部可能会比较便宜。 建立或迁移云计算业务的成本 在将系统移至云端的之前,首先要了解现有基础架构的实际成本,有很多因素要考虑,例如运行数据中心的成本、租用线路之类的额外费用、物理硬件的成本(服务器以及CPU)、存储成本等等。 当然,如果你是初创企业,并且计划在云中运行你所有的系统,那起步非常简单,但是,对于大多数公司而言,情况大不相同:他们需要利用现有的应用程序和数据,弄清楚哪些系统最好保持原样运行,以及哪些系统可以迁移到云基础设施上,这个决策具有潜在的风险以及需要昂贵的费用,如果企业低估了此类项目的规模,迁移到云上可能会付出更大的代价。 其次,你还需要考虑应用程序的成本,你是打算直接淘汰它们,或是原封不动地将它们托管在云中,或是完全重建它们,还是购买全新的SaaS软件包,每种选择都会产生不同的成本。 一项对500家早期采用云计算的企业的调查发现,为了优化云应用程序,重写应用程序是最大的成本之一,尤其是在应用程序很复杂或定制的情况下。三分之一的受访者表示,云迁移的过程中传输数据的费用也非常高昂。还有三分之一的受访者表示,如果迁移应用程序,他们的软件数据库许可成本也将大幅增加。 最后,你还需要了解人员成本,人员成本通常仅次于基础架构成本,还要考虑任何潜在的不利因素,例如,大多数企业仍然担心迁移到云后应用程序的性能会降低,有三分之一的人认为这是不迁移某些关键应用程序的原因。 地理位置与云计算有关吗? 实际上,地理位置对云计算非常重要。首先,地理位置有可能导致延迟问题:如果应用程序来自地球另一端的数据中心,或者来自拥塞网络的另一端,那么与本地连接相比,你会发现它运行缓慢。 其次,还有数据主权问题。许多公司都很在意他们的数据在哪里被处理和存储。例如,欧洲的公司会担心,如果他们的客户数据存储在美国的数据中心或由美国公司拥有,那他们的数据可能会被美国执法部门访问。因此,大型云供应商一直在构建一个区域数据中心网络,以便组织能够将其数据保存在自己的区域中。 世界各地对云计算的监管也大相径庭:例如,由于中国严格的技术法规,AWS将其在中国的一大部分云基础设施出售给了当地合作伙伴,后来,AWS又开通了第二个中国(宁夏)地区,由宁夏西部云数据技术公司运营;英国政府网络安全局警告,政府机构使用云服务,需要考虑云提供商的国籍。 什么是云计算区域?什么是云计算可用区? 云计算服务是在世界各地的大型数据中心运行的。AWS将其划分为“区域”和“可用区域”。每个AWS区域都是一个单独的地理区域,比如EU(伦敦)或US West(俄勒冈州),AWS将这些区域进一步细分为可用区(AZ)。AZ由一个或多个数据中心组成,这些数据中心相距足够远,理论上一次意外故障不会使这两个数据中心都脱机,而对于需要快速转移的应用程序来说,它们之间的距离足够近。每个可用区都有多个互联网连接,并且可以连接到多个网格的电源。AWS有50多个可用区。 Google使用类似的模型,将其云计算资源划分为多个区域,然后将其细分为小区域,一个小区域一个或多个数据中心。目前,它有15个区域,由44个小区域组成。Google建议客户跨多个区域部署应用程序,以防止发生意外故障。 Microsoft Azure对资源的分配略有不同。它提供的区域描述为“在延迟定义的范围内部署,并通过专用区域低延迟网络连接的一组数据中心”。当然它也提供地理上划分的区域,也就是“地理区域”,它通常包含两个或多个区域,有特定数据驻留需求的客户可以使用“地理区域”以“保持其数据和应用程序紧密”。它还提供由一个或多个数据中心组成的可用性区域,这些数据中心配备有独立的电源,散热和网络。 云计算的功耗 数据中心消耗的电力非常庞大,例如,微软与通用电气达成协议,购买爱尔兰37兆瓦风电场15年的所有输出,以为其云数据中心供电。爱尔兰预计到2026年,数据中心将占能源总需求的15%,而2015年还不到2%。 大型云计算公司 Synergy 报告显示,第三季度企业在云基础设施服务上的支出接近330亿美元,同比增长33%。各大云厂商在市场中的表现如下: 亚马逊和微软仍然占据全球几乎一半以上的市场,亚马逊的市场份额一直保持在33%左右,而微软的份额超过18%。 谷歌,阿里云和腾讯的增长速度超过了整个市场,它们共同占据了17%的市场,也正在获得越来越多的市场份额。 前十名中的其他云提供商是IBM,Salesforce,Oracle,NTT和SAP。 总体来看,排名前十的提供商占全球市场的80%,其余的20%来自小型云提供商或逐步向云市场迈进的大公司。 在大多数主要云服务提供商发布了第三季度收益数据的基础上,Synergy预计,第三季度云基础设施服务收入(包括IaaS、PaaS和托管私有云服务)为328亿美元,其中公共IaaS和PaaS服务占据了市场的大部分,第三季度增长了35%。主要云服务提供商在公有云领域的主导地位更为明显,前五大供应商控制着近80%的市场份额。总体看,云市场在全球继续强劲增长。 云计算的未来 云计算打破了数据和组织孤岛,并且帮助公司重新思考业务流程,加速业务变革,推动其数字化转型计划。但是,随着转换成本的增加,企业对云计算的热情也正在减弱。

优秀的个人博客,低调大师

Redis Lua脚本完全入门

1. 前言 Redis是高性能的KV内存数据库,除了做缓存中间件的基本作用外还有很多用途,比如胖哥以前分享的Redis GEO地理位置信息计算。Redis提供了丰富的命令来供我们使用以实现一些计算。Redis的单个命令都是原子性的,有时候我们希望能够组合多个Redis命令,并让这个组合也能够原子性的执行,甚至可以重复使用,在软件热更新中也有一席之地。Redis开发者意识到这种场景还是很普遍的,就在2.6版本中引入了一个特性来解决这个问题,这就是Redis执行Lua脚本。 2. Lua Lua也算一门古老的语言了,玩魔兽世界的玩家应该对它不陌生,WOW的插件就是用Lua脚本编写的。在高并发的网络游戏中Lua大放异彩被广泛使用。 Lua广泛作为其它语言的嵌入脚本,尤其是C/C++,语法简单,小巧,源码一共才200多K,这可能也是Redis官方选择它的原因。 另一款明星软件Nginx也支持Lua,利用Lua也可以实现很多有用的功能。 3. Lua并不难 Redis 官方指南也指出不要在Lua脚本中编写过于复杂的逻辑。 为了实现一个功能就要学习一门语言,这看起来就让人有打退堂鼓的感觉。其实Lua并不难学,而且作为本文的场景来说我们不需要去学习Lua的完全特性,要在Redis中轻量级使用Lua语言。这对掌握了Java这种重量级语言的你来说根本不算难事。这里胖哥只对Redis中的涉及到的基本语法说一说。 Lua 的简单语法 Lua在Redis脚本中我个人建议只需要使用下面这几种类型: nil 空 boolean 布尔值 number 数字 string 字符串 table 表 声明类型 声明类型非常简单,不用携带类型。 --- 全局变量 name = 'felord.cn' --- 局部变量 local age = 18 Redis脚本在实践中不要使用全局变量,局部变量效率更高。 table 类型 前面四种非常好理解,第五种table需要简单说一下,它既是数组又类似Java中的HashMap(字典),它是Lua中仅有的数据结构。 数组不分具体类型,演示如下 Lua 5.1.5 Copyright (C) 1994-2012 Lua.org, PUC-Rio > arr_table = {'felord.cn','Felordcn',1} > print(arr_table[1]) felord.cn > print(arr_table[3]) 1 > print(#arr_table) 3 作为字典: Lua 5.1.5 Copyright (C) 1994-2012 Lua.org, PUC-Rio > arr_table = {name = 'felord.cn', age = 18} > print(arr_table['name']) felord.cn > print(arr_table.name) felord.cn > print(arr_table[1]) nil > print(arr_table['age']) 18 > print(#arr_table) 0 混合模式: Lua 5.1.5 Copyright (C) 1994-2012 Lua.org, PUC-Rio > arr_table = {'felord.cn','Felordcn',1,age = 18,nil} > print(arr_table[1]) felord.cn > print(arr_table[4]) nil > print(arr_table['age']) 18 > print(#arr_table) 3 ❗ # 取table的长度不一定精准,慎用。同时在Redis脚本中避免使用混合模式的table,同时元素应该避免包含空值nil。在不确定元素的情况下应该使用循环来计算真实的长度。 判断 判断非常简单,格式为: local a = 10 if a < 10 then print('a小于10') elseif a < 20 then print('a小于20,大于等于10') else print('a大于等于20') end 数组循环 local arr = {1,2,name='felord.cn'} for i, v in ipairs(arr) do print('i = '..i) print('v = '.. v) end print('-------------------') for i, v in pairs(arr) do print('p i = '..i) print('p v = '.. v) end 打印结果: i = 1 v = 1 i = 2 v = 2 ----------------------- p i = 1 p v = 1 p i = 2 p v = 2 p i = name p v = felord.cn 返回值 像Python一样,Lua也可以返回多个返回值。不过在Redis的Lua脚本中不建议使用此特性,如果有此需求请封装为数组结构。在Spring Data Redis中支持脚本的返回值规则可以从这里分析: public static ReturnType fromJavaType(@Nullable Class<?> javaType) { if (javaType == null) { return ReturnType.STATUS; } if (javaType.isAssignableFrom(List.class)) { return ReturnType.MULTI; } if (javaType.isAssignableFrom(Boolean.class)) { return ReturnType.BOOLEAN; } if (javaType.isAssignableFrom(Long.class)) { return ReturnType.INTEGER; } return ReturnType.VALUE; } 胖哥在实践中会使用 List、Boolean、Long三种,避免出现幺蛾子。 到此为止Redis Lua脚本所需要知识点就完了,其它的函数、协程等特性也不应该在Redis Lua脚本中出现,用到内置函数的话搜索查询一下就行了。 在接触一门新的技术时先要中规中矩的使用,如果你想玩花活就意味着更高的学习成本。 4. Redis中的Lua 接下来就是Redis Lua脚本的实际操作了。 EVAL命令 Redis中使用EVAL命令来直接执行指定的Lua脚本。 EVAL luascript numkeys key [key ...] arg [arg ...] EVAL 命令的关键字。 luascript Lua 脚本。 numkeys 指定的Lua脚本需要处理键的数量,其实就是 key数组的长度。 key 传递给Lua脚本零到多个键,空格隔开,在Lua 脚本中通过 KEYS[INDEX]来获取对应的值,其中1 <= INDEX <= numkeys。 arg是传递给脚本的零到多个附加参数,空格隔开,在Lua脚本中通过ARGV[INDEX]来获取对应的值,其中1 <= INDEX <= numkeys。 接下来我简单来演示获取键hello的值得简单脚本: 127.0.0.1:6379> set hello world OK 127.0.0.1:6379> get hello "world" 127.0.0.1:6379> EVAL "return redis.call('GET',KEYS[1])" 1 hello "world" 127.0.0.1:6379> EVAL "return redis.call('GET','hello')" (error) ERR wrong number of arguments for 'eval' command 127.0.0.1:6379> EVAL "return redis.call('GET','hello')" 0 "world" 从上面的演示代码中发现,KEYS[1]可以直接替换为hello,但是Redis官方文档指出这种是不建议的,目的是在命令执行前会对命令进行分析,以确保Redis Cluster可以将命令转发到适当的集群节点。 numkeys无论什么情况下都是必须的命令参数。 call函数和pcall函数 在上面的例子中我们通过redis.call()来执行了一个SET命令,其实我们也可以替换为redis.pcall()。它们唯一的区别就在于处理错误的方式,前者执行命令错误时会向调用者直接返回一个错误;而后者则会将错误包装为一个我们上面讲的table表格: 127.0.0.1:6379> EVAL "return redis.call('no_command')" 0 (error) ERR Error running script (call to f_1e6efd00ab50dd564a9f13e5775e27b966c2141e): @user_script:1: @user_script: 1: Unknown Redis command called from Lua script 127.0.0.1:6379> EVAL "return redis.pcall('no_command')" 0 (error) @user_script: 1: Unknown Redis command called from Lua script 这就像Java遇到一个异常,前者会直接抛出一个异常;后者会把异常处理成JSON返回。 值转换 由于在Redis中存在Redis和Lua两种不同的运行环境,在Redis和Lua互相传递数据时必然发生对应的转换操作,这种转换操作是我们在实践中不能忽略的。例如如果Lua脚本向Redis返回小数,那么会损失小数精度;如果转换为字符串则是安全的。 127.0.0.1:6379> EVAL "return 3.14" 0 (integer) 3 127.0.0.1:6379> EVAL "return tostring(3.14)" 0 "3.14" 根据胖哥经验传递字符串、整数是安全的,其它需要你去仔细查看官方文档并进行实际验证。 原子执行 Lua脚本在Redis中是以原子方式执行的,在Redis服务器执行EVAL命令时,在命令执行完毕并向调用者返回结果之前,只会执行当前命令指定的Lua脚本包含的所有逻辑,其它客户端发送的命令将被阻塞,直到EVAL命令执行完毕为止。因此LUA脚本不宜编写一些过于复杂了逻辑,必须尽量保证Lua脚本的效率,否则会影响其它客户端。 脚本管理 SCRIPT LOAD 加载脚本到缓存以达到重复使用,避免多次加载浪费带宽,每一个脚本都会通过SHA校验返回唯一字符串标识。需要配合EVALSHA命令来执行缓存后的脚本。 127.0.0.1:6379> SCRIPT LOAD "return 'hello'" "1b936e3fe509bcbc9cd0664897bbe8fd0cac101b" 127.0.0.1:6379> EVALSHA 1b936e3fe509bcbc9cd0664897bbe8fd0cac101b 0 "hello" SCRIPT FLUSH 既然有缓存就有清除缓存,但是遗憾的是并没有根据SHA来删除脚本缓存,而是清除所有的脚本缓存,所以在生产中一般不会再生产过程中使用该命令。 SCRIPT EXISTS 以SHA标识为参数检查一个或者多个缓存是否存在。 127.0.0.1:6379> SCRIPT EXISTS 1b936e3fe509bcbc9cd0664897bbe8fd0cac101b 1b936e3fe509bcbc9cd0664897bbe8fd0cac1012 1) (integer) 1 2) (integer) 0 SCRIPT KILL 终止正在执行的脚本。但是为了数据的完整性此命令并不能保证一定能终止成功。如果当一个脚本执行了一部分写的逻辑而需要被终止时,该命令是不凑效的。需要执行SHUTDOWN nosave在不对数据执行持久化的情况下终止服务器来完成终止脚本。 其它一些要点 了解了上面这些知识基本上可以满足开发一些简单的Lua脚本了。但是实际开发中还是有一些要点的。 务必对Lua脚本进行全面测试以保证其逻辑的健壮性,当Lua脚本遇到异常时,已经执行过的逻辑是不会回滚的。 尽量不使用Lua提供的具有随机性的函数,参见相关官方文档。 在Lua脚本中不要编写function函数,整个脚本作为一个函数的函数体。 在脚本编写中声明的变量全部使用local关键字。 在集群中使用Lua脚本要确保逻辑中所有的key分到相同机器,也就是同一个插槽(slot)中,可采用Redis Hash Tag技术。 再次重申Lua脚本一定不要包含过于耗时、过于复杂的逻辑。 5. 总结 本文对Redis Lua脚本的场景以及Redis Lua脚本所需要的Lua编程语法进行了详细的讲解和演示,也对Redis Lua脚本在实际开发中需要注意的一些要点进行了分享。希望能够帮助你掌握此技术。今天的分享就到这里,下次我将分享如何在实际Redis开发中使用Lua脚本,所以这一篇一定要进行掌握。多多关注:码农小胖哥 获取更多编程知识干货。 关注公众号:Felordcn获取更多资讯 个人博客:https://felord.cn

优秀的个人博客,低调大师

Flink从入门到入土

和其他所有的计算框架一样,flink也有一些基础的开发步骤以及基础,核心的API,从开发步骤的角度来讲,主要分为四大部分 1.Environment Flink Job在提交执行计算时,需要首先建立和Flink框架之间的联系,也就指的是当前的flink运行环境,只有获取了环境信息,才能将task调度到不同的taskManager执行。而这个环境对象的获取方式相对比较简单 //批处理环境valenv=ExecutionEnvironment.getExecutionEnvironment//流式数据处理环境valenv=StreamExecutionEnvironment.getExecutionEnvironment 2.Source Flink框架可以从不同的来源获取数据,将数据提交给框架进行处理, 我们将获取数据的来源称之为数据源. 2.1.从集合读取数据 一般情况下,可以将数据临时存储到内存中,形成特殊的数据结构后,作为数据源使用。这里的数据结构采用集合类型是比较普遍的 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从集合读取数据*/objectSourceList{defmain(args:Array[String]):Unit={//1.创建执行的环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironment//2.从集合中读取数据valsensorDS:DataStream[WaterSensor]=env.fromCollection(//List(1,2,3,4,5)List(WaterSensor("ws_001",1577844001,45.0),WaterSensor("ws_002",1577844015,43.0),WaterSensor("ws_003",1577844020,42.0)))//3.打印sensorDS.print()//4.执行env.execute("sensor")}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 2.2从文件中读取数据 通常情况下,我们会从存储介质中获取数据,比较常见的就是将日志文件作为数据源 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从文件读取数据*/objectSourceFile{defmain(args:Array[String]):Unit={//1.创建执行的环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironment//2.从指定路径获取数据valfileDS:DataStream[String]=env.readTextFile("input/data.log")//3.打印fileDS.print()//4.执行env.execute("sensor")}}/***在读取文件时,文件路径可以是目录也可以是单一文件。如果采用相对文件路径,会从当前系统参数user.dir中获取路径*System.getProperty("user.dir")*//***如果在IDEA中执行代码,那么系统参数user.dir自动指向项目根目录,*如果是standalone集群环境,默认为集群节点根目录,当然除了相对路径以外,*也可以将路径设置为分布式文件系统路径,如HDFSvalfileDS:DataStream[String]=env.readTextFile("hdfs://hadoop02:9000/test/1.txt")*/ 如果是standalone集群环境, 默认为集群节点根目录,当然除了相对路径以外,也可以将路径设置为分布式文件系统路径,如HDFS valfileDS:DataStream[String]=env.readTextFile("hdfs://hadoop02:9000/test/1.txt") 默认读取时,flink的依赖关系中是不包含Hadoop依赖关系的,所以执行上面代码时,会出现错误。 解决方法就是增加相关依赖jar包就可以了 2.3 kafka读取数据 Kafka作为消息传输队列,是一个分布式的,高吞吐量,易于扩展地基于主题发布/订阅的消息系统。在现今企业级开发中,Kafka 和 Flink成为构建一个实时的数据处理系统的首选 2.3.1 引入kafka连接器的依赖 <!--https://mvnrepository.com/artifact/org.apache.flink/flink-connector-kafka-0.11--><dependency><groupId>org.apache.flink</groupId><artifactId>flink-connector-kafka-0.11_2.11</artifactId><version>1.10.0</version></dependency> 2.3.2 代码实现参考 importjava.util.Propertiesimportorg.apache.flink.streaming.api.scala._importorg.apache.flink.streaming.connectors.kafka.FlinkKafkaConsumer011importorg.apache.flink.streaming.util.serialization.SimpleStringSchema/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从kafka读取数据*/objectSourceKafka{defmain(args:Array[String]):Unit={valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentvalproperties=newProperties()properties.setProperty("bootstrap.servers","hadoop02:9092")properties.setProperty("group.id","consumer-group")properties.setProperty("key.deserializer","org.apache.kafka.common.serialization.StringDeserializer")properties.setProperty("value.deserializer","org.apache.kafka.common.serialization.StringDeserializer")properties.setProperty("auto.offset.reset","latest")valkafkaDS:DataStream[String]=env.addSource(newFlinkKafkaConsumer011[String]("sensor",newSimpleStringSchema(),properties))kafkaDS.print()env.execute("sensor")}} 2.4自定义数据源 大多数情况下,前面的数据源已经能够满足需要,但是难免会存在特殊情况的场合,所以flink也提供了能自定义数据源的方式 2.4.1 创建自定义数据源 importcom.atyang.day01.Source.SourceList.WaterSensorimportorg.apache.flink.streaming.api.functions.source.SourceFunctionimportscala.util.Random/***description:ss*date:2020/8/2820:36*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:自定义数据源*/classMySensorSourceextendsSourceFunction[WaterSensor]{varflg=trueoverridedefrun(ctx:SourceFunction.SourceContext[WaterSensor]):Unit={while(flg){//采集数据ctx.collect(WaterSensor("sensor_"+newRandom().nextInt(3),1577844001,newRandom().nextInt(5)+40))Thread.sleep(100)}}overridedefcancel():Unit={flg=false;}} 3.Transform 在Spark中,算子分为转换算子和行动算子,转换算子的作用可以通过算子方法的调用将一个RDD转换另外一个RDD,Flink中也存在同样的操作,可以将一个数据流转换为其他的数据流。 转换过程中,数据流的类型也会发生变化,那么到底Flink支持什么样的数据类型呢,其实我们常用的数据类型,Flink都是支持的。比如:Long, String, Integer, Int, 元组,样例类,List, Map等。 3.1 map 映射:将数据流中的数据进行转换, 形成新的数据流,消费一个元素并产出一个元素 参数:Scala匿名函数或MapFunction 返回:DataStream importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从集合读取数据*/objectTransfrom_map{defmain(args:Array[String]):Unit={//1.创建执行的环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironment//2.从集合中读取数据valsensorDS:DataStream[WaterSensor]=env.fromCollection(//List(1,2,3,4,5)List(WaterSensor("ws_001",1577844001,45.0),WaterSensor("ws_002",1577844015,43.0),WaterSensor("ws_003",1577844020,42.0)))valsensorDSMap=sensorDS.map(x=>(x.id+"_1",x.ts+"_1",x.vc+1))//3.打印sensorDSMap.print()//4.执行env.execute("sensor")}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.1.1 MapFunction Flink为每一个算子的参数都至少提供了Scala匿名函数和函数类两种的方式,其中如果使用函数类作为参数的话,需要让自定义函数继承指定的父类或实现特定的接口。例如:MapFunction sensor-data.log 文件数据 sensor_1,1549044122,10sensor_1,1549044123,20sensor_1,1549044124,30sensor_2,1549044125,40sensor_1,1549044126,50sensor_2,1549044127,60sensor_1,1549044128,70sensor_3,1549044129,80sensor_3,1549044130,90sensor_3,1549044130,100 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从文件读取数据*/objectSourceFileMap{defmain(args:Array[String]):Unit={//1.创建执行的环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironment//2.从指定路径获取数据valfileDS:DataStream[String]=env.readTextFile("input/sensor-data.log")valMapDS=fileDS.map(lines=>{//更加逗号切割获取每个元素valdatas:Array[String]=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})//3.打印MapDS.print()//4.执行env.execute("map")}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} importorg.apache.flink.api.common.functions.MapFunctionimportorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从文件读取数据*/objectTransform_MapFunction{defmain(args:Array[String]):Unit={//1.创建执行的环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironment//2.从指定路径获取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")sensorDS.map()//3.打印//MapDS.print()//4.执行env.execute("map")}/***自定义继承MapFunction*MapFunction[T,O]*自定义输入和输出**/classMyMapFunctionextendsMapFunction[String,WaterSensor]{overridedefmap(t:String):WaterSensor={valdatas:Array[String]=t.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)}}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.1.2 RichMapFunction 所有Flink函数类都有其Rich版本。它与常规函数的不同在于,可以获取运行环境的上下文,并拥有一些生命周期方法,所以可以实现更复杂的功能。也有意味着提供了更多的,更丰富的功能。例如:RichMapFunction sensor-data.log 文件数据 同上一致 importorg.apache.flink.api.common.functions.{MapFunction,RichMapFunction}importorg.apache.flink.configuration.Configurationimportorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:从文件读取数据*/objectTransform_RichMapFunction{defmain(args:Array[String]):Unit={//1.创建执行的环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironment//2.从指定路径获取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")valmyMapDS:DataStream[WaterSensor]=sensorDS.map(newMyRichMapFunction)//3.打印myMapDS.print()//4.执行env.execute("map")}/***自定义继承MapFunction*MapFunction[T,O]*自定义输入和输出**/classMyRichMapFunctionextendsRichMapFunction[String,WaterSensor]{overridedefmap(value:String):WaterSensor={valdatas:Array[String]=value.split(",")//WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)WaterSensor(getRuntimeContext.getTaskName,datas(1).toLong,datas(2).toInt)}//富函数提供了生命周期方法overridedefopen(parameters:Configuration):Unit={}overridedefclose():Unit={}}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} Rich Function有一个生命周期的概念。典型的生命周期方法有: open()方法是rich function的初始化方法,当一个算子例如map或者filter被调 用之前open()会被调用 close()方法是生命周期中的最后一个调用的方法,做一些清理工作 getRuntimeContext()方法提供了函数的RuntimeContext的一些信息,例如函数执行 的并行度,任务的名字,以及state状态 3.1.3 flatMap 扁平映射:将数据流中的整体拆分成一个一个的个体使用,消费一个元素并产生零到多个元素 参数:Scala匿名函数或FlatMapFunction 返回:DataStream importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_FlatMap{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据vallistDS:DataStream[List[Int]]=env.fromCollection(List(List(1,2,3,4),List(5,6,7,1,1,1)))valresultDS:DataStream[Int]=listDS.flatMap(list=>list)resultDS.print()//4.执行env.execute()}} 3.2. filter 过滤:根据指定的规则将满足条件(true)的数据保留,不满足条件(false)的数据丢弃 参数:Scala匿名函数或FilterFunction 返回:DataStream importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:Filter*/objectTransform_Filter{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据vallistDS:DataStream[List[Int]]=env.fromCollection(List(List(1,2,3,4,1,2,3,4),List(5,6,7,1,1,1,1,2,3,4,1,2,3,4),List(1,2,3,4),List(5,6,7,1,1,1),List(1,2,3,4),List(5,6,7,1,1,1)))//true就留下,false就抛弃listDS.filter(num=>{num.size>5}).print("filter")//4.执行env.execute()}} 3.3 keyBy 在Spark中有一个GroupBy的算子,用于根据指定的规则将数据进行分组,在flink中也有类似的功能,那就是keyBy,根据指定的key对数据进行分流 分流:根据指定的Key将元素发送到不同的分区,相同的Key会被分到一个分区(这里分区指的就是下游算子多个并行节点的其中一个)。keyBy()是通过哈希来分区的 参数:Scala匿名函数或POJO属性或元组索引,不能使用数组 返回:KeyedStream importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_KeyBy{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")//3.转换为样例类valmapDS=sensorDS.map(lines=>{valdatas=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})//4.使用keyby进行分组// TODO 关于返回的key的类型://1.如果是位置索引或字段名称,程序无法推断出key的类型,所以给一个java的Tuple类型//2.如果是匿名函数或函数类的方式,可以推断出key的类型,比较推荐使用//***分组的概念:分组只是逻辑上进行分组,打上了记号(标签),跟并行度没有绝对的关系//同一个分组的数据在一起(不离不弃)//同一个分区里可以有多个不同的组//valsensorKS:KeyedStream[WaterSensor,Tuple]=mapDS.keyBy(0)//valsensorKS:KeyedStream[WaterSensor,Tuple]=mapDS.keyBy("id")valsensorKS:KeyedStream[WaterSensor,String]=mapDS.keyBy(_.id)//valsensorKS:KeyedStream[WaterSensor,String]=mapDS.keyBy(//newKeySelector[WaterSensor,String]{//overridedefgetKey(value:WaterSensor):String={//value.id//}//}//)sensorKS.print().setParallelism(5)//4.执行env.execute()}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.4 shuffle 打乱重组(洗牌):将数据按照均匀分布打散到下游 参数:无 返回:DataStream importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_Shuffle{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")valshuffleDS=sensorDS.shufflesensorDS.print("data")shuffleDS.print("shuffle")//4.执行env.execute()}} 3.5. split 在某些情况下,我们需要将数据流根据某些特征拆分成两个或者多个数据流,给不同数据流增加标记以便于从流中取出。 需求:将水位传感器数据按照空高高低(以40cm,30cm为界),拆分成三个流 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_Split{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")//3.转换成样例类valmapDS:DataStream[WaterSensor]=sensorDS.map(lines=>{valdatas:Array[String]=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})valsplitSS:SplitStream[WaterSensor]=mapDS.split(sensor=>{if(sensor.vc<40){Seq("normal")}elseif(sensor.vc<80){Seq("Warn")}else{Seq("alarm")}})//4.执行env.execute()}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.6 select 将数据流进行切分后,如何从流中将不同的标记取出呢,这时就需要使用select算子了。 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_Split{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")//3.转换成样例类valmapDS:DataStream[WaterSensor]=sensorDS.map(lines=>{valdatas:Array[String]=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})valsplitDS:SplitStream[WaterSensor]=mapDS.split(sensor=>{if(sensor.vc<40){Seq("info")}elseif(sensor.vc<80){Seq("warn")}else{Seq("error")}})valerrorDS:DataStream[WaterSensor]=splitDS.select("error")valwarnDS:DataStream[WaterSensor]=splitDS.select("warn")valinfoDS:DataStream[WaterSensor]=splitDS.select("info")infoDS.print("info")warnDS.print("warn")errorDS.print("error")//4.执行env.execute()}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.7 connect 在某些情况下,我们需要将两个不同来源的数据流进行连接,实现数据匹配,比如订单支付和第三方交易信息,这两个信息的数据就来自于不同数据源,连接后,将订单支付和第三方交易信息进行对账,此时,才能算真正的支付完成。 Flink中的connect算子可以连接两个保持他们类型的数据流,两个数据流被Connect之后,只是被放在了一个同一个流中,内部依然保持各自的数据和形式不发生任何变化,两个流相互独立。 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_Connect{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")//3.转换成样例类valmapDS:DataStream[WaterSensor]=sensorDS.map(lines=>{valdatas:Array[String]=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})//4.从集合中再读取一条流valnumDS:DataStream[Int]=env.fromCollection(List(1,2,3,4,5,6))valresultCS:ConnectedStreams[WaterSensor,Int]=mapDS.connect(numDS)//coMap表示连接流调用的map,各自都需要一个functionresultCS.map(sensor=>sensor.id,num=>num+1).print()//4.执行env.execute()}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.8 union 对两个或者两个以上的DataStream进行union操作,产生一个包含所有DataStream元素的新DataStream connect与 union 区别: union之前两个流的类型必须是一样,connect可以不一样 connect只能操作两个流,union可以操作多个。 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:FlatMap*/objectTransform_Union{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.从集合中读取流valnum1DS:DataStream[Int]=env.fromCollection(List(1,2,3,4))valnum2DS:DataStream[Int]=env.fromCollection(List(7,8,9,10))valnum3DS:DataStream[Int]=env.fromCollection(List(17,18,19,110))//TODOunion真正将多条流合并成一条流//合并的流,类型必须一致//可以合并多条流,只要类型一致num1DS.union(num2DS).union(num3DS).print()//4.执行env.execute()}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.9 Operator Flink作为计算框架,主要应用于数据计算处理上, 所以在keyBy对数据进行分流后,可以对数据进行相应的统计分析 3.9.1 滚动聚合算子(Rolling Aggregation) 这些算子可以针对KeyedStream的每一个支流做聚合。执行完成后,会将聚合的结果合成一个流返回,所以结果都是DataStream sum() min() max() 3.9.2 reduce 一个分组数据流的聚合操作,合并当前的元素和上次聚合的结果,产生一个新的值,返回的流中包含每一次聚合的结果,而不是只返回最后一次聚合的最终结果。 importorg.apache.flink.streaming.api.scala._/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:Reduce*/objectTransform_Reduce{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")//3.转换成样例类valmapDS:DataStream[WaterSensor]=sensorDS.map(lines=>{valdatas:Array[String]=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})valsensorKS:KeyedStream[WaterSensor,String]=mapDS.keyBy(_.id)//输入的类型一样,输出类型和输出类型也要一样//组内的第一条数据,不进入reduce计算valreduceDS:DataStream[WaterSensor]=sensorKS.reduce((ws1,ws2)=>{println(ws1+"<===>"+ws2)WaterSensor(ws1.id,System.currentTimeMillis(),ws1.vc+ws2.vc)})reduceDS.print("reduce")//4.执行env.execute()}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 3.9.3process Flink在数据流通过keyBy进行分流处理后,如果想要处理过程中获取环境相关信息,可以采用process算子自定义实现 1)继承KeyedProcessFunction抽象类,并定义泛型:[KEY, IN, OUT] classMyKeyedProcessFunctionextendsKeyedProcessFunction[String,WaterSensor,String]{} 重写方法 //自定义KeyedProcessFunction,是一个特殊的富函数// 1.实现KeyedProcessFunction,指定泛型:K - key的类型, I -上游数据的类型, O -输出的数据类型//2.重写processElement方法,定义每条数据来的时候的处理逻辑/***处理逻辑:来一条处理一条**@paramvalue一条数据*@paramctx上下文对象*@paramout 采集器:收集数据,并输出*/overridedefprocessElement(value:WaterSensor,ctx:KeyedProcessFunction[String,WaterSensor,String]#Context,out:Collector[String]):Unit={out.collect("我来到process啦,分组的key是="+ctx.getCurrentKey+",数据="+value)//如果key是tuple,即keyby的时候,使用的是位置索引或字段名称,那么key获取到是一个tuple//ctx.getCurrentKey.asInstanceOf[Tuple1].f0//Tuple1需要手动引入Java的Tuple} 完整代码: importorg.apache.flink.streaming.api.functions.KeyedProcessFunctionimportorg.apache.flink.streaming.api.scala._importorg.apache.flink.util.Collector/***description:SourceList*date:2020/8/2819:02*version:1.0**@author阳斌*邮箱:1692207904@qq.com*类的说明:Reduce*/objectTransform_Process{defmain(args:Array[String]):Unit={//1.创建执行环境valenv:StreamExecutionEnvironment=StreamExecutionEnvironment.getExecutionEnvironmentenv.setParallelism(1)//2.读取数据valsensorDS:DataStream[String]=env.readTextFile("input/sensor-data.log")//3.转换成样例类valmapDS:DataStream[WaterSensor]=sensorDS.map(lines=>{valdatas:Array[String]=lines.split(",")WaterSensor(datas(0),datas(1).toLong,datas(2).toInt)})//按照ID进行分组valsensorKS:KeyedStream[WaterSensor,String]=mapDS.keyBy(_.id)sensorKS.process(newMyKeyedProcessFunction)//4.执行env.execute()}//自定义KeyedProcessFunction,是一个特殊的富函数// 1.实现KeyedProcessFunction,指定泛型:K - key的类型, I -上游数据的类型, O -输出的数据类型//2.重写processElement方法,定义每条数据来的时候的处理逻辑classMyKeyedProcessFunctionextendsKeyedProcessFunction[String,WaterSensor,String]{/***处理逻辑:来一条处理一条**@paramvalue一条数据*@paramctx上下文对象*@paramout 采集器:收集数据,并输出*/overridedefprocessElement(value:WaterSensor,ctx:KeyedProcessFunction[String,WaterSensor,String]#Context,out:Collector[String]):Unit={out.collect("我来到process啦,分组的key是="+ctx.getCurrentKey+",数据="+value)//如果key是tuple,即keyby的时候,使用的是位置索引或字段名称,那么key获取到是一个tuple//ctx.getCurrentKey.asInstanceOf[Tuple1].f0//Tuple1需要手动引入Java的Tuple}}/***定义样例类:水位传感器:用于接收空高数据**@paramid传感器编号*@paramts时间戳*@paramvc空高*/caseclassWaterSensor(id:String,ts:Long,vc:Double)} 4.Sink Sink有下沉的意思,在Flink中所谓的Sink其实可以表示为将数据存储起来的意思,也可以将范围扩大,表示将处理完的数据发送到指定的存储系统的输出操作 之前我们一直在使用的print方法其实就是一种Sink。 @PublicEvolvingpublicDataStreamSink<T>print(StringsinkIdentifier){PrintSinkFunction<T>printFunction=newPrintSinkFunction(sinkIdentifier,false);returnthis.addSink(printFunction).name("PrinttoStd.Out");} 官方提供了一部分的框架的sink。除此以外,需要用户自定义实现sink 另 琐碎时间想看一些技术文章,可以去公众号菜单栏翻一翻我分类好的内容,应该对部分童鞋有帮助。同时看的过程中发现问题欢迎留言指出,不胜感谢~。另外,有想多了解哪些方面内容的可以留言(什么时候,哪篇文章下留言都行),附菜单栏截图(PS:很多人不知道公众号菜单栏是什么) END 我知道你 “在看” 本文分享自微信公众号 - Java知音(Java_friends)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Scala语言入门三(集合)

一、数组 Scala 语言中提供的数组是用来存储固定大小的同类型元素,数组对于每一门编辑应语言来说都是重要的数据结构之一。数组的第一个元素索引为0,最后一个元素的索引为元素总数减1 1、声明数组 不可变数组 /** * @author Gjing **/ object ArrayApp { def main(args: Array[String]): Unit = { // 声明一个长度为2的不可变数组 val arr = new Array[String](2) // 赋值 arr(0) = "java" arr(1) = "scala" // 使用另外一种方式声明数组 val arr2 = Array("java","scala") } } 不可变数组 /** * @author Gjing **/ object ArrayApp { def main(args: Array[String]): Unit = { val buffer = ArrayBuffer[String]() // 追加一个值 buffer += "java" // 追加一个数组 buffer ++= Array("scala", "vue") } } 2、数组的处理 列出常见的一些操作,其余的自行查阅文档 循环输出 /** * @author Gjing **/ object ArrayApp { def main(args: Array[String]): Unit = { val arr = Array("java", "scala") for (x <- arr) { println(x) } } } 合并数组 /** * @author Gjing **/ object ArrayApp { def main(args: Array[String]): Unit = { val arr = Array("java", "scala") val arr2 = Array("vue", "go") // 这种方式需要引入 import Array._ val arr3 = concat(arr, arr2) // 直接调用 val arr4 = arr.concat(arr2) } } 二、List List的特征是其元素以线性方式存储,集合中可以存放重复对象。 1、创建List 定长list /** * @author Gjing **/ object ListApp { def main(args: Array[String]): Unit = { // 数字列表 var l1 = List(1, 2, 3, 4) var l2 = 1 :: 2 :: 3 :: Nil // 生成空列表 var l3 = Nil } } 构造列表的两个基本单位是 Nil 和 :: Nil 也可以表示为一个空列表。 不定长 /** * @author Gjing **/ object ListApp { def main(args: Array[String]): Unit = { val l = ListBuffer[Int]() // 加一个元素 l += 2 // 加入多个元素 l += (3,4) // 加入一个集合 l ++= List(5,6) // 打印 2,3,4,5,6 println(l.mkString(",")) } } 2、列表的操作 基本操作(返回第一个元素、返回第一个元素以外的列表、判断列表是否为空) /** * @author Gjing **/ object ListApp { def main(args: Array[String]): Unit = { var l = List(1,2,3) // 打印 1 println(l.head) // 打印 List(2,3) println(l.tail) // 打印false println(l.isEmpty) } } 拼接 /** * @author Gjing **/ object ListApp { def main(args: Array[String]): Unit = { val l1 = List(1, 2, 3) val l2 = List(3,4) val l3 = l1 ::: l2 // 较第一种是后者加进去后再列表前面 val l4 = l1.:::(l2) val l5 = List.concat(l1,l2) println(l3.mkString(",")) println(l4.mkString(",")) println(l5.mkString(",")) } } 列表反转 /** * @author Gjing **/ object ListApp { def main(args: Array[String]): Unit = { val l1 = List(1, 2, 3) // 打印 3,2,1 println(l1.reverse.mkString(",")) } } 创建一个指定重复数量的元素列表 /** * @author Gjing **/ object ListApp { def main(args: Array[String]): Unit = { val l1 = List.fill(2)(1) // 打印 1,1 println(l1.mkString(",")) } } 三、Set Set是最简单的一种集合。集合中的对象不按特定的方式排序,并且没有重复对象, 用法和list差不多,这里不过多介绍 四、Map Map 是一种把键对象和值对象映射的集合,它的每一个元素都包含一对键对象和值对象。Map 有两种类型,可变与不可变,区别在于可变对象可以修改它,而不可变对象不可以。默认情况下 Scala 使用不可变 Map。如果你需要使用可变集合,你需要显式的引入import scala.collection.mutable.Map 类在 Scala 中 你可以同时使用可变与不可变 Map,不可变的直接使用 Map,可变的使用 mutable.Map 1、创建Map /** * @author Gjing **/ object MapApp { def main(args: Array[String]): Unit = { // 空map val m1 = Map() // 存在键值对 var m2 = Map("名字" -> "张三", "年龄" -> 12) println(m2.mkString(",")) // 加一个新的键值对进去 m2 += ("性别" -> "男") println(m2.mkString(",")) } } 2、基本操作 /** * @author Gjing **/ object MapApp { def main(args: Array[String]): Unit = { var m2 = Map("名字" -> "张三", "年龄" -> 12) // 返回所有key println(m2.keys) // 返回所有value println(m2.values) // 判断是否为空 println(m2.isEmpty) } } 3、合并 你可以使用 ++ 运算符或 Map.++() 方法来连接两个 Map,Map 合并时会移除重复的 key /** * @author Gjing **/ object MapApp { def main(args: Array[String]): Unit = { val map1 = Map("年龄" -> "12") val map2 = Map("性别" -> "男") println(map1 ++ map2) println(map1.++(map2)) } } 4、查看 Map 中是否存在指定的 Key object MapApp { def main(args: Array[String]): Unit = { var m1 = Map("名字" -> "张三", "年龄" -> 12) // 打印 true println(m1.contains("名字")) } } 四、元组 元组是不同类型的值的集合,与列表一样,元组也是不可变的,但与列表不同的是元组可以包含不同类型的元素 1、定义元组 /** * @author Gjing **/ object TupleApp { def main(args: Array[String]): Unit = { val t1 = (1, "呢", 1.1) val t2 = new Tuple3(1, "呢", 1.1) } } 元组的实际类型取决于它的元素的类型,比如 (99, "runoob") 是 Tuple2[Int, String], 目前 Scala 支持的元组最大长度为 22。对于更大长度你可以使用集合,或者扩展元组 2、访问元组 /** * @author Gjing **/ object TupleApp { def main(args: Array[String]): Unit = { val t1 = (1, "呢", 1.1) // 获取元组第一个内容 println(t1._1) // 获取元组第二个内容 println(t1._2) } } 3、元组的迭代 /** * @author Gjing **/ object TupleApp { def main(args: Array[String]): Unit = { val t1 = (1, "呢", 1.1) t1.productIterator.foreach(e => println(e)) } } 4、元组转字符串 /** * @author Gjing **/ object TupleApp { def main(args: Array[String]): Unit = { val t1 = (1, "呢", 1.1) println(t1.toString()) } }

优秀的个人博客,低调大师

梯度下降极简入门

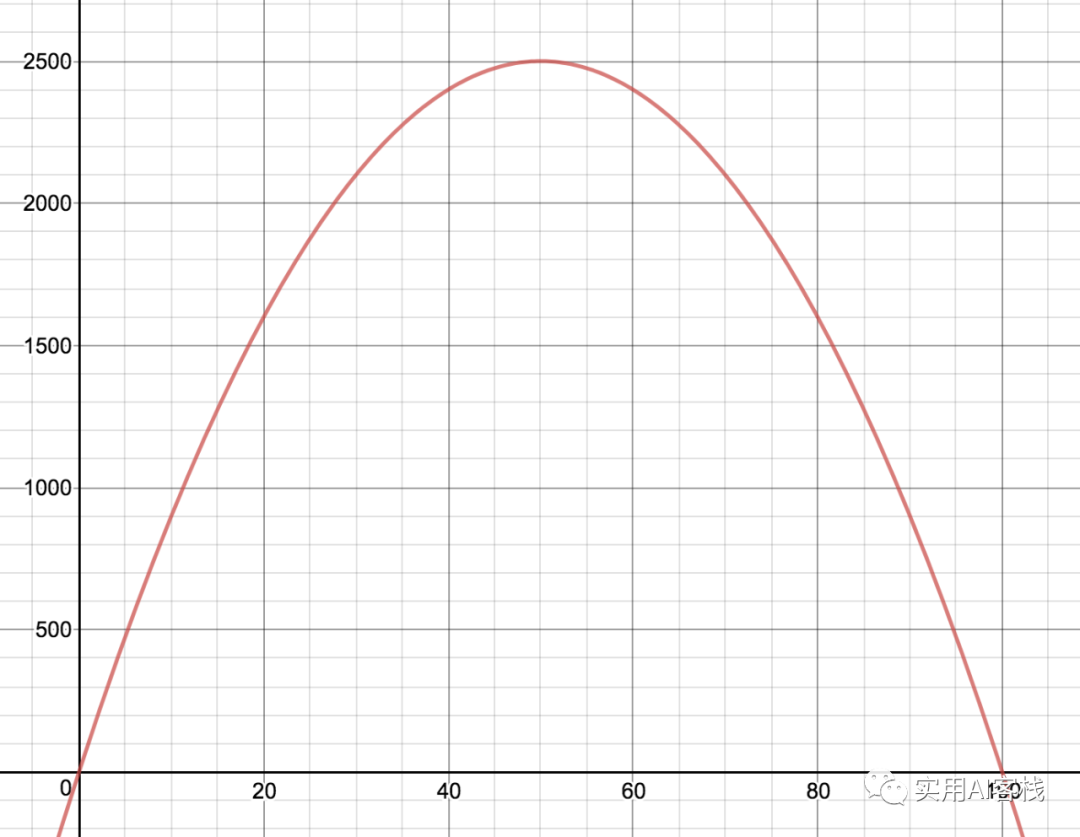
导 语 梯度下降及其变体被用作训练过程的关键部分在机器学习中广泛使用。梯度下降中的“梯度”是指单变量导数的推广形式,即多元变量求导。 梯度下降法是解决“优化问题”的迭代方法,其中优化问题是指围绕寻找函数的全局最小值或最大值而展开的数学问题。我们将很快看到,对于简单的优化问题可以不用梯度下降。当事情变得复杂时,我们则需要用诸如梯度下降之类的迭代法,当然和神经网络相关的优化问题确实足够复杂。 01 重新回顾优化问题 假设你已经购买了200米的铁丝网。您想使用此围栏为羊群创建一个矩形牧场。如何确定使牧场内部面积最大化时,牧场对应的长度和宽度? 使用标准的分析方法来解决这个问题,我们首先要写一个方程式来表示我们的问题。首先,我们知道两件事: area(面积)=length(长度)*width(宽度)(2 * length)+(2 * width)= 200 但是我们想用一个变量而不是两个变量来表示面积,所以我们可以求解这两个方程中的第二个变量的宽度: 2 * width = 200–2 * lengthwidth = [200-2 * length] / 2width = 100 - length 现在我们可以用100- length代替width,则: area= length * [100–length]area = f(length)=100 * length- length² 取面积的导数: area’=100-2*length;length=50 现在,我们找到了函数的“临界点”,即一阶导数等于零时对应的长度,当然函数在该点处的斜率也为零。我们关心这种值,因为它们是唯一能对应函数最小值或函数最大值的数。在临界点处,该点两侧的值可能都小于或都大于临界点处的值。因为函数中该点外的斜率都不为零,这意味着临界点上一边的点对应的面积将小于该临界点对应的面积,而另一边的点对应的面积将大于该临界点对应的面积。也就是说,该函数在非临界点处正在增加或减少,因此不能为最大值或最小值。 area’=100-2*length=0-->length=50 这表明如果存在全局最大值或最小值,则必须在长度= 50时发生。也就是说,如果矩形的长度存在最佳选择,则为50米。可能存在临界点既不是最小值也不是最大值,所以应该检测已发现的临界点确实是最值。在微积分课程中,有相关的检验方法(比如二阶导数检验),现在用更简单的方法(类似梯度下降法)来解决该问题,比如在临界点长度= 50的左右两侧测试2个点。 f(49)= 4900–2401 = 2499f(50)= 5000–2500 = 2500f(51)= 5100–2601 = 2499 这并不能确认矩阵面积最大时对应长度值就是50,或者某些时候有比50更好的点,不过这种近似的方法最终将应用于训练模型。对于这个简单的问题,通过绘制函数了解该方法和实际的误差: 02 梯度下降—迭代式猜测 那么这与梯度下降方法有什么关系呢?梯度下降方法比较粗糙,就像刚才所做的那些不精确的猜测一样。看上去它是比随机猜测稍强一点的显得杂乱的体系,不过它将最终成为我们解决围栏问题的方法: 猜测围栏的最佳长度 计算此时的梯度值 根据梯度的值,调整猜测 重复猜测直到满足条件则终止 假设我们随机选取57当作长度的第一个猜测值,在57处,面积函数的导数为: f(57)=100*57 - 57*57 = 2451f'(57)=100–2*(57)=-14 ‍ length = 57处的斜率不为0,因此不是临界点。此外斜率为-14表示如果将长度增加 1,则面积将减小 14(假设函数的斜率不变)。梯度下降使用此值作为进行下一个猜测的指导。比如要增加面积的值,因为斜率是负数,所以应该57基础上减小长度,以此增加面积的值。 然而即使知道当前应该减少length的值,也没有先验的方法可以确切地知道“合适”的数来调整我们的当前的猜测(length=57)。在像TensorFlow这样的软件包中,我们用来调整当前length的快慢将由一个称为“学习率”的超参数控制,可以在训练时设置该参数。提高学习率将导致梯度下降对当前当前length调整很快;减小学习率会导致梯度下降对当前当前length调整较慢。现在假设将当前length减少3,虽然有点武断,但实际上效果可以接受。 57–3 = 54f(54)= 5400–(54²)-->f(54)= 5400–2916 -->f(54)= 2484 2484大于2451,说明找到的面积比上次大。再次使用导数来检查是否处于临界点,如果不是,则调整猜测值: f'(54)= 100–2 * 54 = 100–108 = -8 我们的当前猜测值(54)仍然很大,斜率-8低于-14,应该适当减缓对当前猜测值的更改幅度,比如在54基础上减少2,则: f(52)= 5200–52² --> f(52)= 5200–2704 -->f(52)= 2496 我们将重复此过程,直到找到一个临界点。或者直到f'(length)的值非常接近零,才能认为length已足够接近临界点。手工完成此过程是重复且繁琐的,但是计算机善于解决重复繁琐的任务。通俗点说,将像在爬山和滚球,一直沿着抛物线上升,直到无法进一步上升为止。 请注意导数(蓝色),它在最大值的右边是负数,在最大值的左边是正数。在这种情况下,很容易找到最大值。 由于试图找到面积的最大值,上面的示例称之为“梯度上升”更好。在梯度下降中,每次计算梯度值时都将其相反数。 马上将提到的梯度下降和在神经网络里面用到的梯度下降有两个不一样的地方。首先,神经网络对应的函数比f(length)更复杂。我们的神经网络具有成千上万的可调参数,而其中f(length)只有一个。我们使用诸如梯度下降之类的迭代方法主要是因为神经网络模型非常复杂,而不是选用之前查找临界点时的分析过程。计算当前如此庞大规模的神经网络所表示的一般性的函数导数根本不可行。第二个区别是,在此示例中,有一个充当标准结果的实函数,并且发现了该函数的最佳值。在神经网络中,没有显式的函数;取而代之的是,我们尝试创建一个不存在标准结果的函数。 03 用于函数查找的梯度下降 在前面的示例中,使用梯度下降方法沿该曲线可以找到最佳值。在机器学习中,对于训练集中的数据,我们希望创建一条曲线来更好地拟合这些数据。回顾一下刚刚研究的围栏问题,将它转化为我们更倾向于用机器学习解决的问题。 我们从围栏数据库中收集了很多数据样本。我们数据集中的每个数据点的背景都是来自用100米围栏材料来建造矩形牧场。每个数据点有2个参数:围栏一侧的长度和围栏的面积。在这个问题中,不是尝试找到围栏的最佳长度,而是试图找到一个函数,该函数可以根据给定的边长来预测矩形围栏的面积。我们的输入数据如下所示: 看起来数据中有一个模式,我们可以使用机器学习来定义模式吗? 机器学习解决此问题的方法是认为:“看起来有点像某种数学函数,想知道到底是哪个函数?”,更进一步,我们猜测该函数是某种抛物线函数,则该函数的一般表达式是: F(x)=ax²+ bx 在数据集中已知x值和y值,现在我们将使用梯度下降法来找到a和b的最佳值。为此,我们引入了另一个函数--损失函数,并运行梯度下降以最小化损失函数。将F(x)当作“正在进行训练的函数”,其中x仍然是围栏一侧的长度,y是围栏的真实面积。单次预测的绝对误差为: L(x)= | F(x)- y | 我们需要给误差加上绝对值。如果不这样做且连续做两次预测,假设一次错了1000,另一次错了-1000,则两次错误刚好抵消,实际上这样一共错了两次。 最终我们会用这样的一个损失函数:平均绝对误差,它是数据集中所有的点对应L(x)的平均值。使用诸如均方误差之类的指标更为常见,但是不同的损失函数对不同的数据集。 假设我们随机选择权重的起始值:a = -2和b = 30。在对应的F(x)变为: L(x)= | -2x²+ 30x-y | 接下来的内容略带技巧性。我们想要调整a和b的值以最小化损失函数。因此我们需要计算损失函数对a和b的梯度(偏导数)。以前的函数中,x的值可以不断变化。但是这个问题里面,情况并非如此。x的值始终只是我们数据集中的某个固定值。因此单个数据点对应的损失函数为:L(a, b) = ax² + bx – y,其中x、y是常数。 使用平均绝对误差的损失函数为: L(a,b)=1/m*SUM(|F(a,b)—yi|)L(a,b)=(1 / m)* SUM(|axi²+ bxi — yi |) 其中xi和yi代表我们数据集中的单个数据点,而m是我们数据集中点的总数。这里有两个细节上的问题:一个是我们必须使用链式规则来计算涉及绝对值的梯度;另一个是绝对值函数在预测值恰好等于真实值的点上是不可求导的,并且。 如果平均绝对误差为0,可以通过停止计算梯度来解决不可导的问题。这是有实际意义的。如果我们在这个数据点上的预测值与实际值都符,那么就不需要用改善绝对误差的方式来调整模型: d | x |/ dx = 1,如果x为正d | x |/ dx = -1,如果x为负则损失函数对a、b求偏导数可以写成:L(a, b) = (1/m) * SUM( | axi² + bxi — yi | )L’_a(a, b) = (1 / m) * SUM( 1 * xi² ); F(xi) > yiL’_a(a, b) = (1 / m) * SUM( -1 * xi² ); F(xi) < yiL’_b(a, b) = (1 / m) * SUM( 1 * x ); F(xi) > yL’_b(a, b) = (1 / m) * SUM( -1 * x );F(xi) < yi 这些公式实际上为我们提供了一个非常简单的更新规则:如果我们的预测太小,则将a和b都增大。如果我们的预测太大,则将a和b都减小。 深刻地理解梯度下降以及优化损失函数的思路可以更好地理解过拟合之类的问题,同时它还可以帮助我们更好地了解神经网络训练的过程。 1 END 1 长 按 关 注 获取最新AI资讯与实战案例 实用AI客栈 小编微信号 : langu86 本文分享自微信公众号 - 实用AI客栈(gh_0b0b5e56231f)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

Charles 从入门到精通

内容清单 Charles 的简介 安装 Charles Charles 初始化设置 过滤网络请求 截取HTTP/HTTPS数据 模拟弱网环境 修改网络请求 修改服务器返回内容 服务器压力测试 反向代理 解决与翻墙软件的冲突 Charles 的简介 Charles 是目前最主流的网络调试工具(Charles、Fiddler、Wireshark...)之一,对于一个开发者来说与网络打交道是日常需求,因此很多时候我们需要调试参数、返回的数据结构、查看网络请求的各种头信息、协议、响应时间等等。所以了解 Charles 并使用它 Charles 通过将自己设置为系统的网络访问代理服务器,这样所有的网络请求都会通过它,从而实现了网路请求的截获和分析。 Chareles 不仅可以分析电脑本机的网络请求(HTTP 和 HTTPS),还可以分析移动端设备的网络请求。 Charles 是收费软件,作者开发出这样一个方便开发者使用的伟大工具,我们鼓励使用正版软件,但是对于一些囊中羞涩或者学生来说,有破解版的更好,别担心,这些我都准备好了,下一个 section 会讲解如何下载安装。 安装 Charles 方式1: Charles 官网地址,根据你的电脑操作系统选择合适的下载方式。此时下载下来的是需要收费的,不差钱的同学当然可以直接购买。购买链接 方式2:按照方式1的方式去官网下载,然后下载相应 JAR 包(链接:https://pan.baidu.com/s/1utD_gS4DwSefgzcfp6mWPg 密码:nv3m)。这里以 MAC 为例,打 Finder,选择应用程序,选中 Charles,右击并选择“显示包内容”,看到 Contents 目录,点击进去选择 Java 文件夹,将下载下来的 JAR包 拖进去替换。至此,完成了 Charles 的破解。 Charles 初始化设置 Charles 的工作原理是将自身设置为系统的代理服务器来捕获所有的网络请求。所以使用 Charles ,我们必须设置 Charles 为系统的代理服务器。 打开 Charles,当第一次启动的时候如果没有购买或者没有破解,会有倒计时,之后会看到软件的主界面,然后会请求你赋予它为系统代理的权限。点击授权会让你输入当前系统用户的密码。当然你也可以忽略或者拒绝该请求,然后等想要抓包的时候将它设置为系统的代理服务器。步骤:**选择菜单中的“Proxy” -> "Mac OS X Proxy"。**如下图: 之后你的电脑上的任何网络请求都可以在 Charles 的请求面板中看到 看看 Charles 的主界面 图上红色圈1:这里代表所有网络请求的展示方式。分别名为 “Structure” 和 “Sequence”。 Structure 将所有的网络请求按照域名划分并展示 Sequence 将所有的网络请求按照时间排序并展示 图上红色圈2:一些的网络请求设置比如 HTTPS 以及端口等信息都在这个菜单栏设置 图上红色圈2:证书设置都在这里进行 过滤网络请求 由于 Charles 可以将电脑或者设置过的手机的所有网络请求捕获到,而且我们分析网络传输应该是针对某个特定的网络下的抓包分析,为了清楚明显地看到我们感兴趣的网络请求通常会用到 Charles 的**“过滤网络请求的功能”**。 方法1:在 Charles 主面板的左侧所有网络请求的下方可以看到看到一个 ”Filter“ 输入栏,在这里你可以输入关键词来筛选出自己感兴趣的网络请求。比如我想分析的网络请求来自于”www.baidu.com" 下,你可以在下面输入"baidu"即可。 方法2:在 Charles 菜单栏的顶部会看到 “Proxy” 的选项,点击菜单栏选择 “Proxy” -> "Recording Settings" 。选择 “include”。看到面板上面有一个 “Add” 按钮,点击后在弹出的面板里面设置好我们需要分析的网络请求的协议、主机名、端口、路径、参数,当然你也可以只设置一些主要的信息,比如协议和主机名的组合。 方法3:一般打开 Charles 并设置好配置信息后(比如电脑本机或者设置过代理的手机)所有的网络请求都将在 Charles 的面板上显示,同时我们感兴趣的网络请求如果也在面板上显示的话,“Structure”模式下可以选中需要分析的网络请求,鼠标右击选择**“Focus”。“Sequence”模式下可以在面板的网络请求显示面板的右下角看到一个Focus**按钮,点击勾选后 Charles 只会显示你感兴趣的网络请求。 截取HTTP/HTTPS数据 截取 HTTP 请求 Charles 的主要目的是抓取捕获网络请求,这里以 iPhone 的抓包为例讲解。 Charles 的设置 要截获 iPhone 的网络请求就需要为 Charles 开启代理功能。在菜单栏选择**“Proxy” ->"Proxy Settings"。填写代理的端口号并将“Enable transparent HTTP proxying”**勾选上。 iPhone 上的设置 在电脑“系统偏好设置”中心打开网络查看本机 IP 地址,打开手机“设置”->“无线局域网”,进入当前使用的网络,点击进入当前 WIFI 的详情页(可以看到当前 WIFI 的基本信息,包括子网掩码、端口、IP地址、路由器),在最下角可以看到**“DNS”和“HTTP代理”2个section。我们点击“配置代理”**,设置 HTTP 代理选中“手动”。服务器处填写电脑ip地址,端口写8888。设置好后,我们打开 iPhone 上的任意需要网络请求的应用,就可以看到 Charles 弹出请求的确认菜单,单击"Allow"按钮,即可完成设置。 截取 HTTPS 请求 如果你需要捕获 HTTPS 协议的网络请求,那么则需要安装 Charles 的 CA 证书。步骤如下; 首先需要在 MAC 上安装证书。点击 Charles 顶部的菜单栏,选择 “Help” -> "SSL Proxying" -> "Install Charles Root Certificate"。 在 keychain 处将新安装的证书设置为永久信任 即使安装了 CA 证书,Charles 默认是不捕获 HTTPS 协议的网络请求,所以我们需要对某个主机下的网络请求抓包分析的话,选中该网络请求右击选中 “SSL Proxying Enabled”。这样就可以看到我们感兴趣的HTTPS 网络请求了。 如果你需要捕获移动设备的 HTTPS 网络请求,则需要在移动设备上安装证书并作简单的设置 选择 Charles 顶部菜单栏选择 “Help” ->"Install Charles Root Certificate on a Mobile Device or Remote Browser"。然后就可以看到 Charles 弹出的安装说明了。 在手机设置好 Charles 代理的情况下,在手机浏览器输入 “chls.pro/ssl”。安装提示下载好CA证书。 验证刚刚安装的 CA证书 iPhone 打开设置 -> 通用 -> 关于本机 -> 证书信任设置 -> 开启开关 在 Charles 菜单栏 Proxy -> SSL Proxying Setting -> 点击 Add 按钮 -> 在弹出的对对话框设置需要监听的 HTTPS 域(*:代表通配符) 设置完毕,尽情抓取你想要的 HTTPS 网络请求吧。 模拟弱网环境 在平时开发的时候我们经常需要模拟弱网环境,并作弱网环境下的适配工作。Charles 为我们提供了这个服务。 在 Charles 菜单栏选择 “Proxy” -> "Throttle Settings"。在弹出的面板上设置网络请求的参数(上行,下行带宽、利用率、可靠性等等信息)。如下图所示。 如果你想对指定主机进行弱网环境下的测试,可以点击上图的“Add”按钮,在弹出的面板上设置协议、主机、端口来对指定的主机进行弱网设置。 修改网络请求 对于捕获的网络请求,我们经常需要修改网络请求的cookie、Headers、Url等信息。Charles 提供了对网络请求的编辑和重发功能。只需要选中需要修改编辑的网络请求,在对应的右上角看到有一个“钢笔”的按钮,点击后就可以对选中的网络请求进行编辑了,编辑好后可以在右下角看到 Execute 按钮。这样我们编辑后的网络请求就可以被执行了。 修改服务器返回内容 很多时候为了方便调试代码,我们会有这种需求,修改接口返回的数据节点或者内容、甚至是状态码。比如数据为空、数据异常、请求失败、多页数据的情况。 Charles 为我们提供了超实用的功能,“Map(Map Local、Map Remote)功能”、Rewrite功能、Breakpoints功能 ,都可以实现修改服务端返回数据的功能。但是有区别和适用场景: Map 功能适合长期地将某一请求重定向到另一个指定的网络地址或者本地 JSON 文件 Rewrite 功能适合对网络请求进行一些正则替换 Breakpoints 功能适合对网络请求进行一些临时性的修改(类似于我们开发的断点作用) Map 功能 Map 功能分为 Map Local(将某个网络请求重定向到本地 JSON 文件) 和 Map Remote 功能(将网络请求重定向到另一个网络接口)。 在 Charles 菜单栏选择 “Tools” -> "Map Remote" 或 “Map Local” 即可进入相应的功能模块。 Map Remote 功能 适合于切换线上到本地、测试服务到正式服务的场景。比如下图从正式服务切换到测试服务 Map Local 功能 我们需要填写重定向的原地址信息和本地目标文件。我们可以先将某个接口的响应内容保存下来(选择对应的网络请求,右击点击 Save Response )成为 data.json 文件。然后我们编辑里面的 status 、message、data 等信息为我们想要的目标映射文件。 如下所示,我将一个网络请求的内容映射到我本地的一个 JSON 文件。之后这个请求的内容都从网络变为返回我本地的数据了。 Map Local 可能会存在一个小缺陷,其返回的 HTTP Response Header 与正常的网络请求不一样,如果程序设置了校验 Header 信息,此时 Map Local 就会失败,解决办法是同时使用 Rewrite功能将相关的HTTP 头部信息 rewrite 成我们需要的信息 Rewrite 功能 Rewrite 适合对某个网络请求进行正则替换,以达到修改结果的目的。 假如我的 App 的界面上的显示的功能模块及其点击事件是根据接口来完成的,我想实现替换功能模块的名称的目的。步骤:点击顶部菜单栏的**“Tools” -> "Rewrite"**。在弹出的面板上勾选 “Enable Rewrite”。点击左下角的 Add按钮,在右上角的 **Name:**处写好本次配置的名称(如果有多个 Rewrite,为了后期容易区分)。 可以针对特定的网络请求进行 Rewrite。可以点击右上角 Location 面板下面的 Add按钮。在弹出的面板上设置网络请求配置信息。注意此时需要同时设置 Protocol、Port、Host、Path信息(我测试加了 Protocol、Host、Port这3个是无效的) 然后对指定的 Type 和 Action 进行 Rewrite。 Type 主要有 Add Header、Modify Header、Remove Header、Host、Path等等。 Where 可以选择 Request 和 Response。指的是下面的修改是针对 Request 还是 Response 完成设置后点击 Apply 按钮,即可生效。下次继续请求该网络,返回的内容就是我们刚刚设置的内容。比如当前的“政策法规”要变成“哈哈哈,我是假的政策法规”。这时候就可以使用 Rewrite 功能 Breakpoints 功能 Breakpoints 相比于其他几个修改网络请求的特点是只是针对当前的网络请求,Breakpoints 只存在于设置过的当前的网络请求,Charles 关闭后下次打开 Breakpoints 消失了。想要修改网络请求 Breakpoints 步骤最简单,跟我们调试工具里面设置的断点一样方便。 对于我们设置了 Breakpoints 的网络请求, Charles 会在下次继续访问该请求的时候停止掉,就跟 debug 一样。此时我们可以 Edit Request,修改过 Request 之后点击右下角的 Execute 按钮。然后等到服务端返回的时候继续是断点状态,此时可以 Edit Response。步骤: 选中某个网络请求 -> 右击 -> 点击“Breakpoints”。 如下图:对该接口设置了 Breakpoints。请求网络后 Edit Response,点击 execute 后服务端返回的结果就是我们编辑的内容了。 服务器压力测试 我们可以使用 Charles 的 Repeat 功能地对服务器进行并发访问进行压力测试。步骤:**选中某个网络请求 -> 右击 -> Repeat Advanced -> 在弹出的面板里面设置总共的迭代次数(Iterations)、并发数(Concurrency) -> 点击“OK” 。**开始执行可以看到以设置的并发数的规模,进行总共达设置的总共迭代次数的访问。(专业的压力测试工具:Load Runner) 反向代理 Charles 的反向代理功能允许我们将本地指定端口的请求映射到远程的另一个端口上。设置:点击顶部菜单栏 Proxy -> 点击 Reverse Proxies。 如下所示,我将本地的 8080 端口映射到远程的 80 端口上,点击 OK 生效后,当我继续访问本地的 80 端口,实际返回的就是远程 80 端口的提供的内容了。 解决与翻墙软件的冲突 Charles 的工作原理是把自己设置为系统的代理服务器,但是我们开发者经常会利用 VPN 翻墙访问谷歌查找资料(这些翻墙软件的工作原理也是把自己设置成为系统的代理服务器),为了2者和平共处。我们可以在 Charles 的 External Proxy Settings 中将翻墙的代理端口等信息填写。同时我们需要关闭翻墙软件的自动设置,更改为**“手动模式”**。(使其不主动修改系统代理) 总结 Charles 功能强大、界面简洁,读完这篇文章并做出练习,相信你能很快掌握它,“工欲善其事,必先利其器” ,掌握了它,相信可以为你大大提高开发中调试网络的效率。Enjoy yourself 参考链接 唐巧的博客

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册