首页 文章 精选 留言 我的

精选列表

搜索[webpack入门],共10000篇文章
优秀的个人博客,低调大师

Docker-Dockerfile入门 - 2

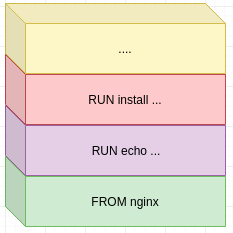
之前我们学会了一个简单的镜像是如何使用Dockerfile来构建出来的,步骤已经列出来了,没有说明白的就是上次的Dockerfile的内容,如下 FROM nginx RUN echo "<h1>Welcome Docker !</h1>" > /usr/share/nginx/html/index.html 如果你了解一点Linux命令,那echo就知道是用来做什么的,那剩下的陌生的就剩下FROM & RUN了 指定基础镜像: FROM 这个命令是一个Dockerfile的基础,它用来指定一个基础的镜像,来作为我们搭建的基础镜像,之后的所有命令和构建都是在此基础镜像上进行构建 有一个特殊的,如下,表示一个空白镜像,就是不以任何镜像为基础镜像,适用于不需要运行时系统支持的操作 FROM scratch 因为是用来指定基础的,所以必须指定,并且必须是第一条命令 执行命令行: RUN 首先这个命令有两种书写格式,一种就是前面说的RUN <Linux命令>,还有一种如下 RUN ["执行文件","参数1","参数2"] 每一个RUN命令都是在原有的基础镜像上新建一层,如下图 下面是一个Dockerfile,它并不是一个可执行的Dockerfile,但是请仔细观察 FROM nginx RUN apt-get update RUN apt-get install git RUN wget "https://xxx.tar" RUN ... 如上是有问题的,并不是用法问题,而是思想问题,RUN了四次也就是在原有的nginx镜像上新建了四层,而我们的目的只是想构建好现在这个基础镜像,以便更方便的使用它,所以我们上面的操作就应该是在一层构建完成的,所以我们应该只是用一个RUN来把环境搭建好,如下 FROM nginx RUN mysoft='git' \ && apt-get update \ && apt-get install $mysoft \ && wget "https://xxx.tar" && <cache clean> 相信你看完上面,就明白我要说什么了,其中刚开始的mysoft是我们定义的变量,而$mysoft就是引用其值,后面的<cache clean>是一些其他的推荐操作,比如更新系统下载下来的软件包清理掉 我们使用RUN就要有这样的思想,我们是在定义每一层是如何构建的,保证无关的东西在本层删除掉 记住并不是上一层不能更改或者触碰到下一层的相关文件,如果知道清理下一层什么文件这是可以清理的,比如这样 FROM centos:latest RUN echo "first" > /hello RUN echo "second" >> /hello RUN rm -f /hello 如上/hello在三次构建的时候都会被影响,而如果第二层不知道第一层有这个hello文件,那么他就修改不了了(意思有点不合适,记住把本层的副作用降到最低这一准则)

优秀的个人博客,低调大师

Docker-Dockerfile入门 - 1

之前说的commit操作会带来各种不好的结果,那么解决办法就是使用Dockerfile来解决这个问题 commit操作不会记录每层的构建过程,而Dockerfile则是记录了每层是如何构建的,那么我们可以通过观察Dockerfile的内容来知道镜像是如何的构建的,达到了镜像透明的目的,并且我们还可以自由的删除Dockerfile中的不需要的构建步骤,来解决镜像臃肿的问题 Dockerfile就是一个文本文件,里面是一条条命令,来指导Docker如何构建我们需要的镜像,比如我们来构建一个index页面为:“welcome Docker”的nginx服务镜像 我们需要先删除之前的nginx:v1,当然不删除也可以,无关紧要 [qidai@qidai-pc docker-file]$ docker images REPOSITORY TAG IMAGE ID CREATED SIZE nginx v1 ca9ac899159e 4 hours ago 109MB nginx latest 881bd08c0b08 4 days ago 109MB ubuntu latest 47b19964fb50 4 weeks ago 88.1MB centos latest 1e1148e4cc2c 3 months ago 202MB [qidai@qidai-pc docker-file]$ docker rmi -f nginx:v1 Untagged: nginx:v1 [qidai@qidai-pc docker-file]$ docker images REPOSITORY TAG IMAGE ID CREATED SIZE <none> <none> ca9ac899159e 4 hours ago 109MB #注意 nginx latest 881bd08c0b08 4 days ago 109MB ubuntu latest 47b19964fb50 4 weeks ago 88.1MB centos latest 1e1148e4cc2c 3 months ago 202MB [qidai@qidai-pc docker-file]$ docker rmi ca9ac899159e #告诉你有容器正在依赖这个镜像在跑着,所以删不掉 Error response from daemon: conflict: unable to delete ca9ac899159e (cannot be forced) - image is being used by running container 1c494ae39be7 [qidai@qidai-pc docker-file]$ docker ps #确实在跑 CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 1c494ae39be7 ca9ac899159e "nginx -g 'daemon of…" 4 hours ago Up 4 hours 0.0.0.0:80->80/tcp recursing_zhukovsky [qidai@qidai-pc docker-file]$ docker stop recursing_zhukovsky recursing_zhukovsky [qidai@qidai-pc docker-file]$ docker rmi ca9ac899159e #停止在删除 Deleted: sha256:ca9ac899159eefe41cf30771cc2f4e23db967d6e2f3d0725226495296b69cb76 Deleted: sha256:c521a0a996057d1e77e13f5badbe3ef8a50b15863dffd7bd71311538ba506472 [qidai@qidai-pc docker-file]$ docker images #删除完成了 REPOSITORY TAG IMAGE ID CREATED SIZE nginx latest 881bd08c0b08 4 days ago 109MB ubuntu latest 47b19964fb50 4 weeks ago 88.1MB centos latest 1e1148e4cc2c 3 months ago 202MB 我们从上面可以看到出现了<none>这样的名字,他之前是有名字和标签的,但这样的镜像基本没有存在价值了,所以可以直接删除,对于只显示这些镜像的过滤条件就是dangling=true,造成这种镜像问题的原因除了上面的这种情况,还会有其他情况会造成,以后遇到了再说吧,不过需要知道的是这种镜像叫做虚悬镜像 好了到这之后,我们使用Dockerfile创建一个index为“welcome Docker”的nginx服务镜像,内容如下 [qidai@qidai-pc docker-file]$ mkdir nginx-index [qidai@qidai-pc docker-file]$ nano nginx-index/Dockerfile [qidai@qidai-pc docker-file]$ cd nginx-index [qidai@qidai-pc nginx-index]$ docker build -t qidai/nginx:welcome . Sending build context to Docker daemon 2.048kB Step 1/2 : FROM nginx ---> 881bd08c0b08 Step 2/2 : RUN echo "<h1>Welcome Docker !</h1>" > /usr/share/nginx/html/index.html ---> Running in 5532922d8639 Removing intermediate container 5532922d8639 ---> 04bf915d6d0d Successfully built 04bf915d6d0d Successfully tagged qidai/nginx:welcome [qidai@qidai-pc nginx-index]$ docker images REPOSITORY TAG IMAGE ID CREATED SIZE qidai/nginx welcome 04bf915d6d0d 11 seconds ago 109MB nginx latest 881bd08c0b08 4 days ago 109MB -t:是指定修建的新镜像的name:tag .:就是Docker当前的context,必须要给出的 Dockerfile内容是这样的 FROM nginx RUN echo "<h1>Welcome Docker !</h1>" > /usr/share/nginx/html/index.html 上面是在Dockerfile所在目录下运行的命令可以成功,如果要指定Dockerfile的目录应该是这样的 [qidai@qidai-pc docker-file]$ docker build -t qidai/nginx:Welcome -f nginx-index/Dockerfile . 到这你就更能了解最后那个.是什么作用了,.代表当前目录,就是Docker会基于当前目录,去寻找-f参数的路径 修建完后,我们来运行一下看看是否成功了 [qidai@qidai-pc docker-file]$ docker run --rm -d -p 80:80 qidai/nginx:Welcome [sudo] qidai 的密码: 83112aeaa80b223d1491ed61a9bed615a606c7545ee34e95ba1724470a85a97a [qidai@qidai-pc docker-file]$ docker ps CONTAINER ID IMAGE COMMAND CREATED STATUS PORTS NAMES 83112aeaa80b qidai/nginx:Welcome "nginx -g 'daemon of…" 4 seconds ago Up 3 seconds 0.0.0.0:80->80/tcp silly_lehmann 访问: localhost 好了到这Dockerfile的初步使用我们就知道了,但是还没有说里面的具体的编写语法,我们下一结来说

优秀的个人博客,低调大师

Java虚拟机入门

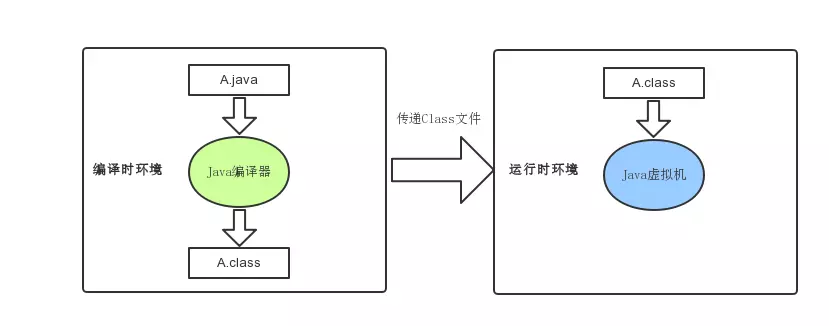
前言 最近在学习java并发,有些地方涉及到java虚拟机的知识,学习java这么久了,其实还没了解过Java虚拟机,这有点说不过去,所以先来学学习下java虚拟机的基础知识。 java虚拟机的概述 oracle官方定义的java技术体系包含以下几种: java程序设计语言 各种平台的java虚拟机 Class文件格式 java API类库 第三方java类库 我们通常所说的JDK(Java Development Kit),他是java开发的最小环境,主要就包含java程序语言设计,java虚拟机与java API类库。而JRE(Java Runtime Environment),它是java程序运行的标准环境,它其实即使由java API的java SE API子集和java虚拟机组成。由此我们可以看到java虚拟机在java中式极其重要的。我么可以把java虚拟机看作一个抽象的计算机,他有各种指令集和运行时数据区域。 java虚拟机家族 sun公司发布了许多种虚拟机,这里我们只学习目前比较主流的存活的虚拟机。 HotSpot VM Oracle JDK 和Open JDK中自带的虚拟机,是最主流和使用最广泛的java虚拟机。一般介绍java虚拟机的文章不作特殊说明,大部分都是介绍HotSpot VM的。HotSpot VM其实不是sun公司开发的,而是一家叫Longview technologies 的公司开发,在1997年被sun公司收购,而sun公司又在2009年被oracle收购 J9 VM J9 VM 是IBM开发的VM,目前是其主力发展的Java虚拟机。J9 VM的市场定位和HotSpot VM接近,它是一款设计上从服务端到桌面应用再到嵌入式都考虑到的多用途虚拟机,目前J9 VM的性能水平大致跟HotSpot VM是一个档次的 Zing VM 以Oracle的HotSpot VM为基础,改进了许多会影响延迟的细节。最大的三个卖点是: 1.低延迟,“无暂停”的C4 GC,GC带来的暂停可以控制在10ms以下的级别,支持的Java堆大小可以到1TB;2.启动后快速预热功能。3.可管理性:零开销、可在生产环境全时开启的、整合在JVM内的监控工具Zing Vision。 java虚拟机的执行流程 当我们执行java程序的时候,他的执行流程可以用下图来说明:可以看到,java虚拟机与java语言没什么关系,而只关心特定的.class文件(二进制文件). java虚拟机的体系结构 这里所讲的体系结构,是指的Java虚拟机的抽象行为,而不是具体的比如HotSpot VM的实现。按照Java虚拟机规范,抽象的Java虚拟机如下图所示。 Class文件格式 Java文件被编译后生成了Class文件,这种二进制格式文件不依赖于特定的硬件和操作系统。每一个Class文件中都对应着唯一一个类或者接口的的定义信息,但是类或者接口并不一定定义在文件中,比如类和接口可以通过类加载器来直接生成。ClassFile的文件结构如下所示。ClassFile { u4 magic; //魔数,固定值为0xCAFEBABE,用来判断当前文件是能被Java虚拟机处理的Class文件 u2 minor_version; //副版本号 u2 major_version; //主版本号 u2 constant_pool_count; //常量池计数器 cp_info constant_pool[constant_pool_count-1]; //常量池 u2 access_flags; //类和接口层次的访问标志 u2 this_class; //类索引 u2 super_class; //父类索引 u2 interfaces_count; //接口计数器 u2 interfaces[interfaces_count]; //接口表 u2 fields_count; //字段计数器 field_info fields[fields_count]; //字段表 u2 methods_count; //方法计数器 method_info methods[methods_count]; //方法表 u2 attributes_count; //属性计数器 attribute_info attributes[attributes_count]; //属性表 } 类加载器子系统 类加载器子系统通过多种类加载器来查找和加载Class文件到 Java 虚拟机中。Java虚拟机有两种类加载器:系统加载器和用户自定义加载器。其中系统加载器包括以下三种: 引导类加载器(Bootstrap Class Loader):用C/C++代码实现的加载器,用以加载Java虚拟机运行时所需要的系统类,这些系统类在{JRE_HOME}/lib目录下。Java虚拟机的启动就是通过引导类加载器创建一个初始类来完成的。由于类加载器是使用平台相关的底层C/C++语言实现的, 所以该加载器不能被Java代码访问到。但是,我们可以查询某个类是否被引导类加载器加载过。引导类装载器并不继承java.lang.ClassLoader。扩展类加载器(Extensions Class Loader):用于加载 Java 的拓展类 ,拓展类一般会放在 {JRE_HOME}/lib/ext/ 目录下,用来提供除了系统类之外的额外功能。应用程序类加载器(Application Class Loader):该类加载器是用于加载用户代码,是用户代码的入口。应用类加载器将拓展类加载器当成自己的父类加载器,当尝试加载类的时候,首先尝试让拓展类加载器加载,如果拓展类加载器加载成功,则直接返回加载结果Class instance,如果加载失败,则会询问引导类加载器是否已经加载了该类,如果没有,应用类加载器才会尝试自己加载。 用户自定义加载器,则是通过继承 java.lang.ClassLoader类的方式来实现自己的类加载器。类加载器子系统除了要加载Class文件类到 Java 虚拟机中,还必须负责验证被导入的Class类的正确性,为类变量分配并初始化内存,以及帮助解析符号引用。这些动作必须严格按以下顺序进行:1.装载:查找并加载Class文件。2.链接:验证、准备、以及解析。 验证:确保被导入类型的正确性。准备:为类的静态字段分配字段,并用默认值初始化这些字段。解析:根据运行时常量池的符号引用来动态决定具体值得过程。3.初始化:将类变量初始化为正确初始值。 数据类型 Java虚拟机与Java语言的数据类型相似,可以分为两类:基本类型和引用类型。Java虚拟机希望编译器在编译期间尽可能的完成类型检查,使得虚拟机在运行期间无需进行类型检查操作。 运行时数据区域 很多人将Java的内存分为堆内存(heap)和栈内存(Stack),这种分发不够准确,Java的内存区域划分实际上远比这复杂。Java虚拟机在执行Java程序的过程中会把它所管理的内存划分为不同的数据区域,根据《Java虚拟机规范(Java SE7版)》的规定,这些数据区域分别为程序计数器、Java虚拟机栈、本地方法栈、Java堆和方法区,下面我们来一一的对它们进行介绍。 程序计数器 为了保证程序能够连续地执行下去,处理器必须具有某些手段来确定下一条指令的地址,而程序计数器正是起到这种作用。程序计数器(Program Counter Register)也叫做PC寄存器,是一块较小的内存空间。在虚拟机概念模型中,字节码解释器工作时就是通过改变程序计数器来选取下一条需要执行的字节码指令,Java虚拟机的多线程是通过轮流切换并分配处理器执行时间的方式来实现的,在一个确定的时刻只有一个处理器执行一条线程中的指令,为了在线程切换后能恢复到正确的执行位置,每个线程都会有一个独立的程序计数器,因此,程序计数器是线程私有的。如果线程执行的方法不是Native方法,则程序计数器保存正在执行的字节码指令地址,如果是Native方法则程序计数器的值则为空(Undefined)。程序计数器是Java虚拟机规范中唯一没有规定任何OutOfMemoryError情况的数据区域。 Java虚拟机栈 每一条Java虚拟机线程都有一个线程私有的Java虚拟机栈(Java Virtual Machine Stacks)。它的生命周期与线程相同,与线程是同时创建的。Java虚拟机栈存储线程中Java方法调用的状态,包括局部变量、参数、返回值以及运算的中间结果等。一个Java虚拟机栈包含了多个栈帧,一个栈帧用来存储局部变量表、操作数栈、动态链接、方法出口等信息。当线程调用一个Java方法时,虚拟机压入一个新的栈帧到该线程的Java栈中,当该方法执行完成,这个栈帧就从Java栈中弹出。我们平常所说的栈内存(Stack)指的就是Java虚拟机栈。Java虚拟机规范中定义了两种异常情况: 如果线程请求分配的栈容量超过Java虚拟机所允许的的最大容量,Java虚拟机会抛出StackOverflowError。如果Java虚拟机栈可以动态扩展(大部分Java虚拟机都可以动态扩展),但是扩展时无法申请到足够的内存,或者在创建新的线程时没有足够的内存去创建对应的Java虚拟机栈,则会抛出OutOfMemoryError异常。 本地方法栈 Java虚拟机实现可能要用到C Stacks来支持Native语言,这个C Stacks就是本地方法栈(Native Method Stack)。它与Java虚拟机栈类似,只不过本地方法栈是用来支持Native方法服务。如果Java虚拟机不支持Native方法,并且也不依赖于C Stacks,可以无需支持本地方法栈。在Java虚拟机规范中对本地方法栈的语言和数据结构等没有强制规定,因此具体的Java虚拟机可以自由实现它,比如HotSpot VM将本地方法栈和Java虚拟机栈合二为一。与Java虚拟机栈类似,本地方法栈也会抛出 StackOverflowError和OutOfMemoryError异常 Java堆 Java堆(Java Heap)是被所有线程共享的运行时内存区域。Java堆用来存放对象实例,几乎所有的对象实例都在这里分配内存。Java堆存储的对象被垃圾收集器管理,这些受管理的对象无需也无法显示的销毁。从内存回收的角度,Java堆可以粗略的分为新生代和老年代。从内存分配的角度Java堆中可能划分出多个线程私有的分配缓冲区。不管如何划分,Java堆存储的内容是不变的,进行划分是为了能更快的回收或者分配内存。Java堆的容量可以时固定的,也可以动态的扩展。Java堆的所使用的内存在物理上不需要连续,逻辑上连续即可。Java虚拟机规范中定义了一种异常情况: 如果在堆中没有足够的内存来完成实例分配,并且堆也无法进行扩展时,则会抛出OutOfMemoryError异常。 方法区 方法区(Method Area)是被所有线程共享的运行时内存区域。用来存储已经被Java虚拟机加载的类的结构信息,包括:运行时常量池、字段和方法信息、静态变量等数据。方法区是Java堆的逻辑组成部分,它一样在物理上不需要连续,并且可以选择在方法区中不实现垃圾收集。方法区并不等同于永久代,只是因为HotSpot VM使用永久代来实现方法区,对于其他的Java虚拟机,比如J9和JRockit等,并不存在永久代概念。Java虚拟机规范中定义了一种异常情况: 如果方法区的内存空间不满足内存分配需求时,Java虚拟机会抛出OutOfMemoryError异常。 运行时常量池运行时常量池(Runtime Constant Pool)是方法区的一部分。在2.1 Class文件格式这一小节中我们得知,Class文件不仅包含了类的版本、接口、字段和方法等信息,还包含了常量池,它用来存放编译时期生成的字面量和符号引用,这些内容会在类加载后存放在方法区的运行时常量池中。运行时常量池可以理解为是类或接口的常量池的运行时表现形式。Java虚拟机规范中定义了一种异常情况:当创建类或接口时,如果构造运行时常量池所需的内存超过了方法区所能提供的最大值,Java虚拟机会抛出OutOfMemoryError异常

优秀的个人博客,低调大师

Python 网络爬虫入门详解

什么是网络爬虫 网络爬虫又称网络蜘蛛,是指按照某种规则在网络上爬取所需内容的脚本程序。众所周知,每个网页通常包含其他网页的入口,网络爬虫则通过一个网址依次进入其他网址获取所需内容。 优先申明:我们使用的python编译环境为PyCharm 一、首先一个网络爬虫的组成结构: 爬虫调度程序(程序的入口,用于启动整个程序) url管理器(用于管理未爬取得url及已经爬取过的url) 网页下载器(用于下载网页内容用于分析) 网页解析器(用于解析下载的网页,获取新的url和所需内容) 网页输出器(用于把获取到的内容以文件的形式输出) 二、编写网络爬虫 (1)准备所需库 我们需要准备一款名为BeautifulSoup(网页解析)的开源库,用于对下载的网页进行解析,我们是用的是PyCharm编译环境所以可以直接下载该开源库。 在学习中有迷茫不知如何学习的朋友小编推荐一个学Python的学习q u n 227 -435- 450可以来了解一起进步一起学习!免费分享视频资料 步骤如下: 选择File->Settings 打开Project:PythonProject下的Project interpreter 点击加号添加新的库 输入bs4选择bs4点击Install Packge进行下载 (2)编写爬虫调度程序 这里的bike_spider是项目名称引入的四个类分别对应下面的四段代码url管理器,url下载器,url解析器,url输出器。 (3)编写url管理器 我们把已经爬取过的url和未爬取的url分开存放以便我们不会重复爬取某些已经爬取过的网页。 (4)编写网页下载器 通过网络请求来下载页面 (5)编写网页解析器 对网页进行解析时我们需要知道我们要查询的内容都有哪些特征,我们可以打开一个网页点击右键审查元素来了解我们所查内容的共同之处。 (6)编写网页输出器 输出的格式有很多种,我们选择以html的形式输出,这样我们可以的到一个html页面。 写在末尾 注意:网页经常发生变化,我们需要根据网页的变化动态修改我们的代码来获得我们所需要的内容。 这只是一个简单的网络爬虫,如果需要完善其功能我们需要考虑更多问题。

优秀的个人博客,低调大师

Java入门—字符串

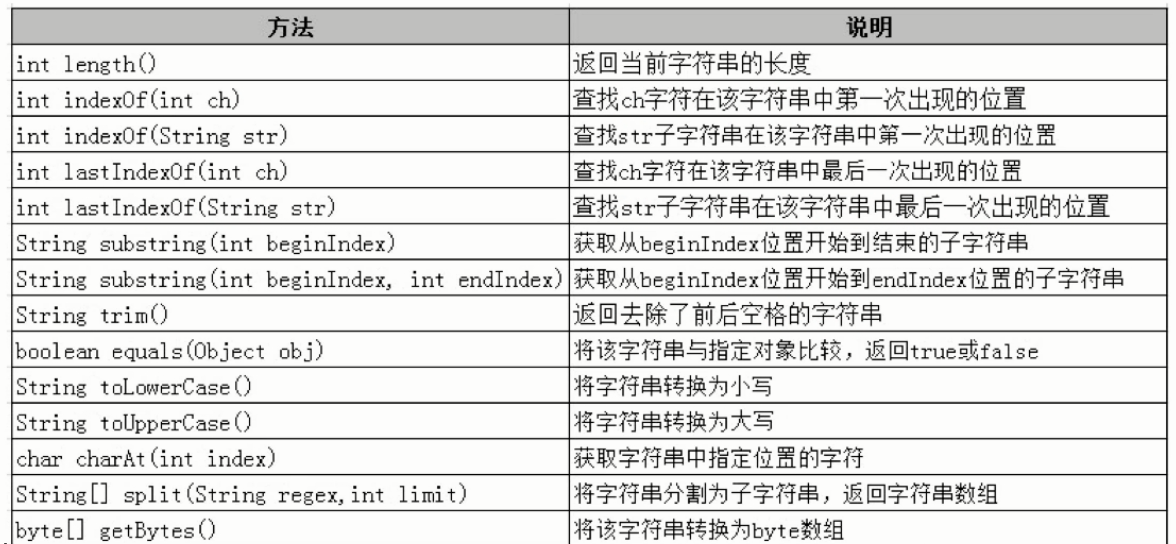
String的常用方法 image.png 以上是我们平时常用的方法,建议自己手动测试练习加以记忆,其他方法可以查阅文档。 将字符串转换为byte数组 示例代码: String name = "java 编程 基础"; byte[] b = name.getBytes(); for(int e: b){ System.out.print(e+" "); } 输出结果: 106 97 118 97 32 -25 -68 -106 -25 -88 -117 32 -27 -97 -70 -25 -95 -128 在utf-8编码中,一个汉字是用三个字节去表示,所以上边输出为三个连续负数。 image.png 每个字节为8位,最大值是不能超过127的,而汉字转换为字节后是超过127的,之后就会发生溢出,以负数的方式显示。 将byte数组转为字符串: String e = new String(b); System.out.println(e); new String()方法可以传入编码方式,(gbk utf-8) byte数组和字符串互转时,编码要相同。 ==和equals方法的区别 String a = "allen"; String b = "allen"; String c = new String("allen"); System.out.println(a==b); System.out.println(a==c); System.out.println(a.equals(b)); System.out.println(a.equals(c)); 对于==, 如果作用于基本数据类型的变量,则直接比较其存储的 “值”是否相等; 如果作用于引用类型的变量,则比较的是所指向的对象的地址 对于equals :注意:equals方法不能作用于基本数据类型的变量如果没有对equals方法进行重写,则比较的是引用类型的变量所指向的对象的地址;诸如String、Date等类对equals方法进行了重写的话,比较的是所指向的对象的内容。 来源于慕课网.png 字符串的不可变性 String对象被创建后,是不可变的。 所谓的修改是创建了新的对象。原变量指向了新的对象。 字符串处理类StringBuilder 区别:StringBuilder 是可变的。 当频繁操作字符串时,建议使用 StringBuilder ,如果使用String,会产生很多中间变量,会在常量池产生很多废弃的数据。 StringBuilder 和 StringBuffer 二者基本相似,StringBuffer是线程安全的(相对来说速度慢),StringBuilder非线程安全,但是性能高。 四种构造方法: image.png 如果文章对你有帮助记得点个赞~ 关注作者后续更新不错过~

优秀的个人博客,低调大师

java8学习:入门

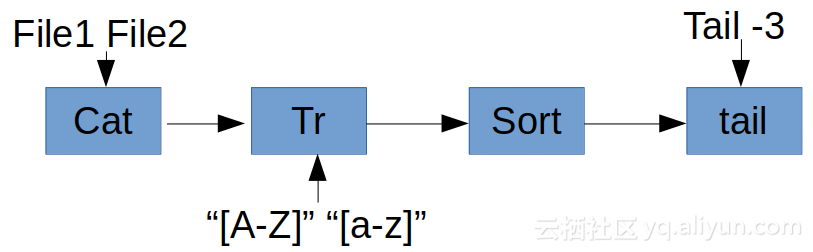
内容来自《 java8实战 》,本篇文章内容均为非盈利,旨为方便自己查询、总结备份、开源分享。如有侵权请告知,马上删除。书籍购买地址:java8实战 sync的使用成本:多核CPU的每个处理器内核都有独立的告诉缓存,加锁需要这些告诉缓存同步运行,然而这有需要在内核间进行较慢的缓存一致性协议通信 流处理 流是一系列数据项,一次只生成一项。程序可以从输入流中一个个读取数据项,然后以 相同的方式将数据项写入输出流 拿Linux的管道命令来演示流过程 如上熟悉linux都清楚cat file1 file2会创建两个文件的输出流,如果加上>那么就会生成一个合并了File1和file2的新文件,cat产生的数据流会通过管道传送给tr进行内容过滤,符合条件的又会传入下一个sort方法进行排序,最后sort排序完成的结果集交给tail -3取三行,至此流算是结束了。这些的流处理行为是高效的,因为cat的数据读一条就会传给tr过滤,tr后传入sort,sort就能在cat或tr完成前先处理几行 基于上面的思想,java8引入了Stream,这样的好处是并行能力得到了极大的提升,并且站在了更高的抽象角度去编程,因为原来的编程习惯的java只能利用一个cpu,除非自己去写thread,并且thread是容易出错的 用行为参数化把代码传递给方法 java8可以通过api传递代码。 对上面的解释就是:看到上面的图的sort函数,可能它默认的只能升序或者降序排序,但是如果我们需要定制排序的话,也就只能对sort进行重新定义,那么就比如下面(java代码演示) @Test public void test() throws Exception { List<Integer> ints = Arrays.asList(1,3,4,5,1,5,7,7,8); ints.sort(new Comparator<Integer>() { @Override public int compare(Integer o1, Integer o2) { return o1.compareTo(o2); //升序 } }); System.out.println(ints); ints.sort(new Comparator<Integer>() { @Override public int compare(Integer o1, Integer o2) { return - o1.compareTo(o2); //降序 } }); System.out.println(ints); } 如上的代码,其实是只有renturn...是有用的,这句代码关乎到排序规则,但是其他的代码都是无用的。那么这时候就会想,只需要写一遍匿名内部类,排序逻辑根据自己需要传入不就行了。这个思想就是:通过api传递代码 并行与共享的可变数据 并发和并行的概念 并发是两个任务可以在重叠的时间段内启动,运行和完成。并行是任务在同一时间运行,例如,在多核处理器上。 并发是独立执行过程的组合,而并行是同时执行(可能相关的)计算。 并发是一次处理很多事情,并行是同时做很多事情。 应用程序可以是并发的,但不是并行的,这意味着它可以同时处理多个任务,但是没有两个任务在同一时刻执行。 应用程序可以是并行的,但不是并发的,这意味着它同时处理多核CPU中的任务的多个子任务。 一个应用程序可以即不是并行的,也不是并发的,这意味着它一次一个地处理所有任务。 应用程序可以即是并行的也是并发的,这意味着它同时在多核CPU中同时处理多个任务。 那么在以往的线程编程中,实现并行的前提就是各个副本可以独立工作,如果在多个副本出现了共享的变量或对象,这就行不通了,因为如果出现同时修改共享变量怎么办 java8的流实现比线程更容易,尽量保持流处理过程中,不访问共享的可变变量,这种函数就被称为纯函数,无副作用函数或无状态函数。但是依旧可以使用sync来实现一个可变数据,但是这样就与并行的概念相悖 函数 方法引用 编写一个目录下查询出所有隐藏文件 @Test public void test() throws Exception { File[] files = new File(".").listFiles(new FileFilter() { @Override public boolean accept(File pathname) { return pathname.isHidden(); } }); for (File file : files) { System.out.println(file); } } 如上啰里啰嗦的只是判断 pathname.isHidden(),java8引入之前只能这么写,但是现在可以这样 @Test public void test() throws Exception { File[] files = new File(".").listFiles((File::isHidden)); for (File file : files) { System.out.println("file = " + file); } } 上面是将isHidden方法做为值传入listFIles方法,与用对象引用传递对象相似,在java8里写下File::isHidden的时候,就创建了一个方法引用,然后可以传递这个引用了 lambda匿名函数 比如代码(int x ) -> x+1,代码的意思就是你传入一个2,那么他会返回3,也可以像上面定义一个方法add1,然后class::add1,但是对于简短逻辑明确的代码来说这样更简洁,如果匿名函数有很多行代码,不能一眼看出这个匿名函数是干嘛的,那么就应该把匿名函数抽出来一个方法使用 实例 bean代码 @AllArgsConstructor @NoArgsConstructor @Data public class Apple { private String color; private Integer weight; } java8之前:苹果根据条件过滤:找出绿色苹果 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); for (Apple apple : apples) { if ("green".equals(apple.getColor())){ System.out.println(apple); } } } java8之前:苹果根据条件过滤:找出1000克以上的大苹果 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); for (Apple apple : apples) { if (1000 < apple.getWeight()){ //其他代码与上面都是一直的,无奈的是只能复制黏贴改条件,复制黏贴是为限的,因为如果有一天需要改一个地方,如果忘记了另一处复制的代码,那么就会出错 System.out.println(apple); } } } java8之后 改变Apple类 @AllArgsConstructor @NoArgsConstructor @Data public class Apple { private String color; private Integer weight; public static boolean filterWeight(Apple apple){ return 1000 < apple.getWeight(); } public static boolean filterColor(Apple apple){ return "green".equals(apple.getColor()); } } 增加接口 public interface FindApple<T> { boolean find(T t); } 编写方法测试 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); filterApple(apples,Apple::filterColor); //java8之后:苹果根据条件过滤:找出绿色苹果 filterApple(apples,Apple::filterWeight); //java8之后:苹果根据条件过滤:找出1000克以上的大苹果 } static void filterApple(List<Apple> apples,FindApple<Apple> f){ for (Apple apple : apples) { if (f.find(apple)){ System.out.println(apple); } } } 自己实现方法引用确实有点复杂,首先要为需要过滤的类增加自实现的static方法,然后编写带有测试方法的结果,之后就是编写方法,此方法是可以接收需要测试类内static方法的。 如上方法filterApple中的f.find(apple),都是可以看出来这是在使用接口中的测试方法,但是这个方法没有实现自己的逻辑,所以到这它是不能按照要求过滤apple的,然后在上面junit测试方法中,传入的Apple::filterColor其实就是为接口中的测试方法添加逻辑,使其能按照我们的要求过滤apple 从传递方法到lambda 如上自己实现方法引用那真是脸上心里全都是mmp,为了实现方法引用,我们增加类Apple的方法,增加了接口等,如果java8要真是这样,那么宁可不用,不过java8是解决了这个问题的,他引入了lambda表达式,这时候上面的写法就可以写为 将增加的接口删掉~ 将在Apple内增加的方法删掉~ 编写代码 @Test public void test() throws Exception { List<Apple> apples = new ArrayList<>(); filterApple(apples,(apple -> "green".equals(apple.getColor()))); filterApple(apples,(apple -> (apple.getWeight() > 1000))); } static void filterApple(List<Apple> apples, Predicate<Apple> f){ for (Apple apple : apples) { if (f.test(apple)){ System.out.println(apple); } } } 这时候看到的变化是从原来的FindApple接口改变为了Predicate接口,其实这个接口的定义跟刚才的FIndApple接口内定义是一样一样的,如下 @FunctionalInterface public interface Predicate<T> { boolean test(T t); .... .... } 最大的变化就是我们并没有使用方法引用,而是直接以更直观的方法来过滤apple 流 日常写代码的时候,在java8之前如果要遍历Map中找出map对应key的特定value值,如果更加复杂的类型就需要嵌套循环并且编写出来的代码是一大坨的 void test() throws Exception {Map maps = new HashMap<>();for (Map.Entry integerStringEntry : maps.entrySet()) { if (integerStringEntry.getKey() > 1000) { if (integerStringEntry.getValue().equals("value")){ System.out.println("integerStringEntry = " + integerStringEntry); } } } } Stream api就类似SQL一样的过滤操作,如上的代码可以写为下面这样的 void test() throws Exception {Map maps = new HashMap<>();maps.entrySet().stream() .filter(entry -> entry.getKey() > 1000) .filter(entry -> entry.getValue().equals("value")) .forEach(System.out::println); } Stream 解决了经典的java程序只能利用一个cpu的问题,可以使程序并行执行,如图 - 在两个cpu上筛选数据,分割数据到两个cpu上,如1 - 按条件过滤数据,如2 - 一个cpu会将结果汇总起来,如3 Stream顺序处理 maps.entrySet().stream().... Stream的并行处理 maps.entrySet().parallelStream().... 默认方法 如上已经看到了,在java8中使用集合类都会有stream方法,那么在java8之前是没有这个方法,如果把java7升级到java8,那么多的这个stream方法不就的需要实现吗,那么不就不能向后兼容了吗? 如上的问题全是由接口内的默认方法实现的 默认方法的定义是由default开始的,比如 public interface MyFunction { default boolean test(String str) { return str.equals(".."); } } public class UU implements MyFunction{ public static void main(String[] args) { UU uu = new UU(); System.out.println(uu.test("..")); } } 如上UU类中根本不要实现接口中的test方法就可以使用,当然也可以覆盖实现 public class UU implements MyFunction{ @Override public boolean test(String str) { return "ll".equals(str); } public static void main(String[] args) { UU uu = new UU(); System.out.println(uu.test("..")); } } 这时候实现的逻辑就是子类重写之后的了 我们都知道接口是可以多重实现的,那么如果IA和IB中方法名重复了咋办 public interface MyFunction1 { default boolean test(String str) { return str.equals(".."); } } public interface MyFunction2 { default boolean test(String str) { return str.equals("ll"); } } public class UU implements MyFunction1,MyFunction2{ //exception public static void main(String[] args) { UU uu = new UU(); System.out.println(uu.test("..")); } } 如上当两个接口中的方法名重复了,那么就会出错,解决办法就是重写重复的方法即可,当然方法重载是没有问题的 这就是为什么在更新为java8之后,之前的代码还是可以使用的原因,java8 在Collection接口中加入了stream默认实现了 default Stream<E> stream() { return StreamSupport.stream(spliterator(), false); }

优秀的个人博客,低调大师

Java入门之包装类

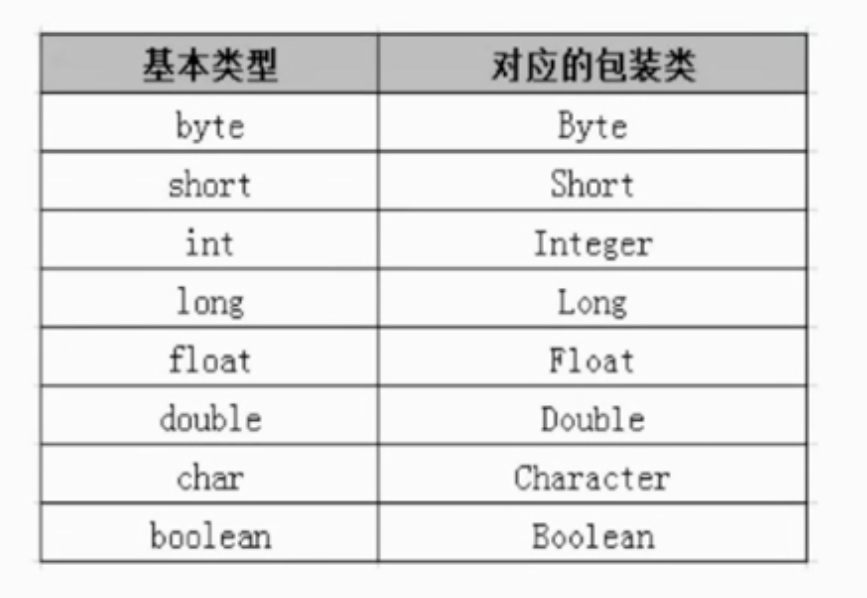
包装类用途 Java中有些异类(8种基本数据类型)它们不能像对象一样进行属性和方法的调用以及进行相互之间的对象化处理,包装类的存在就是为了解决这些异类产生的问题,让它们能像对象一样进行交互。 包装类与基本数据类型之间的关系 image.png 包装类的常用方法 Java中所有包装类都是存放在java.lang这个包中。 以Integer为例,介绍它常用的属性和方法 public final class Integer(){ } 所有的包装类都是用final修饰,不允许被继承,无子类。 image.png 基本数据类型和包装类的转换 装箱 : 基本数据类型转换为包装类 拆箱:包装类转换为基本数据类型 自动装箱(拆箱): int a = 1; Integer b = a; 手动装箱(拆箱): int a = 1; Integer b = new Integer(a); //拆箱 int c = b.intValue(); 基本数据类型和字符串之间转换 通过包装类完成基本数据类型和字符串之间转换。 public class Demo { public static void main(String[] args){ int a = 3; String name = Integer.toString(a); System.out.println(name); //1. int b = Integer.parseInt(name); //2.包装类的valueOf方法先将字符串转为包装类,再通过自动拆箱完成基本数据类型的转换 int d = Integer.valueOf(name); } } 补充知识 包装类对象的初始值 首先看下基本数据类型的初始值: image.png (注:上图中\u是unicode编码) 跟这些基本数据类型对应的包装类,它们的初始值是多少? 包装类的初始值为null。 包装类对象间比较 看代码: public class WrapperTest { public static void main(String[] args) { // TODO Auto-generated method stub Integer one=new Integer(100); Integer two=new Integer(100); System.out.println("one==two的结果:"+(one==two));//1 Integer three=100;//自动装箱 //Integer three=Integer.valueOf(100); //等号两端比较的是值 System.out.println("three==100的结果:"+(three==100));//2 自动拆箱 //执行这个语句时 编译器实际上执行的是这个:Integer four=Integer.valueOf(100); Integer four=100; System.out.println("three==four的结果:"+(three==four));//3 Integer five=200; System.out.println("five==200的结果:"+(five==200));//4 Integer six=200; System.out.println("five==six的结果:"+(five==six));//5 Double d1=Double.valueOf(100); System.out.println("d1==100的结果:"+(d1==100)); Double d2=Double.valueOf(100); System.out.println("d1==d2的结果:"+(d1==d2)); } } 上边代码这个部分:Integer.valueOf(100),为了执行的效率,在这个方法执行的过程中,java内存提供了一个类似于常量数组的缓存区(对象池),如果传入这个方法的参数是大于-128小于127这个范围,会去缓存区查找是否存在,如果有,直接产生,如果没有,实例化新的产生。这也就解释了为什么three==four打印出的值是ture。而five==six的结果是false。 八种基本数据类型中,除了float和double,其他的都是应用对象常量池这个概念的。 后续持续更新ing...

优秀的个人博客,低调大师

Java入门之异常处理

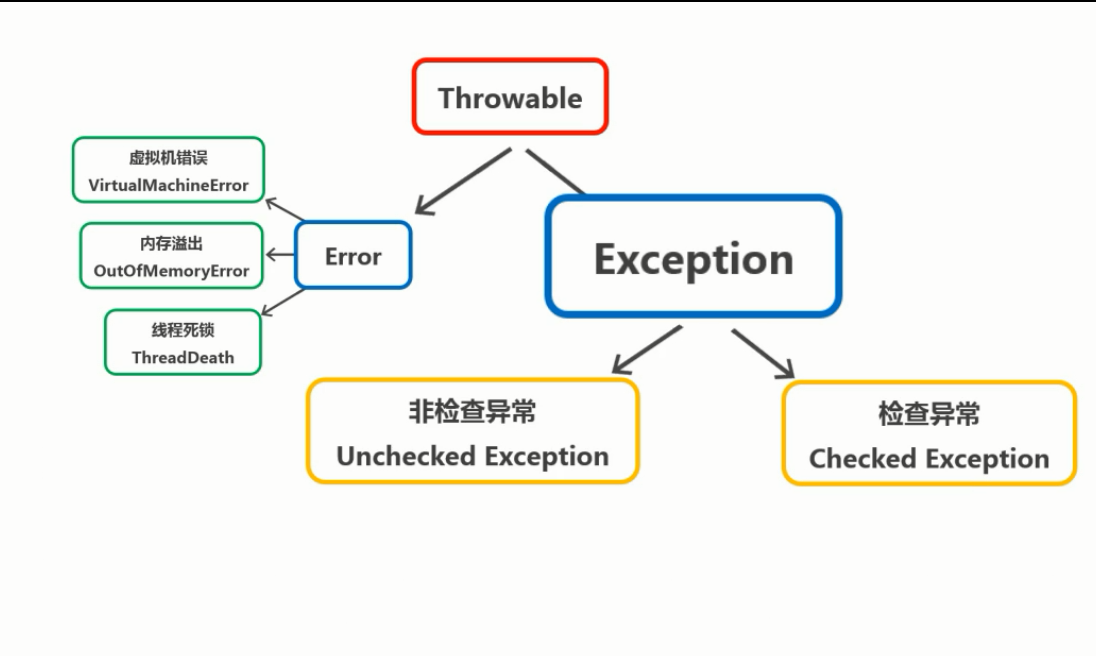
异常处理 如何处理异常 1. try-catch-finally 2. throw 3. throws 4. 自定义异常 5. 异常链 根类:Throwable 两个子类:Error、Exception image.png 上图中非检查异常,表示的是编译器不要求强制处理的异常,包括: image.png 检查异常:在程序编码阶段就被要求必须进行异常处理,否则编译无法通过。 image.png Java中异常通过五个关键字来实现: try catch finally throw throws image.png try-catch-finally public class TryDemo { public static void main(String[] args){ int a = 10; int b = 0; try { int c = a/b; }catch (ArithmeticException e){ System.out.println("出错了"); }finally { System.out.println("一定会执行"); } } } 使用多重catch结构处理异常 public class TryDemo { public static void main(String[] args){ int a = 10; int b = 0; try { int c = a/b; }catch (ArithmeticException e){ System.out.println("出错了"); }catch (Exception e){ System.out.println("33333"); } finally { System.out.println("一定会执行"); } } } Exception 父类异要放在最后一个catch块中。 注意:如果在finally块中和catch块中都有return语句,最终只会执行finally中的return,不会执行catch块中的return。在代码编写中不建议把return放到finally块中。 使用throws声明异常类型 public class TryDemo { public static void main(String[] args){ try { int result = test(); }catch (ArithmeticException e){ System.out.println(e); }catch (InputMismatchException e){ System.out.println(e); } } public static int test() throws ArithmeticException, InputMismatchException{ System.out.println("d"); } } 使用throw抛出异常对象 throw抛出的只能是可抛出类Throwable或者其子类的实例对象。 当方法当中包含throw抛出对象的语句时,常规的处理方法有两种: 方法一: public void method(){ try{ throw new 异常类型(); }catch(异常类型 e){ //处理异常 } } 方法二:谁调用了当前的方法谁就来处理异常 public void method() throws 异常类型{ throw new 异常类型(); } 自定义异常类 使用Java内置的异常类可以描述在编程时出现的大部分异常情况。 也可以通过自定义异常描述特定业务产生的异常类型。 所谓自定义异常,就是定义一个类去继承Throwable类或它的子类。 异常链 有时候我们在捕获一个异常后再抛出另一个异常。 异常链:将异常发生的原因一个传一个串起来,即把底层的异常信息传给上层 ,这样逐层抛出。

优秀的个人博客,低调大师

快速入门 WePY 小程序

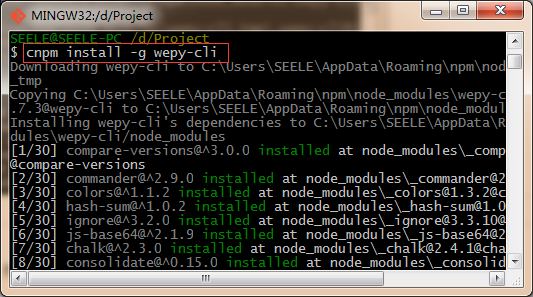
一、WePY介绍 WePY 是腾讯参考了Vue 等框架对原生小程序进行再次封装的框架,更贴近于 MVVM 架构模式, 并支持ES6/7的一些新特性。 二、WePY 使用 1、WePY的安装或更新都通过npm进行: npm install -g wepy-cli //全局安装或更新WePY命令行工具(wepy脚手架): wepy-cli wepy -v //查看wepy-cli版本 wepy init standard <projectName> //新建wepy小程序项目,1.7.0之前的版本使用:wepy new myproject wepy list //查看项目模板 cd <projectName> //切换至项目目录 npm install //安装依赖 wepy build --watch //开启实时编译 git base here: (1)全局安装或更新 wepy-cli: (2)查看 wepy-cli 版本: (3)创建 wepy 小程序项目: (4)切换至项目目录,安装依赖: (5)开启实时编译 2、代码高亮WebStorm/PhpStorm(其他工具参见:wepy官网代码高亮) (1)打开Settings,搜索Plugins,搜索Vue.js插件并安装。 (2) 打开Settings,搜索File Types,找到Vue.js Template,在Registered Patterns添加*.wpy,即可高亮。 3、代码优化 (1)代码规范 wepy标签和原生一样 自定义组件命名应避开:原生组件名(input、button、view、repeat等)、WePY的辅助标签<repeat> 变量/方法名尽量使用驼峰式命名,避免使用$开头($开头的标识符是WePY内建属性/方法,可在js中以this.的方式直接使用,具体请参考API文档) app、pages、components文件名的后缀为.wpy,外链的文件可以是其它后缀。 具体请参考wpy文件说明。 支持ES6/7的一些新特性,框架在ES6(ECMAScript 6)下开发(默认使用babel编译),因此也需要使用ES6开发小程序,ES6中有大量的语法糖可以让我们的代码更加简洁高效。 wepy继承了wx对象的方法,建议在wepy框架开发中不要用到wx对象的方法,虽然运行时效果是一样,但是打包时会cli报错(wepy中没有wx对象)wepy中组件中使用的是class,vue中使用的的是对象。 (2)数据绑定 小程序页面渲染层和JS逻辑层分开的,setData操作实际就是JS逻辑层与页面渲染层之间的通信,在同一次运行周期内多次执行setData操作时,通信的次数是一次还是多次取决于API本身的设计。WePY使用脏数据检查对setData进行封装,在函数运行周期结束时执行脏数据检查,一来可以不用关心页面多次setData是否会有性能上的问题,二来可以更加简洁去修改数据实现绑定,不用重复去写setData方法。 //原生小程序 this.setData({title: 'this is title'});//通过Page提供的setData方法来绑定数据 //wepy this.title = 'this is title'; //wepy 在异步函数中更新数据的时候,必须手动调用$apply方法,才会触发脏数据检查流程的运行 setTimeout(() => { this.title = 'this is title'; this.$apply(); }, 3000) //保留setData方法,但不建议使用setData执行绑定,修复传入undefined的bug,并且修改入参支持: this.setData(target, value) this.setData(object) (3)事件绑定以及传参优化 <view @tap="click"></view> //​​​​​ 原 bindtap="click"(省略了.default后缀 )绑定小程序冒泡型事件 <view @tap.stop="click"></view> //​​​​​ 原catchtap="click" 绑定小程序捕获型事件,如catchtap <view @tap.capture="click"></view> //​​​​​ 原 capture-bind:tap="click" <view @tap.capture.stop="click"></view> //​​​​​ 原 capture-catch:tap="click" <!--事件传参--> <view @tap="click({{index}})"></view> //​​​​​ 原bindtap="click" data-index={{index}} (4)框架默认对小程序提供的API全都进行了 Promise 处理,甚至可以直接使用async/await等新特性进行开发,同时修复了一些原生API的缺陷(如:wx.request的并发问题等) // 原生代码: wx.request({ url: 'xxx', success: function (data) { console.log(data); } }); // WePY 使用方式, 需要开启 Promise 支持,参考开发规范章节 wepy.request('xxxx').then((d) => console.log(d)); // async/await 的使用方式, 需要开启 Promise 和 async/await 支持,参考 WIKI async function request () { let d = await wepy.request('xxxxx'); console.log(d); } (5)computed 计算属性computed计算属性(类型:{ [key: string]: Function }),是一个有返回值的函数,可直接被当作绑定数据来使用,类似于data属性。需要注意的是,只要是组件中有任何数据发生了改变,那么所有计算属性就都会被重新计算。 data = { a: 1 } // 计算属性aPlus,在脚本中可通过this.aPlus来引用,在模板中可通过{{ aPlus }}来插值 computed = { aPlus () { return this.a + 1 } } (6)watcher 监听器 通过监听器watcher(类型:{ [key: string]: Function })能够监听到任何属性的更新。监听器适用于当属性改变时需要进行某些额外处理的情形。 data = { num: 1 } // 监听器函数名必须跟需要被监听的data对象中的属性num同名, // 其参数中的newValue为属性改变后的新值,oldValue为改变前的旧值 watch = { num (newValue, oldValue) { console.log(`num value: ${oldValue} -> ${newValue}`) } } // 每当被监听的属性num改变一次,对应的同名监听器函数num()就被自动调用执行一次 onLoad () { setInterval(() => { this.num++; this.$apply(); }, 1000) } (7)WXS (WeiXin Script) WePY 从1.7.x版本开始支持 wxs 语法,但语法与原生 wxs 稍有出入 a.wxs是基于原生的wxs去实现的,只是通过编译把现在的语法编译为原生语法 ②wxs必须是外链文件。并且后缀为.wxs ③wxs引入后只能在template中使用,不能在script中使用 /** project └── src ├── wxs | └── mywxs.wxs wxs 文件 ├── pages | └── index.wpy 页面 └──app.wpy **/ // mywxs.wxs module.exports = { text: 'This is from wxs', filter: function (num) { return num.toFixed(2); } }; // index.wpy <template> <text>{{m1.text}}</text> <text>{{m1.filter(num)}}</text> </template> <script> import wepy from 'wepy'; import mywxs from '../wxs/mywxs.wxs'; export default class Index extends wepy.page { data = { num: 10 }; wxs = { m1: mywxs } }; </script> (8)interceptor 拦截器 可以使用WePY提供的全局拦截器对原生API的请求进行拦截。具体方法是配置API的config、fail、success、complete回调函数。参考示例: import wepy from 'wepy'; export default class extends wepy.app { constructor () { // this is not allowed before super() super(); // 拦截request请求 this.intercept('request', { // 发出请求时的回调函数 config (p) { // 对所有request请求中的OBJECT参数对象统一附加时间戳属性 p.timestamp = +new Date(); console.log('config request: ', p); // 必须返回OBJECT参数对象,否则无法发送请求到服务端 return p; }, // 请求成功后的回调函数 success (p) { // 可以在这里对收到的响应数据对象进行加工处理 console.log('request success: ', p); // 必须返回响应数据对象,否则后续无法对响应数据进行处理 return p; }, //请求失败后的回调函数 fail (p) { console.log('request fail: ', p); // 必须返回响应数据对象,否则后续无法对响应数据进行处理 return p; }, // 请求完成时的回调函数(请求成功或失败都会被执行) complete (p) { console.log('request complete: ', p); } }); } } 三、WePY项目的目录结构 dist目录为WePY通过build指令生成的目录,除额外增加的npm目录外,其目录结构与原生小程序的目录结构类似。 原生小程序:app(app.js、app.json、app.wxss),page(page.js、page.json、page.wxml、page.wxss),文件必须同名。WePY中则使用了单文件模式:app.wpy,page.wpy。 ==> 一个.wpy文件可分为三大部分,各自对应于一个标签: 脚本<script>部分,又可分为两个部分: 逻辑部分,除了config对象之外的部分,对应于原生的.js文件 配置部分,即config对象,对应于原生的.json文件 结构<template>部分,对应于原生的.wxml文件 样式<style>部分,对应于原生的.wxss文件 <!--lang决定了其代码编译过程,src决定是否外联代码,存在src属性且有效时,会忽略内联代码--> <style lang="less" src="page1.less"></style>//lang值:css(默认)、less、scss、stylus、postcss <template lang="wxml" src="page1.wxml"></template>//lang值:wxml(默认)、xml、pug(原jade)。入口文件app.wpy不需要template,所以编译时会被忽略。 <script></script>//lang值:babel(默认、TypeScript 主要对目录的以下几点分析(其他目录文件详解类似于https://my.oschina.net/wangnian/blog/2050375中做的分析): 1、src文件夹 (1)components组件: 组件实例继承自wepy.component类,除了不需要config配置以及页面特有的一些生命周期函数之外,其属性与页面属性大致相同: import wepy from 'wepy'; export default class MyComponent extends wepy.component { props = {}//接收父组件传来的参数 customData = {} // 自定义数据 customFunction () {} //自定义方法 onLoad () {} // 在Page和Component共用的生命周期函数 data = {}; // 页面所需数据均需在这里声明,可用于模板数据绑定 components = {}; // 声明页面中所引用的组件,或声明组件中所引用的子组件 mixins = []; // 声明页面所引用的Mixin实例 computed = {}; // 声明计算属性(详见后文介绍) watch = {}; // 声明数据watcher(详见后文介绍) methods = {}; // 声明页面wxml中标签的事件处理函数。注意,此处只用于声明页面wxml中标签的bind、catch事件,自定义方法需以自定义方法的方式声明,不能放在methods中,会报错 events = {}; // WePY组件事件处理函数对象,存放响应组件之间通过$broadcast、$emit、$invoke所传递的事件的函数 } /** 与page不同的是component不存在: onShow () {} // 只在Page中存在的页面生命周期函数 config = {}; // 只在Page实例中存在的配置数据,对应于原生的page.json文件,类似于app.wpy中的config onReady() {} // 只在Page中存在的页面生命周期函数 **/ 原生小程序支持js模块化,但彼此独立,业务代码与交互事件仍需在页面处理。无法实现组件化的松耦合与复用(如,模板A中绑定一个bindtap="myclick",模板B中同样绑定一样bindtap="myclick",那么就会影响同一个页面事件、数据) WePY组件的所有业务与功能在组件本身实现,组件与组件之间彼此隔离(上述例子在WePY的组件化开发过程中,A组件只会影响到A所绑定的myclick,B也如此) // 原生代码: <!-- item.wxml --> <template name="item"> <text>{{text}}</text> </template> <!-- index.wxml --> <import src="item.wxml"/> <template is="item" data="{{text: 'forbar'}}"/> <!-- index.js --> var item = require('item.js') // WePY <!-- /components/item.wpy --> <text>{{text}}</text> <!-- index.wpy --> <template> <com></com> </template> <script> import wepy from 'wepy'; import Item from '../components/item'; export default class Index extends wepy.page { components = { com: Item } } </script> ps,在 1.7.2-alpha4 的实验版本中提供了对原生组件的支持 a.引用组件 页面可以引入组件,而组件还可以引入子组件 /** project └── src ├── components | └── child.wpy ├── pages | ├── index.wpy index 页面配置、结构、样式、逻辑 | └── log.wpy log 页面配置、结构、样式、逻辑 └──app.wpy 小程序配置项(全局公共配置、公共样式、声明钩子等) **/ // index.wpy <template> <!-- 以`<script>`脚本部分中所声明的组件ID为名命名自定义标签,从而在`<template>`模板部分中插入组件 --> <view class="child1"> <child></child> </view> <view class="child2"> <!--注意:WePY中,在父组件template模板部分插入驼峰式命名的子组件标签时,不能将驼峰式命名转换成短横杆式命名(比如将childCom转换成child-com,这与Vue中不一致)--> <anotherchild></anotherchild> </view> </template> <script> import wepy from 'wepy'; //引入组件文件 import Child from '../components/child'; export default class Index extends wepy.component { //声明组件,分配组件id为child,需要注意的是,WePY中的组件都是静态组件,是以组件ID作为唯一标识的,每一个ID都对应一个组件实例,当页面引入两个相同ID的组件时,这两个组件共用同一个实例与数据,当其中一个组件数据变化时,另外一个也会一起变化。 components = { //为两个相同组件的不同实例分配不同的组件ID,从而避免数据同步变化的问题 child: Child, anotherchild: Child }; } </script> ②循环渲染组件(1.4.6新增) WePY 1.x 版本中,循环渲染WePY组件时(类似于通过wx:for循环渲染原生的wxml标签),必须使用WePY定义的辅助标签<repeat> WePY组件是静态编译组件(在编译阶段编译进页面),每个组件都是唯一的一个实例,目前只提供简单的repeat支持(不支持在repeat的组件中去使用props,computed,watch等),因此如下: <!-- 错误使用 ---> // list.wpy <view>{{test.name}}</view> // index.wpy <repeat for="{{mylist}}"> <List :test.sync="item"></List> </repeat> <!-- 推荐用法 ---> // list.wpy <repeat for="{{mylist}}"> <view>{{item.name}}</view> </repeat> // index.wpy <List :mylist.sync="mylist"></List> ③props 传值 props传值在WePY中属于父子组件之间传值的一种机制,包括静态传值与动态传值。 静态传值为父组件向子组件传递常量数据,因此只能传递String字符串类型。 动态传值是指父组件向子组件传递动态数据内容,父子组件数据完全独立互不干扰。但可以通过使用.sync修饰符来达到父组件数据绑定至子组件的效果,也可以通过设置子组件props的twoWay: true来达到子组件数据绑定至父组件的效果。如果既使用.sync修饰符,同时子组件props中添加的twoWay: true时,就可以实现数据的双向绑定。 // parent.wpy <!--在父组件template模板部分所插入的子组件标签中,使用:prop属性(等价于Vue中的v-bind:prop属性)来进行动态传值--> <child :title="parentTitle" :syncTitle.sync="parentTitle" :twoWayTitle="parentTitle"></child> <!--通过使用.sync修饰符来达到父组件数据绑定至子组件的效果--> <script> data = { parentTitle: 'p-title' }; </script> // child.wpy <script> props = { // 静态传值 title: String, // 父向子单向动态传值 syncTitle: { type: String, default: 'null' }, // 双向绑定 twoWayTitle: { type: String, default: 'nothing', twoWay: true//twoWay: true(默认false)来达到子组件数据绑定至父组件的效果,如果同时使用.sync修饰符,就可以实现双向绑定 } }; onLoad () { console.log(this.title); // p-title console.log(this.syncTitle); // p-title console.log(this.twoWayTitle); // p-title this.title = 'c-title'; console.log(this.$parent.parentTitle); // p-title. this.twoWayTitle = 'two-way-title'; this.$apply(); console.log(this.$parent.parentTitle); // two-way-title. --- twoWay为true时,子组件props中的属性值改变时,会同时改变父组件对应的值 this.$parent.parentTitle = 'p-title-changed'; this.$parent.$apply(); console.log(this.title); // 'c-title'; console.log(this.syncTitle); // 'p-title-changed' --- 有.sync修饰符的props属性值,当在父组件中改变时,会同时改变子组件对应的值。 } </script> ④组件通信与交互 wepy.component基类提供$broadcast、$emit、$invoke三个方法用于组件之间的通信和交互: $broadcast $broadcast事件是由父组件发起,所有子组件都会收到此广播事件,除非事件被手动取消。事件广播的顺序为广度优先搜索顺序 $emit $emit与$broadcast正好相反,组件发起事件后所有祖先组件会依次接收到$emit事件 //子组件: this.$emit('some-event', 1, 2, 3, 4); //父组件: import wepy from 'wepy' export default class Com extends wepy.component { components = {}; data = {}; methods = {}; // events对象中所声明的函数为用于监听组件之间的通信与交互事件的事件处理函数 events = { 'some-event': (p1, p2, p3, $event) => { console.log(`${this.$name} receive ${$event.name} from ${$event.source.$name}`); } }; // Other properties } $invoke $invoke是一个页面/组件对另一个组件中的方法的直接调用,通过传入组件路径找到相应的组件,然后再调用其方法。 this.$invoke('ComA', 'someMethod', 'someArgs');//在页面Page_Index中调用组件ComA的某个方法 this.$invoke('./../ComB/ComG', 'someMethod', 'someArgs');//在组件ComA中调用组件ComG的某个方法 //只能在methods中使用 在周期函数使用会报错 ⑤组件自定义事件处理函数(.user事件后缀,1.4.8新增) 示例如下(注意,如果用了自定义事件,则events中对应的监听函数不会再执行): // index.wpy <template> <child @childFn.user="parentFn"></child> </template> <script> import wepy from 'wepy' import Child from '../components/child' export default class Index extends wepy.page { components = { child: Child } methods = { parentFn (num, evt) { console.log('parent received emit event, number is: ' + num) } } } </script> // child.wpy <template> <view @tap="tap">Click me</view> </template> <script> import wepy from 'wepy' export default class Child extends wepy.component { methods = { tap () { console.log('child is clicked') this.$emit('childFn', 100) } } } </script> ⑥slot 组件内容分发插槽 WePY中的slot插槽作为内容分发标签的空间占位标签,便于在父组件中通过对相当于扩展板卡的内容分发标签的“插拔”,更为灵活、方便地对子组件进行内容分发。 注意,父组件中的标签必须有slot属性,且值为子组件中对应的slot名,这样父组件内容分发标签中的内容(即便没有内容,子组件插槽中的默认内容也不会显示出来,只有删除了父组件中对应的内容分发标签,才能显示出来)会覆盖掉子组件对应插槽中的默认内容 //首先在子组件template模板部分中声明slot标签作为内容插槽,同时必须在其name属性中指定插槽名称,还可设置默认的标签内容 <view class="panel"> <slot name="title">默认标题</slot> <slot name="content">默认内容</slot> </view> //然后在引入了该带有插槽的子组件的父组件template模板部分中声明用于“插拔”的内容分发标签 <panel> <view slot="title">新的标题</view> <view slot="content"> <text>新的内容</text> </view> </panel> eg:message-com.wpy: <template> <!-- 1.4.6新增:循环渲染时(类似于原生的wx:for),必须使用WePY定义的辅助标签"<repeat>" --> <repeat for="{{messageList}}" index="index" item="message"> <navigator url="/pages/topicDetail?topicId={{message.busiId}}"> <view class="msgList"> <!-- "<text selectable='true'>" 使文字可选--> <text selectable='true'>{{message.content}}</text> <view style="text-align: right;"> <text style="color: rgb(202,202,202);">{{message.createTime}}</text> </view> </view> </navigator> </repeat> </template> <script> import wepy from 'wepy' //引入wepy export default class Message extends wepy.component {//创建组件实例 props = {//接收父组件参数 messageList: {// * 类型和默认值参数不能省略,组件会偶发性接收不到父组件传递的参数 type: Array, default:[] } }; } </script> <style scoped lang="less"> .topicInfo text { font-size: 12px; color: #666; } .topicBottom view { margin-right: 15px; } .msgList { background-color: #fff; margin-top: 7px; padding: 10px 15px; } </style> message-page.wpy: <template> <view wx:if="{{!messageList.length}}" class="noData">暂无消息</view> <block wx:else> <message :messageList.sync="messageList"></message> <downLoad :show.sync="getListParam"></downLoad> </block> </template> <script> import wepy from 'wepy' import Message from '../components/message' import DownLoad from '../components/downLoad' import listMixin from '../mixins/list' import {connect} from 'wepy-redux' import {getMessageList} from '../store/actions' @connect({ messageList(state) { return state.reducer.messageList; } }, { getMessageList }) export default class MineMessages extends wepy.page { config = { navigationBarTitleText: '我的消息' }; components = { message: Message, downLoad: DownLoad }; data = {}; mixins = [listMixin]; methods = { getList(params) { let listParam = { messageType: 4 }; if (wx.getStorageSync('userId')) { this.getMessageList(Object.assign(listParam, params)); } else { wx.showToast({ title: '您还没有登录', icon: 'none' }); } } }; } </script> (2)mixins:Mixin 混合(公用的js) 混合可以将组件之间的可复用部分抽离,从而在组件中使用混合时,可以将混合的数据,事件以及方法注入到组件之中。混合分为两种: 默认式混合(data、components、events、自定义方法),即组件未声明的选项将混合对象中注入组件之中,组件已声明的选项将不受影响 兼容式混合(methods响应事件 、小程序页面事件),即先响应组件本身响应事件,然后再响应混合对象中响应事件(Vue则相反,先执行mixin中的函数, 再执行组件本身的函数) eg:listMixin.js: import wepy from 'wepy' export default class ListMixin extends wepy.mixin {//创建mixin实例 config = { enablePullDownRefresh: true,//开启下拉刷新,默认是关闭的 onReachBottomDistance: 10,//设置触发下拉刷新的底部距离 backgroundColor: "#eab010"//设置背景色 }; data = { getListParam: {//获取列表数据的通用参数 hasMoreData: true, loading: false, noMore: false, page: 1, limit: 10, } }; /** * 页面相关事件处理函数--监听用户下拉动作(下拉刷新) */ onPullDownRefresh() { wx.showNavigationBarLoading(); //在标题栏中显示加载 this.data.getListParam.page = 1;//下拉刷新时参数page=1 this.methods.getList(this.data.getListParam);//调用组件中的获取列表函数 setTimeout(() => { wx.hideNavigationBarLoading(); //完成停止加载 wx.stopPullDownRefresh(); //停止下拉刷新 }, 300) }; /** * 页面上拉触底事件的处理函数(上拉加载) */ onReachBottom() { if (this.data.getListParam.hasMoreData) { this.data.getListParam.page++;//每触发一次page++ this.data.getListParam.hasMoreData = false;//关闭可调用函数 this.data.getListParam.loading = true;//显示加载中...(自己写的底部加载中样式的组件) this.methods.getList(this.data.getListParam);//调用组件中的获取列表函数 setTimeout(() => { this.data.getListParam.loading = false;//关闭显示加载中...(自己写的底部加载中样式的组件) this.$apply();//强制渲染 }, 100); } else { this.data.getListParam.noMore = true;//显示加载完成(自己写的底部加载到底样式的组件) } }; onReady() { this.methods.getList(this.data.getListParam);//初始化请求页面数据 } } 使用时引入然后注入到组件实例(最好放在data属性后,否则会偶发性报错),eg: (3)页面page.wpy Page页面实际上继承自Component组件,即Page也是组件。除扩展了页面所特有的config配置以及特有的页面生命周期函数之外,其它属性和方法与Component一致: import wepy from 'wepy'; export default class MyPage extends wepy.page { customData = {} // 自定义数据 customFunction () {} //自定义方法 onLoad () {} // 在Page和Component共用的生命周期函数 onUnload() {} // 监听页面卸载 onReady() {} // 只在Page中存在的页面生命周期函数 onShow () {} // 只在Page中存在的页面生命周期函数,当小程序启动,或从后台进入前台显示 onHide() {} // 只在Page中存在的页面生命周期函数,当小程序从前台进入后台 config = {}; // 只在Page实例中存在的配置数据,对应于原生的page.json文件,类似于app.wpy中的config data = {}; // 页面所需数据均需在这里声明,可用于模板数据绑定 components = {}; // 声明页面中所引用的组件,或声明组件中所引用的子组件 mixins = []; // 声明页面所引用的Mixin实例 computed = {}; // 声明计算属性(详见后文介绍) watch = {}; // 声明数据watcher(详见后文介绍) methods = {}; // 声明页面wxml中标签的事件处理函数。注意,此处只用于声明页面wxml中标签的bind、catch事件,自定义方法需以自定义方法的方式声明 events = {}; // WePY组件事件处理函数对象,存放响应组件之间通过$broadcast、$emit、$invoke所传递的事件的函数 onPullDownRefresh(){} // 监听用户下拉动作 onReachBottom(){} // 页面上拉触底事件的处理函数 onShareAppMessage(){} // 用户点击右上角分享 onPageScroll(){} // 页面滚动 onTabItemTap(){} // 当前是 tab 页时,点击 tab 时触发 } (4)状态管理store(redux) (5)app.wpy:小程序入口 app.wpy实例继承自wepy.app类,包含:config配置对象(对应原生的app.json文件,build编译时会根据config属性自动生成app.json文件)、globalData全局数据对象、自定义方法与属性、小程序生命周期函数。 在Page页面实例中,可以通过this.$parent来访问App实例。 <script> import wepy from 'wepy'; export default class extends wepy.app { config = { pages:[// pages定义当前小程序所有页面路径,让微信客户端知道当前你的小程序页面定义在哪个目录 'pages/index', 'pages/mine' ], window:{//window定义小程序所有页面的顶部背景颜色,文字颜色定义等。 "backgroundTextStyle": "light", "navigationBarBackgroundColor": "#fff", "navigationBarTitleText": "顶部标题", "navigationBarTextStyle": "black" }, tabBar: { selectedColor: '#ea9100',//底部导航字体选中时的颜色 list: [ { pagePath: 'pages/index',//导航页面路径(必须在pages中定义) text: '首页',//导航名 iconPath: 'img/index.png',//未选中的导航icon selectedIconPath: 'img/index1.png'//选中时的导航icon }, { pagePath: 'pages/mine', text: '我的', iconPath: 'img/mine.png', selectedIconPath: 'img/mine1.png' } ] }, }; onLaunch() {//初始化 console.log(this); } onShow(){}//当小程序启动,或从后台进入前台显示 onHide(){}//当小程序从前台进入后台 } </script> <style lang="less"> /** less **/ </style> (6)index.template.html:web页面的入口文件 2、project.config.json小程序项目配置文件 1.7.0 之后的版本会在根目录包含project.config.json,使用微信开发者工具-->添加项目,项目目录请选择项目根目录即可根据配置完成项目信息自动配置。 1.7.0 之前生成的代码包可能不存在project.config.json文件,建议手动创建该文件后再添加项目。project.config.json文件内容如下: { "description": "project description", "setting": { "urlCheck": true,//对应不检查安全域名选项,开启。 如果已配置好安全域名则建议关闭 "es6": false,//对应关闭ES6转ES5选项,关闭。 重要:未关闭会运行报错 "postcss": false,//对应关闭上传代码时样式自动补全选项,关闭。 重要:某些情况下漏掉此项也会运行报错 "minified": false //对应关闭代码压缩上传选项,关闭。重要:开启后,会导致真机computed, props.sync 等等属性失效。(注:压缩功能可使用WePY提供的build指令代替) }, "compileType": "miniprogram", "appid": "touristappid", "projectname": "Project name", "miniprogramRoot": "./dist" } 3、wepy.config.js const path = require('path'); var prod = process.env.NODE_ENV === 'production'; module.exports = { /*wpyExt:缺省值为'.wpy',IDE默认情况下不会对此文件类型进行高亮处理 除了进行前文代码高亮设置之外 还可以直接将相关文件的后缀名由.wpy修改为.vue,然后将此选项修改为.vue */ wpyExt: '.wpy', eslint: false, cliLogs: !prod, build: { web: { htmlTemplate: path.join('src', 'index.template.html'), htmlOutput: path.join('web', 'index.html'), jsOutput: path.join('web', 'index.js') } }, resolve: { alias: { counter: path.join(__dirname, 'src/components/counter'), '@': path.join(__dirname, 'src') }, aliasFields: ['wepy', 'weapp'], modules: ['node_modules'] }, /** compilers为1.3.1版本之后的功能,如果需要使用其它语法,请先配置compilers,然后再安装相应的compilers 目前支持wepy-compiler-less, wepy-compiler-postcss,wepy-compiler-sass、wepy-compiler-babel、wepy-compiler-pug 其他compiler持续开发中 */ compilers: { less: { compress: prod }, /*sass: { outputStyle: 'compressed' },*/ babel: { sourceMap: true, presets: [ 'env' ], /* plugins为1.1.6版本之后的功能 目前支持js压缩wepy-plugin-ugliyjs、图片压缩wepy-plugin-imagemin 其他plugin持续开发中 */ plugins: [ 'transform-class-properties', 'transform-decorators-legacy', 'transform-object-rest-spread', 'transform-export-extensions', ] } }, plugins: {}, /*在使用的地方先引入import wepy from 'wepy'; 然后wepy.$appConfig.属性名。eg:wepy.$appConfig.baseUrl*/ appConfig: { baseUrl:process.env.NODE_ENV === 'production'? 'https://api.a.com/' : 'https://api.a.com/dev/',// 运行 npm run dev命令时,域名为https://api.a.com/dev/,运行 npm run build时域名为https://api.a.com/ noPromiseAPI: ['createSelectorQuery'] } } if (prod) { // 压缩sass module.exports.compilers['less'] = {outputStyle: 'compressed'} // 压缩js module.exports.plugins = { uglifyjs: { filter: /\.js$/, config: {} }, imagemin: { filter: /\.(jpg|png|jpeg)$/, config: { jpg: { quality: 80 }, png: { quality: 80 } } } } } 相关链接:mpvue文档、原生小程序文档、公众号文档 博客地址:https://my.oschina.net/wangnian
优秀的个人博客,低调大师

Python打包系统简单入门

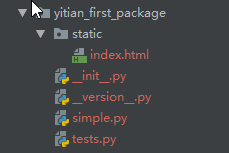
最近把pyenv、pipenv这种都研究了一下,然后我发现一个严重的问题:就是我虽然看了半天这些工具,但是我对Python自己的打包系统却完全没有了解。所以这篇文章就来研究一下Python自带的打包系统。 pip 先来详细介绍一下pip的用法,平时基本上我们用pip的时候也就是一个pip install。其实pip也有很多特性,在此先介绍一下常用的一些特性。此部分参考了pip文档,想了解更多的话可以看原文。 安装 最常用的命令就是安装了,除此以外还可以指定版本号: $ pip install SomePackage # 不指定版本号,安装最新版 $ pip install SomePackage==1.0.4 # 指定版本号 $ pip install 'SomePackage>=1.0.4' # 指定最小版本号 $ pip install -r requirements.txt # 从需求文件安装 $ pip install -e . # 从本地项目setup.py安装 使用代理服务器 当从官方的PyPI源安装比较慢的时候,可以考虑使用代理服务器,指定代理服务器的方法有三种: 使用--proxy参数在命令行指定,代理格式为[user:passwd@]proxy.server:port。 在配置文件中指定。 设置http_proxy, https_proxy 和no_proxy环境变量。 使用需求文件(requirements.txt) 在需要很多pip包的项目中,用pip一个个安装包不是一个好办法,这时候可以考虑使用需求文件。 如果要生成需求文件,用下面的命令。这会将当前Python环境中的所有包的当前版本状态保存下来,将来安装的时候会精确还原到冻结的那个状态。 pip freeze > requirements.txt 要从需求文件中安装,则是用下面的命令: pip install -r requirements.txt 官方文档还给出了一个带注释的实例需求文件: # ####### example-requirements.txt ####### # ###### 没有版本标识符的包,会安装最新版 ###### nose nose-cov beautifulsoup4 # ###### 带版本标识符的包 ###### # 版本标识符的资料 https://www.python.org/dev/peps/pep-0440/#version-specifiers docopt == 0.6.1 # Version Matching. Must be version 0.6.1 keyring >= 4.1.1 # Minimum version 4.1.1 coverage != 3.5 # Version Exclusion. Anything except version 3.5 Mopidy-Dirble ~= 1.1 # Compatible release. Same as >= 1.1, == 1.* # ###### 还可以指定其他的需求文件 ###### -r other-requirements.txt # # ###### 还可以指定本地货网络上的特定包 ###### ./downloads/numpy-1.9.2-cp34-none-win32.whl http://wxpython.org/Phoenix/snapshot-builds/wxPython_Phoenix-3.0.3.dev1820+49a8884-cp34-none-win_amd64.whl # ###### Additional Requirements without Version Specifiers ###### # 和第一部分一样,这里这些部分没有顺序需求,可以随意改变位置 rejected green # 版本标识符用来指定包的版本,有以下几个例子: SomeProject SomeProject == 1.3 SomeProject >=1.2,<.2.0 SomeProject[foo, bar] SomeProject~=1.4.2 从6.0版本开始,pip也支持环境标记(也就是分号后面跟Python版本或者系统类型): SomeProject ==5.4 ; python_version < '2.7' SomeProject; sys_platform == 'win32' 卸载 卸载某个包使用下面的命令: $ pip uninstall SomePackage 列出包 要列出所有已安装的包: $ pip list docutils (0.9.1) Jinja2 (2.6) Pygments (1.5) Sphinx (1.1.2) 要列出过时的包: $ pip list --outdated docutils (Current: 0.9.1 Latest: 0.10) Sphinx (Current: 1.1.2 Latest: 1.1.3) 要列出某个已安装的包的详细信息: $ pip show sphinx --- Name: Sphinx Version: 1.1.3 Location: /my/env/lib/pythonx.x/site-packages Requires: Pygments, Jinja2, docutils 搜索 要搜索一个包,用下面的命令,搜索结果可能有很多: $ pip search "query" 更新 要更新一个包,使用-U或者--upgrade参数: pip install -U <pkg> 如果想更新所有的包,很遗憾,pip并没有提供该功能,我在StackOverFlow上找到一个看起来比较简单的解决办法,就是在Python解释器中执行下面的代码: import pkg_resources from subprocess import call packages = [dist.project_name for dist in pkg_resources.working_set] call("pip install --upgrade " + ' '.join(packages), shell=True) 以上就是pip的一些简单用法,详情可参考官方文档。 打包项目 下面就进入本文的正题,Python的打包系统上。基本上我们不需要完全了解打包系统,只要学会简单的几个点就可以打包自己的类库了。打包需要distutils、setuptools、wheel等类库,不过基本上我们只需要写好其中最重要的setup.py,就可以完成打包工作了。distutils是官方的类库,在当年有很广泛的使用,不过到了现在很难用。distutuils类库的核心就是setup函数,我们需要将项目的各种信息作为参数传递给setup函数,然后就可以用相关命令创建项目分发包了。关于distutils的用法,可以参考官方文档。 当然现在项目基本都不用distutils了,有更好用的第三方替代品,那就是setuptools,它可以算作是distutils的加强版,功能更加强大、使用更加简单,这就是这里要介绍的。其实从文档就可以看出来,distutils毕竟时间比较早,有些接口设计的不太合理甚至有些反人类,setuptools的文档就简单多了。 准备项目 为了做演示,首先需要准备一个项目,一个项目应该包括README和LICENSE等文件,README文件是Markdown格式的文本文件,用于描述项目自身;LICENSE文件是授权文件,列出项目使用者应该遵循的各种条款。下图是我的项目结构。 项目结构 此外还可能存在几个文件: setup.cfg。对应的配置文件,一般情况下可以不要。 MANIFEST.in。清单文件,当项目中需要一些没办法自动包括到源代码分发包的文件时,可能需要用到它。 具体文件内容就不列出了。需要注意my_package/__init__.py文件中应该有如下一行标识包名: name = 'yitian_first_package' 编写setup.py文件 用setuptools来编写setup.py文件是一件非常简单的事情,而且有很多例子可供参考,我挑选了Kenneth Reitz(requests、pipenv等类库的作者)写的例子,做了一些修改并翻译了一些注释: #!/usr/bin/env python # -*- coding: utf-8 -*- # 注意 如果要使用上传功能,需要安装twine包: # $ pip install twine import io import os import sys from shutil import rmtree from setuptools import find_packages, setup, Command # 包的元信息 NAME = 'yitian_first_package' DESCRIPTION = '项目的简短描述,不超过200字符' URL = 'https://github.com/techstay/python-study' EMAIL = 'lovery521@gmail.com' AUTHOR = '易天' REQUIRES_PYTHON = '>=3.6.0' VERSION = '0.1.0' KEYWORDS = 'sample setuptools development' # 项目依赖,也就是必须安装的包 REQUIRED = [ 'requests-html' ] # 项目的可选依赖,可以不用安装 EXTRAS = { # 'fancy feature': ['django'], } # 剩下部分不用怎么管 :) # ------------------------------------------------ # 除了授权和授权文件标识符! # 如果你改了License, 记得也相应修改Trove Classifier! here = os.path.abspath(os.path.dirname(__file__)) # 导入README文件作为项目长描述. # 注意 这需要README文件存在! try: with io.open(os.path.join(here, 'README.md'), encoding='utf-8') as f: long_description = '\n' + f.read() except FileNotFoundError: long_description = DESCRIPTION # 当前面没指定版本号的时候,将包的 __version__.py 模块加载进来 about = {} if not VERSION: with open(os.path.join(here, NAME, '__version__.py')) as f: exec(f.read(), about) else: about['__version__'] = VERSION class UploadCommand(Command): """上传功能支持""" description = 'Build and publish the package.' user_options = [] @staticmethod def status(s): """Prints things in bold.""" print('\033[1m{0}\033[0m'.format(s)) def initialize_options(self): pass def finalize_options(self): pass def run(self): try: self.status('Removing previous builds…') rmtree(os.path.join(here, 'dist')) except OSError: pass self.status('Building Source and Wheel (universal) distribution…') os.system('{0} setup.py sdist bdist_wheel --universal'.format(sys.executable)) self.status('Uploading the package to PyPI via Twine…') os.system('twine upload dist/*') self.status('Pushing git tags…') os.system('git tag v{0}'.format(about['__version__'])) os.system('git push --tags') sys.exit() # 神奇的操作,一个函数完事 setup( name=NAME, version=about['__version__'], description=DESCRIPTION, long_description=long_description, long_description_content_type='text/markdown', author=AUTHOR, author_email=EMAIL, python_requires=REQUIRES_PYTHON, url=URL, keywords=KEYWORDS, # 项目中要包括和要排除的文件,setuptools可以自动搜索__init__.py文件来找到包 packages=find_packages(exclude=('tests',)), # 如果项目中包含任何不在包中的单文件模块,需要添加py_modules让setuptools能找到它们: # py_modules=['yitian_first_package'], # entry_points={ # 'console_scripts': ['mycli=mymodule:cli'], # }, install_requires=REQUIRED, extras_require=EXTRAS, # 老旧的distutils需要手动添加项目中需要的非代码文件,setuptools可以用下面参数自动添加(仅限包目录下) include_package_data=True, # 如果是包的子目录下,则需要手动添加 package_data={ 'yitian_first_package': ['static/*.html'] }, license='MIT', classifiers=[ # Trove classifiers # Full list: https://pypi.python.org/pypi?%3Aaction=list_classifiers 'License :: OSI Approved :: MIT License', 'Programming Language :: Python', 'Programming Language :: Python :: 3', 'Programming Language :: Python :: 3.7', 'Programming Language :: Python :: Implementation :: CPython', 'Programming Language :: Python :: Implementation :: PyPy' ], # $ setup.py publish support. cmdclass={ 'upload': UploadCommand, }, ) 下面再讲一些在注释里没法详细解释的东西,官方文档的内容更丰富,有需要的可以查看。示例文件中其实还有几个setup参数没写全,这里再补充一下。 project_urls project_urls参数可以列出一些相关项目的URL。 project_urls={ 'Documentation': 'https://packaging.python.org/tutorials/distributing-packages/', 'Funding': 'https://donate.pypi.org', 'Say Thanks!': 'http://saythanks.io/to/example', 'Source': 'https://github.com/pypa/sampleproject/', 'Tracker': 'https://github.com/pypa/sampleproject/issues', }, python_requires参数格式就是pip中指定包版本的标识符,,指定我们项目支持的Python版本,这里再补充几个例子。 # 大版本号大于等于3 python_requires='>=3', # 版本号大于等于3.3,但是不能超过4 python_requires='~=3.3', # 支持2.6 2.7以及所有以3.3开头的Python 3版本 python_requires='>=2.6, !=3.0.*, !=3.1.*, !=3.2.*, <4', package_data和data_file package_data和data_file参数用于指定数据文件,也就是在项目中使用到的非代码文件,一般情况下通过设置include_package_data=True自动搜索就够用了,如果需要细粒度的控制,就要使用它们了,详情见setuptools 文档 - Including Data Files。 package_data指定包括在包中的数据文件,也就是“包数据文件”,这些文件会复制到包的相应目录。 package_data={ 'package_name': ['package_data.dat'], }, data_files指定放在包外的数据文件,这些文件会被复制到项目根目录下指定的相对目录中。 data_files=[('my_data', ['data/data_file'])], entry_points entry_points参数指定一些入口点,可以看做是项目提供的一些额外功能,其中最常见的就是console_scripts,用于注册脚本接口。setuptools提供的工具链可以在安装项目分发包的时候将这些接口转化为真正的可执行脚本,更多信息参考setuptools文档 - Automatic Script Creation。 entry_points={ 'console_scripts': [ 'sample=sample:main', ], }, 版本号 下面是开发、A测、B测、发布候选、最终发布等情况的版本号实例。 1.2.0.dev1 # Development release 1.2.0a1 # Alpha Release 1.2.0b1 # Beta Release 1.2.0rc1 # Release Candidate 1.2.0 # Final Release 1.2.0.post1 # Post Release 15.10 # Date based release 23 # Serial release 开发模式 setup.py文件写完之后,项目就算是可打包状态了。当然也可以继续在项目上进行工作,这时候一般希望项目既可以作为包来安装,又希望项目是可以编辑的,这时候就可以进入开发模式。这种情况下需要用下面的命令来安装包,-e选项全称是--editable,也就是可编辑的意思;.表示当前目录,也就是setup.py存在的那个目录: pip install -e . 该命令会安装install_requires中指定的所有包,以及console_scripts部分指定的脚本。依赖项会作为普通包来安装,而项目本身会以可编辑状态来安装。特别的,如果只希望安装项目本身而不安装所有依赖包,用下面的命令: pip install -e . --no-deps 如果有需要的话,还可以安装VCS或者本地目录中保存的包来替代官方索引中的包。详情请查看文档。 打包项目 终于到了观看成果的时候了,项目可以被打包成各种类型的可分发包,这里只介绍几种最常用的。 源码分发包(sdist) 这是最低等级的一种,基本上就是复制源代码,不过因此在安装的时候有一个必须的构建(可能包括编译)过程来生成各种元信息,哪怕项目是纯的Python项目。用下面的命令来生成: python setup.py sdist Wheels(轮子) 在编程界各种第三方包不是被形象地称作轮子吗(著名梗:不要重复造轮子),这里就是这个意思。轮子是一种二进制分发包,是现在最推荐的分发包格式,轮子又可以分为好几种轮子。当然,在构建轮子之前,还需要安装wheel包来提供支持。 pip install wheel 通用轮子。也就是项目中只存在Python代码,同时兼容Python 2和Python 3的轮子,用下面的命令生成。 python setup.py bdist_wheel --universal 当然也可以在setup.cfg配置文件中指定: [bdist_wheel] universal=1 纯Python轮子。和通用轮子差不多,不过只支持Python 2或者Python 3. python setup.py bdist_wheel 平台轮子。这种轮子中不仅有Python代码,一般还包括但不限于C代码写成的扩展等,因此它们只支持特定平台。 python setup.py bdist_wheel 运行以上命令之后,会在dist文件夹中生成打包好的可发布包。 发布项目 项目打包完毕,生成可可分发包之后,最后一步就是发布项目了。几乎所有的项目都被发布到了Python Package Index(简称PyPI)上了,当然如果有需求的话还可以搭建自己的私人索引,不过这就是另一个话题了。 很有意思的是,Python官方还提供了一个测试索引,它是一个和PyPI完全一样的测试网站,定期清理,可以让我们方便的练习上传项目,同时不用担心会污染官方仓库。使用方法很简单,先注册一个账户。 上传项目需要用到另一个类库twine: pip install twine 然后用下面的命令将包上传到测试索引中,该命令会提示输入刚才注册用的用户名和密码: twine upload --repository-url https://test.pypi.org/legacy/ dist/* 稍等片刻,上传应该就完成了。然后就可以在测试索引中找到我的项目了。当然由于测试索引会定期清理的缘故,可能过段时间项目和我的账户就都不存在了。 上传完成 全部流程都熟悉之后,就可以在官方索引上注册账号,并将项目上传上去,这样一来,全世界的开发者都能用到你的项目了!

优秀的个人博客,低调大师

Vuex 快速入门 简单易懂

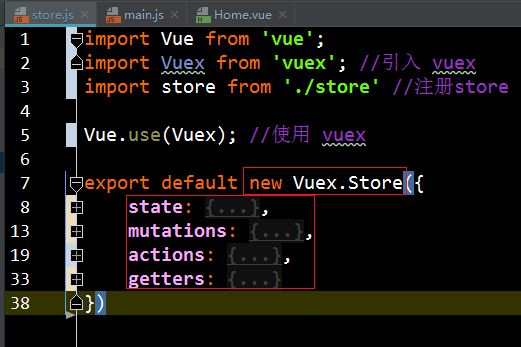
一、vuex介绍 (1)vuex是什么? 1. 借鉴了Flux、Redux、The Elm Architecture 2. 专为 Vue.js 设计的状态管理模式 3. 集中式存储和管理应用程序中所有组件的状态 4. Vuex 也集成到 Vue 的官方调试工具 5. 一个 Vuex 应用的核心是 store(仓库,一个容器),store包含着你的应用中大部分的状态 (state)。 (2)什么情况下我应该使用 Vuex? 1. 不适用:小型简单应用,用 Vuex 是繁琐冗余的,更适合使用简单的store 模式。 2. 适用于:中大型单页应用,你可能会考虑如何把组件的共享状态抽取出来,以一个全局单例模式管理,不管在哪个组件,都能获取状态/触发行为,解决问题如下: ① 多个视图使用于同一状态: 传参的方法对于多层嵌套的组件将会非常繁琐,并且对于兄弟组件间的状态传递无能为力 ② 不同视图需要变更同一状态: 采用父子组件直接引用或者通过事件来变更和同步状态的多份拷贝,通常会导致无法维护的代码 (3)Vuex 和单纯的全局对象有何不同? 1.Vuex 的状态存储是响应式的 当 Vue 组件从 store 中读取状态的时候,若 store 中的状态发生变化,那么相应的组件也会相应地得到高效更新。 2.你不能直接改变 store 中的状态 改变 store 中的状态的唯一途径就是显式地提交 (commit) mutation,方便我们跟踪每一个状态的变化。 二、vuex安装 * vue cli 3 中搭建脚手架预设时选择了“vuex”后便安装了vuex,可跳过此步阅读 (1)<script>引入 在 Vue 之后引入vuex会进行自动安装: <script src="/path/to/vue.js"></script> <script src="/path/to/vuex.js"></script> (2) 包管理 npm install vuex --save //yarn add vuex 在一个模块化的打包系统中,您必须显式地通过 Vue.use() 来安装 Vuex: import Vue from 'vue' import Vuex from 'vuex' Vue.use(Vuex) (3)git clone 自己构建 git clone https://github.com/vuejs/vuex.git node_modules/vuex cd node_modules/vuex npm install npm run build (4)兼容 Vuex 依赖Promise。如果你支持的浏览器并没有实现 Promise (如 IE),那么你可以使用一个 polyfill 的库(如 es6-promis) 1.你可以通过 CDN 将其引入,window.Promise会自动可用: <script src="https://cdn.jsdelivr.net/npm/es6-promise@4/dist/es6-promise.auto.js"></script> 2.包管理器安装: npm install es6-promise --save //yarn add es6-promise 然后,将下列代码添加到你使用 Vuex 之前的一个地方: import 'es6-promise/auto' 三、使用 (1)使用介绍 1.搭建store实例 ①. 在创建vuex实例的地方引入vue、vuex,使用vuex: import Vue from 'vue'//引入vue import Vuex from 'vuex'//引入vuex Vue.use(Vuex); //使用 vuex ②. 如果你的actions中用到 store.dispath() ,要引入store import store from './store' //引入状态管理 store ③. new 一个 Vuex.Store 实例,并注册 state、mutations、actions、getters到Vuex.Store 实例中 ps. 你可以像上面那样将“属性和值”直接写在实例中,当代码量大时,你也可以分别写个.js文件,如下图: 然后引入到 store/index.js 注册到vuex实例中,如: 2.创建好 vuex.store 后,你需要在入口文件 main.js 中引入 store 并注册到 vue 实例中,这样就可以在任何组件使用store了: 3.在组件中使用: ①. 引入vuex中各属性对应的辅助函数: import {mapActions, mapState,mapGetters} from 'vuex' //注册 action 、 state 、getter ②. 使用store中的状态数据、方法: 使用方法有很多,这种事最简单实用的,更多可以查看官网学习:https://vuex.vuejs.org/zh/ (2)具体demo 来个简单易懂的计数 eg:store.js import Vue from 'vue'; import Vuex from 'vuex'; //引入 vuex import store from './store' //注册store Vue.use(Vuex); //使用 vuex export default new Vuex.Store({ state: { // 初始化状态 count: 0, someLists:[] }, mutations: { // 处理状态 increment(state, payload) { state.count += payload.step || 1; } }, actions: { // 提交改变后的状态 increment(context, param) { context.state.count += param.step; context.commit('increment', context.state.count)//提交改变后的state.count值 }, incrementStep({state, commit, rootState}) { if (rootState.count < 100) { store.dispatch('increment', {//调用increment()方法 step: 10 }) } } }, getters: { //处理列表项 someLists: state =>param=> { return state.someLists.filter(() => param.done) } } }) 使用时,eg: main.js: import Vue from 'vue' import App from './App.vue' import router from './router' import store from './store' //引入状态管理 store Vue.config.productionTip = false new Vue({ router, store,//注册store(这可以把 store 的实例注入所有的子组件) render: h => h(App) }).$mount('#app') views/home.vue: <template> <div class="home"> <!--在前端HTML页面中使用 count--> <HelloWorld :msg="count"/> <!--表单处理 双向绑定 count--> <input :value="count" @input="incrementStep"> </div> </template> <script> import HelloWorld from '@/components/HelloWorld.vue' import {mapActions, mapState,mapGetters} from 'vuex' //注册 action 和 state export default { name: 'home', computed: { //在这里映射 store.state.count,使用方法和 computed 里的其他属性一样 ...mapState([ 'count' ]), count () { return store.state.count } }, created() { this.incrementStep(); }, methods: { //在这里引入 action 里的方法,使用方法和 methods 里的其他方法一样 ...mapActions([ 'incrementStep' ]), // 使用对象展开运算符将 getter 混入 computed 对象中 ...mapGetters([ 'someLists' // ... ]) }, components: { HelloWorld } } </script> 运行结果: 博客地址:https://my.oschina.net/wangnian
优秀的个人博客,低调大师

前端概述及网页入门

目录 一、前端简介 二、前端开发技术栈 HTML(超文本标记语言 Hyper Text Markup Language) CSS(层叠样式表 Cascading Style Sheet) JavaScript 三、第一个页面 (一)、基础模板 (二)、模板解读 (三)、其它模板标签 一、前端简介 前端是什么? 前端就是网站的前台,运行在PC端,移动端等浏览器上展现给用户浏览的网页。 - 广义前端:所有用户可以直接看见并交互的界面 - 侠义前端:浏览器上运行的用户交互界面 随着互联网技术的发展,前端领域的技术发展也越来越快,各种新的思想、设计模式、工具和平台都快速发展,对前端工程师的技能要求也越来越高。JavaScript的应用也越来越广泛,在各个端,各个领域,前端也在慢慢地渗入与腐蚀其他开发语言的领地,行业对前端程序员的热度需求并没有下降,未来还是有很好的前景的。 二、前端开发技术栈 前端工程师需要学习哪些技能呢? 首先你需要掌握前端三剑客,再去学习一些框架就可以去上班啦! HTML(超文本标记语言 Hyper Text Markup Language) html为标记语言,非编程语言,不具备编程语言具备的程序逻辑。文件后缀名(.html/.htm) html是一个网页的骨架,无论是静态网页还是动态网页,最终返回到浏览器端的都是HTML代码,浏览器将HTML代码解释渲染后呈现给用户。因此,我们必须掌握HTML的基本结构和常用标记及属性。 有人将html比做建房子的框架(地基,架子),我觉得很好,这里就借鉴一下。 1.html组成(标签、指令、转义字符) 标签:被尖括号包裹,由字母开头包含合法字符的,可以被浏览器解析的标记。eg:系统标签,自定义标签 指令:被尖括号包裹,由!开头的标记。eg:<!doctype html> <!-- --> 转义字符:被&与;包裹的特殊字母组合或#开头的十进制数。eg:&#60; &#62; &nbsp; v_hint:转义字符 2.html发展版本 ① html1:在1993年6月作为互联网工程工作小组(IETF)工作草案发布(并非标准) ② html2:1995年11月作为RFC 1866发布,在RFC 2854于2000年6月发布之后被宣布已经过时 ③ html3.2:1997年1月14日,W3C推荐标准 ④ html4.0:1997年12月18日,W3C推荐标准 ⑤ html4.01(微小改进):1999年12月24日,W3C推荐标准 ⑤ html5:2014年10月28日,W3C推荐标准(h5草案的前身名为Web Applications 1.0。于2004年被WHATWG提出,于2007年被W3C接纳,并成立了新的HTML工作团队。在2008年1月22日,第一份正式草案发布。) 3.文档类型 <!-- 标签语法规范 --> <!DOCTYPE HTML PUBLIC "-//W3C//DTD HTML 4.01//EN" "http://www.w3.org/TR/html4/strict.dtd"> <!DOCTYPE html PUBLIC "-//W3C//DTD XHTML 1.0 Transitional//EN" "http://www.w3.org/TR/xhtml1/DTD/xhtml1-transitional.dtd"> <!DOCTYPE html> CSS(层叠样式表 Cascading Style Sheet) css也是标记语言,非编程语言。文件后缀名(.css) CSS能够对网页中元素位置的排版进行像素级精确控制,支持几乎所有的字体字号样式,拥有对网页对象和模型样式编辑的能力,真正做到网页表现与内容分离的一种样式设计语言。相对于传统HTML的表现而言其样式是可以复用的,这样就极大地提高了我们开发的速度,降低了维护的成本。负责页面的风格设计,样式、美观。 把html比作建房子的架子,那么css就是对房子的装修,粉刷墙壁颜色等。 1.css组成(选择器、作用域、样式块) 选择器:由标签、类、id单独或组合出现 作用域:一组大括号包含的区域 样式块:满足css连接语法的众多样式 2.css发展版本 ① 1990年,Tim Berners-Lee和Robert Cailliau共同发明了Web。1994年,Web真正走出实验室。 ② 1994年哈坤·利提出了CSS的最初建议。而当时伯特·波斯(Bert Bos)正在设计一个名为Argo的浏览器,于是他们决定一起设计CSS。 ③ 哈坤于1994年在芝加哥的一次会议上第一次提出了CSS的建议,1995年的www网络会议上CSS又一次被提出,博斯演示了Argo浏览器支持CSS的例子,哈肯也展示了支持CSS的Arena浏览器。 ④ 1997年初,W3C组织负责CSS的工作组开始讨论第一版中没有涉及到的问题。其讨论结果组成了1998年5月出版的CSS规范第二版。 ⑤ CSS3是CSS(层叠样式表)技术的升级版本,于1999年开始制订,2001年5月23日W3C完成了CSS3的工作草案,主要包括盒子模型、列表模块、超链接方式、语言模块、背景和边框、文字特效、多栏布局等模块。 JavaScript 不同于html和css,它是一门实实在在的编程语言,有完善的语法,可以完成复杂的程序逻辑。 文件后缀名(.js) JavaScript是浏览器脚本语言,可以编写运行在浏览器上的程序,实现更多地动态功能,表现出更加丰富的视觉效果。主要负责编写页面特效、调用浏览器的API\(BOM\)、操作改变页面内容\(DOM\),从后端获取数据\(Ajax\),渲染页面等。 JavaScript就好比房子过程中的人,房子通过打地基建造(html),装修(css),最后住人(js)。有了JavaScript网页才有灵魂。 1.JavaScript的组成(DOM、BOM、ES) DOM:文档对象模型(Document Object Model),是W3C组织推荐的处理可扩展标志语言的标准编程接口。 BOM:浏览器对象模型(Browser Object Model),是用于描述这种对象与对象之间层次关系的模型,浏览器对象模型提供了独立于内容的、可以与浏览器窗口进行互动的对象结构。BOM由多个对象组成,其中代表浏览器窗口的Window对象是BOM的顶层对象,其他对象都是该对象的子对象。 ES:ES是一种开放的、国际上广为接受的脚本语言规范(ECMAScript),正式名称为 ECMA 262 和 ISO/IEC 16262,是宿主环境中脚本语言的国际 Web 标准。 2.JavaScript发展史 它最初由Netscape的Brendan Eich设计。JavaScript是甲骨文公司的注册商标。Ecma国际以JavaScript为基础制定了ECMAScript标准。JavaScript也可以用于其他场合,如服务器端编程。完整的JavaScript实现包含三个部分:ECMAScript,文档对象模型,浏览器对象模型。 Netscape在最初将其脚本语言命名为LiveScript,后来Netscape在与Sun合作之后将其改名为JavaScript。JavaScript最初受Java启发而开始设计的,目的之一就是“看上去像Java”,因此语法上有类似之处,一些名称和命名规范也借自Java。但JavaScript的主要设计原则源自Self和Scheme。JavaScript与Java名称上的近似,是当时Netscape为了营销考虑与Sun微系统达成协议的结果。为了取得技术优势,微软推出了JScript来迎战JavaScript的脚本语言。为了互用性,Ecma国际(前身为欧洲计算机制造商协会)创建了ECMA-262标准(ECMAScript)。两者都属于ECMAScript的实现。尽管JavaScript作为给非程序人员的脚本语言,而非作为给程序人员的脚本语言来推广和宣传,但是JavaScript具有非常丰富的特性。 发展初期,JavaScript的标准并未确定,同期有Netscape的JavaScript,微软的JScript和CEnvi的ScriptEase三足鼎立。1997年,在ECMA(欧洲计算机制造商协会)的协调下,由Netscape、Sun、微软、Borland组成的工作组确定统一标准:ECMA-262。 3.js框架 Angular、React与Vue等均是JavaScript主流框架 三、第一个页面 (一)、基础模板 <!DOCTYPE html> <html> <head> <meta charset="utf-8" /> <title>第一个页面</title> </head> <body> </body> </html> (二)、模板解读 DOCTYPE:指定文档类型,规定html标签语法 html:文档根标签,标注着文档(页面)的开始与结束 head:文档头标签,可以引用脚步文件、指定样式表、书写代码逻辑块、提供元信息 body:文档主体标签,包含文档所有文本与超文本内容 title:文档tag标题标签,设置文档tag的标题内容 (三)、其它模板标签 1、meta(元标签) 字符编码 <meta charset="utf-8"> <meta http-equiv="content-type" content="text/html;charset=utf-8" /> SEO <meta name="keywords" content="8-12个以英文逗号隔开的单词或词语"> <meta name="description" content="80字以内的一段话,与网站内容相关"> 移动适配 <meta name="viewport" content="width=device-width,initial-scale=1,minimum-scale=1,maximum-scale=1,user-scalable=no" /> 2、link(链接标签) 外联样式表 <link rel="stylesheet" type="text/css" href="style.css" /> 文档tag图标 <link rel="shortcut icon" type="image/x-icon" href="http://www.baidu.com/favicon.ico" /> 3、style(样式标签) 内联样式表 <style></style> 4、script(脚本标签) <script type="text/javascript"></script>焚膏油以继晷,恒兀兀以穷年。

优秀的个人博客,低调大师

Noark入门之极速体验

官方网站 www.noark.xyz 开源地址 https://gitee.com/xiaoe/noark3 简介 Noark是一个游戏服务器端框架,可快速开发出一个易维护、易扩展且稳定高能的游戏服务器,让开发者专注于业务功能的开发 实现了配置注入,协议映射,模板加载,数据存储,异步事件,延迟任务,内部指令等功能模块 从而达到了松散耦合的效果,提高了系统的可重用性、可维护性以及可扩展性 精心设计过的它大大简化了网络编程和多线程编程,众多的工具类库就是为了解决开发中那些重复劳动而产生的框架 优点: 使用简单,学习成本低 功能强大,很容易写出性能优秀的服务 十分灵活,并且可与常用技术无缝衔接 安装 Gradle implementation "xyz.noark:noark-game:3.1.18.Final" 当前需要Jdk1.8,Noark版本最新已是3.1.18了 引入Noark,按照历史惯例,先来一个Hello Kitty... 0x01Hello Kitty 第一个游戏服务器Demo,来开始我们的ABC三步走 A、Application应用启动入口 在【com.company.slg】包下创建一个入口类 package com.company.slg; import xyz.noark.game.Noark; public class GameServerApplication { public static void main(String[] args) { Noark.run(GameServerBootstrap.class, args); } } B、Bootstrap启动引导入口 在【com.company.slg】包下创建一个引导启动类,继承BaseServerBootstrap package com.company.slg; import xyz.noark.game.bootstrap.BaseServerBootstrap; public class GameServerBootstrap extends BaseServerBootstrap { @Override protected String getServerName() { return "game-server"; } } C、Configuration配置中心 这个不是必选项,用于配置第三方服务类 package com.company.slg; import xyz.noark.core.annotation.Configuration; @Configuration public class GameServerConfiguration {} 启动游戏服务器 直接运行main方法,一个简单的游戏服务器就跑起来了 2018-08-16 18:23:38.178 [main] INFO AbstractServerBootstrap.java:62 - starting game-server service... 2018-08-16 18:23:38.181 [main] DEBUG NoarkIoc.java:47 - init ioc, packages=com.company.slg 2018-08-16 18:23:38.504 [main] INFO ReloadManager.java:41 - loading template data. checkValidity=true 2018-08-16 18:23:38.504 [main] INFO ReloadManager.java:47 - load template data success. 2018-08-16 18:23:38.504 [main] INFO ReloadManager.java:50 - check template data... 2018-08-16 18:23:38.505 [main] INFO ReloadManager.java:52 - check template success. 2018-08-16 18:23:38.505 [delay-event] INFO DelayEventThread.java:41 - 延迟任务调度线程开始啦... 2018-08-16 18:23:38.505 [main] INFO HttpServer.java:72 - game http server start on 8080 2018-08-16 18:23:38.606 [main] INFO HttpServer.java:93 - game http server start is success. 2018-08-16 18:23:38.606 [main] INFO NettyServer.java:119 - game tcp server start on 9527 2018-08-16 18:23:38.607 [main] INFO NettyServer.java:128 - game tcp server start is success. game-server is running, interval=427.21872 ms 2018-08-16 18:23:38.607 [main] INFO AbstractServerBootstrap.java:76 - game-server is running, interval=427.21872 ms 2018-08-16 18:23:38.609 [main] INFO AbstractServerBootstrap.java:166 - :: Noark :: 3.1.18.Final _ _ U ___ u _ ____ _ __ _____ | \ |"| \/"_ \/U /"\ uU | _"\ u |"|/ / |___"/u <| \| |> | | | | \/ _ \/ \| |_) |/ | ' / U_|_ \/ U| |\ |u.-,_| |_| | / ___ \ | _ < U/| . \\u ___) | |_| \_| \_)-\___/ /_/ \_\ |_| \_\ |_|\_\ |____/ || \\,-. \\ \\ >> // \\_,-,>> \\,-._// \\ (_") (_/ (__) (__) (__)(__) (__)\.) (_/(__)(__) 源码下载 0x02协议映射 负责完成协议请求到控制器的映射功能。 系统内置了一套简单的封包结构 包长(short)+ 协议编号(int) + 内容(Json) BEFORE DECODE (306 bytes) AFTER DECODE (306 bytes) +--------+------------+---------------+ +--------+------------+---------------+ | length | opcode | Json Data |----->| length | opcode | Json Data | | 0xFFFF | 0xFFFFFFFF | (300 bytes) | | 0xFFFF | 0xFFFFFFFF | (300 bytes) | +--------+------------+---------------+ +--------+------------+---------------+ 看不懂,没关系,先把协议跑通再说... 1.先创建一个登录协议结构体,也就是一个标准JavaBean了 package com.company.slg.login; public class LoginRequest { private String username; private String password; ... 省略Get/Set方法 } 2.创建处理协议映射的控制器 package com.company.slg.login; import static xyz.noark.log.LogHelper.logger; import xyz.noark.core.annotation.Controller; import xyz.noark.core.annotation.controller.ExecThreadGroup; import xyz.noark.core.annotation.controller.PacketMapping; @Controller(threadGroup = ExecThreadGroup.ModuleThreadGroup) public class LoginController { @PacketMapping(opcode = 1001, state = State.CONNECTED) public void login(LoginRequest request) { logger.info("登录请求 username={}, password={}", request.getUsername(), request.getPassword()); } } @Controller标识此类为一个协议映射的控制器,threadGroup参数为选择当前逻辑以模块为单位划分来处理,具体线程划分请参照Noark之线程模型 @PacketMapping标识此方法为一个协议映射处理方法,opcode参数就是此协议的编号,state参数选择Connected,刚刚链接的状态 登录方法目前什么都没有做只是简单的打印了一下请求账号和密码 重启服务器,我们来写一个简单的测试客户端 3.测试Socket协议 package com.company.slg; import java.net.Socket; import com.alibaba.fastjson.JSON; import com.company.slg.login.LoginRequest; import xyz.noark.core.util.ByteArrayUtils; public class SocketTest { public static void main(String[] args) throws Exception { Socket socket = new Socket("127.0.0.1", 9527); // 接头暗号,具体个性化功能请参考后续文档 socket.getOutputStream().write("socket".getBytes()); socket.getOutputStream().flush(); Thread.sleep(100); // 构建登录协议 LoginRequest request = new LoginRequest(); request.setUsername("abc"); request.setPassword("12356789"); // 模拟发送一个登录协议 send(socket, 1001, request); } private static void send(Socket socket, int opcode, Object protocal) throws Exception { byte[] body = JSON.toJSONString(protocal).getBytes(); // 包长是一个Short,就是协议编号的长度+协议的长度 socket.getOutputStream().write(ByteArrayUtils.toByteArray((short) (body.length + 4))); socket.getOutputStream().write(ByteArrayUtils.toByteArray(opcode)); socket.getOutputStream().write(body); socket.getOutputStream().flush(); } } 一个再简单不过的Socket链接了,接头暗号功能先不讨论,忽略就好,先来看一下服务器端的运行日志 2018-08-17 16:29:17.941 [nioEventLoopGroup-4-1] INFO NettyServerHandler.java:48 - 发现客户端链接,channel=[id: 0xb81048ab, L:/127.0.0.1:9527 - R:/127.0.0.1:55129] 2018-08-17 16:29:17.954 [nioEventLoopGroup-4-1] DEBUG SocketInitializeHandler.java:43 - Socket链接... 2018-08-17 16:29:19.107 [business-1] INFO LoginController.java:33 - 登录请求 username=abc, password=12356789 2018-08-17 16:29:19.107 [business-1] INFO AsyncTask.java:52 - handle protocal(opcode=1001),delay=0.285446 ms,exe=0.135813 ms 2018-08-17 16:29:19.108 [nioEventLoopGroup-4-1] INFO NettyServerHandler.java:53 - 客户端断开链接,channel=[id: 0xb81048ab, L:/127.0.0.1:9527 ! R:/127.0.0.1:55129] 链接>>判定类型>>登录协议处理日志>>协议执行日志>>断开链接 协议映射功能就这么简单的实现了 源码下载 0x03配置文件 上面网络已跑通了,但要修改端口等配置呢? 在类路径下创建配置文件[application.properties] #服务器对外Tcp端口 network.port=10001 重启服务器,观察日志 2018-08-17 17:02:08.342 [main] INFO NettyServer.java:119 - game tcp server start on 10001 2018-08-17 17:02:08.343 [main] INFO NettyServer.java:128 - game tcp server start is success. 服务器端口已切换到10001了, 其他Noark系统默认的配置请参考Noark默认配置清单 0x04模板加载 载入策划配置的模板数据了,Noark内置了一种CSV格式的模板解析器,简单方便,让我们来看个稀奇 配置中心GameServerConfiguration类中添加CSV模板解析器,参数templatePath为模板文件放置位置,后面那个Tab符,CSV文件中的分隔符 @Value("template.path") private String templatePath; @Bean public CsvTemplateLoader templateLoader() { return new CsvTemplateLoader(templatePath, ' '); } 配置文件也要配置上template.path参数 template.path=E:\\slg\\slg-design\\trunk\\00数值配置\\data Gradle引导CSV解析工程 implementation "xyz.noark:noark-csv:3.1.18.Final" 编码模板配置类 package com.company.slg.chat; import xyz.noark.core.annotation.tpl.TplAttr; import xyz.noark.core.annotation.tpl.TplFile; @TplFile(value = "Chat.tpl") public class ChatTemplate { @TplAttr(name = "Id") private int id; /** 频道名称 */ @TplAttr(name = "Name") private String name; /** 最低发言等级 */ @TplAttr(name = "MinLevel") private int minLevel; /** 发言间隔(单位:秒) */ @TplAttr(name = "WordCd") private int wordCd; /** 所需道具 */ @TplAttr(name = "Item") private String item; /** 消息长度限制 */ @TplAttr(name = "WordLimit") private int wordLimit; ... 省略Get/Set方法 } 编码模板管理类 package com.company.slg.chat; import java.util.Map; import xyz.noark.core.annotation.Service; import xyz.noark.game.template.AbstractTemplateManager; @Service public class ChatTemplateManager extends AbstractTemplateManager { private Map<Integer, ChatTemplate> chat; @Override public String getModuleName() { return "聊天系统"; } @Override public void loadData() { this.chat = templateLoader.loadAll(ChatTemplate.class, ChatTemplate::getId); } public ChatTemplate getChatTemplate(Integer id) { return chat.get(id); } } 重启服务器,发现Noark会自动载入CSV文件了 2018-08-17 17:17:05.572 [main] INFO ReloadManager.java:41 - loading template data. checkValidity=true 2018-08-17 17:17:05.572 [main] INFO ReloadManager.java:43 - [聊天系统] loading template. 2018-08-17 17:17:05.585 [main] INFO ReloadManager.java:45 - [聊天系统] load OK. 2018-08-17 17:17:05.585 [main] INFO ReloadManager.java:47 - load template data success. 关于模板复杂属性的配置,请参考模板转化器 为什么要选择CSV作为模板文件,请参考聊一聊策划配置表问题 0x05数据存储 数据存储,Noark采用了JPA风格的编码方式. Gradle implementation "xyz.noark:noark-orm:3.1.18.Final" implementation "com.alibaba:druid:1.0.27" implementation "mysql:mysql-connector-java:5.1.40" 配置数据源 server.id=100 #Mysql配置 data.mysql.ip=192.168.51.234 data.mysql.port=3306 data.mysql.user=root data.mysql.password=Huiyu@123 data.mysql.db=slg-game-${server.id} @Value("data.mysql.ip") private String mysqlIp; @Value("data.mysql.port") private int mysqlPort; @Value("data.mysql.db") private String mysqlDB; @Value("data.mysql.user") private String mysqlUser; @Value("data.mysql.password") private String mysqlPassword; @Bean public DataAccessor dataAccessor() { DruidDataSource dataSource = new DruidDataSource(); dataSource.setDriverClassName("com.mysql.jdbc.Driver"); dataSource.setUsername(mysqlUser); dataSource.setPassword(mysqlPassword); dataSource.setUrl(String.format("jdbc:mysql://%s:%d/%s?autoReconnect=true&useUnicode=true&characterEncoding=UTF-8&useSSL=false", mysqlIp, mysqlPort, mysqlDB)); dataSource.setInitialSize(4); dataSource.setMinIdle(4); dataSource.setMaxActive(8); dataSource.setPoolPreparedStatements(false); MysqlDataAccessor accessor = new MysqlDataAccessor(dataSource); accessor.setStatementExecutableSqlLogEnable(true); accessor.setStatementParameterSetLogEnable(true); accessor.setSlowQuerySqlMillis(1);// 执行时间超过1秒的都要记录下. return accessor; } @Bean public AsyncWriteService asyncWriteService() { return new DefaultAsyncWriteServiceImpl(); } 创建玩家信息实体类 package com.company.slg.player; import java.util.Date; import xyz.noark.core.annotation.PlayerId; import xyz.noark.core.annotation.orm.Column; import xyz.noark.core.annotation.orm.Entity; import xyz.noark.core.annotation.orm.Id; import xyz.noark.core.annotation.orm.Table; @Entity @Table(name = "player_info") public class PlayerInfo { @Id @PlayerId @Column(name = "username", nullable = false, comment = "账号", length = 64) private String username; @Column(name = "password", nullable = false, comment = "密码", length = 64) private String password; @Column(name = "name", nullable = false, comment = "名称", length = 128) private String name; @Column(name = "level", nullable = false, defaultValue = "0", comment = "玩家等级") private int level; @Column(name = "exp", nullable = false, defaultValue = "0", comment = "玩家经验值") private int exp; @Column(name = "online_time", nullable = false, comment = "上次上线时间", defaultValue = "2018-07-06 05:04:03") private Date onlineTime; @Column(name = "offline_time", comment = "上次下线时间") private Date offlineTime; @Column(name = "create_time", nullable = false, comment = "创建时间", defaultValue = "2018-07-06 05:04:03") private Date createTime; @Column(name = "modify_time", nullable = false, comment = "修改时间", defaultValue = "2018-07-06 05:04:03") private Date modifyTime; ... 省略Get/Set方法 } 创建数据访问类. package com.company.slg.player; import xyz.noark.core.annotation.Repository; import xyz.noark.orm.repository.UniqueCacheRepository; @Repository public class PlayerInfoRepository extends UniqueCacheRepository<PlayerInfo, String> {} 这就完成了数据的存储功能,下面我们来改写一下登录逻辑. public class LoginController { @Autowired private PlayerInfoRepository playerInfoRepository; @PacketMapping(opcode = 1001, state = State.CONNECTED) public void login(LoginRequest request) { // 从缓存中取,如果没有,会自动从Mysql中取... PlayerInfo player = playerInfoRepository.cacheGet(request.getUsername()); if (player == null) { logger.info("账号不存在 username={}", request.getUsername()); } else if (!Md5Utils.encrypt(request.getPassword()).equalsIgnoreCase(player.getPassword())) { logger.info("密码不正确 password={}", request.getPassword()); } else { logger.info("登录成功 username={}, password={}", request.getUsername(), request.getPassword()); } } } 重启服务器,发现Noark会自动为我们创建好player_info表 2018-08-17 18:06:02.567 [main] WARN AbstractSqlDataAccessor.java:243 - 实体类[class com.company.slg.player.PlayerInfo]对应的数据库表不存在,准备自动创建表结构,SQL如下: CREATE TABLE `player_info` ( `username` VARCHAR(64) UNIQUE NOT NULL COMMENT '账号', `password` VARCHAR(64) NOT NULL COMMENT '密码', `name` VARCHAR(128) NOT NULL COMMENT '名称', `level` INT(11) NOT NULL DEFAULT 0 COMMENT '玩家等级', `exp` INT(11) NOT NULL DEFAULT 0 COMMENT '玩家经验值', `online_time` DATETIME NOT NULL DEFAULT '2018-07-06 05:04:03' COMMENT '上次上线时间', `offline_time` DATETIME NULL COMMENT '上次下线时间', `create_time` DATETIME NOT NULL DEFAULT '2018-07-06 05:04:03' COMMENT '创建时间', `modify_time` DATETIME NOT NULL DEFAULT '2018-07-06 05:04:03' COMMENT '修改时间', PRIMARY KEY (`username`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8; 运行Socket测试登录协议,由于刚创建的表,所以没有任何账号 SELECT username,password,name,level,exp,online_time,offline_time,create_time,modify_time FROM player_info WHERE username=abc 2018-08-17 18:07:02.953 [business-1] INFO LoginController.java:44 - 账号不存在 username=abc 2018-08-17 18:07:02.953 [business-1] INFO AsyncTask.java:52 - handle protocal(opcode=1001),delay=0.21093 ms,exe=15.611207 ms 源码下载 0x06异步事件 用于多模块解耦功能,当完成一个动作时,向外抛出一个事件,由关心的模块自己监听处理. 引入事件管理器,发布一个上线事件 @Autowired private EventManager eventManager; // 假装他登录成功了... eventManager.publish(new OnlineEvent(1234)); 自己监听 @EventListener(OnlineEvent.class) public void handleOnlineEvent(OnlineEvent event) { logger.info("{} 上线了....", event.getPlayerId()); } 重启服务器,与测试Socket 2018-08-17 18:18:36.797 [business-2] INFO LoginController.java:61 - 1234 上线了.... 2018-08-17 18:18:36.797 [business-2] INFO AsyncTask.java:52 - handle event(OnlineEvent),delay=0.458517 ms,exe=0.146028 ms 源码下载 0x07延迟任务 Noark也提供了一套延迟执行的任务,就是带有延迟功能的事件,统一了API 编码一个延迟事件 public class OfflineEvent extends AbstractDelayEvent implements PlayerEvent { private Long playerId; public OfflineEvent(long playerId) { this.playerId = playerId; } @Override public Long getPlayerId() { return playerId; } } 发布延迟事件 // 模拟10秒后下线事件 OfflineEvent event = new OfflineEvent(1234); event.setId(123456);// 唯一编号 event.setEndTime(DateUtils.addSeconds(new Date(), 10)); eventManager.publish(event); @EventListener(OfflineEvent.class) public void handleOfflineEvent(OfflineEvent event) { logger.info("{} 下线了....", event.getPlayerId()); } 重启服务器与测试Socket 2018-08-17 18:30:10.057 [business-2] INFO LoginController.java:70 - 1234 上线了.... 2018-08-17 18:30:10.058 [business-2] INFO AsyncTask.java:52 - handle event(OnlineEvent),delay=0.950687 ms,exe=0.092845 ms 2018-08-17 18:30:20.057 [business-3] INFO LoginController.java:75 - 1234 下线了.... 2018-08-17 18:30:20.057 [business-3] INFO AsyncTask.java:52 - handle event(OfflineEvent),delay=0.235568 ms,exe=0.14092 ms 上线与下线日志之间时间刚刚好是10秒 源码下载 目标 我们的目标:稳定、高性能、可扩展、易维护、提高开发效率,我们没有要取代谁,也没有要超越谁,我们只做我们自己。

优秀的个人博客,低调大师

k8s入门

这也是今天用心写的一篇原创文,带段子的技术文。也许有的读者看不懂,没关系,文中有段子,看段子就好了。学习任何东西都要去在基于『理解』的基础上去学,这样往往会事半功倍。也有人说我有点高调,但见过我的人都应该有所接触,现实中完全不是这样的。别人在给我说观点的时候,更多时候我只是一个倾听者。哪怕听到有一些不太认同的观点,我也基本不会去反驳。 废话有点多,前天我生日, 这是我写过最帅的代码!这篇文章赞赏超过 100 多,感谢大家的支持和认可。我继续努力,争取把我所学到的,见到的都后续分享出来,能有帮助就好。我本身就是个念旧的人,身上的钱包从大二开始到现在用了8年左右没换过,媳妇还给我送了一个钱包,大概是希望继续在多多赚钱吧。。 因为最近工作中需要用到k8s,基本白天去公司实操,晚上回来看书。一口气买了两本技术类书籍。今天就把我所学到的分享给大家,对不起,久等了。 记得入职当天,因为我们组就 3 个人。负责公司的 k8s 集群架构。责任比较重大,一旦环境出问题,意味着所有的开发和测试都要歇菜休息,大家想想出问题了,他们肯定不愿意,白天浪费太多的时间意味着他们都要晚上加班。要搁我身上,我也不愿意。 有读者问什么是 k8s? 用来干什么的?这个逼格有那么高吗? k8s其实是一个编排工具,在容器也就是 docker 的基础之上去管理软件应用生命周期的一个工具,主要运行在 linux 上。说到这里得插入一个有趣得题外话题:公司有一个测试妹子,没用过 linux ,不知道如何去链接 linux ,不知道如何在 linux上去解压安装包。同事抓住了机会又调侃了一把测试妹子,说『跑着去啊,右键解压就可以了』。结果妹子去照做了,每成功。我估计他们接下来有戏了。所以多学习还是有好处的。从创建应用——应用部署——提供服务——扩容缩容——应用迭代等一系列流程全部是由它管理的。不用像传统的行业,在升级或者故障切换时还需要去停业务或者停止数据库,可以做到快速切换升级,不停止用用。 k8s集群 集群,为什么要使用集群? 说白了,三个臭皮匠顶个诸葛亮,众人的力量大呀。一根筷子一下就掰断了,多根筷子使劲也很难把它掰断。这个就是机群的作用,你坏了我上,我坏了你上。理解之后没什么难的。看上去名字很唬人,实际上也就是那么一回事。 k8s概念 这个就跟学习数据库是一样的,首先理解数据库能干什么?由哪些东西组成。比如它是存客户业务数据的,由表、表空间等等一些东西组成。在k8s中有这么一些概念:cluster、Master、Node、Pod、Rc、Service、Namespace以及yaml文件、helm包、kube-proxy等等。本身就是一个分布式高可用的东西。 cluster。它是计算、存储、网络资源的整合。k8s利用这些资源去运行各种基于容器的应用。 Master。集群主节点,这个相当于人的大脑,我们的一切行为都是大脑去调配。它主要负责分配和调度任务。决定将应用放在哪里去执行。Master运行与 linux 上,可以使物理机也可以是虚拟机。为了可以实现高可用,可以部署多个Master节点。 Node。它的职责是听从Master的调配并负责容器 docker 的应用。Node由Master管理,去负责监控并汇报容器的状态,同时根据 Master的要求去管理容器的生命周期。它也是运行在 linux 上,可以是物理机也可以是虚拟机。 Pod。Pod是k8s调度的最小单元。每一个Pod包含一个或多个容器。pod中的容器会作为一个整体被Master调度到一个node上运行。 rc控制文件。主要用来管理配置。 service。顾名思义提供服务的,想要跑起来非得靠它不可。 Namespace。其实就类似于数据库中有多个用户,创建了30个视图,每个视图需要分配给不同的用户,并同时将他们的资源切割开来。便于管理。 helm包。k8s用来打包的工具。其实就类似与debian、乌班图得apt,红帽和centos上的 yum 仓库一样。而helm就是 k8s 上的包管理工具。 kube-proxy。它得作用主要用来做负载均衡功能。什么叫负载均衡?比如这里有 180 斤 土豆,大家平均分配哈,要不然两个人背了 30 斤,你让剩下的那个人情以何堪呀? k8s常用命令 # 查看集群信息 kubectl cluster-info# 查看各组件信息 kubectl -s http://localhost:8080 get componentstatuses# 查看pods所在的运行节点 kubectl get pods -o wide# 查看pods定义的详细信息 kubectl get pods -o yaml# 查看rc信息 kubectl get rc# 查看service的信息 kubectl get svc# 查看集群节点信息 kubectl get nodes# 创建 kubectl create -f 文件名# 重建 kubectl replace -f 文件名 [--force]# 删除 kubectl delete -f 文件名 kubectl delete pod pod名 kubectl delete rc rc名 kubectl delete service service名 kubectl delete pod --all docker打镜像: 一般在windows上将压缩包上传到linux上: docker -i load + 名称用来加载; docker images 用来列出本机上的镜像; 给镜像打标签: docker tag+镜像名。 docker push推镜像; docker pull拉镜像 三天学习的结果,我争取继续努力。平时没什么时间去追剧,周六熬夜看了下『沙海』,有人说这部剧不错,也有人吐槽这部剧结局不太看好。但是给我印象最深刻的是吴三石的那个老师说的那段话「复读三个月考了六百六十六分,人才啊,你就是老师的骄傲啊,看来老师的努力没有白费」。你看说话都说的这么有水平。六百六十六,不就是 666 么?要我看,这个老师绝b人才啊,有木有? 原文发布时间为:2018-09-17 本文作者:说点特别的 本文来自云栖社区合作伙伴“说点特别的”,了解相关信息可以关注“说点特别的”。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册