首页 文章 精选 留言 我的

精选列表

搜索[tensorflow],共1985篇文章
优秀的个人博客,低调大师

Tensorflow快餐教程(13) - 程序员学深度学习快速入门五步法

程序员学深度学习快速入门五步法 作为一个程序员,我们可以像学习编程一样学习深度学习模型开发。我们以Keras为例来说明。 我们可以用5步 + 4种基本元素 + 9种基本层结构,这5-4-9模型来总结。 5步法: 构造网络模型 编译模型 训练模型 评估模型 使用模型进行预测 4种基本元素: 网络结构:由10种基本层结构和其他层结构组成 激活函数:如relu, softmax。口诀: 最后输出用softmax,其余基本都用relu 损失函数:categorical_crossentropy多分类对数损失,binary_crossentropy对数损失,mean_squared_error平均方差损失, mean_absolute_error平均绝对值损失 优化器:如SGD随机梯度下降, RMSProp, Adagrad, Adam, Adadelta等 9种基本

优秀的个人博客,低调大师

【机器学习工具榜单】Tensorflow最多使用,Python 取代 R 成最受欢迎编程语言

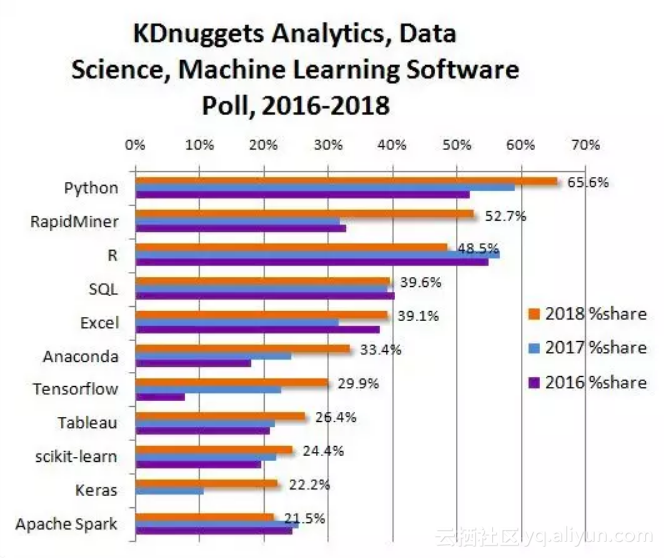
近日,KDnuggets网站公布了2018年度的数据科学和机器学习工具调查结果。2300多名参与者对自己“过去 12 个月内在项目开发中使用过的数据挖掘 / 机器学习工具和编程语言”进行了投票。 最受欢迎的分析、数据科学、机器学习工具 图1:2018年最受欢迎的分析/数据科学/机器学习工具,以及与2016~2017年调查结果的对比 下表列举了最受欢迎的前11个工具,其中每个的占比都达到20%以上。 表1:2018年最受欢迎的分析/数据科学/ 机器学习软件Top 10 上表中,2018 % share 是指使用这个工具的人占所有投票者的百分比,% change是指2018年相较2017年的投票变化。 每个受访者平均使用的工具数量为7.0个,略高于2017年的6.75个(排除了只选择1个工具的投票)。 与2017年的软件调查相比,今年新进入Top

优秀的个人博客,低调大师

【对标TensorFlow】阿里公开内部超大规模分布式机器学习平台

近年来,随着“大”数据及“大”模型的出现,学术界和工业界对分布式机器学习算法引起了广泛关注。针对这一刚需,阿里集团和蚂蚁金服设计了自己的分布式平台——鲲鹏。鲲鹏结合了分布式系统及并行优化算法,解决了大规模机器学习算法带来的一系列问题,不仅囊括了数据/模型并行、负载平衡、模型同步、稀疏表示、工业容错等特性,而且还提供了封闭好的、宜于调用的 API 供普通的机器学习者开发分布式算法,降低使用成本并提升效率。相关论文在本届 KDD 以口头报告的形式发表(应用数据科学 Track)。 论文《鲲鹏:基于参数服务器的分布式学习系统及其在阿里巴巴和蚂蚁金服的应用》(KunPeng: Parameter Server based Distributed Learning Systems and Its Applications in Alibaba and Ant Financial),由蚂蚁金服人工智能部和阿里云团队的周俊,李小龙,赵沛霖,陈超超,李龙飞,杨新星,崔卿,余晋,陈绪,丁轶,漆远合作完成。 文中描述的实验在十亿级别的样本和特征数据上进行。结果表示,鲲鹏的设计使得一系列算法的性能都得到了极大的提升,包括 FTRL,Sparse-LR,以及 MART。此外,鲲鹏在阿里巴巴“双11”狂欢购物节及蚂蚁金服的交易风险检测中,体现出了巨大的应用价值。 研究背景:工业界需要能够训练 TB-PB 级数据量的机器学习平台 现在是个大数据的时代,各个平台的数据量都与时俱进。举例而言,国外的 Twitter 每天新增 5 亿条Tweets,阿里巴巴每天有 5000 万个包裹,蚂蚁金服的支付宝交易峰会达到 12 万笔/秒,仅仅在 2016 年“双11”当天就产生了 10.5 亿笔交易。 如此大的数据量,使得机器学习不得不面临着样本及特征规模巨大的挑战。例如,阿里巴巴内部的模型会达到千亿样本,百亿特征,TB-PB 级的训练数据量。因此,如果搭建能够训练如此大规模数据的机器学习平台是工业界面临的一个巨大问题。图 1:阿里某生产集群中 MPI 任务状态目前,业界已经有一些比较成熟的分布式处理框架,如 Hadoop,Spark,GraphLab 和 GraphX。虽然它们可以支持机器学习算法并行化,但它们很难让开发人员设计出更有效率且支持更大规模的机器学习算法。 具体而言,Hadoop 和 Spark 虽然提供了一些同步和粗粒度运算符(例如,Map,Reduce 和 Join 等),但主要还停留在解决中小规模机器学习的问题。GraphLab/GraphX 主要是为了图存储和计算,并不适用于普通的大规模机器学习算法。MPI 虽然能够支持普通的分布式计算,但其缺乏容错机制。特别是在 worker 很大的情况下,MPI 的运行成功率会大大降低,如图1所示。 因此,如何设计更有效率且支持更大规模的机器学习算法,就成为一个业界难题。 鲲鹏:超大规模分布式计算系统 + 超大规模分布式优化算法 为了解决这一问题,蚂蚁金服人工智能部&阿里云团队开发了鲲鹏。 鲲鹏取名自《庄子·逍遥游》,文中记载“北冥有鱼,其名曰鲲。鲲之大,不知其几千里也;化而为鸟,其名为鹏。鹏之背,不知其几千里也。怒而飞,其翼若垂天之云。” 研究人员表示,在他们的鲲鹏系统中,“鲲”即是超大规模分布式计算系统,拥有超强的计算能力;而“鹏”即是超大规模分布式优化算法,建立在“鲲”之上。“鲲鹏”即同时拥有超大规模分布式计算系统及超大规模分布式优化算法,合二为一使得它有“一飞冲天”的能力,如图2 所示。 图 2:鲲鹏的研究动机及创新性 在系统方面,鲲鹏的创新在于它拥有了以下功能: 强大的容错功能,甚至在复杂且忙碌的线上集群环境中Backup Instance for Straggler Management支持有向无循环图形式的调度和同步,包括BSP/SSP/ASP用户友好的界面和编程 从算法创新角度看,鲲鹏架构使得常用的机器学习算法的大规模化成为了可能,截止目前,已经有众多机器学习算法在鲲鹏上得以实现和应用,包括但不限于LR,FTRL,MART,FM,HashMF,DSSM,DNN,LDA。 鲲鹏的总体架构 鲲鹏的架构建立在阿里巴巴集团内部的大规模分布式 Apasra 平台上面,拥有Robust Failover、Backup Instance,以及 DGA for Scheduling & Synchronization 等特性。 图3:鲲鹏的架构 图3 中的核心模块包括以下几部分: Server nodes:对模型做分片存储 Worker nodes:对训练数据做分片并计算 Coordinator:控制算法整体流程,如初始化,迭代,终止等 ML Bridge:使用脚本形式的工作流对数据进行预处理 PS-Core:核心的参数服务器组件 (servers/workers/coordinator) Fuxi:监控所有机器运行状态,必要时进行容错 用户视角 鲲鹏系统的调用,对普通用户而言也非常简单。用户只需要使用简单的几行脚本形式的命令,即可完成整个算法的调度。整个过程主要包括: 数据预处理,准备成算法接受格式 构建算法的输入/出表 调用鲲鹏算法,ps_train -i demo_batch_input -o demo_batch_result -a xxAlgo -t xxTermination; 评估算法效果 进行A/B测试 图 4:鲲鹏架构用户视角 从图4 中可以看出,整个流程对用户而言都是透明的,使用过程也“如丝般顺滑”,不用感知算法背后复杂的优化及调度过程。 开发者视角 鲲鹏架构对普通的机器学习算法开发者而言也非常简单,它将复杂的通信及调度过程包装成了 API。例如,Worker.PullFrom(Server),开发者只需要这一行简单的代码即可把模型从 server 端 pull 到 worker 端。再如,SyncBarrier(),这开发者只需要这一行简单的代码即可完成 server 端模型的同步。图 5:鲲鹏架构开发者视角 实验结果 1. 与 Spark 和 MPI 比较图 6:鲲鹏与 Spark 和 MPI 训练时间及内存消耗对比 图6 显示了在 7 个不同数据集上(D1-D7),鲲鹏与 Spark 和 MPI 的逻辑回归算法(LR)训练时间及内存消耗对比。如 D1(460K,20M) 指该数据集包含了 46 万特征,2000 万样本。从中可以看出,Spark 和 MPI 的 LR 在特征超大的情况下(D7)会出错,而鲲鹏的LR则可顺利训练成功。 2. Kunpeng-MART 与 XGBoost 比较图 7:Kunpeng-MART 与 XGBoost 内存消耗对比结果图7 显示了基于鲲鹏实现的 Multiple Additive Regression Trees(MART)与开源的 XGBoost 在 4 个不同数据集上的对比结果。从中可以看出,基于鲲鹏的 MART 内存使用情况要稳定的低于 XGBoost。此外,我们在 Ads CVR2 数据上重复跑了 10 次 XGBoost,但无一成功得到结果。 图8 显示了基于鲲鹏的 MART 和 XGBoost 在相同数据集上运行时间的对比,其中也可以看出基于鲲鹏的 MART 训练时间要优于 XGBoost。 图 8:Kunpeng-MART 与 XGBoost 训练时长对比结果 3. Worker 数量对算法的影响实验图 9 Worker 数量与算法加速及单 Worker 内存使用关系图9 显示了 Worker 数量与算法加速及单 Worker 内存使用的关系。在该实验中,我们使用的是基于鲲鹏的稀疏 LR 算法,特征约有 70 亿个,样本约有 180 亿个。从中可以看出,25 个 worker 就能训练这些数据。而且随着 worker 的增多,算法训练速度倍增,同时单机上的内存使用会倍降。 总结 超大规模分布式学习系统能力对大数据的公司而言尤为重要。鲲鹏在阿里和蚂蚁众多实际场景中发挥出了巨大的优势。例如,在 2015 年“双11”中,鲲鹏系统上实现的“楼层”排序(LR 算法)使得 UV CTR 提升了 21%,GMV 提升了10%。再如,基于鲲鹏实现的 GBDT+DNN 算法,应用在支付宝交易风险评估业务中,上线以来在相同覆盖度的情况下,案件召回率从 91% 增加到 98%,每天减少了几千万次用户的打扰。此外,在鲲鹏上实现的 Deep Structured Semantic Model(DSSM),已经广泛被应用于搜索、广告和智能客服等业务中。总体来说,鲲鹏系统上的 10 多个成熟算法已经被广泛应用于 120 多个产品中,这些无一不是阿里生态体系内最大规模的算法。 来源:新智元

优秀的个人博客,低调大师

阿里云机器学习技术分享1——图像识别之TensorFlow实现方法【视频+PPT】

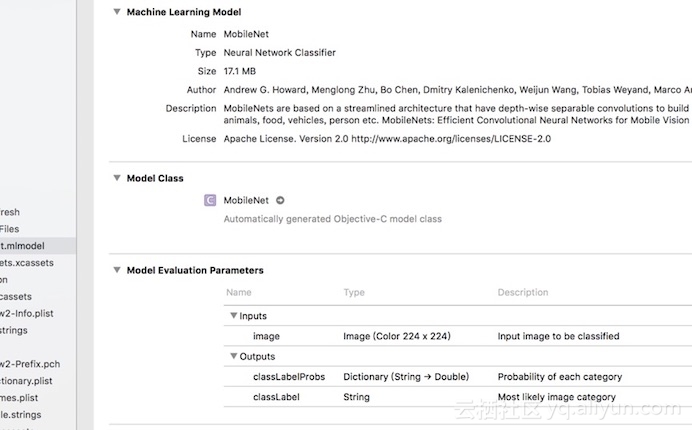
阿里云AI之图像识别技术是如何实现的!?视频+PPT干货奉上 讲师简介:赵昆 阿里巴巴机器学习技术专家 欢迎加入阿里云机器学习大家庭,钉钉群:11768691 , QQ群:567810612 一、阿里云机器学习之图像识别实践-基础篇:观看视频:http://cloud.video.taobao.com/play/u/2339185383/p/1/e/6/t/1/56328343.mp4 二、阿里云机器学习之图像识别实践-高级篇:观看视频:http://cloud.video.taobao.com/play/u/2527642419/p/1/e/6/t/1/57186315.mp4 基础篇PPT 高级篇PPTPPT如下: ******************************

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册