首页 文章 精选 留言 我的

精选列表

搜索[认知分析],共10000篇文章
优秀的个人博客,低调大师

LevelDB源码分析-编码

编码(util/coding.h util/coding.cc) LevelDB将整型编码为二进制字符串的形式,同时又能够和ASCII字符区分。 首先是定长编码: void EncodeFixed32(char *buf, uint32_t value) { if (port::kLittleEndian) { memcpy(buf, &value, sizeof(value)); } else { buf[0] = value & 0xff; buf[1] = (value >> 8) & 0xff; buf[2] = (value >> 16) & 0xff; buf[3] = (value >> 24) & 0xff; } } void EncodeFixed64(char *buf, uint64_t value) { if (port::kLittleEndian) { memcpy(buf, &value, sizeof(value)); } else { buf[0] = value & 0xff; buf[1] = (value >> 8) & 0xff; buf[2] = (value >> 16) & 0xff; buf[3] = (value >> 24) & 0xff; buf[4] = (value >> 32) & 0xff; buf[5] = (value >> 40) & 0xff; buf[6] = (value >> 48) & 0xff; buf[7] = (value >> 56) & 0xff; } } 这里根据机器区分大端和小端,LevelDB编码后的字符串为小端存储。在编码时,只是简单的将8位二进制码存储在一个char字符的位置上。因为定长,所以可以和ASCII字符区分。 接下来是定长编码的一些接口函数: void PutFixed32(std::string *dst, uint32_t value) // 将一个32位整型值定长编码后存入dst void PutFixed64(std::string *dst, uint64_t value) // 将一个64位整型值定长编码后存入dst 然后是变长编码: char *EncodeVarint32(char *dst, uint32_t v) { // Operate on characters as unsigneds unsigned char *ptr = reinterpret_cast<unsigned char *>(dst); static const int B = 128; if (v < (1 << 7)) { *(ptr++) = v; } else if (v < (1 << 14)) { *(ptr++) = v | B; *(ptr++) = v >> 7; } else if (v < (1 << 21)) { *(ptr++) = v | B; *(ptr++) = (v >> 7) | B; *(ptr++) = v >> 14; } else if (v < (1 << 28)) { *(ptr++) = v | B; *(ptr++) = (v >> 7) | B; *(ptr++) = (v >> 14) | B; *(ptr++) = v >> 21; } else { *(ptr++) = v | B; *(ptr++) = (v >> 7) | B; *(ptr++) = (v >> 14) | B; *(ptr++) = (v >> 21) | B; *(ptr++) = v >> 28; } return reinterpret_cast<char *>(ptr); } char *EncodeVarint64(char *dst, uint64_t v) { static const int B = 128; unsigned char *ptr = reinterpret_cast<unsigned char *>(dst); while (v >= B) { *(ptr++) = (v & (B - 1)) | B; v >>= 7; } *(ptr++) = static_cast<unsigned char>(v); return reinterpret_cast<char *>(ptr); } LevelDB的变长编码设计的十分巧妙,它以7个二进制bit为一个单位,存入一个char中,同时为了和ASCII码进行区分,将char的最高位设为1(ASCII码为0-127),同样采用小端存储的形式。但是变长编码的最后一个char的最高位是0,以此作为变长编码后的字符串的结束标志。 例如,11001011101111001会被编码为11111001 10101110 00000110。 接下来是一些变长编码的接口函数: void PutVarint32(std::string *dst, uint32_t v) // 将一个32位整型值变长编码后存入dst void PutVarint64(std::string *dst, uint64_t v) // 将一个64位整型值变长编码后存入dst int VarintLength(uint64_t v) // 获取变长编码后的字符串长度(以字节计数) const char *GetVarint32PtrFallback(const char *p, const char *limit, uint32_t *value) // 将以p到limit之间的变长编码字符串解码为32位整型值 bool GetVarint32(Slice *input, uint32_t *value) // 将以p到limit之间的变长编码字符串解码为32位整型值并封装入Slice中 const char *GetVarint64Ptr(const char *p, const char *limit, uint64_t *value) // 将以p到limit之间的变长编码字符串解码为64位整型值 bool GetVarint64(Slice *input, uint64_t *value) // 将以p到limit之间的变长编码字符串解码为64位整型值并封装入Slice中 227 Love u

优秀的个人博客,低调大师

Erlang PoolBoy 源码分析

问题存疑: 1.如何释放使用过的进程,被再次利用 答:通过try after 的方式,try checkout锁定一个进程,after 用完之后释放被锁定的进程 2.如果出现初始进程不够了,如果处理 答:如果不够用,判定max_overflow参数,确定是否需要重新创建进程,或者将此使用者放入等待列表中,一旦有新释放的,就马上给他使用,受超时器的影响 3.创建新的进程,是如何释放的 答:如果此进程是弹性创建的,则直接释放此进程,如果是work中的进程,则释放使用权 4.如果达到最大的创建进程数,又是如何处理的 答:根据block参数确定,是否忽略或者加入等待列表中 5.如果创建的进程 答:poolboy_sup 通过sample_one_by_one参数形式,动态调用supervisor:start_child创建进程池中的进程 6.为什么需要将初始创建的进程和poolboy进程link起来,有何用意 答:这样就可以将所有的逻辑全部集中在poolboy进程,只是将poolboy_sup当作一个中间件来使用创建进程池中的进程 queue 队列 支持先进先出或者后进先出模式 基本思路 1.通过一个外部sup启动一个poolboy进程,poolboy进程再启动一个poolboy_sup进程 2.poolboy_sup 就是这个进程池,然后启动若干个进程,但是poolboy进程操纵poolboy_sup进程创建很多个进程,然后将这些进程全部保存在poolboy进程 poolboy进程并且与poolboy_sup进程创建的进程进行link 当外部进程需要进程时直接从poolboy进程入口,然后使用,并且poolboy进程还监控所有使用的外部进程 当外部进程down掉后,poolboy进行善后操作,每一个外部进程独享poolboy进程中的一个进程 通过try after 方法,先独享进程,用完后,再释放进程 link的还有一个操作,就是处理poolboy进程池中进程挂掉的情况,先关闭此进程,并进行善后操作,然后,重新启用一个新的进程,带起挂掉的进程 主要的接口就是checkout和checkin的两个接口创建 数据结构采用queue,有两种方式可选,fifo(先进先出),fofi(后进先出)的方式,遍历整个进程池 还采用了一种动态创建进程的机制,就是说,如果发现现有创建的进程不够用了,那就需要创建一个临时的进程,满足使用,当使用完之后,再释放此进程 如果在释放的时候,发现还有等待的进程,则继续使用释放的进程,进行执行 启动 1.创建两个数据结构,wait:queue:new 保存等待的进程吃中分配的进程,monitors=ets:new()创建一个监控使用进程池中进程的数据 2.创建poolboy_sup 监督进程,采用sample_one_by_one 启动,后面采用supervisor:start_child(Sup,Args)启动进程 3.设置启动参数: worker_module:启动进程池的进程模块名 size:进程池中常见size个进程 max_overflow:最多可以弹性创建进程的数量 starategy:lifo|fifo 后进先出|先进先出模式 (一版来说,进程池中的进程没有区别的) Block:true 允许进程获取等待 false 不允许进程获取等待,在checkout接口中设置 4.启动进程池进程 supervisor:start_child(Sup,Args)启动子进程,填充进程池 使用 调用poolboy:transaction(PoolName,Query) 工作机制: 1.首先调用checkout获取进程池中的一个进程,调用的是call同步的方法执行,并设置超时时间 2.使用完毕之后,调用checkin释放进程使用 3.如果出现进程池没有进程,就可以通过max_overflow参数配置,确认是否可以生成新的进程以供使用 4.如果没有,则可以通过Block参数,确认是否可以将当前请求放入waiting中,只要有进程释放,就将此进程返回 5.进程使用完毕,则释放此进程的使用权,清理监控数据列表,然后判定是否弹性创建,决定是否释放,如果有等待进程,则将此进程使用权转移使用 异常处理 1.使用进程挂掉:调用down的handle_info,清理监控列表和工作列表,以及等待列表 2.进程池中进程挂掉:删除监控,重新生成一个进程 执行函数 checkout 获取一个可用进程 checkin 释放一个使用进程 transaction 一个完整的获取和释放进程过程 可能的不足之处 短暂 I/O 任务(比如数据库访问)的大型 worker 池会因为太多迁入和迁出活动而拖垮单个 poolboy 管理器。 参考: Erlang 池管理 maestro Erlang:https://www.oschina.net/p/maestro-erlang

优秀的个人博客,低调大师

Spark 通信原理分析

Spark通信原理(发件箱和收件箱) 更多资源 github: https://github.com/opensourceteams/spark-scala-maven csdn(汇总视频在线看): https://blog.csdn.net/thinktothings/article/details/84726769 Youtube视频分享 youtube:https://youtu.be/3vUVwbEGf1E​ BiliBili视频分享 bilibili : https://www.bilibili.com/video/av37442199/ Spark通信说明图 发件箱Outbox 发送消息在LinkList中存储 private val messages = new java.util.LinkedList[OutboxMessage] /** * Send a message. If there is no active connection, cache it and launch a new connection. If * [[Outbox]] is stopped, the sender will be notified with a [[SparkException]]. */ def send(message: OutboxMessage): Unit = { val dropped = synchronized { if (stopped) { true } else { messages.add(message) false } } if (dropped) { message.onFailure(new SparkException("Message is dropped because Outbox is stopped")) } else { drainOutbox() } } 消息发送 取出列表中的第一个元素 message = messages.poll() 调用消息发送 message.sendWith(_client) /** * Drain the message queue. If there is other draining thread, just exit. If the connection has * not been established, launch a task in the `nettyEnv.clientConnectionExecutor` to setup the * connection. */ private def drainOutbox(): Unit = { var message: OutboxMessage = null synchronized { if (stopped) { return } if (connectFuture != null) { // We are connecting to the remote address, so just exit return } if (client == null) { // There is no connect task but client is null, so we need to launch the connect task. launchConnectTask() return } if (draining) { // There is some thread draining, so just exit return } message = messages.poll() if (message == null) { return } draining = true } while (true) { try { val _client = synchronized { client } if (_client != null) { message.sendWith(_client) } else { assert(stopped == true) } } catch { case NonFatal(e) => handleNetworkFailure(e) return } synchronized { if (stopped) { return } message = messages.poll() if (message == null) { draining = false return } } } } 收件箱Inbox 对RpcMessage类型消息进行端点的 receiveAndReply 方法调用 对OneWayMessage类型消息进行端点的 receive方法调用 /** * Process stored messages. */ def process(dispatcher: Dispatcher): Unit = { var message: InboxMessage = null inbox.synchronized { if (!enableConcurrent && numActiveThreads != 0) { return } message = messages.poll() if (message != null) { numActiveThreads += 1 } else { return } } while (true) { safelyCall(endpoint) { message match { case RpcMessage(_sender, content, context) => try { endpoint.receiveAndReply(context).applyOrElse[Any, Unit](content, { msg => throw new SparkException(s"Unsupported message $message from ${_sender}") }) } catch { case NonFatal(e) => context.sendFailure(e) // Throw the exception -- this exception will be caught by the safelyCall function. // The endpoint's onError function will be called. throw e } case OneWayMessage(_sender, content) => endpoint.receive.applyOrElse[Any, Unit](content, { msg => throw new SparkException(s"Unsupported message $message from ${_sender}") }) case OnStart => endpoint.onStart() if (!endpoint.isInstanceOf[ThreadSafeRpcEndpoint]) { inbox.synchronized { if (!stopped) { enableConcurrent = true } } } case OnStop => val activeThreads = inbox.synchronized { inbox.numActiveThreads } assert(activeThreads == 1, s"There should be only a single active thread but found $activeThreads threads.") dispatcher.removeRpcEndpointRef(endpoint) endpoint.onStop() assert(isEmpty, "OnStop should be the last message") case RemoteProcessConnected(remoteAddress) => endpoint.onConnected(remoteAddress) case RemoteProcessDisconnected(remoteAddress) => endpoint.onDisconnected(remoteAddress) case RemoteProcessConnectionError(cause, remoteAddress) => endpoint.onNetworkError(cause, remoteAddress) } } inbox.synchronized { // "enableConcurrent" will be set to false after `onStop` is called, so we should check it // every time. if (!enableConcurrent && numActiveThreads != 1) { // If we are not the only one worker, exit numActiveThreads -= 1 return } message = messages.poll() if (message == null) { numActiveThreads -= 1 return } } } }

优秀的个人博客,低调大师

Etcd源码分析: 存储

存储数据结构 Etcd存储在集群搭建和使用篇有简介,总结起来有如下特点: 采用kv型数据存储,一般情况下比关系型数据库快。 支持动态存储(内存)以及静态存储(磁盘)。 分布式存储,可集成为多节点集群。 存储方式,采用类似目录结构。 1、只有叶子节点才能真正存储数据,相当于文件。 2、叶子节点的父节点一定是目录,目录不能存储数据。 叶子节点数据结构位于 /store/store.go type store struct { Root *node WatcherHub *watcherHub CurrentIndex uint64 Stats *Stats CurrentVersion int ttlKeyHeap *ttlKeyHeap // need to recovery manually worldLock sync.RWMutex // stop the world lock clock clockwork.Clock readonlySet types.Set } 其父节点数据结构位于/store/node.go type node struct { Path string CreatedIndex uint64 ModifiedIndex uint64 Parent *node `json:"-"` // should not encode this field! avoid circular dependency. ExpireTime time.Time Value string // for key-value pair Children map[string]*node // for directory // A reference to the store this node is attached to. store *store } 其中Path即为key WAL 内存中的数据格式 +-------------------------------+ | F | Pad | | +-----------+ Length | | | +-------------------------------+ | type | +-------------------------------+ | CRC | +-------------------------------+ | Data | +-------------------------------+ 字段名称 含义 占用大小 文本1 文本2 文本3 F 是否存在补齐数据 0:表示没有补齐字段 1:表示存在补齐字段 1bit Pad 表示补齐长度。在F为1时有效 7bit Length 表示数据有效负载长度,不包括F、Pad自身长度、补齐字段。 56bit Type 类型 int64,8字节,有符号 CRC 校验 uint32,4字节,无符号 Data 私有数据 WAL文件数据格式 当我们持久化到文件系统中,数据格式并不是上面介绍,而是grpc格式。 WAL文件以小端序方式存储 启动一个全新etcd,默认会在目录:/var/lib/etcd/default.etcd/member/wal/中生成一个.wal文件。 WAL的定义和创建 定义在wal.go中, WAL日志文件遵循一定的命名规则,由walName()实现,格式为"序号--raft日志索引.wal"。 // 根据seq和index产生wal文件名 func walName(seq, index uint64) string { return fmt.Sprintf("%016x-%016x.wal", seq, index) } WAL对外暴露的创建接口就是Create()函数 // Create creates a WAL ready for appending records. The given metadata is // recorded at the head of each WAL file, and can be retrieved(检索) with ReadAll. func Create(dirpath string, metadata []byte) (*WAL, error) { if Exist(dirpath) { return nil, os.ErrExist } // 先在.tmp临时文件上做修改,修改完之后可以直接执行rename,这样起到了原子修改文件的效果 tmpdirpath := filepath.Clean(dirpath) + ".tmp" if fileutil.Exist(tmpdirpath) { if err := os.RemoveAll(tmpdirpath); err != nil { return nil, err } } if err := fileutil.CreateDirAll(tmpdirpath); err != nil { return nil, err } // dir/filename ,filename从walName获取 seq-index.wal p := filepath.Join(tmpdirpath, walName(0, 0)) // 对文件上互斥锁 f, err := fileutil.LockFile(p, os.O_WRONLY|os.O_CREATE, fileutil.PrivateFileMode) if err != nil { return nil, err } // 定位到文件末尾 if _, err = f.Seek(0, io.SeekEnd); err != nil { return nil, err } // 预分配文件,大小为SegmentSizeBytes(64MB) if err = fileutil.Preallocate(f.File, SegmentSizeBytes, true); err != nil { return nil, err } // 新建WAL结构 w := &WAL{ dir: dirpath, metadata: metadata,// metadata 可为nil } // 在这个wal文件上创建一个encoder w.encoder, err = newFileEncoder(f.File, 0) if err != nil { return nil, err } // 把这个上了互斥锁的文件加入到locks数组中 w.locks = append(w.locks, f) if err = w.saveCrc(0); err != nil { return nil, err } // 将metadataType类型的record记录在wal的header处 if err = w.encoder.encode(&walpb.Record{Type: metadataType, Data: metadata}); err != nil { return nil, err } // 保存空的snapshot if err = w.SaveSnapshot(walpb.Snapshot{}); err != nil { return nil, err } // 重命名,之前以.tmp结尾的文件,初始化完成之后重命名,类似原子操作 if w, err = w.renameWal(tmpdirpath); err != nil { return nil, err } // directory was renamed; sync parent dir to persist rename pdir, perr := fileutil.OpenDir(filepath.Dir(w.dir)) if perr != nil { return nil, perr } // 将上述的所有文件操作进行同步 if perr = fileutil.Fsync(pdir); perr != nil { return nil, perr } // 关闭目录 if perr = pdir.Close(); err != nil { return nil, perr } return w, nil } 其中, SaveSnapshot()是做walpb.Snapshot持久化的, 里面的内容略过, 不过里面有一行代码if err := w.encoder.encode(rec)表示一条Record需要先把序列化后才能持久化,这个是通过encode()函数完成的(encoder.go) 一个Record被序列化之后(这里为JOSN格式),会以一个Frame的格式持久化。Frame首先是一个长度字段(encodeFrameSize()完成,在encoder.go文件),64bit,其中MSB表示这个Frame是否有padding字节,接下来才是真正的序列化后的数据 WAL存储 当raft模块收到一个proposal时就会调用Save方法完成(定义在wal.go)持久化 func (w *WAL) Save(st raftpb.HardState, ents []raftpb.Entry) error { w.mu.Lock() // 上锁 defer w.mu.Unlock() // short cut(捷径), do not call sync // IsEmptyHardState returns true if the given HardState is empty. if raft.IsEmptyHardState(st) && len(ents) == 0 { return nil } // 是否需要同步刷新磁盘 mustSync := raft.MustSync(st, w.state, len(ents)) // TODO(xiangli): no more reference operator // 保存所有日志项 for i := range ents { if err := w.saveEntry(&ents[i]); err != nil { return err } } // 持久化HardState, HardState表示服务器当前状态,定义在raft.pb.go,主要包含Term、Vote、Commit if err := w.saveState(&st); err != nil { return err } // 获取最后一个LockedFile的大小(已经使用的) curOff, err := w.tail().Seek(0, io.SeekCurrent) if err != nil { return err } // 如果小于64MB if curOff < SegmentSizeBytes { if mustSync { // 如果需要sync,就执行sync return w.sync() } return nil } // 否则执行切割(也就是说明,WAL文件是可以超过64MB的) return w.cut() } snapshot snapshot比wal大小要小5倍左右,只有CRC和Data两个字段 etcd中对raft snapshot的定义如下(在文件raft.pb.go): type Snapshot struct { Data []byte `protobuf:"bytes,1,opt,name=data" json:"data,omitempty"` Metadata SnapshotMetadata `protobuf:"bytes,2,opt,name=metadata" json:"metadata"` XXX_unrecognized []byte `json:"-"` } Metadata则是snaoshot的元信息 // snapshot的元数据 type SnapshotMetadata struct { // 最后一次的配置状态 ConfState ConfState `protobuf:"bytes,1,opt,name=conf_state,json=confState" json:"conf_state"` // 被快照取代的最后的条目在日志中的索引值(appliedIndex) Index uint64 `protobuf:"varint,2,opt,name=index" json:"index"` // 该条目的任期号 Term uint64 `protobuf:"varint,3,opt,name=term" json:"term"` XXX_unrecognized []byte `json:"-"` } snapshot持久化使用func (s *Snapshotter) SaveSnap(snapshot raftpb.Snapshot) 过程比较简单, 略去, 里面可以看到snapshot文件的命名规则 // 将raft snapshot序列化后持久化到磁盘 func (s *Snapshotter) save(snapshot *raftpb.Snapshot) error { // 产生snapshot的时间 start := time.Now() // snapshot的文件名Term-Index.snap fname := fmt.Sprintf("%016x-%016x%s", snapshot.Metadata.Term, snapshot.Metadata.Index, snapSuffix) 动态存储 +--------------------+ +--------------------+ | etcdserver/raft.go | | raft/storge.go | | +<-------->+ | | startNode() | | NewMemoryStorge() | +---------^----------+ +--------------------+ | | | +---------v----------+ +--------------------+ | rafe/node.go | | rafe/node.go | | +<-------->+ | | StartNode() | | newRaft() | +---------^----------+ +--------------------+ | | | +---------v----------+ | raft/node.go | | | | run() | +--------------------+ 首先调用NewMemoryStorage进行初始化,然后在newRaft()中生成raftLog对象并且调用InitialState()进行状态初始化,最后在node中run方法接收数据。

优秀的个人博客,低调大师

BroadcastReceiver的源码分析

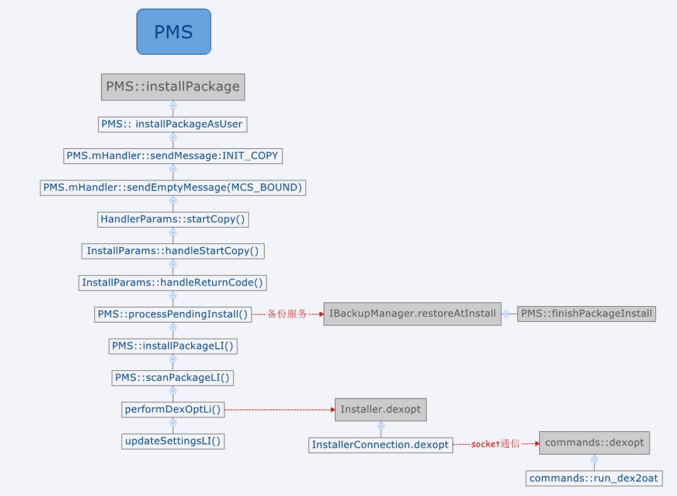
android提供了广播机制,通过BroadcastReceiver可以在不同的进程间传递消息。类似于观察者模式,A应用通过注册广播表示A对消息subject感兴趣,当B应用发出subject类型的消息的时候,A应用就能收到对应的消息。 android提供静态和动态两种方式进行消息注册,静态注册指的是在AndroidManifest.xml中进行注册,动态注册指的是在Activity通过registerReceiver的方式进行广播注册。 静态广播注册流程 静态广播注册指的是在AndroidManifest.xml注册Receiver,当Apk安装时会将静态注册的Receiver信息注册到PMS中,APK的安装流程(https://www.jianshu.com/p/953475cea991)如下: APK安装流程 其中installPackageLI完成了Apk的解析,生成了Package对象,scanPackageLi包括四大组件注册之类的操作。 PMS.scanPackageDirtyLI注册静态广播 解析到APK里的静态广播会注册到PMS的mReceivers对象中,mReceivers类型为ActivityIntentResolver。 动态广播注册流程 Activity通过registerReceiver方式进行广播注册,注册流程如下: registerReceiver流程 ContextImpl.registerReceiverInternal ContextImpl.registerReceiverInternal 该函数根据BroadcastReceiver对象生成IIntentReceiver对象,该对象和ApplicationThread的功能一样,试想一下,APP进程向AMS进程注册广播,当AMS收到广播向APP进程分发时需要用到Binder调用,IIntentReceiver就是进行跨进程调用的。 AMS.registerReceiver AMS将IIntentReceiver保存到mReisterdReceivers中,最终保存到mReceiverResolver.addFilter(bf);中。 sendBroadcast发送广播 sendBroascast流程 发送广播最终走到了AMS.broadcastIntentLocked,其中核心的代码如下所示: AMS.broadcastIntentLocked broadcastIntentLocked中receivers表示静态注册的广播,通过collectReceiverComponents从PMS那里获取;registerdReceivers表示动态注册的广播,从mReceiverResolver那里获取。在获取到要接受所有广播后,就调用如下函数进行广播分发。 广播分发 scheduleBroadcastsLocked开始进行广播发送 BroadcastQueue.scheduleBroadcastsLocked Handler消息最终调用了BroadcastQueue.processNextBroadcast,然后调用了performReceiveLocked, processNextBroadcast processNextBroadcast调用了performReceiverLocked performReceiverLocked performReceiverLocked继续调用IItentReceiver.performReceiver,该调用的Binder方式, IItentReceiver.performReceiver 最终调用了Args.run Args.run Args.run通过类加载器加载Receiver对象,并最终调用onReceive函数,至此,广播发送完成。

优秀的个人博客,低调大师

Android换肤方案分析

0x0 背景 无论是出于用户个性化的考虑,或者是不同场景下的氛围渲染,客户端应用存在着换肤的需求。本文举出三种常见的换肤方案,并加以对比,以作后续参考。无论何种方案,换肤的核心都包含皮肤的管理,皮肤的加载,以及皮肤的生效。不同的方案在解决这些问题上有不同的思路。 0x1 手动重新设置UI资源 这种方式最简单,在业务代码里面手动写设置新皮肤的逻辑,当新皮肤下发时,回调该逻辑重新设置UI资源,就达到了换肤的逻辑。这种方案思路简单,但是业务入侵的,需要手动写代码,有维护成本。而且由于需要手动写重新设置UI的逻辑,因此一般不会对所有的控件都更换UI资源,因此换肤的范围存在局限性。 public void onSkinChanged(JSONObject newSkin) { int newTextColor = newSkin.optIn

优秀的个人博客,低调大师

Kotlin集合框架分析

一、Kotlin中集合框架和Java集合框架特别相似 掌握以下例子就Ok了 package cn.kotliner.kotlin.collections /** * Created by wangdong * 集合框架 * kotlin中集合的映射,最终都映射到Java中的list * kotlin中所有的list和map都是不可变的接口,如下不可以.add或者.remove * 但是kotlin的mutableList和mutablemap是可变的 * public interface MutableList<E> : List<E>, MutableCollection<E> { * Modification Operations *override fun add(element: E): Boolean *override fun remove(element: E): Boolean * Bulk Modification Operations *override fun addAll(elements: Collection<E>): Boolean * * kotlin的mutablemap * public interface MutableMap<K, V> : Map<K, V> { *public fun put(key: K, value: V): V? *public fun remove(key: K): V? *@SinceKotlin("1.1") *@PlatformDependent *public fun remove(key: K, value: V): Boolean { * See default implementation in JDK sources *return true *} *public fun putAll(from: Map<out K, V>): Unit */ fun main(args: Array<String>) { //List集合 val list = listOf("Hello", "World") //list.add() //map集合 val map = mapOf("key" to "value", "2" to "whatever") //map.put() } object Test{ val list = listOf(1, 2,4) }

优秀的个人博客,低调大师

istio网络转发分析

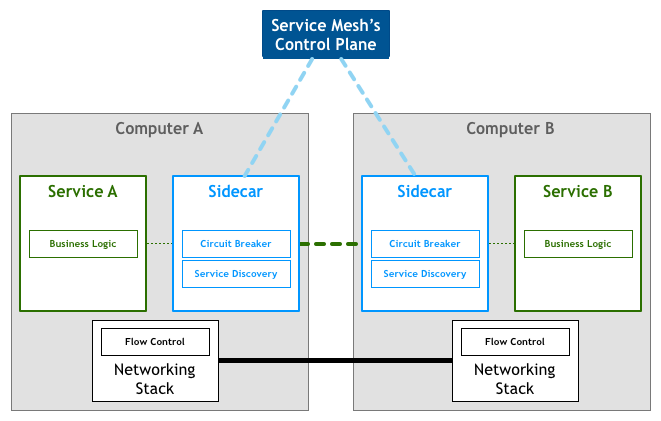
背景介绍 service mesh 和 istio概述 Service Mesh是专用的基础设施层,轻量级高性能网络代理。提供安全的、快速的、可靠地服务间通讯,与实际应用部署一起,但对应用透明。 为了帮助理解, 下图展示了服务网格的典型边车部署方式: 图中应用作为服务的发起方,只需要用最简单的方式将请求发送给本地的服务网格代理,然后网格代理会进行后续的操作,如服务发现,负载均衡,最后将请求转发给目标服务。当有大量服务相互调用时,它们之间的服务调用关系就会形成网格,如下图所示: Istio——一个用来连接、管理和保护微服务的开放service mesh平台。Istio提供一种简单的方式来建立已部署服务网络,具备负载均衡、服务间认证、监控等功能,而不需要改动任何服务代码。想要为服务增加对Istio的支持,您只需要在环境中部署一个特殊的边车(si

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册