首页 文章 精选 留言 我的

精选列表

搜索[递归超智能],共10000篇文章
优秀的个人博客,低调大师

超详细的MySQL数据库优化知识梳理

1 常见问题 阻塞 慢查询 2 可以从以下几个方面入手 服务器硬件优化 系统配置优化 数据库结构优化 SQL和索引 通常优化3和4 3 慢查询日志 show variables like 'slow_query_log'; # 开启慢查询日志 set global slow_query_log=on; # 查询慢查询日志文件存放的位置 show variables like 'slow_query_log_file'; # 设置慢查询日志文件存放的位置 set global slow_query_log_file= '/home/mysql/sql_log/mysql-slow.log' # 设置是否将没有使用索引的SQL记录到慢查询日志中 set global log_queries_not_using_indexes=on; # 设置是否将查询事件超过0秒的SQL记录到慢查询日志中,通产设置0.01秒 set global long_query_time=0; 4 实操 4.1 默认不开启慢查询日志 4.2 慢查询日志存储的位置 查询日志,这里我是Docker容器部署MySQL,映射在服务器上/data/mysql目录下 4.3 日志格式 第一行:执行SQL的主机信息 第二行:SQL的执行信息 第三行:SQL的执行事件 第四行:SQL的内容 5 慢查询日志分析工具 5.1 mysqldumpslow(官方工具) 5.1.1 参数解释 -s 是order的顺序 al 平均锁定时间 ar 平均返回记录时间 at 平均查询时间(默认) c 计数 l 锁定时间 r 返回记录 t 查询时间 -t 是top n的意思,即为返回前面多少条的数据 -g 后边可以写一个正则匹配模式,大小写不敏感的 5.1.2 基本使用 # 得到返回记录集最多的10个SQL。 mysqldumpslow -s r -t 10 /database/mysql/mysql06_slow.log # 得到访问次数最多的10个SQL mysqldumpslow -s c -t 10 /database/mysql/mysql06_slow.log # 得到按照时间排序的前10条里面含有左连接的查询语句。 mysqldumpslow -s t -t 10 -g “left join” /database/mysql/mysql06_slow.log # 另外建议在使用这些命令时结合 | 和more 使用 ,否则有可能出现刷屏的情况。 mysqldumpslow -s r -t 20 /mysqldata/mysql/mysql06-slow.log | more 5.2 pt-query-digest 5.2.1 快速安装 wget https://www.percona.com/downloads/percona-toolkit/2.2.16/RPM/percona-toolkit-2.2.16-1.noarch.rpm && yum localinstall -y percona-toolkit-2.2.16-1.noarch.rpm 5.2.2 参数解释 pt-query-digest [OPTIONS] [FILES] [DSN] --create-review-table 当使用--review参数把分析结果输出到表中时,如果没有表就自动创建。 --create-history-table 当使用--history参数把分析结果输出到表中时,如果没有表就自动创建。 --filter 对输入的慢查询按指定的字符串进行匹配过滤后再进行分析 --limit 限制输出结果百分比或数量,默认值是20,即将最慢的20条语句输出,如果是50%则按总响应时间占比从大到小排序,输出到总和达到50%位置截止。 --host mysql服务器地址 --user mysql用户名 --password mysql用户密码 --history 将分析结果保存到表中,分析结果比较详细,下次再使用--history时,如果存在相同的语句,且查询所在的时间区间和历史表中的不同,则会记录到数据表中,可以通过查询同一CHECKSUM来比较某类型查询的历史变化。 --review 将分析结果保存到表中,这个分析只是对查询条件进行参数化,一个类型的查询一条记录,比较简单。当下次使用--review时,如果存在相同的语句分析,就不会记录到数据表中。 --output 分析结果输出类型,值可以是report(标准分析报告)、slowlog(Mysql slow log)、json、json-anon,一般使用report,以便于阅读。 --since 从什么时间开始分析,值为字符串,可以是指定的某个”yyyy-mm-dd [hh:mm:ss]”格式的时间点,也可以是简单的一个时间值:s(秒)、h(小时)、m(分钟)、d(天),如12h就表示从12小时前开始统计。 --until 截止时间,配合—since可以分析一段时间内的慢查询。 5.2.3 基本使用 # 输出到文件 pt-query-digest slow-log > slow_log.report # 输出到数据库 --create-reviewtable 意思是慢查询日志输出到某一张表中 pt-query-digest slow.log -review h=127.0.0.1,D=test,p=root,P=3306,u=root.t=query_review --create-reviewtable --review-history t= hostname_slow 6 SQL优化 6.1 需要优化的SQL特征 查询次数多且每次查询占用时间长的SQL IO大的SQL(SQL中扫描行数越多,IO越大) 未命中索引的SQL 6.2 使用explain查询SQL的执行计划 6.2.1 解释说明 table 显示这一行数据时关于哪张表的 type 这是重要的列,显示连接使用了那种类型。从最好到最差的连接类型为const,eq_reg,ref,range,index,ALL。const常见于主键/唯一索引查找,eq_reg常见于主键的范围查找,ref常见于连接查询,range常见于索引的范围查找,index常见于索引的扫描,ALL常见于表扫描 possible_keys 显示可能应用在这张表中的索引。如果为空,没有可能的索引。 key 实际使用的索引。如果为NULL,则没有使用索引。 key_len 使用的索引长度。在不损失精确性的情况下,长度越短越好 ref 显示索引的那一列被使用了,如果可的话,是一个常数 rows MySQL认为必须检查的用来返回请求数据的行数 6.3 SQL优化 在经常查询的字段上适当加索引 避免子查询,可优化为连接查询,注意是否存在一对多关系,可能会出现数据重复 6.4 如何选择合理的列建立索引 在where从句,group by 从句,order by 从句,on 从句中出现的列 索引字段越小越好 离散度大的列放在联合索引的前面 例如: select * from payment where staff_id = 2 and customer_id = 584; 由于customer_id的离散度更大,所以应该使用index(customer_id,staff_id) 6.4.1 如何判断列的离散程度 select count(distinct customer_id),count(distinct staff_id) from payment 列的唯一值越高,离散程度越大,可选择性越高。 6.4.2 索引的维护和优化 重复及冗余索引,重复索引是指相同的列以相同的顺序建立的同类型的索引,如下面parmary key 和ID列上的索引就是重复索引 create table test(id int not null primart key),name vachar(10) not null,title varchar(50) not null,unique(id) ) engine=innodb 使用pt-duplicate-key-checker工具检查重复及冗余索引 pt-duplicate-key-checker -uroot -p'' -h 127.0.0.1 7 数据库及表结构优化 7.1 选择合适的数据类型 使用可以存下你的数据的最小的数据类型 使用简单数据类型,int要比varchar类型在MySQL处理上简单 尽可的使用not null 定义字段 尽量少用text类型,非用不可时最好考虑分表 例如 使用bigint来存储IP地址,利用INET_ATON(),INET__NTOA()两个函数进行转换 insert into sessions(ipaddress) values (INET_ATON('127.0.0.1')); select INET__NTOA('127.0.0.1') from sessions; 7.2 范式化和反范式化 7.2.1 范式化 第一范式,强调原子性,要求属性具有原子性,不可再分解 第二范式,强调主键,要求记录有唯一标识,即实体的唯一性,级不存在部分依赖 第三范式,强调外键,要求任何字段不能由其他字段派生出来,要求字段没有冗余,即不存在依赖传递 7.2.2 反范式化 为了查询效率的考虑,把原本符合第三范式的表适当的增加冗余,以达到优化查询效率的目的,反范式化是一种以控件来换时间的操作。 7.3 数据库结构的优化 7.3.1 表的垂直拆分 把原来一个有很多列的表拆分成多个表,这解决了表的宽度问题,通常垂直拆分可以按以下原则进行: 把不常用的字段单独存放在一个表中 把大字段独立存在在一个表中 把经常一起使用的字段放在一起 7.3.2 表的水平拆分 为了解决单表的数据量大的问题,水平拆分的表每一个表的结构都是完全一致的 8 系统配置优化 数据库是基于操作系统的,目前大多数MySQL都是安装在Linux上,所以对于操作系统的一些参数配置也会影响MySQL的性能,下面列出常用的系统配置 8.1 网络配置方面 修改/etc/sysctl.coonf文件 # 增加tcp支持的队列数 net.ip4.tcp_max_syn_backlog=65535 # 减少断开连接时,资源回收 net.ipv4.tcp_max_tw_buckets=8000 net.ipv4.tcp_tw_reuse=1 net.ipv4.tcp_tw_recycle=1 net.ipv4.tcp_fin_timeout=10 打开文件数的限制,可以使用ulimit -a查看目录的各位限制,可以修改/etc/security/limits.conf文件,增加以下内容以修改打开文件数量的限制 soft nofile 65335 hard nofile 65535 除此之外最好在MySQL服务器上关闭iptables,selinux 等防火墙软件 8.2 MySQL配置文件 8.2.1 配置文件路径 Linux:/etc/my.cnf 8.2.2 参数 innodb_buffer_pool_size:非常重要的参数,用于配置innodb的缓冲池如果数据库中只有innodb表,则推荐配置量为总内存的75% innodb_buffer_pool_instances:MySQL5.5中新增的参数,可以控制缓存池的个数,默认情况下只有一个缓存池 innodb_log_buffer_size:innodb log缓存的大小,由于日志最长每秒钟就会刷新所以一般不用太大 innodb_flush_log_at_trx_commit:关键参数,对innodb的IO效率影响最大,默认值为1,可以取0,1,2三个值,一般建议设置为2,但如果数据安全性要求比较高则使用默认值1 innodb_read_io_threads/innodb_write_io_threads:决定innodb读写IO的进程数,默认为4 innodb_file_per_table:关键参数,控制innodb没一个表使用独立的表空间,默认为OFF,也就是所有表都会建立在共享表空间中 innodb_stats_on_metadata:决定MySQL在什么情况下会刷新innodb表的统计信息 8.2.3 第三方配置工具 Percon Configuration Wizard 9 服务器硬件的优化 9.1 CPU 选择合适的CPU,单个频率更快的CPU MySQL一些工作只能使用到单核 MySQL对CPU的核数支持并不是越快越好,MySQL5.5使用的服务器不要超过32核 9.2 disk IO优化 常用RAID级别简介 RAID0:也成为条带,就是把多个磁盘连接成一个硬盘使用,这个级别IO最好 RAID1:也称为镜像,要求至少有两个磁盘,每组磁盘存储的数据相同 RAID5:也是把多个(最少3个)硬盘合并成一个逻辑盘使用,数据读写时会建立奇偶校验信息,并且奇偶校验信息和相对应的数据分别存储于不同的硬盘上。当RAID5的一个磁盘数据发生损坏后,就剩下的数据和相应的奇偶校验信息去恢复被损坏的数据。 RAID1+0:就是RAID1和RAID0的结合,同时具备两个级别的优缺点。一般建议数据库使用这个级别。 SNA和NAT是否适合数据库 常用于高可用的解决方案 顺序读写效率很高,但是随机读写不如人意 数据库随机读写效率很高
优秀的个人博客,低调大师

超全开源爬虫工具箱

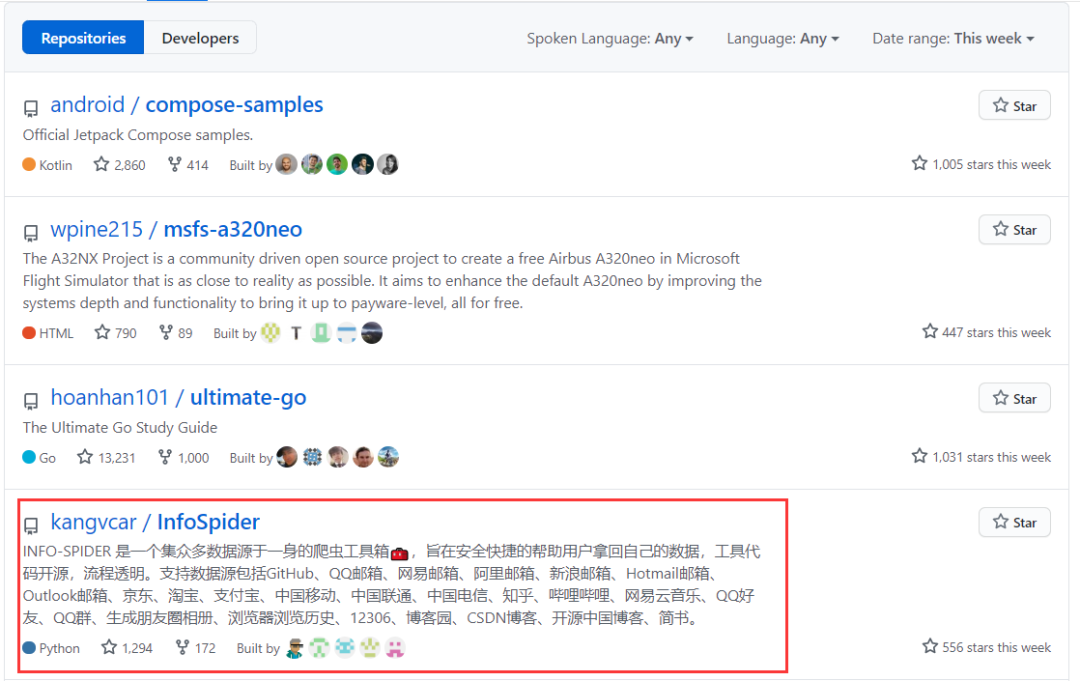
最近国内一位开发者在 GitHub 上开源了个集众多数据源于一身的爬虫工具箱——InfoSpider,一不小心就火了!!! 有多火呢?开源没几天就登上GitHub周榜第四,标星1.3K,累计分支 172 个。同时作者已经开源了所有的项目代码及使用文档,并且在B站上还有使用视频讲解。 项目代码: https://github.com/kangvcar/InfoSpider 项目使用文档: https://infospider.vercel.app 项目视频演示: https://www.bilibili.com/video/BV14f4y1R7oF/ 在这样一个信息爆炸的时代,每个人都有很多个账号,账号一多就会出现这么一个情况:个人数据分散在各种各样的公司之间,就会形成数据孤岛,多维数据无法融合,这个项目可以帮你将多维数据进行融合并对个人数据进行分析,这样你就可以更直观、深入了解自己的信息。 InfoSpider 是一个集众多数据源于一身的爬虫工具箱,旨在安全快捷的帮助用户拿回自己的数据,工具代码开源,流程透明。并提供数据分析功能,基于用户数据生成图表文件,使得用户更直观、深入了解自己的信息。 目前支持数据源包括 GitHub、QQ邮箱、网易邮箱、阿里邮箱、新浪邮箱、Hotmail邮箱、Outlook邮箱、京东、淘宝、支付宝、中国移动、中国联通、中国电信、知乎、哔哩哔哩、网易云音乐、QQ好友、QQ群、生成朋友圈相册、浏览器浏览历史、12306、博客园、CSDN博客、开源中国博客、简书 。 根据创建者介绍,InfoSpider 具有以下特性: 安全可靠 :本项目为开源项目,代码简洁,所有源码可见,本地运行,安全可靠。 使用简单 :提供 GUI 界面,只需点击所需获取的数据源并根据提示操作即可。 结构清晰 :本项目的所有数据源相互独立,可移植性高,所有爬虫脚本在项目的 Spiders 文件下。 数据源丰富 :本项目目前支持多达24+个数据源,持续更新。 数据格式统一:爬取的所有数据都将存储为json格式,方便后期数据分析。 个人数据丰富 :本项目将尽可能多地为你爬取个人数据,后期数据处理可根据需要删减。 数据分析 :本项目提供个人数据的可视化分析,目前仅部分支持。 InfoSpider使用起来也非常简单,你只需要安装python3和Chrome浏览器,运行 python3 main.py,在打开的窗口点击数据源按钮, 根据提示选择数据保存路径,接着输入账号密码,就会自动爬取数据,根据下载的目录就可以查看爬下来的数据。 当然如果你想自己去练习和学习爬虫,作者也开源了所有的爬取代码,非常适合实战。 举个例子,比如爬取taobao的: importjson importrandom importtime importsys importos importrequests importnumpyasnp importmath fromlxmlimportetree frompyqueryimportPyQueryaspq fromseleniumimportwebdriver fromselenium.webdriverimportChromeOptions fromselenium.webdriver.common.byimportBy fromselenium.webdriver.supportimportexpected_conditionsasEC fromselenium.webdriver.support.waitimportWebDriverWait fromselenium.webdriverimportChromeOptions,ActionChains fromtkinter.filedialogimportaskdirectory fromtqdmimporttrange defease_out_quad(x): return1-(1-x)*(1-x) defease_out_quart(x): return1-pow(1-x,4) defease_out_expo(x): ifx==1: return1 else: return1-pow(2,-10*x) defget_tracks(distance,seconds,ease_func): tracks=[0] offsets=[0] fortinnp.arange(0.0,seconds,0.1): ease=globals()[ease_func] offset=round(ease(t/seconds)*distance) tracks.append(offset-offsets[-1]) offsets.append(offset) returnoffsets,tracks defdrag_and_drop(browser,offset=26.5): knob=browser.find_element_by_id('nc_1_n1z') offsets,tracks=get_tracks(offset,12,'ease_out_expo') ActionChains(browser).click_and_hold(knob).perform() forxintracks: ActionChains(browser).move_by_offset(x,0).perform() ActionChains(browser).pause(0.5).release().perform() defgen_session(cookie): session=requests.session() cookie_dict={} list=cookie.split(';') foriinlist: try: cookie_dict[i.split('=')[0]]=i.split('=')[1] exceptIndexError: cookie_dict['']=i requests.utils.add_dict_to_cookiejar(session.cookies,cookie_dict) returnsession classTaobaoSpider(object): def__init__(self,cookies_list): self.path=askdirectory(title='选择信息保存文件夹') ifstr(self.path)=="": sys.exit(1) self.headers={ 'User-Agent':'Mozilla/5.0(Macintosh;IntelMacOSX10_14_3)AppleWebKit/537.36(KHTML,likeGecko)Chrome/73.0.3683.86Safari/537.36', } option=ChromeOptions() option.add_experimental_option('excludeSwitches',['enable-automation']) option.add_experimental_option("prefs",{"profile.managed_default_content_settings.images":2})#不加载图片,加快访问速度 option.add_argument('--headless') self.driver=webdriver.Chrome(options=option) self.driver.get('https://i.taobao.com/my_taobao.htm') foriincookies_list: self.driver.add_cookie(cookie_dict=i) self.driver.get('https://i.taobao.com/my_taobao.htm') self.wait=WebDriverWait(self.driver,20)#超时时长为10s #模拟向下滑动浏览 defswipe_down(self,second): foriinrange(int(second/0.1)): #根据i的值,模拟上下滑动 if(i%2==0): js="varq=document.documentElement.scrollTop="+str(300+400*i) else: js="varq=document.documentElement.scrollTop="+str(200*i) self.driver.execute_script(js) time.sleep(0.1) js="varq=document.documentElement.scrollTop=100000" self.driver.execute_script(js) time.sleep(0.1) #爬取淘宝我已买到的宝贝商品数据,pn定义爬取多少页数据 defcrawl_good_buy_data(self,pn=3): #对我已买到的宝贝商品数据进行爬虫 self.driver.get("https://buyertrade.taobao.com/trade/itemlist/list_bought_items.htm") #遍历所有页数 forpageintrange(1,pn): data_list=[] #等待该页面全部已买到的宝贝商品数据加载完毕 good_total=self.wait.until( EC.presence_of_element_located((By.CSS_SELECTOR,'#tp-bought-root>div.js-order-container'))) #获取本页面源代码 html=self.driver.page_source #pq模块解析网页源代码 doc=pq(html) ##存储该页已经买到的宝贝数据 good_items=doc('#tp-bought-root.js-order-container').items() #遍历该页的所有宝贝 foritemingood_items: #商品购买时间、订单号 good_time_and_id=item.find('.bought-wrapper-mod__head-info-cell___29cDO').text().replace('\n',"").replace('\r',"") #商家名称 #good_merchant=item.find('.seller-mod__container___1w0Cx').text().replace('\n',"").replace('\r',"") good_merchant=item.find('.bought-wrapper-mod__seller-container___3dAK3').text().replace('\n',"").replace('\r',"") #商品名称 #good_name=item.find('.sol-mod__no-br___1PwLO').text().replace('\n',"").replace('\r',"") good_name=item.find('.sol-mod__no-br___3Ev-2').text().replace('\n',"").replace('\r',"") #商品价格 good_price=item.find('.price-mod__price___cYafX').text().replace('\n',"").replace('\r',"") #只列出商品购买时间、订单号、商家名称、商品名称 #其余的请自己实践获取 data_list.append(good_time_and_id) data_list.append(good_merchant) data_list.append(good_name) data_list.append(good_price) #print(good_time_and_id,good_merchant,good_name) #file_path=os.path.join(os.path.dirname(__file__)+'/user_orders.json') #file_path="../Spiders/taobao/user_orders.json" json_str=json.dumps(data_list) withopen(self.path+os.sep+'user_orders.json','a')asf: f.write(json_str) #print('\n\n') #大部分人被检测为机器人就是因为进一步模拟人工操作 #模拟人工向下浏览商品,即进行模拟下滑操作,防止被识别出是机器人 #随机滑动延时时间 swipe_time=random.randint(1,3) self.swipe_down(swipe_time) #等待下一页按钮出现 good_total=self.wait.until(EC.presence_of_element_located((By.CSS_SELECTOR,'.pagination-next'))) good_total.click() time.sleep(2) #while1: #time.sleep(0.2) #try: #good_total=self.driver.find_element_by_xpath('//li[@title="下一页"]') #break #except: #continue ##点击下一页按钮 #while1: #time.sleep(2) #try: #good_total.click() #break #exceptException: #pass #收藏宝贝传入爬几页默认三页https://shoucang.taobao.com/nodejs/item_collect_chunk.htm?ifAllTag=0&tab=0&tagId=&categoryCount=0&type=0&tagName=&categoryName=&needNav=false&startRow=60 defget_choucang_item(self,page=3): url='https://shoucang.taobao.com/nodejs/item_collect_chunk.htm?ifAllTag=0&tab=0&tagId=&categoryCount=0&type=0&tagName=&categoryName=&needNav=false&startRow={}' pn=0 json_list=[] foriintrange(page): self.driver.get(url.format(pn)) pn+=30 html_str=self.driver.page_source ifhtml_str=='': break if'登录'inhtml_str: raiseException('登录') obj_list=etree.HTML(html_str).xpath('//li') forobjinobj_list: item={} item['title']=''.join([i.strip()foriinobj.xpath('./div[@class="img-item-title"]//text()')]) item['url']=''.join([i.strip()foriinobj.xpath('./div[@class="img-item-title"]/a/@href')]) item['price']=''.join([i.strip()foriinobj.xpath('./div[@class="price-container"]//text()')]) ifitem['price']=='': item['price']='失效' json_list.append(item) #file_path=os.path.join(os.path.dirname(__file__)+'/shoucang_item.json') json_str=json.dumps(json_list) withopen(self.path+os.sep+'shoucang_item.json','w')asf: f.write(json_str) #浏览足迹传入爬几页默认三页https://shoucang.taobao.com/nodejs/item_collect_chunk.htm?ifAllTag=0&tab=0&tagId=&categoryCount=0&type=0&tagName=&categoryName=&needNav=false&startRow=60 defget_footmark_item(self,page=3): url='https://www.taobao.com/markets/footmark/tbfoot' self.driver.get(url) pn=0 item_num=0 json_list=[] foriintrange(page): html_str=self.driver.page_source obj_list=etree.HTML(html_str).xpath('//div[@class="item-listJ_redsList"]/div')[item_num:] forobjinobj_list: item_num+=1 item={} item['date']=''.join([i.strip()foriinobj.xpath('./@data-date')]) item['url']=''.join([i.strip()foriinobj.xpath('./a/@href')]) item['name']=''.join([i.strip()foriinobj.xpath('.//div[@class="title"]//text()')]) item['price']=''.join([i.strip()foriinobj.xpath('.//div[@class="price-box"]//text()')]) json_list.append(item) self.driver.execute_script('window.scrollTo(0,1000000)') #file_path=os.path.join(os.path.dirname(__file__)+'/footmark_item.json') json_str=json.dumps(json_list) withopen(self.path+os.sep+'footmark_item.json','w')asf: f.write(json_str) #地址 defget_addr(self): url='https://member1.taobao.com/member/fresh/deliver_address.htm' self.driver.get(url) html_str=self.driver.page_source obj_list=etree.HTML(html_str).xpath('//tbody[@class="next-table-body"]/tr') data_list=[] forobjinobj_list: item={} item['name']=obj.xpath('.//td[1]//text()') item['area']=obj.xpath('.//td[2]//text()') item['detail_area']=obj.xpath('.//td[3]//text()') item['youbian']=obj.xpath('.//td[4]//text()') item['mobile']=obj.xpath('.//td[5]//text()') data_list.append(item) #file_path=os.path.join(os.path.dirname(__file__)+'/addr.json') json_str=json.dumps(data_list) withopen(self.path+os.sep+'address.json','w')asf: f.write(json_str) if__name__=='__main__': #pass cookie_list=json.loads(open('taobao_cookies.json','r').read()) t=TaobaoSpider(cookie_list) t.get_orders() #t.crawl_good_buy_data() #t.get_addr() #t.get_choucang_item() #t.get_footmark_item()

优秀的个人博客,低调大师

超简单使用redisson延迟队列做定时任务

前言:啰嗦的就不写了,就是传一个多久之后执行,然后到点就执行的任务调度,我之前写过一次基于quartz的定时任务,前端和分布式还需要完善https://my.oschina.net/wangnian/blog/758054 ,这个直接是基于时间的,其实多久之后和啥时候执行都一会事。 今天是我疫情复工的第一天上班,有很多小伙伴都已经复工了,戴了半天的口罩,很难受,准备下班之后把耳戴式改造成头戴式。 这个没有啥理论知识,就是对于redisson的delayedQueue延迟队列的封装,接下来直接粘贴代码,有需要的直接粘贴过去去,没需要的可以看看我的代码指指毛病 1.导入redisson包 注意,如果是Springboot的项目强制使用,别单独引入,再自己配置config <dependency> <groupId>org.redisson</groupId> <artifactId>redisson-spring-boot-starter</artifactId> <version>3.10.5</version> </dependency> 2.配置SpringBootRedis标准配置 spring.redis.host=192.168.1.100 spring.redis.port=6379 3.唯一一个封装的工具类 package com.test.redis.demo; import org.redisson.api.RBlockingQueue; import org.redisson.api.RDelayedQueue; import org.redisson.api.RedissonClient; import org.springframework.beans.factory.annotation.Autowired; import org.springframework.stereotype.Service; import java.util.concurrent.TimeUnit; @Service public class RedisDelayedQueue { /** * 任务回调监听 * * @param <T> */ public abstract static class TaskEventListener<T> { /** * 执行方法 * * @param t */ public abstract void invoke(T t); } @Autowired RedissonClient redissonClient; /** * 添加队列 * * @param t DTO传输类 * @param delay 时间数量 * @param timeUnit 时间单位 * @param <T> 泛型 */ public <T> void addQueue(T t, long delay, TimeUnit timeUnit) { RBlockingQueue<T> blockingFairQueue = redissonClient.getBlockingQueue(t.getClass().getName()); RDelayedQueue<T> delayedQueue = redissonClient.getDelayedQueue(blockingFairQueue); delayedQueue.offer(t, delay, timeUnit); delayedQueue.destroy(); } /** * 获取队列 * * @param zClass DTO泛型 * @param taskEventListener 任务回调监听 * @param <T> 泛型 * @return */ public <T> void getQueue(Class zClass, TaskEventListener taskEventListener) { RBlockingQueue<T> blockingFairQueue = redissonClient.getBlockingQueue(zClass.getName()); //由于此线程需要常驻,可以新建线程,不用交给线程池管理 ((Runnable) () -> { while (true) { try { T t = blockingFairQueue.take(); taskEventListener.invoke(t); } catch (InterruptedException e) { e.printStackTrace(); } } }).run(); } } 4.运行并测试 @Override public void run(String... args) throws Exception { //添加需要延迟的DTO TaskBodyDTO taskBody = new TaskBodyDTO(); taskBody.setBody("测试DTO实体类的BODY,3秒之后执行"); taskBody.setName("测试DTO实体类的姓名,3秒之后执行"); //添加队列3秒之后执行 redisDelayedQueue.addQueue(taskBody, 3, TimeUnit.SECONDS); taskBody.setBody("测试DTO实体类的BODY,10秒之后执行"); taskBody.setName("测试DTO实体类的姓名,10秒之后执行"); //添加队列10秒之后执行 redisDelayedQueue.addQueue(taskBody, 10, TimeUnit.SECONDS); taskBody.setBody("测试DTO实体类的BODY,20秒之后执行"); taskBody.setName("测试DTO实体类的姓名,20秒之后执行"); //添加队列20秒之后执行 redisDelayedQueue.addQueue(taskBody, 20, TimeUnit.SECONDS); //监听延迟队列 RedisDelayedQueue.TaskEventListener<TaskBodyDTO> taskEventListener = new RedisDelayedQueue.TaskEventListener<TaskBodyDTO>() { @Override public void invoke(TaskBodyDTO taskBodyDTO) { //这里调用你延迟之后的代码 logger.info("执行...." + taskBodyDTO.getBody() + "===" + taskBodyDTO.getName()); } }; redisDelayedQueue.getQueue(TaskBodyDTO.class, taskEventListener); } 打印的值 2020-02-17 13:45:08.371 INFO 14700 --- [ main] com.test.redis.demo.DemoApplication : 执行....测试DTO实体类的BODY,3秒之后执行===测试DTO实体类的姓名,3秒之后执行 2020-02-17 13:45:15.467 INFO 14700 --- [ main] com.test.redis.demo.DemoApplication : 执行....测试DTO实体类的BODY,10秒之后执行===测试DTO实体类的姓名,10秒之后执行 2020-02-17 13:45:25.463 INFO 14700 --- [ main] com.test.redis.demo.DemoApplication : 执行....测试DTO实体类的BODY,20秒之后执行===测试DTO实体类的姓名,20秒之后执行 结束: 使用是不是很简单,我这里是通过DTO的名字来区分队列名的,所以每一个定时任务的DTO都不要相同。 大家对于定时任务有其他好用的方式,或者开源的好项目,欢迎下方留言评论,我将在评论区选出100位中奖用户送出iPhone5. 哎呀,不对 我没有粉丝,等我粉丝到10000了再选中奖用户吧,哈哈

优秀的个人博客,低调大师

超详细新手建站指南(让你少走弯路)

1.概述 对于一个建站新手来讲,最重要的莫过于2件事 1.时间效率 2.性价比 换句话讲,对于非专业选手,在整个建站过程,如何省时省力,用相对简单的方式,花更少的钱建好网站是关键。 基于上述,给大家带来一版适合新手的建站指南,供大家参考 2.建站指南 建站三大必备条件:域名+主机空间(虚机主机/服务器)+建站程序无论你是自己建站还是外包第三方建站,都需要具备这三个要素才能建网站。 2.1.注册域名 注册域名 (域名就是人们常说的“网址”,好比一个网站的门牌号,不可或缺) 注意事项: 1.域名具有唯一性,同时域名要在63个字符之内,先注先得,一次性最多注册10年,并非永久有效,到期要进行需续费。 2.常见的域名后缀为.com(ps:应用最为广泛),有时候您可能无法获得想要的.com域名,那就建议使用 .net, .org 等后缀的域名。不同后缀代表和适合的行业不同,建议选择有相关性的域名后缀,例如:.com 商业性的机构或公司 .org 非盈利的组织、团体.gov.cn 政府部门 .net 从事互联网相关服务的机构或公司 3.随着互联网发展,域名价格越来越便宜,建议选择大一点的域名服务商,域名所有权和管理权限都 能掌握在自己手里,更有保障,更安全。 4.最后,在注册域名时注意隐私的保护也是很重要的,避免您的信息在公共域名查询平台被公开。 2.2.购买云空间 购买虚机主机/服务器(就是人们常说的“网站空间”,就像房子一样), 然后将编写好的网站程序(通过互联网也可找到一些开源的网站框架、程序)放置其中。在国内数一数二的云服务商属于阿里云和腾讯云了。目前阿里云的市场份额已经在国内占据过半。所以优先推荐使用阿里云的云服务器。 2.3.建站程序 建站程序有很多种,有服务商提供的自动化的建站程序,有纯手工编写好的网站程序。还有免费开源的建站程序,例如wordpress。主流的分为PHP系列,Java系列和.net系统。如果你不想深入了解其中的复杂细节,你完全可以采用阿里云自动化建站方案 【普通版】 : 云·速成美站 【企业版 】:云·企业官网 2.4.建站方案/建站方法 2.4.1.方法一:选择外包服务商 选择服务商,根据预算不同,同样有两种方式。开讲前,还有一点要和大家分享。一般选择服务商做的,企业居多,而新手们也大多是公司的网站负责人、人力、甚至是行政等等。面对老板交给的任务,会涉及一些共性问题: 建站前:不知道花多少钱?找谁做?怎么做? 建站中:会不会繁琐?如何了解制作进度?和设计师沟通是不是必须面谈? 建站后:不懂技术,如何维护?网站运营推广怎么做? 网站会不会被黑客攻击?出了问题该找谁? 因此,在这里温馨提示大家:建站服务商直接决定着网站的品质,中国建站市场没有统一规范和标准,服务商品质参差不齐,整体行业用户满意度偏低,网站“烂尾”及售后服务缺失时有发生,建议大家选择知名服务商或经熟人介绍,确保网站顺利上线及稳定运营。 2.4.1.1.预算5000元-20000元之间 这个预算区间,建站方式的选择相对灵活, 性价比最高的方式就是选择SaaS模式的建站服务,也就是服务商通过SaaS化的建站软件为客户进行网站搭建和设计制作。对于企业而言,基于这种模式,性价比高在哪里? • “省钱”:网站空间/服务器租用、采购的费用省了;• “省时”:网站程序开发、部署的时间省了;• “省力”:通过Web浏览器就能登录网站后台,操作使用,能“上网”就能管理网站;• “省心”:网站安全维护,软件更新由服务商直接做了,不用担心被黑客攻击,也不用招聘专职的网站管理人员。不过,选择这种方式,更适合展示,或者是在官网上有购物车、支付等“轻电商”功能的企业,无法完全满足有个性化或特定业务场景和需求的企业,例如一些炫酷的展示效果、个性化的功能交互、甚至商城这类需求。 2.4.1.2.预算20000元以上 如果预算在20000元以上,相对充足,只要时间和精力允许,通常会直接选择定制开发的建站方式。这种方式优势明显,企业可以根据自己业务场景和实际需求,选择专业的技术团队来做,这其中包括了网站程序及功能开发、前端页面设计等等,针对性更强。不过,选择这种方式,对于后期的维护、更新都有技术要求,需要专人来做,才能确保网站运行稳定和安全,因此会不定期产生费用。另外,网站改版、功能升级也是需要特别关注的事情,会有潜在的风险:一旦找不到当初的建站公司,有可能所有程序都要推翻重来,反而会花费更多的精力和时间,甚至是原来双倍的费用。 2.4.2.方法二:自己建站 如果选择这种(自己做),根据预算不同,有2种实现方式 2.4.2.1.预算2000元以下 使用SaaS化自助建站软件来做,这种方式相比第一种,在搭建操作的过程上无需技术,类ppt操作,完全DIY,容易上手,学习成本较低,更适合新手。同时,这类产品通常会提供模板供用户选择,通过模板,简单替换图片,修改文字,网站可以做到快速上线。这种方式更经济一些,也更省时间,不过有些效果实现起来会有困难,需要具体看产品功能。PS:小科普:什么是SaaS?SaaS是Software-as-a-Service(软件即服务)的简称, 它是一种通过Internet提供软件的模式,用户直接向服务商租用基于Web的软件,无需单独购买和部署。 2.4.2.2.预算2000元-5000元之间 购买虚机主机/服务器(就是人们常说的“网站空间”,就像房子一样), 然后将编写好的网站程序(通过互联网也可找到一些开源的网站框架、程序)放置其中,这种方式比较传统。好的地方是网站自定义程度很高,但是需要技术基础和时间,新手无法直接掌握,这个时候可能要求助懂技术的朋友帮忙,有的干脆放弃,花点钱找个建站公司来做。另外还有个问题,网站安全维护/程序优化更新,都需要亲力亲为。 2.5.网站备案 网站备案对很多新手来说,也是个头痛的事情,所以在这里也简单和大家分享一些关于备案的问题。 2.5.1.为什么要备案? 目前在中国大陆的企业网站/个人网站,(只要你的服务器机房在中国大陆)不管什么网站都是一样,都要求备案,这个备案是指工信部要求,(ps:工信部的网站上大家可以自行去查询相关的法律法规)各省通讯管局审核,然后下发一个备案号,那么这个备案呢,大致可以理解为:工信部是为了预防网站出现违法等相关问题的时候可以直接找到你网站的负责人。 如果你购买的云空间(服务器机房)是香港或者是国外,那么你就可以免去备案流程。阿里云支持选择地域为香港和国外,阿里云的机房遍布全球。 2.5.2.备案号是什么呢? 所谓的备案号就是网站底部的一个“京ICP备12345678号”这样一个文字,大型网站的底部都有。 2.5.3.网站备案前和备案后具体还要有哪些要注意的 ? • 备案要求的网站负责主体地址必须具体到门牌号• 个人备案的网站名称中不得含有禁词,例如:医疗、教育、新闻、论坛等• 特殊行业的备案需要前置审批,例如:医疗、教育、新闻、论坛、视频行业等等• 普通个人备案网站必须是非经营性网站,有经营性信息,如价格设置、购物商城等,必须办理经营许可证。• 备案通过后,必须在网站底部挂上备案号,并且加上指向工信部网站的链接• 部分服务商或者地区要求备案必须邮寄资料过去;主要有《真实性核验单》和《网络安全协议书》这两份原件。• 网站负责人(或者是企业营业执照)以前备过案的,一定要记得以前的备案密码(你用来备案的手机接收的密码)接入后面再次备案的系统。• 所有备案的资料,请务必用黑色中性笔填写,同时请用正楷字认真书写和签字,否则有可能资料不合格,特别是签名字一定要认真用正楷字。• 备案中所有照片请严格按照服务商要求,不能PS修改的一定不要去做,很容易识别的,需要扫描的一定要用扫描仪扫描。• 如果备案通过后:网站有禁止性信息、经营性信息等其他违规信息,如果被发现后一律可能会被随时注销备案。 2.5.4.如何查到网站是否备案了? 到工信部的网站上去查询,首页的右下角可以点击备案查询,然后在打开的页面输入你的域名、或者网址、或者公司备案名称即可查询到。 ps:由于查询人数较多,经常会有查不到的现象,所以:需要你耐心的多输入几次,或者多换几次查询的方式进行。 2.6.建站方法推荐 2.6.1.阿里云建站产品 属于一条龙自动化建站产品 产品特点: 无须懂技术,会打字就能搭建网站。 支持香港主机选择,免备案 独立IP,百度快速收录网站页面 无须额外购买服务器,标配阿里云云空间,无须另购服务器 在阿里云网站建设服务官方自营店,时间效率和性价比的问题全都迎刃而解,阿里云官方自营店为用户提供基于云计算的一站式网站建设服务。主营两款产品云·速成美站和云·企业官网 云·速成美站 为自助型建站产品,1033套模板,覆盖125个行业,模板可以随意切换,〝会打字,就能建网站〞。 云·企业官网为〝企业建站一条龙服务〞,客户经理和设计师1对1服务,应用标准化全自动服务流程体系,所有服务全部在线,真正做到标准价格,标准功能配置,标准服务流程,帮助企业轻松建立官网,做到10天交付。 如果大家在还没有选择好的建站服务商,可以优先选择阿里云自营建站服务。 2.6.2.阿里云三种建站方案 如果不想采用自动化建站方案,可以选择阿里云另外的三种建站产品,需要懂技术,会在主机上搭建网站程序。适合懂技术的自我建站的人士。 阿里云提供独享虚拟主机,轻量应用服务器,云服务器三种建站方案,具体请查看阿里云建站三种主机优劣对比 2.7.结尾 在选择第三方服务商的时候,尽量不要贪一时便宜,要选择大的建站服务商,比如阿里云,大的服务商售后服务和技术服务是可以让你安心的。

优秀的个人博客,低调大师

超详细Dkhadoop虚拟机图文安装步骤

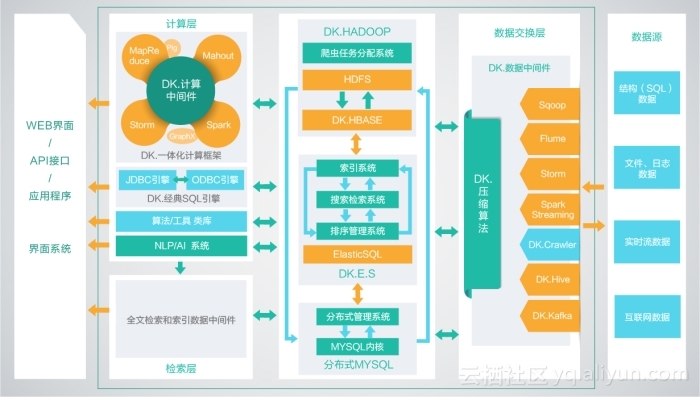
前两天看到有人留言问在什么情况下需要部署hadoop,我给的回答也很简单,就是在需要处理海量数据的时候才需要考虑部署hadoop。关于这个问题在很早之前的一篇分享文档也有说到这个问题,数据量少的完全发挥不了hadoop的优势,所以也没必要部署。但对于正在学习hadoop的朋友来说,hadoop运行环境部署真的是件非常头疼的事情。 计划在接下来的一段时间里,以我之前学习研究大快搜索DKHadoop时经验为基础,给大家整理分享虚拟机的安装、操作系统安装、服务器操作系统配置、DKH系统安装等相关内容。文章篇幅可能会比较长,所以每篇就只分享一到两个点。本篇给大家分享DKHadoop虚拟机的环境安装。 虚拟机的安装 1、下载的链接地址可参考: https://download3.vmware.com/software/wkst/file/VMware-workstation-full-12.5.7-5813279.exe 2、 详细安装步骤: (1)在配置类型选项中,我们选择自定义(高级),选择好之后点击“下一步” 图1 (2)虚拟机的硬件兼容性设置页面,参考下图设置好之后点击“下一步”; 图2 (3)在安装客户机操作系统界面我们选择最后一个“稍后安装操作系统”(见图3-1),然后点击下一步,在客户机操作系统中选择“Linux”(见图3-2)。 图3-1 图3-2 (4)为虚拟机命名,如下图4-1,(命名按照自己喜欢即可),点击“下一步”进行处理器配置。见图4-2 图4-1 图4-2 (5)设置虚拟机的内存,见下图 图5 (6)网络连接类型有四种,在四种网络连接类型中选择“使用桥连接网络”,点击“下一步”; 图6 (7) SCSI控制器类型选择LSI Logic 的推荐类型即可; 图7 (8)磁盘类型同样选择推荐的SCSI; 图8 (9)选择创建新虚拟磁盘(如图9-1),点击下一步设置磁盘容量,详细见图9-2 图9-1 图9-2 (10)设置磁盘存储位置 图10 (11)按照上述步骤完成设置后,单击下图中的“完成”即可,至此虚拟机安装成功。 图11

优秀的个人博客,低调大师

人生苦短:Python里的17个“超赞操作

人生苦短,我选Python”。那么,你真的掌握了Python吗? 1. 交换变量 有时候,当我们要交换两个变量的值时,一种常规的方法是创建一个临时变量,然后用它来进行交换。比如: # 输入 a = 5 b = 10 #创建临时变量 temp = a a = b b = temp print(a) print(b) 但在Python中,其实我们有一种更简洁的写法: 2. 将list中的所有元素转为单个字符串 列表和字符串是Python中最常见的数据类型,它们会遇到互相转换的需要。那么,我们该怎么把list中的所有元素转为字符串呢? 3. 查找list中出现次数最多的元素 给定一个包含多个元素的list,让你查找其中出现次数最多的元素,你会怎么做?在下图中,我们介绍了两种方法,其中第一种是利用max()函数的key参数,第二种则是使用Counter。 4. 判断两个字符串是否是anagram 所谓anagram,就是两个词所用的字母及其个数都是一样的,但是它们字母的位置不一样,比如abc,bac,acb。在Python中,Counter可以解决这个问题, 5. 字符串倒转 字符串倒转,就是把1234转成4321。下面我们介绍了三种方法: 方法一:最简单的切片法,a[::-1]就相当于a[尾:头:-1]。 方法二:用Python自带reversed()函数,它可被用于list倒转。 方法三:第三种是通过倒转数据类型和切片倒转整数。 如果你在学习Python的过程中遇见了很多疑问和难题,可以加-q-u-n227 -435-450里面有软件视频资料免费 6. list倒转 和字符串倒转类似,切片法也可以被用于list倒转,如下面的第一种方法。第二种方法调用的是上面提到的reversed()函数。 7. 二维矩阵转置 如果要转置矩阵,可以直接使用使用zip()函数。除此之外,没有比import numpy更简单的方法了。 8. 链式比较 如果想输出数组中介于4-7之间的元素,java是这么写的:if( b > 4 && b < 7){ },但Python更人性化。包括最后一句1 == b < 20,这和C、java也很不一样。 9. 链式调用 在python中实现链式调用只需在函数返回对象自己就行了。 10. 复制list 如果是刚学习Python的C用户,你可能会想写b = a,但这是错的。在Python中,变量指向的是某个对象的标签。也就是说,按照这种的写法,b和a指向的是内存中的同一个列表,对b操作,就相当于对a操作。所以正确的写法有以下几种: 方法一:b=a[:]。 方法二:b=list(a)。 方法三:使用Python 3的copy()函数,直接复制list,类似a[:]。 方法四:使用copy.deepcopy()。 11. 判断一个key是否在字典中 如果目标key不在字典中,以下代码会返回None或default。 12. 按value排序字典 Python的内置字典数据类型是无序的,而key可以被用来获取对应的value。有时我们需要根据value对字典中的item进行排序输出。方法如下所示: 方法一:用sorted函数排序,其中key参数是lamda表达式。 方法二:用operator.itemgetter而不是lamda表达式进行排序。 方法三:如果只需得到排序后的key,可用.get。 13. for ... else语法 14. 用逗号分隔list 下面分别是字符串list、数字list和混合list的逗号分隔方式。 15. 合并字典 方法一:Python 3.5可以存在重复key值,print({**d1, **d2})。 方法二:在内存中创建两个列表,再创建第三个列表,拷贝完成后,创建新的dict,删除掉前三个列表。 方法三:d1.update()。 16. list中的最小和最大索引 17. 从list中删除重复项 方法一:把list转成set,去除重复项,再转回list。 方法二:调用collections里的OrderedDict,和set差不多。

优秀的个人博客,低调大师

python超详细的基础笔记你学会了么

python简介 python是一种面向对象的解释型计算机程序设计语言,python的是吉多·范罗苏姆(Guido van Rossum)于1989年发明 任何语言都有优缺点,python也不例外,python的优点是简单易懂、可移植性、可扩展性、可嵌入性,python的缺点,一就是运行速度慢,因为python是解释型语言,代码在执行过程中会一行一行翻译成cpu能理解的机器码;二是代码不能加密,如果要发布python程序,实际上就是发布源代码。 python是跨平台的,它可以运行在Windows、Linux、Mac系统中,要开始学习python程序,首先需要把python安装到电脑上,从python的官网下载需要安装的软件版本,www.python.org,Windows系统下安装完毕后 通过cmd命令调取python,exit()退出 第一个python程序 通过python交互器执行程序,最后用exit()退出python,我们第一个python程序完成,唯一的缺憾是没有保存下来,下次运行还需要再输入一遍代码。 通过print()在括号中加入字符串就可以向屏幕上输出指定的文字 再python交互式命令行中写程序,好处是一下就能得到结果,坏处是没法保存,所以实际开发中我们会使用IDE或文本编辑器来写代码,写完后保存为一个python文件,这样程序就能反复运行,创建一个hello.py文件,并输入print("hello world") 进入指定目录通过python hello.py命令打开程序 如果你在学习Python的过程中遇见了很多疑问和难题,可以加-q-u-n227 -435-450里面有软件视频资料免费 变量 在python中变量的定义规则是 变量名只能是 字母、数字或下划线的任意组合 变量名的第一个字符不能是数字 python中的关键字不能声明为变量名 定义变量 name = "Zyy" 上面的代码声明了一个变量,变量名为: name,变量name的值为:"Zyy" python的输入和输出 用print()在括号中加入字符串,就可以向屏幕上输出指定的文字 print()可以接受多个字符串,用逗号","隔开,就可以连成一串,print()会依次打印每个字符串,遇到逗号会输出一个空格,print()也可以打印整数,或者计算结果,也可以组合使用 print()输出 输入字符使用input() input()输入 python的数据类型 可以使用内部函数type()来查看数据的类型 字符串(str) 整数型(int) 布尔型(bool) 浮点型(float) 列表(list) 元组(tuple) 字典(dict) 集合(set) 空值(None) 运算符 算数运算+ 加法 - 减法 * 乘法 / 除(使用/除时,结果为float类型) //地板除(结果为整数int) % 取余数 ** 次幂(2**2 表示2的2次幂结果4) 比较运算,输出结果为bool== 等于 != 不等于(python3.0之后不可以写作<>) > 大于 < 小于 >= 大于等于 <=小于等于 赋值运算= 简单的赋值运算符+=加法赋值运算符 c+=a相当于c=c+a-=减法赋值运算符 c-=a相当于c=c-a*=乘法赋值运算符 c*=a相当于c=c*a/=除法赋值运算符 c/=a相当于c=c/a%=取余赋值运算符 c%=a相当于c=c%a除此之外还有**= //= 逻辑运算符and 布尔与 两者都是True才是True,否则为Falseor 布尔或 两者都是False才是False,否则为Truenot 布尔非 非True就是False,非False就是True 成员运算in 如果在指定的序列找到值,则返回True,否则为Falsenot in 如果在指定的序列中没有找到值,返回True,否则为False 身份运算is is是判断两个标识符是不是引用一个对象is not is not 是判断两个标识符是不是引用不同对象 判断语句和循环语句 python的语法比较简单,采用缩进方式;以#开头表示注释,批量注释使用'''。。。''',其他每一行都是一个语句,当语句以冒号:结尾时,缩进的语句视为代码块(不要tab键和空格混用,python是区分大小写的)。 判断语句简单的if判断语句为if 条件:#条件为True执行结果else: #否则执行结果if中还可以使用elif做更细致的判断,elif 是else if的缩写,if语句是从上往下判断,如果某个判断上是True,就会执行相应的结果,执行完毕后会忽略掉接下来的elif和else 循环语句forfor...in....语句可以循环遍历list或tuple,又称作迭代,for x in ... 就是把每个元素带入变量x,然后执行缩进 循环语句whilewhile循环是,只要条件满足,就不断循环,条件不满足时退出。在循环中,可以使用break和continue,需要配合if语句来使用,break是退出循环,continue是跳过当前循环 循环案例

优秀的个人博客,低调大师

超全!基于Java的机器学习项目、环境、库...

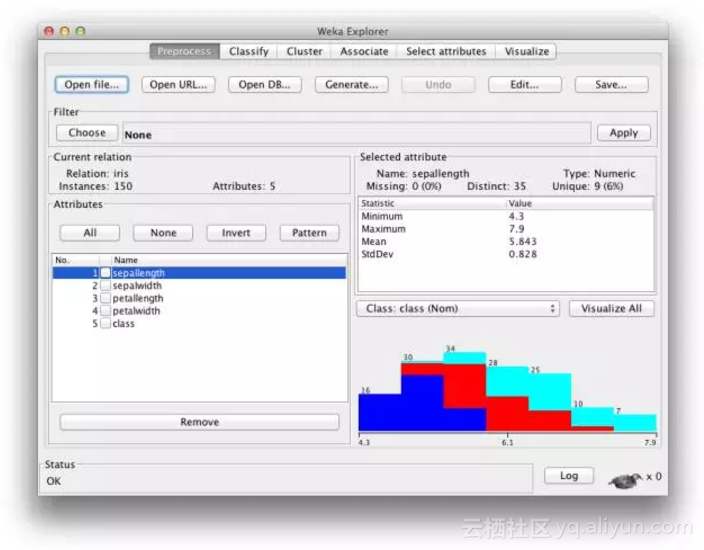
你是一名希望开始或者正在学习机器学习的Java程序员吗? 利用机器学习编写程序是最佳的学习方式。你可以从头开始编写算法,但是利用现有的开源库,你可以取得更大的进步。 本文介绍了主要的平台和开放源码的机器学习库。你可以使用这些机器学习库。 环境 本节描述了用于机器学习的Java环境或工作域。它们提供了用于执行机器学习任务的图形用户界面,还提供了用于开发自己应用程序的Java API。 WEKA 怀卡托环境知识分析(Weka)( https:// www.cs.waikato.ac.nz/ml/weka/)是一个由新西兰怀卡托大学开发的机器学习平台。提供Java的图形用户接口,命令行接口和Java API接口。它可能是最流行的Java机器学习库,也是开始或练习机器学习的好地方。 KNIME 康斯坦茨信息挖掘(KNIME)(https://www.kn

优秀的个人博客,低调大师

GNS3-超好用的CISCO模拟器

以前经常用小凡制作的Dynamips模拟器,最多时在笔记本上能跑八台设备,当时感觉已经很不错了,搭建大型的网络拓扑试验没问题,后来小凡也没更新版本,直到GNS3开始流行,用过才感觉更好用,网上也有很多这方面的推荐,至于这款模拟器为何受到大家的好评? 首先是基于Dynamips内核,Dynamips是由法国贡比涅科技大学的克里斯托弗•菲尔洛特(Christophe Fillot)编写的Cisco设备模拟器。Dynamips不同于传统的纯软件式模拟器,它模拟了多种型号的Cisco路由器的硬件平台,用户可以在模拟器中直接加载并运行真正的IOS镜像,这使得Dynamips可以成功模拟出99%以上的IOS功能,并且确保在绝大多数情况下得到的结果与真实设备的结果相同。 GNS3的界面非常简单直观,跟CISCO官方的Packet Tracer有相同之处,拓扑图查看一目了然,而且也是拖放操作,有一点要注意的是我们要设置好配置存放的路径,需要我们手动设置,不能设置中文路径会出问题,另外我们需要自行获得IOS文件用来模拟相关设备。 在加载IOS之后,我们拖拽路由器图标到拓扑中,点击运行即可,如果需要搭建超过3台以上的设备,我们不能忽略idle-pc值的设置。众所周知dynamips是虚拟的硬件平台,路由器的硬件平台有cpu主板等构成,dynamips自然要在x86上模拟出cisco路由器cpu,又由于dynamips是系统下的应用程序,于是dynamips负责将虚拟cpu发出的指定翻译成保护模式下可执行的指今,这用了JIT(实时编译)技术。所以dynamips每时每刻都在工作,idle-pc的出现改变了这个现实,idle-pc(idle pointer **er)即空闲点计数器,加上此特性后dynamips就能知道路由器的cpu什么时候空闲,什么时候工作,在空闲时就不用编译路由器cpu发出的指令了,从而降低来cpu利用率。通常情况下我们选择idle-pc最大值,然后查看任务管理器CPU占用率才确定idle-pc是否为最佳。GNS3对物理内存要求不是很高,测试在1G内存的电脑中,通过增加虚拟内存后运行GNS3,性能不受到影响。 搭建好拓扑之后,我们需要进入设备配置,使用SecureCRT来连接是最好的选择,大家可以在这个平台搭建属于自己的拓扑环境来做实验。 GNS3 0.7.2 download link:http://downloads.sourceforge.net/gns-3/GNS3-0.7.2-win32-all-in-one.exe?download GNS3 0.7.2 is released.It includes Dynamips, Qemu/Pemu, Putty and WinPCAP 4.1.1 Here is a list of the changes in this version: •Lot of small fixes (relative paths, link removal, .net loading, Ethernet switch connection to a Cloud etc.) •Qemuwrapper: random MAC address for devices •NPE-G2 option for c7200 routers (need a specific and uncompressed IOS image and C7200-IO-2FE, C7200-IO-GE-E, PA-2FE-TX and PA-GE are unlikely to work) •Simulated switches: daisy chaining support •Improved directory selection for new projects •New translations: Bulgarian, Italian and Ukrainian •Frame Relay capture option for all serial links •Dialog to display an Ethernet switch MAC address table 本文转自 zhaiken 51CTO博客,原文链接:http://blog.51cto.com/zhaiken/387723,如需转载请自行联系原作者

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册