首页 文章 精选 留言 我的

精选列表

搜索[递归超智能],共10000篇文章
优秀的个人博客,低调大师

超好用的国内规则引擎框架

前言 LiteFlow的最新版本2.12.4发布了! 在这个版本里,我们带来了2个大特性和诸多的升级。同时这个版本也是向下兼容2.12.X系列的版本的。 JavaX脚本 LF从很早就开始支持Java脚本,让java代码可以像一种脚本语言那样运作,使用java语言编写可以随时热刷新的代码成为了现实,这个脚本很酷,但是社区里一直诟病的就是LF的java脚本竟然不支持lambda和泛型。 这是因为之前java脚本底层用的是Janino框架,这个框架是个老外写的,这个项目已经很久没更新过了并且作者表示不高兴去支持lambda和泛型了。所以我也是没辙。 这次新的Javax采用Liquor框架的方案,支持了java8到java21中所有的用法,多谢solon作者提供Liquor底层的技术支持,才得以让LF解决了一个困扰多时的问题。使得Java脚本得到了一次大的升级! 如果开发者想要从Java脚本更新到Javax脚本,请看官网的升级指南。 #全新的生命周期体系 在2.12.4版本中,LF提供了生命周期体系。开发者可以很方便的实现一些既定的生命周期接口,从而在特定的生命周期织入自定义逻辑。 LF这次提供了5个大的生命周期阶段的接口,扩展LF,让自己的逻辑变得灵活成为了可能。 具体如何使用请参考官网的生命周期全新章节。 数据库插件支持配置自定义SQL 这也是为开发者提供了更加灵活自由的选择,现在开发者可以忽视掉applicationName,enable等字段,自己去定义SQL来返回系统所需要加载的规则/脚本。 具体如何使用请参考官网文档中的SQL数据库配置源。 其他的更新 另外这个版本,我们还修复了一直以来困扰开发者的异步循环中的并发问题。 提供了域名版本的dtd文件。 完整更新列表 特性 #IASS9Z 新的JavaX脚本插件,支持java8~java17的所有语法特性 https://gitee.com/dromara/liteFlow/issues/IASS9Z 特性 #IAJD9H 期望liteflow 有自己的生命周期扩展 https://gitee.com/dromara/liteFlow/issues/IAJD9H 增强 #IASYI0 提供脚本初始化生命周期的扩展点 https://gitee.com/dromara/liteFlow/issues/IASYI0 增强 #I9H6GY SQL脚本在配置上支持用户自定义的过滤条件 https://gitee.com/dromara/liteFlow/issues/I9H6GY 增强 #IAVH8O 把scanner当中的步骤抽象出来,形成一套小的体系,方便的扩展 https://gitee.com/dromara/liteFlow/issues/IAVH8O 增强 #IANY4U 组件中提供getCmpDataList接口 https://gitee.com/dromara/liteFlow/issues/IANY4U 增强 #I5XB03 提供带域名的dtd文件地址,加强xml的提示 https://gitee.com/dromara/liteFlow/issues/I5XB03 修复 #IASW3I 异步循环迭代组件中迭代对象以及迭代下标存在并发问题 https://gitee.com/dromara/liteFlow/issues/IASW3I

优秀的个人博客,低调大师

鸿蒙程序员平均月薪超 1 万 8

据智联招聘数据显示,春招鸿蒙岗位需求是去年近3倍。 本月初,华为 HarmonyOS 在新年贺词中提到,基于开源鸿蒙开发的 HarmonyOS NEXT 鸿蒙星河版将在今年秋天正式和消费者见面,这也促使大量企业急需鸿蒙人才。 春节后开工第一周,鸿蒙相关职位数同比增长163%,投递人数同比增长349%,同时,鸿蒙开发岗的招聘薪资,达到18191元/月,比总体开发岗的平均薪资(16617元/月)高出9%。 来自:现代快报

优秀的个人博客,低调大师

使用 Svelte 来构建 Web Component (超简单方便)

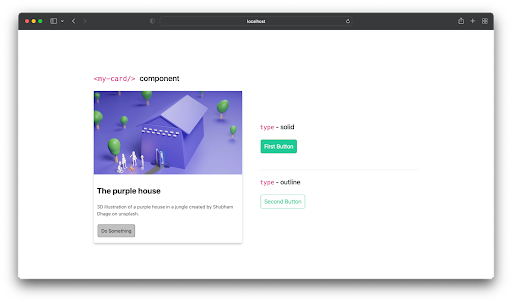
每个开发人员都应该关注代码中的可重用性以及代码的业务隔离,这样可以让业务逻辑与应用架构分离,提升系统的扩展性。而 Web Component 就是这样一个技术,可以让我们创建一个独立的可重用组件。 本文将介绍使用 Svelte 创建通用的 Web Component 的完成过程。『通用』指的是该组件不局限于 Svelte 应用,还可以用于任何 JavaScript 应用程序(如 Vue、React 等),同时还将介绍使用 Svelte 创建 Web Component 的一些局限性。 什么是 Web Component? Web Component 可以让我们创建可重用的、自定义的封装了样式以及功能的 HTML 元素。 例如,我们使用如下代码来创建一个导航条: <style> /* CSS code for our navbar */ </style> <navbar> <!-- Some long code for our navbar --> </navbar> 如果用 Web Component 技术,我们可以定义一个自定义元素(如 <custom-navbar/>),然后你可以在网页任一地方使用该元素显示导航条,同时这个导航条的样式和页面其他元素的样式是完全隔离的,不会相互影响。而这项技术被称之为 Shadow DOM (影子 DOM)。 什么是 Shadow DOM? Shadow DOM 是一个较小的、独立的 DOM,它与主 DOM 分开渲染,允许我们将样式和标记行为隔离到单个组件中。Shadow DOM 本质上允许我们将组件功能进行封装和隔离,我们可以单独对其设置样式、编写功能脚本,而不会干扰应用程序的其余元素。 你大概对 Web Component 有一个基本的认识,下面我们开始用 Svelte 来编写一个简单的组件。 构建 Web Component 准备工作 为了完成本文剩余的内容学习,需要你对掌握以下知识: 对 HTML, CSS 和 JavaScript 有基本的认识 熟悉命令行操作环境 需要一个文本编辑器 最好对 Svelte 有一些基本的了解(可以看看我之前翻译的文章https://my.oschina.net/javayou/blog/5309554) 开始 本文我们将开发两个组件: 第一个组件是一个卡片组件,接收三个属性分别是:卡片标题、卡片描述以及图片,该组件名为<my-card/> 第二个组件是一个带样式的按钮,接收一个type的属性,通过该属性来确定按钮的显示样式,组件名称为<cool-button/> 同时我们将使用两种组件的发布方式,一个是打包到单一文件,另外一个是每个组件发布到一个独立的文件中。 下图显示的是两个组件运行后的外观: 我们从创建一个 Svelte 应用开始,并安装必须的包: npx degit sveltejs/template web-component-tut cd web-component-tut npm install 上述命令执行完毕就可以使用如下命令启动一个测试环境: npm run dev 然后我们打开浏览器访问http://localhost:8080就可以看到一个最基础的 Svelte 应用运行起来后的样子: 开发一个组件 使用 Svelte 生成通用 Web Component 的过程类似于创建常规 Svelte 组件的过程,只是进行了一些修改。 为了创建第一个卡片组件,我们首先创建一个文件src/Card.svelte并定义组件的属性、样式以及 HTML 标签,代码如下: <script> // component props // Camel case not supported for props, see drawback section. export let card_title, card_desc, card_img; </script> <main> <div class="card-container"> <div class="card"> <img src={card_img} alt="My product" /> <div class="card-body"> <div class="row"> <div class="card-title"> <h2>{card_title}</h2> </div> </div> <p> {card_desc} </p> <button>Do Something</button> </div> </div> </div> </main> <style> .card { max-width: 350px; border-radius: 5px; box-shadow: 0 4px 6px 0 #00000033; padding: 0 0 10px 0; } .card img { width: 100%; height: auto; } .card-body { padding: 5px 10px; } .card-body p { color: #575757; margin-bottom: 20px; font-size: 14px; } </style> 你可以在其他组件中使用这个卡片组件,如下所示(这一步可忽略): <script> import Card from "./Card.svelte"; </script> <main> <Card card_title="My Card Title" card_desc="Lorem ipsum dolor…" card_img="path/to/my-image.png" /> </main> 接下来是按钮组件,文件名/src/Button.svelte代码如下: <script> // Component props export let type = "solid"; </script> <button class={type == "solid" ? "btn-solid" : "btn-outline"}> <slot /> </button> <style> button { padding: 10px; color: #fff; font-size: 17px; border-radius: 5px; border: 1px solid #ccc; cursor: pointer; } .btn-solid { background: #20c997; border-color: #4cae4c; } .btn-outline { color: #20c997; background: transparent; border-color: #20c997; } </style> 该组件的使用方法如下(可忽略): import Button from "./Button.svelte"; <Button type="outline">Click me</Button> 将自定义组件转成通用组件 我们需要将自定义 Svelte 组件转成通用的 Web Component ,这样才可以在其他框架中直接使用。 要做这个转换操作,我们需要在 Svelte 配置文件中设置让编译器生成自定义元素。打开rollup.config.js在 plugins 增加一个compilerOptions配置项,在该配置项下增加 customElement: true 配置信息,如下所示: ... plugins: [ svelte({ compilerOptions: { dev: !production, customElement: true, ... 然后我们需要给两个组件分别定义一个元素名称,打开Card.svelte文件,在文件开头第一行插入如下内容: <svelte:options tag="my-card" /> 上述tag属性值代表组件的标签名称。 同样的,打开 Button.svelte 给第二个组件指定一个标签名称: <svelte:options tag="cool-button" /> 最后一步是在main.js中引入这两个组件,打开/src/main.js将里面的内容替换成如下两行: import Button from "./Button.svelte"; import Card from "./Card.svelte"; 这里我们已经完成了两个组件的开发步骤,下一步就是打包组件以便其他的应用可以使用这两个组件,打开命令行窗口进入项目所在目录执行如下命令: npm run build 该命令将生成两个文件,分别是build.js和build.map.js, 文件位于项目下的/build目录。其中build.js是打包的两个组件,而build.map.js是build.js源代码映射文件。 如果上述步骤顺利完成,我们就可以将bundle.js拷贝到一个新目录,然后创建一个index.html文件,内容如下: <!DOCTYPE html> <html> <head> <title>My website</title> <script src="./build.js"></script> </head> <body> <div class="container"> <div class="row"> <div class="col"> <my-card card_title="Red Person" card_desc=" Lorem ipsum dolor sit, amet consectetur.." card_img="https://bit.ly/34B3zHX" > </my-card> <!-- Image credit - Shubham Dhage on unsplash.com --> </div> <div class="col"> <div class="border-bottom py-5"> <cool-button> Solid Cool Button </cool-button> <cool-button type="outline"> Outlined Cool Button </cool-button> </div> </div> </div> </div> </body> </html> 这是一个再简单不过的 HTML 页面了,该页面使用了上述两个组件,在浏览器中显示为如下效果: 组件分割 在某些情况下我们不需要将多个组件打包到同一个 js 文件中,我们希望每个组件有一个独立的 js 文件。要实现这个场景只需在rollup.config.js的input 和 output 中进行配置即可。 在 input 的配置中我们可以指定一个数组,数组的元素就是每个组件的文件路径,而 output 指定为输出的目录即可: export default { input: ["src/Card.svelte", "./src/Button.svelte"], output: { format: "iife", dir: "public/build/", }, ... 修改完成后再次执行npm run build,我们就可以在 build 目录中看到两个文件Button.js和Card.js。 使用方法类似: <script src="Button.js" type="module"></script> <cool-button type="outline">Click Me</cool-button> <!-- another-page.html --> <script src="Card.js" type="module"></script> <my-card card_title="..."></my-card> 主要缺点 到这里我们已经掌握了使用 Svelte 开发 Web Component 的方法,这个过程非常之简单,但是,使用 Svelte 开发 Web 组件会有一些缺点如下: 组件的属性名称不允许使用驼峰命名法,例如你会发现使用形如 cardTitle 这样的属性名就无法正常工作,而驼峰命名法又是 JavaScript 推荐的命名风格。这是一个 Bug,不过如果你使用的是 Vite ,那么有一个workaround plugin可以解决这个问题。 如果不标记Web组件,就无法在Svelte中重用它们 - 不幸的是,您还必须标记要在自定义Web组件中使用的每个Svelte组件 加入你有一个Header.svelte文件需要作为<my-header/>组件输出,但同时这个组件又依赖另外一个Nav.svelte文件,而 Nav.svelte 我们不希望作为 Web 组件输出,这个问题使得我们必须将 Nav.svelte 也作为组件输出,否则程序就会报错。好在这个问题现在也有解了(详情请看 这里),我们可以通过配置来解决这个问题,虽然看起来不是那么的爽,就这样吧,又不是不能用。 浏览器的支持问题 — JavaScriptcustomElementAPI 就是用来创建 Web Component 的底层 API,该 API 目前并没有被所有的浏览器支持,我们需要引入 Polyfill 来解决这个文件,详情请看webcomponents official。 总结 在本文中,我们学习了如何使用 Svelte 创建通用卡片和按钮组件,生成捆绑文件,拆分它们,甚至在单独的 HTML 页面中重用此组件。 动手试试吧? 本文翻译自:Build web components with Svelte - LogRocket Blog

优秀的个人博客,低调大师

超详细 Clickhouse 负载过高问题快速排查思路教程

机器配置 Clickhouse 配置内存大小: 250G Zookeeper 配置内存大小:24G 发现问题 企业相关开发人员通过Grafana监控Clickhouse指标观察到,从12点左右出现了大量的碎片写入,从而引起了相关指标的快速上升。查看云智慧的数字化运维数据平台 DODB (以下简称DODB)概览页也未查看出异常出现源头,而当查看服务器负载情况时,已经上升至900+。 开始排查 检查是否为执行 SQL 太多 当遇到此类问题时,普遍情况下均会猜测是 SQL 执行太多导致。因此,团队开发人员检查了 Clickhouse 的 Process表,以此判断运行中的 SQL 是否过多。与此同时与算法部门的同事进行沟通,最终确认是通过 DODB 写入数据的。随后又查询了一下执行中的 SOL,发现两台机器上运行中的 SOL 不太均衡。 查询 Clickhouse 日志 当查看 Clickhouse 日志时,看到有很多 warn 的日志,但并没有出现有价值的日志。 查询 Zookeeper 日志 当查看 Zookeeper 日志时,发现数据同步有比较大的延迟,超过了1-2s。 排查同步数据延迟是因为需要判断是 load 值上来导致延迟还是因为延迟导致的 load 值上来。可能是一个大查询导致 load 值上来后,引起 Zookeeper 出现问题,从而导致数据无法同步出现数据堆积的情况。因此,在此时查看了监控的读写情况,是由于load值上来后导致写入变慢。 SQL 语句查询 在 Clickhouse 中,所有被执行 Query 均会记录到system.query_log表中。因此可通过该表监控集群的查询情况。以下列举几种用于监控的常用SQL。 最近查询 SELECT event_time, user, query_id AS query, read_rows, read_bytes, result_rows, result_bytes, memory_usage, exception FROM clusterAllReplicas('cluster_name', system, query_log) WHERE (event_date = today()) AND (event_time >= (now() - 60)) AND (is_initial_query = 1) AND (query NOT LIKE 'INSERT INTO%') ORDER BY event_time DESC LIMIT 100 慢查询 SELECT event_time, user, query_id AS query, read_rows, read_bytes, result_rows, result_bytes, memory_usage, exception FROM clusterAllReplicas('cluster_name', system, query_log) WHERE (event_date = yesterday()) AND query_duration_ms > 30000 AND (is_initial_query = 1) AND (query NOT LIKE 'INSERT INTO%') ORDER BY query_duration_ms desc LIMIT 100 Top10大表 SELECT database, table, sum(bytes_on_disk) AS bytes_on_disk FROM clusterAllReplicas('cluster_name', system, parts) WHERE active AND (database != 'system') GROUP BY database, table ORDER BY bytes_on_disk DESC LIMIT 10 Top10查询用户 SELECT user, count(1) AS query_times, sum(read_bytes) AS query_bytes, sum(read_rows) AS query_rows FROM clusterAllReplicas('cluster_name', system, query_log) WHERE (event_date = yesterday()) AND (is_initial_query = 1) AND (query NOT LIKE 'INSERT INTO%') GROUP BY user ORDER BY query_times DESC LIMIT 10 使用慢查询的 SQL 查询 查询结果出来,查看所执行 SQL 具体情况,发现很多都是“异常容器”的。 下图为作战地图所查大屏表,且为 left JOIN 表。由于 life 的 JOIN 在网络及其他因素条件有要求,因此比刚才查询更消耗资源。随后通过时间段查询判断出现异常时间是否匹配,对比发现时间上有些差异。 查询 SQL 查询次数,判断哪次查询 时间 最长以及查询的平均时长。 select left(query, 100) as sql, count() as queryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime("2022-09-23 12:00:00") and event_time < toDateTime("2022-09-23 17:00:00") group by sql order by queryNum desc limit 10 通过该 SQL 查询,发现 5 个小时 SQL 查询了将近 4 万次,且同类型查询执行次数均较高,平均执行时间也比较长。此外,也有许多 5 个小时执行两三千次的 SQL 查询,该类查询平均每次耗时均在二三十秒。 查询不包含insert into语句的5个小时查询次数超过1000次的 SQL select * from (select LEFT(query, 100) as sql, count() as quneryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query not like '%INSERT INTO%' group by sql order by avgTime desc) where queryNum > 1000 limit 50 由于上述 SQL 均做了截取,故需根据所查询 SQL 进一步匹配 SQL。 select query from system.query_log where event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query like '%需要匹配的sql查询%' limit 5; 使用第三条 SQL 用 queryNum 排序,查询出执行次数多且平均耗时比较大的 SQL,随后定位 SQL。以第二条记录为例:5个小时查询了 38000+次,耗时12s,每分钟查 120+次。 使用第三条 SQL ,将 时间 范围改到上午8点到上午12查询。 查询结果对比发现,执行耗时在上午时均很短,但到中午12点以后就变的非常慢了。 由于之前查询发现有部分 left JOIN 的查询,故查询了“异常容器”的left JOIN 的查询,,随后将读取条数为0的排除掉。 select * from (select LEFT(query, 100) as sql, count() as quneryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where sql like '%异常容器%' and read_rows != 0 and event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query not like '%INSERT INTO%' group by sql order by queryNum desc) 根据小时 聚合 每个小时/分钟段查询次数耗时 --按照每小时聚合 select toHour(event_time) as t, count() as queryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime('2022-09-23 08:00:00') and event_time < toDateTime('2022-09-23 17:00:00') and query not like '%INSERT INTO%' and query like '%异常容器%' and read_rows != 0 group by t limit 50 --按照每分钟聚合 select toMinute(event_time) as t, count() as queryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 13:00:00') and query not like '%INSERT INTO%' and query like '%异常容器%' and read_rows != 0 group by t limit 50 查询结果如下:10点开始有,12 点查询响应时间翻了10倍。 从32s开始,响应时间变为24s多,后面的时间也逐渐变长。 查询 left JOIN 的查询个数。 select * from (select LEFT(query, 100) as sql, count() as quneryNum, sum(query_duration_ms) as totalTime, totalTime/queryNum as avgTime from system.query_log ql where query like '% JOIN%' and read_rows != 0 and event_time > toDateTime('2022-09-23 12:00:00') and event_time < toDateTime('2022-09-23 21:00:00') and query not like '%INSERT INTO%' group by sql order by queryNum desc) 发现有问题的表时,查询该表结构。 show create table "shard_2"."cw_db_zabbix_metric_data01_replica" 经查询发现该表创建的比较差,order by 仅有一个 UUID。且该表 JOIN 的 SQL 也比较多,每次查询的读取的条数也特别大。 停掉 SQL ,观察结果 通过观察,发现有不少类似的 JOIN 的 SQL。当停掉一个异常容器指标的 SQL 时会发现 load 值有些许变化,偶尔会降到700多。由于指标管理都是通过 gatewayAPI 调用,停掉 SQL 最快的方法便是直接将 gatewayAPI 停掉,这样只会影响指标 SQL 调,不会影响其他功能使用。将 gatewayAPI 停掉后就不会出现指标调用 SQL 也全部停掉,此时发现 load 值已降低 总结 遇到此类问题可先查看日志,首先在(Clickhouse 日志 Zookeeper 日志)日志中看能否找到有用的信息,例如直接报错信息等,如果在日志中找不到太多有用的信息的话,可以从下面入手。 一般遇到 load 值比较高的情况时,基本上都是发生在查询上面。当遇到这种问题时可先查询带有JOIN 的 SQL 语句是不是很多。随后通过 query_log 表中的一些字段去查询重要信息,通过对字段使用一些函数来获取有用的信息,如获取查询的 SQL,SQL 执行次数、执行时间等。 本次排查过程主要使用query_log表,下面为重要字段: event_time — 查询开始时间. query_duration_ms — 查询消耗的时间(毫秒). read_rows— 从参与了查询的所有表和表函数读取的总行数. query — 查询语句. Clickhouse query_log 表中所有字段 type (Enum8) — 执行查询时的事件类型. 值: 'QueryStart' = 1 — 查询成功启动. 'QueryFinish' = 2 — 查询成功完成. 'ExceptionBeforeStart' = 3 — 查询执行前有异常. 'ExceptionWhileProcessing' = 4 — 查询执行期间有异常. event_date (Date) — 查询开始日期. event_time (DateTime) — 查询开始时间. event_time_microseconds (DateTime64) — 查询开始时间(毫秒精度). query_start_time (DateTime) — 查询执行的开始时间. query_start_time_microseconds (DateTime64) — 查询执行的开始时间(毫秒精度). query_duration_ms (UInt64) — 查询消耗的时间(毫秒). read_rows (UInt64) — 从参与了查询的所有表和表函数读取的总行数. 包括:普通的子查询, IN 和 **JOIN**的子查询. 对于分布式查询 read_rows 包括在所有副本上读取的行总数。 每个副本发送它的 read_rows 值,并且查询的服务器-发起方汇总所有接收到的和本地的值。 缓存卷不会影响此值。 read_bytes (UInt64) — 从参与了查询的所有表和表函数读取的总字节数. 包括:普通的子查询, IN 和 **JOIN**的子查询. 对于分布式查询 read_bytes 包括在所有副本上读取的字节总数。 每个副本发送它的 read_bytes 值,并且查询的服务器-发起方汇总所有接收到的和本地的值。 缓存卷不会影响此值。 written_rows (UInt64) — 对于 INSERT 查询,为写入的行数。 对于其他查询,值为0。 written_bytes (UInt64) — 对于 INSERT 查询时,为写入的字节数。 对于其他查询,值为0。 result_rows (UInt64) — SELECT 查询结果的行数,或**INSERT** 的行数。 result_bytes (UInt64) — 存储查询结果的RAM量. memory_usage (UInt64) — 查询使用的内存. query (String) — 查询语句. exception (String) — 异常信息. exception_code (Int32) — 异常码. stack_trace (String) — Stack Trace. 如果查询成功完成,则为空字符串。 is_initial_query (UInt8) — 查询类型. 可能的值: 1 — 客户端发起的查询. 0 — 由另一个查询发起的,作为分布式查询的一部分. user (String) — 发起查询的用户. query_id (String) — 查询ID. address (IPv6) — 发起查询的客户端IP地址. port (UInt16) — 发起查询的客户端端口. initial_user (String) — 初始查询的用户名(用于分布式查询执行). initial_query_id (String) — 运行初始查询的ID(用于分布式查询执行). initial_address (IPv6) — 运行父查询的IP地址. initial_port (UInt16) — 发起父查询的客户端端口. interface (UInt8) — 发起查询的接口. 可能的值: 1 — TCP. 2 — HTTP. os_user (String) — 运行 clickhouse-client的操作系统用户名. client_hostname (String) — 运行clickhouse-client 或其他TCP客户端的机器的主机名。 client_name (String) — clickhouse-client 或其他TCP客户端的名称。 client_revision (UInt32) — clickhouse-client 或其他TCP客户端的Revision。 client_version_major (UInt32) — clickhouse-client 或其他TCP客户端的Major version。 client_version_minor (UInt32) — clickhouse-client 或其他TCP客户端的Minor version。 client_version_patch (UInt32) — clickhouse-client 或其他TCP客户端的Patch component。 http_method (UInt8) — 发起查询的HTTP方法. 可能值: 0 — TCP接口的查询. 1 — GET 2 — POST http_user_agent (String) — The UserAgent The UserAgent header passed in the HTTP request。 quota_key (String) — 在quotas 配置里设置的“quota key” (见 keyed). revision (UInt32) — ClickHouse revision. ProfileEvents (Map(String, UInt64))) — Counters that measure different metrics. The description of them could be found in the table 系统。活动 Settings (Map(String, String)) — Names of settings that were changed when the client ran the query. To enable logging changes to settings, set the log_query_settings 参数为1。 thread_ids (Array(UInt64)) — 参与查询的线程数. Settings.Names (Array(String)) — 客户端运行查询时更改的设置的名称。 要启用对设置的日志记录更改,请将log_query_settings参数设置为1。 Settings.Values (Array(String)) — Settings.Names 列中列出的设置的值 开源项目推荐 云智慧已开源数据可视化编排平台 FlyFish 。通过配置数据模型为用户提供上百种可视化图形组件,零编码即可实现符合自己业务需求的炫酷可视化大屏。 同时,飞鱼也提供了灵活的拓展能力,支持组件开发、自定义函数与全局事件等配置, 面向复杂需求场景能够保证高效开发与交付。 如果喜欢我们的项目,请不要忘记点击下方代码仓库地址,在 GitHub / Gitee 仓库上点个 Star,我们需要您的鼓励与支持。此外,即刻参与 FlyFish 项目贡献成为 FlyFish Contributor 的同时更有万元现金等你来拿。 GitHub 地址: https://github.com/CloudWise-OpenSource/FlyFish Gitee 地址: https://gitee.com/CloudWise/fly-fish 微信扫描识别下方二维码,备注【飞鱼】加入AIOps社区飞鱼开发者交流群,与 FlyFish 项目 PMC 面对面交流~

优秀的个人博客,低调大师

GitHub 出现超 35000 个恶意攻击文件/克隆仓库

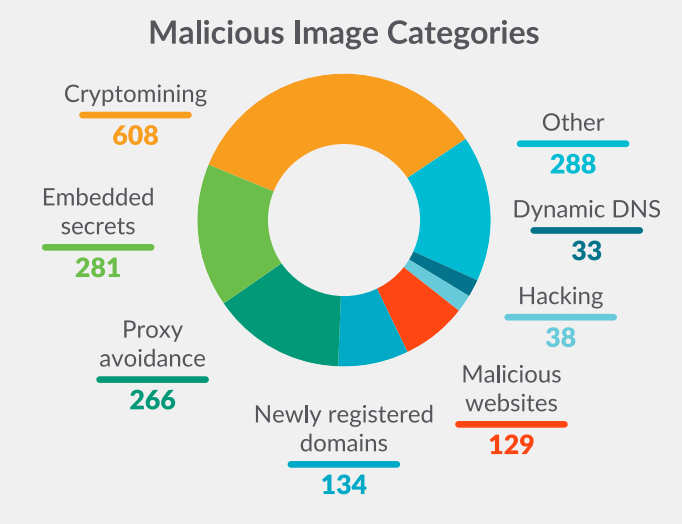
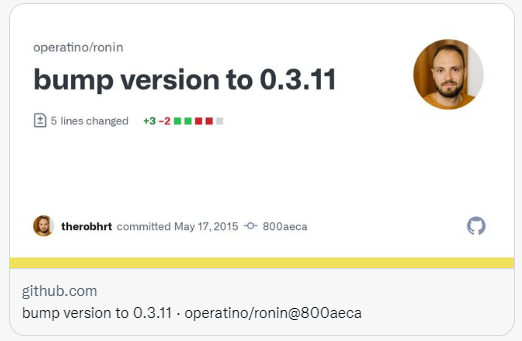
推特用户@Stephen Lacy发现 GitHub 上存在大规模的混淆恶意攻击,目前 GitHub 上有超过 35,000 个恶意文件/克隆仓库,包括crypto、golang、python、js、bash、docker、k8s 等知名项目。 这些恶意文件/克隆仓库会附带一行恶意代码: hxxp://ovz1.j19544519.pr46m.vps.myjino[.]ru 它不仅泄露了用户的环境变量 ,而且还包含一个单行后门,会将脚本、应用程序、笔记本电脑(电子应用程序)等整个 ENV 发送到攻击者的服务器,ENV 包括受害者的安全密钥、AWS 访问密钥、加密密钥等帐户凭证。 在 GiuHub 搜索这行恶意代码会出现 35788 个代码结果,其中约 13000 个搜索结果来自一个名为“redhat-operator-ecosystem”的仓库,这个库现在已从 GitHub 中删除。 这些恶意攻击伪装得非常好,看起来像人畜无害的提交,比如带着“bump version to 0.3.11”之类的消息: 其中一些被混淆成合法的 PR,但其实仓库没有收到任何 PR,反而仓库中的每个 go 文件都被感染了: 其中一些克隆仓库的历史提交记录包括来自原作者的提交,但这些提交未经 GPG 验证,意味着这是攻击者通过克隆仓库伪装的。除了原作者,恶意软件也可能伪装成其他开发者,但点进去就会发现用户不存在。 这部分恶意攻击与 GiuHub 本身的漏洞相关,比如之前我们报道过的Linus利用 GitHub 漏洞发布恶作剧 README,用户可以 “通过 git 电子邮件地址冒充用户” ,然后利用 https://github.com/my/project/blob/<faked_commit> 这种 URL 发布任意提交。 目前大部分恶意文件都已被清理,但仍有新的在产生,建议大家使用官方项目存储库中的软件,注意那些恶意仿冒域名的仓库或分支/克隆,并使用 GPG 签署每个提交。

优秀的个人博客,低调大师

【建议使用】告别if,Java超好用参数校验工具类

一、前言 今天和小伙伴们分享一个常用的工具类,共计四个方法,使用场景比较广泛,有用于校验某个对象或对象中指定属性为空值时,直接返回异常,常用语校验前端请求参数;也有当值不为空时,执行指定动作,可减少大量的if条件,如:mybatis请求参数设置;还有用于判断当值不为空时,替代为新值,完成后续动作。 这样描述可能不够清晰,这里我列举了几个使用场景,更多的场景需要小伙伴们根据自己业务需求合理使用。 //场景一,点击登录时,后端校验用户名 if(StringUtils.isEmpty(name)){ throw new Exception("登录用户名不能为空"); } ​ //场景二:属性内容转换为新值 String address = "浙江省杭州市"; if(StringUtils.isNotEmpty(address)){ address ="地址:"+address; } ​ //场景三:替代过多的if条件 SysUserDto userDto = new SysUserDto();//前端参数 ​ SysUser user = new SysUser();//mybatis参数 if(StringUtils.isEmpty(userDto.getName())){ user.setUserName(userDto.getName()) } if(StringUtils.isEmpty(userDto.getPwd())){ user.setPassword(userDto.getPwd()) } 复制代码 \ 二、正文 首先创建一个测试实体类: import lombok.Data; ​ @Data public class SysUser{ private String name; private String password; } 复制代码 2.1 检查多个对象不能为空 测试范例 SysUser user = new SysUser(); SysUser user2 = null; Args.notEmptys(user,user2); 复制代码 方法内容 public static void notEmptys(Object... objects) { for (Object obj : objects) { if (obj == null) { throw new BusinessException("属性不能为空"); } if (obj.toString().trim().isEmpty()) { throw new BusinessException("属性不能为空"); } } } 复制代码 测试结果 Exception in thread "main" 属性不能为空 at com.basic.business.utils.Args.notEmptys(Args.java:27) at com.basic.business.demo.DemoController.main(DemoController.java:43) 复制代码 2.2 校验对象属性不能为空 若将参数【Boolean isAll】设置为true,则会校验全部属性;若设置为false,就需要将检测字段放入【propertys】中。 测试范例 SysUser user = new SysUser(); //用法一:校验全部参数 Args.checkField(user,true,""); //用法二:只校验password参数 Args.checkField(user,false,"password"); 复制代码 方法内容 /** * 对象多字段判空检查 * @param obj 被检查的对象 * @param isAll 是否检查全部参数 * @param propertys 被检查对象中的字段 可多个 */ public static void checkField(Object obj, Boolean isAll, String... propertys) { if (obj != null) { Class<? extends Object> clazz = obj.getClass(); if (isAll) { PropertyDescriptor[] propertyDescriptors = BeanUtils.getPropertyDescriptors(clazz); for (int p = 0; p < propertyDescriptors.length; p++) { checkEachField(obj, propertyDescriptors[p]); } } else { if (propertys != null && propertys.length > 0) { //遍历所有属性 for (int i = 0; i < propertys.length; i++) { String property = propertys[i]; //获取属性信息 BeanUtils.getPropertyDescriptors(clazz); PropertyDescriptor pd = BeanUtils.getPropertyDescriptor(clazz, property); checkEachField(obj, pd); } } } } } ​ private static void checkEachField(Object obj, PropertyDescriptor pd) { Class<? extends Object> clazz = obj.getClass(); String property = pd.getName(); if (pd != null) { //获取当前字段的javabean读方法 Method readMethod = pd.getReadMethod(); if (readMethod != null) { ​ Object invoke = null; try { invoke = readMethod.invoke(obj); } catch (Exception e) { throw new BusinessException("方法 " + readMethod.getName() + "无法执行"); } ​ if (invoke != null) { //String类型单独处理 Class<?> propertyType = pd.getPropertyType(); if ("java.lang.String".equals(propertyType.getName())) { if (StringUtils.isBlank((String) invoke)) { throw new BusinessException("错误 : [ " + property + " ] 不能为空!"); } } else if ("java.util.List".equals(propertyType.getName())) { List list = (List) invoke; if (list.size() == 0) { throw new BusinessException("错误 : [ " + property + " ] 不能为空!"); } } } else { throw new BusinessException("错误 : [ " + property + " ] 不能为空!"); } } else { throw new BusinessException("在 " + clazz + "中 找不到" + "[ " + property + " ] 的 读方法"); } } else { throw new BusinessException("在 " + clazz + "中 找不到" + "[ " + property + " ] 属性"); } } 复制代码 测试结果 用法一结果: Exception in thread "main" 错误 : [ name ] 不能为空! at com.basic.business.utils.Args.checkEachField(Args.java:116) at com.basic.business.utils.Args.checkField(Args.java:77) 用法二结果: Exception in thread "main" 错误 : [ password ] 不能为空! at com.basic.business.utils.Args.checkEachField(Args.java:116) at com.basic.business.utils.Args.checkField(Args.java:77) 复制代码 2.3 参数不为空时执行指定动作 我们经常会遇到这种场景,根据前端参数来组装数据库查询条件,如果不为空我们就将前端值设置到是实体类中,或者如下面这个例子中,当name不为空时,加入到list当中。 测试范例 List list = Lists.newArrayList(); ​ SysUser user = new SysUser(); user.setName("huage"); Args.doIfNotEmpty(user.getName(),list::add); System.out.println(list); 复制代码 方法内容 public static <R, T> R doIfNotNull(T t, Callback<T, R> callback) { try { return t == null ? null : callback.call(t); } catch (Exception e) { throw new BusinessException("[doIfNotNull error]", e); } } 复制代码 测试结果 [huage] 复制代码 2.4 参数为空时使用新值,并完成指定动作 本方法和2.较为类似,只是当目标值不为空时,使用新值进行后续的操作,如下面这个例子中,name初始值为【test】,执行完doIfNotNullNewValue后会将新值【huage】添加到list中,。 测试范例 List list = Lists.newArrayList(); ​ SysUser user = new SysUser(); user.setName("test"); Args.doIfNotNullNewValue(user.getName(),"huage",list::add); System.out.println(list); 复制代码 方法内容 public static <R, T> R doIfNotNullNewValue(T t,T newt, Callback<T, R> callback) { try { return t == null ? null : callback.call(newt); } catch (Exception e) { throw new BusinessException("[doIfNotNull error]", e); } } 复制代码 测试结果 [huage] 最后 如果你觉得此文对你有一丁点帮助,点个赞。或者可以加入我的开发交流群:1025263163相互学习,我们会有专业的技术答疑解惑 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star:https://gitee.com/ZhongBangKeJi/crmeb_java不胜感激!

优秀的个人博客,低调大师

HashiCorp 提交 IPO 申请,估值超 100 亿美元

专注于云基础设施的软件供应商 HashiCorp 于 2021 年 11 月 4 日向美国证券交易委员会 (SEC) 提交了 S-1 文件,正式启动 IPO 申请,计划在纽约证券交易所上市,股票代码为"HCP"。此次 IPO 由摩根士丹利、高盛和摩根大通主导。 在提交的文件中,HashiCorp 将此次发行的规模设定为 1 亿美元,不过此数据会在股票销售条款确定后发生变化。 援引自彭博社的消息称,知情人士透露 HashiCorp 的目标是在上市时估值超过 100 亿美元,现阶段寻求募集超过 10 亿美元的资金。HashiCorp 未对此消息进行回应。一份报告称 HashiCorp 去年在 E 轮融资中筹集了 1.75 亿美元,估值达 51 亿美元。 HashiCorp 提交的 S-1 文件显示,截至 7 月 31 日的六个月内,该公司净亏损 4050 万美元,收入为 1.42 亿美元。相比之下,去年同期净亏损 6730 万美元,收入为 9480 万美元。其中 98% 的销售额来自订阅收费。 HashiCorp 由 Mitchell Hashimoto 和 Armon Dadgar 于 2012 年创立,总部位于旧金山,崇尚“远程办公”文化,其定位是云基础设施自动化公司,它让其他组织能够采用一致的工作流程来为任何应用程序配置、保护、连接和运行任何基础架构。 HashiCorp提供的软件可帮助公司混合运行公共和私有云系统以及较旧的应用程序。与 HashiCorp 合作的主要云基础设施提供商包括阿里云,AWS, Google Cloud, Microsoft Azure, Oracle Cloud 和 VMware。 HashiCorp 的开源工具包括 Vagrant,Packer,Terraform,Vault,Consul 和 Nomad。这些工具每年的下载量达数千万次,并被全球企业广泛采用。

优秀的个人博客,低调大师

超使用的15个前端小知识点

本文章转自:乐字节 文章主要讲解:前端小知识 获取更多前端相关资料可以关注公众号《乐字节》 发送:999 ### 1. css 一行文本超出... ![image.png](https://p9-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/674afe2ba49848f298883b0455d4ac53~tplv-k3u1fbpfcp-watermark.image) ### 2.多行文本超出显示... ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/f58932f58e8a4ee897e0e908d184c3a2~tplv-k3u1fbpfcp-watermark.image) ### 3.IOS 手机容器滚动条滑动不流畅 ![image.png](https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/1c94b0dfc4004421991f9da41af5337d~tplv-k3u1fbpfcp-watermark.image) ### 4.修改滚动条样式 隐藏 div 元素的滚动条 ![image.png](https://p6-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/59c1e55c2846450480eedd5d3805bb8a~tplv-k3u1fbpfcp-watermark.image) ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/d5424fa59a544f758fee96f9e4b6df04~tplv-k3u1fbpfcp-watermark.image) ### 5.使用 css 写出一个三角形角标 元素宽高设置为 0,通过 border 属性来设置,让其它三个方向的 border 颜色为透明或者和背景色保持一致,剩余一条 border 的颜色设置为需要的颜色。 ![image.png](https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/f178ea4f9b7c402499b864ca8f2f5aff~tplv-k3u1fbpfcp-watermark.image) ### 6.解决 ios audio 无法自动播放、循环播放的问题 ios 手机在使用 audio 或者 video 播放的时候,个别机型无法实现自动播放,可使用下面的代码 hack。 ![image.png](https://p3-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/bfbb93a75f9849cca6cfcb091a130a65~tplv-k3u1fbpfcp-watermark.image) ### 7.水平垂直居中 我一般只使用两种方式 定位 或者 flex,我觉得够用了。 ![image.png](https://p6-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/e3bcbb433f8d4fbdba618129ad09f26c~tplv-k3u1fbpfcp-watermark.image) 父级控制子集居中 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/f1d185f9e47d4f0faee15d8e77a0f86a~tplv-k3u1fbpfcp-watermark.image) ### 8.隐藏页面元素 ![image.png](https://p6-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/10f27c82903144189ec0db53826d97e5~tplv-k3u1fbpfcp-watermark.image) ### 9.前端工程化 一提到前端工程化很多人想到的都是 webpack,这是不对的,webpack 仅仅是前端工程化中的一环。在整个工程化过程中他帮我们解决了绝大多数的问题,但并没有解决所有问题。 前端工程化是通过工具提升效率,降低成本的一种手段。 近些年被广泛的关注和探讨,究其原因主要是因为现代化前端应用功能要求不断提高,业务逻辑日益复杂,作为当下互联网时代唯一不可或缺的技术,前端可以说是占据了整个开发行业的半壁江山。从传统的网站,到现在的 H5,移动 App,桌面应用,以及小程序。前端技术几乎是无所不能的全面覆盖。 在这些表象的背后呢,实际上是行业对开发人员的要求发生了天翻地覆的变化,以往前端写 demo,套模板,调页面这种刀耕火种的方式已经完全不符合当下对开发效率的要求,前端工程化就是在这样一个背景下被提上台面,成为前端工程师必备的手段之一。 一般来说前端工程包含,项目初始化,项目开发,集成,构建,打包,测试,部署等流程。工程化就是以工程的角度来解决这些问题。比如项目初始化我们一般使用npm init, 创建页面模板使用 plop,我们喜欢使用 ES6+开发,但是需要通过 babel 编码成 ES5,持续集成的时候我们使用 git,但是为了保持开发规范我们引入了 ESLint,部署一般使用 ci/cd 或者 jenkins 等等。 前端工程化是一个比较大的话题,后面我们会单开话题来讲。 ### 10.contenteditable html 中大部分标签都是不可以编辑的,但是添加了 contenteditable 属性之后,标签会变成可编辑状态。 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/e568b39576084c96a4240c566f637caf~tplv-k3u1fbpfcp-watermark.image) 不过通过这个属性把标签变为可编辑状态后只有 input 事件,没有 change 事件。也不能像表单一样通过 maxlength 控制最大长度。我也忘记我在什么情况下用到过了,后面想起来再补吧。 ### 11.calc 这是一个 css 属性,我一般称之为 css 表达式。可以计算 css 的值。最有趣的是他可以计算不同单位的差值。很好用的一个功能,缺点是不容易阅读。接盘侠没办法一眼看出 20px 是啥。 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/4550834a36434c6fa077b6987a7ea78d~tplv-k3u1fbpfcp-watermark.image) ### 12.Proxy 和 Object.defineProperty 区别 Proxy 的意思是代理,我一般教他拦截器,可以拦截对象上的一个操作。用法如下,通过 new 的方式创建对象,第一个参数是被拦截的对象,第二个参数是对象操作的描述。实例化后返回一个新的对象,当我们对这个新的对象进行操作时就会调用我们描述中对应的方法。 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/4f35bb42115541aba43b1f041356db45~tplv-k3u1fbpfcp-watermark.image) Proxy 区别于 Object.definedProperty。 Object.defineProperty 只能监听到属性的读写,而 Proxy 除读写外还可以监听属性的删除,方法的调用等。 通常情况下我们想要监视数组的变化,基本要依靠重写数组方法的方式实现,这也是 Vue 的实现方式,而 Proxy 可以直接监视数组的变化。 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/8cbc21d1c848410e9bb80e37edb5a482~tplv-k3u1fbpfcp-watermark.image) Proxy 是以非***的方式监管了对象的读写,而 defineProperty 需要按特定的方式定义对象的属性。 ### 13.Reflect 他是 ES2015 新增的对象,纯静态对象也就是不能被实例画,只能通过静态方法的方式调用,和 Math 对象类似,只能类似 Math.random 的方式调用。 Reflect 内部封装了一系列对对象的底层操作,一共 14 个,其中 1 个被废弃,还剩下 13 个。 Reflect 的静态方法和 Proxy 描述中的方法完全一致。也就是说 Reflect 成员方法就是 Proxy 处理对象的默认实现。 Proxy 对象默认的方法就是调用了 Reflect 内部的处理逻辑,也就是如果我们调用 get 方法,那么在内部,proxy 就是将 get 原封不动的交给了 Reflect,如下。 ![image.png](https://p6-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/3264c8bf353749f2b1145fe951748cd7~tplv-k3u1fbpfcp-watermark.image) Reflect 和 Proxy 没有绝对的关系,我们一般将他们两个放在一起讲是为了方便对二者的理解。 那为什么会有 Reflect 对象呢,其实他最大的用处就是提供了一套统一操作 Object 的 API。判断对象是否存在某一个属性,可以使用 in 操作符,但是不够优雅,还可以使用Reflect.has(obj, name); 删除一个属性可以使用 delete,也可以使用 Reflect.deleteProperty(obj, name); 获取所有属性名可以使用 Object.keys, 也可以使用 Reflect.ownKeys(obj); 我们更推荐使用 Reflect 的 API 来操作对象,因为他才是未来。 ### 14.解析 get 参数 通过 replace 方法获取 url 中的参数键值对,可以快速解析 get 参数。 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/1e9b31861ff7421ea14bfc86a77acf24~tplv-k3u1fbpfcp-watermark.image) ### 15.解析连接 url 可以通过创建 a 标签,给 a 标签赋值 href 属性的方式,获取到协议,pathname,origin 等 location 对象上的属性。 ![image.png](https://p1-juejin.byteimg.com/tos-cn-i-k3u1fbpfcp/def24930085744bf94dee57b75eff14d~tplv-k3u1fbpfcp-watermark.image) **感谢大家的认同与支持,小编会持续转发《乐字节》优质文章**

优秀的个人博客,低调大师

五分钟了解什么是Mybatis(超详细)

MyBatis框架是什么? MyBatis 框架: MyBatis 本是apache 的一个开源项目 iBatis, 2010 年这个项目由apache software foundation 迁移到了google code,并且改名为 MyBatis 。2013 年 11 月迁移到Github。 MyBatis 是一款优秀的持久层框架,它支持定制化 SQL、存储过程以及高级映射。MyBatis 避免了几乎所有的 JDBC 代码和手动设置参数以及获取结果集。MyBatis 可以使用简单的 XML 或注解来配置和映射原生信息,将接口和 Java 的 POJOs(Plain Old Java Objects,普通的 Java对象)映射成数据库中的记录。 通过本视频的学习,可以在最短的时间内学会使用持久层框架MyBatis,在该视频中没有废话,都是干货,该视频的讲解不是学术性研究,项目中用什么,这里就讲什么,如果您现在项目中马上要使用MyBatis框架,那么您只需要学习完,就可以顺利的使用MyBatis开发了。 在线观看:2020最新MyBatis教程【IDEA版】-MyBatis从入门到精通_哔哩哔哩_bilibili 资料下载:Mybatis视频教程全套免费下载【适合零基础入门学习】 - 动力节点 (bjpowernode.com) MyBatis解决的主要问题 减轻使用JDBC 的复杂性,不用编写重复的创建Connetion , Statement ; 不用编写关闭资源代码。 直接使用java 对象,表示结果数据。让开发者专注 SQL 的处理。 其他分心的工作由MyBatis 代劳。 MyBatis 可以完成: 1. 注册数据库的驱动,例如Class.forName(“com.mysql.jdbc.Driver”)) 2. 创建JDBC 中必须使用的 Connection , Statement, ResultSet 对象 3. 从xml 中获取sql,并执行sql 语句,把ResultSet 结果转换java 对象 List<Student> list = new ArrayLsit<>(); ResultSet rs = state.executeQuery(“select * from student”); while(rs.next){ Student student = new Student(); student.setName(rs.getString(“name”)); student.setAge(rs.getInt(“age”)); list.add(student); } 4. 关闭资源 ResultSet.close() , Statement.close() , Conenection.close() 入门案例 MyBatis 开发准备 搭建MyBatis 开发环境,实现第一个案例 使用Mybatis 准备 下载 mybatishttps://github.com/mybatis/mybatis-3/releases 搭建MyBatis 开发环境 (1) 创建 mysql 数据库和表 数据库名 ssm ;表名student CREATE TABLE `student` ( `id` int(11) NOT NULL , `name` varchar(255) DEFAULT NULL, `email` varchar(255) DEFAULT NULL, `age` int(11) DEFAULT NULL, PRIMARY KEY (`id`) ) ENGINE=InnoDB DEFAULT CHARSET=utf8; (2) 创建 maven 工程 创建maven 工程,信息如下: 模板: 工程坐标: (3) 删除默认创建的 App 类文件 (4) 加入 maven 坐标 pom.xml 加入maven 坐标: (5) 加入 maven 插件 (6) 编写 Student 实体类 创建包 com.bjpowernode.domain, 包中创建Student 类 (7) 编写 Dao 接口 StudentDao (8) 编写 Dao 接口 Mapper 映射文件 StudentDao.xml 要求: 1. 在dao 包中创建文件StudentDao.xml 2. 要StudentDao.xml 文件名称和接口StudentDao 一样,区分大小写的一样。 (9) 创建 MyBatis 主配置文件 项目src/main 下创建 resources 目录,设置 resources 目录为 resources root 创建主配置文件:名称为mybatis.xml 说明:主配置文件名称是自定义的,内容如下: 支持中文的url jdbc:mysql://localhost:3306/ssm?useUnicode=true&characterEncoding=utf-8 (10) 创建测试类 MyBatisTest src/test/java/com/bjpowernode/ 创建MyBatisTest.java 文件 (11) 配置日志功能 mybatis.xml 文件加入日志配置,可以在控制台输出执行的sql 语句和参数 insert 操作 (1) StudentDao 接口中增加方法 int insertStudent(Student student); (2) StudentDao.xml 加入 sql 语句 (3) 增加测试方法 MyBatis 对象分析 对象使用 SqlSession , SqlSessionFactory 等 (1) Resources 类 Resources 类,顾名思义就是资源,用于读取资源文件。其有很多方法通过加载并解析资源文件,返回不同类型的IO 流对象。 (2) SqlSessionFactoryBuilder 类 SqlSessionFactory 的创建,需要使用 SqlSessionFactoryBuilder 对象的build()方法。由于 SqlSessionFactoryBuilder 对象在创建完工厂对象后,就完成了其历史使命,即可被销毁。所以,一般会将该 SqlSessionFactoryBuilder 对象创建为一个方法内的局部对象,方法结束,对象销毁。 (3) SqlSessionFactory 接口 SqlSessionFactory 接口对象是一个重量级对象(系统开销大的对象),是线程安全的,所以一个应用只需要一个该对象即可。创建 SqlSession 需要使用SqlSessionFactory 接口的的openSession()方法。 openSession(true):创建一个有自动提交功能的 SqlSession openSession(false):创建一个非自动提交功能的 SqlSession,需手动提交 openSession():同 openSession(false) (4) SqlSession 接口 SqlSession 接口对象用于执行持久化操作。一个 SqlSession 对应着一次数据库会话,一次会话以 SqlSession 对象的创建开始,以 SqlSession 对象的关闭结束。 SqlSession 接口对象是线程不安全的,所以每次数据库会话结束前,需要马上调用其 close()方法,将其关闭。再次需要会话,再次创建。 SqlSession 在方法内部创建,使用完毕后关闭。 创建工具类 (1) 创建 MyBatisUtil 类 package com.bjpowernode.common; (2) 使用 MyBatisUtil 类 MyBatis 使用传统 Dao 开发方式 使用Dao 的实现类,操作数据库 Dao 开发 (1) 创建 Dao 接口实现类 public class StudentDaoImpl implements StudentDao (2) 实现接口中 select 方法 测试查询操作: MyBatisTest 类中创建StudentDaoImpl 对象 (3) 实现接口中 insert 方法 测试insert 传统Dao 开发方式的分析 在前面例子中自定义Dao 接口实现类时发现一个问题:Dao 的实现类其实并没有干什么实质性的工作,它仅仅就是通过 SqlSession 的相关 API 定位到映射文件mapper 中相应 id 的 SQL 语句,真正对 DB 进行操作的工作其实是由框架通过mapper 中的 SQL 完成的。 所以,MyBatis 框架就抛开了Dao 的实现类,直接定位到映射文件mapper 中的相应 SQL 语句,对DB 进行操作。这种对Dao 的实现方式称为Mapper 的动态代理方式。 Mapper 动态代理方式无需程序员实现Dao 接口。接口是由 MyBatis 结合映射文件自动生成的动态代理实现的。

优秀的个人博客,低调大师

勒索软件肆虐,2020 年增长超 400%

网络安全公司Deep Instinct发布的一份《2020 年网络威胁态势》报告指出,与 2019 年相比,2020 年恶意软件总体增长了 358%,勒索软件增长了 435%。 该报告分析了全年发生的数百万次攻击,发现 Emotet 恶意软件的传播激增了 4000%,攻击 Android 手机的恶意软件威胁则增加了 263%。 报告还指出,7 月份的恶意活动增幅最大,与前年相比增长了 653%。其中,微软Office文档是被操纵最多的文档攻击载体,这些攻击增长了 112%。 Deep Instinct 联合创始人兼首席执行官 Guy Caspi称,大流行加速了公司转向在线开展业务的步伐,而突然转向在家工作的模式也扩大了组织的攻击面。因此安全团队难以跟上各种不同类型攻击的冲击也不足为奇。更何况,问题并不局限于攻击的数量。研究表明,攻击的复杂性与先进的规避策略一起增长,使检测变得更加困难。 完整的报告可从Deep Instinct 网站获得。对这方面感兴趣的用户还可以注册参加将于美国东部时间 2 月 23 日下午 1 点举行的网络研讨会。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册