首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10000篇文章
优秀的个人博客,低调大师

DC学院爬虫学习笔记(四):使用Xpath解析豆瓣短评

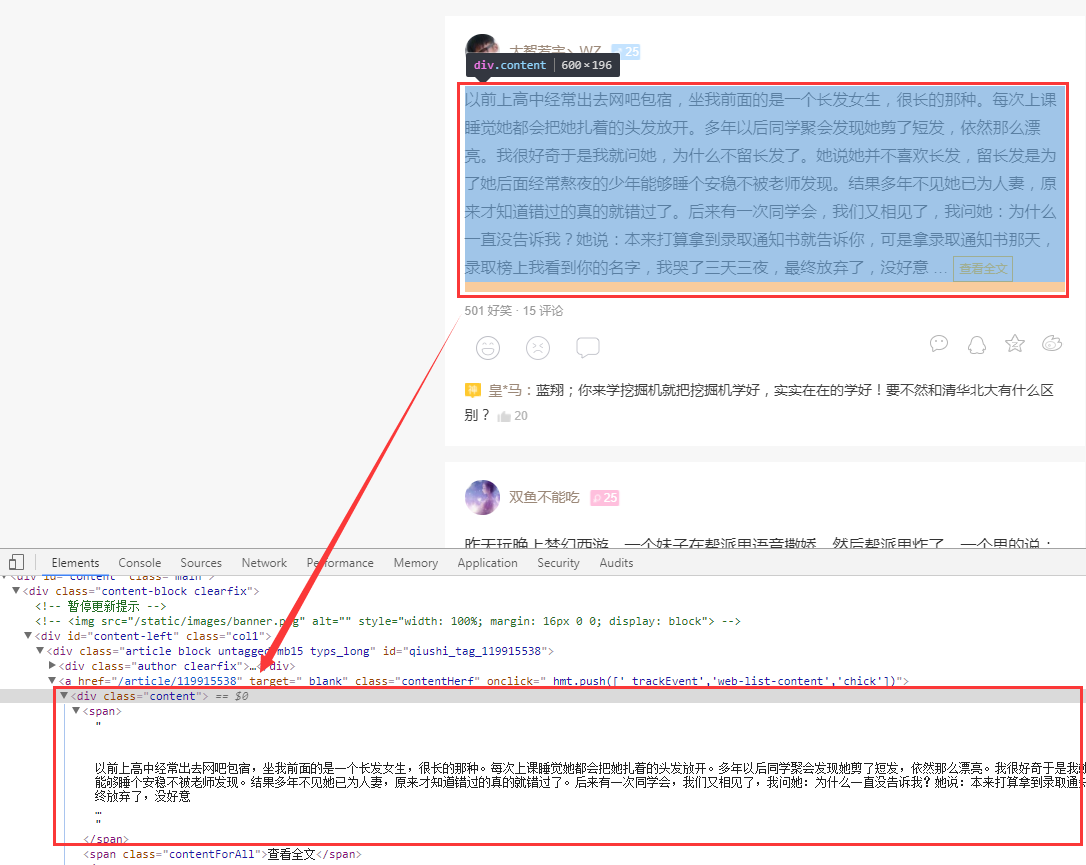
解析神器Xpath: 1. 什么是Xpath XPath即为XML路径语言(XML Path Language),它是一种用来确定XML文档中某部分位置的语言。 XPath基于XML的树状结构,提供在数据结构树中找寻节点的能力。起初XPath的提出的初衷是将其作为一个通用的、介于XPointer与XSL间的语法模型。但是XPath很快的被开发者采用来当作小型查询语言。 2. Xpath解析网页的流程 首先通过Requests库获取网页数据 通过网页解析,得到想要的数据或者新的链接 网页解析可以通过Xpath或者其它解析工具进行,Xpath在是一个非常好用的网页解析工具 3. 常用的网页解析 正则表达式使用比较困难,学习成本较高 BeautifulSoup性能较慢,相对于Xpath较难,在某些特定场景下有用 Xpath使用简单,速度快(Xpath是lxml里面的一种),是抓取数据最好的选择 Xpath的使用: 1. 使用Xpath解析网页数据的步骤 从lxml导入etree 解析数据,返回xml结构 使用.xpath()寻找和定位数据 import requests from lxml import etree url="https://book.douban.com/subject/27147922/comments/" r=requests.get(url).text ##html数据,使用requests获取 ##print (r)| s = etree.HTML(r) #解析html数据 print(s.xpath('//*[@id="comments"]/ul[1]/li[1]/div[2]/p'))#使用.xpath() [<Element p at 0x1d992e8b808>] print(s.xpath('//*[@id="comments"]/ul[1]/li[1]/div[2]/p/text()'))## 获取文本,加上 /text() ['最喜欢《姐妹》这一篇:女性之间有一种镜像的关系,通过对方可以看到自己,看到自己深处的处境。'] 2. 获取Xpath的方法 第一种方法:从浏览器直接复制 首先在浏览器上定位到需要爬取的数据 右键,点击“检查”,在“Elements”下找到定位到所需数据 右键——Copy——Copy Xpath,即可完成Xpath的复制 第二种方法:手写Xpath 获取文本内容用 text() 获取注释用 comment() 获取其它任何属性用@xx,如: src value 想要获取某个标签下所有的文本(包括子标签下的文本),使用string 如”< p>123< a>来获取我啊< /a>< /p>”,这边如果想要得到的文本为”123来获取我啊”,则需要使用string starts-with 匹配字符串前面相等 contains 匹配任何位置相等 #手写Xpath import requests from lxml import etree url = 'https://book.douban.com/subject/1084336/comments/' r = requests.get(url).text s = etree.HTML(r) print(s.xpath('//div[@class="comment"]/p/text()')[0]) 十几岁的时候渴慕着小王子,一天之间可以看四十四次日落。是在多久之后才明白,看四十四次日落的小王子,他有多么难过。 实战环节 使用Xpath爬取豆瓣图书《小王子》短评网页 import requests from lxml import etree url = 'https://book.douban.com/subject/1084336/comments/' r = requests.get(url).text s = etree.HTML(r) #从浏览器复制第一条评论的Xpath print(s.xpath('//*[@id="comments"]/ul/li[1]/div[2]/p/text()')) #从浏览器复制第二条评论的Xpath print(s.xpath('//*[@id="comments"]/ul/li[2]/div[2]/p/text()')) #从浏览器复制第三条评论的Xpath print(s.xpath('//*[@id="comments"]/ul/li[3]/div[2]/p/text()')) #掌握规律,删除li[]的括号,获取全部短评 #print(s.xpath('//*[@id="comments"]/ul/li/div[2]/p/text()')) #手写Xpath获取全部短评 #print(s.xpath('//div[@class="comment"]/p/text()')) ['十几岁的时候渴慕着小王子,一天之间可以看四十四次日落。是在多久之后才明白,看四十四次日落的小王子,他有多么难过。'] ['读了好多年,终于读完了,但是实在共鸣不起来,虽然知道那些道理,但真的觉得没什么了不起啊,是我还太幼稚吗?'] ['我早该猜到,在她那可笑的伎俩后面是缱绻柔情啊。花朵是如此的天真无邪,可是,我毕竟太年轻了,不知该如何去爱她。'] 通过对比可以发现从浏览器复制的Xpath中,“li[]”括号中的数字代表对应的第几条评论,直接删除括号,即可获取全部短评 对于结构清晰的html网页,可以直接手写Xpath,更加简洁且高效 对于结构复杂的html网页,可以通过浏览器复制的方式获取Xpath

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册