首页 文章 精选 留言 我的

精选列表

搜索[爬虫框架],共10000篇文章
优秀的个人博客,低调大师

Python爬虫入门教程 17-100 CSDN博客抓取数据

1.写在前面 写了一段时间的博客了,忽然间忘记了,其实博客频道的博客也是可以抓取的 其实这事情挺简单的,打开CSDN博客首页,他不是有个最新文章么,这个里面都是最新发布的文章。 打开F12抓取一下数据API,很容易就获取到了他的接口 提取链接长成这个样子 https://blog.csdn.net/api/articles?type=more&category=newarticles&shown_offset=1540381234000000 发现博客最新文章是一个瀑布流页面,不断下拉,只有一个参数shown_offset 在变化,按照我多年的行医经验,这个参数是个时间戳,而且肯定是上一次数据最后一条的时间戳。 基于这个理论,看一下数据,咦,猜对了~ 博客返回的数据看一下,是否对味 2.CSDN博客撸代码 这个步骤就非常简单了,就

优秀的个人博客,低调大师

网易云音乐评论爬虫(三):爬取歌曲的全部评论

用过网易云音乐听歌的朋友都知道,网易云音乐每首歌曲后面都有很多评论,热门歌曲的评论更是接近百万或者是超过百万条.现在我就来分享一下如何爬取网易云音乐歌曲的全部评论,由于网易云音乐的评论都做了混淆加密处理,因此我们需要深入了解它的加密过程之后才能爬取到网易云音乐歌曲的全部评论. 一,首先分析数据的请求方式 网易云音乐歌曲页面的URL形式为https://music.163.com/#/song?id=歌曲id号,这里我用Delacey的Dream it possible 为例进行讲解,它的URL为https://music.163.com/#/song?id=38592976.接下来开始分析数据的请求方式. 由于网易云音乐的评论是通过Ajax传输,我们打开浏览器的开发者工具(检查元素),选中控制面板中的Network,再点击XHR(捕获

优秀的个人博客,低调大师

Python网络爬虫(正则, 内涵段子,猫眼电影, 链家爬取)

正则表达式(re模块): 数据的分类: 结构化数据 有固定的格式 如HTML、XML、JSON 非结构化数据 图片、音频、视频 这类数据一般存储为二进制 正则: 使用流程: 创建编译对象:p = re.compile("正则表达式") 对字符串匹配:r = p.match("字符串") 获取匹配结果:print(r.group()) 常用方法: match(str) 字符串开头的第一个 返回对象 search(str) 从头开始匹配 只匹配一个 返回对象 group() 从mat

优秀的个人博客,低调大师

【Python】从0开始写爬虫——扒狗东先流产了

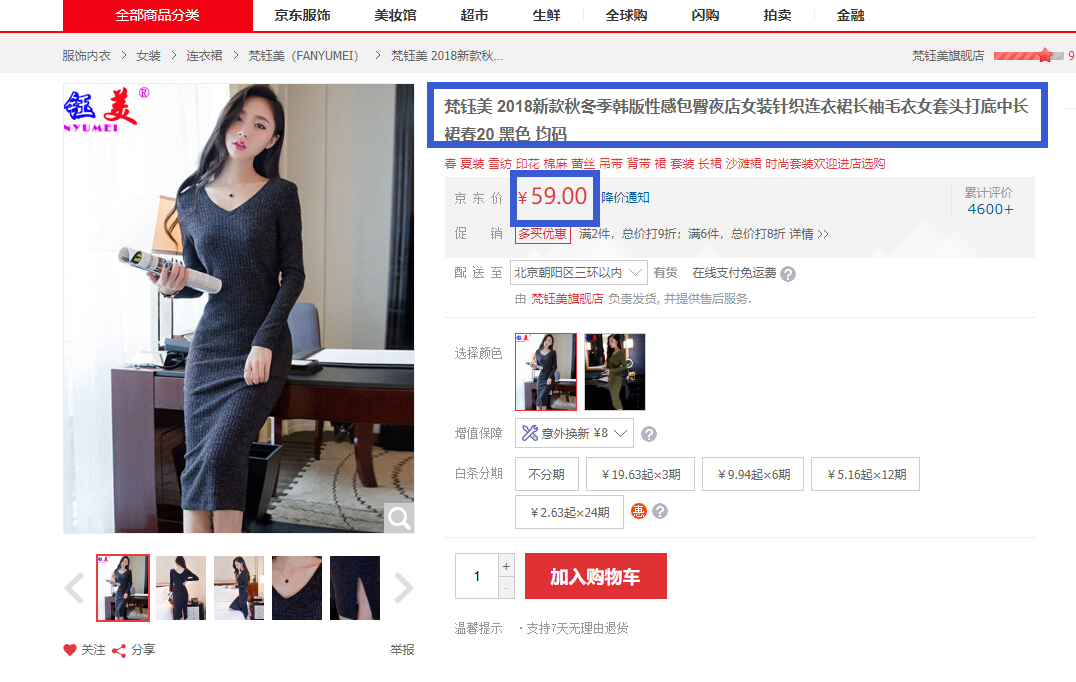
上回写到一半临时有事,竟然没有保存到!!!。这几天也是因为家人过来玩。。我也不知道写到哪儿了。我发现狗东这个奸贼很多数据是请求请求再请求,然后才拿到我们看到的数据显示上去的。我尝试了一下找齐这个数据确实有点头疼(我有查到可以用一个东西模拟浏览器去得到我们最终的页面,但是本着练习为主的思想,先不搞这么无脑的东西)。 所以我们暂时先战略性放弃扒狗东。容我再找个好扒一点网站。下面是现在的代码。 这里给出一个BeautifulSoup的文档链接,是中文的,很好懂:BeautifulSoup中文文档 emmmm我们先上京东找个好看的模特: 恋裳蒂莎2018夏季夜场小女人性感后开叉包臀连衣裙紧身诱人主播超短裙 黑色 S 根据我现在的代码,我应该是封装了一下之前的代码,然后已经爬了商品的id、名称和类目。 目录。我不太懂规范的python项目是什么样的。我是在test目录下中测试一些第三方库的api app.py import urllib.request from bs4 import BeautifulSoup header = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36' } # 因为有时候得到的是一段 json 或者别的数据,有时候是html,所以我们单纯地先获取数据 def get_data(url, headers=header, charset="utf-8"): req = urllib.request.Request(url=url, headers=headers) rep = urllib.request.urlopen(req) data = rep.read() return data.decode(encoding=charset) # 如果是个html我们就可以用BeautifulSoup解析 def get_soup(url, headers=header, charset="utf-8"): data = get_data(url=url, headers=headers, charset=charset) return BeautifulSoup(data, "html.parser") jd.py from scrapy import app import re header = { 'User-Agent': 'Mozilla/5.0 (Windows NT 10.0; WOW64) AppleWebKit/537.36 (KHTML, like Gecko) Chrome/50.0.2661.102 Safari/537.36' # 'Referer': 'https://item.jd.com/10671563387.html' } url = "https://item.jd.com/27934623028.html" soup = app.get_soup(url, header, "gbk") # 获取BeautifulSoup对象 pid = re.search("[0-9]+", url).group() # 用正则筛选id print("商品id:", pid) title = soup.find("div", class_="sku-name").string.strip() # 爬商品名称 print("商品名称:", title) page_config = soup.find("script", {"charset": "gbk"}).string cat = re.search("(?<=cat:\s\[)[,0-9]*(?=\])", page_config).group() # 用正则匹配到商品类目 print("category: ", cat) 控制台输出。说明是可以爬到这些的

优秀的个人博客,低调大师

用爬虫分析互联网大数据行业薪资情况

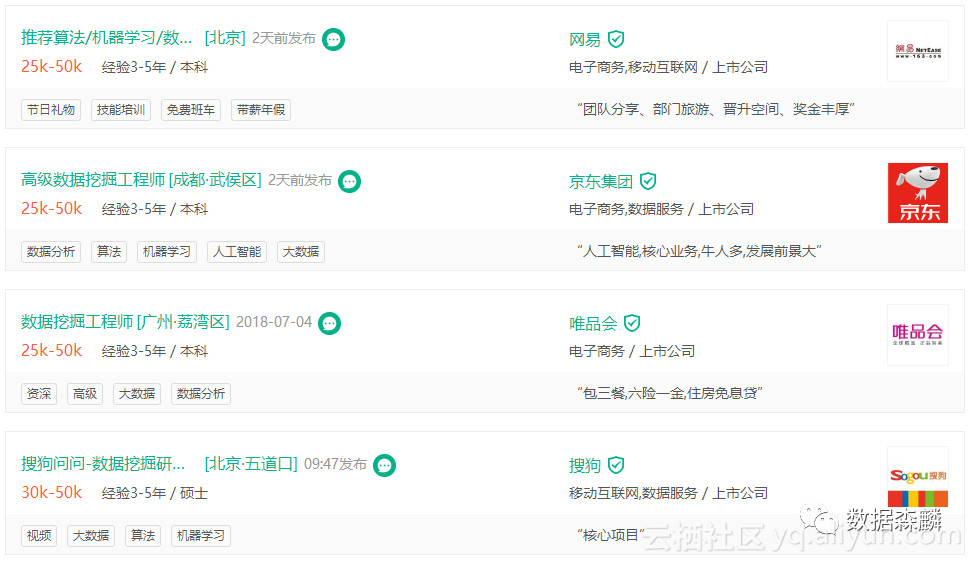
前言:随着互联网大数据行业的日渐兴盛,越来越多的人投身其中,也有很多的朋友对此有着浓厚的兴趣,想要投身其中。从本期开始我们将分四期带大家走进互联网大数据行业,分别了解数据挖掘&机器学习、数据分析、算法&深度学习、数据产品经理这四个不同的与大数据相关的职位。 数据来源:我们未来四期的数据主要来源于拉勾网,目前比较火的招聘网站猎聘、boss直聘、拉勾都有比较多的互联网职位介绍。我们基于以下几点原因选择拉勾:1.薪资大多有直接的范围,较少为面议 2. 企业数量较全,基本上涵盖了互联网相关公司 3.url地址相对比较规整,方便进行批量爬取。数据展示页面如下: 该部分使用Python中Selenium爬取,部分代码如下: while True : try : for j in

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册