首页 文章 精选 留言 我的

精选列表

搜索[提高],共10000篇文章
优秀的个人博客,低调大师

PyTorch 1.5 发布,C++ 前端重大更新、引入新存储格式提高性能

PyTorch 1.5 发布了,此版本包括新增加了几个主要的API 和一些改进、对 C++ 前端有重大更新、用于计算机视觉模型的“通道维持(channels last)”存储格式,以及用于模型并行训练的分布式 RPC 框架的稳定版本。 同时,此版本还提供了针对 hessian 和 jacobian 的 autograd 的新 API,以及一个受 pybind 启发的允许创建 Custom C++ Class(定制类)的 API。 C++ FRONTEND API (STABLE) 之前被标记为实验性质的C++ 前端 API 现在已经与 Python 地位相当,并且总体特性已移至“稳定”状态。一些主要亮点包括: 现在覆盖率达到约 100%,并提供有关 C++ torch::nn 模块/函数的文档,开发者可以轻松地将其模型从 Python API 转换为 C++ API。 C++ 中的优化器与 Python 中的有所不同:C++ 优化器不能将参数组作为输入,而 Python 可以。此外,步骤函数的实现也不完全相同。在 1.5 版本中,C++ 优化器的行为将始终与 Python 等效器相同。 C++ 中缺少张量多维度索引 API 是一个众所周知的问题,并在 PyTorch GitHub issue 跟踪器和论坛中引起了很多讨论。以前的解决方法是结合使用 arrow/select/index_select/masked_select,与 Python API 的优雅张量 [:, 0, ..., mask] 语法相比,它比较笨拙且容易出错。在 1.5 版本中,开发者可以使用 tensor.index({Slice(), 0, “...”, mask}) 达到相同的目的。 ‘CHANNELS LAST’ MEMORY FORMAT FOR COMPUTER VISION MODELS (EXPERIMENTAL) 用于计算机视觉模型的“通道维持(channels last)”存储格式,目前处于实验阶段。该格式的内存布局可以充分发挥性能高效的卷积算法和硬件(NVIDIA 的 Tensor Core、FBGEMM、QNNPACK)的能力。此外,它被设计为通过运算符自动传播,从而允许在内存布局之间轻松切换。 CUSTOM C++ CLASSES (EXPERIMENTAL) 此版本添加了一个新的 API torch.CutomClassHolder,用于将自定义 C++ 类同时绑定到 TorchScript 和 Python,该 API 的语法与 pybind11 几乎相同。它允许开发者向 TorchScript 类型系统和运行时系统暴露其 C++ 类及其方法,以便他们可以实例化和操作 TorchScript/Python 中的任意 C++ 对象。C++ 绑定示例: template <class T> struct MyStackClass : torch::CustomClassHolder { std::vector<T> stack_; MyStackClass(std::vector<T> init) : stack_(std::move(init)) {} void push(T x) { stack_.push_back(x); } T pop() { auto val = stack_.back(); stack_.pop_back(); return val; } }; static auto testStack = torch::class_<MyStackClass<std::string>>("myclasses", "MyStackClass") .def(torch::init<std::vector<std::string>>()) .def("push", &MyStackClass<std::string>::push) .def("pop", &MyStackClass<std::string>::pop) .def("size", [](const c10::intrusive_ptr<MyStackClass>& self) { return self->stack_.size(); }); 它暴露了可以在 Python 和 TorchScript 中使用的类,如下所示: @torch.jit.script def do_stacks(s : torch.classes.myclasses.MyStackClass): s2 = torch.classes.myclasses.MyStackClass(["hi", "mom"]) print(s2.pop()) # "mom" s2.push("foobar") return s2 # ["hi", "foobar"] DISTRIBUTED RPC FRAMEWORK APIS (NOW STABLE) 分布式 RPC 框架在 1.4 版本中以实验性形式出现,现在它已经处于稳定状态。此过程涉及许多增强功能和 bug 修复,以使分布式 RPC 框架总体上更可靠和更健壮。同时还添加了两个新特性,包括概要分析支持,在 RPC 中使用 TorchScript 函数以及一些易于使用的增强功能。 此外,从 1.5 开始,PyTorch 不再支持 Python 2,今后,对 Python 的支持将仅限于 Python 3,特别是 Python 3.5、3.6、3.7 和 3.8。 更多具体的细节见发布公告: https://pytorch.org/blog/pytorch-1-dot-5-released-with-new-and-updated-apis

优秀的个人博客,低调大师

三行Python代码,让数据预处理速度提高2到6倍

在 Python 中,我们可以找到原生的并行化运算指令。本文可以教你仅使用 3 行代码,大大加快数据预处理的速度。 Python 是机器学习领域内的首选编程语言,它易于使用,也有很多出色的库来帮助你更快处理数据。但当我们面临大量数据时,一些问题就会显现…… 目前,大数据(Big Data)这个术语通常用于表示包含数十万数据点的数据集。在这样的尺度上,工作进程中加入任何额外的计算都需要时刻注意保持效率。在设计机器学习系统时,数据预处理非常重要——在这里,我们必须对所有数据点使用某种操作。 在默认情况下,Python 程序是单个进程,使用单 CPU 核心执行。而大多数当代机器学习硬件都至少搭载了双核处理器。这意味着如果没有进行优化,在数据预处理的时候会出现「一核有难九核围观」的情况——超过 50% 的算力都会被浪费。在当前四核处理器(英特尔酷睿 i5)和 6 核处理器(英特尔酷睿 i7)大行其道的时候,这种情况会变得更加明显。 幸运的是,Python 库中内建了一些隐藏的特性,可以让我们充分利用所有 CPU 核心的能力。通过使用 Python 的 concurrent.futures 模块,我们只需要 3 行代码就可以让一个普通的程序转换成适用于多核处理器并行处理的程序。 标准方法 让我们举一个简单的例子,在单个文件夹中有一个图片数据集,其中有数万张图片。在这里,我们决定使用 1000 张。我们希望在所有图片被传递到深度神经网络之前将其调整为 600×600 像素分辨率的形式。以下是你经常会在 GitHub 上看到的标准 Python 代码: import glob import os import cv2 ### Loop through all jpg files in the current folder ### Resize each one to size 600x600 for image_filename in glob.glob("*.jpg"): ### Read in the image data img = cv2.imread(image_filename) ### Resize the image img = cv2.resize(img, (600, 600)) 上面的程序遵循你在处理数据脚本时经常看到的简单模式: 1. 首先从需要处理内容的文件(或其他数据)列表开始。 2. 使用 for 循环逐个处理每个数据,然后在每个循环迭代上运行预处理。 让我们在一个包含 1000 个 jpeg 文件的文件夹上测试这个程序,看看运行它需要多久: time python standard_res_conversion.py 在我的酷睿 i7-8700k 6 核 CPU 上,运行时间为 7.9864 秒!在这样的高端 CPU 上,这种速度看起来是难以让人接受的,看看我们能做点什么。 更快的方法 为了便于理解并行化的提升,假设我们需要执行相同的任务,比如将 1000 个钉子钉入木头,假如钉入一个需要一秒,一个人就需要 1000 秒来完成任务。四个人组队就只需要 250 秒。 在我们这个包含 1000 个图像的例子中,可以让 Python 做类似的工作: ●将 jpeg 文件列表分成 4 个小组; ●运行 Python 解释器中的 4 个独立实例; ●让 Python 的每个实例处理 4 个数据小组中的一个; ●结合四个处理过程得到的结果得出最终结果列表。 这一方法的重点在于,Python 帮我们处理了所有棘手的工作。我们只需告诉它我们想要运行哪个函数,要用多少 Python 实例,剩下的就交给它了!只需改变三行代码。实例: import glob import os import cv2 import concurrent.futures def load_and_resize(image_filename): ### Read in the image data img = cv2.imread(image_filename) ### Resize the image img = cv2.resize(img, (600, 600)) ### Create a pool of processes. By default, one is created for each CPU in your machine. with concurrent.futures.ProcessPoolExecutor() as executor: ### Get a list of files to process image_files = glob.glob("*.jpg") ### Process the list of files, but split the work across the process pool to use all CPUs ### Loop through all jpg files in the current folder ### Resize each one to size 600x600 executor.map(load_and_resize, image_files) 从以上代码中摘出一行: with concurrent.futures.ProcessPoolExecutor() as executor: 你的 CPU 核越多,启动的 Python 进程越多,我的 CPU 有 6 个核。实际处理代码如下: executor.map(load_and_resize, image_files) 「executor.map()」将你想要运行的函数和列表作为输入,列表中的每个元素都是我们函数的单个输入。由于我们有 6 个核,我们将同时处理该列表中的 6 个项目! 如果再次用以下代码运行我们的程序: time python fast_res_conversion.py 我们可以将运行时间降到 1.14265 秒,速度提升了近 6 倍! 注意:在生成更多 Python 进程及在它们之间整理数据时会有一些开销,所以速度提升并不总是这么明显。但是总的来说,速度提升还是非常可观的。 它总是那么快吗? 如果你有一个数据列表要处理,而且在每个数据点上执行相似的运算,那么使用 Python 并行池是一个很好的选择。但有时这不是最佳解决方案。并行池处理的数据不会在任何可预测的顺序中进行处理。如果你对处理后的结果有特殊顺序要求,那么这个方法可能不适合你。 你处理的数据也必须是 Python 可以「炮制」的类型。所幸这些指定类别都很常见。以下来自 Python 官方文件: ●None, True, 及 False ●整数、浮点数、复数 ●字符串、字节、字节数组 ●只包含可挑选对象的元组、列表、集合和字典 ●在模块顶层定义的函数(使用 def ,而不是 lambda ) ●在模块顶层定义的内置函数 ●在模块顶层定义的类 ●这种类的实例,其 __dict__ 或调用__getstate__() 的结果是可选择的(参见「Pickling Class Instances」一节)。 原文发布时间为:2018-10-5 本文来自云栖社区合作伙伴“CDA数据分析师”,了解相关信息可以关注“CDA数据分析师”。

优秀的个人博客,低调大师

【Java入门提高篇】Day26 Java容器类详解(八)HashSet源码分析

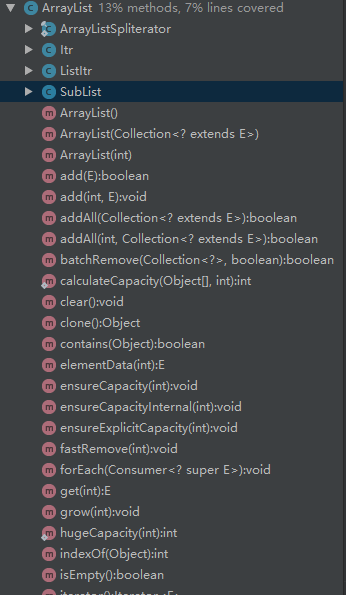
前面花了好几篇的篇幅把HashMap里里外外说了个遍,大家可能对于源码分析篇已经讳莫如深了。别慌别慌,这一篇来说说集合框架里最偷懒的一个家伙——HashSet,为什么说它是最偷懒的呢,先留个悬念,看完本文之后,你就会知道所言不假了。 本篇将从以下几点来进行介绍: 1.HashSet的特点和使用场景 2.HashSet的示例 3.HashSet的继承结构图 4.HashSet的源码解析 HashSet的特点和使用场景 HashSet是Set家族的一员,所以也具有着Set的全部性质,比如元素无序,元素不可重复,但HashSet也有它自己的一些特性,比如它的查找效率很高,跟HashMap的查找效率一样高(滑稽,看完源码分析你就知道为什么了),它的基本操作如,add/remove/contains/size等都只需要常量时间的开销,并且允许存在null值。 所以HashSet的一个很重要的应用就是去重,把一堆存在重复的数据往HashSet里一丢,里面的元素因为是不会存在重复的,所以再取出来的时候就已经是去重过的数据了,这样HashSet就像一个筛子,把数据筛选了一次。另外HashSet由于其查找效率很高,所以也用于数据的查找,比如将处理过的数据往里面一丢,处理下一个数据的时候先到HashSet中查找一次,如果存在则说明已经处理过,不存在则继续处理。 HashSet的示例 接下来,看一个HashSet的小栗子吧。 1 public class Test { 2 3 public static void main(String[] args){ 4 //nameList中可以存在重复元素,且顺序跟插入的顺序相同 5 List<String> nameList = new ArrayList<>(); 6 nameList.add("Alice"); 7 nameList.add("Frank"); 8 nameList.add("Charles"); 9 nameList.add("Emma"); 10 nameList.add("Jessie"); 11 nameList.add("Frank"); 12 System.out.println(nameList); 13 14 //将列表里的元素插入到Set后,可以去除重复元素,但是没有顺序 15 System.out.println("====add===="); 16 Set<String> nameSet = new HashSet<>(); 17 for (String name : nameList){ 18 nameSet.add(name); 19 } 20 System.out.println(nameSet); 21 22 System.out.println("====contains===="); 23 System.out.println(nameSet.contains("Frank")); 24 System.out.println(nameSet.contains("Bob")); 25 26 System.out.println(nameSet.containsAll(nameList)); 27 28 System.out.println("====remove===="); 29 nameSet.remove("Frank"); 30 System.out.println(nameSet); 31 32 nameSet.forEach(System.out::println); 33 34 System.out.println("====Iterator===="); 35 Iterator iterator = nameSet.iterator(); 36 while (iterator.hasNext()){ 37 System.out.println(iterator.next()); 38 } 39 40 } 41 } 输出如下: [Alice, Frank, Charles, Emma, Jessie, Frank] ====add==== [Charles, Alice, Jessie, Frank, Emma] ====contains==== true false true ====remove==== [Charles, Alice, Jessie, Emma] Charles Alice Jessie Emma ====Iterator==== Charles Alice Jessie Emma HashSet的继承结构图 HashSet是继承自AbstractSet类的,同时实现了Set接口,Serializable接口,Cloneable接口,AbstractSet是Set的便利类,实现了Set接口的部分方法框架,AbstractSet里的方法其实很少,它继承自AbstractCollection类,同时实现了Set接口。 1 public abstract class AbstractSet<E> extends AbstractCollection<E> implements Set<E> { 2 3 protected AbstractSet() { 4 } 5 6 // 比较和哈希 7 8 /** 9 * 比较两个HashSet是否相等 10 * 先比较是否是同一个引用,然后判断o是否实现了Set接口 11 * 再比较它们的大小是否一致,最后判断是否包含了o中所有元素 12 */ 13 public boolean equals(Object o) { 14 if (o == this) 15 return true; 16 17 if (!(o instanceof Set)) 18 return false; 19 Collection<?> c = (Collection<?>) o; 20 if (c.size() != size()) 21 return false; 22 try { 23 return containsAll(c); 24 } catch (ClassCastException unused) { 25 return false; 26 } catch (NullPointerException unused) { 27 return false; 28 } 29 } 30 31 /** 32 * hashCode方法,计算所有元素的hashCode之和 33 */ 34 public int hashCode() { 35 int h = 0; 36 Iterator<E> i = iterator(); 37 while (i.hasNext()) { 38 E obj = i.next(); 39 if (obj != null) 40 h += obj.hashCode(); 41 } 42 return h; 43 } 44 45 /** 46 * 移除所有在集合c中的元素 47 * 如果c中元素个数小于该Set中的元素个数,则遍历c中的元素,使用Set中的remove方法进行移除。 48 * 相反,如果c中的元素个数大于Set中的元素个数,则遍历该Set中的元素,如果存在于c中,则调用迭代器的remove方法进行移除。 49 */ 50 public boolean removeAll(Collection<?> c) { 51 Objects.requireNonNull(c); 52 boolean modified = false; 53 54 if (size() > c.size()) { 55 for (Iterator<?> i = c.iterator(); i.hasNext(); ) 56 //这里其实用了一个很巧妙的位操作,只要remove有一次成功,则返回true,modified就会变成true,之后不管remove返回true还是false,与modified进行或操作的时候结果都是true,所以只要remove中有一次是成功的,modified变量就是true 57 modified |= remove(i.next()); 58 } else { 59 for (Iterator<?> i = iterator(); i.hasNext(); ) { 60 if (c.contains(i.next())) { 61 i.remove(); 62 modified = true; 63 } 64 } 65 } 66 return modified; 67 } 68 69 } HashSet的源码解析 先来看看源码的结构: 相比HashMap是不是方法少了很多很多,也许你会好奇,HashSet是如何用将精华操作塞在这么少的方法中的,嗯,一起来看看它是怎样实现的吧: public Iterator<E> iterator() { return map.keySet().iterator(); } public int size() { return map.size(); } public boolean isEmpty() { return map.isEmpty(); } public boolean contains(Object o) { return map.containsKey(o); } public boolean add(E e) { return map.put(e, PRESENT)==null; } public boolean remove(Object o) { return map.remove(o)==PRESENT; } public void clear() { map.clear(); } @SuppressWarnings("unchecked") public Object clone() { try { HashSet<E> newSet = (HashSet<E>) super.clone(); newSet.map = (HashMap<E, Object>) map.clone(); return newSet; } catch (CloneNotSupportedException e) { throw new InternalError(e); } } 看完你也许会觉得,WTF???主要方法全部是一行代码解决??来看看这个map到底是何方神圣: private transient HashMap<E,Object> map; 惊不惊喜,意不意外,HashSet其实就是里面放了一个HashMap实例,所有操作都是通过HashMap去完成的,至于它的元素不可重复特性,也是借助于HashMap的键值不可重复实现的。嗯,说它是最懒的容器类不过分吧。 再来看看它的几个构造函数: 1 /** 2 * 构造一个空的HashSet,其中的HashMap实例使用默认的初始容量(16)和默认的装载因子(0.75) 3 */ 4 public HashSet() { 5 map = new HashMap<>(); 6 } 7 8 /** 9 * 构建一个包含指定集合所有元素的HashSet,其中的HashMap实例使用默认的装载因子(0.75)和能够容纳下集合中所有元素的初始容量(别忘了,必须是2的幂次方) 10 */ 11 public HashSet(Collection<? extends E> c) { 12 map = new HashMap<>(Math.max((int) (c.size()/.75f) + 1, 16)); 13 addAll(c); 14 } 15 16 /** 17 * 构建一个空的HashSet,其中的HashMap实例使用指定的加载因子和初始容量 18 */ 19 public HashSet(int initialCapacity, float loadFactor) { 20 map = new HashMap<>(initialCapacity, loadFactor); 21 } 22 23 /** 24 * 构建一个空的HashSet,其中的HashMap使用默认的加载因子和指定的容量大小 25 */ 26 public HashSet(int initialCapacity) { 27 map = new HashMap<>(initialCapacity); 28 } 29 30 /** 31 * 构建一个空的LinkedHashSet,这是一个包私有的构造器,仅仅被LinkedHashSet使用,里面的HashMap是一个LinkedHashMap实例,使用指定的容量和装载因子 32 * dummy是一个没有意义的参数,目的是为了跟上面的构造函数区分开来,如果没有这个参数,将不能进行有效重载 33 */ 34 HashSet(int initialCapacity, float loadFactor, boolean dummy) { 35 map = new LinkedHashMap<>(initialCapacity, loadFactor); 36 } 37 38 所以,其实可以灵活定制HashSet的大小和装载因子,只是一般情况下,使用默认的即可,除非知道里面要放的元素个数,并且数量比较大时,才需要进行指定容量,这样可以减少扩容次数。 再来看看剩下的几个函数: /** * 序列化 */ private void writeObject(java.io.ObjectOutputStream s) throws java.io.IOException { // Write out any hidden serialization magic s.defaultWriteObject(); // Write out HashMap capacity and load factor s.writeInt(map.capacity()); s.writeFloat(map.loadFactor()); // Write out size s.writeInt(map.size()); // Write out all elements in the proper order. for (E e : map.keySet()) s.writeObject(e); } /** * 反序列化 */ private void readObject(java.io.ObjectInputStream s) throws java.io.IOException, ClassNotFoundException { // Read in any hidden serialization magic s.defaultReadObject(); // Read capacity and verify non-negative. int capacity = s.readInt(); if (capacity < 0) { throw new InvalidObjectException("Illegal capacity: " + capacity); } // Read load factor and verify positive and non NaN. float loadFactor = s.readFloat(); if (loadFactor <= 0 || Float.isNaN(loadFactor)) { throw new InvalidObjectException("Illegal load factor: " + loadFactor); } // Read size and verify non-negative. int size = s.readInt(); if (size < 0) { throw new InvalidObjectException("Illegal size: " + size); } // Set the capacity according to the size and load factor ensuring that // the HashMap is at least 25% full but clamping to maximum capacity. capacity = (int) Math.min(size * Math.min(1 / loadFactor, 4.0f), HashMap.MAXIMUM_CAPACITY); // Constructing the backing map will lazily create an array when the first element is // added, so check it before construction. Call HashMap.tableSizeFor to compute the // actual allocation size. Check Map.Entry[].class since it's the nearest public type to // what is actually created. SharedSecrets.getJavaOISAccess() .checkArray(s, Map.Entry[].class, HashMap.tableSizeFor(capacity)); // Create backing HashMap map = (((HashSet<?>)this) instanceof LinkedHashSet ? new LinkedHashMap<E,Object>(capacity, loadFactor) : new HashMap<E,Object>(capacity, loadFactor)); // Read in all elements in the proper order. for (int i=0; i<size; i++) { @SuppressWarnings("unchecked") E e = (E) s.readObject(); map.put(e, PRESENT); } } /** * 可分割式迭代器 */ public Spliterator<E> spliterator() { return new HashMap.KeySpliterator<E,Object>(map, 0, -1, 0, 0); } 嗯,HashSet的介绍就这么多了,很简单吧。 之后还会继续将容器家族中常见的容器类进行源码解析,如LinkedList,LinkedHashMap,LinkedHashSet,TreeMap,TreeSet。嗯,所以预计关于容器类还有至少五篇文章,希望大家能耐心看下去,当然,如果对于源码解析实在没什么兴趣,也可以先跳过这一部分,先知道怎么用就好了。 之后还会努力更新,欢迎大家继续关注。真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

如何才能真正的提高自己,成为一名出色的架构师?

一、广度: 广度指的是架构师应该对所在领域的主流技术体系有一个全面清晰的认识,每一种技术不需要很深入的了解,但必须知道每种技术的“3W”: 1,Why:每种技术的由来,为什么会出现这种技术,这个技术是用来解决什么问题的? 2,What:每种技术是什么?技术的基本组成部分是什么? 3,Which:解决同一问题的相同技术各自的优缺点是什么,更适合哪种场景?比如,ORM框架(Hibernate与IBatis),MVC框架(Struts与SpringMVC),大数据技术(Hadoop与Spark)它们各自的优缺点是什么,只有清晰认识同一类型技术的优缺点,才能在技术选型时能够使用更加合理的技术。 广度的学习方法:对各主流技术一一通过搜索引擎了解其3W的内容。二、高度: 高度指的是架构师应具备对客观事物的“拔高”能力,能够从纷繁杂乱的信息中建立秩序,也就是我们一般所说的抽象能力。 抽象能力包括: 1,业务抽象:能够软件和产品的复杂的需求中抽象核心业务实体,并给各业务实体建立合理的关系; 2,技术抽象:能够对复杂的技术架构进行分层抽象、服务抽象(微服务抽象)、组件抽象,并为各层和各服务之间的调用建立合理的“关系”; 高度的学习方法:深入理解和学习面向对象、设计模式,琢磨优秀开源框架的设计原理和设计思想。三、深度: 深度指的是架构师能对主流技术有较为深入的理解,主要包括: 1,可以不了解源代码,但对主流技术的原理,运作机理有一个基本的理解; 2,至少对一种技术有深入的认识,是这种技术的专家,熟悉其源代码以上2点,1为必须,2为非必须深度的学习方法:上文已说。四、宽度: 宽度指的是架构师能够熟知当前的技术前沿和热点,能够使用新的技术解决问题。比如,微服务、大数据、云计算、人工智能等。 宽度的学习方法:可以使用手机订阅相关的技术资讯了解,定期了解即可,对于跟所负责工作相关的技术进行进一步的了解。 小结:广度决定了系统架构技术选型的合理性;高度决定了系统架构设计的合理性;深度决定了系统架构的优化能力;宽度决定了系统架构的领先性,不至于三五年被淘汰四度缺一不可! 欢迎工作一到五年的Java工程师朋友们加入Java架构开发:468947140 点击链接加入群聊【Java-BATJ企业级资深架构】:https://jq.qq.com/?_wv=1027&k=5zMN6JB 本群提供免费的学习指导 架构资料 以及免费的解答 不懂得问题都可以在本群提出来 之后还会有职业生涯规划以及面试指导

优秀的个人博客,低调大师

mysql 自动检查并启动slave 线程的小方法,提高运维效率

问题 某些公司数据库架构是两主多从,双活跨IDC机房,这样就存在一个问题。跨机房的数据库同步,必然会 存在网络抖动,异常引起的slave io,slave sql线程关闭的情况。 2.解决的思虑 1)写一个脚本定时监控slave 状态 2)使用shell 写就可以 3)使用crontab 每分钟检查,判断,然后根据判断执行start slave 就可以了。 具体的写法,需要大家自己动手来写了,只有这样才能有提升。 知识点 1)crontab 用法,每多少分钟检查一次 2) shell if [] then 判断即可完成。 本文转自 roidba 51CTO博客,原文链接:http://blog.51cto.com/roidba/1887163,如需转载请自行联系原作者

优秀的个人博客,低调大师

物联网安全性正在不断提高 但还远远不够安全

联网设备现在已经越来越成为一种常见的科技产品。在过去的几年,通常只有电脑、平板电脑和智能手机才能接入网络,而随着传感器和芯片的成本越来越低,任何产品现在都可以变成一种联网设备,包括家用电器在内的许多产品都开始融入了各种各样的新特性。 通过各种传感器,接入网络后的产品能够具有各种各样的新奇功能。但是,围绕着物联网产品的壮大,隐私与安全问题自然而然的又出现在了我们的面前。毕竟没有人愿意别人能够看到自己办公室或家里的网络信息。 消费者的担心 消费者最大的担心,就是一些联网产品,比如汽车或者冰箱,可能会变成安全漏洞,让不法分子进入你的网络。这些不法分子通过进入你的网络当中的设备,如存有个人信息的计算机,便有可能暴露你的个人数据。 要让物联网变得安全, 其实有很多的方法。而最重要的就是在芯片中置入某种防火墙或安全措施,并在设备上置入附加传感器。冰箱能告知主人今天需要开会,这听起来挺方便的。但我认为没有人会因为懒得打开手机里的日历行程,而愿意把冰箱变成自家网络中一个巨大的安全漏洞。 操作过程有漏洞 物联网传感器、设备以及你的网络之间的连接将会被加密,从而保护这些数据,但这可能是不够的。在拉斯维加斯国际黑客大会中,一款三星联网冰箱被攻击,研究人员发现它的安保功能是不够的。特别是这款三星RF28HMELBSR智能冰箱用的是SSL加密通讯协议,但它并不能核实认证是否有效。这样,黑客就能变成中间人攻击窃取数据。 使用这款具有联网功能的冰箱,用户很方便就能知道自己的谷歌日程,还有其他东西。但这样黑客就可能通过冰箱窃取用户的密码和安全令牌,进而窃取另一个更有用的目标:用户的Gmail帐号,黑客动动手指,就可能窃取到很多个人和商务的信息了。 进步 未来几年,物联网产品公司一定要更多地去关注产品的安保问题。冰箱被黑客入侵,这听起来好像有点微不足道,但如果因此暴露了你的邮箱帐号,暴露了纳税申报单,你的个人信息有可能被盗,那最后就有可能酿成大祸。 物联网产品制造商需要把每一个产品都当成有可能被入侵的接入点,并建立强健的安保功能。此外,这些功能在产品投放入市场之前就必须进行广泛的测试,而不是产品投放以后才进行测试。我们不能阻止物联网的萌芽,我们所希望的仅仅是制造商们能认真思考安保方面的问题,因为这些产品,就像车和冰箱,都有可能成为小偷进入你家网络的门。如果制造商们只制造支持物联网的芯片和设备,而不考虑任何安全问题,那么顾客们可能会因为考虑到安全问题而不购买联网产品。能保证安全的物联网产品是个好东西,但没有严格执行安全功能的物联网产品,就有可能产生意外。 美国联邦贸易委员会已经在尽力促进物联网产品制造商更关注安保问题。而作为消费者,随着越来越多的物联网设备成为主流,我们需要向制造商要求更多的安全责任。但是,物联网产品早期使用者,比如我,却打开了这个漏洞,但这也是我们自己选择的。而对于那些仍旧持观望态度的消费者来说,我会建议等到大部分物联网产品都成熟以后再选择购买。 作者:何妍 来源:51CTO

优秀的个人博客,低调大师

《UX最佳实践:提高用户体验影响力的艺术 》一2.4 项目阶段

2.4 项目阶段 项目要经历三个阶段,如图2-4所示。在第一个阶段,我们有意将开发流程与UCD流程分开进行。解决方案管理团队负责通过外部驱动研究方法定义目标解决方案,与此同时,开发团队并行开发技术平台。从一开始,ByDesign用户体验团队就同时协助解决方案管理团队和负责开发技术平台的UI架构团队。用户体验设计师与解决方案经理紧密合作,一起定义应用程序的目标设计。同时,我们也必须确保在UI架构中能完美地实现出UI模式,撰写详尽的UI规范文档,并在开发阶段协助框架开发人员。在第二阶段,我们得让已实现的解决方案更接近目标设计。等到了第三阶段,我们就开始转入精益开发(LEAN)与敏捷开发(agile development)模式。刚开始时,我们并没有明确地区分每个阶段。但随着经验的积累,情况逐渐清晰起来。每个阶段我们都学到许多技术、流程和

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册