首页 文章 精选 留言 我的

精选列表

搜索[提高],共10000篇文章
优秀的个人博客,低调大师

Android Go 使用重新设计的“Recents”视图以提高效率

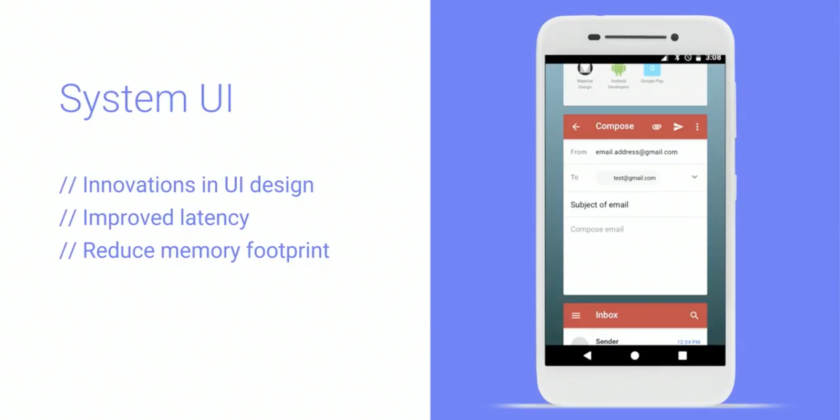
除了特别优化的应用程序,如 YouTube Go,Android Go 将采用全新的 Recents UI,以实现更快速,更节能的切换。 今年 Google I/O 最令人兴奋的消息之一就是推出了 Android Go。Android Go 类似于 Android One,但不是用来取代它的。具有 1GB 或更小内存的 Android 智能手机可在 Android One 上运行,Android One拥有完全修改的系统,可提供显着的节能效果和低数据消耗。 现在我们来看看 Android Go 的部分 UI 设计。谷歌已经对系统用户界面进行了一些重要更改,特别是 Recents 视图,以便于改进延迟并减少内存占用。在设计上,使用 Android Go,不会再看到最近使用过的应用程序的堆叠卡片视图;相反,将会看到完整的预览卡片视图,它足够大且可以占据整个屏幕: 谷歌表示,95% 的入门级设备用户不会进行大量的切换,通常在四个最近使用的 APP 之间来回切换。事实上,对于耗电量大的用户来说,在 Recents 视图中使用几乎全屏卡片视图的效果肯定比在多个应用程序之间来回切换时使用堆叠卡片视图的效率更低。但这对于入门级设备用户来说可能并不那么麻烦;其实这更有意义。毕竟,这个 UI 的更改能够使具有 1GB 甚至 512MB 内存的设备进行快速和流畅的切换。 你对 Android Go 有什么想法?喜欢新的 Recents UI 吗?在评论区分享你的想法吧~~ 本文来自开源中国社区 [http://www.oschina.net]

优秀的个人博客,低调大师

京东云开发者|提高IT运维效率,深度解读京东云AIOps落地实践

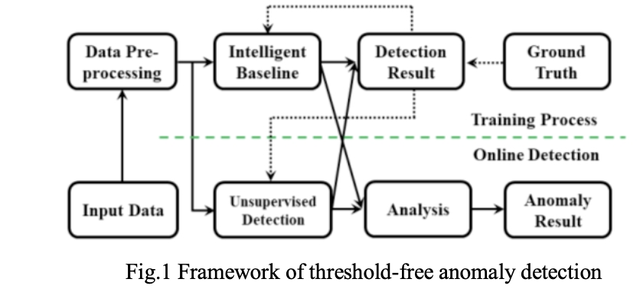
基于深度学习对运维时序指标进行异常检测,快速发现线上业务问题 时间序列的异常检测是实际应用中的一个关键问题,尤其是在 IT 行业。我们没有采用传统的基于阈值的方法来实现异常检测,而是通过深度学习提出了一种无阈值方法:基于 LSTM 网络的基线(一个 LSTM 框架辅助几个优化步骤)和无监督检测(神经网络和多种机器学习算法的组合)协同综合分析时间序列。当时间序列显示出清晰的周期性形态的情况下基线表现良好,而无监督检测在效率要求高且周期性不太清晰的情况下表现出色。通过两个并行模块的互补设计,可以在不依赖阈值设定和调整的情况下实现无阈值异常检测。京东云内部实践证明,我们所提出的无阈值方法获得了准确的预测和可靠的检测。 在过去的几年中,aiops业界提出了各种解决异常检测问题的方法。机器学习 (ML) 和深度学习 (DL) 颇受欢迎。在传统的 ML 中,通常采用 K-means、基于密度的空间聚类和隔离森林 (IForest)等聚类方法。除了 ML,由于其强大的逼近能力,使用深度神经网络 (DNN) 进行时间序列预测和异常检测被越来越多的算法同学使用。多层感知器 (MLP) 是一种基本的 DNN 架构,用于评估时间序列上异常检测的性能。此外,循环神经网络 (RNN) 及其变体,如长短期记忆 (LSTM) 网络和门控循环单元 (GRU) 是解决与时间序列相关的问题的常用方法。 对于大多数上述用于解决异常检测的方法,一般是时间序列是否超出预定义的上限和下限。然而,固定阈值无法表征具有内在动态趋势变化的时间序列,从而导致异常分析不准确。此外,由于单个阈值无法涵盖所有​异常情况,因此该方法也容易遗漏异常。此外,设置上限和下限的过程是一项复杂且重要的任务,总是需要为各种情况定义新的阈值,耗时长且迁移性差。 为了解决上述问题,我们介绍一种新方法,即通过 DL 进行无阈值异常检测。 我们的方法不需要预定义上限和下限,而是通过抽取一些易于调整的参数,在小范围内自动搜索适配不同场景的监控数据,进而实现无阈值异常检测:基于 LSTM 网络的基线模块(LnB)和无监督检测模块(UnD)。具体来说,LnB 生成基线,该基线能够以自适应和自动的方式表征时间序列的动态特征。 LnB 的框架是用 LSTM 网络构建的,长短周期识别方法是此框架的贡献之一,它引入了一种纠正机制,可以实现更准确的拟合,生成的基线描述了检测到的时间序列的主要特征,提供了替代传统阈值的限制。 UnD是一种DL和多种ML算法的合并模型,基于投票机制从各个角度检测到的时间序列是否正常。两个模块中的任何一个检测到异常表明发生了异常。两个模块的融合使我们所提出的方法能够以互补和全面的方式有效地分析具有不确定性或各种周期性的时间序列。 时间序列X=(x1, x2, ..., xt),我们的目标是确定下一步 xt+1 的值是否异常。历史值有助于模型学习指标当前和未来的状态,但与预测值距离越近的点对模型预测的影响越大。因此,我们选择使用时间序列 Xt-T:t 的序列,而不是取时间序列的单个步长或整个历史序列来进行异常检测。 T 是选择作为模型训练输入的序列长度。下图1为无阈值异常检测的总体框架包括两个阶段,即训练过程和在线检测。 LnB 和 UnD两个模块都可以单独完成异常检测。但是两个模块有不同的擅长方面,每个模块的结构差异为检测到的时间序列提供了不同维度的检测结果。其中,LnB将更长时期的历史数据输入到模块中,它可以很好地说明特定时间序列的长期行为,但是 LnB 对那些周期性不明确的指标的异常检测能力较弱。相反,UnD 从一个 DL 模型和多个 ML 模型中获得投票结果,对具有不确定性或各种周期性的时间序列具有更强的鲁棒性。此外,UnD 在输入的检测指标的历史数据不足的情况下提供了更合理的检测。 图 1 中的实线箭头表示前向流,而虚线箭头表示反向传播训练。在得到每个模块的检测结果后,根据为每个模块设置的损失函数分别对LnB和UnD进行反向传播训练,LnB和UnD都进行更新,即模型训练。在模型训练之后,LnB 学习生成一个自适应基线,同时,LnB为UnD赋予 基于无监督学习预测未来异常状态的能力。 在线检测不需要训练步骤,所以按入参格式输入时间序列,可直接得到检测结果。这训练和在线检测两个模块的详细介绍如下: 其中 f 表示模型学习所采用的网络,Ti 表示第 i 天的数据。 在训练阶段,a 和 b 会及时随着传入的指标数据自动更新,形成可适应的基线。在测试状态下,y ' final 是我们的最终预测。长短周期识别的重点是引入校正项,为历史上最有价值的“记忆”赋予更多的权重。 如上所述,有两种方法用于识别长短周期,即峰值检测和 SBD距离计算。每天的峰值数量、每天的峰值最大值以及每天第一和第二个最大值的残差是用于识别长短周期,除了这种峰值检查,SBD 是识别长短周期的替代方法。假设我们有两个输入序列 X 和 Y(在我们的例子中,14 天的数据被平均分成两部分)。两个序列的SBD结果可以根据以下等式计算, 其中 SBD 的范围从 0 到 2,在我们的案例中 s=0。 SBD 越小,说明两个序列属于同一周期的相似度越高。 最佳开始时间通过寻找不同时间粒度(如10s 和 1min)下的最佳开始时间来关注拟合精度。待检测的时间序列总是遵循一定的周期性,但根据我们的实验验证,在不同位置选择的开始时间可能会导致拟合精度不同。我们选取均方根误差 (RMSE) 用作优化搜索过程的目标函数: 其中 y' 代表预测结果,而 y 代表基本事实。 k 表示检测到的序列中的第 k 个起始位置。采用L-BFGS通过最小化目标函数实现自动搜索。 基线生成 LnB 的核心过程是基线生成。与RNN相比,LSTM包含了三个门,即遗忘门、输入门和输出门,这种门设计在识别历史中的重要信息方面表现出更好的性能,减轻了对远程历史的依赖和梯度消失。输入数据经 LSTM,输出理论上暗示了正常数据的期望。因此,我们将损失函数训练为: 通过减少实际值和预测值之间的误差,网络可以学习预测时间序列的正常行为。 我们选择 95% 置信区间,计算基线的上限和下限: LnB 的最后一步是自适应调整,这是实现“自适应”的关键步骤。通过 LSTM 获得的上限和下限是初始基线。然后通过极值点平滑和插值修改初始基线。即初始基线中的所有峰点和谷点都形成了初始上限和下限。然后采用拉格朗日插值进行细粒度数据填充以形成平滑的基线。 DL (GRU) 和 ML(IForest、基于角度的异常值检测-ABOD 和基于集群的局部异常值因子-CBLOF)从多个级别检测异常,不需要标签信息或阈值定义。作为回归任务,GRU 学习给定时间序列的正态分布并输出对未来的预测。与 LSTM 从长期历史中捕捉内在特征的能力相比,GRU 在数据量不足且需要效率的情况下理论上表现良好。与 LnB 不同,UnD 将较短的序列作为输入。因此,UnD 中的 GRU 单元是 LnB 的补充。另一方面,IForest、ABOD 和 CBLOF 是用于异常检测的三种基于 ML 的聚类算法。 UnD的最终检测是GRU、IForest、ABOD和CBLOF通过投票方案的合并结果。 对于 GRU,我们采用与 LnB 相同的损失函数。区别在于输入长度(在下一节中解释)。训练有素的 GRU 会给出预测的准确值 y'。在这里,定义异常权重 (AW) 以确定预测是否异常。 AW 是异常识别的关键决定因素,并且根据经验知识自动学习以满足在我们的案例中检测到的异常百分比应在 1%-3% 以内的条件。当涉及到不同的领域或数据集时,也可以根据经验知识确定 AW。 IForest、ABOD和CBLOF是常用的异常值检测方法,它们的输出结果可以看作是一个描述异常概率的分数。然后将所有 GRU、IForest、ABOD 和 CBLOF 的检测结果编码并拼接成一个 one-hot 矩阵,其中 0 表示正常,1 表示异常,如图 3 所示的示例。接下来,我们得到每个时间步对应的“1”的总数。通过与投票数 n (在我们的例子中 n = 2)的比较,如果“1”的总数不小于 n ,则合并结果被检测为异常,反之亦然。 n 是一个参数,需要通过几个简单的试验来确定,例如逐渐增加值或缩小范围。 通过投票方案的合并结果可以从不同方面揭示内在特征,因为 GRU 的回归结果包含显示增加或减少趋势的精确值,而 ML 结果呈现 0 或 1 仅表示异常与否,但具有更准确的决策,因为这些模型可以利用从附加维度或测量中捕获的信息(例如,基于角度视角的 ABOD 和基于概率视角的 CBLOF)。因此,多个高级算法的合并结果可以充分利用给定的数据进行全面的预测。 我们的模型主要有三个步骤,详细介绍如下: 第一步:数据预处理 LnB和UnD对数据拆分和连接有不同的要求,两个模块的输入数据是不同的。例如,当前时间为 t,时间序列的周期性为 T(如 7 天)。我们的目标是检测 t+1 时刻的值是否异常。在这种情况下,LnB 的输入是过去 2*T 周期(即 14 天)收集的历史数据。选择 2*T 周期的原因是 14 天之前的历史数据重要性较低,如果只收集一个周期的数据,可能会受到异常事件的影响。相反,UnD采用最相关的信息而不是使用长历史,并且选择三个滑动窗口覆盖的序列作为输入数据。三个窗口的长度分别为 30 分钟、60 分钟和 60 分钟。 从图4可以看出,UnD输入中有3个段串联,即[Xt-30min:t, Xt+1-1day-30min:t+1- 1day+30min, Xt+1-7days-30min: t+1-7 天+30 分钟]。这种连接提供了一种新的输入结构设计,为特征学习和未来预测提供了最相关的信息。总之,LnB 将过去 14 天的序列作为输入,而 UnD 将过去 30 分钟、1 天前的 60 分钟和 7 天前的 60 分钟作为输入。 数据填充采用 K-NN 作为数据填充方法,以确保所有输入样本的长度相同且可读。数据过滤为保证输入数据的有效性,对输入数据进行平滑过滤,以消除因噪声引起的毛刺。数据转换对训练结果和快速收敛非常重要。在输入训练过程之前,原始数据还需要一个转换过程,包括归一化和对数转换,如(7)所示。 归一化避免了不同维度的副作用,有利于模型快速收敛。此外,它还确保输出不会超过输入的最小值和最大值,因为在输出上实施了指数变换。同时,对数变换可以在不改变数据特征和数据相关性的情况下,减轻方差,平滑变化。 第二步:模型训练 如图 1 中的流程图所示,LnB 和 UnD 都是根据训练数据分别训练的。但是,如上所述,两个模块的输入是不同的。 LnB 将较长的历史数据作为输入,并尝试捕获检测到的时间序列的丰富信息,而 UnD 将最相关但较短的序列部署为训练数据。 UnD 中的GRU和 LnB通过减少第二部分中介绍的损失函数来学习检测到的序列的正常行为。同时,IForest、ABOD 和 CBLOF 学习了无监督聚类模型。上述单元的所有输出都是一步超前的异常检测。 第三步:在线异常检测 在运行时,传入的数据首先进入预处理模块,然后同时进入LnB和UnD。输入数据的格式应与训练阶段一致。如果两个模块的任一结果异常,则提示待检测数据异常。LnB和UnD的融合机制对时间序列进行了全面的检测,降低了潜在异常遗漏的概率。另一方面,LnB 中较长的历史输入和 UnD 中的多模型投票方案有效地避免了将正常的误认为是异常的。 经过京东内部多场景多组数据验证,模型在线上运行的效果评估如下表所示: 此外,可以灵活选择“and”或“or”来整合LnB和UnD的结果。没有统一的规则,要看实际场景的需求。在我们的落地实践场景中,这两个数据集都需要保证召回率,因此我们采取“或”操作,这意味着无论哪个检测到异常都会报警。如果需要较低的警告级别,我们可以选择“和”作为积分运算。选择三个流行的基线 IForest、ABOD 和 CBLOF 进行比较。此外。我们还比较了我们的方法和单独使用 LnB 或 UnD 的方法的结果,如上表所示。从定量比较中,很明显,所提出的方法,即 LnB+UnD 在两者中都获得了最高的 F1 分数数据集。 LnB+UnD 的组合比单独采用 LnB 或 UnD 效果更好。而且我们的模型优于其他三个基线,这也证明了我们并行机制的有效性和必要性。 我们提出的一种用于时间序列分析的无阈值异常检测方法,即 LSTM 构建的 LnB和DL、ML 模型融合机制构建的 UnD,以互补和智能的方式实现异常检测。在具有不同长短周期和变化趋势的真实实践场景的两个数据集上进行了实验,比较结果证明了我们方法的有效性和准确性。 Threshold-free Anomaly Detection for Streaming Time Series through Deep Learning. ICMLA. ieeexplore检索:https://ieeexplore.ieee.org/abstract/document/9680175 作者:张静

优秀的个人博客,低调大师

Java 引入预览版虚拟线程(协程)功能,大幅提高应用吞吐量

OpenJDK 的 JEP 425 :虚拟线程(预览版)功能提案显示: Java 平台将引入虚拟线程特性(期待已久的协程)。虚拟线程是轻量级线程,可显著地减少编写、维护和观察高吞吐量并发应用程序的工作量。 Java 开发人员一直依赖线程作为并发服务器应用程序的构建块,每个方法中的语句都在一个线程内执行,每个线程提供一个堆栈来存储局部变量和协调方法调用,以及报错时的上下文捕获。线程是 Java 的并发单元,也是 Java 工具的核心基础:调试器逐步执行线程方法中的语句,分析器则可视化多个线程的行为。 目前,JDK 将其平台线程实现为操作系统 (OS) 线程的包装器,JDK 中每个实例都是一个平台线程,平台线程在底层操作系统线程上运行 Java 代码 ,并在代码的整个生命周期内捕获 OS 线程。平台线程数受限于 OS 线程数,而OS 线程的成本很高,不能占用太多。因此,目前 JDK 的这种线程实现方法限制了其应用程序的吞吐量,使吞吐量远低于硬件支持的水平。 关于虚拟线程 虚拟线程java.lang.Thread是在底层操作系统线程(OS 线程)上运行 Java 代码,但在代码的整个生命周期内不捕获 OS 线程的实例。这意味着许多虚拟线程可以在同一个 OS 线程上运行 Java 代码,从而有效地共享它。 虚拟线程是由 JDK 而不是操作系统提供的线程的轻量级实现,也是用户模式线程的一种形式。用户模式线程在 Java 的早期版本中被称为“绿色线程”,当时操作系统线程的概念还不够成熟和普及, Java 的所有绿色线程都共享一个 OS 线程(M:1 调度),随着线程概念的发展,绿色线程最终被现在的平台线程超越,实现为 OS 线程的包装器(1:1 调度),而最新引入的虚拟线程采用 M:N 调度,其中大量 (M) 虚拟线程被调度为在较少数量 (N) 的 OS 线程上运行。 更高的吞吐量 开发者可以选择使用虚拟线程还是平台线程,但虚拟线程在高吞吐量的服务器应用程序中表现更好。比如下面这段休眠一秒钟的代码就创建了大量的虚拟线程,程序首先获得一个ExecutorService,它为每个提交的任务创建一个新的虚拟线程,然后提交 10000 个任务并等待所有任务完成:: try (var executor = Executors.newVirtualThreadPerTaskExecutor()) { IntStream.range(0, 10_000).forEach(i -> { executor.submit(() -> { Thread.sleep(Duration.ofSeconds(1)); return i; }); }); } // executor.close() is called implicitly, and waits 现代硬件可以很容易地支持 10000 个虚拟线程同时运行这样的代码。如果该程序使用为每个任务都创建一个新平台线程的 ExecutorService,例如 Executors.newCachedThreadPool() ,那么它将尝试创建 10000 个平台线程,也就意味着 10000 个 OS 线程,那么这个程序在大多数操作系统上都会崩溃。又或者这个程序使用从池中获取平台线程的 ExecutorService,如 Executors.newFixedThreadPool(200),也好不到哪去。 ExecutorService 将创建 200 个平台线程供这 10000 个任务共享,任务将按顺序运行而不是同时运行,程序需要很长时间才能跑完。 对于上述程序来说,具有 200 个平台线程的池只能实现每秒 200 个任务的吞吐量,而虚拟线程可以实现大约每秒 10000 个任务的吞吐量(在充分预热之后)。此外,如果将示例程序中的 10000 更改为 1,000,000 ,则程序将提交 1,000,000 个任务,创建 1,000,000 个并发运行的虚拟线程,并且(在充分预热后)达到大约 1,000,000 个任务/秒的吞吐量。 总而言之,虚拟线程不是更快的线程 —— 它们运行代码的速度并不比平台线程快。它们的存在是为了提供规模(更高的吞吐量),而不是速度(更低的延迟)。 如何启用虚拟线程? 目前虚拟线程在其他多线程语言中被广泛使用(例如 Go 中的协程 和 Erlang 中的进程,在 C++ 中也是一个稳定特性),但在 Java 中还是一个预览 API,默认禁用。如要在 JDK XX 上尝试该功能,则必须通过以下方法启用预览 API: 使用 javac --release XX --enable-preview Main.java 编译程序,并使用 java --enable-preview Main 运行 使用源代码启动器时,使用 java --release XX --enable-preview Main.java 运行程序 使用 jshell 时,用 jshell --enable-preview 启动 有关虚拟线程的更多信息可在 OpenJDK 的JDK Issue-8277131中查看,目前该提案于 2021/11/15 创立,目前还处于 JEP 流程的第一阶段,距离稳定版本还需要一段时间。

优秀的个人博客,低调大师

想提高运维效率,那就把MySQL数据库部署到Kubernetes 集群中

摘要:Kubernetes 很多看起来比较“繁琐”的设计的主要目的,都是希望为开发者提供更多的“可扩展性”,给使用者带来更多的“稳定性”和“安全感”。 本文分享自华为云社区《如何在 Kubernetes 集群中搭建一个复杂的 MySQL 数据库?》,作者:zuozewei 。 前言 实际生产环境中,为了稳定和高可用,运维团队一般不会把 MySQL 数据库部署在 Kubernetes 集群中,一般是用云厂商的数据库或者自己在高性能机器(如裸金属服务器)上搭建。 但是,对于测试开发环境,我们完全可以把 MySQL 部署到各自的 Kubernetes 集群中,非常有助于提升运维效率,而且还有助于Kubernetes 使用的经验积累。 简易部署 ​如下所示,我们仅需设置 root 用户密码(环境变量 MYSQL_ROOT_PASSWORD), 便可轻松的使用 MySQL 官方镜像构建一个 MySQL 数据库。 apiVersion: extensions/v1beta1 kind: Deployment metadata: labels: app: mysql-min name: mysql-min spec: replicas: 1 selector: matchLabels: app: mysql-min template: metadata: labels: app: mysql-min spec: containers: - image: centos/mysql-57-centos7:latest name: mysql-min imagePullPolicy: IfNotPresent env: - name: MYSQL_ROOT_PASSWORD value: admin@123 ​创建一 Service 以便集群内外均可访问数据库,其中集群外需通过 nodePort 设置的 30336 端口访问。 apiVersion: v1 kind: Service metadata: labels: app: mysql-min release: mysql-min name: mysql-min namespace: default spec: ports: - name: mysql port: 3306 protocol: TCP nodePort: 30336 targetPort: mysql selector: app: mysql-min #目前sessionAffinity可以提供"None""ClientIP"两种设定: #None: 以round robin的方式轮询下面的Pods。 #ClientIP: 以client ip的方式固定request到同一台机器。 sessionAffinity: None type: NodePort #status: # loadBalancer: {} 接着,访问数据库并验证其运行正常: # kubectl get pod # 当前Pod名称 NAME READY STATUS RESTARTS AGE mysql-min-5b5668c448-t44ml 1/1 Running 0 3h # 通过本机访问 # kubectl exec -it mysql-min-5b5668c448-t44ml -- mysql -uroot -padmin@123 mysql> select 1; +---+ | 1 | +---+ | 1 | +---+ # 集群内部通过mysql service访问: # kubectl exec -it mysql-min-5b5668c448-t44ml -- mysql -uroot -padmin@123 -hmysql mysql> select now(); +---------------------+ | now() | +---------------------+ | 2021-03-13 07:19:14 | +---------------------+ # 集群外部,可通过任何一个 K8S 节点访问数据库: # mysql -uroot -padmin@123 -hworker-1 -P30336 mysql> show databases; +--------------------+ | Database | +--------------------+ | information_schema | | mysql | | performance_schema | | sys | +--------------------+ 扩展部署 持久化存储 若要确保 MySQL 重启后数据仍然存在,我们需为其配置可持久化存储,我这里的实验环境使用的是 Local Persistent Volume,也就是说,我希望 Kubernetes 能够直接使用宿主机上的本地磁盘目录,而不依赖于远程存储服务,来提供“持久化”的容器 Volume。这样做的好处很明显,由于这个 Volume 直接使用的是本地磁盘,尤其是 SSD 盘,它的读写性能相比于大多数远程存储来说,要好得多。这个需求对本地物理服务器部署的私有 Kubernetes 集群来说,非常常见。 值得指出的是其次,相比于正常的 PV,一旦这些节点宕机且不能恢复时,本地存储 Volume 的数据就可能丢失。这就要求使用 其的应用必须具备数据备份和恢复的能力,允许你把这些数据定时备份在其他位置。 不难想象, Local Persistent Volume 的设计,主要面临两个难点。 第一个难点在于:如何把本地磁盘抽象成 PV。 可能你会说,Local Persistent Volume 不就等同于 hostPath 加 NodeAffinity 吗? 比如,一个 Pod 可以声明使用类型为 Local 的 PV,而这个 PV 其实就是一个 hostPath 类型的 Volume。如果这个 hostPath 对应的目录,已经在节点 A 上被事先创建好了。那么,我只需要再给这个 Pod 加上一个 nodeAffinity=nodeA,不就可以使用这个 Volume 了吗? 事实上,你绝不应该把一个宿主机上的目录当作 PV 使用。这是因为,这种本地目录的存储行为完全不可控,它所在的磁盘随时都可能被应用写满,甚至造成整个宿主机宕机。而且,不同的本地目录之间也缺乏哪怕最基础的 I/O 隔离机制。 所以,一个 本地存储 Volume 对应的存储介质,一定是一块额外挂载在宿主机的磁盘或者块设备(“额外”的意思是,它不应该是宿主机根目录所使用的主硬盘)。这个原则,我们可以称为“一个 PV 一块盘”。 第二个难点在于:调度器如何保证 Pod 始终能被正确地调度到它所请求的本地 Volume 所在的节点上呢? 造成这个问题的原因在于,对于常规的 PV 来说,Kubernetes 都是先调度 Pod 到某个节点上,然后,再通过“两阶段处理”来“持久化”这台机器上的 Volume 目录,进而完成 Volume 目录与容器的绑定挂载。 可是,对于 Local PV 来说,节点上可供使用的磁盘(或者块设备),必须是运维人员提前准备好的。它们在不同节点上的挂载情况可以完全不同,甚至有的节点可以没这种磁盘。 所以,这时候,调度器就必须能够知道所有节点与 Local Persistent Volume 对应的磁盘的关联关系,然后根据这个信息来调度 Pod。 这个原则,我们可以称为“在调度的时候考虑 Volume 分布”。在 Kubernetes 的调度器里,有一个叫作 VolumeBindingChecker 的过滤条件专门负责这个事情。在 Kubernetes v1.11 中,这个过滤条件已经默认开启了。 基于上述讲述,在开始使用 Local Persistent Volume 之前,你首先需要在集群里配置好磁盘或者块设备。在公有云上,这个操作等同于给虚拟机额外挂载一个磁盘,比如 GCE 的 Local SSD 类型的磁盘就是一个典型例子。 而在我们部署的私有环境中,你有两种办法来完成这个步骤。 第一种,当然就是给你的宿主机挂载并格式化一个可用的本地磁盘,这也是最常规的操作; 第二种,对于实验环境,你其实可以在宿主机上挂载几个 RAM Disk(内存盘)来模拟本地磁盘。 接下来,我会使用第二种方法,在我们之前部署的 Kubernetes 集群上进行实践。首先,在名叫 node-1 的宿主机上创建一个挂载点,比如 /mnt/disks;然后,用几个 RAM Disk 来模拟本地磁盘,如下所示: # 在node-1上执行 $ mkdir /mnt/disks $ for vol in vol1 vol2 vol3; do mkdir /mnt/disks/$vol mount -t tmpfs $vol /mnt/disks/$vol done 需要注意的是,如果你希望其他节点也能支持 Local Persistent Volume 的话,那就需要为它们也执行上述操作,并且确保这些磁盘的名字(vol1、vol2 等)都不重复。接下来,我们就可以为这些本地磁盘定义对应的 PV 了,如下所示: apiVersion: v1 kind: PersistentVolume metadata: name: mysql-min-pv-local namespace: default spec: capacity: storage: 5Gi volumeMode: Filesystem accessModes: - ReadWriteOnce storageClassName: "mysql-min-storageclass-local" persistentVolumeReclaimPolicy: Retain #表示使用本地存储 local: path: /mnt/disks/vol1 #使用local pv时必须定义nodeAffinity,Kubernetes Scheduler需要使用PV的nodeAffinity描述信息来保证Pod能够调度到有对应local volume的Node上。 #创建local PV之前,你需要先保证有对应的storageClass已经创建。 nodeAffinity: required: nodeSelectorTerms: - matchExpressions: - key: kubernetes.io/hostname operator: In values: # pod 需要分不到的主机名,这台主机上开启了 local-pv 资源。 - node-1 可以看到,这个 PV 的定义里:local 字段,指定了它是一个 Local Persistent Volume;而 path 字段,指定的正是这个 PV 对应的本地磁盘的路径,即:/mnt/disks/vol1。 当然了,这也就意味着如果 Pod 要想使用这个 PV,那它就必须运行在 node-1 上。所以,在这个 PV 的定义里,需要有一个 nodeAffinity 字段指定 node-1 这个节点的名字。这样,调度器在调度 Pod 的时候,就能够知道一个 PV 与节点的对应关系,从而做出正确的选择。这正是 Kubernetes 实现“在调度的时候就考虑 Volume 分布”的主要方法。 接下来要创建一个 StorageClass 来描述这个 PV,如下所示: kind: StorageClass apiVersion: storage.k8s.io/v1 metadata: name: mysql-min-storageclass-local #指定存储类的供应者,比如aws, nfs等,具体取值参考官方说明。 #存储类有一个供应者的参数域,此参数域决定PV使用什么存储卷插件。参数必需进行设置 #由于demo中使用的是本地存储,所以这里写kubernetes.io/no-provisioner. provisioner: kubernetes.io/no-provisioner #volumeBindingMode 参数将延迟PVC绑定,直到 pod 被调度。 volumeBindingMode: WaitForFirstConsumer 这个 StorageClass 的名字,叫作 local-storage。需要注意的是,在它的 provisioner 字段,我们指定的是 no-provisioner。这是因为 Local Persistent Volume 目前尚不支持 Dynamic Provisioning,所以它没办法在用户创建 PVC 的时候,就自动创建出对应的 PV。也就是说,我们前面创建 PV 的操作,是不可以省略的。 与此同时,这个 StorageClass 还定义了一个 volumeBindingMode=WaitForFirstConsumer 的属性。它是 Local Persistent Volume 里一个非常重要的特性,即:延迟绑定。 通过这个延迟绑定机制,原本实时发生的 PVC 和 PV 的绑定过程,就被延迟到了 Pod 第一次调度的时候在调度器中进行,从而保证了这个绑定结果不会影响 Pod 的正常调度。 接下来,我们只需要定义一个非常普通的 PVC,就可以让 Pod 使用到上面定义好的 Local Persistent Volume 了,如下所示: apiVersion: v1 items: - apiVersion: v1 kind: PersistentVolumeClaim metadata: #当启用PVC 保护 alpha 功能时,如果用户删除了一个 pod 正在使用的 PVC,则该 PVC 不会被立即删除。PVC 的删除将被推迟,直到 PVC 不再被任何 pod 使用。 #可以看到,当 PVC 的状态为 Teminatiing 时,PVC 受到保护,Finalizers 列表中包含 kubernetes.io/pvc-protection: finalizers: - kubernetes.io/pvc-protection labels: app: mysql-min release: mysql-min name: mysql-min namespace: default spec: #PV 的访问模式(accessModes)有三种: #ReadWriteOnce(RWO):是最基本的方式,可读可写,但只支持被单个 Pod 挂载。 #ReadOnlyMany(ROX):可以以只读的方式被多个 Pod 挂载。 #ReadWriteMany(RWX):这种存储可以以读写的方式被多个 Pod 共享。 accessModes: - ReadWriteOnce resources: requests: storage: 10Gi storageClassName: mysql-min-storageclass-local #表示使用本地磁盘,实际生产中一般都使用nfs。 volumeMode: Filesystem volumeName: mysql-min-pv-local # status: # accessModes: # - ReadWriteOnce # capacity: # storage: 1Gi kind: List 可以看到,这个 PVC 没有任何特别的地方。唯一需要注意的是,它声明的 storageClassName 是 mysql-min-storageclass-local。所以,将来 Kubernetes 的 Volume Controller 看到这个 PVC 的时候,不会为它进行绑定操作。 ​ 最后,我们创建 Local Persistent Volume 资源文件: kubectl apply -f mysql-min-pv-local.yaml kubectl apply -f mysql-min-storageclass-local.yaml kubectl apply -f mysql-min-pvc.yaml 而后,调整 Deploy 并挂载卷: spec: containers: - image: centos/mysql-57-centos7:latest ... volumeMounts: - name: data mountPath: /var/lib/mysql volumes: - name: data persistentVolumeClaim: claimName: mysql-min 自定义配置文件 通过创建 configmap 并挂载到容器中,我们可自定义 MySQL 配置文件。如下所示,名为 mysql-config 的 cm 包含一个 my.cnf 文件: apiVersion: v1 kind: ConfigMap metadata: name: mysql-config data: my.cnf: | [mysqld] default_storage_engine=innodb skip_external_locking lower_case_table_names=1 skip_host_cache skip_name_resolve max_connections=2000 innodb_buffer_pool_size=8589934592 init_connect='SET collation_connection = utf8_unicode_ci' init_connect='SET NAMES utf8' character-set-server=utf8 collation-server=utf8_unicode_ci skip-character-set-client-handshake query_cache_type=0 innodb_flush_log_at_trx_commit = 0 sync_binlog = 0 query_cache_size = 104857600 slow_query_log =1 slow_query_log_file=/var/lib/mysql/slow-query.log log-error=/var/lib/mysql/mysql.err long_query_time = 0.02 table_open_cache_instances=16 table_open_cache = 6000 skip-grant-tables sql_mode=STRICT_TRANS_TABLES,NO_ZERO_IN_DATE,NO_ZERO_DATE,ERROR_FOR_DIVISION_BY_ZERO,NO_AUTO_CREATE_USER,NO_ENGINE_SUBSTITUTION 将 configmap 挂载到容器内: spec: ... containers: - image: centos/mysql-57-centos7:latest ... volumeMounts: - name: mysql-config mountPath: /etc/my.cnf.d/my.cnf subPath: my.cnf ... volumes: - name: mysql-config - name: mysql-config configMap: name: mysql-config ... 设置容器时区 最傻瓜也最方便的处理方式,设置宿主机时区和时间文件与容器的映射。 spec: ... containers: - image: centos/mysql-57-centos7:latest ... volumeMounts: - name: localtime readOnly: true mountPath: /etc/localtime ... volumes: - name: localtime hostPath: type: File path: /etc/localtime ... 加密敏感数据 用户密码等敏感数据以 Secret 加密保存,而后被 Deployment 通过 volume 挂载或环境变量引用。如本例,我们创建root、user用户,将用户的密码加密保存: apiVersion: v1 data: #将mysql数据库的所有user的password配置到secret,统一管理 mysql-password: YWRtaW4= mysql-root-password: OVplTmswRGdoSA== kind: Secret metadata: labels: app: mysql-min release: mysql-min name: mysql-min namespace: default #Secret有三种类型: #Opaque:base64编码格式的Secret,用来存储密码、密钥等;但数据也通过base64 –decode解码得到原始数据,所有加密性很弱。 #kubernetes.io/dockerconfigjson:用来存储私有docker registry的认证信息。 #kubernetes.io/service-account-token: 用于被serviceaccount引用。serviceaccout创建时Kubernetes会默认创建对应的secret。Pod如果使用了serviceaccount,对应的secret会自动挂载到Pod目录/run/secrets/ kubernetes.io/serviceaccount中。 type: Opaque Secret 创建完成后,我们将用户明文密码从 Deployment 去除,采用环境变量方式引用 Secret 数据,参见如下 Yaml 修改: root 用户及 MYSQL_USER 用户,其密码均通过 secretKeyRef 从 secret 获取。 spec: ... containers: - image: centos/mysql-57-centos7:latest name: mysql-min imagePullPolicy: IfNotPresent env: #password存储在secret中 - name: MYSQL_ROOT_PASSWORD valueFrom: secretKeyRef: key: mysql-root-password name: mysql-min - name: MYSQL_PASSWORD valueFrom: secretKeyRef: key: mysql-password name: mysql-min - name: MYSQL_USER value: zuozewei 容器健康检查 K8S 镜像控制器可通过 livenessProbe 判断容器是否异常,进而决定是否重建容器;而 Service 服务可通过 readinessProbe 判断容器服务是否正常,从而确保服务可用性。 ​本例配置的 livenessProbe 与 readinessProbe 是一样的,即连续 3 次查询数据库失败,则定义为异常。对 livenessProbe 与readinessProbe 详细用法,不在本文的讨论范围内,可参考 K8S 官方文档: Configure Liveness and Readiness Probes Pod Lifecycle spec: containers: image: centos/mysql-57-centos7:latest ... #kubelet 使用 liveness probe(存活探针)来确定何时重启容器。例如,当应用程序处于运行状态但无法做进一步操作,liveness 探针将捕获到 deadlock,重启处于该状态下的容器,使应用程序在存在 bug 的情况下依然能够继续运行下去 livenessProbe: exec: command: - /bin/sh - "-c" - MYSQL_PWD="${MYSQL_ROOT_PASSWORD}" - mysql -h 127.0.0.1 -u root -e "SELECT 1" failureThreshold: 3 #探测成功后,最少连续探测失败多少次才被认定为失败。默认是 3。最小值是 1。 initialDelaySeconds: 30 #容器启动后第一次执行探测是需要等待多少秒。 periodSeconds: 10 #执行探测的频率。默认是10秒,最小1秒。 successThreshold: 1 #探测失败后,最少连续探测成功多少次才被认定为成功。默认是 1。对于 liveness 必须是 1。最小值是 1。 timeoutSeconds: 5 #探测超时时间。默认1秒,最小1秒。 #Kubelet 使用 readiness probe(就绪探针)来确定容器是否已经就绪可以接受流量。只有当 Pod 中的容器都处于就绪状态时 kubelet 才会认定该 Pod处于就绪状态。该信号的作用是控制哪些 Pod应该作为service的后端。如果 Pod 处于非就绪状态,那么它们将会被从 service 的 load balancer中移除。 readinessProbe: exec: command: - /bin/sh - "-c" - MYSQL_PWD="${MYSQL_ROOT_PASSWORD}" - mysql -h 127.0.0.1 -u root -e "SELECT 1" failureThreshold: 3 initialDelaySeconds: 5 periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 容器初始化 容器的一些初始化操作显然适合通过 InitContainer 来完成,这里的 initContainer 是为了保证在 POD 启动前,PV盘 要先行绑定成功,同时为了避免 MySQL 数据库目录内的 lost+found 目录被误认为是数据库,初始化容器中将其删除; #Init 容器支持应用容器的全部字段和特性,包括资源限制、数据卷和安全设置。 然而,Init 容器对资源请求和限制的处理稍有不同,在下面 资源 处有说明。 而且 Init 容器不支持 Readiness Probe,因为它们必须在 Pod 就绪之前运行完成。 #如果为一个 Pod 指定了多个 Init 容器,那些容器会按顺序一次运行一个。 每个 Init 容器必须运行成功,下一个才能够运行。 当所有的 Init 容器运行完成时,Kubernetes 初始化 Pod 并像平常一样运行应用容器。 #mysql这里的initContainer是为了保证在POD启动前,PV盘要先行绑定成功。 initContainers: - command: - rm - -fr - /var/lib/mysql/lost+found image: busybox:1.29.3 imagePullPolicy: IfNotPresent name: remove-lost-found resources: {} terminationMessagePath: /dev/termination-log terminationMessagePolicy: File volumeMounts: - mountPath: /var/lib/mysql name: data restartPolicy: Always #scheduler 是 kubernetes 的调度器,主要的任务是把定义的 pod 分配到集群的节点上。 schedulerName: default-scheduler securityContext: {} #如果您的Pod通常需要超过30秒才能关闭,请确保增加优雅终止宽限期。可以通过在Pod YAML中设置terminationGracePeriodSeconds选项来实现. #如果容器在优雅终止宽限期后仍在运行,则会发送SIGKILL信号并强制删除。与此同时,所有的Kubernetes对象也会被清除。 terminationGracePeriodSeconds: 30 #定义数据卷PVC,与PV匹配。 volumes: - name: data persistentVolumeClaim: claimName: mysql-min - name: mysql-config configMap: name: mysql-config - name: localtime hostPath: type: File path: /etc/localtime 完整Deployment 通过如上多步调整,MySQL 数据库的 Deplyment 如下所示: apiVersion: apps/v1 kind: Deployment metadata: annotations: deployment.kubernetes.io/revision: "1" generation: 1 labels: app: mysql-min release: mysql-min name: mysql-min namespace: default spec: replicas: 1 selector: matchLabels: app: mysql-min strategy: rollingUpdate: maxSurge: 1 #滚动升级时会先启动1个pod maxUnavailable: 1 #滚动升级时允许的最大Unavailable的pod个数 type: RollingUpdate #滚动升级 template: metadata: labels: app: mysql-min spec: containers: - env: #password存储在secret中 - name: MYSQL_ROOT_PASSWORD valueFrom: secretKeyRef: key: mysql-root-password name: mysql-min - name: MYSQL_PASSWORD valueFrom: secretKeyRef: key: mysql-password name: mysql-min - name: MYSQL_USER value: apollo image: centos/mysql-57-centos7:latest imagePullPolicy: IfNotPresent #kubelet 使用 liveness probe(存活探针)来确定何时重启容器。例如,当应用程序处于运行状态但无法做进一步操作,liveness 探针将捕获到 deadlock,重启处于该状态下的容器,使应用程序在存在 bug 的情况下依然能够继续运行下去 livenessProbe: exec: command: - /bin/sh - "-c" - MYSQL_PWD="${MYSQL_ROOT_PASSWORD}" - mysql -h 127.0.0.1 -u root -e "SELECT 1" failureThreshold: 3 #探测成功后,最少连续探测失败多少次才被认定为失败。默认是 3。最小值是 1。 initialDelaySeconds: 30 #容器启动后第一次执行探测是需要等待多少秒。 periodSeconds: 10 #执行探测的频率。默认是10秒,最小1秒。 successThreshold: 1 #探测失败后,最少连续探测成功多少次才被认定为成功。默认是 1。对于 liveness 必须是 1。最小值是 1。 timeoutSeconds: 5 #探测超时时间。默认1秒,最小1秒。 name: mysql-min ports: - containerPort: 3306 name: mysql protocol: TCP #Kubelet 使用 readiness probe(就绪探针)来确定容器是否已经就绪可以接受流量。只有当 Pod 中的容器都处于就绪状态时 kubelet 才会认定该 Pod处于就绪状态。该信号的作用是控制哪些 Pod应该作为service的后端。如果 Pod 处于非就绪状态,那么它们将会被从 service 的 load balancer中移除。 readinessProbe: exec: command: - /bin/sh - "-c" - MYSQL_PWD="${MYSQL_ROOT_PASSWORD}" - mysql -h 127.0.0.1 -u root -e "SELECT 1" failureThreshold: 3 initialDelaySeconds: 5 periodSeconds: 10 successThreshold: 1 timeoutSeconds: 1 resources: requests: cpu: 100m memory: 256Mi #为了达到一个相当高水平的实用性,特别是为了积极开发应用,快速调试失败是很重要的。除了一般的日志采集,Kubernetes还能通过查出重大错误原因来加速调试,并在某种程度上通过kubectl或者UI陈列出来。可以指定一个’terminationMessagePath’来让容器写下它的“death rattle“,比如声明失败消息,堆栈跟踪,免责条款等等。默认途径是‘/dev/termination-log’。 terminationMessagePath: /dev/termination-log # 此字段默认为 “File“,这意味着仅从终止消息文件中检索终止消息。 通过将 terminationMessagePolicy 设置为 “FallbackToLogsOnError“,你就可以告诉 Kubernetes,在容器因错误退出时,如果终止消息文件为空,则使用容器日志输出的最后一块作为终止消息。 日志输出限制为 2048 字节或 80 行,以较小者为准。 terminationMessagePolicy: File #要使用的数据盘目录,在initContainer中会关联此处目录。 volumeMounts: - mountPath: /var/lib/mysql name: data - name: mysql-config mountPath: /etc/my.cnf.d/my.cnf subPath: my.cnf - name: localtime readOnly: true mountPath: /etc/localtime dnsPolicy: ClusterFirst #Init 容器支持应用容器的全部字段和特性,包括资源限制、数据卷和安全设置。 然而,Init 容器对资源请求和限制的处理稍有不同,在下面 资源 处有说明。 而且 Init 容器不支持 Readiness Probe,因为它们必须在 Pod 就绪之前运行完成。 #如果为一个 Pod 指定了多个 Init 容器,那些容器会按顺序一次运行一个。 每个 Init 容器必须运行成功,下一个才能够运行。 当所有的 Init 容器运行完成时,Kubernetes 初始化 Pod 并像平常一样运行应用容器。 #mysql这里的initContainer是为了保证在POD启动前,PV盘要先行绑定成功。 initContainers: - command: - rm - -fr - /var/lib/mysql/lost+found image: busybox:1.29.3 imagePullPolicy: IfNotPresent name: remove-lost-found resources: {} terminationMessagePath: /dev/termination-log terminationMessagePolicy: File volumeMounts: - mountPath: /var/lib/mysql name: data restartPolicy: Always #scheduler 是 kubernetes 的调度器,主要的任务是把定义的 pod 分配到集群的节点上。 schedulerName: default-scheduler securityContext: {} #如果您的Pod通常需要超过30秒才能关闭,请确保增加优雅终止宽限期。可以通过在Pod YAML中设置terminationGracePeriodSeconds选项来实现. #如果容器在优雅终止宽限期后仍在运行,则会发送SIGKILL信号并强制删除。与此同时,所有的Kubernetes对象也会被清除。 terminationGracePeriodSeconds: 30 #定义数据卷PVC,与PV匹配。 volumes: - name: data persistentVolumeClaim: claimName: mysql-min - name: mysql-config configMap: name: mysql-config - name: localtime hostPath: type: File path: /etc/localtime 创建此 Deployment 后,我们有如下组件: # kubectl get all,pvc,cm,secret -l app=mysql-min # MySQL pod: NAME READY STATUS RESTARTS AGE pod/mysql-min-f9c9b7b5-q9br4 1/1 Running 6 14d # Service: NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE service/mysql-min NodePort 10.96.184.130 <none> 3306:30336/TCP 16d # MySQL Deployment: NAME READY UP-TO-DATE AVAILABLE AGE deployment.apps/mysql-min 1/1 1 1 16d # 副本集ReplicaSet被Deployment调用,其是自动生成的 NAME DESIRED CURRENT READY AGE replicaset.apps/mysql-min-587cf9fd48 0 0 0 16d replicaset.apps/mysql-min-589bf8cdc5 0 0 0 16d replicaset.apps/mysql-min-6b7447c7dd 0 0 0 14d replicaset.apps/mysql-min-6cc9887459 0 0 0 16d replicaset.apps/mysql-min-7759579d77 0 0 0 16d replicaset.apps/mysql-min-84d4d6bd56 0 0 0 15d replicaset.apps/mysql-min-f9c9b7b5 1 1 1 14d # Pvc: NAME STATUS VOLUME CAPACITY ACCESS MODES STORAGECLASS AGE persistentvolumeclaim/mysql-min Bound mysql-min-pv-local 5Gi RWO mysql-min-storageclass-local 16d # Secret: NAME TYPE DATA AGE secret/mysql-min Opaque 2 16d 定期自动备份 考虑到数据安全性,我们定期备份数据库,在K8S集群中,我们可配置 CronJob 实现自动备份作业。首先,创建一个持久化存储供备份用: apiVersion: v1 items: - apiVersion: v1 kind: PersistentVolumeClaim metadata: #当启用PVC 保护 alpha 功能时,如果用户删除了一个 pod 正在使用的 PVC,则该 PVC 不会被立即删除。PVC 的删除将被推迟,直到 PVC 不再被任何 pod 使用。 #可以看到,当 PVC 的状态为 Teminatiing 时,PVC 受到保护,Finalizers 列表中包含 kubernetes.io/pvc-protection: finalizers: - kubernetes.io/pvc-protection labels: app: mysql-min release: mysql-min name: mysql-min-backup namespace: default spec: #PV 的访问模式(accessModes)有三种: #ReadWriteOnce(RWO):是最基本的方式,可读可写,但只支持被单个 Pod 挂载。 #ReadOnlyMany(ROX):可以以只读的方式被多个 Pod 挂载。 #ReadWriteMany(RWX):这种存储可以以读写的方式被多个 Pod 共享。 accessModes: - ReadWriteOnce resources: requests: storage: 10Gi storageClassName: mysql-min-storageclass-nfs #表示使用本地磁盘,实际生产中一般都使用nfs。 volumeMode: Filesystem volumeName: mysql-min-pv-local # status: # accessModes: # - ReadWriteOnce # capacity: # storage: 1Gi kind: List 继而,配置实际的自动化作业任务,如下所示,每天凌晨零点点将使用 mysqldump 备份 mall 数据库。 apiVersion: batch/v1beta1 kind: CronJob metadata: name: mysql-backup spec: schedule: "0 0 * * *" jobTemplate: spec: template: spec: containers: - name: mysql-min-backup imagePullPolicy: IfNotPresent image: centos/mysql-57-centos7:latest env: #password存储在secret中 - name: MYSQL_ROOT_PASSWORD valueFrom: secretKeyRef: key: mysql-root-password name: mysql-min - name: MYSQL_PASSWORD valueFrom: secretKeyRef: key: mysql-password name: mysql-min - name: MYSQL_HOST value: mysql-min command: - /bin/sh - -c - | set -ex mysqldump --host=$MYSQL_HOST --user=$MYSQL_ROOT_PASSWORD \ --password=$mysql-root-password \ --routines --databases mall --single-transaction \ > /mysql-backup/mysql-`date +"%Y%m%d"`.sql volumeMounts: - name: mysql-min-backup mountPath: /mysql-min-backup restartPolicy: OnFailure volumes: - name: mysql-min-backup persistentVolumeClaim: claimName: mysql-min-backup 小结 ​Kubernetes 很多看起来比较“繁琐”的设计的主要目的,都是希望为开发者提供更多的“可扩展性”,给使用者带来更多的“稳定性”和“安全感”。这两个能力的高低,是衡量开源基础设施项目水平的重要标准。 示例中揉合 Kubernetes 多项技术,构建了一个复杂且可做生产使用的单实例数据库。 本文源码:https://github.com/zuozewei/blog-example/tree/master/Kubernetes/k8s-mysql-pv-local 参考资料: [1]:《深入剖析Kubernetes》 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

自动化会提高测试覆盖率,那测试覆盖率是什么?

测试覆盖率是什么? 测试覆盖率(test coverage)是2018年公布的计算机科学技术名词,它是测试质量的度量标准之一,告诉我们测试了多少代码。它定义了系统的某些实体,目的是用测试覆盖它们。这是一种用来指示我们什么时候进行了充分的测试,并告诉我们还需要测试什么(从而扩大了覆盖范围)的方法。 如果把测试比喻为打扫房子,那些不常用的房间总会被遗漏,我们总会忘记诸如次卧卫生间这样的区域,所以打扫的覆盖范围不包括就那个卫生间。 想象一下,如果我们的打扫标准只包括打扫卧室。按照这个标准,如果打扫了所有的卧室,就意味着整个房子都是干净的吗? 并非如此,因为我们完全忽略了厨房、餐厅、卫生间等房子内的其他部分!因此,务必要细致精准地度量测试覆盖率。具有一定程度的覆盖率是测试质量的一项指标,但它从来不是系统质量的指标,也不能保证所有内容都经过测试。测试覆盖率告诉我们测试代码的百分比,但这并不意味着它在每种情况下都被测试过。 测试覆盖率有什么优势? 依然是以打扫房屋为例,测试覆盖率可以: ● 度量打扫的质量; ● 指示何时该停止打扫; ● 提醒我们还有其他地方需要清理。 某些标准可能比其他标准更强大。了解它们可以让我们知道测试的深度以及何时应用某个或其他标准。例如,如果涵盖标准A的任何测试用例集TS也涵盖标准B,则可以说标准A包括另一个标准B。 按照上述原则,清洁房屋就可以遵循以下标准: 1. 打扫每个卧室; 2. 打扫房子的每一部分(包括卧室、厨房、卫生间等); 3. 打扫每一个小地方,甚至是角落,因为它们很可能会积聚灰尘。 显而易见,标准3包括2,而2又包括1,关系是传递的,即3包括1。如果我们为标准3设计一个测试用例,它也应该包括前两个标准。对于测试软件,标准通常包括程序中的各种路径、条件、语句、函数等。 另一个真实的例子可能是等价类划分,先划分若干个等价类,然后从每个部分中选取具有代表性的数据当做测试用例进行合理的分类,这样就覆盖了所有类。如果考虑白盒测试,又有语句覆盖率、分支覆盖率、路径覆盖率等,特别是对于状态机,我们有指示覆盖所有节点、所有转换等的标准。 自动化测试如何适用? 现在就可以想象一下扔掉扫帚,换成一个超高速的扫地机器人。它可以解放双手、更快地清理地板、减少被遗漏的区域,还可以让自己在工作中专注于更重要的事情。 至此,我们可以得出结论:测试自动化=更高的测试覆盖率。

优秀的个人博客,低调大师

探究微软设置CPU限制和提高运行门槛的动机

在 Windows 11 首个预览版发布之后,虽然微软对 CPU 升级限制和最低设备要求进行了澄清,但依然存在模糊点。微软表示只有第 8 代英特尔芯片、Ryzen 2000 系列以上芯片才能升级 Windows 11 系统。那么之前的设备难道真的就无法运行 Windows 11 了吗?事实可能并非如此。 首先,从此前偷跑的 ISO 镜像以及当前 Windows Insider 分发的 Build 22000.51 镜像,Windows 11 在第 7 代处理器和更低的设备上也运行良好。当从 ISO 镜像安装的时候,Windows 11 绕过 TPM 2.0 限制是非常简单的,只需将一个.dll替换成Windows 10中的一个。根据Albacore在Twitter上的说法,如果你进行清洁安装,Windows 11 甚至不检查 CPU 世代。 对于那些想知道纯净安装 Windows 11 的最低硬件要求是什么(当你从USB启动安装时) 3686MB内存 2个CPU核心 1 GHz基本速度 TPM 1.2 支持 Secure Boot 的固件 如果你是在虚拟机或部署服务器,所有的检查都会被跳过。纯净安装的时候不会检查 CPU。 那么微软为何要对 CPU 代数进行限制? 那么微软为何要这么麻烦呢?首先,CPU代数限制与TPM完全无关,它是为了 "经验原因",正如操作系统安全总监大卫·韦斯顿所指出的:“CPU 是出于经验的原因。和 TPM 的要求是不相关的”。 在过去,只要他们的电脑符合最低规格(大多数第四代、第五代、第六代和第七代设备都符合,只要它们以某种方式启用 TPM),就可以由用户决定他们是否想要一个“伟大的体验”。对于用户来说,如果因为他们完美的第六代设备不符合 CPU 限制而不得不花 1500 美元以上购买一台新机器,这真的是一种“伟大的体验”吗? 那么为何微软从一开始就引起了这些不安,外媒推测原因可能有两个 a:让很多人感到不安,然后升级设备 最被消费者接纳的说法就是微软想迫使用户购买新机器。当然,这对OEM厂商和微软来说都不是一件坏事,但如果有的话,Windows 11可以让人们在Windows 10上停留更长时间。 b:为了运行 Android 应用程序或者其他后续功能 第二种可能涉及到 HVCI,这是一个管理程序的安全措施。它可能会影响到像 Windows Subsystem for Android 这样的东西,它被用来在 Windows 11 上运行 Android 应用程序。如果 Android 应用在旧版 CPU 上表现不佳,微软确实可能非常不愿意允许出现不合格的体验。 而另一个可能性是,微软仍对 Windows 11 有后续的发展计划,这些计划目前并未被披露,需要更现代的 CPU 来运行。从事Azure工作的微软资深人士Carmen Crincoli(他在Twitter上明确表示,他 "代表(他)自己,而不是微软")在Twitter上说,“他的目标是创造一条前进的道路,使生态系统在几年后处于更强大的地位”。 如果ARM上的Windows和Android的Windows子系统、HVCI,以及Windows 11和Windows 10之间的密切关系是这些硬件限制的原因,为什么不直接说出来?即使有最好的意图,有时微软也无法摆脱自己的方式。 【责任编辑:未丽燕 TEL:(010)68476606】

优秀的个人博客,低调大师

中断 Hwi:提高鸿蒙轻内核系统实时性及执行效率的秘密武器

摘要:本文带领大家一起剖析了鸿蒙轻内核的中断模块的源代码,掌握中断相关的概念,中断初始化操作,中断创建、删除,开关中断操作等。 本文分享自华为云社区《鸿蒙轻内核M核源码分析系列五 中断Hwi》,原文作者:zhushy。 本文,我们讲述一下中断,会给读者介绍中断的概念,鸿蒙轻内核的中断模块的源代码。本文中所涉及的源码,以 OpenHarmony LiteOS-M 内核为例,均可以在开源站点gitee.com/openharmony… 获取。 1、中断概念介绍 中断是指出现需要时,CPU 暂停执行当前程序,转而执行新程序的过程。当外设需要 CPU 时,将通过产生中断信号使 CPU 立即中断当前任务来响应中断请求。在剖析中断源代码之前,下面介绍些中断相关的硬件、中断相关的概念。 1.1 中断相关的硬件介绍 与中断相关的硬件可以划分为三类:设备、中断控制器、CPU 本身。 设备 发起中断的源,当设备需要请求 CPU 时,产生一个中断信号,该信号连接至中断控制器。 中断控制器 中断控制器是 CPU 众多外设中的一个,它一方面接收其它外设中断引脚的输入。另一方面,它会发出中断信号给 CPU。可以通过对中断控制器编程来打开和关闭中断源、设置中断源的优先级和触发方式。 CPU CPU 会响应中断源的请求,中断当前正在执行的任务,转而执行中断处理程序。 1.2 中断相关的概念 中断号 每个中断请求信号都会有特定的标志,使得计算机能够判断是哪个设备提出的中断请求,这个标志就是中断号。 中断优先级 为使系统能够及时响应并处理所有中断,系统根据中断时间的重要性和紧迫程度,将中断源分为若干个级别,称作中断优先级。 中断处理程序 当外设产生中断请求后,CPU 暂停当前的任务,转而响应中断申请,即执行中断处理程序。产生中断的每个设备都有相应的中断处理程序。 中断向量 中断服务程序的入口地址。 中断向量表 存储中断向量的存储区,中断向量与中断号对应,中断向量在中断向量表中按照中断号顺序存储。 中断共享 当外设较少时,可以实现一个外设对应一个中断号,但为了支持更多的硬件设备,可以让多个设备共享一个中断号,共享同一个中断号的中断处理程序形成一个链表。当外部设备产生中断申请时,系统会遍历中断号对应的中断处理程序链表,直到找到对应设备的中断处理程序。在遍历执行过程中,各中断处理程序可以通过检测设备 ID,判断是否是这个中断处理程序对应的设备产生的中断。 接下来,我们再看看鸿蒙轻内核中断源代码。 2、鸿蒙轻内核中断源代码 2.1 中断相关的声明和定义 在文件 kernel\arch\arm\cortex-m7\gcc\los_interrupt.c 中定义了一些结构体、全局变量、内联函数,在分析源码之前,我们先看下这些定义和声明。全部变量 g_intCount 表示正在处理的中断数量,每次进入中断处理程序时,都会把该变量数值加 1,完成中断处理退出时,该数值减 1。对应的内联函数 HalIsIntActive()用于获取是否正在处理中断,返回值大于 0,则表示正在处理中断。 UINT32g_intCount=0; inlineUINT32HalIsIntActive(VOID) { return(g_intCount>0); } 我们在再看看中断向量表定义。⑴处代码为系统支持的中断定义了数组 g_hwiForm[OS_VECTOR_CNT],对于每一个中断号 hwiNum,对应的数组元素 g_hwiForm[hwiNum]表示每一个中断对应的中断处理执行入口程序。⑵处的宏 OS_HWI_WITH_ARG 表示中断处理程序是否支持参数传入,默认关闭。如果支持传参,定义⑶处的结构体 HWI_HANDLER_FUNC 来维护中断处理函数及其参数,还需要定义⑷处 g_hwiHandlerForm 数组。如果不支持传参,使用⑹处定义的 g_hwiHandlerForm 数组。对于每一个中断号 hwiNum,对应的数组元素 g_hwiHandlerForm[hwiNum]表示每一个中断对应的中断处理程序。⑸、⑺处定义个函数 OsSetVector()用于设置指定中断号对应的中断处理执行入口程序和中断处理程序。中断处理执行入口程序和中断处理程序的关系是,当中断发生时,会执行中断处理执行入口程序,这个函数会进一步调用中断处理程序。 ⑴STATICHWI_PROC_FUNC__attribute__((aligned(0x100)))g_hwiForm[OS_VECTOR_CNT]={0}; ⑵#if(OS_HWI_WITH_ARG==1) ⑶typedefstruct{ HWI_PROC_FUNCpfnHandler; VOID*pParm; }HWI_HANDLER_FUNC; ⑷STATICHWI_HANDLER_FUNCg_hwiHandlerForm[OS_VECTOR_CNT]={{(HWI_PROC_FUNC)0,(HWI_ARG_T)0}}; ⑸VOIDOsSetVector(UINT32num,HWI_PROC_FUNCvector,VOID*arg) { if((num+OS_SYS_VECTOR_CNT)<OS_VECTOR_CNT){ g_hwiForm[num+OS_SYS_VECTOR_CNT]=(HWI_PROC_FUNC)HalInterrupt; g_hwiHandlerForm[num+OS_SYS_VECTOR_CNT].pfnHandler=vector; g_hwiHandlerForm[num+OS_SYS_VECTOR_CNT].pParm=arg; } } #else ⑹STATICHWI_PROC_FUNCg_hwiHandlerForm[OS_VECTOR_CNT]={0}; ⑺VOIDOsSetVector(UINT32num,HWI_PROC_FUNCvector) { if((num+OS_SYS_VECTOR_CNT)<OS_VECTOR_CNT){ g_hwiForm[num+OS_SYS_VECTOR_CNT]=HalInterrupt; g_hwiHandlerForm[num+OS_SYS_VECTOR_CNT]=vector; } } #endif 2.2 中断初始化 HalHwiInit() 在系统启动时,在 kernel\src\los_init.c 中调用 HalArchInit()进行中断初始化。这个函数定义在 kernel\arch\arm\cortex-m7\gcc\los_context.c,然后进一步调用定义在 kernel\arch\arm\cortex-m7\gcc\los_interrupt.c 文件中 HalHwiInit()函数完成中断向量初始化。我们分析下代码。 宏LOSCFG_USE_SYSTEM_DEFINED_INTERRUPT 表示是否使用系统预定义的向量基地址和中断处理程序,默认开启。⑴处开始,中断向量表的 0 号中断设置为空,1 号中断对应复位处理程序 Reset_Handler。⑵处把其余的中断设置为默认的中断处理执行入口程序 HalHwiDefaultHandler()。⑶处设置系统中断(异常是中断的一种,系统中断也称为异常),系统中断的执行入口函数定义在 kernel\arch\arm\cortex-m7\gcc\los_exc.S,使用汇编语言实现。系统中断中,14 号中断对应 HalPendSV 处理程序,用于任务上下文切换,15 号中断是 tick 中断。 执行⑷处代码把中断向量表赋值给 SCB->VTOR。对于 Cortex-M3 及以上的 CPU 核,还需要执行⑸设置优先级组。⑹处代码使能指定的异常。 LITE_OS_SEC_TEXT_INITVOIDHalHwiInit() { #if(LOSCFG_USE_SYSTEM_DEFINED_INTERRUPT==1) UINT32index; ⑴g_hwiForm[0]=0;/*[0]TopofStack*/ g_hwiForm[1]=Reset_Handler;/*[1]reset*/ ⑵for(index=2;index<OS_VECTOR_CNT;index++){/*2:Thestartingpositionoftheinterrupt*/ g_hwiForm[index]=(HWI_PROC_FUNC)HalHwiDefaultHandler; } /*Exceptionhandlerregister*/ ⑶g_hwiForm[NonMaskableInt_IRQn+OS_SYS_VECTOR_CNT]=HalExcNMI; g_hwiForm[HARDFAULT_IRQN+OS_SYS_VECTOR_CNT]=HalExcHardFault; g_hwiForm[MemoryManagement_IRQn+OS_SYS_VECTOR_CNT]=HalExcMemFault; g_hwiForm[BusFault_IRQn+OS_SYS_VECTOR_CNT]=HalExcBusFault; g_hwiForm[UsageFault_IRQn+OS_SYS_VECTOR_CNT]=HalExcUsageFault; g_hwiForm[SVCall_IRQn+OS_SYS_VECTOR_CNT]=HalExcSvcCall; g_hwiForm[PendSV_IRQn+OS_SYS_VECTOR_CNT]=HalPendSV; g_hwiForm[SysTick_IRQn+OS_SYS_VECTOR_CNT]=SysTick_Handler; /*Interruptvectortablelocation*/ ⑷SCB->VTOR=(UINT32)(UINTPTR)g_hwiForm; #endif #if(__CORTEX_M>=0x03U)/*onlyforCortex-M3andabove*/ ⑸NVIC_SetPriorityGrouping(OS_NVIC_AIRCR_PRIGROUP); #endif /*EnableUSGFAULT,BUSFAULT,MEMFAULT*/ ⑹*(volatileUINT32*)OS_NVIC_SHCSR|=(USGFAULT|BUSFAULT|MEMFAULT); /*EnableDIV0andunalignedexception*/ *(volatileUINT32*)OS_NVIC_CCR|=DIV0FAULT; return; } 2.3 创建中断 UINT32 HalHwiCreate() 开发者可以调用函数 UINT32HalHwiCreate()创建中断,注册中断处理程序。我们先看看这个函数的参数,HWI_HANDLE_T hwiNum 是硬件中断号,HWI_PRIOR_ThwiPrio 中断的优先级,HWI_MODE_T mode 中断模式,保留暂时没有使用。HWI_PROC_FUNC handler 是需要注册的中断处理程序,中断被触发后会调用这个函数。HWI_ARG_T arg 是中断处理程序的参数。 一起剖析下这个函数的源代码,⑴处代码开始,对入参进行校验,中断处理程序不能为空,中断号不能大于支持的最大中断号,中断优先级不能超过指定优先级的大小。如果待创建的中断号对应的中断执行入口程序不等于 HalHwiDefaultHandler,说明已经创建过,返回错误码。关中断,然后执行⑵处的 OsSetVector()函数设置指定中断号的中断处理程序。⑶处调用 CMSIS 函数使能中断、设置中断的优先级,打开中断,完成中断的创建。 LITE_OS_SEC_TEXT_INITUINT32HalHwiCreate(HWI_HANDLE_ThwiNum, HWI_PRIOR_ThwiPrio, HWI_MODE_Tmode, HWI_PROC_FUNChandler, HWI_ARG_Targ) { UINTPTRintSave; ⑴if(handler==NULL){ returnOS_ERRNO_HWI_PROC_FUNC_NULL; } if(hwiNum>=OS_HWI_MAX_NUM){ returnOS_ERRNO_HWI_NUM_INVALID; } if(g_hwiForm[hwiNum+OS_SYS_VECTOR_CNT]!=(HWI_PROC_FUNC)HalHwiDefaultHandler){ returnOS_ERRNO_HWI_ALREADY_CREATED; } if(hwiPrio>OS_HWI_PRIO_LOWEST){ returnOS_ERRNO_HWI_PRIO_INVALID; } intSave=LOS_IntLock(); #if(OS_HWI_WITH_ARG==1) OsSetVector(hwiNum,handler,arg); #else ⑵OsSetVector(hwiNum,handler); #endif ⑶NVIC_EnableIRQ((IRQn_Type)hwiNum); NVIC_SetPriority((IRQn_Type)hwiNum,hwiPrio); LOS_IntRestore(intSave); returnLOS_OK; } 2.4 删除中断 UINT32 HalHwiDelete() 中断删除操作是创建操作的反向操作,也比较好理解。开发者可以调用函数 UINT32 HalHwiDelete(HWI_HANDLE_T hwiNum)来删除中断。函数需要指定中断号参数 HWI_HANDLE_T hwiNum。一起剖析下这个函数的源代码,⑴处代码对入参进行校验,不能大于支持的最大中断号。⑵处调用 CMSIS 函数来失能中断,然后锁中断,执行⑶把中断向量表指定中断号的中断执行入口程序设置为默认程序 HalHwiDefaultHandler。 LITE_OS_SEC_TEXT_INITUINT32HalHwiDelete(HWI_HANDLE_ThwiNum) { UINT32intSave; ⑴if(hwiNum>=OS_HWI_MAX_NUM){ returnOS_ERRNO_HWI_NUM_INVALID; } ⑵NVIC_DisableIRQ((IRQn_Type)hwiNum); intSave=LOS_IntLock(); ⑶g_hwiForm[hwiNum+OS_SYS_VECTOR_CNT]=(HWI_PROC_FUNC)HalHwiDefaultHandler; LOS_IntRestore(intSave); returnLOS_OK; } 2.5 中断处理执行入口程序 我们再来看看中断处理执行入口程序。默认的函数 HalHwiDefaultHandler()如下,调用函数 HalIntNumGet()获取中断号,打印输出,然后进行死循环。其中函数 HalIntNumGet()读取寄存器 ipsr 来获取触发的中断的中断号。 LITE_OS_SEC_TEXT_MINORVOIDHalHwiDefaultHandler(VOID) { UINT32irqNum=HalIntNumGet(); PRINT_ERR("%sirqNum:%d\n",__FUNCTION__,irqNum); while(1){} } 继续来看中断处理执行入口程序 HalInterrupt(),源码如下。 ⑴处把全局变量 g_intCount 表示的正在处理的中断数量加 1,在中断执行完毕后,在⑹处再把正在处理的中断数量减 1。⑵处调用函数 HalIntNumGet()获取中断号,⑶、⑸处调用的函数 HalPreInterruptHandler(),HalAftInterruptHandler()在执行中断处理程序前、后可以处理些其他操作,当前默认为空函数。⑷处根据中断号从中断处理程序数组中获取中断处理程序,不为空就调用执行。 LITE_OS_SEC_TEXTVOIDHalInterrupt(VOID) { UINT32hwiIndex; UINT32intSave; #if(LOSCFG_KERNEL_RUNSTOP==1) SCB->SCR&=(UINT32)~((UINT32)SCB_SCR_SLEEPDEEP_Msk); #endif intSave=LOS_IntLock(); ⑴g_intCount++; LOS_IntRestore(intSave); ⑵hwiIndex=HalIntNumGet(); OsHookCall(LOS_HOOK_TYPE_ISR_ENTER,hwiIndex); ⑶HalPreInterruptHandler(hwiIndex); #if(OS_HWI_WITH_ARG==1) if(g_hwiHandlerForm[hwiIndex].pfnHandler!=0){ g_hwiHandlerForm[hwiIndex].pfnHandler((VOID*)g_hwiHandlerForm[hwiIndex].pParm); } #else if(g_hwiHandlerForm[hwiIndex]!=0){ ⑷g_hwiHandlerForm[hwiIndex](); } #endif ⑸HalAftInterruptHandler(hwiIndex); OsHookCall(LOS_HOOK_TYPE_ISR_EXIT,hwiIndex); intSave=LOS_IntLock(); ⑹g_intCount--; LOS_IntRestore(intSave); } 3、开关中断 最后,分享下开、关中断的相关知识,开、关中断分别指的是: 开中断 执行完毕特定的短暂的程序,打开中断,可以响应中断。 关中断 为了保护执行的程序不被打断,关闭相应外部的中断。 对应的开、关中断的函数定义在文件 kernel\arch\include\los_context.h 中,代码如下。⑴处的 UINT32 LOS_IntLock(VOID)会关闭中断,暂停响应中断。⑵处的函数 VOID LOS_IntRestore(UINT32 intSave)可以用来恢复 UINT32LOS_IntLock(VOID)函数关闭的中断,UINT32 LOS_IntLock(VOID)的返回值作为 VOIDLOS_IntRestore(UINT32 intSave)的参数进行恢复中断。⑶处的函数 UINT32 LOS_IntUnLock(VOID)会使能中断,可以响应中断。 UINTPTRHalIntLock(VOID); ⑴#defineLOS_IntLockHalIntLock VOIDHalIntRestore(UINTPTRintSave); ⑵#defineLOS_IntRestoreHalIntRestore UINTPTRHalIntUnLock(VOID); ⑶#defineLOS_IntUnLockHalIntUnLock 可以看出,LOS_IntLock、LOS_IntRestore 和 LOS_IntUnLock 是定义的宏,他们对应定义在文件kernel\arch\arm\cortex-m7\gcc\los_dispatch.S 中的汇编函数,源码如下。我们分析下这些汇编函数。寄存器 PRIMASK 是单一 bit 位的寄存器,置为 1 后,就关掉所有可屏蔽异常,只剩下 NMI 和硬故障 HardFault 异常可以响应。默认值是 0,表示没有关闭中断。汇编指令 CPSID I 会设置 PRIMASK=1,关闭中断,指令 CPSIEI 设置 PRIMASK=0,开启中断。 ⑴处 HalIntLock 函数把寄存器 PRIMASK 数值写入寄存器 R0 返回,并执行 CPSIDI 关闭中断。⑵处 HalIntUnLock 函数把寄存器 PRIMASK 数值写入寄存器 R0 返回,并执行指令 CPSIEI 开启中断。两个函数的返回结果可以传递给⑶处 HalIntRestore 函数,把寄存器状态数值写入寄存器 PRIMASK,用于恢复之前的中断状态。不管是 HalIntLock 还是 HalIntUnLock,都可以和 ArchIntRestore 配对使用。 .typeHalIntLock,%function .globalHalIntLock HalIntLock: .fnstart .cantunwind ⑴MRSR0,PRIMASK CPSIDI BXLR .fnend .typeHalIntUnLock,%function .globalHalIntUnLock HalIntUnLock: .fnstart .cantunwind ⑵MRSR0,PRIMASK CPSIEI BXLR .fnend .typeHalIntRestore,%function .globalHalIntRestore HalIntRestore: .fnstart .cantunwind ⑶MSRPRIMASK,R0 BXLR .fnend 小结 本文带领大家一起剖析了鸿蒙轻内核的中断模块的源代码,掌握中断相关的概念,中断初始化操作,中断创建、删除,开关中断操作等。后续也会陆续推出更多的分享文章,敬请期待,也欢迎大家分享学习、使用鸿蒙轻内核的心得,有任何问题、建议,都可以留言给我们:gitee.com/openharmony… 。为了更容易找到鸿蒙轻内核代码仓,建议访问 gitee.com/openharmony… ,关注 Watch、点赞 Star、并 Fork 到自己账户下,谢谢。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Intelli J中好用和提高生产力的插件:Lombok 和Free Mybatis Plugin

开头: 做过Java的同学都知道,对编写Bean.class,要写很多Setter和Getter函数,当然我们可以利用IDE中的自带的Setter,Getter插件,完成Bean的属性函数编写 例如,在Mac 中的Intelli J中 直接用command+N,或者右键点击Generate 当然,这种方式还是不够简洁,当属性特别多的时候,整个类都是setter和getter函数,挺烦人的;当你要删除和添加属性的时候,也会很繁琐 Lombok插件: 在Intelli J,Lombok插件就应运而生了,我们就来直接看效果吧, import lombok.Data; @Data public class Product { private int id; } 直接使用类的声明上面添加@Data,或者在属性上添加@Setter或者@Getter import lombok.Getter; import lombok.Setter; public class Product { @Setter @Getter private int id; } 当然,利用@AllArgsConstructor,也可以自动生成构造函数 import lombok.AllArgsConstructor; import lombok.Data; @Data @AllArgsConstructor //所有参数作为构造函数 public class Product { private int id; } 原理: 利用注解,在编译的时期,通过一种抽象语法树,自动匹配和生成Setter和Getter函数 下面就是编译后的.class文件,可以看出整个过程和结果还是很容易理解的,只要你理解注解的原理 // // Source code recreated from a .class file by IntelliJ IDEA // (powered by Fernflower decompiler) // public class Product { private int id; public Product() { } public int getId() { return this.id; } public void setId(int id) { this.id = id; } public boolean equals(Object o) { if (o == this) { return true; } else if (!(o instanceof Product)) { return false; } else { Product other = (Product)o; if (!other.canEqual(this)) { return false; } else { return this.getId() == other.getId(); } } } protected boolean canEqual(Object other) { return other instanceof Product; } public int hashCode() { int PRIME = true; int result = 1; int result = result * 59 + this.getId(); return result; } public String toString() { return "Product(id=" + this.getId() + ")"; } } 2.Free Mybaits Plugin: 做Java EE的时候,用到最多的ORM框架应该就是MyBaits了 MyBaits的主要结构就是service.java,mapper.java,mapper.xml组成,可以简单地理解下,service主要是提供业务接口的,mapper.class就是提供数据库接口的,mapper.xml就是操作数据库的;差不多就是这样的流程,service-->mapper.java-->mapper.xml,其中,mapper.java也和mapper.xml一一对应 如果我们手动编写这些代码,是不是很繁琐,本来Mybaits是帮我们屏蔽了很多数据库操作的细节的,可是,我们还是要编写很多代码和执行很多操作 当然肯定会有各种插件来帮我们减少代码量和操作量,针对Mybaits,国人做了一个插件:https://github.com/wuzhizhan/free-idea-mybatis,这个插件怎么用呢? 请打开这个链接,里面说得很详细, 安装方法: 以Lombok为例 1.直接在Intelli J中Preference--->Plugins--->搜索Lombok 2.上面的方法,可能会经常读取超时的问题,因为我们就需要先把插件文件下载本地,然后从本地安装下载 首先直接百度搜索插件,然后下载本地(推荐方法2) 然后,从Preference--->Plugins--->从本地安装 总结: 在Java这个庞大可持续的生态链中,各种个样的插件都很多,紧跟最新技术发展,那我们的编程效率就会高很多,我们就可以专心在业务中去。当然也要懂基本的原理,遇到问题才能从容应对

优秀的个人博客,低调大师

【Java入门提高篇】Day25 史上最详细的HashMap红黑树解析

当当当当当当当,好久不见,最近又是换工作,又是换房子,忙的不可开交,断更了一小段时间,最重要的一篇迟迟出不来,每次都犹抱琵琶半遮面,想要把它用通俗易懂的方式进行说明,确实有一定的难度,可愁煞我也,但自己挖的坑,哭着也要把它补上。请允许我当一回标题党。 好了,言归正传,本篇主要内容便是介绍HashMap的男二号——TreeNode(男一号还是给Node吧,毕竟是TreeNode的爷爷,而且普通节点一般来说也比TreeNode要多),本篇主要从以下几个方面介绍: 1.红黑树介绍 2.TreeNode结构 3.树化的过程 4.红黑树的左旋和右旋 5.TreeNode的左旋和右旋 6.红黑树的插入 7.TreeNode的插入 8.红黑树的删除 9.TreeNode的删除 讲解红黑树的部分算是理论部分,讲解TreeNode的部分则是代码实践部分,配合服用效果更加。 保守估计,仔细食用本篇大约需要半小时,请各位细细品尝。 红黑树介绍 什么是红黑树?嗯,首先,它是一颗树,所谓的树,便是长的像这样的东西 不像树?emmmm,你把它想象成一颗倒过来的树就好了,A~H都是树的节点,每个节点有零个或者多个子节点,或者说多个孩子,但除了根节点以外,每个节点都只有一个父节点,也称只有一个父亲(老王嘿嘿一笑)。最上面的A是根节点,最下面的D、H、F、G是叶子节点。每一个非根节点有且只有一个父节点;树是具有一层一层的层次结构,这里A位于第一层,B、C位于第二层,依次类推。将左边的B节点部分(包括BDEH)拿出来,则又是一颗树,称为树的子树。 好了,知道树是什么东西了,那么红黑树是什么样的呢? 红黑树,本质上来说是一颗二叉搜索树。嗯,还是先说说这个二叉搜索树吧。二叉代表它的节点最多有两个子节点,而且左右有顺序,不能颠倒,分别叫左孩子和右孩子,这两个节点互为兄弟节点,嗯,其实叫法根现实里的叫法差不多,以下图为例,4、9互为兄弟,7是他们的父亲,9是2的叔叔,8是2的堂兄弟,很简单吧。说完了称谓,再来说说用途,既然叫做搜索树表示它的用途是为了更快的搜索和查找而设计的,所以这棵树本身满足一定的排序规则,即树中的任何节点的值大于它的左孩子,且小于它的右孩子。任意节点的左、右子树也分别为二叉查找树。嗯,结合下图意会一下: 而红黑树,就跟它的名字一样,又红又黑,红黑并进,理实交融,节点是非红即黑的,看起来就像这样: 红黑树的主要特性: (1)每个节点要么是黑色,要么是红色。(节点非黑即红) (2)根节点是黑色。 (3)每个叶子节点(NIL)是黑色。 (4)如果一个节点是红色的,则它的子节点必须是黑色的。(也就是说父子节点不能同时为红色) (5)从一个节点到该节点的子孙节点的所有路径上包含相同数目的黑节点。(这一点是平衡的关键) 说简单也简单,其实就是一颗比较平衡的又红又黑的二叉树嘛。 TreeNode结构 既然我们已经知道红黑树长什么样了,那么我们再来看看HashMap中的TreeNode代码里是如何表示的: /** * 用于Tree bins 的Entry。 扩展LinkedHashMap.Entry(进而扩展Node),因此可以用作常规节点或链接节点的扩展。 */ static final class TreeNode<K,V> extends LinkedHashMap.Entry<K,V> { TreeNode<K,V> parent; // 红黑树父节点 TreeNode<K,V> left; TreeNode<K,V> right; TreeNode<K,V> prev; // 删除后需要取消链接 boolean red; TreeNode(int hash, K key, V val, Node<K,V> next) { super(hash, key, val, next); } //省略后续代码 TreeNode继承自LinkedHashMap中的内部类——LinkedHashMap.Entry,而这个内部类又继承自Node,所以算是Node的孙子辈了。我们再来看看它的几个属性,parent用来指向它的父节点,left指向左孩子,right指向右孩子,prev则指向前一个节点(原链表中的前一个节点),注意,这些字段跟Entry,Node中的字段一样,是使用默认访问权限的,所以子类可以直接使用父类的属性。 树化的过程 在前几篇中已经有所介绍,当HashMap桶中的元素个数超过一定数量时,就会树化,也就是将链表转化为红黑树的结构。 public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { ...省略部分代码... else { for (int binCount = 0; ; ++binCount) { if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); //当桶中元素个数超过阈值(8)时就进行树化 if (binCount >= TREEIFY_THRESHOLD - 1) treeifyBin(tab, hash); break; } ...省略部分代码... } final void treeifyBin(Node<K,V>[] tab, int hash) { int n, index; Node<K,V> e; if (tab == null || (n = tab.length) < MIN_TREEIFY_CAPACITY) resize(); else if ((e = tab[index = (n - 1) & hash]) != null) { TreeNode<K,V> hd = null, tl = null; do { //将节点替换为TreeNode TreeNode<K,V> p = replacementTreeNode(e, null); if (tl == null) //hd指向头结点 hd = p; else { //这里其实是将单链表转化成了双向链表,tl是p的前驱,每次循环更新指向双链表的最后一个元素,用来和p相连,p是当前节点 p.prev = tl; tl.next = p; } tl = p; } while ((e = e.next) != null); if ((tab[index] = hd) != null) //将链表进行树化 hd.treeify(tab); } } 从代码中可以看到,在treeifyBin函数中,先将所有节点替换为TreeNode,然后再将单链表转为双链表,方便之后的遍历和移动操作。而最终的操作,实际上是调用TreeNode的方法treeify进行的。 final void treeify(Node<K,V>[] tab) { //树的根节点 TreeNode<K,V> root = null; //x是当前节点,next是后继 for (TreeNode<K,V> x = this, next; x != null; x = next) { next = (TreeNode<K,V>)x.next; x.left = x.right = null; //如果根节点为null,把当前节点设置为根节点 if (root == null) { x.parent = null; x.red = false; root = x; } else { K k = x.key; int h = x.hash; Class<?> kc = null; //这里循环遍历,进行二叉搜索树的插入 for (TreeNode<K,V> p = root;;) { //p指向遍历中的当前节点,x为待插入节点,k是x的key,h是x的hash值,ph是p的hash值,dir用来指示x节点与p的比较,-1表示比p小,1表示比p大,不存在相等情况,因为HashMap中是不存在两个key完全一致的情况。 int dir, ph; K pk = p.key; if ((ph = p.hash) > h) dir = -1; else if (ph < h) dir = 1; //如果hash值相等,那么判断k是否实现了comparable接口,如果实现了comparable接口就使用compareTo进行进行比较,如果仍旧相等或者没有实现comparable接口,则在tieBreakOrder中比较 else if ((kc == null && (kc = comparableClassFor(k)) == null) || (dir = compareComparables(kc, k, pk)) == 0) dir = tieBreakOrder(k, pk); TreeNode<K,V> xp = p; if ((p = (dir <= 0) ? p.left : p.right) == null) { x.parent = xp; if (dir <= 0) xp.left = x; else xp.right = x; //进行插入平衡处理 root = balanceInsertion(root, x); break; } } } } //确保给定节点是桶中的第一个元素 moveRootToFront(tab, root); } //这里不是为了整体排序,而是为了在插入中保持一致的顺序 static int tieBreakOrder(Object a, Object b) { int d; //用两者的类名进行比较,如果相同则使用对象默认的hashcode进行比较 if (a == null || b == null || (d = a.getClass().getName(). compareTo(b.getClass().getName())) == 0) d = (System.identityHashCode(a) <= System.identityHashCode(b) ? -1 : 1); return d; } 这里的逻辑其实不复杂,仅仅是循环遍历当前树,然后找到可以该节点可以插入的位置,依次和遍历节点比较,比它大则跟其右孩子比较,小则与其左孩子比较,依次遍历,直到找到左孩子或者右孩子为null的位置进行插入。 真正复杂一点的地方在于balanceInsertion函数,这个函数中,将红黑树进行插入平衡处理,保证插入节点后仍保持红黑树的性质。这个函数稍后在TreeNode的插入中进行介绍,这里先看看moveRootToFront,这个函数是将root节点移动到桶中的第一个元素,也就是链表的首节点,这样做是因为在判断桶中元素类型的时候会对链表进行遍历,将根节点移动到链表前端可以确保类型判断时不会出现错误。 /** * 把给定节点设为桶中的第一个元素 */ static <K,V> void moveRootToFront(Node<K,V>[] tab, TreeNode<K,V> root) { int n; if (root != null && tab != null && (n = tab.length) > 0) { int index = (n - 1) & root.hash; //first指向链表第一个节点 TreeNode<K,V> first = (TreeNode<K,V>)tab[index]; if (root != first) { //如果root不是第一个节点,则将root放到第一个首节点位置 Node<K,V> rn; tab[index] = root; TreeNode<K,V> rp = root.prev; if ((rn = root.next) != null) ((TreeNode<K,V>)rn).prev = rp; if (rp != null) rp.next = rn; if (first != null) first.prev = root; root.next = first; root.prev = null; } //这里是防御性编程,校验更改后的结构是否满足红黑树和双链表的特性 //因为HashMap并没有做并发安全处理,可能在并发场景中意外破坏了结构 assert checkInvariants(root); } } 红黑树的左旋和右旋 左旋和右旋,顾名思义嘛,就是将节点以某个节点为中心向左或者向右进行旋转操作以保持二叉树的平衡,让我们看图说话: 图画的有点大。将就着看一下吧,左旋相当于以要旋转的节点为中心,将子树整体向左旋转,该节点变成子树的根节点,原来的父节点A变成了左孩子,如果右孩子C有左孩子D,则将其变为A的右孩子。说起来好像有点绕,可以联系图进行形象化的理解,当节点A向左旋转之后,C的左孩子D可以理解为因为重力作用掉到A的右孩子位置,嗯,就是这样。右旋也是类似理解即可。 TreeNode的左旋和右旋 了解了左旋和右旋,让我们看看代码里是怎样实现的: /** * 左旋 */ static <K,V> TreeNode<K,V> rotateLeft(TreeNode<K,V> root, TreeNode<K,V> p) { //这里的p即上图的A节点,r指向右孩子即C,rl指向右孩子的左孩子即D,pp为p的父节点 TreeNode<K,V> r, pp, rl; if (p != null && (r = p.right) != null) { if ((rl = p.right = r.left) != null) rl.parent = p; //将p的父节点的孩子节点指向r if ((pp = r.parent = p.parent) == null) (root = r).red = false; else if (pp.left == p) pp.left = r; else pp.right = r; //将p置为r的左节点 r.left = p; p.parent = r; } return root; } /** * 右旋 */ static <K,V> TreeNode<K,V> rotateRight(TreeNode<K,V> root, TreeNode<K,V> p) { //这里的p即上图的A节点,l指向左孩子即C,lr指向左孩子的右孩子即E,pp为p的父节点 TreeNode<K,V> l, pp, lr; if (p != null && (l = p.left) != null) { if ((lr = p.left = l.right) != null) lr.parent = p; if ((pp = l.parent = p.parent) == null) (root = l).red = false; else if (pp.right == p) pp.right = l; else pp.left = l; l.right = p; p.parent = l; } return root; } 其实,也很简单嘛。23333 红黑树的插入 现在来看看一个比较麻烦一点的操作,红黑树的插入,首先找到这个节点要插入的位置,即一层一层比较,大的放右边,小的放左边,直到找到为null的节点放入即可,但是如何在插入的过程保持红黑树的特性呢,想想好像比较头疼,但是再仔细想想其实就会发现,其实只有这么几种情况: 1.插入的为根节点,则直接把颜色改成黑色即可。 2.插入的节点的父节点是黑色节点,则不需要调整,因为插入的节点会初始化为红色节点,红色节点是不会影响树的平衡的。 3.插入的节点的祖父节点为null,即插入的节点的父节点是根节点,直接插入即可(因为根节点肯定是黑色)。 4.插入的节点父节点和祖父节点都存在,并且其父节点是祖父节点的左节点。这种情况稍微麻烦一点,又分两种子情况: i.插入节点的叔叔节点是红色,则将父亲节点和叔叔节点都改成黑色,然后祖父节点改成红色即可。 ii.插入节点的叔叔节点是黑色或不存在: a.若插入节点是其父节点的右孩子,则将其父节点左旋, b.若为左孩子,则将其父节点变成黑色节点,将其祖父节点变成红色节点,然后将其祖父节点右旋。 5.插入的节点父节点和祖父节点都存在,并且其父节点是祖父节点的右节点。这种情况跟上面是类似的,分两种子情况: i.插入节点的叔叔节点是红色,则将父亲节点和叔叔节点都改成黑色,然后祖父节点改成红色即可。 ii.插入节点的叔叔节点是黑色或不存在: a.若插入节点是其父节点的左孩子,则将其父节点右旋 b.若为右孩子,则将其父节点变成黑色节点,将其祖父节点变成红色节点,然后将其祖父节点左旋。 然后重复进行上述操作,直到变成1或2情况时则结束变换。说半天,可能还是云里雾里,一图胜千言,让我们从无到有构建一颗红黑树,假设插入的顺序为:10,5,9,3,6,7,19,32,24,17(数字是我拍脑袋瞎想的。) 先来插个10,为情景1,直接改成黑色即可,再插入5,为情景2,比10小,放到10的左孩子位置,插入9,比10小,但是比5大,放到5的右孩子位置,此时,为情景4iia,左旋后变成了情景4iib,变色右旋即可完成转化。插入3后为情景4i,将父节点和叔叔节点同时变色即可,插入6不需要调整,插入7后为情景5i,变色即可。插入19不需要调整,插入32,变成了5iib,左旋变色即可,插入24,变成5iia,右旋后变成5i,变色即可,最后插入17,完美。 看图说话是不是就简单明了了,看在我画图这么辛苦的份上,点个关注给个赞可好(滑稽)。 TreeNode的插入 了解了红黑树的删除之后,我们再来看下TreeNode中是怎样用代码实现的: static <K,V> TreeNode<K,V> balanceInsertion(TreeNode<K,V> root, TreeNode<K,V> x) { x.red = true; for (TreeNode<K,V> xp, xpp, xppl, xppr;;) { //情景1:父节点为null if ((xp = x.parent) == null) { x.red = false; return x; } //情景2,3:父节点是黑色节点或者祖父节点为null else if (!xp.red || (xpp = xp.parent) == null) return root; //情景4:插入的节点父节点和祖父节点都存在,并且其父节点是祖父节点的左节点 if (xp == (xppl = xpp.left)) { //情景4i:插入节点的叔叔节点是红色 if ((xppr = xpp.right) != null && xppr.red) { xppr.red = false; xp.red = false; xpp.red = true; x = xpp; } //情景4ii:插入节点的叔叔节点是黑色或不存在 else { //情景4iia:插入节点是其父节点的右孩子 if (x == xp.right) { root = rotateLeft(root, x = xp); xpp = (xp = x.parent) == null ? null : xp.parent; } //情景4iib:插入节点是其父节点的左孩子 if (xp != null) { xp.red = false; if (xpp != null) { xpp.red = true; root = rotateRight(root, xpp); } } } } //情景5:插入的节点父节点和祖父节点都存在,并且其父节点是祖父节点的右节点 else { //情景5i:插入节点的叔叔节点是红色 if (xppl != null && xppl.red) { xppl.red = false; xp.red = false; xpp.red = true; x = xpp; } //情景5ii:插入节点的叔叔节点是黑色或不存在 else {· //情景5iia:插入节点是其父节点的左孩子 if (x == xp.left) { root = rotateRight(root, x = xp); xpp = (xp = x.parent) == null ? null : xp.parent; } //情景5iib:插入节点是其父节点的右孩子 if (xp != null) { xp.red = false; if (xpp != null) { xpp.red = true; root = rotateLeft(root, xpp); } } } } } } 其实就是一毛一样的,对号入座即可。 红黑树的删除 讲完插入,接下来我们来说说删除,删除的话,比插入还要复杂一点,请各位看官先深呼吸,做好阅读准备。 之前已经说过,红黑树是一颗特殊的二叉搜索树,所以进行删除操作时,其实是先进行二叉搜索树的删除,然后再进行调整。所以,其实这里分为两部分内容:1.二叉搜索树的删除,2.红黑树的删除调整。 二叉搜索树的删除主要有这么几种情景: 情景1:待删除的节点无左右孩子。 情景2:待删除的节点只有左孩子或者右孩子。 情景3:待删除的节点既有左孩子又有右孩子。 对于情景1,直接删除即可,情景2,则直接把该节点的父节点指向它的左孩子或者右孩子即可,情景3稍微复杂一点,需要先找到其右子树的最左孩子(或者左子树的最右孩子),即左(右)子树中序遍历时的第一个节点,然后将其与待删除的节点互换,最后再删除该节点(如果有右子树,则右子树上位)。总之,就是先找到它的替代者,找到之后替换这个要删除的节点,然后再把这个节点真正删除掉。 其实二叉搜索树的删除总体来说还是比较简单的,删除完之后,如果替代者是红色节点,则不需要调整,如果是黑色节点,则会导致左子树和右子树路径中黑色节点数量不一致,需要进行红黑树的调整,跟上面一样,替代节点为其父节点的左孩子与右孩子的情况类似,所以这里只说其为左孩子的情景(PS:上一步的寻找替换节点使用的是右子树的最左节点,所以该节点如果有孩子,只能是右孩子): 情景1:只有右孩子且为红色,直接用右孩子替换该节点然后变成黑色即可。 (D代表替代节点,即要被删除的节点,之前在经过二叉搜索树的删除后,D节点其实已经被删除了,这里为了方便理解这个变化过程,所以把这个节点也画出来了,所以当前的初始状态是待删除节点与其替换节点互换位置与颜色之后的状态) 情景2:只有右孩子且为黑色,那么删除该节点会导致父节点的左子树路径上黑色节点减一,此时只能去借助右子树,从右子树中借一个红色节点过来即可,具体取决于右子树的情况,这里又分成两种: i.兄弟节点是红色,则此时父节点是黑色,且兄弟节点肯定有两个孩子,且兄弟节点的左右子树路径上均有两个黑色节点,此时只需将兄弟节点与父节点颜色互换,然后将父节点左旋,左旋后,兄弟节点的左子树SL挂到了父节点p的右孩子位置,这时会导致p的右子树路径上的黑色节点比左子树多一,此时再SL置为红色即可。 ii.兄弟节点是黑色,那么就只能打它孩子的主意了,这里主要关注远侄子(兄弟节点的右孩子,即SR)的颜色情况,这里分成两种情况: a.远侄子SR是黑色,近侄子任意(白色代表颜色可为任意颜色),则先将S转为红色,然后右旋,再将SL换成P节点颜色,P涂成黑色,S也涂成黑色,再进行左旋即可。其实简单说就是SL上位,替换父节点位置。 b.远侄子SR为红色,近侄子任意(该子树路径中有且仅有一个黑色节点),则先将兄弟节点与父节点颜色互换,将SR涂成黑色,再将父节点左旋即可。 emmmm...好像也不是很麻烦嘛(逃)。 TreeNode的删除节点 TreeNode删除节点其实也是两步走,先进行二叉搜索树的删除,然后再进行红黑树的调整,跟之前的情况分析是一致的。 final void removeTreeNode(HashMap<K,V> map, Node<K,V>[] tab, boolean movable) { ...... //p是待删除节点,replacement用于后续的红黑树调整,指向的是p或者p的继承者。 //如果p是叶子节点,p==replacement,否则replacement为p的右子树中最左节点 if (replacement != p) { //若p不是叶子节点,则让replacement的父节点指向p的父节点 TreeNode<K,V> pp = replacement.parent = p.parent; if (pp == null) root = replacement; else if (p == pp.left) pp.left = replacement; else pp.right = replacement; p.left = p.right = p.parent = null; } //若待删除的节点p时红色的,则树平衡未被破坏,无需进行调整。 //否则删除节点后需要进行调整 TreeNode<K,V> r = p.red ? root : balanceDeletion(root, replacement); //p为叶子节点,则直接将p从树中清除 if (replacement == p) { // detach TreeNode<K,V> pp = p.parent; p.parent = null; if (pp != null) { if (p == pp.left) pp.left = null; else if (p == pp.right) pp.right = null; } } } 麻烦的地方就在删除节点后的调整了,所有逻辑都在balanceDeletion函数里,两个参数分别表示根节点和删除节点的继承者,来看看它的具体实现: static <K,V> TreeNode<K,V> balanceDeletion(TreeNode<K,V> root, TreeNode<K,V> x) { for (TreeNode<K,V> xp, xpl, xpr;;) { //x为空或x为根节点,直接返回 if (x == null || x == root) return root; //x为根节点,染成黑色,直接返回(因为调整过后,root并不一定指向删除操作过后的根节点,如果之前删除的是root节点,则x将成为新的根节点) else if ((xp = x.parent) == null) { x.red = false; return x; } //如果x为红色,则无需调整,返回 else if (x.red) { x.red = false; return root; } //x为其父节点的左孩子 else if ((xpl = xp.left) == x) { //如果它有红色的兄弟节点xpr,那么它的父亲节点xp一定是黑色节点 if ((xpr = xp.right) != null && xpr.red) { xpr.red = false; xp.red = true; //对父节点xp做左旋转 root = rotateLeft(root, xp); //重新将xp指向x的父节点,xpr指向xp新的右孩子 xpr = (xp = x.parent) == null ? null : xp.right; } //如果xpr为空,则向上继续调整,将x的父节点xp作为新的x继续循环 if (xpr == null) x = xp; else { //sl和sr分别为其近侄子和远侄子 TreeNode<K,V> sl = xpr.left, sr = xpr.right; if ((sr == null || !sr.red) && (sl == null || !sl.red)) { xpr.red = true; //若sl和sr都为黑色或者不存在,即xpr没有红色孩子,则将xpr染红 x = xp; //本轮结束,继续向上循环 } else { //否则的话,就需要进一步调整 if (sr == null || !sr.red) { if (sl != null) //若左孩子为红,右孩子不存在或为黑 sl.red = false; //左孩子染黑 xpr.red = true; //将xpr染红 root = rotateRight(root, xpr); //右旋 xpr = (xp = x.parent) == null ? null : xp.right; //右旋后,xpr指向xp的新右孩子,即上一步中的sl } if (xpr != null) { xpr.red = (xp == null) ? false : xp.red; //xpr染成跟父节点一致的颜色,为后面父节点xp的左旋做准备 if ((sr = xpr.right) != null) sr.red = false; //xpr新的右孩子染黑,防止出现两个红色相连 } if (xp != null) { xp.red = false; //将xp染黑,并对其左旋,这样就能保证被删除的X所在的路径又多了一个黑色节点,从而达到恢复平衡的目的 root = rotateLeft(root, xp); } //到此调整已经完毕,进入下一次循环后将直接退出 x = root; } } } //x为其父节点的右孩子,跟上面类似 else { // symmetric if (xpl != null && xpl.red) { xpl.red = false; xp.red = true; root = rotateRight(root, xp); xpl = (xp = x.parent) == null ? null : xp.left; } if (xpl == null) x = xp; else { TreeNode<K,V> sl = xpl.left, sr = xpl.right; if ((sl == null || !sl.red) && (sr == null || !sr.red)) { xpl.red = true; x = xp; } else { if (sl == null || !sl.red) { if (sr != null) sr.red = false; xpl.red = true; root = rotateLeft(root, xpl); xpl = (xp = x.parent) == null ? null : xp.left; } if (xpl != null) { xpl.red = (xp == null) ? false : xp.red; if ((sl = xpl.left) != null) sl.red = false; } if (xp != null) { xp.red = false; root = rotateRight(root, xp); } x = root; } } } } } 呼。。。终于。。酝酿了好多天的一篇文章总算是写完了,为了尽量确认转换的准确性,找了很多资料进行参考,过程中花了不少时间,曾多次准备放弃。。。不过总算是没有死在娘胎里,也算是完成了一桩心事,开心。. 之后还会继续更新,欢迎大家继续关注。也欢迎大家前来打脸真正重要的东西,用眼睛是看不见的。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册