首页 文章 精选 留言 我的

精选列表

搜索[重复报告],共10000篇文章
优秀的个人博客,低调大师

openKylin 社区 2026 年 4 月运营报告

一、社区治理 openKylin常务委员会4月会议召开 4月30日,2026年OpenAtom openKylin(简称“openKylin”)常务委员会4月会议在线上召开,来自麒麟软件、联想开天、海光信息、国防科大、国家工信安全中心常委单位代表参会。会议汇报了当月工作进展,常委们也对openKylin的发展提出了宝贵建议。 openKylin生态委员会第五次会议召开 4 月 16 日,openKylin 生态委员会第五次会议成功举行。开放原子、麒麟软件、联想开天、海光信息、国防科大、国家工信安全中心、沐曦、中科通量、飞腾、中科方德、兆芯、面壁智能、北京麟卓、景美、涛略、进迭时空、安势信息、技德系统、伊世智能、奕斯伟、软通计算机等单位参会。本次会议围绕委员增选变更、生态运营进展、版本规划及全球生态布局等议题深入研讨,凝聚全产业链共识,共推开源操作系统高质量发展。 openKylin技术委员会4月会议召开 4月9日,openKylin技术委员会会议在北京召开。来自麒麟软件、联想开天、海光信息、国防科大、国家工业信息安全发展研究中心、海河实验室、清华大学、沐曦、飞腾、中科通量、苦芽科技、技德等单位的代表参会,围绕社区治理、版本规划、技术演进等议题展开交流。 二、社区荣誉 openKylin斩获2025年软件和信息技术服务明星开源社区 4月21日,在北京国家会议中心盛大开幕的第五届中国国际软件发展大会上,中国领先的开源操作系统根社区——开放麒麟(openKylin)凭借其在生态建设、技术创新和社区治理等维度的硬核实力,从众多竞争者中脱颖而出,一举斩获“2025年软件和信息技术服务业明星开源社区”荣誉。 openKylin荣获首届“杉达杯”产教融合创新创业大赛优秀命题奖 openKylin荣获上海市教委和上海市经信委联合颁发的首届“杉达杯”产教融合创新创业大赛优秀命题奖。该奖项旨在表彰社区紧扣“行业出题、高校解题”理念,贡献真实产业痛点与技术前沿场景,有力推动了开源人才培养与创新链、产业链的深度对接,彰显openKylin在产教融合赛事领域的技术认可度。 三、技术进展 SIG组进展本月新增有效PR提交数774个、仓库Fork 191个;召开SIG组公开例会4次。截至目前,社区累计有效PR数23600+、仓库Fork数12188个、召开SIG组公开例会436次。 ➢SIG组活跃动态: 本月活跃SIG组数为74个,占比为49%。SIG组活跃地图分布情况(颜色越深表示越活跃,参考维度:PR、Issue、SIG会议、成员引入)。 ➢代表SIG组月度动态: UKUI SIG 【开始菜单】完成Qt6环境下通过任务栏唤醒开始菜单的问题定位与修复,解决了Wayland显示协议下的启动异常 【桌面小组件】实现了插件预览拖拽、优化了跨屏拖拽方案,并完成了动态壁纸的解析与播放调试 【文件管理器】启动了“系统/个人/公共磁盘分区”需求开发,并推进了AI接口、白盒测试与模糊测试的相关工作 【主题与样式】启动了联想新主题的开发与集成,并为安全审计等系统应用申请并集成了新图标 【剪切板】智能剪切板预览框架搭建,支持Office文档、PDF、动图及视频的预览,并处理了功耗问题 RISC-V SIG 向 XNNPACK 社区提交了面向 RISC-V Vector 的 fp32/fp16 RVV 微内核扩展,围绕激活函数、双线性插值和矩阵乘等关键路径补齐并优化了向量化实现 解决vLLM实现对固定向量长度的依赖问题,完善了 RISC-V CPU 后端的 RVV 多 VLEN 适配机制,并提交pr合入vLLM社区 适配了Godot .Net环境,成功移植相关游戏 X-TeeOS SIG 技术交流:组织北京线下sig meetup活动,携手清华大学,共拓 Rust 内核新征程 调度子系统升级:EEVDF 调度算法正式上线,带来更精确的延迟控制和更公平的任务调度 网络方面:原始 ICMP 套接字支持让内核能够直接发送和接收原始 ICMP 包,修复了 sockaddr 兼容性问题 文件系统:ext4 崩溃一致性修复,改善了断电恢复场景下的元数据一致性,确保 journal replay 后磁盘状态可预期 GIC 统一初始化:整合 DT 和静态配置的 GIC 初始化 运行时设备 iomap:MMIO 运行时映射基础设施 GlobalTimer 拆分:monotonic 和 rtc 独立计时源 kernel SIG ●合并此芯厂商补丁 ●合并海光厂商补丁 ●初始化7.0分支代码,提供x86编包支持 NativeCloud SIG ●node相关容器镜像改为仅使用官网CDN的软件包构建 ●开始维护并上传大部分主流AI Agent容器镜像,包括mmx-cli,copilot,hermes和atomcode ●构建单独的distroless容器镜像维护系统,包括slices、splitter和相关distroless镜像定义 ●新建并开发slices项目,主要维护distroless镜像中软件运行环境的定义,简称slice ●新建并开发splitter项目,主要功能是生成slice与通过slice生成相关运行环境的rootfs doc SIG ●新增openKylin 2.0 SP2虚拟机安装新手指南.md ●新增SIG组活跃奖惩方案.md ●新增 Linux学习指南-基于openKylin.md SOUI SIG ●新增加两套布局系统:流式布局和MFC的FrameLayout,进一步完善SOUI框架,版本升级到5.2.0.6 ●基于SOUI实现一个跨平台音乐播放器xmusic 版本进展 openKylin 3.0 正式确定采用 Linux 7.0 内核,同步上游最新技术。同时,针对180+核心组件完成了选型升级构建 发布openKylin 2.0 SP2第三次更新推送,优化软件商店安装体验,新增磐石架构直装软件包的功能,优化开明、KARE、系统更新等模块 ●经技术委员会表决通过,openKylin社区在坚持“LTS版+创新版”的版本发行策略基础上,将LTS系列的维护周期延长为“2+3”年,为社区用户提供更加持续、稳定的使用支持 四、生态进展 社区会员 新增长沙镜像科技有限公司、智新未来(北京)信息科技有限公司、矩网科技等39家单位会员,社区会员共计2120家。 软硬件生态 ●完成杭州中谱科技有限公司中谱跨平台振动控制与信号分析软件与openKylin操作系统适配认证 ●从单点登录到全域安全,openKylin支撑国家电投数字身份认证创新实践 方案依托openKylin强大的组件适配能力与环境适应性,通过版本适配中间层、版本精准匹配、兼容矩阵等技术,解决跨版本运行异常、客户端锁屏故障等问题;针对纯内网场景,采用离线依赖包与自动回滚机制,攻克软件 “装不上、起不来、卸不掉” 行业难题。 ●全球见证!openKylin 获 Pixi 官方认可,助力 RISC-V 生态再获硬核突破 作为 RISC-V 生态核心共建方,openKylin被国际Pixi官方点名认可——社区基于RISC-V SIG组在软件生态移植方面的大量积累,深度参与 Conda 生态 RISC-V 移植与软件仓库建设,为 Pixi 落地 RISC-V 奠定坚实基础,让全球开发者在开源硬件上获得与 x86/ARM 一致的开发体验。 校企合作 ●新增河北司法警官学院加入社区,社区高校站共计128家 ●开放原子开源实习计划启动!openKylin入选首批核心社区 开源实习是开放原子开源基金会联合孵化社区、合作单位共同发起的线上实习项目,旨在鼓励在校学生积极参与开源社区,在实际的开源环境中提升实践能力,在社区中成长为优秀的开源人才。openKylin社区作为首批参与该开源实习计划的社区,将充分发挥自身在操作系统开源领域的核心优势,积极推动高校学生深度参与开源实践。 ●依托课程教学实践 武汉学院有序推进 openKylin 专属教材编撰 结合本学期的openKylin课程教学实践,武汉学院正在撰写基于openKylin的教学实践教材,并已列入学校教材计划,目前进程过半,拟于6月底完成初稿。 五、社区活动 ●第五届中国国际软件发展大会-“链源罗盘”正式亮相 4月21日,第五届中国国际软件发展大会在北京国家会议中心开幕。由麒麟软件联合国防科技大学、北京航空航天大学、工信部电子五所、中国科学院软件研究所、上海交通大学、国家工业信息安全发展研究中心、国网湖北公司及openKylin社区等多方共同承担的国家重点研发计划阶段性核心成果——“链源罗盘”开源供应链综合评估平台在大会上正式发布。 ●openKylin×百度飞桨黑客松|打卡赛题启动 openKylin作为飞桨黑客松第十期文心合作伙伴赛道核心出题方之一,携官方专属赛题「打卡赛及终极赛赛题」重磅来袭,邀全球开发者聚焦openKylin开源操作系统生态,用代码打造更稳定、更高效、更易用的智能操作系统开源根社区平台。 ●openKylin助力CCF“开源高校行”长沙站 4月20日-22日,CCF“开源高校行”-长沙站分别在国防科技大学、湖南大学、湖南师范大学、长沙理工大学举行。openKylin连续多年作为支持单位与CCF开源发展委员会共同推进开源教育,建立产学研用一体化的开源创新人才培养体系。 ●openKylin协办中国电子学会计算机分会学术活动&4・10会员日活动 4月9日,以“链接产研、智启未来”为主题的计算机分会学术活动暨中国电子学会“4・10会员日” 活动,在北京师范大学昌平校区顺利举行。本次活动由中国电子学会计算机分会主办,北京师范大学人工智能学院承办,openKylin社区协办。 六、基础设施 社区运营平台 ●链源罗盘平台上线 开源软件全生命周期的综合评估平台正式上线与发布,支持Gitee、GitHub等平台上的开源项目进行质量评估、安全性、合规性、可持续性等多维分析。 平台维护与内容更新 ●完成 openKylin 社区服务器安全运维与版本内容更新工作 修复社区服务 Axios 高危漏洞,开展服务器整体漏洞加固及 Webshell 后门文件排查清理,筑牢社区基础设施安全防线,保障平台持续稳定运行;同步完成 openKylin SP2 X86、ARM、Loong64 架构版本上传、镜像站全量同步,并完成相关页面信息更新维护。 服务更新运维 ●系统监控:实时监控系统,及时发现并解决潜在的系统问题,保障社区平台的稳定运行。 ●用户反馈:及时收集并分析用户意见,不断优化产品,提升用户满意度。 ●安全更新:每周进行安全检查和更新,确保平台的数据安全和用户隐私保护。 ●安全加固:所有服务都已配置安全加速与云防护,保障所有服务安全运行。

优秀的个人博客,低调大师

openKylin 社区 2026 年 2 月运营报告

一、社区大事件 1.发布《2025年度OpenAtom openKylin社区全景案例集》(以下简称‘案例集’)。在2024版的基础上,新增收录了社区成员们在2025年的杰出技术成果和行业应用案例共40余项。通过这些案例,读者可以深入了解openKylin社区在技术创新、AI智能融合、应用生态拓展、行业应用等方面的最新进展,为广大技术爱好者、生态伙伴及行业从业者提供宝贵的参考资料,进一步推动开源技术生态的繁荣发展! 二、SIG组进展 SIG组进展 本月社区无新增SIG组,目前累计成立151个SIG组。本月新增有效PR提交数150个、仓库Fork 26个;召开SIG组公开例会2次。截至目前,社区累计有效PR数22750+、仓库Fork数11927个、召开SIG组公开例会431次。 ➢代表SIG组月度动态: UKUI SIG 1. 【电源管理】AI助手UKUI控制能力接口支持,提供电源显示充放电的开关接口; 2. 【电源管理】优化电池节能计划,电量低于2%时开启休眠模式; 3. 【文件管理】文件管理器三栏工具栏视觉开发,处理自适应后按钮省略的问题; 4. 【文件管理】文件管理器数据盘任务开发,调整为中文数据盘。 kernel SIG 1. linux-6.6-next分支同步900多个官网补丁; 2. 更新rtw89网卡驱动; 3. 提供RTL8192FU无线支持。 X-TeeOS SIG 1. 在x-kernel这个rust开源项目中,推进 Kconfig 机制引入以替代原有 platform config,优化配置规范性与可维护性。借鉴linux的思路,进行rust内核领域的配置创新,目前已经开发了框架,借鉴 Linux 内核成熟的 Kconfig 配置体系; 2. 安全模块,完成可信子系统、动态度量及 API 开发,当前进入联调与测试用例完善阶段; 3. 虚拟化与文件系统:持续推进 QEMU 功能开发与硬件适配。 ROS SIG 1. 完成100余个ROS2 Jazzy相关包的Debian打包规则整理,编写并完善各包debian目录下的control、rules、changelog等打包配置文件; 2. 适配openKylin nile分支构建环境,批量调整ROS2 Jazzy各包的构建依赖及版本信息; 3. 将100余个ROS2 Jazzy包的Debian打包内容推送至Gitee OpenKylin组织已有仓库nile分支。 SOUI SIG 1. 完成ui编辑器的重构; 2. 增加两套新的布局系统 flowlayout, framelayout。flowlayout是流式布局, 和线性布局类似, 但支持子窗口自动换行。 framelayout则参考MFC的CFrameWnd, 实现一套可停靠的子窗口布局框架; 3. 在uieditor中使用windows的api实现了一套完整的文件树管理逻辑, 包括文件copy、paste、delete、 rename等操作及文件在不同文件夹之间的拖放,已在 linux、macos平台测试通过。 RapidAI SIG 1. 完成了推理引擎的重大扩展,新增了MNN推理后端支持,丰富了多平台部署生态; 2. 对OpenVINO引擎进行了重构优化,支持从模型运行时信息中获取字符列表,并修复了多个bug; 3. 完善了项目文档和社区建设,添加了贡献指南、Discord社区链接,并改进了测试覆盖。 三、生态进展 软硬件生态 openKylin基于超睿DP1000芯片与KVM,将OpenStack全栈移植RISC-V平台。 四、社区活动 1.openKylin参与脑机接口开发者大会 2月3日至4日,由脑机接口产业联盟、脑机交互与人机共融海河实验室、天津大学共同举办的“脑机接口开发者大会”在天津盛大启幕。openKylin社区产品负责人张天雄受邀出席“脑机接口生态与人才培育”分论坛,以《OpenAtom openKylin社区建设实践与人才培养》为题发表主题演讲。 2.openKylin春节红包&活动 2月13日,openKylin上线春节活动,用一行“愿望代码”,共同绘制openKylin的新年蓝图。 五、基础设施 社区运营平台 ●完成官网社区用户组模块更新升级 随着社区的快速发展,社区城市用户组规模持续扩张。目前,全球用户组网络已达 49 个,其中国内用户组 22 个、国际用户组 27 个。新的页面从用户组角色体系、权益与义务、加入流程、已有用户组呈现等维度进行了全面更新升级。 ●智能知识库更新升级 为提升智能问答体验,社区逐步完善知识库体系,不断丰富内容广度与深度。已完成2025.1月到现在的核心新闻内容导入到AI问答知识库中,包括技术类、活动类、会员类等社区重要资讯,有效充实知识库内容,为用户链接更多社区内容。 ●内容更新 社区官网中英文首页 Banner 样式更新,新增直接下载入口及多架构下载按钮;修复 openKylin 用户修改手机号后,微信绑定检测异常导致扫码登录失败的问题。 服务更新运维 ●系统监控:实时监控系统,及时发现并解决潜在的系统问题,保障社区平台的稳定运行。 ●用户反馈:及时收集并分析用户意见,不断优化产品,提升用户满意度。 ●安全更新:每周进行安全检查和更新,确保平台的数据安全和用户隐私保护。 ●安全加固:所有服务都已配置安全加速与云防护,保障所有服务安全运行。

优秀的个人博客,低调大师

技术干货 |AutoMQ x AWS FSxN: 性能报告

背景 AutoMQ 是一款基于 S3 构建的下一代"Diskless Kafka",完全兼容 Kafka 协议。其云原生架构通过存算分离和按需弹性,显著提升了运维效率。最核心的突破在于,它利用共享存储消除了昂贵的跨可用区(Cross-AZ)数据传输费用,这能为多可用区集群每月节省数千甚至上万美元的网络成本。 在保持极致性价比的同时,AutoMQ 于 2025 年 12 月发布的版本正式引入了对 AWS FSx 作为 WAL 存储选项的支持,以进一步攻克 Diskless 架构的延迟瓶颈。这一演进使 AutoMQ 能够提供媲美本地磁盘的毫秒级延迟,同时保留零跨可用区流量成本和多可用区容灾能力,在低成本、高可靠与极致性能之间实现了完美平衡。 为了在真实生产环境下验证这些架构优势,我们进行了一系列性能基准测试,重点关注客户端观测到的端到端延迟。 Tips: AutoMQ FSxN 能力的正式发布请参考文章:AutoMQ x FSx: 10ms Latency Diskless Kafka on AWS AutoMQ FSxN 实现原理介绍请参考文章: How does AutoMQ implement a sub-10ms latency Diskless Kafka? 测试场景和结果 要理解测试结果,我们首先需要拆解延迟的产生环节: 延迟的构成 从业务视角来看,延迟主要源于两个方面:Kafka 客户端的排队延迟以及服务端的处理延迟。在接下来的章节中,我们将对这两个部分进行拆解分析,从而让大家能够清晰地理解 AutoMQ 结合 FSxN 设计对二者的具体影响。 服务端处理延迟 传统的 Kafka 架构服务端的主要延迟消耗在:客户端与服务的跨 AZ 通信,以及副本完成跨 AZ 复制(ACK=ALL)。这两段的跨 AZ 通信都是直接的 RPC 请求,在 AWS 上会产生高额的流量。 AutoMQ 从整体架构上做了一些变化:采用 AWS FSx 作为 WAL 存储,省去副本复制的流量费;同时通过 FSx 中继客户端和服务端的跨 AZ 请求,减少客户端和服务端的跨 AZ 流量费。由于增加了转发逻辑,会带来少量额外的处理延迟,但却极大的减少了流量成本。 客户端排队延迟 Kafka 生产者采用"先攒批、后发送"的两阶段设计:首先将消息按分区在内存中累积,当达到batch.size 大小或 linger.ms 时间则会将消息放入就绪队列等待发送;网络层在并发限制内,从队列取出批次并发送到服务端。 在追求极致吞吐的场景下,业务常通过调大 linger.ms 主动攒批,但这会导致请求在客户端排队,从而在业务视角表现为更高的延迟;通常可通过 linger.ms 和 batch.size 两个参数在吞吐与延迟之间进行权衡。这一块可以参考之前的文章,里面有详细介绍:Kafka Performance Tuning: Best Practice for linger.ms and batch.size 测试场景选择 为了全面、客观地评估 AutoMQ 在引入 AWS FSxN 后的性能表现,并提供具备实战参考价值的性能数据,我们将测试场景设定为两个维度:极致性能基准(Baseline)与生产稳态模型(Robustness)。 极致性能基准场景:服务端延迟物理上限测试 在分布式系统中,客户端的排队机制往往会掩盖存储介质真实的 I/O 响应。因此,我们首先通过设置 linger.ms=0 且在低并发压力下进行测试,旨在构建一个"零排队"的理想环境。 测试目的: 剥离客户端干扰,直接探测 AutoMQ 结合 FSxN WAL 后的服务端核心处理时延 与网络中继损耗,确立该方案的物理性能边界。 生产稳态模型场景:高吞吐下的确定性延迟测试 在真实的生产实践中,流量波动(Burst)、生产者扩缩容以及分区负载不均是常态。为了追求吞吐量与成本的平衡,开发者通常会通过 linger.ms 和 batch.size 进行攒批调优。 测试目的: 我们选取了典型的生产配置(如 linger.ms=3),并模拟集群满负载运行 状态。此场景旨在验证在真实业务压力下,AutoMQ 是否能提供高确定性的延迟输出,并观察其在处理海量小包写入(High TPS)时的尾部延迟(P99/P999)表现。 通过这两个维度的对比,我们不仅能展示该方案在理想状态下的爆发力,更能证明其在复杂生产环境下作为核心基础设施的稳定性。 详细测试 测试环境如下: 使用 OpenMessaging 基准测试框架,写入总吞吐 300MiB/s,Fanout 比例为 1:4; Server: m7g.4xlarge *3; WAL Storage: FSx 736MBps、1T SSD、3072IOPS; Client: m7g.4xlarge *3; 集群水位满载运行; 耗时最短的场景 为了探测系统的物理性能上限,我们构建了一个"零排队"的理想环境,重点调整了影响时延的关键参数: batch.size=64K、linger.ms=0(默认) 不开压缩(开启压缩会降低写入吞吐量,带来更低的写入延迟,降低测试场景的挑战) 具体配置如下: name: Kafka driverClass: io.openmessaging.benchmark.driver.kafka.KafkaBenchmarkDriver # Kafka client-specific configuration replicationFactor: 1 topicConfig: | min.insync.replicas=2 commonConfig: | bootstrap.servers=10.0.0.112:9092 producerConfig: | acks=1 batch.size=65536 client.id=automq_type=producer&automq_az=us-east-1b consumerConfig: | auto.offset.reset=earliest enable.auto.commit=true client.id=automq_type=consumer&automq_az=us-east-1b Record Size = 64 KB 写入 TPS = 4,800 分区总数 = 96 Producer 数量 = 48 工作负载配置如下: name: Lowest latency case topics: 1 partitionsPerTopic: 32 messageSize: 65536 payloadFile: "payload/payload-64Kb.data" subscriptionsPerTopic: 4 consumerPerSubscription: 16 producersPerTopic: 16 producerRate: 1600 consumerBacklogSizeGB: 0 运行结果 写入总吞吐图 300MiB/s,读取约 1.2GiB/s; CPU 消耗约 27.5%,内存占用约 10G; 写入平均延迟 6.0ms、P99 13.11ms、P999 17.68ms; 端到端平均延迟 7.79ms、19.0ms、29.0ms; linger.ms=0 即不等待攒批完成,如果当前进行中请求不超过请求最大并发数,则会立即将消息发送到服务端,这种情况下耗时客户端耗时最短。但当随着业务量峰谷的变化,写入吞吐量、TPS 上涨等,可能会受请求并发数限制产生额外的客户端排队,从而影响最终的延迟。 所以,该场景为理想情况下的延迟;虽然耗时更短,但容易受业务量、客户端数量的影响出现起伏,不够稳定。 耗时更加稳定的场景 既然极致性能场景存在波动的风险,那么在追求吞吐量与稳定性平衡的生产环境下,AutoMQ 的表现又会如何呢?接下来让我们观察在开启客户端攒批后的稳态测试结果。 batch.size=64K linger.ms=3(根据服务端处理耗时估算出客户端攒批的时间) 具体配置如下: name: Kafka driverClass: io.openmessaging.benchmark.driver.kafka.KafkaBenchmarkDriver # Kafka client-specific configuration replicationFactor: 1 topicConfig: | min.insync.replicas=2 commonConfig: | bootstrap.servers=10.0.0.112:9092 producerConfig: | acks=1 linger.ms=3 batch.size=65536 client.id=automq_type=producer&automq_az=us-east-1b consumerConfig: | auto.offset.reset=earliest enable.auto.commit=true client.id=automq_type=consumer&automq_az=us-east-1b 更小的消息会带来更多的写入消耗,为了更有通用性,我们将 recordsize 设置了更小,以使结果在更多的场景适用。 record.size = 1K 写入 TPS = 307200 分区总数 = 96 Producer = 15 具体工作负载配置如下: name: 1 Robust latency case topics: 1 partitionsPerTopic: 32 messageSize: 1024 payloadFile: "payload/payload-1Kb.data" subscriptionsPerTopic: 4 consumerPerSubscription: 5 producersPerTopic: 5 producerRate: 102400 consumerBacklogSizeGB: 0 运行结果 写入总吞吐图 300MiB/s,读取约 1.2GiB/s; CPU 消耗约 31.5%,内存占用约 14G; 写入平均延迟 7.89ms、P99 16.30ms、P999 30.26ms; 端到端平均延迟 9.88ms、22.0ms、38.0ms; 增加了linger.ms=3 会带来额外的客户端延迟,但能带来更加稳定的攒批结果,能更好的应对业务流量峰谷,集群扩缩容 Producer 数目变化对延迟的影响,能够提供更加稳定的延迟表现,在实际生产中更具有参考意义。 此外,测试用例是按照集群满负载的情况运行,对 P99、P999 的更具有挑战。AutoMQ 内部经过大量优化,以确保文件系统耗时更加稳定。 从文件系统写入延迟热力图看 90%的写入响应都在 1ms 以下,同时 91%的读取都在 1ms 以下。 关于成本 看到这里,你可能会产生疑问:既然性能实现了如此惊人的飞跃,成本是否也会随之"水涨船高"? 事实恰恰相反。在 AutoMQ 的集成架构中,FSxN 并非用于海量数据的长期堆积,而是仅作为"高速缓冲站"运行。它只负责承载极少量的最新预写日志(WAL),而海量的业务数据依然存储在价格极低的 S3 中。 为什么成本依然极低: 按需占用,规模固定: 由于数据会迅速沉降到 S3 存储桶,FSxN 仅需占用极小且固定的资源容量,不会随业务数据量的增长而产生高额费用。 省下巨额流量费: 虽然集成 FSxN 会带来少量的资源开销,但它彻底消除了传统 Kafka 最昂贵的"跨 AZ 复制流量费"。 99% 的存储在 S3: 绝大部分数据都存储在成本极低的 S3 上。 这意味着即使集成了 FSxN 提升性能,AutoMQ 的整体拥有成本(TCO)依然比传统 Kafka 节省近 90%。 详细可以查看:👉 AutoMQ x FSx: 10ms Latency Diskless Kafka on AWS 总结 通过引入 FSxN 作为 WAL,AutoMQ 在保持跨 AZ 容灾与 S3 存算分离优势的同时,将平均写入延迟从数百毫秒大幅降至 10ms 以内,性能表现媲美本地磁盘。这一突破彻底补齐了 Diskless 架构的性能短板,使其能够以极具竞争力的成本和高稳定性,完美支撑微服务、风控及交易撮合等延迟敏感型核心业务。

优秀的个人博客,低调大师

2021年信创产业融资分析报告

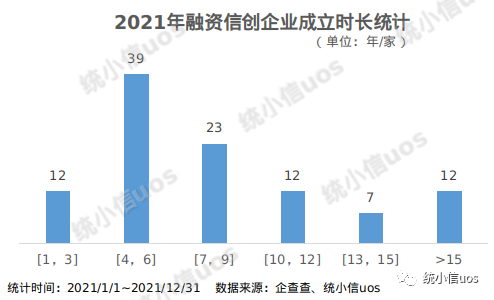
【摘要】 据统小信uos不完全统计,2021年信创领域共发生132起融资事件,涉及105家企业。105家企业成立时长跨度较大,超7成企业成立时长在10年以下。其注册地3/4集中在北上广等经济高度发达地区,东部沿海省份在信创领域的影响力也在逐步增强。 参与融资的信创企业多已达到一定规模,超5成企业融资轮次在B轮及以上。信创企业融资规模不少于258.33亿元人民,TOP10事件融资额占总样本的54.34%,其中近7成融资事件计划将融资所得用于技术研发。 132起融资事件,近3成分布在信创安全领域,融资总额超54亿元人民币,一级市场对数据安全和工控安全赛道存在明显偏好。 出品 |统小信uos 【目录】 一、2021年融资信创企业的基本情况 (一)成立时长跨度大,成立4~6年企业最多 (二)注册地集中在北上广,浙江、江苏影响力增强 二、信创企业融资轮次、金额、领域、目的分析 (一)政策驱动效应明显,融资企业成熟度较高 (二)一级市场投资向头部企业集中趋势显著 (三)信创安全景气度持续走高,操作系统领域融资频次低 (四) 融资资金主要流向技术研发、业务拓展、人才储备 三、结语 近年来,疫情变化和外部环境不确定性的加剧,令资本市场持续承压。在一片“资本寒冬”的喊声中,信创市场却有着不一样的际遇。 继信创推广元年之后,2021年,信创产业进入全面落地阶段,在央地政策的驱动下,新领域不断放量,各行业渗透率持续拉升,产业规模突破新高。值此背景下,投资机构纷纷加速入场,抢占先机。 本文以2021年信创领域发生的132起融资事件为研究对象,从融资企业信息和融资情况两方面展开分析。需要说明的是,研究所指信创为“泛信创”行业,包括但不止于以计算机基础软硬件为核心的国产替代板块,还包括工业互联网、人工智能等涉及国产自主可控领域的多个赛道。信创企业选取标准:信创工委会成员、地方信创联盟成员、信创生态组织成员、积极参与信创适配并在信创领域进行深度布局的企业。 一、2021年融资信创企业的基本情况 (一)成立时长跨度大,成立4~6年企业最多 据统小信uos不完全统计,2021年信创领域共发生132起融资事件,涉及105家企业。 参与融资的105家信创企业,超7成企业成立时长在10年以下,其中成立4至6年的企业数量最多,共39家,占总样本的37.14%;成立时长在10至15年的企业共19家;成立15年以上的企业有12家。 具体看来,105家企业的成立时长跨度较大,成立时间最短的两家企业冲量在线和数安行,年内分别获得Pre-A轮和天使轮融资,而截至融资披露日期,后者成立仅8个月。成立时间最长的浪潮集团,于1989年成立,并于2021年末实施增资扩股,除浪潮外,参与融资的信创企业中,华天软件、中科网威、中软国际、赢时胜和上海CA等5家企业成立时长均在20年以上。 (二)注册地集中在北上广,浙江、江苏影响力增强 参与融资的105家信创企业,超3/4分布在北上广地区,其中,总部位于北京有46家,占总样本的43.81%;广东、上海两地各有17和16家;浙江省和江苏省分别有10家、8家。 北京作为国家科技创新资源的集中地,聚集着顶级的科研院所和教育机构,还有涉党政军等高精尖技术科研力量,承担着大批国家重点研究项目,在科技创新资源方面拥有不同于其他省区的明显优势。2020年北京经开区信创园的落地,进一步增强了北京信创支撑的保障能力。 广东、上海作为我国经济高度发达地区,在高端人才资源、研发机构资源、科研投入强度等方面同样具备较好的基础。2021年,广州市黄埔区在全国范围内率先出台“信创10条”,从培育奖励、成长奖励、信创精英奖励等七个方面进行扶持,推动信创全产业链条要素整合优化和产业生态体系重构。 近年来,浙江、江苏等地在信创领域的影响力也在逐步增强。2020年,浙江省发布《2020年浙江省软件与集成电路产业工作要点》,鼓励企业与科研院所合作共建适配中心,推动国产信息设备及适配款硬件快速迭代升级,全面提升信息技术自主可控核心能力。2021年,江苏省印发南京江北新区“十四五”发展规划,提出聚焦高端软件和信息服务,大力发展云计算和大数据、高端工业软件和工业互联网APP、信息安全等核心产业,推动长三角信创应用场景合作共建,打造信息技术创新应用产业高地。 二、信创企业融资轮次、金额、领域、目的分析 (一)政策驱动效应明显,融资企业成熟度较高 从融资轮次来看,2021年信创领域近3成融资事件发生在战略融资阶段。区别于普通的财务融资,战略融资的双方更看重战略协同效应,多出于整体布局考虑,意在自身业务的优化和拓展,强调合作关系。 战略融资之外,A、B两轮融资事件占总样本的40%,这一阶段的信创企业基本已拥有完整的商业和盈利模式,或开始推出新业务、拓展新领域。C轮及以上轮次融资占比近30%,该阶段项目趋于成熟,部分企业正着力补全商业闭环,准备上市。 我们注意到,2021年参与融资的信创企业大部分已达到一定规模,少数初创项目也基本步入正轨,仅个别企业接受了种子轮和天使轮融资。2020年以来,随着国家战略层面的持续推进,信创产品和信创技术开启了新一轮的推广和规模化落地,各赛道的企业历经多年沉淀,在技术、产品层面已实现了从“可用”到“好用”的过渡,也因此这一阶段的信创企业成熟度较高。 从融资阶段看,参与融资的105家信创企业中,有22家企业完成了两轮及以上轮次融资,随锐科技、复临科技、斗象科技、长扬科技和趋动科技等5家企业年内均完成3轮融资。其中,有9家企业的多起融资事件处在同一轮次,如斗象科技,三轮融资均在D轮阶段。 (二)一级市场投资向头部企业集中趋势显著 融资金额方面,2021年信创领域发生的132起融资事件中,仅90起披露了具体的融资金额,累计融资不少于258.33亿元。 从融资分布上看,连续区间融资额对应的融资事件呈现长尾分布特征。具体看来,超6成事件融资额在2亿元以下,其中,融资额在千万元级别的事件最多,共35起;2亿元到9亿元之间的融资事件共27起,且随着融资金额的上升,事件数量出现递减趋势;10亿元以上的融资事件仅3起。 从融资金额上看,前十大事件的融资额累计超140亿元,占融资总额的54.34%。统小信uos梳理发现,这十家公司的融资额存在一定的梯度分布特征。具体看来,第四范式以7亿美元的融资额独占鳌头;第二名航天云网以26.32亿元的融资额创下当时国内工业互联网领域单笔融资额最高纪录;第三至十名的融资额都在10亿元左右,且按照当时的汇率换算,第五到十名的融资额总和仍不及第四范式。 对于这种梯度分布,我们认为一方面,各企业融资阶段并未处在同一水平,如第四范式为D轮融资,安天、上海弘玑等为C轮融资,滴普科技仍处于B轮阶段;另一方面,各企业不同的规模和主体特征,对资本市场金融服务存在着不同的需求,在满足多元化投融资的同时,多层次资本市场将成为推动新兴业态和新动能成长的有力支撑。 (三)信创安全景气度持续走高,操作系统领域融资频次低 2021年发生的132起融资事件,有35起分布在网络安全领域,涉及企业27家;业务平台、存储和应用软件领域的融资事件占比均超过10%,分别涉及企业21、12和9家;另有数据库、云计算、大数据3个领域的融资企业都在5家以上;操作系统领域融资较少,仅1家。 2020年以来,在政策和需求的双层驱动下,网络安全行业景气度持续走高。2021年信创安全领域35起事件的融资总额超54亿元人民币,除3起未披露事件外,其余32起事件融资规模均逾千万人民币,62.5%的融资规模超过1亿元。 具体看来,安天科技获得9亿元单轮最大融资,青藤云安全和微步在线分别以C轮6亿元和E轮5亿元的融资额分列二、三位。融资轮次方面,神州慧安、威努特、长扬科技、赛宁网安、瑞数信息和斗象科技等6家公司年内均完成两轮及以上轮次融资。 从细分领域看,一级市场对数据安全和工控安全赛道存在着明显偏好。 随着数字经济时代的到来,数据已成为继土地、劳动力、资本、技术之后的第五大生产要素,2021年《数据安全法》、《个人信息保护法》的相继落地,更是把数据安全推到了前所未有的高度,与此同时,数据安全领域的投资也跟着水涨船高。据不完全统计,2021年共有7家专注数据安全领域的信创企业参与融资,包括:安华金和、数安行、美创科技、杭州熙菱、聚铭网络、斗象科技和派拉软件,累计融资额不少于10亿元人民币,其中斗象科技年内历经3轮融资,并获得国资背景的机构注入,融资规模约7亿元人民币。 除了数据安全,工控安全领域的信创企业也备受资本市场青睐。2021年共有安盟信息、神州慧安、威努特、长扬科技和木链科技等5家企业参与融资,其中威努特、长扬科技的融资轮次都在D轮及以上,木链科技获得B轮融资,神州慧安和安盟信息均处于A轮阶段,5家企业累计融资额不少于9.45亿元。 近年来,随着新基建项目的加速推进,“5G+工业互联网”领域的关注度持续升温,与此同时,工业企业生产网络也面临着较大的信息安全挑战,在国际形势日益严峻的情况下,工控安全国产化的必要性不言而喻。2021年《工业互联网安全标准体系》的发布,指明了分类分级安全防护、安全管理、安全应用服务等3个类别、16个细分领域以及76个具体方向,对推动网络安全产业高质量发展具有重要支撑作用。未来,随着工业信息安全政策标准的日趋完善,垂直行业建设提速,工控安全领域仍具有较大的增长潜力。 继网络安全之后,业务平台领域共有21家信创企业参与融资,其中9家企业披露了融资金融,累计49.77亿元,e签宝以E轮12亿元人民币的融资额占据榜首。从细分领域看,各企业所属行业较为分散,包括电子票证、电子合同、CRM、RPA、金融资产管理、网络性能管理等。 存储、应用软件和数据库等领域,根据已披露的数据,融资额分别达到30、15和30亿元人民币。值得关注的是,参与融资9家数据库企业中,除4家处于战略融资阶段,其余5家都集中在A、B轮次。且区别于其他信创赛道引入专业投资机构,数据库领域的投资方多为大型信创企业,如信创集成商东华软件750万元增资快立方,国产中间件头部厂商东方通2000万元领投睿帆科技,中国软件投资易鲸捷信息等,根据披露,相关企业的投资目的主要是加速自身业务延伸,优化产业布局。 操作系统领域,2021年仅中科方德一家获得融资,去年3月消息,中科曙光入股中科方德,公司注册资本由1.2亿元人民币增加至1.8亿元人民币,后者增资50.15%。操作系统作为软件平台,需要向下适配硬件系统,向上支撑应用软件功能,开发难度较大,需要扎实的技术积累和不断改进的产品设计,另外,作为操作系统发展的核心,生态的构建需要大量的外围厂商支持,也因此,在整个信创产业链中,操作系统领域企业较少。除中科方德外,国产操作系统领域最近的一次融资是在2020年,统信软件宣布完成A轮11亿元融资,据了解,该轮融资由亦庄国投领投,并由其他多家顶级投资机构共同完成。 (四)融资资金主要流向技术研发、业务拓展、人才储备 132起融资事件,仅84起披露了融资用途,其中近7成计划将融资所得用于技术研发;28.75%用于业务拓展;分别有27.38%用于产品迭代和人才引进;市场推广、生态建设和战略布局的占比均不足10%。 发展信创产业,技术突破是关键,也因此大部分信创企业在研发方面投入较高。如人工智能企业第四范式,2021年以7亿美元的融资额领先于其他信创企业,而在研发投入方面,2018年~2020年第四范式研发费用分别为1.93亿元、4.16亿元、5.66亿元,占同期收入的比例分别达到151.2%、90.6%、60%。 除了技术研发,信创企业在业务拓展、人才引进等方面也有较高投入。信创企业承载着国产化、自主可控的目标,面对的下游客户主要是国内客户,尤其是前期推广的“2+8”行业,客群特征明确,在保障资金充足的前提下,信创业务运转相对稳定,业务拓展即成为下一阶段的重点目标。而高质量专业人才是信创发展的底层需求,直接关系到信创产业的可持续发展问题。目前,我国信创产业人才短缺问题逐渐凸显,信创工委会发布的一项调研数据显示,到2025年,关键软件领域人才新增缺口将超80万。在这一背景下,各信创企业投入资金储备、培养人才,为后续发展提前打基础,也就不足为奇了。 除此之外,完善战略布局也是企业融资目标之一。据不完全统计,有3家企业在年内的融资中明确披露了“战略意图”。2021年7月,安盟信息宣布完成五千万A轮战略融资,投资方为中电科研投基金,这意味着安盟信息将成为“网络安全国家队”中国电科生态企业,这对其未来在工控安全领域和国家信息安全方面的业务拓展有着积极的推动作用。继安盟信息之后,斗象科技也宣布引入中电科研投基金,正式跻身“国家队”行列。滴普科技年内宣布完成1亿美金B轮融资,重点引入了金融领域的战略投资,加速其完整数字产业发展生态的建立。 三、结语 我国信创产业目前正处在政策引导、项目推广落地的初级阶段,先期应用场景主要集中在党政和重点行业,这一时期攻克核心技术、打磨产品和建立生态是信创企业的首要任务。这一阶段活跃在资本市场的信创企业大致有两类:一是在自主可控领域拥有多年技术积累,此番受政策和市场的双层驱动,引入资本向商业化迈进的企业,这类企业主要集中在底层软硬件厂商中,如CPU、操作系统、中间件等领域。另外,近年来新兴业态及业务场景的涌现,也催生了一批细分赛道的创新型信创企业,如协同办公、远程办公等应用软件类企业,数据安全、零信任等网络安全类企业。从2021年信创企业融资情况看,后者的融资事件居多。 我们认为前者,基础架构领域的信创厂商已形成初步竞争格局,新生企业成长空间被严重挤压,未来一段时间,一级市场的投资对象仍会以中头部企业为主。而对于专注细分赛道的信创企业来说,新兴场景不断涌现给企业带来新挑战的同时,也必将带来巨大的市场需求,与此同时,相关政策也会紧随市场的变化提出更高的要求,因为,我们认为在信创产业步入下一阶段,即进行全行业和消费级市场推广之前,资本市场的活跃状态仍会持续。

优秀的个人博客,低调大师

数据库年度报告:回望 2021

原文作者 Andy Pavlo 是卡内基梅隆大学计算机科学系数据库专业副教授,也是初创公司 OtterTune(为数据库提供自动调优服务)的联合创始人。 数据库产业经历了爆发式增长的一年。在这一年里,数据库产业后浪推前浪,厂商围绕性能测试结果展开角逐,更有一轮又一轮额度惊人的融资。同时,在经历了一系列并购、破产和退出之后,我们也不得不同一些熟悉的数据库告别。 年关将至,在正式进入 2022 年之前,这些事件也值得我们做一次盘点、总结与反思。以下是部分要点事件。关于它们在数据库领域的意义,我做的一些思考。 PostgreSQL 的统治力 开发者的习惯已经转变,PostgreSQL 成了新应用的首选。它可靠性高,功能丰富且依然在持续完善中。2010 年,PostgreSQL 的开发团队转而采用了更为激进的发布策略,每年进行一次大的版本更新(感谢Tomas Vondra)。当然 PostgreSQL 还是开源项目。 如今很多系统都把兼容 PostgreSQL作为差异化竞争力。这种兼容性是通过支持 PostgreSQL 的 SQL 方言 (DuckDB),传输协议 (QuestDB,HyPer),或者整个 Server 层前端 (Amazon Aurora,YugaByte,Yellowbrick) 来实现的。重量级玩家也已经入局。十月,谷歌宣布在 Cloud Spanner 中兼容 PostgreSQL。同样是在十月,Amazon 宣布了Babelfish的功能,它可以转换 SQL Server 的查询,用于 Aurora PostgreSQL。 DB-Engines 排行榜是衡量数据库流行度的标尺。这份排行不是十全十美的,评分也带有主观色彩。但它评选出的前十名还是基本合理的。排行榜显示,截止到 2021 年 12 月,PostgreSQL 在最受欢迎的数据库中仍旧位列第四,排在 Oracle 、MySQL 和 MSSQL 之后。不过,在过去一年里它与 MSSQL 之间的差距已经缩小了。 另一个值得思考的点是 PostgreSQL 在线上社区中被提及的频次。这为我们提供了另一种视角,让我们窥见当人们讨论数据库时他们究竟在讨论什么。我下载了 2021 年度Reddit 中 Database 板块上的所有评论,并清点了各个数据库名称在其中出现的频次 (当然我是用 PostgreSQL 做这项工作的)。我从我的Database of Databases中交叉引用了我了解的所有数据库的列表,对缩写做了清洗(例如, Postgres → PostgreSQL, Mongo → MongoDB, ES → Elasticsearch),最后计算出了十个最常被提及的 DBMS: 当然这张排名表没那么科学,因为我没有对这些评论做情感分析。然而,它确实清晰地展现出,在过去一年里,相较于其他数据库,PostgreSQL 被人们提及的频次要更多。经常有开发者发帖询问该选择哪一个 DBMS 来开发新应用。社区成员对此的回答几乎总是 PostgreSQL。 Andy 观点 先要说明,一个关系型数据库成为待开发应用的首选是件好事。这说明 Tedd Codd 的关系模型自上世纪七十年代长盛不衰。其次,PostgreSQL 是个伟大的数据库系统。当然,和其他所有 DBMS 一样,它也有各种已知和未知的问题。但 PostgreSQL 已经赢得了如此之多的注意,人们也在其上灌注了许多精力。在这两点的加持下,它只会发展得越来越好。 性能测试乱战 这一年,各个数据库厂商对性能测试结果的热爱没有丝毫消退。从上个世纪八十年代起,它们就试图证明自己的数据库系统要快于竞争对手的产品。TPC 就是在这一背景下建立的。它为数据库间的比较提供了一个客观公允的平台。但在过去十年间,TPC 的影响力逐渐消退,普及度渐渐下降。于是如今,我们又被卷入了新一轮的数据库性能测试大战中。 这一年,围绕性能测试结果展开了三场激烈争斗。 Databricks vs.Snowflake Databricks 宣布他们的新 Photon SQL 引擎在100TB TPC-DS 上创下了新的世界纪录。Snowflake 随即回击,声称自己的数据库要二倍于这个速度,而且 Databricks 没有正确运行 Snowflake。Databricks 予以反击,宣称他们的 SQL 引擎有着最佳的执行效率,性价比也高于 Snowflake。 Rockset vs.Apache Druid vs.ClickHouse ClickHouse 跳了进来,表示自己在成本效率上完胜 Druid 和 Rockset。但先别急:作为回应,Imply对 Druid 的新版本进行了一系列测试,并宣告了胜利。Rockset 插进来,声称自家产品在实时分析方面的表现要优于另外两家。 ClickHouse vs.TimescaleDB Timescale 嗅到了血腥气,下场参战。他们发布了自己的性能测试结果,逮到机会指出了 ClickHouse 技术上存在的弱点。有关第三方性能测试的讨论成了 Hacker News 的热门。 Andy 观点 在先前的性能测试争夺战里,数据库社区已是血流漂杵。我承认我也曾热衷于此。但在争吵中我失去了很多朋友。有一次,我甚至因为乱七八糟的性能测试结果和女朋友分了手。年岁渐长之后,我可以说这一切都不值得。 现如今,要在不同的系统之间做对比变得更加困难。因为云 DBMS 有许多可变的部分和可调节的选项。所以,要断定表现差异背后的真实原因通常会很困难。真实场景下的应用也不仅仅是在一遍又一遍地执行同一条指令。录入、变换和清洗数据时的用户体验和干巴巴的性能测试结果同等重要。正如我在此文中和采访者谈论 Databricks 的性能测试结果时说的那样,只有老古董才会在意 TPC 官方数据。 大数据,大投资 从 2020 年下半年开始,额度超过 1 亿美元的融资轮数一直在平稳增长。2020 年共有 327 次这种大额融资。这占据了近半风险投资总交易额。在 2021 年 1 月,一亿美元以上的风投轮数已经过百。 2021 年,许多投资都流向了数据库公司。在事务型数据库领域,CockroachDB 领跑募资大赛。CockroachDB 开年即进行了一轮 1.6 亿美元的融资,并在 2021 年 12 月募资高达 2.78 亿美元,为这一年画上句号。Yugabyte 则完成了 1.88 亿美元的 C 轮融资。作为 Vitess 的托管版本,PlanetScale 开启了 2000 万美元的 B 轮融资。NoSQL 的拥趸,相对较老的 DataStax 也在一轮风投中为他的 Cassandra 生意募集到了 3760 万美元。 这些数字已经很让人印象深刻了,然而分析型数据库的市场甚至要更加火热。2021 年 9 月,TileDB 完成了一轮融资,未透露具体金额。Vectorized.io 为他们兼容 Kafka 的流式平台募集到了 1500 万美元。StarTree 也走到台前,宣布完成了一轮 2400 万美元的融资,用以商业化 Apache Pinot。matviews-on-steroids DBMS Materialize 宣布他们在 C 轮融资中募集到了 6000 万美元。Imply 为基于 Apache Druid 的数据库服务筹集到了 7000 万美元。SingleStore 在 2021 年募集到了 8000 万美元,这让他们离 IPO 又近了一步。这一年伊始,Starburst Data 为 Trino 系统(前身是 PrestoSQL)募集了 1 亿美元。另一家走到台前的 DBMS 创业公司 Firebolt 宣布他们为自己基于 ClickHouse 分支的新型云数据仓库募集到了 1.27 亿美元。ClickHouse 募集到了惊人的 2.5 亿美元,用以围绕该系统建立一家新公司,同时也取得了对 Yandex 名下 ClickHouse 这一名称的使用权。 但今年,当之无愧的融资冠军要属 Databricks。它以在 2021 年 8 月高达 16 亿美元的融资额力压群雄。 Andy 观点 我们正处在数据库的黄金时代。如今我们有许许多多优秀的选择。投资人正在数据库领域的创业公司中寻求下一个 Snowflake 式的 IPO。这些公司的融资额要远超先前的数据库创业公司。 举例来说,直到 D 轮融资,Snowflake 的单轮融资额才达到了 1 亿美元。此时距它初创已经过去了五年。而 Starburst 在成立的三年内便完成了一轮 1 亿美元的融资。当然影响融资的因素有很多。比如说,在脱离 TeraData 出来创业之前,Starburst 的团队就已在 Presto 上躬耕多年。但在我看来,现如今有更多的资金正在涌向这一领域。 纪念堂 很遗憾,在过去的一年里,我们不得不向几位老朋友说再见。 ServiceNow 收购了 Swarm64 这个公司最初的产品是一款 FPGA 加速器,用以在 PostgreSQL 上运行分析任务。之后,他们转向了单纯的软件加速器,为 PostgreSQL 提供插件。但他们缺乏持续发展的动力,尤其是相比其他资金充裕的云数据仓库。在被 ServiceNow 收购后,Swarm64 的产品前景仍不明朗。 Splice Machine 破产了 Splice 推行的是一个混合型 DBMS。它结合了针对事务型任务的 HBase 和针对分析的 Spark SQL。他们更进一步推出了服务于操作型/实时机器学习应用的平台。然而,由于专门的 OLTP 和 OLAP 系统的统治地位,这样一个多位一体的混合系统没能在数据库市场开辟出一条道路。 私募公司收购 Cloudera 过去五年,MapReduce 和 Hadoop 技术渐渐为潮流所抛弃。因此,Cloudera 也同样失去了在云数据仓库市场发展的动力。Impala 和 Kudu 的初代工程师团队大多都已经离开公司,尽管这些项目依旧在持续开发并迭代新版本。它的当前股价已经低于 2018 年 IPO 时的发行价。它的新投资人是否有能力扭转公司局面还有待观望。 Andy 观点 看到数据库项目和公司走上下坡路总归让人伤心,但这就是数据库产业内部的厮杀博弈。开源也许能让一款 DBMS 在母公司消失之后也能继续存在,但事实并不总是如此。由于数据库本身的复杂性,它必须要有全职员工进行维护,修正 bug 并添加新功能。不是说把破产 DBMS 的源代码权限和控制交到 Apache 软件基金会和 CNCF 这样的开源软件基金会手中,这个项目就会奇迹般复活了。 举例来说,公司破产后,RethinkDB 被捐赠给了 Linux 基金会。但从 GitHub 的各项表现看,它已经死透了(基本没有提交,PR 也不并入)。有类似遭遇的还有 DeepDB:它的母公司在倒闭后为它创立了自己的非盈利基金会,但没有人再去维护这个项目了。在下一年里,预计还会有更多的数据库公司因无力与大型云服务商和之前提到的众多资金充裕的创业公司抗衡而走上下坡路。 野火烧不尽 对很多人来说,疫情期间是段艰难的时光。在听到了这么多坏消息后,突然有个振奋人心的故事总能让人倍感欣慰。众所周知,甲骨文联合创始人 Larry Ellison 近几年的运气一路下滑。2015 年的时候,他气运还不错,那时他是世界上第五富有的人。然而人生起起伏伏。到了 2018 年,Larry 在富豪排行榜上已经跌到了第十位。 但在 2021 年 12 月,一切都变了。Larry Ellison 的身家超过了谷歌联合创始人 Larry Page 和 Sergey Brin,重回世界第五富的位置。2021 年 12 月,在公布了超预期的公司收入后,甲骨文的股价经历了过去二十年来的单日第二高涨幅,Larry Ellison 当天挣到了 160 亿美元。媒体将这归功于投资人高涨的信心。他们相信甲骨文向云端转变的策略起效了。 Andy 观点 我和 Larry 相识已久。不管对于数据库社区,还是对于全体人类来说,这都是件好事。运气不好滑到世界第十富的时候他可能有点伤心。但我很高兴能看到他走出低谷,重新回到应有的位置上去。 除了家人,数据库是我生命中最重要的事情。 我们期望能够引领崭新的一年。数据库是一个有着高度韧性和创新性的行业,我们很高兴能成为其中的一份子。 作者:Andy Pavlo 原文链接:https://ottertune.com/blog/2021-databases-retrospective/ 译文经授权转载自Bytebase 公众号

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册