首页 文章 精选 留言 我的

精选列表

搜索[techo day],共2890篇文章
优秀的个人博客,低调大师

【Java入门提高篇】Day28 Java容器类详解(十)LinkedHashMap详解

今天来介绍一下容器类中的另一个哈希表———》LinkedHashMap。这是HashMap的关门弟子,直接继承了HashMap的衣钵,所以拥有HashMap的全部特性,并青出于蓝而胜于蓝,有着一些HashMap没有的特性。接下来就一起来看看这个关门弟子到底有多大能耐。 本文将从以下几点对LinkedHashMap进行介绍: 1、LinkedHashMap简介与简单使用 2、LinkedHashMap的结构以及与HashMap的对比 3、LinkedHashMap的插入和删除 4、LinkedHashMap的源码分析 5、基于LinkedHashMap实现LRU缓存 6、总结 本文预计需食用二十分钟,请各位食客合理分配时间。(别慌别慌,虽然LinkedHashMap也是哈希表,但跟HashMap比起来,内容还是要少很多的,因为很多内容在HashMap中已经讲解过了,2333) LinkedHashMap简介与简单使用 先来看看LinkedHashMap的继承结构: LinkedHashMap属于Map大家族的一员,直接继承自HashMap,所以有着HashMap的全部特性,如高效查找元素,同时,LinkedHashMap保持了内部元素的顺序,有两种顺序模式,保持元素插入顺序或者访问顺序,因此适用于需保持元素顺序的场景。另外,由于LinkedHashMap有保持元素访问顺序的模式,所以也常被用作LRU缓存(Least-Recently-Used Cache,即最近最少使用缓存策略,后面会有介绍)。 LinkedHashMap的结构以及与HashMap的对比 LinkedHashMap中的结构相比HashMap更加复杂,首先它有着HashMap相同的结构,元素用数组+链表的形式存储,除此之外,所有元素还使用了双链表进行连接,相当于HashMap和LinkedList两种结构的结合体,也正是因为元素之间使用了链表连接,所有才能让其中的元素可以保持某种顺序。但也增加了维护这个链表的开销,每次进行增加和删除元素时,除了需要调整HashMap的结构,还需要调整链表结构,不过链表调整的开销并不大,除了数据量特别大的场景,一般情况下可以小到忽略不计。另一方面,由于所有元素使用链表相连,所以遍历的效率略高于HashMap,因为HashMap遍历时,需要每个桶中先遍历到链表尾部,然后再遍历到下一个桶,当元素不多而空桶数量很多时,就会有很多次的无效访问,所以理论上来说,LinkedHashMap的遍历效率是要比HashMap高的。说了这么多,好像LinkedHashMap处处要比HashMap好,为啥不都用LinkedHashMap呢?这个问题就跟LinkedList和ArrayList对比一样,两者都有其适用的场景,并没有绝对的孰优孰劣之分,所以还是要具体情况具体分析。 好了,先来看看LinkedHashMap中的节点: 谜一样的继承关系,看完这个图,你也许会想,贵圈真乱,父类中的TreeNode继承自子类中的Entry,子类中的Entry又继承自父类中的Node。先别慌,这样做自然有它的道理,先来回顾一下Node的结构,Node是HashMap中的普通节点类,内部结构是这样的: static class Node<K,V> implements Map.Entry<K,V> { final int hash; final K key; V value; /** * 指向下一个节点的引用 */ Node<K,V> next; ......省略部分代码 } 最上面的那个Entry是Map接口中的一个内部接口,只是规定了Entry该有的方法,并没有成员变量。在LinkedHashMap中,Entry内部类是这样的: static class Entry<K,V> extends Node<K,V> { Entry<K,V> before, after; Entry(int hash, K key, V value, Node<K,V> next) { super(hash, key, value, next); } } 增加了before和after引用,这样便可以和其他Entry一起组成一个双链表,节点不仅存储了键值对信息,还可以使用next,before,after来链接前后节点,next引用仅用于HashMap结构中链接同一个桶中的后一个元素,而before和after引用则是用来链接LinkedHashMap中的所有元素,将其链接成一个双链表的形式。接下来看一个跟HashMap结构的对比图就很清晰了: 那再来回到之前的问题,为什么TreeNode要继承自LinkedHashMap中的Entry而不是直接继承自Node呢,毕竟在HashMap中并不需要使用到这样的链表性质,增加after和before两个引用只会浪费空间,首先,自然是为了复用代码,如果TreeNode直接继承自Node,则失去了链表的特性,LinkedHashMap继承HashMap后,则需要再使用另一个内部类来继承TreeNode来使得其具有链表特性,并且相关方法均需要重写,大大的增加了工作量,并且代码的可维护性会下降很多,另外,HashMap只会在桶中元素达到一定数量的时候才会将节点转换TreeNode,在哈希表散列良好的情况下,TreeNode是很少被使用到的,所以这一点点的空间浪费是值得的。 LinkedHashMap可以看成由两部分的组成,一部分与HashMap结构完全一致,另一部分则是一个双链表,由于LinkedHashMap是直接继承自HashMap的,所以哈希表的结构维护就在HashMap中的代码里进行,在LinkedHashMap中仅进行双链表的维护。这样也能很好的划分职能,使得代码结构也更加清晰。 下面来通过代码感受一下两者的区别: public class Test { public static void main(String[] args){ Map<String,Integer> linkedHashMap = new LinkedHashMap<>(); Map<String,Integer> hashMap = new HashMap<>(); for (int i = 0; i < 10; i++) { linkedHashMap.put("I" + i, i * i); hashMap.put("I" + i, i * i); } System.out.println("hashMap 遍历:"); foreach(hashMap); System.out.println("linkedHashMap遍历:"); foreach(linkedHashMap); } private static void foreach(Map map){ for (Object key : map.keySet()){ System.out.println("key:" + key.toString() + " value:" + map.get(key).toString()); } } } hashMap 遍历: key:I9 value:81 key:I0 value:0 key:I1 value:1 key:I2 value:4 key:I3 value:9 key:I4 value:16 key:I5 value:25 key:I6 value:36 key:I7 value:49 key:I8 value:64 linkedHashMap遍历: key:I0 value:0 key:I1 value:1 key:I2 value:4 key:I3 value:9 key:I4 value:16 key:I5 value:25 key:I6 value:36 key:I7 value:49 key:I8 value:64 key:I9 value:81 两个哈希表插入同样的元素,使用同样的方式进行遍历,HashMap得到的是无序的结果,而LinkedHashMap得到的是跟插入顺序一致的结果。而产生这样区别的根源就在于LinkedHashMap中的那个双链表。 接下来我们通过LinkedHashMap的插入删除过程来了解双链表的维护过程。 LinkedHashMap的插入和删除 如果你没有看过代码,你也许会想,LinkedHashMap应该是通过重写put和remove方法来实现的,但事实上LinkedHashMap并没有覆盖插入和删除方法,这一点可以通过观察LinkedHashMap代码结构发现: 那么回到前面的栗子,既然没有覆盖put方法,调用LinkedHashMap中的put方法为什么会跟HashMap中的put方法得到的结果不一样呢?让我们再来看看put方法的实现: public V put(K key, V value) { return putVal(hash(key), key, value, false, true); } final V putVal(int hash, K key, V value, boolean onlyIfAbsent, boolean evict) { Node<K,V>[] tab; Node<K,V> p; int n, i; if ((tab = table) == null || (n = tab.length) == 0) n = (tab = resize()).length; if ((p = tab[i = (n - 1) & hash]) == null) tab[i] = newNode(hash, key, value, null);//newNode方法在LinkedHashMap中被覆盖 else { Node<K,V> e; K k; if (p.hash == hash && ((k = p.key) == key || (key != null && key.equals(k)))) e = p; else if (p instanceof TreeNode) e = ((TreeNode<K,V>)p).putTreeVal(this, tab, hash, key, value); else { for (int binCount = 0; ; ++binCount) { if ((e = p.next) == null) { p.next = newNode(hash, key, value, null); if (binCount >= TREEIFY_THRESHOLD - 1) // -1 for 1st treeifyBin(tab, hash); break; } if (e.hash == hash && ((k = e.key) == key || (key != null && key.equals(k)))) break; p = e; } } if (e != null) { // existing mapping for key V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e);//关键方法A return oldValue; } } ++modCount; if (++size > threshold) resize(); afterNodeInsertion(evict);//关键方法B return null; } put方法调用的是putVal方法,在putVal方法的最后几行里,有这么两个方法值得注意, afterNodeAccess(e); afterNodeInsertion(evict); 分别是在元素被访问之后和元素被插入之后调用,而这两个回调方法,在HashMap中并没有具体实现,只有一个空壳,留个LinkedHashMap来覆盖。 // Callbacks to allow LinkedHashMap post-actions void afterNodeAccess(Node<K,V> p) { } void afterNodeInsertion(boolean evict) { } void afterNodeRemoval(Node<K,V> p) { } //在节点被移除后进行双链表的调整,移除调整其实很简单,就是把要移除的节点前一个节点的after引用指向后一个节点,把后一个节点的before引用指向前一个节点 void afterNodeRemoval(Node<K,V> e) { LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.before = p.after = null; if (b == null) head = a; else b.after = a; if (a == null) tail = b; else a.before = b; } //在节点被插入后进行双链表的调整,插入节点时会判断是否需要移除链表头节点,默认实现是不移除的,可以通过继承LinkedHashMap并覆盖removeEldestEntry方法来改变该特性 void afterNodeInsertion(boolean evict) { LinkedHashMap.Entry<K,V> first; if (evict && (first = head) != null && removeEldestEntry(first)) { K key = first.key; removeNode(hash(key), key, null, false, true); } } //在节点被访问之后进行双链表的调整(仅仅在accessOrder为true时进行,把当前访问的元素移动到链表尾部) void afterNodeAccess(Node<K,V> e) { // move node to last LinkedHashMap.Entry<K,V> last; if (accessOrder && (last = tail) != e) { LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.after = null; if (b == null) head = a; else b.after = a; if (a != null) a.before = b; else last = b; if (last == null) head = p; else { p.before = last; last.after = p; } tail = p; ++modCount; } } 再来看看在LinkedHashMap中被覆盖的newNode方法: Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) { LinkedHashMap.Entry<K,V> p = new LinkedHashMap.Entry<K,V>(hash, key, value, e); //新建节点,然后链接到双链表的尾部 linkNodeLast(p); return p; } private void linkNodeLast(LinkedHashMap.Entry<K,V> p) { LinkedHashMap.Entry<K,V> last = tail; tail = p; if (last == null) head = p; else { p.before = last; last.after = p; } } 现在再来梳理一下逻辑,插入节点的时候,会调用覆盖过的newNode方法,将插入的元素链接的链表尾部,删除节点的时候,将该节点的前后节点相连即可,当节点被访问时,可以将其放到链表尾部(该特性后面会讲解)。如果对于双链表的插入删除还是不太了解,可以回头看看前面关于LinkedList的说明,里面有关于双链表结构调整的详细讲解。(理直气壮的偷懒) LinkedHashMap的源码分析 先来看看它的几个内部类,节点类Entry在前面已经介绍过了,剩下的几个类有四个是迭代器类,三个是键、值以及键值对的集合类。先看看迭代器类,在LinkedHashMap中,也在内部实现了自己的迭代器,内部迭代器都继承自LinkedHashIterator类,该类代码如下: abstract class LinkedHashIterator { LinkedHashMap.Entry<K,V> next; LinkedHashMap.Entry<K,V> current; int expectedModCount; LinkedHashIterator() { next = head; expectedModCount = modCount; current = null; } public final boolean hasNext() { return next != null; } final LinkedHashMap.Entry<K,V> nextNode() { LinkedHashMap.Entry<K,V> e = next; if (modCount != expectedModCount) throw new ConcurrentModificationException(); if (e == null) throw new NoSuchElementException(); current = e; next = e.after; return e; } public final void remove() { Node<K,V> p = current; if (p == null) throw new IllegalStateException(); if (modCount != expectedModCount) throw new ConcurrentModificationException(); current = null; K key = p.key; removeNode(hash(key), key, null, false, false); expectedModCount = modCount; } } 这是一个抽象类,实现了迭代器的主要方法,hashNext,remove,nextNode方法,相当于一个类模板,其他迭代器类只需要继承该类然后添加一个next方法即可。 final class LinkedKeyIterator extends LinkedHashIterator implements Iterator<K> { public final K next() { return nextNode().getKey(); } } final class LinkedValueIterator extends LinkedHashIterator implements Iterator<V> { public final V next() { return nextNode().value; } } final class LinkedEntryIterator extends LinkedHashIterator implements Iterator<Map.Entry<K,V>> { public final Map.Entry<K,V> next() { return nextNode(); } } 怎么样,是不是贼简单。 剩下三个集合视图类结构基本一致,跟HashMap中的对应集合视图其实基本是一毛一样的,不信可以对比一下: // HashMap中的EntrySet final class EntrySet extends AbstractSet<Map.Entry<K,V>> { public final int size() { return size; } public final void clear() { HashMap.this.clear(); } public final Iterator<Map.Entry<K,V>> iterator() { return new EntryIterator(); } public final boolean contains(Object o) { if (!(o instanceof Map.Entry)) return false; Map.Entry<?,?> e = (Map.Entry<?,?>) o; Object key = e.getKey(); Node<K,V> candidate = getNode(hash(key), key); return candidate != null && candidate.equals(e); } public final boolean remove(Object o) { if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>) o; Object key = e.getKey(); Object value = e.getValue(); return removeNode(hash(key), key, value, true, true) != null; } return false; } public final Spliterator<Map.Entry<K,V>> spliterator() { return new EntrySpliterator<>(HashMap.this, 0, -1, 0, 0); } public final void forEach(Consumer<? super Map.Entry<K,V>> action) { Node<K,V>[] tab; if (action == null) throw new NullPointerException(); if (size > 0 && (tab = table) != null) { int mc = modCount; for (int i = 0; i < tab.length; ++i) { for (Node<K,V> e = tab[i]; e != null; e = e.next) action.accept(e); } if (modCount != mc) throw new ConcurrentModificationException(); } } } //LinkedHashMap中的EntrySet final class LinkedEntrySet extends AbstractSet<Map.Entry<K,V>> { public final int size() { return size; } public final void clear() { LinkedHashMap.this.clear(); } public final Iterator<Map.Entry<K,V>> iterator() { return new LinkedEntryIterator(); } public final boolean contains(Object o) { if (!(o instanceof Map.Entry)) return false; Map.Entry<?,?> e = (Map.Entry<?,?>) o; Object key = e.getKey(); Node<K,V> candidate = getNode(hash(key), key); return candidate != null && candidate.equals(e); } public final boolean remove(Object o) { if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>) o; Object key = e.getKey(); Object value = e.getValue(); return removeNode(hash(key), key, value, true, true) != null; } return false; } public final Spliterator<Map.Entry<K,V>> spliterator() { return Spliterators.spliterator(this, Spliterator.SIZED | Spliterator.ORDERED | Spliterator.DISTINCT); } public final void forEach(Consumer<? super Map.Entry<K,V>> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (LinkedHashMap.Entry<K,V> e = head; e != null; e = e.after) action.accept(e); if (modCount != mc) throw new ConcurrentModificationException(); } } 仅仅是在迭代器方法中返回各自的内部迭代器实例而已。其余逻辑基本一致。 LinkedKeySet和LinkedValues也很简单: final class LinkedKeySet extends AbstractSet<K> { public final int size() { return size; } public final void clear() { LinkedHashMap.this.clear(); } public final Iterator<K> iterator() { return new LinkedKeyIterator(); } public final boolean contains(Object o) { return containsKey(o); } public final boolean remove(Object key) { return removeNode(hash(key), key, null, false, true) != null; } public final Spliterator<K> spliterator() { return Spliterators.spliterator(this, Spliterator.SIZED | Spliterator.ORDERED | Spliterator.DISTINCT); } public final void forEach(Consumer<? super K> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (LinkedHashMap.Entry<K,V> e = head; e != null; e = e.after) action.accept(e.key); if (modCount != mc) throw new ConcurrentModificationException(); } } final class LinkedValues extends AbstractCollection<V> { public final int size() { return size; } public final void clear() { LinkedHashMap.this.clear(); } public final Iterator<V> iterator() { return new LinkedValueIterator(); } public final boolean contains(Object o) { return containsValue(o); } public final Spliterator<V> spliterator() { return Spliterators.spliterator(this, Spliterator.SIZED | Spliterator.ORDERED); } public final void forEach(Consumer<? super V> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (LinkedHashMap.Entry<K,V> e = head; e != null; e = e.after) action.accept(e.value); if (modCount != mc) throw new ConcurrentModificationException(); } } 看完内部类,我们再来看看它的几个构造函数: /** * 构造一个空的保持插入顺序的LinkedHashMap实例,使用指定的初始容量和装载因子 */ public LinkedHashMap(int initialCapacity, float loadFactor) { super(initialCapacity, loadFactor); accessOrder = false; } /** * 构造一个空的保持插入顺序的LinkedHashMap实例,使用指定的初始容量和默认的装载因子(0.75) */ public LinkedHashMap(int initialCapacity) { super(initialCapacity); accessOrder = false; } /** * 构造一个空的保持插入顺序的LinkedHashMap实例,使用默认的初始容量(16)和默认的装载因子(0.75) */ public LinkedHashMap() { super(); accessOrder = false; } /** * 使用指定Map的所有映射构造一个保持插入顺序的LinkedHashMap实例,使用默认的装载因子和可以容纳指定map中所有映射的合适的容量。 */ public LinkedHashMap(Map<? extends K, ? extends V> m) { super(); accessOrder = false; putMapEntries(m, false); } /** * 使用指定初始容量,指定装载因子和指定顺序模式来创建一个空的LinkedHashMap实例。 */ public LinkedHashMap(int initialCapacity, float loadFactor, boolean accessOrder) { super(initialCapacity, loadFactor); this.accessOrder = accessOrder; } 跟HashMap中的构造函数也几无二致,除了一点,那就是多了一个特殊的成员变量,accessOrder,这个变量是干嘛的呢,其实是一个表示LinkedHashMap中元素存储顺序的标志,前面也提到过,LinkedHashMap中元素其实是可以按两种顺序进行存储的,一种是元素的插入顺序,另一种便是元素的访问顺序,如果accessOrder为true,则使用访问顺序,即最近访问的元素位于链表最后,如果accessOrder为false,则使用插入顺序,即最后被插入的元素位于链表最后。默认是使用插入顺序,当然,也可以通过最后一个构造函数来使用指定顺序。如果你足够细心的话,还会发现有这么一个方法: void afterNodeInsertion(boolean evict) { // possibly remove eldest LinkedHashMap.Entry<K,V> first; // 根据条件判断是否移除最近最少被访问的节点 if (evict && (first = head) != null && removeEldestEntry(first)) { K key = first.key; removeNode(hash(key), key, null, false, true); } } // 移除最近最少被访问条件之一,通过覆盖此方法可实现不同策略的缓存 protected boolean removeEldestEntry(Map.Entry<K,V> eldest) { return false; } removeEldestEntry方法在默认情况下是返回false的,所以在插入节点的时候,默认是不会删除之前节点的,但我们可以通过继承来改变这一特性。 基于LinkedHashMap实现LRU缓存 首先还是对LRU缓存做一个相对简单的介绍: LRU(Leastrecentlyused,最近最少使用)算法根据数据的历史访问记录来进行淘汰数据,其核心思想是“如果数据最近被访问过,那么将来被访问的几率也更高”。 其实是一个缓存淘汰策略,当缓存数量达到一个阈值时,优先淘汰最近最少被访问的数据。当我们使用LinkedHashMap来实现LRU缓存时,可以通过覆写removeEldestEntry方法可以实现自定义策略的 LRU 缓存。比如我们可以根据节点数量判断是否移除最近最少被访问的节点,或者根据节点的存活时间判断是否移除该节点等。下面栗子所实现的缓存是基于判断节点数量是否超限的策略。在构造缓存对象时,传入最大节点数。当插入的节点数超过最大节点数时,移除最近最少被访问的节点。实现代码如下: public class LRUCache<K, V> extends LinkedHashMap<K, V> { private static final int MAX_CACHE_SIZE = 100; private int limit; public LRUCache() { this(MAX_CACHE_SIZE); } public LRUCache(int cacheSize) { super(cacheSize, 0.75f, true); this.limit = cacheSize; } public V save(K key, V val) { return put(key, val); } public V getOne(K key) { return get(key); } public boolean exists(K key) { return containsKey(key); } /** * 判断节点数是否超限 * @param eldest * @return 超限返回 true,否则返回 false */ @Override protected boolean removeEldestEntry(Map.Entry eldest) { return size() > limit; } @Override public String toString() { StringBuilder sb = new StringBuilder(); for (Map.Entry<K, V> entry : entrySet()) { sb.append(String.format("%s:%s ", entry.getKey(), entry.getValue())); } return sb.toString(); } public static void main(String[] args){ LRUCache<String, Integer> cache = new LRUCache<>(3); for (int i = 0; i < 10; i++) { cache.save("I" + i, i * i); } System.out.println("插入10个键值对后,缓存内容为:"); System.out.println(cache + "\n"); System.out.println("访问键值为I8的节点后,缓存内容为:"); cache.getOne("I8"); System.out.println(cache + "\n"); System.out.println("插入键值为I1的键值对后,缓存内容:"); cache.save("I1", 1); System.out.println(cache); } } 输出如下: 插入10个键值对后,缓存内容为: I7:49 I8:64 I9:81 访问键值为I8的节点后,缓存内容为: I7:49 I9:81 I8:64 插入键值为I1的键值对后,缓存内容: I9:81 I8:64 I1:1 在上述代码中,缓存大小设置为3,当在缓存中插入10个键值对后,只有最后3个被保存下来了,其他的都被移除了。然后通过访问键值为I8的节点,使得该节点被移到双向链表的最后位置。当我们再次插入一个键值对时,键值为I7的节点就会被淘汰掉。 总结 本文从 LinkedHashMap 哈希表+链表维护的角度对 LinkedHashMap 的源码进行了分析,并在文章的结尾基于 LinkedHashMap 实现了一个简单的 Cache。在日常开发中,LinkedHashMap 的使用频率虽不及 HashMap,但它也是不可或缺的重要实现。在 Java 集合框架中,HashMap、LinkedHashMap 和 TreeMap 三个映射类基于不同的数据结构,并实现了不同的功能。HashMap 底层基于拉链式的散列结构,并在 JDK 1.8 中引入红黑树优化过长链表的问题。基于这样结构,HashMap 可提供高效的增删改查操作。LinkedHashMap 在其之上,通过维护一条双向链表,实现了散列数据结构的有序遍历。TreeMap 底层基于红黑树实现,利用红黑树的性质,实现了键值对排序功能。TreeMap相关内容将会在后面的文章里进行讲解。 最后是又臭又长的源码注解,大家可以选择自己感兴趣的部分进行阅读,最好在IDE中进行阅读,这样可以很方便的进行跳转。 import java.util.*; import java.util.function.Consumer; import java.util.function.BiConsumer; import java.util.function.BiFunction; import java.io.IOException; /** * Map 接口的哈希表和链表实现,具有可预测的迭代顺序。此实现与 HashMap 的不同之处在于它维护了一个贯穿其所有条目的双向链表。 * 此链接列表定义迭代排序,通常是键插入映射的顺序(插入顺序)。 请注意,如果将键重新插入到Map中,则插入顺序不会受到影响。 * (如果在m.containsKey时调用 m.put(k,v),则将键k 重新插入到map m 中,会在调用之前立即返回true 。) * * 这种实现使客户免于{@link HashMap}(以及{@link Hashtable})提供的不确定的,通常是混乱的排序,并且不会导致类似{@link TreeMap}相关的成本增加。 * 无论原始Map的实现如何,它都可用于生成与原始Map具有相同顺序的Map副本: * * void foo(Map m) { * Map copy = new LinkedHashMap(m); * ... * } * * 如果模块在输入上获取map,复制它,然后返回其顺序由副本确定的结果,则此技术特别有用。 (客户通常会欣赏按照提交的顺序返回的内容。) * * 提供了一个特殊的{@link #LinkedHashMap(int,float,boolean)构造函数}来创建一个链接的哈希映射,其迭代顺序是其条目最后一次访问的顺序, * 从最近最少访问到最近最多访问(按存取顺序)。这种地图非常适合构建LRU缓存。调用{@code put},{@code putIfAbsent},{@code get}, * {@code getOrDefault},{@code compute},{@code computeIfAbsent},{@code computeIfPresent}或{@code merge}方法 * 导致访问相应的条目(假设它在调用完成后存在)。 {@code replace}方法仅在替换值时才会访问该条目。 {@code putAll}方法为指定映射中的 * 每个映射生成一个条目访问,按照指定映射的条目集迭代器提供键 - 值映射的顺序。没有其他方法可以生成条目访问。 * 特别是,对集合视图的操作不会影响支持映射的迭代顺序。 * * TODO LRU缓存 * * 可以重写{@link #removeEldestEntry(Map.Entry)}方法,以强制在将新映射添加到Map中时自动删除过时映射的策略。 * * 此类提供所有可选的Map操作,并允许null元素。 与HashMap一样,假设哈希函数在桶之间正确地分散元素,它将为基本操作(添加,包含和删除)提供了恒定时间 * 性能,由于维护链表的额外费用,性能可能略低于HashMap的性能,但有一个例外: * 无论其容量如何,对LinkedHashMap的集合视图进行迭代需要与映射大小成比例的时间。而对HashMap的迭代可能更昂贵,需要与其容量成比例的时间。 * * 链接的哈希映射有两个影响其性能的参数:初始容量和加载因子。它们的定义与 HashMap 完全相同。 * 但请注意,对于此类,选择过高的初始容量值的惩罚不如 HashMap ,因为此类的迭代次数不受容量影响。 * * 请注意,此实现未同步。如果多个线程同时访问链接的哈希映射,并且至少有一个线程在结构上修改了映射,则<em>必须</ em>外部同步。 * 这通常通过在自然封装地图的某个对象上进行同步来实现。如果不存在此类对象, * 则应使用{@link Collections#synchronizedMap Collections.synchronizedMap}方法“包装”映射。这最好在创建时完成, * 以防止意外地不同步访问地图: * Map m = Collections.synchronizedMap(new LinkedHashMap(...)); * * 结构修改是指任何添加或删除一个或多个映射的操作,或者在访问顺序链接的哈希映射的情况下,影响迭代顺序。 * 在插入有序链接散列映射中,仅更改与已包含在映射中的键相关联的值不是结构修改。在访问顺序链接哈希映射中,仅使用 get 查询地图是一种结构修改。 * * 由该类的所有集合视图方法<tt> iterator </ tt>方法返回的迭代器是 “fail-fast” 的: * 如果map在创建迭代器之后的任何时候进行结构修改,(除了通过迭代器自己的<tt> remove </ tt>方法之外), * 迭代器将抛出{@link ConcurrentModificationException}。因此,在并发修改的情况下,迭代器快速而干净地失败, * 而不是在未来的未确定时间冒任意,非确定性行为的风险。 * * 请注意,迭代器的快速失败行为无法得到保证,因为一般来说,在存在非同步并发修改的情况下,不可能做出任何硬性保证。 * 失败快速的迭代器会尽最大努力抛出<tt> ConcurrentModificationException </ tt>。因此,编写依赖于此异常的程序以确保其正确性是错误的: * 迭代器的故障快速行为应仅用于检测错误。 * * 分裂器返回的分裂器所有此类的集合视图方法返回的集合的方法是后期绑定的,失败快速的和附加报告的{@link Spliterator #OrderED}。 * */ public class LinkedHashMap<K,V> extends HashMap<K,V> implements Map<K,V> { /** * 实现说明。 此类的先前版本的内部结构略有不同。 因为超类HashMap现在为其某些节点使用树节点,所以类Entry现在被视为中间节点类, * 也可以转换为树形式。 这个类的名称Entry在其当前上下文中以多种方式混淆,但无法更改。 否则,即使它未被导出到此包之外, * 已知一些现有的源代码依赖于对removeEldestEntry的调用中的符号解析角案例规则,该删除由于模糊使用而抑制了编译错误。 * 因此,我们保留名称以保留未修改的可编译性。 节点类的更改还需要使用两个字段(头部,尾部)而不是指向标头节点的指针来维护列表之前/之后的双向链接。 * 此类以前还在访问,插入和删除时使用了不同类型的回调方法。 */ /** * 普通 LinkedHashMap 条目的HashMap.Node子类. */ static class Entry<K,V> extends Node<K,V> { Entry<K,V> before, after; Entry(int hash, K key, V value, Node<K,V> next) { super(hash, key, value, next); } } private static final long serialVersionUID = 3801124242820219131L; /** * 第一个条目 */ transient Entry<K,V> head; /** * 最后一个条目 */ transient Entry<K,V> tail; /** * 迭代顺序,true代表使用访问顺序进行迭代,false代表使用插入顺序进行迭代 */ final boolean accessOrder; // 内部工具方法 // 链接到链表尾部 private void linkNodeLast(Entry<K,V> p) { Entry<K,V> last = tail; tail = p; if (last == null) head = p; else { p.before = last; last.after = p; } } // 用dst条目代替src条目 private void transferLinks(Entry<K,V> src, Entry<K,V> dst) { Entry<K,V> b = dst.before = src.before; Entry<K,V> a = dst.after = src.after; if (b == null) head = dst; else b.after = dst; if (a == null) tail = dst; else a.before = dst; } // 重载 HashMap 中的方法 void reinitialize() { super.reinitialize(); head = tail = null; } // 新建条目并链接到链表尾部 Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) { Entry<K,V> p = new Entry<K,V>(hash, key, value, e); linkNodeLast(p); return p; } // 代替节点 Node<K,V> replacementNode(Node<K,V> p, Node<K,V> next) { Entry<K,V> q = (Entry<K,V>)p; Entry<K,V> t = new Entry<K,V>(q.hash, q.key, q.value, next); transferLinks(q, t); return t; } TreeNode<K,V> newTreeNode(int hash, K key, V value, Node<K,V> next) { TreeNode<K,V> p = new TreeNode<K,V>(hash, key, value, next); linkNodeLast(p); return p; } TreeNode<K,V> replacementTreeNode(Node<K,V> p, Node<K,V> next) { Entry<K,V> q = (Entry<K,V>)p; TreeNode<K,V> t = new TreeNode<K,V>(q.hash, q.key, q.value, next); transferLinks(q, t); return t; } // 节点移除之后,将其从双链表中拆分出来 void afterNodeRemoval(Node<K,V> e) { // unlink Entry<K,V> p = (Entry<K,V>)e, b = p.before, a = p.after; p.before = p.after = null; if (b == null) head = a; else b.after = a; if (a == null) tail = b; else a.before = b; } // 节点插入之后判断是否需要将最早的元素进行删除 void afterNodeInsertion(boolean evict) { // possibly remove eldest Entry<K,V> first; // 要同时满足三个条件才能在插入元素后对最早插入条目进行删除 if (evict && (first = head) != null && removeEldestEntry(first)) { K key = first.key; removeNode(hash(key), key, null, false, true); } } // 在节点被访问之后,判断是否需要将被访问过的节点移动到双链表的最末尾 void afterNodeAccess(Node<K,V> e) { // move node to last Entry<K,V> last; // 当accessOrder成员变量为true并且该访问元素不是最后一个元素时,将其移动到双链表的末尾 if (accessOrder && (last = tail) != e) { Entry<K,V> p = (Entry<K,V>)e, b = p.before, a = p.after; p.after = null; if (b == null) head = a; else b.after = a; if (a != null) a.before = b; else last = b; if (last == null) head = p; else { p.before = last; last.after = p; } tail = p; ++modCount; } } // 重写hashmap的internalWriteEntries方法,进行输出流的写入 void internalWriteEntries(java.io.ObjectOutputStream s) throws IOException { for (Entry<K,V> e = head; e != null; e = e.after) { s.writeObject(e.key); s.writeObject(e.value); } } /** * 构造一个空的保持插入顺序的LinkedHashMap实例,使用指定的初始容量和装载因子 */ public LinkedHashMap(int initialCapacity, float loadFactor) { super(initialCapacity, loadFactor); accessOrder = false; } /** * 构造一个空的保持插入顺序的LinkedHashMap实例,使用指定的初始容量和默认的装载因子(0.75) */ public LinkedHashMap(int initialCapacity) { super(initialCapacity); accessOrder = false; } /** * 构造一个空的保持插入顺序的LinkedHashMap实例,使用默认的初始容量(16)和默认的装载因子(0.75) */ public LinkedHashMap() { super(); accessOrder = false; } /** * 使用指定Map的所有映射构造一个保持插入顺序的LinkedHashMap实例,使用默认的装载因子和可以容纳指定map中所有映射的合适的容量。 */ public LinkedHashMap(Map<? extends K, ? extends V> m) { super(); accessOrder = false; putMapEntries(m, false); } /** * 使用指定初始容量,指定装载因子和指定顺序模式来创建一个空的LinkedHashMap实例。 */ public LinkedHashMap(int initialCapacity, float loadFactor, boolean accessOrder) { super(initialCapacity, loadFactor); this.accessOrder = accessOrder; } /** * Returns <tt>true</tt> if this map maps one or more keys to the * specified value. * * @param value value whose presence in this map is to be tested * @return <tt>true</tt> if this map maps one or more keys to the * specified value */ public boolean containsValue(Object value) { // TODO 与hashmap的遍历方式进行比较 // LinkedHashMap中遍历元素时都是使用链表的方式进行遍历 for (Entry<K,V> e = head; e != null; e = e.after) { V v = e.value; if (v == value || (value != null && value.equals(v))) return true; } return false; } /** * 获取指定key对应的value,不存在则返回null * 返回null时有两种可能,一种是该key没有对应的映射,另一种是该key对应的value是null,可以使用containsKey方法对这两种情况进行区分 */ public V get(Object key) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null) return null; if (accessOrder) afterNodeAccess(e); return e.value; } /** * 获取指定key对应的value,如果不存在则返回默认值 */ public V getOrDefault(Object key, V defaultValue) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null) return defaultValue; if (accessOrder) afterNodeAccess(e); return e.value; } /** * 清除元素 */ public void clear() { super.clear(); head = tail = null; } /** * 如果此map应删除其最旧的条目,则返回true 。在将新条目插入Map后,put 和 putAll 将调用此方法。 * 它为实现者提供了在每次添加新条目时删除最旧条目的机会。如果映射表示高速缓存,则此选项非常有用:它允许映射通过删除过时条目来减少内存消耗。 * * 示例:此覆盖实现将允许map增长到100个条目, * 然后在每次添加新条目时删除最旧的条目,保持100个条目的稳定状态。 * * private static final int MAX_ENTRIES = 100; * protected boolean removeEldestEntry(Map.Entry eldest){ * return size(); MAX_ENTRIES; * } * * 此方法通常不会以任何方式修改地图,而是允许地图按其返回值的指示修改自身。 此方法直接修改map是允许的,但如果它这样做, * 它必须返回false(表示map不应该尝试任何进一步的修改)。在此方法中修改地图后返回 true 的效果未指定。此实现仅返回 false * (因此此映射的行为类似于普通映射 - 永远不会删除最旧的元素)。 * * @param eldest map中最近插入的条目,或者如果这是访问顺序地图,则是最近访问的条目。这是将被删除的条目,此方法返回 true 。 * 如果在 put 或 putAll 调用之前映射为空,从而导致此调用,则这将是刚刚插入的条目;换句话说,如果map包含单个条目, * 则最老的条目也是最新的。 * * @return true 表示应从map中删除最年长的条目; false 表示应该保留。 */ protected boolean removeEldestEntry(Map.Entry<K,V> eldest) { return false; } /** * 返回包含该map所有key的{@link Set}视图。 该集合由map支持,因此对map的更改将反映在集中,反之亦然。 如果在对集合进行迭代时修改了映射 * (除了通过迭代器自己的remove 操作),迭代的结果是未定义的。 该集支持元素删除,它通过 Iterator.remove ,Set.remove , removeAll * ,从地map中删除相应的映射。 retainAll 和 clear 操作。 它不支持 add 或 addAll 操作。 它的{@link Spliterator}通常提供更快的顺序性能, * 但并行性能比{@code HashMap}差得多。 */ public Set<K> keySet() { Set<K> ks = keySet; if (ks == null) { ks = new LinkedKeySet(); keySet = ks; } return ks; } final class LinkedKeySet extends AbstractSet<K> { public final int size() { return size; } public final void clear() { this.clear(); } public final Iterator<K> iterator() { return new LinkedKeyIterator(); } public final boolean contains(Object o) { return containsKey(o); } public final boolean remove(Object key) { return removeNode(hash(key), key, null, false, true) != null; } public final Spliterator<K> spliterator() { return Spliterators.spliterator(this, Spliterator.SIZED | Spliterator.ORDERED | Spliterator.DISTINCT); } public final void forEach(Consumer<? super K> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (Entry<K,V> e = head; e != null; e = e.after) action.accept(e.key); if (modCount != mc) throw new ConcurrentModificationException(); } } public Collection<V> values() { Collection<V> vs = values; if (vs == null) { vs = new LinkedValues(); values = vs; } return vs; } final class LinkedValues extends AbstractCollection<V> { public final int size() { return size; } public final void clear() { this.clear(); } public final Iterator<V> iterator() { return new LinkedValueIterator(); } public final boolean contains(Object o) { return containsValue(o); } public final Spliterator<V> spliterator() { return Spliterators.spliterator(this, Spliterator.SIZED | Spliterator.ORDERED); } public final void forEach(Consumer<? super V> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (Entry<K,V> e = head; e != null; e = e.after) action.accept(e.value); if (modCount != mc) throw new ConcurrentModificationException(); } } /** * 返回包含该map中所有映射的Set视图,该set由map支持,因此对map的更改将反映在set中,反之亦然。 如果在对集合进行迭代时修改了映射 * (除非通过迭代器自己的 remove 操作,或者对迭代器返回的映射条目执行 setValue 操作) )迭代的结果是未定义的。 该集支持元素删除, * 它通过 Iterator.remove Set.remove , removeAll ,从地图中删除相应的映射。 retainAll 和 clear 操作。 它不支持 add 或 * addAll 操作。 它的{@link Spliterator}通常提供更快的顺序性能,但并行性能比{@code HashMap}差得多。 */ public Set<Map.Entry<K,V>> entrySet() { Set<Map.Entry<K,V>> es; return (es = entrySet) == null ? (entrySet = new LinkedEntrySet()) : es; } final class LinkedEntrySet extends AbstractSet<Map.Entry<K,V>> { public final int size() { return size; } public final void clear() { this.clear(); } public final Iterator<Map.Entry<K,V>> iterator() { return new LinkedEntryIterator(); } public final boolean contains(Object o) { if (!(o instanceof Map.Entry)) return false; Map.Entry<?,?> e = (Map.Entry<?,?>) o; Object key = e.getKey(); Node<K,V> candidate = getNode(hash(key), key); return candidate != null && candidate.equals(e); } public final boolean remove(Object o) { if (o instanceof Map.Entry) { Map.Entry<?,?> e = (Map.Entry<?,?>) o; Object key = e.getKey(); Object value = e.getValue(); return removeNode(hash(key), key, value, true, true) != null; } return false; } public final Spliterator<Map.Entry<K,V>> spliterator() { return Spliterators.spliterator(this, Spliterator.SIZED | Spliterator.ORDERED | Spliterator.DISTINCT); } public final void forEach(Consumer<? super Map.Entry<K,V>> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (Entry<K,V> e = head; e != null; e = e.after) action.accept(e); if (modCount != mc) throw new ConcurrentModificationException(); } } // Map overrides public void forEach(BiConsumer<? super K, ? super V> action) { if (action == null) throw new NullPointerException(); int mc = modCount; for (Entry<K,V> e = head; e != null; e = e.after) action.accept(e.key, e.value); if (modCount != mc) throw new ConcurrentModificationException(); } public void replaceAll(BiFunction<? super K, ? super V, ? extends V> function) { if (function == null) throw new NullPointerException(); int mc = modCount; for (Entry<K,V> e = head; e != null; e = e.after) e.value = function.apply(e.key, e.value); if (modCount != mc) throw new ConcurrentModificationException(); } // 迭代器 abstract class LinkedHashIterator { Entry<K,V> next; Entry<K,V> current; int expectedModCount; LinkedHashIterator() { next = head; expectedModCount = modCount; current = null; } public final boolean hasNext() { return next != null; } final Entry<K,V> nextNode() { Entry<K,V> e = next; if (modCount != expectedModCount) throw new ConcurrentModificationException(); if (e == null) throw new NoSuchElementException(); current = e; next = e.after; return e; } public final void remove() { Node<K,V> p = current; if (p == null) throw new IllegalStateException(); if (modCount != expectedModCount) throw new ConcurrentModificationException(); current = null; K key = p.key; removeNode(hash(key), key, null, false, false); expectedModCount = modCount; } } final class LinkedKeyIterator extends LinkedHashIterator implements Iterator<K> { public final K next() { return nextNode().getKey(); } } final class LinkedValueIterator extends LinkedHashIterator implements Iterator<V> { public final V next() { return nextNode().value; } } final class LinkedEntryIterator extends LinkedHashIterator implements Iterator<Map.Entry<K,V>> { public final Map.Entry<K,V> next() { return nextNode(); } } } 至此,本篇就算完结啦,一周一篇的小目标也算是完成了,周末要去浪浪浪了,哈哈哈哈。 后续还会继续更新,欢迎继续关注! 真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

【Java入门提高篇】Day27 Java容器类详解(九)LinkedList详解

这次介绍一下List接口的另一个践行者——LinkedList,这是一位集诸多技能于一身的List接口践行者,可谓十八般武艺,样样精通,栈、队列、双端队列、链表、双向链表都可以用它来模拟,话不多说,赶紧一起来看看吧。 本篇将从以下几个方面对LinkedList进行解析: 1.LinkedList整体结构。 2.LinkedList基本操作使用栗子。 3.LinkedList与ArrayList的对比分析。 4.LinkedList整体源码分析。 LinkedList整体结构 先来看看LinkedList中的结构,LinkedList跟ArrayList不一样,ArrayList中是动态维护了一个数组,所有的操作都是 在该数据上进行操作,而LinkedList中其实是一个个的Node节点,每个Node节点首尾相连。如果你还记得前几篇的内容的话,就应该会想起HashMap中其实也是有Node节点的,但两者还是有比较多不一样的地方,先来看看LinkedList中的Node吧。 private static class Node<E> { E item; Node<E> next; Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } 嗯,其实很简单,里面只有三个成员变量,item用来存储具体的元素信息,next指向下一个Node节点,prev指向上一个Node节点,node节点之间通过next和prev相连接,组成了一个双向链表的形式。 嗯,看图说话应该就很好懂了,LinkedList正是由Node这样首尾相连组成了铁索连环的格局。而HashMap中的Node节点其实是一个单链表的节点,只有指向后一个节点的引用(next),并没有指向前一个节点的引用,回顾一下HashMap的Node节点代码便能发现这一点。 static class Node<K,V> implements Map.Entry<K,V> { final int hash; final K key; V value; Node<K,V> next; Node(int hash, K key, V value, Node<K,V> next) { this.hash = hash; this.key = key; this.value = value; this.next = next; } ......省略部分代码 } LinkedList基本操作使用栗子 接下来看看LinkedList中的一些基础操作,以下是一个小栗子: ublic class LinkedListTest { public static void main(String[] args){ // 定义要插入集合的字符串对象 String a = "A", b = "B", c = "C", d = "D", e = "E", f = "F", g = "G"; // 创建List集合 LinkedList<String> list = new LinkedList<>(); // add操作 添加元素 list.add(a); list.add(b); list.add(c); list.add(f); // 迭代器遍历 System.out.println("修改前:"); traverseListByIterator(list); // set操作 // 将索引位置为1的对象修改为对象g list.set(1, g); // 将索引位置为2的对象修改为对象d list.set(2, e); // 新建迭代器进行遍历(注意:迭代器是一次性使用的,遍历到列表尾部之后,无法重置,再次遍历时需要新建迭代器) System.out.println(); System.out.println("set修改后的集合中的元素是:"); traverseListByIterator(list); // 创建ArrayList List<String> strings = new ArrayList<>(); strings.add(d); strings.add(a); strings.add(f); // addAll添加所有元素 list.addAll(strings); //foreach方式遍历 System.out.println("addAll修改后的集合中的元素是:"); traverseListByForEach(list); // remove移除元素 String removeElement = list.remove(); System.out.println("移除的元素是:" + removeElement); System.out.println("remove修改后的集合中的元素是:"); traverseListByForEach(list); // add插入元素(在第四个位置插入元素"gg") list.add(3, "gg"); System.out.println("add插入元素后的集合中的元素是:"); traverseListByForEach(list); } /** * foreach方式遍历列表 * @param list 待遍历的列表 */ private static <T> void traverseListByForEach(List<T> list){ for (T t : list){ System.out.print(t + " "); } System.out.println(); } /** * 迭代器方式遍历列表 * @param list 待遍历的列表 */ private static <T> void traverseListByIterator(List<T> list){ Iterator<T> iterator = list.iterator(); // 循环获取列表中的元素 while (iterator.hasNext()) { System.out.print(iterator.next() + " "); } } } 这里仅仅演示了LinkedList的链表操作,主要有add、addAll、remove、set等,几乎每个常用方法都有重载方法,比如只有一个参数的add方法,会直接将该元素插入到列表的尾部,而有两个参数的add方法,会将元素插入指定位置。 LinkedList与ArrayList的对比分析 也许你会问,ArrayList不是也挺好用的吗,那些操作ArrayList也能做啊,为什么还要用LinkedList呢? 这是一个好问题,ArrayList的最大特点就是能随机访问,因为元素在物理上是连续存储的,所以访问的时候,可以通过简单的算法直接定位到指定位置,所以不管队列的元素数量有多少,总能在O(1)的时间里定位到指定位置,但是连续存储也是它的缺点,导致要在中间插入一个元素的时候,所有之后的元素都要往后挪动。而LinkedList的插入只需要调整前后元素的引用即可。 看图说话,ArrayList插入显然需要进行更多的赋值操作,特别是数组元素个数比较多的时候,会更加明显,如果刚好需要扩容的话,那就会更慢了。而LinkedList只需要将插入位置的前后元素的next或prev引用进行调整即可,而且也没有扩容问题,因为它本身就没有容量的概念,理论上可以无限添加元素。 然后来实际对比一下效率差距: public abstract class TimeCounter { private String name; TimeCounter(String name){ this.name = name; } public void count(){long time = System.currentTimeMillis(); doSomething(); System.out.println(name + " 耗时:" + (System.currentTimeMillis() - time)); } protected abstract void doSomething(); } 先将这个计时抽象成一个模板,每个需要统计耗时的操作只需要继承该类,然后重写doSomeThing方法即可。 public class Test { public static void main(String[] args){ TimeCounter arrayListAddCounter = new TimeCounter("ArrayList add插入到末尾:") { private List<Integer> list = new ArrayList<>(); @Override protected void doSomething() { for (int i = 0; i < 100000; i++) { list.add( i); } } }; TimeCounter linkedListAddCounter = new TimeCounter("LinkedList add插入到末尾:") { private List<Integer> list = new LinkedList<>(); @Override protected void doSomething() { for (int i = 0; i < 100000; i++) { list.add( i); } } }; arrayListAddCounter.count(); linkedListAddCounter.count(); } } ArrayList add插入到末尾: 耗时:11 LinkedList add插入到末尾: 耗时:9 好像勉强符合预期,LinkedList比ArrayList略微快一点,其实如果在ArrayList容量足够的情况下,ArrayList的插入元素到末尾操作是要比LinkedList插入要快的,因为它只需要进行一次赋值即可,而LinkedList还需要先new一个新节点然后再接到链表的最后,这个new的过程看起来微不足道,但是一旦循环次数到达一定量级,开销是不可忽略的。例如把上面的循环次数从100000改成1000000,结果就会变成这样: ArrayList add插入到末尾: 耗时:40 LinkedList add插入到末尾: 耗时:768 这时候,创建节点的开销成了主要时间开销,效率甚至不如ArrayList。我们再换一个插入方式,上面是把元素插入到末尾,这次来把元素插入到首端看看: public class Test { public static void main(String[] args){ TimeCounter arrayListAddCounter = new TimeCounter("ArrayList add插入到首端:") { private List<Integer> list = new ArrayList<>(); @Override protected void doSomething() { for (int i = 0; i < 100000; i++) { list.add(0, i); } } }; TimeCounter linkedListAddCounter = new TimeCounter("LinkedList add插入到首端:") { private List<Integer> list = new LinkedList<>(); @Override protected void doSomething() { for (int i = 0; i < 100000; i++) { list.add(0, i); } } }; arrayListAddCounter.count(); linkedListAddCounter.count(); } } ArrayList add插入到首端: 耗时:607 LinkedList add插入到首端: 耗时:11 当每次都插入在首端时,ArrayList每次都需要进行元素移动,而且列表中元素越多,需要进行移动的次数也越多,在这种情况下,LinkedList是明显优于ArrayList的。 所以说,其实这两者是各有所长各有所短的,一般情况下,选ArrayList就好,除非是需要进行循环操作的次数到达了万的量级的时候,才需要对两者进行选择。也许你会说,既然一般情况下,两者的效率差别不大,那直接用ArrayList就好了,说这么多干嘛呢。哈哈,如果是这样想,那就大错特错了。首先我们不仅需要知其然,还需要知其所以然,如果仅仅知道LinkedList比ArrayList插入效率高,但是却不知道为什么高,高多少,是远远不够的。其次,我们不能仅仅考虑正常情况,对于极端情况也需要有预防措施,对极端情况的思考,正是高手与新手的最大区别。 下面再看看查找元素的比较: public class Test { public static void main(String[] args){ TimeCounter arrayListAddCounter = new TimeCounter("ArrayList get遍历元素:") { private List<Integer> list = new ArrayList<>(); { for (int i = 0; i < 100000; i++) { list.add(i); } } @Override protected void doSomething() { for (int i = 0; i < 100000; i++) { list.get(i); } } }; TimeCounter linkedListAddCounter = new TimeCounter("LinkedList get遍历元素:") { private List<Integer> list = new LinkedList<>(); { for (int i = 0; i < 100000; i++) { list.add(i); } } @Override protected void doSomething() { for (int i = 0; i < 100000; i++) { list.get(i); } } }; arrayListAddCounter.count(); linkedListAddCounter.count(); } } ArrayList get遍历元素: 耗时:3 LinkedList get遍历元素: 耗时:4484 ArrayList完胜,可以看出LinkedList中查找元素是一个十分耗时的操作,甚至比插入元素耗时还要长,因为每次get的时候都是从链表两端进行逐个查找,直到找到指定的位置。想要知道具体细节的话,那就耐心的看看下面的源码解析吧。 LinkedList整体源码分析 先来看看LinkedList的整体结构: 可以看到LinkedList有四个内部类,分别是Node、ListItr、DescendingIterator、LLSpliterator。Node类主要用于存放元素,先来看看Node: private static class Node<E> { //存放元素 E item; //指向下一个Node节点 Node<E> next; //指向上一个Node节点 Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } 这是可以说是最简单的类了,也构成了LinkedList的基础,LinkedList正是由一个个Node节点连接组成。再来看看ListItr类: //列表迭代器类 private class ListItr implements ListIterator<E> { private Node<E> lastReturned; private Node<E> next; private int nextIndex; private int expectedModCount = modCount; ListItr(int index) { // assert isPositionIndex(index); next = (index == size) ? null : node(index); nextIndex = index; } public boolean hasNext() { return nextIndex < size; } public E next() { checkForComodification(); if (!hasNext()) throw new NoSuchElementException(); lastReturned = next; next = next.next; nextIndex++; return lastReturned.item; } public boolean hasPrevious() { return nextIndex > 0; } public E previous() { checkForComodification(); if (!hasPrevious()) throw new NoSuchElementException(); lastReturned = next = (next == null) ? last : next.prev; nextIndex--; return lastReturned.item; } public int nextIndex() { return nextIndex; } public int previousIndex() { return nextIndex - 1; } public void remove() { checkForComodification(); if (lastReturned == null) throw new IllegalStateException(); Node<E> lastNext = lastReturned.next; unlink(lastReturned); if (next == lastReturned) next = lastNext; else nextIndex--; lastReturned = null; expectedModCount++; } public void set(E e) { if (lastReturned == null) throw new IllegalStateException(); checkForComodification(); lastReturned.item = e; } public void add(E e) { checkForComodification(); lastReturned = null; if (next == null) linkLast(e); else linkBefore(e, next); nextIndex++; expectedModCount++; } public void forEachRemaining(Consumer<? super E> action) { Objects.requireNonNull(action); while (modCount == expectedModCount && nextIndex < size) { action.accept(next.item); lastReturned = next; next = next.next; nextIndex++; } checkForComodification(); } final void checkForComodification() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); } } 这个类是LinkedList的迭代器类,主要用于顺序遍历LinkedList,在前面的栗子中有使用迭代器的hasNext方法和next方法,其实它们的实现都很简单,hasNext只是简单的比较下一个要访问的元素序号是否大于列表中的元素个数,next方法则是将next的引用赋值给lastReturned变量,然后将next指向其下一个节点并且将index加1。但跟普通迭代器不一样的地方在于这个迭代器不仅可以正序遍历,还可以使用previous方法进行倒序遍历,DescendingIterator便是使用了迭代器的previous方法进行便利的。 /** * 降序迭代器 */ private class DescendingIterator implements Iterator<E> { private final ListItr itr = new ListItr(size()); public boolean hasNext() { return itr.hasPrevious(); } public E next() { return itr.previous(); } public void remove() { itr.remove(); } } 这个迭代器就比较简单了,只是包裹了一个ListItr实例,然后重载了Iterator的几个方法。LLSpliterator是用于并行流的可分割式迭代器,这里就不做过多介绍了。 再来看看常用的几个方法的实现: /** * 添加指定元素到列表尾部 */ public boolean add(E e) { linkLast(e); return true; } /** * 把元素e链接成尾节点 */ void linkLast(E e) { final Node<E> l = last; final Node<E> newNode = new Node<>(l, e, null); last = newNode; if (l == null) first = newNode; else l.next = newNode; size++; modCount++; } 当插入一个元素时,会new一个Node对象,并将该值放入Node节点中,然后挂到链表的尾部。 /** * 在列表指定位置插入指定元素 */ public void add(int index, E element) { checkPositionIndex(index); if (index == size) linkLast(element); else linkBefore(element, node(index)); } /** * 插入一个元素到指定非空节点之前 */ void linkBefore(E e, Node<E> succ) { // assert succ != null; final Node<E> pred = succ.prev; final Node<E> newNode = new Node<>(pred, e, succ); succ.prev = newNode; if (pred == null) first = newNode; else pred.next = newNode; size++; modCount++; } add的重载版本,可以指定序号进行插入,将元素插入到链表中间,进行的操作过程可以联系前面的图进行理解。 /** * 返回指定位置的元素 */ public E get(int index) { checkElementIndex(index); return node(index).item; } /** * 返回指定元素序号的非空节点。 */ Node<E> node(int index) { // assert isElementIndex(index); //做了一个小优化,如果取的序号小于元素个数的一半,则从链表首端开始遍历,否则从链表尾部开始遍历 if (index < (size >> 1)) { Node<E> x = first; for (int i = 0; i < index; i++) x = x.next; return x; } else { Node<E> x = last; for (int i = size - 1; i > index; i--) x = x.prev; return x; } } 可以看到get方法其实是从头部或者尾部进行遍历定位的,每次将x的引用向后/向前移动一位,当链表数据量比较大时,这个过程其实是很耗时间的,前面的对比中应该也能发现这一点。 /** * 取回并删除此列表的头部(第一个元素)。 */ public E remove() { return removeFirst(); } /** * 移除列表指定位置的元素,如果其后子序列存在,则将其元素左移,将它们的序号减一。 * 返回列表中移除的元素。 */ public E remove(int index) { checkElementIndex(index); return unlink(node(index)); } /** * 移除并返回首节点 */ public E removeFirst() { final Node<E> f = first; if (f == null) throw new NoSuchElementException(); return unlinkFirst(f); } /** * 移除首节点并返回该节点元素值 */ private E unlinkFirst(Node<E> f) { // assert f == first && f != null; final E element = f.item; final Node<E> next = f.next; f.item = null; f.next = null; // help GC first = next; if (next == null) last = null; else next.prev = null; size--; modCount++; return element; } /** * 移除非空节点x */ E unlink(Node<E> x) { // assert x != null; final E element = x.item; final Node<E> next = x.next; final Node<E> prev = x.prev; if (prev == null) { first = next; } else { prev.next = next; x.prev = null; } if (next == null) { last = prev; } else { next.prev = prev; x.next = null; } x.item = null; size--; modCount++; return element; } remove方法也有两个重载版本,不带参数的remove方法仅仅移除并返回最后一个节点,而指定序号参数的remove方法则会移除并返回链表中指定位置的节点。 此外链表还有可以用于队列的诸多方法: 在尾部添加元素:(add, offer),add()会在长度不够时抛出异常:IllegalStateException; offer()则不会,只返回false。 查看头部元素 (element, peek),返回头部元素,但不改变队列。element()会在没元素时抛出异常:NoSuchElementException; peek()返回null; 删除头部元素 (remove,poll),返回头部元素,并且从队列中删除,remove()会在没元素时抛出异常:NoSuchElementException; poll()返回null; 即可以通过以上方法来实现单向队列的操作,也可以使用addFirst,addLast,removeFirst,removeLast方法来实现双向队列的操作。以下是一个简单队列的实现: public class MyQueue<T> { private LinkedList<T> list = new LinkedList<T>(); //清空队列 public void clear() { list.clear(); } //判断队列是否为空 public boolean isEmpty() { return list.isEmpty(); } //进队 public void enqueue(T o) { list.addLast(o); } //出队 public T dequeue(){ if(!list.isEmpty()) { return list.removeFirst(); } return null; } //获取队列长度 public int length() { return list.size(); } //查看队首元素 public T peek() { return list.getFirst(); } //测试队列 public static void main(String[] args) { MyQueue<String> queue = new MyQueue<String>(); System.out.println(queue.isEmpty()); queue.enqueue("a"); queue.enqueue("b"); queue.enqueue("c"); queue.enqueue("d"); queue.enqueue("e"); queue.enqueue("f"); System.out.println(queue.length()); System.out.println(queue.dequeue()); System.out.println(queue.dequeue()); System.out.println(queue.peek()); System.out.println(queue.dequeue()); queue.clear(); queue.enqueue("s"); queue.enqueue("t"); queue.enqueue("r"); System.out.println(queue.dequeue()); System.out.println(queue.length()); System.out.println(queue.peek()); System.out.println(queue.dequeue()); } } 嗯,其实就是借鸡生蛋的事情嘛,哈哈。 再来看看用LinkedList的简单栈实现: public class MyStack<T> { private LinkedList<T> stack = new LinkedList<T>(); // 入栈 public void push(T v) { stack.addFirst(v); } // 出栈,但不删除 public T peek() { return stack.getFirst(); } // 出栈 public T pop() { return stack.removeFirst(); } // 栈是否为空 public boolean empty() { return stack.isEmpty(); } // 打印栈元素 public String toString() { return stack.toString(); } } 你看,其实很简单吧,LinkedList提供的大量的方法,可以很方便的进行链表、双向链表、队列、双端队列、栈等数据结构的实现,可以说非常好用了。 下面是LinkedList的全部源码,行有余力的话可以选择你想要了解的部分进行阅读,如果有不懂的地方可以在本文后面留言,当然,也可以直接跳过,以后想要深入了解的时候再进行阅读也不迟。 /** * 双向链表实现了List接口和Deque接口,实现了多有可选List操作,并且允许放入所有的元素,包括null。 * * 所有的操作都表现得像双向链表,索引到列表中的操作将从开头或者结尾遍历列表,以较接近指定索引为准。 * * 注意,这个实现类不是线程安全的,如果多个线程同时访问一个链表,并且至少一个线程修改了链表的结构, * 则必须在外部实现同步。结构性修改指的是那些增加删除一个或多个元素的操作,仅设置元素的值不是结构修改。 * 这通常通过在封装列表的某个对象上进行同步来实现。 * * 如果没有这样的对象存在,则列表应该使用Collections#synchronizedList方法包装,最好在创建列表的时候进行, * 以防止意外的非同步引用对列表进行了修改。 * List list = Collections.synchronizedList(new LinkedList(...)); * * 该类的iterator方法和listIterator方法返回的迭代器是“fail-fast”的,如果列表在迭代器创建之后的任何时刻被进行 * 结构性的修改了,则调用迭代器自身的remove或者add方法时将会抛出ConcurrentModificationException异常,因此 * 当遇到并发修改时,迭代器会快速的失败,而不是在未来某个不确定的时刻进行武断冒险或不确定性的行为 * * 注意,通常来说,不能保证迭代器的fail-fast机制,在遇到非同步的并发修改时,不可能做出任何严格的保证。 * fail-fast 迭代器只能尽最大努力抛出ConcurrentModificationException异常,因此,如果程序依赖这个异常来 * 进行正确性判断是错误的,fail-fast机制仅应该用于检测异常。 * */ public class LinkedList<E> extends AbstractSequentialList<E> implements List<E>, Deque<E>, Cloneable, java.io.Serializable { transient int size = 0; /** * 指向第一个节点 * 恒等式: (first == null && last == null) || * (first.prev == null && first.item != null) */ transient Node<E> first; /** * 指向最后一个节点 * 恒等式: (first == null && last == null) || * (last.next == null && last.item != null) */ transient Node<E> last; /** * 构造一个空的列表 */ public LinkedList() { } /** * 构造一个包含指定集合内所有元素的列表,存储的顺序为集合的迭代器访问顺序。 * @throws NullPointerException 空指针异常 */ public LinkedList(Collection<? extends E> c) { this(); addAll(c); } /** * 把元素e链接成首节点 */ private void linkFirst(E e) { final Node<E> f = first; final Node<E> newNode = new Node<>(null, e, f); first = newNode; if (f == null) last = newNode; else f.prev = newNode; size++; modCount++; } /** * 把元素e链接成尾节点 */ void linkLast(E e) { final Node<E> l = last; final Node<E> newNode = new Node<>(l, e, null); last = newNode; if (l == null) first = newNode; else l.next = newNode; size++; modCount++; } /** * 插入一个元素到指定非空节点之前 */ void linkBefore(E e, Node<E> succ) { // assert succ != null; final Node<E> pred = succ.prev; final Node<E> newNode = new Node<>(pred, e, succ); succ.prev = newNode; if (pred == null) first = newNode; else pred.next = newNode; size++; modCount++; } /** * 移除首节点并返回该节点元素值 */ private E unlinkFirst(Node<E> f) { // assert f == first && f != null; final E element = f.item; final Node<E> next = f.next; f.item = null; f.next = null; // help GC first = next; if (next == null) last = null; else next.prev = null; size--; modCount++; return element; } /** * 移除尾节点并返回该节点元素值 */ private E unlinkLast(Node<E> l) { // assert l == last && l != null; final E element = l.item; final Node<E> prev = l.prev; l.item = null; l.prev = null; // help GC last = prev; if (prev == null) first = null; else prev.next = null; size--; modCount++; return element; } /** * 移除非空节点x */ E unlink(Node<E> x) { // assert x != null; final E element = x.item; final Node<E> next = x.next; final Node<E> prev = x.prev; if (prev == null) { first = next; } else { prev.next = next; x.prev = null; } if (next == null) { last = prev; } else { next.prev = prev; x.next = null; } x.item = null; size--; modCount++; return element; } /** * 返回列表的首节点 */ public E getFirst() { final Node<E> f = first; if (f == null) throw new NoSuchElementException(); return f.item; } /** * 返回列表的最后一个节点 */ public E getLast() { final Node<E> l = last; if (l == null) throw new NoSuchElementException(); return l.item; } /** * 移除并返回首节点 */ public E removeFirst() { final Node<E> f = first; if (f == null) throw new NoSuchElementException(); return unlinkFirst(f); } /** * 移除并返回尾节点 */ public E removeLast() { final Node<E> l = last; if (l == null) throw new NoSuchElementException(); return unlinkLast(l); } /** * 插入指定元素到列表首端 */ public void addFirst(E e) { linkFirst(e); } /** * 扩展指定元素到列表尾端 */ public void addLast(E e) { linkLast(e); } /** * 返回列表中是否包含指定元素 */ public boolean contains(Object o) { return indexOf(o) != -1; } /** * 返回列表中元素个数 */ public int size() { return size; } /** * 添加指定元素到列表尾部 */ public boolean add(E e) { linkLast(e); return true; } /** * 如果该元素存在,则移除列表中首次出现的该指定元素,如果不存在,则原链表不会改变。 * 如果该列表中包含该指定元素则返回true,否则返回false */ public boolean remove(Object o) { if (o == null) { for (Node<E> x = first; x != null; x = x.next) { if (x.item == null) { unlink(x); return true; } } } else { for (Node<E> x = first; x != null; x = x.next) { if (o.equals(x.item)) { unlink(x); return true; } } } return false; } /** * 添加指定集合中的所有元素到列表的尾部,顺序为指定集合的迭代器遍历顺序。如果该操作正在进行时,指定集合 * 被修改了,那么该操作的行为是不可预测的。 */ public boolean addAll(Collection<? extends E> c) { return addAll(size, c); } /** * 将指定集合中的所有元素插入到该列表的指定位置之后。将当前在该位置的元素及其之后的元素右移。新元素在列表 * 中的顺序为其原集合迭代器遍历顺序。 */ public boolean addAll(int index, Collection<? extends E> c) { checkPositionIndex(index); Object[] a = c.toArray(); int numNew = a.length; if (numNew == 0) return false; Node<E> pred, succ; if (index == size) { succ = null; pred = last; } else { succ = node(index); pred = succ.prev; } for (Object o : a) { @SuppressWarnings("unchecked") E e = (E) o; Node<E> newNode = new Node<>(pred, e, null); if (pred == null) first = newNode; else pred.next = newNode; pred = newNode; } if (succ == null) { last = pred; } else { pred.next = succ; succ.prev = pred; } size += numNew; modCount++; return true; } /** * 移除列表中所有元素 */ public void clear() { // 清除节点之间所有元素的链接不是必要的,但是: // - 如果被清除的节点处于不同代之间,可以帮助分代GC。 // - 一定要释放内存,即便有一个迭代器引用 for (Node<E> x = first; x != null; ) { Node<E> next = x.next; x.item = null; x.next = null; x.prev = null; x = next; } first = last = null; size = 0; modCount++; } // 位置访问操作 /** * 返回指定位置的元素 */ public E get(int index) { checkElementIndex(index); return node(index).item; } /** * 使用指定元素替换指定位置的元素 */ public E set(int index, E element) { checkElementIndex(index); Node<E> x = node(index); E oldVal = x.item; x.item = element; return oldVal; } /** * 在列表指定位置插入指定元素,如果该位置有任何元素,则将其后的子序列元素都往右移(将它们的序号都增加1) */ public void add(int index, E element) { checkPositionIndex(index); if (index == size) linkLast(element); else linkBefore(element, node(index)); } /** * 移除列表指定位置的元素,如果其后子序列存在,则将其元素左移,将它们的序号减一。 * 返回列表中移除的元素。 */ public E remove(int index) { checkElementIndex(index); return unlink(node(index)); } /** * 判断该序号是否在列表中对应位置存在元素 */ private boolean isElementIndex(int index) { return index >= 0 && index < size; } /** * 判断给参数是否是迭代器或者add操作的合法位置 */ private boolean isPositionIndex(int index) { return index >= 0 && index <= size; } /** * 构造一个IndexOutOfBoundsException 异常的详情消息,在错误处理代码的许多可能的重构中, * 这个大纲在服务端和客户端虚拟机中都表现的最好。 */ private String outOfBoundsMsg(int index) { return "Index: "+index+", Size: "+size; } private void checkElementIndex(int index) { if (!isElementIndex(index)) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); } private void checkPositionIndex(int index) { if (!isPositionIndex(index)) throw new IndexOutOfBoundsException(outOfBoundsMsg(index)); } /** * 返回指定元素序号的非空节点。 */ Node<E> node(int index) { // assert isElementIndex(index); //做了一个小优化,如果取的序号小于元素个数的一半,则从链表首端开始遍历,否则从链表尾部开始遍历 if (index < (size >> 1)) { Node<E> x = first; for (int i = 0; i < index; i++) x = x.next; return x; } else { Node<E> x = last; for (int i = size - 1; i > index; i--) x = x.prev; return x; } } // 搜索操作 /** * 返回指定元素在列表中第一次出现的位置,否则返回-1 */ public int indexOf(Object o) { int index = 0; if (o == null) { for (Node<E> x = first; x != null; x = x.next) { if (x.item == null) return index; index++; } } else { for (Node<E> x = first; x != null; x = x.next) { if (o.equals(x.item)) return index; index++; } } return -1; } /** * 返回指定元素在链表中最后一次出现的位置,如果链表中不包含该元素,则返回-1 */ public int lastIndexOf(Object o) { int index = size; if (o == null) { for (Node<E> x = last; x != null; x = x.prev) { index--; if (x.item == null) return index; } } else { for (Node<E> x = last; x != null; x = x.prev) { index--; if (o.equals(x.item)) return index; } } return -1; } // 队列操作 /** * 取回但不删除此列表的头部(第一个元素)。 */ public E peek() { final Node<E> f = first; return (f == null) ? null : f.item; } /** * 取回但不删除此列表的头部(第一个元素)。 * 如果不存在,则会抛出NoSuchElementException异常 */ public E element() { return getFirst(); } /** * 取回并删除此列表的头部(第一个元素)。 * 如果该链表为空,则返回null */ public E poll() { final Node<E> f = first; return (f == null) ? null : unlinkFirst(f); } /** * 取回并删除此列表的头部(第一个元素)。 */ public E remove() { return removeFirst(); } /** * 添加指定元素到链表尾部 */ public boolean offer(E e) { return add(e); } // 双向队列操作 /** * 插入指定元素到队列首部 */ public boolean offerFirst(E e) { addFirst(e); return true; } /** * 插入指定元素到队列尾部 */ public boolean offerLast(E e) { addLast(e); return true; } /** * * 取回但是不删除队列的首元素。如果队列为空则返回null。 */ public E peekFirst() { final Node<E> f = first; return (f == null) ? null : f.item; } /** * 取回但是不删除链表的最后一个元素,如果队列为空,则返回null */ public E peekLast() { final Node<E> l = last; return (l == null) ? null : l.item; } /** * 取回并删除队列的首元素,如果队列为空,则返回null */ public E pollFirst() { final Node<E> f = first; return (f == null) ? null : unlinkFirst(f); } /** * 取回并删除队列的尾元素,如果队列为空,则返回null */ public E pollLast() { final Node<E> l = last; return (l == null) ? null : unlinkLast(l); } /** * 在队列前端插入元素 */ public void push(E e) { addFirst(e); } /** * 删除并返回队列的第一个元素,如果列表为空则抛出NoSuchElementException 异常 */ public E pop() { return removeFirst(); } /** * 删除此队列中第一个出现的指定元素(从头到尾的方式遍历时),如果队列中不包含该元素,则队列不会改变。 */ public boolean removeFirstOccurrence(Object o) { return remove(o); } /** * 删除此队列中最后一次出现的指定元素(从头到尾的方式遍历时),如果队列中不包含该元素,则队列不会改变。 */ public boolean removeLastOccurrence(Object o) { if (o == null) { for (Node<E> x = last; x != null; x = x.prev) { if (x.item == null) { unlink(x); return true; } } } else { for (Node<E> x = last; x != null; x = x.prev) { if (o.equals(x.item)) { unlink(x); return true; } } } return false; } /** * 返回从指定位置开始,以正确的序列迭代该列表的迭代器. * 列表迭代器是“fail-fast”的,如果列表在迭代器创建之后的任何时刻被进行 * 结构性的修改了,则调用迭代器自身的remove或者add方法时将会抛出ConcurrentModificationException异常,因此 * 当遇到并发修改时,迭代器会快速的失败,而不是在未来某个不确定的时刻进行武断冒险或不确定性的行为 * * 注意,通常来说,不能保证迭代器的fail-fast机制,在遇到非同步的并发修改时,不可能做出任何严格的保证。 * fail-fast 迭代器只能尽最大努力抛出ConcurrentModificationException异常,因此,如果程序依赖这个异常来 * 进行正确性判断是错误的,fail-fast机制仅应该用于检测异常。 */ public ListIterator<E> listIterator(int index) { checkPositionIndex(index); return new ListItr(index); } //列表迭代器类 private class ListItr implements ListIterator<E> { //记录上一个返回的节点 private Node<E> lastReturned; //指向下一个节点 private Node<E> next; //下一个节点的序号 private int nextIndex; //用于检测遍历过程中List是否被修改 private int expectedModCount = modCount; ListItr(int index) { // assert isPositionIndex(index); next = (index == size) ? null : node(index); nextIndex = index; } public boolean hasNext() { return nextIndex < size; } public E next() { //检测是否修改 checkForComodification(); if (!hasNext()) throw new NoSuchElementException(); lastReturned = next; next = next.next; nextIndex++; return lastReturned.item; } public boolean hasPrevious() { return nextIndex > 0; } public E previous() { checkForComodification(); if (!hasPrevious()) throw new NoSuchElementException(); lastReturned = next = (next == null) ? last : next.prev; nextIndex--; return lastReturned.item; } public int nextIndex() { return nextIndex; } public int previousIndex() { return nextIndex - 1; } public void remove() { checkForComodification(); if (lastReturned == null) throw new IllegalStateException(); Node<E> lastNext = lastReturned.next; unlink(lastReturned); if (next == lastReturned) next = lastNext; else nextIndex--; lastReturned = null; expectedModCount++; } public void set(E e) { if (lastReturned == null) throw new IllegalStateException(); checkForComodification(); lastReturned.item = e; } public void add(E e) { checkForComodification(); lastReturned = null; if (next == null) linkLast(e); else linkBefore(e, next); nextIndex++; expectedModCount++; } public void forEachRemaining(Consumer<? super E> action) { Objects.requireNonNull(action); while (modCount == expectedModCount && nextIndex < size) { action.accept(next.item); lastReturned = next; next = next.next; nextIndex++; } checkForComodification(); } final void checkForComodification() { if (modCount != expectedModCount) throw new ConcurrentModificationException(); } } private static class Node<E> { //存放元素 E item; //指向下一个Node节点 Node<E> next; //指向上一个Node节点 Node<E> prev; Node(Node<E> prev, E element, Node<E> next) { this.item = element; this.next = next; this.prev = prev; } } /** * 返回一个倒序遍历的迭代器 */ public Iterator<E> descendingIterator() { return new DescendingIterator(); } /** * 降序迭代器 */ private class DescendingIterator implements Iterator<E> { private final ListItr itr = new ListItr(size()); public boolean hasNext() { return itr.hasPrevious(); } public E next() { return itr.previous(); } public void remove() { itr.remove(); } } private LinkedList<E> superClone() { try { return (LinkedList<E>) super.clone(); } catch (CloneNotSupportedException e) { throw new InternalError(e); } } /** * 浅克隆 */ public Object clone() { LinkedList<E> clone = superClone(); // Put clone into "virgin" state clone.first = clone.last = null; clone.size = 0; clone.modCount = 0; // Initialize clone with our elements for (Node<E> x = first; x != null; x = x.next) clone.add(x.item); return clone; } /** * 返回一个包含列表所有元素的数组,元素的顺序为从第一个到最后一个。 */ public Object[] toArray() { Object[] result = new Object[size]; int i = 0; for (Node<E> x = first; x != null; x = x.next) result[i++] = x.item; return result; } /** * 返回一个包含列表所有元素的数组,元素的顺序为从第一个到最后一个。返回元素数组的类型 * 与指定数组的类型一致。如果列表大小适合指定的数组,则返回该数组。 否则,将为新数组分配指定 * 数组的运行时类型和此列表的大小。 * * 如果列表的空间适合指定的数组(数组比列表有更多的元素),紧跟在列表末尾之后的数组中的元素设置 * 为null(仅当调用者知道列表不包含任何null元素时,这在确定列表长度时很有用。) */ @SuppressWarnings("unchecked") public <T> T[] toArray(T[] a) { if (a.length < size) a = (T[])java.lang.reflect.Array.newInstance( a.getClass().getComponentType(), size); int i = 0; Object[] result = a; for (Node<E> x = first; x != null; x = x.next) result[i++] = x.item; if (a.length > size) a[size] = null; return a; } private static final long serialVersionUID = 876323262645176354L; /** * 序列化 */ private void writeObject(java.io.ObjectOutputStream s) throws java.io.IOException { // Write out any hidden serialization magic s.defaultWriteObject(); // Write out size s.writeInt(size); // Write out all elements in the proper order. for (Node<E> x = first; x != null; x = x.next) s.writeObject(x.item); } /** * 反序列化 */ @SuppressWarnings("unchecked") private void readObject(java.io.ObjectInputStream s) throws java.io.IOException, ClassNotFoundException { // Read in any hidden serialization magic s.defaultReadObject(); // Read in size int size = s.readInt(); // Read in all elements in the proper order. for (int i = 0; i < size; i++) linkLast((E)s.readObject()); } /** * 创建一个可分割的迭代器 */ @Override public Spliterator<E> spliterator() { return new LLSpliterator<E>(this, -1, 0); } /** Spliterators.IteratorSpliterator 的定制版本 */ static final class LLSpliterator<E> implements Spliterator<E> { static final int BATCH_UNIT = 1 << 10; // batch array size increment static final int MAX_BATCH = 1 << 25; // max batch array size; final LinkedList<E> list; // null OK unless traversed Node<E> current; // current node; null until initialized int est; // size estimate; -1 until first needed int expectedModCount; // initialized when est set int batch; // batch size for splits LLSpliterator(LinkedList<E> list, int est, int expectedModCount) { this.list = list; this.est = est; this.expectedModCount = expectedModCount; } final int getEst() { int s; // force initialization final LinkedList<E> lst; if ((s = est) < 0) { if ((lst = list) == null) s = est = 0; else { expectedModCount = lst.modCount; current = lst.first; s = est = lst.size; } } return s; } public long estimateSize() { return (long) getEst(); } public Spliterator<E> trySplit() { Node<E> p; int s = getEst(); if (s > 1 && (p = current) != null) { int n = batch + BATCH_UNIT; if (n > s) n = s; if (n > MAX_BATCH) n = MAX_BATCH; Object[] a = new Object[n]; int j = 0; do { a[j++] = p.item; } while ((p = p.next) != null && j < n); current = p; batch = j; est = s - j; return Spliterators.spliterator(a, 0, j, Spliterator.ORDERED); } return null; } public void forEachRemaining(Consumer<? super E> action) { Node<E> p; int n; if (action == null) throw new NullPointerException(); if ((n = getEst()) > 0 && (p = current) != null) { current = null; est = 0; do { E e = p.item; p = p.next; action.accept(e); } while (p != null && --n > 0); } if (list.modCount != expectedModCount) throw new ConcurrentModificationException(); } public boolean tryAdvance(Consumer<? super E> action) { Node<E> p; if (action == null) throw new NullPointerException(); if (getEst() > 0 && (p = current) != null) { --est; E e = p.item; current = p.next; action.accept(e); if (list.modCount != expectedModCount) throw new ConcurrentModificationException(); return true; } return false; } public int characteristics() { return Spliterator.ORDERED | Spliterator.SIZED | Spliterator.SUBSIZED; } } } 最后,再对LinkedList做一个简单的小结: LinkedList是由Node节点首尾相连而成的结构,相比ArrayList而言,在进行插入和删除时不需要进行大量的元素移动,省去了元素复制的开销,也不存在扩容开销,但是每次添加节点都需要创建一个新的Node对象,所以当节点数量很多时,这部分对象将占用很大开销,包括时间成本和空间成本,因此需要根据实际情况进行合理选择。LinkedList因为提供了大量方便的获取元素、插入元素和移除元素的方法,所以可以很方便的进行队列、栈等数据结构的实现。 到此,LinkedList就算讲解完毕了,一不小心又写了这么长,罪过罪过。。。下次还是多分几篇写吧,这么长的文章,确实不便于阅读,面壁中。。。 真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

【Java入门提高篇】Day20 Java容器类详解(三)List接口

今天要说的是Collection族长下的三名大将之一,List,Set,Queue中的List,它们都继承自Collection接口,所以Collection接口的所有操作,它们自然也是有的。 List,Set,Queue,分别是列表,集合,队列的意思,代表着Collection家族下的三种不同的势力,它们各有所长,也各有所短,就像骑兵,步兵和水兵,各有各的优势,并没有谁一定比谁更好的说法,合适的才是最好的。接下来,将会分别介绍这三名大将,从中你也会看到它们各自的特点。 本篇先来介绍一下List接口。 我们先来看看List的源码: public interface List<E> extends Collection<E> { // 查询接口 /** * 列表元素个数 */ int size(); /** * 是否为空 */ boolean isEmpty(); /** * 是否包含某元素 */ boolean contains(Object o); /** * 返回一个List迭代器 */ Iterator<E> iterator(); /** * 将List转换为Object数组 */ Object[] toArray(); /** * 转换为指定类型数组 */ <T> T[] toArray(T[] a); // 修改操作 /** * 添加元素,成功返回true */ boolean add(E e); /** * 移除某一个元素,成功返回true */ boolean remove(Object o); // 批量操作 /** * 判断是否包含集合C 中的所有元素 */ boolean containsAll(Collection<?> c); /** * 将集合C 中所有元素添加到列表 */ boolean addAll(Collection<? extends E> c); /** * 将集合C 中所有元素添加到列表,添加在序号为index的元素之后 */ boolean addAll(int index, Collection<? extends E> c); /** * 从列表中移除集合C 中所有元素 */ boolean removeAll(Collection<?> c); /** * 从列表中移除所有不在集合C 中的元素 */ boolean retainAll(Collection<?> c); /** * 全部替换 */ default void replaceAll(UnaryOperator<E> operator) { Objects.requireNonNull(operator); final ListIterator<E> li = this.listIterator(); while (li.hasNext()) { li.set(operator.apply(li.next())); } } /** * 根据指定的比较器来排序,如果传入的比较器是null,则元素必须实现Comparable 接口 */ @SuppressWarnings({"unchecked", "rawtypes"}) default void sort(Comparator<? super E> c) { Object[] a = this.toArray(); Arrays.sort(a, (Comparator) c); ListIterator<E> i = this.listIterator(); for (Object e : a) { i.next(); i.set((E) e); } } /** * 移除所有元素 */ void clear(); // 比较和hash boolean equals(Object o); int hashCode(); // 根据序号进行的操作 /** * 获取指定序号的元素 */ E get(int index); /** * 替换指定序号的元素 */ E set(int index, E element); /** * 在指定序号的元素后插入元素 */ void add(int index, E element); /** * 移除指定序号的元素 */ E remove(int index); // 搜索操作 /** * 返回元素第一次出现的位置,如果未找到则返回-1 */ int indexOf(Object o); /** * 返回元素出现的最后一个位置 */ int lastIndexOf(Object o); // List迭代器 /** * 返回一个List迭代器 */ ListIterator<E> listIterator(); /** * 返回一个序号从Index开始的List迭代器 */ ListIterator<E> listIterator(int index); // 视图 /** * 返回一个子队列,序列从fromIndex到toIndex,包含fromIndex,不包含toIndex * 对子队列的修改会影响原队列 * 如果原队列修改,那么对子队列的影响是未定义的 */ java.util.List<E> subList(int fromIndex, int toIndex); /** * 创建一个可分割的迭代器(用于并行计算) */ @Override default Spliterator<E> spliterator() { return Spliterators.spliterator(this, Spliterator.ORDERED); } } 其实JDK里的注释已经十分丰富,大家平时有时间可以多看看,为了方便阅读,我这里用简单粗暴的语言进行了精简翻译。 List即列表,存储的是有序集合,里面的元素有序存储,可以重复,所谓有序集合,顾名思义,就是里面的元素存放是有顺序的,每个插入的元素都对应着一个序号,可以根据序号获取元素。 List支持的操作也很丰富,最常用的增删改查,批量添加,批量替换,批量删除,还有搜索,排序操作,还支持普通迭代器和可分割式迭代器,前者主要用于遍历,后者则主要用于并行式计算,关于迭代器的知识后面会统一介绍。下面是使用常见操作的一个小栗子: public class Test { public static void main(String[] args){ test(); } static void test(){ List<Integer> integers = new ArrayList<>(); List<Integer> integersA = new ArrayList<>(); //添加元素 integers.add(1); integers.add(2); integers.add(3); integers.add(4); integersA.add(1); integersA.add(2); integersA.add(33); integersA.add(44); System.out.println("列表大小:" + integers.size()); System.out.println("是否为空:" + integers.isEmpty()); System.out.println("是否包含某元素:" + integers.contains(2)); System.out.println("是否包含全部元素:" + integers.containsAll(integersA)); //转换为数组 Integer[] integerArray = integers.toArray(new Integer[0]); System.out.println("遍历数组:"); for (int i = 0; i < integerArray.length; i++){ System.out.println(integerArray[i]); } System.out.println("当前列表integers:" + integers); //批量添加 System.out.println("批量添加元素"); integers.addAll(integersA); System.out.println("当前列表integers:" + integers); //移除元素 System.out.println("移除元素"); integers.remove(1); System.out.println("当前列表integers:" + integers); //批量移除 System.out.println("批量移除元素"); integers.removeAll(integersA); System.out.println("当前列表integers:" + integers); //开始替换 System.out.println("批量替换元素"); integers.replaceAll(it -> it + 1); System.out.println("当前列表integers:" + integers); //从列表中移除所有不在集合integersA中的元素 integersA.add(2); integersA.add(4); System.out.println("保留元素"); integers.retainAll(integersA); System.out.println("当前列表integers:" + integers); //插入 System.out.println("开始插入"); System.out.println("当前列表integersA:" + integersA); integersA.add(2,155); integersA.add(1,125); System.out.println("当前列表integersA:" + integersA); //排序 System.out.println("开始排序——使用内部比较器"); integersA.sort(null); System.out.println("当前列表integersA:" + integersA); System.out.println("开始排序——使用外部比较器"); integersA.sort((itA, itB) -> itB - itA); System.out.println("当前列表integersA:" + integersA); //序号操作 Integer a = integersA.get(2); System.out.println("integersA第三个元素是:" + a); System.out.println("开始替换"); integersA.set(3, 66); System.out.println("当前列表integersA:" + integersA); System.out.println("开始移除"); integersA.remove(3); System.out.println("当前列表integersA:" + integersA); //搜索操作 System.out.println("查找元素2(第一次出现)位置:" + integersA.indexOf(2)); System.out.println("查找元素2(最后一次出现)位置:" + integersA.lastIndexOf(2)); //子队列操作 List<Integer> subList = integersA.subList(0, 4); System.out.println("子队列:" + subList); subList.add(5); subList.add(5); subList.add(5); System.out.println("当前子列表:" + subList); System.out.println("当前列表integersA:" + integersA); integersA.add(1, 233); integersA.add(1, 233); integersA.add(1, 233); System.out.println("当前列表integersA:" + integersA); System.out.println("当前子列表:" + subList); } } 大家可以先想想结果,再下看面的答案。 实际输出如下: 列表大小:4 是否为空:false 是否包含某元素:true 是否包含全部元素:false 遍历数组: 1 2 3 4 当前列表integers:[1, 2, 3, 4] 批量添加元素 当前列表integers:[1, 2, 3, 4, 1, 2, 33, 44] 移除元素 当前列表integers:[1, 3, 4, 1, 2, 33, 44] 批量移除元素 当前列表integers:[3, 4] 批量替换元素 当前列表integers:[4, 5] 保留元素 当前列表integers:[4] 开始插入 当前列表integersA:[1, 2, 33, 44, 2, 4] 当前列表integersA:[1, 125, 2, 155, 33, 44, 2, 4] 开始排序——使用内部比较器 当前列表integersA:[1, 2, 2, 4, 33, 44, 125, 155] 开始排序——使用外部比较器 当前列表integersA:[155, 125, 44, 33, 4, 2, 2, 1] integersA第三个元素是:44 开始替换 当前列表integersA:[155, 125, 44, 66, 4, 2, 2, 1] 开始移除 当前列表integersA:[155, 125, 44, 4, 2, 2, 1] 查找元素33(第一次出现)位置:4 查找元素33(最后一次出现)位置:5 子队列:[155, 125, 44, 4] 当前子列表:[155, 125, 44, 4, 5, 5, 5] 当前列表integersA:[155, 125, 44, 4, 5, 5, 5, 2, 2, 1] 当前列表integersA:[155, 233, 233, 233, 125, 44, 4, 5, 5, 5, 2, 2, 1] Exception in thread "main" java.util.ConcurrentModificationException at java.util.ArrayList$SubList.checkForComodification(ArrayList.java:1239) at java.util.ArrayList$SubList.listIterator(ArrayList.java:1099) at java.util.AbstractList.listIterator(AbstractList.java:299) at java.util.ArrayList$SubList.iterator(ArrayList.java:1095) at java.util.AbstractCollection.toString(AbstractCollection.java:454) at java.lang.String.valueOf(String.java:2994) at java.lang.StringBuilder.append(StringBuilder.java:131) at com.frank.chapter20.Test.test(Test.java:115) at com.frank.chapter20.Test.main(Test.java:15) 不知道符不符合你的预期,这里关于内部比较器和外部比较器的知识只一笔带过,Integer类型是实现了Comparable接口的,所以sort方法传入null时会使用Integer的内部比较器进行排序,而使用外部比较器时,使用的是Java8的新特性,lamada表达式,省去了方法名和参数类型,因为函数式接口不存在重载方法,所以编译器可以推断出参数类型,这样就不用再大费周章的用new语法去创建一个比较器(当然,只是语法糖而已,如果不是很理解比较器,可以先行百度,后面的文章里也会有详细介绍)。在最后报出了一个ConcurrentModificationException,因为原队列修改后,子队列视图就被破坏了,所以再次访问子视图时就会报错。 List是最常用的容器类,List最大的特点便是要求元素有序存储,List跟数组相比,最大的优势在于List大小可以动态扩展,但数组支持随机存取,所以当元素个数的固定的时候,使用数组往往效率更高。(当然,一般情况下还是使用List吧,因为支持的操作更加丰富,比如进行排序时不需要自己写算法)。 一般来说,对元素没有特殊要求,不需要去重存储,没有先进先出的要求的场景下,List是最好的选择。 List接口下有多个常用的实现类,每个类都有其特点,具体选择哪种类需要根据实际情况进行选择。 希望大家能通过这篇文章,了解List的主要方法及其使用方法以及常用场景,关于List的常见具体实现类的讲解将在之后的文章里进行说明和比较。 本篇到此结束,欢迎大家继续关注。 真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

【Java入门提高篇】Day19 Java容器类详解(二)Map接口

上一篇里介绍了容器家族里的大族长——Collection接口,今天来看看容器家族里的二族长——Map接口。 Map也是容器家族的一个大分支,但里面的元素都是以键值对(key-value)的形式存放的,就像字典一样,用相应的key就可以拿到相应的value。 先来看看Map接口的内容,下面是阉割版的Map接口(去掉了defaultmethod),去掉的部分涉及Stream操作,属于Map的高级用法,所以暂时不做介绍。 import java.io.Serializable; import java.util.Collection; import java.util.Comparator; import java.util.Objects; import java.util.Set; public interface Map<K,V> { // 查询操作 /** * 返回键值对数量 */ int size(); /** * Map是否为空 */ boolean isEmpty(); /** * Map中是否包含指定的key */ boolean containsKey(Object key); /** * Map中是否包含指定的value */ boolean containsValue(Object value); /** * 根据key获取对应的value */ V get(Object key); // Modification Operations /** * 插入键值对,如果Map中已经存在该key,则新的value会覆盖原来的value */ V put(K key, V value); /** * 移除指定key对应的键值对,并返回相应的value */ V remove(Object key); // 批量操作 /** * 将另一个Map中的键值对全部复制过来 */ void putAll(Map<? extends K, ? extends V> m); /** * 移除所有键值对 */ void clear(); // 视图 /** * 返回包含Map中所有key的(Set类型)键视图,对Map的修改也会影响到键视图 */ Set<K> keySet(); /** * 返回包含Map中所有value的(Collection类型)值视图,对Map的修改也会影响到值视图 */ Collection<V> values(); /** * 返回包含Map中所有键值对的(java.util.Map.Entry类型)键值对视图 */ Set<Map.Entry<K, V>> entrySet(); /** * Map 键值对接口 */ interface Entry<K,V> { /** * 返回键 */ K getKey(); /** * 返回值 */ V getValue(); /** * 设置键 */ V setValue(V value); boolean equals(Object o); int hashCode(); /** * 键比较器(内部比较器) */ public static <K extends Comparable<? super K>, V> Comparator<Map.Entry<K,V>> comparingByKey() { return (Comparator<Map.Entry<K, V>> & Serializable) (c1, c2) -> c1.getKey().compareTo(c2.getKey()); } /** * 值比较器(内部比较器) */ public static <K, V extends Comparable<? super V>> Comparator<Map.Entry<K,V>> comparingByValue() { return (Comparator<Map.Entry<K, V>> & Serializable) (c1, c2) -> c1.getValue().compareTo(c2.getValue()); } /** * 键比较器(外部比较器) */ public static <K, V> Comparator<Map.Entry<K, V>> comparingByKey(Comparator<? super K> cmp) { Objects.requireNonNull(cmp); return (Comparator<Map.Entry<K, V>> & Serializable) (c1, c2) -> cmp.compare(c1.getKey(), c2.getKey()); } /** * 值比较器(外部比较器) */ public static <K, V> Comparator<Map.Entry<K, V>> comparingByValue(Comparator<? super V> cmp) { Objects.requireNonNull(cmp); return (Comparator<Map.Entry<K, V>> & Serializable) (c1, c2) -> cmp.compare(c1.getValue(), c2.getValue()); } } // 比较和散列 boolean equals(Object o); int hashCode(); } 可以看到,Map接口的内容,其实比Collection接口更丰富,这里因为省略了很多高级方法,而且里面包含了另外一个接口,Map.Entry接口,也就是一直所说的键值对,这个接口是Map中元素需要实现的接口。 Map有三种遍历方式:1.通过遍历KeySet来遍历所有键值对,2.通过遍历EntrySet来实现,3.通过EntrySet的Iterator来遍历。这里还有一个新概念——视图,视图其实就是一个集合,但是是一个不能修改的集合,只能对视图进行查询和遍历操作,在Map中一共有三个视图,键视图,值视图,键值对视图,下面可以看一个小栗子: public class Test { public static void main(String[] args){ Map<Integer, Integer> map = new HashMap<>(); map.put(1,11); map.put(2,22); map.put(3,33); Set<Integer> keys = map.keySet(); Collection<Integer> values = map.values(); Set<Map.Entry<Integer,Integer>> entries = map.entrySet(); Iterator<Map.Entry<Integer,Integer>> iterator = entries.iterator(); System.out.println(keys); System.out.println(values); System.out.println(entries); System.out.println("按keyset遍历"); for (Integer key : keys){ System.out.println("key:" + key + " value:" + map.get(key)); } System.out.println("按键值对遍历"); for (Map.Entry<Integer,Integer> entry : entries){ System.out.println("entry:" + entry); } System.out.println("按iterator遍历"); while (iterator.hasNext()){ Map.Entry<Integer,Integer> entry = iterator.next(); System.out.println("entry:" + entry); } map.put(2,444); map.put(4,44); System.out.println("修改后的视图"); System.out.println(keys); System.out.println(values); System.out.println(entries); keys.add(5); values.add(55); } } 输出如下: [1, 2, 3] [11, 22, 33] [1=11, 2=22, 3=33] 按keyset遍历 key:1 value:11 key:2 value:22 key:3 value:33 按键值对遍历 entry:1=11 entry:2=22 entry:3=33 按iterator遍历 entry:1=11 entry:2=22 entry:3=33 修改后的视图 [1, 2, 3, 4] [11, 444, 33, 44] [1=11, 2=444, 3=33, 4=44] Exception in thread "main" java.lang.UnsupportedOperationException at java.util.AbstractCollection.add(AbstractCollection.java:262) at com.frank.chapter19.Test.main(Test.java:44) 栗子里介绍了三种遍历方式,也看到了三种视图的样子,当我们试图修改视图时,抛出了一个UnsupportedOperationException异常,表明该视图集合无法修改。 在Map.Entry接口里,还可以看到外部比较器和内部比较器,这两个概念暂时也不做介绍,在之后的文章里会介绍。 关于Map,要说的主要就这么多了,目前来说只需要知道Map是以键值对的形式进行存取,并了解Map接口中的主要方法及其作用,了解Map的遍历方法,和视图的概念就已经足够了。 本篇到此结束,欢迎大家继续关注。 真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

【Java入门提高篇】Day18 Java容器类详解(一)Collection接口

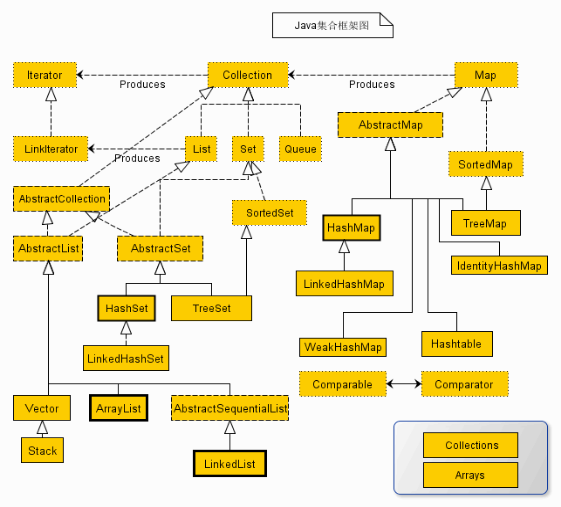
今天来看看Java里的一个大家伙,那就是容器。 所谓容器,就是专门用来装对象的东西,如果你学过高数,没错,就跟里面说的集合是一个概念,就是一堆对象的集合体,但是集合类是容器类中的一个子集,为了区别表示,所以还是叫容器类,之后所说的集合类只是容器里的一个子集,之后会有详细介绍。 容器就是用来存放和管理其他类对象的地方,你可以把它理解为仓库管家,当你有东西需要存放和管理的时候,就要记得来找它。你也许会说,不是有数组吗?确实,用数组存放一堆相同类型对象也是一个不错的选择,但是有一个很大的缺陷,那就是数组大小只能是固定的,不能从数组里动态添加和删除一个对象,要扩容的时候,就只能新建一个数组然后把原来的对象全部复制到新的数组里,而且只能存放相同类型的对象,使用起来不够灵活。然而我们的管家就不一样了。 国际惯例,先来看一个栗子: public class Test { public static void main(String args[]){ //小明打算学Java,买了三本书 Book bookA = new Book("Java核心技术(卷一)", 88.9); Book bookB = new Book("Java核心技术(卷二)", 88.6); Book bookC = new Book("Java编程思想", 99.0); //他想了想,放哪呢?到处放怕之后会找不到,放书架以后书变多了找起来就很麻烦 //于是他找了个管家 Map<String, Book> bookMap = new HashMap<>(3); //然后跟管家说,这三本书先放你这了,要用的时候找你拿 bookMap.put(bookA.getName(), bookA); bookMap.put(bookB.getName(), bookB); bookMap.put(bookC.getName(), bookC); //勤劳的管家兢兢业业的保存好了三本书 //小明回到家,想检查一下管家老不老实 //“管家,把Java核心技术(卷一)给我拿过来” Book bookD = bookMap.get("Java核心技术(卷一)"); //他查看了一下这本书的信息并跟原来的信息校验了一番 System.out.println(bookD); System.out.println(bookA.equals(bookD)); //并同样校验了另外两本书 Book bookE = bookMap.get("Java核心技术(卷二)"); System.out.println(bookE); System.out.println(bookB.equals(bookE)); Book bookF = bookMap.get("Java编程思想"); System.out.println(bookF); System.out.println(bookC.equals(bookF)); //嗯,看来管家没有玩花样,还是原来的书,晚饭给他加个蛋 } } class Book{ private String name; private Double price; public Book(String name, Double price) { this.name = name; this.price = price; } public Double getPrice() { return price; } public void setPrice(Double price) { this.price = price; } public String getName() { return name; } public void setName(String name) { this.name = name; } @Override public String toString() { return "Book{" + "name='" + name + '\'' + ", price=" + price + '}'; } } 输出如下: Book{name='Java核心技术(卷一)', price=88.9} true Book{name='Java核心技术(卷二)', price=88.6} true Book{name='Java编程思想', price=99.0} true 相信大家看过小明和管家的故事之后,对容器这个概念应该有初步的了解了。容器一般来说就是在你需要存放一系列对象时,可以给你管理对象的好管家。 当然,容器家族里并不只有HashMap这一个管家,最开始就说了,容器可是一个庞大的家族。先来看一张图感受一下吧: 好像有点多?关系有点复杂。没错,除了并发包里的集合类以外的大部分容器类差不多都在这了,这个图,emmmm...看看就好,我们还是看下面这个图吧 别慌,其实最常用的就是这么几个了,Collection和Map是两个大的接口,Collection下有三个子接口,List,Queue,Set,下面是最常用的三个类,ArrayList,LinkedList,HashSet。Map接口下最常用的就要数上面栗子里的HashMap了。正如你看到的那样,容器类里有很多不同的实现类,也就是不同的管家,他们有的不同的能力,各有所长也各有所短,至于他们的具体介绍,将会留到之后的几篇文章里介绍,本篇作为集合的介绍篇就不多做讲解了。 需要注意的是,容器中只能存放对象,而不能存放基本类型。所以当你将一个 int 型数据 1放入容器中的时候,其实它会自动装箱转换成 Integer 类后存入的,Java中每一种基本类型都有对应的引用类型。在容器存放的是多个对象的引用,对象本身还是放在堆内存中。容器可以存放不同类型,不限数量的数据类型。 Collection接口 Collection接口是容器家族里的老大哥,是最基本的容器接口,但是这里的Collection跟容器并不是等价关系,因为你仔细看看上面的图就知道,容器家族里还有另外一个老大哥,那就是Map接口。一个Collection代表一组Object,即Collection的元素(Elements)。Collection接口下有三个子接口,分别是List,Set,Queue,它们各有各的特点,下面会一一介绍,但是都继承于Collection接口,所以继承了Collection的所有特性。 我们可以来看看Collection接口都有哪些方法: public interface Collection<E> extends Iterable<E> { //查询操作 /** * 返回集合中元素个数 */ int size(); /** * 集合是否为空 */ boolean isEmpty(); /** * 是否包含某个元素 */ boolean contains(Object o); /** * 取迭代器 */ @Override Iterator<E> iterator(); /** * 转到数组 */ Object[] toArray(); /** * 转到指定数组 */ <T> T[] toArray(T[] a); // 修改操作 /** * 添加元素 */ boolean add(E e); /** * 移除元素 */ boolean remove(Object o); // 批量操作 /** * 是否全部包含 */ boolean containsAll(Collection<?> c); /** * 全部添加 */ boolean addAll(Collection<? extends E> c); /** * 全部移除 */ boolean removeAll(Collection<?> c); /** * 条件移除 */ default boolean removeIf(Predicate<? super E> filter) { Objects.requireNonNull(filter); boolean removed = false; final Iterator<E> each = iterator(); while (each.hasNext()) { if (filter.test(each.next())) { each.remove(); removed = true; } } return removed; } /** * 保留全部 */ boolean retainAll(Collection<?> c); /** * 清空 */ void clear(); // 比较和哈希 /** * 比较是否相等 */ boolean equals(Object o); /** * 取哈希值 */ int hashCode(); @Override default Spliterator<E> spliterator() { return Spliterators.spliterator(this, 0); } //流操作 default Stream<E> stream() { return StreamSupport.stream(spliterator(), false); } default Stream<E> parallelStream() { return StreamSupport.stream(spliterator(), true); } } 可以看出,Collection的操作还是蛮多的,增删该查和批量操作都有,至于迭代器是什么东西,后面的篇章会有详细介绍。最后两个方法涉及到了流操作,这是Java8里新添加的特性,关于流操作的知识,这里暂时不多说,以后在做讲解。 通过本篇,你只需要了解一下集合是什么,为什么要有集合,集合家族的全貌,了解一下Collection接口中有哪些方法就足够了,之后的文章会从以下几方面来介绍容器家族: 1.Map接口 2.Iterable接口 3.List,Set,Queue接口 4.ArrayList使用方式和应用场景+源码剖析 5.HashSet使用方式和应用场景+源码剖析 6.LinkedList使用方式和应用场景+源码剖析 7.HashMap使用方式和应用场景+源码剖析 今天的讲解就到此为止了,仅仅介绍了容器的基本概念,作为容器学习的开胃菜,后面一系列的文章都会围绕容器展开,希望大家继续关注!真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 52)——Cocoa错误处理模式

Swift错误处理模式,在Swift1.x和Swift 2.0是不同的两种模式。 Swift 1.x代码错误处理模式采用Cocoa框架错误处理模式,到现在Objective-C还沿用这种处理模式,而Swift2.0之后采用了do-try-catch错误处理模式。 下面的示例代码是从文件中读取字符串到内存中,如果使用Swift 1.x错误处理模式代码如下: 1 2 3 4 5 6 7 8 9 10 import Foundation varerr:NSError? //定义可选的NSError?变量 letcontents=NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding,error:&err) if err!=nil{ //判断err变量是否还是nil //错误处理 } NSError?一定是可选的变量,因为要给它初始化为nil。 判断err变量是否还是nil,如果还是nil在代码 1 2 letcontents=NSString(contentsOfFile:filePath, encoding:NSUTF8StringEncoding,error:&err) 方法调用过程中没有发生错误,否则说明有错误发生。 上述代码的构造函数,它的Swift语法定义如下: 1 2 3 init?(contentsOfURLurl:NSURL, encodingenc:UInt, errorerror:NSErrorPointer) 构造函数的最后一个参数是NSErrorPointer(即NSError指针),那么在实际调用时候我们需要传递err变量地址(即&err),&是取地址符。当方法调用完成后,如果有错误则err变量会被赋值。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1748299,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 10)——运算符是“ +、-、*、/ ”吗?

运算符是用于执行程序代码运算,会针对一个或一个以上操作数项目来进行运算。例如:2+3,其操作数是2和3,而运算符则是“+”。那么“+、-、*、/”是运算符。 运算符有哪几种呢? 在Swift语言中主要的运算符包括算术、关系、逻辑、位运算符等。 “+、-、*、/”是算术运算符中的二元运算符,一元运算符是是-、++和--。 二元运算符: + 加 求和,还可用String类型,进行字符串连接操作 -减 求差 *乘 求积 /除 求商 %取余求余数 一元运算符: -取反符号取反运算 ++自加一先取值再加一,或先加一再取值 --自减一先取值再减一,或先减一再取值 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746085,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 11)——数据类型那些事儿?

在我们学习语言时都会学到这种语言的数据类型,在Swift中数据类型有那些呢?整型、浮点型、布尔型、字符、字符串这些类型是一定有的,其中集合、枚举、结构体、类也是Swift中的数据类型。元组是Swift中特有的。 其他那些类型我们可能多少知道些或是听说过。元组是在Swift中有的,它是什么呢? 它是一种数据结构,在数学中应用广泛。在计算机科学中,元组是关系数据库中的基本概念,元组表中的一条记录,每列就是一个字段。因此在二维表里,元组也称为记录。 现在使用Swift语法表示Student元组就是: 第一种写法 ("1001", "张三", 30, 90) 第二种写法 (id:"1001", name:"张三",english_score:30,chinese_score:90) 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746094,如需转载请自行联系原作者

优秀的个人博客,低调大师

21天让你成为Horizon View高手—Day1:Horizon View概述

VMware View是全球首款针对桌面虚拟化的企业级解决方案,据Gartner 2010年4月针对全球使用桌面虚拟化数据分析VMware View市场占用率高达56%。VMware View已经在中国掀起了一股桌面虚拟化的热浪,VMware View虚拟桌面技术已经成为IT界的讨论的焦点。 VMware View架构: VMware View 5.2全新登场 VMware桌面虚拟化解决方案View于2013年3月份推出最新的View 5.2版本,经过之前具有革命性一代的View 4.5以及2012年9月份发布的View 5.1产品,VMware View 已经成为市场上知名度最高的桌面虚拟化产品,无论从其后台稳定性,管理简洁性还是用户体验都是企业桌面虚拟化领域最成熟的方案之一。 VMware View 建立在业界最广泛部署的虚拟平台VMware vSphere上,简化了IT管理与控制,同时为最终用户提供最高保真度的体验,无论采用的是WAN还是LAN连接。 在View 5.0版本和View 5.1中改进了PCoIP协议,可将LAN和WAN的连接带宽降低达75%;对3D图形的高级支持;可扩展的统一通信集成,用于Avaya与Mitel等业界领先的语音与视频媒体服务;以及集成了角色管理,用户配置文件漫游等虚拟桌面个性化功能。 2013年3月发布的View 5.2版本依然围绕着基础架构的稳定优化,便捷的管理,良好的用户体验来进行构建,并与 Horizon View 5.2的新增功能 VMware Horizon View 5.2 在最终用户体验和简化管理方面有了长足改进,并可以进一步降低 VDI 的总体拥有成本。 最终用户体验方面的新增功能特性 支持基于 Windows 8 的桌面 硬件加速 3D 图形 支持 Microsoft Lync 2013,改进了视频和 VOIP 通信 通过更简化的方式从 Horizon 访问 View 桌面 借助 HTML Access,轻松从任意设备连接桌面 新增面向移动设备的“统一触摸”功能,工作效率得到提高 简化管理方面的新增功能特性 消除了 8 台主机的限制,同时支持多个 vLAN,因此支持创建大型池 View Administrator 在管理大量桌面时的性能改进 加速的部署和重构操作 vSphere Web Client 中新增集成的服务控制台(技术预览版) 支持基于 vCenter Server Virtual Appliance 的部署 总体拥有成本方面的新增功能特性 通过能节省空间(SE 稀疏)的磁盘技术进一步降低永久桌面所需的存储容量 在2013年3月7号VMware又发布了Horizon View 5.2 Feature Pack 1,提供了以下功能和组件: (1)Remote Experience Agent 安装程序 - 使用 Remote Experience Agent 可以在 Horizon View 桌面上安装 Feature Pack 组件,有助于优化 View Agent 5.2 提供的远程桌面体验。在 Feature Pack 1 中,安装程序会在 Horizon View 桌面上安装 Unity Touch 和 HTML Access Agent。默认情况下,运行安装程序后,两个组件都会进行安装。 (2)HTML Access Agent - 用户使用 HTML Access 可以从 Web 浏览器连接至虚拟桌面,而无需在客户端系统上安装 Horizon View Client 软件。HTML Access Agent 在 Horizon View 桌面上运行,通过该组件,用户可以使用 HTML Access 连接至自己的桌面。您必须在希望通过 HTML Access 访问的桌面上同时安装 Remote Experience Agent 和 HTML Access Agent。 (3)Unity Touch - Unity Touch 可以改善移动客户端用户访问桌面的体验。用户无需在较小的设备屏幕上操作完整桌面映像,可以在无需查看桌面的情况下直接从本机移动用户界面中浏览应用和文档。 (4)HTML Access 安装程序 - 该安装程序可以对 View 连接服务器实例进行配置,以允许用户选择通过 HTML Access 连接至桌面。运行 HTML Access 安装程序后,View Portal 除了显示 View Client 图标外还会显示 HTML Access 图标。 如果您希望在 Horizon View 部署中使用 HTML Access 连接至桌面,则必须运行此安装程序。如果您的用户要使用 Horizon Workspace 并且选择通过 HTML Access 连接至桌面,也必须运行此安装程序。 VMware View基础架构: n 域控制器:为View的必需组件,为View提供统一帐户和验证支持。 n vSphere(ESX/ESXi):后台虚拟机支撑架构 n vCenter Server:虚拟机管理平台 VMware View组件: n View Manager n View Security Server n View Transfer Server n View Composer n Thinapp n View Agent n View Client 本文转自robbindai 51CTO博客,原文链接:http://blog.51cto.com/virtualyourdesk/1194361

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 55)——使用try?和try!区别

在使用try进行错误处理的时候,经常会看到try后面跟有问号(?)或感叹号(!),他们有什么区别呢? 1.使用try? try?会将错误转换为可选值,当调用try?+函数或方法语句时候,如果函数或方法抛出错误,程序不会发崩溃,而返回一个nil,如果没有抛出错误则返回可选值。 示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 //查询所有数据方法 funcfindAll() throws ->[Note]{ guardlistData.count> 0 else { //抛出"没有数据"错误。 throw DAOError.NoData } return listData } letdatas= try ?findAll() print(datas) 上述代码中let datas = try? findAll()语句中使用了try?,datas是一个可选值,本例中输出nil。使用了try?语句没有必要使用do-catch语句将其包裹起来。 2.使用try! 使用try!可以打破错误传播链条。错误抛出后传播给它的调用者,这样就形成了一个传播链条,但有的时候确实不想让错误传播下去,可以使用try!语句。 修改上述代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 //查询所有数据方法 funcfindAll() throws ->[Note]{ guardlistData.count> 0 else { //抛出"没有数据"错误。 throw DAOError.NoData } return listData } funcprintNotes(){ letdatas= try !findAll()① for noteindatas{ print( "date:\(note.date!)-content:\(note.content!)" ) } } printNotes() ② 代码printNotes()函数没有声明抛出错误,在调用它的时候不需要try关键字,错误传播链条在printNotes()函数内被打破了。 代码将try dao.findAll()语句改为try! findAll(),在try后面加了感叹号(!),这样编译器就不会要求printNotes()方法声明抛出错误了,try!打破了错误传播链条,但是如果真的发生错误就出现运行期错误,导致程序的崩溃。 所以使用try!打破错误传播链条时,应该确保程序不会发生错误。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1748320,如需转载请自行联系原作者

优秀的个人博客,低调大师

Android Day07四大组件之广播接收者BroadcastReceiver

1.广播和广播接收者 Android中的广播和广播接收者相当于现实生活中的电台和听收音机的人, Android系统内部相当于已经定义好了电台, 就是内部定义好了一些事件(外拨电话,短信到来 电池电量低 sd卡状态 卸载安装 开机启动等等),我们开发者只需要注册这个事件就ok了(注册事 件就是创建广播接收者之后在清单里配置意图过滤器的action属性,相当于听收音机的人调频一样) 更确切的说,广播接收者就是Android系统的全局监听者,可以监听系统的很多事件,只要广播 接收者注册了这些事件,就会被这些事件触发。 广播接收者被触发,底层原理应该是广播事件会利用隐式意图启动符合条件的广播接收者. 2.注册广播接收者 注册广播接收者有2种方式,而且一个广播接收者配置多个过滤动作Action。 第1种:在清单里注册 在配置文件中注册的接收者的特点是即使应用程序已被关闭,该接收者依然可接受它感兴趣的广播。 上面红色特性,已经验证过,确实如此! 一般大多数的广播接收者都是在清单文件中注册,只有少量的广播接收者是在代码里注册 当然可以在清单里注册的广播接收者,也一定能够在代码里注册。 第2种:在Activity里注册 在Activity中绑定接收者必须依附该应用程序存在,或者一个BroadcastReceiver用于更新UI,就没有必要在 程序关闭时接收者还运行,故无需在AndroidManifest.xml中注册而可以放在Activity中注册。 操作特别频繁的广播事件 比如 锁屏和解锁这种广播接收者在清单文件里面注册是无效的 必需在代码里注册,否则会报下面这个异常。 MainActivity has leaked IntentReceiver ScreenReceiver@b65bb500 that was originally registered here. Are you missing a call to unregisterReceiver()? 代码里注册广播接收者 首先,定义一个类继承BroadcastReceiver: public class ScreenReceiver extends BroadcastReceiver 下一步,在一个Activity中注册上面定义的广播接收者 1 2 3 4 5 6 7 ScreenReceiverscreenReceiver= new ScreenReceiver(); //创建意图对象过滤器 IntentFilterintentFilter= new IntentFilter(); intentFilter.addAction( "android.intent.action.SCREEN_OFF" ); intentFilter.addAction( "android.intent.action.SCREEN_ON" ); //注册锁屏和解锁广播 registerReceiver(screenReceiver,intentFilter); 3.广播接收者开发步骤 第1步:定义一个类继承广播接收者,并在清单或代码里注册,包括receiver的name属性、 过滤器的Action属性。 第2步:复写定义的广播接收者类的onReceive方法,定义广播接收者被触发后想实现的逻辑。 一般如果广播接收者注册了多个事件,还得先判断一下事件的类型。 1 2 3 4 public void onReceive(Contextcontext,Intentintent){ //得到事件的类型 Stringaction=intent.getAction(); } 案例:注意不同的案例获取数据的方式 4.案例1_IP拨号器(外拨电话) ■清单配置 1 2 3 4 5 6 < receiver android:name = "com.itheima.ipdialerListener.OutGoingReceiver" > < intent-filter > <!--配置actionnewoutgoingcall--> < action android:name = "android.intent.action.NEW_OUTGOING_CALL" /> </ intent-filter > </ receiver > ■权限 1 < uses-permission android:name = "android.permission.PROCESS_OUTGOING_CALLS" /> ■广播接收者的接收后的逻辑 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 public class OutGoingReceiver extends BroadcastReceiver{ @Override public void onReceive(Contextcontext,Intentintent){ //获取广播事件的数据-电话号码 StringphoneNumber=getResultData(); //直接调用BroadcastReceiver的方法 System.out.println( "phoneNumber:" +phoneNumber); //假如电话号码开头是0,就是长途。 if (phoneNumber.startsWith( "0" )) { phoneNumber= "95128" +phoneNumber; } //改变广播当前的数据-用修改过后电话号码替换。 setResultData(phoneNumber); //注意这个方法只能与有序广播联用 } } 将应用程序安装好,拨打一个手机号以0开始的电话号码0123,点击拨打按钮,效果如下所示: 5.案例2_sd卡状态监听 ■清单配置 注意过滤器里多了一个<data android:scheme="file"/> 1 2 3 4 5 6 7 < receiver android:name = "com.itheima.sdcard.SDCardReceiver" > < intent-filter > < action android:name = "android.intent.action.MEDIA_MOUNTED" /> < action android:name = "android.intent.action.MEDIA_UNMOUNTED" /> < data android:scheme = "file" /> </ intent-filter > </ receiver > ■权限 1 无 ■广播接收者的接收后的逻辑 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 public class SDCardReceiver extends BroadcastReceiver{ @Override public void onReceive(Contextcontext,Intentintent){ //因为清单里有2个action,所以要获取action的类型。 Stringaction=intent.getAction(); if (Intent.ACTION_MEDIA_MOUNTED.equals(action)) { System.out.println( "sd卡挂载了" ); } else if (Intent.ACTION_MEDIA_UNMOUNTED.equals(action)){ System.out.println( "sd卡卸载了" ); } else { System.out.println( "sd监听出错了" ); } } } 进入2.3这些低版本的模拟器,settings-storage里面可以模拟sd的挂载与卸载。 6.案例3_短信监听器 短信监听的底层原理,应该是短信数据库内容提供者者安插了内容观察者,一旦手机接收到短 信,势必短信数据库会发生变化,内容观察者分析到了就会发送一条短信接收的广播,并且把短 信相关的信息封装在了意图对象里。 ■清单配置 高版本的ADT提示里没有action对应的选项,应从低版本ADT拷贝action值到清单中。 1 2 3 4 5 < receiver android:name = "com.itheima.msglistener.MsgListener" > < intent-filter > < action android:name = "android.provider.Telephony.SMS_RECEIVED" /> </ intent-filter > </ receiver > ■权限 1 < uses-permission android:name = "android.permission.RECEIVE_SMS" /> ■广播接收者的接收后的逻辑 注意SmsMessage对象所在的包 1 2 3 4 5 6 7 8 9 10 11 12 13 //获取短信数据,可能有多条短信数据吧。 //由此可见,短信的数据在intent里的封装的格式是Bundle,也就是map集合。 Object[]object=(Object[])intent.getExtras().get( "pdus" ); //创建SmsMessage对象来分离短信的各项内容,注意SmsMessage所在的包。 for (Objectobj:object){ //创建SmsMessage实例,解析短信信息:发送者、短信内容 SmsMessagesmsMessage=SmsMessage.createFromPdu(( byte [])obj); StringmessageBody=smsMessage.getMessageBody(); StringoriginatingAddress=smsMessage.getOriginatingAddress(); System.out.println( "短信发送者:" +originatingAddress); System.out.println( "短信内容:" +messageBody); } 关于短信监听,android2.3版本时没有考虑到安全问题,4.0之后,考虑到安全问题,广播接 收者需要有一个启动界面才能生效(但不一定要求界面就要启动,也就是说只要有个activity就行了 )。 对于用户来说,在2.3这些低版本设备上,对于没有界面的短信监听应用,如果一旦有短信发送过 来,应用就会被激活,在setting中的forcestop按钮也才会变得可选,可以在setting中点击这个按 钮就能关闭应用 对于流氓程序员来说,不但可以做个没有启动界面和图标的应用,更可以结合卸载监听事件,不让 安装的流氓应用卸载,还可以加个密码确认之后才能输入,要多流氓就有多流氓。 7.案例4_应用安装与卸载的监听 ■清单配置 注意过滤器多了一个<data android:scheme="package" /> 1 2 3 4 5 6 7 < receiver android:name = "com.itheima.packageaddandremove.PackageReceiver" > < intent-filter > < action android:name = "android.intent.action.PACKAGE_ADDED" /> < action android:name = "android.intent.action.PACKAGE_REMOVED" /> < data android:scheme = "package" /> </ intent-filter > </ receiver > ■权限 1 无 ■广播接收者的接收后的逻辑 1 2 3 4 5 6 7 8 9 10 11 12 13 //得到包名 UripackageName=intent.getData(); //获取事件类型 Stringaction=intent.getAction(); if ( "android.intent.action.PACKAGE_ADDED" .equals(action)) { System.out.println(packageName+ "安装了。。。。。" ); } else if ( "android.intent.action.PACKAGE_REMOVED" .equals(action)) { System.out.println(packageName+ "卸载了。。。。。" ); } 8.案例5_开机启动监听 如果想在广播接收者里启动activity,必须要为意图指定一个任务栈标记。 ■清单配置 ■权限 ■广播接收者的接收后的逻辑 开机启动广播监听,可以与很多地方相结合。如启动activity或service,可以在service里又与 其它的监听事件如短信、电话监听相结合,做出电话窃听器这样子之类的应用。 另外,开机启动监听比较的费时,有时候其实是实现了,但是 Log就是不出信息,可以采用开 启Activity的方式(记得intent要setFlags),这样效果就明显了。 #################################################################################### 上面讲到几个案例,都有一个共同的特点:广播都是由系统发送的。那么可以自己定义并发送广播吗? 查看API会发现Context类有发送广播的方法,Activity和Service都继承了Context,所以这两个对象 都可以发送广播,或者只要有Context对象的对象都可以发送广播。广播就是在发送Intent,Intent用 来封装数据并且过滤广播接收者,发送广播有2种方式:(系统发送广播也是用的这2个方法) 1.发送无序广播 ■发送广播代码:sendBroadcast 1 2 3 4 5 6 7 8 9 10 public void sendUnOrder(Stringcontent) { Intentintent= new Intent(); //注意设置意图对象的action,以便过滤发送给哪个广播接收者。 intent.setAction( "com.itheima.UNORDER_SEND" ); intent.putExtra( "content" ,content); //无序广播的发送方法 sendBroadcast(intent); } ■广播接收者清单配置: 只要定义一个广播接收者,在清单里配置它的action属性和发送代码里的action参数一样,发送广 播的方法就会将意图Intent发送给符合条件的广播接收者的onReceive参数里,这也印证了为什么广播 接收者的接收方法里会有一个Intent参数的原因:onReceive参数里的Intent就是发送这个广播的对象 传递的Intent。 2.发送有序广播 ■发送广播代码:sendOrderedBroadcast 1 2 3 4 5 6 7 public void sendOrder(Stringcontent) { Intentintent= new Intent(); intent.setAction( "com.itheima.ORDER_SEND" ); //注意有序广播的发送方法 sendOrderedBroadcast(intent, null , new FinalReceiver(), null , 1 ,content, null ); } ■广播接收者清单配置: 和接收无序广播的广播接收者不同,接收有序广播的广播接收者的过滤器除了要配置action 标签之外,过滤器本身还要设置priority属性,表示过滤器的优先级,优先级高的过滤器的广播 接收者会优先接收到广播。 终极接收者无须在清单配置任何信息,连receiver也不用配置。 ■广播接收者接收广播代码: 3.有序广播与无序广播的区别(**********重点***********) ■有序广播 广播的数据可以被修改,广播可以被拦截,但是终极接收者仍然可以接受到。 ■无序广播 广播的数据不可以被修改,广播不可以被拦截。 --------------------------------广播的一些异常------------------------------------ 1)IllegalStateException: Can not perform this action after onSaveInstanceState http://www.tuicool.com/articles/yU3Yji http://stackoverflow.com/questions/7575921/illegalstateexception-can-not-perform-this-action-after-onsaveinstancestate-wit 一是要解注册广播,二是在fragmentManager提交的时候采用 transaction.commitAllowingStateLoss(); 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/1679400,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 25)——类和结构体定义

Swift中的类和结构体定义的语法是非常相似的。类使用class关键词定义类,使用struct关键词定义结构体,它们的语法格式如下: 1 2 3 4 5 6 class 类名{ 定义类的成员 } struct结构体名{ 定义结构体的成员 } 从语法格式上看,Swift中的类和结构体的定义更类似于Java语法,不需要像C++和Objective-C那样把接口部分和实现部分放到不同的文件中。 下面来看一个示例: 1 2 3 4 5 6 7 8 9 10 11 12 13 class Employee{ //定义的类 varno:Int= 0 varname:String= "" varjob:String? varsalary:Double= 0 vardept:Department? } structDepartment{ //定义的结构体 varno:Int= 0 varname:String= "" } 里面定义了一些属性。 Employee和Department是有关联关系的。 下列语句实例化: 1 2 letemp=Employee() vardept=Department() Employee()和Department()是调用它们的构造函数实现实例化。 注意:类声明为let常量还是var变量呢?从编程过程讲类一般声明为let常量,由于类是引用数据类型,声明为let常量只是说明不能修改引用,但是引用指向的对象可以被修改。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746423,如需转载请自行联系原作者

优秀的个人博客,低调大师

亚马逊封杀、0day 漏洞与三重危机

Muse 上线两周登顶 App Store 的同时,我注意到它几乎同步陷入了多重争议。直接说结论:它的争议主要有四块——被安全研究员曝出零日漏洞、被亚马逊技术拦截、遭多家银行预警,以及「AI 打电话其实是真人代打」的隐私风波。这些争议不是要否定它的产品价值,而是暴露了一款能替人办事的 AI 必须面对的现实挑战。下面我按自己梳理的脉络,一件件讲清楚。 ## 一、零日漏洞:安全研究员说「变后门轻而易举」 我最先关注的是技术安全层面的争议。 macOS 安全研究员帕特里克·沃德尔(Patrick Wardle)公布了一段针对 Muse 的零日漏洞,并表示把 Muse 变成一个后门「轻而易举」,直指该产品的安全问题。他还提到,目前可能还存在更严重的 AI 智能体漏洞,因为已上报给相关供应商,暂时不便透露细节。 在我看来,对一款拥有账户操作权限、能替人花钱办事的应用来说,这类漏洞的潜在影响远比普通聊天软件严重,也让外界对智能体的安全性打上了问号。 ## 二、被亚马逊技术拦截:撞上「生态墙」 第二块争议来自平台生态,这一点很值得玩味。 在 Muse 登顶前后,亚马逊对它启动了技术拦截,限制 Muse 在自家平台上代替用户完成购物等操作。这类似于一个平台限制第三方工具在自己生态内的自动化行为。 它暴露了 AI 智能体商业化的一道现实障碍:智能体想替用户「跨平台办事」,但各大平台未必愿意让外部 AI 在自己的地盘上自由抓取信息、执行操作。Muse 想连接整个互联网,却先撞上了平台之间的「生态墙」——这是我认为整个行业短期内都绕不过去的问题。 ## 三、金融机构预警:谁来替你的钱包把关 第三块争议指向资金安全。 有报道提到,多家银行针对 Muse 代替用户操作账户、协商账单等行为发出了预警。当一个 AI 可以登录你的账户、查看甚至协商账单时,金融机构担心欺诈、误操作和授权边界问题,是完全可以理解的。 这也把一个根本问题摆到台前:当 AI 能替你花钱,谁来为你的钱包把关?在我看来,这既是技术问题,更是责任归属问题。 ## 四、真人代打风波:AI 打电话,接线的却是真人 第四块争议传播最广,也最有戏剧性,和 Muse 的电话功能有关。 据路透社报道,Meta 一直在 Muse 中内测一项名为「human concierge(真人礼宾)」的功能:用户以为把打电话的任务交给了 AI,但部分电话实际会被转交给真人承包商拨打完成。起因是 AI 自己打电话的成功率并不稳定——有员工让 Muse 联系保险公司,对方一听出是 AI 就反复挂断。为提高成功率,Meta 上周向约一半员工开放了真人代打测试,据内部帖子,真人拨打的任务成功率可达 95%~98%。 但这引发了内部隐私担忧:如果通话交给呼叫中心的真人承包商,用户原以为只与 AI 分享的信息,就可能暴露给真人接线员。有员工直言「很难理解为什么这个功能值得冒这样的风险」。争议之下,Meta 已紧急撤回该功能。网友也调侃「人类驱动的 AI 果然真实存在」。 ## 五、这些争议背后的共同命题 把这几块争议放在一起看,我发现它们指向同一个核心命题:AI 智能体的能力越强、越接近替人做决定,它对安全、隐私、平台规则和责任边界的挑战就越大。 漏洞考验的是技术可靠性,亚马逊拦截考验的是生态协作,银行预警考验的是资金责任,真人代打考验的是透明与信任。这些都不是 Muse 一款产品独有的问题,而是整个 AI 智能体行业走向大众时必须共同回答的课题。 所以我的看法是:这些争议不否定 Muse 的探索价值,但确实给整个行业敲了警钟。当 AI 从「会说」走向「会做」,便利和风险是同步放大的。对用户,我建议保持知情、谨慎授权;对行业,把安全、透明和责任做在前面,才是让「能替人办事的 AI」真正走远的前提。

优秀的个人博客,低调大师

Every Day of a DBA,第155期: 备库归档磁盘耗尽 DG 异常恢复记录

## **1.故障** 对oracle adg 进行巡检,发现错误: ``` DGMGRL> show configuration Configuration - ycjj2dg Protection Mode: MaxPerformance Databases: ycjj - Primary database Error: ORA-16778: redo transport error for one or more databases ycjj2dg - Physical standby database Warning: ORA-16857: standby disconnected from redo source for longer than specified threshold Fast-Start Failover: DISABLED Configuration Status: ERROR DGMGRL> ``` ## **2.错误说明** - **ORA-16778**:主库向备库传输 Redo 日志时发生通信 / 链路 / 配置类故障 - **ORA-16857**:备库长时间无法接收主库 Redo 流,心跳链路断开超时 ## **3.故障排查** 1. 查看主库是否运行正常,归档日志是否正常产生 1. 查看备件是否运行正常,归档日志是否正常存储(主库发送的归档日志) 根据上面的排查思路: 发现备库的磁盘空间写满,主库的归档日志无法写入到备库。 备库磁盘空间耗尽,无法接收、存储主库传输的归档Redo日志: 1. 主库Redo传输进程投递失败 → 上报 `ORA-16778` 重做传输错误; 1. 备库长期收不到Redo流,心跳超时 → 上报 `ORA-16857` 备库断开源库告警; 1. DGMGRL整体配置状态变为 `ERROR`,ADG同步完全中断。 --- ## **4. 紧急恢复步骤** ### **步骤1:清理备库磁盘,释放存储空间** 1. 登录备库服务器,定位归档/Flash Recovery Area目录(归档存放路径) ``` # 查看备库归档路径 sqlplus / as sysdba show parameter log_archive_dest; show parameter db_recovery_file_dest; ``` 1. 安全清理冗余文件(优先操作) - 方案A:删除已完成应用、不再需要的过期归档(备库已apply完成的归档可删) ``` RMAN> crosscheck archivelog all; # 删除7天前已应用归档 RMAN> delete noprompt archivelog until time 'sysdate-7' applied on standby; ``` - 方案B:清理过期备份、审计日志、trash临时文件释放空间 > ⚠️ 禁止删除**尚未在备库完成恢复**的归档,否则会出现日志缺口,需要重建DG。 1. 确认磁盘使用率下降,目录可正常写入文件 ``` df -h # 校验归档所在文件系统使用率 connect sys/主库sys密码@ycjj DGMGRL> edit database ycjj set property LogXptStatus=reset; DGMGRL> edit database ycjj2dg set property StatusReport=reset; DGMGRL> show configuration ``` #### **方式2:主库手动重启Redo传输进程** ``` -- 主库执行 altersystemset log_archive_dest_state_2 = defer; altersystem switch logfile; altersystemset log_archive_dest_state_2 =enable; altersystem switch logfile; ``` ### **步骤4:验证ADG同步恢复正常** 1. DGMGRL查看整体状态 ``` DGMGRL> show configuration ``` 预期结果:无Error、Warning,`Configuration Status: SUCCESS` 1. 查看主库Redo传输状态 ``` select dest_id,status,error from v$archive_dest where dest_id=2; ``` `STATUS`显示`VALID`、`ERROR`字段为空即正常。 1. 备库校验归档接收&应用进度 ``` -- 查看备库已接收归档 select sequence#,applied from v$archived_log order by sequence# desc; -- 查看MRP恢复进程是否运行 select process,statusfrom v$managed_standby; ``` `MRP0`进程状态为`APPLYING_LOG`代表日志恢复正常。 --- ## **5.长期预防方案** ### **1. 磁盘容量监控告警** 对备库归档目录、闪回区磁盘使用率配置监控阈值: - 使用率≥80%:触发预警通知运维; - 使用率≥90%:触发紧急告警,及时扩容/清理归档。 ### **2. 归档自动清理策略** 在备库配置RMAN定时清理脚本,自动删除已应用归档: ``` crosscheck archivelog all; delete noprompt archivelog all completed before 'sysdate-5' applied on standby; ``` 配合crontab每日定时执行。 ### **3. ADG传输断连兜底配置** 主库配置`REOPEN`参数,链路恢复后自动重试传输: ``` altersystemset log_archive_dest_2='service=ycjj2dg ASYNC VALID_FOR=(ONLINE_LOGFILES,PRIMARY_ROLE) DB_UNIQUE_NAME=ycjj2dg REOPEN=30'; ``` ### **4. 扩容规划** 若业务归档增长快,提前扩容备库归档存储,划分独立磁盘存放归档文件,避免和系统盘、数据盘共用空间。 --- ## **6、补充风险提示** 1. 若清理磁盘时误删**未应用归档**:备库存在日志缺口,MRP进程无法继续恢复,需要从主库重新传输缺失归档或重建物理备库; 1. 若空间释放后DG仍报ORA-16778:检查防火墙、端口、redo传输加密、密码文件一致性; 1. MaxPerformance异步模式下,主库不会阻塞业务,但长期断连会导致主库归档堆积,主库磁盘同样有写满风险,需同步监控主库归档磁盘。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

用户登录
用户注册
修改密码
忘记密码