首页 文章 精选 留言 我的

精选列表

搜索[techo day],共2890篇文章
优秀的个人博客,低调大师

Android Day01-电话拨号器案例&Android开发流程

电话拨号器开发步骤: 1.在清单文件中添加打电话的权限 1 2 3 4 5 6 7 8 9 10 <? xml version = "1.0" encoding = "utf-8" ?> < manifestxmlns:android = "http://schemas.android.com/apk/res/android" package = "cn.itcast.action" android:versionCode = "1" android:versionName = "1.0" > 略.... < uses-sdkandroid:minSdkVersion =“6"/> < uses-permission android:name = "android.permission.CALL_PHONE" />//拨打权限 </ manifest > 注意CALL权限,只会跳到拨打界面,要手动点击拨打按钮。CALL_PHONE会直接打通电话。 2.打电话核心代码 1 2 3 4 5 6 7 8 //新建一个意图对象 Intentintent_call= new Intent(); //为意图对象添加动作 intent_call.setAction(Intent.ACTION_CALL); //为意图对象添加数据 intent_call.setData(Uri.parse( "tel:" +电话号码); //执行意图 startActivity(intent_call); Android开发流程: 产品经理设计产品需求及产品原型图 设计师根据原型图设计UI 架构师要写产品架构,接口文档 程序员,根据UI做相应的展示布局及代码逻辑开发 测试人员测试 运营人员上线到各个市场 商务人员做商务推广 本文转自屠夫章哥 51CTO博客,原文链接:http://blog.51cto.com/4259297/1675137 ,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 22)——闭包那些事儿!

我给Swift中的闭包一个定义:闭包是自包含的匿名函数代码块,可以作为表达式、函数参数和函数返回值,闭包表达式的运算结果是一种函数类型。 Swift中的闭包类似于Objective-C中的代码块、Java中的匿名内部类。 使用闭包表达式 Swift中的闭包表达式很灵活,其标准语法格式如下: { (参数列表) ->返回值类型in 语句组 } 其中,参数列表与函数中的参数列表形式一样,返回值类型类似于函数中的返回值类型,但不同的是后面有in关键字。 Swift提供了多种闭包简化写法,我来介绍下面几种不同形式: 1、类型推断简化 类型推断是Swift的强项,Swift可以根据上下文环境推断出参数类型和返回值类型。以下代码是标准形式的闭包: 1 2 3 {(a:Int,b:Int)->Intin return a+b } Swift能推断出参数a和b是Int类型,返回值也是Int类型。简化形式如下: 1 2 {(a,b)in return a+b} {a,bin return a+b} //参数列表括号也可以省略 2、隐藏return关键字 在闭包内部语句组只有一条语句,如return a + b等,那么这种语句都是返回语句。前面的关键字return可以省略,省略形式如下: {a, b in a + b } 使用这种简化方式修改后的示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 funccalculate(opr:String)->(Int,Int)->Int{ varresult:(Int,Int)->Int switch (opr){ case "+" : result={a,bina+b} //return关键字省略了 default : result={a,bina-b} //return关键字省略了 } return result } 省略的前提是闭包中只有一条return语句。 3、省略参数名称 Swift提供了参数名省略功能,我们可以用$0、$1、$2…来指定闭包中参数,$0指代第一个参数,$1指代第二个参数,$2指代第三个参数,以此类推$n+1指代第n个参数。 使用参数名省略功能,在闭包中必须省略参数列表定义,Swift能够推断出这些缩写参数的类型。参数列表省略了,in关键字也需要省略。参数名省略之后如下所示: {$0 + $1} 使用参数名省略后的示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 funccalculate(opr:String)->(Int,Int)->Int{ varresult:(Int,Int)->Int switch (opr){ case "+" : result={$ 0 +$ 1 } //采用了参数名省略 default : result={$ 0 -$ 1 } //采用了参数名省略 } return result } letf1:(Int,Int)->Int=calculate( "+" ) print( "10+5=\(f1(10,5))" ) letf2:(Int,Int)->Int=calculate( "-" ) print( "10-5=\(f2(10,5))" ) 4、使用闭包返回值 闭包表达本质上是函数类型,是有返回值的,我们可以直接在表达式中使用闭包的返回值。重新修改add和sub闭包,示例代码如下: 1 2 3 4 5 letc1:Int={(a:Int,b:Int)->Intin return a+b }( 10 , 5 ) print( "10+5=\(c1)" ) 解释:给c1赋值,后面是一个闭包表达式。但是闭包表达式不能直接赋值给c1,因为c1是Int类型,需要闭包的返回值。这就需要在闭包结尾的大括号后面接一对小括号(10,5),通过小括号(10,5)为闭包传递参数。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746406,如需转载请自行联系原作者

优秀的个人博客,低调大师

82亿蓝牙设备受威胁 这8个"0 day"或为罪魁

安全公司Armis识别出了8个零日漏洞,共同称为BlueBorne,它们有着损坏蓝牙可用设备的隐患。Armis公司认为漏洞的数字可能会随着调查研究进展而继续增加。 Armis标出了其中四个隐患最为重要。这几个漏洞使攻击者可以控制用户的设备、盗窃机密数据、进入公司网络、进行远程编码执行和MITM攻击、向邻近的设备传播恶意软件,甚至是进入未联网的电脑。 所有这些攻击都可以被无线操作,空中下载技术(airborne)是蓝牙技术的一个优势。这便是为什么这些漏洞被称为BlueBorne。 受到影响的硬件设备包括一些日常使用的设备,例如使用安卓、iOS、Windows、Linux操作系统的智能手机、平板电脑、个人电脑以及其他IoT设备。蓝牙SIG估算一共有大约82亿蓝牙兼容的设备。根据研究者的调查,这几乎是所有蓝牙设备。 Armis研究者更加细致的描述介绍了BlueBorne。他们认为攻击的进行需要设备的蓝牙功能被打开。不需要设备与攻击者匹配,即使目标设备是不可发现的攻击也可以进行。 BlueBorne可以在未联网的状态下从一台设备转播到另一台设备的能力是十分危险的。它还可以作为创立大型僵尸网络的平台,例如Mirai和WireX。 什么设备将受到BlueBorne的影响? “Armis公司公布的漏洞可以影响所有安卓、Linux、Windows和iOS 10之前版本的设备,无论使用哪种蓝牙的版本”,研究者在博客中写道。 从四月起,研究者已经通知了谷歌、微软、苹果、三星和Linux公司,并与他们合作寻找解决方案。于九月十二日发表了协调后的公开声明。 iOS iOS设备的漏洞只出现在iOS 9.3.5以及更早的版本。对于Apple TV,则是7.2.2以及更早的版本。对于iOS 10,鉴于漏洞已经被移除,则不再需要补丁。 安卓 所有安卓设备,除了只用Bluetooth Low Energy的设备以外,都受到BlueBorne中四个漏洞(CVE-2017-0781, CVE-2017-0782, CVE-2017-0785, CVE-2017-0783)的影响。 漏洞会影响到包括谷歌Pixel、三星Galaxy、Pumpkin Car Audio系统在内的设备。你可以从Google Play上下载Armis BlueBorne Scanner应用程序来检查你的安卓设备是否被影响。 谷歌在九月安全公告板中发布了安卓Nougat和Marshmallow的安全补丁,但没有提到安卓Oreo。 Windows 自Vista之后发布的Windows版本都受到漏洞“Bluetooth Pineapple”(CVE-2017-8628)的影响。它可以被用来进行MITM攻击。 微软通过它们的“周二补丁”更新于九月十二日发布了修补方案。 Linux 目前还没有Linux设备可用的补丁,Linux位于不同操作系统的核心,这通常被称为Linux分布。 研究者称,运行BlueZ程序的设备会被信息泄露漏洞(CVE-2017-1000250)影响。自2011年十月(3.3-rc1)后发布的Linux设备会被远程编码执行漏洞(CVE-2017-1000251)影响。 受到影响的设备包括三星Gear S3、三星智能TV和三星Family Hub智能冰箱。 如何及时保护我的设备不受BlueBorne影响? 根据研究者表明,BlueBorne漏洞可以通过新的方式传播。所以,传统的安全措施,包括防火墙、移动数据管理、网络安全解决方法、端点保护,面对那样的攻击都不够有效,因为它们致力于抵抗来自互联网的威胁。 首先以及最重要的是,如果制造商会提供安全补丁,你应该更新你的设备。 保证你设备的蓝牙功能在不需要的时候被关闭。当你使用手机的蓝牙功能时,应该格外的注意,对看似不可疑的活动也要保持警惕。 本文转自d1net(转载)

优秀的个人博客,低调大师

Red hat Summit 2017 Day 1:让应用开发、部署、管理更简单

美国时间5月2日,Red hat Summit 2017拉开了序幕。今年也Red hat连续第13次举办该活动。由于红帽在开源领域的领导者地位,Red hat Summit已经成为了开源领域最重要的活动,历年来每年都会聚集上万名的参会者,今年也不会例外。 大会第一天的主角应该属于Red hat执行副总裁兼产品和技术总裁Paul Cormier,而从产品角度上而言则是OpenShift无疑。在Red hat总裁兼CEO Jim Whitehurst 为一位获得年度最佳RHCP(red hat certified professional)的高级系统管理员颁奖并做简单致辞后,时间就交给了Paul Cormier。接下来第一天所有的演讲都在围绕应用(Application)展开,所有的产品发布也都是围绕如何更简单地开发、部署和管理应用。 Red hat总裁兼CEO Jim Whitehurst “今天的IT环境正在变得日益复杂:异构的底层IT基础设施、传统应用与云原生应用并存,特别是容器、微服务、多云环境的引入更是加剧了这种复杂性。而对企业而言,即使它们再复杂也是值得的,因为它们赋予企业前所未有的创新能力。”Paul在演讲时表示,红帽的使命和目标急救室将通过一致、开放和创新的技术来降低这种复杂性。 OpenShift:经过验证的企业级容器平台 软件正在成为企业的核心竞争力,“未来每一家公司都应该是软件公司”这句话很好地诠释了软件的价值,然而,软件应用程序的开发、部署和管理正变得越来越复杂,在此背景下容器的价值被凸显出来,而成为近两年市场关注度最高的词汇之一。 不过,从容器的兴起到开始商用毕竟只是一两年的时间,市场上可信赖的企业级容器平台并不多,OpenShift正是一个业已经过验证的企业级容器平台。OpenShift是Red hat在2015年推出的一个PaaS平台,随着容器的升温,Red hat开始强化了对容器技术的支持,特别是对Kubernetes(K8S)的全面支持,其定位也从最初的PaaS转变成为容器平台。由于同时拥有PaaS和K8S两大属性,再加上Red hat的背书使得OpenShift很快成为市场上的一颗明星,也成为容器商用最主要的推动者。 在今天的大会上,红帽公布了一批采用OpenShift的客户名单,其中不乏汉莎航空、德意志银行、沃尔沃汽车等知名的企业。从中也可以看出,容器进入生产环境已经不是一个梦想,而是一个现实。根据大会提供的资料,在大会期间会有近30名客户来到这里讨论他们在生产环境中的容器部署。 Red hat执行副总裁兼产品和技术总裁Paul Cormier “OpenShift是目前业内最全面的企业级容器+Kubernetes平台。”Paul在发布会上表示。 为了强化OpenShift的技术领先性,Red hat一直在不断丰富和完善。在今天的大会上,Red hat对外发布了几个与OpenShif有关的产品。 OpenShift.io :这是一个免费的、端到端的SaaS开发环境,用于帮助开发人员使用最新技术基于流行的开源代码来构建云原生应用程序。它基于Eclipse Chees开发。OpenShift.io中包含有支持团队远程协作的工具,用于分析和分配工作。OpenShift.io中开发的代码自动进行容器化,可以轻松地部署到OpenShift。 OpenShift Application Runtime:一个与OpenShift原生集成的用于多语言微服务(Spring Boot,Java EE,Eclipse MicroProfile,Eclipse Vert.x和Node.js)的运行时。和Red Hat OpenShift Application Services(运行在OpenShift上的容器化的中间件服务)一起工作,已经容器化了,借此这个强大的组合可以创建、集成、部署和管理云原生应用程序。 Container Health Index(容器健康指数):红帽正在为企业级容器制定新标准,用于评估容器的安全性和可靠性。该指数检查和评估所有红帽和经认证的ISV合作伙伴的容器产品,使客户部署安全、稳定和支持的容器。红帽将在未来90天内认证20个ISV合作伙伴产品。 Gluster Storage with OpenShift Container Platform on AWS:一个新的存储解决方案,可帮助客户为有状态应用程序提供一致性、软件定义的存储。 AWS服务与OpenShift的集成 大会第一天的另一个重大发布是与AWS的一个战略合作,基于Red hat和AWS的这项合作,用户能够把AWS的各项服务集成到Red hat的产品中,包括OpenShift Container Platform、JBoss Middleware、Enterprise Linux 等,这也就意味着Red hat的用户可以无缝配置和部署如Amazon的Aurora、Redshift、EMR、Athena、CloudFront、Route 53和Elastic Load Balancing等AWS服务,而无论Red hat的这些软件产品是运行自己的数据中心还是在AWS的云上,并且由双方提供联合的支持。 这可以大大简化适用AWS服务的难度。传统上,AWS的这些服务需要通过API来调用的,但现在用户即便不是程序员也可以使用服务,因为可以直接从OpenShift控制台中访问这些服务。 “这是一个具有里程碑意义的联盟,我们对通过将世界上最受欢迎的公共云与行业最全面的企业Kubernetes平台相结合的潜力感到兴奋。”在红帽的新闻稿中如此评论说。 当然,这件事情的价值不只是在OpenShift中调用AWS服务,还有将AWS和OpenShift集成起来整合到了一个混合云平台里, 从而践行了Red hat现在所倡导的一致性的体验。 实际上,一致性体验是在大会第一天被频频提及的一个词汇。“无论这个应用是预装软件、还是运行在虚拟化、私有云、公有云以及多云中,我们都要保证用户的一致性体验,而不用担心复杂性来统治他们的生活。”Paul在演讲时表示,红帽的最终目的是要“开发一切、随处可部署、实现所有功能(Build anything. Deploy everywhere. Do everything.),这是计算的未来,红帽正在使其成为可能。而无论这个应用是采用哪种语言、运行在哪个环境中(传统预配置、虚拟化、私有云或者公有云)、要完成何种功能。” 原文发布时间为:2017年5月3日 本文作者:作者:邹大斌 本文来自云栖社区合作伙伴至顶网,了解相关信息可以关注至顶网。

优秀的个人博客,低调大师

每日学习总结:局部变量、成员变量、嵌套for循环、方法(Day04)

2 --> 1 变量 1.1 概念 一般通过“变量类型 变量名 = 变量值 ;”这三部分来描述一个变量。如:int a = 3 ;变量的使用原则:就近原则,即尽量控制变量的使用范围到最小。 1.2 局部变量 位置: 定义在方法里或者局部代码块中 注意: 必须手动初始化/赋值来分配内存.如:int i = 5;或者int i; i = 5; 作用域: 也就是方法里或者局部代码块中,方法运行完内存就释放了 注意事项:变量的使用原则,成员变量与局部变量同名时,使用近的局部变量 1.2 成员变量 位置: 定义在类里方法外 注意: 不用初始化,也会自动被初始化成默认值 作用域: 整个类中,类消失了,变量才会释放 public class TestVariable2 { /** 本类测试成员变量与局部变量 */ /** 创建成员变量 * 1.位置:类里方法外 * 2.注意:无需手动初始化,会自动赋予对应类型的默认值 * 3.作用域:在整类里都生效,类消失,变量才消失 * */ int count; static int sum; public static void main(String[] args) { /**创建局部变量, * 1.位置:方法里/局部代码块里 * 2.注意:使用时必须手动初始化 * 3.作用域:当方法里/局部代码块执行完毕,变量就释放 * */ int sum = 100; System.out.println(sum); TestVariable2 test2 = new TestVariable2(); System.out.println(test2.count); /**变量:变量的使用原则,就近原则,当成员变量与局部变量同名时,使用局部变量*/ System.out.println(sum); } } 默认值: 基本类型 默认值 boolean false char ‘\u0000’ (null) byte (byte)0 short (short)0 int 0 long 0L float 0.0f double 0.0d public class TestVariable1 { /** 本类用于测试各种类型变量的默认值 */ //定义各种类型的成员变量,测试变量的默认值 byte b; short s; int i; long l; float f; char a; double d; boolean t; String x; public static void main(String[] args) { TestVariable1 test = new TestVariable1(); System.out.println(test.b); System.out.println(test.s); System.out.println(test.i); System.out.println(test.l); System.out.println(test.f); System.out.println(test.d); System.out.println(test.a); System.out.println(test.t); System.out.println(test.x); } } 2 嵌套for循环 2.1 概述 存在至少2层for循环,根据外层的条件,判断里层能否执行如果能执行,就把里层代码都循环完毕后,再继续判断是否执行外层循环的下一次循环 2.2 嵌套for循环的形式 2.2.1 练习:嵌套for循环,入门案例 总结1:外循环执行1次,内循环执行多次总结2:外循环控制行,内循环控制列 public class TestForDemo { /** 本类用于测试嵌套for循环的入门案例 */ public static void main(String[] args) { /** 外层执行一次,内层执行多次 * 外层控制的是轮数,内存控制的是每轮执行的次数 * */ for(int i = 1; i<=3; i++){ //内存循环 System.out.println("外层循环第:"+i+"轮"); for (int j = 1; j<=5 ;j++){ //外层循环 System.out.println("内层循环第第:"+j+"次"); } } System.out.println("···································"); /** 打印一个由 * 组成的矩形 */ for(int i = 1; i<=3; i++){ //内存循环 for (int j = 1; j<=5 ;j++){ //外层循环 System.out.print("*"); } System.out.println(); //空白行用来换行 } } } 2.2.2 练习2:打印直角三角形 public class TestForTriangles { /** 利用for循环打印一个左直角三角形 * * * * ** * *** * **** * ***** * ****** * */ public static void main(String[] args) { for (int i = 1; i<=6;i++){ /** 此处列数要随着行数而变化,列数最大值就是行数 */ for(int j = 1 ; j<=i;j++){ System.out.print("*");//在同一轮/同一行打印不换行 } System.out.println();//空白行用来换行 } } } 2.2.3 练习:打印99乘法表 public class TestFor99Excel { /** 打印99乘法表 */ public static void main(String[] args) { for (int i = 1;i<=9;i++){ //控制行数,打印9行 for (int j= 1; j<=i;j++){ //控制列数,i行打印i列 //拼接打印算式,后面拼接一个"\t"表示这是表格格式,\t也被称作制表符 System.out.print(j+"*"+i+"="+(j*i)+"\t"); } System.out.println( ); } } } 3 break与continue 3.1 概念 break: 直接结束当前循环,跳出循环体,简单粗暴 break以后的循环体中的语句不会继续执行,循环体外的会执行注意如果是嵌套for循环,在内层循环遇到了break,只会跳出当前这一层内循环哦 continue: 跳出本轮循环,继续下一轮循环 continue后本轮循环体中的语句不会继续执行,但是会继续执行下轮循环,循环体外的也会执行 3.2练习:测试Break与Continue import java.util.Scanner; /**需求:找数字88 * 提示并接受用户输入100次数字,如果不是88,则继续输入,找到88就结束*/ public class TestBreakAndContinue { public static void main(String[] args) { //循环体可以帮助我们执行重复的事情,控制for循环执行100次 for(int i = 1;i <= 100; i++) { //在每一次循环中都要提示并接收用户输入的数字 System.out.println("请输入数字:"); int input = new Scanner(System.in).nextInt(); if(input != 88) {//用户输入的不是88 continue;//直接继续输入 /**注意,不管是不是加continue,都可以在猜不对的情况下继续输入 * 只不过加了continue后效率更高,只要数据不等于88,就无需执行后面的代码 * 直接进行下一轮的猜数字即可* */ /**break或者continue之后都不允许写代码,都是不可到达的代码*/ //System.out.println(0);//Unreachable code } System.out.println("我是用来测试continue有没有跳过循环后半部分代码的哦"); if(input == 88) {//找到88了 System.out.println("恭喜您,猜对了!"); break;//结束程序 //System.out.println(0);//Unreachable code } } } } 4 循环结构2 : while 4.1 形式(先判断,再执行) 4 循环结构3 : do-while 4.2形式(先执行,再判断,循环体代码保证最少执行一次) 4.3 练习:猜数字之while与do-while练习 import java.util.Random; import java.util.Scanner; /** * 本类用于练习while循环 * 需求: 产生一个随机数,和用户一直在输入的数字做比较,直到用户猜对 * */ public class TestWhile { public static void main(String[] args) { int r = createNum();//调用可以生成随机数的方法,并且接收生成的随机数 System.out.println("打个小抄:"+r); //调用猜数字方法1--while //guessNum1(r); //调用猜数字方法2--do-while guessNum2(r); } public static void guessNum2(int r) { do {//先执行一次 //2.接收用户输入的值 System.out.println("猜猜看~"); int input = new Scanner(System.in).nextInt(); //3.判断是否猜对(拿用户猜的数字与生成的随机数做比较) if(input > r) { System.out.println("猜大了,继续猜猜看"); }else if(input < r) { System.out.println("猜小了,继续努力"); }else if(input == r) { System.out.println("猜对了!"); //一定注意:要设置程序出口!!! break; } }while(true); } //创建猜数字的方法 public static void guessNum1(int r) { //1.写一个死循环 while(true) {//死循环--需要设置程序的出口 //2.接收用户输入的值 System.out.println("猜猜看~"); int input = new Scanner(System.in).nextInt(); //3.判断是否猜对(拿用户猜的数字与生成的随机数做比较) if(input > r) { System.out.println("猜大了,继续猜猜看"); }else if(input < r) { System.out.println("猜小了,继续努力"); }else if(input == r) { System.out.println("猜对了!"); //一定注意:要设置程序出口!!! break; } } } //创建一个用来生成随机数的方法 public static int createNum() { //让程序产生一个随机数 //java.util.Random,注意导包,快捷键:Ctrl+Shift+O int random = new Random().nextInt(100);//参数100是自定义的,此时生成的随机数范围是[0,100)的整数 return random; } } 4.4 拓展:三种循环的区别 for:知道循环次数 while/do while:当循环次数不确定时 while:先判断,不符合规则,不执行代码 do while:代码最少被执行一次,再去判断,符合规则,再次执行代码 循环之间都可以互相替代,但是一般最好选择合适的循环结构来完成代码哦~ 5 方法 5.1 概述 被命名的代码块,方法可以含参数可以不含参数,可以提高代码的复用性。 5.2 方法定义的格式 5.3 方法调用顺序图 顺序执行代码,调用指定方法,执行完毕,返回调用位置 5.4 练习:测试方法的调用顺序/参数/返回值 public class TestMethod { //1.创建程序的入口函数main() public static void main(String[] args) { System.out.println(1); /**2.我们通过方法名+参数列表的方式来调用方法的功能*/ method1();//调用method1() System.out.println(2); method2(3);//调用method2() int result = method3(1,2);//调用method3() System.out.println(result); } /**3.如果方法想要返回值,必须修改返回值类型 * 并且return对应类型的结果 * 如果方法的返回值类型是void,不允许有返回值 * */ /*本方法用来测试方法的返回值类型*/ public static int method3(int i, int j) { /**4.通过return关键字将方法结果返回到调用位置*/ return i+j; } /**1.方法的修饰符 方法的返回值类型 方法名(方法参数){方法体}*/ /*method1()想测试方法的调用顺序*/ public static void method1() { System.out.println(5); System.out.println(6); System.out.println(7); } /*本方法用来测试方法的参数,参数的位置在小括号里*/ public static void method2(int a) { System.out.println("海绵宝宝今年:"+ a +"岁啦~"); } }

优秀的个人博客,低调大师

Day5 鸿蒙,是如何精简安卓应用的界面开发的

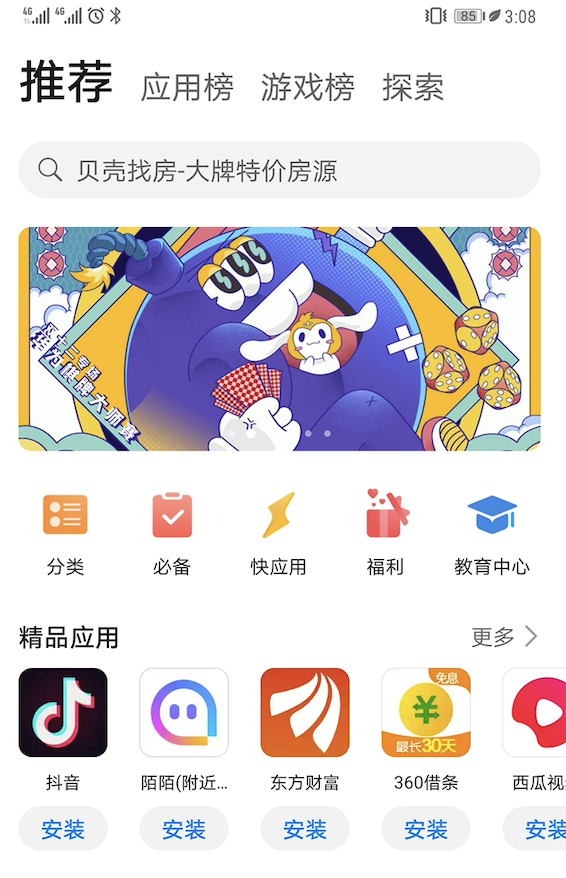
图中展示的华为应用市场的主页面,安卓形形色色的百万级应用,界面也是各有不同,但总的来说还是,还是脱离不了七大布局,软件工程师将组件通过不同的布局组合,进行一系列的加工,最后成为我们手机现在使用的应用。 【安卓】 安卓的七大布局又是什么呢? 七大布局分别为:线性布局(LInearLayout)、相对布局(RelativeLayout)、帧布局(FrameLayout)、表格布局(TableLayout)、绝对布局(absoluteLayout)、网格布局(GridLayout)、约束布局(ConstraintLayout) 这么多的布局也并非一开始就有,比如约束布局(ConstraintLayout)是Android Studio 2.2推出的新布局,并从Android Studio 2.3开始成为默认布局;网格布局(GridLayout)是Android4.0(API Level 14)新引入的等等。 不同的布局适用于不同的场景,下面详细介绍七大布局的特点及使用:(布局属性具体见附录) 【鸿蒙】 鸿蒙包含2种常用布局: 定向布局(DirectionalLayout)、从属布局(DependentLayout) 对比结论: 以目前的常用布局能够满足应用开发的大部分需求,但相较于安卓的帧布局(FrameLayout),如加载自定义视图时提供容器,需要额外考虑实现方式。其中定向布局(DirectionalLayout)可与安卓的线性布局(LinearLayout)做横向比较,从属布局(DependentLayout)可与安卓的相对布局(RelativeLayout)做横向比较,两者是相似的。 后续是否有更多的布局种类加入,可以拭目以待,下面详细介绍2种布局的特点及使用: 附录:(后面内容较长) 【安卓】 线性布局(LinearLayout)属性列表: 相对布局(RelativeLayout)属性列表: 绝对布局(AbsoluteLayout)属性列表: 表格布局(TableLayout)属性列表: 帧布局(FrameLayout)属性列表: 网格布局(GridLayout)属性列表: 约束布局(ConstraintLayout)属性列表: 【鸿蒙】 定向布局(DirectionalLayout)属性列表: 从属布局(DependentLayout)属性列表: 本文由GZH程序员小小叶发布!

优秀的个人博客,低调大师

Android 0day 漏洞影响 Google、小米和华为等品牌手机

Google 安全团队Project Zero 的研究人员近日披露了一个活跃的 Android 漏洞,该漏洞影响了一些受欢迎的设备,其中包括 Pixel 2, 华为 P20 Pro 和红米 Note 5 等。 Project Zero 发表的帖子显示该漏洞是在上周被发现的,当时攻击者正在利用它完全控制 Android 设备。帖子还指出,要利用此漏洞无需或只需最小自定义的 Root 权限即可。 团队还列出了一些受影响的运行 Android 8.x 或更高版本的设备: 搭载 Android 9 或 Android 10 preview 的 Pixel 1, 1 XL, 2 和2 XL(Pixel 3 和 3a 设备不受攻击) 华为 P20 红米 5A 红米 Note 5 小米 A1 Oppo A3 Moto Z3 Oreo LG 手机 三星 Galaxy S7, S8, S9 …… 对此,Google 表示即将发布的 Android 10 月安全更新将修复该漏洞,并已通知 Android 合作伙伴推送更新,安全补丁可在 Android Common Kernel 上获取。 据了解,该漏洞早已在 Android 内核的早期版本(3.18, 4.4 和 4.9)中被修复,但现在却再次出现了。事实上该漏洞最早源于Linux 内核,早在 2018 年初就被发现并修复,但出于未解释的原因,补丁没有整合进 Android 的安全更新。 安全研究人员介绍,攻击者无法使用远程代码执行(RCE)来利用此漏洞。但是,如果我们从不受信任的来源安装应用程序,则攻击者可以通过这个过程来利用漏洞。如果攻击者将其与 Chrome 浏览器中的漏洞进行配对以渲染内容,则他也可以通过此来利用该漏洞。 为此,他们建议用户不要从非可信来源安装应用程序,并最好使用其他浏览器,例如 Firefox 或Brave,直到问题解决为止。 另外,安全研究人员还推测该漏洞已被以色列公司 NSO 使用,该组织是一个基于 Isreal 的组织,它向政府出售工具以利用 iOS 和 Android。而 NSO 的代表则否认了这一说法。

优秀的个人博客,低调大师

【Java入门提高篇】Day34 Java容器类详解(十五)WeakHashMap详解

在Java容器详解系列文章的最后,介绍一个相对特殊的成员:WeakHashMap,从名字可以看出它是一个Map。它的使用上跟HashMap并没有什么区别,所以很多地方这里就不做过多介绍了,可以翻看一下前面HashMap中的内容。本篇主要介绍它与HashMap的不同之处。 WeakHashMap特殊之处在于WeakHashMap里的entry可能会被垃圾回收器自动删除,也就是说即使你没有调用remove()或者clear()方法,它的entry也可能会慢慢变少。所以多次调用比如isEmpty,containsKey,size等方法时可能会返回不同的结果。 接下来希望能带着这么几个问题来进行阅读: 1、WeakHashMap中的Entry为什么会自动被回收。 2、WeakHashMap与HashMap的区别是什么。 3、WeakHashMap的引用场景有哪些。 WeakHashMap探秘 从说明可以看出,WeakHashMap的特殊之处便在于它的Entry与众不同,里面的Entry会被垃圾回收器自动回收,那么问题来了,为什么会被自动回收呢?HashMap里的Entry并不会被自动回收,除非把它从Map中移除掉。 其实这个秘密就在于弱引用,WeakHashMap中的key是间接保存在弱引用中的,所以当key没有被继续使用时,就可能会在GC的时候被回收掉。 只有key对象是使用弱引用保存的,value对象实际上仍旧是通过普通的强引用来保持的,所以应该确保value不会直接或者间接的保持其对应key的强引用,因为这样会阻止key被回收。 如果对于引用类型不熟悉的话,可以先阅读这篇文章。 下面来从源码角度看看具体是如何实现这个特性的。 继承结构 WeakHashMap并不是继承自HashMap,而是继承自AbstractMap,跟HashMap的继承结构差不多。 存储结构 WeakHashMap中的数据结构是数组+链表的形式,这一点跟HashMap也是一致的,但不同的是,在JDK8中,当发生较多key冲突的时候,HashMap中会由链表转为红黑树,而WeakHashMap则一直使用链表进行存储。 成员变量 // 默认初始容量,必须是2的幂 private static final int DEFAULT_INITIAL_CAPACITY = 16; // 最大容量 private static final int MAXIMUM_CAPACITY = 1 << 30; // 默认装载因子 private static final float DEFAULT_LOAD_FACTOR = 0.75f; // Entry数组,长度必须为2的幂 Entry<K,V>[] table; // 元素个数 private int size; // 阈值 private int threshold; // 装载因子 private final float loadFactor; // 引用队列 private final ReferenceQueue<Object> queue = new ReferenceQueue<>(); // 修改次数 int modCount; 跟HashMap的成员变量几乎一致,这里多了一个ReferenceQueue,用来存放那些已经被回收了的弱引用对象。如果想知道ReferenceQueue是如何工作的,可以参考这篇文章。 构造函数 WeakHashMap中也有四个构造函数: public WeakHashMap(int initialCapacity, float loadFactor) { ... } public WeakHashMap(int initialCapacity) { this(initialCapacity, DEFAULT_LOAD_FACTOR); } public WeakHashMap() { this(DEFAULT_INITIAL_CAPACITY, DEFAULT_LOAD_FACTOR); } public WeakHashMap(Map<? extends K, ? extends V> m) { this(Math.max((int) (m.size() / DEFAULT_LOAD_FACTOR) + 1, DEFAULT_INITIAL_CAPACITY), DEFAULT_LOAD_FACTOR); putAll(m); } 可以看到后三个,都是调用的第一个构造函数,下面再来看一下第一个构造函数的内容: // 校验initialCapacity if (initialCapacity < 0) throw new IllegalArgumentException("Illegal Initial Capacity: "+ initialCapacity); if (initialCapacity > MAXIMUM_CAPACITY) initialCapacity = MAXIMUM_CAPACITY; // 校验loadFactor if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal Load factor: "+ loadFactor); int capacity = 1; // 将容量设置为大于initialCapacity的最小2的幂 while (capacity < initialCapacity) capacity <<= 1; table = newTable(capacity); this.loadFactor = loadFactor; threshold = (int)(capacity * loadFactor); 再看看newTable函数。 private Entry<K,V>[] newTable(int n) { return (Entry<K,V>[]) new Entry<?,?>[n]; } 这里其实只是简单的创建一个Entry数组。 Entry剖析 接下来看看WeakHashMap中的核心角色——Entry。上面已经看到了,WeakHashMap中的table是一个Entry数组: Entry<K,V>[] table; 来看看Entry长什么样: private static class Entry<K,V> extends WeakReference<Object> implements Map.Entry<K,V> { ... } Entry继承自WeakReference,继承关系图如下: 再来看看Entry中的内容: // 成员变量 V value; final int hash; Entry<K,V> next; // 构造函数 Entry(Object key, V value, ReferenceQueue<Object> queue, int hash, Entry<K,V> next) { super(key, queue); this.value = value; this.hash = hash; this.next = next; } 细心的你可能会发现,哎?key哪里去了,成员变量里没有key。别着急,看看构造函数就可以发现,它调用了父类的构造函数。 super(key, queue); 这里调用的WeakReference的构造函数,将key传入Reference中,保存在referent成员变量中。对Reference和WeakReference不熟悉的话可以参考这篇文章和这篇文章。 再看看其它几个方法: @SuppressWarnings("unchecked") public K getKey() { // 这里调用了Reference的get方法,从中取出referent对象 // WeakHashMap中,key如果为null会使用NULL_KEY来替代 return (K) WeakHashMap.unmaskNull(get()); } public V getValue() { return value; } public V setValue(V newValue) { V oldValue = value; value = newValue; return oldValue; } public boolean equals(Object o) { if (!(o instanceof Map.Entry)) return false; Map.Entry<?,?> e = (Map.Entry<?,?>)o; K k1 = getKey(); Object k2 = e.getKey(); if (k1 == k2 || (k1 != null && k1.equals(k2))) { V v1 = getValue(); Object v2 = e.getValue(); if (v1 == v2 || (v1 != null && v1.equals(v2))) return true; } return false; } public int hashCode() { K k = getKey(); V v = getValue(); // 这里只是简单的把key和value的hashcode做一个异或处理 return Objects.hashCode(k) ^ Objects.hashCode(v); } public String toString() { return getKey() + "=" + getValue(); } 这里稍微说一下getKey方法,调用了WeakHashMap.unmaskNull,之所以要调用这个方法,其实是因为WeakHashMap中对key为null时的特殊处理,会将其指向一个特殊的内部变量: private static final Object NULL_KEY = new Object(); 与其对应的两个方法便是: private static Object maskNull(Object key) { return (key == null) ? NULL_KEY : key; } static Object unmaskNull(Object key) { return (key == NULL_KEY) ? null : key; } 所以,其他WeakHashMap中的Entry最大的不同就是继承自WeakReference,并把key保存在了WeakReference中。可以说WeakHashMap的特性绝大部分都是WeakReference的功劳。 常用方法 主要的方法有这些: void clear() Object clone() boolean containsKey(Object key) boolean containsValue(Object value) Set<Entry<K, V>> entrySet() V get(Object key) boolean isEmpty() Set<K> keySet() V put(K key, V value) void putAll(Map<? extends K, ? extends V> map) V remove(Object key) int size() Collection<V> values() 这里选其中的三个最常用的方法进行解析: put方法 public V put(K key, V value) { // 处理null值 Object k = maskNull(key); // 计算hash int h = hash(k); // 获取table Entry<K,V>[] tab = getTable(); // 计算下标 int i = indexFor(h, tab.length); // 查找Entry for (Entry<K,V> e = tab[i]; e != null; e = e.next) { if (h == e.hash && eq(k, e.get())) { V oldValue = e.value; if (value != oldValue) e.value = value; return oldValue; } } modCount++; Entry<K,V> e = tab[i]; tab[i] = new Entry<>(k, value, queue, h, e); // 如果元素个数超过阈值,则进行扩容 if (++size >= threshold) resize(tab.length * 2); return null; } 这里涉及到的方法比较多,不慌不慌,一个一个来。 先来看看hash方法: final int hash(Object k) { int h = k.hashCode(); // 这里做了二次散列,来扩大低位的影响 h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } hash方法对key的hashcode进行了二次散列,主要是为了扩大低位的影响。因为Entry数组的大小是2的幂,在进行查找的时候,进行掩码处理,如果不进行二次散列,那么低位对index就完全没有影响了,如果不清楚也没有关系,之后在get方法里会有说明。 至于为什么要选20,12,7,4。emmm,大概是效果奇佳吧(一本正经的胡说八道,有兴趣的话可以自行研究)。 再看看indexFor函数,这里就是将数组长度减1后与hashcode做一个位与操作,因为length必定是2的幂,所以减1后就变成了掩码,再进行与操作就能直接得到hashcode mod length的结果了,但是这样操作效率会更高。 private static int indexFor(int h, int length) { return h & (length-1); } 再来看看getTable方法: private Entry<K,V>[] getTable() { // 清除被回收的Entry对象 expungeStaleEntries(); return table; } private void expungeStaleEntries() { for (Object x; (x = queue.poll()) != null; ) { // 循环获取引用队列中的对象 synchronized (queue) { @SuppressWarnings("unchecked") Entry<K,V> e = (Entry<K,V>) x; // 查找对应的位置 int i = indexFor(e.hash, table.length); // 找到之前的Entry Entry<K,V> prev = table[i]; Entry<K,V> p = prev; // 在链表中寻找 while (p != null) { Entry<K,V> next = p.next; if (p == e) { if (prev == e) table[i] = next; else prev.next = next; // 将对应的value置为null,帮助GC回收 e.value = null; size--; break; } prev = p; p = next; } } } } 所以每次调用getTable的时候,都会将table中key已经被回收掉的Entry移除掉。 resize方法: void resize(int newCapacity) { // 获取当前table Entry<K,V>[] oldTable = getTable(); int oldCapacity = oldTable.length; if (oldCapacity == MAXIMUM_CAPACITY) { threshold = Integer.MAX_VALUE; return; } // 新建一个table Entry<K,V>[] newTable = newTable(newCapacity); // 将旧table中的内容复制到新table中 transfer(oldTable, newTable); table = newTable; if (size >= threshold / 2) { threshold = (int)(newCapacity * loadFactor); } else { expungeStaleEntries(); transfer(newTable, oldTable); table = oldTable; } } // 新建Entry数组 private Entry<K,V>[] newTable(int n) { return (Entry<K,V>[]) new Entry<?,?>[n]; } private void transfer(Entry<K,V>[] src, Entry<K,V>[] dest) { for (int j = 0; j < src.length; ++j) { Entry<K,V> e = src[j]; src[j] = null; while (e != null) { Entry<K,V> next = e.next; Object key = e.get(); if (key == null) { e.next = null; e.value = null; size--; } else { int i = indexFor(e.hash, dest.length); e.next = dest[i]; dest[i] = e; } e = next; } } } get方法 public V get(Object key) { // 对null值特殊处理 Object k = maskNull(key); // 取key的hash值 int h = hash(k); // 取当前table Entry<K,V>[] tab = getTable(); // 获取下标 int index = indexFor(h, tab.length); Entry<K,V> e = tab[index]; // 链表中查找元素 while (e != null) { if (e.hash == h && eq(k, e.get())) return e.value; e = e.next; } return null; } 在查找元素的时候调用了一个eq方法: private static boolean eq(Object x, Object y) { return x == y || x.equals(y); } remove方法 public V remove(Object key) { // 对null值特殊处理 Object k = maskNull(key); // 取key的hash int h = hash(k); // 取当前table Entry<K,V>[] tab = getTable(); // 计算下标 int i = indexFor(h, tab.length); Entry<K,V> prev = tab[i]; Entry<K,V> e = prev; while (e != null) { Entry<K,V> next = e.next; // 查找对应Entry if (h == e.hash && eq(k, e.get())) { modCount++; size--; if (prev == e) tab[i] = next; else prev.next = next; // 如果找到,返回对应Entry的value return e.value; } prev = e; e = next; } return null; } 使用栗子 public class WeakHashMapTest { public static void main(String[] args){ testWeakHashMap(); } private static void testWeakHashMap() { // 创建3个String对象用来做key String w1 = new String("key1"); String w2 = new String("key2"); String w3 = new String("key3"); // 新建WeakHashMap Map weakHashMap = new WeakHashMap(); // 添加键值对 weakHashMap.put(w1, "v1"); weakHashMap.put(w2, "v2"); weakHashMap.put(w3, "v3"); // 打印出weakHashMap System.out.printf("weakHashMap:%s\n", weakHashMap); // containsKey(Object key) :是否包含键key System.out.printf("contains key key1 : %s\n",weakHashMap.containsKey("key1")); System.out.printf("contains key key4 : %s\n",weakHashMap.containsKey("key4")); // containsValue(Object value) :是否包含值value System.out.printf("contains value v1 : %s\n",weakHashMap.containsValue("v1")); System.out.printf("contains value 0 : %s\n",weakHashMap.containsValue(0)); // remove(Object key) : 删除键key对应的键值对 weakHashMap.remove("three"); System.out.printf("weakHashMap: %s\n", weakHashMap); // ---- 测试 WeakHashMap 的自动回收特性 ---- // 将w1设置null。 // 这意味着“弱键”w1再没有被其它对象引用,调用gc时会回收WeakHashMap中与“w1”对应的键值对 w1 = null; // 内存回收。这里,会回收WeakHashMap中与“w1”对应的键值对 System.gc(); // 遍历WeakHashMap Iterator iter = weakHashMap.entrySet().iterator(); while (iter.hasNext()) { Map.Entry en = (Map.Entry)iter.next(); System.out.printf("next : %s - %s\n",en.getKey(),en.getValue()); } // 打印WeakHashMap的实际大小 System.out.printf("after gc WeakHashMap size:%s\n", weakHashMap.size()); } } 输出如下: weakHashMap:{key1=w1, key2=w2, key3=w3} contains key key1 : true contains key key4 : false contains value w1 : true contains value 0 : false weakHashMap: {key1=w1, key2=w2, key3=w3} next : key2 - w2 next : key3 - w3 after gc WeakHashMap size:2 可以看到,w1对应的Entry被回收掉了,这就是WeakHashMap的最重要特性,当然,实际使用的时候一般不会这样使用, 应用场景 由于WeakHashMap可以自动清除Entry,所以比较适合用于存储非必需对象,用作缓存非常合适。 public final class ConcurrentCache<K,V> { private final int size; private final Map<K,V> eden; private final Map<K,V> longterm; public ConcurrentCache(int size) { this.size = size; this.eden = new ConcurrentHashMap<>(size); this.longterm = new WeakHashMap<>(size); } public V get(K k) { V v = this.eden.get(k); if (v == null) { synchronized (longterm) { v = this.longterm.get(k); } if (v != null) { this.eden.put(k, v); } } return v; } public void put(K k, V v) { if (this.eden.size() >= size) { synchronized (longterm) { this.longterm.putAll(this.eden); } this.eden.clear(); } this.eden.put(k, v); } } 在put方法里,在插入一个键值对时,先检查eden缓存的容量是不是超过了阈值,如果没有超就直接放入eden缓存,如果超了就将eden中所有的键值对都放入longterm(这里longterm类似于老年代,eden类似于年轻代),再将eden清空并插入相应键值对。 在get方法中,也是优先从eden中找对应的value,如果没有则进入longterm缓存中查找,找到后就加入eden缓存并返回。 这样设计的好处是,能将相对常用的对象都能在eden缓存中找到,不常用的则存入longterm缓存,并且由于WeakHashMap能自动清除Entry,所以不用担心longterm中键值对过多而导致OOM。 WeakHashMap还有这样一个不错的应用场景,配合事务进行使用,存储事务过程中的各类信息。可以使用如下结构: WeakHashMap<String,Map<K,V>> transactionCache; 这里key为String类型,可以用来标志区分不同的事务,起到一个事务id的作用。value是一个map,可以是一个简单的HashMap或者LinkedHashMap,用来存放在事务中需要使用到的信息。 在事务开始时创建一个事务id,并用它来作为key,事务结束后,将这个强引用消除掉,这样既能保证在事务中可以获取到所需要的信息,又能自动释放掉map中的所有信息。 小结 WeakHashMap是一个会自动清除Entry的Map WeakHashMap的操作与HashMap完全一致 WeakHashMap内部数据结构是数组+链表 WeakHashMap常被用作缓存

优秀的个人博客,低调大师

【Java入门提高篇】Day33 Java容器类详解(十五)PriorityQueue详解

今天要介绍的是基础容器类(为了与并发容器类区分开来而命名的名字)中的另一个成员——PriorityQueue,它的大名叫做优先级队列,想必即使没有用过也该有所耳闻吧,什么?没。。没听过?emmm。。。那就更该认真看看了。 通过本篇你将了解到: 1、PriorityQueue是什么? 2、PriorityQueue的内部结构是什么? 3、二叉堆、大顶堆、小顶堆分别是什么?有什么特性? 4、小顶堆是如何实现的,如何用数组表示? 5、小顶堆的删除、插入操作是如何进行的? 6、PriorityQueue的源码解析。 7、PriorityQueue的应用场景。 一、PriorityQueue简介 PriorityQueue也是Queue的一个继承者,相比于一般的列表,它的特点便如它的名字一样,出队的时候可以按照优先级进行出队,所以不像LinkedList那样只能按照插入的顺序出队,PriorityQueue是可以根据给定的优先级顺序进行出队的。这里说的给定优先级顺序既可以是内部比较器,也可以是外部比较器。PriorityQueue内部是根据小顶堆的结构进行存储的,所谓小顶堆的意思,便是最小的元素总是在最上面,每次出队总是将堆顶元素移除,这样便能让出队变得有序,至于什么是小顶堆,后面会有详细介绍。 比如说,比较常见的场景就是任务队列,队列动态插入,后面的任务优先级高的需要被先执行,那么使用优先级队列就可以比较好的实现这样的需求。下面我们模拟一下这个场景: public class PriorityQueueTest { public static void main(String[] args){ // 传入外部比较器, //PriorityQueue<Task> taskQueue = new PriorityQueue<>(Comparator.comparingInt(Task::getPriority)); //PriorityQueue<Task> taskQueue = new PriorityQueue<>((t1, t2) -> t1.getPriority() - t2.getPriority()); PriorityQueue<Task> taskQueue = new PriorityQueue<>(new Comparator<Task>() { @Override public int compare(Task t1, Task t2) { return t1.getPriority() - t2.getPriority(); } }); // 添加六个任务 taskQueue.add(new Task(1, "learn java")); taskQueue.add(new Task(3, "learn c++")); taskQueue.add(new Task(4, "learn c#")); taskQueue.add(new Task(2, "learn python")); taskQueue.add(new Task(2, "learn php")); taskQueue.add(new Task(5, "learn js")); // 出队 while (!taskQueue.isEmpty()){ System.out.println(taskQueue.poll()); } } } class Task{ /** * 任务优先级 */ private int priority; /** * 任务名称 */ private String taskName; public Task() { } public Task(int priority, String taskName) { this.priority = priority; this.taskName = taskName; } public int getPriority() { return priority; } public void setPriority(int priority) { this.priority = priority; } public String getTaskName() { return taskName; } public void setTaskName(String taskName) { this.taskName = taskName; } @Override public String toString() { return "Task{" + "priority=" + priority + ", taskName='" + taskName + '\'' + '}'; } } 输出如下: Task{priority=1, taskName='learn java'} Task{priority=2, taskName='learn python'} Task{priority=2, taskName='learn php'} Task{priority=3, taskName='learn c++'} Task{priority=4, taskName='learn c#'} Task{priority=5, taskName='learn js'} 可以看到,输出的时候是按照我们设定的优先级顺序进行输出的,由于默认的是小顶堆,所以这里Priority值小的会被先输出。 二、PriorityQueue的内部结构 上面已经提到了,PriorityQueue的内部结构其实是按照小顶堆的结构进行存储的,那么什么是小顶堆呢?说到小顶堆,还是先从堆开始介绍吧。 堆和栈一样是一种很基础的数据结构,在维基百科中的介绍如下: 堆(英语:Heap)是计算机科学中一类特殊的数据结构的统称。堆通常是一个可以被看做一棵树的数组对象。在队列中,调度程序反复提取队列中第一个作业并运行,因为实际情况中某些时间较短的任务将等待很长时间才能结束,或者某些不短小,但具有重要性的作业,同样应当具有优先权。堆即为解决此类问题设计的一种数据结构。 用图来表示的话就像这样: 说完了堆,再来聊聊它的进化版——二叉堆,同样引用维基百科中的介绍: 二叉堆(英语:binary heap)是一种特殊的堆,二叉堆是完全二叉树或者是近似完全二叉树。二叉堆满足堆特性:父节点的键值总是保持固定的序关系于任何一个子节点的键值,且每个节点的左子树和右子树都是一个二叉堆。 当父节点的键值总是大于或等于任何一个子节点的键值时为最大堆。 当父节点的键值总是小于或等于任何一个子节点的键值时为最小堆。 其中,最大堆也叫做大顶堆或者大根堆,最小堆也叫做小顶堆或者小根堆。上面的图一其实就是一个大顶堆,而图二则是小顶堆。PriorityQueue是通过数组表示的小顶堆实现的,既然如此,PriorityQueue的排序特性自然与小顶堆的特性一致,下面便介绍小顶堆如何使用数组进行表示以及插入删除时的调整。 下面是一个由10,16,20,22,18,25,26,30,24,23构成的小顶堆: 将其从第一个元素开始依次从上到下,从左到右给每个元素添加一个序号,从0开始,这样就得到了相应元素在数组中的位置,而且这个序号是很有规则的,第k个元素的左孩子的序号为2k+1,右孩子的序号为2k+2,这样就很容易根据序号直接算出对应孩子的位置,时间复杂度为o(1)。这也就是为什么可以用数组来存储堆结构的原因了。 再来看看小顶堆是如何插入元素的,假设我们插入一个元素15: 插入元素的调整其实很简单,就是先插入到最后,然后再依次与其父节点进行比较,如果小于其父节点,则互换,直到不需要调整或者父节点为null为止。 那再来看看移除元素: 嗯,过程其实也很简单,先用最后的元素当替补,然后再从上往下进行调整。 三、PriorityQueue源码解析 小顶堆已经介绍完了,那PriorityQueue就没什么内容可讲了,嗯,那散了吧好了好了,不开玩笑了,接下来让我们一起来看看源码中是如何实现的。 先来继承结构: PriorityQueue继承自AbstractQueue,像这样的Abstract开头的抽象类,想必应该不陌生了,就是继承自指定接口然后进行了一些默认实现。 来看看PriorityQueue的内部成员: // 默认初始化容量 private static final int DEFAULT_INITIAL_CAPACITY = 11; /** * 优先级队列是使用平衡二叉堆表示的: 节点queue[n]的两个孩子分别为 * queue[2*n+1] 和 queue[2*(n+1)]. 队列的优先级是由比较器或者 * 元素的自然排序决定的, 对于堆中的任意元素n,其后代d满足:n<=d * 如果堆是非空的,则堆中最小值为queue[0]。 */ transient Object[] queue; /** * 队列中元素个数 */ private int size = 0; /** * 比较器 */ private final Comparator<? super E> comparator; /** * 修改次数 */ transient int modCount = 0; 可以看到内部使用的是一个Object数组进行元素的存储,并对该数组进行了详细的注释,所以不管是根据子节点找父节点,还是根据父节点找子节点都肥肠的方便。 再来看看它的构造函数,有点多,一共有六个构造函数: /** * 使用默认的容量(11)来构造一个空的优先级队列,使用元素的自然顺序进行排序(此时元素必须实现comparable接口) */ public PriorityQueue() { this(DEFAULT_INITIAL_CAPACITY, null); } /** * 使用指定容量来构造一个空的优先级队列,使用元素的自然顺序进行排序(此时元素必须实现comparable接口) * 但如果指定的容量小于1则会抛出异常 */ public PriorityQueue(int initialCapacity) { this(initialCapacity, null); } /** * 使用默认的容量(11)构造一个优先级队列,使用指定的比较器进行排序 */ public PriorityQueue(Comparator<? super E> comparator) { this(DEFAULT_INITIAL_CAPACITY, comparator); } /** * 使用指定容量创建一个优先级队列,并使用指定比较器进行排序。 * 但如果指定的容量小于1则会抛出异常 */ public PriorityQueue(int initialCapacity, Comparator<? super E> comparator) { if (initialCapacity < 1) throw new IllegalArgumentException(); this.queue = new Object[initialCapacity]; this.comparator = comparator; } /** * 使用指定集合的所有元素构造一个优先级队列, * 如果该集合为SortedSet或者PriorityQueue类型,则会使用相同的顺序进行排序, * 否则,将使用元素的自然排序(此时元素必须实现comparable接口),否则会抛出异常 * 并且集合中不能有null元素,否则会抛出异常 */ @SuppressWarnings("unchecked") public PriorityQueue(Collection<? extends E> c) { if (c instanceof SortedSet<?>) { SortedSet<? extends E> ss = (SortedSet<? extends E>) c; this.comparator = (Comparator<? super E>) ss.comparator(); initElementsFromCollection(ss); } else if (c instanceof PriorityQueue<?>) { PriorityQueue<? extends E> pq = (PriorityQueue<? extends E>) c; this.comparator = (Comparator<? super E>) pq.comparator(); initFromPriorityQueue(pq); } else { this.comparator = null; initFromCollection(c); } } /** * 使用指定的优先级队列中所有元素来构造一个新的优先级队列. 将使用原有顺序进行排序。 */ @SuppressWarnings("unchecked") public PriorityQueue(PriorityQueue<? extends E> c) { this.comparator = (Comparator<? super E>) c.comparator(); initFromPriorityQueue(c); } /** * 根据指定的有序集合创建一个优先级队列,将使用原有顺序进行排序 */ @SuppressWarnings("unchecked") public PriorityQueue(SortedSet<? extends E> c) { this.comparator = (Comparator<? super E>) c.comparator(); initElementsFromCollection(c); } 从集合中构造优先级队列的时候,调用了几个初始化函数: private void initFromPriorityQueue(PriorityQueue<? extends E> c) { if (c.getClass() == PriorityQueue.class) { this.queue = c.toArray(); this.size = c.size(); } else { initFromCollection(c); } } private void initElementsFromCollection(Collection<? extends E> c) { Object[] a = c.toArray(); // If c.toArray incorrectly doesn't return Object[], copy it. if (a.getClass() != Object[].class) a = Arrays.copyOf(a, a.length, Object[].class); int len = a.length; if (len == 1 || this.comparator != null) for (int i = 0; i < len; i++) if (a[i] == null) throw new NullPointerException(); this.queue = a; this.size = a.length; } private void initFromCollection(Collection<? extends E> c) { initElementsFromCollection(c); heapify(); } initFromPriorityQueue即从另外一个优先级队列构造一个新的优先级队列,此时内部的数组元素不需要进行调整,只需要将原数组元素都复制过来即可。但是从其他非PriorityQueue的集合中构造优先级队列时,需要先将元素复制过来后再进行调整,此时调用的是heapify方法: private void heapify() { // 从最后一个非叶子节点开始从下往上调整 for (int i = (size >>> 1) - 1; i >= 0; i--) siftDown(i, (E) queue[i]); } // 划重点了,这个函数即对应上面的元素删除时从上往下调整的步骤 private void siftDown(int k, E x) { if (comparator != null) // 如果比较器不为null,则使用比较器进行比较 siftDownUsingComparator(k, x); else // 否则使用元素的compareTo方法进行比较 siftDownComparable(k, x); } private void siftDownUsingComparator(int k, E x) { // 使用half记录队列size的一半,如果比half小的话,说明不是叶子节点 // 因为最后一个节点的序号为size - 1,其父节点的序号为(size - 2) / 2或者(size - 3 ) / 2 // 所以half所在位置刚好是第一个叶子节点 int half = size >>> 1; while (k < half) { // 如果不是叶子节点,找出其孩子中较小的那个并用其替换 int child = (k << 1) + 1; Object c = queue[child]; int right = child + 1; if (right < size && comparator.compare((E) c, (E) queue[right]) > 0) c = queue[child = right]; if (comparator.compare(x, (E) c) <= 0) break; // 用c替换 queue[k] = c; k = child; } // queue[k] = x; } // 同上,只是比较的时候使用的是元素的compareTo方法 private void siftDownComparable(int k, E x) { Comparable<? super E> key = (Comparable<? super E>)x; int half = size >>> 1; // 如果是非叶子节点则继续循环 while (k < half) { int child = (k << 1) + 1; Object c = queue[child]; int right = child + 1; if (right < size && ((Comparable<? super E>) c).compareTo((E) queue[right]) > 0) c = queue[child = right]; if (key.compareTo((E) c) <= 0) break; queue[k] = c; k = child; } queue[k] = key; } 这里可能一眼看过去有点难以理解,嗯,那就多看两眼吧。 siftDown方法是这里面比较重要的方法之一,有两个参数,一个是序号k,另一个是元素x,这个方法的作用,便是把x从k开始往下调整,使得在节点k在其子树的每相邻层中,父节点都小于其子节点。所以heapify的作用就比较明显了,从最后一个非叶子节点开始,从下往上依次调整其子树,使得最终得到的树里,根节点是最小的。这里要先理解一下为什么heapify中i的初始值要设置为(size >>> 1) - 1。因为这是最后一个非叶子节点的位置,不信的话可以随便画几个图验证一下,至于在siftDownUsingComparator方法中,int half = size >>> 1;这里half则是第一个叶子节点的位置,小于这个序号的节点都是非叶子节点,这里也可以画图验证,当然,注释中我已经做了解释。 说了这么多,也许还是不太明白,以集合{14,7,12,6,9,4,17,23,10,15,3}为例画个图吧: 嗯,这样最小的元素就被顶上去了,有没有觉得有点像冒泡排序,嗯,确实有点像。 siftDown说完了,再来看一眼siftUp吧,这里操作是十分类似的。 private void siftUp(int k, E x) { if (comparator != null) siftUpUsingComparator(k, x); else siftUpComparable(k, x); } @SuppressWarnings("unchecked") private void siftUpComparable(int k, E x) { Comparable<? super E> key = (Comparable<? super E>) x; while (k > 0) { int parent = (k - 1) >>> 1; Object e = queue[parent]; if (key.compareTo((E) e) >= 0) break; queue[k] = e; k = parent; } queue[k] = key; } @SuppressWarnings("unchecked") private void siftUpUsingComparator(int k, E x) { while (k > 0) { int parent = (k - 1) >>> 1; Object e = queue[parent]; if (comparator.compare(x, (E) e) >= 0) break; queue[k] = e; k = parent; } queue[k] = x; } 嗯,相信如果理解了siftDown的话,这里应该就不难理解了吧,如果还有疑问,欢迎留言。 再来看看几个常用的方法: public boolean add(E e) { return offer(e); } public boolean offer(E e) { if (e == null) throw new NullPointerException(); modCount++; int i = size; if (i >= queue.length) grow(i + 1); size = i + 1; if (i == 0) queue[0] = e; else siftUp(i, e); return true; } // 扩容函数 private void grow(int minCapacity) { int oldCapacity = queue.length; // 如果当前容量比较小(小于64)的话进行双倍扩容,否则扩容50% int newCapacity = oldCapacity + ((oldCapacity < 64) ? (oldCapacity + 2) : (oldCapacity >> 1)); // 如果发现扩容后溢出了,则进行调整 if (newCapacity - MAX_ARRAY_SIZE > 0) newCapacity = hugeCapacity(minCapacity); queue = Arrays.copyOf(queue, newCapacity); } private static int hugeCapacity(int minCapacity) { if (minCapacity < 0) // overflow throw new OutOfMemoryError(); return (minCapacity > MAX_ARRAY_SIZE) ? Integer.MAX_VALUE : MAX_ARRAY_SIZE; } public boolean contains(Object o) { return indexOf(o) != -1; } private int indexOf(Object o) { if (o != null) { // 查找时需要进行全局遍历,比搜索二叉树的查找效率要低 for (int i = 0; i < size; i++) if (o.equals(queue[i])) return i; } return -1; } public E poll() { if (size == 0) return null; int s = --size; modCount++; E result = (E) queue[0]; E x = (E) queue[s]; queue[s] = null; if (s != 0) siftDown(0, x); return result; } 这里对照一下最开始说的小顶堆的插入和移除就能比较好的理解了。 最后源码中还有一个remove方法,需要稍微说明一下: // 这里不是移除堆顶元素,而是移除指定元素 public boolean remove(Object o) { // 先找到该元素的位置 int i = indexOf(o); if (i == -1) return false; else { removeAt(i); return true; } } // 移除指定序号的元素 private E removeAt(int i) { // assert i >= 0 && i < size; modCount++; // s为最后一个元素的序号 int s = --size; if (s == i) queue[i] = null; else { // moved记录最后一个元素的值 E moved = (E) queue[s]; queue[s] = null; // 用最后一个元素代替要移除的元素,并向下进行调整 siftDown(i, moved); // 如果向下调整后发现moved还在该位置,则再向上进行调整 if (queue[i] == moved) { siftUp(i, moved); if (queue[i] != moved) return moved; } } return null; } 当移除的不是堆顶元素的时候,同样先用最后一个元素代替,然后先从被移除的位置开始向下调整,如果发现没有改动,则再向上调整。 四、PriorityQueue的应用场景 最后,来聊聊PriorityQueue的应用场景,由于内部是用数组实现的小顶堆,所以堆适用的场景它都适用,比如典型的从n个元素中取出最小(最大)的前k个,这样的场景适用PriorityQueue就能以比较小的空间代价和还算ok的时间代价进行实现,另外,优先级队列适用场景的特点便是需要动态插入元素,并且元素有优先级,需要根据一定的规则进行优先级排序。 下面以从10000个整数中取出最大的10个整数为例进行介绍。 public class Test { public static void main(String[] args){ ArrayList<Integer> integers = new ArrayList<>(10000); Random random = new Random(); for (int i = 0; i < 10000; i++) { Integer integer = random.nextInt(); if (!integers.contains(integer)) integers.add(integer); } Integer[] largest = getLargest10(integers); for (Integer i : largest){ System.out.print(i + " "); } System.out.println(); // 验证一下是否是最大的前10个 integers.sort(Comparator.comparingInt(Integer::intValue)); ArrayList<Integer> largest2 = new ArrayList<>(10); for (int i = integers.size() - 1; i >= integers.size() - 10; i--){ largest2.add(integers.get(i)); } // 在largest数组中查找 System.out.println(Arrays.asList(largest).containsAll(largest2)); } public static Integer[] getLargest10(ArrayList<Integer> integers){ PriorityQueue<Integer> queue = new PriorityQueue<>(10); for (Integer integer : integers){ queue.add(integer); if (queue.size() > 10){ queue.poll(); } } return queue.toArray(new Integer[10]); } } 输出如下,由于是取的随机数,所以每个人的输出都会不一样。 2143974860 2143998490 2144350843 2145111627 2144739333 2145674658 2144667271 2145543903 2147209906 2145466260 true 最后,我们来回答一下开头的问题: 1、PriorityQueue是什么?PriorityQueue是优先级队列,取出元素时会根据元素的优先级进行排序。 2、PriorityQueue的内部结构是什么?PriorityQueue内部是一个用数组实现的小顶堆。 3、二叉堆、大顶堆、小顶堆分别是什么?有什么特性?二叉堆是完全二叉树或者近完全二叉树,大顶堆即所有父节点大于子节点,小顶堆即所有父节点小于子节点。 4、小顶堆是如何实现的,如何用数组表示?小顶堆是用二叉树实现的,用数组表示时,父节点n的左孩子为2n+1,右孩子的序号为2n+2。 5、小顶堆的删除、插入操作是如何进行的?小顶堆删除堆顶元素后用最后一个元素替补,然后从上往下调整,插入一个元素时,先放到最后的位置,然后再从下往上调整。 6、PriorityQueue的源码解析。如上。 7、PriorityQueue的应用场景。适用于需要动态插入元素,且元素有优先级顺序的场景。 到此,本篇圆满结束。如果觉得还不错的话,记得动动小手点个赞,也欢迎关注博主,你们的支持是我写出更好博客的动力。 有兴趣对Java进行更深入学习和交流的小伙伴,欢迎加入QQ群交流:529253292

优秀的个人博客,低调大师

【Java入门提高篇】Day32 Java容器类详解(十四)ArrayDeque详解

今天来介绍一个不太常见也不太常用的类——ArrayDeque,这是一个很不错的容器类,如果对它还不了解的话,那么就好好看看这篇文章吧。 看完本篇,你将会了解到: 1、ArrayDeque是什么? 2、ArrayDeque如何使用? 3、ArrayDeque的内部结构是怎样的? 4、ArrayDeque的各个方法是如何实现的? 5、ArrayDeque是如何扩容的? 6、ArrayDeque的容量有什么限制? 7、ArrayDeque和LinkedList相比有什么优势? 8、ArrayDeque的应用场景是什么? 一、ArrayDeque简介 ArrayDeque是JDK容器中的一个双端队列实现,内部使用数组进行元素存储,不允许存储null值,可以高效的进行元素查找和尾部插入取出,是用作队列、双端队列、栈的绝佳选择,性能比LinkedList还要好。听到这里,不熟悉ArrayDeque的你是不是有点尴尬?JDK中竟然还有这么好的一个容器类? 别慌,现在了解还来得及,趁响指还没有弹下去,快上车吧,没时间解释了。 来看一个ArrayDeque的使用小栗子: public class DequeTest { public static void main(String[] args){ // 初始化容量为4 ArrayDeque<String> arrayDeque = new ArrayDeque<>(4); //添加元素 arrayDeque.add("A"); arrayDeque.add("B"); arrayDeque.add("C"); arrayDeque.add("D"); arrayDeque.add("E"); arrayDeque.add("F"); arrayDeque.add("G"); arrayDeque.add("H"); arrayDeque.add("I"); System.out.println(arrayDeque); // 获取元素 String a = arrayDeque.getFirst(); String a1 = arrayDeque.pop(); String b = arrayDeque.element(); String b1 = arrayDeque.removeFirst(); String c = arrayDeque.peek(); String c1 = arrayDeque.poll(); String d = arrayDeque.pollFirst(); String i = arrayDeque.pollLast(); String e = arrayDeque.peekFirst(); String h = arrayDeque.peekLast(); String h1 = arrayDeque.removeLast(); System.out.printf("a = %s, a1 = %s, b = %s, b1 = %s, c = %s, c1 = %s, d = %s, i = %s, e = %s, h = %s, h1 = %s", a,a1,b,b1,c,c1,d,i,e,h,h1); System.out.println(); // 添加元素 arrayDeque.push(e); arrayDeque.add(h); arrayDeque.offer(d); arrayDeque.offerFirst(i); arrayDeque.offerLast(c); arrayDeque.offerLast(h); arrayDeque.offerLast(c); arrayDeque.offerLast(h); arrayDeque.offerLast(i); arrayDeque.offerLast(c); System.out.println(arrayDeque); // 移除第一次出现的C arrayDeque.removeFirstOccurrence(c); System.out.println(arrayDeque); // 移除最后一次出现的C arrayDeque.removeLastOccurrence(c); System.out.println(arrayDeque); } } 输出如下: [A, B, C, D, E, F, G, H, I] a = A, a1 = A, b = B, b1 = B, c = C, c1 = C, d = D, i = I, e = E, h = H, h1 = H [I, E, E, F, G, H, D, C, H, C, H, I, C] [I, E, E, F, G, H, D, H, C, H, I, C] [I, E, E, F, G, H, D, H, C, H, I] 可以看到,从ArrayDeque中取出元素的姿势可谓是五花八门,不过别慌,稍后会对这些方法进行一一讲解,现在只需要知道,get、peek、element方法都是获取元素,但是不会将它移除,而pop、poll、remove都会将元素移除并返回,add和push、offer都是插入元素,它们的不同点在于插入元素的位置以及插入失败后的结果。 二、ArrayDeque的内部结构 ArrayDeque的整体继承结构如下: ArrayDeque是继承自Deque接口,Deque继承自Queue接口,Queue是队列,而Deque是双端队列,也就是可以从前或者从后插入或者取出元素,也就是比队列存取更加方便一点,单向队列只能从一头插入,从另一头取出。 再来看看ArrayDeque的内部结构,其实从名字就可以看出来,ArrayDeque自然是基于Array的双端队列,内部结构自然是数组: //存储元素的数组 transient Object[] elements; // 非private访问限制,以便内部类访问 /** * 头部节点序号 */ transient int head; /** * 尾部节点序号,(指向最后一点节点的后一个位置) */ transient int tail; /** * 双端队列的最小容量,必须是2的幂 */ private static final int MIN_INITIAL_CAPACITY = 8; 这里可以看到,元素都存储在Object数组中,head记录首节点的序号,tail记录尾节点后一个位置的序号,队列的容量最小为8,而且必须为2的幂。看到这里,有没有想到HashMap的元素个数限制也必须为2的幂,嗯,这里同HashMap一样,自有妙用,后面会有分析。 三、ArrayDeque的常用方法 从队列首部插入/取出 从队列尾部插入/取出 失败抛出异常 失败返回特殊值 失败抛出异常 失败返回特殊值 插入 addFirst(e) push() offerFirst(e) addLast(e) offerLast(e) 移除 removeFirst() pop() pollFirst() removeLast() pollLast() 获取 getFirst() peekFirst() getLast() peekLast() 嗯,几乎绝大多数常用方法都在这里了,基本上可以分成两类,一类是以add,remove,get开头的方法,这类方法失败后会抛出异常,一类是以offer,poll,peek开头的方法,这类方法失败之后会返回特殊值,如null。大部分方法基本上都是可以根据命名来推断其作用,如addFirst,当然就是从队列头部插入,removeLast,便是从队列尾部移除,get和peek只获取元素而不移除,getFirst方法调用时,如果队列为空,会抛出NoSuchElementException异常,而peekFirst在队列为空时调用则返回null。 一下摆出这么多方法有些难以接受?别慌别慌,接下来让我们从源码的角度一起来看看这些方法,用图说话,来解释我们最开始那个栗子中到底发生了哪些事情。 四、ArrayDeque源码分析 先来看看构造函数: /** * 构造一个初始容量为16的空队列 */ public ArrayDeque() { elements = new Object[16]; } /** * 构造一个能容纳指定大小的空队列 */ public ArrayDeque(int numElements) { allocateElements(numElements); } /** * 构造一个包含指定集合所有元素的队列 */ public ArrayDeque(Collection<? extends E> c) { allocateElements(c.size()); addAll(c); } 所以之前栗子中, ArrayDeque<String> arrayDeque = new ArrayDeque<>(4); 调用的是第二个构造函数,里面有这么一个函数allocateElements,让我们来看看它的实现: 1 private void allocateElements(int numElements) { 2 elements = new Object[calculateSize(numElements)]; 3 } 4 5 private static int calculateSize(int numElements) { 6 int initialCapacity = MIN_INITIAL_CAPACITY; 7 if (numElements >= initialCapacity) { 8 initialCapacity = numElements; 9 initialCapacity |= (initialCapacity >>> 1); 10 initialCapacity |= (initialCapacity >>> 2); 11 initialCapacity |= (initialCapacity >>> 4); 12 initialCapacity |= (initialCapacity >>> 8); 13 initialCapacity |= (initialCapacity >>> 16); 14 initialCapacity++; 15 16 if (initialCapacity < 0) 17 initialCapacity >>>= 1; 18 } 19 return initialCapacity; 20 } allocateElements方法主要用于给内部的数组分配合适大小的空间,calculateSize方法用于计算比numElements大的最小2的幂次方,如果指定的容量大小小于MIN_INITIAL_CAPACITY(值为8),那么将容量设置为8,否则通过多次无符号右移进行最小2次幂计算。先将initialCapacity赋值为numElements,接下来,进行5次无符号右移,下面将以一个小栗子介绍这样运算的妙处。 在Java中,int类型是占4字节,也就是32位。简单起见,这里以一个8位二进制数来演示前三次操作。假设这个二进制数对应的十进制为89,整个过程如下: 可以看到最后,除了第一位,其他位全部变成了1,然后这个结果再加一,即得到大于89的最小的2次幂,怎么样,很巧妙吧,也许你会想,为什么右移的数值要分别是1,2,4,8,16呢?嗯,好问题。其实仔细观察就会发现,先右移在进行或操作,其实我们只需要关注第一个不为0的位即可,下面以64为例再演示一次: 所以,事实上,在这系列操作中,其他位只是配角,我们只需要关注第一个不为0的位即可,假设其为第n位,先右移一位然后进行或操作,得到的结果,第n位和第n-1位肯定为1,这样就有两个位为1了,然后进行右移两位,再进行或操作,那么第n位到第n-3位一定都为1,然后右移4位,依次类推。int为32位,因此,最后只需要移动16位即可。1+2+4+8+16 = 31,所以经过这一波操作,原数字对应的二进制,操作得到的结果将是从其第一个不为0的位开始,往后的位均为1。然后: initialCapacity++; 再自增一下,目标完成。观察到还有下面这一小节代码: if (initialCapacity < 0) initialCapacity >>>= 1; 其实它是为了防止进行这一波操作之后,得到了负数,即原来第31位为1,得到的结果第32位将为1,第32位为符号位,1代表负数,这样的话就必须回退一步,将得到的数右移一位(即2 ^ 30)。 嗯,那么这一部分就先告一段落了。 来看看之前的那些函数。 public boolean add(E e) { addLast(e); return true; } /** * 在队列头部插入元素,如果元素为null,则抛出异常 */ public void addFirst(E e) { if (e == null) throw new NullPointerException(); elements[head = (head - 1) & (elements.length - 1)] = e; if (head == tail) doubleCapacity(); } /** * 在队列尾部插入元素,如果元素为null,则抛出异常 */ public void addLast(E e) { if (e == null) throw new NullPointerException(); elements[tail] = e; if ( (tail = (tail + 1) & (elements.length - 1)) == head) doubleCapacity(); } add的几个函数比较简单,在头部或者尾部插入元素,如果直接调用add方法,则是在尾部插入,这时直接在对应位置塞入该元素即可。 elements[tail] = e; 然后把tail记录其后一个位置,如果tail记录的位置已经是数组的最后一个位置了怎么办?嗯,这里又有一个巧妙的操作,跟HashMap中的取模是一样的: tail = (tail + 1) & (elements.length - 1) 因为elements.length是2的幂次方,所以减一后就变成了掩码,tail如果记录的是最后一个位置,即elements.length - 1,tail + 1 则等于elements.length,与elements.length - 1 做与操作后,就变成了0,嗯,没错,这样就变成了一个循环数组,如果tail与head相等,则表示没有剩余空间可以存放更多元素了,则调用doubleCapacity进行扩容: private void doubleCapacity() { assert head == tail; int p = head; int n = elements.length; int r = n - p; // number of elements to the right of p int newCapacity = n << 1; if (newCapacity < 0) throw new IllegalStateException("Sorry, deque too big"); Object[] a = new Object[newCapacity]; System.arraycopy(elements, p, a, 0, r); System.arraycopy(elements, 0, a, r, p); elements = a; head = 0; tail = n; } 扩容其实也是很简单粗暴的,先记录一下原来head的位置,然后把容量变为原来的两倍,然后把head之后的元素复制到新数组的开头,把剩余的元素复制到新数组之后。以之前的栗子为例,新建的ArrayDeque实例容量为8,然后我们调用add插入元素,插入H之后,tail指向第一个位置,与head重合,就会触发扩容。 arrayDeque.add("A"); arrayDeque.add("B"); arrayDeque.add("C"); arrayDeque.add("D"); arrayDeque.add("E"); arrayDeque.add("F"); arrayDeque.add("G"); arrayDeque.add("H"); arrayDeque.add("I"); 看图应该就比较清楚了,然后来看看获取元素的几个方法: // 获取元素 String a = arrayDeque.getFirst(); String a1 = arrayDeque.pop(); String b = arrayDeque.element(); String b1 = arrayDeque.removeFirst(); String c = arrayDeque.peek(); String c1 = arrayDeque.poll(); String d = arrayDeque.pollFirst(); String i = arrayDeque.pollLast(); String e = arrayDeque.peekFirst(); String h = arrayDeque.peekLast(); String h1 = arrayDeque.removeLast(); System.out.printf("a = %s, a1 = %s, b = %s, b1 = %s, c = %s, c1 = %s, d = %s, i = %s, e = %s, h = %s, h1 = %s", a,a1,b,b1,c,c1,d,i,e,h,h1); System.out.println(); getFirst方法直接取head位置的元素,如果为null则抛出异常。 public E getFirst() { @SuppressWarnings("unchecked") E result = (E) elements[head]; if (result == null) throw new NoSuchElementException(); return result; } getLast也是类似,取出tail所在位置的前一个位置,这里也做了掩码操作。 public E getLast() { @SuppressWarnings("unchecked") E result = (E) elements[(tail - 1) & (elements.length - 1)]; if (result == null) throw new NoSuchElementException(); return result; } element方法直接调用的是getFirst方法: public E element() { return getFirst(); } remove方法有三个: public E remove() { return removeFirst(); } public E removeFirst() { E x = pollFirst(); if (x == null) throw new NoSuchElementException(); return x; } public E removeLast() { E x = pollLast(); if (x == null) throw new NoSuchElementException(); return x; } remove方法其实是调用的对应的poll方法,poll方法也有三个: public E poll() { return pollFirst(); } public E pollFirst() { int h = head; @SuppressWarnings("unchecked") E result = (E) elements[h]; // 如果结果为null则返回null if (result == null) return null; elements[h] = null; // Must null out slot head = (h + 1) & (elements.length - 1); return result; } public E pollLast() { int t = (tail - 1) & (elements.length - 1); @SuppressWarnings("unchecked") E result = (E) elements[t]; if (result == null) return null; elements[t] = null; tail = t; return result; } 其实也很简单,都是先取出对应的元素,如果为null则返回null,否则取出对应的元素并对head或tail进行调整。 pop方法调用的是removeFirst方法,removeFIrst方法调用的是pollFirst方法,所以方法看起来这么多,实际上最后真正调用的就那么几个。 public E pop() { return removeFirst(); } peek方法是取出元素但是不移除,也有三个方法: public E peek() { return peekFirst(); } @SuppressWarnings("unchecked") public E peekFirst() { // elements[head] is null if deque empty return (E) elements[head]; } @SuppressWarnings("unchecked") public E peekLast() { return (E) elements[(tail - 1) & (elements.length - 1)]; } 这里没有做任何校验,所以如果如果取到的元素是null,返回的也是null。 再来看看插入元素的其它几个方法: public boolean offer(E e) { return offerLast(e); } public boolean offerLast(E e) { addLast(e); return true; } public boolean offerFirst(E e) { addFirst(e); return true; } public void push(E e) { addFirst(e); } offer方法直接调用的是add方法。 emmm,都是相互调用,为啥要设置那么多方法呢?其实主要是为了模拟不同的数据结构,如栈操作:pop,push,peek,队列操作:add,offer,remove,poll,peek,element,双端队列操作:addFirst,addLast,getFirst,getLast,peekFirst,peekLast,removeFirst,removeLast,pollFirst,pollLast。不过确实稍微多了一点。 之前的栗子里还有用到两个方法,removeFirstOccurrence和removeLastOccurrence,前者是移除首次出现的位置,后者是移除最后一次出现的位置。 public boolean removeFirstOccurrence(Object o) { if (o == null) return false; int mask = elements.length - 1; int i = head; Object x; while ( (x = elements[i]) != null) { if (o.equals(x)) { delete(i); return true; } i = (i + 1) & mask; } return false; } public boolean removeLastOccurrence(Object o) { if (o == null) return false; int mask = elements.length - 1; int i = (tail - 1) & mask; Object x; while ( (x = elements[i]) != null) { if (o.equals(x)) { delete(i); return true; } i = (i - 1) & mask; } return false; } 其实都是通过循环遍历的方式进行查找一个是从head开始往后查找,一个是从tail开始往前查找。 最后,我们再来看看它的迭代器类。 public Iterator<E> iterator() { return new DeqIterator(); } private class DeqIterator implements Iterator<E> { private int cursor = head; private int fence = tail; private int lastRet = -1; public boolean hasNext() { return cursor != fence; } public E next() { if (cursor == fence) throw new NoSuchElementException(); @SuppressWarnings("unchecked") E result = (E) elements[cursor]; if (tail != fence || result == null) throw new ConcurrentModificationException(); lastRet = cursor; cursor = (cursor + 1) & (elements.length - 1); return result; } public void remove() { if (lastRet < 0) throw new IllegalStateException(); if (delete(lastRet)) { cursor = (cursor - 1) & (elements.length - 1); fence = tail; } lastRet = -1; } public void forEachRemaining(Consumer<? super E> action) { Objects.requireNonNull(action); Object[] a = elements; int m = a.length - 1, f = fence, i = cursor; cursor = f; while (i != f) { @SuppressWarnings("unchecked") E e = (E)a[i]; i = (i + 1) & m; if (e == null) throw new ConcurrentModificationException(); action.accept(e); } } } 在迭代器类中,cursor记录的是head的位置,fence记录的是tail的位置,lastRet记录的是调用next返回的元素的序号,如果调用了remove方法,lastRet会置为-1,这里没有像其它容器那样使用modCount来实现fast-fail机制,而是通过在next方法中进行修改判断。 // 如果移除了尾部元素,会导致 tail != fence // 如果移除了头部元素,会导致 result == null if (tail != fence || result == null) throw new ConcurrentModificationException(); 当然,这种检测比较弱,如果先移除一个尾部元素,然后再添加一个尾部元素,那么tail依旧和fence相等,这种情况就检测不出来了。 在调用remove方法的时候,调用了一个delete方法,这是ArrayDeque类中的一个私有方法。 private boolean delete(int i) { // 先做不变性检测,判断是否当前结构满足删除需求 checkInvariants(); final Object[] elements = this.elements; // mask即掩码 final int mask = elements.length - 1; final int h = head; final int t = tail; // front代表i到头部的距离 final int front = (i - h) & mask; // back代表i到尾部的距离 final int back = (t - i) & mask; // 再次校验,如果i到头部的距离大于等于尾部到头部的距离,表示当前队列已经被修改了,通过最开始检测后,i是不应该满足该条件的 if (front >= ((t - h) & mask)) throw new ConcurrentModificationException(); // 为移动尽量少的元素做优化,如果离头部比较近,则将该位置到头部的元素进行移动,如果离尾部比较近,则将该位置到尾部的元素进行移动 if (front < back) { if (h <= i) { System.arraycopy(elements, h, elements, h + 1, front); } else { // Wrap around System.arraycopy(elements, 0, elements, 1, i); elements[0] = elements[mask]; System.arraycopy(elements, h, elements, h + 1, mask - h); } elements[h] = null; head = (h + 1) & mask; return false; } else { if (i < t) { // Copy the null tail as well System.arraycopy(elements, i + 1, elements, i, back); tail = t - 1; } else { // Wrap around System.arraycopy(elements, i + 1, elements, i, mask - i); elements[mask] = elements[0]; System.arraycopy(elements, 1, elements, 0, t); tail = (t - 1) & mask; } return true; } } 所以这个delete还是花了一点心思的,不仅做了两次校验,还对元素移动进行了优化。嗯,到此为止,源码部分就差不多了。 那么现在再回到最开始提的问题。 1、ArrayDeque是什么?ArrayDeque是一个用循环数组实现的双端队列。 2、ArrayDeque如何使用?通过add,offer,poll等方法进行操作。 3、ArrayDeque的内部结构是怎样的?内部结构是一个循环数组。 4、ArrayDeque的各个方法是如何实现的?嗯,见上文。 5、ArrayDeque是如何扩容的?扩容成原来的两倍,然后将原来的内容复制到新数组中。 6、ArrayDeque的容量有什么限制?容量必须为2的幂次方,最小为8,默认为16. 7、ArrayDeque和LinkedList相比有什么优势?ArrayDeque通常来说比LinkedList更高效,因为可以在常量时间通过序号对元素进行定位,并且省去了对元素进行包装的空间和时间成本。 8、ArrayDeque的应用场景是什么?在很多场景下可以用来代替LinkedList,可以用做队列或者栈。 到此,本篇圆满结束。如果觉得还不错的话,记得动动小手点个赞,也欢迎关注博主,你们的支持是我写出更好博客的动力。 有兴趣对Java进行更深入学习和交流的小伙伴,欢迎加入QQ群交流:529253292

优秀的个人博客,低调大师

【Java入门提高篇】Day31 Java容器类详解(十三)TreeSet详解

上一篇很水的介绍完了TreeMap,这一篇来看看更水的TreeSet。 本文将从以下几个角度进行展开: 1、TreeSet简介和使用栗子 2、TreeSet源码分析 本篇大约需食用10分钟,各位看官请随意享用。 一、TreeSet简介 TreeSet是Set家族中的又一名懒将,跟其他两位一样,与对应的Map关系密不可分 我们先来回顾一下其他两个Set类,HashSet借助于HashMap拥有快速元素插入和查找的特性,LinkedHashSet借助于LinkedHashMap拥有快速插入查找以及使元素保持插入顺序的特性,TreeSet则是借助于TreeMap拥有使内部元素保持有序的特性,当然,所有的Set集合类都有元素去重的特性。当然,要区别一下的是,TreeSet中的有序是指可以按照内部比较器或者外部比较器的顺序对插入的元素进行排序,也就是每次插入后都会调整顺序以保持内部元素整体有序,而LinkedHashSet只能保持元素的插入顺序。 Talkischeap,showme your code.嗯,还是来看代码吧: public class TreeSetTest { public static void main(String[] args){ TreeSet<String> treeSet = new TreeSet<>(); treeSet.add("Frank"); treeSet.add("Alice"); treeSet.add("Bob"); treeSet.add("Allen"); treeSet.add("Ada"); treeSet.add("Adora"); System.out.println(treeSet); LinkedHashSet<String> linkedHashSet = new LinkedHashSet<>(); linkedHashSet.add("Frank"); linkedHashSet.add("Alice"); linkedHashSet.add("Bob"); linkedHashSet.add("Allen"); linkedHashSet.add("Ada"); linkedHashSet.add("Adora"); System.out.println(linkedHashSet); } } 输出如下: [Ada, Adora, Alice, Allen, Bob, Frank] [Frank, Alice, Bob, Allen, Ada, Adora] 可以看到TreeSet给插入的元素自动排序了。那么可不可以放入我们自定义的类元素呢?当然是可以的,不然要它何用 public class TreeSetTest { public static void main(String[] args){ List<Goods> goods = new ArrayList<>(); goods.add(new Goods("Iphone4S",500.00)); goods.add(new Goods("Iphone5",800.00)); goods.add(new Goods("Iphone6S",2500.00)); goods.add(new Goods("Iphone7S",4500.00)); goods.add(new Goods("Iphone8",6500.00)); goods.add(new Goods("IphoneX",8500.00)); System.out.println(goods); TreeSet<Goods> treeSet = new TreeSet<>(); treeSet.addAll(goods); System.out.println(treeSet); LinkedHashSet<Goods> linkedHashSet = new LinkedHashSet<>(); linkedHashSet.addAll(goods); System.out.println(linkedHashSet); } public static class Goods{ private String name; private Double price; public Goods(String name, Double price) { this.name = name; this.price = price; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Double getPrice() { return price; } public void setPrice(Double price) { this.price = price; } @Override public String toString() { return "Goods{" + "name='" + name + '\'' + ", price=" + price + '}'; } } } 输出如下: Exception in thread "main" java.lang.ClassCastException: com.frank.chapter22.TreeSetTest$Goods cannot be cast to java.lang.Comparable [Goods{name='Iphone4S', price=500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='IphoneX', price=8500.0}] at java.util.TreeMap.compare(TreeMap.java:1294) at java.util.TreeMap.put(TreeMap.java:538) at java.util.TreeSet.add(TreeSet.java:255) at java.util.AbstractCollection.addAll(AbstractCollection.java:344) at java.util.TreeSet.addAll(TreeSet.java:312) at com.frank.chapter22.TreeSetTest.main(TreeSetTest.java:25) 欢迎来到大型翻车现场。。。 别慌别慌,问题不大。TreeSet与TreeMap一样,是需要元素实现Comparable接口或者传入一个外部比较器的。为什么String可以不用?看看String的实现吧,人家可是实现了Comparable接口的。 所以有两种方式解决,一种是让Goods类实现Comparable接口,另一种是传入一个外部比较器,我们先来看第一种: public class TreeSetTest { public static void main(String[] args){ List<Goods> goods = new ArrayList<>(); goods.add(new Goods("Iphone7S",4500.00)); goods.add(new Goods("Iphone4S",500.00)); goods.add(new Goods("Iphone5",800.00)); goods.add(new Goods("IphoneX",8500.00)); goods.add(new Goods("Iphone6S",2500.00)); goods.add(new Goods("Iphone8",6500.00)); goods.add(new Goods("Iphone8",6500.00)); System.out.println(goods); TreeSet<Goods> treeSet = new TreeSet<>(); treeSet.addAll(goods); System.out.println(treeSet); LinkedHashSet<Goods> linkedHashSet = new LinkedHashSet<>(); linkedHashSet.addAll(goods); System.out.println(linkedHashSet); } public static class Goods implements Comparable{ private String name; private Double price; public Goods(String name, Double price) { this.name = name; this.price = price; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Double getPrice() { return price; } public void setPrice(Double price) { this.price = price; } @Override public String toString() { return "Goods{" + "name='" + name + '\'' + ", price=" + price + '}'; } @Override public int compareTo(Object o) { if (!(o instanceof Goods)){ return -1; } Goods goods = (Goods) o; return this.price.compareTo(goods.getPrice()); } } } 为了看出效果,把几个商品的顺序调整了一下,输出如下: [Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone4S', price=500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='IphoneX', price=8500.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='Iphone8', price=6500.0}] [Goods{name='Iphone4S', price=500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='IphoneX', price=8500.0}] [Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone4S', price=500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='IphoneX', price=8500.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='Iphone8', price=6500.0}] 这里我们按价格进行了升序排列,接下来使用外部比较器的方式进行价格的倒序排列: public class TreeSetTest { public static void main(String[] args){ List<Goods> goods = new ArrayList<>(); goods.add(new Goods("Iphone7S",4500.00)); goods.add(new Goods("Iphone4S",500.00)); goods.add(new Goods("Iphone5",800.00)); goods.add(new Goods("IphoneX",8500.00)); goods.add(new Goods("Iphone6S",2500.00)); goods.add(new Goods("Iphone8",6500.00)); goods.add(new Goods("Iphone8",6500.00)); System.out.println(goods); // 1、使用Lamada表达式 //TreeSet<Goods> treeSet = new TreeSet<>((g1,g2) -> g2.getPrice().compareTo(g1.getPrice())); // 2、使用匿名内部类 TreeSet<Goods> treeSet = new TreeSet<>(new Comparator<Goods>() { @Override public int compare(Goods o1, Goods o2) { return o2.getPrice().compareTo(o1.getPrice()); } }); treeSet.addAll(goods); System.out.println(treeSet); LinkedHashSet<Goods> linkedHashSet = new LinkedHashSet<>(); linkedHashSet.addAll(goods); System.out.println(linkedHashSet); } public static class Goods{ private String name; private Double price; public Goods(String name, Double price) { this.name = name; this.price = price; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Double getPrice() { return price; } public void setPrice(Double price) { this.price = price; } @Override public String toString() { return "Goods{" + "name='" + name + '\'' + ", price=" + price + '}'; } } } 在传入外部比较器的时候,也有很多种姿势,这里还是选了匿名内部类的方式进行传入,因为这里只需要使用一次,Lamada表达式还没有做介绍,这里就先不讲了,欣赏一下就好,先领略一下它的强大。 [Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone4S', price=500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='IphoneX', price=8500.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='Iphone8', price=6500.0}] [Goods{name='IphoneX', price=8500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='Iphone4S', price=500.0}] [Goods{name='Iphone7S', price=4500.0}, Goods{name='Iphone4S', price=500.0}, Goods{name='Iphone5', price=800.0}, Goods{name='IphoneX', price=8500.0}, Goods{name='Iphone6S', price=2500.0}, Goods{name='Iphone8', price=6500.0}, Goods{name='Iphone8', price=6500.0}] 这样,就完成了倒序排列了,很简单吧。 二、TreeSet源码分析 先来看看TreeSet的继承关系图: 跟TreeMap的继承机构差不多,NavigableSet接口中存在大量的导航方法,可以帮助更快定位想要查找的元素,AbstractSet提供Set的部分默认实现,这样只需要实现其它方法即可。 可以看到,TreeSet中的方法并不是很多,除了导航方法之外,就是几个最常用的方法了,如add,addAll,remove,contains。接下来让我们一起看看这几个方法是如何实现的: 先来看看内部成员和构造函数: /** * 内部默默无闻工作的Map */ private transient NavigableMap<E,Object> m; // map中共用的一个value private static final Object PRESENT = new Object(); //默认构造方法,根据其元素的自然顺序进行排序 public TreeSet() { this(new TreeMap<E,Object>()); } //构造一个包含指定 collection 元素的新 TreeSet,它按照其元素的自然顺序进行排序。 public TreeSet(Comparator<? super E> comparator) { this(new TreeMap<>(comparator)); } //构造一个新的空 TreeSet,它根据指定比较器进行排序。 public TreeSet(Collection<? extends E> c) { this(); addAll(c); } //构造一个与指定有序 set 具有相同映射关系和相同排序的新 TreeSet。 public TreeSet(SortedSet<E> s) { this(s.comparator()); addAll(s); } TreeSet(NavigableMap<E,Object> m) { this.m = m; } add方法,嗯,够简明扼要。 public boolean add(E e) { return m.put(e, PRESENT)==null; } addAll: public boolean addAll(Collection<? extends E> c) { // 先检测集合是否继承了SortedSet接口,内部map是否为TreeMap // 并且检测使用的比较器是否与内部Map的比较器一致 // 如果一致的话则使用TreeMap的addAllForTreeSet方法进行批量插入 // addAllForTreeSet方法可以在常量时间对有序元素进行插入 if (m.size()==0 && c.size() > 0 && c instanceof SortedSet && m instanceof TreeMap) { SortedSet<? extends E> set = (SortedSet<? extends E>) c; TreeMap<E,Object> map = (TreeMap<E, Object>) m; Comparator<?> cc = set.comparator(); Comparator<? super E> mc = map.comparator(); if (cc==mc || (cc != null && cc.equals(mc))) { map.addAllForTreeSet(set, PRESENT); return true; } } // 如果不满足条件,则使用父类的addAll方法进行添加 return super.addAll(c); } 嗯,这里会先激进优化,不行再用笨办法一个个添加,因为如果是将大量元素插入TreeMap中相对而言还是比较耗时耗力的,每次插入一个元素都可能导致整体结构的调整,而如果插入的元素刚好是有序的,那么就可以对这个过程进行一次很不错的优化。 public boolean remove(Object o) { return m.remove(o)==PRESENT; } public boolean contains(Object o) { return m.containsKey(o); } remove和contains方法也很简单。而且还带一点粗暴 到此,本篇就结束了,其实也没太多内容,因为TreeSet本身也没有太多东西。当然,了解它的内部结构目的是为了更好的使用它。在遇到问题时,每个知识点就是你手中的一张牌,能不能打好这手牌,先要看你这牌好不好,牌不好的话,再聪明也难翻盘。 . 真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

【Java入门提高篇】Day30 Java容器类详解(十二)TreeMap详解

今天来看看Map家族的另一名大将——TreeMap。前面已经介绍过Map家族的两名大将,分别是HashMap,LinkedHashMap。HashMap可以高效查找和存储元素,LinkedHashMap可以在高效查找的基础上对元素进行有序遍历,那么TreeMap又有什么特点呢?别急别急,看完这篇你就知道了。 本篇主要从以下几个方面对TreeMap进行介绍: 1、TreeMap的特性以及使用栗子 2、TreeMap继承结构简介 3、TreeMap源码分析 本篇预计食用10分钟,请各位食客合理分配时间。 一、TreeMap的特性以及使用栗子 1. 键值不允许重复2. 默认会对键进行排序,所以键必须实现Comparable接口或者使用外部比较器3. 查找、移除、添加操作的时间复杂度为log(n)4.底层使用的数据结构是红黑树 没错,又是让你欲仙欲死的红黑树,不过不要慌,跟之前介绍HashMap时的红黑树是一毛一样的,所以这一篇里,不打算再做介绍啦,如果对红黑树的内容有些遗忘了,可以动动小手,往前面翻一翻。 先来看一个TreeMap的使用小栗子。 public class TreeMapTest { public static void main(String[] args){ TreeMap<String, Integer> grades = new TreeMap<>(); grades.put("Frank", 100); grades.put("Alice", 95); grades.put("Mary", 90); grades.put("Bob", 85); grades.put("Jack", 90); System.out.println(grades); System.out.println(grades.subMap("Bob", "Jack")); System.out.println(grades.subMap("Bob", true, "Jack", true)); System.out.println(grades.ceilingEntry("Bob")); System.out.println(grades.ceilingKey("Bob")); System.out.println(grades.higherEntry("Bob")); System.out.println(grades.higherKey("Bob")); System.out.println(grades.headMap("Bob")); System.out.println(grades.headMap("Bob", true)); System.out.println(grades.tailMap("Bob")); System.out.println(grades.tailMap("Bob", true)); System.out.println(grades.containsKey("Bob")); System.out.println(grades.containsValue(90)); System.out.println(grades.descendingMap()); System.out.println(grades.descendingKeySet()); } } 输出如下: {Alice=95, Bob=85, Frank=100, Jack=90, Mary=90} {Bob=85, Frank=100} {Bob=85, Frank=100, Jack=90} Bob=85 Bob Frank=100 Frank {Alice=95} {Alice=95, Bob=85} {Bob=85, Frank=100, Jack=90, Mary=90} {Bob=85, Frank=100, Jack=90, Mary=90} true true {Mary=90, Jack=90, Frank=100, Bob=85, Alice=95} [Mary, Jack, Frank, Bob, Alice] 可以看到,放入TreeMap中的元素默认按键值升序排列,这里的键值类型为String,使用String的CompareTo方法进行比较和排序。subMap返回当前Map的子Map,headMap和tailMap也是如此, 二、TreeMap继承结构简介 TreeMap继承自AbstractMap,实现了NavigableMap接口,继承关系图如下: 对于AbstractMap相信大家已经不陌生了,HashMap也是继承自AbstractMap,里面有对Map接口的一些默认实现。这里我们可以看到两个新的接口——SortedMap和NavigableMap。SortedMap接口继承自Map接口,从名字就能看出。SortedMap相比Map接口,憎加了排序的功能,内部的方法也不多,简单了解一下就好了 NavigableMap接口继承自SortedMap接口,主要提供一下导航方法: 说了这么多没啥营养的,接下来还是讲讲真正的干货吧。 三、TreeMap源码分析 JDK 1.8中的TreeMap源码有两千多行,还是比较多的。所以本文并不打算逐句分析所有的源码,而是挑选几个常用的内部类和方法进行分析。这些方法实现的功能分别是查找、遍历、插入、删除等,其他的方法小伙伴们有兴趣可以自己分析。TreeMap实现的核心部分是关于红黑树的实现,其绝大部分的方法基本都是对底层红黑树增、删、查操作的一个封装。就像前面所说,只要弄懂了红黑树原理,TreeMap 就没什么秘密了。关于红黑树的原理,可以参考前面关于HashMap红黑树的文章,本篇文章不会对此展开讨论。 TreeMap的主要数据结构是红黑树,而这红黑树结构的承载者便是内部类Entry,先来看看这个Entry类: static final class Entry<K,V> implements Map.Entry<K,V> { K key; V value; Entry<K,V> left; Entry<K,V> right; Entry<K,V> parent; boolean color = BLACK; /** * 构造函数*/ Entry(K key, V value, Entry<K,V> parent) { this.key = key; this.value = value; this.parent = parent; } public K getKey() { return key; } public V getValue() { return value; } public V setValue(V value) { V oldValue = this.value; this.value = value; return oldValue; } public boolean equals(Object o) { if (!(o instanceof Map.Entry)) return false; Map.Entry<?,?> e = (Map.Entry<?,?>)o; return valEquals(key,e.getKey()) && valEquals(value,e.getValue()); } public int hashCode() { int keyHash = (key==null ? 0 : key.hashCode()); int valueHash = (value==null ? 0 : value.hashCode()); return keyHash ^ valueHash; } public String toString() { return key + "=" + value; } } 其实内部的结构也很简单,主要有key,value和三个分别指向左孩子,右孩子,父节点的引用,以及用来标识颜色的color成员变量。再来看看TreeMap中的几个重要的成员变量: /** * 外部比较器 */ private final Comparator<? super K> comparator; private transient Entry<K,V> root; /** * 键值对数量 */ private transient int size = 0; private transient int modCount = 0; private static final boolean RED = false; private static final boolean BLACK = true; /** * 键值对集合 */ private transient EntrySet entrySet; /** * 键的集合 */ private transient KeySet<K> navigableKeySet; /** * 倒序Map */ private transient NavigableMap<K,V> descendingMap; comparator用于对map中的键进行排序,root指向红黑树的根节点,size表示键值对的数量,modCount相信已经不陌生了,表示内部结构被修改的次数,RED和BLACK是两个内部常量,即红黑两种颜色,false表示红,true表示黑。entrySet是键值对的集合,navigableKeySet是键的集合,最后一个descendingMap是当前map的一个倒序map。 在TreeMap中有很多内部类,可以先看图了解一下: 前前后后一共18个内部类,不过不要慌,其实里面跟迭代器相关的类就占了一半多(10个),跟子Map相关的类占4个,剩下4个就是跟内部集合相关的了。接下来还是一起来看看那些最常用的方法吧: // 插入元素 public V put(K key, V value) { TreeMap.Entry<K,V> t = root; if (t == null) { // 检查类型以及key是否为null // 如果外部比较器为null,且key也为null则会抛出空指针异常 // 如果TreeMap未设置外部比较器,且传入的对象未实现Comparable接口 // 则会抛出ClassCastException异常 compare(key, key); // type (and possibly null) check // 如果根节点不存在,则用传入的键值对信息生成一个根节点 root = new TreeMap.Entry<>(key, value, null); size = 1; modCount++; return null; } int cmp; TreeMap.Entry<K,V> parent; // split comparator and comparable paths Comparator<? super K> cpr = comparator; if (cpr != null) { do { // 如果外部比较器不为空,则依次与各节点进行比较 parent = t; cmp = cpr.compare(key, t.key); if (cmp < 0) // 小于则与左孩子比较 t = t.left; else if (cmp > 0) // 大于则与右孩子比较 t = t.right; else // 找到相等的key则替换其value return t.setValue(value); // 一直循环,直到待比较的节点为null } while (t != null); } else { // 如果外部比较器为null // 如果key为null则抛出空指针 if (key == null) throw new NullPointerException(); // 如果key未实现comparable接口则会抛出异常 @SuppressWarnings("unchecked") Comparable<? super K> k = (Comparable<? super K>) key; do { // 跟上面逻辑类似,只是用key的compareTo方法进行比较,而不是用外部比较器的compare方法 parent = t; cmp = k.compareTo(t.key); if (cmp < 0) t = t.left; else if (cmp > 0) t = t.right; else return t.setValue(value); } while (t != null); } // 生成键值对 TreeMap.Entry<K,V> e = new TreeMap.Entry<>(key, value, parent); // 连接到当前map的左孩子位置或者右孩子位置 if (cmp < 0) parent.left = e; else parent.right = e; // 插入后的调整 fixAfterInsertion(e); size++; modCount++; return null; } 其实这里的逻辑跟HashMap中TreeNode的插入逻辑十分类似,也是先找到要插入的位置,然后再进行结构调整。这里的结构调整即红黑树的结构调整,在前面HashMap中已经详细介绍过了,这里就不重复介绍了,调整过程是完全一样的。 /** * 插入后的调整 */ private void fixAfterInsertion(TreeMap.Entry<K,V> x) { // 将插入的节点初始化为红色节点 x.color = RED; // 如果x不为null且x不是根节点,且x的父节点是红色,此时祖父节点一定为黑色 while (x != null && x != root && x.parent.color == RED) { // 如果x的父节点为祖父节点的左孩子 if (parentOf(x) == leftOf(parentOf(parentOf(x)))) { // y指向x的叔叔节点 TreeMap.Entry<K,V> y = rightOf(parentOf(parentOf(x))); // 如果叔叔节点也是红色,则进行变色处理 if (colorOf(y) == RED) { // 父节点变成黑色 setColor(parentOf(x), BLACK); // 叔叔节点变成黑色 setColor(y, BLACK); // 祖父节点变成黑色 setColor(parentOf(parentOf(x)), RED); // 将x指向祖父节点,继续往上调整 x = parentOf(parentOf(x)); } else { // 如果叔叔节点是黑色节点 // 如果x是父节点的右孩子 if (x == rightOf(parentOf(x))) { // 将x指向其父节点 x = parentOf(x); // 左旋 rotateLeft(x); } // 将x的父节点置为黑色 setColor(parentOf(x), BLACK); // 将x的祖父节点置为红色 setColor(parentOf(parentOf(x)), RED); // 将祖父节点右旋 rotateRight(parentOf(parentOf(x))); } } else { // 这里类似操作 TreeMap.Entry<K,V> y = leftOf(parentOf(parentOf(x))); if (colorOf(y) == RED) { setColor(parentOf(x), BLACK); setColor(y, BLACK); setColor(parentOf(parentOf(x)), RED); x = parentOf(parentOf(x)); } else { if (x == leftOf(parentOf(x))) { x = parentOf(x); rotateRight(x); } setColor(parentOf(x), BLACK); setColor(parentOf(parentOf(x)), RED); rotateLeft(parentOf(parentOf(x))); } } } root.color = BLACK; } 说完了插入,再来看看删除操作。 // 删除节点 public V remove(Object key) { // 先找到该key对应的键值对 TreeMap.Entry<K,V> p = getEntry(key); if (p == null) // 如果未找到则返回null return null; V oldValue = p.value; // 找到后删除该键值对 deleteEntry(p); return oldValue; } final TreeMap.Entry<K,V> getEntry(Object key) { // 为了性能,卸载了比较器的版本 if (comparator != null) return getEntryUsingComparator(key); if (key == null) throw new NullPointerException(); @SuppressWarnings("unchecked") Comparable<? super K> k = (Comparable<? super K>) key; TreeMap.Entry<K,V> p = root; // 使用compareTo方法进行查找 while (p != null) { int cmp = k.compareTo(p.key); if (cmp < 0) p = p.left; else if (cmp > 0) p = p.right; else return p; } return null; } // 使用比较器的getEntry版本。 从getEntry分离以获得性能。 // (对于大多数方法而言,这不值得做,这些方法较少依赖于比较器性能,但在这里是值得的。) final TreeMap.Entry<K,V> getEntryUsingComparator(Object key) { @SuppressWarnings("unchecked") K k = (K) key; Comparator<? super K> cpr = comparator; // 使用比较器进行二分查找 if (cpr != null) { TreeMap.Entry<K,V> p = root; while (p != null) { int cmp = cpr.compare(k, p.key); if (cmp < 0) p = p.left; else if (cmp > 0) p = p.right; else return p; } } return null; } /** * 删除节点,并调整红黑树以保持它的平衡 */ private void deleteEntry(TreeMap.Entry<K,V> p) { modCount++; size--; // 如果p的左右孩子均不为空,则找到p的后继节点,并且将p指向该后继节点 if (p.left != null && p.right != null) { TreeMap.Entry<K,V> s = successor(p); p.key = s.key; p.value = s.value; p = s; } // p has 2 children // 修复替补节点 // 用替补节点替换待删除的节点后,需要对其原来所在位置结构进行修复 TreeMap.Entry<K,V> replacement = (p.left != null ? p.left : p.right); if (replacement != null) { replacement.parent = p.parent; if (p.parent == null) root = replacement; else if (p == p.parent.left) p.parent.left = replacement; else p.parent.right = replacement; p.left = p.right = p.parent = null; // 如果p的颜色是黑色,则进行删除后的修复 if (p.color == BLACK) fixAfterDeletion(replacement); } else if (p.parent == null) { root = null; } else { if (p.color == BLACK) fixAfterDeletion(p); if (p.parent != null) { if (p == p.parent.left) p.parent.left = null; else if (p == p.parent.right) p.parent.right = null; p.parent = null; } } } /** * 返回指定节点的后继节点 */ static <K,V> TreeMap.Entry<K,V> successor(TreeMap.Entry<K,V> t) { if (t == null) return null; else if (t.right != null) { TreeMap.Entry<K,V> p = t.right; // 如果右子树不为空,则找到右子树的最左节点作为后继节点 while (p.left != null) p = p.left; return p; } else { TreeMap.Entry<K,V> p = t.parent; TreeMap.Entry<K,V> ch = t; // 如果右子树为空且当前节点为其父节点的左孩子,则直接返回 // 如果为其父节点的右孩子,则一直往上找,直到找到根节点或者当前节点为其父节点的左孩子时,用其做为后继节点 while (p != null && ch == p.right) { ch = p; p = p.parent; } return p; } } /** * 进行删除后的结构修复 * @param x */ private void fixAfterDeletion(TreeMap.Entry<K,V> x) { while (x != root && colorOf(x) == BLACK) { // 如果x是父节点的左孩子 if (x == leftOf(parentOf(x))) { // sib指向x的兄弟节点 TreeMap.Entry<K,V> sib = rightOf(parentOf(x)); // 如果sib是红色,则进行变色处理 if (colorOf(sib) == RED) { // 兄弟节点改为黑色 setColor(sib, BLACK); // 父节点改为红色 setColor(parentOf(x), RED); // 父节点左旋 rotateLeft(parentOf(x)); // sib指向x的父节点的右孩子 sib = rightOf(parentOf(x)); } // 如果sib的左孩子和右孩子都是黑色,则进行变色处理 if (colorOf(leftOf(sib)) == BLACK && colorOf(rightOf(sib)) == BLACK) { // 将sib置为红色 setColor(sib, RED); // x指向其父节点 x = parentOf(x); } else { // 如果sib的右孩子是黑色而左孩子是红色,则变色右旋 if (colorOf(rightOf(sib)) == BLACK) { setColor(leftOf(sib), BLACK); setColor(sib, RED); rotateRight(sib); sib = rightOf(parentOf(x)); } // 变色左旋 setColor(sib, colorOf(parentOf(x))); setColor(parentOf(x), BLACK); setColor(rightOf(sib), BLACK); rotateLeft(parentOf(x)); x = root; } } else { // symmetric // 跟上面操作类似 TreeMap.Entry<K,V> sib = leftOf(parentOf(x)); if (colorOf(sib) == RED) { setColor(sib, BLACK); setColor(parentOf(x), RED); rotateRight(parentOf(x)); sib = leftOf(parentOf(x)); } if (colorOf(rightOf(sib)) == BLACK && colorOf(leftOf(sib)) == BLACK) { setColor(sib, RED); x = parentOf(x); } else { if (colorOf(leftOf(sib)) == BLACK) { setColor(rightOf(sib), BLACK); setColor(sib, RED); rotateLeft(sib); sib = leftOf(parentOf(x)); } setColor(sib, colorOf(parentOf(x))); setColor(parentOf(x), BLACK); setColor(leftOf(sib), BLACK); rotateRight(parentOf(x)); x = root; } } } setColor(x, BLACK); } 嗯,对比一下HashMap的删除操作,核心步骤是完全一样的,所以可以对照前面的HashMap红黑树详解进行食用。 到此,这一篇就很水的讲完啦= = 最近这段时间烦心事比较多,对发展方向也考虑了很多,想做的事情很多,反而让我止步不前,不过很多事情是急不来的,还是好好写写博客,多做总结分享吧。 机会只留给有准备的人。 真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

【Java入门提高篇】Day29 Java容器类详解(十一)LinkedHashSet详解

当当当当当当当,本来打算出去浪来着,想想还是把这个先一起写完吧,毕竟这篇的主角跟我一样是一个超级偷懒的角色——LinkedHashSet,有多偷懒?看完你就知道了。 本篇将从以下几个方面对LinkedHashSet进行介绍: 1、LinkedHashSet中的特性 2、LinkedHashSet源码分析 3、LinkedHashSet应用场景 本篇预计需要食用10分钟,快的话五分钟也够了,完全取决于各位看官心情。 LinkedHashSet中的特性 前面已经介绍过了HashSet,本篇要介绍的LinkedHashSet正是它的儿子,作为HashSet的唯一法定继承人,可以说是继承了HashSet的全部优点——懒,并且将其发挥到了极致,这一点在之后的源码分析里可以看到。 LinkedHashSet继承了HashSet的全部特性,元素不重复,快速查找,快速插入,并且新增了一个重要特性,那就是有序,可以保持元素的插入顺序,所以可以应用在对元素顺序有要求的场景中。 先来看一个小栗子: public class LinkedHashSetTest { public static void main(String[] args){ LinkedHashSet<String> linkedHashSet = new LinkedHashSet<>(); HashSet<String> hashSet = new HashSet<>(); for (int i = 0; i < 10; i++) { linkedHashSet.add("I" + i); hashSet.add("I" + i); } System.out.println("linkedHashSet遍历:"); for (String string : linkedHashSet){ System.out.print(string + " "); } System.out.println(); System.out.println("hashSet遍历:"); for (String string : hashSet){ System.out.print(string + " "); } } } linkedHashSet遍历: I0 I1 I2 I3 I4 I5 I6 I7 I8 I9 hashSet遍历: I9 I0 I1 I2 I3 I4 I5 I6 I7 I8 可以看到,在HashSet中存储的元素遍历是无序的,而在LinkedHashSet中存储的元素遍历是有序的。嗯,它和HashSet就这唯一的区别了。 LinkedHashSet源码分析 那么问题来了,LinkedHashSet中的元素为什么会是有序的呢?难道也跟LinkedHashMap一样用了链表把元素都拴起来了?别着急,让我们一起来看看源码。 public class LinkedHashSet<E> extends HashSet<E> implements Set<E>, Cloneable, java.io.Serializable { private static final long serialVersionUID = -2851667679971038690L; /** * 使用指定初始容量和装载因子构造一个空的LinkedHashSet实例 */ public LinkedHashSet(int initialCapacity, float loadFactor) { super(initialCapacity, loadFactor, true); } /** * 使用指定的初始容量和默认的装载因子构造一个空的LinkedHashSet实例 */ public LinkedHashSet(int initialCapacity) { super(initialCapacity, .75f, true); } /** * 使用默认的初始容量和默认的装载因子构造一个空的LinkedHashSet实例 */ public LinkedHashSet() { super(16, .75f, true); } /** * 构造一个与指定集合有相同元素的空LinkedHashSet实例,使用默认的装载因子和能够容纳下指定集合所有元素的合适的容量。 */ public LinkedHashSet(Collection<? extends E> c) { super(Math.max(2*c.size(), 11), .75f, true); addAll(c); } /** * 可分割式迭代器 */ @Override public Spliterator<E> spliterator() { return Spliterators.spliterator(this, Spliterator.DISTINCT | Spliterator.ORDERED); } } 你没看错,这应该是所有容器类中最短小精悍的了,这也就是开头为什么说这家伙懒到家的原因了。 可是,LinkedHashSet中并没有覆盖add方法,只是加了几个构造函数和一个迭代器,其他全部和HashSet一毛一样,为什么它就能有序呢?? 玄机就藏在这个构造函数中,这几个构造函数其实都是调用了它父类(HashSet)的一个构造函数: HashSet(int initialCapacity, float loadFactor, boolean dummy) { map = new LinkedHashMap<>(initialCapacity, loadFactor); } 嗯,这个构造函数跟其他构造函数唯一的区别就在于,它创建的是一个LinkedHashMap对象,所以元素之所以有序,完全是LinkedHashMap的功劳。该构造函数是默认访问权限的,所以在HashSet中是不能直接调用的,留给子类去调用或覆盖(讲道理使用protected权限不是更合理吗)。 LinkedHashSet应用场景 现在假设这样的场景,现在我有一堆商品,商品有名称和价格,但是里面有重复商品,我希望把重复的商品(名称和价格都一样的)过滤掉,只保留一个,并且希望输出后的顺序跟原来的顺序一致。嗯,这时候LinkedHashSet就派上用场了。(废话,那是你特意给主角加的戏) 商品的结构是这样的: public class Commodity { private String name; private Double price; public Commodity(String name, Double price) { this.name = name; this.price = price; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Double getPrice() { return price; } public void setPrice(Double price) { this.price = price; } @Override public String toString() { return "Commodity{" + "name='" + name + '\'' + ", price=" + price + '}'; } } 来用LinkedHashSet解决一下这个需求: public class CommodityTest { public static void main(String[] args){ //有7个商品,A和E、D和G信息完全一样,希望能过滤掉,只保留一个,C和F虽然名称一样,但是价格不同,希望保留 Commodity commodityA = new Commodity("Iphone6S", 6666.66); Commodity commodityB = new Commodity("Iphone7", 7777.77); Commodity commodityC = new Commodity("Iphone8", 8888.88); Commodity commodityD = new Commodity("IphoneX", 9999.99); Commodity commodityE = new Commodity("Iphone6S", 6666.66); Commodity commodityF = new Commodity("Iphone8", 6666.66); Commodity commodityG = new Commodity("IphoneX", 9999.99); LinkedHashSet<Commodity> commodities = new LinkedHashSet<>(); commodities.add(commodityA); commodities.add(commodityB); commodities.add(commodityC); commodities.add(commodityD); commodities.add(commodityE); commodities.add(commodityF); commodities.add(commodityG); for (Commodity commodity : commodities){ System.out.println(commodity); } } } 输出如下: Commodity{name='Iphone6S', price=6666.66} Commodity{name='Iphone7', price=7777.77} Commodity{name='Iphone8', price=8888.88} Commodity{name='IphoneX', price=9999.99} Commodity{name='Iphone6S', price=6666.66} Commodity{name='Iphone8', price=6666.66} Commodity{name='IphoneX', price=9999.99} 翻...翻...翻车了?虽然输出的顺序与插入的顺序是一致的最后一个IphoneX和Iphone6S并没有被去掉,怎么回事呢?说好的可以去重呢? 嗯,别慌,我既然可以让车翻过来,那就有办法让它再翻回去。 想要利用LinkedHashSet自动去重性质,那么我们就要先理解它是怎样去重的,其实和HashSet是一样的,往里面添加元素的时候,其实是这样的: public boolean add(E e) { return map.put(e, PRESENT)==null; } 所以当该元素在map中存在的时候,map.put方法就会返回旧值,此时add方法会返回false,在查找map中put元素的时候,会先调用hashCode方法得到该元素的hashCode值,然后查看table中是否存在该hashCode值,如果存在则调用equals方法重新确定是否存在该元素,如果存在,则更新value值,否则将新的元素添加到HashMap中,如果没有覆盖过hashcode方法,那么就会使用对象默认的hashcode,这个值跟对象成员变量的具体值就没有直接关联了,所以我们需要覆盖hashcode方法和equals方法。 public class Commodity { private String name; private Double price; public Commodity(String name, Double price) { this.name = name; this.price = price; } public String getName() { return name; } public void setName(String name) { this.name = name; } public Double getPrice() { return price; } public void setPrice(Double price) { this.price = price; } @Override public String toString() { return "Commodity{" + "name='" + name + '\'' + ", price=" + price + '}'; } @Override public boolean equals(Object o) { if (this == o) return true; if (o == null || getClass() != o.getClass()) return false; Commodity commodity = (Commodity) o; return Objects.equals(name, commodity.name) && Objects.equals(price, commodity.price); } @Override public int hashCode() { return Objects.hash(name, price); } } 这里用的equals方法和hashCode方法是很通用的,在其他地方也可以使用类似的写法,现在再来重新跑一下程序看下: Commodity{name='Iphone6S', price=6666.66} Commodity{name='Iphone7', price=7777.77} Commodity{name='Iphone8', price=8888.88} Commodity{name='IphoneX', price=9999.99} Commodity{name='Iphone8', price=6666.66} 好的,现在已经达到我们想要的效果了。任务完成,午饭加个蛋。 真正重要的东西,用眼睛是看不见的。

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

用户登录
用户注册
修改密码
忘记密码