首页 文章 精选 留言 我的

精选列表

搜索[techo day],共2891篇文章
优秀的个人博客,低调大师

微服务架构Day21-SpringCloud之分布式配置中心

SpringCloud Config SpringCloud整合了微服务中的整体解决方案:分布式配置中心,分布式锁,分布式任务调度平台,分布式事务,分布式日志收集 产生背景:在微服务中如果使用传统的方式管理配置文件,配置文件管理器将会非常复杂;在生产环境中,配置文件改变时,需要重新配置war包,重新读取配置文件信息到JVM中 SpringCloud Config分布式配置中心: 在微服务中使用同一个服务器管理所有服务配置文件信息 在服务器运行的过程中,如果配置文件发生改变,不需要重启服务器就可以实时更改配置文件信息 Config配置文件的实时刷新不等同于热部署 热部署的底层实现其实还是重启服务器,不适合于生产环境,只适合于本地的开发测试 Config架构 当一个系统中的配置文件发生改变的时候,需要重新启动该服务,才能使配置文件生效 SpringCloud Config可以实现微服务中所有系统的配置文件的统一管理,还可以实现当配置文件发生变化时,系统会自动更新获取新的配置 分布式配置中心框架 阿波罗: 携程的分布式配置中心框架,有图形界面可以管理配置文件信息,配置文件信息存放在数据库中 SpringCloud Config: SpringCloud自带的分布式配置中心框架,没有后台可管理的分布式配置中心,配置文件信息存放在版本控制器中,如git,svn zookeeper实现分布式配置中心,利用持久节点+事件通知实现 分布式配置中心设计原理 设计分布式配置中心的组件 web管理系统: 可以在web后台使用图形界面管理配置文件(SpringCloud Config没有图形化管理组件) 存放分布式配置文件的服务器: 使用数据库存放配置文件:Apollo 使用版本控制器(git,svn等)存放配置文件信息:SpringCloud Config ConfigServer: 缓存配置文件的服务器(用于缓存git服务器上的配置文件信息) ConfigClient: 用于读取ConfigServer配置文件信息 存放分布式配置文件的服务器:持久化存储的服务器 ConfigServer:临时缓存存放的服务器 分布式配置中心原理 用户提交配置文件信息到版本控制器:git/SVN服务器上存放 ConfigServer缓存从git服务器上获取到的配置文件信息 ConfigClient端从ConfigServer端获取配置文件信息 搭建git环境:持久化存储配置文件信息 1.新建项目 2.新建文件夹(git上的文件夹以服务进行区分) 3.把配置文件存放到git文件夹中 搭建ConfigServer环境 1.引入configServer依赖spring-cloud-config-server 2.配置文件 eureka.client.service-url.defaultZone:http://loaclhost:8100/eureka # 注册中心服务地址 spring.application.name=config-server # config-server服务注册别名 spring.cloud.config.server.git.url=(git文件夹url地址) # config-server读取git项目的地址 spring.cloud.config.server.git.search-paths=- config # 读取配置文件的目录地址 spring.cloud.config.label=master # 读取的分支环境 server.port=8888 # 服务端口号 3.在主类上标注@EnableEurekaClient注解注册到注册中心,标注@EnableConfigServer注解开启ConfigServer功能模块 搭建ConfigClient环境 1.引入configClient依赖spring-cloud-config-client 2.配置文件 spring.application.name=config-client # 服务别名(要与git服务器保存的配置文件名一致) spring.cloud.config.profile=dev #读取的版本环境 spring.cloud.config.discovery.service-id=config-server # 读取的configServer环境,configServer在注册中心的别名 spring.cloud.config.discovery.enable=true # 开启读取权限 eureka.client.service-url.defaultZone=http://loaclhost:8100/eureka #注册中心地址 server.port=8889 #服务端口号 3.创建cotroller类读取配置文件信息,标注@RestController注解和@RequestMapping注解 4.创建configClient启动类,标注@EnableEurekaClient注解注册到注册中心 git上创建配置文件名称规范: 服务名称-环境.properties(ticket-dev.properties) Config配置文件实时刷新 默认情况下不能实时刷新配置文件信息,需要重启服务器才能刷新配置文件,这样不是很方便 SpringCloud Config分布式配置中心支持手动刷新和自动刷新: 手动刷新: 需要人工调用接口,读取最新配置文件信息--监控中心 SpringBoot Actuator监控中心 1.引入actuator依赖spring-boot-starter-actuator 2.在配置文件中开启监控端点 management.endpoints.web.exposure.include="*" # 开启所有端点 3.启动运行configClient 4.在需要刷新的controller类中的bean当标注@RefreshScope注解使actuator刷新生效 自动刷新: 消息总线进行实时通知--springbus

优秀的个人博客,低调大师

MOXA启动30周年Solution Day全国巡演,引领智能制造

Moxa全球工业通讯领导品牌在创办30周年之际,即将在中国市场启动大规模全国巡演活动。本次巡演将于4月-5月在全国举办8场研讨会活动。Moxa希望借此与中国客户进行对话,分享在中国制造业转型升级过程中实现智能互联,提高工业生产率并降低设备互联成本的优秀解决方案。 在“中国制造2025”新一轮制造强国战略中,中国正在推进新型工业化以及工业化与信息化"两化融合",而工业互联网在中国制造业转型升级过程中扮演着重要角色。随着工业互联网时代的到来,云计算、物联网、大数据在工业领域持续引入,利用信息通信技术提升传统制造业的竞争力正成为趋势。同时制造企业也面临着新的挑战: 如何缩短产品上市时间、提高灵活性和效能、同时达到更高的质量标准。中国制造业在全球新一轮产业革命中保持和提升核心能力和全球竞争力,需要强大的技术支撑。 在创办30周年之际, Moxa希望能带着30年来的创新技术及领先的解决方案,以工匠精神协助企业提升竞争力,推动中国制造业转型升级,助力制造业企业向智能制造迈进。此次全国巡演Moxa行业及产品专家将亲临现场,为您解读我们国内外智能工厂最新案例及解决方案的同时也为您提供智能工厂连网方案的新产品展示及动态演示环节,当然也将您分享Moxa “可靠连网,真诚服务” 的品牌承诺及30年恒久不变的坚持。我们希望携手制造企业和自动化厂商共同拥抱智能制造新时代。 全国8场研讨会巡演,Moxa已整装待发,期待您的到来。 本文出处:畅享网 本文来自云栖社区合作伙伴畅享网,了解相关信息可以关注vsharing.com网站。

优秀的个人博客,低调大师

【Java入门提高篇】Day14 Java中的泛型初探

泛型是一个很有意思也很重要的概念,本篇将简单介绍Java中的泛型特性,主要从以下角度讲解: 1.什么是泛型。 2.如何使用泛型。 3.泛型的好处。 1.什么是泛型? 泛型,字面意思便是参数化类型,平时所面对的类型一般都是具体的类型,如果String,Integer,Double,而泛型则是把所操作的数据类型当作一个参数。如,ArrayList<String>(),通过传入不同的类型来指定容器中存储的类型,而不用为不同的类型创建不同的类,这种参数类型可以用在类、接口和方法的创建中,分别称为泛型类、泛型接口、泛型方法。 2.如何使用泛型? 我们先来看看泛型是什么样子的: public interface List<E> { void add(E); Iterator<E> iterator(); } 这是List接口,这里用E来代替具体类型,这样就可以往里面传入任意类型,也许你要问了,直接使用Object不好吗?我们来用一个栗子比较一下: 先用非泛型方式来实现一下: public class ObjHolder { private Object a; public ObjHolder(Object a) { this.a = a; } public void set(Object a) { this.a = a; } public Object get(){ return a; } public static void main(String[] args) { ObjHolder holderA = new ObjHolder("Frank"); System.out.println((String) holderA.get()); holderA.set(233); System.out.println((Integer) holderA.get()); } } 这样就实现了一个包装类,可以用来存取一个任意类型的对象。但是每次取出来都需要进行类型转化,如果方法的参数类型是ObjHolder的话,无法知道它里面存放的对象的确切类型,这样就反而带来很多不必要的麻烦。 现在来看一下用泛型实现是怎样的: public class GenericHolder<T> { private T obj; public GenericHolder(T obj){ this.obj = obj; } public T getObj() { return obj; } public void setObj(T obj) { this.obj = obj; } public static void main(String[] args) { GenericHolder<String> holderA = new GenericHolder<String>("Frank"); System.out.println(holderA.getObj()); //holderA.set(233);无法编译通过,因为只能往holderA中存入String类型 GenericHolder<Integer> holderB = new GenericHolder<Integer>(233); System.out.println(holderB.getObj()); } } 这样通过传入类型信息如String和Integer,来代替其中的泛型参数T,这里的T可以理解为一个占位符,用其他字母也是可以的,一旦传入具体类型,如String,则所有使用T的地方都会用String类型替换。 对比一下上面两种方式,区别在哪呢?打个比方,不用泛型的实现方式,相当于一个袋子,里面可以装任意类型的黑盒子,你什么都可以往里放,但是你可能不知道你下一个取出来的是什么东西,而泛型的实现方式,相当于一个贴了标签的黑盒子,标签上可以写任何信息,如写上水果,那么这个盒子就只能装水果,你也会知道每次取出来的肯定是水果而不是其它东西,同理类似如写上杂粮,那么这个袋子就只能用来装杂粮,但其实上都是同一种袋子,并不是为每一种类型的东西准备一种袋子。(因为Java的泛型使用了类型擦除机制,至于类型擦除是什么,暂时不做过多介绍,以后会有文章做更详细的说明)。 泛型被广泛应用在容器类中,如ArrayList<T>() 表示用于存储特定类型的数组,除此之外,还有很多泛型接口,如Comparable<T>。使用泛型能带来极大的便利性。 在泛型中可以对类型进行限制,如:<T extends Comparable<T>>表示只能传递已经实现了Comparable接口的类型对象,这里是使用extends而不是implement,而且对于接口也只能写一个。<T extends Number>表示只能接收Number类或者其子类的对象。与之相反的边界通配符是super,如:<T extends Phone>表示只能接收类型为Phone或其父类的对象。 在使用extends和super的时候需要特别注意,因为使用它们是有副作用的,比如: List<T extends Number> list = new ArrayList<Number>(); list.add(4.0);//编译错误 list.add(3);//编译错误 因为泛型是为了类型安全设计的,如果往List<? extends Number> list 塞值的话,在取的时候就无法确认它到底是什么类型了,编译器只知道它是Number类型或者它的派生类型,但无法确定是哪个具体类型。通配符T表示其中存的都是同一种类型,因此使用extend下边界的话是无法进行存操作的。同理super下边界是不能取值的。 那什么时候该用extends,什么时候该用super呢?先说结论: PECS原则: 频繁往外读取内容的,适合用上界Extends。 经常往里插入的,适合用下界Super。 3.泛型的好处? 泛型看起来很炫酷,但初看起来,好像没什么卵用?客官且慢,进屋里坐(滑稽)。 使用泛型的好处我们来一项一项列出来: 1,类型安全。 这是最显而易见的,泛型的主要目标是提高 Java 程序的类型安全。通过使用泛型定义的变量的类型限制,可以很容易实现编译期间的类型检测,避免了大量因为使用Object带来的不必要的类型错误。 没有泛型,这些对Object变量的类型假设就只存在于程序员的头脑中(或者如果幸运的话,还存在于代码注释中),而且每次使用前还需要进行不安全的强制类型转换。 2,代码复用。 泛型的一个很大好处就是增加了代码的复用性,比如上面的 GenericHolder 类,就能存取任意类型的对象,而不用为每种类型写一个包装类。 3,潜在的性能收益。 泛型为较大的优化带来可能。在泛型的初始实现中,编译器将强制类型转换(没有泛型的话,程序员会指定这些强制类型转换)插入生成的字节码中。但是更多类型信息可用于编译器这一事实,为未来版本的 JVM 的优化带来可能。由于泛型的实现方式,支持泛型(几乎)不需要 JVM 或类文件更改。所有工作都在编译器中完成,编译器生成类似于没有泛型(和强制类型转换)时所写的代码,只是更能确保类型安全而已。Java语言引入泛型的好处是安全简单。泛型的好处是在编译的时候检查类型安全,并且所有的强制转换都是自动和隐式的,提高代码的重用率。 至此,本篇讲解完毕,如果想要更好的理解,还需要多写代码,在实践中去应用。 欢迎大家继续关注! 我的博客即将搬运同步至腾讯云+社区,邀请大家一同入驻:https://cloud.tencent.com/developer/support-plan真正重要的东西,用眼睛是看不见的。

优秀的个人博客,低调大师

java基础学习_常用类01_Object类_day11总结

==========================================================================================================================================================涉及的知识点有: 1:Eclipse的概述和使用(掌握) 2:API的概述(了解) 3:Object类的概述和使用握) (1)Object类的概述 (2)Object类的构造方法 (3)要掌握的Object类的方法(掌握) A:public String toString() B:public boolean eauals(Object obj) (4)要了解的Object类的方法 A:public int hashCode() B:public final Class getClass() C:protected void finalize() D:protected Object clone() (5)两个注意问题==========================================================================================================================================================1:Eclipse的概述和使用(掌握)-----------------------------------------------------------------------------2:API的概述(了解) (1) API(Application Programming Interface,应用程序编程接口)是一些预先定义的函数。 目的是:提供应用程序与开发人员基于某软件或硬件的以访问一组例程的能力,而又无需访问源码,或无需理解内部工作机制的细节。 (2)Java API就是Java提供给我们使用的类(也即就是JDK提供给我们的一些提高编程效率的java类), 这些类将底层的实现封装了起来,我们不需要关心这些类是如何实现的,只需要学习这些类如何使用。 我们可以通过查询帮助文档(.chm文件)来了解Java提供的API如何使用。 例如:JDK_API_9.0_zh_CN.CHM JDK_API_1.6_zh_CN.CHM 1.6版本是最常用的版本,是由之前未被Oracle收购的SUN公司为我们中国程序猿写的。给SUN打call!!!-----------------------------------------------------------------------------3:Object类(掌握) (1)Object类的概述 Object n 物体;东西;对象 从JDK1.0版本开始。 Object是类层次结构的根类,所有的类都直接或者间接的继承自Object类。所有对象(包括数组)都实现了这个类的方法。 (2)Object类的构造方法 public Object() {} 有且只有一个,并且是无参构造。 这其实就是理解当时我们说过的:子类的构造方法默认访问的是父类的无参构造。--------------------------------------- (3)要掌握的Object类的方法(掌握) A:public String toString() 返回对象的字符串表示,默认是由类的全路径+@+哈希值的十六进制表示。 结果应该是一个简明扼要的表达,容易让人阅读。 上面的表示其实是没有意义的,建议一般子类都会重写该方法。 没有重写该方法前: Student s = new Student(); System.out.println(s.toString()); // cn.itcast_02.Student@424c0bc4 System.out.println(s.getClass().getName() + '@' + Integer.toHexString(s.hashCode())); // cn.itcast_02.Student@424c0bc4 这两个是等价的。 因为当我们编写了很多类的时候,经常在程序运行时要查看对象中各个属性的值,就要重写toString()方法, 那么如何快速的生成toString()方法呢?过程我也讲解过了,基本要求就是要求信息简单明了。 但是最终还是自动生成。 重写该方法后: 在ecplise中,若直接输出一个对象的名称,其实就是调用该对象的toString()方法。示例如下: Student s = new Student(); System.out.println(s.toString()); // Student [name=null, age=0] System.out.println(s); // Student [name=null, age=0] 这两个也是等价的。 Integer类下的一个静态方法: public static String toHexString(int i) 把一个整数转成一个十六进制表示的字符串--------------------------------------- B:public boolean eauals(Object obj) 比较两个对象是否相同(相等)。默认情况下,比较的是地址值是否相同。 而比较地址值是没有意义的,所以,一般子类也会重写该方法。 重写的代码优化:提高效率,提高程序的健壮性。 怎么重写呢?答:一般都是用来比较对象的成员变量值是否相同。 重写过程,我也详细的讲解和分析了。 但是最终还是自动生成。 注意: ==(等号的比较的是): 基本类型:比较的就是值是否相同。 引用类型:比较的就是地址值是否相同。 equals(该方法比较的是): 只能是引用类型:默认情况下,比较的是地址值。 不过,我们可以根据情况自己重写该方法。一般重写都是自动生成,比较的是对象的成员变量值是否相同。--------------------------------------- (4)要了解的Object类的方法 A:public int hashCode() 返回对象的哈希码值。不是实际地址值,但可以理解为地址值。 注意:哈希值是根据哈希算法计算出来的一个值,这个值和地址值有关,但是不是实际地址值。但可以理解为地址值。 B:public final Class getClass() 返回对象的字节码文件对象,反射中我们会详细讲解。 Class类的方法: public String getName() 以 String 的形式返回此 Class 对象所表示的实体名称。(实体包括:类、接口、数组名、基本类型或 void) 即:可以通过Class类中的一个方法,获取对象的真实类的全名称。 C:protected void finalize() 当垃圾回收器确定不存在对该对象的更多引用时,由对象的垃圾回收器调用此方法。用于垃圾回收,但是什么时候回收不确定。子类重写该方法,以配置系统资源或执行其他清除。 D:protected Object clone() 创建并返回此对象的一个副本。可以实现对象的克隆,包括成员变量的数据复制,但是它和两个引用指向同一个对象是有区别的。 Cloneable接口 此类实现了 Cloneable 接口,以指示 Object.clone() 方法可以合法地对该类实例进行按字段复制。 这个接口是标记接口,告诉我们只有实现该接口的类才可以实现对对象的复制了。(因为不是所有的类都可以复制的) 注意: 我们讲解的示例是一个浅度克隆,后面会学习深度克隆。 深度克隆:因为一个类可能还有父类,可能还有实现接口,那么继承体系越庞大,克隆就会变得很复杂。--------------------------------------- (5)两个注意问题: A:直接输出一个对象名称,其实是默认调用了该对象的toString()方法。 B:面试题 == 和 equals() 的区别? A:==(等号的比较的是): 基本类型:比较的是值是否相同 引用类型:比较的是地址值是否相同 B:equals(该方法比较的是): 只能比较引用类型。默认情况下,比较的是地址值是否相同。 不过,我们可以根据情况自己重写该方法。一般重写都是自动生成,比较的是对象的成员变量值是否相同。=============================================================================我的GitHub地址: https://github.com/heizemingjun 我的博客园地址: http://www.cnblogs.com/chenmingjun 我的蚂蚁笔记博客地址: http://blog.leanote.com/chenmingjun Copyright ©2018 黑泽明军 【转载文章务必保留出处和署名,谢谢!】

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 47)——final关键字

在类的定义中使用final关键字声明类、属性、方法和下标。final声明的类不能被继承,final声明的属性、方法和下标不能被重写。 下面看一个示例: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 final class Person{ //声明为final,说明它是不能被继承的 varname:String final varage:Int //定义的age属性 final funcdescription()->String{ //定义description实例方法 return "\(name)年龄是:\(age)" } final class funcprintClass()->(){ //定义printClass静态方法 print( "Person打印..." ) } init(name:String,age:Int){ self.name=name self.age=age } } class Student:Person{ //编译错误 varschool:String convenienceinit(){ self.init(name: "Tony" ,age: 18 ,school: "清华大学" ) } init(name:String,age:Int,school:String){ self.school=school super .init(name:name,age:age) } overridefuncdescription()->String{ //编译错误//试图重写description实例方法 print( "父类打印\(super.description())" ) return "\(name)年龄是:\(age),所在学校:\(school)。" } override class funcprintClass()->(){ //编译错误//试图重写printClass静态方法 print( "Student打印..." ) } overridevarage:Int{ //编译错误//试图重写age属性 get{ return super .age } set{ super .age=newValue< 8 ? 8 :newValue } } } 定义Student类,并声明为Person子类时,会报如下编译错误: Inheritance from a finalclass 'Person' 定义的age属性也是final,那么在试图重写age属性时,会报如下编译错误: Var overrides a 'final'var 定义description实例方法,它被声明为final,那么在试图重写description实例方法时,会报如下编译错误: Instance method overridesa 'final' instance method 定义printClass静态方法,它被声明为final,那么在试图重写printClass静态方法时,会报如下编译错误: Class method overrides a'final' class method 使用final可以控制我们的类被有限地继承,特别是在开发一些商业软件时,适当地添加final限制是非常有必要的。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1747532,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 21)——函数返回值

返回值3种形式:无返回值、单一返回值和多返回值。 无返回值函数 所谓无返回结果,事实上是Void类型,即表示没有数据的类型。 无返回值函数的语法格式有如下3种形式: func函数名(参数列表) { 语句组 } func函数名(参数列表) ->() { 语句组 } func函数名(参数列表) ->Void { 语句组 } 无返回值函数不需要“return返回值”语句。 多返回值函数 两种方式来实现。 一种是在函数定义的时候,将函数的多个参数声明为引用类型传递,这样当函数调用结束时,这些参数的值就变化了。 另一种是将返回定义为元组类型。 介绍元组类型返回多值的实现。看一个示例: 1 2 3 4 5 6 7 8 9 10 funcposition(dt:Double,speed:(x:Int,y:Int))->(x:Int,y:Int){ letposx:Int=speed.x*Int(dt) letposy:Int=speed.y*Int(dt) return (posx,posy) } letmove=position( 60.0 ,speed:( 10 ,- 5 )) print( "物体位移:\(move.x),\(move.y)" ) 参数speed:(x:Int,y:Int)是元组类型。 position函数的返回值是(x:Int,y:Int)的元组类型。 代码调用函数,传递的时期间是60.0秒,速度是(10, 5)。 输出结果,结果如下: 物体位移:600 , -300 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746403,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day60)——Core Foundation框架

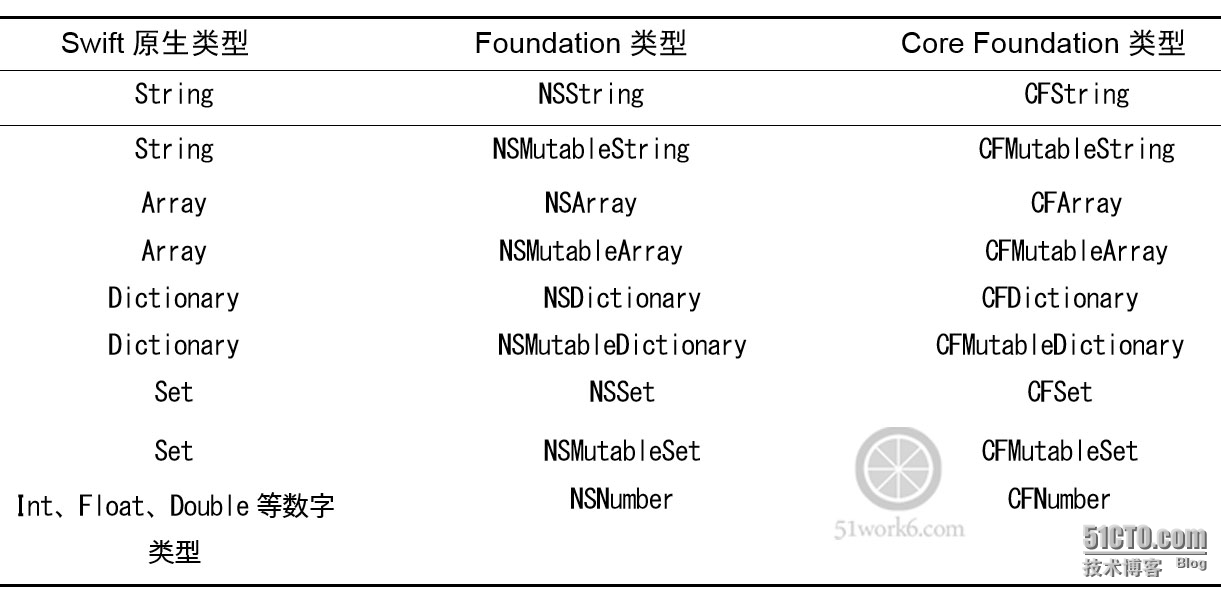
Core Foundation框架是苹果公司提供一套概念来源于Foundation框架,编程接口面向C语言风格的API。虽然在Swift中调用这种C语言风格的API比较麻烦,但是在OS X和iOS开发过程中,有时候使用CoreFoundation框架的API是非常方便的,例如在与C语言混合编码的时候。 Core Foundation框架与Foundation框架紧密相关,他们具有与相同的接口,但是不同。Core Foundation框架是基于C语言风格的,而Foundation框架是基于Objective-C语言风格的。在OS X和iOS程序代码中经常会有多种语言风格的代码混合在一起的情况,这使得我们开发变得更加麻烦。 数据类型映射 Core Foundation框架提供了一些不透明的数据类型,这些数据类型封装了一些数据和操作,他们也可以称为“类”,他们都继承于CFType类,CFType是所用Core Foundation框架类型的根类。这些数据类型在Foundation框架中都有相应的数据类型与之对应,这些数据类型也有一些与Swift原生数据类型有对应关系。 看看Swift原生类型与Core Foundation类型之间的转换示例: 1 2 3 4 5 6 7 8 import CoreFoundation import Foundation varcfstr1:CFString= "Hello,World" //创建CFString字符串 varstr:String=cfstr1asString //将CFString字符串转换为Swift原生字符串String varcfstr2:CFString=str //将Swift原生字符串String转换为CFString字符串 这个转换过程中Core Foundation类型转换为Swift原生类型是需要强制类型转换的。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1748349,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 18)——有几个分支语句?

分支语句又称条件语句,Swift编程语言提供了if、switch和guard三种分支语句。 if语句 由if语句引导的选择结构有if结构、if-else结构和else-if结构3种。 if结构示例代码如下: 1 2 3 4 5 varscore= 95 if score>= 85 { print( "您真优秀!" ) } 程序运行结果如下: 您真优秀! if-else结构示例代码如下: 1 2 3 4 5 6 7 varscore= 95 if score< 60 { print( "不及格" ) } else { print( "及格" ) } 程序运行结果如下: 及格 else-if结构示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 lettestscore= 76 vargrade:Character if testscore>= 90 { grade= "A" } else if testscore>= 80 { grade= "B" } else if testscore>= 70 { grade= "C" } else if testscore>= 60 { grade= "D" } else { grade= "F" } print( "Grade=\(grade)" ) 输出结果如下: Grade = C switch语句 switch语句也称开关语句,它提供多分支程序结构。 switch语句基本形式示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 lettestscore= 86 vargrade:Character switchtestscore/ 10 { case 9 : grade= "优" case 8 : grade= "良" case 7 , 6 : grade= "中" default : grade= "差" } print( "Grade=\(grade)" ) 输出结果如下: Grade =良 guard语句 guard语句是Swift 2.0新添加的关键字,它与if语句非常类似,它设计的目的是提高程序的可读性。 guard语句必须带有else语句,它的语法如下: guard条件表达式else{ 跳转语句 } 语句组 当条件表达式为true时候跳过else语句中的内容,执行语句组内容。条件表达式为false时候执行else语句中的内容,跳转语句一般是return、break、continue和throw。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746243,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 50)——扩展计算属性、方法

可以在原始类型上扩展计算属性,包括实例计算属性和静态计算属性。添加计算属性的定义,与普通的计算属性的定义是一样的。 实例计算属性示例:在网络编程时,为了减少流量,从服务器端返回的不是信息描述,而是编码,然后在本地再将编码转换为描述信息。为此定义了如下Int类型扩展: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 extensionInt{ //定义Int类型的扩展 varerrorMessage:String{ //只读计算属性 varerrorStr= "" switch (self){ case - 7 : errorStr= "没有数据。" case - 6 : errorStr= "日期没有输入。" case - 5 : errorStr= "内容没有输入。" case - 4 : errorStr= "ID没有输入。" case - 3 : errorStr= "据访问失败。" case - 2 : errorStr= "您的账号最多能插入10条数据。" case - 1 : errorStr= "用户不存在,请到http://51work6.com注册。" default : errorStr= "" } return errorStr } } letmessage=(- 7 ).errorMessage //获得-7编码对应的描述信息 print( "ErrorCode:-7,ErrorMessage:\(message)" ) 注意整个-7包括负号是一个完整的实例,因此调用它的属性时需要将-7作为一个整体用小括号括起来。然而,如果是7则不需要括号。 下面再看一个静态属性的示例: 1 2 3 4 5 6 7 8 9 10 11 12 structAccount{ //定义Account结构体 varamount:Double= 0.0 //账户金额 varowner:String= "" //账户名 } extensionAccount{ //定义Account结构体的扩展静态 static varinterestRate:Double{ //利率 return0. 0668 } } print(Account.interestRate) //打印输出interestRate属性 打印输出interestRate属性,访问方式与其他的静态计算属性一样,通过“类型名”加“.”来访问静态计算属性。 扩展方法 可以在原始类型上扩展方法,包括实例方法和静态方法。这些添加方法的定义与普通方法的定义是一样的。 下面先看一个示例: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 extensionDouble{ //定义Double类型的扩展 static varinterestRate:Double= 0.0668 //利率 funcinterestBy1()->Double{ return self*Double.interestRate //静态属性利率 } mutatingfuncinterestBy2(){ //定义实例方法interestBy2 self=self*Double.interestRate } static funcinterestBy3(amount:Double)->Double{ //定义静态方法interestBy3 return interestRate*amount //返回值是计算利息结果 } } letinterest1=(10_000. 00 ).interestBy1() //调用interestBy1方法计算利息 print( "利息1:\(interest1)" ) varinterest2=10_000. 00 //调用interestBy2方法计算利息 interest2.interestBy2() print( "利息2:\(interest2)" ) varinterest3=Double.interestBy3(10_000. 00 ) //调用interestBy3方法计算利息 print( "利息3:\(interest3)" ) 代码self = self *Double.interestRate,把计算结果直接赋值给当前实例self。在结构体和枚举类型中给self赋值会有编译错误,需要在方法前面加上mutating关键字,表明这是变异方法。 调用interestBy1方法计算利息,调用它的实例10_000.00,它的返回值被赋值给interest1常量,这是很常见的调用过程。 调用interestBy2方法计算利息,我们不能使用10_000.00实例调用,而是需要一个Double类型的变量interest2。interestBy2是变异方法,它会直接改变变量interest2的值,因此interest2.interestBy2()语句调用完成后,变量interest2的值就改变了。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1747538,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day54)——抛出错误

能放到try后面调用函数或方法都是有要求的,他们是有可能抛出错误,在这些函数或方法声明的参数后面要加上throws关键字,表示这个函数或方法可以抛出错误。 声明抛出错误方法示例代码如下: 1 2 3 4 5 6 7 8 //删除Note记录方法 funcremove(model:Note) throws { ... } //查询所有记录数据方法 funcfindAll() throws ->[Note]{ ... } 上述代码remove(_:)方法没有返回值,throws关键字放到参数后面。findAll()有返回值throws关键字放到参数和返回值类型之间。 在函数或方法中抛出错误 一个函数或方法能够声明抛出错误,是因为在函数或方法中产生并抛出了错误,这样函数或方法声明抛出错误才有实际的意义。 在产生并抛出错误方式: 在函数或方法中通过throw语句,人为地抛出错误。 在函数或方法中调用的其他可以抛出错误函数或方法,但是没有捕获处理,会导致错误被传播出来。 示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 //删除Note方法 funcremove(model:Note) throws { guardletdate=model.date else { //判断抛出时候是有了guard语句 //抛出"主键为空"错误 throw DAOError.PrimaryKeyNull } //比较日期主键是否相等 for (index,note)inlistData.enumerate()wherenote.date==date{ listData.removeAtIndex(index) } } //查询所有数据方法 funcfindAll() throws ->[Note]{ guardlistData.count> 0 else { //判断抛出时候是有了guard语句 //抛出"没有数据"错误。 throw DAOError.NoData } return listData } funcprintNotes() throws { //声明抛出错误 letdatas= try findAll() for noteindatas{ print( "date:\(note.date!)-content:\(note.content!)" ) } } try printNotes() guard语句最擅长处理这种早期判断,条件为false情况下抛出错误。 findAll()语句本身有可能产生错误,但是并没有使用catch语句捕获并处理,这样就导致了这个错误传播给该函数或方法的调用者,如果它的调用者也都不捕获处理,那么最后程序会出现运行期错误。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1748307,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day43)——构造函数继承

Swift中的子类构造函数的来源有两种:自己编写和从父类继承。并不是父类的所有的构造函数都能继承下来,能够从父类继承下来的构造函数是有条件的,如下所示。 条件1:如果子类没有定义任何指定构造函数,它将自动继承所有父类的指定构造函数。 条件2:如果子类提供了所有父类指定构造函数的实现,无论是通过条件1继承过来的,还是通过自己编写实现的,它都将自动继承所有父类的便利构造函数。 下面看示例代码: classPerson{ varname:String varage:Int funcdescription()->String{ return"\(name)年龄是:\(age)" } convenienceinit(){ self.init(name:"Tony") self.age=18 } convenienceinit(name:String){ self.init(name:name,age:18) } init(name:String,age:Int){ self.name=name self.age=age } } classStudent:Person{ varschool:String init(name:String,age:Int,school:String){ self.school=school super.init(name:name,age:age) } convenienceoverrideinit(name:String,age:Int){ self.init(name:name,age:age,school:"清华大学") } } classGraduate:Student{ varspecial:String="" } 来看看符合条件1的继承,Graduate继承Student,Graduate类没有定义任何指定构造函数,它将自动继承所有Student的指定构造函数。符合条件1后,Graduate从Student继承了如下指定构造函数: init(name : String,age : Int,school : String) 再看符合条件2的继承,由于Graduate实现了Student的所有指定构造函数,Graduate将自动继承所有Student的便利构造函数。符合条件2后,Graduate从Student继承了如下3个便利构造函数: init(name:String,age:Int) init(name:String) init() Student继承Person后有4个构造函数。 条件1对Student不满足,因为它有指定构造函数,Student类中的便利构造函数init (name: String, age: Int)满足了条件2,它实现了父类指定构造函数init (name: String, age: Int)。另外,由于子类构造函数与父类构造函数参数相同,需要使用override关键字,表示子类构造函数重写(overriding)了父类构造函数。 由于Student类实现了父类指定构造函数,因此也继承了父类的另外两个便利构造函数。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1747499,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 35)——会使用下标吗?

看下面的示例代码是不是使用过: 1 <span style= "font-size:14px;" >var studentList:String[] = [ "张三" , "李四" , "王五" ]<br>studentList[ 0 ] = "诸葛亮" <br><br>var studentDictionary =[ 102 : "张三" , 105 : "李四" , 109 : "王五" ]<br>studentDictionary[ 110 ] = "董六" </span> 在访问数组和字典的时候,可以采用下标访问。其中数组的下标是整数类型索引,字典的下标是它的“键”。 下标 Swift中的下标相当于Java中的索引属性和C#中的索引器。 下标访问的语法格式如下: 1 <span style= "font-size:14px;" >面向对象类型类型名 { <br> 其他属性<br> ...<br> subscript(参数: 参数数据类型) -> 返回值数据类型 { <br> get{ <br> return 返回值<br> } <br><br> set(新属性值) {<br> ...<br> } <br> } <br>}</span> 下标也有类似于计算属性的getter和setter访问器。 getter访问器是一个方法,在最后使用return语句将计算结果返回。 setter访问器“新属性值”是要赋值给属性值。参数的声明可以省略,系统会分配一个默认的参数newValue。 示例:二维数组 在Swift中没有提供二维数组,只有一维数组Array。可以自定义一个二维数组类型,然后通过两个下标参数访问它的元素,形式上类似于C语言的二维数组。 采用下标的二维数组示例代码如下: 1 <span style= "font-size:14px;" >structDoubleDimensionalArray { //定义了二维数组结构体<br> <br> let rows: Int, columns: Int //存储属性rows和columns<br> var grid: [Int]<br> <br> init(rows: Int, columns: Int) { //构造函数<br> self.rows = rows<br> self.columns = columns<br> grid = Array(count: rows * columns,repeatedValue: 0) //初始化存储属性grid<br> }<br> <br> subscript(row: Int, col: Int) -> Int { //定义下标<br> <br> get {<br> return grid[(row * columns) + col] <br> }<br> <br> set (newValue1){<br> grid[(row * columns) + col] =newValue1 <br> }<br> }<br> <br>}<br><br>var ary2 =DoubleDimensionalArray(rows: 10, columns: 10)//创建并初始化10×10大小的二维数组<br><br>//初始化二维数组<br>for var i = 0; i < 10;i++ {<br> for var j = 0; j < 10; j++ {<br> ary2[i,j] = i * j <br><br> }<br>}<br><br>//打印输出二维数组<br>for var i = 0; i < 10;i++ {<br> for var j = 0; j < 10; j++ {<br> print("\t \(ary2[i,j])")<br> }<br> print("\n")<br>}<br></span> 输出结果如下: 0 000000000 0123456789 024681012141618 0369121518212427 04812162024283236 051015202530354045 061218243036424854 071421283542495663 081624324048566472 091827364554637281 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746615,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 33)——属性观察者

为了监听属性的变化,Swift提供了属性观察者。属性观察者能够监听存储属性的变化,即便变化前后的值相同,它们也能监听到。 属性观察者主要有以下两个: willSet:观察者在修改之前调用。 didSet:观察者在修改之后立刻调用。 属性观察者的语法格式如下: 面向对象类型类型名{ 1 2 3 4 5 6 7 8 9 10 ... var存储属性:属性数据类型=初始化值{ willSet(新值){ //定义willSet观察者。“新值”是传递给willSet观察者的参数,它保存了将要替换原来属性的新值 ... } didSet(旧值){ //定义didSet观察者。“旧值”是传递给didSet观察者的参数,它保存了被新属性替换的旧值。 ... } } } 属性观察者的语法格式比计算属性要混乱。 属性观察者可以在类和结构体中使用,不能在枚举中使用。 示例代码如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Employee{ varno:Int= 0 varname:String= "Tony" { willSet(newNameValue){ //定义name属性的willSet观察者,newNameValue是由我们分配的传递新值的参数名 print( "员工name新值:\(newNameValue)" ) } didSet(oldNameValue){ //定义name属性的didSet观察者,oldNameValue是由我们分配的传递旧值的参数名 print( "员工name旧值:\(oldNameValue)" ) } } varjob:String? varsalary:Double= 0 vardept:Department? } structDepartment{ varno:Int= 10 { willSet{ //定义no属性的willSet观察者,注意这里没有声明参数,但是我们可以在观察者内部使用newValue print( "部门编号新值:\(newValue)" ) } didSet{ //定义no属性的didSet观察者,注意这里也没有声明参数,但是我们可以在观察者内部使用oldValue print( "部门编号旧值:\(oldValue)" ) } } varname:String= "RESEARCH" } varemp=Employee() emp.no= 100 emp.name= "Smith" vardept=Department() dept.no= 30 上述代码运行结果如下: 员工name新值:Smith 员工name旧值:Tony 部门编号新值:30 部门编号旧值:10 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1746600,如需转载请自行联系原作者

优秀的个人博客,低调大师

《从零开始学Swift》学习笔记(Day 42)——构造函数调用规则

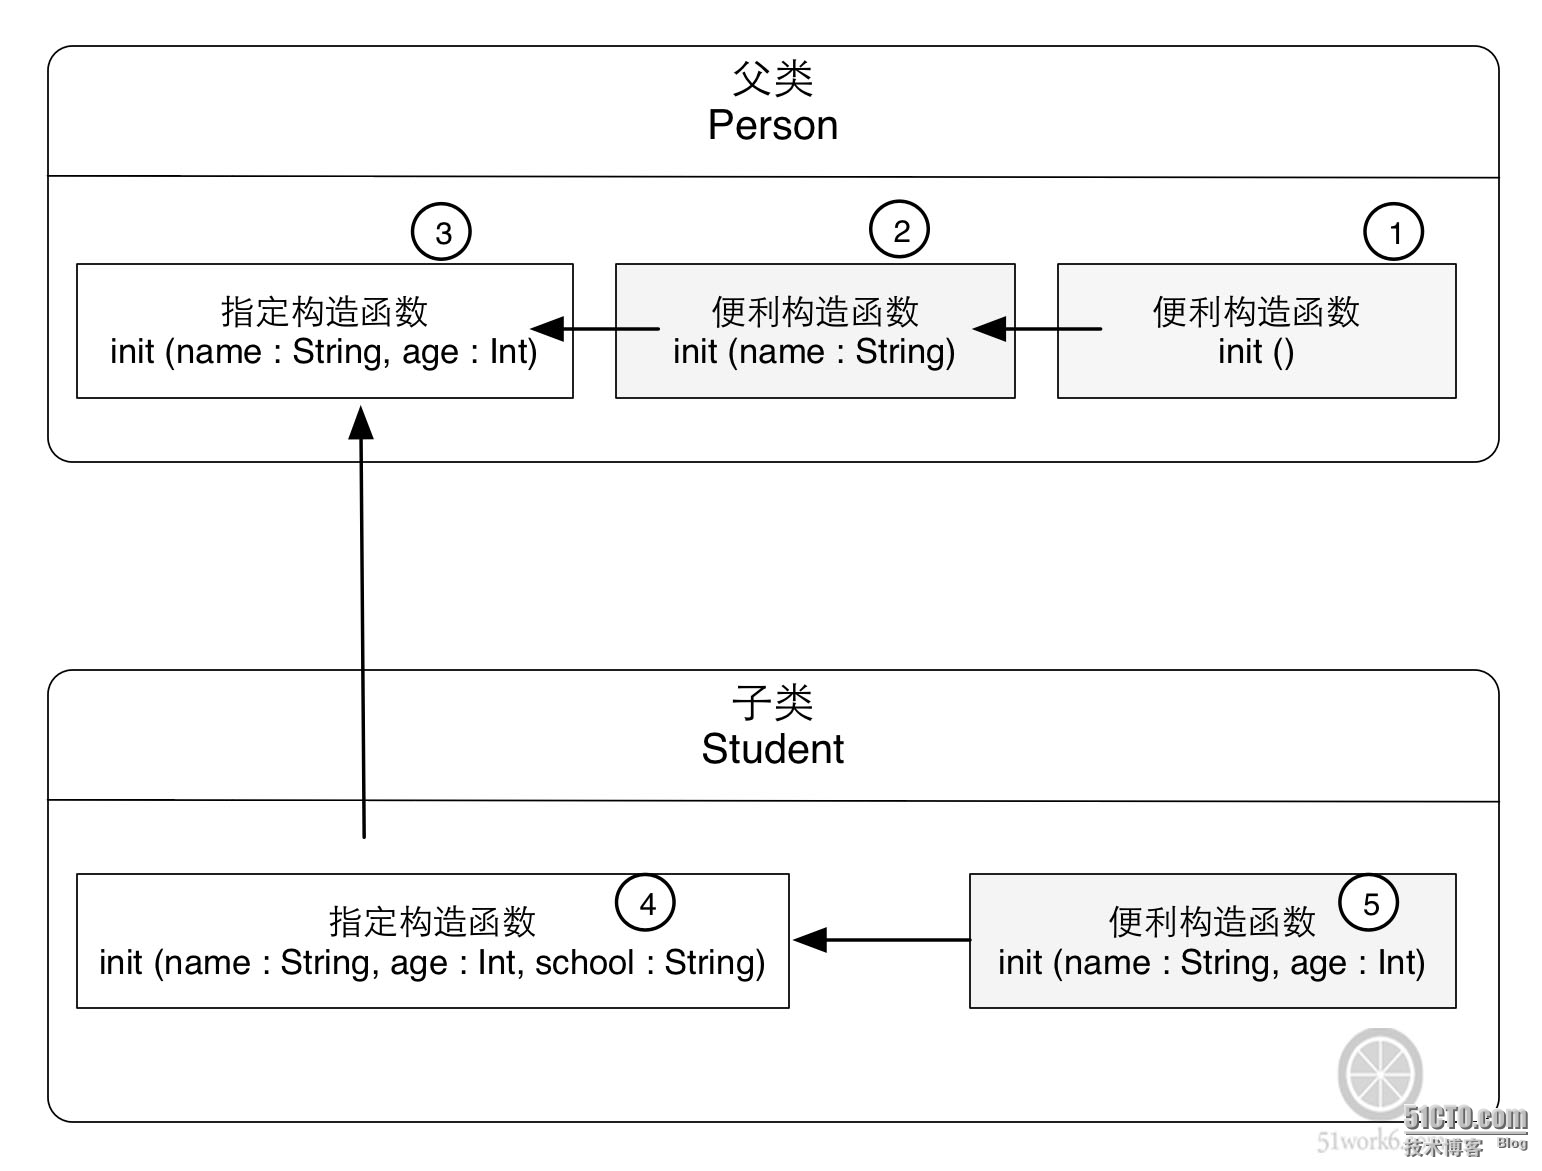
在构造函数中可以使用构造函数代理帮助完成部分构造工作。类构造函数代理分为横向代理和向上代理,横向代理只能在发生在同一类内部,这种构造函数称为便利构造函数。向上代理发生在继承的情况下,在子类构造过程中,要先调用父类构造函数初始化父类的存储属性,这种构造函数称为指定构造函数。 构造函数调用规则 Person和Student类示例: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 class Person{ varname:String varage:Int funcdescription()->String{ return "\(name)年龄是:\(age)" } convenienceinit(){ //便利构造函数 self.init(name: "Tony" ) self.age= 18 } convenienceinit(name:String){ //便利构造函数 self.init(name:name,age: 18 ) } init(name:String,age:Int){ //指定构造函数 self.name=name self.age=age } } class Student:Person{ varschool:String init(name:String,age:Int,school:String){ //指定构造函数 self.school=school super .init(name:name,age:age) } convenienceoverrideinit(name:String,age:Int){ //便利构造函数 self.init(name:name,age:age,school: "清华大学" ) } } letstudent=Student() print( "学生:\(student.description())" ) 构造函数之间的调用形成了构造函数链,如图所示。 Swift限制构造函数之间的代理调用的规则有3条,如下所示。 指定构造函数必须调用其直接父类的的指定构造函数。从图可见,Student中的④号指定构造函数调用Person中的③号指定构造函数。 便利构造函数必须调用同一类中定义的其他构造函数。从图可见,Student中的⑤号便利构造函数调用同一类中的④号便利构造函数,Person中的①号便利构造函数调用同一类中的②号便利构造函数。 便利构造函数必须最终以调用一个指定构造函数结束。从图可见,Student中的⑤号便利构造函数调用同一类中的④号指定构造函数,Person中的②号便利构造函数调用同一类中的③号指定构造函数。 本文转自 tony关东升 51CTO博客,原文链接:http://blog.51cto.com/tonyguan/1747498,如需转载请自行联系原作者

资源下载

更多资源
优质分享App

优质分享App

近一个月的开发和优化,本站点的第一个app全新上线。该app采用极致压缩,本体才4.36MB。系统里面做了大量数据访问、缓存优化。方便用户在手机上查看文章。后续会推出HarmonyOS的适配版本。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册
修改密码
忘记密码