首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

PHP的面向对象解析

面向对象 早期编程由于受电脑硬件限制,程序都是追求效率,而忽略可理解性,扩充性,随着硬件技术的发展,编程越来越重视多人开发,程序员越来越重视程序的可靠性,可扩展性,可维护性,所以刺激了程序语言的发展 面向过程 程序员设计好程序代码流程图,辅助程序设计。优点:用什么功能就编写什么函数 缺点:数据管理上比较混乱 ,主要集中在函数成面上,面向对象把属性和方法进行封装,更好的可重用性和可扩展性 面向对象 万物皆对象,将构成问题的事务分解到各个对象上,建立对象的目的不是为了完成一个工作,而是为了描述某个事务在解决问题中的行为,更符合人的思维习惯,代码重用性高,可扩展性好 面向对象和面向过程的核心区别是如何分配职责。 类和对象 面向对象是由一系统具有属性和方法的对象构成,对象之间相互交互 ,从而实现业务需求。 属性 在类中定义的变量,即为成员属性,用于描述对象静态特性的数据。如人的姓名,性别,首字母小写 方法 函数定义在类中即为成员方法,用于描述对象动态特性的操作行为,方法名不区分大小写,不可重名,首字母小写 对象生命周期 创建后,生命周期开始,当程序结束后或程序员清除对象后即销毁,PHP会自动销毁对象 类是一种抽象的概念,是具有相同语义定义对象的集合(具有相同属性和方法的集体),使用具体的类是不可行的,只能实例化。拿汽车举例,汽车的设计图纸就是类,汽车是对象。设计中重点是类的创建 类名书写规范 类名首字母大写 一个类定义在一个文件中 $this 对象中使用 $this 指针可以访问属性或方法。 class Code { protected $len = 5; public function make() { return $this->len . $this->show(); } public function show() { return ' : is show'; } } echo (new Code)->make(); 继承 通过使用 extends 可以继承父类的属性与方法,在PHP中继承是单一的。 class Notify { public function message() { return 'notify message'; } } class User extends Notify { } echo (new User)->message(); 父类调用 子类可以使用 parent 关键字调用父类方法 ... public function message() { return parent::message(); } ... 方法重写 子类可以重写父类的方法,除非父类的方法没有使用 final 修饰。 class Notify { public function message() { return 'notify message'; } } class User extends Notify { public function message() { return 'user notify'; } } echo (new User)->message(); 禁止重写 使用final声明的方法,将禁止在子类中重写父类方法。 public final function message() { return 'notify message'; } 封装 public 公有 在类的内部与外部或子类都可以访问,是最开放的权限 private 私有 定义类的属性和方法,在类的内部可以访问,在类的外部或子类都不可以访问 protected 受保护 定义类的属性和方法,在类的内部或子类可以访问,类的外部不可以访问 模块设计 强内聚(功能尽量在类的内部完成),弱耦合(开放尽量少的方法给外部调用)。例:公司销售接项目,具体工作交给公司内部程序员,设计人员,服务器管理人员协同完成 trait 使用trait 机制可以变相的使用多重继承。 class Alipay { use Pay; } class WePay { use Pay; } trait Pay { public function sn() { return 'ABCDEF'; } } echo (new WePay)->sn(); 如果本类与 trait 中存在同名的属性和方法时,将使用本类中的属性与方法。 ... class WePay { use Pay; public function sn() { return __METHOD__; } } trait Pay { public function sn() { return 'ABCDEF'; } } ... 多个trait 可以使用多个 trait 用逗号连接 ... use Pay,Site; ... 解决冲突 class WePay { use Pay, Email { Pay::notify insteadof Email; Email::notify as EmailNotify; } trait Pay { public function notify() { return __METHOD__; } } trait Email { public function notify() { return __METHOD__; } } echo (new WePay)->notify(); Pay::notify insteadof Email 表示使用 Pay::notify 方法替代 Email::notify 方法。 Email::notify as EmailNotify` 将`Email:notify` 别名为 `EmailNotify 访问控制 可以为继承的 trait 方法重新定义访问控制 class WePay { use Pay, Email { Pay::notify insteadof Email; Email::notify as protected EmailNotify; ... } 多重trait 可以通过多个trait 组合来使用。 trait Notify { public function response() { return 'notify response'; } } trait Pay { use Notify; } class User { use Pay; } echo (new User)->response(); 抽象方法 trait Notify { public function response() { return 'notify response' . $this->sn(); } abstract protected function sn(); } trait Pay { use Notify; } class User { use Pay; protected function sn() { return 'SN999'; } } echo (new User)->response(); 静态方法 在 trait 中可以使用静态方法、抽象方法、静态属性。 ... trait Pay { public function sn() { return 'ABCDEF'; } public static function notify() { return __METHOD__; } } class WePay { use Pay; ... } echo WePay::notify(); static static: 需要一个数据对象只服务于类,即类内部可用,对外不可用时。建对象是极其耗费资源的,因此当一个方法具有比较强的公用性的时候,没有必要为了调用这个方法而重新再生成该类的实例。定义的方法或变量在程序第一次加载时即驻留内存,程序结束释放。 static变量: 通过static声明的成员变量为静态变量或叫类变量,是该类的公共变量,在第一次使用时即生成,对于该类的所有对象只有一份,是属于类的,不是属于对象的。static变量是属于类而不属于对象,可以在任何地方通地类来访问,是类的全局变量,类创建时即存入内存。对多个对象来说,静态数据成员只存储一处,可以节省内存。只要对静态数据成员的值更新一次,保证所有对象存取更新后的相同的值。 static方法: 用static声明的方法为静态方法或叫类方法,执行该方法时不会将对象引用传给函数,所以我们不能访问非静态成员,只能访问静态方法或静态变量。只能使用关于类的方式如self static parent等。使用时不用生成对象即可执行 类常量 使用 const 来定义类常量,常量使用 self::来调用。 class Model implements ArrayAccess, Iterator { use ArrayIterator, Relation, Validate, Auto, Filter; //----------自动验证---------- //有字段时验证 const EXIST_VALIDATE = 1; //值不为空时验证 const NOT_EMPTY_VALIDATE = 2; ... } $this self:: parent:: $this 是当前对象的引用, 一般出现在方法里,用于获取类的成员属性,或执行类的成员方法 self:: 对本类的引用 ,用于获取当前类的表态成员属性或静态成员方法self::run() parent:: 对父类的引用,调用父类的方法或属性。 魔术方法 构造方法&析构方法 构造方法__construct() 在创建对象时自动执行,没有返回值,用于执行类的一些初始化工作,如对象属性的初始化工作,构造方法为__construct()。 可以在构造方法中传递参数,用于定义属性,在父类和子类都定义构造方法时,执行子类的构造方法 析构方法__destruct(): 当所有对象的引用被销毁时执行。 __get 与__set 读取不可访问或不存在的属性时,__get() 会被调用,同理获取不可访问或不存的的属性时会执行 __set() 方法。 <?php abstract class Query { abstract protected function record(array $data); public function select() { return $this->record(['name' => '后盾人', 'age' => 33]); } } class Model extends Query { protected $field = [ 'name' ]; public function all(){ $this->select(); return $this->field; } protected function record(array $data) { $this->field = $data; } public function __get($name) { return $this->field[$name] ?? null; } public function __set($name, $value) { $this->field[$name] = $value; } } $user = new Model; $user->all(); echo $user->name; $user->name = '向军大叔'; echo $user->name;ry ### __isset() 与 __unset() 当使用 isset()函数或者empty()函数 判断属性是否存在或者是否为空的时候会自动触发。 当使用 unset() 函数判断属性时,如果存在__unset() 方法将会执行。 ... public function __unset($name) { if (!isset($this->field[$name]) || in_array($name, $this->deny)) { throw new Exception('禁止操作'); } } public function __isset($name) { return isset($this->field[$name]); } ... 抽象类&抽象方法 具有抽象方法的类为抽象类,抽象方法即为没有内容的空方法,要求子类进行完善内容,抽象类不能实例化,只能继承,通过extends来实现,抽象类中也可以定义普通方法 父类方法执行方式不确定,但子类还都有这个方法 例1:如交通工具类:定义抽象方法控制交通工具运行方式,这样每个交通工具如飞机,汽车都要重写父类方法。如果在父类工具类定义该方法(比如在地上走)没有任何意义,因为每个交通工具都要重写(飞机要重写方法,船要重写方法),所以针对你类方法的不确定性,我们需要抽象方法,实现多态。 例2:定义动物类,每个动物都有叫声方法,但是表面不同,所以要定义为抽象类,让每种动物类去实现功能。 当父类为抽象类时,子类必须重写父类的抽象方法 抽象类里不一定非要写抽象方法,但有抽象方法的类必须定义为抽象类 抽象类必须继承使用 抽象方法不能有主体即{} <?php abstract class AbstractClass { // 强制要求子类定义这些方法 abstract protected function getValue(); abstract protected function prefixValue($prefix); // 普通方法(非抽象方法) public function printOut() { print $this->getValue(); } } 接口 接口是一组成员声明方法的集合,包含空的成员方法和常量,空的方法要求继承类去具体实现。成员方法为public,属性为常量。 例如:现实中的电脑USB或PCI插槽,插线板等都有接口例子 继承是一级一级层次式,如果某一层出现问题,整个继承就会出现意外。而接口只影响实现接口的类,接口可以在破坏原来的继承基础上对类扩展。接口可以实现多继承。 例:电脑USB接口,规定各个厂商必须构造合适的接口方法,比如手机,数码相机,网银U盾。要让各个厂商写自己的方法如U盾插到USB上他会自动安装网银驱盾,弹出网页,手机装上后可以打开手机里的内容,同时可以充电 抽象类及普通类都可以实现接口,通过关键字implements 接口与抽象类的区别: 1 接口只能用implements实现 抽象类用extends继承实现 2 接口没有数据成员,可以定义常量,抽象类可以有 3 接口没有构造函数,抽象类可以定义构造函数 4 接口方法都是public 抽象类方法可以用protected private public来修饰 5 一个类可以实现多个接口,但只能继承一个抽象类 6 接口中不可以有成员方法,抽象类可以有成员方法 interface DbInterface { public function connectDb(); //获得连接 参数为表名 public function close(); //关闭数据库 public function exe($sql); //发送没有返回值的sql public function query($sql); //有返回值的sql } class Db implements DbInterface { public function exe($sql){ } public function query($sql{ } } 以上内容希望帮助到大家,更多PHP大厂PDF面试文档,PHP进阶架构视频资料,PHP精彩好文免费获取可以微信搜索关注公众号:PHP开源社区,或者访问: 2021金三银四大厂面试真题集锦,必看! 四年精华PHP技术文章整理合集——PHP框架篇 四年精华PHP技术文合集——微服务架构篇 四年精华PHP技术文合集——分布式架构篇 四年精华PHP技术文合集——高并发场景篇 四年精华PHP技术文章整理合集——数据库篇

优秀的个人博客,低调大师

Lock 解析,如何避免死锁?

Lock 前面聊了聊 synchronized,今天再聊聊 Lock。Lock 接口是 Java 5 引入的,最常见的实现类是 ReentrantLock、ReadLock、WriteLock,可以起到 “锁” 的作用。 PS:篇幅原因,这章不聊实现类,后面再聊,只专注于 Lock 以及它与 synchronized 的区别。 Lock.png Lock 和 synchronized 是 java 中两种最常见的锁,"锁" 是一种工具。它用于控制对共享资源的访问。需要注意的是 Lock 设计的初衷并不是为了取代 synchronized ,而是一种升级。当 synchronized 不合适或者不能满足需求时(后面会说两者区别),Lock 顶上。 一般情况下,Lock 同一时间只允许一个线程来访问这个共享资源。但是也有特殊的时候允许并发访问。比如读写锁(ReadWriteLock)里面的读锁(ReadLock)。PS:这就是其中一个 synchronized 不能满足的场景。 Lock 的方法 如下图所示,Lock 有 5 个方法,1 个条件: publicinterfaceLock{voidlock();voidlockInterruptibly()throwsInterruptedException;booleantryLock();booleantryLock(longtime,TimeUnitunit)throwsInterruptedException;voidunlock();ConditionnewCondition();} lock 加锁主要有 4 个方法:lock、lockInterruptibly、tryLock、tryLock (long time, TimeUnit unit) 。解锁只有一个 unlock 方法。此外,还有一个线程间通信的条件(Condition)。下面逐一讲解: lock Lock 有 4 种加锁方法,其中 lock 是最基础的。Lock 获取锁和释放锁都是显式的,不像 synchronized 是隐式的。所以 synchronized 会在抛异常时自动释放锁,而 Lock 只能是主动释放,加解锁都必须有显式的代码控制。所以就有了以下伪代码: Locklock=...;//代码显式加锁lock.lock();try{//获取到了被本锁保护的资源,处理任务//捕获异常}finally{//代码显式释放锁lock.unlock();} 这种 lock 的写法才是最安全的,先获取 lock,然后在 try 中操作资源,最后 finally 中释放锁,以保证绝对释放(这一步非常重要,它防止代码走不到这里,导致跳过了 unlock () 语句,使得这个锁永远不能被释放)。 此外,lock () 方法有个缺点就是它不能被中断,一旦陷入死锁,lock () 就会陷入永久等待。所以,一般来说我们会用 tryLock 来代替 lock。 tryLock tryLock 顾名思义是尝试获取锁的意思,返回值是 boolean,获取成功返回 true,获取失败返回 false*。使用方法如下: Locklock=...;if(lock.tryLock()){try{//操作资源}finally{//释放锁lock.unlock();}}else{//如果不能获取锁,则做其他事情} 使用 if 判断是否获取锁,成功获取则去操作共享资源,失败则去干别的事(比如,几秒之后重试,或者跳过此任务),最后还是记得要在 finally 中释放锁。 tryLock 解决死锁问题 想象这样一个场景:比如有两个线程同时调用以下这个方法,传入的 lock1 和 lock2 恰好是相反的。如果第一个线程获取了 lock1,第二个线程获取了 lock2,两个线程都需要获取对方的锁才能工作。如果用 lock 这就很容易陷入死锁,原因前面也说了。 这个时候 tryLock 就发挥作用了:其中一个线程尝试获取锁 lock1,获取不到,则去隔段时间重试(这样做的目的在于等另一个获取到锁的线程在这段时间内完成任务,释放锁)。获取到了,则继续获取 lock2 ,获取到就操作共享资源,获取不到则释放 lock1,继续进入重试。 publicvoidtryLock(Locklock1,Locklock2)throwsInterruptedException{while(true){if(lock1.tryLock()){try{if(lock2.tryLock()){try{System.out.println("获取到了两把锁,完成业务逻辑");return;}finally{lock2.unlock();}}}finally{lock1.unlock();}}else{Thread.sleep(newRandom().nextInt(1000));}}} tryLock(long time, TimeUnit unit) 这个方法是 tryLock 的重载,区别在于 tryLock (long time, TimeUnit unit) 方法会有一个超时时间。在拿不到锁时会等待指定的时间,在指定时间内获取不到锁返回 false;获取到锁或者等待期间内获取到锁,返回 true。 此外,超时之后,它将放弃主动获取锁。它还可以响应中断,抛出 InterruptException,避免死锁的产生。 lockInterruptibly lockInterruptibly 去获取锁,获取到了马上返回 true。它非常执拗,如果获取不到锁就会一直尝试获取直到获取到为止,除非当前线程在获取锁期间被中断。可以把它理解为不限时的 tryLock (long time, TimeUnit unit)。 publicvoidlockInterruptibly()throwsInterruptException{lock.lockInterruptibly();try{System.out.println("操作资源");}finally{lock.unlock();}} unlock unlock 顾名思义就是释放锁。就 ReentrantLock 而言,调用 unlock 方法时,内部会把锁的 “被持有计数器” 减 1,减到 0 代表当前线程已经完全释放这把锁。 newCondition() Condition 的用法就不说了,不会的看之前这篇文章:线程之生产者消费者模式。它有两个主要的方法 await 和 signal 分别用于阻塞线程和唤醒线程。对应于 Object 的 wait 和 notify。 -END- 如果看到这里,喜欢这篇文章的话,请帮点个好看。微信搜索「一个优秀的废人」,关注后回复「1024」送你一套完整的 java 教程(包括视频)。回复「电子书」送你全编程领域电子书(不只Java)。 教程节选 本文分享自微信公众号 - 一个优秀的废人(feiren_java)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

TensorFlow On Flink 原理解析

作者:陈戊超(仲卓),阿里巴巴技术专家 深度学习技术在当代社会发挥的作用越来越大。目前深度学习被广泛应用于个性化推荐、商品搜索、人脸识别、机器翻译、自动驾驶等多个领域,此外还在向社会各个领域迅速渗透。 背景 当前,深度学习的应用越来越多样化,随之涌现出诸多优秀的计算框架。其中 TensorFlow,PyTorch,MXNeT 作为广泛使用的框架更是备受瞩目。在将深度学习应用于实际业务的过程中,往往需要结合数据处理相关的计算框架如:模型训练之前需要对训练数据进行加工生成训练样本,模型预测过程中需要对处理数据的一些指标进行监控等。在这样的情况下,数据处理和模型训练分别需要使用不同的计算引擎,增加了用户使用的难度。 本文将分享如何使用一套引擎搞定机器学习全流程的解决方案。先介绍一下典型的机器学习工作流程。如图所示,整个流程包含特征工程、模型训练、离线或者是在线预测等环节。 在此过程中,无论是特征工程、模型训练还是模型预测,中间都会产生日志。需要先用数据处理引擎比如 Flink 对这些日志进行分析,然后进入特征工程。再使用深度学习的计算引擎 TensorFlow 进行模型训练和模型预测。当模型训练好了以后再用 tensor serving 做在线的打分。 上述流程虽然可以跑通,但也存在一定的问题,比如: 同一个机器学习项目在做特征工程、模型训练、模型预测时需要用到 Flink 和 TensorFlow 两个计算引擎,部署相对而言更复杂。 TensorFlow 在分布式的支持上还不够友好,运行过程中需要指定机器的 IP 地址和端口号;而实际生产过程经常是运行在一个调度系统上比如 Yarn,需要动态分配 IP 地址和端口号。 TensorFlow 的分布式运行缺乏自动的 failover 机制。 针对以上问题,我们通过结合 Flink 和 TensorFlow,将 TensorFlow 的程序跑在 Flink 集群上的这种方式来解决,整体流程如下: 特征工程用 Flink 去执行,模型训练和模型的准实时预测目标使 TensorFlow 计算引擎可以跑在 Flink 集群上。这样就可以用 Flink 一套计算引擎去支持模型训练和模型的预测,部署上更简单的同时也节约了资源。 Flink 计算简介 Flink 是一款开源大数据分布式计算引擎,在 Flink 里所有的计算都抽象成 operator,如上图所示,数据读取的节点叫 source operator,输出数据的节点叫 sink operator。source 和 sink 中间有多种多样的 Flink operator 去处理,上图的计算拓扑包含了三个 source 和两个 sink。 机器学习分布式拓扑 机器学习分布式运行拓扑如下图所示: 在一个机器学习的集群当中,经常会对一组节点(node)进行分组,如上图所示,一组节点可以是 worker(运行算法),也可以是 ps(更新参数)。 如何将 Flink 的 operator 结构与 Machine Learning 的 node、Application Manager 角色结合起来?下面将详细讲解 flink-ai-extended 的抽象。 Flink-ai-extended 抽象 首先,对机器学习的 cluster 进行一层抽象,命名为 ML framework,同时机器学习也包含了 ML operator。通过这两个模块,可以把 Flink 和 Machine Learning Cluster 结合起来,并且可以支持不同的计算引擎,包括 TensorFlow。 如下图所示: 在 Flink 运行环境上,抽象了 ML Framework 和 ML Operator 模块,负责连接 Flink 和其他计算引擎。 ML Framework ML Framework 分为 2 个角色。 Application Manager(以下简称 am) 角色,负责管理所有 node 的节点的生命周期。 node 角色,负责执行机器学习的算法程序。 在上述过程中,还可以对 Application Manager 和 node 进行进一步的抽象,Application Manager 里面我们单独把 state machine 的状态机做成可扩展的,这样就可以支持不同类型的作业。 深度学习引擎,可以自己定义其状态机。从 node 的节点抽象 runner 接口,这样用户就可以根据不同的深度学习引擎去自定义运行算法程序。 ML Operator ML Operator 模块提供了两个接口: addAMRole,这个接口的作用是在 Flink 的作业里添加一个 Application Manager 的角色。Application Manager 角色如上图所示就是机器学习集群的管理节点。 addRole,增加的是机器学习的一组节点。 利用 ML Operator 提供的接口,可以实现 Flink Operator 中包含一个Application Manager 及 3 组 node 的角色,这三组 node 分别叫 role a、 role b,、role c,三个不同角色组成机器学习的一个 cluster。如上图代码所示。Flink 的 operator 与机器学习作业的 node 一一对应。 机器学习的 node 节点运行在 Flink 的 operator 里,需要进行数据交换,原理如下图所示: Flink operator 是 java 进程,机器学习的 node 节点一般是 python 进程,java 和 python 进程通过共享内存交换数据。 TensorFlow On Flink TensorFlow 分布式运行 TensorFlow 分布式训练一般分为 worker 和 ps 角色。worker 负责机器学习计算,ps 负责参数更新。下面将讲解 TensorFlow 如何运行在 Flink 集群中。 TensorFlow Batch 训练运行模式 Batch 模式下,样本数据可以是放在 HDFS 上的,对于 Flink 作业而言,它会起一个source 的 operator,然后 TensorFlow 的 work 角色就会启动。如上图所示,如果 worker 的角色有三个节点,那么 source 的并行度就会设为 3。同理下面 ps 角色有 2 个,所以 ps source 节点就会设为 2。而 Application Manager 和别的角色并没有数据交换,所以 Application Manager 是单独的一个节点,因此它的 source 节点并行度始终为 1。这样 Flink 作业上启动了三个 worker 和两个 ps 节点,worker 和 ps 之间的通讯是通过原始的 TensorFlow 的 GRPC 通讯来实现的,并不是走 Flink 的通信机制。 TensorFlow stream 训练运行模式 如上图所示,前面有两个 source operator,然后接 join operator,把两份数据合并为一份数据,再加自定义处理的节点,生成样本数据。在 stream 模式下,worker 的角色是通过 UDTF 或者 flatmap 来实现的。 同时,TensorFlow worker node 有3 个,所以 flatmap 和 UDTF 相对应的 operator 的并行度也为 3, 由于ps 角色并不去读取数据,所以是通过 flink source operator 来实现。 下面我们再讲一下,如果已经训练好的模型,如何去支持实时的预测。 使用 Python 进行预测 使用 Python 进行预测流程如图所示,如果 TensorFlow 的模型是分布式训练出来的模型,并且这个模型非常大,比如说单机放不下的情况,一般出现在推荐和搜索的场景下。那么实时预测和实时训练原理相同,唯一不同的地方是多了一个加载模型的过程。 在预测的情况下,通过读取模型,将所有的参数加载到 ps 里面去,然后上游的数据还是经过和训练时候一样的处理形式,数据流入到 worker 这样一个角色中去进行处理,将预测的分数再写回到 flink operator,并且发送到下游 operator。 使用 Java 进行预测 如图所示,模型单机进行预测时就没必要再去起 ps 节点,单个 worker 就可以装下整个模型进行预测,尤其是使用 TensorFlow 导出 save model。同时,因为 saved model 格式包含了整个深度学习预测的全部计算逻辑和输入输出,所以不需要运行 Python 的代码就可以进行预测。 此外,还有一种方式可以进行预测。前面 source、join、UDTF 都是对数据进行加工处理变成预测模型可以识别的数据格式,在这种情况下,可以直接在 Java 进程里面通过 TensorFlow Java API,将训练好的模型 load 到内存里,这时会发现并不需要 ps 角色, worker 角色也都是 Java 进程,并不是 Python 的进程,所以我们可以直接在 Java 进程内进行预测,并且可以将预测结果继续发给 Flink 的下游。 总结 在本文中,我们讲解了 flink-ai-extended 原理,以及Flink 结合 TensorFlow 如何进行模型训练和预测。希望通过本文大分享,大家能够使用 flink-ai-extended, 通过 Flink 作业去支持模型训练和模型的预测。

优秀的个人博客,低调大师

AnalyticDB for MySQL技术架构解析

企业数据需求不断变化,近年来变化趋势日益明显,从数据的3V特性看:体积,速度和变化;Big Data强调数据量,PB级以上,是静态数据。而Fast Data在数据量的基础上,意味着速度和和变化,意味着客户可以更加实时化、更加快速地进行数据处理。 在Forrester最近的一项研究中,超过75%的受访公司已经使用Fast Data解决方案。 在接受调查的人中,88%表示他们需要近乎实时地对数据执行分析。 AnalyticDB是阿里巴巴自主研发、唯一经过超大规模以及核心业务验证的PB级实时数据仓库,是FastData的最佳代表。自2012年第一次在集团发布上线以来,至今已累计迭代发布近百个版本,支撑起集团内的电商、广告、菜鸟、文娱、飞猪等众多在线分析业务。AnalyticDB于2014年在阿里云开始正式对外输出,支撑行业既包括传统的大中型

优秀的个人博客,低调大师

ConcurrentHashMap 1.8原理解析

JDK 1.8中,Hash家族有这么一些存在,HashMap,HashTable,LinkedHashMap,ConcurrentHashMap。这里面支持线程安全的有HashTable以及ConcurrentHashMap。对Hash有一个基本了解可以参考本人的从Hash到一致性Hash原理(深度好文) 。 那既然说到ConcurrentHashMap,自然要讨论的就是它的线程安全性和效能。我们先来看一下HashTable的线程安全性以及效能的低下。 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) { throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } public synchronized V get(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return (V)e.value; } } return null; } 我们对比一下HashMap 1.7的这两个方法(因为1.8点HashMap会生成红黑树,我们暂时先不考虑红黑树的问题) public V put(K key, V value) { if (key == null) return putForNullKey(value); int hash = hash(key); int i = indexFor(hash, table.length); for (Entry<K,V> e = table[i]; e != null; e = e.next) { Object k; if (e.hash == hash && ((k = e.key) == key || key.equals(k))) { V oldValue = e.value; e.value = value; e.recordAccess(this); return oldValue; } } modCount++; addEntry(hash, key, value, i); return null; } public V get(Object key) { if (key == null) return getForNullKey(); Entry<K,V> entry = getEntry(key); return null == entry ? null : entry.getValue(); } final int hash(Object k) { int h = 0; if (useAltHashing) { if (k instanceof String) { return sun.misc.Hashing.stringHash32((String) k); } h = hashSeed; } h ^= k.hashCode(); // This function ensures that hashCodes that differ only by // constant multiples at each bit position have a bounded // number of collisions (approximately 8 at default load factor). //一种算法,进行4次位移,得到相对比较分散的链表 h ^= (h >>> 20) ^ (h >>> 12); return h ^ (h >>> 7) ^ (h >>> 4); } 在这里我们可以看到,他们除了key的hash算法不同,HashTable的比较简单,只是用key的哈希值与0x7FFFFFFF(十进制2147483647,二进制1111111111111111111111111111111)进行一次与运算,即为只要相同二进制位上不论0,1全部都变成1,再对table数组的长度取模。而HashMap 1.7则为key的哈希值进行各位无符号位移加异或运算,取得最终哈希值。然后是HashTable不接收null的key,而HashMap接受。他们最大的区别就在于synchronized显示器锁了。 synchronized的本质是所有对象的字节码中有一个monitor的对象头,任何线程拿到了这个monitor的对象头就可以对这个对象进行操作,而拿不到monitor对象头的线程就只能等待,直到拿到了monitor的线程放弃,其他线程才能争夺这个对象头来对对象进行操作。那么问题来了,当大量线程高并发的时候,只要有一个线程拿到了这个对象头,其他线程对这个对象是既不能读也不能写。而对于HashMap来说,如果多线程对其进行操作,那么任意线程都可以胡乱修改里面值的内容造成脏读,所以HashMap是线程不安全的。 那么我们今天的主角登场了ConcurrentHashMap。我们同样来看一下这两个方法。以下是1.8的源码,首先我们要清楚的是1.8跟1.7已经完全不同,1.7是使用segements(16个segement),每个segement都有一个table(Map.Entry数组),相当于16个HashMap,同步机制为分段锁,每个segment继承ReentrantLock;而1.8只有1个table(Map.Entry数组),同步机制为CAS + synchronized保证并发更新。如果不搞清楚这个问题,那么你看1.8的源码可能会很懵逼。 public V put(K key, V value) { return putVal(key, value, false); } final V putVal(K key, V value, boolean onlyIfAbsent) { //无论key还是value,不允许空 if (key == null || value == null) throw new NullPointerException(); //此处获取hash值的方法与HashTable类似 int hash = spread(key.hashCode()); int binCount = 0; //无限循环 for (Node<K,V>[] tab = table;;) { Node<K,V> f; int n, i, fh; //如果节点数组为null,或者长度为0,初始化节点数组 if (tab == null || (n = tab.length) == 0) tab = initTable(); //如果节点数组的某个节点为null,则put的时候就会采用无锁竞争来获取该节点的头把交椅 else if ((f = tabAt(tab, i = (n - 1) & hash)) == null) { if (casTabAt(tab, i, null, new Node<K,V>(hash, key, value, null))) break; // no lock when adding to empty bin } //需要扩容的时候先扩容,再写入 else if ((fh = f.hash) == MOVED) tab = helpTransfer(tab, f); else { //如果hash冲突的时候,即多线程操作时,大家都有一样的hash值 V oldVal = null; synchronized (f) { //锁定节点数组的该节点 if (tabAt(tab, i) == f) { //如果当前该节点为链表形态 if (fh >= 0) { binCount = 1; for (Node<K,V> e = f;; ++binCount) { K ek; //找链表中找到相同的key,把新value替代老value if (e.hash == hash && ((ek = e.key) == key || (ek != null && key.equals(ek)))) { oldVal = e.val; if (!onlyIfAbsent) e.val = value; break; } Node<K,V> pred = e; //如果找不到key,就添加到链表到末尾 if ((e = e.next) == null) { pred.next = new Node<K,V>(hash, key, value, null); break; } } } //如果当前为红黑树形态,进行红黑树到查找和替代(存在相同的key),或者放入红黑树到新叶节点上(key不存在) else if (f instanceof TreeBin) { Node<K,V> p; binCount = 2; if ((p = ((TreeBin<K,V>)f).putTreeVal(hash, key, value)) != null) { oldVal = p.val; if (!onlyIfAbsent) p.val = value; } } } } if (binCount != 0) { //如果链表长度超过了8,链表转红黑树 if (binCount >= TREEIFY_THRESHOLD) treeifyBin(tab, i); if (oldVal != null) return oldVal; break; } } } //统计节点个数,检查是否需要扩容 addCount(1L, binCount); return null; } public V get(Object key) { Node<K,V>[] tab; Node<K,V> e, p; int n, eh; K ek; int h = spread(key.hashCode()); if ((tab = table) != null && (n = tab.length) > 0 && (e = tabAt(tab, (n - 1) & h)) != null) { if ((eh = e.hash) == h) { if ((ek = e.key) == key || (ek != null && key.equals(ek))) return e.val; } else if (eh < 0) return (p = e.find(h, key)) != null ? p.val : null; while ((e = e.next) != null) { if (e.hash == h && ((ek = e.key) == key || (ek != null && key.equals(ek)))) return e.val; } } return null; } 读取的时候,我们没有看见锁到存在,说明读不受多线程影响。 对比ConcurrentHashMap和HashTable,我们可以明显的看到,ConcurrentHashMap在写的时候,并没有锁住整个节点数组,在新节点上使用的是无锁竞争,在老节点上锁住的仅仅是一个节点,读的时候如果不是恰好读到写线程写入相同Hash值的位置,不受影响(可以认为我们的操作一般是读多写少,这种几率也比较低)。而HashTable是对整个节点数组进行锁定,读到时候不能写,写的时候不能读,这么一对比就可以明显感觉到性能差距是巨大的。 虽然ConcurrentHashMap的并发性能还算比较优异,但在亿级计算中,却依然会成为性能瓶颈,具体可以参考本人的Fork/Join框架原理和使用探秘 至于这里为什么会慢,我认为在这种超高并发下,节点数组的单节点的的写写竞争是互斥的,其次,由于红黑树具有读快写慢的特性,它要不断保持树的平衡而不断返转,所以才会使得高并发写的性能急剧下降。

优秀的个人博客,低调大师

Redis radix tree源码解析

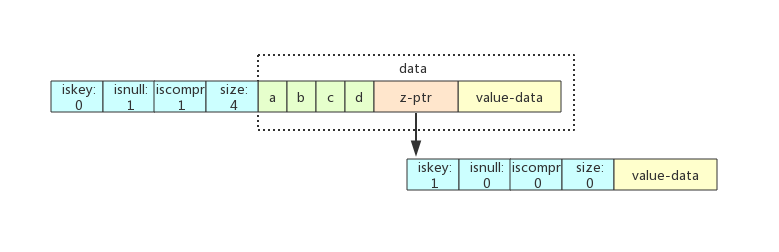
Redis实现了不定长压缩前缀的radix tree,用在集群模式下存储slot对应的的所有key信息。本文将详述在Redis中如何实现radix tree。 核心数据结构 raxNode是radix tree的核心数据结构,其结构体如下代码所示: typedef struct raxNode { uint32_t iskey:1; uint32_t isnull:1; uint32_t iscompr:1; uint32_t size:29; unsigned char data[]; } raxNode; iskey:表示这个节点是否包含key 0:没有key 1:表示从头部到其父节点的路径完整的存储了key,查找的时候按子节点iskey=1来判断key是否存在 isnull:是否有存储value值,比如存储元数据就只有key,没有value值。value值也是存储在data中 iscompr:是否有前缀压缩,决定了data存储的数据结构 size:该节点存储的字符个数 data:存储子节点的信息 iscompr=0:非压缩模式下,数据格式是:[header strlen=0][abc][a-ptr][b-ptr][c-ptr](value-ptr?),有size个字符,紧跟着是size个指针,指向每个字符对应的下一个节点。size个字符之间互相没有路径联系。 iscompr=1:压缩模式下,数据格式是:[header strlen=3][xyz][z-ptr](value-ptr?),只有一个指针,指向下一个节点。size个字符是压缩字符片段 Rax Insert 以下用几个示例来详解rax tree插入的流程。假设j是遍历已有节点的游标,i是遍历新增节点的游标。 场景一:只插入abcd z-ptr指向的叶子节点iskey=1,使用了压缩前缀。 场景二:在abcd之后插入abcdef 从abcd父节点的每个压缩前缀字符比较,遍历完所有abcd节点后指向了其空子节点,j = 0, i < len(abcded)。 查找到abcd的空子节点,直接将ef赋值到子节点上,成为abcd的子节点。ef节点被标记为iskey=1,用来标识abcd这个key。ef节点下再创建一个空子节点,iskey=1来表示abcdef这个key。 场景三:在abcd之后插入ab ab在abcd能找到前两位的前缀,也就是i=len(ab),j < len(abcd)。 将abcd分割成ab和cd两个子节点,cd也是一个压缩前缀节点,cd同时被标记为iskey=1,来表示ab这个key。 cd下挂着一个空子节点,来标记abcd这个key。 场景四:在abcd之后插入abABC abcABC在abcd中只找到了ab这个前缀,即i < len(abcABC),j < len(abcd)。这个步骤有点复杂,分解一下: step 1:将abcd从ab之后拆分,拆分成ab、c、d 三个节点。 step 2:c节点是一个非压缩的节点,c挂在ab子节点上。 step 3:d节点只有一个字符,所以也是一个非压缩节点,挂在c子节点上。 step 4:将ABC 拆分成了A和BC, A挂在ab子节点上,和c节点属于同一个节点,这样A就和c同属于父节点ab。 step 5:将BC作为一个压缩前缀的节点,挂在A子节点下。 step 6:d节点和BC节点都挂一个空子节点分别标识abcd和abcABC这两个key。 场景五:在abcd之后插入Aabc abcd和Aabc没有前缀匹配,i = 0,j = 0。 将abcd拆分成a、bcd两个节点,a节点是一个非压缩前缀节点。 将Aabc拆分成A、abc两个节点,A节点也是一个非压缩前缀节点。 将A节点挂在和a相同的父节点上。 同上,在bcd和abc这两个节点下挂空子节点来分别表示两个key。 Rax Remove 删除 删除一个key的流程比较简单,找到iskey的节点后,向上遍历父节点删除非iskey的节点。如果是非压缩的父节点并且size > 1,表示还有其他非相关的路径存在,则需要按删除子节点的模式去处理这个父节点,主要是做memove和realloc。 合并 删除一个key之后需要尝试做一些合并,以收敛树的高度。 合并的条件是: iskey=1的节点不能合并 子节点只有一个字符 父节点只有一个子节点(如果父节点是压缩前缀的节点,那么只有一个子节点,满足条件。如果父节点是非压缩前缀的节点,那么只能有一个字符路径才能满足条件) 结束语 云数据库Redis版(ApsaraDB for Redis)是一种稳定可靠、性能卓越、可弹性伸缩的数据库服务。基于飞天分布式系统和全SSD盘高性能存储,支持主备版和集群版两套高可用架构。提供了全套的容灾切换、故障迁移、在线扩容、性能优化的数据库解决方案。欢迎各位购买使用:云数据库 Redis 版 作者:羽洵 原文链接 本文为云栖社区原创内容,未经允许不得转载。

优秀的个人博客,低调大师

Android Handler原理实践解析

前言 Handler消息处理机制在Android开发中起着举足轻重的作用,我们有必要好好理解下其原理,下面我们先从一个简单的例子出发 一、日常使用 假设我们有这么一个需要,请求网络然后将图片展示出来,我们知道网络请求是不允许在主线程执行的,而UI是不能在子线程(具体是不允许在非创建UI的原始线程)更新的,因此我们需要在子线程请求网络获得了数据以后再切换回主线程更新UI,这个例子中Handler就是起着切换线程的作用,下面的代码演示了这个例子 classMainActivity : AppCompatActivity() { private lateinit var mImageView: ImageView override fun onCreate(savedInstanceState: Bundle?){

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册