首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

Helm源码解析 资料下载

Helm 是Kubernetes 集群的包管理器(charts), charts 是Kubernetes资源的一个打包集合。 Helm之于Kubernetes好比yum之于RHEL,或者apt-get之于Ubuntu。Helm使用Chart帮助我们管理应用,Chart就好像RPM一样,里面描述了应用及其依赖关系。这篇分享会简单介绍 Helm 的用法 以及chart 的介绍,随后会针对Helm 源码以一个简单的chart 创建为示例,从源码级别分析Helm 的创建流程。最后会简单介绍一下Helm v3的进展以及改变。 本次分享专家:阿里云技术专家 陈显鹭 直播视频全程链接:https://yq.aliyun.com/live/826 PPT精彩内容一览: PPT下载地址:https://yq.aliyun.com/download/32

优秀的个人博客,低调大师

应用基础框架全面解析

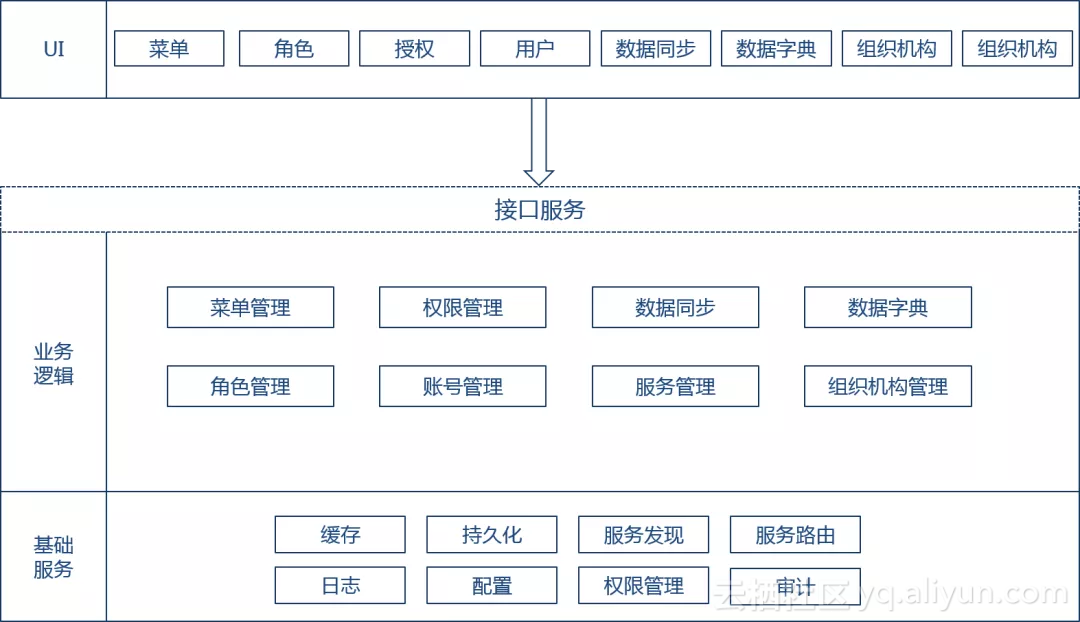
引言: 应用基础框架Coframe是EOS产品自带的开源应用基础框架,提供了资源管理、权限管理、用户以及角色管理等业务应用基础能力,用户可以根据自己的需要进行二次开发与扩展。本文向大家分享Coframe的主要功能和设计实现方案。 目录: 一、简介 二、系统资源 三、权限管理 四、组织管理 一、简介 应用基础框架也叫Coframe,是产品自带的开源应用基础框架,提供了一些基础功能,用户可以根据自己的需要进行二次开发与扩展。 Coframe提供3大核心功能: 系统资源:提供了功能菜单管理、字典码表、应用管理折几个应用框架基础能力。 权限管理:提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 组织管理:提供了机构、岗位、员工、 用户、工作组等组织机构相关管理功能,支持与已有业务系统对接,使得基于普元EOS Platform 8.0开发的应用可方便地使用同一套组织机构。 逻辑架构逻辑架构图展示了基础应用框架的基本功能模块,前端Restful形式接口调用后端服务。进程架构应用基础框架有两种部署模式:微服务架构Coframe集成模式和单应用架构Coframe集成模式。 单应用架构很好理解,即直接使用Coframe源码或者jar包开发应用,后端只有一个server,而集成模式可以将应用要对外暴露的服务封装在Coframe中,这样Coframe可以对应用进行权限管理。前端使用VUE开发,可以很方便的使用源码进行二次开发。 数据模型应用基础框架的数据模型即DB表结构,展示了主要的一些表结构,包括权限表,用户表等。用户可以很方便的进行二次开发扩展应用。 二、系统资源 菜单管理 菜单框架支持两级菜单,用户可以自定义菜单的路径和打开方式等。应用基础框架提供了几个基础的菜单,用户可以在页面编辑菜单或者直接在数据库端编辑菜单。目前应用基础框架前端Ui支持二级菜单,用户可以根据自己的需求扩展到三级菜单。 字典码表 字典码表即为系统内部定义的具有业务属性的数据字典。系统管理员可以配置字典类型和字典项,用于管理系统中的枚举类型的基础数据,并且支持excel导入导出。字典类型和字典数据均支持一级子项。 字典类型:对数据进行分类管理 字典数据项:需要管理的枚举数据 应用管理 应用管理又叫服务权限控制,是指在多应用系统以及单应用系统下,实现对应用的服务功能的权限控制。实现角色、用户、功能的灵活绑定。在需要进行权限管理的功能接口方法定义上添加@TarestOperation注解,发布服务。 @RequestMapping("/say-hello") @TarestService(group = "SP1", displayName = "服务提供组1", version = "1.0.0.0", groupName = "服务提供组1", name = "ISampleAppHello") public interface ISampleAppHello { @GetMapping @TarestOperation(checkPermission=false,name="DEMO_001",displayName="功能1") String sayHello(); /** * @TarestOperation 在@TarestOperation中默认是不进行权限管理的 * 通过设置checkPermission = true,打开权限控制功能 * **/ @GetMapping(value = "/user") @TarestOperation(checkPermission =true,name="DEMO_002",displayName="功能2") String insertDemo(@RequestParam String name, @RequestParam Integer age); } 单应用系统即只有一个后端应用的系统,(直接以嵌入方式集成Coframe)无需新建应用。 多应用系统即有多个后端应用的系统,Coframe作为一个独立的应用部署的系统,需要在coframe中新建应用。如图所示: 三、权限管理 提供了基于Party(参与者) 的复杂权限计算模型和授权模型。 基于参与者、资源与授权等概念可扩展开发出符合用户个性化需求的参与者模型。 角色:角色是Coframe一个重要的对象,也可以成为权限集,表示系统中权限一个子集,用于控制用户可以使用的功能集合,赋予用户一个角色表示给用户一定功能的使用权限。Coframe中角色的分配本身赋予某些用户,员工,机构等之外,还要向角色授予可访问某些功能,模块,表单,视图等资源的权限。拥有某角色的用户可访问角色被授予的资源的权限。 用户:所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。 用户管理所有能登录系统的用户都是系统中的用户,需要增加登录账号有两种方式。一种是在用户管理中新增用户,第二种是在组织管理中新增员工时关联一个用户,如果用户的登录名不存在会创建一个新的用户。当Coframe使用IAM的统一认证登录的时候能够同步IAM端的同一租户下的用户信息。 Coframe的用户账号由其登录认证方式决定是本地创建的还是又IAM即同一认真平台同步过来的用户信息。 本地登录:用户账号及其认证密码在本地存储,本地认证配置可以参考:http://t.cn/EUrzEtL 单点登录:即与IAM集成的sso方式登录,可以参考:http://t.cn/EUrZPOs 授权管理 目前提供了菜单授权与服务授权,授权管理即将资源与参与者之间建立关系。如下图所示,菜单和应用: 即可以视为资源,而账号、角色、组织机构、工作中等,即可以视为参与者。授权表结构如下图所示: 此注解用来标志一个数据实体为授权实体,授权实体需要指定类型:资源、授权主体,比如: @Entity // 此实体名称为order,类型为resource @AuthEntity(name = "order", type = AuthEntityType.RESOURCE) @Table(name = "SAMPLE_ORDER") public class SampleOrder { @Id @GeneratedValue private Long id; private String name; private Date date; } 四、组织管理 机构管理机构指企业的组织机构,一般包含机构、岗位、员工等信息。 机构管理通过对一棵机构人员树的维护把机构、岗位、人员等信息和关系维护好,并可设置这些组织对象的角色。工作组管理工作组与机构类似,是为了将项目组、工作组等临时性的组织机构管理起来,业务上通常工作组有一定的时效性,是一个非常设机构。 工作组是企业动态创建的组织机构分组,工作组下可以有子工作组、员工信息。总结: 以上介绍了应用基础框架的主要基础功能,以及设计过程中的一些理念,比如授权模型等。 作为开源应用基础框架会随着规划发展不断完善,用户可以根据自身的需求来更改适配。也非常欢迎大家能够更多参与使其更加健壮。 原文发布时间为:2018-12-19本文作者:许方杰本文来自云栖社区合作伙伴“ EAWorld”,了解相关信息可以关注“eaworld”微信公众号

优秀的个人博客,低调大师

Hystrix降级技术解析-Fallback

一、降级 所谓降级,就是指在在Hystrix执行非核心链路功能失败的情况下,我们如何处理,比如我们返回默认值等。如果我们要回退或者降级处理,代码上需要实现HystrixCommand.getFallback()方法或者是HystrixObservableCommand. HystrixObservableCommand()。 publicclassCommandHelloFailureextendsHystrixCommand<String>{ privatefinalStringname; publicCommandHelloFailure(Stringname){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.name=name; } @Override protectedStringrun(){ thrownewRuntimeException("thiscommandalwaysfails"); } @Override protectedStringgetFallback(){ return"HelloFailure"+name+"!"; } } 二、Hystrix的降级回退方式 Hystrix一共有如下几种降级回退模式: 1、Fail Fast 快速失败 @Override protectedStringrun(){ if(throwException){ thrownewRuntimeException("failurefromCommandThatFailsFast"); }else{ return"success"; } } 如果我们实现的是HystrixObservableCommand.java则 重写 resumeWithFallback方法 @Override protectedObservable<String>resumeWithFallback(){ if(throwException){ returnObservable.error(newThrowable("failurefromCommandThatFailsFast")); }else{ returnObservable.just("success"); } } 2、Fail Silent 无声失败 返回null,空Map,空List fail silent.png @Override protectedStringgetFallback(){ returnnull; } @Override protectedList<String>getFallback(){ returnCollections.emptyList(); } @Override protectedObservable<String>resumeWithFallback(){ returnObservable.empty(); } 3、Fallback: Static 返回默认值 回退的时候返回静态嵌入代码中的默认值,这样就不会导致功能以Fail Silent的方式被清楚,也就是用户看不到任何功能了。而是按照一个默认的方式显示。 @Override protectedBooleangetFallback(){ returntrue; } @Override protectedObservable<Boolean>resumeWithFallback(){ returnObservable.just(true); } 4、Fallback: Stubbed 自己组装一个值返回 当我们执行返回的结果是一个包含多个字段的对象时,则会以Stubbed 的方式回退。Stubbed 值我们建议在实例化Command的时候就设置好一个值。以countryCodeFromGeoLookup为例,countryCodeFromGeoLookup的值,是在我们调用的时候就注册进来初始化好的。CommandWithStubbedFallback command = new CommandWithStubbedFallback(1234, "china");主要代码如下: publicclassCommandWithStubbedFallbackextendsHystrixCommand<UserAccount>{ protectedCommandWithStubbedFallback(intcustomerId,StringcountryCodeFromGeoLookup){ super(HystrixCommandGroupKey.Factory.asKey("ExampleGroup")); this.customerId=customerId; this.countryCodeFromGeoLookup=countryCodeFromGeoLookup; } @Override protectedUserAccountgetFallback(){ /** *Returnstubbedfallbackwithsomestaticdefaults,placeholders, *andaninjectedvalue'countryCodeFromGeoLookup'thatwe'lluse *insteadofwhatwewouldhaveretrievedfromtheremoteservice. */ returnnewUserAccount(customerId,"UnknownName", countryCodeFromGeoLookup,true,true,false); } 5、Fallback: Cache via Network 利用远程缓存 通过远程缓存的方式。在失败的情况下再发起一次remote请求,不过这次请求的是一个缓存比如redis。由于是又发起一起远程调用,所以会重新封装一次Command,这个时候要注意,执行fallback的线程一定要跟主线程区分开,也就是重新命名一个ThreadPoolKey。 Cache via Network.png publicclassCommandWithFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; protectedCommandWithFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueCommand"))); this.id=id; } @Override protectedStringrun(){ //RemoteServiceXClient.getValue(id); thrownewRuntimeException("forcefailureforexample"); } @Override protectedStringgetFallback(){ returnnewFallbackViaNetwork(id).execute(); } privatestaticclassFallbackViaNetworkextendsHystrixCommand<String>{ privatefinalintid; publicFallbackViaNetwork(intid){ super(Setter.withGroupKey(HystrixCommandGroupKey.Factory.asKey("RemoteServiceX")) .andCommandKey(HystrixCommandKey.Factory.asKey("GetValueFallbackCommand")) //useadifferentthreadpoolforthefallbackcommand //sosaturatingtheRemoteServiceXpoolwon'tprevent //fallbacksfromexecuting .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("RemoteServiceXFallback"))); this.id=id; } @Override protectedStringrun(){ MemCacheClient.getValue(id); } @Override protectedStringgetFallback(){ //thefallbackalsofailed //sothisfallback-of-a-fallbackwill //failsilentlyandreturnnull returnnull; } } } 6、Primary + Secondary with Fallback 主次方式回退(主要和次要) 这个有点类似我们日常开发中需要上线一个新功能,但为了防止新功能上线失败可以回退到老的代码,我们会做一个开关比如使用zookeeper做一个配置开关,可以动态切换到老代码功能。那么Hystrix它是使用通过一个配置来在两个command中进行切换。 Primary + Secondary with Fallback.png /** *Sample{@linkHystrixCommand}patternusingasemaphore-isolatedcommand *thatconditionallyinvokesthread-isolatedcommands. */ publicclassCommandFacadeWithPrimarySecondaryextendsHystrixCommand<String>{ privatefinalstaticDynamicBooleanPropertyusePrimary=DynamicPropertyFactory.getInstance().getBooleanProperty("primarySecondary.usePrimary",true); privatefinalintid; publicCommandFacadeWithPrimarySecondary(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimarySecondaryCommand")) .andCommandPropertiesDefaults( //wewanttodefaulttosemaphore-isolationsincethiswraps //2otherscommandsthatarealreadythreadisolated //采用信号量的隔离方式 HystrixCommandProperties.Setter() .withExecutionIsolationStrategy(ExecutionIsolationStrategy.SEMAPHORE))); this.id=id; } //通过DynamicPropertyFactory来路由到不同的command @Override protectedStringrun(){ if(usePrimary.get()){ returnnewPrimaryCommand(id).execute(); }else{ returnnewSecondaryCommand(id).execute(); } } @Override protectedStringgetFallback(){ return"static-fallback-"+id; } @Override protectedStringgetCacheKey(){ returnString.valueOf(id); } privatestaticclassPrimaryCommandextendsHystrixCommand<String>{ privatefinalintid; privatePrimaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("PrimaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("PrimaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa600mstimeoutforprimary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(600))); this.id=id; } @Override protectedStringrun(){ //performexpensive'primary'servicecall return"responseFromPrimary-"+id; } } privatestaticclassSecondaryCommandextendsHystrixCommand<String>{ privatefinalintid; privateSecondaryCommand(intid){ super(Setter .withGroupKey(HystrixCommandGroupKey.Factory.asKey("SystemX")) .andCommandKey(HystrixCommandKey.Factory.asKey("SecondaryCommand")) .andThreadPoolKey(HystrixThreadPoolKey.Factory.asKey("SecondaryCommand")) .andCommandPropertiesDefaults( //wedefaulttoa100mstimeoutforsecondary HystrixCommandProperties.Setter().withExecutionTimeoutInMilliseconds(100))); this.id=id; } @Override protectedStringrun(){ //performfast'secondary'servicecall return"responseFromSecondary-"+id; } } publicstaticclassUnitTest{ @Test publicvoidtestPrimary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",true); assertEquals("responseFromPrimary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } @Test publicvoidtestSecondary(){ HystrixRequestContextcontext=HystrixRequestContext.initializeContext(); try{ //将属性"primarySecondary.usePrimary"设置为true,则走PrimaryCommand;设置为false,则走SecondaryCommand ConfigurationManager.getConfigInstance().setProperty("primarySecondary.usePrimary",false); assertEquals("responseFromSecondary-20",newCommandFacadeWithPrimarySecondary(20).execute()); }finally{ context.shutdown(); ConfigurationManager.getConfigInstance().clear(); } } } } 三、总结 降级的处理方式,返回默认值,返回缓存里面的值(包括远程缓存比如redis和本地缓存比如jvmcache)。 但回退的处理方式也有不适合的场景: 1、写操作 2、批处理 3、计算 以上几种情况如果失败,则程序就要将错误返回给调用者。 参考资料:https://github.com/Netflix/Hystrix/wiki

优秀的个人博客,低调大师

Dubbo (二) ——- 项目结构解析

本文主要说明点 概述 背景 需求 架构 Dubbo源代码项目结构 概述 分享Dubbo 的项目结构,通过本文可以大致了解到Dubbo整个项目的结构 背景 将一个项目进行拆分, 进行分布式架构。 需要解决下面的问题 单一应用架构 网站流量少时单一架构,简化开发。此时,用于简化增删改查工作量的数据访问框架(ORM)是关键。 垂直应用架构 访问大时单一应用速度过小,需要进行应用拆分。此时,用于加速前端页面开发的Web框架(MVC)是关键。 分布式服务架构 当垂直应用过多,将核心业务独立服务。然后提供给其他项目内部调用。此时,用于提高业务复用及整合的分布式服务框架(RPC)是关键。 流动计算架构 当服务更多的时候,对流量的控制,服务的限流,熔断等操作。而且还需要管理集群容量,提供集群利用率。此时,用于提高机器利用率的资源调度和治理中心(SOA)是关键。 需求 dubbo解决下面几个需求 当服务越来越多时,服务 URL 配置管理变得非常困难,F5 硬件负载均衡器的单点压力也越来越大 服务间依赖关系变得错踪复杂,甚至分不清哪个应用要在哪个应用之前启动 服务的调用量越来越大,服务的容量问题就暴露出来机器管理,流量的控制等 架构 节点角色说明 节点角色说明 Provider暴露服务的服务提供方 Consumer调用远程服务的服务消费方 Registry服务注册与发现的注册中心 Monitor统计服务的调用次数和调用时间的监控中心 Container服务运行容器 调用关系说明 服务容器负责启动,加载,运行服务提供者 服务提供者在启动时,向注册中心注册自己提供的服务 服务消费者在启动时,向注册中心订阅自己所需的服务。 注册中心返回服务提供者地址列表给消费者,如果有变更,注册中心将基于长连接推送变更数据给消费者。 服务消费者,从提供者地址列表中,基于软负载均衡算法,选一台提供者进行调用,如果调用失败,再选另一台调用。 服务消费者和提供者,在内存中累计调用次数和调用时间,定时每分钟发送一次统计数据到监控中心。 Dubbo 架构 下面特点 连通性、健壮性、伸缩性、以及向未来架构的升级性 连通性 注册中心负责服务地址的注册与查找,相当于目录服务,服务提供者和消费者只在启动时与注册中心交互,注册中心不转发请求,压力较小 监控中心负责统计各服务调用次数,调用时间等,统计先在内存汇总后每分钟一次发送到监控中心服务器,并以报表展示 服务提供者向注册中心注册其提供的服务,并汇报调用时间到监控中心,此时间不包含网络开销 服务消费者向注册中心获取服务提供者地址列表,并根据负载算法直接调用提供者,同时汇报调用时间到监控中心,此时间包含网络开销 注册中心,服务提供者,服务消费者三者之间均为长连接,监控中心除外 注册中心通过长连接感知服务提供者的存在,服务提供者宕机,注册中心将立即推送事件通知消费者 注册中心和监控中心全部宕机,不影响已运行的提供者和消费者,消费者在本地缓存了提供者列表 注册中心和监控中心都是可选的,服务消费者可以直连服务提供者 健壮性 监控中心宕掉不影响使用,只是丢失部分采样数据 数据库宕掉后,注册中心仍能通过缓存提供服务列表查询,但不能注册新服务 注册中心对等集群,任意一台宕掉后,将自动切换到另一台 注册中心全部宕掉后,服务提供者和服务消费者仍能通过本地缓存通讯 服务提供者无状态,任意一台宕掉后,不影响使用 服务提供者全部宕掉后,服务消费者应用将无法使用,并无限次重连等待服务提供者恢复 伸缩性 注册中心为对等集群,可动态增加机器部署实例,所有客户端将自动发现新的注册中心 服务提供者无状态,可动态增加机器部署实例,注册中心将推送新的服务提供者信息给消费者 升级性 需要实现动态部署,进行流动计算 下图是未来可能的一种架构 节点角色说明 节点角色说明 Deployer自动部署服务的本地代理 Repository仓库用于存储服务应用发布包 Scheduler调度中心基于访问压力自动增减服务提供者 Admin统一管理控制台 Registry服务注册与发现的注册中心 Monitor统计服务的调用次数和调用时间的监控中心 Dubbo源代码项目结构 **模块分包 ** 每个模块都是相互隔离的,可插拔的。下面的这个图是模块引用图 下面对着这些模块做个简单介绍 **dubbo-common ** 公共逻辑模块:包括 Util 类和通用模型。 **dubbo-remoting ** 远程通讯模块:相当于 Dubbo 协议的实现,如果 RPC 用 RMI协议则不需要使用此包。 dubbo-rpc ** 远程调用模块**:抽象各种协议,以及动态代理,只包含一对一的调用,不关心集群的管理。 dubbo-cluster ** 集群模块**:将多个服务提供方伪装为一个提供方, 包括:负载均衡, 容错,路由等,集群的地址列表可以是静态配置的,也可以是由注册中心下发。 **dubbo-registry ** 注册中心模块:基于注册中心下发地址的集群方式,以及对各种注册中心的抽象 dubbo-monitor ** 监控模块**:统计服务调用次数,调用时间的,调用链跟踪的服务。 **dubbo-config ** 配置模块:是 Dubbo 对外的 API,用户通过 Config 使用D ubbo,隐藏 Dubbo 所有细节。 **dubbo-container ** 容器模块:是一个 Standlone 的容器,以简单的 Main 加载 Spring 启动, 因为服务通常不需要 Tomcat/JBoss 等 Web 容器的特性,没必要用 Web 容器去加载服务。 整体上按照分层结构进行分包,与分层的不同点在于: container 为服务容器,用于部署运行服务,没有在层中画出。 protocol 层和 proxy 层都放在 rpc 模块中,这两层是 rpc 的核心,在不需要集群也就是只有一个提供者时,可以只使用这两层完成 rpc 调用。 transport 层和 exchange 层都放在 remoting 模块中,为 rpc 调用的通讯基础。 serialize 层放在 common 模块中,以便更大程度复用。 依赖关系 图例说明: 图中小方块 Protocol, Cluster, Proxy, Service, Container, Registry, Monitor 代表层或模块,蓝色的表示与业务有交互,绿色的表示只对 Dubbo 内部交互。 图中背景方块 Consumer, Provider, Registry, Monitor 代表部署逻辑拓扑节点。 图中蓝色虚线为初始化时调用,红色虚线为运行时异步调用,红色实线为运行时同步调用。 图中只包含 RPC 的层,不包含 Remoting 的层,Remoting 整体都隐含在 Protocol 中。 下面对各个模块进行分解介绍 dubbo-common 公共逻辑模块:包括 Util 类和通用模型。 作用提供一些工具类和通用模型例如com.alibaba.dubbo.common.URL: dubbo-remoting 远程通讯模块:相当于 Dubbo 协议的实现,如果 RPC 用 RMI协议则不需要使用此包。 dubbo-remoting-zookeeper 相当于 Zookeeper 客户端,与ZK 服务器通信 dubbo-remoting-api 定义Dubbo CLient和 Dubbo Server的接口规则 实现dubbo-remoting-api dubbo-remoting-grizzly,基于Grizzly实现。 dubbo-remoting-http,基于Jetty或Tomcat实现。 dubbo-remoting-mina,基于Mina实现。 dubbo-remoting-netty,基于Netty 3实现。 dubbo-remoting-netty4,基于Netty 4实现。 dubbo-remoting-p2p,P2P 服务器。注册中心dubbo-registry-multicast项目的使用该项目。 dubbo-rpc 远程调用模块:抽象各种协议,以及动态代理,只包含一对一的调用,不关心集群的管理 集群相关的管理,由dubbo-cluster提供特性 dubbo-rpc-api 抽象各种协议以及动态代理,实现了一对一的调用。 其他模块,实现dubbo-rpc-api,提供对应的协议实现 协议参考手册 dubbo-rpc-default 对应dubbo://协议。 dubbo-cluster 集群模块:将多个服务提供方伪装为一个提供方,包括:负载均衡, 集群容错,路由,分组聚合等。集群的地址列表可以是静态配置的,也可以是由注册中心下发。 ​ 注册中心下发,由dubbo-registry提供特性。 容错 com.alibaba.dubbo.rpc.cluster.Cluster接口 +com.alibaba.dubbo.rpc.cluster.support包。 Cluster 将 Directory 中的多个 Invoker 伪装成一个 Invoker,对上层透明,伪装过程包含了容错逻辑,调用失败后,重试另一个。 拓展参见《Dubbo 用户指南 —— 集群容错》和《Dubbo 开发指南 —— 集群扩展》文档。 目录 com.alibaba.dubbo.rpc.cluster.Directory接口 +com.alibaba.dubbo.rpc.cluster.directory包。 Directory 代表了多个 Invoker ,可以把它看成 List ,但与 List 不同的是,它的值可能是动态变化的,比如注册中心推送变更。 路由 com.alibaba.dubbo.rpc.cluster.Router接口 +com.alibaba.dubbo.rpc.cluster.router包。 负责从多个Invoker中按路由规则选出子集,比如读写分离,应用隔离等。 拓展参见《Dubbo 用户指南 —— 路由规则》和《Dubbo 开发指南 —— 路由拓展》文档。 配置 com.alibaba.dubbo.rpc.cluster.Configurator接口 +com.alibaba.dubbo.rpc.cluster.configurator包。 拓展参见《Dubbo 用户指南 —— 配置规则》文档。 负载均衡 com.alibaba.dubbo.rpc.cluster.LoadBalance接口 +com.alibaba.dubbo.rpc.cluster.loadbalance包。 LoadBalance 负责从多个 Invoker 中选出具体的一个用于本次调用,选的过程包含了负载均衡算法,调用失败后,需要重选。 拓展参见《Dubbo 用户指南 —— 负载均衡》和《Dubbo 开发指南 —— 负载均衡拓展》文档。 合并结果 com.alibaba.dubbo.rpc.cluster.Merger接口 +com.alibaba.dubbo.rpc.cluster.merger包。 合并返回结果,用于分组聚合。 拓展参见《Dubbo 用户指南 —— 分组聚合》和《Dubbo 开发指南 —— 合并结果扩展》文档。 整体流程如下: dubbo-registry 注册中心模块:基于注册中心下发地址的集群方式,以及对各种注册中心的抽象。 dubbo-registry-api,抽象注册中心的注册与发现接口。 其他模块,实现dubbo-registry-api,提供对应的注册中心实现。在《用户指南 —— 注册中心参考手册》中,可以看到每种注册中心的介绍。 另外,dubbo-registry-default对应 Simple 注册中心。 拓展参见《Dubbo 开发指南 —— 注册中心扩展》文档。 dubbo-monitor 监控模块:统计服务调用次数,调用时间的,调用链跟踪的服务 拓展参见《Dubbo 开发指南 —— 监控中心扩展》。 dubbo-config 配置模块:是 Dubbo 对外的 API,用户通过 Config 使用Dubbo,隐藏 Dubbo 所有细节。 dubbo-config-api,实现了API 配置和属性配置功能。 dubbo-config-spring,实现了XML 配置和注解配置功能。 dubbo-container 容器模块:是一个 Standlone 的容器,以简单的 Main 加载 Spring 启动, 因为服务通常不需要 Tomcat/JBoss 等 Web 容器的特性,没必要用 Web 容器去加载服务。 dubbo-container-api:定义了com.alibaba.dubbo.container.Container接口,并提供 加载所有容器启动的 Main 类。 实现 dubbo-container-api dubbo-container-spring,提供了com.alibaba.dubbo.container.spring.SpringContainer。 dubbo-container-log4j,提供了com.alibaba.dubbo.container.log4j.Log4jContainer。 dubbo-container-logback,提供了com.alibaba.dubbo.container.logback.LogbackContainer。 拓展参考《Dubbo 用户指南 —— 服务容器》和《Dubbo 开发指南 —— 容器扩展》文档。 dubbo-filter 过滤器模块:提供了内置的过滤器。 dubbo-filter-cache ,缓存过滤器。 拓展参考《Dubbo 用户指南 —— 结果缓存》和《Dubbo 开发指南 —— 缓存拓展》文档。 dubbo-filter-validation ,参数验证过滤器。 拓展参考《Dubbo 用户指南 —— 参数验证》和《Dubbo 开发指南 —— 验证扩展》文档。 dubbo-plugin 过滤器模块:提供了内置的插件。 dubbo-qos ,提供在线运维命令。 拓展参考《Dubbo 用户指南 —— 新版本 telnet 命令使用说明》和《Dubbo 开发指南 —— Telnet 命令扩展》文档。 hessian-lite hessian-lite:Dubbo 对Hessian 2的序列化部分的精简、改进、BugFix 。 提交历史如下: dubbo-demo dubbo-demo快速启动示例。 参见《Dubbo 用户指南 —— 快速启动》文档。 dubbo-test dubbo-test测试模块。 在此我向大家推荐一个架构学习交流群。交流学习群号:821169538 里面会分享一些资深架构师录制的视频录像:有Spring,MyBatis,Netty源码分析,高并发、高性能、分布式、微服务架构的原理,JVM性能优化、分布式架构等这些成为架构师必备的知识体系。还能领取免费的学习资源,目前受益良多。 dubbo-test-benchmark ,性能测试。 dubbo-test-compatibility ,兼容性测试。 dubbo-test-spring3,测试对 Spring 3 的兼容性。 dubbo-test-example,使用示例。 Maven POM dubbo-dependencies-bom dubbo-dependencies-bom/pom.xml,Maven BOM(Bill Of Materials) ,统一定义了 Dubbo 依赖的三方库的版本号: dubbo-parent会引入该 BOM : dubbo-bom dubbo-bom/pom.xml,Maven BOM(Bill Of Materials) ,统一定义了 Dubbo 的版本号: dubbo-parent dubbo/pom.xml,Dubbo Parent Pom 。 Dubbo 的 Maven 模块,都会引入该 pom 文件。以dubbo-cluster举例子: 出处:http://wsccoder.top/2018/10/15/Dubb

优秀的个人博客,低调大师

深度解析volatile—底层实现

我们都知道,Java关键字volatile的作用 1、内存可见性 2、禁止指令重排序 可见性是指,在多线程环境,共享变量的操作对于每个线程来说,都是内存可见的,也就是每个线程获取的volatile变量都是最新值;并且每个线程对volatile变量的修改,都直接刷新到主存。 下面重点介绍指令重排序。 为什么要指令重排序? 为了提高程序执行的性能,编译器和执行器(处理器)通常会对指令做一些优化(重排序) 1、编译器重排序。编译器在不改变单线程程序语义的前提下,可以重新安排语句的执行顺序; 2、处理器重排序。如果不存在数据依赖性,处理器可以改变语句对应机器指令的执行顺序; 学过《编译原理》同学应该知道,现代高级编程语言的编译器,实现都很复杂。 编译器基本构造包括:语法分析、词法分析、语义分析、中间代码生成、指令优化、目标代码产生。 第一阶段:编译器优化,就是发生在编译阶段,就Java而言,就是java源码编译生成class字节码的时候,对编译生成的中间代码进行的一次指令优化。Java的编译器是javac.exe。 第二阶段:执行器(处理器)优化,和不同的处理器硬件厂商的实现有关,也和Java的执行器(java.exe,也称Java解释器)有关。执行器优化,是对于机器指令在目标平台的机器上运行,做的一层优化。 我们知道,现代高级编程语言,经过编译后,产生目标代码,如.java的源文件编译后生成.class字节码文件,.cpp源文件经过C++编译器编译后生成.o对象文件。 这些编译后生成的文件,不能直接在机器上运行,而是需要转化成特定平台的机器指令。机器能够运行的指令,是需要这个平台、这个机器能正确识别的。 相同的一份源码,最终转化成不同平台上的机器指令,是不同的。 这也更容易理解:汇编指令,并不是跨平台的。Windows下通常使用Intel汇编,而Linux下多用AT&T汇编,它们在语法上存在差异,运行效果也依赖于各自平台的实现。 在Java中,为了提高运行效率,javac编译器,和java解释器,在2个阶段分别对指令进行了优化,也就是重排序。 Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 指令重排序对单线程没有什么影响,它不会影响程序的运行结果,但是会影响多线程的正确性。 Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。既然指令重排序会影响到多线程执行的正确性,那么我们就需要某些情景下禁止重排序。Java提供给我们禁止重排序能力的操作——就是volatile。 那么JVM的volatile是如何禁止重排序的呢? 在具体探究之前,我们先看另一个原则happens-before,happen-before原则保证了程序的“有序性”,它规定如果两个操作的执行顺序无法从happens-before原则中推到出来,那么他们就不能保证有序性,可以随意进行重排序。其定义如下: 1、同一个线程中的,前面的操作 happen-before 后续的操作。(即单线程内按代码顺序执行。但是,在不影响在单线程环境执行结果的前提下,编译器和处理器可以进行重排序,这是合法的。换句话说,这一是规则无法保证编译重排和指令重排)。 2、监视器上的解锁操作 happen-before 其后续的加锁操作。(Synchronized 规则) 3、对volatile变量的写操作 happen-before 后续的读操作。(volatile 规则) 4、线程的start() 方法 happen-before 该线程所有的后续操作。(线程启动规则) 5、线程所有的操作 happen-before 其他线程在该线程上调用 join 返回成功后的操作。 6、如果 a happen-before b,b happen-before c,则a happen-before c(传递性)。 在JVM中,将Happens-Before的程序顺序规则与其他某个顺序规则(通常是监视器锁规则、volatile变量规则)结合起来,从而对某个未被锁保护的变量的访问操作进行排序。 我们着重看第三点volatile规则:对volatile变量的写操作 happen-before 后续的读操作。为了实现volatile内存语义,JMM会重排序,其规则如下: 是否重排序 第二个操作 第一个操作 普通读/写 volatile读 volatile写 普通读/写 volatile读 NO NO NO volatile写 NO NO 为了探究volatile底层的实现原理,进行了如下探究。 通过javap 命令,将字节码文件反编译。观察反编译的结果,对于volatile修饰的变量,发现反编译得到的代码并没有什么帮助,和不加volatile修饰的变量没有任何区别。也就是说,字节码层面volatile变量并没有什么不同。 下面通过查看Java的汇编指令,查看Java代码最真实的运行细节。 如何查看Java的汇编指令,可以阅读:https://www.jianshu.com/p/93821b08e774 通过使用-XX:+UnlockDiagnosticVMOptions -XX:+PrintAssembly IDEA打印出了源代码的汇编指令。我们看到红色线框里面的那行指令:putstatic a ,将静态变量a入栈,注意观察add指令前面有一个lock前缀指令。 加入volatile关键字和没有加入volatile关键字时所生成的汇编代码发现,加入volatile关键字时,会多出一个lock前缀指令。我们发现,volatile变量在字节码级别没有任何区别,在汇编级别使用了lock指令前缀。 lock是一个指令前缀,Intel的手册上对其的解释是: Causes the processor's LOCK# signal to be asserted during execution of the accompanying instruction (turns the instruction into an atomic instruction). In a multiprocessor environment, the LOCK# signal insures that the processor has exclusive use of any shared memory while the signal is asserted. 简单理解也就是说,lock后就是一个原子操作。原子操作是指不会被线程调度机制打断的操作;这种操作一旦开始,就一直运行到结束,中间不会有任何 context switch (切换到另一个线程)。 当使用 LOCK 指令前缀时,它会使 CPU 宣告一个 LOCK# 信号,这样就能确保在多处理器系统或多线程竞争的环境下互斥地使用这个内存地址。当指令执行完毕,这个锁定动作也就会消失。 是不是感觉有点像Java的synchronized锁。但volatile底层使用多核处理器实现的lock指令,更底层,消耗代价更小。 因此有人将Java的synchronized看作重量级的锁,而volatile看作轻量级的锁 并不是全无道理。 lock前缀指令其实就相当于一个内存屏障。内存屏障是一组CPU处理指令,用来实现对内存操作的顺序限制。volatile的底层就是通过内存屏障来实现的。 编译器和执行器 可以在保证输出结果一样的情况下对指令重排序,使性能得到优化。插入一个内存屏障,相当于告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行。正如去西藏途中各个站点的先后顺序在你心中都一清二楚。 内存屏障另一个作用是强制更新一次不同CPU的缓存。例如,一个写屏障会把这个屏障前写入的数据刷新到缓存,这样任何试图读取该数据的线程将得到最新值,而不用考虑到底是被哪个cpu核心或者哪个CPU执行的。这正是volatile实现内存可见性的基础。 内存屏障细说来有写屏障、读屏障、读写屏障,而且内存屏障的实现依赖于编译器和机器两部分。 编译器在编译过程中可能会对指令重排序,这样开发者通过显式地标注告知编译器,避免编译器最终生成的代码行为违背预期,对于 Java 而言,不光生成的 bytecode 需要保存 volatile 的语义,连运行时的 JIT 代码的行为也要遵守相应的约束;即插入内存屏障后,告诉CPU和编译器先于这个命令的必须先执行,后于这个命令的必须后执行,从而实现了禁止重排序。 关于内存屏障的一些具体细节,大佬Martin写了一篇文章《going into memory barriers》介绍,外网可以看看。 小结: 1、Java重排序的前提:在不影响 单线程运行结果的前提下进行重排序。也就是在单线程环境运行,重排序后的结果和重排序之前按代码顺序运行的结果相同。 2、指令重排序对单线程没有什么影响,它不会影响程序的运行结果,反而会优化执行性能,但会影响多线程的正确性。 3、Java因为指令重排序,优化我们的代码,让程序运行更快,也随之带来了多线程下,指令执行顺序的不可控。 4、volatile的底层是通过lock前缀指令、内存屏障来实现的。 存档文章 查看Java的汇编指令 终于有人把Java内存模型(JMM)说清楚了 JVM体系结构-----深入理解内存结构 从多核硬件架构,看Java内存模型

优秀的个人博客,低调大师

Java LinkedHashMap类源码解析

LinkedHashMap继承了HashMap,他在HashMap的基础上增加了一个双向链表的结构,链表默认维持key插入的顺序,重复的key值插入不会改变顺序,适用于使用者需要返回一个顺序相同的map对象的情况。还可以生成access-order顺序的版本,按照最近访问顺序来存储,刚被访问的结点处于链表的末尾,适合LRU,put get compute merge都算作一次访问,其中put key值相同的结点也算作一次访问,replace只有在换掉一个键值对的时候才算一次访问,putAll产生的访问顺序取决于原本map的迭代器实现。 在插入键值对时,可以通过对removeEldestEntry重写来实现新键值对插入时自动删除最旧的键值对 拥有HashMap提供的方法,迭代器因为是通过遍历双向链表,所以额外开销与size成正比与capacity无关,因此选择过大的初始大小对于遍历时间的增加没有HashMap严重,后者的遍历时间依赖与capacity。 同样是非线程安全方法,对于LinkedHashMap来说,修改结构的操作除了增加和删除键值对外,还有对于access-order时进行了access导致迭代器顺序改变,主要是get操作,对于插入顺序的来说,仅仅修改一个已有key值的value值不是一个修改结构的操作,但对于访问顺序,put和get已有的key值会改变顺序。迭代器也是fail-fast设计,但是fail-fast只是一个调试功能,一个设计良好的程序不应该出现这个错误 因为HashMap加入了TreeNode,所以现在LinkedHashMap也有这个功能 以下描述中的链表,若无特别说明都是指LinkedHashMap的双向链表 先来看一下基本结构,每个键值对加入了前后指针,集合加入了头尾指针来形成双向链表,accessOrder代表链表是以访问顺序还是插入顺序存储 static class Entry<K,V> extends HashMap.Node<K,V> { Entry<K,V> before, after;//增加了先后指针来形成双向链表 Entry(int hash, K key, V value, Node<K,V> next) { super(hash, key, value, next); } } /** * The head (eldest) of the doubly linked list.头部 */ transient LinkedHashMap.Entry<K,V> head; /** * The tail (youngest) of the doubly linked list.尾部 */ transient LinkedHashMap.Entry<K,V> tail; //true访问顺序 false插入顺序 final boolean accessOrder; 然后是几个内部方法。linkNodeLast将p连接到链表尾部 private void linkNodeLast(LinkedHashMap.Entry<K,V> p) { LinkedHashMap.Entry<K,V> last = tail; tail = p; if (last == null) head = p;//原本链表为空则p同时为头部 else { p.before = last; last.after = p; } } transferLinks用dst替换src private void transferLinks(LinkedHashMap.Entry<K,V> src, LinkedHashMap.Entry<K,V> dst) { LinkedHashMap.Entry<K,V> b = dst.before = src.before; LinkedHashMap.Entry<K,V> a = dst.after = src.after; if (b == null) head = dst; else b.after = dst; if (a == null) tail = dst; else a.before = dst; } reinitialize在调用HashMap方法的基础上,将head和tail设为null void reinitialize() { super.reinitialize(); head = tail = null; } newNode生成一个LinkedHashMap结点,next指向e,插入到LinkedHashMap链表末端 Node<K,V> newNode(int hash, K key, V value, Node<K,V> e) { LinkedHashMap.Entry<K,V> p = new LinkedHashMap.Entry<K,V>(hash, key, value, e);//新建一个键值对,next指向e linkNodeLast(p);//p插入到LinkedHashMap链表末端 return p; } replacementNode根据原结点生成一个LinkedHashMap结点替换原结点 Node<K,V> replacementNode(Node<K,V> p, Node<K,V> next) { LinkedHashMap.Entry<K,V> q = (LinkedHashMap.Entry<K,V>)p; LinkedHashMap.Entry<K,V> t = new LinkedHashMap.Entry<K,V>(q.hash, q.key, q.value, next);//生成一个新的键值对next是给出的next参数 transferLinks(q, t);//用t替换q return t; } newTreeNode生成一个TreeNode结点,next指向next,插入到LinkedHashMap链表末端 TreeNode<K,V> newTreeNode(int hash, K key, V value, Node<K,V> next) { TreeNode<K,V> p = new TreeNode<K,V>(hash, key, value, next);//生成一个TreeNode,next指向参数next linkNodeLast(p);//p插入到LinkedHashMap链表末端 return p; } replacementTreeNode根据结点p生成一个新的TreeNode,next设为给定的next,替换原本的p TreeNode<K,V> replacementTreeNode(Node<K,V> p, Node<K,V> next) { LinkedHashMap.Entry<K,V> q = (LinkedHashMap.Entry<K,V>)p; TreeNode<K,V> t = new TreeNode<K,V>(q.hash, q.key, q.value, next); transferLinks(q, t);//根据结点p生成一个新的TreeNode,next设为给定的next,替换原本的p return t; } afterNodeRemoval从LinkedHashMap的链上移除结点e void afterNodeRemoval(Node<K,V> e) { LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.before = p.after = null; if (b == null) head = a; else b.after = a; if (a == null) tail = b; else a.before = b; } afterNodeInsertion可能移除最旧的结点,需要evict为true同时链表不为空同时removeEldestEntry需要重写 void afterNodeInsertion(boolean evict) { LinkedHashMap.Entry<K,V> first; if (evict && (first = head) != null && removeEldestEntry(first)) {//removeEldestEntry需要重写才从发挥作用,否则一定返回false K key = first.key;//移除链表头部的结点 removeNode(hash(key), key, null, false, true); } } afterNodeAccess在访问过后将结点e移动到链表尾部,需要Map是access-order,若移动成功则增加modCount void afterNodeAccess(Node<K,V> e) { LinkedHashMap.Entry<K,V> last; if (accessOrder && (last = tail) != e) {//Map是access-order同时e不是链表的尾部 LinkedHashMap.Entry<K,V> p = (LinkedHashMap.Entry<K,V>)e, b = p.before, a = p.after; p.after = null; if (b == null)//将结点e从链表中剪下 head = a; else b.after = a; if (a != null) a.before = b; else last = b; if (last == null) head = p; else { p.before = last; last.after = p; } tail = p;//结点e移动到链表尾部 ++modCount;//因为有access-order下结点被移动,所以增加modCount } } 构造函数方面,accessOrder默认是false插入顺序,初始大小为16,负载因子为0.75,这里是同HashMap。复制构造也是调用了HashMap.putMapEntries方法 containsValue遍历链表寻找相等的value值,这个操作一定不会造成结构改变 public boolean containsValue(Object value) { for (LinkedHashMap.Entry<K,V> e = head; e != null; e = e.after) {//检查同样是根据LinkedHashMap提供的链表顺序进行遍历 V v = e.value; if (v == value || (value != null && value.equals(v))) return true; } return false; } get方法复用HashMap的getNode方法,若找到结点且Map是访问顺序时,要将访问的结点放到链表最后,若没找到则返回null。而getOrDefault仅有的区别是没找到时返回defaultValue public V get(Object key) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null)//复用HashMap的getNode方法 return null; if (accessOrder) afterNodeAccess(e);//access-order时将e放到队尾 return e.value; } public V getOrDefault(Object key, V defaultValue) { Node<K,V> e; if ((e = getNode(hash(key), key)) == null) return defaultValue;//复用HashMap的getNode方法,若没有找到对应的结点则返回defaultValue if (accessOrder) afterNodeAccess(e);//access-order时将e放到队尾 return e.value; } clear方法在HashMap的基础上要把head和tail设为null public void clear() { super.clear(); head = tail = null; } removeEldestEntry在put和putAll插入键值对时调用,原本是一定返回false的,如果要自动删除最旧的键值对要返回true,需要进行重写。比如下面这个例子,控制size不能超过100 private static final int MAX_ENTRIES = 100; protected boolean removeEldestEntry(Map.Entry eldest) { return size() > MAX_ENTRIES; } 下面两个方法和HashMap相似,返回key的Set和value的Collection还有返回键值对的Set,这个是直接引用,所以对它们的remove之类的修改会直接反馈到LinkedHashMap上 public Set<K> keySet() { Set<K> ks = keySet; if (ks == null) { ks = new LinkedKeySet(); keySet = ks; } return ks;//返回key值的set } public Collection<V> values() { Collection<V> vs = values; if (vs == null) { vs = new LinkedValues(); values = vs; } return vs;//返回一个包含所有value值的Collection } public Set<Map.Entry<K,V>> entrySet() { Set<Map.Entry<K,V>> es; return (es = entrySet) == null ? (entrySet = new LinkedEntrySet()) : es;//返回一个含有所有键值对的Set } 检查HashMap的putVal方法,我们可以看到在找到了相同key值并修改value值时会调用afterNodeAccess,对于access-order会改变结点顺序 if (e != null) { // 找到了相同的key则修改value值并返回旧的value V oldValue = e.value; if (!onlyIfAbsent || oldValue == null) e.value = value; afterNodeAccess(e); return oldValue; }

优秀的个人博客,低调大师

Java Hashtable类源码解析

老生常谈的问题——Hashtable和HashMap有什么区别 大家一般都能说出几条,比如Hashtable是线程安全的,不支持null作为key和value值等等。那么,要仔细了解这个问题还是直接从Hashtable的源码入手。 先列一下我找到的区别: 继承类不同,Hashtable继承的是Dictionary这是一个废弃类,而HashMap继承的是AbstractMap 产生时间不同,Hashtable自JDK1.0版本就有了,而HashMap是JDK1.2才加入的,同时Hashtable可能因为历史原因并不是我们习惯的驼峰法命名的 Hashtable比HashMap多提供了elments()方法用于返回此Hashtable中的value的枚举 Hashtable既不支持null key也不支持null value Hashtable的默认大小是11,扩大的逻辑是*2+1,对于给定大小不会做扩展。而HashMap是16,扩大时*2,初始大小会转换成恰好大于等于的2的指数次幂 Hashtable中的遍历操作是从高位开始的,而HashMap是从低位开始 Hashtable处理冲突元素时插入到链表头部,而HashMap是插入到链表尾部 Hashtable的hashcode方法计算所有entry的hashcode总和,HashMap没有这样的方法,同时HashMap在计算hash值时会用高位右移16位与低位异或来打散散列值,避免位与操作造成冲突过多 Hashtable每一次定位都要做一次完整的除法取余数,而HashMap使用的是与数组大小-1的位与计算,效率高很多 Hashtable的方法都加上了synchronized是线程安全的方法,而HashMap不是,所以单线程时前者额外开销很大。JDK8以后Hashtable也用了modCount来保证在遍历过程中其他线程修改对象的fast-fail机制。但是,即使是多线程环境下,依然应该优先选择对HashMap进行一些特殊处理而不是用Hashtable,因为所有方法都加上synchronized的程序并发性很差。实际上就我个人经验而言,在一些特定的具体情况下,比如大规模写入key值连续数据(出自今年的第四届阿里中间件性能挑战赛复赛题),链表法解决冲突性能可能不如开放地址法,即使加上了红黑树。所以说对于一些对极致压榨性能的情况下,适当的可以抛弃一些通用的集合而尝试自由发挥造轮子。 首先从最上方的注释中可以看到Hashtable自JDK1.0版本就有了,而HashMap是JDK1.2才加入的。观察一下类的声明,我们可以看到他们继承的类也是不同的,Hashtable继承的是Dictionary, Dictionary这个类从注释上写着已经是obsolete被废弃了,所以连带Hashtable也基本不用了 。 Hashtable 也有元素个数,数组大小,负载因子这些属性,不用元素个数用的是 count 不是 size 。也是使用链表法来解决冲突。 public class Hashtable<K,V> extends Dictionary<K,V> implements Map<K,V>, Cloneable, java.io.Serializable public class HashMap<K,V> extends AbstractMap<K,V> implements Map<K,V>, Cloneable, Serializable 构造函数可以看出默认大小是 11,同时初始大小给定多少初始数组就多大,不会做扩展到2的指数次幂这样的操作。 threshold=initialCapacity*loadFactor 这点和 HashMap 相同。 public Hashtable(int initialCapacity, float loadFactor) { if (initialCapacity < 0) throw new IllegalArgumentException("Illegal Capacity: "+ initialCapacity); if (loadFactor <= 0 || Float.isNaN(loadFactor)) throw new IllegalArgumentException("Illegal Load: "+loadFactor); if (initialCapacity==0) initialCapacity = 1; this.loadFactor = loadFactor; table = new Entry<?,?>[initialCapacity]; threshold = (int)Math.min(initialCapacity * loadFactor, MAX_ARRAY_SIZE + 1); } public Hashtable() { this(11, 0.75f); } contains 这个方法是从表尾开始向前搜索的,同时也没有使用 ==来比较 public synchronized boolean contains(Object value) { if (value == null) { throw new NullPointerException(); } Entry<?,?> tab[] = table; for (int i = tab.length ; i-- > 0 ;) { for (Entry<?,?> e = tab[i] ; e != null ; e = e.next) { if (e.value.equals(value)) { return true; } } } return false; } 从 containsKey 可以看出, Hashtable的index计算逻辑是使用key.hashCode()的后31位然后除以tab.length 取余数。 HashMap 的那种按位与的操作仅当操作数低位全是 1 时才等价为取余操作,也就是 2 的指数次幂 -1 才可成立,这样做计算速度比除法快很多,不过冲突数量会增加,所以加入了一些打散的设计比如hashCode高位与低位异或。 public synchronized boolean containsKey(Object key) { Entry<?,?> tab[] = table; int hash = key.hashCode(); int index = (hash & 0x7FFFFFFF) % tab.length; for (Entry<?,?> e = tab[index] ; e != null ; e = e.next) { if ((e.hash == hash) && e.key.equals(key)) { return true; } } return false; } 扩展方法rehash的 扩大方式是旧数组大小*2+1 ,而HashMap是*2,要重新计算每一个的index所以效率低,同时冲突时将 后面的元素插入到前面元素的前一位 ,所以会改变顺序 protected void rehash() { int oldCapacity = table.length; Entry<?,?>[] oldMap = table; // overflow-conscious code int newCapacity = (oldCapacity << 1) + 1;//新大小=旧大小*2+1 if (newCapacity - MAX_ARRAY_SIZE > 0) { if (oldCapacity == MAX_ARRAY_SIZE) // Keep running with MAX_ARRAY_SIZE buckets return; newCapacity = MAX_ARRAY_SIZE; } Entry<?,?>[] newMap = new Entry<?,?>[newCapacity];//创建一个新的数组 modCount++; threshold = (int)Math.min(newCapacity * loadFactor, MAX_ARRAY_SIZE + 1); table = newMap; for (int i = oldCapacity ; i-- > 0 ;) { for (Entry<K,V> old = (Entry<K,V>)oldMap[i] ; old != null ; ) { Entry<K,V> e = old; old = old.next; int index = (e.hash & 0x7FFFFFFF) % newCapacity;//重新计算每一个元素的index e.next = (Entry<K,V>)newMap[index];//前后元素有冲突时,后面的元素插入到前面元素的前面 newMap[index] = e; } } } 对于插入结点同样要先检查是否存在key值相同的点,存在则不插入,然后检查是否需要扩展数组,插入时如果发生冲突,也是将要 插入的元素放在链表的首位 ,而putVal方法是放入尾部的。同时,可以看到Hashtable是 不支持null作为key或value值的 public synchronized V put(K key, V value) { // Make sure the value is not null if (value == null) {//value为null直接报错 throw new NullPointerException(); } // Makes sure the key is not already in the hashtable. Entry<?,?> tab[] = table; int hash = key.hashCode();//若key为null这里会报错 int index = (hash & 0x7FFFFFFF) % tab.length; @SuppressWarnings("unchecked") Entry<K,V> entry = (Entry<K,V>)tab[index]; for(; entry != null ; entry = entry.next) { if ((entry.hash == hash) && entry.key.equals(key)) { V old = entry.value; entry.value = value; return old; } } addEntry(hash, key, value, index); return null; } private void addEntry(int hash, K key, V value, int index) { modCount++; Entry<?,?> tab[] = table; if (count >= threshold) { // Rehash the table if the threshold is exceeded rehash(); tab = table; hash = key.hashCode(); index = (hash & 0x7FFFFFFF) % tab.length; } // Creates the new entry. @SuppressWarnings("unchecked") Entry<K,V> e = (Entry<K,V>) tab[index]; tab[index] = new Entry<>(hash, key, value, e); count++; }Hashtable的 hashcode方法计算所有entry的hash值总和 public synchronized int hashCode() { int h = 0; if (count == 0 || loadFactor < 0) return h; // Returns zero loadFactor = -loadFactor; // Mark hashCode computation in progress Entry<?,?>[] tab = table; for (Entry<?,?> entry : tab) { while (entry != null) { h += entry.hashCode(); entry = entry.next; } } loadFactor = -loadFactor; // Mark hashCode computation complete return h; } elements 这个方法是Hashtable多出来的, 返回所有value值的枚举 public synchronized Enumeration<V> elements() { return this.<V>getEnumeration(VALUES); }我们可以注意到,Hashtable的 方法都加上了synchronized,他们是线程安全的,但是对于本身是线程安全的情况就会大幅度影响性能,JDK8开始引入modCount来作为fast-fail机制,防止其他线程的非synchronzied方法对Hashtable进行修改。

优秀的个人博客,低调大师

Java LinkedList类源码解析

LinkedList底层为双向链表同样继承了AbstractSequentialList<E>,跟ArrayList的数组相比读取效率低,不支持随机读取,碎片化空间利用率高,平均随机插入效率相对高。同时可以用来实现queue。属性有: transient int size = 0;list大小 transient Node<E> first;头指针 transient Node<E> last;尾指针 private void linkFirst(E e) void linkLast(E e) 将e添加到链表的头部和尾部,size与modCount加一 void linkBefore(E e, Node<E> succ)将e插入到succ结点之前 private E unlinkFirst(Node<E> f) private E unlinkLast(Node<E> l) 移除头部或尾部结点,size减1,modCount加1,将移除结点的next prev item值都设为null以触发gc E unlink(Node<E> x)移除结点x,需要再判断有无前驱和后驱结点,若没有则要改变头尾指针,同样将移除结点的next prev item值都设为null以触发gc public E getFirst() public E getLast() 返回first或last指向的结点,链表为空时抛错 public E removeFirst() public E removeLast() 调用unlinkLast移除并返回头部或尾部的结点,链表为空时抛错 public void addFirst(E e)调用linkFirst(e),将元素插入到头部 public void addLast(E e) public boolean add(E e) 两个方法都是调用linkLast(e),除了返回值外是等价的 public boolean remove(Object o)o==null时,通过unlink方法移除所有x==null的元素,否则移除o.equals(x)的元素,每有一个符合的元素就调用一次unlink所以modCount的增加值为移除元素的个数 public boolean addAll(int index, Collection<? extends E> c)将c中的集合插入到index位置。首先检查index是否符合链表长度范围,若c中没有元素则直接返回false,否则遍历c中的元素产生新的结点并链接到index指向位置,检查是否需要修改first和last的位置,最后修改size和modCount++ public void clear()遍历所有结点,将last prev item全部设为null,size为0,modCount++ public E set(int index, E element)检查index范围后设置为item=element,不会改变modCount public void add(int index, E element)检查index范围,若index==size即插入再末尾,调用linkLast(element),否则调用linkBefore(element, node(index))因此会造成modCount++ public E remove(int index) 检查index范围,index >= 0 && index < size则调用unlink(node(index))移除元素,modCount++ Node<E> node(int index)返回index下标的结点,若index超过size的一半则从last开始向头寻找,否则从first开始向后寻找 public int indexOf(Object o)寻找与o相等的下标最小的链表元素,若没有则返回-1,比较逻辑依然根据o是否是null来区分 public int lastIndexOf(Object o)从尾部开始搜索第一个符合条件的元素下标,和上面一个方法类似 public E peek()返回first指向结点的item,若为空则返回null public E element()也是返回first.item,区别是为空会抛错 public E poll()在peek()的基础上,若不为null会删除第一个元素 public boolean offer(E e)同add(e) public boolean offerFirst(E e)同addFirst public boolean offerLast(E e)同addLast public E peekFirst()同peek() public E peekLast()返回尾部元素,为空则返回null public E pollFirst()同poll() public E pollLast()返回尾部元素,为空则返回null,不为空移除尾部元素 public void push(E e)将e添加到头部 public E pop()移除头部元素 public boolean removeFirstOccurrence(Object o)同remove(o) public boolean removeLastOccurrence(Object o)移除最后一个与o相等的元素 public Object[] toArray()新建一个数组,遍历链表将元素复制到数组中 private void writeObject(java.io.ObjectOutputStream s) private void readObject(java.io.ObjectInputStream s) 序列化的方式和ArrayList相同,是通过对象输入输出流来完成,输入时调用linkLast将读取到的元素加入链表末尾个人GitHub地址: https://github.com/GrayWind33

优秀的个人博客,低调大师

Java ArrayList类源码解析

ArrayList是最常用的集合类,底层是由数组实现的 首先可以看到,有两个static final对象数组,也就是被线程间共享的,EMPTY_ELEMENTDATA是非default大小的空集合,原因是要辨别第一次添加元素时应该扩展的大小。 private static final Object[] EMPTY_ELEMENTDATA = {}; private static final Object[] DEFAULTCAPACITY_EMPTY_ELEMENTDATA = {}; transient Object[] elementData;这里是存储实际元素的对象数组,transient关键字表示该部分内容不能被序列化,ArrayList实际上序列化调用的是writeObject和readObject方法,而不是直接由elementData进行序列化,原因是elementData里面有空元素,这部分不需要进行序列化,可以节约内存和时间。 private int size;是实际元素的个数 protected transient int modCount = 0;modCount的作用的保证线程安全,ArrayList本身是非同步的集合类,出现遍历操作都要检查modCount值是否改变。除了自身的set方法外,其他所有存在对elementData写入的操作都会增加modCount值。 public ArrayList(int initialCapacity)给定参数为0时elementData直接赋值为EMPTY_ELEMENTDATA,否则新建一个指定大小的数组 public ArrayList()直接赋值DEFAULTCAPACITY_EMPTY_ELEMENTDATA public ArrayList(Collection<? extends E> c)若集合c不为空,elementData引用c.toArray产生的数组,若产生的不是Object[]需要再调用Arrays.copyOf进行复制。集合为空则赋值为EMPTY_ELEMENTDATA public void trimToSize()通过Arrays.copyOf将elementData中的空元素去掉,若size==0则赋值为EMPTY_ELEMENTDATA public void ensureCapacity(int minCapacity)参数给定所需的最小大小,检查该大小是否大于最小扩展大小(DEFAULTCAPACITY_EMPTY_ELEMENTDATA时该值为10否则为0),大于时调用ensureExplicitCapacity(minCapacity)对集合进行扩展,可以手动调用 private void ensureCapacityInternal(int minCapacity)和上一个相似,add元素时检查大小是否足够,仍未DEFAULTCAPACITY_EMPTY_ELEMENTDATA时扩展10和minCapacity的较大值,否则直接扩展minCapacity private void ensureExplicitCapacity(int minCapacity) minCapacity大于elementData的元素个数时,调用grow(minCapacity),无论是否增长了大小,该方法都会增加modCount private void grow(int minCapacity)增长大小为minCapacity和elementData.length*1.5中的较大值,最大不能超过Integer.max(2的31次)-8,通过Arrays.copyOf复制元素 public int size()返回size值 public boolean isEmpty()返回size是否为0 public int indexOf(Object o)o为null时检查elementData中是否有元素==o,否则检查是否有o.equals(x),存在则返回第一个符合的下标,不存在返回-1 public int lastIndexOf(Object o)与上一个方法相比区别在于从尾部开始遍历,返回的是下标最大的一个 public boolean contains(Object o)调用indexOf,返回不为-1时为true public Object clone()新建一个ArrayList,elementData复制过去,其他内部变量也相同 public Object[] toArray()返回Arrays.copyOf(elementData, size),所以不含后面的空数组 public <T> T[] toArray(T[] a)若a.length<size,则新建一个包含elementData中实际对象的数组返回。否则将elementData中的元素复制给a并设a[size] = null,返回a public E get(int index)获取指定下标元素内容 public E set(int index, E element)将指定下标元素改为element并返回旧值 public boolean add(E e)检查数组大小是否需要扩展后,添加元素,增加size,一定会增加modCount public void add(int index, E element)先检查index是否符合范围,然后检查数组大小是否需要扩展,将index后的元素向后复制以为,然后elementData[index]=element,一定会增加modCount public E remove(int index) 先检查index是否符合范围,然后modCount增加,index后的元素往前复制一位,elementData[size]的值为null便于触发gc,size减一,返回旧元素的值 public boolean remove(Object o)首先按照indexOf的逻辑寻找第一个相等的元素,如果存在则将后面的元素往复制一位最后一个元素设为null并增加modCount返回true,否则返回false。因为index肯定是符合返回的,所以调用不检查index是否符合范围private void fastRemove(int index) public void clear()modCount增加,将size个元素都设为null,size改为0 public boolean addAll(Collection<? extends E> c)通过System.arraycopy将c的元素复制到集合的后面,modCount增加,size增加c的元素个数,若新size不为0则返回true public boolean addAll(int index, Collection<? extends E> c)和上面相比区别在于要将c复制到从index开始的位置而不是末尾,同样会增加modCount protected void removeRange(int fromIndex, int toIndex)增加modCount,将toIndex后面的元素复制到fromIndex开始的位置,多余的设为null便于触发GC,修改size值 public boolean removeAll(Collection<?> c)移除和c中相同的元素,若原本集合中元素个数变动增加modCount public boolean retainAll(Collection<?> c)保留和c中相同的元素,若原本集合中元素个数变动增加modCount private void writeObject(java.io.ObjectOutputStream s) 序列化函数,通过s.writeObject将对象写入到输出流中,通过检查modCount的值是否改变来确保线程安全 private void readObject(java.io.ObjectInputStream s)序列化函数,通过s.readObject()将输入流中的对象读取到elementData中 public Iterator<E> iterator()返回一个实现的迭代器,只能从头向尾移动,移动时元素个数不能被其他线程改变。可以移除和forEachRemaining (Consumer<? super E> consumer)进行批量操作,批量操作时modCount不能被其他线程改变 public ListIterator<E> listIterator(int index)返回一个从指定下标开始的列表迭代器是Iterator<E>的继承类,若不输入参数默认从0开始。可以前后移动,移动时检查元素个数不能被其他线程修改。额外提供了set和add方法。 public List<E> subList(int fromIndex, int toIndex)返回一个子集合,对子集合的add remove set操作会改变parent对应的元素,并改变两者的modCount值。subList为抽象类,本身并没有elementData区域,对他元素的操作会直接操作在parent的elementData上 public boolean removeIf(Predicate<? super E> filter)根据过滤器filter移除符合的元素,整个过程要求modCount不能被其他线程改变,先用一个BitSet存储要删除的序号,然后通过removeSet.nextClearBit(i)进行复制移动,最后modCount++ public void replaceAll(UnaryOperator<E> operator)根据规则替换所有符合的元素,会改变modCount public void sort(Comparator<? super E> c)排序,会改变modCount个人GitHub地址: https://github.com/GrayWind33

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册