首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10000篇文章
优秀的个人博客,低调大师

React Hooks源码深度解析

作者:京东零售 郑炳懿 前言 React Hooks是React16.8 引入的一个新特性,它允许函数组件中使用state和其他 React 特性,而不必使用类组件。Hooks是一个非常重要的概念,因为它们提供了更简单、更易于理解的React开发体验。 React Hooks的核心源码主要包括两个部分:React内部的Hook管理器和一系列预置的Hook函数。 首先,让我们看一下React内部的Hook管理器。这个管理器是React内部的一个重要机制,它负责管理组件中的所有Hook,并确保它们在组件渲染期间以正确的顺序调用。 内部Hook管理器 示例: const Hook = { queue: [], current: null, }; function useState(initialState) { const state = Hook.current[Hook.queue.length]; if (!state) { Hook.queue.push({ state: typeof initialState === 'function' ? initialState() : initialState, setState(value) { this.state = value; render(); }, }); } return [state.state, state.setState.bind(state)]; } function useHook(callback) { Hook.current = { __proto__: Hook.current, }; try { callback(); } finally { Hook.current = Hook.current.__proto__; } } function render() { useHook(() => { const [count, setCount] = useState(0); console.log('count:', count); setTimeout(() => { setCount(count + 1); }, 1000); }); } render(); 在这个示例中,Hook对象有两个重要属性:queue和current。queue存储组件中所有Hook的状态和更新函数,current存储当前正在渲染的组件的Hook链表。useState和useHook函数则分别负责创建新的Hook状态和在组件中使用Hook。 预置 Hook 函数 useState Hook 以下是useState Hook的实现示例: function useState(initialState) { const hook = updateWorkInProgressHook(); if (!hook.memoizedState) { hook.memoizedState = [ typeof initialState === 'function' ? initialState() : initialState, action => { hook.queue.pending = true; hook.queue.dispatch = action; scheduleWork(); }, ]; } return hook.memoizedState; } 上述代码实现了useState Hook,其主要作用是返回一个state和更新函数的数组,state 初始值为initialState。 在这个实现中,updateWorkInProgressHook()函数用来获取当前正在执行的函数组件的 fiber 对象并判断是否存在对应的hook。它的实现如下: function updateWorkInProgressHook() { const fiber = getWorkInProgressFiber(); let hook = fiber.memoizedState; if (hook) { fiber.memoizedState = hook.next; hook.next = null; } else { hook = { memoizedState: null, queue: { pending: null, dispatch: null, last: null, }, next: null, }; } workInProgressHook = hook; return hook; } getWorkInProgressFiber()函数用来获取当前正在执行的函数组件的fiber对象,workInProgressHook则用来存储当前正在执行的hook对象。在函数组件中,每一个useState调用都会创建一个新的 hook 对象,并将其添加到fiber对象的hooks链表中。这个hooks链表是通过fiber对象的memoizedState属性来维护的。 我们还需要注意到在useState Hook的实现中,每一个hook对象都包含了一个queue对象,用来存储待更新的状态以及更新函数。scheduleWork()函数则用来通知React调度器有任务需要执行。 在React的源码中,useState函数实际上是一个叫做useStateImpl的内部函数。 下面是useStateImpl的源码: function useStateImpl<S>(initialState: (() => S) | S): [S, Dispatch<SetStateAction<S>>] { const dispatcher = resolveDispatcher(); return dispatcher.useState(initialState); } 可以看到,useStateImpl函数的作用就是获取当前的dispatcher并调用它的useState方法,返回一个数组,第一个元素是状态的值,第二个元素是一个dispatch函数,用来更新状态。这里的resolveDispatcher函数用来获取当前的dispatcher,其实现如下: function resolveDispatcher(): Dispatcher { const dispatcher = currentlyRenderingFiber?.dispatcher; if (dispatcher === undefined) { throw new Error('Hooks can only be called inside the body of a function component. (https://fb.me/react-invalid-hook-call)'); } return dispatcher; } resolveDispatcher函数首先尝试获取当前正在渲染的fiber对象的dispatcher属性,如果获取不到则说 明当前不在组件的渲染过程中,就会抛出一个错误。 最后,我们来看一下useState方法在具体的dispatcher实现中是如何实现的。我们以useReducer的 dispatcher为例,它的实现如下: export function useReducer<S, A>( reducer: (prevState: S, action: A) => S, initialState: S, initialAction?: A, ): [S, Dispatch<A>] { const [dispatch, currentState] = updateReducer<S, A>( reducer, // $FlowFixMe: Flow doesn't like mixed types [initialState, initialAction], // $FlowFixMe: Flow doesn't like mixed types reducer === basicStateReducer ? basicStateReducer : updateStateReducer, ); return [currentState, dispatch]; } 可以看到,useReducer方法实际上是调用了一个叫做updateReducer的函数,返回了一个包含当前状态和dispatch函数的数组。updateReducer的实现比较复杂,涉及到了很多细节,这里不再展开介绍。 useEffect Hook useEffect是React中常用的一个Hook函数,用于在组件中执行副作用操作,例如访问远程数据、添加/移除事件监听器、手动操作DOM等等。useEffect的核心功能是在组件的渲染过程结束之后异步执行回调函数,它的实现方式涉及到 React 中的异步渲染机制。 以下是useEffect Hook的实现示例: function useEffect(callback, dependencies) { // 通过调用 useLayoutEffect 或者 useEffect 方法来获取当前的渲染批次 const batch = useContext(BatchContext); // 根据当前的渲染批次判断是否需要执行回调函数 if (shouldFireEffect(batch, dependencies)) { callback(); } // 在组件被卸载时清除当前 effect 的状态信息 return () => clearEffect(batch); } 在这个示例中,useEffect接收两个参数:回调函数和依赖项数组。当依赖项数组中的任何一个值发生变化时, React会在下一次渲染时重新执行useEffect中传入的回调函数。 useEffect函数的实现方式主要依赖于React中的异步渲染机制。当一个组件需要重新渲染时,React会将所有的state更新操作加入到一个队列中,在当前渲染批次结束之后再异步执行这些更新操作,从而避免在同一个渲染批次中连续执行多次更新操作。 在useEffect函数中,我们通过调用useContext(BatchContext)方法来获取当前的渲染批次,并根据shouldFireEffect方法判断是否需要执行回调函数。在回调函数执行完毕后,我们需要通过clearEffect方法来清除当前effect的状态信息,避免对后续的渲染批次产生影响。 总结 总的来说,React Hooks的实现原理并不复杂,它主要依赖于React内部的fiber数据结构和调度系统,通过这些机制来实现对组件状态的管理和更新。Hooks能够让我们在函数组件中使用状态和其他React特性,使得函数组件的功能可以和类组件媲美。 除了useState、useEffect等hook,React还有useContext等常用的Hook。它们的实现原理也基本相似,都是利用fiber架构来实现状态管理和生命周期钩子等功能。 以上是hook简单实现示例,它们并不是React中实际使用的代码,但是可以帮助我们更好地理解hook的核心实现方式。

优秀的个人博客,低调大师

Function源码解析与实践

作者:陈昌浩 1 导读 if…else…在代码中经常使用,听说可以通过 Java 8 的 Function 接口来消灭 if…else…!Function 接口是什么?如果通过 Function 接口接口消灭 if…else…呢?让我们一起来探索一下吧。 2 Function 接口 Function 接口就是一个有且仅有一个抽象方法,但是可以有多个非抽象方法的接口,Function 接口可以被隐式转换为 lambda 表达式。可以通过 FunctionalInterface 注解来校验 Function 接口的正确性。Java 8 允许在接口中加入具体方法。接口中的具体方法有两种,default 方法和 static 方法。 @FunctionalInterfaceinterface TestFunctionService{ void addHttp(String url);} 那么就可以使用 Lambda 表达式来表示该接口的一个实现。 TestFunctionService testFunctionService = url -> System.out.println("http:" + url); 2.1 FunctionalInterface 2.1.1 源码 @Documented@Retention(RetentionPolicy.RUNTIME)@Target(ElementType.TYPE)public @interface FunctionalInterface {} 2.1.2 说明 上图是 FunctionalInterface 的注解说明。通过上面的注解说明,可以知道 FunctionalInterface 是一个注解,用来说明一个接口是函数式接口。 函数式接口只有一个抽象方法。 可以有默认方法,因为默认方法有一个实现,所以不是抽象的。函数接口的实例可以用 lambda 表达式、方法引用或构造函数引用创建。 FunctionalInterface 会校验接口是否满足函数式接口: 类型必须是接口类型,不能是注释类型、枚举或类。 只能有一个抽象方法。 可以有多个默认方法和静态方法。 可以显示覆盖 java.lang.Object 中的抽象方法。 编译器会将满足函数式接口定义的任何接口视为函数式接口,而不管该接口声明中是否使用 FunctionalInterface 注解。 3 Function 接口主要分类 Function 接口主要分类: Function:Function 函数的表现形式为接收一个参数,并返回一个值。 Supplier:Supplier 的表现形式为不接受参数、只返回数据。 Consumer:Consumer 接收一个参数,没有返回值。 Runnable:Runnable 的表现形式为即没有参数也没有返回值。 3.1 Function Function 函数的表现形式为接收一个参数,并返回一个值。 3.1.1 源码 @FunctionalInterfacepublic interface Function<T, R> { R apply(T t); default <V> Function<V, R> compose(Function<? super V, ? extends T> before) { Objects.requireNonNull(before); return (V v) -> apply(before.apply(v)); } default <V> Function<T, V> andThen(Function<? super R, ? extends V> after) { Objects.requireNonNull(after); return (T t) -> after.apply(apply(t)); } static <T> Function<T, T> identity() { return t -> t; }} 3.1.2 方法说明 apply:抽象方法。将此函数应用于给定的参数。参数 t 通过具体的实现返回 R。 compose:default 方法。返回一个复合函数,首先执行 fefore 函数应用于输入,然后将该函数应用于结果。如果任意一个函数的求值引发异常,则将其传递给组合函数的调用者。 andThen:default 方法。返回一个复合函数,该复合函数首先对其应用此函数它的输入,然后对结果应用 after 函数。如果任意一个函数的求值引发异常,则将其传递给组合函数的调用者。 identity:static 方法。返回一个始终返回其输入参数的函数。 3.1.3 方法举例 1)apply 测试代码: public String upString(String str){ Function<String, String> function1 = s -> s.toUpperCase(); return function1.apply(str);} public static void main(String[] args) { System.out.println(upString("hello!")); } 通过 apply 调用具体的实现。执行结果: 2)compose 测试代码: public static void main(String[] args) { Function<String, String> function1 = s -> s.toUpperCase(); Function<String, String> function2 = s -> "my name is "+s; String result = function1.compose(function2).apply("zhangSan"); System.out.println(result);} 执行结果 如结果所示:compose 先执行 function2 后执行 function1。 3)andThen 测试代码: public static void main(String[] args) { Function<String, String> function1 = s -> s.toUpperCase(); Function<String, String> function2 = s -> "my name is "+s; String result = function1.andThen(function2).apply("zhangSan"); System.out.println(result);} 执行结果: 如结果所示: andThen 先执行 function1 后执行 function2。 identity 测试代码: public static void main(String[] args) { Stream<String> stream = Stream.of("order", "good", "lab", "warehouse"); Map<String, Integer> map = stream.collect(Collectors.toMap(Function.identity(), String::length)); System.out.println(map);} 执行结果: 3.2 Supplier Supplier 的表现形式为不接受参数、只返回数据。 3.2.1 源码 @FunctionalInterfacepublic interface Supplier<T> { /** * Gets a result. * * @return a result */ T get();} 3.2.2 方法说明 get:抽象方法。通过实现返回 T。 3.2.3 方法举例 public class SupplierTest { SupplierTest(){ System.out.println(Math.random()); System.out.println(this.toString()); }} public static void main(String[] args) { Supplier<SupplierTest> sup = SupplierTest::new; System.out.println("调用一次"); sup.get(); System.out.println("调用二次"); sup.get();} 执行结果: 如结果所示:Supplier 建立时并没有创建新类,每次调用 get 返回的值不是同一个。 3.3 Consumer Consumer 接收一个参数,没有返回值。 3.3.1 源码 @FunctionalInterfacepublic interface Consumer<T> { void accept(T t); default Consumer<T> andThen(Consumer<? super T> after) { Objects.requireNonNull(after); return (T t) -> { accept(t); after.accept(t); }; }} 3.3.2 方法说明 accept:对给定参数 T 执行一些操作。 andThen:按顺序执行 Consumer -> after ,如果执行操作引发异常,该异常被传递给调用者。 3.3.3 方法举例 public static void main(String[] args) { Consumer<String> consumer = s -> System.out.println("consumer_"+s); Consumer<String> after = s -> System.out.println("after_"+s); consumer.accept("isReady"); System.out.println("========================"); consumer.andThen(after).accept("is coming");} 执行结果: 如结果所示:对同一个参数 T,通过 andThen 方法,先执行 consumer,再执行 fater。 3.4 Runnable Runnable:Runnable 的表现形式为即没有参数也没有返回值。 3.4.1 源码 @FunctionalInterfacepublic interface Runnable { public abstract void run();} 3.4.2 方法说明 run:抽象方法。run 方法实现具体的内容,需要将 Runnale 放入到 Thread 中,通过 Thread 类中的 start()方法启动线程,执行 run 中的内容。 3.4.3 方法举例 public class TestRun implements Runnable { @Override public void run() { System.out.println("TestRun is running!"); }} public static void main(String[] args) { Thread thread = new Thread(new TestRun()); thread.start(); } 执行结果: 如结果所示:当线程实行 start 方法时,执行 Runnable 的 run 方法中的内容。 4 Function 接口用法 Function 的主要用途是可以通过 lambda 表达式实现方法的内容。 4.1 差异处理 原代码: @Datapublic class User { /** * 姓名 */ private String name; /** * 年龄 */ private int age; /** * 组员 */ private List<User> parters;} public static void main(String[] args) { User user =new User(); if(user ==null ||user.getAge() <18 ){ throw new RuntimeException("未成年!"); }} 执行结果: 使用 Function 接口后的代码: @FunctionalInterfacepublic interface testFunctionInfe { /** * 输入异常信息 * @param message */ void showExceptionMessage(String message);} public static testFunctionInfe doException(boolean flag){ return (message -> { if (flag){ throw new RuntimeException(message); } }); } public static void main(String[] args) { User user =new User(); doException(user ==null ||user.getAge() <18).showExceptionMessage("未成年!");} 执行结果: 使用 function 接口前后都抛出了指定的异常信息。 4.2 处理 if…else… 原代码: public static void main(String[] args) { User user =new User(); if(user==null){ System.out.println("新增用户"); }else { System.out.println("更新用户"); }} 使用 Function 接口后的代码: public static void main(String[] args) { User user =new User(); Consumer trueConsumer = o -> { System.out.println("新增用户"); }; Consumer falseConsumer= o -> { System.out.println("更新用户"); }; trueOrFalseMethdo(user).showExceptionMessage(trueConsumer,falseConsumer);}public static testFunctionInfe trueOrFalseMethdo(User user){ return ((trueConsumer, falseConsumer) -> { if(user==null){ trueConsumer.accept(user); }else { falseConsumer.accept(user); } });}@FunctionalInterfacepublic interface testFunctionInfe { /** * 不同分处理不同的事情 * @param trueConsumer * @param falseConsumer */ void showExceptionMessage(Consumer trueConsumer,Consumer falseConsumer);} 执行结果: 4.3 处理多个 if 原代码: public static void main(String[] args) { String flag=""; if("A".equals(flag)){ System.out.println("我是A"); }else if ("B".equals(flag)) { System.out.println("我是B"); }else if ("C".equals(flag)) { System.out.println("我是C"); }else { System.out.println("没有对应的指令"); }} 使用 Function 接口后的代码: public static void main(String[] args) { String flag="B"; Map<String, Runnable> map =initFunctionMap(); trueOrFalseMethdo(map.get(flag)==null).showExceptionMessage(()->{ System.out.println("没有相应指令"); },map.get(flag));}public static Map<String, Runnable> initFunctionMap(){ Map<String,Runnable> result = Maps.newHashMap(); result.put("A",()->{System.out.println("我是A");}); result.put("B",()->{System.out.println("我是B");}); result.put("C",()->{System.out.println("我是C");}); return result;}public static testFunctionInfe trueOrFalseMethdo(boolean flag){ return ((runnable, falseConsumer) -> { if(flag){ runnable.run(); }else { falseConsumer.run(); } });} 执行结果: 5 总结 Function 函数式接口是 java 8 新加入的特性,可以和 lambda 表达式完美结合,是非常重要的特性,可以极大的简化代码。

优秀的个人博客,低调大师

Autograd解析|OneFlow学习笔记

撰文|月踏 更新|赵露阳 前文《AI杂谈:手推BP》讲了Backward Propagation的数学原理。本文以OneFlow的代码为例,梳理Autograd模块的实现细节。 1 一个求梯度的小例子 先看下面这个简单的例子: import oneflow as ofx = of.randn(2, 2, requires_grad=True)y = x + 100z = y.sum()z.backward() forward pass可以对应到下面的计算图: 图1 即对应下面公式: 根据前文《 AI杂谈:手推‍BP 》很容易手动计算出x的梯度值,即: x1、x2、x3的计算过程类似,不再赘述,下面看一下OneFlow的执行结果,执行print(x.grad)可得到如下输出: tensor([[1., 1.], [1., 1.]], dtype=oneflow.float32) 可以看出,结果和前面公式(3)的计算结果一致,下面通过具体的代码实现来分析OneFlow的Autograd模块。 2 backward接口 上面例子中的python端的backward接口,调用的是python/oneflow/framework/tensor.py中的_backward接口: def _backward(self, gradient=None, retain_graph=False, create_graph=False): if not lazy_mode.is_enabled(): flow.autograd.backward(self, gradient, retain_graph, create_graph) else: ... 可以看到backward只支持eager模式,这是因为graph静态图模式下,计算图是提前编译好的,无需手动通过.backward()调用。flow.autograd.backward()会调用 oneflow/api/python/autograd/autograd.cpp 中导出的backward方法: ONEFLOW_API_PYBIND11_MODULE("autograd", m) { m.def("backward", &Backward); m.def("grad", &Grad);} 从pybind定义来看,这里面总共导出了两个接口(autograd.backward和autograd.grad)。其中,backward是对所有的requires_grad属性为True的节点求梯度,grad只对指定的叶子结点求梯度,原理上是相同的,本文只以backward为例来看代码的实现,backward接口会调用到同一个文件中的Backward函数: Maybe<one::TensorTuple> Backward(const one::TensorTuple& outputs, const one::TensorTuple& out_grads, bool retain_graph, bool create_graph) { if (create_graph) { retain_graph = true; } std::shared_ptr<one::TensorTuple> gradients = JUST(CheckAndInitOutGrads(outputs, out_grads)); JUST(one::GetThreadLocalAutogradEngine()->RunBackwardAndSaveGrads4LeafTensorIf( outputs, *gradients, retain_graph, create_graph)); return std::make_shared<one::TensorTuple>(0);} 这里的GetThreadLocalAutogradEngine()可以看作是一个thread_local的单例,位于 oneflow/core/autograd/autograd_engine.cpp ,返回一个autograd引擎(AutogradEngine)对象的指针: AutogradEngine* GetThreadLocalAutogradEngine() { thread_local static GraphAutogradEngine autograd_engine; return &autograd_engine;} AutogradEngine是OneFlow的Autograd的核心数据结构,它的继承关系如下: 图2 这里autograd引擎的子类实现有基于栈式的、基于图式的实现,默认使用基于图式的GraphAutogradEngine。从前面代码中可以看到,获取autograd引擎指针后,通过调用RunBackwardAndSaveGrads4LeafTensor函数,位于 oneflow/core/autograd/autograd_engine.cpp:L315 : Maybe<void> GraphAutogradEngine::RunBackwardAndSaveGrads4LeafTensor(const TensorTuple& outputs, const TensorTuple& out_grads, bool retain_graph, bool create_graph) { for (int i = 0; i < outputs.size(); ++i) { JUST(JUST(outputs.at(i)->current_grad())->PushPartialTensor(out_grads.at(i))); } GraphTask graph_task(outputs, retain_graph, create_graph); JUST(graph_task.ComputeDependencies()); JUST(graph_task.Apply(/*save_grad_for_leaf=*/true)); return Maybe<void>::Ok();} 这就真正进入了autograd模块的内部处理流程,后面继续分析。 3 FunctionNode和建立反向图 在进行backward pass时,执行的是一张反向图,反向图中的节点是在forward pass的时候建立的,其中的每个节点被称作FunctionNode,主要数据结构如下: 图3 先说图3中FunctionNode( oneflow/core/autograd/autograd_engine.h:L42) ,包含next_functions_、input_meta_data_、output_meta_data_这三个数据成员,其中next_functions_表示出边,另外两个表示一些meta信息,下面列几个主要的: is_leaf_:是不是叶子节点 requires_grad_:是不是需要求梯度值 retain_grad_:对于非叶子节点,是不是保存梯度值 acc_grad_:在gradient accumulation的的情况下,多个mini-batch的梯度累加 current_grad_:当前这个batch的梯度值 我们用到的是GraphFunctionNod( oneflow/core/autograd/autograd_engine.cpp:L178) GraphFunctionNode::GraphFunctionNode(const std::string& name, const std::shared_ptr<BackwardFunction>& backward_fn, const TensorTuple& inputs, const TensorTuple& outputs) : FunctionNode(name, backward_fn) { input_meta_data_.resize(inputs.size()); next_functions_.reserve(inputs.size()); for (int i = 0; i < inputs.size(); ++i) { if (inputs.at(i)->requires_grad()) { input_meta_data_.at(i) = inputs.at(i)->mut_autograd_meta(); next_functions_.emplace_back(inputs.at(i)->mut_grad_fn_node()); } } output_meta_data_.resize(outputs.size()); output_tensor_infos_.reserve(outputs.size()); for (int i = 0; i < outputs.size(); ++i) { const auto& autograd_meta = NewAutogradMeta(outputs.at(i)->requires_grad(), outputs.at(i)->is_leaf()); outputs.at(i)->set_autograd_meta(autograd_meta); output_meta_data_.at(i) = outputs.at(i)->mut_autograd_meta(); output_tensor_infos_.emplace_back(TensorInfo(*outputs.at(i))); } backward_fn_ = backward_fn;} 可见它主要对FunctionNode中的重要数据成员做了初始化,其中input_meta_data_、output_meta_data_中的AutogradMeta信息是从相应的input、output tensor中获取的,tensor通过桥接模式保存了一个TensorImpl对象指针,这个TensorImpl对象则维护了一个AutogradMeta对象。 继续看下FunctionNode中的反向函数backward_fn_,在《 OneFlow学习笔记:从Functor到OpExprInterpreter 》中讲到了在进行一个op调用的时候会执行AutogradInterpreter::Apply这个函数( oneflow/core/framework/op_interpreter/op_interpreter.cpp:L86 ),里面会创建这个反向函数: Maybe<void> AutogradInterpreter::Apply( const OpExpr& op_expr, const TensorTuple& inputs, TensorTuple* outputs, const OpExprInterpContext& ctx) const { ... autograd::AutoGradMode mode(false); JUST(internal_->Apply(op_expr, inputs, outputs, ctx)); std::shared_ptr<OpExprGradClosure> grad_closure(nullptr); if (requires_grad && !LazyMode::is_enabled()) { grad_closure = JUST(op_expr.GetOrCreateOpGradClosure()); auto backward_fn = std::make_shared<BackwardFunction>(); backward_fn->body = [=](const TensorTuple& out_grads, TensorTuple* in_grads, bool create_graph) -> Maybe<void> { autograd::AutoGradMode mode(create_graph); JUST(grad_closure->Apply(out_grads, in_grads)); return Maybe<void>::Ok(); }; backward_fn->status = [=]() { return grad_closure->state()->SavedTensors().size() > 0; }; JUST(GetThreadLocalAutogradEngine()->AddNode(op_expr.op_type_name() + "_backward", backward_fn, inputs, outputs)); } ... return Maybe<void>::Ok();} 可以看到反向图节点的名字是以正向图op的type name加上_backward的后缀来组成的,使用AddNode方法来创建FunctionNode( oneflow/core/autograd/autograd_engine.cpp:L356 ) Maybe<FunctionNode> GraphAutogradEngine::AddNode( const std::string& name, const std::shared_ptr<BackwardFunction>& backward_fn, const TensorTuple& inputs, TensorTuple* outputs) { // Firstly push function_node of tensor in stack which is leaf and requires_grad for (const std::shared_ptr<Tensor>& in_tensor : inputs) { if (in_tensor->is_leaf() && in_tensor->requires_grad()) { if (!in_tensor->grad_fn_node()) { JUST(AddAccumulateFunctionNode(in_tensor)); } } } std::shared_ptr<FunctionNode> func_node = std::make_shared<GraphFunctionNode>(name, backward_fn, inputs, *outputs); for (const std::shared_ptr<Tensor>& out_tensor : *outputs) { out_tensor->set_grad_fn_node(func_node); } return func_node;} 可见FunctionNode是挂在Tensor上的,通过Tensor的set_grad_fn_node接口维护到Tensor的数据结构中,在《 OneFlow学习笔记: Gl o bal View的相关概念和实现 》中画过Tensor的继承关系图,FunctionNode就是保存在TensorIf中: 图4 至此,已经理清了FunctionNode中各个成员的作用以及来历,假如以第二节的图1为例来画出对应的反向图的话,如下图所示: 图5 计算好的梯度值会被放到output_meta_data_中得AutogradMeta中,它可以通过tensor的acc_grad、current_grad接口来获取。 4 反向图的执行流程 接第三节列出的最后一段代码,其中最重要的两句话是: ...JUST(graph_task.ComputeDependencies());JUST(graph_task.Apply(/*save_grad_for_leaf=*/true));... 这里面的graph_task是GraphTask类型,它是一个很重要的数据结构,用来调度反向图中所有FunctionNode的执行,下面列一下它的主要成员: class GraphTask final { bool retain_graph_; bool create_graph_; std::vector<FunctionNode*> roots_; HashMap<FunctionNode*, int> dependencies_; HashSet<FunctionNode*> need_execute_;}; 先看本节开头的graph_task.ComputeDependencies,它主要是在初始化dependencies_这个map,这个map维护了每个FunctionNode的入度信息,再看graph_task.Apply,它主要是在通过拓扑序来访问反向图中的每个FunctionNode,并且对当前的FunctionNode进行各种操作( oneflow/core/autograd/autograd_engine.cpp:L287 ) Maybe<void>GraphTask::Apply(boolsave_grad_for_leaf){ std::queue<FunctionNode*> queue; for (FunctionNode* node : roots_) { if (dependencies_[node] == 0) { queue.push(node); } } while (!queue.empty()) { FunctionNode* node = queue.front(); queue.pop(); if (!need_execute_.empty() && need_execute_.find(node) == need_execute_.end()) { node->ReleaseOutTensorArgs(); continue; } if (/*bool not_ready_to_apply=*/!(JUST(node->Apply(create_graph_)))) { continue; } if (save_grad_for_leaf) { JUST(node->AccGrad4LeafTensor(create_graph_)); } JUST(node->AccGrad4RetainGradTensor()); node->ReleaseOutTensorArgs(); if (!retain_graph_) { node->ReleaseData(); } for (const auto& next_grad_fn : node->next_functions()) { FunctionNode* next_node = next_grad_fn.get(); dependencies_[next_node] -= 1; if (dependencies_[next_node] == 0) { queue.push(next_node); } } } return Maybe<void>::Ok();} 这里最重要的是下面两个语句: node->Apply node->AccGrad4LeafTensor 下面来逐个分析,先看node->Apply( oneflow/core/autograd/autograd_engine.cpp:L143 ),首先利用output_meta_data_初始化了output_grads,把它作为反向函数的输入,调用反向函数来求梯度值,求出的梯度值暂存在input_grads中,然后再更新到input_meta_data_中: Maybe<bool> FunctionNode::Apply(bool create_graph) { ... JUST(backward_fn_->body(output_grads, &input_grads, create_graph)); for (int i = 0; i < input_meta_data_.size(); ++i) { if (input_grads.at(i)) { ... JUST(input_meta_data_.at(i)->current_grad()->PushPartialTensor(input_grads.at(i))); } } return true;} 再看node->AccGrad4LeafTensor,这个函数最终会调用到CopyOrAccGrad,它主要用于在gradient accumulation的时候,多个mini-batch之间把梯度值多累加,和如果有hook函数的的话,使用注册的hook对当前的梯度值进行处理: Maybe<void> CopyOrAccGrad(AutogradMeta* autograd_meta, bool autograd_mode) { autograd::AutoGradMode mode(autograd_mode); auto current_grad = JUST(autograd_meta->current_grad()->GetAccTensor({})); if (!current_grad) { return Maybe<void>::Ok(); } if (autograd_meta->acc_grad()) { ... DevVmDepObjectConsumeModeGuard guard(DevVmDepObjectConsumeMode::NONE); const auto& output = JUST(functional::Add(autograd_meta->acc_grad(), current_grad, /*alpha=*/1, /*inplace=*/autograd_meta->is_grad_acc_inplace())); JUST(autograd_meta->set_acc_grad(output)); } else { JUST(autograd_meta->set_acc_grad(current_grad)); } for (const auto& hook : autograd_meta->post_grad_accumulation_hooks()) { auto new_grad = hook(autograd_meta->acc_grad()); if (new_grad) { JUST(autograd_meta->set_acc_grad(new_grad)); } } return Maybe<void>::Ok();} (特别感谢同事yinggang中间的各种答疑解惑。本文主要参考代码:https://github.com/Oneflow-Inc/oneflow/commit/a4144f9ecb7e85ad073a810c3359bce7bfeb05e1) 其他人都在看 25倍性能加速,OneFlow“超速”了 一个GitHub史上增长最快的AI项目 手把手推导Ring All-reduce的数学性质 DeepMind爆发史:决定AI高峰的“游戏玩家” 解读Pathways(二):向前一步是OneFlow 五年ML Infra生涯,我学到最重要的3个教训 OneFlow v0.7.0发布:全新分布式接口,LiBai、Serving等一应俱全 欢迎下载体验OneFlow v0.7.0:https://github.com/Oneflow-Inc/oneflow/ 本文分享自微信公众号 - OneFlow(OneFlowTechnology)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

解析HetuEngine实现On Yarn原理

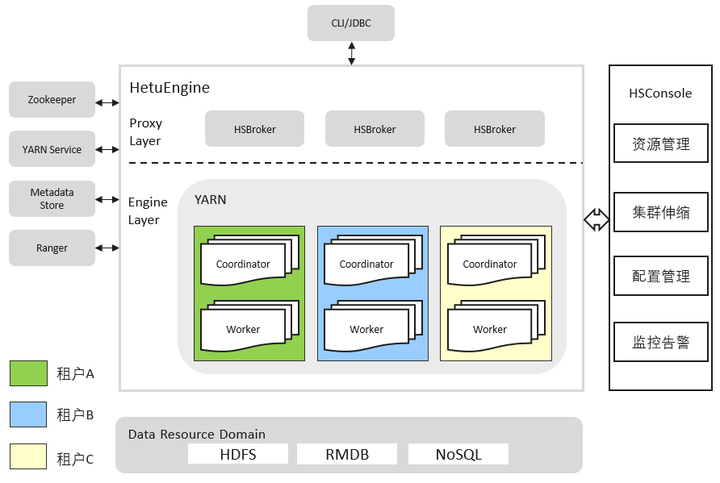
摘要:本文介绍HetuEngine实现On Yarn的原理,通过阅读本文,读者可以了解HetuEngine如何在资源使用方面融入Hadoop生态体系。 本文分享自华为云社区《MRS HetuEngine 特性之 On Yarn原理介绍》,作者:一颗柠檬。 HetuEngine是华为自研高性能分布式SQL查询&数据虚拟化引擎。与大数据生态无缝融合,实现海量数据秒级查询;支持多源异构协同,使能数据湖内一站式SQL融合分析。在整合开源能力的同时,MRS HetuEngine相较于开源社区也做了大量的优化,其中一个重要的特性就是On Yarn。 什么是On Yarn? 顾名思义,就是将进程运行在Yarn上,由Yarn进行资源的管理和调度。 不论是TrinoDB/PrestoDB还是openLooKeng,部署方式都是将coordinator和worker进程直接运行在主机上,与主机上的其他应用程序共享资源,无法做到资源隔离,并且难以扩展。 MRS HetuEngine借助Yarn Service提供的能力,将coordinator和worker进程以Yarn application的形式运行在Yarn container中,通过MRS集群的租户划分,可以将HetuEngine计算实例启动在特定租户队列里,从而实现资源隔离。 HetuEngine架构 下图是HetuEngine的拓扑图。HetuEngine向下可以对接各类数据源(比如Hive,GaussDB,HBASE,Elasticsearch等),对外向用户提供CLI/JDBC接口。在同一套MRS集群中,HetuEngine可以在不同租户队列中启动多个HetuEngine计算实例,支持一个租户队列上启动一个计算实例。由HetuEngine的HSBroker实例与Yarn Service交互,将租户队列与计算实例绑定,由HSConsole提供运维管理页面,对HetuEngine的多个计算实例进行运维管理操作,包括启动、停止、删除计算实例,对计算实例进行资源配置,扩缩容等。 HetuEngine On Yarn原理 如前所述,On Yarn就是把进程运行在了Yarn 的container中。HetuEngine 是如何实现将coordinator 和worker运行中Yarn中呢? Yarn Service提供了一系列API以及一个通用的AM,让用户可以调用API即可将任务提交到Yarn上,由Yarn实现任务的容器化,对容器进行资源和生命周期管理。详细请参考开源社区的介绍。https://hadoop.apache.org/docs/r3.1.0/hadoop-yarn/hadoop-yarn-site/yarn-service/Overview.html HetuEngine的 On Yarn实现正是借助了Yarn Service所提供的能力。在HetuEngine的HSBroker中,调用Yarn Service的API,拉起application,在container中运行HetuEngine自己的进程,也就是coordinator和worker。其中有以下几个关键点: Yarn Service API 创建一个Yarn Service服务的接口是/app/v1/services,参数json结构如下。 POST /app/v1/services { "name": "hello-world", "version": "1.0.0", "description": "hello world example", "components" : [ { "name": "hello", "number_of_containers": 1, "artifact": { "id": "nginx:latest", "type": "DOCKER" }, "launch_command": "./start_nginx.sh", "resource": { "cpus": 1, "memory": "256", "additional" : { "yarn.io/gpu" : { "value" : 4, "unit" : "" } } } } ] name:服务名称,显示在Yarn的resource manager WEB界面servicename; version:版本号 description:服务的描述 components:一个service中可以包含多个component,以运行不同的任务; components.name:component名称 number_of_containers:此component中container的数量; artifact:进程依赖的资源文件,包含id和type信息,type支持docker和tarball launch_command:进程启动命令 resource:此component所需的资源。 HetuEngine的HSBroker根据用户输入构造此json,然后调用Yarn Service API,实现On Yarn。此外Yarn Service还提供stop/delete等API,也由HSBroker调用,实现对HetuEngine计算实例的停止/删除等运维操作。 依赖文件 Yarn Service支持资源文件在HDFS上的形式启动进程,其提供的API可以接收tar包以及docker等形式的资源文件,由Yarn Service自行将HDFS上的文件进行资源本地化。因此,HetuEngine只需将依赖的jar包和资源文件提前部署在HDFS上的指定位置,在调用Yarn Service的API时指定资源文件即可。 租户绑定 HetuEngine支持将计算实例与Yarn的租户队列绑定,每个队列上都可以运行一套coordinator + worker的组合。基于前面Yarn Service能力,只需在构造json时,指定队列信息即可。除了队列,还可以设置container的放置策略(plecement policy),这里不进行详述,可以参考yarn的文档。 资源管理 HetuEngine支持用户自定义coordinator和worker的个数以及CPU内存大小。如下图,在HetuEngine的HSConsole页面,用户可以设置计算实例的CPU,内存,节点个数。内部实现是由HSBroker接收用户输入,将container运行所需的资源大小设置在json的resource段中。 当前HetuEngine支持横向扩展worker的个数,实现资源的弹性伸缩。即使在计算实例处于运行中时,也可以手动调整worker的个数,无需重启计算实例。这得益于Yarn Service的API中提供的flex接口,可以实现向一个运行中的application增加或者减少container的数量。 客户端使用 HetuEngine的计算实例创建完成后,用户可以通过hetu-cli或者JDBC程序进行访问,需要用户绑定对应的租户队列权限,才能向指定的队列提交任务。 Hetu CLI示例: hetu-cli --catalog hive --tenant tenantName --schema schemaName 租户名:(可选)租户名。指定HetuEngine启动的租户资源队列,不指定为租户的默认队列。使用此参数时,kinit的用户需要具有该租户对应角色的权限。 Hetu JDBC示例: Properties properties = new Properties(); ...… properties.setProperty("tenant", "default"); properties.setProperty("deploymentMode", "on_yarn"); …… connection = DriverManager.getConnection(url, properties); …… 本文主要介绍了HetuEngine On Yarn的原理,其实现主要是借助了Yarn Service提供的能力,感兴趣的读者可以深入阅读开源社区相关的介绍。 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

Greenplum测试框架最全解析

软件测试是开发过程中十分重要的一环,在数据库领域更是如此。一款稳定、可靠的数据库离不开大量的测试作为支撑。 Greenplum 作为一款基于 Postgres 的开源数据库,在测试方面做出了大量的探索。除继承了 Postgres 原有的 regress 测试外,增加了 Fault Injector 框架。允许开发者在回归测试中,通过执行简单的 SQL 函数,对数据库注入真实场景中可能出现各种的故障。此外, Greenplum 还开发了新的 isolation 测试框架 (isolation2),开发者可以用更简单易懂的语法编写出在各种并发情况下,可能出现的数据竞争的测试用例。配合 Fault Injector 框架,能够涵盖范围非常广的测试场景。 本文主要结合一些实际的案例介绍这些测试框架的使用场景和使用方式, 在后续的文章中会介绍这些框架的原理,欢迎大家留言交流。 regress regress 测试位于 Greenplum/Postgres 源代码的 src/test/regress 目录下。这些测试通常包含: 测试用例:一组 SQL 语句 (.sql 文件) 期待输出:测试用例执行后, Postgres 的正确输出 (.out 文件) 这些测试由 pg_regress 调度执行。执行结束后通过对预期输出和实际输出进行对比 (通常会自动生成一个 regression.diffs 的文件),即可知道哪些测试没有通过,以及原因是什么。利用 regress 测试,我们可以做一些功能性的测试。例如:测试一些带有复杂过滤条件的 SELECT 语句的输出结果是否正确,测试一些 SQL 生成的执行计划是否符合预期。这些测试都有一个特点,那就是不管在什么情况下,它们的输出都应该是一致且恒定的。 尽管 regress 测试能够满足大部分的功能性测试,但还有一些有趣的测试场景值得讨论。比如数据库中的隔离和并发问题。虽然 pg_regress 支持并行地执行多个测试用例,但我们并不能利用它来验证一些时序上的问题 (我们倒是可以利用它来加速一些测试)。因为这些并行的测试用例中 SQL 语句的执行次序是没有保证的,我们无法得到稳定的输出,也就无法跟预期的输出进行对比了。而下面要介绍的 isolation & isolation2 就是为这类测试而设计的。 isolation & isolation2 isolation 测试位于 Greenplum/Postgres 源代码的 src/test/isolation 目录下。目前 Greenplum 中的 isolation 测试框架还不是很完善,Greenplum 仅在 Utility 模式下运行 Postgres 原生的 isolation 测试。Greenplum 大部分的和并发/隔离相关的测试由 isolation2 完成。 Postgres 原生的 isolation 测试包含: 测试用例:一组 .spec 文件,这些 .spec 文件除了包含待测试的 SQL 语句外,最重要的是还包含了对执行这些 SQL 语句顺序的定义。 期待输出:测试用例的 spec 被执行后, Postgres 的正确输出 (.out 文件)。 这些测试由 pg_isolation_regress 根据 .spec 文件中定义的执行顺序,调度不同的 Session 执行,下面给出的是 Postgres 中, 对于一种死锁的测试用例。 ## file: src/test/isolation/specs/deadlock-simple.spec setup { CREATE TABLE a1 (); } teardown { DROP TABLE a1; } session s1 setup { BEGIN; } step s1as { LOCK TABLE a1 IN ACCESS SHARE MODE; } step s1ae { LOCK TABLE a1 IN ACCESS EXCLUSIVE MODE; } step s1c { COMMIT; } session s2 setup { BEGIN; } step s2as { LOCK TABLE a1 IN ACCESS SHARE MODE; } step s2ae { LOCK TABLE a1 IN ACCESS EXCLUSIVE MODE; } step s2c { COMMIT; } permutations1ass2ass1aes2aes1cs2c 其中,setup 和 teardown 中包含的 SQL 语句分别会在测试运行前和结束后运行,在这个例子中是创建和删除表 a1. s1 和 s2 分别是这个测试中两个 Session 的名称。 在 s1 中,定义了 setup 时需要开始一段事务,还定义了 s1as, s1ae, s1c 这三个执行步骤: s1as:对表 a1 以 ACCESS SHARE 模式上锁 s1ae:对表 a1 以 ACCESS EXCLUSIVE 模式上锁 s1c:提交当前事务 在 s2 中,定义了 setup 时需要开始一段事务,还定义了 s2as, s2ae, s2c 这三个执行步骤: s2as: 对表 a1 以 ACCESS SHARE 模式上锁 s2ae: 对表 a1 以 ACCESS EXCLUSIVE 模式上锁 s2c: 提交当前事务 permutation 中定义了这些 SQL 语句执行的顺序: s1: 对表 a1 以 ACCESS SHARE 模式上锁 s2: 对表 a1 以 ACCESS SHARE 模式上锁 s1: 对表 a1 以 ACCESS EXCLUSIVE 模式上锁 <等待, s2 拿了 ACCESS SHARE 模式的锁> s2: 对表 a1 以 ACCESS EXCLUSIVE 模式上锁 <死锁发生, s1, s2 互相等待> pg_isolation_regress 执行完上面 .spec 文件中定义的 SQL 后, 正确输出如下: ## file: src/test/isolation/expected/deadlock-simple.out Parsed test spec with 2 sessions starting permutation: s1as s2as s1ae s2ae s1c s2c step s1as: LOCK TABLE a1 IN ACCESS SHARE MODE; step s2as: LOCK TABLE a1 IN ACCESS SHARE MODE; step s1ae: LOCK TABLE a1 IN ACCESS EXCLUSIVE MODE; <waiting ...> step s2ae: LOCK TABLE a1 IN ACCESS EXCLUSIVE MODE; ERROR: deadlock detected step s1ae: <... completed> step s1c: COMMIT; steps2c:COMMIT; 开发者可以在 .spec 文件中灵活的描述在不同 Session 中执行 SQL 语句的顺序,使得一些与并发/隔离相关的测试更为容易编写。 Greenplum 团队开发的 isolation2 测试框架,也是类似的思路,但 isolation2 的语法更简单易懂。下面是笔者利用 isolation2 编写的与上面一致的测试用例。 CREATE TABLE a1(); 1: BEGIN; -- s1 开始一段事务 1: LOCK TABLE a1 IN ACCESS SHARE MODE; -- s1 以 ACCESS SHARE 模式对 a1 上锁 2: BEGIN; -- s2 开始一段事务 2: LOCK TABLE a1 IN ACCESS SHARE MODE; -- s2 以 ACCESS SHARE 模式对 a1 上锁 1&: LOCK TABLE a1 IN ACCESS EXCLUSIVE MODE; -- s1 以 ACCESS EXCLUSIVE 模式对 a1 上锁 2: LOCK TABLE a1 IN ACCESS EXCLUSIVE MODE; -- s2 以 ACCESS EXCLUSIVE 模式对 a1 上锁 1<: -- 等待 s1 返回 1: COMMIT; -- s1 提交事务 2: COMMIT; -- s2 提交事务 DROPTABLEa1; 其中不同的数字表示在不同的 Session 中执行对应的 SQL,由上至下表示了 SQL 的执行顺序。‘&’ 表示当前的 Session 执行的 SQL 会被阻塞,‘<’ 表示等待当前的 Session 返回。isolation2 支持的语法非常丰富,这里就不一一列举了,有兴趣的读者可以浏览 Greenplum 源代码中 src/test/isolation2/sql 目录下的测试用例。 通过对比 isolation 与 isolation2,在功能方面,二者并没有很大的区别;在语法方面, isolation 的 .spec 文件更为严谨,当测试用例中需要多次调用相同的 SQL 语句时会十分方便。solation2 的语法更为灵活直观, 编写起来比较容易上手。 FaultInjector 真实世界中的故障往往要复杂许多,比如:网络可能会有很大的延迟,磁盘中的数据可能丢失,集群中的某台主机可能突然下线。Greenplum 团队开发的 Fault Injector 框架让这类测试变得十分容易。例如,我们希望在 heap 中插入 tuple 的时候,注入一些故障,观察这些故障对系统的影响。在 Greenplum master 分支的 src/backend/access/heap/heapam.c 中,有如下代码: // 注: 笔者为了叙述方便, 对这里的代码进行了调整, 与实际代码可能有些出入. void heap_insert(Relation relation, HeapTuple tup, CommandId cid, int options, BulkInsertState bistate, TransactionId xid) { ... #ifdef FAULT_INJECTOR FaultInjector_InjectFaultIfSet("heap_insert", /*faultname*/ DDLNotSpecified, /*ddlstatement*/ "", /*databasename*/ RelationGetRelationName(relation)); #endif ... } 当我们启用了 Fault Injector 后,每当代码执行到 FaultInjector_InjectFaultIfSet() 时,Fault Injector 会检测当前的注入点是否被注入了故障,如果有,则执行相关的故障逻辑。利用 gp_inject_fault 插件可以很容易的在注入点注入故障逻辑。下面这段 SQL 演示了如何在 Greenplum 集群中,在编号为 1 的 Segment Server 上, ‘heap_insert’ 这一注入点,注入一段死循环。以此来模拟实际场景中,某个 Segment Server 发生了故障,无法正常地插入 tuple 到表 my_table 中的情况。 CREATE EXTENSION gp_inject_fault; SELECT gp_inject_fault('heap_insert' /* inject location */, 'infinite_loop' /* fault type */, '' /* DDL */, '' /* database name */, 'my_table' /* table name */, 1 /* start occurrence */, 10 /* end occurrence */, 0 /* extra arg */, dbid) FROMgp_segment_configurationWHEREcontent=1ANDrole='p'; 除了可以注入 ‘infinite_loop’ 外,Fault Injector 还支持注入以下常见的几种故障: error:等价于 elog(ERROR) fatal:等价于 elog(FATAL) panic:等价于 elog(PANIC) sleep:休眠一段时间 suspend:阻塞当前的进程, 并且不检查中断信号 resume:恢复被注入 ‘suspend’ 故障的进程 skip:用来注入一些自定义的故障逻辑 reset:移除之前注入的故障 segv:使当前的进程崩溃 (发送 SIGSEGV 信号) ... 有关其它的故障类型以及更多的使用方法,可以参阅 gpcontrib/gp_inject_fault/README。目前 Postgres 还不支持 Fault Injector 框架, Greenplum 团队向上游提交了 Patch,感兴趣的读者可以下载这个 Patch[1] 体验。 后 记 ‍ ‍ ‍ ‍ ‍ ‍ 笔者自己上手一个新项目时,喜欢从一些测试用例开始摸索。通过一些简单的测试用例可以窥知一款软件的基本功能,之后配合 git blame 便可以顺藤摸瓜,找到引入这些测试用例的 commit 记录。有时候它可能是修复了一个 Bug,也可能是引入了一个新功能,这样就可以学习到开发这个功能时该如何写测试,该去修改哪些代码。最后,希望大家多多为 Greenplum 贡献代码/Issue。 参考资料 [1] Fault Injector Framework: https://www.postgresql.org/message-id/flat/CANXE4TdxdESX1jKw48xet-5GvBFVSq%3D4cgNeioTQff372KO45A%40mail.gmail.com 郭兴,VMware Greenplum实习生 东南大学研究生在读, 2021 年 9 月加入 Greenplum 团队开启实习工作, 参与 Greenplum Extension 研发。 点击文末“ 阅读原文 ”,获取Greenplum中文资源。 来一波 “在看”、“分享” 和 “赞” 吧! 本文分享自微信公众号 - Greenplum中文社区(GreenplumCommunity)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

@vue/composition-api 解析

前言 组合式 API 是 vue3 提出的一个新的开发方式,而在 vue2 中我们可以使用新的组合式 API 进行组件开发。本篇通过一个例子,来分析这个插件是如何提供功能。 关于该插件的安装、使用,可以直接阅读文档。 安装 我们从最开始安装分析,一探究竟。 vue.use 按照文档所提到的,我们必须通过 Vue.use() 进行安装: // vue.use 安装 import Vue from 'vue' import VueCompositionAPI from '@vue/composition-api' Vue.use(VueCompositionAPI) 复制代码 我们先看入口文件: // index.js import type Vue from 'vue' import { Data, SetupFunction } from './component' import { Plugin } from './install' export default Plugin // auto install when using CDN if (typeof window !== 'undefined' && window.Vue) { window.Vue.use(Plugin) } 复制代码 可以知道我们 Vue.use 时,传入的就是 install 文件中的 Plugin 对象。 // install.ts 折叠源码 export function install(Vue: VueConstructor) { if (isVueRegistered(Vue)) { if (__DEV__) { warn( '[vue-composition-api] already installed. Vue.use(VueCompositionAPI) should be called only once.' ) } return } if (__DEV__) { if (Vue.version) { if (Vue.version[0] !== '2' || Vue.version[1] !== '.') { warn( `[vue-composition-api] only works with Vue 2, v${Vue.version} found.` ) } } else { warn('[vue-composition-api] no Vue version found') } } Vue.config.optionMergeStrategies.setup = function ( parent: Function, child: Function ) { return function mergedSetupFn(props: any, context: any) { return mergeData( typeof parent === 'function' ? parent(props, context) || {} : undefined, typeof child === 'function' ? child(props, context) || {} : undefined ) } } setVueConstructor(Vue) mixin(Vue) } export const Plugin = { install: (Vue: VueConstructor) => install(Vue), } 复制代码 install 通过上面的代码和 Vue.use 可知,我们安装时其实就是调用了 install 方法,先分析一波 install。根据代码块及功能可以分成三个部分: 前两个大 if 的开发 check 部分 关于 setup 合并策略 通过 mixin 混入插件关于 组合式 API 的处理逻辑 第一部分中的第一个 if 是为了确保该 install 方法只被调用一次,避免浪费性能;第二个 if 则是确保vue版本为2.x。不过这里有个关于第一个if的小问题:多次注册插件时,Vue.use 自己本身会进行重复处理——安装过的插件再次注册时,不会调用 install 方法(Vue.use代码见下)。那么这个 if 的目的是啥? // Vue.use 部分源码 Vue.use = function (plugin: Function | Object) { const installedPlugins = (this._installedPlugins || (this._installedPlugins = [])) if (installedPlugins.indexOf(plugin) > -1) { return this } // additional parameters const args = toArray(arguments, 1) args.unshift(this) if (typeof plugin.install === 'function') { plugin.install.apply(plugin, args) } else if (typeof plugin === 'function') { plugin.apply(null, args) } installedPlugins.push(plugin) return this } 复制代码 根据上面代码可知 Vue.use 实际上还是传入 vue 并调用插件的 install 方法,那么如果有大神(或者是奇葩?)绕过 Vue.use 直接调用,那么这个 if 的判断就生效了。如下方代码,此时第二个 install 会判断重复后,抛出错误 // 直接调用 install import Vue from 'vue' import VueCompositionAPI from '@vue/composition-api' import App from './App.vue' Vue.config.productionTip = false VueCompositionAPI.install(Vue) VueCompositionAPI.install(Vue) 复制代码 报错: 第二部分的合并策略是“Vue.config.optionMergeStrategies”这个代码块。Vue 提供的这个能力很生僻,我们日常的开发中几乎不会主动接触到。先上文档: 这是用来定义属性的合并行为。比如例子中的 extend 在调用时,会执行 mergeOptions。 // Vue.extend Vue.extend = function (extendOptions) { const Super = this extendOptions = extendOptions || {} Sub.options = mergeOptions( Super.options, extendOptions ) } 复制代码 而 mergeOptions 里关于 _my_option的相关如下: const strats = config.optionMergeStrategies function mergeOptions (parent, child, vm){ for (key in parent) { mergeField(key) } for (key in child) { if (!hasOwn(parent, key)) { mergeField(key) } } function mergeField (key) { const strat = strats[key] || defaultStrat options[key] = strat(parent[key], child[key], vm, key) } } 复制代码 这里的 parent 就是 Super.options 也就是 Vue.options,而 child 就是 extendOptions 也就是我们传入的 { _my_option: 1 }。在这里使用了两个 for 循环,确保父子元素种所有的 key 都会执行到 mergeField,而第二个 for 循环中的 if 判断确保不会执行两次,保证了正确性及性能。而 mergeField 则是最终执行策略的地方。从 strats 中获取到我们定义的方法,把对应参数传入并执行,在这里就是: // demo执行 strat(undefined, 1, vm, '_my_option') // return 2 复制代码 顺便一提,Vue.mixin 的实现就是 mergeOptions,也就是说当我们使用了 mixin 且里面具有 setup 属性时,会执行到上述合并策略。 Vue.mixin = function (mixin) { this.options = mergeOptions(this.options, mixin) return this } 复制代码 而我们插件中相关的策略也很简单,获取好定义的父子 setup,然后合并成一个新的,在调用时会分别执行父子 setup,并通过 mergeData 方法合并返回: // optionMergeStrategies.setup Vue.config.optionMergeStrategies.setup = function ( parent: Function, child: Function ) { return function mergedSetupFn(props: any, context: any) { return mergeData( typeof parent === 'function' ? parent(props, context) || {} : undefined, typeof child === 'function' ? child(props, context) || {} : undefined ) } } 复制代码 第三部分则是通过调用 mixin 方法向 vue 中混入一些事件,下面是 mixin 的定义: function mixin(Vue) { Vue.mixin({ beforeCreate: functionApiInit, mounted(this: ComponentInstance) { updateTemplateRef(this) }, updated(this: ComponentInstance) { updateTemplateRef(this) } }) function functionApiInit() {} function initSetup() {} // 省略... } 复制代码 可以看到 mixin 内部调用了 Vue.mixin 来想 beforeCreate、mounted、updated 等生命周期混入事件。这样就完成 install 的执行, Vue.use(VueCompositionAPI) 也到此结束。 初始化 — functionApiInit functionApiInit 执行 我们知道在new Vue 时,会执行组件的 beforeCreate 生命周期。此时刚才通过 Vue.mixin 注入的函数 “functionApiInit”开始执行。 function Vue (options) { this._init(options) } Vue.prototype._init = function (options) { initLifecycle(vm) initEvents(vm) initRender(vm) callHook(vm, 'beforeCreate') // 触发 beforeCreate 生命周期,执行 functionApiInit initInjections(vm) // resolve injections before data/props initState(vm) initProvide(vm) // resolve provide after data/props callHook(vm, 'created') } 复制代码 该方法也很清晰,分别暂存了组件最开始的 render方法和 data方法(我们平常写的 data 是一个函数),然后在这基础上又扩展了一下这两个方法,达到类似钩子的目的。 function functionApiInit(this: ComponentInstance) { const vm = this const $options = vm.$options const { setup, render } = $options if (render) { // keep currentInstance accessible for createElement $options.render = function (...args: any): any { return activateCurrentInstance(vm, () => render.apply(this, args)) } } if (!setup) { return } if (typeof setup !== 'function') { if (__DEV__) { warn( 'The "setup" option should be a function that returns a object in component definitions.', vm ) } return } const { data } = $options // wrapper the data option, so we can invoke setup before data get resolved $options.data = function wrappedData() { initSetup(vm, vm.$props) return typeof data === 'function' ? (data as ( this: ComponentInstance, x: ComponentInstance ) => object).call(vm, vm) : data || {} } } 复制代码 虽然是先扩展的 render,但在 new Vue 的实际执行中会优先执行下方扩展的方法 “wrappedData”。因为 data 的执行是在 new Vue 时发生,而 render 的执行在 $mount 中。所以我们这里就按照执行顺序来看看如何扩展我们的 wrappedData。 wrappedData 这里只是简单执行了 initSetup 方法,对原先的 data 做了判断。这里是因为 Vue 执行时拿到的 data 已经是 wrappedData 这个函数而不是用户编写的 data,所以关于原 data 的处理移交在了 wrappedData 中。可以说 99%的逻辑都在 initSetup 中。我们接下来看这个方法。 setup 调用及处理 这块是通过 initSetup 函数实现的,代码很长且仅有几行是这里不用关心的(可自行研究),整体上可以跟着注释走一遍。 function initSetup(vm: ComponentInstance, props: Record<any, any> = {}) { // 获取定义好的 setup const setup = vm.$options.setup! // 创建 setup 方法接收的第二个参数 context,主流程中使用不上,先忽略 const ctx = createSetupContext(vm) // fake reactive for `toRefs(props)` // porps 相关,主流成可先忽略(毕竟可以不写 props...) def(props, '__ob__', createObserver()) // resolve scopedSlots and slots to functions // slots 相关,同 props 先忽略 // @ts-expect-error resolveScopedSlots(vm, ctx.slots) let binding: ReturnType<SetupFunction<Data, Data>> | undefined | null // 执行 setup activateCurrentInstance(vm, () => { // make props to be fake reactive, this is for `toRefs(props)` binding = setup(props, ctx) }) // 以下都是根据 setup 返回值,进行的一些处理 if (!binding) return if (isFunction(binding)) { // setup 可以返回一个渲染函数(render) // keep typescript happy with the binding type. const bindingFunc = binding // keep currentInstance accessible for createElement // 获取到渲染函数后,手动添加再 vue 实例上 vm.$options.render = () => { // @ts-expect-error resolveScopedSlots(vm, ctx.slots) return activateCurrentInstance(vm, () => bindingFunc()) } return } else if (isPlainObject(binding)) { // setup 返回的是一个普通对象 if (isReactive(binding)) { // 如果返回的是通过 reactive 方法定义的对象,需要通过 toRefs 结构 binding = toRefs(binding) as Data } // 用于 slots 及 $refs ,先忽略 vmStateManager.set(vm, 'rawBindings', binding) const bindingObj = binding // 遍历返回值,做一些处理 Object.keys(bindingObj).forEach((name) => { let bindingValue: any = bindingObj[name] if (!isRef(bindingValue)) { if (!isReactive(bindingValue)) { if (isFunction(bindingValue)) { bindingValue = bindingValue.bind(vm) } else if (!isObject(bindingValue)) { bindingValue = ref(bindingValue) } else if (hasReactiveArrayChild(bindingValue)) { // creates a custom reactive properties without make the object explicitly reactive // NOTE we should try to avoid this, better implementation needed customReactive(bindingValue) } } else if (isArray(bindingValue)) { bindingValue = ref(bindingValue) } } asVmProperty(vm, name, bindingValue) }) return } // 不是对象和方法时,在开发环境下抛错 if (__DEV__) { assert( false, `"setup" must return a "Object" or a "Function", got "${Object.prototype.toString .call(binding) .slice(8, -1)}"` ) } } 复制代码 我们先聚焦到 setup 的执行。setup 包裹在 activateCurrentInstance 方法中,activateCurrentInstance 目的是为了设置当前的实例。类似我们平常写的交换a、b变量的值。setup 在调用前,会先获取 currentInstance 变量并赋值给 preVm,最开始时currentInstance 为 null。接着再把 currentInstance 设置成当前的 vue 实例,于是我们变可以在 setup 通过 插件提供的 getCurrentInstance 方法获取到当前实例。在执行完毕后,又通过 setCurrentInstance(preVm) 把 currentInstance 重置为null。所以印证了文档中所说的,只能在 setup 及生命周期(不在本篇重点)中使用 getCurrentInstance 方法。 // setup执行 activateCurrentInstance(vm, () => { // make props to be fake reactive, this is for `toRefs(props)` binding = setup(props, ctx) }) function activateCurrentInstance(vm, fn, onError) { let preVm = getCurrentVue2Instance() setCurrentInstance(vm) try { return fn(vm) } catch (err) { if (onError) { onError(err) } else { throw err } } finally { setCurrentInstance(preVm) } } let currentInstance = null function setCurrentInstance(vm) { // currentInstance?.$scopedSlots currentInstance = vm } function getCurrentVue2Instance() { return currentInstance } function getCurrentInstance() { if (currentInstance) { return toVue3ComponentInstance(currentInstance) } return null } 复制代码 这里有个思考,为什么需要在最后把 currentInstance 设置为 null?我们写了一个点击事件,并在相关的事件代码里调用了getCurrentInstance 。如果在 setup 调用重置为 null ,那么在该事件里就可能导致获取到错误的 currentInstance。于是就置为null 用来避免这个问题。(个人想法,期待指正)。 setup 内部可能会执行的东西有很多,比如通过 ref 定义一个响应式变量,这块放在后续单独说。 当获取完 setup 的返回值 binding 后,会根据其类型来做处理。如果返回函数,则说明这个 setup 返回的是一个渲染函数,便把放回值赋值给 vm.$options.render 供挂载时调用。如果返回的是一个对象,则会做一些相应式处理,这块内容和响应式相关,我们后续和响应式一块看。 // setup 返回对象 if (isReactive(binding)) { binding = toRefs(binding) as Data } vmStateManager.set(vm, 'rawBindings', binding) const bindingObj = binding Object.keys(bindingObj).forEach((name) => { let bindingValue: any = bindingObj[name] if (!isRef(bindingValue)) { if (!isReactive(bindingValue)) { if (isFunction(bindingValue)) { bindingValue = bindingValue.bind(vm) } else if (!isObject(bindingValue)) { bindingValue = ref(bindingValue) } else if (hasReactiveArrayChild(bindingValue)) { // creates a custom reactive properties without make the object explicitly reactive // NOTE we should try to avoid this, better implementation needed customReactive(bindingValue) } } else if (isArray(bindingValue)) { bindingValue = ref(bindingValue) } } asVmProperty(vm, name, bindingValue) }) 复制代码 我们这里只看重点函数 “asVmProperty”。我们知道 setup 返回的是一个对象 (赋值给了 binding / bindingObj),且里面的所有属性都能在 vue 的其他选项中使用。那么这块是如何实现的呢? 访问 setup 返回值 — asVmProperty 实现 这个函数执行后,我们就可以在 template 模版及 vue 选项中访问到 setup 的返回值,的下面是“asVmProperty” 这个函数的实现: function asVmProperty(vm, propName, propValue) { const props = vm.$options.props if (!(propName in vm) && !(props && hasOwn(props, propName))) { if (isRef(propValue)) { proxy(vm, propName, { get: () => propValue.value, set: (val: unknown) => { propValue.value = val }, }) } else { proxy(vm, propName, { get: () => { if (isReactive(propValue)) { ;(propValue as any).__ob__.dep.depend() } return propValue }, set: (val: any) => { propValue = val }, }) } } } function proxy(target, key, { get, set }) { Object.defineProperty(target, key, { enumerable: true, configurable: true, get: get || noopFn, set: set || noopFn, }) } 复制代码 函数很短,这里有3个处理逻辑: 普通属性的 get 和 set 正常返回 如果是 ref 类型的属性(通过 ref 创建),通过 vm.xxx 访问/修改时,访问/修改 ref 的 value 属性 代理 reactive 类型的属性 (通过 reactive 创建),reactive 返回的是一个响应式对象。当访问这个对象时, 需要调用 响应式对象种的 depend 收集watcher(观察者),以便数据更新时通知 watcher 进行更新。 总之 asVmProperty 是拿到 setup 返回值中的一个键值对后,再通过 Object.defineProperty 劫持了 this(是vm,也就是组件实例)中访问改键值对的 get 和 set,这样我们便可以通过 this.xxx 访问到 setup 中return 出去的属性。 而模版访问也同理,因为 template 编译成 render 后,上面的变量都实际会编译成 _vm.xxx,而 _vm 就是 this ,也就是组件实例。 结语 创作不易,如果对大家有所帮助,希望大家点赞支持,有什么问题也可以在评论区里讨论😄~ 如果你觉得这篇文章对你有点用的话,麻烦请给我们的开源项目点点star: http://github.crmeb.net/u/defu 不胜感激 ! 来自 “开源独尊 ” ,链接: https://ym.baisou.ltd/post/847.html

优秀的个人博客,低调大师

基本操作命令解析(续)

文章目录 1. 链接文件 (1)软链接: (2)硬链接: 2. 复制、删除、移动目录和文件 (1) cp (2)mv (3) rm 3. 查找目录和文件 (1) Which: (2) whereis (3)find 4. 查看文件内容 (1) cat (2) more (3) less (4) head (5) tail 5. 统计文件内容 6. 检索和过滤文件内容 (1) grep (2) cut (3) sort 7. 归档和压缩命令 (1) gzip命令、bzip2命令 (2)tar命令 8. 如何从linux 服务器上传/下载文件 9. vim 文档编辑 (1)vim工作模式 (2)vim光标操作: (3) vim编辑文档 (4)vim查找与替换 (5)vim保存并退出 (6)vim扩展小知识 1. 链接文件 (1)软链接: [root@rhcsa ~]# touch hello.txt [root@rhcsa ~]# ln -s /root/hello.txt /tmp/hi.txt //创建文件软链接 [root@rhcsa ~]# ll /tmp/hi.txt lrwxrwxrwx. 1 root root 15 Jan 27 17:36 /tmp/hi.txt -> /root/hello.txt [root@rhcsa ~]# mkdir test [root@rhcsa ~]# ln -s /root/test/ /var/test/ [root@rhcsa ~]# ll /var/test/ //创建目录软链接 total 0 lrwxrwxrwx. 1 root root 11 Jan 27 17:48 test -> /root/test/ (2)硬链接: [root@rhcsa ~]# ln /root/hello.txt /root/hello-1.txt //创建硬链接 [root@rhcsa ~]# rm -rf hello.txt //源文件删除后,链接文件仍可以正常使用 [root@rhcsa ~]# ll /root/hello-1.txt -rw-r--r--. 1 root root 0 Jan 27 17:34 /root/hello-1.txt 2. 复制、删除、移动目录和文件 (1) cp 功能描述:复制(copy)文件或目录 语法:cp [选项]… 源文件或目录… 目标文件或目录 选项: -r:递归复制整个目录树 -p:保持源文件的属性不变 -f:强制覆盖目标同名文件或目录 -i:需要覆盖文件或目录时进行提醒 (2)mv 功能描述:移动(move)文件或目录—若如果目标位置与源位置相同,则相当于改名 语法:mv [选项]... 源文件或目录... 目标文件或目录 [root@Gming ~]# mv file file.bak //将file改名为file.bak [root@Gming ~]# mv /tmp/vitest/ ./ //将/tmp/vitest/移动到当前目录 (3) rm 功能描述:删除(remove)文件或目录 语法:rm [选项] [文件或目录] 选项: -r 删除目录以及目录下的所有内容(递归删除) -f 不提示,强制删除 -I 删除前,提示是否删除 3. 查找目录和文件 (1) Which: 功能描述:查找linux命令文件并显示所在的位置----搜索范围由PATH环境变量指定 语法:which命令或程序名 [root@rhcsa tmp]# which cd /usr/bin/cd [root@rhcsa tmp]# which mkdir /usr/bin/mkdir [root@rhcsa tmp]# (2) whereis 功能描述:该指令会在特定目录中查找符合条件的文件。这些文件应属于原始代码、二进制文件,或是帮助文件。 该指令只会用于查找二进制文件、源代码文件和man手册页,一般文件的定位需使用locate命令。 语法:whereis 命令 选项: -b 只查找二进制文件 -m 只查找说明文件 [root@rhcsa tmp]# whereis bash bash: /usr/bin/bash /usr/share/man/man1/bash.1.gz /usr/share/info/bash.info.gz [root@rhcsa tmp]# whereis -b bash bash: /usr/bin/bash [root@rhcsa tmp]# whereis -m bash bash: /usr/share/man/man1/bash.1.gz /usr/share/info/bash.info.gz (3)find 功能描述:用于查找文件或目录 语法:find【path】-option 选项: -name 按文件名称查找 -size 按文件大小查找 -user 按文件属主查找 —用的不多 -type 按文件类型查找常用查找条件:  f:文件  d:目录  l:符号链接(软链接)高级查找条件: -perm 按权限进行查找 -ctime(-cmin) 按文件创建时间(天为单位)查找 -atime (-amin) 按访问时间查找 -mtime (-min) 修改时间查找 -maxdepth 限制find的递归层级 ! 取反操作 -exec 查找后再执行操作 find /etc -name "resol*.conf" # 查找/etc/下名字为resol开头以.conf结尾的文件 find / -type d -empty # 检索用户主目录下所有的空目录 find /usr -type f ! -name &apos;*.txt&apos; # 检索 /usr 下所有文件名不以 .txt 为后缀的文件。 按照时间相关 -mtime 2 :该文件 2 天前被修改过 -mtime -2:该文件 2 天以内被修改过 -mtime +2:该文件距离上次修改已经超过 2 天时间 find /usr -type f -mtime +50 -mtime -100 # 检索 /usr 下 50 到 100 天之前修改过的文件 find /usr -type f -mtime 2 -amin 5 # 检索 /usr 下两天前被修改过且 5 分钟前又读取过的文件 按照文件大小查找 find / -size +1G 检索文件大小高于 1 GB 的文件按照权限查找 find /usr -perm 644 # 搜索 /usr 目录下权限为 644(即 rw-r--r--)的文件 限制递归层级 find 命令默认是以递归的方式检索项目的,这有时候会导致得到的结果数量非常巨大。可以使用 -maxdepth 限制 find 命令递归的层数。 find / -maxdepth 3 # 搜索时向下递归的层数最大为 3 逻辑组合: find 命令支持 “and” 和 “or” 两种逻辑运算 find / -name *.log -a -type l #查找文件名有".log"并且类型为链接的文件 find / -name *.log -o -name "*.txt" #查找文件名为".log"或".txt"的文件 执行自定义命令 -exec 命令 {} ; find / -type f -exec grep -l root {} ; find /etc -name “*” | xargs grep -nH “root” # 查找/etc下 name所有 过滤出内容包含hello 的文件内容 4. 查看文件内容 (1) cat 功能描述:显示文件内容(文件内容全部显示出来) cat [选项] [文件] 选项: -b 显示行号,空白行不显示行号 -n 显示行号,包括空白行 [root@Gming ~]# cat -n passwd [root@Gming ~]# cat -b passwd (2) more 功能描述:全屏方式分页显示文件内容 语法:more [选项] 文件名… (空格)或f 显示下一页 (enter)显示下一行 Q或Q 退出 [root@Gming ~]# more /var/log/messages (3) less 功能描述:查看分页文件内容,空格(下一页)、方向键(上下回翻)、q键(推出查看) [root@Gming ~]# less /var/log/messages (4) head 功能描述:查看文件的前几行,默认显示前10行内容 语法:head [选项] [文件名] 语法: -c nk 显示文件前nkb的内容 -n 显示文件前n行的内容 [root@Gming ~]# head -c 2k /var/log/messages //查看文件的前2kb内容 [root@Gming ~]# head -5 /var/log/messages //查看文件前5行的内容 (5) tail 功能描述:查看文件的尾部内容 语法:tail [选项] [文件] 选项: -n 显示文件的后n行 -f 动态显示文件内容 -c nk 显示文件末尾nkb的内容 5. 统计文件内容 wc: 功能描述:统计文件中的单词数量(word count)等信息 语法:wc [选项]… 目标文件… 选项: -l 统计行数 -w 统计单词个数 -c 统计字节数 [root@Gming ~]# wc /etc/passwd 25 50 1229 /etc/passwd //依次显示文件的行数、单词数、字节数 [root@Gming ~]# wc -l < /etc/passwd 25 //显示文件的行数 [root@Gming ~]# wc -w < /etc/passwd 50 //显示文件的单词数 [root@Gming ~]# wc -c < /etc/passwd 1229 //显示文件的字节数 6. 检索和过滤文件内容 (1) grep 功能描述:在文件中查找并显示包含指定字符串的行 语法:grep [选项]… 查找条件 目标文件 常用命令选项: -i 查找时忽略大小写 -v 反转查找,输出与查找条件不相符的行 -l 列出文件内容符合指定的样式的文件名称 -An 搜索时显示匹配到的那一行以及下n行 -Bn 搜索时显示匹配到的那一行以及上n行 -Cn 搜索时显示匹配到的那一行以及上下n行 查找条件设置: 要查找的字符串用双引号括起来 “^……”表示以……开头 “……KaTeX parse error: Expected group after '^' at position 11: ”表示以……结尾 “^̲”表示空行 [root@Gming ~]# grep root /etc/passwd root: x:0:0:root:/root:/bin/bash //在/etc/passwd文件中过滤出包含root的行 operator:x11:0:operator:/root:/sbin/nologin [root@Gming ~]# grep --color root /etc/passwd //对匹配度的关键字高亮显示 [root@Gming ~]# grep -v root /etc/passwd //查找文件中不包含root的行 [root@Gming ~]# grep -v "^#" /etc/hosts //查找非注释行(不是以“#”开头的行) 显示/etc/passwd文件中以“lp”开头那一行以及上下4行内容: (2) cut 功能描述:命令用于显示每行从开头算起num1 到num2的文字 语法:cut [选项] 选项: -b 以字节为单位进行分割。这些字节位置将忽略多字节字符边界,除非也指定 -n标志 -c 以字符为单位进行分割 -d 自定义分隔符,默认为制定符 -f 与-d一起使用,指定显示哪个区域 -n 取消分割多字节字符。仅和-b标志一起使用 打印/etc/passwd文件中每一行以“:”为分隔符的第一个区域 [root@Gming ~]# cut -d':' -f1 /etc/passwd 在过滤/etc/passwd文件的’/bin/bash’后以“:”为分隔符打印第1,6行内容 [root@Gming ~]# grep '/bin/bash' /etc/passwd | cut -d':' -f1,6 root:/root redhat:/home/redhat (3) sort 功能描述:用于将文本文件内容加以排序 语法:sort [选项] [文件] 选项: -b 忽略每行前面开始处的空格字符 -c 检查文件是否已经按照顺序排序 -d 排序时,处理英文字母、数字及空格字符外,忽略其他的字符 -f 排序时,将小写字母视为大写字母 -m 将几个排序好的文件进行合并 -M 将前面的3个字母依照月份的缩写进行排序 -n 依照数值的大小排序 -r 以相反的顺序来排序 -u 以为这是唯一的(unique),输出结果是去掉重复值 -o<输出文件> 将排序后的结果存入指定的文件 -t<分隔字符> 指定分隔符 -k 与-t一起使用,定义排序数值区域 [root@Gming ~]# sort -t: -k3 -n /etc/passwd //以“:”为分隔符,按照第3行顺序排序 [root@Gming ~]# sort -u /etc/passwd //去掉连续重复的字符 [root@Gming ~]# sort -r /etc/passwd //反向排序 7. 归档和压缩命令 (1) gzip命令、bzip2命令 .gz :gzip程序压缩的⽂件 *.bz2 :bzip2程序压缩的⽂件 *.tar :tar程序打包的数据,并没有经过压缩 *.tar.gz :tar程序打包的⽂件,其中经过gzip的压缩 *.tar.bz2:tar程序打包的⽂件,其中经过bzip2的压缩 ⽤途:制作压缩⽂件、解开压缩⽂件 命令格式: gzip [-9] ⽂件名… bzip2 [-9] ⽂件名… gzip -d .gz格式的压缩⽂件 bzip2 -d *.bz2格式的压缩⽂件 常用命令选项: -9 表示高压缩比,多在创建压缩包时用 -d 用于解开已经压缩过的文件 (2)tar命令 用途:制作归档文件、释放归档文件 格式:tar [选项]… 归档文件名 源文件或目录 tar [选项]… 归档文件名 [-C 目标文件] 常用命令选项: -c 创建.tar格式的包文件 -x 解开.tar格式的包文件 -v 输出详细信息 -f 表示使用归档文件 -p 打包时保留原始文件及目录的权限 -t 列表查看包内的文件 -C解包时指定释放的目标文件夹 -z 调用gzip程序进行压缩或解压 -j 调用bzip2程序进行压缩或解压 创建: -czvf -cjvf 解压: -xzvf -xjvf 8. 如何从linux 服务器上传/下载文件 (1)客户端是linux的操作系统 服务器-服务器之间传输 从服务器下载普通文件: scp 用户名@目标IP地址:文件名 目录名 向服务器上传文件: srp 要上传文件的全路径 用户名@目标IP地址:文件名 (2)客户端是windows的操作系统 从windows向linux上传:rz或者xftp工具 从linux下载文件:sz 文件路径或者xftp工具 scp ./aaa.sh root@192.168.88.100:/tmp 从普通用户复制文件到root用户的/tmp/目录 scp root@192.168.88.100:/tmp/bbb.sh ./ 复制root用户文件到普通用户的当前位置 9. vim 文档编辑 (1)vim工作模式 vim编辑器默认会进⼊普通模式,插⼊模式可以通过以下按键进⼊: a 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的后⾯ A 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的断尾 i 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的前⾯ I 进⼊插⼊模式,后续输⼊的内容将插⼊⾄当前光标的段⾸ o 进⼊插⼊模式并在当前⾏的后⾯创建新的空⽩⾏ O 进⼊插⼊模式并在当前⾏的前⾯创建新的空⽩⾏ (2)vim光标操作: h 光标向左移动⼀位 j 光标向下移动⼀⾏(以回⻋为换⾏符) k 光标向上移动⼀位 I 光标向右移动⼀位 gg 移动光标⾄⽂件⾸⾏ G 移动光标⾄⽂件末尾 nG 移动光标⾄第n⾏(n为数字,如n为10时表示第10⾏) ^ 光标移⾄当前⾏的⾸字符 $ 光标移⾄当前⾏的尾字符 fx 光标移⾄当前⾏的下⼀个x字符处(任意字符) Fx 光标移⾄当前⾏的上⼀个x字符处 w 光标向右移动⼀个单词 nw 光标向右移动n个单词(n为数字) b 光标向左移动⼀个单词 nb 光标向左移动n个单词(n为数组) (3) vim编辑文档 dd 删除⼀⾏ ndd 删除n⾏(n为数字) d$ 删除光标⾄⾏尾的内容 J 删除换⾏符,可以将两⾏合并为⼀⾏ u 撤销上⼀步操作,可以多次使⽤uu表示撤销两步操作 rx 将光标当前字符替换为x (x为任何键盘单个输⼊) yy 复制当前⾏ nyy 复制n⾏内容 p 粘贴⾄当前⾏之后 P 粘贴⾄当前⾏之前 (4)vim查找与替换 当⽂档很⻓时,我们可以通过查找快速定位要找的内容,在vim中通过“/” 关键词实现⾃上往下的查找功能: 如 /host 在当前⽂档的光标处向下查找host并显示,如果⼀个⽂档中有多个host,可以通过快捷键n 跳转⾄下⼀个匹配的关键词处, 快捷键 N 将跳转⾄上⼀个匹配的关键词处。 “?” 关键词实现了⾃下往上的查找功能: 如 ?host 从当前⽂档的光标处向上查找host并显示,此时快捷键n表示查看上⼀匹配, N 表示查找下⼀个匹配。 例如: [root@localhost ~]# cp /etc/passwd /root [root@localhost ~]# vim /root/passwd 通过上⾯两条命令复制⼀份临时测试⽂档并编辑,我们可以对该⽂件实现多种替换功能 : s/root/admin/ 将光标当前⾏中第⼀个出现的root替换为admin,没有则不替换 : s/root/admin/g 将光标当前⾏中所有的root替换为admin :3,5 s/sbin/bin/g 将第三⾏⾄第五⾏之间的所有sbin替换为bin :% s/nologin/fault/g 将所有⾏的nologin都替换为fault (5)vim保存并退出 :q! 不保存并退出(强制退出) :wq 保存并退出 :x 保存并退出 :w 保存(不退出) :w b.txt 另存为 b.txt (6)vim扩展小知识  显示行号::set number 或者简写为 :set nu  忽略大小写::set ignorecase  多窗口编辑 水平分割窗口 :split 垂直分割窗口 :vsplit Ctrl+w+h:快捷键表示跳转⾄左边⼀个窗⼝ Ctrl+w+I: 快捷键表示跳转⾄右边⼀个窗⼝ Ctrl+w+j: 快捷键表示跳转⾄上⾯⼀个窗⼝ Ctrl+w+k:快捷键表示跳转⾄下⾯⼀个窗⼝ 在命令模式下输⼊ :close 可以关闭当前窗⼝ 在命令模式下输⼊ :split second.txt 此命令会分割窗⼝并打开新的⽂件

优秀的个人博客,低调大师

HiPlot —— 高维数据解析

HiPlot是一款轻巧的交互式可视化工具,可帮助AI研究人员使用并行绘图和其他图形方式来表示信息,从而发现高维数据中的相关性和模式。 HiPlot 支持两种模式: 作为 Web 服务运行 (如果你的数据是 CSV 格式) 作为 jupyter notebook 运行(用于对 Python 数据进行可视化) pip install hiplot 如果你有 jupyter notebook, 可以使用如下方法快速上手: import hiplot as hip data = [{'dropout':0.1, 'lr': 0.001, 'loss': 10.0, 'optimizer': 'SGD'}, {'dropout':0.15, 'lr': 0.01, 'loss': 3.5, 'optimizer': 'Adam'}, {'dropout':0.3, 'lr': 0.1, 'loss': 4.5, 'optimizer': 'Adam'}] hip.Experiment.from_iterable(data).display() 实际运行效果

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册