首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10007篇文章
优秀的个人博客,低调大师

Flink 源码解析 —— 深度解析 Flink 是如何管理好内存的?

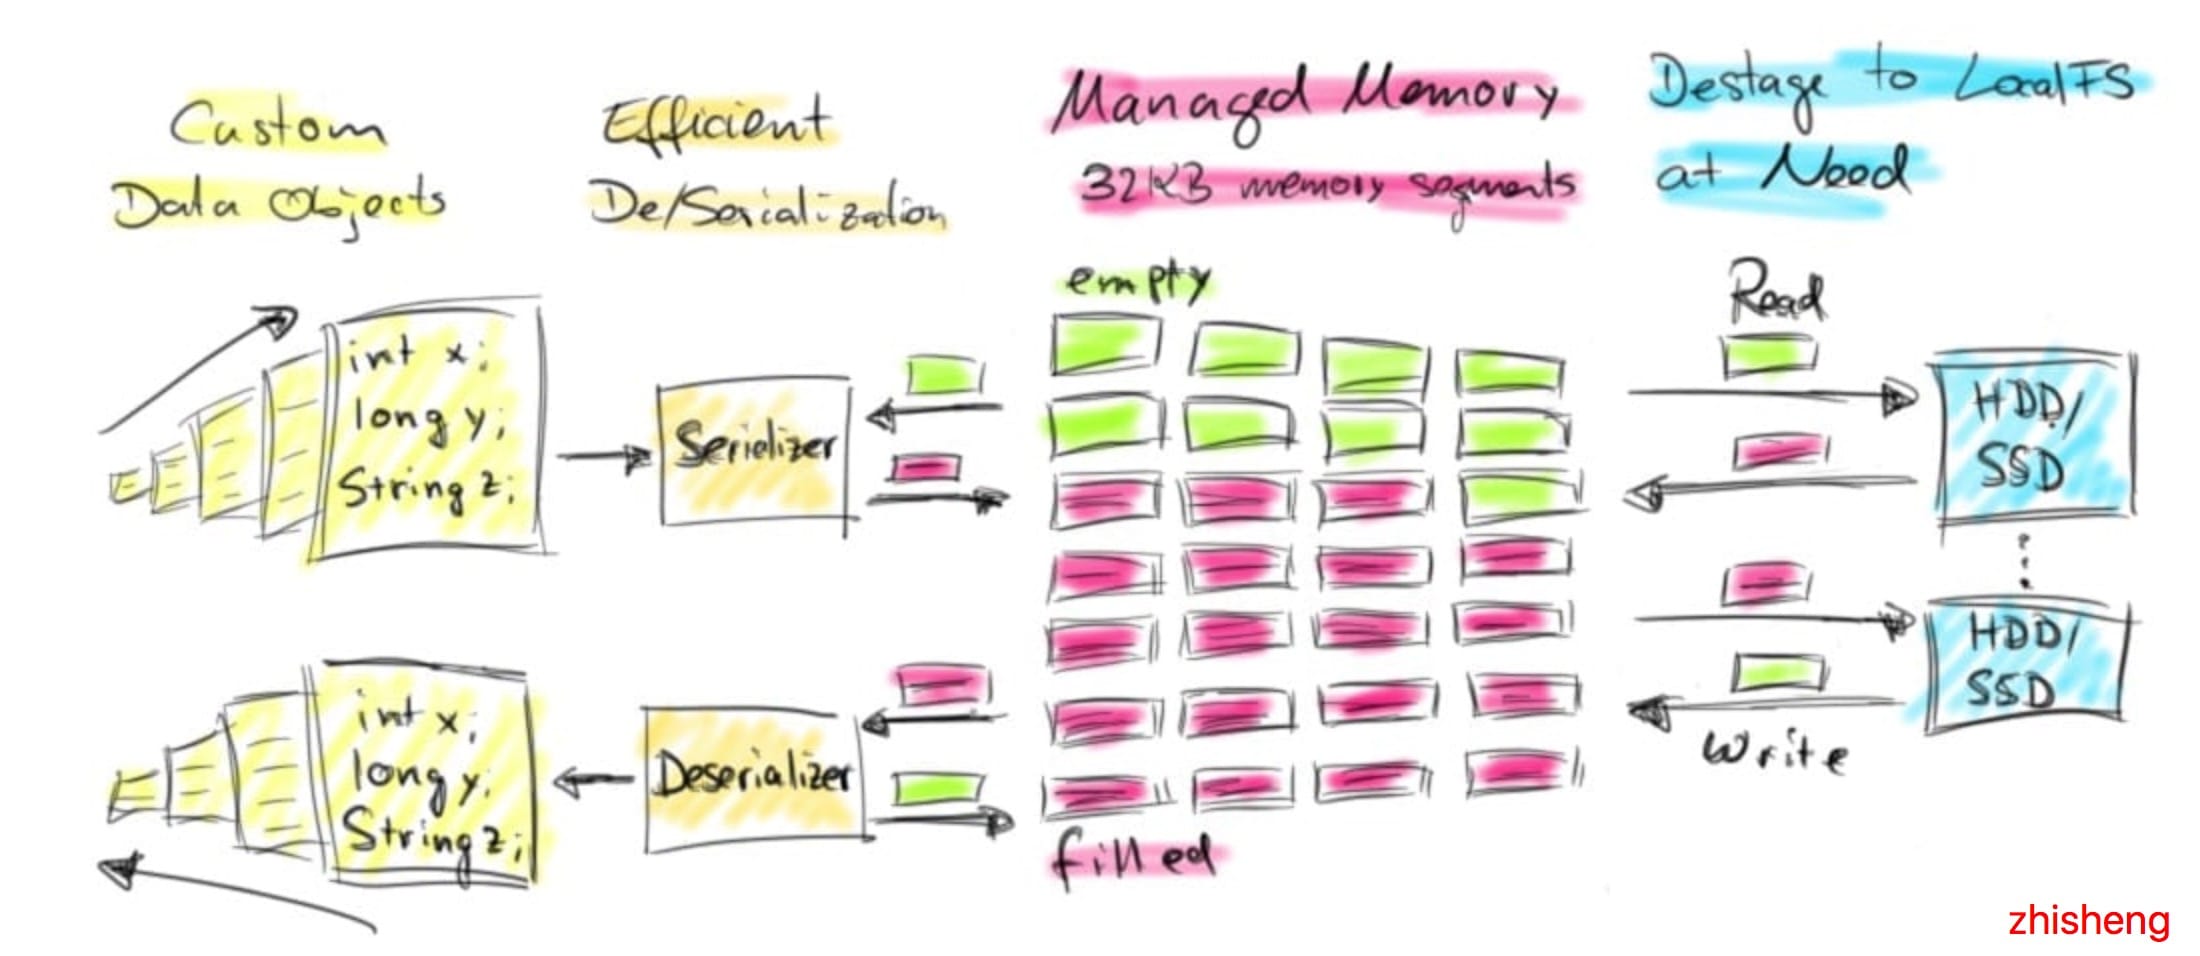
前言如今,许多用于分析大型数据集的开源系统都是用 Java 或者是基于 JVM 的编程语言实现的。最着名的例子是 Apache Hadoop,还有较新的框架,如 Apache Spark、Apache Drill、Apache Flink。基于 JVM 的数据分析引擎面临的一个常见挑战就是如何在内存中存储大量的数据(包括缓存和高效处理)。合理的管理好 JVM 内存可以将 难以配置且不可预测的系统 与 少量配置且稳定运行的系统区分开来。在这篇文章中,我们将讨论 Apache Flink 如何管理内存,讨论其自定义序列化与反序列化机制,以及它是如何操作二进制数据的。数据对象直接放在堆内存中在 JVM 中处理大量数据最直接的方式就是将这些数据做为对象存储在堆内存中,然后直接在内存中操作这些数据,如果想进行排序则就是对对象列表进行排序。然而这种方法有一些明显的缺点,首先,在频繁的创建和销毁大量对象的时候,监视和控制堆内存的使用并不是一件很简单的事情。如果对象分配过多的话,那么会导致内存过度使用,从而触发 OutOfMemoryError,导致 JVM 进程直接被杀死。 另一个方面就是因为这些对象大都是生存在新生代,当 JVM 进行垃圾回收时,垃圾收集的开销很容易达到 50% 甚至更多。最后就是 Java 对象具有一定的空间开销(具体取决于 JVM 和平台)。对于具有许多小对象的数据集,这可以显著减少有效可用的内存量。如果你精通系统设计和系统调优,你可以根据系统进行特定的参数调整,可以或多或少的控制出现 OutOfMemoryError 的次数和避免堆内存的过多使用,但是这种设置和调优的作用有限,尤其是在数据量较大和执行环境发生变化的情况下。Flink 是怎么做的?Apache Flink 起源于一个研究项目,该项目旨在结合基于 MapReduce 的系统和并行数据库系统的最佳技术。在此背景下,Flink 一直有自己的内存数据处理方法。Flink 将对象序列化为固定数量的预先分配的内存段,而不是直接把对象放在堆内存上。它的 DBMS 风格的排序和连接算法尽可能多地对这个二进制数据进行操作,以此将序列化和反序列化开销降到最低。如果需要处理的数据多于可以保存在内存中的数据,Flink 的运算符会将部分数据溢出到磁盘。事实上,很多Flink 的内部实现看起来更像是 C / C ++,而不是普通的 Java。下图概述了 Flink 如何在内存段中存储序列化数据并在必要时溢出到磁盘: Flink 的主动内存管理和操作二进制数据有几个好处:1、内存安全执行和高效的核外算法 由于分配的内存段的数量是固定的,因此监控剩余的内存资源是非常简单的。在内存不足的情况下,处理操作符可以有效地将更大批的内存段写入磁盘,后面再将它们读回到内存。因此,OutOfMemoryError 就有效的防止了。2、减少垃圾收集压力 因为所有长生命周期的数据都是在 Flink 的管理内存中以二进制表示的,所以所有数据对象都是短暂的,甚至是可变的,并且可以重用。短生命周期的对象可以更有效地进行垃圾收集,这大大降低了垃圾收集的压力。现在,预先分配的内存段是 JVM 堆上的长期存在的对象,为了降低垃圾收集的压力,Flink 社区正在积极地将其分配到堆外内存。这种努力将使得 JVM 堆变得更小,垃圾收集所消耗的时间将更少。3、节省空间的数据存储 Java 对象具有存储开销,如果数据以二进制的形式存储,则可以避免这种开销。4、高效的二进制操作和缓存敏感性 在给定合适的二进制表示的情况下,可以有效地比较和操作二进制数据。此外,二进制表示可以将相关值、哈希码、键和指针等相邻地存储在内存中。这使得数据结构通常具有更高效的缓存访问模式。主动内存管理的这些特性在用于大规模数据分析的数据处理系统中是非常可取的,但是要实现这些功能的代价也是高昂的。要实现对二进制数据的自动内存管理和操作并非易事,使用 java.util.HashMap 比实现一个可溢出的 hash-table (由字节数组和自定义序列化支持)。当然,Apache Flink 并不是唯一一个基于 JVM 且对二进制数据进行操作的数据处理系统。例如 Apache Drill、Apache Ignite、Apache Geode 也有应用类似技术,最近 Apache Spark 也宣布将向这个方向演进。下面我们将详细讨论 Flink 如何分配内存、如果对对象进行序列化和反序列化以及如果对二进制数据进行操作。我们还将通过一些性能表现数据来比较处理堆内存上的对象和对二进制数据的操作。Flink 如何分配内存?Flink TaskManager 是由几个内部组件组成的:actor 系统(负责与 Flink master 协调)、IOManager(负责将数据溢出到磁盘并将其读取回来)、MemoryManager(负责协调内存使用)。在本篇文章中,我们主要讲解 MemoryManager。MemoryManager 负责将 MemorySegments 分配、计算和分发给数据处理操作符,例如 sort 和 join 等操作符。MemorySegment 是 Flink 的内存分配单元,由常规 Java 字节数组支持(默认大小为 32 KB)。MemorySegment 通过使用 Java 的 unsafe 方法对其支持的字节数组提供非常有效的读写访问。你可以将 MemorySegment 看作是 Java 的 NIO ByteBuffer 的定制版本。为了在更大的连续内存块上操作多个 MemorySegment,Flink 使用了实现 Java 的 java.io.DataOutput 和 java.io.DataInput 接口的逻辑视图。MemorySegments 在 TaskManager 启动时分配一次,并在 TaskManager 关闭时销毁。因此,在 TaskManager 的整个生命周期中,MemorySegment 是重用的,而不会被垃圾收集的。在初始化 TaskManager 的所有内部数据结构并且已启动所有核心服务之后,MemoryManager 开始创建 MemorySegments。默认情况下,服务初始化后,70% 可用的 JVM 堆内存由 MemoryManager 分配(也可以配置全部)。剩余的 JVM 堆内存用于在任务处理期间实例化的对象,包括由用户定义的函数创建的对象。下图显示了启动后 TaskManager JVM 中的内存分布: Flink 如何序列化对象? Java 生态系统提供了几个库,可以将对象转换为二进制表示形式并返回。常见的替代方案是标准 Java 序列化,Kryo,Apache Avro,Apache Thrift 或 Google 的 Protobuf。Flink 包含自己的自定义序列化框架,以便控制数据的二进制表示。这一点很重要,因为对二进制数据进行操作需要对序列化布局有准确的了解。此外,根据在二进制数据上执行的操作配置序列化布局可以显著提升性能。Flink 的序列化机制利用了这一特性,即在执行程序之前,要序列化和反序列化的对象的类型是完全已知的。Flink 程序可以处理表示为任意 Java 或 Scala 对象的数据。在优化程序之前,需要识别程序数据流的每个处理步骤中的数据类型。对于 Java 程序,Flink 提供了一个基于反射的类型提取组件,用于分析用户定义函数的返回类型。Scala 程序可以在 Scala 编译器的帮助下进行分析。Flink 使用 TypeInformation 表示每种数据类型。 Flink 有如下几种数据类型的 TypeInformations:BasicTypeInfo:所有 Java 的基础类型或 java.lang.StringBasicArrayTypeInfo:Java 基本类型构成的数组或 java.lang.StringWritableTypeInfo:Hadoop 的 Writable 接口的任何实现TupleTypeInfo:任何 Flink tuple(Tuple1 到 Tuple25)。Flink tuples 是具有类型化字段的固定长度元组的 Java 表示CaseClassTypeInfo:任何 Scala CaseClass(包括 Scala tuples)PojoTypeInfo:任何 POJO(Java 或 Scala),即所有字段都是 public 的或通过 getter 和 setter 访问的对象,遵循通用命名约定GenericTypeInfo:不能标识为其他类型的任何数据类型 每个 TypeInformation 都为它所代表的数据类型提供了一个序列化器。例如,BasicTypeInfo 返回一个序列化器,该序列化器写入相应的基本类型;WritableTypeInfo 的序列化器将序列化和反序列化委托给实现 Hadoop 的 Writable 接口的对象的 write() 和 readFields() 方法;GenericTypeInfo 返回一个序列化器,该序列化器将序列化委托给 Kryo。对象将自动通过 Java 中高效的 Unsafe 方法来序列化到 Flink MemorySegments 支持的 DataOutput。对于可用作键的数据类型,例如哈希值,TypeInformation 提供了 TypeComparators,TypeComparators 比较和哈希对象,并且可以根据具体的数据类型有效的比较二进制并提取固定长度的二进制 key 前缀。Tuple,Pojo 和 CaseClass 类型是复合类型,它们可能嵌套一个或者多个数据类型。因此,它们的序列化和比较也都比较复杂,一般将其成员数据类型的序列化和比较都交给各自的 Serializers(序列化器) 和 Comparators(比较器)。下图说明了 Tuple3<Integer, Double, Person>对象的序列化,其中Person 是 POJO 并定义如下: public class Person { public int id; public String name;} 通过提供定制的 TypeInformations、Serializers(序列化器) 和 Comparators(比较器),可以方便地扩展 Flink 的类型系统,从而提高序列化和比较自定义数据类型的性能。Flink 如何对二进制数据进行操作?与其他的数据处理框架的 API(包括 SQL)类似,Flink 的 API 也提供了对数据集进行分组、排序和连接等转换操作。这些转换操作的数据集可能非常大。关系数据库系统具有非常高效的算法,比如 merge-sort、merge-join 和 hash-join。Flink 建立在这种技术的基础上,但是主要分为使用自定义序列化和自定义比较器来处理任意对象。在下面文章中我们将通过 Flink 的内存排序算法示例演示 Flink 如何使用二进制数据进行操作。Flink 为其数据处理操作符预先分配内存,初始化时,排序算法从 MemoryManager 请求内存预算,并接收一组相应的 MemorySegments。这些 MemorySegments 变成了缓冲区的内存池,缓冲区中收集要排序的数据。下图说明了如何将数据对象序列化到排序缓冲区中: 排序缓冲区在内部分为两个内存区域:第一个区域保存所有对象的完整二进制数据,第二个区域包含指向完整二进制对象数据的指针(取决于 key 的数据类型)。将对象添加到排序缓冲区时,它的二进制数据会追加到第一个区域,指针(可能还有一个 key)被追加到第二个区域。分离实际数据和指针以及固定长度的 key 有两个目的:它可以有效的交换固定长度的 entries(key 和指针),还可以减少排序时需要移动的数据。如果排序的 key 是可变长度的数据类型(比如 String),则固定长度的排序 key 必须是前缀 key,比如字符串的前 n 个字符。 请注意:并非所有数据类型都提供固定长度的前缀排序 key。将对象序列化到排序缓冲区时,两个内存区域都使用内存池中的 MemorySegments 进行扩展。一旦内存池为空且不能再添加对象时,则排序缓冲区将会被完全填充并可以进行排序。Flink 的排序缓冲区提供了比较和交换元素的方法,这使得实际的排序算法是可插拔的。默认情况下, Flink 使用了 Quicksort(快速排序)实现,可以使用 HeapSort(堆排序)。下图显示了如何比较两个对象: 排序缓冲区通过比较它们的二进制固定长度排序 key 来比较两个元素。如果元素的完整 key(不是前缀 key) 或者二进制前缀 key 不相等,则代表比较成功。如果前缀 key 相等(或者排序 key 的数据类型不提供二进制前缀 key),则排序缓冲区遵循指向实际对象数据的指针,对两个对象进行反序列化并比较对象。根据比较结果,排序算法决定是否交换比较的元素。排序缓冲区通过移动其固定长度 key 和指针来交换两个元素,实际数据不会移动,排序算法完成后,排序缓冲区中的指针被正确排序。下图演示了如何从排序缓冲区返回已排序的数据: 通过顺序读取排序缓冲区的指针区域,跳过排序 key 并按照实际数据的排序指针返回排序数据。此数据要么反序列化并作为对象返回,要么在外部合并排序的情况下复制二进制数据并将其写入磁盘。基准测试数据那么,对二进制数据进行操作对性能意味着什么?我们将运行一个基准测试,对 1000 万个Tuple2<Integer, String>对象进行排序以找出答案。整数字段的值从均匀分布中采样。String 字段值的长度为 12 个字符,并从长尾分布中进行采样。输入数据由返回可变对象的迭代器提供,即返回具有不同字段值的相同 Tuple 对象实例。Flink 在从内存,网络或磁盘读取数据时使用此技术,以避免不必要的对象实例化。基准测试在具有 900 MB 堆大小的 JVM 中运行,在堆上存储和排序 1000 万个 Tuple 对象并且不会导致触发 OutOfMemoryError 大约需要这么大的内存。我们使用三种排序方法在Integer 字段和 String 字段上对 Tuple 对象进行排序:1、对象存在堆中:Tuple 对象存储在常用的 java.util.ArrayList 中,初始容量设置为 1000 万,并使用 Java 中常用的集合排序进行排序。2、Flink 序列化:使用 Flink 的自定义序列化程序将 Tuple 字段序列化为 600 MB 大小的排序缓冲区,如上所述排序,最后再次反序列化。在 Integer 字段上进行排序时,完整的 Integer 用作排序 key,以便排序完全发生在二进制数据上(不需要对象的反序列化)。对于 String 字段的排序,使用 8 字节前缀 key,如果前缀 key 相等,则对 Tuple 对象进行反序列化。 3、Kryo 序列化:使用 Kryo 序列化将 Tuple 字段序列化为 600 MB 大小的排序缓冲区,并在没有二进制排序 key 的情况下进行排序。这意味着每次比较需要对两个对象进行反序列化。所有排序方法都使用单线程实现。结果的时间是十次运行结果的平均值。在每次运行之后,我们调用System.gc()请求垃圾收集运行,该运行不会进入测量的执行时间。下图显示了将输入数据存储在内存中,对其进行排序并将其作为对象读回的时间。 我们看到 Flink 使用自己的序列化器对二进制数据进行排序明显优于其他两种方法。与存储在堆内存上相比,我们看到将数据加载到内存中要快得多。因为我们实际上是在收集对象,没有机会重用对象实例,但必须重新创建每个 Tuple。这比 Flink 的序列化器(或Kryo序列化)效率低。另一方面,与反序列化相比,从堆中读取对象是无性能消耗的。在我们的基准测试中,对象克隆比序列化和反序列化组合更耗性能。 查看排序时间,我们看到对二进制数据的排序也比 Java 的集合排序更快。使用没有二进制排序 key 的 Kryo 序列化的数据排序比其他方法慢得多。这是因为反序列化带来很大的开销。在String 字段上对 Tuple 进行排序比在 Integer 字段上排序更快,因为长尾值分布显着减少了成对比较的数量。为了更好地了解排序过程中发生的状况,我们使用 VisualVM 监控执行的 JVM。以下截图显示了执行 10次 运行时的堆内存使用情况、垃圾收集情况和 CPU 使用情况。 测试是在 8 核机器上运行单线程,因此一个核心的完全利用仅对应 12.5% 的总体利用率。截图显示,对二进制数据进行操作可显著减少垃圾回收活动。对于对象存在堆中,垃圾收集器在排序缓冲区被填满时以非常短的时间间隔运行,并且即使对于单个处理线程也会导致大量 CPU 使用(排序本身不会触发垃圾收集器)。 JVM 垃圾收集多个并行线程,解释了高CPU 总体利用率。另一方面,对序列化数据进行操作的方法很少触发垃圾收集器并且 CPU 利用率低得多。实际上,如果使用 Flink 序列化的方式在 Integer 字段上对 Tuple 进行排序,则垃圾收集器根本不运行,因为对于成对比较,不需要反序列化任何对象。Kryo 序列化需要比较多的垃圾收集,因为它不使用二进制排序 key 并且每次排序都要反序列化两个对象。内存使用情况上图显示 Flink 序列化和 Kryo 序列化不断的占用大量内存存使用情况图表显示flink-serialized和kryo-serialized不断占用大量内存。这是由于 MemorySegments 的预分配。实际内存使用率要低得多,因为排序缓冲区并未完全填充。下表显示了每种方法的内存消耗。1000 万条数据产生大约 280 MB 的二进制数据(对象数据、指针和排序 key),具体取决于使用的序列化程序以及二进制排序 key 的存在和大小。将其与数据存储在堆上的方法进行比较,我们发现对二进制数据进行操作可以显著提高内存效率。在我们的基准测试中,如果序列化为排序缓冲区而不是将其作为堆上的对象保存,则可以在内存中对两倍以上的数据进行排序。 总而言之,测试验证了文章前面说的对二进制数据进行操作的好处。展望未来Apache Flink 具有相当多的高级技术,可以通过有限的内存资源安全有效地处理大量数据。但是有几点可以使 Flink 更有效率。Flink 社区正在努力将管理内存移动到堆外内存。这将允许更小的 JVM,更低的垃圾收集开销,以及更容易的系统配置。使用 Flink 的 Table API,所有操作(如 aggregation 和 projection)的语义都是已知的(与黑盒用户定义的函数相反)。因此,我们可以为直接对二进制数据进行操作的 Table API 操作生成代码。进一步的改进包括序列化设计,这些设计针对应用于二进制数据的操作和针对序列化器和比较器的代码生成而定制。总结Flink 的主动内存管理减少了因触发 OutOfMemoryErrors 而杀死 JVM 进程和垃圾收集开销的问题。Flink 具有高效的数据序列化和反序列化机制,有助于对二进制数据进行操作,并使更多数据适合内存。Flink 的 DBMS 风格的运算符本身在二进制数据上运行,在必要时可以在内存中高性能地传输到磁盘。本文地址: http://www.54tianzhisheng.cn/2019/03/24/Flink-code-memory-management/

优秀的个人博客,低调大师

openGauss数据库源码解析系列文章——存储引擎源码解析(四)

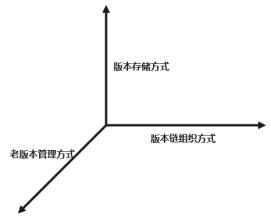
上一篇我们详细讲述“3. astore元组多版本机制”、“4.astore访存管理”及“5.astore空间管理和回收”相关内容。本篇我们将继续为小伙伴们带来“4.2.4 ustore”的详细介绍。 4.2.4 ustore ustore属于In-place Update更新模式,中文意思为:原地更新,是openGauss内核新增的一种存储模式。openGauss内核当前使用的行引擎采用的是Append Update(追加更新)模式,该模式在INSERT、DELETE、HOT UPDATE(页面内更新)的场景下有较好的表现。但对于非HOT UPDATE场景,垃圾回收不够高效。 In-place Update存储模式提供“原地更新”能力,主要思路是将最新版本的“有效数据”和历史版本的“垃圾数据”分离存储。将最新版本的“有效数据”存储在数据页面上,而单独开辟一段undo(回滚)空间,用于统一管理历史版本的“垃圾数据”,因此数据空间不会由于频繁更新而膨胀,垃圾回收效率更高。通过NUMA-aware的undo子系统设计,使得undo子系统在多核平台上高效扩展。同时通过对元组和数据页面结构的重新设计,减少存储空间的占用。采用多版本索引技术,解决索引膨胀问题,彻底去除autovacuum(垃圾清理线程)机制,提升存储空间的回收复用效率。 1. 整体框架及代码概览 数据库中数据处理的本质是在保证ACID的基础上支持尽量高的并发查询。这种状况下,并发控制、页面多版本控制以及页面存储结构相互耦合在一起,数据库存储引擎需要进行整体设计从而在高并发的状况下保证各个事务处理看到类似串行执行的效果。 在整个技术体系中多版本控制用来提升读写并发能力,按照多版本排列方式可以分为两类。 (1)Oldest to New,即版本按照从最老到最新的方式进行链接,当一个事务访问该元组时,先看到这个元组最老的版本,同时使用对应的可见性判断机制,看是否是自己可见的版本,如果不是则沿着版本链条继续往后看较新的版本是不是自己需要的。 (2)Newest to Old,即版本按照从最新到最老的方式进行连接,当一个事务访问该元组时,先看到这个元组最新的版本,同时使用对应的可见性判断机制,看是否是自己可见的版本,如果不是则沿着版本链条继续往后看较老的版本是不是自己需要的。 在上面的描述中又引出一个设计点,如何组织新老数据,有如下几种方式。 (1) 将新数据和老数据放在同样的页面内,即每个数据页内放置着各个元组的新老数据,在需要进行不可见数据版本回收的时候需要遍历所有的页面。 (2) 将最新数据和老数据分离存储,在实际的数据页面内放置最新版本数据,所有的老版本数据都集中存储,新版本数据通过一个指针指向老版本所在的数据区域,当进行不可见老版本数据回收的时候只要扫描老版本集中存放的位置即可。 当新老数据分别存储的时候又引出第三个设计点,在对同一个页面或者元组反复读取时,是否要还原对应的页面在数据缓冲区中,这个设计点有如下几种方式。 (1) 访问旧元组所在的页面时,还原该页面,并将该页面的旧版本放入数据缓冲区中,节省一定时间内其他线程多次访问该版本页面带来的合成开销。弊端是占用更大的内存空间,同时缓冲区淘汰管理在原始LRU(Least Recently Used,最近最少使用算法)基础上同时要考虑页面版本。这种方式对应PCR(Page Consistency Read,页面一致性读),其本质的设计理念是空间换时间。 (2) 访问元组时,沿着版本链还原该元组,直到找到自己对应的版本。这种方式对于短时间访问冲突不高的场景能够降低内存使用,但如果短时间内高频访问一个页面内的元组,则每次都会遍历版本链造成访问效率低下。这种方式对应RCR(Row Consistency Read,行一致性读)。 按照上面的描述,整个多版本控制设计分为三个维度,如图4-10、表4-15所示。 图4-10 多版本控制设计维度 表4-15 多版本控制设计维度 维度 备选 版本存储方式 集中存储、分离存储 版本链组织方式 Oldest to New、Newest to Old 老版本管理方式 1、RCR,2、PCR 当前openGauss在版本存储方式、版本链组织方式上的设计选择是集中存储 + Oldest to New,在清理数据旧版本时需要遍历所有的页面找到不可见的元组版本然后清除。商用及开源的常见数据库的多版本控制设计三维度选择如表4-16所示。 表4-16 当前数据库多版本控制设计选择 数据库 架构设计选择 版本存储方式 版本链组织方式 老版本管理方式 常见数据库 分离存储 Newest to Old PCR 集中存储 Oldest to New PCR 分离存储 Oldest to New PCR 不同的多版本控制设计都不能做到尽善尽美,都有些不足之处,相关的缺点如下。 (1)多核系统上扩展性较差,不支持多核处理器的NUMA感知; (2)依赖于Vacuum进行老版本回收,后台线程定期清理; (3)缺乏对索引多版本,全局索引、闪回等功能的支持; (4)PCR管理方式,内存管理开销较大。 openGauss的ustore存储模式最大程度结合各种设计的优势,在多版本管理上的架构设计采取的组合如表4-17所示。 表4-17 ustore在多版本管理上的架构设计 维度 架构设计选择 版本存储方式 分离存储 版本链组织方式 Newest to old 老版本管理方式 PbRCR(Page Based RCR,基于页面的行一致性读) 同时为了事务能够跨存储格式查询,并复用现有备份、恢复、升级等能力,openGauss定义如下的融合引擎架构设计原则。 (1) 一套并发控制系统。 (2) 一套系统表管理系统。 (3) 一套日志管理系统。 (4) 一套锁管理系统。 (5) 一套恢复系统。 ustore架构如图4-11所示。 ustore和astore共用事务管理、并发控制、缓冲区管理、检查点、故障恢复管理与介质管理器管理。ustore主要功能模块如表4-18所示。 表4-18 ustore主要功能模块 模块 说明 代码位置 ustore表存取管理 向上对接SQL引擎,提供对ustore表的行级查询、插入、删除、修改等操作接口,向下根据ustore表页间、页内结构,以及ustore表元组结构,完成对ustore表文件的遍历和增删改查操作 主要在“src/gausskernel/storage/access/ustore”目录(单表文件管理)下 ustore索引存取管理 向上对接SQL引擎,提供对索引表的行级查询、插入、删除等操作接口,向下根据索引表页间、页内结构,以及索引表元组结构,完成对指定索引键的查找和增删操作 抽象框架代码在“src/gausskernel/storage/access/ubtree”目录下 ustore表页面结构 包括ustore表元组在页面内的具体组织形式,在页面内插入元组操作、页面整理操作、页面初始化操作等 主要代码在“src/gausskernel/storage/access/ustore/knl_upage”目录中 ustore表元组结构 包括ustore表元组的结构、填充、解构、修改、字段查询、变形等操作 主要代码在“src/gausskernel/storage/access/ustore/knl_utuple.cpp”文件中 Undo记录结构 包括undo记录的结构、填充、编码、解码等操作 主要代码在“src/gausskernel/storage/access/ustore/undo”目录中 多版本索引 包括 ustore 专用多版本索引 ubtree 的页面结构、查询、修改、可见性检查、垃圾回收等模块 主要代码在“src/gausskernel/storage/access/ubtree”目录中 2. 页面元组结构 1) 元组结构 本节介绍行存储引擎ustore表的页面元组结构。 元组结构的定义如下: typedef struct UHeapDiskTupleData { ShortTransactionId xid; uint16 td_id : 8, locker_td_id : 8; uint16 flag; uint16 flag2; uint8 t_hoff; uint8 data[FLEXIBLE_ARRAY_MEMBER]; } UHeapDiskTupleData; 该结构体只是元组头部的定义,真正的元组内容跟在该结构体之后,距离元组头部起始处的偏移由t_hoff成员保存。上面元组头部结构体部分成员信息同时也构成了该元组的系统字段(字段序号小于0的那些字段)。对各个结构体成员的含义说明如下。 (1) flag,元组属性掩码。包含是否有空字段标记、是否有外部TOAST标记、是否有变长字段标记、指定的事务槽位是否已被重复使用标记,以及更新、删除、锁等标记。 (2) flag2,元组另一个属性掩码。包含元组中字段个数。 (3) t_hoff,元组数据距离元组头部结构体起始位置的偏移。 (4) data,字段的NULL值bitmap,每个字段对应一个bit位,因此是变长数组。 ustore元组头部比astore元组头部小一半,因此在相同大小的页面上,ustore可以放置更多的元组。 在内存中,上述元组结构体使用时被嵌入在一个更大的元组数据结构体中,除了保存元组内容的disk_tuple成员之外,其他的成员保存了该元组的一些其他系统信息,并构成了该元组剩余的一些系统字段内容,定义如下: typedef struct UHeapTupleData { uint32 disk_tuple_size; uint1 tupTableType = UHEAP_TUPLE; uint1 tupInfo; int2 t_bucketId; ItemPointerData ctid; Oid table_oid; TransactionId t_xid_base; TransactionId t_multi_base; UHeapDiskTupleData* disk_tuple; } UHeapTupleData; 该结构体几个主要成员的含义如下。 (1) disk_tuple_size,元组长度。 (2) ctid,元组所在页面号和页面内元组指针下标。 (3) table_oid,该元组属主表的OID。 常用的元组操作接口和说明如表4-19所示。 表4-19 常用的元组操作接口 函数名 操作含义 UHeapFormTuple 利用传入的、各个元组字段的值数组,生成一条完整的元组,一般用于插入操作 UHeapDeformTuple 利用传入的完整元组以及各个字段的类型定义,解构各个字段的值,生成值数组,一般用于更新前的准备工作 UHeapFreetuple 释放一条元组对应的内存空间 UHeapCopyTuple 复制一条完整的元组,包括元组头和元组内容 UHeapSlotGetAttr 获取一条元组中指定的用户或系统字段值 UHeapGetSysAttr 获取一条元组中指定的系统字段值 UHeapCopyHeapTuple 从ustore槽位构造一条astore元组 UHeapToHeap 将一条ustore元组转换为一条astore元组 HeapToUHeap 将一条astore元组转换为一条ustore元组 2) 页面结构 ustore与astore相同,在openGauss中也使用默认的8kB页面。其结构如图4-12所示。 图4-12 ustore引擎页面结构示意图 在一个页面中,页面头部分对应的UHeapPageHeaderData结构体存储了整个页面的重要元信息。UHeapPageHeaderData之后有一个共享的页内事务目录(Transaction Directory,TD),对应元组指针变长数组。元组指针变长数组的每个数组成员存储了页面中从后往前的、每个元组的起始偏移和元组长度。如图4-12所示,真正的元组内容从页面尾部开始插入,向页面头部扩展;相应地,TD插槽目录与记录每条元组的元组指针从页面头定长成员之后插入,往页面尾部扩展。这样整个页面中间就会形成一个空洞,以供后续插入的元组和元组指针使用。每一个ustore表里的一条具体元组都有一个全局唯一的逻辑地址(和astore表里的元组相同),它由元组所在的页面号和页面内元组指针数组下标组成。 页面头具体结构体定义如下: typedef struct UHeapPageHeaderData { PageXLogRecPtr pd_lsn; uint16 pd_checksum; uint16 pd_flags; uint16 pd_lower; uint16 pd_upper; uint16 pd_special; uint16 pd_pagesize_version; uint16 potential_freespace; uint16 td_count; TransactionId pd_prune_xid; TransactionId pd_xid_base; TransactionId pd_multi_base; uint32 reserved; } UHeapPageHeaderData; 其中各个成员的含义如下。 (1) pd_lsn:该页面最后一次修改操作对应的预写日志位置的下一位,用于检查点推进和保持恢复操作的幂等性。 (2) pd_checksum:页面的CRC校验值。 (3) pd_flags:页面标记位,用于保存各类页面相关的辅助信息,如页面是否有空闲的元组指针、页面是否已满等。 (4) pd_lower:页面中间空洞的起始位置,即当前已使用的元组指针数组的尾部。 (5) pd_upper:页面中间空洞的结束位置,即下一个可以插入元组的起始位置。 (6) pd_special:页面尾部特殊区域的起始位置。该特殊位置位于第一条元组记录和页面结尾之间,用于存储一些变长的页面级元信息,如索引的辅助信息等。 (7) pd_pagesize_version:页面的大小和版本号。 (8) potential_freespace:页面中已被删除和更新的元组的潜在空间。 (9) td_count:共享的页内事务信息描述插槽的数量。 (10) pd_prune_xid:页面清理辅助事务号(64位),通常为该页面内现存最老的删除或更新操作的事务号,用于判断是否要触发页面级空闲空间整理。 (11) pd_xid_base:该页面内所有元组的基准事务号(64位)。该页面所有元组实际生效的64位XID事务号由pd_xid_base(64位)和元组头部的XID成员(32位)相加得到。 (12) pd_multi_base:类似pd_xid_base。当对元组加锁时,会将持锁的事务号写入元组中,该64位事务号由pd_multi_base(64位)和元组头部的XID(32位)相加得到。 页面的主要管理接口如表4-20所示。 表4-20 页面管理接口函数 函数名 操作含义 UPageInit 初始化一个新的ustore页面 UPageAddItem 在页面中插入一条新的元组 UHeapPagePruneOptPage 页面空闲空间整理 为了节省每个元组存储空间,元组头部UHeapDiskTupleData采用32位元组XID的组合设计方式。64位的pd_xid_base和pd_multi_base储存在页面上,元组上储存32位的XID。页面上pd_xid_base和pd_multi_base也需要通过额外的逻辑进行维护:同一个页面中所有元组实际的64位XID,一定要在pd_xid_base和pd_xid_base+232之间,所以如果新写入的事务号和页面上现有任意一个元组的XID事务号差距已经超过232,那么需要尝试对现有元组进行基线移位操作,更新pd_xid_base和pd_multi_base。 3)事务目录 事务目录是一种常用的共享资源。它可以为数据页上的元组(tuple)链接相应的事务表(Transaction Table)及undo子系统中的undo页面。数据库中的每个表可以自定义事务目录的数量,并可以复用那些已完成事务占据的事务目录。 每个数据页默认会有4个事务目录。根据并发需求的不同,事务目录的数量可设置为2到128之间的任意值。在使用CREATE TABLE命令创建表时添加了一个新的选项INIT_TD以声明所需的事务目录数量: CREATE TABLE t1 ( c1 integer; c2 boolean; ) WITH (INIT_TD=16); 当需要为新事务目录留位置时,系统会先查找当前页面中是否有空事务目录。若无空事务目录,系统将遍历事务目录列表来寻找可以复用的条目。条目是否可以复用取决于与该条目关联的事务的状态。 通常可以复用那些与已冻结或已中止的事务关联的事务目录。 (1) 对于已经冻结的XID,并复用该事务目录。 对于astore而言,冻结的XID代表着事务在所有的会话中都已经不再活跃。 而在ustore中,仅当一个事务创建的所有的回滚记录都被丢弃后,或者说没有其他的Snapshot需要再观察该事务创建的元组历史版本(tuple version)时,才将该XID视为冻结。ustore中的undo回收进程会维护一个oldestXidInUndo变量,系统将通过比较XID与该变量来确定XID是否含有回滚记录。如果XID < oldestXidInUndo,代表所有该XID产生的回滚记录都已经被丢弃。 (2) 对于已中止的事务,在该事务被回滚后,系统才会复用相应的事务目录条目。 (3) 对于已提交的事务,系统将不会无效化回滚记录地址,这样可以保证undo链的完整性。 当没有事务目录可以复用时,事务目录将会自动扩容以容纳更多的条目。需注意的是,事务目录的后面跟随着元组指针区,在扩展时,首先需要将row pointer array向右挪动来腾出空间。扩展后,新的事务目录条目将会在先前的事务目录条目之后依序添加。设计上,允许事务目录的容量最多扩至页面大小的约25%,即约100个事务目录(在8kB大小的页面中,约20Bytes/事务目录)。目前,系统将以每次增加两个事务目录的方式逐步扩容,最多扩至128个事务目录。ustore暂不支持收缩事务目录空间。 在扩容时,可以增加的总条目数也取决于当前页面中的可用空间。有时,页面中的总剩余空间并不能支持事务目录的扩容。此时若当前操作为INSERT或MULTI-INSERT,事务将会索取一个新的页面来进行操作。若操作为UPDATE或DELETE,事务将等待10毫秒后重试获取事务目录。Lock timeout设置可以控制获取事务目录的最大等待时间。在多由短事务组成的工作负载中,等待是可以接受的。 PG stats会报告事务目录等待等信息,以方便监测系统及描述工作负载。 事务目录申请的过程(UHeapPageReserveTransactionSlot函数)如图4-13所示。 图4-13 事务目录申请处理流程 如果当前事务需要申请一个新的事务目录,且系统中不存在空的事务目录时,系统会遍历所有事务目录并寻找可复用的事务目录。 (1) 首先系统会遍历事务目录,寻找XID < oldestXidInUndo的事务目录。这些条目将被视为已冻结。 (2) 接着系统会遍历目标页面上的元组。 ① 系统把已删除的元组标记为死亡,其余的标记为闲置。 ② 如果系统发现元组还在活跃状态,且相应的TD条目存在于步骤(1)给出的冻结列表之中,系统会把该事务目录设置为UHEAPTUP_SLOT_FROZEN(冻结)。 ③ 设置为冻结之后,事务目录中的XID及Undo指针会被无效化。 (3) 如果上述的冻结操作并未产生可用的槽位,系统会遍历事务目录并寻找与已提交或已中止事务关联的条目。这些条目在满足一定条件的状况下可被复用。 (4) 遍历目标页面上的元组。 ① 如果系统发现元组关联的事务目录存在于步骤(3)给出的已提交列表中,系统就把该TD条目的flag设为UHEAP_INVALID_XACT_SLOT(无效)。 ② 此外,这些事务目录的XID被重设为无效XID。但为了维护undo链的完整,undo指针将被保留。 (5) 如果并未找到与已提交事务关联的事务目录,最后将寻找与已中止事务关联的事务目录。 (6) 遍历与已中止事务关联的事务目录:对于每个事务目录,沿着undo链执行相关的undo操作。 (7) 如果并未找到事务目录,扩展事务目录。 (8) 返回结果。 3. 回滚段设计与MVCC 1) 回滚段 旧版本数据会集中在回滚段的undo目录中,为了减少读写冲突,旧版本数据(回滚记录)采用追加写的方式写入数据目录的undo目录下。这样旧版本数据的读取和写入不会发生冲突,同一个事务的旧版本数据也会连续存放,便于进行回滚操作。为了减少并发写入时的竞争,undo目录空间被划分成多个逻辑区域(UndoZone,回滚段逻辑区域)。线程会在自己的逻辑区域上进行分配,与其他线程完全隔离,从而写入旧数据分配空间时就不会有额外的锁开销。UndoZone还可以按照CPU的NUMA核进行划分,每个线程会从当前的NUMA核上的UndoZone进行分配,进一步提升分配效率。在分配undo空间时会按照事务粒度进行记录,旧版本数据一旦确认没有事务进行访问,就会进行回收。 为了在回滚段的空间寻址,回滚记录使用8字节的指针来进行寻址,如图4-14所示。 图4-14 回滚记录寻址指针 其中各个字段的含义如下: (1) zoneId:占用20bit,表示逻辑区域的ID。 (2) blockId:占用31bit,表示块号,默认为8k。 (3) offset:占用13bit,表示块内偏移。 旧版本的数据采用回滚记录的格式存入回滚段中,其中回滚记录的格式如下所示: Class UndoRecord { … UndoRecordHeader whdr_; UndoRecordBlock wblk_; UndoRecordTransaction wtxn_; UndoRecordPayload wpay_; UndoRecordOldTd wtd_; UndoRecordPartition wpart_; UndoRecordTablespace wtspc_; StringInfoData rawdata_; } 其中,除了rawdata_代表了旧版本数据,其他成员均为结构体,下面对每个结构体分别进行说明。 whdr_成员由下面的结构组成: typedef struct { TransactionId xid; CommandId cid; Oid reloid; Oid relfilenode; uint8 utype; uint8 uinfo; } UndoRecordHeader; 各个字段的含义如下。 (1) xid:生成此回滚记录的事务ID,用于检查事务的可见性。“2)MVCC”小节有介绍。 (2) CID(Command ID,命令ID):生成此回滚记录的命令ID,用于判断可见性。 (3) reloid:relation对象的ID,回滚时需要。 (4) relfilenode:relfilenode对象的ID,回滚时需要。 (5) utype:操作类型,像UNDO_INSERT、UNDO_DELETE、UNDO_UPDATE等。 (6) uinfo:控制字段,用来判断后续的结构是否存在,用来减少回滚记录的占用空间。 wblk_成员由下面的结构组成: typedef struct { UndoRecPtr blkprev; BlockNumber blkno; OffsetNumber offset; } UndoRecordBlock; (1) blkprev:指向同一个block前一条回滚记录,用于回滚和事务可见性。“2)MVCC”小节有介绍。 (2) blkno:block number(块号)。 (3) Offset:修改的tuple在row pointer中的偏移。 wtxn_成员由下面的结构组成。 typedef struct { UndoRecPtr prevurp; } UndoRecordTransaction; prevurp:当一个事务的回滚记录跨越两个UndoZone时,后续的回滚记录使用此指针指向前一条回滚记录。 wpay_成员由下面的结构组成。 typedef struct { UndoRecordSize payloadlen; } payloadlen:rawdata_的长度。 wtd_成员由下面的结构组成。 typedef struct { TransactionId oldxactid; } UndoRecordOldTd; oldxactid:旧版本数据里事务目录的事务ID。 wpart_成员由下面的结构组成。 typedef struct { Oid partitionoid; } UndoRecordPartition; partitionoid:分区表的分区对象OID。 wtspc_成员由下面的结构组成。 typedef struct { Oid tablespace; } UndoRecordTablespace; tablespace:表空间的OID。 回滚段使用事务目录来记录每个事务分配的undo空间,便于事务回滚和回收。事务发生回滚时,会读取事务目录中记录的undo空间的起始位置,再读取undo空间中的回滚记录进行回滚操作,其中回滚记录中的字段如下: class TransactionSlot { TransactionId xactId_; UndoRecPtr startUndoPtr_;/*事务分配的undo空间开始*/ UndoRecPtr endUndoPtr_;/*事务分配的undo空间结束*/ uint8 info_;/*标记:如事务回滚状态*/ Oid dbId_;/*数据库对象ID*/ } (1) xactId:事务ID。 (2) startUndoPtr:事务分配的undo空间开始位置。 (3) endUndoPtr:事务分配的undo空间结束位置。 (4) info_:标记值,如事务回滚状态。 (5) dbId:数据库对象ID。 回滚段提供分配undo空间和更新事务目录的接口,主要接口如表4-21所示。 表4-21 回滚段主要接口 接口名 含义 AllocateUndoSpace 为回滚记录分配undo空间 UpdateTransactionSlot 更新事务目录 以ustore的删除操作为例,undo空间分配流程如下。 (1) UheapDelete作为ustore的删除接口,会调用UHeapPrepareUndoDelete函数准备回滚记录(undo record)。UHeapPrepareUndoDelete函数会填充回滚记录的各个字段(其中旧数据会设置到回滚记录的raw data字段上),再调用PrepareUndoRecord函数分配undo空间。PrepareUndoRecord函数调用“undo::AllocateUndoSpace”函数分配undo空间,再读取对应的回滚记录到缓冲池中。AllocateUndoSpace函数不仅会为回滚记录分配空间(使用“UndoZone::AllocateSpace”函数),如果是事务的第一条回滚记录,还会调用“UndoZone::AllocateSlotSpace”函数为事务目录分配空间。AllocateSpace函数会进行判断,如果回滚记录超过当前undo file的大小,就扩展当前的undo file,AllocateSlotSpace函数的逻辑类似。 (2) UheapDelete函数调用InsertPreparedUndo函数,将准备好的回滚记录追加写到缓冲池中的回滚段页面。 (3) UheapDelete函数调用UpdateTransactionSlot,记录下该事务分配的undo空间起始、事务ID、数据库ID。如果是事务的第一次更新,会从事务目录空间分配新的事务目录再进行更新。 undo空间需要回收回滚记录来保证undo空间不会无限膨胀,一旦事务id小于当前快照中最小的Xmin(oldestXmin),回滚记录中的旧版本数据就不会被访问,此时就可以对回滚记录进行回收。 如前述描述undo空间中的回滚记录按照事务ID递增的顺序存放在UndoZone中,回收的条件如下所示。 (1) 事务已经提交并且小于oldestXmin的undo空间可以回收。 (2) 事务发生回滚但已经完成回滚的undo空间可以回收。 图4-15 undo回收过程 如图4-15所示,UndoZone1中回收到小于oldestXmin的已提交事务16068,UndoZone2中回收到16050,UndoZone m回收到16056。而UndoZone n回收到事务16012,而事务16014待回滚但未发生回滚,因此UndoZone n回收事务id上限只到16014。其他zone的上限是oldestXmin,oldestXidInUndo会取所有undozone上的上限最小值,因此oldestXidInUndo等于16014。undo回收主要函数如表4-22所示。 表4-22 undo回收主要函数 函数名 操作含义 UndoRecycleMain 回收线程的入口函数,会在每个zone上调用RecycleUndoSpace函数 RecycleUndoSpace 按照前述条件回收undo空间,记录日志 2) MVCC ustore的可见性检查和astore类似,将快照CSN和元组删除和插入事务的CSN进行比较,判断元组是否可见。ustore和astore使用同一套事务管理机制和快照管理机制。 ustore和astore最大的区别在于astore会在页面上保留旧版本数据,而ustore在将旧版本数据放到回滚段统一存放。在需要获取旧版本数据时,astore可以直接从tuple的头部读取到元组的插入和删除的事务号(XID),来判断元组的可见性。但是ustore需要从回滚段里读取旧版本的事务信息,来判断旧版本是否可见。由于从回滚段中读取旧版本数据存在相对昂贵的开销,ustore通过一系列的优化手段来避免从回滚段中读取旧版本数据。 ustore在获取元组时,会先检查对应的事务目录。事务目录分成有效和无效两种。当事务目录是有效的,ustore直接就会得到元组上最新的事务。 如果事务目录被冻结(FROZEN),意味着元组已经在所有的事务中都会可见。如果事务目录中的事务id小于oldestXidInUndo,意味着元组已经足够旧在所有事务中都可见。同时会把事务目录置成冻结,来加速后续的查询。 如果元组被标记有一个无效事务目录,意味着修改元组的事务已经提交,并且比当前的事务目录中的事务旧。此时ustore会使用事务目录中的事务进行可见性判断。如果可见,意味着修改元组的事务更已经可见,就不需要从undo目录中再读取事务信息。 图4-16 元组查询过程 元组不可见的场景,ustore会从undo目录中读取回滚记录中的旧版本数据查找元组。例子如图4-16所示。查找tbl表中c1=1的数据项,从索引中读取到数据项位于block 1和offset 2,使用UHeapTupleFetch函数再从block 1中查询到元组,需要判断该元组的可见性。 (1) 从元组的TD读到ITL2,和astore类似,根据CSN的大小,判断TD2中的XID不可见,需要使用GetTupleFromUndo函数读取回滚记录。 (2) GetTupleFromUndo函数调用GetTupleFromUndoRecord函数读取回滚记录,使用InplaceSatisfyUndoRecord函数判断其中的block 1和offset 2是满足要求的元组。但是XID=1610可以判断出当前页面的tuple不可见,ustore继续查询更老的版本。由于旧元组的TD 1和当前的TD 2不一致,使用UHeapUpdateTDInfo从TD 2 undo链条进行切换,根据旧元组的TD 1找到当前的undo指针找到前一次修改。 (3) 再次读取到回滚记录,其中的block 1和offset 1并非要找的元组,ustore继续查询更老的版本,根据blkprev指针读取前一次修改。 (4) 读取到回滚记录,其中的block 1和offset 3并非要找的元组,ustore继续查询更老的版本,根据blkprev指针读取前一次修改。 (5) 读取到回滚记录,其中的block 1和offset 2是要求的元组,ustore判断可见性。根据CSN的大小,事务可见。因此前一次命中的元组可见,即(1, abc)可见,因此查找到元组的c2等于abc。 4. 多版本索引 在openGauss中实现了多版本索引ubtree,是专用于ustore的B-Tree索引变种,相比原有的B-Tree索引有如下差异点。 (1) 支持索引数据的多版本管理及可见性检查,能够自主鉴别旧版本元组并进行回收,同时索引层的可见性检查使得索引扫描(Index Scan)及仅索引扫描(Index Only Scan)性能有所提升。 (2) 在索引插入操作之外,增加了索引删除操作,用于对被删除或修改的元组对应的索引元组进行标记。 (3) 索引按照key + TID的顺序排列,索引列相同的元组按照对应元组的TID作为第二关键字进行排序。 (4) 添加新的可选页面分裂策略“insertpt”。 ubtree实现了索引访问接口所要求的全部接口,如表4-23所示: 表4-23 ubtree访问接口函数 接口名称 对应函数 接口含义 aminsert ubtinsert 插入一个索引元组 ambeginscan ubtbeginscan 开始一次索引扫描 amgettuple ubtgettuple 获取一个索引元组 amgetbitmap ubtgetbitmap 通过索引扫描获取所有元组 amrescan ubtrescan 重新开始一次索引扫描 amendscan ubtendscan 结束索引扫描 ammarkpos ubtmarkpos 标记一个扫描位置 amrestpos ubtrestpos 恢复到一个扫描位置 ammerge ubtmerge 合并多个索引 ambuild ubtbuild 建立一个索引 ambuildempty ubtbuildempty 建立一个空索引 ambulkdelete ubtbulkdelete 批量删除索引元组 amvacuumcleanup ubtvacuumcleanup 索引后置清理 amcanreturn ubtcanreturn 是否支持 Index Only Scan amcostestimate ubtcostestimate 索引扫描代价估计 amoptions ubtoptions 索引选项 此外,还实现了新增的的索引删除函数UBTreeDelete。 1) 索引页面组织 多版本索引层次结构与B-Tree索引基本相同,非叶子节点与B-Tree索引保持一致,仅页尾的Special字段有所不同。ubtree中的Special字段UBTPageOpaqueDataInternal如下所示: typedef struct UBTPageOpaqueDataInternal { …… /* 以上部分与BTPageOpaqueDataInternal一致 */ TransactionId last_delete_xid; /* 记录页面上最后一次删除事务的 XID */ TransactionId xid_base; /* 页面上的 xid-base */ int16 activeTupleCount; /* 页面上活跃元组计数 */ } UBTPageOpaqueDataInternal; typedef UBTPageOpaqueDataInternal* UBTPageOpaqueInternal; 其中last_delete_xid与activeTupleCount用于索引的自治式回收,会在ustore中的“6. 空间管理和回收”一节详细讲解。 通过xid_base字段,页面上的XID可以仅储存基于该xid_base的一个32位偏移(Offset),节省XID存储的空间开销。实际的XID为页面上的xid_base加上存储的XID(也就是偏移)得到。 多版本中的叶子页面的结构如图4-17所示。 图4-17 ubtree 叶子页面结构示意图 与astore堆页面中维护版本信息的方法类似,ubtree的叶子节点中每个索引元组尾部都附加了对应的xmin和xmax。由于索引只是用于加速搜索的结构,本身不与历史版本概念强相关,仅通过xmin和xmax来标识这个索引元组是从什么时候开始有效的,又是什么时候被删除的,而不像astore中堆元组一样会有指向旧版本元组的指针。 新插入的索引元组尾部用于存放xmin和xmax 空间在ubtinsert函数执行的过程中预留出来。预留的空间及xmin在索引元组插入时通过UBTreePageAddTuple函数中写入页面,而xmax在索引元组删除时通过UBTreeDeleteOnPage函数中写入页面。 在UBTreePagePruneOpt函数中,索引元组通过其xmin和xmax信息来判断该元组是否已经无效(Dead),进而进行独立的页面清理。该函数会尝试清除所有无效的元组,并进行相应的碎片整理。 索引扫描时会调用UBTreeFirst函数定位到第一个满足扫描条件的索引元组,然后调用UBTreeReadPage获取当前页面中符合索引扫描条件,且能够通过可见性检查的元组。可见性检查通过UBTreeVisibilityCheckXid函数及UBTreeVisibilityCheckCid函数处理,其基本逻辑与astore类似,通过xmin与xmax及当前的快照进行可见性判断。 在ubtree中,索引元组除了按照索引列有序排列之外,对于索引列相同的元组,还将其对应堆元组的TID作为第二关键字进行排序。其具体实现大致都集中在ubtbuild函数及ubtinsert函数调用的过程中,这中间对索引列相同的元组会按照TID来进行额外的比较。实现还借助了BTScanInsert结构体,该结构体定义如下: typedef struct BTScanInsertData { bool heapkeyspace; /* 标志索引是否额外按 TID 排序 */ bool anynullkeys; /* 标志待查找的索引元组是否有为 NULL的列 */ bool nextkey; /* 标志是否希望寻找第一个大于扫描条件的元组 */ bool pivotsearch; /* 标志是否希望查找 Pivot 元组 */ ItemPointer scantid; /* 用于作为排序依据的 TID */ int keysz; /* scankeys 数组的大小 */ ScanKeyData scankeys[INDEX_MAX_KEYS]; } BTScanInsertData; 在索引元组将TID作为第二关键字排序之后,用于划分搜索空间的非叶子节点元组及叶子节点的Hikey元组(统称Pivot元组)也需要携带对应的TID信息。这会使得Pivot元组占用空间增加,非叶子的扇出(fan out)降低。为了避免这一特性导致的扇出降低,若不需要比较TID即可区分两个叶子页面,则对应的Pivot原则中就不需要储存TID信息。类似地,Pivot元组中也可以去掉一些不需要进行比较的索引列,这一逻辑在UBTreeTruncate函数中进行处理。原则是当比较前几列就可以区分两个叶子页面时,Pivot元组中就不需要储存后续的列。 2) 索引操作 对于原有的B-Tree索引而言,主要有四类操作:索引创建、索引扫描、索引插入以及索引删除。下面将依次进行介绍。 (1) 索引创建。 索引创建操作由索引上的ubtbuild函数及ustore上的IndexBuildUHeapScan函数配合完成。IndexBuildUHeapScan函数负责扫描对应的ustore表,并取出每个元组的最新版本(遵循SnapshotNow的语义)以及其对应的xmin和xmax。若发现某个元组存在被就地更新的旧版本,则会将该索引标记为HotChainBroken。被标记为HotChainBroken的索引,会复用astore原有的逻辑,禁止隔离级别为可重复读(Read Repeatable)的老事务访问。ubtbuild函数会接收IndexBuildUHeapScan传过来的元组,将其按照索引列及TID排序后依次插入到索引页面中,并构建相应的元页面及上层页面。整个创建流程需要将所有页面都记录到XLOG中,并强制将存储管理中的内容刷到永久存储介质后才算成功结束。 (2) 索引扫描。 索引扫描与B-Tree索引基本一致,但是需要对索引元组进行可见性检查。没有通过可见性检查的索引元组不会被返回,通过可见性检查的元组仍需要在ustor 堆表上进行可见性检查,并找到正确的可见版本。在IndexOnlyScan场景中,通过可见性检查的元组即可直接返回,不需要再访问堆表。 不过索引进行可见性检查时,由于索引元组只存放了xmin和xmax而没有CID(对应“4.2.3 astore”节堆表元组中的t_cid字段)信息,如果发现了当前事务修改过的索引元组则不能正确地通过CID来判断其可见性。此时会将该元组视为可见,但会标记xs_recheck_itup,告知ustore的数据页面需要在取到对应的数据元组后,再次构建对应的索引元组并与返回的索引元组进行比较,来确认该索引元组是不是真正可见。相关逻辑在 UBTreeVisibilityCheckXid、UBTreeVisibilityCheckCid以及RecheckIndexTuple函数中进行处理。 (3) 索引插入。 索引元组需要存储对应的xmin和xmax版本信息,但其所占用的空间并不表现在IndexTupleSize中,而是对外部透明。索引插入的接口函数为ubtinsert,为了正确插入带有版本信息的元组,需要在执行插入前增加IndexTupleSize以预留用于储存版本信息的空间。真正将元组插入到页面的时候,会将版本信息所占用的空间大小从IndexTupleSize中去除。 在索引插入的过程中若页面空间不足,会首先调用UBTreePagePruneOpt函数尝试对已经无效的元组进行清理。若清理失败或清理成功后空间仍然不足,会进行索引页面分裂。索引页面分裂会在UBTreeInsertOnPage函数中进行。ubtree中存在两种分裂策略:default以及insertpt。其中default策略会将原页面上的内容均匀地分配到两个页面上,而insertpt会根据新插入元组的插入规律、插入位置及TID等信息选择合适的分裂点。 在ubtree需要申请新的页面时,并不会像原有的B-Tree索引一样调用_bt_getbuf通过FSM来查找可用页面。ubtree带有自治式的空间管理机制,通过UBtreeGetNewPage函数获取新页面。该自治式空间管理机制将在空间管理和回收部分介绍。 (4) 索引删除。 索引删除操作用于在堆元组被删除的同时,将对应的索引元组也标上对应的xmax。索引删除的流程与插入类似,通过二分查找定位到待删除元组的位置,并将xmax写入到对应的位置。需要注意的是,要删除的元组是索引列以及TID都匹配,且还未被写入xmax的那个元组,这部分逻辑在UBTreeFindDeleteLoc函数中处理。在最后会调用UBTreeDeleteOnPage函数为对应的索引元组写上xmax,更新页面上的last_delete_xid以及activeTupleCount,并在检测到activeTupleCount为0时将该页面放入潜在空页队列(Potential Empty Page Queue)中。关于潜在空页队列会在空间管理和回收部分介绍。 5. 存取管理 openGauss中的ustore表访存接口如表4-24所示。由于openGauss中ustore表只有一种页面和元组结构,因此在上述接口中,直接实现了底层的页面和元组操作流程。 表4-24 ustore表访存接口 函数名称 接口含义 heap_open 打开一个ustore表,得到表的相关元信息 heap_close 关闭一个ustore表,释放该表的加锁或引用 UHeapRescan 重新开始ustore表(顺序)扫描操作 UHeapGetNext (顺序)获取下一条元组 UHeapGetTupleFromPage UHeapGetNext内部实现,单页校验模式 UHeapScanGetTuple UHeapGetNext内部实现,单条校验模式 UHeapGetPage (顺序)获取并扫描下一个ustore表页面 UHeapInsert 在ustore表中插入一条元组 UHeapMultiInsert 在ustore表中批量插入多条元组 UHeapDelete 在ustore表中删除一条元组 UHeapUpdate 在ustore表中更新一条元组 UHeapLockTuple 在ustore表中对一条元组加锁 6. 空间管理和回收 不同于astore的空间管理和回收机制,ustore实现了自治式的空间管理机制。ustore里堆以及索引的空间分配和回收都在业务运行的过程中平稳地进行,不依赖中量级的VACUUM及AUTOVACUUM清理机制。 1) 自治式堆页面空间管理 ustore中堆页面的自治式空间管理,建立在与astore类似的轻量级堆页面清理机制的基础上。在执行DML及DQL操作的过程中,ustore都会进行堆数据页面清理,以取代VACUUM清理机制。UHeapPagePruneOptPage函数是页面清理的入口函数,会清理已经提交的被删除元组。 对于astore而言,复用数据元组的行指针前必须保证对应的索引元组已经被清理。这是为了防止通过索引元组访问已经被复用的行指针,导致取到错误的数据。在astore中需要通过VACUUM操作将这样的无效索引元组统一清除掉后才能复用行指针,这使得堆页面和索引页面的清理逻辑耦合在一起,也会导致间断性的大量I/O。在ustore中能高效地单独进行数据和索引页面的清理,因为带有版本信息的ubtree能够独立检测并过滤掉无效的索引元组,不会通过无效索引元组访问对应的数据表。 堆页面的空间管理机制复用openGauss中的FSM来管理UHeap中的可用空间。在UHeapPagePruneOptPage函数成功对页面进行清理后,会将其空闲空间刷新到对应的FSM页面中。为了避免每次页面清理都需要更新整个树状结构的FSM,从而带来额外的开销,引入了一个更新整个FSM的概率计算。考虑当前清理后的可用空间占预留可用空间(Reserved Free Space)阈值的百分比,计算得出清理一个页面后调用FreeSpaceMapVacuum函数的概率。也就是说,页面清理获得的可用空间越大,更新整个FSM的概率也就越大。 当数据元组被删除时,会在页面上记录对应的潜在空闲空间(Potential Free Space),该值用于估计页面上的空闲空间。在运行过程中,有多个场景会调用UHeapPagePruneOpt对页面尝试进行清理。DML语句执行过程中,INSERT、UPDATE以及DELETE操作都会拿到页面的写锁。如果发现空间不足,或者检测到潜在空闲空间到达某个阈值,会尝试对页面进行清理。DQL查询语句执行的过程中若检测到页面上潜在空闲空间到达阈值,也同样会尝试申请页面的写锁;如果拿到了页面的写锁,会尝试对页面进行清理。 存在可清理的元组,但一直不被访问的页面不能通过这一机制正确地清理。为了解决这一问题,引入了基于概率的清理方案。在RelationGetBufferForUTuple函数寻找新的可用空间时,若通过FSM发现没有足够的可用空间,在对物理文件进行扩展前,会“随机”选取一些页面进行清理。该机制并非完全随机选取,在多次尝试后选取的页面会覆盖到整个关系的全部页面。为了性能考虑,该过程中默认最多选取10个页面进行清理,该数量可以通过GUC参数max_search_length_for_prune进行设置。具体的页面选取数量通过DeadTupleRatio以及PruneSuccessRatio计算得出。其中DeadTupleRatio表示该表中无效元组的大致比例,该变量以统计信息的方式进行收集,在进行DML的过程中会进行更新;PruneSuccessRatio大致表示近几次尝试清理的成功率。 2) 自治式索引页面空间管理 索引页面的空间管理不依靠FSM数据结构,而是依靠特有的URQ(UBtree Recycle Queue)结构,简称为回收队列。索引回收队列单独储存在ubtree索引对应的.urq文件中,没有原有B-Tree索引的.fsm文件。索引回收队列相关代码在“ubtrecycle.cpp”文件中。涉及到的主要函数接口见表4-25。 表4-25 索引回收队列主要接口 函数名称 接口含义 UBTreeTryRecycleEmptyPage 尝试从潜在空页队列回收一个页面 UBTreeGetAvailablePage 获取有效页面(潜在空页或空闲页面) UBTreeRecordUsedPage 记录被成功使用的页面 UBTreeRecordEmptyPage 记录潜在的空页 UBTreeGetNewPage 获取新的可用页面 索引中的回收队列分为两部分,一部分是潜在空页队列(Potential Empty Page Queue),一部分是可用页面队列(Available Page Queue)。两个队列都是跨页面的循环队列,其中每个元素都会储存blkno以及XID。其中blkno表示该元素对应索引页面的block number;XID表示该页面在哪个时刻能够被回收或复用。这些元素在循环队列单个页内按照XID的顺序进行排序,以便于快速找到XID 小(最可能被回收或复用)的页面。其结构如图4-18所示。 图4-18 ubtree回收队列结构示意图 对于潜在空页队列而言,里面存放页内元组已经被全部删除但还没有全部无效的页面,其中的XID就标志页面中最后一个元组无效的可能时机。在系统整体的oldestXmin超过该XID后,该页面就有可能被从索引上删除,但也可能因为新插入元组或删除元组的事务中止而导致页面不能被删除。潜在空页队列中的页面在成功被删除后会被放入可用页面队列,并记录删除时最新事务的XID。 对于可用页面队列而言,里面存放已经被删除,可以或即将可以被复用的页面。其中XID就表示该页面可以被复用的时机。这样的页面复用时延是来自B-Tree索引页面删除时可能的并发访问导致的,可以参考nbtree文件夹下README 关于页面删除的部分。 在ubtree进行索引删除时,会更新页面上的last_delete_xid字段以及activeTupleCount字段。若更新后activeTupleCount变为0,会将该页面放入潜在空页队列,并将此时的last_delete_xid作为对应的可回收时间点。 在业务运行的过程中,索引会通过UBTreeTryRecycleEmptyPage函数不断尝试对潜在空页队列中的页面进行回收。在索引申请新的页面时,会通过UBTreeGetNewPage函数与可用页面队列交互,查找当前可用的空闲页面。当可用页面队列中没有可用页面时,一般会通过扩展索引物理文件的方式来获得新的页面。但也存在物理文件批量扩展,或扩展后还未来得及使用就出错退出的情况。此时在回收队列的元信息页面中保存了已正确追踪的页面数量,若该数量少于整个索引表的页面数量,会尝试去使用这一部分未追踪的页面,并更新已追踪的页面数量。 3) 中量级和重量级手动页面清理 与astore相同,ustore也提供VACUUM语句来让用户主动执行对某个ustore表及其上的索引进行中量级清理。其对外表现与astore一致,可参考astore的空间管理和回收内容。 在ustore中,中量级清理同样通过lazy_vacuum_rel函数进入,但不会调用lazy_scan_heap,而是调用LazyScanUHeap函数来进行数据页面的清理。在进行索引清理时,会调用lazy_vacuum_index接口及LazyVacuumHeap函数来清理索引文件和堆表文件,索引清理时会调用ubtbulkdelete函数。 重量级的VACUUM FULL也与astore一致,会清理无效数据并对数据空间和索引空间重新进行组织。重量级清理的对外接口是cluster_rel函数,本质上是重新对数据进行聚簇,清理过程中会阻塞对该表的所有操作。 介绍完“4.2.4 ustore”,下篇我们将详细介绍“4.2.5 行存储索引机制”相关内容,敬请期待!

优秀的个人博客,低调大师

openGauss数据库源码解析系列文章——存储引擎源码解析(三)

上一篇我们将详细介绍“4.2.3 astore”相关内容,本篇我们将讲述“3. astore元组多版本机制”、“4.astore访存管理”及“5.astore空间管理和回收”。 4.2.3 astore 3. astore元组多版本机制 openGauss行存储表支持多版本元组机制,即为同一条记录保留多个历史版本的物理元组以解决对同一条记录的读、写并发冲突(读事务和写事务工作在不同版本的物理元组上)。 astore存储格式为追加写优化设计,其多版本元组产生和存储方式如图4-5所示。当一个更新操作将v0版本元组更新为v1版本元组之后,如果v0版本元组所在页面仍然有空闲空间,则直接在该页面内插入更新后的v1版本元组,并将v0版本的元组指针指向v1版本的元组指针。在这个过程中,新版本元组以追加写的方式和被更新的老版本元组混合存放,这样可以减少更新操作的I/O开销。然而,需要指出的是,由于新、老版本元组是混合存放的,因此在清理老版本元组时需要的清理开销会比较大。因此,astore存储格式比较适合频繁插入、少量更新的业务场景。 图4-5 astore多版本元组产生和存储方式示意图 下面结合图4-6,介绍openGauss中行存储格式多版本元组的运行机制: 图4-6 行存储格式多版本元组运行机制示意图 (1) 首先事务号为10的事务插入一条值为value1的新记录。对应的页面修改为:在0号物理页面的第一个元组指针指向位置,插入一条“xmin”字段为10、“xmax”字段为0、“ctid”字段为(0,1)、“data”字段为value1的物理元组。该事务提交,将CSN从3推进到4,并且在CSN日志中对应事务号10的槽位处记下该CSN的值。 (2) 然后事务号为12的事务将上面这条记录的值从value1修改为value2。对应的页面修改为:在0号物理页面的第二个元组指针指向位置,插入另一条“xmin”字段为12、“xmax”字段为0、“ctid”字段为(0,2)、“data”为value2的物理元组。同时保留上面第一条插入的物理元组,但是将其“xmax”字段从0修改为12,将其“ctid”字段修改为(0,2),即新版本元组的物理位置。该事务提交,将CSN从7推进到8,并且在CSN日志中对应事务号12的槽位处记下该CSN的值。 (3) 最后事务号为15的事务将上面这条记录的值从value2又修改为value3,对应的页面修改为:(假设0号页面已满)在1号物理页面的第一个元组指针指向位置,插入一条“xmin”字段为15、“xmax”字段为0、“ctid”字段为(1,1)、“data”字段为value3的物理元组;同时,保留上面第1、第2条插入的物理元组,但是将第2条物理元组的“xmax”字段从0修改为15,将其“ctid”字段修改为(1,1),即最新版本元组的物理位置。该事务提交,将CSN从9推进到10,并且在CSN日志中对应事务号15的槽位处记下该CSN的值。 (4) 对于并发的读事务,其在查询执行开始时,会获取当前的全局CSN值作为查询的快照CSN。对于上面同一条记录的3个版本的物理元组来说,该读查询操作只能看到同时满足如下两个条件的这个物理元组版本。 元组“xmin”字段对应的CSN值小于等于读查询的快照CSN。 元组“xmax”字段为0,或者元组“xmax”字段对应的CSN值大于读查询的快照CSN。 比如,若并发读查询的快照CSN为8,那么这条查询将看到value2这条物理元组;若并发读查询的快照CSN为11,那么这条查询将看到value3这条物理元组。 对于不同的行存储子格式,上述多版本元组的格式和存储方式可能有所不同,但是可见性判断和并发控制方式都是如图4-6中所示的。通过上面介绍的元组可见性判断流程,可以发现:并发的读事务会根据自己的查询快照在同一个记录的多个历史版本元组中选择合适的那个来返回。并且即使是在可重复读的事务隔离级别下,只要使用相同的快照总可以筛选出相同的那个历史版本元组。在整个过程中读事务不阻塞任何对该记录的并发写操作(更新和删除)。 更详细的元组可见性判断流程将在第5章中详细介绍。 最后,对于astore行存储格式,更新一条记录的详细执行流程如图4-7所示,该图可以帮助读者更形象地理解多版本元组的产生流程,以及写、写并发下的处理逻辑。 图4-7 更新astore记录的执行流程示意图 4. astore访存管理 openGauss中的astore堆表访存接口如表4-13所示。 表4-13 astore堆表访存接口 接口名称 接口含义 对应的行存储统一访存接口 heap_open 打开一个表,得到表的相关元信息 无 heap_close 关闭一个表,释放该表的加锁或引用 无 heap_beginscan 初始化堆表(顺序)扫描操作 tableam_scan_begin heap_endscan 结束并释放堆表(顺序)扫描操作 tableam_scan_end heap_rescan 重新开始堆表(顺序)扫描操作 tableam_scan_rescan heap_getnext (顺序)获取下一条元组 tableam_scan_getnexttuple heap_markpos 记录当前扫描位置 tableam_scan_markpos heap_restrpos 重置扫描位置 tableam_scan_restrpos heapgettup_pagemode heap_getnext内部实现,单页校验模式 无 heapgettup heap_getnext内部实现,单条校验模式 无 heapgetpage (顺序)获取并扫描下一个堆表页面 tableam_scan_getpage heap_init_parallel_seqscan 初始化并行堆表(顺序)扫描操作 tableam_scan_init_parallel_seqscan heap_insert 在堆表中插入一条元组 tableam_tuple_insert heap_multi_insert 在堆表中批量插入多条元组 tableam_tuple_multi_insert heap_delete 在堆表中删除一条元组 tableam_tuple_delete heap_update 在堆表中更新一条元组 tableam_tuple_update heap_lock_tuple 在堆表中对一条元组加锁 tableam_tuple_lock heap_inplace_update 在堆表中(就地)更新一条元组 无 以astore堆表顺序扫描为例,执行流程如下。 (1) 调用heap_open接口打开待扫描的堆表,获取表的相关元信息,如表的行存储子格式为astore格式等。该步通常要获取AccessShare一级表锁,防止并发的DDL操作。 (2) 调用tableam_scan_begin接口,从g_tableam_routines数组中找到astore的初始化扫描接口,即heap_beginscan接口,完成初始化顺序扫描操作相关的结构体。 (3) 循环调用tableam_scan_getnexttuple接口,从g_tableam_routines数组中找到astore的扫描元组接口,即heap_getnext接口,顺序获取一条astore元组,直到完成全部扫描。顺序扫描时,每次先获取下一个页面,然后依次返回该页面上的每一条元组。这里提供了两种元组可见性的判断时机: a) heapgettup_pagemode。在第一次加载下一个页面时,加上页面共享锁,完成对页面上所有元组的可见性判断,然后将可见的元组位置保存起来,释放页面共享锁。后面每次直接从保存的可见性元组列表中返回下一条可见的元组,无须再对页面加共享,使用快照的查询,默认都使用该批量模式,因为元组的可见性在同一个快照中不会再发生变化。 b) heapgetpage。除了第一次加载下一个页面时需要批量校验元组可见性之外,在后面每一次返回该页面下一条元组时,都要重新对页面加共享锁,判断下一条元组的可见性。该模式的查询性能较批量模式要稍低,适用于对系统表的顺序扫描(系统表的可见性不参照查询快照,而是以实时的事务提交状态为准)。 (4) 调用tableam_scan_end接口,从g_tableam_routines数组中找到astore的扫描结束接口,即heap_endscan接口,结束顺序扫描操作,释放对应的扫描结构体。 (5) 调用heap_close接口,释放对表加的锁或引用计数。 5. astore空间管理和回收 openGauss中采用最大堆二叉树结构来记录和管理astore堆表页面的空闲空间,该最大堆二叉树结构按照页面粒度进行与存储介质的读写操作,并单独储存于专门的空闲空间位图文件中(free space map,简称FSM)。该FSM文件的结构如图4-8所示。 图4-8 astore FSM文件结构示意图 所有页面分为叶子节点页面和内部节点页面两种。两种页面的页面内部结构完全相同,区别在于:对于叶子节点页面,其页面中记录的二叉树的叶子节点对应堆/索引表页面的空闲空间程度;对于内部节点页面,其页面中记录的二叉树的叶子节点对应下层FSM页面的最大空闲空间程度。 使用FSM页面中的1个字节(即256档)来记录一个堆/索引页面的空闲空间程度。在FSM页面中不会记录任何堆/索引页面的页号信息,也不会记录任何根、子FSM节点页面的页号信息,这些信息主要通过以下的规则来计算得到: (1) 在一个FSM页面内部,二叉树节点按照从上到下、从左到右逐层排布,即:第一个字节为根节点的空闲程度,第二个字节为第一层内部节点最左边节点的空闲程度,依次类推。 (2) 所有FSM页面在物理存储上采用深度优先顺序,即某个FSM页面之前所有的物理页面包括:该FSM页面所在子树的所有上层节点,加上该FSM页面所有左侧子树。 (3)所有FSM叶子节点页面中的二叉树的叶子节点,对应堆/索引表页面的空闲空间程度,且根据从左到右的顺序,分别对应第1个、第2个、….、第n个堆/索引表物理页面。 (4)除了(3)中这些FSM节点之外,其他FSM父节点保存子节点(子树)中空闲空间的最大值。 根据上述算法,可以高效地查询出具有足够空闲空间的堆/索引页面的页面号,并将待插入的数据插入其中。 FSM模块主要的对外接口和含义如表4-14所示。 表4-14 FSM模块主要的对外接口 接口名称 接口含义 GetPageWithFreeSpace 获取空闲程度大于入参的堆/索引页面号 RecordAndGetPageWithFreeSpace 更新当前(不满足条件的)堆/索引页面的空闲空间程度,寻找新的空闲程度大于入参的堆/索引页面号 RecordPageWithFreeSpace 更新单个堆/索引页面的空闲空间程度 UpdateFreeSpaceMap 更新多个(批量插入的)堆/索引页面的空闲空间程度 FreeSpaceMapTruncateRel 删除所有储存大于某个堆/索引页面号空闲信息的FSM页面 FreeSpaceMapVacuum 修正所有FSM内部节点的空闲空间信息 此外,为了保证FSM信息的维护操作不会带来明显的开销,因此FSM的所有修改都是不记录日志的。同时,对于某个堆/索引页面对应的FSM信息,只在页面初始化和页面空闲空间整理(见本节后面介绍)两种场景下才会主动更新,除此之外,只有当新插入的数据发现该页面实际空间不足时才会被动更新该页面对应的FSM信息(也包括由于宕机导致的FSM页面损坏)。 空闲空间的管理难点在于空闲空间的回收。在openGauss中,对于astore存储格式,有3种回收空闲空间的方式,如图4-9所示。 图4-9 astore空闲空间回收机制示意图 1. 轻量级堆页面清理 当查询扫描到某个astore堆表页面时,会顺带尝试清理该页面上已经被删除的、足够老的元组(足够老是指在元组对于所有并发查询均为已经删除状态,具体参见事务处理章节)。由于只是顺带清理该页面内容,因此只能删除元组内容本身,元组指针还需要保留,以免在索引侧造成空引用或空指针(可参见4.2.5 行存储索引机制)。一个比较特殊的情况是HOT场景。HOT场景是指对于该表上所有的索引更新前后的索引键值均没有发生变化,因此对于更新后的元组只需要插入堆表元组而不需要新插入索引元组。对于同一个页面内一条HOT链上的多个元组,如果它们都足够老了,那么在清理时可以额外删除所有中间的元组指针,只保留第一个版本的元组指针,并将其重定向到第一个不用被清理的元组版本的元组指针。 轻量级堆页面清理的接口是heap_page_prune_opt函数,关键的数据结构是PruneState结构体,定义代码如下: typedef struct { TransactionId new_prune_xid; TransactionId latestRemovedXid; int nredirected; /* 待重定向的元组个数 */ int ndead; /* 待标记死亡的元组个数 */ int nunused; /* 待回收的元组个数 */ OffsetNumber redirected[MaxHeapTuplesPerPage * 2]; OffsetNumber nowdead[MaxHeapTuplesPerPage]; OffsetNumber nowunused[MaxHeapTuplesPerPage]; bool marked[MaxHeapTuplesPerPage + 1]; } PruneState; 其中,“new_prune_xid”字段用于记录页面上此次没有被清理的、但是已经被删除的元组的xmax,用于决定下次何时再次清理该页面;“latestRemovedXid”字段用于记录该页面上被清理的元组的最大的xmax,用于判断热备上回放页面整理时是否需要等待只读查询;nredirected、ndead、nunused、redirected、nowdead和nowunused分别记录该页面上待重定向的、待标记死亡的、待回收的元组。 2. 中量级堆页面和索引页面清理 openGauss提供VACUUM语句来让用户主动执行对某个astore表(或某个库中所有的astore表)及其上的索引进行中量级清理。中量级清理过程中,不阻塞相关表的查询和DML操作。由于在astore表中,新、老版本元组是混合存储的,因此,与顺带执行的轻量级清理相比,astore表的中量级清理需要进行全表顺序(或索引)扫描,才能识别出所有待清理的老版本元组。对于扫描出来的确认要清理的元组,会首先清理索引中的元组,然后再清理堆表中的元组,从而可以避免出现索引空指针的问题。 中量级清理的对外接口是lazy_vacuum_rel函数,内部逐层调用lazy_scan_rel、lazy_scan_heap和heap_page_prune(同轻量级清理)来扫描和暂存几类待清理的元组。当待清理的元组积攒到一定数量之后(受maintenance_work_mem内存上限控制),先后调用lazy_vacuum_index接口和lazy_vacuum_heap接口来分别清理索引文件和堆表文件。其中,与堆表页面将元组指针置为UNUSED不同,索引页面直接删除被清理的元组指针,并进行页面重整。 中量级清理的关键数据结构是LVRelStats结构体,定义代码如下: typedef struct LVRelStats { bool hasindex; /* 表上是否有索引 */ /* 统计信息 */ BlockNumber old_rel_pages; /* 之前的页面个数统计 */ BlockNumber rel_pages; /* 当前的页面个数统计 */ BlockNumber scanned_pages; /* 已经扫描的页面个数 */ double scanned_tuples; /* 已经扫描的元组个数 */ double old_rel_tuples; /* 之前的元组个数统计 */ double new_rel_tuples; /* 当前的元组个数统计 */ BlockNumber pages_removed; double tuples_deleted; BlockNumber nonempty_pages; /* 最后一个非空页面的页面号加1 */ /* 待清理的元组的行号信息(已排序) */ int num_dead_tuples; /* 当前待清理的元组个数 */ int max_dead_tuples; /* 单次最多可记录的待清理元组个数 */ ItemPointer dead_tuples; /* 待清理元组行号数组 */ int num_index_scans; TransactionId latestRemovedXid; bool lock_waiter_detected; BlockNumber* new_idx_pages; double* new_idx_tuples; bool* idx_estimated; Oid currVacuumPartOid; } LVRelStats; 其中hasindex表示该表是否有索引表,num_dead_tuples表示目前已经积攒的要清理的元组,dead_tuples是保存这些元组位置的TID数组,max_dead_tuples是根据maintenance_work_mem计算出来的单次允许积攒的最大待清理元组个数。 需要指出的是,如果在元组更新时就把老版本元组集中存储,那么清理时就无须全表扫描,只需要清理集中存储的老版本元组页面即可,这样可以有效降低清理过程带来的I/O开销,使得整体存储引擎的I/O开销和性能更平稳,这也是后续openGauss版本将支持的ustore行存储格式的设计出发点。 3. 重量级堆页面和索引页面清理 无论是轻量级清理,或是中量级清理,都只能局部清理astore页面中的死亡元组,无法真正实现对这些空闲空间的释放(被清理出的空间,仍然只能被该表使用)。因此,openGauss还提供了VACUUM FULL语句来让用户主动执行对某个astore表(或某个库中所有astore表)及其上的索引进行重量级清理。重量级清理将一个表中所有仍未死亡(但是可能已经被删除)的元组重新紧密插入到新的堆表文件中并在此基础上重新创建所有索引,从而实现对空闲空间的彻底回收。在重量级清理的主体流程中只允许用户执行只读查询操作,在重量级清理的提交流程中只读查询操作也会被阻塞。 为了尽可能提高重新创建的索引性能,如果用户堆表上有索引,那么上述全表扫描会采用索引扫描。 重量级清理的对外接口是cluster_rel函数,内部逐层调用rebuild_relation、copy_heap_data、tableam_relation_copy_for_cluster、heapam_relation_copy_for_cluster、copy_heap_data_internal、reform_and_rewrite_tuple、rewrite_heap_tuple。其中,“rewrite_heap_tuple”接口将每一条扫描的未死亡元组进行重构(去除被删除的字段)之后,插入到新的紧密排列的堆表中。在这个过程中,对原来多个元组之间的更新链关系采用两个哈希表来进行暂存。当一对更新元组的双方都扫描到之后,就进行新表的填充,并将更新后元组的新的TID(transaction ID,事务ID)保存到更新前的元组中。上述机制保证重量级清理过程中并发更新事务的执行机制不会受到破坏。 重量级清理的关键数据结构是RewriteStateData结构体,其定义代码如下: typedef struct RewriteStateData { Relation rs_old_rel; /* 源表 */ Relation rs_new_rel; /* 整理后的目标表 */ Page rs_buffer; /* 当前整理的源表页面 */ BlockNumber rs_blockno; /* 当前写入的目标表页面号 */ bool rs_buffer_valid; /* 当前缓冲区是否有效 */ bool rs_use_wal; /* 整理操作是否产生日志 */ TransactionId rs_oldest_xmin; /* 用于可见性判断的最老活跃事务号 */ TransactionId rs_freeze_xid; /* 用于元组冻结判断的事务号 */ MemoryContext rs_cxt; /* 哈希表内存上下文 */ HTAB *rs_unresolved_tups; /* 未匹配的更新前元组版本 */ HTAB *rs_old_new_tid_map; /* 未匹配的更新后元组版本 */ /* 元组压缩相关信息 */ PageCompress *rs_compressor; Page rs_cmprBuffer; HeapTuple *rs_tupBuf; Size rs_size; int rs_nTups; bool rs_doCmprFlag; /* 异步-同步读写相关 */ char *rs_buffers_queue; /* adio write queue */ char *rs_buffers_queue_ptr; /* adio write queue ptr */ BufferDesc *rs_buffers_handler; /* adio write buffer handler */ BufferDesc *rs_buffers_handler_ptr; /* adio write buffer handler ptr */ int rs_block_start; /* adio write start block id */ int rs_block_count; /* adio write block count */ } RewriteStateData; 其中,rs_old_rel是被清理的表,rs_new_rel是清理之后的表,rs_oldest_xmin是判断元组是否死亡的xid阈值,rs_freeze_xid是判断是否进行freeze操作的xid阈值。rs_unresolved_tups是保存一对更新元组中老元组的哈希表,rs_old_new_tid_map是保存一对更新元组中新元组的哈希表,这两个成员共同保证更新链信息不被丢失(在原表中更新后的元组的物理位置可能比更新前的元组的物理位置还要小)。 最后,重量级操作实际上是一种数据重聚簇操作,对于其他行存储子格式和cstore列存储格式同样适用,只是具体实现机制略有不同。 本期精彩内容将告一段落,下篇我们将详细介绍“4.2.4 ustore”相关内容,敬请期待!

优秀的个人博客,低调大师

openGauss数据库源码解析系列文章——存储引擎源码解析(二)

上一篇我们讲述了“4.2 磁盘引擎”中“4.2.1 磁盘引擎整体框架及代码概览”与“4.2.2 行存储统一访存接口”。本篇我们将讲述“4.2.3 astore”。 4.2.3 astore astore整体框架 astore整体框架如图4-2所示。如上所述,作为行存储子格式之一,astore需要实现自己的堆表存取(访存)管理接口、堆表页面结构、堆表元组结构、元组多版本机制,以及空闲空间管理和回收机制。 图4-2 astore整体框架示意图 astore堆表页面元组结构 本节介绍astore堆表的页面和元组结构。 所谓堆表,是指元组无序存储,数据按照“先来后到”的方式存储在页面中的空闲位置。作为对比,在索引表中,元组根据索引键键值的排序,在页面内部有序存储,且各个页面之间在逻辑上也是有序存储的。堆表存储数据主体,索引表仅存储索引键键值以及对应的、完整元组的物理位置(即完整元组在堆表中的页面号和页内偏移)。 1) astore堆表元组结构 astore堆表元组结构的定义部分代码如下: typedef struct HeapTupleFields { ShortTransactionId t_xmin; /* 插入元组事务的事务号 */ ShortTransactionId t_xmax; /* 删除元组事务的事务号 */ union { CommandId t_cid; /* 插入或删除命令在事务中的命令号 */ ShortTransactionId t_xvac; } t_field3; } HeapTupleFields; typedef struct HeapTupleHeaderData { union { HeapTupleFields t_heap; DatumTupleFields t_datum; } t_choice; ItemPointerData t_ctid; /* 当前元组或更新后元组的行号 */ uint16 t_infomask2; /* 字段个数和标记位 */ uint16 t_infomask; /* 标记位 */ uint8 t_hoff; /* 包括NULL字段位图、对齐填充在内的元组头部大小 */ bits8 t_bits[FLEXIBLE_ARRAY_MEMBER]; /* NULL字段位图 */ /* 实际元组数据再该元组头部结构体之后,距离元组头部处偏移t_hoff字节 */ } HeapTupleHeaderData; 该结构体只是元组头部的定义,元组内容跟在该结构体后面,距离元组头部起始处的偏移由“t_hoff”成员保存。上面元组头部结构体部分成员信息,同时也构成了该元组的系统字段(字段序号小于0的那些字段)。对各个结构体成员的含义说明如下。 (1) t_xmin,插入元组的事务号(32位)。对应系统字段序号是MinTransactionIdAttributeNumber(-3)。 (2) t_xmax,删除元组的事务号(32位)。如果元组还没有被删除,那么为零。对应系统字段序号MaxTransactionIdAttributeNumber(-5)。 (3) t_cid,插入或删除元组的命令号。对应系统字段序号MinCommandIdAttributeNumber(-4)和MaxCommandIdAttributeNumber(-6)。 (4) t_ctid,当前元组的页面和页面内元组指针下标。如果该元组被更新,为更新后元组的页面号和页面内元组指针下标。 (5) t_infomask2,元组属性掩码,包含元组中字段个数、HOT(heap only tuple,堆内元组)更新标记、HOT元组标记等。 (6) t_infomask,元组另一个属性掩码,包含是否有空字段标记、是否有变长字段标记、是否有外部TOAST(the oversized-attribute storage technique,过长字段存储技术)标记、是否有OID字段标记、是否有压缩标记、插入事务是否提交/回滚标记、删除事务是否提交/回滚标记、是否被更新标记等。如果OID标记存在,那么元组OID从“t_hoff”偏移位置之前4个字节获得,对应系统字段序号ObjectIdAttributeNumber(-2)。 (7) t_hoff,元组数据距离元组头部结构体起始位置的偏移。 (8) t_bits,所有字段的NULL值bitmap。每个字段对应t_bits中的一个bit位,因此是变长数组。 上述元组结构体在内存中使用时嵌入在一个更大的元组数据结构体中,该结构体的定义代码如下。除了保存元组内容的t_data成员之外,其他的成员保存了该元组的一些其他系统信息,这些信息构成了该元组剩余的一些系统字段内容: typedef struct HeapTupleData { uint32 t_len; /* 包括元组头部和数据在内的元组总大小 */ ItemPointerData t_self; /* 元组行号 */ Oid t_tableOid; /* 元组所属表的OID */ TransactionId t_xid_base; TransactionId t_multi_base; HeapTupleHeader t_data; /* 指向元组头部 */ } HeapTupleData; 该结构体主要成员的含义如下。 (1) t_len,元组长度。 (2) t_self,元组所在页面号和页面内元组指针下标,对应系统字段序号SelfItemPointerAttributeNumber(-1)。 (3) t_tableOid,该元组所属表的OID,对应系统字段序号TableOidAttributeNumber(-7)。 介绍了astore堆表元组结构,下面介绍常用的astore堆表元组操作接口。如表4-11所示。 表4-11 常用的元组操作接口 操作接口名 操作含义 对应的行存储统一访存接口 heap_form_tuple 使用传入的、各个元组字段的values数组和nulls数组,生成一条完整的元组。一般用于插入操作 tableam_tops_form_tuple heap_deform_tuple 使用传入的完整元组以及各个字段的类型定义,解构各个字段的值,生成values数组和nulls数组。一般用于更新前的准备工作 tableam_tops_deform_tuple heap_modify_tuple 先调用heap_deform_tuple解构传入的原始元组,然后将解构得到的values和nulls数组中需要更新的字段替换为新的值,最后再调用heap_form_tuple生成修改后的完整元组。一般用于更新操作 tableam_tops_modify_tuple heap_freetuple 释放一条元组对应的内存空间 tableam_tops_free_tuple heap_copytuple 复制一条完整的元组,包括元组头和元组内容 tableam_tops_copy_tuple heap_form_cmprs_tuple 类似heap_form_tuple,生成一条压缩后的元组 tableam_tops_form_cmprs_tuple heap_deform_cmprs_tuple 类似heap_deform_tuple,解构一条压缩后的元组 tableam_tops_deform_cmprs_tuple heap_getattr 获取一条元组中指定的用户或系统字段值 tableam_tslot_getattr heap_getsysattr 获取一条元组中指定的系统字段值 tableam_tops_getsysattr 在上述操作接口中,heap_getattr操作接口是最常用的操作接口之一,执行流程如图4-3所示。 图4-3 heap_getattr操作接口从元组中获取单个字段值的流程图 heap_getattr操作接口在代码上做了多处优化: (1) 判断待访问的字段序号是否大于元组头部保存的元组实际字段个数;如果大于,则通过访问pg_attribute系统表得到。该优化来自快速追加表字段特性。该特性允许用户在不需要重写一张表所有行的情况下,在一张表的最后增加一个或多个带默认值约束的字段。 (2) 如果该元组的字段全部非空并且待查询字段之前所有的字段都是定长的,那么在上一个heap_getattr查询该字段的操作过程中,会缓存该字段在元组中的字节偏移;之后再次查询时,当满足元组字段全部非空的情况下会使用上述缓存的偏移位置直接读取字段内容。 (3) 读取元组头部的NULL值bitmap,如果该字段对应的bitmap中的比特位非0,则直接返回NULL值。 2) astore堆表页面结构 由于整体行存储格式默认的介质管理器是磁盘文件系统,因此采用了和文件系统类似的段页式设计,最小I/O单元为一个页面,这样可以在大多数场景下获得比较好的I/O性能和较低的I/O开销。一个astore堆表页面默认大小为8kB,其结构如图4-4所示。 图4-4 astore堆表页面结构示意图 在一个astore堆表页面中,页面头部分对应HeapPageHeaderData结构体。其中,pd_multi_base以及之前的部分对应定长成员,存储了整个页面的重要元信息;pd_multi_base之后的部分对应元组指针变长数组,其每个数组成员存储了页面中从后往前的、每个元组的起始偏移和元组长度。如图4-4所示,真正的元组内容从页面尾部开始插入,向页面头部扩展;相应的,记录每条元组的元组指针从页面头定长成员之后插入,往页面尾部扩展;整个页面中间形成一个空洞,供后续插入的元组和元组指针使用。 对于一个astore堆表的一条具体元组,有一个全局唯一的逻辑地址,即元组头部的t_ctid,其由元组所在的页面号和页面内元组指针数组下标组成;该逻辑地址对应的物理地址,则由ctid和对应的元组指针成员共同给出。通过页面、对应元组指针数组成员、页面内偏移和元组长度的访问顺序,就可以完整获取到一条元组的完整内容。t_ctid结构体和元组指针结构体的定义代码如下。 /* t_ctid结构体*/ typedef struct ItemPointerData { BlockIdData ip_blkid; /* 页号 */ OffsetNumber ip_posid; /* 页面偏移,即对应的页内元组指针下标 */ } ItemPointerData; /* 页面内元组指针结构体 */ typedef struct ItemIdData { unsigned lp_off : 15, /* 元组起始位置(距离页头) */ lp_flags : 2, /* 元组指针状态 */ lp_len : 15; /* 元组长度 */ } ItemIdData; 如上两级的元组访问设计,主要有两个优点。 (1) 在索引结构中(参见“4.2.5 行存储索引机制”小节),只需要保存元组的t_ctid值即可,无须精确到具体字节偏移,从而降低了索引元组的大小(节约两个字节),提升索引查找效率; (2) 将页面内元组的地址查找关系自封闭在页面内部的元组指针数组中,和外部索引解耦,从而在某些场景下可以让页面级空闲空间整理对外部索引数据没有影响,降低空闲空间回收的开销和设计复杂度。具体实现机制在“5. astore空间管理和回收”小节中介绍。 astore堆表页面头具体结构体定义代码如下: typedef struct { PageXLogRecPtr pd_lsn; /* 页面最新一次修改的日志lsn */ uint16 pd_checksum; /* 页面CRC */ uint16 pd_flags; /* 标志位 */ LocationIndex pd_lower; /* 空闲位置开始出(距离页头) */ LocationIndex pd_upper; /* 空闲位置结尾处(距离页头) */ LocationIndex pd_special; /* 特殊位置起始处(距离页头) */ uint16 pd_pagesize_version; ShortTransactionId pd_prune_xid; TransactionId pd_xid_base; TransactionId pd_multi_base; ItemIdData pd_linp[FLEXIBLE_ARRAY_MEMBER]; } HeapPageHeaderData; 其中各个成员的含义如下。 (1) pd_lsn:该页面最后一次修改操作的预写日志结束位置的下一个字节,用于检查点推进和保持恢复操作的幂等性(幂等指对接口的多次调用所产生的结果和调用一次是一致的)。 (2) pd_checksum:页面的CRC校验值。 (3) pd_flags:页面标记位,用于保存各类页面相关的辅助信息,如页面是否有空闲的元组指针、页面是否已满、页面元组是否都可见、页面是否被压缩、页面是否是批量导入的、页面是否加密、页面采用的CRC校验算法等。 (4) pd_lower:页面中间空洞的起始位置,即当前已使用的元组指针数组的尾部。 (5) pd_upper:页面中间空洞的结束位置,即下一个可以插入元组的起始位置。 (6) pd_special:页面尾部特殊区域的起始位置。该特殊位置位于第一条元组记录和页面结尾之间,用于存储一些变长的页面级元信息,如采用的压缩算法信息、索引的辅助信息等。 (7) pd_pagesize_version:页面的大小和版本号。 (8) pd_prune_xid:页面清理辅助事务号(32位),通常为该页面内现存最老的删除或更新操作的事务号,用于判断是否要触发页面级空闲空间整理。实际使用的64位prune事务号由“pd_prune_xid”字段和“pd_xid_base”字段相加得到。 (9) pd_xid_base:该页面内所有元组的基准事务号(64位)。该页面所有元组实际生效的64位xmin/xmax事务号由“pd_xid_base”(64位)和元组头部的“t_xmin/t_xmax”字段(32位)相加得到。 (10) pd_multi_base:类似“pd_xid_base”字段,当对元组加锁时,会将持锁的事务号写入元组中,该64位事务号由“pd_multi_base”字段(64位)和元组头部的“t_xmax”字段(32位)相加得到。 (11) pd_linp:元组指针变长数组。 对于astore堆表页面的主要管理接口如表4-12所示。鉴于astore采用的元组多版本设计实现方式(参见“3. astore元组多版本机制”小节),删除操作并不会直接从页面中删除指定的元组,页面管理也没有提供这样的接口。对于被删除的、过于陈旧的元组,通过页面空闲空间整理流程(参见“5. astore空间管理和回收”小节)完成。 表4-12 页面管理接口函数 函数名 操作含义 PageAddItem 在页面中插入一条新的元组 PageRepairFragmentation 页面空闲空间整理 在astore堆表页面中,采用64位页面“pd_xid_base”字段和32位元组“t_xmin/t_xmax”字段组合设计方式的原因如下。 早期openGauss版本采用32位事务号,所以对于OLTP类系统事务号消耗速度很快。当消耗的事务号超过最大事务号一半左右时,整个系统会强制对所有元组进行防止事务号回卷的整理工作。这个过程将阻塞所有写查询,系统不可用。 为了解决这个问题,openGauss将事务号升级到64位。为了平滑兼容之前32位事务号的元组头部结构,没有改变元组的结构和长度,而是在32位事务号页面头部结构体的基础上,扩展增加了标识整个页面所有元组事务号范围的64位基准事务号“pd_xid_base”和“pd_multi_base”两个字段。同一个页面中所有元组实际的64位“xmin/xmax”字段,一定在“pd_xid_base”字段和“pd_xid_base+2322”之间。 可以通过astore堆表页面头部“pd_pagesize_version”字段中页面版本号来区分32位事务号页面和64位事务号页面: (1) 版本号等于4,为32位事务号页面。 (2) 版本号等于5,为64位非堆表页面(如索引页面)。这类页面的页头无须保存64位事务号信息,因此和32位事务号页面采用相同的结构。这类页面中可能涉及的64位事务号信息,保存在页面尾部的“”pd_special”字段区域中。 (3) 版本号等于6,即为64位astore堆表页面。 对于从32位事务号系统升级上来的astore堆表页面,在部分页面访问场景中(如RelationGetBufferForTuple/heap_delete/heap_update/heap_lock_tuple),首先会判断访问的页面是否是4号版本。若是4号版本,则调用heap_page_upgrade尝试进行页面版本升级。当页面空闲空间足够放下扩展的两个成员(共16个字节)时,调用PageLocalUpgrade函数将页面格式升级到64位,且升级后的pd_xid_base字段和pd_multi_base字段一定为0;如果剩余空间不够,系统会给出报错或告警,并提示用户执行VACUUM FULL命令来手动升级页面。 对于需要修改元组事务号的操作(如heap_insert/heap_multi_insert/heap_delete/heap_update/heap_lock_tuple),需要判断新写入的64位事务号是否满足在页面的“pd_xid_base”和“pd_xid_base+232”之间。如果满足,则通过检查;否则,需要调整页面的“pd_xid_base”字段或“pd_multi_base”字段的值以满足上述条件。如果新写入的事务号和页面上现有任意一个元组的“xmin/xmax”事务号差距已经超过232,系统还会尝试对现有元组进行“freeze”(冻结)操作。如果“freeze”操作之后,上述事务号差距还是超过232,该查询会报错退出。 32位事务号astore堆表页面头结构代码如下所示,各成员含义可参考64位事务号页面头结构: typedef struct { PageXLogRecPtr pd_lsn; uint16 pd_checksum; uint16 pd_flags; LocationIndex pd_lower; LocationIndex pd_upper; LocationIndex pd_special; uint16 pd_pagesize_version; ShortTransactionId pd_prune_xid; ItemIdData pd_linp[FLEXIBLE_ARRAY_MEMBER]; } PageHeaderData; 下篇我们将详细介绍“3. astore元组多版本机制”相关内容,敬请期待!

优秀的个人博客,低调大师

openGauss数据库源码解析系列文章——存储引擎源码解析(一)

OLTP、OLAP业务各自对数据库的存储引擎提出了不同的要求,而openGauss能够支持多个存储引擎来满足来自不同场景的业务诉求。本章将逐一介绍各种存储引擎和对应的源码。 4.1 存储引擎整体架构及代码概览 从整个数据库服务的组成构架来看,存储引擎向上对接SQL引擎,为SQL引擎提供或接收标准化的数据格式(元组或向量数组);向下对接存储介质,按照特定的数据组织方式,以页面、列存储单元(CU,compression unit)或其他形式为单位,通过存储介质提供的特定接口,对存储介质中的数据完成读、写操作。在此基础之上,存储引擎通过日志系统提供数据的持久化和可靠性能力;通过并发控制(事务)系统保证同时执行的、多个读写操作之间的原子性、一致性和隔离性;通过索引系统提供对特定数据的加速寻址和查询能力;通过主备复制系统提供整个数据库服务的高可用能力。 图4-1 openGauss存储引擎整体构架示意图 图4-1是openGauss存储引擎整体构架的示意图。总体上,根据存储介质和并发控制机制,存储引擎分为磁盘引擎和内存引擎两大类。磁盘引擎主要面向通用的、大容量的业务场景,内存引擎主要面向容量可控的、追求极致性能的业务场景。在磁盘引擎中,为了满足不同业务场景对于数据不同的访问和使用模式,openGauss进一步提供了astore(append-store,追加写优化格式)、cstore(column store,列存储格式)以及可拓展的数据元组和数据页面组织格式。在内存引擎中,openGauss当前提供基于Masstree结构组织的mstore(memory-store,内存优化格式)数据组织格式。 上述几种引擎和存储格式的介绍如表4-1所示。 表4-1 openGauss存储引擎种类 父类 (存储介质和并发控制) 子类 (数据组织形式) 说明 磁盘引擎 (磁盘介质, 多版本和悲观并发控制(pessimistic concurrency control,PCC)) astore (追加写优化格式) 主要面向通用的在线交易处理类业务应用场景,适合高并发、小数据量的单点或小范围数据读、写操作。astore为行存储格式,向上提供元组形式的读、写;向下以页面为单位通过可扩展的介质管理器对存储介质进行读、写操作;并通过页面粒度的共享缓冲区来优化读、写操作的效率。当前行存存储格式默认的介质管理器采用磁盘文件系统接口,后续可扩展支持块设备等其他类型的存储介质 cstore (列存储格式) cstore (列存储格式) 面向联机分析处理类业务应用场景,适合大数据量的复杂查询和数据导入。cstore为列存存储格式,向上提供向量数组形式的读、写接口;向下以压缩单元为单位将数据保存在磁盘文件系统中(当前列存存储格式唯一支持的存储介质)。考虑到联机分析处理类业务通常以读操作为主,因此还提供了以压缩单元为粒度的只读共享缓冲区,以加速压缩单元的读操作性能 扩展存储格式 扩展存储格式 对于行存储类存储格式,openGauss提供了与上层SQL引擎对接的、统一的、可扩展的访存接口层(table access method)。该行存储统一访存接口层为SQL引擎提供元组形式的读、写接口,同时屏蔽了下层各种不同行存储类存储格式的内部实现,从而实现了SQL引擎与存储引擎(行存储类磁盘引擎)的解耦,大幅提升了不同存储格式之间的隔离性和开发效率 当前行存储类存储格式支持追加写优化的astore格式,后续会支持更新写优化的ustore格式等其他数据组织格式 内存引擎 (内存介质, 乐观并发控制(OCC,optimistic concurrency control)) mstore (内存存储格式) mstore内存引擎面向超低时延和超高吞吐量的OLTP场景。数据以元组粒度存储于内存介质中,得益于内存介质读、写操作的超低时延(与磁盘介质相比),内存引擎可以提供极致的OLTP业务性能。内存引擎通过openGauss的外表访存接口实现与SQL引擎的数据交互 有如下几个特点。 (1) 统一的日志系统。 在openGauss的存储引擎中,磁盘引擎和内存引擎共用同一套日志系统,以保证在数据库故障恢复场景下,各个引擎内和各个引擎间的数据持久性和一致性。基于上述统一的日志系统,openGauss支持主、备机(主、备数据库服务进程)之间的流式日志复制,并通过Quorum复制协议,在保证复制一致性的前提下,尽可能降低日志同步对主机业务的影响。 (2)多种并发控制和事务系统。 在openGauss的存储引擎中,有两种并发控制和事务系统:适合高并发、高冲突、追求确定性结果的悲观并发控制机制;适合低冲突、短平快、低时延的乐观并发控制机制。 在磁盘引擎中,采用读写冲突优化的悲观并发控制机制:对于读、写并发操作,采用多版本并发控制(MVCC,multi-version concurrency control);对于写、写并发操作,采用基于两阶段锁协议(2PL,two-phase locking)的悲观并发控制(PCC,pessimistic concurrency control)。 在内存引擎中,采用乐观并发控制来尽可能降低并发控制系统对业务的阻塞,以获得极致的事务处理性能和时延。 (3) 表级存储格式/存储引擎和跨格式事务。 在openGauss的存储引擎中,支持在建表语句中指定目标表的存储格式和存储引擎,即行存储astore、列存储cstore、内存mstore和后续扩展的其他存储格式或存储引擎。因此,在同一个数据库中,为了适配不同的业务场景,用户可以创建不同存储格式或不同存储引擎的表。进一步,当前openGauss在同一个事务内,支持对同一引擎不同存储格式的表的读写查询,这将极大地简化不同存储格式表中数据一致性、同步性和实时性的运维难度。后续openGauss版本计划支持跨引擎事务,这将使得openGauss数据库在面对多样化的业务场景时显得更为游刃有余。 (4)统一的行存储访存接口。 在openGauss的磁盘引擎中,行存储类存储格式是最传统也是使用场景最广泛的存储格式。针对不同的业务场景,行存储格式需要进行不同的优化和设计。为了便于后续新型行存储格式的扩展,在openGauss中提供了统一的行存储访存接口层,为上层SQL引擎屏蔽了底层不同的行存储数据组织形式。 对于不同的行存储数据格式,它们向上对接统一的行存储访存接口,向下共享缓冲区管理、事务并发控制、日志系统、持久化和故障恢复、主备系统、索引机制。同时,不同的行存储数据格式内部又实现了不同的元组和页面格式,以及在此之上的访存接口、元组多版本、页面多版本、空闲空间管理回收等不同功能。 openGauss存储引擎的代码主要位于“src/gausskernel/storage/”目录下,具体目录结构如下: --src --gausskernel --storage --access --buffer --bulkload --cmgr --cstore --dfs --file --freespace --ipc --large_object --lmgr --mot --page --remote --replication --smgr 每个子目录都是一个相对独立的模块,和本章内容相关的如表4-2所示。 表4-2 存储引擎子目录 模块名 子目录 说明 访存模块 access子目录 主要包括:各种行存储格式中,元组格式;元组与页面之间的转换和访存管理;元组扫描、插入、删除和更新功能的接口实现;几类索引,包括B-Tree、hash、GIN(generalized inverted index,通用倒排索引)、GiST(generalized search tree,通用搜索树)、psort(列存储局部排序索引),的访存管理和接口实现;各类数据库操作对应的日志实现和恢复机制;以及事务模块实现 行存储共享缓冲区模块 buffer子目录 主要包括:行存储共享缓冲区的结构;物理页面和缓冲区页面的映射管理;缓存页面的加载和淘汰算法等 列存储只读共享缓冲区模块 cmgr子目录 主要包括:cstore列存储格式只读共享缓冲区的结构;压缩单元和缓冲区的映射管理;缓冲压缩单元的加载和淘汰算法等 列存储访存模块 cstore子目录 主要包含:cstore列存储格式中,向量数组与压缩单元之间的转换和访存管理;以及在此基础之上向量数组的扫描、插入、删除和更新功能的接口实现 文件操作和虚拟文件描述符模块 file子目录 主要包含:磁盘文件系统存储介质的文件和目录操作;虚拟文件描述符的实现和管理 行存储空闲空间管理模块 freespace子目录 主要包含:各种行存储格式中,页面空闲空间的管理 内存引擎模块 mot子目录 主要包含:内存引擎的实现 页面模块 page子目录 主要包含:各种行存储格式中,页面格式、页面校验、页面加密和页面压缩 备机页面修复模块 remote子目录 主要包含:从备机获取完整页面或压缩单元,用于修复主机损坏的页面或压缩单元 主备日志复制模块 replication子目录 主要包含:主备日志发送和接收线程的实现;流式日志同步功能的实现;Quorum复制协议的实现,逻辑日志的实现以及主备重建;主备心跳检测功能的实现 存储介质管理模块 smgr子目录 主要包含:存储介质管理层的实现;磁盘文件系统(当前默认的存储介质)的基本功能接口实现 除了以上的这些模块之外,storage目录下剩余的子目录分别属于:外表批量导入模块(bulkload子目录)、外表服务器连接模块(dfs子目录)、进程间通信模块(ipc子目录)、大对象模块(large\_object子目录)、锁管理模块(lmgr子目录)。 openGauss存储引擎相关的后台线程实现代码包含在“src/gausskernel/process/postmaster”目录下,简要介绍如表4-3。在后序介绍具体相关模块消息序列时会详细介绍这些线程的工作原理和执行流程。 表4-3 存储引擎后台线程 线程名 文件名 说明 ADIO线程 aiocompleter.cpp 该线程主要负责异步-同步读写操作(ADIO,asynchronous-direct input-ouput)的后台预取和回写 autovacuum线程 autovacuum.cpp 该线程主要负责磁盘引擎的后台空闲空间回收 bgwriter线程 bgwriter.cpp 该线程主要负责行存储表的后台脏页写入磁盘(当内存数据页跟磁盘数据页内容不一致的时候,称这个内存页为“脏页”。内存数据写入到磁盘后,内存和磁盘上的数据页的内容就一致了,称为“干净页”) cbmwriter线程 cbmwriter.cpp 该线程主要负责增量页面修改信息的后台异步提取和CBM(changed block map,修改页面位图)日志的记录 checkpointer线程 checkpointer.cpp 该线程主要负责在后台定期推进数据库的故障恢复点 lwlockmonitor线程 lwlockmonitor.cpp 该线程主要负责业务线程轻量级锁的死锁检测 pagewriter线程 pagewriter.cpp 该线程主要负责行存储共享缓冲区的脏页写入磁盘 pgarch线程 pgarch.cpp 该线程主要负责在后台定期执行日志归档命令 remoteservice线程 remoteservice.cpp 该线程主要负责接收主机页面修复RPC(remote procedure call,远程函数调用)请求 startup线程 startup.cpp 该线程为数据库故障恢复和回放日志的主线程 walwriter线程 walwriter.cpp 该线程主要负责在后台异步写入磁盘日志 4.2 磁盘引擎 磁盘引擎是数据库系统中最常用的存储引擎,openGauss提供不同存储格式的磁盘引擎来支持大容量(数据量大于内存空间)场景下的OLTP、OLAP和HTAP(hybrid transactions and analytics processing,混合交易和分析处理)业务。本节主要介绍openGauss数据库内核中磁盘引擎的实现方式。 4.2.1 磁盘引擎整体框架及代码概览 磁盘引擎的整体框架如图4-1中所示。根据与上层SQL引擎之间交互的数据结构类型,可以分为行存储格式和列存储格式。这两种数据格式共用相同的事务并发控制、日志系统、持久化和故障恢复、主备系统。 在此基础之上,行存储格式内部设计为可以支持多种不同子格式的可扩展架构。不同行存储子格式之间共用相同的行存储统一访存接口(table access method)、共享缓冲区、索引机制等。当前仅支持追加写优化的astore子格式,后续计划支持写优化的ustore子格式以及面向其他场景优化的其他子格式。另一方面,在openGauss行存储格式中,对同一行数据的写-写查询冲突通过两阶段锁协议来实现并发控制(参见第5章中关于行级锁的介绍),对同一行数据的读-写查询冲突通过行级多版本技术来实现互不阻塞的、高效的并发控制。对于不同的行存储子格式,可能采用不同的行级多版本实现方式,从而也会引入不同的、清理历史版本的空闲空间管理和回收机制。 磁盘引擎的主要功能模块和代码分布如表4-4所示。 表4-4 磁盘引擎功能模块 功能模块名 说明 行存储统一访存管理 向上对接SQL引擎,提供对行存储表各类访存操作的抽象接口,包括:行级查询、插入、删除、修改等操作接口;向下根据行存储表实际的行存储子格式,调用与子格式对应的具体访存操作实现 代码主要在“src/gausskernel/storage/access/table”目录下 astore访存管理 提供astore行存储格式表的具体访存操作实现,包括:对astore堆表的行级查询、插入、删除、修改等操作接口;astore堆表行级多版本机制和元组可见性判断;根据astore堆表页间、页内结构,以及astore堆表元组结构,完成对astore堆表文件的遍历和增删改查操作 代码主要在“src/gausskernel/storage/access/heap”目录(单表文件管理)和“src/gausskernel/storage/access/hbstore”目录(段页式文件管理)下 astore堆表/索引表页面结构 包括astore堆表/索引表元组在页面内的具体组织形式,在页面内插入元组操作、页面整理操作、页面初始化、页面加解密、页面CRC(cyclic redundancy check,循环冗余码校验)校验操作等 代码主要在“src/gausskernel/storage/access/redo/bufpage.cpp”文件、“redo_bufpage.cpp”文件和对应头文件中 astore堆表元组结构 包括astore堆表元组的结构、填充、解构、修改、字段查询、变形、压缩、解压等操作 代码主要在“src/gausskernel/storage/access/common/heaptuple.cpp”文件和对应头文件中 行存储索引访存管理 向上对接SQL引擎,提供对索引表的行级查询、插入、删除等操作接口;向下根据索引表页间、页内结构,以及索引表元组结构,完成对指定索引键的查找和增删操作 索引访存层抽象框架代码在“src/gausskernel/storage/access/index”目录下,每种索引结构具体对应的实现代码在同级的gin目录、gist目录、hash目录、nbtree目录、spgist目录 行存储索引表元组结构 包括行存储索引表元组的结构、填充、解构、拷贝等操作 代码主要在“src/gausskernel/storage/access/common/indextuple.cpp”文件和对应头文件中 行存储共享缓冲区管理 包括共享缓冲区的结构、页面查找方式、页面淘汰方式等 代码主要在“src/gausskernel/storage/buffer”目录下 行存储介质管理器管理和堆表/索引表文件管理 包括几种主要介质操作的抽象接口以及几种主要的、基于磁盘文件系统的堆表/索引表文件操作接口 代码在“src/gausskernel/storage/smgr”目录下 cstore访存管理 向上对接SQL引擎,提供对cstore列存储表的向量数组(vector batch)粒度的查询、插入、删除、修改等操作接口;向下根据cstore列存储表CU间、CU内结构,完成对cstore列存储表文件的遍历和增删改查操作;cstore列存储表CU内和CU间的多版本并发控制和可见性判断 代码主要在“src/gausskernel/storage/cstore”目录下的cstore_系列文件中 cstore索引访存管理 向上对接SQL引擎,提供对cstore索引表的向量数组粒度的查询、插入等操作接口;向下根据cstore索引表组织结构,完成对指定索引键的查询和插入等操作 代码主要在“src/gausskernel/storage/access/cbtree”目录(cstore列储存B-Tree索引)下和“src/gausskernel/storage/access/psort”目录(cstore列存储psort索引)下 cstore列存储表 CU结构 ① 和行存不同,cstore列存储表与外存的I/O单元为CU。该部分主要包括CU的内部结构、CU的填充和压缩等操作 ② 代码在“src/gausskernel/storage/cstore/cu.cpp”文件中 cstore列存储表 CU只读共享缓冲区管理 包括以CU为单位的只读共享缓冲区的结构、查找、淘汰等 代码主要在“src/gausskernel/storage/cmgr”目录下 cstore列存储表 CU持久化介质模块 包括以CU为粒度的、基于磁盘介质的cstore列存储表文件外存I/O操作 代码在“src/gausskernel/storage/cstore/custorage.cpp”文件中 预写日志共享缓冲区和文件管理 包括日志记录格式、日志页面格式、日志文件格式、日志插入、日志写入磁盘、日志缓冲区管理、日志归档、日志恢复等操作 代码在“src/gausskernel/storage/access/transam/xlog”系列文件中 检查点和故障恢复管理 包括页面淘汰算法和检查点推进算法、双写刷盘(写入磁盘)、页面故障恢复等 代码主要分布在“src/gausskernel/process/postmaster/pagewriter.cpp”、“src/gausskernel/process/postmaster/bgwriter.cpp”、“src/gausskernel/storage/access/transam/double_write.cpp”、“src/gausskernel/storage/access/transam/xlog.cpp”、对应头文件和“src/gausskernel/storage/access/redo”目录 事务管理和并发控制 包括锁管理、事务提交流程、快照维护、提交时间戳维护、可见性判断等 代码主要在“src/gausskernel/storage/access/transam”目录下 该部分内容较为复杂,在第5章单独介绍 事务提交日志SLRU(Simple Least Recently Used,简单最近最少使用)共享缓冲区和文件管理 包括事务提交日志的页面格式、读写操作、SLRU缓存算法、清理操作等,与事务管理模块一起介绍 事务提交时间戳日志SLRU共享缓冲区和文件管理 包括事务提交日志(CSNLOG)的页面格式、读写操作、SLRU缓存算法、清理操作等,与事务管理模块一起介绍 关键控制文件管理 主要包括控制文件、根系统表文件等关键文件的读、写操作 代码分布较广 在上述模块基础之上,openGauss磁盘引擎还包括CU压缩、外表、批量导入等功能,代码分布在“src/gausskernel/storage/cstore/compression”、“src/gausskernel/storage/access/dfs”、“src/gausskernel/storage/bulkload”等目录下。 openGauss磁盘引擎的关键技术整体来说包括: (1) 基于事务提交逻辑时间戳的快照隔离机制以及多版本并发控制技术。 (2) 基于事务号(xid,全称transaction identifier)的行级多版本管理技术。 (3) 基于大内存设计的共享缓冲区管理和淘汰算法。 (4) 平滑无性能波动的增量检查点(checkpoint)技术。 (5) 基于并行回放的快速故障实例恢复技术。 (6) 支持事务语义的DML操作和DDL操作。 (7) 面向OLAP场景的cstore列存储格式。当表中列数比较多、但是访问的列数比较少时可以大大减少不必要的列的I/O开销。 (8) 面向OLAP场景的cstore列存储批量访存接口。向上支持以向量数组为粒度的批量数据访存接口,结合向量化执行引擎提升CPU缓存命中率和系统吞吐率。 (9) 面向OLAP场景的cstore列存储高效压缩算法。基于同一列比较相似的数据特征,在大数据量下获得很高的压缩效果,减少系统的I/O开销。 4.2.2 行存储统一访存接口 如上所述,在openGauss中,提供行存储统一访存接口层,来屏蔽不同行存储子格式内部实现机制对SQL引擎的影响。该行存储统一访存接口层被称为Table Access Method层。根据SQL引擎对行存储表的访存方式,将访存接口分为5类,如表4-5所示。每一类接口的具体操作如表4-6至4-10所示。 表4-5 Table Access Method定义的访存接口 接口类别 接口含义 Tuple AM Slot AM 元组(tuple)和元组槽(slot)操作抽象层,包括元组数据结构的抽象、元组操作的抽象,执行引擎无须关注元组属于哪种行存储子格式,只需调用元组数据结构基类的抽象操作接口,就可操作不同行存储子格式的元组,从而屏蔽不同行存储子格式物理元组结构、访问方法的差异 TableScan AM 表扫描(table scan)抽象层,包括TableScan数据结构的抽象、TableScan管理操作的抽象,执行引擎无须关注行存储子格式内部TableScan结构的差异,通过调用TableScan数据结构基类的抽象管理接口,就可完成不同行存储子格式的TableScan管理,屏蔽不同行存储子格式内部实现的差异 DQL AM 元组查询(data query language,DQL)操作抽象层,包括获取元组、元组可见性判断等查询操作的抽象 DML AM 元组写操作抽象层,包括元组插入、批插、删除、更新、锁定等接口的抽象 DDL AM 表物理操作抽象层,这里统称为DDL抽象层,涉及表物理文件操作的相关接口的抽象,例如CTAS、TRUNCATE、LOAD/COPY、VACUUM、VACUUM FULL、ANALYZE、REBUILD INDEX、ALTER TABLE RESTRUCT等DDL语法。该层也可以支持存储管理的抽象功能,如屏蔽不同行存储子格式的文件/目录管理模块、SMGR访问等差异 表4-6 Tuple AM、Slot AM类访存接口 接口名称 接口含义 tableam_tslot_clear 清理slot tuple,主要是被ExecClearTuple调用 tableam_tslot_materialize 该方法在ExecMaterializeSlot被调用, 将slot中的tuple进行local copy(本地拷贝) tableam_tslot_get_minimal_tuple 获取slot中的minimal tuple(最小化元组),slot负责管理/释放minimal tuple的内存 tableam_tslot_copy_minimal_tuple 返回slot中minimal tuple的副本,该副本在当前内存上下文中被分配,需要调用者进行释放操作 tableam_tslot_store_minimal_tuple 此函数在指定的TupleTableSlot结构体中存储minimal tuple tableam_tslot_get_heap_tuple 该函数获取slot中的tuple tableam_tslot_copy_heap_tuple 该函数返回slot中tuple的副本,该副本在当前内存上下文中被分配,需要调用者进行释放操作 tableam_tslot_store_tuple 该方法将对应的物理元组存储到slot中 tableam_tslot_getsomeattrs 强制更新slot中tuple某个属性的values和isnull数组信息 tableam_tslot_getattr 获取当前slot中tuple的某个属性信息 tableam_tslot_getallattrs 强制更新slot中tuple的values和isnull数组 tableam_tslot_attisnull 检查slot中tuple的属性是否为null tableam_tslot_get_tuple_from_slot 从slot中获取一个tuple,并根据relation结构体中行存储子格式信息转换为对应子格式的tuple tableam_tops_getsysattr 获取tuple的系统属性 tableam_tops_form_minimal_tuple 根据values和isnull数组内容,新建一个tuple tableam_tops_form_tuple 根据values和isnull数组内容,新建一个minimal tuple tableam_tops_form_cmprs_tuple 根据values和isnull数组内容,新建一个被压缩的tuple tableam_tops_deform_tuple 抽取指定tuple中的data数据到values和isnull数组 tableam_tops_deform_cmprs_tuple 抽取被压缩的tuple中的data数据到values和isnull数组 tableam_tops_computedatasize_tuple 计算需要构造的tuple的data区域的大小 tableam_tops_fill_tuple 根据values和isnull数组中的数据填充到tuple的data区域 tableam_tops_modify_tuple 根据一个旧tuple新建一个tuple并更新其values tableam_tops_free_tuple 释放一个tuple的内存 tableam_tops_tuple_getattr 获取tuple的某个属性信息 tableam_tops_tuple_attisnull 检查tuple的属性是否为null tableam_tops_copy_tuple 拷贝并返回一个tuple tableam_tops_copy_minimal_tuple 拷贝并返回一个minimal tuple tableam_tops_free_minimal_tuple 释放minimal tuple的内存 tableam_tops_new_tuple 新建一个tuple tableam_tops_destroy_tuple 销毁一个tuple tableam_tops_get_t_self 获取tuple中的self指针,指向自己在表中的位置 tableam_tops_exec_delete_index_tuples 删除索引的tuple tableam_tops_exec_update_index_tuples 更新索引的tuple tableam_tops_get_tuple_type 获取tuple属于哪种存储引擎 tableam_tops_copy_from_insert_batch copy from场景进行批量INSERT(插入) tableam_tops_update_tuple_with_oid 根据table OID(表的唯一标识号)更新tuple 表4-7 TableScan AM类访存接口 接口名称 接口含义 tableam_scan_begin 初始化scan结构体,准备执行table scan(全表扫描)算子 tableam_scan_begin_bm 准备执行bitmap scan(位图扫描)算子 tableam_scan_begin_sampling 初始化堆表(顺序)扫描操作 tableam_scan_getnexttuple 返回scan中的下一个tuple tableam_scan_getpage 获取scan中的下一页 tableam_scan_end 结束scan,并释放内存 tableam_scan_rescan 重置scan tableam_scan_restrpos 重置扫描位置 tableam_scan_markpos 记录当前扫描位置 tableam_scan_init_parallel_seqscan 初始化并行sequence scan(顺序扫描) 表4-8 DQL AM类访存接口 接口名称 接口含义 tableam_tuple_fetch 根据tid(元组物理位置)获取tuple tableam_tuple_satisfies_snapshot 指定元组对于快照是否可见 tableam_tuple_get_latest_tid 获取tid指向的当前snapshot(快照)可见的最新物理元组 表4-9 DML AM类访存接口 接口名称 接口含义 tableam_tuple_insert 插入一条元组到表中 tableam_tuple_multi_insert 插入多条元组到表中 tableam_tuple_delete 删除一条元组,返回并发冲突状态,由调用者根据并发冲突状态决定下步操作 tableam_tuple_update 更新一条记录,返回并发冲突状态,由调用者根据并发冲突状态决定下步操作 tableam_tuple_lock 锁定一条元组 tableam_tuple_lock_updated 解锁一条元组 tableam_tuple_check_visible 检查元组的可见性 tableam_tuple_abort_speculative 终止upsert操作的尝试插入操作,转为更新操作 表4-10 DDL AM类访存接口 接口名称 接口含义 tableam_index_build_scan 该方法用于创建索引的首次全表扫描 tableam_index_validate_scan 该方法用于并发创建索引的第二次全表扫描 tableam_relation_copy_for_cluster 将源表数据根据指定的聚簇方式复制到新表中 对于每一个行存储子格式,需要提供上述这五类访存接口的各自实现方式,并注册到g_tableam_routines全局行存储访存接口数组中。SQL引擎在调用某个访存接口时,根据Relation结构体中表的子格式类型(rd_tam_type成员),来调用对应的子格式访存接口。 由于内容较多,下篇我们将详细介绍“4.2.3 astore”相关内容,敬请期待!

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册