首页 文章 精选 留言 我的

精选列表

搜索[智能解析],共10007篇文章
优秀的个人博客,低调大师

Android AIDL实例解析

AIDL这项技术在我们的开发中一般来说并不是很常用,虽然自己也使用新浪微博的SSO登录,其原理就是使用AIDL,但是自己一直没有动手完整的写过AIDL的例子,所以就有了这篇简单的文章。 AIDL(AndRoid接口描述语言)是一种借口描述语言; 编译器可以通过aidl文件生成一段代码,通过预先定义的接口达到两个进程内部通信进程的目的. 如果需要在一个Activity中, 访问另一个Service中的某个对象, 需要先将对象转化成 AIDL可识别的参数(可能是多个参数), 然后使用AIDL来传递这些参数, 在消息的接收端, 使用这些参数组装成自己需要的对象. 说白了,AIDL就是定义一个接口,客户端(调用端)通过bindService来与远程服务端简历一个连接,在该连接建立时会将返回一个IBinder对象,该对象是服务端Binder的BinderProxy,在建立连接时,客户端通过asInterface函数将该BinderProxy对象包装成本地的Proxy,并将远程服务端的BinderProxy对象赋值给Proxy类的mRemote字段,就是通过mRemote执行远程方法调用。需要对Binder机制有更深的理解,请转到老罗的系列文字吧,Android系统进程间通信Binder机制在应用程序框架层的Java接口源代码分析。下面我们看一个AIDL实例。 AIDL接口声明 在src目录下创建一个com.example.advanceandroid.aidl包,然后在该包下创建一个ILogin.aidl文件,注意是创建文件而不是类或者接口类型。在ILogin.aidl中声明接口,实例如下 : package com.example.advanceandroid.aidl; interface ILogin { String login(); } 注意看,接口和方法声明都不用public,方法加入public会提示错误。编写完后如果eclipse开启了自动编译则会在gen/com.example.advanceandroid.aidl下生成一个ILogin.java类,内容大致如下: 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 40 41 42 43 44 45 46 47 48 49 50 51 52 53 54 55 56 57 58 59 60 61 62 63 64 65 66 67 68 69 70 71 72 73 74 75 76 77 78 79 80 81 82 83 84 85 86 87 88 89 90 91 92 93 94 95 96 97 98 99 100 101 102 103 package com.example.advanceandroid.aidl; public interface ILogin extends android.os.IInterface { /** Local-side IPC implementation stub class. */ public static abstract class Stub extends android.os.Binder implements com.example.advanceandroid.aidl.ILogin { private static final java.lang.String DESCRIPTOR = "com.example.advanceandroid.aidl.ILogin" ; /** Construct the stub at attach it to the interface. */ public Stub() { this .attachInterface( this , DESCRIPTOR); } /** * Cast an IBinder object into an com.example.advanceandroid.aidl.ILogin * interface, generating a proxy if needed. */ public static com.example.advanceandroid.aidl.ILogin asInterface(android.os.IBinder obj) { if ((obj == null )) { return null ; } android.os.IInterface iin = obj.queryLocalInterface(DESCRIPTOR); if (((iin != null ) && (iin instanceof com.example.advanceandroid.aidl.ILogin))) { return ((com.example.advanceandroid.aidl.ILogin) iin); } return new com.example.advanceandroid.aidl.ILogin.Stub.Proxy(obj); } @Override public android.os.IBinder asBinder() { return this ; } @Override public boolean onTransact( int code, android.os.Parcel data, android.os.Parcel reply, int flags) throws android.os.RemoteException { switch (code) { case INTERFACE_TRANSACTION: { reply.writeString(DESCRIPTOR); return true ; } case TRANSACTION_login: { // 1、登录请求,执行的是this.login(); data.enforceInterface(DESCRIPTOR); java.lang.String _result = this .login(); reply.writeNoException(); reply.writeString(_result); return true ; } } return super .onTransact(code, data, reply, flags); } private static class Proxy implements com.example.advanceandroid.aidl.ILogin { private android.os.IBinder mRemote; Proxy(android.os.IBinder remote) { mRemote = remote; } @Override public android.os.IBinder asBinder() { return mRemote; } public java.lang.String getInterfaceDescriptor() { return DESCRIPTOR; } @Override public java.lang.String login() throws android.os.RemoteException // 2、Proxy中的login,通过Binder机制实现IPC { android.os.Parcel _data = android.os.Parcel.obtain(); android.os.Parcel _reply = android.os.Parcel.obtain(); java.lang.String _result; try { _data.writeInterfaceToken(DESCRIPTOR); mRemote.transact(Stub.TRANSACTION_login, _data, _reply, 0 ); _reply.readException(); _result = _reply.readString(); } finally { _reply.recycle(); _data.recycle(); } return _result; } } static final int TRANSACTION_login = (android.os.IBinder.FIRST_CALL_TRANSACTION + 0 ); } public java.lang.String login() throws android.os.RemoteException; } 可以看到,该类中自动生成了ILogin接口,该接口中又一个login()函数。但最重要的是里面生成了一个Stub类,该类集成子Binder类,并且实现了ILogin接口。Stub里面最重要的就是asInterface()这个函数,在这个函数中会判断obj参数的类型,如果是该obj是本地的接口类似,则认为不是IPC,会将该obj转换成ILogin类型;否则会通过自动生成的另一个内部类Proxy来包装obj,将其赋值给Proxy中的mRemote属性。Proxy类也实现了ILogin接口,在login()函数中,Proxy将通过Binder机制向服务端传递请求和数据,如上面代码中的注释2。这是客户端的工作算是完成了。 服务端AIDL接口 服务端也需要在相同的包下创建同名的aidl文件,我们直接将客户端的com.example.advanceandroid.aidl包下的ILogin.aidl拷贝到服务端即可,如果用到了自定义的类型,那么该自定义类型也需要在客户端、服务端都有。拷贝完aidl后,在服务端程序中也会在gen中生成对应的ILogin.java文件,内容同客户端一样。这里的重点我们要看onTransact函数,即上述代码中的注释1处,可以看到,在case TRANSACTION_login处执行了this.login()函数,意思是当接收到客户端的TRANSACTION_login请求时,执行this.login()函数,通过客户端的分析我们知道,当我们调用login()时实际上就是通过mRemote向服务端提交了一个TRANSACTION_login请求,因此就两端通过Binder机制就对接上了,我们可以简单的理解为C/S模式。 服务端还没有完,最重要的一步时建立一个Service,内容大致如下 : 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 /** * AIDL服务端接口,LoginStubImpl实现了ILogin接口. * * @author mrsimple */ public class LoginService extends Service { /** * */ IBinder mBinder = new LoginStubImpl(); /** * @author mrsimple */ class LoginStubImpl extends Stub { @Override public String login() throws RemoteException { return "这是从 " + this .getClass().getName() + " 返回的字符串" ; } } /* * 返回Binder实例,即实现了ILogin接口的Stub的子类,这里为LoginStubImpl * [url=home.php?mod=space&uid=133757]@see[/url] android.app.Service#onBind(android.content.Intent) */ @Override public IBinder onBind(Intent intent) { return mBinder; } } 该Service我们这里命名为LoginService,继承自Service,然后建一个名为LoginServiceImpl的内部类,该类继承自自动生成的Stub,然后实现login()方法。在LoginService中声明一个IBinder字段mBinder : IBinder mBinder = new LoginStubImpl(); 并且在LoginService的onBind函数中将mBinder对象返回。即在客户端建立与服务端的连接时,会调用onBind方法将mBinder对象返回,在客户端的ServiceConnection类的onServiceConnected函数中得到的对象IBinder就是经过BinderProxy包装的LoginService中的mBinder对象。因此在服务端中的onTransact中调用的this.login()函数实际上就是调用的LoginStubImpl中的login()函数。 在服务端程序的AndroidManifest.xml中注册LoginService,如下 : 1 2 3 4 5 6 <!-- aidl server service --> <service android:name= "com.example.advanceandroid.aidl.LoginService" > <intent-filter> </action></intent-filter> </service> 客户端建立连接 在Activity中加入如下代码 : 1 2 3 4 5 6 7 8 9 10 11 12 13 14 15 16 17 18 19 20 21 22 23 24 25 26 27 28 29 30 31 32 33 34 35 36 37 38 39 ServiceConnection mLoginConnection = new ServiceConnection() { @Override public void onServiceDisconnected(ComponentName name) { Log.d( "" , "### aidl disconnected." ); } @Override public void onServiceConnected(ComponentName name, IBinder service) { Log.d( "" , "### aidl onServiceConnected. service : " + service.getClass().getName()); ILogin login = Stub.asInterface(service); Log.d( "" , "### after asInterface : " + login.getClass().getName()); try { Log.d( "" , "### login : " + login.login()); // Toast.makeText(MainActivity.this, "onServiceConnected : " + // login.login(), // Toast.LENGTH_SHORT).show(); } catch (RemoteException e) { e.printStackTrace(); } } }; @Override protected void onResume() { super .onResume(); // 服务端的action Intent aidlIntent = new Intent( "com.example.advanceandroid.aidl.LoginService" ); bindService(aidlIntent, mLoginConnection, Context.BIND_AUTO_CREATE); } @Override protected void onStop() { super .onStop(); // unbind unbindService(mLoginConnection); } 运行 先运行服务端程序,然后在启动客户端程序,可以看到客户端输出如下Log: 1 2 3 09 - 02 10 : 40 : 54.662 : D/( 9589 ): ### aidl onServiceConnected. service : android.os.BinderProxy 09 - 02 10 : 40 : 54.662 : D/( 9589 ): ### after asInterface : com.example.advanceandroid.aidl.ILogin$Stub$Proxy 09 - 02 10 : 40 : 54.662 : D/( 9589 ): ### login : 这是从 com.example.advanceandroid.aidl.LoginService$LoginStubImpl 返回的字符串 可以看淡onServiceConnected(ComponentName name, IBinder service)中的service对象是BinderProxy类型,经过asInterface转换后被包装成了Proxy类型,但是调用的时候,执行的是服务端LoginStubImpl中的login()函数。因此,LoginStubImpl实例mBinder被服务端包装成BinderProxy类型,再经过客户端的Proxy进行包装,通过Binder机制进行数据传输,实现IPC。 本文转自 一点点征服 博客园博客,原文链接:http://www.cnblogs.com/ldq2016/p/7306173.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

fragment和fragmentactivity解析

一、为什么要使用Fragment 1、当我们须要动态的多界面切换的时候,就须要将UI元素和Activity融合成一个模块。在2.3中我们一般通过各种Activity中进行跳转来实现多界面的跳转和单个界面动态改变。在4.0或以上系统中就能够使用新的特性来方便的达到这个效果--Fragment类。Fragment类似一个嵌套Activity,能够定义自己的layout和自己的生命周期。 2、 多个Fragment能够放在一个Activity中(所以上面讲到类似一个嵌套Activity)。而这个类能够对这些Fragment进行配置以适应不同的屏幕尺寸(比方平板和手机)。 二、使用Fragment 1、Fragment 是 activity 的界面中的一部分或一种行为。 能够把多个 Fragment 组合到一个 activity 中来创建一 个多面界面而且能够在多个 activity 中重用一个 Fragment。 能够把 Fragment 觉得模块化的一段 activity,它具 有自己的生命周期,接收它自己的事件,并能够在 activity 执行时被加入或删除。 2、Fragment 不能独立存在,它必须嵌入到 activity 中,并且 Fragment 的生命周期直接受所在的 activity 的影 响。 3、当向 activity 中加入一个 Fragment 时,它须置于 ViewGroup 控件中,而且需定义 Fragment 自己的界面。 可 以在 layoutxml 文件里声明 Fragment,元素为:<fragment>;也能够在代码中创建 Fragment,然后把它加入到 ViewGroup 控件中。 然而,Fragment 不一定非要放在 activity 的界面中,它能够隐藏在后台为 actvitiy 工作。 三、 生命周期 通常, 应当至少实现例如以下的生命周期方法: onCreate() 当创建fragment时, 系统调用该方法. 在实现代码中,应当初始化想要在fragment中保持的必要组件, 当fragment被暂停或者停止后能够恢复. onCreateView() fragment第一次绘制它的用户界面的时候, 系统会调用此方法. 为了绘制fragment的UI,此方法必须返回一个View, 这个view是你的fragment布局的根view. 假设fragment不提供UI, 能够返回null. onPause() 用户将要离开fragment时,系统调用这种方法作为第一个指示(然而它不总是意味着fragment将被销毁.) 在当前用户会话结束之前,通常应当在这里提交不论什么应该持久化的变化(由于用户有可能不会返回). 大多数程序应最少对 fragment 实现这三个方法。 当然还有其他几个回调方法可应该按情况实现之。 下图为 fragment 的生命周期(它所在的 activity 处于执行状态)。 四、怎样使用Fragment 1、加入一个用户界面 fragment通经常使用来作为一个activity的用户界面的一部分,并将它的layout提供给activity.为了给一个fragment提供一 个layout,你必须实现 onCreateView()回调方法, 当到了fragment绘制它自己的layout的时候,Android系统调用它.你的此方法的实现代码必须返回一个你的fragment的 layout的根view. 从onCreateView()返回的View, 也能够从一个layout的xml资源文件里读取并生成. 为了帮助你这么做, onCreateView() 提供了一个LayoutInflater 对象. 举个样例, 这里有一个Fragment的子类, 从文件 frament_main.xml 载入了一个layout: @Override public View onCreateView(LayoutInflater inflater, ViewGroup container, Bundle savedInstanceState) { View view = inflater.inflate(R.layout.frament_main, container, false); return view; } PS 传入onCreateView()的container參数是你的fragmentlayout将被插入的父ViewGroup(来自activity的layout) savedInstanceState 參数是一个Bundle, 假设fragment是被恢复的,它提供关于fragment的之前的实例的数据, inflate() 方法有3个參数: a、想要载入的layout的resource ID. b、载入的layout的父ViewGroup.传入container是非常重要的, 目的是为了让系统接受所要载入的layout的根view的layout參数,由它将挂靠的父view指定. c、布尔值指示在载入期间, 展开的layout是否应当附着到ViewGroup (第二个參数). 2、将fragment加入到activity 通常地, fragment为宿主activity提供UI的一部分, 被作为activity的整个viewhierarchy的一部分被嵌入. 有2种方法你能够加入一个fragment到activity layout:2.1、使用XML将Fragment加入到一个Activity中 在这样的情况下。你能够像为View一样, 为fragment指定layout属性。 <?xml version="1.0" encoding="utf-8"?> <LinearLayout xmlns:android="http://schemas.android.com/apk/res/android" android:orientation="horizontal" android:layout_width="match_parent" android:layout_height="match_parent"> <fragment android:name="com.example.news.ArticleListFragment" android:id="@+id/list" android:layout_weight="1" android:layout_width="0dp" android:layout_height="match_parent" /> <fragment android:name="com.example.news.ArticleReaderFragment" android:id="@+id/viewer" android:layout_weight="2" android:layout_width="0dp" android:layout_height="match_parent" /> </LinearLayout> PS 1、<fragment> 中的 android:name属性指定了在layout中实例化的Fragment类. 当系统创建这个activity layout时,它实例化每个在layout中指定的fragment,并调用每个上的onCreateView()方法,来获取每个 fragment的layout.系统将从fragment返回的 View直接插入到<fragment>元素所在的地方. 2、通过在xml中定义fragment的方式。我们不能在执行时移除fragment。假设我们想要通过切换fragments来跟用户有更好的互动。那么就须要在activity启动的时候定义fragment了。 2.2、在执行时加入一个Fragment到Activity 上面一节的在activity的布局文件(layout xml)中加入Fragment的方法我们已经知道了。 如今我们将学习第二种方式。这样的方式同意我们在执行时动态的显示和隐藏fragment。为了达到在activity中动态管理Fragment,我们须要用到FragmentManager,而且通过它创建FragmentTransaction。 activity同意移除或者替换fragment须要有例如以下条件: 1、activity的onCreate()方法中加入初始化的fragment 2、fragment放置位置的布局中必须有一个视图容器 比方:res/layout/news_articles.xml文件提供了视图容器。 <FrameLayout xmlns:android="http://schemas.android.com/apk/res/android" android:id="@+id/fragment_container" android:layout_width="match_parent" android:layout_height="match_parent" /> Activity中使用getSupportFragmentManager()获取FragmentManager,之后调用beginTransaction去创建一个FragmentTransaction对象, 再调用add()方法就可以加入一个fragment。 在activity中能够使用同一个FragmentTransaction对象去运行多个fragment事务,当做这样操作时。必须调用commint()方法。 以下的代码演示如何加入一个fragment到res/layout/news_articles.xml的layout: import android.os.Bundle; import android.support.v4.app.FragmentActivity; public class MainActivity extends FragmentActivity { @Override public void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.news_articles); if (findViewById(R.id.fragment_container) != null) { if (savedInstanceState != null) { return; } HeadlinesFragment firstFragment = new HeadlinesFragment(); firstFragment.setArguments(getIntent().getExtras()); // Add the fragment to the 'fragment_container' FrameLayout getSupportFragmentManager().beginTransaction() .add(R.id.fragment_container, firstFragment).commit(); } } } add()的第一个參数是fragment要放入的ViewGroup, 由resource ID指定,第二个參数是须要加入的fragment.一旦用FragmentTransaction做了改变,为了使改变生效,必须调用commit(). PS 如今再来说明另外一个实例,实例图例如以下。我要在四个标签页面切换(主页。手机,配件,购物车) 代码例如以下,详细就是通过影藏和显示fragment来实现切换 import android.os.Bundle; import android.support.v4.app.Fragment; import android.support.v4.app.FragmentActivity; import android.view.View; import android.view.Window; public class FramentMainActivity extends FragmentActivity { private Fragment[] fragments; @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); requestWindowFeature(Window.FEATURE_NO_TITLE); setContentView(R.layout.activity_frament_main); fragments = new Fragment[4]; fragments[0] = getSupportFragmentManager().findFragmentById(R.id.farment_main); fragments[1] = getSupportFragmentManager().findFragmentById(R.id.farment_phone); fragments[2] = getSupportFragmentManager().findFragmentById(R.id.farment_accessory); fragments[3] = getSupportFragmentManager().findFragmentById(R.id.farment_cart); getSupportFragmentManager().beginTransaction(). hide(fragments[1]).hide(fragments[2]).hide(fragments[3]).show(fragments[0]).commit(); } public void mainClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[1]).hide(fragments[2]).hide(fragments[3]).show(fragments[0]).commit(); } public void phoneClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[2]).hide(fragments[3]).show(fragments[1]).commit(); } public void accessoryClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[1]).hide(fragments[3]).show(fragments[2]).commit(); } public void cartClick(View view){ getSupportFragmentManager().beginTransaction().hide(fragments[0]).hide(fragments[1]).hide(fragments[2]).show(fragments[3]).commit(); } } 3、Frament 管理 要管理 fragment,需使用 FragmentManager,要获取它,需在 activity 中调用方法 getFragmentManager()。 能够用 FragmentManager 来做以上事情: 用法 findFragmentById()或 findFragmentByTag(),获取 activity 中已存在的 fragment 用法 popBackStack()从 activity 的后退栈中弹出 fragment(这能够模拟后退键引发的动作) 用方法 addOnBackStackChangedListerner()注冊一个侦听器以监视后退栈的变化 还能够使用 FragmentManager 打开一个 FragmentTransaction 来运行 fragment 的事务,比方加入或删除 fragment。 在 activity 中使用 fragment 的一个伟大的优点是能跟据用户的输入对 fragment 进行加入、删除、替换以及运行 其他动作的能力。 提交的一组 fragment 的变化叫做一个事务。 事务通过 FragmentTransaction 来运行。还能够把每一个 事务保存在 activity 的后退栈中,这样就能够让用户在 fragment 变化之间导航(跟在 activity 之间导航一样)。 能够通过 FragmentManager 来取得 FragmentTransaction 的实例,例如以下: FragmentManagerfragmentManager = getFragmentManager(); FragmentTransactionfragmentTransaction =fragmentManager.beginTransaction(); 一个事务是在同一时刻运行的一组动作(非常像数据库中的事务)。 能够用 add(),remove(),replace()等方法构成事务,最后使用 commit()方法提交事务。在调用 commint()之前,能够用addToBackStack()把事务加入到一个后退栈中, 这个后退栈属于所在的 activity。有了它,就能够在用户按下返回键时,返回到 fragment 运行事务之前的状态。如 下例:演示了怎样用一个 fragment 取代还有一个 fragment,同一时候在后退栈中保存被取代的 fragment 的状态。 4、为Activity创建事件回调方法 在一些情况下, 你可能须要一个fragment与activity分享事件. 一个好的方法是在fragment中定义一个回调的interface, 并要求宿主activity实现它.当activity通过interface接收到一个回调, 必要时它能够和在layout中的其它fragment分享信息. 比如, 假设一个新的应用在activity中有2个fragment – 一个用来显示文章列表(framgent A), 还有一个显示文章内容(fragment B) – 然后 framgent A必须告诉activity何时一个list item被选中,然后它能够告诉fragmentB去显示文章. PS 最后在简单说说一个项目的大致实现,比方在手机上面实现了一个FragmentActivity + 多个fragment(登录。菜单,具体,账户等页面)。 1、每个项目包含非常多活动,每个活动(FragmentActivity)相互不影响,每个活动(FragmentActivity)包含非常多子活动(fragment,一个页面),每个子活动也相互不影响. 2、每个活动(FragmentActivity)用FrameLayout来显示子活动,而且对活动进行堆栈管理,实现数据不用反复拉取。就跟搜狐新闻一样的效果. 3、登录(FragmentActivity):logo页面,登录页面 4、菜单(FragmentActivity):菜单选择页面(側边栏,滑动),子菜单功能(每个新闻页面) 5、其它(FragmentActivity):上传页面,下载页面等 每个活动(FragmentActivity)实现了相互不影响。 本文转自mfrbuaa博客园博客,原文链接:http://www.cnblogs.com/mfrbuaa/p/5393911.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

Hbase原理解析

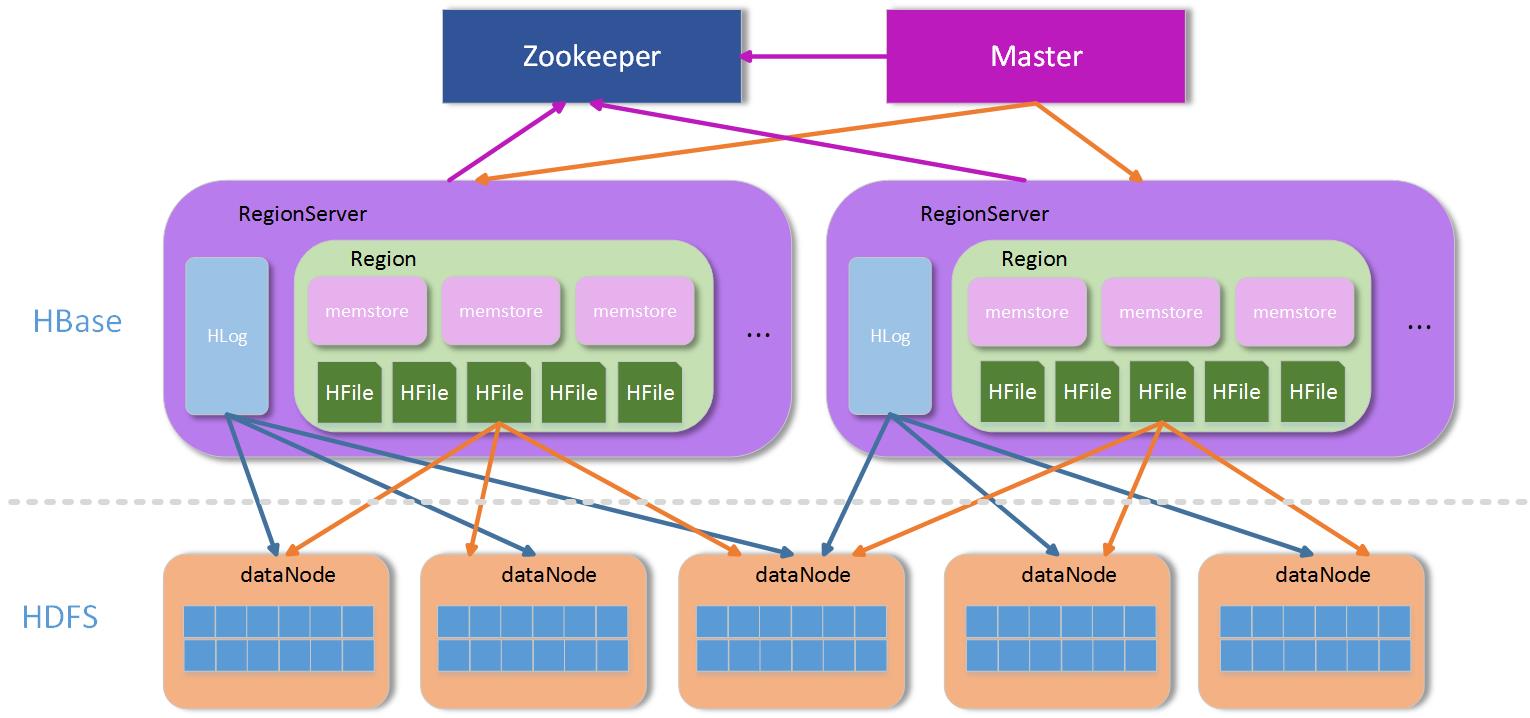
原文网站已经打不开了,其他都是转载地址,在此就不列了 简介 [HBase]——Hadoop Database的简称,Google BigTable的另一种开源实现方式,从问世之初,就为了解决用大量廉价的机器高速存取海量数据、实现数据分布式存储提供可靠的方案。从功能上来讲,HBase不折不扣是一个数据库,与我们熟悉的Oracle、MySQL、MSSQL等一样,对外提供数据的存储和读取服务。而从应用的角度来说,HBase与一般的数据库又有所区别,HBase本身的存取接口相当简单,不支持复杂的数据存取,更不支持SQL等结构化的查询语言;HBase也没有除了rowkey以外的索引,所有的数据分布和查询都依赖rowkey。 所以HBase在表的设计上会有很严格的要求。 架构上,HBase是分布式数据库的典范,这点比较像MongoDB的sharding模式,能根据键值的大小,把数据分布到不同的存储节点上,MongoDB根据configserver来定位数据落在哪个分区上,HBase通过访问Zookeeper来获取-ROOT-表所在地址,通过-ROOT-表得到相应.META.表信息,从而获取数据存储的region位置。 架构 上面提到,HBase是一个分布式的架构,除去底层存储的HDFS外,HBase本身从功能上可以分为三块:Zookeeper群、Master群和RegionServer群。 Zookeeper群:HBase集群中不可缺少的重要部分,主要用于存储Master地址、协调Master和RegionServer等上下线、存储临时数据等等。 Master群:Master主要是做一些管理操作,如:region的分配,手动管理操作下发等等,一般数据的读写操作并不需要经过Master集群,所以Master一般不需要很高的配置即可。 RegionServer群:RegionServer群是真正数据存储的地方,每个RegionServer由若干个region组成,而一个region维护了一定区间rowkey值的数据,整个结构如下图: HBase结构图 上图中,Zookeeper(简称ZK)是一个集群,通常有奇数个ZK服务组成。Master为了服务可用性,也建议部署成集群方式,因为Master是整个管理操作的发起者,如果Master一旦发生意外停机,整个集群将会无法进行管理操作,所以Master也必须有多个,当然多个Master也有主从之分,如何区分哪个是主,哪个是从?关键看哪个Master能竞争到ZK上对应Master目录下的锁,持有该目录锁的Master为主Master,其他从Master轮询竞争该锁,所以一旦主Master发生意外停机,从Master很快会因为竞争到Master文件夹上的锁而接管服务。 RegionServer(简称RS)在非Replication模式下,整个系统中都是唯一的,也就是说,在整个非Replication的HBase集群中,每台RS上保存的数据都不一样,所以相对于前面两者,该模式下的RS并不是高可用的,至少RS可能存在单点故障的问题,但是由于HBase内部数据分region存储和region可以迁移的机制,RS服务的单点故障可能会在极小代价下很快恢复,但是一旦停掉的RS上有-ROOT-或者.META.表的region,那后果还是比较严重,因为数据节点的RS停机,只会在短时间内影响该台RS上的region不可访问,等到region迁移完成后即可恢复,如果是-ROOT-、.META.所在的RS停机,整个HBase的新的求情都将受到影响,因为需要通过.META.表来路由,从而寻找到region所在RS的地址。 数据组织 整个架构中,ZK用于服务协调和整个集群运行过程中部分信息的保存和-ROOT-表地址定位,Master用于集群内部管理,所以剩下的RS主要用于处理数据。 RS是处理数据的主要场所,那么在RS内部的数据是怎么分布的?其实RS本身只是一个容器,其定义了一些功能线程,比如:数据合并线程(compact thread)、storeFile分割线程(split thread)等等。容器中的主要对象就是region,region是一个表根据自身rowkey范围划分的一部分,一个表可以被划分成若干部分,也就是若干个region,region可以根据rowkey范围不同而被分布在不同的RS上(当然也可以在同一个RS上,但不建议这么做)。一个RS上可以包含多个表的region,也可以只包含一个表的部分region,RS和表是两个不同的概念。 这里还有一个概念——列簇。对HBase有一些了解的人,或多或少听说过:HBase是一个列式存储的数据库,而这个列式存储中的列,其实是区别于一般数据库的列,这里的列的概念,就是列簇。列簇,顾名思义就是很多列的集合,而在数据存储上来讲,不同列簇的数据,一定是分开存储的,即使是在同一个region内部,不同的列簇也存储在不同的文件夹中,这样做的好处是,一般我们定义列簇的时候,通常会把类似的数据放入同一个列簇,不同的列簇分开存储,有利于数据的压缩,并且HBase本身支持多种压缩方式。 原理 前面介绍了HBase的一般架构,我们知道了HBase有ZK、Master和RS等组成,本节我们来介绍下HBase的基本原理,从数据访问、RS路由到RS内部缓存、数据存储和刷写再到region的合并和拆分等等功能。 RegionServer定位 访问HBase通过HBase客户端(或API)进行,整个HBase提供给外部的地址,其实是ZK的入口,前面也介绍了,ZK中有保存-ROOT-所在的RS地址,从-ROOT-表可以获取.META.表信息,根据.META.表可以获取region在RS上的分布,整个region寻址过程大致如下: RS定位过程 首先,Client通过访问ZK来请求目标数据的地址。 ZK中保存了-ROOT-表的地址,所以ZK通过访问-ROOT-表来请求数据地址。同样,-ROOT-表中保存的是.META.的信息,通过访问.META.表来获取具体的RS。.META.表查询到具体RS信息后返回具体RS地址给Client。Client端获取到目标地址后,然后直接向该地址发送数据请求。 上述过程其实是一个三层索引结构,从ZK获取-ROOT-信息,再从-ROOT-获取.META.表信息,最后从.META.表中查到RS地址后缓存。这里有几个问题: 既然ZK中能保存-ROOT-信息,那么为什么不把.META.信息直接保存在ZK中,而需要通过-ROOT-表来定位? Client查找到目标地址后,下一次请求还需要走ZK —> -ROOT- —> .META.这个流程么? 先来回答第一个问题:为什么不直接把.META.表信息直接保存到ZK中?主要是为了保存的数据量考虑,ZK中不宜保存大量数据,而.META.表主要是保存Region和RS的映射信息,region的数量没有具体约束,只要在内存允许的范围内,region数量可以有很多,如果保存在ZK中,ZK的压力会很大。所以通过一个-ROOT-表来转存到RS中是一个比较理想的方案,相比直接保存在ZK中,也就多了一层-ROOT-表的查询,对性能来说影响不大。 第二个问题:每次访问都需要走ZK –> -ROOT- —> .META.的流程么?当然不需要,Client端有缓存,第一次查询到相应region所在RS后,这个信息将被缓存到Client端,以后每次访问都直接从缓存中获取RS地址即可。当然这里有个意外:访问的region若果在RS上发生了改变,比如被balancer迁移到其他RS上了,这个时候,通过缓存的地址访问会出现异常,在出现异常的情况下,Client需要重新走一遍上面的流程来获取新的RS地址。总体来说,region的变动只会在极少数情况下发生,一般变动不会很大,所以在整个集群访问过程中,影响可以忽略。 Region数据写入 HBase通过ZK —> -ROOT- —> .META.的访问获取RS地址后,直接向该RS上进行数据写入操作,整个过程如下图: RegionServer数据操作过程 Client通过三层索引获得RS的地址后,即可向指定RS的对应region进行数据写入,HBase的数据写入采用WAL(write ahead log)的形式,先写log,后写数据。HBase是一个append类型的数据库,没有关系型数据库那么复杂的操作,所以记录HLog的操作都是简单的put操作(delete/update操作都被转化为put进行) HLog HLog写入 HLog是HBase实现WAL方式产生的日志信息,其内部是一个简单的顺序日志,每个RS上的region都共享一个HLog,所有对于该RS上的region数据写入都被记录到该HLog中。HLog的主要作用就是在RS出现意外崩溃的时候,可以尽量多的恢复数据,这里说是尽量多,因为在一般情况下,客户端为了提高性能,会把HLog的auto flush关掉,这样HLog日志的落盘全靠操作系统保证,如果出现意外崩溃,短时间内没有被fsync的日志会被丢失。 HLog过期 HLog的大量写入会造成HLog占用存储空间会越来越大,HBase通过HLog过期的方式进行HLog的清理,每个RS内部都有一个HLog监控线程在运行,其周期可以通过hbase.master.cleaner.interval进行配置。 HLog在数据从memstore flush到底层存储上后,说明该段HLog已经不再被需要,就会被移动到.oldlogs这个目录下,HLog监控线程监控该目录下的HLog,当该文件夹下的HLog达到hbase.master.logcleaner.ttl设置的过期条件后,监控线程立即删除过期的HLog。 Memstore 数据存储 memstore是region内部缓存,其大小通过HBase参数hbase.hregion.memstore.flush.size进行配置。RS在写完HLog以后,数据写入的下一个目标就是region的memstore,memstore在HBase内部通过LSM-tree结构组织,所以能够合并大量对于相同rowkey上的更新操作。 正是由于memstore的存在,HBase的数据写入都是异步的,而且性能非常不错,写入到memstore后,该次写入请求就可以被返回,HBase即认为该次数据写入成功。这里有一点需要说明,写入到memstore中的数据都是预先按照rowkey的值进行排序的,这样有利于后续数据查找。 数据刷盘 memstore中的数据在一定条件下会进行刷写操作,使数据持久化到相应的存储设备上,触发memstore刷盘的操作有多种不同的方式如下图: Memstore刷写流程以上1,2,3都可以触发memstore的flush操作,但是实现的方式不同: 1、通过全局内存控制,触发memstore刷盘操作memstore整体内存占用上限通过参数hbase.regionserver.global.memstore.upperLimit进行设置,当然在达到上限后,memstore的刷写也不是一直进行,在内存下降到hbase.regionserver.global.memstore.lowerLimit配置的值后,即停止memstore的刷盘操作。这样做,主要是为了防止长时间的memstore刷盘,会影响整体的性能。在该种情况下,RS中所有region的memstore内存占用都没达到刷盘条件,但整体的内存消耗已经到一个非常危险的范围,如果持续下去,很有可能造成RS的OOM,这个时候,需要进行memstore的刷盘,从而释放内存。 2、手动触发memstore刷盘操作HBase提供API接口,运行通过外部调用进行memstore的刷盘 3、memstore上限触发数据刷盘前面提到memstore的大小通过hbase.hregion.memstore.flush.size进行设置,当region中memstore的数据量达到该值时,会自动触发memstore的刷盘操作。 刷盘影响 memstore在不同的条件下会触发数据刷盘,那么整个数据在刷盘过程中,对region的数据写入等有什么影响?memstore的数据刷盘,对region的直接影响就是:在数据刷盘开始到结束这段时间内,该region上的访问都是被拒绝的,这里主要是因为在数据刷盘结束时,RS会对改region做一个snapshot,同时HLog做一个checkpoint操作,通知ZK哪些HLog可以被移到.oldlogs下。从前面图上也可以看到,在memstore写盘开始,相应region会被加上UpdateLock锁,写盘结束后该锁被释放。 StoreFile memstore在触发刷盘操作后会被写入底层存储,每次memstore的刷盘就会相应生成一个存储文件HFile,storeFile即HFile在HBase层的轻量级分装。数据量的持续写入,造成memstore的频繁flush,每次flush都会产生一个HFile,这样底层存储设备上的HFile文件数量将会越来越多。不管是HDFS还是Linux下常用的文件系统如Ext4、XFS等,对小而多的文件上的管理都没有大文件来的有效,比如小文件打开需要消耗更多的文件句柄;在大量小文件中进行指定rowkey数据的查询性能没有在少量大文件中查询来的快等等。 Compact 大量HFile的产生,会消耗更多的文件句柄,同时会造成RS在数据查询等的效率大幅度下降,HBase为解决这个问题,引入了compact操作,RS通过compact把大量小的HFile进行文件合并,生成大的HFile文件。RS上的compact根据功能的不同,可以分为两种不同类型,即:minor compact和major compact。 Minor Compact minor compact又叫small compact,在RS运行过程中会频繁进行,主要通过参数hbase.hstore.compactionThreshold进行控制,该参数配置了HFile数量在满足该值时,进行minor compact,minor compact只选取region下部分HFile进行compact操作,并且选取的HFile大小不能超过hbase.hregion.max.filesize参数设置。 Major Compact 相反major compact也被称之为large compact,major compact会对整个region下相同列簇的所有HFile进行compact,也就是说major compact结束后,同一个列簇下的HFile会被合并成一个。major compact是一个比较长的过程,对底层I/O的压力相对较大。 major compact除了合并HFile外,另外一个重要功能就是清理过期或者被删除的数据。前面提到过,HBase的delete操作也是通过append的方式写入,一旦某些数据在HBase内部被删除了,在内部只是被简单标记为删除,真正在存储层面没有进行数据清理,只有通过major compact对HFile进行重组时,被标记为删除的数据才能被真正的清理。 compact操作都有特定的线程进行,一般情况下不会影响RS上数据写入的性能,当然也有例外:在compact操作速度跟不上region中HFile增长速度时,为了安全考虑,RS会在HFile达到一定数量时,对写入进行锁定操作,直到HFile通过compact降到一定的范围内才释放锁。 Split compact将多个HFile合并单个HFile文件,随着数据量的不断写入,单个HFile也会越来越大,大量小的HFile会影响数据查询性能,大的HFile也会,HFile越大,相对的在HFile中搜索的指定rowkey的数据花的时间也就越长,HBase同样提供了region的split方案来解决大的HFile造成数据查询时间过长问题。 一个较大的region通过split操作,会生成两个小的region,称之为Daughter,一般Daughter中的数据是根据rowkey的之间点进行切分的,region的split过程大致如下图: region split流程 1、region先更改ZK中该region的状态为SPLITING。 2、Master检测到region状态改变。 3、region会在存储目录下新建.split文件夹用于保存split后的daughter region信息。 4、Parent region关闭数据写入并触发flush操作,保证所有写入Parent region的数据都能持久化。 5、在.split文件夹下新建两个region,称之为daughter A、daughter B。 6、Daughter A、Daughter B拷贝到HBase根目录下,形成两个新的region。 7、Parent region通知修改.META.表后下线,不再提供服务。 8、Daughter A、Daughter B上线,开始向外提供服务。 9、如果开启了balance_switch服务,split后的region将会被重新分布。 上面1 ~ 9就是region split的整个过程,split过程非常快,速度基本会在秒级内,那么在这么快的时间内,region中的数据怎么被重新组织的? 其实,split只是简单的把region从逻辑上划分成两个,并没有涉及到底层数据的重组,split完成后,Parent region并没有被销毁,只是被做下线处理,不再对外部提供服务。而新产生的region Daughter A和Daughter B,内部的数据只是简单的到Parent region数据的索引,Parent region数据的清理在Daughter A和Daughter B进行major compact以后,发现已经没有到其内部数据的索引后,Parent region才会被真正的清理。 HBase设计 HBase是一个分布式数据库,其性能的好坏主要取决于内部表的设计和资源的分配是否合理。 Rowkey设计 rowkey是HBase实现分布式的基础,HBase通过rowkey范围划分不同的region,分布式系统的基本要求就是在任何时候,系统的访问都不要出现明显的热点现象,所以rowkey的设计至关重要,一般我们建议rowkey的开始部分以hash或者MD5进行散列,尽量做到rowkey的头部是均匀分布的。禁止采用时间、用户id等明显有分段现象的标志直接当作rowkey来使用。 列簇设计 HBase的表设计时,根据不同需求有不同选择,需要做在线查询的数据表,尽量不要设计多个列簇,我们知道,不同的列簇在存储上是被分开的,多列簇设计会造成在数据查询的时候读取更多的文件,从而消耗更多的I/O。 TTL设计 选择合适的数据过期时间也是表设计中需要注意的一点,HBase中允许列簇定义数据过期时间,数据一旦超过过期时间,可以被major compact进行清理。大量无用历史数据的残余,会造成region体积增大,影响查询效率。 Region设计 一般地,region不宜设计成很大,除非应用对阶段性性能要求很多,但是在将来运行一段时间可以接受停服处理。region过大会导致major compact调用的周期变长,而单次major compact的时间也相应变长。major compact对底层I/O会造成压力,长时间的compact操作可能会影响数据的flush,compact的周期变长会导致许多删除或者过期的数据不能被及时清理,对数据的读取速度等都有影响。 相反,小的region意味着major compact会相对频繁,但是由于region比较小,major compact的相对时间较快,而且相对较多的major compact操作,会加速过期数据的清理。 当然,小region的设计意味着更多的region split风险,region容量过小,在数据量达到上限后,region需要进行split来拆分,其实split操作在整个HBase运行过程中,是被不怎么希望出现的,因为一旦发生split,涉及到数据的重组,region的再分配等一系列问题。所以我们在设计之初就需要考虑到这些问题,尽量避免region的运行过程中发生split。 HBase可以通过在表创建的时候进行region的预分配来解决运行过程中region的split产生,在表设计的时候,预先分配足够多的region数,在region达到上限前,至少有部分数据会过期,通过major compact进行清理后, region的数据量始终维持在一个平衡状态。 region数量的设计还需要考虑内存上的限制,通过前面的介绍我们知道每个region都有memstore,memstore的数量与region数量和region下列簇的数量成正比,一个RS下memstore内存消耗 Memory = memstore大小 * region数量 * 列簇数量 如果不进行前期数据量估算和region的预分配,通过不断的split产生新的region,容易导致因为内存不足而出现OOM现象。 个人介绍: 高广超:多年一线互联网研发与架构设计经验,擅长设计与落地高可用、高性能互联网架构。 本文首发在 高广超的简书博客 转载请注明! image.png

优秀的个人博客,低调大师

WKWebView代理方法解析

一.前言 上一篇文章已经对WKWebView做了一个简单的介绍,主要对它的一些方法和属性做了一个简单的介绍,今天看一下WKWebView的两个协议:WKNavigationDelegate 和 WKUIDelegate。 二.WKNavigationDelegate 根据字面意思,它的作用是用于导航(navigation)的代理。其实里面定义了n多个方法,用于处理网页接受、加载和导航请求等自定义的行为。直接拿下面的例子来看: #pragma mark - WKWebView NavigationDelegate //WKNavigationDelegate - (void)webView:(WKWebView *)webView decidePolicyForNavigationAction:(WKNavigationAction *)navigationAction decisionHandler:(void (^)(WKNavigationActionPolicy))decisionHandler { NSLog(@"是否允许这个导航"); decisionHandler(WKNavigationActionPolicyAllow); } - (void)webView:(WKWebView *)webView decidePolicyForNavigationResponse:(WKNavigationResponse *)navigationResponse decisionHandler:(void (^)(WKNavigationResponsePolicy))decisionHandler { // Decides whether to allow or cancel a navigation after its response is known. NSLog(@"知道返回内容之后,是否允许加载,允许加载"); decisionHandler(WKNavigationResponsePolicyAllow); } - (void)webView:(WKWebView *)webView didStartProvisionalNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"开始加载"); self.progress.alpha = 1; [UIApplication sharedApplication].networkActivityIndicatorVisible = YES; } - (void)webView:(WKWebView *)webView didReceiveServerRedirectForProvisionalNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"跳转到其他的服务器"); } - (void)webView:(WKWebView *)webView didFailProvisionalNavigation:(null_unspecified WKNavigation *)navigation withError:(NSError *)error { NSLog(@"网页由于某些原因加载失败"); self.progress.alpha = 0; [UIApplication sharedApplication].networkActivityIndicatorVisible = NO; } - (void)webView:(WKWebView *)webView didCommitNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"网页开始接收网页内容"); } - (void)webView:(WKWebView *)webView didFinishNavigation:(null_unspecified WKNavigation *)navigation { NSLog(@"网页导航加载完毕"); [UIApplication sharedApplication].networkActivityIndicatorVisible = NO; self.title = webView.title; [webView evaluateJavaScript:@"document.title" completionHandler:^(id _Nullable ss, NSError * _Nullable error) { NSLog(@"----document.title:%@---webView title:%@",ss,webView.title); }]; self.progress.alpha = 0; } - (void)webView:(WKWebView *)webView didFailNavigation:(null_unspecified WKNavigation *)navigation withError:(NSError *)error { NSLog(@"加载失败,失败原因:%@",[error description]); self.progress.alpha = 0; } - (void)webViewWebContentProcessDidTerminate:(WKWebView *)webView { NSLog(@"网页加载内容进程终止"); } //- (void)webView:(WKWebView *)webView didReceiveAuthenticationChallenge:(NSURLAuthenticationChallenge *)challenge completionHandler:(void (^)(NSURLSessionAuthChallengeDisposition, NSURLCredential * _Nullable))completionHandler { // NSLog(@"receive"); //} 首先看一下(WKN1): - (void)webView:(WKWebView *)webView decidePolicyForNavigationAction:(WKNavigationAction *)navigationAction decisionHandler:(void (^)(WKNavigationActionPolicy))decisionHandler { NSLog(@"是否允许这个导航"); decisionHandler(WKNavigationActionPolicyAllow); } 这个方法是加载网页第一个执行的方法,因为它要确定是否允许或者取消加载这个导航。这里有一个枚举WKNavigationActionPolicy,其结构如下: typedef NS_ENUM(NSInteger, WKNavigationActionPolicy) { WKNavigationActionPolicyCancel, WKNavigationActionPolicyAllow, } API_AVAILABLE(macosx(10.10), ios(8.0)); 这里的两个枚举确定了这个网页是否加载,我们只需要在decisionHandler回调里面传入相应的枚举值即可。这里可以用来处理自己不允许加载的网页,比如你的app里面的网页很多,但是domain只有两个,如果你只想加载这两个domain里面的网页,其他的domain不加载,那么可以在这里进行处理。(可以用来屏蔽移动或联通运营商推送的网页,让其不在app中展示) 这里还有一个WKNavigationAction。它是一个导航动作, 包含了点击之后的导航动作,我们做过滤的时候可以通过该动作决定是否允许加载。它有两个关键的FrameInfo: sourceFrame targetFrame 他们都是WKFrameInfo的实例。该类包含了网页加载的frame的信息。该类有一个重要的属性:mainFrame。它是一个Bool值,用于标识该frame是不是当前网页的主frame或者是子frame。举个例子: 当我们第一次打开百度的时候,navigationAction是这样的: <WKNavigationAction: 0x100410fa0; navigationType = -1; syntheticClickType = 0; request = <NSMutableURLRequest: 0x170019a10> { URL: https://www.baidu.com/ }; sourceFrame = (null); targetFrame = <WKFrameInfo: 0x100401200; isMainFrame = YES; request = (null)>> 它的request url是https://www.baidu.com/。它的sourceFrame是nil,也就是请求导航的frame是空的。它的targetFrame是: <WKFrameInfo: 0x100401200; isMainFrame = YES; request = (null)> 这里是在当前的frame打开,也就是目的的frame。当我点击新闻那个链接的时候,其navigationAction是这样的: <WKNavigationAction: 0x1004120b0; navigationType = -1; syntheticClickType = 0; request = <NSMutableURLRequest: 0x17001af30> { URL: http://m.news.baidu.com/news?fr=mohome&ssid=0&from=844b&uid=&pu=sz%401320_2001%2Cta%40iphone_1_10.2_3_602&bd_page_type=1 }; sourceFrame = (null); targetFrame = <WKFrameInfo: 0x100414ff0; isMainFrame = YES; request = <NSMutableURLRequest: 0x17001b080> { URL: https://www.baidu.com/ }>> 可以看到,此时的导航动作是要请求的 http://m.news.baidu.com/news?fr=mohome&ssid=0&from=844b&uid=&pu=sz%401320_2001%2Cta%40iphone_1_10.2_3_602&bd_page_type=1 也就是网页版百度新闻的链接。此时它的sourceFrame是nil,它的targetFrame是: <WKFrameInfo: 0x100414ff0; isMainFrame = YES; request = <NSMutableURLRequest: 0x17001b080> { URL: https://www.baidu.com/ }> 它的目标frame的request是baidu。其中的isMainFrame属性是YES,说明是主的frame,所以还是在当前的网页中打开一个新链接。 此时我们也许会遇到另外一种情况,就是sourceFrame不为空,但是targetFrame为空,这里如果targetFrame为空,那么这个就是新建一个window 导航。用我们自己的话来说就是重新打开了一个tab页面。 就类似这样,我点击了PC版的网页链接,然后新开了一个tab,这样的话sourceFrame就是当前的百度,而targetFrame就是空的。此时(我用这个网页测试)你会发现这个代理方法不执行了,好尴尬。。。。处理都不知道怎么处理了。由于新打开了tab,也就意味着我们的请求不在当前的网页加载了,那么也无法调用到这个代理方法了。因此我们需要重新配置这个新打开的网页,这里就会调用: - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures; 这个代理方法是WKUIDelegate的代理方法,可在下面查看。 接着就是开始加载(WKN2): - (void)webView:(WKWebView *)webView didStartProvisionalNavigation:(null_unspecified WKNavigation *)navigation; 这个方法比较好理解,就是当网页内容开始加载到web view的时候调用,这里的navigation没有其他特殊含义,看一下WKNavigation这个类可以知道,他就是NSObject的一个子类,而且里面没有任何新增的其他方法或者属性。我想仅仅是为了名字上能够好理解才这样写的吧。 再接着就是(WKN3): - (void)webView:(WKWebView *)webView decidePolicyForNavigationResponse:(WKNavigationResponse *)navigationResponse decisionHandler:(void (^)(WKNavigationResponsePolicy))decisionHandler; 这个代理方法了。我们知道了网页是否允许加载,那么一旦不允许,那么这个加载过程就已经结束了,不会再执行其他的代理方法;如果允许,那么就会执行开始加载的代理方法,执行完开始加载的代理方法的时候再执行这个代理方法。 根据意思可知,它的作用就是要根据导航的返回信息来判断是否加载网页。我们首先打印出navigationResponse的信息: <WKNavigationResponse: 0x100323e50; response = <NSHTTPURLResponse: 0x170226780> { URL: https://www.baidu.com/ } { status code: 200, headers { "Cache-Control" = "no-cache"; Connection = "keep-alive"; "Content-Encoding" = gzip; "Content-Length" = 20059; "Content-Type" = "text/html;charset=utf-8"; Date = "Mon, 27 Mar 2017 05:29:56 GMT"; Server = "bfe/1.0.8.18"; "Set-Cookie" = "H_WISE_SIDS=108266_100186_114821_114654_114743_109815_103550_114996_114701_112106_107314_114132_115245_115109_115056_115244_115043_114797_114513_114998_115227_114329_114534_115032_114276_114975_110085; path=/; domain=.baidu.com, BDSVRTM=182; path=/, __bsi=11762462753482193024_00_281_N_N_189_0303_C02F_N_N_Y_0; expires=Mon, 27-Mar-17 05:30:01 GMT; domain=www.baidu.com; path=/"; "Strict-Transport-Security" = "max-age=172800"; Traceid = 149059259607016350822661639119137312881; } }> 这个response有个属性叫做forMainFrame,用于标识导航的frame是不是主frame。 navigationResponse的canShowMIMEType属性用于表示WebKit是否能够展示返回的MIME类型。 如果我们拿到了返回的信息,发现这些信息我们不需要,我们可以在此方法里面进行处理,然后决定是否加载该网页。 接下来执行的是(WKN4): - (void)webView:(WKWebView *)webView didCommitNavigation:(null_unspecified WKNavigation *)navigation; 这个代理方法是在网页开始接受网络内容的时候调用,也就是网络内容开始要往网页中加载。 再接着就是(WKN5): - (void)webView:(WKWebView *)webView didFinishNavigation:(null_unspecified WKNavigation *)navigation; 意思就是这个导航我们已经加载完成了。我的理解就是这个当前网页加载完毕。 还有剩下的三个方法,一个加载网页失败的方法,一个接收服务器跳转方法和一个网页加载进程终止的方法。 网页加载失败方法: - (void)webView:(WKWebView *)webView didFailProvisionalNavigation:(null_unspecified WKNavigation *)navigation withError:(NSError *)error; 当网页由于error加载失败就会调用这个代理方法,它会将具体的error信息给抛出,然后供开发者具体情况具体处理。这里的error code具体在NSURLError.h里面定义。 这里有个小小的问题需要说明一下: 当我是用这个URL来进行加载的时候。我点击进去一个连接,然后再返回上一个页面的时候,发现会执行加载失败,查看原因是-999,也就是NSURLErrorCancelled。我理解的应该是因为之前上一个网页已经加载过了,再次加载的时候发现已经加载过了,所以这次返回上一个页面会报一个加载取消,应该是webview发现要加载的这个网页之前已经加载过,然后就取消了这个加载,加载了缓存。 另外两个代理方法: - (void)webView:(WKWebView *)webView didReceiveServerRedirectForProvisionalNavigation:(null_unspecified WKNavigation *)navigation; 和 - (void)webViewWebContentProcessDidTerminate:(WKWebView *)webView API_AVAILABLE(macosx(10.11), ios(9.0)); 前者重定向跳转我们也许会经常遇到,但是一般不怎么去处理其内容,这里就不在介绍了,后者进程终止这个我也不太清楚怎么去触发,也就不再介绍了。 接下来就来看一下各个代理方法的执行顺序(直接跑百度): 2017-03-27 14:16:22.028051 WKWebViewDemo[561:39556] 是否允许这个导航 2017-03-27 14:16:22.028486 WKWebViewDemo[561:39556] 开始加载 2017-03-27 14:16:24.102160 WKWebViewDemo[561:39556] 知道返回内容之后,是否允许加载,允许加载 2017-03-27 14:16:24.106276 WKWebViewDemo[561:39556] 网页开始接收网页内容 2017-03-27 14:16:29.156518 WKWebViewDemo[561:39556] 网页导航加载完毕 2017-03-27 14:16:29.177006 WKWebViewDemo[561:39556] ----document.title:百度一下---webView title:百度一下 这就是顺序了。 忘了还有一个身份验证的: - (void)webView:(WKWebView *)webView didReceiveAuthenticationChallenge:(NSURLAuthenticationChallenge *)challenge completionHandler:(void (^)(NSURLSessionAuthChallengeDisposition disposition, NSURLCredential * _Nullable credential))completionHandler; 具体没做了解,以后如果用到会进一步补充,这里感兴趣的也可以自己看一下。 二.WKUIDelegate 该协议的代理方法的作用是使用原生的用户界面来代表网页。 说白了就是我们去手动写新加载页面的UI、alert框的样式、对话框的样式等等。直接拿下面的例子来看: #pragma mark - WKWebView WKUIDelegate - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures { NSLog(@"创建一个新的webView"); if (!navigationAction.targetFrame.isMainFrame) { [webView loadRequest:navigationAction.request]; } return nil; } - (void)webView:(WKWebView *)webView runJavaScriptAlertPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(void))completionHandler { UIAlertController *alert = [UIAlertController alertControllerWithTitle:@"alert" message:message preferredStyle:UIAlertControllerStyleAlert]; [alert addAction:[UIAlertAction actionWithTitle:@"确定1" style:UIAlertActionStyleDefault handler:^(UIAlertAction * _Nonnull action) { completionHandler(); }]]; [self presentViewController:alert animated:YES completion:nil]; } - (void)webViewDidClose:(WKWebView *)webView { } - (void)webView:(WKWebView *)webView runJavaScriptConfirmPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(BOOL result))completionHandler { completionHandler(YES); } - (void)webView:(WKWebView *)webView runJavaScriptTextInputPanelWithPrompt:(NSString *)prompt defaultText:(nullable NSString *)defaultText initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(NSString * _Nullable result))completionHandler { completionHandler(@"oc对象"); } - (BOOL)webView:(WKWebView *)webView shouldPreviewElement:(WKPreviewElementInfo *)elementInfo { return YES; } - (void)webView:(WKWebView *)webView commitPreviewingViewController:(UIViewController *)previewingViewController { NSLog(@"Called when the user performs a pop action on the preview."); } 首先来看一下: - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures; 在上面也提到了,如果我们新打开了一个tab,就会调用此方法。如果我们打开tab但是没有实现这个方法,那么网页就会取消这个导航,也就是没有做出任何反应。所以使用WKWebView的时候一定要记得对这个方法进行处理,如果没有处理也许就会导致点击网页没有任何反应。此时可以这样处理: - (nullable WKWebView *)webView:(WKWebView *)webView createWebViewWithConfiguration:(WKWebViewConfiguration *)configuration forNavigationAction:(WKNavigationAction *)navigationAction windowFeatures:(WKWindowFeatures *)windowFeatures { NSLog(@"创建一个新的webView"); if (!navigationAction.targetFrame.isMainFrame) { [webView loadRequest:navigationAction.request]; } return nil; } 这样做就是说如果是新打开的网页,那么我们可以直接在当前网页去加载要load的请求,然后返回nil,这样就是在当前的网页去打开新的tab页面了。也可以直接判断targetFrame是否空来进行loadRequest。 当我们的网页中调用alert()方法的时候,我们就要去实现: - (void)webView:(WKWebView *)webView runJavaScriptAlertPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(void))completionHandler; 如果我们没有实现这个方法,那么alert是没有办法弹出来的(我这边测试的是弹不出来)。因此我们可以这样实现此代理方法: - (void)webView:(WKWebView *)webView runJavaScriptAlertPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(void))completionHandler { UIAlertController *alert = [UIAlertController alertControllerWithTitle:@"alert" message:message preferredStyle:UIAlertControllerStyleAlert]; [alert addAction:[UIAlertAction actionWithTitle:@"确定" style:UIAlertActionStyleDefault handler:^(UIAlertAction * _Nonnull action) { completionHandler(); }]]; [self presentViewController:alert animated:YES completion:nil]; } 我们将alert的UI设置为我们系统的UIAlertController。这里的message就是要alert出来的数据信息。 接下来是: - (void)webView:(WKWebView *)webView runJavaScriptConfirmPanelWithMessage:(NSString *)message initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(BOOL result))completionHandler { completionHandler(YES); } 此方法的作用是展示一个js确认框。这里的completionHandler的回调是确认框的yes or no。例如一个网页的按钮处理操作如下: // confirm选择框 function firm() { var r=confirm("Press a button") if (r==true) { document.write("You pressed OK!") } else { document.write("You pressed Cancel!") } } 如果我们传入的是YES,那么就会执行“You pressed OK”,否则就是执行“You pressed Cancel”。 接下来是: - (void)webView:(WKWebView *)webView runJavaScriptTextInputPanelWithPrompt:(NSString *)prompt defaultText:(nullable NSString *)defaultText initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(NSString * _Nullable result))completionHandler; 这里如果我们不去手动实现该方法,那么点击的动作就像我们点击取消,是一样的效果。 例如 在HTML中button的click方法如下: function prom() { var result = prompt("演示一个带输入的对话框", "请输入内容"); if(result) { alert("谢谢使用,你输入的是:" + result) } } 那么这个result就是我们在上面的代理方法里面传入的result。例如: - (void)webView:(WKWebView *)webView runJavaScriptTextInputPanelWithPrompt:(NSString *)prompt defaultText:(nullable NSString *)defaultText initiatedByFrame:(WKFrameInfo *)frame completionHandler:(void (^)(NSString * _Nullable result))completionHandler { completionHandler(@"oc对象"); } 那么他就会弹出:“谢谢使用,你输入的是oc对象”。 其实这里我们可以对上面的三个代理方法进行深度定制UI,那么就能按照我们原生的UI显示出来效果。 当我们设置WKWebView的属性allowsLinkPreview为YES的时候,那么我们就可以进行3D touch预览。默认的值是NO。如果我们设置YES,但是: - (BOOL)webView:(WKWebView *)webView shouldPreviewElement:(WKPreviewElementInfo *)elementInfo { return NO; } 此代理方法中返回NO,那么依然无法展示预览视图,因为该代理方法的作用就是决定是否允许加载预览视图。(safari默认是支持3D touch预览的)。而: - (nullable UIViewController *)webView:(WKWebView *)webView previewingViewControllerForElement:(WKPreviewElementInfo *)elementInfo defaultActions:(NSArray<id <WKPreviewActionItem>> *)previewActions { return nil; } 这个方法就是用于我们自己定义预览界面。另外还有: - (void)webViewDidClose:(WKWebView *)webView API_AVAILABLE(macosx(10.11), ios(9.0)); 和 - (void)webView:(WKWebView *)webView commitPreviewingViewController:(UIViewController *)previewingViewController API_AVAILABLE(ios(10.0)); 前者是DOM window成功关闭的时候调用。后者是当用户在预览中执行弹出操作时调用。 四.总结 简单就对WKWebView的代理介绍这么多,在后面如果有其他需要补充的再补充。

优秀的个人博客,低调大师

Android AsyncTask 源码解析

AsyncTask中的几个方法才能完成对任务的定制。经常需要去重写的方法有以下四个: 1.onPreExecute() 这个方法会在后台任务开始执行之间调用,用于进行一些界面上的初始化操作,比如显示一个进度条对话框等。 2.doInBackground(Params...) 这个方法中的所有代码都会在子线程中运行,我们应该在这里去处理所有的耗时任务。任务一旦完成就可以通过return语句来将任务的执行结果进行返回,如果AsyncTask的第三个泛型参数指定的是Void,就可以不返回任务执行结果。注意,在这个方法中是不可以进行UI操作的,如果需要更新UI元素,比如说反馈当前任务的执行进度,可以调用publishProgress(Progress...)方法来完成。 3.onProgressUpdate(Progress...) 当在后台任务中调

优秀的个人博客,低调大师

docker存储结构解析

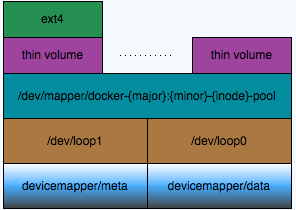
由于aufs并未并入内核,故而目前只有Ubuntu系统上能够使用aufs作为docker的存储引擎,而其他系统上使用lvm thin provisioning(overlayfs是一个和aufs类似的union filesystem,未来有可能进入内核,但目前还没有;Lvm snapshot are useful for doing e.g. backup of a snapshot, but regress badly in performance when you start having many snapshots of the same device.)。为了实现lvm thin provisioning,docker启动时会设置一个100G的sparse文件( /var/lib/docker/devicemapper/devicemapper/data,元数据为/var/lib/docker/devicemapper/devicemapper/metadata),并将其作为devicemapper的存储池,而所有容器都从该存储池中分配默认10G的存储空间使用,如下图所示: 比如创建一个apache容器时devicemapper处理流程如下所示: Create a snapshot of the base device. Mount it and apply the changes in the fedora image. Create a snapshot based on the fedora device. Mount it and apply the changes in the apache image. Create a snapshot based on the apache device. Mount it and use as the root in the new container. thin provisioning管理 使用lvm工具来创建一个thin pool: dd if=/dev/zero of=lvm.img bs=1M count=100 losetup /dev/loop7 lvm.img losetup -a pvcreate /dev/loop7 vgcreate lvm_pool /dev/loop7 # create thin pool lvcreate -L 80M -T lvm_pool/thin_pool # create volume in thin pool lvcreate -T lvm_pool/thin_pool -V 500M -n first_lv docker启动时创建的默认存储池: #dmsetup table docker-253:1-138011042-pool 0 209715200 thin-pool 7:2 7:1 128 32768 1 skip_block_zeroing #209715200*512/1024/1024/1024=100GB 当启动容器后,会从该池中分配10G出来: #dmsetup table docker-253:1-138011042-641cdebd22b55f2656a560cd250e661ab181dcf2f5c5b78dc306df7ce62231f2 0 20971520 thin 253:2 166 # 20971520*512/1024/1024/1024=10GB 该10G存储的分配过程为: dmsetup message /dev/mapper/docker-253:1-138011042-pool 0 "create_thin 166" dmsetup create docker-253:1-138011042-641cdebd22b55f2656a560cd250e661ab181dcf2f5c5b78dc306df7ce62231f3 --table "020971520thin /dev/mapper/docker-253:1-138011042-pool 166" 创建快照: dmsetup suspend /dev/mapper/thin dmsetup message /dev/mapper/yy_thin_pool 0 "create_snap 1 0" dmsetup resume /dev/mapper/thin dmsetup create snap --table "0 40960 thin /dev/mapper/yy_thin_pool 1" docker服务在启动的时候可以配置devicemapper的启动参数,docker -d --storage-opt dm.foo=bar,可选参数有以下几个: dm.basesize 默认为10G,限制容器和镜像的大小 dm.loopdatasize 存储池大小,默认为100G dm.datadev 存储池设备,默认生成一个/var/lib/docker/devicemapper/devicemapper/data文件 dm.loopmetadatasize 元数据大小,默认为2G dm.metadatadev 元数据设备,默认生成一个/var/lib/docker/devicemapper/devicemapper/metadata文件 dm.fs 文件系统,默认ext4 dm.blocksize blocksize默认64K dm.blkdiscard 默认true 最后看看启动一个容器后,该容器的配置是如何组织的。 每个容器创建后都会将其基本配置写入到/var/lib/docker/containers/中: #ls /var/lib/docker/containers/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e -l total 20 -rw------- 1 root root 0 Nov 18 16:31 49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e-json.log -rw-r--r-- 1 root root 1741 Nov 18 16:31 config.json -rw-r--r-- 1 root root 368 Nov 18 16:31 hostconfig.json -rw-r--r-- 1 root root 13 Nov 18 16:31 hostname -rw-r--r-- 1 root root 175 Nov 18 16:31 hosts -rw-r--r-- 1 root root 325 Nov 18 16:31 resolv.conf 分配10G空间后会将容器存储配置写入到以下两个文件中: # cd /var/lib/docker #cat ./devicemapper/metadata/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e-init {"device_id":174,"size":10737418240,"transaction_id":731,"initialized":false} #cat ./devicemapper/metadata/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e {"device_id":175,"size":10737418240,"transaction_id":732,"initialized":false} 而容器的rootfs会mount到/var/lib/docker/devicemapper/mnt/container_id下: #mount | grep 49f1 /dev/mapper/docker-253:1-138011042-49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e on /var/lib/docker/devicemapper/mnt/49f19ee979f6bf125c62779dcabf3bdce310b13d22e5c826752db202e509154e type ext4 (rw,relatime,discard,stripe=16,data=ordered) 本文转自feisky博客园博客,原文链接:http://www.cnblogs.com/feisky/p/4106212.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

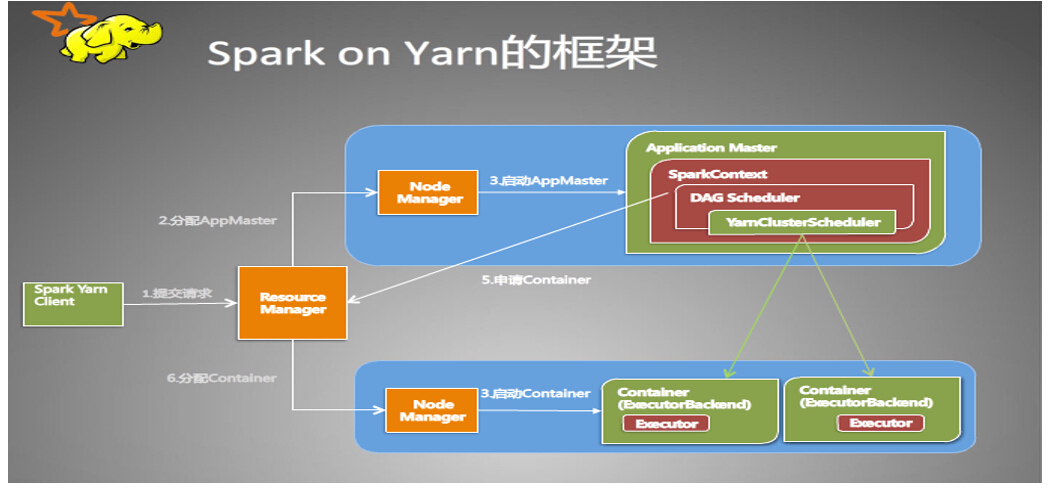
Spark on Yarn 架构解析

。 一、Hadoop Yarn组件介绍: 我们都知道yarn重构根本的思想,是将原有的JobTracker的两个主要功能资源管理器 和 任务调度监控 分离成单独的组件。新的架构使用全局管理所有应用程序的计算资源分配。 主要包含三个组件ResourceManager 、NodeManager和ApplicationMaster以及一个核心概念Container. 1.ResourceManager(RM) 就是所谓的资源管理器,每个集群一个,实现全局的资源管理和任务调度。它可以处理客户端提交计算作业的请求,启动并监听ApplicationMaster,监控NodeManager,进行资源分配与调度。每一个应用程序需要不同类型的资源,因此就需要不同的容器。这里的资源包括内存、CPU、磁盘、网络等。(比如使用spark-submit 执行程序jar包,就需要向ResourceManager注册,申请相应的容器,资源),其中该ResourceManager提供一个调度策略的插件,负责将集群资源分配给多个队列和应用程序.(可以基于现有的能力调度和公平调度模型) 2.NodeManager(NM) 节点管理器,每个节点一个,实现节点的监控与报告。处理来自ResourceManager的命令,也处理来自ApplicationMaster的命令,同时监控资源可用性,报告错误,管理资源的生命周期。NodeManager是每一台机器框架的代理,是执行应用程序的容器,监控应用程序的资源使用情况(CPU、内存、硬盘、网络)并向调度器汇报。 3.ApplicationMaster(AM) 应用控制器,每个作业或应用一个,实现应用的调度和资源协调。具体来说呢,它进行数据的切分,为应用申请资源并分配给任务,完成任务监控与容错。实际上,每个应用的ApplicationMaster是一个详细的框架库。它结合从ResourceManager获得的资源和NodeManager协同工作来运行和监听任务。ApplicationMaster负责向ResourceManager索要适当的资源容器(containter)来运行任务,跟踪应用程序的状态和监控她们的进程,处理任务的失败原因。 4.Container 容器,封装了及其资源,包括内存、CPU、磁盘、网络等。每个任务会被分配一个容器,该任务只能在该容器中执行,并使用该容器封装的资源。当应用程序发出资源请求时,ResourceManager并不会立刻返回满足要求的资源,需要ApplicationMaster与ResourceManager不断地通信,检测分配到的资源足够,才会进行分配。一旦分配完毕,ApplicationMaster便可从ResourceManager处获取以Container表示的资源。(Container可以看做一个可序列化的Java对象,包含字段信息)一般来说,每个Container可用于执行一个任务。ApplicationMaster在收到一个或多个Container后,再将该Container进一步分配给内部的某个任务,确定该任务后,ApplicationMaster将该任务运行环境(包含运行命令、环境变量、依赖的外部文件等)连同Container中的资源信息封装到ContainerLaunchContext对象中,进而与对应的NodeManager通信,启动该任务。 二、Spark on Yarn 1.当提交一个spark-submit任务时,spark将在startUserClass函数专门启动了一个线程(名称为Driver的线程)来启动用户提交的Application,也就是启动了Driver。在Driver中将会初始化SparkContext。 2.等待SparkContext初始化完成,最多等待spark.yarn.applicationMaster.waitTries次数(默认为10),如果等待了的次数超过了配置的,程序将会退出;否则用SparkContext初始化yarnAllocator. 3.当SparkContext、Driver初始化完成的时候,通过ApplicationMasterClient向ResourceManager注册ApplicationMaster. 4.分配并启动Executeors。在启动Executeors之前,先要通过yarnAllocator获取到numExecutors个Container,然后在Container中启动Executeors。(启动Executeors是通过ExecutorRunnable实现的,而ExecutorRunnable内部是启动CoarseGrainedExecutorBackend的) 5.最后,Task将在CoarseGrainedExecutorBackend里面运行,然后运行状况会通过Akka通知CoarseGrainedScheduler,直到作业运行完成。 Spark on Yarn只需要部署一份spark,当应用程序启动时,spark会将相关的jar包上传注册给ResoureManager,任务的执行由ResourceManager来调度,并执行spark的代码。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册