首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

海量数据 "写入、共享、存储、计算" 最佳实践

标签 PostgreSQL , 冷热分离 , 数据共享 , 打破孤岛 , 无盘工作 , 存储计算分离 , 行为数据 , 轨迹数据 , 金融数据 , 监控数据 , 物联网 , GIS , 范围 , 数组 , 图片 背景 数据是为业务服务的,业务方为了更加透彻的掌握业务本身或者使用该业务的群体,往往会收集,或者让应用埋点,收集更多的日志。 随着用户量、用户活跃度的增长,时间的积累等,数据产生的速度越来越快,数据堆积的量越来越大,数据的维度越来越多,数据类型越来越多,数据孤岛也越来越多。 日积月累,给企业IT带来诸多负担,IT成本不断增加,收益确不见得有多高。 上图描绘了企业中可能存在的问题: 1. 数据孤岛问题严重(如果没有大数据平台时)。 2. 对成本预估不足,计算能力扩容麻烦,又或者铺张浪费严重。 3. 数据冗余问题突出。 4. 存储成本昂贵。 5.

优秀的个人博客,低调大师

Android应用性能优化最佳实践导读

前 言 为什么写这本书 一个好的应用,除了要有吸引人的功能和交互之外,在性能上也应该有高的要求,即使应用非常具有特色,或者功能和业务具有唯一性,在产品前期可能吸引了部分用户,但用户体验不好的话,也会给产品带来很差的口碑,如果有在体验上更好的竞品,用户也会很快转移。那么一个好的应用应该如何定义呢?主要有三方面: 业务/功能 符合逻辑的交互 优秀的性能 众所周知,Android系统作为以移动设备为主的一款操作系统,硬件配置有一定的限制,虽然配置现在越来越高级,但仍然无法和PC相比,在CPU和内存上的使用不合理或者耗费资源多时,就会碰到内存不足导致的稳定性问题、CPU消耗太多导致的卡顿问题等。例如,我们发布一款产品后会收到很多的反馈,这些反馈来自很多渠道,有用户反馈,有应用发布平台的反馈通道等。 面对这些问题时,大家想到的都是联系用户,然后看日志,

优秀的个人博客,低调大师

分区索引的应用和实践 - 阿里云RDS PostgreSQL最佳实践

标签 PostgreSQL , partial index , partition index 背景 当表很大时,大家可能会想到分区表的概念,例如用户表,按用户ID哈希或者范围分区,拆成很多表。 又比如行为数据表,可以按时间分区,拆成很多表。 拆表的好处: 1、可以将表放到不同的表空间,表空间和块设备挂钩,例如历史数据访问量低,数据量大,可以放到机械盘所在的表空间。而活跃数据则可以放到SSD对应的表空间。 2、拆表后,方便维护,例如删除历史数据,直接DROP TABLE就可以了,不会产生REDO。 索引实际上也有分区的概念,例如按USER ID HASH分区,按时间分区等。 分区索引的好处与分区表的好处类似。同时还有其他好处: 1、不需要被检索的部分数据,可以不对它建立索引。 例如一张用户表,我们只检索已激活的用户,对于未激活的用户,我们不对它进行检索

优秀的个人博客,低调大师

【最佳实践】实践总结 阿里云Elasticsearch 智能化运维思路

作者:梵寞—阿里云 Elasticsearch 团队高级开发工程师 阿里云 Elasticsearch 作为一个开箱即用的搜索引擎,其丰富的功能和极低的使用门槛吸引着越来越多的公司和用户选择它作为搜索和数据分析的工具。用户在运维 Elasticsearch 集群时往往会遇到很多难题,具体来说有下面列举的几点: 使用方式往往比较粗糙,默认的设置并不适合每一个集群和业务,非精细化的设计将会极大的增加集群隐患; 集群出现问题,无法及时定位原因、寻找解决方案,低效的沟通或者解决问题的方式可能会使得问题变得愈发严重; Elasticsearch 提供的监控指标繁杂,指标多,意义不明确,需要一定的专业知识才可以理解,缺乏全局视角; 此外,集群潜在的异常无法发现,更不能及时规避风险。 随着越来越多的用户选择使用阿里云 Elasticsearch 服务来支持

优秀的个人博客,低调大师

全能 Agent 养成 | 腾讯云 AI Skills 最佳实践

当下,智能体应用正加速渗透到千百行业的业务和流程中,如何拓展更丰富的场景应用成为重要命题。腾讯云将文字识别、语音识别、语音合成、人脸核身、3D生成、智能创作、内容识别等核心 AI 能力,封装为一系列标准化、开箱即用的Skills(技能包),可一键接入WorkBuddy、CodeBuddy、ADP等Agent产品,快速打造从语音交互、文档处理、语音反馈到创意生成、安全认证等多元化的智能体验。

优秀的个人博客,低调大师

Apache Cloudberry 集成 ZomboDB 最佳实践以及中文检索

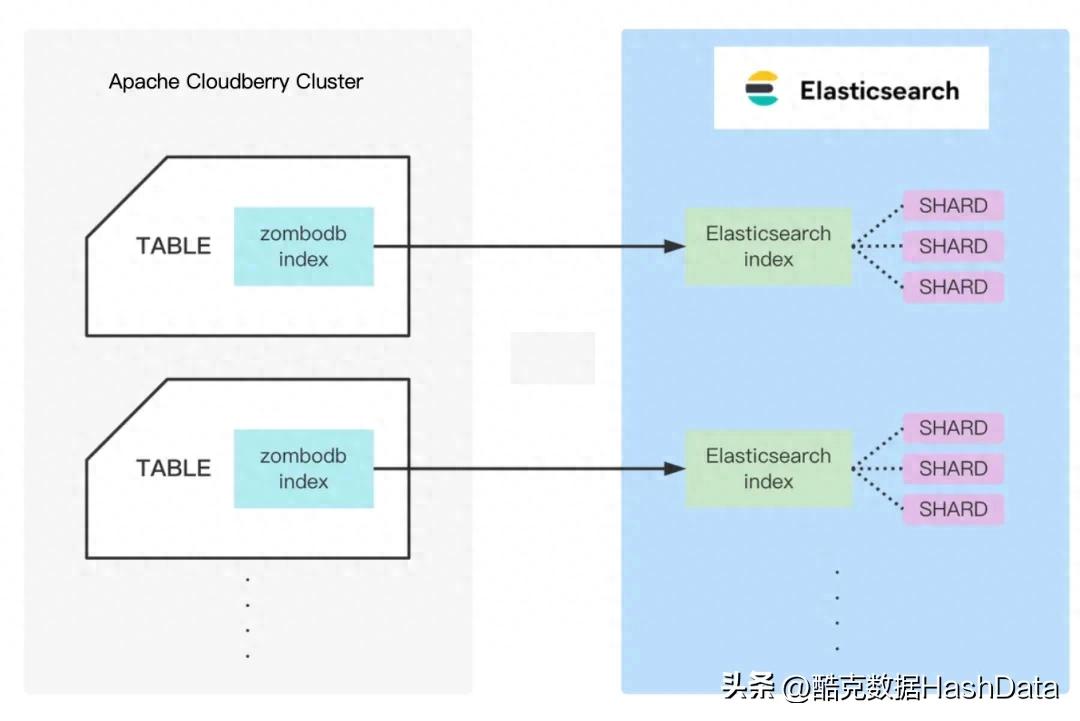
Apache Cloudberry™ (Incubating) 是 Apache 软件基金会孵化项目,由 Greenplum 和 PostgreSQL 衍生而来,作为领先的开源 MPP 数据库,可用于建设企业级数据仓库,并适用于大规模分析和 AI/ML 工作负载。 GitHub: https://github.com/apache/cloudberry 文章作者:陈亮,酷克数据售后工程师;整理:酷克数据 ZomboDB 是 PostgreSQL 的扩展组件,通过与 Elasticsearch 的集成,为数据库系统引入了高性能的全文检索与文本分析功能。我们对 ZomboDB 进行了兼容性改造与优化,使其能够支持Apache Cloudberry,从而让 Cloudberry 拥有 Elasticsearch 丰富的全文检索与文本分析能力。通过简单的 SQL 语法,用户即可在已有的 Cloudberry 表上创建 ZomboDB 索引,实现高性能、可事务化的全文搜索。 ZomboDB 实际上是基于 Elasticsearch 外部索引的实现,它可以管理 Elasticsearch 集群上的索引,并确保在事务层面上保持数据与索引的一致性。 此外,ZomboDB 支持大多数 Cloudberry 的 SQL 操作,包括:CREATE INDEX、COPY、INSERT、UPDATE、DELETE、SELECT、ALTER、DROP、REINDEX、(auto)VACUUM 等。 工作原理 ZomboDB 通过连接 Cloudberry 集群与 Elasticsearch 集群,实现两者的数据同步与检索协作。无论两个集群是否位于同一主机,只需保证网络通信畅通即可正常运行。 Cloudberry 中的每一个 ZomboDB 索引实际上对应 Elasticsearch 中的一个 Index。当数据量较大时,为避免每个 Segment 扫描全量索引数据,ZomboDB 会将不同 Segment 的数据映射到 Elasticsearch 索引下的不同分片(Shard),从而提升并行扫描与查询性能。 创建索引和加载数据流程 下图展示了数据表创建 ZomboDB 索引,并加载数据的大致流程。 整个过程都是在和 Cloudberry集群中的 Coordinator 节点进行通信和交互。 在 Cloudberry集群中创建数据表,并且加载相应的数据。 使用 CREATE INDEX 语法创建 ZomboDB 的索引。此时需要保证 Elasticsearch 的集群处于可用状态,并且网络和 Cloudberry集群互通。 创建的过程中,ZomboDB 会自动将表中已有的数据插入到 Elasticsearch 中对应的 index 里面,如果发生了错误,或者手动回滚事务,那么也会自动清理 ES 中的数据。 在索引创建完成后,后续有新的数据插入到表中,都会自动将数据插入到对应 Elasticsearch 的 index 里。 查询数据流程 下图展示了存在 ZomboDB 索引的情况下,对数据进行查询的大致流程。 用户侧使用 ZomboDB 的查询语法,基于 ZomboDB 的索引进行查询。ZomboDB 的查询和普通的 select 基本上没有区别,只是需要使用 ZomboDB 特定的标识符 ==>。 Cloudberry集群中的 Coordinator 节点将查询分发给各个 Segment。 每个 Segment 各自执行查询,只需要查询对应的 Elasticsearch 的 index 中某个 Shard 的数据。 每个 Segment 将查询的结果返回给 Coordinator 节点。 Coordinator 节点收到 Segment 的结果,进行聚合或者其他操作,并返回给用户。 安装 ZomboDB 插件 注意:当前 ZomboDB 插件尚未开源,此安装方式适用于 HashData Lightning(基于 Apache Cloudberry)版本。 // 通过 psql postgres 进入数据库,创建 zombodb 扩展 postgres=# create extension zombodb; // 出现如下结果表示安装成功 CREATE EXTENSION 安装 Elasticsearch 下载对应平台 elasticserch 安装包 wgethttps://artifacts.elastic.co/downloads/elasticsearch/elasticsearch-8.6.1-x86_64.rpm 安装 elasticsearch yum-y install ./elasticsearch-8.6.1-x86_64.rpm 修改/etc/elasticsearch/elasticsearch.yml,设置 xpack.security.enabled 为 false xpack.security.enabled:false 启动 elasticsearch systemctlstart elasticsearch 安装 elasticsearch-analysis-ik 中文分词插件 注意插件的版本必须与 elasticsearch 版本一致。上面的 elasticsearch 版本是 8.6.1,所以这里插件也要使用同样的版本。 有 2 种安装方式: 自动安装: cd/usr/share/elasticsearch/bin ./bin/elasticsearch-plugin install https://github.com/medcl/elasticsearch-analysis-ik/releases/download/v8.6.1/elasticsearch-analysis-ik-8.6.1.zip 手动安装: 从这个链接下载对应版本的安装包:https://github.com/medcl/elasticsearch-analysis-ik/releases 安装 mkdir/usr/share/elasticsearch/plugins/ik unzip-d/usr/share/elasticsearch/plugins/ik ./elasticsearch-analysis-ik-8.6.1.zip 重启 elasticsearch systemctlrestart elasticsearch Cloudberry 实现中文检索 创建一个名称是'myik'的 analyzer。 SELECTzdb.define_analyzer('myik','{"tokenizer": "ik_max_word"}'); 创建 domain CREATE DOMAIN myik AStext; 创建测试表,注意这里列 c1 的数据类型要对应上面创建的 domain 名称。 create tablezombodb_t1(c1 myik); 创建索引 create index idx_zombodb_t1onzombodb_t1usingzombodb((zombodb_t1.*))with(url='http://localhost:9200/'); 测试效果 gpadmin=#insert intozombodb_t1values('中文测试'); INSERT01 gpadmin=#insert intozombodb_t1values('中 文测试'); INSERT01 gpadmin=#select*fromzombodb_t1wherezombodb_t1==>'中文'; c1 ---------- 中文测试 (1row) gpadmin=#select*fromzombodb_t1wherezombodb_t1==>'中 文'; c1 ----------- 中 文测试 (1row) gpadmin=#select*fromzombodb_t1wherezombodb_t1==>'测试'; c1 ----------- 中文测试 中 文测试 (2rows) 创建 index 报错 在创建 index(例如 create index idx_fulltext_client_extended_info)时,出现了以下错误信息: ERROR: code=Some(429), "error": { "root_cause": [ { "type":"es_rejected_execution_exception", "reason":"rejected execution of coordinating operation [coordinating_and_primary_bytes=...]" } ], "type":"es_rejected_execution_exception", "reason":"rejected execution of coordinating operation [coordinating_and_primary_bytes=...]", "status":429 } 从错误信息可以看出,Elasticsearch 在协调节点执行操作时因为内存压力过大而拒绝了请求( es_rejected_execution_exception),导致索引创建失败。 解决方法: 修改/etc/elasticsearch/elasticsearch.yml, 添加如下参数。如果不指定,这个参数的默认值是 10%的 ES heap 内存大小。 indexing_pressure.memory.limit:8g 重启 elasticsearch systemctlrestart elasticsearch 结语 通过将 ZomboDB 与 Apache Cloudberry 深度集成,用户能够在 MPP 架构下直接使用 Elasticsearch 的全文检索与中文分词能力,实现高性能的结构化与非结构化数据混合查询。这种融合方案不仅扩展了 Cloudberry 的应用边界,也为日志分析、智能检索、文本挖掘等场景提供了开源可行的新路径。 未来,随着社区的发展与多语言分词支持的增强,Cloudberry + ZomboDB + Elasticsearch 的组合将成为构建智能数据仓库与搜索分析平台的重要技术基石。

优秀的个人博客,低调大师

Gitee Repo 联邦仓库能力展示及最佳实践

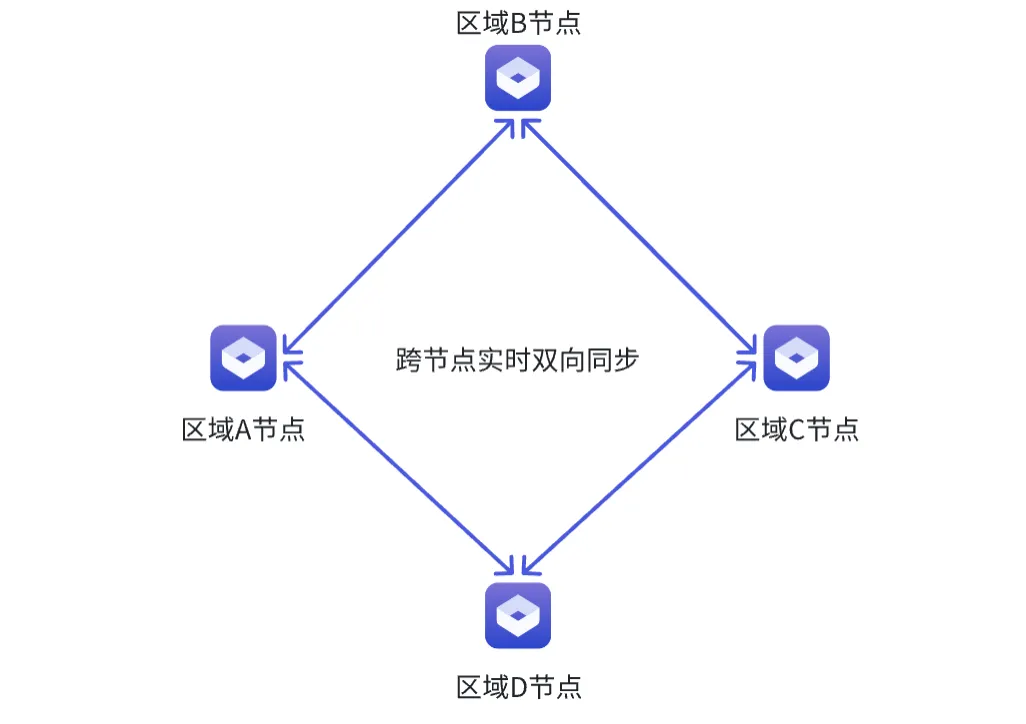
在数字化研发与生产中,团队分布在不同地区,团队间往往会共同协作,开发、测试到最终交付制品的软件研发流程中,经常需要把制品向不同地区的团队流转。 我们希望让不同地域、不同团队的开发、测试流程更顺畅,制品交付更高效,但这也带来了新问题:怎么让制品在向不同地区同步时,既够快(实时)、又没遗漏(完整),还能清楚看到同步的情况(过程监控)呢? Gitee Repo 联邦仓库完美解决这些问题,联邦仓库作为新型制品存储方案,通过「联合」多独立仓库,以实时双向同步能力破解这些痛点,在企业跨地域及跨团队的软件开发及制品流转场景下,更好的完成各地域各团队协同开发、测试及制品交付过程,提升协同效率与业务连续性的关键能力。 核心能力:重新定义仓库协同逻辑 什么是联邦仓库? 联邦仓库并非单一仓库,而是能将多个独立仓库「串联」起来的协同系统。其核心是跨节点实时双向同步,既保留每个仓库的独立使用权限,又能让所有成员仓库的数据实时一致,彻底打破传统仓库的区域隔绝问题。 在仓库组成联邦仓库后,对任意一个成员仓库内制品进行的制品变更以及属性变更,都将实时同步至其他成员仓库,以确保所有成员数据一致性。 联邦仓库通过同步技术连接多个独立仓库,实现数据实时互通 联邦仓库与仓库的同步能力有什么区别? 目前Gitee Repo已支持四种类型的仓库: 本地仓库支持推送式单向同步,可以实现预生产-->准生产跨节点发版制品同步 远程仓库支持拉取式单向同步,可以用于 DMZ 隔离区-->研发网依赖同步 虚拟仓库无同步能力,在实际使用场景中用于聚合多个仓库,对用户提供统一地址的仓库服务 以上的三种类型仓库均无法实现多个节点之间的双向同步,无法满足用户对于仓库之间制品双向流转的诉求,基于此 Gitee Repo 率先支持联邦仓库,通过动态同步技术,实现了数据的无缝流通。 具体差异如下表所示: 三大技术优势 保障高效协同 实时双向同步:任一仓库的变更(如发布新制品、修改属性),会以事件形式近乎实时同步到所有联邦节点,无需人工干预。 数据一致性保障:通过动态校验机制,实时核对各节点制品数据,确保所有仓库的数据完全一致,避免版本混乱。 分布式架构:无需依赖中心化节点,每个联邦节点均可独立运行,大幅降低单点故障风险,提升系统稳定性。 核心应用场景:解决企业实际业务难题 多地域共同研发:让跨区域协作「零延迟」 许多企业的研发团队分布在不同城市甚至国家,传统模式下,无有效的仓库体系进行支撑,各区域团队获取彼此的制品需手动传输,不仅效率低,还易出现版本偏差。 通过联邦仓库,各区域仓库可实时共享制品,为多地域协同研发提供有效的实时双向同步能力: 区域 A 发布的新组件,区域 B、C、D 能立即获取,无需重复开发。 任一区域修改制品属性,其他区域同步更新,确保研发进度一致。 最终可减少 30%-50% 的协同沟通成本,显著提升研发效率。 区域 A、B、C、D 通过联邦仓库实现制品双向同步,各区域研发团队实时获取最新制品 生产灾备仓库:分钟级切换,保障业务不中断 生产系统的稳定性至关重要,传统灾备方案需独立搭建系统,成本高且数据同步滞后,故障时切换往往需要数小时,易造成业务中断。 联邦仓库作为灾备方案时,具备三大核心价值: 业务连续性:主仓库故障时,灾备仓库可实现分钟级切换,直接接管业务,避免生产中断。 数据零丢失:主仓库的所有制品变更实时同步至灾备仓库,故障期间灾备仓库的修改也会反向同步,确保数据完全一致。 成本优化:无需单独搭建灾备系统,复用现有仓库资源,降低硬件与运维成本 20%-30% 甚至更高。 正常场景下,生产主节点提供服务并同步数据至灾备节点;异常场景下,灾备节点接管服务并在主节点恢复后同步变更数据 企业实际应用案例:协同研发&灾备能力双提升 某跨国科技企业:跨洲研发协同效率提升 45% 该企业在新加坡、青岛、北京均设有研发中心,此前各中心依赖手动传输制品,当制品较大时,无法准确、及时获取到制品,版本不一致问题频发。部署联邦仓库后: 各中心仓库实时同步制品,工程师可直接获取全球最新组件,避免重复开发。 版本冲突率从 30% 降至 5%,研发沟通成本减少 40%。 新品研发周期大大缩短,协同效率整体提升 45%。 某全国性商业银行:灾备切换时间从 1 小时缩至 5 分钟 该银行内部此前采用传统灾备方案,主仓库故障时需人工切换,曾因切换耗时 1 小时导致订单损失。引入联邦仓库后: 主备仓库实时同步数据,故障时自动触发切换,耗时仅 5 分钟。 近一年经历 1 次主仓库异常,均未造成业务中断,订单损失降至 0。 灾备系统运维成本减少 25%,硬件资源利用率提升 30%。 实施价值:哪些企业应该使用联邦仓库? 企业部署的核心收益 协同效率提升:跨区域协同效率提升30%-50%,缩短研发周期。 灾备响应提升:灾备响应时间从小时级压缩至分钟级,降低业务中断风险。 维护成本降低:总体 IT 运维成本降低20%-30%,减少资源浪费。 最适合的企业类型 全球化研发企业:如科技、高端制造企业,需要多区域团队协同开发,且对跨地域制品共享需求迫切。 关键领域企业:如金融、电商、能源企业,对业务连续性要求极高,需可靠的灾备方案保障系统稳定。 高实时性需求组织:如大型集团、跨国公司,需要跨区域数据实时同步,避免信息差影响决策与业务推进。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。


用户登录
用户注册