首页 文章 精选 留言 我的

精选列表

搜索[AIOps最佳实践],共10000篇文章
优秀的个人博客,低调大师

分布式锁实现原理与最佳实践

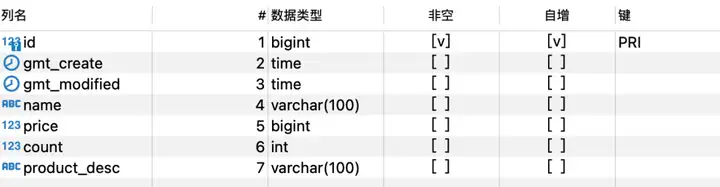
一、超卖问题复现 1.1 现象 存在如下的几张表: 商品表 订单表 订单item表 商品的库存为1,但是并发高的时候有多笔订单。 错误案例一:数据库update相互覆盖 直接在内存中判断是否有库存,计算扣减之后的值更新数据库,并发的情况下会导致相互覆盖发生: @Transactional(rollbackFor = Exception.class) public Long createOrder() throws Exception { Product product = productMapper.selectByPrimaryKey(purchaseProductId); // ... 忽略校验逻辑 //商品当前库存 Integer currentCount = product.getCount(); //校验库存 if (purchaseProductNum > currentCount) { throw new Exception("商品" + purchaseProductId + "仅剩" + currentCount + "件,无法购买"); } // 计算剩余库存 Integer leftCount = currentCount - purchaseProductNum; // 更新库存 product.setCount(leftCount); product.setGmtModified(new Date()); productMapper.updateByPrimaryKeySelective(product); Order order = new Order(); // ... 省略 Set orderMapper.insertSelective(order); OrderItem orderItem = new OrderItem(); orderItem.setOrderId(order.getId()); // ... 省略 Set return order.getId(); } 错误案例二:扣减串行执行,但是库存被扣减为负数 在 SQL 中加入运算避免值的相互覆盖,但是库存的数量变为负数,因为校验库存是否足够还是在内存中执行的,并发情况下都会读到有库存: @Transactional(rollbackFor = Exception.class) public Long createOrder() throws Exception { Product product = productMapper.selectByPrimaryKey(purchaseProductId); // ... 忽略校验逻辑 //商品当前库存 Integer currentCount = product.getCount(); //校验库存 if (purchaseProductNum > currentCount) { throw new Exception("商品" + purchaseProductId + "仅剩" + currentCount + "件,无法购买"); } // 使用 set count = count - #{purchaseProductNum,jdbcType=INTEGER}, 更新库存 productMapper.updateProductCount(purchaseProductNum,new Date(),product.getId()); Order order = new Order(); // ... 省略 Set orderMapper.insertSelective(order); OrderItem orderItem = new OrderItem(); orderItem.setOrderId(order.getId()); // ... 省略 Set return order.getId(); } 错误案例三:使用 synchronized 实现内存中串行校验,但是依旧扣减为负数 因为我们使用的是事务的注解,synchronized加在方法上,方法执行结束的时候锁就会释放,此时的事务还没有提交,另一个线程拿到这把锁之后就会有一次扣减,导致负数。 @Transactional(rollbackFor = Exception.class) public synchronized Long createOrder() throws Exception { Product product = productMapper.selectByPrimaryKey(purchaseProductId); // ... 忽略校验逻辑 //商品当前库存 Integer currentCount = product.getCount(); //校验库存 if (purchaseProductNum > currentCount) { throw new Exception("商品" + purchaseProductId + "仅剩" + currentCount + "件,无法购买"); } // 使用 set count = count - #{purchaseProductNum,jdbcType=INTEGER}, 更新库存 productMapper.updateProductCount(purchaseProductNum,new Date(),product.getId()); Order order = new Order(); // ... 省略 Set orderMapper.insertSelective(order); OrderItem orderItem = new OrderItem(); orderItem.setOrderId(order.getId()); // ... 省略 Set return order.getId(); } 1.2 解决办法 从上面造成问题的原因来看,只要是扣减库存的动作,不是原子性的。多个线程同时操作就会有问题。 单体应用:使用本地锁 + 数据库中的行锁解决 分布式应用: 使用数据库中的乐观锁,加一个 version 字段,利用CAS来实现,会导致大量的 update 失败 使用数据库维护一张锁的表 + 悲观锁 select,使用 select for update 实现 使用Redis 的 setNX实现分布式锁 使用zookeeper的watcher + 有序临时节点来实现可阻塞的分布式锁 使用Redisson框架内的分布式锁来实现 使用curator 框架内的分布式锁来实现 二、单体应用解决超卖的问题 正确示例:将事务包含在锁的控制范围内 保证在锁释放之前,事务已经提交。 //@Transactional(rollbackFor = Exception.class) public synchronized Long createOrder() throws Exception { TransactionStatus transaction1 = platformTransactionManager.getTransaction(transactionDefinition); Product product = productMapper.selectByPrimaryKey(purchaseProductId); if (product == null) { platformTransactionManager.rollback(transaction1); throw new Exception("购买商品:" + purchaseProductId + "不存在"); } //商品当前库存 Integer currentCount = product.getCount(); //校验库存 if (purchaseProductNum > currentCount) { platformTransactionManager.rollback(transaction1); throw new Exception("商品" + purchaseProductId + "仅剩" + currentCount + "件,无法购买"); } productMapper.updateProductCount(purchaseProductNum, new Date(), product.getId()); Order order = new Order(); // ... 省略 Set orderMapper.insertSelective(order); OrderItem orderItem = new OrderItem(); orderItem.setOrderId(order.getId()); // ... 省略 Set return order.getId(); platformTransactionManager.commit(transaction1); } 正确示例:使用synchronized的代码块 public Long createOrder() throws Exception { Product product = null; //synchronized (this) { //synchronized (object) { synchronized (DBOrderService2.class) { TransactionStatus transaction1 = platformTransactionManager.getTransaction(transactionDefinition); product = productMapper.selectByPrimaryKey(purchaseProductId); if (product == null) { platformTransactionManager.rollback(transaction1); throw new Exception("购买商品:" + purchaseProductId + "不存在"); } //商品当前库存 Integer currentCount = product.getCount(); System.out.println(Thread.currentThread().getName() + "库存数:" + currentCount); //校验库存 if (purchaseProductNum > currentCount) { platformTransactionManager.rollback(transaction1); throw new Exception("商品" + purchaseProductId + "仅剩" + currentCount + "件,无法购买"); } productMapper.updateProductCount(purchaseProductNum, new Date(), product.getId()); platformTransactionManager.commit(transaction1); } TransactionStatus transaction2 = platformTransactionManager.getTransaction(transactionDefinition); Order order = new Order(); // ... 省略 Set orderMapper.insertSelective(order); OrderItem orderItem = new OrderItem(); // ... 省略 Set orderItemMapper.insertSelective(orderItem); platformTransactionManager.commit(transaction2); return order.getId(); 正确示例:使用Lock private Lock lock = new ReentrantLock(); public Long createOrder() throws Exception{ Product product = null; lock.lock(); TransactionStatus transaction1 = platformTransactionManager.getTransaction(transactionDefinition); try { product = productMapper.selectByPrimaryKey(purchaseProductId); if (product==null){ throw new Exception("购买商品:"+purchaseProductId+"不存在"); } //商品当前库存 Integer currentCount = product.getCount(); System.out.println(Thread.currentThread().getName()+"库存数:"+currentCount); //校验库存 if (purchaseProductNum > currentCount){ throw new Exception("商品"+purchaseProductId+"仅剩"+currentCount+"件,无法购买"); } productMapper.updateProductCount(purchaseProductNum,new Date(),product.getId()); platformTransactionManager.commit(transaction1); } catch (Exception e) { platformTransactionManager.rollback(transaction1); } finally { // 注意抛异常的时候锁释放不掉,分布式锁也一样,都要在这里删掉 lock.unlock(); } TransactionStatus transaction = platformTransactionManager.getTransaction(transactionDefinition); Order order = new Order(); // ... 省略 Set orderMapper.insertSelective(order); OrderItem orderItem = new OrderItem(); // ... 省略 Set orderItemMapper.insertSelective(orderItem); platformTransactionManager.commit(transaction); return order.getId(); } 三、常见分布式锁的使用 上面使用的方法只能解决单体项目,当部署多台机器的时候就会失效,因为锁本身就是单机的锁,所以需要使用分布式锁来实现。 3.1 数据库乐观锁 数据库中的乐观锁,加一个version字段,利用CAS来实现,乐观锁的方式支持多台机器并发安全。但是并发量大的时候会导致大量的update失败 3.2 数据库分布式锁 db操作性能较差,并且有锁表的风险,一般不考虑。 3.2.1 简单的数据库锁 select for update 直接在数据库新建一张表: 锁的code预先写到数据库中,抢锁的时候,使用select for update查询锁对应的key,也就是这里的code,阻塞就说明别人在使用锁。 // 加上事务就是为了 for update 的锁可以一直生效到事务执行结束 // 默认回滚的是 RunTimeException @Transactional(rollbackFor = Exception.class) public String singleLock() throws Exception { log.info("我进入了方法!"); DistributeLock distributeLock = distributeLockMapper. selectDistributeLock("demo"); if (distributeLock==null) { throw new Exception("分布式锁找不到"); } log.info("我进入了锁!"); try { Thread.sleep(1000); } catch (InterruptedException e) { e.printStackTrace(); } return "我已经执行完成!"; } <select id="selectDistributeLock" resultType="com.deltaqin.distribute.model.DistributeLock"> select * from distribute_lock where businessCode = #{businessCode,jdbcType=VARCHAR} for update </select> 使用唯一键作为限制,插入一条数据,其他待执行的SQL就会失败,当数据删除之后再去获取锁 ,这是利用了唯一索引的排他性。 insert lock 直接维护一张锁表: @Autowired private MethodlockMapper methodlockMapper; @Override public boolean tryLock() { try { //插入一条数据 insert into methodlockMapper.insert(new Methodlock("lock")); }catch (Exception e){ //插入失败 return false; } return true; } @Override public void waitLock() { try { Thread.sleep(10); } catch (InterruptedException e) { e.printStackTrace(); } } @Override public void unlock() { //删除数据 delete methodlockMapper.deleteByMethodlock("lock"); System.out.println("-------释放锁------"); } 3.3 Redis setNx Redis 原生支持的,保证只有一个会话可以设置成功,因为Redis自己就是单线程串行执行的。 <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> spring.redis.host=localhost 封装一个锁对象: @Slf4j public class RedisLock implements AutoCloseable { private RedisTemplate redisTemplate; private String key; private String value; //单位:秒 private int expireTime; /** * 没有传递 value,因为直接使用的是随机值 */ public RedisLock(RedisTemplate redisTemplate,String key,int expireTime){ this.redisTemplate = redisTemplate; this.key = key; this.expireTime=expireTime; this.value = UUID.randomUUID().toString(); } /** * JDK 1.7 之后的自动关闭的功能 */ @Override public void close() throws Exception { unLock(); } /** * 获取分布式锁 * SET resource_name my_random_value NX PX 30000 * 每一个线程对应的随机值 my_random_value 不一样,用于释放锁的时候校验 * NX 表示 key 不存在的时候成功,key 存在的时候设置不成功,Redis 自己是单线程,串行执行的,第一个执行的才可以设置成功 * PX 表示过期时间,没有设置的话,忘记删除,就会永远不过期 */ public boolean getLock(){ RedisCallback<Boolean> redisCallback = connection -> { //设置NX RedisStringCommands.SetOption setOption = RedisStringCommands.SetOption.ifAbsent(); //设置过期时间 Expiration expiration = Expiration.seconds(expireTime); //序列化key byte[] redisKey = redisTemplate.getKeySerializer().serialize(key); //序列化value byte[] redisValue = redisTemplate.getValueSerializer().serialize(value); //执行setnx操作 Boolean result = connection.set(redisKey, redisValue, expiration, setOption); return result; }; //获取分布式锁 Boolean lock = (Boolean)redisTemplate.execute(redisCallback); return lock; } /** * 释放锁的时候随机数相同的时候才可以释放,避免释放了别人设置的锁(自己的已经过期了所以别人才可以设置成功) * 释放的时候采用 LUA 脚本,因为 delete 没有原生支持删除的时候校验值,证明是当前线程设置进去的值 * 脚本是在官方文档里面有的 */ public boolean unLock() { // key 是自己才可以释放,不是就不能释放别人的锁 String script = "if redis.call(\"get\",KEYS[1]) == ARGV[1] then\n" + " return redis.call(\"del\",KEYS[1])\n" + "else\n" + " return 0\n" + "end"; RedisScript<Boolean> redisScript = RedisScript.of(script,Boolean.class); List<String> keys = Arrays.asList(key); // 执行脚本的时候传递的 value 就是对应的值 Boolean result = (Boolean)redisTemplate.execute(redisScript, keys, value); log.info("释放锁的结果:"+result); return result; } } 每次获取的时候,自己线程需要new对应的RedisLock: public String redisLock(){ log.info("我进入了方法!"); try (RedisLock redisLock = new RedisLock(redisTemplate,"redisKey",30)){ if (redisLock.getLock()) { log.info("我进入了锁!!"); Thread.sleep(15000); } } catch (InterruptedException e) { e.printStackTrace(); } catch (Exception e) { e.printStackTrace(); } log.info("方法执行完成"); return "方法执行完成"; } 3.4 zookeeper 瞬时znode节点 + watcher监听机制 临时节点具备数据自动删除的功能。当client与ZooKeeper连接和session断掉时,相应的临时节点就会被删除。zk有瞬时和持久节点,瞬时节点不可以有子节点。会话结束之后瞬时节点就会消失,基于zk的瞬时有序节点实现分布式锁: 多线程并发创建瞬时节点的时候,得到有序的序列,序号最小的线程可以获得锁; 其他的线程监听自己序号的前一个序号。前一个线程执行结束之后删除自己序号的节点; 下一个序号的线程得到通知,继续执行; 以此类推,创建节点的时候,就确认了线程执行的顺序。 <dependency> <groupId>org.apache.zookeeper</groupId> <artifactId>zookeeper</artifactId> <version>3.4.14</version> <exclusions> <exclusion> <groupId>org.slf4j</groupId> <artifactId>slf4j-log4j12</artifactId> </exclusion> </exclusions> </dependency> zk 的观察器只可以监控一次,数据发生变化之后可以发送给客户端,之后需要再次设置监控。exists、create、getChildren三个方法都可以添加watcher ,也就是在调用方法的时候传递true就是添加监听。注意这里Lock 实现了Watcher和AutoCloseable: 当前线程创建的节点是第一个节点就获得锁,否则就监听自己的前一个节点的事件: /** * 自己本身就是一个 watcher,可以得到通知 * AutoCloseable 实现自动关闭,资源不使用的时候 */ @Slf4j public class ZkLock implements AutoCloseable, Watcher { private ZooKeeper zooKeeper; /** * 记录当前锁的名字 */ private String znode; public ZkLock() throws IOException { this.zooKeeper = new ZooKeeper("localhost:2181", 10000,this); } public boolean getLock(String businessCode) { try { //创建业务 根节点 Stat stat = zooKeeper.exists("/" + businessCode, false); if (stat==null){ zooKeeper.create("/" + businessCode,businessCode.getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.PERSISTENT); } //创建瞬时有序节点 /order/order_00000001 znode = zooKeeper.create("/" + businessCode + "/" + businessCode + "_", businessCode.getBytes(), ZooDefs.Ids.OPEN_ACL_UNSAFE, CreateMode.EPHEMERAL_SEQUENTIAL); //获取业务节点下 所有的子节点 List<String> childrenNodes = zooKeeper.getChildren("/" + businessCode, false); //获取序号最小的(第一个)子节点 Collections.sort(childrenNodes); String firstNode = childrenNodes.get(0); //如果创建的节点是第一个子节点,则获得锁 if (znode.endsWith(firstNode)){ return true; } //如果不是第一个子节点,则监听前一个节点 String lastNode = firstNode; for (String node:childrenNodes){ if (znode.endsWith(node)){ zooKeeper.exists("/"+businessCode+"/"+lastNode,true); break; }else { lastNode = node; } } synchronized (this){ wait(); } return true; } catch (Exception e) { e.printStackTrace(); } return false; } @Override public void close() throws Exception { zooKeeper.delete(znode,-1); zooKeeper.close(); log.info("我已经释放了锁!"); } @Override public void process(WatchedEvent event) { if (event.getType() == Event.EventType.NodeDeleted){ synchronized (this){ notify(); } } } } 3.5 zookeeper curator 在实际的开发中,不建议去自己“重复造轮子”,而建议直接使用Curator客户端中的各种官方实现的分布式锁,例如其中的InterProcessMutex可重入锁。 <dependency> <groupId>org.apache.curator</groupId> <artifactId>curator-recipes</artifactId> <version>4.2.0</version> <exclusions> <exclusion> <artifactId>slf4j-api</artifactId> <groupId>org.slf4j</groupId> </exclusion> </exclusions> </dependency> @Bean(initMethod="start",destroyMethod = "close") public CuratorFramework getCuratorFramework() { RetryPolicy retryPolicy = new ExponentialBackoffRetry(1000, 3); CuratorFramework client = CuratorFrameworkFactory. newClient("localhost:2181", retryPolicy); return client; } 框架已经实现了分布式锁。zk的Java客户端升级版。使用的时候直接指定重试的策略就可以。 官网中分布式锁的实现是在curator-recipes依赖中,不要引用错了。 @Autowired private CuratorFramework client; @Test public void testCuratorLock(){ InterProcessMutex lock = new InterProcessMutex(client, "/order"); try { if ( lock.acquire(30, TimeUnit.SECONDS) ) { try { log.info("我获得了锁!!!"); } finally { lock.release(); } } } catch (Exception e) { e.printStackTrace(); } client.close(); } 3.6 Redission 重新实现了Java并发包下处理并发的类,让其可以跨JVM使用,例如CHM等。 3.6.1 非SpringBoot项目引入 https://redisson.org/ 引入Redisson的依赖,然后配置对应的XML即可: <dependency> <groupId>org.redisson</groupId> <artifactId>redisson</artifactId> <version>3.11.2</version> <exclusions> <exclusion> <artifactId>slf4j-api</artifactId> <groupId>org.slf4j</groupId> </exclusion> </exclusions> </dependency> 编写相应的redisson.xml <beans xmlns="http://www.springframework.org/schema/beans" xmlns:xsi="http://www.w3.org/2001/XMLSchema-instance" xmlns:context="http://www.springframework.org/schema/context" xmlns:redisson="http://redisson.org/schema/redisson" xsi:schemaLocation=" http://www.springframework.org/schema/beans http://www.springframework.org/schema/beans/spring-beans.xsd http://www.springframework.org/schema/context http://www.springframework.org/schema/context/spring-context.xsd http://redisson.org/schema/redisson http://redisson.org/schema/redisson/redisson.xsd "> <redisson:client> <redisson:single-server address="redis://127.0.0.1:6379"/> </redisson:client> </beans> 配置对应@ImportResource("classpath*:redisson.xml")资源文件。 3.6.2 SpringBoot项目引入 或者直接使用springBoot的starter即可。 https://github.com/redisson/redisson/tree/master/redisson-spring-boot-starter <dependency> <groupId>org.redisson</groupId> <artifactId>redisson-spring-boot-starter</artifactId> <version>3.19.1</version> </dependency> 修改application.properties即可:#spring.redis.host= 3.6.3 设置配置类 @Bean public RedissonClient getRedissonClient() { Config config = new Config(); config.useSingleServer().setAddress("redis://127.0.0.1:6379"); return Redisson.create(config); } 3.6.4 使用 @Test public void testRedissonLock() { RLock rLock = redisson.getLock("order"); try { rLock.lock(30, TimeUnit.SECONDS); log.info("我获得了锁!!!"); Thread.sleep(10000); } catch (InterruptedException e) { e.printStackTrace(); }finally { log.info("我释放了锁!!"); rLock.unlock(); } } 3.7 Etcd 参考以下文章,普通项目不会为了一把锁引入etcd,此处不再赘述:https://time.geekbang.org/column/article/350285 四、常见分布式锁的原理 4.1 Redisson Redis 2.6之后才可以执行lua脚本,比起管道而言,这是原子性的,模拟一个商品减库存的原子操作: //lua脚本命令执行方式:redis-cli --eval /tmp/test.lua , 10 jedis.set("product_stock_10016", "15"); //初始化商品10016的库存 String script = " local count = redis.call('get', KEYS[1]) " + " local a = tonumber(count) " + " local b = tonumber(ARGV[1]) " + " if a >= b then " + " redis.call('set', KEYS[1], a-b) " + " return 1 " + " end " + " return 0 "; Object obj = jedis.eval(script, Arrays.asList("product_stock_10016"), Arrays.asList("10")); System.out.println(obj); 4.1.1 尝试加锁的逻辑 上面的org.redisson.RedissonLock#lock()通过调用自己方法内部的lock方法的org.redisson.RedissonLock#tryAcquire方法。之后调用org.redisson.RedissonLock#tryAcquireAsync: 首先调用内部的org.redisson.RedissonLock#tryLockInnerAsync:设置对应的分布式锁 到这里获取锁的逻辑就结束了,如果这里没有获取到,在Future的回调里面就会直接return,会在外层有一个while true的循环,订阅释放锁的消息准备被唤醒。如果说加锁成功,就开始执行锁续命逻辑。 4.1.2 锁续命逻辑 lua脚本最后是以毫秒为单位返回key的剩余过期时间。成功加锁之后org.redisson.RedissonLock#scheduleExpirationRenewal中将会调用org.redisson.RedissonLock#renewExpiration,这个方法内部就有锁续命的逻辑,是一个定时任务,等10s执行。 执行的时候尝试执行的续命逻辑使用的是Lua脚本,当前的锁有值,就续命,没有就直接返回0: 返回0之后外层会判断,延时成功就会再次调用自己,否则延时调用结束,不再为当前的锁续命。所以这里的续命不是一个真正的定时,而是循环调用自己的延时任务。 4.1.3 循环间隔抢锁机制 如果一开始就加锁成功就直接返回。 如果一开始加锁失败,没抢到锁的线程就会在while循环中尝试加锁,加锁成功就结束循环,否则等待当前锁的超时时间之后再次尝试加锁。所以实现逻辑默认是非公平锁: 里面有一个subscribe的逻辑,会监听对应加锁的key,当锁释放之后publish对应的消息,此时如果没有到达对应的锁的超时时间,也会尝试获取锁,避免时间浪费。 4.1.4 释放锁和唤醒其他线程的逻辑 前面没有抢到锁的线程会监听对应的queue,后面抢到锁的线程释放锁的时候会发送一个消息。 订阅的时候指定收到消息时候的逻辑:会唤醒阻塞之后执行while循环 4.1.5 重入锁的逻辑 存在对应的锁,就对对应的hash结构的value直接+1,和Java重入锁的逻辑是一致的。 4.2 RedLock解决非单体项目的Redis主从架构的锁失效 https://redis.io/docs/manual/patterns/distributed-locks/ 查看Redis官方文档,对于单节点的Redis ,使用setnx和lua del删除分布式锁是足够的,但是主从架构的场景下:锁先加在一个master节点上,默认是异步同步到从节点,此时master挂了会选择slave为master,此时又可以加锁,就会导致超卖。但是如果使用zookeeper来实现的话,由于zk是CP的,所以CP不存在这样的问题。 Redis文档中给出了RedLock的解决办法,使用redLock真的可以解决吗? 4.2.1 RedLock 原理 基于客户端的实现,是基于多个独立的Redis Master节点的一种实现(一般为5)。client依次向各个节点申请锁,若能从多数个节点中申请锁成功并满足一些条件限制,那么client就能获取锁成功。它通过独立的N个Master节点,避免了使用主备异步复制协议的缺陷,只要多数Redis节点正常就能正常工作,显著提升了分布式锁的安全性、可用性。 注意图中所有的节点都是master节点。加锁超过半数成功,就认为是成功。具体流程: 获取锁 获取当前时间T1,作为后续的计时依据; 按顺序地,依次向5个独立的节点来尝试获取锁 SET resource_name my_random_value NX PX 30000; 计算获取锁总共花了多少时间,判断获取锁成功与否; 时间:T2-T1; 多数节点的锁(N/2+1); 当获取锁成功后的有效时间,要从初始的时间减去第三步算出来的消耗时间; 如果没能获取锁成功,尽快释放掉锁。 释放锁 向所有节点发起释放锁的操作,不管这些节点有没有成功设置过。 public String redlock() { String lockKey = "product_001"; //这里需要自己实例化不同redis实例的redisson客户端连接,这里只是伪代码用一个redisson客户端简化了 RLock lock1 = redisson.getLock(lockKey); RLock lock2 = redisson.getLock(lockKey); RLock lock3 = redisson.getLock(lockKey); /** * 根据多个 RLock 对象构建 RedissonRedLock (最核心的差别就在这里) */ RedissonRedLock redLock = new RedissonRedLock(lock1, lock2, lock3); try { /** * waitTimeout 尝试获取锁的最大等待时间,超过这个值,则认为获取锁失败 * leaseTime 锁的持有时间,超过这个时间锁会自动失效(值应设置为大于业务处理的时间,确保在锁有效期内业务能处理完) */ boolean res = redLock.tryLock(10, 30, TimeUnit.SECONDS); if (res) { //成功获得锁,在这里处理业务 } } catch (Exception e) { throw new RuntimeException("lock fail"); } finally { //无论如何, 最后都要解锁 redLock.unlock(); } return "end"; } 但是,它的实现建立在一个不安全的系统模型上的,它依赖系统时间,当时钟发生跳跃时,也可能会出现安全性问题。分布式存储专家Martin对RedLock的分析文章,Redis作者的也专门写了一篇文章进行了反驳。 Martin Kleppmann:How to do distributed locking https://martin.kleppmann.com/2016/02/08/how-to-do-distributed-locking.html Antirez:Is Redlock safe? http://antirez.com/news/101 4.2.2 RedLock 问题一:持久化机制导致重复加锁 如果是上面的架构图,一般生产都不会配置AOF的每一条命令都落磁盘,一般会设置一些间隔时间,比如1s,如果ABC节点加锁成功,有一个节点C恰好是在1s内加锁,还没有落盘,此时挂了,就会导致其他客户端通过CDE又会加锁成功。 4.2.3 RedLock 问题二:主从下重复加锁 除非多部署一些节点,但是这样会导致加锁时间变长,这样比较下来效果就不如zk了。 4.2.4 RedLock 问题三:时钟跳跃导致重复加锁 C节点发生了时钟跳跃,导致加上的锁没有到达实际的超时时间,就被误以为超时而释放,此时其他客户端就可以重复加锁了。4.3 Curator InterProcessMutex 可重入锁的分析 五、业务中使用分布式锁的注意点 获取的锁要设置有效期,假设我们未设置key自动过期时间,在Set key value NX 后,如果程序crash或者发生网络分区后无法与Redis节点通信,毫无疑问其他 client 将永远无法获得锁,这将导致死锁,服务出现中断。 SETNX和EXPIRE命令去设置key和过期时间,这也是不正确的,因为你无法保证SETNX和EXPIRE命令的原子性。 自己使用 setnx 实现Redis锁的时候,注意并发情况下不要释放掉别人的锁(业务逻辑执行时间超过锁的过期时间),导致恶性循环。一般: 1)加锁的时候需要指定value的内容是当前进程中的当前线程的唯一标记,不要使用线程ID作为当前线程的锁的标记,因为不同实例上的线程ID可能是一样的。 2)释放锁的逻辑会写在finally ,释放锁时候要判断锁对应的value,而且要使用lua脚本实现原子 del 操作。因为if逻辑判断完之后也可能失效导致删除别人的锁。 3)针对扣减库存这个逻辑,lua脚本里面实现Redis比较库存、扣减库存操作的原子性。通过判断Redis Decr命令的返回值即可。此命令会返回扣减后的最新库存,若小于0则表示超卖。 5.1 自己实现分布式锁的坑 setnx不关心锁的顺序导致删除别人的锁 锁失效之后,别人加锁成功,自己把别人的锁删了。 我们无法预估程序执行需要的锁的时间。 public String deductStock() { String lockKey = "lock:product_101"; Boolean result = stringRedisTemplate.opsForValue().setIfAbsent(lockKey, "deltaqin"); stringRedisTemplate.expire(lockKey, 10, TimeUnit.SECONDS); try { int stock = Integer.parseInt(stringRedisTemplate.opsForValue().get("stock")); // jedis.get("stock") if (stock > 0) { int realStock = stock - 1; stringRedisTemplate.opsForValue().set("stock", realStock + ""); // jedis.set(key,value) System.out.println("扣减成功,剩余库存:" + realStock); } else { System.out.println("扣减失败,库存不足"); } } finally { stringRedisTemplate.delete(lockKey); } return "end"; } setnx关心锁的顺序还是删除了别人的锁 并发会卡在各种地方,卡住的时候过期了,就会删掉别人加的锁: 错误的原因还是因为解锁的逻辑不是原子性的,这里可以参考Redisson的解锁逻辑使用lua脚本实现。 public String deductStock() { String lockKey = "lock:product_101"; String clientId = UUID.randomUUID().toString(); Boolean result = stringRedisTemplate.opsForValue().setIfAbsent(lockKey, clientId, 30, TimeUnit.SECONDS); //jedis.setnx(k,v) if (!result) { return "error_code"; } try { int stock = Integer.parseInt(stringRedisTemplate.opsForValue().get("stock")); // jedis.get("stock") if (stock > 0) { int realStock = stock - 1; stringRedisTemplate.opsForValue().set("stock", realStock + ""); // jedis.set(key,value) System.out.println("扣减成功,剩余库存:" + realStock); } else { System.out.println("扣减失败,库存不足"); } } finally { if (clientId.equals(stringRedisTemplate.opsForValue().get(lockKey))) { // 卡在这里,锁过期了,其他线程又可以加锁,此时又把其他线程新加的锁删掉了 stringRedisTemplate.delete(lockKey); } } return "end"; } 解决办法 这种问题解决的办法就是使用锁续命,比如使用一个定时任务间隔小于锁的超时时间,每隔一段时间就给锁续命,除非线程自己主动删除。这也是Redisson的实现思路。 5.2 锁优化:分段加锁逻辑 针对一个商品,要开启秒杀的时候,会将商品的库存预先加载到Redis缓存中,比如有100个库存,此时可以分为5个key,每一个key有20个库存。可以把分布式锁的性能提升5倍。例如: product_10111_stock = 100 product_10111_stock1 = 20 product_10111_stock2 = 20 product_10111_stock3 = 20 product_10111_stock4 = 20 product_10111_stock5 = 20 请求来了可以随机可以轮询,扣减完之后就标记不要下次再分配到这个库存。 六、分布式锁的真相与选择 6.1 分布式锁的真相 需要满足的几个特性 互斥:不同线程、进程互斥。 超时机制:临界区代码耗时导致,网络原因导致。可以使用额外的线程续命保证。 完备的锁接口:阻塞的和非阻塞的接口都要有,lock和tryLock。 可重入性:当前请求的节点+ 线程唯一标识。 公平性:锁唤醒时候,按照顺序唤醒。 正确性:进程内的锁不会因为报错死锁,因为崩溃的时候整个进程都会结束。但是多实例部署时死锁就很容易发生,如果粗暴使用超时机制解决死锁问题,就默认了下面这个假设: 锁的超时时间 >> 获取锁的时延 + 执行临界区代码的时间 + 各种进程的暂停(比如 GC) 但上述假设其实无法保证的。 将分布式锁定位为,可以容忍非常小概率互斥语义失效场景下的锁服务。一般来说,一个分布式锁服务,它的正确性要求越高,性能可能就会越低。 6.2 分布式锁的选择 数据库:db操作性能较差,并且有锁表的风险,一般不考虑。 优点:实现简单、易于理解 缺点:对数据库压力大 Redis:适用于并发量很大、性能要求很高而可靠性问题可以通过其他方案去弥补的场景。 优点:易于理解 缺点:自己实现、不支持阻塞 Redisson:相对于Jedis其实更多用在分布式的场景。 优点:提供锁的方法,可阻塞 Zookeeper:适用于高可靠(高可用),而并发量不是太高的场景。 优点:支持阻塞 缺点:需理解Zookeeper、程序复杂 Curator 优点:提供锁的方法 缺点:Zookeeper,强一致,慢 Etcd:安全和可靠性上有保证,但是比较重。 不推荐自己编写的分布式锁,推荐使用Redisson和Curator实现的分布式锁。 作者 | 秦泽涛 原文链接 本文为阿里云原创内容,未经允许不得转载。

优秀的个人博客,低调大师

PieCloudDB Database 云上商业智能的最佳实践

「商业智能(Business Intelligence,BI)」这个概念最早是 Gartner 在上个世纪九十年代提出的,它认为从功能上来说,商业智能是一种解决方案,其关键是处理企业来自多个来源的各种数据,提取有用的数据并清理,然后经过抽取(Extraction)、转换(Transformation)和加载(Load),即 ETL 过程,合并到一个企业级的数据仓库里,按照一定的建模方式组织数据,再利用合适的商业智能工具来形成各种可视化的分析报表,将数据转化为洞察(Insight),为管理者的决策提供支持。 对于企业而言,打造一套完善的商业智能解决方案,可以让业务需求更贴合真实数据,让商业决策更加理性和“智能”。决策者接收到的直接结果大多数是数据可视化后的分析报表,「数据可视化(Data Visualization)」作为商业智能的一个重要特征,可以通过交互式数据仪表板、图表、图形和映射的方式来呈现企业故事,使展示结果更易于理解和共享,为决策者提供更多的洞察,这都是传统的报告和分发工具所无法企及的。虽然前端可视化分析最为直观,但它仅仅是商业智能的一个环节,底层数据库的建设才是基石。PieCloudDB Database 作为一款云原生数据库产品,搭建了底层业务系统数据源和可视化分析报表之间的桥梁,在整个商业智能解决方案中起到了承上启下的核心作用。 PieCloudDB Database 兼容 PostgreSQL 协议,支持 ODBC、JDBC 等标准数据库接口。对 SQL 的全面支持使得 PieCloudDB Database 可以无缝集成业内常见的 ETL 和 BI 工具;而对多种过程语言(Procedural Language)的支持为用户基于数据库的二次开发提供了便利。的本文将借助一个商业智能场景,介绍如何使用 Python 编程语言和 BI 工具 Tableau 连接 PieCloudDB Database ,从而形成以下完整的商业智能解决方案: 确定数据来源 数据采集 数据入库 数据清洗 探索性数据分析 数据建模 数据洞察 商业智能场景介绍 随着今年初对新冠疫情防控政策的重大调整,旅游行业逐渐开始回温,在这种趋势下,如何提升景点品质、提高商业竞争力成为了摆在景区规划人员面前的问题。在这种场景下,基于我们的解决方案结构,可以对某旅游网站的中文评论进行内容分析,充分发挥文本数据的作用,从而为旅游行业的规划升级提供决策帮助。本文会侧重介绍解决方案中所涉及的 PieCloudDB Database 外部连接方式,后续的文章则会重点介绍该场景下的数据分析过程。 使用 Python 访问 PieCloudDB Database PieCloudDB Database 完全兼容 PostgreSQL 的客户端协议,所以我们可以使用 PostgreSQL 驱动访问 PieCloudDB Database。同时 psycopg 是一种用于执行 SQL 语句的 Python API,可以为 PostgreSQL 数据库访问接口,所以我们可以利用 psycopg 模块连接 PieCloudDB Database。大家可以参考以下步骤进行操作: # 安装 psycopg 模块 pip install psycopg2 # 导入 psycopg 模块 import psycopg2 # 连接到 PieCloudDB Database conn = psycopg2.connect(database='openpie', user='username', password='token', host='127.0.0.1', port='5432') # 参数信息: # Ÿ database – 数据库名 #Ÿ user – 数据库用户名 #Ÿ password – 数据库接入 token 即密码 #Ÿ host – 数据库IP地址 #Ÿ port – 端口号 # 创建指针对象 cur = conn.cursor() # 执行 SQL 语句 cursor.execute(sql) # 提交执行结果 conn.commit() # 关闭指针和数据库连接 cursor.close() conn.close() 使用 Tableau 连接 PieCloudDB Database 市场上常见的 BI 工具有很多,从软件成熟度和市场接受度考量,我们使用 Tableau 进行探索性数据分析。经过测试,我们可以从 Tableau Desktop 使用 PostgreSQL 驱动访问 PieCloudDB Database。大家可以参考以下步骤进行操作: · 选择连接方式 选择左侧“连接”窗格 > 到服务器 > 更多... > PostgreSQL 由于 Tableau 的要求,在连接操作之前,用户需要从 https://jdbc.postgresql.org/download/ 下载和安装 PostgreSQL 所需的驱动程序,然后将相关的 .jar 文件复制到以下文件夹中(可能需要手动创建该文件夹):~/Library/Tableau/Drivers ,详细步骤请参考 Tableau 官网。 · 填写连接信息 根据提示,填写需要连接的数据库IP地址、端口号、数据库名、用户名和密码即可。 在整个商业智能解决方案中,我们会借助 Python 丰富的数据科学工具进行数据采集、数据清洗和数据建模,并通过 Tableau 强大的可视化分析功能进行探索性数据分析、形成动态化看板。如果大家对中文文本分析这个主题感兴趣,想了解详细的数据建模过程和完整的商业智能场景流程,请持续关注我们的后续技术博文。

优秀的个人博客,低调大师

最佳实践:使用阿里云CDN加速OSS访问

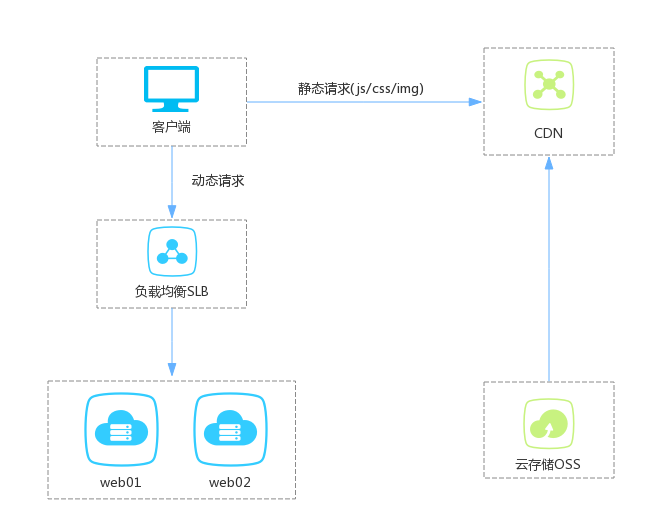
阿里云内容分发网络(Content Delivery Network,简称CDN)是建立并覆盖在承载网之上,由分布在不同区域的边缘节点服务器群组成的分布式网络。阿里云CDN分担源站压力,避免网络拥塞,确保在不同区域、不同场景下加速网站内容的分发,提高资源访问速度。阿里云CDN将源站资源缓存至阿里云遍布全球的加速节点上,当终端用户请求访问和获取该资源时,无需回源,系统自动调用离终端用户最近的CDN节点上已缓存的资源。 阿里云对象存储(Object Storage Service,简称OSS)是阿里云提供的海量、安全、低成本、高可靠的云存储服务,其数据设计持久性不低于99.9999999999%(12个9),服务可用性(或业务连续性)不低于99.995%。企业客户通过阿里云提供的API、SDK接口或者OSS迁移工具轻松地将海量数据移入或移出阿里云OSS,同时可选择标准存储(Standard)作为移动应用、大型网站、图片分享或热点音视频的主要存储方式,也可以选择成本更低、存储期限更长的低频访问存储(Infrequent Access)、归档存储(Archive)作为不经常访问数据的存储方式。 为什么要使用CDN+OSS架构? 传统网站架构下,动态资源和静态资源不分离,随着访问量的增长,性能会成为瓶颈,如下图所示: 用户直接访问OSS资源,访问速度会受到OSS的下行带宽以及Bucket地域的限制。如果通过CDN来访问OSS资源,带宽上限更高,并且可以将OSS的资源缓存至就近的CDN节点,通过CDN节点进行分发,访问速度更快,且费用更低。如果采用动静分离的网站架构,就能够解决海量用户访问的性能瓶颈问题,如下图所示: 该架构的要点如下: 将动态资源如Web程序、数据库等存放在云服务器ECS上。将静态资源如图片、音视频、静态脚本等存放在对象存储OSS上。将OSS作为CDN的源站,通过CDN加速分发,使用户通过CDN节点就近获得文件。 CDN+OSS架构有什么优势? 降低了Web服务器负载——OSS的资源缓存至就近的CDN节点,通过CDN节点进行分发,缩短了网络传输距离,加快了用户的调用速度。支持海量存储——OSS的存储空间弹性无限扩展,您无需考虑存储架构升级。降低了存储费用和流量费用——使用该架构会产生OSS的存储费用、CDN的下行流量费用,以及极少量的回源流量费用。 CDN+OSS的应用场景 在线教育 播放流畅无卡顿:支撑高峰期海量并发,稳定高效的性能:95%+命中率,毫秒级响应时间图片/视频处理:OSS丰富的图片处理与媒体处理的能力,可以帮助客户降低开发成本。OSS支持在线教育客户直接通过RTMP视频推流方式将视频流推到OSS,无需额外的文件类型转换工具。安全性:解决盗链危害,保障课程安全成本优化:阿里云CDN回源OSS按照“回源流量”收费,较常规的下行流量费最高便宜70%。 网站/APP/小程序 访问效率提升:CDN通过全球2800+节点及智能调度系统,让用户可以就近访问海量静态资源。无缝迁移:提供无缝迁移工具让业务快速上云,从而免除了高昂的迁移成本和接入成本丰富图片处理能力:OSS提供图片裁剪、旋转、水印、视频截帧等,客户无需额外的开发成本。成本降低:下行流量费用远低于享带宽费用,有效解决源站带宽压力 行业音视频 CDN保证性能:95%+命中率,毫秒级响应时间,结合弹性伸缩服务,及时调整服务器带宽,应对突发访问流量OSS可靠性:强大的技术保障提供11个9的数据写入可靠性保障,与阿里云CDN和视频转码无缝结合降本增效:下行流量费用远低于独享带宽费用,有效解决源站带宽压力 游戏/APP下载 稳定高效:支持各类文件的下载、分发及在线点播加速业务(如MP4、FLV 视频或者平均单个文件大小在20M以上文件),主要用于视音频点播、大文件下载时成本降低:搭配OSS接入CDN加速,节约近2/3回源带宽成本一键加速:针对存储在OSS上的游戏的动态业务加速,使用OSS传输加速功能,只需修改OSS域名,即可一键加速 如何进一步提升网站加速效率? 阿里云还推出全站加速DCDN产品,融合了动态加速和静态加速的CDN产品,可以一站式应对页面动静态资源混杂、跨运营商、网络不稳定、单线源站、突发流量、网络拥塞等一系列因素,优化和解决访问响应慢、丢包、服务不稳定等问题,从而提升整个网站应用的性能和用户体验。 全站加速的核心原理主要分了两大块,一个是节点层,一个是一个控制层,节点层可以类比在SDWAN中的数据面,而路由决策则是控制面,其中整个传输网络的建立是通过探测和路由计算来完成的。边缘节点则保证了用户最后一公里用可以最快速的接入,优化建联和握手的时间。 当请求进入网络中之后,边缘节点跟内部的整张大网、源站之间,通过探测去实时的发现整个网络当中最优的链路,基于这个探测数据结果,通过路由算法和基础数据的分析和决策,最终会在整个网络里面去高效迭代出最优的传输链路,当链路遭遇流量汇聚的情况,链路选择也会实现流量和质量等多重因素之下的平衡。 点击了解更多阿里云CDN+OSS组合,使用更划算

优秀的个人博客,低调大师

MaxCompute/Dataworks云数仓高可用最佳实践

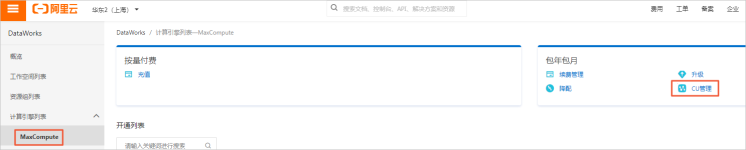
学习工具通过MaxCompute官方文档和DataWorks官方文档了解相关产品的最新功能和使用方式MaxCompute官方文档:MaxCompute官方文档DataWorks官方文档:DataWorks官方文档一、logview排查作业在日常的开发过程中我们偶尔会发现某些任务突然耗时比较长,或者某些任务突然挂掉需要排查原因。Logview将用来协助我们完成这件事情。Logview是MaxCompute Job提交后查看和Debug任务的工具。通过Logview可看到一个Job的运行状态、运行结果以及运行细节和每个步骤的进度。当Job提交到MaxCompute后,会生成Logview的链接,用户可以直接在浏览器上打开Logview链接,进入查看Job的信息,而对于Logview上的诸多参数信息,究竟应该怎么发现问题所在呢?又如何通过Logview了解每个instance、task运行状态及资源占用情况,如何分析执行计划,分析query存在问题。下面主要介绍如何去使用Logview。1、Logview参数详解主要的信息包括ODPS Instance,其涵盖了队列信息以及子状态信息,另外一部分包括Fuxi Job,这可以进一步拆解成Task信息和Fuxi Instance信息。在整个任务结束之后可以看到其Summary以及Diagnosis诊断信息,此外还有上传下载的小功能。(1)ODPS Instance信息ODPS Instance中有这样的几个字段:URL、Project、InstanceID、Owner、StartTime、EndTime、Latency、Status以及Process等。URL是Endpoint的地址,Project存放项目的名称,InstanceID其实是时间戳跟着随机字符串,这个时间戳是精确到毫秒的,而这个时间是UTC时间,与电脑提交任务的时间是不一致的。StartTime和EndTime分别是任务开始和结束的时间,Latency则是任务运行所消耗的时间。而对于Status而言,则有四种状态:Waiting状态代表任务正在ODPS中处理,还没提交到Fuxi中运行;Waiting List代表任务已经到了Fuxi,并且在Fuxi中排队,N代表排队的位置;Running代表在Fuxi中运行;Terminated代表运行已经结束了。在表格里面,只要Status不是Terminated的状态,只要双击就能打开Queue Detail和SubStatus History详细信息。(2)Queue Detail&SubStatus History信息Queue Detail&SubStatus History最上面的Table是关于队列的信息,首先是Fuxi Job的name,SubStatus则是目前Job的运行状态,Progress是目前的执行进度。红框里面有两个字段,分别是WaitPOS和QueueLength,前者是目前排队的位置,后者是队列长度,根据这两个字段就能看到整个队列里面有多少任务在排队,这个任务排在第几位。Total Priority是其优先级,点击SubStatus History的图标可以打开下图中下侧的Table。对于SubStatus History而言着重介绍一下SubStatus Code以及其含义,在下图中列出了一些常见的SubStatus Code以及其对应含义。(3)ODPS Task信息ODPS Task信息,上面的表格的第一个字段是TaskName,Type指的是作业类型,Status指的是运行状态,双击Rusult会输出作业的整个结果集,双击Detail信息则会打开整个Fuxi Job的详细Table。(4)Fuxi Job Detail信息Fuxi Job详细信息主要分为三个部分,最左侧是任务的执行计划,这个执行计划是在Executor里面生成的,执行计划就是将一个任务分成不同的Stage来执行,每个Stage的都可以看做一个图上的点,而Stage之间的依赖关系就可以看做图的边,这样就构成一个有向无环图。(5)Fuxi Task Detail信息对于Fuxi Job Detail信息而言,又有哪些需要关注呢?第一个字段就是TaskName,其和执行计划的生成是相关的。后面的字段Fatal/Finished/TotalInstCount,在表格里面Fatal表示严重错误个数,因此被标红了;Finished表示已经结束的Instance的个数,后面的TotalInstCount指的是为每个Task启动的总Task数量。下一个字段I/O Records指的是输入和输出的记录的个数,I/O Bytes指的是输入和输出的字节数。FinishedPercentage指的是进度条,Status则指的是每个Task的运行状态。(6)Fuxi Instance Detail信息Fuxi Instance是整个作业流中最小的颗粒,其左侧的Terminated、Running、Ready以及Failed分别是相应状态的实例个数。而SmartFilter则会给出最早结束、最晚结束、运行时间最短和运行时间最长的四个Instance,将其筛选处理方便观察。Latency Chart则是以图表的形式展示所有的Instance的运行时长分布,而在Latency里面则是最长运行时间和最短运行时间以及平均运行时长,其实这三个时间对于分析长尾任务是非常有用的。在每个Instance的表格里面详细信息里面有一个StdOut,这是每个Instance在执行过程中打印的信息,而StuErr则是当Instance失败的时候可以用来查看出错原因的。(7)Fuxi Job Detail信息 之 Summary信息FuxiJob的Summary是在整个Job运行完之后才能查看的信息,主要包括Job消耗的CPU、内存、Job输入的表名以及记录数和字节数。此外,Job的运行时间单位是秒。Fuxi Task的Summary信息则主要包括Instance数量、Task运行时间、所有Instance里面的最大、最小和平均运行时间。2、Logview排查问题 (1)任务出错对于出错任务而言,从控制台输出就可以看到出错的原因,如果想要查看更加详细的信息,则可以打开Logview去查看ODPS的Result信息,如果失败了可以看到Status变成红色了。当双击Result之后就可以看到报错输出的整体信息。在出错信息里面会有错误码,而错误码与详细错误的对照表可以在官网找到。所以查看出错任务的方式有两种,一种是在作业结束之后查看其Result信息,另外一种方式则是去查看Instance的StdErr信息。**(2)慢作业诊断a、作业排队**对于慢任务诊断而言,可能看到一种现象就是作业一直在排队或者在控制台看到Fuxi Job一直在Waiting。进一步在Logview里面查看,发现Status到底是Waiting还是Waiting List,这样就可以发现其到底在哪里排队,如果状态是Waiting List则可以进一步地看其详细队列长度到底是多少,排到了第几位。还可以在SubStatus里面看到其子状态的信息。对于慢任务而言,如果不能够知道到底是哪一个作业是慢任务,可以采取两种方法:一种是“show p”,可以查看所有示例信息;而“top instance”可以查看当前正在执行的作业,而运行时间最长的作业可能就是阻塞队列导致其他任务排队的任务。对于由于资源抢占所导致的问题,可以做如下的优化:• 对于后付费用户而言,可以根据作业特性把相对稳定的周期性常规任务放到预付费资源组去执行,可以保证资源不被抢占。• 对于预付费用户而言,如果并行执行多个作业,最好合理安排作业执行时间,让作业错峰执行,临时任务则建议在后付费资源组执行。b、大量小文件大量小文件的存在也会导致任务执行很慢,比如在作业开始执行的时候,执行计划图中当Reduce的Task执行之后,发现系统自动增加一个MergeTask,这就是因为系统在做合并小文件的操作。其实,分布式文件系统的数据文件是按照块来存储的,盘古的块大小就是64M,所以如果文件小于64M就可以称为小文件。小文件的产生主要有这样的3种原因:(1)当Reduce计算过程中会产生大量小文件;(2)Tunnel数据采集过程中会生成小文件;(2)Job执行过程中生成的各种临时文件、回收站保留的过期文件等。而因为小文件过多,就会导致在Map阶段读取的数据出现分布不均匀的情况,进而引起长尾。如果存在大量的小文件,除了会浪费资源并降低磁盘空间利用率之外,还会影响整体的执行性能,因此从存储和性能两方面考虑都需要将计算过程中的小文件都合并。其实MaxCompute系统已经做了很多的优化,系统会自动分配一个Fuxi的MergeTask来做小文件的合并,但是其实还有很多情况下产生的小文件没有被合并。因此,MaxCompute提供了一些参数帮助用户进行小文件的合并。c、合并小文件首先可以查看小文件的数量,也就是判断自己的表里面是否存在很多小文件。可以用“desc extended TableName”命令就可以输出小文件数量。如果小文件数量很多就可以通过如图中下面的SQL来整合小文件。ALTER TABLE tablename [PARTITION] MERGE SMALLFILES;d、如何避免小文件产生为了避免小文件的操作,可以给出一些相关建议。比如在Reduce过程中产生的小文件建议可以使用insert overwrite向原表写入数据,或者把数据写入新表之后,将原表删除。其次,为了避免在Tunnel的数据采集过程中产生小文件,可以调用Tunnel SDK。也就是在上传数据的时候最好等到Buffer达到64M的时候再进行提交,不要过于频繁地进行提交。在导入分区表的时候建议为表设置生命周期,对于过期的数据可以进行自动清理。而针对大量临时表的情况,也可以加上生命周期,到期之后进行自动回收。(3)数据倾斜导致长尾任务数据倾斜导致长尾任务也会导致慢作业。其实数据倾斜就是因为数据分布不均匀,少数的Fuxi Instance处理的数据量远远超过其他的Instance,因此导致长尾任务。在MaxCompute的Logview里面,将鼠标放在Longtails标签上面就可以看到提示“Latency is more than twice average”,也就是说运行时间超过平均的两倍,就将其定义为长尾任务。如何判断任务是否长尾通过Logview有两种方式查看其是否属于长尾任务,第一种方法就是查看Long-Tails的Fuxi Instances的Max Lantency。如果括号里面的数量大于0,那就说明已经出现了长尾,点击标签之后就会将所有长尾Instance列出来,并且可以查看其各种信息。另外一种查看长尾任务的方法就是查看Fuxi Job的Summary信息以及Diagnosis信息,通过分析Summary可以查看长尾分布在哪个阶段。如果instance time的max和avg两个值相差很大就说明出现了长尾;而对于input records而言,如果输入数据量的max和avg相差也很大就说明发生了数据倾斜。在Diagnosis信息里面专门有一项是检查数据倾斜和长尾的,所以通过系统所给出的信息就能够查看出是否出现了长尾还是数据倾斜,也同时给出了一些改进意见。二、MaxCompute CU管家MaxCompute管家为系统运维人员提供作业、存储资源查询、配额组设置等功能。使用MaxCompute管家前,您需要购买MaxCompute包年包月CU资源。1、进入MaxCompute管家执行如下步骤进入MaxCompute管家。(1)登录DataWorks控制台。(2)单击左侧导航栏计算引擎列表 > MaxCompute,进入 计算引擎列表-MaxCompute页面,并选择您所在的Region。(3)单击包年包月区域的CU管理,进入MaxCompute管家页面。 2、概览概览页面可以按照不同的配额组和时间段查看当前使用CU、总CU、当前存储量、CU资源使用趋势、存储使用趋势。配额组:指定需要查看的配额组信息。默认为空,表示查看全部配额组。您可以在配额组后选择需要查询的时间段,默认为最近24小时。当前使用CU:指定配额组下全部的项目在搜索截止时刻的CU资源使用量。总CU:配额组为空时(即选择所有配额组):总CU=(搜索截止时刻的订单预留CU)+(搜索截止时刻的订单非预留CU)。配额组非空时(即指定单个配额组):总CU=(搜索截止时刻的指定配额组预留CU最大配额)+(搜索截止时刻的指定配额组非预留CU最大配额)。当前存储量:指定配额组下全部的项目在搜索截止时刻的存储使用量。申请CU趋势:指定配额组下的全部项目在搜索时段内作业计划申请的CU资源量(包括预留CU资源和非预留CU资源)。已用CU趋势:指定配额组下的全部项目在搜索时段内作业实际使用的CU资源量(包括预留CU资源和非预留CU资源)。总CU趋势:指定配额组在搜索时间段内总CU资源的使用量(包括预留CU资源和非预留CU资源)。存储大小趋势:指定配额组下的全部项目在搜索时间段内存储使用量。3、查看作业运行情况作业运行情况每2分钟采集一次。(1)单击左侧导航栏上的作业,进入作业快照页面。(2)选择需要查询的配额组以及时间段,查看选择时间段内当前配额组下所有作业情况。支持查看历史作业快照。(3)在概览页面,单击CU资源使用趋势图上的任意一点可跳转至该时刻下指定配额组对应全部项目内的作业历史快照。(4)终止作业,对于没有必要继续运行的作业,主账号可以单个或批量终止提交的作业。批量终止作业时,一次不能超过10个。在包年包月作业列表页面,单击作业列表上方的终止作业,在终止作业页面,输入将要终止作业对应instance Id列表和备注信息。4、查看作业快照操作记录MaxCompute管家支持查看作业快照操作的记录,目前最多保存7天的操作记录。单击左侧导航栏作业。单击作业快照操作记录页签,查看作业快照操作记录。5、查看存储资源消耗您可以通过包年包月项目列表页面,了解存储的消耗情况。 存储量每1个小时采集一次。(1)单击左侧导航栏上的项目,进入包年包月项目列表页面,列表中会显示项目的已用存储量。您也可以通过右上角的筛选器筛选配额组查看存储量。(2)单击指定项目名称,查看项目某段时间的存储水位。(3)选择查看的时间段。单击时间下拉框,选择开始时间和结束时间后,单击OK。6、查看CU资源消耗您可以通过包年包月配额组列表页面,查看CU资源消耗。 计算资源CU每2分钟采集1次。(1)单击左侧导航栏上的配额,进入包年包月配额组列表页面。(2)单击指定的资源组名称,查看资源消耗情况。(3)选择查看的时间段。单击时间下拉框,选择开始时间和结束时间后,单击OK。7、配额组设置您可以在包年包月配额组列表页面,进行相关配额组设置,例如,新建配额组、修改和删除配额组。8、修改项目配额组支持将项目当前指定的配额组修改为其它配额组,新建的配额组即可通过该功能进行资源隔离。(1)单击项目,进入包年包月项目列表页面。(2)选择需要修改配额组的项目名称,单击其后的修改,进入修改配额组信息页面。(3)在Quota名称的下拉框中,选择配额组。(4)单击执行,完成修改。9、注意事项CU过小无法发挥计算资源及管家的优势。如果禁用主账号的AccessKey,会导致相应的子账号无法使用MaxCompute管家。三、数据备份和恢复日常开发过程中会存在误删表数据这个时候应该怎么去恢复呢?MaxCompute提供数据备份与恢复功能(目前处于公测阶段),系统会自动备份数据的历史版本(例如被删除或修改前的数据)并保留一定时间,您可以对保留周期内的数据进行快速恢复,避免因误操作丢失数据。1、数据备份相关命令查看所有表的备份数据:show history for tables;查看指定表的备份数据:show history for table ;查看已删除表的备份数据:show history for table table_name ('id'='xxxx');查看分区表的备份数据:show history for table table_name ('id'='xxxx');查看分区的备份数据:show history for table table_name partition_spec;或show history for table table_name PARTITION('id'='xxxx');2、数据恢复相关命令恢复已删除的表:restore table table_name ('id'='xxxxx'); 如果存在同名的表,您需要将同名的表重命名后才能执行恢复操作。恢复表至指定版本:restore table table_name to LSN 'xxxx';恢复表至指定版本,并命名为新表或将数据更新到不同名的表中:restore table table_name to LSN 'xxxx' as new_table_name;恢复分区表:restore table table_name ('id'='xxxxx');恢复分区:restore table table_name PARTITION('id'='xxxx')[PARTITION('id'='xxxx')];恢复分区至指定版本,并命名为新表:restore table table_name partition_spec1[partition_spec2 ]to LSN 'xxxx' as new_table_name;**四、类型转换1、支持的数据类型**当前Maxompute一共支持3个数据类型版本。1.0数据类型版本、2.0数据类型版本和Hive兼容数据类型。MaxCompute设置数据类型版本属性的参数共有3个:odps.sql.type.system.odps2:MaxCompute 2.0数据类型版本的开关,属性值为True或False。odps.sql.decimal.odps2:MaxCompute 2.0的Decimal数据类型的开关,属性值为True或False。odps.sql.hive.compatible:MaxCompute Hive兼容模式(即部分数据类型和SQL行为兼容Hive)数据类型版本的开关,属性值为True或False。在新增项目时MaxCompute可以对3个版本的数据类型进行选择。当我们开启2.0数据类型版本需要注意以下问题:• 部分隐式类型转换会被禁用。例如,STRING->BIGINT、STRING->DATETIME、DOUBLE->BIGINT、DECIMAL->DOUBLE、DECIMAL->BIGINT有精度损失或者报错的风险。禁用类型可以通过CAST函数强制进行数据类型转换。• VARCHAR类型常量可以通过隐式转换为STRING常量。2、谨慎修改类型flag根据以往客户经验,有客户任务每天都是正常执行的。突然某一天凌晨任务失败,导致依赖作业都在等待。排查发现是有账号需改了数据类型的flag,导致部分数据类型转换失败任务报错。所以在日常的开发过程中需要谨慎设置数据类型的fla。以免造成任务报错。五、权限控制日常开发中MaxCompute的项目空间所有者(Project Owner)或安全管理员需要对项目空间进行日常安全运维和数据安全保障,如何去合理的控制权限是一个非常关键的环节。权限控制包括MaxCompute安全模型,DataWorks的安全模型。当通过DataWorks使用MaxCompute,而DataWorks的安全模型不满足业务安全需求时,需要合理地将两个安全模型结合使用。1、MaxCompute和DataWorks权限关系通过MaxCompute的安全模型进行权限控制,并不会影响成员在DataWorks界面上的操作。但是通过DataWorks的用户角色分配,则有可能影响成员的MaxCompute资源权限。可以参考这个文档:https://help.aliyun.com/document_detail/105012.html?spm=a2c4g.11186623.6.913.3a7c713fH2gG3k2、MaxCompute管理员Admin一个企业使用多款阿里云产品,MaxCompute是其中一个产品,用的是同个主账号,主账号不是由使用MaxCompute的大数据同学管理,大数据同学使用的是子账号。大数据同学日常需要给MaxCompute项目 操作新增子账号(add user),新的子账号授权(grant xx on project/table)等操作,即日常权限管理。 但是MaxCompute项目权限管理默认只有owner可以操作,而MaxCompute项目的owner只能是主账号。当我们使用子账号开通MaxCompute并创建项目,项目的owner依然是对应的主账号。DataWorks中,子账号拥有项目空间的“项目管理员”或“安全管理员”角色,都只是拥有对应DataWorks的操作权限,并不能操作MaxCompute 项目的权限管理。所以需要指定一个子账号作为大数据MaxCompute的权限管理账号,让主账号给该子账号授admin role--如主账号是bob@aliyun.com,作为日常权限管理的子账号是Allengrant admin TO ram$bob@aliyun.com:Allen;注意:admin可以满足常用的一些日常权限管理,但并不能代替owner做所有管理,此时还是必须要owner才能进行操作。3、MaxCompute超级管理员主账号不是大数据团队管理,使用MaxCompute员工都只持有子账号,而project的owner只能为主账号,但是很多MaxCompute的权限管理还需要owner才可以操作(如项目级别的flag设置,package跨项目资源共享配置等),因此非常需要一个子账号拥有超级管理员权限。(1)关于super_administrator roleSuper_Administrator role:MaxCompute内置的管理角色,拥有操作项目内所有类型资源的权限和管理类权限,具体权限请参考文档管理角色。该角色可由project owner指派给子账号,子账号获得该角色后,即可代替owner对该project在进行数据开发过程中所需的各种管理操作,包括常用的项目级别的flag设置以及所有权限管理操作。(2)指派子账号为超级管理员前提建议:• 可以将有权限创建project的子账号指派为super_administrator role,这样该账号既可以很好的管理DataWorks项目的同时管理对应的Max Compute project。如何授权子账号可创建project可参考子账号创建project子账号创建project• 建一个project只能指派一个子账号为super_administrator role,其他需要有基本的权限管理可以指派admin role• 需要注意明确该子账号持有人的职责,建议一个子账号对应一个开发者,避免账号共用,以便能更好的保障数据安全。确认好具体哪个子账号可以用户超级管理员(同时该子账号可以创建项目空间),子账号创建好project,此时projec的owner依然是主账号,主账号可以通过以下方式将super_administrator role 授权给该子账号。• 通过MaxCompute客户端授权:假设主账号用户bob@aliyun.com是项目空间project_a的Owner,Allen是bob@aliyun.com中的RAM子账号。打开项目空间project_a。use project_a;为项目空间project_a添加RAM子账号Allen。add user ram$bob@aliyun.com:Allen;为子账号Allen授权Super_Administrator角色权限。grant super_administrator TO ram$bob@aliyun.com:Allen;为子账号Allen授权Admin角色权限。grant admin TO ram$bob@aliyun.com:Allen;• 通过DataWorks授权:a、 登录DataWorks,进入工作空间配置页面。b、添加子账号为项目空间成员(已经添加过可忽略)。1) 单击左侧导航栏上的成员管理,进入成员管理页面。2) 单击右上角的添加成员。3) 在添加成员页面,从待添加账号列表中选择需要添加的组织成员显示在已添加账号列表中。4) 勾选角色并单击确定。c、 为子账号授权Super_Administrator角色。1) 单击左侧导航栏MaxCompute高级配置。2) 单击左侧导航栏自定义用户角色。3) 单击需要授权角色后的成员管理,从待添加账号列表中选择需要添加的组织成员显示在已添加账号列表中。20/jpeg/36371/1580893560423-d5235e7c-b42f-4809-805b-faa68d5c9d08.jpeg) 单击确定,完成账号授权。• 子账号查看自身的权限:cmd中执行 show grants;,如果有Super_Administrator 这个role,说明已经赋权成功。(3)成员、权限管理拥有super_administrator 角色的子账号本身已经拥有所有project资源的查询和操作权限,所以无须再给自身授权。以下给出针对其他成员和成员权限管理的建议。成员管理•MaxComopute 支持云账号和RAM子账号(子账号只能为Project owner的子账号),为了更好的保障数据安全,建议project中添加的user均为owner主账号的RAM子账号。主账号可控制子账号,如人员转岗离职等,主账号可以注销或更新对应的子账号。若通过DataWorks进行项目成员管理,只能添加owner的RAM子账号。• RAM子账号只能通过主账号添加(这个不是MaxCompute可以改变的事实),所以对于某project 成员即使拥有super_administrator 角色的超级管理员,也只能先需要主账号先创建好其他子账号才可以将其他子账号添加到project中。• 建议只添加需要在当前project进行数据开发(即会在当前project执行job)的user,对于有数据交互业务需求的user,建议通过package方式进行跨project资源共享,避免把user添加到project增加成员管理的复杂度。• 员工转岗或离职,先把对应子账号在project里remove掉,然后再通知owner注销子账号。如果是拥有super_administrator 角色的子账号持有者转岗或离职,则需要由主账号进行remove以及注销账号。权限管理• 建议通过角色进行权限管理,即权限和role关联,role和user关联。• 建议实施最小够用原则,避免权限过大造成安全隐患。• 跨project使用数据时,建议通过package方式实现,避免资源提供方增加成员管理成本,只需要管理package。权限审计可以通过MaxCompute的元数据服务Information_Schema服务提供的相关视图进行权限审计。4、跨项目访问资源和函数这篇文章通过3种方式介绍跨项目访问函数和资源,可以参考使用:https://developer.aliyun.com/article/741262?groupCode=maxcompute5、如何仅给某个子账号所有表的select权限(1)在项目工作空间中创建一个自定义角色create role select_only_role;(2)为自定义角色select_only_role对项目内所有表(包括未来项目内新建的表)赋予Describe,Select权限项目下的所有表:GRANT SELECT ON table * TO Role select_only_role privilegeproperties("policy" = "true");(3)给用户赋予自定义角色权限(也可以在Dataworks的自定义角色web-ui界面里,添加某个成员到该自定义角色下)grant role select_only_role to RAM$account@company_name.com:ram_account;六、DataWorks任务未按时调度运行 被提交发布至生产环境的任务,会按照调度周期来产生实例。通常来讲,实例的状态有:未运行、等待时间、等待资源、运行中、运行失败、运行成功。定时时间到了,但是实例的状态还是「未运行」,此时需要检查上游节点的运行情况。只有上游节点全部运行成功,该节点才会开始调度。1、如何处理DataWorks任务未按时调度运行,运行日志中显示槽位等待、正在等待在云端的gateway资源等信息的情况?DataWorks免费为您提供了一定的任务调度能力,但如果达到一定的任务并发量,则需要等待运行中的任务结束后,才可以继续运行等待中的任务。在满足业务诉求的前提下,建议您合理安排任务错峰运行,以便在各个时间段,充分利用已购买的计算资源。 如果需要获得更高任务并发调度能力,可以购买独享资源组。2、运行诊断同时运维中心新推出「运行诊断」的功能,针对实例各个环节可能出现的问题,为您提供全链路的诊断和建议。定时时间到了还不运行?任务一直在等资源?运行失败但是日志看不懂?这些问题通通帮您解决。运行诊断功能的介绍文档链接: https://help.aliyun.com/document_detail/158815.html七、数据同步任务出现脏数据怎么办? 1、产生脏数据的可能场景同步任务在任务运行过程中遇到插件的所有异常都会作为脏数据进行统计。• 数据类型转换(源端表和目的表字段类型不匹配,大概率)• 源端表数据过长• 数据源异常• Reader/Writer插件异常• 数据中有表情符2、解决方案(1)增大脏数据限制条数,扩大阈值,容忍脏数据(源端脏数据仍存在,不同步到目的端,日志会显示脏数据记录,任务不会报错)。(2)根据运行日志定位源端脏数据。日志中会显示具体是哪个列有问题,同时会有列数据信息,根据日志去修复后再同步。(3)当同步任务脏数据报错 XXXX command denied to user ‘XXXX’这类报错是因为没有数据源权限造成的问题,联系对应DBA申请一下update、insert、delete权限。(4)当我们的数据源有带表情的数据做同步时,需要注意只有utf8mb4编码支持同步表情符。例如:添加JDBC格式的数据源时,需要修改utf8mb4的设置,如jdbc:mysql://xxx.x.x.x:3306/database?com.mysql.jdbc.faultInjection.serverCharsetIndex=45。八、如何排查周期任务取不到数据(产出数据为空)的问题?首先我们需要知道节点依赖和业务逻辑之间是什么关系,其实任务依赖关系(调度关系)和业务逻辑并没有确切性的关联,业务依赖(即抽数/写数表之间的逻辑)并不等于任务依赖之间的关系。举个栗子:A任务产出A表,B任务产出B表,A、B同级,C任务依赖A、B的表数据产出C表,但是任务依赖关系上C可以不依赖A而只依赖B,这样C任务仍然能够取得符合业务逻辑的数据并对表C进行写入数据。1、几种容易取不到源表数据的情况(1)分区&参数的影响:比如说我有A、B两个小时任务。A任务业务逻辑样例:create table if not exists A(id bigint,name string)partitioned by(dt string,hh string);insert overwrite table A partition(dt='${bidate}',hh='${hh}') select * from S wheredt='${bizdate}';其中S表为初始数据表(即底表);B表的业务逻辑样例:create table if not exists B(id bigint,name string)partitioned by(dt string,hh string);insert overwrite table B partition (dt='${bidate}',hh='${hh}') select * from A wheredt='${bizdate}' and hh='${hh}';当A任务的参数中hh这个参数前推了一个小时,实际hh值变成了hh='$[hh24-1],而B任务的hh参数不变,hh='$[hh24]'这种形式,那么一定会找不到A表对应的分区而导致inputs数据为空,从而B表没有写入数据.(2)没有严格的依赖关系而直接取源表的某一个还没有产出数据的分区导致没有数据:比如说,A、B两个小时表作为C表的数据来源端,但是C并没有严格依赖A、B两个任务(即C任务没有依赖A、B只在业务上对A、B取数)。当A表任务产出ds='20200421',hh='10'的这个二级分区的时间是 10点30分,而C任务执行并取A表的ds='20200421',hh='10'这个分区的时间是10点10分,那么,就会导致C任务执行时取不到具体的A表对应分区数据而输入为空。(3)sql逻辑问题导致输入为空在A、B做join关联后并将数据写入到C表,不符合sql逻辑的条件筛选,没有select出符合条件的数据.九、数据源连通性测试失败怎么办?测试数据源连通性失败,是大家在使用数据集成时经常会遇到的问题。排除某些时候粗心大意填错配置信息外,很多时候大家发现都配置对了,但为什么还不通?此时怎么知道问题出在什么地方了呢?1、测试原理数据集成由管控服务和执行集群两部分组成,数据源连通性测试由管控服务发起,而同步任务实际运行在执行集群,由于二者部署在不同服务器,所以可能存在数据源连通性测试成功但同步任务执行失败,或者数据源连通性测试失败但同步任务执行成功等情况。2、可能的原因对于用户添加的数据源,不能连通具体原因可能有:• 网络不可达• 数据源应用层权限控制• 白名单、应用层acl限制等至于后两者,是没有办法来推断的,但是判断物理网络通与不通非常关键,如果网络是通的,但是权限受控,就直接找对应的数据源管理员协调就好了。3、网络通路排查借助FTP/SFTP数据源辅助验证数据源网络是否可达。操作方法:(1)添加ftp数据源,设置ip、port为待测试数据源的相关信息(2)协议Protocol类型选择SFTP(3)用户名、密码任意填写(4)点击【测试连通性】 十、员工离职,任务如何去修改如果有员工离职,运维人员应该在相关人员离职之前修改离职人员创建的任务节点、资源、表的Owner。同时注意检查生产环境MaxCompute访问者身份。1、修改MaxCompute访问者身份需要注意事项一般建议生产环境配置MaxCompute访问者身份为主账号。如果生产环境配置MaxCompute访问者身份为子账号那么离职员工离职前需要修改为其他员工账号或者主账号。开发环境离职员工账号删除RAM账号之后,该账号创建的所有节点在开发环境冒烟测试、开发环境运维中心执行其名下任务会失败。需要在员工离职之前做好任务节点、资源、表的Owner。(1)主账号需要转交任务,批量转交任务操作如下:批量修改任务节点责任人如果人员流动,需要将离职人员的任务批量修改责任人。可以去运维中心周期任务找到该责任人节点。选中节点之后修改责任人即可。 (2)修改表的OwnerMaxCompute SQL支持通过changeowner命令来修改表的拥有人(表Owner),相应的语法格式如下。alter table table_name changeowner to 'ALIYUN$xxx@aliyun.com';(3)修改资源权限该账号可以访问的资源可以通过角色的形式授权给交接人相同的资源访问权限。十一、Spark访问VPCSpark on MaxCompute可以访问位于阿里云VPC内的实例(例如ECS、HBase、RDS),默认MaxCompute底层网络和外网是隔离的,Spark on MaxCompute提供了一种方案通过配置spark.hadoop.odps.cupid.vpc.domain.list来访问阿里云的vpc网络环境的Hbase。Hbase标准版和增强版的配置不同,本文通过访问阿里云的标准版和增强版的Hbase简单的描述需要加的配置。1、配置步骤如下(1)需要添加spark.hadoop.odps.cupid.vpc.domain.list配置,该配置描述了需要访问的一个或多个实例的网络情况。配置值为json格式,注意,需要把json压缩成一行。以下给出了示例,把regionId, vpcId, 实例域名,端口等替换成真实值即可。{"regionId":"cn-beijing", "vpcs":[{"zones":[{"urls":[{ "domain":"spark-oss.oss-cn-beijing-internal.aliyuncs.com", "port":80}] }]}]}(2)在要访问的服务中添加ip白名单,允许100.104.0.0/16网段的访问(3)如果region是cn-shanghai或者cn-beijing,需要设置spark.hadoop.odps.cupid.smartnat.enable=true注意: 只能配置访问本Region下面某一个vpc的服务,不支持同时和多个vpc打通。必须要将配置压缩为一行,并且配置在spark-defaults.conf或dataworks的配置项中,而不能写在代码中!!!十二、任务执行慢调度任务执行缓慢首先我们可以找到周期任务执行的节点。然后查看任务运行的日志。1、如何区分哪些是DataWorks资源延迟哪些是MaxCompute计算延迟呢?日志中如果看到的是正在等待在云端的gateway资源那么可能是执行的任务达到一定的任务并发量,则需要等待运行中的任务结束后,才可以继续运行等待中的任务。在满足业务诉求的前提下,建议您合理安排任务错峰运行,以便在各个时间段,充分利用已购买的计算资源。同时可以购买独享资源组来保证高峰时间任务的正常运行。如果看任务的日志是Job Queueing,那基本是等待计算资源了。对于慢任务而言,如果不能够知道到底是哪一个作业是慢任务,可以采取两种方法:一种是“show p”,可以查看所有示例信息;而“top instance”可以查看当前正在执行的作业,而运行时间最长的作业可能就是阻塞队列导致其他任务排队的任务。对于由于资源抢占所导致的问题,可以做如下的优化:• 对于后付费用户而言,可以根据作业特性把相对稳定的周期性常规任务放到预付费资源组去执行,可以保证资源不被抢占。• 对于预付费用户而言,如果并行执行多个作业,最好合理安排作业执行时间,让作业错峰执行,临时任务则建议在后付费资源组执行。如果按量付费用户需要转包年包月可以提交工单咨询。2、按量付费转包年包月思路先通过元数据统计下过去的job消耗情况。https://help.aliyun.com/document_detail/135433.html?spm=a2c4g.11186623.6.944.40527312UEAT6A#title-r2c-tak-zfi大致思路:(1)统计最近1个月所有需要转预付的Project每日cost_cpu消耗总和。表 information_schema.tasks_history,cost_cpu原始单位为core.s,需转换成CU.时(cost_cpu/100/3600)。找出正常消费中最高消费的那一天。(2)对正常消费最高的那一天按小时分别统计所有任务CU时消耗。(3)按业务划分时间段,取最高时间段进行分析。如业务是0-7点为业务高峰期划分为“ETL夜间高峰段”,其他的使用都很低则为一个时间段。(4)汇总高峰期时间段CU时总量/时间,得出该时间段内需要的CU量。如:0-7点这8个小时,CU时为800,则需要100CU跑8个小时才能跑完800CU时的计算量。当然这个是最理想的状态,任务不都是很平均,所以需要根据情况设置一定的冗余。另外还有比较极端的情况, 比如有些任务有依赖关系到5点的时候才需要超大量的CU量,但是这个时候用100CU来跑即使跑3个小时也跑不完,所以这种情况就要结合业务需求,如果这个实在不能延迟时间,要么加大CU量,要么这个Project不适合用包年包月资源。(5)建议不要一次性转所有Project,逐步转,每转一个Project需要通过MaxCompute管家监控资源使用情况,看情况进行扩容/缩容。 欢迎加入“MaxCompute开发者社区2群”,点击链接MaxCompute开发者社区2群申请加入或扫描二维码

优秀的个人博客,低调大师

【最佳实践】简单配置,实现Filebeat多行日志传送

在解决应用程序问题时,多行日志为开发人员提供了宝贵的信息。 堆栈跟踪就是一个例子。 堆栈跟踪是引发异常时应用程序处于中间的一系列方法调用。 堆栈跟踪包括遇到错误的相关行以及错误本身。 可以在此处查看 Java 堆栈跟踪的示例: Exception in thread "main" java.lang.NullPointerException at com.example.myproject.Book.getTitle(Book.java:16) at com.example.myproject.Author.getBookTitles(Author.java:25) at com.example.myproject.Bootstrap.main(Bootstrap.java:14) 当使

优秀的个人博客,低调大师

Cassandra 最佳实践系列(4) - 管理篇之一

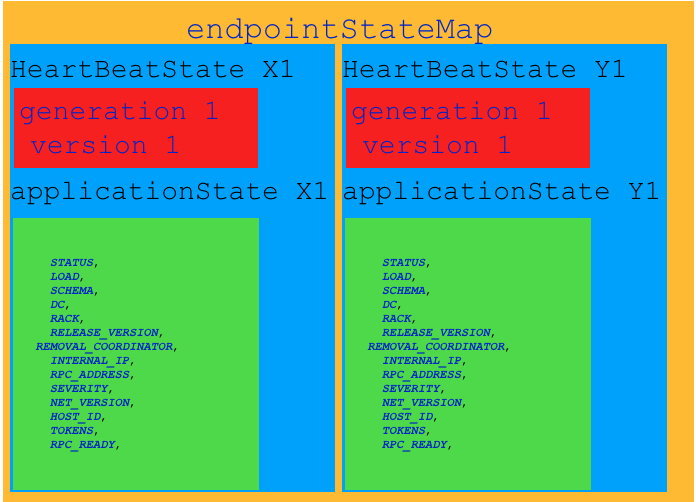
基本集群运维操作 集群信息获取 cassandra项目官方没有给我们提供一个中控的地方让我们获取集群的相关信息,但是由于cassandra是对等的,且集群种节点通过gossip可以拿到集群的整个视图,所以如果想要获取得到集群的整个视图信息也是可以通过单节点的nodetool工具获取得到我们将获取的信息做一下分类: 1.nodetool describecluster 显示集群的基本信息,包括:集群的名字(cassandra.yaml里面配置的)、Snitch类型、是否开启dynamicendpointsnitch、集群partitioner、schmema version,因为我们是通过gossip进行信息同步,可能会存在某些节点一时间与另外节点schema version不一致,可以通过这个命令判断。 eg: Cluster Information: Name: Test Cluster Snitch: org.apache.cassandra.locator.SimpleSnitch DynamicEndPointSnitch: enabled Partitioner: org.apache.cassandra.dht.Murmur3Partitioner Schema versions: ea63e099-37c5-3d7b-9ace-32f4c833653d: [127.0.0.1] 2../nodetool describering keyspace 打印出给定的keyspace以及与其相关的token ring信息,此处我的token_number设置为2,方便展示信息,如果我们希望想要知道某个keyspace与其相关的token信息,可以通过这个命令获取。 eg: Schema Version:ea63e099-37c5-3d7b-9ace-32f4c833653d TokenRange: TokenRange(start_token:-7410294471124200252, end_token:2438009623152110684, endpoints:[127.0.0.1], rpc_endpoints:[127.0.0.1], endpoint_details:[EndpointDetails(host:127.0.0.1, datacenter:datacenter1, rack:rack1)]) TokenRange(start_token:2438009623152110684, end_token:-7410294471124200252, endpoints:[127.0.0.1], rpc_endpoints:[127.0.0.1], endpoint_details:[EndpointDetails(host:127.0.0.1, datacenter:datacenter1, rack:rack1)]) 3.nodetool gossipinfo 显示集群的gossip信息,下面显示的是一个三节点的集群中,各个节点相关的gossip信息输出: /192.168.0.250 generation:1578559963 heartbeat:289 STATUS:18:NORMAL,-1000610182680759021 LOAD:273:111238.0 SCHEMA:20:ea63e099-37c5-3d7b-9ace-32f4c833653d DC:6:datacenter1 RACK:8:rack1 RELEASE_VERSION:4:3.11.4 RPC_ADDRESS:3:127.0.0.1 NET_VERSION:1:11 HOST_ID:2:012ed1eb-0dac-4562-9812-415a7b58e6d6 RPC_READY:32:true TOKENS:17:<hidden> /192.168.0.245 generation:1578560055 heartbeat:196 STATUS:58:NORMAL,-112189776392027338 LOAD:153:115665.0 SCHEMA:20:ea63e099-37c5-3d7b-9ace-32f4c833653d DC:6:datacenter1 RACK:8:rack1 RELEASE_VERSION:4:3.11.4 RPC_ADDRESS:3:127.0.0.1 NET_VERSION:1:11 HOST_ID:2:0dbd4aca-7dd4-4833-b3db-c7d9dda0aef9 RPC_READY:68:true TOKENS:57:<hidden> /192.168.0.246 generation:1578559991 heartbeat:260 STATUS:56:NORMAL,-1045048566066926798 LOAD:213:91038.0 SCHEMA:18:ea63e099-37c5-3d7b-9ace-32f4c833653d DC:6:datacenter1 RACK:8:rack1 RELEASE_VERSION:4:3.11.4 RPC_ADDRESS:3:127.0.0.1 NET_VERSION:1:11 HOST_ID:2:3ca695aa-edd2-435c-b9ee-89e143648351 RPC_READY:66:true TOKENS:55:<hidden> 上述信息表示了集群种三个节点对应的相关gossip信息,就第一个节点解释下相关的信息意义: 第一行的ip 192.168.0.250表示的是对应节点进行gossip交互ip信息; generation 表示的每个节点的相关的generation信息,节点的generation是交互信息的一部分,最初是当前时间的秒数(从1970年UTC时间开始到现在); heartbeat 表示在当前这个generation下面执行了多少次gossip交互,默认的情况下,每隔1s会主动进行一次gossip交互任务,这里看来是经过289秒; 余下都是集群的状态相关的信息:在Cassandra里面都是applicationstate里的VersionedValue,可以参考下面这个图: ​ 我们可以看到的是接下来的模块都是string0:number0:string1,其中string0 的格式就是STATUS、LOAD、SCHEMA等等这些需要的状态字符串,number0是这些状态每个一次变更就加1的version版本号,我们主要介绍是string1的具体意义;但是不是说string0 和number0 不重要。 STATUS:表示的是对应的ip节点的状态,有9种状态(3.11.4版本代码),BOOT、BOOT_REPLACE、NORMAL、shutdown、removing、removed、LEAVING、LEFT、MOVING; LOAD: 表示对应节点的节点的磁盘存储容量,单位是byte; SCHEMA: 对应节点上面schema keyspace下面的所有table 按照顺序计算出来的一个md5值转换为的一个UUID; DC: 对应节从属的datacenter; RACK:对应节点从属的rack; RELEASE_VERSION:节点机器的release 软件包的版本号; RPC_ADDRESS: RPC的地址 NET_VERSION:这里主要是我们的网络版本号,如果是force使用3.0 的协议版本就是10,否则是11; HOST_ID:节点的hostid,基于对应节点的ip等计算 RPC_READY: 如果9042的端口或者9142(ssl)的rpc端口已经准备初始化完成,可以接收响应就是true; TOKENS:本来是对应节点负责的tokens,但是在这里显示的时候是hindden表示。 4.nodetool ring 展示集群的token ring环信息,由于我这里的vnode用了默认的256,所以只列部分数据: Datacenter: datacenter1 ========== Address Rack Status State Load Owns Token 9171192753316195244 192.168.0.245 rack1 Up Normal 266.49 KiB 64.99% -9183757132875531958 192.168.0.250 rack1 Up Normal 242.16 KiB 70.75% -9159199665119898622 192.168.0.250 rack1 Up Normal 242.16 KiB 70.75% -9135911702874518408 192.168.0.250 rack1 Up Normal 242.16 KiB 70.75% -9120077450536389482 192.168.0.246 rack1 Up Normal 238.16 KiB 64.26% -9106101311114100850 192.168.0.246 rack1 Up Normal 238.16 KiB 64.26% -9069141338515824351 Datacenter : 对应的datacenter的名字,这里使用的是默认的; Address、Rack:表示的是对应节点以及从属的rack信息; Status 、State :对应的节点的状态:Up、Down;Normal、leaving等等; Load:集群的对应节点的load信息,参考上面的gossip info的输出信息; Owns:这个ip负责的tokens的范围占整个数据范围的占比多少 Token:对应负责的token是哪些

优秀的个人博客,低调大师

阿里云上实现全站https最佳实践(一)

为什么我们需要实现全站https? 目前主流大厂的网站和服务都已经实现了全站https, 例如: baidu, taobao, jd等.关于这方面的好处和优势, 互联网上太多文章在进行介绍. 例如: 为什么我们应该尽快升级到 HTTPS?对于一般的创业型公司, 迫切需要实现全站https的理由: 苹果要求所有iOS应用在年底前默认使用HTTPS连接微信小程序的开发, 要求必须使用https通信HTTP2.0其实可以支持非HTTPS的,但是现在主流的浏览器chrome,firefox表示还是只支持基于TLS部署的HTTP2.0协议,所以要想升级成HTTP2.0还是先升级HTTPS为好. 升级之前的准备工作. 先领取代金券礼包:https://promotion.aliyun.com/ntms/yunparter/invite.html?userCode=czfmwdn3SSL的证书类型?DV (Domain Validation): 面向个体用户,安全体系相对较弱,验证方式就是向 whois 信息中的邮箱发送邮件,按照邮件内容进行验证即可通过.OV (Organization Validation): 面向企业用户,证书在DV证书验证的基础上,还需要公司的授权,CA通过拨打信息库中公司的电话来确认.EV (Extended Validation): 在浏览器URL地址栏当中,展示了注册公司的信息,这会让用户产生更大的信任,这类证书的申请除了以上两个确认外,还需要公司提供金融机构的开户许可证,要求十分严格.需要强调的是,不论是 DV、OV 还是 EV 证书,其加密效果都是一样的! 点我领取阿里云2000元代金券,(阿里云优惠券的作用:购买阿里云产品,最后支付结算的时候,阿里云优惠券可抵扣一部分费用。 重要的区别: 1、DV证书的审核速度较快, 由程序完成审核, 一般申请了之后马上就能够完成证书颁发; OV和EV证书审核较慢, 由人工审核, 一般需要数天的时间.2、EV证书会在浏览器当中显示公司的信息, 通常被称为绿色地址栏, 以增加用户的信任感. 参考如下访问github时, chrome浏览器的显示方式:3、EV证书不支持单个泛域名(.example.com)或者多个泛域名(.example1.com, *.example2.com), OV和DV证书则支持.如何选择?通常的情况下, 一个处于初创阶段的互联网公司有多少个子系统是很难在前期就界定出来的. 因此, 如果能够无法明确规划出未来有多少个子系统, 需要使用多少个二级域名, 最好购买支持单个或者多个泛域名的证书. 至于是DV还是OV, 我个人觉得不是那么重要. 点我领取阿里云2000元代金券,(阿里云优惠券的作用:购买阿里云产品,最后支付结算的时候,阿里云优惠券可抵扣一部分费用。 一些经验总结:HTTPS网页中加载的HTTP资源被称之为Mixed Content, 不同的浏览器有不同的block http资源的策略, 因此最好提前整理出你的程序依赖的内部http资源, 和外部http资源(统计资源[GA, CNZZ, 百度统计], 第三方分享, 第三方地图服务等). 尤其是外部的http资源, 需要评估是否提供了https的服务. 到哪里获取https证书?免费资源: Let’s Encrypt: 目前个人站点使用的非常普遍的证书.特点/限制: 如果你在使用云服务提供商的CDN或者负载均衡服务(例如阿里云的CDN或者SLB), Let’sEncrypt就不太适合了, 阿里云的CDN或者SLB要求在云平台上上传证书的公钥和私钥, 而Let’s Encrypt强制90天过期, 虽然我们可以通过自动化的方式renew证书, 但我目前还没有找到比较好的解决方案.只支持单个域名. 阿里云Symantec免费DV证书:特点/限制: 点我领取阿里云2000元代金券,(阿里云优惠券的作用:购买阿里云产品,最后支付结算的时候,阿里云优惠券可抵扣一部分费用。 赛门铁克-顶级证书颁发机构.1年过期.只支持单个域名. 腾讯云GeoTrust免费DV证书:特点/限制: GeoTrust-顶级证书颁发机构.1年过期.只支持单个域名.强烈不推荐: StartSSL.com: 详见官网的以下描述: 点我领取阿里云2000元代金券,(阿里云优惠券的作用:购买阿里云产品,最后支付结算的时候,阿里云优惠券可抵扣一部分费用。 Wosign(沃通):聊聊“沃通/WoSign”的那些破事儿 点我领取阿里云2000元代金券,(阿里云优惠券的作用:购买阿里云产品,最后支付结算的时候,阿里云优惠券可抵扣一部分费用。 Mozilla发布的wosign-issue新浪的报道 PS: 阿里云在之前的一段时间也能够购买wosign的证书, 目前也已经下线了.wosign的SEO做得不错, 搜索SSL证书, google和baidu都排在了第一页, 导致很多不明真相的群众被忽悠了.付费资源: 阿里云: 提供了赛门铁克, GeoTrust, CFCA三个颁发的证书. PS: 其它都没有用过, 就不推荐了. 最终我选了什么?阿里云上的GeoTrust DV SSL: 价格便宜, 支持泛域名, 颁发迅速(30 min之内), 最重要的是统一使用了阿里云进行管理.aliyunssl 阿里云服务器:活动地址 购买可领取:阿里云代金券

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

用户登录
用户注册