首页 文章 精选 留言 我的

精选列表

搜索[脑洞落地],共10001篇文章
优秀的个人博客,低调大师

Kafka 负载均衡在 vivo 的落地实践

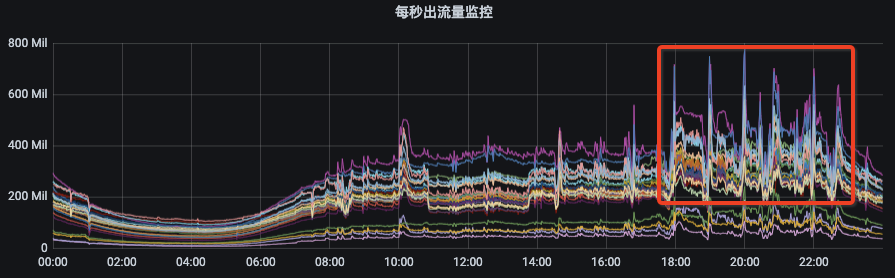
vivo 互联网服务器团队-You Shuo 副本迁移是Kafka最高频的操作,对于一个拥有几十万个副本的集群,通过人工去完成副本迁移是一件很困难的事情。Cruise Control作为Kafka的运维工具,它包含了Kafka 服务上下线、集群内负载均衡、副本扩缩容、副本缺失修复以及节点降级等功能。显然,Cruise Control的出现,使得我们能够更容易的运维大规模Kafka集群。 备注:本文基于 Kafka 2.1.1开展。 一、 Kafka 负载均衡 1.1 生产者负载均衡 Kafka 客户端可以使用分区器依据消息的key计算分区,如果在发送消息时未指定key,则默认分区器会基于round robin算法为每条消息分配分区; 否则会基于murmur2哈希算法计算key的哈希值,并与分区数取模的到最后的分区编号。 很显然,这并不是我们要讨论的Kafka负载均衡,因为生产者负载均衡看起来并不是那么的复杂。 1.2 消费者负载均衡 考虑到消费者上下线、topic分区数变更等情况,KafkaConsumer还需要负责与服务端交互执行分区再分配操作,以保证消费者能够更加均衡的消费topic分区,从而提升消费的性能; Kafka目前主流的分区分配策略有2种(默认是range,可以通过partition.assignment.strategy参数指定): range:在保证均衡的前提下,将连续的分区分配给消费者,对应的实现是RangeAssignor; round-robin:在保证均衡的前提下,轮询分配,对应的实现是RoundRobinAssignor; 0.11.0.0版本引入了一种新的分区分配策略StickyAssignor,其优势在于能够保证分区均衡的前提下尽量保持原有的分区分配结果,从而避免许多冗余的分区分配操作,减少分区再分配的执行时间。 无论是生产者还是消费者,Kafka 客户端内部已经帮我们做了负载均衡了,那我们还有讨论负载均衡的必要吗?答案是肯定的,因为Kafka负载不均的主要问题存在于服务端而不是客户端。 二、 Kafka 服务端为什么要做负载均衡 我们先来看一下Kafka集群的流量分布(图1)以及新上线机器后集群的流量分布(图2): 图1 图2 从图1可以看出资源组内各broker的流量分布并不是很均衡,而且由于部分topic分区集中分布在某几个broker上,当topic流量突增的时候,会出现只有部分broker流量突增。 这种情况下,我们就需要扩容topic分区或手动执行迁移动操作。 图2是我们Kafka集群的一个资源组扩容后的流量分布情况,流量无法自动的分摊到新扩容的节点上。此时,就需要我们手动的触发数据迁移,从而才能把流量引到新扩容的节点上。 2.1 Kafka 存储结构 为什么会出现上述的问题呢?这个就需要从Kafka的存储机制说起。 下图是Kafka topic的存储结构,其具体层级结构描述如下: 每个broker节点可以通过logDirs配置项指定多个log目录,我们线上机器共有12块盘,每块盘都对应一个log目录。 每个log目录下会有若干个[topic]-[x]字样的目录,该目录用于存储指定topic指定分区的数据,对应的如果该topic是3副本,那在集群的其他broker节点上会有两个和该目录同名的目录。 客户端写入kafka的数据最终会按照时间顺序成对的生成.index、.timeindex、.snapshot以及.log文件,这些文件保存在对应的topic分区目录下。 为了实现高可用目的,我们线上的topic一般都是2副本/3副本,topic分区的每个副本都分布在不同的broker节点上,有时为了降低机架故障带来的风险,topic分区的不同副本也会被要求分配在不同机架的broker节点上。 了解完Kafka存储机制之后,我们可以清晰的了解到,客户端写入Kafka的数据会按照topic分区被路由到broker的不同log目录下,只要我们不人工干预,那每次路由的结果都不会改变。因为每次路由结果都不会改变,那么问题来了: 随着topic数量不断增多,每个topic的分区数量又不一致,最终就会出现topic分区在Kafka集群内分配不均的情况。 比如:topic1是10个分区、topic2是15个分区、topic3是3个分区,我们集群有6台机器。那6台broker上总会有4台broker有两个topic1的分区,有3台broke上有3个topic3分区等等。 这样的问题就会导致分区多的broker上的出入流量可能要比其他broker上要高,如果要考虑同一topic不同分区流量不一致、不同topic流量又不一致,再加上我们线上有7000个topic、13万个分区、27万个副本等等这些。 这么复杂的情况下,集群内总会有broker负载特别高,有的broker负载特别低,当broker负载高到一定的时候,此时就需要我们的运维同学介入进来了,我们需要帮这些broker减减压,从而间接的提升集群总体的负载能力。 当集群整体负载都很高,业务流量会持续增长的时候,我们会往集群内扩机器。有些同学想扩机器是好事呀,这会有什么问题呢?问题和上面是一样的,因为发往topic分区的数据,其路由结果不会改变,如果没有人工干预的话,那新扩进来机器的流量就始终是0,集群内原来的broker负载依然得不到减轻。 三、如何对 Kafka 做负载均衡 3.1 人工生成迁移计划和迁移 如下图所示,我们模拟一个简单的场景,其中的T0-P0-R0表示topic-分区-副本,假设topic各分区流量相同,假设每个分区R0副本是leader。 我们可以看到,有两个topic T0和T1,T0是5分区2副本(出入流量为10和5),T1是3分区2副本(出入流量为5和1),如果严格考虑机架的话,那topic副本的分布可能如下: 假设我们现在新扩入一台broker3(Rack2),如下图所示:由于之前考虑了topic在机架上的分布,所以从整体上看,broker2的负载要高一些。 我们现在想把broker2上的一些分区迁移到新扩进来的broker3上,综合考虑机架、流量、副本个数等因素,我们将T0-P2-R0、T0-P3-R1、T0-P4-R0、T1-P0-R1四个分区迁移到broker3上。 看起来还不是很均衡,我们再将T1-P2分区切换一下leader: 经历一番折腾后,整个集群就均衡许多了,关于上面迁移副本和leader切换的命令参考如下: Kafka 副本迁移脚本 # 副本迁移脚本:kafka-reassign-partitions.sh # 1. 配置迁移文件 $ vi topic-reassignment.json {"version":1,"partitions":[ {"topic":"T0","partition":2,"replicas":[broker3,broker1]}, {"topic":"T0","partition":3,"replicas":[broker0,broker3]}, {"topic":"T0","partition":4,"replicas":[broker3,broker1]}, {"topic":"T1","partition":0,"replicas":[broker2,broker3]}, {"topic":"T1","partition":2,"replicas":[broker2,broker0]} ]} # 2. 执行迁移命令 bin/kafka-reassign-partitions.sh --throttle 73400320 --zookeeper zkurl --execute --reassignment-json-file topic-reassignment.json # 3. 查看迁移状态/清除限速配置 bin/kafka-reassign-partitions.sh --zookeeper zkurl --verify --reassignment-json-file topic-reassignment.json 3.2使用负载均衡工具-cruise control 经过对Kafka存储结构、人工干预topic分区分布等的了解后,我们可以看到Kafka运维起来是非常繁琐的,那有没有一些工具可以帮助我们解决这些问题呢? 答案是肯定的。 cruise control是LinkedIn针对Kafka集群运维困难问题而开发的一个项目,cruise control能够对Kafka集群各种资源进行动态负载均衡,这些资源包括:CPU、磁盘使用率、入流量、出流量、副本分布等,同时cruise control也具有首选leader切换和topic配置变更等功能。 3.2.1cruise cotnrol 架构 我们先简单介绍下cruise control的架构。 如下图所示,其主要由Monitor、Analyzer、Executor和Anomaly Detector四部分组成: (来源:cruise control 官网) (1)Monitor Monitor分为客户端Metrics Reporter和服务端Metrics Sampler: Metrics Reporter实现了Kafka的指标上报接口MetricsReporter,以特定的格式将原生的Kafka指标上报到topic __CruiseControlMetrics中。 Metrics Sampler从__CruiseControlMetrics中获取原生指标后按照broker和分区级指标分别进行聚合,聚合后的指标包含了broker、分区负载的均值、最大值等统计值,这些中间结果将被发送topic__KafkaCruiseControlModelTrainingSamples和__KafkaCruiseControlPartitionMetricSamples中; (2)Analyzer Analyzer作为cruise control的核心部分,它根据用户提供的优化目标和基于Monitor生成的集群负载模型生成迁移计划。 在cruise control中,“用户提供的优化目标”包括硬性目标和软性目标两大类,硬性目标是Analyzer在做预迁移的时候必须满足的一类目标(例如:副本在迁移后必须满足机架分散性原则),软性目标则是尽可能要达到的目标,如果某一副本在迁移后只能同时满足硬性目标和软性目标中的一类,则以硬性目标为主,如果存在硬性目标无法满足的情况则本次分析失败。 Analyzer可能需要改进的地方: 由于Monitor生成的是整个集群的负载模型,我们的Kafka平台将Kafka集群划分为多个资源组,不同资源组的资源利用率存在很大差别,所以原生的集群负载模型不再适用于我们的应用场景。 大多数业务没有指定key进行生产,所以各分区的负载偏差不大。如果topic分区副本均匀分布在资源组内,则资源组也随之变得均衡。 原生的cruise control会从集群维度来展开均衡工作,指定资源组后可以从资源组维度展开均衡工作,但无法满足跨资源组迁移的场景。 (3)Executor Executor作为一个执行者,它执行Analyzer分析得到的迁移计划。它会将迁移计划以接口的形式分批提交到Kafka集群上,后续Kafka会按照提交上来的迁移脚本执行副本迁移。 Executor可能需要改进的地方: cruise control 在执行副本迁移类的功能时,不能触发集群首选leader切换:有时在集群均衡过程中出现了宕机重启,以问题机器作为首选leader的分区,其leader不能自动切换回来,造成集群内其他节点压力陡增,此时往往会产生连锁反应。 (4)Anomaly Detector Anomaly Detector是一个定时任务,它会定期检测Kafka集群是否不均衡或者是否有副本缺失这些异常情况,当Kafka集群出现这些情况后,Anomaly Detector会自动触发一次集群内的负载均衡。 在后面的主要功能描述中,我会主要介绍Monitor和Analyzer的处理逻辑。 3.2.2 均衡 broker 出入流量 / 机器上下线均衡 对于Kafka集群内各broker之间流量负载不均的原因、示意图以及解决方案,我们在上面已经介绍过了,那么cruise control是如何解决这个问题的。 其实cruise control均衡集群的思路和我们手动去均衡集群的思路大体一致,只不过它需要Kafka集群详细的指标数据,以这些指标为基础,去计算各broker之间的负载差距,并根据我们关注的资源去做分析,从而得出最终的迁移计划。 以topic分区leader副本这类资源为例: 服务端在接收到均衡请求后,Monitor会先根据缓存的集群指标数据构建一个能够描述整个集群负载分布的模型。 下图简单描述了整个集群负载信息的生成过程,smaple fetcher线程会将获取到的原生指标加载成可读性更好的Metric Sample,并对其进行进一步的加工,得到带有brokerid、partition分区等信息的统计指标,这些指标保存在对应broker、replica的load属性中,所以broker和repilca会包含流量负载、存储大小、当前副本是否是leader等信息。 Analyzer会遍历我们指定的broker(默认是集群所有的broker),由于每台broker及其下面的topic分区副本都有详细的指标信息,分析算法直接根据这些指标和指定资源对broker进行排序。 本例子的资源就是topic分区leader副本数量,接着Analyzer会根据我们提前设置的最大/最小阈值、离散因子等来判断当前broker上某topic的leader副本数量是否需要增加或缩减,如果是增加,则变更clustermodel将负载比较高的broker上对应的topic leader副本迁移到当前broker上,反之亦然,在后面的改造点中,我们会对Analyzer的工作过程做简单的描述。 遍历过所有broker,并且针对我们指定的所有资源都进行分析之后,就得出了最终版的clustermodel,再与我们最初生成的clustermodel对比,就生成了topic迁移计划。 cruise control会根据我们指定的迁移策略分批次的将topic迁移计划提交给kafka集群执行。 迁移计划示意图如下: 3.2.3 首选 leader 切换 切换非首选leader副本,迁移计划示意图如下: 3.2.4 topic配置变更 改变topic副本个数,迁移计划示意图如下: 3.3 改造 cruise control 3.3.1 指定资源组进行均衡 当集群规模非常庞大的时候,我们想要均衡整个集群就变得非常困难,往往均衡一次就需要半个月甚至更长时间,这在无形之中也加大了我们运维同学的压力。 针对这个场景,我们对cruise control也进行了改造,我们从逻辑上将Kafka集群划分成多个资源组,使得业务拥有自己的资源组,当某个业务出现流量波动的时候,不会影响到其他的业务。 通过指定资源组,我们每次只需要对集群的一小部分或多个部分进行均衡即可,大大缩短了均衡的时间,使得均衡的过程更加可控。 改造后的cruise control可以做到如下几点: 通过均衡参数,我们可以只均衡某个或多个资源组的broker。 更改topic配置,比如增加topic副本时,新扩的副本需要和topic原先的副本在同一个资源组内。 在资源组内分析broker上的资源是迁入还是迁出。对于每一类资源目标,cruise control是计算资源组范围内的统计指标,然后结合阈值和离散因子来分析broker是迁出资源还是迁入资源。 如下图所示,我们将集群、资源组、以及资源组下的topic这些元数据保存在数据库中,Analyzer得以在指定的资源组范围内,对每个broker按照资源分布目标做均衡分析。 例如:当对broker-0做均衡分析的时候,Analyzer会遍历goals列表,每个goals负责一类资源负载目标(cpu、入流量等),当均衡分析到达goal-0的时候,goal-0会判断broker-0的负载是否超出上限阈值,如果超出,则需要将broker-0的一些topic副本迁移到负载较低的broker上;反之,则需要将其他broker上的副本迁移到broker-0上。 其中,下面的recheck goals是排在后面的goal在做均衡分析的时候,在更新cluster model之前会判断本次迁移会不会与之前的goal冲突,如果冲突,那就不更新cluster model,当前的goal会继续尝试往其他broker上迁移,直到找到适合的迁移目标,然后更新cluster model。 3.3.2 topic/topic分区往指定broker上迁移 考虑这些场景: 一个项目下会有几个资源组,由于业务变更,业务想要把A资源组下的topic迁移到B资源组。 业务想要把公共资源组的topic迁移到C资源组。 均衡完成之后,发现总有几个topic/分区分布不是很均匀。 面对这些场景,我们上面指定资源组进行均衡的功能就满足不了我们的需求了。所以,我们针对上述场景改造后的cruise control可以做到如下几点: 只均衡指定的topic或topic分区; 均衡的topic或topic分区只往指定的broker上迁移。 3.3.3 新增目标分析——topic分区leader副本分散性 业务方大多都是没有指定key进行发送数据的,所以同一topic每个分区的流量、存储都是接近的,即每一个topic的各个分区的leader副本尽可能均匀的分布在集群的broker上时,那集群的负载就会很均匀。 有同学会问了,topic分区数并不总是能够整除broker数量,那最后各broker的负载不还是不一致嘛? 答案是肯定的,只通过分区的leader副本还不能做到最终的均衡。 针对上述场景改造后的cruise control可以做到如下几点: 新增一类资源分析:topic分区leader副本分散性。 首先保证每个topic的leader副本和follower副本尽可能的均匀分布在资源组的broker上。 在2的基础上,副本会尽可能的往负载较低的broker上分布。 如下图所示,针对每一个topic的副本,Analyzer会依次计算当前broker的topic leader数是否超过阈值上限,如果超过,则Analyzer会按照topic的leader副本数量、topic的follower副本数量、broker的出流量负载等来选出AR中的follower副本作为新的leader进行切换,如果AR副本中也没有符合要求的broker,则会选择AR列表以外的broker。 3.3.4 最终均衡效果 下图是某个资源组均衡后的流量分布,各节点间流量偏差非常小,这种情况下,既可以增强集群扛住流量异常突增的能力又可以提升集群整体资源利用率和服务稳定性,降低成本。 3.4 安装/部署cruise control 3.4.1 客户端部署:指标采集 【步骤1】:创建Kafka账号,用于后面生产和消费指标数据 【步骤2】:创建3个Kafka内部topic:a是用来存储Kafka服务原生jmx指标;b和c分别是用来存储cruise control处理过后的分区和模型指标; 【步骤3】:给步骤1创建的账号授予读/写以及集群的操作权限,用于读/写步骤2创建的topic; 【步骤4】:修改kafka的server.properties,增加如下配置: 在Kafka服务上配置采集程序 # 修改kafka的server.properties metric.reporters=com.linkedin.kafka.cruisecontrol.metricsreporter.CruiseControlMetricsReporter cruise.control.metrics.reporter.bootstrap.servers=域名:9092 cruise.control.metrics.reporter.security.protocol=SASL_PLAINTEXT cruise.control.metrics.reporter.sasl.mechanism=SCRAM-SHA-256 cruise.control.metrics.reporter.sasl.jaas.config=org.apache.kafka.common.security.scram.ScramLoginModule required username=\"ys\" password=\"ys\"; 【步骤5】:添加cruise-control-metrics-reporter的jar包到Kafka的lib目录下:mv cruise-control-metrics-reporter-2.0.104-SNAPSHOT.jar kafka_dir/lib/; 【步骤6】:重启Kafka服务。 3.4.2 服务端部署:指标聚合/均衡分析 (1)到https://github.com/linkedin/cruise-control 下载zip文件并解压; (2)将自己本地cruise control子模块下生成的jar包替换cruise control的:mv cruise-control-2.0.xxx-SNAPSHOT.jarcruise-control/build/libs; (3)修改cruise control配置文件,主要关注如下配置: # 修改cruise control配置文件 security.protocol=SASL_PLAINTEXT sasl.mechanism=SCRAM-SHA-256 sasl.jaas.config=org.apache.kafka.common.security.scram.ScramLoginModule required username=\"ys\" password=\"ys\"; bootstrap.servers=域名:9092 zookeeper.connect=zkURL (4)修改数据库连接配置: # 集群id cluster_id=xxx db_url=jdbc:mysql://hostxxxx:3306/databasexxx db_user=xxx db_pwd=xxx 四、总结 通过以上的介绍,我们可以看出Kafka存在比较明显的两个缺陷: Kafka每个partition replica与机器的磁盘绑定,partition replica由一系列的Segment组成,所以往往单分区存储会占用比较大的磁盘空间,对于磁盘会有很大压力。 在集群扩容broker时必须做Rebalance,需要broker有良好的执行流程,保证没有任何故障的情况下使得各broker负载均衡。 cruise control就是针对Kafka集群运维困难问题而诞生的,它能够很好的解决kafka运维困难的问题。 参考文章: linkedIn/cruise-control Introduction to Kafka Cruise Control Cloudera Cruise Control REST API Reference http://dockone.io/article/2434664 . https://www.zhenchao.org/2019/06/22/kafka/kafka-log-manage/

优秀的个人博客,低调大师

字节跳动是如何落地微前端的

作者:字节跳动终端技术—周晓 本文内提及的 Garfish 微前端解决方案已开源: https://github.com/modern-js-dev/garfish(目前的 Garfish 作为字节跳动各部门应用最广泛的微前端解决方案已经服务超过 100+ 前端团队,400+ 项目),另外字节跳动的现代 Web 工程体系即将开源( Modern.js),深度集成 Garfish 提供了对微前端的原生支持,提供更开箱即用的能力,敬请期待! 微前端的出现的背景和意义 微前端是什么:微前端是一种类似于微服务的架构,是一种由独立交付的多个前端应用组成整体的架构风格,将前端应用分解成一些更小、更简单的能够独立开发、测试、部署的应用,而在用户看来仍然是内聚的单个产品。 微前端诞生在两个大的背景下,在提倡拥抱变化的前端社区可以看到新的框架、技术、概念层出不穷,并且随着 Web 标准的演进,前端应用已经具备更好的性能、更快的开发效率。但随着而来的是应用的复杂程度更高、涉及的团队规模更广、更高的性能要求,应用复杂度已经成为阻塞业务发展的重要瓶颈。 微前端就是诞生于 Web 应用日益复杂化的场景中,因为随着网络速度、计算机硬件水平的提升和 Web 标准的演进,过去 Web 应用用户体验远不如传统的应用软件时代已逐渐远去,两者之间在用户体验上的差距不断缩减,并且由于 Web 应用开发速度快、用完即走等特性,导致的一个最终结果就是「能用 Web 技术实现的应用,最终都会通过 Web 来实现」。在近几年涌现了一大批之前只能在传统 PC 软件中才能看到的优秀产品,例如:Photoshop、Web Office、Web IDE。尽管随着 Web 标准的演进,前端工程化也在不断演变,从模块化到组件化在到现在的工程化,但在面对跨团队大规模开发、跨团队企业级应用协作,现有的分治设计模式仍然显得有心无力。 大规模 Web 应用的困局 尽管 Web 应用的复杂度和参与人数以爆炸式的增长速度,但却没有一种新的架构模式来解决现有的困境,并同时兼顾 DX(developer experience)和 UX(user experience)。 以字节跳动内「研发中台」举例,在研发日常工作中需要使用非常多的研发系统,例如:代码管理、代码构建、域名管理、应用发布、CDN 资源管理、对象存储等。站在整个公司研发的角度考虑,最好的产品形态就是将所有的研发系统都放置同一个产品内,用户是无法感知他在使用不同的产品,对于用户而言就是单个产品不存割裂感,也不需要去学习多个平台,仅仅需要学习和了解字节跳动内的「研发中台」即可。 在字节跳动内这一类应用随处可见,由于字节跳动内存在大量业务线,每一条业务线都会诞生大量的中台系统,并且还在指数增长,以字节跳动内电商业务举例,对于电商运营的日常工作来说,其实与研发日常工作一样,围绕在:商品、商家、品牌、风控、营销等工作上,那么对于电商运营来说怎么样才最高效的电商运营系统呢,由于整个系统涉及范围较广,在实际的研发过程中必然会以功能或业务需求垂直的切分成更小的子系统,切分成各种小系统后尽管由于分治的设计理念提升了开发者体验,但是一定程度上降低了用户体验。那能否以一种新的架构模式,既保开发者体验,又能提升用户体验呢。 传统 Web 应用的利与弊 这里简单分析一下传统 Web 应用在开发大规模应用和涉及多研发团队协作时遇到的一些困境,以上面案例中的「电商运营平台」举例,对于电商运营而言商品、商家、品牌等都是电商运营平台能力的一部分,而不是独立之间的孤岛。若以传统的前端研发模式进行开发,那么此时有两种项目设计策略: 将平台内多个系统放置同一个代码仓库维护 ,采用 SPA(Single-page Application) 单页应用模式 将系统分为多个仓库维护,在首页聚合所有平台的入口,采用 MPA(Multi-page Application)多页应用模式 若采用多个系统放置同一个项目内维护: 优势: 更好的性能 具备局部更新,无缝的用户体验 提前预加载用户下一页的内容 统一的权限管控、统一的 Open API 开发能力 更好的代码复用,基础库复用 统一的运营管理能力 不同系统可以很好的通信 SPA 应用特有优势 劣势: 代码权限管控问题 项目构建时间长 需求发布相互阻塞 代码 commit 混乱、分支混乱 技术体系要求统一 无法同时灰度多条产品功能 代码回滚相互影响 错误监控无法细粒度拆分 采用方案一的劣势非常明显,在日常开发中研发:代码构建半小时以上、发布需求时被需求阻塞、无法局部灰度局部升级、项目遇到问题时回滚影响其他业务、无法快速引进新的技术体系提高生产力,项目的迭代和维护对于研发同学而言无疑是噩梦。 尽管降低了开发体验,如果对项目整体的代码拆分,懒加载控制得当,其实对于使用平台的用户而言体验却是提升的,这一切都归咎于 SPA 应用带来的优势,SPA 应用跳转页面时无需刷新整个页面,路由变化时仅更新局部,不用让用户产生在 MPA 应用切换时整个页面刷新带来的抖动感而降低体验,并且由于页面不刷新的特性可以极大程度的复用页面间的资源,降低切换页面时带来的性能损耗,用户也不会感知他在使用不同平台。 若采用拆分成多个仓库维护 优势 可以以项目维度拆分代码,解决权限管控问题 仅构建本项目代码,构建速度快 可以使用不同的技术体系 不存在同一个仓库维护时的 commit 混乱和分支混乱等问题 功能灰度互不影响 劣势 用户在使用时体验割裂,会在不同平台间跳转,无法达到 SPA 应用带来的用户体验 只能以页面维度拆分,无法拆分至区块部分,只能以业务为维度划分 多系统同灰度策略困难 公共包基础库重复加载 不同系统间不可以直接通信 公共部分只能每个系统独立实现,同一运维通知困难 产品权限无法进行统一收敛 采用方案二在一定程度上提升了开发体验,但却降低了用户体验,研发在日常开发工作中需要使用大量的平台,但是却需要跳转到不同的平台上进行日常的研发工作,整体使用体验较差。体验较差的原因在于将由于通过项目维度拆分了整体「研发中台」这样的一个产品,使各个产品之间是独立的孤岛,系统间相互跳转都是传统意义上的 MPA,跳转需要重新加载整个页面的资源,除了性能是远不如 SPA 应用的并且应用间是没法直接通信,这就进一步增强了用户在使用产品时的割裂感。 背景和意义总结 通过以上两个场景案例,其实可以发现由于 Web 应用在逐步取代传统的 PC 软件时,大规模 Web 应用在面对高复杂度和涉及团队成员广下无法同时保证 DX 和 UX 的困境。传统的分而治之的策略已经无法应对现代 Web 应用的复杂性,因此衍生出了微前端这样一种新的架构模式,与后端微服务相同,它同样是延续了分而治之的设计模式,不过却以全新的方法来实现。 微前端解决方案 上一节总结了微前端出现的背景和意义,并且了解了两种传统 Web 应用的研发模式:SPA(Single-page Application)、MPA(Multi-page Application)在涉及人员广和项目复杂度高的场景下带来的劣势,那么期望能有一种新的架构能同时具备 SPA 和 MPA 两种架构优势,并同时提升 DX(developer experience)和 UX(user experience)呢? 那在理想的情况下,期望能达到,将一个复杂的单体应用以功能或业务需求垂直的切分成更小的子系统,并且能够达到以下能力: 子系统间的开发、发布从空间上完成隔离 子系统可以使用不同的技术体系 子系统间可以完成基础库的代码复用 子系统间可以快速完成通信 子系统间需求迭代互不阻塞 子应用可以增量升级 子系统可以走向同一个灰度版本控制 提供集中子系统权限管控 用户使用体验整个系统是一个单一的产品,而不是彼此的孤岛 项目的监控可以细化到到子系统 那么基于上面理想情况,如何从零设计一套全新的架构用于解决现代 Web 应用在面对企业级系统遇到的困境呢。 微前端的整体架构 那么如何提供一套既具备 SPA 的用户体验,又具备 MPA 应用带来的灵活性,并且可以实现应用间同灰度,监控也可以细化到子系统的解决方案呢?目前在字节跳动内应用的微前端解决方案「Garfish」就是这样的一套方案 ,该解决方案主要分为三层:部署侧、框架运行时、调试工具,采用的是 SPA 的架构。 解决方案整体架构 微前端部署平台 部署平台作为微前端研发流程中重要的一环,主要提供了:微前端的服务发现、服务注册、子应用版本控制、多个子应用间同灰度、增量升级子应用、下发子应用信息列表,分析子应用依赖信息提取公共基础库降低不同应用的依赖重复加载。 用于解决微前端中子应用的独立部署、版本控制和子应用信息管理,通过 Serverless 平台提供的接口或在渲染服务中下发主应用的 HTML 内容中包含子应用列表信息,列表中包括了子应用的详细信息例如:应用 id、激活路径、依赖信息、入口资源等信息,并通过对于子应用的公共依赖进行分析,下发子应用的公共依赖,在运行时获取到子应用的信息后注册给框架,然后在主应用上控制子应用进行渲染和销毁。 微前端运行时 Why not iframe 谈到微前端绕不开的话题就是为什么不适用 iframe 作为承载微前端子应用的容器,其实从浏览器原生的方案来说,iframe 不从体验角度上来看几乎是最可靠的微前端方案了,主应用通过iframe 来加载子应用,iframe 自带的样式、环境隔离机制使得它具备天然的沙盒机制,但也是由于它的隔离性导致其并不适合作为加载子应用的加载器,iframe 的特性不仅会导致用户体验的下降,也会在研发在日常工作中造成较多困扰,以下总结了 iframe 作为子应用的一些劣势: 使用iframe 会大幅增加内存和计算资源,因为 iframe 内所承载的页面需要一个全新并且完整的文档环境 iframe 与上层应用并非同一个文档上下文导致 主应用劫持快捷键操作 事件无法冒泡顶层,针对整个应用统一处理时效 事件冒泡不穿透到主文档树上,焦点在子应用时,事件无法传递上一个文档流 跳转路径无法与上层文档同步,刷新丢失路由状态 iframe 内元素会被限制在文档树中,视窗宽高限制问题 iframe 登录态无法共享,子应用需要重新登录 iframe 在禁用三方 cookie 时,iframe 平台服务不可用 iframe 应用加载失败,内容发生错误主应用无法感知 难以计算出 iframe 作为页面一部分时的性能情况 无法预加载缓存 iframe 内容 无法共享基础库进一步减少包体积 事件通信繁琐且限制多 基于 SPA 的微前端架构 尽管难以将 iframe 作为微前端应用的加载器,但是却可以参考其设计思想,一个传统的 iframe 加载文档的能力可以分为四层:文档的加载能力、HTML 的渲染、执行 JavaScript、隔离样式和 JavaScript 运行环境。那么微前端库的基础能力也可以参考其设计思想。 从设计层面采取的是基座+子应用分治的概念,部署平台负责进行服务发现和服务注册,将注册的应用列表信息下发至基座,通过基座来动态控制子系统的渲染和销毁,并提供集中式的模式来完成应用间的通信和应用的公共依赖管理,因此 Garfish 在 Runtime 层面主要提供了以下四个核心能力: 加载器(Loader) HTML 入口类型,拆解 HTML Dom、Script、Style JS 入口类型,提供基础 Dom 容器 负责注册平台侧提供的应用列表 负责加载和解析子应用入口资源 预加载能力 解析子应用导出内容 沙箱隔离(Sandbox) 提供代码执行能力,收集执行代码时存在的副作用 提供销毁收集副作用的能力 支持沙箱多实例,收集不同实例的副作用 路由托管(Router) 解决不同应用间的路由不同步问题 提供路由劫持能力,在主应用上管控子应用路由 提供路由驱动能力来拼装完整的平台的能力 子应用通信(Store) 建立通信桥梁 提供共享机制 应用生命周期 整个微前端子应用的生命周期基本可以总结为: 渲染阶段 若入口类型为 HTML 类型,将开始解析和拆解子应用资源 若入口类型为 JS,创建子应用的挂点 DOM 主应用通过路由驱动或手动挂载的方式触发子应用渲染 开始加载应用的资源内容,并初始化子应用的沙箱运行时环境 判断入口类型 将子应用存在”副作用“(对当前页面可能产生影响的内容)交由沙箱处理 开始渲染子应用的 DOM 树 触发子应用的渲染 Hook 销毁阶段 若路由变化离开子应用的激活范围或主动触发销毁函数,触发应用的销毁 清除应用在渲染时和运行时产生的副作用 移除子应用的 DOM 元素 加载器的设计 加载器的整体设计理念其实与 React-loadable 非常类似,具备以下能力: 异步加载组件资源 可以预加载资源 可以缓存组件资源 缓存组件实例 与组件不同的是微前端作为一种能够将单体应用拆解成多个子应用的架构模式,不同于组件,这些被拆分出去的子应用最好的研发模式是在开发、测试、部署都与宿主环境分离,子应用本身应具备自治能力,那么此时就与 iframe 提供的能力非常类似,iframe 通过加载 HTML 文档的形式加载整个子应用的资源,那么子应用本身就可作为一个独立站点,天然具备独立开发、测试的能力。因此 Garfish 的加载器提供了两种应用入口类型:HTML 类型和 JS 入口类型,但需要注意的是 Garfish 并非像 iframe 一样将其分为了另一个文档流,而是将其与主应用作为同一个文档流处理,用以规避其不再同一个文档流带来的体验感割裂问题。 由于 HTML 入口类型天然具备独立、开发、测试的特性,在微前端整体架构设计中,对于跨团队协作而言,最好的研发模式是能降低其沟通成本,而降低沟通成本的最好方式是不沟通,所以一般项目类型都尽可能的推荐用户使用 HTML 的入口类型。 那么针对 HTML 入口类型的加载器需要做一些什么呢,下面是一张浏览器的渲染过程图: 针对浏览器的渲染过程也可将其分为:HTML 文本下载、 HTML 拆解为语法树、拆解语法树中具备”副作用的内容“(对当前页面可能产生影响的内容)如 Script、Style、Link 并交由沙箱处理进行后渲染,与一般的子应用不同的是需要子应用提供 provider,provider 中包含了子应用渲染和销毁的生命周期,这两个 Hook 可以应用缓存模式中进一步增强应用的渲染速度和性能。 沙箱的设计 为什么需要沙箱 其实在过去的 Web 应用中是很少提及到沙箱这一概念的,因为组件的开发一般都会由研发通过研发规范来尽可能的去避免组件对当前应用环境造成副作用,诸如:组件渲染后添加了定时器、全局变量、滚动事件、全局样式并且在组件销毁后会及时的清除子应用对当前环境产生的副作用。 与组件完全不同的是微前端是由多个独立运行的应用组成的架构风格,这些系统可能分别来自不同的技术体系。项目的开发、测试从空间和时间上都是分离的,由于没有 iframe 一样原生能力的隔离很难应用间不发生冲突,这些冲突可能会导致应用发生异常、报错、甚至不可用等状态。 以 Webpack4 JsonpFunction 为例 在 Webpack5 中提供了一个重要的功能就是 Module Federation,随着 Webpack 5 推出 Module Federation ,与 Webpack 4 发生变化的一个重要配置就是JsonpFunction属性变为了chunkLoadingGlobal,并且由原来的默认值webpackJsonp变成了默认使用output.library名称或者上下文中的package.json的 包名称(package name)作为唯一值(webpack.js.org/issues/3940)。 为什么会发生这个转变呢,如果了解过 Webpack 构建产物的一定会知道 Webpack 通过全局变量存储了分 chunk 后的产物,用于解决分包 chunk 的加载问题。由于 Webpack 5 引入 Module Federation 页面中可能会同时存在两个以上的 Webpack 构建产物,如果还是通过是通过同一个变量存储要加载的 chunk ,必然会造成产物之间的互相影响。 通过 Webpack 4 到 Webpack 5 支持 Module Federation 之后可以发现,在一个基础库尚未考虑默认兼容多实例的场景下,贸然将其作为多实例使用很可能会造成应用无法按照预期运行,更为严重的是你以为其正常运行了其实应用已经发生了严重的内存泄漏或不可预知的情况,倘若将 Webpack 构建产物的应用多次动态的在页面中运行,将会发现已经造成严重的内存泄漏,因为 Webpack 会增量的向全局存储 chunk 的变量上挂载模块以及依赖信息,简单来说就是每次执行 Webpack 构建的子应用代码都会向 webpackJsonp 数组 push 大量的数据,最终造成内存泄漏,直至页面崩溃。 沙箱的核心能力 为了保证应用能够稳定的运行且互不影响,需要提供安全的运行环境,能够有效地隔离、收集、清除应用在运行期间所产生的副作用,那应用运行期间主要会产生哪些副作用呢,可以将其分为以下几类:全局变量、全局事件、定时器、网络请求、localStorage、Style 样式、DOM 元素。 在 Garfish Runtime 中的沙箱主要能力也是围绕在这一块的能力建设上,针对子应用可能产生的副作用类型主要分为两类,一类是:静态副作用、另一类则是:动态副作用。这里静态副作用和动态副作用分别指的是什么呢,静态副作用指的是 HTML 中静态标签内容例如:Script 标签、Style 标签、Link 标签,这些内容属于在 HTML 文档流中就包含的,另外一部分副作用属于动态副作用,动态副作用指的是由 JavaScript 动态创建出来的,例如 JavaScript 可以动态创建 Style、动态创建 Script、动态创建 Link、动态执行代码、动态添加 DOM 元素、添加全局变量、添加定时器、网络请求、localStorage 等对当前页面产生副作用的内容。 针对子应用的静态副作用的收集比较简单,Loader 核心模块上已经提供了子应用入口资源类型的分析和拆解,可以从子应用 DOM 树中轻松拆解获取副作用内容,那么对于静态副作用已经可以完成有效的收集、清除,但是尚未具备隔离的能力。动态创建的副作用都是通过 JavaScript 来动态创建的,需要收集到 JavaScript 运行时产生的副作用,并提供副作用的隔离和销毁能力。 沙箱设计的两种思路 在 Garfish 微前端中,如何有效收集、隔离、清除应用的副作用是保障应用能够平稳运行的核心能力之一。沙箱的主要能力也在于能够捕获动态创建的副作用,对应用的副作用进行隔离和清除。 那么如何能够有效的捕获到动态创建的副作用、收集、并隔离呢?目前 Garfish 提供了两种设计思路,一种是快照模式,另外一种是 VM 模式。 快照沙箱 顾名思义,在应用运行前通过快照的模式来保存当前执行环境,在应用销毁后恢复回应用之前的执行环境,用于实现应用间副作用的隔离和清除。类似于 “SL 大法”,通过 save 存储环境,通过 load 加载环境的模式。 代码实现思路 核心设计思想简述: 针对每一种副作用提供一个 Patch 类,这个类需要提供 save 和 load 两个方法 Save 对应着该副作用的环境快照存储,Load 对应着销毁该副作用的销毁恢复环境 并且针对每一种 Patch 还可以存储其在运行期间发生的变化,在优化场景时并不用所有代码,仅恢复执行环境即可 VM 沙箱 通过快照沙箱的最简化的核心实现后可以发现,它的设计理念依赖于整个代码的执行属于线性的过程,即:存储执行环境=>执行具备副作用的代码=>恢复执行环境,但在实际的场景中对于应用的划分并以页面为维度划分,同一个页面可能存在多个应用,所以它的执行顺序并非线性,可能同时存在多个快照沙箱的实例环境,也就是快照沙箱多实例,以下面代码举例: 通过上面的代码可以发现,在同时运行多个快照沙箱实例时,在代码执行顺序非线性的场景下,并不能有效的收集和处理应用的副作用,也基于此快照沙箱无法使用在非线性呢多实例的场景中,因此也进一步推出了 VM(virtual machine) 沙箱。 维基百科关于 VM 的解释:在计算机科学中的体系结构里,是指一种特殊的软件,可以在计算机平台和终端用户之间创建一种环境,而终端用户则是基于虚拟机这个软件所创建的环境来操作其它软件。虚拟机(VM)是计算机系统的仿真器,通过软件模拟具有完整硬件系统功能的、运行在一个完全隔离环境中的完整计算机系统,能提供物理计算机的功能。 在 Node 中也提供了 VM 模块,不过不过不同于传统的 VM,它并不具备虚拟机那么强的隔离性,并没有从模拟完整的硬件系统,仅仅将指定代码放置了特定的上下文中编译并执行代码,所以它无法用于不可信来源的代码。 参考 Node 中 VM 模块的设计,以及 JavaScript 词法作用域 的特性,可以设计出 VM 沙箱,不过与传统的 VM 差异也同样存在,它并能执行不可信的代码,因为它的隔离能力仅限于将其运行在一个指定的上下文环境中。 从而得出以下设计 隔离环境需要哪些上下文 针对副作用的类型:全局变量、全局事件、定时器、网络请求、localStorage、Style 样式、DOM 元素,分别提供了全新的执行上下文: Window 用于隔离全局环境 document 收集 DOM 副作用 收集 Style 副作用,进行处理 收集 Script,继续放置沙箱处理 用于捕获动态创建的 DOM 节点、Style、Script timeout、interval 处理定时器 localstorage 隔离 localStorage listener 收集全局事件 新的执行上下文哪里来 新的执行上下文有两个来源, 来源于当前环境 来源于 iframe 的执行环境 由于 iframe 创建后需要需要较多的内存资源和计算资源,而微前端中的 VM 沙箱并不需要一个完全的执行上下文,所以可以基于当前环境。 快照沙箱和 VM 沙箱能力对比 路由系统的设计 在于现代 MVC 的设计思想,前端框架的设计思想也一直在发生变更,现代 Web 前端框架提供的最经典的能力莫过于将 MVC 中的 Constroller 变为了 Router,目前几乎主流的前端框架都支持路由驱动视图,仅提供一个 Router Map 路由表,无需关注控制任何路由状态即可完成跳转后的路由更新。 通过微前端出现的背景和意义,可以了解到微前端主要是用于解决:应用增量升级、多技术体系并存、构建大规模企业级 Web 应用而诞生的。那么在基于 SPA 的微前端架构中也可以了解到,目前微前端主要是采用应用分而治之 + 动态加载 + SPA 应用的模式来解决大规模应用带来的一系列问题。在以组件为颗粒度的 SPA 应用中组件内部是不需要关心路由的,但是在微前端中主要通过应用维度来拆分,那么拆分的应用也可能是一个独立的 SPA 应用,那么此时主应用与子应用的关系如何编排呢? 微前端应用中理想的路由调度 假设存在一个 Garfish 站点,这个站点它是由主应用+三个子应用构成,主应用的 basename 为/demo,并存在三个 Tab 分别指向跳转至不同的应用,理想的路由效果: 在点击 vue-app Tab,跳转至/demo/vue-app路由后,分别激活vue-app下,为 Vue 类型的 A 应用和 B 应用,并激活 A 应用和 B 应用中的 Home 组件 点击 React-app Tab 进入到/demo/react-app路由后,分别激活react-app下,为 React 类型的 C 应用,并激活 C 应用的 Home 组件 在激活 C 应用的基础上,点击 Detail 按钮,跳转至/demo/react-app/detail,并激活 C 应用的 detail 组件。 点击浏览器返回按钮展示,跳转/demo/react-app/detail,并激活 C 应用的 Home 组件,至此完成浏览器的基本路由跳转能力。 不考虑任何路由处理的场景 假设存在一个 Garfish 站点,这个站点它是由主应用+一个子应用构成。由于 Garfish 采用的是 SPA 架构,子应用与主应用所处于同一个执行上下文,子应用的路由原样反应在主应用上。 那么此时分别跳转到:/home、/detail路由会发现哪些问题呢? 假定跳转的方法可以同时触发主子应用路由更新,主应用路由和子应用路由会同时发生抢占情况,后渲染的组件会覆盖先渲染的路由组件 在触发路由跳转方后,只有主应用视图触发刷新、只有子应用视图刷新、或都不刷新 「视图的路由状态维护在框架内部」,通过原生跳转无法触发视图更新 此时当分别跳转到:/home、/detail、/test路由时分别触发对应的组件视图,但是倘若子应用路由中也存在/detail视图呢,由于应用的开发采用分治的模式,应用的开发从空间和时间上都是分离的,无法保证应用间的路由不发生路由抢占的情况。 「通过 history 路由跳转无法保证应用能够触发视图更新」,在通过 history api 进行路由跳转时,是无法触发应用视图更新,假设存在一个 React 应用 A,存在一个组件视图 Test,分别通过 React 提供的路由方法跳转和原生的路由跳转进行观察: Hash 和 History 路由模式 目前主流的 SPA 前端应用基本上都支持两种路由模式,一种是:hash 模式、另一种则是 History 路由模式,两者的优劣和使用并不在本文的讨论范围之内,这里仅做在微前端这种分离式开发模式下的介绍,在微前端这种分离式 SPA 应用开发的模式下该选择哪种路由模式,以及多 SPA 应用下他们的路由应该如何编排: 假设站点地址为:http://garfish.bytedance.net 正常路由情况 主应用 history 模式、子应用 history 模式 主应用(basename: /example): 主应用所有路由基于:http://garfish.bytedance.net/example例 例如跳转到:/appA,http://garfish.bytedance.net/example/appA/子 子应用(basename: /example/appA): 子应用所有路由基于:http://garfish.bytedance.net/example/appA 跳转到子应用的 /detail 页,http://garfish.bytedance.net/example/appA/detail 特点: 当主子应用分别为 history 模式时,子应用的路由基于主应用基础路由并带上自己的业务路由 路由同步到主应用路由上,通过 子应用 scope 命名空间隔离(子应用 A,提供 appA 的 scope)主应用和其他应用的路由冲突,并将子应用 路径符合用户和开发者认知和理解 支持嵌套层级使用,并继续通过 scope 的命名空间保证路由可读 主应用 history 模式、子应用 hash 模式 主应用(basename: /example): 主应用所有路由基于:http://garfish.bytedance.net/example 例如跳转到:/appA,http://garfish.bytedance.net/example/appA/ 子应用(basename: /example/appA): 子应用所有路由基于:http://garfish.bytedance.net/example/appA 从主应用:http://garfish.bytedance.net/example/appA,跳转到子应用的 /detail 页,http://garfish.bytedance.net/example/appA#/detail特 特点: 在一定程度上具备主子应用都为 history 模式的优势,不支持嵌套层级使用 目前多数框架都不支持以 hash 值作为 basename 可读性尚可 异常路由情况 主应用 hash 模式、子应用 history 模式 主应用(basename: /example): 主应用所有路由基于:http://garfish.bytedance.net/example 例如跳转到:/detail,http://garfish.bytedance.net/example#/appA 子应用(basename: /example#/appA): 子应用所有路由基于:http://garfish.bytedance.net/example#/appA 跳转到子应用的 /detail 页,http://garfish.bytedance.net/example/detail#/appA 特点: 「路由混乱」,不符合用户和开发者直觉 目前多数框架都不支持以 hash 值作为 basename 主应用 hash 模式、子应用 hash 模式 主应用(basename: /example): 主应用所有路由基于:http://garfish.bytedance.net/example 例如跳转到:/detail,http://garfish.bytedance.net/example#/appA 子应用(basename: /example#/appA): 子应用所有路由基于:http://garfish.bytedance.net/example#/appA 跳转到子应用的 /detail 页,http://garfish.bytedance.net/example#/detail 特点: 「路由混乱」,不符合用户和开发者直觉 目前多数框架都不支持以 hash 值作为 basename 可能与主应用或其他子应用发生路由冲突 Garfish Router 如何处理路由 通过上面理想的路由模式案例发现,微前端应用拆分成子应用后,子应用路由应具备自治能力,可以充分的利用应用解耦后的开发优势,但与之对应的是应用间的路由可能会发生冲突、两种路由模式下可能产生用户难以理解的路由状态、无法激活不同前端框架的下带来的视图无法更新等问题。 目前 Garfish 主要提供了以下四条策略 提供 Router Map,减少典型中台应用下的开发者理解成本 为不同子应用提供不同的 basename 用于隔离应用间的路由抢占问题 路由发生变化时能准确激活并触发应用视图更新 Router Map 降低开发者理解成本 在典型的中台应用中,通常可以将应用的结构分为两块,一块是菜单另一块则是内容区域,依托于现代前端 Web 应用的设计理念的启发,通过提供路由表来自动化完成子应用的调度,将公共部分作为拆离后的子应用渲染区域。 自动计算出子应用所需的 basename 当应用处于激活状态时,根据应用的激活条件自动计算出应用所需的基础路径,并在渲染时告诉框架,以便于应用间路由不发生冲突。 如何有效的触发不同应用间的视图更新 目前主流框架实现路由的方式并不是监听路由变化触发组件更新,让开发者通过框架包装后的 API 进行跳转,并内部维护路由状态,在使用框架提供 API 方法发生路由更新时,内部状态发生变更触发组件更新。 由于框架的路由状态分别维护在各自的内部,那么如何保证在路由发生变化时能及时有效的触发应用的视图更新呢,答案是可以的,目前主要有两种实现策略: 收集框架监听的 popstate 事件 主动触发 popstate 事件 因为目前支持 SPA 应用的前端框架都会监听浏览器后退事件,在浏览器后退时根据路由状态触发应用视图的更新,那么其实也可以利用这种能力主动触发应用视图的更新,可以通过收集框架的监听事件,也可以触发 popstate 来响应应用的 popstate 事件 基于「现代 Web 框架」的微前端最佳实践 微前端作为一种全新的 Web 应用类型,不同于以往传统的 Web 应用开发,微前端需要采用主子应用分治的开发模式后带来了一系列新的挑战,这些挑战包括但不限于:主子应用开发调试、普通 Web 应用如何快速变为微前端应用、如何支持微前端应用 SSR、主子应用数据通信触发视图更新。Modern.js作为 Garfish 上层的现代 Web 框架,能够很好的解决这些问题,并提供开箱即用的开发体验。 微前端应用的调试开发 由于微前端应用采用分治的开发策略,应用间的维护和开发可能在时间和空间上都是分离的,那么在开发环境时启动整个微前端项目的所有主子应用,是一个并不明智的策略,不仅需要 clone 其他仓库并完成应用的运行,还要保证其代码的时效性。Modern.js 提供了更优的的策略: 某些子应用需要更新时 主应用线上环境 需要开发的子应用线下环境 不需要开发的子应用上线 主应用需要更新时 主应用线下环境 所有子应用线上环境 通过以上更优的调试策略,可以保证开发者仅运行自己的关注的应用即可。那么如何达到这种更优的,可以采用应用列表的下发模式,框架运行时加载下发的应用列表,在开发主应用时拉取线上的应用列表,在开发某个子应用时代理代理列表中的资源为子应用的列表。 传统 Web 应用支持微前端模式 通过微前端运行时章节可以发现传统 Web 应用与微前端应用间进行切换成本并不高,但需要研发关注应用的路由的调度、应用的生命周期导出、额外的构建配置、应用通信数据触发视图更新,微前端模式应用和传统 Web 应用间如何进行切换都存在一定的学习和理解成本。 在 Modern.js 中作为上层框架集成了 Garfish,原生支持微前端应用,可以通过简单配置即可完成微前端应用类型的转换,帮助用户快速搭建应用基础结构,以降低其学习成本,快速生成微前端应用。 微前端应用如何支持 SSR 微前端作为一种全新的架构模式,其分治设计模式除了带来的诸多优点外,但与之对应的是引入了新的问题,如何支持传统 Web 应用提供的 SSR 能力,由于微前端采用了分治的开发模式,应用拆分成了多个子应用,那么需要实现整体应用的 SSR 能力,则需要与具体的 Web 框架相结合,通过制定微前端应用的加载规则,达到微前端应用也能有效的实现 SSR 能力。 Modern.js 作为 Garfish 的上层框架,提供更开箱即用的上层能力 ,并解决了以上微前端不同于传统 Web 应用开发后带来的弊端,文末有关于Modern.js的发布预告,可以了解并关注。 微前端的优点 适用于大规模 Web 应用的开发 更快的开发速度 支持迭代可开发和增强升级 拆解后的部分降低了开发者的理解成本 同时具备 UX 和 DX 的开发模式 微前端的缺点 复杂度从代码转向基础设施 整个应用的稳定性和安全性变得更加不可控 具备一定的学习和了解成本 需要建立全面的微前端周边设施,才能充分发挥其架构的优势 调试工具 监控系统 上层 Web 框架 部署平台 何时使用微前端 大规模企业级 Web 应用开发 跨团队及企业级应用协作开发 长期收益高于短期收益 不同技术选型的项目 内聚的单个产品中部分需要独立发布、灰度等能力 微前端的目标并非用于取代 iframe 应用的来源必须可信 用户体验要求更高 总结 微前端概念的出现是前端发展的必然阶段,PC 互联网转向移动互联网时代时,PC 的场景并未完全被消灭,反而转向了衍生出了更多沉浸感更高、体验感更强的应用,与之对应的应该是出现新的架构模式来应对这些应用规模的增长。 微前端也并非银弹,采用微前端后复杂度并未凭空消失,而是由代码转向了基础设施,对架构设计带来了更大的挑战,并且在新的架构下需要设计并提供更多的周边工具和生态来助力这一新的研发模式。 本文更多的是从背景和设计层面讲清楚微前端解决方案应具备哪些能力,以及核心模块的设计。每一部分并未包含过于详细的细节,如果想要了解「微前端运行时」详细设计,可以通过https://github.com/modern-js-dev/garfish仓库了解细节。 参考 如何设计微前端中的主子路由调度:https://mp.weixin.qq.com/s/TAXP7ipDdtb2Jb-L3QHszA 如何取巧实现一个沙箱:https://mp.weixin.qq.com/s/Mg3fU0WvZUQnlWHdxc-b5A 微服务架构及其最重要的 10 个设计模式:https://www.infoq.cn/article/kdw69bdimlx6fsgz1bg3 single-spa:https://github.com/single-spa/single-spa Modern.js 开源预告 Modern.js 和 Garfish 都是字节跳动 Web Infra 发起的「现代 Web 工程体系」开源项目,Modern.js 原生支持微前端,在 Garfish 基础上提供了完整的微前端最佳实践。 Modern.js计划在 10 月 14 号发布 1.0.0 版和上线文档站,欢迎关注和参与。 点击查看Garfish 仓库。

优秀的个人博客,低调大师

云计算快速落地,云安全发展可期

云栖号:https://yqh.aliyun.com第一手的上云资讯,不同行业精选的上云企业案例库,基于众多成功案例萃取而成的最佳实践,助力您上云决策! 中国企业上云步骤加快,但与发达国家差距明显。随着科技的发展和信息技术的不断普及,经济数字化的浪潮愈演愈烈,人们在生产生活中要面对和处理的数据规模与数据种类越来越庞大,对于运算效率和资源环境的需求也越来越高,传统的硬件计算机和服务器模式已经难以满足人们的需求,越来越多的企业选择将各种信息、业务上云,企业的应用和管理也逐渐云端化。 根据《中国云计算产业发展白皮书》,2016年,欧洲国家的上云率已经超过60%,美国企业上云率更是高达80%,但我国企业的上云率才不到40%,这意味着云计算产业在我国至少还有3-5的成长期。 与全球相比,中国的云计算市场成长空间大。从全球视野来看,我国的云计算技术的发展和应用目前仍处于起步阶段。根据艾媒咨询的研究,尽管云计算已经发展10年,但中国云计算市场整体规模较小,落后全球云计算市场3至5年。在全球云计算市场趋于稳定增长的背景下,中国云计算市场正处于高速增长阶段。 国内政策利好推动企业上云,云计算市场未来可期。从2015年开始,政府就陆续出台多种政策促进企业运用云计算加快数字化发展。2017年,工信部出台《云计算发展三年行动计划(2017-2019年)》,在计划的指导下,各地政府陆续推出鼓励企业上云的行动计划和实施方案,从应用端扩大云计算市场的需求量。 2018年,工信部印发了《推动企业上云实施指南(2018-2020)》,提出了企业上云的工作目标,到2020年,云计算在企业生产、经营、管理中的应用广泛普及,全国上升新增上云企业100万家。云计算作为国家正在加快培育和发展的七大战略性新兴产业之一,正在享受政策红利进入快速发展赛道。 云计算应用范围广,政商数据安全需求高 目前,由于云计算显著的弹性计算,应用灵活的优势,在各个领域都有所运用。 当前我国的云计算技术主要运用于政务、金融、交通、能源和和电信方面,在政务云、金融云、交通云、能源云和电信云等领域发挥着重要的作用。 根据《中国云计算产业发展白皮书》,互联网、物流、金融、电信、能源、制造、政府、医疗占比分别为60.3%、7.8%、6.2%、5.7%、5.5%、4.2%、3.6%和3.1%。 云计算覆盖范围广,政商数据安全需求高。随着云计算逐渐在各个领域发挥重要作用,政商企业对其安全要求也越来越高。目前,云计算主要覆盖政务、金融、交通、电信等影响范围广、数据保密性要求高的行业,这些行业的数据具有私密性和广泛性的特点,一旦泄露,将会对国家经济金融安全和民生安全造成巨大的影响。 因此,安全可控成为政企用户上云的一个重要考量。因此,鉴于云计算承载的业务应用日益增强的重要性,政府和大型企业用户对云计算技术的自主、安全、可控等安全合规的要求会明显提升。 云攻击形态多样化,云安全需求提升 在云成为趋势的情况下,攻击形态更加严峻。随着云计算市场规模的不断扩大,其所面临安全问题也日益增多,除了传统安全问题外,它还面临着云计算场景所带来的新的安全挑战。 在传统的家用网络或企业网络中,攻击者会根据攻击目标暴露的资产和服务情况,自外向内逐层进入,使用相对固定的攻击路径。但是在云平台上,不仅传统网络架构中的DDoS、入侵、病毒等安全问题是常态问题;针对云平台架构的虚拟机逃逸、资源滥用、横向穿透等新的安全问题也层出不穷;而且,由于云服务成本低、便捷性高、扩展性好的特点,利用云提供的服务或资源去攻击其他目标的也成为一种新的安全问题。 云生态环境下的攻击路径增加,云资源作为攻击源的比例高。根据腾讯云安全团队的研究,在云生态环境下,攻击者可以拥有比传统攻击方式更多的选择。 不仅可以选择从Internet环境下攻击云租户和平台的纵向攻击路径,而且还可以在成功获取到租户或平台系统的一定权限后,利用网络或共享资源进行横向迁移的横向攻击路径,从而进一步扩大攻击范围,获取其他租户和系统的资源、数据或访问权限,从而扩大攻击效果。 云资源作为攻击源的比例在所有国内攻击源中已接近一半。在云计算生态环境下,由于云生态环境下虚拟化技术、共享资源、相对复杂的架构、以及逻辑层次的增加,从而使得攻击者可使用的攻击路径和复杂度也大大增加,进一步加大了防护的难度。 根据国家互联网应急中心最新发布的《2018年互联网网络安全报告》中显示,云平台已经成为发生网络攻击的重灾区,在各类型的网络安全事件数量中,云平台上的DdoS攻击次数、被植入后门的网络数量、被篡改的网站数量占比均超过50%。 据中商产业研究院的数据显示,2018年中国云安全市场规模达约38亿元,增长45%。随着信息安全越来越受到重视,云安全市场将进一步扩大。预计2019年,中国云安全市场规模将达56亿元,增长近50%。到2021年,预计我国云安全市场规模将超100亿元。 多重政策利好,云安全迎来发展良机 随着互联网的广泛应用和信息技术的日益更新,随之而来的网络安全问题也日益严重。在一系列网络安全事件之后,我国对网络安全的重视迅速提升。 2016年,我国颁布《网络安全法》,将其作为网络安全领域基础性、全局性的法律。它的实施正式将网络安全上升到国家安全的战略高度,使网络安全成为国家安全观的重要组成部分。而伴随着2017年《网络安全法》的实施,我国新一代的等级保护制度的发布,网络安全迎来快速发展时期。 等保2.0加入云计算安全扩展要求,云计算安全规划化和标准化。等保2.0中加入了对于云计算的安全扩展要求,企业对安全对象进行定级后,需要满足相应的安全规范。其中,云计算安全扩展要求控制项目一级11项、二级29项、三级46项、四级49项。 同时,每一级安全扩展要求都分为五个部分,即安全物理环境、安全通信网络、安全区域边界、安全计算环境和安全建设管理。等保2.0将云平台和云上信息系统都纳入了等级保护的范围,这意味着企业需要在此基础之上更好地进行网络安全合规建设,网络安全行业需求将在未来迎来重要的边际改善。 云计算平台风险评估加快,云安全问题越来越受关注。云安全作为信息安全的子行业,根据安全牛的分类,包括云抗D、云WAF、云身份管理、云基础架构安全和云主机安全。 随着云计算在政府、金融、电信等领域的广泛应用,云安全也逐渐成为政府着重关注的领域。在2019年1月开始实施的《云计算服务安全评估办法》就是为了提高党政机关、关键信息基础设施运营者采购使用云计算服务的安全可控水平。 其重点评估内容包括:云服务商的征信、经营状况等基本情况;云服务商人员背景及稳定性,特别是能够访问客户数据、能够收集相关元数据的人员;云平台技术、产品和服务供应链安全情况;云服务商安全管理能力及云平台安全防护情况;客户迁移数据的可行性和便捷性;云服务商的业务连续性等。 行业标准确立,云安全迎来发展良机。我国从2013年起就发布了可信云评估参考办法,为企业各种信息和业务上云奠定基础。在2015年发布的《云计算综合标准化体系建设指南》更是将云计算平台的安全体系建设推入了规范化发展阶段。 公有云安全集中度持续提升 从2006年谷歌首次提出“云计算”概念,2008年趋势科技提出“云安全”概念,到今日云计算市场达到千亿级规模,云生态圈已经发展了10年有余,在这个过程中,企业的需求端和政府的政策端都为云计算市场的发展提供了良好的环境。与此同时,基于云计算技术架构(Cloud-Client)构建的下一代内容安全防护解决方案,以及Web信誉服务、电子邮件信誉服务、文件信誉服务、行为关联分析技术、自动反馈机制、威胁信息汇总等技术的先进性、高效率、有效性都得到用户的充分验证与认可。各大安全厂商对于云安全技术的研发投入也逐渐加大,市场呈现出了更加细分化、多元化的产业格局。 公有云安全市场从分散到融合,产业集中度进一步提升。云安全市场的蓬勃发展也使得云安全领域的收购与结盟正变得愈加频繁,众多大型公司都在努力地发展其云安全业务,借助资本市场的相互渗透,完善自身的技术、市场和产品。 Gartner数据显示,AWS、微软Azure、阿里云、谷歌作为2017年全球公有云IaaS市场份额前四名,已占据69.4%的市场份额,且各厂商份额均有增长,市场集中化趋势更加显著。国内也是同样的市场格局,阿里云、腾讯云、中国电信等云服务商占据头部市场并不断扩大份额。在公有云IaaS厂商的市场集中度提升的基础上,凭借强大的研发实力,这些公司自身提供了大部分公有云安全相关产品,同时合作伙伴提供了剩下的部分产品。 私有云安全,发展前景广阔 出于数据安全性和定制化服务的考虑,政府金融等云计算用户将会选择私有云。对政府金融等云计算用户,数据和应用的安全性考量将优先于云计算平台经济性的考量,因此将重要数据放在私有云上是这类客户优先的选择。实际上,由于这类客户的体量较大,需要建立的私有云平台通常也会有较大的规模,因此这类的云平台通常也会有足够的经济性。 同时,对于大型政府和企业客户来说,由于业务繁杂,通常需要云服务提供者提供较多的定制化服务来适应客户自身的业务流程,公有云提供者由于经济和规模化的考虑,通常很少提供定制化的服务,因此,私有云将成为更好的选择。 聚焦到国内,我国传统IT产业大客户主要集中在政府、电信、金融等中大型国企央企,信息安全需求很高,对定制化也有较大需求,基于以上考虑,这些客户通常会选择私有云作为IT上云的路径,国内私有云安全市场仍将持续快速发展。 云栖号在线课堂,每天都有产品技术专家分享立即加入圈子:https://c.tb.cn/F3.Z8gvnK与专家面对面,及时了解课程最新动态! 原文发布时间:2020-03-10本文作者:5G产业园本文来自:“5G产业园公众号”,了解相关信息可以关注“5G产业园”

优秀的个人博客,低调大师

视觉技术进化 工业物联网加速落地

近年来智能化成为各产业的热门议题,工业4.0现在已开始进入实质导入阶段,而工业物联网是工业4.0的基础架构,系统建构时必须与现有设备全面串接,随着制造业的厂商规模增大,机台数量势必会越来越多,在整合概念下,各机台之间的通讯互连已是必然.工业物联网的系统建置目标,聚焦于制造业前端设计与后端制程系统,用以提高产线弹性,现在市场上的工业物联网作法有两种,一是设备中建置传感器,传感器可快速判断工件的类别,改变生产方式,不过一旦所需处理的工件种类变多,这需要系统复杂度也必须同步提升,另一是将产线系统设备模块化,一旦产品或制程将产线拆开重组,即可组装成适合的生产系统。这两种方式都会牵涉到不同系统的整合,一是视觉技术,品管是最后产品质量最后把关的环节,在机器视觉技术未臻成熟之前,过去一向以人力为主,以太阳能、LED产业为例,就有超过20%的人力投注在此,不过产品检测单调且冗长的作业模式,容易使操作者出现疲劳、注意力分散等问题,现在机器视觉技术逐渐精进,足以担当产品检测重任,因此可以被导入产线以提高了产能、降低成本。目前机器可视化的检测作法,是将视觉传感器与镜头,直接建在系统设备上,当产品传送至该站时,即可被检测,这种作法的好处是可以全检,不像一般用抽检的方式,产品质量可全面获得保障,另一个优点是速度快,可加快检测速度。视觉检测是现代自动化系统相当重要的部份,而此一技术也是现代与传统自动化的主要差异,20年前机器视觉因技术尚未成熟,与自动化系统整合的难度相当高,就算整合进去,判别速度也有限,不过随着视觉演算、判断法则的进步,再加上现在PC的强大功能,未来视觉检测会大量应用在各类制程。就整个历程来看,视觉检测在2000年开始被大量应用,当时主要应用领域是PCB(Printed Circuit Board;印刷电路板)与FPD(Flat Panel Display;平面显示器),不过主要都用来做瑕疵检测,随着技术进步,现在的视觉检测功能已不再只局限于此,包括尺寸检测与颜色、条形码、车牌等辨识都已能胜任,其应用也仍不断扩大,例如以前立体工件的量测,必须将对象放至3D设备进行扫描,不过这类扫描会有尺寸限制。另外,现在视觉技术也可用来进行定位与尺寸的量测,例如工研院机械所就曾接过马达厂的案子,利用视觉技术检测马达内的线圈,由于受测马达的线圈相当大,整体长度超过2公尺,这种产品对于尺寸的准确度要求相当高,因此在绕线完后,必须确定尺寸的正确与否?对此,工研院就特别开发专属机台,用视觉检测大型马达线圈尺寸,马达的尺寸量测非常复杂,不仅是3D量测,还有曲度、各个旋转的R角等,这些复杂的尺寸量测,以前用人工,光是一个线圈就需要数小时,而机械所开发的机台,只要在2~3分钟可完成,大幅提升了量测效率。另一种视觉应用是与机器人整合,进行定位、导引,过去机器人动作时,因没有视觉配合,必须事先规划行径路线,因此应用不但大为受限且缺少弹性,若工件规格有所变化,就必须更改程序,在机器人身上加入视觉装置后,由视觉传感器可回馈讯号,让机器人自主判断工件的形状、颜色、位置,即便尺寸、位置更动,也不必重写程序,如此将可大幅提升自动化产线的弹性。在制程监控方面,工业物联网系统可透过感测技术进行节能与效率两种监控,由于这方面的监测,其物理量通常都不太好量,因此多采间接量测,例如工具机里的切削力量测,不是将传感器设置在基座就是在刀具底部,再利用推论模式推测出所要的数值,这种推论模式,是利用过去累积的数据,来预测下一步的状况,以进行控制、补偿,藉以提升准确率。监测部份,现在业界的研发走向是设备预诊,此作法除了建有历史数据库外,还可依据数据库进行预测,例如若发现系统性能除线问题,就可由此系统推算出可能出错的系统环节,这种预测诊断的功能,主要是根据既有数据来预测系统未来的性能与状况,并诊断系统中未来的可能损坏部位与时间,让设备厂商可提前备料、维修,这类系统在大型设备如核能、大型风力发电等相当常见,一般来说,越大型的设备,对预测诊断的系统需求会越高。

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册