首页 文章 精选 留言 我的

精选列表

搜索[脑洞落地],共10001篇文章
优秀的个人博客,低调大师

LLM测试落地实战:从理论到交付

2024年,LLM已深度嵌入智能客服、代码辅助、金融风控、医疗问答等核心业务场景。但随之而来的,是大量因提示词漂移、上下文截断、幻觉输出、安全越界导致的线上事故——某头部银行AI理财顾问因温度参数未约束,连续3天向高风险客户推荐杠杆产品;某云厂商SDK在v2.3升级后,因未覆盖多轮对话状态一致性测试,导致用户历史偏好丢失率达17%。这些并非技术缺陷,而是LLM测试体系缺位的直接后果。

优秀的个人博客,低调大师

测试专家必看:测试预测分析落地实践

在传统软件测试中,测试范围划定、用例优先级排序、缺陷风险预判往往高度依赖测试工程师的个人经验与直觉。然而,随着系统复杂度指数级增长、迭代周期压缩至天级(如CI/CD流水线每小时触发多次构建),仅靠人工判断已难以应对质量保障的实时性与精准性挑战。测试预测分析(Test Prediction Analytics)正成为新一代质量工程的核心能力——它通过融合历史测试数据、代码变更特征、构建日志、环境指标等多源信息,利用机器学习模型预测‘哪里最可能出错’‘哪些用例最值得优先执行’‘本次发布缺陷逃逸概率是多少’,从而将质量决策从‘事后拦截’转向‘事前干预’。

优秀的个人博客,低调大师

Vibe Coding 在企业中的落地实践

2025 年被称为 Vibe Coding 元年,2026 年则是「Spec-Driven Development(SDD,规范驱动开发)」被主流工具全面采纳的一年——GitHub Spec Kit、AWS Kiro、Claude Code、Cursor、OpenSpec、BMAD、Google Antigravity 等几乎所有主流 AI 编程工具都在 2026 年上线了自己的 SDD 方案。今天分享的核心不是「要不要用 AI 写代码」,而是「企业级场景下,如何用 AI 写出能长期维护的代码」。

优秀的个人博客,低调大师

Shiply助力Kuikly动态化场景落地实践

移动互联网已进入存量竞争阶段,用户增长放缓迫使企业转向精细化运营,业务需要通过高频更新来优化体验、开展A/B测试与活动运营。然而传统应用商店审核流程在iOS端通常需1至3天,远无法满足分钟级响应的需求,版本覆盖率提升慢、碎片化问题也难以根除。H5、React Native、Flutter等跨端方案虽试图缓解迭代压力,却普遍面临动态化能力受限的困局——Flutter采用AOT模式无法直接动态执行Dart代码,紧急修复必须走商店审核;React Native则在发布效率、灰度能力与风险管控上短板明显,且依赖第三方工具时存在服务停服中断业务的风险。在此背景下,Shiply作为腾讯端服务(TDS)产品联盟核心成员,顺势成为打通"开发—发布—监控"闭环的关键基础设施,为Kuikly等跨端框架提供一站式端云一体动态发布解决方案,有效降低技术门槛、减少研发成本。

优秀的个人博客,低调大师

得物向量数据库落地实践

一、背景 信息通信技术(ICT)正经历着前所未有的变革浪潮,以大模型和生成式人工智能(GenAI)为代表的技术突破,正在引发全球产业体系的深刻变革,成为驱动企业技术架构革新和商业模式转型的关键引擎。 得物是广受年轻人喜爱的品质生活购物社区。在AI鉴别、图搜、算法、安全风控等场景下都广泛使用了GenAI技术。 向量数据库作为GenAI的基础设施之一,通过量化的高维空间数据结构(如HNSW算法),实现对嵌入向量(Embeddings Vector)的高效存储、索引和最近邻搜索(ANN),支撑包括多模态数据表征在内的复杂智能应用。 二、认识向量数据库 向量数据来源和存储 一般向量数据库中向量的来源是将图片、音频、视频、文本等非结构化数据,将这些非结构化数据通过对应的量化算法计算出一个多维度的向量(生产使用一般向量维度会大于512),并且将向量数据持久化在特定的存储上。 向量数据库是如何工作 向量数据库在查询的时候一般会将需要查询的非结构化数据通过量化,计算成一个多维度向量数据,然后在数据库中搜索出和查询向量相似的数据。(需要注意的是这边查询的是相似的数据而不是相同的数据)。 三、向量数据库对比传统数据库 向量数据库在数据结构、检索方法、擅长领域与传统数据库有很大的不同。 传统数据库 结构是处理离散的标量数据类型(例如数字和字符串),并通过行和列来表达组织数据(就是一个表格)。传统数据库主要为了解决结构化数据的精确管理和高效查询问题。并且传统数据库通过B树索引、哈希索引等数据结构,能够快速定位到精确匹配的记录。更重要的是,传统数据库通过ACID事务特性(原子性、一致性、隔离性、持久性)确保了在数据中数据的绝对准确性。 向量数据库 为了解决非结构化数据的语义搜索问题,解决如何在海量的高维向量数据中,快速找到与查询向量最相似的结果。比如在推荐系统中找到与用户喜好相似的物品,或在图像库中检索出与查询图片最相近的图片。这类问题的特点是: 查询的不是精确匹配,而是相似度排名。 数据维度极高(通常128-2048维)。 数据规模庞大(可能达到十亿级别)。 传统数据库的精确查询方式在这种场景下完全失效,因为: 无法为高维向量建立有效的B树索引。 计算全量数据的精确相似度代价过高。 无法支持"相似但不完全相同"的搜索需求。 四、如何选择向量数据库 向量数据库比较 下面我们通过10个不同维度来比较一下不同向量数据库的区别: 从上面表格可以看到: 自 2016 年起 ,向量数据库逐渐崭露头角,成为 AI 和大数据领域的重要基础设施。而到了 2021 年之后 ,随着深度学习、大模型和推荐系统的迅猛发展,向量数据库正式迈入爆发式增长时代 ,成为现代数据架构中不可或缺的核心组件。 超过半数的向量数据库均采用分布式架构设计,并且这些支持分布式部署的系统普遍具备弹性扩缩容能力,能够根据业务需求实现资源的动态调整。 当业务需要处理亿级甚至更高规模的向量数据时,推荐以下高性能、可扩展的向量数据库:Vespa、Milvus/Zilliz、Vald、Qdrant。 当前主流的向量数据库普遍采用模块化、插件式的设计理念。其核心引擎大多基于 C/C++ 开发,以追求极致的性能表现。与此同时,Go 和 Rust 也正在这一领域崭露头角。 在向量数据库领域,HNSW(Hierarchical Navigable Small-World)和 DiskANN 正逐渐成为主流索引方案。其中HNSW主要以内存搜索为主,DiskANN主要以磁盘搜索为主。值得注意的是,Qdrant 在优化 HNSW 的基础上,进一步实现了 基于磁盘的 HNSW 检索能力。 选择流行的索引 在向量数据库技术领域,有HNSW 和 DiskANN 作为两大主流索引方案,各自展现了独特的技术优势。我们从以下关键维度进行专业对比分析。 从上表格我们可以得到,HNSW和DiskANN适用于不同的场景: HNSW :以 内存优先 的设计实现高性能搜索,适合 低延迟、高吞吐 要求严格的场景,如实时推荐、广告检索等。 DiskANN :以 磁盘存储优化 为核心,在保证较高召回率的同时 显著降低硬件成本 ,适用于大规模数据下的经济型检索需求。 随着数据规模的持续增长,HNSW 和 DiskANN 的混合部署模式 或将成为行业标准,让用户能根据业务需求灵活选择 "极致性能" 或 "最优成本" 的检索策略。 综合比较和选择 从表格中可以得到: 如果数据流比较小,并且自身对Redis、PG、ES比较熟悉,就可以选择Redis、PG、ES。如DBA团队就比较适合。 如果数据量比较大,并且前期人力不足可以使用云托管方案。选择Zilliz、Pinecone、Vespa或者Qdrant,如果后期计划从云上迁移到自建可以选择Zilliz、Vespa或者Qdrant。 得物选择Milvus作为向量数据库 我们的需求 社区图搜和AI鉴别需要大量的数据支持,得物业务场景要求能支持十亿级向量数据搜索,有如下要求: 大数据量高性能搜索,RT需要在90ms以内。 大数据量但是性能要求不高时,RT满足500ms以内。 需要支持快速扩缩容: 满足上面2点就已经锁定在Milvus、Qdrant这两个向量数据库。如果从架构复杂度和维护/学习成本的角度考虑,我们应该优先选择Qdrant,因为它的架构相比Milvus没有那么复杂,并且维护/学习成本没有Milvus高,重要的Qdrant可以单独集群部署,不需要k8s技术栈的支撑。 Milvus 和 Qdrant 架构比较 Milvus架构:Milvus部署依赖许多外部组件,如存储元信息的ETCD、存储使用的MinIO、消息存储Pulasr 等。 Qdrant:Qdrant完全独立开发,支持集群部署,不需要借助ETCD、Pulsar等组件。 选择Milvus的原因 ※ 业务发展需求 业务属于快速发展阶段,数量的变化导致扩缩容频繁,使用支持k8s的Milvus在扩缩容方面会比Qdrant快的多。 ※ 技术储备和社区良好 对DBA而言,向量数据库领域需要持续的知识更新和技术支持。从问题解决效率来看,国内技术社区对Milvus的支持体系相较于Qdrant更为完善。 ※ 契合得物DBA开发栈 Milvus使用的开发语言是Go,契合DBA团队技术栈,在部分运维场景下,通过二次开发满足运维需求。例如:使用milvus-backup工具做迁移,部分的segment有问题需要跳过。自行修改一下代码编译运行即可满足需求。 五、Milvus在得物的实践 部署架构演进 小试牛刀 初始阶段,我们把Milvus部署在K8S上,默认使用HNSW索引。架构图如下,Milvus整个架构较为复杂,外部依赖的组件多,每个集群需要部署自己的 ETCD、ZK、消息队列模块,多套集群共享着同一个存储。 存储拆分,每个集群独立存储 共享存储瓶颈导致稳定性问题凸显。 随着业务规模扩展,集群数量呈指数级增长,我们观测到部分集群节点出现异常重启现象,经诊断确认该问题源于底层共享存储存在性能瓶颈。 独立资源池迁移至共享资源池 通过混布的方式提升资源利用率。 前期为了在性能和稳定性上更好的服务业务,Milvus部署的底层机器都是独立的,目的就是为了和其他应用隔离开,不相互影响。但是随着集群的越来越多,并不是所有的集群对稳定性和性能要求那么高,从监控上看Milvus集群池的资源使用不超过10%。为了提高公司资源利用率,我们将独立部署的Milvus迁移高共享资源池中,和大数据、业务应用等K8S部署相关服务进行混合部署。 DiskANN索引的使用 数据量大且搜索QPS小时选择DiskANN 作为索引。通过监控发现有很多集群数据量比较大,但是QPS并不是那么高,这时候就考虑对这些性能要求不高的集群是否有降本的方案。通过了解我们默认使用的HNSW索引需要将所有数据都加载到内存中进行搜索,第一反应就是它的内存查询和Redis一样,那是否有类似pika的方案内存只存少部分数据大部分数据存在磁盘上。这时候发现DiskANN就能达到这样的效果。 性能压测 ※ 集群规格 QPS 延时(ms) 新增DiskANN索引后集群架构 增加DiskANN后我们需要对相关服务器上挂载 NVME SSD 磁盘,用于在磁盘上搜索最终数据。 DiskANN 加载数据过程 引入Zilliz 经过大规模生产验证,Milvus在实际业务场景中展现出卓越的性能表现和稳定性,获得业务方的高度认可。并且也吸引来了C端核心业务系统的使用。在使用前,我们使用了业务真实流量充分的对Milvus进行了压测,发现Milvus在亿级别数据量的情况下满足不了业务,因此对于部分核心场景我们使用了Zilliz。 Milvus和Zilliz 压测 业务的要求是集群返回的RT不能操过90ms。 使用真实的业务数据(亿级别)和业务请求对Milvus进行压测,发现Milvus并不能满足业务的需求。 Milvus RT 200不满足业务需求,并且QPS一直上不去,无论我们对QueryNode扩容多大,其中还发生过,将Query扩容到60个后,反而RT上升的问题,排查后是因为有的QueryNode和Proxy交互的时候网络会抖动影响了整体的RT。 从上面可以看出就算业务能容忍RT=200ms的,Milvus也需要创建3个相同的集群提供业务访问,并且业务需要改造代码实现多写、多读的功能,最终还会发现3个集群的成本远高于Zilliz。 通过成本和性能上的考虑,对于大数据量并且性能和稳定性要求高场景,我们将选用Zilliz。 迁移方案 对于不同业务场景,我们分别制定了以下3种迁移方案: 方案1:业务自行导入数据使用 方案2:备份恢复 + 业务增量 方案3:全量 + 增量 + 业务双写/回滚 高可用架构部署 随着业务关键性持续提升,Milvus对应的SLA变得越来越重要。在此背景下,构建完善的Milvus高可用架构与灾备体系已成为系统设计的核心考量要素。比如:主从、多zone部署,Proxy高可用,Minio高可用,一个zone完全挂了怎么办等问题? 方案1: 同城多机房混部 正常访问: 当 Zone1 不可用: 访问会切换到 Zone 2 的备用SLB中。 备用SLB会访问本机房的Proxy。 由于 QueryNode 1 和 QueryNode 2 已经不可用,需要重建QueryNode,新生成 QueryNode 5、QueryNode 6并且加载数据提供访问。 方案2: 同城多zone多副本就近访问 整个Zone不可用: 当Zone1整个不可用,不影响Zone2的访问。 方案3: 同城多zone单独部署业务交叉访问互相backup 当整个zone不可用 整个zone1不可用,由于线路1会访问到zone1的SLB,因此线路1访问会报错,业务需要将线路1切换成线路2。 六、向量数据库运维沉淀 索引结构和搜索原理 HNSW 索引 ※ 相关信息 ※ 内存结构 由于空间问题,图中并没有完全按 M=16、ef=200 参数进行画图。 ※ HNSW搜索过程 现在需要搜索向量N = [....] DiskANN 索引 ※ 相关信息 ※ 存储结构和裁剪过程 由于画图空间问题,没办法将 聚类数=10、100/内存聚类、1w/磁盘聚类 信息画全。 初始化随机连接:DiskANN算法会将向量数据生成一个密集的网络图,其中点和点是随机链接的,并且每个点大概有500个链接。 裁剪冗余链接:通过计算点和点点距离裁剪掉一些冗余的链接,留下质量高的链接。 添加快速导航链接:计算出图中若干个中心点,并且将这些中心点进行链接,并且这些链接会跳过其他点,如果图中黄色链接。 重复进行裁剪优化过程,达到最优的情况。 PQ量化操作生成索引: 将向量分成多个子空间。 独立对每个子空间进行聚类操作,并且计算出多个质心。 将每个子向量映射到最近的质心ID。 ※ DiskANN搜索过程 现在需要搜索向量N = [....] 并不是你想的那样 querynode 越多越快? querynode 越多,查询越快,并发越高? ※误区原因 将querynode看成redis cluster,增加节点数能提高查询并发,然而并不是。redis cluster 增加节点,数据量会尽可能的打散到每个节点中,所以增加节点和性能提升是相对成正比。但是milvus不一样,milvus打散的基本单位是segment,一般segment大小(1G/个),他的粒度比redis cluster要大。理论上的理想情况是1个segment对应1个querynode,但是实际情况会收到多因素的干扰,会导致querynode越多出现不稳定的概率越大,如某个querynode网络抖动会影响整体的查询RT。 标量索引提高性能 在标量上创建索引,搜索带上标量过来能提高性能? ※误区原因 使用传统关系型数据库的索引查询来理解Milvus的索引查询,字段上创建了索引能使用到索引扫描进行数据查询,比全表扫描快。然而并不是,关系型数据库的属于精确查询,Milvus属于近似最近邻搜索(ANNS),milvus的查询是不保证绝对精确,使用了标量索引查询反而会导致数据变稀疏查询会变慢。 使用标量索引筛选不一定快原因,如下示例: 通过ANNS搜索后再使用标量搜索,过程如下: 思考: 在第二步如果使用ANNS搜索完成之后到底是否需要使用标量索引进行搜索。 如果需要使用标量索引进行搜索那边在ANNS搜索后的结果集需要额外的进行索引构建,然后再进行过滤。构建构建过程其实也是需要便利结果集,那么是不是可以直接在便利的时候直接进行结果集的筛选。 那么其实在某种程度上是不是标量索引没那么好用。 大量单行dml不批量写入能提高数据库性能 大量单行dml,不使用批量写入操作,能提高数据库性能。 ※误区原因 使用传统关系型数据库为了让系统尽量少的大事务,减少锁问题并且提高数据库性能。然而实际上Milvus如果有很多的小事务反而会影响到数据库的性能。因为Milvus进行dml操作会生成deltalog、insertlog,当dml都是小事务就会生成大量的相对较小的deltalog和insertlog文件,deltalog和insertlog在和segment做合并的时候会增加打开和关闭文件次数,并且增加做合并次数,导致io一直处于繁忙状态。 deltalog 和 insertlog 生成的契机有2种: 当数据量达到了一定的阈值会进行生成deltalog 或 insertlog。 Milvus会定时进行生成deltalog 或 insertlog。 eltalog、insertlog 和 segment 合并过程 人为让 deltalog、segment 执行时机可预测 如果业务对数据实现要求不是那么高,建议使用定时批量的方式对数据进行写入,比如可以通过监控获取到每天的波谷时间段,在波谷时间段内进行集中式数据写入。原因是如果不停的在做写入,无法判断进行合并segment的时间点,要是在高峰期进行了合并操作,很有可能会影响到集群性能。 错误处理 ※ 2.2.6 批量删除数据bug,导致业务无法查询 报错: 解决:将集群升级到2.2.16,并且让业务 批量删除和写入数据。 ※ find no available rootcoord, check rootcoord state 报错: 问题:rootcoord和其他pod通信出现了问题。 解决:先重建rootcoord,再依次重建相关的querynode、indexnode、queryrecord、indexrecord。 ※ 页面查询报错 (Search 372 failed, reason Timestamp lag too large lag) 问题:pulsar 组件对应相关pod问题导致不进行消费。 解决:将pulsar 组件相关pod进行重建,查看日志,并且等待消费pulsar完成。 ※ Query Node 限制内存不足 (memory quota exhausted) 报错: <MilvusException: (code=53, message=deny to write, reason: memory quota exhausted, please allocate more resources, req: /milvus.proto.milvus.MilvusService/Insert)> 原因:配置中Query Node配置内存上线达到瓶颈。 解决:增加Query Node配置或者增加QueryNode节点数。 ※ 底层磁盘瓶颈导致ETCD访问超时 报错: 解决:从架构方面上进行解决,在集群维度将磁盘进行隔离,每个集群使用独立磁盘。 七、未来展望 数据迁移闭环 数据迁移闭环:对于业务数据加载到向量数据库的场景,业务只关心数据的读取和使用,不需要关心数据的量化和写入。DBA侧建立数据迁移闭环(下图绿色部分)。 数据准确性校验 对于上游数据(如MySQL)和下游向量数据库数据库一致性校验问题,DBA业将协同业务、Milvus进行共建校验工具,保障数据的准确性。 往期回顾 1.社区搜索离线回溯系统设计:架构、挑战与性能优化|得物技术 2.从Rust模块化探索到DLB 2.0实践|得物技术 3.eBPF 助力 NAS 分钟级别 Pod 实例溯源|得物技术 4.正品库拍照PWA应用的实现与性能优化|得物技术 5.汇金资损防控体系建设及实践 | 得物技术 文 / 呆呆 少晖 关注得物技术,每周更新技术干货 要是觉得文章对你有帮助的话,欢迎评论转发点赞~ 未经得物技术许可严禁转载,否则依法追究法律责任。 注:本文部分代码上传代码可读性差,换成截图上传,需要复制代码的小伙伴可以去得物技术公众号查询。

优秀的个人博客,低调大师

供应链 PC 实操落地实践

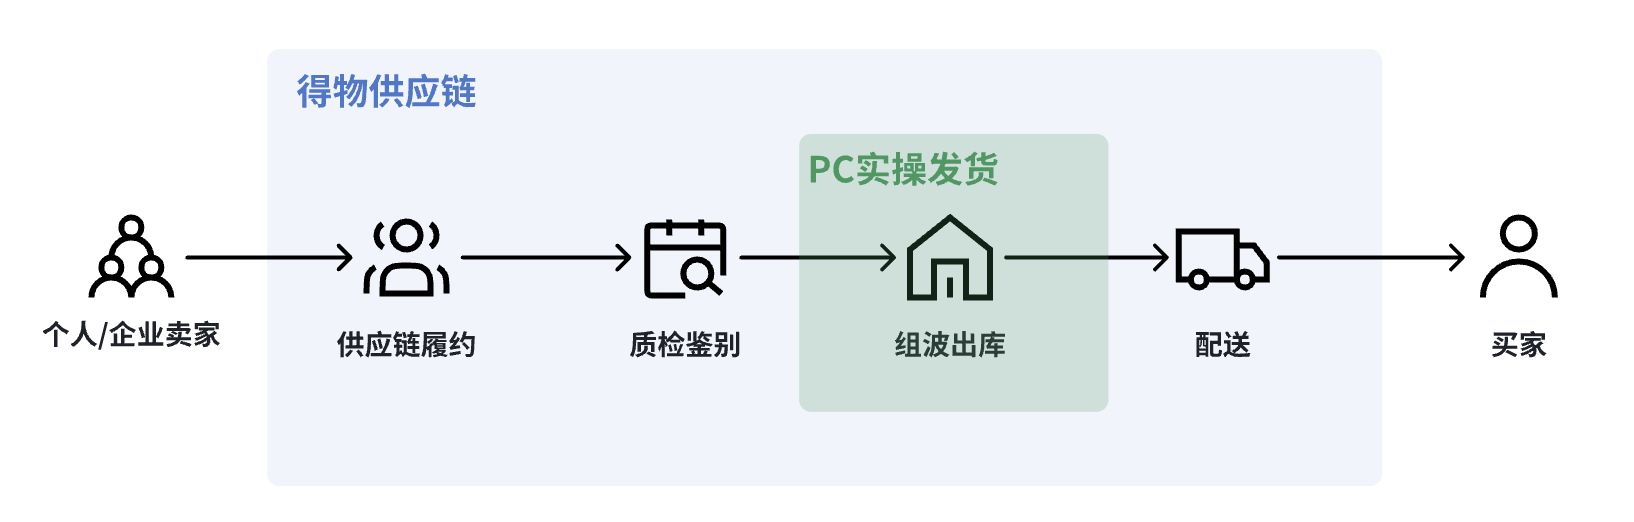
目录 一、背景 二、实操模式 三、快捷码设计和使用 快捷码布局 快捷码的准确识别 快捷码的高亮反馈 快捷码打印和黏贴建议 四、问题复盘 基准体验的梳理 五、实操环境检测 实操环境的安装和配置 实操环境检测能力的使用流程 实操检测能力的技术架构 实操环境的检查时机 输入法的检测和自动修复 统一打印组件 软件更新 六、信息反馈及异常SOP 七、效率指标的定义、监控和分析 八、后续规划 一、背景 在供应链履约流程中,PC实操发货主要负责 "完成复查入库商品的数量、规格和质量,并核对证书和防伪扣的正确性,确保商品无问题后,对订单内的商品进行打包、打印黏贴物流面单,并交接给3PL配送"。 作为配送前的最后一道屏障,需要确保供应链从生产入库到出库的环节的质量符合预期,最终将包裹交付到物流供应商,配送给消费者。 随着得物业务规模变大,供应链对成本、效率、质量的要求在不断提升,云仓业务模式开始逐步测试并铺开,仓内的设备环境与得物自有仓出现差异,因此PC实操系统需要在设备采购成本和实操的效率之间寻找平衡点。 云仓内的设备环境不一致,实操系统会面临如下问题: 大部分云仓BPO没有平板电脑,无法直接使用得物既有的实操系统(Pink Flutter App); 打印机型号众多,打印指令无法统一,容易造成打印配置和打印效果不一致; 设备类型和配置的不一致,带来了更多的适配问题,很容易形成业务流程的卡点,影响开仓和实操的效率。 为了解决这些问题,PC实操系统需要是跨平台的,从而保障系统使用的灵活性 ,并降低对设备种类的依赖度 ;其次通过接入得物统一打印组件,来抹平打印机型号的差异带来的成本。 本文主要介绍实操发货交互模式的实现、实操环境的检测及自动修复 ,文章最后也介绍了实操效率指标的定义。 二、实操模式 实操系统的信息输入有多种选择,可以是触屏电脑、扫码枪、键盘鼠标等。实操过程需要向系统内的录入多种条形码、二维码等信息,以及复检、打包的结果信息。按照不同的输入设备类型,可以将实操分为如下几种: PC实操系统同时支持了以上三种模式,但考虑到实际的设备环境和使用效率 ,推荐仓内使用扫码实操模式,即采用扫码枪 + 屏显二维码 + 粘贴实体码的混合扫码实操方案。 三、快捷码设计和使用 在扫码模式中,可以将这些快捷指令二维码简称为"快捷码"。设计快捷码的初衷,是为了简化实操的输入设备种类,在不切换到键盘鼠标的情况下,仅通过扫码枪就可以完成信息的录入、操作指令的执行。快捷码除了可以进行数据接口通信、交互操作,也可以执行多个指令的组合指令。 快捷码布局 如何将快捷码融合到PC实操系统,考虑过多个方案: 1. 环绕布局 2. 左右布局 3. 二级指令菜单 指令折叠:有些指令使用频次很少,且具有一定的"误操作风险",因此考虑二级指令菜单的交互,将不常用的折叠起来。借助扫码枪即可扫码打开二级菜单,此时操作区收窄,或者以Popup形式呈现,二级菜单发生有效扫码即可关闭,或者主动扫交互码关闭。 快捷指令交互系统:所有流程支持快捷指令,可以扫码展开、折叠,也可以扫码查看订单明细等,扫码关闭弹窗,代替鼠标,大部分操作需要做到扫完即关,确保操作区的可用性。 大部分快捷码在正向流程里的使用频率并不高,并且屏显快捷码过多,会增加扫错二维码的风险 。因此在方案3的基础上,将二维码进行归类,并收纳到功能导航中,同时会建议将常用快捷码打印黏贴至工位使用。 为了提升扫码的效率,屏幕上的快捷码会保持简洁,只会存在1-3个快捷码,并且在布局的设计上有较大的分布间距,避免扫码失误的情况出现。 快捷码的准确识别 我们定义以**"@"字符开头标识一个快捷指令的开始**,数字则代表快捷码类型,如 @01 代表打印面单。这样的设计可以降低生成的快捷码的复杂度,提升识别的准确率。 扫码枪扫码后会以连续字符串输入给活跃的焦点设备 ,并以Enter结尾;基于这个特点, 要准确识别一个快捷码指令有三个必要条件:@开头、 Enter结尾、连续输入。完成指令识别后,就可以准确执行指令注册的函数了。然而,在识别过程也会遇到一些问题。 字符录入冲突。在一个连续的指令输入过程中,会禁用默认键入的内容,这样可以避免焦点处于输入框的同时扫描了快捷码,意外将快捷码字符录入到输入框中。 焦点冲突。由于实操系统同时支持键盘模式操作,可以通过Enter键模拟鼠标对按钮的点击;当焦点处于按钮上时扫描了快捷码,扫码枪输入的Enter会造成按钮意外触发点击。因此在识别到扫码内容为快捷指令类型时,会在短时间将按钮移除焦点,指令结束后再重新设置焦点。 (e: KeyboardEvent) => { const enterKey = e.key === "Enter"; // @ 开头,开启一个新的快捷指令 if (e.key === "@") { e.preventDefault(); scaning.current = true; } // ... // 处理按钮输入锁定等兼容逻辑 if (scaning.current && !enterKey) { activeCode.current += String(e.key); e.preventDefault(); } else if (activeCode.current && enterKey) { scaning.current = false; // next // 快捷指令执行函数和标记高亮等 } //... // 输入解锁等能力 }; 快捷码的高亮反馈类似 支付宝商家二维码收款的到账提示音,实操过程的操作和信息录入,需要对结果进行反馈。 目前,除提示"成功"、"失败"的声音反馈外,还会对命中的二维码添加高亮块进行视觉反馈,这也解决了部分仓库没有音响设备,可以通过视觉反馈的形式感知操作行为。 快捷码打印和黏贴建议 为了更方便的让仓内打印黏贴快捷指令二维码,将常用的快捷指令码分为两大类:正向流程和逆向流程;并支持在实操系统直接打印。 实操流程简单的仓库,只需要把必要的 1 - 4 个快捷码黏贴于工位即可。 快捷码的打印通过动态渲染html片段并执行打印来实现,如下: /** * 打印html片段 */ export function printHTMLOutWithCSS(config: { content?: string; cssText?: string; }) { if (!config?.content) return; const cssText = config?.cssText; const iframeEle = document.createElement("iframe"); iframeEle.style.display = "none"; document.body.append(iframeEle); const iframeDoc = iframeEle?.contentDocument || iframeEle?.contentWindow?.document; if (iframeDoc?.body) { iframeDoc.body.innerHTML = `<style>${cssText || ""}</style>${ config?.content }`; iframeEle?.contentWindow?.print(); } document.body.removeChild(iframeEle); } printHTMLOutWithCSS({ content: `${dom.outerHTML}<div class="qrcode-button-name">${ config?.name || "-" }</div>`, cssText: STYLE_PRINT_STR, }); 四、问题复盘 8月中旬开始PC实操已在部分云仓生产环境使用起来,我们梳理了仓内遇到的问题及操作效率,可以归类如下: 异常流程、逆向流程,无SOP。依赖经验和培训。如:订单被取消,后续的操作建议。 实操环境检测及自动化配置。如输入法检测、扫码枪配置检测、打印机环境检测和配置等。 正向流程存在冗余。除了必要的信息输入,其余部分可以自动化完成。如:防伪完成。 基准体验的梳理 解决这些问题前,需要先了解好的体验和正确的流程是什么样的,再去优化才有据可依。一个好用的实操流程的特征可以枚举如下: 开仓或实操开始前"实操助手" 可以保障实操环境、设备配置的可用性,并可以自助修复卡点问题; 保障大部分订单仅需扫码必要的订单、商品、防伪信息,即可自动化完成发货,操作链路无冗余; 提升高频操作的无键盘化的覆盖率,全程仅需用到扫码枪,降低用户设备上的使用负担; 针对异常流程,可以系统化低成本的录入异常SOP预案,自动呈现提示语、解决问题的快捷指令等。 接下来介绍下PC实操如何通过"实操环境检测"和"异常SOP链路"来解决这些问题的。 五、实操环境检测 实操环境的安装和配置 进入实操系统后,会引导安装得物打印软件,并对打印机进行配置。 实操环境检测能力的使用流程 仓内实操人员开工后,通过如下流程来保障实操环境的可用性。 实操检测能力的技术架构 实操环境检测能力内置于得物打印Electron应用中,通过Socket长链接通信,借助Electron系统级API的优势能力来拓展Web端实操系统的能力边界。实操Web系统和得物打印Electron系统的调用交互过程如下: 实操环境的检查时机 PC实操系统会在心跳检查的循环里自动检查实操环境(输入法、打印机、软件版本);实操系统焦点到前台后,也会立即触发一次检查。扫码枪属于手动输入设备,因此需要手动点击进行检测(大小写转换、输入速度)。 输入法的检测和自动修复 实操过程需要一个英文的输入法语言环境,这是由于在中文环境下,扫码枪录入信息时,键入的英文字符很容易意外命中中文字符,导致输入内容错误。因此实操开始前,需要对输入法自动进行检查和设置。 Electron Nodejs主进程拥有强大的动态脚本的执行能力,我们可以即此对Windows系统语言进行检测和设置。Windows官方提供的国际化语言相关系统API文档,出于安全和体验考量,没有提供活跃窗口语言修改后立即生效的能力,需要切换焦点后才可以生效,如果强行切换到英语输入法,会导致系统其他输入法被卸载,这可能会对实操用户带来困扰。 为了解决这个问题,目前会对已安装输入法的进行缓存(Shell变量$restoreLanguageList),卸载全部输入法后,再异步进行已安装输入法的复原,同时也会安装英语输入法 en-US,并设置为首选输入法。 // # constant const PLAT_WIN = os.platform() === 'win32' const LANG_CONFIG = { 'en-US': { name: 'en-US', code: '0409:00000409', delay: 1.5, }, 'zh-CN': { name: 'zh-CN', code: '0804:{81D4E9C9-1D3B-41BC-9E6C-4B40BF79E35E}{FA550B04-5AD7-411F-A5AC-CA038EC515D7}', delay: 1.5, }, } /** * 获取shell指令集 */ function getShellLangScripts({ delay, name, code, }: { delay: number name: string code: string }) { const tplName = name || 'en-US' const tplCode = code || '0409:00000409' const tplDelay = delay || 1.5 // powershell 指令集 return { // ## 脚本: 重置系统输入法为 name 如en-US,删除其他输入法,立即生效,无需切换窗口焦点 // ## 优点,避免用户意外打开中文输入法,缺点,用户已有输入法被卸载 RESET: [ `Set-WinSystemLocale ${tplName};`, `Set-WinUserLanguageList ${tplName} -Force;`, `Set-WinDefaultInputMethodOverride -InputTip "${tplCode}";`, ], // ## 脚本: 添加系统输入法 name 如en-US,合并其他输入法,立即生效,无需切换窗口焦点 // ## 优点,用户已有输入法依然存在,缺点,中文输入法可能还存在于用户的输入法列表中 COMPATIBLE: [ `$restoreLanguageList = Get-WinUserLanguageList;`, `$restoreLanguageList.Remove("${tplName}");`, `$restoreLanguageList.Insert(0, "${tplName}");`, `Set-WinUserLanguageList ${tplName} -Force;`, // windows未开放当前窗口立即生效,这里通过hack实现 `Start-Sleep -Seconds ${tplDelay};`, `Set-WinUserLanguageList -LanguageList $restoreLanguageList -Force;`, // 设置默认输入法和系统语言 `Set-WinDefaultInputMethodOverride -InputTip "${tplCode}";`, `Set-WinSystemLocale zh-CN;`, // 调整语言顺序后,Win11下会将首个语言设置为展示语言,这里重置为中文 `Set-WinUILanguageOverride -Language zh-CN;`, ], } } /** * 添加系统输入法 en-US,合并其他输入法,立即生效,无需切换窗口焦点 */ */ export type ActionTypeLangAdapt = 'COMPATIBLE' | 'RESET' | 'CAT' export type NameTypeLangAdapt = 'zh-CN' | 'en-US' let lockExecLang = false export function adaptOrCatLang( actionType?: ActionTypeLangAdapt, nameType?: NameTypeLangAdapt, delay?: string, fn?: (status: 'success' | 'failed', msg: string) => void ) { if (lockExecLang) return lockExecLang = true const fnAffair = (status: 'success' | 'failed', msg: string) => { fn?.(status, msg) lockExecLang = false } if (!PLAT_WIN) { fnAffair('failed', '仅支持windows系统') return } const langTplConfig = LANG_CONFIG[nameType] langTplConfig.delay = Number(delay) || langTplConfig.delay if (!langTplConfig) { fnAffair('failed', '语言类型错误') return } const shellLangScripts = getShellLangScripts(langTplConfig) switch (actionType) { case 'CAT': const out = childProcess.execSync( 'powershell.exe (Get-WinUserLanguageList)[0].LanguageTag;' ) fnAffair('success', out?.toString('utf8')?.trim() || '') break default: const langScript = shellLangScripts?.[actionType]?.join('') if (langScript) { const out = childProcess.spawn(langScript, { shell: 'powershell.exe', }) out.on('exit', function () { fnAffair('success', `语言切换成功(${nameType})`) }) } else { fnAffair('failed', '指令类型错误') } break } } 语言环境自动修复效果如下: 具体视频见得物技术公众号 统一打印组件 新版实操接入了"得物打印"提供的统一打印组件能力(基于 Chromium 统一内核实现),主要考虑到两点原因: 新版打印机组件,可以实现和打印机机型解耦,不再要求 BPO 购买指定机型打印机,节省 BPO 成本; 保证打印效果的一致性,为后边统一面单打印做基础。 借助统一打印组件能力,可以屏蔽不同打印机型号给实操环境带来的复杂性和不可控性,大大降低了开仓的成本,提升实操效率和一致性。统一打印组件的连接状态检查和实操环境的检测是同步进行的,因此只需要按照指引安装即可。 软件更新 实操系统需要保证得物打印的是最新版本,因此在检测到软件版本需要更新后,通过URL Schemes唤起Electron应用,进行软件的更新和配置更新。 六、信息反馈及异常SOP 实操人员的工作就是识别信息并做出判断和操作的过程。在实操界面的头部增加操作状态反馈,增强状态呈现和信息反馈,可以帮助提升实操用户的专注度。用于明确告诉用户当前处于什么流程,结果成功/失败。 一般有两种信息反馈形式: 声音,仓内无音响设备则无法触达; 通知,有常驻通知和非常驻两种。 当系统出现预期之外的情况,比如订单被取消了,那么供应链流程也需要执行返架和挂起重置。此时如果没有Case by Case的SOP指引,实操流程就会被卡住,此时过于依赖培训和经验来解决。因此目前会将已知的异常链路和用户反馈,不断迭代到异常SOP中,提升系统的易用性。 七、效率指标的定义、监控和分析 业务产品迭代到后期,问题的定位和流程的优化,往往不是可以通过经验上的判断来完成的,需要借助数据来驱动体验优化。Q4云仓会逐步铺开,随着使用量的提升,基础实操数据的指标定义、监控和数据分析的能力就愈发重要。 目前定义了衡量实操效率和易用性的基础指标,核心关注用户能否顺滑的完成发货流程,避免逆向反复。 对应的实操效率看板如下: 八、后续规划 实操开仓效率 完成实操检测能力的验证,确定后续开仓流程细节,确认检测能力短板; 提升实操效率指标的可用性、逆向流程分析和发现问题的效率。 实操开仓保障 保障后续开仓顺利进行,补齐商品图无键盘切换、关键词信息和AI复检等能力; 保障PC实操在云仓DB和得物仓的兼容性和可用性,通过微前端兼容云仓登录,从而提升迭代的一致性和效率。 系统体验提升 信息透出屏效和自动录入能力; 设备环境问题可以通过"实操助手"检测能力自行解决; 业务异常不中断操作流程,并可以自行解决问题。 *文 / Tony 本文属得物技术原创,更多精彩文章请看:得物技术 未经得物技术许可严禁转载,否则依法追究法律责任!
优秀的个人博客,低调大师

干货|DataEase 嵌入式分析落地指南

作为一款“人人可用的开源数据可视化分析工具”,DataEase提供了强大的嵌入式分析能力,支持将分析功能直接嵌入到其他应用程序或业务流程中,以便用户在其日常使用的业务系统中开展数据分析和数据洞察。这种BI分析能力可以无缝集成到现有的业务应用程序中,用户无需离开应用程序,即可进行数据探索、可视化操作和报告生成。 ISV(独立软件开发商)和SI(系统集成商)可以轻松将DataEase的自助式分析能力嵌入到其软件产品或应用系统中,从而快速提升其产品的竞争力和客户使用体验,同时有效降低技术实现成本。 本文为您详细介绍DataEase嵌入式分析的技术架构、选型考量、集成方案和用户价值,旨在为广大ISV和SI伙伴高效采纳DataEase嵌入式分析解决方案提供指引。 一、什么是嵌入式分析? 在数字经济时代,BI和数据分析工具被广泛应用于实际业务中。但传统的BI和数据分析工具都是独立的应用平台,用户在实际使用中需要不断地切换所使用的业务系统(例如ERP、OA、CRM等),繁杂的过程和较高的使用门槛大大降低了数据分析工具的推广效果。如果能够降低数据分析和数据应用的使用门槛,把分析过程和分析结果直接放置到业务系统内部,则会极大地提升用户的使用体验,有助于提高业务决策效率,释放业务数据的价值。 嵌入式分析是指可以嵌入在商业应用程序中,为应用软件提供或者增强分析功能的专业BI软件。研究机构Gartner在题为《2023 Market Guide for Embedded Analytics》(2023嵌入式分析市场指南)的报告中指出,通过API将分析和数据科学功能嵌入到网站或者商业应用中,能够有效减少变更管理并提高数据分析的采纳率。 二、常见的嵌入式分析场景 嵌入式分析的的应用场景主要包含分析结果嵌入、设计能力嵌入、平台整体嵌入和其他嵌入四大类别。 ▲ 图1 嵌入式分析的应用场景 ■分析结果嵌入:将设计好的视图和可视化仪表板集成到业务系统中,提供上卷、下钻、联动、过滤、传参等可交互式自助分析能力; ■设计能力嵌入:将可视化仪表板和数据大屏的设计器嵌入到业务系统中,用户可在集成后的业务系统中自助构建个性化的数据探索; ■平台整体嵌入:通过API对接,实现全流程嵌入,可以在业务系统中进行数据源、数据集、仪表板、数据权限的管理和控制; ■其他嵌入:包括单点登录系统对接,与办公软件(例如企业微信、飞书、钉钉)的无缝对接,以及OEM白标嵌入。 三、基于DataEase的嵌入式分析解决方案介绍 DataEase开源数据可视化分析平台的嵌入式版本支持单点登录系统以及与第三方权限管理系统的对接。DataEase的嵌入式分析功能架构如图2所示。 ▲ 图2 DataEase嵌入式分析架构设计 通过轻量级、松耦合的架构设计,DataEase提供了完善的嵌入式分析能力,依托平台API层、前端技术层、应用功能层的交付体系赋能业务系统,使其拥有原生的BI能力。 ■平台API层:提供完善的API对接能力,可以实现仪表板、数据源、数据集、用户、权限等功能的API对接管理,兼容各类型场景的调用; ■前端技术层:采用纯前端技术栈即可完成嵌入式分析集成,通过使用HTML、CSS和JavaScript技术,即可在已有系统中轻松拥有嵌入式分析能力; ■应用功能层:提供三大嵌入类型和六大嵌入场景,赋能业务系统,满足使用者的数据分析与数据展示需求。 DataEase嵌入式分析解决方案为ISV和SI伙伴提供了两大嵌入方式、三大嵌入类型,以及六大嵌入场景: ■两大嵌入方式:iframe嵌入和DIV嵌入; ■三大嵌入类型:结果嵌入、设计器嵌入和整体嵌入; ■六大嵌入类型:仪表板/数据大屏图表嵌入、仪表板/数据大屏页面嵌入、仪表板/数据大屏设计器嵌入、BI功能模块嵌入、门户嵌入和OEM白标定制。 四、两种不同嵌入方式的选型考量 目前,DataEase提供iframe和DIV两种前端嵌入方式,两种嵌入方式各有特点,ISV和SI可以根据实际情况灵活选择。 上述两种嵌入方式的特点对比: iframe嵌入方式: ■简单快速,可以快速集成可视化大屏; ■隔离性好,嵌入内容独立,松耦合。 DIV嵌入方式: ■灵活性高,可以通过CSS控制嵌入内容; ■兼容性好,可以耦合成页面主题的一部分。 注意:用户可以在DateEase嵌入式版的在线体验环境(https://embedded-bi.dataease.cn/)实际体验这两种嵌入方式,DataEase官方同时提供了源码示例(https://github.com/dataease/embedded-demo)。 五、用户集成方案 在进行嵌入式分析功能集成时往往会涉及到用户体系的打通,DataEase提供了丰富的用户集成方案,包括移动办公软件对接、域控对接、单点登录系统对接、API对接和模拟登录等方式,ISV和SI可以根据实际情况灵活选择。 六、DataEase嵌入式分析解决方案的价值 嵌入式分析在各种行业和不同的应用场景中已经得到了广泛的应用,包括企业资源规划(ERP)、客户关系管理(CRM)、电子商务、医疗保健、物联网(IoT)等领域。通过嵌入式分析,企业可以将数据驱动的决策能力直接融入到其核心业务流程中,从而获得更好的业务结果和竞争优势。 对于独立软件开发商(ISV)/系统集成商(SI),可以获得的收益包括: ■提高开发效率:专注产品本身业务功能的开发工作,无需花费大量的时间和精力在数据应用方面,有效释放生产力; ■提高交付效率:灵活应对甲方随时变化的可视化分析需求,通过简单的拖拉拽操作快速调整,提升产品或项目交付效率; ■提升产品差异化能力:将数据分析/展示功能放权给软件使用者,使其能够根据自身业务的实际情况开展自助式分析,打造沉浸式用户体验; ■提升用户满意度:嵌入式分析可以根据特定业务系统的需求进行定制,提供与业务系统一致的用户界面和体验。 对于企业客户,可以获得的收益包括: ■无缝集成:嵌入式分析直接嵌入到其业务系统中,用户可以在不离开业务系统的情况下使用数据分析功能; ■个性化体验:嵌入式分析可以根据特定业务系统的需求进行定制,提供与业务系统一致的用户界面和体验; ■即时决策:用户可以在业务系统中即时访问分析功能,从而更快地获取数据洞察,并且做出即时决策; ■提高生产力:用户无需切换到其他分析工具或平台,可以在熟悉的工作环境中开展数据分析,提高了工作效率和生产力; ■增强数据驱动决策:嵌入式分析让数据分析成为业务流程的一部分,有助于推动数据驱动的决策制定和业务优化; ■可扩展性和定制化:嵌入式分析体系具有高度的可扩展性和定制化能力,可以根据不同的业务需求进行定制和扩展。

优秀的个人博客,低调大师

【BegCode,来自 JHipster 的国产化落地!】

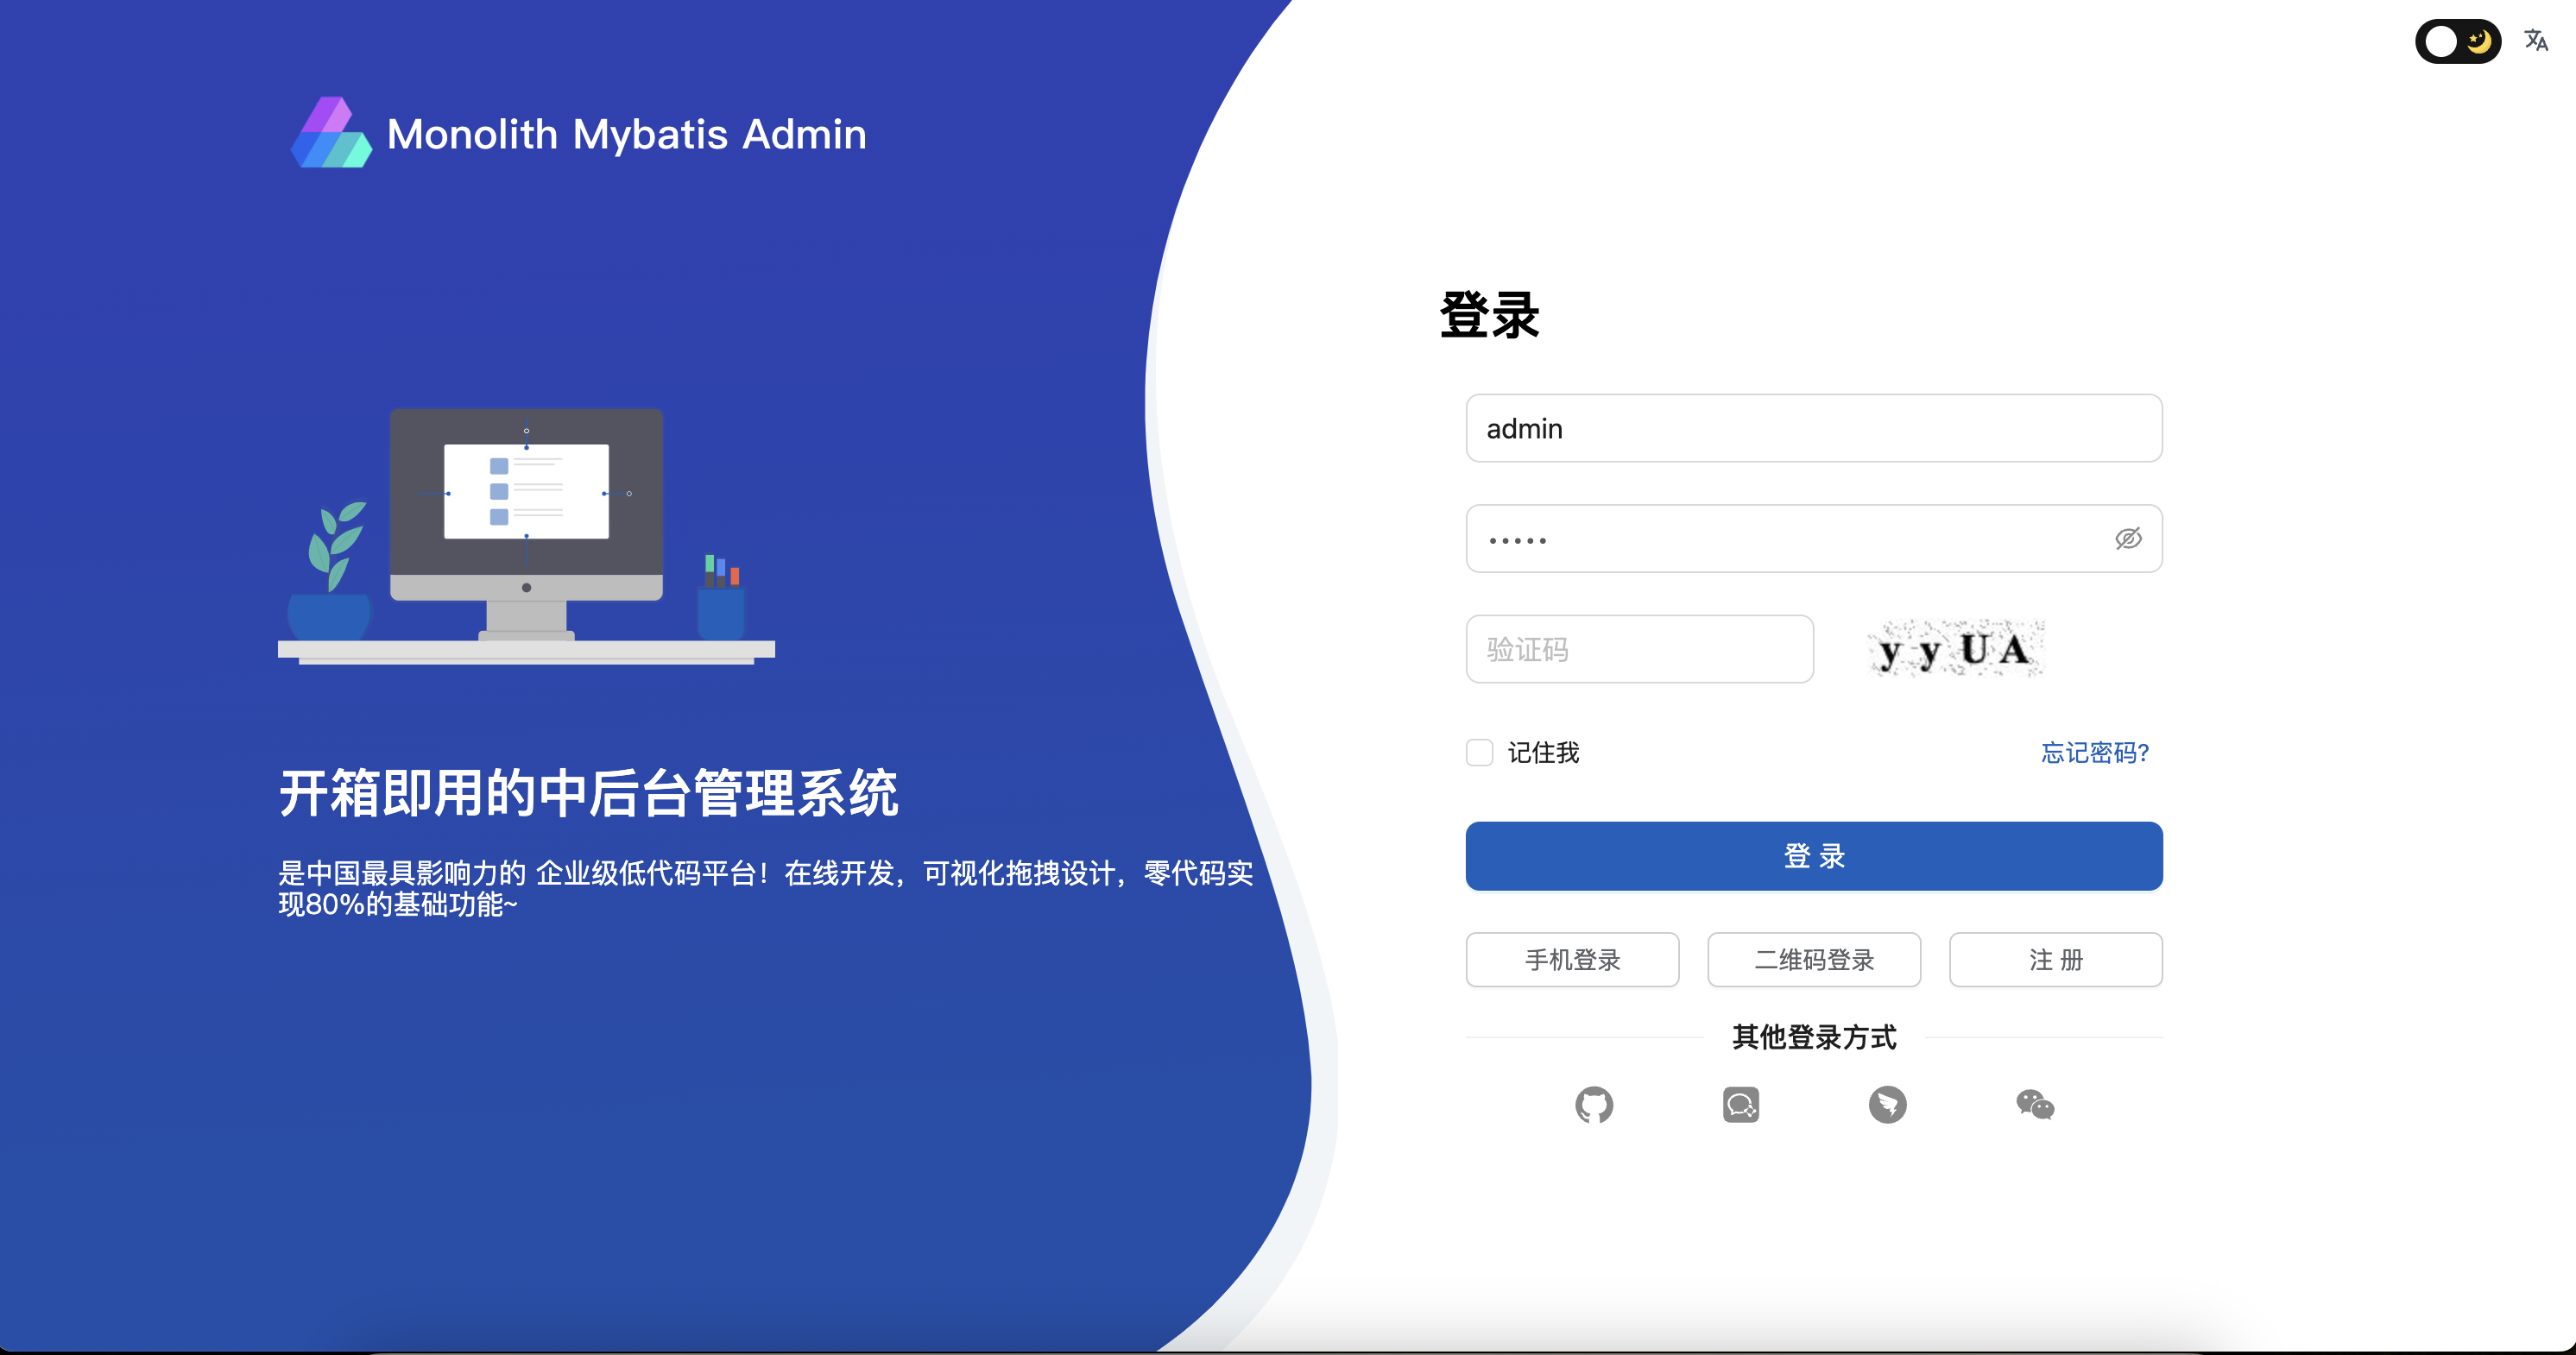
一、BegCode是什么? BegCode是基于JHipster,同时又对前端和核心代码模板进行增强了的一个代码生成工具,该工具是为了解决快速产品开发和推广JHipster理念诞生的。 JHipster应用本身支持很多扩展方式,如BluePrint的方式,利用JHipster核心功能的同时,又可以增加扩展。但BegCode没有使用BluePrint的方式,主要原因是BegCode对一些底层代码进行了改进,无法在BluePrint中达到目的。 二、BegCode亮点 BegCode这些亮点,结合了大量的JHipster爱好者期望并在在长期的实践中总结出来的,让JHipster离我们开发目标更近一步。 1.ORM框架增加Mybatis支持 这一块,不是简单的增加Mybatis本身的支持,还是多方调研,组合了Mybatis-Plus和Diboot-core两个技术框架。 其中Mybatis-Plus简化了Mybatis下的开发,又做了很多动态的查询功能增强,是Mybatis下选择比较多的一种方案。但Mybatis-Plus和Jpa比较,缺失了关联关系的自动化处理。而Diboot-core在这一方面,有自己的优势,是一个不错的选择,二都相结合,在关系处理上又增强了一步,同时这些理念与JHipster的处理方案又比较契合。 2.前端增加Ant-Design-Vue组件库 国内对于Vue.js还是比较喜欢的。但JHipster官方提供的前端效果和功能,不太适合国内一些应用的开发,尤其是缺少了Admin管理平台的部分。 Ant-Design-Vue的组件库受到了Ant Design的影响,具有类似的设计语言和风格,提供了丰富的UI组件来满足各种应用的需求。它还提供了灵活的主题定制和国际化支持。Ant-Design-Vue是一个非常受欢迎的UI组件库,在Vue.js开发社区中被广泛使用。 我们也看到在Ant-Design-Vue组件应用方面,Vben Admin脚手架和Jeecg Boot都做的非常好,相信很多人也有过应用。 基于以上情况,增加了Vben为基础的Admin管理页面的内容并对相应的功能进行了整合,包括用户、角色、菜单、日志、数据字典、定时任务等等。 3.增加更丰富的JDL注解 JHipster基于JDL的注解,是一个非常好用的功能,也是BluePrint方式可定制的一块。丰富的注解,为代码生成增加了很多的可能性。 BegCode在JHipster增加了11个Entity注解,10个Field注解,13个Relationship注解选项。大大增强了生成代码的控制功能。 4.丰富Java的后端接口功能 传统的代码生成工具,包括JHipster在内,针对后端接口的生成方面,除了基本的CURD功能外,增加的不多。 BegCode在JHipster的基础上增加统计汇总接口、关联关系处理接口、排序操作接口,同时增强了多条件查询的能力,丰富了修改信息接口的处理方式。 5.强化生成代码与手工代码的融合 一直以来生成代码与手写代码整合都是一个问题,BegCode在Java方面通过继承来解决用户手写代码被覆盖的问题,在前端方面,通过配置与页面控制分离的方式解决代码覆盖的问题。同时为了更好用户体验,可通过页面注释去定义,这个文件本身是否允许生成器生成的内容将其覆盖。 这些优化,都提高了用户的体验,提高了开发效率,随时生成代码,随时修改代码,让代码生成器总能发挥作用,而不是生成一次后再也不敢使用生成器来自动化生成代码。 6.对JHipster功能的改进 JHipster做为一个生成器工具,其技术和理念非常棒,但内置的业务功能有限,国内用户更喜欢集成更多开箱即用的功能。 BegCode对JHipster内置的用户、权限进行了增强,更符合产品实际需求。 同时增加菜单管理、部门管理、文件上传、短信发送、操作日志、编辑生成、通知公告等功能,而这些功能也是通过jdl进行定义的,BegCode在生成基础代码后,自动生成一次上述功能的代码。如果用户对内置的jdl进行了修改,还可以通过命令行或修改参数的方式让BegCode重新生成上述功能相关的代码。 三、效果展示 1.登录页面 2.默认首页 3.用户列表 4.菜单列表 5.角色列表 6.数据字典 7.短信服务商配置 8.通知公告 9.图片上传 10.消息查看 11.操作日志 12.接口说明 13.图标选择参考 四、使用步骤 1.全局安装generator-begcode npm install -g generator-begcode 2.创建项目目录并在项目目录下执行命令begcode begcode 上述截图表示已经正常启动 3.配置选项 根据系统的提示完成相关的选项。不太了解的选项使用默认值 4.代码生成 随着屏幕的不断滚动,你想要的代码已经生成了 5.启动系统 在全部文件生成后系统会提示如何使用: 启动后端,使用./mvnw启动前端,使用pnpm start 6.进入系统 后端启动完成: 前端启动完成: 现在可以通过http://localhost:3100/进行系统体验了。 源代码参考地址:https://github.com/begcode/monolith-mybatis-antdv 总结 以上内容简单介绍了一下BegCode对JHipster的增强,以及如何更适合国内的开发者,从而进一步提高开发效率。后续有机会再介绍如何快速定义JDL并生成代码。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册