首页 文章 精选 留言 我的

精选列表

搜索[百万tokens],共7455篇文章
优秀的个人博客,低调大师

阿里如何实现秒级百万TPS?搜索离线大数据平台架构解读

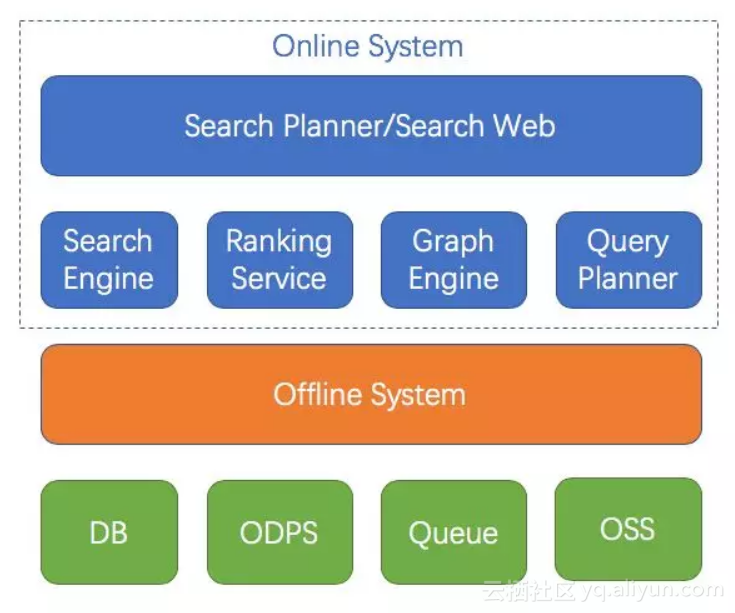
背景 什么是搜索离线? 一个典型的商品搜索架构如下图所示,本文将要重点介绍的就是下图中的离线数据处理系统(Offline System)。 何谓离线?在阿里搜索工程体系中我们把搜索引擎、在线算分、SearchPlanner等ms级响应用户请求的服务称之为“在线”服务;与之相对应的,将各种来源数据转换处理后送入搜索引擎等“在线”服务的系统统称为“离线”系统。商品搜索的业务特性(海量数据、复杂业务)决定了离线系统从诞生伊始就是一个大数据系统,它有以下一些特点: 1. 任务模型上区分全量和增量 1)全量是指将搜索业务数据全部重新处理生成,并传送给在线引擎,一般是每天一次。这么做有两个原因:有业务数据是daily更新;引擎需要全量数据来高效的进行索引整理和预处理,提高在线服务效率。 2)增量是指将上游数据源实时发生的数据变化更新到在线引擎中。 3)性能

优秀的个人博客,低调大师

谷歌商店百余APP感染木马 数百万用户受影响

Android手机系统由于开放深受欢迎,现如今Android平台已经占据了全球手机市场份额绝大多数,不过开放也带来了安全问题,甚至包括谷歌自己的应用商店。 根据Dr.Web的报道,谷歌应用商店目前已经有155个应用程序也就是APP感染了木马,这些木马导致了全球越280万用户收到不同程度的影响。 这些木马手机用户设备的信息和详细参数,然后让手机的操作系统通知栏显示各种广告,这些广告多数存在恶意嫌疑。该安全公司表示,他们已经把这个木马通知谷歌,但谷歌并未删除所有侵权软件或者标示已感染的App避免客户下载。 该木马的名字为Android.Spy.305,早在今年四月份就已经发现了,当时安全人员发现谷歌应用商店已经有不下百余APP感染,下载次数超过300万次,感染了用户达到280万。幸运的是,目前为止木马只是专注于提供广告,并没有从用户设备上窃取敏感数据。 ====================================分割线================================ 本文转自d1net(转载)

优秀的个人博客,低调大师

CDP技术系列(三):百万级QPS的人群命中服务接口性能优化指南

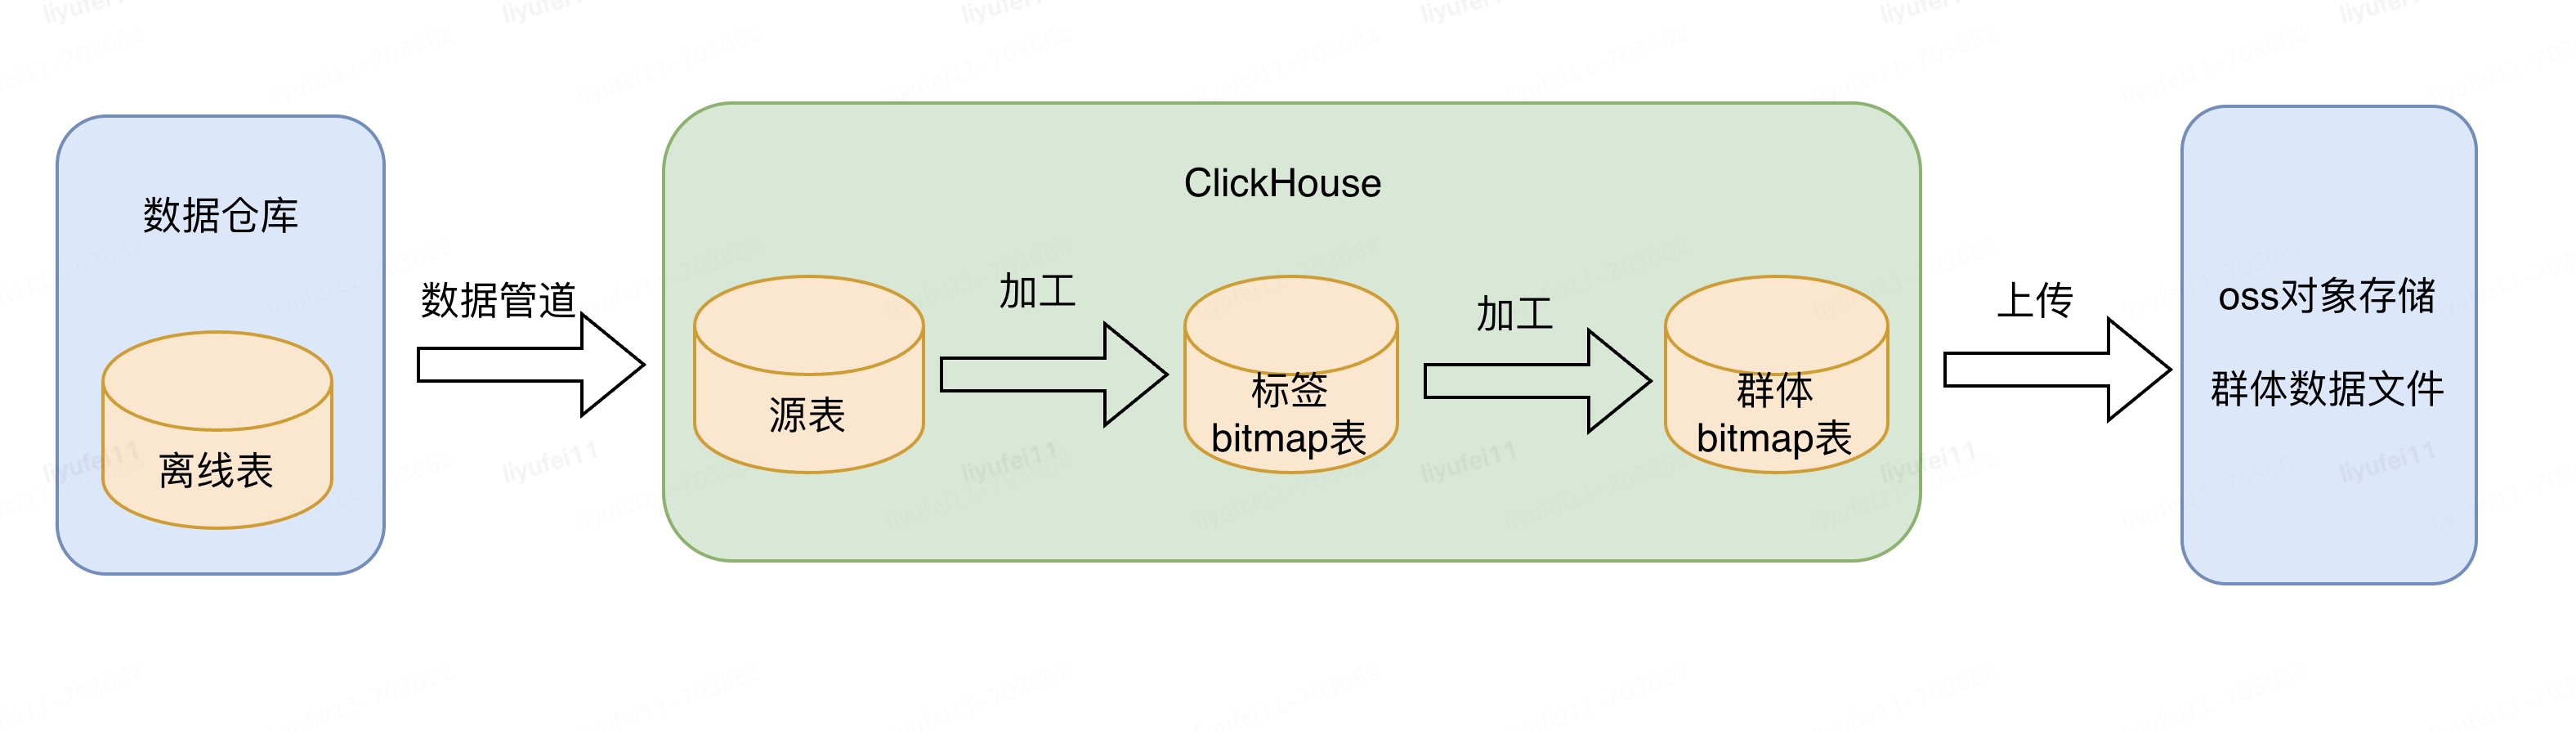
一、背景介绍 CDP系统提供了强大的标签和群体的构建能力,面对海量数据的标签和群体,我们采用了Bitmap+ClickHouse的存储与计算方案。详细内容可以参考之前文章。 有了群体之后,它们被广泛的应用到支付,消金,财富,营销等各种核心业务的用户拉新,交易转化,促活等核心链路中。 而人群应用方式中,基于人群的命中服务,是非常重要的P0级接口(日常TPS峰值40W+,响应耗时50ms以内,大促备战120W+) 它主要用来查询指定用户ID是否包含在指定群体中,这篇文章就来分享人群命中接口的演进迭代过程。  二、问题描述 前文已经介绍了CDP中群体的加工和存储方式,采用了ClickHouse(以下简称CK)+Bitmap的方案,为了减轻ClickHouse的计算和存储压力,我们的22000+群体目前只在CK中存储了最新的版本。 这是因为CDP中标签和群体的计算都在CK中,而且依赖的都是最新数据,所以只存储最新数据即可满足需求。如下图:  上图可以看到除了CK中的数据外,我们在OSS对象存储中也放了一份群体数据。 由前文可知,群体的bitmap文件中可以理解为存储的都是offset,这时候如果想查询某一个ID是否在指定群体中,即人群命中服务,需要两个步骤。 首先要将ID转换为bitmap中对应的唯一offset,之后可以尝试直接利用CK SQL查询,bitmapContains(bitmap, offset)来进行判断是否在指定bitmap中。 也可以从CK或OSS中加载指定群体的bitmap,在JAVA程序中使用Roaring64NavigableMap的能力进行判断。 但是,直接使用CK SQL或者oss文件加载方式,肯定都无法直接满足50ms性能的问题。接下来就对我们的前后两套方案进行讲解。  三、历史方案 首先介绍我们的上一版方案,针对上文的问题,可以分解为两步,第一步解决ID到offset的高性能转换;第二步判断offset是否包含在指定群体的bitmap中。  1)解决数十亿ID和offset的快速转换 之前文章中提到,由于用户ID是唯一且不变的,所以对所有的ID进行了编码,每个ID对应一个唯一的offset,并生成了最终的一张ID池表,比如id_offset_table。 有了这些数据之后,就可以考虑如何进行快速查询来进行ID和offset的转换了。 最简单的思路就是每次去表中查询: SELECT `offset` FROM id_offset_table where id='id1' 但是这种直接查询的方式,显然不能满足高性能的需求,所以,最自然的方式是将常用的ID的结果进行缓存;而常用缓存的方式可以选择缓存到请求的服务器内存,也可以加入到Redis缓存中。 由于目前的ID池已经达到了惊人的数十亿,放到请求服务器内存中,极限情况预计需要500G的内存,单机存放显然是不太现实的。 所以这里最终选择的是放入到Redis缓存中,这也是目前我们采用的方式。   2)判断offset是否包含在指定群体的bitmap中 有了ID对应的offset,接下来就是如何判读是否存在于指定bitmap中;bitmap目前由两个地方存储,一个是CK中,另一个是OSS对象存储中。  之前方案,没有从CK中获取bitmap,采用的是从OSS中将群体文件,直接拉取到大内存物理中,然后再通过接口读取内存数据实现。 这样做的好处是,减少了CK的访问次数,减轻它的压力,毕竟CDP平台的几千个标签和上万个群体的更新都依赖于CK,减轻它的压力,同样的集群配置可以让更多资源留给计算。  但由于群体太多,将OSS文件放入单机内存中,是无法装载所有群体的(采用了32核192G的机器),所以针对群体还进行了分片处理(分为8片,每片中又包含若干台机器),将一个群体的大bitmap拆成若干个小的bitmap,再按照分片通过hash算法加载到不同分组机器的内存中,如下图:   这套方案是将物理机内存作为存储空间,并且使用自研的分片方案,再通过接口层直接读取bitmap数据来获取命中结果。 // 获取命中结果示例 Roaring64NavigableMap bitmap = getBitmap(); boolean isHit = bitmap.contains(offset); 需要注意的是由于对群体数据进行了分片存储,所以存和取的逻辑需要保持统一才能取到正确结果。  3)方案优缺点 通过Redis存储ID和offset的关系,人群数据拆分到8分组机器内存中,实现了群体命中接口的性能需求,总结此历史方案的优缺点,如下: 优点: 1、通过从OSS拉取文件方式,减少CK的查询次数,降低CK压力。 2、拆分逻辑自研,实际上是替换小文件,直接覆盖小文件更新速度快。 3、可分组内水平扩容机器,增加接口整体承载量,经过压测单机可到30000QPS。 4、直接机器内存取值,快速返回结果,满足接口TP999:50ms内需求,但严重依赖机器性能。 缺点: 1、由于加载到机器内存,导致每次重启机器总要全量加载所有群体,启动非常慢(虽然经过优化启动效率已经提升了很多,但随着群体数量的增加重启也会越来越慢) 2、虽然分组内可以水平扩容,但是固定分组后,单机器的内存有限,一旦达到上限需要扩容分组时,必须成倍的扩容,导致扩容分组困难; 3、由于是自研的依赖于机器内存的存储方案,整体结构复杂,在运维的能力方面偏弱,运维的相关工具少;无法有效监控内存数据,这就间接造成了系统的稳定性较差。 4、使用物理机,曾经在大促期间占用了100+台物理机,耗费资源很大。  四、最新方案 上述历史方案中,可以看到ID转offset的方案没有问题;主要问题出在判断offset是否包含在指定群体bitmap这一步中。所以在最新方案中,只对群体加载与offset的判断进行重新梳理及优化。 1)Redis多集群多分片写入 思路和上文中的内存方案类似,都是部署多个集群(或分组),将群体bitmap进行拆分,并根据一定的路由策略存储到不同的集群上,通过不同的集群提供查询能力,如下图:   在新方案中,增加了一整套的群体推送服务,包括数据的新增,更新,删除,检测,重试以及预警等策略,大大增强了群体加载的可监测性及有效性,而在之前的方案中,非常缺少这些有效的运维手段。  2)数据加载策略 和内存加载不同的是,Redis存储中不能再使用文件替换方案,只能采用其他的写入方案。 在这之中,还需要考虑如何保证写入的过程中不影响命中接口的性能。 针对群体数据,同样采用了拆分的思路,把每一个群体按照固定区间切成若干个小的bitmap,并为每个小bitmap编号(即桶号,此桶号同样采用bitmap存储在索引里),缓存key为群体code加上桶号,以便快速取到offset值。 然后将小bitmap的数据转化成字符串的形式,并且拆分之后可以将数据按照Hash规则,均匀的分布到不同的缓存分片(我们最终的分片数达到了16个集群*64分片=1024片)。如下图:   对于读取来说,假如人群命中有1000万QPS,则每个集群分到62.5万,均摊到64个分片也才不到1万,可以说对缓存的单分片来说毫无压力。 对于写入来说,如果按照一个个bit写入的方式,耗时是不可接受的,在这方面我们采用的是将Java字节码转换为Redis字节码,最终以set(key, string)的方式进行数据写入。   这种方式具有以下优点: 1、单值小:每个bitmap最多有65536个Offset(bit位),相当于最大8kb,不会在缓存中产生较大key而导致性能差 2、写入快:每个key一次性写入到缓存,但是最多可以含有65536个offset(ID),42.94亿群体只需要65536次写入 3、查询效率高:getbit支持查询key下面每个offset,时间复杂度是O(1) 4、拆分压缩数据:拆分多个小的bitmap,相当于是对bitmap进行了压缩  在验证过程中,一个42亿的群体按bit写入需要11.6个小时,而采用字节码转换的方式写入,只需要65~120秒之间,写入效率提升99.9%。 写入完成之后,使用Redis的getbit方法即可获取对应位的值,正如前文提到的即使是1000w的QPS,也能达到高性能命中的目标。 // 获取指定偏移量的值,例如某ID对应的offset为3 jedis.getbit("crowdBitmap", 3);  3)方案优缺点 优点: 1、采用公司内部存储中间件,有专业的运维团队支持。 2、Redis缓存支持主从备份,甚至是一主多从,支持高可用。 3、支持多分片,支持高并发场景,分摊到单个分片的流量较少。 4、写入与读取也很快,满足群体的快速更新需求。 5、只需要很少的机器写入与维护缓存,应用启动效率大大提升。 6、存储扩容方便,即使面对猛增的业务也可以从容应对。 缺点: 1、依赖于公司内部缓存中间件,倘若中间件出现问题,会造成很大影响;虽然理论上概率非常小。当然,也可以再做一个备份存储,这时需要考虑存储成本与收益之间的平衡。  五、现状及展望 上述方案上线后,可以看到非常明显的提升,接口整体TP999耗时从40ms下降到25ms左右 ,如下图:   目前最新的方案经过23年双十一大促的检验,TPS峰值:49.7w/s,TP999峰值:24ms,单次访问查询达到了500w/s,(甚至在某一天军演压测时达到了1000w/s)平稳顺利地完成新老方案的过渡。   随着业务的不断发展,CDP中的群体数量还在持续增加中,按当前的增速评估,此方案已经能够完全支撑业务的持续发展,理论上可以支持到千万级TPS而无压力。  作者:京东科技 黎宇飞 来源:京东云开发者社区 转载请注明来源

优秀的个人博客,低调大师

1Password 报告:Secrets 管理不善致使企业每年损失数百万美元

1Password 发布的一份《Hiding in Plain Sight》报告指出,企业平均每年因基础设施代码、凭证和密钥的泄露而导致的损失已达120 万美元;60% 的 IT/DevOps 组织都有过泄密的经历。 报告基于对 500 名 IT 和 DevOps 工作者的调查,并辅以 1Password 研究人员的分析。主要探讨了企业如何管理爆炸性的敏感信息、普遍存在的机密管理(secrets management)缺陷以及对 bottom line 的严重影响,包括受损的企业声誉、疏远的客户和延迟的产品周期。 1Password 首席执行官 Jeff Shiner称,Secrets 现在是 IT 和 DevOps 的命脉,因为他们要支持现代企业现在需要的爆炸性应用和服务。研究显示,Secrets 正在蓬勃发展,但 IT 和 DevOps 团队却没有达到严格的标准来保护它们,这使得企业需要面临承担巨大成本的风险。“现在是企业认真审视他们如何管理 Secrets,并采用实践和解决方案来'put the secret back into secrets'的时候了,以便于支持安全文化。 调查报告指出,三分之二(65%)的 IT 和 DevOps 员工估计他们的公司拥有超过 500 个 secrets,近五分之一(18%)的人表示他们拥有的 secrets 数不胜数。员工每天必须花费大约 25 分钟来管理这些 secrets,有超过一半(51%)的员工表示,这一数字在过去一年中显着增加;10% 的人花费的时间则增加了一倍以上。 10% 的受访者透露,其公司由于 secret 泄露造成的损失超过了 500 万美元。除了资金损失外,40% 的受访者表示他们的组织遭受了品牌声誉损害,29% 的受访者表示企业客户因此流失。另有 61% 的项目由于 secret管理不善而导致延迟。 还有77% 的受访者表示他们仍然可以访问前雇主的系统,37% 的人表示他们可以完全访问;这也凸显了secret继续泄露的一大主要因素。此外,三分之一(36%)的IT 和 DevOps 员工承认他们通过不太安全的渠道共享了有关公司 secret的信息以提高生产力和速度,从而造成了一定的泄露风险。包括电子邮件(59%)、Slack(40%)、电子表格/共享文件(36%)和文本(26%)。 80% 的 IT/DevOps 组织承认没有很好地管理他们的 secret;52% 的人表示,云计算应用的爆炸性增长使管理secret变得更加困难。 几乎所有(97%)的 IT/DevOps 工作人员都表示他们的组织制定了保密政策,但只有超过三分之一(36%)的人表示他们的公司严格执行了该政策。且这一问题在组织高层中更为严重,63% 的团队领导和经理以及 67% 的副总裁及以上人员为了满足 COVID-19 的工作需求而忽视或绕过公司的安全政策,这一数据几乎是个人 IT/DevOps 贡献者(25%)的三倍。 完整报告可查看此处。

优秀的个人博客,低调大师

APIJSON 4.6.0 发布 腾讯项目百万数据 6s 响应(2.3KW 大表)

在 2.3KW 记录大表中查询 LIMIT 1000000(100W) ---------- | ---------- | ---------- | ---------- | ------------- Total | Received | Time Total | Time Spent | Current Speed 72.5M | 72.5M | 0:00:05 | 0:00:05 | 20.0M /get >> http请求结束:5624 APIJSON 4.6.0 更新内容 解决 bug 解决 "toId%": "0,10" 等连续范围报错 value 类型不合法; 解决 "id{}@": "[]/Moment/praiseUserIdList" 等引用赋值的值有时类型为 List 时报错; 解决 "key<>": "a" 这种包含字符串的格式报错,从原来要用 "" 包装简化成直接写即可; 增强安全 对 MySQL 的 DELETE 和 PUT 强制加 LIMIT,限制一次操作记录的数量; 提升性能 通过缓存及复用数组主表 ObjectParser 来大幅提升大量数据的数组内主表的查询性能; 通过减少不必要的 newSQLConfig 及 getSQL 等步骤来大幅提升大量数据的数组内主表的查询性能; 对比 4.5.2 在 Log.DEBUG = true(开启日志)的情况下 TestRecord[] 耗时降低至原来 24%,性能提升 300% 至原来 4 倍; Moment[] 耗时降低至原来 33%,性能提升 200% 至原来 3 倍; 朋友圈列表耗时降低至原来 77%,性能提升 23% 至原来 1.2 倍。 其中每个数组都按 100 条来测试,如果每页数量更大或每项数据量更大,则提升会更加明显。 腾讯 CSIG 某项目线上生产环境实测 Log.DEBUG = false 时2.3KW 大表查询 LIMIT 100 相比原来从 2s 降到 164ms 提升 11 倍; LIMIT 1000 相比原来从 30s 降到 197ms 提升 151 倍; LIMIT 10000(一次 /get 1W 条记录) 整个网络请求耗时仅 633ms; LIMIT 1000000(一次 /get 100W 条记录共 72.5M 数据) 整个网络请求耗时仅 5.624s。 具体见Release 发布版本。 APIJSON 简介 APIJSON 是一种专为 API 而生的 JSON 网络传输协议 以及 基于这套协议实现的 ORM 库。 为 简单的增删改查、复杂的查询、简单的事务操作 提供了完全自动化的万能 API。 能大幅降低开发和沟通成本,简化开发流程,缩短开发周期。 适合中小型前后端分离的项目,尤其是 BaaS、Serverless、互联网创业项目和企业自用项目。 为什么选择 APIJSON? 解决十大痛点(APIJSON 大幅提振开发效率、强力杜绝联调扯皮、巧妙规避文档缺陷、非常节省流量带宽 等) 开发提速巨大(CRUD 零代码热更新自动化,APIJSONBoot 对比 SSM、SSH 等保守估计可提速 20 倍以上) 腾讯官方开源(使用 GitHub、Gitee、工蜂 等平台的官方账号开源,微信公众号、腾讯云+社区 等官方公告) 社区影响力大(GitHub 9.9K Star 在 350WJava 项目中排名前 150,远超 FLAG, BAT 等国内外绝大部分开源项目) 各项荣誉成就(腾讯开源五个第一、腾讯首个 GVP 获奖项目、腾讯后端项目 Star 第一、GitHub Java 周榜第一 等) 多样用户案例(腾讯内部用户包含 互娱、音乐、云与智慧,外部用户包含 500 强上市公司、数千亿资本国企 等) 适用场景广泛(社交聊天、阅读资讯、影音视频、办公学习 等各种 App、网站、公众号、小程序 等非金融类项目) 周边生态丰富(Android, iOS, Web 等各种 Demo、继承 JSON 的海量生态、零代码 接口测试 和 单元测试 工具等) 文档视频齐全(项目介绍、快速上手、安装部署 等后端、前端、客户端的 图文解说、视频教程、代码注释 等) 功能丰富强大(增删改查、分页排序、分组聚合、各种 JOIN、各种子查询、跨库跨表、性能分析等零代码实现) 使用安全简单(自动增删改查、自动生成文档、自动管理版本、自动控制权限、自动校验参数、自动防SQL注入等) 灵活定制业务(在后端编写 远程函数,可以拿到 session、version、当前 JSON 对象 等,然后自定义处理) 高质可靠代码(代码严谨规范,商业分析软件源伞 Pinpoint 代码扫描报告平均每行代码 Bug 率低至 0.15%) 兼容各种项目(对各类 Web 框架集成友好且提供 SpringBoot, JFinal 的 Demo,协议不限 HTTP,与其它库无冲突) 工程轻量小巧(仅依赖 fastjson,Jar 仅 280KB,Java 文件仅 59 个共 13719 行代码,例如 APIJSONORM 4.3.1) 多年持续迭代(自 2016 年开源至今已连续维护 4 年,累计 2000+ Commits、70+ Releases,不断更新迭代中...) APIJSON 生态项目 APIAuto敏捷开发最强大易用的 HTTP 接口工具,机器学习零代码测试、生成代码与静态检查、生成文档与光标悬浮注释 UnitAuto机器学习单元测试平台,零代码、全方位、自动化 测试 方法/函数 的正确性和可用性 APIJSON.NETC# 版 APIJSON ,支持 MySQL, PostgreSQL, SQL Server, Oracle, SQLite apijson-phpPHP 版 APIJSON,基于 ThinkPHP,支持 MySQL, PostgreSQL, SQL Server, Oracle 等 apijson-nodeNode.ts 版 APIJSON,提供 nestjs 和 typeorm 的 Demo,支持 MySQL, PostgreSQL, SQL Server, Oracle uliweb-apijsonPython 版 APIJSON,支持 MySQL, PostgreSQL, SQL Server, Oracle, SQLite 等 APIJSONParser第三方 APIJSON 解析器,将 JSON 动态解析成 SQL ApiJsonByJFinal整合 APIJSON 和 JFinal 的 Demo SpringServer1.2-APIJSON智慧党建服务器端,提供 上传 和 下载 文件的接口 apijson-builder一个方便为 APIJSON 构建 RESTful 请求的 JavaScript 库 感谢热心的作者们的贡献,点 ⭐Star 鼓励他们继续完善吧^_^ 腾讯 APIJSON - 零代码接口与文档 ORM 库 https://gitee.com/Tencent/APIJSON
优秀的个人博客,低调大师

百万级高并发mongodb集群性能数十倍提升优化实践(上篇)

关于作者前滴滴出行技术专家,现任OPPO文档数据库mongodb负责人,负责oppo千万级峰值TPS/十万亿级数据量文档数据库mongodb研发和运维工作,一直专注于分布式缓存、高性能服务端、数据库、中间件等相关研发。后续持续分享《MongoDB内核源码设计、性能优化、最佳运维实践》,Github账号地址:https://github.com/y123456yz1.背景线上某集群峰值TPS超过100万/秒左右(主要为写流量,读流量很低),峰值tps几乎已经到达集群上限,同时平均时延也超过100ms,随着读写流量的进一步增加,时延抖动严重影响业务可用性。该集群采用mongodb天然的分片模式架构,数据均衡的分布于各个分片中,添加片键启用分片功能后实现完美的负载均衡。集群每个节点流量监控如下图所示:从上图可以看出集群流量比较大,峰值已经突破120万/秒,其中delete过期删除的流量不算在总流量里面(delete由主触发删除,但是主上面不会显示,只会在从节点拉取oplog的时候显示)。如果算上主节点的delete流量,总tps超过150万/秒。 2.软件优化在不增加服务器资源的情况下,首先做了如下软件层面的优化,并取得了理想的数倍性能提升:1.业务层面优化2.Mongodb配置优化3.存储引擎优化2.1 业务层面优化该集群总文档数百亿条,每条文档记录默认保存三天,业务随机散列数据到三天后任意时间点随机过期淘汰。由于文档数目很多,白天平峰监控可以发现从节点经常有大量delete操作,甚至部分时间点delete删除操作数已经超过了业务方读写流量,因此考虑把delete过期操作放入夜间进行,过期索引添加方法如下:Db.collection.createIndex( { "expireAt": 1 }, { expireAfterSeconds: 0 } )上面的过期索引中expireAfterSeconds=0,代表collection集合中的文档的过期时间点在expireAt时间点过期,例如:db.collection.insert( {//表示该文档在夜间凌晨1点这个时间点将会被过期删除"expireAt": new Date('July 22, 2019 01:00:00'), "logEvent": 2,"logMessage": "Success!"} )通过随机散列expireAt在三天后的凌晨任意时间点,即可规避白天高峰期触发过期索引引入的集群大量delete,从而降低了高峰期集群负载,最终减少业务平均时延及抖动。 Delete过期Tips1: expireAfterSeconds含义 在expireAt指定的绝对时间点过期,也就是12.22日凌晨2:01过期Db.collection.createIndex( { "expireAt": 1 }, { expireAfterSeconds: 0 } )db.log_events.insert( { "expireAt": new Date(Dec 22, 2019 02:01:00'),"logEvent": 2,"logMessage": "Success!"}) 2.在expireAt指定的时间往后推迟expireAfterSeconds秒过期,也就是当前时间往后推迟60秒过期db.log_events.insert( {"createdAt": new Date(),"logEvent": 2,"logMessage": "Success!"} )Db.collection.createIndex( { "expireAt": 1 }, { expireAfterSeconds: 60 } ) Delete过期Tips2: 为何mongostat只能监控到从节点有delete操作,主节点没有? 原因是过期索引只在master主节点触发,触发后主节点会直接删除调用对应wiredtiger存储引擎接口做删除操作,不会走正常的客户端链接处理流程,因此主节点上看不到delete统计。 主节点过期delete后会生存对于的delete oplog信息,从节点通过拉取主节点oplog然后模拟对于client回放,这样就保证了主数据删除的同时从数据也得以删除,保证数据最终一致性。从节点模拟client回放过程将会走正常的client链接过程,因此会记录delete count统计,详见如下代码: 官方参考如下: https://docs.mongodb.com/manual/tutorial/expire-data/ 2.2 Mongodb配置优化(网络IO复用,网络IO和磁盘IO做分离)由于集群tps高,同时整点有大量推送,因此整点并发会更高,mongodb默认的一个请求一个线程这种模式将会严重影响系统负载,该默认配置不适合高并发的读写应用场景。官方介绍如下:2.2.1 Mongodb内部网络线程模型实现原理mongodb默认网络模型架构是一个客户端链接,mongodb会创建一个线程处理该链接fd的所有读写请求及磁盘IO操作。Mongodb默认网络线程模型不适合高并发读写原因如下: 在高并发的情况下,瞬间就会创建大量的线程,例如线上的这个集群,连接数会瞬间增加到1万左右,也就是操作系统需要瞬间创建1万个线程,这样系统load负载就会很高。 此外,当链接请求处理完,进入流量低峰期的时候,客户端连接池回收链接,这时候mongodb服务端就需要销毁线程,这样进一步加剧了系统负载,同时进一步增加了数据库的抖动,特别是在PHP这种短链接业务中更加明显,频繁的创建线程销毁线程造成系统高负债。 一个链接一个线程,该线程除了负责网络收发外,还负责写数据到存储引擎,整个网络I/O处理和磁盘I/O处理都由同一个线程负责,本身架构设计就是一个缺陷。 2.2.2 网络线程模型优化方法为了适应高并发的读写场景,mongodb-3.6开始引入serviceExecutor: adaptive配置,该配置根据请求数动态调整网络线程数,并尽量做到网络IO复用来降低线程创建消耗引起的系统高负载问题。此外,加上serviceExecutor: adaptive配置后,借助boost:asio网络模块实现网络IO复用,同时实现网络IO和磁盘IO分离。这样高并发情况下,通过网络链接IO复用和mongodb的锁操作来控制磁盘IO访问线程数,最终降低了大量线程创建和消耗带来的高系统负载,最终通过该方式提升高并发读写性能。2.2.3 网络线程模型优化前后性能对比在该大流量集群中增加serviceExecutor: adaptive配置实现网络IO复用及网络IO与磁盘IO做分离后,该大流量集群时延大幅度降低,同时系统负载和慢日志也减少很多,具体如下:2.2.3.1 优化前后系统负载对比验证方式:1.该集群有多个分片,其中一个分片配置优化后的主节点和同一时刻未优化配置的主节点load负载比较:未优化配置的load优化配置的load2.2.3.2 优化前后慢日志对比验证方式:该集群有多个分片,其中一个分片配置优化后的主节点和同一时刻未优化配置的主节点慢日志数比较: 同一时间的慢日志数统计: 未优化配置的慢日志数(19621): 优化配置后的慢日志数(5222): 2.2.3.3 优化前后平均时延对比验证方式:该集群所有节点加上网络IO复用配置后与默认配置的平均时延对比如下:从上图可以看出,网络IO复用后时延降低了1-2倍。2.3 wiredtiger存储引擎优化从上一节可以看出平均时延从200ms降低到了平均80ms左右,很显然平均时延还是很高,如何进一步提升性能降低时延?继续分析集群,我们发现磁盘IO一会儿为0,一会儿持续性100%,并且有跌0现象,现象如下:从图中可以看出,I/O写入一次性到2G,后面几秒钟内I/O会持续性阻塞,读写I/O完全跌0,avgqu-sz、awit巨大,util次序性100%,在这个I/O跌0的过程中,业务方反应的TPS同时跌0。此外,在大量写入IO后很长一段时间util又持续为0%,现象如下:总体IO负载曲线如下:从图中可以看出IO很长一段时间持续为0%,然后又飙涨到100%持续很长时间,当IO util达到100%后,分析日志发现又大量满日志,同时mongostat监控流量发现如下现象:从上可以看出我们定时通过mongostat获取某个节点的状态的时候,经常超时,超时的时候刚好是io util=100%的时候,这时候IO跟不上客户端写入速度造成阻塞。有了以上现象,我们可以确定问题是由于IO跟不上客户端写入速度引起,第2章我们已经做了mongodb服务层的优化,现在我们开始着手wiredtiger存储引擎层面的优化,主要通过以下几个方面:1.cachesize调整2.脏数据淘汰比例调整3.checkpoint优化 2.3.1 cachesize调整优化(为何cacheSize越大性能越差)前面的IO分析可以看出,超时时间点和I/O阻塞跌0的时间点一致,因此如何解决I/O跌0成为了解决改问题的关键所在。找个集群平峰期(总tps50万/s)查看当时该节点的TPS,发现TPS不是很高,单个分片也就3-4万左右,为何会有大量的刷盘,瞬间能够达到10G/S,造成IO util持续性跌0(因为IO跟不上写入速度)。继续分析wiredtiger存储引擎刷盘实现原理,wiredtiger存储引擎是一种B+树存储引擎,mongodb文档首先转换为KV写入wiredtiger,在写入过程中,内存会越来越大,当内存中脏数据和内存总占用率达到一定比例,就开始刷盘。同时当达到checkpoint限制也会触发刷盘操作,查看任意一个mongod节点进程状态,发现消耗的内存过多,达到110G,如下图所示:于是查看mongod.conf配置文件,发现配置文件中配置的cacheSizeGB: 110G,可以看出,存储引擎中KV总量几乎已经达到110G,按照5%脏页开始刷盘的比例,峰值情况下cachesSize设置得越大,里面得脏数据就会越多,而磁盘IO能力跟不上脏数据得产生速度,这种情况很可能就是造成磁盘I/O瓶颈写满,并引起I/O跌0的原因。此外,查看该机器的内存,可以看到内存总大小为190G,其中已经使用110G左右,几乎是mongod的存储引起占用,这样会造成内核态的page cache减少,大量写入的时候内核cache不足就会引起磁盘缺页中断,引起大量的写盘。解决办法:通过上面的分析问题可能是大量写入的场景,脏数据太多容易造成一次性大量I/O写入,于是我们可以考虑把存储引起cacheSize调小到50G,来减少同一时刻I/O写入的量,从而规避峰值情况下一次性大量写入的磁盘I/O打满阻塞问题。 2.3.2 存储引擎dirty脏数据淘汰优化调整cachesize大小解决了5s请求超时问题,对应告警也消失了,但是问题还是存在,5S超时消失了,1s超时问题还是偶尔会出现。因此如何在调整cacheSize的情况下进一步规避I/O大量写的问题成为了问题解决的关键,进一步分析存储引擎原理,如何解决内存和I/O的平衡关系成为了问题解决的关键,mongodb默认存储因为wiredtiger的cache淘汰策略相关的几个配置如下:wiredtiger淘汰相关配置 默认值 工作原理eviction_target 80 当用掉的内存超过总内存的百分比达到eviction_target,后台evict线程开始淘汰eviction_trigger 95 当用掉的内存超过总内存的eviction_trigger,用户线程也开始淘汰eviction_dirty_target 5 当cache中脏数据比例超过eviction_dirty_target,后台evict线程开始淘汰eviction_dirty_trigger 20 当cache中脏数据比例超过eviction_dirty_trigger, 用户线程也开始淘汰evict.threads_min 4 后台evict线程最小数evict.threads_max 4 后台evict线程最大数 调整cacheSize从120G到50G后,如果脏数据比例达到5%,则极端情况下如果淘汰速度跟不上客户端写入速度,这样还是容易引起I/O瓶颈,最终造成阻塞。 解决办法: 如何进一步减少持续性I/O写入,也就是如何平衡cache内存和磁盘I/O的关系成为问题关键所在。从上表中可以看出,如果脏数据及总内占用存达到一定比例,后台线程开始选择page进行淘汰写盘,如果脏数据及内存占用比例进一步增加,那么用户线程就会开始做page淘汰,这是个非常危险的阻塞过程,造成用户请求验证阻塞。平衡cache和I/O的方法: 调整淘汰策略,让后台线程尽早淘汰数据,避免大量刷盘,同时降低用户线程阀值,避免用户线程进行page淘汰引起阻塞。优化调整存储引起配置如下: eviction_target: 75%eviction_trigger:97%eviction_dirty_target: %3eviction_dirty_trigger:25%evict.threads_min:8evict.threads_min:12 总体思想是让后台evict尽量早点淘汰脏页page到磁盘,同时调整evict淘汰线程数来加快脏数据淘汰,调整后mongostat及客户端超时现象进一步缓解。 2.3.3 存储引擎checkpoint优化调整存储引擎得checkpoint检测点,实际上就是做快照,把当前存储引擎的脏数据全部记录到磁盘。触发checkpoint的条件默认又两个,触发条件如下:1.固定周期做一次checkpoint快照,默认60s2.增量的redo log(也就是journal日志)达到2G当journal日志达到2G或者redo log没有达到2G并且距离上一次时间间隔达到60s,wiredtiger将会触发checkpoint,如果在两次checkpoint的时间间隔类evict淘汰线程淘汰的dirty page越少,那么积压的脏数据就会越多,也就是checkpoint的时候脏数据就会越多,造成checkpoint的时候大量的IO写盘操作。如果我们把checkpoint的周期缩短,那么两个checkpoint期间的脏数据相应的也就会减少,磁盘IO 100%持续的时间也就会缩短。checkpoint调整后的值如下:checkpoint=(wait=25,log_size=1GB)2.3.4 存储引擎优化前后IO对比通过上面三个方面的存储引擎优化后,磁盘IO开始平均到各个不同的时间点,iostat监控优化后的IO负载如下:从上面的io负载图可以看出,之前的IO一会儿为0%,一会儿100%现象有所缓解,总结如下图所示:2.3.5 存储引擎优化前后时延对比优化前后时延对比如下(注: 该集群有几个业务同时使用,优化前后时延对比如下):从上图可以看出,存储引擎优化后时间延迟进一步降低并趋于平稳,从平均80ms到平均20ms左右,但是还是不完美,有抖动。3 服务器系统磁盘IO问题解决3.1 服务器IO硬件问题背景如第3节所述,当wiredtiger大量淘汰数据后,发现只要每秒磁盘写入量超过500M/s,接下来的几秒钟内util就会持续100%,w/s几乎跌0,于是开始怀疑磁盘硬件存在缺陷。从上图可以看出磁盘为nvMe的ssd盘,查看相关数据可以看出该盘IO性能很好,支持每秒2G写入,iops能达到2.5W/S,而我们线上的盘只能每秒写入最多500M。 3.2 服务器IO硬件问题解决后性能对比于是考虑把该分片集群的主节点全部迁移到另一款服务器,该服务器也是ssd盘,io性能达到2G/s写入(注意:只迁移了主节点,从节点还是在之前的IO-500M/s的服务器)。 迁移完成后,发现性能得到了进一步提升,时延迟降低到2-4ms/s,三个不同业务层面看到的时延监控如下图所示:从上图时延可以看出,迁移主节点到IO能力更好的机器后,时延进一步降低到平均2-4ms。虽然时延降低到了平均2-4ms,但是还是有很多几十ms的尖刺,鉴于篇幅将在下一期分享大家原因,最终保存所有时延控制在5ms以内,并消除几十ms的尖刺。此外,nvme的ssd io瓶颈问题原因,经过和厂商确认分析,最终定位到是linux内核版本不匹配引起,如果大家nvme ssd盘有同样问题,记得升级linux版本到3.10.0-957.27.2.el7.x86_64版本,升级后nvme ssd的IO能力达到2G/s以上写入。 4 总结及遗留问题通过mongodb服务层配置优化、存储引擎优化、硬件IO提升三方面的优化后,该大流量写入集群的平均时延从之前的平均数百ms降低到了平均2-4ms,整体性能提升数十倍,效果明显。但是,从4.2章节优化后的时延可以看出,集群偶尔还是会有抖动,鉴于篇幅,下期会分享如果消除4.2章节中的时延抖动,最终保持时间完全延迟控制在2-4ms,并且无任何超过10ms的抖动,敬请期待,下篇会更加精彩。此外,在集群优化过程中采了一些坑,下期会继续分析大流量集群采坑记。 注意: 文章中的一些优化方法并不是一定适用于所有mongodb场景,请根据实际业务场景和硬件资源能力进行优化,而不是按部就班。

优秀的个人博客,低调大师

详解阿里云第六代增强型实例,性能强劲,百万IOPS加持

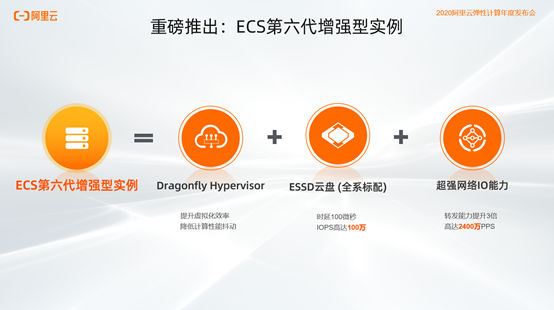
据悉,第六代增强型实例全系搭配ESSD系列云盘,存储转发能力最多提升四倍;单卷延时大幅下降;性能等级按需配置,在线无损变配;同时ESSD使用门槛大幅下降50%, 性价比大幅提升。 网络方面,小规格实例全面支持10Gbps突发内网带宽,最高提升2.3倍以上。为了配合网络转发能力和带宽的提升,六代增强型实例支持大帧传输,让带宽做到物尽其用,同时在队列数、网卡数量上也都有大幅提升。 依托自研神龙架构,第六代增强型实例在性能、安全性、稳定性和端对端性能均有大幅提升,Mysql和Redis性能提升超过15%,Nginx性能提升达100%。配合Alibaba Cloud Linux 2 LTS,启动速度最多提升60%、运行时性能最多提升30%、稳定性最多提升50%。 本次阿里云推出的第三代神龙云服务器产品家族提供了最多208核、最大6TB内存,云盘IOPS高达 100万、网络转发高达2400万、网络带宽高达100G,均为全球最高性能水平,支持CPU、GPU、NPU、FPGA等多种计算形态,具备3分钟交付50万核vCPU的极速扩容能力,是云原生的最佳载体。 此外,阿里云ECS的单实例稳定性从原来的99.95%提升到99.975%,跨AZ多实例稳定性从原来的99.99%提升到99.995%,均为全球最高水准。 2017年,阿里云推出首款自研神龙云服务器,创新性地降虚拟化性能损耗降低为0,能发挥物理机100%的计算性能。2019年,双11核心系统100%跑在神龙云服务器上,不仅业务系统性能提升20%,抗高负载压力表现更好,整个业务性能非常平稳和线性,让消费者双11购买体验“如丝般顺滑”。 点击链接,观看 2020阿里云弹性计算年度发布会,了解详情:https://yqh.aliyun.com/live/2020ecsevent

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册