首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

架构之:软件架构漫谈

简介 每一个程序员心中都有个架构师的梦想,架构是如此的重要,以至于每个程序员都在谈架构,仿佛没有架构的软件是没有灵魂的,不想做架构师的程序员不是一个好的码农一样。 那么架构到底是什么呢?架构是怎么得到的呢?今天本文将会从自身的经验来阐述一下对架构的看法。 什么是架构 在软件发展的初期是没有架构而言的。从最早的汇编语言到过程语言,他们处理的是一个个任务,为此编制了一个个的函数来执行对应的任务。这时候的软件编程语言还是过程语言,所以谈不上架构。 随着硬件技术的成熟,能够处理的任务越来越多,为了处理这么多的任务,编程语言也从面向过程转变为面向对象,从而更好的适应任务的发展。软件越来复杂,要处理的任务越来越多,最终导致了系统架构的产生。 架构是在复杂软件结构中产生的,它的任务就是让这些复杂软件中的任务能够互相协作从而来完成共同的任务。当然这是从软件的目标来说的。如果再考虑软件的实现和扩展性,那么好的架构需要让系统可读性和可扩展性更强,给未来留出一定的空间。如果从可靠性和可用性来讲,好的架构还需要保证系统高可用和容错性。 我们要注意的是,架构并不是空想而来的,它的基石在于编写的程序。所以架构需要跟程序紧密结合才能产生活力。 系统的架构主要描述的是系统的主要组件和这些组件之间的关系和他们如何进行交互。 架构的关键设计原则 为了最大程度的降低成本,满足功能需求,并最大程度的提高系统结构的可扩展性和可用性,我们需要考虑下面几个关键的设计原则: 1. 关注点分离原则 将系统的组件按照特定的功能进行划分,从而是组件的功能之间没有重复。从而保证高内聚力和低耦合度。这种方法避免了系统组件之间的相互依赖性,有助于简化系统。 单一责任原则 系统的每个模块都应负一个特定的责任,这有助于用户清楚地了解系统。它还有助于组件与其他组件的集成。 最少知识原理 任何组件或对象都不应该获取其他组件的内部细节。这种方法避免了相互依赖,并提高可维护性。 最大限度地减少前期的大型设计 如果应用程序的需求不清楚,则最大程度地减少前期的大型设计。从小的原型出发,在探索中确认好需求。避免后期因为需求变动导致的巨大重构工作量。 不要重复功能 “不重复功能”指的是不要重复组件的功能,一个逻辑的实现,只应该存在于一段代码中。如果有多处代码的拷贝,那么在逻辑发生变化的时候,功能的重复会使其难以实施更改,降低清晰度并引入潜在的不一致之处。 重用功能时要优先考虑组合而不是继承 继承会在子类和父类之间建立依赖关系,因此会阻止子类的自由使用。相反,组合提供了很大的自由度并减少了继承层次结构。 定义不同层之间的通信协议 要对部署方案和生产环境有完整的了解,从而制定出或者使用合适的通信协议。 定义组件之间交互的数据格式 各种组件将通过数据格式相互交互。最好统一数据格式,从而使应用程序易于实现,扩展和维护。通过使用相同的数据格式,以便各个组件在相互通信时无需对数据进行编码/解码。它减少了处理开销。 系统服务组件应该是抽象的 与安全性,通信或系统服务(例如日志记录,概要文件和配置)相关的代码应在单独的组件中抽象出来。请勿将此代码与业务逻辑混合使用,这样扩展设计和维护将会变得容易。 设计异常和异常处理机制 预先定义异常,有助于组件以优雅的方式管理错误或意外情况。最好在整个系统中使用相同的异常处理机制。 命名约定 命名约定应事先定义。它们提供了一个一致的模型,可以帮助用户轻松理解系统。团队成员更容易验证其他人编写的代码,因此会增加可维护性。 架构的描述 既然架构这么重要,我们可以使用什么样的手段才能够描述架构中的组件、组件之间的联系和他们的交互呢?业界也探讨了很多方法。这里我们也来介绍几种方法。 UML UML大家应该都很熟悉了,它的全称是统一建模语言,它是一种图形语言。UML1.0规范是在1997年1月由对象管理组(OMG)提出的。它用作软件需求分析和设计文档的标准,这些文档是开发软件的基础。 UML是可视化的建模语言,里面包含很多组件,这些组件通过不同的方式关联,从而形成了完整的UML图。尽管通常使用UML对软件系统进行建模,但它并不局限于此范围。UML也被用于建模非软件系统,例如制造单元中的流程。 UML主要分成两大类别:结构图和行为图。 结构图表示系统的静态组件。 这些静态组件由类,接口,对象,组件和节点表示。结构图包含下面几个部分: 类图: 表示面向对象系统中的各个类和他们间的关系。 对象图:对象图表示的是运行时的对象和他们的关系。 组件图:组件图描述的是系统中的所有组件、接口和他们的交互关系。 复合结构:描述组件的内部结构,包括所有类,组件的接口等。 包:包主要是包含类和其他的包。 部署图:部署图是一组节点及其关系。 这些节点是部署组件的物理实体。 行为图表示的是系统中可能出现的动作,行为图可以包含下面几种: 用例图:描述功能及其内部/外部控制器之间的关系。 这些控制器被称为参与者。 活动图:描述系统中的控制流。 它由活动和链接组成。 该流可以是顺序的,并发的或分支的。 状态图:表示系统的事件驱动状态更改。 它描述了类,接口等的状态变化。 序列图:可视化系统中执行特定功能的顺序。 组合活动图和序列图以提供系统和业务流程的控制流概述。 架构视图 视图是从一组相关关注点的角度对整个系统的表示。它用于从不同的利益相关者(例如最终用户,开发人员,项目经理和测试人员)的角度描述系统。这里给大家介绍一个叫做4 + 1的视图模式。 4 + 1视图模型是由Philippe Kruchten发明的。该模型基于对多个视图和并发视图的使用来描述软件密集型系统的体系结构。它是一个多视图模型,解决了系统的不同功能和关注点。它使软件设计文档标准化,并使所有利益相关者易于理解设计。 它包含了4个基本的视图,分别是: 1. 逻辑视图或概念视图-它描述了设计的对象模型。 2. 流程视图-描述了系统的活动,包括并发和同步。 3. 物理视图-它描述了软件到硬件的映射并反映了其分布式关系。 4. 开发视图-它描述了环境开发中软件的静态组织和结构。 最后的+1视图表示的是为最终用户或客户添加一个称为方案视图或用例视图的视图。它和其他的4个视图是一致的,所以被称为+1 视图。 ADL 架构描述语言ADL是一种语言,提供用于定义软件体系结构的语法和语义。它是一种注释规范,提供了用于对软件系统的概念体系结构进行建模的功能,这与系统的实现有所不同。 架构描述语言是一种形式化的规范语言,它描述诸如进程,线程,数据和子程序之类的软件功能,以及诸如处理器,设备,总线和内存之类的硬件组件。 总结 今天的架构漫谈就讲到这里,有不住之处还希望大家多多指正。后续会给大家介绍几种常见的架构模式。希望大家能够喜欢。 本文已收录于http://www.flydean.com/06-software-architecture/ 最通俗的解读,最深刻的干货,最简洁的教程,众多你不知道的小技巧等你来发现! 欢迎关注我的公众号:「程序那些事」,懂技术,更懂你!

优秀的个人博客,低调大师

实时同步工具之rsync

1.1什么是rsync软件 rsync软件是开源的、快速的、多功能的、可实现全量及增量的本地或远程数据同步备份的优秀工具,并且可以不进行改变原有数据的属性信息,实现数据的备份迁移特性。 Rsync软件食用与uinx/linux/windows等多种操作系统平台 1.2概念 全量复制:一次性复制 增量复制:只把增加的复制过去(别人家没有的东西复制过去) 1.3 使用场景 1.yum总源和分源之前的同步 2.批量小文件的同步 3.增量同步(nginx配置目录config.d等) 1.4Rsync的特性如下(7个特性信息说明): 01.支持拷贝普通文件与特殊文件如链接文件,设备等。 02.可以有排除指定文件或目录同步的功能,相当于打包命令tar的排除功能。 tarzcvfbackup_1.tar.gz/opt/data-exclude=oldboy 说明:在打包/opt/data时就排除了oldboy命名的目录和文件。 03.可以做到保持原文件或目录的权限、时间(访问时间修改时间创建时间)、软硬链接、属主、组等所有属性均不改变-p。 04.可实现增量同步,既只同步发生变化的数据,因此数据传输效率很高(tar-N)。 将备份/home目录自2008-01-29以来修改过的文件 tar-N2008-01-29-zcvf/backups/inc-backup_$(date+%F).tar.gz/home 将备份/home目录昨天以来修改过的文件 tar-N$(date-dyesterday"+%F")-zcvf/backups/inc-backup_$(date+%F).tar.gz/home 添加文件到已经打包的文件 tar-rfall.tar*.gif 说明:这条命令是将所有.gif的文件增加到all.tar的包里面去。-r是表示增加文件的意思。 05.可以使用rcp,rsh,ssh等方式来配合进行隧道加密传输文件(rsync本身不对数据加密) 06.可以通过socket(进程方式)传输文件和数据(服务端和客户端)*****。重点掌握 07.支持匿名的或认证(无需系统用户)的进程模式传输,可实现方便安全的进行数据备份及镜像 1.5三种同步方式详解 1.5.1本地同步方式 例子:rsync/etc/hosts/tmp 1.5.2通过shell方式,隧道模式 1.5.2.1put:推送 例子:rsync-rp/etc/hostsroot@172.16.1.31:/tmp 1.5.2.2get:拉取 例子:rsync-rproot@172.16.1.31/etc/hosts/opt 1.5.3 守护进程,密码认证 拉格式:rsync-avzrsync_backup@172.16.1.41::backup/文件到哪里 推格式:rsync-avz/etcrsync_backup@172.16.1.41::backup +++--password-file=/etc/rsync.password免密码 参数扩展

优秀的个人博客,低调大师

Selenium之页面元素定位

单个元素定位 WebDriver提供了八种页面元素定位的方法,下面来依次为大家介绍一下: id定位:find_element_by_id("") HTML页面规定了id属性在HTML文档中必须是唯一的(页面id不唯一时,在编辑器中会标红显示,但是页面依然能正常加载)。id定位方法就是通过元素的id属性来查找元素,比如通过id定位百度输入框: find_element_by_id("kw") name定位:find_element_by_name("") HTML页面元素中有时候会指定name属性,有name属性的元素可以通过name进行定位,但要注意name属性在同一个页面可能存在多个相同的元素. 通过name属性定位百度输入框: find_element_by_name("wd") class定位:find_element_by_class_name("") class定位方式与id、name类似,下面通过class定位百度输入框: find_element_by_class_name("s_ipt") tag定位:find_element_by_tag_name("") 通过html元素的标签类型去定位元素,这个在页面中会存在很多tag name相同的元素,用这种方式识别元素的概率很低。 find_element_by_class_name("input")find_element_by_class_name("div") link定位:find_element_by_link_text() link通常用来定位文本链接,比如百度首页上方的链接就可以通过link的方式定位: find_element_by_link_text("新闻")find_element_by_link_text("hao123")find_element_by_link_text("地图") partial link定位:driver.find_element_by_link_text() partial link定位是对link定位的一种补充,有些文本链接会比较长,这个时候可以取文本链接的一部分进行定位,只要这一部分信息可以唯一地标识这个链接。 一个很长很长很长的文本链接find_element_by_link_text("一个很长的")find_element_by_link_text("很长的文本链接") xpath定位:driver.find_element_by_xpath() xpath有很多种定位策略,最简单直观的就是写出元素的绝对路径: xpath-利用绝对路径定位如果一个层级下有多个相同的标签名时,那么就按上下顺序确定是第几个,比如div[2]表示当前层级下的第二个div标签。 find_element_by_xpath("/html/body/div/div[2]/div/form/span[2]/input") xpath-利用元素属性定位 find_element_by_xpath("//input[@id='kw']") //表示当前页面某个目录下,imput表示定位元素的标签名,[@id='kw']表示这个元素的id属性值等于kw。下面演示通过name和class定位: find_element_by_xpath("//input[@name='wd']")find_element_by_xpath("//input[@class='s_ipt']")find_element_by_xpath("//*[@class='bg_s_btn']") 如果不想指定标签名,则也可以用星号(*)代替。用xpath不局限与id,name,class等属性,元素的任意属性值都可以使用,只要它能唯一的标识一个元素。 find_element_by_xpath("//input[@maxlength='100']")find_element_by_xpath("//input[@autocomplete='off']")find_element_by_xpath("//input[@type='submit']") xpath-利用层级和属性结合起来定位 如果一个元素本身没有可以唯一标识这个元素的属性值,那么我们可以往上找其对应的其他层级是否有可以唯一标识属性的值,也可以拿来使用。 find_element_by_xpath("//form[@id='form']/input")find_element_by_xpath("//form[@id='form']/span[2]/input") xpath-使用逻辑运算符连接多个属性值定位 如果一个属性不能唯一地区分一个元素,我们还可以使用逻辑运算符连接多个属性来查找元素。 比如:现在有以下一段元素要定位: ............ 此时,要定位第一行的input元素,就可以采用下面的写法: find_element_by_xpath("//input[@id='kw'and@class='su']") xpath定位除以上几种方式手写定位外,谷歌浏览器还可以借助浏览器自带的功能进行xpath元素定位的复制,火狐浏览器还可以借助FireBug插件进行元素xpath等方式定位复制。下面演示一下如果在谷歌浏览器上复制百度首页某个元素的xpath路径: 1、鼠标选中要定位的元素,右键->选择检查 2、选择屏幕下方高亮的元素,右键->copy->copy xpath /copy full xpath,然后粘贴即可 copy xpath:会根据工具智能的复制出精简的xpath路径, copy full xpath:复制的是全路径的绝对地址定位元素,但这2种方式复制出来的路径并不能保证100%就一定可用,有时候需要自己再进行一些调整。 CSS定位:find_element_by_css_selector(".s_ipt") css可以比较灵活的选择控件的任意属性,一般情况下定位速度要比xpath快,但对于初学者来说的话,学习起来稍微有点难度,下面就简单地介绍一下css的语法和使用。 css选择器的常见语法 选择器 例子 描述 .class .intro class选择器,选择class="intro"的所有元素 #id #kw id选择器,选择id="kw"的所有元素 * * 选择所有元素 element p 元素所有元素 element > element div > input 选择父元素为的所有元素 element + element div + input 选择同一级中紧接在元素之后的所有元素 [attribute=value] [target=_blank] 选择target="_blank"的所有元素 具体用法演示: 1、通过class属性定位find_element_by_css_selector(".s_ipt")2、通过id属性定位find_element_by_css_selector("#kw")3、通过标签定位find_element_by_css_selector("input")4、通过父子关系定位find_element_by_css_selector("span>input")5、通过属性定位find_element_by_css_selector("[autocomplete=off]")find_element_by_css_selector("[name=kw]")6、组合定位find_element_by_css_selector("form.fm>span>input.s_ipt")find_element_by_css_selector("form#form>span>input#kw") 以上简单的介绍了8中定位方法,WebDriver还提供了另外一套写法,即统一调用find_element()方法,通过By来声明定位的方法,并且传入对应定位方法的定位参数。具体如下: •find_element(By.ID,"loginName")•find_element(By.NAME,"SubjectName")•find_element(By.CLASS_NAME,"u-btn-levred")•find_element(By.TAG_NAME,"input")•find_element(By.LINK_TEXT,"退出")•find_element(By.PARTIAL_LINK_TEXT,"退")•find_element(By.XPATH,"//*[@id='Title']")•find_element(By.CSS_SELECTOR,"[type=submit]") 其实前面8中定位方法,底层也是调用的find_element()方法: deffind_element_by_id(self,id_): """Findsanelementbyid. :Args: -id\_-Theidoftheelementtobefound. :Returns: -WebElement-theelementifitwasfound :Raises: -NoSuchElementException-iftheelementwasn'tfound :Usage: element=driver.find_element_by_id('foo') """ returnself.find_element(by=By.ID,value=id_) find_element(),find_elements()区别 细心的同学会发现,在使用的时候,除了find_element()之外,还会有一个find_elements()方法,那么他们两有什么区别呢? 1.只查找一个元素的时候:可以使用find_element(),find_elements() find_element()会返回一个WebElement节点对象,但是没找到会报错,而find_elements()不会,之后返回一个空列表 2.查找多个元素的时候:只能用find_elements(),返回一个列表,列表里的元素全是WebElement节点对象 3.如果想要获取元素相关内容,find_element()可直接获取,find_elements()需要获取列表某个指定元素之后才能获取相关内容 一组元素定位 前面已经介绍了单个元素定位的方法,这里再介绍一种定位一组元素的方法: find_elements_by_id() find_elements_by_name() find_elements_by_class_name() find_elements_by_tag_name() find_elements_by_link_text() find_elements_by_partial_link_text() find_elements_by_xpath() find_elements_by_css_selector() 看出区别了吗?这几个方法在element后面加了一个s,能够定位多个属性相同的元素,返回的是一个元素对象的数组,定位不到时,返回的是一个空数组,不会报元素找不到的异常。 应用场景:比如下拉框的时候 ,先定位获取下拉框的所有选项,再循环遍历,找到满足条件的某个元素,选中或者做其他操作。

优秀的个人博客,低调大师

Netty之线程唤醒wakeup

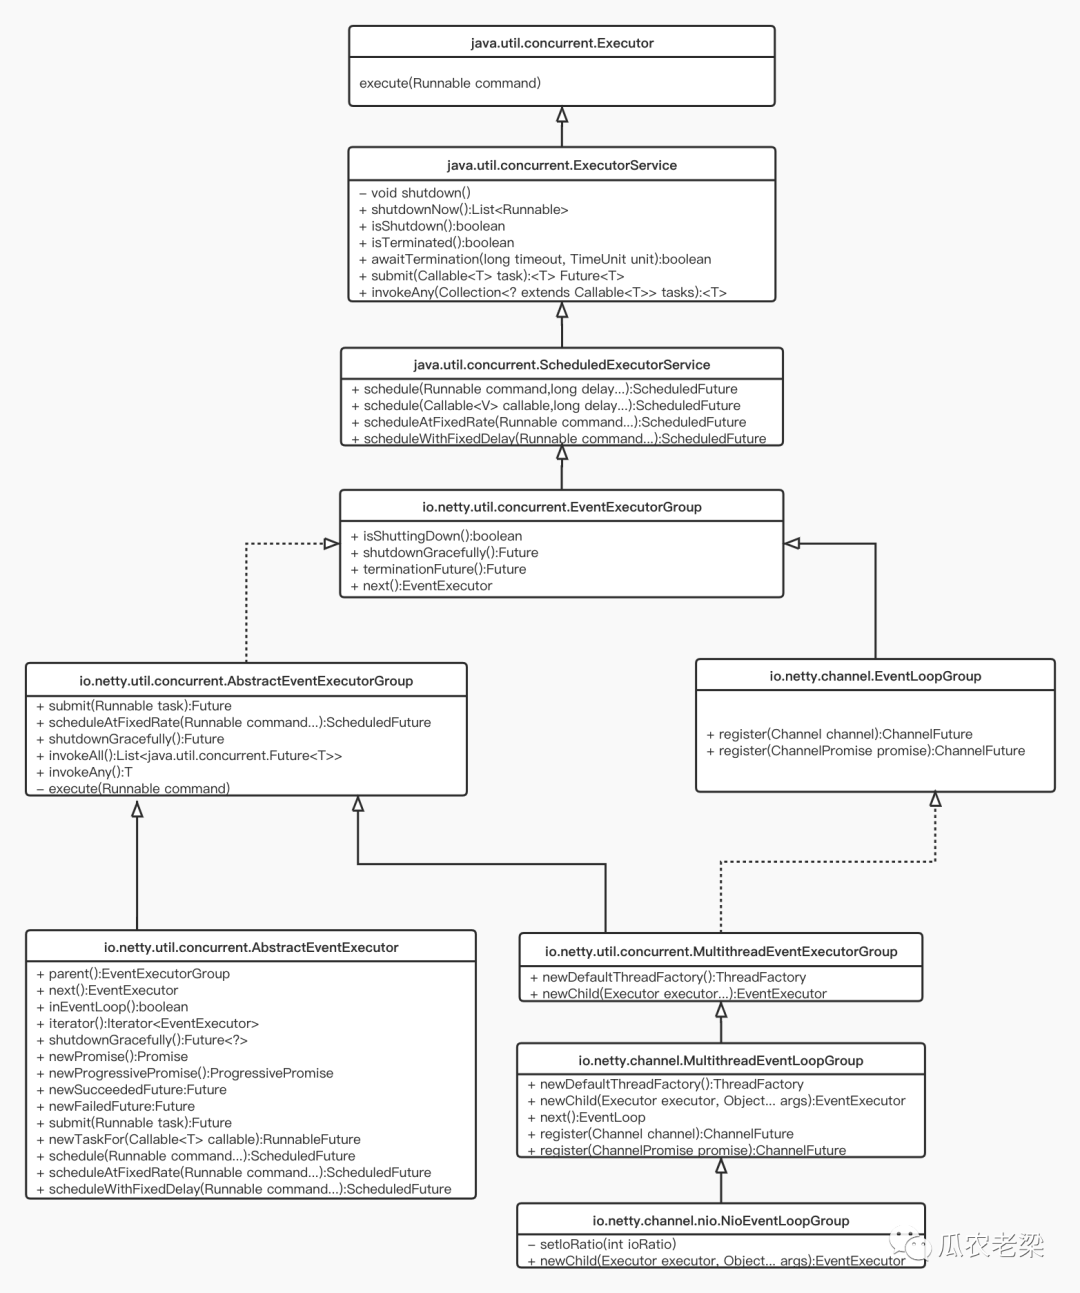
首先回顾下, Netty中的IO线程主要完成三件事 1.轮询IO事件 2.处理IO事件 3.执行任务 在轮询IO事件的过程中,在Linux系统下, 使用epoll实现. 涉及的Netty代码如下 private void select() { // ... int selectedKeys = selector.select(timeoutMillis); // ... } 具体源码位置: io.netty.channel.nio.NioEventLoop#select 当IO线程执行以上代码的时候, 如果超时时间timeoutMillis还没有到达的情况下, IO线程就会处于阻塞状态. 这个时候如果非IO线程需要向对端写数据, 由于Netty是异步的框架, 它的实现是非IO线程将写数据封装成一个任务提交到IO线程的任务队列里. 当任务提交到任务队列后, 那么就会面临一个问题.此时的IO线程处于阻塞状态, 是否需要唤醒它呢? 答案是需要唤醒, 之所以要把它唤醒, 是需要让IO线程可以及时的处理刚刚非IO线程提交的任务. @Override protected void wakeup(boolean inEventLoop) { if (!inEventLoop && wakenUp.compareAndSet(false, true)) { // 唤醒IO线程 selector.wakeup(); } } 源码位置: io.netty.channel.nio.NioEventLoop#wakeup 以上代码, 就是唤醒的代码, 主要调用的方法就是wakeup. 接下来通过查看它的系统调用, 弄清楚它到底是如何实现的. 代码如下 // WakeUp.java import java.net.InetSocketAddress; import java.nio.channels.SelectionKey; import java.nio.channels.Selector; import java.nio.channels.ServerSocketChannel; public class WakeUp { public static void main(String[] args) throws Exception { ServerSocketChannel serverSocketChannel; Selector selector = Selector.open(); serverSocketChannel = ServerSocketChannel.open(); serverSocketChannel.socket().bind(new InetSocketAddress("127.0.0.1", 8080), 64); serverSocketChannel.configureBlocking(false); serverSocketChannel.register(selector, SelectionKey.OP_ACCEPT); new Thread() { @Override public void run() { try { System.out.print("Thread[" + Thread.currentThread().getName() + "]invoke select\r\n"); // 底层调用epoll_wait而阻塞 int readyChannels = selector.select(); } catch (Exception x) { x.printStackTrace(); } System.out.print("Success...\r\n"); } }.start(); // 之所以设置的时间比较久, 是为了让程序暂时不结束 Thread.sleep(5_60_000); System.out.print("Thread[" + Thread.currentThread().getName() + "]invoke wakeup\r\n"); // 唤醒阻塞线程 selector.wakeup(); } } 以上代码的逻辑比较简单, 一个线程调用select()方法阻塞, 另一个线程唤醒它. 首先javac编译以上代码, 然后使用一个查看系统调用的命令strace. strace -ff -o strace java WakeUp 具体如何使用strace请童鞋自行Google 执行以后, 通过以下步骤进行分析 使用jps查看进程ID号 获得PID=1141 进入 /proc/1141/fd目录下, 就可以查看到当前进程(PID=1141)打开的文件描述符 0,1,2这三个文件描述符是标准输入,标准输出和错误输出. 4号文件描述符是在使用epoll实现的多路复用IO创建的一个文件描述符. 5,6这两个文件描述符是一对管道. 7,8这两个文件描述符是一对套接字. 在上面执行strace命令的时候, 在它的同目录下会生成如下文件 通过搜索strace命令打印的文件内容, 查看具体的系统调用方法. 使用grep命令搜索关键字pipe 程序调用pipe这个系统调用创建管道. 其中的5和6是两个文件描述符,也就是在/proc/1141/fd目录下的那两个5和6文件描述符. 5这个描述符用来读取数据, 6这个描述符用来写入数据, 这样就实现了两个进程之间的通信. 使用grep命令搜索关键字socketpair 程序调用socketpair这个系统调用创建套接字. 其中的8和9是两个文件描述符,也就是在/proc/1141/fd目录下的那两个8和9文件描述符. 8这个描述符用来读取数据, 9这个描述符用来写入数据, 这样就实现了两个进程之间的通信. epoll三个关键的方法: epoll_create,epoll_ctl,epoll_wait. epoll_create用于创建epoll文件描述符 epoll_ctl用于管理其他文件描述符 epoll_wait用于阻塞等待其他文件描述符就绪. 使用grep命令搜索关键字epoll 通过epoll_create创建4号文件描述符. 5和7这两个文件描述符添加到epoll上(底层是添加到内核的红黑树). 在上面的Java代码中, 当调用int readyChannels = selector.select()方法的时候, 底层就会调用epoll_wait方法, 那么线程就会阻塞在此. 当另一个线程调用selector.wakeup()的时候, 它就会向6号文件描述符写入数据, 通过pipe通信的方式, 唤醒另一个阻塞的线程. 可以通过grep搜索关键字write验证结论. 通过write系统调用向6号文件描述符写入数据, 具体数据没有任何含义, 它就是想唤醒阻塞的线程. 与6号文件描述符对应的是5号文件描述符. 由于epoll管理着5号文件描述符, 这样epoll发现有文件描述符就绪(5号文件描述符就绪), 被阻塞的线程也就会被操作系统重新调度. 以上简单介绍了Netty中IO线程如何阻塞和被唤醒的底层系统调用.

优秀的个人博客,低调大师

机器学习算法之BIRCH

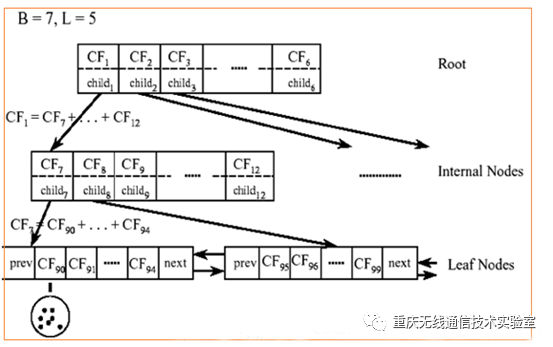
BIRCH(BalancedIterative Reducing and Clustering Using Hierarchies)全称是:利用层次方法的平衡迭代规约和聚类。BIRCH算法是1996年由TianZhang提出来的。Birch算法就是通过聚类特征(CF)形成一个聚类特征树,root层的CF个数就是聚类个数。 BIRCH算法实现分为4个步骤: 1、扫描所有数据,建立初始化的CF树,把稠密数据分成簇,稀疏数据作为孤立点对待。 2、这个步骤是可选的,步骤3的全局或半全局聚类算法有着输入范围的要求,以达到速度与质量的要求,所以此阶段在步骤1的基础上,建立一个更小的CF树。 3、补救由于输入顺序和页面大小带来的分裂,使用全局/半全局算法对全部叶节点进行聚类。 4、这个步骤也是可选的,把步骤3的中心点作为种子,将数据点重新分配到最近的种子上,保证重复数据分到同一个簇中,同时添加簇标签。 聚类特征(CF):每一个CF都是一个三元组,可以用(N,LS,SS)表示。其中N代表了这个CF中拥有的样本点的数量;LS代表了这个CF中拥有的样本点各特征维度的和向量,SS代表了这个CF中拥有的样本点各特征维度的平方和。 比如:CF中含有N=5个点,以两维样本点值为:(3,4)、(2,6)、(4,5)、(4,7)、(3,8)。 然后计算: LS=(3+2+4+4+3,4+6+5+7+8)=(16,30) SS=(32+22+42+42+32,42+62+52+72+82)=(54,190) 对于上图中的CF Tree,限定了B=7,L=5,也就是说内部节点最多有7个CF(含有的分支点数目),而叶子节点最多有5个CF(每个叶子还有的CF个数,实际上就是每个叶子中包含的样本数目)。叶子节点是通过双向链表连通的。 BIRCH算法举例: Birch算法在sklearn.cluster中 具体代码如下 #coding = utf-8##算法涉及主要参数##n_clusters:簇数##threshold :扫描阈值##branches_factors: 每个节点中CF子集群的最大数量,默认值为50##最后通过读取:label_;来获知每个数据点的分类情况import numpy as npimport matplotlib.pyplot as pltfrom sklearn.datasets.samples_generator import make_blobsfrom sklearn.cluster import Birch## X为样本特征,Y为样本簇类别,共500个样本,每个样本2个特征,共4个簇,## 簇中心在[-1,-1],[0,0],[1,1],[2,2]X,Y = make_blobs(n_samples = 500,n_features = 2, centers=[[-1,-1],[0,0],[1,1],[2,2]], cluster_std=[0.5,0.4,0.5,0.4],random_state=9)##设置birch函数birch = Birch(n_clusters = None)##训练数据y_pred = birch.fit_predict(X)##绘图plt.figure()plt.subplot(2,2,1)plt.scatter(X[:,0],X[:,1])plt.title('DataSample')plt.subplot(2,2,2)plt.scatter(X[:,0],X[:,1],c=y_pred)plt.title('None')##设置birch函数birch =Birch(n_clusters = 4)##训练数据y_pred =birch.fit_predict(X)plt.subplot(2,2,3)plt.scatter(X[:,0], X[:, 1], c=y_pred)plt.title('n_clusters=4')plt.show() 最后的效果:

优秀的个人博客,低调大师

Google Guice之绑定方式

在Guice中,注入器的工作是装配对象图,当请求某一类型实例时,注入器根据对象图来判断如何创建实例、解析依赖。要确定如何解析依赖就需要通过配置注入器的绑定方式。 要创建绑定(Binding)对象,可以继承自AbstractModule类,然后覆盖其configure方法,在方法调用bind()方法来指来定每一次绑定,这些方法带有类型检查,如果你使用了错误的类型编译器就会报告编译错误。如果你已经写好了Module类,则创建一个Module类对象作为参数传递给Guice.createInjector()方法用于创建一个注入器。 通过Module对象可以创建链接绑定(linked bindings)、实例绑定(instance bindings)、@Provides methods、提供者绑定(provider bindings)、构建方法绑定(constructor bindings)与无目标绑定(untargetted bindings)。这些绑定方式统称为内置绑定,相对应的还有种及时绑定,如果在解析一个依赖时如果在内置绑定中无法找到,那么Guice将会创建一个及时绑定。 一、链接绑定(LinkdedBindings) 链接绑定即映射一类型到它的实现类,例如映射TransactionLog接口到实现类DatabaseTransactionLog: public class BillingModule extends AbstractModule { @Override protected void configure() { bind(TransactionLog.class).to(DatabaseTransactionLog.class); } } 这样,当你调用injector.getInstance(TransactionLog.class)方法,或者当注入器碰到TransactionLog依赖时,就会使用DatabaseTransactionLog对象。链接是从一类型到它任何的子类型,这包括接口实现类,类的子类;所以如下映射也是可以的:bind(DatabaseTransactionLog.class).to(MySqlDatabaseTransactionLog.class);并且链接绑定支持链式写法: public class BillingModule extends AbstractModule { @Override protected void configure() { bind(TransactionLog.class).to(DatabaseTransactionLog.class); bind(DatabaseTransactionLog.class).to(MySqlDatabaseTransactionLog.class); } } 在这种情况下,当请求一个TransactionLog类型对象时,注入器将返回一个MySqlDatabaseTransactionLog对象。 二、绑定注解 某些情况下你可能想为同一种类型设置多种绑定。这就可以通过绑定注解来实现,该注解与绑定的类型用于唯一结识一个绑定,合在一起称为Key。示例: package example.pizza; import com.google.inject.BindingAnnotation; import java.lang.annotation.Target; import java.lang.annotation.Retention; import static java.lang.annotation.RetentionPolicy.RUNTIME; import static java.lang.annotation.ElementType.PARAMETER; import static java.lang.annotation.ElementType.FIELD; import static java.lang.annotation.ElementType.METHOD; @BindingAnnotation @Target({ FIELD, PARAMETER, METHOD }) @Retention(RUNTIME) public @interface PayPal {} 这里关键的是@BindingAnnotation元注解,当Guice描述到该注解时,就会把PayPal作为绑定注解。然后在Module的configure方法中使用annotatedWith语句,如下:bind(CreditCardProcessor.class).annotatedWith(PayPal.class).to(PayPalCreditCardProcessor.class);这样就把CreditCardProcessor映射到了PayPalCreditCardProcessor。 用法如下: public class RealBillingService implements BillingService { @Inject public RealBillingService(@PayPal CreditCardProcessor processor, TransactionLog transactionLog) { ... } } 还有一种情况,我们可以使用Guice已经定义好的@Named注解,例如: public class RealBillingService implements BillingService { @Inject public RealBillingService(@Named("Checkout") CreditCardProcessor processor, TransactionLog transactionLog) { ... } } 要绑定一具体名称,使用Names.named()来创建一个实现传给annotatedWith方法: bind(CreditCardProcessor.class) .annotatedWith(Names.named("Checkout")) .to(CheckoutCreditCardProcessor.class); 因为编译器不会对字符串进行检查,Guice建议我们少使用@Named注解,但是我个人认为,只要自己写代码时只要名称不要写错,通过这种方法式是最容易为同一类型映射多个绑定的,这很类似Spring中的实现方式,Spring的@Service, @Controller, @Repository不就可以指定名称吗? 三、实例绑定(Instance Bindings) 通过实例绑定我们可以为某类型绑定一个具体的实例,这仅仅适用于这些实例类型没有其它依赖的情况,例如值对象: bind(String.class) .annotatedWith(Names.named("JDBC URL")) .toInstance("jdbc:mysql://localhost/pizza"); bind(Integer.class) .annotatedWith(Names.named("login timeout seconds")) .toInstance(10); 使用方式如下 : @Inject @Named("JDBC URL") private String url Guice建议我们避免使用.toInstance来创建复杂的对象,因为这会延迟应用启动。类似地,可以使用@Provides方法实现。 四、@Provides方法 当使用@Provides方法创建对象时,该方法必须定义在Module类中,并且它必须加以@Provides注解,该方法的返回值类型就是被绑定的对象。当注入器需要该类型的实例时,它就会来调用该方法。 public class BillingModule extends AbstractModule { @Override protected void configure() { ... } @Provides TransactionLog provideTransactionLog() { DatabaseTransactionLog transactionLog = new DatabaseTransactionLog(); transactionLog.setJdbcUrl("jdbc:mysql://localhost/pizza"); transactionLog.setThreadPoolSize(30); return transactionLog; } } 如果在@Provides方法上有@PayPal或@Named("Checkout")绑定注解,Guice以绑定注解优先。Guice在调用@Provides方法之前会先解析该方法的依赖: @Provides @PayPal CreditCardProcessor providePayPalCreditCardProcessor(@Named("PayPal API key") String apiKey) { PayPalCreditCardProcessor processor = new PayPalCreditCardProcessor(); processor.setApiKey(apiKey); return processor; } 关于异常:Guice不允许在@Provides方法中抛出异常。如果有异常抛出,那么异常将会被包装在ProvisionException对象中。 五、提供者绑定(Provider Bindings) 如果@Provides方法越来越复杂,我们可能会想把它们移到一个单独的类中。一个提供者类实现了Provider接口,它是一个用于提供值的简单通用接口。 public interface Provider<T> { T get(); } 如果提供者实现类有其自己的依赖时,可以通过在其构造方法上添加@Inject注解进行注入,以保证值安全返回。 public class DatabaseTransactionLogProvider implements Provider<TransactionLog> { private final Connection connection; @Inject public DatabaseTransactionLogProvider(Connection connection) { this.connection = connection; } public TransactionLog get() { DatabaseTransactionLog transactionLog = new DatabaseTransactionLog(); transactionLog.setConnection(connection); return transactionLog; } } 最后使用.toProvider语句来绑定到提供者: public class BillingModule extends AbstractModule { @Override protected void configure() { bind(TransactionLog.class) .toProvider(DatabaseTransactionLogProvider.class); } } 六、无目标绑定 Guice允许我们创建绑定时不指定目标类,也就是没有to语句,这对于具体类或者使用了@ImplementedBy或@ProvidedBy注解类型很有用。例如: bind(MyConcreteClass.class); bind(AnotherConcreteClass.class).in(Singleton.class); 然而,在使用绑定注解时,我们依赖必须指定绑定目标,即它是一个具体类,例如: bind(MyConcreteClass.class) .annotatedWith(Names.named("foo")) .to(MyConcreteClass.class); bind(AnotherConcreteClass.class) .annotatedWith(Names.named("foo")) .to(AnotherConcreteClass.class) .in(Singleton.class); 七、构造方法绑定 有些时候你可能需要将某一类型绑定到任一构建方法,例如在@Inject注解无法添加到目标类构造方法,其原因可能是这个类是第三方提供的,或者说该类有多个构建方法参与依赖注入。此时@Provides方法是解决这个问题的最好方案,因为它可以明确指定调用哪个构造方法,而且不需要使用反射机制。但是使用@Provides方法在某些地方有限制,例如:手动创建对象不能在AOP中使用。 正是因为这个原因,Guice使用了toConstructor()进行绑定,这需要我们使用反射来选择构造方法与处理异常。 public class BillingModule extends AbstractModule { @Override protected void configure() { try { bind(TransactionLog.class).toConstructor( DatabaseTransactionLog.class.getConstructor(DatabaseConnection.class)); } catch (NoSuchMethodException e) { addError(e); } } } 上这个例子中DatabaseTransactionLog类必须有一个带DatabaseConnection参数的构造方法,该构造方法中不需要使用@Inject注解Guice会自动调用该构造方法。每一条toConstructor()语句创建的绑定,其作用域是独立的,如果你创建了多个单例绑定并且使用目标类的同一个构造方法,每一个绑定还是拥有各自的实例。 八、及时绑定 当注入器需要某一类型实例的时候,它需要获取一个绑定。在Module类中的绑定叫做显示绑定,只要它们可用,注入器就可以使用它们。如果需要某一类型实例,但它又不是显示绑定,那么注入器将试图创建一个及时绑定(Just-In-Time bindings),它也被称为JIT绑定与隐式绑定。 可用于创建及时绑定的情况如下: 有一个合适的构建方法,即非私有,不带参数或者标有@Inject注解的构造方法,例如: public class PayPalCreditCardProcessor implements CreditCardProcessor { private final String apiKey; @Inject public PayPalCreditCardProcessor(@Named("PayPal API key") String apiKey) { this.apiKey = apiKey; } } Guice不会创建内部类实例除非它有static修饰符,因为内部类含有一个指向外问类的隐式引用,而这个隐式引用无法注入。 @ImplementedBy @ImplementedBy注解于用告诉注入器某类型的缺省实现类型是什么,这与链接绑定很相似。为某一类型绑定一子类型如下: @ImplementedBy(PayPalCreditCardProcessor.class) public interface CreditCardProcessor { ChargeResult charge(String amount, CreditCard creditCard) throws UnreachableException; } @ImplementedBy(PayPalCreditCardProcessor.class)等效于下面的bind()语句: bind(CreditCardProcessor.class).to(PayPalCreditCardProcessor.class); 如果某一类型即有bind()语句又有@ImplementedBy注解,则bind()语句优先。使用@ImplementedBy请小心,因为它为接口添加了编译时依赖。 @ProvidedBy @ProvidedBy注解用于告诉注入器,Provider类的实现是什么,例如: @ProvidedBy(DatabaseTransactionLogProvider.class) public interface TransactionLog { void logConnectException(UnreachableException e); void logChargeResult(ChargeResult result); } 这等价于bind(TransactionLog.class).toProvider(DatabaseTransactionLogProvider.class);类似@ImplementedBy注解,如果某个类型既使用了bind()语句,又使用了@ProvidedBy注解,那么bind()语句优先。 -------------------------------- END ------------------------------- 及时获取更多精彩文章,请关注公众号《Java精讲》。

优秀的个人博客,低调大师

AQS之ReentrantReadWriteLock写锁

1. 用法 1.1 定义一个安全的list集合 public class LockDemo { ArrayList<Integer> arrayList = new ArrayList<>();//定义一个集合 // 定义读锁 ReentrantReadWriteLock.ReadLock readLock = new ReentrantReadWriteLock(true).readLock(); // 定义写锁 ReentrantReadWriteLock.WriteLock writeLock = new ReentrantReadWriteLock(true).writeLock(); public void addEle(Integer ele) { writeLock.lock(); // 获取写锁 arrayList.add(ele); writeLock.unlock(); // 释放写锁 } public Integer getEle(Integer index) { try{ readLock.lock(); // 获取读锁 Integer res = arrayList.get(index); return res; } finally{ readLock.unlock();// 释放读锁 } } } 1.2 Sync 源码中的属性与方法在上一篇文章中已经讲过了 2. 获取写锁源码分析 ReentrantReadWriteLock中的lock方法 public void lock() { sync.acquire(1); } AbstractQueuedSynchronizer中的acquire方法 public final void acquire(int arg) { // 获取锁失败则进入阻塞队列 if (!tryAcquire(arg) && acquireQueued(addWaiter(Node.EXCLUSIVE), arg)) selfInterrupt(); } acquireQueued(addWaiter(Node.EXCLUSIVE), arg))**,中的acquireQueued方法和addWaiter方法在前面的文章中都已经进行了详细的解释说明。** ReentrantReadWriteLock中的tryAcquire方法 protected final boolean tryAcquire(int acquires) { // 获取当前线程 Thread current = Thread.currentThread(); // 获取状态 int c = getState(); // 计算写线程数量就是独占锁的可从入数量 int w = exclusiveCount(c); // 当前同步状态state != 0,说明已经有其他线程获取了读锁或写锁 if (c != 0) { // 当前state不为0,此时:如果写锁状态为0说明读锁此时被占用返回false; // 如果写锁状态不为0且写锁没有被当前线程持有返回false if (w == 0 || current != getExclusiveOwnerThread()) return false; // 判断同一线程获取写锁是否超过最大次数(65535),支持可重入 if (w + exclusiveCount(acquires) > MAX_COUNT) throw new Error("Maximum lock count exceeded"); //更新状态 //此时当前线程已持有写锁,现在是重入,所以只需要修改锁的数量即可 setState(c + acquires); return true; } //到这里说明此时c=0,读锁和写锁都没有被获取 //writerShouldBlock表示是否阻塞 if (writerShouldBlock() || !compareAndSetState(c, c + acquires)) return false; // 设置锁为当前线程所有 setExclusiveOwnerThread(current); return true; } static final class FairSync extends Sync { // 写锁是否应该被阻塞 final boolean writerShouldBlock() { return hasQueuedPredecessors(); } } 3. 获取写锁流程图 3.1 流程图获取写锁过程 3.2 流程图获取写锁过程解析 写锁的获取过程如下: 首先获取c、w。c表示当前锁状态;w表示写线程数量。然后判断同步状态state是否为0。如果state!=0,说明已经有其他线程获取了读锁或写锁。 如果锁状态不为零(c != 0),而写锁的状态为0(w = 0),说明读锁此时被其他线程占用,所以当前线程不能获取写锁,自然返回false。或者锁状态不为零,而写锁的状态也不为0,但是获取写锁的线程不是当前线程,则当前线程也不能获取写锁。 判断当前线程获取写锁是否超过最大次数,若超过,抛异常,反之更新同步状态(此时当前线程已获取写锁,更新是线程安全的),返回true。 如果state为0,此时读锁或写锁都没有被获取,判断是否需要阻塞(公平和非公平方式实现不同),在非公平策略下总是不会被阻塞,在公平策略下会进行判断(判断同步队列中是否有等待时间更长的线程,若存在,则需要被阻塞,否则,无需阻塞),如果不需要阻塞,则CAS更新同步状态,若CAS成功则返回true,失败则说明锁被别的线程抢去了,返回false。如果需要阻塞则也返回false。 成功获取写锁后,将当前线程设置为占有写锁的线程,返回true。 获取锁失败的话,将当前线程进行放入阻塞队列中。 4. 释放写锁源码分析 ReentrantReadWriteLock中的unlock方法 public void unlock() { sync.release(1); } AbstractQueuedSynchronizer中的release方法 public final boolean release(int arg) { // 如果返回true 那么释放成功了 if (tryRelease(arg)) { Node h = head; // 如果头部不为空,并且头节点的waitStatus是唤醒状态那么唤醒后继线程 if (h != null && h.waitStatus != 0) // 唤醒后继线程 unparkSuccessor(h); return true; } return false; } ReentrantReadWriteLock中tryRelease方法 protected final boolean tryRelease(int releases) { // 若锁的持有者不是当前线程,抛出异常 if (!isHeldExclusively()) // 非法的监控器异常 throw new IllegalMonitorStateException(); // 计算写锁的新线程数 int nextc = getState() - releases; // 如果独占模式重入数为0了,说明独占模式被释放 boolean free = exclusiveCount(nextc) == 0; if (free) // 设置独占线程为空 setExclusiveOwnerThread(null); // 设置写锁的新线程数 // 不管独占模式是否被释放,更新独占重入数 setState(nextc); return free; } protected final boolean isHeldExclusively() { // 若当前线程是当前锁的持有线程那么返回true return getExclusiveOwnerThread() == Thread.currentThread(); } 5. 释放写锁流程图 5.1 流程图释放过程 5.2 流程图释放过程解析 写锁的释放过程: 首先查看当前线程是否为写锁的持有者,如果不是抛出异常。然后检查释放后写锁的线程数是否为0,如果为0则表示写锁空闲了,释放锁资源将锁的持有线程设置为null,否则释放仅仅只是一次重入锁而已,并不能将写锁的线程清空。 说明:此方法用于释放写锁资源,首先会判断该线程是否为独占线程,若不为独占线程,则抛出异常,否则,计算释放资源后的写锁的数量,若为0,表示成功释放,资源不将被占用,否则,表示资源还被占用。 6. 总结 6.1 state 解析 private volatile int state; int 类型占有 4个字节一个字节8位,所以 state 一个 32 位,高 16 位 代表读锁 低 16 位代表 写锁。 // 0x0000FFFF 16 进制 // 1111111111111111 2 进制 // 65535 10 进制 static final int SHARED_SHIFT = 16; static final int SHARED_UNIT = (1 << SHARED_SHIFT); // 65536 static final int MAX_COUNT = (1 << SHARED_SHIFT) - 1; //65535 // 1111111111111111 static final int EXCLUSIVE_MASK = (1 << SHARED_SHIFT) - 1; // 65535 // 1111111111111111 如果此时同步状态位 c 那么获取写状态 c & EXCLUSIVE_MASK如果此时同步状态位 c 那么获取读状态 c >>>16 无符号补0,右移16位 6.2 注意 *以上便是ReentrantReadWriteLock中写锁的分析,下一篇文章将是***Condition**的分析,如有错误之处,帮忙指出及时更正,谢谢,如果喜欢谢谢点赞加收藏加转发(转发注明出处谢谢!!!)

优秀的个人博客,低调大师

消息队列原理之rabbitmq

导读 谈起消息队列,我们的脑海可能会不由自主的冒出这么几个关键词,解耦、异步化、消峰、广播等,消息队列的种类也很多,如 rabbitmq、rocketmq、activemq、kafka等还有各个云厂商提供的消息队列。 它们都有各种的特点和使用场景,所以这个系列的文章主要谈各个消息的原理,目前规划了两篇文章,rabbitmq 和 kafka ,其他的暂时还没有用到,还没有深究。 这篇主要介绍 rabbitmq 的原理和基于 golang 如何使用。 本文首发于 https://russellgao.cn/mq-rabbitmq/ 介绍 RabbitMQ 是一个由 Erlang 开发的 AMQP(Advanced Message Queuing Protocol,高级消息队列协议)的开源实现,用于在分布式系统中存储转发消息,在易用性、扩展性、高可用性等方面表现不俗。支持多种客户端语言。 架构 整体架构对照下面的图说明 先看看图片上各个名次的解释: Broker:它提供一种传输服务,它的角色就是维护一条从生产者到消费者的路线,保证数据能按照指定的方式进行传输,简单来说就是消息队列服务器实体。 Connection: 客户端与 Rabbitmq Broker 直接的 TCP 连接,通常一个客户端与 Broker 之间只需要一个连接即可。 Channel: 消息通道,在客户端的每个连接里,可建立多个channel,最好每个线程都用独立的Channel,后续的对 Queue 和 Exchange 的操作都是在 Channel 中完成的。 Producer: 消息生产者,通过和 Broker 建立 Connection 和 Channel ,向 Exchange 发送消息。 Consumer: 消息消费者,通过和 Broker 建立 Connection 和 Channel,从 Queue 中消费消息。 Exchange: 消息交换机,按照一定的策略把 Producer 生产的消息投递到 Queue 中,等待消费者消费。 Queue: 消息队列载体,每个消息都会被投入到一个或多个队列。 Vhost: 虚拟主机,一个broker里可以开设多个vhost,用作权限分离,把不同的系统使用的rabbitmq区分开,共用一个消息队列服务器,但看上去就像各自在用不用的rabbitmq服务器一样。 Binding:绑定,它的作用就是把exchange和queue按照路由规则绑定起来,这样RabbitMQ就知道如何正确地将消息路由到指定的Queue了。 RoutingKey:路由关键字,生产者在将消息发送给Exchange的时候,一般会指定一个routing key,来指定这个消息的路由规则,而这个routing key需要与Exchange Type及binding key联合使用才能最终生效。 这里面比较难理解的概念是 RoutingKey,Exchange,Binding ,消费发送时不会直接发送给 Queue ,而是先发送给 Exchange,由 Exchange 按照一定的规则投递到与它绑定的 Queue 中,那这个规则是什么呢? 规则就与 Exchange 的 Type、Binding、RoutingKey 相关,Exchange 支持的类型有 4 种,direct,fanout,topic,headers,含义如下: direct: Queue 和 Exchange 在绑定时需要指定一个 key, 我们称为 Bindkey。Producer 往 Exchange 发送消息时,也需要指定一个 key ,这个 key 就是 Routekey。这种模式下 Exchange 会把消息投递给 Routekey 和 Bindkey 相同的队列 fanout: 类似于广播的方式,会把消息投递给和 Exchange 绑定的所有队列,不需要检查 Routekey 和 Bindkey 。 topic: 类似于组播的方式,这种模式下 Bingkey 支持模糊匹配,* 代表匹配一个任意词组,#代表匹配0个或多个词组。如 Producer 产生一条 RouteKey 为 benz.car 的消息, 同时这个 Exchange 绑定了3组队列(请注意是3组不是3个,意思是Exchange可以和同一个Queue进行多次绑定,通过Bindkey 的不同,它们之间是多对多的关系),Bindkey 分别为: car ,*.car ,benz.car ,那么会把这个消息投递到 *.car、benz.car 对应的 Queue 中。 headers: 这个类型 Routekey 和 Bindkey 的匹配规则来路由消息,而是根据发送的消息内容中的 headers 属性进行匹配。 对照上面图和名次解释应该比较清晰明了了,下面我们通过几个例子说明如何使用。 用法(golang) direct 先看看 Rabbitmq 默认的 exchange ,其中第一个(AMQP default) 是默认的,默认绑定了所有的 Queue ,会把消息投递到 Routekey 对应的队列中,即: Routekey==QueueName 。 package main import ( "fmt" "github.com/streadway/amqp" "log" ) func handlerError(err error, msg string) { if err != nil { log.Fatalf("%s: %s", msg, err) } } var url = "amqp://username:password@ip:port" func main() { conn, err := amqp.Dial(url) handlerError(err, "Failed to connect to RabbitMQ") defer conn.Close() channel, err := conn.Channel() handlerError(err, "Failed to open a Channel") defer channel.Close() queueNameCar := "car" if _, err := channel.QueueDeclare(queueNameCar, false, false, false, false, nil); err != nil { handlerError(err, "Failed to decare Queue") } if err := channel.Publish("", queueNameCar, false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } } 这里是一个完整的 Demo, 后面只会提供main() 函数的示例代码,其他的和这里这里类似。 申明了一个名称为 car 的消息队列,并没有做任何的绑定,往 defalut exchange 发送一条消息,routekey 为 car ,可以看到和队列名相同。 为了方便演示,结果以图片的方式展现,可以看到这里有 car 的队列,并且有一条消息。 在创建队列有几个参数可以关注一下 Durability: 持久化,是否将队列持久化到磁盘,当选择持久化时当 rabbitmq 重启了,这个队列还在,否则当重启了之后这个队列就没有了,需要重新创建,这个需要设计程序时考虑到。 Auto delete: 当其中一个消费者已经完成之后,会删除这个队列并断开与其他的消费者的连接。 Arguments: x-message-ttl: 消息的过期时间,发布到队列中的消息在被丢弃之前可以存活多久。 x-expires: 队列的过期时间,一个队列在多长时间内未使用会被自动删除。 x-max-length: 队列的长度,最多剋容纳多少条消息。 x-max-length-bytes: 队列最大可以包含多大的消息。 x-dead-letter-exchange: 当消息过期或者被客户端reject 之后应该重新投递到那个exchange ,类似与一个producer发送消息时选择exchange x-dead-letter-routing-key: 当消息过期或者被客户端reject 之后重新投递时的 Routekey,类似与一个producer发送消息时设置routekey,默认是原消息的 routekey x-max-priority: 消息的优先级设置,设置可以支持的最大优先级,如设置为10,则可以在发送消息设置优先级,可以根据优先级处理消息,默认为空,当为空时则不支持优先级 x-queue-mode: 将队列设置为懒惰模式,尽可能多地将消息保留在磁盘上,以减少RAM的使用量;如果不设置,队列将保留内存中的缓存,以尽可能快地传递消息。 我们自己创建一个 direct 类型的 exchange 并绑定一些队列看看是什么效果。 func main() { conn, err := amqp.Dial(url) handlerError(err, "Failed to connect to RabbitMQ") defer conn.Close() channel, err := conn.Channel() handlerError(err, "Failed to open a Channel") defer channel.Close() directExchangeNameCar := "direct.car" if err := channel.ExchangeDeclare(directExchangeNameCar, "direct", true, false, false, false, nil); err != nil { handlerError(err, "Failed to decalare exchange") } queueNameCar := "car" queueNameBigCar := "big-car" queueNameMiddleCar := "middle-car" queueNameSmallCar := "small-car" channel.QueueDeclare(queueNameCar, false, false, false, false, nil) channel.QueueDeclare(queueNameBigCar, false, false, false, false, nil) channel.QueueDeclare(queueNameMiddleCar, false, false, false, false, nil) channel.QueueDeclare(queueNameSmallCar, false, false, false, false, nil) if err := channel.QueueBind(queueNameCar, "car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameBigCar, "car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameBigCar, "big.car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameMiddleCar, "car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameMiddleCar, "middler.car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "small.car", directExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.Publish(directExchangeNameCar, "car", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } } 代码中申明了 1 一个 Exchange ,4个 Queue,7个 Binding ,其中一个 Binding 详情如下: 可以看到向这个 Exchange 中发消息,Routekey 为 car ,匹配的队列有个,那么这4个队列中都应该有消息才对 和我们的设想是一直 Queue 的创建上面已经讲过了,这里有 Exchange 的创建,那么再看看创建 Exchange 有哪些参数 Type: 类型,上面已经涉及到了 Durability: 持久化 Auto delete: 是否自动删除,如果为yes 则当其中队列完成 unbind 操作,则其他的 queue 或者 exchange 也会 unbind 并且删除这个 exchange 。 Internal: 如果为yes ,则客户端不能直接往这个 exchange 上发送消息,只能用作和 exchange 绑定。 fanout fanout 工作方式类似于广播,看看下面的代码 func main() { conn, err := amqp.Dial(url) handlerError(err, "Failed to connect to RabbitMQ") defer conn.Close() channel, err := conn.Channel() handlerError(err, "Failed to open a Channel") defer channel.Close() fanoutExchangeNameCar := "fanout.car" if err := channel.ExchangeDeclare(fanoutExchangeNameCar, "fanout", true, false, false, false, nil); err != nil { handlerError(err, "Failed to decalare exchange") } queueNameCar := "car" queueNameBigCar := "big-car" queueNameMiddleCar := "middle-car" queueNameSmallCar := "small-car" channel.QueueDeclare(queueNameCar, false, false, false, false, nil) channel.QueueDeclare(queueNameBigCar, false, false, false, false, nil) channel.QueueDeclare(queueNameMiddleCar, false, false, false, false, nil) channel.QueueDeclare(queueNameSmallCar, false, false, false, false, nil) if err := channel.QueueBind(queueNameCar, "car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameBigCar, "car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameBigCar, "big.car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameMiddleCar, "car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameMiddleCar, "middler.car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "small.car", fanoutExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.Publish(fanoutExchangeNameCar, "middle.car", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } } 这个申明了一个 fanout 类型的 exchange ,和上面的代码类似,只有 exchange 不同。 可以先在脑海中想想每个 queue 中有几条消息。 向 fanout.car 这个 exchange 发消息指定 Routekey 为 middle.car ,但是由于是广播模式,所以和 routekey 是没有关系的,每个消息队列中各有一条消息。 请注意有些 binding 指向的是同一个 queue ,那么会产生多条消息到相同的 queue 中,答案是否定的。producer 产生一条消息,根据一定的规则,每个队列只会收到一条(如何符合投递规则的话)。 topic topic 比较有意思了,和之前的简单粗暴的用法不一样了,先看看下面的代码,声明了一个 topic 类型的 exchange, 4个 queue func main() { conn, err := amqp.Dial(url) handlerError(err, "Failed to connect to RabbitMQ") defer conn.Close() channel, err := conn.Channel() handlerError(err, "Failed to open a Channel") defer channel.Close() topicExchangeNameCar := "topic.car" if err := channel.ExchangeDeclare(topicExchangeNameCar, "topic", true, false, false, false, nil); err != nil { handlerError(err, "Failed to decalare exchange") } queueNameCar := "car" queueNameBigCar := "big-car" queueNameMiddleCar := "middle-car" queueNameSmallCar := "small-car" channel.QueueDeclare(queueNameCar, false, false, false, false, nil) channel.QueueDeclare(queueNameBigCar, false, false, false, false, nil) channel.QueueDeclare(queueNameMiddleCar, false, false, false, false, nil) channel.QueueDeclare(queueNameSmallCar, false, false, false, false, nil) if err := channel.QueueBind(queueNameCar, "car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameBigCar, "car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameBigCar, "big.car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameMiddleCar, "car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameMiddleCar, "middler.car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "small.car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "*.small.car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } if err := channel.QueueBind(queueNameSmallCar, "#.small.car", topicExchangeNameCar, false, nil); err != nil { handlerError(err, "Failed to bind queue to exchange") } } 现在思考每个 producer 产生消息之后,会有哪些 queue 会收到消息。 if err := channel.Publish(topicExchangeNameCar, "car", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } 每个 queue 都会收到消息 if err := channel.Publish(topicExchangeNameCar, "small.car", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } small-car 这一个队列会收到消息。 符合 Routekey 为 small.car 、*.small.car、#.small.car 的binding if err := channel.Publish(topicExchangeNameCar, "benz.small.car", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } small-car 这一个队列会收到消息。 符合 Routekey 为 *.small.car、#.small.car 的binding if err := channel.Publish(topicExchangeNameCar, "auto.blue.benz.small.car", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } small-car 这一个队列会收到消息。 符合 Routekey 为 #.small.car 的binding if err := channel.Publish(topicExchangeNameCar, "bike", false, false, amqp.Publishing{ContentType: "text/plain", Body: []byte("test car")}); err != nil { handlerError(err, "Failed to publish message") } 都不会收到消息,没有符合的 routekey 。 headers 这种类型很少有实际的应用场景。 参考 https://www.rabbitmq.com/documentation.html

优秀的个人博客,低调大师

JDK之ConcurrentLinkedQueue的Bug

今天在社区看到一个有意思的JDK Bug,链接地址https://club.perfma.com/article/2041676 问题是这样的,ConcurrentLinkedQueue在JDK7中remove方法会发生内存溢出,写代码去验证我这里就省略了 JDK7 如下List-1是JDK7中的源码 List-1 public boolean remove(Object o) { if (o == null) return false; Node<E> pred = null; for (Node<E> p = first(); p != null; p = succ(p)) { E item = p.item; if (item != null && o.equals(item) && p.casItem(item, null)) { Node<E> next = succ(p); if (pred != null && next != null)//1 pred.casNext(p, next);//2 return true; } pred = p; } return false; } 来分析下是如何产生内存溢出的,如下图1,首先add(1),之后add(2),此时2的next是null,用List-1中的remove()删除2后,如下图2,该节点的value只是设置为null,但是并没有将该节点从链表中删除,这是因为List-1中1处,由于链表中最后一个节点的next总是null,所以无法执行3处的代码,即释放最后一个节点 图1 图2 此时add(3)后,变为如下图3,之后再将3删除后,是如下图4,节点3还是未移除,还是和2节点未删除的原因一致,所以可以看出这就是内存溢出的原因 图3 图4 JDK8 JDK8中的remove如下List-2所示 List-2 public boolean remove(Object o) { if (o != null) { Node<E> next, pred = null; for (Node<E> p = first(); p != null; pred = p, p = next) { boolean removed = false; E item = p.item; if (item != null) {//1 if (!o.equals(item)) { next = succ(p); continue; } removed = p.casItem(item, null); } next = succ(p);//2 if (pred != null && next != null) // unlink 3 pred.casNext(p, next); if (removed) return true; } } return false; } JDK8中add(1)和add(2)后,还是如图1所示,之后用List-2中的remove删除2后,还是如图2所示,即2节点未被移除链表,不要慌,看接下来 之后add(3)后,还是如图3,此时用List-2的remove删除3后,实际上3节点未被移除队列,而是2节点被移除了队列,如下图5 图5 类分析下,在List-2的1处,由于2节点值是null,所以不会执行if中的语句,在2处将next指向3节点,之后再3处由于pred(节点1)不为null且next(节点3)不为null,所以将pred的next设置为节点3,这样节点2的next虽然连着节点3,但是由于没有对象引用节点2,所以节点2会被GC回收。 Reference Jetty中报出的这个Bug,https://bugs.eclipse.org/bugs/show_bug.cgi?id=477817 https://bugs.java.com/bugdatabase/view_bug.do?bug_id=8137185

优秀的个人博客,低调大师

安全运营之攻击溯源

前言 根据美国国防部安全事故处置流程,攻击溯源作为安全事故中事后响应的重要组成部分,一定程度上还原攻击者的攻击路径与攻击手法,从切入角度上看,安全告警事件,漏洞视角,网络和主机层面的异常以及APT攻击都可以帮助安全运营人员发现攻击源头,并且帮助其完成溯源工作。在传统的安全运营工作中,如果我们不知道黑客是怎么进入到系统内部,其实我们无法彻底根除安全隐患。从用户角度也会常常碰到这种情况,特别是高层无法理解为啥安全事件层出不穷。那么加大对溯源能力的投入,可以缓解这种情况的出现。 溯源切入详细分析 从安全运营的角度上切入,用户最想要的是,通过安全系统的分析,能捕捉到整个攻击链事件。知道攻击路径和攻击手段。攻击阶段一般定义为:攻击入口、载荷投放、权限提升、逃逸检测、权限未知、横向移动、远程公职、数据泄露、痕迹清楚、影响破坏。 首先聊聊攻击入口,ATT&CK其实也定义的非常明晰,针对服务器端攻击,最常用的方式: @1、T1190、公开漏洞攻击&0day攻击 (自定义扫描脚本,比如这次HW用的比较多的fastjson漏洞等) @2、T1133、外部远程服务攻击(暴力破解) @3、T1078、合法账号攻击(弱口令/社工库) 检测手段: @1、通过WAF感知到漏洞入侵,或者通过主机安全发现漏洞利用程序运行事件,发送告警事件到安全运营中心综合分析。 @2、通过主机安全产品感知,暴力破解成功(SSH/RDP)、Redis执行异常指令、Java应用执行异常指令、Postgres导出功能被误用写入可疑UDF库文件、Mysql导出功能误用写入可疑文件、Redis入侵后修改Crontab、Linux可疑命令序列、访问敏感文件,发送告警事件到安全运营中心综合分析。 @3、异地登录、异常IP、异常时间登陆、弱口令账户登录,发送告警事件到安全运营中心综合分析。 处置手段: @1、当安全运营中心通过综合分析,发现主机层面存在相关的漏洞,并且进程正在运行,并且有网路层数据已经触达到主机,可调用WAF阻断该IP的访问。 @2、主机层暴力破解阻断,这个目前主机安全软件都有。 @3、禁用账号,还有一些攻击切入点主要是通过入侵客户端,然后进入数据中心的曲线救国方法,也就是我们常说的APT攻击。 T1189、水坑攻击 T1093、附件钓鱼攻击、T1092链接钓鱼攻击、T1094、服务钓鱼攻击 T1095、供应链攻击 T1200、硬件添加攻击 T1199、利用可靠关系 检测手段:需要通过OA网络中的终端安全产品来完成。需要同时把这部分告警日志接入到安全运营中心分析。 处置手段:隔离终端电脑 真实的海莲花(APT32)攻击事件,攻击链分析:T1093(附件钓鱼攻击)- > T1037(安装木马) - > T1563(横向移动) - >T1189(水坑攻击) - > T1567(通过web服务泄漏数据) 由于篇幅有限,先分析到这。其他攻击技术都可以按照以上的方法分析。 产品解决方案 要想实现攻击链分析展示,我们需要组成攻击链的ATT&CK告警事件;要想得到ATT&CK告警事件就需要图分析、时序分析、统计分析等多种计算形式组合;同时也需要安全运营人员的手工编写规则的加持;要想自动或者人工的规则有更好的效果,我们需要提供有价值的基础数据。那么整个产品解决方案可通过架构图展示: 1.数据采集层 主要是分两个层面:在网络层面需要获取netflow流信息,主要是对外信息泄露监控。DNS对外请求的信息主要是为了分析外联,http流量解析对比IDS规则、对比威胁情报;通过LB或者硬件解密卡处理https流量对比IDS规则,对比威胁情报。更重要的一点是需要和CMDB资产服务对接,找到这些网络连接所对应的主机。 在主机层,针对linux服务器,需要采集与主机进程关联的网络连接、文件访问、计划任务、账号、登陆流水、软件信息等。这些数据都可以导入图分析软件中,分析出攻击路径,根据不同时间段的过滤会得出不同的结论。 针对windows服务器,我们可通过集成sysmon中采集指标达到我们的目的,包括:主机进程、与主机进程关联网络连接、文件访问、注册表、命令行、DNS请求、WMI等。 2.规则处理层 主要是安全运营人员编写ATT&CK攻击规则,并且通过规则转换器,转换成上层分析引擎能识别的机器语言。 例如:T1168 - Local Job Scheduling There are 2 ways to capture Crontab replace 1.bash_history : track the command "crontab" - you may need to look for the commands crontab index=linux sourcetype=bash_history bash_command="crontab *" | table host, user_name, bash_command 2. /var/log/cron : look for "crontab" & "REPLACE" in the cron logsindex=linux crontab replace 3. /var.log/crom - track CMD command cat /var/log/cron | grep CMD | cut -d " " -f 9 |sort | uniq -c | sort -rn will give you all the jobs which run in the environment with its number starting from high to low. You can look for a suspecious job/s which are not a part of a whitelisted jobs. 4. index=linux sourcetype=bash_history at 3.规则引擎层 这部分可以通过上一步安全运营人员编写的规则,并且通过规则转换器转换,上层的全量日志分析引擎可快速的把人容易理解的规则转换成可机读的规则。 4.业务展示层 这部分主要有3个业务需求,ATT&CK攻击告警事件展示,攻击链展示,监管溯源查询。 运营效率提升 通过产品化攻击溯源,安全运营人员投入比现有降低50%。

优秀的个人博客,低调大师

【MySQL】之join算法详解

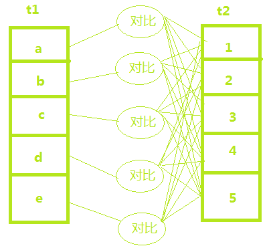
在阿里巴巴的java开发手册有这么一条强制规定:超过三个表禁止join,需要join的字段,数据类型保持绝对一致,多表关联查询时,要保证被关联的字段需要有索引。 为什么尽量避免使用join?如果使用join,我们应该怎么用呢?接下来我们就一起聊一聊关于join的几种算法。 Simple Nested-Loop Join Simple Nested-Loop Join算法是指读取驱动表t1中的每行数据,将每行数据传递到被驱动表t2上,取出被驱动表t2中满足条件的行,和t1组成结果集。 在这个算法中,需要对t1进行全表扫描,假设t1表1000行数据,那么需要对t2表进行1000次全表扫描,假设t2表也是1000行数据,那么就需要扫描1000 X 1000=1000000行。 示例图如下:当t1表5行数据,t2表5行数据时,需要扫描25行数据。 Index Nested-Loop Join index nested-loop join算法的优化思路是通过驱动表的匹配条件,直接与被驱动表的索引进行匹配,减少了被驱动表的扫描次数。 该算法同样要对驱动表t1进行全表扫描,但是我们在拿着t1表的数据去被驱动表t2进行匹配时可以利用t2表的索引,如果t1表中1000行数据,t2表中1000行数据,那么一共就需要扫描1000+1000=2000行数据。这个过程就跟我们写程序时的嵌套查询类似,并且可以用上被驱动表的索引,所以称之为“Index Nested-Loop Join”,简称 NLJ。 示例如下:当t1表有5行数据,t2表有5行数据时,一共需要扫描5+5=10行数据。 Block Nested-Loop Join Block Nested-Loop join,基于块的嵌套循环,简称BNL算法,其优化思路主要是减少被驱动表的循坏次数,它会将驱动表的数据缓存起来,把参与查询的列缓存到join buffer里,然后拿join buffer里的数据批量与内层表的数据在join buffer中进行匹配,满足join条件的,作为结果集的一部分返回。 可以看到该算法对两个表都进行了全表扫描,因此扫描的行数是两个表的行数之和。这种场景下,虽然在扫描行数上和NLJ算法一样,但是由于BNL算法是在内存中进行判断,速度上会快很多。 join buffer的大小是由参数join_buffer_size设定,默认256k。如果一次放不下驱动表的所有数据,会分段放,这种情况下会导致被驱动表扫描多次。如果被驱动表是冷数据表,并且多次扫描读取被驱动表间隔超过1S的话,就会将他放入LRU链表的young区域,导致业务数据无法进入热数据区,减少了bufferpool的命中率,这又是另外一个课题了,暂不过多展开。我们可以通过调大join_buffer_size来提高缓存的数据量,减少对被驱动表的扫描次数。 启用BNL算法需要在optimizer_switch参数中设置block_nested_loop=on。 Batched Key Access BNL算法提升了join的性能,但是它在通过辅助索引连接后需要回表,就会消耗大量的随机I/O,我们知道随机IO对MySQL的影响是非常大的。因此MySQL5.6引入了Batched Key Access(BKA,批量键访问联接)算法。 再说BKA算法时不得不提的就是MySQL的Multi-Range Read 优化,MRR的目的主要是减少磁盘的随机访问。我们都知道,Innodb索引采用的是B+tree的数据结构,数据保存在主键索引中,并且是按照主键递增的顺序插入的,但是二级索引的排列顺序和主键的排列顺序一般是不一样的,它保存的主键值也并非按照主键顺序排列,在回表时就会出现随机访问主键索引的情况。所以如果可以按照主键递增顺序查询的话,对磁盘的读比较接近顺序读,这样就能够提升读性能。 MRR优化的思路就是在进行范围查询时,在得到主键值之后,先按照主键的顺序进行排序,然后拿着排好序的主键ID再去主键索引进行查询,这样就能体现出顺序性的优势了。因为是多值查询,所以一般用于range、ref类型的查询。 再说会BKA算法,当被驱动表上有索引可以利用时,那么就在行提交给被 join 的表之前,先对两个表的对应列的索引字段进行join,得到主键值后,按照主键排好序后,利用 MRR 技术,批量访问表取数据,减少了随机 IO。但是如果被 join 的表没用索引的话,那就只能使用BNL算法了。 具体算法如下图: 开启BKA和MRR的方式: set optimizer_switch='mrr=on,mrr_cost_based=off,batched_key_access=on'; MySQL在8.0版本已经实现了hash join,这里暂不做介绍。 小结 如何优化join的速度呢,这里给出如下几点建议: 尽量避免使用join。 用小表作为驱动表,减少外层循环的次数。 多表关联查询时,要保证被关联的字段要有索引。 适当增大join_buffer_size的值,缓存的数据越多,就越能减少被驱动表扫描的次数。 减少不必要的字段查询。 需要join的字段,数据类型保持绝对一致。 本文分享自微信公众号 - MySQL数据库技术栈(Mysqltechnology)。如有侵权,请联系 support@oschina.cn 删除。本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

troubleshoot之:分析OutOfMemoryError异常

简介 java.lang.OutOfMemoryError应该java应用程序中非常常见的一个的错误了。 那么OutOfMemoryError产生的原因是什么呢?我们怎么去查找相应的错误呢?一起来看看吧。 OutOfMemoryError 先看一下OutOfMemoryError的定义,OutOfMemoryError继承自VirtualMachineError,它是Error的一种,表示的是应用程序无法处理的异常,一般情况下会导致虚拟机退出。 public class OutOfMemoryError extends VirtualMachineError { @java.io.Serial private static final long serialVersionUID = 8228564086184010517L; /** * Constructs an {@code OutOfMemoryError} with no detail message. */ public OutOfMemoryError() { super(); } /** * Constructs an {@code OutOfMemoryError} with the specified * detail message. * * @param s the detail message. */ public OutOfMemoryError(String s) { super(s); } } 一般情形下,如果heap没有更多的空间来分配对象,就会抛出OutOfMemoryError。 还有一种情况是没有足够的native memory来加载java class。 在极少数情况下,如果花费大量时间进行垃圾回收并且只释放了很少的内存,也有可能引发java.lang.OutOfMemoryError。 如果发生OutOfMemoryError,同时会输出相应的stack trace信息。 下面我们分析一下各个不同的OutOfMemoryError。 java.lang.OutOfMemoryError: Java heap space Java heap space表示的是新对象不能在java heap中分配。 如果遇到这种问题,第一个要想到的解决方法就是去看配置的heap大小是不是太小了。 当然,如果是一个一直都在运行的程序,突然间发生这种问题就要警惕了。因为有可能会存在潜在的内存泄露。需要进一步分析。 还有一种情况,如果java对象实现了finalize方法,那么该对象在垃圾回收的时候并不会立刻被回收。而是放到一个finalization队列中。 这个队列会由终结器守护线程来执行。如果终结器守护线程的执行速度比对象放入终结器队列中的速度要慢的话,就会导致java对象不能被及时回收。 如果应用程序创建了高优先级的线程,那么高优先级的线程将有可能会导致对象被放入finalization队列的速度比终结器守护线程的处理速度慢。 java.lang.OutOfMemoryError: GC Overhead limit exceeded GC overhead limit exceeded表示的是GC一直都在运行,从而导致java程序本身执行非常慢。 如果一个java程序98%的时间都在做GC操作,但是只恢复了2%的heap空间,并且持续5次。那么java.lang.OutOfMemoryError将会被抛出。 可以使用下面的参数来关闭这个功能。 -XX:-UseGCOverheadLimit java.lang.OutOfMemoryError: Requested array size exceeds VM limit 这个错误的意思是,要分配的array比heap size大。 比如说设置的最大heap大小是256M,但是分配了一个300M的数组,就会出现这个问题。 java.lang.OutOfMemoryError: Metaspace 从JDK8之后,Metaspace已经移到了java的本地内存空间中。如果Metaspace超出了限制的大小,那么java.lang.OutOfMemoryError也会抛出。 Metaspace的空间大小可以通过MaxMetaSpaceSize来设置。 java.lang.OutOfMemoryError: request size bytes for reason. Out of swap space? 当本地堆分配失败并且本地堆即将耗尽的时候就会报这个异常。 java.lang.OutOfMemoryError: Compressed class space 在64位的平台,对象指针可以用32位表示(对象指针压缩)。 对象指针压缩可以通过: UseCompressedClassPointers 来启用,默认这个参数是开启的。 我们可以使用CompressedClassSpaceSize来设置指针压缩空间的大小。 注意,只有klass元信息是存放在CompressedClassSpaceSize设置的空间中的,而其他的元信息都是存放在Metaspace中的。 OutOfMemoryError: reason stack_trace_with_native_method 这个错误表示本地方法遇到分配失败。 遇到这种问题可能需要操作系统的本地调试工具来解决。 总结 本文介绍了OutOfMemoryError的不同种类,希望大家能够有所收获。 本文作者:flydean程序那些事 本文链接:http://www.flydean.com/jvm-outofmemoryerror-analysis/ 本文来源:flydean的博客 欢迎关注我的公众号:程序那些事,更多精彩等着您!

优秀的个人博客,低调大师

Java 之单元测试

单元测试编写 Junit 单元测试框架 对于Java语言而言,其单元测试框架,有Junit和TestNG这两种,下面是一个典型的JUnit测试类的结构 package com.example.demo; import org.junit.jupiter.api.*; import static org.junit.jupiter.api.Assertions.*; @DisplayName("售票器类型测试") class DemoTest { // 定义测试的实例 private Demo demo; // 定义前缀 整个测试类开始执行的地方 @BeforeAll public static void init(){ } // 定义后缀,整个测试类完成后执行的操作

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册