首页 文章 精选 留言 我的

精选列表

搜索[然之],共10000篇文章
优秀的个人博客,低调大师

玩转Arduino之开篇

之前大学时候有玩过最基本的51单片机,还记得用C语言初学者的水平,颤抖着看着键盘敲打着 "# include<stdio.h>",可能有时候还无法拼写正确include这个单词,仅仅靠着编译器的高亮才找到正确的写法。记得开始学着用Keil IDE开发套件编写一些main()函数,纯粹的面向过程的拿来主义思想,大学的生活总是这样惬意,就像单片机代码一样单纯,都没有使用复杂的指针和递归算法,总是顺利的从头开始执行到尾,最多加上个while(1)循环,连最后的return都依赖编译器给我完成了。到了大学后期,感觉对着双列直插式的芯片,写些无聊的processing。。。感觉生活需要些速度和激情,于是将51单片机架上智能小车的外壳,似乎让我有了兴趣,于是一发不可收!从简单的循迹小车,到开始运用烧复杂传感器的避障智能车,再到了研究生时期做的视频和无线互联智能小车,以后后来做的车车互联通讯的图像识别智能车。小车的造价和运用的处理单元也越来越豪华,从8位8K内存的51单片机到可以运行操作系统的ARM11处理器,从简单的手工焊接的51单片机最小系统,到Friendly ARM6410开发板,一起越来越牛逼的传感器。小车一直伴随着我离开校园步入职场,所有的实习经历和目前的工作,感觉都没有离开嵌入式开发这个主线。每次我都提醒自己,不要被“嵌入式”这个流行词给欺骗了,因为我只是个寄存器程序员,即对着各种SPEC,然后板着指头省内存空间的码农,还不是高级互联网码农。互联网码农们早已经开始用面向对象的思维看待世间万物,而我们还是刀耕火种的时代,所有的努力只是让神秘的上层不要吐槽低层的“慢”!这几天,我在无意间,看到了Arduino这玩意,其实和51单片机差不多,只是浪漫的意大利人给这个Atmega328P-PU单片机开发板取了个貌似浪漫的名字。Arduino可以看做是一套很成熟的开发套件,包括开发板在内的其他外围设备,而且最吸引人的是它有一套带UI的开发软件IDE,这个软件将枯燥的C语言进行了封装,并且隐藏了复杂的编译过程,让开发自己的程序变得乐趣无穷!这也是我在苦逼的工作之余自娱自乐的不二选择。目前,Arduino的开发环境已经搭建完毕,开发套件花费了158¥备齐,好了,废话不说了,后续开始玩起来吧~!

优秀的个人博客,低调大师

读数学之美

第一章1.文字的起源,是由于人类信息量的增加超出人类的记忆能力 2.人类进位制(进制)多采用十进制来源于人有十个手指 3.中国数字采用乘法表示量级(个十百千),罗马数字采用加减描述量级(50 = XXXXX) 4.阿拉伯数字之所以成为通用记数法,主要因为0可以无需量词,直接表示量级,是最抽象和简洁的数字表示法。 5.拼音文字常用字短,生僻字长,中国文字文言文短,口头语长,缘于书写与口头是不同宽窄的信道.遵循信息论的窄信道压缩,宽信道不压缩。 第二章机器智能的主要课题是自然语言处理,主要分为两个阶段50年代-70年代基于文法规则的分析处理70年代后 基于统计方法的机器翻译,识别.

优秀的个人博客,低调大师

Android驱动之 Linux Input子系统之TP——A/B(Slot)协议【转】

转自:http://www.thinksaas.cn/topics/0/646/646797.html 将A/B协议这部分单独拿出来说一方面是因为这部分内容是比较容易忽视的,周围大多数用到input子系统的开发人员也不甚理解;另一方面是由于这部分知识一旦扩展到TP(触摸屏Touch Panel)的多点触摸就要与Middleware/Framework一起结合起来看才能完全掌握,复杂性所在。这里的Middleware/Framework是针对android来说的,本人从事android这几个层次的工作,所以就从android的角度来讲讲这部分内容,其他系统虽然代码不同,但原理上是完全一样的。 B协议又称为slot协议,那么input子系统里面使用的slot是什么,A/B协议究竟是如何划分的? slot直译为位置、槽,有两层含义,一层是位置,另一层是容器。在Input子系统中,它扮演的就是这两个角色。它产生于这样一个背景: 如果从Device获取的当前数据与上一个数据相同,我们有必要再上报当前数据吗?如果我们不管两次数据是否一致都上报,那就是A协议;如果我们选择不上报,那么既然需要比较,总需要把上一次数据存起来吧,slot就是做这个事情的,显然这就是Slot(B)协议。 其实到这里,对TP不感兴趣的童鞋可以不继续向下看了,了解了两个协议的区别看或者写一般模块的代码不会有问题了。需要注意的是,想要测试Device驱动的input部分是否正常的时候,假如使用的是B协议,input_report数据的时候要记得每次都要report不同的值,否则在HAL层是看不到数据不停上报的,因为前后两个数据相同的时候,B协议是不会上报到系统的。另外,在上层测试数据上报频率的时候,采用 数据总量/时间差 的方法,如果驱动采用的是B协议,测试结果也是不准确的。 下面要说的与TP的多点触摸(MT Multi-touch)的功能关系密切,没有兴趣的可以略过。由于这部分代码不从事TP或者android的人是不会接触到的,所以代码就不贴出来了,有兴趣的童鞋可以单独交流O(∩_∩)O~ 我们都知道,在支持MT的手机上多指滑动的时候,多条手指滑动过的轨迹彼此是不相交的,这也是我们所期望的。但这个功能究竟是如何实现的呢?看了上面的分析应该就知道,A/B两种协议方式都可以实现该功能。 A协议不会使用slot,多指处理中,它的报点序列如下(每一个序列都以input_report_***函数实现): 点击(此处)折叠或打开 ABS_MT_POSITION_X x[0] ABS_MT_POSITION_Y y[0] SYN_MT_REPORT ABS_MT_POSITION_X x[1] ABS_MT_POSITION_Y y[1] SYN_MT_REPORT … SYN_REPORT 上面的序列中需要说明的是系统以SYN_MT_REPORT为一个点的信息的结尾,以SYN_REPORT为一次事件的结尾。也就是说多指触摸的时候,android的中间件部分每收到一次SYN_MT_REPORT就形成一个点信息,收到一个点之后并不会立即处理,而是一个事件完成之后才会处理,SYN_REPORT就是这个事件的标志。A协议比较简单,我们也可以发现在上面的序列中根本就没有轨迹跟踪的信息,有的只是点坐标等信息,那么系统如果去判断当前的多个点各属于哪一条线呢? 我们假设前一次事件共有5个点,本次触摸也有5个点,系统会分别计算前一次5个点与本次5个点的距离,distance[prev_i, curr_j] (i=0,1,...,4; j=0,1,...4),这样会产生总共5*5=25个数字。然后对这25个数字进行排序,android用的是堆排序。(我们在系统上如果用多指,一般最多也是双值,也就是4个数据,这里采用了堆排序,不知是出于什么情况考虑,感觉换个方法可能更实用些。)下面的任务就是判断哪些当前点与前一次的点最近,那么赋予它们相同的id,应用收到这个信息后,就可以知道当前点属于哪条线了。 手抬起来的时候又用什么样的序列来通知系统呢, 点击(此处)折叠或打开 SYN_MT_REPORT SYN_REPORT 只有SYNC,没有其它任何信息,系统就会认为此次事件为UP。 B协议使用了slot,还有一个新面孔TRACKING_ID. 点击(此处)折叠或打开 ABS_MT_SLOT 0 ABS_MT_TRACKING_ID ** ABS_MT_POSITION_X x[0] ABS_MT_POSITION_Y y[0] ABS_MT_SLOT 1 ABS_MT_TRACKING_ID ** ABS_MT_POSITION_X x[1] ABS_MT_POSITION_Y y[1] SYN_REPORT 没有SYN_MT_REPORT,那么它用什么来跟踪当前点属于哪一条线呢,用的就是ABS_MT_TRACKING_ID,当前序列中某点的ID值,如果与前一次序列中某点的ID值相等,那么他们就属于同一条线。既然如此,那么android系统中还需要做排序等运算吗?当然不需要。那么手指全部抬起的时候序列又是怎样的呢? 点击(此处)折叠或打开 ABS_MT_SLOT 0 ABS_MT_TRACKING_ID -1 SYN_REPORT ABS_MT_SLOT 1 ABS_MT_TRACKING_ID -1 SYN_REPORT 这里上报的ABS_MT_TRACKING_ID为-1,也只有这里该值才可以小于零,收到该值,系统就会清除对应的ID。看似简单的两个协议内容到这里就分析完毕了。 看了上面的分析,明显可以看出B协议要由于A协议,但事实上并不如此简单。B协议需要硬件上的支持,ID值并不是随便赋值的,而是硬件上跟踪了点的轨迹;如果硬件上满足不了这个条件,那么采用B协议只能闹成笑话。另外,B协议的复杂性如果掌握不好往往会带来一些莫名其妙的问题,比如如果因为某些因素(同步等),在UP的时候少清除了一个slot的信息,那么下次单击的时候你也会惊奇地发现竟然有两个点(采用了B协议,slot已经保存了点信息,除非明确清除)。 希望本文对希望了解TP或者多点触摸功能的童鞋有所帮助。 参考于:http://www.cnblogs.com/rutian2013/p/3341118. html PS:多点触控协议相关知识 Multi-touch (MT) Protocol ------------------------- Copyright(C) 2009-2010 Henrik Rydberg<rydberg@euromail.se> 简介 ------------ 为了发挥新近的多点触摸和多用户设备的强大功能,为多点触摸定义一种上报详细数据的方法(比如有多个物体直接接触到设备的表面),是非常有必要的。这篇文档描述了多点触摸协议(multi-touch,MT),是的内核驱动可以对多个随意数量的触控事件上报详细的数据信息。 基于硬件的能力,该协议被分为两种类型。对于只能处理匿名接触(type A)的设备,该协议描述了如何把所有的原始触摸数据发送给接收者。对于那些有能力跟踪并识别每个触摸点的设备(type B),该协议描述了如何把每个触摸点的单独更新通过事件slots发送给接受者。 ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~ 本部分由DroidPhone 翻译:http://blog.csdn.net/droidphone Kernel版本:V3.7 ~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~~ 协议的使用 -------------- 详细的触控信息被按顺序地分割为多个ABS_MT事件数据包进行发送。只有ABS_MT事件信息被识别为触控数据包的一部分,因为这些事件在当前的单点触控(single-touch,ST)应用中是被忽略掉的,我们可以在现有的驱动中基于ST协议之上来实现MT协议。 对于type A设备的驱动,在每个数据包的结尾用input_mt_sync()对多个触控包进行分割,这将会产生一个SYN_MT_REPORT事件,它通知接收者接受当前的触控信息并准备接收下一个信息。 对于type B设备的驱动,在每个数据包的开始,通过调用input_mt_slot()进行分割,同时带入一个参数:slot。这会产生一个ABS_MT_SLOT事件,它通知接收者准备更新给定slot的信息。. 两种类型的驱动通常都通过调用input_sync()函数来标记一个多点触摸数据传送的结束,这通知接收者对从上一个EV_SYN/SYN_REPORT以来的所有累加事件作出响应,并准备接收新的一组事件/数据包。 无状态的type A协议和有状态的type B slot协议之间的主要区别是通过识别相同接触点来减低发送到用户空间的数据量。slot协议需要使用到ABS_MT_TRACKING_ID,它要不由硬件来提供,或者通过原始数据进行计算【5】。 对于type A设备,内核驱动应该根据设备表面上全部有效触控进行列举并生成事件。每个触控点数据包在这次事件流中的顺序并不重要。事件过滤和手指跟踪的工作留给用户空间来实现【3】。 对于type B设备,内核驱动应该把每一个识别出的触控和一个slot相关联,并使用该slot来传播触摸状态的改变。通过修改关联slot的ABS_MT_TRACKING_ID来达到对触摸点的创建,替换和销毁。一个非负数的跟踪id被解释为有效的触摸,-1则代表一个不再使用的slot。一个之前没有出现过的跟踪id被认为是一个新的接触点,当一个跟踪id不再出现时则认为该接触点已经被移除。因为只有变化的部分被传播,每个被启动的接触点的状态信息必须驻留在接收端。每当接收到一个MT事件,只需对当前slot的相关属性进行一次简单的更新即可。 有些设备可以识别和/或跟踪比它能报告给驱动更多的接触点,对于这种设备的驱动应该使得硬件上报的每一个接触点关联一个type B的slot。一旦识别到一个关联了slot的接触点发生了变化,驱动应该通过改变他的ABS_MT_TRACKING_ID使得该slot无效。如果硬件发出通知它跟踪到了比目前上报的还要多的接触点,驱动应该使用BTN_TOOL_*TAP事件知会用户空间此刻硬件跟踪的总的接触点数目已经改变。要完成此工作,驱动应该显式地发送BTN_TOOL_*TAP事件,并在调用input_mt_report_pointer_emulation()时把use_count参数设为false。驱动应该只通告硬件所能报告的slots数量。用户空间可以通过注意到最大支持的BTN_TOOL_*TAP事件大于在ABS_MT_SLOT轴的absinfo中报告的type B的slots总数,来检测驱动是否能报告比slots数还多的触控点。 Protocol Example A ------------------ 对于一个两点触控的触摸信息,type A设备的最小的事件序列看起来就像下面这样: ABS_MT_POSITION_X x[0] ABS_MT_POSITION_Y y[0] SYN_MT_REPORT ABS_MT_POSITION_X x[1] ABS_MT_POSITION_Y y[1] SYN_MT_REPORT SYN_REPORT 实际上,在移动其中一个触控点后的上报序列看起来是一样的、所有存在触控点的原始数据被发送,然后在它们之间用SYN_REPORT进行同步。 当第一个接触点离开后,事件序列如下: ABS_MT_POSITION_X x[1] ABS_MT_POSITION_Y y[1] SYN_MT_REPORT SYN_REPORT 当第二个接触点离开后,事件序列如下: SYN_MT_REPORT SYN_REPORT 假如驱动在ABS_MT事件之外上报一个BTN_TOUCH 或ABS_PRESSURE事件,最后一个SYN_MT_REPORT可以省略掉,否则,最后的SYN_REPORT会被input核心层扔掉,结果就是一个0触控点事件被传到用户空间中。 Protocol Example B ------------------ 对于一个两点触控的触摸信息,type B设备的最小的事件序列看起来就像下面这样: ABS_MT_SLOT 0 ABS_MT_TRACKING_ID 45 ABS_MT_POSITION_X x[0] ABS_MT_POSITION_Y y[0] ABS_MT_SLOT 1 ABS_MT_TRACKING_ID 46 ABS_MT_POSITION_X x[1] ABS_MT_POSITION_Y y[1] SYN_REPORT id 45的触控点在x方向移动后的事件序列如下: ABS_MT_SLOT 0 ABS_MT_POSITION_X x[0] SYN_REPORT slot 0对应的接触点离开后,对应的事件序列如下: ABS_MT_TRACKING_ID -1 SYN_REPORT 上一个被修改的slot也是0,所以ABS_MT_SLOT被省略掉。这一消息移除了接触点45相关联的slot 0,于是接触点45被销毁,slot 0被释放后可以被另一个接触点重用。 最后,第二个接触点离开后的时间序列如下: ABS_MT_SLOT 1 ABS_MT_TRACKING_ID -1 SYN_REPORT 事件的使用 ----------- 一组ABS_MT事件集合按需要的特性被定义。这些事件被分成几个组,以便允许只实现其中的一部分。最小的集合由ABS_MT_POSITION_X和ABS_MT_POSITION_Y组成,用于跟踪多点接触。如果设备支持,ABS_MT_TOUCH_MAJOR和ABS_MT_WIDTH_MAJOR可以用来提供接触面积和对应的接触工具。 TOUCH和WIDTH参数有一个几何解释。想象一下通过一个窗户观察一个人把一个手指按压在对面的玻璃上,你会看到两个区域,内圈的区域包含了手指实际和玻璃接触的部分,而外圈则是手指的外轮廓。接触区域(a)就是ABS_MT_POSITION_X/Y,而手指轮廓区域(b) 的中心就是ABS_MT_TOOL_X/Y。接触区域的直径是ABS_MT_TOUCH_MAJOR,而手指轮廓的直径就是ABS_MT_WIDTH_MAJOR。现在想象一下此人把手指向玻璃压得更紧,接触区域会增加,通常,ABS_MT_TOUCH_MAJOR / ABS_MT_WIDTH_MAJOR的比值,总是小于1的,它和接触的压力相关。不过对于基于压力的设备,应该改为使用ABS_MT_PRESSURE来提供接触的压力值。可以检测悬浮的设备可以使用ABS_MT_DISTANCE来指出离表面的距离。 LinuxMT Win8 __________ _______________________ / | | / | | / ____ | | / / | | a | a | ____/ | | | | b | b | | | | | | | / | | / | | / | | __________/ |_______________________| 除了MAJOR参数之外,接触和手指区域的椭圆外形还可以增加一个MINOR参数,MAJOR和MINOR参数相当于椭圆的长轴和短轴。接触区域的椭圆的方向可以用ORIENTATION参数描述,而手指区域的椭圆方向可以通过向量运算(a-b)来获得。 对于type A设备,将来的规格可能会通过ABS_MT_BLOB_ID来描述接触的外形。 ABS_MT_TOOL_TYPE可以用来指出触控工具是手指还是笔或者其它物体。最后,ABS_MT_TRACKING_ID应该一直用来跟踪被识别的接触点【5】。 在type B协议里,ABS_MT_TOOL_TYPE和ABS_MT_TRACKING_ID被隐藏在input核心层中进行处理,驱动程序应该改为调用input_mt_report_slot_state()。 事件的语义说明 --------------- ABS_MT_TOUCH_MAJOR 接触区域的长轴的长度。该长度应该按接触表面的单位提供。如果表面的分辨率是X-Y,则ABS_MT_TOUCH_MAJOR可能的最大值是sqrt(X^2 + Y^2),它的对角线【4】。 ABS_MT_TOUCH_MINOR 接触区域短轴的表面单位长度。如果区域是圆形,该事件可以忽略【4】。 ABS_MT_WIDTH_MAJOR 工具轮廓区域长轴的表面单位长度。这应该就是工具本省的大小。接触面和轮廓面的方向被假设是一样的【4】。 ABS_MT_WIDTH_MINOR 工具轮廓区域短轴的表面单位长度,圆形的话可以被忽略【4】。 上述4个值可以被用来推导出接触面的额外信息。ABS_MT_TOUCH_MAJOR / ABS_MT_WIDTH_MAJOR可以被用作接近的压力。手指和手掌有不用的特征宽度。 ABS_MT_PRESSURE 接触区域的压力值,可以是任意单位。基于压力的设备应该使用该事件而不是TOUCH和 WIDTH事件。也用于可以报告空间信号强度的设备。 ABS_MT_DISTANCE 接触物到接触表面之间的表面单位距离。距离为0表明已经接触到了表面。一个正值表示接触物悬浮在表面之上。 ABS_MT_ORIENTATION 接触椭圆区域的方向。该值描述了围绕触摸中心做1/4顺时针转动的有符号数。没有限定该数值的范围,但是在椭圆和表面的Y方向对齐时应该返回0值,椭圆往左转时应该返回负值,往右转时应该返回正值。当和X轴完全对齐时,应该返回最大值。 接触的椭圆默认为是对称点。对于可以360度转动的设备,需要报告超出最大范围来指出转动多于1/4圈。对于倒置的手指,应该上报最大范围的两倍。 如果接触面是一个圆形,或者方向信息在内核驱动中不可用,此时方向参数可以被忽略。如果设备可以识别出两个轴方向,有可能只支持部分不连续的方向,在这种情况下,ABS_MT_ORIENTATION的范围应该是[0,1]【4】。 ABS_MT_POSITION_X 接触中心的X坐标。 ABS_MT_POSITION_Y 接触中心的Y坐标 ABS_MT_TOOL_X 接触工具轮廓中心的X坐标。如果设备不能区分接触面和工具本身时,可以忽略该事件。 ABS_MT_TOOL_Y 接触工具轮廓中心的Y坐标。如果设备不能区分接触面和工具本身时,可以忽略该事件。 这4个位置值可以用于从触控工具位置中分离实际的接触位置。如果两种位置信息都存在,那么触控工具的长轴指向接触点,否则,工具和接触面的轴互相对其。 ABS_MT_TOOL_TYPE 接近工具的类型。很多内核驱动程序不能区分不同的触控工具,比如手指和笔。这种情况下,该事件可以被忽略。目前的协议支持MT_TOOL_FINGER 和MT_TOOL_PEN【2】两种类型。对于type B设备,该事件由input核心层处理,驱动应该改为使用input_mt_report_slot_state()来上报。 ABS_MT_BLOB_ID BLOB_ID事件把几个数据包组合在一起来组成一个任意的接触形状。一些点组成的序列定义了一个多边形的外形。这是一个type A设备的底层匿名数据组合,不应该和上层的跟踪ID相混淆。多数type A设备没有blog这一能力,所以驱动可以放心地忽略该事件。 ABS_MT_TRACKING_ID TRACKING_ID识别一个被启动的触控点的整个生命周期【5】。TRACKING_ID的范围应该足够大,从而保证在足够长的时间内都可以维护一个唯一的值。对于type B设备,该事件由input核心层处理,驱动程序应该改为使用input_mt_report_slot_state()来上报该事件。 事件的计算 ----------------- 一堆不同的硬件不可避免地导致一些设备比另一些更适合于MT协议。为了简单和统一地进行对应,本节给出一些方法来确定如何计算某些事件。 对于那些报告接触形状为矩形的设备,我们不能获得带符号的方向值,假设X和Y分别是接触面矩形的两个边长,以下这些公式可以最大可能地获取最多的信息: ABS_MT_TOUCH_MAJOR := max(X, Y) ABS_MT_TOUCH_MINOR := min(X, Y) ABS_MT_ORIENTATION := bool(X > Y) ABS_MT_ORIENTATION的范围应该被设为[0,1],以便设备可以区分手指是沿着Y轴还是沿着X轴【1】。 对于有T和C坐标的win8设备,位置信息的对应关系是: ABS_MT_POSITION_X := T_X ABS_MT_POSITION_Y := T_Y ABS_MT_TOOL_X := C_X ABS_MT_TOOL_X := C_Y 很不幸的是,没有足够的信息可以确定触摸椭圆和工具椭圆,所以只能求助于近似算法。一种兼容早期使用方式的简单的方案是: ABS_MT_TOUCH_MAJOR := min(X, Y) ABS_MT_TOUCH_MINOR := <not used> ABS_MT_ORIENTATION := <not used> ABS_MT_WIDTH_MAJOR := min(X, Y) + distance(T, C) ABS_MT_WIDTH_MINOR := min(X, Y) 基本原理是:我们没有关于触摸椭圆的相关信息,所以改用它的内切圆形来近似它。触控工具的椭圆应该与向量(T - C)对齐,所以它的直径必须增加(T, C)之间的距离。最后,假设触摸区域的直径等于触控工具的厚度,我们可以得到上述公式。 手指跟踪 --------------- 跟踪手指的处理过程,例如,为在表面上启动的每个触控点分配一个唯一的trackingID,是一个欧几里得偶匹配问题。在每一次的事件同步中,一组实际的触控点要和上一个同步的一组触控点进行匹配,完整的实现请参考【3】。 手势 -------- 在某些可以产生手势事件的特殊应用中,可以使用TOUCH和WIDTH参数,比如,近似手指的压力或者区分食指和拇指。利用额外的MINOR参数,可以区分整个手指压下还是只是手指的一个点压。利用ORIENTATION参数,我们可以检测手指的拧动。 注意事项 ------------ 为了和现有的应用兼容,一个手指数据包中报告的数据不能被识别为单点触控事件。 对于type A设备,所有的手指数据都要略过输入过滤算法,因为接下来的同一类型的事件指向的是不同的手指。 使用type A协议设备的例子,请参考bcm5974的驱动。对于type B协议的例子,请参考hid-egalax的驱动。 [1] Also, the difference (TOOL_X -POSITION_X) can be used to model tilt. [2] The list can of course be extended. [3] mtdev 项目: http://bitmath.org/code/mtdev/. [4] 参看事件计算一节的内容。 [5] 参看手指跟踪一节的内容。 【作者】 张昺华 【出处】 http://www.cnblogs.com/sky-heaven/ 【博客园】 http://www.cnblogs.com/sky-heaven/ 【新浪博客】 http://blog.sina.com.cn/u/2049150530 【知乎】 http://www.zhihu.com/people/zhang-bing-hua 【我的作品---旋转倒立摆】 http://v.youku.com/v_show/id_XODM5NDAzNjQw.html?spm=a2hzp.8253869.0.0&from=y1.7-2 【我的作品---自平衡自动循迹车】 http://v.youku.com/v_show/id_XODM5MzYyNTIw.html?spm=a2hzp.8253869.0.0&from=y1.7-2 【新浪微博】 张昺华--sky 【twitter】 @sky2030_ 【facebook】 张昺华 zhangbinghua 本文版权归作者和博客园共有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出原文连接,否则保留追究法律责任的权利.

优秀的个人博客,低调大师

源码分析Dubbo网络通讯篇之NettyServer网络事件之线程池

本文主要分析Dubbo线程池的构建过程,主要介绍官方文档中有关于ThreadPool的种类: fixed 固定大小线程池,启动时建立线程,不关闭,一致持有。(缺省) cached :缓存线程池,空闲一分钟,线程会消费,需要时重新创建新线程。 limited :可伸缩线程池,但池中的线程数只会增长不会收缩。 eager :优先使用线程来执行新提交任务。(渴望立即执行,而不是进入队列排队执行)。配置标签:< dubbo:protocol threadpool = "fixed" ../> 各种类型的线程池,内部就是根据规则创建不同的ThreadPoolExecutor对象,那我们先简单回顾一下线程池的基本知识,其构造方法如下所示: public ThreadPoolExecutor( int corePoolSize, // 线程池核心线程数、常驻线程数。 int maximumPoolSize, // 线程池中最大线程数量 long keepAliveTime, // 线程保持活跃时间,(如果线程创建,并空闲 //指定值后,线程会被回收,0表示不开启该特性,其范围针对 // corePoolSize的线程) TimeUnit unit, // keepAliveTime的时间单位。 BlockingQueue&lt; Runnable&gt; workQueue,// 任务队列 ThreadFactory threadFactory, // 线程工厂类,一般通过该线程工厂,为线程命名,以便区分线程。 RejectedExecutionHandler handler) // 拒绝策略。 提交任务流程(线程创建流程) 如果线程池中线程数量小于corePoolSize,则创建一个线程来执行该任务。 如果线程池中的线程大于等于corePoolSize,则尝试将任务放入队列中。 如果成功将任务放入队列,则本次提交任务正常结束,如果放入任务队列失败则继续下一步。 如果线程池中的线程数量小于最大线程数,则创建先的线程,否则执行拒绝策略。 更多有关线程池,请参考作者的另外一篇博文:源码分析JDK线程池 1、fixed 固定大小线程池 public class FixedThreadPool implements ThreadPool { @Override public Executor getExecutor(URL url) { String name = url.getParameter(Constants.THREAD_NAME_KEY, Constants.DEFAULT_THREAD_NAME); int threads = url.getParameter(Constants.THREADS_KEY, Constants.DEFAULT_THREADS); int queues = url.getParameter(Constants.QUEUES_KEY, Constants.DEFAULT_QUEUES); return new ThreadPoolExecutor(threads, threads, 0, TimeUnit.MILLISECONDS, queues == 0 ? new SynchronousQueue<runnable>() : (queues &lt; 0 ? new LinkedBlockingQueue<runnable>() : new LinkedBlockingQueue<runnable>(queues)), new NamedThreadFactory(name, true), new AbortPolicyWithReport(name, url)); } } 实现要点: 首先获取可配置参数threadname、threads、queues三个参数,分别代表线程池中线程名前缀、线程中最大线程数量、任务队列长度。 要实现fixed固定大小线程池,故名思议,就是线程池自创建以来,线程数量始终保持一致。其实现要点是,corePoolSize、maximumPoolSize相等,并且其值等于threads(默认200),并且keepAliveTime=0,表示线程始终活跃。 任务队列,如果queues 为0,则使用SynchronousQueue,如果小于0,则使用无界队列,如果大于0,则创建容量为LinkedBlockingQueue的队列,超过容量,则拒绝入队。 线程工厂,NamedThreadFactory,主要设置线程名称,默认为Dubbo-thread-序号。 拒绝策略AbortPolicyWithReport,其主要是如果拒绝任务,首先会打印出详细日志,包含线程池的核心参数,并且会dump jstack 日志,日志文件默认存储在 user.home/Dubbo_JStack.log.timestamp,可以通过 dump.directory 属性配置,可通过< dubbo:protocol> < dubbo:parameter key =“” value = ""/> < /dubbo:protocol>。 >这里再简单介绍如果队列长度为0(默认),为什么是选用SynchronousQueue队列。 SynchronousQueue的一个简单理解:调用offer、put之前,必须先调用take,也就是先调用take方法的线程阻塞,然后当别的线程调用offer之后,调用take的线程被唤醒,如果没有线程调用take方法,一个线程调用offer方法,则会返回false,并不会将元素添加到SynchronousQueue队列中,因为SynchronousQueue内部的队列长度为0。 与该线程池相关的配置属性:threadname、theadpool、threads、queues。 2、cached 缓存线程池,线程空闲后会被回收 public class CachedThreadPool implements ThreadPool { @Override public Executor getExecutor(URL url) { String name = url.getParameter(Constants.THREAD_NAME_KEY, Constants.DEFAULT_THREAD_NAME); int cores = url.getParameter(Constants.CORE_THREADS_KEY, Constants.DEFAULT_CORE_THREADS); int threads = url.getParameter(Constants.THREADS_KEY, Integer.MAX_VALUE); int queues = url.getParameter(Constants.QUEUES_KEY, Constants.DEFAULT_QUEUES); int alive = url.getParameter(Constants.ALIVE_KEY, Constants.DEFAULT_ALIVE); return new ThreadPoolExecutor(cores, threads, alive, TimeUnit.MILLISECONDS, queues == 0 ? new SynchronousQueue<runnable>() : (queues &lt; 0 ? new LinkedBlockingQueue<runnable>() : new LinkedBlockingQueue<runnable>(queues)), new NamedThreadFactory(name, true), new AbortPolicyWithReport(name, url)); } } 实现要点:既然要实现线程可以被回收,则必然要设置 keepAliveTime。 故对应线程池核心参数设置,对应如下: corePoolSize:通过参数corethreads设置,默认为0 maximumPoolSize:通过参数threads设置,默认200 keepAliveTime:通过参数alive设置,默认为60 * 1000 workQueue :通过queues参数设置,默认为0 其他与fixed相同,则不重复介绍 3、limited 可伸缩线程池,其特征:线程数只增不减 public class LimitedThreadPool implements ThreadPool { @Override public Executor getExecutor(URL url) { String name = url.getParameter(Constants.THREAD_NAME_KEY, Constants.DEFAULT_THREAD_NAME); int cores = url.getParameter(Constants.CORE_THREADS_KEY, Constants.DEFAULT_CORE_THREADS); int threads = url.getParameter(Constants.THREADS_KEY, Constants.DEFAULT_THREADS); int queues = url.getParameter(Constants.QUEUES_KEY, Constants.DEFAULT_QUEUES); return new ThreadPoolExecutor(cores, threads, Long.MAX_VALUE, TimeUnit.MILLISECONDS, queues == 0 ? new SynchronousQueue<runnable>() : (queues &lt; 0 ? new LinkedBlockingQueue<runnable>() : new LinkedBlockingQueue<runnable>(queues)), new NamedThreadFactory(name, true), new AbortPolicyWithReport(name, url)); } } 就不回收,与cached不同的就是 keepAliveTime 的取值不同,limited 取值为:Long.MAX_VALUE,其他与 cached 相同。 4、eager 其核心实现主要由 TaskQueue、EagerThreadPoolExecutor 共同完成。 首先,我们关注一下 TaskQueued 的 offer方法。 public boolean offer(Runnable runnable) { if (executor == null) { throw new RejectedExecutionException("The task queue does not have executor!"); } int currentPoolThreadSize = executor.getPoolSize(); // [@1](https://my.oschina.net/u/1198) // have free worker. put task into queue to let the worker deal with task. if (executor.getSubmittedTaskCount() &lt; currentPoolThreadSize) { // @2 return super.offer(runnable); } // return false to let executor create new worker. if (currentPoolThreadSize &lt; executor.getMaximumPoolSize()) { // [@3](https://my.oschina.net/u/2648711) return false; } // currentPoolThreadSize &gt;= max // @4 return super.offer(runnable); } 代码@1:获取当前线程池中线程的数量。 代码@2:如果当前已提交到线程池中的任务数量小于当前存在在的线程数,则走默认的提交流程。 代码@3:如果当前已提交到线程中的数量大于当前的线程池,并线程池中数量并未达到线程池允许创建的最大线程数时,则返回false,并不入队,其效果是会创建新的线程来执行。 代码@4:如果当前线程池中的线程已达到允许创建的最大线程数后,走默认的提交任务逻辑。 EagerThreadPoolExecutor#execute public void execute(Runnable command) { if (command == null) { throw new NullPointerException(); } // do not increment in method beforeExecute! submittedTaskCount.incrementAndGet(); // @1 try { super.execute(command); } catch (RejectedExecutionException rx) { // retry to offer the task into queue. final TaskQueue queue = (TaskQueue) super.getQueue(); try { if (!queue.retryOffer(command, 0, TimeUnit.MILLISECONDS)) { submittedTaskCount.decrementAndGet(); throw new RejectedExecutionException("Queue capacity is full."); } } catch (InterruptedException x) { submittedTaskCount.decrementAndGet(); throw new RejectedExecutionException(x); } } catch (Throwable t) { // decrease any way submittedTaskCount.decrementAndGet(); // @2 } } 其核心实现逻辑:如果提交任务失败,则再走一次默认的任务提交流程。 最总后结一下Eager的核心特性。 public class EagerThreadPool implements ThreadPool { @Override public Executor getExecutor(URL url) { String name = url.getParameter(Constants.THREAD_NAME_KEY, Constants.DEFAULT_THREAD_NAME); int cores = url.getParameter(Constants.CORE_THREADS_KEY, Constants.DEFAULT_CORE_THREADS); int threads = url.getParameter(Constants.THREADS_KEY, Integer.MAX_VALUE); int queues = url.getParameter(Constants.QUEUES_KEY, Constants.DEFAULT_QUEUES); int alive = url.getParameter(Constants.ALIVE_KEY, Constants.DEFAULT_ALIVE); // init queue and executor TaskQueue<runnable> taskQueue = new TaskQueue<runnable>(queues &lt;= 0 ? 1 : queues); EagerThreadPoolExecutor executor = new EagerThreadPoolExecutor(cores, threads, alive, TimeUnit.MILLISECONDS, taskQueue, new NamedThreadFactory(name, true), new AbortPolicyWithReport(name, url)); taskQueue.setExecutor(executor); return executor; } } 其核心特性如下: 首先,其配置参数与cached类型的线程池相同,说明eager也是基于缓存的。 eager与cached类型线程池不同的一点是,提交任务后,线程优先于队列,默认的提交流程是如果线程数达到核心线程数后,新提交的任务是首先进入队列,但eager是优先创建线程来执行,这有点与公平锁,非公平锁一样的概念了。 >作者介绍:丁威,《RocketMQ技术内幕》作者,RocketMQ 社区优秀布道师、CSDN2019博客之星TOP10,维护公众号:中间件兴趣圈目前已陆续发表源码分析Java集合、Java 并发包(JUC)、Netty、Mycat、Dubbo、RocketMQ、Mybatis等源码专栏。可以点击链接加入中间件知识星球 ,一起探讨高并发、分布式服务架构,交流源码。 </runnable></runnable></runnable></runnable></runnable></runnable></runnable></runnable></runnable></runnable></runnable>

优秀的个人博客,低调大师

杨老师课堂之JavaWeb项目架构之NFS文件服务器

版权声明:本文为博主原创文章,未经博主允许不得转载。 https://blog.csdn.net/kese7952/article/details/81013750 NFS简介 NFS(Network File System)即网络文件系统。 主要功能:通过网络(局域网)让不同的主机系统之间可以共享文件或目录。 主要用途:NFS网络文件系统一般被用来存储共享视频,图片,附件等静态资源文件。 NFS存储服务 无NFS文件共享存储 当用户A通过互联网上传文件时,经过负载均衡,随机或者定向分配到某个节点。但是当用户B去下载这个文件的时候,并不确定会向哪个节点发送请求,这样会导致用户存在一定几率下载不到的情况。 NFS_A.png 有NFS文件共享存储 当用户A通过互联网上传文件时,经过负载均衡,无论发送到哪个节点都会被存储到NFS文件服务器。但是当用户B去下载这个文件的时候,任何节点都可以读取NFS文件服务器的文件。 NFS_B.png NFS服务的优缺点 优点 简单容易上手 方便部署非常快速,维护十分简单 节省本地存储空间将常用的数据存放在一台服务器可以通过网络访问 缺点 在高并发下NFS效率/性能有限 NFS的数据是明文的,对数据完整性不做验证 多台机器挂载NFS服务器时,连接管理维护麻烦 容易发生单点故障,如果服务端宕机,所有客户端将不能访问 客户端没用用户认证机制,且数据是通过明文传送,安全性一般(一般建议在局域网内使用) RPC工作流程 170621082430983.png NFS支持的功能非常多,不同的功能会有不同的服务来完成,很多服务都需要监听在一些端口,其中的很多端口并不是固定的。这些服务在启动时,都需要向rpcbind服务注册一个端口,rpcbind服务随机选取一个未被使用的端口予以分配。rpcbind服务监听在111端口,所以rpcbind的主要功能就是指定每个RPC service对应的port number,并且通知给客户端,让客户端连接到正确的端口上去。 客户端向NFS服务器端请求的步骤: 首先用户访问网站程序,由程序在NFS客户端上发出存取NFS文件的请求,这是NFS客户端的RPC服务就不通过网络向NFS服务器端的RPC服务的111端口发出NFS文件存取功能的查询请求,包括要实现的什么功能。 NFS服务器端的RPC服务找到对应的已注册的NFS端口,通知NFS客户端的RPC服务。 此时NFS客户端获取到正确的端口,并与NFS联机存取数据。 NFS客户端把数据存取成功后,返回给客户端程序,告知用户存取结果。 注意:由于rpc service在启动时需要向rpcbind注册端口,所以rpcbind要先启动。另外若rpcbind重新启动,原来注册的数据也会不见,因此一但rpcbind重新启动,让所管理的服务因为需要重新启动以重新向rpcbind注册。 NFS服务器端配置 NFS服务器:192.168.1.180 检查并安装NFS [root@iZ2ze74fkxrls31tr2ia2fZ ~]# rpm -qa rpcbind nfs-utils nfs-utils-1.3.0-0.48.el7_4.1.x86_64 rpcbind-0.2.0-42.el7.x86_64 如果没有,安装 NFS 服务器所需的软件包,实际上需要安装两个包nfs-utils(nfs服务主程序)和rpcbind(rpc主程序), 不过当使用yum安装nfs-utils时会把rpcbind一起安装上。 yum install -y nfs-utils 配置说明 /etc/sysconfig/nfs #NFS的主配置文件 /etc/exports #配置共享目录的文件 /etc/exports的配置格式: nfs共享目录 nfs客户端地址1(参1,参2…..) 客户端地址2(参1,参2…) 说明: nfs共享目录:为nfs服务器要共享的实际目录,绝对目录。注意权限问题。 nfs客户端地址:为nfs服务器授权可以访问的客户端的地址,可以是单独的ip地址或主机名,域名。也可以是整个网段。 授权整个网段:eg:10.0.0.0/24 文件配置实例说明: /data/fileserver 192.168.1.190(rw,sync,no_root_squash) 若服务器端对/etc/exports文件进行了修改,可以通过exportfs命令重新加载服务而不需要重启服务。若重启服务需要重新向prcbind注册,而且对客户端的影响也很大,所以尽量使用exportfs命令来使配置文件生效。 exportfs: exportfs -ar #重新导出所有的文件系统 exportfs -r #导出某个文件系统 exportfs -au #关闭导出的所有文件系统 exportfs -u #关闭指定的导出的文件系统 相关参数 (man exports) A. 选项:选项用来设置输出目录的访问权限、用户映射等。 设置输出目录只读:ro 设置输出目录读写:rw B. 用户映射选项 all_squash:将远程访问的所有普通用户及所属组都映射为匿名用户或用户组(nfsnobody); no_all_squash:与all_squash取反(默认设置); root_squash:将root用户及所属组都映射为匿名用户或用户组(默认设置); no_root_squash:与rootsquash取反; anonuid=xxx:将远程访问的所有用户都映射为匿名用户,并指定该用户为本地用户(UID=xxx); anongid=xxx:将远程访问的所有用户组都映射为匿名用户组账户,并指定该匿名用户组账户为本地用户组账户(GID=xxx); C. 其它选项 secure:限制客户端只能从小于1024的tcp/ip端口连接nfs服务器(默认设置); insecure:允许客户端从大于1024的tcp/ip端口连接服务器; sync:将数据同步写入内存缓冲区与磁盘中,效率低,但可以保证数据的一致性; async:将数据先保存在内存缓冲区中,必要时才写入磁盘; wdelay:检查是否有相关的写操作,如果有则将这些写操作一起执行,这样可以提高效率(默认设置); no_wdelay:若有写操作则立即执行,应与sync配合使用; subtree:若输出目录是一个子目录,则nfs服务器将检查其父目录的权限(默认设置); no_subtree:即使输出目录是一个子目录,nfs服务器也不检查其父目录的权限,这样可以提高效率; 启动NFS服务端上nfs服务 1、先为rpcbind和nfs做开机启动: systemctl enable rpcbind.service systemctl enable nfs-server.service 2、然后分别启动rpcbind和nfs服务: systemctl start rpcbind.service systemctl start nfs-server.service 查看服务是否启动 [root@iZ2ze74fkxrls31tr2ia2fZ ~]# rpcinfo -p program vers proto port service 100000 4 tcp 111 portmapper 100000 3 tcp 111 portmapper 100000 2 tcp 111 portmapper 100000 4 udp 111 portmapper 100000 3 udp 111 portmapper 100000 2 udp 111 portmapper 100024 1 udp 47426 status 100024 1 tcp 35379 status 100005 1 udp 20048 mountd 100005 1 tcp 20048 mountd 100005 2 udp 20048 mountd 100005 2 tcp 20048 mountd 100005 3 udp 20048 mountd 100005 3 tcp 20048 mountd 100003 3 tcp 2049 nfs 100003 4 tcp 2049 nfs 100227 3 tcp 2049 nfs_acl 100003 3 udp 2049 nfs 100003 4 udp 2049 nfs 100227 3 udp 2049 nfs_acl 100021 1 udp 53046 nlockmgr 100021 3 udp 53046 nlockmgr 100021 4 udp 53046 nlockmgr 100021 1 tcp 38280 nlockmgr 100021 3 tcp 38280 nlockmgr 100021 4 tcp 38280 nlockmgr 使用exportfs查看本机上已经共享的目录: exportfs NFS客户端配置 NFS客户端:192.168.1.190 安装nfs,并启动服务。 yum install -y nfs-utils systemctl enable rpcbind.service systemctl start rpcbind.service 客户端不需要启动nfs服务,只需要启动rpcbind服务。 检查 NFS 服务器端是否有目录共享 showmount -e 192.168.1.180 挂载远程服务 mount -t nfs 192.168.1.180:/data/fileserver /data/itstyle 查看挂载 df -h 开机挂载,编辑/etc/fstab vim /etc/fstab 加入以下内容: # 设备文件 挂载点 文件系统类型 mount参数 dump参数 fsck顺序 192.168.1.180:/data/fileserver /data/itstyle nfs defaults,_netdev 0 0 _netdev明确说明这是网络文件系统,避免网络启动前挂载出现错误。 保存后,重新挂载 /etc/fstab 里面的内容。 mount -a 作者: 杨校 出处: https://blog.csdn.net/kese7952 分享是快乐的,也见证了个人成长历程,文章大多都是工作经验总结以及平时学习积累,基于自身认知不足之处在所难免,也请大家指正,共同进步。 本文版权归作者所有,欢迎转载,但未经作者同意必须保留此段声明,且在文章页面明显位置给出, 如有问题, 可邮件(397583050@qq.com)咨询。

优秀的个人博客,低调大师

FlinkSQL 之 temporary join 开发

在实时开发中,双流join获取目标对应时刻的属性时,经常使用temporary join。笔者在流量升级的实时迭代中,需要让流量日志精准的匹配上浏览时间里对应的商品属性,使用temporary join开发过程中踩坑不少,将一些经验沉淀在此文中,供各位同学参考与交流。 背景介绍 关于实时flinkSQL的双流join的背景知识可以先阅读以下文章: https://www.51cto.com/article/713922.html 目前我们有一条流量日志明细的TT流A,以及一条商品标签的TT流B,在flink中对A流和B流进行双流join类似于将A流关联一个hbase维表。temporary join有以下特点: 1. 单流驱动:虽然是双流join,但数据下发只由一条流驱动。 2. 需要定义versioned table,versioned table记录了每个时刻的属性信息,双流join时被动查询。类似于银行汇率表,在货币兑换的时候需要参考兑换时刻的汇率。 3. 查询携带时间版本信息:temporary join携带由两条流的watermark触发,因此查询到的属性是对应时间内的属性。 图片来源:孙金城, 《Blink 漫谈系列 - Temporal Table JOIN》 应用场景&实例分享 当需要根据实时汇率*货币金额计算总金额,实时商品价格*成交件数计算总成交金额时,经常会使用temporary join获取实时的汇率和价格信息。在笔者的流量升级业务迭代中,我们需要获取实时的商品标签,因此需要定义商品标签的versioned table,写法如下: CREATE TEMPORARY TABLE `tag_ri` ( `id` VARCHAR, `tag` VARCHAR, `time` VARCHAR, `ts` AS `TO_TIMESTAMP`(`time`, 'yyyy-MM-dd HH:mm:ss'), WATERMARK FOR `ts` AS `withOffset`(`ts`, 0) --定义watermark) WITH ( 'connector' = 'tt', 'router' = '******', 'topic' = 'tag_ri', 'lineDelimiter' = '\n', 'fieldDelimiter' = '\u0001', 'encoding' = 'utf-8');--定义version tableCREATE TEMPORARY VIEW `tag`ASSELECT `id` , `tag` , `time` , `ts`FROM ( SELECT `id` , `tag` , `time` , `ts` , ROW_NUMBER() OVER (PARTITION BY `id` --关联主键 ORDER BY `time` DESC) AS `rownum` FROM `tag_ri` )WHERE `rownum` = 1; 同上我们也需要定义流量日志明细流的watermark,并进行双流join CREATE TEMPORARY TABLE `log_ri` ( `id` VARCHAR, `time` VARCHAR, ...... `ts` AS `TO_TIMESTAMP`(`time`, 'yyyy-MM-dd HH:mm:ss'), WATERMARK FOR `ts` AS `withOffset`(`ts`, 0)) WITH ( 'connector' = 'tt', 'router' = '******', 'topic' = 'log_ri', 'lineDelimiter' = '\n', 'fieldDelimiter' = '\u0001', 'encoding' = 'utf-8',);select `a`.`id` ,...... ,`b`.`tag`from ( SELECT * FROM `log_ri` ) AS `a`LEFT JOIN `tag` FOR SYSTEM_TIME AS OF `a`.`ts` AS `b` ON `a`.`id` = `b`.`id` 结果如下: --商品标签信息12:00> SELECT * FROM tag_ri; id tag(商品标签)======= ======================= t1 A12:30> SELECT * FROM tag_ri; id tag(商品标签)======= ======================= t1 B--流量明细日志查询 t1商品共三条明细SELECT * FROM log_ri; id time======= ======== t1 12:00 t1 12:15 t1 12:30 --执行temporary joinselect `a`.`id` ,`a`.`time` ,`b`.`tag`from ( SELECT * FROM `log_ri` ) AS `a`LEFT JOIN `tag` FOR SYSTEM_TIME AS OF `a`.`ts` AS `b` ON `a`.`id` = `b`.`id` id time tag(商品标签)======= ======== ======================= t1 12:00 A t1 12:15 A t1 12:30 B 开发经验 ▐稀疏数据处理 由于temporary join是由两条流的watermark触发,如果versioned table是一条稀疏的流(在一段时间内无数据流入),那么join可能存在等待不下发数据的现象,可以通过设置参数settable.exec.source.idle-timeout = 10s ,可以让A流数据不进行等待,具体参数介绍可以参考: https://nightlies.apache.org/flink/flink-docs-release-1.17/docs/dev/table/config/#table-exec-source-idle-timeout ▐数据延迟下发 问题 在实际开发中,我们发现temporay join后数据一直等待不下发,整点才会进行下发的现象。 原因分析 我们结合SQL语法,对TT日志进行回流分析:代码逻辑是四路source union后, join 定义的versioned table select a.* ,b.tagfrom(select * from source_1 union all select * from source_2union all select * from source_3union all select * from source_4) atemporay join b流 source_4会在整点流入少部分当前小时59分钟的数据,而temporay join 是由两边的watermark所触发,所以会有a流等待b流的时间到达当前小时59分钟后再触发的现象。 解法 对source_4中log_time>当前时间的部分,做temporary join时将log_time置为当前时间,该问题就解决了。 总结 1. 在单流驱动的双流join场景中,temporary join是一种常见的处理方式。 2. temporary join由两条流的watermark触发,需要对两条流的watermark进行预处理,防止数据稀疏和数据抢跑等现象影响数据下发。 参考资料 https://www.51cto.com/article/713922.html https://nightlies.apache.org/flink/flink-docs-release-1.17/docs/dev/table/config/#table-exec-source-idle-timeout 团队介绍 我们是淘天集团-业务技术-商家数据团队,专注于开发和维护生意参谋这一全渠道、全链路、一站式的数据平台,同时也负责品牌数据银行和策略中心两大产品。旨在为商家提供全面的数据服务,包括但不限于经营分析、市场洞察、客群洞察等,以帮助商家提高商业决策效率。 ¤ 拓展阅读 ¤ 3DXR技术| 终端技术| 音视频技术 服务端技术|技术质量|数据算法 本文分享自微信公众号 - 大淘宝技术(AlibabaMTT)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

TiKV 源码分析之 PointGet

作者:来自 vivo 互联网存储研发团队-Guo Xiang 本文介绍了TiDB中最基本的PointGet算子在存储层TiKV中的执行流程。 一、背景介绍 TiDB是一款具有HTAP能力(同时支持在线事务处理与在线分析处理 )的融合型分布式数据库产品,具备水平扩容或者缩容等重要特性。TiDB 采用多副本+Multi-Raft 算法的方式将数据调度到不同的机器节点上,具备较高的可靠性和容灾能力。TiDB中的存储层TiKV组件,能够独立于TiDB作为一款分布式KV数据库使用,目前已经捐赠给CNCF并于2020年正式毕业。目前vivo公司内部的磁盘KV产品采用了开源的TiKV作为存储层实现, 目前已经在公司的不同业务产品中有深度实践。 TiKV作为一款KV数据库产品,同时提供了RawAPI和TxnAPI两套接口: RawAPI仅支持最基本的针对单Key操作的Set/Get/Del及Scan语义 TxnAPI提供了基于ACID事务标准的接口,支持多Key写入的原子性 TxnAPI采用了分布式事务来保证多Key写入的原子性,其适用的业务场景与RawAPI相比来说更为广泛。本文后续内容将重点对PointGet在TiKV侧的执行流程进行分析,其内容涉及到storage和txn模块。阅读本文后,读者将会深入了解TiKV源码中Get流程的实现细节,包括如何处理读请求、如何进行数据定位和读取、如何实现事务隔离级别等方面,并且能够更好地理解TiKV的内部工作原理和性能优化。 二、PointGet介绍 2.1 TiDB视角中的PointGet PointGet顾名思义即"点查", 它是TiDB中最为基本的几种算子之一,以下列举了两个常见的PointGet算子的使用场景: 根据主键Id查询 MySQL [test]> explain select * from user where id = 1024;+-------------+---------+------+-------------------------------+---------------+| id | estRows | task | access object | operator info |+-------------+---------+------+-------------------------------+---------------+| Point_Get_1 | 1.00 | root | table:user, index:PRIMARY(id) | |+-------------+---------+------+-------------------------------+---------------+ 根据唯一索引查询 MySQL [test]> explain select * from users where name = "test";+-------------+---------+------+-------------------------------+---------------+| id | estRows | task | access object | operator info |+-------------+---------+------+-------------------------------+---------------+| Point_Get_1 | 1.00 | root | table:users, index:name(name) | |+-------------+---------+------+-------------------------------+---------------+ 2.2 纯KV用户视角中的PointGet 部分业务没有完整地使用TiDB组件,而是使用官方提供的client-go/client-rust直接访问PD和TiKV。 func testGet(k []byte) (error) { txn, err := client.Begin() if err != nil { return err } v, err := txn.Get(context.TODO(), k) if err != nil { return err } fmt.Printf("value of key is: %+v", v) return nil} 三、PointGet在TiDB中的实现 TiDB层为计算层,其主要职能为MySQL协议的实现以及SQL优化器和执行器的构建。客户端发起的所有SQL, 都会经过以下生命周期流程: Lexer/Parser解析后得到AST,并转换为执行计划。 执行计划经过RBO/CBO后得到优化过后的执行计划。 基于执行计划构建执行器,其本质是不同的算子"套娃",整体构成一个树型结构。 TiDB的执行器基于"火山模型"构建,不同的操作算子具有不同的Executor实现: type Executor interface { base() *baseExecutor Open(context.Context) error Next(ctx context.Context, req *chunk.Chunk) error Close() error Schema() *expression.Schema} Executor中最为核心的是三个函数分别是Open/Next/Close,分别对应算子的初始化、迭代以及收尾逻辑。本文涉及的PointGet算子由PointGetExector实现,其核心的查询逻辑位于PointGetExector::Next()函数中。由于相关逻辑耦合了悲观事务,以及tikv/client-go中部分Percolator的实现,且不属于本文重点分析的主要内容,这里不展开描述,感兴趣的读者可以自行阅读。 四、PointGet在TiKV中的实现 4.1 PointGet接口定义 TiKV和TiDB使用gRPC进行通信,其接口契约定义采用了protobuf,我们可以在pingcap/kvproto项目中找到与PointGet相关的接口定义KvGet如下: // Key/value store API for TiKV.service Tikv { // Commands using a transactional interface. rpc KvGet(kvrpcpb.GetRequest) returns (kvrpcpb.GetResponse) {} // ... other api definations ...} 其中入参GetRequest定义如下代码片段,我们可以看到,TiKV的点查接口除了key之外,还额外需要一个名为version的参数,即当前事务的start_ts(事务开始时间戳),这个时间戳是由TiDB在启动事务时从Pd组件申请而来。与很多数据库类似,TiKV也采用了MVCC机制,即同一个key在底层的存储中在不同时刻拥有不同的值,因此要想进行查询,除了key之外,还需要带上版本。 // A transactional get command. Lookup a value for `key` in the transaction with// starting timestamp = `version`.message GetRequest { Context context = 1; bytes key = 2; uint64 version = 3;} 4.2 TiKV侧调用堆栈 TiKV作为gRPC的Server端,提供了KvGet接口的实现,相关调用堆栈为: +TiKV::kv_get (grpc-poll-thread) +future_get +Storage::get +Storage::snapshot (readpool-thread) +SnapshotStore::get +PointGetterBuilder::build +PointGetter::get 在一次KvGet调用中,函数执行流程会在grpc-poll-thread和readpool-thread中切换,其中前者为gRPC的poll thread,请求在被路由到Storage层后,会根据读写属性路由到不同的线程池中,只读语义的Get/Scan请求都会被路由到ReadPool中执行,这是一个特定用于处理只读请求的线程池。 4.3 Read through locks介绍 在分析后续逻辑之前,我们需要对Read through locks机制先做个简单介绍。TiKV使用Percoaltor模型来实现分布式事务,同时也引入了MVCC机制。然而其实现和传统的MVCC实现略有差异:TiKV的读取过程中若遇到其他事务提交时写入的Lock, 则需要等待或者尝试解锁,这会阻塞读取直到事务状态确定,一定程度上会损失并发性能。 然而在一些场景(如SecondaryLocks),在Key对应的锁仍然存在的情况下,我们已经知道相关事务的最终状态(提交或回滚)。如果我们将这些事务的最终状态与查询请求一起发送给TiKV, 那么TiKV可以根据这些事务状态来确定能否在有Lock的情况下安全读取,避免不必要的等待, 即本小节提到的Read through lock机制。 Context是所有的TiKV请求都会携带的上下文信息,为了实现Read through lock, https://github.com/pingcap/kvproto/pull/833 这个PR在Context中添加了如下字段: message Context { // Read requests can ignore locks belonging to these transactions because either // these transactions are rolled back or theirs commit_ts > read request's start_ts. repeated uint64 resolved_locks = 13; // Read request should read through locks belonging to these transactions because these // transactions are committed and theirs commit_ts <= read request's start_ts. repeated uint64 committed_locks = 22;} 其中resolved_locks用于记录读取时可以忽略的锁,这些锁对应的事务可能已被回滚,或者已成功提交但CommitTS大于当前的读StartTS,直接忽略这些锁也不影响快照一致性。 其中committed_locks则用于记录逻辑上已被正确提交但物理上Lock还未被清理的、且CommitTS小于当前读取使用的StartTS的事务。由于事务本质上已经被提交,因此读取时可以不需要返回等待,只需要通过Lock查询DefaultCF中的数据即可。 通过Read through lock机制,TiKV可以在一些Lock尚未被清理的情况下直接返回正确的结果,避免了客户端层面的Wait和ResolveLock,其具体实现在后续小节会涉及到。 4.4 Storage::get流程分析 下方代码块是经过精简过后的伪代码,主要标注了get流程中一些比较关键的步骤。 pub fn get(&self, mut ctx: Context, key: Key, start_ts: TimeStamp) -> impl Future<Output = ... >> { self.read_pool.spawn_handle(async move { // 1. 创建创建快照需要的上下文 let snap_ctx = prepare_snap_ctx(...); // 2. 申请一个快照 let snapshot = Self::with_tls_engine(|engine| Self::snapshot(engine, snap_ctx)).await?; // 3. 创建SnapshotStore对象并执行查询 let snap_store = SnapshotStore::new(...); let result = snap_store.get(key); // 4. 更新Metrics和Stats统计信息 });} 4.4.1 准备快照上下文 prepare_snap_ctx顾名思义即准备用于创建快照所需要的上下文对象,即SnapContext对象,其完整定义如下: pub struct SnapContext<'a> { pub pb_ctx: &'a Context, pub read_id: Option<ThreadReadId>, // When start_ts is None and `stale_read` is true, it means acquire a snapshot without any // consistency guarantee. pub start_ts: Option<TimeStamp>, // `key_ranges` is used in replica read. It will send to // the leader via raft "read index" to check memory locks. pub key_ranges: Vec<KeyRange>, // Marks that this snapshot request is allowed in the flashback state. pub allowed_in_flashback: bool,} fn prepare_snap_ctx<'a>(...) -> Result<SnapContext<'a>> { if !pb_ctx.get_stale_read() { concurrency_manager.update_max_ts(start_ts); } if need_check_locks(isolation_level) { concurrency_manager.read_key_check(...) } let mut snap_ctx = SnapContext {...}; if need_check_locks_in_replica_read(pb_ctx) { snap_ctx.key_ranges = ... }} prepare_snap_ctx只需要创建一个SnapContext对象,但目前实现中多出了如下判断或操作,绝大部分都源于TiKV5.0中的AsyncCommit特性所需。 1.当本次读取非StaleRead时,需要将当前读取请求的start_ts与CurrencyManager中的max_ts进行比较,并将二者中的最大值更新为全局max_ts。这一操作用于保证异步提交事务计算出来的MinCommitTs不会破坏快照一致性。 2. 若当前的隔离级别是SnapshotIsolation或者RcCheckTs时, 则需要额外检查CurrencyManager中的内存锁。如果存在锁且当前start_ts大于锁中的MinCommitTs,TiKV会直接拒绝本次读取请求。其原因在于AsyncCommit事务Prewrite结束之前需要暂时阻止使用更新的start_ts发起的快照读,否则会导致正在异步提交的事务计算出的MinCommitTS无法满足快照一致性。 4.4.2 向Engine申请Snapshot Engine是TiKV中对上层存储组件的一次抽象,所有实现了Engine Trait的具体实现都可以作为TiKV中的存储层组件。目前TiKV中已经实现了BTreeEngine/MockEngine/RocksEngine/RaftKV等多个实现。 pub trait Engine: Send + Clone + 'static { // 获取用于查询的快照 fn async_snapshot(&mut self, ctx: SnapContext<'_>) -> Self::SnapshotRes; // 提交写入的Mutation fn async_write(&self,ctx: &Context,batch: WriteData,subscribed: u8, on_applied: Option<OnAppliedCb>) -> Self::WriteRes; // 其他接口...} Engine的接口定义中与读写相关的接口分别是async_snapshot和async_write。目前TiKV中的默认Engine实现为RaftKV,即一个基于Raftstore的实现。在RaftKV中,所有的写入都会通过Raft状态机进行propose/commit/apply流程,用户可以基于订阅机制获得这3个事件的通知从而做出不同处理,默认情况下,TiKV会在一次写入请求被RaftLeader apply成功后返回用户。而读取操作则需要遵循先行一致性读取,在早期版本中,一次读取需要通过Raft状态机进行一次ReadIndex才能进行,在新版中TiKV实现了基于租约的LeaseRead, 简化了读取流程。本次介绍的PointGet读取流程中,会涉及到使用async_snapshot获取一个Engine在当前时刻的快照,并基于快照进行读取。 TiKV按照KeyRange将Key拆分为不同的Region, 每个Region都是一个RaftGroup,且拥有独立的状态机推进运转。因此,RaftKV-Engine中async_snapshot返回的是一个名为RegionSnapshot的对象,其定义如下: pub struct RegionSnapshot<S: Snapshot> { snap: Arc<S>, region: Arc<Region>, apply_index: Arc<AtomicU64>, pub term: Option<NonZeroU64>, pub txn_extra_op: TxnExtraOp, // `None` means the snapshot does not provide peer related transaction extensions. pub txn_ext: Option<Arc<TxnExt>>, pub bucket_meta: Option<Arc<BucketMeta>>,} RegionSnapshot本质是对底层的KV引擎RocksDB层面的快照的封装,其逻辑视图如下: 4.4.3 MVCC实现和快照隔离级别实现 前文提到的Engine::async_snapshot接口返回的快照本质是Engine在当下时刻的快照,并不等于事务层面的MVCC快照,因此在具体查询时,需要配合StartTS进行使用。TiKV中封装了一个SnapshotStore用于辅助MVCC层面的查询。其定义如下: pub struct SnapshotStore<S: Snapshot> { snapshot: S, start_ts: TimeStamp, isolation_level: IsolationLevel, fill_cache: bool, bypass_locks: TsSet, access_locks: TsSet, check_has_newer_ts_data: bool, point_getter_cache: Option<PointGetter<S>>,} SnapshotStore中集合了从Engine获取的快照和客户端请求附带的StartTS, 因此可以被认为是一个MVCC层面的快照。用户对SnapshotStore发起的点查会被委托给内部的PointGetter。 // PointGetter::getpub fn get(&mut self, user_key: &Key) -> Result<Option<Value>> { fail_point!("point_getter_get"); // 根据当前请求使用的隔离级别判定是否需要检查锁 if need_check_locks(self.isolation_level) { // 如果需要检查锁且锁存在,则需要根据判定锁 if let Some(lock) = self.load_and_check_lock(user_key)? { return self.load_data_from_lock(user_key, lock); } } // Percoaltor正常读取流程:从WriteCF中找到<=start_ts中最大的commit_ts,并基于其存储的start_ts到DefaultCF中读取 self.load_data(user_key)} 在执行查询前,TiKV需要根据当前请求的隔离级别判定是否需要检查锁。 pub fn need_check_locks(iso_level: IsolationLevel) -> bool { matches!(iso_level, IsolationLevel::Si | IsolationLevel::RcCheckTs)} TiKV支持SnapshotIsolation/ReadCommitted/ ReadCommittedCheckTs三种隔离级别,其中前两种需要检查锁。其原因在于LockCf中的锁是由于事务在2PC的第一阶段提交阶段写入的,事务的最终状态无法确定,如果不检查锁直接读取,那么可能导致快照读取被破坏。 fn load_and_check_lock(&mut self, user_key: &Key) -> Result<Option<Lock>> { // 从LockCf查询该Key的锁信息 let lock_value = self.snapshot.get_cf(CF_LOCK, user_key)?; if let Some(ref lock_value) = lock_value { let lock = Lock::parse(lock_value)?; // 如果存在锁则检查锁是否冲突 if let Err(e) = Lock::check_ts_conflict( Cow::Borrowed(&lock), user_key, self.ts, &self.bypass_locks, self.isolation_level, ) // ...} 其中Lock::check_ts_conflict的实现中会根据当前的事务隔离级别进行判定,不同的隔离级别的判定逻辑略有差异。由于本文篇幅有限,这里只分析我们常用的快照隔离级别的实现。 fn check_ts_conflict_si(lock: Cow<'_, Self>, key: &Key, ts: TimeStamp, bypass_locks: &TsSet ) -> Result<()> { if lock.ts > ts || lock.lock_type == LockType::Lock || lock.lock_type == LockType::Pessimistic { return Ok(()); } if lock.min_commit_ts > ts { // Ignore lock when min_commit_ts > ts return Ok(()); } if bypass_locks.contains(lock.ts) { return Ok(()); } let raw_key = key.to_raw()?; if ts == TimeStamp::max() && raw_key == lock.primary && !lock.use_async_commit { // When `ts == TimeStamp::max()` (which means to get latest committed version // for primary key), and current key is the primary key, we ignore // this lock. return Ok(()); } // There is a pending lock. Client should wait or clean it. Err(Error::from(ErrorInner::KeyIsLocked( lock.into_owned().into_lock_info(raw_key), )))} 当lock.ts > ts时,当前查询请求可以直接忽略这个锁。其原因在于当前的lock是由具有更高start_ts的事务写入,因此即便这个事务后续被提交,其commit_ts一定大于当前的start_ts,其新写入的数据是不可见的,不会破坏快照一致性。 当lock_type==Lock时,也可以直接忽略这个锁突, 其原因在于LockType::Lock是由于创建索引产生,它只用于指示被锁定但不会修改数据,因此也可以直接被忽略。 当lock_type==Pessistics时,也可以直接忽略这个锁突,LockType::Pessistics是由于悲观事务执行DML时写入,并未进行到事务提交阶段,即使这个事务很快被提交,由于其commit_ts也一定大于当前读取的start_ts, 直接忽略并不会影响快照一致性。 当lock.min_commit_ts > ts时,也可以直接忽略这个锁,其原因在于它能保证这个AsyncCommit事务的最终计算出的commit_ts一定大于ts,即使这个事务会被提交,也不会破坏快照一致性。 当bypass_locks中包含了当前锁的start_ts时, 也可以直接忽略这个锁。bypass_locks即前面Read through locks小节中提到了resloved_locks,这些锁虽然存在,但它们对应事务要么已经被回滚,要么使用了大于当前读取start_ts的commit_ts进行提交,无论是哪种情况都不会破坏快照一致性。 其他情况则需要返回KeyIsLocked错误给客户端,客户端收到这个错误后则会检查这个锁的过期时间,如果锁尚未过期则需要做wait,否则会尝试进行解锁恢复这个事务的状态。 若check_ts_conflict_si返回KeyIsLocked或其他错误后,TiKV会额外检查access_locks里是否包含该锁,如果该锁存在,则KeyIsLocked错误则会被忽略,同时锁会被直接返回,外层函数可以通过锁找到start_ts从而直接读取DefaultCF中的数据。这里的access_locks即Read through locks中的committed_locks,即已经知晓被提交的且commit_ts小于当前快照读start_ts的事务,在这种情况下,直接读取DefaultCF是一个超前但安全的操作,原因在在于一旦这个Lock被Resolve,用户通过新的commit_ts可以定位到同一个start_ts。 if let Err(e) = Lock::check_ts_conflict(Cow::Borrowed(&lock),user_key,self.ts,&self.bypass_locks,self.isolation_level) { if self.access_locks.contains(lock.ts) { return Ok(Some(lock)); } Err(e.into())} 在不存在Key被锁定或冲突,且没有使用Read through locks读取后,TiKV则会进行正常的Percolator读取流程,即从WriteCF中找到<=start_ts中最大的commit_ts,并基于其存储的start_ts到DefaultCF中读取。 4.4.4 RegionSnapshot的Get实现 RegionSnapshot::get的实现相对比较简单,逻辑如下: fn get_value_cf_opt(&self, opts: &ReadOptions, cf: &str, key: &[u8]) -> EngineResult<Option<Self::DbVector>> { // 1. 检查查询的key是否在Region的范围内, 如果不在则直接返回错误。 check_key_in_range(key,self.region.get_id(),self.region.get_start_key(),self.region.get_end_key()).map_err(|e| EngineError::Other(box_err!(e)))?; // 2. 基于查询的key拼接出raftstore层面的DataKey (raftstore在写入时会给用户key前添加一个前缀'z')。 let data_key = keys::data_key(key); // 3. 使用内部的RocksSnapshot查询RocksDB获取key对应的值。 self.snap.get_value_cf_opt(opts, cf, &data_key).map_err(|e| self.handle_get_value_error(e, cf, key))} 4.4.5 RocksDB/Titan的Get实现 TiKV使用rust-rocksdb库使用FFI实现与RocksDB C-API的交互,RocksSnapshot::get会通过crocksdb_get_pinned_cf将查询接口委托给底层的RocksDB。值得注意的是,TiKV使用的并不是官方的RocksDB,而是自行维护的一个整合了Titan插件的版本。Titan是一个受WiscKey论文启发而创建的项目,其主要目的是将存入RocksDB的大Value从LSM-Tree中分离出来,存储到额外的Blob文件中,从而达到减小写放大的目的。 本小节我们着重分析一下TitanDB中一次查询的实现过程(做过大量精简): Status TitanDBImpl::GetImpl(const ReadOptions& options, ColumnFamilyHandle* handle, const Slice& key, PinnableSlice* value) { // 先查询RocksDB s = db_impl_->GetImpl(options, key, gopts); // 如果Key的Value不存在或者不是BlobIndex, 则直接返回 if (!s.ok() || !is_blob_index) return s; // Value是BlobIndex,说明这是一个索引,还需要额外查询BlobStorage BlobIndex index; s = index.DecodeFrom(value); assert(s.ok()); if (!s.ok()) return s; BlobRecord record; PinnableSlice buffer; mutex_.Lock(); // 根据索引查询BlobStorage auto storage = blob_file_set_->GetBlobStorage(handle->GetID()).lock(); mutex_.Unlock(); if (s.ok()) { value->Reset(); value->PinSelf(record.value); } return s;} 五、总结 TiKV对数据存储层的职能进行了非常合理的抽象,通过Engine/Snapshot/Iterator等trait定义实现了存储层与上层的解耦。 TiKV在RocksDB提供的多列族原子性写入能力之上实现了Percolator模型,提供了分布式事务和MVCC等能力,并实现了AsyncCommit和1PC等改善了事务提交延迟。 TiKV实现了一个基于RocksDB的KV分离插件titan, 借鉴了Wisckey的思想将大Value从LSM-Tree中分离,在大Value的业务场景下能够通过降低写放大改善性能。 从PointGet的实现我们可以看到在使用了MVCC的情况下,查询时遇到前一事务Prewrite产生的Lock仍然需要等待Resolve, 因此在AsyncCommit开启的前提下,业务开发需要尽量避免设计事务提交后即刻发起查询的场景,此外也要尽量避免由于大事务提交延迟高影响相关的查询。 参考资料: Async Commit 原理介绍 TiDB sig transaction design docs TiDB 新特性漫谈:悲观事务 TiKV 源码解析系列文章(十九)read index 和 local read 情景分析 END 猜你喜欢 vivo 制品管理在 CICD 落地实践 分布式任务调度内的 MySQL 分页查询优化 HBase Meta 元信息表修复实践 本文分享自微信公众号 - vivo互联网技术(vivoVMIC)。 如有侵权,请联系 support@oschina.cn 删除。 本文参与“OSC源创计划”,欢迎正在阅读的你也加入,一起分享。

优秀的个人博客,低调大师

OLAP进阶之“性能提升”

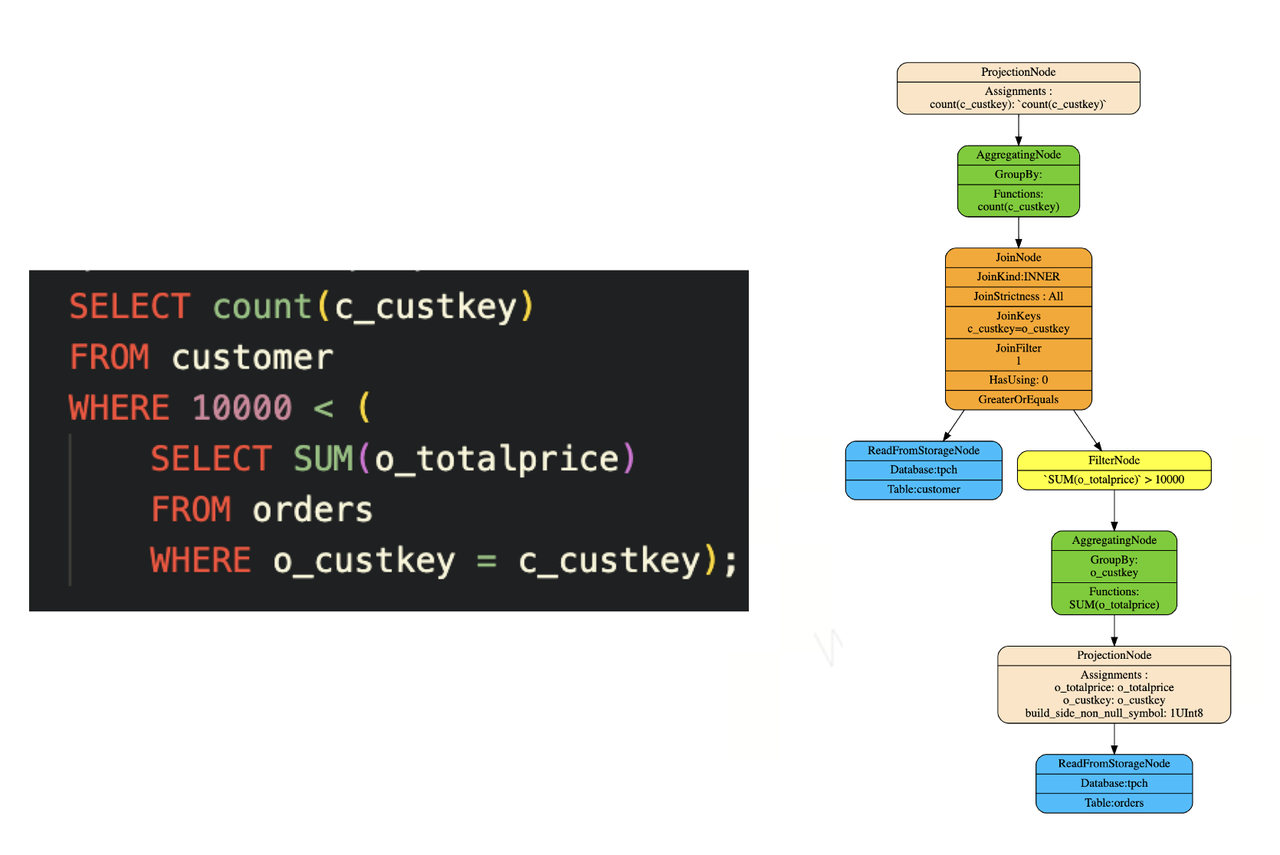
更多技术交流、求职机会,欢迎关注字节跳动数据平台微信公众号,回复【1】进入官方交流群 在数据处理和分析的领域,提升查询效率始终是一项关键挑战。对于 OLAP 来说,性能的关键需求在于能支持实时分析,应对复杂查询,提供快速响应,并具备良好的可扩展性。这些方面,对于满足高效、准确的数据分析需求至关重要。 火山引擎正式发布《云原生数据仓库ByteHouse性能白皮书》,白皮书通过使用 SSB 100G、TPC-H 100G、TPC-DS 100G 数据集进行性能测试,展示出 ByteHouse 在查询效率方面的显著成果,并详细介绍ByteHouse在实时数仓、复杂查询等八大应用场景的高性能应用表现。 作为一款OLAP引擎,伴随字节跳动各业务的发展,ByteHouse已经过数百个应用场景和数万用户锤炼,在2022年3月,部署规模已超过1万8000台,最大的集群规模在 2400 余个节点,管理总数据量超过700PB,并逐步在外部金融、泛互等场景应用和推广。为了更好支持字节内外部大规模数据和复杂场景应用,性能一直以来是ByteHouse重点打磨的产品基本功。 SSB、TPC-H 和 TPC-DS 是常用于测试分析型数据库/数据仓库的数据集。在白皮书中,通过使用以上三种数据集进行性能测试,并以性能著称的某开源OLAP为基准测试产品,ByteHouse在不同查询项上都有显著的性能提升。以TPC-H 数据集举例,在相同硬件和软件环境下, ByteHouse 查询效率高于本次基准测试产品几十倍。 背景 ByteHouse是字节跳动数据平台自主研发的云原生数据仓库产品,在开源ClickHouse引擎之上做了技术架构重构,实现了云原生环境的部署和运维管理、存储计算分离、多租户管理等功能,已通过火山引擎对外提供服务。在可扩展性、稳定性、可运维性、性能以及资源利用率方面,ByteHouse都有巨大的提升。 ByteHouse以提供高性能、高资源利用率、高稳定性、低运维成本为目标,进行了优化设计和工程实现,产品特性和优势如下: 存储计算分离:解决了全局元数据管理,过多小文件存储性能差等等技术难题。在最小化性能损耗的情况下,实现存储层与计算层的分离,独立扩缩容。 新一代 MPP 架构:结合 Shared-nothing 的计算层以及 Shared-everything 的存储层,有效避免了传统 MPP 架构中的 Re-sharding 问题,同时保留了MPP并行处理能力。 数据一致性与事务支持。 计算资源隔离,读写分离:通过计算组(VW)概念,对宿主机硬件资源进行灵活切割分配,按需扩缩容。资源有效隔离,读写分开资源管理,任务之间互不影响,杜绝了大查询打满所有资源拖垮集群的现象。 ANSI-SQL:SQL兼容性全面提升,支持ANSI-SQL 2011标准,TPC-DS测试集100%通过率。 UDF:支持Python UDF/UDAF创建与管理,补足函数的可扩展性。(Java UDF/UDAF已在开发中) 自研优化器:自研Cost-Based Optimizer,优化多表JOIN等复杂查询性能,性能提升若干倍。 产品能力上,在引擎外提供更加丰富的企业级功能和可视化管理界面: 库表资产管理:控制台建库建表,管理元信息。 多租户管理:支持多租户模型,租户间互相隔离,独立计费。 RBAC权限管理:支持库、表、列级,读、写、资源管理等权限。通过角色进行管理。 VW自动启停,弹性扩展:计算资源按需分配,闲时关闭。降低总成本,提高资源使用率。 性能诊断:提供Query History和Query Profiler功能,帮助用户自助地排查慢查询的原因。 ByteHouse性能优化:复杂查询、宽表查询 ByteHouse来源于ClickHouse,但又基于字节跳动内部实践场景经验,进行了一系列升级。在性能层面,主要复杂查询以及宽表查询两方面进行优化。 复杂查询优化 其中相比单表查询或者宽表查询而言,复杂查询主要包含较多的Agg join和嵌套子查询等特征。在复杂查询优化项中,相比于社区版ClickHouse,ByteHouse升级的能力包含自研优化器以及在引擎层新引入的exchange runtime Filiter模块以及为提升并行化能力而做的一些重构工作。 优化一:RBO(基于规则的优化能力) 首先,自研优化器RBO,即基于规则的优化,包含列裁剪、分区裁剪、表达式简化、子查询解关联、谓词下推、冗余算子消除、Outer-Join 转 Inner-Join、算子下推存储、分布式算子拆分等常见的启发式优化能力。 相对社区版ClickHouse,ByteHouse实现了完整的解关联,从而确保tpcds所有查询能够运行。如下图所示,一个customer表和一个含orders表的子查询进行关联,最后的计划会展开成对应的join、agg和filter等算子。 另外,针对非等值join,相对于先outer join后再执行非等值过滤这种组合,非等值join可以直接在join算子中完成非等值判断,从而提升了1倍的性能。 最后,针对很多通用的业务场景,RBO还实现了对多个列计算count distinct的优化,主要原理是基于复制的方式从而提升并行度来实现。 优化二:CBO(基于代价的优化能力) 在自研优化器CBO,即基于代价优化部分,ByteHouse主要基于Cascade搜索框架,从而可以边生成物理计划边寻求最优解。并针对join order枚举问题采用了Join graph partition的方式减少了重复计划的生成从而提升搜索性能;另外代价则为基于统计信息生成。 在Join Recorder方面,针对10表级别规模的join recorder问题,ByteHouse能够在秒级别全量枚举并生成最优解,另外,针对大于10表的则使用了启发式,ByteHouse还支持混合Outer Semi Anti Join的reorder功能。 在CTE层面,ByteHouse支持了Inline, shared及partial inline等不同粒度的代价计算,从而计算最优解。 除此之外,ByteHouse具备基于magic set placement能力,通过计算join过滤度代价来选择下推到agg,从而减少agg计算热点的能力。 优化三:分布式计划生成方面推出了自研优化器 在生成计划过程中,区别于业界主流的二阶段方式,即先生成最优单机计划再生成分布式计划的方式。ByteHouse优化器融合了两个阶段,先展开所有分布式计划,然后基于全局代价生成最优解,并减少shuffle。其中,ByteHouse也会通过表的元数据信息和属性推论,利用数据分布来减少agg和join的shuffle开销。 优化器生成的物理计划往往按照数据重分布会拆解成多个计划片段即plan segment,相比于社区版ClickHouse,除了优化器生成的物理计划不同之外,plan segment之间数据的传输也是依赖我们新引入的exchange模块能力。模块分为两层,数据传输层和算子层。 数据传输层支持同进程传输,基于队列跨进程,基于 BRPC stream,并支持保序状态码传输、压缩和连接池复用等功能。为了确保稳定性,连接池可以让上下游 plan segment 在集群做数据 shuffle 的时候始终维持在固定数量的连接,从而提升稳定性。 在传输层之上,算子层提供了一对多的broadcast,多对多的repetition、多对一的gather、其进程内的round、 Robin 等算子。 此外,ByteHouse还实现了更多exchange性能相关优化,如尽量减少重复的序列化及载批等逻辑。 相对于社区对于join能力,ByteHouse提供了runtime filter能力,这是在执行引擎中动态构建filter的能力,例如在 Hash Join 的 Probe 阶段前,提前过滤掉大部分不会参与 Join 的左表数据,从而减少数据传输和计算的开销,提升性能。这里的Runtime Filter是在 Hash Join 的 Build 阶段后,结合 Join Key 和 Hash表生成。此外,ByteHouse支持根据不同的场景生成最优的 RuntimeFilter,优化了 Runtime Filter 的生成和执行的流程。同时,也支持 Distributed 和 Local 的 RuntimeFilter,及自适应的 Shuffle-Aware 能力。 优化四:并行化重构 除了以上介绍的优化器、exchange和runtime filter能力外,ByteHouse也是一直朝着提升并行计算能力的方向持续在演进。 针对agg和join,社区版ClickHouse的解法通常不会考虑数据的分布特性,以及一些算子的聚合度特性,从而产生大量的无意义的blocking的中间结果的merge开销以及join跨节点的shuffle开销。 针对agg,ByteHouse实现了自适应的agg streaming能力,可以根据聚合度减少无意义的中间merge开销。 另外,结合优化器,和bucket表能力,ByteHouse用了数据分布特性,大量减少了agg和join的shuffle开销,从而提升了并行度。 宽表查询优化项 针对社区ClickHouse典型宽表场景,ByteHouse做了全局字典、Zero copy以及Uncompress Cache优化。 首先,全局字典主要功能是通过全局字典编码的方式将变长的字符串转化为电长的数值。针对 AGG function 和 exchange 算子,不仅在单节点上单节点以,也可以在跨节点间直接进行这个编码值的计算,以此提升计算效率。 其次,Zero copy是应对内存墙的一种优化方式,通过减少数据传输中引发的深拷贝开销,尽量提升内存带宽在真正计算上的使用。 最后,针对单节点上多线程同时并发访问Uncompress cache引发常见的锁竞争的现象,ByteHouse做了针对性优化,保证了Cache带来的性能收益。 性能表现 以下是ByteHouse在标准数据集的性能表现。本次发布会主要聚焦100G 的规模。针对每项测试,ByteHouse和某款开源的 OLAP 引擎进行了性能对比。 TPCDS 100G 从 TPC-DS 100G 的结果可以观察到,经过测试发现在完成 TPC-DS 标准测试数据集的 99 个查询中,ByteHouse比开源产品OLAP 引擎总体时间超出 6 倍多,并且开源产品部分语句无法正常执行。在两者均完成查询的结果中,开源产品与 ByteHouse 查询时间相差 15.7 倍,其中Q53、Q63、Q82 等语句的查询效率相差 200 倍左右。 针对TPC-DS 100G 数据集,涉及到前面的收益相关优化项,包括资源的优化器、 exchange 算子、 runtime filter 以及全局字典等。详细的结果可以在ByteHouse性能白皮中仔细阅览。 TPCH 100G 针对 TPCH 100 数据集,在经过 TPCH 的标准测试数据集的 22 个查询中,开源产品部分与给予无法正常执行,整体查询周期很长,在两者均完成查询的结果中,开源产品与 ByteHouse 的查询时间相差无数倍,其中Q3、Q5、 Q7 等语句的查询效率相差 100 倍以上。相关 TPCH 相关的收益优化项包含优化器 exchange、 runtime filter以及前面提到的并行化重构和全局字典等。 SSB Flat 100G 以及Standard SSB 公布的完整的SSB 测试结果,不仅是 13 条针对宽表的测试,还包另外 13 条在星状模型场景下的进行多表关联的测试。 首先从 13 条宽表查询的结果来看, SSD 宽表测试的 13 个查询中, ByteHouse 查询性能全面超越开源产品,整体查询性能达到该产品的 3.6 倍多。对其中涉及的收益相关的优化项包括优化器 exchange 全区字典 Zero copy 以及 Uncompressed Cache 。 除了以上的宽表查询之外,针对标准的 SSB 多表关联的查询,从结果可以看出,在 13 个查询中,开源产品最后 3 个查询因为内存问题查询失败,整体查询性能与ByteHouse相差较大,其中涉及的优化项包含优化器exchange、 runtime filter、全局字典等。 高性能场景之高并发点查 在大数据和实时分析的时代,在很多业务场景,比如广告等,都对OLAP点查能力有强需求。高并发点查对于商业决策、市场分析、用户行为研究场景中的使用体验和查询精准度都起到重要作用。 如果OLAP系统的高并发点查能力不足,就会存在响应时间慢等情况,在技术层面则体现为索引计算繁重、点查读放大严重、执行链路冗长、锁竞争激烈等问题,ByteHouse通过采用短链路的执行方式、建立unique table 点查索引、提升读链路效率等方式进行优化 高并发瓶颈 索引计算繁重:ByteHouse在做索引计算时会引入很多表达式计算,导致比较高的CPU消耗,因此优化索引计算开销是提升QPS水平的关键。 点查读放大严重:在下图中有很多decompress函数,对于通用的OLAP引擎,读一行数据通常也需要读取大量的block,再将block解压反序列化成内存格式,需要消耗大量的CPU资源。在高并发的场景下,点查读放大的问题更加突出。 执行链路冗长:ByteHouse自研优化器的规则,众多的 RBO 规则和CBO优化,导致执行链路非常长。 锁竞争激烈:由于较长的执行链路中间有很多共享变量,在多线程环境下需要加锁保护,导致锁竞争激烈。 优化手段 优化一:更简洁的短路执行计划 首先,我们为高并发的点查场景设计一套更简洁的短路执行计划。 当执行计划分析完后,如果query是一个点查场景,ByteHouse可以为其生成一个特定的优化的规则。 简化后只保留简单的几个规则,例如: 把limit下推,删除冗余的条件并精简plan,将谓词表达式下推到存储层。 普通的query会生成执行计划,分为两个阶段:阶段一,segment 1下发到各个节点去执行,阶段二 segment 0 汇聚各个节点的数据,这种计划会带来大量的 plan 序列化反序列化,网络传输、数据汇总等一系列的开销;而在点查场景中,可能存在点查只会命中一条数据,那么这一条数据势必就会存在于某一个节点上,那么没有必要把计划发送到各个节点。为此,我们做了如下优化: 将两阶段的计划合并成一个segment 计划 ByteHouse在生成完计划之后,会计算出计划命中的节点,并将节点裁掉,将精简的执行计划发送到特定的节点。 优化二:基于 unique table 点查索引 完成执行计划上的优化之后,在真正做查询的时候,ByteHouse引入了一个基于unique table 的点查索引。 该索引为一个内存的结构(KV结构),k是检查中所用到的谓词值,value是行号,直接访问点查索引就能得到对应的行号或者对应的mark。点查索引可以和行存复用,通过索引得到行号的集合后可以直接访问对应行的数据。 优化三:高效的读链路优化 读链路中首先会进行分区的裁剪,和之前主键过滤一样,分区的裁剪里面有大量的表达式的计算,为此ByteHouse做了更轻量的分区的裁剪,并基于分区裁剪和 unique index 的过滤的结果得到 part 和 mark 的值。针对 limit 可以下推的场景,ByteHouse在 mark 的粒度上建了一个 Min-Max 的索引,然后按照 Min-Max 索引做排序就可以通过 limit 值来判断出真正需要读的 mark 是哪些。这样就可以只读少量的mark,不必要读所有筛选出来的 mark 再做过滤。 读链路里面存在两种格式,一种是列存的格式,一种是行存的格式。 ByteHouse为列存的格式的底层做了一层 bucket cache,在多线程访问mark 数据时能有效减少锁竞争。 在访问行存的时候,ByteHouse在行存的下一层做了一个基于行存的 cache,这会大大提高行存查询的效率。 最后一个优化点是新语法prepared statement,它可以用来优化parser解析时间和queryplan 生成的时间。比如,ByteHouse会定义 prepared statement,然后在需要定义的query 里面去指定查询的参数模板。当真正运行的时候,就可以通过 prepare statement 填充上它的值并做查询。有了该查询模板之后,parser解析时间和queryplan 生成的时间基本上可以被消除。 性能表现 测试环境:32core/128G/1T SSD 数据:100000000行数据 测试场景为 unique 表,点查query为用 unique 表的 key 为谓词。下图中展示了每个优化阶段完成后对应的 QPS 变化,baseline 表示的是未进行任何优化时候的表现 当做完锁优化、pipeline 优化之后,性能达到 5, 500- 8, 000 QPS。 当引入了比较精简的执行计划之后,性能达到 18, 000 的QPS。 再将AST 解析和plan build 时间去掉之后,ByteHouse能获得32000 QPS 的水平。 结语 不仅仅是技术层面的性能提升,ByteHouse在实时数仓、复杂查询、宽表查询、人群圈选、行为分析等八大场景中,也将高性能落地。其中,在人群圈选场景中,ByteHouse可以满足大规模数据的分析和查询需求,并具有一套用于解决集合的交并补计算的定制模型BitEngine,该模型能解决实时分析场景中的性能提升问题。相比于普通和Array或者用户表方式,BitEngine在查询速度上有10-50倍提升,解决了人群圈选中误差大、实时性不强以及存储成本高的痛点。 通过一系列技术优化手段,ByteHouse实现性能进一步提升,缩短查询执行时间、优化资源利用,能应对更复杂的查询场景,为用户提供更流程的数据分析体验。不仅仅是探索性能突破,ByteHouse也在持续拓展产品一体化、易用性、生态兼容性,为业务带来更多的价值,推动各行各业数字化转型。 #活动推荐# 限额50位 ByteHouse性能挑战赛正式开启! ● 活动时间:3月26日-4月26日截止 ● 如果你对OLAP性能调优感兴趣,如果你正在进行数据库选型,如果你遇到数据库性能瓶颈...... ⭐️参与性能复现和挑战,即有机会获取airpods、智能手表、机械键盘等大奖 添加小助手,回复“性能挑战赛”立即报名

优秀的个人博客,低调大师

pnpm 之降本增效

作者:京东科技于振京 受众简介 前端研发工程师 还在为npm i安装大量依赖等待时间较长,npm扁平化node_modules依赖版本冲突在苦恼吗,不用苦恼pnpm为你保驾护航 主要影响:安装依赖包的过程,假如使用的是npm install会根据package-lock.json进行软件包的安装,如果没有package-lock.json会根据package.json进行生成并对安装的依赖包扁平化处理,安装依赖包的时长由两个因素导致: 1.package.json依赖包的量 2.网速 运维工程师 前端服务器由于部署工程较多,依赖包占用磁盘空间太大,不够用怎么办,还在花钱申请扩容吗,使用pnpm解决你的问题 主要影响:构建前端工程时jenkin任务一般会清除服务器的node_modules然后重新安装依赖,避免构建最新分支代码缺少依赖,另外一台服务器可能会部署很多前端工程,这样就会存在不同工程中安装了相同的依赖浪费服务器磁盘空间 没用pnpm时 我们使用以下几种工具管理依赖包 npm:nodejs自带工具,万物之主它的诞生给前端带来了春天 npx:与npm同根同源,区别在于npm将依赖安装在本地,而npx避免了本地安装,直接对依赖包寻址执行 nrm:npm的镜像源管理工具,使用它可以快速切换npm源 cnpm:淘宝镜像包管理工具 yarn:facebook推出的包管理工具,曾风靡一时 由于本章的主角是pnpm以上工具不做详细介绍,但以上包管理工具都有以下几个问题 安装包耗时较长,虽yarn做了下载优化和缓存,但与pnpm相比还是略逊一些 占用存储空间较大,当开发机或服务器前端工程较多时,工程越多冗余包就会越多 扁平化处理,npm v3之后引入了扁平化机制,解决地域依赖问题,但又带来了以下几个问题 -- 依赖结构的不确定性 -- 扁平化算法本身复杂性很高,耗时较长 -- 项目中仍然可以非法访问没有声明过依赖的包 (幽灵依赖) 用了pnpm后 我们会得到以下几个buff加持 快速:官网解释:比其他包管理模块快2倍 高效:通过软硬链接寻址存储库,已达到节省磁盘的目的 严格:pnpm默认创建了一个非平铺的node_modules,因此避免了相同插件不同版本引用不对称的问题,此设计完美解决了地域依赖和幽灵依赖 认识软硬链接 对于pnpm为什么能达到【快速】和【高效】,就需要认识下软链接和硬链接了 硬链接 电脑文件系统中的多个文件共享一个文件存储单元 window: mklink /H aaa_hard.js aaa.js macos: ln aaa.js aaa_hard.js 软链接 以绝对或者相对路径的形式指向其他文件目录的引用 window: mklink aaa_soft.js aaa.js macos: ln -s aaa.js aaa_soft.js 在执行pnpm install或pnpm add <pkg>命令时,PNPM会自动使用硬链接、软链接的方式管理依赖包 npm与pnpm命令对比 pnpm官网:https://pnpm.io/zh/ 收益 上图是同一个工程使用npm和pnpm所需时间比较,npm耗时179.612秒而pnpm只需要27.3秒

优秀的个人博客,低调大师

HarmonyOS实战之入门 HelloWorld

欢迎大家关注我的CSDN博客:https://xdr630.blog.csdn.net/ 第一个入门应用:HelloWorld 新建完项目之后,自带HelloWorld,在第一个案例中,我们主要学习以下几点: 1. 如何运行项目 登录账号,Tools-->Device Manager 或 点击右上角的头像 选择并开启模拟器,这个模拟器是不需要下载的,运行在华为的服务器上,不占用本地资源 每次运行时不超过一个小时,超过了重新开启就行了 运行项目 2. 页面中的包含关系 在鸿蒙当中,一个页面就是一个Ability 为什么要有子页面的存在呢? 直接在最外面的页面里面添加文本信息不更简单吗? 一个鸿蒙APP安装包结构如下,一个 Ability 对应 一个 Hap 包 把三个 hap 包打包成一个 APP 鸿蒙有个特点:可分、可合 如果要使用这个APP,不需要完整的把这个APP下载给安装,用到什么就下载什么,而APP中每一个Hap包都是可以单独下载并安装的 举例:构建 游戏功能.hap 3. 学习项目的配置文件:config.json app deviceConfig module 4. 了解程序的运行过程

优秀的个人博客,低调大师

Android之CheckBox实例实现

XML <?xml version="1.0" encoding="utf-8"?> <androidx.constraintlayout.widget.ConstraintLayout xmlns:android="http://schemas.android.com/apk/res/android" xmlns:app="http://schemas.android.com/apk/res-auto" xmlns:tools="http://schemas.android.com/tools" android:layout_width="match_parent" android:layout_height="match_parent" tools:context=".checkbox"> <TextView android:id="@+id/showresult" android:layout_width="150dp" android:layout_height="30dp" android:layout_marginTop="68dp" android:layout_marginEnd="140dp" android:layout_marginRight="140dp" android:text="TextView2" app:layout_constraintEnd_toEndOf="parent" app:layout_constraintTop_toBottomOf="@+id/btn_notall" /> <CheckBox android:id="@+id/checkBox" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="36dp" android:text="电竞" app:layout_constraintEnd_toStartOf="@+id/checkBox2" app:layout_constraintHorizontal_bias="0.555" app:layout_constraintStart_toEndOf="@+id/textView" app:layout_constraintTop_toTopOf="parent" /> <CheckBox android:id="@+id/checkBox2" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="36dp" android:layout_marginEnd="64dp" android:layout_marginRight="64dp" android:text="旅游" app:layout_constraintEnd_toStartOf="@+id/checkBox3" app:layout_constraintTop_toTopOf="parent" /> <CheckBox android:id="@+id/checkBox3" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="36dp" android:layout_marginEnd="36dp" android:layout_marginRight="36dp" android:text="看书" app:layout_constraintEnd_toEndOf="parent" app:layout_constraintTop_toTopOf="parent" /> <TextView android:id="@+id/textView" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="36dp" android:text="爱好:" app:layout_constraintStart_toStartOf="parent" app:layout_constraintTop_toTopOf="parent" /> <Button android:id="@+id/btn_all" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="68dp" android:text="全选" app:layout_constraintStart_toStartOf="parent" app:layout_constraintTop_toBottomOf="@+id/textView" /> <Button android:id="@+id/btn_notall" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="60dp" android:text="全不选" app:layout_constraintEnd_toEndOf="parent" app:layout_constraintHorizontal_bias="0.2" app:layout_constraintStart_toEndOf="@+id/btn_all" app:layout_constraintTop_toBottomOf="@+id/checkBox2" /> <Button android:id="@+id/btn_get" android:layout_width="wrap_content" android:layout_height="wrap_content" android:layout_marginTop="56dp" android:text="获取内容" app:layout_constraintEnd_toStartOf="@+id/showresult" app:layout_constraintHorizontal_bias="0.163" app:layout_constraintStart_toStartOf="parent" app:layout_constraintTop_toBottomOf="@+id/btn_all" /> </androidx.constraintlayout.widget.ConstraintLayout> 需要实现的需求 XML我是通过约束布局通过拖拽的方式来实现的,三个checkbox选项, 以及全选,全部选,获取内容三个Button按钮,和一个获取内容结果的TextView文本框。 1.需要实现的是点击全选,上面的checkBox全部被选中; 2.点击全不选,上面的checkBox全部不被选中, 3.点击获取内容,右边的TextView显示选中的内容 分析 如果想要实现上述内容,我们就需要通过java监听事件来实现, 我们为三个按钮绑定一个监听事件setOnClickListener; 通过switch(R.getId())来进行判断,如果点击了全选按钮,就让checkbox为True 如果全不选,就为false。 对于获取内容按钮,我们首先需要一个List来进行添加,如果我们点击电竞,电竞被点击,就向List中添加其checkbox中的文本。 话不多说,上代码 package com.example.appcheckbox; import androidx.annotation.NonNull; import androidx.annotation.Nullable; import androidx.appcompat.app.AppCompatActivity; import android.graphics.Color; import android.os.Bundle; import android.view.View; import android.widget.Button; import android.widget.CheckBox; import android.widget.CompoundButton; import android.widget.TextView; import android.widget.Toast; import java.util.ArrayList; import java.util.Collection; import java.util.Iterator; import java.util.List; import java.util.ListIterator; public class checkbox extends AppCompatActivity { private CheckBox box1,box2,box3; private Button btn_all,btn_notall,btn_get; private TextView showresult; private checkBoxListenner checkListenner; private ButtonListenner btlistenner; private List<String> lists;//集合 @Override protected void onCreate(Bundle savedInstanceState) { super.onCreate(savedInstanceState); setContentView(R.layout.activity_checkbox); init(); initData(); setListenner(); } //对List进行初始化 private void initData() { //初始化数据 lists = new ArrayList<>(); } //初始化获取将xml中的按钮转换值java private void init() { box1=findViewById(R.id.checkBox); box2=findViewById(R.id.checkBox2); box3=findViewById(R.id.checkBox3); btn_all=findViewById(R.id.btn_all); btn_notall=findViewById(R.id.btn_notall); btn_get=findViewById(R.id.btn_get); showresult=findViewById(R.id.showresult); } //设置并为按钮绑定监听事件 private void setListenner() { checkListenner=new checkBoxListenner(); box1.setOnCheckedChangeListener(checkListenner); box2.setOnCheckedChangeListener(checkListenner); box3.setOnCheckedChangeListener(checkListenner); btlistenner=new ButtonListenner(); btn_all.setOnClickListener(btlistenner); btn_notall.setOnClickListener(btlistenner); btn_get.setOnClickListener(btlistenner); } //实现checkBox点击的响应Toast public class checkBoxListenner implements CompoundButton.OnCheckedChangeListener{ @Override public void onCheckedChanged(CompoundButton buttonView, boolean isChecked) { CheckBox checkBox=(CheckBox)buttonView; switch (checkBox.getId()){ case R.id.checkBox: if(isChecked){ Toast.makeText(checkbox.this,"少玩游戏多写代码",1000).show(); box1.setTextColor(Color.RED); }else { box1.setTextColor(Color.BLACK); } Toast.makeText(checkbox.this,"电竞"+isChecked,1000).show(); break; case R.id.checkBox2: Toast.makeText(checkbox.this,"旅游"+isChecked,1000).show(); break; case R.id.checkBox3: Toast.makeText(checkbox.this,"看书"+isChecked,1000).show(); break; } } } //为按钮实现监听 class ButtonListenner implements View.OnClickListener{ @Override public void onClick(View v) { switch (v.getId()){ case R.id.btn_all: box1.setChecked(true); box2.setChecked(true); box3.setChecked(true); break; case R.id.btn_notall: box1.setChecked(false); box2.setChecked(false); box3.setChecked(false); break; case R.id.btn_get: if(box1.isChecked()){ lists.add(box1.getText().toString()); } if(box2.isChecked()){ lists.add(box2.getText().toString()); } if(box3.isChecked()){ lists.add(box2.getText().toString()); } showresult.setText(lists.toString()); lists.clear(); break; } } } }

优秀的个人博客,低调大师

LayaAir之脚本的使用

一, 前景 我所说的脚本是 runtime , 扩展脚本, 附加脚本 其中, runtime和扩展脚本需要使用继承方案,而附加脚本使用的是组合的方案二, 美术的操作 Ⅰ,runtime Ⅱ,扩展脚本 类似于Unity / Cocos Creator中组件的感觉, 会在UI编辑器中显示相关属性, 具体操作如下 1,打开"新建"面板, 操作如下图 2,先择"扩展脚本" , 注意"脚本名称"和运行名称, 如下图 3,添加属性 4, 拖动进行附加到相关的组件,如下图我对Box(myBox)绑定了这个扩展脚本 Ⅲ,附加脚本 和"扩展脚本"一样也有Unity / Cocos Creator中组件的感觉.操作上除了脚本类型要改成"附加类型",其余的一下,如下 添加类似的属性 ①, speed ②,userName 注意,也需要拖动绑定,这次我绑定的是Box(myBox1),如下: 三, 编写相关的脚本代码 Ⅰ,runtime namespacegame{ /** *脚本(runtime脚本类型) */ exportclassImageRuntimeextendsLaya.Image{ privatereadonlyscaleTime:number=100; publicconstructor(){ super(); } protectedcreateChildren():void{ super.createChildren(); console.log("addruntime"); //设置组件的中心点 this.anchorX=this.anchorY=0.5; this.addEvent(); } privateaddEvent():void{ this.on(Laya.Event.MOUSE_DOWN,this,this.onEventHandler); this.on(Laya.Event.MOUSE_UP,this,this.onEventHandler); this.on(Laya.Event.MOUSE_OUT,this,this.onEventHandler); } privateremoveEvent():void{ this.off(Laya.Event.MOUSE_DOWN,this,this.onEventHandler); this.off(Laya.Event.MOUSE_UP,this,this.onEventHandler); this.off(Laya.Event.MOUSE_OUT,this,this.onEventHandler); } privateonEventHandler(e:Laya.Event):void{ switch(e.type){ caseLaya.Event.MOUSE_DOWN: Laya.Tween.to(this,{scaleX:0.8,scaleY:0.8},this.scaleTime); break; caseLaya.Event.MOUSE_UP: caseLaya.Event.MOUSE_OUT: Laya.Tween.to(this,{scaleX:1,scaleY:1},this.scaleTime); break; } } /** *doSomething *@paramdata */ publicdoSomething(data:string):void{ console.log(`runtimedoSmothing:${data}`); } publicdestroy():void{ super.destroy(); console.log("removeruntime"); this.removeEvent(); } } } Ⅱ,扩展脚本( 很可惜 : speed 和 userName 还是需要再定义一下 ) /** *Createdbyalexhuon2021/6/2. */ namespacescripts{ /** *扩展脚本 */ exportclassExtendsScriprsextendsLaya.Box{ publicspeed:number=0; publicuserName:string=""; privatestate:number=0; publicconstructor(){ super(); this.frameOnce(2,this,this.onFrame);//2帧后运行 } privateonFrame():void{ varusrN:Laya.Label=this.getChildByName("userN")asLaya.Label; usrN.text=this.userName; this.frameLoop(1,this,this.onLoop); } privateonLoop():void{ if(this.x=Laya.stage.width-this.width){ this.state=1; this.x-=this.speed; }else{ switch(this.state){ case0: this.x+=this.speed; break; case1: this.x-=this.speed; break; } } } /** *doSomething *@paramdata */ publicdoSomething(data:string):void{ console.log(`扩展脚本doSmothing:${data}`); } publicdestroy():void{ super.destroy(true); this.clearTimer(this,this.onLoop); } } } Ⅲ,附加脚本( 很可惜 : speed 和 userName 还是需要再定义一下 ) /** *Createdbyalexhuon2021/6/3. */ namespacescripts{ /** *脚本(附加脚本) */ exportclassAdditionalScripts{ publicspeed:number=0; publicuserName:string=""; privatetarget:Laya.Box; privatetw:Laya.Tween; /** *重点:规定的函数owner,引擎会自动的调用 *@paramvalue */ publicsetowner(value:Laya.Box){ console.log(`自动执行owner`); this.target=value; this.target.frameOnce(2,this,this.onFrame);//在2帧后执行操作 } privateonFrame():void{ letuserName:Laya.Label=this.target.getChildByName("addName")asLaya.Label; userName.text=this.userName; this.startTweenAnim(); } privatestartTweenAnim():void{ this.target.scaleX=this.target.scaleY=1.0; this.anim_1(); } privateanim_1:()=>void=()=>{ this.clearTw(); this.tw=Laya.Tween.to(this.target,{scaleX:0.5,scaleY:0.5},500,Laya.Ease.backIn,Laya.Handler.create(this,this.anim_2)); }; privateanim_2:()=>void=()=>{ this.clearTw(); this.tw=Laya.Tween.to(this.target,{scaleX:1.0,scaleY:1.0},500,Laya.Ease.backIn,Laya.Handler.create(this,this.anim_1)); }; privateclearTw():void{ if(this.tw){ Laya.Tween.clear(this.tw); } } privatecallback:(tag:string,...args)=>void=(tag,...args)=>{ switch(tag){ case"add_demo": console.log(`得到传值:${args[0]}`); break; } } publicdestroy():void{ this.clearTw(); this.tw=null; this.target=null; } } } 注意附加脚本 , 没有没法定义单独的diSomething方法, 我定义了一个callback, 需要更改laya.ui.js底层如下: (注意这个需要自己修改底层) 四,调用脚本的方法 五,结果 使用的是,1.8.14Bate 版本引擎

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册