首页 文章 精选 留言 我的

精选列表

搜索[快速模式],共10016篇文章
优秀的个人博客,低调大师

JavaJDBC(快速理解)

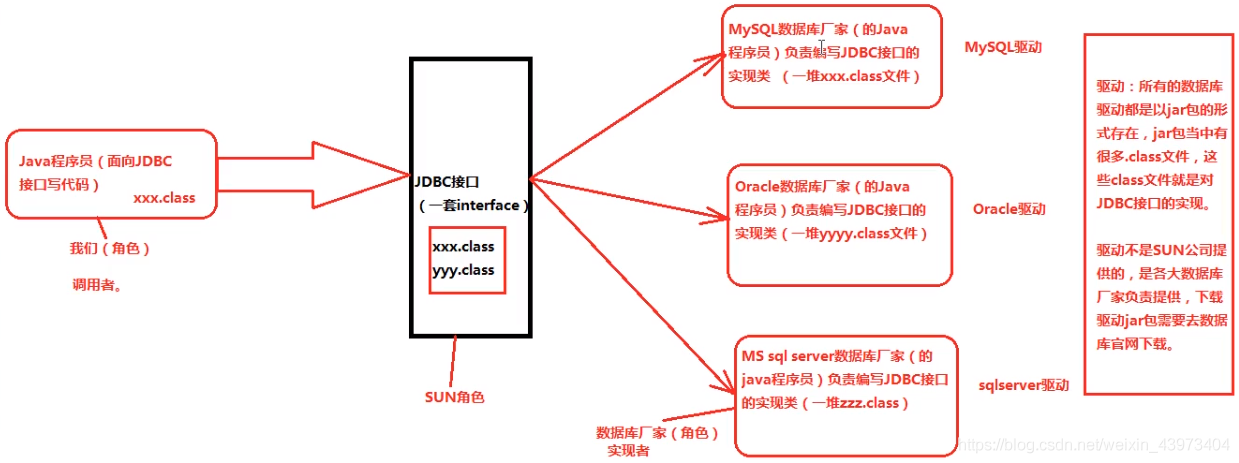
1.JDBC是什么? Java DataBase Connectivity(Java语言连接数据库) 2.JDBC的本质是什么? JDBC是SUN公司制定的一套接口(interface) java.sql.*; (这个软件包下有很多接口。) 3.JDBC开发前的准备工作,先从官网下载对应的驱动jar包,然后将其配置到环境变量classpath当中。 classpath=.;D:\course\06-JDBC\resources\MySql Connector Java 5.1.23\mysql-connector-java-5.1.23-bin.jar 以上的配置是针对于文本编辑器的方式开发,使用IDEA工具的时候,不需要配置以上的环境变量。 IDEA有自己的配置方式。 4.JDBC编程六步(需要背会) 第一步:注册驱动(作用:告诉Java程序,即将要连接的是哪个品牌的数据库) 第二步:获取连接(表示JVM的进程和数据库进程之间的通道打开了,这属于进程之间的通信,重量级的,使用完之后一定要关闭通道。) 第三步:获取数据库操作对象(专门执行sql语句的对象) 第四步:执行SQL语句(DQL DML....) 第五步:处理查询结果集(只有当第四步执行的是select语句的时候,才有这第五步处理查询结果集。) 第六步:释放资源(使用完资源之后一定要关闭资源。Java和数据库属于进程间的通信,开启之后一定要关闭。) import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Connection; import java.sql.Statement; public class JDBCTest{ public static void main(String[] args) { Connection conn= null; Statement stmt = null; ResultSet rs = null; try{ //1.注册驱动 //第一种方式 Driver driver = new com.mysql.jdbc.Driver(); DriverManager.registerDriver(driver); //第二种方式(一下方法不需要返回值,我们只需要它的类加载动作) class.forName("com.mysql.jdbc.Driver"); //2.获取连接 String url = "jdbc:mysql://127.0.0.1:3306/bjpowernode"; String user = "root"; String password = "333"; conn = DriverManager.getConnection(url,user,password); System.out.println("数据库连接对象:"+conn); //com.mysql.jdbc.JDBC4Connection@34340fab //3.获取数据库操作对象(statement专门执行sql语句) stmt = conn.createStatement(); //4.执行sql String sql = "select empno as a,ename,sal from emp"; rs= stmt.executeQuery(sql); //executeUpdate执行DML语句 executeQuery(sql)执行DQL语句 //5.处理查询结果集 while(rs.next()) { int empno = rs.getInt("a"); String ename = rs.getString("ename"); double sal = rs.getDouble("sal"); System.out.pritnln(empno+","+ename+","+sal); } } catch(SQLException e){ e.printStackTrace(); }finally{ try{ if(stmt !=null){ stmt.close(); } }catch(SQLException e){ e.printStackTrace(); } try{ if(conn !=null){ conn.close(); } }catch(SQLException e){ e.printStackTrace(); } } } } 使用属性配置文件 //jdbc.propertes属性配置文件 driver=com.mysql.jdbc.Driver url=jdbc:mysql://localhost:3306/bjpowernode user=root password=333 import java.sql.Driver; import java.sql.DriverManager; import java.sql.SQLException; import java.sql.Connection; import java.sql.Statement; import java.util.*; public class JDBCTest{ public static void main(String[] args) { //使用资源绑定器绑定属性配置文件 ResourceBundle bundle = ResourceBundle.getBundle("jdbc"); String driver = bundle.getString("driver"); String url = bundle.getString("url"); String user = bundle.getString("user"); String password = bundle.getString("password"); Connection conn= null; Statement stmt = null; try{ //1.注册驱动 class.forName(driver); //2.获取连接 conn = DriverManager.getConnection(url,user,password); System.out.println("数据库连接对象:"+conn); //com.mysql.jdbc.JDBC4Connection@34340fab //3.获取数据库操作对象(statement专门执行sql语句) stmt = conn.createStatement(); //4.执行sql String sql = "insert into dept(deptno,dname,loc) values(50,'人事部','北京')"; int count = stmt.executeUpdate(sql); //执行DML语句 System.out.println(count == 1 ? "保存成功":"保存失败"); //5.处理查询结果集 } catch(Exception e){ e.printStackTrace(); }finally{ try{ if(stmt !=null){ stmt.close(); } }catch(SQLException e){ e.printStackTrace(); } try{ if(conn !=null){ conn.close(); } }catch(SQLException e){ e.printStackTrace(); } } } } 5.登录功能实现(防止SQL注入,PreparedStatement) package com.bjpowernode.jdbc; import java.sql.*; import java.util.HashMap; import java.util.Map; import java.util.Scanner; /*实现功能: 1.需求:模拟用户登录功能的实现。 2.业务描述: 程序运行的时候,提供一个输入的入口,可以让用户输入用户名和密码 合法:显示登录成功。 不合法:显示登录失败。 3.数据准备: 在实际的开发中使用建模工具 4.Sql注入现象(安全隐患): 根本原因 fdsa ''or 将用户名或密码的or 当做了sql语句 解决SQL注入问题: 要想用户信息不参与Sql语句编译,那么必须使用java.sql.PreparedStatement PreparedStatement是属于预编译数据库操作对象,编译一次执行多次。 PreparedStatement ps = null; 其中一个?代表一个占位符,站位符不能用点引号括起来 String sql = "select * from t_user where loginName = ? and loginPwd = ?"; ps = conn.prepareStatement(sql); 给占位符传值 ps.setString(1,loginName); ps.setString(2,loginPwd); */ public class JDBCTest06 { public static void main(String[] args) { //初始一个界面 Map<String,String> userLoginInfo = initUI(); boolean loginSuccess = login(userLoginInfo); System.out.println(loginSuccess? "登录成功!":"登录失败用户名密码错误!"); } private static boolean login(Map<String, String> userLoginInfo) { boolean loginSuccess = false; Connection conn = null; PreparedStatement ps = null;//这里是PreParedStatement(预编译数据库操作对象) ResultSet rs = null; try{ //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //连接语句 conn = DriverManager.getConnection("jdbc:mysql://127.0.0.1:3306/bjpowernode","root","333"); //获取数据库操作对象 String sql = "select * from t_user where loginName = ? and loginPwd = ?"; ps = conn.prepareStatement(sql); //给占位符传值 ps.setString(1,userLoginInfo.get("loginName")); ps.setString(2,userLoginInfo.get("loginPwd")); rs = ps.executeQuery(); if (rs.next()) { loginSuccess = true; } }catch (ClassNotFoundException e){ e.printStackTrace(); }catch (SQLException e) { e.printStackTrace(); }finally { if (rs !=null){ try { rs.close(); }catch (SQLException e) { e.printStackTrace(); } } if (ps !=null){ try { ps.close(); }catch (SQLException e) { e.printStackTrace(); } } if (conn !=null) { try{ conn.close(); }catch (SQLException e) { e.printStackTrace(); } } } return loginSuccess; } /* * 初始化用户页面 * @return 用户输入用户名密码等登录信息 * */ private static Map<String, String> initUI() { Scanner s = new Scanner(System.in); System.out.println("用户名:"); String loginName = s.nextLine(); System.out.println("密码:"); String loginPwd = s.nextLine(); Map<String,String> userLoginInfo = new HashMap<>(); userLoginInfo.put("loginName",loginName); userLoginInfo.put("loginPwd",loginPwd); return userLoginInfo; } } Statement的用处(需要SQL注入) Statement存在SQL注入问题,是编译一次执行一次。PreparedStatement执行效率高。 需要先 用户台输入desc降序,输入asc升序,此时需要使用Sql注入 String keyWords = desc或者asc String sql = "select ename = from emp order by ename " + keyWords; 6.账户转账演示事务 sql脚本 drop table if exists t_act; create table t_act( actno bigint, balance double(7,2) //注意:7表示有效数字,2表示小数位个数 ); insert into t_act(actno,balance) values(111,20000); insert into t_act(actno,balance) values(222,0); commit; select * from t_act; 重点三句: conn.setAutoCommit(false); conn.commit(); conn.rollback(); public class HelloWorld { public static void main(String []args) { Connection conn = null; PreparedStatement ps = null; try{ //注册驱动 Class.forName("com.mysql.jdbc.Driver"); //获取连接 conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/bjpowernode","root","333"); //将自动提交机制改为手动提交 conn.setAutoCommit(false);//开启事务 //获取预编译的数据库操作系统 String sql = "update t_act set balance = ? where actno = ?"; ps = conn.prepareStatement(sql); //给替换符赋值 ps.setDouble(1,10000); ps.setInt(2,111); int count = ps.executeUpdate(); ps.setDouble(1,10000); ps.setInt(2,222); count +=ps.executeUpdate(); //程序到这里表示成功 conn.commit(); //提交事务 Syste.out.println(count == 2 ?"转账成功":"转账成功"); }catch(Exception e) { if(conn != null) { try{ //回滚事务 conn.rollback(); }catch(SQLException e) { e.printStackTrace(); } } e.printStackTrace(); } } } 7.JDBC工具类封装 import java.sql.*; public class DBUtil { private DBUtil() { } //工具类的构造方法是私有的; //因为工具类的方法是静态的,不需要实例化 static { try { Class.forName("com.mysql.jdbc.Driver"); } catch (ClassNotFoundException e) { e.printStackTrace(); } } //获取数据库连接对象 //@return 连接对象 public static PreparedStatement createStatement(String sql) throws SQLException { Connection conn = DriverManager.getConnection("jdbc:mysql://localhost:3306/bjpowernode", "root", "333"); PreparedStatement ps = conn.prepareStatement(sql); return ps; } //关闭资源 //conn 连接对象 //ps 数据库操作对象 //rs 结果集 public static void close(Connection conn, Statement ps, ResultSet rs) { if (rs != null) { try { rs.close(); } catch (SQLException e) { e.printStackTrace(); } } if (ps != null) { try { ps.close(); } catch (SQLException e) { e.printStackTrace(); } } if (conn != null) { try { conn.close(); } catch (SQLException e) { e.printStackTrace(); } } } }

优秀的个人博客,低调大师

PySpider 快速上手

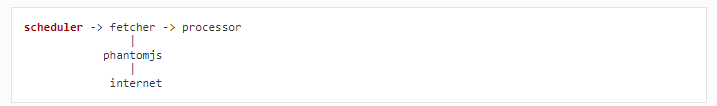
因为工作原因,最近一段时间都在做项目的数据建设工作,涉及到使用Pyspider进行数据的爬取及入库,所以此处系统的整理一下; pyspider简介 一个国人编写的强大的网络爬虫系统并带有强大的WebUI。 采用Python语言编写,分布式架构,支持多种数据库后端,强大的WebUI支持脚本编辑器,任务监视器,项目管理器以及结果查看器。 不过目前对代理支持的话,不太好,只能支持单代理,本身不支持多代理,有两种解决方法: 修改源码,在发起请求的时候,从代理中心获取代理地址进行配置访问; 通过 类似squid方法进行获取,详细点这里 GitHub地址:https://github.com/binux/pyspider 中文网地址:http://www.pyspider.cn PySpider特性 用Python编写脚本,支持Python 2. {6,7},3。{3,4,5,6}等 功能强大的WebUI,包括脚本编辑器,任务监视器,项目管理器和结果查看器 支持多种数据库存储(MySQL,MongoDB,Redis,SQLite,Elasticsearch,PostgreSQL,SQLAlchemy) 支持多种消息队列(RabbitMQ,Beanstalk,Redis,Kombu) 支持爬虫任务优先级设置,超时重爬等 支持分布式部署 支持抓取Javascript页面 PySpider组件及架构 PySpider核心组件有以下几个: Scheduler(调度器): 从task_queue中接收任务 确定任务是新任务还是重爬任务 进行优先级排序, 处理定期任务,重试丢失或失败的任务 Fetcher(提取器): 负责获取网页内容 支持url或JavaScript的页面(通过phantomjs) Processor(处理器): 负责处理内容的解析,内置PyQuery解析库 组件之间架构图如下: 每个组件相互独立,通过消息队列连接,从单进程到多机分布式灵活拓展 存储 Pyspider支持多种存储,默认使用的sqlite,具体支持如下图源码中所列 默认情况下,运行的时候,运行目录的下会生成一个data文件夹,里面会存储几个db文件: project.db (存储爬虫项目信息,一般指的一个单独的爬虫脚本) result.db (存储任务执行结果信息) task.db (存储爬虫任务信息,也就是on_start后生成的爬虫任务信息) PySpider使用 安装Pyspider 安装的话,比较简单,只有两步: pip install pyspider 运行命令pyspider,访问http://localhost:5000/ 首页介绍 操作按钮 Recent Active Tasks (查看最近活动的任务,会跳转到一个页面有列表显示) Create (创建一个新的爬虫任务) 项目列表 group:分组,点击进行修改,用于区分任务类型,可以通过点击表头进行排序,要是能做成文件夹就更好了 project name:项目名称,创建爬虫项目时填写 status (任务状态,有以下几种状态) TODO:当一个脚本刚刚被创建时的状态 STOP:你可以设置项目状态为STOP让项目停止运行 CHECKING:当一个运行中的项目被编辑时项目状态会被自动设置成此状态并停止运行. DEBUG/RUNNING:这两状态都会运行爬虫,但是他们之间是有区别的.一般来说调试阶段用DEBUG状态,线上用RUNNING状态. rate/burst:rate:每秒执行多少个请求,burst:任务并发数,可以点击进行修改 avg time:任务平均时间 progress:记录任务状态,按时间区分,会标示任务的创建数,成功数,失败数等值 actions:对爬虫项目的一些操作 Run:立即执行任务,需要status为running或debug状态;如果在配置的调度执行时间内已经执行过,再点run是无效的,需要删除task.db里的数据才行(我都是直接把文件都干掉了。。) Active Tasks:查看当前爬虫项目的活动任务 Results:查看活动任务结果 编辑页面介绍 左侧页面栏为调试信息可视化,相关区域及按钮介绍一下: 上面绿色区域,为调试信息显示,显示当前任务的相关信息; Run:调试按钮,点击即可运行当前任务 "<",">"箭头为上一步下一步,用于调试过程中切换到上一步骤 web:将当前拉取到的页面内容以web形式展示(不过显示范围很窄。。) html:显示当前页面的html源码 follow:子任务,该任务下的子任务,点击链接上的按钮,即可进行下一步调试 messages,enable css selector helper 这两个还不知道有啥用 右侧主要就是用于编写爬虫脚本了,新建默认脚本如下: 核心代码都在BaseHandler中,Handler类继承BaseHandler,该类在base_handler.py文件中 crawl_config :为全局配置对象,通过源码我们可以看到,可以支持很多配置,但是需要注意,配置是有作用区域的 on_start 入口方法:一般为主页面的方法,这名字不能改,因为源码里启动的话入口方法就是on_start,其余index_page,跟detail_page没有说强制性的,可根据自己需求起名字,就不说了; @every 注解:用于定时调度,有两个参数:minutes,seconds;分别也是代表指的多少分钟执行一次,多少秒执行一次,代码也在base_handler.py中 @config 注解:用于核心方法self.crawl的配置,在通过配置的,会作为self.crawl的默认配置; crawl 核心方法:这个方法就是告诉Pyspider抓取哪个页面,我目前为止也没都用全,完整的API点击这里,有很详细的解释 Response 返回对象:通过默认的示例代码中可以看到,通过crawl爬取返回的对象就是这个类型,可以通过response.doc方法,将返回值转换成PyQuery对象,剩下来的就根据需求去解析元素,提取你需要的东西了;完整API点击这里 总结: 因为第一次接触爬虫,对别的爬虫技术也不太了解,不好做对比,就PySpider来说,用久了还是方便的,特别是页面调试,不过刚开始用的话,对Response对象不熟悉,会比较麻烦一点,毕竟没有PyCharm通过断点查看对象属性来的方便; 因为整体来讲,比较简单,这里就不上传示例代码了,看编辑页面介绍截图的代码,就是之前爬保监会网站的代码,可以借鉴一下,比较简单。 另吐槽一下开源中国 对MarkDown的支持,在编辑预览中看到的,跟发布出来看到的格式不一样。。难受

优秀的个人博客,低调大师

Redis快速使用

1.导包(坐标) <!-- https://mvnrepository.com/artifact/redis.clients/jedis --> <dependency> <groupId>redis.clients</groupId> <artifactId>jedis</artifactId> <version>2.9.0</version> </dependency> <!-- 配置使用redis启动器 --> <dependency> <groupId>org.springframework.boot</groupId> <artifactId>spring-boot-starter-data-redis</artifactId> </dependency> 2.使用 2.1存数据: @Autowired private RedisTemplate<String, String> redisTemplate; public void run(){ /* 参数一: key 参数二:value 参数三:title 参数四:时间类型 */ redisTemplate.opsForValue().set(customer.getTelephone(), activecode, 24,TimeUnit.HOURS); } 2.2取数据 String getUUid = redisTemplate.opsForValue().get(telephone);

优秀的个人博客,低调大师

pipenv快速入门

学过Python的同学应该都了解pip这个工具,我们用pip绝大部分的第三方库都可以用pip来安装,用起来很方便。但是如果我们要把项目部署到服务器上面的话,就稍微有些麻烦了,因为还需要在服务器上用pip安装这些包,假如项目中用到很多包的话,一个个安装会很麻烦,而且没有通用性。Java上的maven、gradle,NodeJS的npm这些工具就不存在这个问题,它们有一个或多个的专门的依赖文件来管理这些包。pipenv就是这样一个类似的工具,可以帮助我们管理Python和第三方库的版本。 安装 安装pipenv很简单,用pip命令就可以安装。 pip install pipenv 将来需要更新pipenv的时候,运行: pip install --user --upgrade pipenv 首次运行 如果是第一次在项目中运行pipenv命令的话,会在项目中创建一个名为Pipfile的文件,文件内容类似下面这样。用过maven、gradle等工具的同学对此应该熟悉,相信不用我解释其中的含义。 [[source]] url = "https://pypi.org/simple" verify_ssl = true name = "pypi" [packages] requests-html = "*" [dev-packages] [requires] python_version = "3.7" 如果运行过install、update等命令的话,还会创建一个Pipfile.lock文件,类似npm中的lock文件。这两个文件就是pipenv用于管理第三方库的配置文件,如果同时使用版本控制软件的话,需要将它们也加入进去。 常用命令 安装 例如,我想在项目中安装requests这个包,运行: pipenv install requests 如果需要指定具体版本号,可以这样: pipenv install requests==2.13.0 如果是第一次运行pipenv的话,会先创建Pipfile文件,否则会修改Pipfile`文件。 该命令还有一个常用参数-d或--dev,用于安装仅供开发使用的包。 卸载 相应的还有命令来卸载第三方包,该命令还有两个参数--all和--all-dev用于卸载所有包和所有开发包。 pipenv uninstall requests 更新 查看所有需要更新的包: pipenv update --outdated 更新所有包: pipenv update 更新指定的包: pipenv update <包名> 从requirements.txt导入 如果项目中有requirements.txt文件,pipenv会在安装的时候自动导入。如果需要导入其他位置的requirements.txt,可以用下面的命令: pipenv install -r path/to/requirements.txt 指定Python版本 pipenv会创建虚拟Python环境,并在其中用pip安装所有包。如果要指定Python版本,可以用下面的命令,三种版本号都支持: pipenv --python 3 pipenv --python 3.6 pipenv --python 2.7.14 如果不指定版本号,pipenv会使用系统默认的Python版本。需要注意,这里指定的Python必须是系统已经安装的、可以在环境变量中搜索到的版本号,如果指定未安装的版本,会提示错误。 运行命令 用下面的命令可以启动一个在虚拟环境中的shell: pipenv shell 如果不想启动shell,而是直接在虚拟环境中执行命令,可以使用run: pipenv run python --version 高级用法 一开始我文档没看全,然后用pipenv的时候发现有一些问题,后来我发现官方文档还有一部分高级内容也很重要,所以再来补充一下。当然如果有需要的话还是得看原文。 导出requirements.txt 用下面的命令就可以将Pipfile和Pipfile.lock文件里面的包导出为requirements.txt文件。 pipenv lock -r 如果只想导出开发用的包,可以添加--dev参数: pipenv lock -r --dev 自动安装Python pipenv只能搜索系统中已经安装的Python版本,对于未安装的版本,会提示错误。但是如果你同时安装了pyenv的话,pipenv会自动发现pyenv,然后直接询问你是否要安装。这样一来,原来的工作流程是:用pyenv安装某个Python->用virtualenv或venv创建虚拟环境->用pip从requirements.txt中安装包->将来可能还要更新包。现在完全可以用pipenv一两条命令解决,真的是非常方便。 自动加载.env文件 .env文件可以设置一些环境变量,在程序开发的时候模拟环境变量。pipenv也可以自动加载.env文件。 $ cat .env HELLO=WORLD⏎ $ pipenv run python Loading .env environment variables… Python 2.7.13 (default, Jul 18 2017, 09:17:00) [GCC 4.2.1 Compatible Apple LLVM 8.1.0 (clang-802.0.42)] on darwin Type "help", "copyright", "credits" or "license" for more information. >>> import os >>> os.environ['HELLO'] 'WORLD' 环境变量支持 在Pipfile中也可以引用环境变量的值,格式为${MY_ENVAR}或$MY_ENVAR,在Windows系统中还支持%MY_ENVAR%。 [[source]] url = "https://${PYPI_USERNAME}:${PYPI_PASSWORD}@my_private_repo.example.com/simple" verify_ssl = true name = "pypi" [dev-packages] [packages] requests = {version="*", index="home"} maya = {version="*", index="pypi"} records = "*" 自定义虚拟环境路径 很多工具遵循Linux开发习惯,将东西全存在用户目录中,在Linux中可能没啥,但是在Windows下可能有人不喜欢把这些东西放在用户目录。当然pipenv也可以自定义,只需要设置或修改WORKON_HOME环境变量的值即可。 如果设置了PIPENV_VENV_IN_PROJECT环境变量,pipenv会把虚拟环境放在项目目录的.venv目录下。 配置pipenv pipenv还有一些配置,都是使用环境变量配置的,由于配置项比较多,这里就不介绍了,直接看官方文档好了。 从setup.py安装 pipenv也可以从setup.py安装: pipenv install -e . 那么为什么不全用pipenv来安装呢?官方文档这里为我们做出了解释:项目可以分为两种,程序和库,对于程序来说应该使用pipenv,而对于库来说则是在setup.py中安装。详细解释说实话我没太看懂,大意就是抽象依赖和具体依赖,还有一个责任分配的问题,原文在这里。

优秀的个人博客,低调大师

pyenv快速入门

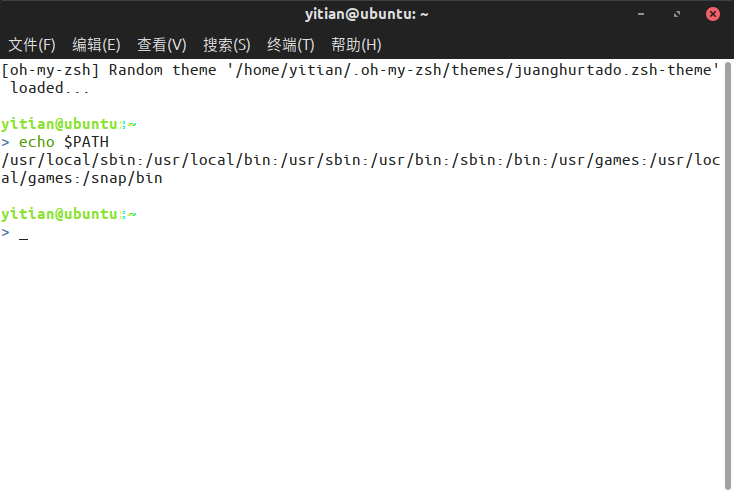
在开发Python程序的时候,有时候可能需要在不同版本的Python上进行测试。pyenv就是这么一个管理多版本Python的工具。由于在Windows中我们可以同时安装多个版本的Python,所以这里是在Linux下介绍该工具。 安装 首先当然是安装pyenv了,最简单的办法就是利用官方Github仓库中的安装脚本了: $ curl -L https://github.com/pyenv/pyenv-installer/raw/master/bin/pyenv-installer | bash 安装脚本有可能会提示你手动把几行命令添加到shell的配置文件中。 如果你用的是zsh的话,别忘了替换命令中的bash。将来如果要删除的话,需要在.zshrc文件中删除。如果你用oh-my-zsh的话,不需要在.zshrc中添加那几行(加了也没用),而是在.zshrc中启用pyenv插件。 将来要进行更新的话: $ pyenv update 要卸载pyenv的话更加简单,直接删除目录即可: $ rm -fr ~/.pyenv 别忘了把.bashrc中的这几行也一并删掉: export PATH="~/.pyenv/bin:$PATH" eval "$(pyenv init -)" eval "$(pyenv virtualenv-init -)" 工作原理 Linux环境变量 当执行命令的时候,系统会在环境变量中从左到右依次寻找匹配的命令并执行。环境变量中是一组以冒号:分隔的路径。 环境变量 垫片(Shims) pyenv的工作原理其实很简单,将它自己管理的Python目录插到环境变量的最前面,这样一来系统在搜索Python的时候第一个找到的就是pyenv管理的Python环境。这个插到最前面的路径就叫做垫片(shims),当然这是在英文语境下,在中文环境下我老觉得怪怪的,反正理解意思就好。 选择Python版本 当执行pyenv命令的时候,它会按照以下顺序来决定要使用的Python版本: 使用PYENV_VERSION环境变量(如果存在). 你可以使用pyenv shell 命令来在当前shell环境中设置该环境变量. 当前目录中应用程序指定的.python-version文件(如果存在). 你可以用pyenv local 命令来修改当前目录的.python-version文件. 自底向上搜索各层上级目录,找到的第一个.python-version, 直到到达文件系统根目录. 全局的$(pyenv root)/version文件. 可以使用 pyenv global 命令来修改. 如果全局版本文件不存在, pyenv假设你使用系统安装的Python. (换句话说就是未安装pyenv时环境变量中找到的Python.) 常用命令 完整命令请参考官方文档。 安装 列出所有可安装的Python版本: pyenv install -l|--list 安装某个Python: pyenv install <version> 卸载 卸载某个Python,-f参数指定是否强制卸载,如果强制卸载的话不会弹出提示,而且如果版本不存在的话也不会显示错误信息: pyenv uninstall [-f|--force] <version> versions 列出所有已安装的Python,当前使用的Python会用星号标出: $ pyenv versions 2.5.6 2.6.8 * 2.7.6 (set by /home/yyuu/.pyenv/version) 3.3.3 jython-2.5.3 pypy-2.2.1 global 通过写~/.pyenv/version文件的方式设置全局Python: $ pyenv global 2.7.6 local 通过在当前目录写.python-version文件的方式设置当前目录下的Python: pyenv local 2.7.6 当不再需要本地Python的时候,用--set来清除: $ pyenv local --unset shell 指定当前shell使用的Python: $ pyenv shell pypy-2.2.1 当不再需要的时候,用--set来清除: $ pyenv shell --unset 最后展示一下pyenv install -l的输出,可以看到,pyenv可以方便的安装大部分版本的Python,省略号表示中间有一大堆: yitian@ubuntu:~ $ pyenv install -l Available versions: 2.1.3 ... 2.7.15 ... 3.6.6 3.7.0 3.7-dev 3.8-dev activepython-2.7.14 activepython-3.5.4 activepython-3.6.0 anaconda-1.4.0 ... anaconda3-5.2.0 ironpython-dev ironpython-2.7.4 ironpython-2.7.5 ironpython-2.7.6.3 ironpython-2.7.7 jython-dev jython-2.5.0 jython-2.5-dev jython-2.5.1 jython-2.5.2 jython-2.5.3 jython-2.5.4-rc1 jython-2.7.0 jython-2.7.1 micropython-dev micropython-1.9.3 micropython-1.9.4 miniconda-latest miniconda-2.2.2 ... miniconda3-4.3.30 pypy-c-jit-latest pypy-c-nojit-latest pypy-dev pypy-stm-2.3 pypy-stm-2.5.1 pypy-1.5-src pypy-1.5 ... pypy3.5-6.0.0 pyston-0.5.1 pyston-0.6.0 pyston-0.6.1 stackless-dev stackless-2.7-dev stackless-2.7.2 ... stackless-3.5.4 常见问题 用pyenv安装Python的时候可能会出现各种各样问题,例如缺少zlib、缺少ctypes模块等等。对此pyenv也有专门一个页面解决。对于我的Ubuntu 18.04虚拟机来说,安装以下一坨软件可以解决问题: sudo apt-get install -y make build-essential libssl-dev zlib1g-dev libbz2-dev \ libreadline-dev libsqlite3-dev wget curl llvm libncurses5-dev libncursesw5-dev \ xz-utils tk-dev libffi-dev liblzma-dev libedit-dev 其他系统请查看pyenv的页面,如果有其它问题请自行搜索Stack Overflow。

优秀的个人博客,低调大师

JetCache快速入门

创建缓存实例 通过@CreateCache注解创建一个缓存实例,默认超时时间是100秒 @CreateCache(expire = 100) private Cache<Long, UserDO> userCache; 用起来就像map一样 UserDO user = userCache.get(123L); userCache.put(123L, user); userCache.remove(123L); 创建一个两级(内存+远程)的缓存,内存中的元素个数限制在50个。 @CreateCache(name = "UserService.userCache", expire = 100, cacheType = CacheType.BOTH, localLimit = 50) private Cache<Long, UserDO> userCache; name属性不是必须的,但是起个名字是个好习惯,展示统计数据的使用,会使用这个名字。如果同一个area两个@CreateCache的name配置一样,它们生成的Cache将指向同一个实例。 创建方法缓存 使用@Cached方法可以为一个方法添加上缓存。JetCache通过Spring AOP生成代理,来支持缓存功能。注解可以加在接口方法上也可以加在类方法上,但需要保证是个Spring bean。 public interface UserService { @Cached(name="UserService.getUserById", expire = 3600) User getUserById(long userId); } 基本配置(使用Spring Boot) 如果使用Spring Boot,可以按如下的方式配置。 POM <dependency> <groupId>com.alicp.jetcache</groupId> <artifactId>jetcache-starter-redis</artifactId> <version>2.4.4</version> </dependency> 配置一个spring boot风格的application.yml文件,把他放到资源目录中 jetcache: statIntervalMinutes: 15 areaInCacheName: false local: default: type: linkedhashmap keyConvertor: fastjson remote: default: type: redis keyConvertor: fastjson valueEncoder: java valueDecoder: java poolConfig: minIdle: 5 maxIdle: 20 maxTotal: 50 host: 127.0.0.1 port: 6379 然后创建一个App类放在业务包的根下,EnableMethodCache,EnableCreateCacheAnnotation这两个注解分别激活Cached和CreateCache注解,其他和标准的Spring Boot程序是一样的。这个类可以直接main方法运行。 package com.company.mypackage; import com.alicp.jetcache.anno.config.EnableCreateCacheAnnotation; import com.alicp.jetcache.anno.config.EnableMethodCache; import org.springframework.boot.SpringApplication; import org.springframework.boot.autoconfigure.SpringBootApplication; @SpringBootApplication @EnableMethodCache(basePackages = "com.company.mypackage") @EnableCreateCacheAnnotation public class MySpringBootApp { public static void main(String[] args) { SpringApplication.run(MySpringBootApp.class); } } 未使用SpringBoot的配置方式 如果没有使用spring boot,可以按下面的方式配置(这里使用jedis客户端连接redis为例)。 <dependency> <groupId>com.alicp.jetcache</groupId> <artifactId>jetcache-anno</artifactId> <version>2.4.4</version> </dependency> <dependency> <groupId>com.alicp.jetcache</groupId> <artifactId>jetcache-redis</artifactId> <version>2.4.4</version> </dependency> 配置了这个JetCacheConfig类以后,可以使用@CreateCache和@Cached注解。 package com.company.mypackage; import java.util.HashMap; import java.util.Map; import com.alicp.jetcache.anno.CacheConsts; import com.alicp.jetcache.anno.config.EnableCreateCacheAnnotation; import com.alicp.jetcache.anno.config.EnableMethodCache; import com.alicp.jetcache.anno.support.GlobalCacheConfig; import com.alicp.jetcache.anno.support.SpringConfigProvider; import com.alicp.jetcache.embedded.EmbeddedCacheBuilder; import com.alicp.jetcache.embedded.LinkedHashMapCacheBuilder; import com.alicp.jetcache.redis.RedisCacheBuilder; import com.alicp.jetcache.support.FastjsonKeyConvertor; import com.alicp.jetcache.support.JavaValueDecoder; import com.alicp.jetcache.support.JavaValueEncoder; import org.apache.commons.pool2.impl.GenericObjectPoolConfig; import org.springframework.context.annotation.Bean; import org.springframework.context.annotation.Configuration; import redis.clients.jedis.Jedis; import redis.clients.jedis.JedisPool; import redis.clients.util.Pool; @Configuration @EnableMethodCache(basePackages = "com.company.mypackage") @EnableCreateCacheAnnotation public class JetCacheConfig { @Bean public Pool<Jedis> pool(){ GenericObjectPoolConfig pc = new GenericObjectPoolConfig(); pc.setMinIdle(2); pc.setMaxIdle(10); pc.setMaxTotal(10); return new JedisPool(pc, "localhost", 6379); } @Bean public SpringConfigProvider springConfigProvider() { return new SpringConfigProvider(); } @Bean public GlobalCacheConfig config(SpringConfigProvider configProvider, Pool<Jedis> pool){ Map localBuilders = new HashMap(); EmbeddedCacheBuilder localBuilder = LinkedHashMapCacheBuilder .createLinkedHashMapCacheBuilder() .keyConvertor(FastjsonKeyConvertor.INSTANCE); localBuilders.put(CacheConsts.DEFAULT_AREA, localBuilder); Map remoteBuilders = new HashMap(); RedisCacheBuilder remoteCacheBuilder = RedisCacheBuilder.createRedisCacheBuilder() .keyConvertor(FastjsonKeyConvertor.INSTANCE) .valueEncoder(JavaValueEncoder.INSTANCE) .valueDecoder(JavaValueDecoder.INSTANCE) .jedisPool(pool); remoteBuilders.put(CacheConsts.DEFAULT_AREA, remoteCacheBuilder); GlobalCacheConfig globalCacheConfig = new GlobalCacheConfig(); globalCacheConfig.setConfigProvider(configProvider); globalCacheConfig.setLocalCacheBuilders(localBuilders); globalCacheConfig.setRemoteCacheBuilders(remoteBuilders); globalCacheConfig.setStatIntervalMinutes(15); globalCacheConfig.setAreaInCacheName(false); return globalCacheConfig; } } 进一步阅读 CreateCache的详细使用说明可以看这里 使用@CacheCache创建的Cache接口实例,它的API使用可以看这里 关于方法缓存(@Cached, @CacheUpdate, @CacheInvalidate)的详细使用看这里 详细的配置说明看这里。

优秀的个人博客,低调大师

TensorFlow——快速安装

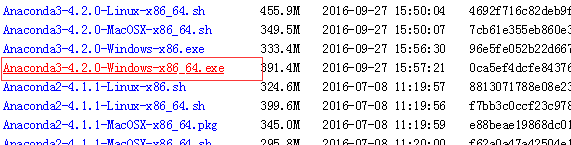
TensorFlow:2015年Google开源的机器学习框架 1、Anoconda安装 (1)Window,MacOS,Linux都已支持Tensorflow。 (2) Window用户只能使用 python3.5 (64bit) 。MacOS,Linux支持python2.7和python3.3+。 (3)有GPU可以安装带GPU版本的,没有GPU就安装CPU版本的。 推荐安装Anaconda,pip版本大于8.1 Anoconda官网: https://www.anaconda.com/ Anaconda版本下载: https://repo.continuum.io/archive/ python3.5(64bit对应的是Anaconda3-4.2.0版本,如下) 注 :更新pip版本: 管理员 方式打开命令提示符,输入命令: python -m pip install --upgrade pip 2、Windows安装Tensorflow (1) Windows安装Tensorflow CPU版本: 管理员 方式打开命令提示符,输入命令: pip install tensorflow GPU版本: 管理员方式打开命令提示符,输入命令: pip install tensorflow-gpu (2) Windows更新Tensorflow 先卸载 : pip uninstall tensorflow 再安装 : pip install tensorflow 注: 【安装完成后,打开Anoconda自带的Jupyter Notebook,输入 import tensorflow ,运行( shift+Enter ),如果不缺少文件的话就运行成功,如果缺少文件则根据错误提示安装文件。 例如:出现如下错误,则点击下面的链接,根据提示安装即可 ImportError : Could not find 'cudart64_90.dll'. TensorFlow requires that this DLL be installed in a directory that is named in your %PATH% environment variable. Download and install CUDA 9.0 from this URL: https://developer.nvidia.com/cuda-toolkit 】 3、Linux和MacOS安装Tensorflow CPU版本: Python 2.7用户: pip install tensorflow Python3.3+用户: pip3 install tensorflow GPU版本: Python 2.7用户: pip install tensorflow-gpu Python3.3+用户: pip3 install tensorflow-gpu 官方网站: https://www.tensorflow.org/ 官方GitHub仓库: https://github.com/tensorflow/tensorflow 官方文档: https://www.tensorflow.org/get_started/ 官方文档中文版: https://github.com/jikexueyuanwiki/tensorflow-zh TensorFlow 中文社区 http://www.tensorfly.cn/

优秀的个人博客,低调大师

python快速排序

#_*_coding:utf-8_*_ __author__ = 'Alex Li' def quick_sort(array,left,right): ''' :param array: :param left: 列表的第一个索引 :param right: 列表最后一个元素的索引 :return: ''' if left >=right: return low = left high = right key = array[low] #第一个值 while low < high:#只要左右未遇见 while low < high and array[high] > key: #找到列表右边比key大的值 为止 high -= 1 #此时直接 把key(array[low]) 跟 比它大的array[high]进行交换 array[low] = array[high] array[high] = key while low < high and array[low] <= key : #找到key左边比key大的值,这里为何是<=而不是<呢?你要思考。。。 low += 1 #array[low] = #找到了左边比k大的值 ,把array[high](此时应该刚存成了key) 跟这个比key大的array[low]进行调换 array[high] = array[low] array[low] = key quick_sort(array,left,low-1) #最后用同样的方式对分出来的左边的小组进行同上的做法 quick_sort(array,low+1, right)#用同样的方式对分出来的右边的小组进行同上的做法 if __name__ == '__main__': array = [96,14,10,9,6,99,16,5,1,3,2,4,1,13,26,18,2,45,34,23,1,7,3,22,19,2] #array = [8,4,1, 14, 6, 2, 3, 9,5, 13, 7,1, 8,10, 12] print("before sort:", array) quick_sort(array,0,len(array)-1) print("-------final -------") print(array)

优秀的个人博客,低调大师

AMFPHP快速入门

AMFPHP是PHP的远程调用(RPC, Remote Procedure Call)工具。它可以使PHP与下述技术无缝通信: (1) Flash 和 Flex Remoting (2) JavaScript JSON 和 Ajax JSON (3) XML 和XML-RPC 什么是RPC 远端程序调用(RPC, Remote Procedure Call) 是一种客户端与服务器端交换数据方式。我们可以调用本地对象带对各种参数方法设置回调并接受调用结果。我们不用关心发送和接收数据的实现细节。实现细节通常是抽象的,就像我们在调用本地方法一样。 AMFPHP的工作原理 客户端(Flash / Flex)与服务器端(PHP) 使用相同的方式描述方法调用和复杂数据。客户端序列化请求并将它发送到网关AMFPHP。AMFPHP再执行: (1) 反序列化请求 (2) 找到相应的远程服务类 (3) 实例化类 (4) 执行安全检查 (5)(使用指定参数)调用服务器端方法 (6) 序列化返回的数据 AMFPHP可以正确地序列化、反序列化复杂类型数据。除了对象和数组,它还支持 resources 数据连接资源,这就意味着我们可以通过调用远程方法简单返回mysql_query,amfphp 会处理这一切。如果平台支持 (目前来说,Flash Remoting 和Flex Remoting),AMFPHP还可以处理循环引用和自定义数据它也支持简单的远程调试。还有AMFPHP附带一个浏览器,它可以在创建客户端代码前测试远程服务。AMFPHP 1.0.1还添加了模板,可以自动生成客户端代码。AMFPHP 1.9 beta更是新增了对AMF3的支持。 简单示例 下面我们通过一个简单的登录示例来对AMFPHP有一个初步的认识,将分别从客户端和服务器端两个部分进行介绍。 一,Flex客户端: 复制代码 代码 import mx.controls.Alert; import mx.rpc.remoting.mxml.RemoteObject; import mx.rpc.events.*; public var login_remoteObj:RemoteObject = null; public function initLoginRemoteObject():void {//初始化RemoteObject this.login_remoteObj = new RemoteObject(); this.login_remoteObj.source = "Login"; this.login_remoteObj.destination = "amfphp"; this.login_remoteObj.showBusyCursor = true; this.login_remoteObj.endpoint = "http://localhost/MyTest/amfphp/gateway.php"; this.login_remoteObj.doLogin.addEventListener("result", loginHandler); this.login_remoteObj.doLogin.addEventListener("fault", faultHandler); } public function doLogin():void {//登陆操作,向服务器提交数据 var name:String = this.txtName.text; var pwd:String = this.txtPassword.text; var data:Array = new Array(); data.push(name); data.push(pwd); this.login_remoteObj.getOperation("doLogin").send(data); } public function loginHandler(event: ResultEvent):void {//处理服务器返回的结果 var result:Array = event.result as Array; var flag:String = result[0]; if (flag == "0") { Alert.show("登陆失败: " + result[1]); } else if (flag == "1") { Alert.show("登陆成功: " + result[1]); } else if (flag == "-1") { Alert.show("异常: " + result[1]); } } public function faultHandler(event: FaultEvent):void {//出错处理 Alert.show("sorry,出错了!!!"); } } 复制代码 二,PHP服务器端 1,将amfphp文件夹置于MyTest项目的根目录下,打开浏览器输入下述地址验证amfphp是否安装成功 http://localhost/MyTest/amfphp/gateway.php amfphp就是通过这个gateway来定位我们的服务类,并将请求转发给这些服务类进行处理的。 2,Login.php文件,包含了处理登陆请求的Login类,此文件置于BusinessLogic目录下 复制代码 代码 <?php class Login { public function doLogin($data) { $result = array(); try { $name = array_shift($data); $pwd = array_shift($data); if ($name == "phinecos" && $pwd == "123") { $result[] = "1"; $result[] = "you are valid user!"; } else { $result[] = "0"; $result[] = "login failed"; } } catch (Exception $ex) { $result[] = "-1"; $result[] = $ex->getMessage(); } return $result; } } ?> 复制代码 3,将globals.php中的服务路径项修改如下,为amfphp指明服务类所在的目录 $servicesPath = "../BusinessLogic/"; 本文转自Phinecos(洞庭散人)博客园博客,原文链接:http://www.cnblogs.com/phinecos/archive/2010/05/10/1731595.html,如需转载请自行联系原作者

优秀的个人博客,低调大师

ELKStack快速安装

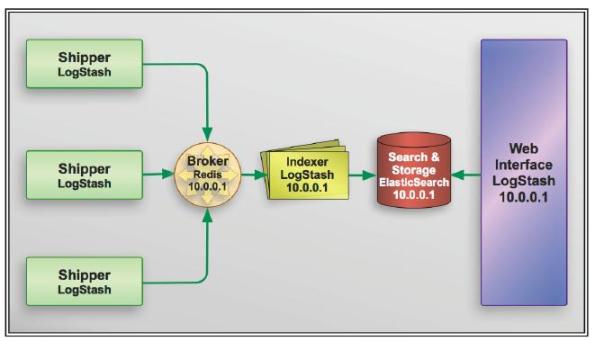
ELKStack简介 对于日志来说,最常见的需求就是收集、存储、查询、展示,开源社区正好有相对应的开源项目:logstash(收集)、elasticsearch(存储+搜索)、kibana(展示),我们将这三个组合起来的技术称之为ELKStack,所以说ELKStack指的是Elasticsearch、Logstash、Kibana技术栈的结合,一个通用的架构如下图所示: Elasticsearch部署 Elasticsearch首先需要Java环境,所以需要提前安装好JDK,可以直接使用yum安装。也可以从Oracle官网下载JDK进行安装。开始之前要确保JDK正常安装并且环境变量也配置正确:安装JDK [root@linux-node1~]#yuminstall-yjava [root@linux-node1~]#java-version openjdkversion"1.8.0_65" OpenJDKRuntimeEnvironment(build1.8.0_65-b17) OpenJDK64-BitServerVM(build25.65-b01,mixedmode) YUM安装ElasticSearch 1.下载并安装GPG key [root@hadoop-node1~]#rpm--import[url]https://packages.elastic.co/GPG-KEY-elasticsearch[/url] 2.添加yum仓库 [root@hadoop-node1~]#vim/etc/yum.repos.d/elasticsearch.repo[elasticsearch-2.x] name=Elasticsearchrepositoryfor2.xpackages baseurl=http://packages.elastic.co/ela...entosgpgcheck=1 gpgkey=http://packages.elastic.co/GPG-KEY-elasticsearchenabled=1 3.安装elasticsearch [root@hadoop-node1~]#yuminstall-yelasticsearch LogStash部署与配置 和Elasticsearch一样,在开始部署LogStash之前也需要你的环境中正确的安装的JDK。可以下载安装Oracle的JDK或者使用 yum安装openjdk。安装JDK [root@linux-node1~]#yuminstall-yjava[root@linux-node1~]#java-version openjdkversion"1.8.0_65" OpenJDKRuntimeEnvironment(build1.8.0_65-b17) OpenJDK64-BitServerVM(build25.65-b01,mixedmode) YUM部署LogStash 1.下载并安装GPG key [root@linux-node2~]#rpm--importhttps://packages.elastic.co/GPG-KEY-elasticsearch 2.添加yum仓库 [root@linux-node2~]#vim/etc/yum.repos.d/logstash.repo[logstash-2.3] name=Logstashrepositoryfor2.3.xpackages baseurl=https://packages.elastic.co/logstash/2.3/centosgpgcheck=1 gpgkey=https://packages.elastic.co/GPG-KEY-elasticsearchenabled=1 3.安装logstash [root@linux-node2~]#yuminstall-ylogstash Kibana简介 Kibana 是为 Elasticsearch 设计的开源分析和可视化平台。你可以使用 Kibana 来搜索,查看存储在 Elasticsearch 索引中的数据并与之交互。你可以很容易实现高级的数据分析和可视化,以图表的形式展现出来。Yum安装Kibana 1.下载并安装GPG key [root@linux-node2~]#rpm--importhttps://packages.elastic.co/GPG-KEY-elasticsearch 2.添加yum仓库 [root@test~]#vim/etc/yum.repos.d/kibana.repo [kibana-4.5] name=Kibanarepositoryfor4.5.xpackages baseurl=http://packages.elastic.co/kibana/4.5/centosgpgcheck=1 gpgkey=http://packages.elastic.co/GPG-KEY-elasticsearchenabled=1 3.安装kibana [root@test~]#yuminstall-ykibana 使用Cobbler创建ELKStack仓库 当然生产环境,肯定不能使用外网的YUM仓库,可以使用Cobbler来创建自己的yum仓库。 [root@log-node1~]#cobblerrepoadd--name=logstash-2.3--mirror=http://packages.elastic.co/logstash/2.3/centos--arch=x86_64--breed=yum [root@log-node1~]#cobblerrepoadd--name=elasticsearch2--mirror=http://packages.elastic.co/ela...entos--arch=x86_64--breed=yum [root@log-node1~]#cobblerrepoadd--name=kibana4.5--mirror=http://packages.elastic.co/kibana/4.5/centos--arch=x86_64--breed=yum [root@log-node1~]#cobblerreposync 本文转自 蜗牛远途 51CTO博客,原文链接:http://blog.51cto.com/ywliyq/1959537

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册