首页 文章 精选 留言 我的

精选列表

搜索[what],共2558篇文章
优秀的个人博客,低调大师

What is Apache Hadoop?

本文来自:自译+百度Apache Hadoop 是一款可靠、可升级、分布式计算的开源软件。Apache Hadoop 的开源软件库是专门为处理跨大数据簇而设计的处理模型族。它主要被设计用来按比例从一个到成千上万的无服务平均的分配计算任务和内存。而不是依靠硬件提供高可用性,库本身的目的是检测和处理应用层的故障,因此再一组计算机上提供高可用性服务,每一台计算机都容易出现故障。这个项目包括这些模型:Hadoop Common:支持其它Hadoop模块的通用实用程序。 Hadoop Distributed File System(HDFS):提供对应用程序数据的高通量访问的分布式文件系统。Hadoop YARN:作业调度与集群资源管理框架。 Hadoop MapReduce:基于线性的大数据量并行处理系统。Apache 中的其它与Hadoop相关的项目包括:Ambari:一个基于网络的工具、配置、管理、监控Apache的Hadoop集群包括Hadoop HDFSHiveHCatalogHBaseZooKeeperOoziePig and Sqoop.Ambari还提供了一个仪表板查看集群健康如热图和查看MapReduce能力,Pig和Hive应用视觉和功能,一个用户友好的方式其性能诊断。Avro:数据序列化系统。Cassandra:无单点故障的可扩展多主数据库。ChukWa:一个用于管理大型分布式系统的数据采集系统。HBase:一个可扩展的,支持结构化数据存储的大型分布式数据库。Hive:数据仓库的基础设施,提供数据汇总和专案查询。Mahout:一个可扩展的机器学习和数据挖掘库。Pig:高级数据流语言和执行框架的并行计算。Spark:快速和通用计算的Hadoop数据引擎。Spark提供了一个简单而富有表现力的比那成模型,支持多种应用,包括ETL, 机器学习,数据流处理,图形计算。Tez:广义数据流变成框架,建立在Hadoop之上,他提供了一个强大灵活的引擎来执行任务的任意DAG为批处理和交互式的使用情况数据的过程。Tez采用Hadoopd的生态系统,在Pig等框架和其它的商业软件中渠道MapReduce Hadoop作为执行表的存在。ZooKeeper:分布式应用的高性能的协调服务。

优秀的个人博客,低调大师

What is Citrix X1

最近接触Citrix比较多的用户和合作伙伴应该会经常听到X1这个新词。那X1是什么! 现阶段大家可能听得比较多的是X1鼠标。一款在Citrix 的虚拟化平台中专用的蓝牙鼠标。在使用Citrix虚拟桌面XenDesktop、应用XenApp亦或其他Citrix的一些产品Gotomypc,ShareConnect,WorxDesktop时,专门用来解决那些在iOS设备由于不能接入鼠标而导致Windows应用在iOS设备上触控使用体验不好的问题。毕竟操作Windows应用还是键盘、鼠标来的靠谱啊!您说是吗? 这样,一款iOS设备+Citrix虚拟产品+X1鼠标+蓝牙键盘,就可以作为真正的移动办公平台,携带一台iPad走天下将不是梦。详情,大家可以观看如下视频: http://v.youku.com/v_show/id_XODc3NTkyMDQ4.html 那这就是X1全部吗?回答当然是:No 过去的两年Citrix一直在提一个叫Mobile Workspace的概念。在这个概念中目标是让用户可以将所有的设备,比如Windows、MAC、iOS、Android等各种设备的统一接入,而且无论是传统的Windows应用还是新型的原生应用iOS/Android都能统一进行管理。同时,提供企业级的网盘方便用户随时读取、存取数据,在线会议系统,方便企业员工之间的随时沟通。核心的目的是让企业用户可以随时随地使用任意的设备合规的访问企业各种IT资源,提高生产效率。 而在目前的架构中,对于用户来说,访问Windows虚拟应用、桌面需要,终端设备需要装Receiver,移动设备管理、原生应用推送则需要使用WorxHome。在普通用户看来安装两个客户端是一件很麻烦的事情,对于用户来说越简单、需要接入的事情越少越好。 所以Citrix做出一个决定,对于Receiver和Worxhome,进行整合,将两者合并为一个统一的Agent方便用户的使用。并对包括Web页面UI、新Agent UI、各种终端设备上的UI进行完全的统一。而且做到后台管理员对于Agent的UI配置、LOGO更新,前端是所有客户端都推送更新。这样对于企业级用户来说,其统一特性的门户UI在任何终端上都保持一致。 这才是我认为的Citrix X1 project。 而经过一年的潜心研发,Citrix X1已经发布了数个X1相关的产品的TP: 包括最新的Citrix StoreFront 3.0,Windows、MAC、Linux版本,以及HTML5版本、ChromApp版本的Receiver X1。都可以通过如下地址下载: https://www.citrix.com/downloads/storefront-web-interface/betas-and-tech-previews/citrix-receiver-and-storefront-30-technology-preview.html 对于X1版的StoreFront,整个界面显得更加清新; 登陆进去将桌面、应用以及收藏夹有机的整合。 而且对应应用可以分组归纳,方便提醒用户使用。 而在终端设备上配置好Receiver,其界面与Web方面几乎完全一样,这样可以大幅度减少最终用户培训成本。 而对于管理员来说可以通过如下的方式来直接修改StoreFront3.0的包括外观配色、企业logo在内的各项参数。当然如果您是一个站点开发人员,使用CSS则您的可调整余地会更大。 详情见Citrix官方Blog: X1 Customization: Going deeper with CSS http://blogs.citrix.com/2015/03/12/x1-customization-going-deeper-with-css/?utm_source=feedburner&utm_medium=feed&utm_campaign=Feed%3A+CitrixBlogs+%28Citrix+Blogs%29 这里我们只提到了Windows、MAC、Linux3款桌面操作系统级别的新版Receiver,那移动设备的就没有了吗?当然不是,作为Mobile Workspace的重要接入终端,iOS、Android以及未来的Windows 10 Mobile我们都会逐步推出,尽情期待哦! 本文转自sesame.qian 51CTO博客,原文链接:http://blog.51cto.com/kaiqian/1652259,如需转载请自行联系原作者

优秀的个人博客,低调大师

Elasticsearch学习笔记(一)之what?

一句话介绍 Elasticsearch 是一个分布式、RESTful 风格的搜索和数据分析引擎,能够解决不断涌现出的各种用例。作为 Elastic Stack 的核心,它集中存储您的数据,帮助您发现意料之中以及意料之外的情况。---摘自官方文档 他的父亲 Elasticsearch 的前世或者父亲应该可以说是Lucene。它是基于Java开发并且开源,目前被认为性能最好的全文检索引擎,但是它并不能直接拿来用或是对外提供服务。它本质上只是一个工具包,需要对它进行二次封装。目前基于Lucene组件的全文搜索应用有两个:Solr和Elasticsearch 。 他的兄弟 他的老大哥solr也是基于Lucene,2007发布第一版,作为企业级应用的全文检索服务,solr曾经也是风云一时。2010年,一个程序员为让他的妻子能够方便检索菜谱而开发的全文搜索服务横空出世,顺应大数据时代的潮流,他以其分布式,大数据量方面的处理优势迅速占领一席之位。Elasticsearch发展至今风头甚至可以说已经盖过了他曾经的老大哥solr。 兄弟PK 那么,到底是选择 Solr 还是 Elasticsearch?有时很难找到明确的答案。无论您选择 Solr 还是 Elasticsearch,首先需要了解正确的用例和未来需求,总结它们的每个属性。 记住下面这些要点: 由于易于使用,Elasticsearch 在新开发者中更受欢迎。但是,如果您已经习惯了与 Solr 合作,请继续使用它,因为迁移到 Elasticsearch 没有特定的优势。如果除了搜索文本之外还需要它来处理分析查询,Elasticsearch 是更好的选择。如果需要分布式索引,则需要选择 Elasticsearch。对于需要良好可伸缩性和性能的云和分布式环境,Elasticsearch 是更好的选择。两者都有良好的商业支持(咨询,生产支持,整合等)。两者都有很好的操作工具,尽管 Elasticsearch 因其易于使用的 API 而更多地吸引了 DevOps 人群,因此可以围绕它创建一个更加生动的工具生态系统。Elasticsearch 在开源日志管理用例中占据主导地位,许多组织在 Elasticsearch 中索引它们的日志以使其可搜索。虽然 Solr 现在也可以用于此目的,但它只是错过了这一想法。Solr 仍然更加面向文本搜索。另一方面,Elasticsearch 通常用于过滤和分组,分析查询工作负载,而不一定是文本搜索。Elasticsearch 开发人员在 Lucene 和 Elasticsearch 级别上投入了大量精力使此类查询更高效(降低内存占用和 CPU 使用)。因此,对于不仅需要进行文本搜索,而且需要复杂的搜索时间聚合的应用程序,Elasticsearch 是一个更好的选择。Elasticsearch 更容易上手,一个下载和一个命令就可以启动一切。Solr 传统上需要更多的工作和知识,但 Solr 最近在消除这一点上取得了巨大的进步,现在只需努力改变它的声誉。在性能方面,它们大致相同。我说“大致”,因为没有人做过全面和无偏见的基准测试。对于 95% 的用例,任何一种选择在性能方面都会很好,剩下的 5% 需要用它们的特定数据和特定的访问模式来测试这两种解决方案。从操作上讲,Elasticsearch 使用起来比较简单,它只有一个进程。Solr 在其类似 Elasticsearch 的完全分布式部署模式 SolrCloud 中依赖于 Apache ZooKeeper,ZooKeeper 是超级成熟,超级广泛使用等等,但它仍然是另一个活跃的部分。也就是说,如果您使用的是 Hadoop,HBase,Spark,Kafka 或其他一些较新的分布式软件,您可能已经在组织的某个地方运行 ZooKeeper。虽然 Elasticsearch 内置了类似 ZooKeeper 的组件 Xen,但 ZooKeeper 可以更好地防止有时在 Elasticsearch 集群中出现的可怕的裂脑问题。公平地说,Elasticsearch 开发人员已经意识到这个问题,并致力于改进 Elasticsearch 的这个方面。如果您喜欢监控和指标,那么使用 Elasticsearch,您将会进入天堂。这个东西比新年前夜在时代广场可以挤压的人有更多的指标!Solr 暴露了关键指标,但远不及 Elasticsearch 那么多。总之,两者都是功能丰富的搜索引擎,只要设计和实现得当,它们或多或少都能提供相同的性能。

优秀的个人博客,低调大师

What's new in Pika v3.5.2

Pika 社区近期发布了备受期待的 v3.5.2 版本 https://github.com/OpenAtomFoundation/pika/releases/tag/v3.5.2-alpha ,不仅解决了历史遗留的 Bug问题,还引入了多项新特性。这些新特性主要包括 Pika 支持 Redis 事务、Pika 上层增加缓存层实现冷热数据分离、提升读性能、Codis-Proxy 支持动态修改配置参数等等,无疑将会让用户感受到更为高效和稳定的使用体验。 1 新特性 Pika 支持 Redis 事务,使得 Pika 的数据够在一系列命令的执行中保持数据的一致性和可靠性 https://github.com/OpenAtomFoundation/pika/pull/2124 Pika 上层增加缓存层实现冷热数据分离,提升读性能 https://github.com/OpenAtomFoundation/pika/pull/2171 Codis-Proxy 支持动态修改配置参数,方便我们做参数调整 https://github.com/OpenAtomFoundation/pika/pull/2110 补全 Go Test 测试用例 https://github.com/OpenAtomFoundation/pika/pull/2082 CI 增加 cache 提升编译速度 https://github.com/OpenAtomFoundation/pika/pull/2093 增加 redis-copy 流量复制工具 https://github.com/OpenAtomFoundation/pika/pull/2060 2 bugfix 修复 pika 在使用 SETRANGE 命令出现 coredump的问题 https://github.com/OpenAtomFoundation/pika/pull/2141 修复因删除 Clearreplicationid 写进 binlog 导致的全量复制问题 https://github.com/OpenAtomFoundation/pika/pull/2135 修改锁粒度,提升 pika 写 binlog 的性能 https://github.com/OpenAtomFoundation/pika/pull/2129 修复复杂数据类型成员变量可能出现数据溢出 https://github.com/OpenAtomFoundation/pika/pull/2106 修复 decr 命令返回值错误问题 https://github.com/OpenAtomFoundation/pika/pull/2092 修复 setrange 和 setbit 命令没有保留原 key 的过期时间的问题 https://github.com/OpenAtomFoundation/pika/pull/2095 3 下期版本规划 预计再过两个月左右,我们会在农历新年前发布 3.5.3 版本,相关关键特性有: Pika 通过快慢命令分离提升读写性能 https://github.com/OpenAtomFoundation/pika/pull/2162 Redis ACL,在 Pika 中引入用户概念,进行权限控制 ttps://github.com/OpenAtomFoundation/pika/pull/2013 Redis Stream,实现消息队列 ttps://github.com/OpenAtomFoundation/pika/pull/1955 Pika 特有命令 compactrange,对指定范围内的 key 进行 compact,以解决大key删除时读放大的问题 ttps://github.com/OpenAtomFoundation/pika/pull/2163 支持 lastsave 指令 https://github.com/OpenAtomFoundation/pika/pull/2167 4 致谢 向社区的贡献者们致谢。 感谢大家对 Pika 开源公众号的关注 ,Pika 3.5 版本重大特性及使用规范我们会在稍后的文章中进行介绍,我们下期再见~

优秀的个人博客,低调大师

What's new in Arana v0.2.0

Arana 定位于云原生数据库代理,它可以以 sidecar 模式部署为数据库服务网格,项目地址是 https://github.com/arana-db/arana 。Arana 提供透明的数据访问能力,当用户在使用时,可以不用关心数据库的“分片”细节,像使用单机 MySQL 数据库一样使用 Arana。 在这个秋高气爽的季节,Arana 社区很高兴的宣布,经过社区 47 位贡献者一年多的努力,我们正式发布了 0.2.0 版本。该版本不仅做了很多优化工作,修复了一些 bug,还引入了多项新功能。这些新功能包括 配置中心支持 watch 机制动态监听配置变更,支持可视化的 admin 配置管理后台,对数据库表的 sharding 能力进一步增强,支持更丰富的 DDL 语句,同时支持影子表特性,方便进行数据库压测工作,这些能力将会为用户提供更为稳定和高效的使用体验。 1. 新特性 支持配置中心 watch 机制,可以将修改的配置信息实时推送到 Arana,确保更新配置及时生效 PR 347 作者:chuntaojun; 配置中心支持使用 Nacos 中间件 PR 659 作者:Mulavar; 支持可视化 admin 配置管理后台 PR arana-ui/1 作者:GavinLam164; 对已有数据库表 sharding 特性进行增强,sequence 支持段模式 PR 400 作者:Mulavar、多字段片键支持 PR 681 作者:jjeffcaii; 优化 SQL 函数执行器,将 javascript 函数执行方案转换成 Go 语言原生实现方案,提升函数代码实现可维护性 Issue 454 作者:Charlie17Li、gongna-au、mengchuang123、baerwang、raspberry-hu、JasonZhang95、csynineyang、PangXing 等等; 支持更丰富的 DDL 语句操作,包括:create/drop table PR 653 作者:csynineyang、alter table PR 184 作者:PangXing、create/drop index PR 254 作者:cjphaha; 主持影子表特性,方便进行数据库压测工作 PR 412 作者:csynineyang、PR 433 作者:PangXing、PR 405 作者:csynineyang、PR 363 作者:Lvnszn、PR 303 作者:Lvnszn; 支持 MySQL 8.0 版本 PR 450 作者:jjeffcaii; 2. Bug 修复 修复 select 语句中当 table 不存在时导致的应用崩溃 PR 693 作者:gongna-au; 修复并发更新数据时导致的数据库连接泄露 PR 669 作者:jjeffcaii; 修复空查询结果返回值,参照 MySQL 规范 PR 654 作者:jjeffcaii; 修复 etcd 作为配置中心是出现的 too large lease TTL 错误 PR 651 作者:PangXing; 修复 use 语句执行结果出现 Unknown database 错误 PR 618 作者:jjeffcaii; 修复配置中心 watch event 机制导致的启动异常 PR 589 作者:PangXing; 修复使用 jdbc 连接 arana 时出现 Unknown system variable 'query_cache_size' 错误 PR 357 作者:csynineyang; 修复 index 不存在时,show index 语句返回信息异常 PR 372 作者:jjeffcaii; 3. 未来规划 随着 0.2.0 版本的发布,Arana 社区 0.3.0 版本的功能特性进行了规划,在 0.3.0 版本中我们规划如下几个重大特性功能: 实现跨数据库实例的 join 能力,完善不同数据库表之间的连接查询能力; 实现基于 XA 的分布式事务能力; 实现 shardingless 能力,向上层用户屏蔽分库分表细节,降低用户学习使用成本。 以上就是在 0.3.0 中规划的新特性,大家敬请期待。 如果你对 arana 产品或者这个开源项目感兴趣,欢迎扫描上面二维码或者微信搜索 PikiwiDB 加为好友,并备注 “加入 Arana”,它会拉你加入 Arana 微信交流群。

优秀的个人博客,低调大师

What's new in Pika v3.5.1

Pika 社区很高兴宣布,我们今天发布已经过我们生产环境验证 v3.5.1 版本 https://github.com/OpenAtomFoundation/pika/releases/tag/v3.5.1 。 该版本不仅做了很多优化工作,还引入了多项新功能。这些新功能包括 动态关闭WAL、ReplicationID 检测是否增量复制、在 K8s 环境上 Pika 服务的自动注册从而实现集群的自组织、以及 exporter 检测集群指标等等,无疑将会让用户享受到更为稳定和高效的 NoSQL 使用体验。 1 新特性 1 Slow log 增加队列等待时间统计,在队列阻塞的时候方便我们进行问题定位。PR 1997, 作者 wangshao1。 2 主从复制使用 ReplicationID 判断是否进行增量同步,解决原主从同步方式切主后整个数据集会进行全量复制的问题,可以提升 Pika 性能。PR 1951, 作者 Mixficsol。 3 WAL 以 'disablewal' 命令方式支持动态关闭,在写性能遇到瓶颈的时候,可以通过命令关闭 WAL 缓解写性能下降的问题,关闭 WAL 有机器宕机后丢失数据的风险,用户需要根据自己的使用习惯权衡。PR 2015,作者 Mixficsol。 4 flush 线程数和 compaction 线程数合二为一,在 Compaction 性能瓶颈时,可以动态调整线程数,缓解 Comapction 损耗 Pika 性能的问题。PR 2014, 作者 Tianpingan。 5 升级了 RocksDB 版本到 v8.3.3。PR 2000, 作者 dingxiaoshuai123。 6 新增周期性打印工作队列的长度功能,在队列阻塞的时候可以快速定位问题。PR 1978, 作者 Tianpingan。 7 新增利用一个pika_exporter监测整个集群的指标,实现一个 Pika Exporter 实例监控整个集群,解决了 3.5.0 版本一个Pika Exporter 监测一个 Pika 实例消耗资源的问题。PR 1953, 作者 chenbt-hz。 8 实现在 K8s 环境上 Pika 服务的自动注册,在启动时自动注册,从而实现集群的自组织 ,实现了通过命令拉起整个 Pika Cluster 集群。PR 1931, 作者 machinly。 2 bug 修复 1 调整了 Rate_limit 参数,修复了压测时出现 RPS 为 0 的情况 。PR 2009, 作者 Mixficsol。 2 修复了 INFODATA 命令中对于遍历数据文件时出现空路径的逻辑判断。PR 1996, 作者 Mixficsol。 3 修复了 Codis 在线上出现大毛刺的问题。PR 2016, 作者 chejinge。 4 修复了 macOS 环境下编译使用 tools 导致编译不过的问题 。PR 2011, 作者 A2ureStone。 5 减少了 exporter 非必要日志的打印,降低 了资源利用率。PR 1945, 作者 Mixficsol。 3 使用建议 本次新增了几个配置参数,大家在使用过程中,需要根据使用情况按需调整: 1 max-rsync-parallel-num:主从全量复制线程数,需要根据自己机器CPU核数和部署实例个数进行调整,建议最小设置为2。 2 rate-limiter-bandwidth:限制 RocksDB 数据库读写速度,限制数据库在一定时间内可以读写的数据量,默认 2000MiB/s,需要根据自己的机器性能和部署实例做调整。 max-background-jobs: compaction 和 flushdb 线程数,要根据自己机器 CPU 核数和部署实例个数进行调整,建议最小设置为 4。 3 throttle-bytes-per-second:主从复制传输限速参数,默认为 200MiB/s,该参数可以根据机器网卡的配置及部署 pika 实例的个数进行调整。

优秀的个人博客,低调大师

What's new in Pika v3.5.0

时隔两年,Pika 社区正式发布经由社区 50 多人参与开发并在 360 生产环境验证可用的 v3.5.0 版本,新版本在提升性能的同时,也支持了 Codis 集群部署,BlobDB KV 分离,增加 Exporter 等新特性。 我们将详细介绍该版本引入的重要新特性。 1 去除 Rsync 在 v3.5.0 版本之前,Pika 使用 Rsync 工具进行引擎中存量数据的同步,Pika 进程启动时创建 Rsync 子进程。这种同步方式在实际使用中出现了一些问题,包括Pika 进程 crash 后重新拉起无法正常同步以及同步过程中 Rsync 进程无故退出等。在今年发布的 v3.5.0 版本中,我们在全量同步方案方面进行了重要的改进,摒弃了以往使用的 Rsync,实现了全新的数据同步方案,支持了断点续传,动态调节传输限速等特性,以确保同步过程更加稳定、可控。这些改进不仅增强了同步的可靠性,还为用户提供了更好的使用体验。 去除 Rsync 进程,使用自研全量同步方式 实现断点续传,传输限速功能 Pika 主从同步时,进行 master run_id 的检验 2 兼容更多 Redis 命令 在 v3.5.0 版本中,我们迈出了更大的一步,提升了对 Redis 命令的兼容性,对 Redis 命令提供了更广泛的支持。这个版本的改进使得 Pika 在与 Redis 生态系统的集成中表现更加出色,为用户提供了更丰富的功能和更广阔的可能性。我们对命令支持的扩展,为用户提供了更多的灵活性,以满足不同场景下的需求。 支持 UNLINK 命令 支持 INFO COMMANDSTATS 命令 支持 HELLO、SETNAME 命令 支持 BLPOP、BRPOP 命令 新增 Pika 原创 DISKRECOVERY 命令 3 RocksDB 版本升级和分级压缩 在 v3.5.0 版本中,我们进行了一项重要的升级,将 RocksDB 引擎升级至 v8.1.1 版本,并实现了分级压缩功能的整合。这一升级不仅是技术的飞跃,也是我们对系统性能和优化的持续关注的体现。通过这项升级,我们为 Pika 增加了更高级别的数据管理能力,同时也让系统更好地适应不同的压缩需求,为用户的数据存储和检索提供了更大的灵活性和效率。 升级 RocksDB 版本到 v8.1.1 实现 RocksDB 分级压缩 新增 RocksDB 缓存配置项 num-shard-bits 能够从配置文件中读取 4 支持 BlobDB 在 v3.5.0 版本中,我们引入了引人瞩目的创新--对 BlobDB 和 KV 存储层进行了分离,为我们的系统注入了新的活力。这个版本的升级使得 Pika 在数据存储方面更加灵活和高效。我们通过支持 BlobDB KV 分离,提供了更优化的数据存储结构,为用户的数据管理和查询操作带来了更深层次的优势。这一重要改进将在更多应用场景下展现出其强大的潜力。 支持 BlobDB KV 分离 5 基于 Codis 的集群模式 在 v3.5.0 版本中,我们积极引入了 Codis 集群模式,此外,我们不仅仅将 Codis 集群模式融入了系统中,还为其提供了迁移 slot 的命令支持,从而实现了更加智能化的集群管理。这一重大变革不仅扩展了 Pika 在大规模数据存储场景中的应用范围,还进一步提升了系统的可扩展性和高可用性。通过引入 Codis 集群模式,我们对用户的数据处理和管理提供了更优化的解决方案。 引入 Codis 到 Pika 引入 Codis 的 CI 支持 Codis 迁移 slot 命令 新增是否在 reload 的 slotmigrate 状态 6 可观测性 在 v3.5.0 版本中,我们引入了一个创新性的工具--pika_exporter,以提升对 Pika 数据库的可观测性。这一工具的加入不仅是对我们对系统监测能力的持续增强的反映。而在版本的后续更新中,我们进一步充实了指标,不断丰富了 Pika 的可观测性。为用户提供了更为全面和精准的数据洞察力。 新增 Pika 可观测系统 pika_exporter 新增网络 I/O 流量监控指标 新增命令统计耗时指标 新增 estimate_pending_compaction_bytes 度量来分析碎片率指标 新增 RocksDB 指标 7 容器化部署 在 v3.5.0 版本中,我们引入了一个具有创新意义的里程碑--pika-operator mvp 版本,这一版本在技术上实现了一个重要目标:将 Pika 单实例服务迁移到 Kubernetes(K8s)平台上的快速部署。这不仅是对我们持续关注行业发展的体现,也是我们不断提升用户体验的追求。通过 pika-operator,我们为用户提供了更便捷的部署方案,将 Pika 的高性能数据库引擎与 Kubernetes 的灵活性相融合,从而为用户的应用环境带来更高效、更弹性的支持。 实现 Pika 单例服务在 K8s 上快速部署 实现了在 MiniKube 环境中部署 Pika 给 pika-operator 添加 E2E 测试 8 跨平台编译 在 v3.5.0 版本中,Pika 呈现出一种全面性的蓬勃发展态势,得以在不同操作系统平台上展现其优越性。此版本的突破性之处在于,Pika 实现了对 MacOS、CentOS 和 Ubuntu 这些主要平台的完整编译和使用支持。这个举措不仅仅体现了我们对多样化技术环境的关注,也是为了最大程度地拓展用户基础,为广泛的用户群体提供灵活、高效的数据库解决方案。这种跨平台兼容性的加强将 Pika 推向更广阔的技术生态。 支持 MacOS 平台 9 多平台 CI、Go 集成测试、TCL 单元测试、PythonE2E 测试、CTest 单元测试 在 v3.5.0 版本中,我们迈出了一个令人瞩目的步伐,不仅在多个主要操作系统平台上实现了支持,还在测试领域实施了全面升级。我们为 Ubuntu、CentOS 和 MacOS 这三大平台搭建了持续集成(CI)环境,以确保系统的完整性和稳定性。在测试方面,我们引入了更为广泛的覆盖,包括 Go 语言的集成测试、TCL 的单元测试以及 Python 的端到端(E2E)测试。通过这些测试策略的升级,我们在确保系统性能和可靠性方面迈出了更大的一步。 新增 CentOS 环境下的 CI 新增 MacOS 环境下的 CI 新增 E2E 测试框架 新增在 Github CI Workflow 中添加 CMake 编译环境 新增在 TCL 脚本中 populate 方法模拟 Redis debug populate 方法,用以填充测试数据 新增在 blackwidow 中添加 CMake 文件,添加对 blackwidow 的单元测试 移植 Redis 测试脚本 10 Others 若您有任何疑问,诚挚欢迎您扫描微信二维码,加入我们的交流群,与一众志同道合的成员展开深入的讨论,我们热切期待与您分享见解、交流心得,为共同的技术探索和创新之旅添砖加瓦。在这个群体中,我们将以卓越的智慧和互动的合作精神,构建出一个相互学习、不断进步的技术共同体。

优秀的个人博客,低调大师

what's new in dubbogo v1.5.6

作者 | 铁城dubbo-go 社区 committer dubbogo 社区近期发布了 dubbogo v1.5.6。该版本和 dubbo 2.7.8 对齐,提供了命令行工具,并提供了多种加载配置的方式。相关改进实在太多,本文只列出相关重大 feature 和性能提升项。 1. 命令行工具 熟悉dubbo的朋友可能知道 dubbo 支持 telnet 命令行在线调试。 本次发布也增加了 dubbo-go 的 cli 命令行工具,可以方便用户直连特定服务,通过编写 json 文件来定义传输结构和数据,发起调用进行在线调试,打印返回数据和耗时情况。 目前支持嵌套 struct,但是只支持单个参数的请求包和回包。数据类型由于需要在 json 中定义,只支持 golang 基本数据类型:字符串、整形、浮点。 社区后续会再发一篇文章,着重讲解其原理和实现。相关 pr 为 https://github.com/apache/dubbo-go/pull/818 由 dubbogo 最年轻的 00 后 apache committer 李志信同学实现。 2. 代理实现扩展 重构 Proxy,添加 ImplementFunc 函数,允许项目对 Proxy 的代理进行重新实现。在使用 ProxyFactory 自定义注册的场景下,创建的 proxy.Proxy 也自定义实现,可以对返回数据进行修改。主要应用场景为在网关泛化调用场景下。懂得的人自然懂。相关 pr https://github.com/apache/dubbo-go/pull/1019 由本文作者亲自操刀。 3. 启动时指定配置文件的路径 用户使用之前版本的 dubbogo 时,一直吐槽其只提供环境变量的方式,加载指定的配置文件。 exportCONF_PROVIDER_FILE_PATH="../profiles/dev/server.yml"exportCONF_CONSUMER_FILE_PATH="../profiles/dev/server.yml"exportAPP_LOG_CONF_FILE="../profiles/dev/log.yml" v1.5.6 提供了新的配置文件加载接口:在启动命令行通过 proConf、conConf、logConf三个 flag 设定配置文件路径。 服务提供方: gorun.-proConf../profiles/dev/server.yml-logConf../profiles/dev/log.yml 服务消费方: gorun.-conConf../profiles/dev/client.yml-logConf../profiles/dev/log.yml 相关 pr https://github.com/apache/dubbo-go/pull/1039 由南京信息工程大学大三学生 陈家鹏实现。 4. 自定义加载 ServerConfig 和 ReferenceConfig 新增 ConfigPostProcessor 接口,用户可以依据该接口提供两个的方法,在部署 dubbogo 服务时加载自定义的配置。 // 服务提供方配置PostProcessServiceConfig(*common.URL)// 服务消费方配置PostProce***eferenceConfig(*common.URL) 相关 pr https://github.com/apache/dubbo-go/pull/943 由即将奔五十的 dubbo chairman 北纬亲自操刀实现,chairman 同志老当益壮,号召大家向 chairman 筒子学习。 5. 扩展URL 的比较 在common/url.go里面提供 CompareURLEqualFunc,可以让用户自定义 URL 比较,提高比对效率。相关技术细节见如下链接。 common/url.go: https://github.com/apache/dubbo-go/pull/854/files#diff-5111f14762c010c3029a67743796fea97ab1015d35c96670a4cfa25f30145464 目前的 URL 实现并未达到最终状态。未来的 dubbogo 3.x 版本中,将借鉴 dubbo 的 URL 实现,将 common.URL 拆分为ServiceConfigURL、ServiceAddressURL和InstanceAddressURL,分别对应配置中心、注册中心和元数据中心的 schema,尽量将变更压力降低到最低粒度。该功能对应的prhttps://github.com/apache/dubbo-go/pull/854 由阿里双十一中间件大队长展图同学实现。展图同学一直奋战在编程一线。 6. 注册中心优化 复用了 zookeeper 链接以及优化了服务发现中心逻辑,大大减少了与 zookeeper 的 tcp 链接数目,减少了使用的 goroutine 数目,降低了 dubbo-go 的内存占用量。我们会把同样的逻辑服用到 nacos、etcd、consul 等各个注册中心,通过减少 goroutine 数目,减轻注册中心压力,并减少 consumer 和 provider 内存的使用。该功能对应的 pr https://github.com/apache/dubbo-go/pull/1010 由现在蚂蚁中间件工作的 王文学 同学在涂鸦工作时实现。 7.API 形式进行配置 以前版本的 dubbogo 只提供了从配置文件读取配置选项,该功能增加以 API 的方式进行配置,用户可以通过调用相关 API 初始化配置。用户可以通过 API 进行相关参数设定,无需再加载配置文件。可以参考示例:https://github.com/apache/dubbo-go-samples/tree/master/config-api相关 pr https://github.com/apache/dubbo-go/pull/1020 也是由李志信实现。 8.grpc 优化 打通 dubbo-go中 consumer config 的超时时间 connect_timeout 和 gRPC server 的超时时间,用户可以自定义 gRPC 超时时间机制。 # connect timeoutconnect_timeout: "3s"# application configapplication: organization: "dubbo.io" name: "GreeterGrpcConsumer" module: "dubbo-go greeter grpc client" version: "0.0.1" environment: "dev" 将处理注册中心服务变更事件的机制改为同步,防止 provider 端服务频繁重启导致上下线事件处理顺序出错。 使用 gRPC 协议时,异步等待 dubbo-go 的 service 都暴露完后,才将所有 dubbo-go service 对应的 gRPC service 注册到 gRPC server 上并启动 gRPC server。以此修复 provider 端的只能注册一个 service 的问题。 总体功能由 https://github.com/apache/dubbo-go/pull/1056 等多个 pr 构成,由 All In 了 dubbogo 的 上海识装信息科技有限公司【知名 APP 得物所在公司】工程师 柯瞻、 dubbogo 社区负责人 于雨、阿里工程师云兴 以及 南京某公司的张天同学 共同负责实现。 9.hessian2 go 最新 feature 除了 dubbo-go 自身的改进外,dubbo-go-hessian2 项目截止目前最新版本 v1.9.2 也做了如下重大改进: 内置支持 java.util.Locale:https://github.com/apache/dubbo-go-hessian2/pull/264 内置支持 java.util.UUID:https://github.com/apache/dubbo-go-hessian2/pull/256 支持编码 no pojo object:https://github.com/apache/dubbo-go-hessian2/pull/243 内置支持 java.sql.Time:https://github.com/apache/dubbo-go-hessian2/pull/219 内置支持 java.sql.Date:https://github.com/apache/dubbo-go-hessian2/pull/221 dubbo-go-hessian2: https://github.com/apache/dubbo-go-hessian2 总体 pr 由 dubbo-go-hessian2 项目负责人望哥、李志信、张艳明等同学完成。 10. 回顾与展望 dubbogo 目前处于一个比较稳定成熟的状态,1.5 版本会被持续维护,以修复 BUG 和进行一些必要的最低幅度的优化。更多信息:https://github.com/apache/dubbo-go/releases/tag/v1.5.6目前最新的朝云原生方向的发展3.0 版本基于 v1.5.x,在兼容 dubbo 3.0 的同时,将向后兼容 v2.7.x,计划于 4 月底发布第一个版本。如果你有任何疑问,欢迎钉钉扫码加入交流群【钉钉群号 31363295】: 作者简介 铁城 (Github ID cityiron),dubbo-go 社区 committer,主要参与 dubbo-go 1.5 版本迭代、 dubbo-go 3.0 服务路由和云原生方面工作、以及 dubbo-go-pixiu 项目负责人。目前就职于阿里盒马事业群,从事交易流程工作,擅长使用 Java/Go 语言,专注于云原生和微服务等技术方向。 在 PC 端登录 start.aliyun.com 知行动手实验室,沉浸式体验在线交互教程。

优秀的个人博客,低调大师

React v16.7 "Hooks" - What to Expect

什么是 Hooks? Hooks 是一个 React 函数组件内一类特殊的函数(通常以 “use” 开头,比如 “useState”),使开发者能够在 function component 里依旧使用 state 和 life-cycles,以及使用 custom hook 复用业务逻辑。 动机 在 React 里,function component 就是一个 pure render component,没有 state 和 component life-cycle。如果需要这两个中的任意一个,就需要变成 class component。在既有的 React API 下,这个模式有如下一些缺点: 组件间交流的耦合度很高,组件树臃肿 在既有的模式下,React 的组件间通信无非是两种,一种是单项数据流,另一种是通过 redux 之类的 global store 来实现全局状态和各组件间的解耦。当有些状态不适合放在 global store 的情况下,组件间逻辑的复用和沟通就变得十分困难(必须一层一层往下传)。这一点在 Higher order component (高阶组件) 和 render props 中尤其常见。我们为了复用一些逻辑,单独创造了很多 HOC(高阶组件) 来向下传递状态。这导致的问题就是当我们的应用规模变得越来越大的时候,一些无关 UI 的 wrapper 组件越来越多,React 组件树变得越来越臃肿(在 devtool 中可以甚至看到数十层 wrapper)。某些业务场景下,一个 Tooltip component 里面都嵌套了三四层额外的组件,使开发和调试的效率变得很低。 在新的 React hook 中,我们可以创建 custom hook,在其中复用一些逻辑,这些逻辑不再出现在组件树中,而是成为一个单独的,独立的逻辑单元,但是他们仍然响应 React 在渲染之间的变化。 JavaScript 的 class 产生的诸多疑惑 这一点是相对于 JavaScript 来说的。还记得刚入门 JavaScript 的时候,需要跨越的一个重要难关就是 ”this” 指向,以及原型链,继承这些问题。即使我们真正觉得明白了其中的原理,在日常的开发中也难免因为疏忽而踩坑,这一系列的问题导致新手相对比较难上手 React。举个简单的例子,React 组件内的 event listener 之前需要手动 bind this 的问题,这个问题就很难对一个 JavaScript 入门的新手解释明白。 而这一系列的问题,将在 Hook 中被极大地解决。如果没有 class,没有了 this,可能上述的种种问题都不再是问题了。 Write Hooks 说了这么多,Hooks API 是什么样呢?首先需要声明的是,Hooks 是向后兼容的,class component 不会被移除。作为开发者,可以慢慢迁移到这个新的 API。 Hooks 主要分为三种: ● State hooks (在 function component 中使用 state) ● Effect hooks (在 function component 中使用生命周期和 side effect) ● Custom hooks (自定义 hooks 用来复用组件逻辑,解决了上述的第一个动机中阐述的问题,这一部分就不在此多费篇幅介绍了,请大家移步文档)。 State hooks import { useState } from 'react';function Example() { // Declare a new state variable, which we'll call "count" const [count, setCount] = useState(0); return ( <div> <p>You clicked {count} times</p> <button onClick={() => setCount(count + 1)}> Click me </button> </div> );} 之前讲过 hook 本质是一个特殊的函数(通常以 “use” 开头)。在这里,”useState” 就是一个 hook,通过它我们能够嵌入组件内部的 state。这个函数返回一个 pair,第一个值是当前对应这个 hook 的 state 值,第二个是怎样更新这个值。 我们可以从中感觉到,这两个返回值分别对应的以前的用法是: ● this.state ● this.setState 除此之外,我们还可以在一个函数组件中使用多个 useState: function ExampleWithManyStates() { // Declare multiple state variables! const [age, setAge] = useState(42); const [fruit, setFruit] = useState('banana'); const [todos, setTodos] = useState([{ text: 'Learn Hooks' }]); // ...} 这给我们的一个非常大的好处就是我们能够避免组件的 state 结构过于臃肿(因为之前每个 component class 只能有一个 state),能够独立处理每个 state。另一个好处就是这种写法非常直观,一眼就可以看出和这个 state 相关的两个变量,比如 [age, setAge]。 Effect hooks import { useState, useEffect } from 'react';function Example() { const [count, setCount] = useState(0); // Similar to componentDidMount and componentDidUpdate: useEffect(() => { // Update the document title using the browser API document.title = `You clicked ${count} times`; }); return ( <div> <p>You clicked {count} times</p> <button onClick={() => setCount(count + 1)}> Click me </button> </div> );} 我们还需要解决一个问题,那就是怎样在 function component 里使用 life-cycles,生命周期函数。在这里,所有的 life-cycles,比如 componentDidMount, componentDidUpdate, shouldUpdate, 等等都集合成一个 Hook,叫做 useEffect。这个函数类似 redux 中的 subscribe,每当 React 因为 state 或是 props 而重新 render 的之后,就会触发 useEffect 里的这个 callback listener(在第一次 render 和每次 update 后触发)。 为什么叫 useEffect 呢?因为我们通常在生命周期内做的操作很多都会产生一些 side-effect(副作用)的操作,比如更新 DOM,fetch 数据,等等。 Other Built-in Hooks 除了 useState, useEffect 还有另外一些 React 自带的 hooks。比如: ● useContext 替代了 <Context.Consumer> 使用 render props 的写法,使组件树更加简洁。 ● useReducer 相当于组件自带的 redux reducer,负责接收 dispatch 分发的 action 并更新 state。 详细用法请看文档。 总结 读到这里,你可能理解了为什么这个新的 API 被叫做 “Hooks” 了。”Hooks” 本意是”钩子“的意思。在 React 里,hooks 就是一系列特殊的函数,使函数组件 (functional component) 内部能够”钩住“ React 内部的 state 和 life-cycles。 这个向后兼容的 API 在解决了一些既有问题的情况下,不仅使我们能够更好地使用 state 和 life-cycles,真正功能强大的地方是使我们能够更轻松地复用组件逻辑(custom hooks)。但是限于篇幅,很多功能强大的部分和一些注意事项在这篇文章里并没有过多讲解,请大家移步官方文档学习更详细的姿势(墙裂推荐)。 原文发布时间为:2018-11-02 本文作者:cyan 本文来自云栖社区合作伙伴“前端大学”,了解相关信息可以关注“前端大学”。

优秀的个人博客,低调大师

javascript基础修炼(3)—What's this(下)

开发者的javascript造诣取决于对【动态】和【异步】这两个词的理解水平。 这一期主要分析各种实际开发中各种复杂的this指向问题。 一. 严格模式 严格模式是ES5中添加的javascript的另一种运行模式,它可以禁止使用一些语法上不合理的部分,提高编译和运行速度,但语法要求也更为严格,使用use strict标记开启。 严格模式中this的默认指向不再为全局对象,而是默认指向undefined。这样限制的好处是在使用构造函数而忘记写new操作符时会报错,而不会把本来需要绑定在实例上的一堆属性全绑在window对象上,在许多没有正确地绑定this的场景中也会报错。 二. 函数和方法的嵌套与混用 词法定义并不影响this的指向 , 因为this是运行时确定指向的。 2.1 函数定义的嵌套 function outerFun(){ function innerFun(){ console.log('innerFun内部的this指向了:',this); } innerFun(); } outerFun(); 控制台输出的this指向全局对象。 2.2 对象属性的嵌套 当调用的函数在对象结构上的定义具有一定深度时,this指向这个方法所在的对象,而不是最外层的对象。 var IronMan = { realname:'Tony Stark', rank:'1', ability:{ total_types:100, fly:function(){ console.log('IronMan.ability.fly ,作为方法调用时this指向:',this); }, } } IronMan.ability.fly(); 控制台输出的this指向IronMan的ability属性所指向的对象,调用fly( )这个方法的对象是IronMan.ability所指向的对象,而不是IronMan所指向的对象。 this作为对象方法调用时,标识着这个方法是如何被找到的。IronMan这个标识符指向的对象信息并不能在运行时找到fly( )这个方法的位置,因为ability属性中只存了另一个对象的引用地址,而IronMan.ability对象的fly属性所记录的指向,才能让引擎在运行时找到这个匿名方法。 三. 引用转换 引用转换实际上并不会影响this的指向,因为它是词法性质的,发生在定义时,而this的指向是运行时确定的。只要遵循this指向的基本原则就不难理解。 3.1 标识符引用转换为对象方法引用 var originFun = function (){ console.log('originFun内部的this为:',this); } var ironMan = { attack:originFun }; ironMan.attack(); 这里的this指向其调用者,也就是ironMan引用的对象。 3.2 对象方法转换为标识符引用 var ironMan = { attack:function(){ console.log('对象方法中this指向了:',this); } } var originFun = ironMan.attack; originFun(); 这里的this指向全局对象,浏览器中也就是window对象。3.2中的示例被认为是javascript语言的bug,即this指向丢失的问题。同样的问题也可能在回调函数传参时发生,本文【第5章】将对这种情况进行详细说明。 四. 回调函数 javascript中的函数是可以被当做参数传递进另一个函数中的,也就有了回调函数这样一个概念。 4.1 this在回调函数中的表现 var IronMan = { attack:function(findEnemy){ findEnemy(); } } function findEnemy(){ console.log('已声明的函数被当做回调函数调用,this指向:',this); } var attackAction = { findEnemy:function(){ console.log('attackAction.findEnemy本当做回调函数调用时,this指向',this); }, isArmed:function(){ console.log('check whether the actor is Armed'); } } //1.直接传入匿名函数 IronMan.attack(function(){ console.log(this); }); //2.传入外部定义函数 IronMan.attack(findEnemy); //3.传入外部定义的对象方法 IronMan.attack(attackAction.findEnemy); 从控制台打印的结果来看,无论以哪种方式来传递回调函数,回调函数执行时的this都指向了全局变量。 4.2 原理 javascript中函数传参全部都是值传递,也就是说如果调用函数时传入一个原始类型,则会把这个值赋值给对应的形参;如果传入一个引用类型,则会把其中保存的内存指向的地址赋值给对应的形参。所以在函数内部操作一个值为引用类型的形参时,会影响到函数外部作用域,因为它们均指向内存中的同一个函数。详细可参考[深入理解javascript函数系列第二篇——函数参数]这篇博文。 理解了函数传参,就很容易理解回调函数中this为何指向全局了,回调函数对应的形参是一个引用类型的标识符,其中保存的地址直接指向这个函数在内存中的真实位置,那么通过执行这个标识符来调用函数就等同于this基本指向规则中的作为函数来调用的情况,其this指向全局对象也就不难理解了。 五. this指针丢失 在第三节和第四节中,通过原理分析就能够明白为何在一些特定的场合下this会指向全局对象,但是从语言的角度来看,却很难理解this为什么指向了全局对象,因为这个规则和语法的字面意思是有冲突的。 5.1 回调函数的字面语境 var name = 'HanMeiMei'; var liLei = { name:'liLei', introduce:function () { console.log('My name is ', this.name); } }; var liLeiSay = liLei.introduce; liLeiSay();//同第三节中的引用转换示例 setTimeout(liLei.introduce,2000);//同第四节中的回调函数示例 上面的代码从字面上看意义是很明确的,就是希望liLei立刻介绍一下自己,在2秒后再介绍一下他自己。但控制台输出的结果中,他却两次都说自己的名字是HanMeiMei。 5.2 this指针丢失 5.1中的示例,也称为this指针丢失问题,被认为是Javascript语言的设计失误,因为这种设计在字面语义上造成了混乱。 5.3 this指针修复 方式1-使用bind 为了使代码的字面语境和实际执行保持一致,需要通过显示指定this的方式对this的指向进行修复。常用的方法是使用bind( )生成一个确定了this指向的新函数,将上述示例改为如下方式即可修复this的指向: var liLeiSay = liLei.introduce.bind(liLei); setTimeout(liLei.introduce.bind(liLei),2000); bind( )的实现其实并不复杂,是闭包实现高阶函数的一个简单的实例,感兴趣的读者可以自行了解。 方式2-使用Proxy Proxy是ES6中才支持的方法。 //绑定This的函数 function fixThis (target) { const cache = new WeakMap(); //返回一个新的代理对象 return new Proxy(target, { get (target, key) { const value = Reflect.get(target, key); //如果要取的属性不是函数,则直接返回属性值 if (typeof value !== 'function') { return value; } if (!cache.has(value)) { cache.set(value, value.bind(target)); } return cache.get(value); } }); } const toggleButtonInstance = fitThis(new ToggleButton()); 两种修复this指向的思路其实很类似,第一种方式相当于为调用的方法创建了一个代理方法,第二种方式是为被访问的对象创建了一个代理对象。 六. this的透传 实际开发过程中,往往需要在更深层次的函数中获取外层this的指向。 常规的解决方案是:将外层函数的this赋值给一个局部变量,通会使用_this,that,self,_self等来作为变量名保存当前作用域中的this。由于在javascript中作用域链的存在,嵌套的内部函数可以调用外部函数的局部变量,标识符会去寻找距离作用域链末端最近的一个指向作为其值,示例如下: document.querySelector('#btn').onclick = function(){ //保存外部函数中的this var _this = this; _.each(dataSet, function(item, index){ //回调函数的this指向了全局,调用外部函数的this来操作DOM元素 _this.innerHTML += item; }); } 七. 事件监听 事件监听中this的指向情况其实是几种情况的集合,与代码如何编写有很大关系。 7.1 表现 1. 在html文件中使用事件监听相关的属性来触发方法 <button onclick="someFun()">点击按钮</button> <button onclick="someObj.someFun()">点击按钮</button> 如果以第一种方式触发,则函数中的this指向全局; 如果以第二种方式触发,则函数中的this指向someObj这个对象。 2. 在js文件中直接为属性赋值 //声明一个函数 function callFromHTML() { console.log('callFromHTML,this指向:',this); } //定义一个对象方法 var obj = { callFromObj:function () { console.log('callFromObj',this); } } //注册事件监听-方式1 document.querySelector('#btn').onclick = function (event) { console.log(this); } //注册事件监听-方式2 document.querySelector('#btn').onclick = callFromHTML; //注册事件监听-方式3 document.querySelector('#btn').onclick = obj.callFromObj; 以上三种注册的事件监听响应函数,其this均指向id="btn"的DOM元素。 3. 使用addEventListener方法注册响应函数 //低版本IE浏览器中需要使用另外的方法 document.querySelector('#btn').addEventListener('click',function(event){ console.log(this); }); //也可以将函数名或对象方法作为回调函数传入 document.querySelector('#btn').addEventListener('click',callFromHTML); document.querySelector('#btn').addEventListener('click',obj.callFromObj); 这种方式注册的响应函数,其this与场景2相同,均指向id="btn"的DOM元素。区别在于使用addEventListener方法添加的响应函数会依次执行,而采用场景2的方式时,只有最后一次赋值的函数会被调用。 7.2 基本原理 1. 通过标签属性注册 <button id="btn" onclick="callFromHTML()">点我</button> <script> function callFromHTML() { console.log(document.querySelector('#btn').onclick); } </script> 在html中绑定事件处理程序,然后当按钮点击时,在控制台打印出DOM对象的onclick属性,可以看到: 这种绑定方式其实是将监听方法包裹在另一个函数中去执行,相当于: document.querySelector('#btn').onclick = function(event){ callFromHTML(); } 这样上述的表现就不难理解了。 2. 通过元素对象属性注册 document在javascript中是一个对象,通过其暴露的查找方法返回的节点也是一个对象,那么方式二绑定的监听函数在运行时,实际上就是在执行指定节点的onclick方法,根据this指向的基本规则可知其函数体中的this应该指向调用对象,也就是onclick这个方法所在的节点对象。 3. 通过addEventListener方法注册 这种方式是在DOM2事件模型中扩展的,用于支持多个监听器绑定的场景。DOM2事件模型的描述中规定了通过这种方式添加的监听函数执行时的this指向所在的节点对象,不同内核的浏览器实现方式有区别。 7.3 使用建议 不同的使用方式实质上是伴随着DOM事件模型升级而发生改变的,现代浏览器对于以上几种模式都是支持的,只有需要兼容老版本浏览器时需要考虑对DOM事件模型的支持程度。开发中DOM2级事件模型中addEventListener()和removeEventListener()来管理事件监听函数是最为推荐的方法。 八. 异步函数 1. setTimeout( )和setInterval( ) 这里的情况相当于上文中的回调函数的情况。 2. 事件监听 详见第7章。 3. ajax请求 几乎没有遇到过。 4. Promise 这里的情况相当于上文中的回调函数的情况。 九. 箭头函数和this 箭头函数是ES6标准中支持的语法,它的诞生不仅仅是因为表达方式简洁,也是为了更好地支持函数式编程。箭头函数内部不绑定this,arguments,super,new.target,所以由于作用域链的机制,箭头函数的函数体中如果使用到this,则执行引擎会沿着作用域链去获取外层的this。 十. Nodejs中的this Nodejs是一种脱离浏览器环境的javascript运行环境,this的指向规则上与浏览器环境在全局对象的指向上存在一定差异。 1. 全局对象global Nodejs的运行环境并不是浏览器,所以程序里没有DOM和BOM对象,Nodejs中也存在全局作用域,用来定义一些不需要通过任何模块的加载即可使用的变量、函数或类,全局对象中多为一些系统级的信息或方法,例如获取当前模块的路径,操作进程,定时任务等等。 2. 文件级this指向 Nodejs是支持模块作用域的,每一个文件都是一个模块,可通过require( )的方式同步引入,通过module.exports来暴露接口供其他模块调用。在一个文件中最顶级的this指向当前这个文件模块对外暴露的接口对象,也就是module.exports指向的对象。示例: var IronMan = { name:'Tony Stark', attack: function(){ } } exports.IronMan = IronMan; console.log(this); 在控制台即可看到,this指向一个对象,对象中只有一个属性IronMan,属性值为文件中定义的IronMan这个对象。 3. 函数级this指向 this的基本规则中有一条—当作为函数调用时,函数中的this指向全局对象,这一条在nodejs中也是成立的,这里的this指向了全局对象(此处的全局对象Global对象是有别于模块级全局对象的)。 思考题— React组件中为什么要bind(this) 如果你尝试使用过React进行前端开发,一定见过下面这样的代码: //假想定义一个ToggleButton开关组件 class ToggleButton extends React.Component{ constructor(props){ super(props); this.state = {isToggleOn: true}; this.handleClick = this.handleClick.bind(this); this.handleChange = this.handleChange.bind(this); } handleClick(){ this.setState(prevState => ({ isToggleOn: !preveState.isToggleOn })); } handleChange(){ console.log(this.state.isToggleOn); } render(){ return( <button onClick={this.handleClick} onChange={this.handleChange}> {this.state.isToggleOn ? 'ON':'OFF'} </button> ) } } 思考题:构造方法中为什么要给所有的实例方法绑定this呢?(强烈建议读者先自己思考再看笔者分析) 1. 代码执行的细节 上例仅仅是一个组件类的定义,当在其他组件中调用或是使用ReactDOM.render( )方法将其渲染到界面上时会生成一个组件的实例,因为组件是可以复用的,面向对象的编程方式非常适合它的定位。根据this指向的基本规则就可以知道,这里的this最终会指向组件的实例。 组件实例生成的时候,构造器constructor会被执行,此处着重分析一下下面这行代码: this.handleClick = this.handleClick.bind(this); 此时的this指向新生成的实例,那么赋值语句右侧的表达式先查找this.handleClick( )这个方法,由对象的属性查找机制(沿原型链由近及远查找)可知此处会查找到原型方法this.handleClick( ),接着执行bind(this),此处的this指向新生成的实例,所以赋值语句右侧的表达式计算完成后,会生成一个指定了this的新方法,接着执行赋值操作,将新生成的函数赋值给实例的handleClick属性,由对象的赋值机制可知,此处的handleClick会直接作为实例属性生成。总结一下,上面的语句做了一件这样的事情: 把原型方法handleClick( )改变为实例方法handleClick( ),并且强制指定这个方法中的this指向当前的实例。 2. 绑定this的必要性 在组件上绑定事件监听器,是为了响应用户的交互动作,特定的交互动作触发事件时,监听函数中往往都需要操作组件某个状态的值,进而对用户的点击行为提供响应反馈,对开发者来说,这个函数触发的时候,就需要能够拿到这个组件专属的状态合集(例如在上面的开关组件ToggleButton例子中,它的内部状态属性state.isToggleOn的值就标记了这个按钮应该显示ON或者OFF),所以此处强制绑定监听器函数的this指向当前实例的也很容易理解。 React构造方法中的bind会将响应函数与这个组件Component进行绑定以确保在这个处理函数中使用this时可以时刻指向这一组件的实例。 3. 如果不绑定this 如果类定义中没有绑定this的指向,当用户的点击动作触发this.handleClick( )这个方法时,实际上执行的是原型方法,可这样看起来并没有什么影响,如果当前组件的构造器中初始化了state这个属性,那么原型方法执行时,this.state会直接获取实例的state属性,如果构造其中没有初始化state这个属性(比如React中的UI组件),说明组件没有自身状态,此时即使调用原型方法似乎也没什么影响。 事实上的确是这样,这里的bind(this)所希望提前规避的,就是第五章中的this指针丢失的问题。 例如使用解构赋值的方式获取某个属性方法时,就会造成引用转换丢失this的问题: const toggleButton = new ToggleButton(); import {handleClick} = toggleButton; 上例中解构赋值获取到的handleClick这个方法在执行时就会报错,Class的内部是强制运行在严格模式下的,此处的this在赋值中丢失了原有的指向,在运行时指向了undefined,而undefined是没有属性的。 另一个存在的限制,是没有绑定this的响应函数在异步运行时可能会出问题,当它作为回调函数被传入一个异步执行的方法时,同样会因为丢失了this的指向而引发错误。 如果没有强制指定组件实例方法的this,在将来的使用中就无法安心使用引用转换或作为回调函数传递这样的方式,对于后续使用和协作开发而言都是不方便的。 参考 [1]《javascript高级程序设计(第三版)》 [2]《深入理解javascript函数系列第二篇》https://www.cnblogs.com/xiaohuochai/p/5706289.html [3]《ES6-Class基本语法》https://www.cnblogs.com/ChenChunChang/p/8296350.html
优秀的个人博客,低调大师

What's new in PikiwiDB(Pika) v3.5.5

尊敬的社区朋友及 PikiwiDB(Pika) 用户们: 非常高兴地宣布 --- PikiwiDB(Pika)【下文简称 Pika】长期维护版本 v3.5的最新版本 --- v3.5.5 今天正式发布。在这个版本中,除了修复所有已知的主从复制 bug 外,通过引入 RTC 特性其性能又有了大幅度提升,且主从 failover 机制兼容了 Redis-Sentinel。 1 重大改进 1.1 RTC 模型 在 v3.5.5 版本中我们引入了 RTC 模型,旨在提高缓存的访问效率,具体修改流程如下所示: 上图左侧展示的是 Pika 服务请求的 IO 处理路径:请求依次经过网络线程、请求队列、工作线程,最终到达内存或硬盘引擎进行处理。这种设计的不足之处在于,请求在各个线程间传递会导致频繁的 CPU 上下文切换以及 CPU 高速缓存的 Cache Miss 问题,从而增加 CPU 资源的消耗。在高并发场景下,这种额外的 CPU 消耗尤为显著。 年初(2024年3 月)美团发布了 《美团大规模 KV 存储挑战与架构实践》一文,给出了一个名为 RTC(Run-to-Completion) 的技术方案,网络线程被赋予了直接处理读请求的能力,特别是那些能直接从内存引擎中命中的读请求。 当时 Pika 已经实现了混合存储:在内存 RedisCache 中缓存热数据,在磁盘中存储全量数据。在这个基础之上,恰好看到这个 RTC 解决方案,我们觉得这个方案甚好,可以优化 Pika 的读写流程,提高吞吐,降低延时。引入 RTC 方案后,新读写流程如上图右侧: 当网络线程接收到请求后,Pika 首先判断该请求是否为读操作请求。 如果是读请求,并且能在 RedisCache 中找到所需的数据(RedisCache 命中读请求),则网络线程直接返回结果给客户端。 对于写请求或 RedisCache 未命中的读请求,则依旧沿用原有的处理路径,访问 DB 硬盘引擎进行读写。 RTC 在网络线程内部就能实现 Redis 读命中的闭环处理,避免了由于请求在不同线程间的流转而带来的 CPU 资源开销。具体而言,Pika 的多个 Worker 线程争抢同一个 TaskQueue,且 Worker 在等待任务队列时,没有任何轻量级等待策略,直接使用了"很重" 的cv.wait(std::condition_variable::wait),如果不使用 RedisCache,这或许不构成瓶颈,因为读写请求都打在 RocksDB 上,此时 Pika 工作线程需要等待 RocksDB 的读写流程。但如果打开了 Pika RedisCache 开关且缓存命中率超过 60% 时,热点数据集中度较高,在读操作远多于写操作的高并发场景下,这个线程池中转的过程就会构成性能瓶颈。 通过压测发现,打开 RedisCache 和 RTC 模型开关,且在 Pika 内嵌 Redis Cache 缓存命中率达到 60% 以上的高并发情况下,Get QPS 能提高到原本的 1.5 倍(从 18.4w 到 27.2w),P99 延时降低 47.5% (2.4ms 以下)。尽管此模型仅针对读缓存命中的读多写少请求,但鉴于实际应用场景中读操作远多于写操作,并且热点数据集中度较高,因此在多数业务集群部署后均实现了显著的性能提升。 关键 ISSUE/PR: Improve the RTC process of Read/Write model https://github.com/OpenAtomFoundation/pika/issues/2542 Pika 使用 RTC 模型访问 Rediscache https://github.com/OpenAtomFoundation/pika/pull/2837 Pika RTC 模型开关 https://github.com/OpenAtomFoundation/pika/pull/2841 1.2 通过 Redis-Sentinel 对 Pika 主从实例进行故障自愈 自一年前 (2023年7月)发布 v3.5.0 版本以来,Pika 无法兼容 Redis-Sentinel 进行 auto failover,主要有以下几个原因: 事务冲突 Redis-Sentinel 选举以后,进行主从切换操作时会给 slave 发送 "slaveof no one" 等一批 事务形式的命令: multisalveof no oneconfig rewriteclient kill type pubsubclient kill type normalexec 当时 Pika 不支持 "client kill type pubsub" 与 "client kill type normal" 命令,整个事务会 abort 不执行,导致实际的 slaveof 命令没有执行,所以无法完成新主切换。针对这个问题,在PR 2854 中支持了这两个命令:"client kill type pubsub" 杀掉所有 pubsub client 连接,"client kill type normal" 命令杀掉除 pubsub 外的其他 client 连接。 指标不兼容 Redis-Sentinel 通过 "info" 命令的指标 "slave_repl_offset" 作为选主依据,这个指标反映了某个 slave 实例从 master 接收的主从同步字节数的总量(多 DB 场景下这个值就是多 DB 同步字节数的总和),而 Pika 的主从体系下每个 DB 各自独立,每个 DB 都有一个 binlog 偏移量,由 (filenum, offset) 这样二维坐标形式的两个数字构成,没有提供 "slave_repl_offset" 指标供 Redis-Sentinel 做判断。Pika v3.3.6 版本没有提供这个指标,但通过 fake 数据方式兼容了 Redis-Sentinel, 但这样的选主其实是不可靠的。 在 PR 2854 中,Pika 通过算式 "slave_repl_offset = filenum * filesize + offset" 给出了 "info" 命令的 "slave_repl_offset" 指标。 slave-priority 默认参数的变更 Pika Slave "info" 命令的 "slave-priority" 指标默认值为 0,这个值导致 Pika Slave 不会被 Redis-Sentinel 列入候选 master。 在 PR 2854 中,Pika 将这个默认值改为 100,Redis-Sentinel 会将 Pika Slave 实例列入候选 master。 进程 coredump 在修复以上问题后,在测试过程中 发现 Redis-Sentinel 连接 Pika 实例并发出 "shutdown" 命令 Pika 实例会 coredump。追查后发现:Pika 退出时的资源释放流程中,网络线程关闭的时机不对(关的太晚了),有些重要资源对象已经析构了,但网络线程还能收发包,这就导致 Pika 实例收到 "shutdown" 命令时使用已经析构的资源对象进行命令处理,最终导致 Pika 实例 coredump。 在 PR 2854 中,修改了网络线程 Stop 函数的位置,提前终止线程 pika_dispatcher_thread_,停止 dispatcher 进行网络任务分配。 一个意外收获 在测试过程中,还发现了一个资源退出时的主从同步相关的问题:Pika Slave 消费 Binlog 时,先将 Binlog 落盘,然后异步提交 WriteDB 任务进行数据的物化(重放至 RocksDB),Pika 退出时不会等待这些异步 WriteDB 任务,这就可能导致 Slave 丢数据。 在 PR 2854 中,Pika 退出时,会等到 WriteDBWorker TaskQueue 为空才继续往下释放资源,退出进程。 关键PR: Pika 兼容 Redis-Sentinel 进行主从切换 https://github.com/OpenAtomFoundation/pika/pull/2854 1.3 主从复制 Pika v3.3.6 有很多主从复制的缺陷,如丢数据、数据污染、死锁等问题。v3.5.5 版本对 Pika 全量复制及增量复制进行了大量优化和 bug 修复,取得了非常好的效果。 例如,PR 2638 在 "info" 命令中输出了 "repl_connect_status" 指标,以方便用户更加清晰看到当前 Pika 实例的主从复制状态。 关键 PR: 优化主从复制,确保 Master 端的 SlaveNode 在提交 bgsave 任务前进入 DBSync 状态,防止bgsave执行时的 binlog 在极端情况下被清除 https://github.com/OpenAtomFoundation/pika/pull/2798 修改主从复制过程中 flushdb binlog 的处理逻辑,确保按照顺序执行,避免出现主从不一致的情况 https://github.com/OpenAtomFoundation/pika/pull/2790 优化 Apply binlog 时锁机制,减少不必要的锁竞争 https://github.com/OpenAtomFoundation/pika/pull/2773 修复批量扩容时,多个 slave 同时连接 master,短时间多次 bgsave 导致部分从节点数据不完整的问题 https://github.com/OpenAtomFoundation/pika/pull/2746 修复 Spop 在写 binlog 时可能会出现竞态问题 https://github.com/OpenAtomFoundation/pika/pull/2647 修复多 DB 下全量同步超时后不重试的问题 https://github.com/OpenAtomFoundation/pika/pull/2667 修复多 DB 主从超时场景下,可能会出现窗口崩溃的问题 https://github.com/OpenAtomFoundation/pika/pull/2666 修复主从同步限速逻辑中重复解锁的问题 https://github.com/OpenAtomFoundation/pika/pull/2657 增加主从复制状态指标 repl_connect_status,方便运维人员清晰明确的判断当前的主从复制状态 https://github.com/OpenAtomFoundation/pika/pull/2656 重构主从复制模式 slave 节点的主从同步线程模型,尽可能减少 binlog 消费阻塞问题 https://github.com/OpenAtomFoundation/pika/pull/2638 1.4 RocksDB Compaction Pika 的底层磁盘存储引擎 RocksDB 在进行 compaction 时会显著影响 Pika 的读写性能。因此,控制好 compaction 是优化 Pika 读写性能的关键。 v3.5.5 使用了 v8.7.3 版本的 RocksDB,开放了更多 RocksDB 参数,以方便用户优化 RocksDB 性能: min-write-buffer-number-to-merge: 默认值为 1,如果将此值设置得更大,意味着需要更多的写缓冲区被填满后才进行 flush。这样可以减少 flush 的频率,增加数据在内存中的累积量,从而可能提高写入吞吐量。 level0-stop-writes-trigger: 默认值为 36,定义了 L0 层中 sst 文件的最大数量,一旦达到这个数量,RocksDB 将会采取 暂停写入、强制 compaction 等措施来防止写入操作继续累积,以避免 L0 层变得过于庞大,进而可能导致写入放大、查询性能下降等问题。 level0-slowdown-writes-trigger:默认值为 20,用于控制当 Level 0 的 SST 文件数量达到这个阈值时,触发写减速(write slowdown),防止 Level 0 的文件数量过多,导致后续 compaction 操作的压力过大。 level0-file-num-compaction-trigger:默认值为 4,当 Level 0 的 SST 文件数量达到这个参数设定的阈值时,RocksDB 会开始执行 compaction 操作,将 Level 0 的文件合并到 Level 1,以减少 Level 0 的文件数量,降低读取延迟,并优化存储空间的利用率。 max-subcompactions:默认值为 1,用于控制 RocksDB 中并发执行的 sub-compaction 任务数量,其值为 1 表示关闭 sub-compaction。如果系统资源充足,建议提升该参数以优化 compaction 效率。 max-bytes-for-level-base:指定了 L1 SST 文件总的大小。这个大小是 RocksDB 进行数据分层管理和 compaction 决策的重要依据:如果 L1 层的大小设置得太小,可能会导致 L0 层的 compaction 过于频繁,进而影响写性能。反之,如果设置得太大,可能会占用较多的磁盘空间,并且影响读取性能,因为读取操作可能需要跨越更多的层级。Pika 没有在 pika.conf 中开放此参数给用户配置,而是使用其他参数(level0-file-num-compaction-trigger 和 write-buffer-size)计算后的结果。 storage_options_.options.max_bytes_for_level_base = g_pika_conf->level0_file_num_compaction_trigger() * g_pika_conf->write_buffer_size() 关键 PR: 新增 RocksDB Compaction 策略动态调整参数,用户可以根据业务调整 Compaction 策略,降低 Compaction 操作对服务性能的损耗 https://github.com/OpenAtomFoundation/pika/pull/2538 1.5 测试集 Pika 测试集由 gTest 单测集、Redis TCL 测试集和 Go 测试集组成。v3.5.5 丰富了诸多特性的 go test 功能,并进一步完善了基本数据类型的 TCL 测试。 关键 PR: Pika Geo 数据类型增加 TCL 测试,并修复测试过程中遇到的缺陷 https://github.com/OpenAtomFoundation/pika/pull/2753 2 改进列表 下面详细列出了本次发版的主要功能升级和改进。 2.1 新特性 给 RTC 模型增加处理开关,可以根据开关控制是否开启 RTC 模型 https://github.com/OpenAtomFoundation/pika/pull/2841 用 RTC 模型处理 Pika 访问缓存部分,提升 Pika 服务的读性能 https://github.com/OpenAtomFoundation/pika/pull/2837 Incr、append 命令在传输 binlog 时,使用 pksetexat 命令,防止因为不正确的操作导致数据无法过期,出现脏数据 https://github.com/OpenAtomFoundation/pika/pull/2833 将管理命令移出主线程,防止因为管理命令调用频繁或者耗时过高,阻塞主线程 https://github.com/OpenAtomFoundation/pika/pull/2727 Pika 线程整理,避免启动无用线程造成资源浪费 https://github.com/OpenAtomFoundation/pika/pull/2697 添加 pika benchark 工具,旨在提升压测效率,并输出可视化的统计图表 https://github.com/OpenAtomFoundation/pika/pull/2663 2.2 bug 修复 修改 Pika 自动化测试客户端链接 server 端的超时时间,避免因为长时间断开导致测试失败 https://github.com/OpenAtomFoundation/pika/pull/2683 修复 kill client 命令杀连接流程不正确的 https://github.com/OpenAtomFoundation/pika/pull/2682 修复 blpop/brpop 更新数据库的时候未更新缓存可能回导致数据库、缓存不一致的现象 https://github.com/OpenAtomFoundation/pika/pull/2858 修复 Pika 不支持 Redis-Sentinel 的问题 https://github.com/OpenAtomFoundation/pika/pull/2854 修改 flushall 的逻辑避免统一处理时,多清理一次数据 https://github.com/OpenAtomFoundation/pika/pull/2846 PkPatternMatchDel 命令在删除 DB 的同时删除 cache,避免出现数据库、缓存不一致的情况 https://github.com/OpenAtomFoundation/pika/pull/2839 优化读锁的范围,避免因为重复消费 binlog 导致主、从数据不一致的问题 https://github.com/OpenAtomFoundation/pika/pull/2818 修改 client watch 的 key,被任何人修改(包括自己的改动),都会失效的问题 https://github.com/OpenAtomFoundation/pika/pull/2815 修改 slave_priority 的默认值,防止因为运维同学没有设置该值,导致主从切换失败 https://github.com/OpenAtomFoundation/pika/pull/2813 Multi 命令更新数据库的同时更新缓存,避免读取不到数据 https://github.com/OpenAtomFoundation/pika/pull/2810 修复执行 slaveof no one 时出现异常日志输出的问题 https://github.com/OpenAtomFoundation/pika/pull/2800 修复 Pika block-cache 信息计算不准确,内存使用计算不标准的问题 https://github.com/OpenAtomFoundation/pika/pull/2797 修改主从复制过程中 flushdb binlog 的处理逻辑,确保按照顺序执行,避免出现主从不一致的情况 https://github.com/OpenAtomFoundation/pika/pull/2794 添加标志位、时间戳和返回值机制,确保 Pika 在执行 flushdb 且处理异步删除旧目录时冲突时正确处理 https://github.com/OpenAtomFoundation/pika/pull/2790 修改主从复制过程中 flushdb binlog 的处理逻辑,确保按照顺序执行,避免出现主从不一致的情况 https://github.com/OpenAtomFoundation/pika/pull/2793 修复 PKPatternMatchDel 命令未删除迭代器可能会导致 RocksDB 删除数据不彻底的问题 https://github.com/OpenAtomFoundation/pika/pull/2786 timerTaskThread_ 重命令为 timer_task_thread_ https://github.com/OpenAtomFoundation/pika/pull/2776 修复 min-blob-size 参数解析失败,导致 kv 分离使用出错的问题 https://github.com/OpenAtomFoundation/pika/pull/2767 修复 sentinel 主从切换时,由于主节点和从节点数据量不一致导致主从切换状态扭转错误问题 https://github.com/OpenAtomFoundation/pika/pull/2766 修复 Zverank 命令计算错误,导致返回值错误的问题 https://github.com/OpenAtomFoundation/pika/pull/2763 修复 Pksetat 命令更新 DB 的同时未更新缓存,可能会存在数据库、缓存不一致的问题 https://github.com/OpenAtomFoundation/pika/pull/2759 修复 Pika-port 传输数据过程中报错的问题 https://github.com/OpenAtomFoundation/pika/pull/2758 修复 RsynClient 异常退出后,未做失败处理导致全量复制数据不完整的问题 https://github.com/OpenAtomFoundation/pika/pull/2756 修复 Pika 不能批量扩容的问题 https://github.com/OpenAtomFoundation/pika/pull/2746 修复参数未初始化导致 slotsscan 等命令不能和 bgsave 命令相互制衡的问题 https://github.com/OpenAtomFoundation/pika/pull/2745 修复 SlotMigrate 返回值错误,可能会导致数据迁移中断的问题 https://github.com/OpenAtomFoundation/pika/pull/2741 修复 RedisCache 层因为没有使用 storage 层解析的 ttl 可能会导致数据库、缓存不一致的问题 https://github.com/OpenAtomFoundation/pika/pull/2729 修复 Stream 类型数据不能被 RocksDB compact 会导致过期数据一直存在的问题 https://github.com/OpenAtomFoundation/pika/pull/2724 修复 ACL 认证可能会偶发性失败的问题 https://github.com/OpenAtomFoundation/pika/pull/2714 修复 Pika cmdID 赋值在 Cmd 初始函数中,可能会导致并发构造的时候出现内存泄漏的问题 https://github.com/OpenAtomFoundation/pika/pull/2692 修复 Spop 在写 binlog 时可能会出现竞态问题 https://github.com/OpenAtomFoundation/pika/pull/2674 修复 server_stat 中的数据竞态问题 https://github.com/OpenAtomFoundation/pika/pull/2671 修复多 DB 下全量同步超时后不重试的问题 https://github.com/OpenAtomFoundation/pika/pull/2667 修复多 DB 主从超时场景下,可能会出现窗口崩溃的问题 https://github.com/OpenAtomFoundation/pika/pull/2666 修复主从同步限速逻辑中重复解锁的问题 https://github.com/OpenAtomFoundation/pika/pull/2657 2.3 提升改进项 优化主从复制,确保 Master 端的 SlaveNode 在提交 bgsave 任务前进入 DBSync 状态,防止 bgsave 执行时的 binlog 在极端情况下被清除 https://github.com/OpenAtomFoundation/pika/pull/2798 优化 Apply binlog 时锁机制,减少不必要的锁竞争 https://github.com/OpenAtomFoundation/pika/pull/2773 添加 Geo 数据类型的 TCL 测试,并修复测试过程中遇到的 bug https://github.com/OpenAtomFoundation/pika/pull/2753 更新 Pika Docker Readme, 可以按照 Readme 在 Docker 中部署 Pika 服务 https://github.com/OpenAtomFoundation/pika/pull/2743 支持对更多的 RocksDB 参数进行动态调整,用户根据不同的业务使用场景调整参数提升 Pika 的读写性能 https://github.com/OpenAtomFoundation/pika/pull/2728 Pkpatternmatchdel 命令支持删除 Redis Stream 数据类型 https://github.com/OpenAtomFoundation/pika/pull/2723 重构主从复制模式 slave 节点的主从同步线程模型,尽可能减少 binlog 消费阻塞问题 https://github.com/OpenAtomFoundation/pika/pull/2638 增加主从复制状态指标 repl_connect_status,方便运维人员清晰明确的判断当前的主从复制状态 https://github.com/OpenAtomFoundation/pika/pull/2656 新增 RocksDB Compaction 策略动态调整参数,用户可以根据业务调整 Compaction 策略,降低 Compaction 操作对服务性能的损耗 https://github.com/OpenAtomFoundation/pika/pull/2538 对事务新增 TCL 测试并修复测试中遇到的 bug https://github.com/OpenAtomFoundation/pika/pull/2844 2.4 发版 tag ​ https://github.com/OpenAtomFoundation/pika/releases/tag/v3.5.5 3 社区 感谢所有为 v3.5.5 做出贡献的社区成员,包括 issue/PR 提交者、代码 reviewer 【排名不分先后,依据字母顺序】: baerwang baixin01 bigdaronlee163 cheniujh chejinge haiyang426 lqxhub luky116 Mixficsol QlQlqiqi saz97 VanessaXWGUO wangshao1 XiaoLiang2333 PikiwiDB (Pika) 开源社区热烈欢迎您的参与和支持。如果您有任何问题、意见或建议,请添加 PikiwiDB 小助手【微信号: PikiwiDB】为好友,它会拉您加入官方微信群。

优秀的个人博客,低调大师

What’s new in Apache/dubbo-getty 1.5.0

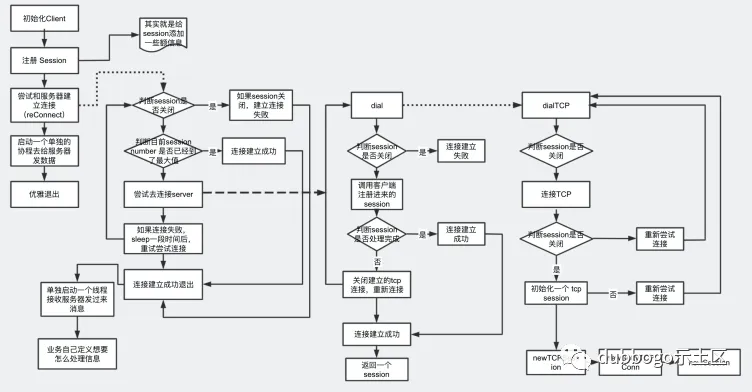
经过半年改进,dubbo-getty 发布了 v1.5.0 版本,致力于提升稳定性,并修复已知问题,为用户提供更可靠的网络通信服务。 如昔,依然坚持 "Getty 只考虑使用 Go 语言原生的网络接口,如果遇到网络性能瓶颈也只会在自身层面寻找优化突破点" Go 语言网络库 getty 的那些事 。 1. 限制 TCP 客户端重连行为 Getty 支持 TCP lazy reconnect,所谓 lazy reconnect,Go 语言网络库 getty 的那些事 有详细描述。 lazy reconnect 整体流程图如上。 近期社区 No-SilverBullet 筒子觉得:服务端的连接数是动态的,所以我觉得 getty 还是应该有一个兜底的逻辑,而不是 "无脑的" 一直去重连,可以 "添加一个最多重来次数或者重连时间限制": 客户端在 read EOF 时,停止重连维护连接池的行为 reconnect 增加最大次数,当重连次数超过设定的连接数时,退出 具体改进是: session 增加了新的 attribute(ignoreReconnectKey),用于标识是否重连 最大重连次数设定为用户设定的连接数 相关 PR 是 https://github.com/apache/dubbo-getty/pull/117。 2. 修复 WebSocket 并行安全问题 Getty WebSocket 通信依赖于 gorilla/websocket 这个包,进行 WebSocket 网络通信时只能 "支持一个并发 reader 和一个并发 writer"。 Connections support one concurrent reader and one concurrent writer. Applications are responsible for ensuring that no more than one goroutine calls the write methods (NextWriter, SetWriteDeadline, WriteMessage, WriteJSON, EnableWriteCompression, SetCompressionLevel) concurrently and that no more than one goroutine calls the read methods (NextReader, SetReadDeadline, ReadMessage, ReadJSON, SetPongHandler, SetPingHandler) concurrently. The Close and WriteControl methods can be called concurrently with all other methods. -- from https://pkg.go.dev/github.com/gorilla/websocket#hdr-Concurrency Getty WebSocket 以往没有注意到这个规则,近期有人在 [issue 120] 中报出了这个 bug,社区筒子立即响应,添加了 gettyWSConn:threadSafeWriteMessage 和 gettyWSConn:threadSafeReadMessage 这两个接口以解决并行通信的 data race 问题,相关代码详见 PR 121 和 PR 123。 相关 PR 是: https://github.com/apache/dubbo-getty/pull/121 https://github.com/apache/dubbo-getty/pull/123 在 PR 121 中我们顺便解决了 [issue 103] 描述的 session 异常关闭问题。 3 致谢 感谢所有为 Dubbo-Getty 1.5.0 做出贡献的社区成员,包括 issue/PR 提交者、代码 reviewer 以及文章作者【排名不分先后,依据字母序列】: chenbaoding2818 FoghostCn Lvnszn No-SilverBullet seven-ali alexstocks/getty 作为 dubbo-getty 的上游仓库,已在 alexstocks/gettyv1.5.0 中吸收了本次更新。 另外,我们搜到一些第三方作者对 getty 的解析文章,代表社区向这些传播 getty 的文章作者致敬: 用golang实现的dubbo-getty是怎么进行tcp通信的?客户端篇 用golang实现的dubbo-getty是怎么进行tcp通信的?服务篇

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册