首页 文章 精选 留言 我的

精选列表

搜索[what],共2560篇文章
优秀的个人博客,低调大师

What's new in PikiwiDB(Pika) v3.5.4

PikiwiDB(Pika) 社区非常荣幸地宣布,我们的最新 v3.5.4 正式生产可用版本现已发布。 v3.5.4 解决了历史遗留的 bug,对 PikiwiDB(Pika) 的一些遗留 bug 进行修复和优化,旨在打造出一个高稳定性的版本。本次的重点优化主要包括,PikiwiDB(Pika)支持动态调整限速参数、增强 PikiwiDB(Pika) 的客观测性指标、 磁盘 IO 限速支持读限速及写限速等。 1 新特性 Pika 支持动态调整全量同步限速参数 rsync-timeout-ms 和 throttle-bytes-per-second 自 v3.5.0 版本开始,PikiwiDB(Pika) 服务摒弃了通过子进程内使用原来 rsync 工具进行主从全量同步的逻辑,在 PikiwiDB(Pika) 内部以线程方式【称作 rsync 线程】自行实现了新的全量同步逻辑,避免因为外部进程不可控引起的主从同步问题,根据 360 内部 Pika 线上大规模集群运维的经验,在 PikiwiDB(Pika) 主从进行全量同步的过程中,如果遇到某些不利的外部因素,如网络波动,硬件故障(如网卡降速导致的主从网卡速率不匹配)等,可能引起 rsync 线程请求持续超时(PikiwiDB(Pika) 内置 rsync 模块用于全量同步阶段的文件传输),且超时重试所发出的包可能引发更大的网络信道负担。此时对于运维人员来说,如果能动态调整 rsync 请求的超时时间和 rsync 传输的速率上限,不仅意味着对全量同步阶段控制粒度的进一步细化,更大大降低了在该场景下的运维处置难度。 关键PR: https://github.com/OpenAtomFoundation/pika/pull/2633 将 info key space 1 的结果输出至 info all 并展示到监控界面中 PikiwiDB(Pika) 是通过 Info 命令采集数据至 Pika-Exporter,展示到 Grafana 界面上的,目前界面上部分数据是没有展示的,如 keys 的数量,本次将执行 info keyspace 的结果展示到监控界面,用户可以通过这个指标来查看存储的量级等。 关键PR: https://github.com/OpenAtomFoundation/pika/pull/2603 Pika 磁盘IO 限速参数支持 OnlyRead、OnlyWrite、ReadAndWrite,默认支持OnlyWrite 自 3.5.0 版本开始,PikiwiDB(Pika) 服务可以通过调整 rate-limit 参数实现写限速,防止在网卡质量不高的情况下磁盘 IO 过重导致服务不可用,或者 binlog 阻塞的情况发生。360内部 Pika 线上大规模集群运维的经验,在 PikiwiDB(Pika) 实例的网卡较差情况下,也需要对读实例进行限速,本次修改支持读、写限速,默认是写限速,调整 config 配置中的 rate-limiter-mode 可以设置为读限速,或者同时读写限速。 关键PR: https://github.com/OpenAtomFoundation/pika/pull/2599 2 改进列表 slotmigrate 添加 go test。 https://github.com/OpenAtomFoundation/pika/pull/2576 INFO 命令耗时优化,降低查磁盘频率,避免因为数据采集调用 info 命令时查磁盘太过频繁导致服务性能下降。 https://github.com/OpenAtomFoundation/pika/pull/2554 对五种基本数据类型命令增加 Redis tcl 测试。 https://github.com/OpenAtomFoundation/pika/pull/2527 3 Bug 修复 修复使用 Pika Exporter 时可能会出现 slots 分配不均衡的问题。 https://github.com/OpenAtomFoundation/pika/pull/2651 修复 Codis dashboard 不能正确更新 master 实例状态的问题。 https://github.com/OpenAtomFoundation/pika/pull/2650 修复 Redis 事务 binlog 解析失败导致的主从同步异常问题。 https://github.com/OpenAtomFoundation/pika/pull/2642 修复 Pika Expoter 启动时不带参数导致启动失败问题。 https://github.com/OpenAtomFoundation/pika/pull/2640 修复使用 Pika Operater 拉起集群 Codis-proxy panic 的问题。 https://github.com/OpenAtomFoundation/pika/pull/2633 修复 CI 编译出的二进制进行自动化测试时 cp 命令失败问题。 https://github.com/OpenAtomFoundation/pika/pull/2614 修复变量未初始化导致 cache 启动失败的问题。 https://github.com/OpenAtomFoundation/pika/pull/2613 修复 userpass 和 userblacklist 动态修改参数功能异常问题。 https://github.com/OpenAtomFoundation/pika/pull/2600 修复 scard sscan 结果不一致的问题。 https://github.com/OpenAtomFoundation/pika/pull/2596 修复当 max-rsync-parallel-num 大于4,slave 会在主从复制时 coredump 的问题。 https://github.com/OpenAtomFoundation/pika/pull/2595 调整不常用的线程池线程数,避免因为空跑导致性能损耗。 https://github.com/OpenAtomFoundation/pika/pull/2590 修复 Pika 事务边缘测试 case 不通过的问题。 https://github.com/OpenAtomFoundation/pika/pull/2586 将 cache-model 修改成 cache-mode。 https://github.com/OpenAtomFoundation/pika/pull/2585 修复使用 info keyspace 后,info all 死锁的问题。 https://github.com/OpenAtomFoundation/pika/pull/2584 修复因修改 zsetscorekey comparator impl 字典序比较熟顺序,导致 353 352极端场景不兼容的问题。 https://github.com/OpenAtomFoundation/pika/pull/2583 修复 compact 死锁的问题。 https://github.com/OpenAtomFoundation/pika/pull/2581 Slotmigrate 添加 go test。 https://github.com/OpenAtomFoundation/pika/pull/2576 更新 Pika Operater 使用的 pika 版本。 https://github.com/OpenAtomFoundation/pika/pull/2572 修复 config rewrite 后 blockcache 数值异常的问题。 https://github.com/OpenAtomFoundation/pika/pull/2561 修复 slotmigrate 动态修复后值错误的问题。 https://github.com/OpenAtomFoundation/pika/pull/2548 修复 spop 可能会出现主从数据不一致的问题。 https://github.com/OpenAtomFoundation/pika/pull/2541 修复 CloseFd(it->second[i]) 出现越界的问题。 https://github.com/OpenAtomFoundation/pika/pull/2539 修复 Flushall 和 FlushDB 死锁的隐患,并删除 FlushSubDB 接口。 https://github.com/OpenAtomFoundation/pika/pull/2533 增加参数控制是否清理 tcl 测试后产生的数据文件,防止废弃数据占据磁盘。 https://github.com/OpenAtomFoundation/pika/pull/2507 4 社区 PikiwiDB (Pika) 开源社区热烈欢迎您的参与和支持。如果您有任何问题、意见或建议,可通过以下渠道联系我们:

优秀的个人博客,低调大师

What’s new in Apache/dubbo-getty 1.4.10

1 概述 Dubbo-Getty 1.4.10 版本带来了一些重要的改进和修复,旨在提高性能和稳定性,不过依然坚持 “Getty 只考虑使用 Go 语言原生的网络接口,如果遇到网络性能瓶颈也只会在自身层面寻找优化突破点” 【Go 语言网络库 getty 的那些事】。 以下是本次发布的主要亮点和更新。 2 主要更新 2.1 Timer 优化算法禁用 2016 年开始构建 getty 网络库时,当时 Go 语言的 timer 实现很低效,有一个有名的 “一把全局大锁” 的问题 (the global timers mutex),详见 issue https://github.com/golang/go/issues/15133 。Getty 借鉴当时 fasthttp 的实现,在使用 SetReadDeadline 和 SetWriteDeadline 两个函数时,有如下类似代码: // Optimization: update read deadline only if more than 25% // of the last read deadline exceeded. // See https://github.com/golang/go/issues/15133 for details. currentTime = time.Now() if currentTime.Sub(t.rLastDeadline.Load()) > t.rTimeout.Load()>>2 { if err = t.conn.SetReadDeadline(currentTime.Add(t.rTimeout.Load())); err != nil { // just a timeout error return 0, perrors.WithStack(err) } t.rLastDeadline.Store(currentTime) } 2021 年拼多多的朋友发现这项 “优化” 会造成超时时间 “漂移” 问题,详见 https://github.com/AlexStocks/getty/issues/14#issuecomment-972583219。 近几年随着 Go Timer 的性能优化,Go 1.1x 版本能做到把每个 timer 绑定多核减小锁粒度,Go 1.2x 已经通过 “时间轮” 进一步优化,timer 已经没有了 CPU 使用率过高的问题,详见 https://github.com/golang/go/issues/15133#issuecomment-271571395 。 所以在 PR https://github.com/apache/dubbo-getty/pull/109 中禁用了 SetReadDeadline 和 SetWriteDeadline 优化算法。这个更改将有助于减少不必要的性能开销,并确保应用程序能够更高效地处理 I/O 操作。 2.2 Go 版本升级 PR https://github.com/apache/dubbo-getty/pull/112/files 将 Go 语言版本从 1.14 升级到 1.20。这个升级不仅带来了 Go 语言的新特性和改进,还提高了整体的安全性和稳定性: 使用 os.ReadFile 替换了 ioutil.ReadFile 使用 net.Timeout 替换了 net. Temporary 2.3 添加网络任务处理时先 check 连接是否关闭 当请求过多时,Getty 一直在调用 encode 或者 decode 逻辑导致 CPU 飙升,从消息和请求时间结合看的话,应该是请求过多。 在 PR https://github.com/apache/dubbo-getty/pull/108 中,在 conn close 的时候直接把相关过时的网络请求抛掉,不做这些耗 CPU 的逻辑。 2.4 修复 TLS 死循环 bug Getty 支持 TCP/UDP/Websocket 三种通信协议,在 TCP 之上还提供了 TLS 安全通信,近期杭州一家公司的朋友在使用 TLS 时发现一个死循环 bug:把 demo/hello/tls/server/server.go 服务跑起来,然后用 telnet 127.0.0.1 8090服务端程序就会陷入死循环,把一个 CPU 打满。 其原因是 TLS 握手时没有设置超时时间。这位朋友在 PR https://github.com/apache/dubbo-getty/pull/115 中修复了该 bug。 3 贡献者 感谢以下贡献者对 Dubbo-Getty 1.4.10 版本的支持和贡献【排名不分先后,依据字母序列】: DMwangnima hongshengjie Lvnszn alexstocks/getty 作为 dubbo-getty 的上游仓库,已经在 PR https://github.com/AlexStocks/getty/pull/79 中吸收了本次更新,将要发布的 alexstocks/getty v1.3.3 中将会包含这些更新。 4 社区 如果你有任何疑问,欢迎加社区助手微信号 "PikiwiDB" 为好友,并备注 “dubbogo”,它会邀请你进入社区微信群进行交流。

优秀的个人博客,低调大师

What's new in dubbo-go-pixiu 0.5.1

dubbo-go-pixiu v0.5.1(链接https://github.com/apache/dubbo-go-pixiu/releases/tag/v0.5.1-rc2 ) 经过 apache 发版投票流程今天正式发版 ,在此感谢关注 dubbo-go-pixiu 的伙伴,以及社区伙伴们的无私奉献。 1 Pixiu 是什么 Pixiu 是 dubbogo 社区推出的一款基于 Dubbo 生态的高性能网关。 2 Pixiu 0.5.1 发版内容 Features 1 可观测性之分布式链路追踪 我们常说的可观测性大致分为三个方向:Logging、Tracing 和 Metrics。皆在帮助开发者快速分析和诊断分布式应用的性能瓶颈,提高开发诊断效率,而在 0.5.1 版本,Pixiu 也投入了相当一部分精力在 Tracing 方向,下面简单介绍一下由社区 Maxingg 同学为 Pixiu 提供了HTTP场景 Tracing 能力。 关于分布式应用可观测性领域感兴趣的同学可以加入社区,一起探讨、建设。 PR:https://github.com/apache/dubbo-go-pixiu/pull/394 2.1 健康检查 Pixiu 新增了服务健康检查机制,为 Pixiu 的增加更多可靠的使用场景,由社区 ztelur 提供基于与端点建立 tcp 网络拨号来探活,下面简单介绍一下 Pixiu Heath Check。 PR: https://github.com/apache/dubbo-go-pixiu/pull/421 2.3 代理 Dubbo 直连模式 Dubbo/Dubbo-go 的直连模式大家都不陌生,而这个版本,为了更好的帮助 Pixiu 在云原生(Sidecar)的方向迈步,Pixiu 在现有基于服务发现代理请求 dubbo 的基础上,新增了直连的模式,更好的助力 Pixiu 的 Sidecar 形态。 下面是使用直连时配置: static_resources: listeners: - name: "http-listener" protocol_type: "HTTP" address: socket_address: address: "0.0.0.0" port: 8888 filter_chains: filters: - name: dgp.filter.httpconnectionmanager config: route_config: routes: - match: prefix: "/UserService" route: cluster: "user" http_filters: - name: dgp.filter.http.directdubboproxy config: clusters: - name: "dubbo-server" lb_policy: "lb" endpoints: - id: 1 socket_address: address: 127.0.0.1 port: 20000 PR: https://github.com/apache/dubbo-go-pixiu/pull/434 2.4 在云原生方向继续探索:xDS 文件订阅模式 本 feature 由社区 mark4z 提供。Pixiu 基于文件订阅方式通过 xDS 协议动态更新资源,这会很直观的反应 xDS 获取资源的流程。 PR:https://github.com/apache/dubbo-go-pixiu/pull/417 目前为止,Pixiu Sidecar 形态已经支持了 LDS 和 CDS 两种协议,也已经实现了与 Pixiu Admin(Pixiu xDS Server https://github.com/dubbo-go-pixiu/pixiu-admin )动态发现资源,这是 Pixiu 在 Dubbo Proxy Mesh 上的一大步,相信未来的 Pixiu ,在云原生道路上会越走越好,并且走出 Pixiu 自己独一无二的道路。 3 BUG 修复与优化 修复 Nacos registry bug https://github.com/apache/dubbo-go-pixiu/pull/389 优化 SpringCloud 订阅机制,可自定义订阅应用 https://github.com/apache/dubbo-go-pixiu/pull/425 优化路由器匹配机制 https://github.com/apache/dubbo-go-pixiu/pull/451 4 关注社区

优秀的个人博客,低调大师

what?

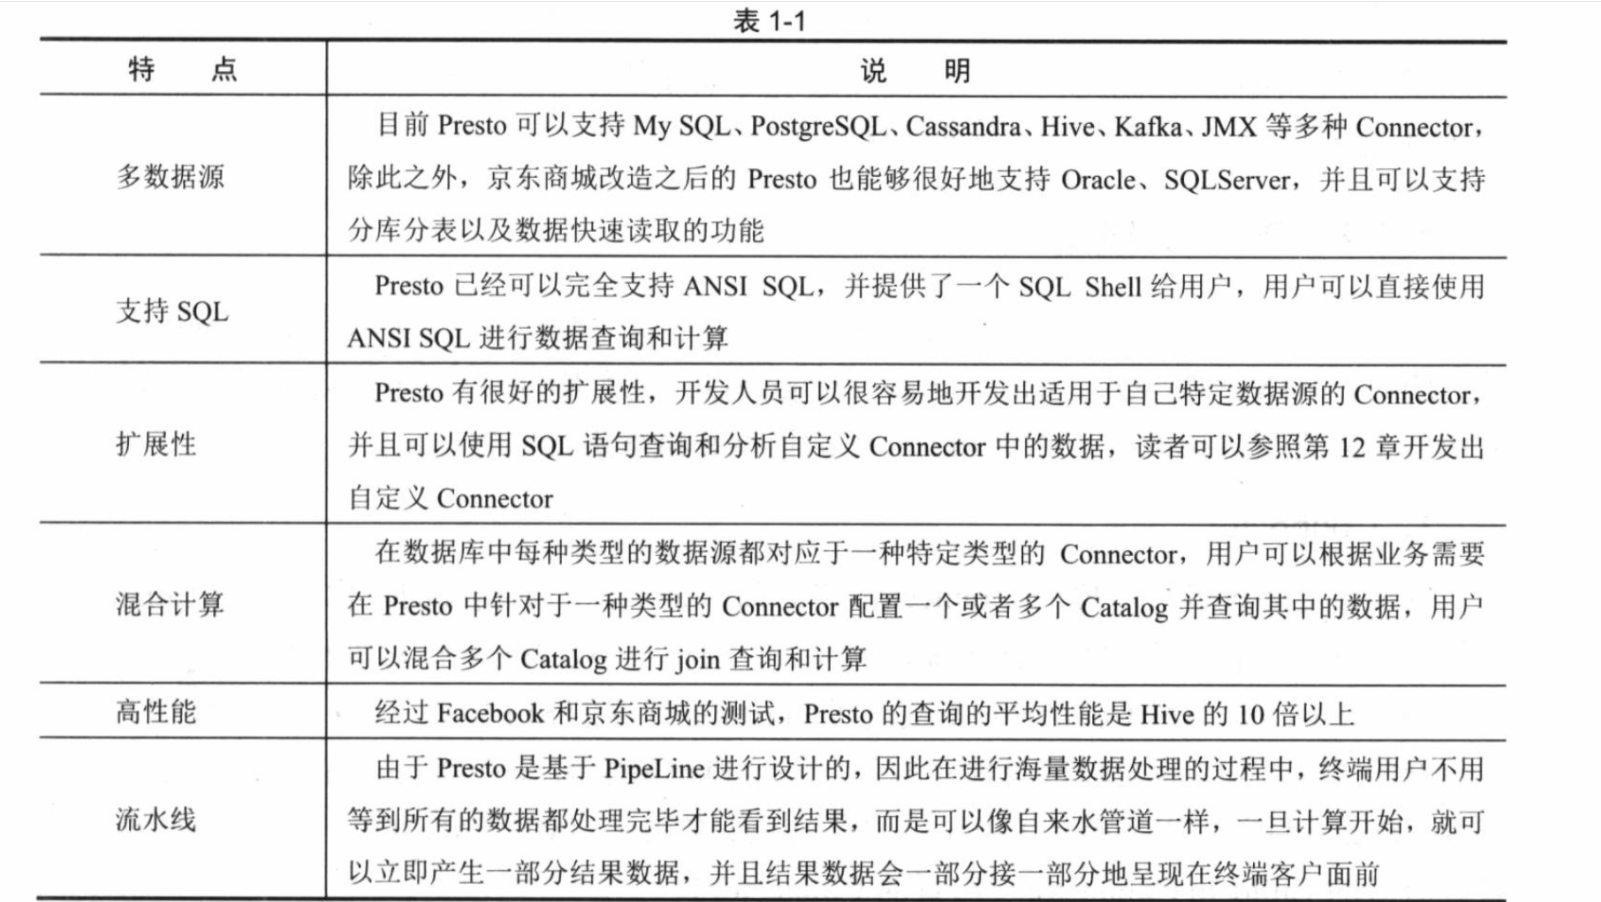
1.说明 p:presto a:allixop z:zeppelin r:rancher分为三部分讲解1.什么是presto+Alluxio,大数据presto+Alluxio集成详细部署说明2.大数据zeppelin+rancher,docker的集成部署3.presto+alluxio集成ldap实操测试,zeppelin+rancher集成ldap实操测试 1.1什么是presto 于内存的并行计算,Facebook推出的分布式SQL交互式查询引擎 多个节点管道式执行支持任意数据源 数据规模GB~PB 是一种Massively parallel processing(mpp)(大规模并行处理)模型数据规模PB 不是把PB数据放到内存,只是在计算中拿出一部分放在内存、计算、抛出、再拿 为什么要用&优点&特点多数据源、支持SQL、扩展性(可以自己扩展新的connector)、混合计算(同一种数据源的不同库 or表;将多个数据源的数据进行合并)、高性能、流水线(pipeline) 1.2 presto架构 2.1什么是alluxio Alluxio(前身Tachyon)是世界上第一个以内存为中心的虚拟的分布式存储系统。它统一了数据访问的方式,为上层计算框架和底层存储系统构建了桥梁。 2.2Alluxio架构 Alluxio是大数据和机器学习生态系统中的新数据访问层。Alluxio作为据访问层处于持久存储层(如Amazon S3,Microsoft Azure Object Store,Apache HDFS或OpenStack Swift)和计算框架层(如Apache Spark,Presto或Hadoop MapReduce)之间。 3.presto+Alluxio Starbrust + Alluxio = 在一起更好和Alluxio一起的Starbrust Presto是一个真正独立的数据栈,支持任何文件或对象存储进行交互式大数据分析。Starbrust Presto和Alluxio整合后能够共同帮助作业运行速度提高10倍,使重要数据本地化,并连接到各种存储系统和云。 用户现在可以将他们遗留的数据仓库构建方法改为来使用现代云数据栈,在Presto、Alluxio和任何文件或对象存储上构建真正不同的数据栈。 3.1 presto部署 3.1.1Presto安装3.1.2角色分配 3.1.3测试环境:1.CM6.32.Presto版本0.2263.操作系统版本为Redhat7.34.采用root用户进行操作 3.1.4下载下载最新版本Presto服务的安装目录为/opt/cloudera/parcels/prestohttps://repo1.maven.org/maven2/com/facebook/presto/presto-server/0.226/presto-server-0.226.tar.gz 3.1.5将下载好的presto-server-0.226.tar.gz上传至Presto集群的所有服务器上 mkdir -p /opt/cloudera/parcels/presto scp -r -P53742 presto-server-0.226.* root@incubator-t3-dc-002:/opt/cloudera/parcels/presto/ presto-server-0.226.jar 3.1.6解压安装(presto集群所有机器) 将presto-server-0.205.tar.gz压缩包解压至/opt/cloudera/parcels目录 # tar -zxvf presto-server-0.226.tar.gz -C /opt/cloudera/parcels/ #cd /opt/cloudera/parcels/ mv presto presto-soft mv presto-server-0.226/ presto 3.1.7Java环境变量设置 vim /opt/cloudera/parcels/presto/bin/launcher文件如下位置添加JAVA环境变量 JAVA_HOME=/usr/java/jdk1.8.0_181-cloudera PATH=$JAVA_HOME/bin:$PATH 3.1.8准备Presto的配置文件 #mkdir -p /opt/cloudera/parcels/presto/etc #presto配置文件 #mkdir -p /data/presto #数据盘 vim /opt/cloudera/parcels/presto/etc/node.properties node.environment=presto node.id=presto-cdh01 node.data-dir=/data/presto 配置说明: node.environment:集群名称。所有在同一个集群中的Presto节点必须拥有相同的集群名称。 node.id:每个Presto节点的唯一标示。每个节点的node.id都必须是唯一的。在Presto进行重启或者升级过程中每个节点的node.id必须保持不变。如果在一个节点上安装多个Presto实例(例如:在同一台机器上安装多个Presto节点),那么每个Presto节点必须拥有唯一的node.id。 node.data-dir:数据存储目录的位置(操作系统上的路径)。Presto将会把日期和数据存储在这个目录下。 3.1.9Presto的jvm配置文件 配置Presto的JVM参数,创建jvm.config文件 vim /opt/cloudera/parcels/presto/etc/jvm.config -server -Xmx8G -XX:+UseConcMarkSweepGC -XX:+ExplicitGCInvokesConcurrent -XX:+CMSClassUnloadingEnabled -XX:+AggressiveOpts -XX:+HeapDumpOnOutOfMemoryError -XX:OnOutOfMemoryError=kill -9 %p -XX:ReservedCodeCacheSize=150M #配置文件的格式是:一系列的选项,每行配置一个单独的选项。由于这些选项不在shell命令中使用。因此即使将每个选项通过空格或者其他的分隔符分开,java程序也不会将这些选项分开,而是作为一个命令行选项处理。(就想下面例子中的OnOutOfMemoryError选项)。 由于OutOfMemoryError将会导致JVM处于不一致状态,所以遇到这种错误的时候我们一般的处理措施就是将dump headp中的信息(用于debugging),然后强制终止进程。 Presto会将查询编译成字节码文件,因此Presto会生成很多class,因此我们我们应该增大Perm区的大小(在Perm中主要存储class)并且要允许Jvm class unloading。 3.1.10创建config.properties文件 该配置文件包含了Presto Server的所有配置信息。每个Presto Server既是Coordinator也是一个Worker。在大型集群中,处于性能考虑,建议单独用一台服务器作为Coordinator。 coordinator节点的配置如下: Presto会将查询编译成字节码文件,因此Presto会生成很多class,因此我们我们应该增大Perm区的大小(在Perm中主要存储class)并且要允许Jvm class unloading。 vim /opt/cloudera/parcels/presto/etc/coordinator-config.properties coordinator=true node-scheduler.include-coordinator=false http-server.http.port=6660 query.max-memory=4GB query.max-memory-per-node=1GB discovery-server.enabled=true discovery.uri=http://incubator-t3-dc-001:6660 worker节点的配置如下: vim /opt/cloudera/parcels/presto/etc/worker-config.properties coordinator=false http-server.http.port=6660 query.max-memory=4GB query.max-memory-per-node=1GB discovery.uri=http://incubator-t3-dc-001:6660 配置项说明:coordinator:指定是否运维Presto实例作为一个coordinator(接收来自客户端的查询情切管理每个查询的执行过程)。node-scheduler.include-coordinator:是否允许在coordinator服务中进行调度工作。对于大型的集群,在一个节点上的Presto server即作为coordinator又作为worke将会降低查询性能。因为如果一个服务器作为worker使用,那么大部分的资源都不会被worker占用,那么就不会有足够的资源进行关键任务调度、管理和监控查询执行。http-server.http.port:指定HTTP server的端口。Presto 使用 HTTP进行内部和外部的所有通讯。discovery.uri:Discoveryserver的URI。由于启用了Prestocoordinator内嵌的Discovery 服务,因此这个uri就是Prestocoordinator的uri。修改example.net:80,根据你的实际环境设置该URI。注意:这个URI一定不能以“/“结尾。 3.1.11新建日志文件log.properties vim /opt/cloudera/parcels/presto/etc/log.properties com.facebook.presto=INFO 3.1.12重命名config文件 主节点 /opt/cloudera/parcels/presto/etc/ mv coordinator-config.properties config.properties work节点 cd /opt/cloudera/parcels/presto/etc/ mv worker-config.properties config.properties 3.1.13Presto服务启停/opt/cloudera/parcels/presto/bin/launcher start#启动/opt/cloudera/parcels/presto/bin/launcher stop停止 3.1.14Presto-webhttp://172.16.16.241/ui/ 3.2 presto集成hive 1.在Presto集群的所有节点创建目录mkdir -p /opt/cloudera/parcels/presto/etc/catalog2.创建hive.properties,该文件与Hive服务集成使用 vim /opt/cloudera/parcels/presto/etc/catalog/hive.properties connector.name=hive-hadoop2 hive.metastore.uri=thrift://incubator-t3-dc-003:9083 3.修改presto的jvm.config,在配置文件中增加Presto访问HDFS的用户名 vim /opt/cloudera/parcels/presto/etc/jvm.config 添加-DHADOOP_USER_NAME=presto 4.上面的配置中指定了presto用户作为访问HDFS的用户,需要在集群所有节点添加presto用户useradd presto修改完后重启presto/opt/cloudera/parcels/presto/bin/launcher restart(所有集群机器执行) 3.3 Presto集成hive测试 这里测试Presto与Hive的集成使用Presto提供的Presto CLI,该CLI是一个可执行的JAR文件,也意味着你可以想UNIX终端窗口一样来使用CLI。 1.下载Presto的presto-cli-0.226-executable.jar,并重命名为presto并赋予可以执行权限 https://repo1.maven.org/maven2/com/facebook/presto/presto-cli/0.226/presto-cli-0.226-executable.jar 2.复制客户端到所有主机上 scp -r -P53742 /home/t3cx/presto-cli-0.226-executable.jar root@incubator-t3-dc-005:/opt/cloudera/parcels/presto/etc/ 3.复制客户端到所有主机上 cd /opt/cloudera/parcels/presto/etc/ mv presto-cli-0.226-executable.jar presto chmod +x presto 3.集群启用了Sentry,这里我们使用presto用户访问Hive所以为presto用户授权default库的所有权限 4.Hive创建角色并授权 #beeline #!connect jdbc:hive2://incubator-t3-dc-001:10000/;user=hive;password=**** create role presto; grant role presto to group presto; grant ALL on database default to role presto; 5.impala创建角色并授权 su hive #impala-shell -i incubator-t3-dc-002 create role presto; grant role presto to group presto; grant ALL on database default to role presto; 执行查询语句 [root@incubator-t3-dc-001 etc]# ./presto --server localhost:6660 --catalog hive --schema=default 3.4 Presto集成kudu测试 添加kudu配置分发到所有节点上面 # vim /opt/cloudera/parcels/presto/etc/catalog/kudu.properties connector.name=kudu kudu.client.master-addresses=incubator-t3-dc-001:7051,incubator-t3-dc-002:7051,incubator-t3-dc-003:7051 #重启服务 /opt/cloudera/parcels/presto/bin/launcher restart #验证kudu select * from kudu.default."default.test_kudu_table" 3.5 Presto集成ldap #apacheds安装ldaps groupadd apacheds #添加用户组 useradd -s /bin/sh -g apacheds apacheds 添加用户 wget http://mirrors.ocf.berkeley.edu/apache//directory/apacheds/dist/2.0.0.AM25/apacheds-2.0.0.AM25-64bit.bin #下载授权 chmod +x apacheds-2.0.0.AM25-64bit.bin ./apacheds-2.0.0.AM25-64bit.bin #启动 /etc/init.d/apacheds-2.0.0.AM25-default start [root@incubator-t3-dc-002 presto_hue]# netstat -anplt |grep 10389 tcp 0 0 0.0.0.0:10389 0.0.0.0:* LISTEN 24770/java #配置用户名和密码,ip地址设置用户名密码,默认:user:uid=admin,ou=system password:secret#连接客户端配置客户端远程登录,这里使用Apache Directory Studio,配置界面如下打开配置-添加分区Ctrl+S保存重启服务 [root@incubator-t3-dc-002 presto_hue]# /etc/init.d/apacheds-2.0.0.AM25-default restart Stopping ApacheDS - default... Stopped ApacheDS - default. Starting ApacheDS - default... [root@incubator-t3-dc-002 presto_hue]# 添加组添加#添加用户 #启用ldaps cd /var/lib/apacheds-2.0.0.AM25/default/conf/ 密码:t3CDH123! /opt/jdk1.8.0_181/bin/keytool -genkeypair -alias apacheds -keyalg RSA -validity 7 -keystore ads.keystore chown apacheds:apacheds ./ads.keystore #配置apacheds.cer /opt/jdk1.8.0_181/bin/keytool -export -alias apacheds -keystore ads.keystore -rfc -file apacheds.cer #默认口令 changeit ## 将证书导入系统证书库,实现自认证,这里的密钥库口令是默认的: /opt/jdk1.8.0_181/bin/keytool -import -file apacheds.cer -alias apacheds -keystore /usr/java/jdk1.8.0_181-cloudera/jre/lib/security/cacerts #配置证书 /var/lib/apacheds-2.0.0.AM25/default/conf/ads.keystore /etc/init.d/apacheds-2.0.0.AM25-default restart 配置客户端 #测试presto-ldaps cd /data/presto-server-0.228/etc /opt/jdk1.8.0_181/bin/keytool -genkeypair -alias presto -keyalg RSA -keystore presto.jks 修改config.properties,添加 http-server.authentication.type=PASSWORD http-server.https.enabled=true http-server.https.port=8443 http-server.https.keystore.path=/data/presto-server-0.228/etc/presto.jks http-server.https.keystore.key=t3CDH123! # vi password-authenticator.properties password-authenticator.name=ldap ldap.url=ldaps://172.16.16.246:10636 ldap.user-bind-pattern=uid=${USER},ou=people,dc=t3,dc=hadoop ldap.user-base-dn=dc=t3,dc=hadoop 3.6 Alluxio 内存存储系统部署安装 下载并解压 wget https://downloads.alluxio.io/downloads/files/2.0.1/alluxio-2.0.1-bin.tar.gz cp conf/alluxio-site.properties.template conf/alluxio-site.properties 拷贝软件到所有节点 scp -r -P53742 /opt/cloudera/parcels/alluxio/ root@incubator-t3-dc-002:/opt/cloudera/parcels/ cd /opt/cloudera/parcels/alluxio/alluxio-2.0.1 cp conf/alluxio-site.properties.template conf/alluxio-site.properties 修改配置(集群所有机器) vim alluxio-site.properties alluxio.master.hostname=172.16.16.241 vim alluxio-site.properties 更新conf/alluxio-site.properties中的alluxio.master.hostname为你将运行Alluxio Master的机器的主机名。添加所有worker节点的IP地址到conf/workers文件 alluxio.home=/opt/cloudera/parcels/alluxio/alluxio-2.0.1 alluxio.work.dir=/opt/cloudera/parcels/alluxio/alluxio-2.0.1 alluxio.conf.dir=${alluxio.home}/conf alluxio.logs.dir=${alluxio.home}/logs alluxio.master.mount.table.root.ufs=hdfs://incubator-t3-dc-001:8020/alluxio #hdfs挂载地址 alluxio.metrics.conf.file=${alluxio.conf.dir}/metrics.properties alluxio.master.hostname=incubator-t3-dc-001 alluxio.underfs.address=hdfs://incubator-t3-dc-001:8020/alluxio alluxio.underfs.hdfs.configuration=/etc/hadoop/conf/core-site.xml alluxio.master.bind.host=172.16.16.241 alluxio.master.journal.folder=/opt/cloudera/parcels/alluxio/alluxio-2.0.1/journal alluxio.master.web.bind.host=172.16.16.241 alluxio.master.web.hostname=incubator-t3-dc-001 alluxio.master.web.port=6661 alluxio.worker.bind.host=0.0.0.0 alluxio.worker.memory.size=2048MB alluxio.worker.tieredstore.levels=1 alluxio.worker.tieredstore.level0.alias=MEM alluxio.worker.tieredstore.level0.dirs.path=/mnt/ramdisk JAVA_HOME=/usr/java/jdk1.8.0_181-cloudera alluxio.user.network.netty.timeout.ms=600000 alluxio.master.security.impersonation.presto.users=* #scp所有机器 scp -r -P53742 alluxio-site.properties root@incubator-t3-dc-002:/opt/cloudera/parcels/alluxio/alluxio-2.0.1/conf/ scp -r -P53742 alluxio-masters.sh alluxio-workers.sh alluxio-start.sh root@incubator-t3-dc-002:/opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin vim workers 172.16.16.246 172.16.16.250 172.16.16.242 172.16.16.249 cp -rf alluxio-env.sh.template alluxio-env.sh vim alluxio-env.sh(所有机器) #添加 export ALLUXIO_SSH_OPTS="-p 53742" export JAVA_HOME=/usr/java/jdk1.8.0_181-cloudera cd /opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin vim alluxio-masters.sh 添加-p 53742 cd /opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin vim alluxio-workers.sh 搜索ssh 添加-p 53742 [root@incubator-t3-dc-001 bin]# ln -s /opt/jdk1.8.0_181/bin/java /usr/bin/java [root@incubator-t3-dc-001 bin]# /usr/bin/java -version java version "1.8.0_181" Java(TM) SE Runtime Environment (build 1.8.0_181-b13) Java HotSpot(TM) 64-Bit Server VM (build 25.181-b13, mixed mode) [root@incubator-t3-dc-001 bin]# ./alluxio format 报错需要在所有节点 创建mkdir -p /mnt/ramdisk/alluxioworker 如果不创建会报如下错误。 初始化alluxio cd /opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin [root@incubator-t3-dc-001 bin]# ./alluxio format Executing the following command on all worker nodes and logging to /opt/cloudera/parcels/alluxio/alluxio-2.0.1/logs/task.log: /opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin/alluxio formatWorker Waiting for tasks to finish... All tasks finished Executing the following command on all master nodes and logging to /opt/cloudera/parcels/alluxio/alluxio-2.0.1/logs/task.log: /opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin/alluxio formatJournal Waiting for tasks to finish... All tasks finished 启动alluxio ./alluxio-start.sh all NoMountalluxio-start.sh ./alluxio-start.sh all SudoMount http://172.16.16.241:6661/overview 测试 [root@incubator-t3-dc-001 bin]# echo "1.txt">1.txt [root@incubator-t3-dc-001 bin]# ll total 68 -rw-r--r-- 1 root root 6 Oct 14 20:27 1.txt -rwxrwxrwx 1 501 games 11808 Oct 12 14:35 alluxio -rwxrwxrwx 1 501 games 2758 Oct 12 14:38 alluxio-masters.sh -rwxrwxrwx 1 501 games 9668 Oct 14 20:06 alluxio-monitor.sh -rwxrwxrwx 1 501 games 5591 Aug 23 12:52 alluxio-mount.sh -rwxrwxrwx 1 501 games 18761 Oct 14 20:06 alluxio-start.sh -rwxrwxrwx 1 501 games 3806 Aug 23 12:52 alluxio-stop.sh -rwxrwxrwx 1 501 games 2128 Oct 14 19:48 alluxio-workers.sh [root@incubator-t3-dc-001 bin]# chmod 777 1.txt [root@incubator-t3-dc-001 bin]# ./alluxio fs copyFromLocal 1.txt / Copied file:///opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin/1.txt to / 上传文件到alluxio cd /opt/cloudera/parcels/alluxio/alluxio-2.0.1/bin #alluxio文件固化到HDFS ./alluxio fs persist /1.txt hadoop fs -ls /alluxio 3.7 Alluxio 集成presto 在hive-core-site.xml添加 在hive-core-site.xml添加 配置core-site.xml 你需要向你的hive.properties指向的core-site.xml中添加以下配置项: <property> <name>fs.alluxio.impl</name> <value>alluxio.hadoop.FileSystem</value> </property> <property> <name>fs.AbstractFileSystem.alluxio.impl</name> <value>alluxio.hadoop.AlluxioFileSystem</value> <description>The Alluxio AbstractFileSystem (Hadoop 2.x)</description> </property> hive-site.xml <property> <name>alluxio.user.file.writetype.default</name> <value>CACHE_THROUGH</value> </property> 修改jvm.properties修改alluxio-site.properties另外,你也可以将alluxio-site.properties的路径追加到Presto JVM配置中,该配置在Presto目录下的etc/jvm.config文件中。该方法的好处是只需在alluxio-site.properties配置文件中设置所有Alluxio属性。-Xbootclasspath/p:/opt/cloudera/parcels/alluxio/alluxio-2.0.1/#所有work节点必须添加此外,我们建议提高alluxio.user.network.netty.timeout.ms的值(比如10分钟),来防止读异地大文件时的超时问题。 Create a Hive table on Alluxio Create a Hive table on Alluxio Here is an example to create an internal table in Hive backed by files in Alluxio. You can download a data file (e.g., ml-100k.zip) from http://grouplens.org/datasets/movielens/. Unzip this file and upload the file u.user into /ml-100k/ on Alluxio: # ./bin/alluxio fs mkdir /ml-100k Successfully created directory /ml-100k # ./bin/alluxio fs copyFromLocal /opt/cloudera/parcels/alluxio/alluxio-2.0.1/ml-100k/u.user alluxio://incubator-t3-dc-001:19998/ml-100k Copied file:///opt/cloudera/parcels/alluxio/alluxio-2.0.1/ml-100k/u.user to alluxio://incubator-t3-dc-001:19998/ml-100k Hive create table WARNING: Hive CLI is deprecated and migration to Beeline is recommended. hive> CREATE TABLE u_user ( > userid INT, > age INT, > gender CHAR(1), > occupation STRING, > zipcode STRING) > ROW FORMAT DELIMITED > FIELDS TERMINATED BY '|' > LOCATION 'alluxio://incubator-t3-dc-001:19998/ml-100k'; FAILED: Execution Error, return code 1 from org.apache.hadoop.hive.ql.exec.DDLTask. MetaException(message:java.lang.RuntimeException: java.lang.ClassNotFoundException: Class alluxio.hadoop.FileSystem not found) 集成hive #第一步环境变量 export HIVE_AUX_JARS_PATH=/opt/cloudera/parcels/alluxio/alluxio-2.0.1/client/alluxio-2.0.1-client.jar:${HIVE_AUX_JARS_PATH} #拷贝java路径 cp -rf /opt/cloudera/parcels/alluxio/alluxio-2.0.1/client/alluxio-2.0.1-client.jar /opt/cloudera/parcels/CDH/lib/hive/lib #权限 chmod 777 /opt/cloudera/parcels/CDH/lib/hive/lib/alluxio-2.0.1-client.jar 重启hive服务 集成hdfs # cp -rf /opt/cloudera/parcels/alluxio/alluxio-2.0.1/client/alluxio-2.0.1-client.jar /opt/cloudera/parcels/CDH/lib/hadoop-hdfs/lib/ [root@incubator-t3-dc-001 lib]# chmod 777 /opt/cloudera/parcels/CDH/lib/hadoop-hdfs/lib/alluxio-2.0.1-client.jar 重启hdfs服务 测试hive集成 #切换hive用户 cubator-t3-dc-001:19998, Error: alluxio.exception.status.UnauthenticatedException: Plain authentication failed: Failed to authenticate client user="hive" connecting to Alluxio server and impersonating as impersonationUser="root" to access Alluxio file system. User "hive" is not configured to allow any impersonation. Please read the guide to configure impersonation at https://docs.alluxio.io/os/user/2.0/en/advanced/Security.html) su hive 重新创建表 hive> CREATE TABLE u_user ( > userid INT, > age INT, > gender CHAR(1), > occupation STRING, > zipcode STRING) > ROW FORMAT DELIMITED > FIELDS TERMINATED BY '|' > LOCATION 'alluxio://incubator-t3-dc-001:19998/ml-100k'; #创建表 create EXTERNAL table rating_alluxio( userId INT,movieId INT, rating FLOAT, timestamps STRING) row format delimited fields terminated by ',' LOCATION 'alluxio://incubator-t3-dc-001:19998/ml-100k'; 使用presto查询表 需要关联java包,否则会报错 使用 Presto 查询表,关联java包,重启服务 cp -rf /opt/cloudera/parcels/alluxio/alluxio-2.0.1/client/alluxio-2.0.1-client.jar /opt/cloudera/parcels/presto/lib/ chmod 777 /opt/cloudera/parcels/presto/lib/alluxio-2.0.1-client.jar #复制客户端到presto-hive里面 复制Alluxio client jar cp -rf /opt/cloudera/parcels/alluxio/alluxio-2.0.1/client/alluxio-2.0.1-client.jar /opt/cloudera/parcels/presto/plugin/hive-hadoop2/ 重启presto /opt/cloudera/parcels/presto/bin/launcher restart #查询表 ./presto --server localhost:6660 --execute "use default;select * from u_user limit 10;" --catalog hive --debug text_QDUxQ1RP5Y2a5a6i,color_FFFFFF,t_100,g_se,x_10,y_10,shadow_90,type_ZmFuZ3poZW5naGVpdGk=)Failed to authenticate client user="root" connecting to Alluxio server and impersonating as impersonationUser="presto" to access Alluxio file system.#master机器vim alluxio/alluxio-2.0.1/conf/alluxio-site.propertiesalluxio.master.security.impersonation.root.users=*#添加用户到site里面然后重启alluxio服务完全禁用客户端模拟机制。这就需要将客户端配置参数(不在服务器上)作如下设置:alluxio.security.login.impersonation.username=NONE正确显示 4.1Zeppelin Apache Zeppelin 是一个让交互式数据分析变得可行的基于网页的开源框架。Zeppelin提供了数据分析、数据可视化等功能。Zeppelin 是一个提供交互数据分析且基于Web的笔记本。方便你做出可数据驱动的、可交互且可协作的精美文档,并且支持多种语言,包括 Scala(使用 Apache Spark)、Python(Apache Spark)、SparkSQL、 Hive、 Markdown、Shell。 4.2 zeppelin部署 在机器上安装zeppelin #zeppelin安装 cd /opt/cloudera/parcels/zeppelin tar zxvf zeppelin-0.8.2-bin-all.tgz #修改端口 vim /opt/cloudera/parcels/zeppelin/zeppelin-0.8.2-bin-all/conf/zeppelin-env.sh export ZEPPELIN_PORT=80 export ZEPPELIN_ADDR=172.16.16.241 禁止匿名登陆 [root@incubator-t3-dc-001 conf]# cp -rf shiro.ini.template shiro.ini [root@incubator-t3-dc-001 conf]# cp -rf zeppelin-site.xml.template zeppelin-site.xml vim zeppelin-site.xml #禁止匿名登录 修改zeppelin.anonymous.allowed属性为false <property> <name>zeppelin.anonymous.allowed</name> <value>false</value> <description>Anonymous user allowed by default</description> </property> 集成ldap #配置ldap vim shiro.ini [main] ldapRealm=org.apache.zeppelin.realm.LdapRealm ldapRealm.contextFactory.authenticationMechanism=simple ldapRealm.contextFactory.url=ldap://172.16.16.245:389 ldapRealm.userDnTemplate=uid={0},ou=People,dc=t3,dc=com ldapRealm.pagingSize = 200 ldapRealm.authorizationEnabled=true ldapRealm.searchBase= dc=t3,dc=com ldapRealm.userSearchBase = ou=People,dc=t3,dc=comd ldapRealm.groupSearchBase = ou=group,dc=t3,dc=com ldapRealm.groupObjectClass= posixGroup ldapRealm.userLowerCase = true ldapRealm.userSearchScope = subtree; ldapRealm.groupSearchScope = subtree; ldapRealm.contextFactory.systemUsername= cn=Manager,dc=t3,dc=com ldapRealm.contextFactory.systemPassword= CFXZ6EU3bCpIMFpFZX0LqjEq ldapRealm.groupSearchEnableMatchingRuleInChain = true ldapRealm.rolesByGroup = group: admin #关联组合admin角色 sessionManager = org.apache.shiro.web.session.mgt.DefaultWebSessionManager cookie = org.apache.shiro.web.servlet.SimpleCookie cookie.name = JSESSIONID cookie.httpOnly = true sessionManager.sessionIdCookie = $cookie securityManager.sessionManager = $sessionManager securityManager.sessionManager.globalSessionTimeout = 86400000 shiro.loginUrl = /api/login [roles] role1 = * role2 = * role3 = * admin = * [urls] /api/version = anon /api/interpreter/setting/restart/** = authc /api/interpreter/** = authc, roles[admin] /api/configurations/** = authc, roles[admin] /api/credential/** = authc, roles[admin] #/** = anon /** = authc Ldap和用户认证只能二选一#权限认证其中的[users]部分,即登录时的账号。等号前是用户名,等号后是密码,逗号后是用户的角色。账号可以不定义角色,也可以定义多个角色。比如用户名user1,对应密码password2,拥有角色role1和role2。 [users] admin = t, admin bi_wkx = bi_wkx, read, write bi_ch = bi_ch, read, write bi_fyc = bi_fyc read, write [roles]配置用户的角色,[urls]部分配置不同web接口的认证方式和需要的角色,/表示任意路径,验证时按照定义顺序匹配,所以/一般放在最后一行。比如,下面的配置定义了4种角色。接口version验证方式anon,即不需要验证,不用登录就能访问。接口interperter需要表格形式的验证,且用户具有admin角色才能访问。/** = authc表示其他接口只需要登录验证即可访问,不需要用户有额外的角色。 [roles] admin = * read = * write = * [urls] # anon means the access is anonymous. # authcBasic means Basic Auth Security # authc means Form based Auth Security /api/version = anon /api/interpreter/** = authc, roles[admin] /api/credentail/** = authc, roles[admin] /api/configurations/** = authc, roles[admin] /** = authc 重启服务 sh ../bin/zeppelin-daemon.sh restart 集成zeppelin各插件 #zeppelin配置hive 配置文件vim zeppelin-env.sh:在文件末尾添加以下配置,根据自己的路径设置。 export JAVA_HOME=/usr/java/jdk1.8.0_181-cloudera export MASTER=yarn-client export HADOOP_HOME=/opt/cloudera/parcels/CDH/lib/hadoop export SPARK_HOME=/opt/cloudera/parcels/CDH/lib/spark export HIVE_HOME=/opt/cloudera/parcels/CDH/lib/hive export IMPALA_HOME=/opt/cloudera/parcels/CDH/lib/impala export HADOOP_CONF_DIR=/etc/hadoop/conf export ZEPPELIN_LOG_DIR=/opt/cloudera/parcels/zeppelin/zeppelin-0.8.2-bin-all/log export ZEPPELIN_PID_DIR=/opt/cloudera/parcels/zeppelin/zeppelin-0.8.2-bin-all/run/ export ZEPPELIN_WAR_TEMPDIR=/var/tmp/zeppelin #配置zeppelin 页面 common.max_count 1000 hive.driver org.apache.hive.jdbc.HiveDriver hive.password hive hive.url jdbc:hive2://incubator-t3-dc-003:10000 hive.user hive zeppelin.interpreter.localRepo /opt/cloudera/parcels/zeppelin/zeppelin-0.8.2-bin-all/local-repo/helium-registry-cache zeppelin.interpreter.output.limit 102400 zeppelin.jdbc.auth.type zeppelin.jdbc.concurrent.max_connection 10 zeppelin.jdbc.concurrent.use true zeppelin.jdbc.keytab.location zeppelin.jdbc.principal Dependencies artifact exclude org.apache.hive:hive-jdbc:2.1.1 hive-jdbc-2.1.1-cdh6.3.0.jar org.apache.hadoop:hadoop-common:3.0.0 hadoop-common-3.0.0-cdh6.3.0.jar mysql:mysql-connector-java:5.1.47 mysql-connector-java-5.1.47.jar 新建一个作业进行测试 notebook --> Create new node填写名称,选择hive即可输入查询语句,注意查询语句前需要有前缀(hive):%hiveselect * from test limit 10语句末尾不能加分号,不然会有错误。#python集成%pythonimport syssys.version语句末尾不能加分号,不然会有错误。#impala 新建;jdbc_impala default.driver = org.apache.hive.jdbc.HiveDriver default.url = jdbc:hive2://incubator-t3-dc-003:21050/default;auth=noSasl(验证模式是NOSASL才能正常使用impala,但是这个会让impala查询数据时,跳过rander中设置的掩码规则) default.user = zeppelin url 的 NOSASL模式需要任意一个用户名(如Hive),不需要密码,不填写用户名会报错。 Dependencies artifact exclude org.apache.hive:hive-jdbc:2.1.1 hive-jdbc-2.1.1-cdh6.3.0.jar org.apache.hadoop:hadoop-common:3.0.0 hadoop-common-3.0.0-cdh6.3.0.jar mysql:mysql-connector-java:5.1.47 mysql-connector-java-5.1.47.jar #impala测试 %impala select * from nation limit 10 #spark local[*] in local mode yarn-client in Yarn client mode yarn-cluster in Yarn cluster mode #修改hdfs参数dfs.permissions.superusergroup=supergroup,root%sqlshow databases #presto presto %jdbc (default) %presto select * from kudu.default."default.test_kudu_table" limit 10 Option Shared Properties name value default.driver com.facebook.presto.jdbc.PrestoDriver default.url jdbc:presto://172.16.16.241:6660 default.user root default.passwd 密码 zeppelin.jdbc.concurrent.max_connection 10 zeppelin.jdbc.concurrent.use true Dependencies artifact exclude com.facebook.presto:presto-jdbc:0.170 cd /opt/cloudera/parcels/zeppelin/zeppelin-0.8.2-bin-all/interpreter/jdbc rz presto-jdbc-0.226.jar 5.1 rancher Rancher是一个开源的企业级容器管理平台。通过Rancher,企业再也不必自己使用一系列的开源软件去从头搭建容器服务平台。Rancher提供了在生产环境中使用的管理Docker和Kubernetes的全栈化容器部署与管理平台。 为什么需要Rancher在原来, 如果我们需要做一个分布式集群我们需要学习一全套的框架并编码实现如 服务发现, 负载均衡等逻辑, 给开发者造成很大的负担, 不过好在现在有Docker以及他周边的一些技术能在上层解决这些问题, 而应用该怎么开发就怎么开发. 当你选择使用Docker技术栈的时候, 会发现在生产环境中不光光是 docker run就能解决的. 还需要考虑比如docker之间的组网, 缩扩容等问题, 于是你去学习kubernetes, 发现好像有点复杂啊, 有没有更傻瓜化一点的? 那就是rancher了. 5.2 rancher部署zeppelin #安装docker sudo yum-config-manager --add-repo http://mirrors.aliyun.com/docker-ce/linux/centos/docker-ce.repo sudo yum makecache fast yum list docker-ce --showduplicates | sort -r sudo yum install docker-ce-17.12.0.ce-1.el7.centos docker version docker pull rancher/server netstat -anplt | grep 8000 # Error starting daemon: error initializing graphdriver: devmapper: Base Device UUID and Filesystem veri(报错) systemctl stop docker (停止docker 服务) dmsetup udevcomplete_all (释放未完成的磁盘操作) sudo rm -rf /var/lib/docker/* (清空docker 数据) * reboot (注:当有镜像或容器文件删除不了时,重启服务器) systemctl start docker (重启docker服务) 以下是创建数据库和数据库用户的SQL命令例子 #创建rancher数据库 CREATE DATABASE IF NOT EXISTS cattle COLLATE = 'utf8_general_ci' CHARACTER SET = 'utf8'; GRANT ALL ON cattle.* TO 'cattle'@'%' IDENTIFIED BY 'cattle'; GRANT ALL ON cattle.* TO 'cattle'@'localhost' IDENTIFIED BY 'cattle'; 启动一个Rancher连接一个外部数据库,你需要在启动容器的命令中添加额外参数。 #启动rancher docker run -d --restart=unless-stopped -p 80:8080 rancher/server \ --db-host incubator-t3-dc-001 --db-port 3306 --db-user cattle --db-pass cattle --db-name cattle docker search nginx docker pull docker.io/nginx docker images #启动rancher docker run --name rancher -d -p 80:8080 rancher/server docker start 9b04ff050ddd 为了安全可以给Rancher配置登录账号(选择 系统管理 --》访问控制 --》LOCAL)-添加本地账号 管理员 admin admin #安装zeppelin docker pull apache/zeppelin:0.8.2 docker volume create zeppelin-logs docker volume create zeppelin-notebook 3.启动zeppelin docker run -d -p 80:8081 \ -v zeppelin-logs:/logs \ -v zeppelin-notebook:/notebook \ --env HOST_IP=0.0.0.0 \ --env ZEPPELIN_LOG_DIR='/logs' \ --env ZEPPELIN_NOTEBOOK_DIR='/notebook' \ --volume /etc/localtime:/etc/localtime \ --restart=always \ --name zeppelin apache/zeppelin:0.8.2 5.3 rancher集成ldap认证 http://172.16.16.241/admin/access/openldap设置ldap用户 组:ou=Group,dc=t3,dc=com 用户:ou=People,dc=t3,dc=com 域:172.16.16.245 端口:389 #设置 常规 服务器: 172.16.16.245:389 TLS: No 服务账号: cn=Manager,dc=t3,dc=com Connection Timeout: 1000毫秒 用户 搜索起点: ou=People,dc=t3,dc=com 对象分类: posixAccount 登录字段: uid 名称字段: givenName 搜索字段: uid 启用字段: 必须创建api到此实战结束。 大数据运维更多技巧和技术 CDH+Ambari实战带你搞定大数据运维详情在《大数据安全运维实战》大数据安全运维实战扫码加入大数据运维大家庭共同学习进步。 学习专栏你能收获什么? 专栏以CDH和ambari二个大数据平台为主,内容全都是笔者多年的工作中提炼出来的,不仅包含了大数据的基本知识,最主要的是大数据安全维领域的常见案例和实战技巧,借以本专栏分享给大家,希望大家通过学习,能够解决在日常工作中所遇到的问题,提高自己的工作效率,收获满满。 最后的最后,希望每一个学习我专栏的小伙伴,能够转型成功,升职加薪!

优秀的个人博客,低调大师

What's new in dubbo-go v3.0.3

dubbogo 社区近期发布了 https://github.com/apache/dubbo-go/releases/tag/v3.0.3-rc2。相关改进内容较多,本文只列出相关重大 feature、bugfix 、 性能提升项。 1. Proxyless模式下证书文件获取 在Proxy模式下,Istio颁发的证书可以通过sidecar进行获取和轮换。但在Proxyless模式下,需要主动去获取证书。本功能实现了在有无istio-agent的两种情况下,获取istio颁发的证书,交给dubbogo框架使用。相关pr为: https://github.com/apache/dubbo-go/pull/1945, 由dubbogo社区的@ZLBer同学负责实现。 2. 配置文件支持占位符查找 使用dubbo-go需要创建dubbogo的配置文件,在当前版本中对配置文件的编写进行了增强,支持使用占位符来减少一些重复配置。使用方式如下: 相关pr https://github.com/apache/dubbo-go/pull/2014 由社区的ZLBer 同学提交pr 3. 其他新 Features 支持 Triple 协议的健康检查 API https://github.com/apache/dubbo-go/pull/1935 不基于注册中心的优雅下线支持滑动窗口维护请求 https://github.com/apache/dubbo-go/pull/1973 支持使用环境配置配置Nacos和 Polaris IP和Port https://github.com/apache/dubbo-go/issues/2060 4. BUG 修复与优化 修复rand.seed重复调用 https://github.com/apache/dubbo-go/pull/1958 修复并发创建监控指标问题 https://github.com/apache/dubbo-go/pull/1961 删除Polaris consumer https://github.com/apache/dubbo-go/pull/1962 修复打印限流日志的参数问题 https://github.com/apache/dubbo-go/pull/1964 修复getting attributes拼写错误 https://github.com/apache/dubbo-go/pull/1968 修复Polaris 订阅问题 https://github.com/apache/dubbo-go/pull/1988 修复多个invoker包含不同的方法时的调用问题 https://github.com/apache/dubbo-go/pull/2000 修复shutdown InternalSignal 的默认值 https://github.com/apache/dubbo-go/pull/2003 增加 mesh proxy开关 https://github.com/apache/dubbo-go/pull/2022 修复柔性服务引发的死锁问题 https://github.com/apache/dubbo-go/pull/2022 移除了Apollo配置中心 https://github.com/apache/dubbo-go/pull/1932 增强MetadataService中的ServiceDefinition https://github.com/apache/dubbo-go/pull/1963 升级Gost版本 https://github.com/apache/dubbo-go/pull/1993 升级Hessian2版本 https://github.com/apache/dubbo-go/pull/1995 添加Getty日志打印 https://github.com/apache/dubbo-go/pull/2029 对于侦听器事件notify使用notifyAll代替notify https://github.com/apache/dubbo-go/pull/2043 5. hessinan2 go 最新 feature 除了dubbogo自身的改进外,dubbo-go-hessian2 项目截止目前最新版本 v1.11.3 https://github.com/apache/dubbo-go-hessian2/releases/tag/v1.11.3 升级其依赖的 gost,修复 bytes.AcquireBytes 导致的 memory leak,gost pr 为 https://github.com/dubbogo/gost/pull/108 该改进有蚂蚁集团文徐【王文学】同学提交; 修复 enum 解码过程中的错误 https://github.com/apache/dubbo-go-hessian2/pull/332 修复一个 Java list corner case 解析错误,相关 pr https://github.com/apache/dubbo-go-hessian2/pull/330 ,由纵横文学网 沈超 同学提交 6. Other 如果你有任何疑问,欢迎钉钉扫码加入交流群【钉钉群号 23331795】 作者简介 张斌斌,github 账号 binbin0325,dubbo-go 社区 committer,主要参与 dubbo-go Proxyless以及注册中心等功能建设与优化等工作。目专注于混沌工程、云原生和微服务等技术方向。

优秀的个人博客,低调大师

What?构造的查询语句会导致堆栈溢出

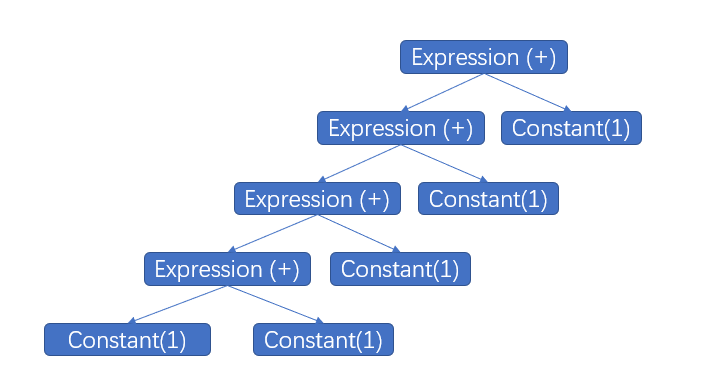
摘要:本文归纳了Neo4j和Nebula两个开源图数据库的两个pull request修复的堆栈溢出问题,并试着写写通过阅读pr中的问题而得到的一些启发 本文分享自华为云社区《巧妙构造的查询语句会导致堆栈溢出?从两个开源图数据库PR看查询执行时的编码设计问题》,作者:蜉蝣与海 。 导读&简介 查询语言(Query Language)的出现方便了用户在计算引擎上执行各种操作,就图数据库而言,neo4j支持查询语言cypher,nebula有其独有的查询语言nGQL。由于查询语言规则依赖语言自身文法,用户使用查询语言自由度较大,输入灵活,一般测试手段难以覆盖到所有情况,所以在某种程度上复杂的查询语句是各类计算产品健壮性的试金石,本文归纳了两个开源产品pr(pull request)时修复的堆栈溢出问题,并试着写写通过阅读pr中的问题而得到的一些启发。 先上链接,如果你更喜欢读代码而不是听我叨叨:StackOverFlowError occurs when reducing a List(neo4j): issue:https://github.com/neo4j/neo4j/issues/12683 pr:https://github.com/neo4j/neo4j/commit/8336c2f75f4baa4283babe31293899020092d5d1 fix crash when the expression exceed the depth(nebula): https://github.com/vesoft-inc/nebula/pull/3606 代码分析 在这两个PR中都提到了StackOverFlow。我们先试着描述一下问题,Nebula的pr要稍微好懂一点:可以试着打开测试用例来看之前有问题的语句,是一堆 1+1+1+…+1+1 as result, 当+1+1这样的语法要素出现的次数太多时,会报栈溢出。通过阅读parser.yy可以看到,对于每个加法符号,都会生成一个表达式对象: // parser.yy expression_internal :constant_expression { $$ = $1; } ... | expression_internal PLUS expression_internal { $$ = ArithmeticExpression::makeAdd(qctx->objPool(), $1, $3); } static ArithmeticExpression* makeAdd(ObjectPool* pool, Expression* lhs = nullptr, Expression* rhs = nullptr) { return pool->add(new ArithmeticExpression(pool, Expression::Kind::kAdd, lhs, rhs)); } 对于像“1+1+1+1+1”这样的表达式,调用栈就会成这样: 当用户输入的+1的数目比较多时,头部expression下就会链式挂载若干个子expression,如果在语法解析层和语法执行层没有对表达式做特殊的处理,这些子链会被递归调用(即父expression会调用子expression),递归的深度取决于子链的数目。 neo4j的issue有些小众,其关注的是对这样自定义聚集操作的语句: unwind range(0,15000) as xxx with collect([xxx]) as set1 with reduce(c = [], x in set1| c + x) as fromNodes unwind fromNodes as x return x 其中range(0,15000)会生成一个列表,共15000个元素,如[0,1,2,…,14998,14999]这样。unwind会对这个链表进行展开,通过collect([xxx])对每个元素生成一个独立的列表并打包成set1([0],[1],…[14998],[14999]),然后通过reduce操作对这些独立的元素进行拼接。问题就是出在拼接的时候:reduce看起来是不断在进行foreach(x in set1){c = c + x}这样的操作,然而实际代码实现时,对15000个元素进行了展开,生成的是c=x0+x1+x2+…+x14999。并没有使用一个变量去缓存c的中间状态,而是试图通过不断的二元计算直接算出c的结果。代码如下: // CypherMath.Add if ( lhsIsListValue && rhs instanceof ListValue ) { return VirtualValues.concat( (ListValue) lhs, (ListValue) rhs ); } // VirtualValues.concat public static ListValue concat( ListValue... lists ) { return new ListValue.ConcatList( lists ); } 这样会有15000个ConcatList链式连接,实际计算时15000个ConcatList被递归调用,生成了一个深为15000的函数调用栈。 上述代码的问题和PR中的解决方案 可以看到,不管是C++的nebula,还是java写的neo4j,通过巧妙地构造查询语句,都可以使得内部执行时生成深度较深的函数调用栈。而函数调用栈的深度,在不同编程语言下都是有限制的(大部分查询语言栈空间是M级的,参见附录[1]和附录[2])。超过这个限制,轻则直接导致语句崩溃,如果系统的异常处理机制不够完善,也可能导致更严重的问题。 nebula和neo4j对这个问题采用了两种不同的解决方案。在nebula中,通过在parser.yy中调用checkExprDepth方法,去检查最大递归调用深度,超出则报错;而在neo4j中,通过构建一个list来缓存concat的元素列表,进而消除了递归调用。 // neo4j更新list的代码,解析语句阶段,原始list调用add方法,会生成一个包含value元素的新的list,这个新list会替换调原始的list public ListValue add( ListValue value ) { var newSize = lists.length + 1; var newArray = new ListValue[newSize]; System.arraycopy( lists, 0, newArray, 0, lists.length ); newArray[lists.length] = value; return new ConcatList( newArray); } 容易发现nebula的解决方案更直接一点,过深的调用栈一律拒绝;而neo4j则是通过一些容器(如List,Stack)等消除了递归调用,对用户更加友好,但是如果其他地方也出现类似情况,可能需要做针对性修改。 PR带来的启示 在查询语言的解析和计划执行的编码设计阶段,为查询语句中的某个语法成分(如表达式、函数、子句)编写执行逻辑的代码往往是相对直观且易于理解的。比如加法操作可以直接构造一个ArithmeticExpression对象,List拼接可以直接构造一个ConcatList对象。然而由于用户输入的不确定性,需要考虑多个语法成分联动,或者某几个语法成分批量出现时带来的问题(例如深度过深的递归)。要么像nebula一样在量上做限制,量太大直接报错;要么像neo4j一样针对每个会因为批量联动带来问题的点给出不会出错的编码设计。通过这两种手段,可以减少极端语句对系统的影响,提高系统的健壮性。 附录 [1]C++函数调用栈溢出demo:https://blog.csdn.net/qq_44989173/article/details/115986871?spm=1001.2101.3001.6650.1&utm_medium=distribute.pc_relevant.none-task-blog-2~default~CTRLIST~Rate-1.pc_relevant_paycolumn_v3&depth_1-utm_source=distribute.pc_relevant.none-task-blog-2~default~CTRLIST~Rate-1.pc_relevant_paycolumn_v3&utm_relevant_index=2 [2]JVM StackOverFlow和OOM 场景模拟:https://blog.csdn.net/HUDCHSDI/article/details/113817579 点击关注,第一时间了解华为云新鲜技术~

优秀的个人博客,低调大师

What’s New in Dubbo-go v1.5

引语 计算机技术浪潮每 10 年都有一次技术颠覆,相关知识体系最迟每 5 年都会革新一次,大概每两年贬值一半,在应用服务通信框架领域亦然。凡是有长期生命的通信框架,大概有 5 年的成长期和 5 年的稳定成熟期。每个时代都有其匹配的应用通信框架,在 20 年前的 2G 时代,强跨语言跨平台而弱性能的 gRPC 是不会被采用的。 每个通信框架,不同的人从不同角度看出不同的结论:初学者看重易用易学,性能测评者注重性能,应用架构师考虑其维护成本,老板则考虑则综合成本。一个应用通信框架的性能固然重要,其稳定性和进化能力更重要,得到有效维护的框架可在长时间单位内降低其综合成本:学习成本、维护成本、升级成本和更换成本。 什么是 Dubbo-go?第一,它是 Dubbo 的 Go 语言版本,全面兼容 Dubbo 是其第一要义。第二,它是一个 Go 语言应用通信框架,会充分利用作为云原生时代第一语言---Go 语言的优势,扩展 dubbo 的能力。 2008 年诞生的 Dubbo 已有十多年历史,依靠阿里和其社区,历久弥新。2016 年发布的 Dubbo-go 也已进入第五个年头,如今全面兼容 Dubbo v2.7.x 的 Dubbo-go v1.5 终于发布了。 回首过往,Dubbo-go 已经具备如下能力: 互联互通:打通了 gRPC 和 Spring Cloud 生态; 可观测性:基于 OpenTracing 和 Prometheus,使得其在 Logging、Tracing 和 Metrics 方面有了长足进步; 云原生:Dubbo-go 实现了基于 Kubernetes API Server 为注册中心的通信能力,做到了升级成本最低。 毋庸讳言,相较于现有成绩,发展阶段的 Dubbo-go 对未来有更多的期待之处: 易用性:Dubbo-go 的入门成本并不低,把很多感兴趣者挡在了门外。但好消息是,随着 Dubbo-go 在阿里内部的逐步推开,阿里中间件团队对其进行了进一步的封装,经生产环境检验后会开放给社区使用。 云原生:目前的 Dubbo-go 的基于 kubernetes 的方案,从技术分层角度来看, Kubernetes API Server 终究是系统的运维态组件,不应该暴露给应用层,否则会造成 APIServer 自身通信压力过大,且系统整体风险很高:应用层使用不当,或者框架自身的流量方面的 bug,可能会把 APiServer 打垮,后果就是造成整体后端服务能力的瘫痪!所以应用层需要感知的是 kubernetes 提供给应用层的 Operator,不断进化的 Dubbo-go 计划在 v1.6 版本中发布 Dubbo-go Operator。 雄关漫道真如铁,而今迈步从头越。Dubbo-go 社区【钉钉群 23331795】与 Dubbo-go 同在。 应用维度注册模型 经过一段时间的努力之后,我们终于完成了应用维度的服务注册与发现。和原本已有的接口维度的注册模型比起来,新的注册模型有两个突出特点: 和主流的注册模型保持一致。目前的主流做法都是按照应用为基本单位来进行注册的,如Spring Cloud。在支持应用维度注册之后,对于接下来的云原生支持,奠定了基础; 大幅度减轻对注册中心的压力。在该模型之下,从注册中心的视角看过去,集群规模只和实例数量成正比,而不是现有的和服务数量成正比; 当然,我们在设计的时候就考虑到了用户的迁移成本。要迁移到新的注册模型,只需要将现有使用的注册中心换成新的 ServiceDiscoveryRegistry就可以。 ServiceDiscoveryRegistry是支持多种实现的。目前来说,我们支持: nacos; etcd; zookeeper; 我们提倡新上线的业务尽量使用 nacos 和 etcd 这种更可靠稳定的注册中心。 Metadata Report 元数据中心 v1.5 版本在支持应用维度注册模型时,有很重要的一个问题需要解决,即接口维度的元数据存储。服务维度的注册模型和应用维度的注册模型,本质的区别是往注册中心注册的数据维度的不一致。虽然我们在应用维度注册模型中,将接口维度的数据从注册中心中剔除了,但是在rpc的框架中,一个 consumer 要想真正找到想要调用的服务地址,就必须得到 provider 端开放的服务信息。这部分数据,在 v1.5 版本中,我们将它们存储到了元数据中心中。 元数据中心,是一个接口定义。泛指一块存储区域,可以对接口级别的元数据进行存储、读取,provider 端调用存储,consumer 端调用读取。元数据中心中的数据需要保持准确性、实时性。 目前元数据中心,有两个父类(Go 中没有继承,此处说的父子类,单纯指子类对父类的组合关系)实现,一个是 local 实现,一个是 remote 实现。local 实现是将 provider 的内存作为虚拟元数据中心,remote 实现是指依赖 ZooKeeper、etcd、nacos 等注册中心作为元数据中心。目前 remote 有 zookeeper、nacos、etcd 和 consul 的子类实现。即用户可以将元数据信息,通过以上的第三方注册中心进行数据存储和分发。 Invocation 接口支持 attribute 属性 invocation 结构中新增 attribute 属性支持,用于流程内部的属性存储。和 attachment 不同点在于,attachment会从 consumer 传递到 provider,但 attribute 属性不会。 k8s注册中心 在 v1.5 版本之前,k8s 注册中心的实现是通过直接使用 k8s client 中Pod对象的 List&&Watch 接口。在本次迭代中引入了 k8s informer。这样做的原因在于两点,首先一定的程度上来讲 dubbo-go 的 k8s 注册中心也是一个 k8s controller,使用 informer 的模式更加 k8s native。更重要的是社区计划后续向 CRD+Operator 的模式演进,informer 模式是对后续的演进的探索。除了这个铺垫之外,本次迭代还对跨 namespace 的服务发现做了支持。再有就是为了减少对 kube-apiserver List&&Watch 的压力,对 provider 和 consumer 的行为进行了区分,provider 不再进行 Watch 而仅对 kube-apiserver 进行写操作。 优化路由模型 在 1.5 版本之前,Router 模型中属性是包含:优先级与路由属性,Router Chain 只包含路由属性。从中能识别出其实 Router Chain 也是一种特殊 Router。1.5 版本之后,使 Router 更抽象,分离出其优先级属性,新增 Priority Router、Chain 继承 Router 使其变为特殊的 Router,使关系上看起来更加清晰。如下图: 回顾与展望 Dubbo-go 处于一个比较稳定成熟的状态。目前新版本正处于往云原生方向的尝试,应用服务维度注册是首先推出的功能,这是一个和之前模型完全不一样的新注册模型。该版本是我们朝云原生迈进新一步的关键版本。除此之外,包含在该版本也有一些之前提到的优化。 下一个版本 v1.5.1,虽然仍是以兼容 Dubbo 2.7.x 为主要任务,但在分布式能力的增强上,也是我们关注的重点。 在分布式事务方面,有一个重要的基于 Seata 扩展实现。通过增加过滤器,在服务端接收 xid 并结合 seata-golang[2] 达到支持分布式事务的目的。 从而使 Dubbo-go 在分布式场景下,让用户有更多的选择,能适应更多的个性化场景。 与此同时,在传输链路安全性上,TLS 安全传输链路是该版本重要功能之一。通过提供统一入口,未来能引入更多的与传输链路安全性相关的功能,适应用户不一样的使用场景。 注册中心模型上,支持多注册中心集群负载均衡。业务部署假设是双注册中心(图 1 ),从原来双注册中心中所有 Provider 一起选址。优化成选址时的多了一层注册中心集群间的负载均衡(图 2 )。 (图 1 ) (图 2 ) 以前的 dubbo-go RPC 层直接复用了 getty 框架 的 RPC[3],未能实现协议和应用通信地址的隔离。阿里中间件展图同学重构了 dubbo-go RPC 层,实现了连接复用:可以实现 consumer 与 provider 端的同一个 TCP 连接上进行多协议通信。相关 PR 业已合并,会在 dubbo-go v1.5.1 中发布。 目前下一个版本正在紧锣密鼓的开发中,具体规划及任务清单[1] ,都已经在 Github 上体现。 [1] : https://github.com/apache/dubbo-go/projects/8 [2] : https://github.com/seata-golang/seata-golang [3] : https://github.com/AlexStocks/getty/tree/master/rpc

优秀的个人博客,低调大师

What's new in dubbo-go-pixiu v0.6.0

pixiu 0.6.0 虽然艰辛,但在社区小伙伴的努力下发布了。这个版本不止有常规社区功能,还有很多功能特性是来源于ASoC-2022 Alibaba Summer of Code,OSPP(中科院软件所[开源软件供应链点亮计划]) , GSoC(Google Summer of Code) 提案内容。 New Features In v0.6.0 nacos config 背景:pixiu 的配置,启动配置项(conf.yaml),日志配置(log.yml)均是从本地文件加载,没有接入动态配置中心的能力,而日常生产环境中,配置通过配置中心集中下发管理是更为灵活和安全的方式之一。 动态配置下发的场景还有很多扩展,接入的组件也因公司的选型有所不同,当前我们主要考虑接入 nacos 配置中心。 注:在设计上可以考虑,如何在二次开发场景下更为“标准、安全、简单”的接入其他配置中心。 Pixiu 启动时从配置中心Nacos 拉取配置 conf.yaml 数据 pixiu.conf的配置不用配置static_resources,需要配置config-center和nacos: config-center: type: nacos enable: true nacos: server-configs: - ip_addr: "127.0.0.1" port: 8848 client-config: username: nacos password: nacos 原来我们熟悉pixiu.conf配置内容放到了nacos中: static_resources: listeners: - name: "net/http" protocol_type: "HTTP" address: socket_address: address: "0.0.0.0" port: 8881 filter_chains: filters: - name: dgp.filter.httpconnectionmanager config: route_config: routes: - match: prefix: "*" http_filters: - name: dgp.filter.http.dubboproxy config: dubboProxyConfig: auto_resolve: true registries: "zookeeper": protocol: "zookeeper" timeout: "3s" address: "127.0.0.1:2181" username: "" password: "" timeout_config: connect_timeout: 5s request_timeout: 5s server_name: "test_http_dubbo" generate_request_id: false config: idle_timeout: 5s read_timeout: 5s write_timeout: 5s shutdown_config: timeout: "60s" step_timeout: "10s" reject_policy: "immediacy" 更详细的配置参考samples: https://github.com/apache/dubbo-go-pixiu-samples/tree/main/dubbogo/simple/farconfnacos nacos配置支持还需要进一步完善的功能: 动态托管/下发用户自定义配置 动态下发Pixiu配置 OSPP: Traffic Distribution 流量分发提供两种策略,基于 Request Header 和服务权重的流量切分。 canary-by-header canary-by-header是要匹配的 Request Header 的值,当 Request Header 设置此值时,它将被路由到相应的cluster(cluster中绑定canary-by-header键值)。当请求不包含这一 Request Header 或 Header 值不匹配时,请求不会被发送到Canary版本,该策略适用于蓝绿发布以及A/B测试 canary-weight 这种策略适用于金丝雀部署,权重范围 0 - 100 按百分比将请求路由到指定的服务。权重为 0 意味着该金丝雀规则不会向 Canary 服务发送任何请求;权重为 100 意味着所有请求都将被发送到 Canary。 Add Graceful Shutdown 通过graceful shutdown 能力,在进程获得系统型号:SIGINT, SIGKILL, SIGTERM信号时执行graceful shutdown过程:拒绝新的请求;等待处理中请求完成直到timeout. static_resources: ....... ....... shutdown_config: timeout: "60s" step_timeout: "10s" reject_policy: "immediacy" 配置方式参考: https://github.com/apache/dubbo-go-pixiu-samples/tree/main/shutdown WASM Plugin for Pixiu Pixiu 支持 WASM 插件机制,实现http fitler。 PIxiu与WASM扩展代码交互采取 Proxy-Wasm 规范,该规范是开源社区针对「网络代理场景」设计的一套 ABI 规范,采用该规范能让PIxiu复用社区既有的WASM扩展。 WASM原则上应该支持多种语言,这里以Go语言为例,最终通过tinygo编译成wasm文件。如果要实现我们的扩展WASM程序,需要按以下模版进行编码实现: package main import ( "github.com/tetratelabs/proxy-wasm-go-sdk/proxywasm" "github.com/tetratelabs/proxy-wasm-go-sdk/proxywasm/types" ) func main() { proxywasm.SetNewHttpContext(newHttpContext) } type myHttpContext struct { // you must embed the default context so that you need not to re-implement all the methods by yourself proxywasm.DefaultHttpContext contextID uint32 } func newHttpContext(rootContextID, contextID uint32) proxywasm.HttpContext { return &myHttpContext{contextID: contextID} } // override func (ctx *myHttpContext) OnHttpRequestHeaders(numHeaders int, endOfStream bool) types.Action { return types.ActionContinue } deploy pixiu as dubbo service ingress gateway in k8s istio 当dubbo部署istio + k8s环境中,pixiu可以作为dubbo provider的ingress gateway,接收dubbo/triple/http的流量,并将请求转发到dubbo provider中。 samples: https://github.com/apache/dubbo-go-pixiu-samples/tree/main/xds/dubbo-go-istio ASoC 2022: Pixiu Metrics Implementation Pixiu Metrics提供四个prometheus运行指标: var reqCnt = &Metric{ ID: "reqCnt", Name: "requests_total", Description: "How many HTTP requests processed, partitioned by status code and HTTP method.", Type: "counter_vec", Args: []string{"code", "method", "host", "url"}, } var reqDur = &Metric{ ID: "reqDur", Name: "request_duration_seconds", Description: "The HTTP request latencies in seconds.", Args: []string{"code", "method", "url"}, Type: "histogram_vec", Buckets: reqDurBuckets, } var resSz = &Metric{ ID: "resSz", Name: "response_size_bytes", Description: "The HTTP response sizes in bytes.", Args: []string{"code", "method", "url"}, Type: "histogram_vec", Buckets: resSzBuckets, } var reqSz = &Metric{ ID: "reqSz", Name: "request_size_bytes", Description: "The HTTP request sizes in bytes.", Args: []string{"code", "method", "url"}, Type: "histogram_vec", Buckets: reqSzBuckets, } var standardMetrics = []*Metric{ reqCnt, reqDur, resSz, reqSz, } config配置http_filters: dgp.filter.http.prometheusmetric: static_resources: listeners: - name: "net/http" protocol_type: "HTTP" address: socket_address: address: "0.0.0.0" port: 8888 filter_chains: filters: - name: dgp.filter.httpconnectionmanager config: route_config: routes: - match: prefix: /health route: cluster: user cluster_not_found_response_code: 505 - match: prefix: /user route: cluster: user cluster_not_found_response_code: 505 - match: prefix: /prefix route: cluster: user cluster_not_found_response_code: 505 http_filters: - name: dgp.filter.http.prometheusmetric metric_collect_rules: metric_path: "/metrics" push_gateway_url: "http://127.0.0.1:9091" counter_push: true push_interval_threshold: 3 push_job_name: "prometheus" - name: dgp.filter.http.httpproxy config: idle_timeout: 5s read_timeout: 5s write_timeout: 5s clusters: - name: "user" lb_policy: "lb" endpoints: - id: 1 socket_address: address: 127.0.0.1 port: 1314 health_checks: - protocol: "tcp" timeout: 1s interval: 2s healthy_threshold: 4 unhealthy_threshold: 4 shutdown_config: timeout: "60s" step_timeout: "10s" reject_policy: "immediacy" sample参考: https://github.com/apache/dubbo-go-pixiu-samples/tree/main/dubbogo/simple/prometheus feat:consistent hashing 为cluster 提供基于一致性hash的请求负载算法; clusters: - name: "test_dubbo" lb_policy: "ConsistentHashing" registries: "zookeeper": timeout: "3s" address: "127.0.0.1:2181" username: "" password: "" Enhancement in v0.6.0 Remove "Types" on Http to dubbo proxy 在通过http调用dubbo服务的场景中,v0.6.0以前版本需要再请求中包含"types": ...., 来描述dubbo parameters的结构描述,示例 :{"types":"string".... func TestPost1(t *testing.T) { url := "http://localhost:8883/UserService/com.dubbogo.pixiu.UserService/GetUserByName" data := "{"types":"string","values":"tc"}" client := &http.Client{Timeout: 5 * time.Second} req, err := http.NewRequest("POST", url, strings.NewReader(data)) req.Header.Set("x-dubbo-http1.1-dubbo-version", "1.0.0") req.Header.Set("x-dubbo-service-protocol", "dubbo") req.Header.Set("x-dubbo-service-version", "1.0.0") req.Header.Set("x-dubbo-service-group", "test") assert.NoError(t, err) req.Header.Add("Content-Type", "application/json") resp, err := client.Do(req) assert.NoError(t, err) assert.NotNil(t, resp) assert.Equal(t, 200, resp.StatusCode) s, _ := ioutil.ReadAll(resp.Body) assert.True(t, strings.Contains(string(s), "0001")) } 改进之后data中不需要types数据。 sample 代码: https://github.com/apache/dubbo-go-pixiu-samples/blob/main/dubbogo/simple/direct/test/pixiu_test.go ASoC 2002: Optimization of Pixiu timeout feature dgp.filter.http.dubboproxy 支持超时配置: .......... ......... - name: dgp.filter.http.dubboproxy config: dubboProxyConfig: registries: "zookeeper": protocol: "zookeeper" timeout: "3s" address: "127.0.0.1:2181" username: "" password: "" timeout_config: connect_timeout: 5s request_timeout: 5s 欢迎钉钉扫码加入 dubbogo 社区钉钉群【钉钉群号 23331795】进行交流。

优秀的个人博客,低调大师

kubernetes文档中文翻译-Kubernetes是什么(What is Kubernetes)

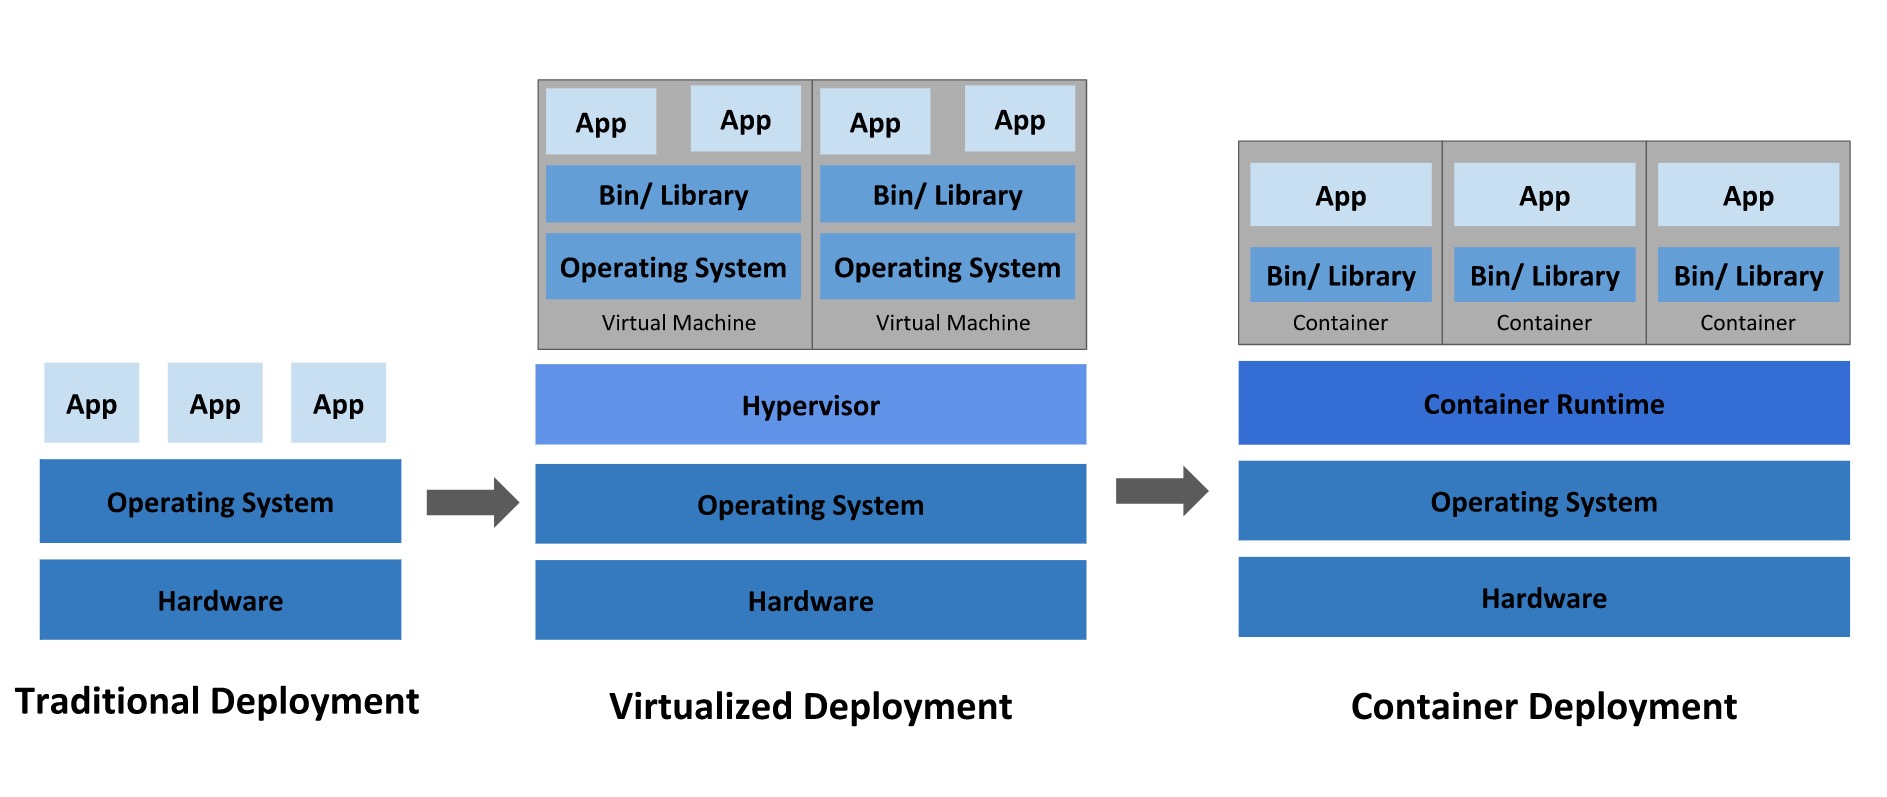
Kubernetes概述 回顾历史 你为什么需要Kubernetes,它能为我们做什么 Kubernetes不适宜的场景 接下来的内容 Kubernetes是一个可移植的、可扩展的开源平台,用于管理容器化的场景和服务,Kubernetes有利于声明性的配置和自动化运维。Kubernetes拥有庞大的,快速发展的生态系统。Kubernetes拥有广泛的服务,支持和工具。 Kubernetes的名字源于希腊,它的含义是舵手和飞行员。google在2014年开源了该项目。Kubernetes构建在google的15年大规模生产环境部署运维的经验上,同时结合和社区的创意和经验。 回顾历史 我们通过回顾历史来阐述为什么Kubernetes的意义 传统部署应用方式:早期,企业在物理机上部署应用程序。在这种部署模式下,无法限制应用程序使用物理机的资源、并且导致了资源分配的问题。例如,如果物理机上运行多个应用程序,可能存在一个应用程序占用过多的物理机资源,从而造成其他的应用程序性能下降。该问题的解决方案是在不同的物理机上运行每一个应用程序,这种方式资源利用率低,并且不能扩展、企业维护大量的物理机的运维成本很高。 虚拟机部署应用方式:为了解决传统部署应用带来的问题,引入了虚拟化的解决方案。它允许你在单一的物理机上运行多个虚拟机。虚拟化能够在多个虚拟机之间进行隔离,并且提供一定程度的安全性,使得不同的虚拟机之间不能自由访问对方。虚拟化能够更好的利用物理机资源,并且提供了可扩展性,因为添加和更新应用程序更加方便,同时降低了硬件成本。每个VM都是在硬件虚拟化上运行所有的组件,包括其自己的操作系统。 容器化部署方式:容器类似于VM,但是他们具有宽松的隔离属性,可在应用之间共享操作系统。所以,容器被认为是轻量化的。和VM类似,容器具有自己的文件系统、CPU、内存和进程空间等。容器和底层基础架构分离,它们可以跨云和OS进行移植。 容器越来越受到欢迎,它可以给你带来很多好处,下面列出容器的一些优势: 敏捷的应用程序构建和部署。和VM镜像相比,构建容器镜像更加容易和便捷。 持续开发、集成和部署。通过快速和简便的回滚,提供了可靠和快捷的容器的构建和部署。 dev和ops分离的考虑。在构建和发布时创建容器镜像,从而将应用程序和基础架构分离。 可观测性。不仅仅是OS级别的监控指标,还可以显示应用程序的健康状况和其他信息。 开发、测试和生产的环境一致性。在笔记本电脑上运行和在云上运行一致。 云和OS发布的可移植性。可以在Ubuntu, RHEL, CoreOS, on-prem, Google Kubernetes Engine等上运行 以应用为中心的管理。提高抽象层次,从虚拟化硬件上运行操作系统到使用逻辑资源在OS上运行应用程序 松耦合、分布式、弹性,开放的微服务。应用程序被拆分为更小的独立单元,可以动态部署和管理,而不是单体应用 资源隔离。可预测的应用性能 资源利用,高效和高密度的利用资源。 我们为什么需要Kubernetes,它能做什么 容器是运行应用程序的一种好的方式,在生产环境中,你需要管理运行应用程序的容器,并且确保它不宕机,如果一个容器宕机,需要启动另外一个容器来补充。如果系统处理这种情况,是不是使生产环境运维更加容易?Kubernetes为您提供了一种弹性运行分布式系统的架构。Kubernetes负责您的应用扩展需求,故障转移,部署模式等。例如,Kubernetes可以轻松的管理系统金丝雀部署。Kubernetes提供了如下功能: 服务发现和负载均衡Kubernetes可以通过DNS的名称或者容器的IP对外暴露服务,如果请求量比较大,Kubernetes能够负载均衡和分配请求来确保部署的稳定。 存储编排Kubernetes允许你自动挂载您选择的存储系统,例如本地存储,公有云提供商。 自动部署和回滚你可以使用Kubernetes描述你部署应用的期望状态,并且以受控的速率将实际状态修改成期望的状态。例如,你可以自动让Kubernetes为您的部署创建新的容器,移除现有的容器并将所有的资源用于新的容器。 自动装箱Kubernetes允许指定每个容器的CPU和内存的需求,当容器指定了资源请求时,Kubernetes可以更好的管理容器的资源。 自我恢复Kubernetes重启宕机的容器,替换容器,杀死无法响应用户自定义健康检查的容器。 秘钥和配置管理Kubernetes允许你存储和管理敏感的信息,例如密码,OAuth tokens和ssh keys。你可以部署和更新应用程序配置,而不用重新构建容器的镜像,也不需要在您大量配置中暴露您的秘钥。 Kubernetes不是什么 Kubernetes不是传统的,包罗万象的Paas系统,因为Kubernetes运行在容器层次而不是硬件层次,它提供Paas产品的一些通用的功能,例如部署、扩展、负载均衡、日志和监控。然而,Kubernetes并不是一个庞大的系统,这些默认的功能是可选的和可插拔的,Kubernetes提供了构建开发者平台的可选的能力,在重要的地方保留了用户的选择和灵活性。Kubernetes: Kubernetes不限制支持的应用的类型,Kubernetes目标是支持各种运行场景,包括无状态的应用场景、有状态的应用场景、数据处理应用场景,如果应用程序可以在容器中运行,那么它应该在Kubernetes中运行的很好。 不部署源代码和不构建您的应用程序,持续集成、交付、部署(CI/CD)的工作流程由企业的约定规则和技术要求来决定。 不提供应用程序层次的服务,例如中间件(例如消息总线),数据处理框架(例如spark),数据库(例如mysql),缓存,分布式存储(例如Ceph)来作为内置的服务,这些组件可以在Kubernetes中运行,或者通过方便的机制(例如Open Service Broker)能够让运行在Kubernetes中的容器访问。 并不指定日志、监控、报警系统,它提供了一些概念的集成组件,一种机制来采集、暴露指标。 不提供,更没有强制规定一种配置语言。它提供一种声明式的API,通过任意形式的声明性规范来实现。 没有提供或者采用任何全面的机器配置,维护,管理或自我修复系统。 此外,Kubernetes不仅仅是一个编排系统,事实上,它消除了编排的需求。编排的技术性定义是执行定义的工作流程。首先做A,然后做B,最后做C。相反,Kubernetes由一组独立的,可组合的控制处理器组成。这些控制处理器将容器的当前状态更改成你所期望的状态。你不用关心如果从A到C。集中的控制系统是不需要的,这使得系统更容易使用、更强大、更健壮、更有弹性、并且可以扩展。

优秀的个人博客,低调大师

what?how?)金融领域的机器学习

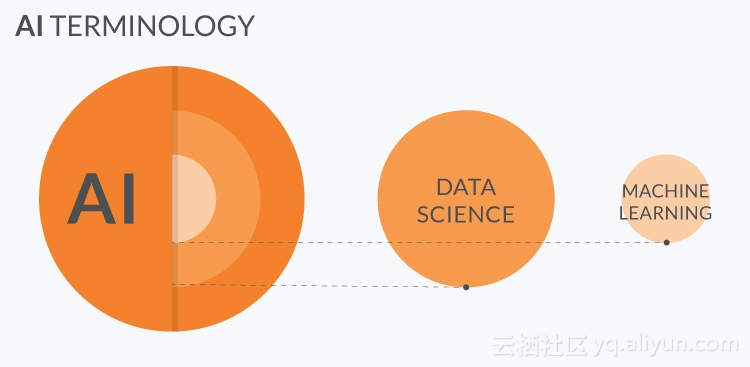
机器学习可能会很有魔力,即使它背后没有魔法。尽管如此,机器学习项目的成功更多地取决于构建高效的基础架构,收集合适的数据集以及应用正确的算法。 机器学习已经在金融服务行业中取得重大进展。让我们看看为什么金融公司可以通过AI和机器学习实现什么解决方案,以及他们如何应用这项技术。 定义 我们可以将机器学习定义为数据科学的一个子集,它使用统计模型来绘制洞察并进行预测。下图解释了人工智能,数据科学和机器学习之间的关系。为了简单起见,我们在这篇文章中专注于机器学习。 机器学习解决方案的神奇之处在于,他们可以从经验中学习而无需明确编程。简而言之,你需要选择模型并将数据提供给它们。然后,模型会自动调整其参数以改善结果。 数据科学家使用现有数据集训练机器学习模型,然后将训练有素的模型应用于现实生活中。 模型作为后台进程运行,并根据其训练方式自动提供结果。数据科

优秀的个人博客,低调大师

J0ker的CISSP之路:What's CISSP

文章同时发表在: [url]http://netsecurity.51cto.com/art/200708/53179.htm[/url] 写在前面:《J0ker的CISSP之路》将由15到20篇文章组成。其中详细的介绍了CISSP的相关知识、认证备考经过和心得,另外J0ker还会从CISSP的角度,向大家简单介绍信息安全的组成。希望《J0ker的CISSP之路》能给大家都带来帮助。最后你们的支持就是我不断努力向前的动力:) 正文 作为《J0ker的CISSP之路》系列的第一篇文章,J0ker打算先简要向读者介绍一下CISSP的背景知识,下面我们先来看CISSP认证的颁发机构(ISC)2: (ISC)2是信息安全领域的顶级认证机构之一,成立于1989年,到现在已经给超过120个国家的五万多名安全专家授予了相关认证。(ISC)2目前提供如下6种认证: SSCP(System Security Certificated Practitioner)认证系统安全实践者 CAP(Certification and Accreditation Professional)认证和评估专家 CISSP (Certificated Information System Security Professional) 认证信息系统安全专家 CISSP的升级版本CISSP-ISSAP(Information System Security Architecture Professional) 信息系统安全架构专家 CISSP-ISSMP(Information System Security Management Professional)信息系统安全管理专家 CISSP-ISSEP(Information System Security Engineering Professional)信息系统安全工程专家 (ISC)2同时也向公众提供信息安全方面的教育和咨询服务。(ISC)2的官方网站是[url]http://www.isc2.org[/url] (ISC)2提供的6种认证中,知名度最高和持有者人数最多的是CISSP。截至2007年4月底,全球共有48598名CISSP,其中人数最多的是美国,现有30385名,中国大陆有371名。因为CISSP的升级版本ISSAP和ISSMP要求考试的报名者必须是CISSP,而且有一定的相关领域工作经验要求,所以在国内除了香港18名台湾4名持有者之外,大陆还没有持有者。至于(ISC)2较为低端的SSCP和CAP认证,由于其定位和考核内容的原因,在国际上的接受程度不高,所以除了美加两国外,其他国家的持有者都很少。 CISSP认证是国际上最权威、最受认可的信息安全认证,它同时也是信息安全领域第一个通过ISO17024:2003标准的认证。CISSP主要的认证对象为在企业处于中高层、已经或将成为CISO(ChiefInformationSecurityOfficer)、CSO(ChiefSecurityOfficer)或高级安全工程师的信息安全专家。 CISSP认证的考核范围包括10个方向,称为CBK(CommonBodyofKnowledge)以下按首字母排序:1、AccessControl访问控制 2、ApplicationSecurity应用安全(包括开发) 3、BusinessContinuityandDisasterRecoveryPlanning业务持续性和灾难恢复计划 4、Cryptography信息加密 5、InformationSecurityandRiskManagement信息安全和风险管理 6、Legal、Regulation、ComplianceandInvestigation法律、法规、调查 7、OperationsSecurity操作安全 8、Physical(Environment)Security物理(环境)安全 9、SecurityArchitectureandDesign安全架构和设计 10、TelecommunicationandNetworkSecurity通讯和网络安全 CISSP认证以考察考生对信息安全技术掌握的全面程度而著称,这10个CBK里面几乎全部包含了当前信息安全领域的知识。不过CISSP的试题难度并不是大家想象中那么难,排除语言的原因之外(CISSP试题是全英文的),几年安全从业经验再加上考前抽时间认真复习,一次通过考试的几率还是挺大的。用一个最恰当的句子来形容CISSP的考试,就是“Onemilewide,Oneinchdeep“,考试范围之广和试题的难易程度可见一斑。 但试题的简单并不说明CISSP的试题可以轻松搞定,因为,即使没有语言障碍,考前也经过充分的复习,拿到试卷后考生会发现CISSP的考试将是一场严峻的考验——在6个小时内,考生需要完成250道选择题,平均每道选择题只有一分半钟的时间可以思考,而且由于CISSP考试使用标准化答卷,考生要留出大概半个小时的时间把答案填到答卷上,事实上考生用来完成每道题的时间只有一分钟左右。CISSP考试也不是光靠死记硬背复习资料就能解决的,大部分题目都是给出现实中的一个场景,让考生分析后再选出正确的答案,有些迷惑性比较强的题目不是4选1,而只能凭感觉在2个相似答案中选其一。 每次CISSP考试的通过率都不算低,但还是有大概一半的考生无法通过考试。他们并不是说个人能力有问题,很大程度上还是因为CISSP考试考察的范围太广。尽管如此,J0ker依然相信,即使他们没有通过CISSP的考试,但通过学习CISSP的课程,他们对信息安全的知识水平和整体把握能力都会有一个较大的提升,这将成为他们安全从业经历中一份不可多得的宝贵经验。 下篇预告:《Why CISSP》,J0ker将向大家介绍为什么要获得CISSP认证,以及CISSP主要从事的工作等,敬请期待! 本文转自J0ker51CTO博客,原文链接:http://blog.51cto.com/J0ker/37738,如需转载请自行联系原作者

优秀的个人博客,低调大师

What!物联网企业不卖产品改卖服务?

每个产业都有机会摆脱线性经济的宿命,转型成“产品即服务”(PaaS)的蓝海企业 史达夫妮计划去加州的峡谷(Fern Canyon)度假。令她烦心的是,她的车子遭小偷打破玻璃偷走汽车音响。一想到要开车四天却没有音乐的陪伴,她就感到沮丧。幸好,她打开手机的应用程序(App),在网络分享家用器具的平台Peerby打出想借汽车音响的四十分钟后,就有人愿意免费借她一套Beats蓝芽音响。 共享平台翻转线性经济 根据《纽约时报》的报导,Peerby这个家用器具版的Airbnb、优步(Uber),自从2012年在阿姆斯特丹创立以来,已经在伦敦、巴黎、美国十个城市提供服务。想在家里墙壁钻洞装书架,却又不想花大钱买一个可能只用一次的电钻?上Peerby借。想要骑着脚踏车去邻近城市旅行?上Peerby借。 听起来是天方夜谭,但《纽约时报》的报导指出,Peerby有五十万会员,数据库里有十亿项品项,已经有十万次出借纪录。像这样设立共享平台的新创公司怎么营利?威德普尔并不担心,Peerby最近推出了“Peerby Go”,为每次出借的交易提供保险和运送的服务。只要能黏住人们,经营好社群,未来会有更多可能的商业模式。 曾经投资脸书(Facebook)与Airbnb的硅谷著名创投公司Greylock就相信,我们正处在一个转型时刻:注重拥有权的社会,将因为千禧时代喜欢分享甚于拥有,而转移成注重使用权的社会。 共享平台愈蓬勃,就愈有潜力颠覆“卖愈多产品赚愈多钱”的线性经济价值观。线性经济的商业模式是卖愈多产品赚愈多钱,生产者也容易倾向“设计”出较不耐用的产品,透过不断耗用资源,推陈出新,来换取营收。 一张办公桌卖三次 在把循环经济当作国策的荷兰,有一家办公家具公司Desko设计出一张桌子能卖三次桌子的服务方案。 Desko发现,虽然自己的产品设计得耐久坚固,甚至可以用二十年以上,但办公室家具常因为办公室迁移、转换,平均寿命只有七年。通常公司搬迁,旧家具未必符合新空间的需求,就用廉价的方式请清运公司处理,把家具给“回 Desko看到这个机会,他们想:“为何不以资产的角度看待自家设计制造的桌子,想办法提高资产的价值与使用次数呢?” Desko第一次卖出办公桌,过了一段和客户协议好的使用时间后,会用原价的10%向客户买回,重新整修上漆后,再用原价的50%第二次卖出给第二手的客户。第二次的客户使用完毕,Desko会再用原价的5%买回,整修后再以原价的25%卖给愿意以较便宜价格使用三手家具的客户,最后再由Desko回收。这样一来,Desko同样一张桌子使用率翻三倍,不但带进更多营收,更重要的是,为Desko开发出愿意以较便宜价格使用二手、甚至三手家具的新客户群。 根据荷兰循环经济组织的估算,这个新的商业模式足足减少了60%的碳足迹。这种模式让消费者不需花大钱买全新的家具;制造商回收使用过的家具再利用,不需要采购新的原材料制造,省成本、省资源、减少废弃物、开发新市场,企业赚钱又照顾地球。 一开始,产品、制程设计就要考虑到容易回收、拆解、再利用,并且搭配相因应的逆物流做回收。Desko董事克伊帕(Michael Kuipers)表示,愈来愈多的客户有这样的需求,这是一个系统性的改变。藉由这样的商业模式,Desko和客户有了更紧密的关系,把桌椅带走时,客户不但不需要烦恼清理废弃物的问题,也是Desko和客户讨论下次服务的机会。Desko用一张办公桌一举颠覆大量生产、大量消费的僵化模式。 不卖灯泡,改卖照明服务 早在2011年,飞利浦就采用“产品做为一种服务”的概念,推出“不卖灯泡、卖照明时数”(Pay per Lux)的创新服务,已经应用在史基浦机场。 飞利浦依照机场需求,设计三千七百个LED灯具和照明设备,以租约的方式和史基浦机场签订十五年的照明服务解决方案。 飞利浦保留了照明设备的所有权,合约期间,飞利浦包办管理和保养维修,机场只需要每月支付固定服务费。透过物联网技术,飞利浦可以随时监控照明设备运作与用电状况,一故障就马上派人维修,让照明设备维持最佳能源效率。汰换的灯具则直接由飞利浦回收再利用。 当生产者拿回产品的所有权时,企业的行为也会随之改变。由于每月收取固定服务费,飞利浦会希望在合约期间,维修或更换产品次数愈少愈好,成本才会愈低。因此,飞利浦必须把产品设计得更坚固耐用、更容易拆解、维修。一个明显的证据是,推出Pay per Lux服务之后,飞利浦就重新设计LED灯泡,将容易故障的驱动器从灯泡内移到外侧,坏了只要更换驱动器,不用把整个灯泡丢掉。如此一来,不但延长使用寿命,也减少需要处置的废灯泡,一举两得。 产品即服务,这不仅嘉惠生产者,对客户来说也受益匪浅。 史基浦机场因为有飞利浦代为管理、维护照明设备,电力消耗比过去降低了一半。等于可以花最少的钱,使用更好的产品和服务。 租洗衣机比买的还划算 荷兰一家新创公司Bundles推出洗衣机租赁服务,让消费者把商用洗衣机租回家。英国艾伦麦克阿瑟基金会针对洗衣机租赁模式的分析结果显示,高端洗衣机机型在其寿命期间,洗涤次数比便宜机型高出四倍,平均摊提下来,单次洗衣的成本比便宜的机型还少。 当洗衣机所有权不再属于消费者而属于生产者,生产者更有动机提升洗衣机的质量,利用物联网技术实时监测洗衣机使用状况,并且做好维修及保养。当产业有技术突破时,业者会倾向于将洗衣机各个零组件的价值做最大化的利用,以节省原材料成本。 原本若要提供消费者二十年的洗衣服务,可能要制造四台洗衣机才能满足消费者。现在只要制造一台可持续升级的洗衣机就好,边际成本较低。更重要的是,原本舍不得花钱买高端洗衣机的人,也许会因为入门的门坎低而开始尝试,等于为业者吸引到更多新客户。 对消费者来说,透过家电租赁,可以用较低的价格买到高端洗衣机的“使用权”。享受高质量的洗衣服务,所负担的总成本比购买来得低,长久下来可减轻荷包负担,也无需承担洗衣机折旧的问题,还可依不同的季节需求或家庭人数的变异,弹性选择洗衣方案,创造了生产者和消费者的双赢局面。 把产品转换成服务,以租代买,就能不再靠着耗竭原物料来刺激成长。 从采购、制造、销售、使用、寿命终点、逆物流,整条价值链的每个环节,都隐含着循环经济带来的商业机会。从纺织、成衣、物流,到照明、建筑、石化、钢铁,每一个必须使用地球资源的产业,都有化身循环产业的新生机会。 关键是,企业必须先相信自己能够朝“产品即服务”的新商业模式转型,勇敢迎向下一轮的成长挑战。 本文转自d1net(转载)

优秀的个人博客,低调大师

What's new in PikiwiDB (Pika) v3.5.3 (正式版)

随着 Redis 宣布采用双协议以维护其商业利益,PikiwiDB(Pika) 社区非常荣幸地宣布之际,我们的最新 v3.5.3 正式生产可用版本现已发布。 v3.5.3 版本不仅修复了长期存在的 Bug,还引入了一系列新特性。这些新特性包括 Pika 对 ACL 的支持、移除了 Sharing 模式的残留 Slot 代码、命令执行的快慢分离、Redis Stream 支持、大 key 分析工具、以及 Pika 分布式集群的全自动化 failover 等。此外,我们在 3.5.3 版本中增加了更多的自动化测试用例,以提高 Pika 服务的稳定性和健壮性,确保用户能够享受到更高效、更稳定的使用体验。本文将详细介绍本次更新的主要功能、Bug 修复和性能提升。 在深入探讨 3.5.3 版本的更新内容之前,请注意以下几点声明: 由于商标问题,Pika 项目已更名为 PikiwiDB。在本文中,我们将使用 PikiwiDB(Pika) 来指代项目,项目地址为:https://github.com/OpenAtomFoundation/pika 我们创建了一个新项目 https://github.com/OpenAtomFoundation/pikiwidb,这是一个基于 Raft 协议实现的兼容 Redis 协议的大容量 KV 数据库,主要面向强一致性数据场景,例如存储约 10TiB 规模的元数据。PikiwiDB 将专门用于指代此项目。 我们为 PikiwiDB 设计了一个新的 logo,作为其商标,并已在相关政府机构注册。 1 主要更新 1.1 支持 ACL PikiwiDB(Pika) 3.5.3 版本正式全面支持 Redis ACL,为未来在云原生 Pika 集群中支持多租户场景奠定了基础。在此之前,Pika 已经支持了 Redis 的用户认证方式,如 auth/userpass/requirepass,以及通过 pika.conf 中的 userblacklist 配置命令黑名单模式。本次更新保持了向后兼容,并支持这些已有的使用方式。 我们还确保 PikiwiDB(Pika) 的 ACL 实现与 Redis ACL 完全兼容,通过将 Redis 的所有 ACL TCL 测试集纳入 PikiwiDB(Pika) 的测试集中。 关键 PR 链接: PikiwiDB(Pika) 支持 ACL 修正 ACL 用户认证错误问题 ACL 向前兼容 userblacklist 添加 Redis ACL 测试集 1.2 混合存储模型支持 bitmap 在单体环境下,同时优化 PikiwiDB(Pika) 的读/写/compaction 是一项挑战。在 v3.5.2 版本中,我们引入了由缓存 Redis 和 RocksDB 构成的混合存储模型,并支持了 string/list/set/zset/hashtable 五种数据结构。在 3.5.3 版本中,我们增加了对 bitmap 的支持。 此外,我们在 3.5.3 版本中支持对 Redis 缓存进行动态参数调整。 关键 PR 链接: PikiwiDB(Pika) 支持 bitmap 支持对 Redis 缓存进行动态调参 1.3 快慢命令分离 为了避免慢命令阻塞快命令的执行,我们在 Codis-Proxy 和 PikiwiDB(Pika) 两个层面实现了快慢命令分离。 关键 PR 链接: 实现快慢命令分离 1.4 Redis Stream 支持 虽然 PikiwiDB(Pika) 之前支持了 Redis pubsub,但它只能进行在线消息传递。在 3.5.3 版本中,我们增加了对 Redis Stream 的有限支持,类似于消息队列(MQ),以便更安全地传递消息。为了确保数据的安全性,我们在底层引擎 BlackWidow 中特别添加了对 Stream 数据类型的支持。 关键 PR 链接: Pika 支持 Redis Stream 请注意,Pika Stream 目前还不支持消费组消费,这将在后续版本中实现。 1.5 云原生集群 在 PikiwiDB(Pika) 3.5.0 版本中,我们开源了 Pika-Operator,它支持在 K8s 上部署 Pika 主从对。在 3.5.2 版本中,我们基于 Kubeblocks 的 Pika-Operator 支持了在 K8s 上部署类似 Codis 的 Pika Cluster,但当时还不支持动态扩缩容。 在 3.5.3 版本中,最新的 Pika-Operator 已经支持了 Codis Group 级别的节点扩缩容,并且支持数据的 Rebalance。 关键 PR 链接: Pika-Operator 支持 Pika 集群自动扩容 优化 codis slot 迁移速度,支持动态修改迁移线程和速度 Pika-operator 支持 namespace,可在不同 namespace 下部署不同的集群 Pika-operator 支持监控指标采集,自动拉起 pika-expoter 1.6 Compaction 优化 PikiwiDB(Pika) 的底层磁盘存储引擎 RocksDB 在进行 compaction 时会显著影响 PikiwiDB(Pika) 的读写性能。因此,控制好 compaction 是优化 Pika 读写性能的关键。 关键 PR 链接: 添加 CompactRange 命令,支持对一定范围内的 key 进行 compact 提升 Compaction 速度,减少 Compaction 耗时 执行 shutdown 命令时调用 disable compaction,提升进程退出速度 1.7 自动 Failover PikiwiDB(Pika) 集群目前是基于 Codis 实现的。为了提高基于 Codis 的 PikiwiDB(Pika) Cluster 的易用性,我们对 Codis 进行了许多扩展。 原始的 Codis 不支持 Group 内的 Failover,需要使用 Redis Sentinel,这会导致运维成本增加。我们在 Codis Dashboard 中加入了 sentinel 的功能,实现了对 Group 内主从的自动 failover。 关键 PR 链接: PikiwiDB(Pika) 分布式集群支持自动 failover 1.8 可观测性提升 PikiwiDB(Pika) 的可观测性关键组件是 Pika-Exporter。在 3.5.2 版本中,我们虽然添加了 Redis Cache 缓存热数据,但缺少监控指标。在 3.5.3 版本中,我们增加了包括命中率、每秒命中次数、Redis Cache 内存使用量、Redis Cache 个数、Redis Cache DB 个数 等指标。 关键 PR 链接: Pika exporter 暴露 cache 相关的数据采集指标 PikiwiDB(Pika) 分布式集群 Codis proxy 新增可观测指标 修复 dbsize 计算错误问题 修复网络监控指标统计不准确的问题 1.9 数据一致性 3.5.3 版本修复了许多 PikiwiDB(Pika) 主从同步问题,确保数据的一致性。 关键 PR 链接: 修复主从复制过程中,slave 节点收到 master 异常回包后的处理逻辑 修复 Pika cache 部分场景下 cache 和 DB 数据不一致的问题 修复全量复制失败后,未做处理导致数据丢失问题 修复主从复制过程中,主实例执行 bgsave 过程中,没有正确回应从的同步请求 全量复制过程中,添加数据同步状态,明确数据同步进度 修复从库在 Apply binlog 时,没有对操作的 key 加锁,导致数据不一致的问题 修复迁移数据后数据不一致的问题 1.10 测试集增加 PikiwiDB(Pika) 的测试集由 gtest 单测、Redis TCL 测试集和 Go 测试集组成。在 3.5.3 版本中,我们增加了 Codis 集群 e2e 测试。 关键 PR 链接: Pika TCL 测试集 Pika Gotest 测试集 1.11 工具集更新 PikiwiDB(Pika) 一直重视工具集的建设,所有相关工具都可以在 https://github.com/OpenAtomFoundation/pika/tree/unstable/tools 中找到。在 3.5.3 版本中,我们新增了一个工具: PikiwiDB(Pika) 支持大 key 分析工具 1.12 文档更新 PikiwiDB(Pika) 的文档主要是 wiki 文档。在 3.5.3 版本中,我们更新了 Pika 支持的 Redis 命令文档。 文档链接:https://github.com/OpenAtomFoundation/pika/wiki/pika-%E6%94%AF%E6%8C%81%E7%9A%84redis%E6%8E%A5%E5%8F%A3%E5%8F%8A%E5%85%BC%E5%AE%B9%E6%83%85%E5%86%B5 2 发版详情 在第一章节中,我们概述了 3.5.3 版本的主要功能升级和改进。下面详细列出了本次发版的相关 PR。 新特性 Pika 支持 ACL 在全量复制过程中,pika 服务的从节点不接收读请求 删除 Sharing 模式残留的 Slot 代码,回归 3.0,以后一个 Pika 下有多个 DB,每个 DB 只有一个 Blackwidow 在 Codis dashboard 协程 panic 时自动恢复服务 Pika cache 新增 bimap数据类型 Pika 支持快慢命令分离 Pika exporter 暴露 cache 相关的数据采集指标 Pika 执行完成 Bgsave 后, 保留 unix timepoint Pika 支持动态配置 disable_auto_compations 参数 Pika 支持 Redis Stream Pika 支持大 key 分析工具 Pika 支持动态调整 Pika cache 参数 更新 Pika benchmark 工具支持更多的接口压测 Pika Operator 支持 Pika 集群自动扩容 添加 CompactRange 命令支持对一定范围内的 key 进行 compact 提升 Compaction 速度减少 Compaction 耗时 升级 RocksDB 版本到 v8.7.3 Pika 分布式集群 Codis proxy 新增可观测指标 Pika 分布式集群支持自动 failover Pika 支持 redis rename-command 功能 优化 codis slot 迁移速度,支持动态修改迁移线程和速度 Pika 支持动态调整 max-conn-rbuf-size 参数 Pika-operator 支持 namespace,可以在不同的 namespace 下部署不同的集群 Pika-operator 支持监控指标采集,自动拉起 pika-expoter ACL 向前兼容 userblacklist 丰富了 Pika TCL 测试集 丰富了 Pika Gotest 测试集 Bug 修复 修复 Pika 有从节点进行全量复制期间会误删除 dump 文件的问题 修复主从复制过程中, slave 节点收到 master 异常回包后的处理逻辑 在 Pika 执行 shutdown 命令时调用 disable compaction, 提升进程退出速度 修复 Codis-dashboard Redis Memory 值不准确的问题 INFO 命令耗时优化,降低查磁盘使用量的频率 修复 Rsync 删除临时文件路径不对,删除失败,导致rocksdb打开失败的问题 修复 Compact, Bgsave, Info keyspace 命令未指定db名称,导致部分命令 coredump 的问题 Codis dashboard 用 info replication 替代 info 命令查寻 master ip 降低对 Pika 的性能影响 修复 Pika cache 使用边缘case,解决部分场景下 cache 和 DB 数据不一致的问题 修复当 dump 文件夹为空时,会启动报错 Segmentation fault 的问题 修复因为 flag 计算错误,导致的部分命令缓存没有生效问题 修复主从复制模式下,主实例 flushdb 后,从实例因为死锁导致的不能访问的问题 修复部分命令未对 RocksDB 的返回值进行判断的问题 规范函数的返回值及初始值 修复网络监控指标统计不准确的问题 修复配置文件加载部分参数异常的问题 修复 Codis dashboard cpu 100% 的问题 修复 Codis fe pika 主从角色显示异常的问题 修复迁移数据后数据不一致的问题 修复 dbsize 计算错误问题 修复扩缩容或者 pod 起停后,Codis-dashboard 界面显示不准确的问题 修复 DB 层重复上锁的问题 修复全量复制失败后,未做处理导致数据丢失问题 修复主从复制过程中,主实例执行 bgsave 过程中,没有正确回应从的同步请求 全量复制过程中,添加数据同步状态,明确数据同步进度 修复从库在 Apply binlog 时,没有对操作的 key 加锁,导致数据不一致的问题 修复 codis slot 迁移过程中 master 实例 coredump 的问题 修复在主从复制过程中,删除正在使用的 dump 文件的问题 修复主从复制过程中从实例 rsync 响应错误的问题 发版标签 https://github.com/OpenAtomFoundation/pika/releases/tag/v3.5.3 社区 PikiwiDB(Pika) 开源社区感谢您的支持,如果您有任何疑问或建议,欢迎加入我们的社区交流群: telegram 群 https://t.me/+gMlTzNacOF1iMTM1 微信助手【请在微信中搜索 PikiwiDB】

优秀的个人博客,低调大师

What‘s New | 数据库产品技术月刊(2019.12—2020.1)

重点事件 1、阿里云峰会首次走进印尼,助力印尼实现“数字化愿景”,共享云上福利 1月16日,阿里云峰会首次来到了印度尼西亚首都雅加达,一同见证了印尼的数字化转型过程和取得的丰厚硕果。作为亚太区市场份额第一,并且也是唯一一家在印尼拥有数据中心的全球化公共云服务商,阿里云一直致力于帮助印尼企业实现“数字化愿景”,共享云上福利。在发布会现场,阿里巴巴集团副总裁、阿里云数据库产品事业部总裁李飞飞介绍了阿里云在下一代企业级数据库系统上的技术创新与实践。作为全球云数据库领跑者之一,阿里云数据库希望帮助亚太区合作伙伴加速数字化转型,利用云原生数据库技术,不断挑战新的业务高峰。 链接:https://developer.aliyun.com/article/742971 2、阿里云峰会广州站圆满收官,一同探索产业数字化转型的核心技术 12月2日-3日,阿里云峰会广州站圆满收官,来自政府、企业界的参会嘉宾围绕“数字经济的新型基础设施”主题,探索产业数字化转型的核心技术,探讨如何实现数据化和智能化。 在全面上云专场,阿里云数据库资深技术专家天羽代表数据库团队分享《云时代企业数据库上云与数据库架构方案》,介绍“低成本、智能化、高安全的数据库能力 ”;合作伙伴广州嘉为科技CTO黄史浩现场分享了“传统数据库如何选型以及上云”,专业的实践分享获得现场听众频频点赞;此外,在峰会的合作伙伴授牌仪式上,阿里云数据库资深解决方案架构师佳毅向4家合作伙伴授予“数据库合作计划优秀合作伙伴”奖杯。 3,阿里云分析型数据库AnalyticDB 荣膺中国信通院大数据产品评测双料认证 12月10日,由中国信息通信研究院、中国通信标准化协会、中国互联网协会联合主办的《2019数据资产管理大会》在北京召开。阿里云分析型数据库产品AnalyticDB获得了分析型数据库基础能力和性能双料认证。尤其在大规模性能认证方面,本次评测采用了全球最大规模的 TPC-DS 100TB 测试标准,阿里云 AnalyticDB 完成640节点的分布式分析型数据库性能测试,是迄今为止通过信通院评测认证的最大规模分布式分析型数据库集群,综合评测结果同领域领先。 链接:https://developer.aliyun.com/article/739161 4,大型企业数据库服务首选,专属主机组RDS MySQL服务正式上线 2020年1月9号,RDS专属主机组和ECS专有宿主机召开联合发布会, RDS MySQL正式上线专属主机组产品。在RDS MySQL的所有能力之外,提供更多产品增值功能,包括数据库主机资源100%独占,提供数据库CPU超配能力。客户通过CPU超配,可实现在离线系统混部、低利用率的多业务系统共享超配CPU资源,可降低50%成本。为企业提供可靠、安全、高可用数据库服务,提供和RDS一样的SLA保障。 链接:https://developer.aliyun.com/article/742236 5,第七届CCF BDCI大赛圆满落幕,阿里云荣获“优秀合作伙伴”奖项 2019年12月22日,2019年第七届 CCF BDCI大数据与人工智能总决赛在河南省郑州市国展中心圆满落下帷幕。浙江大学“数据库性能挑战者”团队在561支参赛队伍及656位参赛选手中脱颖而出,摘得本次大赛桂冠。同时,阿里云作为本次大赛的重要合作伙伴,工作与努力也得到了赛事组织方的认可,被授予了“优秀合作伙伴奖”。 链接:https://mp.weixin.qq.com/s/mvTOetOWPM8SKHwFibT-jQ 6,马来知名电商企业PrestoMall转投阿里云PolarDB,成本大幅降低 1月8日,马来西亚第三大电商企业PrestoMall抛弃传统甲骨文数据库,转投阿里云自主研发的PolarDB云数据库,替换后系统运行平稳,费用约为传统商业数据库的1/6。PolarDB协助PrestoMall在电商大促活动中创下了流量峰值,是国际去ORACLE数据库的第一单。同时在国内,零售ISV伯俊与PolarDB Oracle完成产品兼容性测试与性能压力测试,具备复制推广能力。数据显示,采用云上数据库,费用约为传统商业数据库的1/6,成本可下降80%以上。链接:https://developer.aliyun.com/article/742578 7,数据库发布年终成绩单,回望2019“高光时刻” 2019年,我们获得了Gartner、forrester等权威认可,荣誉上身,责任也更加艰巨; 2019年,我们的生态体系正逐渐丰富且完善,努力满足上云的多样化需求;2019年,我们有许多个闪耀的“高光时刻”,迫不及待地第一时间与大家分享;2019年,20余款产品提供了升级后的全新版本,给数据上云创造了愈来愈好的体验;2019年,我们还迎来了与多家企业的合作,阿里云数据库也将在实践中不断接受检验;2020年,我们的故事继续,将为客户提供更好的云数据库服务体验!链接:https://developer.aliyun.com/article/741503 二、重大产品更新 PolarDB下一代云原生数据库 PolarDB支撑马来第三大电商公司Prestomall顺利去“O” 海外,马来第三大电商公司Prestomall借助PolarDB Oracle兼容版顺利替换Oracle数据库,替换后系统运行平稳,是国际去ORACLE数据库第一单。同时在国内,零售ISV伯俊与PolarDB Oracle完成产品兼容性测试与性能压力测试,具备复制推广能力。 PolarDB 菜鸟云和深圳金融云开服售卖 菜鸟物流云上线售卖PolarDB,支持MySQL、PostgreSQL、Oracle三个引擎, 开放全球11个地域,申通等客户已经开始试用,承载线下数据库上云重担。PolarDB Oracle版本月新增深圳金融云、印度尼西亚两个Region。 PolarDB 产品功能体验改进 PolarDB 持续优化与关联云产品的联合体验:本月云监控上线新版PolarDB报警规则、弹性伸缩ESS支持自动修改PolarDB白名单,帮助更多的存量用户使用PolarDB。PolarDB 本月还支持了经典网络地址,满足米哈游、众安保险等老客户平滑升级的诉求。 PolarDB 本月在内核上也做了大量的性能提升和体验优化。MySQL 版共完成17处代码优化,其中8.0版本全面升级加固,修复若干已知问题,保障客户业务稳定。Oracle兼容版完成了 索引DML支持预扩展、Logindex Buffer IO锁优化、审计日志buffer定期下刷、OOM优化,RO延迟优化等工作,同时完成4项兼容性开发和支持。 OLAP新一代在线交互式实时数仓 AnalyticDB MySQL基础版发布 2019年12月27日分析型数据库AnalyticDB重磅升级,推出新的产品系列—AnalyticDB MySQL基础版。基础版采⽤单ECS+云盘部署方式,可大幅减低用户IT成本,较之前的集群版本平均约50%的降幅。在成本降低的同时,相比开源MySQL仍然有10倍以上的分析性能提升。基础版的推出,可大幅降低企业用户使用大数据的成本,可方便用户快速享受到数据实时分析所带来的技术红利。其推出的多种规格,可满足中小规模用户的数据分析需求 AnalyticDB MySQL发布日志服务SLS实时投递功能 SLS实时投递到AnalyticDB MySQL版本月上线并全网发布。针对海量的日志类大数据,此产品提供了实时数仓解决方案,一站式提供数据收集、清洗和分析功能。大幅降低企业级客户日志分析的技术门槛,全面提升海量日志在线处理能力,实时挖掘日志数据价值。 云数据库ClickHouse发布公测 2019年12月18日,阿里云正式发布云数据库ClickHouse产品公测。开源列式数据库ClickHouse是2019年最火的开源分析型数据库产品,具有优异的海量数据分析查询性能。国内头部大型互联网公司均在大规模应用,部分企业甚至有上千台的规模。云数据库ClickHouse提供了一套企业级数据库管理平台,包括备份恢复、安全审计、弹性伸缩等增值服务的同时,提供完善的云上生态包括丰富的数据接入 & 和可视化功能。 分析型数据库AnalyticDB for PostgreSQL 6.0 正式商业化 分析型数据库PostgreSQL 6.0于12月31号正式商业化。6.0在功能和性能上均大幅提升,PG内核从8.3升级至9.4升级,DTS同步性能提升3倍; 另外新增复制表、在线平滑扩容、磁盘配额、zstd压缩功能。在存储格式上新增JSONB、HSTORE类型,满足日志等非结构化数据分析需求;数据管理角色和权限更加精细化;新版6.0的商业化为中小型企业混合事务分析HTAP场景,以及金融领域实时数仓构建提供更稳定、更具性价比的解决方案。 分析型数据库PostgreSQL版推出普惠型规格,进一步降低企业级客户入门门槛 分析型数据库AnalyticDB for PostgreSQL正式推出普惠型2节点规格,单实例2核CPU 16GB内存、160GB SSD有效存储空间,最低月消费860元,AnalyticDB for PostgreSQL 支持HTAP数据库混合负载,支持全并行分析计算,支持分布式下的数据库事务及隔离级别,具备高并发事务吞吐能力,是云上构建分布式数据分析和交易处理的高性价比选择。此次普惠型规格的推出,进一步降低了企业级客户的入门门槛。 分析型数据库MySQL版推出存储密集型规格,大幅降低使用成本 分析型数据库AnalyticDB for MySQL正式推出存储密集型规格S8。存储密集规格采用高效云盘,单节点容量从最大1TB提升到12TB,大容量场景下单位TB年成本从7.5w+ 降至 2w+。存储密集型和现有的基础版-单机型、集群版-计算密集型,共同构成AnalyticDB for MySQL较为完整的产品族,覆盖了从小规格、到中大规格;从高性能、到海量存储多类场景客户。 分析型数据库MySQL版海外开服加速,进一步迎接东南亚、大洋洲等潜在市场需求 为更好地满足海外市场对分析型数据库AnalyticDB for MySQL的需求,在首批开服的新加坡和日本的region后, 近期再次加速海外服务的速度,新开包括香港、孟买、雅加达、吉隆坡和悉尼五大region,进一步迎接未来潜在的东南亚、大洋洲市场客户需求。 RDS&NoSQL&管控工具 RDS for MySQL 8.0 发布三节点企业版: RDS MySQL 8.0 发布三节点企业版形态,三节点企业版三可用区部署实例支持可用性SLO是99.99%,同时实例主节点和备节点之间数据复制是强同步,提供RPO=0的数据库解决方案。本次发布的核心功能包括:① 8.0 三节点企业版形态,存储类型是本地SSD盘; ② 8.0 三节点企业版只读实例; ③ 8.0 三节点企业版独享代理,支持自动读写分离。 SQL Server Sa权限账号灰度开放,解决权限诉求 线下客户使用Sysadmin角色,上云后可无缝适配RDS SQL Server,适用于各大ISV的软件系统无缝适配上云。Sysadmin是最SQL Server高级别的权限开放,用户更加自主可控。当前有条件限制短期开放中,可供意向客户临时适配验证。预计二月份中旬可支持长期开放。 RDS PostgreSQL 发布V12云盘基础版 低成本1TB内实时分析,数据库引擎的最佳选择。OLTP在线事务处理与OLAP在线分析业务混合场景。对可用性要求较低、可靠性要求很高对业务,例如偏分析的业务。 Redis 支持专享主机组形态 提供专享主机形态,实现主机级别用户资源隔离,另外未来还会提供 OS 开放能力,释放更高的自由度给客户,对齐客户 IDC 管理模式,降低上云成本。提供超卖设置,在业务允许范围内尽可能降低单实例成本。同时该产品形态完全复用 Redis 管控能力,方便客户进行基础运维管理。 MongoDB集群版支持可用区迁移 MongoDB集群版支持可用区迁移,方便客户进行资源管理。 HBase Serverless商用 低成本、免运维、即买即用、高弹行、按量计费 TSDB 2.0公测 面向时序时空一体化数据模型设计,动态Schema提高业务应用灵活;兼容ANSI SQL生态降低接入门槛,通过丰富的时序时空函数,支持时序聚合,空间查询等复杂分析 云Cassandra支持同城多DC部署。支持已有单DC实例在线扩展成为多DC实例 基于多DC部署,用户可构建同城多DC容灾方案,从而具备更高的容灾等级。 GDB支持实例监控告警 用户可以在GDB控制台监控告警页面,查看已有实例的性能(IOPS、时延等)、资源使用率(如CPU、内存、硬盘等)等指标。当实例有异常后,后台会告警给用户。使用户可便捷的管理数据库实例。 三、前沿技术 智能数据库ClouDBench完成7项业务场景测试,计划三月中旬上线 智能数据库 集团上云基于ClouDBench完成交易、库存等7个业务场景的压测和验证,除了性能和稳定性测试外,还可以帮助专家服务选型上云机型;确认了公有云用户使用智能调参进行数据库配置初始化,该功能是云上用户的强需求,计划三月中旬上线。 全加密数据库CFO线战投系统MySQL全加密版完成项目Kickoff 全加密数据库 CFO线战投系统MySQL全加密版正式完成项目Kickoff,目标3月中旬跑通数据库侧模拟业务场景,3月底启动业务联调;推动全加密技术实现国产化,启动基于FPGA加密卡的加密计算方案设计工作。 实验室与事业部合作3篇论文被系统与存储方向顶级会议收录 实验室与事业部合作3篇论文被系统与存储方向顶级会议USENIX ATC FAST 2020 (18th USENIX Conference on File and Storage Technologies) 收录。今年FAST共收到投稿138篇,仅接收23篇,而实验室就有3篇。我们的工作分别介绍了Tair (集团内以及双11核心系统,目前也在准备上云对外提供商业化服务),PolarDB存储利用计算存储加速,以及FPGA加速LSM compaction。这也是阿里巴巴第一次在FAST上发表论文。 四、最佳实践: Tair 阿里云数据库产品事业部Tair产品全面上云,打造企业版Redis。Tair除了满足通用缓存服务的需求外,在大型客户上的服务能力久经阿里集团考验。云上发布之后,Tair的高性能,抗冲击能力,更丰富的扩展数据结构(modules),异地多活受到了不少客户认可;疫情期间,更是诸多在线教育和视频游戏类客户支持大流量客户访问的首选。 · 广州视源测试8节点Tair集群,稳定工作在200w+ OPS场景,对能力表示满意,随即下单开通数十套集群版,后续有更多套数的开通需求;而CC视频同样因为其高性能购入数十套套集群版。 · 百家互联由于在线教育业务暴涨,原使用社区版Redis的读写分离版,在mget 4w hgetall 1.1w cpu被打满;升级到企业版的读写分离后稳定服务了 10w mget和2.3w hgetall的峰值,客户后续全部变配到企业版。Tair虽然是社区版2倍的价格,但切实满足了客户更大流量的需求。 · Tair的扩展数据结构,例如bloomfilter module和doc module,也被基分(登陆设备检测等),中青(过滤已推荐过的文章),凡卓互动(使用Doc构建前端)等大量使用,业务更加简化高效。 · 同时,Tair全球分布式缓存能力,满足了vipkid和寺库等大客户混合云的需求,通过Tair敏捷Paas版,帮助用户建设混合云之间稳定的双向乃至多向数据复制能力。 Lindorm Lindorm是面向大数据领域的低成本NoSQL存储,在淘宝、支付宝、菜鸟等众多阿里核心业务久经大规模验证,目前已经全面上云,打造企业版HBase。其具备高性能、高压缩、主备多活、冷热分离、企业级备份、智能诊断等独家能力,同时内置多种索引及查询接口,赢得了申通、莉莉丝、兑吧等诸多大客户的认可,成为推荐、广告、风控、车联网、海量数据实时存取等场景首选数据库。 · 莉莉丝使用Lindorm存储游戏战斗回放、游戏聊天、广告日志等数据,通过冷热分离、FeedStream、高吞吐等特性满足游戏场景下的数据存储需求,良好保障了业务使用过程的平稳,助力其新游剑与远征的全国发行。 · 申通物流使用Lindorm存储包裹轨迹数据,顺利帮助客户平稳支撑双十一下的高吞吐,并通过高压缩、冷热分离、TTL等能力实现海量数据的低成本存储. 杭州兑吧广告平台使用Lindorm存储人群特征、实时行为流量等数据,通过主备双活、高吞吐、低延迟等特性满足广告实时匹配场景的需求,迁移至企业版后获得2倍的业务效果提升,得到用户高度认可。 五、客户案例 阿里云数据库助力中国联通,实现核心计费CBSS系统全国大集中 客户简介 中国三大运营商之一国内31个省(自治区、直辖市)和境外多个国家和地区设有分支机构,2018世界品牌500强排名第236 业务挑战 省级系统做全国大集中,传统Oracle架构无法支撑超大系统。 目前架构缺乏弹性扩展能力。 核心计费业务需要解耦,采用分布式架构,但系统数量过多,会面临巨额Oracle license。 集团要求落地多活数据中心,树立行业标杆,传统Oracle数据库架构只支持主备模式。 解决方案 采用分布式集群数据库DRDS支撑核心计费CBSS系统,实现全国大集中。 业务改造为微服务架构,微服务底层采用分布式数据库DRDS做为支撑,云数据库原生具有弹性能力,增加节点集群整体并发和容量线性提升。 把阿里集团多活中心能力输出给客户,帮助用户建设客服系统双活数据中心。 阿里云数据库助力国家电网中台战略转型,同期线损系统迁移上云 业务/技术亮点: 各省接入5000W+设备量测数据 业务挑战 当前使用Oracle、GBase、Mysql、Hadoop的商业+开源数据架构,技术组件多样,应用难度大。各省接入5000W+设备量测数据,需满足100W/s的数据写入性能。 海量量测数据实时查询需要秒级响应。线损模型计算结果,要支撑应用层业务场景服务调用,满足高并发、低延时、毫秒级、海量数据实时多维分析需求。 解决方案 TSDB作为量测数据存储引擎,批量导入HBase历史量测数据,实时接入Oracle/E文件中增量量测数据,提供高速数据写入能力。 TSDB作为量测数据实时查询引擎,提供批量历史数据、历史时刻断面数据实时查询能力。 AnalyticDB MySQL作为分析层MPP数据库,接收共享层MaxCompute线损模型分析、计算结果数据,提供实时高并发在线分析,提供实时交互式查询能力。 用户档案数据与量测热数据汇总至AnalyticDB(ADB),提供量测数据与用户关系模型的联合查询能力。

优秀的个人博客,低调大师

What?一个 Dubbo 服务启动要两个小时!

前言 前几天在测试环境碰到一个非常奇怪的与 dubbo 相关的问题,事后我在网上搜索了一圈并没有发现类似的帖子或文章,于是便有了这篇。 希望对还未碰到或正在碰到的朋友有所帮助。 现象 现象是这样的,有一天测试在测试环境重新部署一个 dubbo 应用的时候发现应用“启动不起来”。 但过几个小时候之后又能自己慢慢恢复,并能够对外提供 dubbo 服务。 但其实经过我后续排查发现刚开始其实并不是启动不起来,而是启动速度非常缓慢,所以当应用长时间启动后才会对外提供服务。 而这个速度慢到居然要花费 2 个小时。 导致的一个结果是测试完全不敢在测试环境发版验证了,每验证一个功能修复一个 bug 就得等上两个小时,这谁受得了😂。 而且经过多次观察,确实每次都是花费两小时左右应用才能启动起来。 尝试解决 最后测试顶不住了,只能让我这个“事故报告撰写专家”来看看。 当我得知这个问题的现象时其实完全没当一回事: 都不用想,这不就是主线程阻塞了嘛,先看看是否在初始化的时候数据库、Zookeeper 之类的连不上导致阻塞了-------来之多次事故处理的经验告诉我。 于是我把这事打回给测试让他先找运维排查下,不到万不得已不要影响我 Touch fish🐳。 第二天一早看到测试同学的微信头像跳动时我都已经准备接受又一句 “膜拜大佬👍” 的回复时,却收到 “网络一切正常,没人动过,再不解决就要罢工了🤬”。 好吧,忽悠不过去了。 首先这类问题的排查方向应该不会错,就是主线程阻塞了,至于是啥导致的阻塞就不能像之前那样瞎猜了。 我将应用重启后用 jstack pid 将线程快照打印到终端,直接拉到最后看看 main 线程到底在干啥。 前几次的快照都是很正常: 加载 Spring ---->连接 Zookeeper ---> 连接 Redis,都是依次执行下来没有阻塞。 隔了一段后应用确实还没起来,我再次 jstack 后得到如下信息: 翻源码 我一直等了十几分钟再多次 jstack 得到的快照得到的信息都是一样的。 如图所示可见主线程是卡在了 dubbo 的某个方法 ServiceConfig.java 的 303 行中。 于是我找到此处的源码: 简单来说这里的逻辑就是要获取本机的 IP 将其注册到 Zookeeper 中用于其他服务调用。 再往下跟就如堆栈中一样是卡在了 Inet4AddressImpl.getLocalHostName 处。 但这是一个 native 方法,我们应用也根本干涉不了,最终的现象就是调用这个本地方法非常耗时。 于是这问题貌似也阻塞在这儿了,没有太多办法。 最终解决 既然这是一个 native 方法,那说明和应用本身没有啥关系(确实也是这样,这个问题是突然间出现的。) 那是否是服务器本身的问题呢,想到在 native 方法里是获取本机的 hostname,那是否和这个 hostname 有关系呢。 这是在我自己的阿里云服务器上测试,真正的测试环境不是这个名字。 拿到服务器 hostname 后再尝试 ping 这个 hostname,奇怪的现象发生了: 命令刚开始会卡住一段时间(大概几十秒),然后才会输出 hostname 对应的 ip 以及对应的延迟。 而当我直接 ping 这个 ip 时却能快速响应后面的输出。 最后我尝试在 /etc/hosts 配置文件中加入了对应的 host 配置: xx.xx.xx.xx(ip) hostname 再次 ping hostname 的效果就和直接 ping ip 一样了。 于是我再次重启应用,一切都正常了。 总结 最后根据我调整的内容尝试分析下本次问题的原因: 当 Dubbo 在启动获取本地 ip 时,是通过服务器 hostname 从 dns 服务器返回当前的 ip 地址。 由于 dns 服务器或者是本地服务器与 dns 服务器之间存在网络问题,导致这个过程的时间被拉长(猜测)。 我在本地的 host 文件中配置后,就相当于本地有一个缓存,优先取本地配置的 ip ,避免了和 dns 服务器交互的过程,所以速度提升了。 虽然问题得到解决了,但还是有几个疑问: 第一个是为什么和 DNS 服务器的交互会这么慢,即便是慢也没有像应用那样需要 2 个小时才能返回,这里我也没搞得太清楚,有相关经验的朋友可以留言讨论。 第二就是 Dubbo 在这个依赖外部获取资源时健壮性是否可以做的更好,虽说我这问题估计也几人碰到。 对于这种长时间没有启动成功的问题是否可以加上提示,比如直接抛出异常退出程序,将问题可能的原因告诉开发者,方便排查问题。 你的点赞与分享是对我最大的支持

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册