首页 文章 精选 留言 我的

精选列表

搜索[kvcache],共41篇文章
优秀的个人博客,低调大师

大部分token根本不该重复计算,不止于KVCache

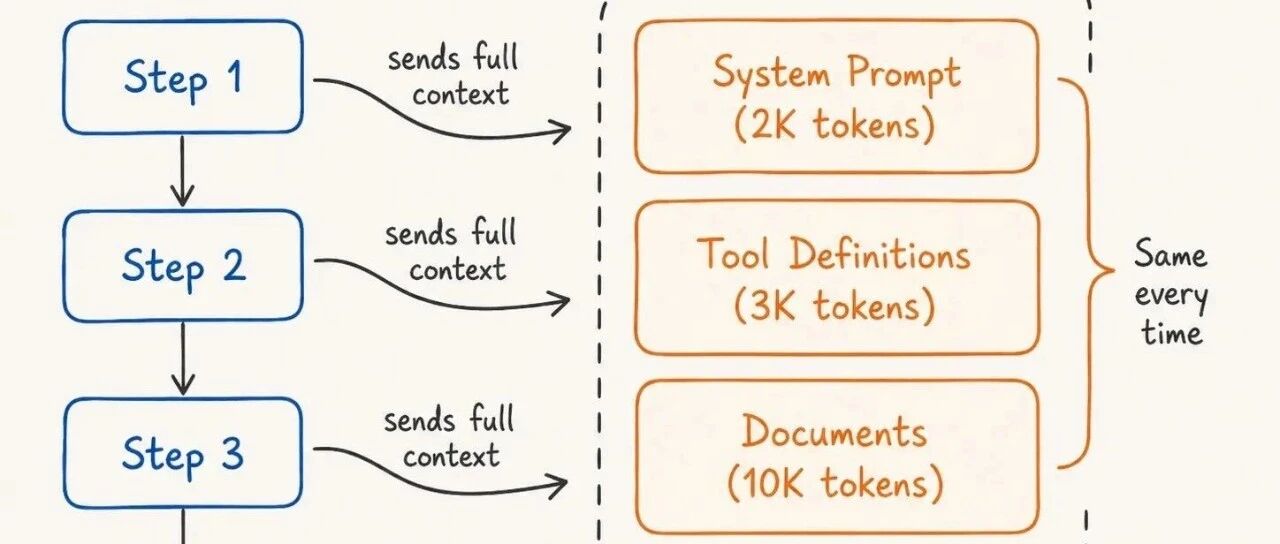
斯坦福研究团队统计过,AI Agent 每一次调用里,62% 的内容都是重复发送的。系统提示没变,工具定义没变,知识库的文档也没变,模型却要每次从头再算一遍 KV 缓存。 相当于你每次问一个关于第七章的问题,都要把整本教材从第一页重新读一遍。已经读完的内容,为什么不能存起来下次用? 现在我们用的前缀缓存(prompt caching)已经解决了一部分问题。对于固定前缀的请求,能省最多 90% 的缓存输入成本,稳定场景下命中率能到 60% 到 85%。但它的天花板太低了。 ![](https://developer.qcloudimg.com/http-save/yehe-11563501/1933c0a503aae40f1b554a0cdd026fa8.jpg) 前缀缓存要求缓存内容必须是新请求一字不差的前缀。改一个字符,整个缓存全废。实际生产里,三种常见场景直接让缓存失效: 1. RAG 多文档检索:你单独缓存了文档 A 和文档 B,新请求同时需要 A 和 B,B 的缓存就用不了,它之前计算的时候没有 A 在前面 1. 文档顺序变化:同样三个文档换个顺序拼接,所有缓存全部失效,文档本身一点没变 1. 多轮对话:每一轮新增内容都会改变前缀后面的位置信息,稳定前缀之外的缓存全部作废 根因在于 KV 缓存是位置相关的。每个 token 的 KV 编码了它对前面所有内容的注意力,一个缓存块只在它被计算时的那个精确上下文里才有效。 阿里云的生产数据统计过,10% 的缓存块贡献了 77% 的缓存命中,剩下 90% 的缓存占着空间,一次都没被用过。 除了命中率问题,现有缓存架构本身就在拖慢推理。所有 KV 缓存工具都跑在推理引擎的同一个进程里,缓存读写、移动数据和推理计算抢同一份 GPU 资源,两个活儿不能同时干。 Google 的 TurboQuant 把 KV 缓存压缩到 3 比特,精度一点没降,但因为跑在推理进程里,直接导致推理慢了 20% 以上。压缩本身没问题,问题出在它和推理挤在同一个进程里。 缓存管理和推理服务是两种完全不同的工作负载。一个是 I/O 密集型(在 GPU、CPU、存储之间搬运大块张量),一个是计算密集型(GPU 上的矩阵乘法)。把两者塞进同一个进程,就像把数据库和 Web 服务器跑在同一个线程里。低负载没事,负载一上来,所有东西都在抢同一份资源。 ![](https://developer.qcloudimg.com/http-save/yehe-11563501/7864c61059c6ccb0b1fe2d55c4ccac0e.jpg) LMCache 的做法很直接,把缓存管理变成独立进程。推理引擎只通过共享 GPU 内存传区块 ID,大块数据的移动全部在 LMCache 进程里并行处理。就像厨师只管炒菜,专门雇一个人负责去仓库取食材,两个人同时干活。 ![](https://developer.qcloudimg.com/http-save/yehe-11563501/0fa6e729d5722ba98ff66bdfe370547e.jpg) 三个实打实的好处: - 没有资源争抢:之前压缩、移动缓存导致的 20% 推理速度损失直接消失 - 多 GPU 零拷贝共享:传统方案共享缓存要多次拷贝内存,LMCache 让多个 GPU 直接读写同一块内存 - 多层级并行查找:缓存可以存在 GPU、CPU、SSD、远程存储,传统方案挨个找,LMCache 同时查,哪里有就从哪里拿 ![](https://developer.qcloudimg.com/http-save/yehe-11563501/cd97fe72e3f431147130986bcf4c6f15.jpg) 分离架构解决了性能问题,但前缀缓存的天生缺陷还在。LMCache 的 CacheBlend 技术(EuroSys 2025 最佳论文奖)专门解决这个。 核心观察很简单:Transformer 里大部分 token 只关注自己附近的上下文,只有很少一部分 token 需要跨文档计算注意力。CacheBlend 只重新计算这少量跨边界的 token,剩下的缓存全部直接复用。不管文档是什么顺序、怎么组合。 ![](https://developer.qcloudimg.com/http-save/yehe-11563501/81b0540b1c0bf1faba782b60ffdb2b53.jpg) 对做 RAG 的团队来说,这意味着知识库里的每一篇文档都能变成可复用的缓存资产。实测多文档处理速度提 2 到 4 倍,没有质量损失。 在 H200 GPU 上跑 Qwen3-235B,50 个并发用户的场景下,对比传统进程内缓存,LMCache 把首 token 延迟降到原来的 1/14,解码速度提 4 倍。启动时间从 3 分钟以上压缩到约 30 秒。 LMCache 不是一个原型产品。已经做好了生产环境需要的所有配套:Prometheus 和 OpenTelemetry 监控,Kubernetes 部署,CLI 调试和压测。故障容错也考虑到位了。推理引擎崩溃,缓存数据不丢;LMCache 崩溃,推理引擎自动降级继续运行,等缓存恢复自动重连。 它适配了所有主流推理引擎:vLLM、SGLang、TensorRT-LLM,支持 NVIDIA 和 AMD GPU。存储后端覆盖 CPU 内存、本地 SSD、Redis/Valkey、Mooncake、InfiniStore、S3 兼容对象存储、NIXL 和 GDS。还支持 PD 分离(prefill/decode 解耦),以及可插拔的 KV 变换接口,方便研究者做压缩、token 丢弃、自定义序列化实验。 超过 10k GitHub star,已被 PyTorch 基金会接纳,NVIDIA Dynamo 也集成了 LMCache。Apache 2.0 许可证。 有读者提到,epistemic-graph 已经把 LMCache 作为默认的 KV 缓存 L2 持久化层,把多模态数据库和 KV 缓存做了结合,感兴趣可以去看他们的项目。 对于现在做 AI Agent 和大规模 RAG 的团队来说,KV 缓存管理已经不是未来的优化选项,而是现在就要做的成本决策。 Token 单价确实在降。2023 到 2026 年,GPT-4 级别模型的单价从每百万 token 30 美元跌到了 0.40 美元,降了 80%。但 Agent 场景下单次任务的 token 消耗是普通聊天的 5 到 30 倍,因为每一步都要把全部上下文重发一遍。价格降了,用量涨得更猛,总账单反而更高。Uber 用 Claude Code 四个月烧完一整年预算就是例子,Gartner 预测 40% 的 AI Agent 项目会因为成本超支在 2027 年前取消。 单张 MI300X GPU 每天产生约 15 TB 的 KV 缓存,大部分用完就扔了。大部分团队现在还在拼怎么把 token 单价打下来,却没看到大部分 token 根本就不应该重复计算。 项目地址:https://github.com/LMCache/LMCache

资源下载

更多资源
Mario

Mario

马里奥是站在游戏界顶峰的超人气多面角色。马里奥靠吃蘑菇成长,特征是大鼻子、头戴帽子、身穿背带裤,还留着胡子。与他的双胞胎兄弟路易基一起,长年担任任天堂的招牌角色。

腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册