首页 文章 精选 留言 我的

精选列表

搜索[作品],共2090篇文章
优秀的个人博客,低调大师

【参赛作品3】浅聊openGauss体系架构

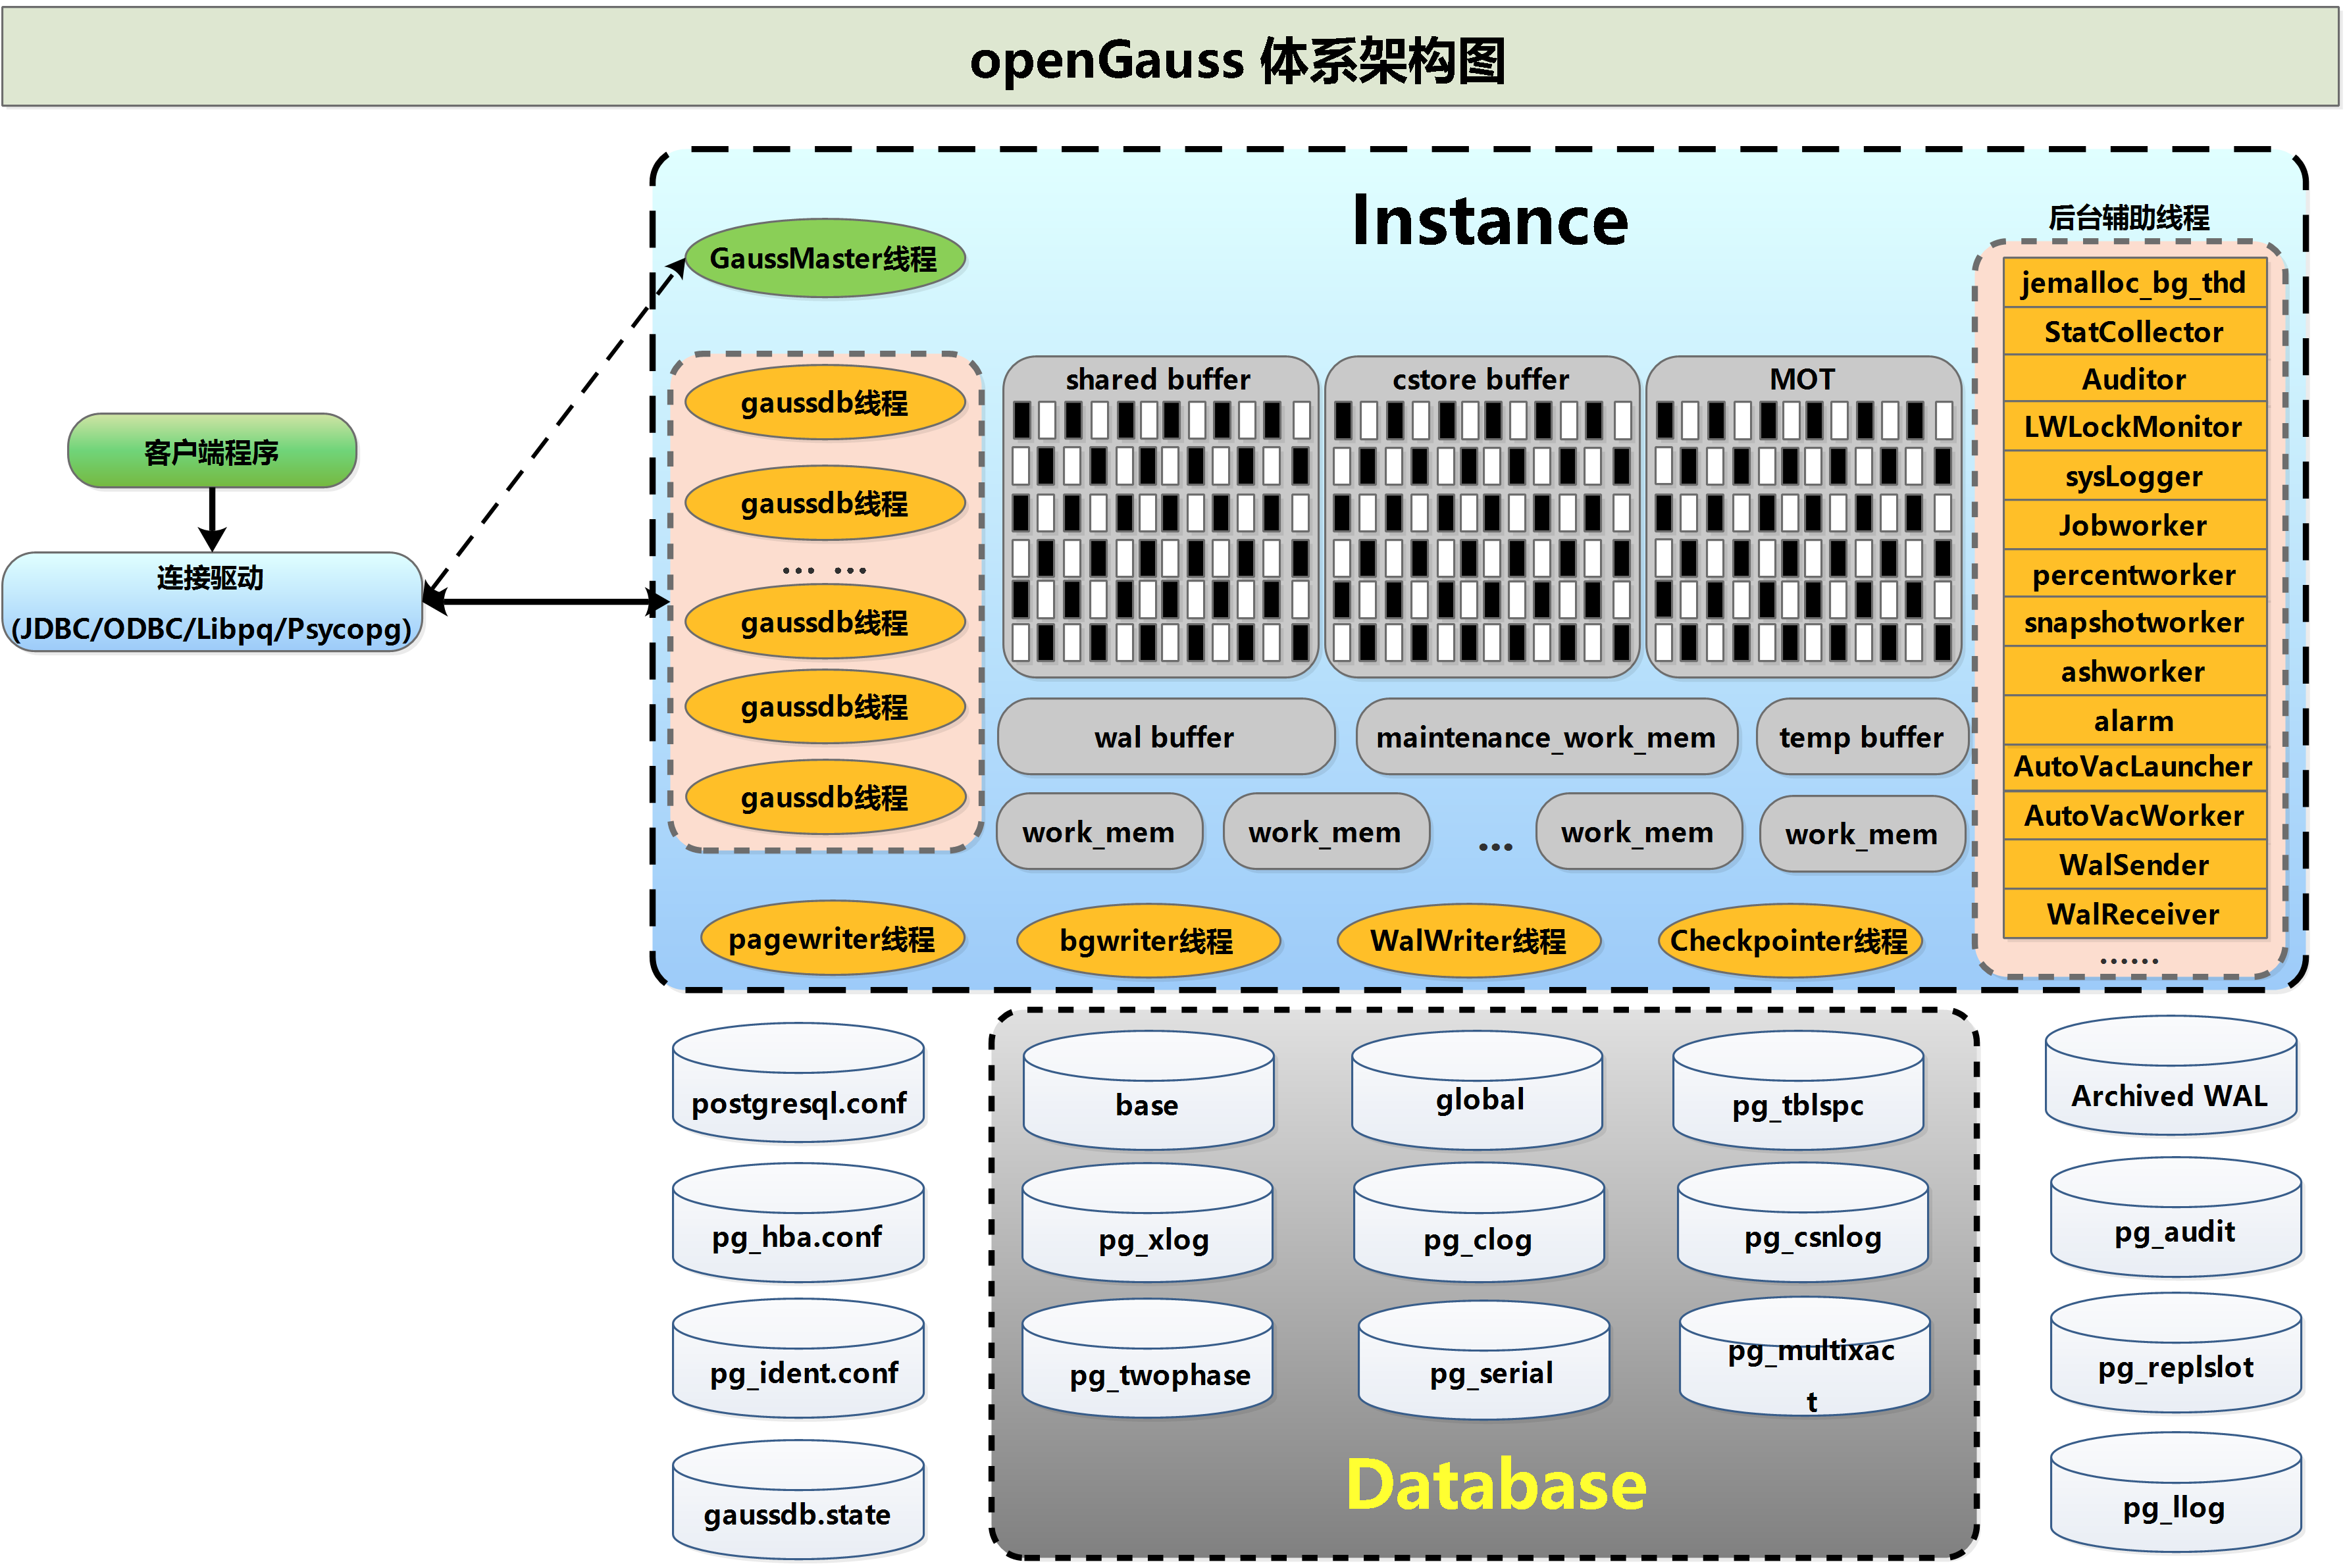
2020年7月openGauss刚刚开源,我便开始对openGauss数据库的学习。根据以往学习数据库的经验,最先想了解的是openGauss数据库的架构,希望对即将使用的数据库各个模块有所了解。但鉴于时间有限,仅有的资料图是源码doc目录内的“openGauss逻辑结构图”,便针对该图做了简单介绍,并形成文档《浅聊openGauss逻辑架构》,感兴趣的小伙伴可以参考。 虽然已发表关于openGauss逻辑架构介绍的文章供大家参考,但总感觉缺少点什么(想念学习Oracle时的那张体系架构图)。今年初准备培训资料时参考相关资料绘制了一份简易的openGauss体系架构图,后来因为忙于其他工作,把这个事情忘记了。借着本次墨天轮举办的“我的国产数据库之路”,使我重新想起了这件事情,希望将这张图和相关介绍分享出来供大家参考。 说明: 本文内容仅代表个人观点。 一、首先了解一下架构图中的Instance部分 学习过Oracle等主流数据库的小伙伴都清楚,Instance部分其实主要指的是数据库运行时的内存部分。 openGauss属于单进程多线程模型的数据库,客户端可以使用JDBC/ODBC/Libpq/Psycopg等驱动程序,向openGauss的后端管理线程GaussMaster发起连接请求。 补充知识点: JDBC JDBC(Java Database Connectivity,Java数据库连接)是一种用于执行SQL语句的Java API,可以为多种关系数据库提供统一访问接口,应用程序可基于它操作数据。openGauss库提供了对JDBC 4.0特性的支持,需要使用JDK1.8版本编译程序代码,不支持JDBC桥接ODBC方式。 ODBC ODBC(Open Database Connectivity,开放数据库互连)是由Microsoft公司基于X/OPEN CLI提出的用于访问数据库的应用程序编程接口。应用程序通过ODBC提供的API与数据库进行交互,增强了应用程序的可移植性、扩展性和可维护性。openGauss目前提供对ODBC 3.5的支持。但需要注意的是,当前数据库ODBC驱动基于开源版本,对于tinyint、smalldatetime、nvarchar2类型,在获取数据类型的时候,可能会出现不兼容。 Libpq Libpq是openGauss的C语言程序接口。 客户端应用程序可以通过Libpq向openGauss后端服务进程发送查询请求并且获得返回的结果。需要注意的是,在官方文档中提到,openGauss没有对这个接口在应用程序开发场景下的使用做验证,不推荐用户使用这个接口做应用程序开发,建议用户使用ODBC或JDBC接口来替代。 Psycopg Psycopg可以为openGauss数据库提供统一的Python访问接口,用于执行SQL语句。openGauss数据库支持Psycopg2特性,Psycopg2是对libpq的封装,主要使用C语言实现,既高效又安全。它具有客户端游标和服务器端游标、异步通信和通知、支持“COPY TO/COPY FROM”功能。支持多种类型Python开箱即用,适配PostgreSQL数据类型;通过灵活的对象适配系统,可以扩展和定制适配。Psycopg2兼容Unicode和Python 3。 当 GaussMaster 线程接收到客户端程序发送过来的服务请求后,会根据收到的信息会立即fork()一个子线程,这个子线程对请求进行身份验证成功后成为对应的后端业务处理子线程( gaussdb )。之后该客户端发送的请求将由此业务处理子线程(gaussdb)负责处理。当业务处理子线程(gaussdb)接收到客户端发送过来的查询(SQL)后,会调用openGauss的SQL引擎对SQL语句进行词法解析、语法解析、语义解析、查询重写等处理操作,然后使用查询优化器生成最小代价的查询路径计划。之后,SQL执行器会按照已制定的最优执行计划对SQL语句进行执行,并将执行结果反馈给客户端。 在SQL执行器的执行过程中通常会先访问内存的共享缓冲区(如:shared buffer、cstore buffer、MOT等),内存共享缓冲区缓存数据库常被访问的索引、表数据、执行计划等内容, 共享缓冲区的高速RAM硬件,为SQL的执行提供了高效的运行环境,大幅减少了磁盘IO,极大地提升了数据库性能,是数据库非常重要的组件之一。 如图所示: shared buffer 是行存引擎默认使用的缓冲区,openGauss的行存引擎是将表按行存储到硬盘分区上,采用MVCC多版本并发控制,事务之间读写互不冲突,有着很好的并发性能,适合于OLTP场景。 cstore buffers 是列存引擎默认使用的缓冲区,列存引擎将整个表按照不同列划分为若干个CU(Compression Unit,压缩单元),以CU为单位进行管理,适合于OLAP场景。 MOT 是内存引擎默认使用的缓冲区,openGauss的MOT内存引擎的索引结构以及整体的数据组织都是基于Masstree模型实现的,其乐观并发控制和高效的缓存块利用率使得openGauss可以充分发挥内存的性能,同时,在确保高性能的前提下,内存引擎有着与openGauss原有机制相兼容的并行持久化和检查点能力(CALC逻辑一致性异步检查点),确保数据的永久存储,适合于高吞吐低时延的业务处理场景。 SQL执行器在共享缓冲区中对数据页的操作会被记录到 WAL buffer 中,当客户端发起事务的commit请求时,WAL buffer的内容将被WalWriter线程刷新到磁盘并保存在WAL日志文件中,确保那些已提交的事务都被永久记录,不会丢失。 但需要注意的是,当walwriter的写操作跟不上时数据库实际的需求时,常规后端线程仍然有权进行WAL日志的刷盘动作。这意味着WALWriter不是一个必要的进程,可以在请求时快速关闭。 maintenance_work_mem 一般是在openGauss执行维护性操作时使用,如:VACUUM、CREATE INDEX、ALTER TABLE ADD FOREIGN KEY等操作,maintenance_work_mem内存区域的大小决定了维护操作的执行效率。 temp_buffer 是每个数据库会话使用的LOCAL临时缓冲区,主要缓存会话所访问的临时表数据。需要注意的是,openGauss支持全局临时表和会话级临时表,全局临时表的表定义是全局的,而临时表的数据是各个会话私有的。 work_mem 是事务执行内部排序或Hash表写入临时文件之前使用的内存缓冲区。 二、接下来我们再了解一下openGauss的后台辅助线程 线程名称 描述 jemalloc_bg_thd 管理并实现内存的动态分配 StatCollector 负责统计openGauss数据库的信息,包括:物理硬件资源使用信息、对象属性及使用信息、SQL运行信息、会话信息、锁信息、线程信息等,并且将这些收集到的统计信息保存在pgstat.stat文件中 Auditor 使用重定向的方式从管理线程、后台线程以及其他子线程获取审计数据,并保存在审计文件中 LWLockMonitor 负责检测轻量级锁(LWLock)产生的死锁,轻量级锁主要提供对共享内存的互斥访问控制,比如Clog buffer(事务提交状态缓存)、Shared buffers(数据页缓存)、Substran buffer(子事务缓存)等 sysLogger 使用重定向的方式捕获管理线程、后台线程以及其他子线程的stderr输出,并写入日志文件中 Jobworker JOB线程分为调度线程和工作线程。调度线程(JobScheduler)会根据pg_job表里面定义的JOB周期,对已经过期的JOB进行调用,由工作线程(Jobworker)执行实际的JOB任务 percentworker 根据percentile参数设置的值计算sql响应时间的百分比信息,目前percentile参数仅支持80和95 snapshotworker 收集snapshot信息,openGauss数据库的WDR报告依赖于snapshot ashworker 统计历史活动会话相关信息 alarm openGauss的告警检测线程 清理线程(AutoVacLauncher+AutoVacWorker) AutoVacLauncher线程由Postmaster线程启动,它不断地将数据库需要做vacuum的对象信息保存在共享内存中,当表上被删除或更新的记录数超过设定的阈值时,会调用AutoVacWorker线程对表的存储空间执行回收清理工作 WalSender 运行在openGauss主备环境中主节点,发送预写日志给备节点 WalReceiver 运行在openGauss主备环境中备节点,接收预写日志记录 pagewriter 负责将脏页数据拷贝至双写(double-writer)区域并落盘,然后将脏页转发给bgwriter子线程进行数据下盘操作,如果发生数据页"折断"的问题,就会从双写空间里找到完整的数据页进行恢复 bgwriter 负责对共享缓冲区的脏页数据持续的进行刷盘操作,目的是让数据库线程在进行用户查询时可以很少或者几乎不等待写动作的发生,这样的机制同样也减少了检查点造成的性能下降 Checkpointer 周期性的发起数据库检查点,在这个检查点时刻,所有的数据文件都被更新,脏数据页也被刷新到磁盘,此刻数据库是一致的。openGauss支持全量检查点和增量检查点,增量检查点打开后会小批量的分阶段的滚筒式的去进行脏页刷盘 关于其他后台辅助线程的介绍,可以参考文章《浅聊openGauss逻辑架构》。 三、Database相关文件 目录名称 描述 base openGauss数据库对象默认存储在该目录,如默认的数据库postgres、用户创建的数据库及关联的表等对象 global 存储openGauss共享的系统表或者说是共享的数据字典表 pg_tblspc 即是openGauss的表空间目录,里面存储openGauss定义的表空间的目录软链接,这些软链接指向openGauss数据库表空间文件的实际存储目录 pg_xlog 存储openGauss数据库的WAL日志文件 pg_clog 存储openGauss数据库事务提交状态信息 pg_csnlog 存储openGauss数据库的快照信息,openGauss事务启动时会创建一个CSN快照,在MVCC机制下,CSN作为openGauss的逻辑时间戳,模拟数据库内部的时序,用来判断其他事务对于当前事务是否可见 pg_twophase 存储两阶段事务提交信息,用来确保数据一致性 pg_serial 存储已提交的可序列化事务信息 pg_multixact 存储多事务状态信息,一般用于共享行级锁(shared row locks) 四、openGauss配置相关文件 文件名称 描述 postgresql.conf openGauss的配置文件,在gaussmaster线程启动时会读取该文件,获取监听地址、服务端口、内存分配、功能设置等配置信息,并且根据该文件,在openGauss启动时创建共享内存和信号量池等 pg_hba.conf 基于主机的接入认证配置文件,主要保存鉴权信息(如:允许访问的数据库、用户、IP段、加密方式等) pg_ident.conf 客户端认证的配置文件,主要保存用户映射信息,将主机操作系统的用户与openGauss数据库用户做映射 gaussdb.state 主要保存数据库当前的状态信息(如:主备HA的角色、rebuild进度及原因、sync状态、LSN信息等) 五、openGauss其他重要文件 目录名称 描述 Archived WAL openGauss数据库WAL日志的归档目录,保存openGauss的历史WAL日志 pg_audit 存储openGauss数据库的审计日志文件 pg_replslot 存储openGauss数据库的复制事务槽数据 pg_llog 保存逻辑复制时的状态数据 关于openGauss体系架构就为大家介绍到这里,鉴于笔者并非openGauss内核开发人员,这里仅从DBA的角度粗浅的对openGauss数据库体系架构为大家做一个简单介绍,若文章有描述错误之处,欢迎指正。将及时修正以免误导大家。 文末寄语: openGauss开源至今已将近1年,合作伙伴和广大数据库爱好者的努力使得openGauss数据库得以快速健康地向前发展,openGauss目前已发布至 2.0.0 版本,按照发布计划应该会在6月31日发布新的版本,欢迎各位小伙伴关注。 在个人的工作中,偶尔有小伙伴反馈openGauss有些不足之处使其对国产数据库失去了信心,为国产数据库的发展前景画了一个问号。这里我想阐述一下个人观点: Oracle起源于1977年,MySQL起源于1979年,SQL Server1987年,那么我们国产数据库呢? 根据墨天轮发布的2021年6月份《国产数据库流行度排行榜》,前三甲国产数据库中,2016年12月TiDB RC1发布,2011年OceanBase 0.1发布,2017年PolarDB发布。而国产数据库真正的发力时间点个人认为应该是在2020年,从2020年至今,国产数据库可谓是百家争鸣,无论是开源建设、技术发展还是生态建设都处于突飞猛进的状态。从时间上看,国产数据库真正的发展时间比国外主流数据库晚将近40载,在一个良好的数据库技术生态环境下,经历40载的光阴打磨,形成一款优秀的数据库软件是理所当然。所以,综合起来看,以Oracle为代表的数据库无论是生态建设还是技术成熟度都比国产数据库有一定的先天优势。 但当今的国产数据库发展现状已经不可同日而语,IT从业人员基本也都意识到核心IT技术国产化的重要性。无论是传统数据库厂商、互联网厂商还是其他IT厂商等等诸多厂商都在做属于自己的数据库产品,仅墨天轮《国产数据库流行度排行榜》所统计的数据库就多达130+种,而且这些数据库的技术起点已经处于一个较高且成熟的水平。在互联网、金融、政府、能源、电信等诸多核心行业中都在不断地尝试国产数据库在核心业务场景下的使用。 为了打造一个更好的国产数据库技术生态,openGauss、TiDB、OceanBase等优秀的数据库源代码已对外开放,合作伙伴可以根据源代码,发行属于自己的商业版本数据库,促进国产数据库的生态建设。 同时,我国的各大高等院校也增加了大量国产数据库的课程内容,为国产数据库后续的人才建设提供了有力保障,这些是国产数据库的未来。 所以,理性且客观的看,国产数据库和全球主流数据库存在些许差距,但国产数据库的发展环境已经不可同日而语,生态建设、人才发展、技术演进正在紧锣密鼓的向前“奔跑”,对国产数据库未来的发展应该有绝对的信心和自信,国产数据库与全球主流数据库的差距正在迅速缩小,至于什么时候与全球主流数据库比肩甚至超越,我相信只是时间问题,但不会太久。 关于国产数据库,您怎么看? 欢迎留言讨论。

优秀的个人博客,低调大师

【参赛作品10】openGauss之indexadvisor测试与总结

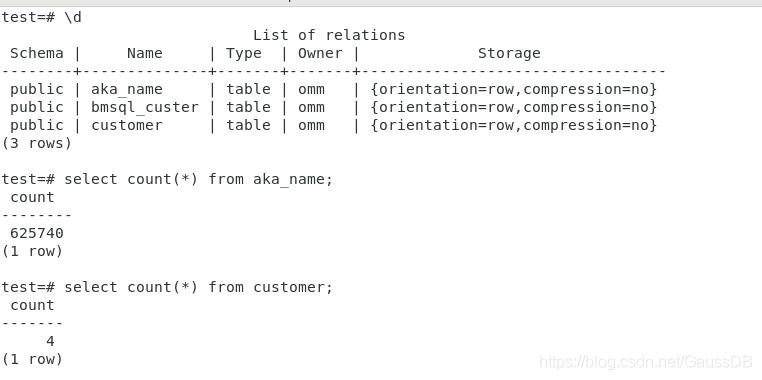
测试种类:单query索引推荐、虚拟索引推荐(由于数据限制没有进行workload测试) 1. 测试的表数据量如下:在test数据库下的aka_name、customer表。 aka_name为60多万条数据(取自imdb数据集数据中一个表的数据)、customer为4条数据(自己创建的)。 2.单query索引推荐:gs_index_advise 用于针对单挑查询语句生成推荐索引 (1)where语句只有一个属性的情况 (2)where语句有多个属性的情况 ① 两个属性,范围查找.只推荐了id,没有推荐person_id。发现哪个属性在前面就推荐谁。 ②三个属性,两个范围查找,一个=精准查找.推荐id与=的属性。 ③四个属性,两个like模糊查询。 like属性不给推荐。 ④五个属性,两个like模糊查询。 like属性不给推荐。 ⑤五个属性,一个like模糊查询,一个=。 like不给于推荐,=给予推荐。 ⑥五个属性,一个like精准查询,一个=。 like依旧不给于推荐索引。 ⑦五个属性,两个=。 =的属性全部给予推荐索引。 (3)order by 与 group by 3.虚拟索引 ①hypopg_create_index:创建虚拟索引。 ②hypopg_display_index:显示所有创建的虚拟索引信息。 hypopg_drop_index:删除指定的虚拟索引。 hypopg_reset_index:清除所有虚拟索引。 hypopg_estimate_size:估计指定索引创建所需的空间大小。 总结如下: 目前对gauss的单索引推荐和虚拟索引推荐进行了测以及结果情况如下: 单索引推荐:适用于表中数据量大的情况,数据量过小不会进行推荐。 (1)当where中的查询条件只有一个的时候,推荐单一索引,如只有id在where中,只推荐id为索引;当where中的查询条件有多个的时候推荐多重索引,如id,name在where中被当做条件,则一起被推荐为联合索引,但是如果同时存在id、person_id则默认推荐id( 目前不知道原因) (2)当query中除了where这个语句时,还存在order by 和 group by等条件时,将where、order by、group by中的属性全部作为联合索引进行推荐。 (3)使用like模糊查询时或精准查询都不对该属性进行索引建立,并且=属性一定给予索引推荐建立。 (4)当query中的条件过多时存在的属性也超过三个时,依旧推荐联合属性是在三个以上,会不会导致推荐索引过多从而性能下降,这个有待商榷,最好推荐索引中的属性在三个以内最好。不过这个可能需要通过DRL来学习,判断究竟选择一条query中的哪几个属性来建立索引。 虚拟索引 (1)通过使用hypopg这个建立虚拟索引可以加快查询速度,具体可以通过explain命令发现cost得到了很大程度上的减少,并且会显示在什么地方建立虚拟索引达到这种效果的。 (2)同时发现openGuass的index_advior在虚拟索引上和论文中的索引推荐都使用到hypopg这个工具,都是用于创建虚拟索引,进行索引推荐,不同的地方可能在于论文中使用了DRL进行学习以及建立了DQN模型,论文中找到全部能够建立的索引候选项,都是可以在一定程度上减少cost的,但是具体上不知道是哪一种的索引候选项能够使cost最小,然后通过DQN来学习,但是通过学习最终的Q-value不一定是全局最优的,但一定是局部最优的。所以就是gauss可能就是更加hypopg进行虚拟的创建得到一个索引,然后通过改索引在一定程度上对query进行了优化,而论文中则是先获取所有可能建立索引的索引候选项,然后通过学习来从所有的索引候选项里面找到一个最优的索引。 workload级别索引推荐 暂未测试。 Gauss松鼠会是汇集数据库爱好者和关注者的大本营, 大家共同学习、探索、分享数据库前沿知识和技术, 互助解决问题,共建数据库技术交流圈。 openGauss官网

优秀的个人博客,低调大师

Mitaka:OpenStack迄今为止最成熟作品面世

美国时间4月7日,OpenStack社区发布了OpenStack的第13个版本——Mitaka,新版本聚焦于可管理性、可扩展性和终端用户体验。目前OpenStack在云构建领域已经成为了使用最为广泛的开源软件,成为了企业和服务提供商的云平台选项,为企业应用优化和云原生软件开发架起了桥梁。此外,它们还是一个整合引擎,可以通过单独的一套API实现对裸机、虚拟机和容器编排框架的管理。 由来自293个组织的2,336名开发者、运营者和用户组成的国际化社区共同设计并创建了OpenStack Mitaka版本。随着OpenStack发布六周年的临近,该项目拥有一个成熟且稳定的内核这一事实已经得到了广泛认可。因此,OpenStack社区近期的开发努力将在更大程度上聚焦于让软件的部署、管理和可扩展变得更加便捷。 简化可管理性 Mitaka版本包含了大量的改进,重点提升了云部署者和管理者日常使用的便携性。其中一个亮点是,通过引入附加的标准默认值和减少必须手动选择的选项数量,简化了对Nova计算服务的配置。由于将云网络身份管理功能的多个设置步骤——安装、运行、认证、分配令牌等整合成了一个步骤,Keystone身份服务也得到了大幅简化。在Mitaka版本中,Neutron的可管理性也得到了进一步增强,新增了对改进的Layer 3网络和分布式虚拟路由器(DVR)的支持。 更高的可扩展性 Mitaka还针对可扩展的OpenStack云进行了持续改进。例如,首次出现在Liberty版本中的Heat聚合引擎在Mitaka版本中可以处理更大的负载和更为复杂的横向扩展,从而为无状态操作提供更为优秀的性能。同样,在Keystone中,fernet令牌增加了身份服务所支持的API操作数量。开发者还对Cells v2进行了重大改进,这是另一个在Liberty版本中被增加的功能,该功能可以帮助对OpenStack计算节点进行横向扩展。 提升用户体验 Mitaka版本表明社区正在致力于提升云的用户体验,这些用户体验不仅包括云运营者的体验,还包括了那些正在开发,或是正在云资源上部署应用的终端用户的体验。例如,统一的OpenStack客户端为创建资源提供了一套一致的调用,终端用户不必学习每个服务的API。Mitaka版本还通过添加大量不同的语言提升了对软件开发工具包的支持。 另外的一处改进是提升了应用开发者的体验,在Neutron中增加了一项名为“get me a network”的功能。这一功能可以消除创建网络、为网络添加服务器、为服务器分配IP、让网络具有可访问性等一系列操作中的所有必须步骤,将这些步骤合并为一个操作。这一功能的要素都被引入到了Mitaka版本中。 可用性 OpenStack生态系统在未来数周和数月内将开始大规模推出基于OpenStack Mitaka的产品和服务。用户可以找到OpenStack Powered认证的发行版,在OpenStack Marketplace中找到符合互操作测试的服务提供商。 用户接纳的趋势 伴随着部署的样式越来越多、规模越来越大,尤其是许多组织机构已经认可了OpenStack的灵活性和敏捷性,OpenStack的接纳程度在过去一年里正在持续加速增长。OpenStack在支持组织机构解决所面临的“双模”(bimodal)挑战方面具有独特的能力,因为当前许多组织机构既要管理传统的老旧IT工作负载,同时还要部署现代化的敏捷IT系统,从而推动业务差异化发展,通过软件开发的快速迭代获取竞争优势,以更快地为客户带来新的价值。 在奥斯汀OpenStack Summit上,与会者将会听到来自eBay、SAP、沃尔玛和富国银行等企业的演讲,分享OpenStack对实现应用、大数据分析和物联网的快速开发与部署的价值。这一软件还将成为电信产业的创新推动力。AT&T、中国移动、NTT Docomo和Orange等大型运营商讨论将OpenStack作为NFV(网络功能虚拟化)平台的问题。此外,OpenStack正在被越来越多提供公有云服务的公司所采用。例如,德国电信、Datacentred和City Network在过去几个月里均宣布了他们的新的重要客户和重大部署情况。一些大型的研究机构和大学,例如欧洲原子能机构(CERN)、Chameleon Cloud、克莱姆森大学也将在即将到来的OpenStack奥斯汀峰会上进行演讲。 本文转自d1net(转载)

优秀的个人博客,低调大师

SerenityOS 作者新作品:跨平台 Web 浏览器 Ladybird

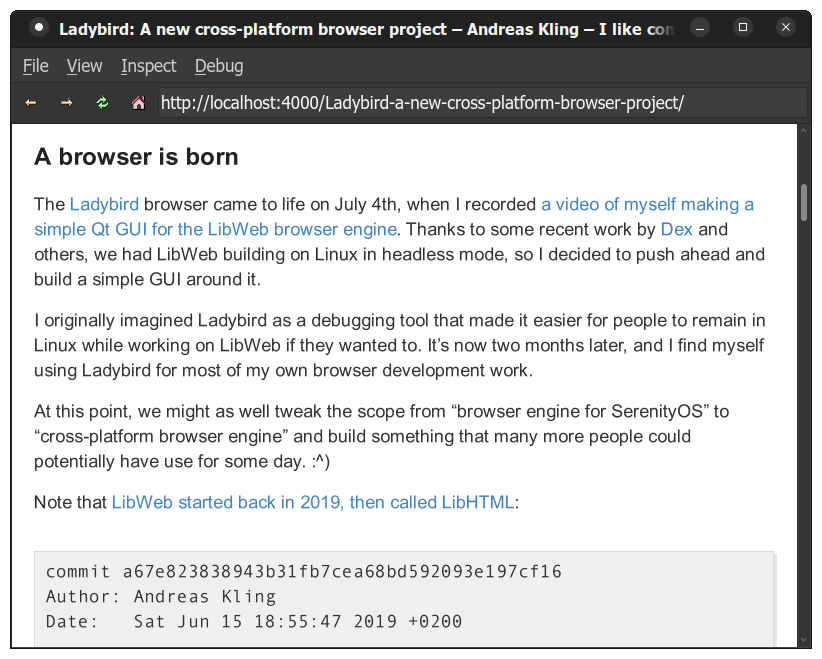
SerenityOS 系统的作者 Andreas Kling 近日介绍了他开源的跨平台浏览器项目: Ladybird。 Ladybird 浏览器于今年 7 月 4 日诞生,最初 Ladybird 的开发是作为 SerenityOS 系统的 “ LibWeb” 浏览器引擎调试工具,随后 Andreas 想给它构建一个简单的 GUI 。随着 Ladybird 的不断完善,两个月后,Andreas 发现自己完成了一个 Web 浏览器的大部分开发工作, Ladybird 已经算是一个跨平台的 Web 浏览器。 (Ladybird 浏览器视觉效果) Ladybird 浏览器基于 SerenityOS 的 LibWeb 和 LibJS 引擎,LibWeb 于 2019 年开始开发,当时被称为 LibHTML ,其 JavaScript 引擎 LibJS 则于 2020 年开发。 基本架构 LibWeb 和 LibJS 都是新的引擎。作者有 Qt 和 WebKit 项目的开发历史,所以从中得到了一些灵​​感,但所有的代码都是新的,浏览器和库用则 C++ 编写。 这是当前浏览器堆栈的粗略细分: Ladybird : 选项卡式浏览器 GUI 应用程序 LibWeb:Web 引擎,多种标准:HTML、DOM、CSS、SVG,…… LibJS:ECMAScript 语言、运行时库、垃圾收集器 LibGfx:2D 图形、文本渲染、图像格式(PNG、JPG、GIF,...) LibRegex:正则表达式引擎 LibXML : XML 解析器 LibWasm:WebAssembly 解析器和解释器 LibUnicode:Unicode 支持库 LibTextCodec : 文本编码转换库 LibMarkdown : Markdown 解析器 LibCore:其他支持功能(I/O、日期时间、MIME 数据……) Qt:跨平台 GUI 和网络 LibWeb 有一个Platform层,Ladybird 为事件循环、计时器、系统字体设置等注入 Qt 支持代码。目前 Ladybird 使用 Qt 进行网络任务,因为在 SerenityOS 之外还没有多进程 RequestServer 系统。同样,Ladybird 目前是单进程的,而 SerenityOS 浏览器是每个选项卡的进程。 完成度:较低 目前 Ladybird 可在 Linux、macOS、Windows (WSL) 和 Android 上运行,但它仍处于开发初期,许多网络平台的功能仍缺失或损坏,需要很长时间才能准备好进行日常浏览。 Ladybird 已经通过了经典的 Acid3 标准测试,它涵盖了一堆基本的 CSS 布局特性和各种 DOM/HTML API。 Acid3 测试是来自Web Standards Project的Web 测试页面,用于检查Web 浏览器是否符合各种Web 标准的元素,尤其是文档对象模型(DOM) 和JavaScript。 但该测试并未涵盖最新 Web 标准及功能,如 CSS flexbox、CSS Gird 等。这就导致它会出现很多布局和兼容性问题。例如用 Ladybird 浏览器浏览 Reddit 页面: 明显看到,还存在很多错位、换行等渲染问题。 目前 Ladybird 其 GUI 及引擎代码都在 BSD-2-Clause 许可证下开源,代码托管在 GitHub 上。

优秀的个人博客,低调大师

Qt编写的项目作品5-气体安全管理系统

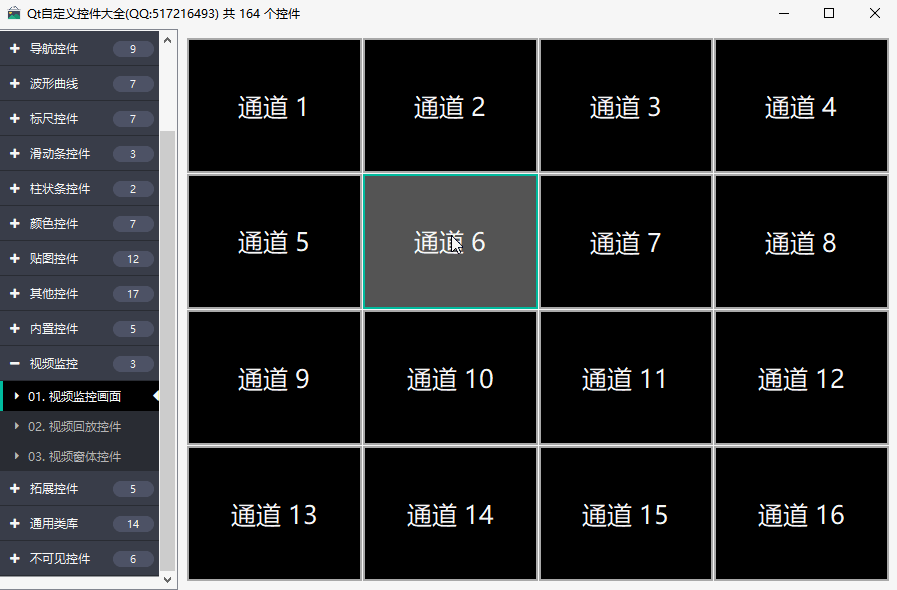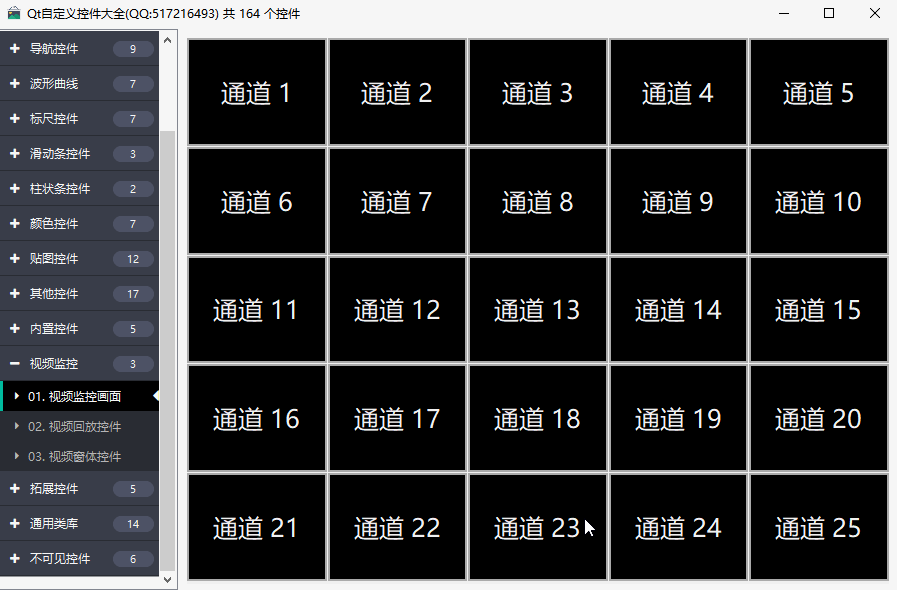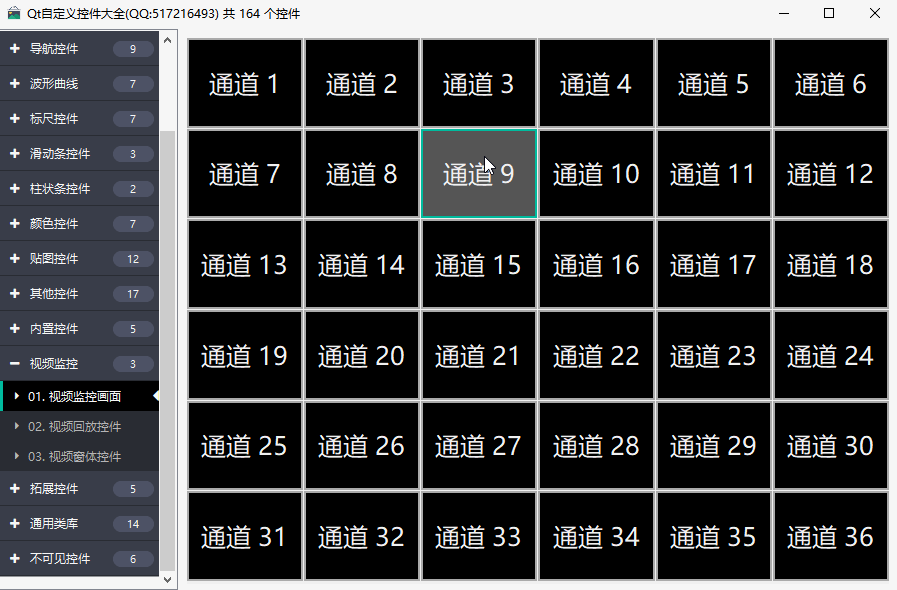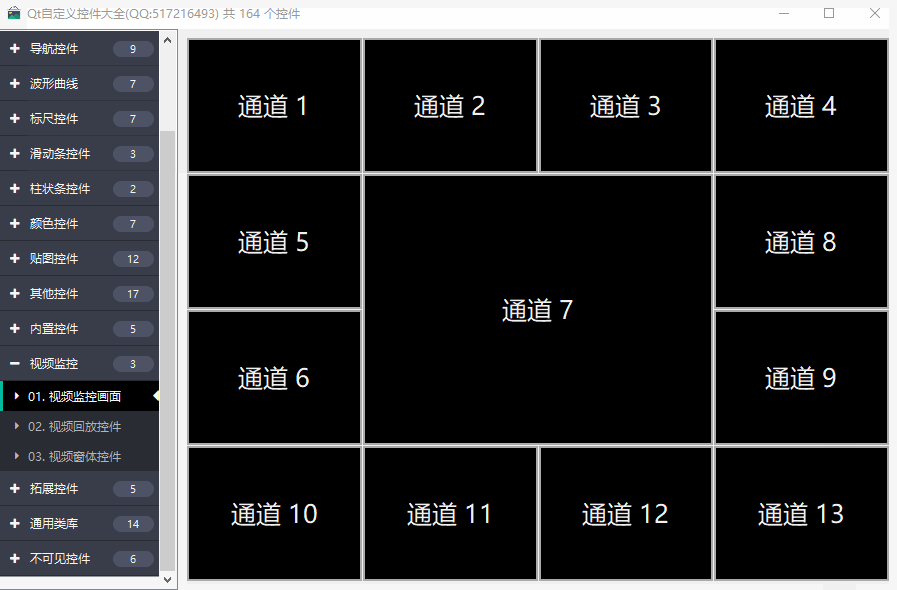
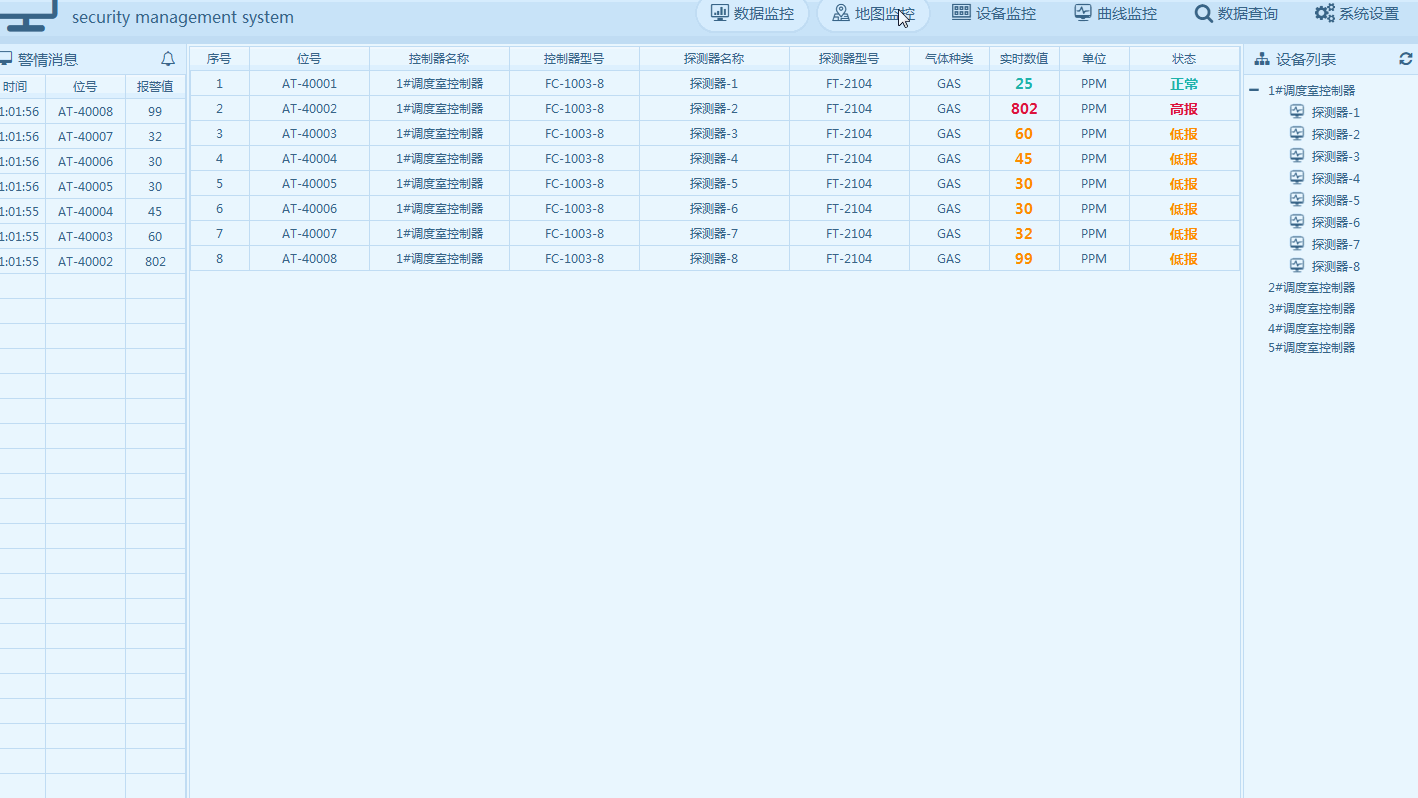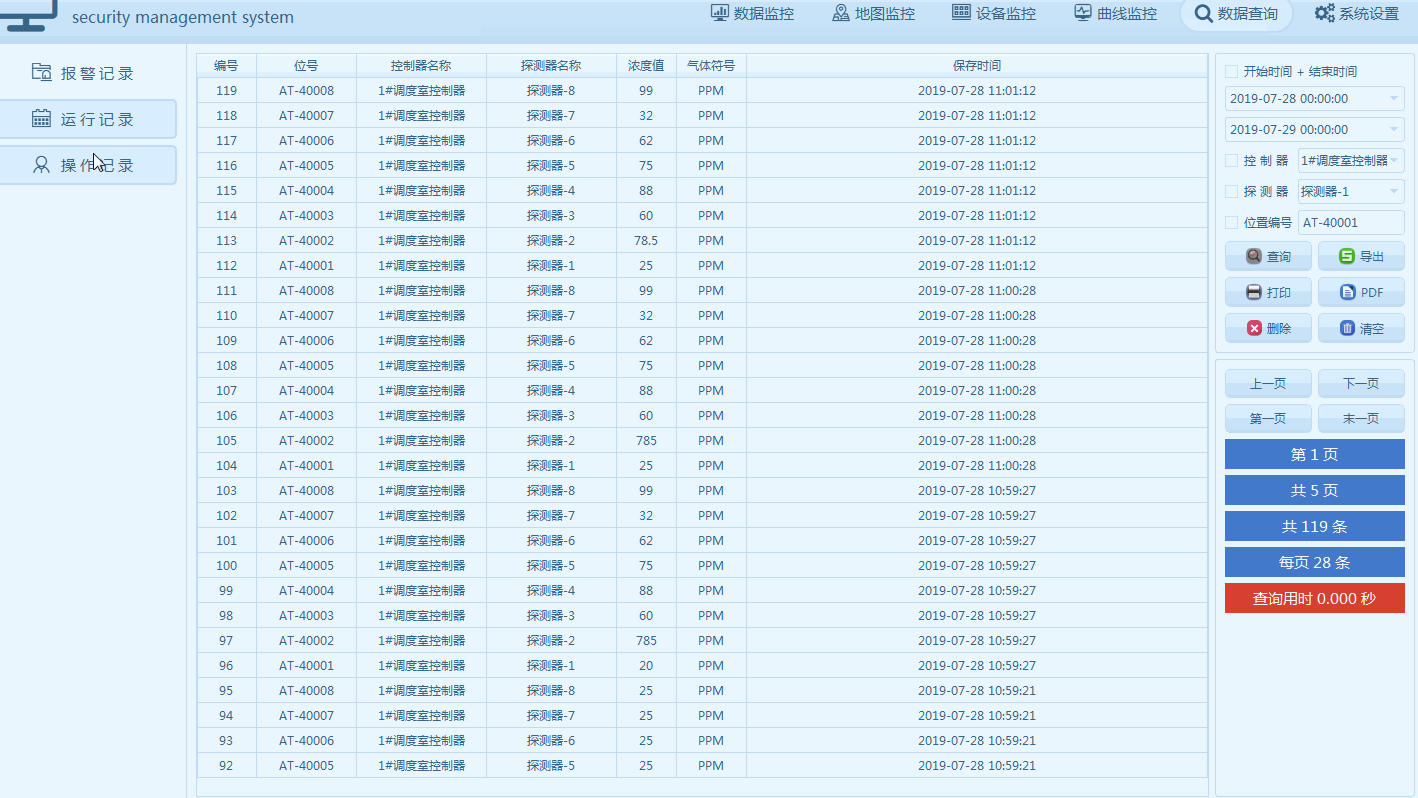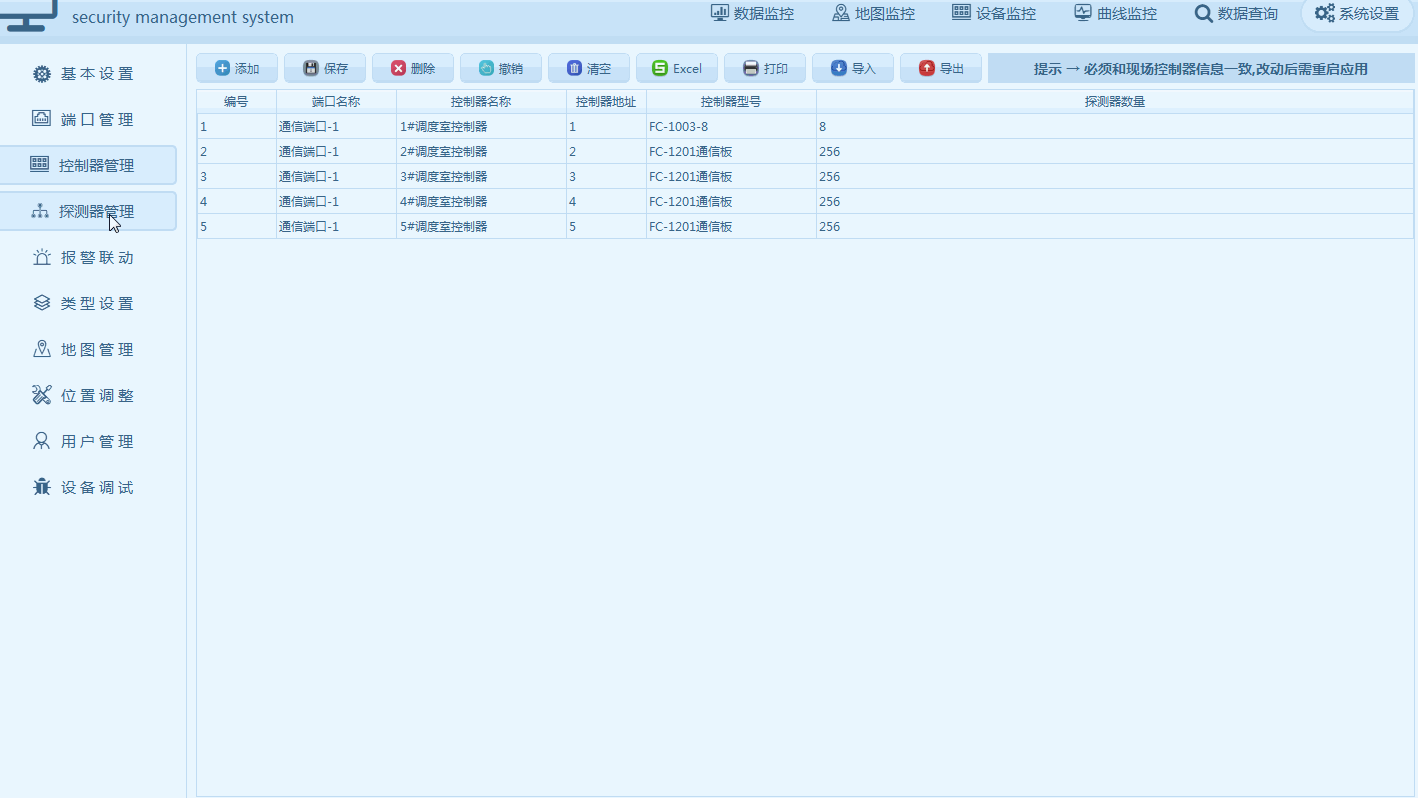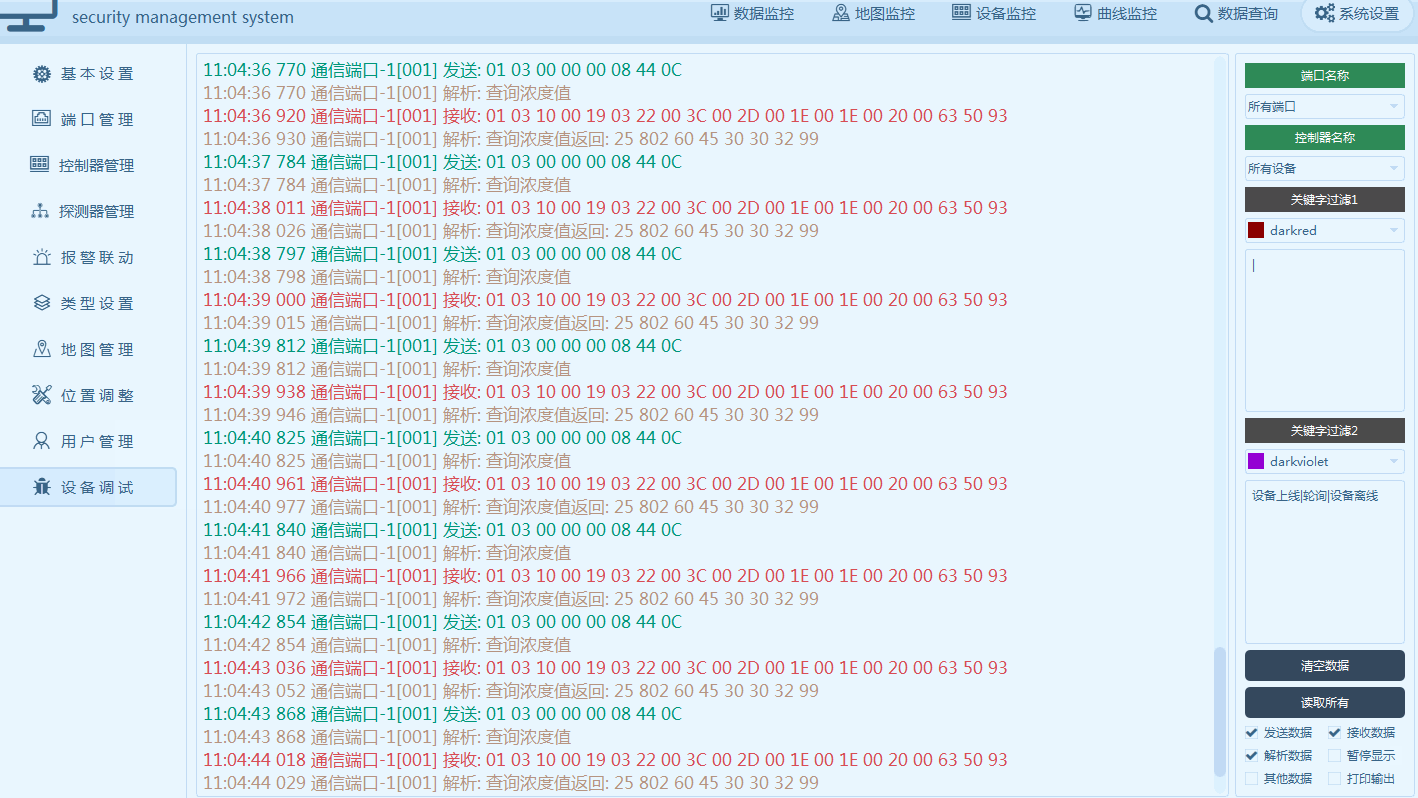
一、功能特点 采集数据端口,支持串口端口+网络端口,串口支持自由设置串口号+波特率,网络支持自由设置IP地址+通讯端口,每个端口支持采集周期,默认1秒钟一个地址,支持设置通讯超时次数,默认3次,支持最大重连时间,用于重新读取离线的设备。 控制器信息,能够添加控制器名称,选择控制器地址+控制器型号,设置该控制器下面的探测器数量。 探测器信息,能够添加位号,可自由选择探测器型号,气体种类,气体符号,高报值,低报值,缓冲值,清零值,是否启用,报警声音,背景地图,存储周期,数值换算小数点位数,报警延时时间,报警的类型(HH,LL,HL)等。 控制器型号+探测器型号+气体种类+气体符号,均可自由配置。 地图支持导入和删除,所有的探测器对应地图位置可自由拖动保存。 端口信息+控制器信息+探测器信息,支持导入导出+导出到excel+打印。 运行记录+报警记录+用户记录,支持多条件组合查询,比如时间段+控制器+探测器等,所有记录支持导出到excel+打印。 导出到excel的记录支持所有excel+wps等表格文件版本,不依赖excel等软件。 可删除指定时间范围内的数据,支持自动清理早期数据,设置最大保存记录数。 支持报警短信转发,支持多个接收手机号码,可设定发送间隔,比如即时发送或者6个小时发送一次所有的报警信息,短信内容过长,自动拆分多条短信。 支持报警邮件转发,支持多个接收邮箱,可设定发送间隔,比如即时发送或者6个小时发送一次所有的报警信息,支持附件发送。 高报颜色+低报颜色+正常颜色+0值颜色+曲线背景+曲线颜色等,都可以自由选择。 软件的中文标题+英文标题+logo路径+版权所有都可以自由设置。 提供开关设置开机运行+报警声音+自动登录+记住密码等。 报警声音可设置播放次数,界面提供17种皮肤文件选择。 支持云端数据同步,可设置云端数据库的信息,比如数据库名称,用户名+密码等。 支持网络转发和网络接收,网络接收开启后,软件从udp接收数据进行解析。网络转发支持多个目标IP,这样就实现了本地采集的软件,自由将数据转到客户端,随时查看探测器数据。 自动记住用户最后停留的界面+其他信息,重启后自动应用。 报警自动切换到对应的地图,探测器按钮闪烁。 双击探测器图标,可以进行回控。 支持用户权限管理,管理员+操作员两大类,用户登录+用户退出,可以记住密码和自动登录,超过三次报错提示并关闭程序。 支持四种监控模式,设备面板监控+地图监控+表格数据监控+曲线数据监控,可自由切换,四种同步应用。 支持报警继电器联动,一个位号可以跨串口联动多个模块和继电器号,支持多对多。 本地数据存储支持sqlite+mysql,支持远程数据同步到云端数据库。自动重连。 本地设备采集到的数据实时上传到云端,以便手机APP或者web等其他方式提取。 支持两种数据源,一种是串口和网络通过协议采集设备数据,一种是数据库采集。数据库采集模式可以作为通用的系统使用。 自带设备模拟工具,支持16个设备数据模拟,同时还带数据库数据模拟,以便在没有设备的时候测试数据。 默认通信协议采用modbus协议,后期增加mqtt等物联网协议的支持,做成通用系统。 支持所有windows操作系统+linux操作系统和其他操作系统。 二、效果图 三、体验地址 体验地址:https://pan.baidu.com/s/1uQsDQO5E5crUBN2J-nPeLQ 提取码:1jkp 名称:bin_sams.zip 国内站点:https://gitee.com/feiyangqingyun 国际站点:https://github.com/feiyangqingyun 个人主页:https://blog.csdn.net/feiyangqingyun 知乎主页:https://www.zhihu.com/people/feiyangqingyun/

资源下载

更多资源
Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册