首页 文章 精选 留言 我的

精选列表

搜索[伪集群],共10009篇文章
优秀的个人博客,低调大师

Hadoop3单机部署,实现最简伪集群

1.节点说明 ip hostname 说明 10.0.0.120 hadoop-all 主节点+数据节点 2.环境准备 需要JDK1.8运行环境,搭建请参考[Jdk安装(Linux,MacOS,Windows)] 3.设置主机名 sh 复制代码 # 主节点 hostnamectl set-hostname hadoop-all 4.设置host sh 复制代码 # 所有节点配置 echo "10.0.0.120 hadoop-all" >> /etc/hosts 5.设置ssh免密码登录(主节点) sh 复制代码 # 设置主节点自身ssh免密码登录以及主节点对各个数据节点ssh免密码登录 # 以下操作在主节点进行 # 生成公钥 ssh-keygen -t rsa # 向主节点(本机)复制公钥 cat ~/.ssh/id_rsa.pub >> ~/.ssh/authorized_keys # 验证,输入yes,如果此时没有要求输入密码则配置成功 ssh hadoop-all 6.开放端口 sh 复制代码 # 主节点 firewall-cmd --add-port=9870/tcp && firewall-cmd --add-port=9870/tcp --permanent firewall-cmd --add-port=8088/tcp && firewall-cmd --add-port=8088/tcp --permanent firewall-cmd --add-port=9000/tcp && firewall-cmd --add-port=9000/tcp --permanent firewall-cmd --add-port=50090/tcp && firewall-cmd --add-port=50090/tcp --permanent # 或者关闭关闭防火墙 systemctl stop firewalld.service && systemctl disable firewalld.service 7.准备hadoop安装包 sh 复制代码 # 下载地址 http://hadoop.apache.org/ # 镜像地址 https://mirrors.cloud.tencent.com/apache/hadoop/common/ # 下载hadoop-3.3.6.tar.gz并解压到指定目录,如/data0/hadoop/hadoop-3.3.6 mkdir -p /data0/hadoop/ tar -zxvf hadoop-3.3.6.tar.gz # 创建hadoop数据存放目录 mkdir -p /data1/hadoop/repo 8.修改配置 8.1.进入配置文件目录 sh 复制代码 cd /data0/hadoop/hadoop-3.3.6/etc/hadoop 8.2.修改hadoop-env.sh配置文件 sh 复制代码 # 编辑文件 vi hadoop-env.sh # 添加 export JAVA_HOME=/data0/java/jdk1.8.0_361 export HADOOP_LOG_DIR=/data1/hadoop/repo/logs/hadoop # /data0/java/jdk1.8.0_291为jdk安装目录 # /data1/hadoop/repo为hadoop数据存放目录 8.3.修改core-site.xml配置文件 sh 复制代码 # 编辑文件 vi core-site.xml # 修改configuration节点配置 <configuration> <property> <name>fs.defaultFS</name> <value>hdfs://hadoop-all:9000</value> </property> <property> <name>hadoop.tmp.dir</name> <value>/data1/hadoop/repo</value> </property> </configuration> # hadoop-all为主节点主机名 # 9000为端口 8.4.修改hdfs-site.xml配置文件 sh 复制代码 # 编辑文件 vi hdfs-site.xml # 修改configuration节点配置 <configuration> <property> <name>dfs.replication</name> <value>1</value> </property> </configuration> # 1为数据副本个数 8.5.修改mapred-site.xml配置文件 sh 复制代码 # 编辑文件 vi mapred-site.xml # 修改configuration节点配置 <configuration> <property> <name>mapreduce.framework.name</name> <value>yarn</value> </property> </configuration> 8.6.修改yarn-site.xml配置文件 sh 复制代码 # 编辑文件 vi yarn-site.xml # 修改configuration节点配置 <configuration> <property> <name>yarn.nodemanager.aux-services</name> <value>mapreduce_shuffle</value> </property> <property> <name>yarn.nodemanager.env-whitelist</name> <value>JAVA_HOME,HADOOP_COMMON_HOME,HADOOP_HDFS_HOME,HADOOP_CONF_DIR,CLASSPATH_PREPEND_DISTCACHE,HADOOP_YARN_HOME,HADOOP_MAPRED_HOME</value> </property> </configuration> 9.修改hadoop启动/停止配置 9.1.进入启动脚本目录 sh 复制代码 cd /data0/hadoop/hadoop-3.3.6/sbin 9.2.修改dfs.sh的启动/停止命令 sh 复制代码 # 编辑文件 vi start-dfs.sh vi stop-dfs.sh # 都添加 HDFS_DATANODE_USER=root HDFS_DATANODE_SECURE_USER=hdfs HDFS_NAMENODE_USER=root HDFS_SECONDARYNAMENODE_USER=root 9.3.修改yarn.sh的启动/停止命令 sh 复制代码 # 编辑文件 vi start-yarn.sh vi stop-yarn.sh # 都添加 YARN_RESOURCEMANAGER_USER=root HADOOP_SECURE_DN_USER=yarn YARN_NODEMANAGER_USER=root 10.格式化hdfs sh 复制代码 # 进入hadoop根目录 cd /data0/hadoop/hadoop-3.3.6 # 格式化 bin/hdfs namenode -format 11.启动/停止 sh 复制代码 # 进入hadoop根目录 cd /data0/hadoop/hadoop-3.3.6/sbin # 启动 ./start-all.sh # 停止 ./stop-all.sh # 查看启动状态 jps # 主节点启动[ResourceManager,NameNode,SecondaryNameNode,DataNode,NodeManager] 12.web查看状态 sh 复制代码 # 浏览器访问 10.0.0.120:9870 10.0.0.10:8088 13.配置环境变量 sh 复制代码 # 打开文件 vi ~/.bash_profile # 添加环境变量 # HADOOP export HADOOP_HOME=/data0/hadoop/hadoop-3.3.6 export PATH=$HADOOP_HOME/bin:$PATH #保存退出 :x # 让配置马上生效 source ~/.bash_profile

优秀的个人博客,低调大师

Linux CentOS下Hadoop伪分布再配置,再次一定要玩真的集群啦~~

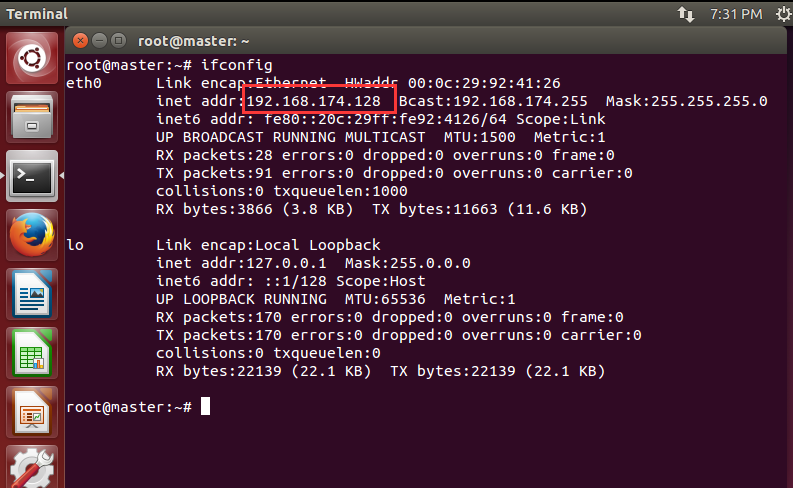
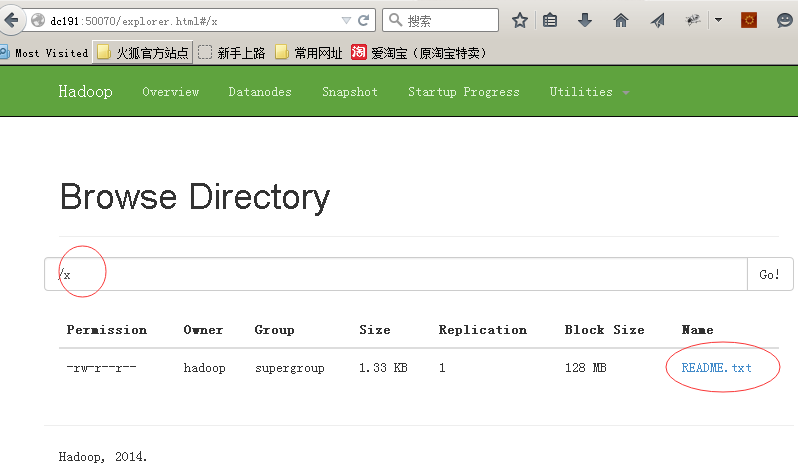
上次配了一次,没多少感觉。 代码看累了。 配置一次再轻松一下脑袋。。。 不过,这次是在家里的VM上,用最新的JDK-7U-17和上HADOOP-1.1.2搞的。 CENTOS版本来6.3-I386. 一次OK。 这次参考的贴子是: http://bjbxy.blog.51cto.com/854497/352692 相关输出如下: # jps2614 Jps2280 TaskTracker1908 NameNode2110 SecondaryNameNode2012 DataNode2169 JobTracker 报告输出: HDFS管理界面: WORDCOUNT的JOB测试样例运行: ]# ./hadoop jar hadoop-examples-1.1.2.jar wordcount bxy outputException in thread "main" java.io.IOException: Error opening job jar: hadoop-examples-1.1.2.jar at org.apache.hadoop.util.RunJar.main(RunJar.java:90)Caused by: java.io.FileNotFoundException: hadoop-examples-1.1.2.jar (No such file or directory) at java.util.zip.ZipFile.open(Native Method) at java.util.zip.ZipFile.<init>(ZipFile.java:214) at java.util.zip.ZipFile.<init>(ZipFile.java:144) at java.util.jar.JarFile.<init>(JarFile.java:153) at java.util.jar.JarFile.<init>(JarFile.java:90) at org.apache.hadoop.util.RunJar.main(RunJar.java:88)[root@localhost bin]# pwd/usr/local/hadoop/hadoop-1.1.2/bin[root@localhost bin]# ./hadoop jar /usr/local/hadoop/hadoop-1.1.2/hadoop-examples-1.1.2.jar wordcount bxy output12/12/20 07:35:43 INFO input.FileInputFormat: Total input paths to process : 112/12/20 07:35:43 INFO util.NativeCodeLoader: Loaded the native-hadoop library12/12/20 07:35:43 WARN snappy.LoadSnappy: Snappy native library not loaded12/12/20 07:35:45 INFO mapred.JobClient: Running job: job_201212200705_000112/12/20 07:35:46 INFO mapred.JobClient: map 0% reduce 0%12/12/20 07:36:10 INFO mapred.JobClient: map 100% reduce 0%12/12/20 07:36:26 INFO mapred.JobClient: map 100% reduce 100%12/12/20 07:36:30 INFO mapred.JobClient: Job complete: job_201212200705_000112/12/20 07:36:30 INFO mapred.JobClient: Counters: 2912/12/20 07:36:30 INFO mapred.JobClient: Job Counters 12/12/20 07:36:30 INFO mapred.JobClient: Launched reduce tasks=112/12/20 07:36:30 INFO mapred.JobClient: SLOTS_MILLIS_MAPS=2580512/12/20 07:36:30 INFO mapred.JobClient: Total time spent by all reduces waiting after reserving slots (ms)=012/12/20 07:36:30 INFO mapred.JobClient: Total time spent by all maps waiting after reserving slots (ms)=012/12/20 07:36:30 INFO mapred.JobClient: Launched map tasks=112/12/20 07:36:30 INFO mapred.JobClient: Data-local map tasks=112/12/20 07:36:30 INFO mapred.JobClient: SLOTS_MILLIS_REDUCES=1547212/12/20 07:36:30 INFO mapred.JobClient: File Output Format Counters 12/12/20 07:36:30 INFO mapred.JobClient: Bytes Written=113512/12/20 07:36:30 INFO mapred.JobClient: FileSystemCounters12/12/20 07:36:30 INFO mapred.JobClient: FILE_BYTES_READ=160012/12/20 07:36:30 INFO mapred.JobClient: HDFS_BYTES_READ=128012/12/20 07:36:30 INFO mapred.JobClient: FILE_BYTES_WRITTEN=10552612/12/20 07:36:30 INFO mapred.JobClient: HDFS_BYTES_WRITTEN=113512/12/20 07:36:30 INFO mapred.JobClient: File Input Format Counters 12/12/20 07:36:30 INFO mapred.JobClient: Bytes Read=116612/12/20 07:36:30 INFO mapred.JobClient: Map-Reduce Framework12/12/20 07:36:30 INFO mapred.JobClient: Map output materialized bytes=160012/12/20 07:36:30 INFO mapred.JobClient: Map input records=3412/12/20 07:36:30 INFO mapred.JobClient: Reduce shuffle bytes=160012/12/20 07:36:30 INFO mapred.JobClient: Spilled Records=23012/12/20 07:36:30 INFO mapred.JobClient: Map output bytes=182412/12/20 07:36:30 INFO mapred.JobClient: Total committed heap usage (bytes)=13166592012/12/20 07:36:30 INFO mapred.JobClient: CPU time spent (ms)=897012/12/20 07:36:30 INFO mapred.JobClient: Combine input records=16912/12/20 07:36:30 INFO mapred.JobClient: SPLIT_RAW_BYTES=11412/12/20 07:36:30 INFO mapred.JobClient: Reduce input records=11512/12/20 07:36:30 INFO mapred.JobClient: Reduce input groups=11512/12/20 07:36:30 INFO mapred.JobClient: Combine output records=11512/12/20 07:36:30 INFO mapred.JobClient: Physical memory (bytes) snapshot=18721587212/12/20 07:36:30 INFO mapred.JobClient: Reduce output records=11512/12/20 07:36:30 INFO mapred.JobClient: Virtual memory (bytes) snapshot=75515494412/12/20 07:36:30 INFO mapred.JobClient: Map output records=169

优秀的个人博客,低调大师

谈 Windows 的伪开源

最近一则 Windows 未来可能走向开源的报道,在业内引起了强烈反响。多数评论认为这是传统PC产业疲软下自救的选择,但事实真的如此吗? https://yqfile.alicdn.com/fa00965d11e107e601a3f3f02d4dcb0225898eba.png" > PC市场的疲软,和在智能手机市场表现不佳,并不是因为Windows闭源。PC市场疲软的原因很多,其中用户需求的疲软及平板电脑和智能手机的衝击,是比较重要的因素。但从整个PC软生态环境看,Windows 仍然佔据著不可替代的位置和优势,儘管有Mac OS X和Chrome OS与其竞争,但目前收效甚微。再看智能手机市场,微软之所以在这个市场的表现不佳,是因为之前对移动市场战略不重视。微软意识到移动市场重要性之后,採取了所谓「系统融合」策略。融合的想法很好,但从 Windows 10推出之前,微软的融合策略实际上都不是真正融合,没有採用统一的 Windows 核心。传统PC和以智能手机和平板电脑为代表的移动市场,是完全不同的应用场景和方式。这就决定了用同一个系统,要兼顾跨界体验的技术是困难的,这也是为何Apple和Google到今天依然在移动和PC市场採用不同系统的原因。 另外就是微软在移动市场本身发展策略的问题,例如併购诺基亚期间,竟出现推出自身Meego系统的N9手机和基于Android系统的手机,让业内对于微软在移动市场的Windows生态系统产生摇摆。更重要的是併购诺基亚后,微软主打的低价策略(手机ASP仅为45美元),让本就脆弱的微软移动生态系统更加脆弱。相关研究分析,购买高价手机的用户,更愿意付费购买应用程序,反之亦然。而微软手机的低价策略,让用户很难购买应用程序,至少与iOS和Android相比如是。但随之导致的连锁效应,就是开发者很难从微软的移动生态系统中获得收入,进而影响了他们为微软开发应用的热情,形成了恶性循环。例如作为WP的热门天气应用之一的Weather Flow,最近就正式从应用商店下架,开发者Gergely Orosz称原因是入不敷出。Weather Flow的数据使用费高达每月1,500美元,但他从Weather Flow所得的收益才每月500美元,还在下降之中。另据据统计,目前在iOS和Android平台许多的主流应用程序,都尚未进驻到Windows平台。即使已经进驻,其体验与在iOS和Android平台上的也存有差距。 如果 Windows 真的开源会怎样?在PC市场,现有的Windows生态系统将会被打破,诸多的应用程序将要推倒重来。这对于一直依赖于微软的企业用户,无疑是最大打击。开源之后会怎样,在移动市场可以对比下Android,碎片化将不可避免。碎片化的结果,是Google未能通过Android,将新应用程序安装到用户的手机上,这也是Android One出现的主因,即通过该系统收回对于Android的控制权。但从目前看,效果并不明显。因此 Windows 开源无论是在PC,还是在移动市场,对于微软弊大于利。况且所谓Windows开源的说法,仅来自微软一位技术员工口中,他仅是说说而已,大家不用太过认真。文章转载自 开源中国社区 [http://www.oschina.net]

优秀的个人博客,低调大师

Hbase伪分布式

其实我就是要让数据存储在hdfs上而已。。。。。。。。 多配置点东西就好了,在hbase-site.xml中加入: <configuration> <property> <name>hbase.rootdir</name> <value>hdfs://yangsy132:9000/user/hive/warehouse/</value> </property> <property> <name>hbase.cluster.distributed</name> <value>true</value> </property> <property> <name>hbase.zookeeper.property.dataDir</name> <value>/home/hadoop/zookeeper-3.4.6/data</value> </property> </configuration> 然后启动hbase即可,但我发现查询时报错啊。。报错信息被刷掉了- -大概错误是: ERROR:org.apache.hadoop.hbase.PleaseHoldException:org.apache.hadoop.hbase.PleaseHoldException:Masterisinitializing 修改 vi /etc/host中 如果IP地址为127.0.1.1或:1 则改为127.0.0.1 重启即可 重启后又发现 继续报错啊。。。错误信息大概是: ERROR: Can't get master address from ZooKeeper; znode data == null 进入zookeeper的data目录下 删除红框中的 重启即可 唉~所有环境都好了木有时间玩~ 只能等周末好好玩一把~

优秀的个人博客,低调大师

AI手机是伪需求吗?

从两年前的Apple Intelligence,到去年的豆包AI手机、千问打通支付宝,再到最近的微信“小微”,大家一直在寻找通用AI Agent在手机上的落地场景,希望在专业AI应用和AI陪聊之外,挖掘更多价值。 而几乎所有厂商都展示过类似的功能:AI点咖啡、叫外卖、购物。 但这些真的是AI Agent在手机上的有效PMF吗? 接下来要泼凉水了。 *声明,下面讨论的“AI手机”,特指能接受开放指令、调用多个应用帮用户执行任务的通用Agent。那些相册搜图、修图、实时字幕、语音转写等垂类AI功能,不在讨论范围内。* ## **AI点咖啡的进化** 先来看AI点咖啡。 点咖啡的需求可不是简单就能说清楚的,有大量的细节选项:品种、冷热、杯型、糖度等等。真要全部说一遍,再等AI思考几轮,就不觉得方便了。早期的AI点咖啡似乎都跳过了这些细节,直接用默认值下单。但现在千问的点奶茶咖啡已经进化了。 实际操作是这样的: ![图片](https://developer.qcloudimg.com/http-save/yehe-12515385/5ba090d7eaf4e2a5ac078ba8667e3ee0.png) 可以看到,AI直接帮你找到对应的小程序页面,剩下的工作都交给图形化界面了。定制化选项点两下搞定,一眼确认。 实际上AI只帮你找到了入口,进入图形化界面后,就没AI什么事了。 ## **对话式交互是软件的未来吗** 有人认为APP会消失,传统软件界面会消失,取而代之的是对话式交互和生成式UI。 但只要看看公司的产品有多卷,就会发现这个判断有多不靠谱。 一款成熟的产品界面,都经历过反复修改打磨的设计稿、像素级的还原、几百上千次的AB Test,最终沉淀出用户最喜欢、转化率最高的界面。 而一个充满不确定性、每次随机生成的GenUI,真的能够打败它吗? 更何况,一问一答的交互方式,其信息传递效率非常低。GUI可以在一个卡片内展示图片、价格、评分、参数、和促销信息,用户1秒就能接收。对话却只能按照句子一段段输出,信息密度和浏览效率远低于精心设计的界面。 此外,对话式交互其实比图形化界面更费力。只要人类还在用手机,用拇指滑动屏幕、触摸屏幕就是最省力、最轻松、最不费脑的操作,没有之一。这就是为什么很多APP都做成了Feed无限刷的模式,因为没有比这个更无脑、更简单的了。 反过来看对话式交互,你需要动用大脑的“系统2”来组织语言,把你想要做的事情说清楚。不要小看这点,把需求说清楚其实并不容易。 前两天邻居群里有人发了条消息:“东区89平四房两卫,高楼层东南向,安静舒适。看房方便,欢迎推荐!” 下面有人问:“是出租还是卖房呀?” 语言传递信息的难度比想象中大。一般人跟AI对话时,很难一次性把话说完整。可能你想订的是双床房,而AI却默认给你订成了大床房。 图形化界面的优势恰恰在于,用户不需要把需求完整地说出来,只需要做选择。 ## **不存在“最优解”的任务** 继续看点外卖和购物。 很多人期望AI自动比价,买到全网最低价的商品,认为最便宜的就是最好的选择。 但在大部分时候这都不成立(想想医保集采)。 很多时候“最优解”根本不存在。用户会考虑品质、口碑、评论、店铺的信任度,还有很多其他因素,这些都是主观判断。 如果一个任务不存在最优解,而是取决于用户的主观判断,那AI大概率很难提效。 退一步说,假如AI真能提高购物的效率,是好事吗? 很多人刷购物APP,并不是因为很想买什么,而是“逛”的过程本身就很开心。AI帮用户跳过了系统推荐,跳过精心包装的文案和配图,跳过在多个选项里选择的过程,那购物的乐趣也大打折扣。 豆包AI手机的能力可能没有想象中那么重要。 ## **手机上的任务,往往不值得用Agent跑** AI Agent在手机上就一点用都没有吗? 问题的核心在于,手机本来就不是为了处理复杂任务而设计的。 AI能提效的场景,需要满足这几个条件:任务足够复杂、操作成本足够高、发生频率足够高,并且用户相信AI能做出正确的判断(不依赖用户个人喜好)。比如编程、写文档、做PPT等。这些任务足够复杂,也有足够高的时间成本,AI能够带来巨大的收益。这些任务主要集中在桌面端,或者说B端。 而手机上的大部分任务,点几下屏幕就能完成。 也许个人办证、报税和各种申请勉强符合任务复杂这点,可是却不够高频。点咖啡和叫外卖足够高频,却又不够复杂。即使AI能够代替用户操作,节省的成本也非常有限。 这就有点尴尬了。它不是完全没用,但是否足以让用户为此买单呢? AI Agent的执行成本非常高。传统软件每新增一个用户、一次访问的边际成本接近于零,但Agent每执行一次任务,都要消耗token资源。 精明的消费者为了几元优惠,愿意领优惠券、签到、找好友“砍一刀”,又有多少人愿意额外付费,让AI替自己完成几次点击。 ## **AI手机可能的价值,是找到入口** 对话式交互+传统GUI界面,也许是不错的方向。 在没有AI的时候,点咖啡最难的过程,是找到对应的小程序。只要打开小程序,一切都不难了。很多低频的手机操作也类似,APP越来越多,功能入口越来越深,用户经常要花很长时间去找对应的功能入口。 这时候AI可以帮上忙。 用户说出大致的目的,AI自动提供入口,用户点进图形化界面,完成任务。这可以看作高级版的搜索。 事实上,千问的交互就很类似这样。微信聚合了上百万的小程序,并且无需安装,小微也非常适合这种帮用户找入口的任务。 只不过,这种AI功能不够纯粹,也不够性感。 ## **手机的主要场景不是生产** 大家说AI是生产力的革命,但手机首先是一个通信和休闲娱乐设备。大部分用户把时间花在短视频、聊天、游戏、看新闻和购物上,而这些活动本身就是目的。 难道让AI替你刷短视频、聊天,好让用户腾出更多时间多写几个PPT? 把一个提效工具,塞进休闲娱乐场景里,价值要打个大大的折扣。 虽然AI手机不会完全没用,但不要抱有太大期望,也不要期望能诞生颠覆性产品。

资源下载

更多资源
腾讯云软件源

腾讯云软件源

为解决软件依赖安装时官方源访问速度慢的问题,腾讯云为一些软件搭建了缓存服务。您可以通过使用腾讯云软件源站来提升依赖包的安装速度。为了方便用户自由搭建服务架构,目前腾讯云软件源站支持公网访问和内网访问。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

WebStorm

WebStorm

WebStorm 是jetbrains公司旗下一款JavaScript 开发工具。目前已经被广大中国JS开发者誉为“Web前端开发神器”、“最强大的HTML5编辑器”、“最智能的JavaScript IDE”等。与IntelliJ IDEA同源,继承了IntelliJ IDEA强大的JS部分的功能。

用户登录
用户注册