首页 文章 精选 留言 我的

精选列表

搜索[MySQL],共10000篇文章
优秀的个人博客,低调大师

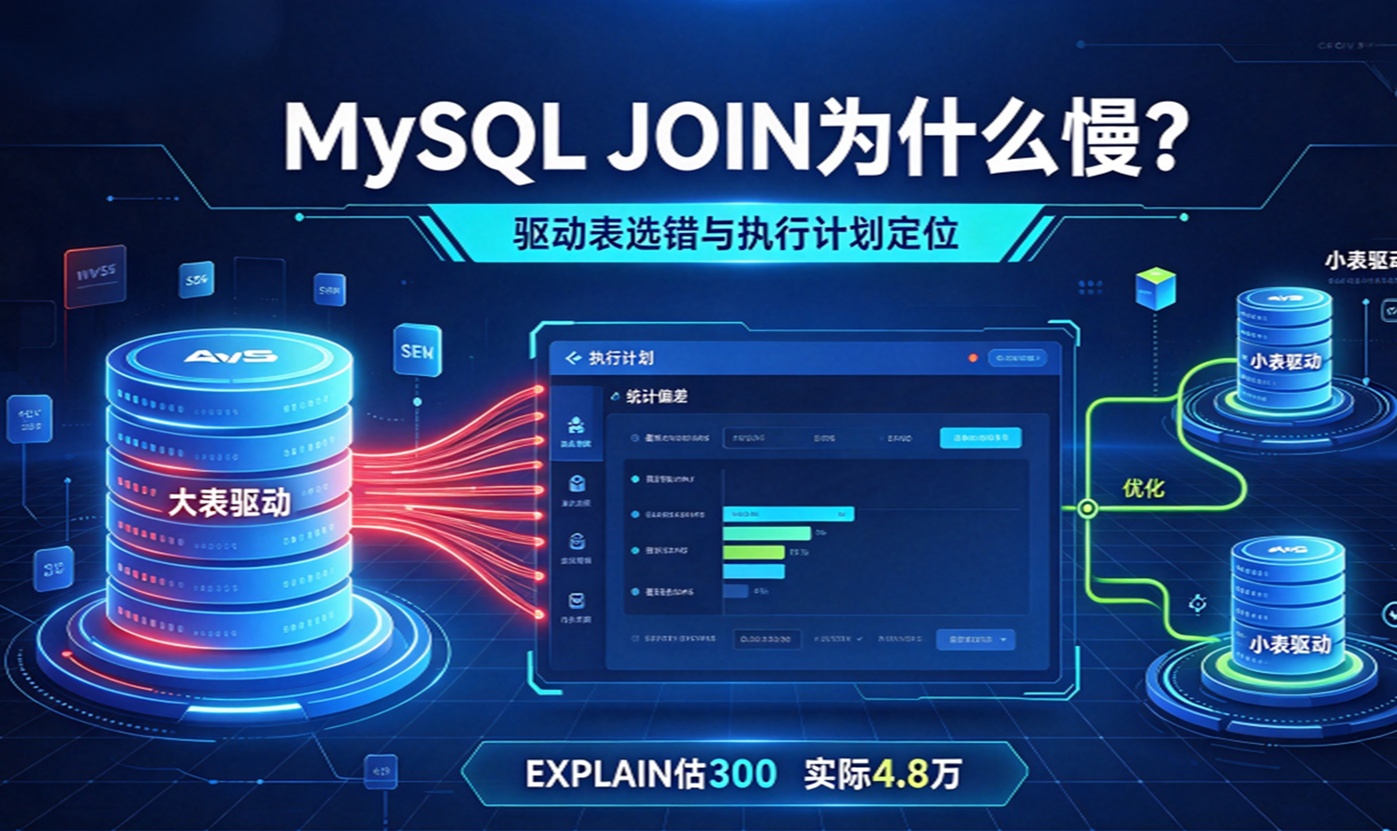
MySQL JOIN突然变慢怎么查?从驱动表到执行计划的完整定位

大家好,我是数据库小学妹👋 我踩过的坑,你别再踩。 上周一条报表 JOIN 从两百毫秒变成两秒,我第一反应是索引掉了。看了一遍,两边连接列都有索引,一个都没少。再跑 `EXPLAIN`,驱动表从订单表换成了用户表。订单表只过滤两万行,用户表却按城市筛出四万多行。同一条 SQL,换了个开车的人,路就堵死了。 ## 一、 索引都在,为什么还是慢 这条 SQL 不复杂。订单表连用户表,按订单时间和用户城市过滤。订单表的 `created_at` 有索引,用户表的 `city` 有索引。连接列一个走主键,一个走普通索引。单看索引,找不出毛病。 问题在顺序。优化器先扫用户表,按城市拿到一批用户。再拿每个用户去订单表查订单。用户表估算只有三百行,看着很划算。实际跑出来四万八千行,内表就被执行了四万八千次。单次查找几十微秒,乘起来正好两秒。 慢日志里只有这一条 SQL,看不出其它异常。CPU 不高,磁盘也不忙。`EXPLAIN` 里每张表都在走索引,没有 `ALL`。这类慢最容易误判,因为每个局部都对,错的是整体。 ## 二、三条连接路径 JOIN 的执行路径只有三种。第一种是嵌套循环,简称 NLJ。外表每读一行,就拿连接键去内表查一次。内表连接列有索引,这一步就是索引查找。没有索引,就退化成第二种,块嵌套循环,也就是 BNL。它把外表的一批行放进 `join_buffer`,再整表扫一遍内表。 8.0.18 引入哈希连接,8.0.20 之后取代了 BNL。等值连接、内表没有可用索引,才会走哈希连接。优化器把小的一侧建成哈希表。然后扫另一侧,逐行去哈希表里碰。不等值连接用不上它,比如 `BETWEEN`、`LIKE` 前缀模糊。执行计划里会写 `Using join buffer`,括号里注明是 hash join 还是 BNL。 三条路径的代价差得很远。NLJ 的成本是外表行数乘以内表单次查找。BNL 的成本是外表行数乘以内表扫描,再加内存开销。哈希连接建表一次,探测每行一次。它适合两侧都不小、又没有索引的场景。 ## 三、 驱动表不是越小越好 驱动表越小越好,这是一个流传很广的误会。优化器算的是代价,不是行数。代价大致等于外表的行数,乘以每行去内表查一次的成本。外表再小,内表没有索引,每行都要全表扫,代价也会爆。反过来,外表大一点,内表走主键,循环成本很低,反而更快。 所以真正要看两件事。被驱动表的连接列,有没有能用的索引。驱动表过滤之后,还剩多少行。这两件事都取决于估算,估算来自统计信息。统计信息偏了,驱动表就会选错。索引都在,计划照样能翻车。 优化器搜连接顺序时,不会把所有排列都算一遍。表一多,组合是阶乘级的。它用贪心加剪枝,靠 `optimizer_search_depth` 控制搜索深度。代价模型本身没问题,问题在输入。输入就是每张表的行数和选择率。 ## 四、join_buffer 不是万能药 `join_buffer` 是给 BNL 和哈希连接用的内存。它按连接分配,不是按连接池连接分配。一条 SQL 里有三个 JOIN,就可能开三块。默认 256KB,很多人一看到 JOIN 慢就调大。调大只影响没有索引的那条路,改不了驱动表选错。并发一高,每块都按上限分配,内存会被吃穿。 更麻烦的是,调大以后计划可能不变。因为优化器估的代价没变,它还是选同一条路。内存只是让那条慢路稍微快一点,掩盖了问题。看起来有效,过一阵负载上来又慢。参数能缓解症状,改不了选择。 ## 五、EXPLAIN 要看估算和实际 先看 `EXPLAIN` 的逐表输出。`type` 告诉你访问方式,`ALL` 是全表扫,`ref` 和 `eq_ref` 是索引查找。`rows` 是估算行数,`filtered` 是过滤后剩下的比例。`Extra` 里出现 `Using join buffer`,说明内表没走索引。出现 `Using filesort` 或 `Using temporary`,是另一类问题,别混在一起看。 估算和实际差多少,要靠 `EXPLAIN ANALYZE`。8.0.18 之后支持,它会真跑一遍,给出实际行数和实际耗时。看 `loops`,那是这一层被执行的次数。外表四万多行,内表这一层就会跑四万多次。单次只要几十微秒,乘起来就是秒级。 ```sql EXPLAIN ANALYZE SELECT o.order_no, o.amount, u.nickname FROM t_order o JOIN t_user u ON o.user_id = u.id WHERE o.created_at >= '2026-10-20' AND u.city = '杭州'; ``` ``` -> Nested loop inner join (cost=662937 rows=1043) (actual time=0.297..2013 rows=1852 loops=1) -> Index lookup on u using idx_city (city='杭州') (cost=10435 rows=300) (actual time=0.043..71.5 rows=48210 loops=1) -> Index lookup on o using idx_user_created (user_id=u.id, created_at>='2026-10-20') (cost=2.11 rows=1) (actual time=0.019..0.039 rows=1 loops=48210) ``` 这张图里有两个数最关键。用户表这一层,估算三百行,实际跑出四万八。内表这一层 `loops` 是四万八,单次耗时看着很低。两者一乘,就是两秒。换成订单表驱动,外层两万行,内表走主键,总耗时回到两百毫秒。 ## 六、计划漂移怎么修 那次的原因是统计信息采样偏了。InnoDB 默认只采 20 个页,`innodb_stats_persistent_sample_pages` 控制这个数。杭州用户集中在新写入的页里,采样没扫到。估算出来三百行,实际四万八。优化器按三百行算代价,自然觉得用户表适合当驱动表。 修复分三层。第一层是 `ANALYZE TABLE`,重新采样。分布偏斜的列,加直方图,让优化器看到真实分布。第二层是索引。检查被驱动表的连接列和过滤列,能不能合并成一个联合索引。第三层才是强制顺序,用 `STRAIGHT_JOIN` 或 `JOIN_ORDER`。 ```sql -- 1. 重新采样 ANALYZE TABLE t_user; -- 2. 给偏斜列建直方图(8.0 支持) ANALYZE TABLE t_user UPDATE HISTOGRAM ON city WITH 64 BUCKETS; -- 3. 临时止血:把订单表固定在驱动位 SELECT STRAIGHT_JOIN o.order_no, o.amount, u.nickname FROM t_order o JOIN t_user u ON o.user_id = u.id WHERE o.created_at >= '2026-10-20' AND u.city = '杭州'; ``` `STRAIGHT_JOIN` 是止血,不是根治。它把顺序写死,数据一变,可能从最优变成最差。我一般只在发版窗口或报表临时用。用完记一笔,下次数据分布变了要复查。直方图也不是一劳永逸,数据偏斜变了要重采。 还有一点,别把 `Using join buffer` 当成必死信号。小表连大表,哈希连接往往比索引查找还快。要看 `loops` 和实际行数,不能只看出没出这个提示。真正的坏信号,是外层行数大,内层还在全表扫。 ## 七、 避坑清单 JOIN 慢,先看驱动表是谁,再看被驱动表的连接列有没有索引。索引都在还慢,去比估算行数和实际行数。差值大,问题在统计信息,不在 SQL 写法。别一上来就改 SQL,改写法可能把计划带得更偏。 `join_buffer_size` 不是 JOIN 的万能药。它只服务没有索引的连接路径。驱动表选错,调多大都没用。并发高的库,调大还可能把内存打满。先把索引和统计信息弄对,再谈这块内存。 最后一条是我自己踩的。有次报表慢,我加了 `STRAIGHT_JOIN`,当天确实快了。过了半年,订单量翻了几倍,这个固定顺序成了最差的一条路。报表又慢,我查了半天 SQL,才想起那个提示还在。现在我加这类提示,一定在注释里写日期和原因。到期复查,比凭记忆可靠。 ## 写在最后 JOIN 的代价,不在 SQL 长什么样,在优化器怎么估。估得准,索引对,计划就稳。估偏了,索引全在也能翻车。驱动表换了,往往不是 SQL 变了,是数据变了。 下次遇到 JOIN 突然变慢,先跑 `EXPLAIN ANALYZE`。看驱动表,看估算和实际,看 `loops`。这三眼看完,方向基本就有了。参数和提示词都放后面,它们是工具,不是答案。 你们遇到过同一条 JOIN 突然变慢吗?最后是统计信息、索引还是驱动表的问题?当时是怎么发现驱动表换人的?评论区聊聊。 我是数据库小学妹,帮你少走弯路少踩坑,咱们下篇见👋

资源下载

更多资源
Nacos

Nacos

Nacos /nɑ:kəʊs/ 是 Dynamic Naming and Configuration Service 的首字母简称,一个易于构建 AI Agent 应用的动态服务发现、配置管理和AI智能体管理平台。Nacos 致力于帮助您发现、配置和管理微服务及AI智能体应用。Nacos 提供了一组简单易用的特性集,帮助您快速实现动态服务发现、服务配置、服务元数据、流量管理。Nacos 帮助您更敏捷和容易地构建、交付和管理微服务平台。

Spring

Spring

Spring框架(Spring Framework)是由Rod Johnson于2002年提出的开源Java企业级应用框架,旨在通过使用JavaBean替代传统EJB实现方式降低企业级编程开发的复杂性。该框架基于简单性、可测试性和松耦合性设计理念,提供核心容器、应用上下文、数据访问集成等模块,支持整合Hibernate、Struts等第三方框架,其适用范围不仅限于服务器端开发,绝大多数Java应用均可从中受益。

Rocky Linux

Rocky Linux

Rocky Linux(中文名:洛基)是由Gregory Kurtzer于2020年12月发起的企业级Linux发行版,作为CentOS稳定版停止维护后与RHEL(Red Hat Enterprise Linux)完全兼容的开源替代方案,由社区拥有并管理,支持x86_64、aarch64等架构。其通过重新编译RHEL源代码提供长期稳定性,采用模块化包装和SELinux安全架构,默认包含GNOME桌面环境及XFS文件系统,支持十年生命周期更新。

Sublime Text

Sublime Text

Sublime Text具有漂亮的用户界面和强大的功能,例如代码缩略图,Python的插件,代码段等。还可自定义键绑定,菜单和工具栏。Sublime Text 的主要功能包括:拼写检查,书签,完整的 Python API , Goto 功能,即时项目切换,多选择,多窗口等等。Sublime Text 是一个跨平台的编辑器,同时支持Windows、Linux、Mac OS X等操作系统。

用户登录
用户注册